潜在预测误差何时能支撑视频世界模型的物理惊讶主张 When Does Latent Prediction Error Support Physical Surprise Claims in Video World Models?
系统检验表明:世界模型预测误差并非可靠的物理惊讶度量,外观等干扰常反超物理违规
前置知识
世界模型
学习环境动态规律、能预测未来视觉状态的模型。给定历史观测帧(上下文)和可选动作,模型预测未来帧或其潜层表征。视频世界模型期望捕获使视觉未来可预测的物理规律,如刚体运动、支撑、碰撞与物体属性恒常等,是具身智能和视频生成评估的基础组件。
本文的分析对象就是视频世界模型的原生预测误差,理解误差如何产生是判断其能否解释为物理惊讶的前提。
JEPA 与潜空间预测误差
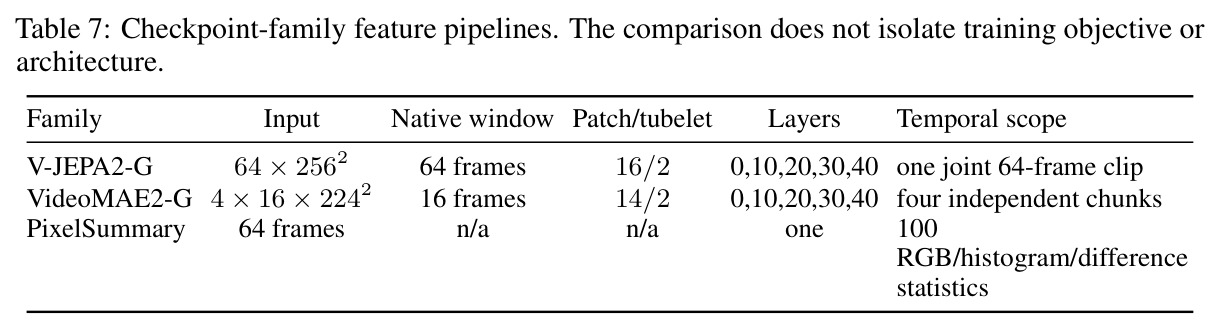
联合嵌入预测架构(JEPA)不在像素空间预测,而是让预测器 $p$ 拟合目标编码器 $f_T$ 的输出。预测误差得分定义为 $S(x,a)=d(p(f_C(x),a),f_T(x))$,其中 $f_C$ 编码上下文帧,$d$ 为距离度量(如归一化 token 的 $L_1$ 或潜层 MSE)。V-JEPA2-G 即此类模型,VideoMAE2 则通过掩码像素重建学习表征。
论文质疑的正是这个潜空间得分 $S(x,a)$ 能否解释为物理惊讶,所有六项检查都围绕它的行为展开。
违反期望范式
源自发展心理学的实验范式:若婴儿对不可能事件注视更久,说明其内部存在物理预期。计算版本用模型预测误差替代注视时间——不可能事件的误差更高即被视为模型理解物理。IntPhys、IntPhys2、Physion 系列基准及 anomaly-detection 式评估均基于此推断链条。
这条推断链正是论文标题中 physical surprise claims 的直接对象,全文目的是检验它在何种条件下成立。
线性探针
在冻结的预训练表征上训练线性分类器,检验某类信息是否线性可解码。若探针能从表征中读出物理标签,说明编码器以线性形式编码了该信息。该方法不改动原模型、计算成本低,是表征内容分析的标准手段,常配合五折交叉拟合与分层抽样防止场景泄漏。
Readout 检查与外观分类实验都依赖线性探针,用于区分表征里有什么信息与误差实际响应了什么。
IntPhys2 / Physion++ / Kubric
IntPhys2 是配对的物理可能/不可能事件合成视频基准,测试物体永存、运动连续性、支撑性与属性恒常;Physion++ 评估物理结果预测与质量等潜属性推断;Kubric 是可编程的物理仿真渲染框架,本文用它自造交叉支撑等受控场景。三者分别服务于读出/几何、静态与外观对照、受控干预实验。
它们是论文三大类实验的数据来源,理解各自提供什么标签与设置才能读懂实验设计。
研究动机
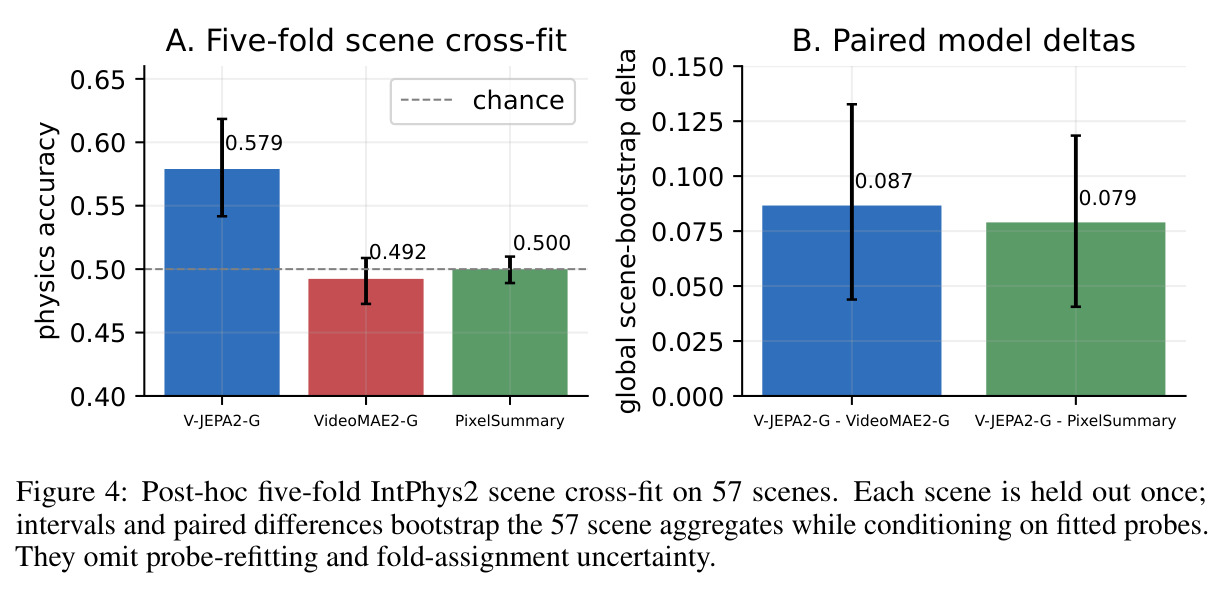
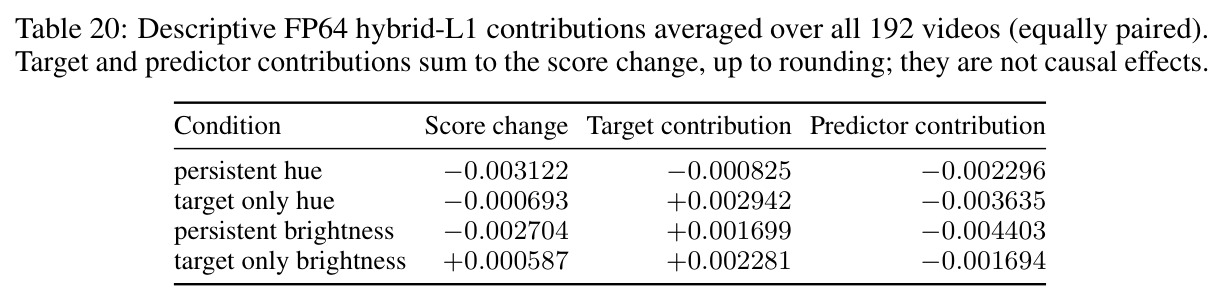
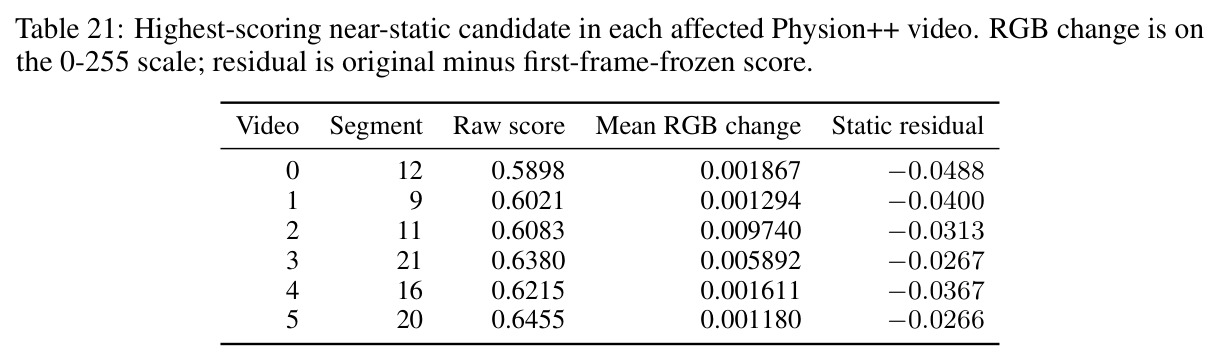
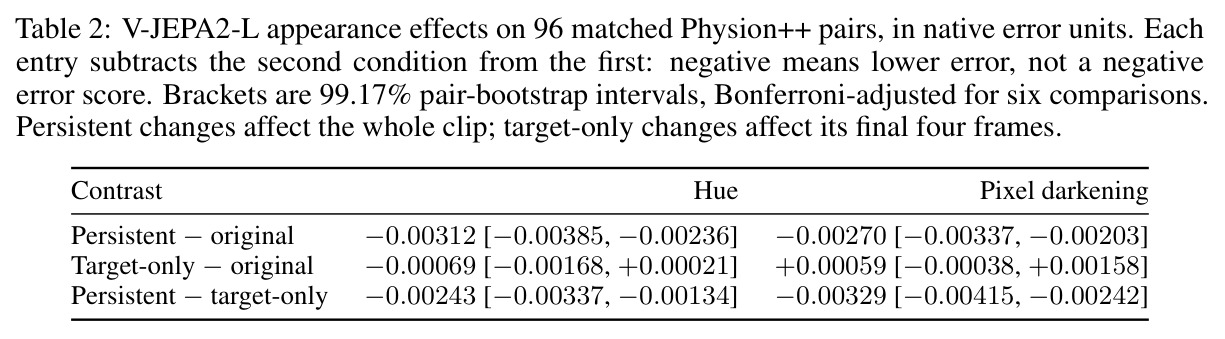
视频世界模型的预测误差被广泛当作物理惊讶的代理:违反期望实验用它判断模型是否理解物理,视频生成管线用它筛选物理合理的样本,甚至用它给规划轨迹打奖励。但原生得分 $S(x,a)=d(p(f_C(x),a),f_T(x))$ 度量的只是选定表征中的预测难度,数值偏大可能来自外观变化、静态内容、运动本身或普通模型误差,而非物理违规。论文给出具体反例:在 Physion++ 视频中把整段剪辑替换成重复单帧,误差反而高于原始运动视频(约 84% 的窗口误差不低于原视频);整段持续变色反而把误差降低约 0.003 个原生单位。同时线性探针从 V-JEPA2-G 表征中读外观标签可达约 97.7%,而读物理标签只有约 57.9%,说明可解码信息与误差行为严重脱节,把误差直接解释为物理惊讶存在系统性风险。
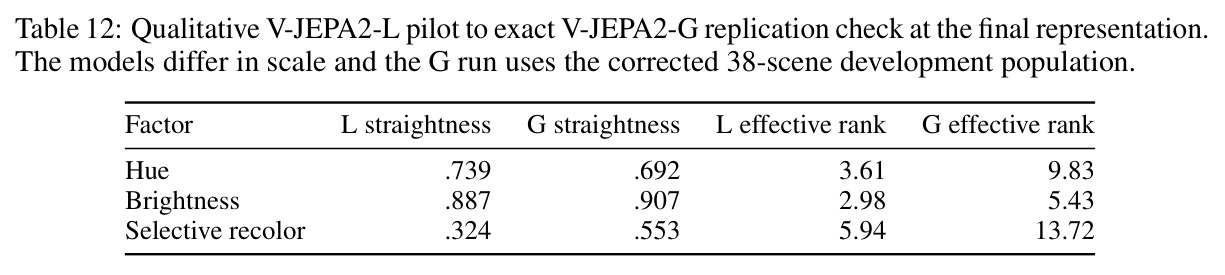
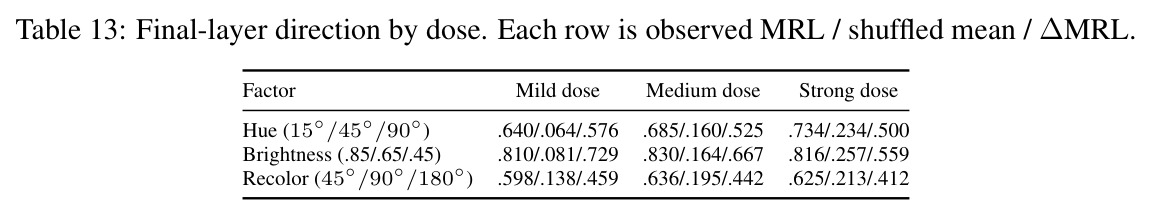
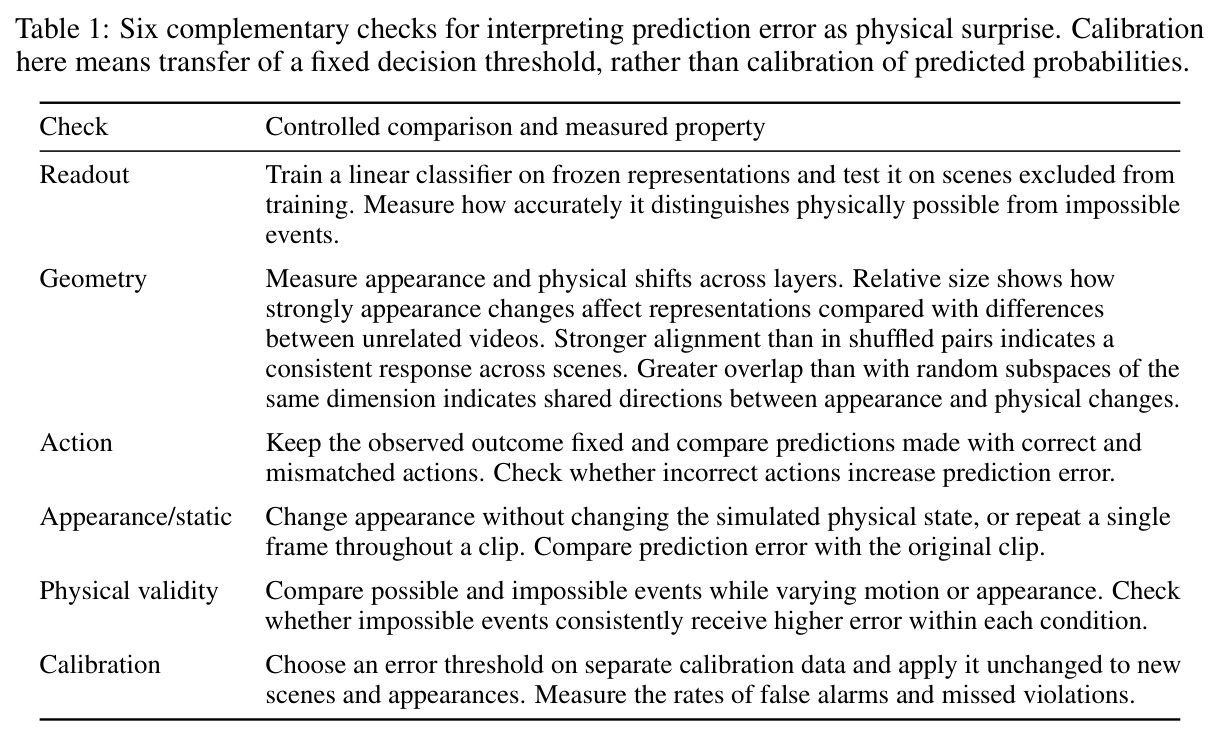
本文的目标是本文不提出新模型,而是建立一个评估框架,把「预测误差等于物理惊讶」这一笼统主张拆解成六个可证伪的检查:表征中是否含有物理标签;表征几何如何随深度组织外观与物理差异;错误动作是否抬高误差;外观与静态内容是否独立影响误差;同一条件下不可能事件是否一致地获得更高误差;在独立数据上拟合的固定阈值迁移到新场景时误报与漏报率如何。框架覆盖 V-JEPA2-G、V-JEPA2-L、VideoMAE2-G 与 LeWM/DINO-WM/JEPA-WM 三个动作条件模型,保留各模型原生管线与得分,最终判断在哪些设置下把误差当物理惊讶是站得住脚的。
与已有工作不同的是,已有研究要么只做表征层面的探针——证明 V-JEPA2、VideoMAE2 中存在物理相关结构、逆向动力学可恢复动作——要么直接把误差当惊讶信号用于下游,很少在同一模型、同一数据上把两者连起来检验:表征里可读出物理信息,是否意味着模型自身的原生误差就会对物理违规做出一致响应?本文的独特切入正是这条同模型链条:用交叉支撑实验把物理有效性与轨迹身份解耦,用回归分析检验几何量能否超越场景条件与低层视觉统计来预测原生误差差异,并给出否定答案,从而把「表征包含物理」与「误差测量惊讶」明确区分为两个独立命题。
核心方法
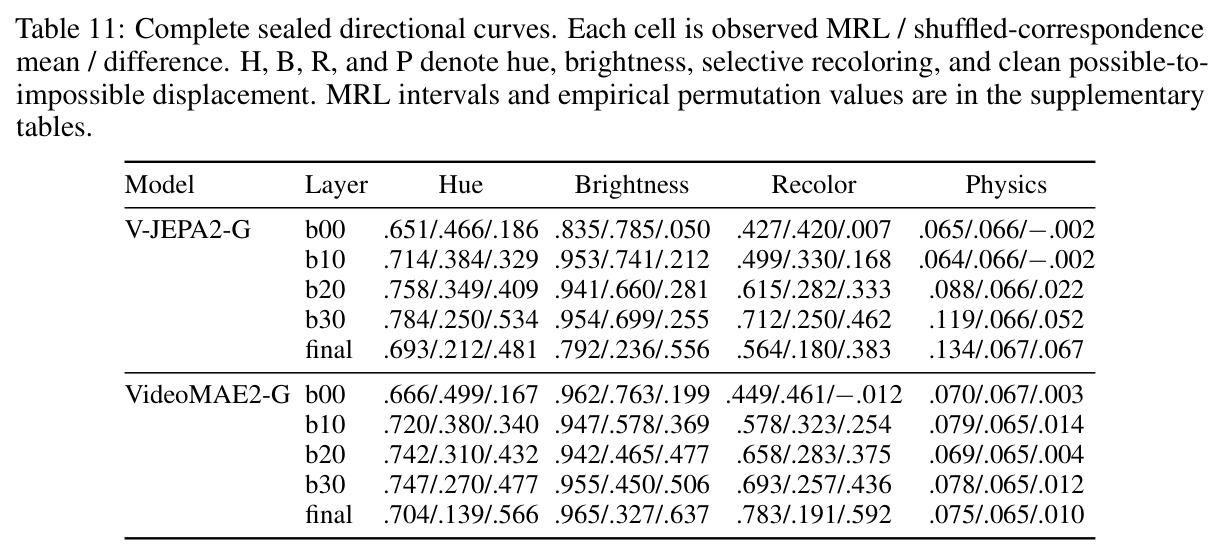
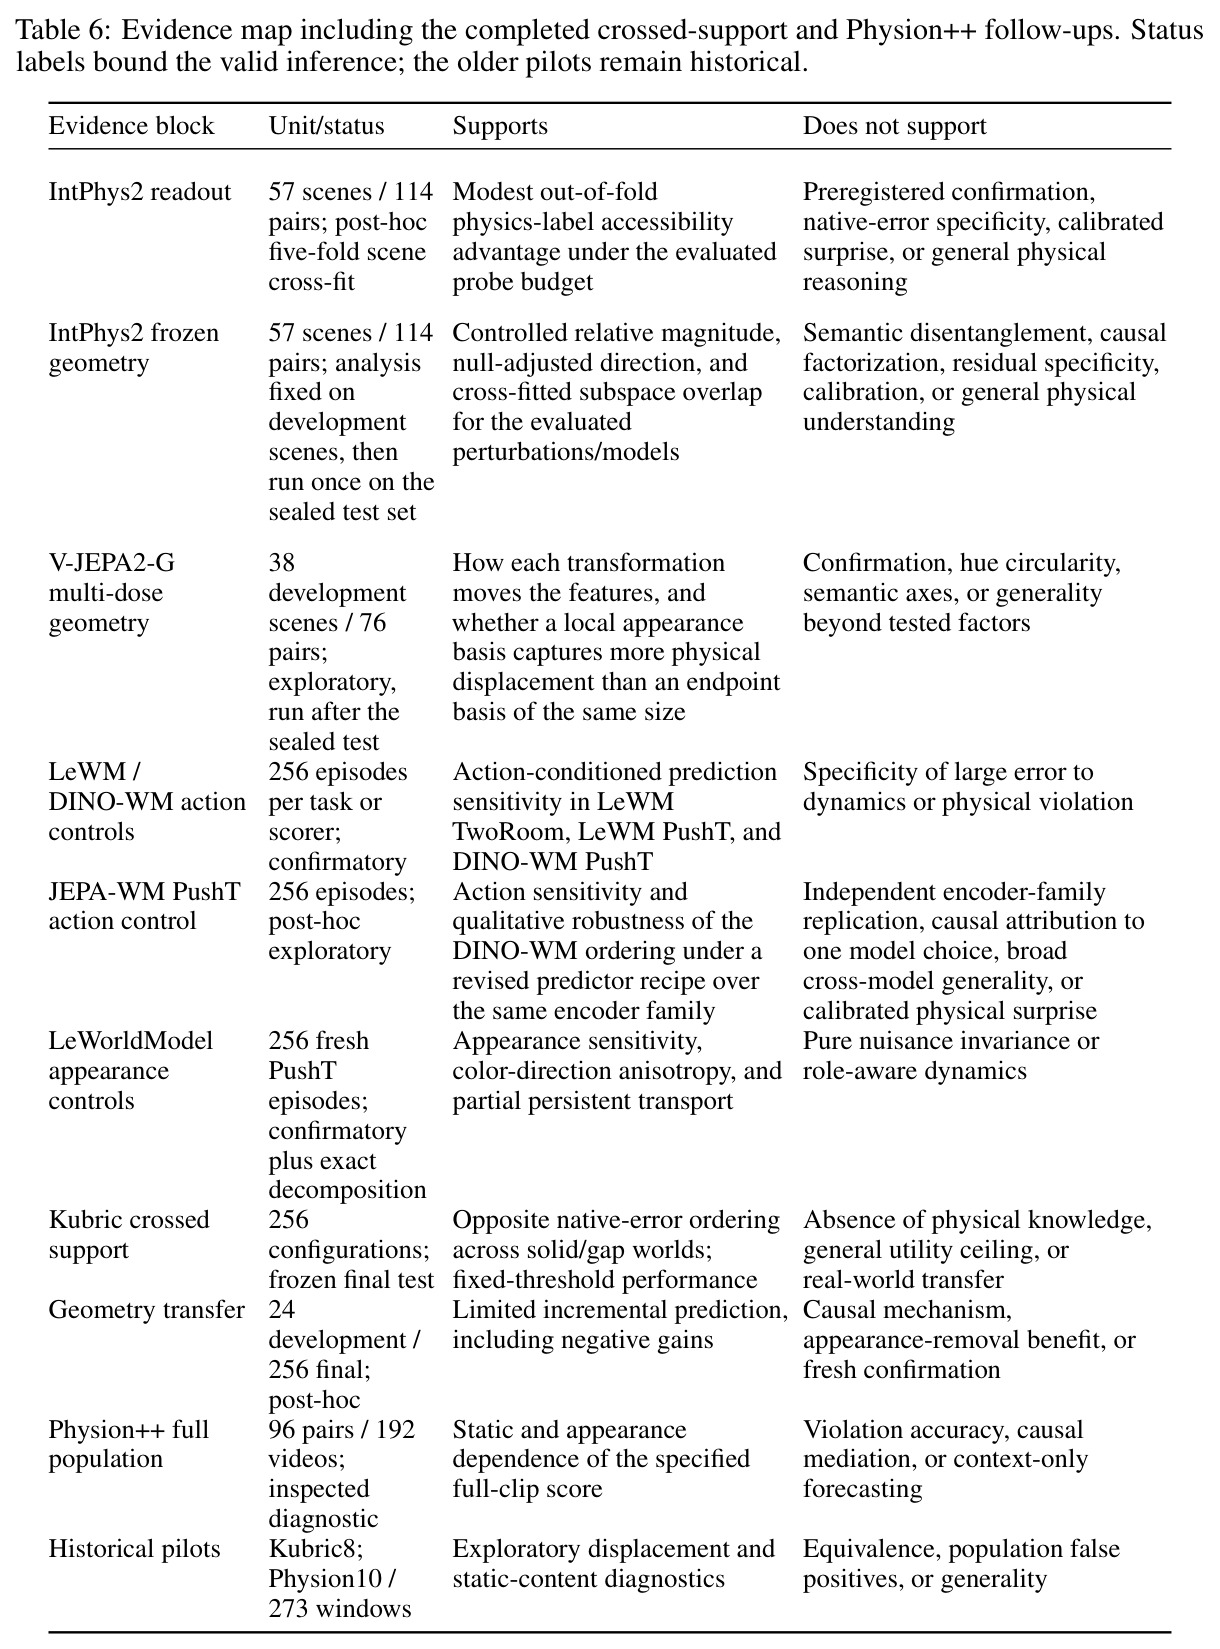
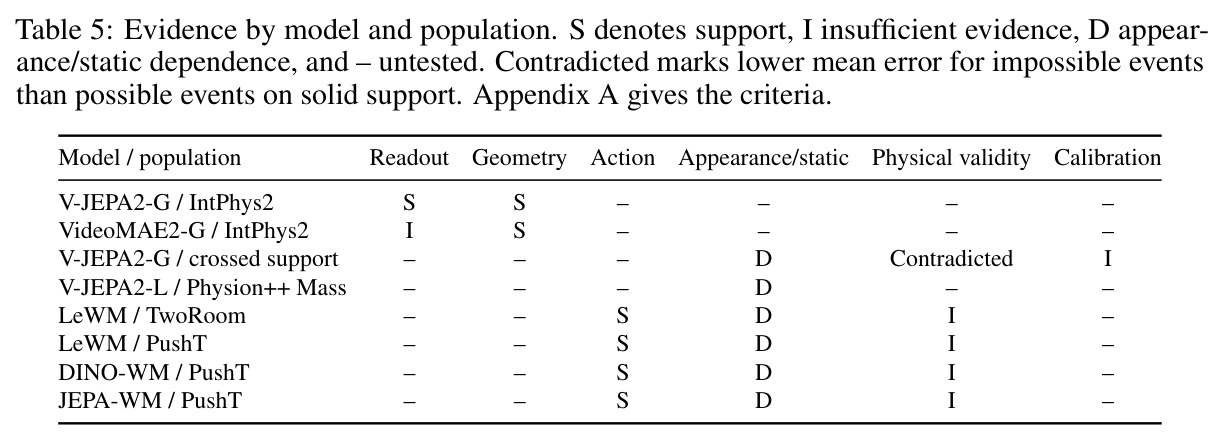
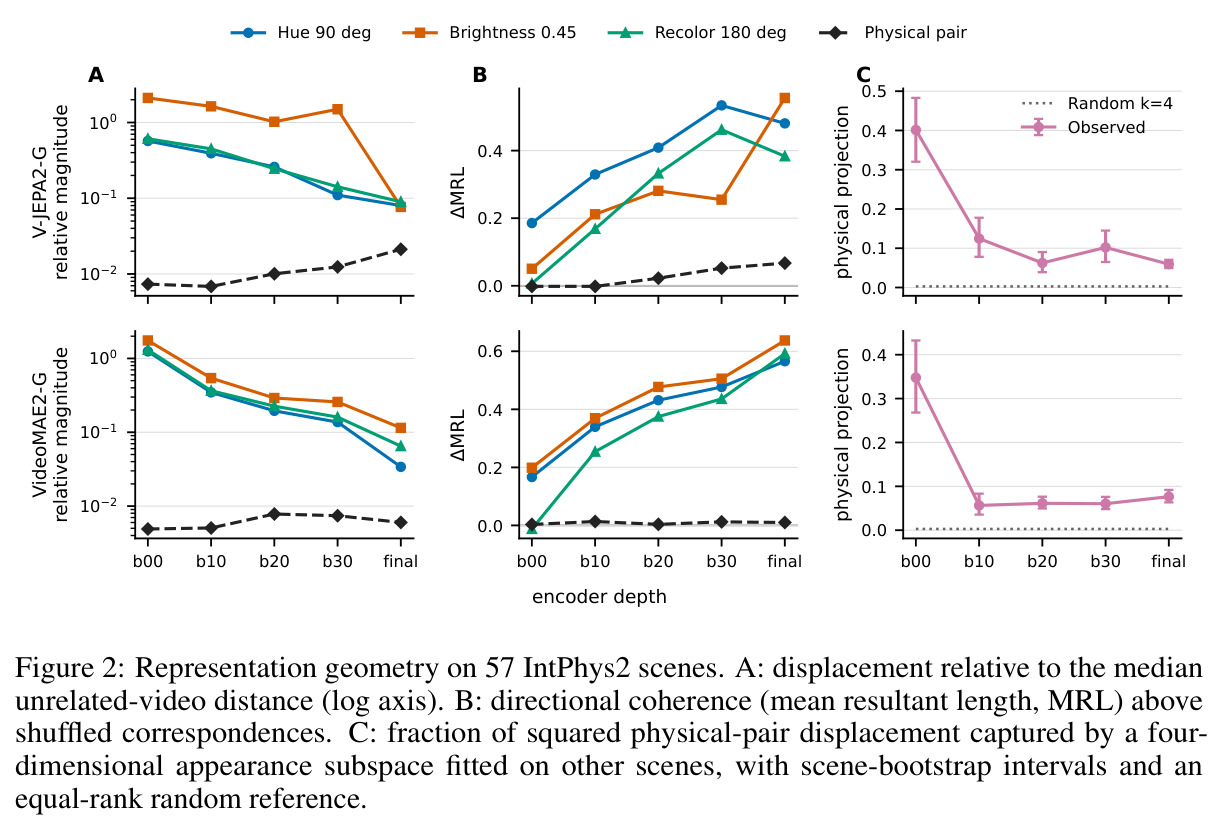
框架的核心是一张六项检查表(Table 1):Readout 在冻结表征上训练线性分类器,区分物理可能与不可能事件;Geometry 测量外观位移与物理位移在各层的相对大小、跨场景方向一致性(平均合成长度 MRL)及与外观子空间的重叠;Action 固定观测结果、对比正确与错误动作下的误差;Appearance/Static 在不改物理状态的前提下改颜色或重复单帧;Physical validity 在同一条件下比较可能与不可能事件;Calibration 检验独立校准数据上拟合的固定阈值迁移到新场景时的误报与漏报。评估对象包括 V-JEPA2-G(潜层预测)、VideoMAE2-G(掩码像素重建)、PixelSummary(RGB 统计基线)、V-JEPA2-L 以及三个动作条件模型。所有比较保留各管线原生编码器、token 选择与距离定义,不确定性用配置级 bootstrap 加 Bonferroni 校正的置信区间量化。
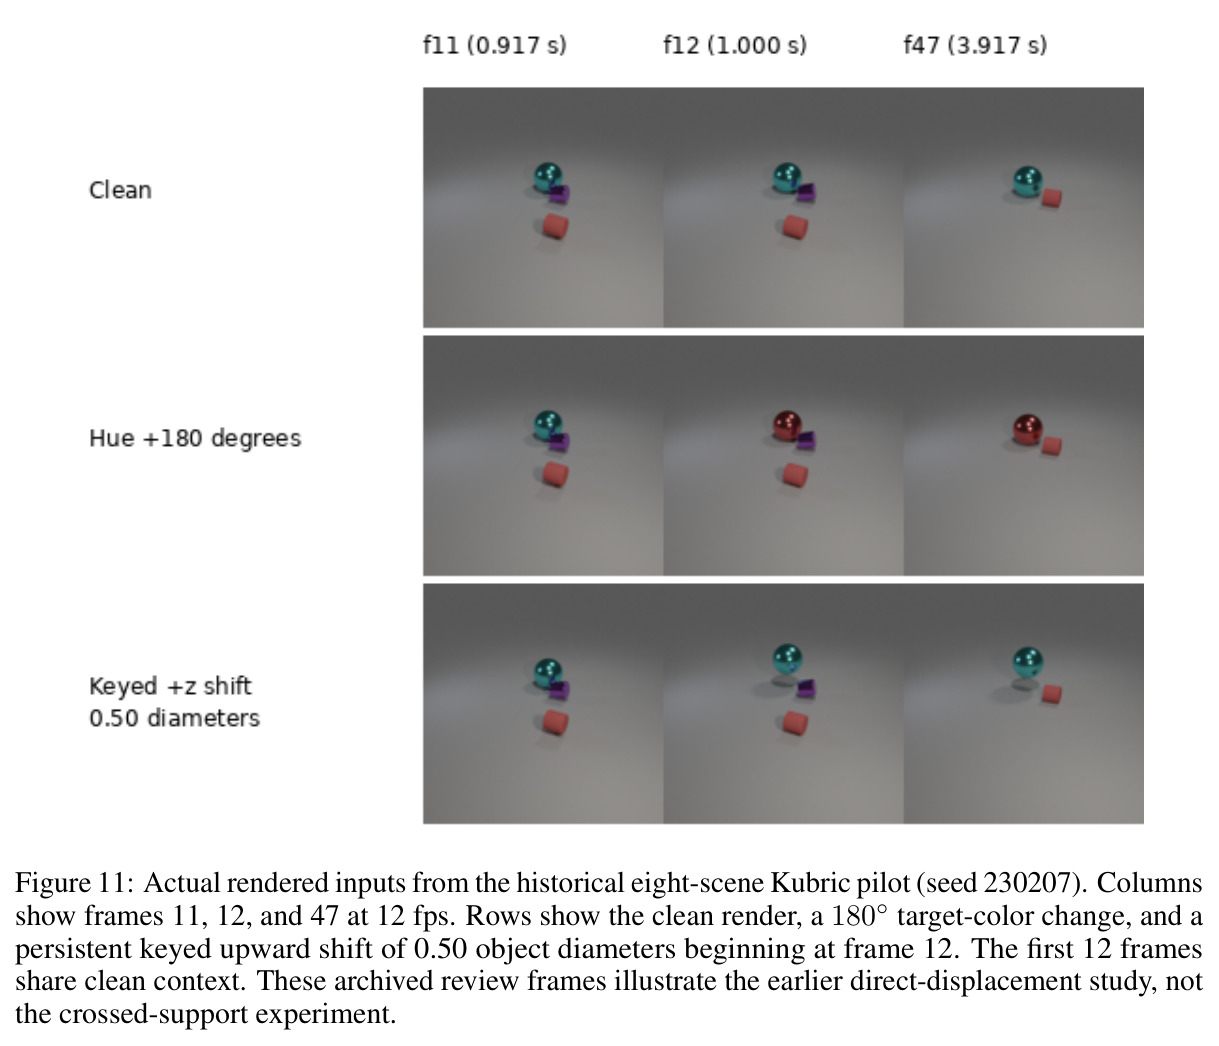
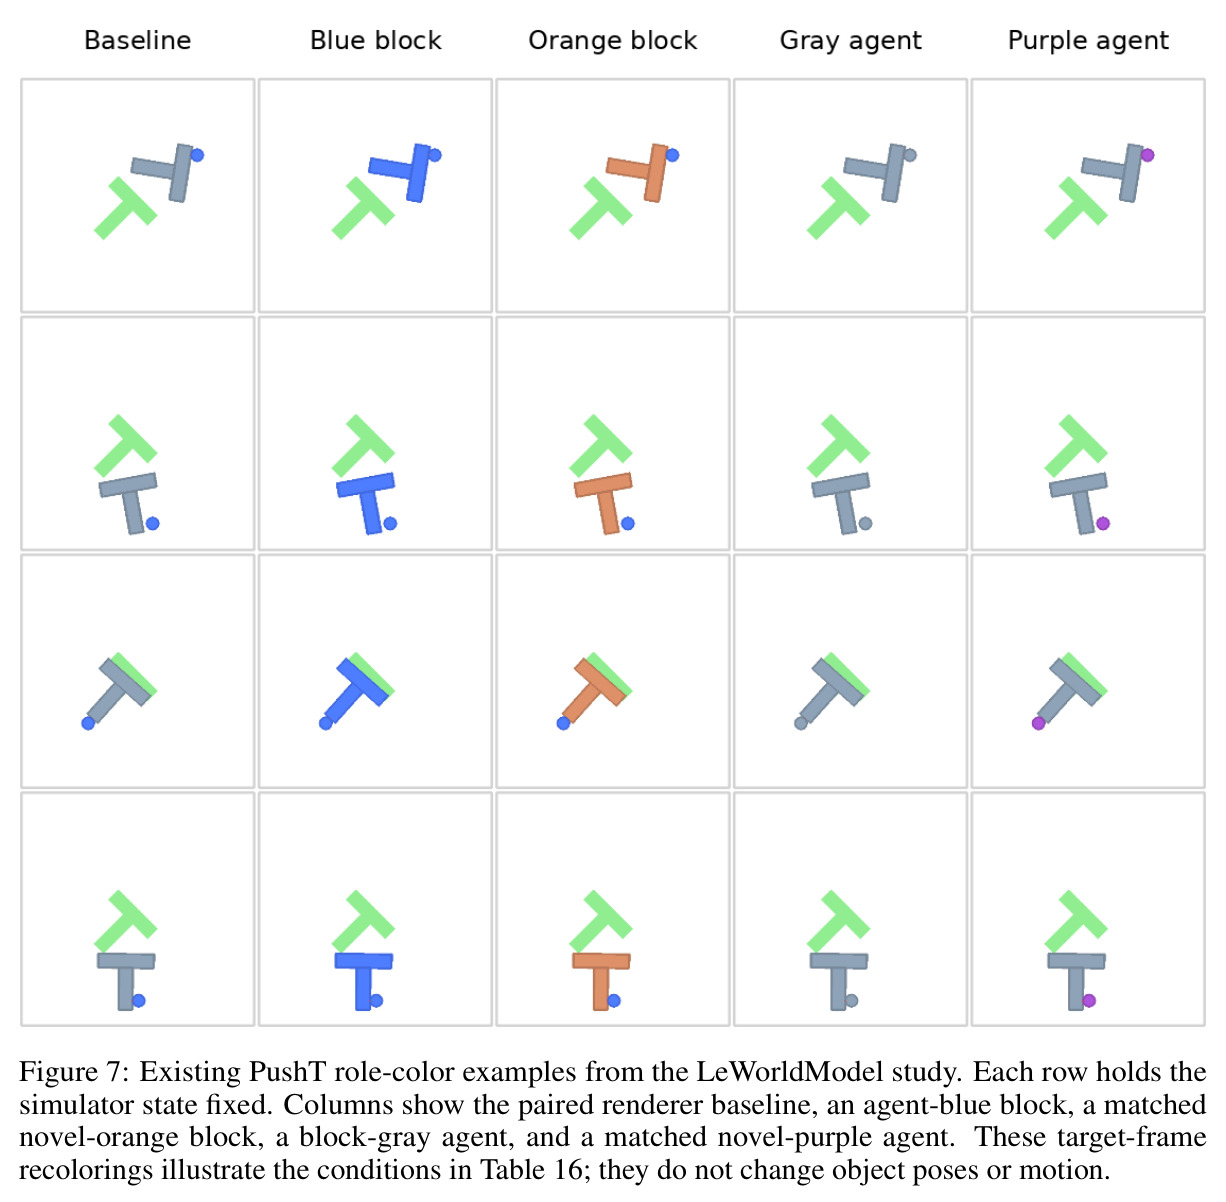
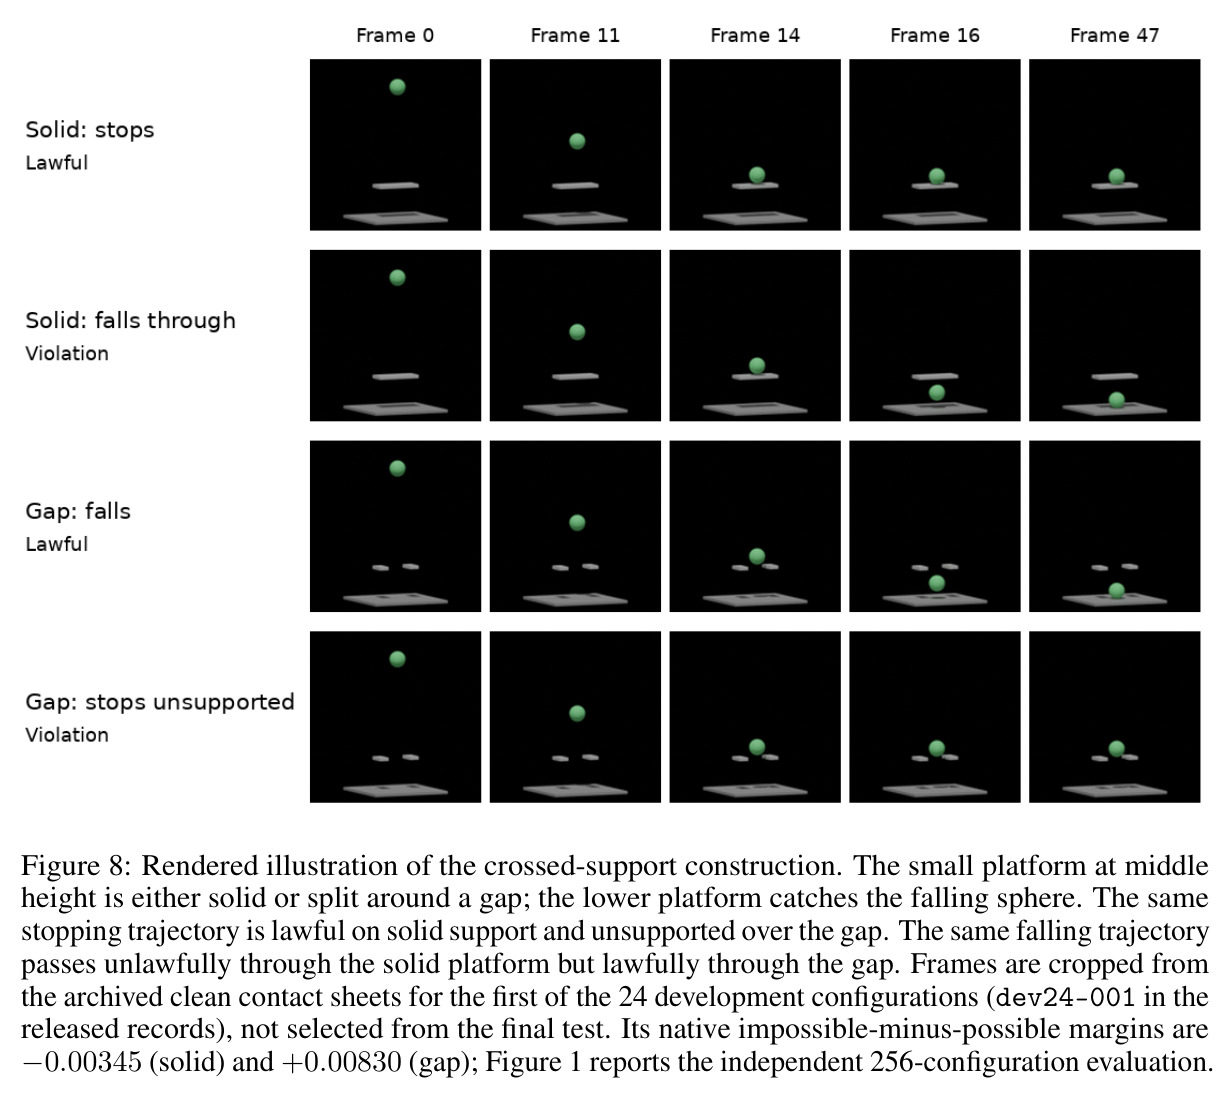
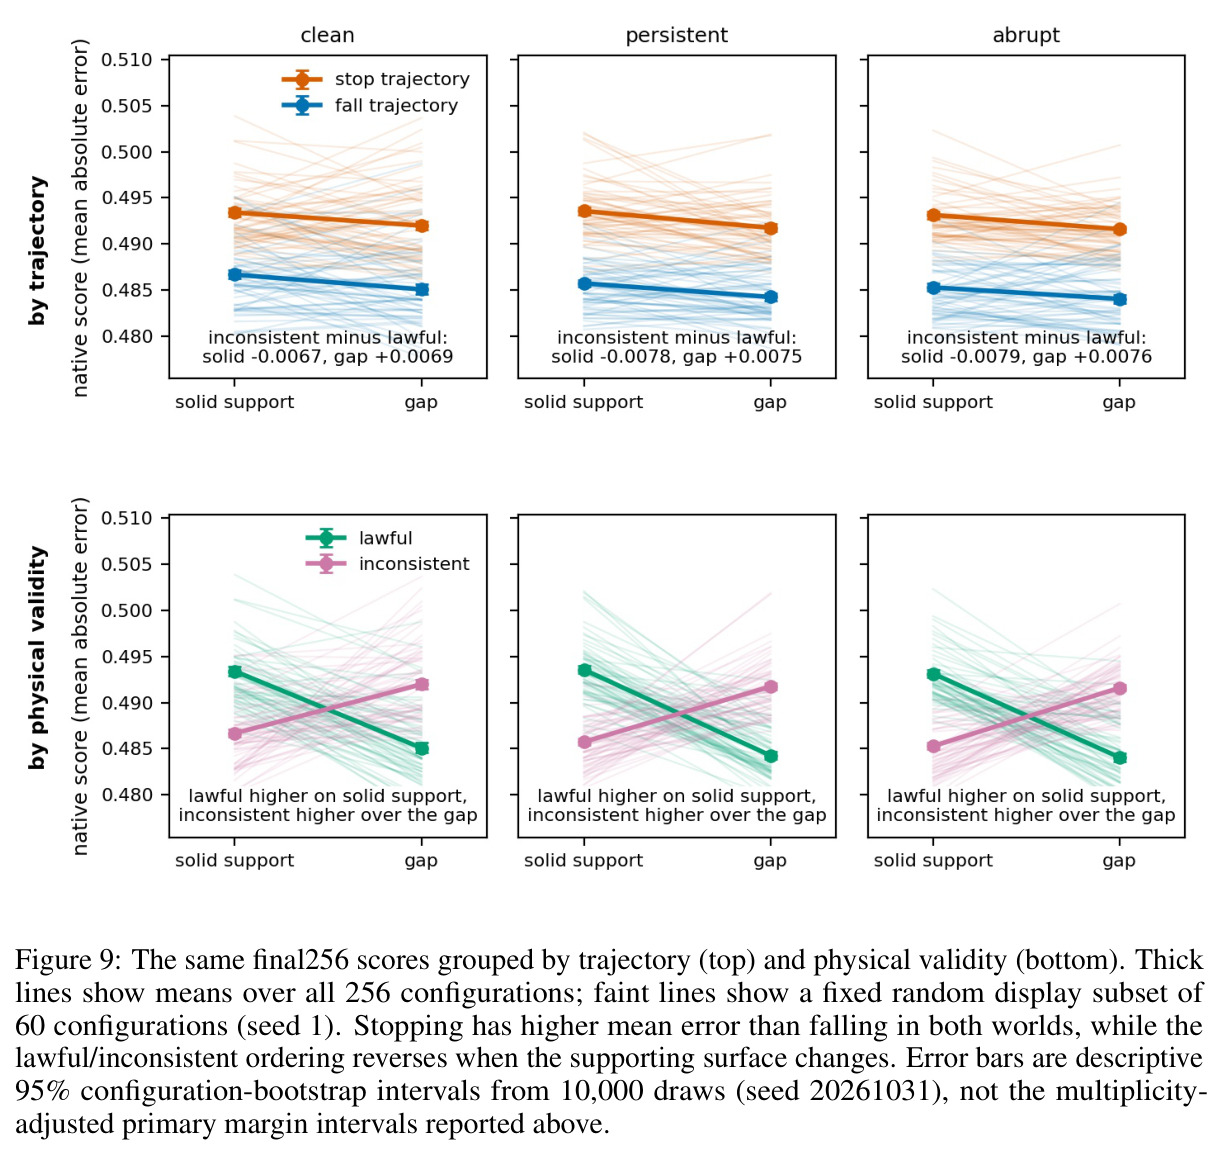
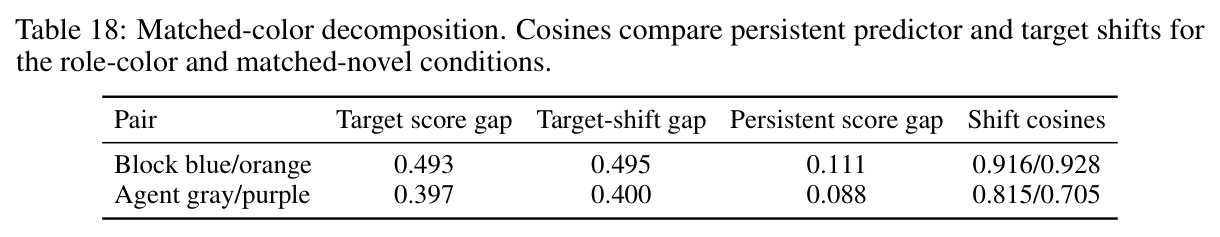
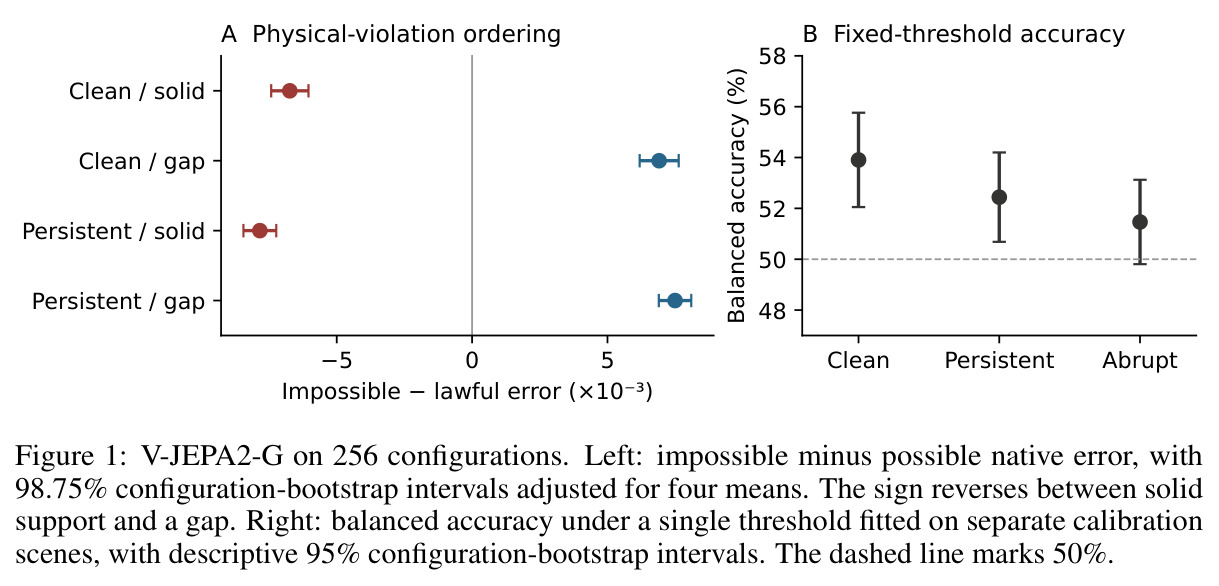
核心思想是把宽泛的「模型理解物理吗」转译为一组受控干预下可测量的具体主张,关键设计有三。其一是交叉支撑解耦:在 Kubric 中渲染下落小球,支撑物设为实体平台或开口,「停止」与「坠落」两种续接在实体支撑上前者合法、在开口上后者才合法,同一轨迹在不同支撑条件下物理有效性互换,从而把误差排序归因于物理有效性而非轨迹形状。其二是区分持续型与仅目标帧型外观编辑:突兀变色本身违反物体属性恒常,而整段持续变色不引入转场,二者可分开考察模型对稳定外观变化的敏感性。其三是代数分解:仅目标帧编辑下预测不变,得分差几乎完全由目标编码器位移解释,可直接指认误差来源而非停留在相关性描述。
方法步骤详情
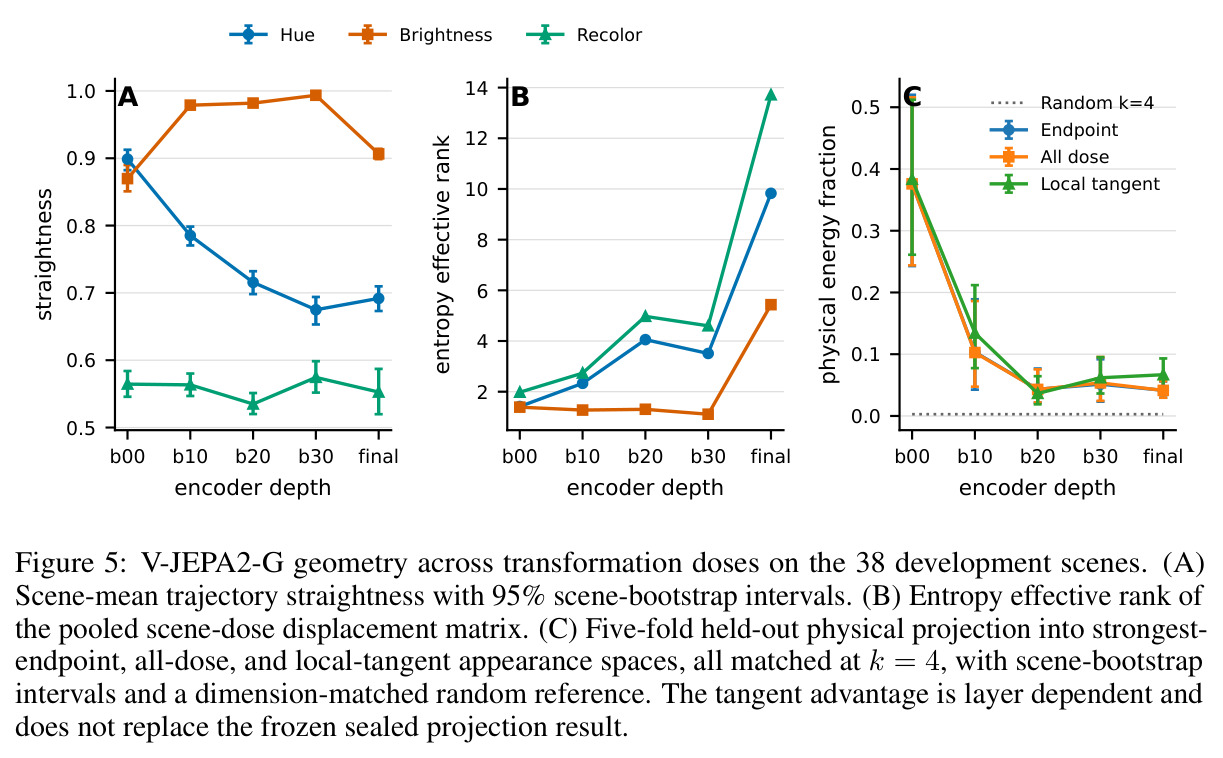
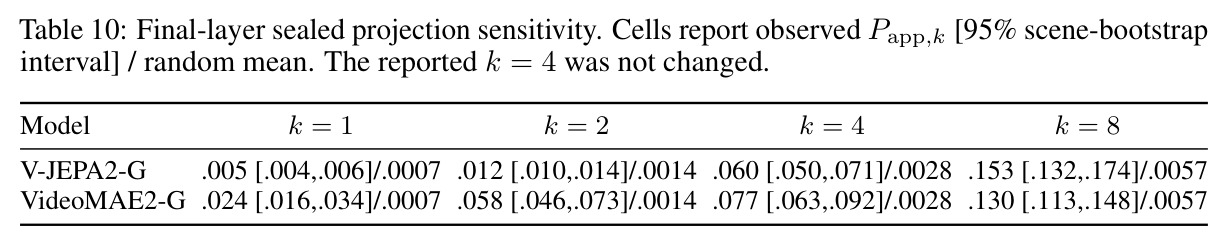
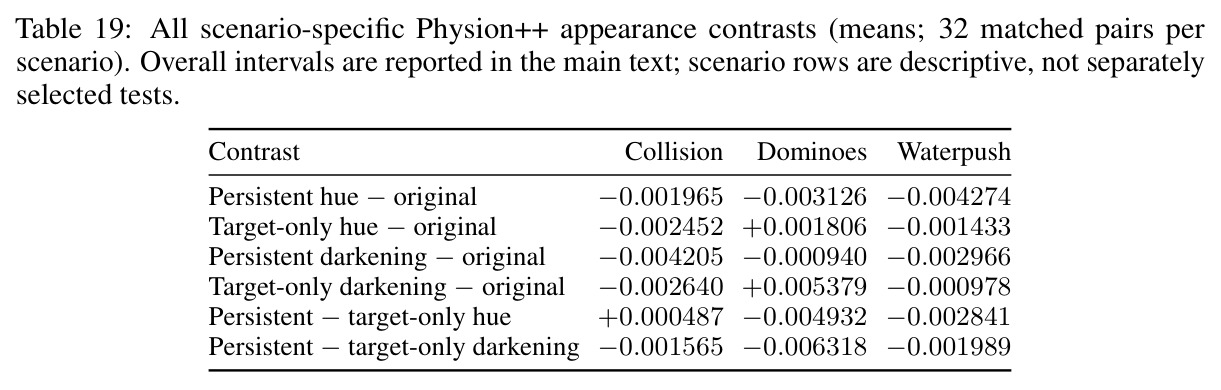
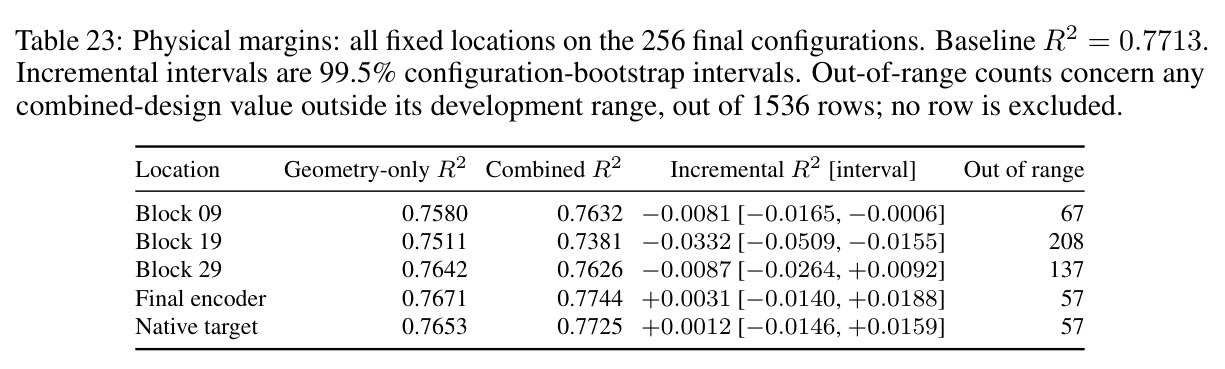
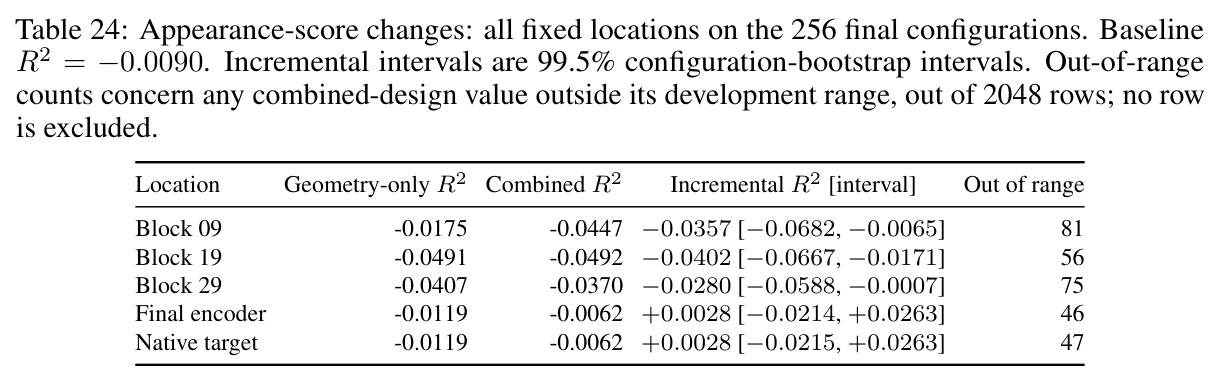
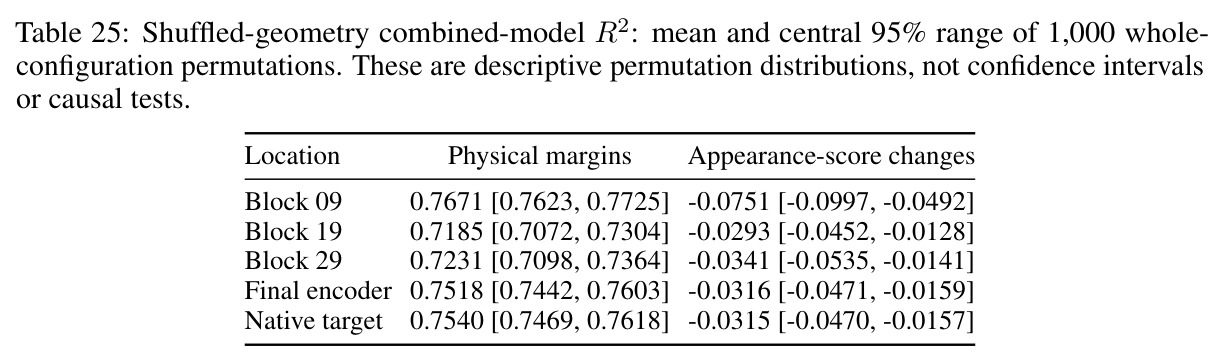
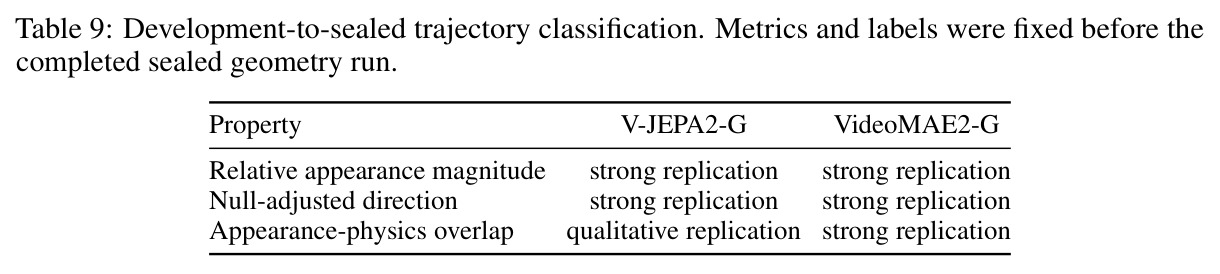
第一步构造交叉支撑数据:256 个 Kubric 配置(实体平台或开口,各配停止与坠落两种续接),叠加原始外观、整段 30 度色相偏移、仅目标段偏移三种条件,共 3,072 段视频;预测器观测 48 帧中的前 12 帧,V-JEPA2-G 原生误差为其余 36 帧上归一化 EMA 目标 token 的平均绝对差。第二步在 IntPhys2 上做五折场景交叉拟合的类平衡线性探针,比较 V-JEPA2-G、VideoMAE2-G 与 PixelSummary(RGB 统计、颜色直方图、帧差),外观四分类与物理二分类分别评估。第三步几何测量:对色相、亮度、重着色位移计算相对无关视频中位距离的比例、相对随机配对的 MRL 提升,以及四维外观子空间捕捉的物理位移比例。第四步 Physion++ 静态诊断:把每个 16 帧窗口与重复其首/中/末帧的版本比较,并在固定中段窗口上施加持续型或仅末 4 帧的色相与压暗编辑。第五步动作干预:每任务 256 回合,施加正确、零、反向三种动作。第六步 OLS 回归:在 24 个独立配置上拟合基线模型与加入几何特征的扩展模型,在 256 个评估配置上预测物理边际与外观诱导的得分变化。
技术新颖性
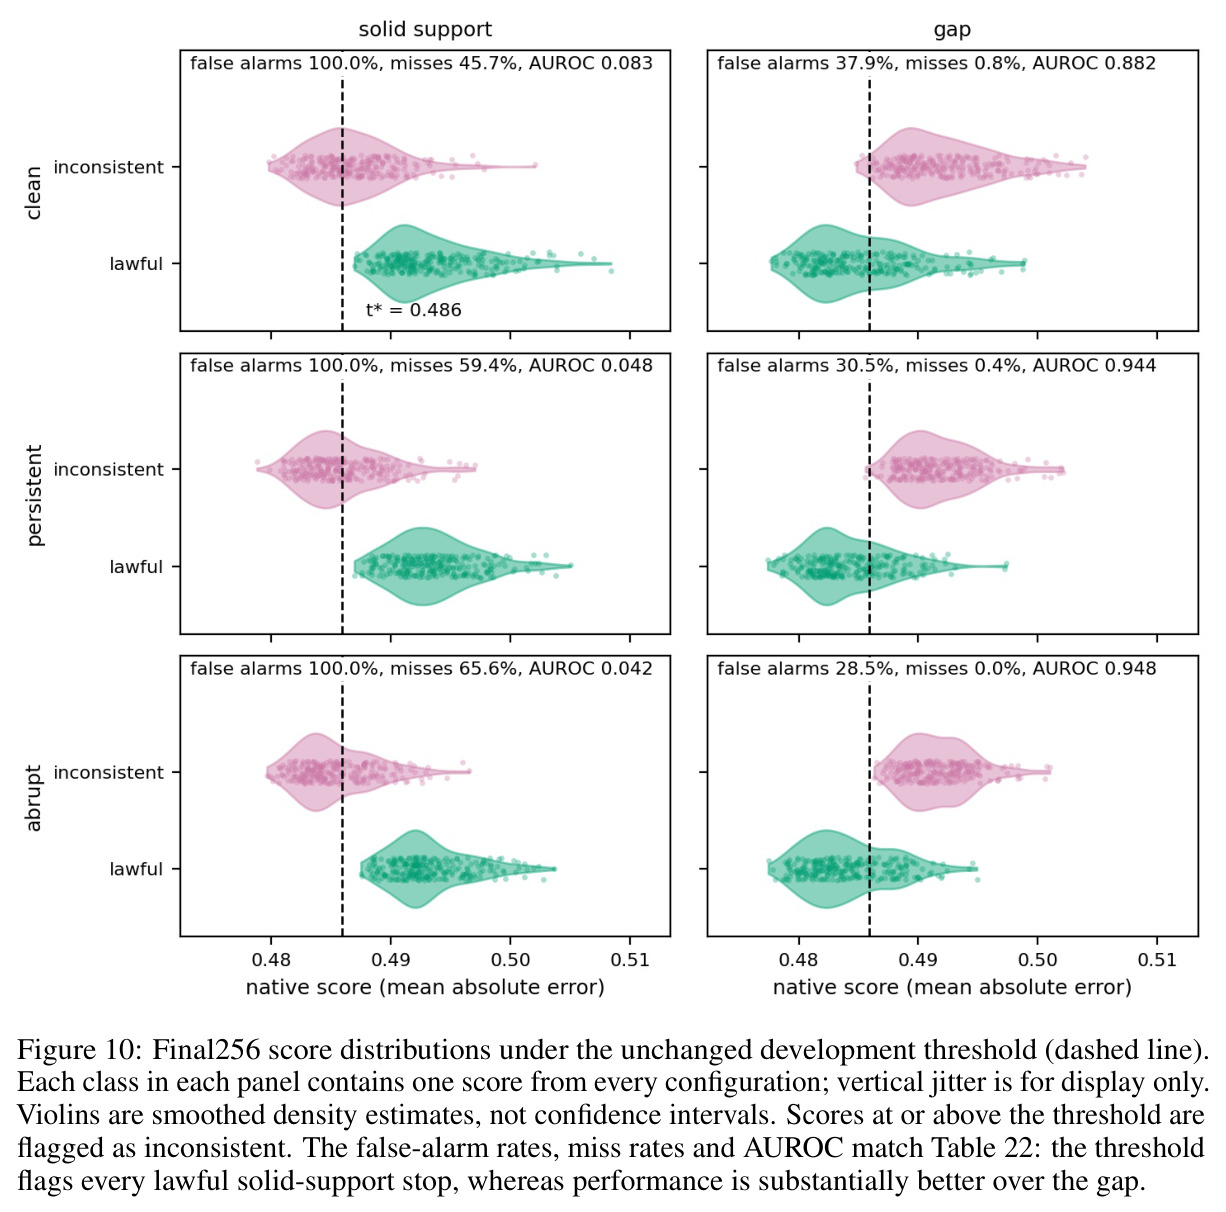
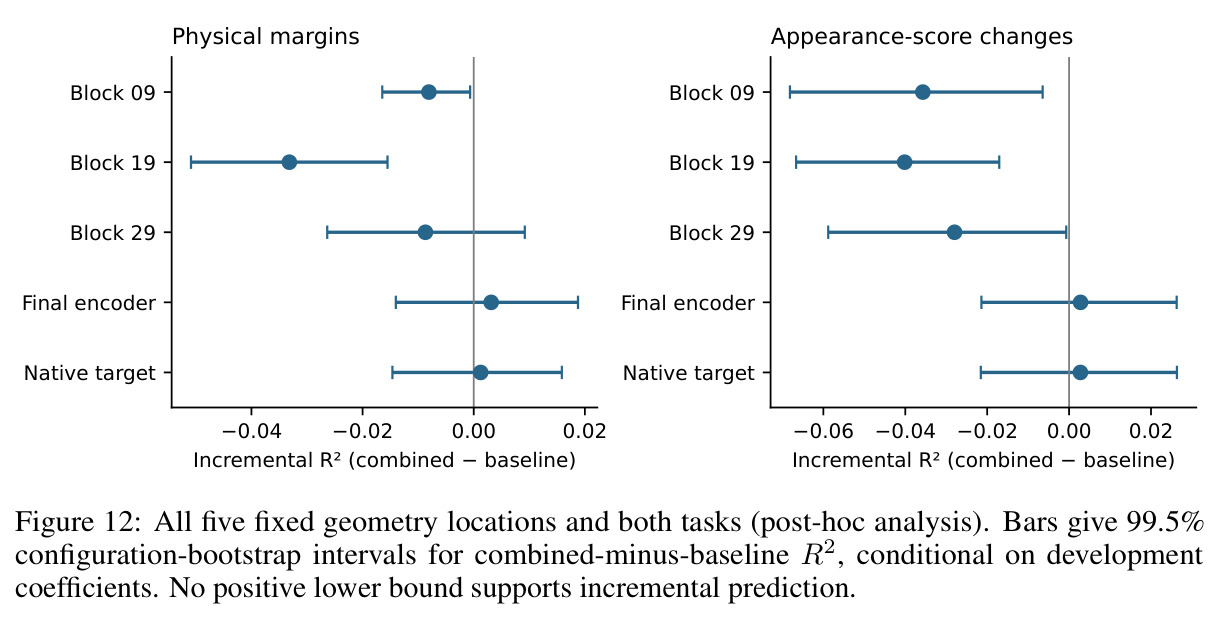
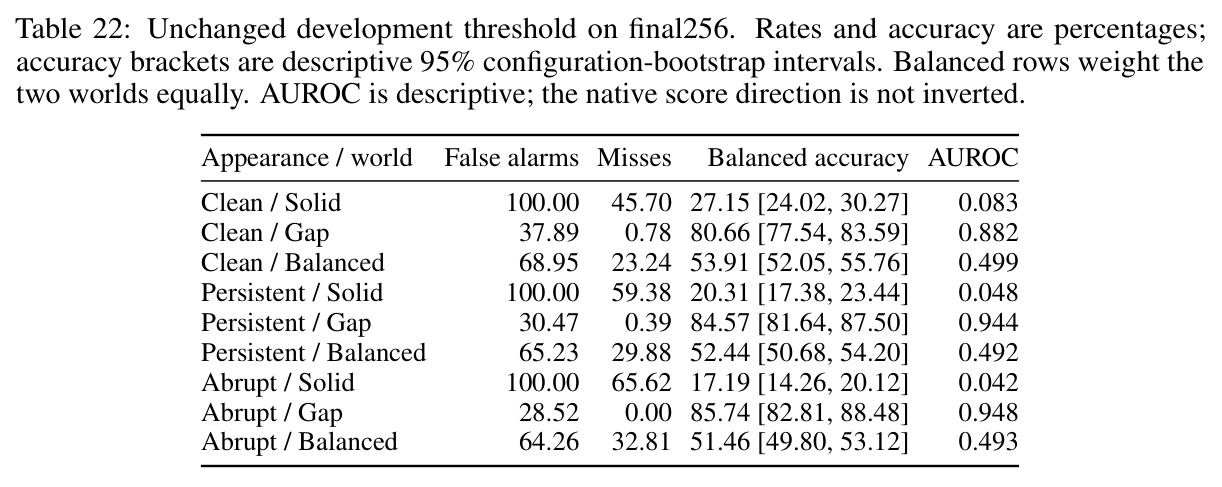
技术新颖性不在新模型或新基准,而在评估方法学。首先,同模型回归分析把表征几何与原生误差第一次在同一设置中连接:加入末层几何特征仅把 $R^2$ 从约 0.771 提升到 0.774,且置信区间含零,直接证伪「几何物理结构预示误差行为」的假设。其次,交叉支撑设计实现了物理有效性与轨迹身份的完全解耦,单一固定阈值整体平衡准确率仅 53.9%、误报约 69% 的失效模式是此前文献未报告的。再次,统计纪律严格:bootstrap 以独立配置为单位、Bonferroni 校正对比族、阈值与回归在独立数据上拟合、附录保留完整分析历史与失败记录。最后,比较保留各发布管线的原生得分与预处理,明确声明无法单独隔离 JEPA 训练目标,避免对架构的过度归因。
实验结果
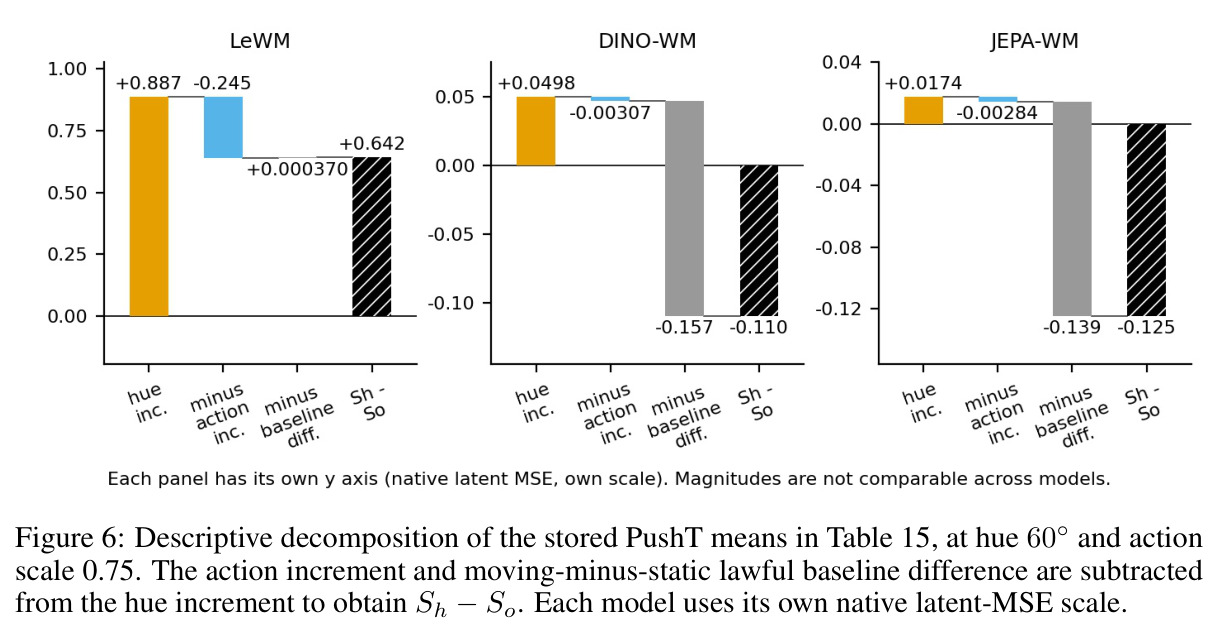
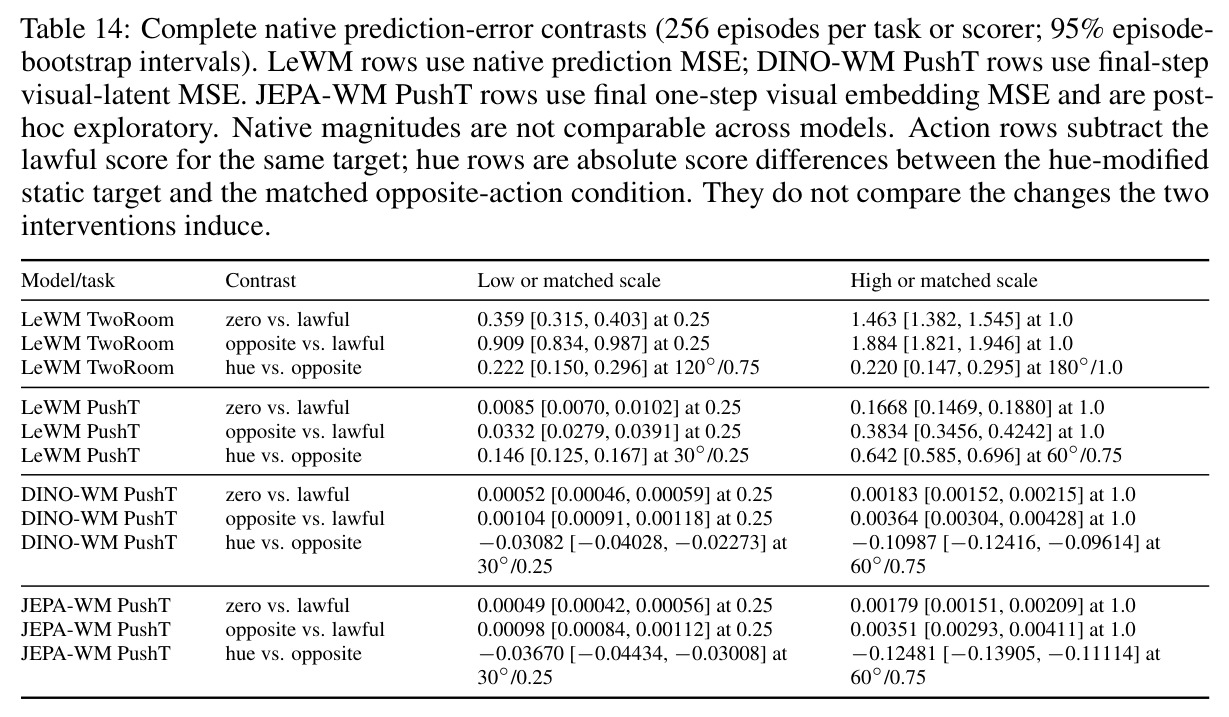
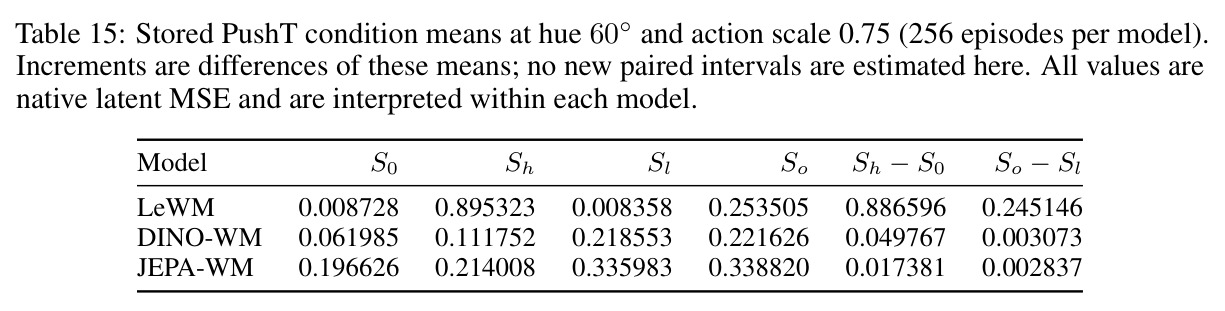
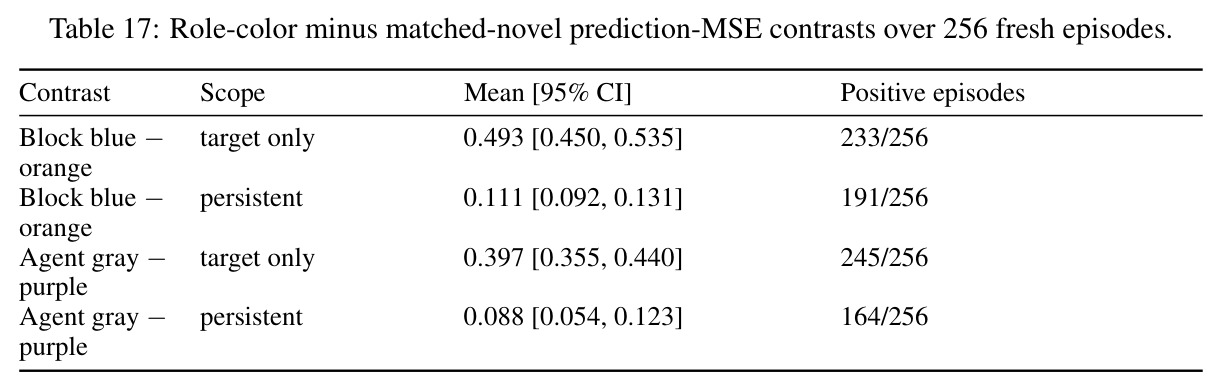
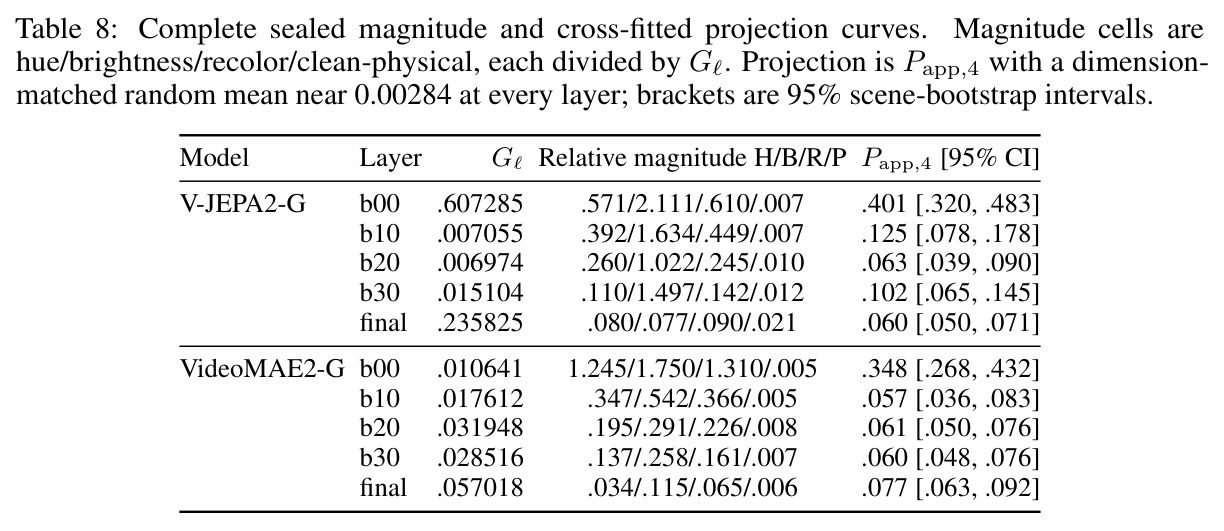
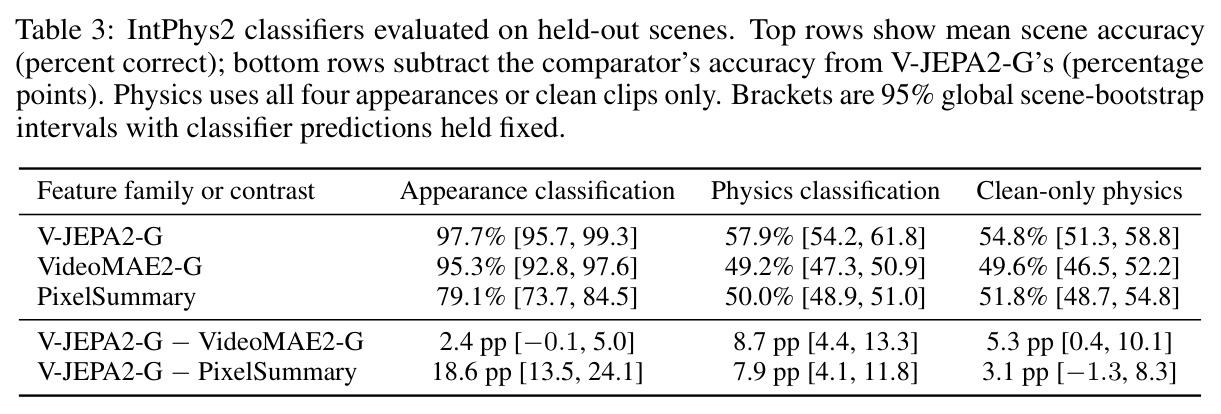
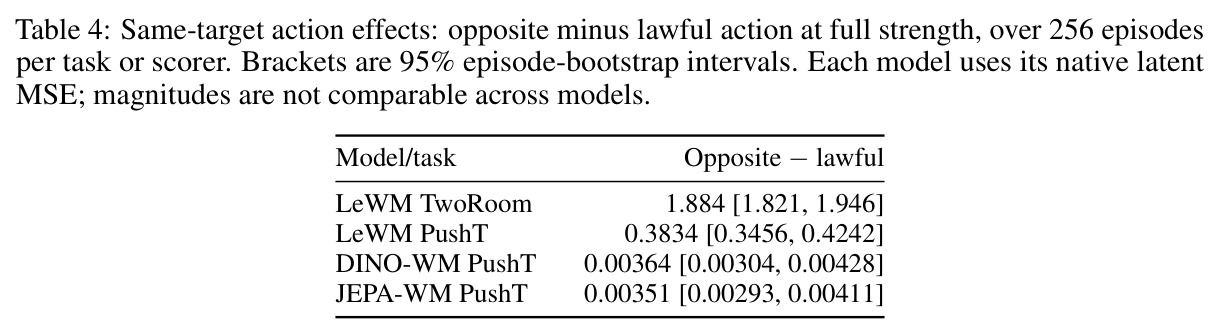
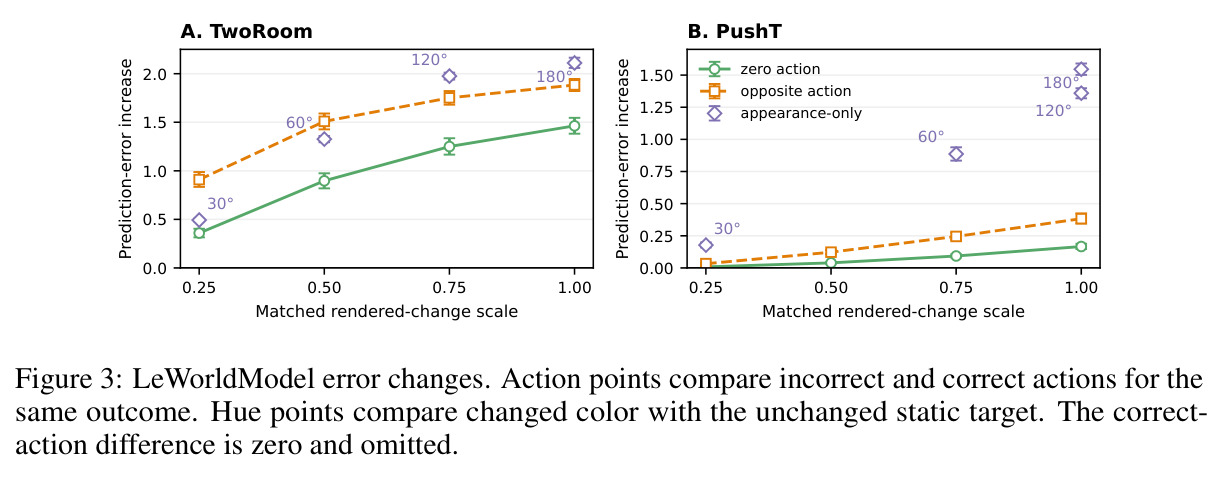
六项检查给出一致结论。读出:IntPhys2 上 V-JEPA2-G 物理标签准确率约 57.9%(仅干净片段 54.8%),高于 VideoMAE2-G 的 49.2%(差 $+8.7$pp)与 PixelSummary 的 50.0%($+7.9$pp),但外观四分类高达 97.7%。几何:V-JEPA2-G 色相位移相对比例从首层约 57% 降到末层约 8%,方向一致性随深度上升并超过随机配对,末层外观子空间对物理位移的捕捉约 6%(随机参照约 0.28%)。交叉支撑:两种支撑设定中停止均比坠落误差更高,不可能减可能的误差符号随支撑反转;固定阈值整体平衡准确率仅 53.9%(开口 80.7%、实体支撑 27.1%),误报约 69% 的合法片段。Physion++:重复单帧的静态对照在约 84% 的窗口中误差不低于原视频,持续变色使误差降低 $-0.00312$、压暗 $-0.00270$。动作:反向动作一致抬高误差(LeWM TwoRoom $+1.884$、PushT $+0.3834$、DINO-WM $+0.00364$、JEPA-WM $+0.00351$),但色相变化同样甚至更大幅度抬高误差(DINO-WM 色相 $+0.04977$ 对动作错配 $+0.00307$)。回归:几何特征把 $R^2$ 从 0.771 提到 0.774,所有区间均非整体为正。结论:模型可以表征物理信息并响应错误动作,但其原生误差并不可靠地度量物理惊讶。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| IntPhys2 物理标签线性读出(四类外观混合) | held-out 场景准确率 | V-JEPA2-G 57.9%(仅干净片段 54.8%) | VideoMAE2-G 49.2%,PixelSummary 50.0% | 对 VideoMAE2-G $+8.7$pp,对 PixelSummary $+7.9$pp |
| IntPhys2 外观四分类读出 | held-out 场景准确率 | V-JEPA2-G 97.7% | VideoMAE2-G 95.3%,PixelSummary 79.1% | 外观信息在所有表征中都极易解码,物理读出相对很弱 |
| 交叉支撑固定阈值物理违规检测(Kubric,256 配置) | 平衡准确率 | 整体 53.9%(开口 80.7%、实体支撑 27.1%),误报约 69% | 50% 随机水平 | 仅略高于随机且在实体支撑上低于随机,阈值迁移失败 |
| Physion++ Mass 静态内容与外观对照(V-JEPA2-L,96 匹配对) | 原生误差差值 | 静态重复帧高于原视频(约 84% 窗口),持续色相 $-0.00312$、持续压暗 $-0.00270$ | 原始视频误差 | 外观与静态内容显著改变误差,方向与物理有效性无关 |
| 动作敏感性(每任务 256 回合) | 反向减合法动作的原生误差差 | LeWM TwoRoom $+1.884$、LeWM PushT $+0.3834$、DINO-WM $+0.00364$、JEPA-WM $+0.00351$ | 合法动作(差值为 0) | 全部显著为正,模型确实使用动作;但色相干预同样抬高误差 |
局限与改进
作者承认的局限:交叉支撑实验只覆盖一个程序化生成族,相机、颜色、光照受限,真实世界与材质泛化未测试,而材质外观本身可能携带质量与摩擦线索;IntPhys2 读出与几何回归属事后分析,区间条件于已拟合的模型与折分配,存在多重探索风险;线性探针无法刻画非线性可解码信息;Physion++ 只有接触标签、没有物理违规标签,且其全窗口打分实现允许目标帧信息渗入上下文 token;跨模型比较同时改变架构、预训练、容量与得分尺度,无法单独隔离 JEPA 训练目标;论文也未估计对规划或异常检测性能的一般性上限。我的补充:57.9% 的读出准确率虽统计显著但实用价值存疑;几何测量仅覆盖少数探针层位且趋势在层间有反复;外观干预以色相和压暗为主,纹理、遮挡、光照等更自然的分布偏移未覆盖。
独立分析的弱点
第一,物理读出与检测任务脱节:57.9% 的线性准确率远低于可用检测器的水平,论文把它记为 Support,但距离真实的物理惊讶检测还很远,改进方向是训练专用物理预测头或参数高效微调而非线性探针。第二,误差对颜色的敏感性提示此类预测目标可能把低层外观统计留在预测路径中,改进方向是在目标编码器上做外观不变化训练或显式去外观正则。第三,交叉支撑实验规模小且单一,应扩展到多物体、多材质、多视角,检验阈值迁移失效是否普遍复现。第四,回归分析只用线性模型和五类几何特征,非线性模型或因果式干预(删除外观子空间后再测误差)可能得出不同结论。第五,各模型原生得分尺度不可比,跨模型结论只能停留在定性层面,未来需要统一得分做受控重训。
未来方向
作者提出的方向:把受控检验扩展到真实视频与材质线索(质量、摩擦),用更大的训练多样性重测外观敏感性;预测误差作为奖励或安全信号使用前必须在目标任务与环境上完成校准。可延伸方向:其一,对表征做因果式清理——移除外观子空间后重测误差,直接检验外观依赖是否可消除;其二,设计外观不变的预测目标或对比目标,训练「误差即物理」的专用世界模型并用本框架审计;其三,把六项检查推广为视频生成筛选与具身规划中误差信号的标准准入测试;其四,研究静态帧为何抬高误差——可能源于时间统计或上下文 token 的历史编码,理解它有助于修正打分实现;其五,把单点阈值校准扩展为分条件校准曲线,系统报告跨条件的误报/漏报权衡。
复现评估
复现条件较好。代码与全部数值实验记录开源于 https://github.com/3-ml/jepa-surprise(附录 G),模型全部使用公开检查点:V-JEPA2-G/L、VideoMAE2-G、共享冻结 DINOv2 编码器的 DINO-WM 与 JEPA-WM,以及 LeWM 的任务专用发布权重;数据为公开基准 IntPhys2、Physion++ Mass、TwoRoom、PushT,Kubric 场景可由其开源框架重新渲染。计算需求中等:所有编码器冻结,主要开销是线性探针、几何统计、三千余段合成视频的前向推理与 Kubric 渲染,单卡 GPU 即可覆盖大部分实验。统计协议(bootstrap 单位、Bonferroni 族、拟合与划分历史)在附录完整给出,并保留失败与被排除的后续分析。复现难度评估为中等偏低,主要工作量在多模型管线的工程对接与渲染配置。
论文图表