随机近乎足够:基于 BestRand 的稳定低成本基准压缩 Random Is Almost Enough? Stable and Low-Cost Benchmark Compression via BestRand
证明随机抽样压缩高效却长尾不稳定,用少量探针模型优选随机子集,低成本削减高误差风险
前置知识
基准压缩(Benchmark Compression)
指不再让模型跑完基准的全部题目,而是选一个小子集(如保留 10%–20% 的题)进行评测,用子集上的分数近似全量分数。它与模型压缩无关,压缩的对象是评测本身。常见做法分三类:纯随机抽样、基于历史分数学习代表题目(IRT、聚类、预测器)、以及只看题目文本嵌入的无响应方法。
本文的全部理论和方法都围绕'用 k 题子集估计 N 题全量分数会产生多大误差、如何更稳'展开,理解这一任务设定是读懂论文的前提。
MAE 与共同偏移(Common Shift)
MAE 是子集估计分数与全量分数之差的绝对值在 M 个模型上的平均:$\mathrm{MAE}=\frac{1}{M}\sum_m |E_m|$,是本文的主指标。共同偏移 $\bar E=\bar g_S-\bar g_N$ 指子集的平均题目难度相对全量的整体偏移——子集偏易则所有模型分数同被抬高。理论证明 $\mathrm{MAE}\ge|\bar E|$ 恒成立,故共同偏移是误差的'下界'与长尾主要来源。
BestRand 的选择准则和全部定理都建立在'削减共同偏移方差'之上,不掌握这个量就无法理解方法为何有效。
长尾分布与众数(Mode)
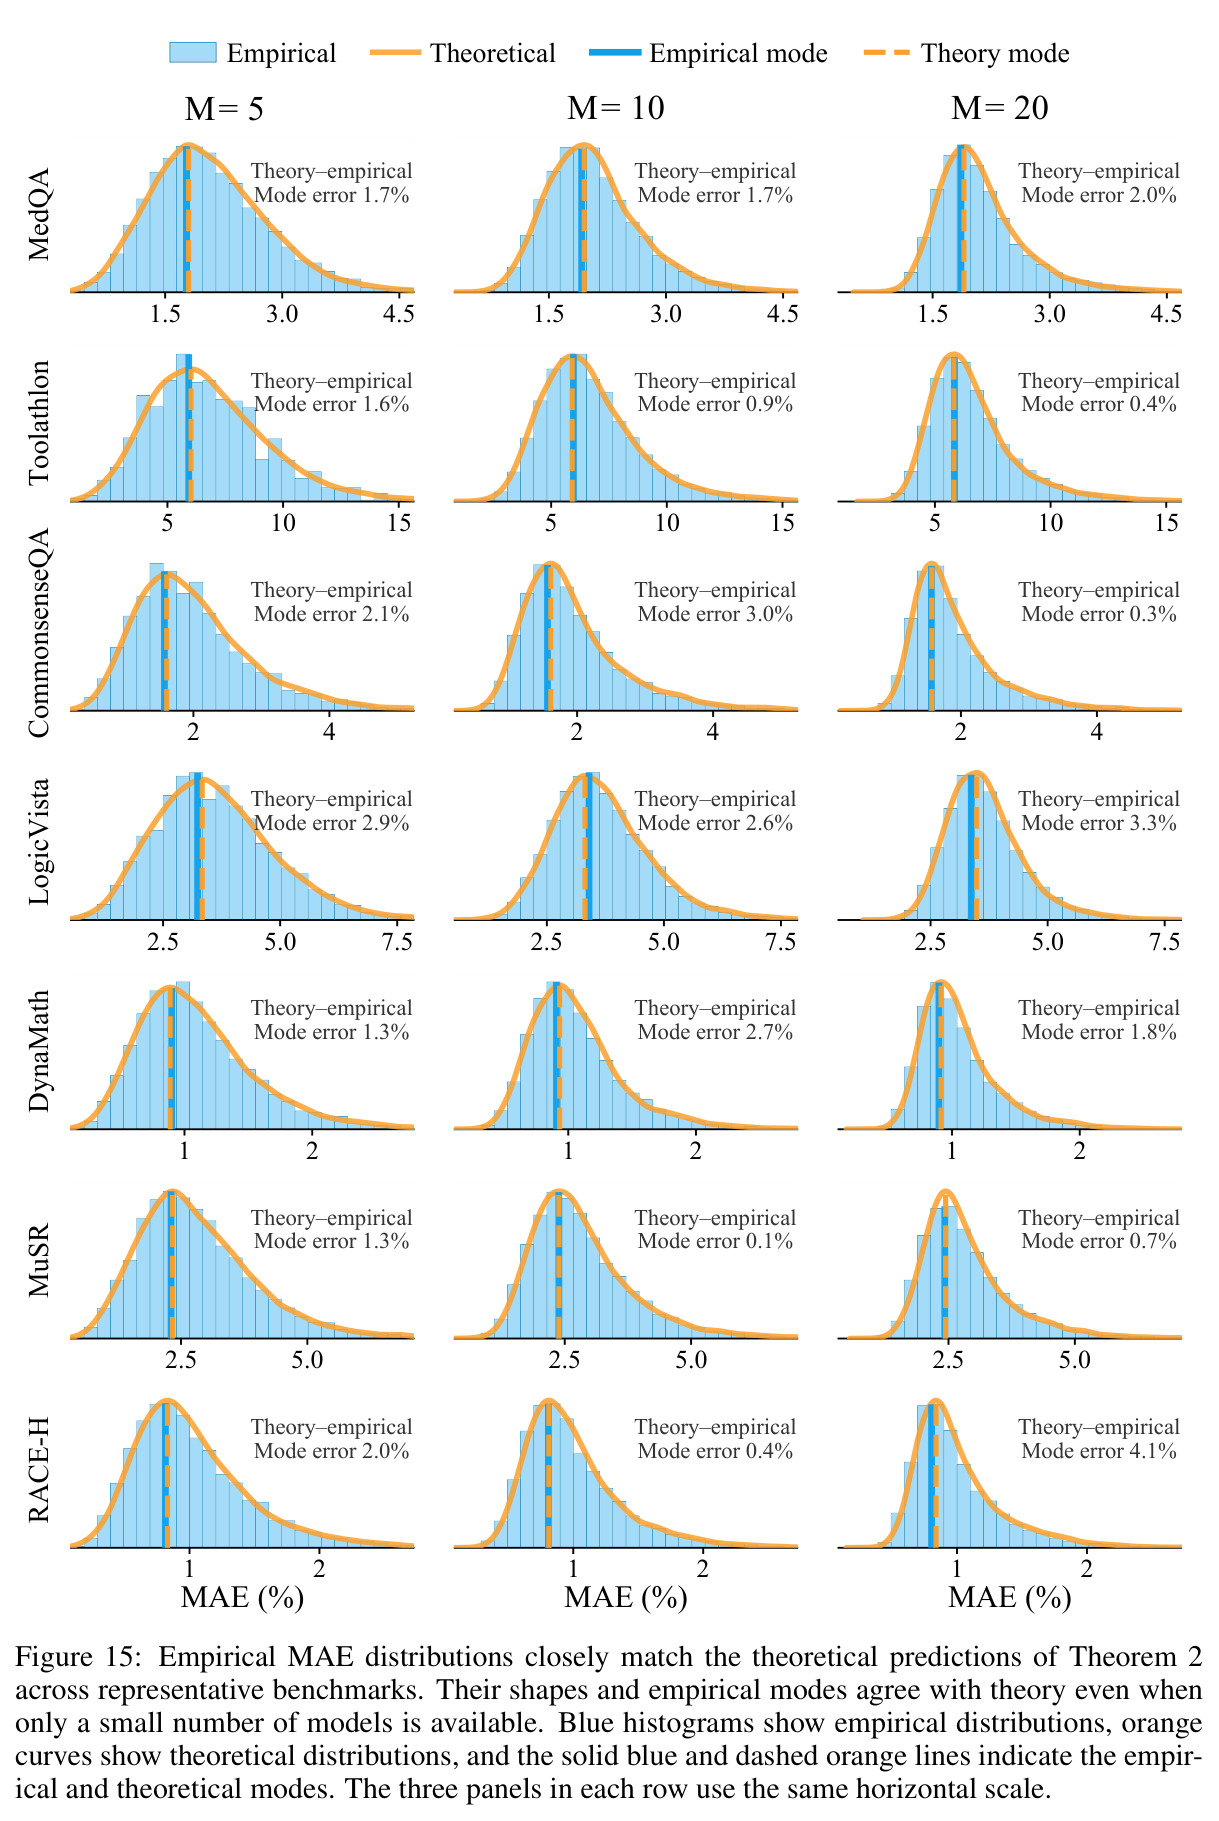
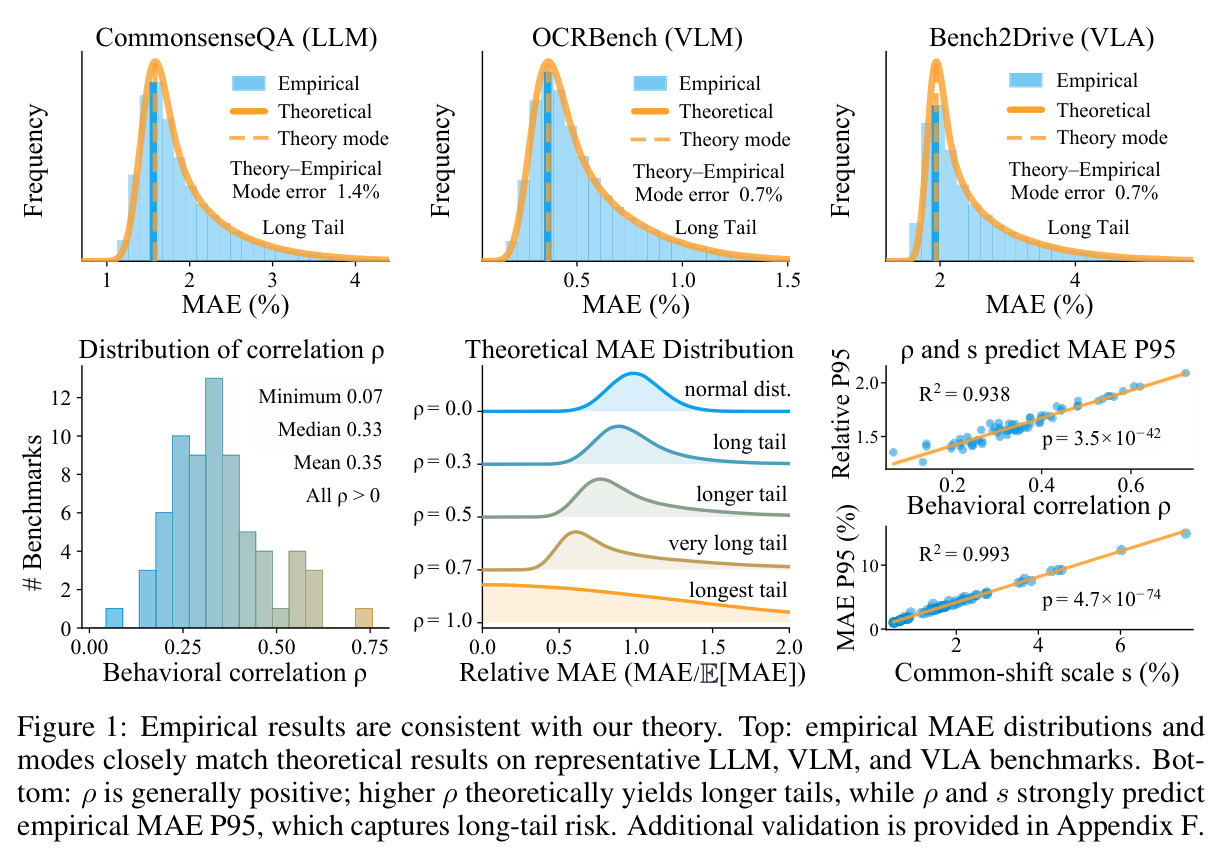
长尾分布指大部分取值集中在低误差区、但右侧拖着一条包含罕见大误差的'尾巴'的分布。众数是分布密度最高的点。本文证明随机抽样的 MAE 分布众数靠近分布下端点 $y_0=\sqrt{2/\pi}\,c(k)\sigma\sqrt{1-\rho}$,逼近速率为 $1+C_0/\sqrt{M}$($C_0\approx0.578$),即'大多数子集已经很准,少数抽签很糟'。
'随机几乎够用但偶尔失败'这一标题问题的答案完全由分布形状给出:众数位置解释'够用',右尾解释'不稳定'。
行为相关性 ρ 与协方差矩阵
把每个模型在每道题上的去均值分数组成向量,可计算模型间分数的协方差矩阵 $C$。Assumption 1 假设对角相等($C_{mm}=\sigma^2$)、非对角相等($C_{ml}=\rho\sigma^2$),$\rho$ 即模型间错误行为的平均两两相关。基础模型因共享骨干、重叠语料和蒸馏而在相同的题上一起对或一起错,导致 $\rho$ 显著为正(实测中位 0.33)。
本文把随机抽样不稳定的根源归结为 $\rho$:误差尺度 $s=c(k)\sigma\sqrt{\rho+(1-\rho)/M}$ 随 $\rho$ 增大,且 $M\to\infty$ 时极限非零,这是全文最核心的洞察。
有限总体抽样与校正因子 c(k)
题目全集被视作固定的有限总体,随机性只来自无放回抽取 k 题。与独立同分布抽样不同,无放回抽样的方差带有限总体校正因子 $c(k)=\sqrt{(N-k)/[k(N-1)]}$:保留越少方差越大,$k=N$ 时误差为零。其极限理论由 Hájek 的有限总体中心极限定理支撑,保证误差向量近似多元正态。
论文所有公式($s$、尾部概率 $2\Phi(-t/s)$、定理证明)都显式依赖 $c(k)$,它是连接'保留率'与'误差大小'的桥梁。
研究动机
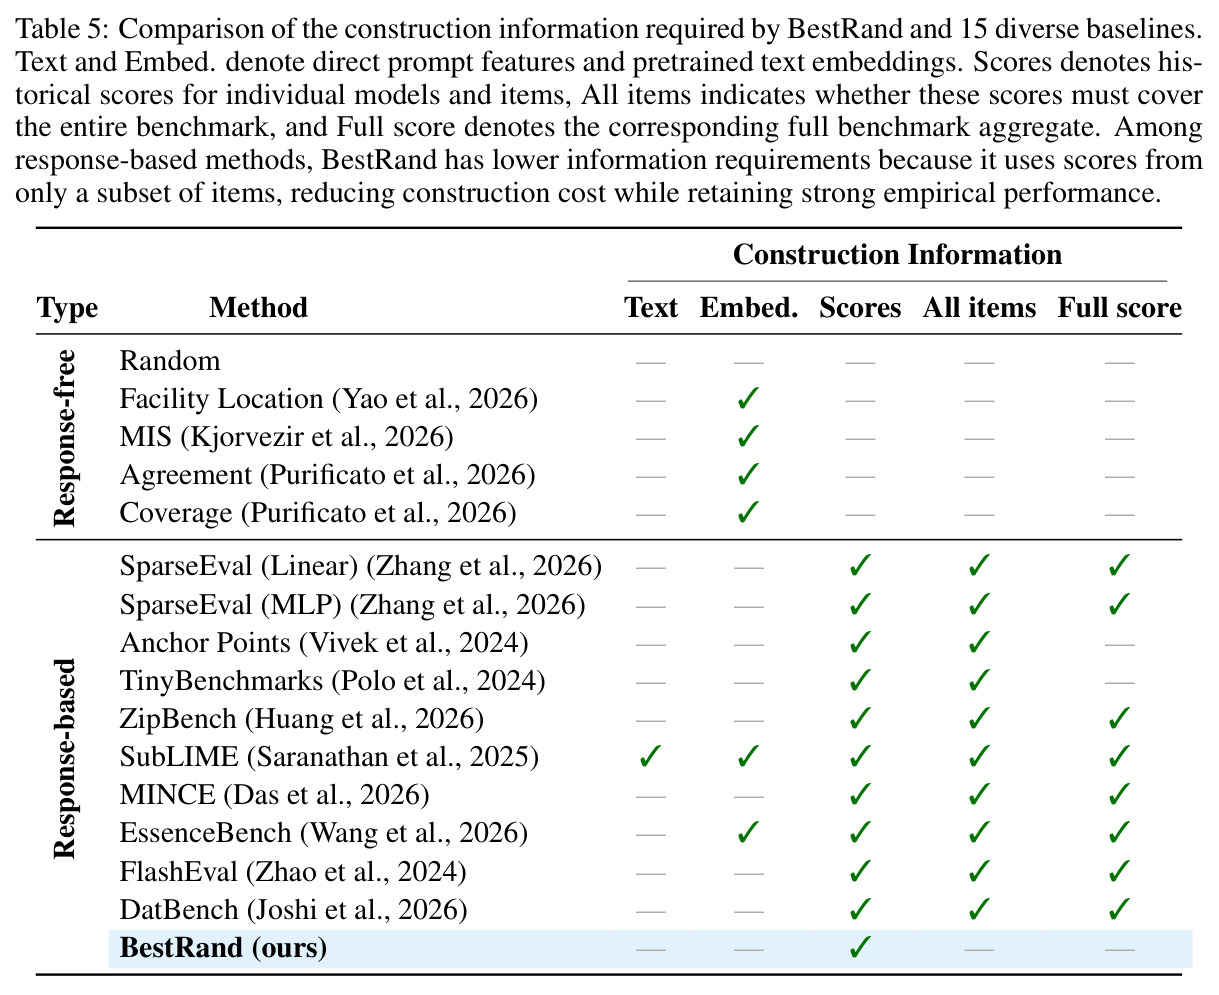
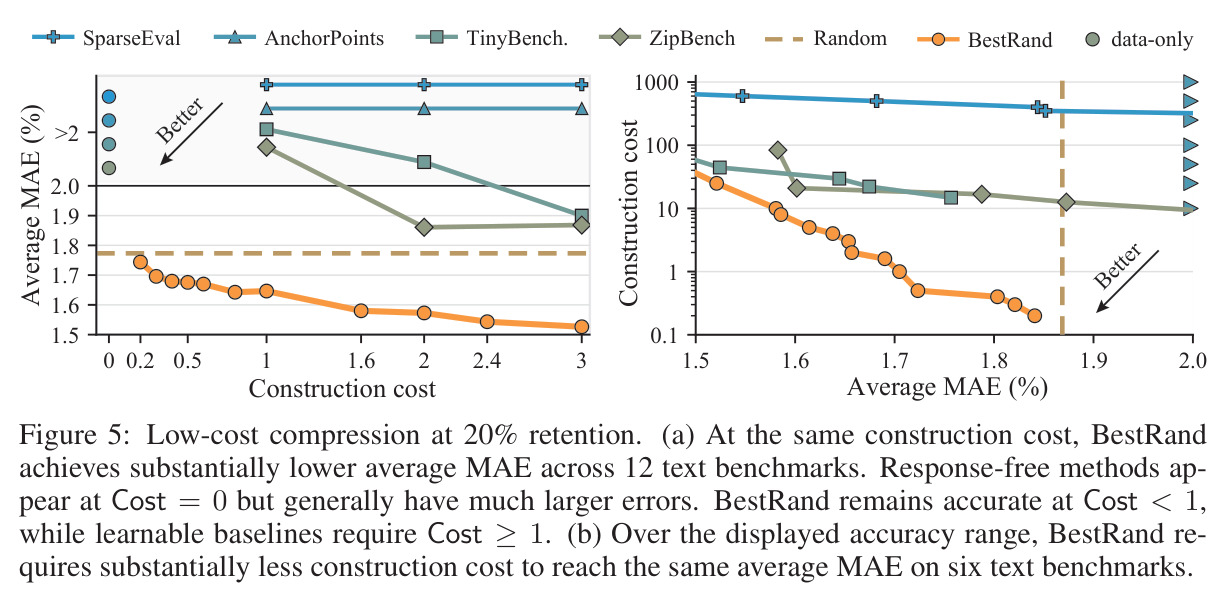
评测一个大模型动辄要在数千道题上完整推理:MMLU、GSM8K、MMMU 等基准题量大且含冗余,完整评测的时间与算力成本高企,对每天迭代大量检查点的研发流程尤其难以承受。基准压缩试图只用一个小子集近似全量分数,但现有方法对'近似有多准、多可靠'缺乏理论刻画。实践中存在两个痛点:其一,随机抽个子集往往意外地准,但偶尔会偏差极大——单一随机抽取不可靠,没人敢只凭一次随机子集的分数下结论;其二,TinyBenchmarks、ZipBench、SparseEval 等学习型方法依赖覆盖全基准的历史'模型-题目'分数记录(归一化构建成本 $\mathrm{Cost}\ge1$,即至少相当于一个模型的完整评测),构建昂贵,且本文实验显示它们在分数区间、模型家族、时间等分布漂移下误差严重恶化——SparseEval 线性版平均 MAE 高达约 21%–23%,在所有 OOD 设置下反而不如纯随机抽样。
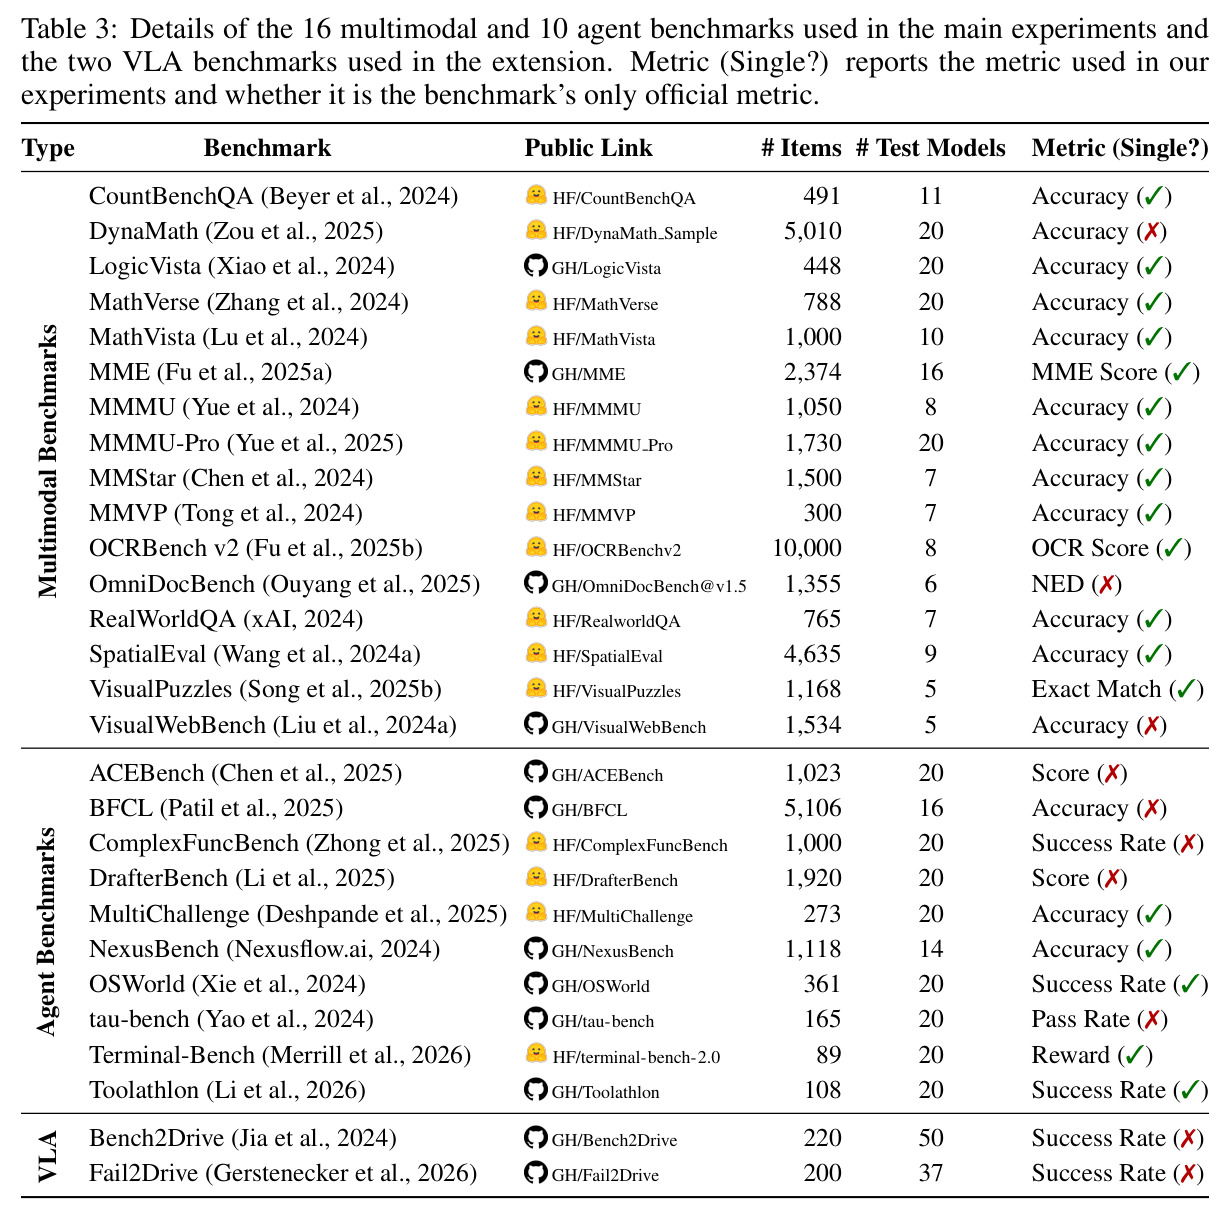
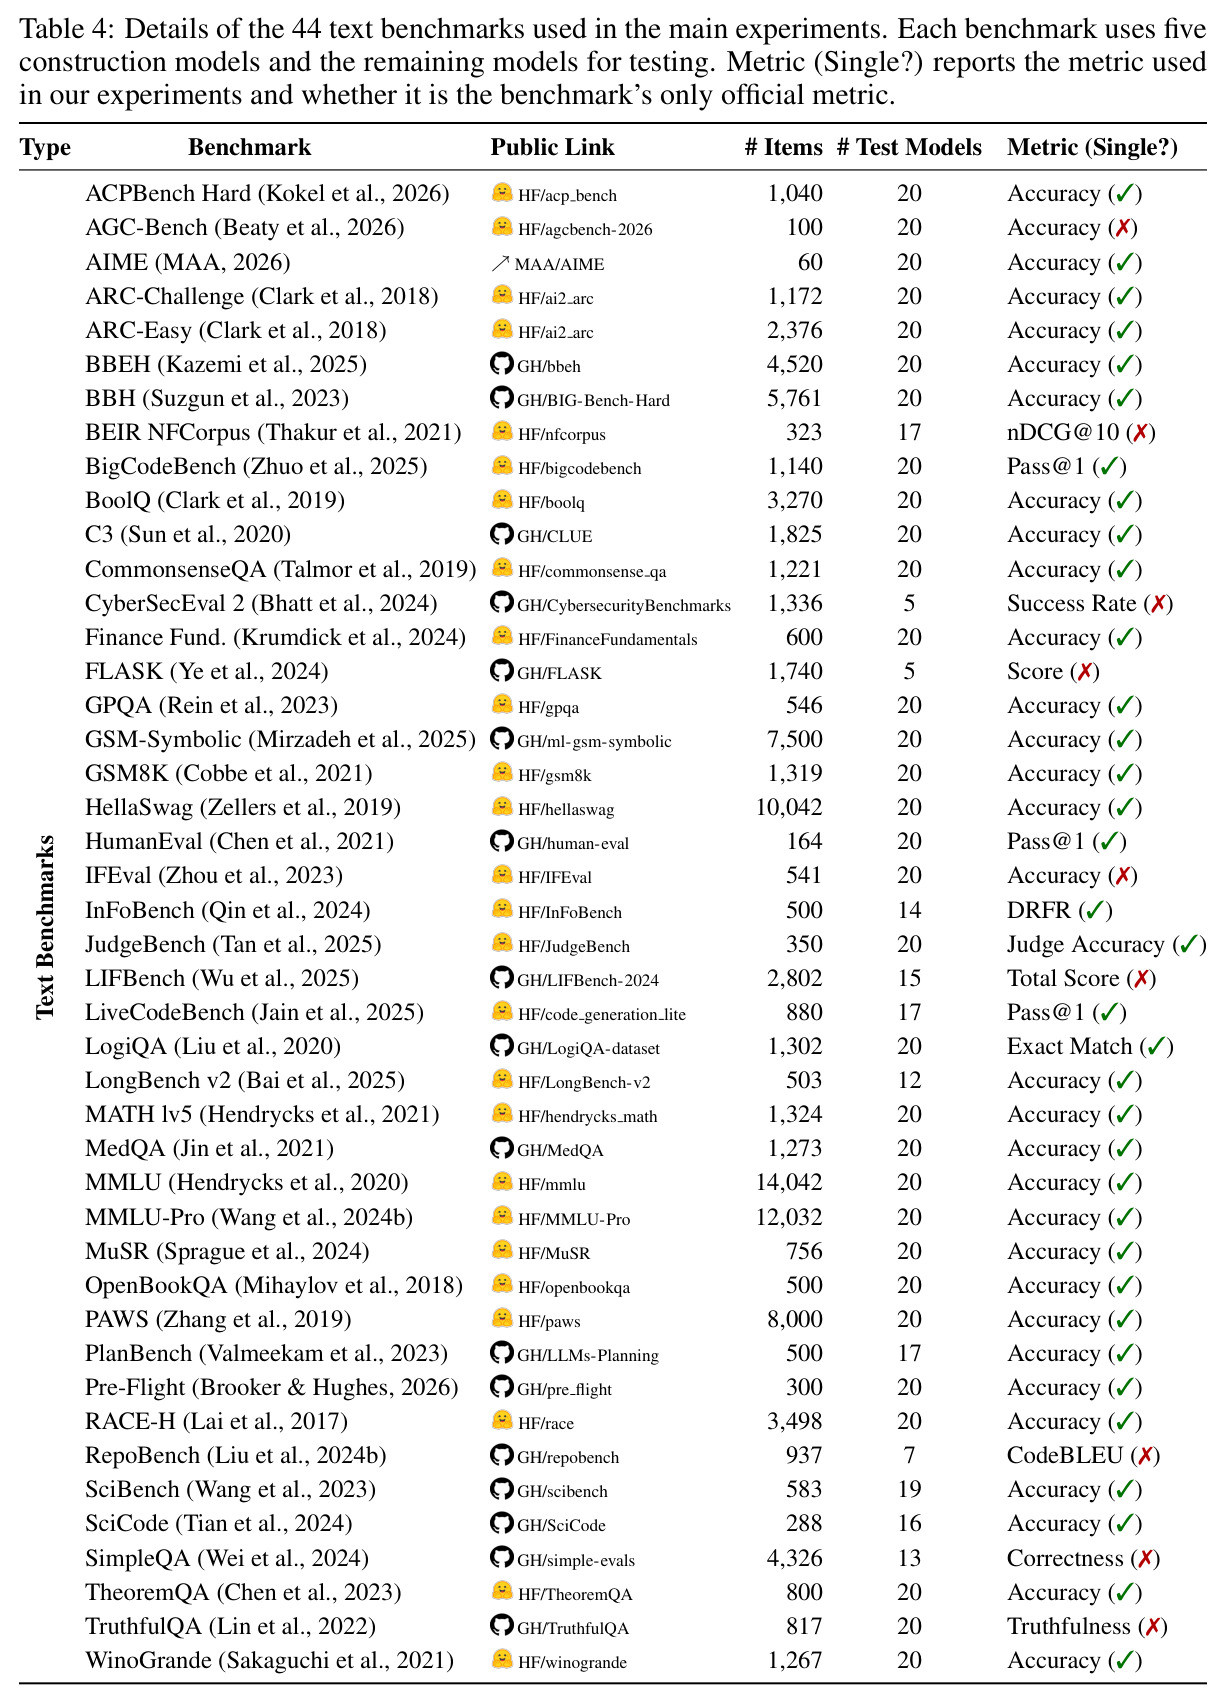
本文的目标是本文目标分两层。理论层:推导'用 k 题子集估计全基准分数'这一抽样过程的误差分布解析近似,回答三个问题——随机抽样误差的分布形状是什么?为什么大多数子集已经够准?偶尔的大误差从何而来、能否随评测模型增多而消除?并给出子集大小 $k$、模型间行为相关性 $\rho$ 与误差尺度 $s$ 的定量关系,用于指导精度-成本权衡。方法层:在不放弃随机抽样低成本优势的前提下,设计一个能大幅削减高误差尾部、且构建成本低于现有数据依赖方法的压缩器;在 70 个文本/多模态/智能体基准、6 档保留率(2%–50%)、15 个对比方法、三类 OOD 漂移以及 Bench2Drive、Fail2Drive 两个 VLA 基准上系统验证其精度、稳定性、OOD 鲁棒性与成本效率。
与已有工作不同的是,本文的独特切入是把'随机抽样本身'当作研究对象,而不是急着设计更复杂的选择算法。作者先证明随机抽样的 MAE 分布呈长尾:众数靠近下端点 $y_0=\sqrt{2/\pi}\,c(k)\sigma\sqrt{1-\rho}$,以 $\hat y(M)/y_0=1+C_0/\sqrt{M}$($C_0\approx0.578$)的普适速率逼近,这解释了'随机几乎够用';同时尾部下界 $\Pr(\mathrm{MAE}>t)\ge 2\Phi(-t/s)$ 由共同偏移尺度 $s=c(k)\sigma\sqrt{\rho+(1-\rho)/M}$ 控制,而 $\rho$ 源自基础模型共享骨干、重叠语料与蒸馏造成的内在行为相似性——$M\to\infty$ 时 $s\to c(k)\sigma\sqrt{\rho}$ 非零,说明多评测模型也平均不掉这种不稳定。既然好子集本占多数,方法上就无需'学'代表子集,只需从一批随机候选中挑出探针均值最均衡的那个,把长尾修剪掉即可——这是与 IRT/聚类/预测器路线方向相反的极简思路。
核心方法
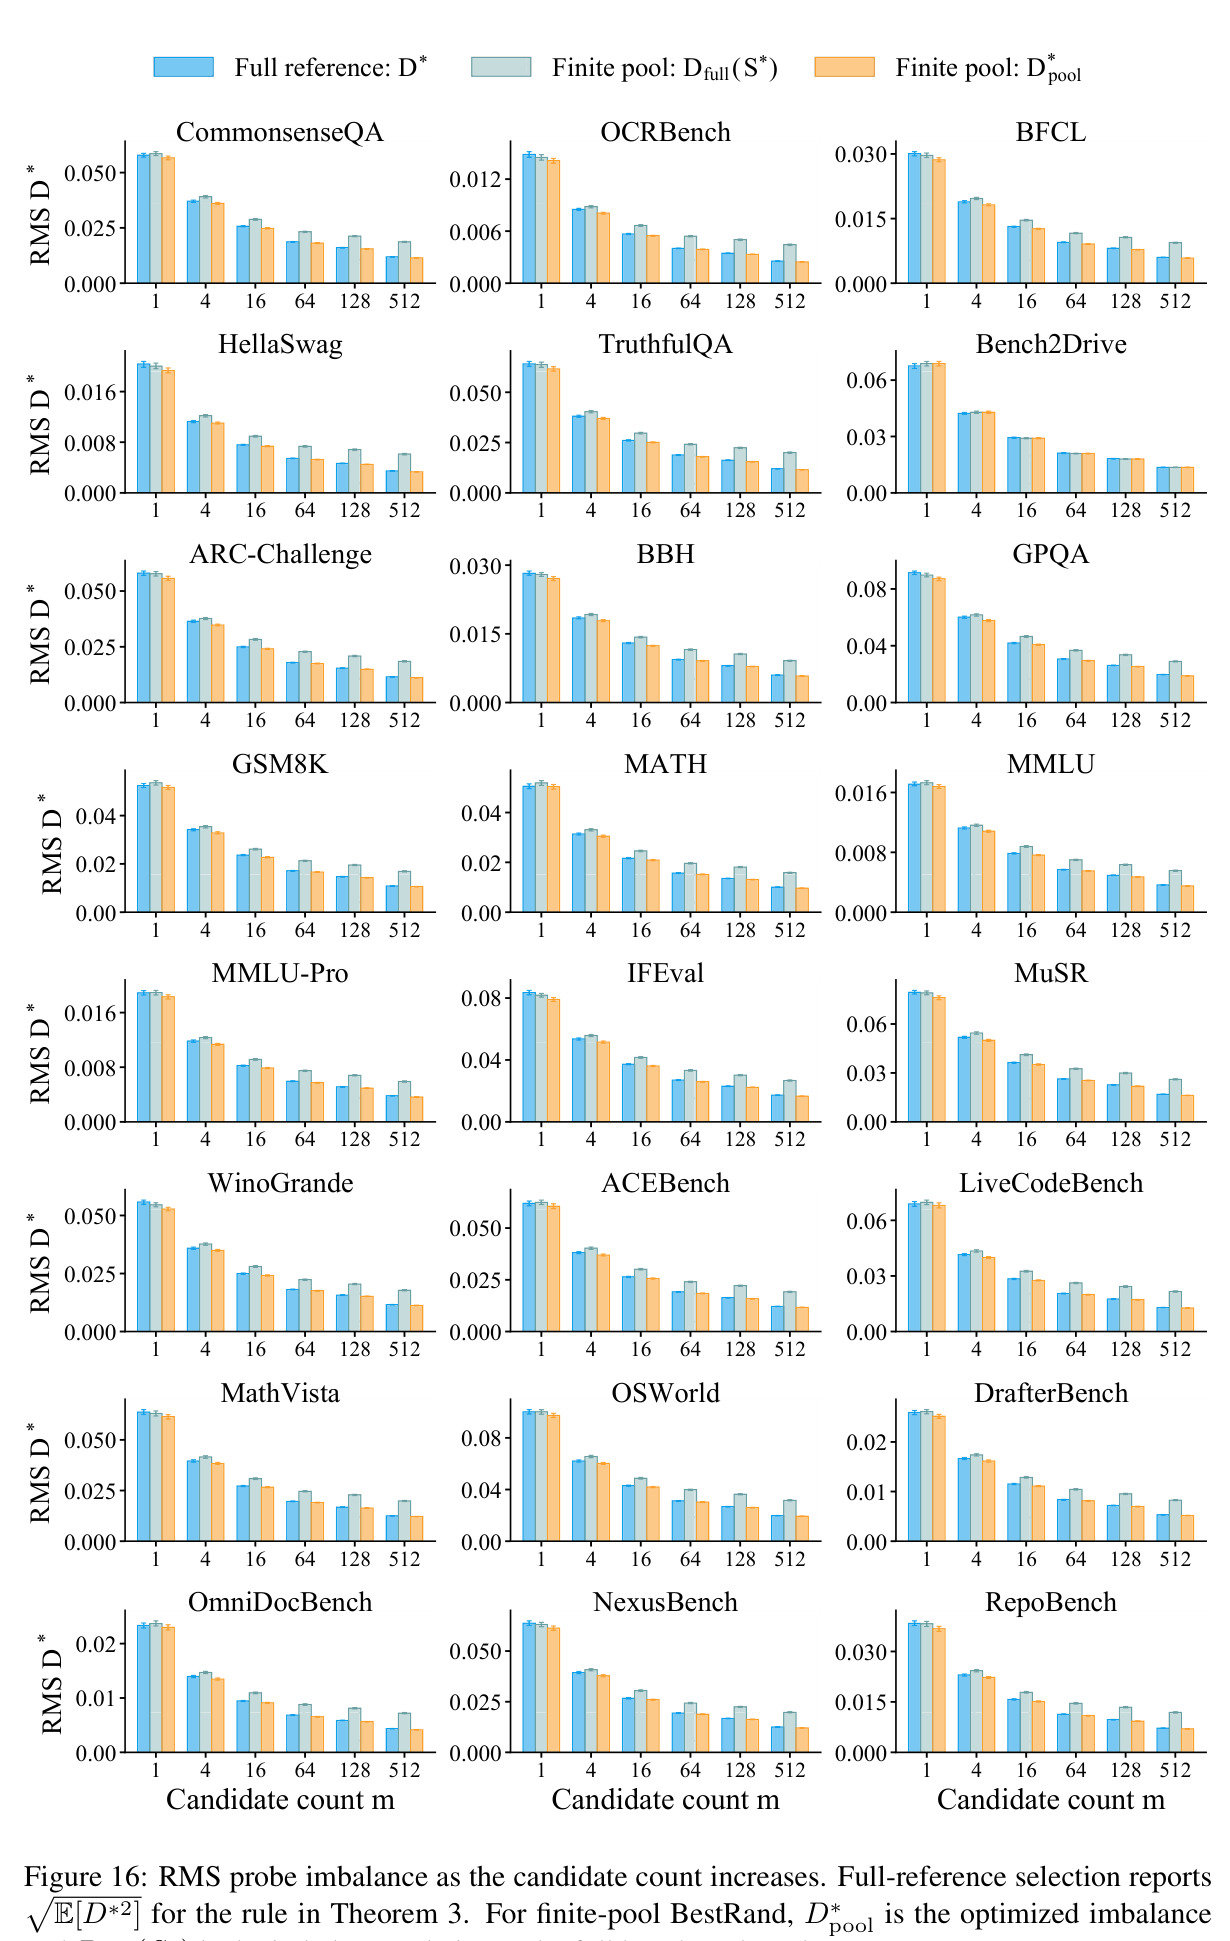
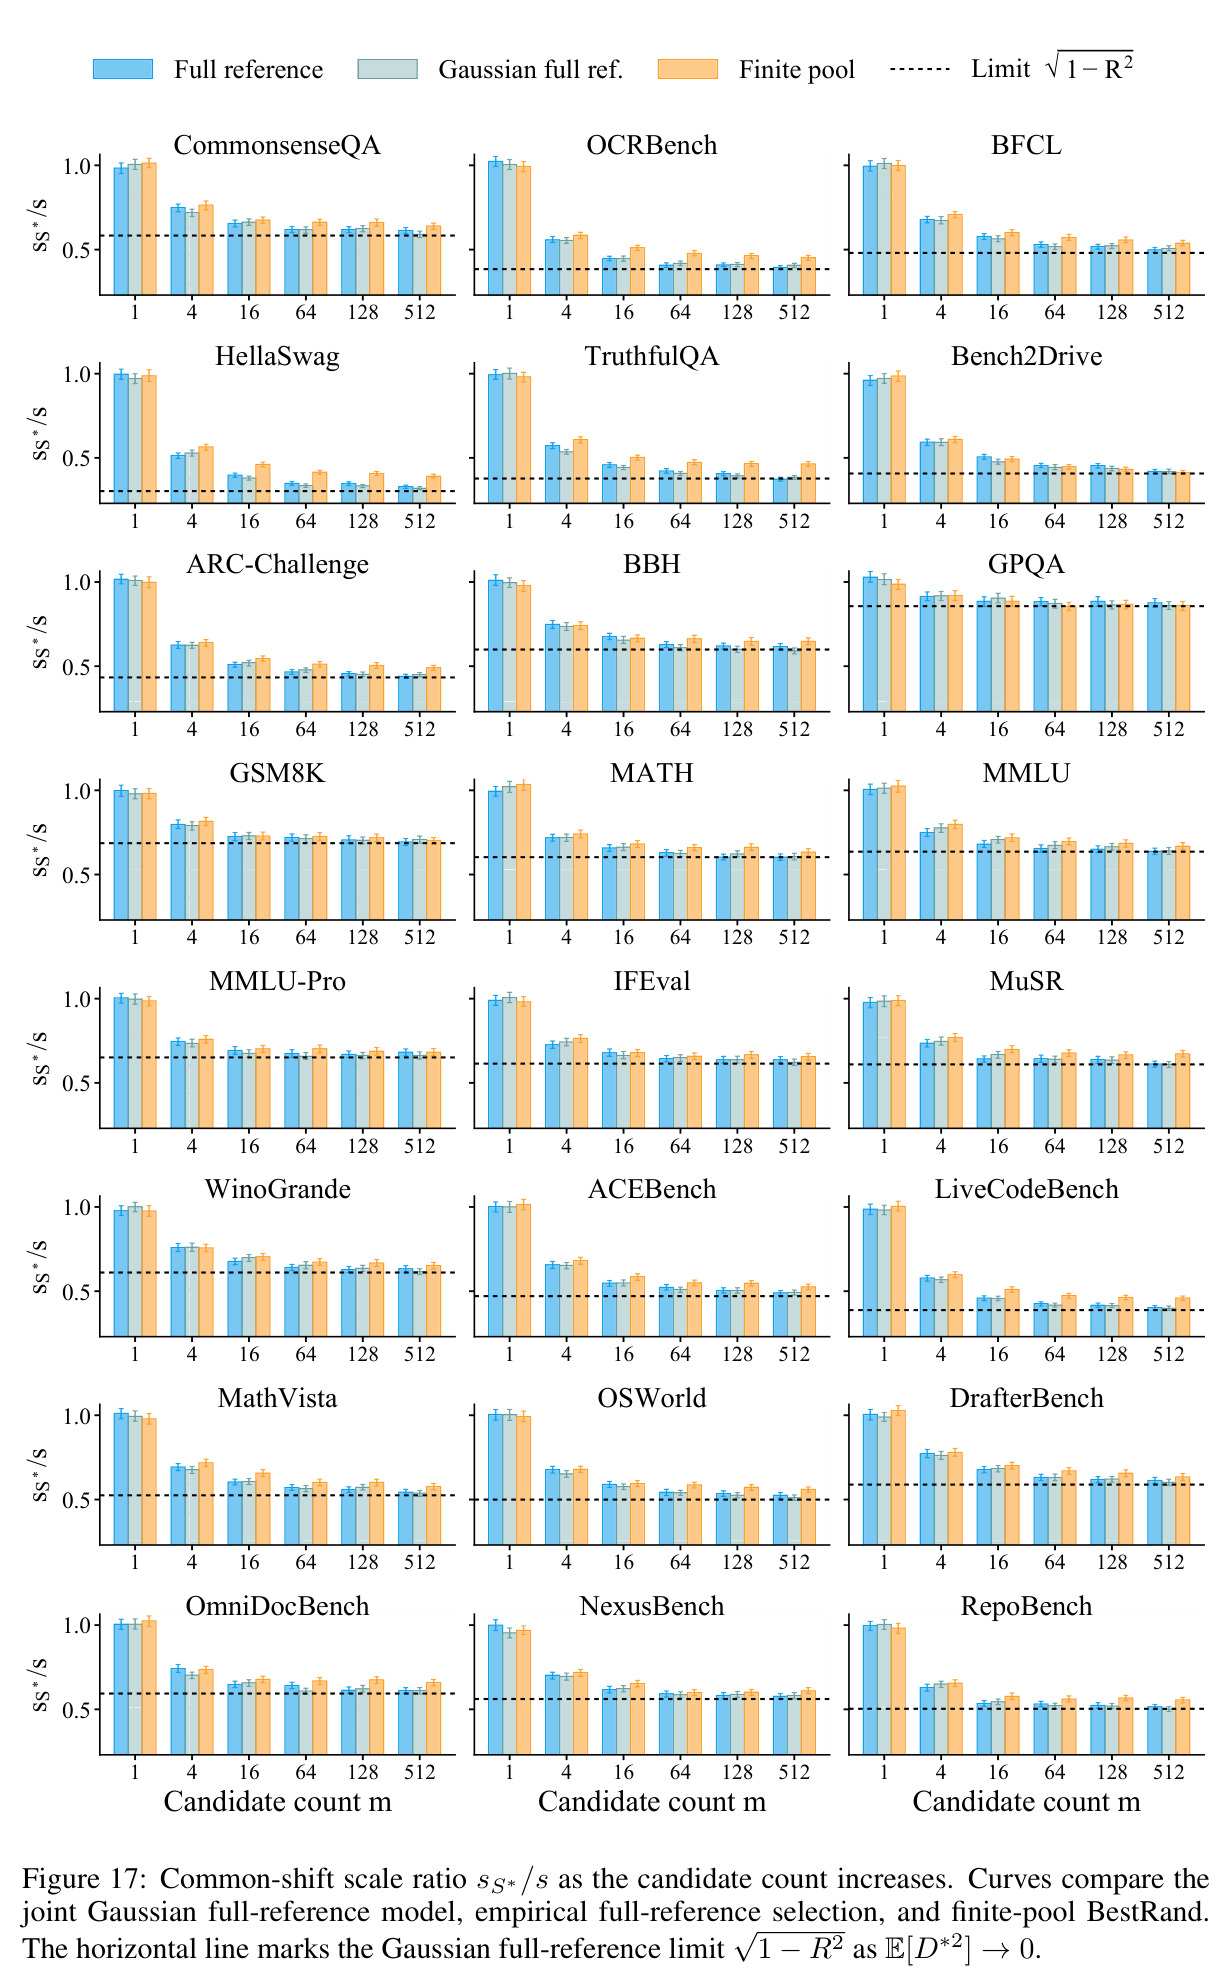
直觉上,随机子集的误差主要由'共同偏移'驱动:$\bar E=\bar g_S-\bar g_N$,即子集整体比全基准偏易或偏难,它会同时抬高或压低所有模型的分数,是 MAE 的下界($\mathrm{MAE}\ge|\bar E|$)和长尾的主要来源。BestRand 因此把压缩问题转化为'从多个随机候选中挑一个共同偏移最小的',而判断偏移是否小并不需要目标模型的分数——只用几个便宜的小探针模型即可。技术路线:把分数矩阵 $X\in[0,1]^{N\times M}$ 视为固定总体,唯一随机性来自无放回抽 $k$ 题;Theorem 1 给出误差向量近似 $\mathcal N(0,c(k)^2C)$;Theorem 3 用最小二乘正交性把共同偏移分解为探针可解释部分(方差 $R^2s^2$)与残差部分($(1-R^2)s^2$),再由 Cauchy–Schwarz 不等式说明:让子集探针均值贴近全量参考,就能在不知道回归系数 $\beta$ 的情况下压掉可解释部分。
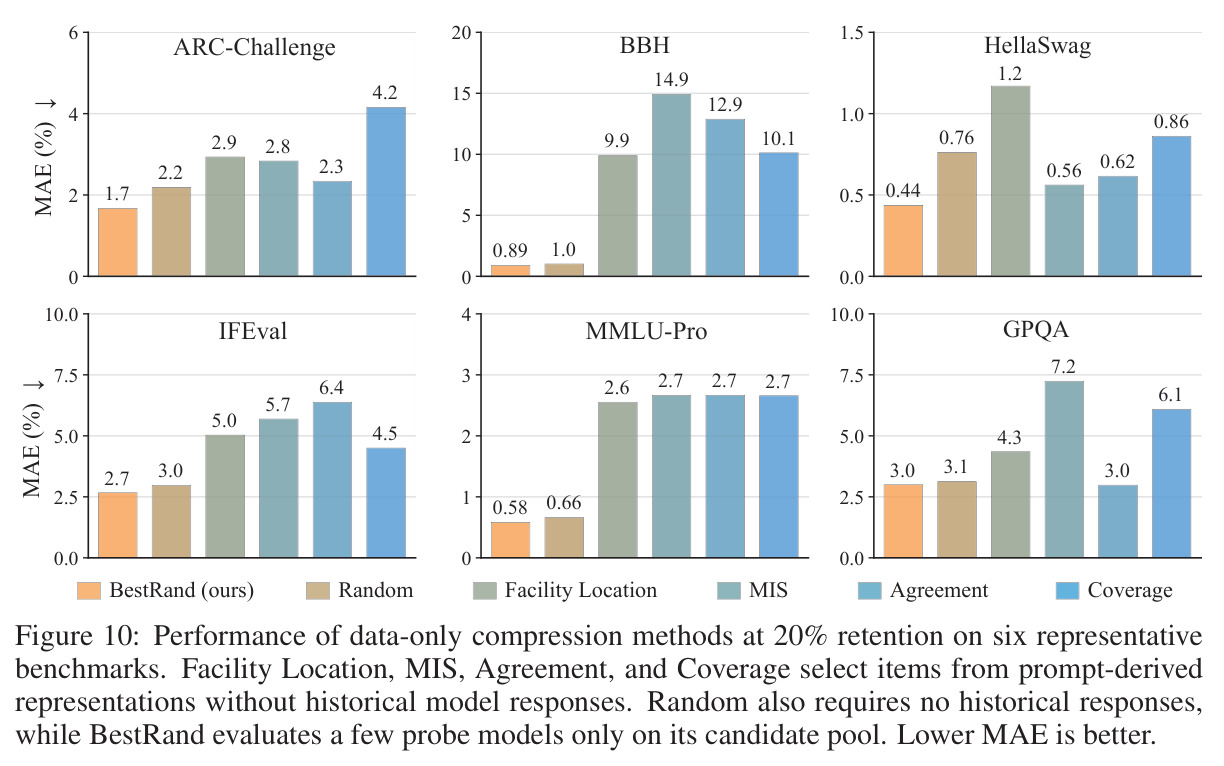
核心创新是'随机生成 + 探针筛选'的反向思路。已有方法(TinyBenchmarks 的 IRT、Anchor Points 的 k-medoids 聚类、SparseEval 的预测器、ZipBench 等)都在学习'哪些题目有代表性',必须先收集覆盖全基准的历史分数($\mathrm{Cost}\ge1$);BestRand 不学习任何题目表示或预测器,只是抽 $m=128$ 个随机候选,用 $p=5$ 个探针模型挑出探针均值失衡 $\|h_j-H\|_2$ 最小的那个。本质区别有三:一是把'选择'退化为'对随机性的再利用'——好子集本占多数(众数靠近下端点),筛选只需消除罕见坏抽;二是有理论保证——Theorem 3 证明选中子集的共同偏移方差 $s^2_{S^*}\le\|\beta\|^2\mathbb E[D_*^2]+(1-R^2)s^2$,当搜索失衡 $D_*\to0$ 时收敛到 $(1-R^2)s^2<s^2$,精确削减可解释份额;三是成本结构不同——探针只在大小 $\min(nk,N)$ 的池上推理一次,候选筛选是对缓存分数的 GPU 批量张量运算,几乎零成本。
方法步骤详情
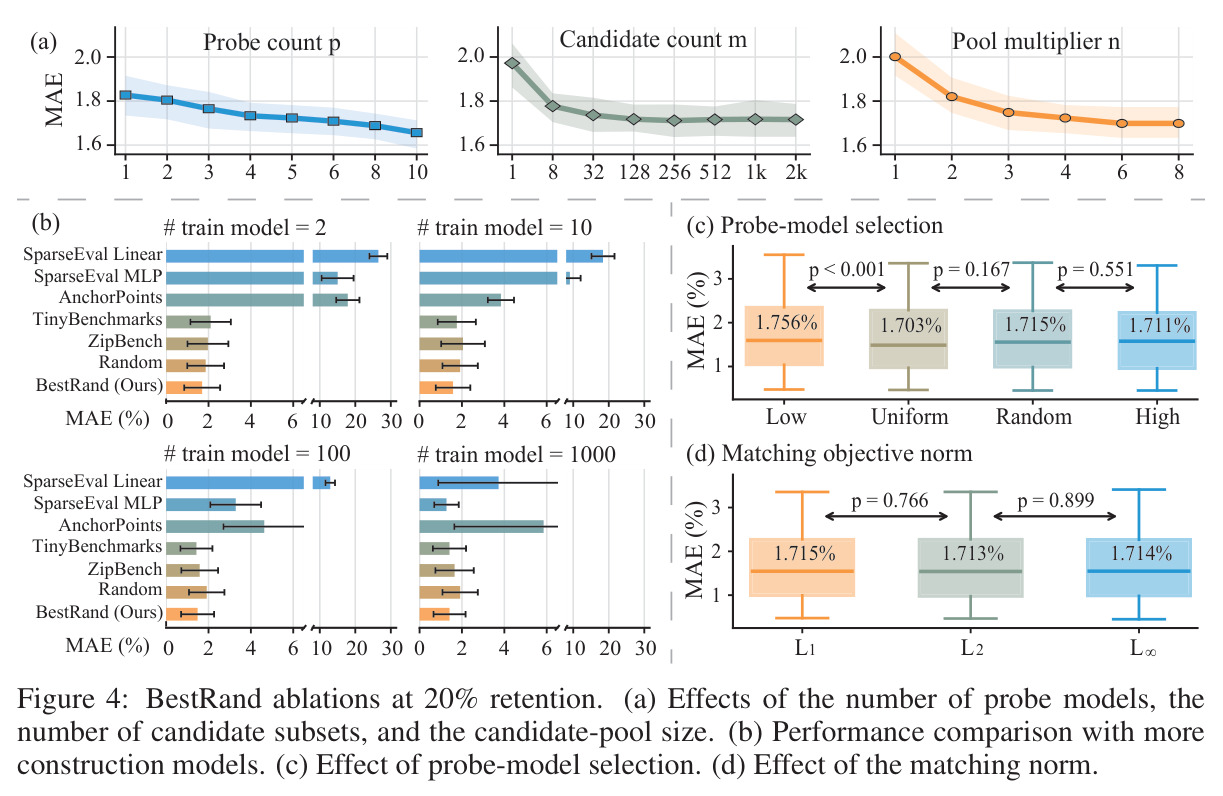
BestRand 四步流程,输入为基准 $N$ 题、目标大小 $k$、探针数 $p$、池倍数 $n$、候选数 $m$。第一步建池:从 $N$ 题无放回抽容量 $\min(nk,N)$ 的池 $P$(默认 $n=4$),让 $p=5$ 个探针模型在 $P$ 上完整推理,记录每题探针分数向量 $x_s\in\mathbb R^p$,输出是缓存的探针分数。第二步建参考:计算池均值 $H=|P|^{-1}\sum_{s\in P}x_s$ 近似全量探针均值 $\bar x_N$,使探针无需跑全基准。第三步搜索:重复 $m=128$ 次,从 $P$ 无放回抽 $k$ 题候选 $S_j$,计算探针均值 $h_j$ 与失衡度 $d_j=\|h_j-H\|_2$;此步只做缓存向量的平均,无任何模型调用,GPU 上单批张量运算瞬时完成。第四步输出:返回失衡最小的 $S^*=\arg\min_j d_j$,所有目标模型只在 $S^*$ 上评测一次。总构建成本是一次探针过池 $p\times|P|$ 次评测:2% 保留率时仅为数据依赖基线的 8.0%,六档平均 51.3%。消融显示 $p,m,n$ 增大均有收益但边际递减,默认探针随机选取、L2 匹配。
技术新颖性
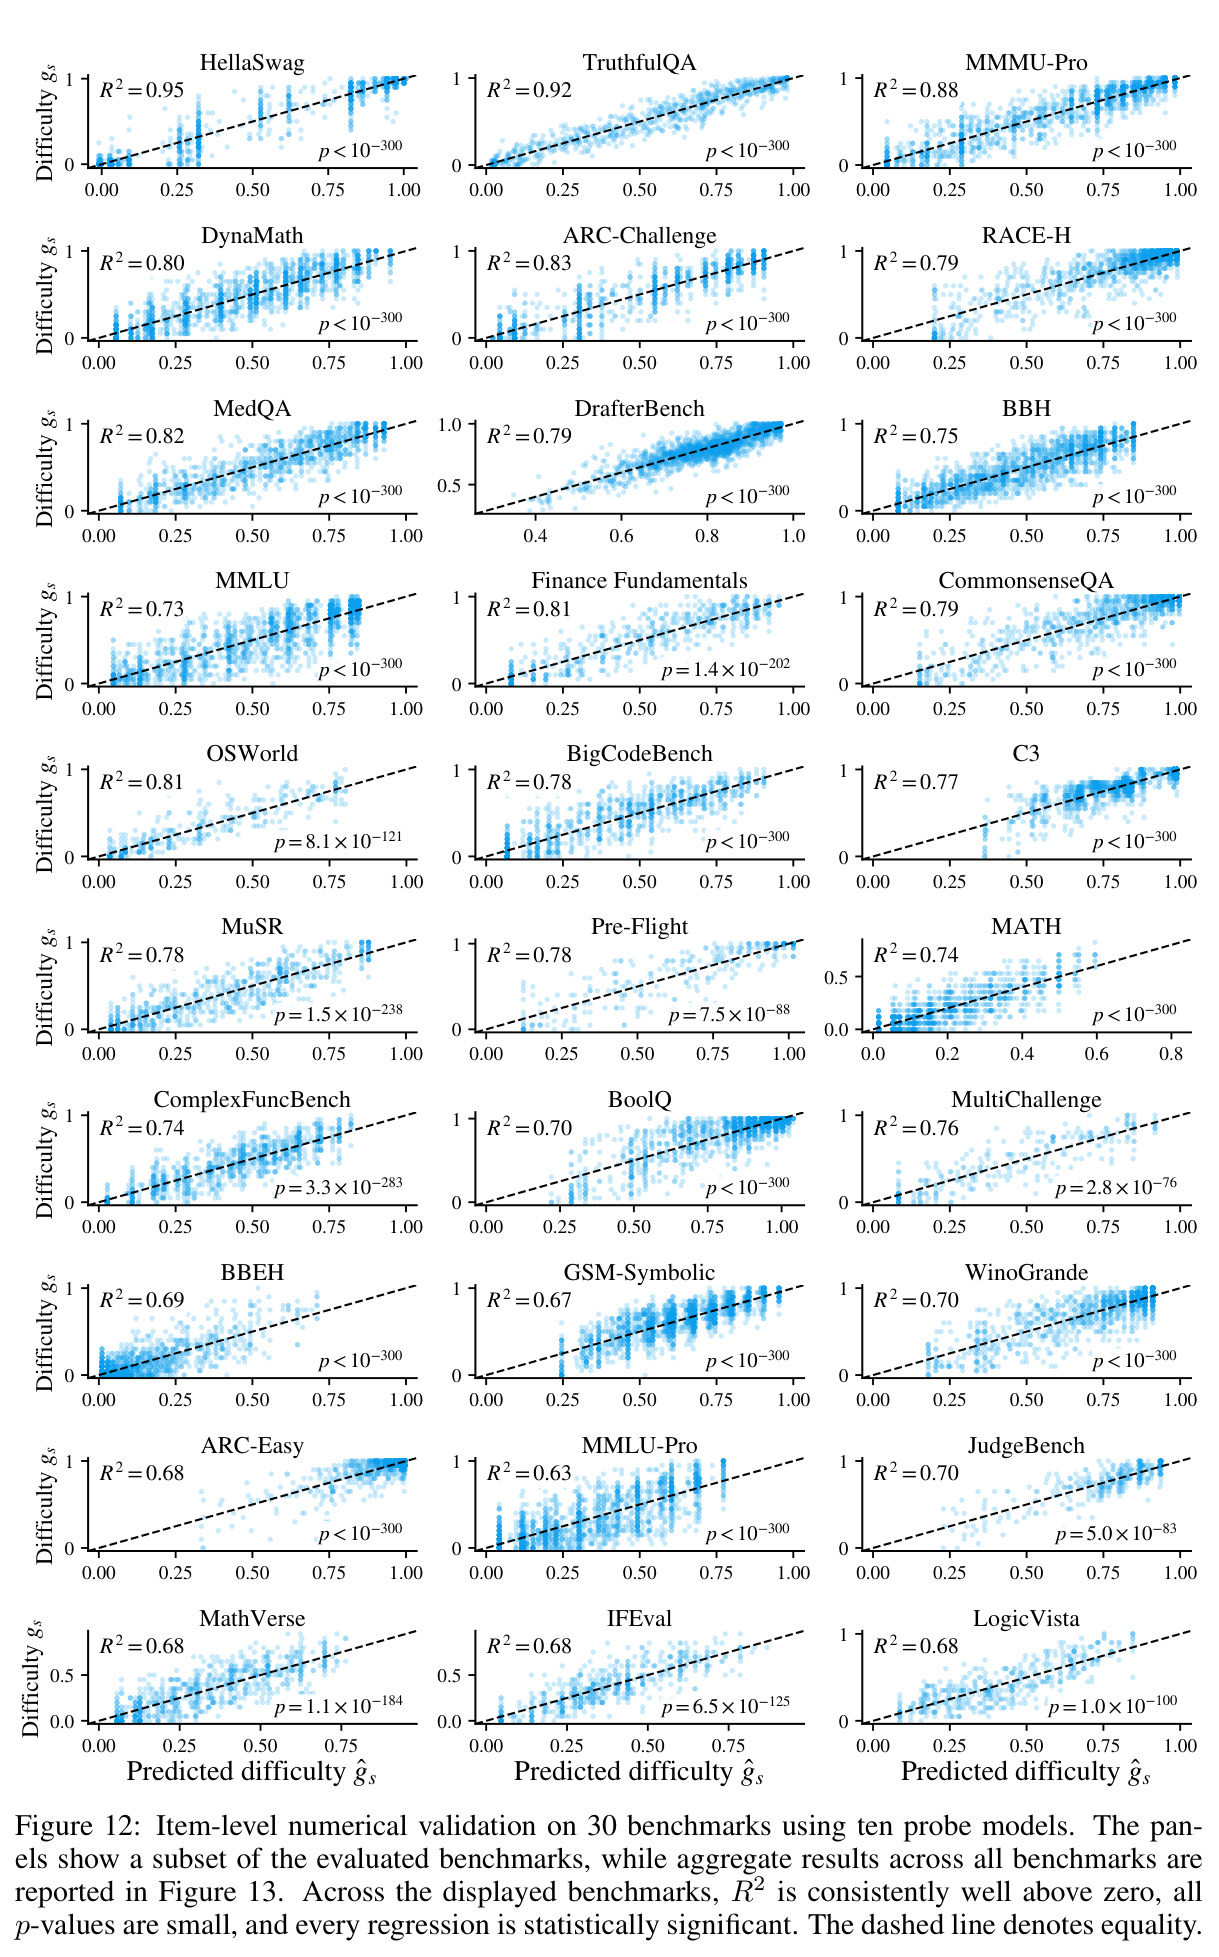
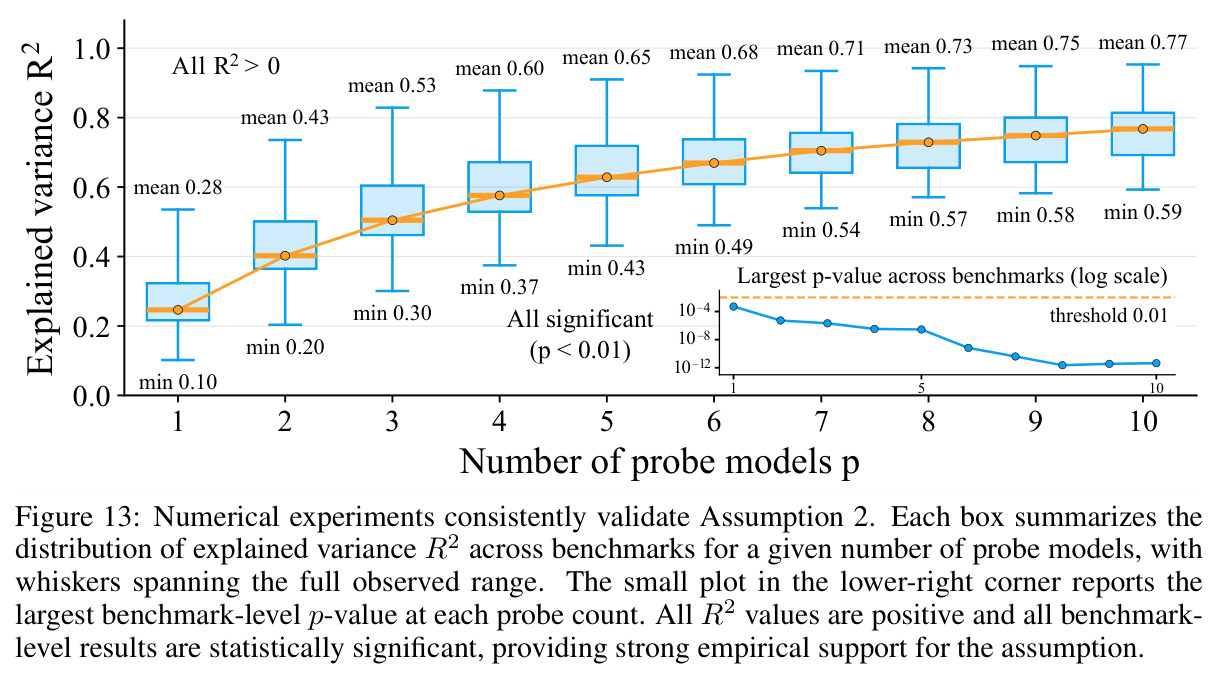
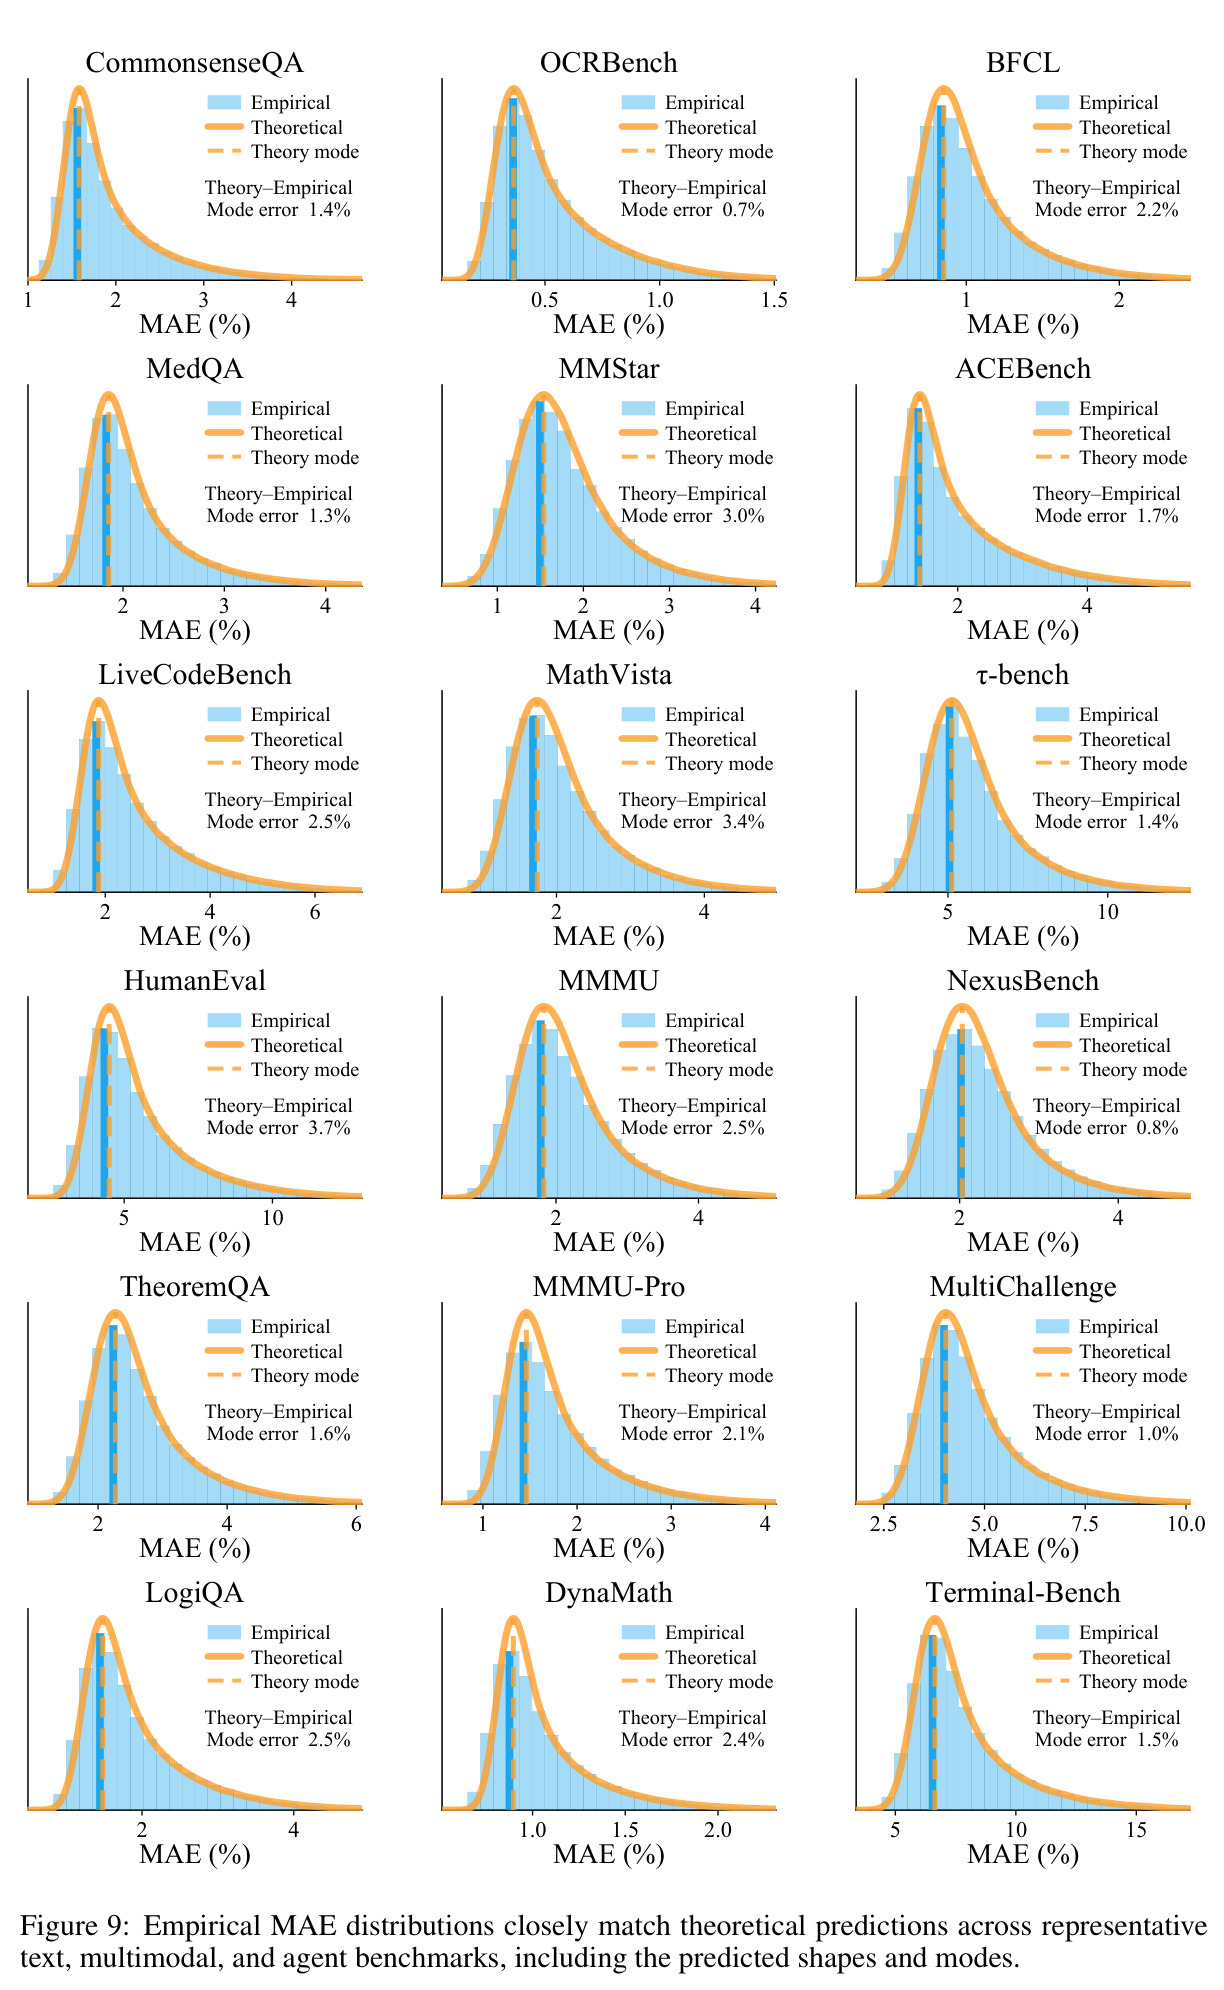
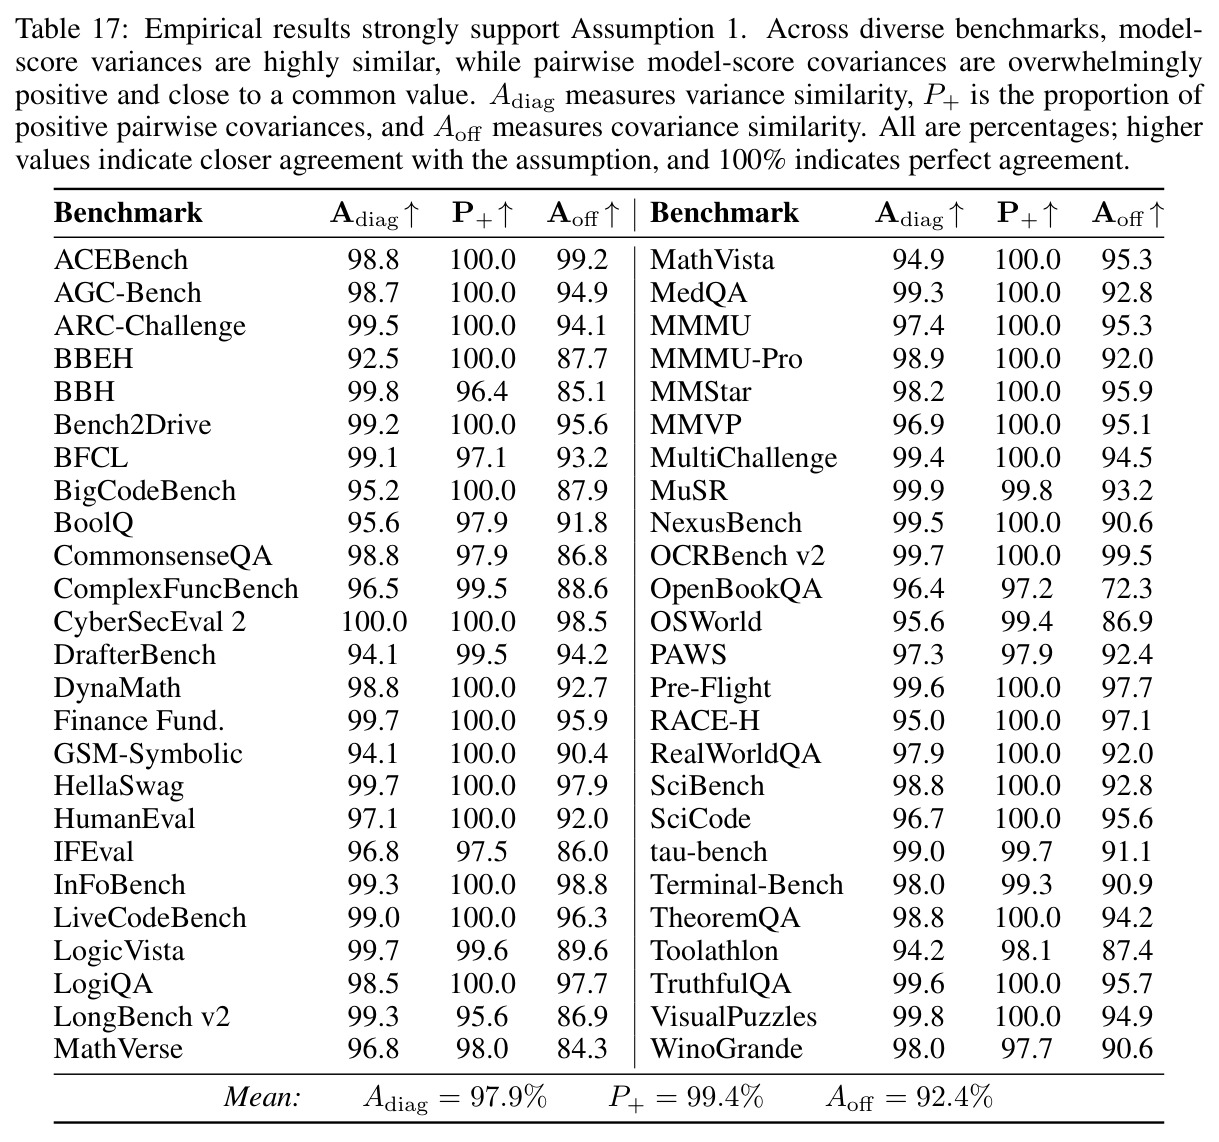
理论新颖性:这是少有的给出基准压缩误差分布闭式近似的工作。利用有限总体中心极限定理加'等方差等相关'协方差假设(Assumption 1:$C_{mm}=\sigma^2$,$C_{ml}=\rho\sigma^2$),得到三条可检验结论——误差向量近似多元正态、MAE 长尾(尾部下界 $2\Phi(-t/s)$)、众数以普适常数逼近下端点;并把不稳定根源定位到模型间相关性 $\rho$:误差尺度 $s=c(k)\sigma\sqrt{\rho+(1-\rho)/M}$ 随 $\rho$ 单调增,且 $M\to\infty$ 时极限非零,说明'再多评测几个模型'无法根治,问题归结为基础模型的内在同质性。方法新颖性:与'学代表子集'范式相反,BestRand 只做一阶矩匹配(探针均值对齐),无需训练、无需嵌入,却有明确的方差削减机制与收敛目标 $\sqrt{1-R^2}\,s$。实证闭环完整:假设检验(Table 17:方差相似度 97.9%、正协方差比例 99.4%、协方差相似度 92.4%)与数值验证(理论众数误差仅 0.7%–1.4%,$\rho+s$ 联合预测 MAE P95 的 $R^2=0.993$)高度吻合。
实验结果
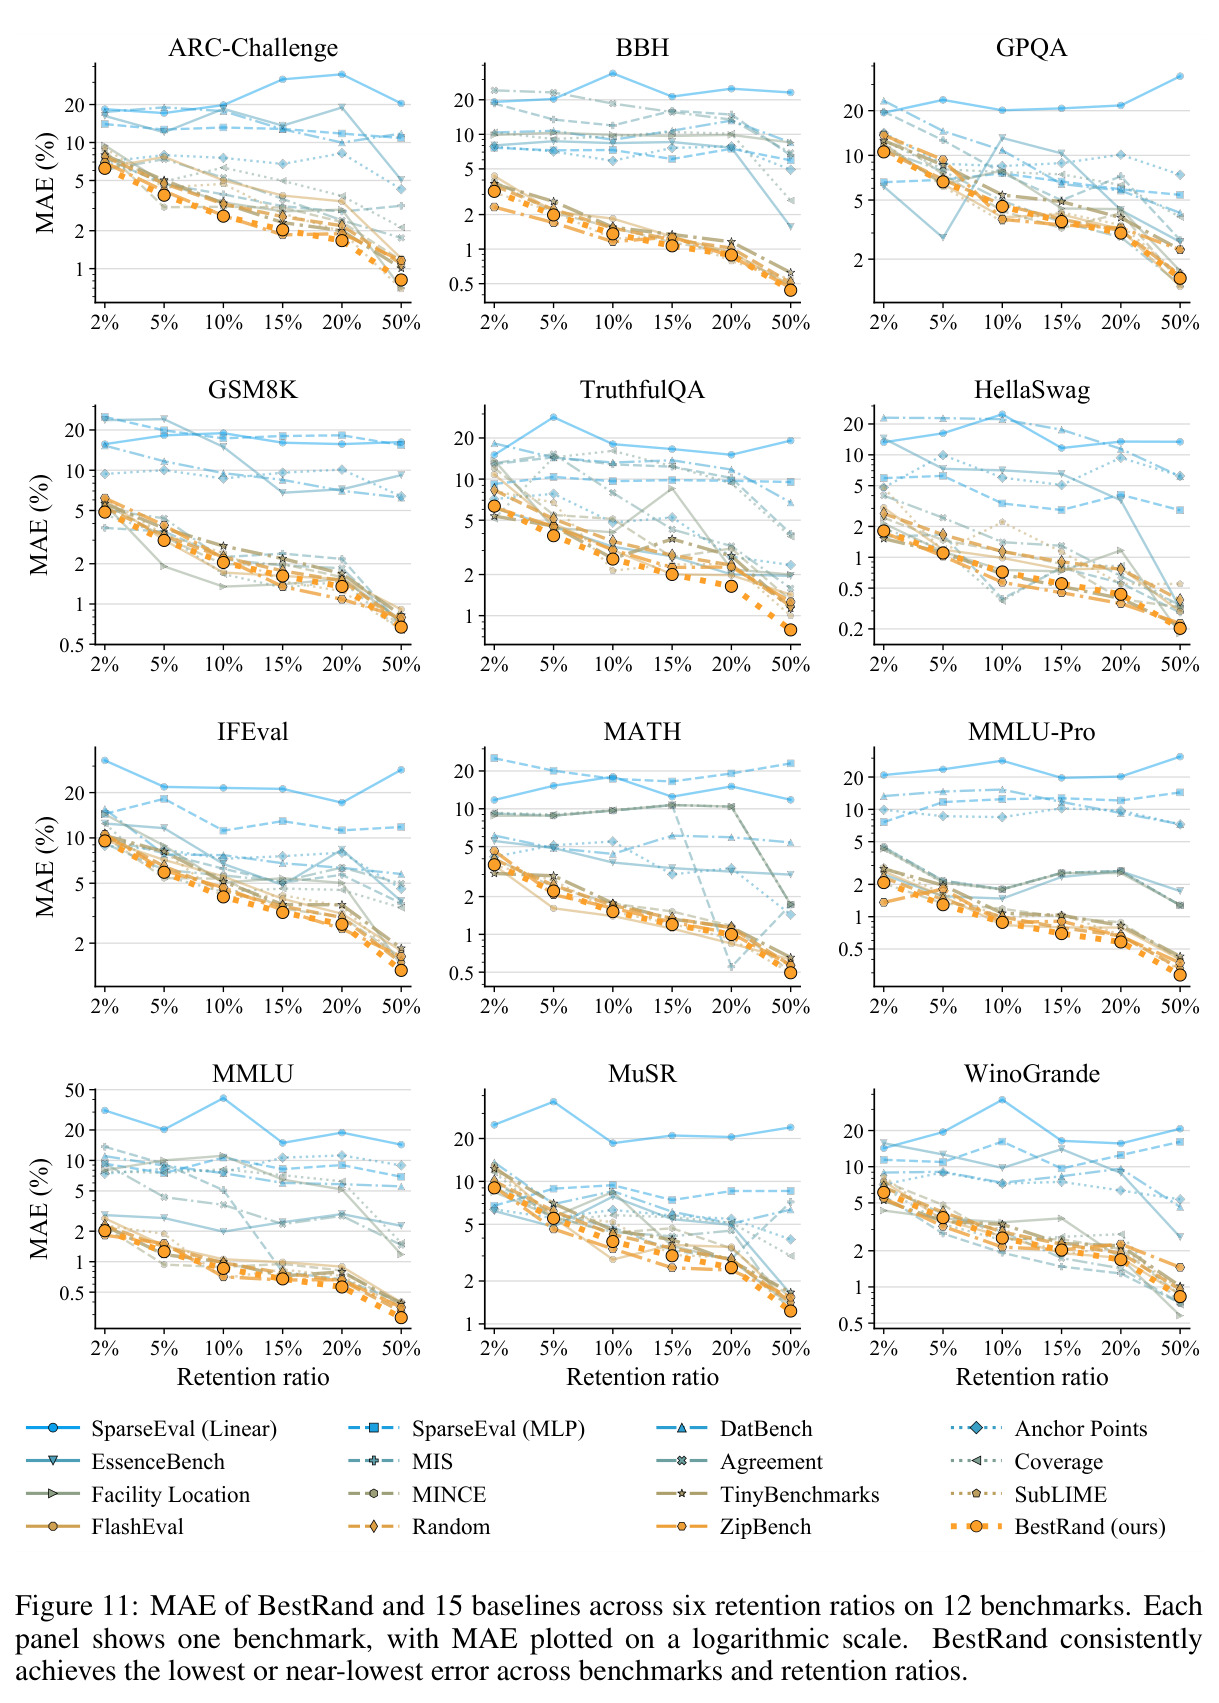
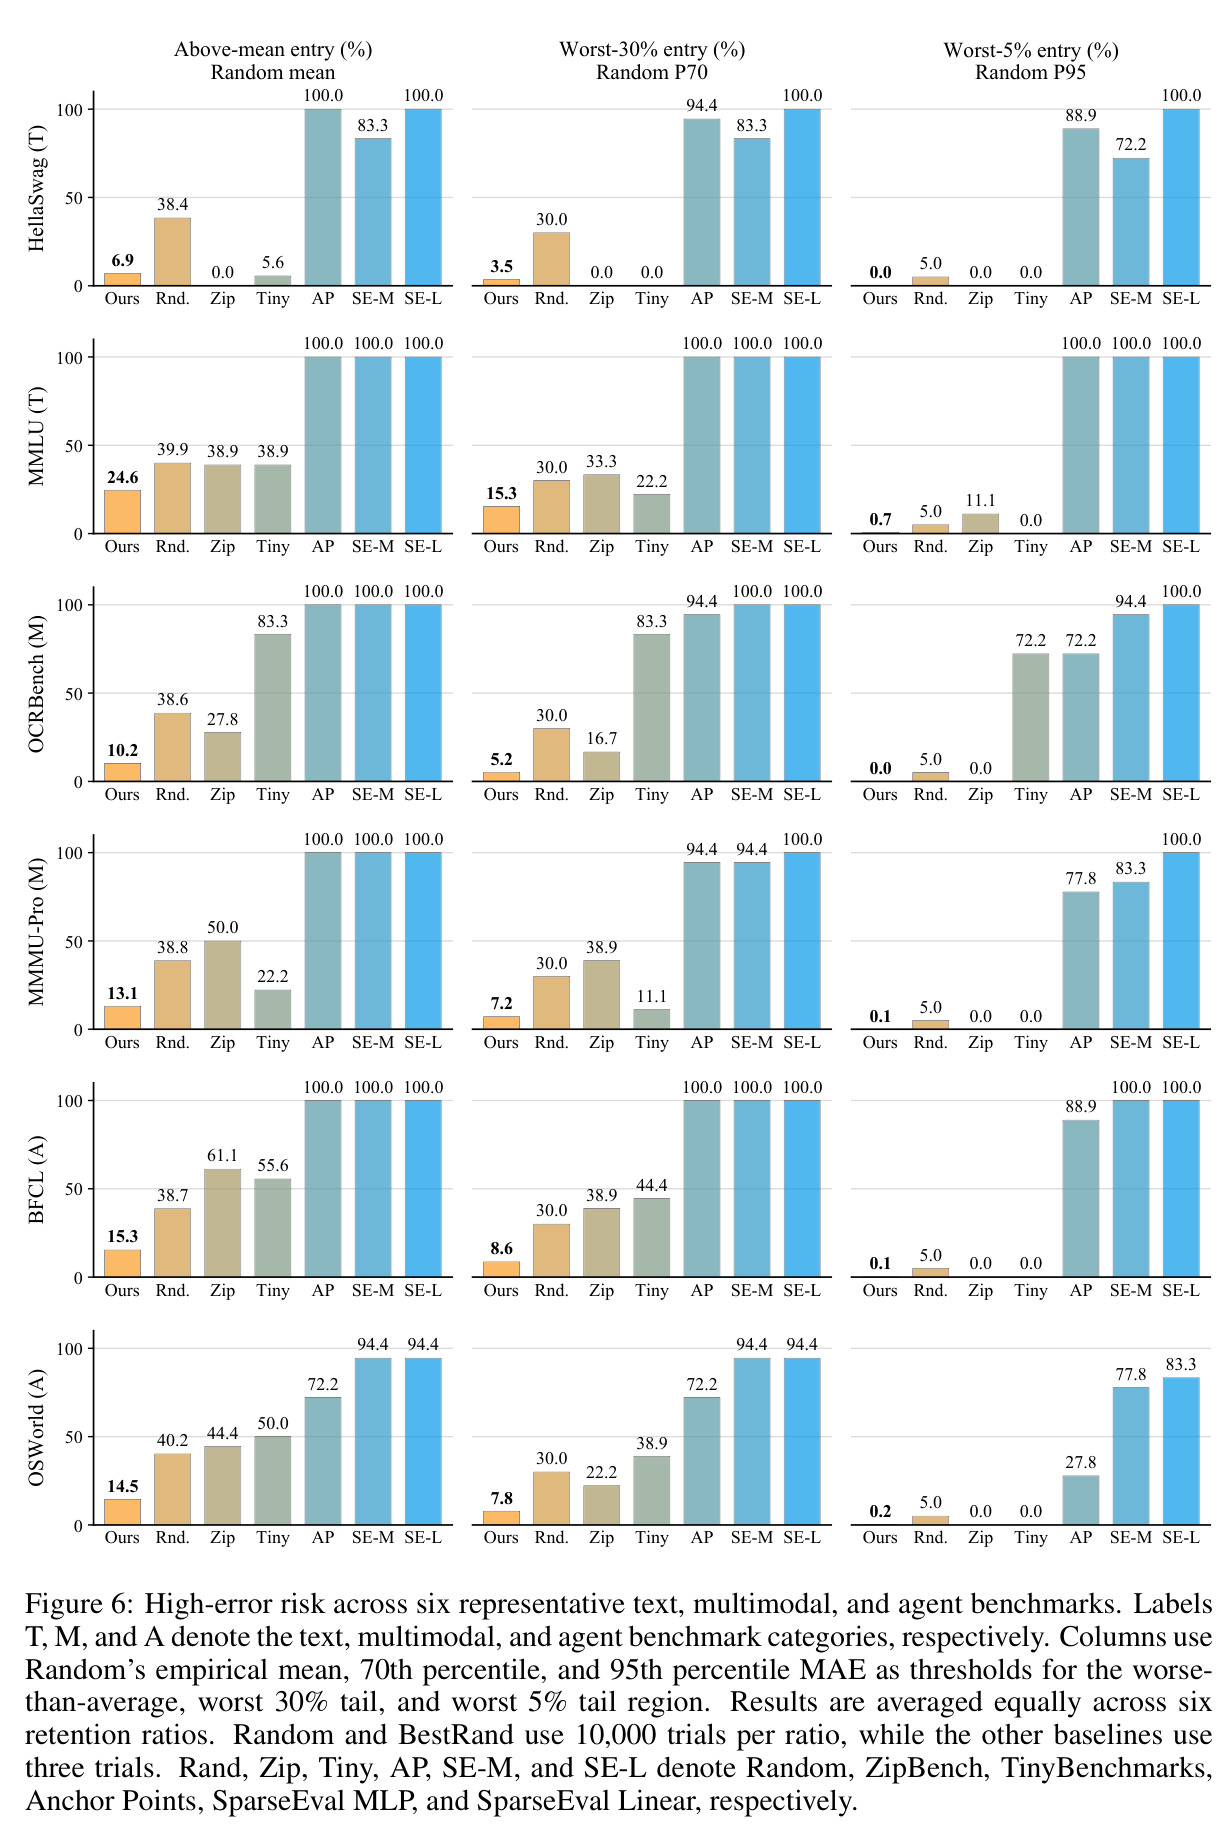
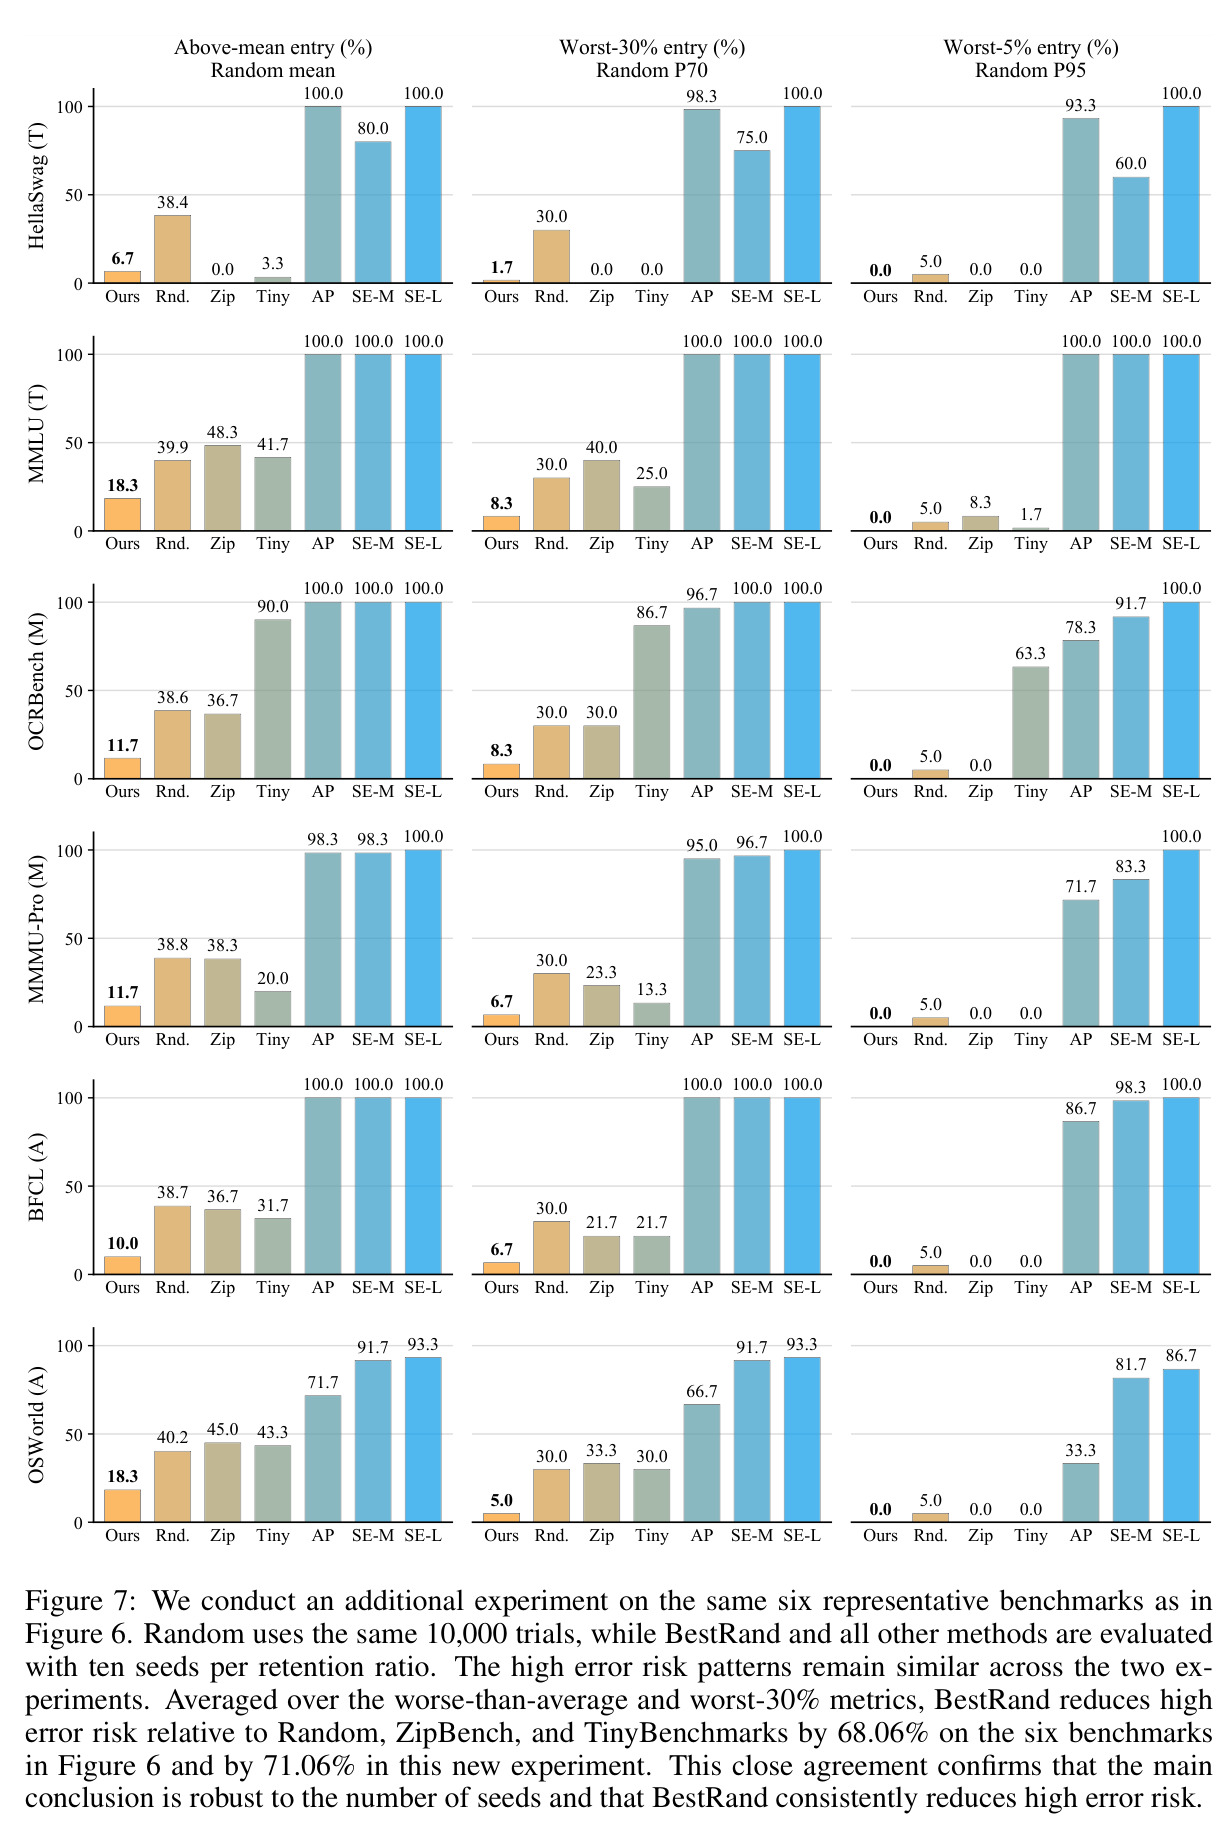
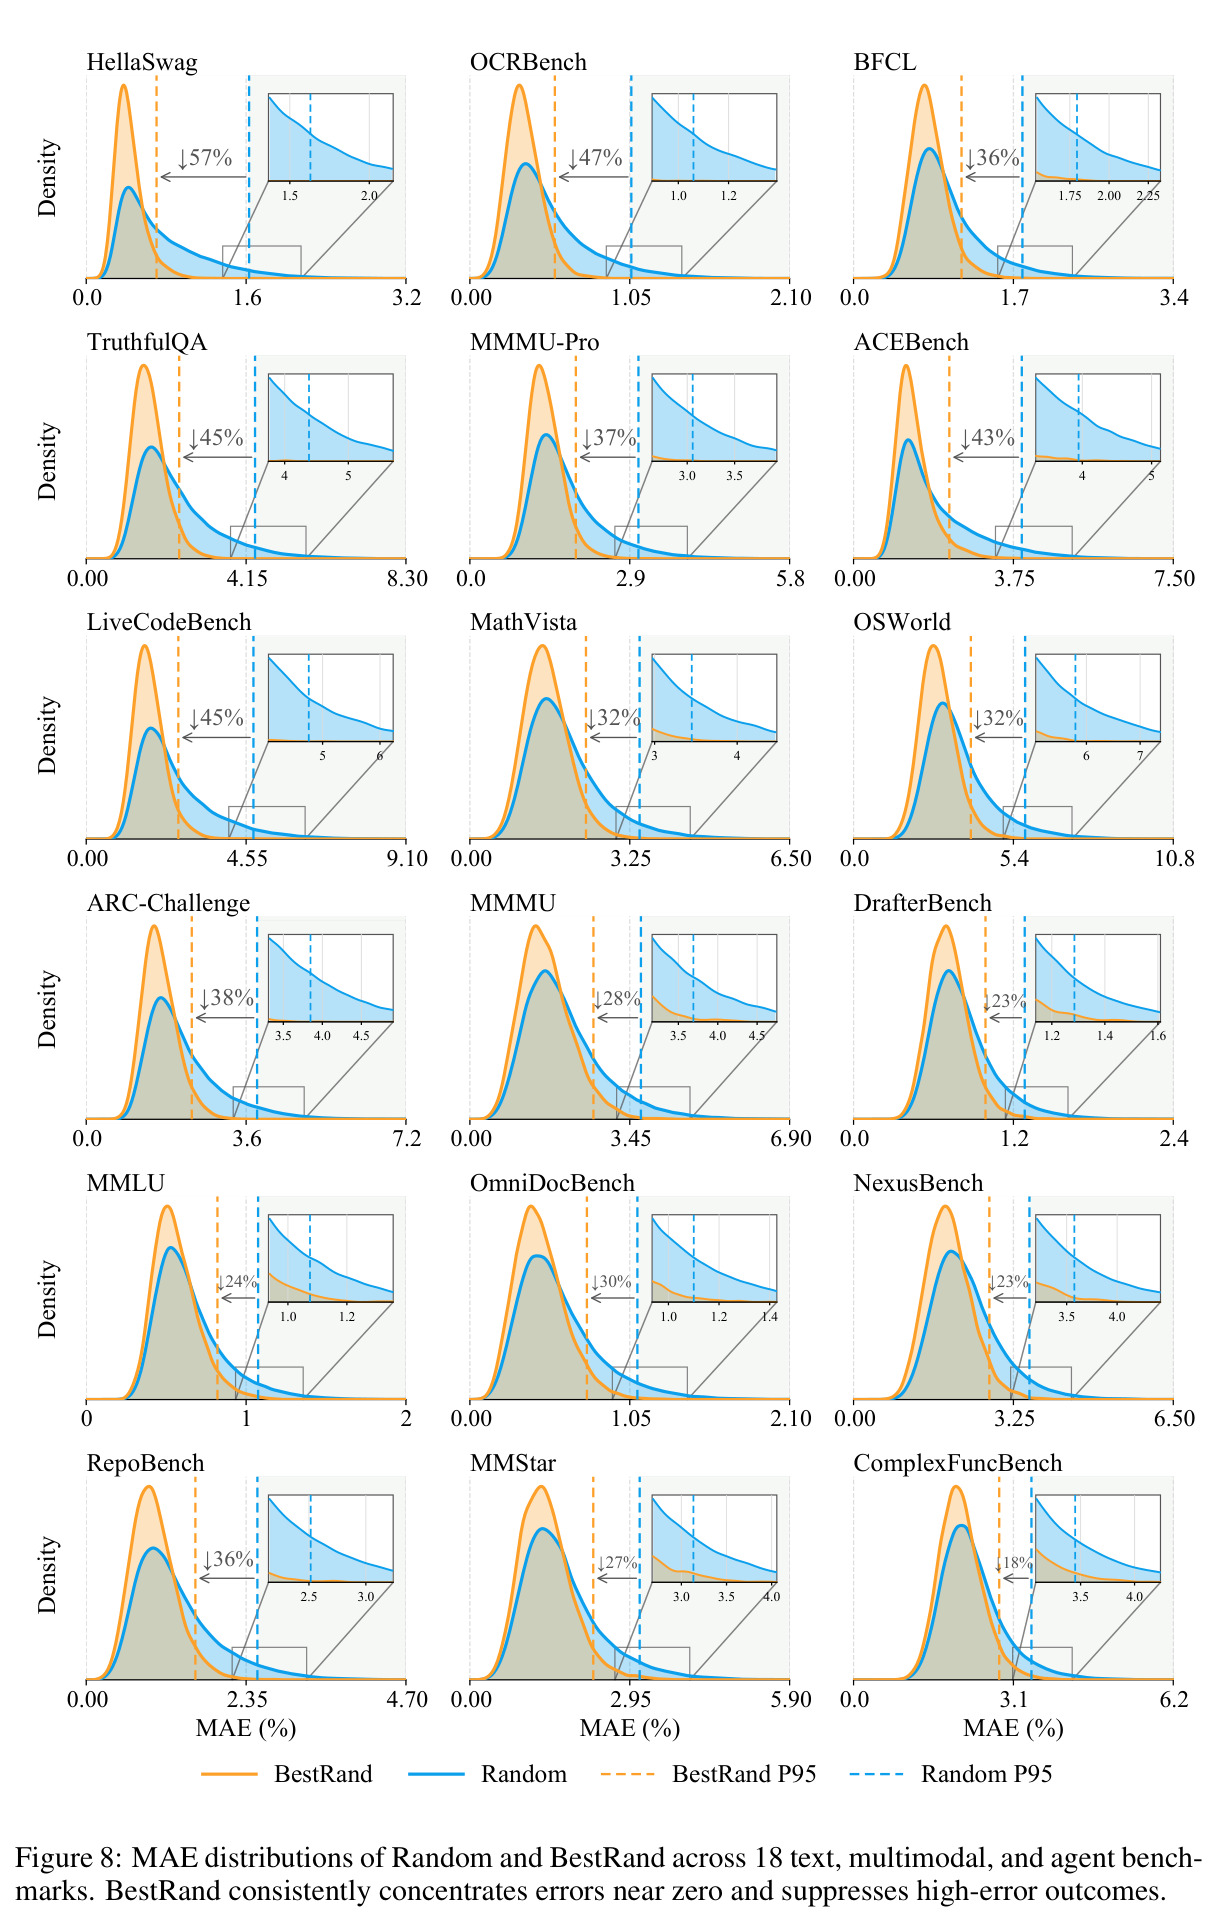
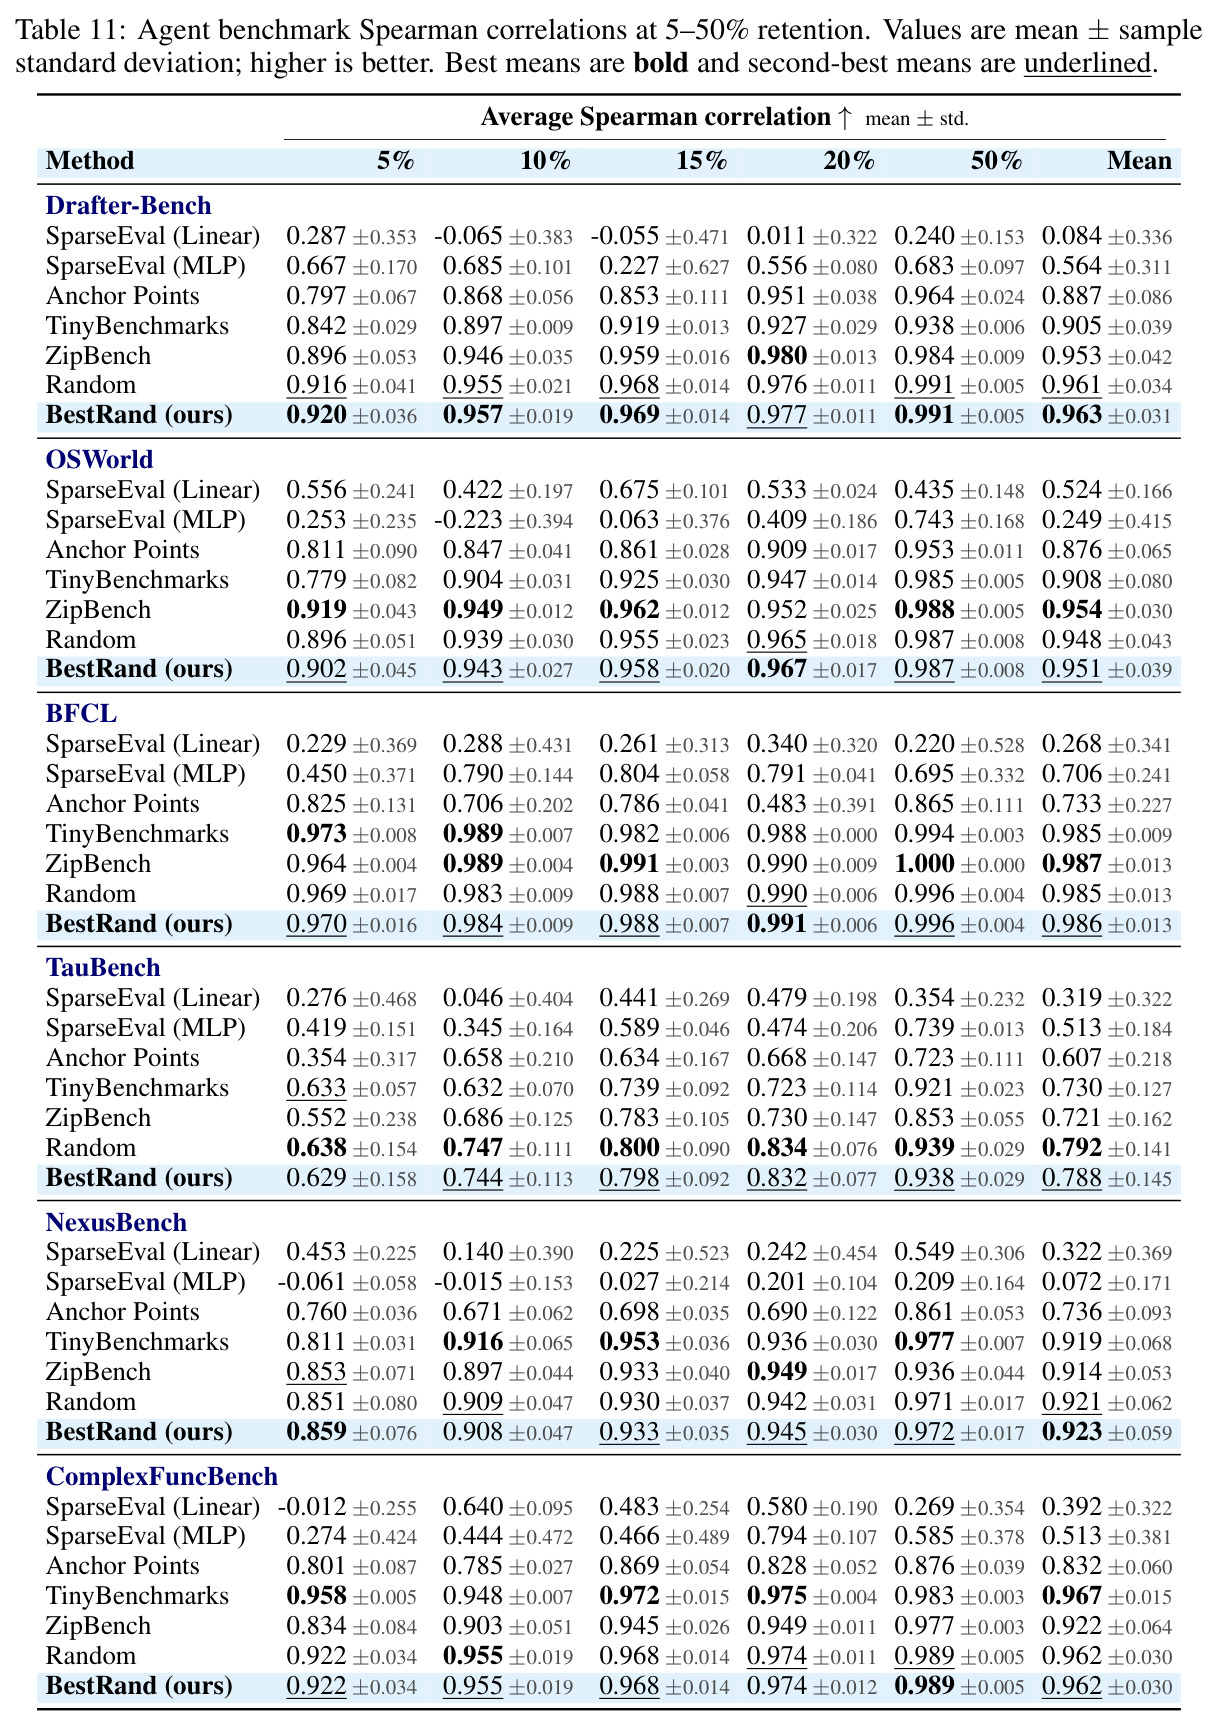
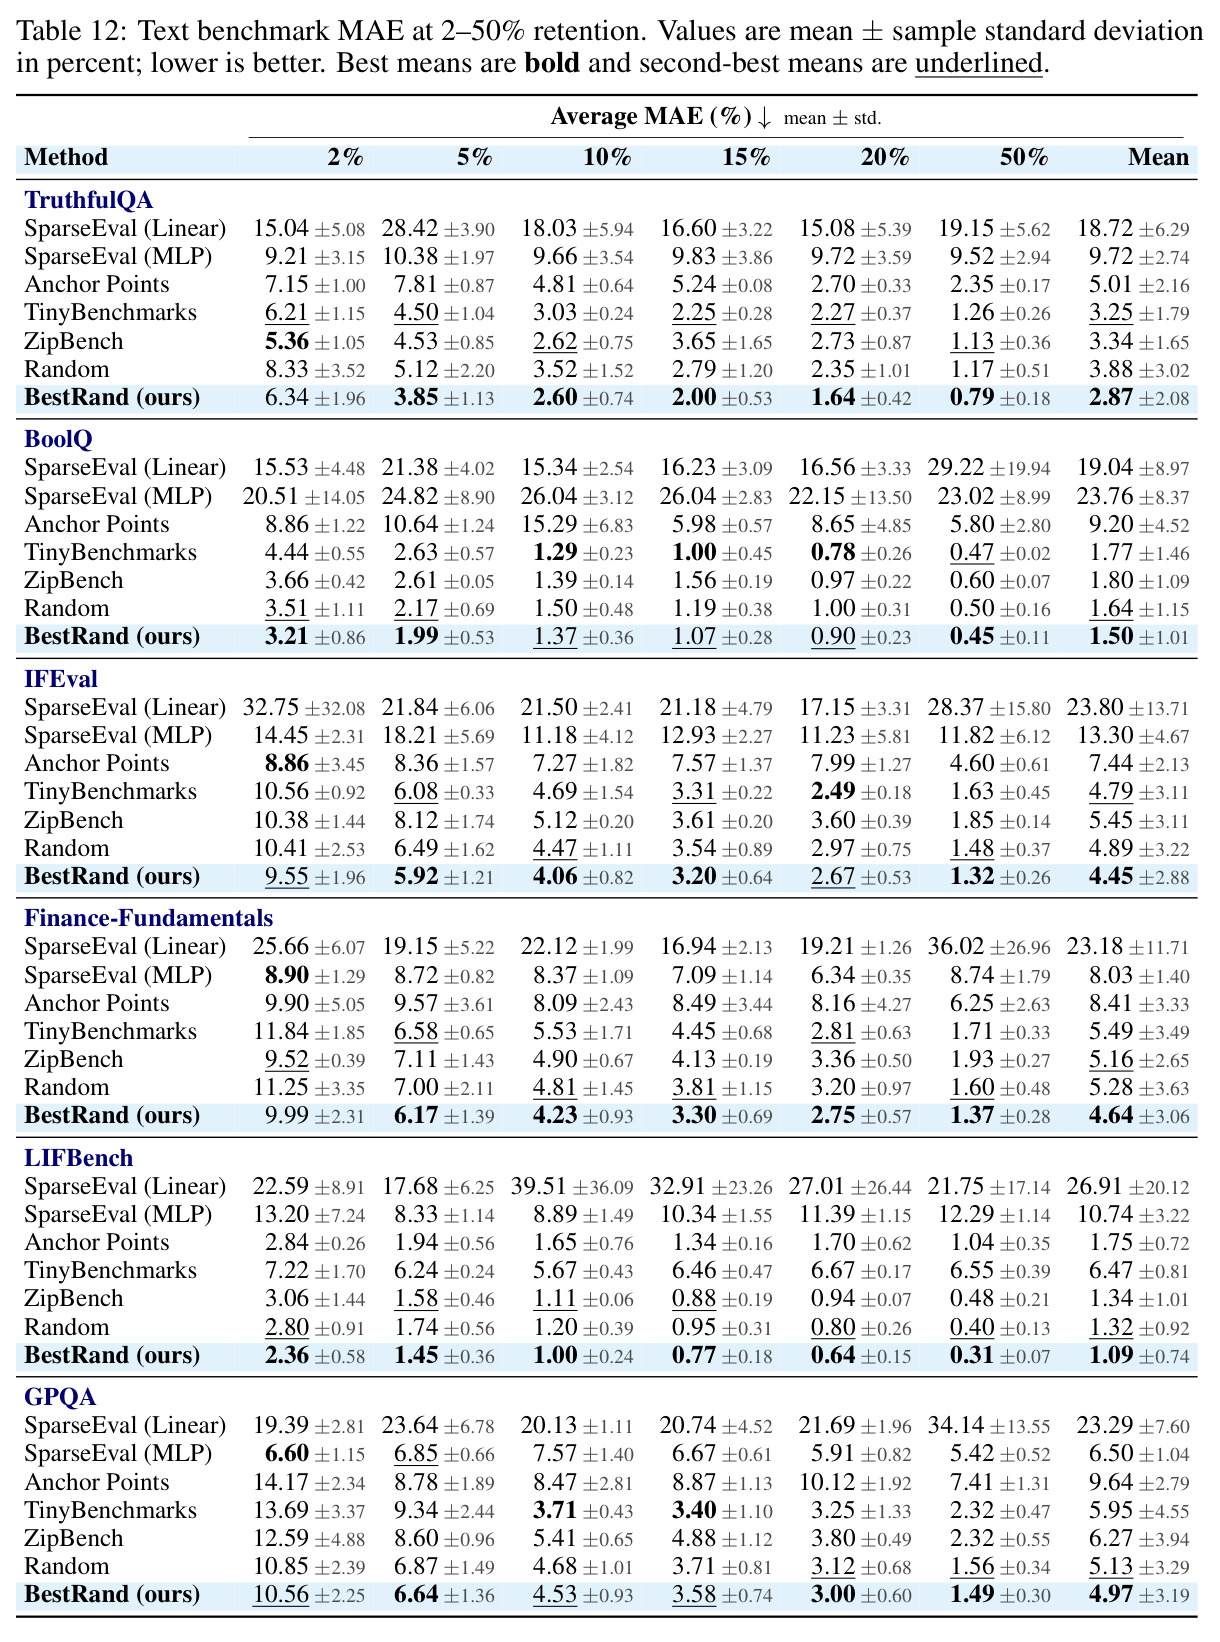
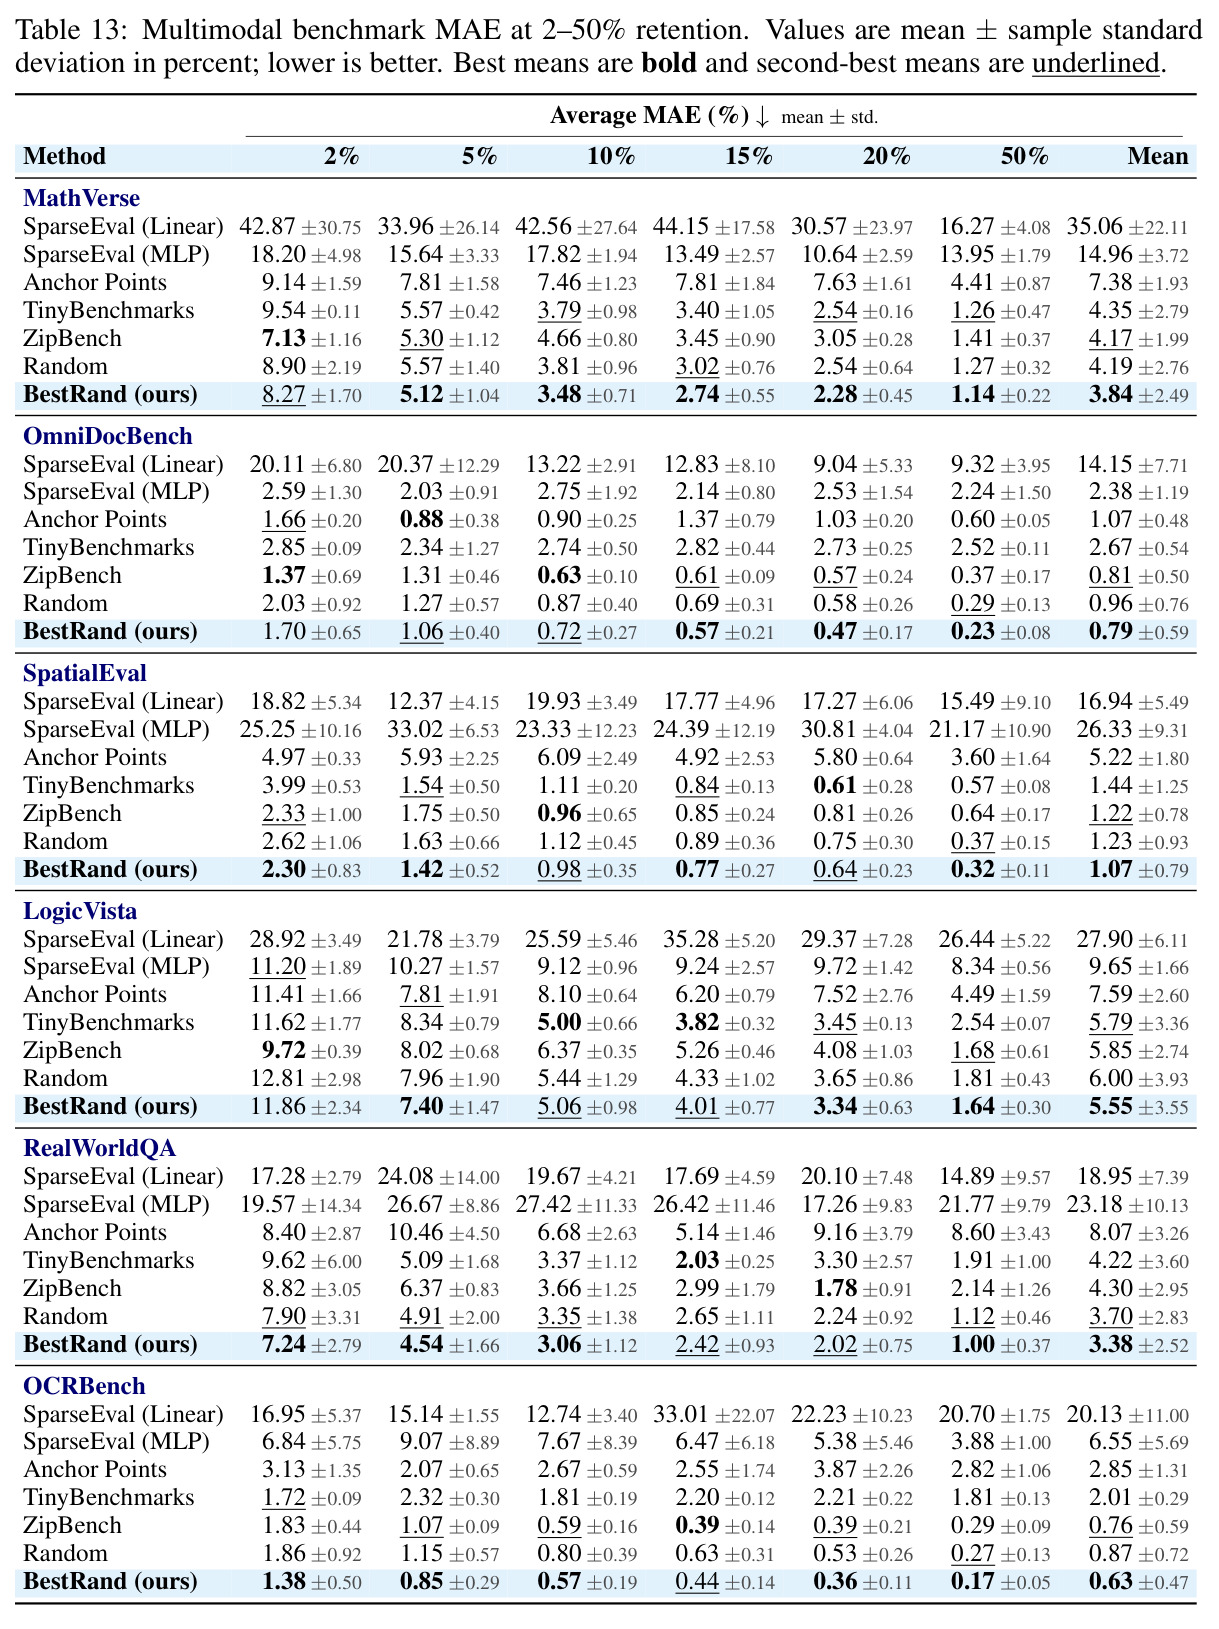
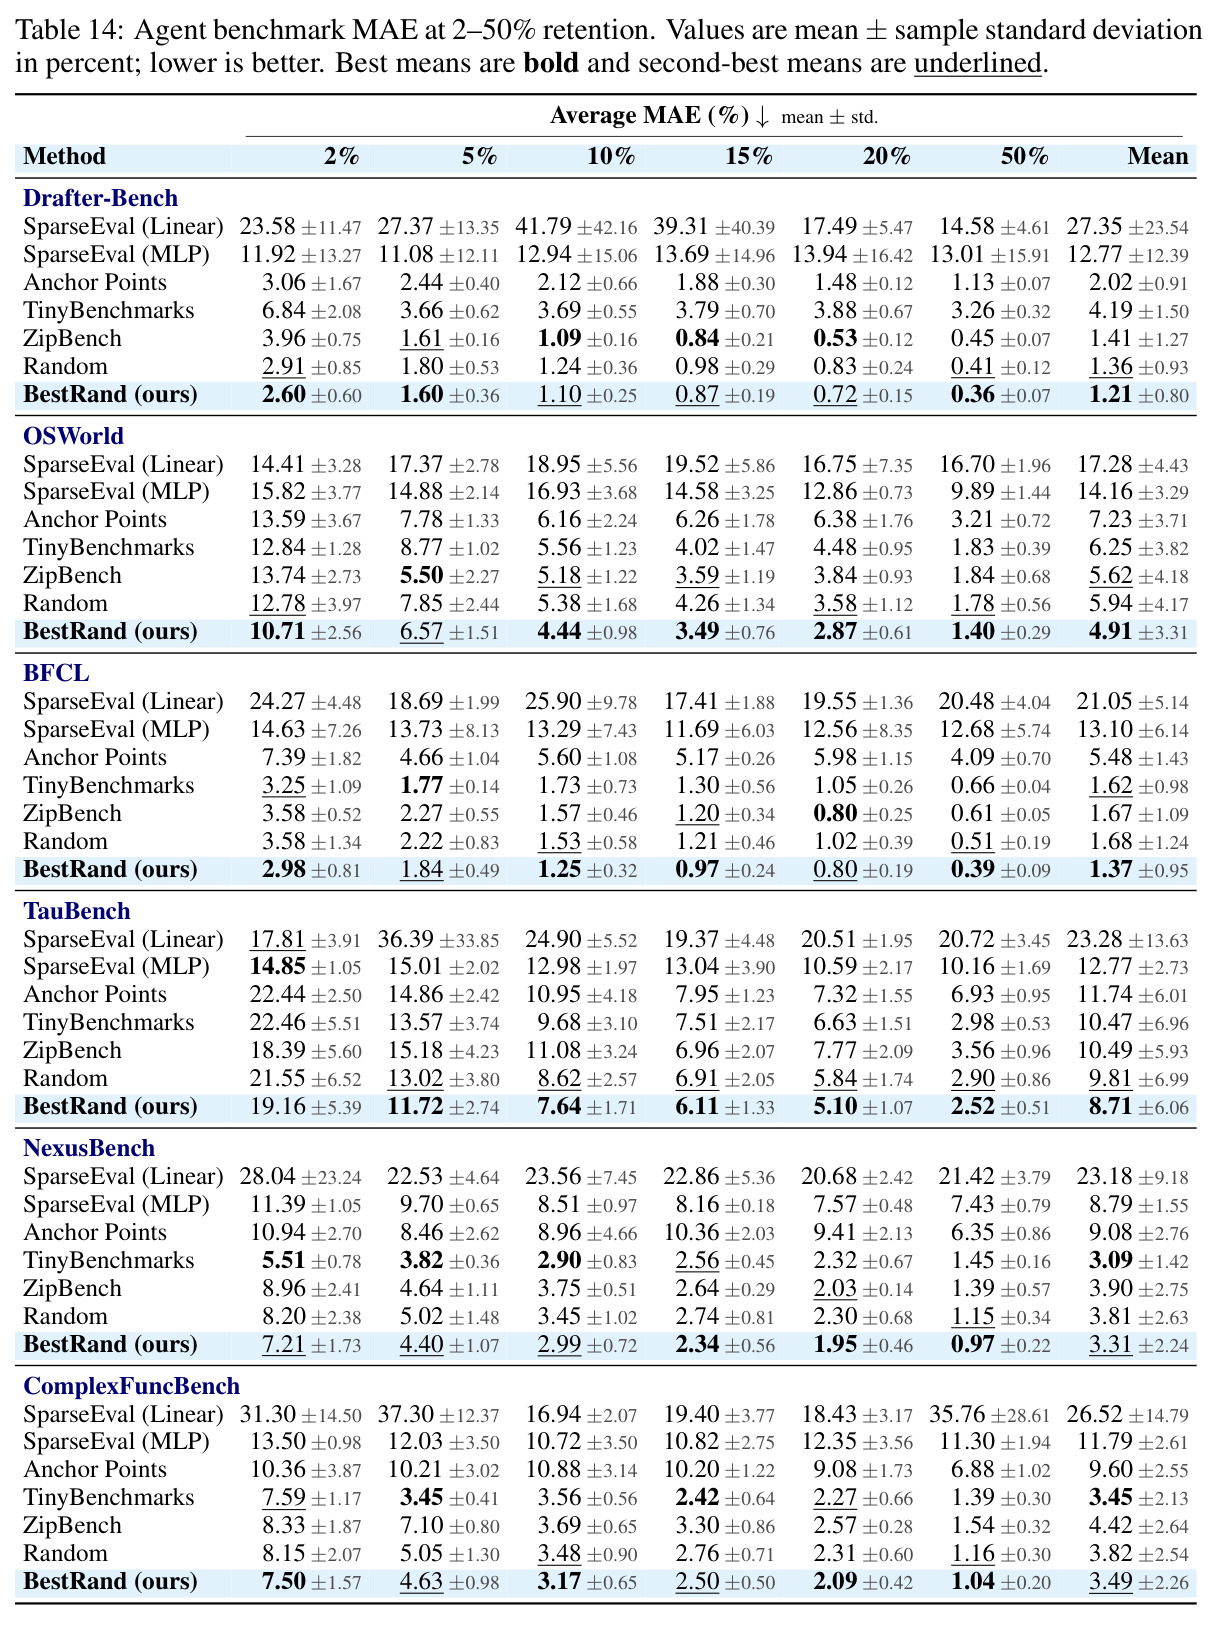
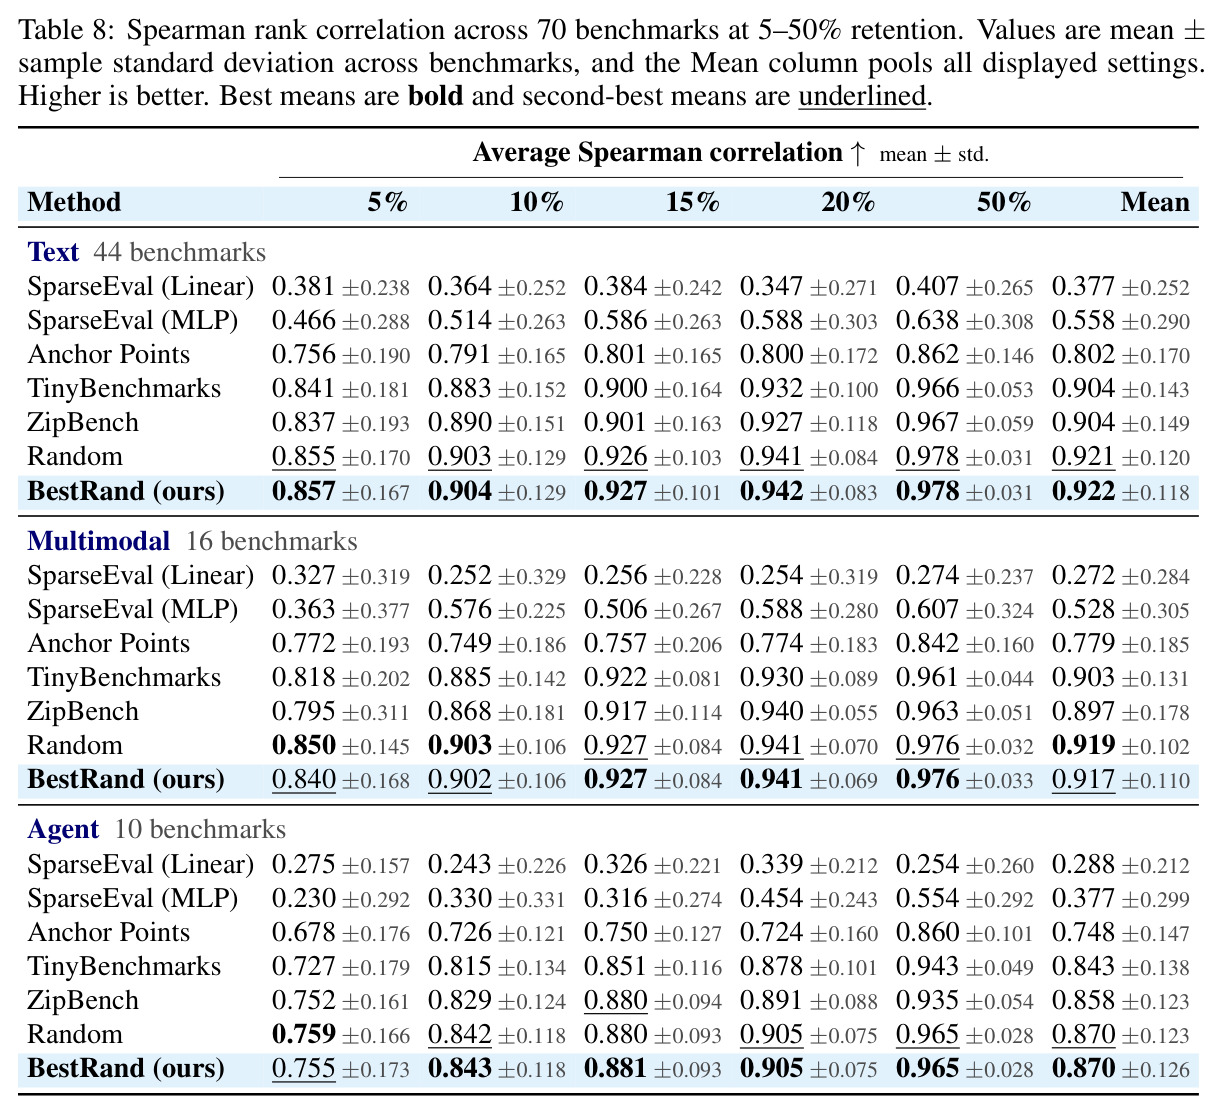
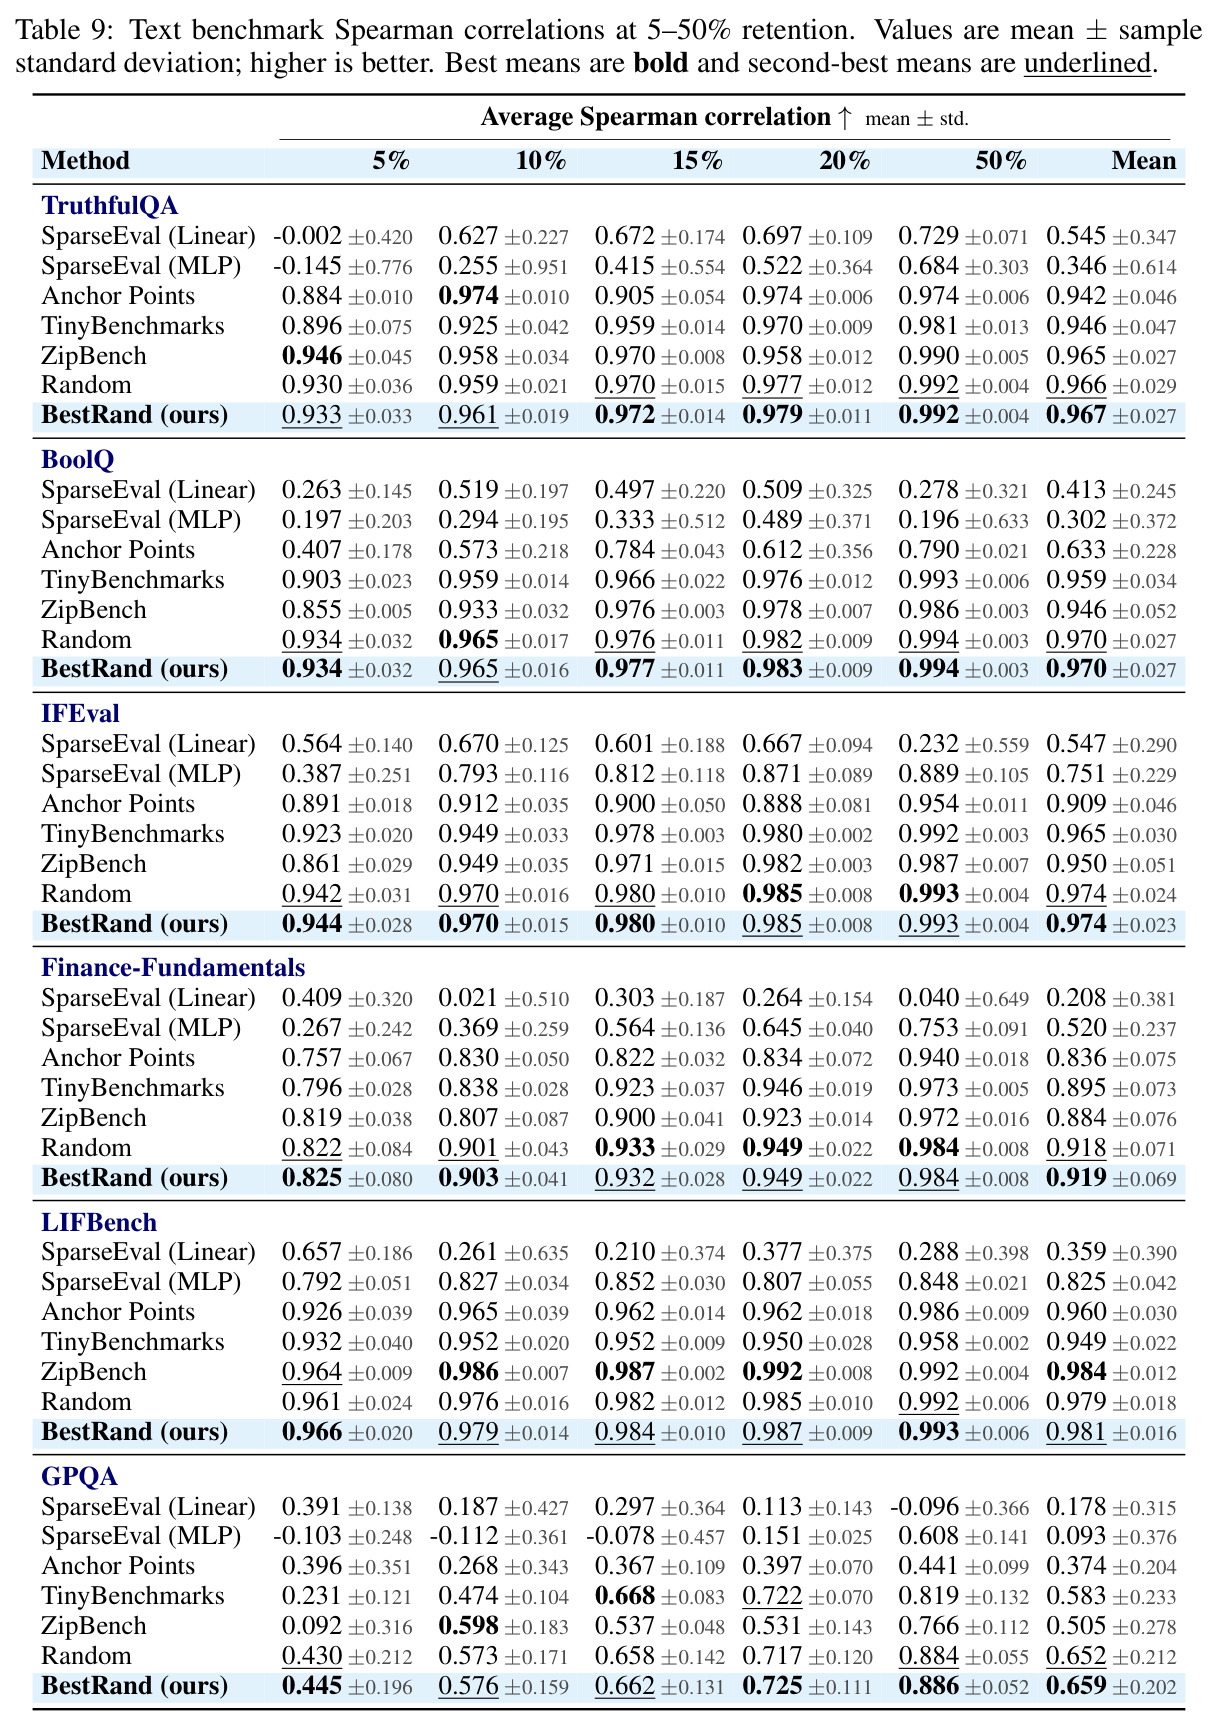
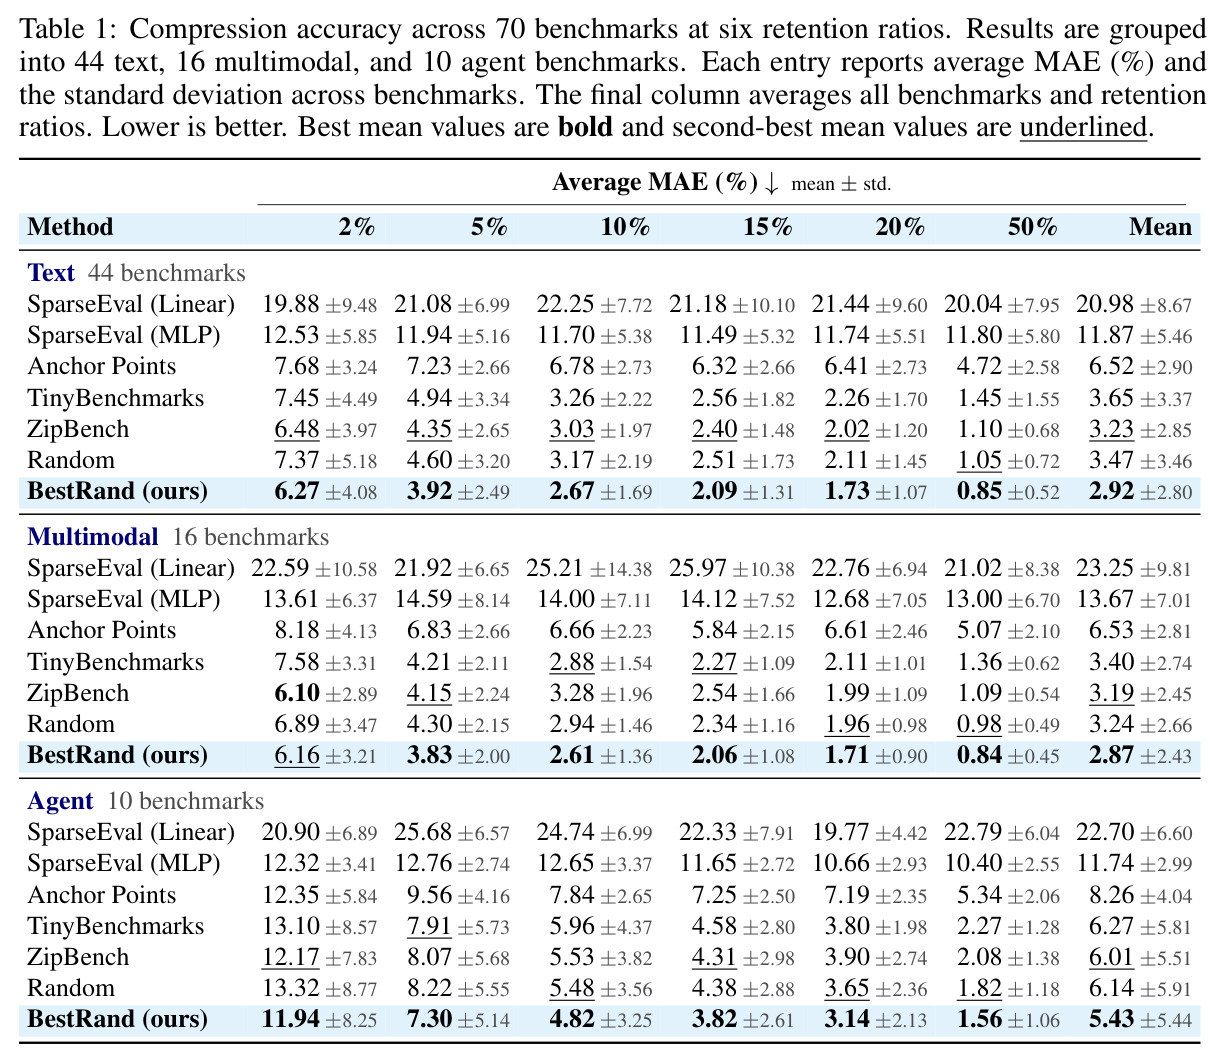
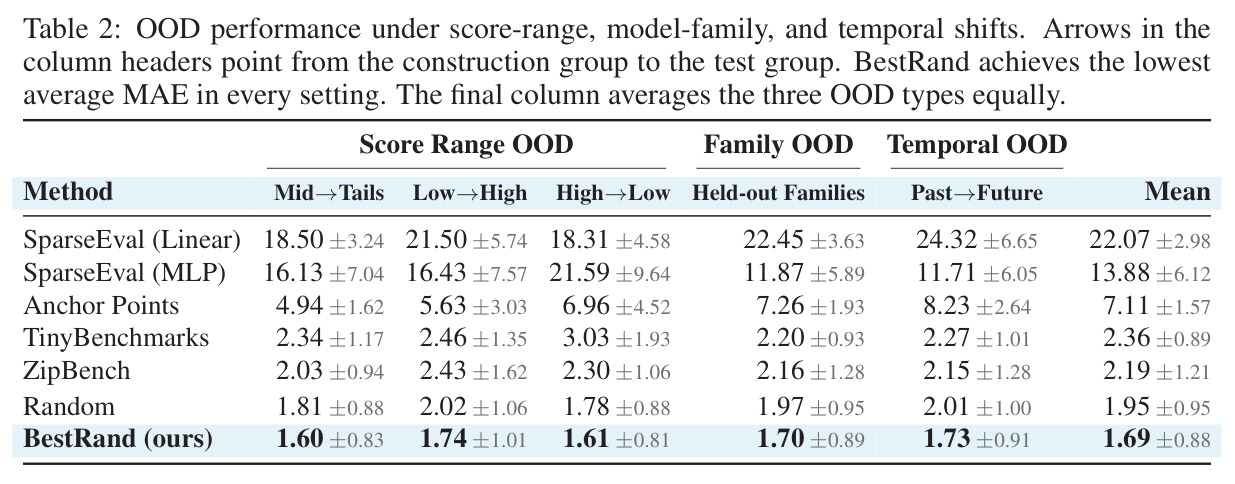
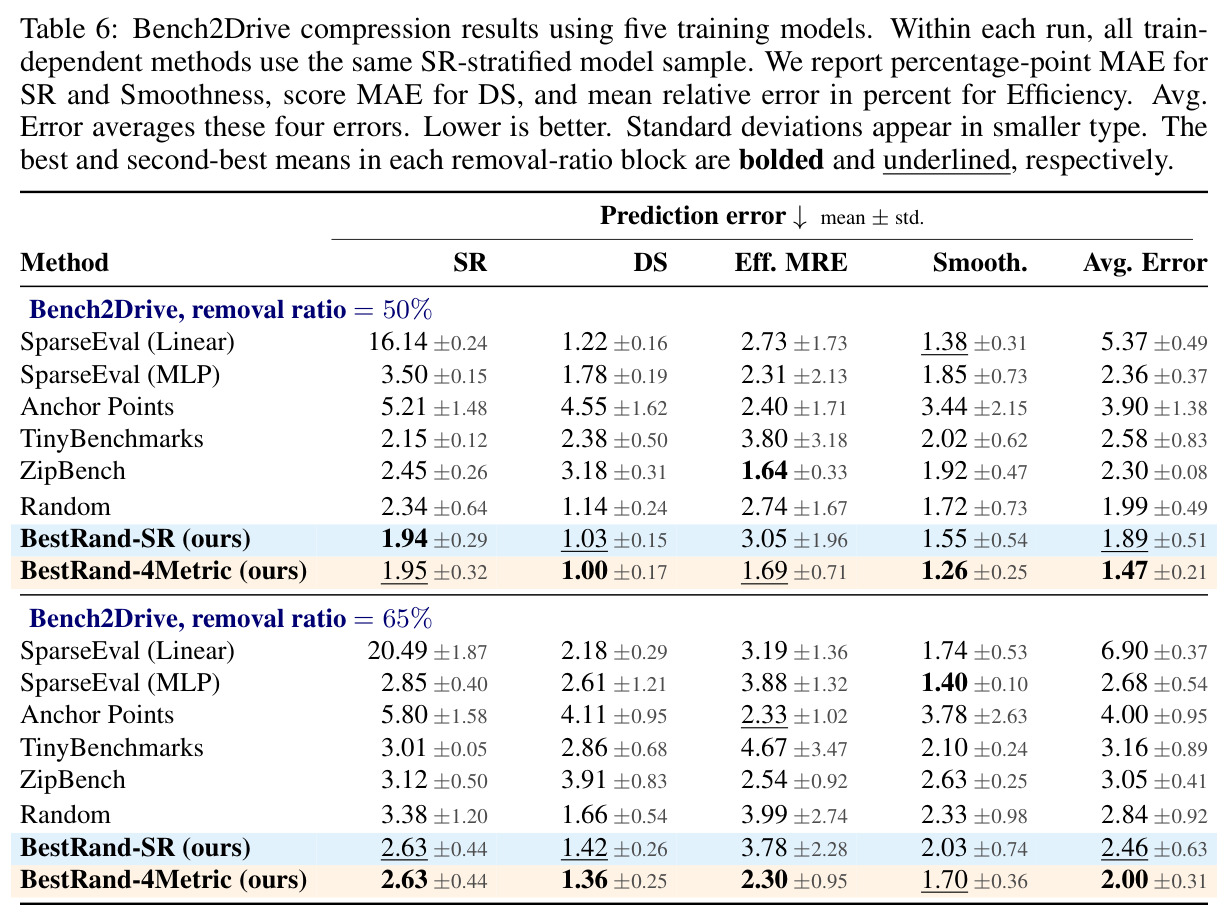
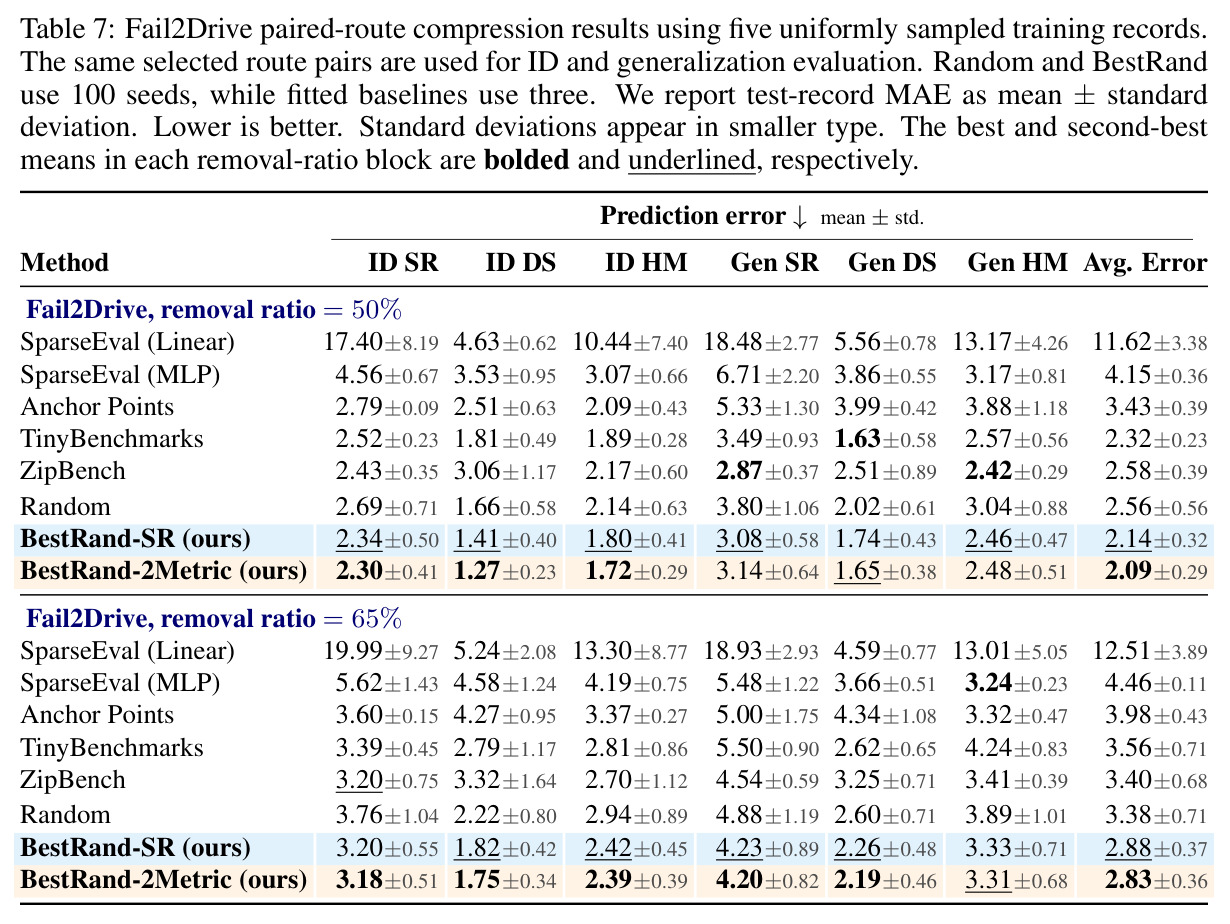
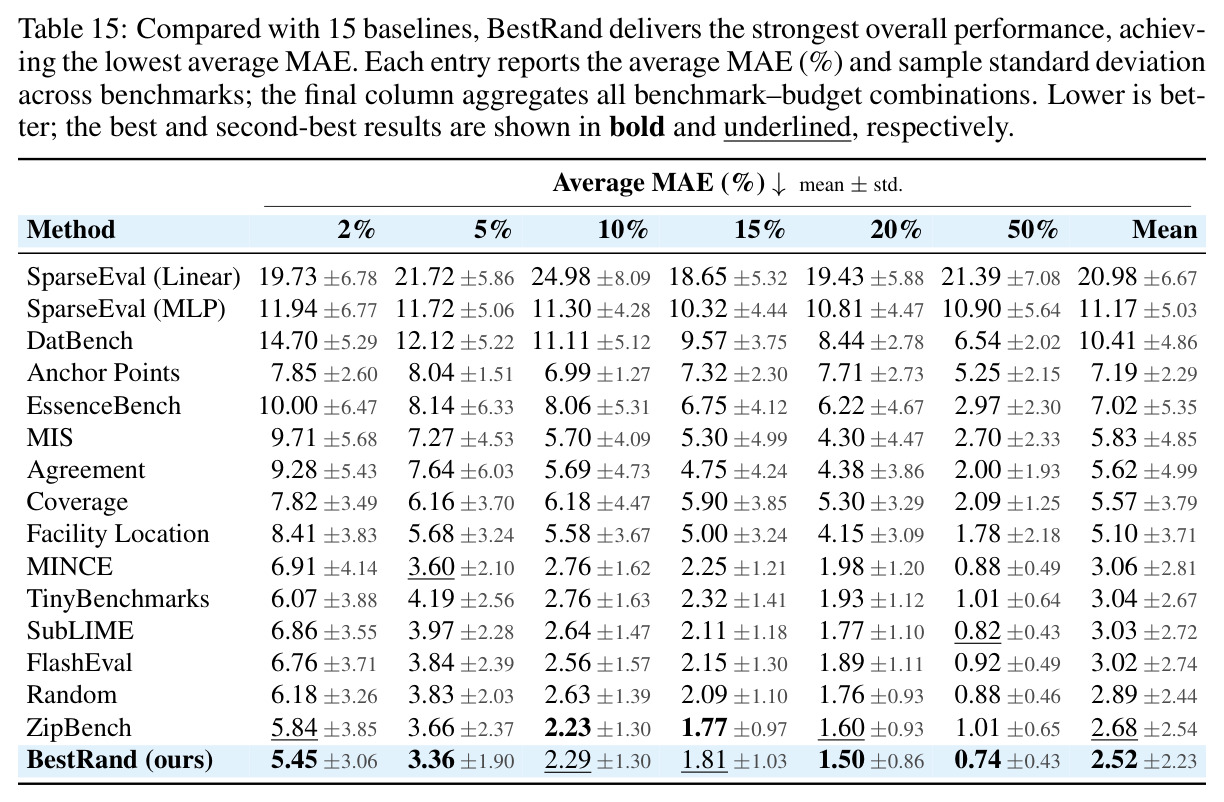
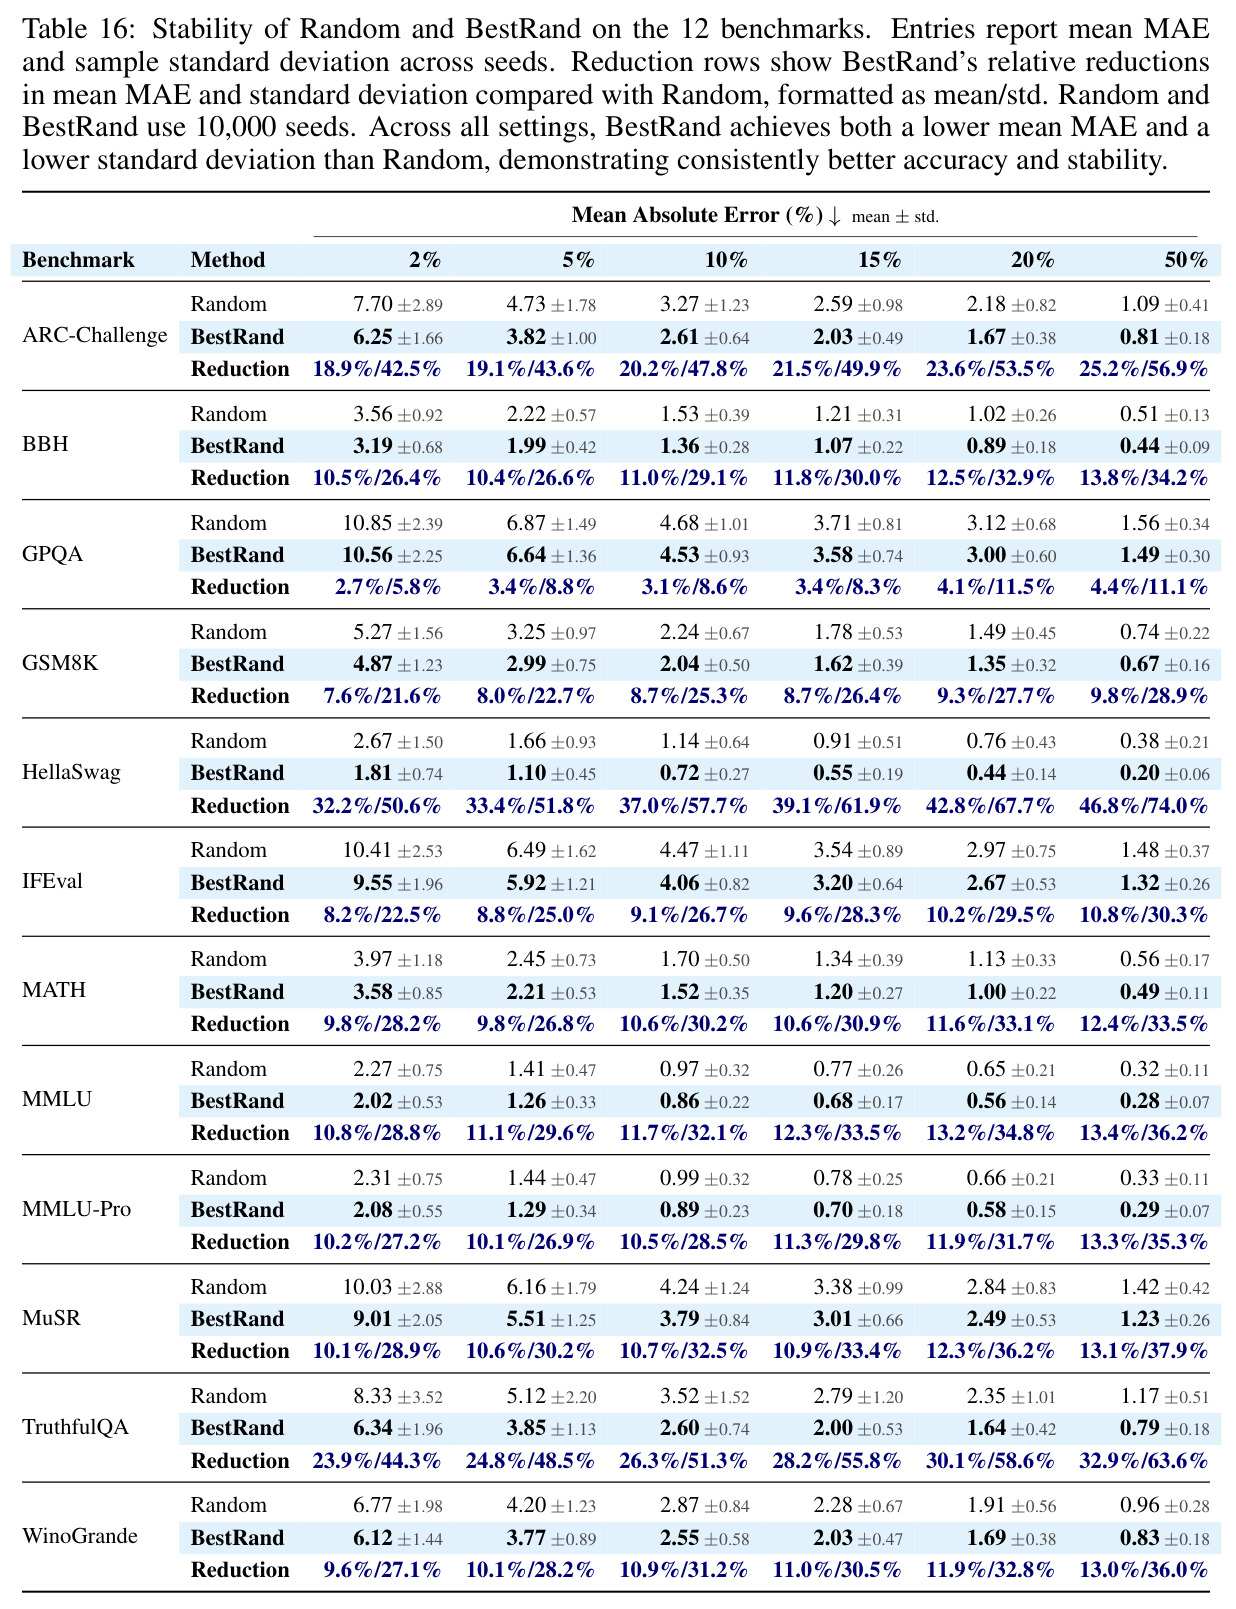
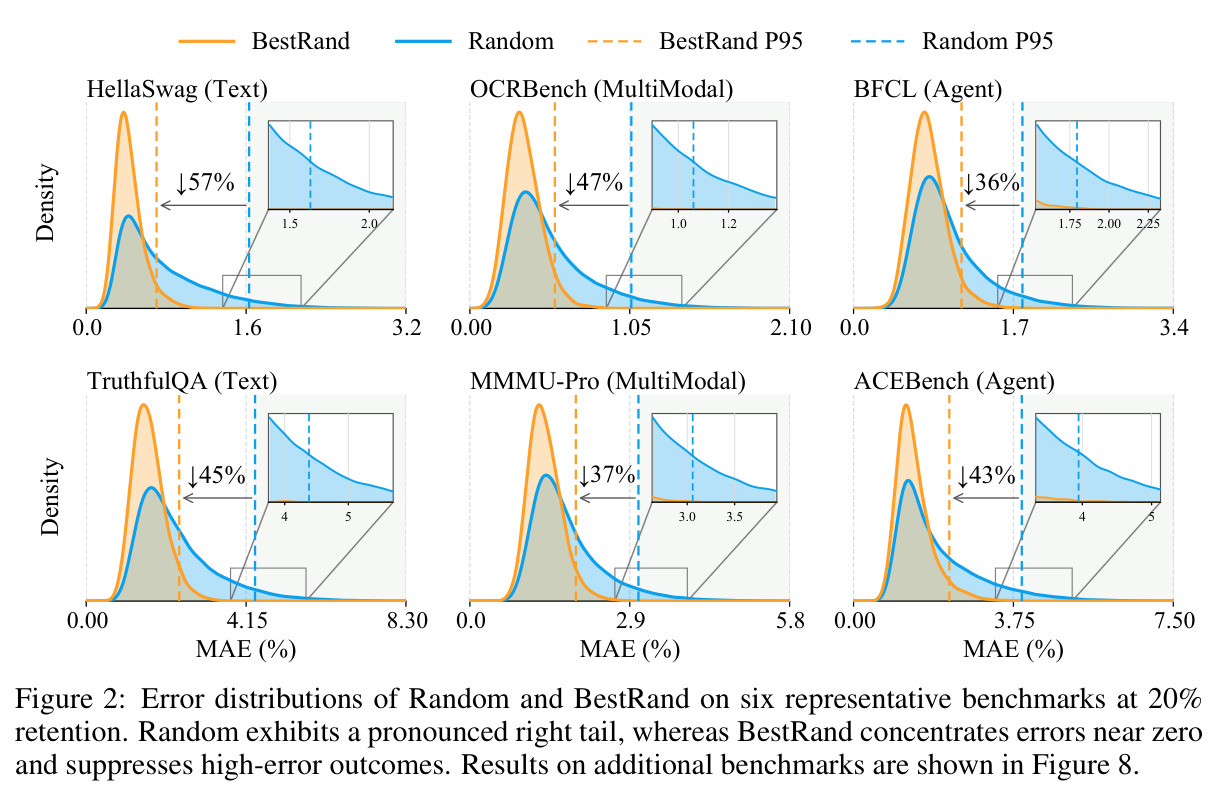
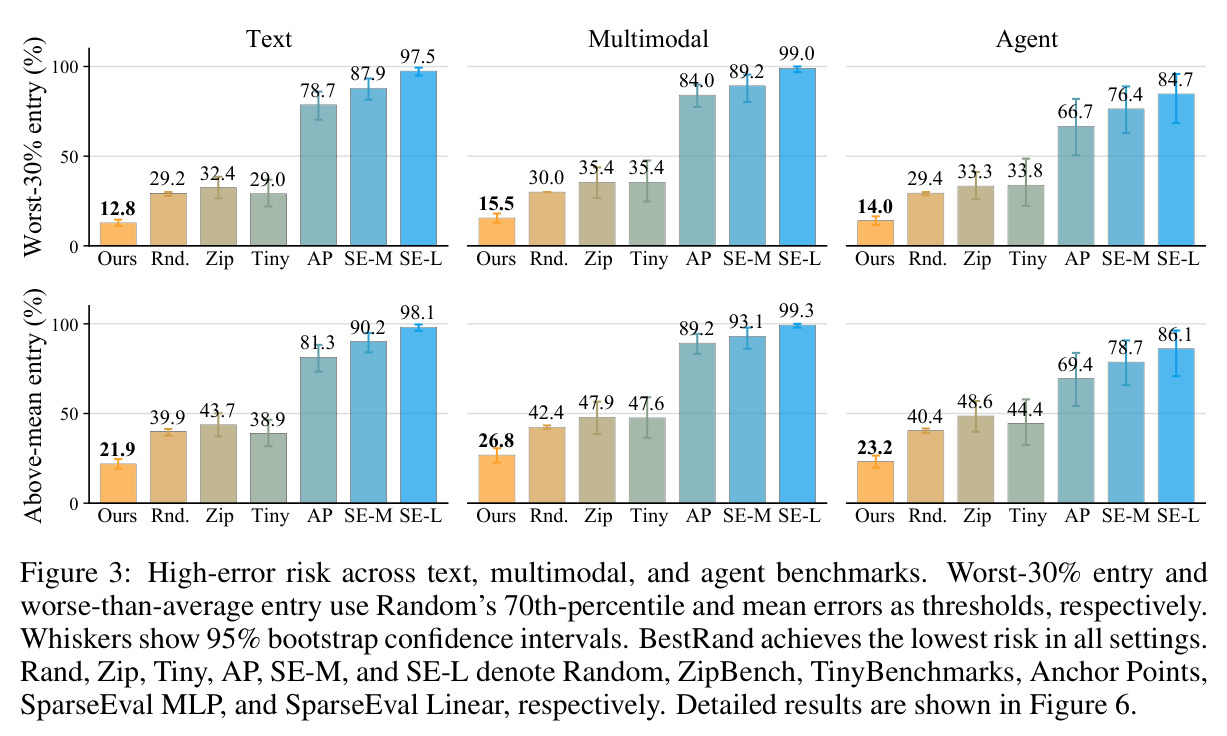
主实验(Table 1,70 基准 × 6 档保留率):BestRand 全面最优——44 文本基准平均 MAE 2.92%(Random 3.47%、ZipBench 3.23%、TinyBenchmarks 3.65%、SparseEval 线性 20.98%),16 多模态 2.87%(Random 3.24%),10 智能体 5.43%(Random 6.14%),对三个强基线平均降 16.4%。高误差风险(Figure 2/3):20% 保留率下六代表基准尾部削减为 HellaSwag ↓57%、OCRBench ↓47%、TruthfulQA ↓45%、ACEBench ↓43%、MMMU-Pro ↓37%、BFCL ↓36%;以 Random 的 P70/均值为阈值,风险全类别最低,平均降 50.2%。成本(Figure 5、Table 5):仅为数据依赖基线的 51.3%(2% 时 8.0%),且 Cost<1 即达可学习基线 Cost≥1 才有的精度。OOD(Table 2):分数区间、家族、时间漂移五个设置全最优,均值 1.69% vs Random 1.95%,降 21.8%,学习型方法全部输给 Random。15 基线对比(Table 15):2.52% 全场最低,每档保留率第一或第二。稳定性(Table 16):72 个设置均值与标准差同时更低,如 HellaSwag 20% 降 42.8%/67.7%。VLA(Table 6/7):Bench2Drive 移除 50%/65% 时 Avg. Error 1.47/2.00(多指标版)vs Random 1.99/2.84,Fail2Drive 2.09/2.83 vs 2.56/3.38。理论验证(Figure 1):众数误差仅 0.7%–1.4%,$\rho$ 全为正(中位 0.33),$\rho+s$ 联合预测 MAE P95 的 $R^2=0.993$。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文本基准压缩(44 个,6 档保留率) | 平均 MAE (%) | 2.92 ± 2.80 | Random 3.47 / ZipBench 3.23 / TinyBenchmarks 3.65 / SparseEval 线性 20.98 | 较三个强基线平均降 16.4%;较 Random 降约 15.8% |
| 多模态基准压缩(16 个) | 平均 MAE (%) | 2.87 ± 2.43 | Random 3.24 / ZipBench 3.19 / TinyBenchmarks 3.40 | 较 Random 降约 11.4% |
| 智能体基准压缩(10 个) | 平均 MAE (%) | 5.43 ± 5.44 | Random 6.14 / ZipBench 6.01 / TinyBenchmarks 6.27 | 较 Random 降约 11.6% |
| 高误差风险(误差超过 Random 的 P70/均值) | 高误差概率 (%) | 所有文本/多模态/智能体设置下最低 | Random / ZipBench / TinyBenchmarks | 相对三个强基线平均降 50.2%;六代表基准尾部削减 36%–57% |
| OOD 泛化(分数区间/模型家族/时间漂移) | 平均 MAE (%) | 1.69 ± 0.88(五个设置全部最优) | Random 1.95 / ZipBench 2.19 / TinyBenchmarks 2.36 / SparseEval 线性 22.07 | 较竞争基线平均降 21.8% |
| 与 15 个基线对比(12 个基准) | 平均 MAE (%) | 2.52 ± 2.23 | ZipBench 2.68 / Random 2.89 / FlashEval 3.02 / MINCE 3.06 / DatBench 10.41 | 全场最低,每个保留率排名第一或第二 |
| VLA 评测(Bench2Drive,移除率 50%/65%) | 四指标平均误差(Avg. Error) | 1.47 / 2.00(BestRand-4Metric);单指标版 1.89 / 2.46 | Random 1.99 / 2.84 | 多指标版降约 26.1%/29.6% |
| VLA 评测(Fail2Drive,移除率 50%/65%) | 六项误差平均(Avg. Error) | 2.09 / 2.83(BestRand-2Metric) | Random 2.56 / 3.38 | 降约 18.4%/16.3% |
| 构建成本 | 归一化成本 Cost = R/N(1 等于一个模型的完整评测) | 平均 0.513(2% 保留率时 0.08) | 数据依赖基线 ≥ 1.0 | 节省约 48.7%(低保留率下省 92%) |
局限与改进
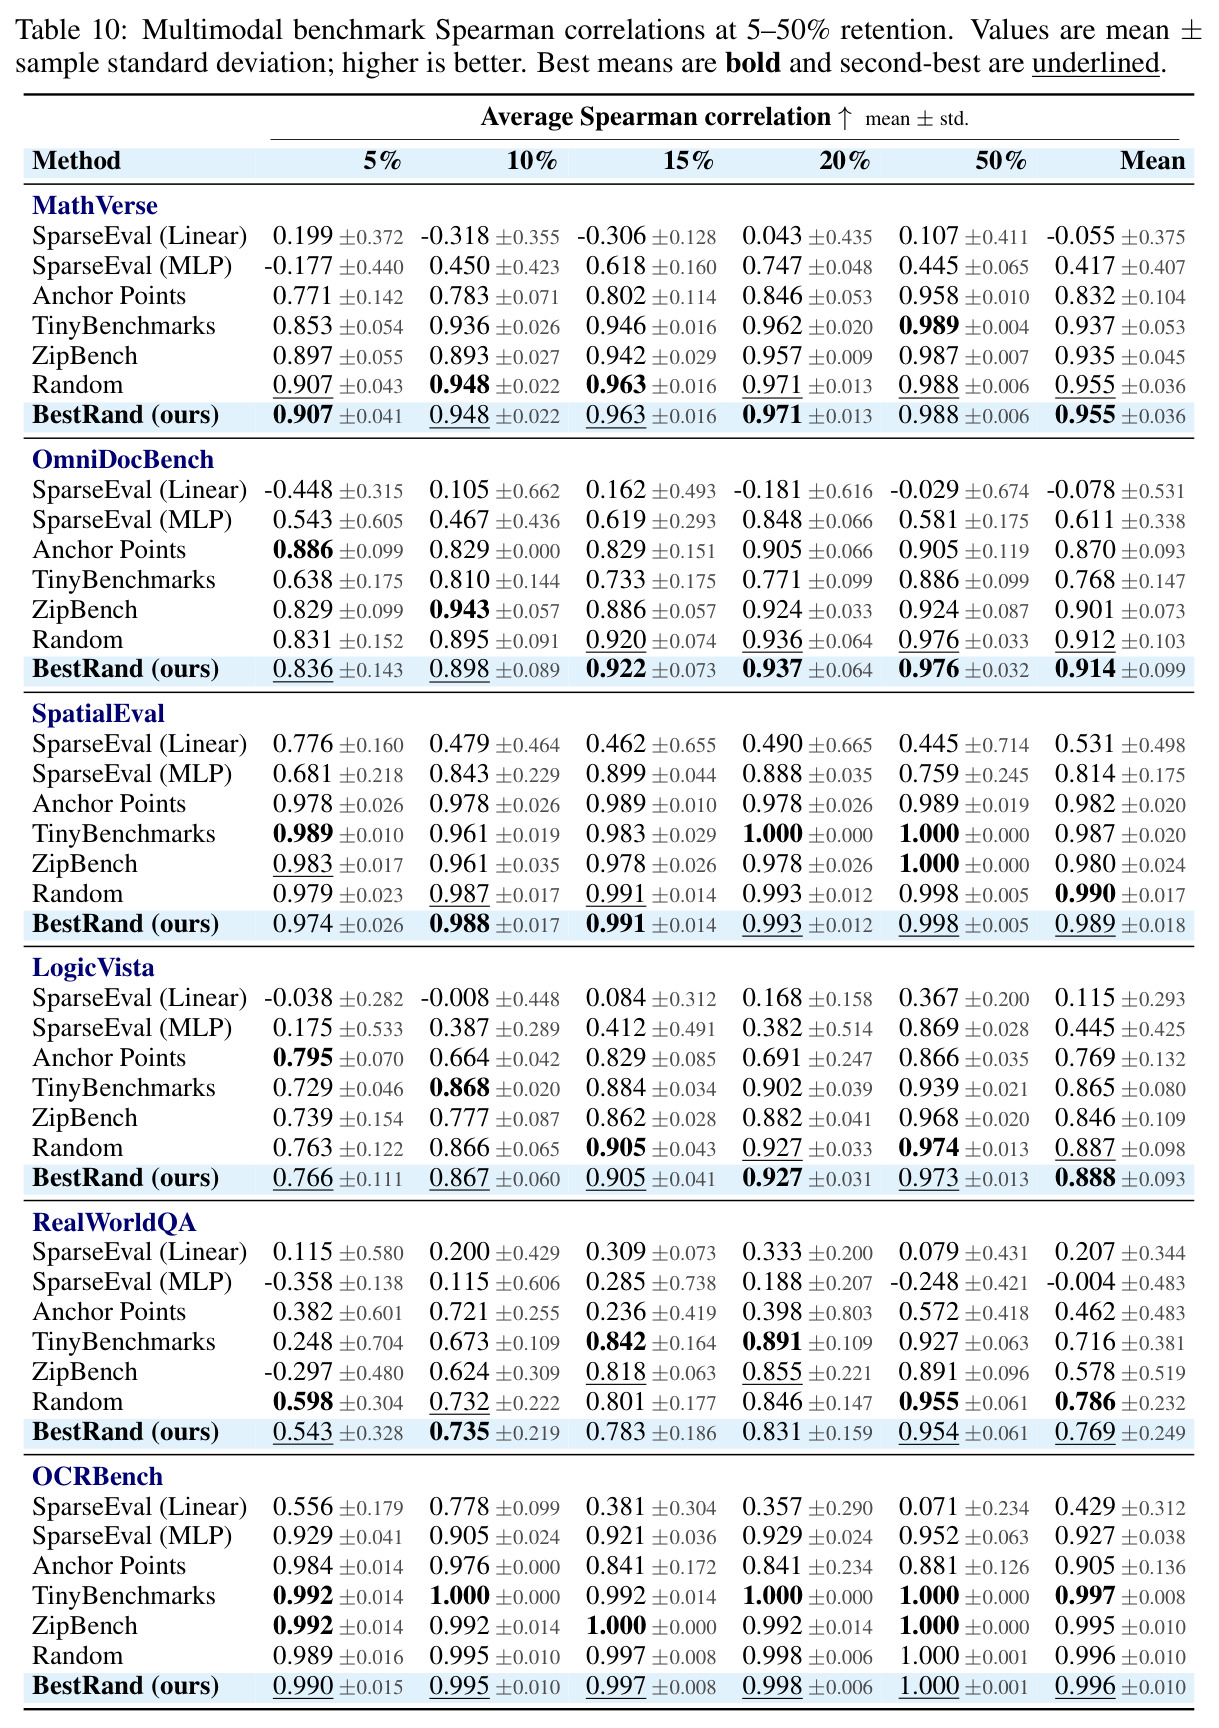
作者承认的局限(附录 D.1):其一,压缩估计误差非零,压缩基准不能完全替代最终全量评测,只适合快速迭代与横向比较,正式结论仍应报告全量分数;其二,探针推理成本非零——$p$ 个探针模型仍需在候选池上完整推理,只是远低于基线的全量记录要求。我的补充观察:(1)理论建立在等方差等相关假设上,Table 17 显示协方差相似度均值 92.4%,但个别基准偏离较大(OpenBookQA 仅 72.3%、BBH 85.1%),这些基准上理论预测会变粗;(2)收益不均匀——GPQA 等高难基准上相对 Random 仅降 2.7%–4.4%,探针-目标相关性弱或难度方差结构复杂时增益收窄;(3)Figure 4(c) 显示只选低分探针会显著变差(Uniform vs Low,$p<0.001$),探针选择仍依赖经验判断;(4)优化目标是 MAE,排序保真(Spearman)只在附录报告,若下游关心头部模型排名或路由决策,该子集未必最优;(5)多指标扩展需人工挑选并归一化指标,默认超参是否随基准规模自适应也未系统研究。
独立分析的弱点
独立弱点分析:(1)残差偏移不可削减——Theorem 3 只消除探针可解释部分 $R^2s^2$,剩下的 $(1-R^2)s^2$ 无法靠增加候选数压掉;若探针与目标模型代差大(如用旧开源模型探针评 frontier 模型),$R^2$ 下降、收益收窄。改进:多组异构探针集成并在线估计 $R^2$,自适应分配候选数 $m$。(2)池内搜索的多样性瓶颈——候选全部来自 $\min(nk,N)$ 的池,低保留率时池小、候选差异有限,参考 $H$ 自身也有方差,理论中的 $\|H-\bar x_N\|$ 项未单独量化。改进:分层抽样构造池,并对 $H$ 做有限总体校正。(3)静态子集——一次选定后所有目标模型共用,无法随模型演化在线更新;时间漂移下误差最大(1.73%)。改进:增量式维护或定期低成本重搜索。(4)评测目标单一——MAE 不区分对排名、路由等决策真正有害的误差。改进:把选择目标对齐下游用途,构造任务感知的失衡准则。(5)非退化假设排除全对/全错模型,在极难基准($\sigma^2$ 趋小)上理论失效,需稳健化。
未来方向
作者明确方向较少,结论只给出'理解简单抽样何时、为何失败并低成本修正'的总纲。基于成果可延伸:(1)反向使用误差公式做预算规划——由 $s=c(k)\sigma\sqrt{\rho+(1-\rho)/M}$ 与尾部下界 $2\Phi(-t/s)$,给定可容忍的 P95 误差即可反解最小保留率 $k$,做成评测成本计算器;(2)把 $\rho$ 提升为基础模型同质性的度量工具,连接模型可区分性、基准饱和与能力趋同研究;(3)理论推广到非二值分数、多指标联合分布、排序统计量的抽样分布以及探针-目标相关性变化时的渐近行为;(4)探针选择理论化——目前只有'避免只用低分探针'(Uniform 显著优于 Low,$p<0.001$)的经验结论,可研究探针覆盖度与 $R^2$ 的定量关系;(5)与数据工程结合:压缩+去冗余+去污染一体化,或处理智能体 Rollout 型非平稳分数;(6)在线/增量压缩:新模型到来时只更新失衡统计而不重跑搜索;(7)把'随机生成+轻量筛选'范式迁移到合成数据筛选、模型路由等选代表场景。
复现评估
复现条件较好。开源:摘要与可复现性声明承诺代码与数据将在 GitHub 公开(正文写作时为承诺式,需关注仓库实际发布)。文档完整度高:附录 A 给出 70 个基准的来源、指标、模型划分(主实验 5 个构建模型)与全部基线超参——如 IRT 训练 2000 epochs、学习率 0.1、衰减 0.9999;SparseEval MLP 隐层 128/64/32、学习率 $5\times10^{-4}$;附录 F 给出三个定理的完整证明、假设的经验检验(Table 17)与逐题数值验证(Figure 12/13);附录 E 报告 Spearman 与逐基准明细。算力分层看:方法本身极轻——探针只需 5 个中小模型在 $\min(4k,N)$ 题上推理一次,候选搜索是 GPU 批量张量运算,单卡即可;真正昂贵的是重建 70 基准 × 多模型的全量分数矩阵(Random/BestRand 用 10000 个种子),若从公开排行榜复用分数记录则门槛大降。综合评估:核心算法复现容易(数百行代码),全套实验复现中等偏难,瓶颈在推理预算而非算法复杂度。
论文图表