我们是否测试得太多?面向大语言模型高效评测的基准压缩综述 Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
首篇系统综述119篇论文,为LLM基准压缩建立统一分类、成本与可靠性框架
前置知识
评测基准(Benchmark)与评估契约
评测基准是用于测量模型能力的标准化题集。本文进一步抽象出统一的"评估契约":全集单元 $U$(每道题、每次人工评审、每对比较或每次 agent rollout),对每个单元获得结果 $Y_U$,再由聚合规则 $G$ 得到完整评估结果 $\hat{\theta}_{full}=G(Y_U)$,如总分或排名。压缩评估只观测低成本子集 $S\subseteq U$,由恢复规则 $R$ 估计 $\hat{\theta}_{comp}=R(Y_S,Z)$。
全文所有方法都被放进这一个形式化框架里比较,不理解这个契约就无法理解分类法的逻辑和各章的术语。
题目反应理论(IRT)
心理测量学的标准建模工具:为每道题估计参数(难度、区分度),为每个被试(这里是模型)估计潜在能力 $\theta$,用诸如 $P(\text{correct}|\theta, \text{难度}, \text{区分度})$ 的函数联系二者。在 LLM 评测中,IRT 被用于从少量题目响应恢复能力值、映射回全基准分数,或挑选信息量最大的下一道题。
tinyBenchmarks、Fluid、metabench 等大量代表方法都以 IRT 为数学底座,附录还专门讨论了 IRT 在少模型场景下的不稳定问题。
LLM-as-a-Judge
用一个(通常更强的)大语言模型代替人类评审,对开放式生成结果打分或在两个回答间比较。它把评测成本从"模型推理"扩展到"评审调用",也引入了评审偏差、位置偏差、自偏好等可靠性问题。
本文把"节省单元"从题目扩展到人工评审与 judge 调用,Target-Conditioned 家族中一大类方法(如 AutoEval、Judge Sampling)正是用少量金标审计去校正大量廉价 judge 评分。
计算机化自适应测试(CAT)
源自教育测量的技术:每答完一题就更新对被试能力的估计,再从题库中挑选对该能力估计信息量最大的下一题(如 Fisher 信息最大化),用远少于全卷的题数达到同等测量精度。停止条件可以是达到目标精度或固定题数。
本文 Adaptive Item Selection 类(21 篇)几乎就是 CAT 在 LLM 评测上的迁移与改造,Fluid、ATLAS、SafetyCAT 等方法直接沿用其术语与理论。
逆概率加权与预测功率推断(IPW/PPI)
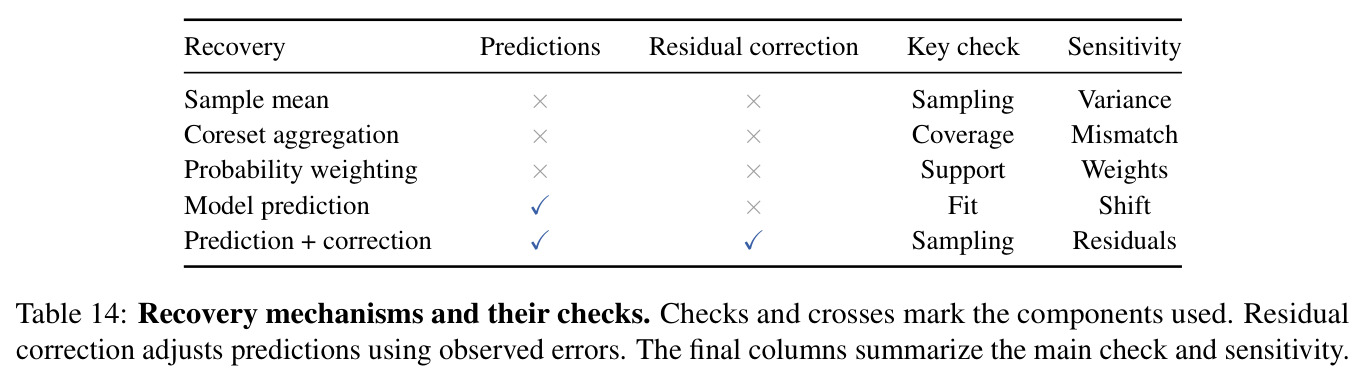
当样本不是均匀随机抽取、而是按已知概率 $\pi_i$ 偏向性选择时,用 $1/\pi_i$ 加权观测值可以让估计量仍然无偏地针对原始全集;预测功率推断(PPI)则用廉价代理预测加少量金标残差校正,在保证统计效力的同时降低标注成本。
这是理解"为什么有偏选样仍能恢复无偏全分数"的关键,也是 CollabEval、AIPW、AutoEval 等方法正确性声称的来源。
anytime-valid 序贯检验
一类统计方法(如 e-process、置信序列):允许在数据到来过程中任意时刻进行检验或构造置信区间,而不用为"偷看多次"付出多重比较代价,且保证错误率控制。与固定样本量的经典检验相对。
序贯决策与停止类方法(CELEUS、AV-AIVAT 等)依赖它来回答"测到什么时候可以停"这一核心问题,并给出可证明的停止保证。
研究动机
大语言模型的评测成本正随基准规模一起膨胀。以 MMLU、GSM8K、LongBench 为代表的主流基准动辄包含成千上万道测试题,每次完整评估都要对全部题目执行模型推理,这既拖慢模型迭代速度,也推高了算力与资金开销。更关键的是,这种大规模测试存在大量冗余:已有研究表明(Polo et al., 2024b; Huang et al., 2025),在这些广泛使用的基准上,只用不到 20% 的测试样本就能复现与全集几乎相同的分数和排名,意味着 80% 以上的推理开销被浪费。自 2024 年起,"基准压缩"研究随之爆发——本综述统计,从 2023 年到 2026 年 8 月共出现 119 篇相关论文,2023 年仅 6 篇早期研究,2024 年增至 18 篇,2025 年 29 篇,2026 年前三个季度已新增约 35 篇。然而这些方法的信息需求、成本假设、恢复机制和验证方式各不相同:有的只需要题目文本,有的依赖历史模型的完整响应矩阵,有的要在测试时先对目标模型跑探针。文献高度分散,研究者既不清楚哪类方法适合自己的场景,也不清楚它到底省了什么成本、结果是否仍然可靠,业界缺少一张统一的"地图"。
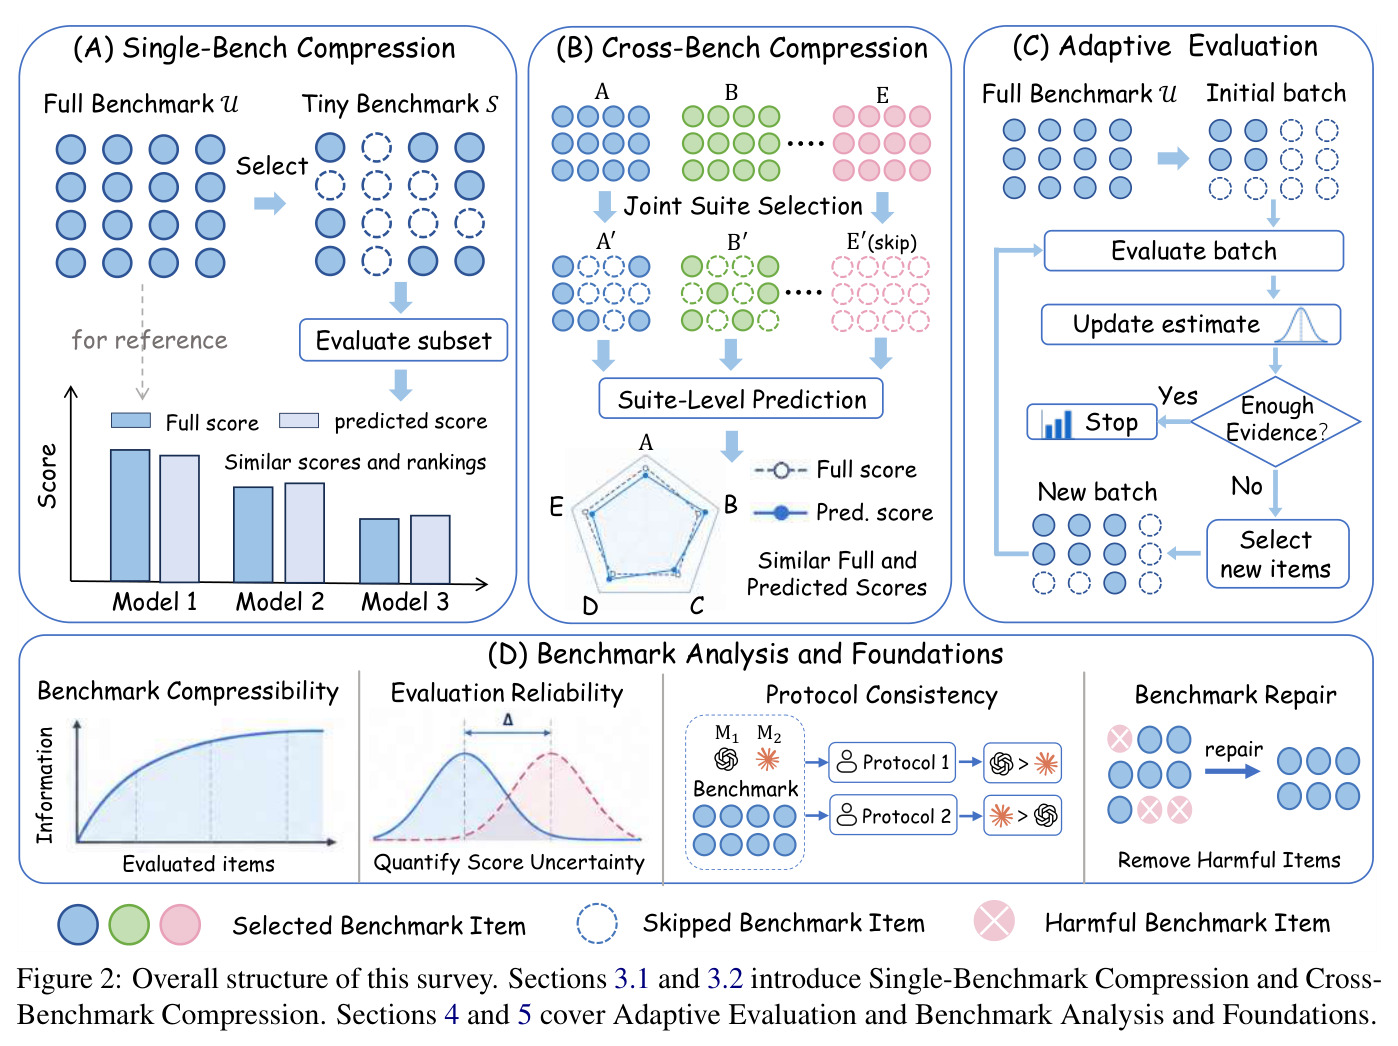
本文的目标是本文的目标是为 benchmark compression 这一快速生长的领域建立首个系统性框架。具体包括四件事:其一,给出统一的数学形式化——把完整评估表示为 $\hat{\theta}_{full} = G(Y_U)$,把压缩评估表示为 $\hat{\theta}_{comp} = R(Y_S, Z)$,并明确其目标是在成本约束 $C_{comp} < C_{full}$ 下使误差 $L(\hat{\theta}_{comp}, \hat{\theta}_{full}) \leq \varepsilon$,其中 $L$ 度量分数或排名的差异;其二,用一套固定的三问决策路径(贡献类型→子集选择时机→范围与信息源)把 119 篇论文组织成 4 大主类、7 个叶子类别,每篇论文一个主标签、其余机制记为二级属性;其三,跨家族深入比较各方法的信息需求、全生命周期成本(构建、刷新、每次运行)、可靠性检查手段与失败条件;其四,给出方法选择与验证的实践指南,并规划该领域的未来研究路线图。最终让研究者能按自身场景快速定位合适的方法,并知道如何验证其可靠性。
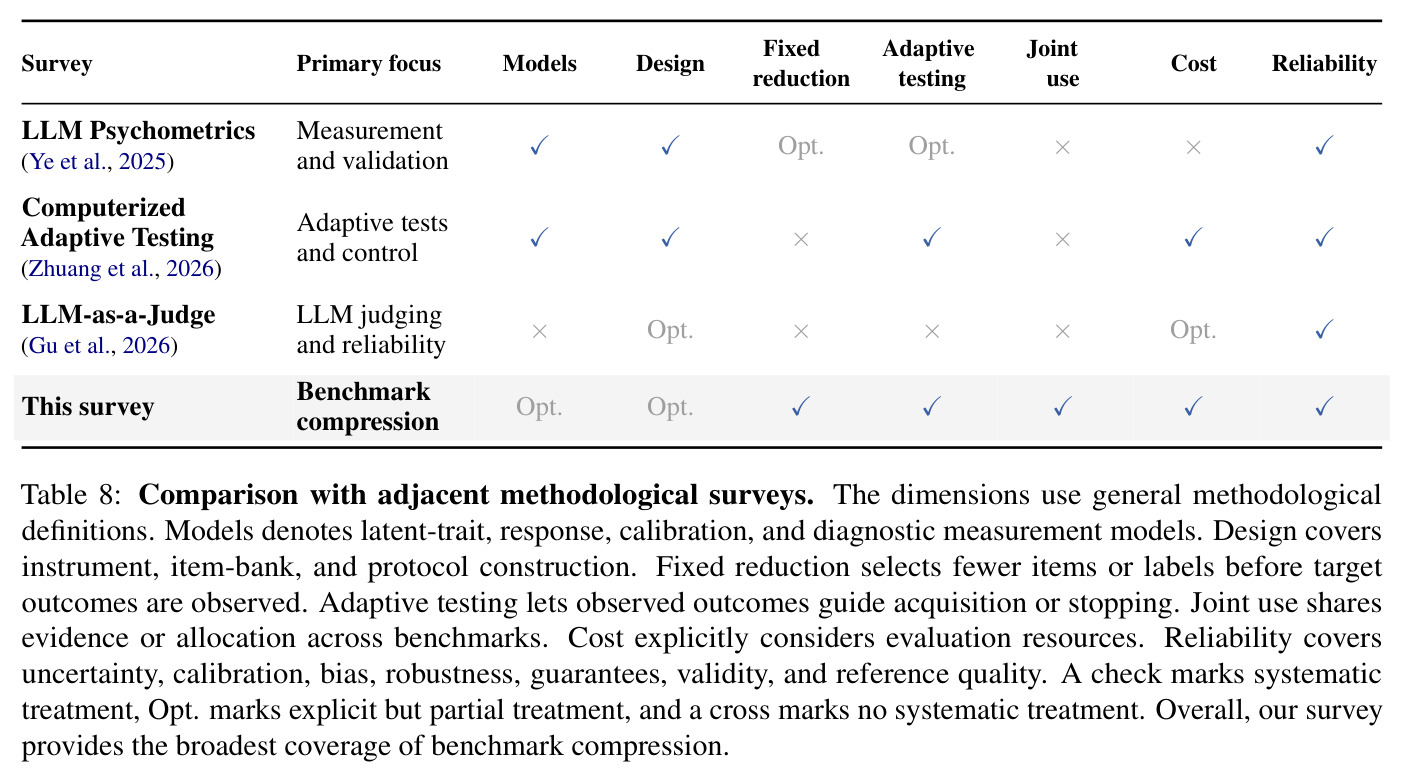
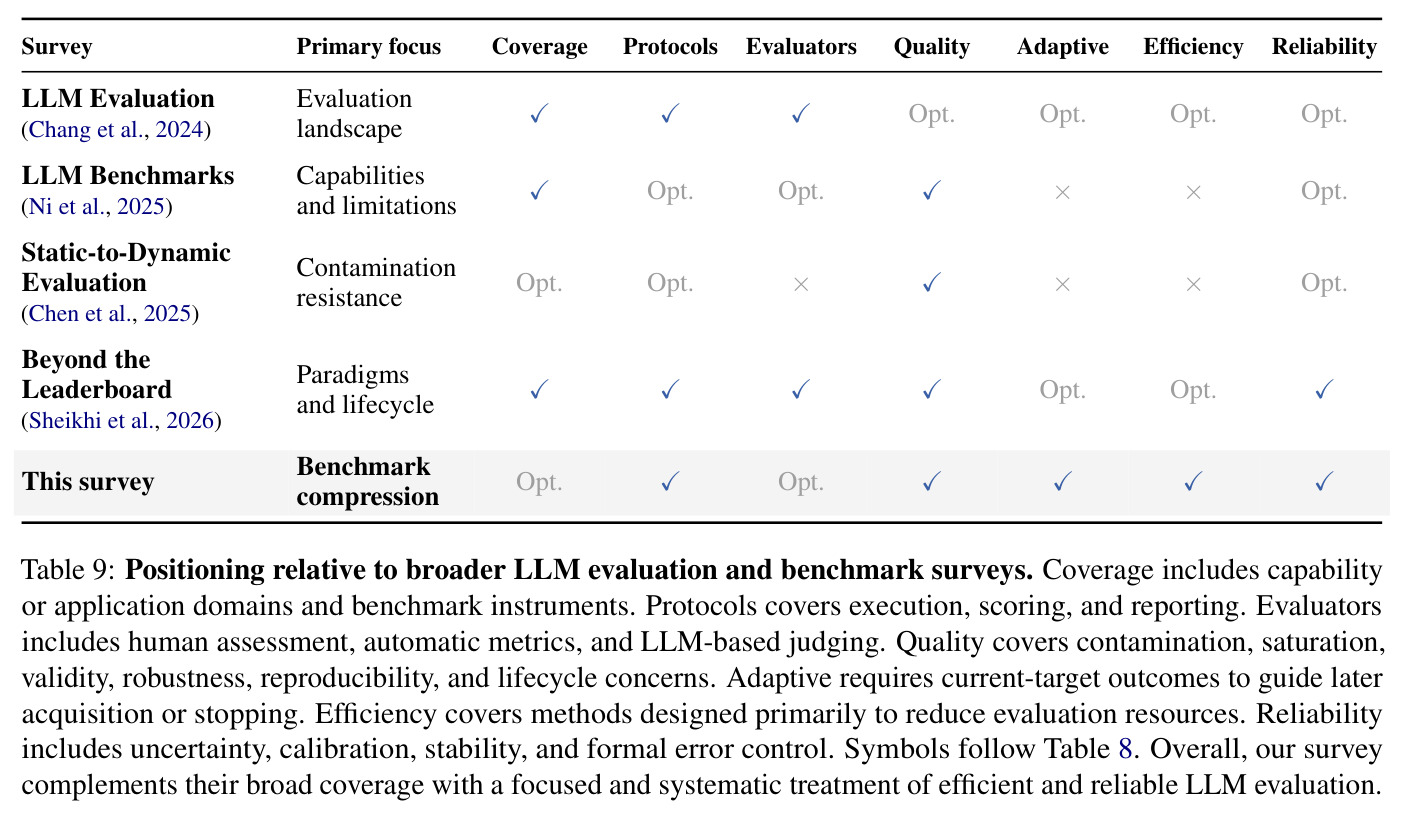
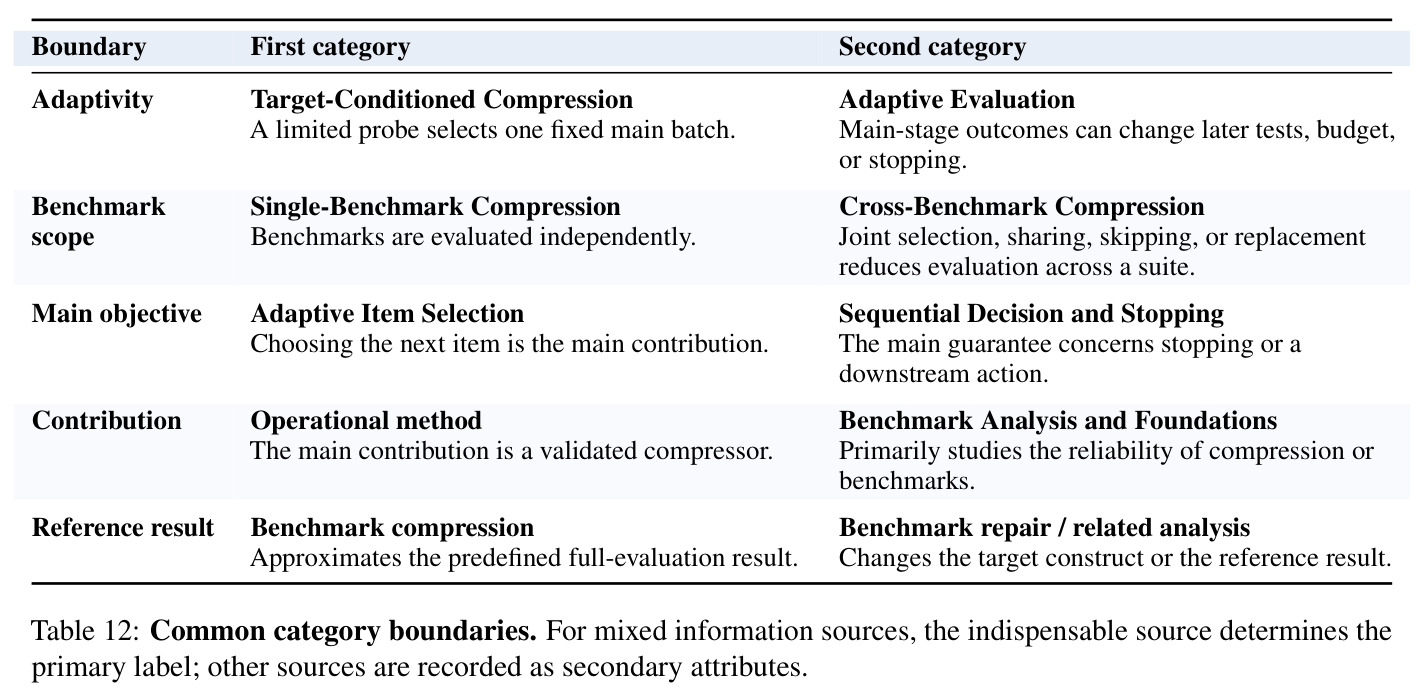
与已有工作不同的是,在本文之前,没有任何综述把 LLM 基准压缩当作一个统一领域来处理。相邻的三个方法学传统各管一段:LLM 心理测量学综述(Ye et al., 2025)关注测量与效度,计算机化自适应测试综述(Zhuang et al., 2026)覆盖自适应选题但不限于 LLM,LLM-as-a-Judge 综述(Gu et al., 2026)聚焦评判可靠性;更广的评估综述(Chang et al., 2024; Ni et al., 2025 等)描绘评测全景,但对"降本"只有零星涉及——论文 Table 8、Table 9 用多个维度逐一对比了这些综述与本综述的覆盖差异。本文的独特切入角度有三:第一,用"评估契约"(预定义全集、聚合规则、恢复规则)作为公共语言,使原本各自表述的异质方法变得可比较;第二,明确把"压缩"(复现预定义全评估的结果)与"基准修复"(改变测量目标本身)区分开,此前文献中这一界限普遍模糊;第三,把构建/刷新等全生命周期成本和 model/family/time/task 四种 holdout 验证设计纳入比较维度,而不只看单次评测省了多少。
核心方法
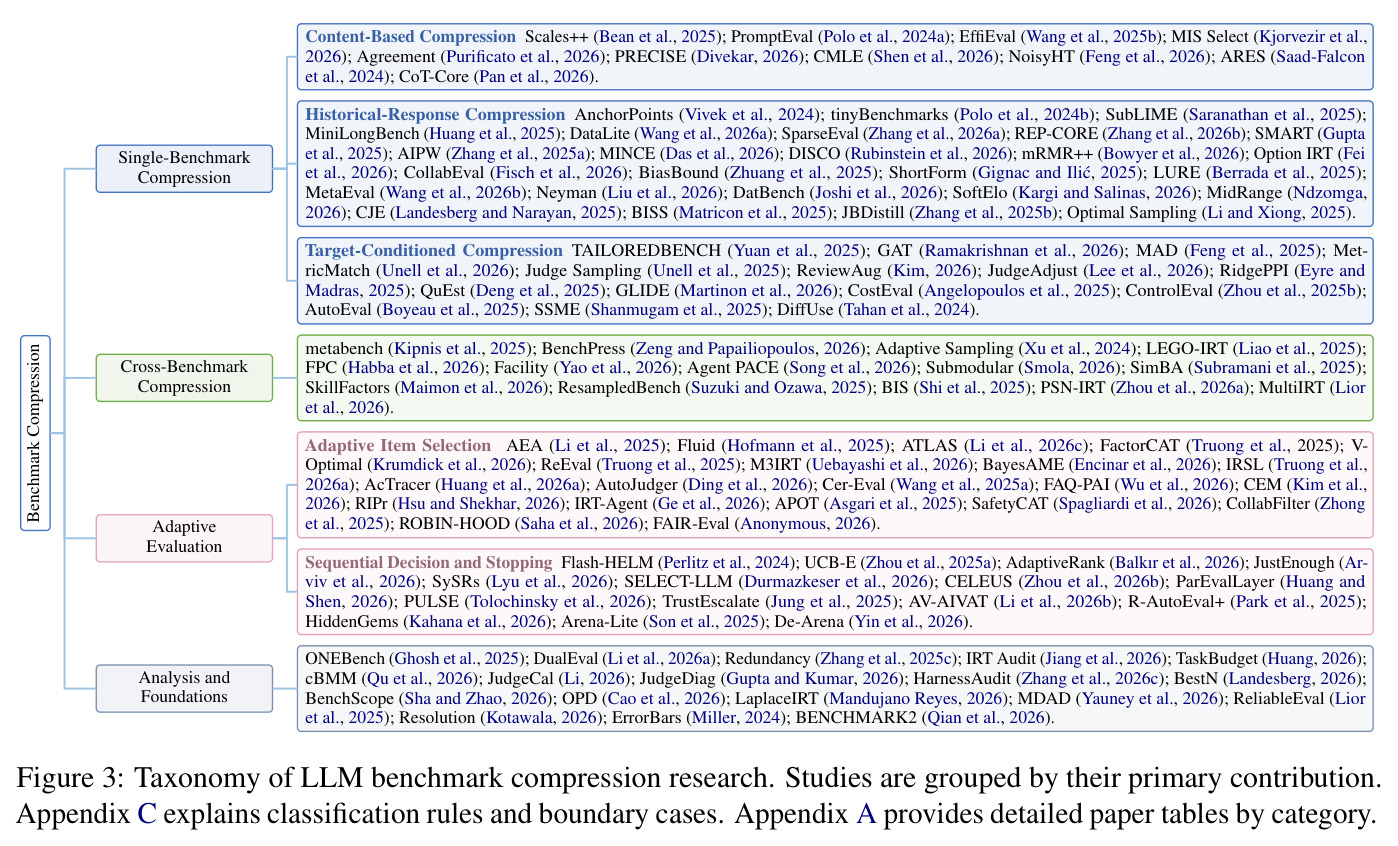
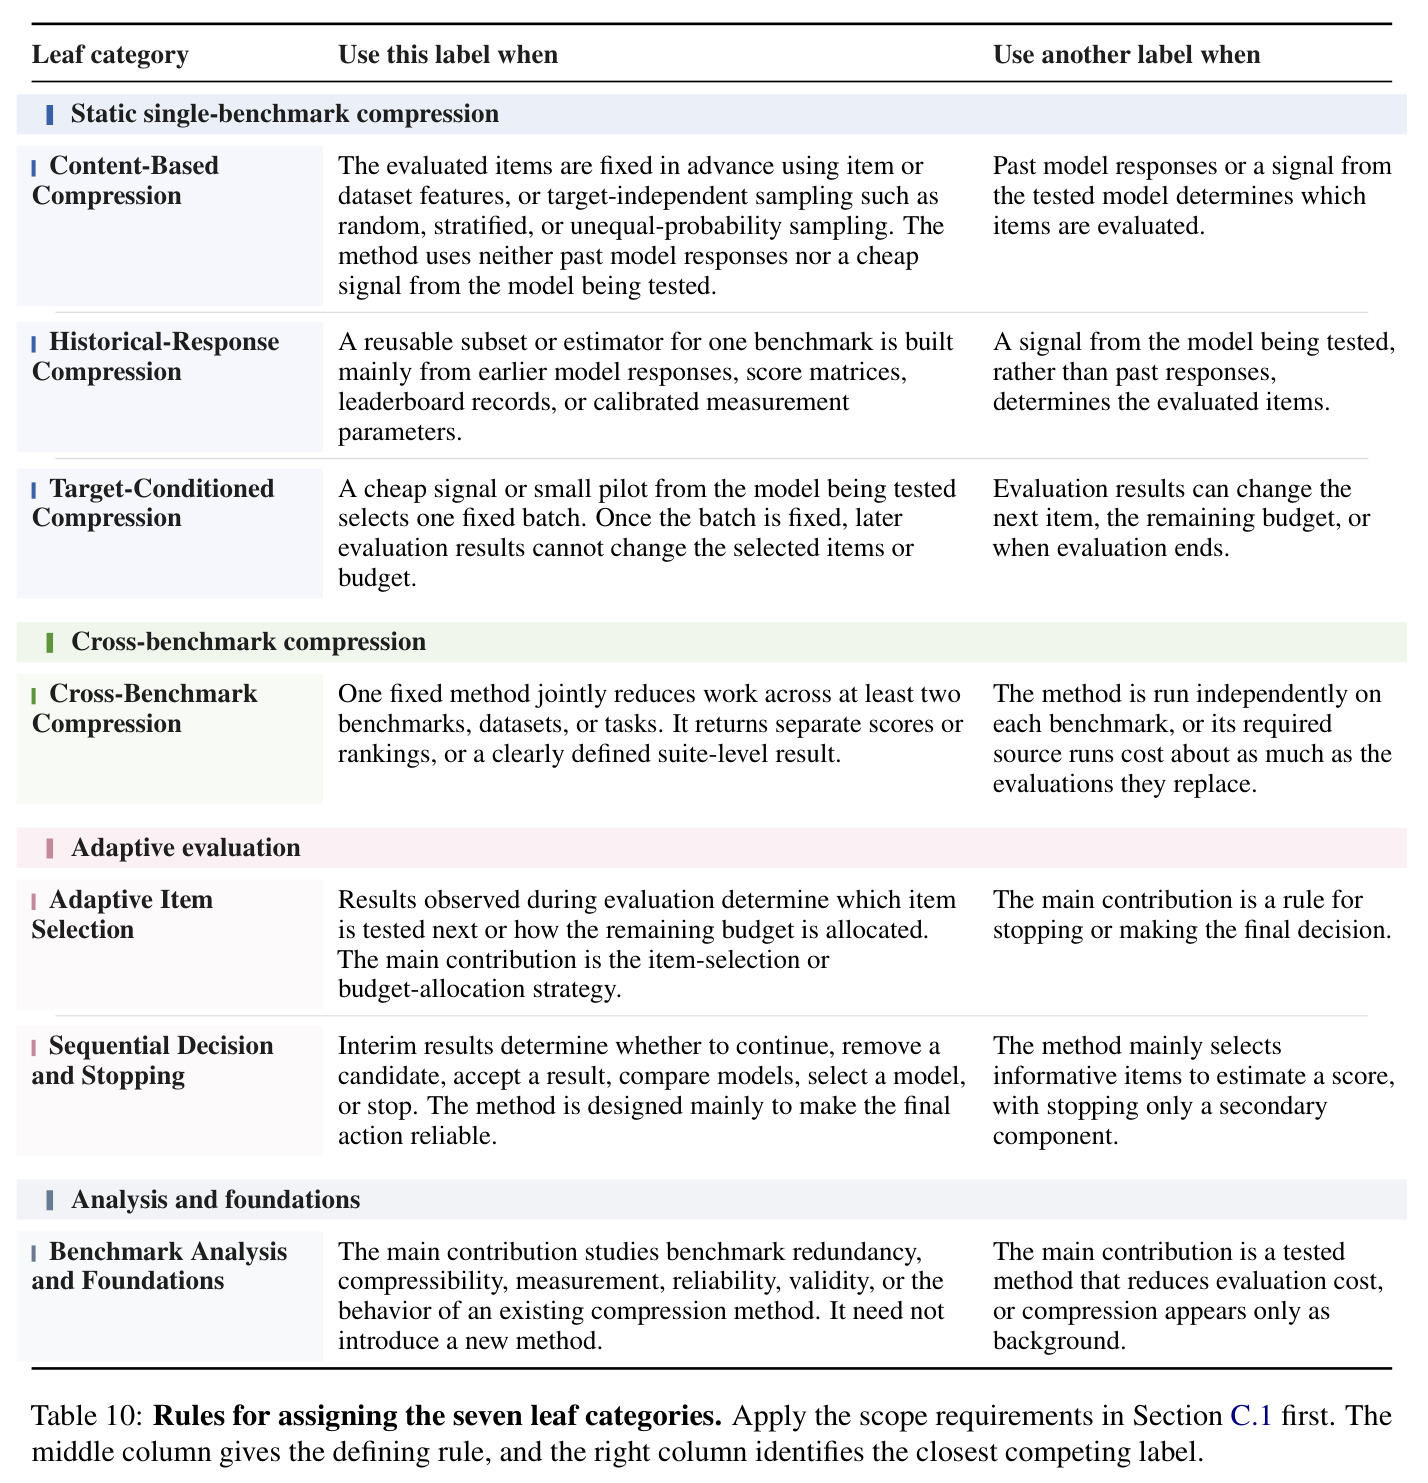
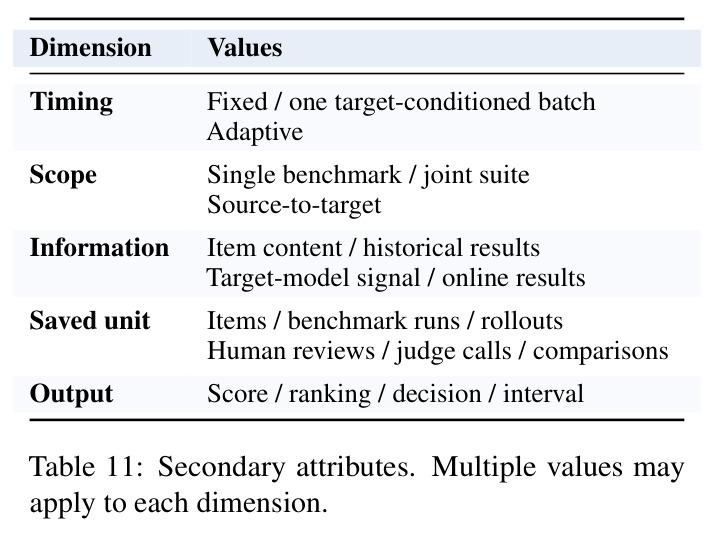
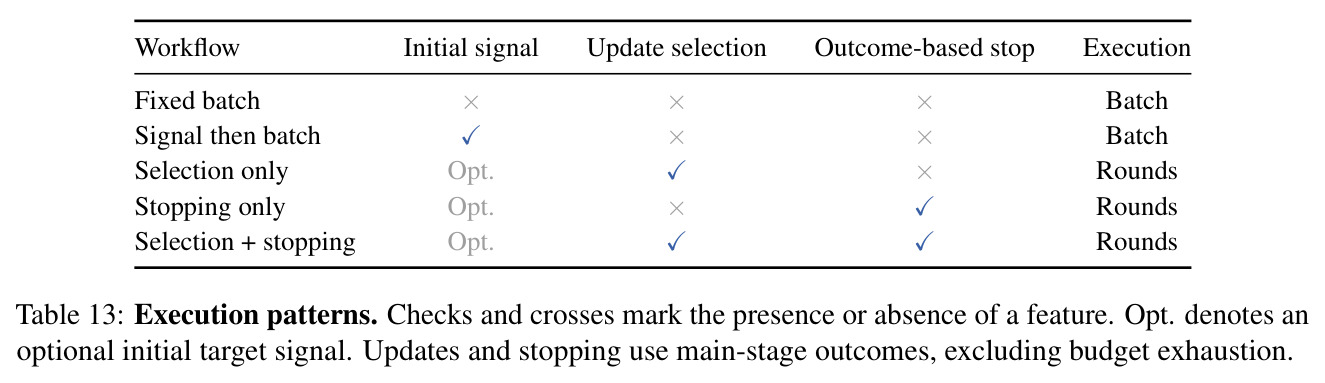
直觉上,压缩之所以可行,是因为多数基准的题目所测量的能力高度重叠,模型—题目响应矩阵呈现低有效维度:题目间响应高度相关、单题区分度低,因此小得多的子集就能保留恢复分数或排名所需的信息。技术上,作者先把评估抽象为统一契约:全集单元 $U$(题目、人工评审、成对比较或 agent rollout),完整评估得到结果 $Y_U$,聚合规则 $G$ 给出 $\hat{\theta}_{full}=G(Y_U)$;压缩评估只观测低成本子集 $S \subseteq U$,并利用辅助信息 $Z$(题目特征、历史响应、目标模型的廉价信号),由恢复规则 $R$ 估计 $\hat{\theta}_{comp}=R(Y_S,Z)$,目标是 $L(\hat{\theta}_{comp},\hat{\theta}_{full}) \leq \varepsilon$ 且 $C_{comp}<C_{full}$。在此契约之上,按"贡献类型→子集是否固定→范围与信息源"的决策树组织文献:非操作型研究归入 Benchmark Analysis and Foundations;操作型中子集随结果动态变化的归入 Adaptive Evaluation(下分自适应选题、序贯决策与停止);子集预先固定的按范围分为 Cross-Benchmark 与 Single-Benchmark,后者再按必要信息分为三型,共 7 个叶子类别。
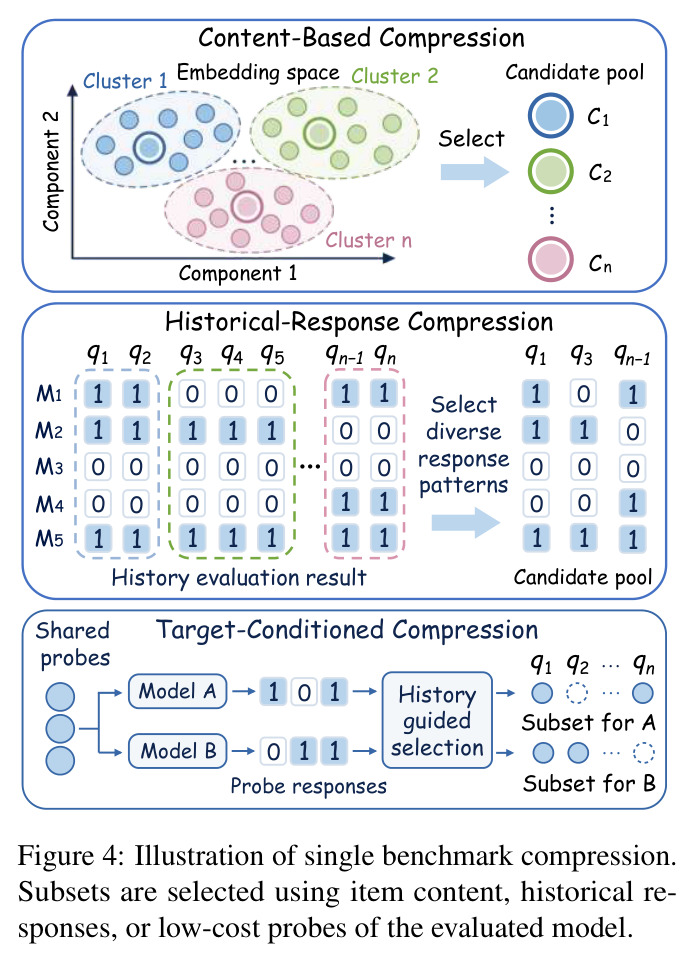
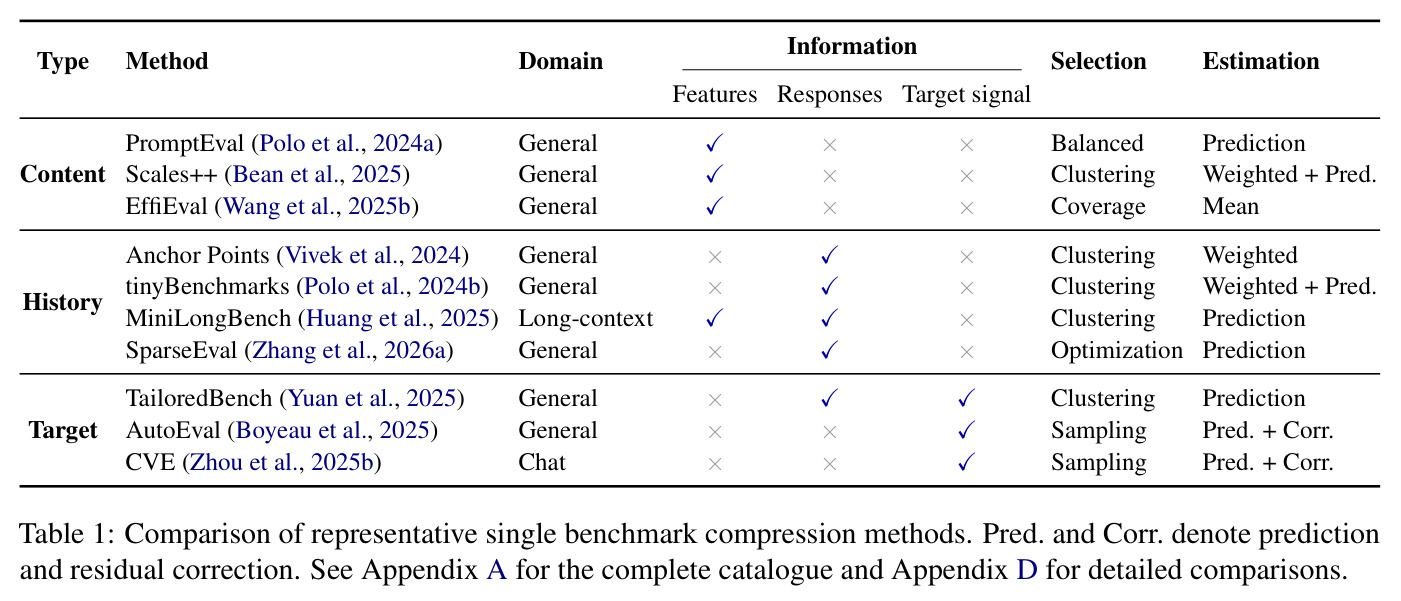
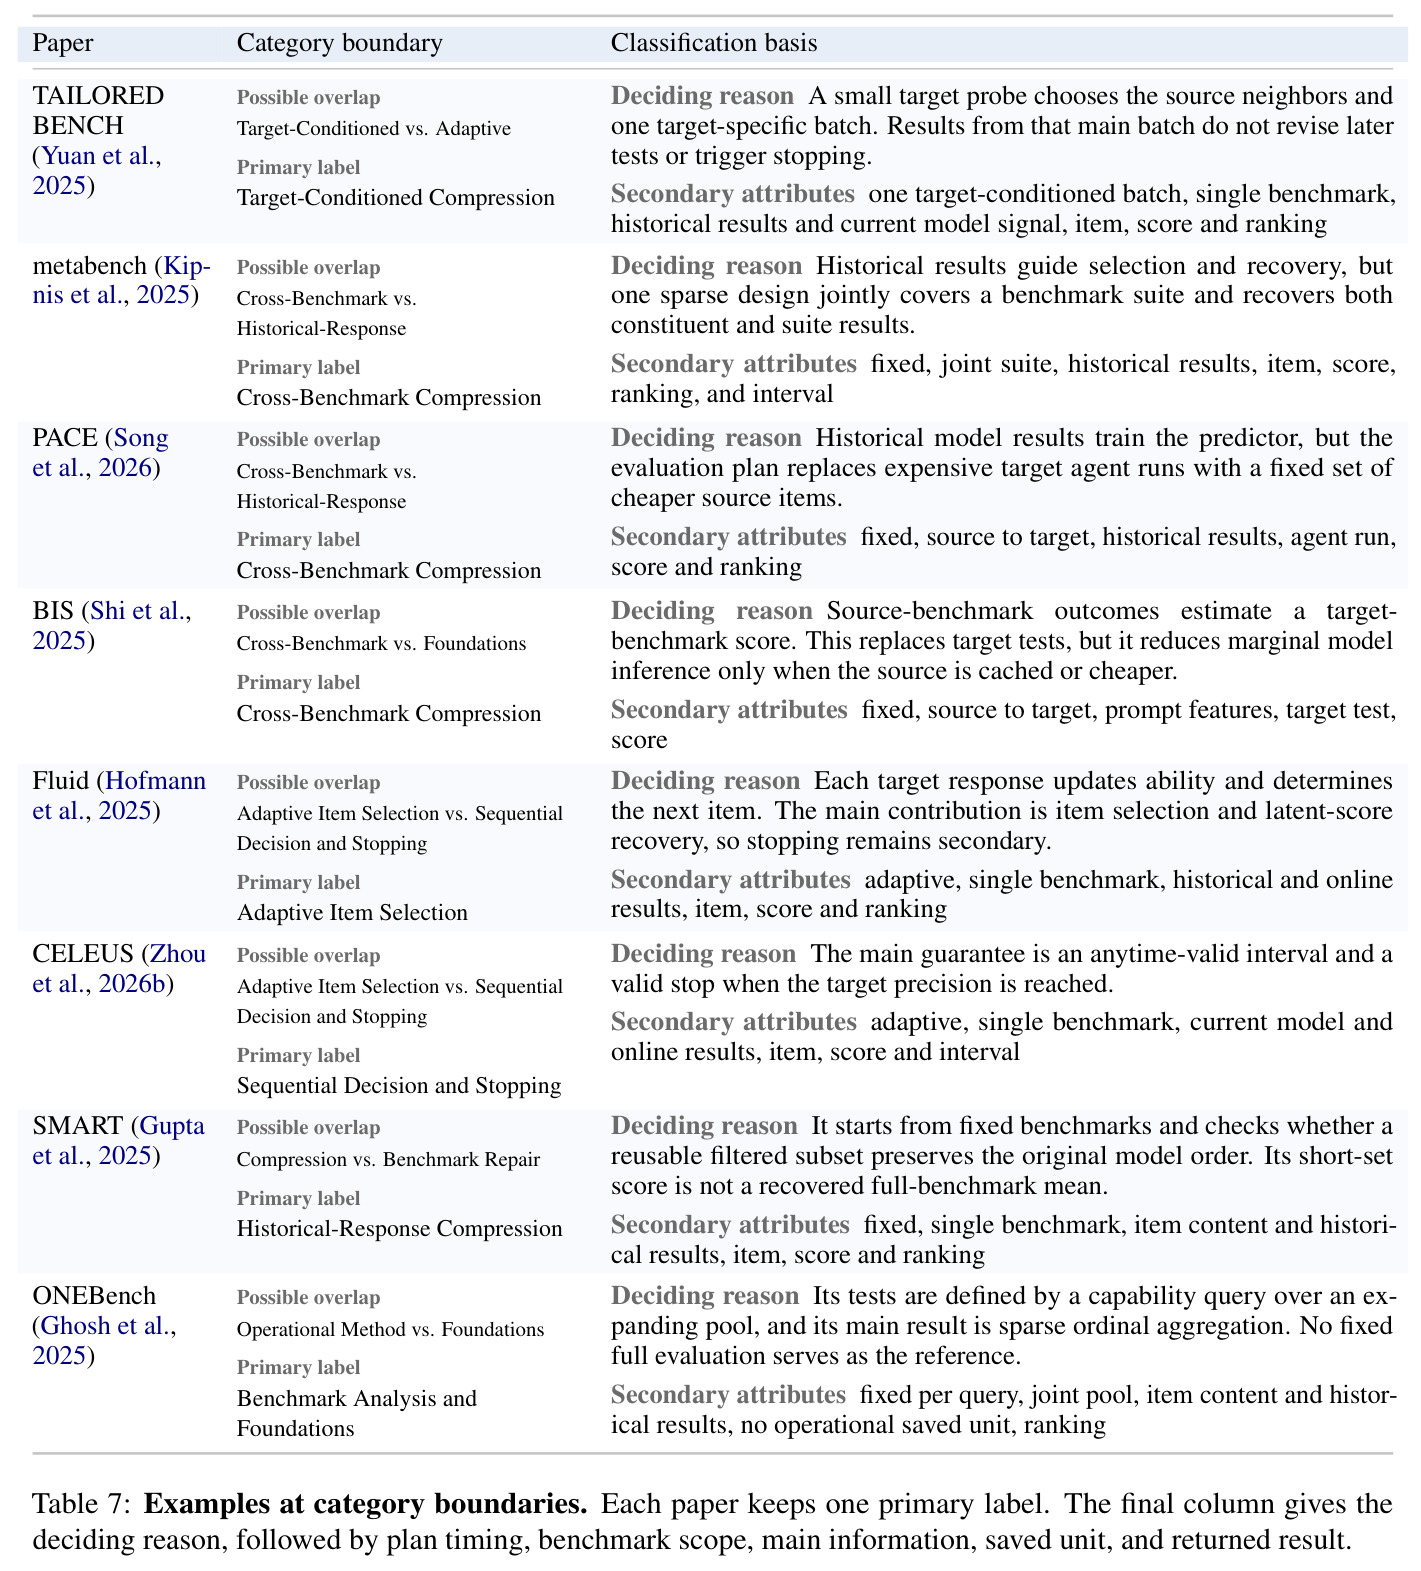
核心创新在于"统一形式化 + 层级分类学 + 跨家族成本/可靠性比较"这一组织框架本身,而不是提出新的压缩算法。与以往只覆盖单一片段的综述不同,本文用三个按固定顺序提出的问题给每篇论文唯一的主标签:它是否为操作型降本方法(否则归入 Benchmark Analysis and Foundations)?子集是在评估前固定还是随结果动态变化(前者为静态压缩,后者为自适应评估)?范围与信息源是什么(联合压缩多个基准为 Cross-Benchmark;单基准内按不可或缺的信息分为只用题目数据的 Content-Based、用先前模型响应的 Historical-Response、用当前模型廉价信号的 Target-Conditioned)?次要机制记录为五个二级维度:时机、范围、信息源、节省单元(item/基准运行/rollout/人工评审)、返回结果(score/ranking/decision/interval)。这一设计使"用历史响应矩阵做选择"与"用目标模型探针做选择"这类本质差异被显式编码为类别差异,而边界案例(如 TailoredBench 算目标条件还是自适应、ONEBench 算操作方法还是基础研究)都有明确判定规则,由两位作者独立评审并讨论裁定。
方法步骤详情
综述按类别逐步展开并逐一说明机制。静态单基准压缩:Content-Based(10 篇)只用题目数据或抽样规则,如 PromptEval 把固定预算摊在稀疏的 prompt×示例矩阵上用 IRT 恢复性能分布,Scales++ 按认知需求描述聚类后以组权重加预测估计全分;Historical-Response(26 篇)复用先前模型的响应矩阵,如 AnchorPoints 按源模型置信度聚类取加权 medoids,tinyBenchmarks 拟合多维 IRT 模型并选择覆盖题目参数空间的锚点,CollabEval 均匀采样目标单元后做矩阵补全并用已测单元的残差校正;Target-Conditioned(15 篇)先用当前模型的廉价信号固定主批次,如 TailoredBench 用小共享探针集找答案相似的源模型再扩展出定制的 medoids 子集,MAD 只把语义差异大的候选对交给人类比较。Cross-Benchmark(13 篇)联合压缩套件:metabench 跨基准选信息锚点以恢复各基准分数与套件均值,SimBA 以整个基准为单元做分数矩阵补全,Agent PACE 用便宜源任务预测昂贵 agent 基准。自适应评估:Adaptive Item Selection(21 篇)如 Fluid 每答一题更新 IRT 能力估计并选 Fisher 信息最大的下一题,FAQ-PAI 在保留均匀探索的同时收窄分数区间并按抽样概率校正;Sequential Decision and Stopping(15 篇)如 Flash-HELM 逐级扩大样本直到排行榜层级稳定,CELEUS 用 e-process 构造 anytime-valid 区间并按目标精度停止,TrustEscalate 把不确定判断升级给更强 judge 或人类、无人合格时弃权。分析基础类(18 篇)研究冗余来源、IRT 可信度、judge 校准与 harness 敏感性。
技术新颖性
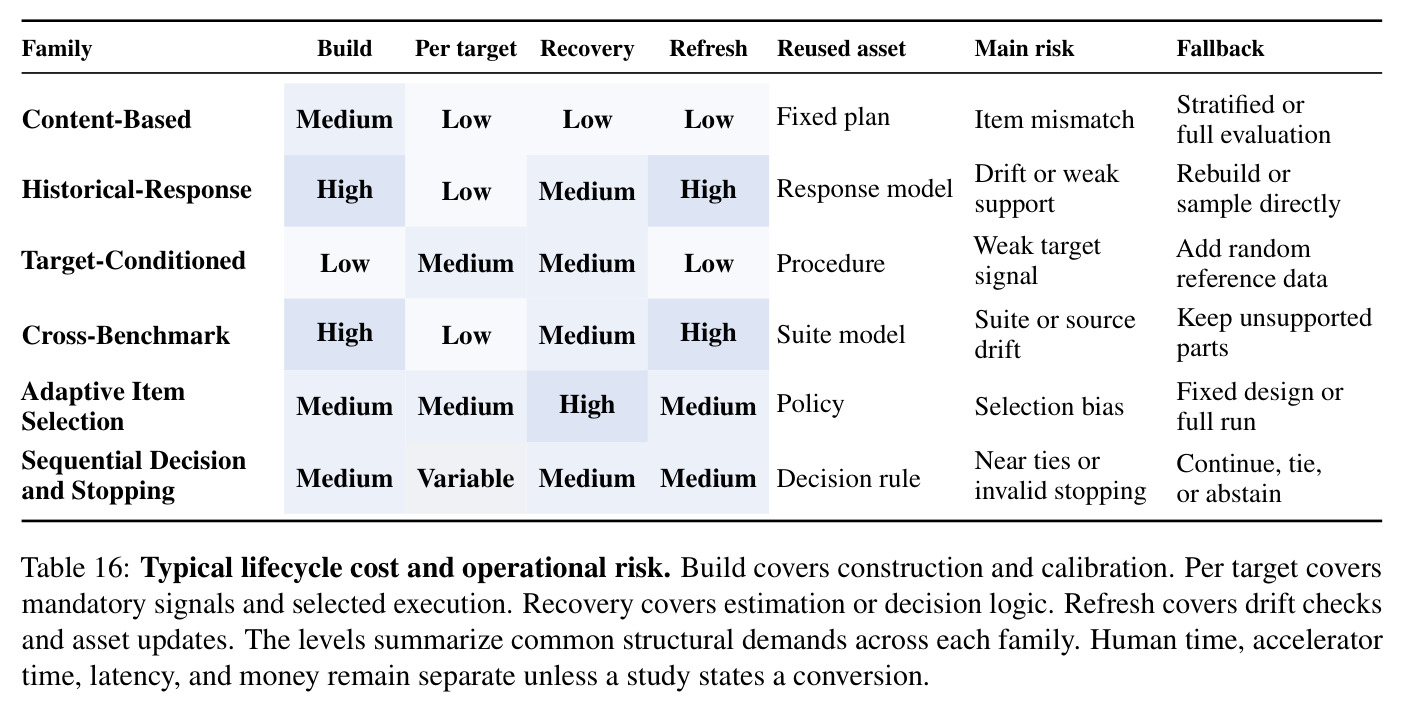
新颖性体现在四个层面。第一,问题定义的形式化:明确压缩的对象是"复现预定义全评估的结果",用 $L(\hat{\theta}_{comp},\hat{\theta}_{full})\le\varepsilon$ 与 $C_{comp}<C_{full}$ 这对约束统一了以往各自表述的 119 篇工作,并区分"恢复完整结果表"与"估计统计目标(如期望准确率)"两种情形,还指出保持排名不必恢复绝对均值、找出赢家不必恢复每个分数。第二,压缩与修复的范畴切分:像 OPD、BENCHMARK2 这类删除可猜测或有害题目、允许分数排名改变的工作被归为 repair 而非 compression,必须作为新基准单独验证——这一区分在既往文献中普遍缺失。第三,生命周期成本视角:以 $C^{(K)}_{comp} = C_{build} + C^{(K)}_{refresh} + \sum_{k=1}^{K} C_{run,k}$ 把构建与刷新成本显式纳入,据此指出 Historical-Response 与 Cross-Benchmark 是"高构建、低边际"的资产型方法,Target-Conditioned 每个目标都要付探针或 judge 信号成本,自适应方法用串行轮次换针对性。第四,验证方法学:提出 model/family/time/task 四种 holdout 以及 replay/live/prospective 执行方式的区分,使"压缩方法在新模型上是否仍可靠"成为可操作的检验。
实验结果
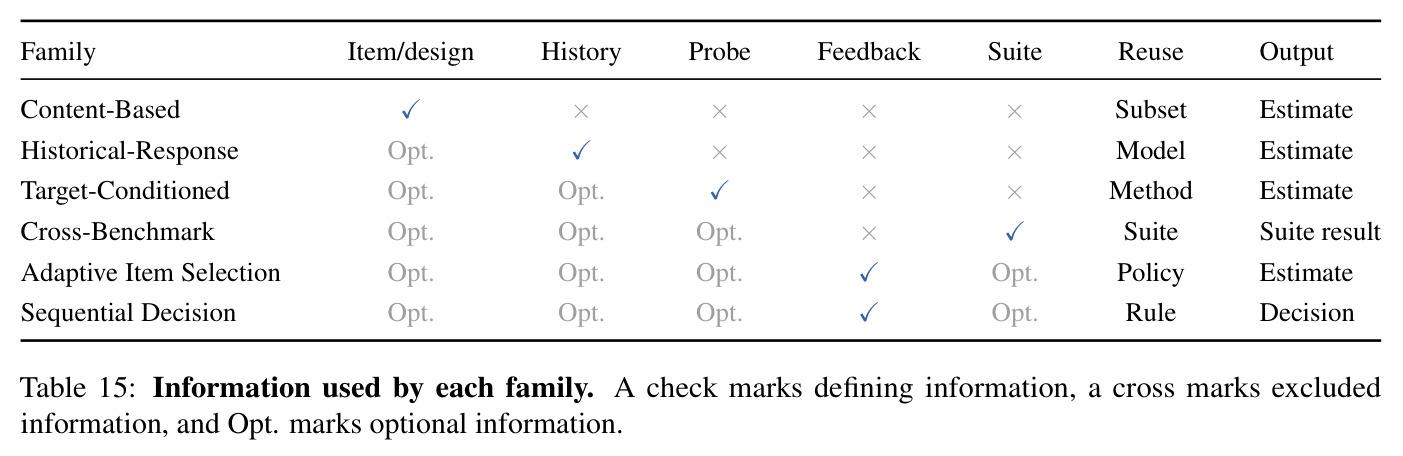
作为综述,本文的"结果"是分类统计与跨家族比较结论。规模与结构上:共收录 119 篇论文,分为 Content-Based 10 篇、Historical-Response 26 篇、Target-Conditioned 15 篇、Cross-Benchmark 13 篇、Adaptive Item Selection 21 篇、Sequential Decision and Stopping 15 篇、Analysis and Foundations 18 篇(Tables 3–6),历史响应类最庞大,说明"复用过往评测"是当前主流路线。发表趋势上(Figure 1):2023 年仅 6 篇早期研究,2024 年增至 18 篇,2025 年 29 篇,2026 年前 8 个月已达 35 篇,自 tinyBenchmarks(ICML 2024)以来持续加速。冗余证据方面:在 MMLU、GSM8K、LongBench 等常用基准上,不到 20% 的样本即可保持接近全集的分数与排名。文献中的代表性降本数字包括:DataLite(ICLR 2026)探究用 200 倍更少的数据评估 LLM;AV-AIVAT(2026)在 agent 博弈评估上实现约 74 倍降本并带认证的 anytime-valid 停止;ShortForm(2025)给出仅 60 题的心理测量学短表。跨家族比较的核心结论有:不存在普适的安全压缩率,所需题量取决于关注的分数差、成对方差与允许错误率;当保留题目无法可靠区分两个模型时,该比较应保持未定;随机采样常与更复杂的选择器竞争力相当(Zhang et al., 2025a);历史响应法在模型大跃迁时优势可能消失;近距打平的模型可能耗尽序贯方法的预算;信息越多选择越准,但复用性与并行性越差(Tables 15–16)。
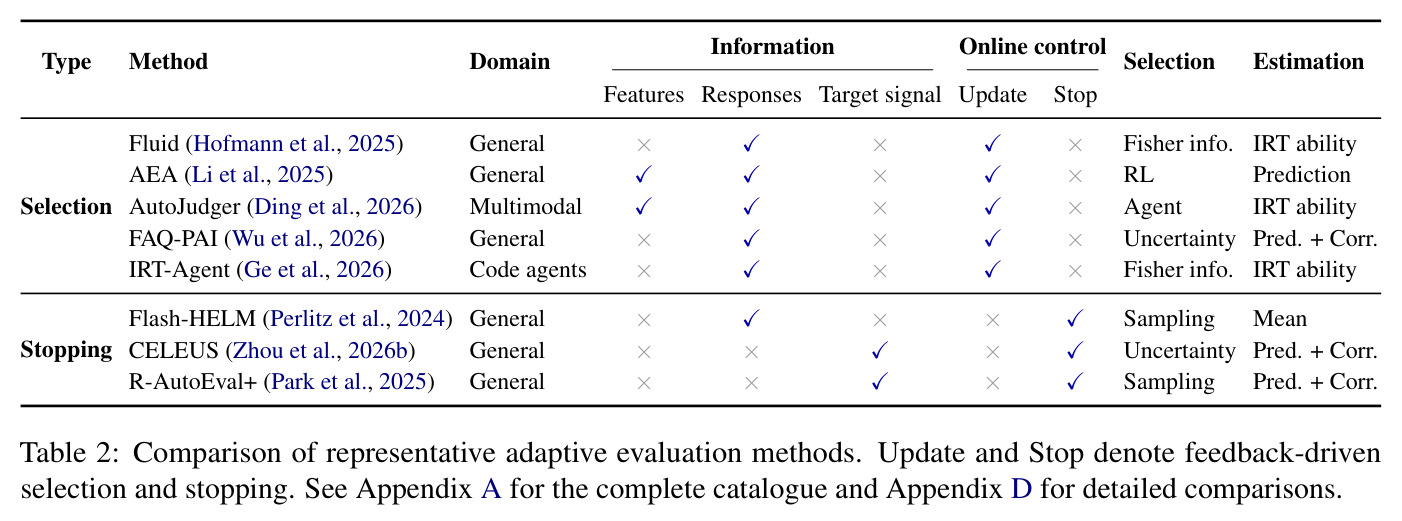
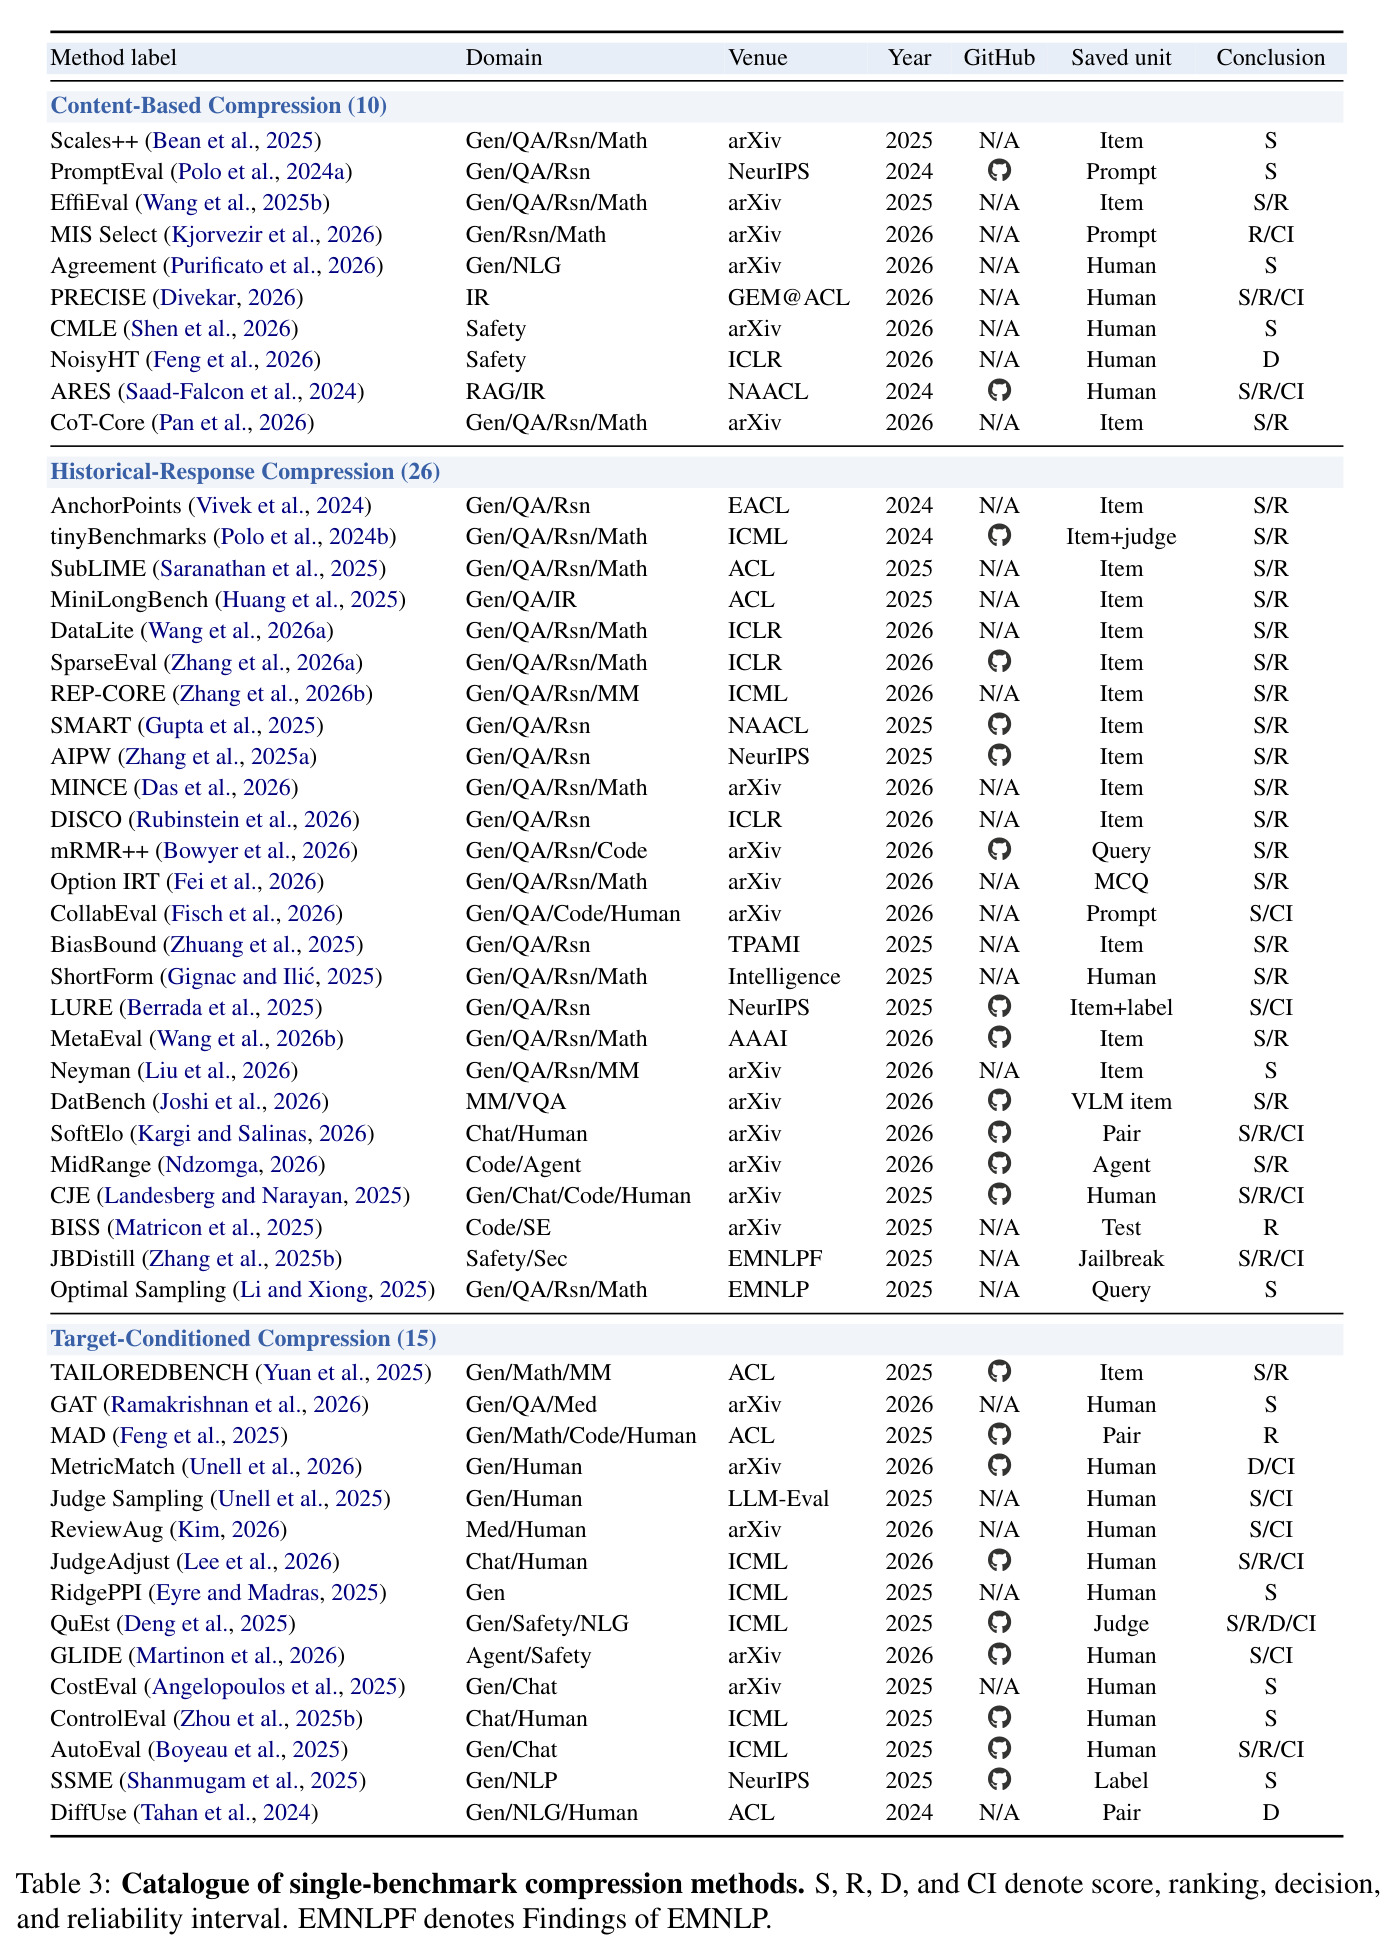
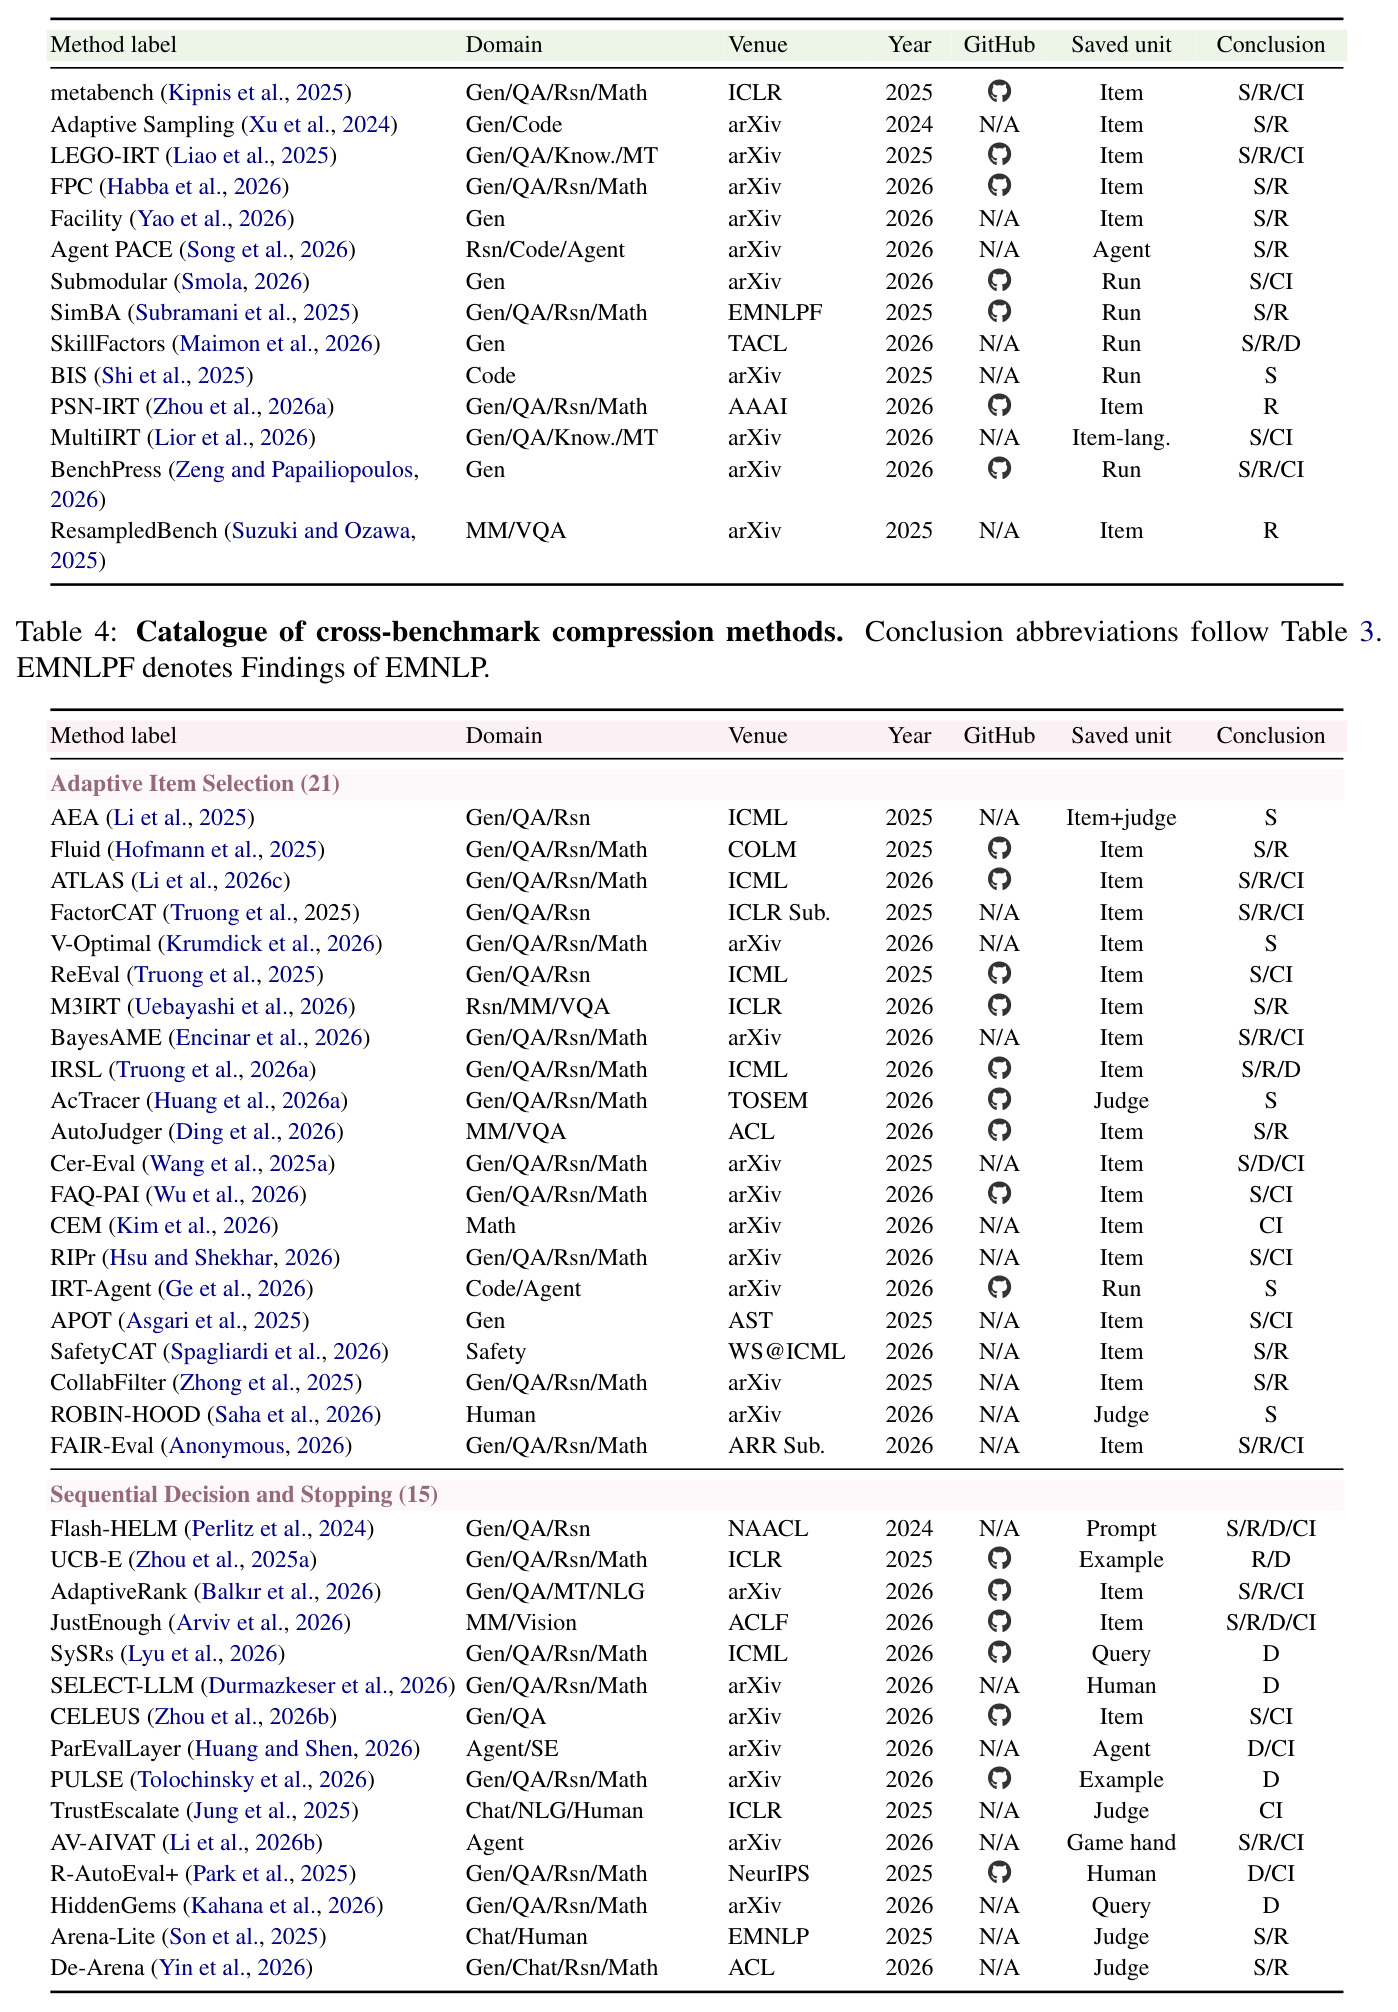
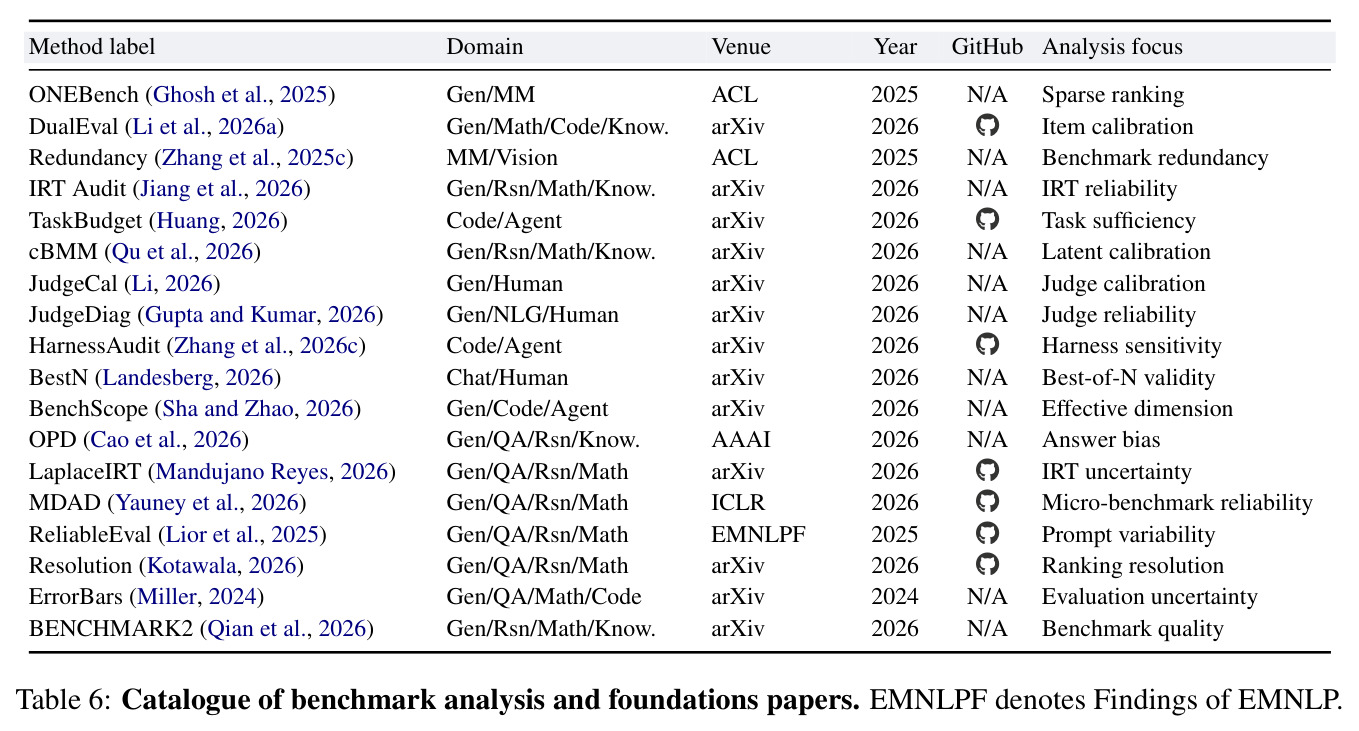
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全基准分数复现(MMLU / GSM8K / LongBench) | 保持接近全集结果所需的样本比例 | 综述引证 Polo et al. 2024b、Huang et al. 2025 的结论:少于 20% 的测试样本即可 | 100% 全集评估 | 评测样本减少 80% 以上,是整个领域存在的经验前提 |
| Agent 博弈评估(文献代表 AV-AIVAT, Li et al. 2026b) | 评估成本倍数 | 综述引证:约 74× 降本,附带认证的 anytime-valid 停止保证 | 完整 agent rollout 评估 | 成本降低约 74 倍 |
| 通用 LLM 评测(文献代表 DataLite, Wang et al. 2026a, ICLR 2026) | 数据缩减倍数 | 综述引证:200× 更少数据评估 LLM | 全量基准评估 | 200 倍数据缩减 |
| 心理测量学短表(文献代表 ShortForm, Gignac & Ilić 2025) | 题量 | 综述引证:60 题 | 数千题量级的完整基准 | 题量缩减 1–2 个数量级且保持人—AI 可比性 |
局限与改进
作者明确承认三点局限(Limitations 部分):第一,语料截止 2026 年 8 月 9 日,之后的论文未收录,综述需持续更新;第二,受篇幅与领域增速所限,正文只提供高层分类法与路线图,逐方法的细节描述被推到附录 E,读者无法在正文获得直接复现某个方法的足够信息;第三,各研究的评估设置差异极大,结果难以定量合并,本文只提出共同形式化为未来的定量综合铺路,而未实际做元分析。我的补充观察有四:其一,"一篇论文一个主标签"的规则虽清晰,但可能掩盖方法的混合本质,例如 tinyBenchmarks 同时使用 IRT 锚点与加权预测,实际部署时组合方式很重要;其二,119 篇中相当比例是 Venue 为 arXiv 的预印本(目录可见 2026 年大量条目尚无正式发表渠道),结论的同行评审成熟度参差;其三,目录虽标注 Domain(含多模态、翻译、代码、agent),但对多语言与非英语场景的覆盖分析很薄弱;其四,综述未量化标注一致性(如标注者间 Kappa),分类的主观性无法外部校验。
独立分析的弱点
弱点一:纯定性比较。Tables 13–16 用 Medium/High/Variable 等定性等级描述各家族的成本与风险,没有把各论文实际报告的误差指标(如 MAE、排名翻转率、覆盖率)归一化汇总,读者仍无法回答"tinyBenchmarks 与 SparseEval 在 MMLU 上谁的恢复误差更小"这类问题。改进方向:作者在 D.6 已铺垫统一报告清单,下一步应建立标准格式(单元数、成本单位、误差、holdout 类型)并做定量元分析。弱点二:可操作性信息不足。目录显示只有少数方法有验证过的 GitHub 仓库(如 tinyBenchmarks、PromptEval、metabench、Fluid 等),多数 2026 年的 arXiv 方法无从直接使用,也没有"给定信息条件与目标输出,用哪个工具"的可执行决策脚本。改进:发布可交互的分类数据库与选型向导。弱点三:对失败模式的讨论停留在家族级别(如"历史模式不迁移时失效"),缺少按模型代际、基准类型细分的定量脆弱性证据,例如历史响应法在多大性能跃迁下失效并无数字。改进:组织跨论文的标准压力测试(新家族模型、时间外推、任务外推)。弱点四:自适应与序贯方法的统计前提(IRT 校准需要足够多模型、CELEUS 需要有界分数、FAQ-PAI 依赖方差与抽样概率条件)分散在附录 E,实践者容易误用;综述虽给出检查清单(D.6),但未给出违反前提时的定量后果。改进:为每类前提配套敏感性分析示范。
未来方向
作者在第 7 节提出三个方向:第一,跨模型与时间的泛化——压缩子集多由现有模型的响应记录选出,面对新模型家族和更强的新模型可能失去覆盖与区分度,需要更可迁移的压缩方法、对新发布模型的例行测试,以及覆盖度或区分度衰退时的周期性/持续刷新机制;第二,更新既有基准——把压缩与基准修复结合,发布去除有缺陷、冗余、过易、弱区分题目的再校准版本,既降本又提升强模型间的区分度,同时保留全集结果以便与历史排行榜对齐;第三,发布前压缩(compression by design)——新基准在构建阶段就集成压缩,公开版本从一开始就是紧凑而有信息量的题集,而非先发布庞大冗余基准再事后压缩,从而同时加速评测与模型迭代、降低计算与环境成本。基于本文成果还可延伸:建立社区共享的模型—题目响应矩阵基础设施,摊薄 Historical-Response 方法的高构建成本;为压缩评估制定类似 CONSORT 的标准化报告清单(强制报告节省单元、holdout 设计、近距打平处理),使定量综合成为可能;把 anytime-valid 序贯统计深度集成进主流评测 harness;探索压缩感知的 leaderboard 制度,官方同时报告全集与压缩分数及其一致性与不确定性。
复现评估
作为综述,其"复现"意味着复现文献收集与分类过程,这方面透明度较高。附录 F 完整给出检索策略:语料截止 2026 年 8 月 9 日,覆盖 Google Scholar、Semantic Scholar、OpenAlex、arXiv、ACL Anthology、OpenReview、ACM DL、IEEE Xplore、PMLR 九个数据库,并辅以 Crossref、DBLP 做元数据核验;查询族分四类(评估对象、效率与子集、预测与恢复、自适应与测量);从种子论文出发对每篇入选论文做迭代扩展(提取新关键词、回溯参考文献与前向引用、追踪作者与项目),循环直到最终全库清扫不再有新论文;用 DOI、arXiv 号与归一化标题去重,两名作者筛查标题摘要,模糊时审读方法与实验章节;入选标准要求"从预定义全评估出发、减少或自适应分配执行单元、用保留证据恢复分数/排名/决策且降本为主要贡献",并显式排除训练数据选择、推理加速等边界工作。附录 C 提供形式化的七叶子类别规则(Table 10)、固定顺序决策路径(C.3)与边界案例(C.5,两位作者独立评审后讨论裁定)。未随文发布代码或结构化数据库文件,逐篇标注仍需大量人工判断且有主观空间;但规则足够明确,配合附录 A 的完整目录,第三方大体可以审计其分类。整体复现难度中等:检索过程可复现,分类判断有裁量余地。
论文图表
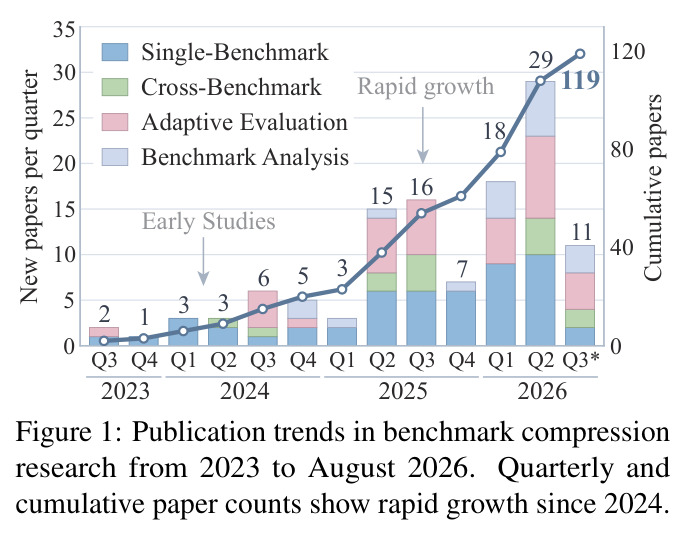
2023 年第三季度至 2026 年 8 月的季度与累计论文数趋势图:2023 年仅有 6 篇早期研究,2024 年快速增长到 18 篇,2025 年 29 篇,2026 年前 8 个月已达 35 篇,累计 119 篇。
用发表数量证明该领域自 2024 年 tinyBenchmarks 以来处于爆发期,是"亟需一篇系统综述"的最直接证据,也是理解论文写作动机的第一张图。
自适应评估 36 篇方法目录:Adaptive Item Selection 21 篇(Fluid、ATLAS、AutoJudger、SafetyCAT 等)与 Sequential Decision and Stopping 15 篇(Flash-HELM、UCB-E、CELEUS、AV-AIVAT、Arena-Lite 等),含领域、venue、年份、开源与返回结论。
自适应家族的完整索引,涵盖通用、多模态、代码 agent、安全等场景,便于按应用域查找。