速度匹配:免模拟的连续时间动力学系统学习 Learning to evolve by matching velocities
用随机配点回归速度场取代轨迹模拟训练,精度高一个数量级且无求解器偏差
前置知识
轨迹目标与 rollout / 教师强制(TF)训练
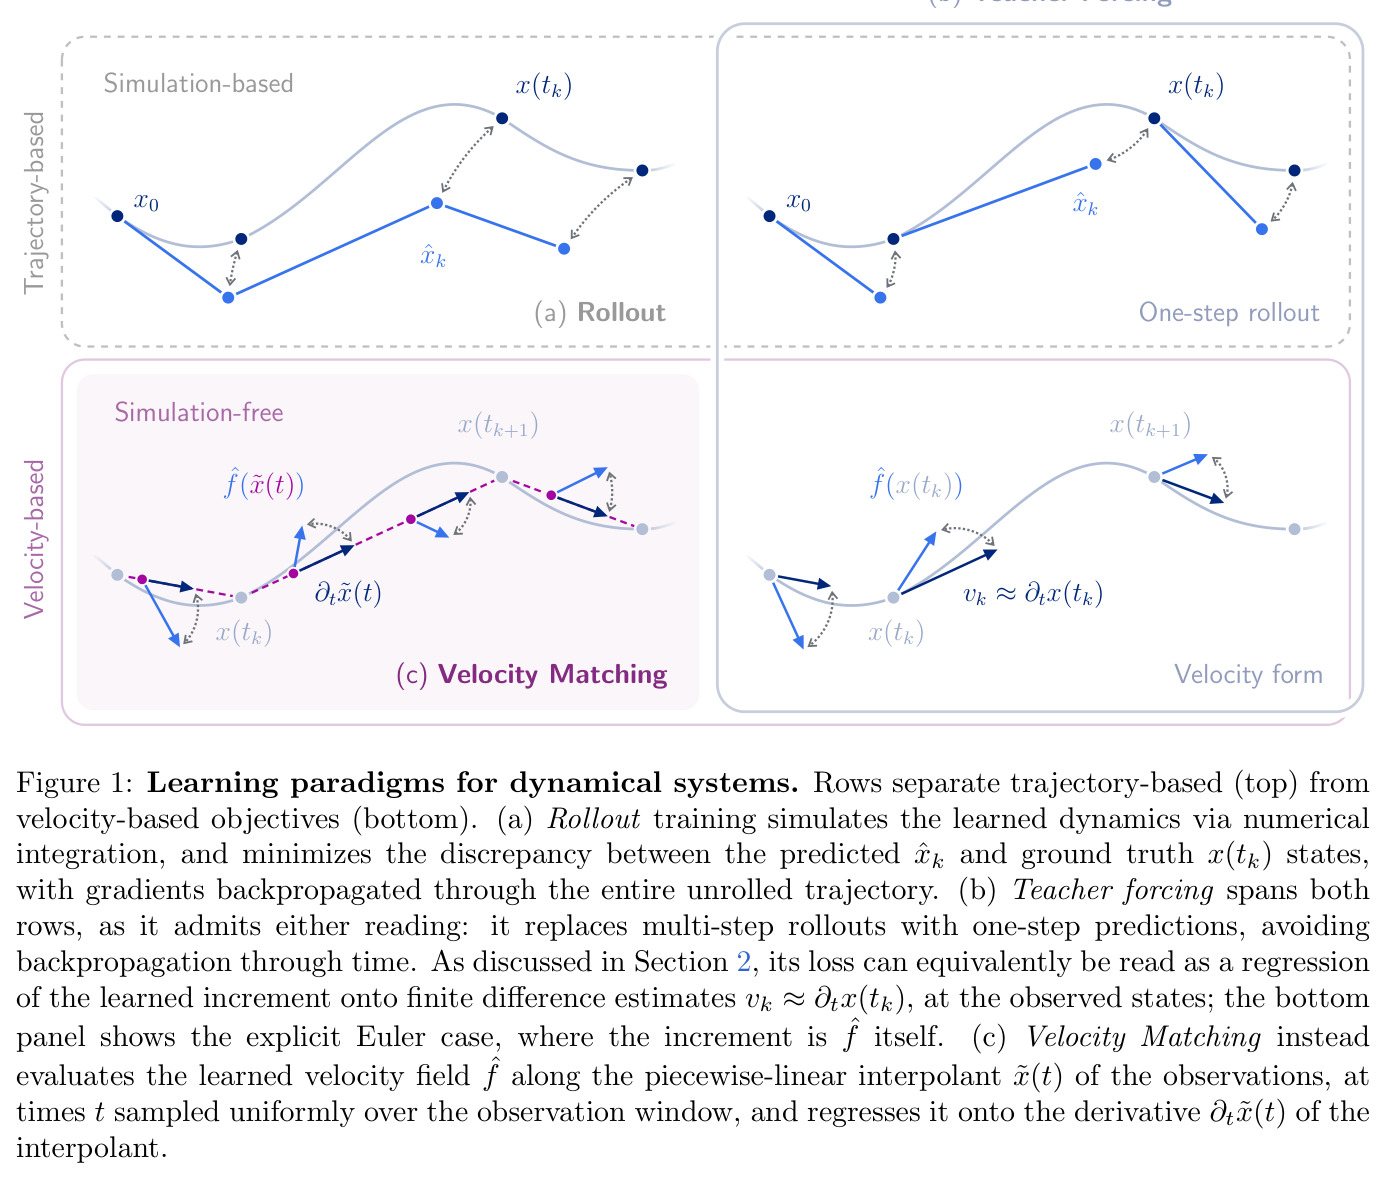
学习动力系统时,轨迹目标把模型预测轨迹与真实轨迹的 $L^2$ 偏差作为损失,需要训练中反复用数值积分模拟学到的动力学并通过 BPTT 反传梯度;按展开长度 $L$ 可分为多步 shooting($L<N_t$)与单步教师强制($L=1$,每步用真实状态喂入模型预测下一状态)。
本文全部动机与分析都围绕轨迹目标在长 rollout 下的退化(梯度爆炸/消失、损失塌缩到稳定性区域)以及 TF 只有一阶 $O(\Delta t)$ 偏差展开,读懂对比才能理解 VM 的定位。
绝对稳定性区域与稳定性函数 $R(z)$
对测试方程 $\dot{x}=\lambda x$,数值方法一步放大因子记为稳定性函数 $R(z)$($z=\lambda\Delta t$),如显式 Euler 的 $R(z)=1+z$。绝对稳定性区域 $A_{\Delta t}=\{z:|R(z)|<1\}$ 决定哪些模式的数值解会衰减;区域外的模式会被数值格式人为阻尼或放大。
论文证明了 rollout 损失在长时域极限下会塌缩到该区域(Proposition 2.1),并由此约束学得 Jacobian 的谱,这是轨迹训练引入系统性数值偏差、学到伪耗散的核心机制。
隐式龙格–库塔、配点法与平均向量场方法
配点法要求 ODE 残差在区间内若干配点上成立,等价于隐式 RK(IRK)格式;连续段 RK(csRK)把有限个阶段推广为连续分布。平均向量场方法($a(\gamma)=\gamma, b=1$)是二阶、A-稳定的 csRK,对哈密顿系统保能量,稳定性函数 $R(z)=\frac{1+z/2}{1-z/2}$ 与隐式中点法相同。
VM 损失的偏差项恰好等于把观测端点代入该 csRK 更新后得到的残差,因此 VM 无需任何隐式求解就继承了 A-稳定格式的无阻尼偏置,这是其保结构性质的来源。
占据测度(occupation measure)
对流量 $x(t,x_0)$、初值 $x_0\sim\rho_0$,占据测度 $\mu=\frac{1}{T}\int_0^T x(t,\cdot)_\#\rho_0\,dt$ 度量轨迹在状态空间各区域停留的时间比例。速度回归的理论目标可改写为 $\mathbb{E}_{x\sim\mu}|f(x)-\hat{f}(x)|^2$。
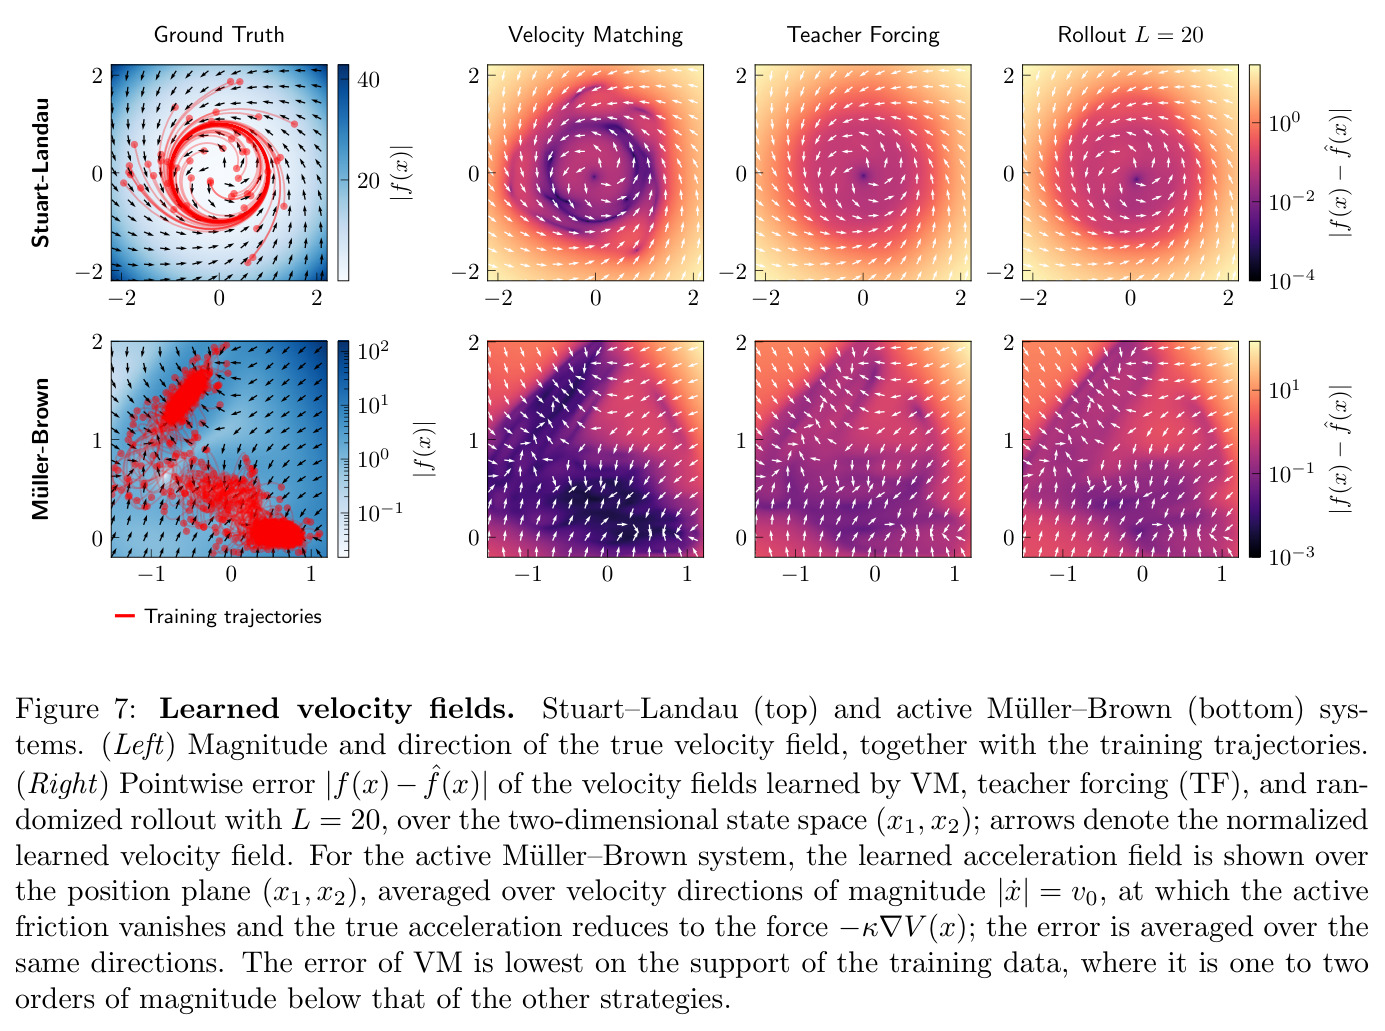
它把时间平均的速度回归转化为空间平均的回归,给出真速度场是唯一极小者的变分刻画,也解释了为何模型只在训练轨迹覆盖的支撑上被确定、其余区域不受约束(Figure 7 的现象)。
Grönwall 稳定性估计与 Lax 等价视角
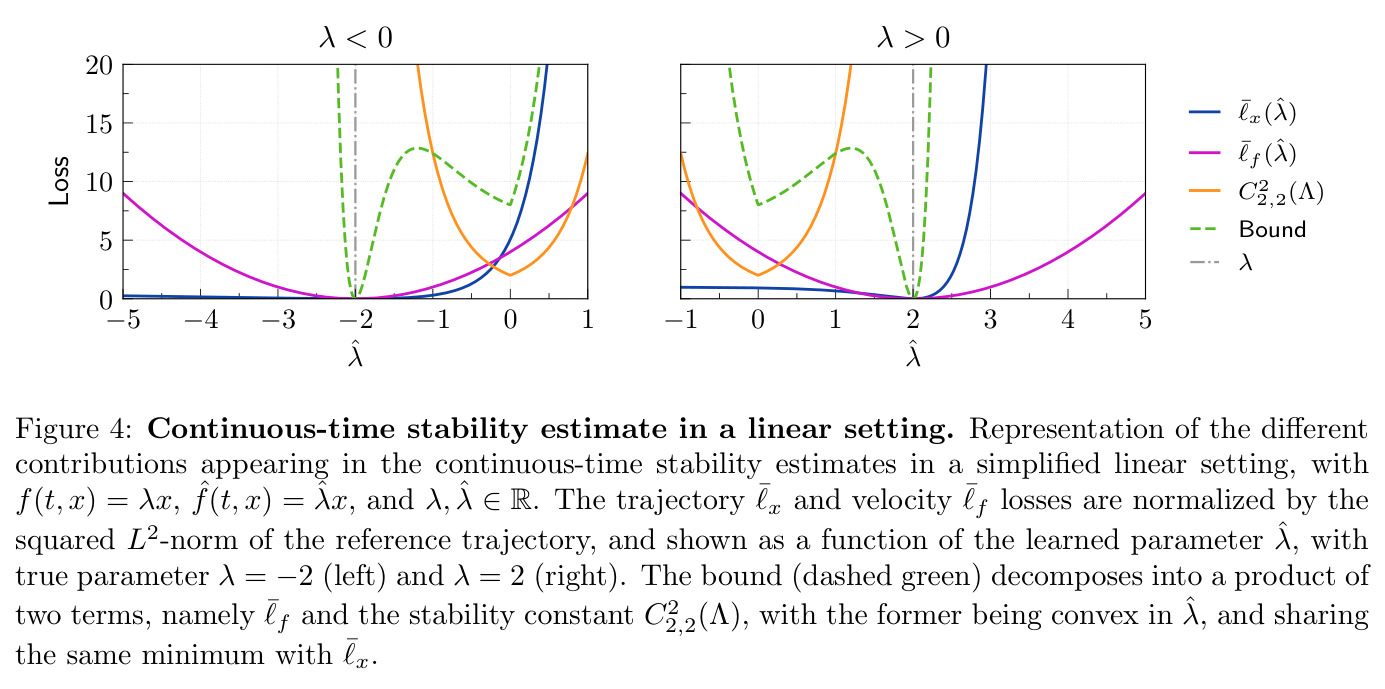
Grönwall 不等式给出双曲型误差传播界:轨迹误差被速度误差乘以稳定性常数控制,如 $L^2$-$L^2$ 估计 $\|x-\hat{x}\|_{L^2}\le C_{2,2}(\Lambda)\|f-\hat{f}\|_{L^2}$,其中 $C_{2,2}(\Lambda)=\sqrt{(e^{2\Lambda T}-2\Lambda T-1)/(2\Lambda)}$,$\Lambda=\mathrm{Lip}[\hat{f}]$。数值分析中的 Lax 等价定理讲“一致性+稳定性 $\Rightarrow$ 收敛”。
这套估计是全文的理论支柱:它论证了只需沿真实轨迹监督速度场(无需模拟)即可控制轨迹误差,并把数值方法的收敛理论平移到“学到的场 vs 真场”的学习场景。
流匹配(flow matching)与随机插值
流匹配通过回归沿插值曲线的速度场来免模拟训练连续归一化流:在两个端点样本间构造插值(可加噪声扰动,即随机插值),让网络 $\hat{f}$ 在插值点上回归插值的时间导数,从而学到搬运概率路径的速度场。
VM 在形式上就是一个流匹配目标,但端点耦合是确定性的(来自真实轨迹),学到的是物理速度场本身;理解这一联系与差异(沿插值扰动 vs 各向同性噪声)是把握 VM 创新机制的关键。
研究动机
用神经网络作为常微分方程(ODE)和半离散化偏微分方程(PDE)的代理模型时,主流做法是自回归加轨迹监督:训练中要数值积分模拟学到的动力学、用 BPTT/伴随方法反传梯度,代价随 rollout 长度增长,对细网格、长时域、大模型往往不可承受。作者进一步指出两个结构性缺陷:其一,在标量线性系统 $\dot{x}=\lambda x$ 的解析分析中(Figure 2),轨迹损失的梯度随视界 $T$ 指数级消失或爆炸——在不稳定区域 $\lambda>0$ 处,$\hat{\lambda}>\lambda$ 时梯度以 $e^{2(\hat{\lambda}-\lambda)T}$ 爆炸、$\hat{\lambda}<\lambda$ 时以 $\sim e^{-\lambda T}$ 消失,极小值锐度按 $2^T$ 发散,梯度下降局部收敛要求学习率按 $T^{-2}$ 缩放、保证收敛半径按 $T^{-1}$ 收缩;其二,离散时间下 rollout 损失在 $N_t\to\infty$ 时以 $N_t^{-1}$ 速率塌缩到数值格式的绝对稳定性区域 $A_{\Delta t}$,产生连续统个全局极小(Proposition 2.1,Figure 3),在非线性情形等价于把学得 Jacobian 的谱约束在显式 Euler 稳定区域内(Proposition 2.2)——即长 rollout 带来的“稳定”只是数值效应而非对真动力学的忠实。教师强制虽免模拟,但只有 $O(\Delta t)$ 的一阶偏差且存在 exposure bias;PDE 实验(Burgers、KdV)中 rollout 目标随 $L$ 增大还会训练失稳。
本文的目标是本文要回答:能否在不模拟学得动力学的条件下,通过直接回归速度场来训练,同时(i)控制轨迹误差——即给出轨迹目标与速度目标之间带稳定性常数的定量关系;(ii)保证连续时间近似性质(CTA),使学得模型在推理时可以用与训练不同的步长和任意 Runge–Kutta 格式模拟而不掉精度;(iii)不依赖真速度场 $f$ 或其 Jacobian $\partial_x f$(实践里都拿不到);(iv)避免轨迹训练强加的显式 Euler 稳定区域偏差。为此需要一套速度式学习的理论框架,并据此设计一个可操作、每步代价与 TF 相当的经验目标——这就是 Velocity Matching(VM)。
与已有工作不同的是,速度监督并非全新想法:Zhou & Barati Farimani (2025) 经验性地展示了速度回归带来更平滑的优化地形;Hou et al. (2026) 把流匹配搬到算子学习,但依赖五次样条插值和带各向同性噪声的随机插值。真正的空白在于:轨迹式与速度式学习目标之间的关系缺乏系统刻画,速度式训练为何有效没有理论依据。本文的独特切入是:证明分段线性插值就足够($L^2$ 目标对节点处不可导不敏感,目标速度就是一阶有限差分,成本与显式 Euler TF 一步相同),并识别出真正起作用的机制是“沿插值弦的扰动”(随机配点 $\tau\sim U[0,\Delta t]$),而非各向同性噪声——这一机制同时造就了 $O(\Delta t^2)$ 的高阶一致性、与 A-稳定隐式格式的对应,以及对 Jacobian 的隐式方向性匹配。
核心方法
直觉上,VM 把学习问题从“模拟之后轨迹对不对”改写为“任意时刻的瞬时速度对不对”:给定离散观测轨迹,用分段线性插值 $\tilde{x}(t)$ 连接相邻观测点,其导数 $v_k=\frac{x(t_{k+1})-x(t_k)}{\Delta t}$ 作为速度监督目标,让 $\hat{f}$ 在插值弦上随机采样的点 $t_k+\tau$($\tau\sim U[0,\Delta t]$)处回归 $v_k$。每个样本只需一次 $\hat{f}$ 前向,无需积分器、无需 BPTT,代价与显式 Euler TF 相当。技术路线是一条环环相扣的理论链:(1)把连续时间学习重构为速度场回归,借助占据测度 $\mu$ 给出 $L_f[\hat{f}]=\mathbb{E}_{x\sim\mu}|f(x)-\hat{f}(x)|^2$ 的变分刻画,真场 $f$ 是唯一极小者(Proposition 3.1/3.2);(2)用 Grönwall 型 $L^p$-$L^q$ 稳定性估计把轨迹误差用速度误差控制(Lemma 3.3/3.4),形似学习场景下的 Lax 等价定理,并推出 $L_x\le C_{2,2}^2(\Lambda)L_f$(Corollary 3.5);(3)在 $W^{1,\infty}$ 范数下证明深度网络逼近流映射的万能逼近定理(Theorem 3.8)与连续时间近似性质(Theorem 3.9);(4)对 VM 损失做偏差–方差分解,证明它以 $O(\Delta t^2)$ 逼近理论速度风险(Theorem 4.4),从而得到免模拟的轨迹误差上界(Corollary 4.5)和极小者的一致性 $\|\hat{f}^*-f\|^2\le 2(C^{VM}_1\Delta t^2+C^{VM}_2\Delta t^4)$(Corollary 4.6)。
核心创新是那个看似平凡的均匀随机偏移 $\tau\sim U[0,\Delta t]$:它把 TF 只在观测节点处的点态监督变成沿每个子区间连续体的监督,由此同时产生三重效应。第一,随机求积视角:VM 损失是对理论速度目标 $\ell_f$ 的 $O(\Delta t^2)$ 逼近,而 TF 只达 $O(\Delta t)$(Theorem 4.4),偏差项由弦估计控制在 $\Delta t^2$ 量级、方差项因被积函数对 $\tau$ Lipschitz 而为 $\Delta t^2$ 量级。第二,隐式积分视角:偏差项 $v_k-\mathbb{E}_\tau[\hat{f}_k(\tau)]$ 恰是把观测端点代入连续段 RK(stage 表 $a(\gamma,\sigma)=\gamma, b(\gamma)=1, c(\gamma)=\gamma$)更新的残差,该格式即二阶 A-稳定的平均向量场方法,对哈密顿系统保能量;VM 在前向中不做隐式求解,而是把“隐式格式该满足的残差”直接塞进优化目标——隐式方法被装进了训练过程而非前向传播。第三,隐式正则视角:偏差项首阶为 $\frac{\Delta t^2}{4}\left|(\partial_x f-\partial_x\hat{f})f\right|^2$,方差项为 $\frac{\Delta t^2}{12}\left|\partial_x\hat{f}\,f\right|^2$(Proposition 4.7),前者沿流方向隐式匹配真 Jacobian 的作用(不需要知道 $\partial_x f$,也不用 $O(n^2)$ 地组装 Jacobian),后者惩罚学得场沿流的变化(类似加速度罚),且都是 $\Delta t^2$ 阶、不破坏收敛阶。
方法步骤详情
完整流程见 Algorithm 1。输入:$N$ 条观测轨迹 $\{x(t_k;x_0^{(i)})\}_{k=0}^{N_t}$、步长 $\Delta t$、可学习场 $\hat{f}_\theta$、批大小 $B$、迭代数与学习率。每次迭代:(i)独立抽取 $B$ 个样本索引 $(i_j,k_j,\tau_j)\sim U\{1,N\}\times U\{0,N_t-1\}\times U[0,\Delta t]$;(ii)构造速度目标 $v_j=\frac{x(t_{k_j+1};x_0^{(i_j)})-x(t_{k_j};x_0^{(i_j)})}{\Delta t}$(一阶有限差分,即插值导数);(iii)构造配点 $\tilde{t}_j=t_{k_j}+\tau_j$、$\tilde{x}_j=x(t_{k_j};x_0^{(i_j)})+\tau_j v_j$(沿弦推进);(iv)计算损失 $L_{f,batch}^{VM}(\theta)=\frac{1}{B}\sum_{j=1}^B\left|v_j-\hat{f}_\theta(\tilde{t}_j,\tilde{x}_j)\right|^2$;(v)梯度步 $\theta\leftarrow\theta-\eta\nabla_\theta L$。理论上再叠加四层保证:Lemma 3.3 给出 $C_{\infty,\infty}=(e^{\Lambda T}-1)/\Lambda$ 等稳定性常数,把速度误差转成轨迹误差;Theorem 4.4 给出 $|\ell^{VM}_{f,N_t}-\ell_f|\le C^{VM}_1\Delta t^2+C^{VM}_2\Delta t^4$(常数仅依赖假设类界 $M$);Corollary 4.5 得到免模拟轨迹界 $\ell_x\le C^2_{2,2}(M)(\ell^{VM}_{f,N_t}+C^{VM}_1\Delta t^2+C^{VM}_2\Delta t^4)$;Theorem 3.8/3.9 保证 GELU 网络(常数层数、$O(n\epsilon^{-(n+1)})$ 权重)能以任意精度逼近流映射,并在推理时可用任意 $p$ 阶 RK、任意 $\Delta t\le\Delta t^*$ 模拟而不损失精度。
技术新颖性
与 TF 相比:TF 只在观测节点评估 $\hat{f}$,只以 $O(\Delta t)$ 逼近理论速度目标,且其残差含显式 Euler 的局部截断误差,学到的往往是“补偿离散误差的 Euler 更新”而非真场;VM 沿插值连续体监督,二阶一致且与任何积分器无关。与两阶段梯度匹配(三次/五次样条、Bonnaffé–Coulson 神经插值、Hou et al. 五次样条+噪声随机插值)相比:VM 证明高阶样条并不必要,分段线性+随机配点即可达到高阶精度,且噪声注入不必是各向同性的——沿插值的扰动才是有效机制(Hou et al. 自己的实验也显示低噪声水平最优,与此分析吻合)。与流匹配相比:FM 端点通常独立耦合、学到的是搬运概率路径的场;VM 的耦合是轨迹给定的 Dirac 耦合,全区间共享单一速度场,逼近的是物理的 $f$。与 Jacobian matching(Park et al. 2024、Kang et al. 2026)相比:后者需要真 Jacobian、$O(n)$ 次导数评估和 $O(n^2)$ 内存;VM 的方向性 Jacobian 匹配是随机配点免费附带的产物。与 rollout 相比:VM 的偏差对应 A-稳定格式,不把学得 Jacobian 的谱压进显式 Euler 稳定区域,因此能学保守/混沌动力学。
实验结果
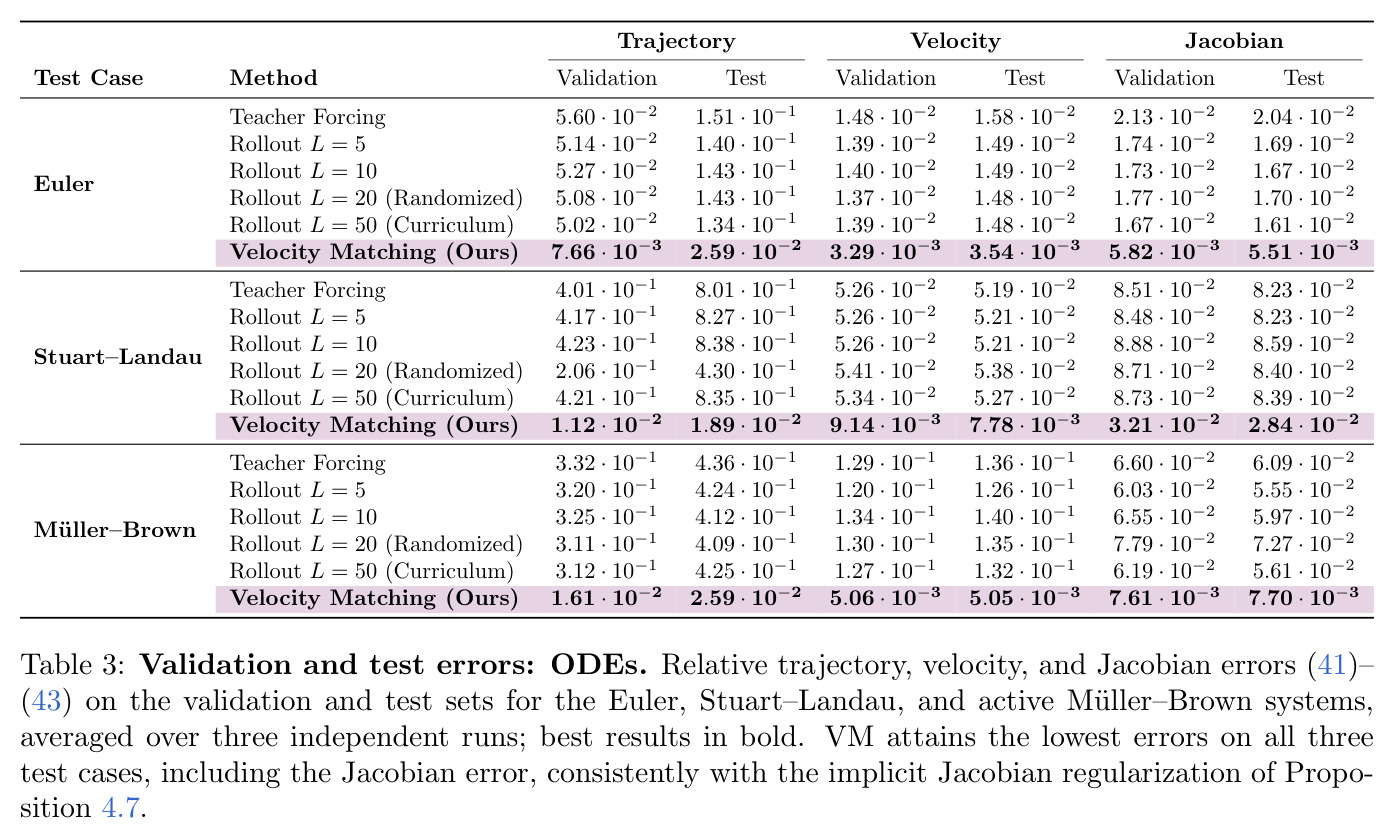
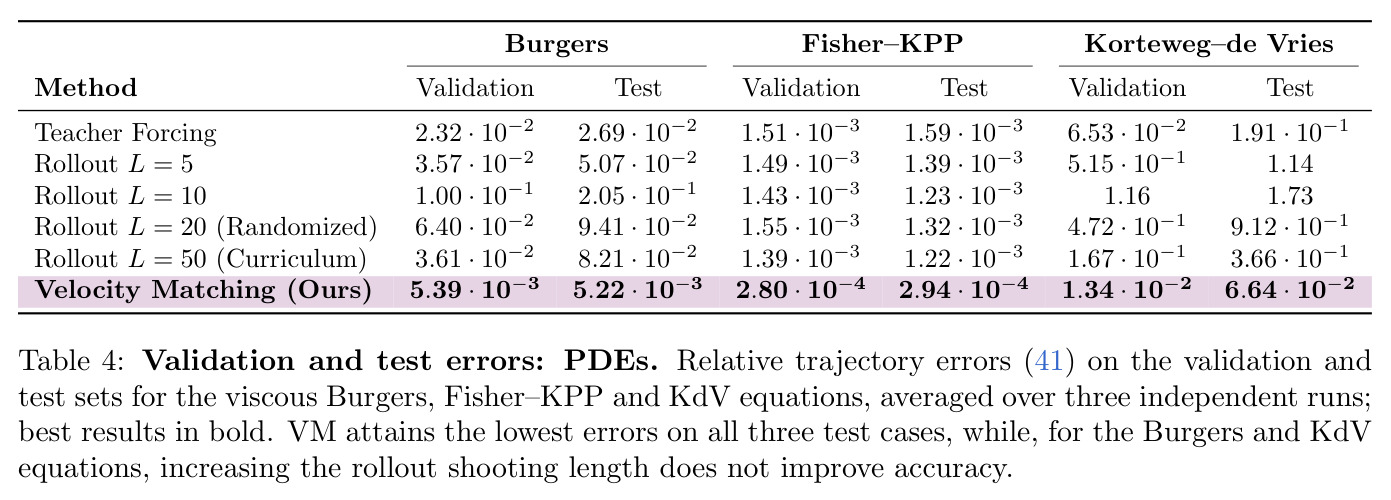
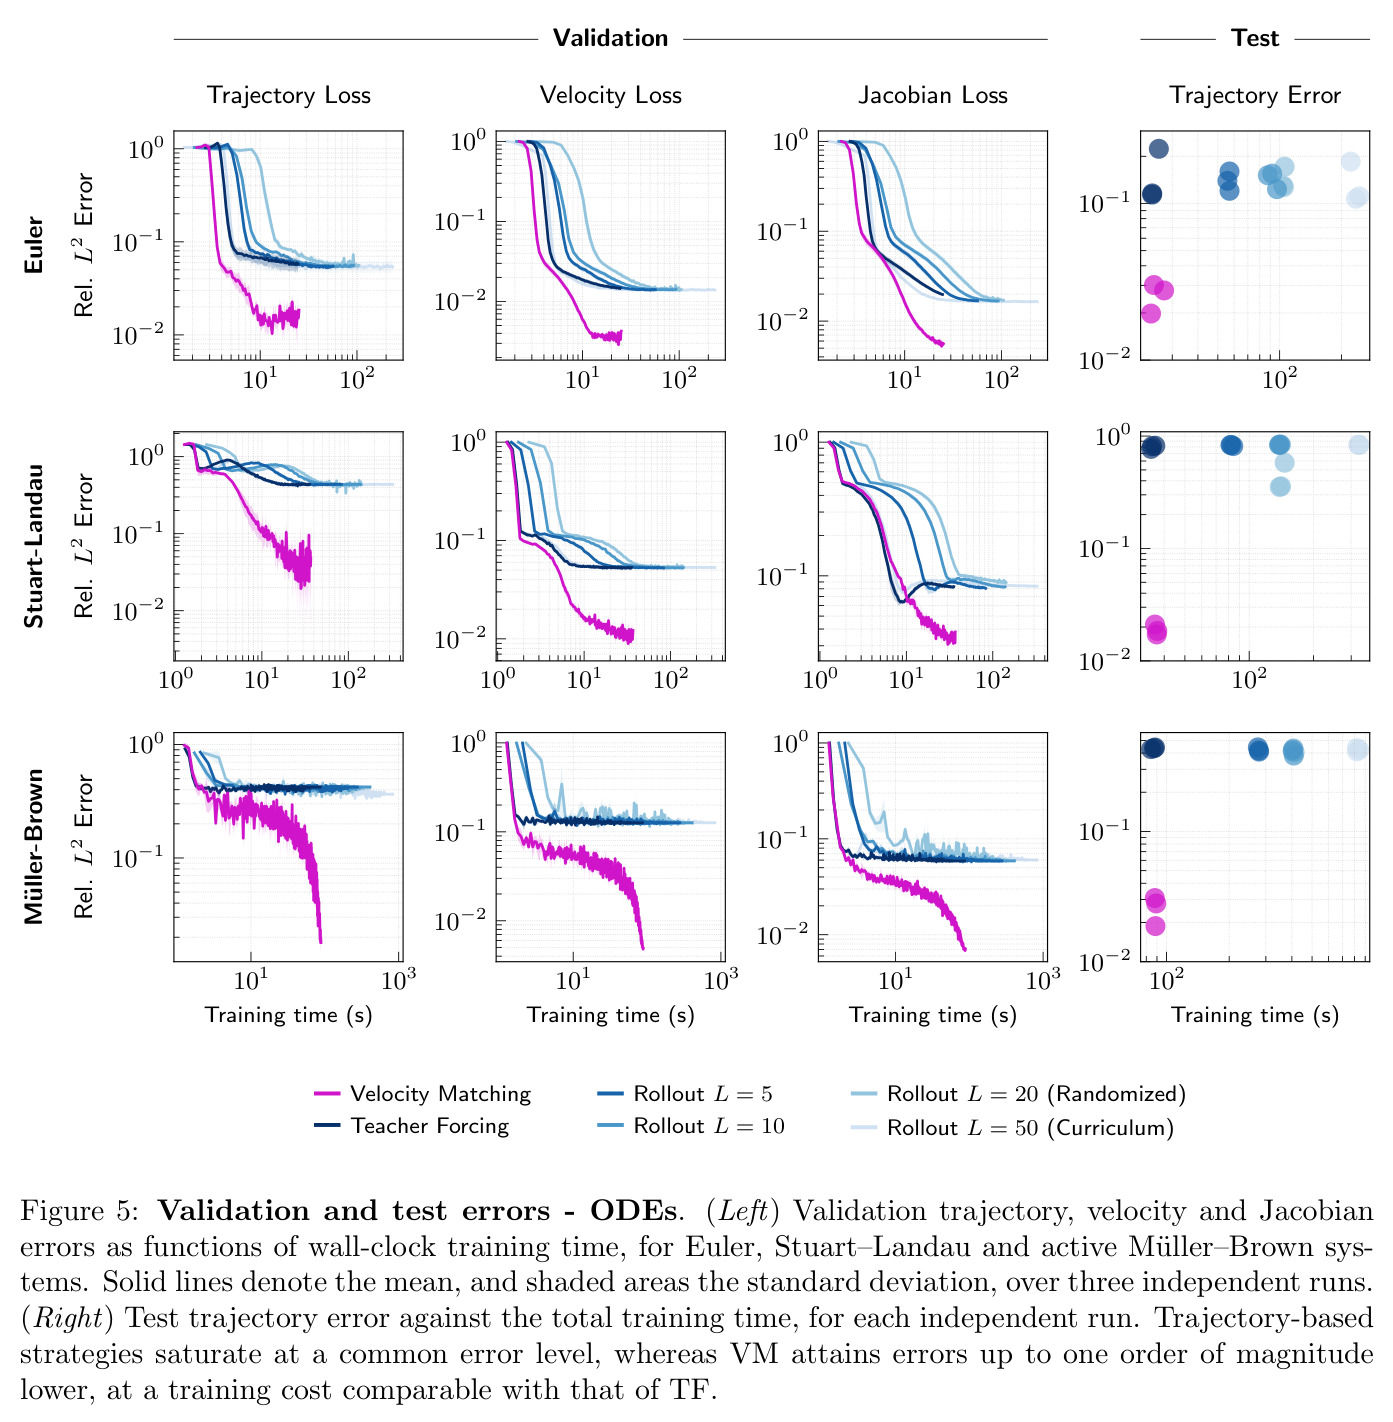
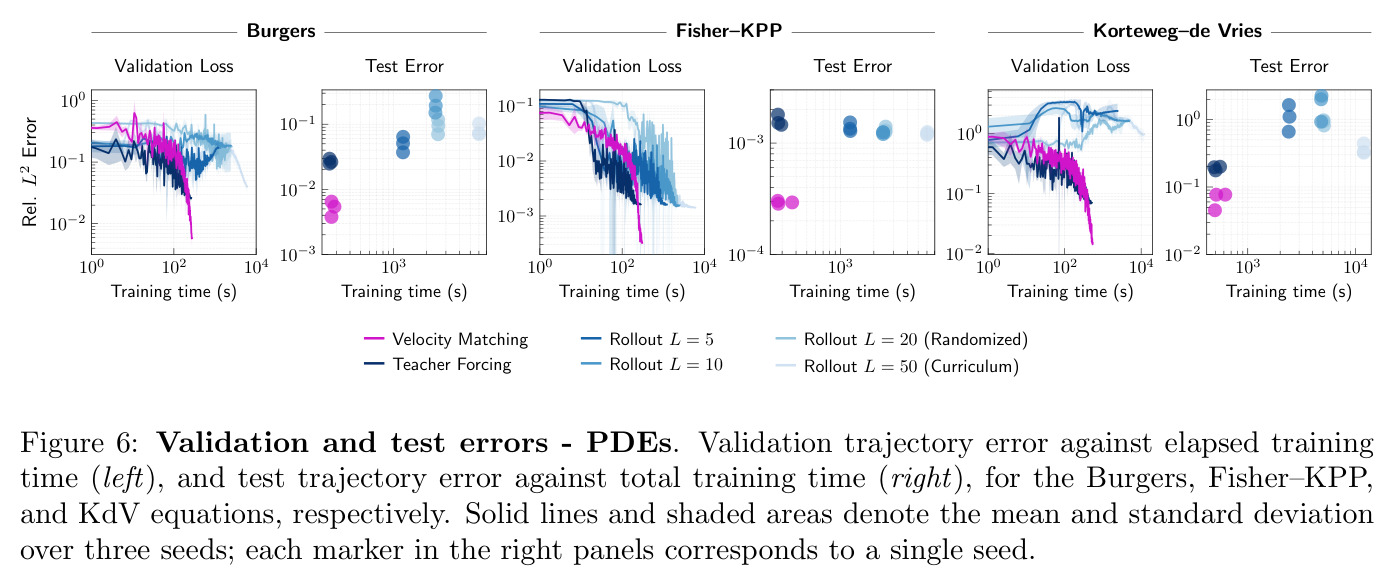
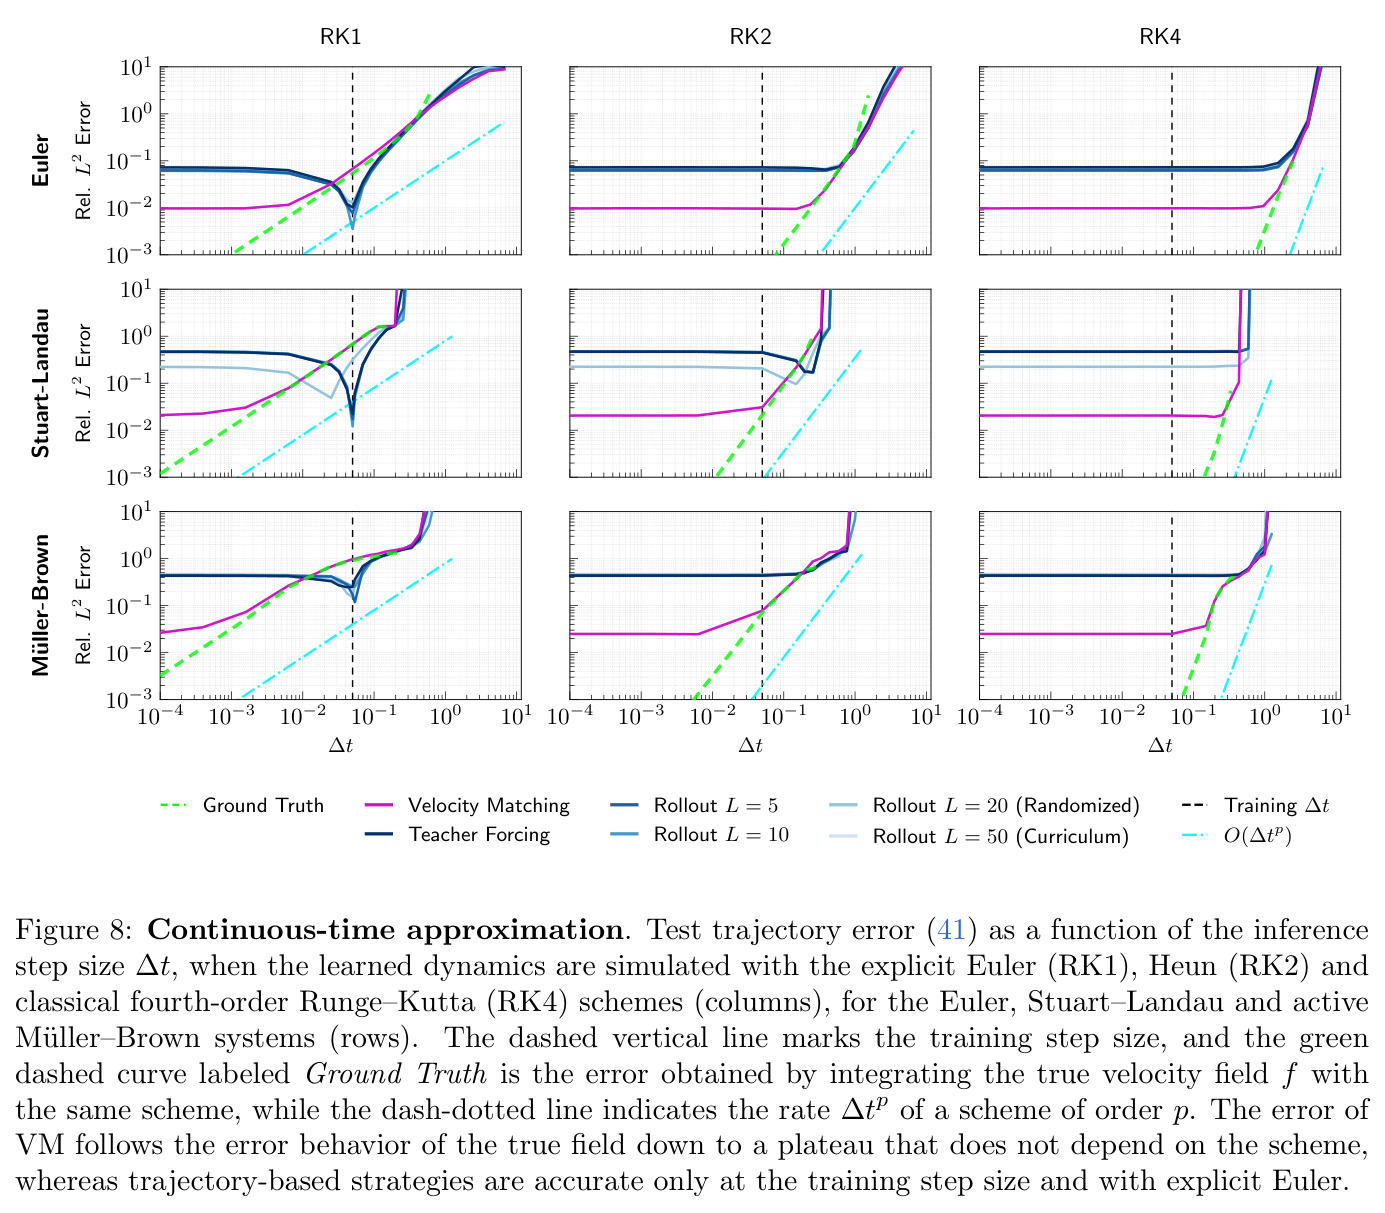
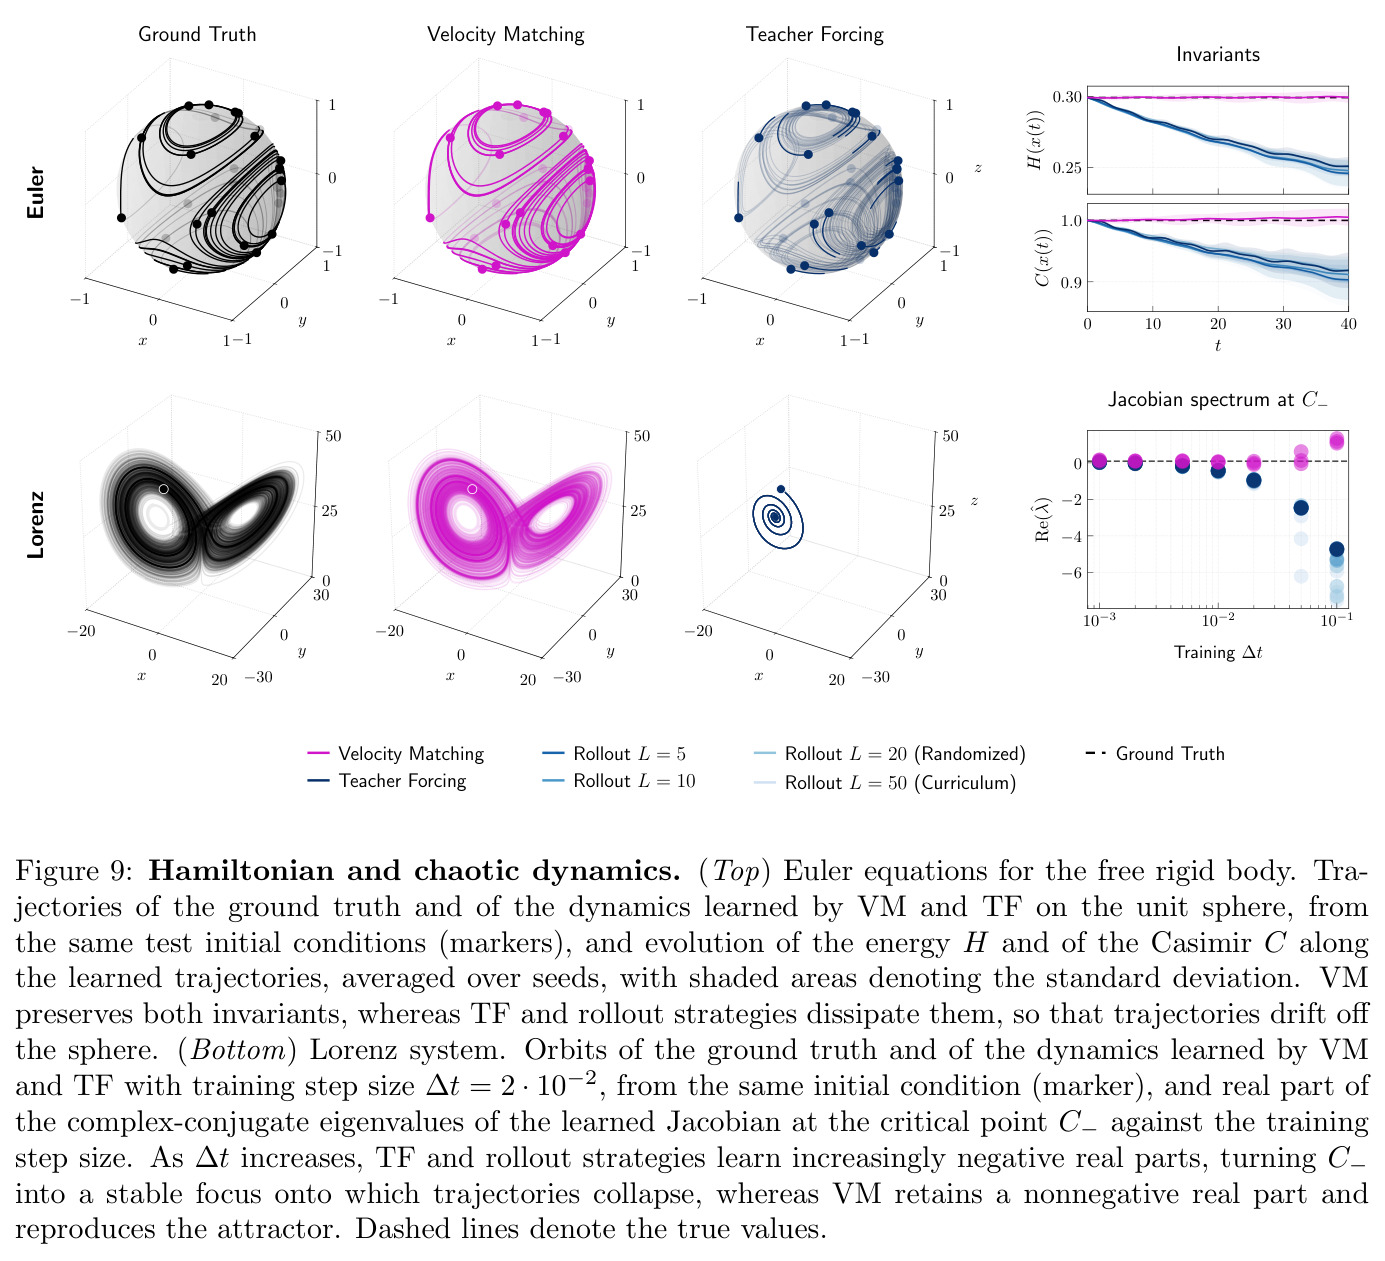
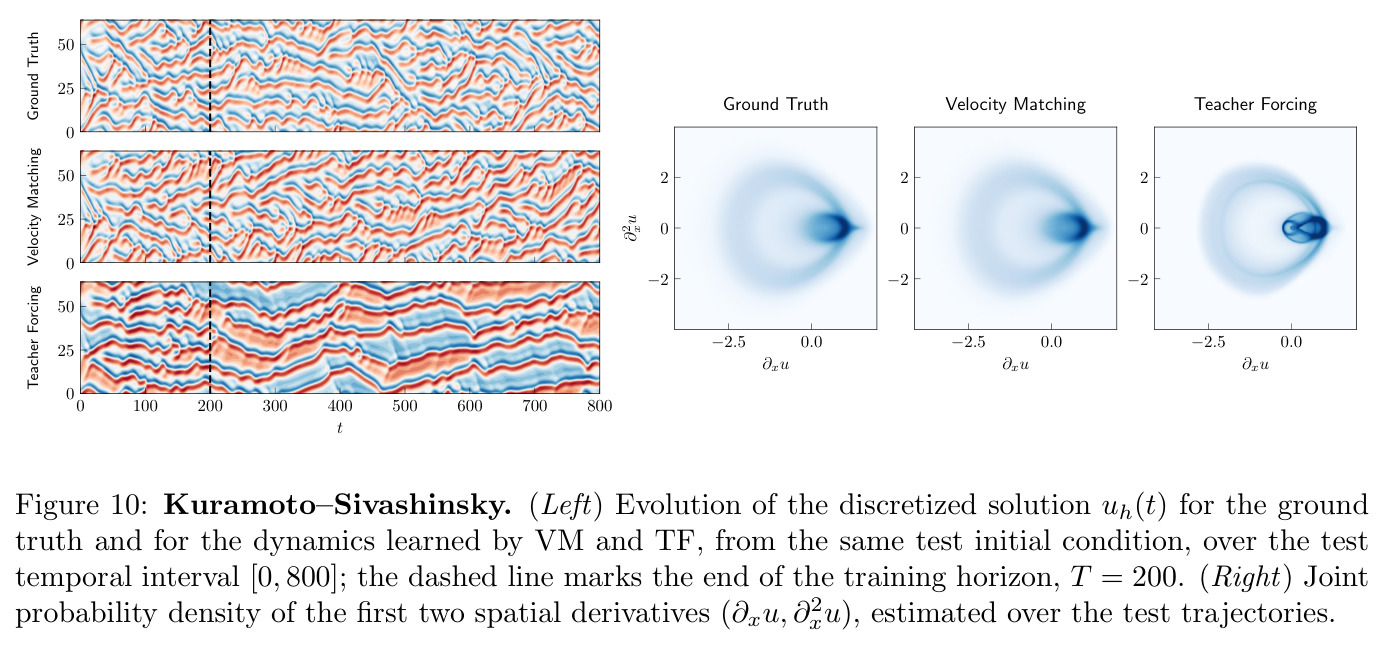
在统一的数据、架构(GELU 网络)、优化超参数和迭代预算下,与 TF、rollout $L=5$、$L=10$、随机 $L\in\{1..20\}$、课程 $L:1\to50$ 五种轨迹策略对比(3 个随机种子)。ODE 基准(Euler 刚体、Stuart–Landau、Müller–Brown,Figure 5/Table 3):VM 与 TF 每步代价相当,而 rollout 代价随 $L$ 增长;所有轨迹策略在三指标上饱和到同一误差水平、与 $L$ 无关,VM 的验证误差则持续下降,测试轨迹误差最多比 rollout 低一个数量级(基线普遍 $\ge10^{-1}$),速度与 Jacobian 误差同步下降,其中 Jacobian 相对误差比基线低 3–9 倍——尽管训练中没有任何 Jacobian 信息。PDE 基准(Burgers、Fisher–KPP、KdV,状态维 1024,Figure 6/Table 4):Burgers 与 KdV 的 rollout 随 $L$ 增大出现失稳,Fisher–KPP 随 $L$ 略有改善,VM 在三个方程上全程稳定优化并取得跨方程、跨种子的最低测试误差。连续时间近似(Figure 8):VM 的测试误差随推理步长 $\Delta t$($10^{-4}$ 到 $10$)先按格式阶 $\Delta t^p$ 衰减、与真场 $f$ 用同样 RK1/RK2/RK4 积分的误差曲线重合,随后饱和到与格式无关的 plateau 且不超过训练精度;而 rollout 模型只在训练步长+显式 Euler 处有尖锐极小,细化步长误差反而升高到远高于 VM 的平台,高阶格式也救不回来,证明它们过拟合了训练离散化。Euler 刚体(Figure 9 上):VM 在两倍训练视界上保持能量 $H$ 与 Casimir $C=|x|^2$ 的小涨落,轨迹留在单位球面;TF 与 rollout 单调漂移,到视界末端约损失 15% 的 $H$ 和 10% 的 $C$。Lorenz 混沌(训练步长 $\Delta t\in[10^{-3},10^{-1}]$,Figure 9 下):TF/rollout 学得的临界点 $C_-$ 复共轭特征值实部随 $\Delta t$ 增大越来越负,把 $C_-$ 变成稳定焦点、轨迹坍缩;VM 在大部分步长范围内准确恢复非负实部并复现吸引子。KS 方程(周期域长 64、256 网格、训练 $T=200$、测试 $T=800$,Figure 10):VM 在训练视界内外都生成与真值定性相似的时空混沌,$(\partial_x u,\partial_x^2 u)$ 联合概率密度与参考吻合;TF 演化到低波数主导的规则 regime,密度向原点集中。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ODE 轨迹预测(Euler 刚体 / Stuart–Landau / Müller–Brown) | 相对 $L^2$ 测试轨迹误差 | VM:比所有 rollout 策略低至多一个数量级,持续下降无饱和 | TF 与 rollout($L=5/10$/随机/课程):饱和于 $\ge10^{-1}$ 的共同误差水平 | 约 $10\times$ |
| 速度场与 Jacobian 精度(沿参考轨迹) | 相对 $L^2$ 误差($E_{vel}$、$E_{Jac}$,Jacobian 用 Frobenius 范数) | VM:Jacobian 测试误差比轨迹式策略低 3–9 倍(无需任何 Jacobian 信息) | TF / rollout 训练 | 3–9 倍 |
| 速度总体风险的离散化逼近 | 对观测步长 $\Delta t$ 的收敛阶 | VM:$O(\Delta t^2)$(Theorem 4.4) | TF:仅 $O(\Delta t)$ | 提高一阶 |
| 连续时间近似(任意步长/格式模拟) | 测试轨迹误差 vs $\Delta t$(RK1/RK2/RK4) | VM:与真场积分误差曲线重合,按 $\Delta t^p$ 衰减后饱和到与格式无关且不超过训练精度的 plateau | rollout:仅在训练步长+显式 Euler 处准确,细化步长误差升高,高阶格式无改善 | 定性翻转(可用 vs 不可用) |
| 保守系统不变量(Euler 刚体) | 能量 $H$ 与 Casimir $C=|x|^2$ 的漂移 | VM:两倍训练视界上仅小涨落,轨迹保持在单位球面 | TF/rollout:单调耗散,末端约失去 15% $H$、10% $C$ | 从 ~15%/~10% 漂移降到近零 |
| 混沌统计(Lorenz / Kuramoto–Sivashinsky) | 吸引子形态、临界点特征值实部、$(\partial_x u,\partial_x^2 u)$ 联合概率密度 | VM:复现吸引子、$C_-$ 特征值实部非负、KS 联合密度与参考吻合(测试至 $T=800$) | TF/rollout:轨迹坍缩到 $C_-$;KS 退化为低波数规则 regime、密度向原点集中 | 定性(成功 vs 失败) |
局限与改进
作者承认的局限:稳定性估计中的 Grönwall 型常数随视界 $T$ 和 Lipschitz 常数指数增长,长时域或大 $\mathrm{Lip}[\hat{f}]$ 时可能完全失去信息量;随机配点对不同类型非线性系统(振荡、保守、耗散、多尺度)以及含噪观测的效果仍是未探索的开放问题;第 4 节分析依赖 Assumption 3/4(场对时间 Lipschitz、$W^{1,\infty}$/$W^{2,\infty}$ 范数有界 $M$);隐式 Jacobian 匹配是方向性的(只沿真实速度方向),弱于完整匹配,且偏差项的首阶展开要求学得场在观测点已 $O(\Delta t^2)$ 接近真场;方差项“惩罚加速度”的类比只是形式化的(formal),未给出严格定理;KS 等刚性问题中衰减时间尺度远快于 $\Delta t$ 的模式对任何目标都不可辨识。我自己的观察:全部理论假设无噪观测(脚注 2),而有限差分速度目标会把观测噪声放大 $1/\Delta t$ 倍,实际含噪数据的鲁棒性未验证;实验规模停留在 $n\le1024$ 的 ODE/一维 PDE,未在天气级别大模型上检验;方差项由批大小 $B$ 控制,小批次下梯度噪声与正则效应的权衡未系统研究;理论要求轨迹配对数据,对只有边际分布的场景不直接适用。
独立分析的弱点
第一,Grönwall 常数指数爆炸:$C_{2,2}(\Lambda)\sim e^{\Lambda T}$ 级别的界对混沌系统(Lyapunov 时间只有几个单位)几乎无约束力,理论保证与实际效果脱节;改进方向是利用收缩性、耗散性等结构导出多项式甚至均匀的稳定性估计。第二,速度目标是一阶有限差分:观测噪声被 $1/\Delta t$ 放大,且目标本身分段常值、在节点不连续,平滑性完全依赖网络的谱偏置去“猜”回来;改进方向是引入正则化插值(广义平滑)或对差分目标做去噪/鲁棒损失。第三,方向性 Jacobian 匹配只约束流方向:横穿流方向的谱信息(决定横向收缩/发散率)不受控,而对混沌统计(Lyapunov 谱、不变测度)恰恰需要全谱信息;改进方向是以随机方向导数低成本补充横向约束。第四,强依赖轨迹配对数据:只有边际分布 $\{\rho(t_k)\}$ 的场景(人口动力学、无轨迹视频)需要先推断轨迹;改进方向是与随机插值/群体演化建模结合。第五,基线覆盖面:对比的 rollout 全部用显式 Euler 更新,未对比高阶格式 rollout 或推理时一致的自回归基线;改进方向是补齐不同数值格式下的公平对照。第六,规模可扩展性:VM 每样本一次 $\hat{f}$ 前向虽然便宜,但大模型+长序列下批采样策略、与课程训练的组合仍未检验。
未来方向
作者明确提出三个方向:(1)为特定系统类别(振荡、保守、耗散、多尺度)设计自适应的配点分布 $\tau$ 的采样规律,弄清随机配点在哪些动力学上最有益;(2)利用动力学结构(如耗散性、守恒量)特化第 3.2 节的稳定性估计,得到随视界不退化的更锐利界;(3)从遍历理论角度把隐式 Jacobian 正则与混沌系统不变测度的统计保证联系起来(呼应 Park et al. 的 shadowing 分析)。基于本文成果还可延伸:含噪观测下的 VM 理论与去噪目标设计;把 VM 目标嵌入大规模自回归神经算子(transformer/GNN)训练管线以根治其离散化过拟合;与保结构架构(Hamiltonian NN、Lie–Poisson 网络)结合,用 A-稳定偏差进一步增强守恒性;扩展到随机微分方程和控制仿射系统;在模型约简的潜空间神经 ODE 中以 VM 训练潜动力学(与 Farenga et al. 2025 的 CTA 框架衔接);以及把“隐式格式残差进目标”的思想推广到多步法或其他 A-稳定族。
复现评估
复现条件较好。代码已开源:github.com/farenga/velocity-matching;核心算法(Algorithm 1)只有几行——三个索引采样、一次差分、一次前向、一次梯度步——可以作为即插即用的目标函数替换 TF。基准全部是标准系统:4 个 ODE(Euler 刚体、Stuart–Landau 振子、Müller–Brown 势中的活性粒子、混沌 Lorenz)加 4 个一维 PDE(黏性 Burgers、Fisher–KPP、KdV、Kuramoto–Sivashinsky,周期域长 64、256 网格、训练 $T=200$/测试 $T=800$,半离散状态维 1024),数据生成、网络架构(GELU 前馈网络+归一化)、训练与评估协议(3 个种子、按验证误差选模型、测试视界为训练两倍)在附录 D 有完整描述。算力需求温和:VM 每样本仅一次 $\hat{f}$ 前向、代价与 TF 相当,ODE 实验维数很低,PDE 实验 1024 维也在单卡范围。理论复现难度较高但自成体系:证明分布在附录 A–C,需要数值分析(RK 格式、稳定性理论、csRK)与逼近论(Sobolev 范数下的深度网络逼近)背景;不过使用层面只需读懂损失定义即可落地。总体评估:代码级复现低到中等难度,理论级复现需要较扎实的数学功底。
论文图表
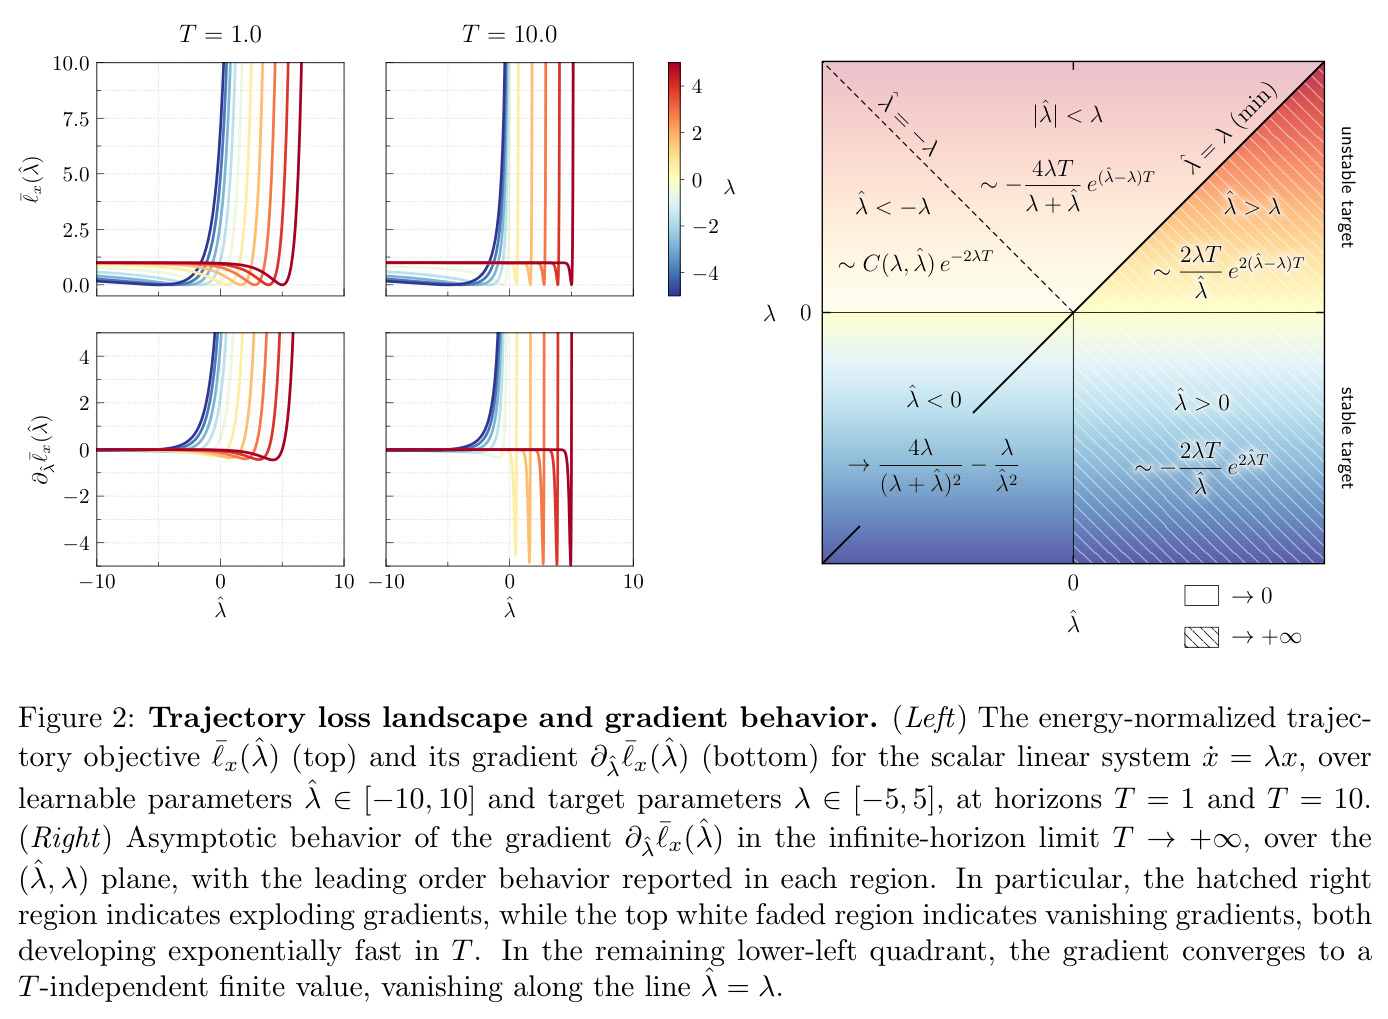
左:标量线性系统 $\dot{x}=\lambda x$ 的能量归一化轨迹损失 $\bar{\ell}_x(\hat{\lambda})$ 及其梯度在 $T=1$ 与 $T=10$、$\hat{\lambda}\in[-10,10]$、$\lambda\in[-5,5]$ 上的曲面;右:$T\to\infty$ 时梯度在 $(\hat{\lambda},\lambda)$ 平面上的渐近行为分区,标注各区域主阶(如 $e^{2(\hat{\lambda}-\lambda)T}$ 爆炸区、$\sim e^{-\lambda T}$ 消失区),不稳定情形极小值锐度按 $2^T$ 发散。
可视化轨迹目标的核心退化——梯度随视界指数消失/爆炸与非凸化,是放弃轨迹目标转向速度目标的第一性证据。
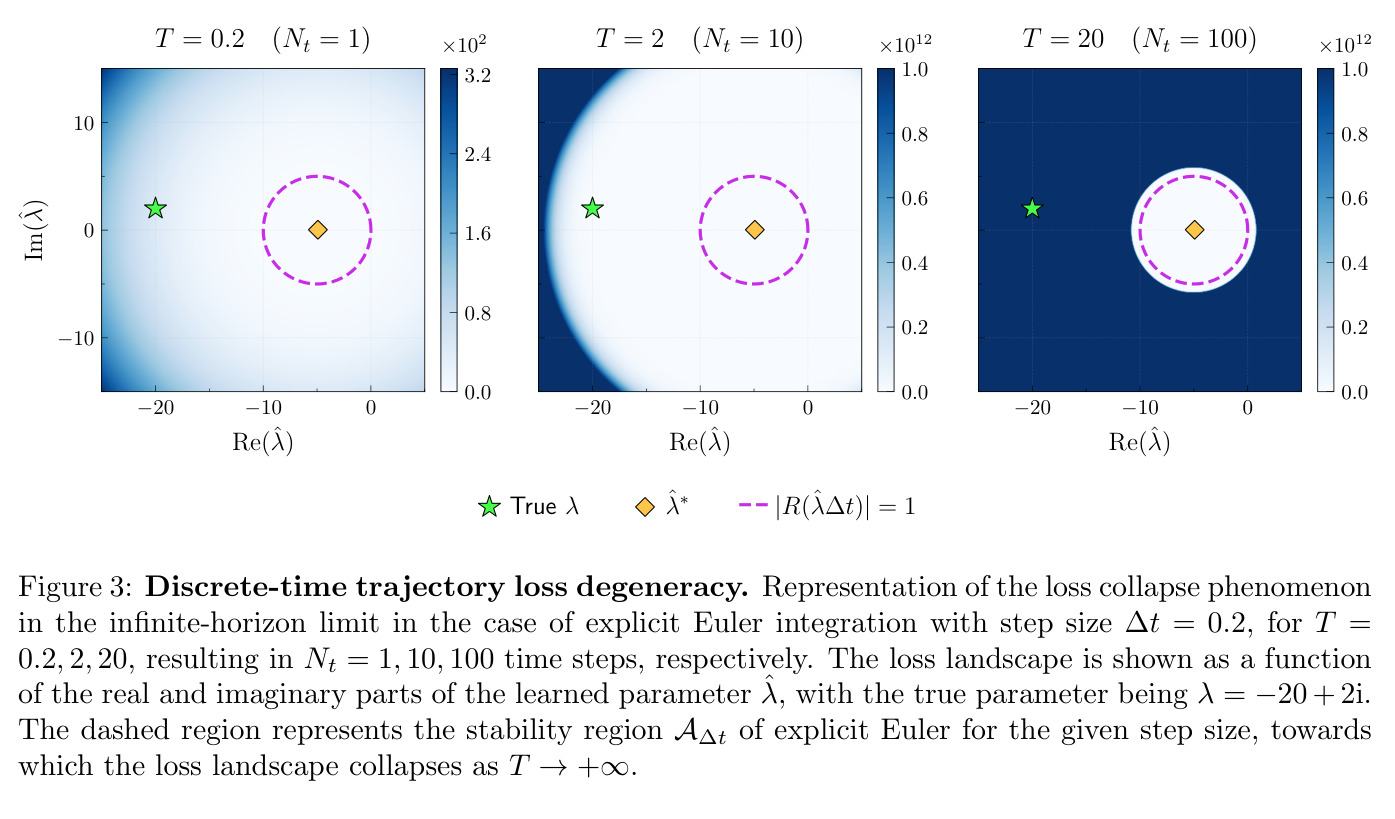
显式 Euler($\Delta t=0.2$)下对真参数 $\lambda=-20+2i$ 学习 $\hat{\lambda}$ 的复平面损失地形,$T=0.2,2,20$($N_t=1,10,100$)三列;斜线阴影标出稳定区域 $A_{\Delta t}$,随 $T$ 增大损失地形塌缩到该区域(速率 $N_t^{-1}$),区域内处处近乎全局极小。
直观呈现 Proposition 2.1:长 rollout 让损失对真动力学“失明”,最优解坍缩为由积分器和步长单独决定的稳定区域。