MEND:基于近端速度匹配的流模型强化学习 MEND: RL For Flow Models via Proximal Velocity Matching
逐样本验证奖励收益是否值得位移代价,100次更新超越数千次更新的RL基线
前置知识
整流流与速度匹配(Rectified Flow / Flow Matching)
整流流用线性插值 $z_t = (1-t)x_0 + t\epsilon$ 把干净数据 $x_0$ 与高斯噪声 $\epsilon$ 连接起来,网络 $v_\theta(z_t, t, c)$ 预测沿该路径的速度,并且可以从速度恢复出对干净图像的预测 $\hat{x}_\theta(z_t) = z_t - t\, v_\theta(z_t, t, c)$。训练目标通常是让速度预测逼近某个目标速度(速度匹配)。SD3、SD3.5 等新一代文本到图像模型都基于这一框架。
MEND 的损失函数和命名都建立在速度匹配之上:本文的核心操作是把回归目标写成 $\hat{x}_{old}(z_q) + d$ 再翻译成速度目标 $v^* = v_{old} - d/t_q$。不懂 clean prediction 与速度的等价换算,就无法理解为什么一次回归就能让模型朝奖励方向移动。
奖励后训练与人类偏好奖励模型
PickScore、HPSv2.1、ImageReward、HPSv3 等是在大规模人类偏好数据上训练的打分模型,给(图像,提示词)对输出一个标量分数,刻画人类对图文匹配和美学的偏好。奖励后训练(reward post-training)指用这类现成奖励继续微调已训好的生成模型,让生成结果分数更高,相当于 RLHF 在文生图领域的对应物。
本文要解决的全部问题就是:如何把一个标量奖励信号转化为安全、高效的参数更新。所有基线(Flow-GRPO、ReFL、DiffusionNFT)和评估指标(六个 evaluator)都来自这个生态。
GRPO 类重加权方法与 KL 正则
Flow-GRPO 把大语言模型里的组相对策略优化搬到流模型:每个提示词采样一组轨迹,用组内相对优势重加权各样本的梯度贡献,并用 KL 惩罚(相对冻结参考模型)限制分布漂移。DiffusionNFT 则在回归损失内对模型自身样本按奖励/优势加权。这类方法的共同点是只调整已有样本的权重,不构造新的回归目标。
它们是 MEND 的主要对比对象。理解『只调权重』与 MEND『构造并验证新目标』的本质区别,以及 KL 惩罚在分布层面失灵(无法阻止模式坍缩)的例子,是读懂本文动机的关键。
近端点算法(Proximal Point / JKO 格式)
近端点思想来自 Rockafellar (1976) 的单调算子理论和 Jordan-Kinderlehrer-Otto (1998) 对 Fokker-Planck 方程的变分格式:每一步只求 $\arg\max_y \{R(y) - \|y-x\|^2/(2\tau)\}$,用二次位移项作为步长代价,保证每步收益必须超过代价,且位移随势能趋平而自动收缩。
MEND 的候选验证规则 $J(y) = R_\kappa(y,c) - \|y-x\|^2/(2\tau)$ 就是这个目标在包含不动点在内的 4 个有限候选上的离散化。理解了近端点,就理解了论文标题中 proximal 一词和 Proposition 1 的所有保证。
LoRA 适配器与 EMA 行为模型
LoRA 在冻结的骨干模型旁挂一对低秩矩阵作为可训练适配器,大幅降低后训练的显存和算力开销。EMA(指数滑动平均)则维护一份滞后于训练参数的权重副本 $\theta_{old} \leftarrow \mu_u \theta_{old} + (1-\mu_u)\theta$。扩散 RL 中常见做法是用冻结的基础模型做参考来计算 KL 或构建正则。
MEND 用两个 LoRA 适配器(训练的 $\theta$ 和行为的 $\theta_{old}$),且速度目标锚定在滞后的行为适配器而非冻结参考上。行为模型负责生成样本,训练模型负责回归目标,这一双模型设计是理解算法流程的前提。
可微奖励与奖励反传(ReFL/DRaFT)
ReFL、DRaFT、AlignProp 等方法把可微奖励模型接到采样链末端,直接把奖励对图像的梯度 $\nabla_x R$ 反向传播穿过整个采样过程,让每个样本都沿奖励梯度移动。这类方法收敛快,但梯度会移动所有样本——包括已经打高分的样本——且没有任何机制检查一次移动是否值得它的幅度。
Proposition 2 证明 MEND 的回归梯度恰好等价于『被验证过滤、按所选步长缩放』的奖励反传,这把两大流派统一起来:ReFL 类方法是 MEND 全部样本都通过验证时的特例。
研究动机
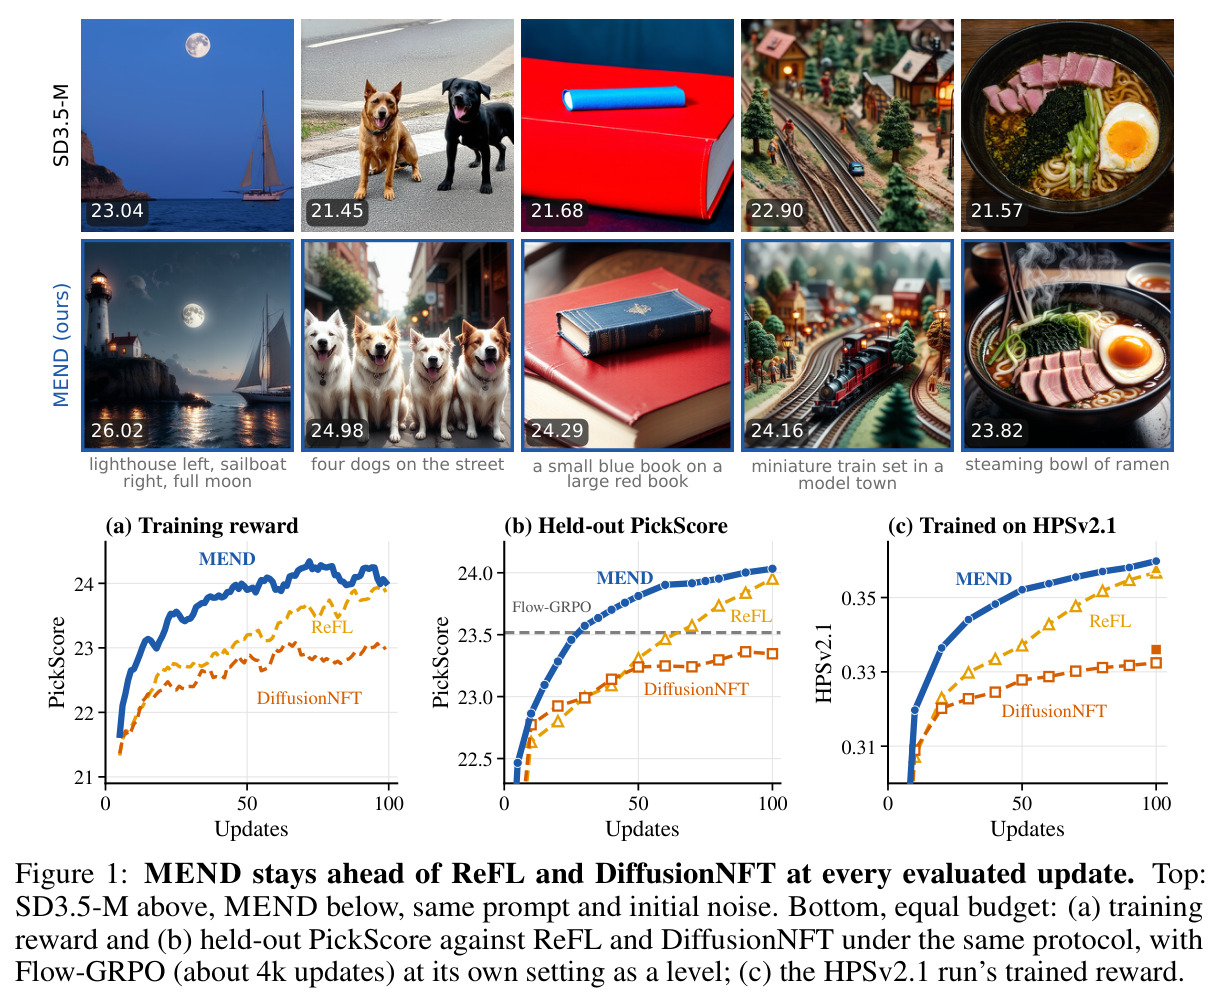
用学习到的奖励模型(PickScore、HPSv2.1、ImageReward 等)对文本到图像流模型做后训练已成为对齐人类偏好的标准做法,但一个标量分数本身并不告诉你哪些样本该改、往哪改、改多少。现有两类方法都回避了逐样本决策。第一类是重加权方法:Flow-GRPO 在 KL 惩罚下用组相对优势重加权随机轨迹(对比模型训练约 4k 次更新),DiffusionNFT 在回归损失内重加权模型自身样本(对比模型 1.7k 次更新),二者本质上只是调整已有样本的贡献权重;KL 惩罚只在分布整体层面限制漂移,对每个样本不做任何决定,也无法阻止模式坍缩。第二类是奖励反传方法(ReFL、DRaFT):把奖励梯度反传穿过采样过程,提供移动方向,但梯度会移动每一个样本——包括已经得分很好的样本,而且没有任何东西检查这次移动是否值得它的幅度。论文用三高斯混合玩具模型(均值 2.2、0、-2.2,权重 0.22、0.43、0.35)具体演示这两种失败:KL 倾斜($\beta=0.05$)把质量集中到奖励峰顶,丢掉了权重 0.35 的『难模式』;而 18 步无约束梯度上升(步长 0.03)把 12.7% 的质量推到 $|x|>3.25$ 的数据空白区。也就是说,重加权抑制难模式、无检查的上升把样本推进低密度区,两条现有路线都会侵蚀基模型已有的能力和多样性。
本文的目标是本文的目标是设计一个奖励后训练方法,把『这个样本值不值得改』变成显式的逐样本决策,并以此同时达成四个可度量的目标。第一是更新效率:把 Flow-GRPO 约 4k 次更新、DiffusionNFT 1.7k 次更新才能达到的奖励水平压缩到 100 次更新以内,使奖励后训练的成本降到 10 GPU 小时量级,便宜到『每出一个新奖励或新骨干都可以重跑一次』。第二是保真度:在与基线相同的『到基模型图像的 DreamSim 距离』下取得更高奖励,而不是靠偏离基模型更远来换取分数。第三是多样性:避免重加权导致的模式坍缩和无约束上升导致的分布漂移,用多样性指标(组内 DreamSim 成对余弦距离)显式衡量。第四是通用性:方法不依赖特定骨干(在 SD3.5-M、SD3-M、蒸馏 9 步的 Z-Image-Turbo 上都有效)和特定奖励(PickScore、ImageReward、HPSv2.1、CLIPScore 四种都验证),并且去掉 KL 项、冻结参考模型和优势权重这三个重加权方法的标配组件。
与已有工作不同的是,本文的独特切入角度是把奖励后训练重新表述为近端点问题(proximal point):在每个样本周围,以(封顶后的)奖励为势能、以二次位移项为步长代价,在一组有限候选上做一步 JKO 式的近端最大化——这就是标题中 proximal velocity matching 的含义。与重加权方法(Flow-GRPO、DiffusionNFT、AWM)只给已有样本调权不同,MEND 为每个样本构造新的局部回归目标并逐一验证;与奖励反传方法(ReFL、DRaFT)把所有样本都移动不同,MEND 保留了反传给出的方向,但补上它缺失的两个决策:哪些样本移动、移动多远。另一组独特设计包括:用组内分位数封顶(quantile cap)加缓慢上升的全局下限替代 KL 正则来约束漂移;用每轮自适应的价格 $\tau$(以 30%-60% 接受率为目标带)替代手工调学习率;用滞后 EMA 行为适配器而非冻结参考来锚定速度目标。理论上还给出目标级的模式质量守恒界(Corollary 5),说明为什么 KL 倾斜的目标会丢模式而 MEND 的目标不会。
核心方法
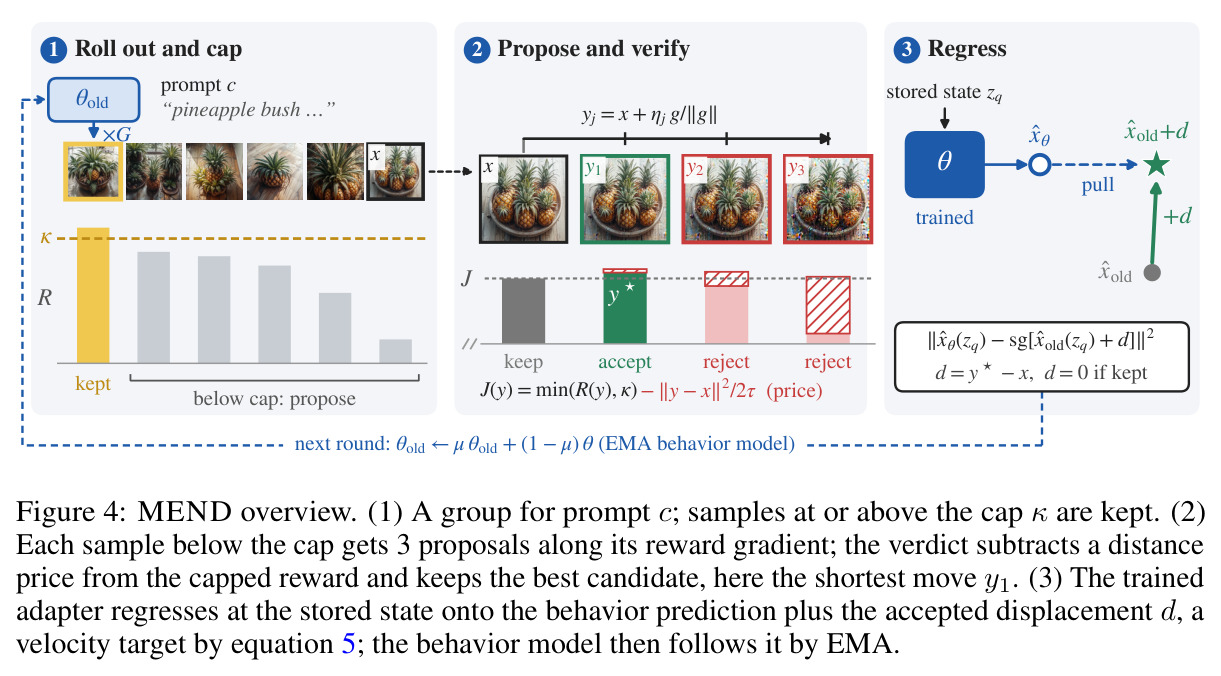
先说直觉:一张已经打高分的图不该被继续推着改;一张低分图也不该被无限制地推——只有当移动带来的封顶奖励增益超过二次位移价格时,这次移动才被接受,而且移动必须是短程的、沿奖励梯度方向的、在真实解码图像上验证过的。技术路线每轮分三步(对应 Figure 4)。第一步 Rollout 与封顶:行为适配器 $\theta_{old}$ 为每个提示词生成 $G$ 条确定性 10 步轨迹,记录终点 $x$ 和最接近 $t_q=0.278$ 的状态 $z_q$;组内奖励按分位数 $q=0.75$ 封顶,$\kappa(c) = \max\{Q_q\{R(x^{(k)},c)\}, \kappa_{glob}\}$,达到或超过封顶的样本位移为零,且封顶函数 $R_\kappa(x,c)=\min\{R(x,c),\kappa(c)\}$ 对超过封顶的奖励不再给任何信用。第二步 Propose 与 Verify:低于封顶且梯度 $g=\nabla_x R \neq 0$ 的样本,沿归一化梯度提出 3 个候选 $y_j = x + \eta_j g/\|g\|$,$\eta_j \in \{0.1, 0.2, 0.4\}$,各自解码并打分一次;然后选择 $J(y) = R_\kappa(y,c) - \|y-x\|^2/(2\tau)$ 最大的候选,候选集合始终包含不动的 $x$,平局偏向 $x$ 再偏向最短步。第三步 Regress:接受样本记 $d = y^\star - x$,其余样本 $d=0$,在存储状态 $z_q$ 处用普通回归损失训练。整个过程没有 KL、没有冻结参考、没有优势权重——只有一次普通的 AdamW 步。
核心创新是『构造并验证速度目标』这一范式本身,它同时区别于两大流派。区别一:分位数封顶使组内前 25% 的高分样本零位移,从机制上排除了对高分样本的过度推挤和对众数的侵蚀;Proposition 1 进一步保证任何被接受的位移满足 $\|y^\star-x\| \le \sqrt{2\tau(\kappa - R_\kappa(x))}$,样本越接近封顶,允许的位移越小直至归零——这是 KL 惩罚做不到的逐样本软着陆。区别二:每次移动必须在解码后的真实候选图像上验证(而非相信一阶预测),且以『封顶增益严格大于二次价格』为硬门槛,这成为第一个逐样本的移动价值检查,替代了 KL/冻结参考的分布级约束;$\tau$ 在轮内固定、轮间调整以维持 30%-60% 的接受率。区别三:回归目标不是验证后的终点 $y^\star$ 本身,而是 $\hat{x}_{old}(z_q) + d$——因为终点与一步预测之间还隔着 rollout 剩余路径中与奖励无关的差距,直接回归 $y^\star$ 会把这个噪声混入更新。用位移 $d$ 作为目标后,保留的样本要求零变化、移动的样本恰好要求修正量 $d$。写成速度形式 $\|\hat{x}_\theta(z_q) - (\hat{x}_{old}(z_q)+d)\|^2 = t_q^2 \|v_\theta - v^\star\|^2$,$v^\star = \mathrm{sg}\, v_{old}(z_q,t_q,c) - d/t_q$,这正是速度匹配,也是方法命名的由来。
方法步骤详情
完整流程见 Algorithm 1/2。准备:训练适配器 $\theta$ 与行为适配器 $\theta_{old}$(rank-32 LoRA)、价格 $\tau$(初始 0.1)、封顶分位 $q=0.75$、步长档 $\{0.1, 0.2, 0.4\}$、$\lambda_{keep}=10$、学习率 $3\times10^{-4}$、行为 EMA 系数 $\mu_u = \min(0.001u, 0.5)$。第 1 步 Rollout:$\theta_{old}$ 对每个提示词(协议中 48 个)生成 $G=24$ 条确定性 10 步轨迹(512 像素),存储终点 $x$ 和最接近 $t_q=0.278$ 的中间状态 $z_q$。第 2 步打分与封顶:对所有终点做一次奖励反向传播,得到 $R(x,c)$ 和 $g=\nabla_x R$;全局下限 $\kappa_{glob}$ 向本轮中位数奖励抬升且只升不降;组内设 $\kappa(c) = \max\{Q_{0.75}\{R\}, \kappa_{glob}\}$。第 3 步 Propose:对 $R < \kappa$ 且 $g \neq 0$ 的样本生成 3 个候选 $y_j = x + \eta_j g/\|g\|$,各解码并打分一次(每样本至多 3 次解码 + 3 次奖励前向,无反向传播)。第 4 步 Verify:$y^\star = \arg\max_{y \in \{x, y_1, y_2, y_3\}} R_\kappa(y) - \|y-x\|^2/(2\tau)$,平局先给 $x$ 再给最短档;接受样本记 $d = y^\star - x$,其余 $d=0$。第 5 步 Regress:对 $\mathcal{L}(\theta) = \mathbb{E}_{moved}\|\hat{x}_\theta(z_q) - \mathrm{sg}[\hat{x}_{old}(z_q)+d]\|^2 + \lambda_{keep}\,\mathbb{E}_{kept}\|\hat{x}_\theta(z_q) - \mathrm{sg}[\hat{x}_{old}(z_q)]\|^2$ 做一次 AdamW 步($\epsilon=10^{-12}$)。第 6 步簿记:统计接受率,若离开 [30%, 60%] 目标带则重缩放 $\tau$;$\theta_{old} \leftarrow \mu_u \theta_{old} + (1-\mu_u)\theta$;评估用另一个独立的 EMA $\theta_{ema}$。每更新的总开销为:每样本 1 次奖励反向、至多 3 次解码与奖励评估、1 次网络前向加反向,从不穿过采样器反传梯度。
技术新颖性
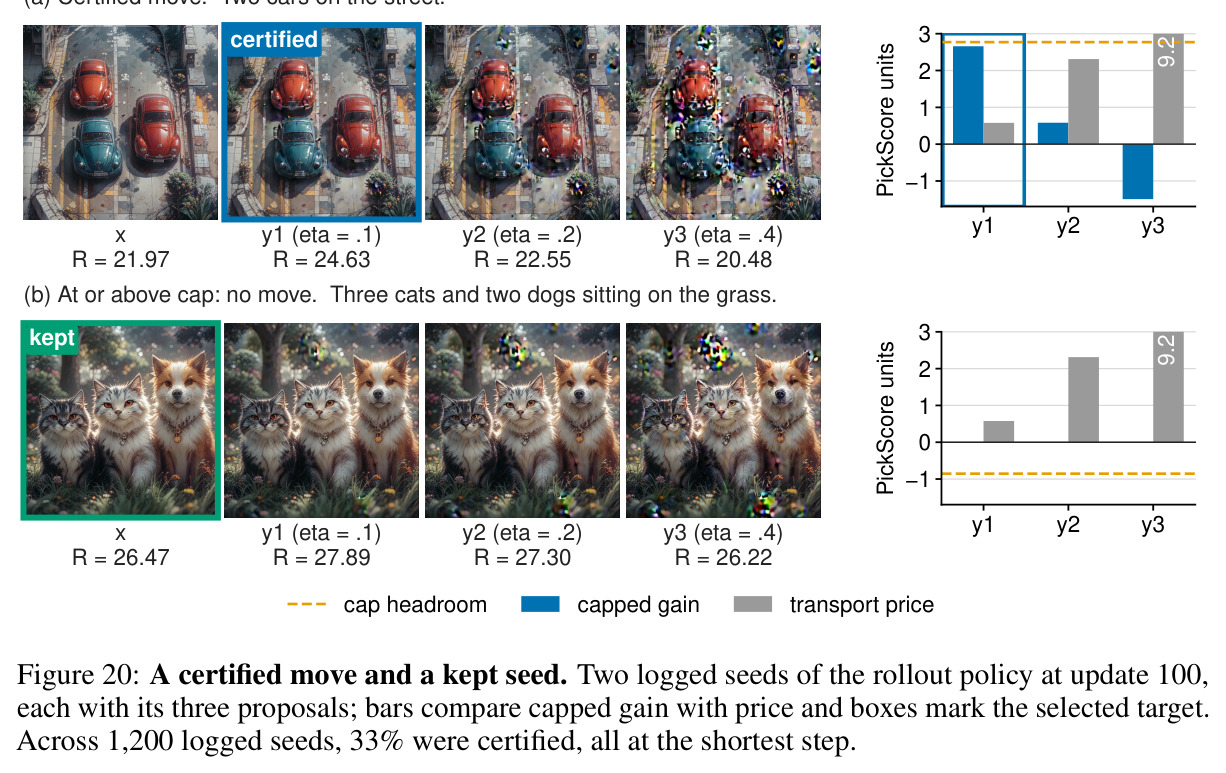
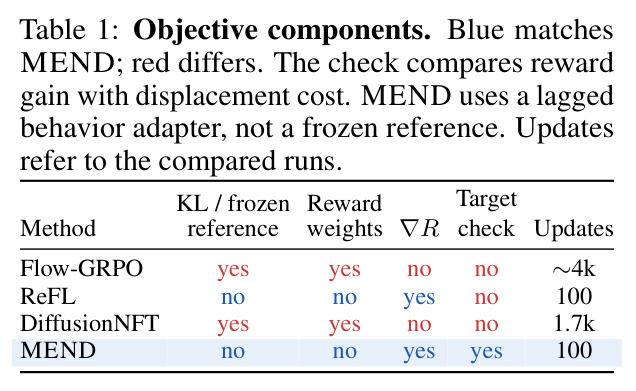
技术新颖性有五点。其一,决策显式化:Table 1 的组件对比显示 Flow-GRPO/DiffusionNFT 有 KL 和权重但无 $\nabla R$ 无检查,ReFL 有 $\nabla R$ 但无检查,只有 MEND 同时拥有梯度方向和逐样本检查,这填补了奖励后训练里『该不该改』这个从未被显式建模的决策。其二,近端点视角:把经典 proximal point / JKO 步在 4 个有限候选上离散化用于生成模型后训练,并证明每轮构造的目标满足增益-价格不等式(Proposition 1)和随封顶余量收缩的位移上界,这类目标级保证在扩散 RL 文献中是新的。其三,Proposition 2 证明回归损失在 $\theta_{old}$ 处的负梯度为 $-\nabla\mathcal{L} = \sum_{i \in A} \frac{2\eta_i}{|A|} \nabla_\theta \langle \hat{h}_i, \hat{x}_\theta(z_q)\rangle$,即奖励反传被自动限制在通过验证的样本上并按所选步长缩放——ReFL 类方法由此成为 MEND 全员通过的特例,两大流派被统一。其四,模式质量界(Corollary 5):目标质量只能在位移上界 $\rho(x)=\min\{\eta_K, \sqrt{2\tau(\kappa-R_\kappa(x))}\}$ 内跨越区域边界,而 KL 倾斜 $\pi_\beta$ 的质量分配只取决于区域内的平均奖励、与距离无关——从理论上解释了为什么重加权丢模式而 MEND 不丢(三模式玩具中 MEND 一轮后三个模式质量 0.218/0.430/0.353,与训练前 0.217/0.430/0.350 几乎一致)。其五,行为 EMA 取代冻结参考,消融显示去掉 EMA 也几乎不掉分(全预算下变动不超过 0.06 PickScore),说明关键在于锚定目标本身的构造而非参考的强度。实现细节上也有巧思:最长档 $\eta=0.4$ 的候选几乎从不被接受,它的作用是验证最短档 $\eta=0.1$ 确实处在奖励的上升沿上。
实验结果
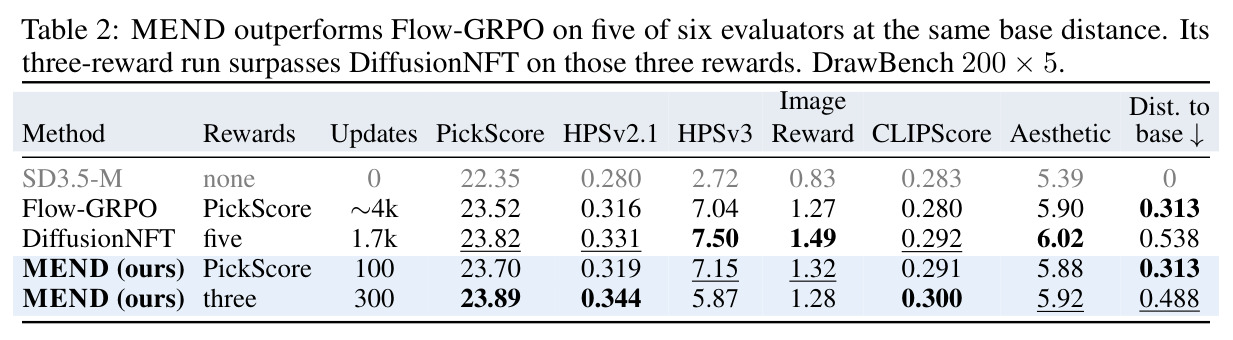
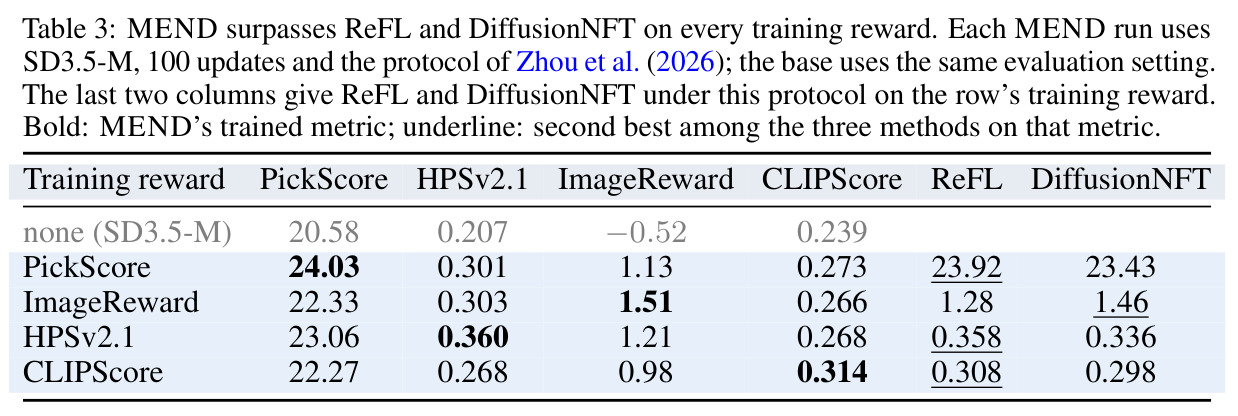
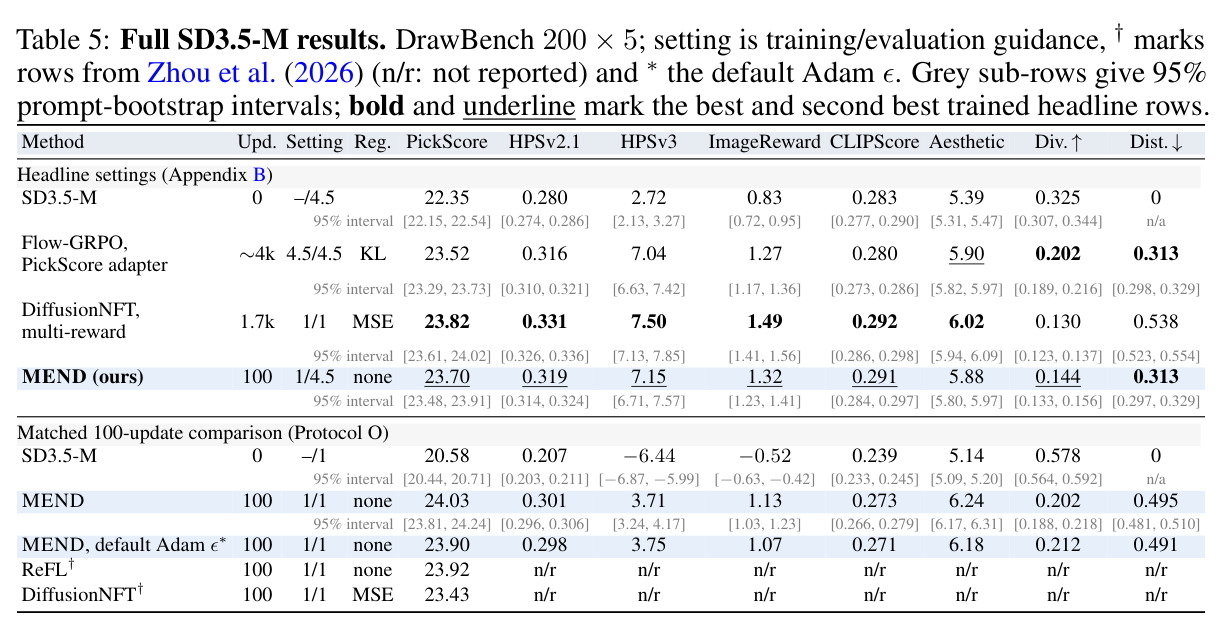
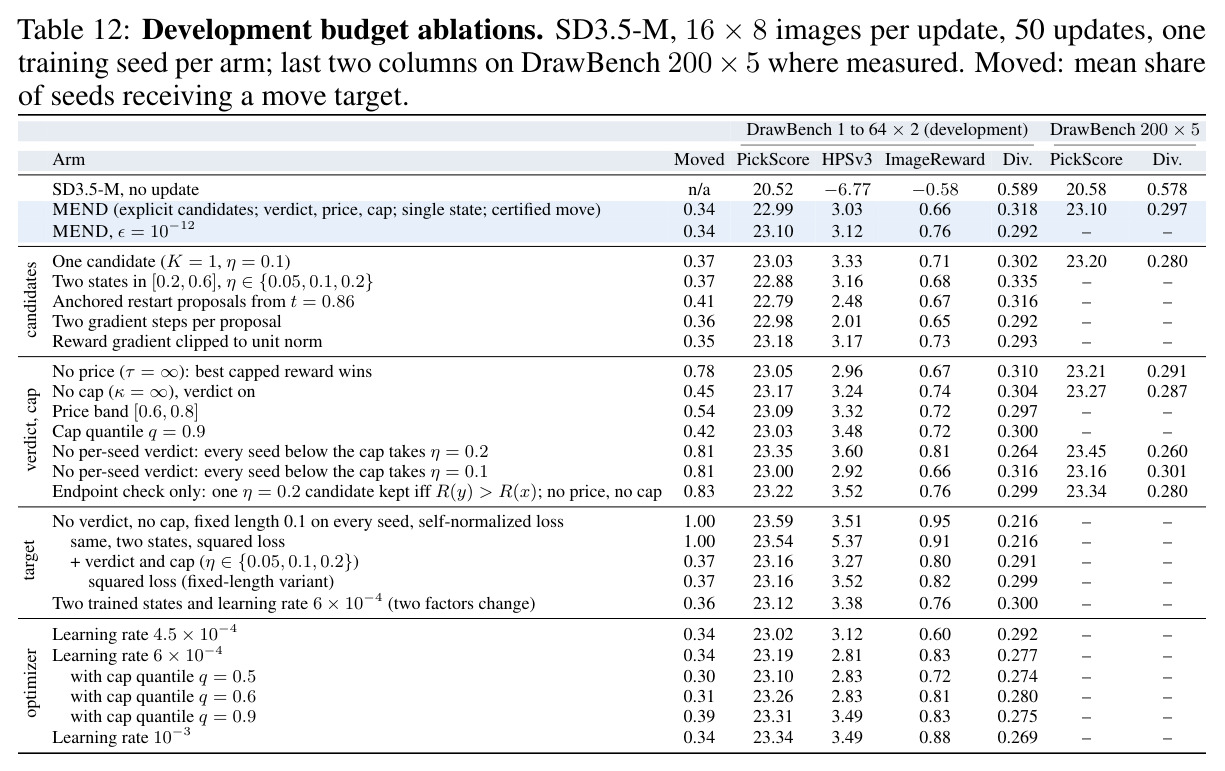
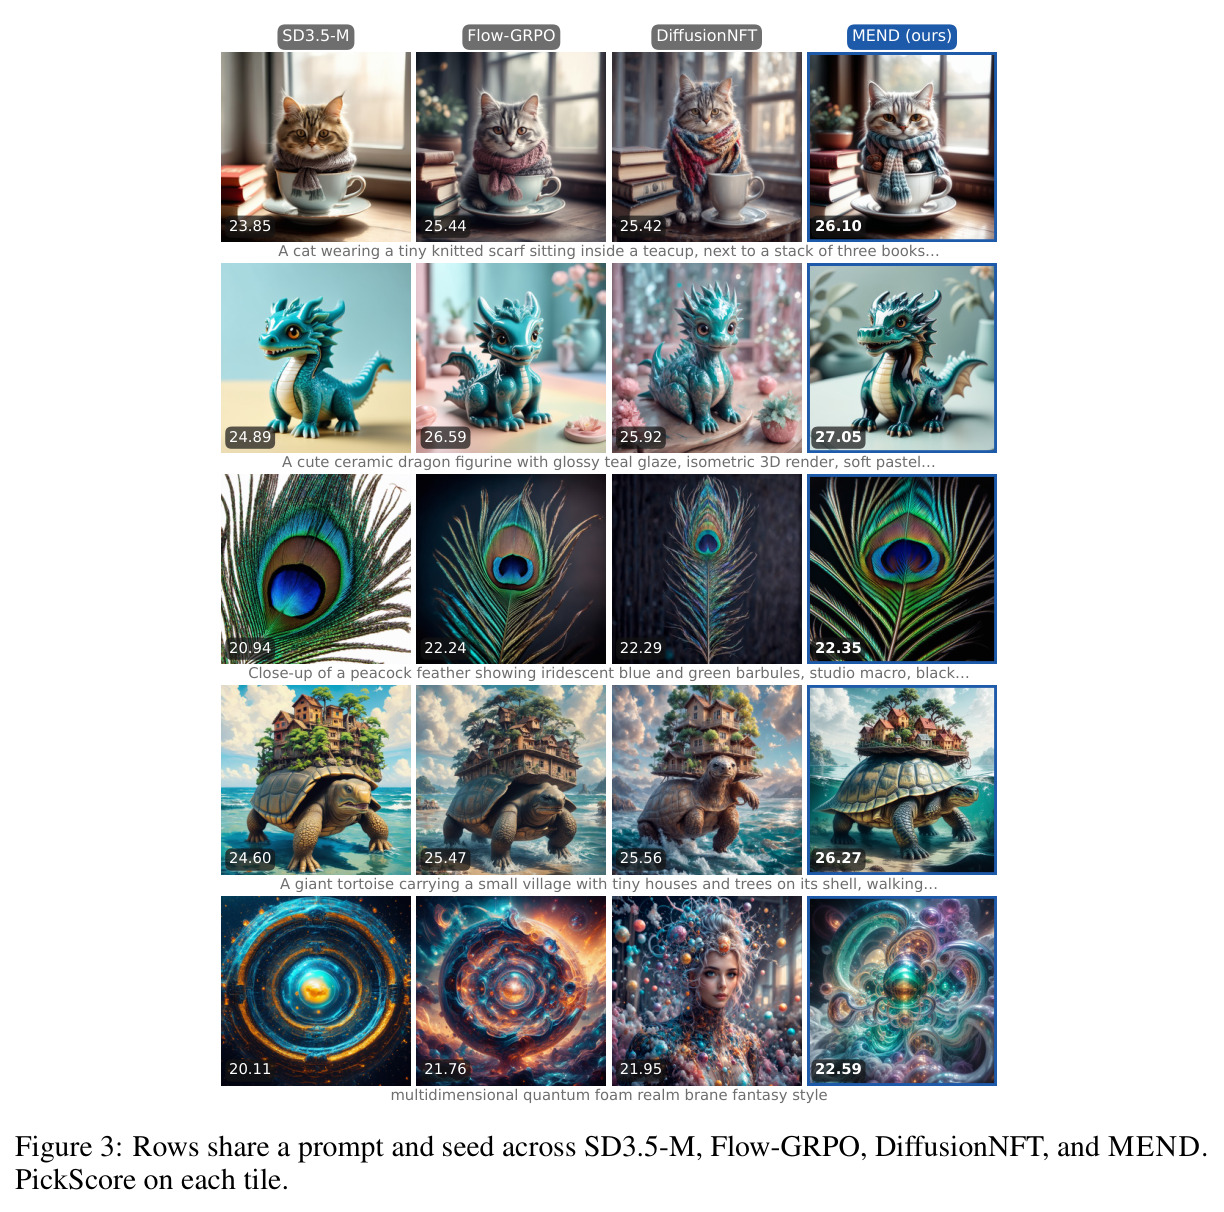
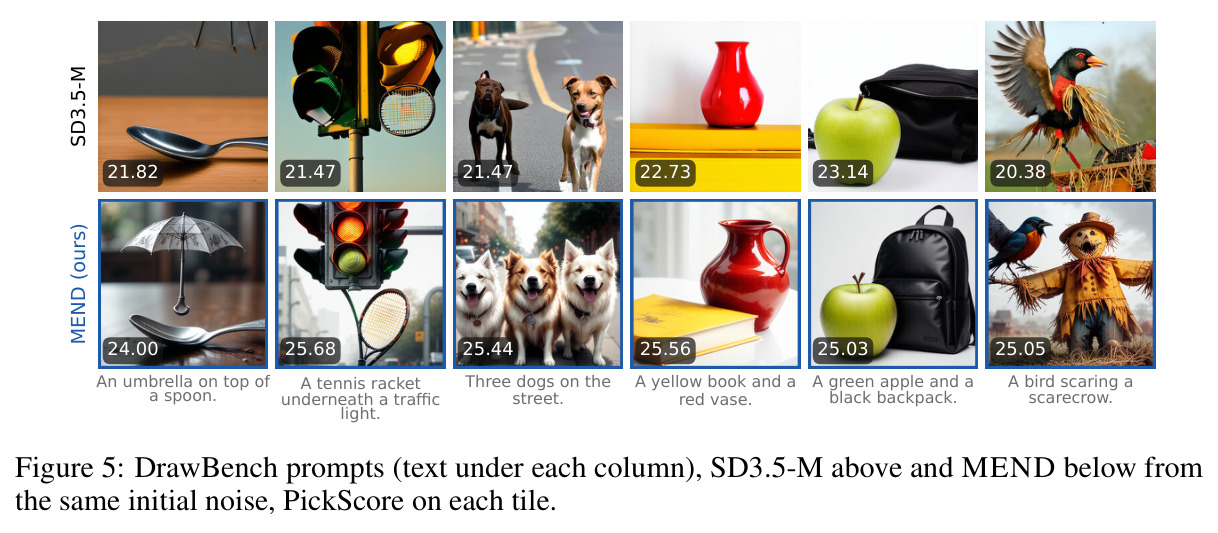
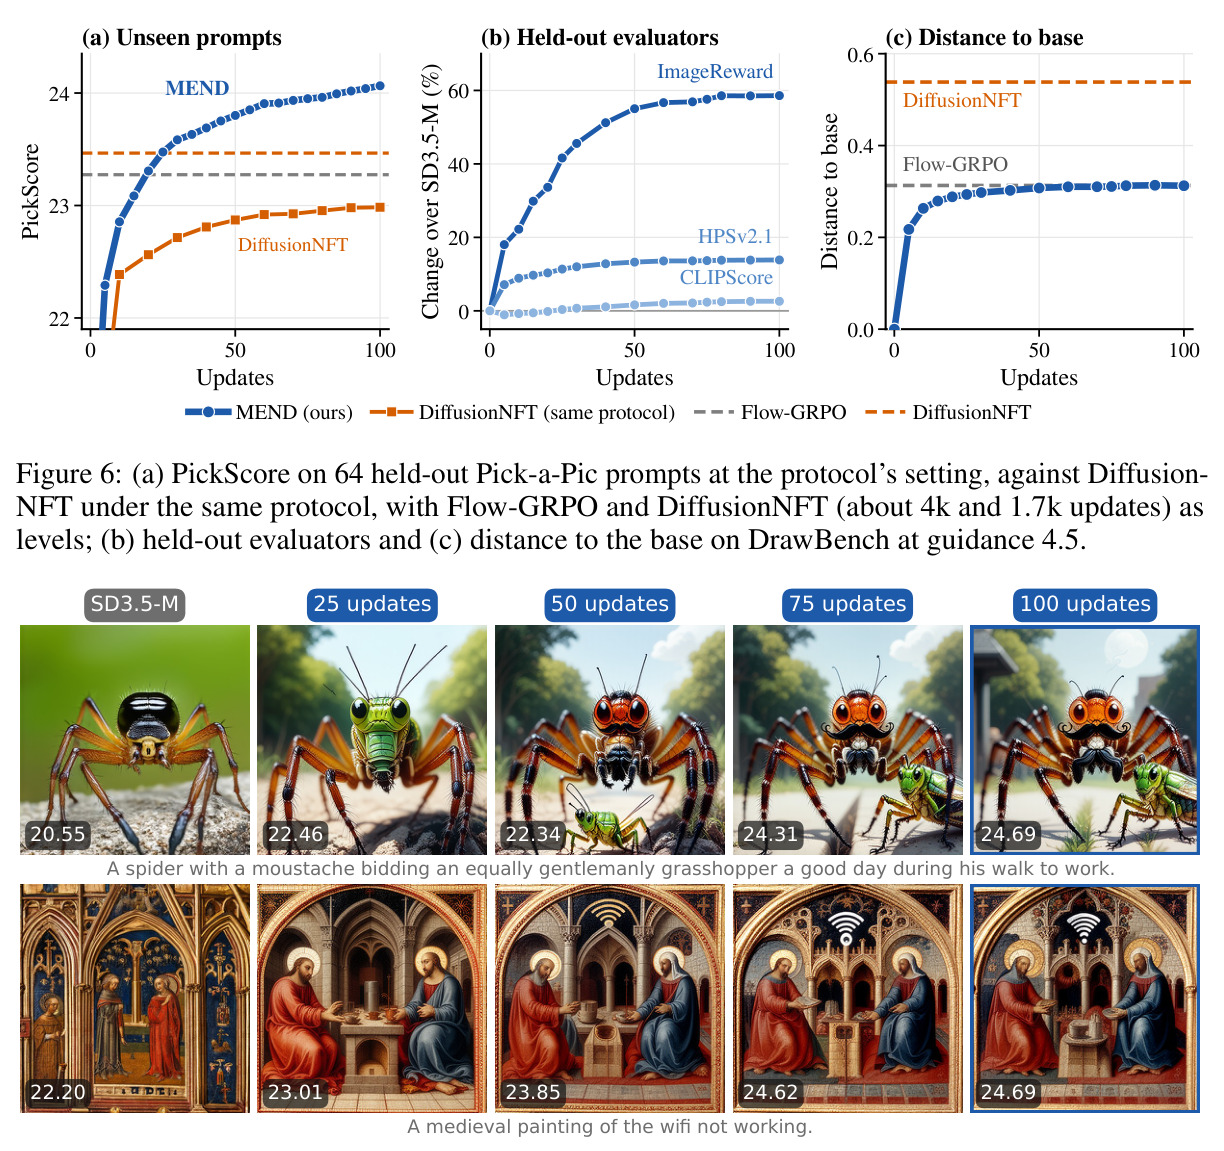
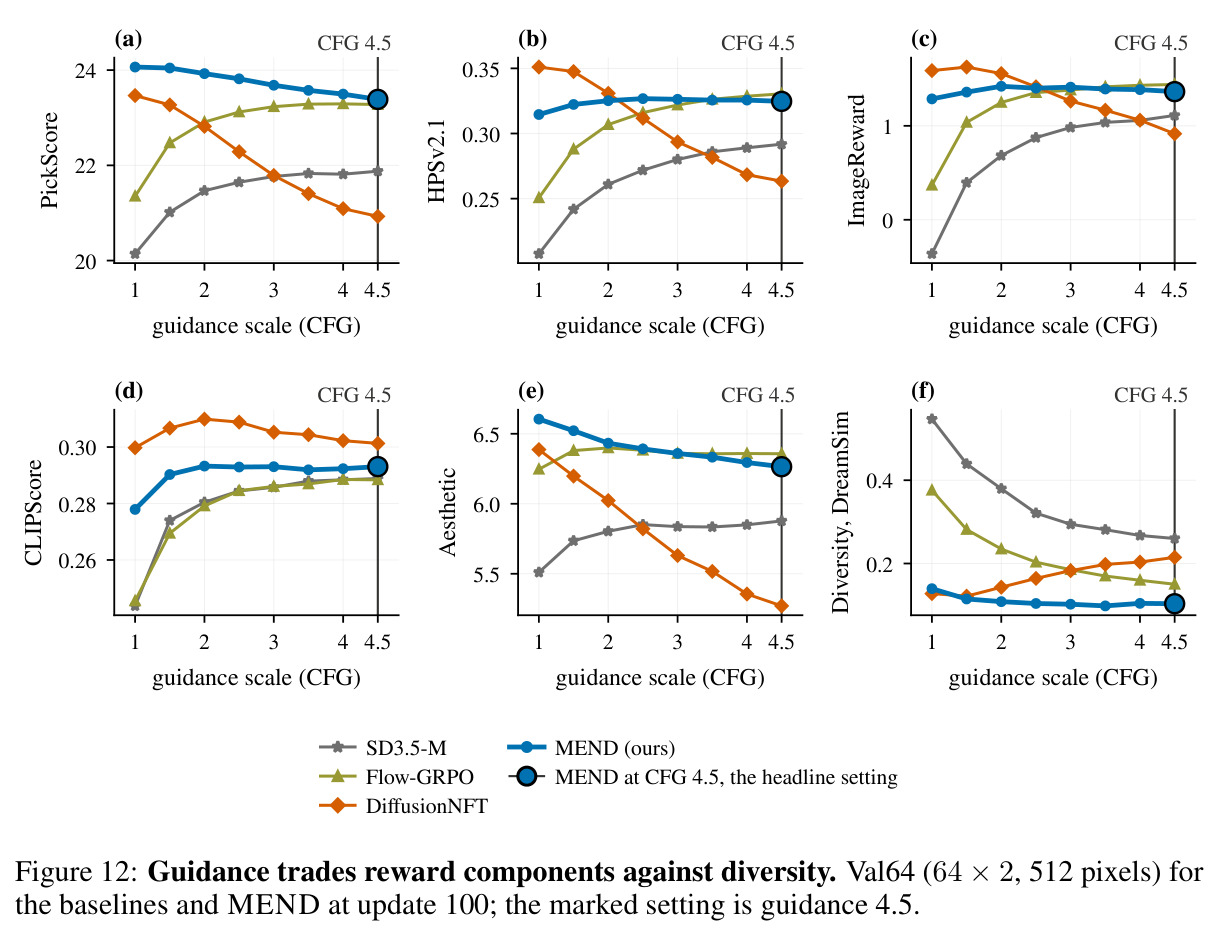
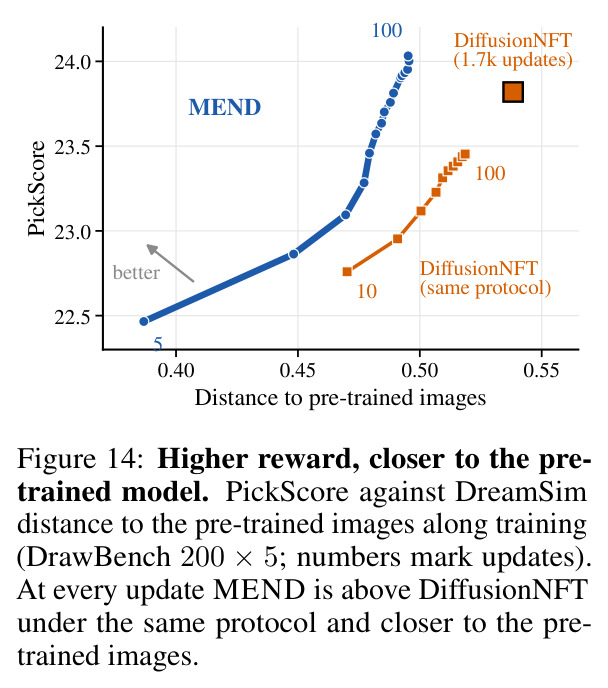
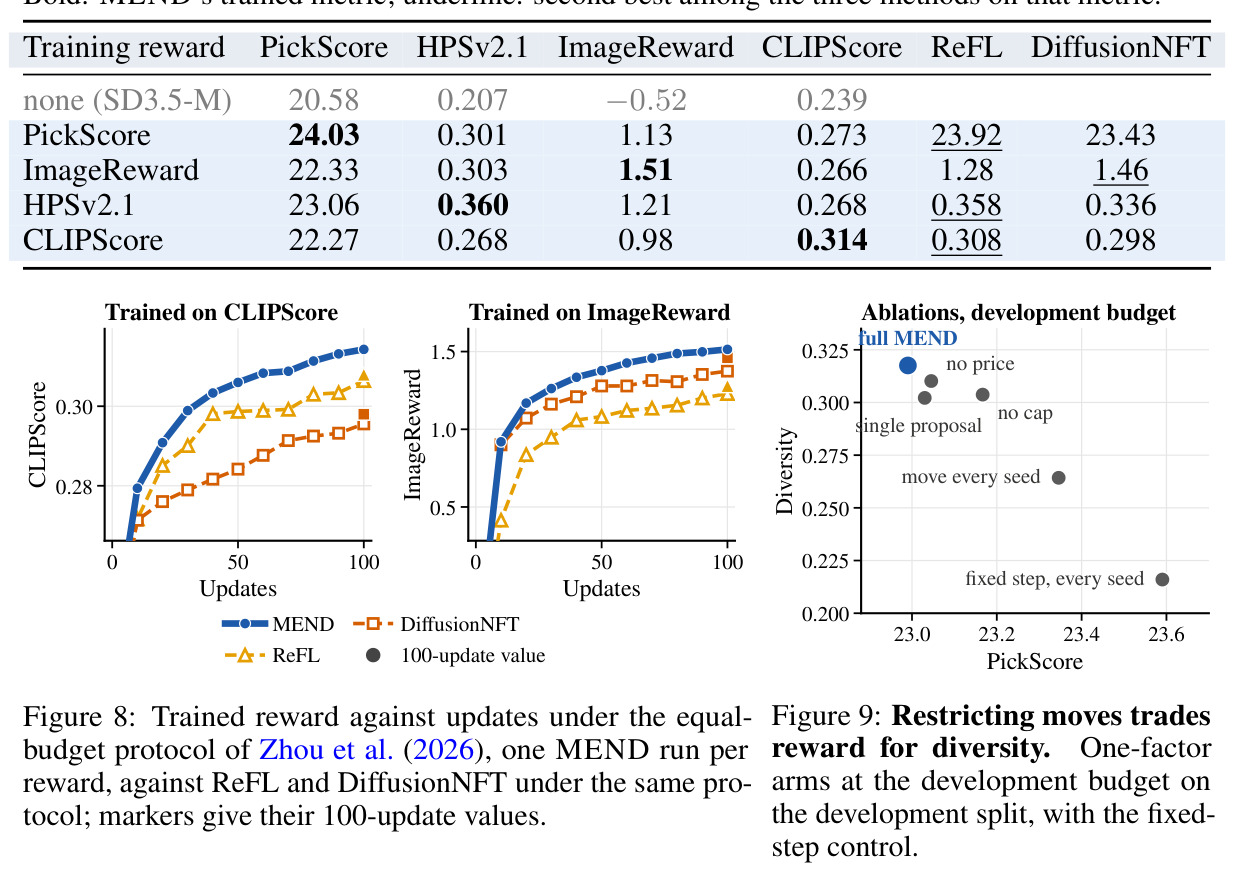
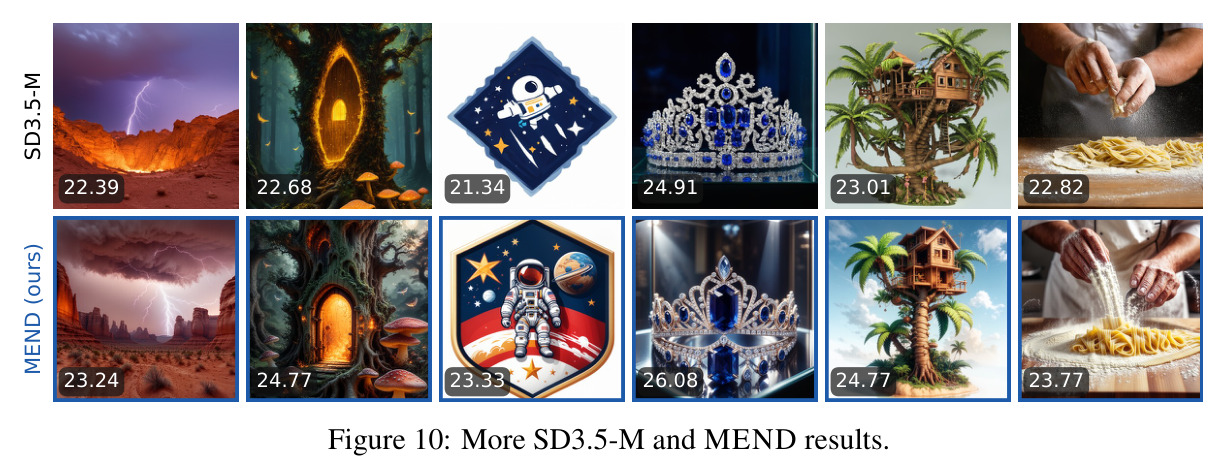
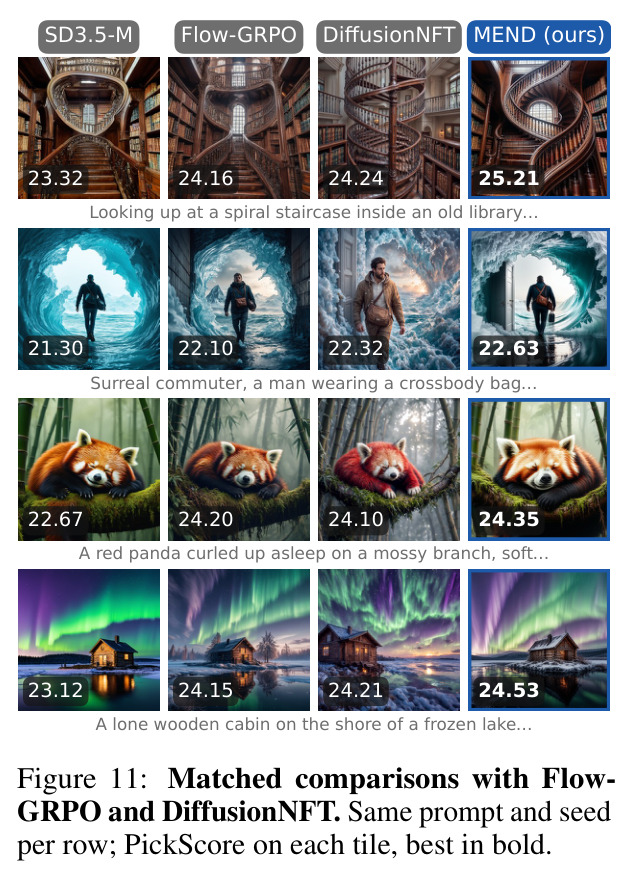
第一组实验对比 Flow-GRPO PickScore 适配器(约 4k 更新):100 更新的 MEND 在相同基模型距离 0.313 下于六个评估器中的五个领先——PickScore 23.70 对 23.52、HPSv2.1 0.319 对 0.316、HPSv3 7.15 对 7.04、ImageReward 1.32 对 1.27、CLIPScore 0.291 对 0.280,仅 Aesthetic 5.88 对 5.90 落后(Table 2),而更新次数少约 40 倍。第二组:三奖励(PickScore+HPSv2.1+CLIPScore)300 更新的 MEND 在它训练的三个指标上全面超过五奖励、1.7k 更新的 DiffusionNFT——PickScore 23.89 对 23.82、HPSv2.1 0.344 对 0.331、CLIPScore 0.300 对 0.292,且基距离更小(0.488 对 0.538);未训练的 HPSv3(5.87 对 7.50)、ImageReward(1.28 对 1.49)、Aesthetic(5.92 对 6.02)更低,符合预期。第三组是等预算协议(Zhou et al. 2026,guidance 1):MEND 100 更新达到 PickScore 24.03,超过 ReFL 的 23.92 和 DiffusionNFT 的 23.43,且在每个被评估的更新点都领先(Figure 1b);在 64 个未见过的 Pick-a-Pic 提示上对同协议 DiffusionNFT 每个评估更新都占优,第 25 更新就已超过 Flow-GRPO(23.52)和 DiffusionNFT(23.82)的最终水平;25 到 100 更新间 DrawBench PickScore 从 23.36 升到 23.70 而基距离仅从 0.294 移到 0.313,说明后期奖励增长几乎不牺牲保真度;训练总成本 10.0 GPU 小时(3 块 GB200),同一配置二次启动在更新 50 处仅差 0.01 PickScore。第四组(Table 3):四个单奖励运行全部超过两个基线——PickScore 24.03 对 23.92/23.43,ImageReward 1.51 对 1.28/1.46,HPSv2.1 0.360 对 0.358/0.336,CLIPScore 0.314 对 0.308/0.298。第五组跨骨干:SD3-M 的 PickScore 从 20.36 升到 23.70(Linear-DPO 只有 20.96),held-out HPSv2.1 从 0.215 到 0.298;蒸馏 9 步的 Z-Image-Turbo 在 1024 像素下 PickScore 从 22.86 到 24.10,held-out HPSv2.1 从 0.295 到 0.315。消融(Table 12):完整规则每轮接受 34% 的种子,dev 预算 PickScore 23.10、多样性 0.297;去掉封顶接受率升至 45%、多样性降到 0.287;去掉价格升至 78%、多样性 0.291;封顶下每个种子都移动(81%)得到最高的全量 PickScore 23.45 但多样性最低 0.260——即封顶加价格用 0.35 PickScore 换回 0.037 多样性。全预算敏感性(Table 13)显示初始价格、单候选、去 EMA 的影响至多 0.06,而五个候选会损失 0.25。附加 held-out 检查:GenEval 在 guidance 1 下 0.62 对基座 0.32;guidance 4.5 下与 Flow-GRPO 持平(0.74 对 0.74)但 OCR 0.53 低于 0.68。定性上,同种子对比中 MEND 修正了基座在计数、属性绑定和空间关系上的错误(如三只狗、黄色书与红色花瓶、雨伞在勺子上)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文本到图像奖励后训练(等预算协议,DrawBench 200×5) | PickScore | 24.03(100 更新) | ReFL 23.92;DiffusionNFT 23.43(均 100 更新) | +0.11 / +0.60,且在每个评估更新点都领先 |
| 对比 Flow-GRPO(guidance 4.5,基距离 0.313) | PickScore | 23.70(100 更新) | Flow-GRPO 23.52(约 4k 更新) | +0.18,更新次数少约 40 倍 |
| 对比 Flow-GRPO(同上设置) | HPSv2.1 / HPSv3 / ImageReward / CLIPScore | 0.319 / 7.15 / 1.32 / 0.291 | 0.316 / 7.04 / 1.27 / 0.280 | 四项 held-out 全部领先 |
| 三奖励训练 vs DiffusionNFT 五奖励模型 | HPSv2.1 | 0.344(300 更新) | DiffusionNFT 0.331(1.7k 更新) | +0.013,且基距离更小(0.488 对 0.538) |
| ImageReward 单奖励训练(等预算) | ImageReward | 1.51 | ReFL 1.28;DiffusionNFT 1.46 | +0.23 / +0.05 |
| HPSv2.1 单奖励训练(等预算) | HPSv2.1 | 0.360 | ReFL 0.358;DiffusionNFT 0.336 | +0.002 / +0.024 |
| CLIPScore 单奖励训练(等预算) | CLIPScore | 0.314 | ReFL 0.308;DiffusionNFT 0.298 | +0.006 / +0.016 |
| SD3-M 骨干迁移 | PickScore | 23.70(基座 20.36) | Linear-DPO 20.96 | 高出 Linear-DPO 2.74 |
| Z-Image-Turbo 蒸馏骨干(9 步,1024 像素) | PickScore / HPSv2.1 | 24.10 / 0.315(基座 22.86 / 0.295) | Z-Image-Turbo 基座 22.86 / 0.295 | +1.24 / +0.020 |
局限与改进
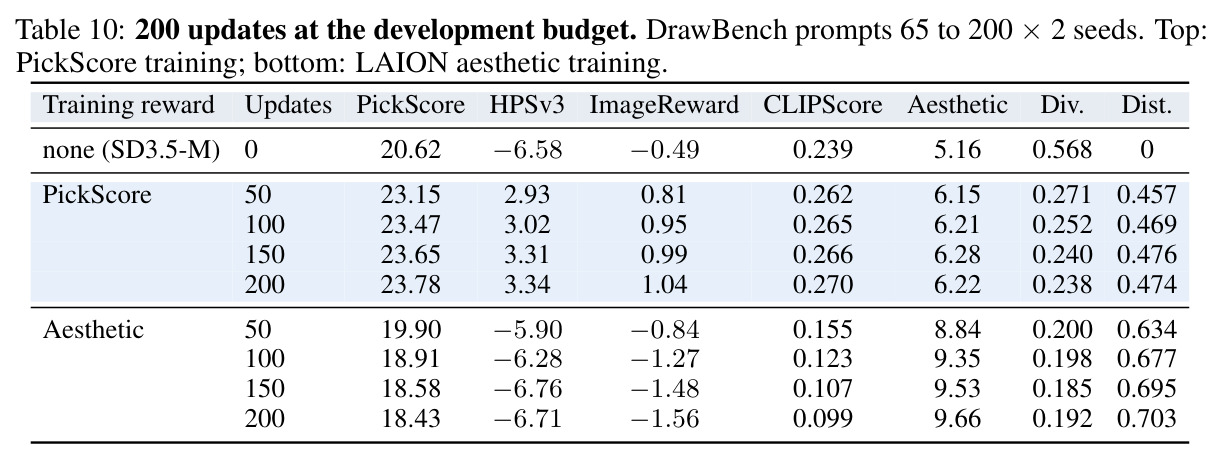
作者明确承认的局限有三条:其一,MEND 要求奖励可微,不可微的奖励只能退回重加权路线;其二,理论保证只覆盖每轮构造的目标,不覆盖有限步的 AdamW 更新或整个训练轨迹(Remark 1 明确说参数更新本身不是近端的,共享参数也会改变被保留的样本);其三,更长训练会过度优化单个奖励,部分单奖励运行在 100 更新预算内就出现 held-out 分数先降后升。我自己的观察补充如下。第一,验证机制对错误奖励不设防:F.4 的玩具实验显示,当学习到的奖励在样本可达的方向上系统性错误时,从第 16 轮起 MEND 也会认证离开数据分布的移动,18 轮后被梯度上升反超——封顶只是把漂移推迟(15 轮内离数据质量至多 0.0003,对比梯度上升的 16%),并不能纠正错误奖励本身;LAION aesthetic 训练的崩溃(aesthetic 5.16→9.66,PickScore 20.62→18.43,CLIPScore 0.239→0.099)是同一问题在真实奖励上的体现。第二,单奖励训练的 held-out 代价真实存在:CLIPScore 和 ImageReward 训练的 held-out PickScore 只有 22.27 和 22.33,远低于 PickScore 训练的 24.03,说明奖励间冲突并未被机制化解。第三,多样性整体仍低于基座(guidance 4.5 下 0.144 对 0.325),与基线的多样性对比部分依赖等预算设定。第四,对 OCR 类细粒度文本渲染有损(0.53 对 Flow-GRPO 的 0.68)。第五,每轮需要 $G$ 条 rollout 加每样本至多 3 次解码和奖励前向,奖励推理开销不可忽略;接受率带 [30%, 60%] 也是启发式设定。
独立分析的弱点
弱点一:对奖励模型的系统性错误完全不设防。验证只对训练奖励认证增益,软错误奖励(如 LAION aesthetic 预测器)会在 200 更新内把其他评估器全部拖垮(aesthetic 5.16→9.66,PickScore 20.62→18.43,CLIPScore 0.239→0.099),而封顶只能延迟不能阻止。改进方向:引入多奖励联合验证(候选需在多个奖励上同时通过价格检验)、对封顶增益做 held-out 一致性抽查、或按奖励模型的不确定性给价格加噪声项。弱点二:固定档位 $\{0.1, 0.2, 0.4\}$ 太粗糙——1200 个记录种子中 33% 被认证且全部落在最短档 $\eta=0.1$,长档因奖励更低(而非仅价格更高)几乎从不被接受(F.1),说明搜索粒度不足且长档浪费解码预算。改进方向:线搜索式自适应步长或按接受率动态调整档位分布。弱点三:组内统计功效有限——协议每组只有 24 个样本,0.75 分位封顶的估计噪声大;全局下限 $\kappa_{glob}$ 只升不降,在长训练中可能过度收紧。改进方向:用跨轮收缩估计或贝叶斯分位估计封顶。弱点四:目标级保证与参数级现实脱节——作者自己承认(F.1),优化器步之后被验证器保留的种子移动得与被移动种子一样多,移动在认证方向上的投影中位数仅 0.001。改进方向:对保留样本加显式约束项,或按验证结果分组使用不同学习率。弱点五:所有验证都在 512/1024 像素、9-10 步的短 rollout 设置下进行,长轨迹、视频或 3D 流模型的适用性完全未验证。
未来方向
作者方向暗示的延伸:论文强调 MEND『便宜到可以每个新奖励或骨干重复一次』(10 GPU 小时),自然延伸是与奖励模型的在线更新、主动学习形成快速迭代闭环,以及扩展到更多模态(视频、3D 生成均为流模型)。基于成果可延伸的方向:第一,不可微奖励的验证框架——把『解码候选打分』保留、把梯度提议换成无梯度方向(参数化编辑方向、有限差分或代理模型梯度,类似论文引用的 FDFO 思路),验证规则本身不需要梯度。第二,多奖励约束优化——把标量封顶推广为向量奖励的 Pareto 前沿封顶,价格 $\tau$ 随奖励间冲突自动调整,以缓解本文观察到的单奖励训练 held-out 下降。第三,理论深化——把 Proposition 4 的 held-out 传递性从线性化的提示投影提升到奖励值本身,并研究有限 AdamW 步下的累积误差界,回应对 Remark 1 的缺口。第四,错误奖励下的防线——玩具实验揭示了『封顶延迟漂移』现象,可以在价格项中加入数据密度或多样性依赖的分量,或周期性把行为模型拉回基模型的信任域。第五,自适应提议几何——目前提议严格沿单点奖励梯度,可以引入组内共享方向或二阶信息(如 HPSv2.1 与 PickScore 冲突时的折中方向)。第六,把接受率控制器从启发式带状调节换成理论导出的步长调度。
复现评估
复现条件总体友好。代码:摘要和正文标注了 Code 链接(承诺开源;使用前需确认仓库已实际发布)。数据全部公开:训练只用 Pick-a-Pic 的提示词(每更新 48 个提示 × 24 张图),评估用 DrawBench(200 提示 × 5 种子)、val64 held-out 集和 GenEval/OCR 脚本(沿用 Flow-GRPO 官方实现)。协议对齐工作做得非常扎实:基线数字取自 Zhou et al. (2026) 的 Protocol O 并在自家管线中复现校准(SD3.5-M 20.58 对原文 20.51,Flow-GRPO 适配器 23.52 对 23.53,DiffusionNFT 同协议 23.45 对 23.43),附录 B 逐图表列出了每张图每张表的确切设置。实现细节完整:rank-32 LoRA、10 步确定性 rollout、$t_q=0.278$、$q=0.75$、$\eta\in\{0.1,0.2,0.4\}$、$\lambda_{keep}=10$、学习率 $3\times10^{-4}$、$\mu_u=\min(0.001u,0.5)$、$\tau$ 接受率带 [30%,60%],附录 A 给出与实现完全一致的伪代码,附录 F 的消融和敏感性表格粒度很细。算力:主结果 10.0 GPU 小时(3 块 GB200,不含评估),单节点可负担,但在 A100/H100 上需按算力折算数倍时长。难度评估:中等偏低——方法组件少、无 KL/参考模型/优势估计,主要工程量在奖励反传管线与批量解码;风险点主要是多处 guidance 设置(1 与 4.5 并存)容易错配,照抄附录 B 的逐图表对照表即可避免;另需注意奖励评估的实现差异会直接影响封顶与验证的结果。
论文图表
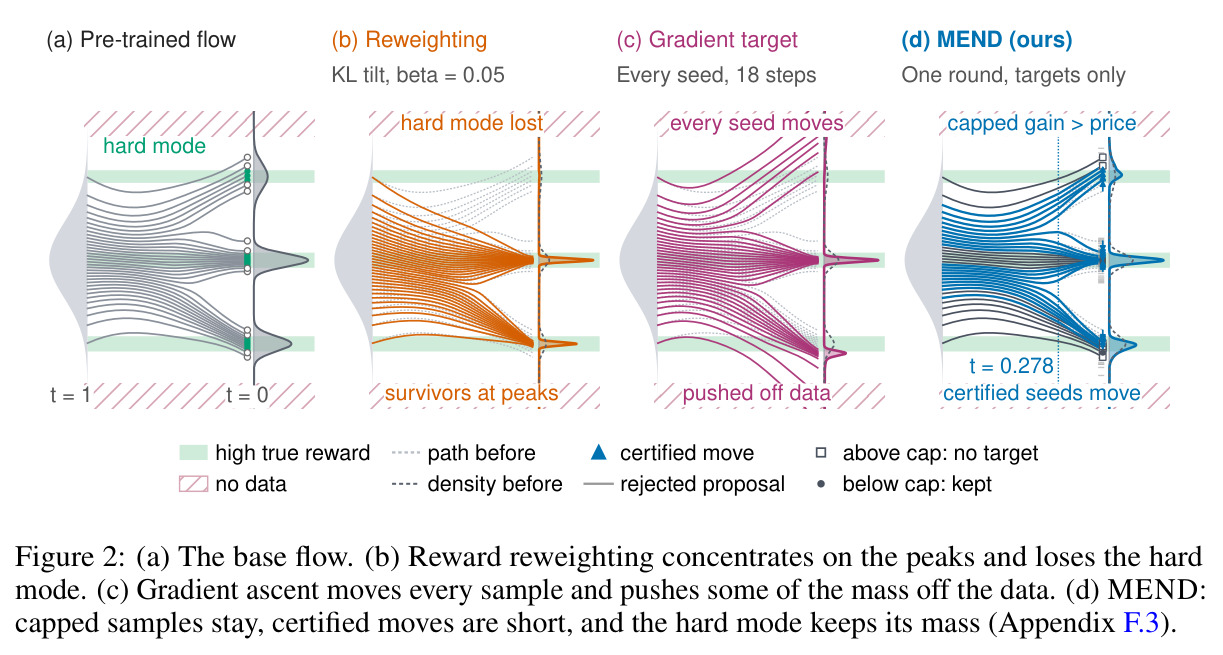
一维三高斯玩具模型上的四种机制对比:(a) 预训练整流流的路径与数据密度;(b) KL 倾斜(β=0.05)把质量集中到峰顶并丢失『难模式』;(c) 18 步梯度上升使每个种子都移动,把部分质量推出数据分布;(d) MEND 一轮后的目标:封顶样本原地不动、被认证的移动很短、难模式保持质量(t=0.278 处标注了认证移动的例子)。
这是动机部分的核心示意图,直观展示了现有两类方法的失败模式与 MEND 如何同时避免它们,配合 F.3 的定量数字(模式质量 0.218/0.430/0.353 对训练前 0.217/0.430/0.350)。
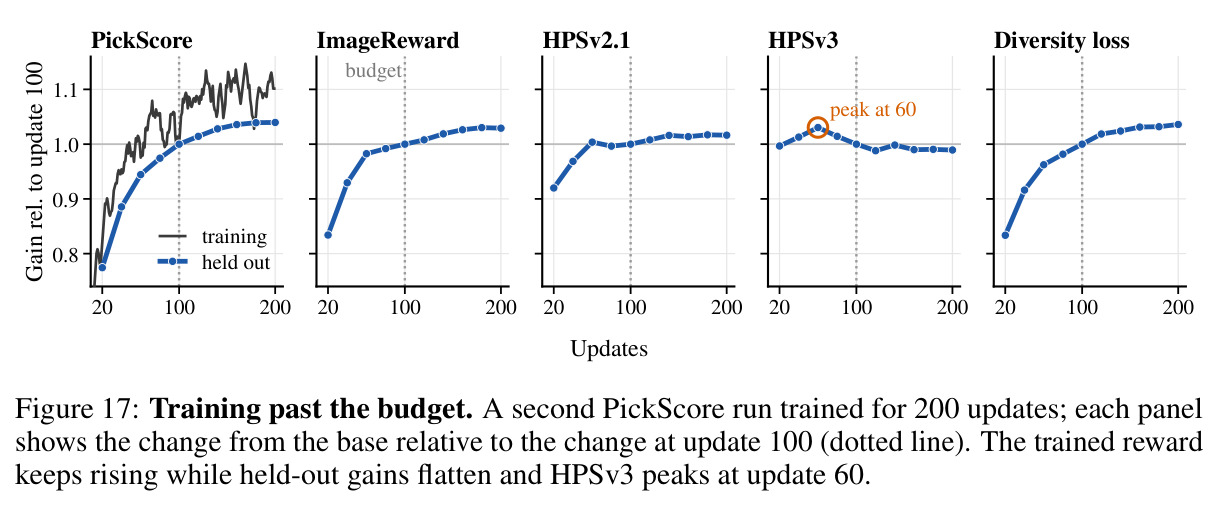
第二次 PickScore 训练延长到 200 更新的五面板图:训练奖励持续上升,held-out 增益趋平,HPSv3 在第 60 更新见顶,多样性损失持续。每面板显示相对第 100 更新的变化(虚线)。
直观展示过度优化的时间线:训练奖励与 held-out 质量脱节的拐点,是理解 100 更新预算合理性的关键证据。
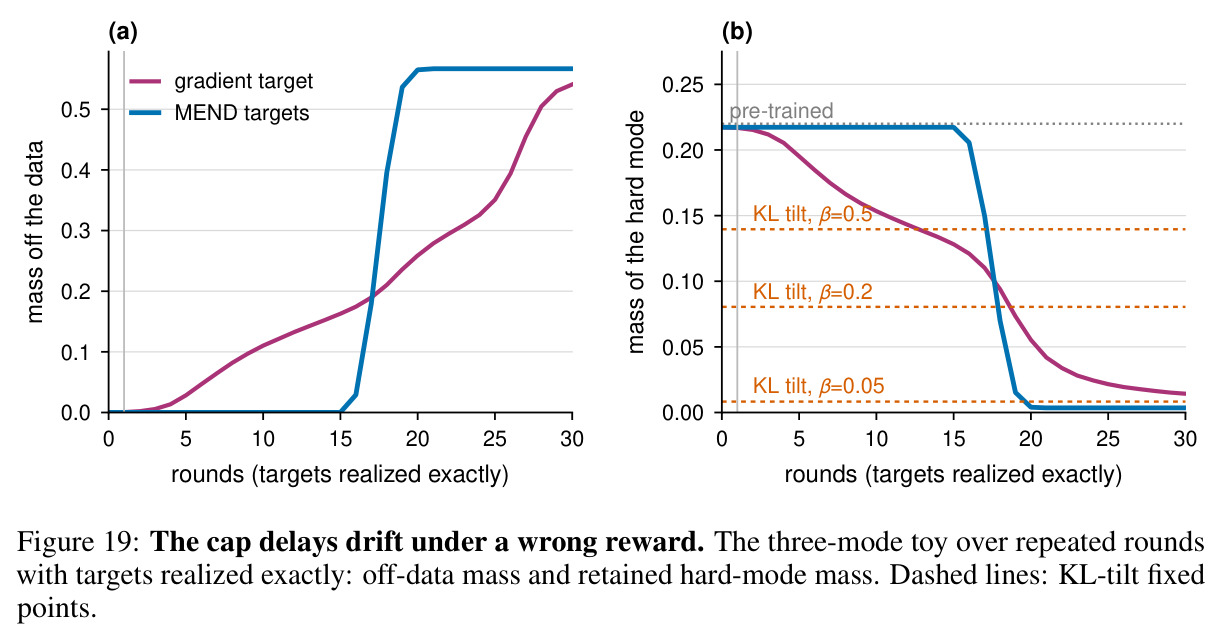
玩具模型多轮实验:(a) 离数据质量与 (b) 难模式保留质量随轮数变化(目标被精确实现)。15 轮内 MEND 离数据质量至多 0.0003 且保住全部模式;梯度上升移出 16% 质量并排空难模式;KL 倾斜(β=0.2/0.05)收敛到丢失难模式的不动点。但从第 16 轮起错误奖励也开始认证离数据移动,18 轮后 MEND 被反超。
诚实展示方法的边界:封顶只能延迟、不能纠正错误奖励导致的漂移,这直接支撑局限性的核心讨论。