实体替换响应的跨提示词复用:保真度、关系选择性与注入形式 Cross-Prompt Reuse of Entity-Replacement Responses
量化实体替换激活响应跨问题迁移的保真度、关系选择性与注入形式
前置知识
实体替换响应
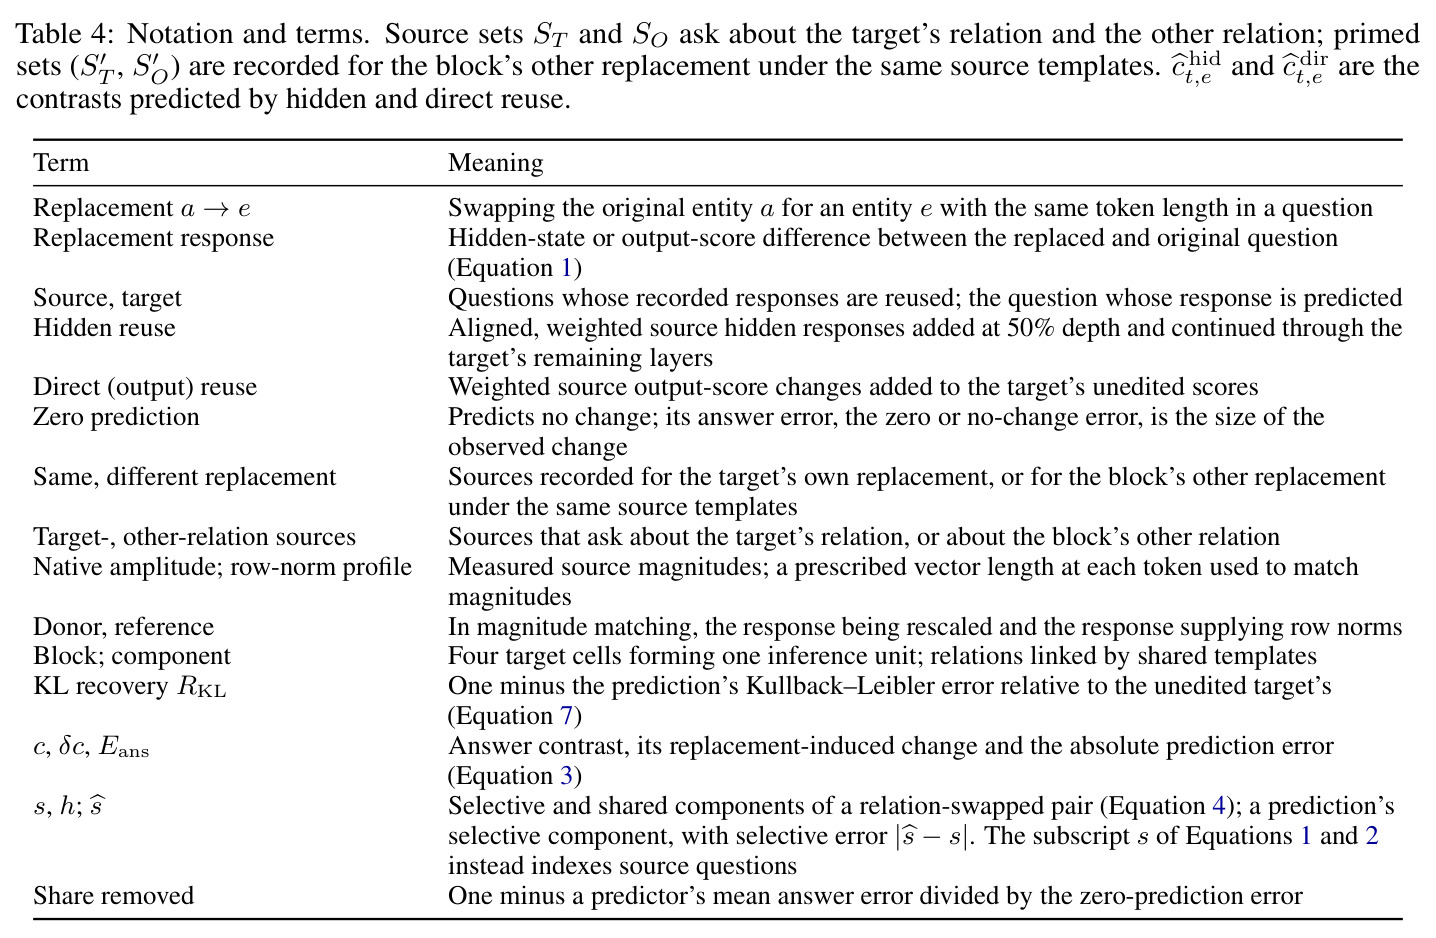
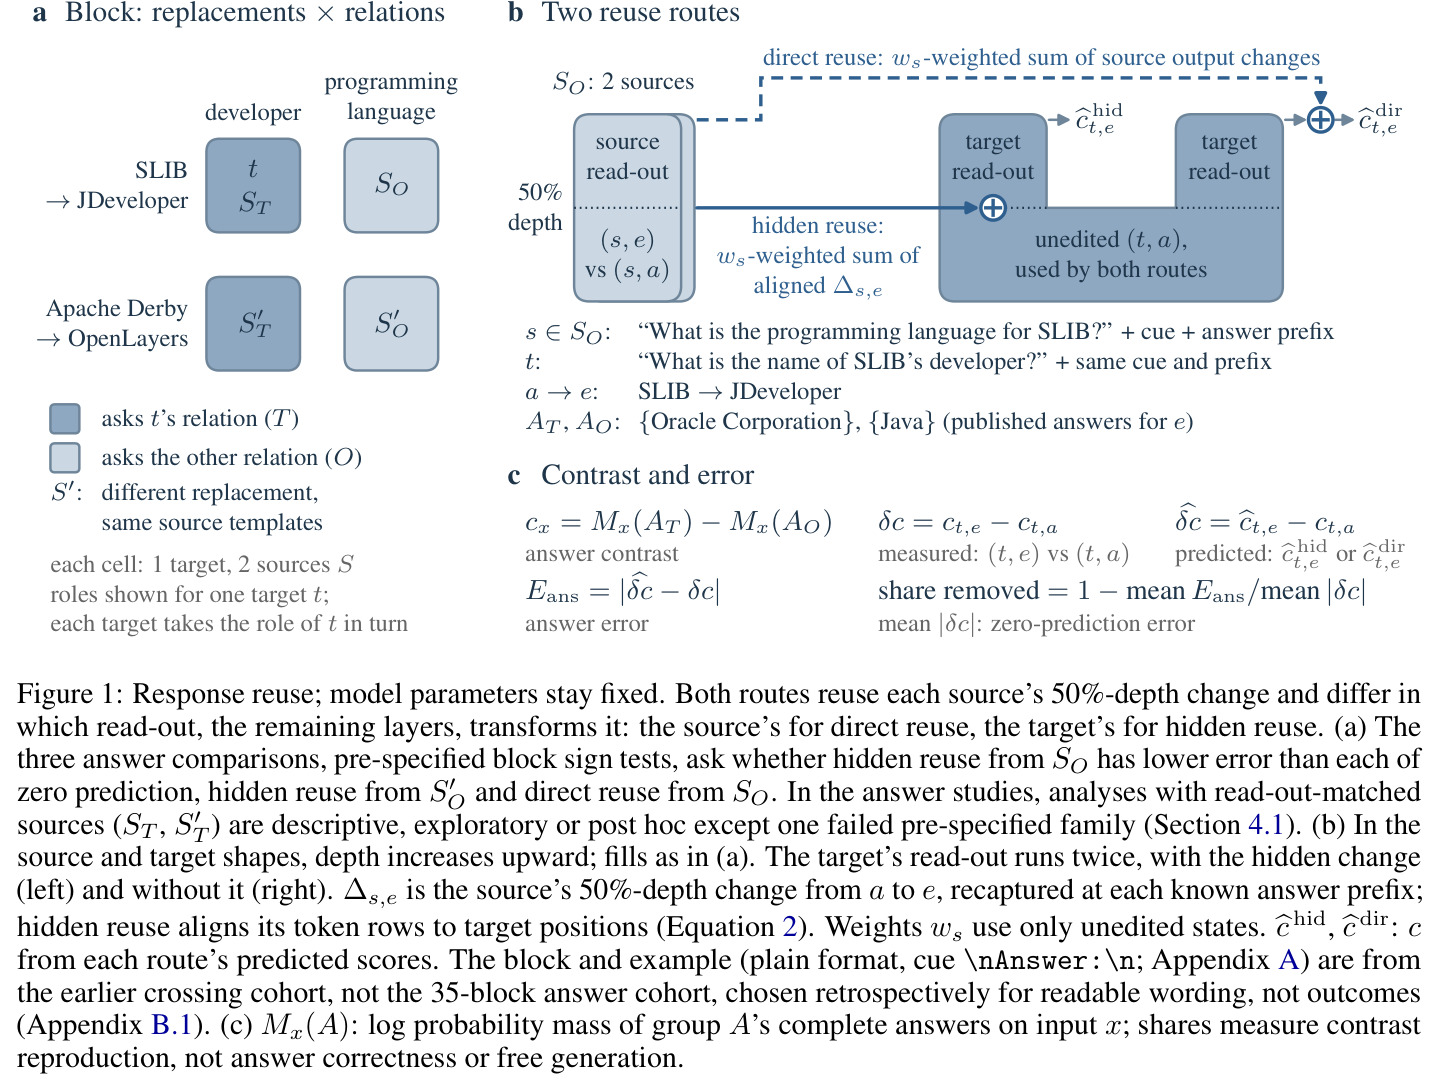
把事实问题中的主语实体替换为另一个实体(如把 SLIB 换成 JDeveloper),模型隐藏状态或输出分数因此产生的变化被定义为实体替换响应:$\Delta_{s,e} = H_\ell(s,e) - H_\ell(s,a)$。它是对「该实体贡献了什么」的因果度量,本文把它当作可以在问题之间搬运、再读出的对象。
本文的全部「复用」实验都以这个响应为迁移对象,理解它的定义与记录方式是读懂方法的前提。
答案对比度
对输入 $x$,把两个关系各自的发布答案集合 $A_T$、$A_O$ 的完整字符串对数概率质量求差:$c_x = M_x(A_T) - M_x(A_O)$,其中 $M_x(A) = \log \sum_{y \in A} p(y|x)$。替换实体引起的对比度变化 $\delta c = c_{t,e} - c_{t,a}$ 是本文量化迁移保真度的参照。
论文用预测对比度变化与真实变化的误差 $E_{ans} = |\hat{\delta c} - \delta c|$ 衡量复现程度,所有主结果都以「消除零预测误差的比例」表述。
激活迁移与函数向量
从若干提示中记录激活变化(steering vectors、function vectors、任务向量等),再以加权求和等方式加到新提示的中间层激活上,可以诱导相应行为或输出。机理研究普遍假设实体 token 处的中层变化可被另一个问题的后续层读出(Geva et al. 2023、Nanda et al. 2023)。
本文检验的正是这类方法究竟能复制目标提示自身响应的多大比例,而不只是答案是否改变。
BOS token
beginning-of-sequence 标记,Llama 与 Gemma 的分词器默认在输入前添加,而本文原始协议的 plain 格式刻意省略它。Gemma 系列对 BOS 极其敏感,缺失时行为会显著退化。
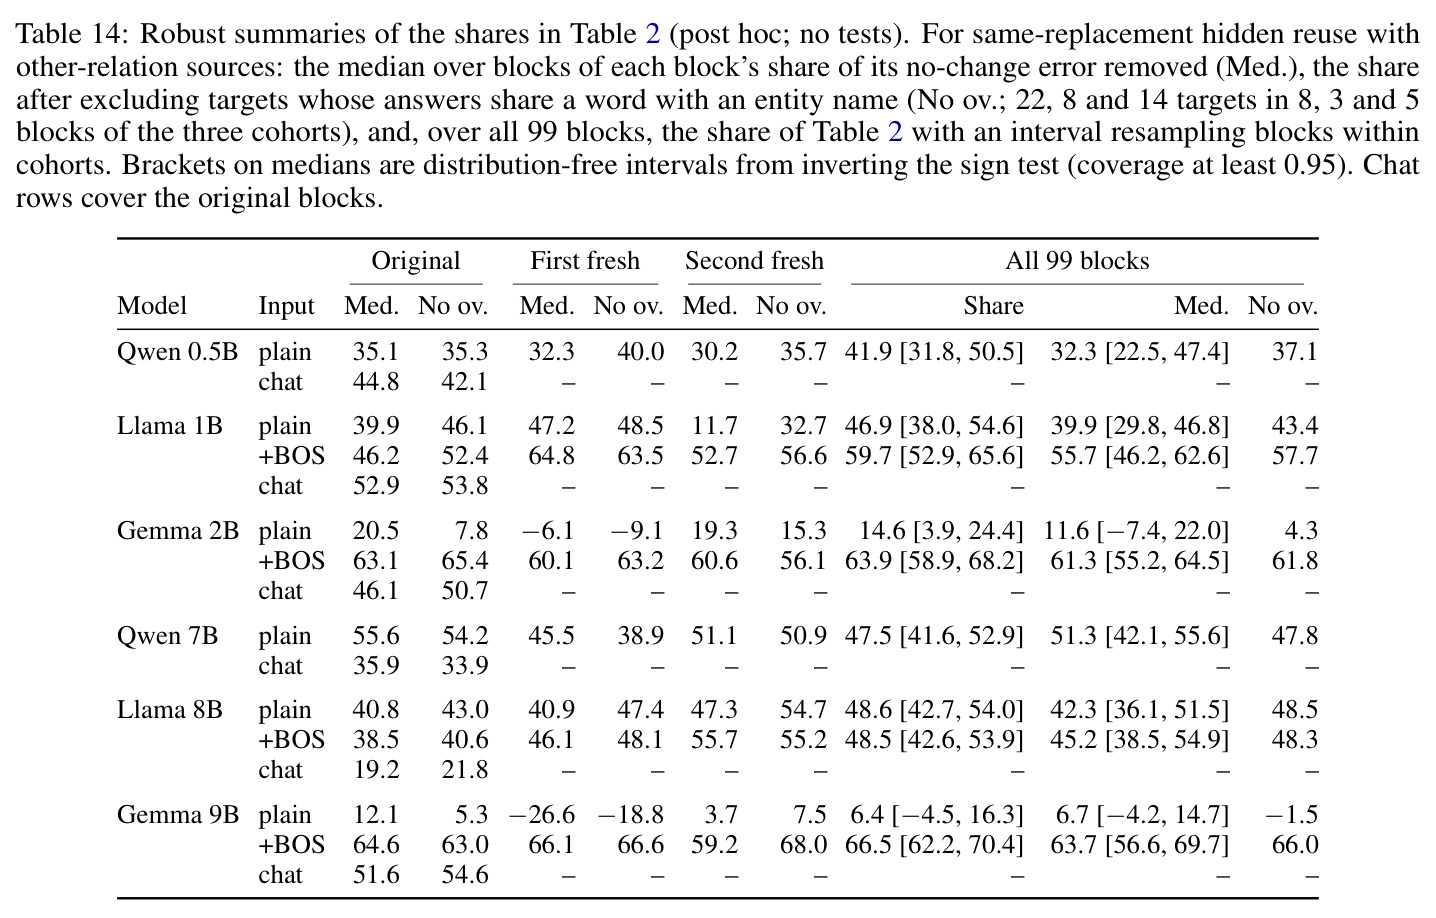
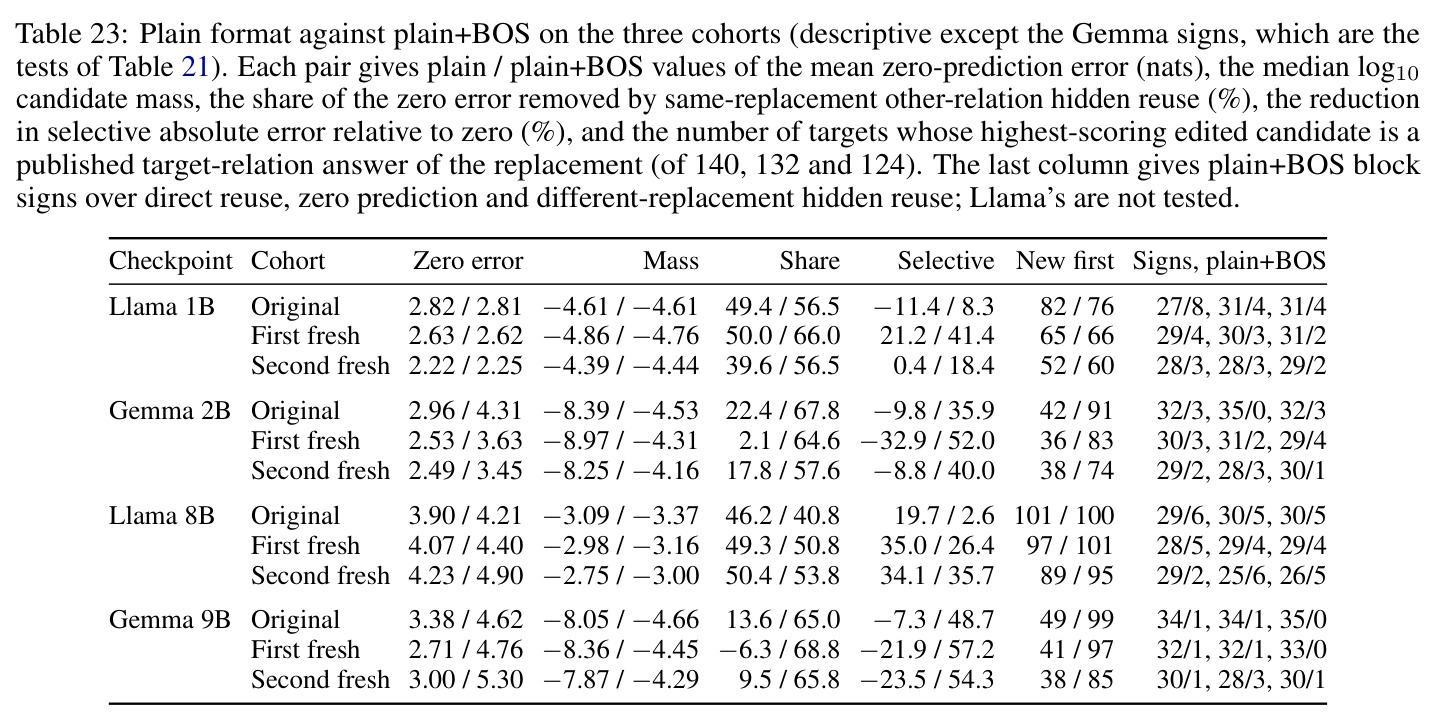
论文发现 plain 格式下 Gemma 只消除 2–22% 的零预测误差,恢复 BOS 后跃升至 58–69%,这是理解格式依赖性失败的关键变量。
共享成分与关系选择性成分
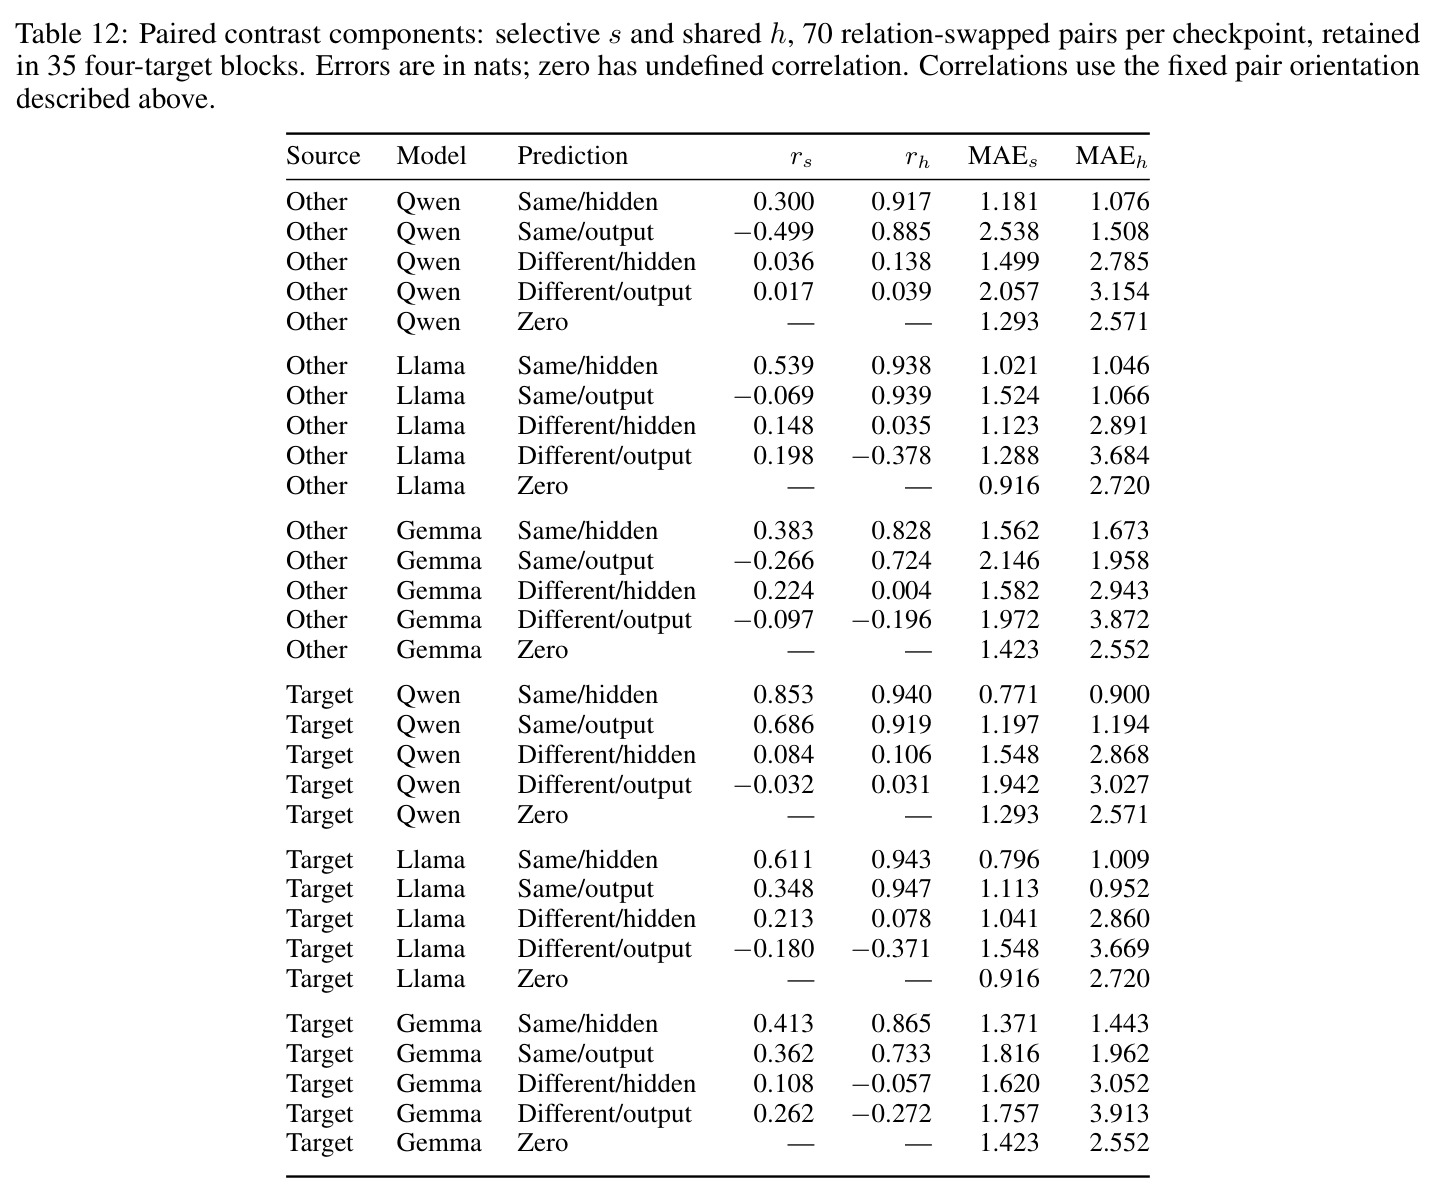
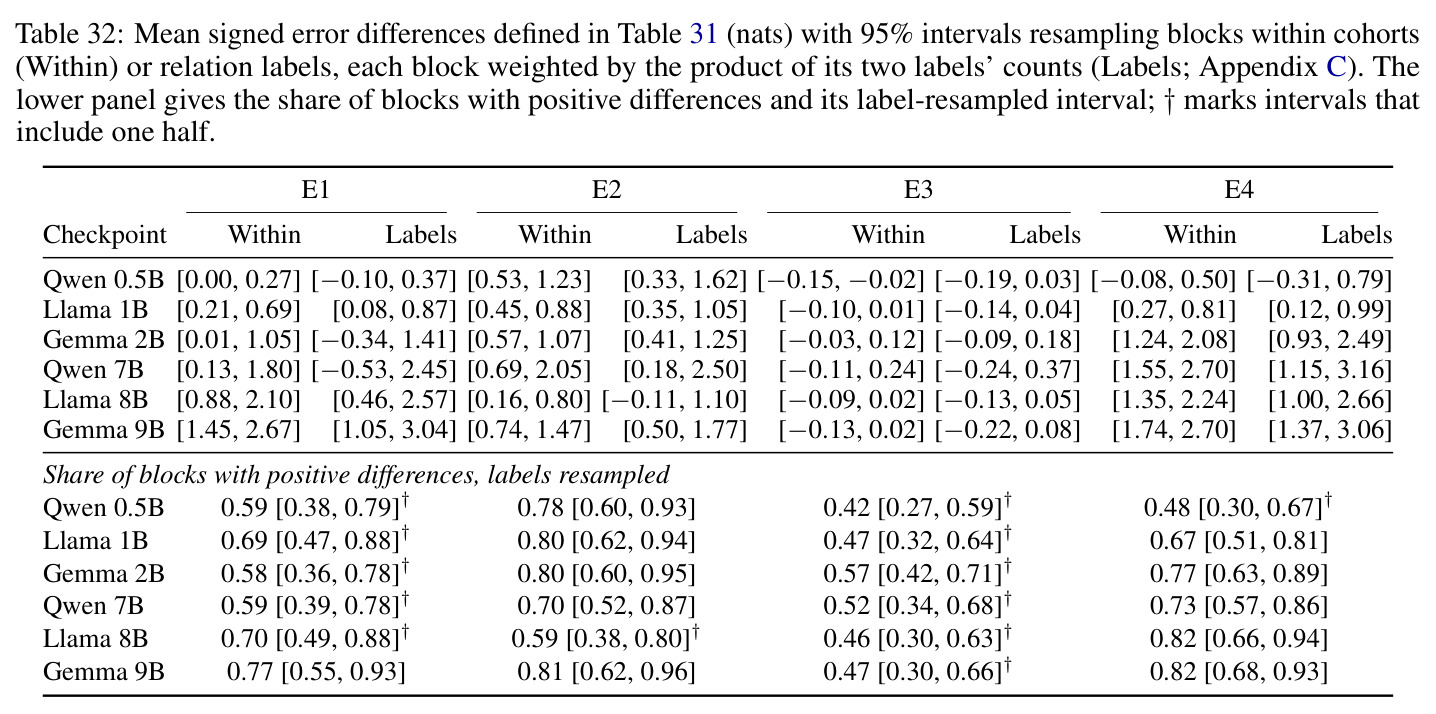
同一替换作用于两个关系互换的目标问题,产生对比度变化 $\delta c_1$、$\delta c_2$,可代数分解为 $s = (\delta c_1 + \delta c_2)/2$(各问题朝自己关系答案移动的部分)与 $h = (\delta c_1 - \delta c_2)/2$(两问题共享的移动)。
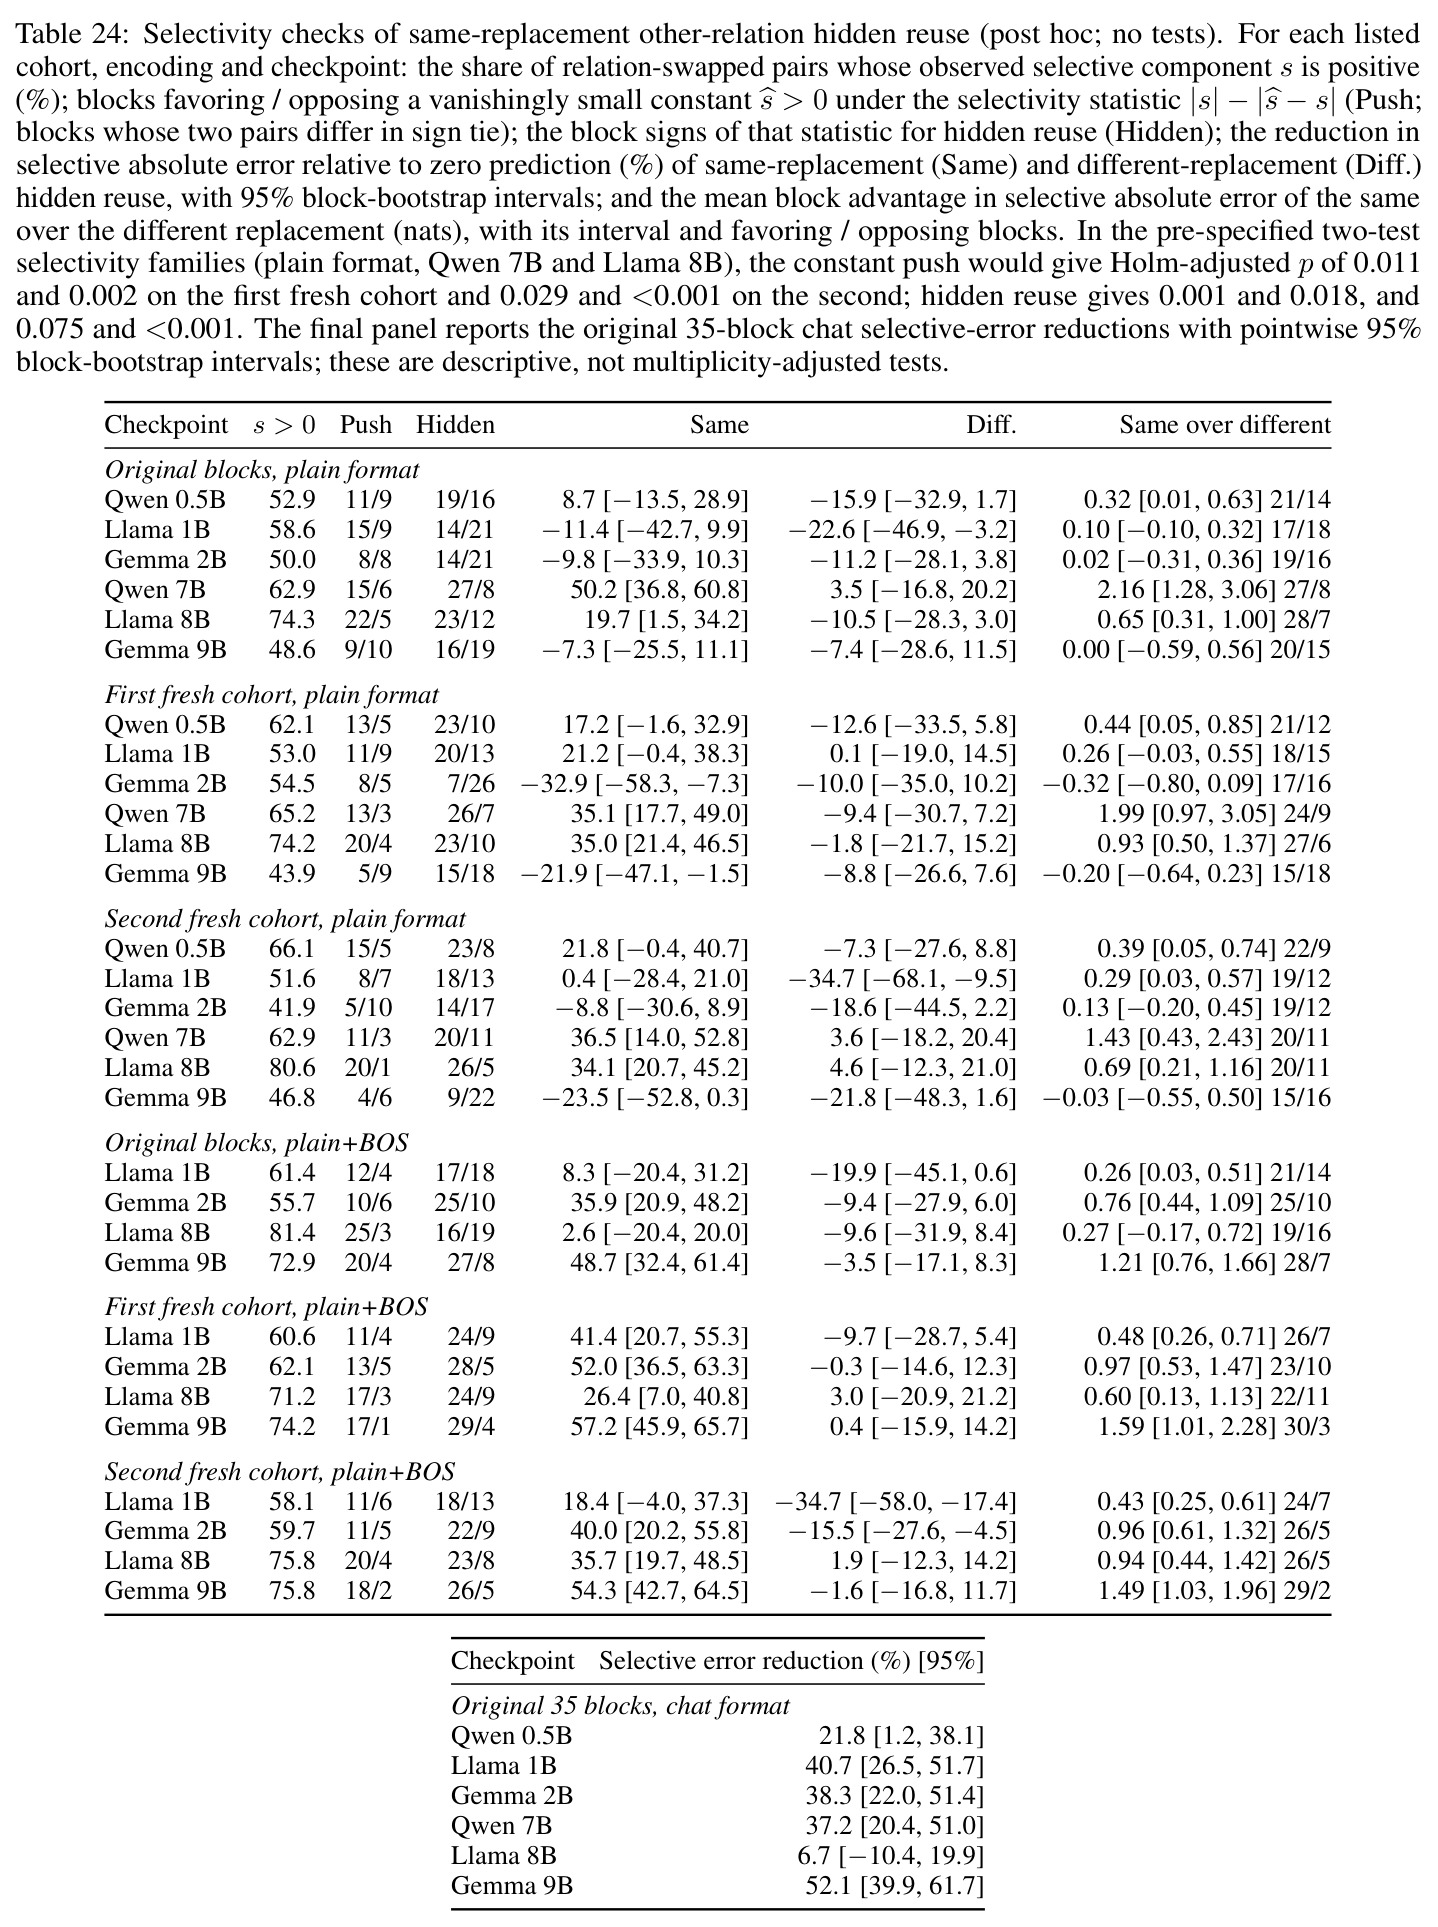
本文的核心发现之一是迁移主要复现共享成分 $h$,而关系选择性成分 $s$ 在小模型 plain 格式下不能被可靠复现。
符号检验与 Holm 校正
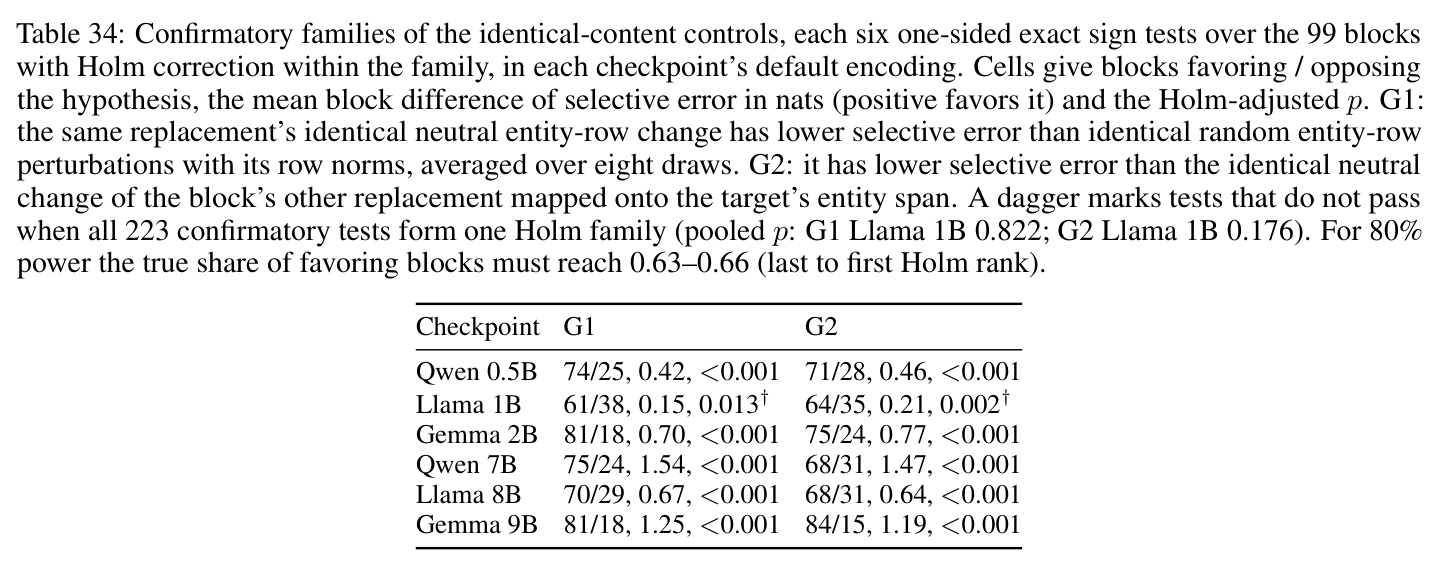
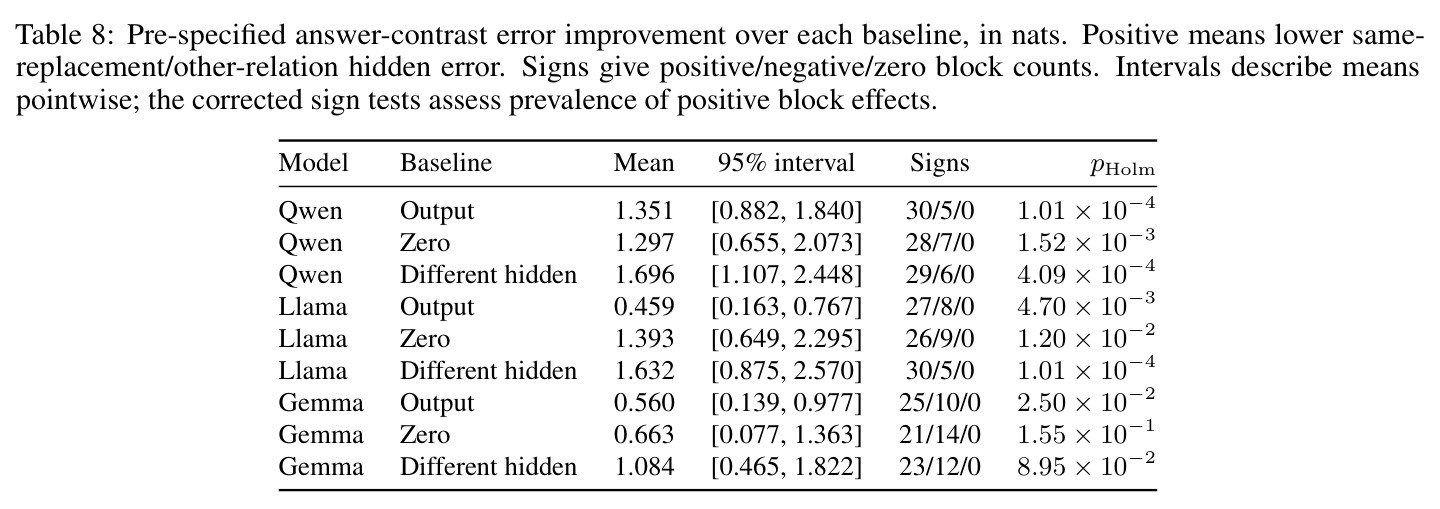
对每个 block 计算基线误差减去预测误差的配对效应,用精确单侧符号检验统计正负 block 数;Holm 校正在预设检验族内把族错误率控制在 0.05。本文共有 223 项确认性检验,分属 11 项研究的检验族。
论文的每个「通过/不通过」结论都由这套预指定协议给出,不了解它就无法区分确认性、描述性与事后分析结果。
研究动机
转向向量与函数向量等工作会把从一个提示记录的激活变化迁移到另一个提示,事实召回的机理研究(Geva et al. 2023、Nanda et al. 2023)也预测实体 token 处的中层变化能被另一问题的后续层读出。然而这些工作的评估大多是二元的:RAVEL、Patchscopes 等互换实体表示后只看最终答案是否与文本替换一致,或者只报告答案命中率。答案变了并不告诉我们接收问题的响应被复制了多少——迁移可能只推动了一个两问题共享的整体概率偏移,却没有复制出针对提问关系的那部分带符号移动。此外,单向量构造(如最后一个实体 token 的广播向量)与逐 token 对齐的矩阵变化哪种更好、注入在哪个深度和哪些 token 行最有效,也一直缺乏在同一量化参照下的系统比较,导致「迁移成功」这一说法既无法定量也无从分解。
本文的目标是本文的目标是在模型权重完全固定的情况下,量化一个实体替换响应跨英文事实问题迁移的保真度,并进一步判断迁移是否复现了响应中针对提问关系的部分。具体做法是给每个目标问题一个可测参照:目标问题自身替换实体后的真实带符号对比度变化 $\delta c$,然后比较三种预测的误差——零预测(不迁移)、不同替换来源的迁移(对照,检验预测是否依赖替换内容)与同替换来源的迁移。作者还想知道:迁移在哪个深度、哪些 token 位置仍然有效;对齐的矩阵变化与调优后的最佳单向量构造相比如何;以及共享成分与关系选择性成分各自被复制到什么程度。
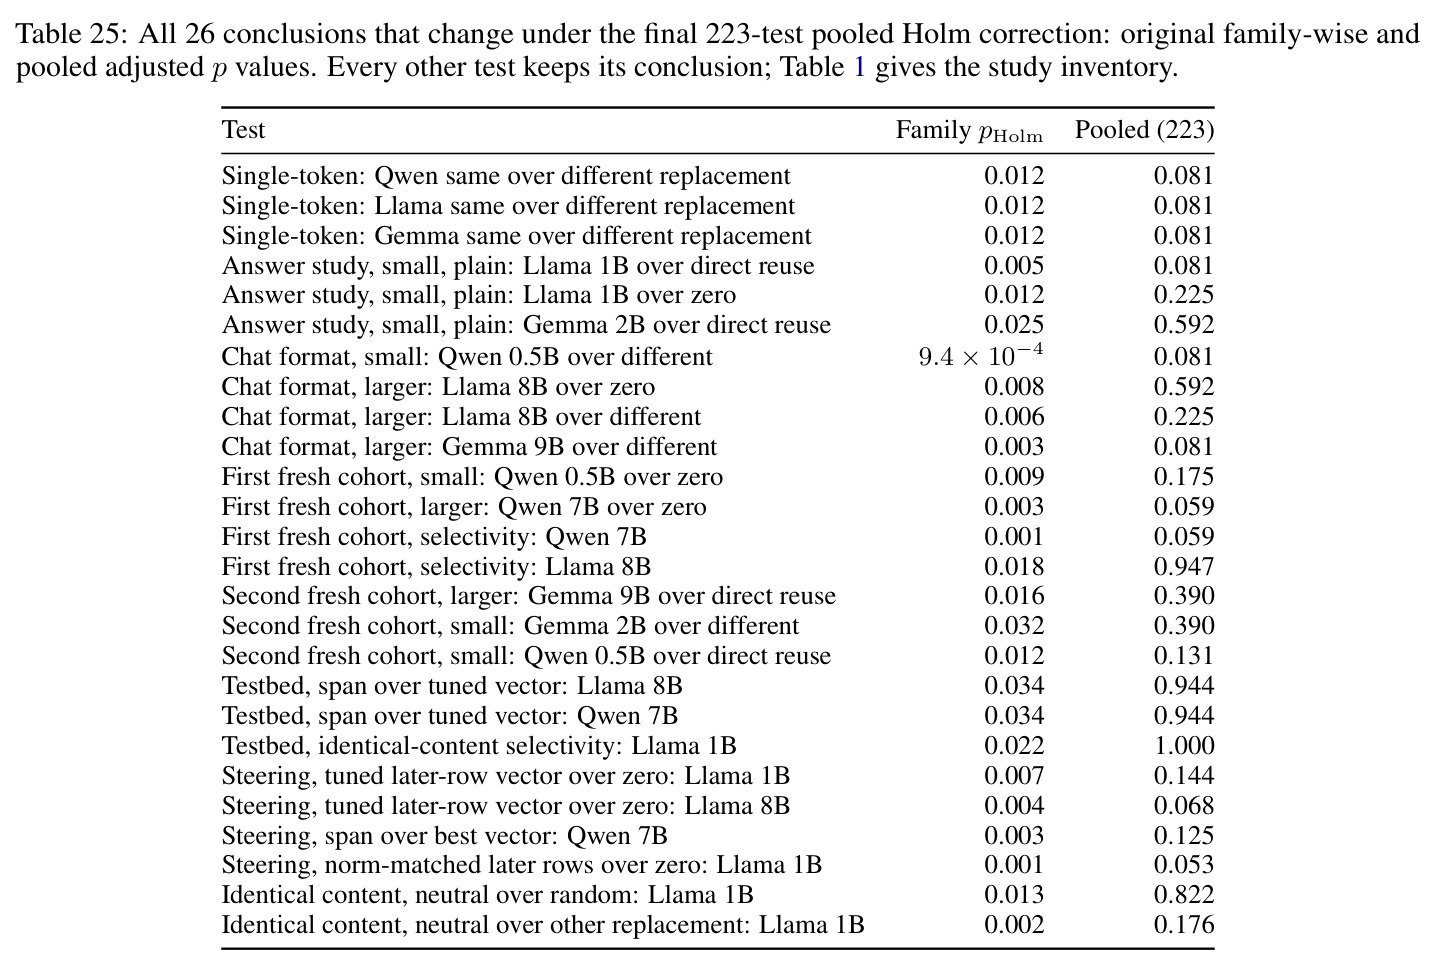
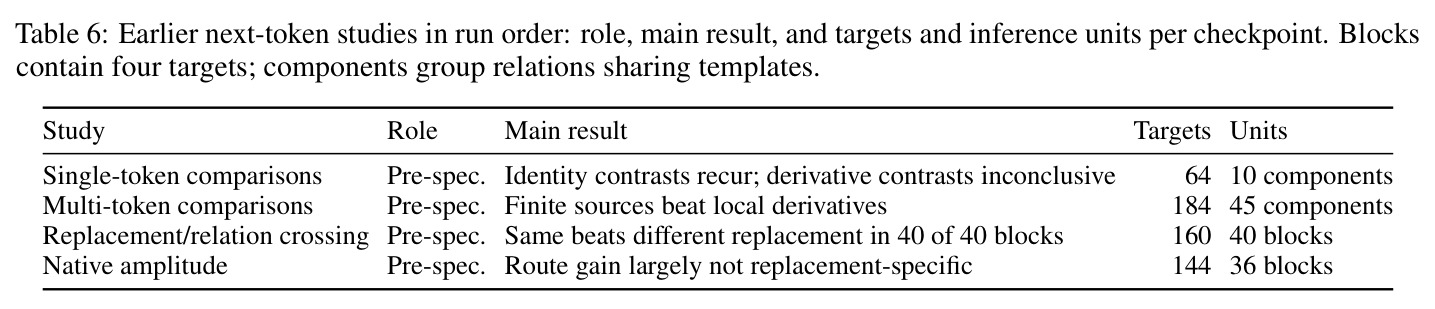
与已有工作不同的是,独特之处有三点。第一,参照的选取:不同于 interchange 研究在提示间交换实体表示再评估答案一致率,本文用目标问题自身替换后的带符号对比度变化作参照,可以度量迁移复现了目标自身响应的百分之几,误差以 nat 计。第二,分解:利用同一替换下两个关系互换的目标问题,把变化代数分解为共享成分 $h$ 与关系选择性成分 $s$,把「整体保真」与「关系选择保真」分开评估——这是以往二元评估完全看不到的维度。第三,统计纪律:11 项研究、223 项确认性检验全部由内部书面协议在看到结果之前固定比较对象,族内 Holm 校正,并明确区分确认性、描述性与事后分析,还报告了合并校正会推翻 26 项结论这一敏感性。
核心方法
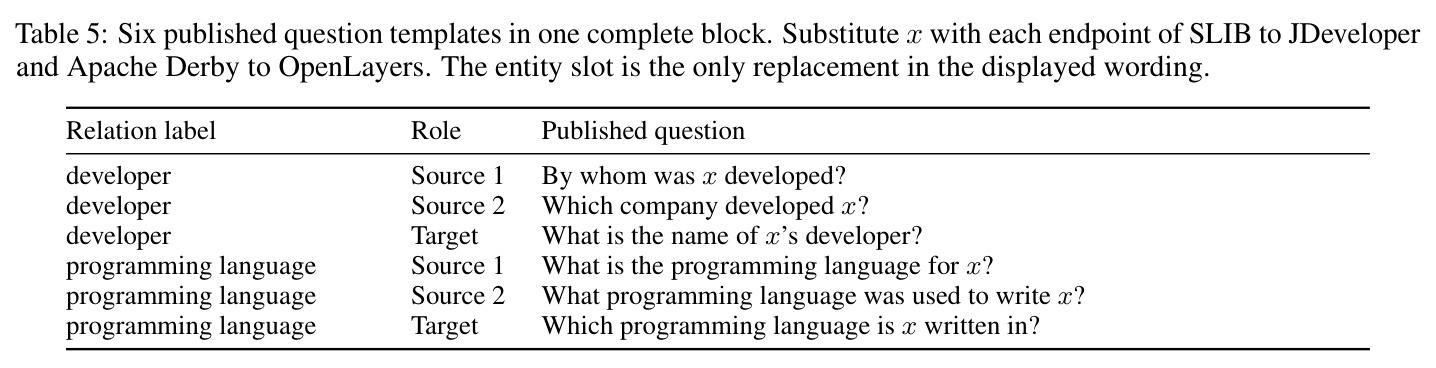
直觉上,作者把「换实体」看作对模型的输入扰动,把扰动引起的隐藏态变化当作可在问题之间搬运的包裹,再检验包裹在目的地能被读出多少。技术上,数据是从 ZsRE 关系抽取数据集构建的 block:每个 block 交叉两个实体替换与两个关系,每个替换与关系的组合有两个源问题和一个目标问题;同一 cohort 内各 block 的关系、实体、别名、模板与完整输入完全不相交。对每个源问题,在解码器 50% 深度的层边界记录替换响应 $\Delta_{s,e} = H_\ell(s,e) - H_\ell(s,a)$;同组两个源按未编辑最终隐藏态距离的归一化逆平方权 $w_s$ 加权求和,经后缀插值矩阵对齐 token 行得到预测 $\hat{\Delta}_{t,e}$。隐藏复用把对齐后的变化加到目标未编辑的 50% 深度激活上、跑完剩余层再读出 logits;直接复用则把源输出分数变化(源隐藏变化经源自身剩余层传播的结果)直接加到目标分数上。答案在已知前缀条件下按完整字符串逐 token 评分,最终以对比度误差衡量保真度。
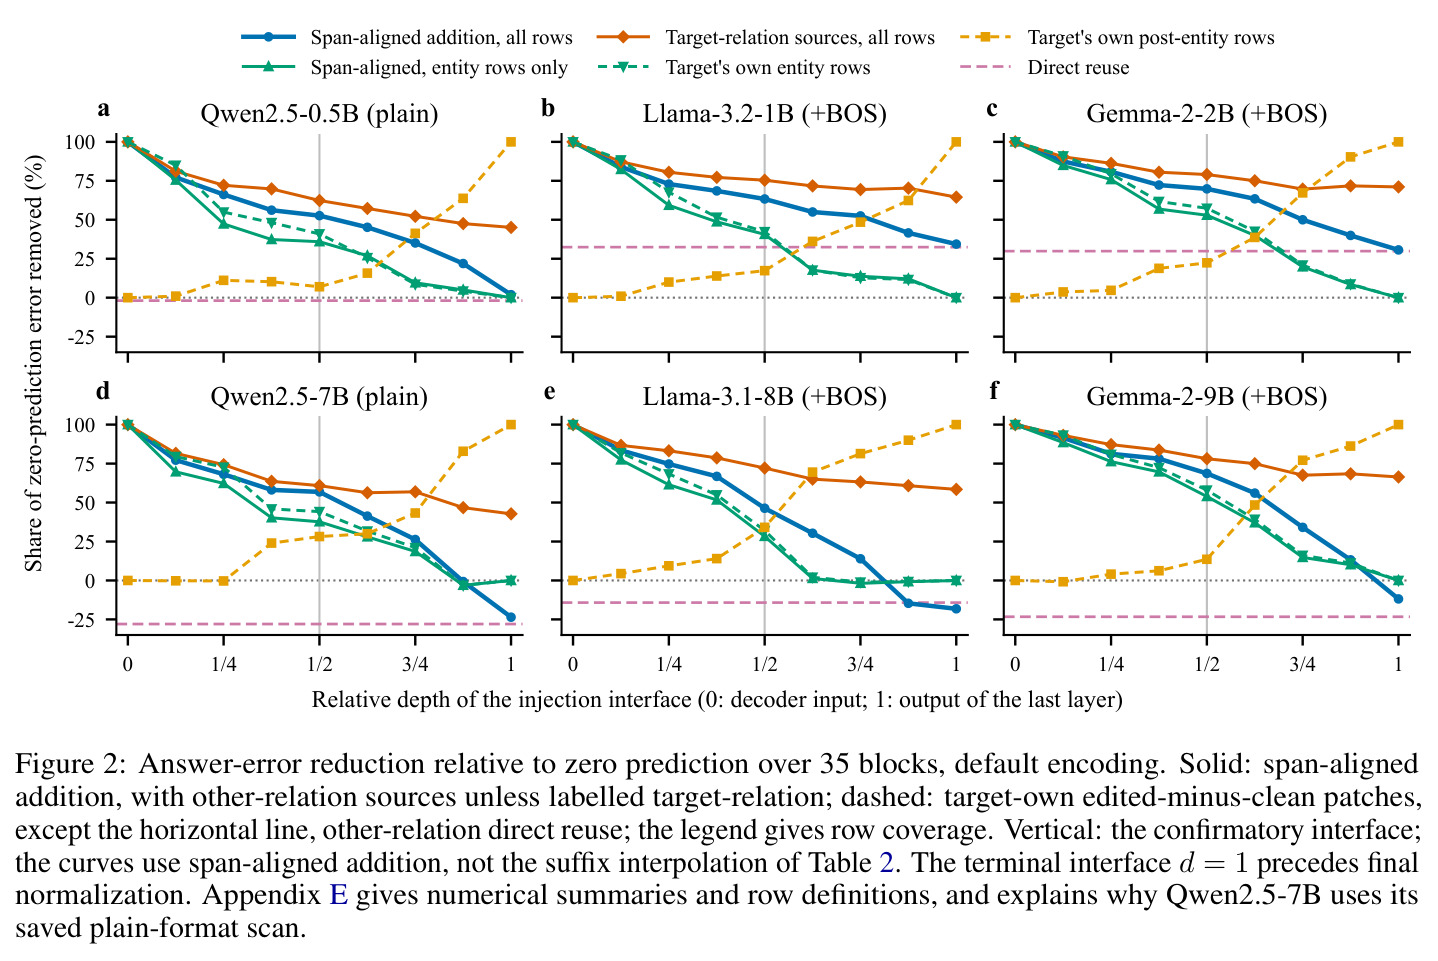
核心创新是把「迁移是否成功」重新定义为「复现了多少目标自身带符号对比度变化」。公式上,预测误差 $E_{ans} = |\hat{\delta c} - \delta c|$,零预测误差为 mean $|\delta c|$,某方法的消除比例为 $1 - \text{mean } E_{ans} / \text{mean } |\delta c|$。第二条关键思想是读出分离:隐藏复用让目标自身的剩余层把注入变化读出,直接复用则导入源问题的读出映射;当来源问的是「其他关系」时两条路由读出不同,由此可以检验迁移是否复现关系选择性。第三条是分解恒等式 $s = (\delta c_1 + \delta c_2)/2$、$h = (\delta c_1 - \delta c_2)/2$,其中 $s$ 只含各问题朝自己关系答案的移动。最后,span 对齐加法把变更实体 span 逐 token 一一复制对齐,在 $d=0$ 处按构造复现编辑后的目标,以此对照各种单向量广播构造。
方法步骤详情
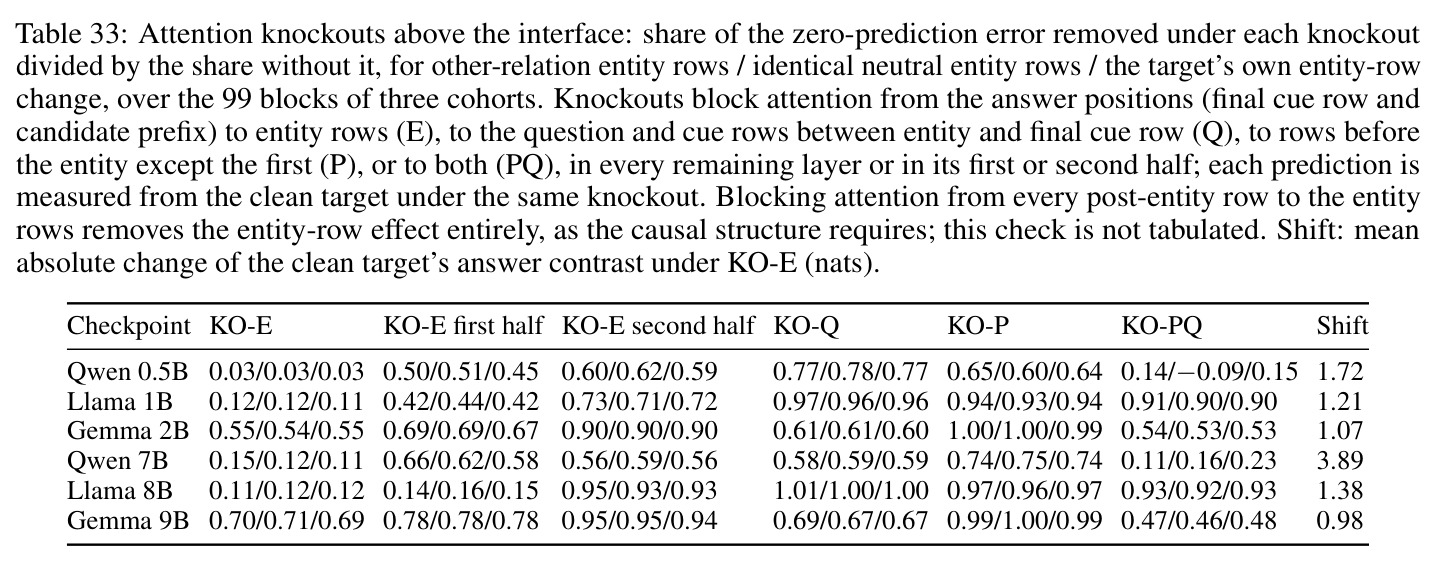
第一步,材料构建:从 ZsRE 取已发布的事实问题、答案与关系标签,用 Wikidata 校验实体身份与别名,替换实体保持 token 长度相等;答案研究用三个新实体 cohort(35、33、31 个 block,共 99 个),block 间材料不相交。第二步,记录响应:在 50% 深度层边界,对每个候选答案前缀单独捕获一次源的变更(前缀条件化),变更起点之前的 token 行置零。第三步,路由预测:按 $\hat{\Delta}_{t,e} = \sum_{s \in S} w_s W^{s \to t}_{suffix} \Delta_{s,e}$ 加权对齐;隐藏复用注入后跑目标剩余层并减去未编辑 logits,直接复用加源输出变化。第四步,评分:全词表 softmax 下对候选组求对数概率质量 $M_x(A)$,得到 $c_x$、$\delta c$ 与误差 $E_{ans}$,并按 $s$、$h$ 分解。第五步,统计:精确单侧符号检验、族内 Holm 校正、20,000 次 block 级 bootstrap 区间。第六步,附加研究:从 $d=0$ 到 $d=1$ 共 9 个界面的深度扫描、90 种单向量构造的 testbed、注意力阻断的 identical-content 对照实验。
技术新颖性
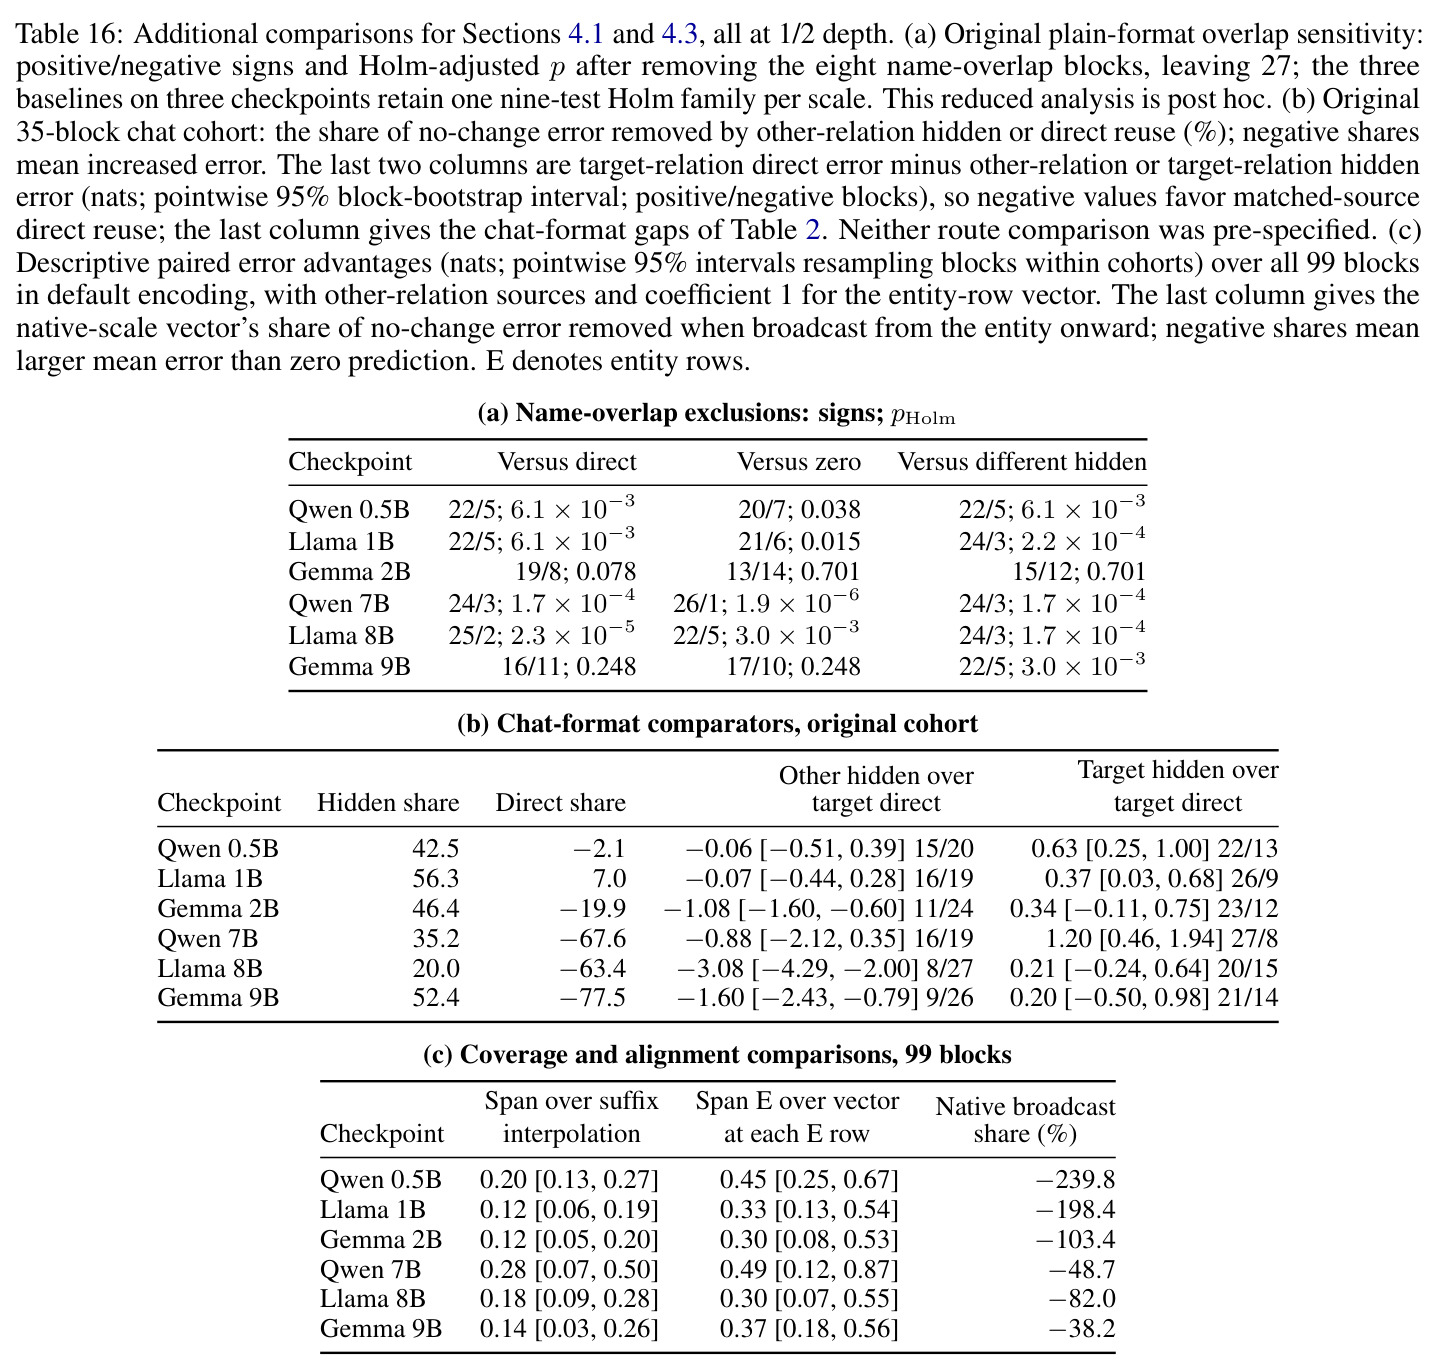
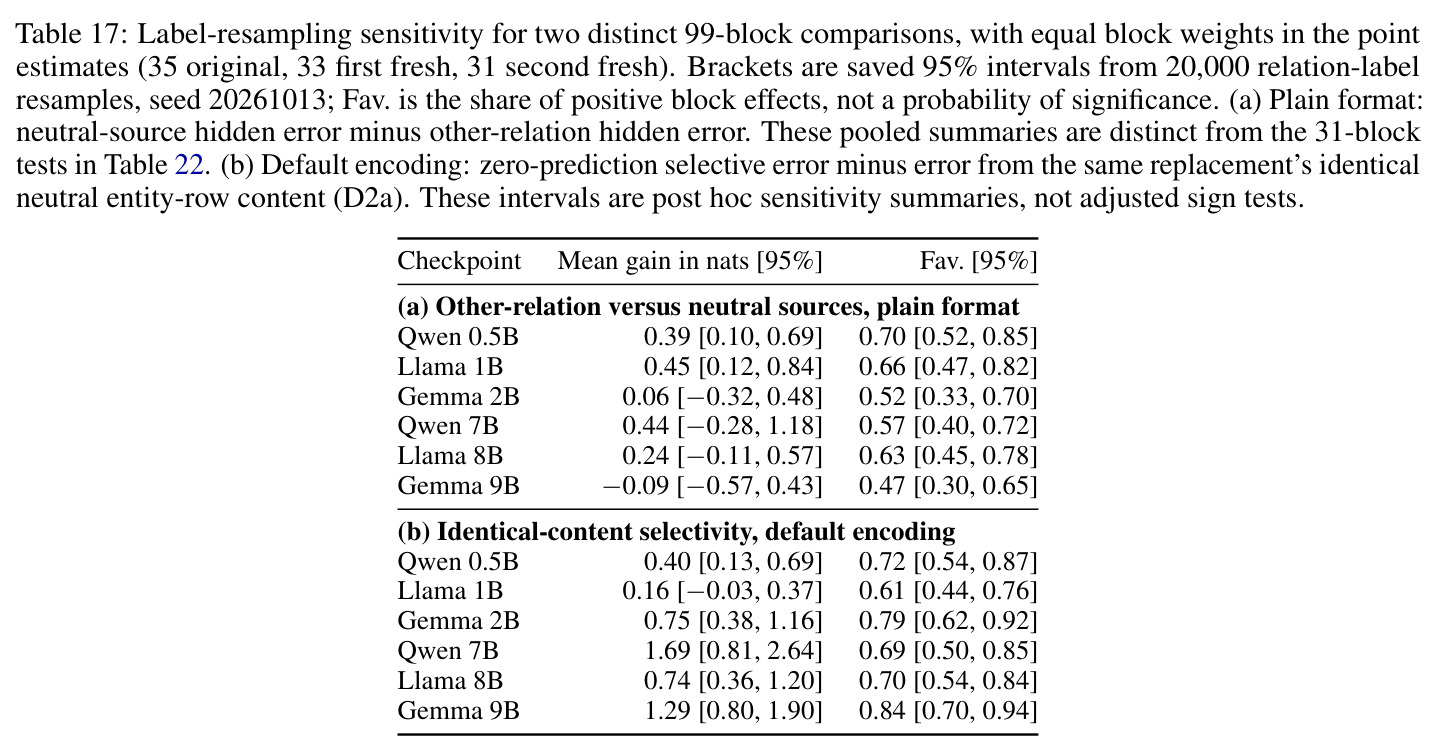
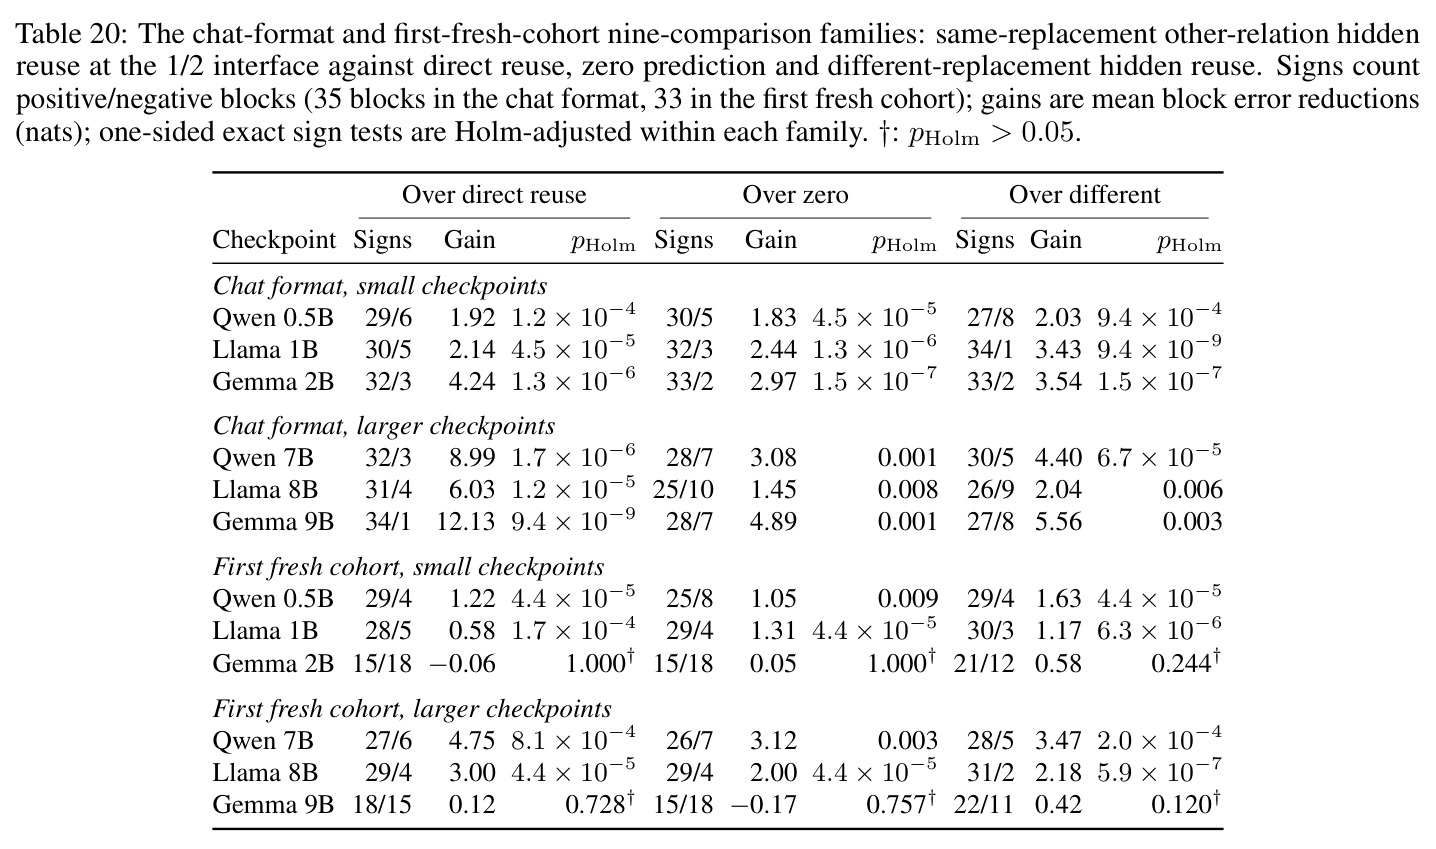
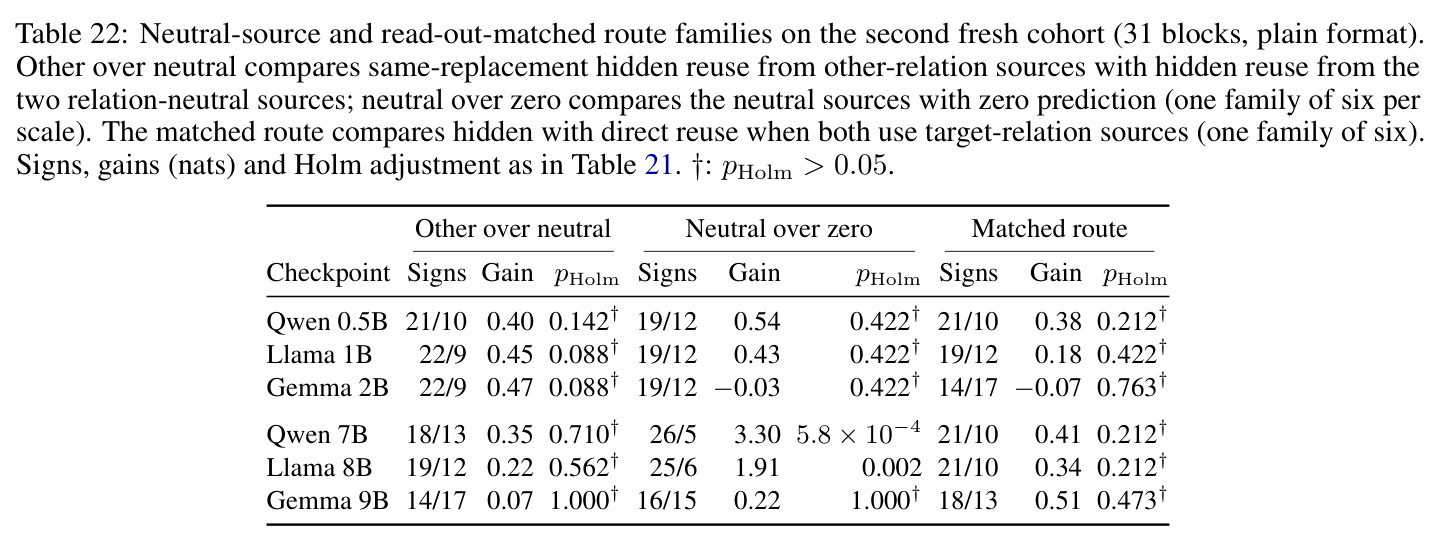
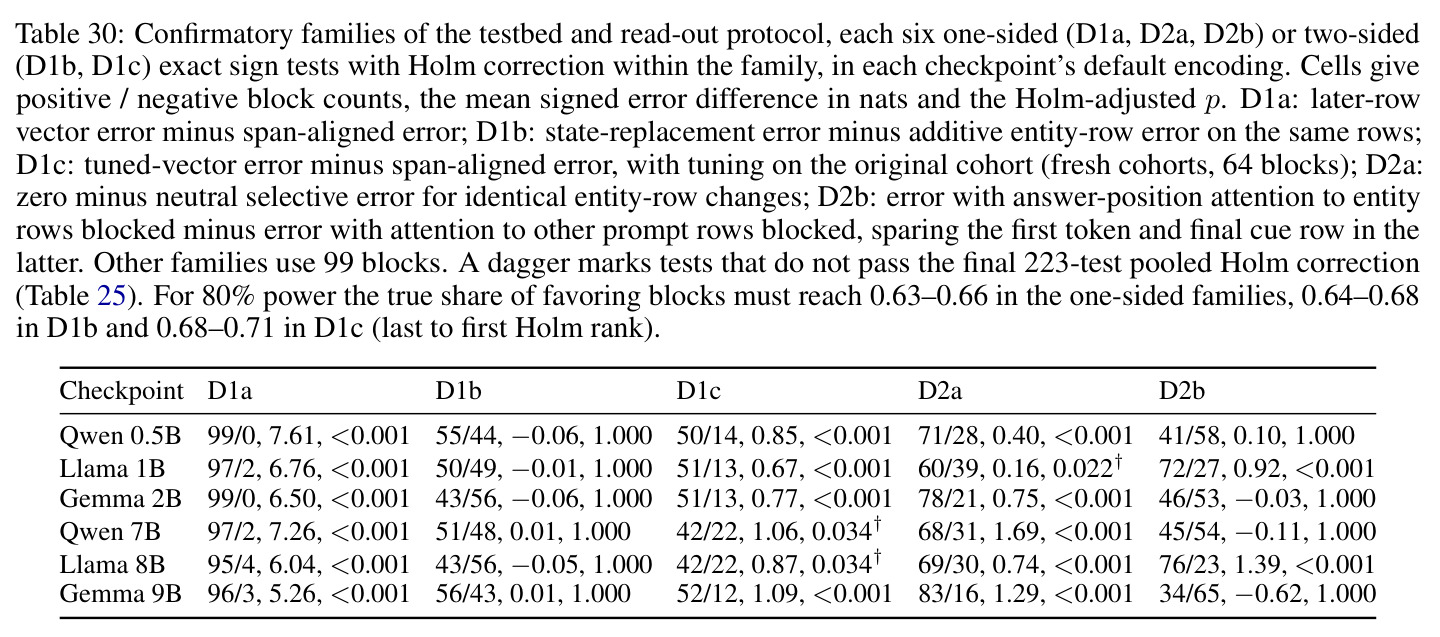
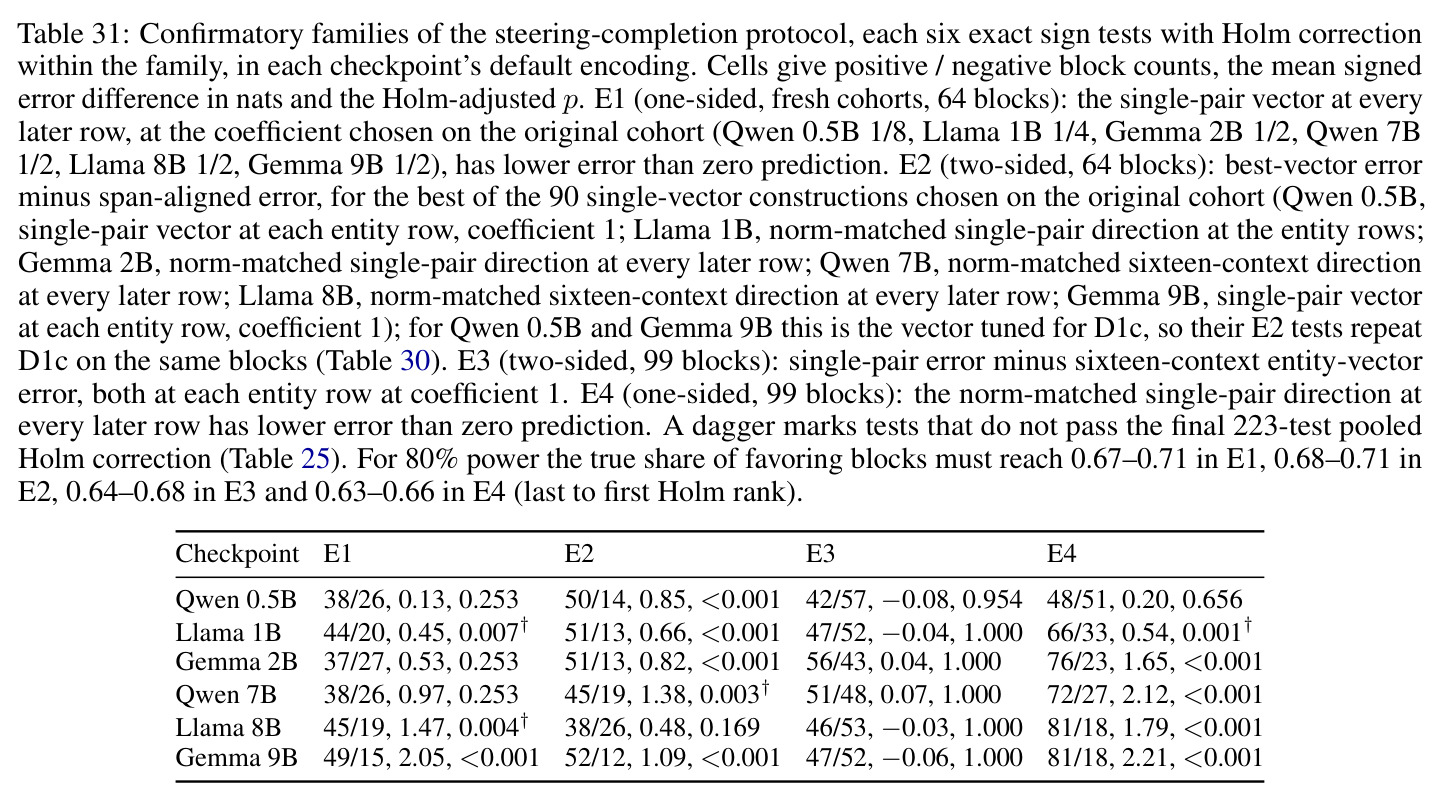
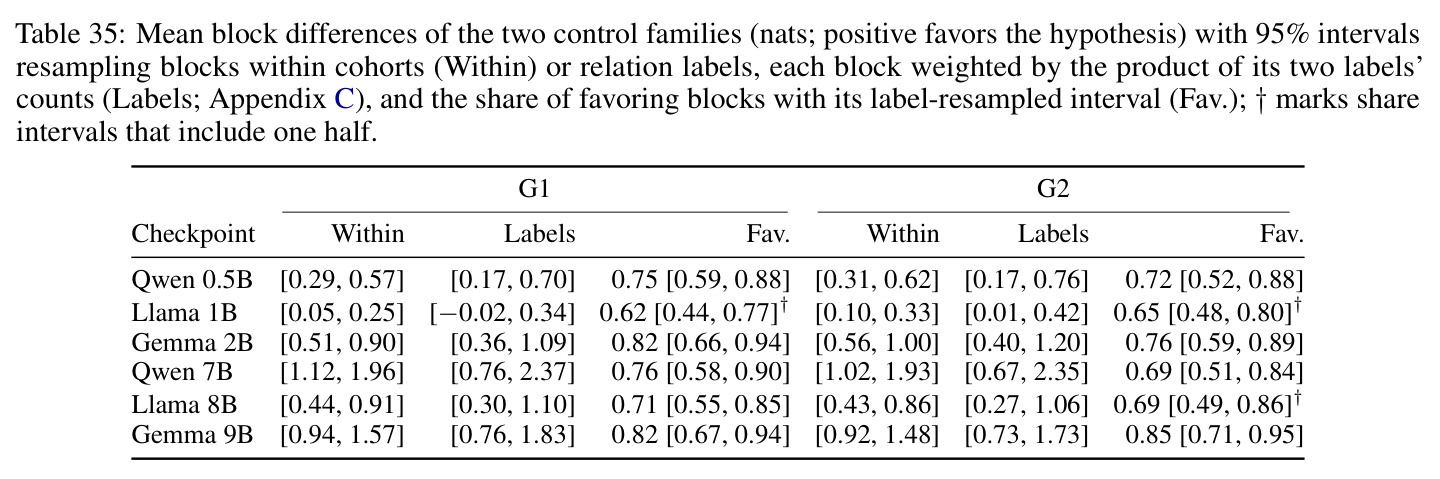
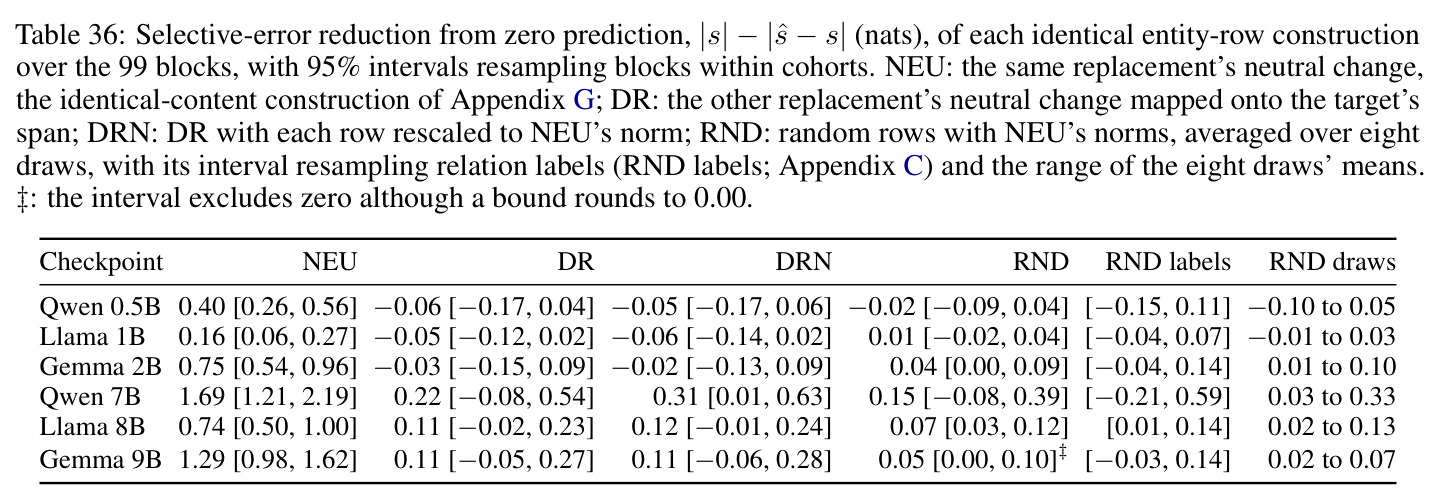
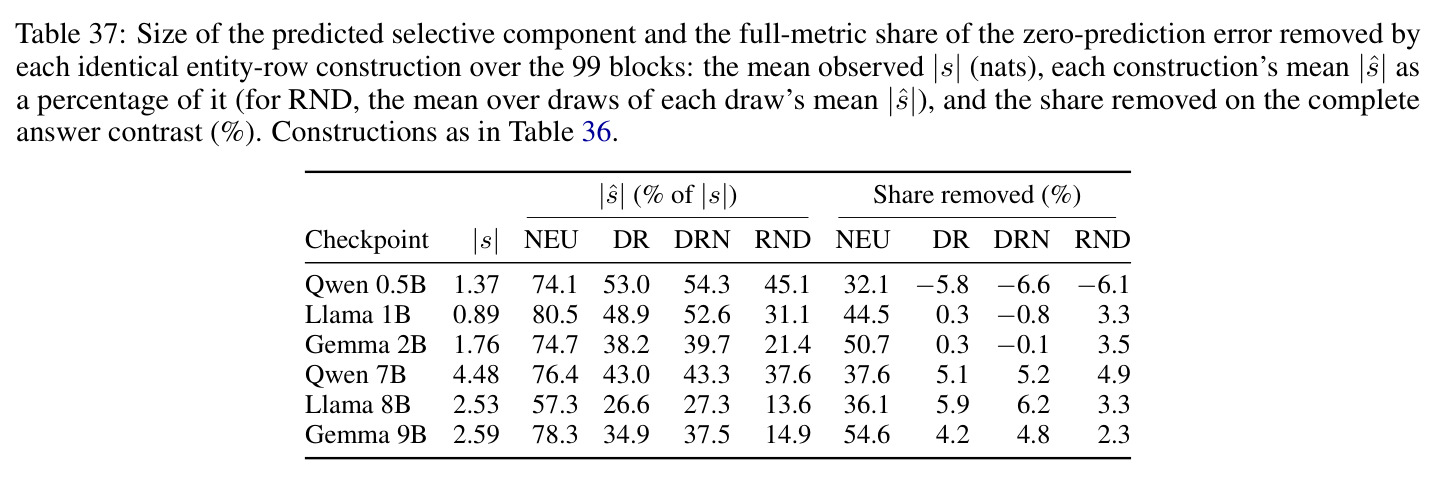
技术新颖性体现在四处。(1)量化指标:以 nat 为单位的带符号对比度误差与「消除零预测误差比例」取代以往 interchange 研究的答案一致率,使「迁移复现了 45%」这类定量结论成为可能。(2)后缀插值与前缀条件化捕获:每个候选前缀单独记录源响应再逐 token 对齐,保证多 token 答案评分下的可加性与行对齐。(3)span 对齐加法:证明逐 token 对齐的矩阵优于 90 种单向量构造中的最优者(6 个 checkpoint 中 5 个胜出,增益 0.48–1.38 nats),说明 token 级行结构携带的信息是单向量广播丢失的关键。(4)关系中性对照:把「介绍一下 X」这类中性来源的同一变化等权注入两个关系互换的目标,发现它反而更能降低关系选择性误差(99 个 block 中 60–83 个),证明选择性效果依赖接收问题而非注入内容本身携带关系信息——这一反直觉结果来自精心设计的对照,而非事后解释。
实验结果
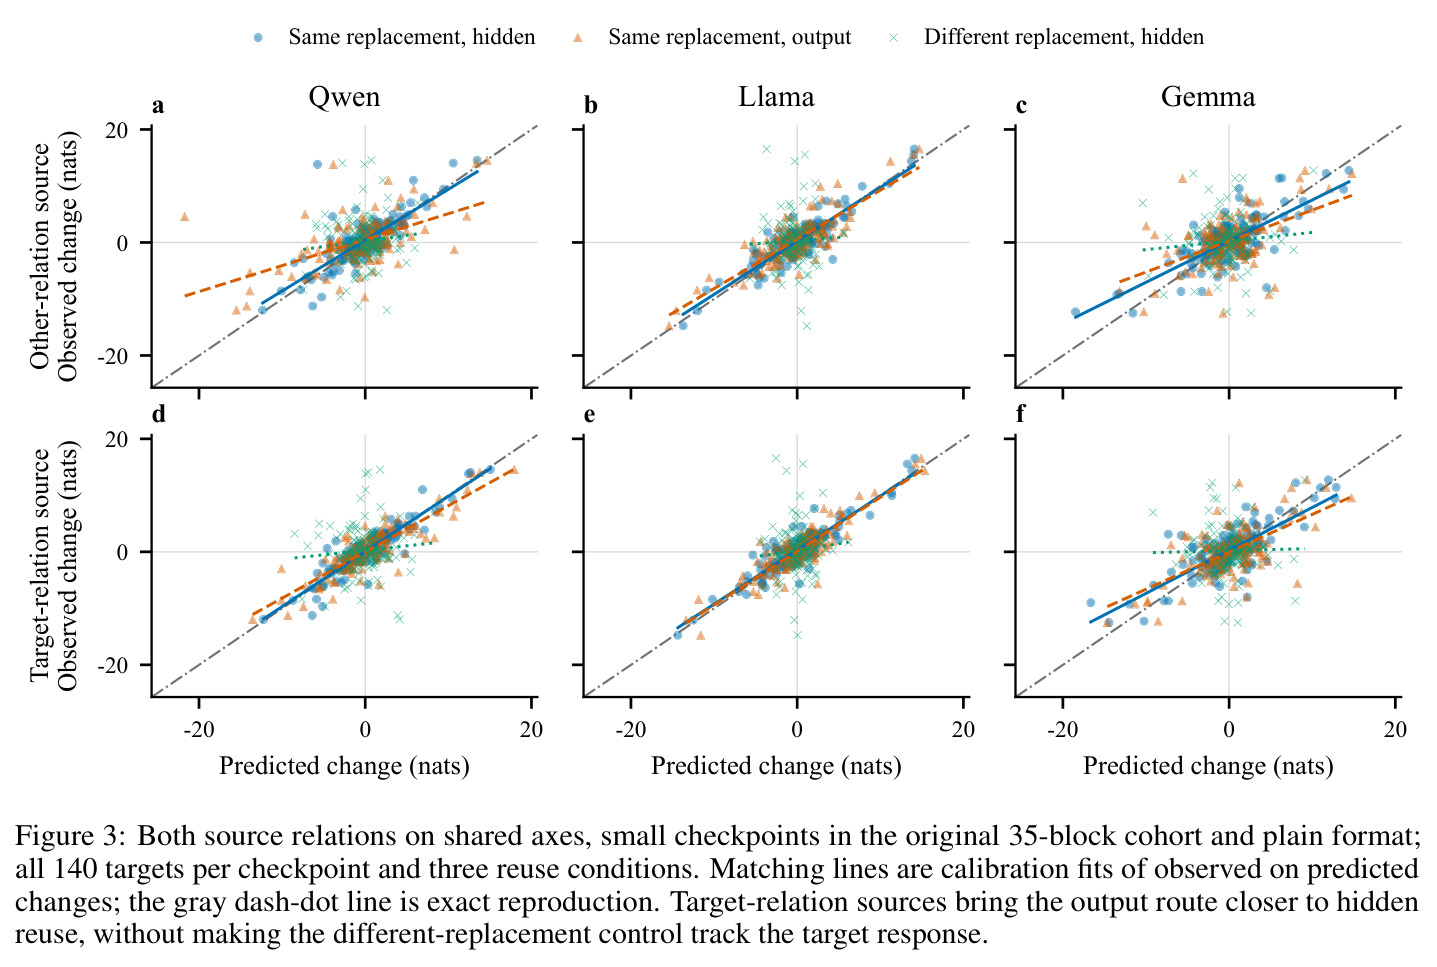
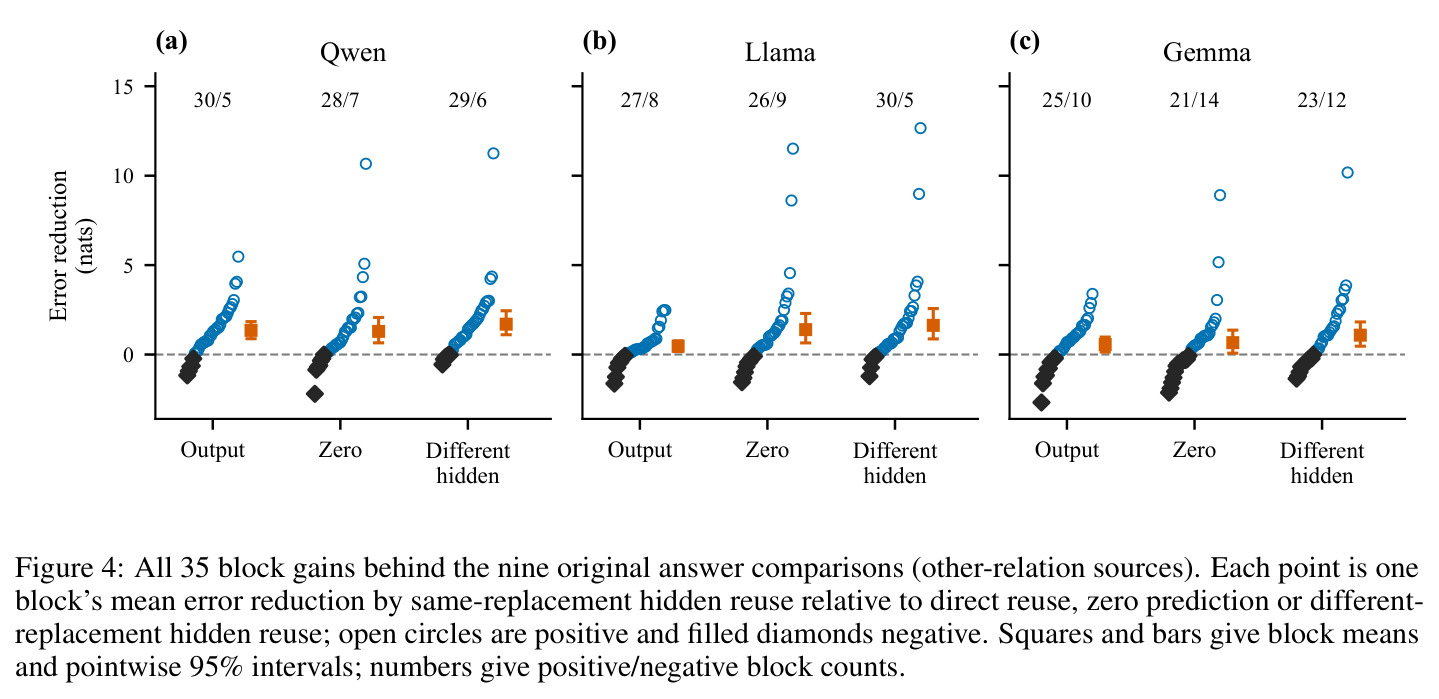
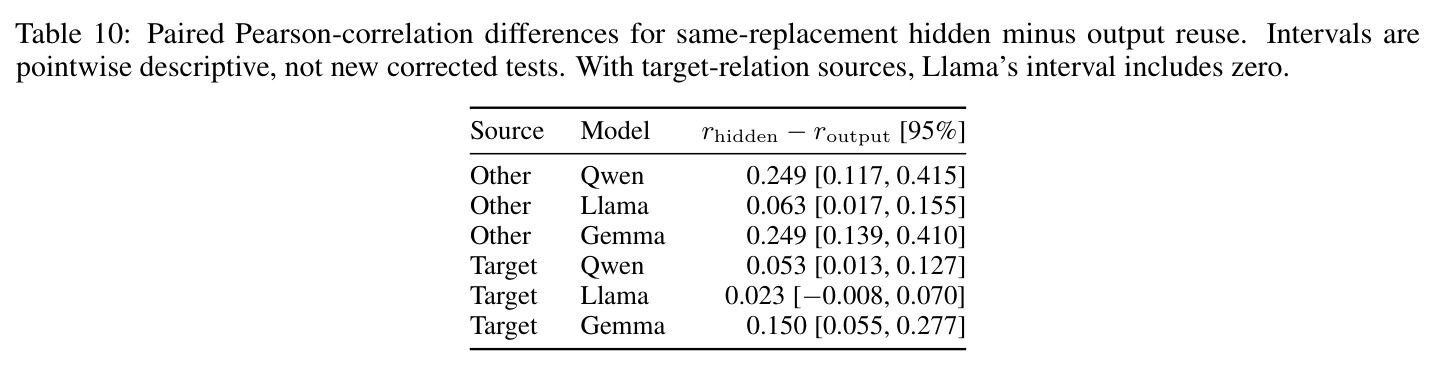
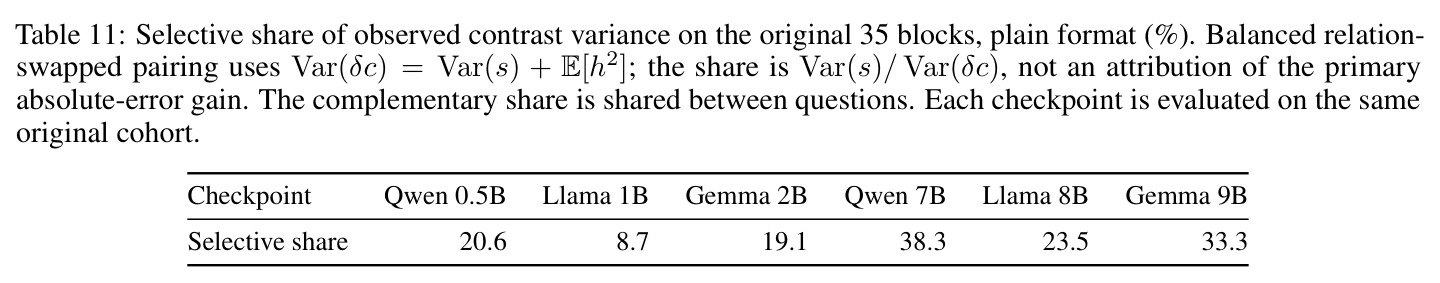
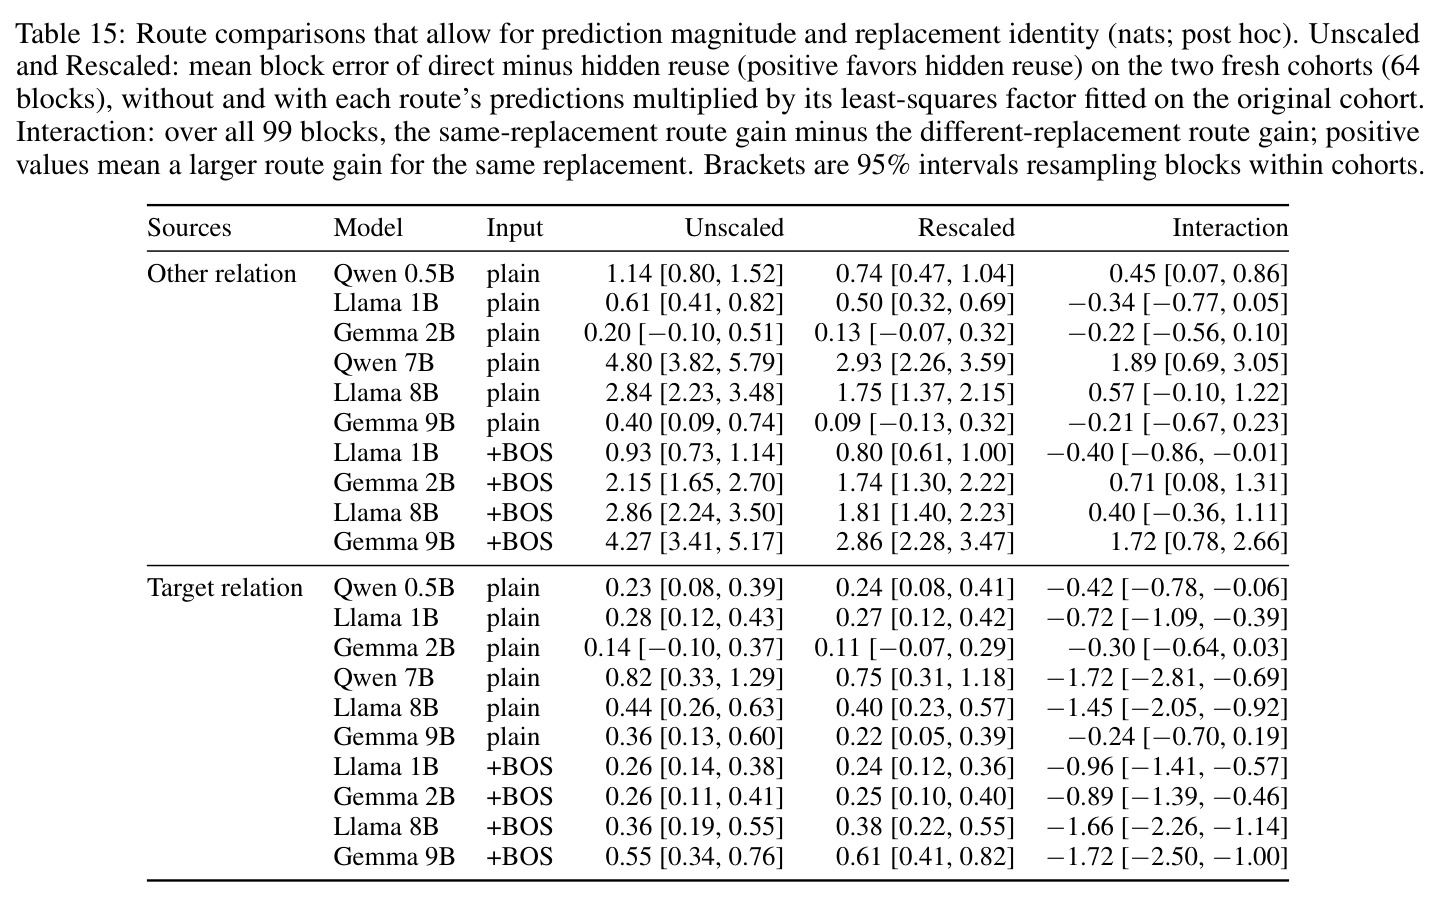
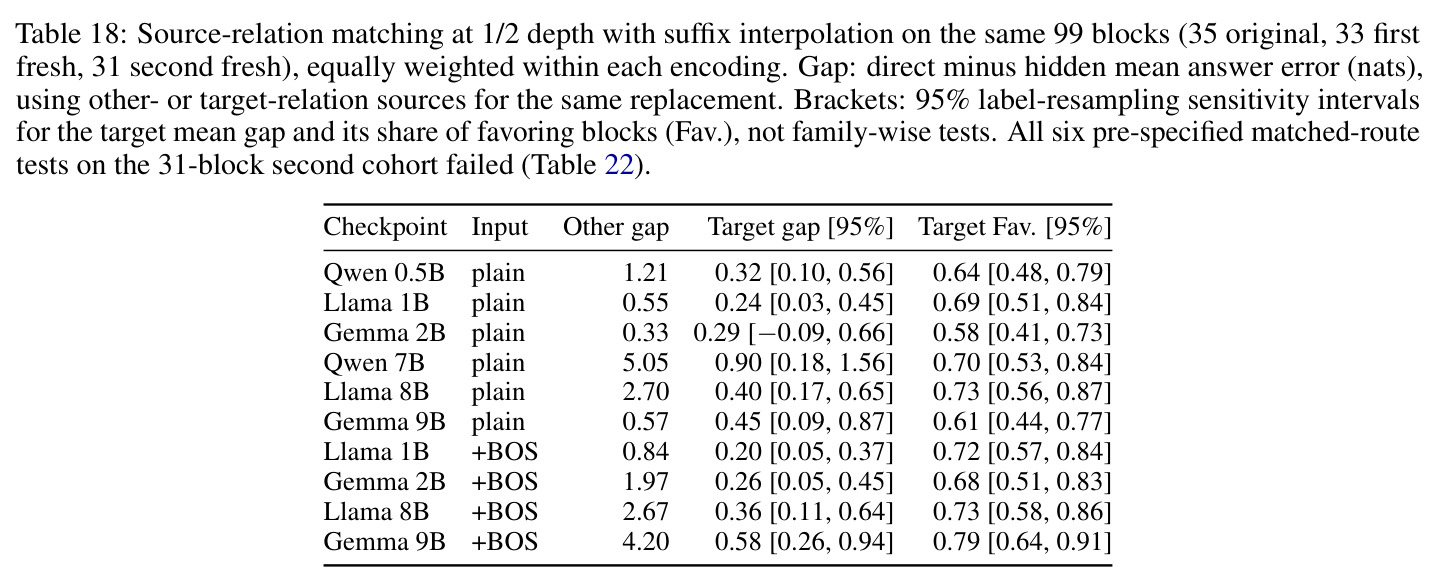
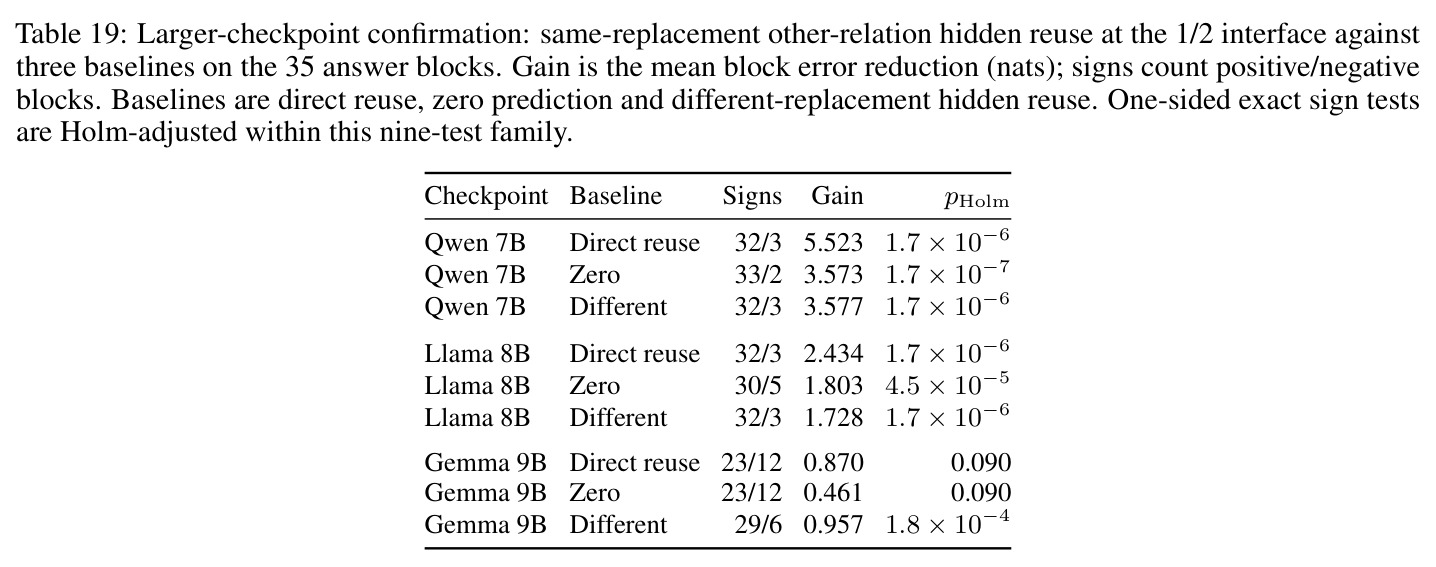
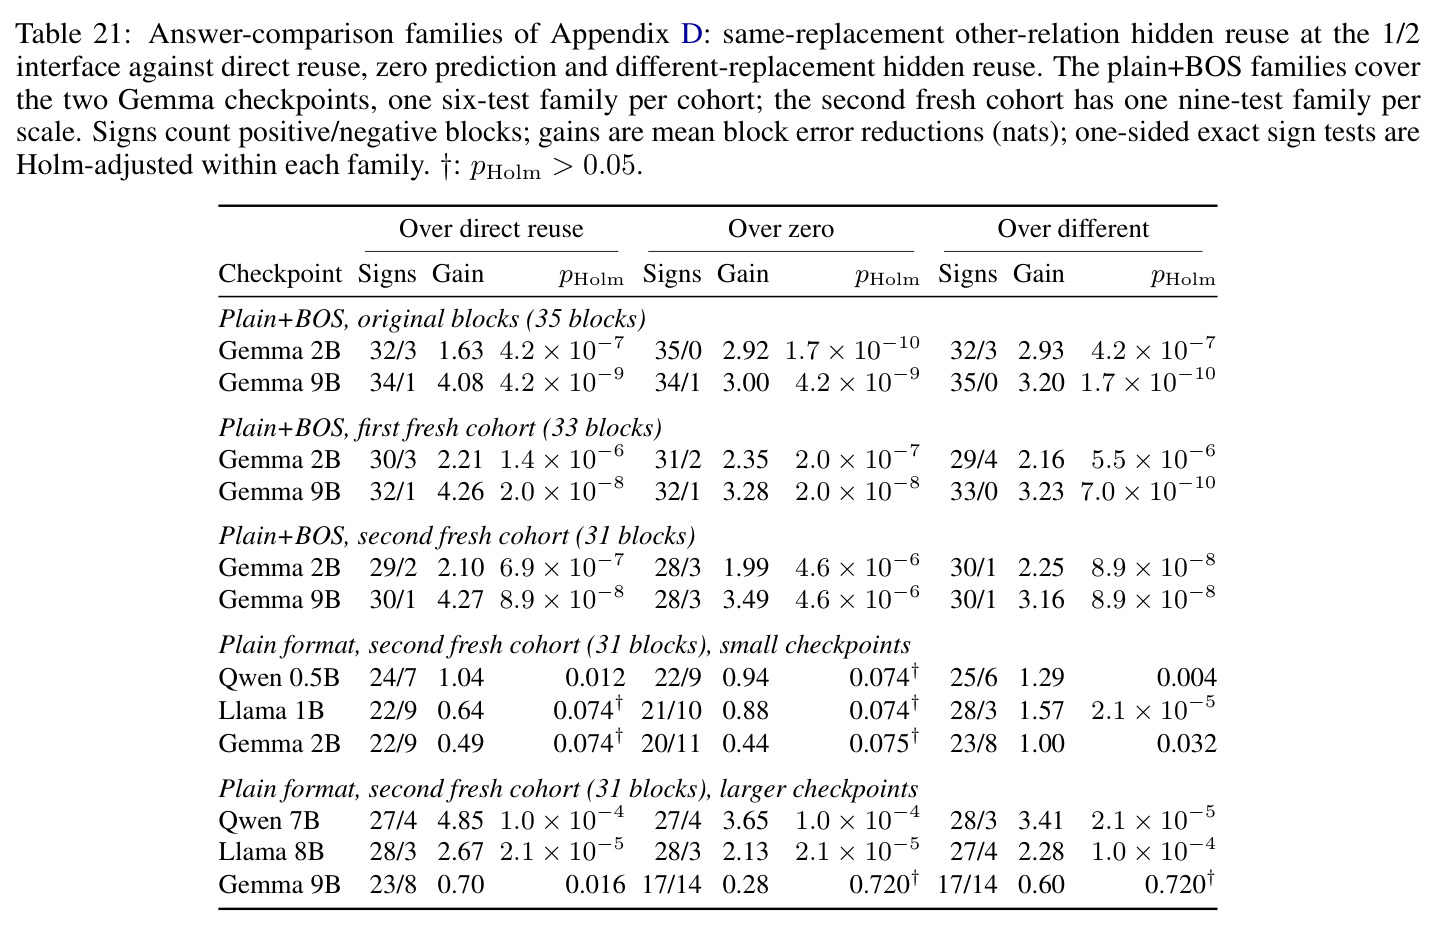
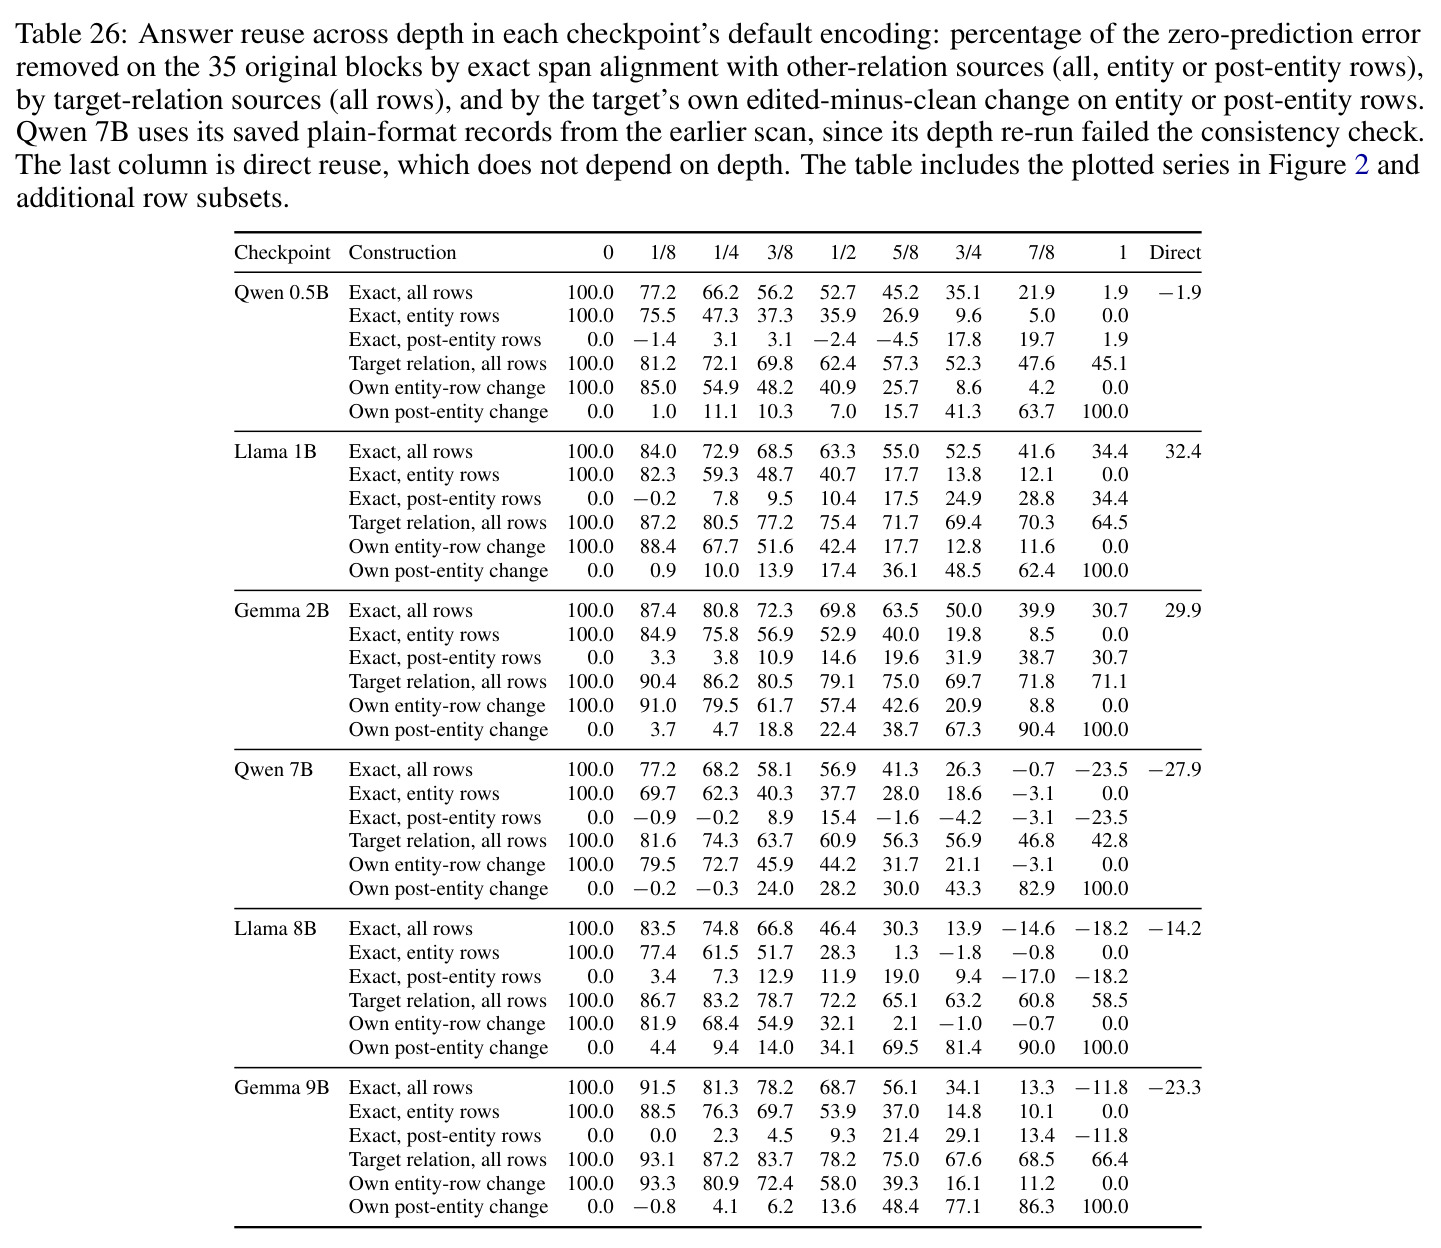
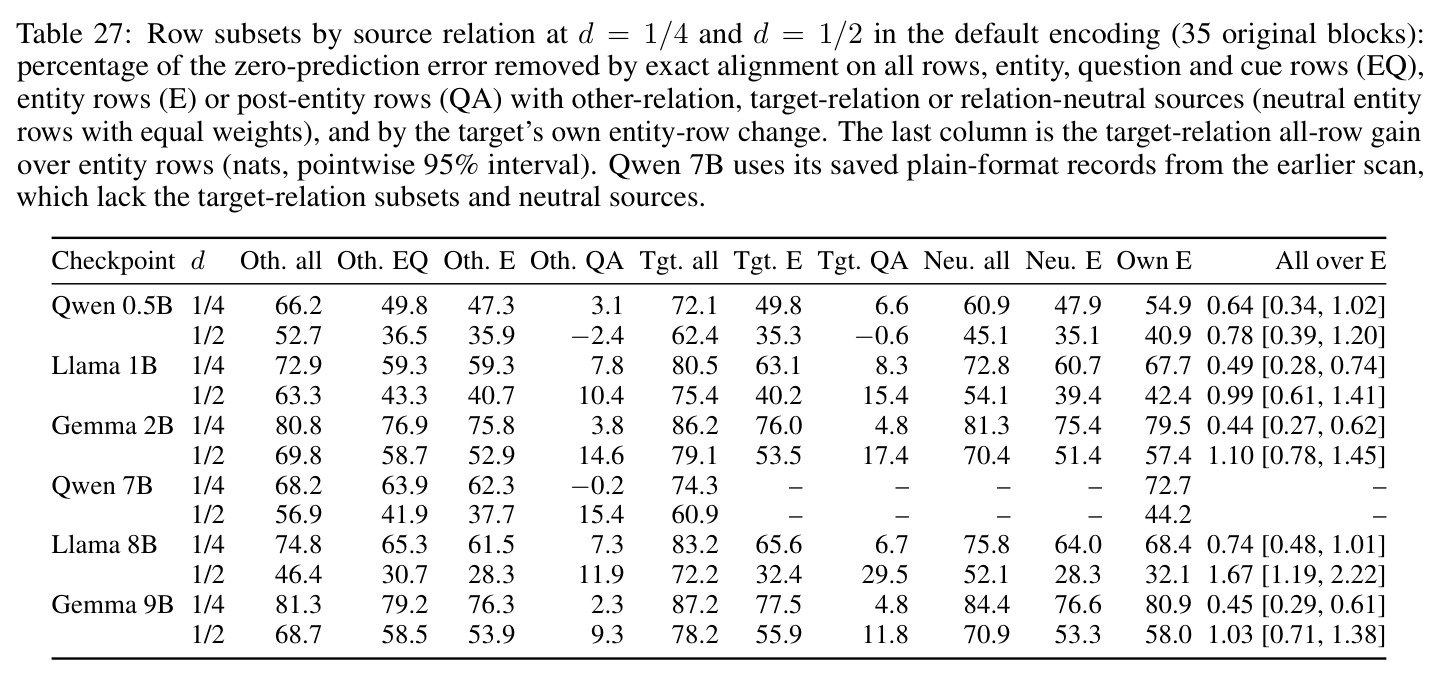
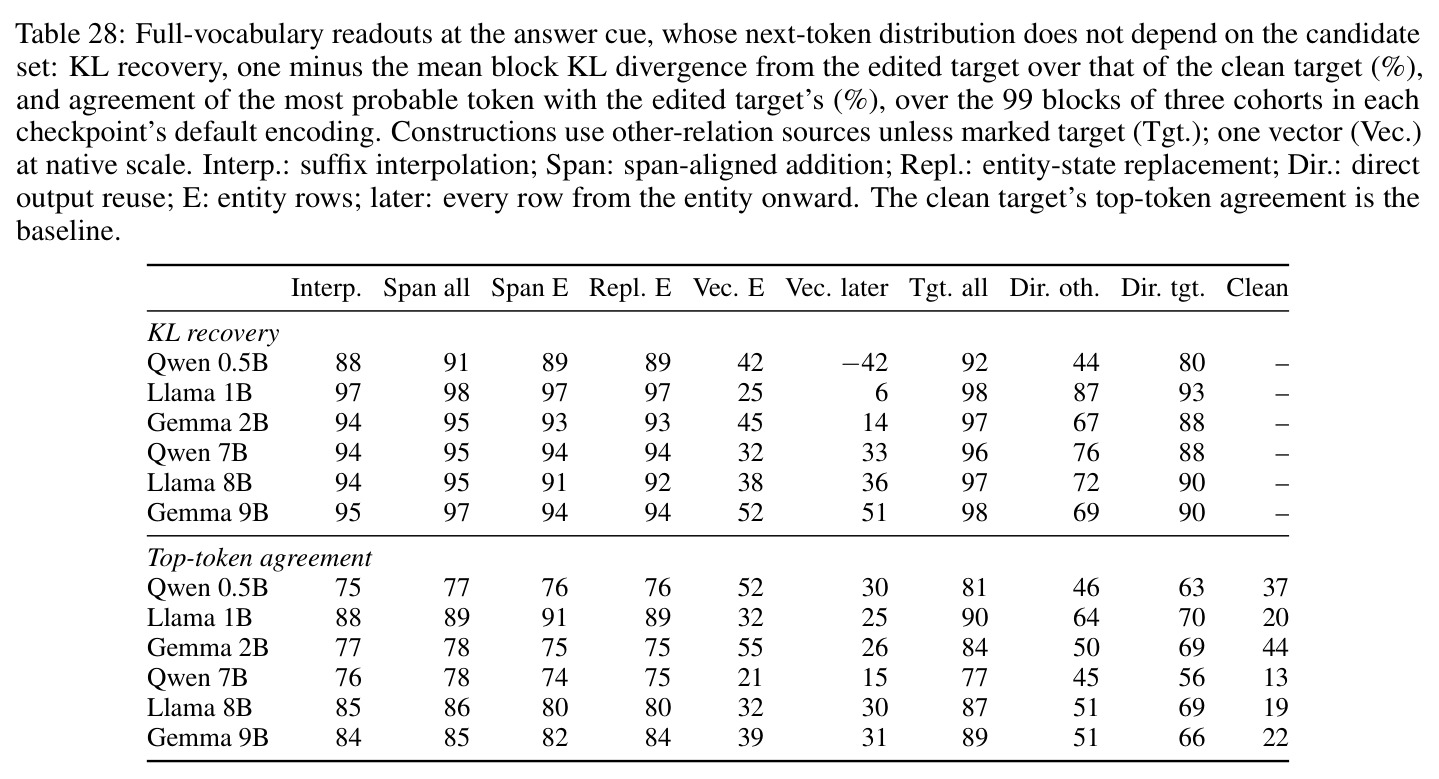
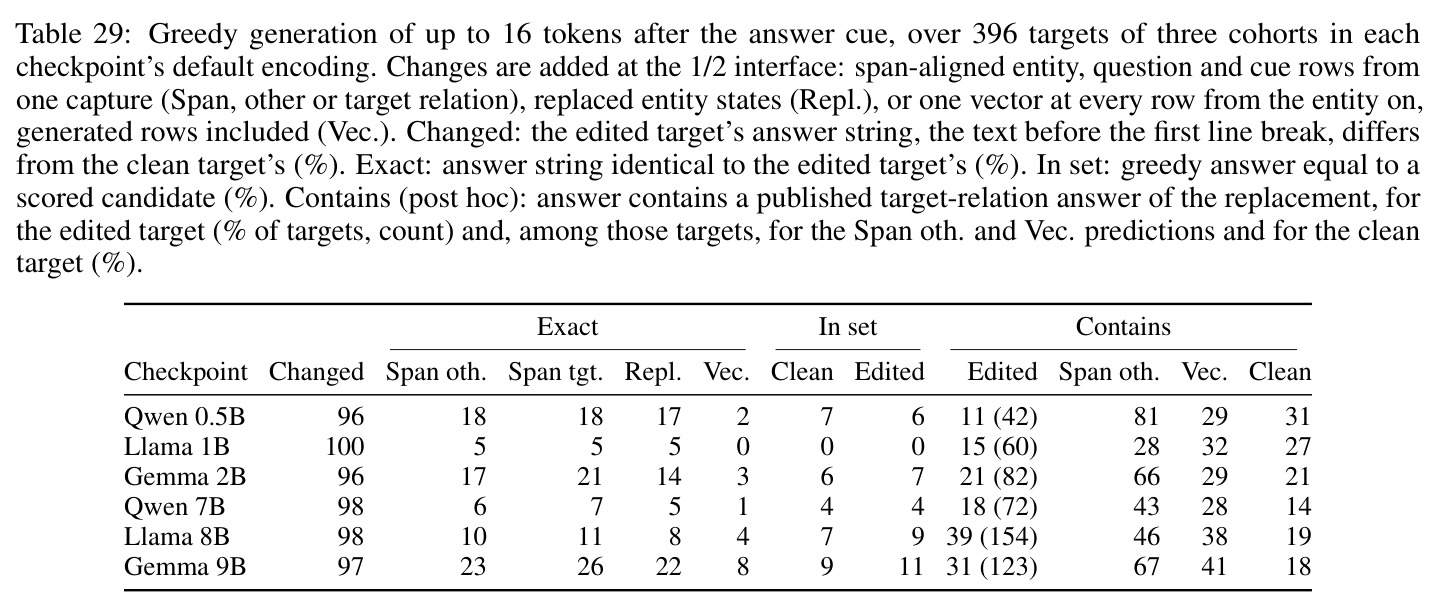
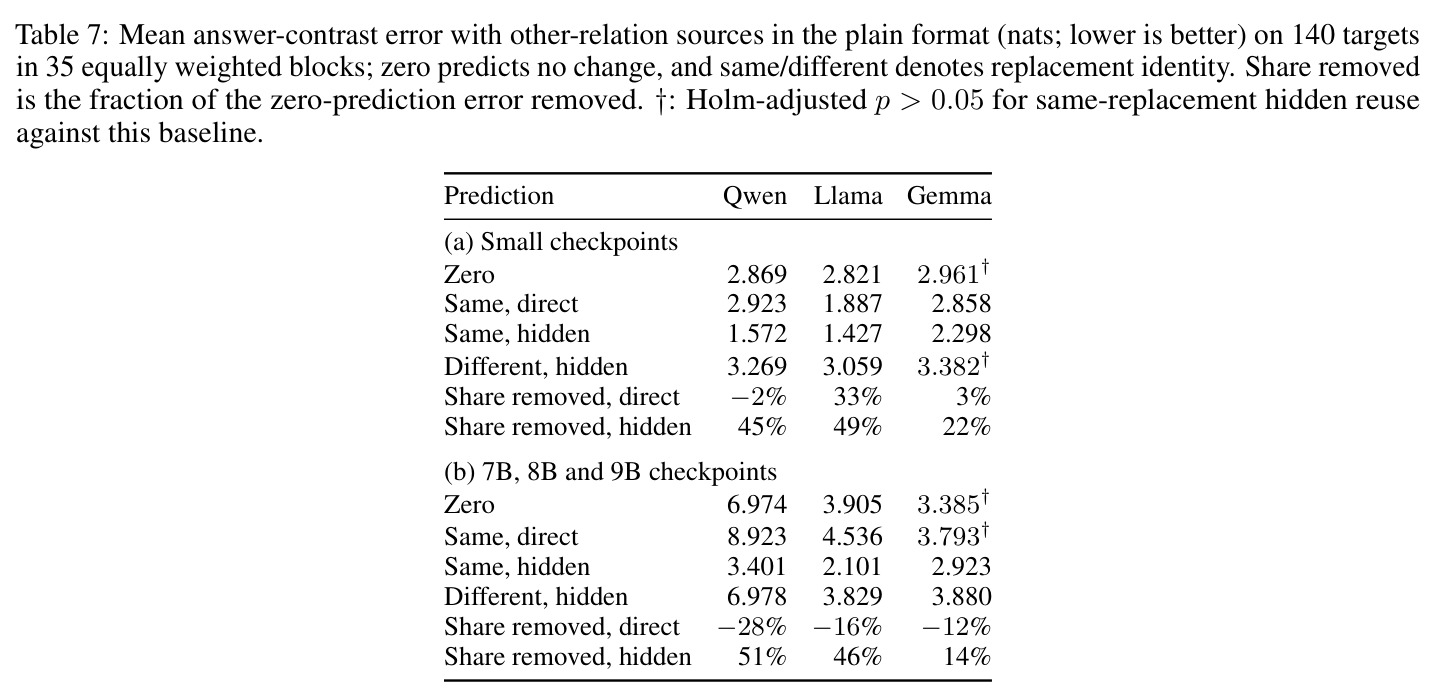
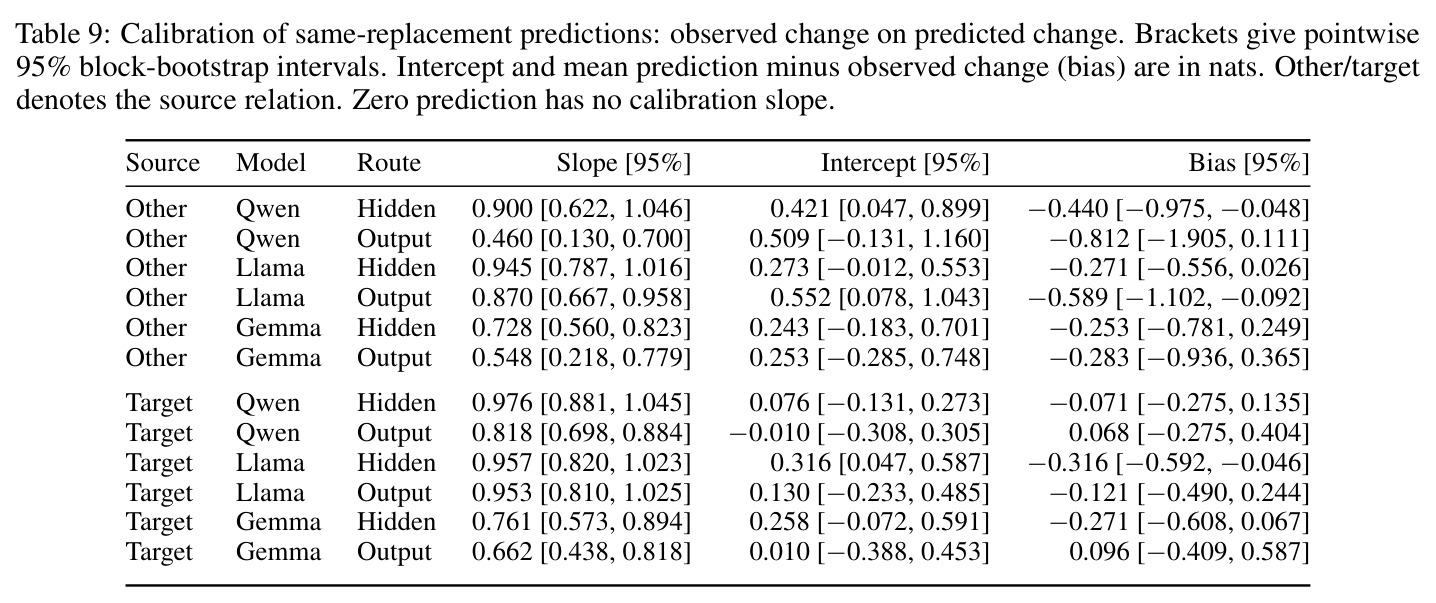
答案确认研究(35 个 block,plain 格式):其他关系来源的隐藏复用消除零预测误差的 45%(Qwen2.5-0.5B,2.869 降至 1.572 nats)、49%(Llama-3.2-1B)、22%(Gemma-2-2B);Qwen 与 Llama 通过全部 3 项预指定比较,Gemma 仅过 1 项。恢复 BOS 后两个 Gemma checkpoint 在三个 cohort 消除 58–69% 并通过全部比较;chat 格式下 18 项比较全部通过。7B/8B/9B plain 消除 51/46/14%,第一个新 cohort 上 Qwen-7B 与 Llama-8B 全过,第二个新 cohort 上小 checkpoint 对零预测全败。关系选择性方面:$s$ 仅携带观测方差的 9–38%;隐藏复用把共享误差削掉 34–62%,但 Llama-1B plain 的选择性误差变化为 −11.4%,小 checkpoint 的描述性区间从未整体为正。目标关系来源把隐藏对直接复用的优势从 0.55–5.05 压缩到 0.20–0.90 nats(plain Gemma 除外),且该残差优势不具替换特异性——错误替换反而多得 0.24–1.72 nats。关系中性同一变化在 99 个 block 中的 60–83 个降低选择性误差,通过全部 6 项检验并胜过随机与其他替换对照(后者的降低至多 0.22 nats)。深度扫描:span 对齐的消除比例从 $d=0$ 的 100% 降至 $d=1/2$ 的 46–70%,$d=7/8$ 处目标自身实体后行的 patch 占大头而其他关系响应远不及。testbed:广播向量误差甚至高于零预测,span 对齐在 6 个 checkpoint 中 5 个上胜过 90 种构造的最优者,增益 0.85/0.66/0.82/1.38/0.48/1.09 nats。答案 cue 处隐藏复用把与编辑目标的 KL 散度降低 88–97%(直接复用 44–87%);但贪心生成仅复现 5–23% 目标的答案串。全部 223 项确认性检验若合并为单一 Holm 族将改变 26 项结论。
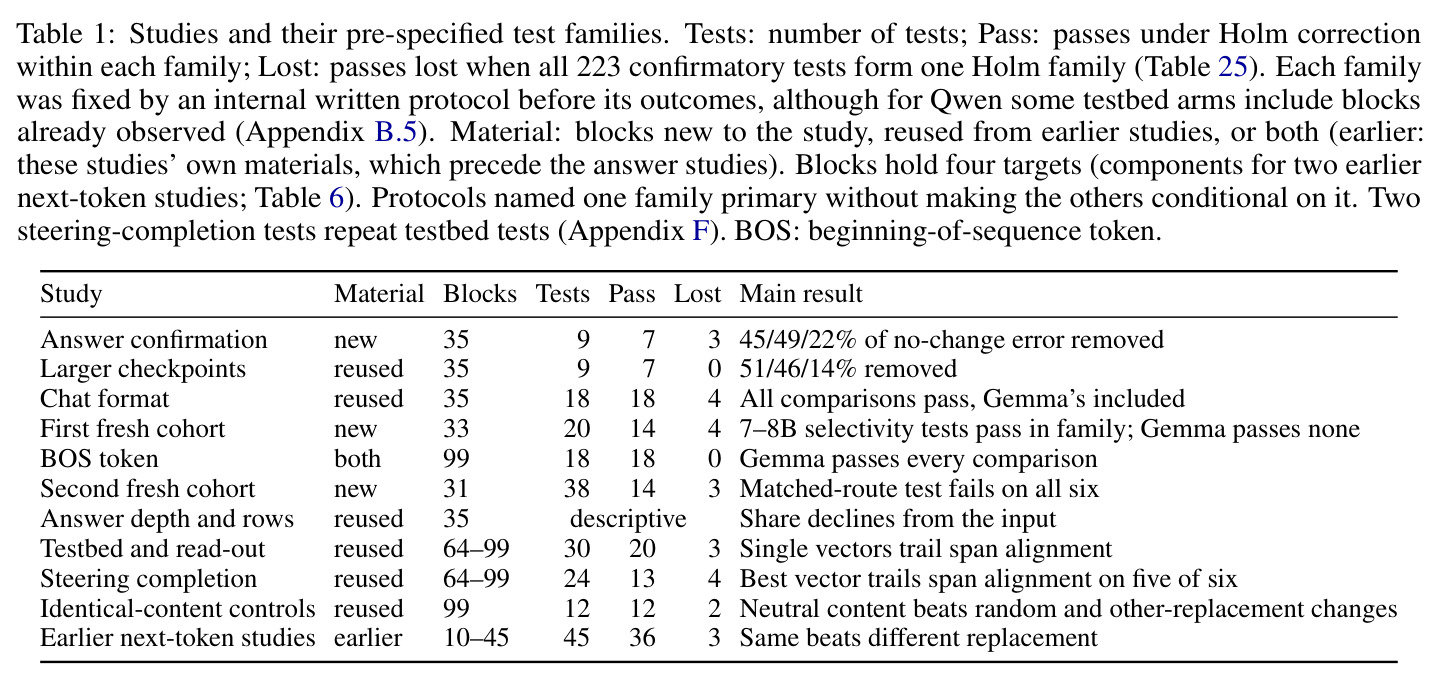
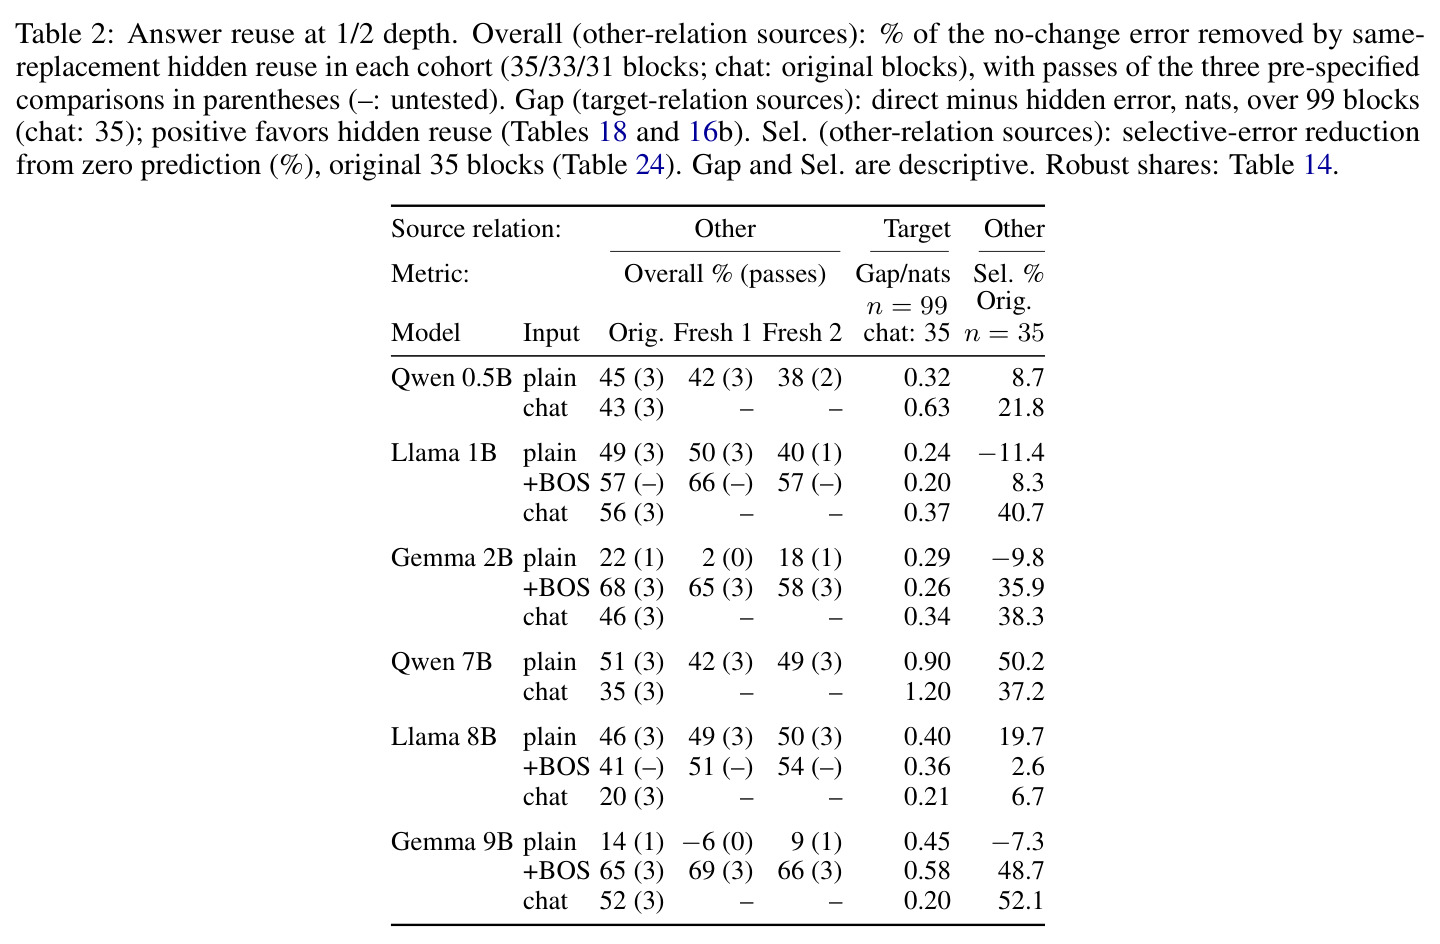
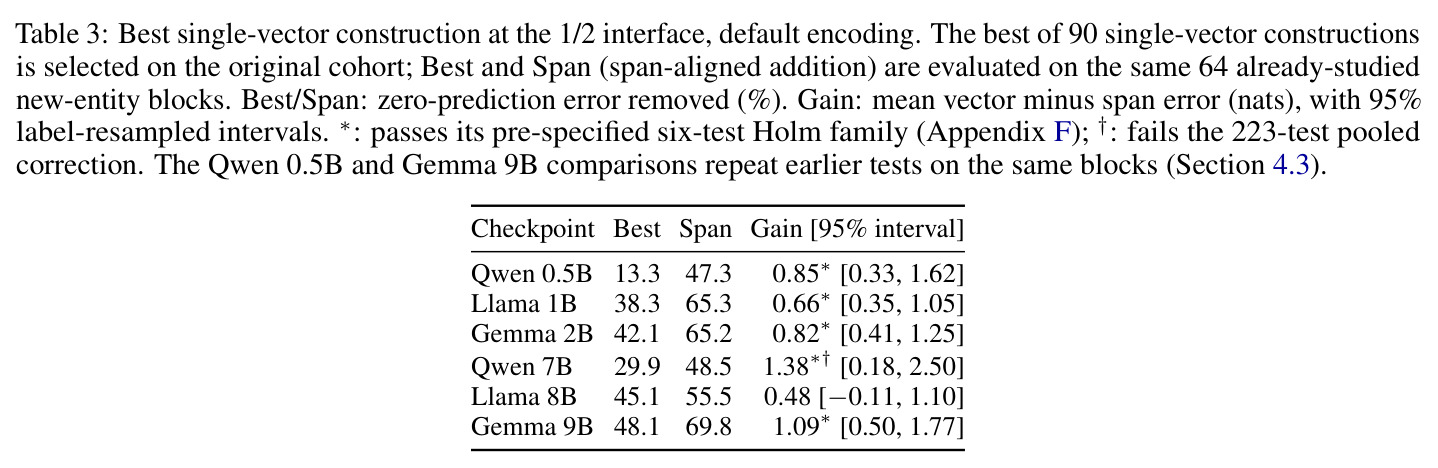
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 答案对比度复现(原始 35 block,plain 格式) | 零预测误差消除比例 | 隐藏复用:Qwen2.5-0.5B 45%、Llama-3.2-1B 49%(各 3 项预指定比较全部通过) | 零预测(不迁移)与直接复用 | Qwen 2.869→1.572 nats;直接复用几乎不消除误差,7–9B 反而增加 12–28% |
| Gemma 格式依赖性 | 零预测误差消除比例 | BOS 恢复后 58–69%(三个 cohort 全部比较通过);chat 格式 18 项比较全过 | plain 格式 Gemma-2-2B 的 22%(原始 cohort,仅过 1 项) | 提升约 36–58 个百分点,由单一 BOS token 驱动 |
| 关系选择性成分复现 | 选择性误差相对零预测的变化 | Llama-1B plain 为 −11.4%;小 checkpoint 描述区间未整体为正;7–8B 仅在新 cohort 部分通过 | 零预测 | 不可靠:共享误差降 34–62% 但选择性成分未被可靠复现,合并校正下多失败 |
| 构造形式比较(testbed,99 block,1/2 深度) | 相对最优单向量的平均误差差 | span 对齐加法胜 6 个 checkpoint 中 5 个,增益 0.48–1.38 nats | 90 种单向量构造的最优者(含广播向量、norm matching 等) | 广播向量误差高于零预测;5 项通过预指定族、4 项在合并校正下保持 |
局限与改进
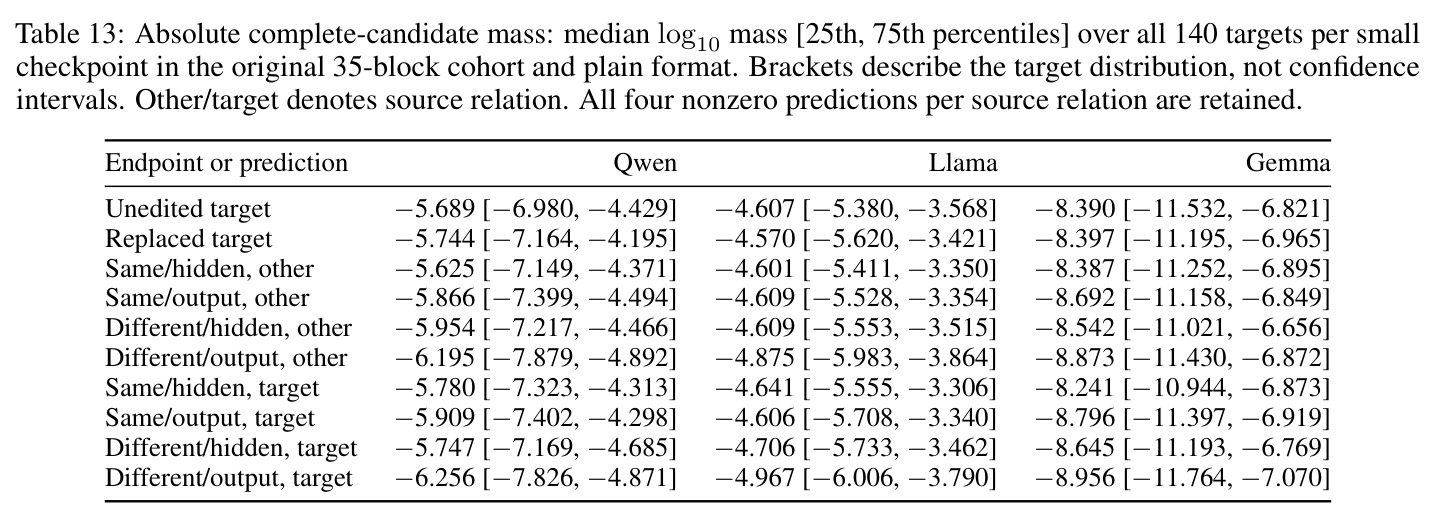
作者承认:关系标签与措辞一同变化,无法分离语义关系与表面措辞;新实体仍在熟悉的关系与模板族内,外推有限;只覆盖三个家族的六个 instruct checkpoint,规模与训练谱系混杂;chat 格式同时改变模板、BOS、指令与终止符,无法归因单一因素;确认性研究只在 50% 深度单一界面;后缀插值在 $d=0$ 不精确且会让实体行接收非实体源行;注意力阻断定位的是路径而非头或特征;完整答案评估的候选概率质量极低(中位数 $10^{-8.4}$ 至 $10^{-4.6}$),不含别名与等价格式;协议为内部而非外部注册;块独立性假设可能与跨 cohort 复用的标签与别名冲突。我的补充:所有结论对输入格式高度敏感——仅一个 BOS token 就让 Gemma 从 2–22% 跃升至 58–69%,说明所测现象与 tokenization 细节强耦合,机制层面的解释需要谨慎;选择性结论多为「区间未整体为正」的否定性证据,而每个 cohort 只有 31–35 个 block,80% 功效要求真实正号概率约 71–80%,检验失败不等于等价;此外 CPU float32 确定性设置与真实推理环境的 batch 与精度效应可能不同。
独立分析的弱点
独立分析出的弱点:其一,候选答案概率质量中位数仅 $10^{-8.4}$ 至 $10^{-4.6}$,评估的是模型几乎不会生成的字符串,贪心生成下复现率只有 5–23%,因此「45% 保真」外推到自由文本生成时要打折扣,改进方向是在开放式生成或采样式评估上重复该协议。其二,关系标签与模板措辞混杂且新 cohort 复用旧关系标签,「关系选择性」可能部分是措辞选择性,改进方向是构建控制措辞、只变关系谓词的对照集。其三,Gemma 对 BOS 的极端敏感性提示部分结果可能是预处理 artifact 而非机制性质,改进方向是系统报告各 checkpoint 对格式扰动的稳健性曲线。其四,90 种单向量构造的选择 cohort 与评估 cohort 都被早期研究观察过,存在选择偏倚风险(作者自己也承认),改进方向是使用真正留出的全新 cohort 重新调优与评估。其五,$s$ 与 $h$ 的分解只是输出对比度的代数分解,并非已识别的内部机制,把它解释为「共享回路与选择性回路」需要跨层电路追踪等独立的机制证据;注意力阻断实验只提供了部分且跨模型不一致的线索(Llama 上实体行阻断影响大,Gemma 上则否)。
未来方向
作者提出的方向:定位共享成分与关系选择性成分对应的内部回路(当前只是代数分解);解开 chat 格式中模板、BOS、指令与终止符各自的贡献(作者已发现恢复 BOS 能复现 Gemma 的提升但不复现 Llama-1B 的选择性增益);把注意力阻断细化到头与特征级别。基于成果可延伸的方向:其一,在 7B 以上的更大模型与前沿开源模型上重复实验,检验 span 对齐优势与选择性失败是否随规模消失;其二,与知识编辑(ROME、MEMIT)及 REMEDI 的学习式编辑结合,用本文的保真度指标评估编辑的跨问题泛化能力;其三,把候选评分扩展到别名、语义等价字符串与自由生成、采样路径,弥合 45% 候选复现与 5–23% 贪心复现之间的鸿沟;其四,研究单向量为何系统性落后于 span 对齐——是方向、幅度还是前缀信息缺失(norm matching 已显示部分缩窄但方向、覆盖与前缀信息仍混杂);其五,把 $s$ 与 $h$ 分解用于重新解释 RAVEL 类 interchange 结果,统一两条评估路线并检验跨研究的一致性。
复现评估
复现条件非常友好:模型全部为公开 checkpoint(Qwen2.5-0.5B/7B-Instruct、Llama-3.2-1B/Llama-3.1-8B-Instruct、Gemma-2-2B-it/2-9B-it),数据来自公开的 ZsRE 加 Wikidata 实体校验,所有实验在 CPU 上以 float32 确定性运行、构造与评分用 float64,算力需求极低,没有 GPU 门槛。论文附带了极详尽的方法学描述:附录 A 的符号表与构造细节、附录 B 的准入规则与协议顺序、附录 C 的功效分析(31–35 个 block 需要约 71–80% 的真实正号概率)、附录 E–G 的扫描与对照实现。但正文未提供代码仓库链接,后缀插值的逐行插值、前缀条件化捕获以及 90 种构造的精确定义都需要从文字重建,实现细节多、容易引入偏差;内部(非外部注册)协议也意味着无法核对预注册时间戳。总体难度评估为中高:算力不是问题,难点在于忠实地重造多 token 评分管线与统计协议,建议先复现 Table 2 中 Qwen plain 的数字(45%,2.869 降至 1.572 nats)作为健全性检查。
论文图表