DecisionRank:面向决策模型重排器的在策略蒸馏训练方法 DecisionRank: On-Policy Distillation for Decision-Model Rerankers
条目空间在策略蒸馏把生成式教师的排序能力压进单token决策模型,超越27B教师且快24.5倍
前置知识
Listwise 重排(生成式排序)
LLM 重排范式:把 query 与全部候选文档放进同一 prompt,让模型自回归地逐个生成按相关性降序排列的文档 ID 序列(RankGPT 的滑动窗口是代表)。相比 pointwise 逐对独立打分,它利用文档间相对信息,精度更高;代价是多步解码带来显著推理延迟。
本文的教师(Qwen3.8-27B)就是一个生成式 listwise 重排器,而要解决的痛点正是这类模型延迟高;理解教师按序列表达偏好这一特性,才能看懂师生之间的结构性错配。
首 token 排序(first-token ranking / 决策模型)
决策模型不做文本生成:模型读完 query 和全部候选后,直接读取第一个输出位置上各文档 ID token 的 logits $s_i$,将 $s_i$ 降序排列即得完整排名,单次前向就完成 100 篇文档的排序,代表工作为 FIRST。
DecisionRank 正是这样的单 token 重排器,论文所有训练目标(RankNet、OPD、GRPO 消融)都作用在同一批 first-token logits 上,这是理解方法的前提。
在策略蒸馏(On-Policy Distillation,GKD 范式)
传统蒸馏让学生模仿教师事先固定的输出(离线蒸馏);在策略蒸馏则先用学生自己生成的序列构造状态,让教师在这些学生实际会到达的状态上给出条件分布,再用 KL 散度对齐(GKD、MiniLLM)。它能缓解训练与推理的分布漂移,但通常要求学生能自回归 rollout。
本文的核心难题是:单 token 排序模型没有自回归 rollout,token 级在策略蒸馏无法直接套用,必须重新设计——这正是 item-space OPD 的出发点。
Plackett–Luce 分布
概率排序模型:把产生一个排列分解为一连串无放回选择。第 $t$ 步在剩余候选集 $R_t$ 上按 $p(i)=\exp(s_i)/\sum_{j\in R_t}\exp(s_j)$ 选一个文档,各步概率连乘得到整个排列的概率。它是 softmax 分类到排序任务的自然推广,能把静态分数向量变成合法的序贯选择分布。
论文用它把学生一次前向得到的 first-token 分数转化为每一步在剩余候选中选择的概率分布,从而与教师的条件选择分布逐步对齐。
反向 KL 散度(reverse KL)
$D_{KL}(p_\theta\|p_T)=\sum_i p_\theta(i)\log\frac{p_\theta(i)}{p_T(i)}$,方向与前向 KL 相反:前向 KL 要求学生在教师有任何概率的地方都覆盖(mode-covering),反向 KL 要求学生把概率集中在教师认可的地方(mode-seeking),会重罚学生选择了教师认为差的候选。
论文的 OPD 损失取学生分布在前、教师在后的反向 KL,直觉是直接惩罚学生当前排名里教师不同意的选择;这也是与 Offline KL 基线(前向 KL)对比的关键变量。
RankNet 损失
经典 pairwise 学习排序损失:对教师排名中 $d_i\succ d_j$ 的文档对,惩罚学生分数逆序,$\mathcal{L}_{RN}=\sum_{(i,j)} w_{ij}\log(1+\exp(s_j-s_i))/\sum w_{ij}$;权重用秩效用差 $w_{ij}=u(r_i^T)-u(r_j^T)$,$u(r)=1/\log_2(1+r)$,越靠前的错排罚得越重。
它是本文全部训练配置的共同离线基础(表 2 中每个对比目标都是在 RankNet 之上叠加的),也是最终联合目标 $\mathcal{L}=\mathcal{L}_{RN}+\lambda\mathcal{L}_{on}$ 中的第一项。
nDCG@10 与 ECE 校准误差
nDCG@10 对前 10 位结果按相关性增益和位置折扣 $\log_2(r+1)$ 加权求和再除以理想排序得分,论文统一报告 nDCG@10×100。ECE(期望校准误差)衡量模型置信度与实际正确频率的差距:把成对偏好预测按置信度分箱,累加各箱准确率与平均置信度之差的绝对值,越低越校准。
nDCG@10 是全文四个基准的主指标(Listwise GRPO 基线甚至直接拿它当 RL 奖励);ECE 则用于论文的额外发现——学生比教师校准得更好。
研究动机
生成式 listwise 重排器(RankGPT、RankZephyr、DirectRank 等)通过自回归逐个解码文档 ID 来产生排名,精度虽高,但每条查询要执行多轮前向与解码,延迟显著——论文实测 listwise DirectRank-8B 在 TREC DL 上每查询约需数秒,而决策模型(如 FIRST,对 first-token 文档 ID logits 排序)只需一次前向。要把生成式教师的排序知识迁移进决策模型,存在结构性错配:教师通过文档 ID 序列表达偏好,每一步选择都以已选文档为条件;学生则用一次前向产生的静态 first-token 分数向量决定整个排名。朴素做法均不理想:只匹配教师的 first-token 分布(Offline KL)会浪费后续所有条件选择信息;让学生自回归生成完整排名序列(AR SFT / AR OPD)又与推理时只用 first-token 分数的方式不一致。此外,传统离线蒸馏用教师事先生成的固定排名做监督,无法随学生预测的演化给出针对性反馈。
本文的目标是论文的核心问题被明确表述为:如何把自回归教师的序贯排序偏好,蒸馏进一个只需单次前向就能给全部候选排序的学生?具体目标是构建 DecisionRank:以 Qwen3(1.7B/4B/8B)为学生、Qwen3.8-27B 生成式重排器为教师,同时利用两种监督——教师离线排名的全局排序监督(RankNet),以及针对学生当前排名状态的教师条件反馈(在策略);推理时学生保持单次前向、零自回归解码。成功标准是在 TREC DL、BEIR(通用检索)与 BRIGHT、R2MED(推理密集检索)四个基准上超过现有 pointwise/listwise 重排器,同时把每查询延迟降低一个数量级,并在不同教师家族与学生规模上保持一致增益。
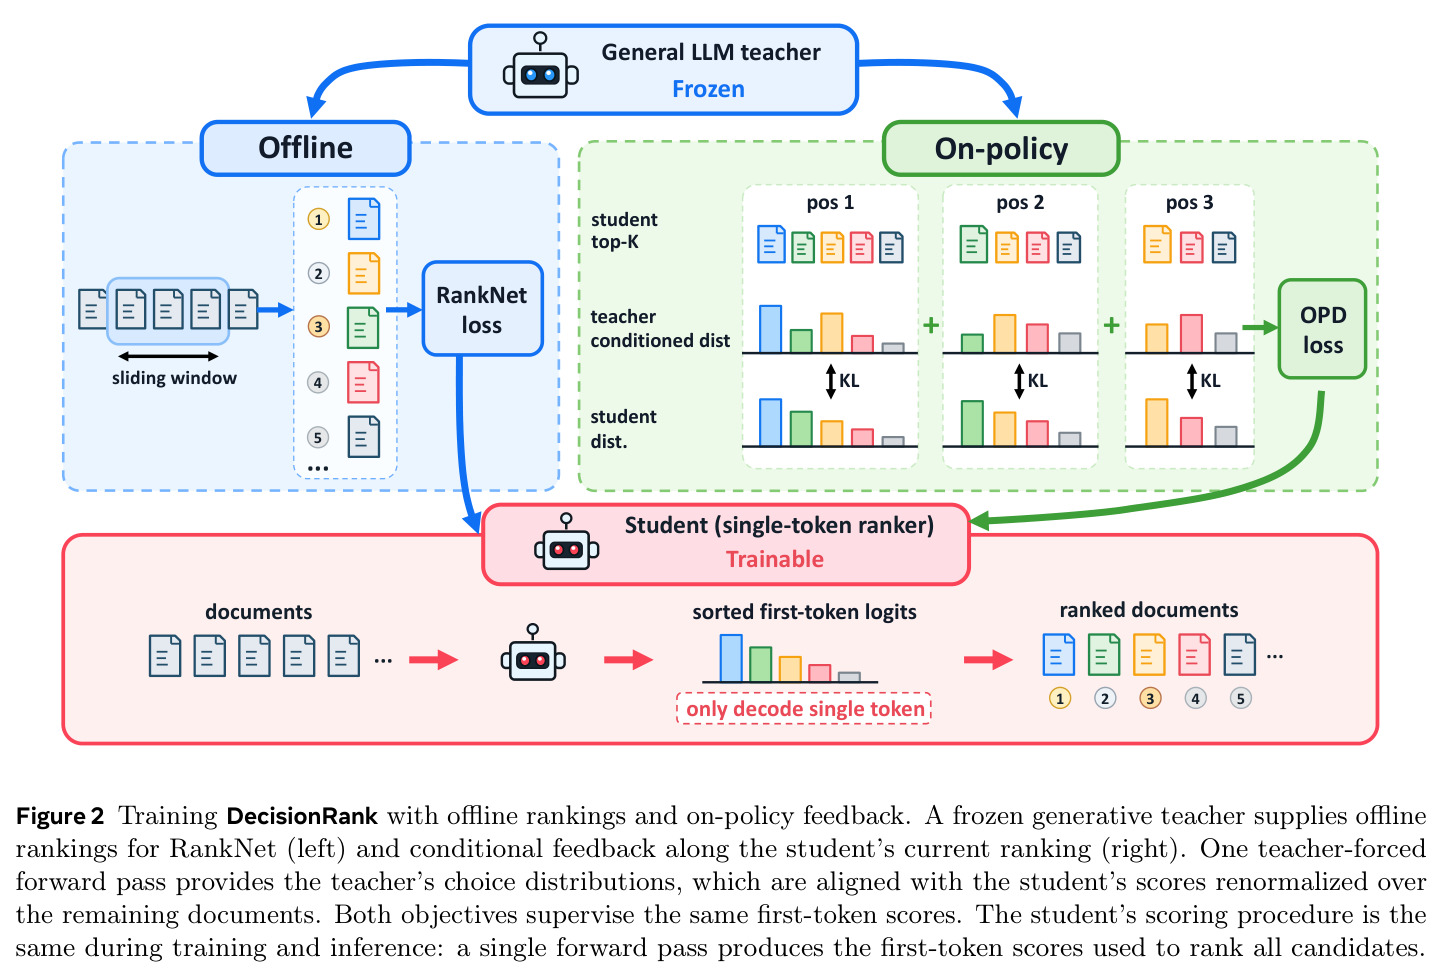
与已有工作不同的是,独特切入点是条目空间在策略蒸馏(item-space OPD)。与 GKD、MiniLLM 等 token 级在策略蒸馏不同,作者不让学生自回归 rollout,而是把学生自己的 first-token 分数降序排列,用其当前 top-K(K=20)排名前缀充当学生的 rollout;再让冻结的教师以 teacher forcing 方式对该前缀做一次前向,读出每一步在剩余候选上的条件选择分布;最后在条目空间(候选文档身份)而非词表 token 空间对齐师生分布——因此两者无需共享词表或架构,可跨家族蒸馏(Gemma 教师→Qwen 学生)。该设计把教师只能按序列给反馈与学生只用静态分数两个世界接起来,使反馈直接作用于推理时真正使用的 first-token logits,并与离线 RankNet 全局监督形成互补。
核心方法
直觉上,好的排序教学应包含两部分:告诉学生全局上哪些文档该排前面(离线标准答案),以及在学生自己排出一个排名后,逐位指出此刻还剩这些候选、教师会怎么选(在策略纠正)。技术上,学生输入 query 与全部 $N\le100$ 个候选,为每个候选分配一个单 token 文档 ID $v_i$(从词表中 100 个单 token ID 池取),取第一输出位置的 logits $s_i$,降序排列得排名 $\pi=\mathrm{argsort}^{\downarrow}_{i\in\{1..N\}} s_i$。训练目标为 $\mathcal{L}=\mathcal{L}_{RN}+\lambda\mathcal{L}_{on}$($\lambda=0.1$):$\mathcal{L}_{RN}$ 是教师在离线排名(滑窗 $W=20$、stride $s=10$ 生成)上的加权 RankNet 损失;$\mathcal{L}_{on}$ 是条目空间 OPD——取学生 top-K 前缀,教师一次 teacher-forced 前向给出各步条件分布,与学生在相同剩余候选集上重归一化的 Plackett–Luce 分布做反向 KL。两个损失只更新同一批 first-token 分数,教师全程冻结;推理时学生单次前向即可排序全部候选,无任何自回归生成。
本质创新是把在策略从序列空间搬进条目空间。已有在策略蒸馏需要学生自回归 rollout、反馈是下一个 token 的分布;而单 token 排序器的推理行为是一组静态分数,没有 rollout。作者用学生分数的排序本身充当确定性轨迹:第 $t$ 步设已选前缀 $h_t=(\pi_1,\dots,\pi_{t-1})$、剩余集合 $R_t=S\setminus\{\pi_1,\dots,\pi_{t-1}\}$,学生分布 $p_{\theta,t}(i)=\exp(s_i)/\sum_{j\in R_t}\exp(s_j)$——每一步都复用同一批 first-token 分数,只是剩余集合在收缩;教师分布 $p_{T,t}(i)=a_{T,t}(i)/\sum_j a_{T,t}(j)$ 来自对 query 与已选文档的一次 teacher-forced 前向。反向 KL $\ell_t=D_{KL}(p_{\theta,t}\|p_{T,t})$ 在 $T_{step}=\{2,\dots,K-1\}$ 上平均(第一步交给离线监督管全局排序;最后一步只剩一个候选、KL 恒为 0 故省略)。对齐按候选身份而非词表 token 进行,因此异构师生(如 Gemma-4-31B 教 Qwen3 学生)也能蒸馏。
方法步骤详情
完整流程:(1)数据准备——10,000 条 MS MARCO 查询(Rank-DistiLLM)+ 6,000 条 ReasonEmbed 合成查询(12 类各 500),共 16,000 条;教师用滑窗($W=20$、stride $10$、关闭思考)生成离线排名。(2)学生前向——query+100 候选一次前向,读 first-token 文档 ID logits $s_i$,排序得 $\pi$,取 top-$K$($K=20$)。(3)教师反馈——把学生 top-K 排名译成教师数值 ID,作为 teacher-forced 答案序列,教师一次前向读出所有步的条件分数 $a_{T,t}(i)$,无需多次调用。(4)OPD 损失——师生在相同剩余集 $R_t$ 上归一化,反向 KL 在 $t\in\{2,\dots,19\}$ 平均得 $\mathcal{L}_{on}$。(5)RankNet 损失——$\mathcal{L}_{RN}=\sum w_{ij}\log(1+e^{s_j-s_i})/\sum w_{ij}$,$w_{ij}=u(r_i^T)-u(r_j^T)$,$u(r)=1/\log_2(1+r)$。(6)联合优化 $\mathcal{L}=\mathcal{L}_{RN}+0.1\,\mathcal{L}_{on}$:batch=32,学习率 1.7B 用 $2\times10^{-5}$、4B/8B 用 $6\times10^{-6}$;参数更新后重新排序、重新获取教师反馈,形成在策略循环。(7)推理——单次前向+排序,无自回归解码;TREC DL 截断 128 token,其余基准 384 token。
技术新颖性
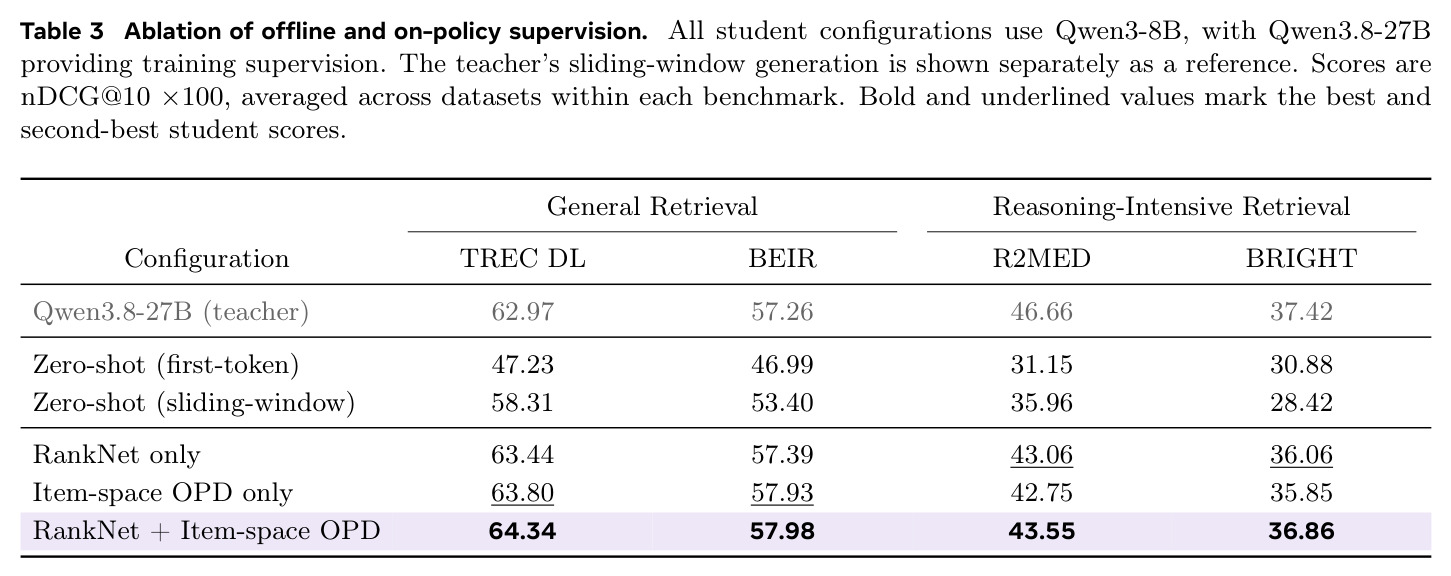
新颖性有三层。第一,结构层面:首次为没有 rollout 的决策模型定义了在策略蒸馏——用排序本身作为确定性轨迹、用 Plackett–Luce 把静态分数变成逐步选择分布,使序贯条件反馈能作用于一次前向的分数向量;这既不同于 FIRST/Rank-DistiLLM 的纯离线监督,也不同于 GKD 式的 token 级 AR-OPD(论文实测 AR SFT/AR OPD 因训练-推理错配反而损害通用检索)。第二,空间层面:按候选条目身份而非词表 token 对齐师生分布,解除了师生必须同词表/同架构的限制,实验证明 Gemma-4-31B、Qwen3.8-27B、ReasonRank-32B(基于 Qwen2.5)三种教师都能有效教 Qwen3 学生。第三,目标互补性:消融(表 3)显示 RankNet-only 与 OPD-only 各有强弱(OPD-only 在 R2MED 42.75、BRIGHT 35.85 均低于联合的 43.55/36.86),联合后四个基准全部最优,证明全局排序监督与当前状态条件反馈是正交互补而非二选一;反向 KL 直接矫正学生在自己当前排名上的过度自信错误,这是固定离线标签做不到的。
实验结果
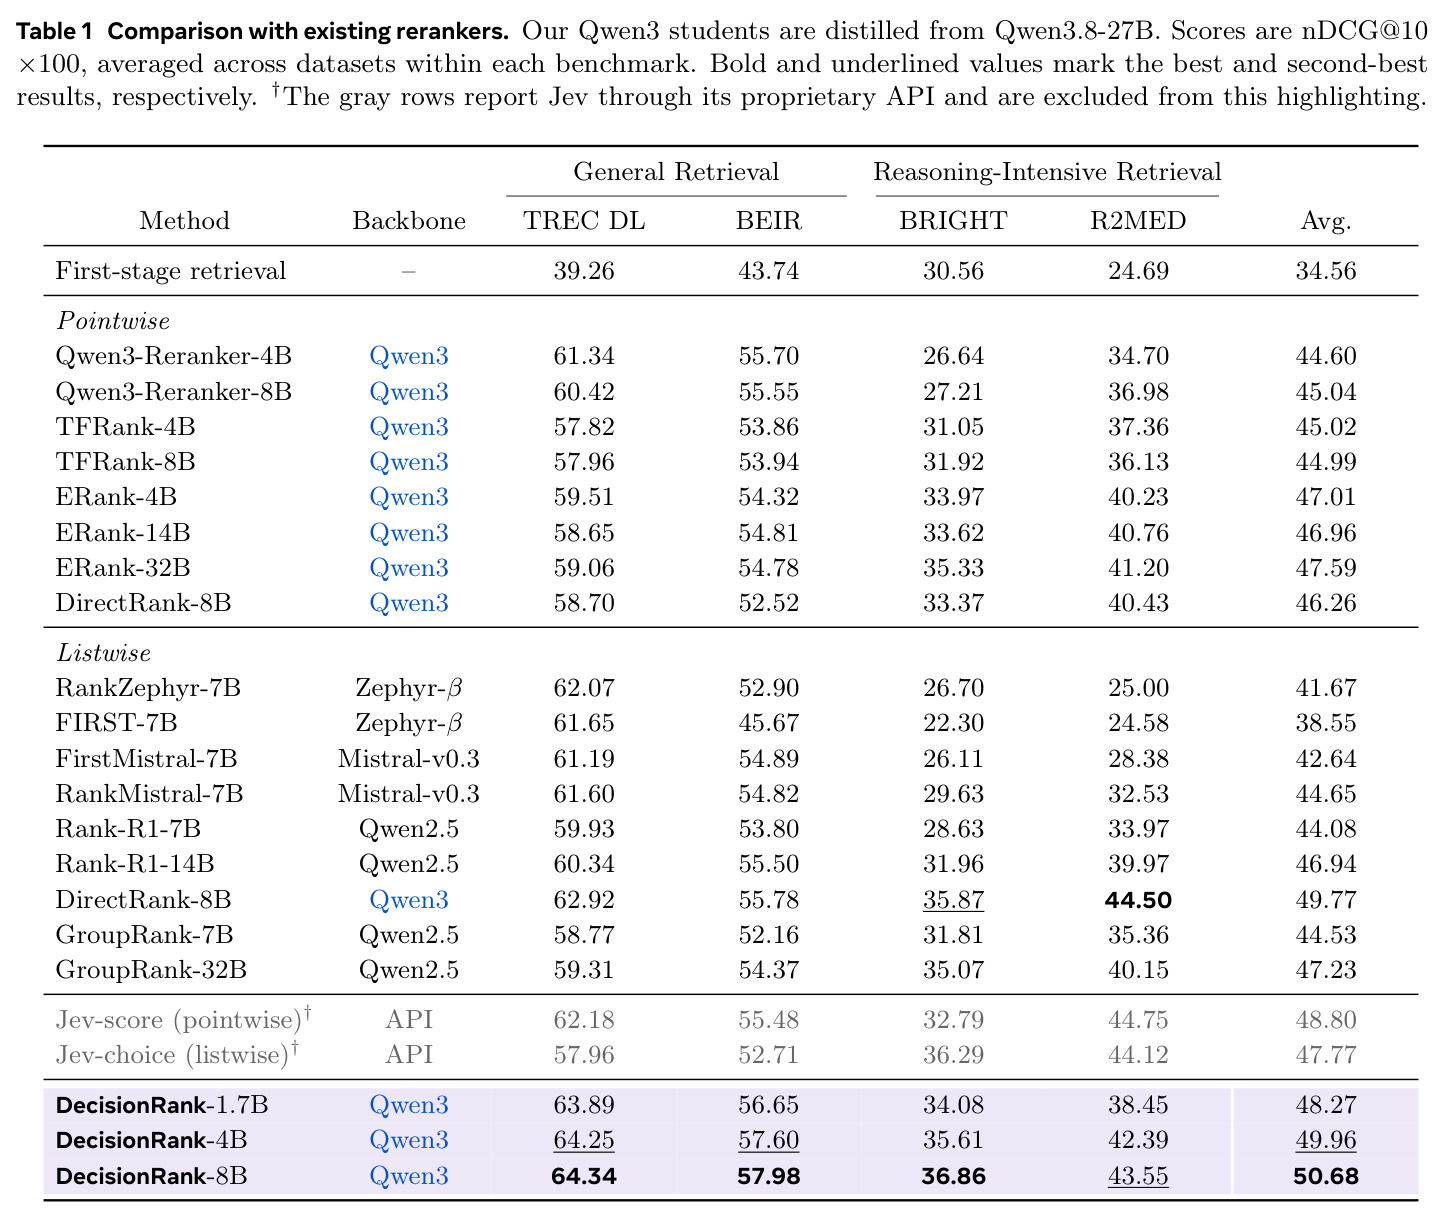
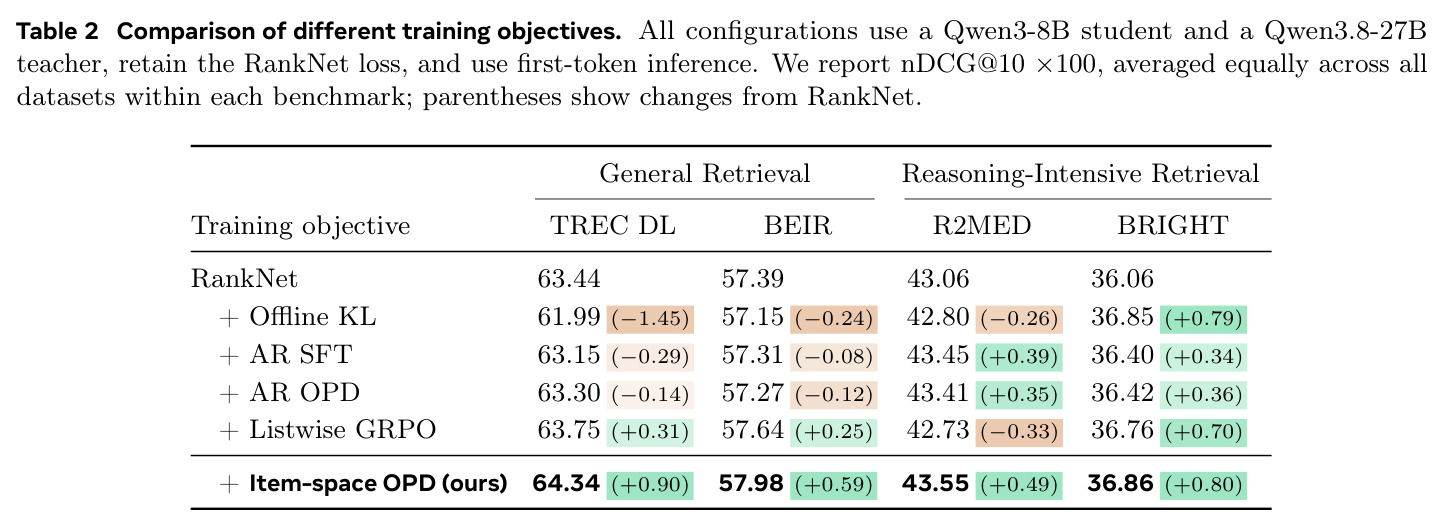
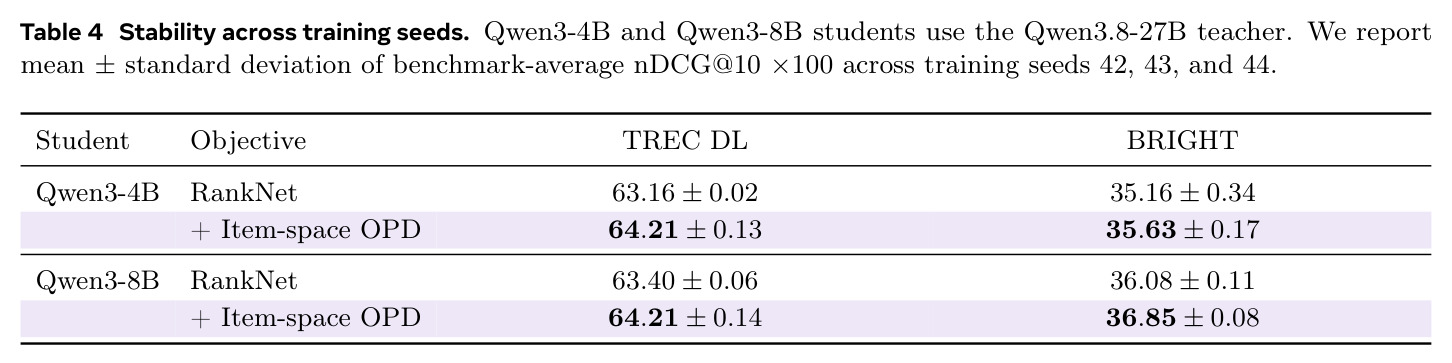
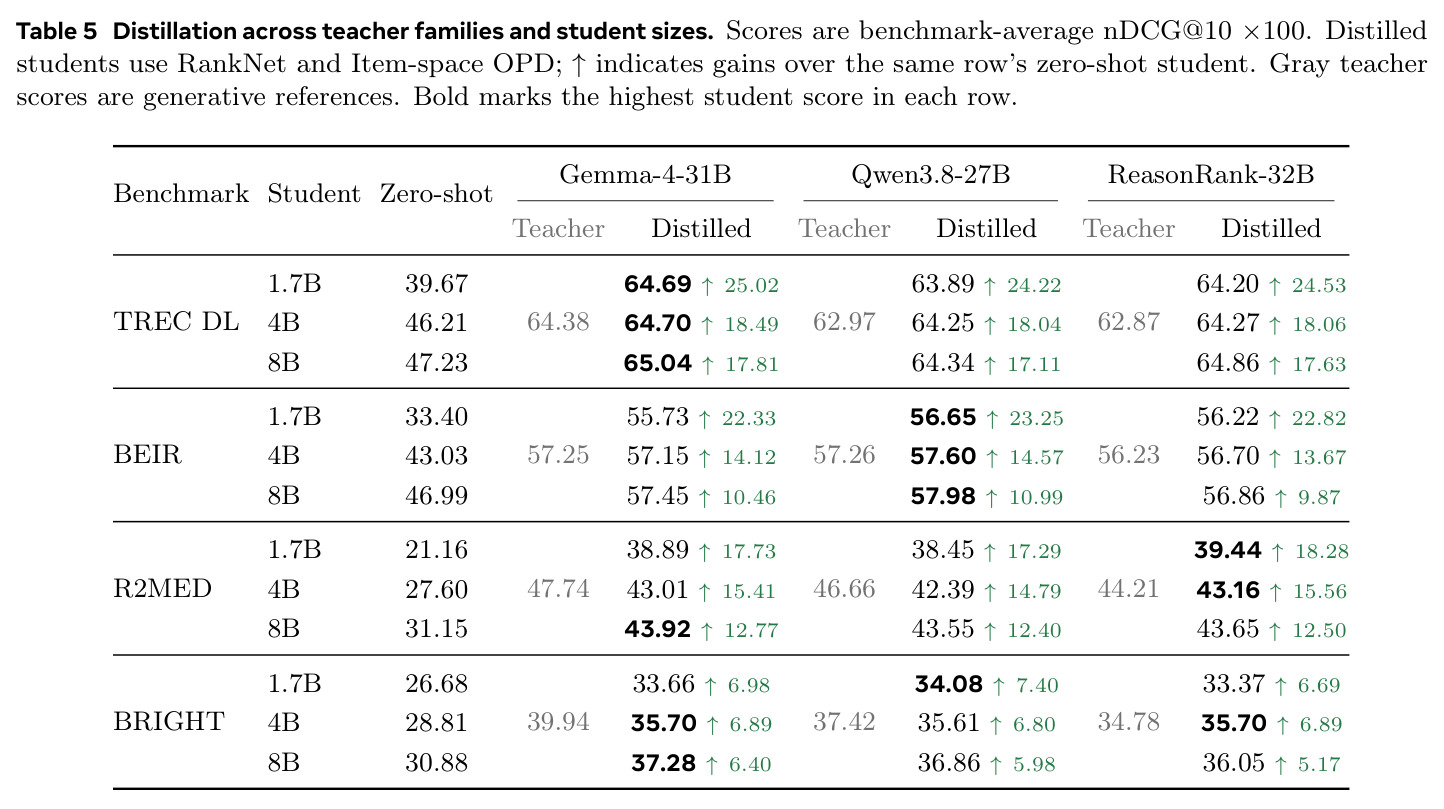
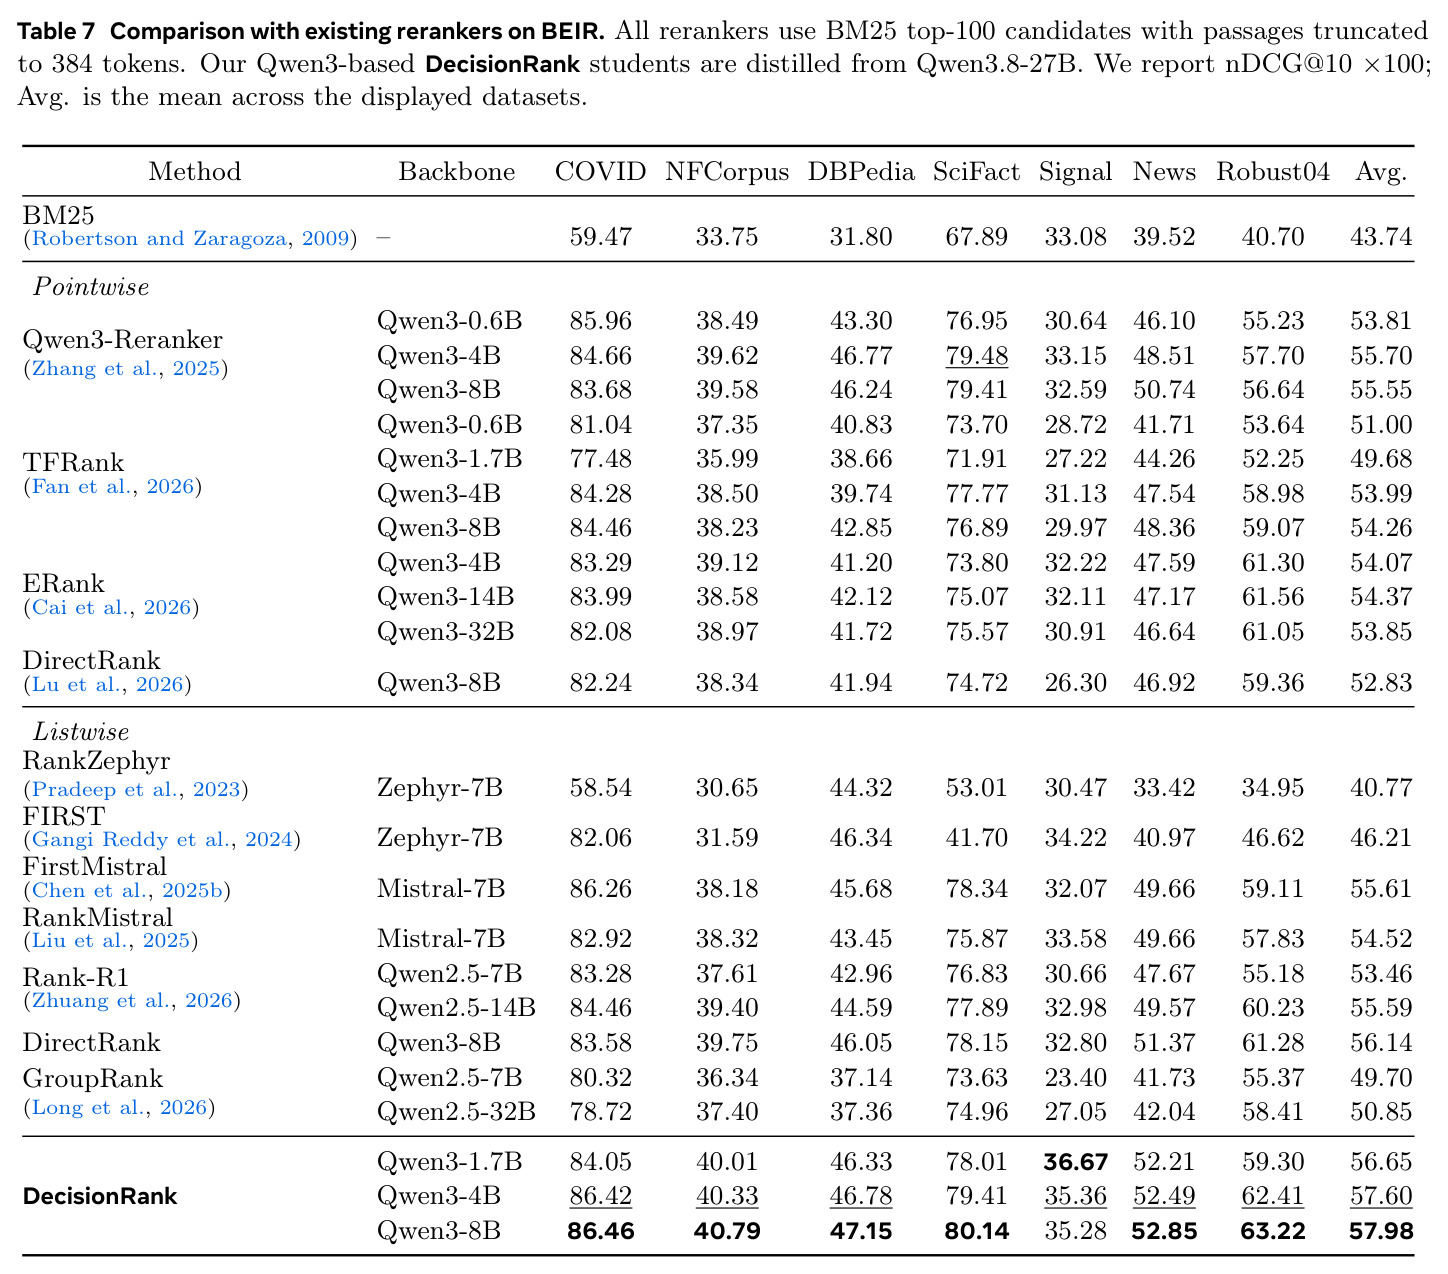
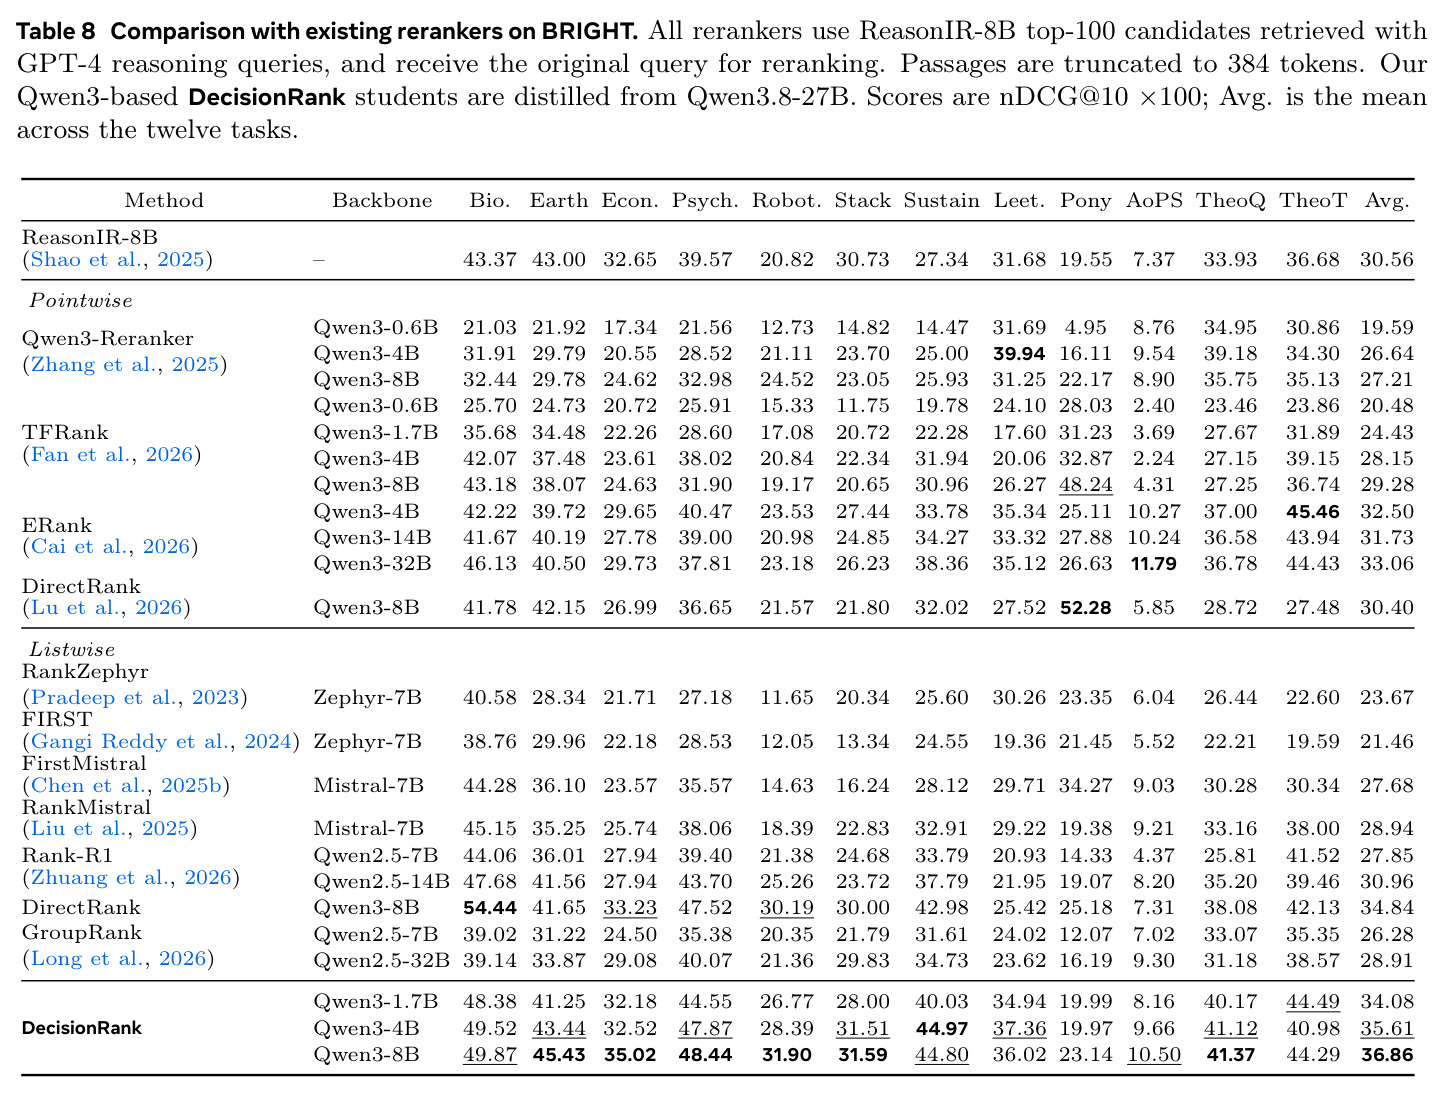
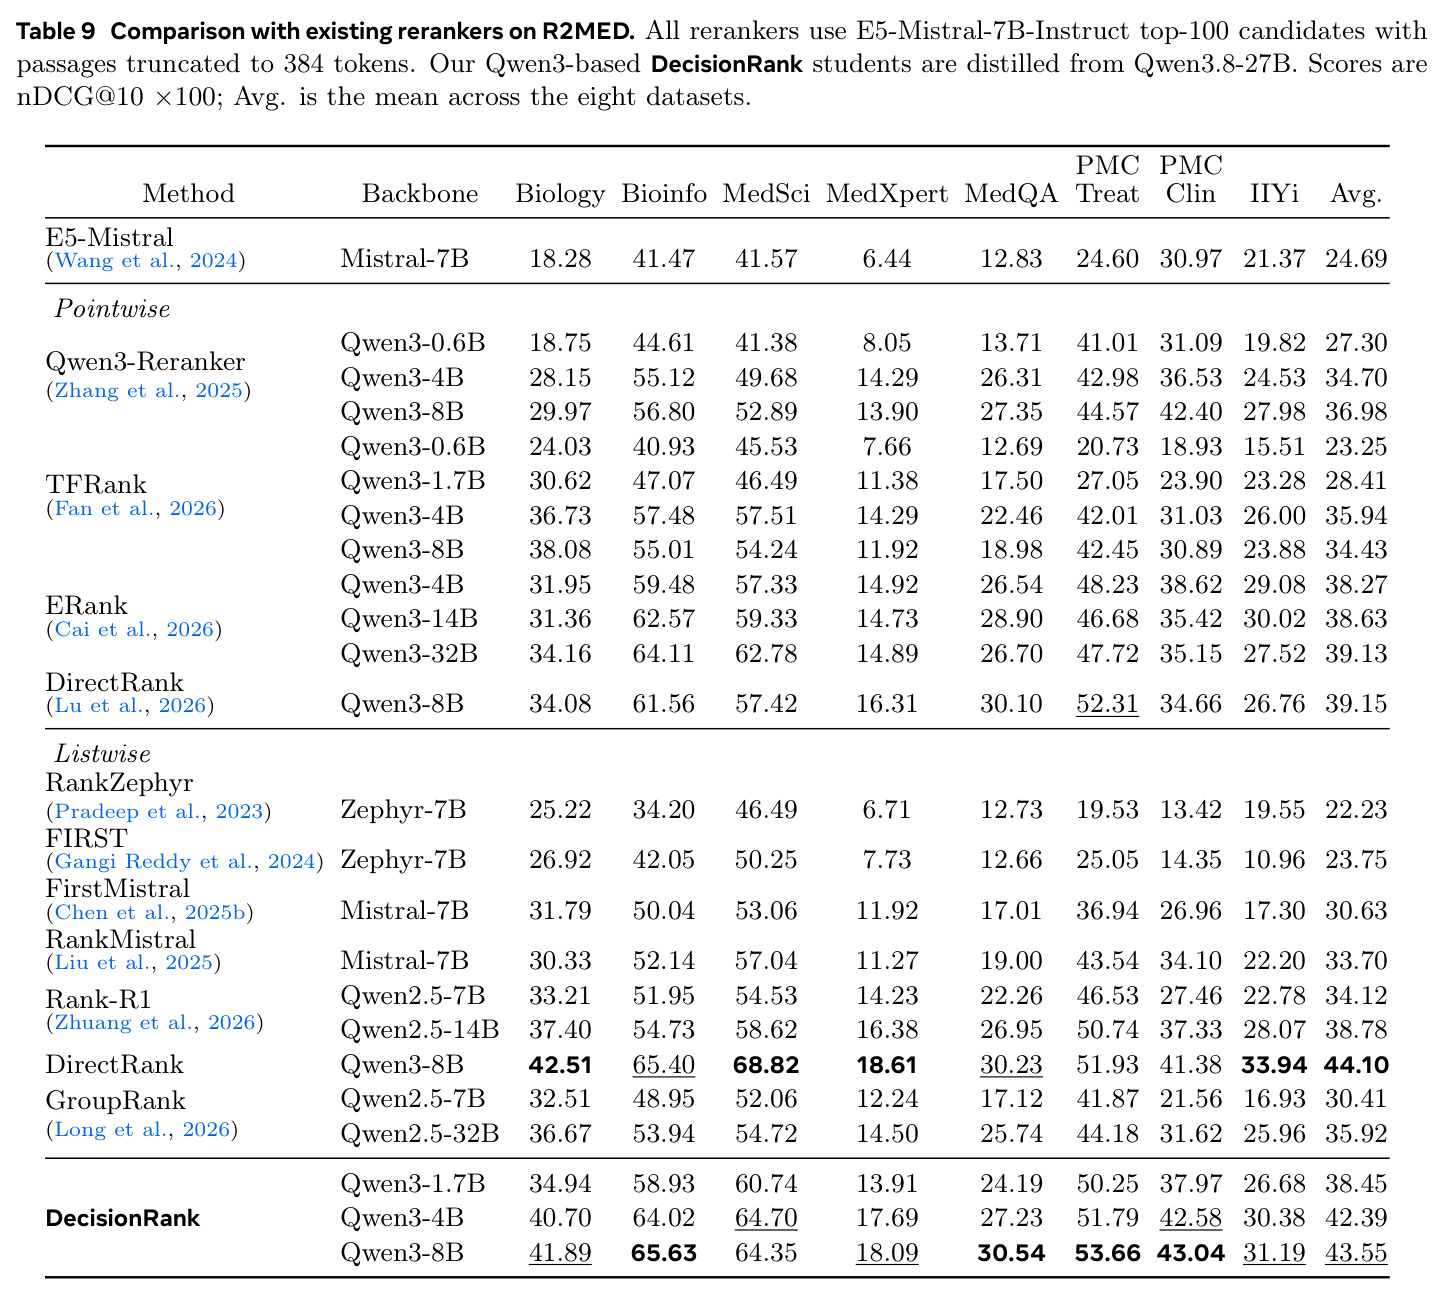
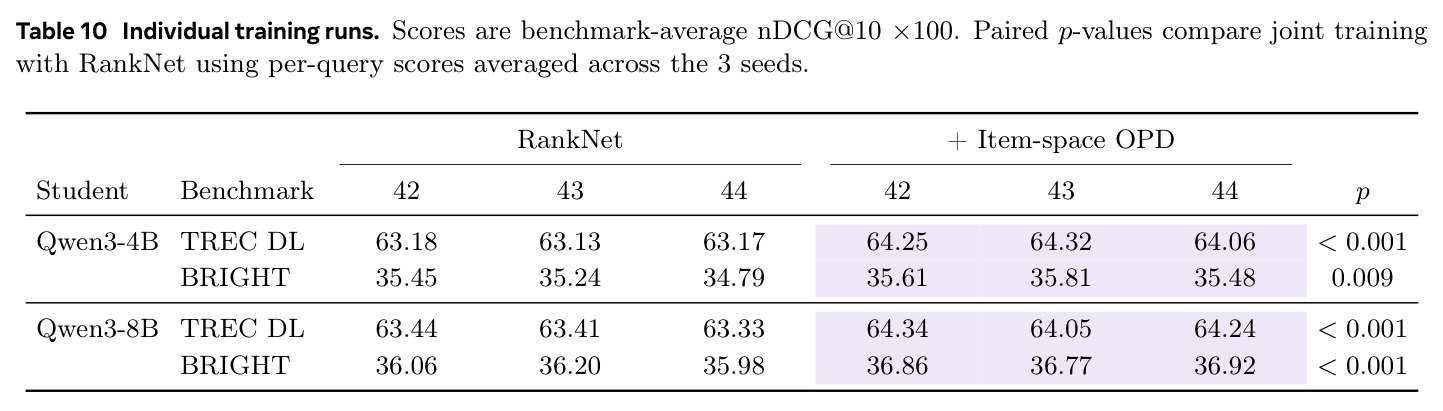
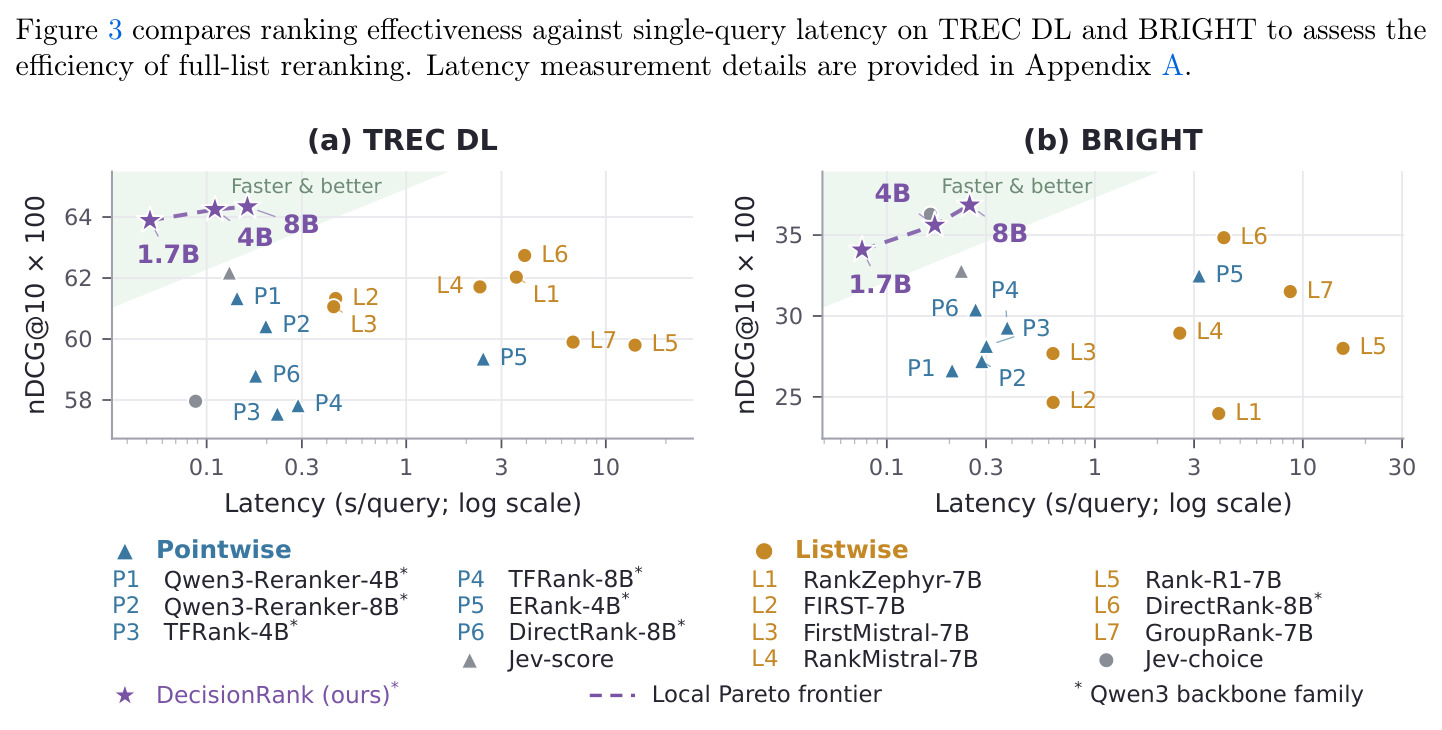
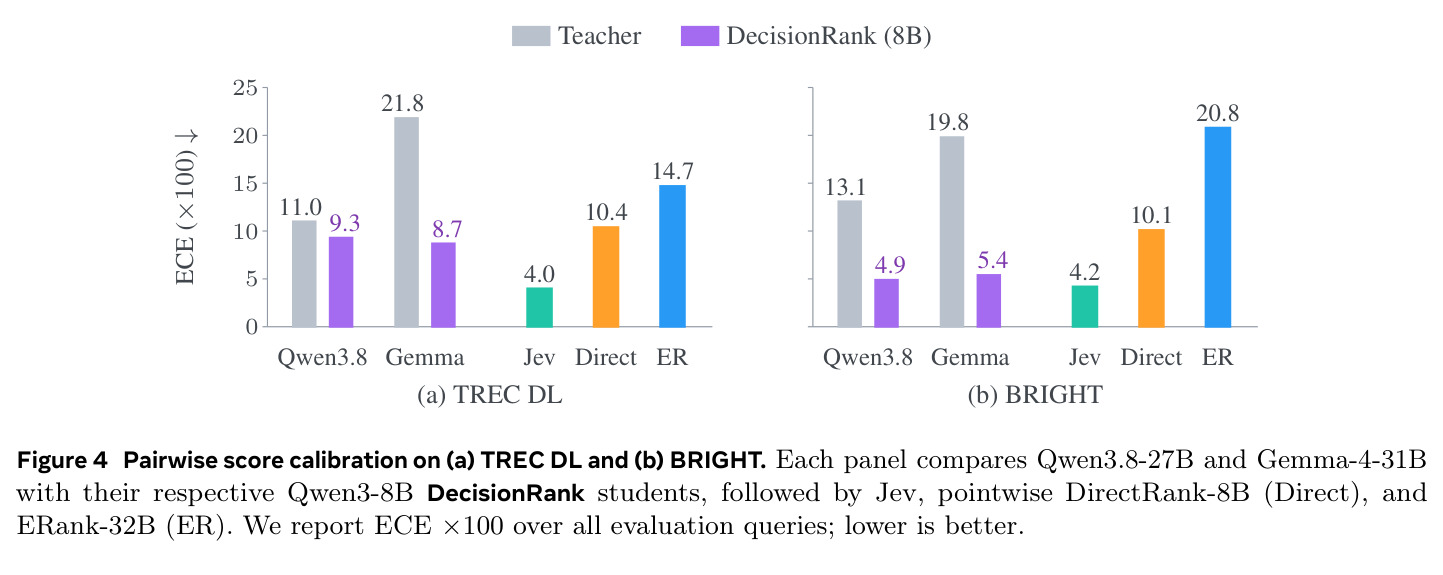
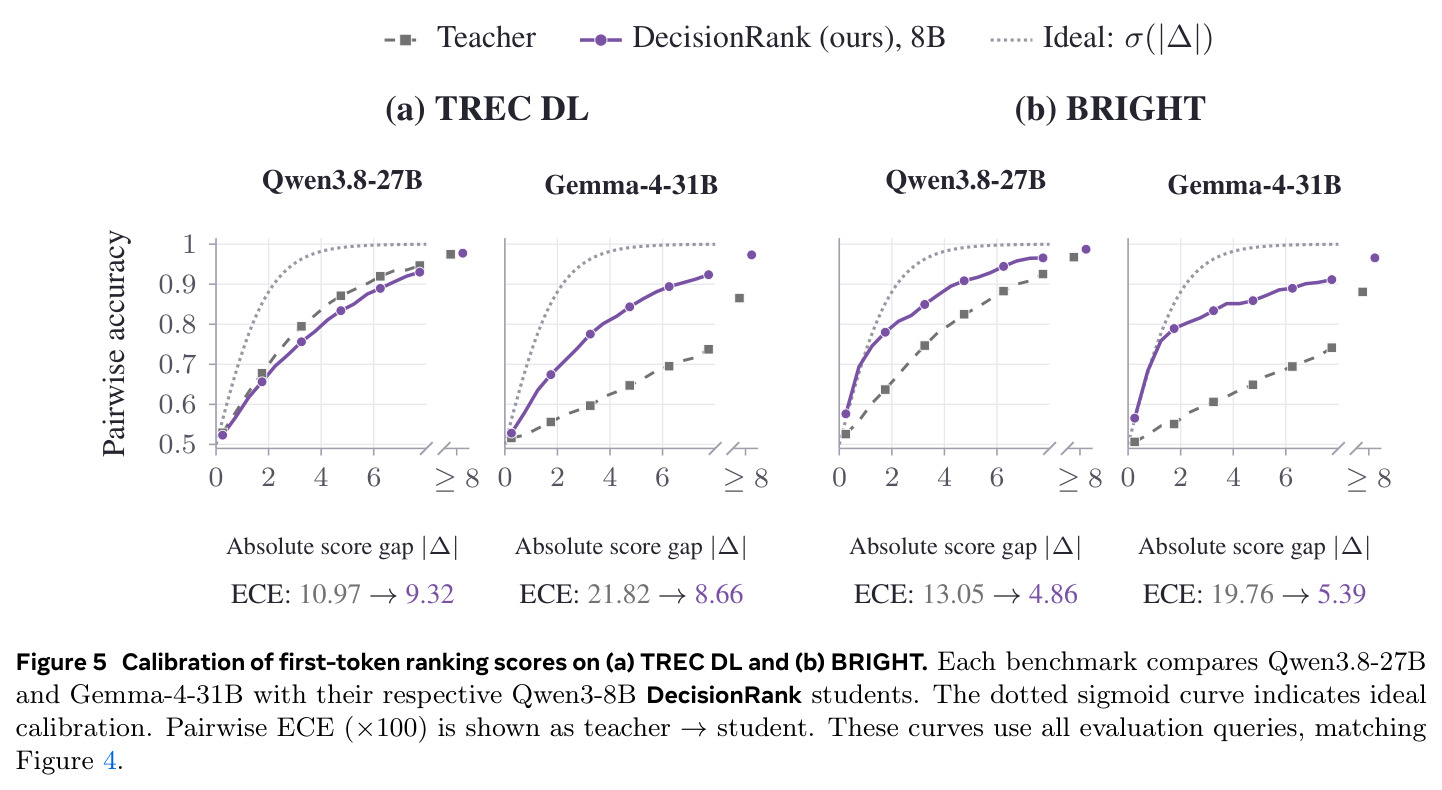
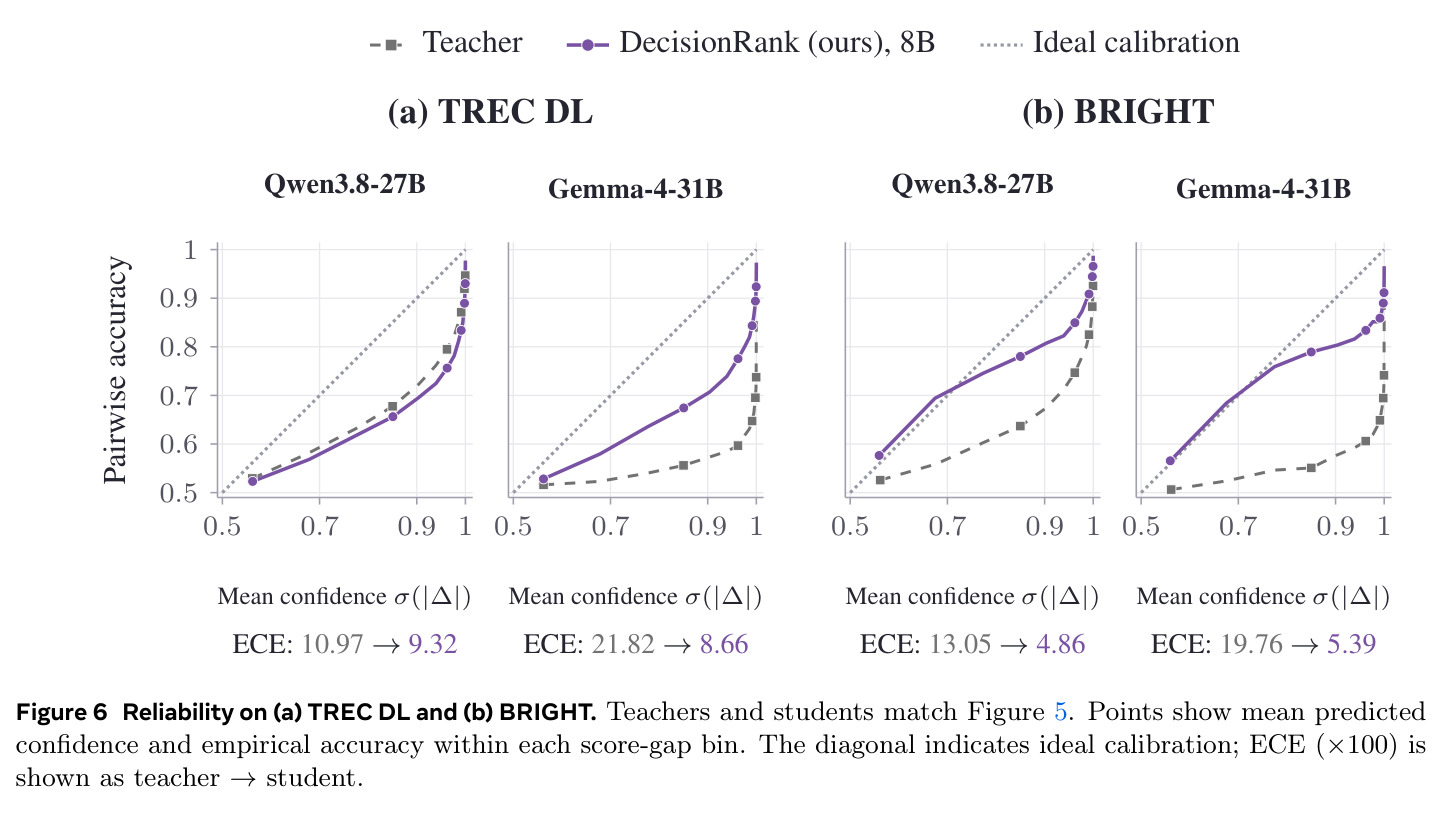
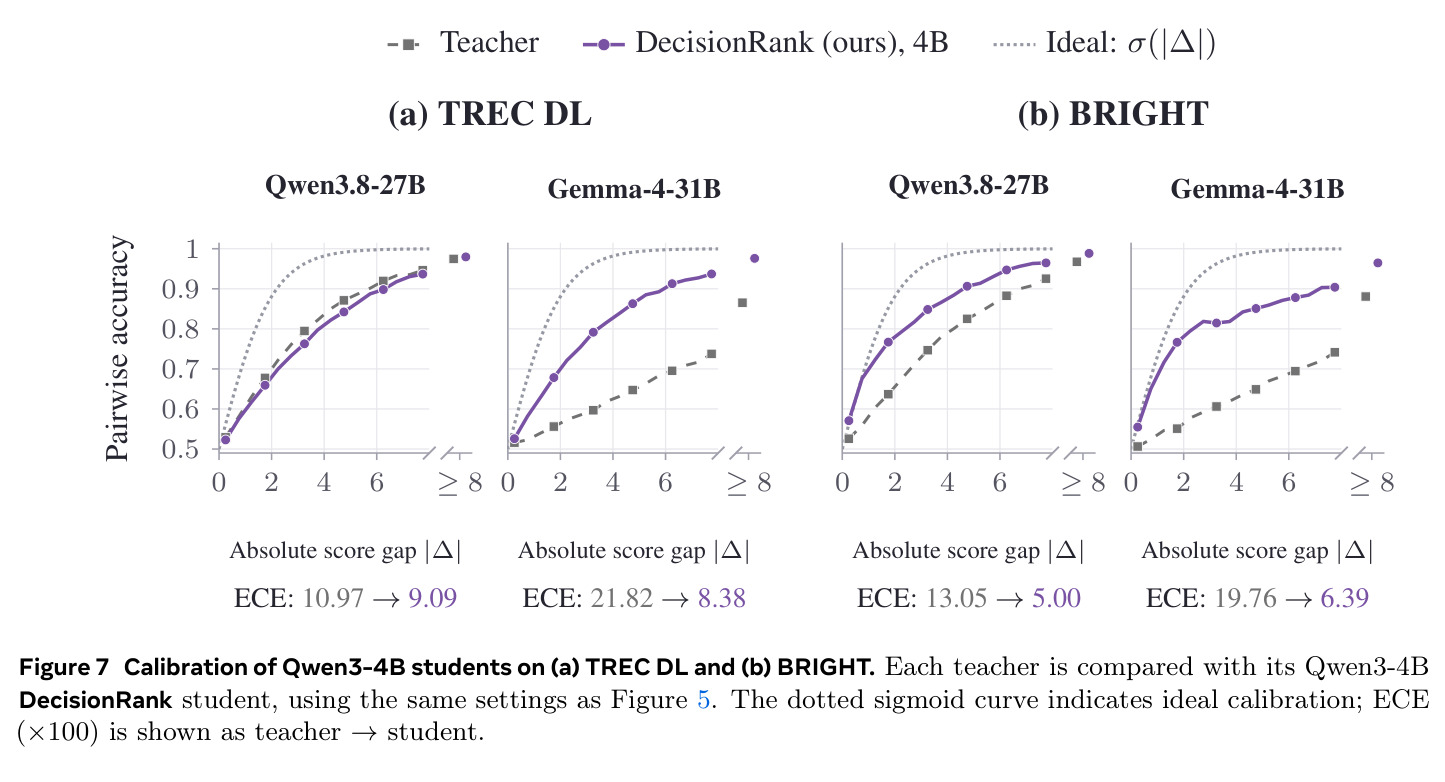
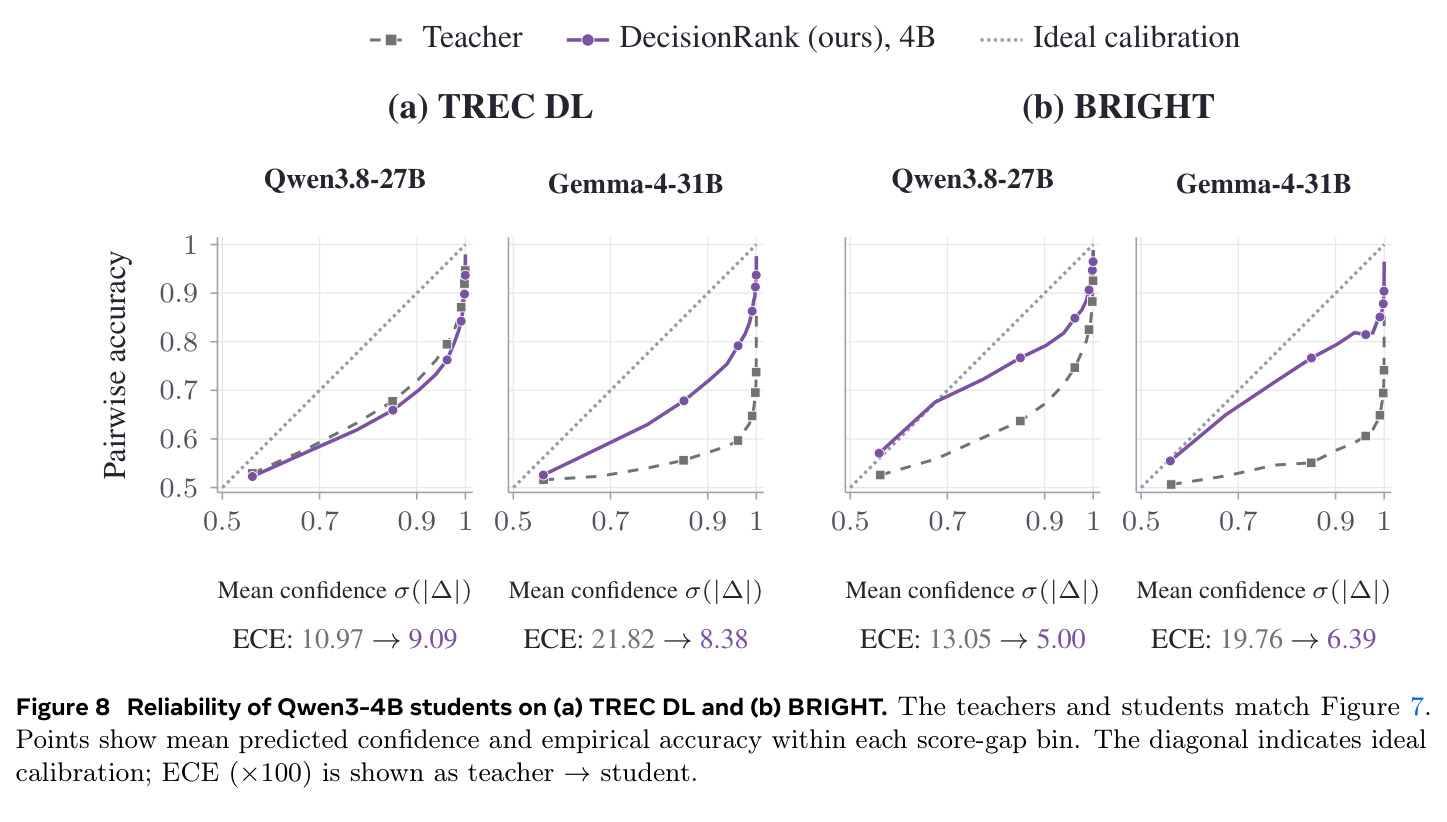
逐一分析。(1)主对比(表 1):DecisionRank-8B 四基准平均 50.68 全场最高;TREC DL 64.34(超最强基线 listwise DirectRank-8B 的 62.92 达 +1.42)、BEIR 57.98(+2.20)、BRIGHT 36.86(+0.99),R2MED 43.55 略低于 DirectRank-8B 的 44.50。三个学生全部超过 27B 生成式教师(TREC DL 教师 62.97 vs 学生 63.89/64.25/64.34),1.7B 已超过含 32B 在内的所有基线。(2)效率(图 3):8B 学生比 DirectRank-8B 在 TREC DL 快 24.5 倍、BRIGHT 快 16.7 倍,三个学生构成局部模型的效果-延迟 Pareto 前沿;1.7B 延迟最低,且 TREC DL 上效果与延迟均优于闭源 Jev 的两种模式。(3)目标对比(表 2):Item-space OPD 是唯一四基准全部稳定改进 RankNet 的目标(+0.90/+0.59/+0.49/+0.80);Offline KL 损害通用检索(−1.45),AR SFT/AR OPD 也损害通用检索,Listwise GRPO 在 R2MED 为负(−0.33)。(4)消融与稳定性(表 3/4):联合目标 64.34/57.98/43.55/36.86 四基准均学生最优,且每个配对种子上联合训练都更好,配对检验多数 p<0.001。(5)跨教师泛化(表 5):三种教师均把三个规模学生在全部基准提升于 zero-shot 之上,如 TREC DL 1.7B 从 39.67 提至 63.89–64.69。(6)校准(图 4–8):8B 学生 ECE 低于教师——TREC DL 上 Qwen3.8-27B 10.97→9.32、Gemma-4-31B 21.82→8.66;BRIGHT 上 13.05→4.86、19.76→5.39,且无需专门校准目标。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| TREC DL19–23 文档重排(通用检索) | nDCG@10×100 | 64.34(DecisionRank-8B) | 62.92(listwise DirectRank-8B,最强基线) | +1.42 |
| BEIR(7 数据集均值,域外通用检索) | nDCG@10×100 | 57.98(DecisionRank-8B) | 55.78(DirectRank-8B) | +2.20 |
| BRIGHT(12 任务推理密集检索) | nDCG@10×100 | 36.86(DecisionRank-8B) | 35.87(DirectRank-8B) | +0.99 |
| R2MED(8 医学数据集,域外迁移) | nDCG@10×100 | 43.55(DecisionRank-8B) | 44.50(DirectRank-8B) | −0.95(唯一未超越的基准) |
| TREC DL 重排延迟(B200/vLLM,中位数) | 秒/查询 | DecisionRank-8B:单次前向 | listwise DirectRank-8B:多步解码 | 快 24.5 倍 |
| BRIGHT 重排延迟(B200/vLLM,中位数) | 秒/查询 | DecisionRank-8B | DirectRank-8B | 快 16.7 倍 |
| TREC DL 学生 vs 生成式教师 | nDCG@10×100 | 63.89 / 64.25 / 64.34(1.7B/4B/8B 学生) | 62.97(Qwen3.8-27B 教师) | +0.92 ~ +1.37(小模型反超教师) |
| 训练目标消融(TREC DL,基于 RankNet 63.44) | nDCG@10×100 变化 | +0.90(Item-space OPD→64.34,四基准全正) | −1.45(Offline KL)/ −0.29(AR SFT)/ −0.14(AR OPD)/ +0.31(Listwise GRPO) | 唯一四基准一致提升的目标 |
| 成对分数校准(BRIGHT) | ECE×100(越低越好) | 4.86(8B 学生,Qwen3.8 教师蒸馏) | 13.05(教师 Qwen3.8-27B) | 降低 8.19 |
局限与改进
作者呈现的局限:(1)R2MED 上 8B 学生 43.55 仍低于 listwise DirectRank-8B 的 44.50,且教师本身在 R2MED/BRIGHT 也高于学生(46.66/37.42 vs 43.55/36.86),说明推理密集域外蒸馏尚未完全榨出教师能力;(2)在策略反馈只覆盖学生 top-K=20 前缀、监督步为 2–19,排名 20 之后的文档只受全局 RankNet 约束,头部与尾部的反馈粒度不一致;(3)候选池固定 $N\le100$ 且与 100 个单 token ID 绑定,扩展到更大候选集需重新设计 ID 分配;(4)训练依赖教师先对 16k 查询做滑窗排名生成($W=20$、stride $10$ 意味着每查询多次教师调用),教师前向成本不小;(5)延迟测量排除排序耗时与一阶段检索,且在 B200 中位数口径下测得,与端到端系统有差距;(6)闭源 Jev 只能以服务端报告延迟对比,硬件条件不同;(7)教师生成离线排名时关闭思考(仅 ReasonRank-32B 例外),更强 thinking 教师的潜力未挖。我的补充观察:推理密集域的蒸馏数据只有 6k 条 ReasonEmbed 合成查询,域覆盖可能不足,这与 R2MED 上增益最小(+0.49)相互印证;另外反向 KL 的 mode-seeking 特性可能让学生只紧盯教师头部偏好,对长尾相关性关注不足。
独立分析的弱点
独立分析的弱点与改进方向:(1)反馈范围窄——OPD 只监督 top-20 前缀,而真实检索还关心 top-10 之外的多样性、去重与边界文档,改进方向是按评估截断深度自适应 K,或对尾部候选分层采样监督。(2)单 token ID 池上限 100——候选超过 100 或需要更长文档时编码容量不足,可探索多 token ID 的条目空间对齐或层次化分桶排序。(3)蒸馏上限受教师制约——教师排名由滑窗贪心生成,自带 exposure bias 与位置偏差(已选文档按一阶段检索顺序呈现),学生会继承这些偏差,可用教师集成或随机化呈现顺序去偏。(4)$\lambda=0.1$ 的权重与监督步选择主要靠实验,缺乏理论指导;R2MED 增益最小或与反向 KL 过度 mode-seeking 有关,可尝试前向/反向 KL 混合或 λ 调度。(5)评估止步于 100 候选重排,未测工业级两阶段级联(数十万候选)下对下游 QA 答案质量的端到端影响。(6)校准评估只考察成对偏好按分数差分箱的 ECE,排序级校准(如 top-k 召回的置信区间)未涉及,对需要置信度的下游决策场景仍是空白。
未来方向
作者明确提出的方向:把条目空间 OPD 推广到更广泛的决策模型任务——任何一次前向输出结构化选择/分数的场景(选择、分类、推荐),论文结论称其为蒸馏高效决策模型的有前景路径。基于成果可延伸的研究:(1)与强化学习结合——表 2 显示 Listwise GRPO 单独用增益有限且不稳定,但 GRPO 的探索性 + OPD 的教师条件反馈可能互补,类似 RLHF 中策略梯度加 KL 正则的组合;(2)用 thinking-enabled 的强推理教师做 OPD(论文仅对 ReasonRank-32B 开启思考),研究推理链能力能否被压进单 token 分数及其上限;(3)自适应 K 与课程式监督:训练早期偏全局 RankNet、后期加大在策略反馈比重;(4)扩展到 100+ 候选与多 token ID,或与粗排-精排级联联合训练;(5)显式校准目标:学生已无监督地获得好校准,加入校准损失可能进一步改善;(6)理论分析一个有趣现象——为何 1.7B/8B 学生能在 TREC DL 反超 27B 教师(RankNet+OPD 组合是否构成对教师排名噪声的正则化);(7)把 item-space OPD 应用于 AnyJev 等其他决策模型验证普适性。
复现评估
复现条件较友好,但代码未明示开源:论文正文没有给出代码或模型发布链接(全文无 GitHub 链接)。有利因素是所有组件均基于公开资源——训练数据为 Rank-DistiLLM 发布的 10,000 条 MS MARCO 查询加 ReasonEmbed 数据集 12 类各 500 条(共 16,000 条);师生均为公开权重(Qwen3-1.7B/4B/8B,教师 Qwen3.8-27B、Gemma-4-31B、ReasonRank-32B);四个基准全部公开,一阶段候选也用公开检索器(BM25、ReasonIR-8B、E5-Mistral-7B-Instruct)的标准 top-100。超参完整给出:batch=32,学习率 $2\times10^{-5}$(1.7B)/ $6\times10^{-6}$(4B/8B),$K=20$,$T_{step}=\{2,\dots,19\}$,$\lambda=0.1$,滑窗 $W=20$、stride $10$;附录还提供全部 prompt 模板、校准概率计算细节、逐种子结果与配对显著性检验。算力方面:训练约 16k 查询、最大 8B 学生,主要开销在教师离线排名生成与 OPD 教师前向(27B 量级推理),延迟测量用 NVIDIA B200 + vLLM。综合评估:有 LLM 微调与 vLLM 经验的团队数天内可复现主结果,难度中等;最大不确定性在于教师模型(Qwen3.8-27B 等)的获取与推理成本。
论文图表
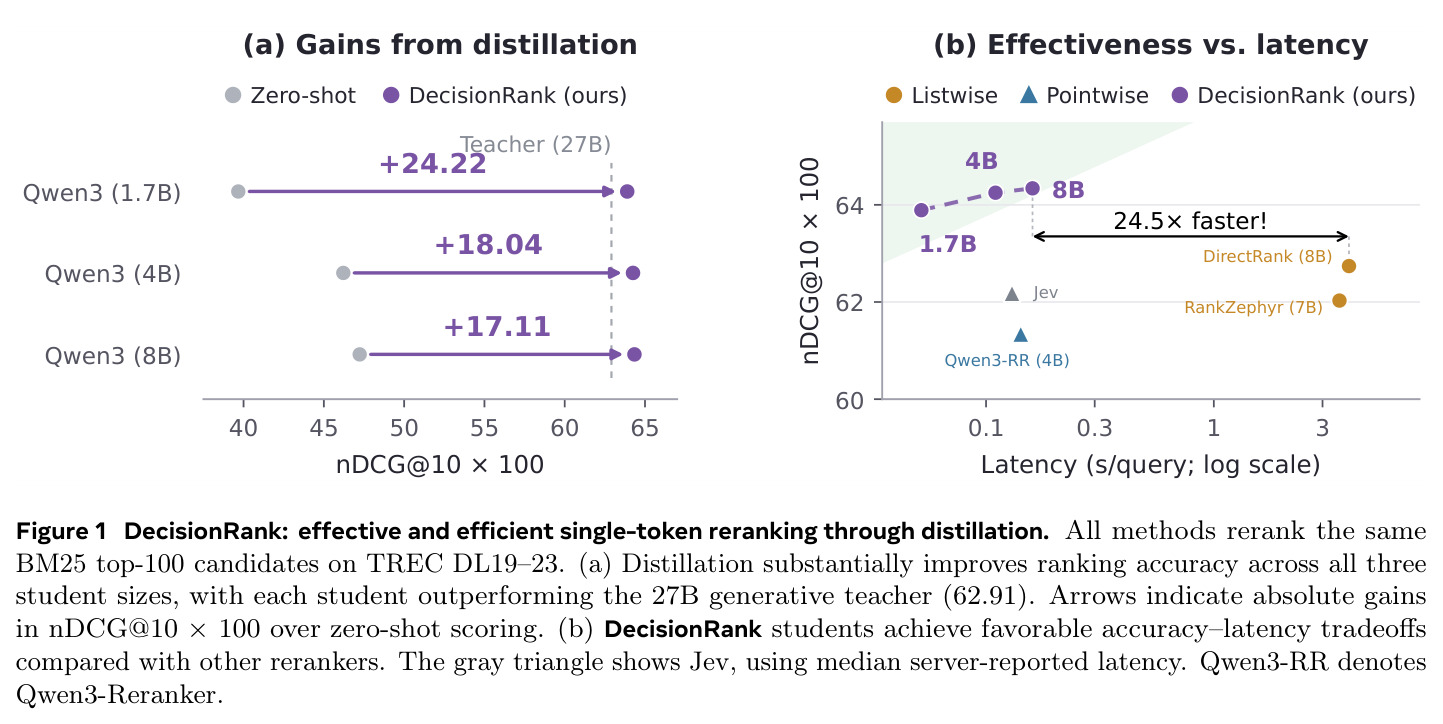
全文 teaser。(a) 蒸馏增益:三个规模学生在 TREC DL19–23 上相对 zero-shot 打分的 nDCG@10×100 绝对提升(1.7B +24.22、4B +18.04、8B +17.11),且全部超过 27B 生成式教师(62.91);(b) 效果-延迟散点(对数延迟轴):DecisionRank 学生位于左上更快更好区域,与 Qwen3(1.7B) zero-shot、DirectRank-8B、RankZephyr-7B、Qwen3-RR 等对比,闭源 Jev 用服务端中位延迟(灰色三角)。
一图概括全文两大卖点——蒸馏收益幅度与数量级的延迟优势,读者第一眼即可判断方法价值与适用场景。
TREC DL19–23 逐年分数(BM25 top-100、128 token 截断):DecisionRank-8B 为 75.63/72.61/71.45/52.27/49.73,均值 64.34;优势在更难的近年份(DL22–23)尤其明显,如 DL23 上领先 listwise DirectRank-8B(45.92)近 4 分。
提供主表的逐年细节,显示增益并非来自简单年份,在分布更新、更难的 DL21–23 上蒸馏收益反而更大。