无通道掉队:透过残差门控理解扩散Transformer加速 No Channels Left Behind: Understanding Diffusion Acceleration through Residual Gates
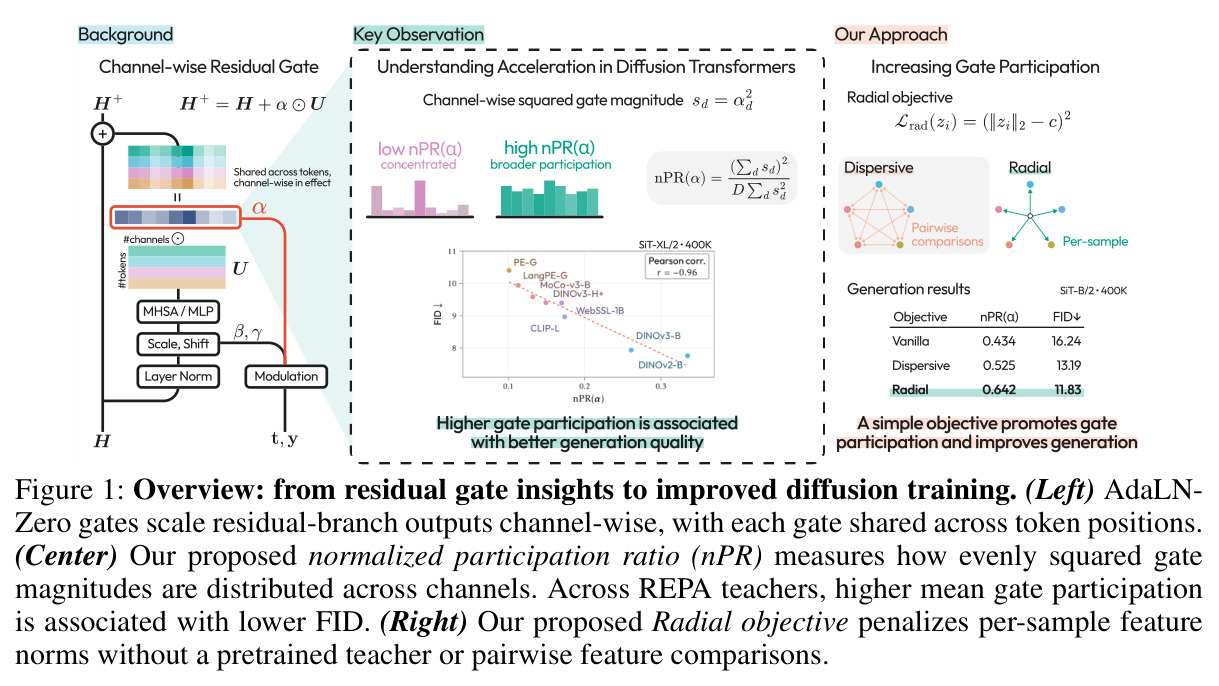
扩散训练加速伴随残差门控α通道参与度提升,无教师的Radial目标据此改善生成质量
前置知识
AdaLN-Zero 与残差门控 α
DiT/SiT 中除 LayerNorm 外,由时间步与类别嵌入生成三组调制向量:$\gamma$(缩放)与 $\beta$(平移)作用于归一化后的分支输入,$\alpha$(门控)以逐通道 Hadamard 积 $\alpha \odot U$ 缩放分支输出 $U$(MHSA 或 MLP 分支)后再加入残差流,即 $H^+ = H + \alpha \odot U$,零初始化以保证训练稳定。$\alpha$ 逐通道取值、跨所有 token 位置共享,且无需图像前向即可由条件通路算出。
本文全部论点围绕 $\alpha$ 展开:作者认为它是条件信息进入残差流的最直接入口($\beta,\gamma$ 还会被后续投影层中介),加速方法对它的重组是被忽视的机制,不理解其计算位置就无法理解诊断实验与方法设计。
DiT / SiT 扩散 Transformer
把潜空间图像切成 2×2 patch token,用含 MHSA 与 MLP 分支的预归一化 transformer 块预测扩散/流匹配的速度;SiT 采用线性插值路径 $x_t=(1-t)x_{data}+t\,x_{noise}$ 与速度预测损失。SiT-B/2 有 12 块、宽 768,SiT-XL/2 有 28 块、宽 1152。
论文所有实验(FID 评估、门控测量、消融)都在 SiT-B/2 与 SiT-XL/2 上进行,辅助损失施加位置也按层号描述(如 L4、L8、L12),需要了解其结构与训练目标才能跟上实验设置。
REPA 表示对齐
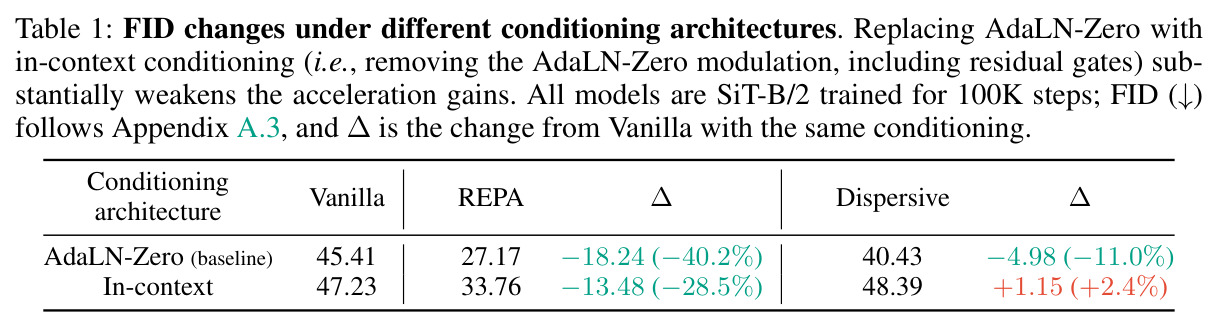
训练时通过可学习投影头把扩散模型中间层特征对齐到冻结视觉基础模型(如 DINOv2)的表示,辅助对齐损失加在速度损失上,可大幅加速训练(本文设定下 100K 步时 FID 从 45.41 降到 27.17)。iREPA 进一步把 MLP 投影头换成卷积并强调空间结构传递。
REPA 是本文重点分析的加速方法:教师扫描(8 个教师编码器)与投影头扫描(4 种架构)都以它为载体,用来检验“门控参与度与 FID 的相关性”是否在目标与架构两个维度上都成立。
分散损失(Dispersive Loss)
无教师的训练加速正则项:鼓励同一 batch 内样本隐特征的两两 $\ell_2$ 距离变大(如 InfoNCE-L2 形式,系数 0.25、温度 1),从而“分散”表示几何。本文配置中作用于最后一块(L12)输出,每 GPU batch 32、8 卡。
它是与 Radial 目标对比的主要无教师基线(FID 13.19 vs Radial 的 11.83);其“需要 $O(B^2)$ 成对样本比较”的特点正是 Radial 设计刻意规避的成本,理解它才能看清 Radial 的定位。
参与度 Participation Ratio / nPR
衡量向量能量在各通道分布均匀程度的稀疏性统计量:$PR(\alpha)=\frac{(\sum_d s_d)^2}{\sum_d s_d^2}$($s_d=\alpha_d^2$),归一化 $nPR(\alpha)=PR(\alpha)/D$,取值 $[1/D,1]$,对均匀非零缩放不变;若 $m$ 个通道幅度相等则 $nPR=m/D$。
nPR 是论文提出的核心度量——“门控参与度”。全文用它量化残差门的通道组织,在教师/投影头/目标三组扫描中与 FID 建立强负相关,并作为 Radial 目标的设计依据与评价指标。
FID
Fréchet Inception Distance:用 Inception 网络特征对生成图像与真实图像分布做高斯拟合后计算 Fréchet 距离,越低越好。本文用 ADM 评估器、5 万张样本、CFG 1.5、dopri5 自适应采样器、EMA 权重。
FID 是所有质量结论的量化基础:两个试点研究、三组相关性扫描、主对比表(Radial 11.83 vs Vanilla 16.24 vs Dispersive 13.19 vs REPA 7.71)全部以 FID 及其变化量为准绳。
研究动机
REPA、iREPA、分散损失等方法能把扩散 transformer 训练加速数倍,但社区通常用辅助目标显式施加的“表示结构”来解释:REPA 说对齐了 DINOv2 等预训练表示,iREPA 强调空间结构传递,分散损失说重塑了特征几何。这种解释停留在被监督的特征本身,并未回答“这些结构就是加速的原因吗”。作者注意到一个被共同忽略的事实:所有这些方法都共用 AdaLN-Zero 条件通路,时间步与类别嵌入生成的残差门 $\alpha$ 决定每条通道的分支更新以多强的幅度进入残差流。两个试点研究印证了门控通路的重要性:把 AdaLN-Zero 换成 in-context 条件(彻底去掉调制与门控)后,加速收益大幅缩水——100K 步下 REPA 相对 Vanilla 的 FID 增益从 $-18.24$(45.41→27.17,$-40.2\%$)缩到 $-13.48$($-28.5\%$),分散损失更是从 $-4.98$ 变成 $+1.15$(反而变差);在采样时对 SiT-XL/2 的 L8 MLP 门做幅度重布($\delta=0.30$),REPA 的 $\Delta$FID 高达 $+5.356$,比 Vanilla 和分散损失敏感得多。这说明现有解释未覆盖一个真实起作用的机制。
本文的目标是本文目标分三层。其一是诊断:确认加速方法是否系统性重组残差门 $\alpha$,并检验这种重组是否携带可解释结构——先用 WordNet 语义距离检验类条件门之间的距离是否随语义距离增长,再提出归一化参与度 $nPR(\alpha)$ 量化门的通道幅度分布。其二是关联:在受控扫描中检验“平均门控参与度更高是否伴随更好生成质量”,分别在 8 个 REPA 教师、固定教师下 4 种投影头架构、5 个 radial 目标这三组独立扫描中验证相关性是否稳定复现。其三是干预:基于上述发现设计一个尽量简单的无教师目标——Radial 目标 $\mathcal{L}=\mathcal{L}_{velocity}+\lambda\,E_i[(\|z_i\|_2-c)^2]$,只惩罚每个样本展平特征的范数,希望它同时提升门控参与度并降低 FID,从而反向支持“门控参与度是加速的可操作维度”这一命题。
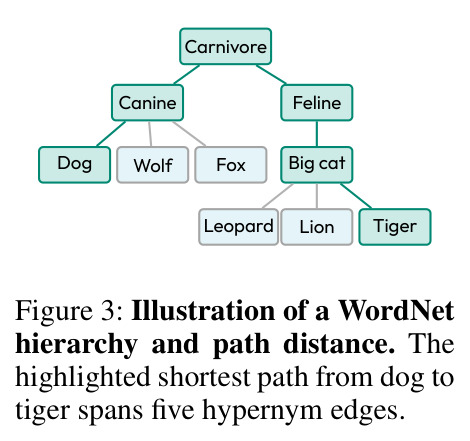
与已有工作不同的是,独特切入角度在于把分析对象从“被监督的特征”转移到“条件更新的注入方式”。先前对 AdaLN 的分析只涉及其初始化与参数更新动态(Zhu et al.)或条件嵌入中的语义瓶颈(Pham et al.),没有人研究过加速训练下分支特定残差门 $\alpha$ 的通道组织。作者的递进论证也很独特:先做两组干预实验(去掉调制通路、测试时扰动门)证明加速模型对门控更脆弱;再用 WordNet 层次证明门本身携带语义结构,且 REPA 下语义分离最强(WordNet 距离 22 处欧氏距离达起点的 1.678 倍,Vanilla 仅 1.217 倍);最后用尺度不变、无需图像前向的 nPR 把“门控组织”变成可监控的标量,并据此提出无需预训练教师( unlike REPA)、无需成对样本比较( unlike 分散损失的 $O(B^2)$ 距离)的 Radial 目标——每样本只需计算一个标量范数惩罚,方法与诊断在成本和概念上都形成清晰对照。
核心方法
直觉:如果条件信息主要通过 $\alpha$ 注入残差流,那么“加速”可能不只是让特征变好,而是让模型学会更均衡地使用所有通道——门控幅度不再集中在少数通道,而是更广泛地摊开,这对应更高的 $nPR(\alpha)$。技术路线分三步。(1)诊断:两组干预证明门控重要性——去掉 AdaLN-Zero 后加速收益缩水(REPA 增益从 $-18.24$ 缩至 $-13.48$,分散损失从 $-4.98$ 变 $+1.15$);测试时保持符号与 $\ell_2$ 范数重布门幅度,$\delta=0.30$ 时 REPA 的 FID 恶化 $+5.356$,远比 Vanilla 和分散损失敏感。(2)度量:定义 $nPR(\alpha)=\frac{(\sum_d \alpha_d^2)^2}{D\sum_d \alpha_d^4}$,在 101 个均匀时间步 × 1000 类上取平均,发现它与 FID 在三组独立扫描中高度负相关($r=-0.962/-0.991/-0.916$)。(3)干预:提出 Radial 目标 $\mathcal{L}=\mathcal{L}_{velocity}+\lambda\,E_i[(\|z_i\|_2-c)^2]$,其中 $z_i$ 是最后一块输出 $Z_i\in\mathbb{R}^{N\times D}$ 的展平向量,并以命题 1 说明其在通道对称假设下的小步更新不会降低 $nPR(\alpha)$。
核心创新有两点。第一是度量层面:用参与度 nPR 刻画残差门的通道组织,并发现“更宽的门控参与 ⇔ 更低 FID”在 REPA 教师扫描(8 个教师,$r=-0.962$)、固定教师投影头扫描($r=-0.991$)、radial 目标扫描($r=-0.916$)中一致成立——这与已有方法“直接监督表示结构”的思路本质不同,它关注的是未被任何辅助目标直接触碰的条件通路。第二是方法层面:Radial 目标 $\lambda(\|z_i\|_2-c)^2$ 逐样本独立计算,没有任何外部教师或样本间比较;其促进门控参与度的机制由相对门梯度揭示:$-\frac{1}{\alpha_d}\frac{\partial \tilde{\mathcal{L}}_{rad}}{\partial \alpha_d}=2\,E\big[(\tfrac{c}{\tilde r_\alpha}-1)\tfrac{\|U_{:,d}\|_2^2}{\tilde r_\alpha^2}\mid t,y\big]$,系数 $c/\tilde r_\alpha-1$ 对同一输入的所有通道共享,通道间差异只来自预门控范数与门自身。在通道对称假设下可证明弱门的相对更新不小于强门:$|\alpha_i|>|\alpha_j|\Rightarrow\Delta\alpha_i/\alpha_i\le\Delta\alpha_j/\alpha_j$(即弱门相对增长更快或收缩更慢),故充分小步长下 $nPR(\alpha^+)\ge nPR(\alpha)$;而正负二次型范数目标只能做均匀缩放、保持 nPR 不变——目标函数的“形状”决定了对门控几何的效应。
方法步骤详情
具体流程(以 SiT-B/2、ImageNet 256×256 为例):(1)常规流匹配速度损失训练(batch 256、AdamW、lr $10^{-4}$、EMA 0.9999、bfloat16、标签丢弃 0.1);(2)取最后一层块(L12)输出 $Z_i\in\mathbb{R}^{256\times 768}$,展平为 $z_i$ 并计算范数 $\|z_i\|_2$;(3)加入径向惩罚 $\lambda(\|z_i\|_2-c)^2$,目标设为 $c=k\sqrt{ND}$,在 $k\in\{2,4,8,10,14\}$ 中扫描并按 FID 选 $k=10$($c\approx4434$);$\lambda$ 在前 5 个迭代自动校准,使辅助梯度范数约为速度损失梯度范数的 10%(400K 主实验取 $5\times10^{-8}$,扫描用 $6.032\times10^{-8}$);(4)训练 400K 步后用 EMA 权重、CFG 1.5、dopri5 采样 5 万张图,用 ADM 评估器报告 FID/sFID/IS/Precision/Recall;(5)诊断:对 L12 MLP 门在 101 个时间步 × 1000 类计算 nPR 并平均(Radial 0.642 vs Vanilla 0.434 vs Dispersive 0.525),并追踪 50K/100K/200K/400K 四个检查点的参与度轨迹。理论侧:(6)固定条件 $(t,y)$,把分支输出写成 $Z=H+U\,\mathrm{diag}(\alpha)$,剔除跳连交叉项定义 $\tilde r_\alpha=(\|H\|_F^2+\sum_d \alpha_d^2\|U_{:,d}\|_2^2)^{1/2}$,在通道对称假设(所有通道范数模式在置换意义下等概率)与充分小、保号步长下证明 $nPR(\alpha^+)\ge nPR(\alpha)$,且当存在通道使门幅度与范数同时不等时严格递增。
技术新颖性
新颖性体现在四个层面。概念上:首次把“残差门的通道组织”确立为扩散加速的可测维度——门由条件通路直接给出,无需图像前向即可计算,是极轻量的监控量。度量上:把参与度(Participation Ratio)从表示稀疏性分析迁移到门控坐标上,并强调它度量“幅度分配”而非整体门尺度(三种模型的门标准差分别为 0.049/0.285/0.793,但 nPR 与尺度无关,这正是可比性的来源)。方法上:Radial 是已知加速目标的最简形式——REPA 需要预训练教师与投影头,分散损失需要 batch 内成对距离,Radial 只有每样本一个标量惩罚;它是首个“通过特征范数间接提升门控参与度”的加速目标,作用机制由命题 1 的逆范数加权给出梯度级解释。理论上:命题 1 给出了跨通道相对更新的排序不等式 $|\alpha_i|>|\alpha_j|\Rightarrow\Delta\alpha_i/\alpha_i\le\Delta\alpha_j/\alpha_j$,并对照证明二次型目标只做均匀缩放、无法改变 nPR,这种“目标函数形状 ⇒ 门控几何效应”的分析在扩散加速文献中是新的。作者同时明确边界:结论限于剔除交叉项后的条件小步分析,不保证完整 AdamW 优化器下的单调增长,也不建立因果性。
实验结果
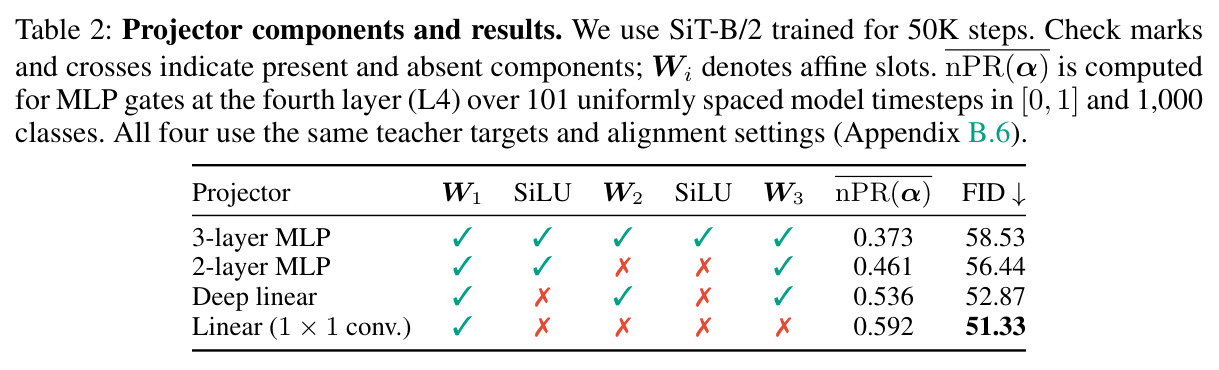
逐实验梳理。(1)试点 1(条件架构消融,SiT-B/2 100K 步):AdaLN-Zero 下 REPA 把 FID 从 45.41 降至 27.17(−40.2%)、分散损失降至 40.43(−11.0%);换成 in-context 条件后 REPA 仅 33.76(−28.5%)、分散损失 48.39(+2.4%,反而变差)——门控通路承载了相当部分加速收益。(2)试点 2(测试时门扰动,SiT-XL/2 400K):保持符号与 $\ell_2$ 范数、重布 L8 MLP 门平方幅度,$\delta=0.30$ 时 REPA 的 $\Delta$FID 达 +5.356,远超 Vanilla 与分散损失。(3)语义结构:类条件门距离随 WordNet 语义距离增大,距离 22 处 REPA 欧氏距离达起点 1.678 倍(Dispersive 1.428、Vanilla 1.217),居中余弦距离分别 +0.574/+0.441/+0.225。(4)教师扫描:8 个 REPA 教师(CLIP-L、DINOv2-B、DINOv3-B/H+、LangPE-G、PE-G、MoCo-v3-B、WebSSL-1B)的 L8 门 nPR 与 FID 相关 $r=-0.962$。(5)投影头扫描(固定 DINOv2-B,50K 步):3 层 MLP nPR 0.373/FID 58.53 → 2 层 MLP 0.461/56.44 → 深线性 0.536/52.87 → 线性 1×1 卷积 0.592/51.33,$r=-0.991$;另 1×1+额外 3×3 卷积仅得 51.68,说明投影头内邻域混合并非必需。(6)Radial 目标扫描(100K 步):FID 从最低目标 45.72 降到所选 $c=10\sqrt{ND}$ 的 39.43,nPR 从 0.381 升到 0.577,$r=-0.916$。(7)主表(400K 步):Radial FID 11.83、sFID 5.27、IS 105.93、Precision 0.714,优于 Vanilla(16.24)与分散损失(13.19),仍不及教师引导的 REPA(7.71);L12 门参与度 0.642 为三者最高(0.434/0.525)。(8)训练动态:Radial 在 50K–400K 全程保持高于 Vanilla 的参与度,分散损失在 200K 达峰。
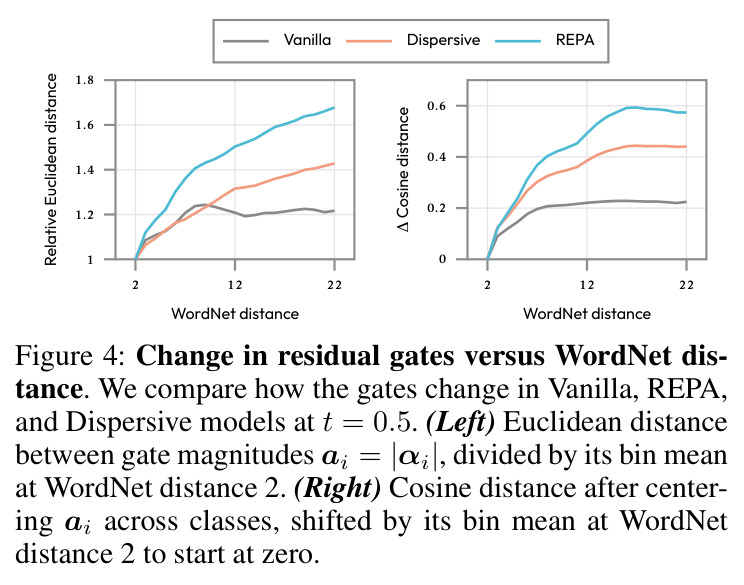
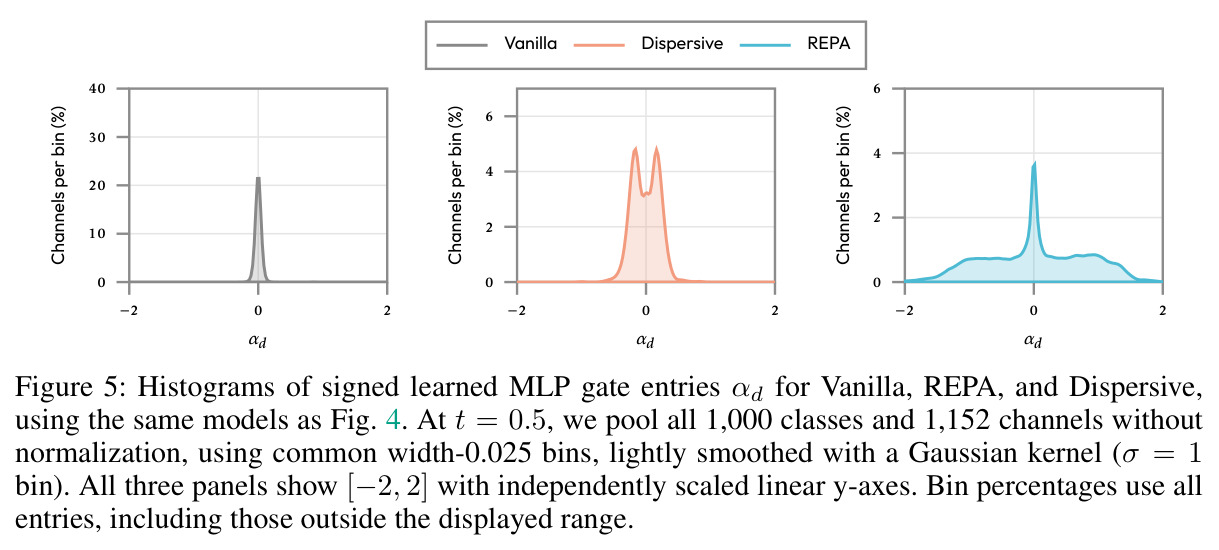
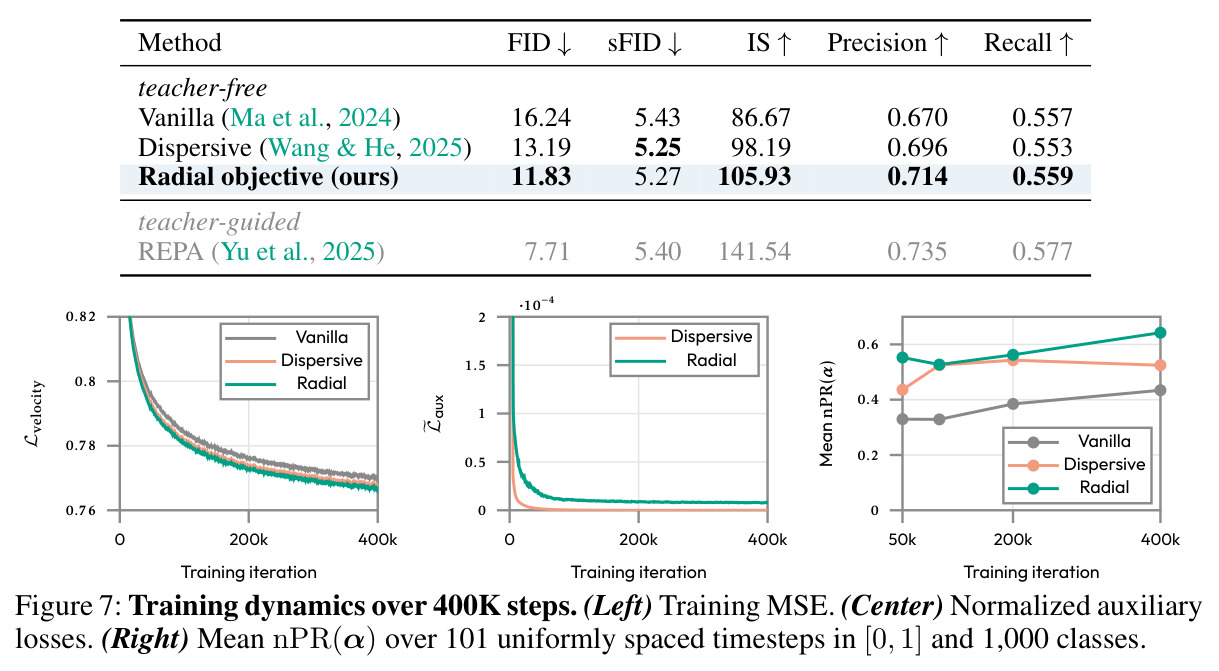
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet 256×256 类条件生成(SiT-B/2,400K 步) | FID ↓ | 11.83 | Vanilla SiT 16.24 | 降低 4.41 点(−27.2%) |
| 同上(无教师对比) | FID ↓ | 11.83 | Dispersive 13.19 | 降低 1.36 点(−10.3%) |
| 同上(教师引导参照) | FID ↓ | 11.83 | REPA(DINOv2-B)7.71 | 落后 4.12 点(REPA 仍最优) |
| 同上 | IS ↑ | 105.93 | Vanilla 86.67 / Dispersive 98.19 | +22.2% / +7.9% |
| 同上 | Precision ↑ | 0.714 | Vanilla 0.670 / Dispersive 0.696 | +0.044 / +0.018 |
| 同上 | Recall ↑ | 0.559 | Vanilla 0.557 / Dispersive 0.553 | 基本持平 |
| L12 MLP 门控参与度(101 时间步 × 1000 类平均) | nPR(α) ↑ | 0.642 | Vanilla 0.434 / Dispersive 0.525 | +47.9% / +22.3% |
| 三组扫描中 nPR-FID 相关性 | Pearson r | 教师扫描 r=−0.962;投影头 r=−0.991;Radial 目标 r=−0.916 | 无(新提出的经验规律) | 三组独立扫描一致强负相关 |
局限与改进
作者坦承:全文是相关性而非因果性证据——试点 2 只证明“偏离学到的门会变差”,不证明“均匀门更好”,均匀化干预并未一致改善生成质量;命题 1 只覆盖剔除交叉项后的条件小步更新,不保证完整优化器下 nPR 单调增长,也不证明参与度增长导致 FID 下降;WordNet 分析只说明门携带类相关结构,不给出表达语义层次所需的参与度下界;Radial 只通过特征范数间接作用于门。我补充观察:绝对性能差距大,Radial 11.83 vs REPA 7.71,无教师路线与教师引导路线仍有代差,且比分散损失的改进(13.19→11.83)幅度有限;验证范围窄——只在类条件 ImageNet 256×256 的 SiT-B/2(400K 步)上训练验证,文本到图像、更大模型与更长训练未涉及,XL 规模上只用公开 checkpoint 做了教师扫描;超参选择不轻——目标 $c$ 要在 5 个值中按 FID 扫描($k=10$ 最优),系数 $\lambda$ 依赖训练初期梯度范数统计(10% 校准);度量范围窄——只测 MLP 门且只测施加辅助目标的单块(L12/L8/L4),MHSA 门与其他层的作用未考察。
独立分析的弱点
(1)因果链未闭合:nPR 与 FID 的强相关可能被共同因素(如训练整体健康度、表示有效秩)驱动;固定教师扫描排除了教师质量这一混杂,但没有干预性证据表明“直接抬高 nPR 能降 FID”。改进方向:设计直接以 nPR 为目标的显式正则(如对门向量做熵最大化惩罚)做干预实验,或训练时在线监测 nPR 并在其饱和后关闭辅助损失。(2)通道对称假设过强:命题 1 要求预门控通道范数在置换意义下对称,而真实 batch 中的 $H$、$U$ 与已训练门都高度各向异性,理论与实际优化距离较远。改进方向:用实测通道范数分布做数值模拟检验命题的稳健性,或把假设放宽到均值相等/近似对称。(3)全局单目标过于粗糙:范数目标 $c$ 对所有时间步与类别一视同仁,而门结构随 $t$ 与类明显变化(REPA 在 $t=0.5$ 的门 std 达 0.793)。改进方向:让目标范数自适应,如 $c(t)$、$c(y)$ 或分位数目标。(4)改进幅度与规模有限:11.83 vs 13.19 的提升发生在 400K 步 SiT-B/2 的小设定上,距实用加速尚远。改进方向:与 REPA 组合验证互补性,并在 XL 规模与文本条件模型(MM-DiT 类)上验证。(5)度量只覆盖单块 MLP 门:忽视 MHSA 门与跨层交互,可能低估或错置“参与度”的作用位置。改进方向:对全部门控做联合 nPR 分析,系统观察辅助损失施加位置的影响。
未来方向
作者方向:把门控参与度作为轻量监控信号——它无需图像前向、只从条件通路计算,可实时跟踪加速训练的健康状态;进一步厘清投影头非线性(深线性头 52.87 优于非线性 MLP 58.53)与空间混合必要性(1×1 卷积 51.33 vs 加 3×3 卷积 51.68)的作用;Radial 只是“一个简单方向”,更直接的门控参与度目标值得探索。基于成果可延伸:(1)将 Radial 与 REPA/分散损失组合,检验是否互补(尤其 REPA+Radial 能否突破 7.71);(2)自适应目标范数 $c(t,y)$ 或按类别分位数设定目标;(3)在文本到图像扩散 transformer(MM-DiT 类)中检验门控参与度是否同样跟踪质量,使其成为跨架构诊断工具;(4)结合 HASTE 式的对齐早停思路,用 nPR 轨迹自动调度辅助损失的开与关;(5)理论上放宽通道对称假设,或在完整 AdamW 动态下分析 nPR 演化,缩小理论-实践差距;(6)把 nPR 与谱秩、内在维度等其他表示几何度量对照,定位“门控广度”在其中的独特信息;(7)探索逆向应用——若某配置出现高参与度但 FID 不降,可反证相关性的边界条件。
复现评估
复现条件较好。代码已在 GitHub 开源(naver-ai/radialobj);实验细节集中在附录 A–C:SiT-B/2 训练超参完整(seed 42、batch 256、AdamW、lr $10^{-4}$、$\beta_2=0.999$、零权重衰减、EMA 0.9999、bfloat16、标签丢弃 0.1),教师扫描直接使用作者在 HuggingFace(REPA-E/iREPA-collections)公开的 8 个 SiT-XL/2 checkpoint,FID 协议完全指定(ADM 评估器、5 万样本、CFG 1.5、dopri5 自适应采样、ft-EMA/ft-MSE 解码器、采样 seed 42)。Radial 目标本身超参极少:一个目标 $c$、一个系数 $\lambda$,且 $\lambda$ 可在前 5 个迭代自动校准到辅助梯度范数 ≈ 速度梯度的 10%。算力方面:主结果为 SiT-B/2 在 ImageNet 256×256 上 400K 步、全局 batch 256(8 卡、每卡 32),属中等规模,单节点多卡可复现;诊断部分(nPR、WordNet 距离、门直方图)只需前向条件通路,成本几乎可忽略。主要门槛是 ImageNet 训练的 GPU 时间与潜变量缓存的磁盘空间。综合难度中等偏低:方法简单、协议详尽、有公开 checkpoint 与代码;风险点是 FID 绝对值依赖评估器与采样器配置,需严格按附录 A.3 复现才能对齐论文数字。
论文图表
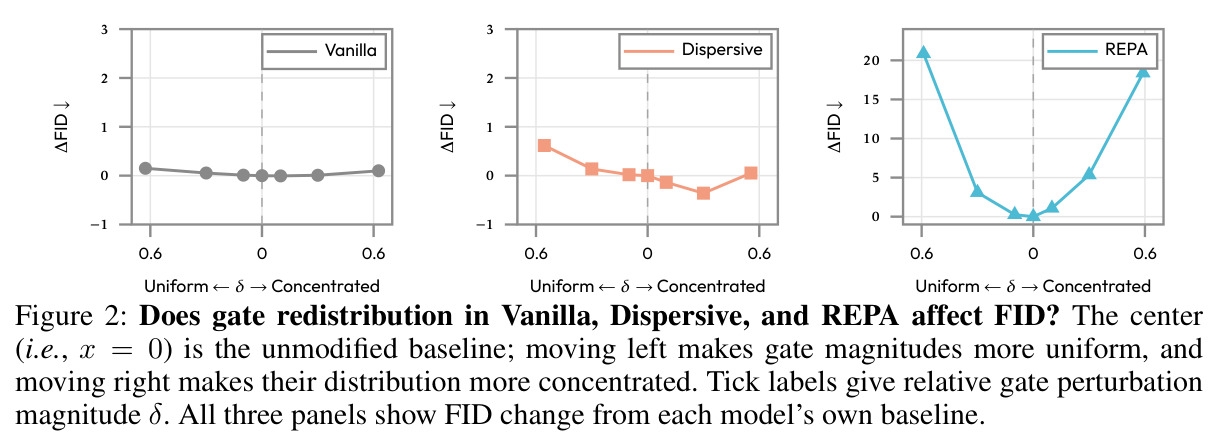
采样时对 SiT-XL/2 的 L8 MLP 门做保持符号与 $\ell_2$ 范数的幅度重布:横轴向左更均匀、向右更集中,刻度为相对扰动 $\delta$。$\delta=0.30$ 时 REPA 的 $|\Delta$FID$|$ 最大(达 +5.356),Dispersive 次之,Vanilla 最小。
这是证明“加速模型更依赖门控”的关键干预证据:在权重冻结的前提下,加速程度与门扰动敏感度正相关,直接支撑全文核心假设。
三幅 FID–nPR(α) 散点图(均含 OLS 拟合线与 Pearson r):(a) 8 个 REPA 教师的 SiT-XL/2 检查点,$r=-0.962$;(b) 固定 DINOv2-B 教师下 4 种投影头,$r=-0.991$;(c) 5 个 radial 目标(100K 步,Vanilla/Dispersive 仅作参照点),$r=-0.916$。
论文核心经验规律“参与度越高、FID 越低”的三重独立验证,涵盖对齐目标、投影架构与正则目标三个维度,是全文论点的支柱。
在与 Figure 4 相同的检查点、距离定义下,于 $t=0.25$ 与 $t=0.75$ 重复分析:两个时间步均呈现门距离随 WordNet 距离增大、REPA 分离最强的定性关系。
说明语义结构结论不依赖代表性时间步 $t=0.5$ 的选择,是结论稳健性的重要补充。
在 $t=0.25$ 与 $t=0.75$ 下重复 Figure 5 的有符号门直方图,Vanilla/Dispersive/REPA 之间的门尺度差异在两个时间步均保持(各方法跨时间步共享 y 轴范围)。
补充 Figure 5 的稳健性检验,确认加速方法对门的重组是全局性的而非特定时间步的局部现象。
FID 与 nPR(α) 随目标 $c$ 的变化:$c=875.885$ 时 FID 45.72(接近 Vanilla 的 45.41),$c=3503.54$ 时 40.02,选中目标 $c=4500$($k=10$)时 39.43,$c=6000$ 时 39.44;nPR 从 0.381 升至 0.577(选中目标)、$c=6000$ 时 0.564。
展示方法对关键超参的敏感性与收益饱和点,是复现与调参的最直接依据。
主对比表:无教师组中 Radial FID 11.83 / sFID 5.27 / IS 105.93 / Precision 0.714 / Recall 0.559,优于 Vanilla(16.24/5.43/86.67/0.670/0.557)与 Dispersive(13.19/5.25/98.19/0.696/0.553);教师引导参照 REPA 为 7.71/5.40/141.54/0.735/0.577。Radial 的 L12 门参与度 0.642 亦为无教师最高(0.434/0.525)。
论文的核心量化结论:以最简的无教师目标同时刷新参与度与 FID,是衡量方法实际价值与“参与度可操作”主张的最终检验。