扩散Transformer中的结构化残差连接 Structured Residual Connectivity Matters for Diffusion Transformers
把DiT残差流从被动求和改为跨层主动检索,镜像路由最多省1.73倍训练步数
前置知识
扩散模型
一类通过逐步加噪再学习逆过程去噪来建模数据分布的生成模型。训练时对干净数据加噪得到 $z_t$,网络学习预测噪声 $\epsilon$ 或速度场 $v$;采样时从纯噪声出发迭代去噪生成图像。本文实验采用 DDPM 的 $\epsilon$-预测与线性插值流匹配两种参数化,在 ImageNet 256×256 潜空间上做类条件生成。
本文所有实验都在扩散模型框架下进行,FID 评测和训练协议均源自这一范式,理解去噪目标才能明白残差结构如何影响梯度流与收敛速度。
Diffusion Transformer (DiT)
把扩散模型骨干从 U-Net 换成纯 Transformer 的架构:潜空间图像切成 patch,经 patchify 与位置编码得到 token 序列,再堆叠同质的 Transformer 块(自注意力+MLP,adaLN 条件注入),所有层共享同一 token 分辨率。DiT-XL/2 有 675M 参数、28 层,是可扩展生成模型的代表骨干。
本文研究对象就是 DiT 的残差流设计;其单尺度、同质化结构正是作者指出的'缺乏结构化连接'的根源,也是改进的落点。
残差连接与残差流
残差连接让每层输出为 $x_{l+1} = x_l + f_l(x_l)$,恒等捷径保证梯度直通、优化稳定。展开递推可得 $x_L = x_0 + \sum_{l=0}^{L-1} f_l(x_l)$,即最终表示是各层输出的等权累加——这条'残差流'既决定前向信息如何跨层聚合,也规定了反向梯度的拓扑结构。
论文核心论点是:固定系数的均匀残差流会稀释各层贡献并导致表征同质化,需要改造成可学习的主动路由机制。
U-Net 跳跃连接
U-Net 采用编码器-解码器结构,把编码器各尺度特征经长程跳跃连接直接送给解码器对应尺度,为重建保留多尺度空间细节。这种对称的阶段配对连接是强归纳偏置,让浅层细节与深层语义在解码端显式融合。
本文发现 DiT 在自由路由时自发偏好镜像对称层对,说明对称连接不是 U-Net 的启发式设计而是潜在结构需求,这直接催生了 mirror routing。
REPA(表示对齐)
一种加速扩散 Transformer 训练的方法:在中间层加投影头,使其输出与预训练自监督视觉编码器的表示对齐,让生成模型更快学到可泛化语义表征。SiT-XL/2+REPA 训练 4M 迭代达到 5.9 FID,是本文微调实验的强基线。
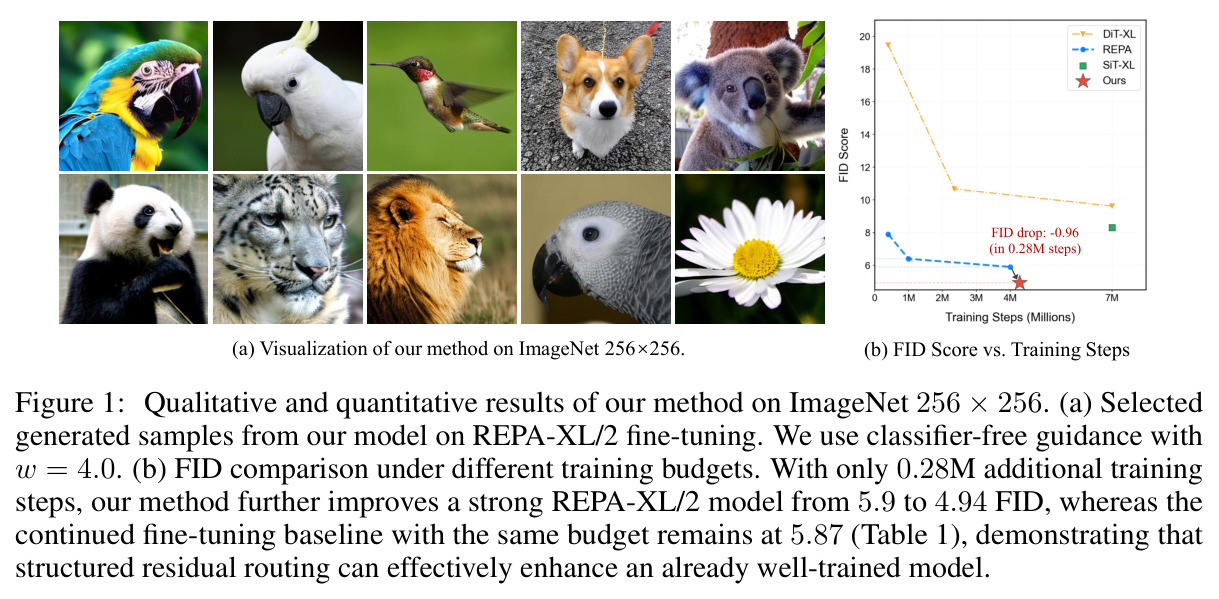
论文最重要的结果之一是在已收敛的 REPA-XL/2 检查点上继续微调,用本文路由把 FID 从 5.9 降到 4.34,证明后期瓶颈在连接结构而非模型容量。
FID(Fréchet Inception Distance)
衡量生成图像分布与真实分布距离的标准指标:两批图像过 Inception 网络提取特征后分别拟合高斯分布,再计算两个高斯间的 Fréchet 距离。FID 越低表示生成质量与多样性越好,通常报告 5 万样本的 FID-50K,是图像生成领域的通用评测。
本文主结果与全部消融都以 FID 为核心指标,比较各路由策略、判断收益大小都依赖对 FID 数值差异的解读。
研究动机
扩散 Transformer(DiT)正取代 U-Net 成为高保真图像合成的主流骨干,但两者的残差设计存在根本差异:U-Net 依赖人工设计的长程跳跃连接,为不同抽象层级显式维护结构化通路;DiT 则采用均匀残差流,把所有前序层输出以固定系数 1 累加成单一状态($x_L = x_0 + \sum_l f_l(x_l)$)。这种均匀累加会逐渐稀释单个层的贡献,并在反向传播上强加刚性拓扑,限制模型在不同去噪阶段自适应优化梯度流的能力。后果已在实践中显现:强基线 SiT-XL/2+REPA 在 1M 迭代达到 6.4 FID 后进入平台期,再多花 3M 迭代也只把 FID 从 6.4 提到 5.9(仅 0.5 增益),说明在原架构与优化路径下模型已接近饱和。
本文的目标是本文要回答一个架构设计问题:扩散 Transformer 的残差通路应如何设计,才能兼顾 Transformer 的可扩展性与结构化连接带来的有效生成能力?具体目标有三:一是系统性分析 DiT 内部表征,弄清模型'想'从哪些层取信息,为结构设计提供实证依据;二是在几乎不增加参数(<0.1%)的前提下,把残差流从被动求和改造成主动检索机制,让每个块能选择性取用关键的早期表征;三是同时在从头训练与强预训练模型微调两种场景验证收益,例如用最多 1.73 倍更少的迭代达到基线 FID,并把 REPA-XL/2 从 5.9 FID 进一步压低。
与已有工作不同的是,已有工作从两个方向接近过该问题:U-ViT 与 U-DiTs 把 U-Net 式长跳跃连接搬回 Transformer 骨干,但融合用静态可学习投影,权重不随 token 或去噪时刻变化;LLM 侧的 Attention Residuals 让残差聚合依赖输入,却对所有前序层做稠密路由,显存与计算开销随深度增长。本文的独特之处在于先'诊断'再'设计':让 DiT 自由地对全层做注意力式残差路由并可视化路由权重,首次发现两个反直觉现象——DiT 在全深度持续偏好早期层表征(编码器依赖),且明显偏好镜像对称的层对(自发对称偏置)。这两个发现直接推导出稀疏、阶段匹配的 mirror routing,而非凭直觉套用 U-Net 结构。
核心方法
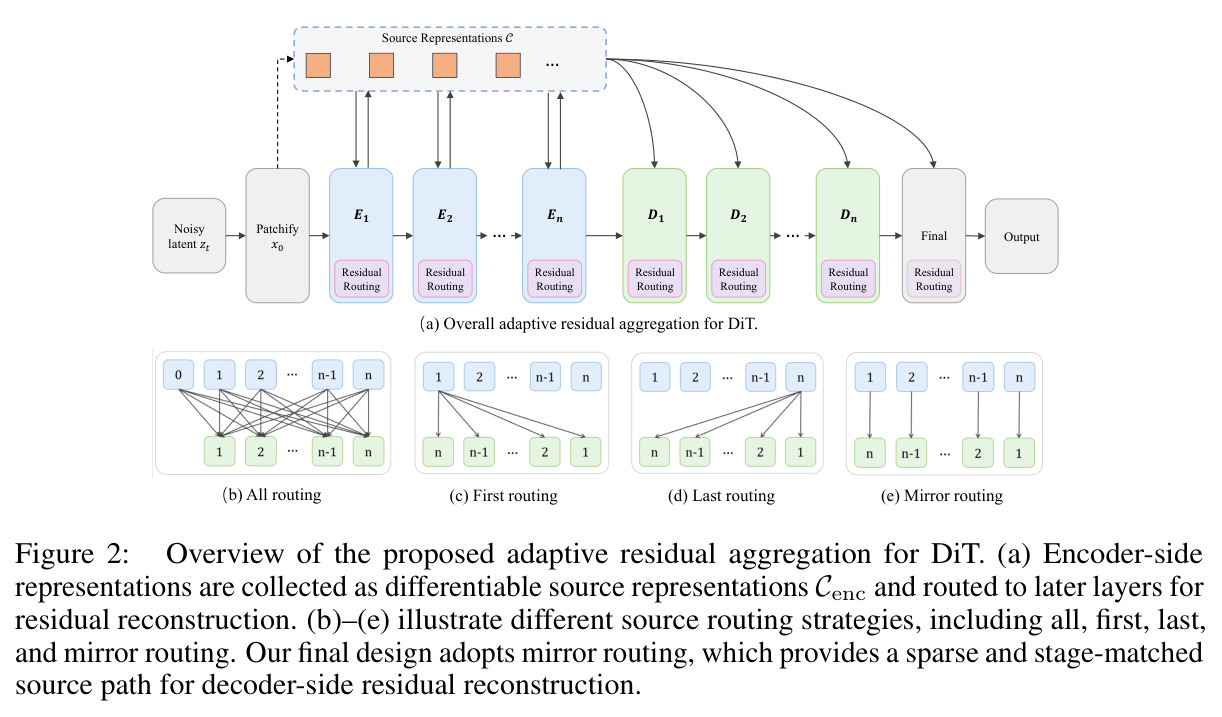
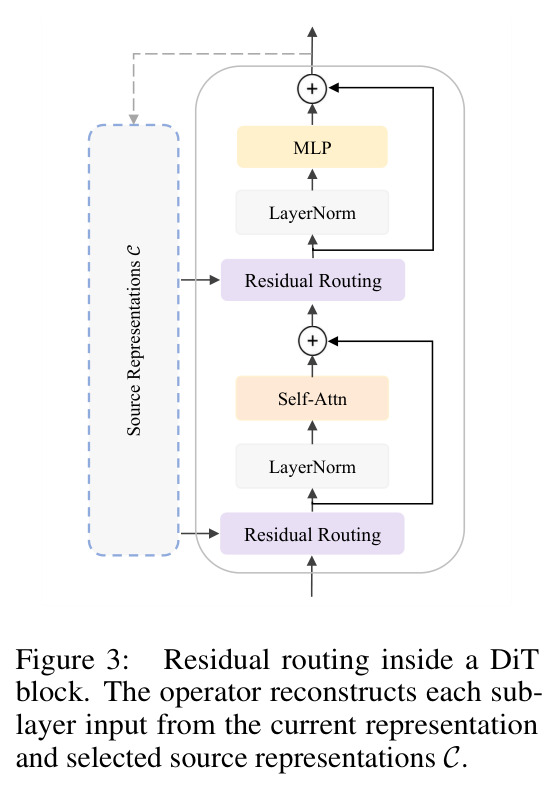
方法的直觉是:既然 DiT 获得自由路由能力时会自发选择早期层与镜像对称层对,那就把这个偏好直接固化成结构先验。技术路线上,把 DiT 沿深度均分为编码阶段和解码阶段(保持单尺度 token 分辨率不变),把 patch 嵌入输出 $x_0$ 和编码器各块输出 $x_1,\dots,x_K$ 收集为可微分残差源集合 $\mathcal{C}_{enc}$;解码器从最后的编码表征 $x_K$ 初始化,每个解码层的每个子层(自注意力和 MLP 之前)先经过残差路由算子 $R(\mathcal{C}, x)$,用 softmax 权重从候选源中自适应重构残差输入,再做子层变换。整个源集合不与计算图分离,解码端路由的梯度可直接回传到编码端表征,形成跨深度的直接优化路径,这是它区别于静态特征缓存的关键。
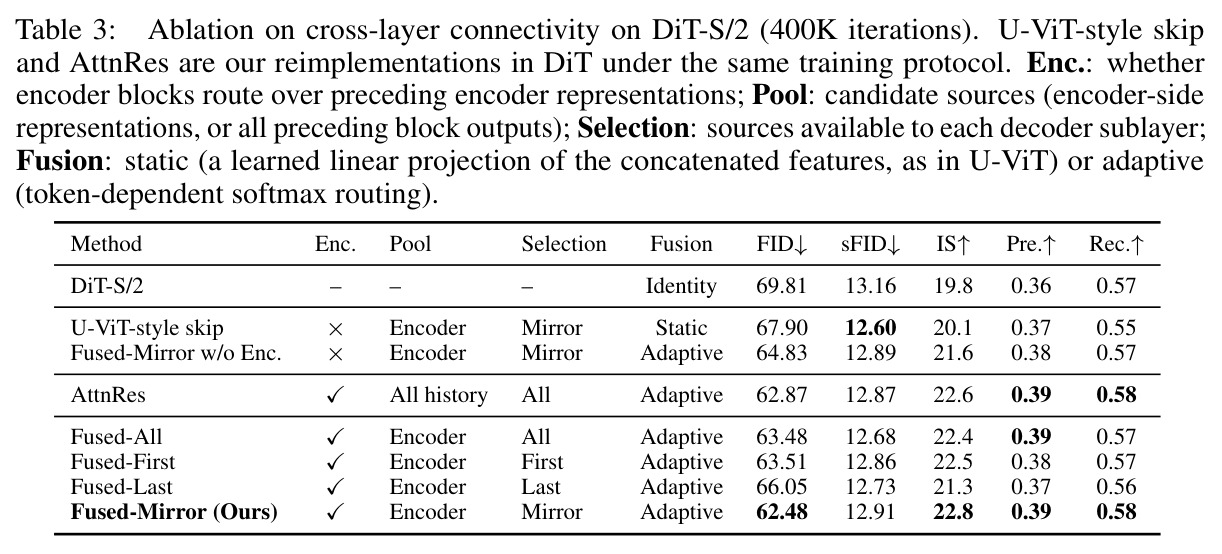
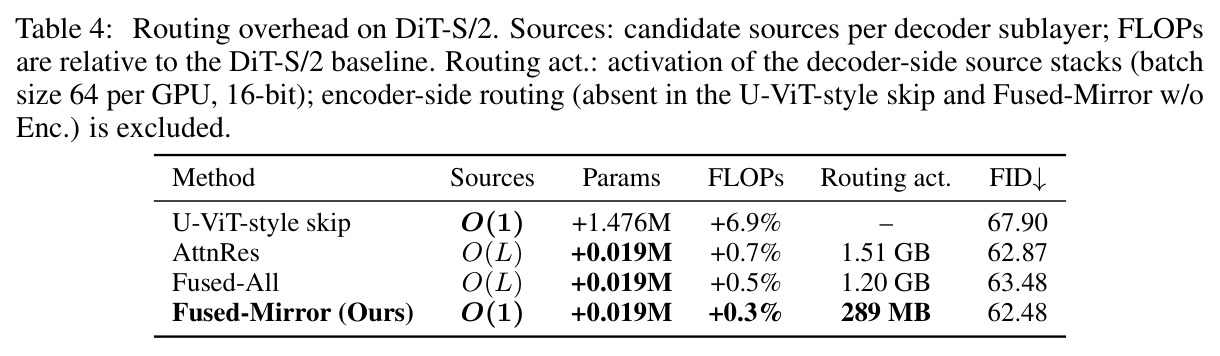
核心创新是 mirror routing(镜像路由):解码层 $j$ 只访问其镜像位置的编码表征,镜像索引 $m(j) = K - j + 1$,即 $\mathcal{C}^{mirror}_j = \{x_{m(j)}\}$。它与已有方法的本质区别有两点。其一,与 U-ViT/U-DiTs 的静态跳跃连接不同:静态版用拼接加学习线性投影融合,权重对所有 token、空间位置和扩散时刻固定;本文路由权重由 token 表征计算($s_i = w^\top \mathrm{RMSNorm}(v_i)$ 后 softmax),逐输入、逐位置、逐子层、逐时刻自适应,消融显示同一镜像对上自适应融合达 64.83 FID,远优于静态投影的 67.90,且静态版参数多约 77 倍。其二,与 Attention Residuals 的稠密全层路由不同:本文把源池限制在编码侧,每层只取单个阶段匹配的源,候选源从 $O(L)$ 降到 $O(1)$,解码端源栈激活从 1.51 GB 降到 289 MB(省约 81%),FID 还略优(62.48 vs 62.87)。
方法步骤详情
方法流程分四步。第一步,含噪潜变量 $z_t$ 经 patch 化与位置编码得到初始 token 表征 $x_0$,它同时作为残差源,提供任何块之前的 patch 级表征入口。第二步,前 $K$ 个块构成编码阶段,每块的自注意力和 MLP 子层前都插入路由算子并对前序编码表征做路由,各块输出收集进源集合 $\mathcal{C}_{enc}$。第三步,后 $K$ 个块构成解码阶段并以 $x_K$ 初始化;解码层按镜像索引 $m(j)=K-j+1$ 选源,先算路由表征 $\tilde{x}_l = R(\mathcal{C}_l, x_l)$,再执行 $x_{l+1} = \tilde{x}_l + f_l(\tilde{x}_l)$。第四步,算子内部对候选 $v_i$ 打分 $s_i = w^\top \mathrm{RMSNorm}(v_i)$,softmax 归一化后加权求和,$w \in \mathbb{R}^d$ 是唯一新增参数。全程仅加轻量归一化与投影层:DiT-S/2 +0.019M 参数、+0.3% FLOPs。
技术新颖性
技术新颖性体现在三个层面。第一,实证发现新颖:以往工作把 U-Net 的对称跳跃连接当作启发式设计,本文首次用路由权重可视化(Figure 4)证明对称性是模型在自由路由下'自发寻找'的结构需求,为架构设计提供了从模型内部行为出发的证据链。第二,设计空间定位精确:论文用消融把'融合方式(静态 vs 自适应)'、'源池(全历史 vs 仅编码侧)'与'源选择(全选/首层/末层/镜像)'三个正交维度拆开,证明收益来自三者组合而非单一因素——例如完整 Fused-Mirror 为 62.48 FID,去掉编码器内部路由退到 64.83。第三,成本结构优势:mirror routing 以 $O(1)$ 候选源匹配稠密 AttnRes 的 FID,避免深模型的源栈激活爆炸,且新增参数可忽略,说明提升来自信息路由质量而非模型容量。
实验结果
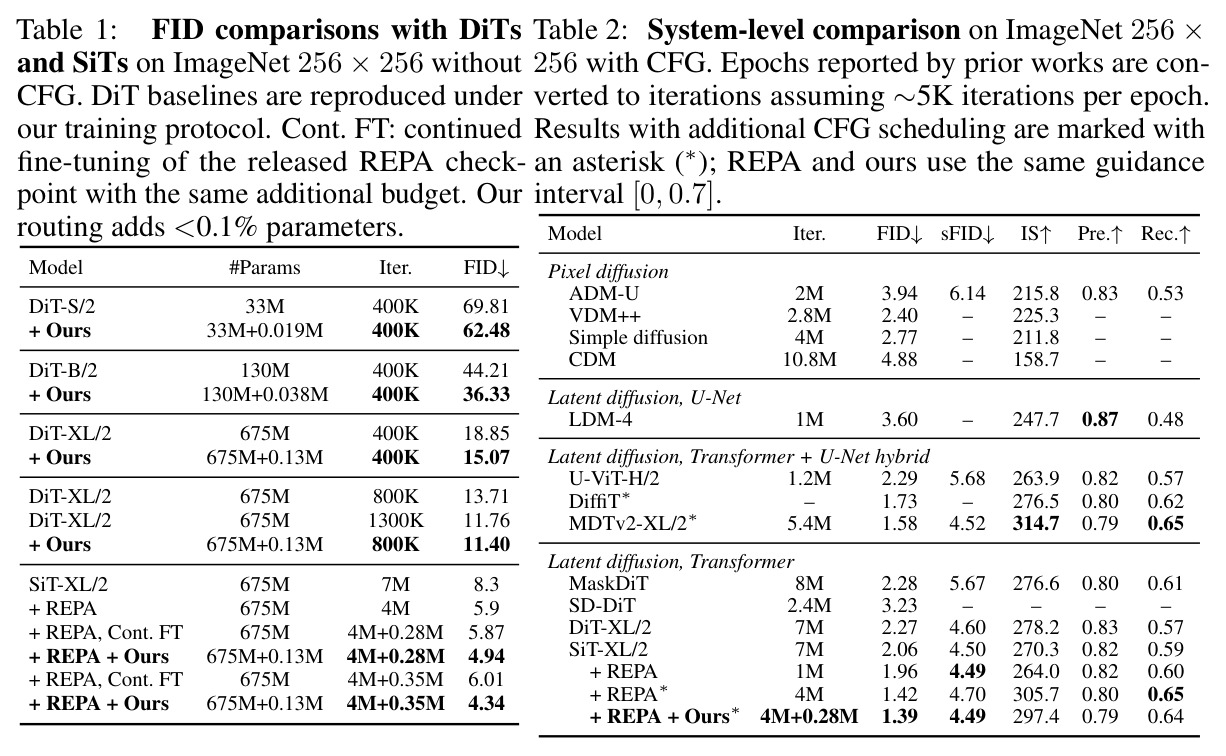
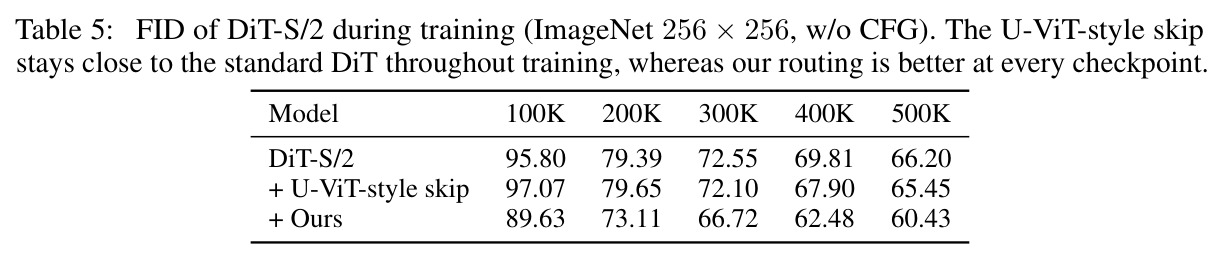
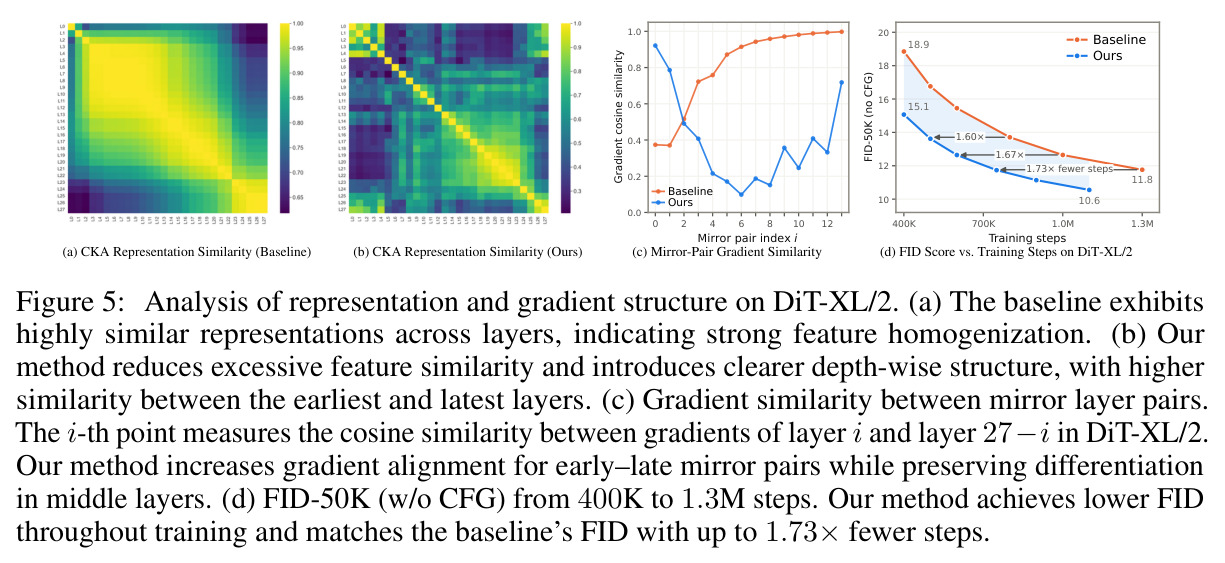
主结果分四组。(1)从头训练(400K):FID 从 DiT-S/2 的 69.81 降到 62.48、DiT-B/2 从 44.21 降到 36.33、DiT-XL/2 从 18.85 降到 15.07,相对降幅 10.5%→20.1% 随规模增大;长训 800K 达 11.40,超过基线 1300K 的 11.76,匹配 FID 最多省 1.73 倍迭代。(2)强模型微调:在 REPA-XL/2 的 4M 检查点上加路由微调 0.28M 步即从 5.9 降到 4.94,同预算基线仅 5.87;0.35M 步到 4.34;加 CFG 后 1.39 FID,超过 REPA 的 1.42。(3)消融(DiT-S/2):静态 U-ViT 式 skip 67.90;同镜像对自适应融合 64.83;AttnRes 62.87、Fused-All 63.48、Fused-Last 66.05,mirror 最优 62.48。(4)机理与效率:CKA 显示基线表征同质化严重,本文显现反对角结构与更强镜像对梯度对齐;开销仅 +0.019M 参数,源栈激活从 1.51 GB 降至 289 MB。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet 256×256 类条件生成(DiT-S/2 从头训练,400K 迭代) | FID-50K(无 CFG) | 62.48 | 69.81(DiT-S/2) | 相对降低 10.5% |
| ImageNet 256×256 类条件生成(DiT-B/2 从头训练,400K 迭代) | FID-50K(无 CFG) | 36.33 | 44.21(DiT-B/2) | 相对降低 17.8% |
| ImageNet 256×256 类条件生成(DiT-XL/2 从头训练,400K 迭代) | FID-50K(无 CFG) | 15.07 | 18.85(DiT-XL/2) | 相对降低 20.1%,参数仅 +0.13M |
| DiT-XL/2 匹配 FID 训练效率 | 达到基线 FID 所需迭代数 | 800K 迭代达 11.40 FID | 基线 1300K 迭代 11.76 FID | 最多节省 1.73 倍训练步数 |
| REPA-XL/2 预训练模型微调 | FID-50K(无 CFG) | 4.94(+0.28M 步)/ 4.34(+0.35M 步) | 5.9(REPA 4M);继续微调基线 5.87/6.01 | FID 降低 0.96~1.56 |
| ImageNet 256×256 系统级对比(带 CFG) | FID-50K(引导区间 [0, 0.7]) | 1.39(4M+0.28M 步) | 1.42(REPA*,4M 步) | 总步数更少且超过 REPA |
局限与改进
作者明确承认的局限:验证范围限于 ImageNet 256×256 类条件生成(DiT-S/B/XL 与 REPA 微调),尚未在更大的文本到图像、文本到视频模型上验证;这些模型有更复杂的条件机制、更大数据集和不同训练配方,可能改变最优路由结构;mirror routing 在强多模态条件或时间依赖下是否仍最优也不确定。我的补充观察:其一,编码/解码各 $K$ 层的均分是未消融的超参,最优分割比例与深度、分辨率的关系未知;其二,镜像对梯度相似度分析(Figure 5c)部分由镜像连接自身诱导,作者也承认这只是对优化行为的刻画而非因果证据;其三,REPA 微调时去掉了 REPA 投影损失(附录 A),与'结构收益可叠加表示对齐收益'的严格对照略有出入;其四,小模型相对收益(DiT-S/2 的 10.5%)明显小于 XL(20.1%),小算力场景的性价比需权衡。
独立分析的弱点
独立分析出的弱点及改进方向。(1)泛化边界不明:类条件 ImageNet 与真实文生图(交叉注意力条件、多分辨率、更大 batch)差异巨大,镜像配对假设可能被条件层打乱,建议先在 DiT 风格的文生图模型上复现路由权重可视化,验证编码器依赖与对称偏置是否仍成立。(2)均分编码/解码缺乏依据:论文假设前后各 $K$ 层功能对称,但不同模型最优分割点可能不同,可引入可学习的分割或软镜像(允许访问镜像±邻域少数几个源)让结构自行退化到最优点。(3)源池仅编码侧可能丢失解码侧信息:Fused-All 与 mirror 差距很小(63.48 vs 62.48),说明解码侧源边际价值有限,但在视频等时间维展开的任务中解码层间依赖可能更重要,值得重估。(4)评估维度单一:除 FID/IS/Precision/Recall 外缺少细粒度多样性分析,定性样本仅限 ImageNet 类别,建议补充高频细节与伪影的人类评测。(5)微调场景需适应新参数:路由向量随机初始化插入已收敛模型,0.28M 步微调成本虽小但非零,可探索零初始化或蒸馏初始化缩短适应期。
未来方向
作者提出的方向:把结构化残差路由推广到大规模文本到图像、文本到视频扩散 Transformer,研究多模态条件与时间依赖下的最优路由结构。基于本文成果还可延伸:(1)把'先分析再设计'的流程自动化——用可微架构搜索在大模型上直接学稀疏连接模式,检验 mirror 是否是学得的解;(2)将镜像路由与 Hyper-Connections、mHC 等多残差流方法正交结合,同时拓宽'深度路由'与'流宽度'两个设计维度;(3)分析不同去噪时刻路由权重的漂移规律,探索时刻自适应的跳层推理加速;(4)在 REPA 之上叠加连接结构改造,检验结构收益与表示对齐收益是否可乘性叠加;(5)理论层面解释对称配对为何能稳定梯度流——本文 Figure 5c 只是现象刻画,可建立镜像对梯度相似度与训练稳定性的定量关系模型。
复现评估
复现评估:论文正文未给出官方开源代码链接,但方法描述足够详细——路由算子只有逐子层一个 $d$ 维向量加 RMSNorm,在标准 DiT 代码上改动量很小。算力门槛分层明显:DiT-S/2 消融(400K 迭代,batch 256,学习率 $1\times10^{-4}$)在少量 H200 上即可完成,是最经济的验证路径;DiT-XL/2 从头训练 800K~1300K 迭代需大规模 GPU 集群,个人难以承受;最划算的复现路径是下载公开的 REPA-XL/2 4M 检查点,只加路由模块微调 0.28M 步(不含 REPA 投影损失),单节点多卡即可验证 5.9→4.94 的核心结论。数据为公开 ImageNet(需自行获取),评测用标准 FID-50K 套件。总体难度:微调实验中等偏易,从头训练偏难;建议作者开源代码与路由权重可视化脚本以降低复现摩擦。
论文图表
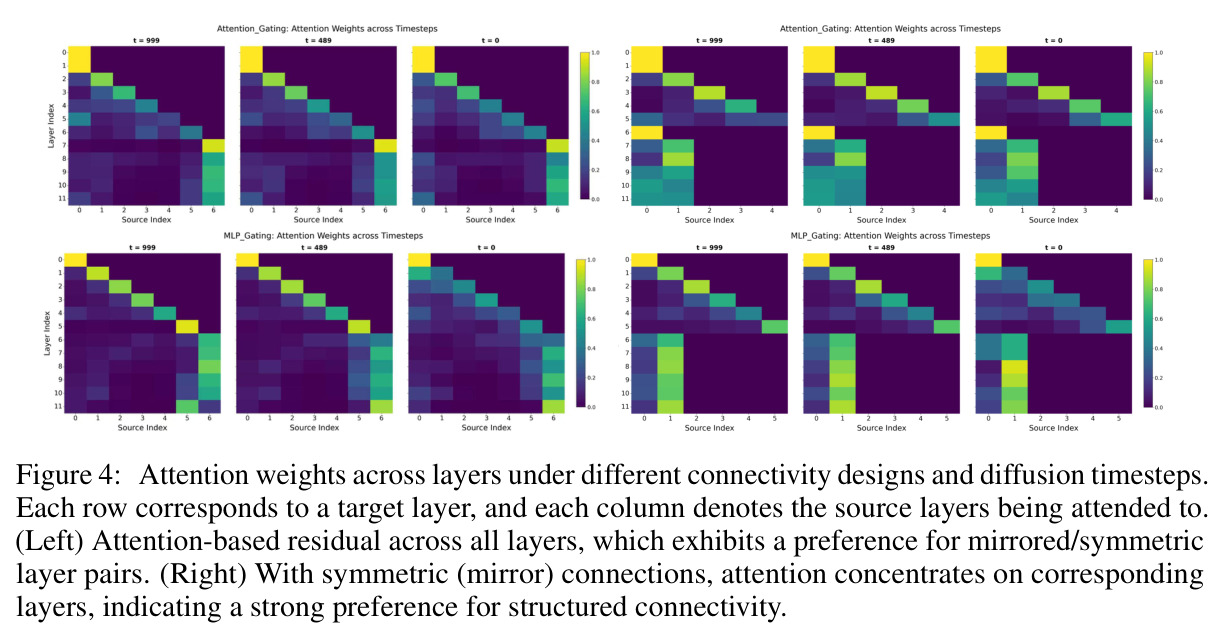
路由权重热力图:行为目标层、列为被关注的源层。左侧为跨全层的注意力式残差路由,可见对镜像对称层对的明显偏好;右侧为施加对称(镜像)连接后,注意力集中到对应配对层。不同扩散时刻下模式保持一致。
全文最重要的实证依据:直接可视化出'编码器依赖'与'自发对称偏置'两大发现,mirror routing 的设计动机由此而来。
左半:相同协议下 DiT-S/2、B/2、XL/2 加本文路由的 FID(69.81→62.48、44.21→36.33、18.85→15.07),XL/2 长训(800K 11.40 vs 基线 1300K 11.76)及 REPA 微调(5.9→4.94/4.34,继续微调基线 5.87/6.01);右半:与 ADM、VDM++、LDM-4、U-ViT-H/2、DiffiT、MDTv2-XL/2、MaskDiT、SD-DiT、DiT-XL/2、SiT-XL/2+REPA 等系统级对比。
论文主结果表:从头训练的规模化收益、训练效率(1.73×)与微调强模型的核心数字都在这里。