TSFLab:自改进、代理无关的时间序列预测研究工作台 TSFLab: A Self-Improving Agent-Agnostic Workbench for Time Series Forecasting Research
外置共享工作台赋能任意编码代理,低成本完成TSF复现、基准测试与新方法开发
前置知识
Harness 与 Workbench
Harness(线束)是围绕 LLM 的代理本体基础设施,负责工具调度、上下文管理和内部工作流,随代理一起发布、只服务该代理;Workbench(工作台)则是位于代理之外的共享基础设施,提供领域知识、研究流程与实验工具,任何兼容代理无需改动即可接入复用。TSFLab 的全部设计都建立在'域支持应放在工作台层'这一立场之上。
论文的动机、架构与实验对比都围绕这对概念展开,不理解它就无法理解 agent-agnostic(代理无关)的真正含义和工作台与库、代理系统的本质区别。
知识卡与渐进式披露
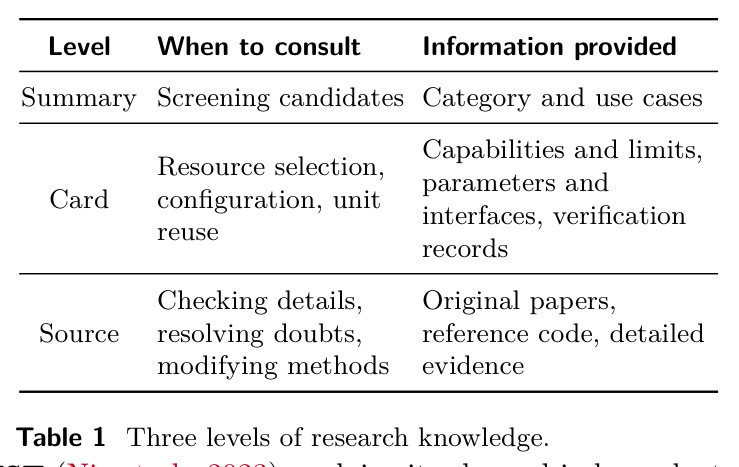
把每个方法、数据集、可复用单元的知识组织成三级结构:summary(一句话类别与用途,用于筛选候选)、card(能力边界、参数接口、验证记录,用于选型配置)、source(原论文、参考代码、详细证据,仅在排查疑问时读取)。代理按决策需要逐级深入,避免一次性读入昂贵的源码和数据细节。
Knowledge Structurer 是 TSFLab 四大模块之一,实验中 token 成本下降 11–66% 的关键机制就是这种分级读取策略。
RevIN 与通道独立建模
RevIN(可逆实例归一化)先移除输入窗口的 level 并做缩放,预测输出后再还原,用于对抗时间序列分布漂移;通道独立(channel-independent)指每个变量用共享权重的同一模型分别建模、不做跨变量交互,PatchTST 是代表。两者都是 TSF 中被广泛复用的共享单元。
论文用它们举例说明单元复用机制(263/323 个方法至少复用一个单元),一致性审查也会核查号称通道独立的方法是否暗藏跨变量计算。
圈复杂度
静态度量函数中独立执行路径数量的指标(可用 $CC = E - N + 2P$ 计算,$E$ 为控制流图边数、$N$ 为节点数、$P$ 为连通分量数),数值越高越难理解、测试和维护。TSFLab 对函数级圈复杂度和方法代码行数设置上限,超限的实现必须拆简逻辑或改用共享单元后重新验证。
Recursive Improver 的复杂度检查以及 Table 2、Table 3 中的 ΔCC、ΔFuncs 指标都以它为基础,是理解'代码更简单'这一结论的前提。
MSE 与相对复现误差
均方误差 $\mathrm{MSE} = \frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2$ 是时间序列预测的主要评估指标;本文额外定义相对误差来衡量复现质量,即 $|\mathrm{MSE}_{\mathrm{rep}} - \mathrm{MSE}_{\mathrm{paper}}| / \mathrm{MSE}_{\mathrm{paper}}$,误差在 10% 以内视为高质量复现。
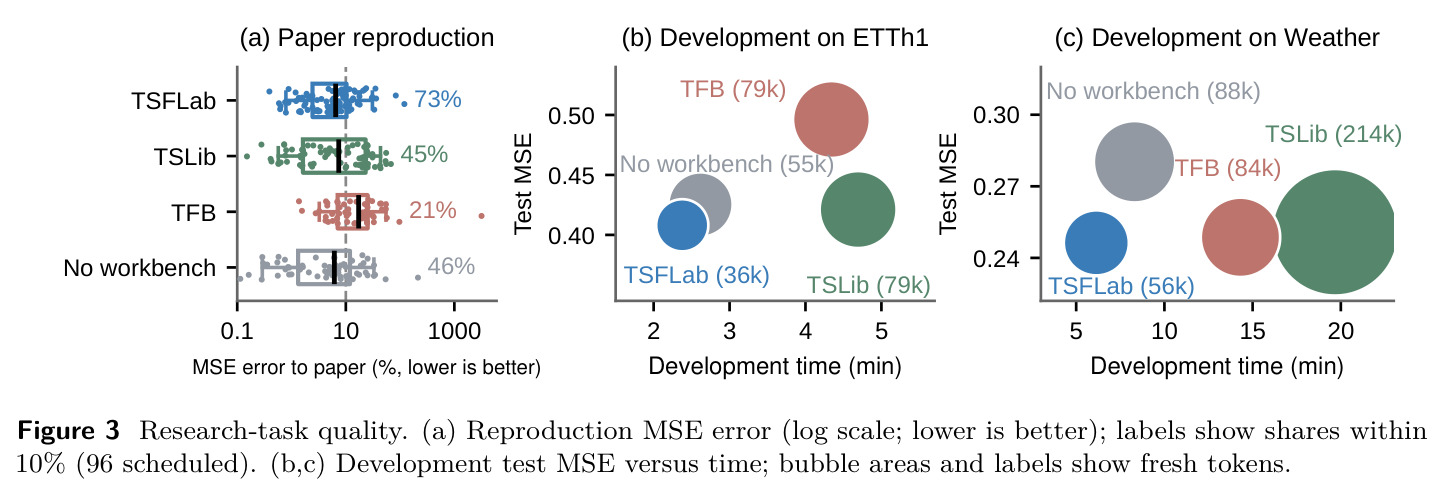
Fig. 3a 中 73% 对 21–46% 的核心对比以及复现任务的全部结论都建立在这个度量上,完成率评审与数值误差构成互补的两种质量视角。
研究动机
时间序列预测(TSF)论文爆炸式增长,可复用代码却远远滞后。论文统计 2020 年以来 arXiv 上的 1,707 篇 TSF 预印本,只有约 20%(约五分之一)附有代码链接;主流库 TSLib 的方法数仅从 18 个缓慢涨到 41 个,而 2024 年以来新增论文超过 1,200 篇,且因维护人力不足已在 2026 年 4 月宣布停止维护。研究者(尤其是新手)被迫反复手动重实现基线与评估流程。直接使用 Claude Code、Codex 这类编码代理做基准测试也不理想:一是 LLM 知识停留在训练截止日期,不认识新模型和新协议,反复联网检索既昂贵又不可靠——Informer 官方代码评估时错误丢弃最后一个测试批次,这一错误设定被后续大量论文沿用;二是各代理自行配置实验,信息来源不同导致设定、实现与结果互不可比,造成跨代理、跨团队的大量重复实验。两大问题叠加使代理式 TSF 研究成本高企、难以规模化。
本文的目标是作者要构建一个自改进、代理无关(agent-agnostic)的 TSF 研究工作台 TSFLab:它位于代理外部而非内部,不修改任何代理的模型或 harness,就能为 Claude Code、Codex、Pi 等兼容代理提供共享的领域知识、结构化资源、统一实验执行与持续维护能力。形式化目标是 $\pi^{*} = \mathrm{Augment}(\pi, W)$:对兼容代理集合 $\Pi$ 中任意代理 $\pi$,叠加工作台 $W$ 后提升'有效任务完成率'(严格按要求完成研究任务)并降低每完成任务的成本(时间、新鲜 token、工具调用次数)。工作台需覆盖三类研究任务——无官方代码论文的复现、新数据上的方法基准测试、以及探索性新方法开发(autoresearch),并借 Recursive Improver 把验证过的模型、数据集与修复沉淀回共享资源,独立于代理版本演进。
与已有工作不同的是,已有方案各有盲区:TSLib、BasicTS、TFB 等库靠人工添加方法,覆盖滞后文献,代理必须读库代码才能考古出隐藏的评估设定;TimeSeriesScientist、TimeCopilot、MetaCaster 等 TSF 代理把领域支持做进自身 harness,服务单一系统,新代理出现后要推倒重建;ToolUniverse、Scientific Agent Skills、Biomni-E1 等通用/生物医学工作台虽然把工具放在代理外部,但不提供'在声明的统一评估协议下比较 TSF 方法'的能力;STOP、Darwin Gödel Machine 等自改进方法改进的是单个代理而非共享资源。TSFLab 的独特切入是把领域支持整体外置成'工作台'这一层:代理即插即用,复现产物可跨代理、跨团队共享(复现代理添加的验证实现可被基准测试代理直接复用),并通过验证-合并循环让每次会话的产出反哺工作台本身。
核心方法
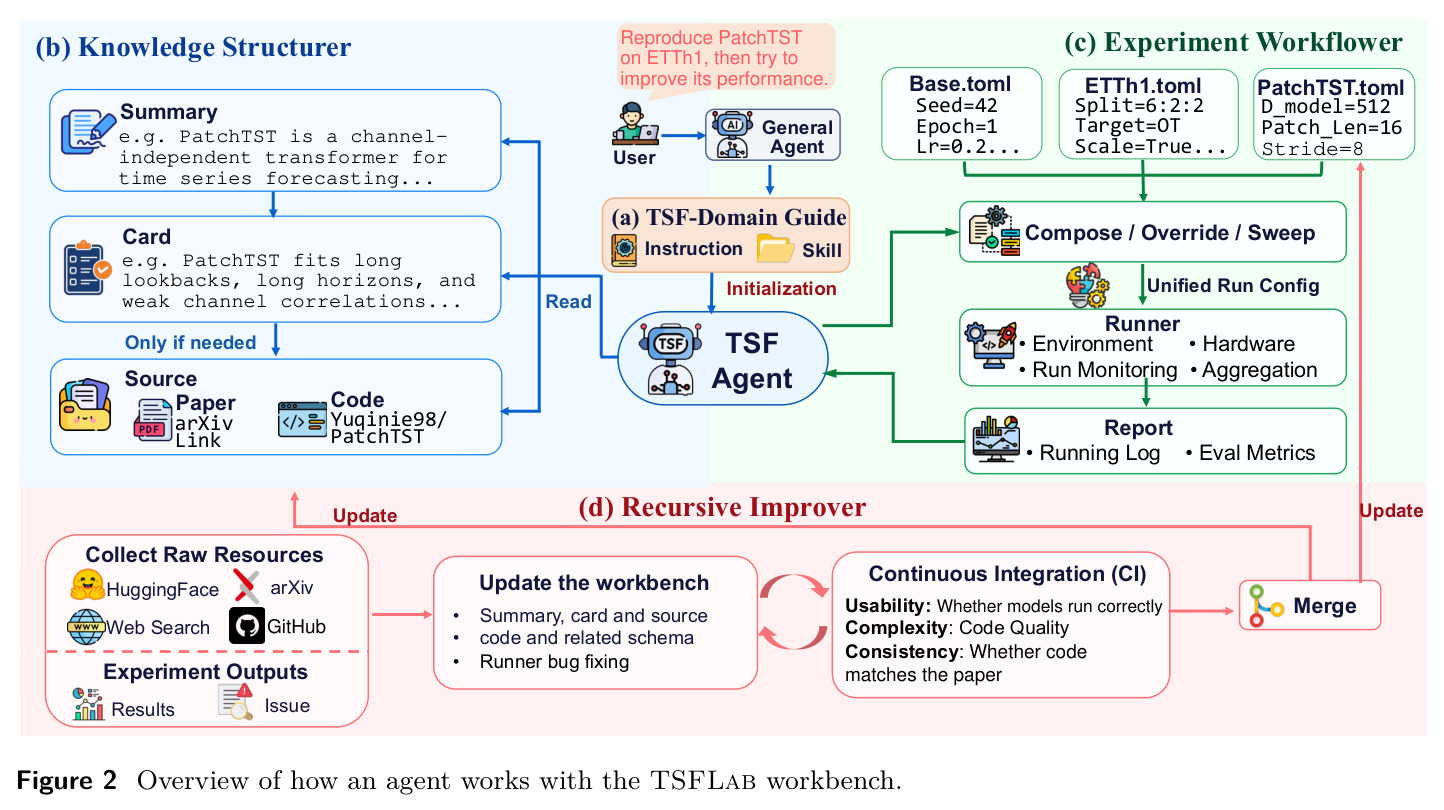
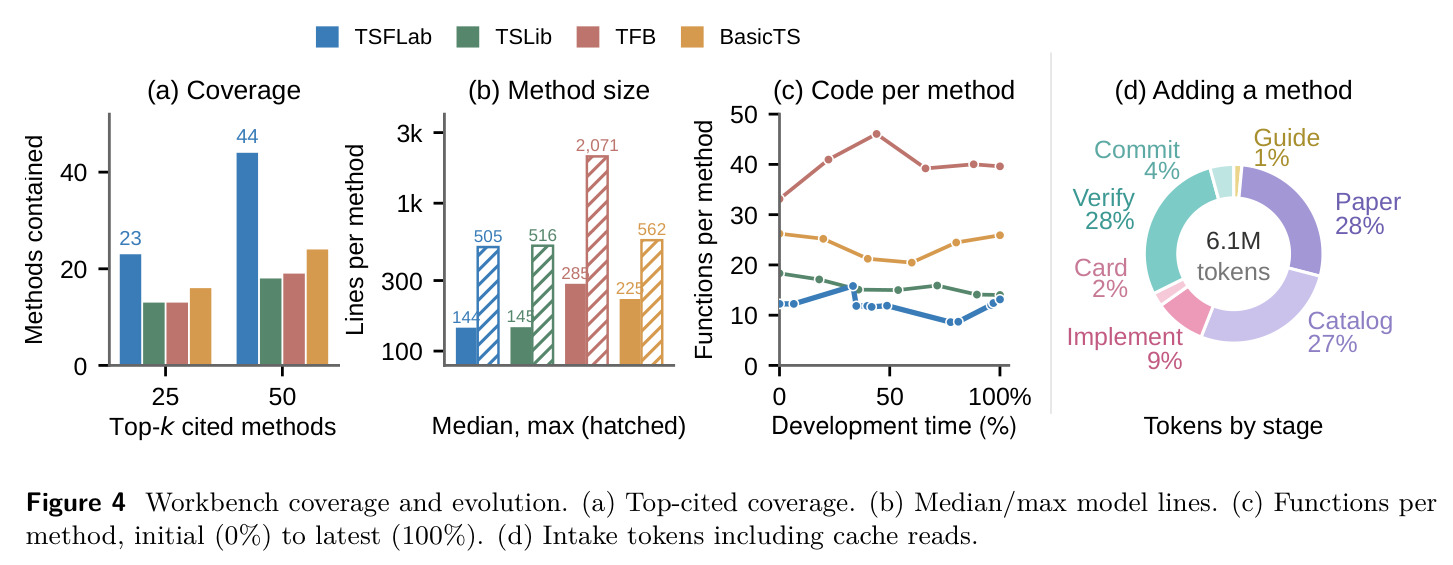
直觉上,TSFLab 相当于给任意编码代理配一间'共享实验室':试剂(方法与数据)、说明书(领域指南)、仪器(统一运行器)和质检员(递归改进器)都在代理外部,代理只负责推理与决策。技术上由四个模块组成:(a) TSF-Domain Guide 用入口指令加 17 个任务技能传授研究流程、实验设定、评估协议和已知坑;(b) Knowledge Structurer 把 323 个 TSF 方法、93 个数据集和 71 个可复用单元组织成三级知识卡(summary/card/source),263 个方法至少复用一个共享单元(如 RevIN、序列分解、注意力变体),覆盖 50 个高被引方法中的 44 个;(c) Experiment Workflower 以声明式配置(Compose/Override/Sweep)驱动统一运行器,预检配置后批量执行训练与评估,共享例程保证数据划分、缩放、checkpoint 选择和指标计算一致;(d) Recursive Improver 以可用性、复杂度、一致性三类 CI 检查,把外部资源与会话产出验证后合并回工作台,形成自维护循环。
核心创新是'工作台位于代理之外'这一架构决策及三个推论。第一,知识卡按 summary→card→source 三级渐进披露:筛候选只读摘要,配置读参数接口卡,只有排查疑问才回源码原文,避免 token 昂贵的整库阅读;而 TSLib/TFB 要求代理自己从代码里考古评估设定。第二,方法被拆解为可复用单元(如 RevIN 移除输入窗口 level 并缩放、预测后还原),共享维护使中位数实现仅 144 行,基准测试甚至做到零代码改动。第三,实验以声明式配置交给共享运行器执行:数据按配置切分、scaler 仅在训练集拟合、验证集选 checkpoint、统一计算指标,把最容易出错的评估环节从代理手里拿走。第四,Recursive Improver 改进的是共享工作台而非单个代理:一致性由独立只读审查代理核对论文、钉死版本的官方代码与实现,修复必须在集成前通过 CI,此后所有代理都继承这些修复。
方法步骤详情
一次典型会话分四步。(1) 读指南:入口指令介绍约定与模块交互,技能给出步骤、检查点与坑——例如新数据基准测试技能要求先识别时间字段、预测变量、采样频率与评估设定(单目标还是全变量指标),再经工作台 add 接口注册数据、用 split 接口检查划分与缩放。(2) 查知识卡:按 summary 筛方法、按 card 定参数(如 PatchTST 的 patch 长度 16、stride 8,通道独立设计是否支持外生输入与概率预测),数据相关参数(输入通道数)由声明的依赖自动设定,存疑才读 source。(3) 声明并执行实验:用 Compose 合并预设、Override 修改设定、Sweep 扫方法或参数值,运行器展开为运行矩阵并预检配置合法性、数据与模型兼容性、环境与预算,然后共享例程按 6:2:2 等配置切分数据、只在训练集拟合缩放、验证集选 checkpoint、统一算 MSE 等指标;支持断点续跑(校验配置/数据/代码指纹后从最后一个完整 epoch 恢复)与状态、等待、取消接口,返回指标、训练时长、峰值显存与产物路径。(4) 回收改进:产出经可用性(构建/训练一步/存取测试)、复杂度(圈复杂度与行数上限)、一致性(只读代理比对论文与实现)检查后合并,单元抽取要求抽取前后参数、输出、输入梯度逐位一致。
技术新颖性
技术新颖性体现在四个'此前未被同时做到'。其一,TSF 领域首次把研究支持做成代理外的工作台:既区别于人工维护、设定隐匿在代码里的库(TSLib/TFB/BasicTS),也区别于绑定单一系统的 harness 型 TSF 代理。其二,三级知识卡加声明式实验把'可复现性'编码成数据结构而非代码注释:方法规格定义参数约束、构造方式与输入输出接口,运行器据此实例化并接入共享训练评估,基准测试会话实现零代码改动。其三,自改进的对象是共享基础设施而非代理本身:与 Voyager 攒技能、DGM 改代理代码不同,每次会话贡献的方法、单元、协议修复经 CI 验证后惠及所有代理——一次单元抽取把平均函数数从 11.9 降到 8.6,一次重构把最大圈复杂度从 20 降到 9,且对全部 323 个方法保持逐位一致的参数、输出与梯度。其四,一致性审查由独立只读代理执行,论文与官方代码的设定差异被显式记录,而非隐式信任任何单一实现。
实验结果
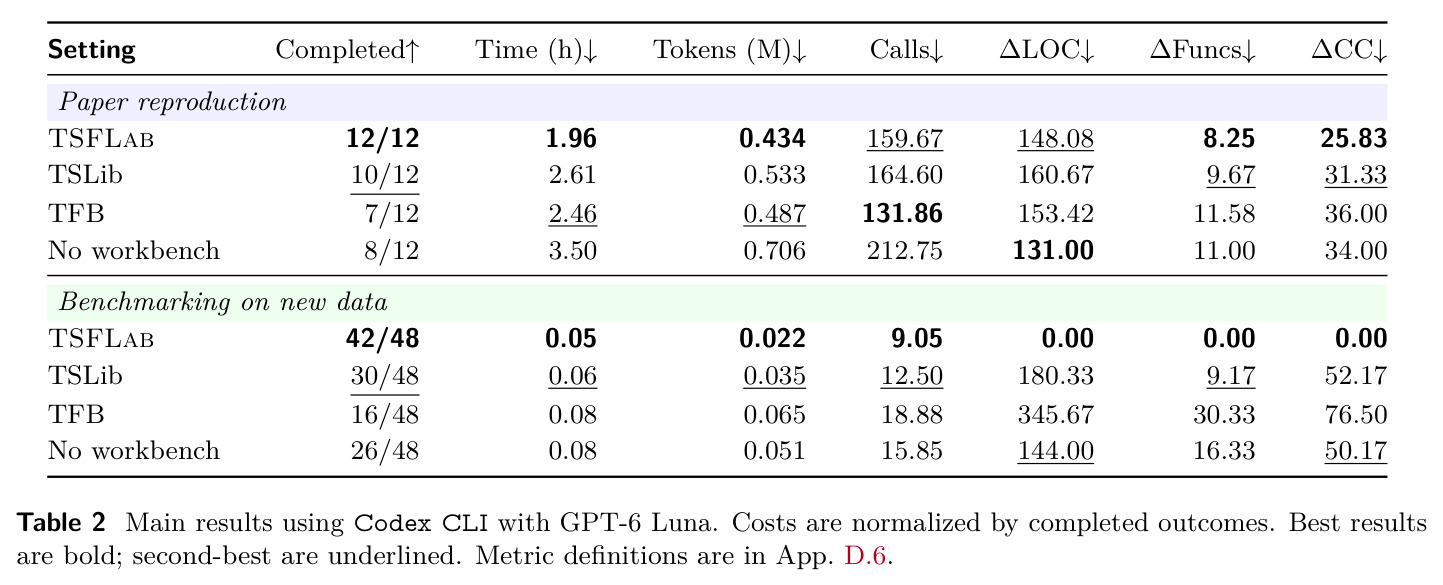
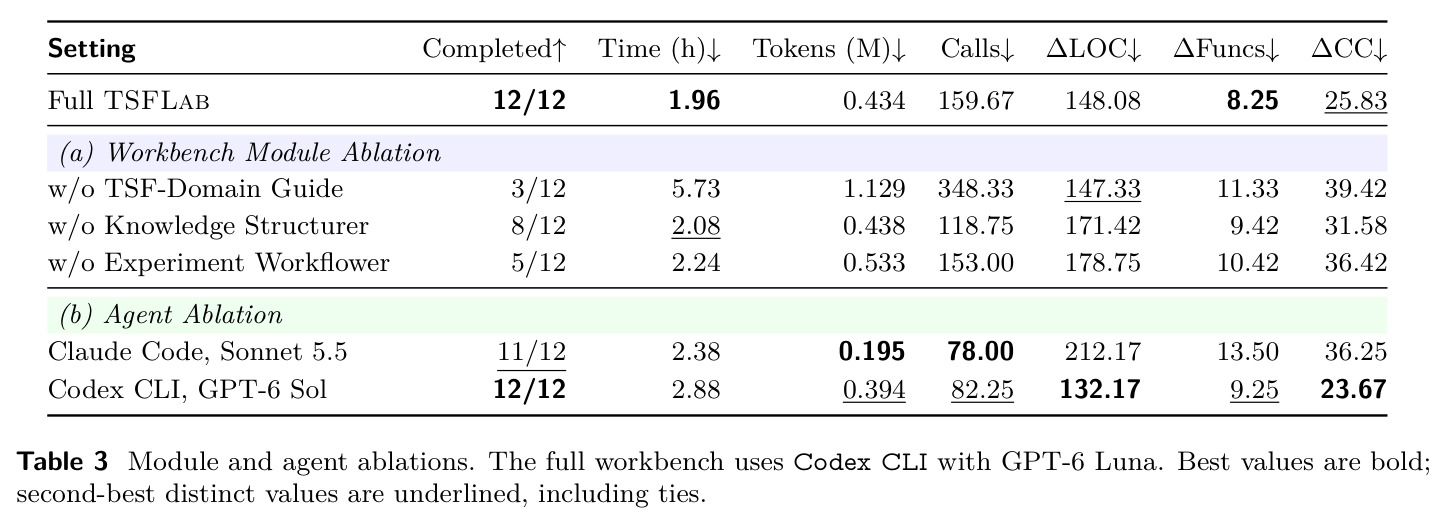
主实验用 Codex CLI + GPT-6 Luna,对比 TSLib、TFB 与无工作台。(1) 论文复现(RhyMix、StateFlow、AdaRDiff、CoRe 四篇无代码论文×3 次):TSFLab 12/12 全部通过评审,TSLib 10/12、TFB 7/12、无工作台 8/12;每完成结果 1.96h、0.434M 新鲜 token,优于无工作台的 3.50h/0.706M;Fig. 3a 显示 96 个计划结果中 TSFLab 73% 的复现 MSE 与论文误差在 10% 内,其余设定仅 21–46%。(2) 新数据基准测试(ERCOT、Openmeteo×8 方法×3 次):TSFLab 42/48,对 TSLib 30/48、无工作台 26/48、TFB 16/48;零代码改动,每结果仅 0.022M token、9.05 次调用;TFB 垫底,主因是代理用替代方法偷换要求的方法。综合两项,完成率提升 20–163%,每完成任务 token 降 11–66%。(3) 方法开发试点:ETTh1 与 Weather 上 TSFLab 取得最低测试 MSE,新鲜 token 36k/56k 对 TSLib 的 79k/214k,降 32.8–73.6%,开发时间少 9.2–68.8%。(4) 模块消融:去掉 Guide 跌至 3/12(被拒尝试均切错 ETTh1 划分边界),去掉 Knowledge Structurer 8/12 但代码更多($\Delta$LOC 171.42 对 148.08),去掉 Workflower 5/12 且错误转入评估(在测试分数上调参、按 batch 平均误差)。(5) 代理消融:Sonnet 5.5 完成 11/12(0.195M token、78 次调用),GPT-6 Sol 12/12(0.394M、82.25 次),调用分别少 51.1%/48.5%,但估费是 Luna 的 9.0×/18.2×——轻量代理借工作台即可匹敌更强配置。
局限与改进
作者承认的局限有三点:工作台目前只覆盖时间序列预测,指南、资源描述与实验接口都为 TSF 协议定制,迁移到其他领域需重新适配;方法开发试点尚未产出能显著超越所有领先模型的新方法,结果只证明'支持开发'而非'更优模型';搜索时间受限,更有效的搜索策略与更长研究周期留待未来。我的补充观察:评估规模偏小——复现仅 4 篇论文、基准测试仅 2 个数据集 8 个方法,主实验绑定单一代理(Codex CLI + GPT-6 Luna),结论对其他代理-模型组合的外推有限;'完成'与否由评审流程判定,可能对自家协议存在偏好;论文-代码一致性依赖只读审查代理,审查者本身也是 LLM,可能漏检巧妙的机制性偏差;固定共享协议保证了可比性,却可能把社区沿袭的争议设定(如 Informer 式 drop-last 评估的教训)固化为唯一标准;成本结论按统一 token 混合比例折算,对实际 API 定价敏感。
独立分析的弱点
第一,一致性审查代理是 LLM,对'通道独立'这类机制声明的核查可能被巧妙实现骗过,改进方向是为关键机制配可执行的检验(如对通道独立性做输入扰动等价性测试)。第二,目录偏向有官方代码或高被引的方法,低被引但正确的新方法进入慢,可增设社区提名通道与更快的小额验证流程。第三,共享运行器把协议固定成一套默认值,虽规避了 Informer 式错误,却缺少协议变体(不同划分比例、是否丢弃最后批次)的一等支持,改进方向是把评估协议本身也做成可声明的知识卡,并自动报告不同协议下的结果差异。第四,'忠实实现并按协议评估'的完成判定可能循环依赖 LLM 评审,建议引入少量人工盲审或与论文报告数值的自动比对(Fig. 3a 的相对误差是很好的起点,但目前只覆盖复现任务,基准测试尚无真值可对照)。第五,成本结论依赖特定定价假设(GPT-6 Sol 估费 18.2×Luna、Sonnet 9.0×),不同定价或私有化部署下'轻量代理够用'的判断可能反转。
未来方向
作者提出的方向:把工作台模式推广到其他研究领域,为每个领域定制指南、知识卡与验证检查;设计更有效的方法搜索策略,让 autoresearch 运行更长的实验周期,以真正产出超越领先模型的新方法。基于本文成果还可延伸:把 93 个数据集卡与统一评估协议接入 GIFT-Eval 等基础模型榜单,形成跨代理、跨团队的持续排行榜;把 Recursive Improver 的三类检查扩展为可插拔的验证器生态;探索多工作台联邦与跨域单元复用(RevIN 等模块在许多序列任务中通用);支持协议变体的自动消融,量化评估设定对方法排名的影响(呼应 TFB 论文的发现);结合沙箱与权限系统落实伦理节中'代理带网络访问执行代码须沙箱化'的要求;以及纵向追踪 TSLib 停止维护后社区新方法被工作台吸收的效率,作为自维护能力的长期案例研究。
复现评估
复现条件较好,但需要商业代理预算。代码已在 GitHub 开源(D2I-Group/TSFLab),工作台自带 323 个方法、93 个数据集、71 个单元的知识卡与实现;数据集均为公开数值时间序列(ERCOT、Openmeteo、ETTh1、Weather),不含个人信息,不可再分发数据从提供方获取。主实验需要 Codex CLI(GPT-6 Luna/Sol)或 Claude Code(Sonnet 5.5)账号:复现任务每完成一个约消耗 0.434M 新鲜 token,单个方法集成的平均摄入量为 6.1M token(含缓存读),可据此估算 API 开销。难点有三:(1) 结论绑定这些特定代理与模型版本,更换需重跑实验;(2) 作者明确提醒代理带网络访问执行代码,应在沙箱中运行并对外部操作显式授权;(3) 对比库 TFB、BasicTS 的安装配置本身有门槛。总体属于中等难度、以 token 成本为主要开销的复现。
论文图表
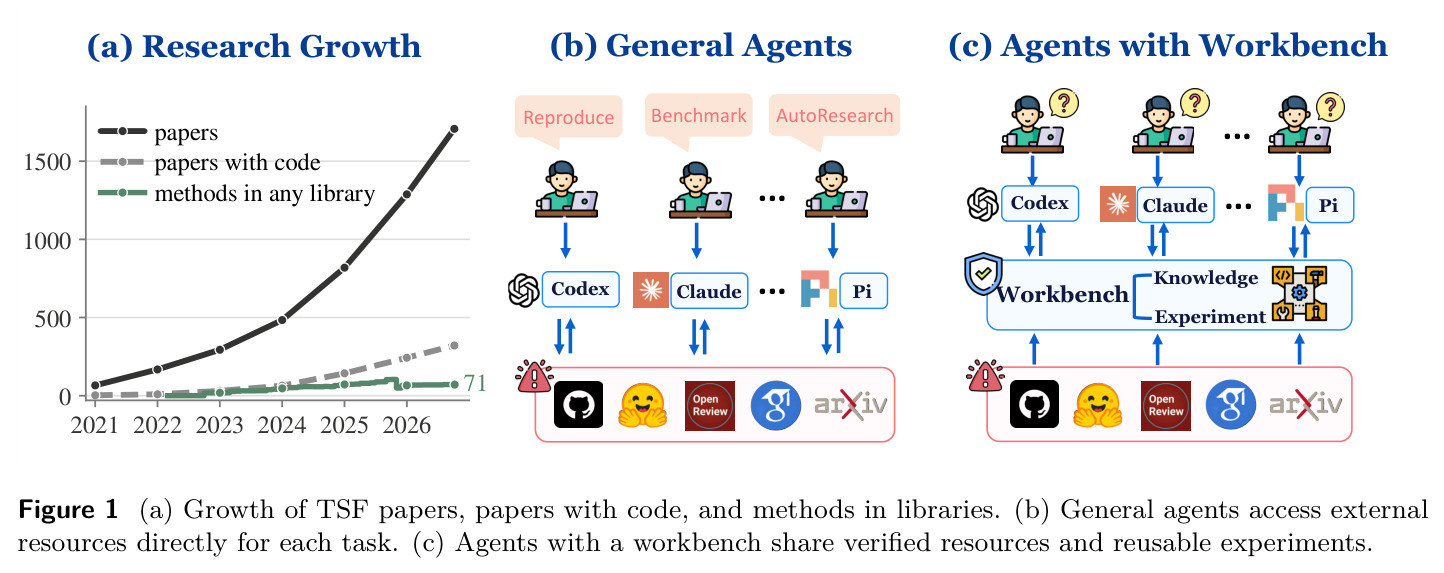
三联图。(a) 用 arXiv 数据展示 2020 年以来 1,707 篇 TSF 论文、约 20% 附代码的增长曲线,以及 TSLib 方法数从 18 到 41 的缓慢增长;(b) 一般代理(Codex、Claude 等)各自直接访问外部资源,实验设定互不一致;(c) 挂载工作台的代理共享已验证的资源和可复用实验,复现、基准、autoresearch 三类任务串联复用。
同时给出问题规模(代码_release_率仅 20%、库覆盖滞后)和核心概念对比(harness 型 vs workbench 型),是理解全文动机与架构差异的入口。