PhysInsert:基于几何先验与双向物体-场景交互的物理合理物体插入 PhysInsert: Physically Plausible Object Insertion with Geometric Priors and Bidirectional Object-Scene Interactions
用反事实渲染数据与VGGT几何流,实现物体插入时物体与场景的双向物理适配
前置知识
参考图物体插入(Reference-based Object Insertion)
给定一张或几张目标物体的参考图与一张背景场景图,模型需把该物体『贴入』场景:保持物体身份(外观、纹理)不变,同时调整其尺度、透视、姿态与光照,使其看起来真实存在于该场景。典型方法有 AnyDoor、Insert-Anything、ObjectDrop、OmniPaint。
本文的任务设定正是参考图插入,理解任务边界才能看清它相比既有方法多解决了哪些物理适配问题。
反事实数据对(Counterfactual Pairs)
指除『物体是否存在』这一个变量外其余条件完全相同的图像对:同一场景固定相机与光照,分别渲染有物体与无物体两帧。两帧逐像素对齐,差分恰好是物体及其引发的全部可见变化(阴影、镜面成像、反射),可直接作为监督信号。
InsertWorld 数据集的核心就是严格对齐的反事实对,COSS 损失的物体占据图与外部效应图都由此导出。
VGGT(Visual Geometry Grounded Transformer)
一种前馈式三维视觉 Transformer,输入一张或多张图像即可直接输出相机参数、深度、点图与三维感知特征,无需逐场景优化。本文使用冻结的 VGGT 作为几何特征提取器,分别编码背景与插入后场景。
几何流 GGA 的初始化特征 $F^-$ 与监督目标 $F^+$ 都来自同一个冻结 VGGT,它是整个几何适配机制的基础。
DiT / MMDiT 多流联合注意力
Diffusion Transformer 用 Transformer 替代 U-Net 做扩散去噪;MMDiT(SD3、Qwen-Image-Edit 等)让图像与文本 token 各有独立的 QKV 投影,在注意力层拼接后做联合交互,再用各自的输出投影与调制回路更新。本文进一步扩展为图像、文本、几何三流。
PhysInsert 以 Qwen-Image-Edit-2511 为底座,新增几何流并改造为三流 DiT 块是其最核心的架构改动。
KL 散度分布对齐
KL 散度 $\mathrm{D}_{\mathrm{KL}}(P\Vert Q)$ 衡量两个概率分布的差异。把图像-文本注意力相关性经温度 $\tau_a$ 的 softmax 归一化为概率分布后,与另一个目标分布做 KL 最小化,可以软性地把模型注意力『推』向指定区域而不需硬掩码。
SSG(软掩码空间接地)正是用 KL 散度把空间文本注意力分布对齐到物体占据分布,是实现纯文本控制放置位置的关键。
LoRA 与流匹配(Flow Matching)
LoRA 在冻结权重旁注入低秩分解矩阵(本文秩 32)实现参数高效微调;流匹配是扩散模型的一类训练目标,直接回归从噪声到数据的速度场,本文预测 $v^{*}=\varepsilon-z_0$,采样时沿速度场积分完成去噪。
本文只微调 LoRA 而冻结底座,总损失中的 $\mathcal{L}_{\mathrm{flow}}$ 即流匹配项,理解这两点才能读懂训练配置与损失定义。
研究动机
参考图物体插入要求把指定物体放进目标场景且保持其身份不变,但现有方法在三个方面受限。其一,跨环境适配不足:ObjectDrop、Insert-Anything 等方法的训练对多由掩码构造或生成式编辑得到,同一物体在不同光照环境下的外观变化缺乏受控监督。其二,双向物体-场景交互缺失:掩码填充式方法(Gong et al. 2026、Yu et al. 2025)能调整物体自身光照,却难以生成一致的场景变化——苹果放进场景后玻璃上没有倒影、镜子里缺失瓶子等伪影很常见;而掩码或生成式编辑构造的训练对无法保证阴影与反射的准确监督,简化背景的训练样本又低估了复杂遮挡与空间关系。其三,跨视角适配弱:固定视角训练对限制了透视与姿态变化的监督,纯 2D 图像监督又缺乏对物体-场景几何的直接约束,难以引导目标视角和姿态的适配。
本文的目标是本文目标是构建一个物理合理的参考图物体插入框架 PhysInsert:输入无物体背景图 $I^-$、若干参考物体图像 $I_r$ 和文本指令 $p$,生成带物体的图像 $I^+$,要求同时保持参考物体的身份,并把物体的透视、姿态、光照及其对周围环境的影响(阴影、镜面成像、反射、遮挡)都适配到目标场景。为此需要配套三件事:提供严格反事实监督的 InsertWorld 数据集、以『插入后几何』为受监督中间表示的对齐机制、以及把文本空间指令落到图像区域的空间引导;同时建立超越『外观复制』的评测基准 PhysInsert-Bench,专门考察光照与姿态适配能力。
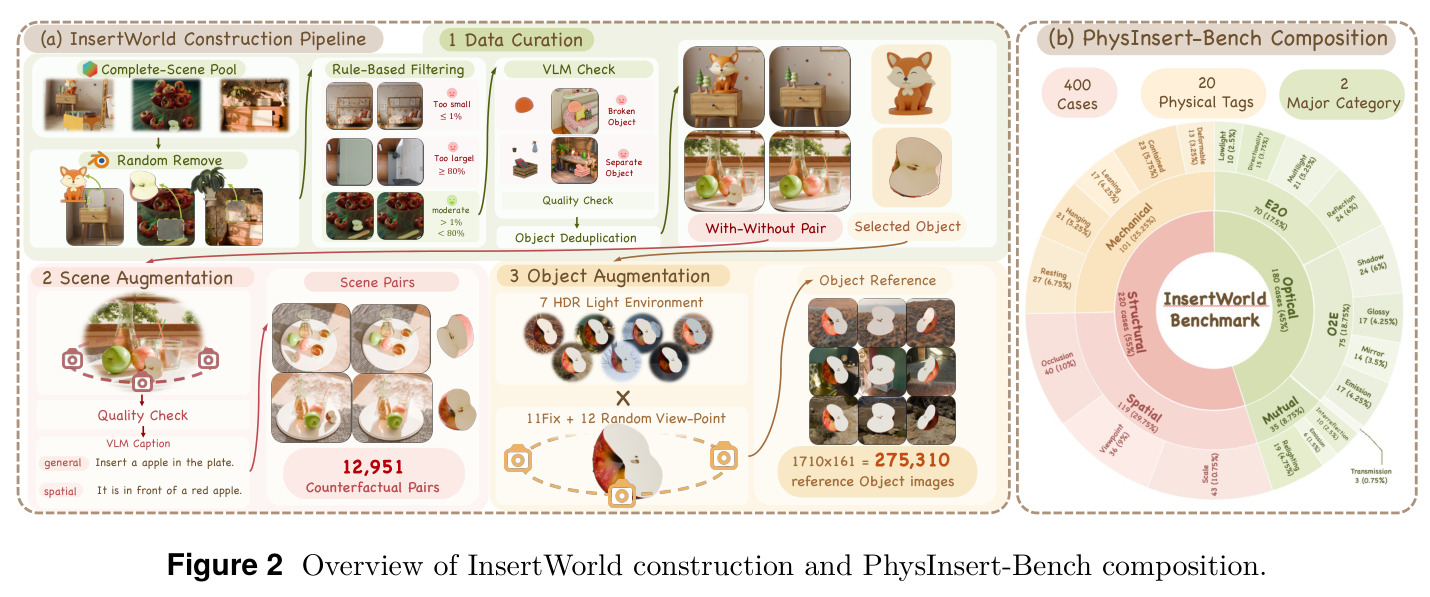
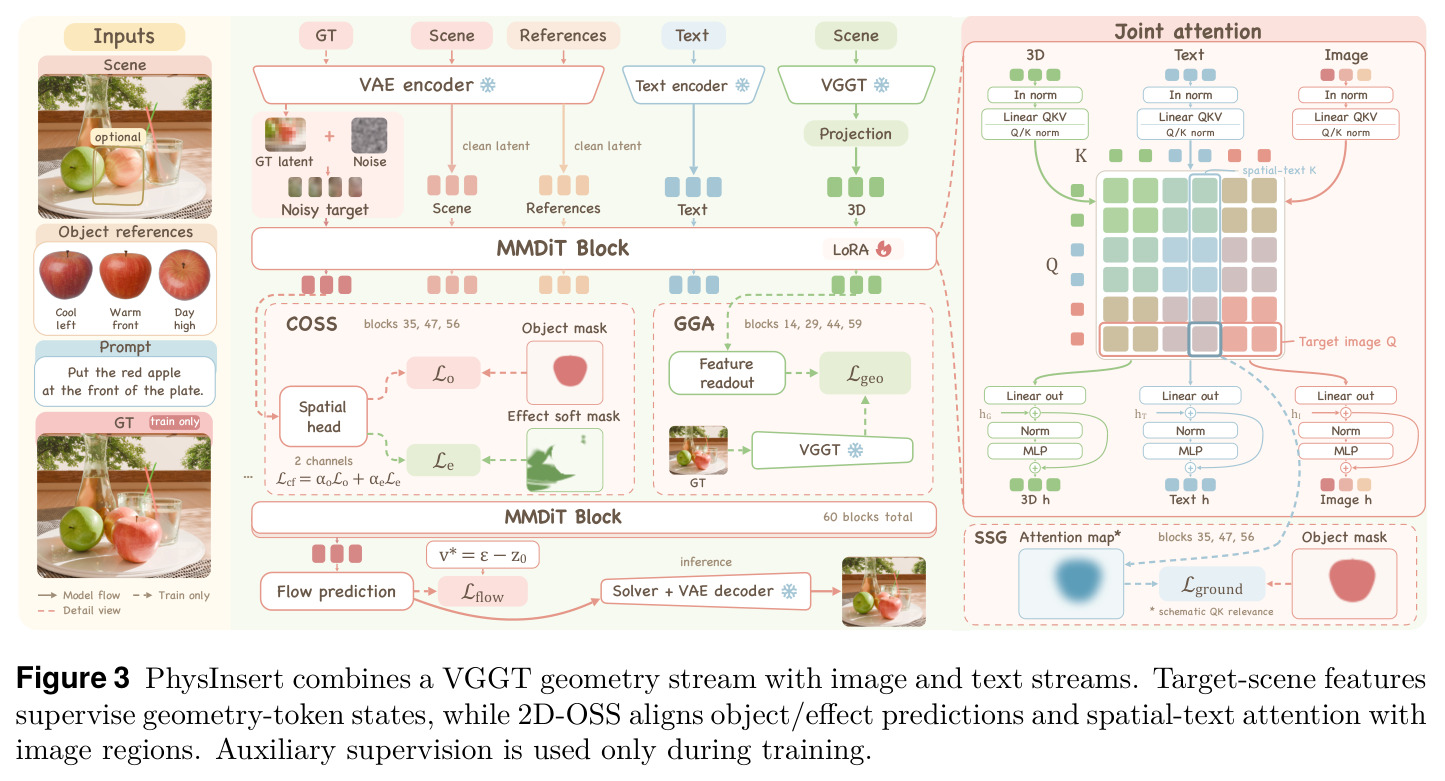
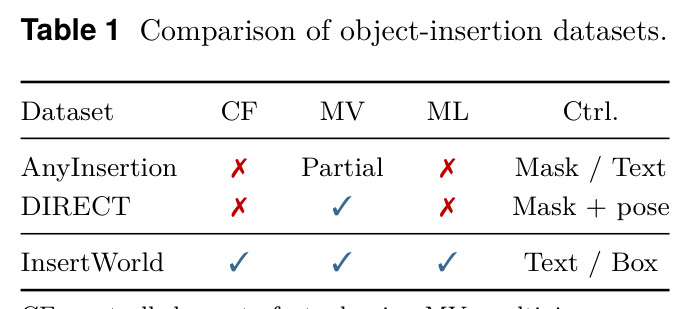
与已有工作不同的是,本文的独特切入是把『插入后几何』当作受监督的中间表示。以往方法主要靠 2D 图像损失,缺乏物体-场景几何约束;本文用冻结 VGGT 提取背景与插入后场景的特征,让一条专门的几何流在生成过程中显式演化并被目标场景特征监督(目标特征仅作 stop-gradient,不注入生成器)。数据上,不从随机摆放合成场景出发(易产生穿插和悬浮伪影),而是从完整 BlenderKit 场景中『移除』物体,固定相机与光照重渲染,得到严格逐像素对齐的反事实对,从而同时监督物体占据区域与环境外部效应;参考图则覆盖多视角与多光照,支撑跨环境与跨视角适配。监督上,用对齐差分图构造效应软掩码,并用注意力与物体掩码的 KL 对齐把文本空间指令落到像素区域,无需框或掩码输入。
核心方法
整体思路是『数据给监督、几何给先验、2D 给定位』。底座为 Qwen-Image-Edit-2511(DiT 编辑模型),保留冻结的 Qwen2.5-VL 文本编码器与 VAE,仅用 LoRA(秩 32)微调 DiT,并新增一条 VGGT 几何流:图像流 $U_0$ 含噪声目标隐变量与背景、参考图的冻结 VAE 编码,文本流 $T_0$ 来自指令,几何流 $G_0=A_\phi(F^-)+e_G$ 由背景 VGGT 特征映射而来,三类 token 在 60 个 DiT 块中做联合注意力交互。总损失 $\mathcal{L}=\mathcal{L}_{\mathrm{flow}}+\lambda_{\mathrm{geo}}\mathcal{L}_{\mathrm{geo}}+\lambda_{\mathrm{cf}}\mathcal{L}_{\mathrm{cf}}+\lambda_{\mathrm{ground}}\mathcal{L}_{\mathrm{ground}}$。训练在 8 张 L20X 上以批量 8、1024² 像素、学习率 $10^{-4}$ 进行约 16,000 步;推理 40 步去噪、CFG 4.0。
核心创新有三点。第一,几何作为受监督中间表示:几何流从背景 VGGT 特征初始化,训练时用同一冻结 VGGT 提取插入后场景特征 $F^+$,在选定层读出几何状态并对其回归;推理时几何流保持活跃,持续引导物体按场景三维结构调整透视与姿态——这是与纯 2D 监督方法的本质区别。第二,反事实物体-场景监督(COSS):利用严格对齐的场景对,同时监督物体占据图 $M_o$ 与排除物体区域后的外部效应图 $M_e$(由差分图经 $\delta_{\mathrm{low}},\delta_{\mathrm{high}}$ 软阈值并按膨胀掩码 $1[M_o>\delta_{\mathrm{obj}}]$ 排除物体邻域得到),直接约束阴影、反射等可见变化。第三,软掩码空间接地(SSG):把空间文本 token 与目标图像 token 的注意力相关性 $r_i^{(\ell)}$ 归一化后,与物体占据分布做 KL 对齐,从而无需框/掩码输入即可用文本控制放置位置与姿态。
方法步骤详情
流程分数据与模型两段。数据构建:从 BlenderKit 完整场景经规则过滤与 VLM 质检后随机移除一个物体,固定相机与光照重渲染『有/无物体』两帧,得 12,951 个严格对齐反事实对;再对去重后的 1,710 个物体在多视角、多 HDR 光照下渲染 275,310 张参考图(每物体 161 张),并由 Gemini 生成指令、放置与姿态三类标注。模型训练:干净目标图加噪得噪声隐变量;冻结 VGGT 分别编码背景与插入后场景得 $F^-$、$F^+$;三流经 60 块 MMDiT(GGA 在第 14、29、44、59 块读出几何特征,2D-OSS 在第 35、47、56 块施加);共享空间头输出物体与效应概率图,$\mathcal{L}_{\mathrm{cf}}=\alpha_o\mathcal{L}_o+\alpha_e\mathcal{L}_e$(BCE+Dice);SSG 用 log-mean-exp 聚合空间文本相关性并以温度 $\tau_a$ softmax 后与归一化 $M_o$ 做 KL。以 LoRA 秩 32、批量 8、学习率 $10^{-4}$ 训练约 16,000 步;推理仅输入 $I^-$、$I_r$、$p$。
技术新颖性
技术新颖性体现在组合层面而非单点。与 PhysEdit/PhyEdit 等物理编辑工作相比,本文面向『外部参考物体的身份保持插入』而非已有物体的移动或指令编辑;与 ObjectDrop/OmniPaint 依赖真实反事实捕获或生成自举相比,InsertWorld 用 Blender 渲染获得严格像素对齐并可任意重打光、重取视角的参考;与 DIRECT 需要 3D 代理重建与摆放相比,本文仅凭文本即可控制姿态与位置。几何流的『推理期活跃、训练期被监督』设计(目标特征 stop-gradient、从不注入生成器)避免了推理时依赖不可得的 GT 场景特征;COSS 的效应图是可见变化的代理标签而非光学效应的语义分解,工程上简单稳健;SSG 的 log-mean-exp 注意力聚合加软掩码 KL 是把语言落到像素区域的轻量方案。数据集本身也有独立价值:Insert-Anything、OmniPaint 换用 InsertWorld 微调后指标普遍提升。
实验结果
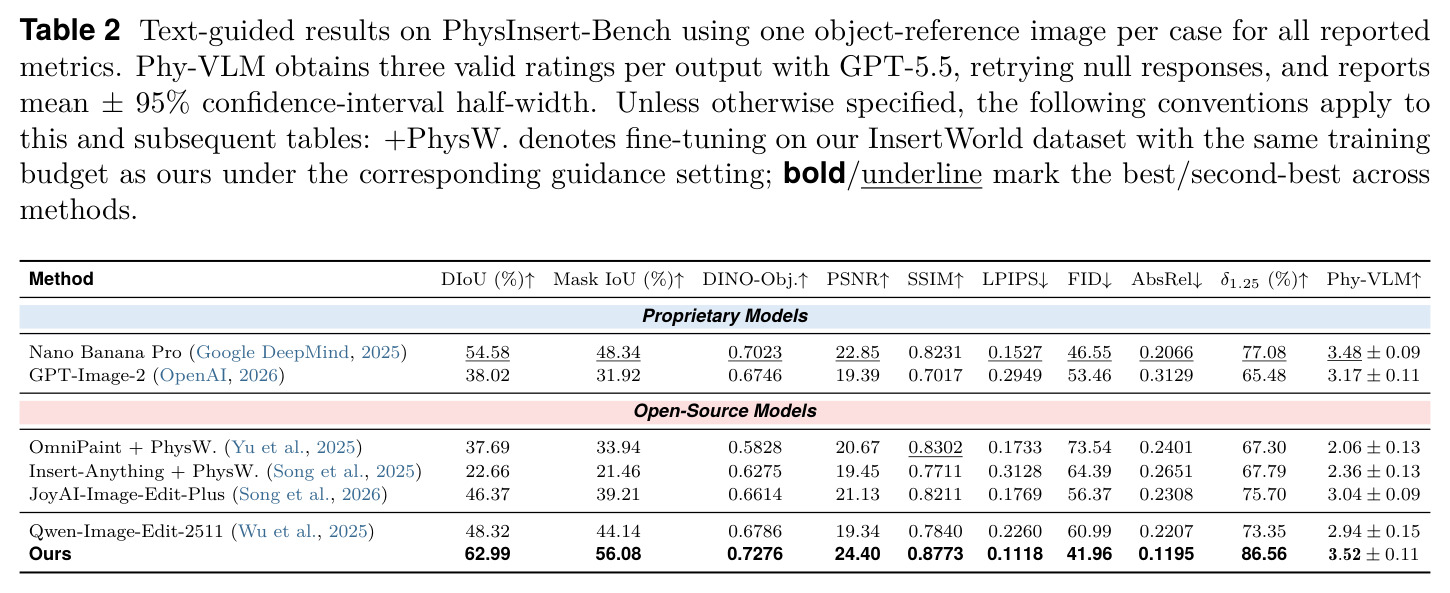
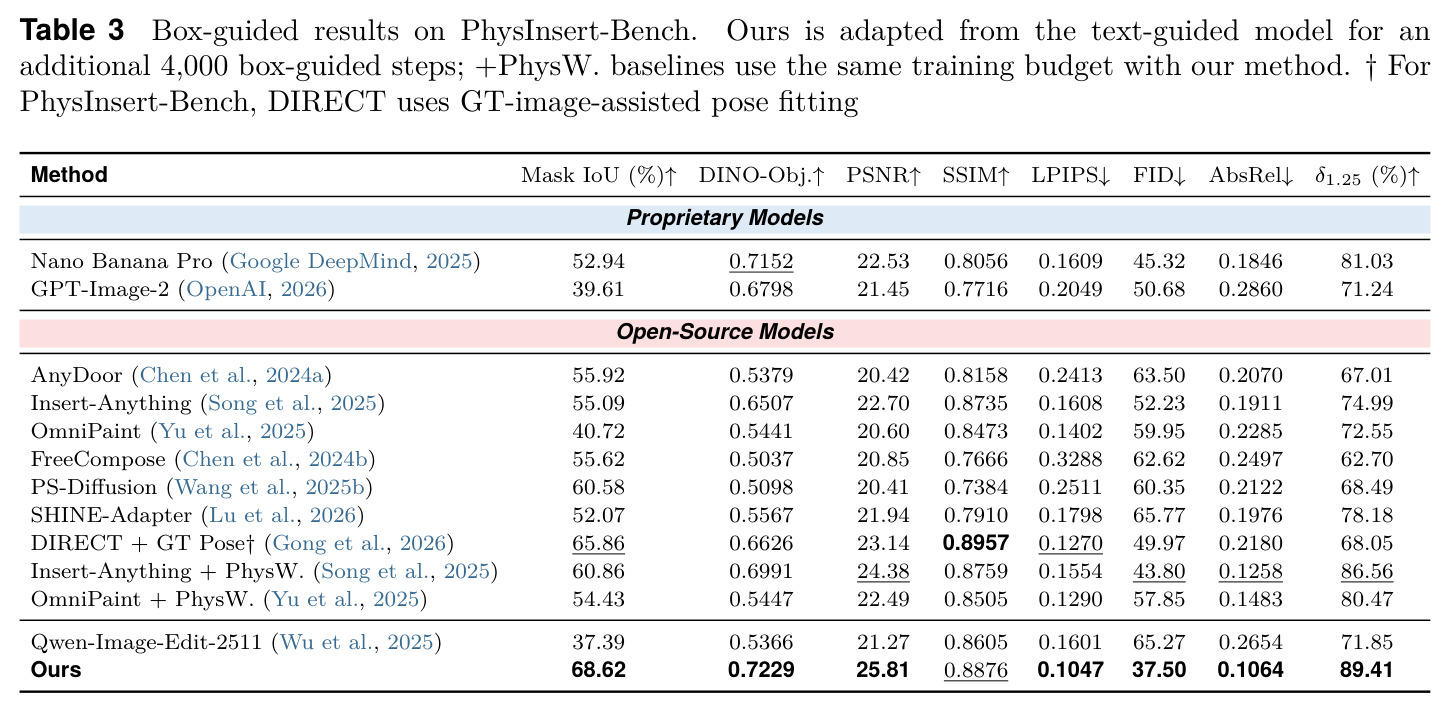
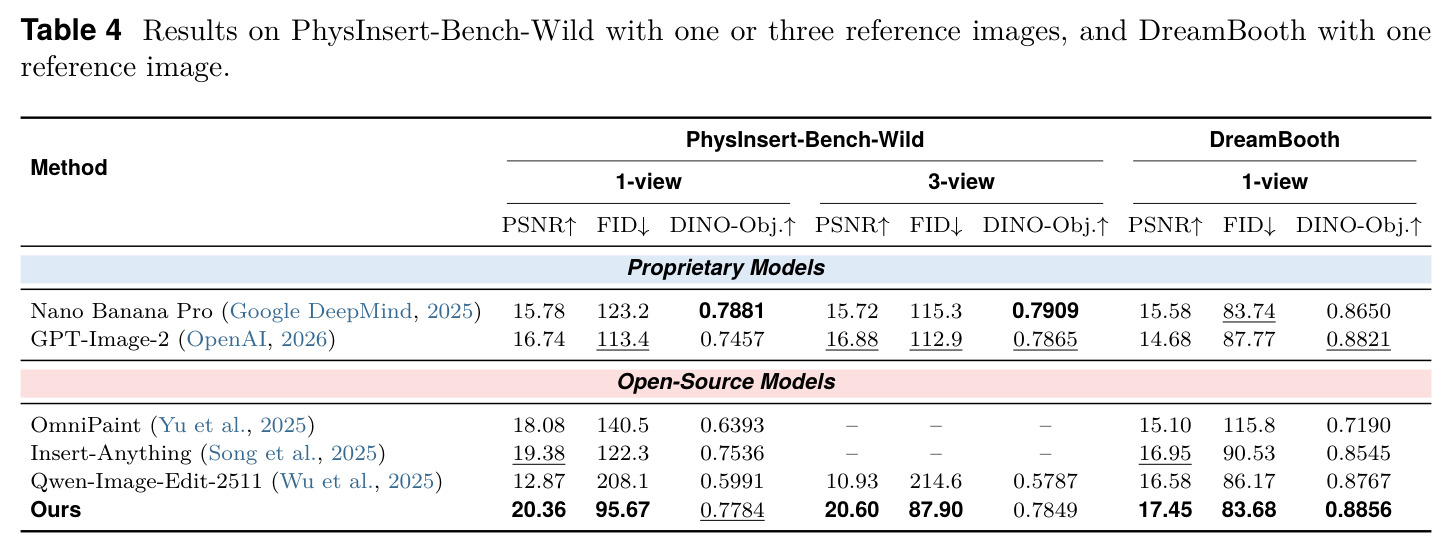
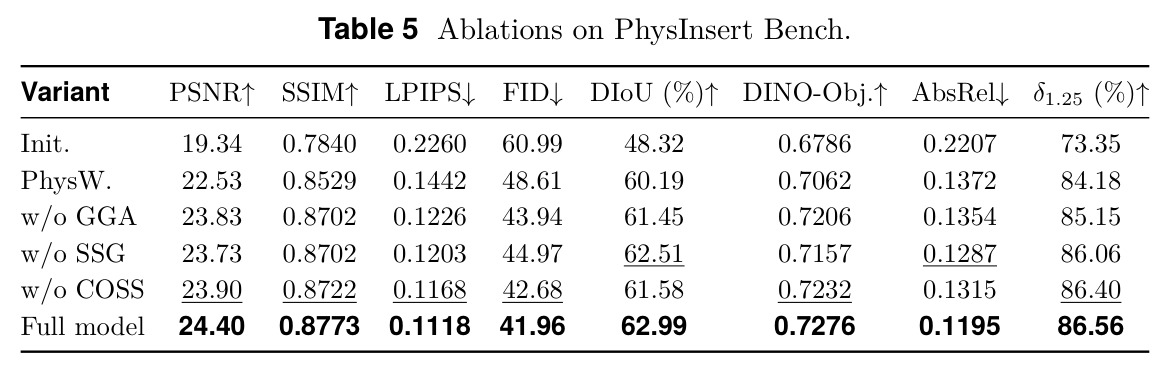
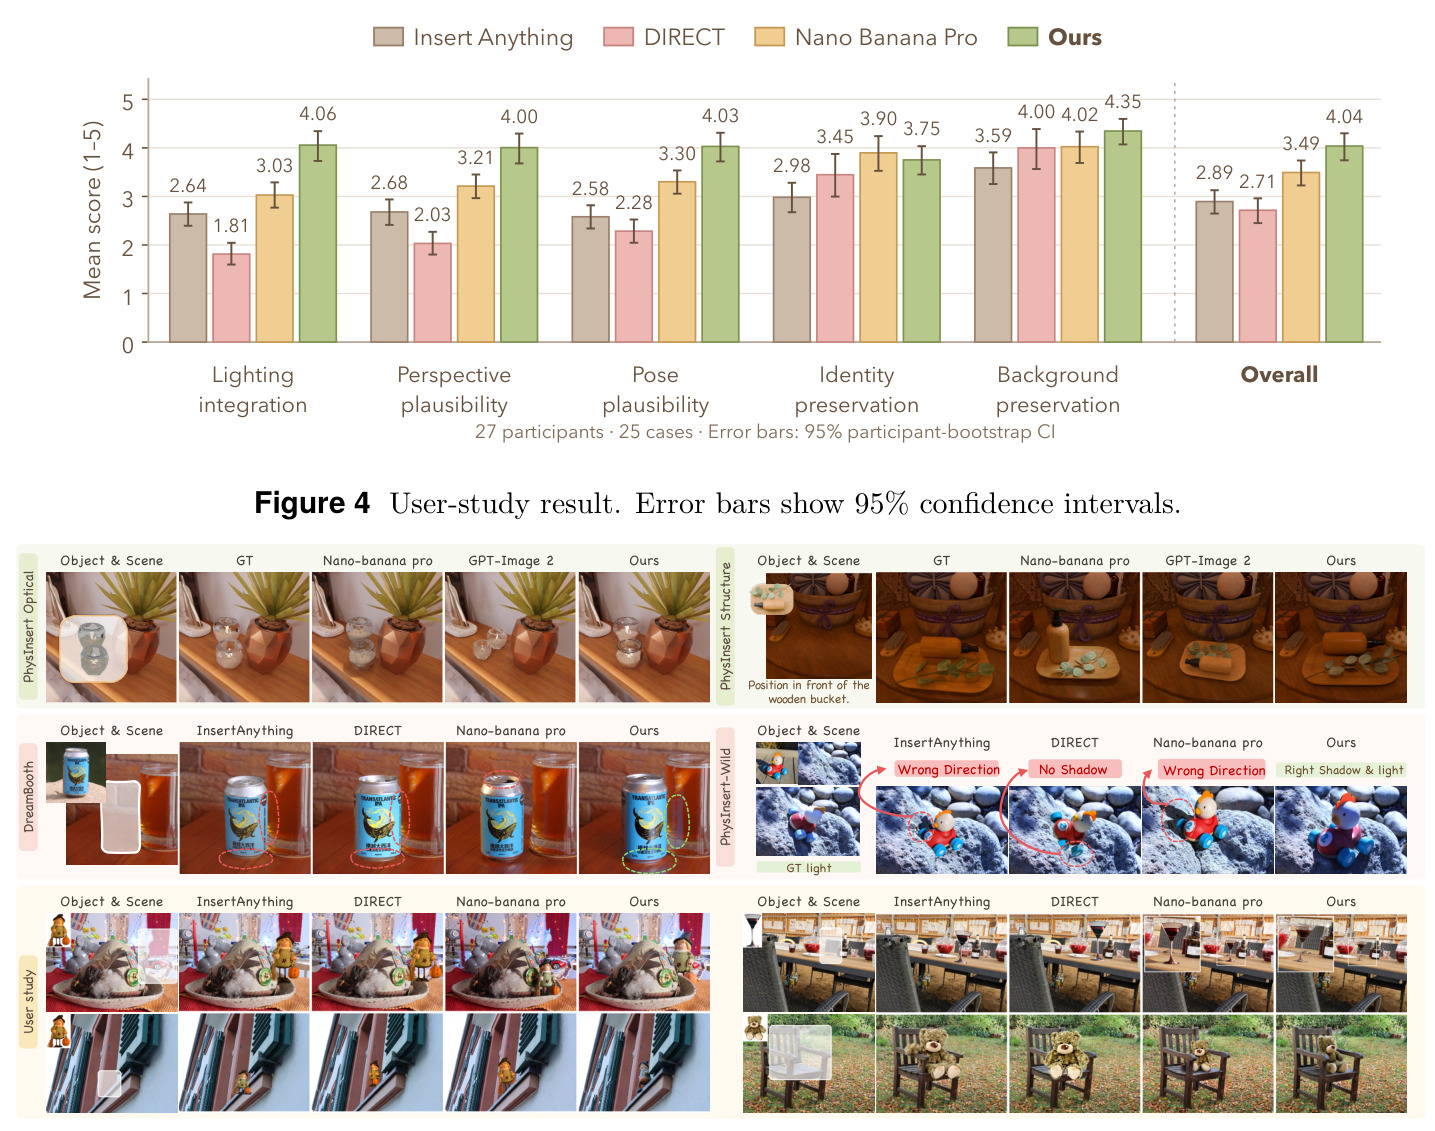
文本引导(Table 2):PhysInsert 在 Bench 上取得 DIoU 62.99%、Mask IoU 56.08%、PSNR 24.40、FID 41.96、Phy-VLM 3.52±0.11,全面领先 Nano Banana Pro(DIoU 54.58%、PSNR 22.85、FID 46.55、Phy-VLM 3.48±0.09)与基座 Qwen-Image-Edit-2511(DIoU 48.32%、PSNR 19.34、FID 60.99)。框引导(Table 3):Mask IoU 68.62%、PSNR 25.81、FID 37.50,超过 DIRECT+GT Pose 的 65.86%/23.14;且 Insert-Anything、OmniPaint 换用 InsertWorld 微调后全指标提升,证明数据集普适价值。真实场景(Table 4):Wild 集单参考 PSNR 20.36、FID 95.67,三参考 20.60/87.90;DreamBooth PSNR 17.45、FID 83.68 均为最佳。用户研究(Figure 4):27 人盲评 25 例,总体 4.04 最高,光照融合 4.35 领先。消融(Table 5):完整模型 PSNR 24.40,较数据微调 PhysW 22.53、基座 19.34 逐级提升,去掉 GGA/SSG/COSS 降至 23.83/23.73/23.90。
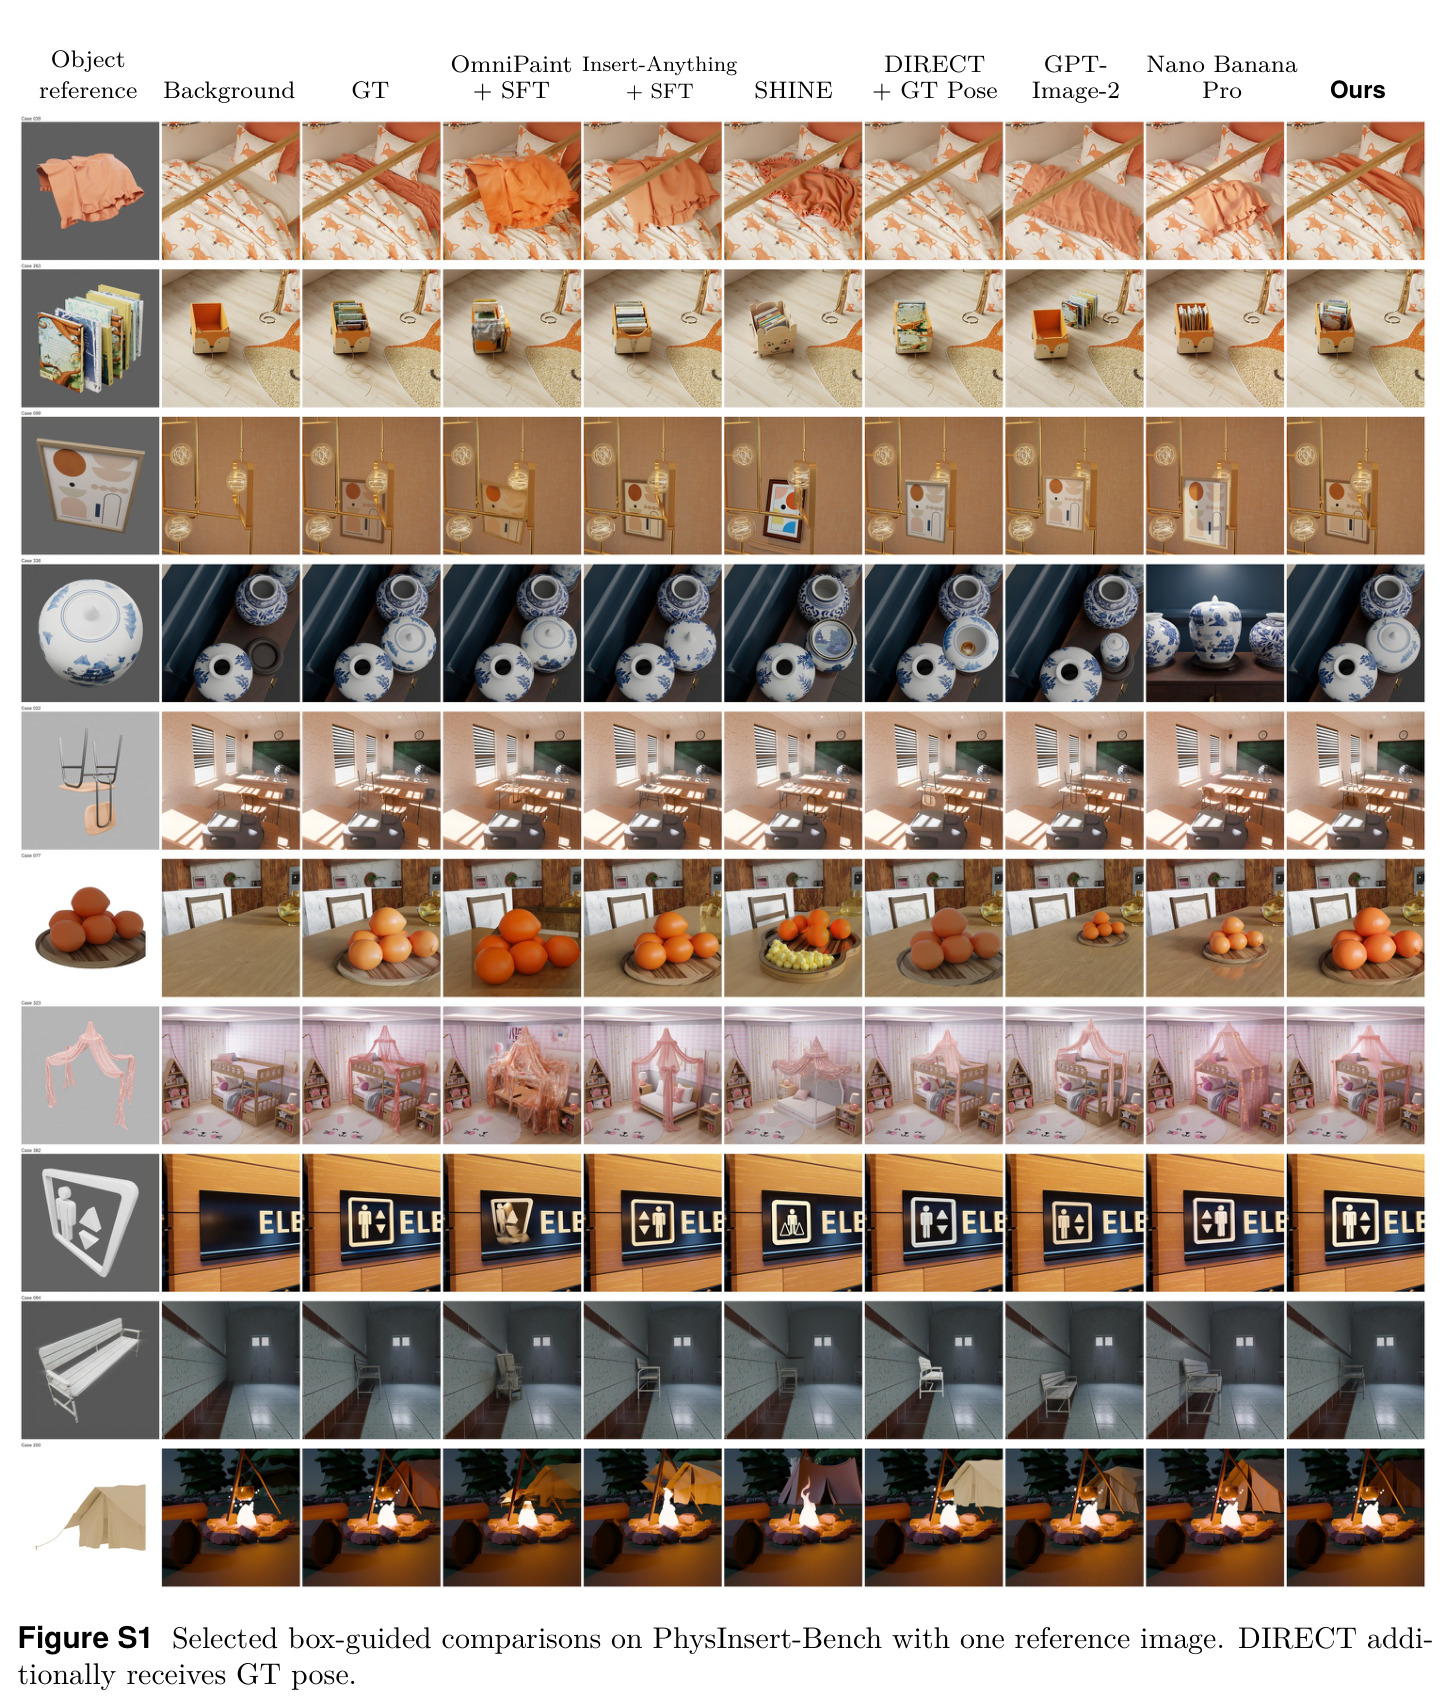
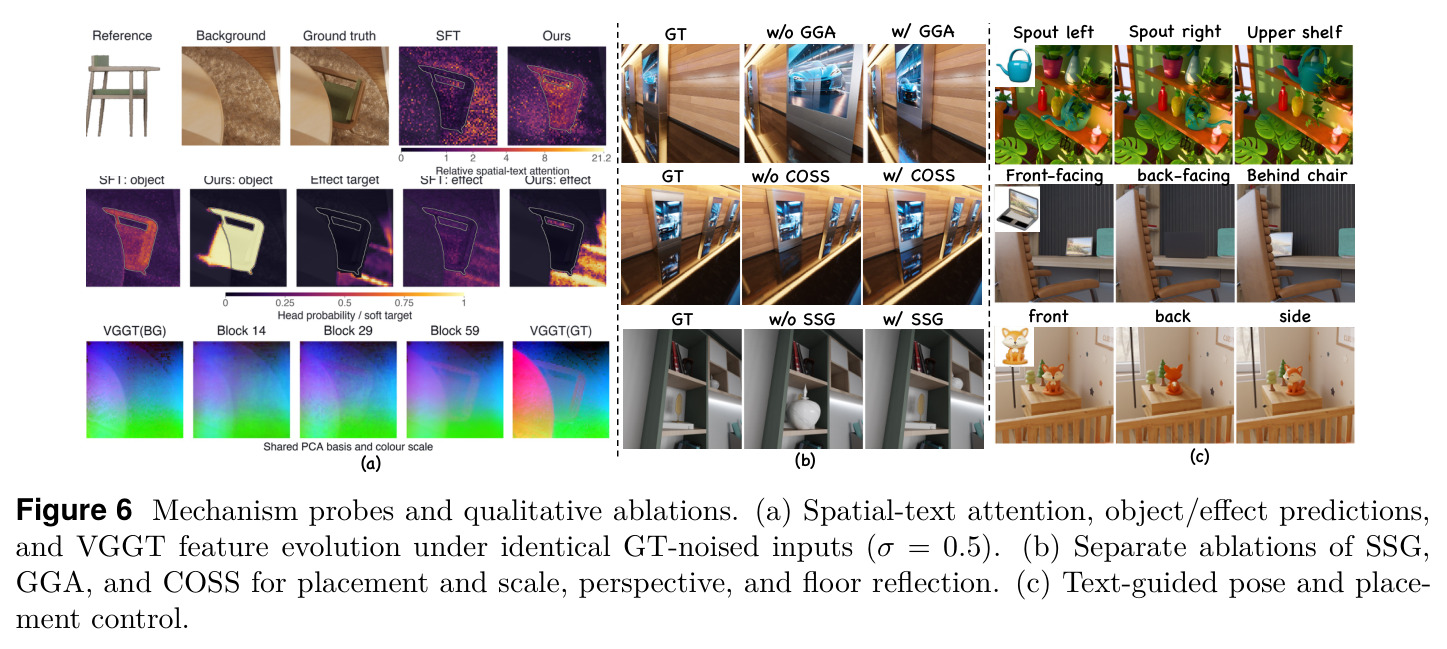
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文本引导插入(PhysInsert-Bench) | DIoU / PSNR | 62.99% / 24.40dB | Nano Banana Pro 54.58% / 22.85dB;Qwen-Image-Edit-2511 48.32% / 19.34dB | +8.41pp / +1.55dB(vs 最强闭源) |
| 文本引导插入(PhysInsert-Bench) | FID / Phy-VLM(物理合理性) | 41.96 / 3.52±0.11 | Nano Banana Pro 46.55 / 3.48±0.09 | FID −4.59,Phy-VLM 最高分 |
| 框引导插入(PhysInsert-Bench) | Mask IoU / PSNR / FID | 68.62% / 25.81dB / 37.50 | DIRECT+GT Pose 65.86% / 23.14dB / 49.97 | +2.76pp / +2.67dB / −12.47 |
| 真实场景插入(PhysInsert-Bench-Wild,1 参考图) | PSNR / FID / DINO-Obj. | 20.36dB / 95.67 / 0.7784 | Insert-Anything 19.38dB / 122.3 / 0.7536 | +0.98dB / FID −26.63 / +0.0248 |
| 真实场景插入(DreamBooth 40 例,1 参考图) | PSNR / FID / DINO-Obj. | 17.45dB / 83.68 / 0.8856 | Insert-Anything 16.95dB / 90.53 / 0.8545 | +0.50dB / FID −6.85 / 身份保持最佳 |
| 用户研究(27 人 × 25 例盲评) | 总体评分(1–5) | 4.04(光照融合 4.35) | Nano Banana Pro 4.03;Insert Anything 4.00;DIRECT 3.90 | 总分最高,光照融合领先次名 +0.29 |
| 消融(PhysInsert-Bench) | PSNR | 完整模型 24.40dB | w/o GGA 23.83 / w/o SSG 23.73 / w/o COSS 23.90;PhysW 22.53;Init 19.34 | 数据增益 +3.19dB,方法增益 +1.87dB |
局限与改进
作者承认的局限包括:效应图 $M_e$ 只是可见变化(阴影、反射)的代理标签,并非光学效应的语义分解,无法区分阴影、镜面成像、透射等不同物理机制;消融显示单个组件贡献有限(去掉任一组件 PSNR 仅降约 0.5–0.7dB),增益更多来自数据与组合。我自己的观察:训练数据全部来自 BlenderKit 合成场景,与真实照片存在域差——Wild 集上 PSNR 仅 20.36、FID 高达 95.67,明显劣于 Bench 内的 24.40/41.96;AbsRel/δ1.25 依赖估计深度作为几何合理性代理,本身带噪声;Phy-VLM 用 GPT-5.5 打分,结果依赖提示模板与标注的物理效应标签;基准仅 400 例、103 个场景,规模偏小;新增几何流带来额外显存与计算开销,论文未报告推理时延;文本控制仅覆盖训练中出现过的交互类型(悬挂、贴合、接触、光照适应),开放指令的泛化能力未测。
独立分析的弱点
弱点一,合成-真实域差:InsertWorld 全部来自 Blender 渲染,金属、透明、自发光材质在真实世界的成像分布不同,Wild 集 FID 95.67 显著劣于 Bench 的 41.96 即为证据;改进方向是引入真实反事实采集(固定机位摆拍有/无物体两帧)或仿真到真实的域随机化。弱点二,几何监督目标带噪:$F^+$ 来自冻结 VGGT 对渲染图的编码,而 VGGT 在反射、透明表面上的几何估计本身不稳定,可考虑多种几何先验融合或对 $\omega_\ell$ 做不确定性加权。弱点三,效应阈值超参敏感:$\delta_{\mathrm{low}},\delta_{\mathrm{high}},\kappa,\rho_d$ 均需手工设定,暗场景与亮场景的最优阈值不同,可改为可学习或按场景亮度自适应。弱点四,三组件消融增益均小于 1dB,说明 COSS/SSG/GGA 的监督信号可能部分冗余,可探索统一的几何-空间联合头。弱点五,几何流使每步去噪多一路三流注意力,推理开销未量化,实际部署需蒸馏或缓存背景几何初始化。
未来方向
作者在结论中隐含的方向是继续强化物体与环境的联合建模。在此基础上可延伸:其一,把双向交互扩展到视频插入,要求阴影与反射随时间一致,InsertWorld 的 Blender 管线可直接扩展出视频反事实对;其二,多视角一致的插入,几何流天然适合输出 VGGT 式多视角特征,可同时生成多个视角的插入结果并保持 3D 一致;其三,把效应图从代理标签升级为语义分解(阴影/镜面成像/焦散/透射分别监督),并允许光源方向、材质参数等物理量显式控制;其四,引入真实世界反事实数据与域适应,弥合 Wild 集上约 3dB 的 PSNR 差距;其五,把文本接地从物体区域扩展到效应区域,支持『把影子拉长一点』这类细粒度编辑;其六,用合成数据预训练加真实数据蒸馏,降低 8 卡 L20X、16,000 步的训练门槛,推动社区复用。
复现评估
论文提供了项目主页,但正文未明确承诺代码、数据集与基准的开源时间;InsertWorld 依赖 BlenderKit 场景资产,受其许可条款与下载成本约束。复现所需算力为 8 张 NVIDIA L20X、约 16,000 步、LoRA 秩 32、最大 1024² 像素、批量 8,属于中等偏高的学术实验室配置;底座 Qwen-Image-Edit-2511、VGGT、Qwen2.5-VL 均为公开可得的模型,LoRA 微调本身门槛不高。数据管线涉及 Blender 批量渲染、HDR 光照增强、Gemini 三字段标注与 VLM 质检,工程量不小且部分依赖闭源 API。论文附录 D/E/F/I 声称提供指标定义、实现细节、完整超参与数据构建细节,若随论文释出则复现难度中等;若不释出,仅凭正文公式难以重建同等质量的数据与标注。Phy-VLM 评测依赖 GPT-5.5,复现评测数字也需要相应 API 配额。
论文图表
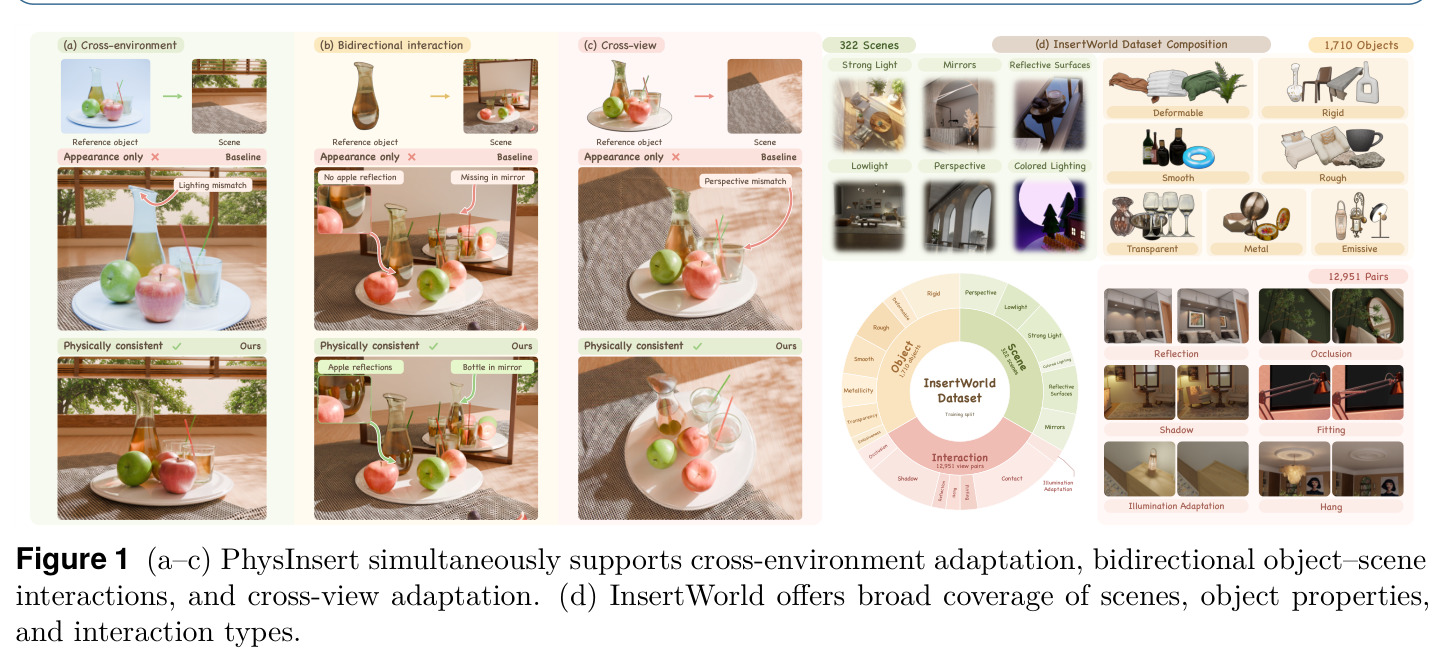
三组对比示例展示 PhysInsert 的三大能力:(a) 跨环境适配——同一参考物体在不同光照下正确变色;(b) 双向交互——苹果在玻璃上产生倒影、瓶子出现在镜中(基线出现光照不匹配、无苹果倒影、镜中缺失等失败);(c) 跨视角适配——参考图与目标视角不同时的透视适配;(d) InsertWorld 数据集组成:322 个场景、1,710 个物体、12,951 个视图对,覆盖刚性/可变形、透明/金属/自发光、强光/低光/彩色光照以及悬挂/贴合/接触/阴影/反射/遮挡等交互类型。
一图总览论文的问题设定、方法卖点与数据资产规模,是快速把握全文贡献的入口;双向交互的具体失败案例(镜中缺瓶子、无倒影)直观说明了现有方法的痛点。