VideoPhysEdit:基于刚体物理场景重建的物理反事实视频编辑 VideoPhysEdit: Physical Counterfactual Video Editing via Rigid-Body Physical Scene Reconstruction
重建可复现观测的物理场景,施加物理干预后引导视频生成反事实
前置知识
物理反事实视频编辑(PCVE)
把视频编辑形式化为反事实推理:给定源视频 $V_{src}=\{I_t\}_{t=1}^T$、自然语言物理编辑 $e$ 和执行帧 $t_e$,生成反事实视频 $V_{cf}=\mathcal{F}(V_{src}, e, t_e)$——执行帧前逐帧保留事实历史,之后呈现干预在改变物理条件下的演化。编辑分三类:插入/删除物体、修改物体运动状态、改变物体或场景的物理参数(初速度、质量、摩擦、恢复系数)。
这是本文定义的核心任务,问题设定、基准构建(PCVE-RigidBench)与指标(PES)全部建立在这个形式化之上,不先弄清它就无法理解实验到底在测什么。
物理反演(Physical Inversion / 系统辨识)
从观测到的运动反推让仿真复现观测的物理量:估计 $\eta=(\Theta, s_1, \mathcal{G}_{col})$,其中 $\Theta$ 是质量、摩擦、恢复系数等参数,$s_1$ 是初始状态,$\mathcal{G}_{col}$ 是碰撞代理。本文先用支撑与接触事件导出的刚体约束初始化,再以逐步仿真搜索最小化仿真掩码与观测掩码的差异。
Stage 5 是整个 pipeline 的引擎,理解物理反演才能明白为什么仿真轨迹能正确外推编辑的下游后果,而不是生成模型凭空猜测。
刚体动力学仿真与 PyBullet
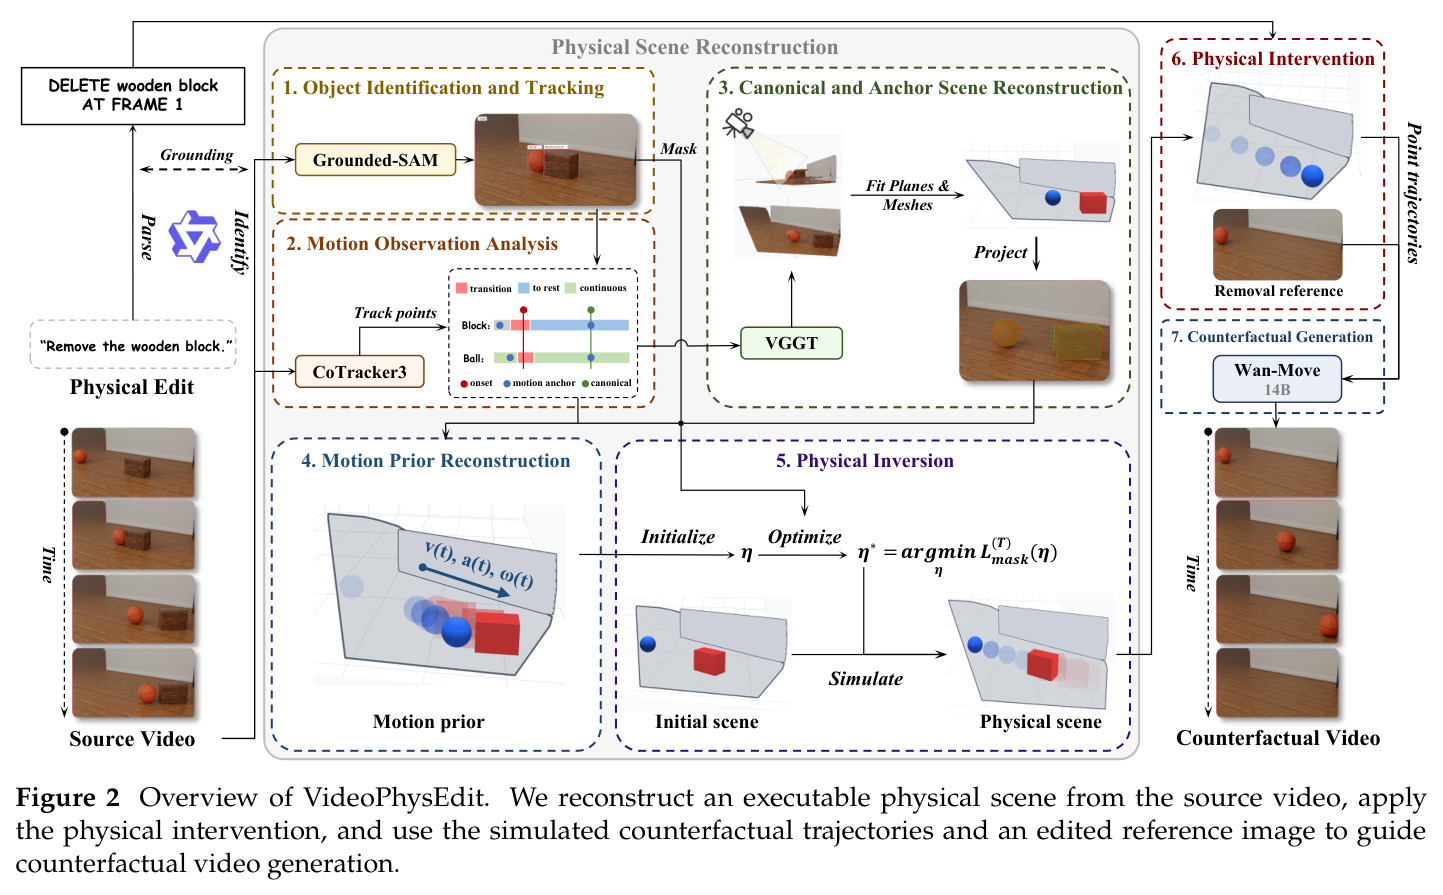
刚体假设物体形状不变,状态由位置、朝向、线速度、角速度描述,演化由碰撞与接触约束决定。PyBullet 是开源刚体物理引擎,本文用它仿真观测演化(Stage 5)与反事实演化(Stage 6),PCVE-RigidBench 的 20 个合成场景同样在其中仿真并用 Blender 渲染成视频。
论文中所有'物理真值'和轨迹推演都来自刚体仿真,读者需要知道仿真输出什么状态量、如何与视频帧对齐。
开放词汇分割与点迹跟踪(Grounding DINO / SAM 2 / CoTracker3)
Grounding DINO 用文本类别在首帧定位物体实例,SAM 2 以视频传播方式输出身份一致的逐帧掩码 $M_{i,t}$,CoTracker3 提供像素级点迹。三者把视频转成'哪个物体在哪个位置'的可计算观测,供运动分析、3D 重建与物理反演的损失使用。
整个方法以掩码作为观测与监督接口——物理反演的损失就是仿真掩码与观测掩码的 IoU 差,分割跟踪质量直接决定上限。
VGGT 与共享世界坐标系
VGGT 是前馈式 3D 重建模型,配合 SuperGlue 特征匹配,从 canonical 帧(世界坐标系参考帧)和各运动锚点帧估计相机参数与点云,恢复静态场景平面,并用带纹理的球/盒网格拟合物体;再借助静态背景把锚点场景对齐到 canonical 场景,得到各时刻物体的 6DoF 位姿。
把 2D 观测抬升到统一 3D 坐标系后,物理仿真、物体放置和反事实轨迹的投影才能在同一空间中进行,这是'仿真对齐视频'的前提。
轨迹控制视频生成与 FVD
Wan-Move 是轨迹控制的视频生成模型(14B),接受投影点轨迹、参考图像和场景 prompt 生成视频,本文用它在 Stage 7 渲染反事实内容。FVD(Fréchet Video Distance)衡量生成视频与真实视频的分布距离,与 PSNR/SSIM/LPIPS/CLIP 相似度一起构成本文的视觉保真指标。
Stage 7 决定最终画质,论文用'物理准确且 FVD 最优(182.46)'作为卖点,需要理解这些指标分别衡量什么。
研究动机
近年视频编辑在'视觉后果'上进步显著——阴影、反射、遮挡等随编辑产生的像素级变化已能较好处理,但编辑的'物理后果'仍被忽视:往台球桌上插一个新球会引入新的碰撞,把粉球恢复系数降到 0.25 倍会改变反弹轨迹,移除大球会让后续碰撞链消失。现有生成式编辑方法(开源的 VACE、Ditto 与商业模型 Seedance 2.5、MiniMax H3)依赖图像/视频表征中隐含的信息,难以完成这类物理推理;物理感知方法则要么只支持物体删除(VOID),要么依赖预定义物理模型(Bazin et al.)或外部 CAD 代理与多视角重建(Calipso、AutoVFX)。更根本的困难是数据与评价缺口:一段视频只记录事实演化,'同一场景在另一种干预下会如何演化'的反事实视频天然不存在,配对监督数据无法采集,而传统编辑指标(PSNR、FVD 等)也完全不衡量生成运动的物理正确性。
本文的目标是论文的目标是把'编辑的物理后果'定义为一个统一任务 PCVE:给定源视频 $V_{src}=\{I_t\}_{t=1}^T$、物理编辑 $e$(自然语言描述)和执行帧 $t_e$,生成反事实视频 $V_{cf}=\mathcal{F}(V_{src}, e, t_e)$——$t_e$ 之前逐帧保留事实历史,之后呈现干预诱导的运动与交互。具体交付三样东西:(1) 一个训练自由的 pipeline(VideoPhysEdit),能统一处理物体插入/删除、运动状态修改、物理参数(初速度、质量、摩擦、恢复系数)修改三类干预;(2) 合成基准 PCVE-RigidBench,含 20 个刚体场景、129 个编辑任务,覆盖碰撞、反弹、滚动、滑动、坠落与碰撞链,每个任务带反事实目标视频和物理真值;(3) 专门指标 Physical Edit Score,衡量生成视频相对未编辑源视频在轨迹误差上的降幅。
与已有工作不同的是,本文的独特切入是'先逆向、再正向':不让生成模型凭表征隐式猜测编辑后果,而是先从单目视频重建一个可执行物理场景——其刚体仿真逐帧复现观测到的运动与碰撞——再把编辑作为干预施加到该场景上,用仿真出的反事实轨迹显式引导视频生成。与最接近的工作相比:ΔYNAMICS 用 VLM 推断刚体配置,但训练于合成仿真且假设无场景特定支撑/碰撞几何的平面地面;PhysMind 拟合解析动力学构建可执行世界,但目标是物理推理而非可与视频对齐的反事实生成;VOID 用 Kubric/HUMOTO 构造配对合成监督,且只覆盖删除。本文以'仿真掩码匹配观测掩码'来精炼物理场景,恰好提供反事实视频生成所需的几何与时间对齐,这是它区别于所有前作的关键。
核心方法
直觉上,VideoPhysEdit 先把源视频'逆向工程'成一个按同样剧本演出的物理仿真,再在仿真里改剧本、重新推演、把新剧本画出来。技术上是七个阶段的训练自由 pipeline(图 2):Stage 1 用 Qwen3-VL 加 Grounding DINO 识别并定位物体,SAM 2 传播身份一致的逐帧掩码;Stage 2 用 CoTracker3 点迹分析运动,划分稳定区间与转变片段,选出 canonical 帧和运动锚点帧;Stage 3 用 VGGT+SuperGlue 重建共享世界坐标系,拟合球/盒视觉网格,优化放置损失 $\mathcal{L}_{place}$(3D 对应+轮廓 IoU/Dice+正则+支撑一致性),得到 canonical 与锚点场景;Stage 4 把观测抬升到世界系,拟合允许碰撞时刻速度突变的连续 6DoF 运动先验;Stage 5 物理反演,用 PyBullet 仿真匹配观测;Stage 6 解析并施加物理干预,产出反事实点轨迹与编辑参考图;Stage 7 用 Wan-Move 14B 生成反事实视频。
核心创新是'物理场景重建':恢复一个仿真即复现观测的场景 $\mathcal{S}_t=(\mathcal{G}_{vis}, \mathcal{G}_{col}, \mathcal{C}, \Theta, s_t)$,把物理推理从生成模型的隐式知识变成显式的可执行模型。与已有方法的本质区别:(1) 无需预定义物理模型、多视角/CAD 代理或配对训练数据;(2) 以掩码为接口——反演损失是仿真掩码 $\hat{M}_{i,t}(\eta)$ 与观测掩码的 IoU 差 $\mathcal{L}^{(h)}=\frac{1}{|\Omega_h|}\sum[1-\mathrm{IoU}]$,使仿真结果能直接投影成生成模型可用的点轨迹控制信号;(3) 逐步仿真搜索:从首个稳定区间开始每次加入一个区间或转变片段,每步只保留最优加至多两个备选仿真,最后全局比较再精炼,把单帧歧义的影响摊到整段证据上。配套提出的 PES 指标 $\mathrm{PES}=\max(1-\sum_i TE^i_{pred}/\sum_i TE^i_{null}, -1)$ 衡量相对未编辑基线的轨迹误差降幅。
方法步骤详情
Stage 1(输入:源视频+编辑描述;输出:逐帧掩码 $M_{i,t}$):VLM 给类别、检测器给首帧框、SAM 2 传播掩码并保持身份。Stage 2(输出:稳定区间、转变片段、canonical 帧与运动锚点帧):结合 CoTracker3 点迹与掩码估计 2D 位置/朝向/可靠性。Stage 3(输出:共享世界系的视觉网格、相机、canonical 与锚点场景):恢复静态平面、拟合球/盒网格,优化放置损失 $\mathcal{L}_{place}$。Stage 4(输出:6DoF 运动先验 $s_{1:T}$):稳定区间用简单运动模型、转变片段用边界约束曲线连接,允许碰撞时速度突变。Stage 5(输出:$\eta^*$ 与状态序列):由支撑/接触关系导出刚体约束(力平衡、摩擦、能量、动量平衡、恢复系数)初始化 $\eta=(\Theta, s_1, \mathcal{G}_{col})$,再逐步仿真搜索精炼,损失为掩码 IoU。Stage 6(输出:反事实点轨迹+编辑参考图):把指令解析为 Add/Delete/Set 操作并绑定物体身份,在 $t_e$ 施加干预后仿真。Stage 7(输出:反事实视频):Wan-Move 14B 以点轨迹、参考图和场景 prompt 生成。
技术新颖性
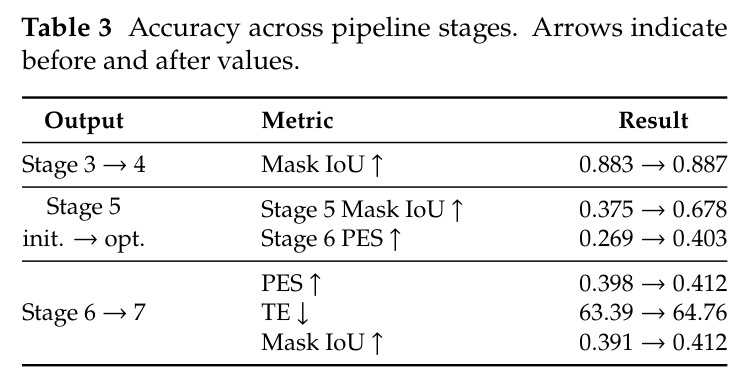
新颖性可从四个层面看:(1) 任务层——首次把多样物理干预(插入/删除、运动状态、物理参数)的下游后果统一为 PCVE 任务,此前 VOID 只做删除、Bazin/Calipso 依赖外部模型;(2) 方法层——训练自由、无需配对数据,用'仿真复现观测'这一自洽性准则从单目视频反推物理场景,逐步仿真搜索(每步保留至多两个备选、最后全局比较)是对病态逆问题的务实解法;(3) 对齐层——以掩码 IoU 为损失、以投影点轨迹为生成控制信号,把 3D 仿真与 2D 视频生成耦合成闭环,Stage 6→7 消融显示生成阶段几乎不损失轨迹精度(TE 仅 63.39→64.76);(4) 评测层——PCVE-RigidBench(20 场景、129 任务、PyBullet 仿真+Blender 渲染)与 PES 指标填补物理编辑评测空白。需要注意的是,各组件(Qwen3-VL、SAM 2、VGGT、PyBullet、Wan-Move)均为现有工作,创新在系统集成与物理反演机制,而非单点模型突破。
实验结果
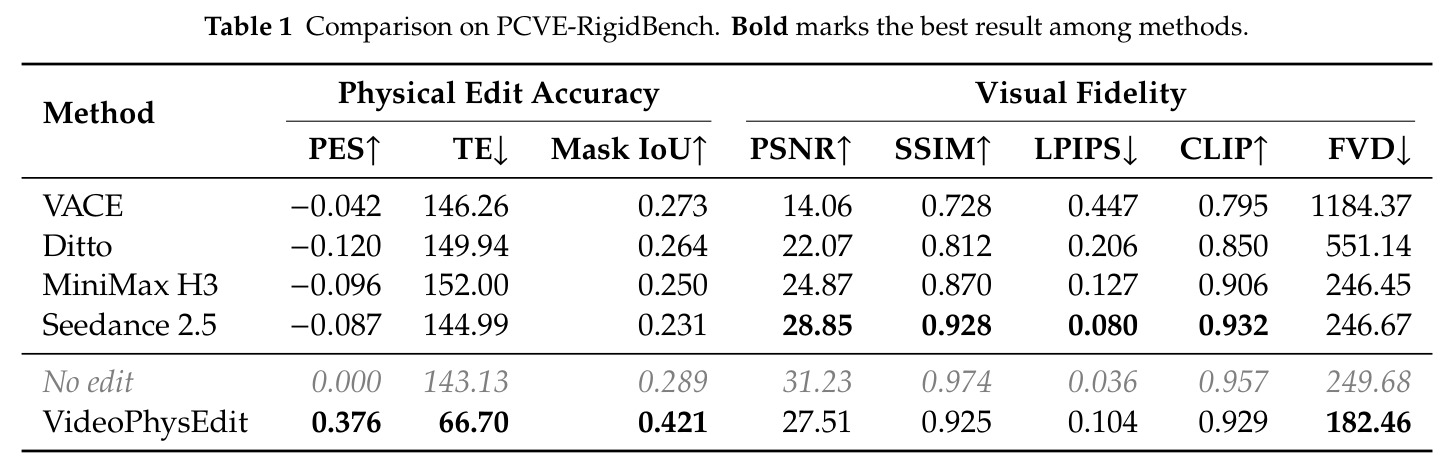
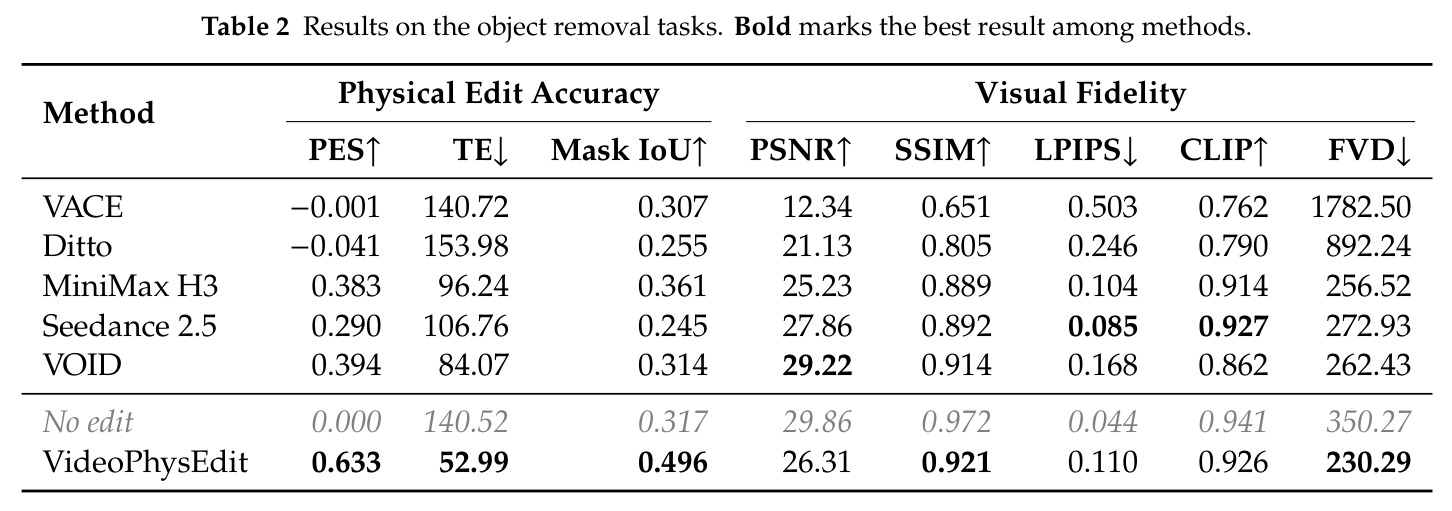
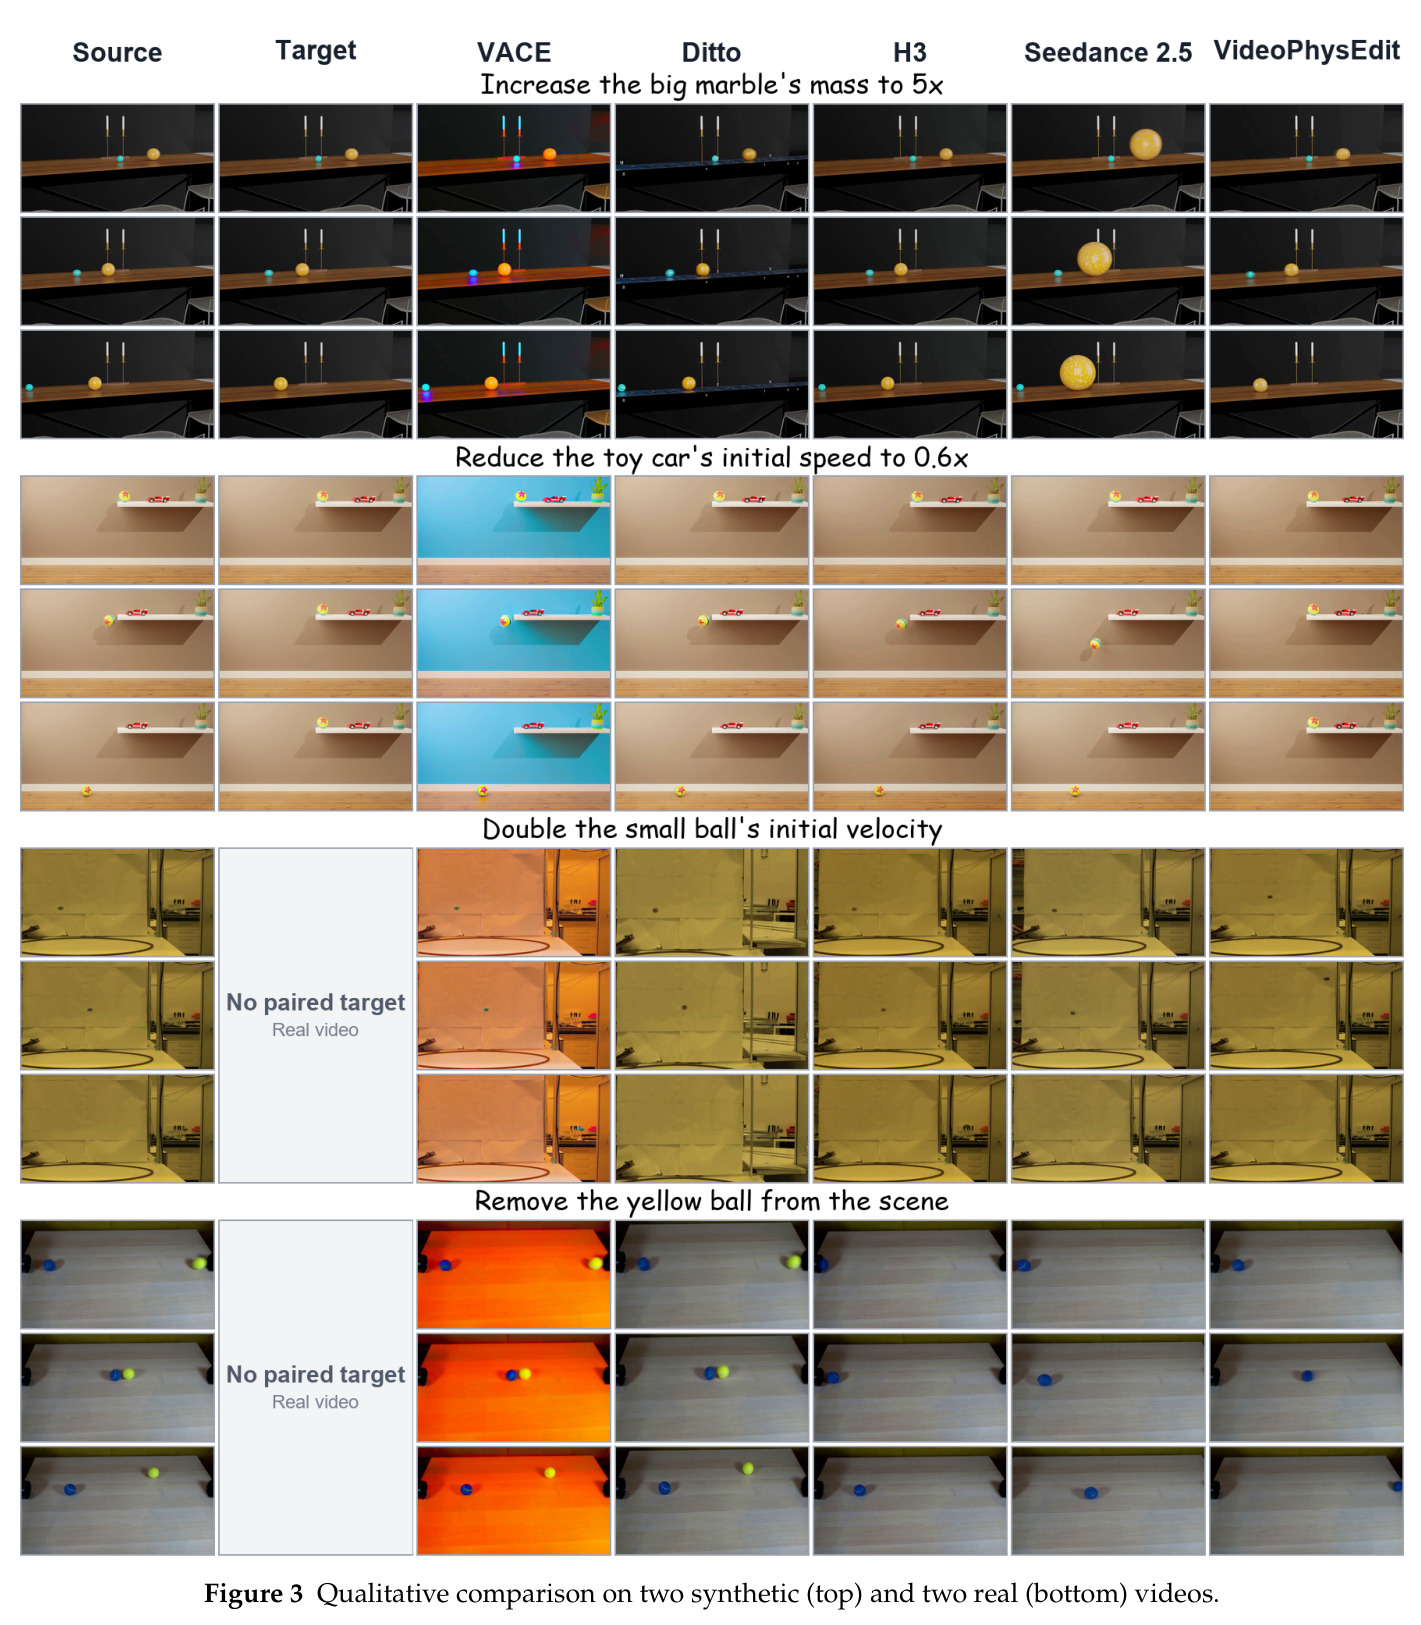
主实验在 PCVE-RigidBench 的 129 个任务上进行(表 1):VideoPhysEdit 的 PES 达 0.376,是唯一正值——VACE、Ditto、MiniMax H3、Seedance 2.5 分别为 −0.042、−0.120、−0.096、−0.087,均比完全不动(No edit,PES=0)还差;TE 66.70 比最强竞品 Seedance 2.5 的 144.99 降低 54.0%,Mask IoU 0.421 最高。视觉保真上 PSNR 27.51/SSIM 0.925 与 Seedance 2.5(28.85/0.928)接近,FVD 182.46 全场最佳。删除子集(表 2)对比 VOID:PES 0.633 对 0.394,TE 52.99 对 84.07(降 37.0%),Mask IoU 0.496 最高;VOID 凭局部重绘拿到最高 PSNR 29.22,但本文 SSIM 0.921 与 FVD 230.29 最佳。对因编辑而改变运动的其他物体,PES 0.276 仍是唯一正值(附录表 9)。阶段消融(表 3):Stage 5 优化把 rollout Mask IoU 从 0.375 提到 0.678,Stage 6 反事实 PES 0.269→0.403,Stage 6→7 生成阶段 TE 仅 63.39→64.76。真实视频定性对比(图 3)同样占优;且在指令中显式写出下游后果并无一致提升(附录 C.5),印证显式物理场景的必要性。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PCVE-RigidBench 全部 129 个物理编辑任务 | Physical Edit Score (PES) ↑ | 0.376(唯一正值) | 最强竞品 Seedance 2.5 为 −0.087;VACE −0.042、Ditto −0.120、MiniMax H3 −0.096;No edit 定义为 0 | 唯一正向改善:从未编辑基线 0 提升至 0.376,其余全部为负 |
| PCVE-RigidBench 全量任务 | 轨迹误差 TE ↓ | 66.70 | Seedance 2.5 为 144.99;No edit 143.13 | 相对最强竞品降低 54.0% |
| PCVE-RigidBench 全量任务 | Mask IoU ↑ | 0.421 | No edit 0.289;VACE 0.273;Seedance 2.5 0.231 | +0.132,全场最高 |
| PCVE-RigidBench 全量任务 | FVD ↓ | 182.46 | MiniMax H3 246.45;Seedance 2.5 246.67;Ditto 551.14 | 降低约 26%,在物理精度领先的同时保真也最佳 |
| PCVE-RigidBench 物体删除子集 | PES ↑ | 0.633 | VOID 0.394;MiniMax H3 0.383;Seedance 2.5 0.290 | 比专项删除方法 VOID 高 0.239 |
| PCVE-RigidBench 物体删除子集 | TE ↓ | 52.99 | VOID 84.07;No edit 140.52 | 相对 VOID 降低 37.0% |
局限与改进
作者明确承认的局限:框架限定刚体场景与静止相机,结论部分把相机运动、更丰富几何、铰接或主动受控智能体的物理模型列为未来工作;附录 C.2.3 披露了两个场景无法产出有效编辑视频的边界案例。我自己的观察还有几点:(1) 物理量不被观测决定时依赖显式先验——恢复系数这类内部属性本质上不可直接观测,单目证据不足时反演结果可能不唯一;(2) 视觉网格用球/盒近似,编辑复杂形状物体的外观时会露馅;(3) 视觉保真略逊于只重绘局部的方法(删除子集 PSNR 26.31 对 VOID 的 29.22),全场景重绘有代价;(4) PCVE-RigidBench 全部由 PyBullet+Blender 合成,与真实视频存在域差距,真实场景的定量精度未知;(5) 七阶段串行 pipeline 的延迟与显存开销不小(附录 C 报告运行时与峰值显存),难以交互式使用。
独立分析的弱点
独立分析几点弱点并给改进方向:(1) 仿真搜索每步只保留最优加至多两个备选,在多物体碰撞链这类分支爆炸的场景里,正确假设可能在早期就被剪掉——可引入自适应束宽或基于不确定性的回溯机制;(2) 掩码 IoU 损失对遮挡和小物体不敏感,快速运动区域一帧错位就会误导物理参数——可加入点迹一致性或光流损失作为补充信号;(3) 球/盒视觉网格与碰撞代理限制了几何复杂度——可换用 3D Gaussian Splatting 或凸分解(如 VHACD)获得更精细的几何与碰撞体;(4) 每次编辑都要完整重跑七阶段,同一场景多次编辑无法增量复用——可缓存重建的物理场景,只重做 Stage 6-7,把交互延迟降到秒级;(5) 刚体假设排除软体、流体、布料,PCVE 的普适性受限——可接入 MPM/FEM 求解器做同款反演;(6) 对 VLM 指令解析的依赖意味着语言歧义会直接传导为错误干预,缺少对解析结果的置信度校验与向用户确认的机制。
未来方向
作者提出的方向:扩展到相机运动、更丰富几何,以及铰接体或主动受控智能体的物理模型——这需要从刚体动力学升级到更一般的动力学表述,并把运动先验重建推广到非刚体。基于本文成果还可自然延伸:(1) 用 PCVE-RigidBench 式仿真配对数据训练端到端物理感知编辑模型,摆脱训练自由 pipeline 的推理开销;(2) 把物理反演改为可微仿真优化,端到端联合精炼几何、相机与物理参数;(3) 反过来把反事实视频用作世界模型的物理一致性训练数据——PES 显示商业视频模型物理编辑得分为负,这类数据正对口;(4) 与交互应用结合,缓存场景后支持拖拽式准实时编辑;(5) 把 PES 推广到软体/流体场景,建立更广谱的物理编辑评测体系。
复现评估
复现友好度中上。论文明确所有预训练组件均用已发布 checkpoint:Qwen3-VL(指令解析)、Grounding DINO+SAM 2(检测分割)、CoTracker3(点迹)、VGGT+SuperGlue(重建)、PyBullet(仿真)、ObjectClear/Insert Anything/Cube3D(参考图与插入几何)、Wan-Move 14B(视频生成),无自训练模块,因此不需要训练算力,但推理需要高端 GPU(14B 生成模型的峰值显存与运行时在附录 C 报告)。PCVE-RigidBench 的构建方式(PyBullet 仿真+Blender 渲染,20 场景 129 任务)描述完整可自行重建,项目页 videophysedit.github.io 提供结果展示。主要难度在系统工程:七个阶段的衔接、各损失权重与搜索超参的细节在附录,组件版本敏感,独立复现预计需数周;若作者开源代码则难度大幅下降。
论文图表
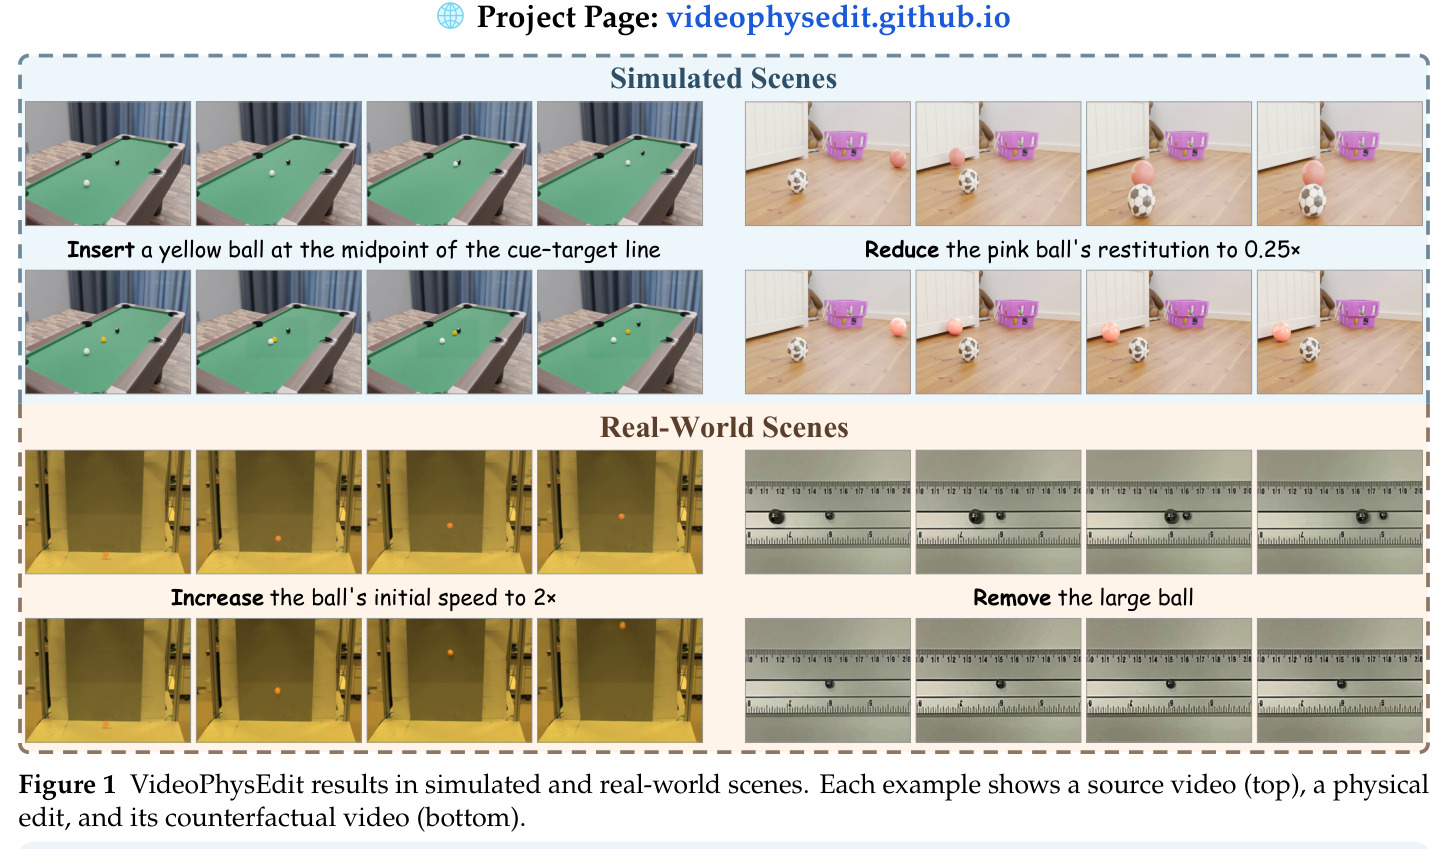
展示四组结果:模拟场景中在母球与目标球连线中点插入黄球、把粉球恢复系数降为 0.25 倍;真实场景中把球的初速度增至 2 倍、移除大球。每组上为源视频、中为物理编辑、下为生成的反事实视频。
一图看懂任务定义:编辑改变的不是画面本身,而是之后的运动与交互(新碰撞、不同反弹、碰撞链消失),这是全文的问题起点。