VideoMemBench:多轮视频对话中多模态大模型的上下文记忆基准 VideoMemBench: How Well Do MLLMs Remember in Video Conversations?
首个以情景/答案依赖链度量视频对话记忆的基准,最佳模型仅得45.7%
前置知识
多模态大语言模型(MLLM)
在 LLM 基础上加入视觉编码器与模态对齐训练的模型,能把视频帧序列与文本一起编码进统一上下文并生成回答。前沿模型拥有百万级 token 上下文,可一次性处理带时间戳的整段长视频,把视频当作一份可问答的视觉文档。
本文的评测对象就是 MLLM,全部评测协议(统一 128 帧输入、多轮自回放)都建立在其视频与对话联合建模的能力之上,不了解 MLLM 的输入方式就无法理解实验设置。
上下文内记忆(in-context memory)
与训练时写入参数的长期记忆不同,它指模型在单次推理会话内从上下文中检索并复用信息的能力:既要找回先前看过的内容(情景),也要记得自己先前说过什么(答案)。上下文越长、对话越深,对这种工作记忆的要求越高。
这是论文定义并度量的核心能力(in-context video memory),两种依赖类型、三个指标与全部分析实验都围绕它设计,是全文的关键词。
自回放评估协议(self-rollout)
评测时按对话顺序逐轮提问,并把模型自己先前生成的回答保留在上下文里充当历史:第 $t$ 轮输入为 $V \| (q_1,\hat{a}_1) \| \cdots \| (q_{t-1},\hat{a}_{t-1}) \| q_t$,其中 $V$ 是带时间戳的帧序列。与之相对的 oracle 协议则用标准答案替换历史中的模型回答。
自回放让早期回答的错误会污染后续轮次,这正是答案依赖想要放大的失败模式;论文靠它与 oracle 历史的对比来定位误差来源。
类型化依赖图
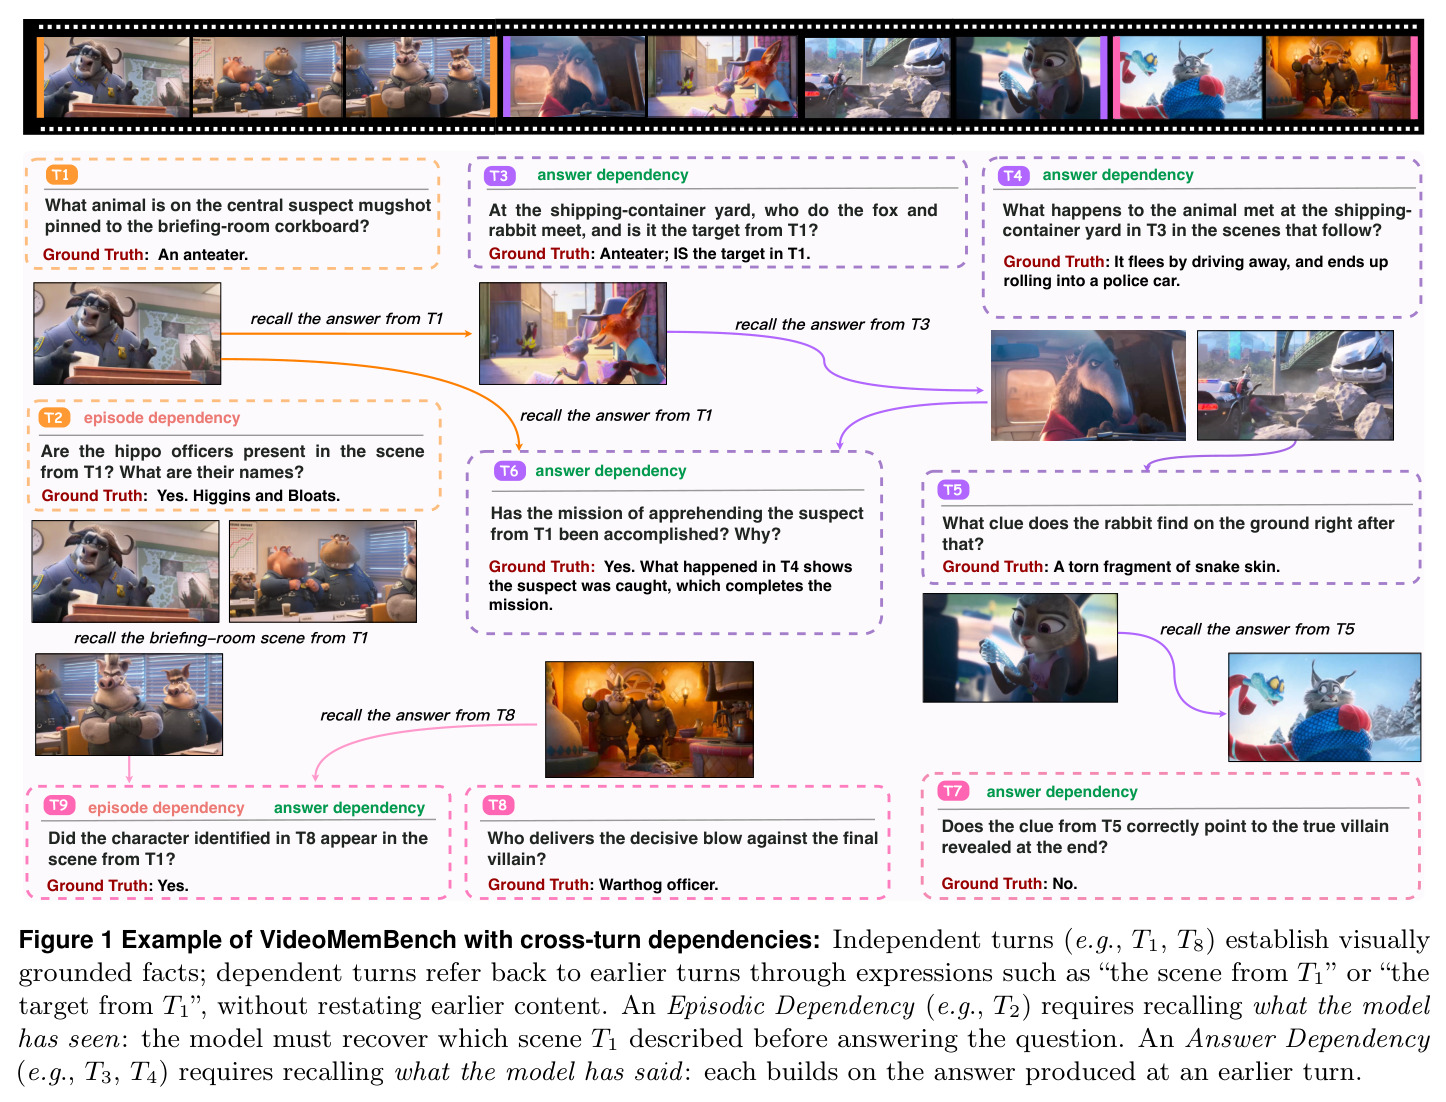
把多轮对话表示成有向图:节点是一个 QA 轮,边从父轮指向依赖它的子轮并带类型标签——情景边表示引用父轮描述过的视觉片段,答案边表示延续父轮给出的答案。图支持多父节点与长程边,可表达同时依赖 T1+T4 或 T1 直达 T9 这类结构。
依赖图是数据集的结构骨架,也是分项指标(EpiDepAcc/AnsDepAcc)和按距离、父数、位置分层分析的计算基础,没有它就无法把失败归因到具体记忆环节。
LLM-as-a-Judge
用强模型代替人工给开放式回答判分:判分器拿到问题、参考答案与待评回答,输出对/错二值判定。本文用 GPT-5.4 mini 判开放式回答、选择题直接抽取选项;构造流水线中的 judger 角色也复用同一思路,自动校验必要性、非泄漏与视觉接地。
判分器既是评测的打分员又是数据构建的质检员,理解其工作方式与潜在偏差是评估这个基准可信度的前提。
链式记分(chain crediting)
答案依赖轮的专用计分规则:某轮得分为自身正确性乘以其沿答案边全部祖先轮正确性的连乘积,即 $\mathrm{corr}(t) \prod_{a} \mathrm{corr}(a)$,祖先链上任何一环出错该轮即为零分。它衡量的是整条推理链都可靠,而不是孤立答对当前问题。
不掌握这条规则会把 AnsDepAcc 误读成普通子集准确率;正是它使 AnsDepAcc 系统性低于 TurnAcc,构成论文最核心的观察之一。
研究动机
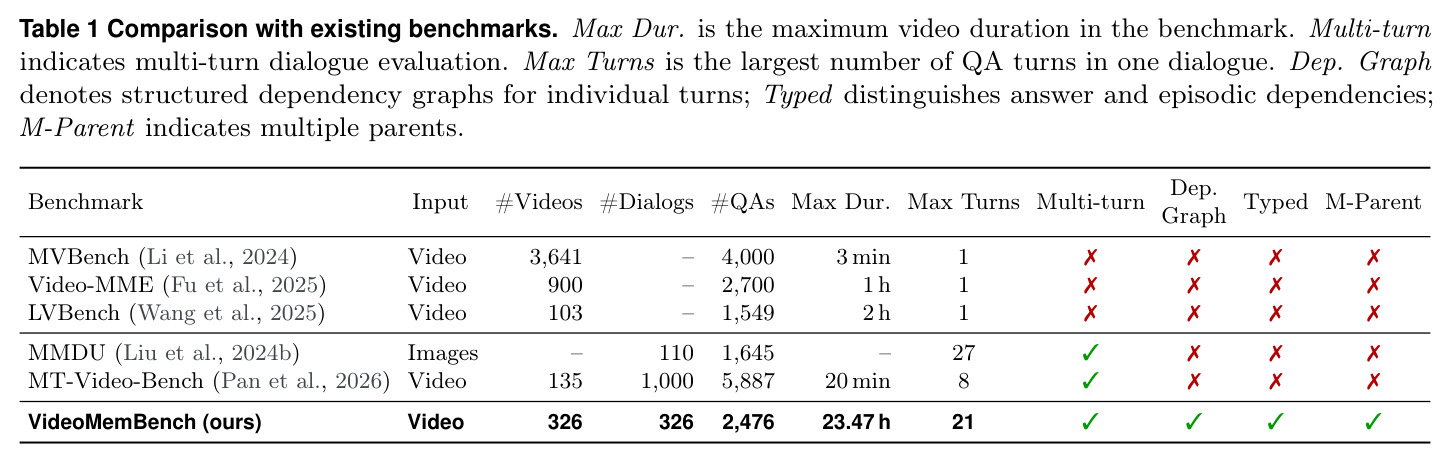
现有视频理解基准在结构上无法度量对话记忆:MVBench(4000 题)、Video-MME(900 视频、2700 题)、LVBench(1549 题)等把 QA 评测拆成相互独立的问题——没有任何问题引用另一个问题的内容或答案,每个问题都能仅凭视频本身回答,对话历史从不承重。即便是多轮基准,MMDU(110 段对话、最多 27 轮)和 MT-Video-Bench(1000 段对话、5887 问)也没有结构化依赖图,无法判断哪些轮次真正需要历史信息。文本领域已有 LoCoMo、LongMemEval、MemBench 等评测 LLM 上下文记忆的工作,但迁移到视频存在一个关键难题:必须区分真正依赖先前对话的问题,与仅凭视频加当前问题就可回答的问题——比如烹饪视频里只有一种食材时,问“那种食材用了多少”看似引用历史实则不必依赖。缺乏经过验证的依赖构造方法,是该方向的核心障碍。
本文的目标是本文要定义并量化“上下文内视频记忆”:当连续多轮问题都关于同一视频时,模型能否正确检索并复用对话已建立的信息——既包括它看过的(先前轮描述的视觉片段),也包括它说过的(自己先前的回答)。具体目标是构建 VideoMemBench:每个样本由一段视频和一条长多轮对话组成,轮次之间由显式、类型化的跨轮依赖连接;回答一个依赖轮必须同时用到对话(提供父轮建立的信息)与视频(提供当前轮的视觉事实),两个信息源缺一不可。数据规模定为 326 段视频、2476 轮问题,其中 1387 轮依赖先前轮次,包含多父依赖与最长跨越八轮的长程回溯,并系统评测 20 多个开源与闭源 MLLM,给出可归因到依赖类型的分项指标。
与已有工作不同的是,本文的独特切入是把“依赖”从隐式的多轮对话形式升级为显式的类型化依赖图,并用双重性质验证每条边:必要性要求删掉父轮后问题变得不可答,非泄漏要求问题不复述父轮的信息(哪怕部分复述也算泄漏)。它同时把记忆拆成两种可分别度量的形式——情景依赖测“记过所看”,答案依赖测“记过所说”。与 MMDU、MT-Video-Bench 这类只有对话形式、没有依赖标注的基准不同,VideoMemBench 提供完整依赖图(类型化边、多父节点、最多 21 轮),使评测失败可以归因;与 LoCoMo 等纯文本记忆基准不同,它把每条依赖锚定在视频的视觉事实上,要求对话与视频联合才可作答。另一个关键差异是构造顺序:依赖结构先于任何问题被规划出来,而非事后标注。
核心方法
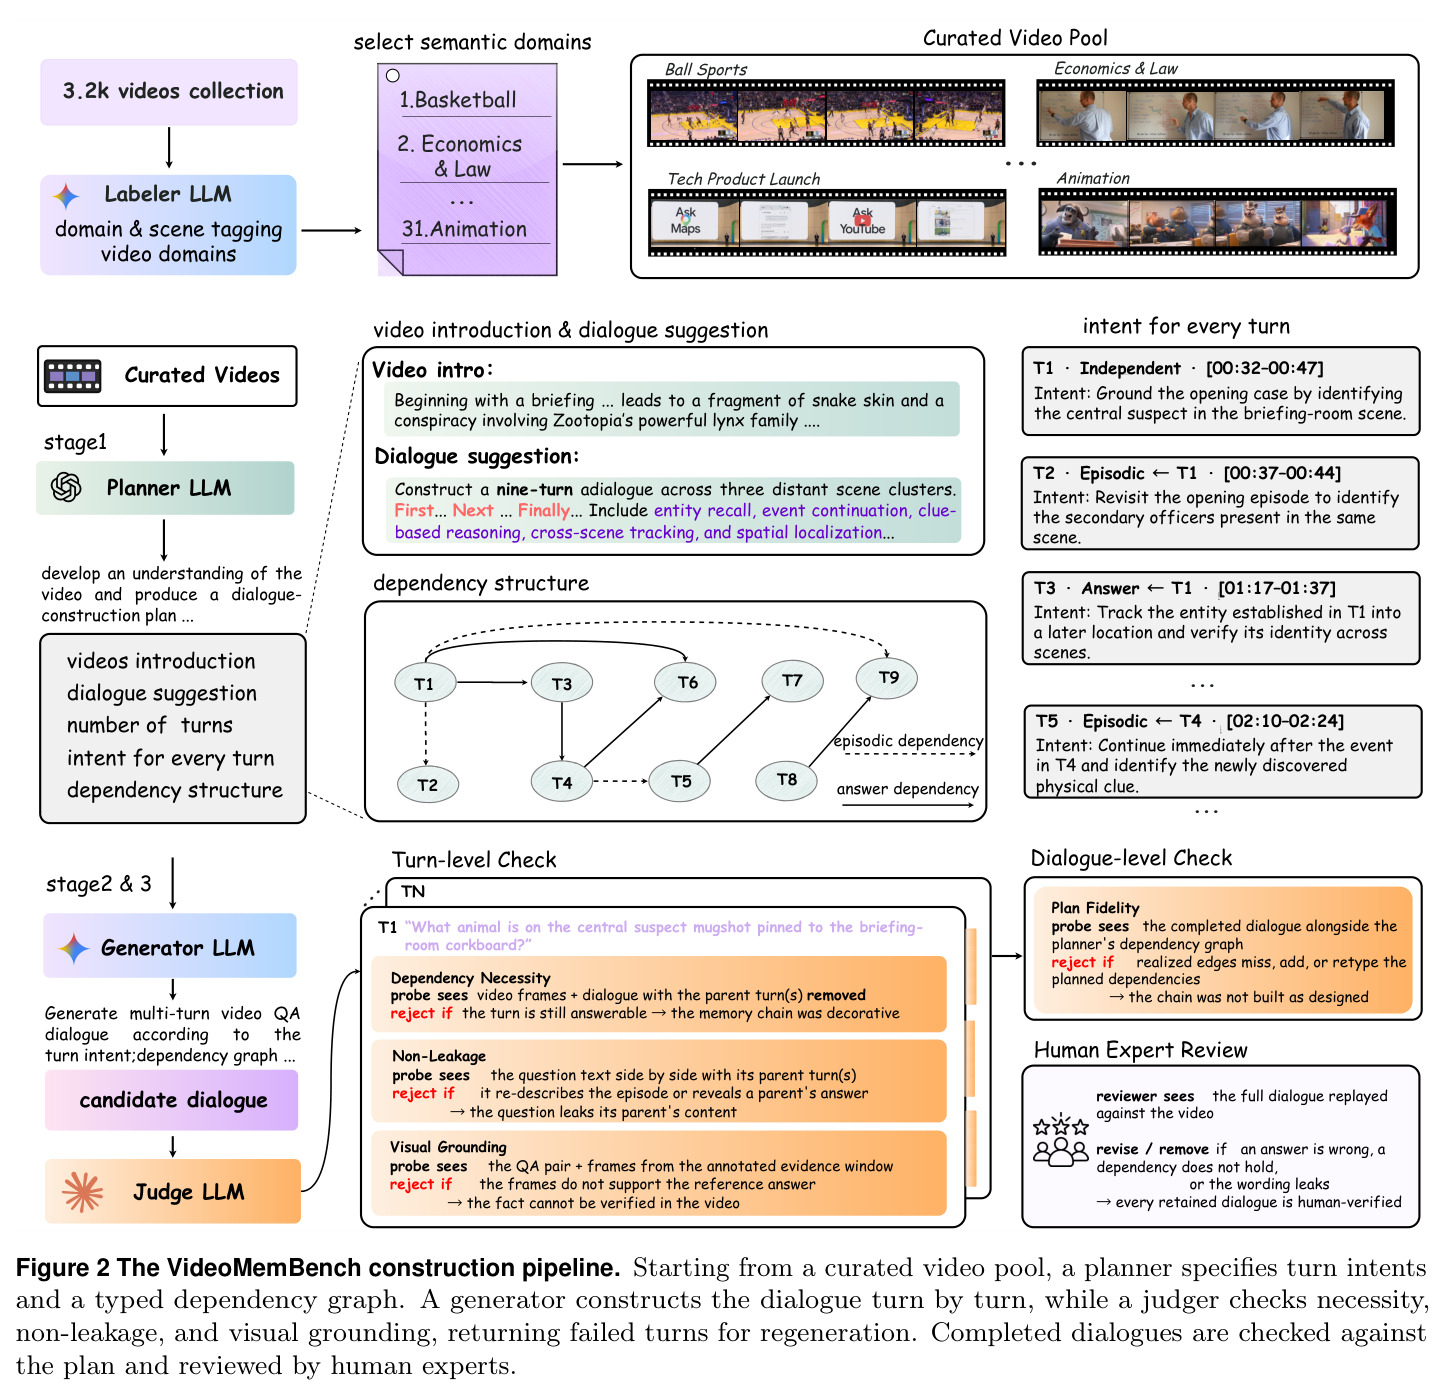
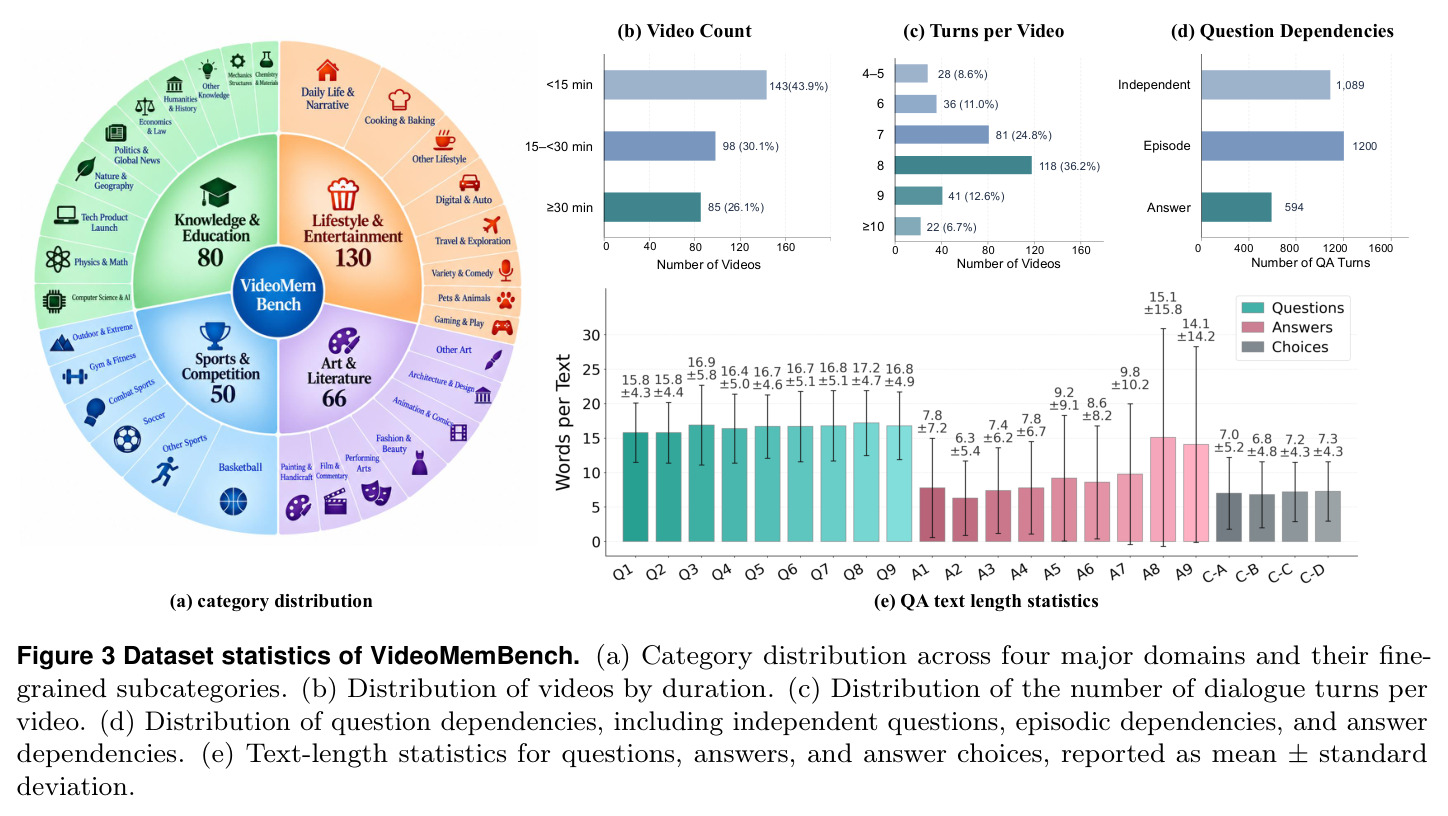
直觉上,要测“记忆”就必须让问题离开历史不可答,且不能复述历史。技术路线是一个三角色 LLM 流水线加人工复核:planner 在任何问题写出之前规划全局依赖结构(视频梗概、对话指南、依赖图、逐轮意图);generator 按计划逐轮生成问题与参考答案,依赖轮只用指代表达(如“T1 的那个场景”)而不复述内容;judger 逐轮做必要性(删除父轮后仍可答则拒绝)、非泄漏与视觉接地三项校验,未通过则带着反馈重新生成,连续两次失败就重新规划受影响的对话部分;最后由 8 名人类专家逐段复核。数据来自约 3.2k 视频池(Video-MME、VSI-Bench、Video-MMMU、LongVideoBench、EgoLife 与网络视频),覆盖 31 个语义域,最终保留 326 段视频、2476 轮、1794 条类型化依赖(1200 条情景依赖 + 594 条答案依赖),对话 4–21 轮、平均 7.6 轮,最长视频达 23.47 小时。
核心创新有三点。第一,依赖先于问题存在:planner 先给出依赖图,generator 只是实现它,使必要性成为结构性保证而非事后标注的巧合。第二,把记忆拆成两种类型并设计对应的边:情景依赖(Episodic)要求回忆父轮描述过的视觉片段,答案依赖(Answer)要求延续模型自己先前的回答;后者用链式记分评估,公式为 $$\mathrm{AnsDepAcc} = \frac{1}{|\mathcal{T}_{ans}|} \sum_{t \in \mathcal{T}_{ans}} \mathrm{corr}(t) \prod_{a \in \mathcal{A}_{ans}(t)} \mathrm{corr}(a)$$ ,即当前轮及其沿答案边回溯的全部祖先都正确才得分。第三,用指代表达实现非泄漏:问题只说“the scene from T1”而不重述那个场景是什么,迫使模型从对话中恢复指涉对象。这三点共同保证回答一个依赖轮必须把对话与视频联合起来,任何单一信息源都不够用。
方法步骤详情
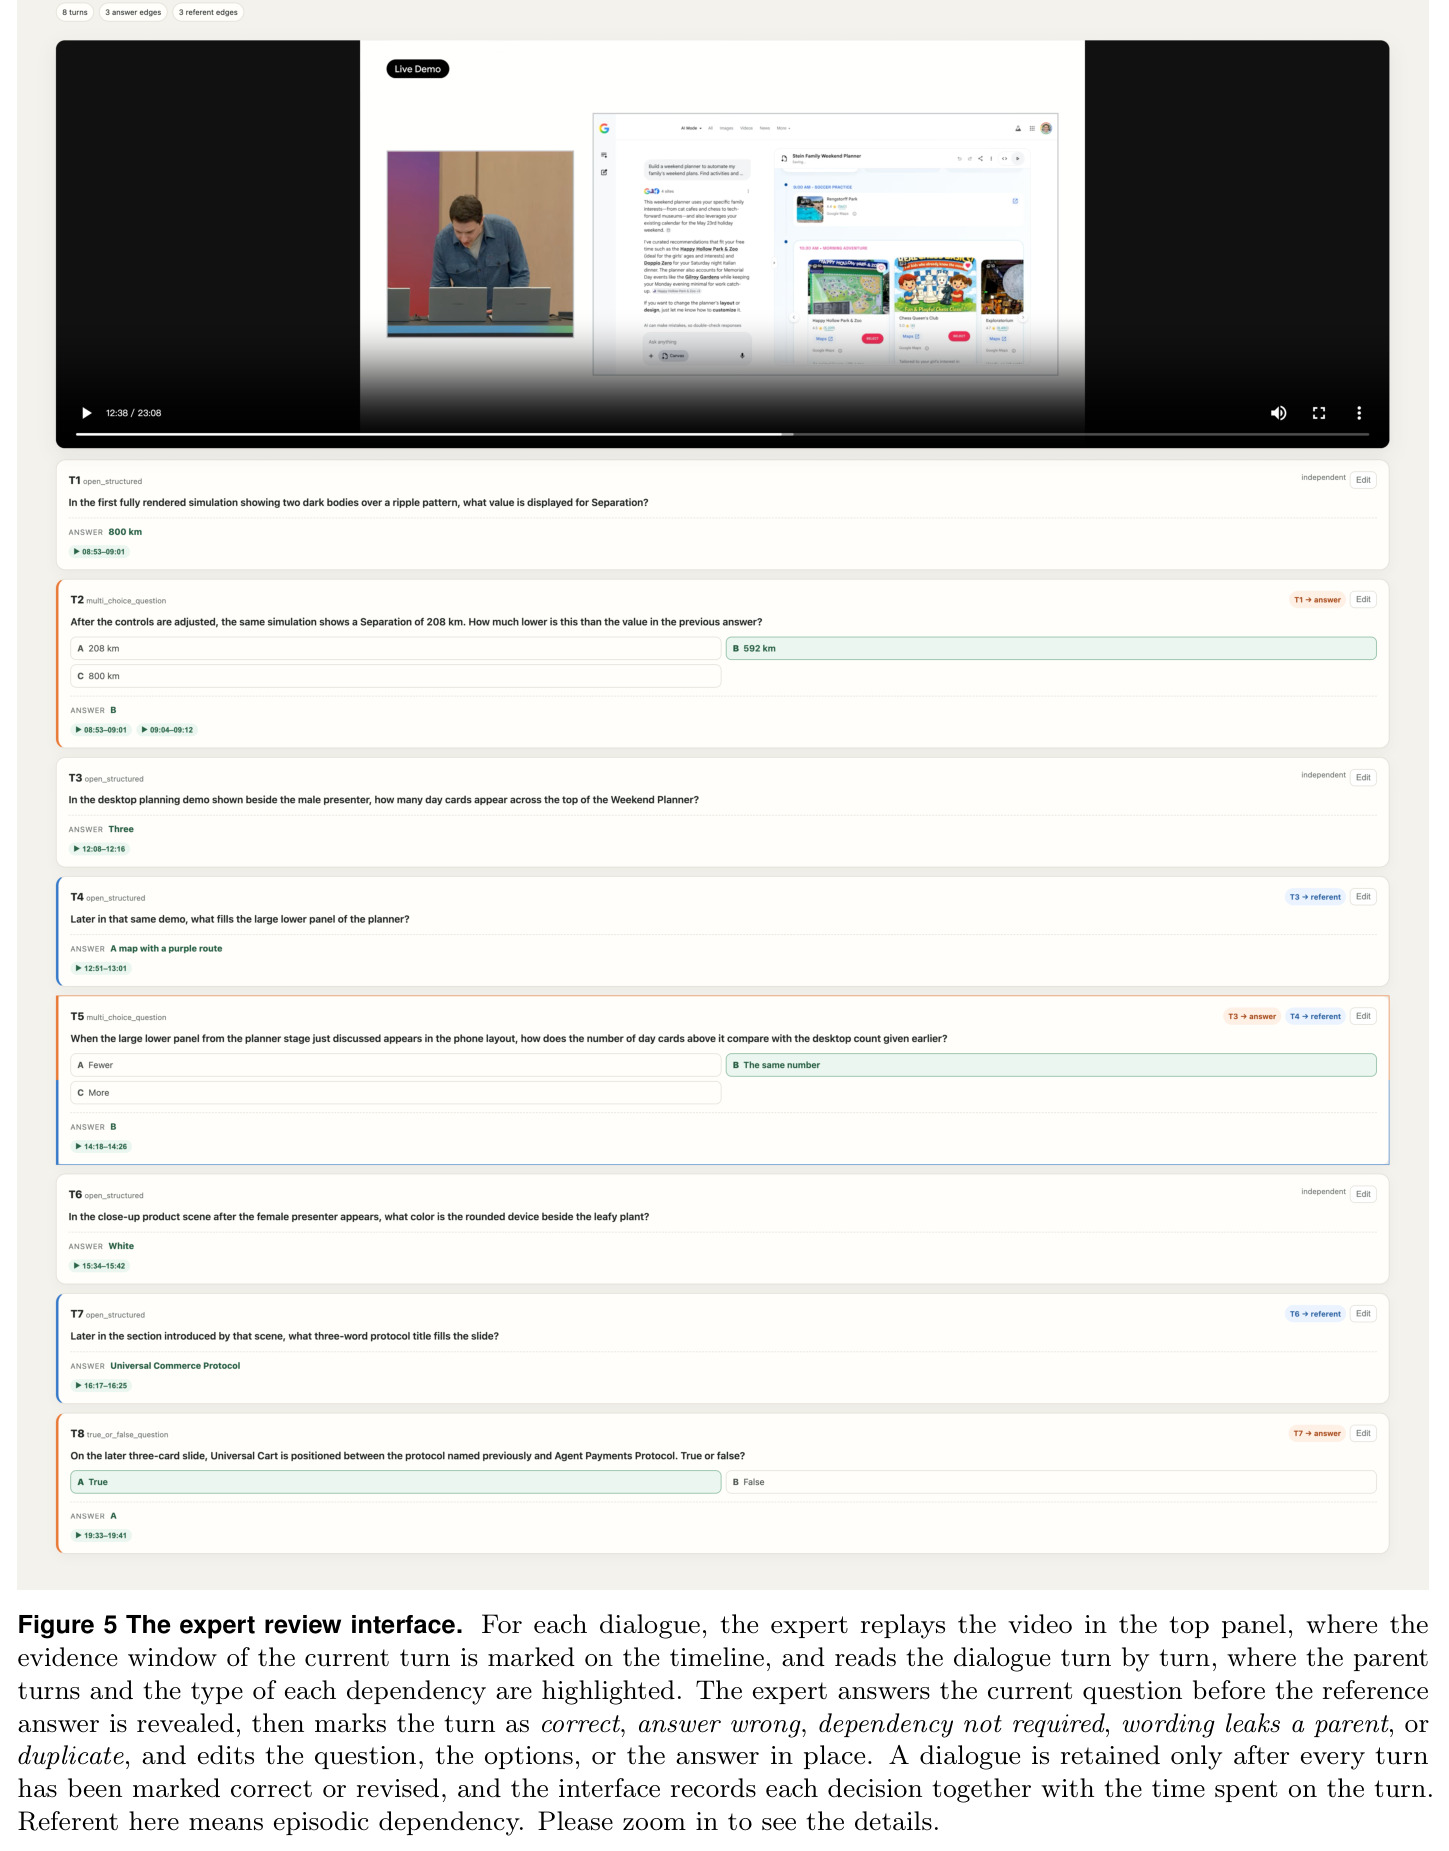
第一步视频收集:从五个现有基准与网络汇聚约 3.2k 视频,用预训练 LLM 标注领域与场景构成,选出具有重复实体、适合跨轮依赖的 31 个语义域。第二步依赖规划:planner 对视频采样关键帧,产出四件套——视频梗概、对话指南(目标能力与轮数)、依赖图(每轮的父节点与边类型)、逐轮意图(要建立的信息、目标片段、需要的父信息),并要求规划轮次覆盖全片。第三步逐轮生成:generator 对每轮目标片段密集采样帧,先确定一个可验证的视觉事实作为参考答案,再按意图措辞问题;依赖轮使用指代表达;同时记录证据时间窗。第四步轮级校验:judger 用“删除父轮后仅凭视频帧与剩余对话作答”的反事实探针测必要性,并排比对问题与父轮测非泄漏,用证据窗帧验证视觉接地,并拒绝语义重复的问题。第五步专家复核:8 名专家回放对话与视频,修订或删除错误答案、无效依赖与泄漏。第六步定义指标:TurnAcc 覆盖全部轮次,EpiDepAcc 覆盖至少含一条情景边的轮,AnsDepAcc 用链式记分,Overall 为三者算术均值;评测统一 128 帧输入与自回放协议,GPT-5.4 mini 判分开放式回答。
技术新颖性
技术上最具新意的是生成-判分对抗式流水线中的反事实必要性探针:把父轮从上下文中删掉后让判分模型仅凭视频帧和剩余对话作答,仍能答对就拒绝该轮——这把“是否真正依赖历史”变成了可自动执行的谓词,而非人工直觉。链式记分也有独到之处:它只沿答案边回溯祖先(情景边不参与遍历),从而把“没记住自己说过的话”与“没记住看过的场景”解耦;人类基线显示 AnsDepAcc 与 TurnAcc 仅差 3.9 个百分点,而闭源模型的差距达 16.6–22.9 个百分点,证明该指标确实捕捉到跨轮一致性这一独立能力,而非普遍的答题难度。类型化依赖图本身(348 个多父轮、最长 9 轮依赖距离、最深 7 级链)也超出此前多轮基准的表达能力,使分析实验能够按距离、父数、对话位置分层展开。
实验结果
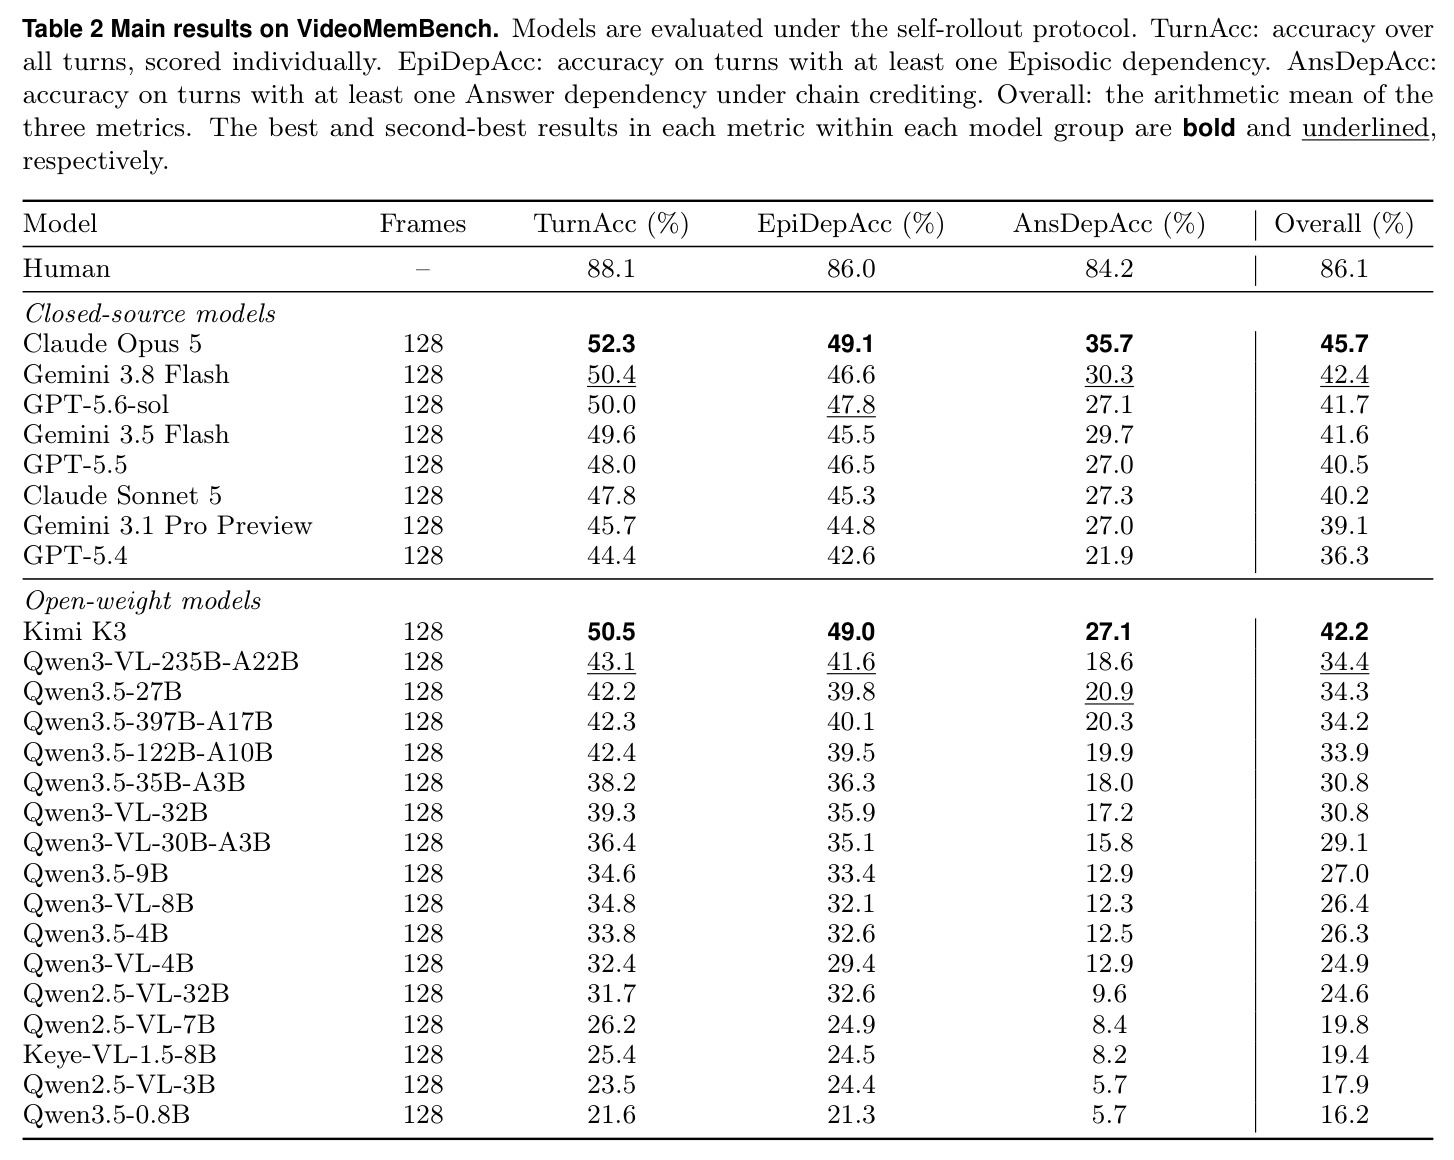
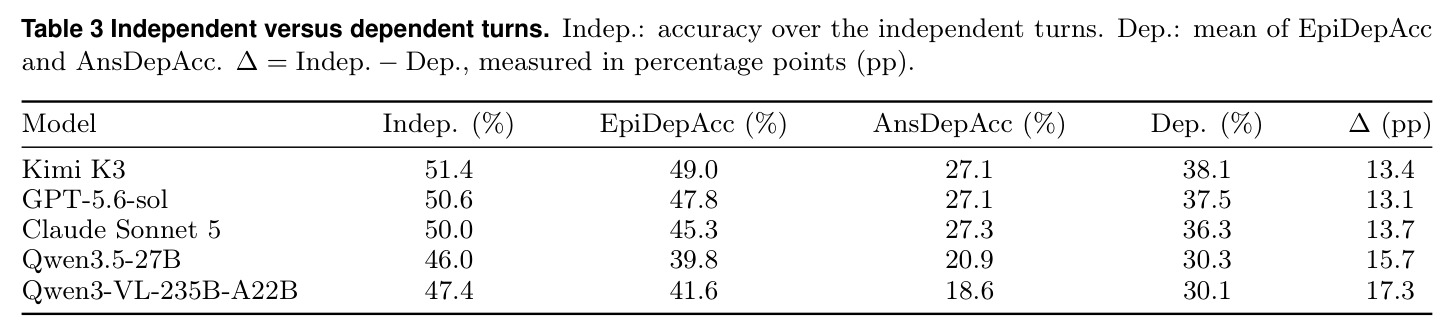
共评测 25 个模型(8 闭源 + 17 开源),人类基线 Overall 86.1%。Claude Opus 5 全面领先:TurnAcc 52.3%、EpiDepAcc 49.1%、AnsDepAcc 35.7%、Overall 45.7%,距人类约 40 个百分点,Gemini 3.8 Flash(42.4)与 GPT-5.6-sol(41.7)随后。闭源模型 AnsDepAcc 比 TurnAcc 低 16.6–22.9 个百分点而人类只低 3.9,说明跨轮一致性是主要短板。开源方面 Kimi K3 以 42.2 名列全场第三,其余开源均低于闭源最低的 GPT-5.4(36.3);Qwen3.5 从 0.8B 的 16.2% 升到 27B 的 34.3%。分析显示依赖距离从 1 增到 5 以上时平均准确率从 30.2% 降到 23.1%,父节点从 1 到 3 时 Kimi K3 从 40.8% 降到 29.8%。oracle 历史替换后 Qwen3-VL-8B 从 12.3% 升至 32.4%、Gemini 3.5 Flash 从 29.7% 升至 47.2%,但仍低于各自独立轮准确率,说明错误历史是重要拖累却非唯一瓶颈。
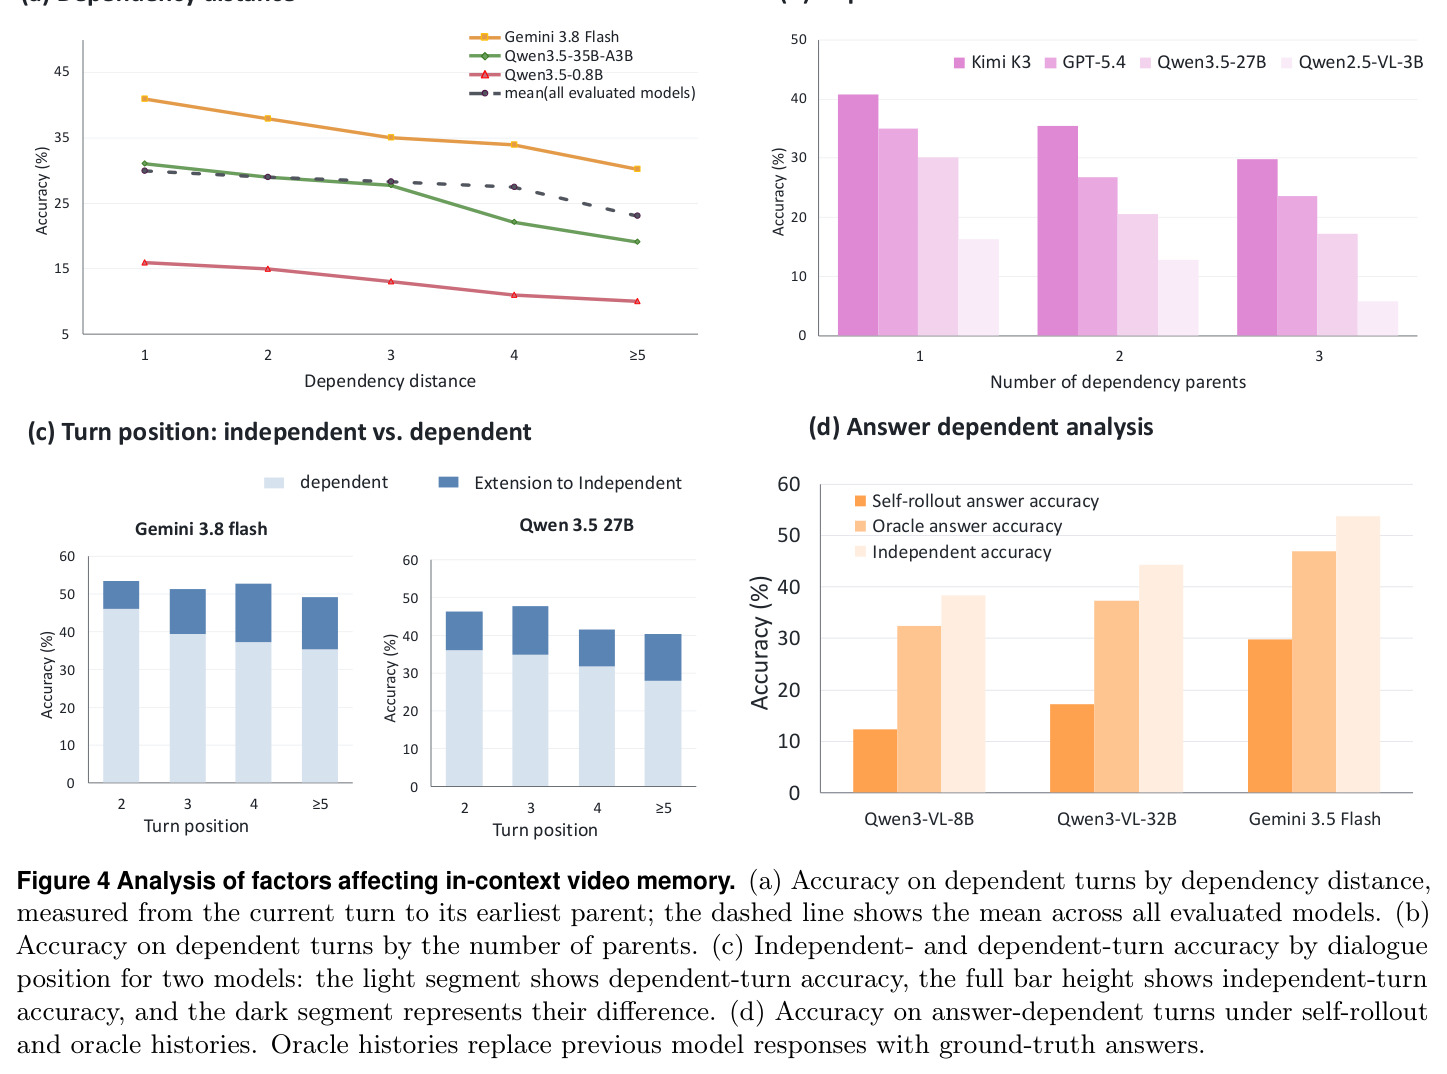
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视频多轮对话全轮准确率 | TurnAcc (%) | Claude Opus 5:52.3(全场最佳) | 人类 88.1;闭源最低 GPT-5.4 44.4 | 距人类 35.8 个百分点,无模型过半 |
| 情景依赖轮准确率(记过所看) | EpiDepAcc (%) | Claude Opus 5:49.1 | 人类 86.0;开源最佳 Kimi K3 49.0 | 开源最佳与闭源最佳打平,仍落后人类 36.9 个百分点 |
| 答案依赖轮准确率(记过所说,链式记分) | AnsDepAcc (%) | Claude Opus 5:35.7 | 人类 84.2;GPT-5.5 27.0 | 领先第二名 Gemini 3.8 Flash 5.4 个百分点,仍落后人类 48.5 |
| 三项指标算术均值 | Overall (%) | Claude Opus 5:45.7 | 人类 86.1;开源最佳 Kimi K3 42.2 | 最佳模型距人类 40.4 个百分点,凸显任务难度 |
| 开源模型对比 | Overall (%) | Kimi K3:42.2(50.5/49.0/27.1) | 次优开源 Qwen3-VL-235B-A22B 34.4;最小模型 Qwen3.5-0.8B 16.2 | 领先次优开源 7.8 个百分点,超过多数闭源模型 |
| 依赖距离对准确率的影响 | 依赖轮平均准确率 (%) | 全体模型均值:距离 1 时 30.2 → 距离 5+ 时 23.1 | 人类在同等条件下 86.1(Overall) | 长程依赖普遍更难,长距离组跌幅更大 |
| oracle 历史对照(答案依赖轮) | AnsDepAcc (%) | Gemini 3.5 Flash 替换正确历史后 29.7 → 47.2 | 自回放历史下的原始分数 | 提升 17.5 个百分点,但仍低于独立轮准确率 |
局限与改进
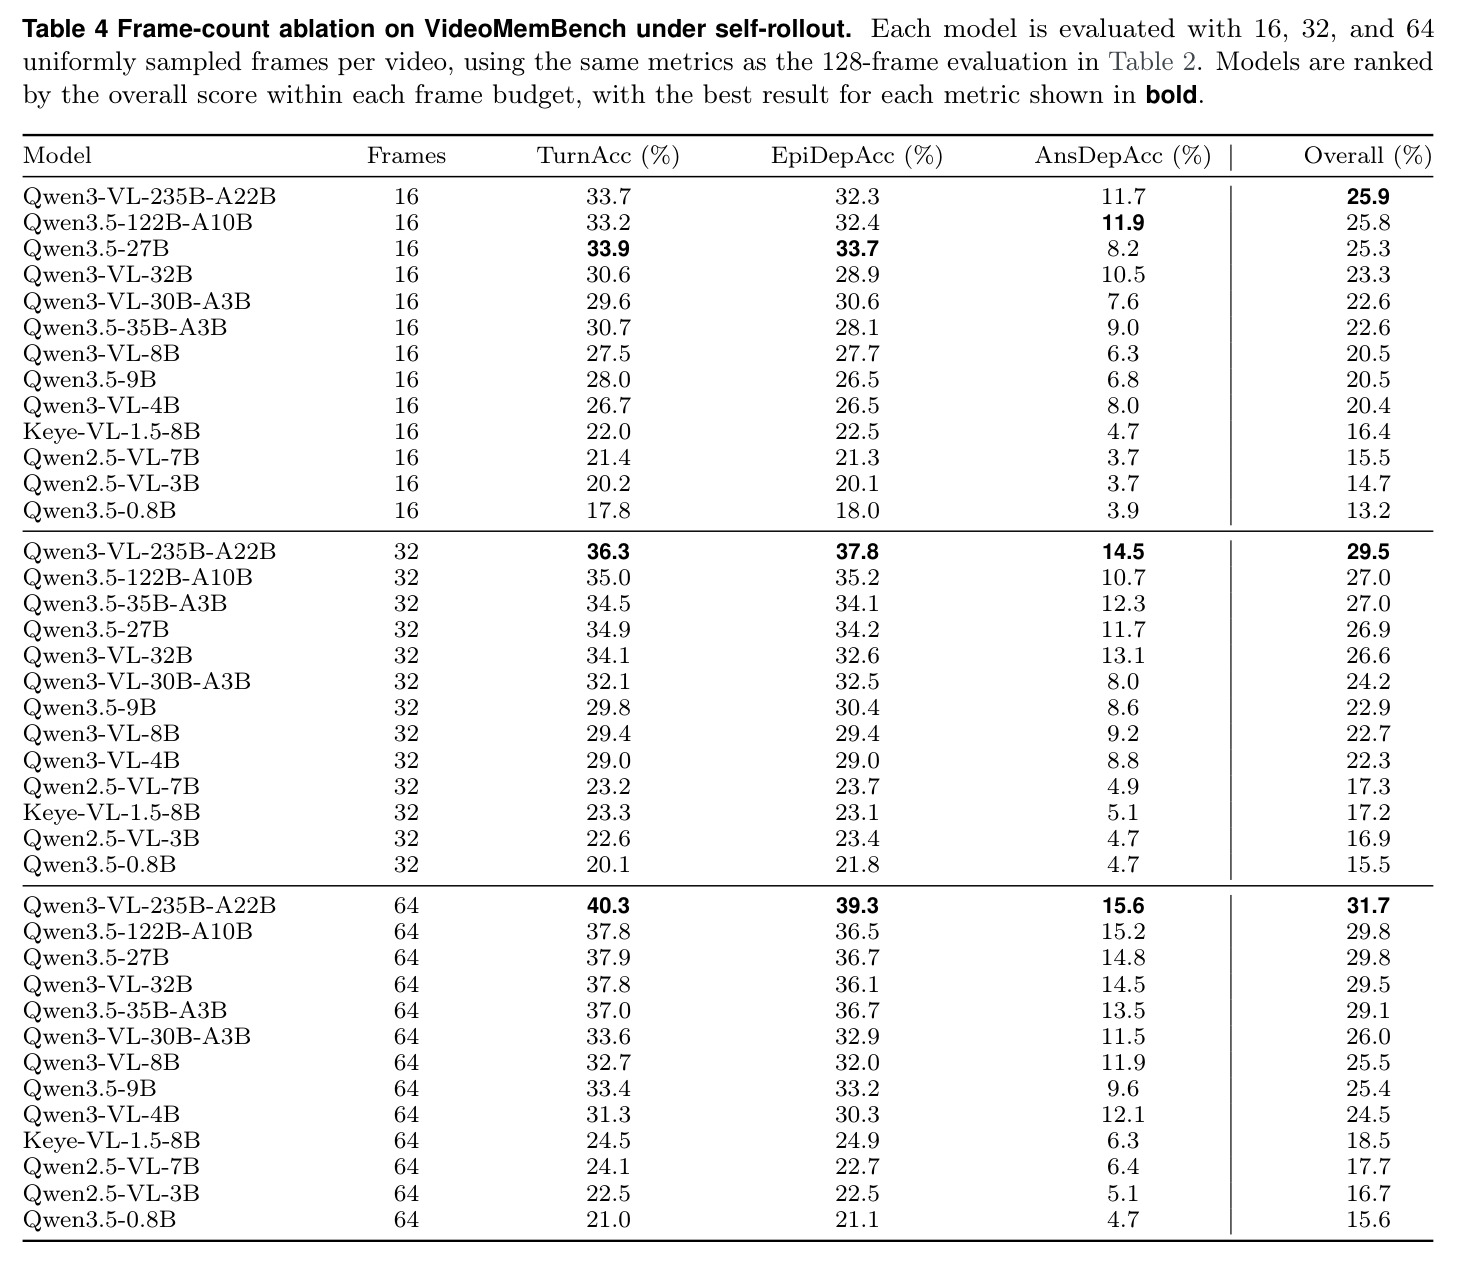
作者承认的局限:开放式回答的判分依赖 GPT-5.4 mini 单一判分器;Overall 是三个相互重叠子集的算术均值,并非独立题集上的准确率;评测固定使用 128 帧带时间戳的统一采样协议。我自己的观察:其一,326 段视频全部来自公开基准与 YouTube,很难排除候选模型预训练时见过这些视频甚至相关标注的污染风险;其二,23.47 小时的视频只采 128 帧,平均约 11 分钟一帧,对依赖细粒度视觉细节的轮次可能系统性偏难,附录虽有 16/32/64 帧消融但未测更高帧数;其三,AnsDepAcc 的链式记分让一个早期错误使其后整条答案链得零分,可能低估模型当前的局部检索能力;其四,研究只在协议层做 oracle 历史替换,没有评测任何显式记忆机制(外部记忆库、检索、对话摘要)或记忆增强架构,因此只能说测出了问题,尚未给出解决路径的实验证据。
独立分析的弱点
第一,判分器单点依赖:所有开放式回答只由 GPT-5.4 mini 判一次对错,判分偏差会直接传导到全部指标,改进方向是多判分器集成加人工抽样校准,并公开判分一致性数据。第二,帧预算刚性:23 小时视频与 3 分钟视频都用 128 帧,长视频每帧覆盖约 11 分钟,帧数上限可能同时压低所有模型的绝对分数,建议按视频时长自适应采样并扫描到 256/512 帧重新评测。第三,污染风险未量化:视频源自 Video-MME、VSI-Bench 等公开基准,改进方向是补充新采集、未公开视频组成的保留测试集,并做成员推断式污染检测。第四,指标粒度:Overall 混合三种重叠子集,AnsDepAcc 的链式全有全无计分也偏严厉,可引入分链长度报告或部分记分。第五,缺少记忆机制基线:没有对比检索增强、对话摘要、外部记忆等方案,读者无法判断多大的工程投入能挽回多少分数,建议在榜单中加入至少一个记忆增强基线。
未来方向
作者展望是推动能可靠回忆并延续先前观察与回答的视频 MLLM。在此之上可以延伸:其一,显式记忆机制评测——在自回放之外加入关键帧索引、对话状态追踪、情境摘要压缩等机制,量化每种机制在 AnsDepAcc 上的收益;其二,训练信号——把链式一致性作为强化学习奖励,或构造偏好对(同一上下文下正确延续与自相矛盾的回答)做 DPO 训练;其三,流式场景——把全程帧可见改为增量到达的视频流,考察记忆在上下文截断下的鲁棒性;其四,多通道扩展——纳入音频、字幕与屏幕文字,因为许多长视频的关键信息并非纯视觉;其五,自我纠错探测——当历史回答错误时,模型能否借助视频证据发现并更正,这正对应 oracle 实验留下的“正确历史仍不够”的缺口;其六,把依赖图用作错误归因工具,自动定位失败发生在检索、接地还是一致性维持环节。
复现评估
复现条件较好:数据集在 HuggingFace(VideoMemBench/data)发布,代码与评测在 GitHub(Oliiveralien/VideoMemBench)开源,项目页 videomembench.github.io 汇总了入口,构造各阶段的提示模板在附录 C 公开。评测侧:闭源模型需要 Claude、GPT、Gemini 的 API 配额;开源模型覆盖 Qwen3.5(0.8B 到 397B-A17B)、Qwen3-VL、Qwen2.5-VL、Keye-VL-1.5-8B 与 Kimi K3,本地复现需要能容纳 128 帧长视频上下文的显存或 vLLM 类推理框架。规模估算:326 段视频、最多 21 轮对话、25 个模型,约数万次多轮推理加同等数量的判分调用,中等规模实验室一周内可完成。难度评级:复现评测榜单较容易(协议、帧数、判分器都写得明确);完整重建数据集较难——流水线虽公开,但需要可观的 LLM 生成预算和接近论文水准的 8 人专家复核投入。
论文图表