EvoTeam:基于可进化团队的多智能体协作框架 EvoTeam: Multi-Agent Collaboration via Evolving Teams
维护可复用团队库,协同进化团队组织、团队专属交互规则与个体技能的多智能体自进化框架
前置知识
LLM 多智能体系统(MAS)
由多个基于大语言模型的专用智能体组成的协作系统:每个智能体有自己的角色(如规划者、检索者、实现者、验证者)、上下文和工具集,通过信息交接(handoff)与任务分解共同完成单个智能体难以处理的复杂任务,如软件工程、多步检索问答。
本文研究的是 MAS 层面的持续改进,全文围绕团队组织、责任分配、智能体间交互展开,不理解 MAS 的基本运行方式就无法理解“进化团队”到底在进化什么。
经验驱动的智能体自进化
不更新模型参数,而是从历史任务执行轨迹和评估反馈中蒸馏可复用知识(prompt 修正、技能、工作流、交互规则),供后续任务复用,使系统能力随任务量增长而提升,代表工作包括 Reflexion、ExpeL、ReCreate、Meta-Team 等。
EvoTeam 属于这一流派,但把进化对象从“个体智能体”上移到“团队协作层”。理解这个背景才能看出本文与 Meta-Team、Skill-MAS 等基线的区别和实验设计的动机。
交互规则与信息交接(interaction rules / handoffs)
交互规则约束智能体之间如何传递信息:规定某条消息必须由谁发给谁(有向的 sender–recipient 对)、在什么触发条件下生效、必须携带哪些信息与证据、需要何种验证和回退方案。它相当于智能体间的“信息契约”,是多智能体失败(如信息丢失、过早终止)的主要来源之一。
本文的核心机制之一就是“团队专属交互规则”的隔离进化: preliminary study 证明不合适的规则复用(如诊断型“报告后终止”规则被带入实现任务)会导致任务在编码测试前就停止,这是理解 EvoTeam 设计的关键。
团队组织与责任分配
指多智能体系统中“哪些角色参与、各自负责什么子任务”的结构设计。研究表明即使各智能体都具备所需专长,不恰当的责任分配也会让能力无法发挥,缺失的验证角色会让正确贡献在最后一步被破坏。
EvoTeam 把团队组织(描述 $d_T$ + 候选名单 $C_T$)当作一等公民来选择、创建和进化,这是它区别于“只优化个体智能体”方法的根本出发点。
研究动机
现有 LLM 多智能体系统的进化研究主要沿“改进个体”路线:从任务反馈中精炼每个智能体的 prompt、技能和执行策略。但个体变强不等于团队变强——协作性能取决于互补能力如何被组织和协调:责任分配不当会让专家能力无法发挥,信息交接不完整或验证不足会让正确的个体贡献被后续步骤破坏。作者用初步实验(Figure 2a)量化了这一点:让 Meta-Team 在异构任务上做跨任务(Cross-Task, CT)进化后再回到目标任务继续进化,无论 Inter-CT(从另一个 benchmark 继承不合适的团队模板)还是 Intra-CT(同 benchmark 内不同任务类别、模板兼容),在全部三个指标上都劣于“只在目标任务上进化”的 target-only 版本。轨迹分析(Figure 2b)给出两个具体失败模式:一是团队模板僵化,面向 GAIA 网页检索与答案合成的团队无法建立 LocoBench PII 匿名化任务所需的“实现+测试”分工,file_agent 陷入无休止搜索循环直至 TIMEOUT;二是交互规则越界复用,从诊断任务学到的“file_agent 向 planner 报告后 finalize”规则被带到实现任务后,系统在写代码和跑测试之前就终止,直接继承诊断结论导致“没有代码改动也没有测试”。
本文的目标是本文要回答的问题是:MAS 如何在持续适应异构任务的同时进化协作本身,而不破坏已积累的有用经验?具体拆成三个设计目标:(i) 团队重组不应被限制在单一共享结构内——应能按任务需求选择或创建团队,为不同协作需求维护不同的分工结构;(ii) 交互规则只应在协作需求兼容的任务之间共享和精炼——规则更新要有明确的复用范围,防止为某类任务更新的规则破坏其他类型任务所需的协调;(iii) 个体技能(智能体自身的可复用过程知识)应跨团队保持可用,不因团队边界而割裂。EvoTeam 的目标就是以协作为中心,把团队组织、交互规则、个体技能三层知识同时纳入进化,并让三层知识各自有正确的作用域。
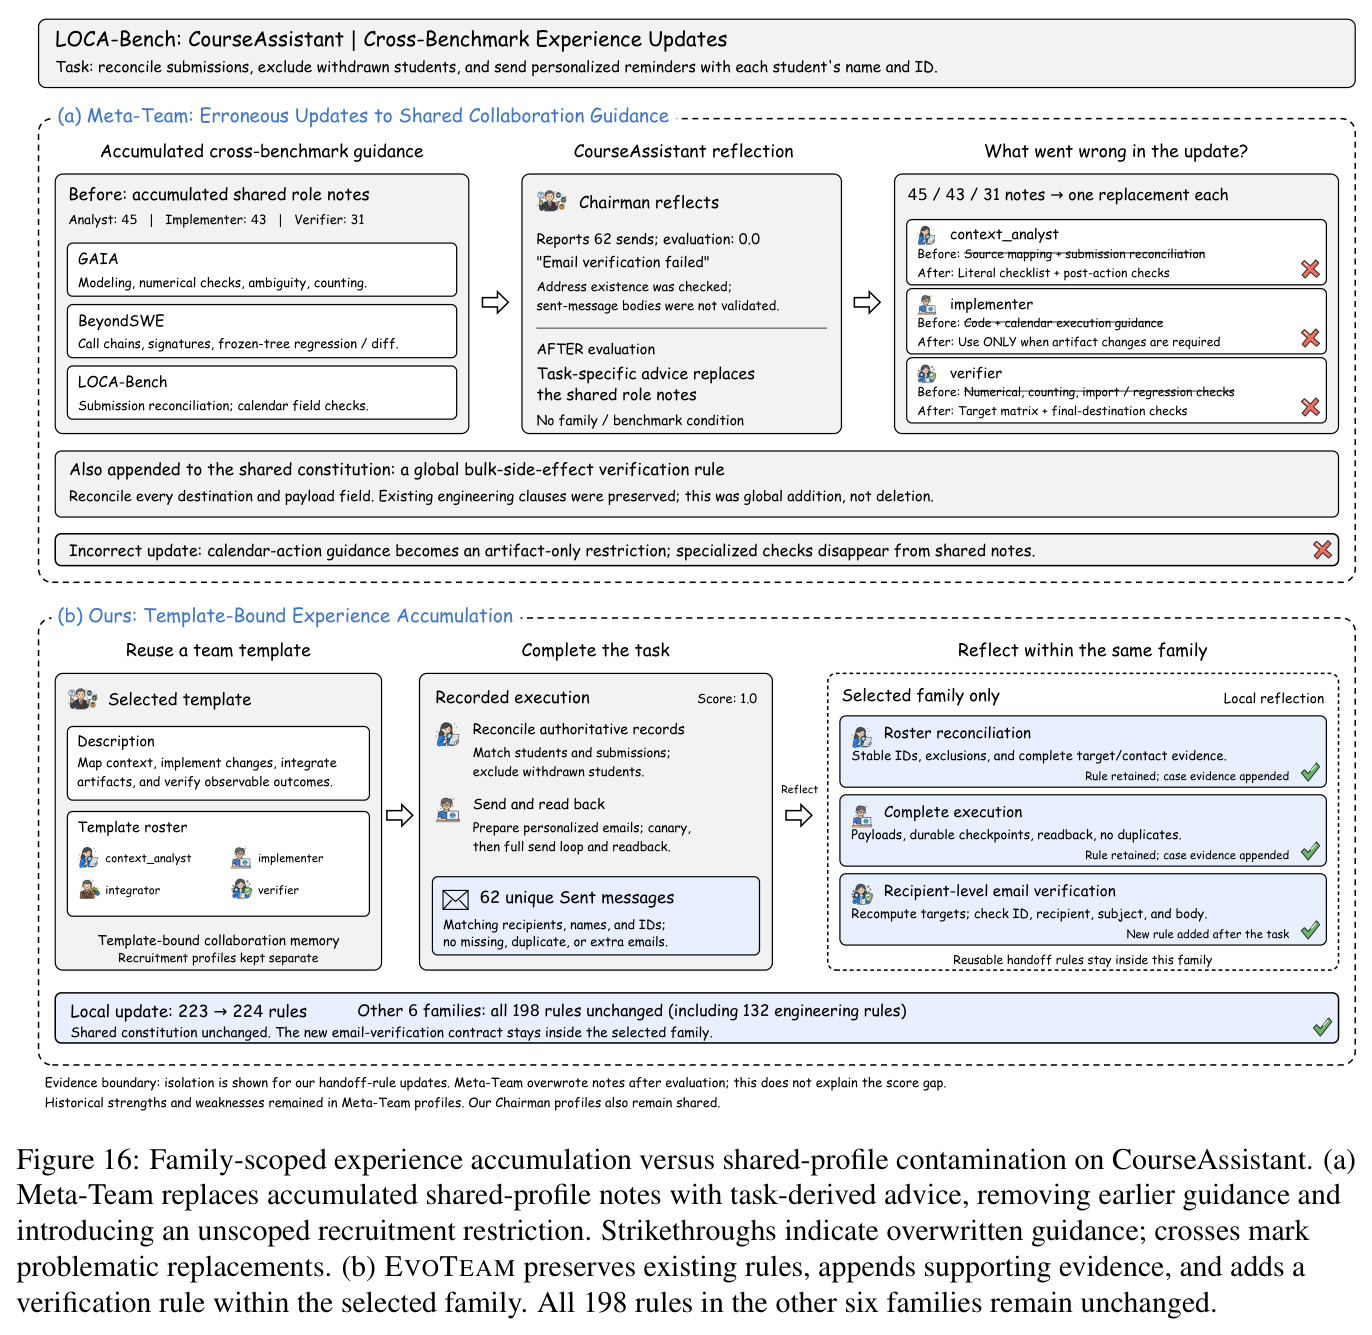
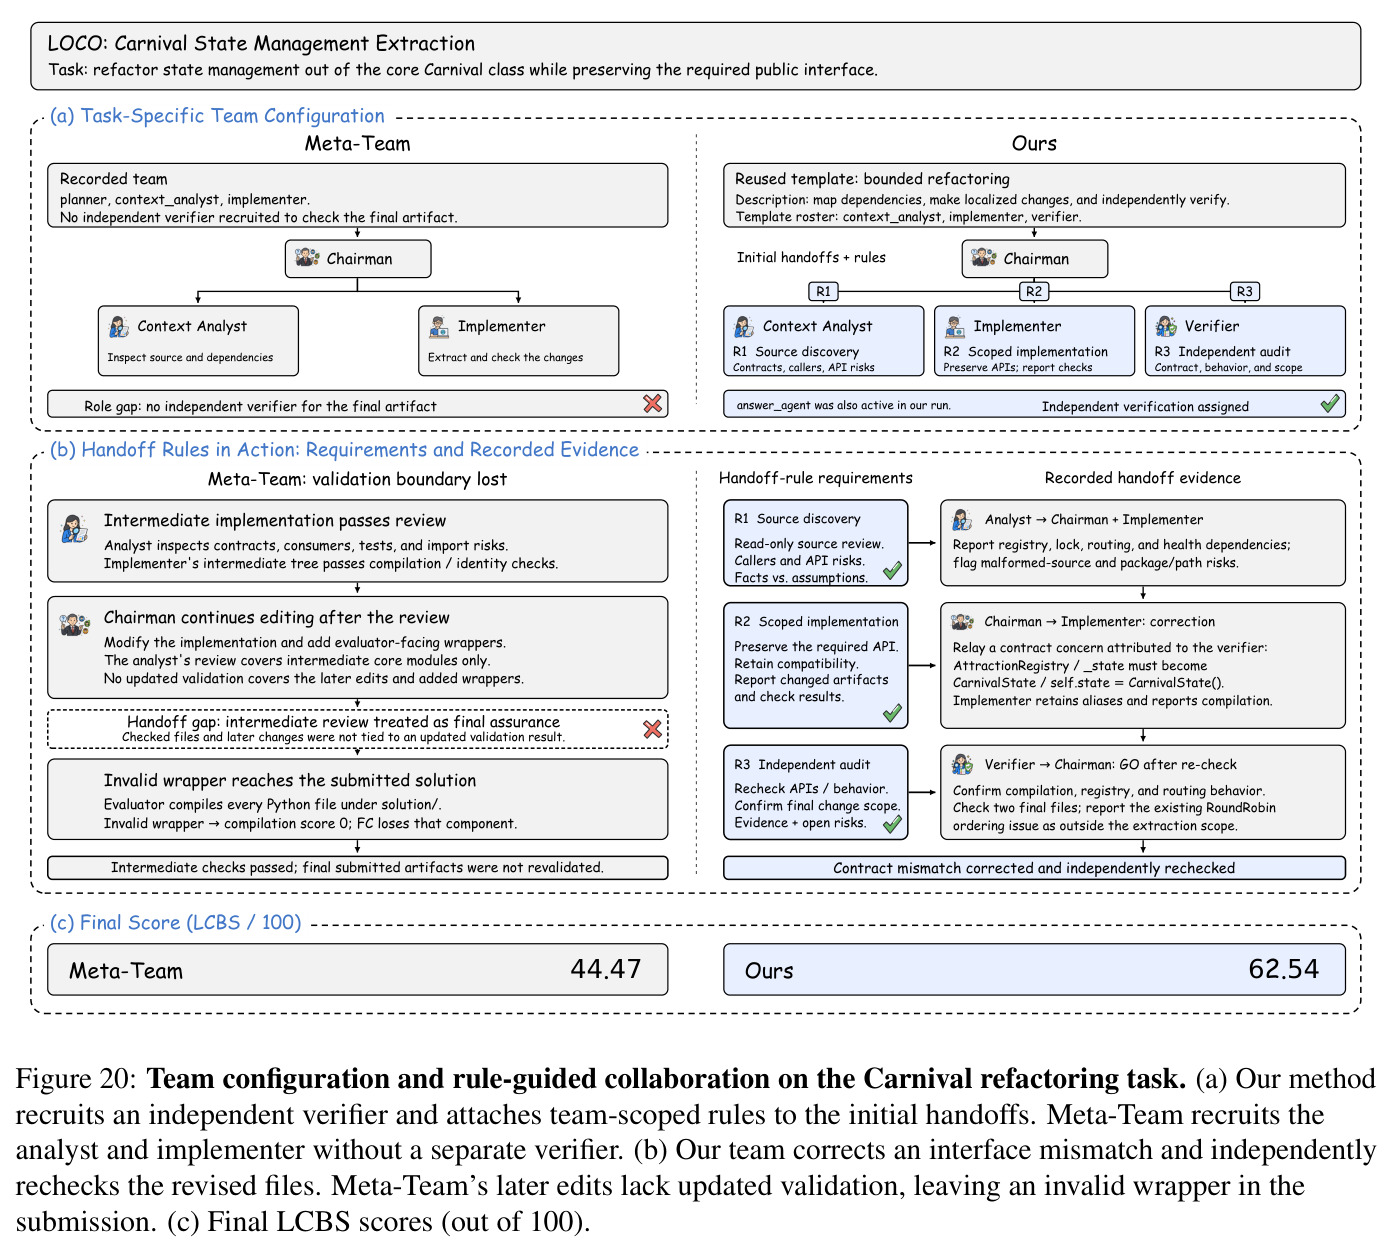
与已有工作不同的是,已有协作层进化方法的共同盲区是“经验的存储与作用域没有和协作结构对齐”:Meta-Team 把跨 benchmark 积累的经验写进所有成员共享的角色 notes,一次任务反思就能用任务专属建议覆盖 45/43/31 条历史积累(Figure 16a 所示的污染案例);Skill-MAS 把编排知识蒸馏进单一的 Meta-Skill;自动化搜索类方法(AgentSquare、ADAS 等)搜索一次后结构固定。EvoTeam 的独特切入是把经验按“团队”索引:协作经验(交互规则)在兼容的团队上下文内积累和隔离更新,个体技能则跟着智能体跨团队流动。同时团队按“协作需求”而非主题相似度或 benchmark 边界组织——不同 benchmark 的任务只要分工模式兼容就可复用同一团队(附录 E.3 中三个不同 benchmark 的 holdout 任务复用同一团队)。这把问题从“进化更好的智能体”重构为“在正确的作用域内进化正确的协作知识”。
核心方法
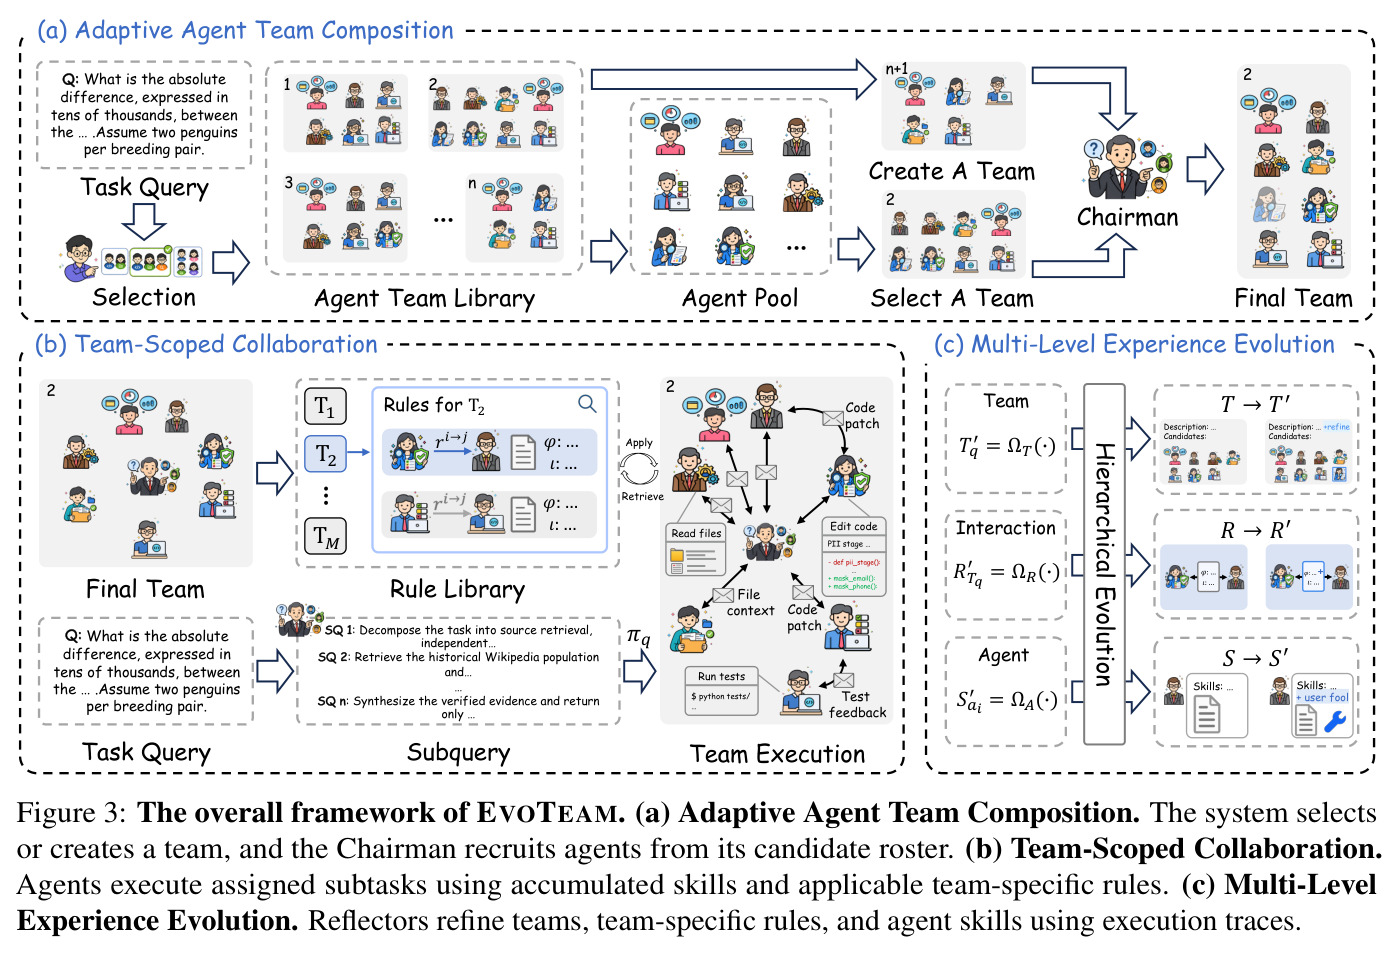
直觉上,EvoTeam 把多智能体系统管理成一个“工程组织”:组织里有一个全局智能体人才池 $\mathcal{A} = \{a_1,\dots,a_N\}$ 和一个可复用团队库 $\mathcal{T} = \{T_1,\dots,T_M\}$,每个团队 $T = \langle d_T, C_T \rangle$ 由协作需求描述 $d_T$ 和候选成员名单 $C_T \subseteq \mathcal{A}$ 定义。每个新任务到来时走三个阶段:(i) 自适应团队组建——LLM 团队选择器 $\Phi_S$ 判断库中是否有团队的描述覆盖当前任务的协作需求,没有则由 Composer $\Phi_C$ 从人才池组建临时团队;(ii) 团队范围内的协作——LLM“主席”Chairman $\Phi_{\mathrm{Chair}}$ 从选中团队的候选名单中招募任务执行团队、分解子任务并分配,执行时该团队积累的交互规则集 $R_{T_q}$ 作为软性协调指导注入各智能体上下文;(iii) 多层经验进化——任务结束后三个反思器分别用综合执行轨迹 $\tau_c = \langle \{\tau_{a_i}\}_{a_i \in E_q}, \tau_t \rangle$ 更新团队($T_q' = \Omega_T$)、该团队专属规则集($R_{T_q}' = \Omega_R$)和个体技能($S_{a_i}' = \Omega_A$)。协作经验只在对应团队内累积,技能则随智能体跨团队复用(Figure 3)。在指定的进化数据流上顺序执行(Algorithm 1),完成后冻结全部持久知识,在互斥的 holdout 集上评估。
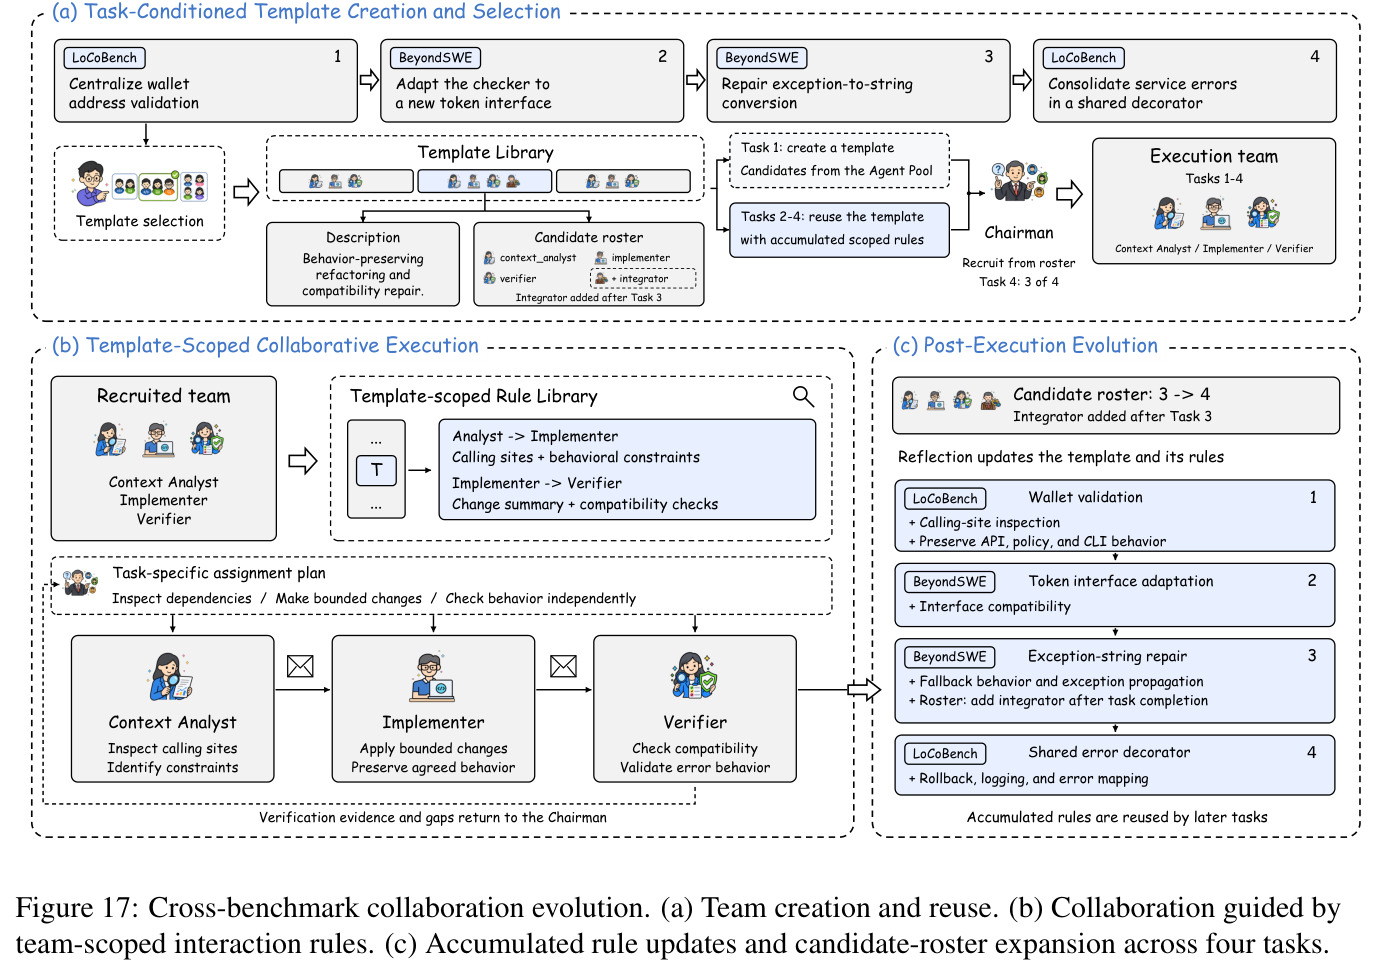
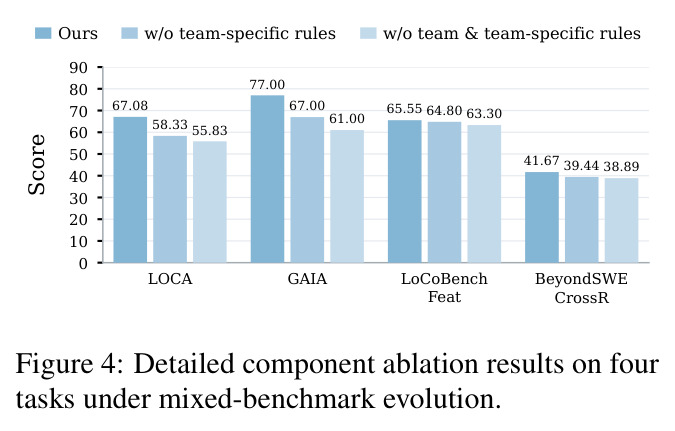
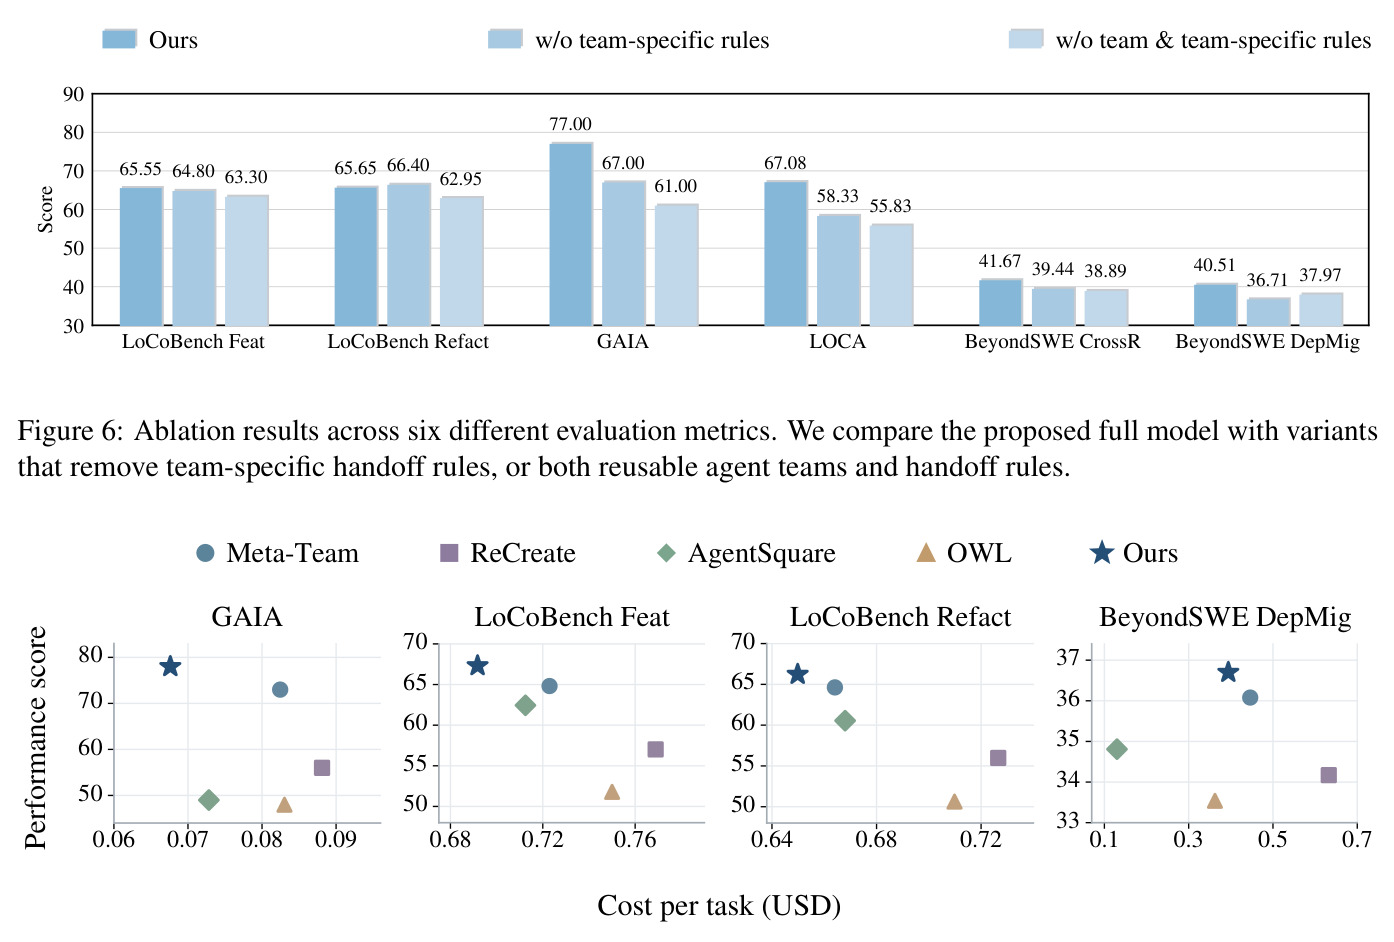
核心创新是“经验作用域管理”这条设计原则:交互规则与团队绑定、按团队隔离进化;个体技能与智能体绑定、跨团队全局复用。这和已有方法的本质区别在于:Meta-Team 等把所有经验写入共享配置(角色 notes、全局 constitution),任何任务的任务性建议都可能污染其他类型任务的历史经验;Skill-MAS 把编排知识压进单一 Meta-Skill;AgentSquare 等则一次性搜索固定结构。EvoTeam 中规则是“信息契约”而非固定工作流——每条规则约束一次有向交接必须携带的信息、证据、来源、不确定性与回退要求,发送方按 sender–recipient 匹配、触发条件、当前信息需求判断适用性,无适用规则就直接沟通而不强行套用。团队也按协作需求而非主题组织(附录 FAQ Q2 明确:主题相似不足以证明可复用),因此 LoCoBench 和 BeyondSWE 的任务可共享同一个“行为保持式重构”团队(Figure 17),而新团队需通过准入审查(名单支持所需分工且组织可复用)才能入库。消融实验证明两个组件各自独立有效:仅保留任务条件化团队就带来收益(GAIA +6.00),叠加团队专属规则收益更大(GAIA +10.00)。
方法步骤详情
完整流程共八步。(1) 团队选择:对查询 $q$,$\Phi_S(q, \mathcal{T})$ 逐一检查每个团队的 $d_T$ 是否覆盖任务的协作模式、所需专业角色与验证需求,返回兼容团队;若库为空或无兼容团队,Composer 构建临时团队 $\tilde{T}_q = \Phi_C(q, \mathcal{A})$ 且规则集置空(公式 (1))。(2) 招募:Chairman 执行 $E_q = \Phi_{\mathrm{Chair}}(q, T_q) \subseteq C_{T_q}$(公式 (2)),按功能需求从候选名单匹配最小充足执行团队。(3) 规划:$(U_q, \pi_q) = \Phi_{\mathrm{Chair}}(q, T_q, E_q)$(公式 (3)),把任务分解为子任务集 $U_q = \{u_1,\dots,u_m\}$ 并按子任务需求与智能体档案分配 $\pi_q: U_q \to E_q$,只定责任不预设交互伙伴;执行中若进展受阻可动态重分配。(4) 协作执行:各智能体携带自身技能集 $S_{a_i}$ 执行子任务,$R_{T_q}$ 注入上下文;每次交接时发送方用规则选择 prompt(附录 D.4)核对触发条件与信息需求,选中规则作为信息契约适配当前任务。(5) 轨迹记录:Chairman 汇总个体轨迹 $\tau_{a_i}$(推理步骤、工具输出、中间产物)与交接轨迹 $\tau_t$(交互事件、传递载荷、所用规则)为 $\tau_c$(公式 (4))。(6) 团队反思:$T_q' = \Omega_T(T_q, \tau_c, q)$(公式 (5))修订候选名单并同步更新描述;新团队按“名单支持分工+组织可复用”决定准入。(7) 规则反思:$R_{T_q}' = \Omega_R(R_{T_q}, \tau_t, q)$(公式 (6))审查交接事件与载荷,对每条有向规则做 create/refine/retire/retire/no_update 决策。(8) 智能体反思:$S_{a_i}' = \Omega_A(a_i, \tau_{a_i}, q, S_{a_i})$(公式 (7))从个体轨迹蒸馏 prompt patch 或带激活条件与验证步骤的技能。进化 split 结束后冻结 $\mathcal{A}$、$\mathcal{T}$ 与规则集用于评估。
技术新颖性
技术新颖性体现在四点。第一,三层并行进化且作用域正交:团队组织(名单+描述)、团队专属规则、个体技能由三个独立反思器同时维护,规则隔离而技能共享,这一“正交性”在已有协作进化工作中没有先例——Meta-Team 只维护共享角色档案,EMAS 用证据引导修订 prompt/拓扑但无团队索引。第二,把“信息契约”作为规则的语义单位:规则约束的是一次交接需要什么信息、证据、验证与回退,而不是执行顺序,配合 Chairman 的动态重分配,避免了规则退化为僵化工作流(FAQ Q3 专门澄清这一点)。第三,团队准入与身份保持机制:新团队需通过反思器审查才入队,已有团队修订时保持身份和规则连续性,使库是“演化的组织记忆”而非快照集合。第四,初步研究给出了可复现的反例证据(Figure 2):同 benchmark 内模板兼容的跨任务进化(Intra-CT)仍然全面劣于 target-only,说明问题不在模板本身而在规则越界复用——这为“按团队隔离规则”提供了直接的实验动机,而不只是直觉论证。
实验结果
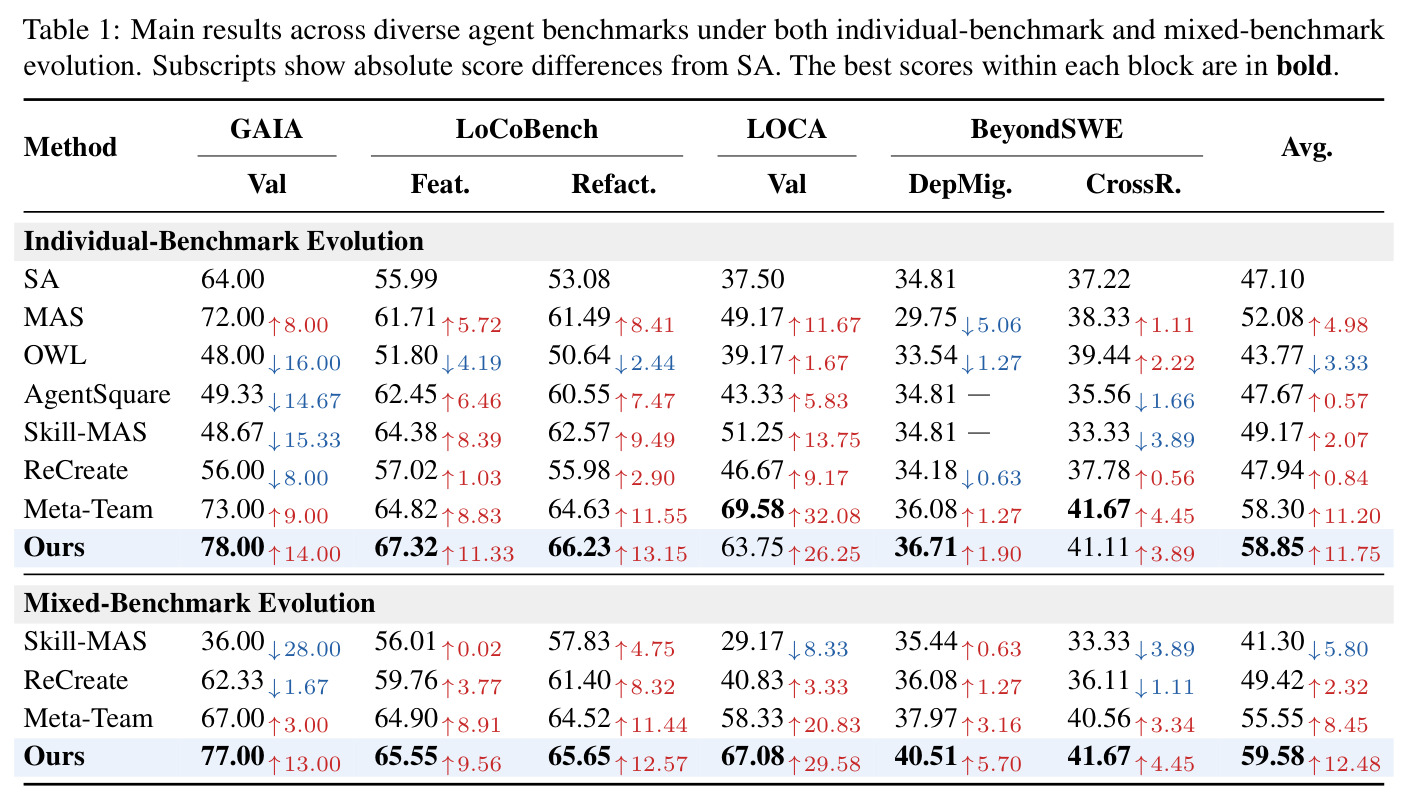
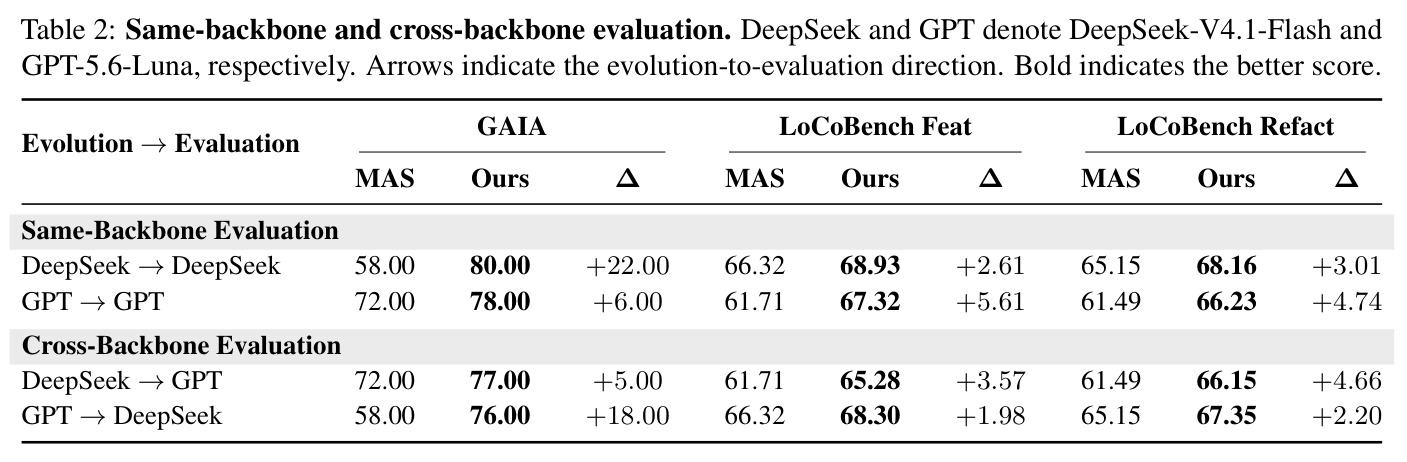
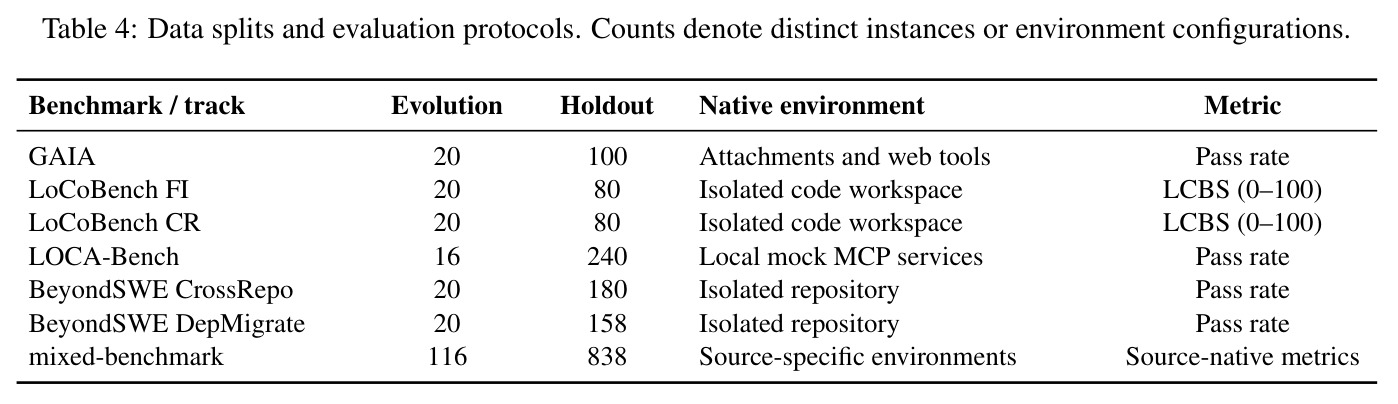
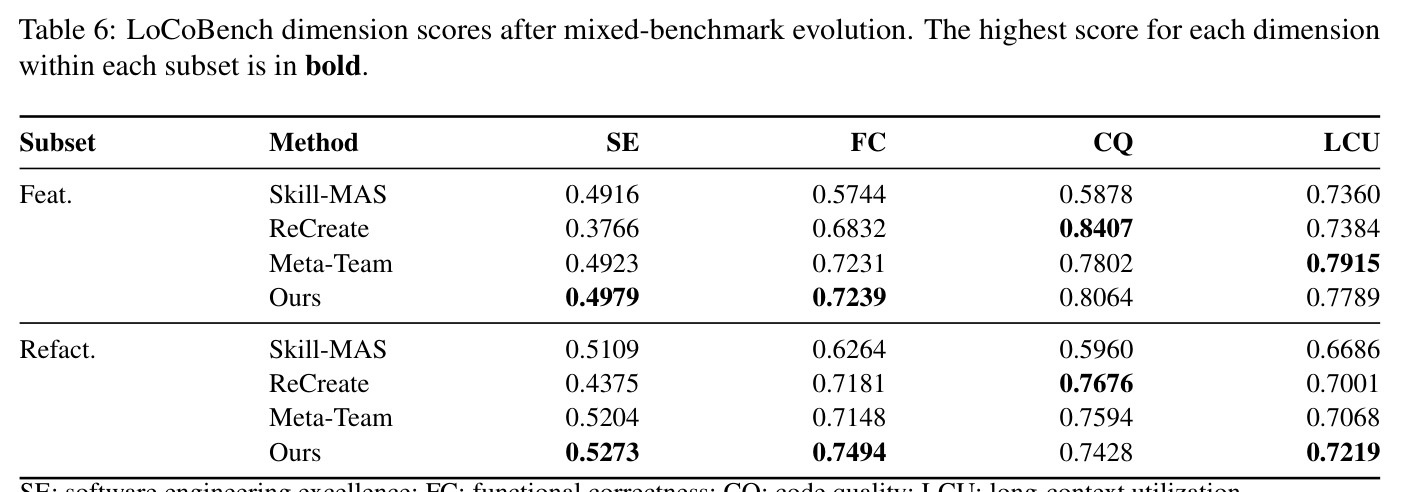
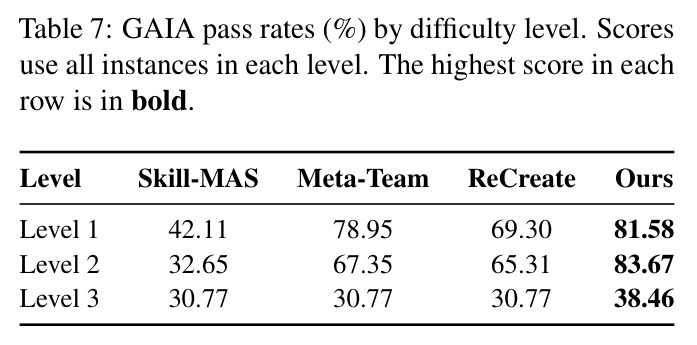
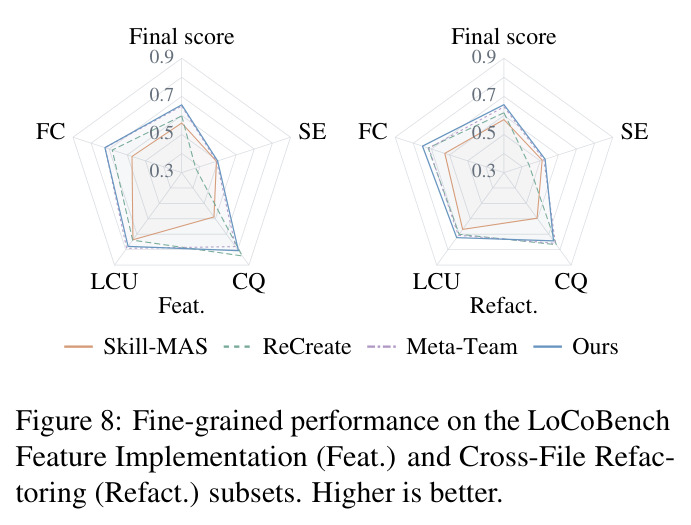
实验覆盖 4 个 benchmark、6 个任务类别,均用 GPT-5.6-Luna、avg@3、进化集与 holdout 集互斥。(1) 总体效果(Table 1):individual-benchmark 进化下 EvoTeam 平均 58.85 分居首,6 项指标中 4 项领先,GAIA 78.00(比最强基线 Meta-Team 的 73.00 高 5 分),并全面超过非进化 MAS 基线;mixed-benchmark 进化下 EvoTeam 全部 6 项指标第一,平均 59.58,领先 Meta-Team(55.55)4.03 分,且比自身 individual 成绩还高(58.85→59.58),而 Meta-Team 反而下降(58.30→55.55),直接支持“规则隔离使异构经验可叠加”。注意例外:individual 设定的 LOCA 上 Meta-Team 69.58 高于 EvoTeam 的 63.75。(2) 跨骨干迁移(Table 2):DeepSeek-V4.1-Flash 与 GPT 双向进化-评估 6 组配置全部优于 MAS 基线,DeepSeek→DeepSeek 的 GAIA 提升 +22.00(58→80),GPT→DeepSeek +18.00(58→76);所有跨骨干成绩与同骨干差距不超过 4.00 分(GAIA 77.00 vs 78.00),说明团队索引的经验对底座更换鲁棒。(3) 消融(Figure 4/6):去掉团队专属规则,GAIA 掉 10.00 分(77→67)、LOCA 掉 8.75 分(67.08→58.33);再去掉任务条件化团队,GAIA 只剩 61.00;完整版在 6 项中 5 项最佳,例外是 LoCoBench Refact 去规则反而 66.40>65.65、BeyondSWE DepMig 去全部组件 37.97>仅去规则的 36.71。(4) GAIA 难度分层(Table 7):L1 81.58 / L2 83.67 / L3 38.46,对 Meta-Team 分别 +2.63、+16.32、+7.69,收益最大在 L2,但 L3 所有方法都低于 39,说明最难题仍是瓶颈。(5) LoCoBench 维度(Table 6):Refact 上 SE 0.5273、FC 0.7494(Meta-Team 0.7148)、LCU 0.7219 均第一,但 CQ 0.7428 低于 ReCreate;Feat 上 SE/FC 最高而 CQ、LCU 分别输给 ReCreate(0.8407)和 Meta-Team(0.7915)。(6) 成本(Figure 5/7):GAIA 与 BeyondSWE DepMig 上 EvoTeam 分数最高且单任务成本低于 Meta-Team 与 ReCreate;Skill-MAS 更便宜但分数明显更低,EvoTeam 位于性能-成本前沿。(7) 案例:CourseAssistant(Figure 16)Meta-Team 因覆盖共享 notes 得 0.0 而 EvoTeam 得 1.0,且 EvoTeam 仅在选中 family 内 223→224 条规则,其余 6 个 family 的 198 条不变;Carnival 重构(Figure 20)EvoTeam 62.54 vs Meta-Team 44.47,后者因缺独立 verifier、后续修改未复检而提交了编译失败的 wrapper。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GAIA(mixed-benchmark 进化) | 答案准确率 (%) | 77.00 | Meta-Team 67.00 / MAS 基线 64.00(SA 64.00 系 individual 设定值) | +10.00(对 Meta-Team) |
| GAIA(individual-benchmark 进化) | 答案准确率 (%) | 78.00 | Meta-Team 73.00,MAS 72.00,SA 64.00 | +5.00(对 Meta-Team),+14.00(对 SA) |
| LoCoBench Feature Implementation | LCBS(0–100) | 67.32(individual)/ 65.55(mixed) | Meta-Team 64.82 / 64.90 | +2.50 / +0.65 |
| LoCoBench Cross-File Refactoring | LCBS(0–100) | 66.23(individual)/ 65.65(mixed) | Meta-Team 64.63 / 64.52,SA 53.08 | +1.60 / +1.13 |
| LOCA-Bench(mixed-benchmark) | 最终状态成功率 (%) | 67.08 | Meta-Team 58.33 | +8.75 |
| BeyondSWE DepMigrate(mixed-benchmark) | 解决率 (%)(F2P 全过且 P2P 不回归) | 40.51 | Meta-Team 37.97,Skill-MAS 35.44 | +2.54 |
| 六指标平均(mixed-benchmark) | 平均分 | 59.58 | Meta-Team 55.55,ReCreate 49.42,Skill-MAS 41.30 | +4.03 |
| GAIA(DeepSeek→DeepSeek 同骨干) | 答案准确率 (%) | 80.00 | MAS 58.00 | +22.00 |
| GAIA Level 2 难度(mixed) | 通过率 (%) | 83.67 | Meta-Team 67.35 | +16.32 |
| Carnival 重构任务(案例 E.4) | LCBS(0–100) | 62.54 | Meta-Team 44.47 | +18.07 |
局限与改进
作者明确承认两点:(1) 未系统考察多模态交互环境下的协作进化——此类环境中智能体需解读视觉观察、沟通证据并随环境变化协调行动,多模态执行轨迹如何指导团队/规则/技能精炼仍是开放问题;(2) 经验通过显式文本更新积累而模型参数冻结,其效果完全依赖底座模型正确理解和应用存储的指导,未与模型适配(微调)结合。我自己观察到的问题:第一,individual 设定的 LOCA 上 EvoTeam(63.75)落后 Meta-Team(69.58)5.83 分,说明团队选择与规则机制并非对所有任务类型都有利,论文未深入分析这一反例;第二,进化集极小(GAIA 仅 20 条、LOCA 仅 16 条),收益可能部分来自对 benchmark 分布的拟合,缺少跨域泛化验证;第三,团队兼容性判断完全交给 LLM 主观评估“描述是否覆盖协作需求”,误判会导致错误复用或不必要的新建团队,且规则库大小、团队库规模 $M$ 的增长动态与选择成本未被系统报告;第四,消融中有两处反向结果(Refact 去规则更好、DepMig 去全部组件更好),提示规则在某些编码任务上可能是噪声源,但作者仅一笔带过;第五,反思发生在评估之后(案例 E.1 也承认隔离性论证不构成分数差距的因果解释),三层更新的贡献缺乏细粒度归因。
独立分析的弱点
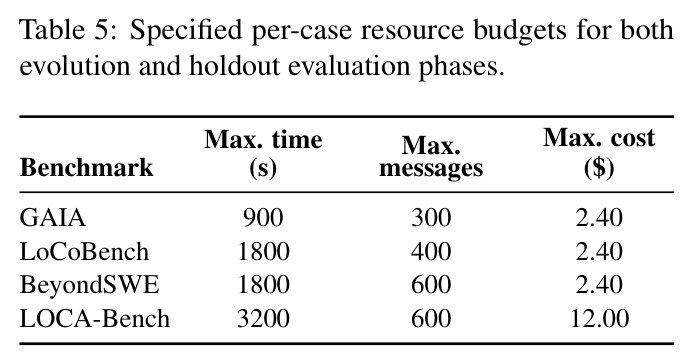
弱点一:团队/规则兼容性判断是纯 LLM 主观决策。选择器靠阅读 $d_T$ 判断覆盖度,无任何量化校准;当库增长到几十个团队时,长上下文比较易出错。改进方向:为团队描述引入嵌入检索做粗筛,再用校准过的兼容性打分器(甚至小模型)做精判,并对误选做事后统计。弱点二:规则库无界增长与冲突风险。每条任务都可能 create/refine 规则,同一 sender–recipient 对可有多条不同触发条件的规则,长期运行后检索负担和互相冲突的概率上升。改进方向:引入周期性合并/修剪(基于使用频次与通过率)、规则依赖图与一致性检查,参考 ACE 的增量 curated playbook 思路。弱点三:小进化集易过拟合。GAIA 20 条、LOCA 16 条的任务流很难覆盖真实协作需求分布,表 1 的 mixed 收益可能高估了部署场景表现。改进方向:扩大并轮换任务流、报告对完全未见领域的零样本迁移。弱点四:缺乏更新的因果归因。反思基于文本证据决定 create/refine,但不知道某条规则改动到底贡献了多少分。改进方向:对候选更新做小规模 A/B 重放或反事实评估(类似 EviSkill 的 replayable evidence 思路),只接受有量化证据的更新。弱点五:成本与延迟。每个反思器都要调用强模型,单任务预算上限 $2.40–12.00,mixed 进化需 116 个任务串行处理。改进方向:用蒸馏的小模型承担反思/选择,强模型只做执行;或异步化反思流程。弱点六:安全与污染。持续积累的规则和技能若被恶意任务注入(参照文中引用的 SkillPoison 攻击面),会持久影响后续所有复用该团队的任务。改进方向:为规则更新增加来源审计与回滚机制。
未来方向
作者提出的方向:(1) 扩展到多模态交互环境,研究视觉观察与动作轨迹如何指导团队组织、交互规则与技能的精炼;(2) 将显式经验复用与模型适配结合,把高频有用的协调实践内化进参数,而不只依赖底座模型读取文本指导。基于本文成果可以自然延伸的方向:(3) 团队库的组织结构——目前是扁平集合,可引入层次化组织(团队族/能力图谱)与自动合并,降低选择成本;(4) 把团队选择形式化为可学习的策略(如用强化学习或 bandit 优化“选队-招募-分配”链路),替代纯 prompt 决策;(5) 跨系统共享的“团队经验市场”:团队描述+规则集作为可移植工件在不同组织间迁移,需配套安全审计(防 SkillPoison 类污染);(6) 反思的因果化:结合反事实重放为每条规则维护量化收益档案,实现证据引导的规则演进;(7) 动态环境下的在线适应——目前进化在评估前冻结,可探索持续学习设定下“进化-评估”边界的放松与遗忘机制;(8) 对规则隔离的形式化分析:什么样的协作需求相似度度量能保证规则安全复用,这可以给出可检验的理论保证。
复现评估
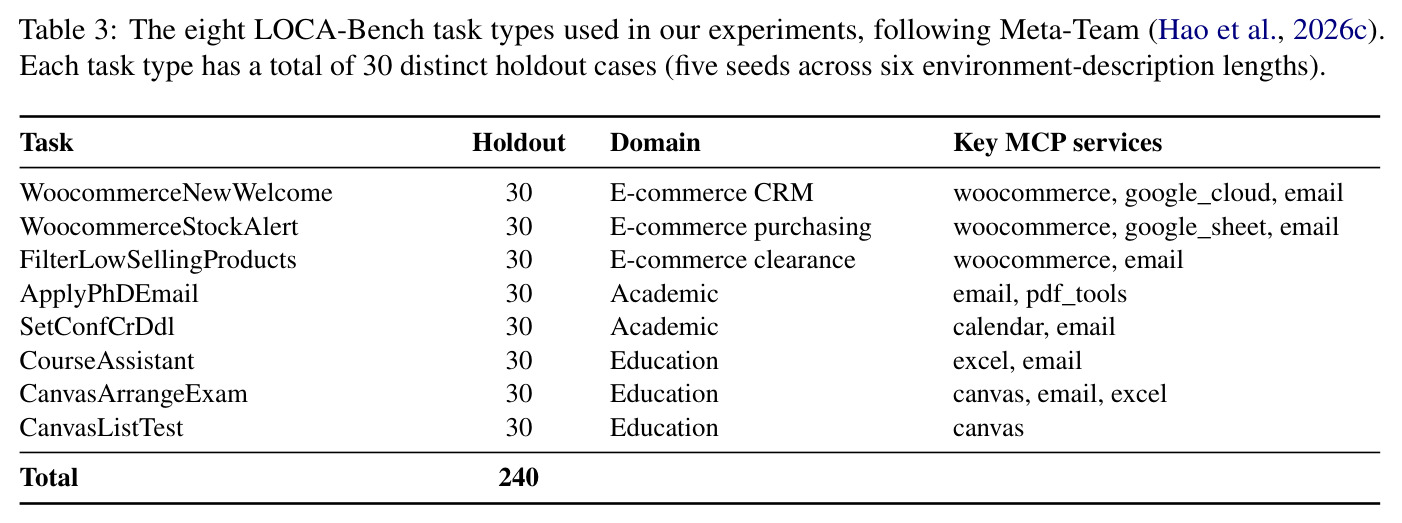
复现条件总体较好但成本不低。开源情况:代码在 GitHub(DEEP-JLU/EvoTeam)公开;附录 D 完整给出 7 个核心 prompt(团队选择、冷启动组建、Chairman 协调、规则选择与使用、团队反思、规则反思、智能体反思),附录 B 给出全部数据划分、指标定义与资源预算,附录 A 给出算法伪代码,透明度高。数据:四个 benchmark 均公开(GAIA 120 条 validation 子集、LoCoBench FI/CR 各 100 条、LOCA-Bench 8 任务类型、BeyondSWE CrossRepo/DepMigrate),划分与 Meta-Team 对齐并固定随机种子(mixed 流用 seed 20260828),LOCA 需自建本地 mock MCP 服务,BeyondSWE 需隔离的仓库执行环境(Docker)。算力与费用:无训练,但推理成本显著——单任务预算上限 GAIA/LoCoBench/BeyondSWE 为 $2.40、LOCA 为 $12.00,且评测用 avg@3;mixed 进化需串行处理 116 个任务加 838 个 holdout 评估,主力模型 GPT-5.6-Luna 与 DeepSeek-V4.1-Flash 均需 API。综合难度评级:中等偏高——工程上需要实现三阶段编排与三个反思器的完整流水线,经济上需要数百美元量级的 API 预算;有了官方代码和 prompt 后主要风险在于复现 LLM 行为的随机性与弱底座模型下效果缩水(Table 2 显示底座对绝对分数影响很大)。
论文图表
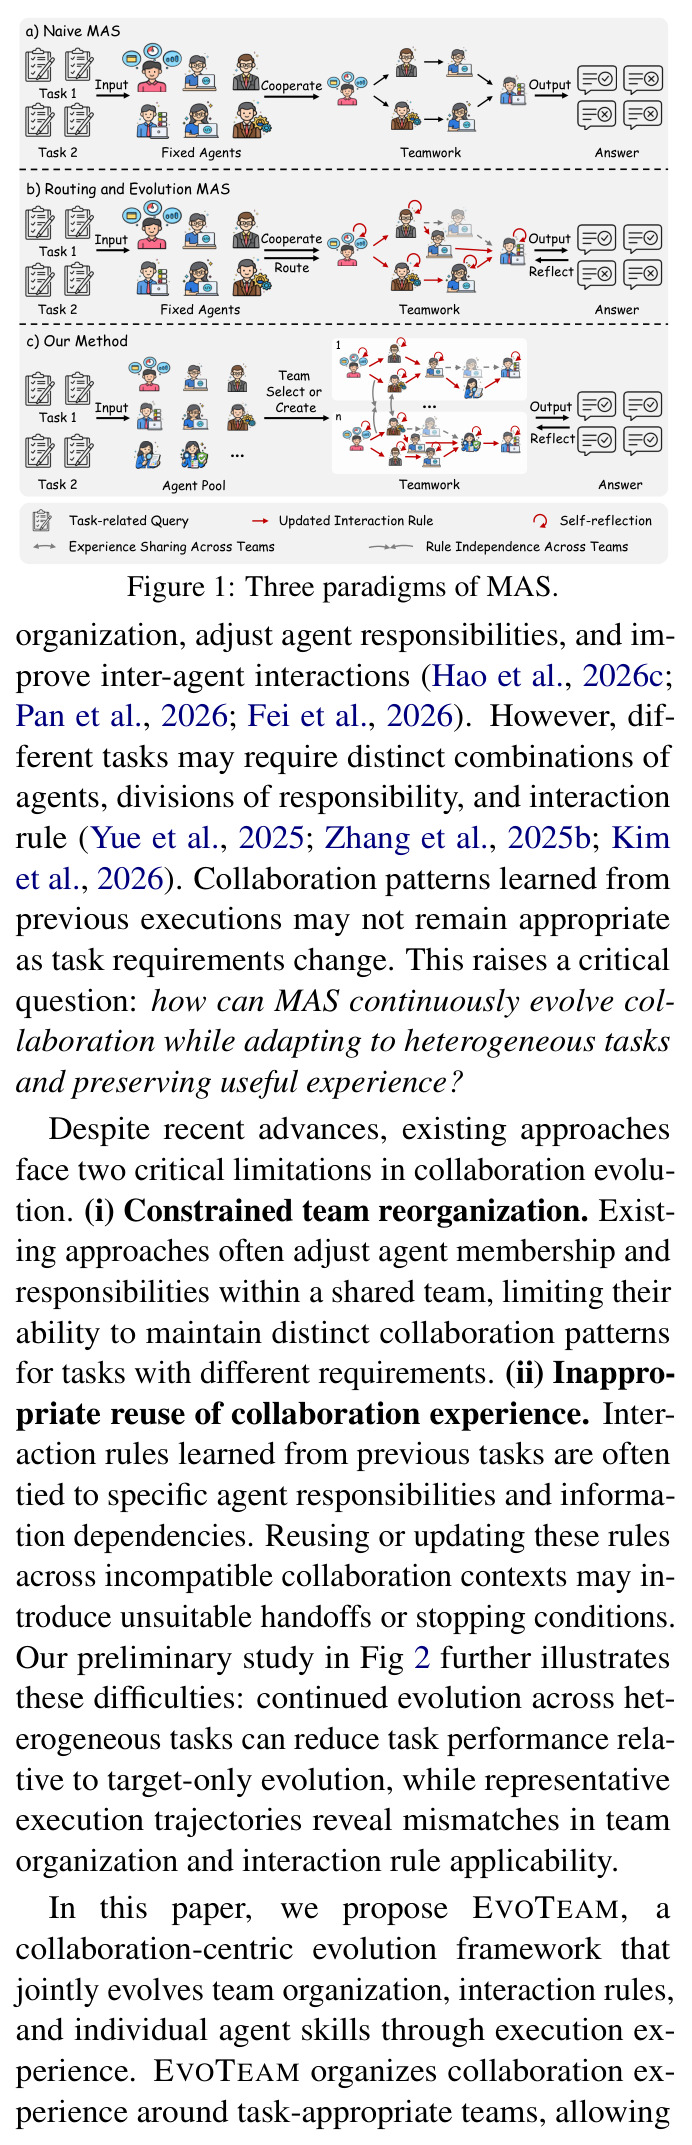
对比三种 MAS 范式:(a) 朴素 MAS——固定智能体直接协作;(b) 路由与进化 MAS——固定智能体池,通过反思更新交互但结构单一;(c) 本文方法——从智能体池中选择或创建团队,团队间共享经验但规则按团队独立更新。
一图定位 EvoTeam 在 MAS 研究谱系中的位置:与前两代范式的本质差异是引入了“团队”这一组织层和经验的作用域分离。
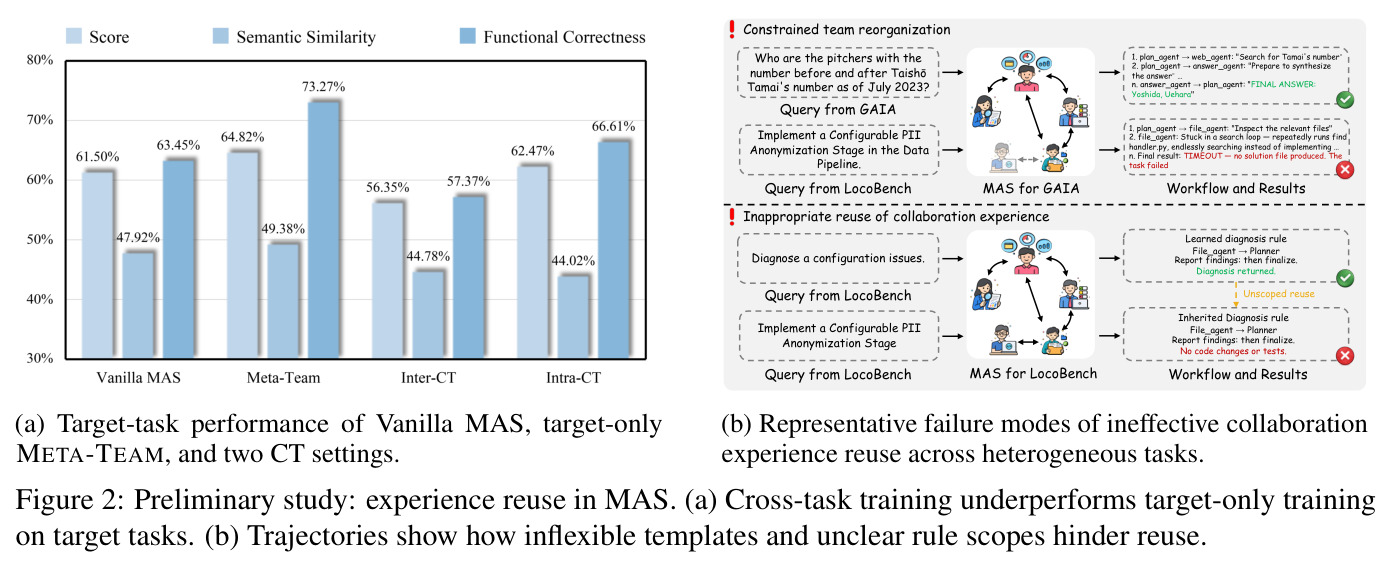
(a) 柱状图比较 Vanilla MAS、target-only Meta-Team 与两种跨任务进化(Inter-CT/Intra-CT)的目标任务性能,两种 CT 设定全面落后;(b) 两条真实轨迹分别展示 GAIA 团队做 LocoBench 任务时陷入搜索循环直至 TIMEOUT,以及诊断型规则被复用到实现任务导致在编码前就 FINAL ANSWER 终止。
这是全文的实证动机:证明“跨任务经验复用可能有害”并非直觉推测,直接引出团队重组自由与规则作用域两大设计原则。
以单任务成本为横轴、性能为纵轴比较 Meta-Team、ReCreate、Skill-MAS 与 EvoTeam:EvoTeam 在两个任务上分数最高且成本低于 Meta-Team 与 ReCreate;Skill-MAS 成本最低但分数明显更低。
证明团队范围的协作复用不仅提分还省成本,方法处于性能-成本前沿,是实用性论证的关键。
individual 设定下五个方法在 GAIA、LoCoBench Feat/Refact、BeyondSWE DepMig 上的成本-性能散点:EvoTeam 在 GAIA 与两个 LoCoBench 任务上以最低成本取得最高分;BeyondSWE 上 AgentSquare 和 OWL 更便宜但分数更低。
与 Figure 5 互补,验证成本优势在不同进化设定下均成立。
团队选择 prompt:根据任务的协作模式、专业角色与验证需求匹配团队库,明确“主题相似不足以复用”,不适配时输出冷启动与临时团队描述,且此阶段不招募成员。
体现“按协作需求而非主题组织团队”这一关键设计如何落地为具体指令。
冷启动组建 prompt:从公共智能体池为临时团队选择覆盖所需能力的候选名单,不发明智能体、不预设工作流和交互规则,招募与分工留给 Chairman。
说明候选名单与执行团队的解耦:名单定“可用的人”,任务级招募另做,这是降低不必要参与和 token 消耗的机制。
Chairman prompt:招募最小充足团队、分配互补且可验证的工作、审查返回结果并调解冲突、受阻时重新分配;明确不得因一次失败推断成员能力缺陷。
Chairman 是团队模板的“实例化者”,该 prompt 定义了规划与动态重分配的行为边界。
规则选择 prompt:要求发送方核对规则的发送者-接收者对、触发条件与信息转移需求是否匹配,多规则适用时选最具体的;无适用规则选 NONE 直接沟通;把规则用作信息契约而非固定工作流。
展示“软协调指导”的实现细节,是理解规则为何不会退化成僵硬流程的关键。
团队反思 prompt:基于执行证据决定 create/refine/retain/no_update;要求区分团队结构问题与执行/交互/环境故障,不得因单次失败修改团队;描述只编码可复用协作模式而不含任务专属内容。
揭示团队进化的证据标准与防误伤规则,是库质量保证的核心。
规则反思 prompt:每条规则限定为团队内有向的发送者-接收者契约,基于交接观察与结果决定 create/refine/retain/retire/no_update,要求把任务细节转写为可复用的信息、证据、来源、不确定性、验证与回退要求。
定义了规则“信息契约”语义的具体形式,是规则隔离进化机制的执行单元。
智能体反思 prompt:区分短期行为指令(prompt patch)与可复用过程(skill,含激活条件、步骤与验证);禁止把一次性答案、任务专属事实、团队/基础设施故障存为可复用改进;要求最小充分修改。
说明技能层为何能跨团队安全复用:存储时已剥离任务语境并限定适用条件。
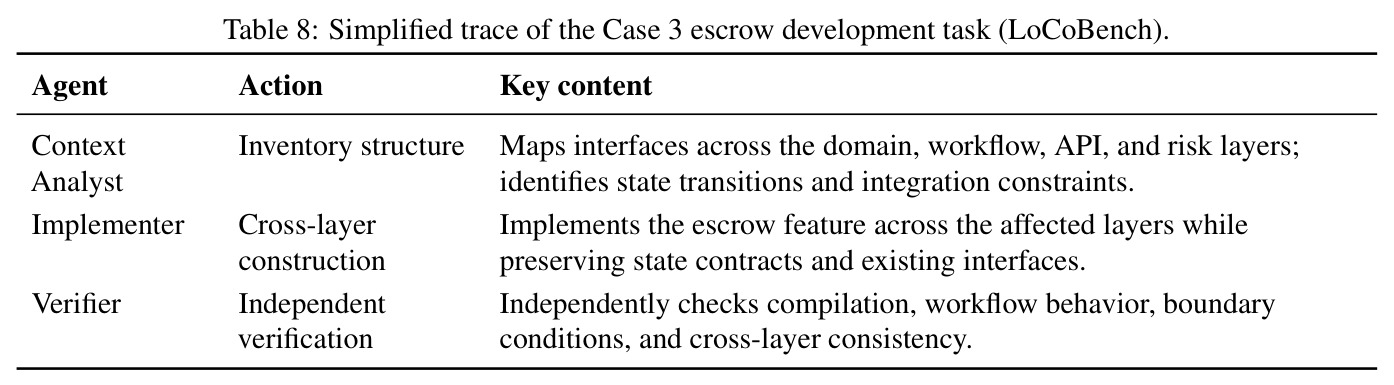
展示一条实际学到的团队专属规则全文:适用范围(跨组件、需一致接口与状态迁移的特性)、交接要求(verifier 接收接口清单与改动摘要)、验证责任(独立核对编译/工作流/边界条件)、必需证据(审查组件、执行的测试、结果与未解决缺口)以及依赖不可用时的处理。
让读者看到“信息契约”的真实粒度——这不是工作流步骤,而是带验证与证据要求的交接合同。
案例 3 中被三个不同 benchmark 的 holdout 任务复用的团队:描述为“仓库锚定的构建与验证协作”,含上下文分析师、实现者、集成者、验证者四个候选成员,并说明适用于多界面软件变更而非孤立编辑。
证明团队库的跨 benchmark 复用能力:三个来源不同的任务因协作模式相同而选中同一团队。