用JEPA证明并改进柏拉图表征假说 Proving and Improving the Platonic Representation Hypothesis with JEPAs
证明好视角让各模态JEPA学到相差一个旋转的同一表征,且比next-token高效42倍
前置知识
JEPA(联合嵌入预测架构)
一类自监督目标:对同一内容的两个视图分别编码,要求从一个视图的嵌入预测另一个(本文中预测器取恒等,直接比较两个嵌入),并配合只依赖嵌入分布的防坍缩项 $\Omega$(如白化约束、VICReg、Barlow Twins 的白化极限、LeJEPA 的 SIGReg)防止所有嵌入塌缩成常数。I-JEPA、V-JEPA 是其视觉实例。
本文定理刻画的对象正是“白化二阶防坍缩的 JEPA”,所有实验中的文本/图像编码器都用 LeJEPA 目标训练,读懂理论与实验必须先熟悉该目标的形状。
柏拉图表征假说(PRH)
Huh 等人(ICML 2024)提出的猜想:不同模态、不同目标训练的模型随规模增长会收敛到同一个共享的“世界统计模型”,证据是视觉与语言大模型嵌入空间的相似度随规模上升。原文只有观察和一个理想化对比学习论证,没有证明,也没有何时成立、如何改进的配方。
本文的全部目的就是把这一假说升级为定理并加以改进,理解 PRH 的原始表述与证据才知道论文问题的出发点。
正样本对与好/坏视角(good/bad views)
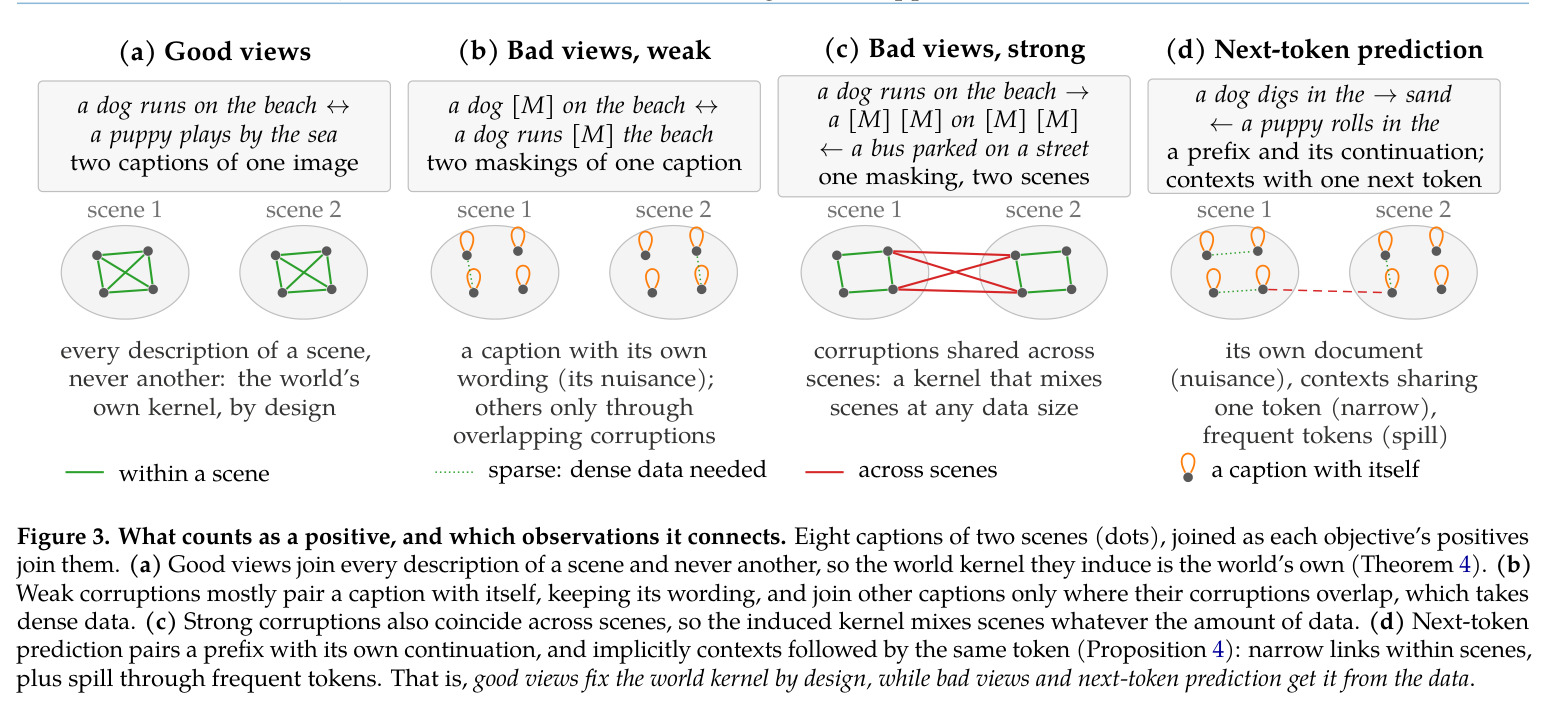
自监督目标中声明“互为视图”的输入对。本文区分:good views 是同一场景的两个独立观测(同一照片的两条描述、同一段视频的两帧),共享的只有世界状态本身;bad views 是同一观测的两个破坏(同图两裁剪、同句两掩码),还会共享措辞、视角、光照等模态特有 nuisance。
好坏视角的区分是全文的核心概念,四个定理与全部实验分组都围绕它展开,是理解“为何 next-token 对齐差”的钥匙。
谱嵌入与拉普拉斯特征映射
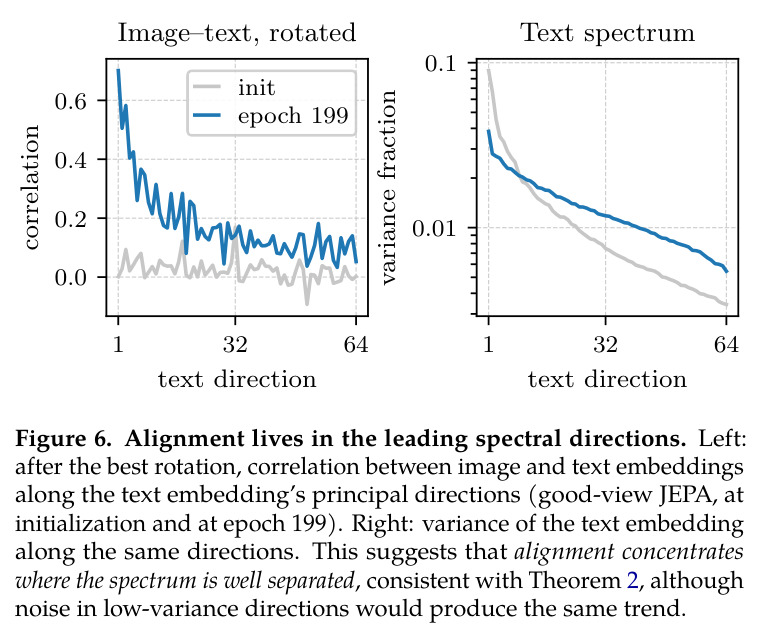
正样本分布在世界状态上画出一张图,其归一化邻接矩阵 $K_\pi = D^{-1/2}\Pi D^{-1/2}$ 的前 k 个特征向量除以 $\sqrt{p(z)}$ 构成谱嵌入;白化二阶 JEPA 的总体最优解恰是它(Proposition 1),目标最小值为 $2\sum_{i=1}^k(1-\mu_i)$,谱隙 $\delta=\mu_k-\mu_{k+1}$ 保证解唯一到旋转。
定理 1 的“唯一到旋转”、定理 2 的错配上界、图 6 的谱方向分析全部用这套谱语言表达,没有它就无法读懂证明。
正交 Procrustes 对齐
给定两组对应嵌入 $\{a_i\},\{b_i\}$,求 $R=\arg\min_{R\in O(k)}\sum_i\|a_i-Rb_i\|^2$。若两个空间只差一个旋转,则残差为 0。本文用 1k 或 30k 图文对拟合这一个旋转,再做检索评测;Proposition 2 还证明 k 对样本即可唯一确定它,而未配对数据的前两阶矩不行。
论文几乎所有检索类指标(R@1/R@5)都建立在“拟合一个旋转”之上,这是“相差一个旋转相等”的可操作检验。
评测指标:mutual 10-NN、CIDEr、FOSCTTM
mutual 10-NN 比较两个嵌入空间中最近邻集合的重叠,不拟合任何参数,是 PRH 论文的标准协议(chance 10/N);CIDEr 是图像描述生成的共识评分(n-gram TF-IDF 加权),常以 0-1 或乘 100 报告;FOSCTTM 衡量免配对对齐中真配对排在前面的比例(0 完美,0.5 随机)。
三大类结果(几何对齐、免训练描述、免配对对齐)分别用这三个指标衡量,读实验表必须知道它们的含义与随机水平。
研究动机
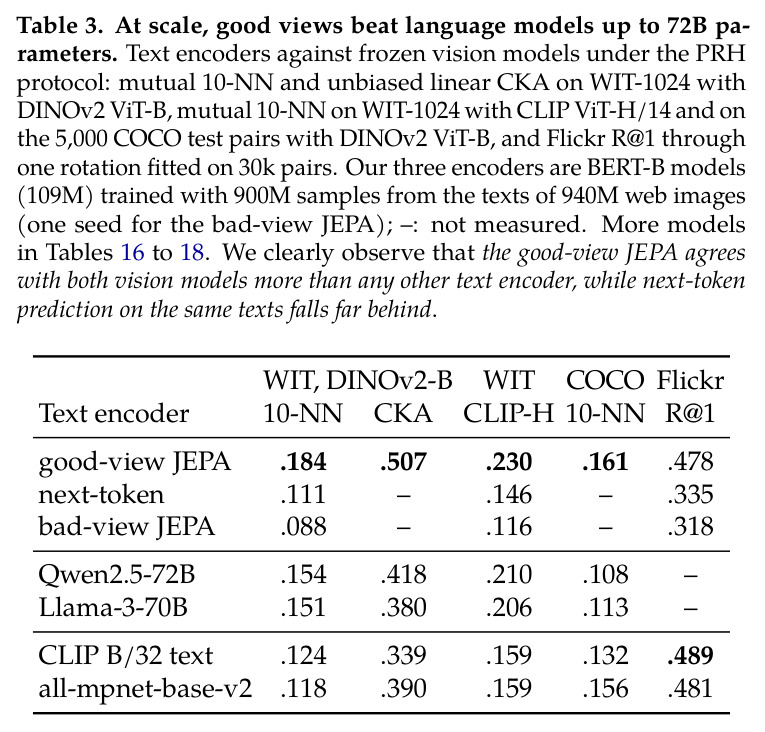
柏拉图表征假说(Huh et al., ICML 2024)观察到视觉与语言模型的表征随规模增大越来越相似,于是猜想它们正收敛到同一个“世界统计模型”。但这始终只是一个观察:其支持论证是一个理想化的对比学习者(kernel 收敛到共现世界事件的逐点互信息),已知最接近的证明只覆盖 SGD 训练的深度线性网络。没有定理,就无法预测假说何时成立,也没有改进配方,社区唯一的杠杆是堆数据与参数——而语言模型在这条路上效率很差:在 PRH 论文的 WIT-1024 基准上,与 DINOv2 的 mutual 10-NN 即便 Qwen2.5-72B 也只有 .154、Llama-3-70B .151,且都是在 15-18 万亿 token 上训练出来的。深层原因是 next-token prediction 的正样本是文档内的前缀与续写,天然携带作者措辞等模态特有 nuisance,这被怀疑是“语言模型只能靠规模与视觉对齐”的原因,但此前无人将其形式化,更没有可证明的充分条件来指导训练。
本文的目标是本文的具体目标是把柏拉图表征假说从观察升级为定理,并把它变成可操作的工具,分三层。理论层:在理想化设定(有限世界、单射渲染、总体最优、解唯一到旋转)下,给出“分别在不同模态上训练的模型何时可证学到同一表征”的充分条件,并在条件不满足时给出错配的定量上界。实证层:在完全受控的实验中验证理论——相同数据、相同编码器、相同训练步数,只改变正样本对的构造方式——并拟合一个能在训练前预测对齐结果的缩放律。应用层:利用“相差一个旋转即相等”的性质,做出除一个旋转外完全不训练图文对的图像描述器,以及完全不用配对样本的跨模态对齐,并证明基于 good views 的 1.09 亿参数文本编码器能在对齐上战胜 720 亿参数的语言模型。
与已有工作不同的是,本文的独特切入是把 PRH 的成立条件从“规模”换成“正样本对的结构”。作者将 JEPA 的正样本分为 good views(同一场景的两个观测)与 bad views(同一观测的两个破坏),证明前者使编码器学到世界自身的谱嵌入——各模态解相差一个旋转(Theorem 1),后者使编码器把嵌入维度花在模态特有 nuisance 上,任何旋转都无法对齐(Theorem 3)。在此框架下,next-token prediction 首次被形式化为一种 bad-view JEPA:正样本是文档内的前缀与续写,防坍缩项是 softmax 的 log-partition(Proposition 4),这为“LLM 只能靠规模对齐”提供了机理解释。与 Huh et al. 依赖双射观测与共现正样本的理想化论证不同,本文定理适用于任意数量、任意模态(图像、文本、视频、音频、动作),并配有错配定量上界(Theorem 2)与可直接测量的 nuisance 占用指标。
核心方法
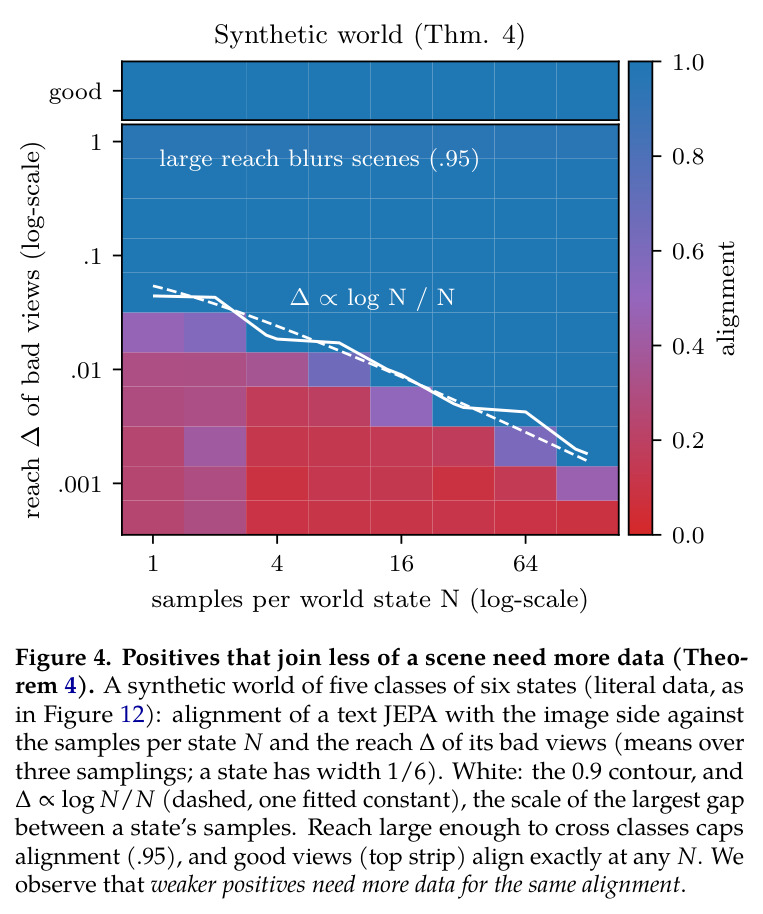
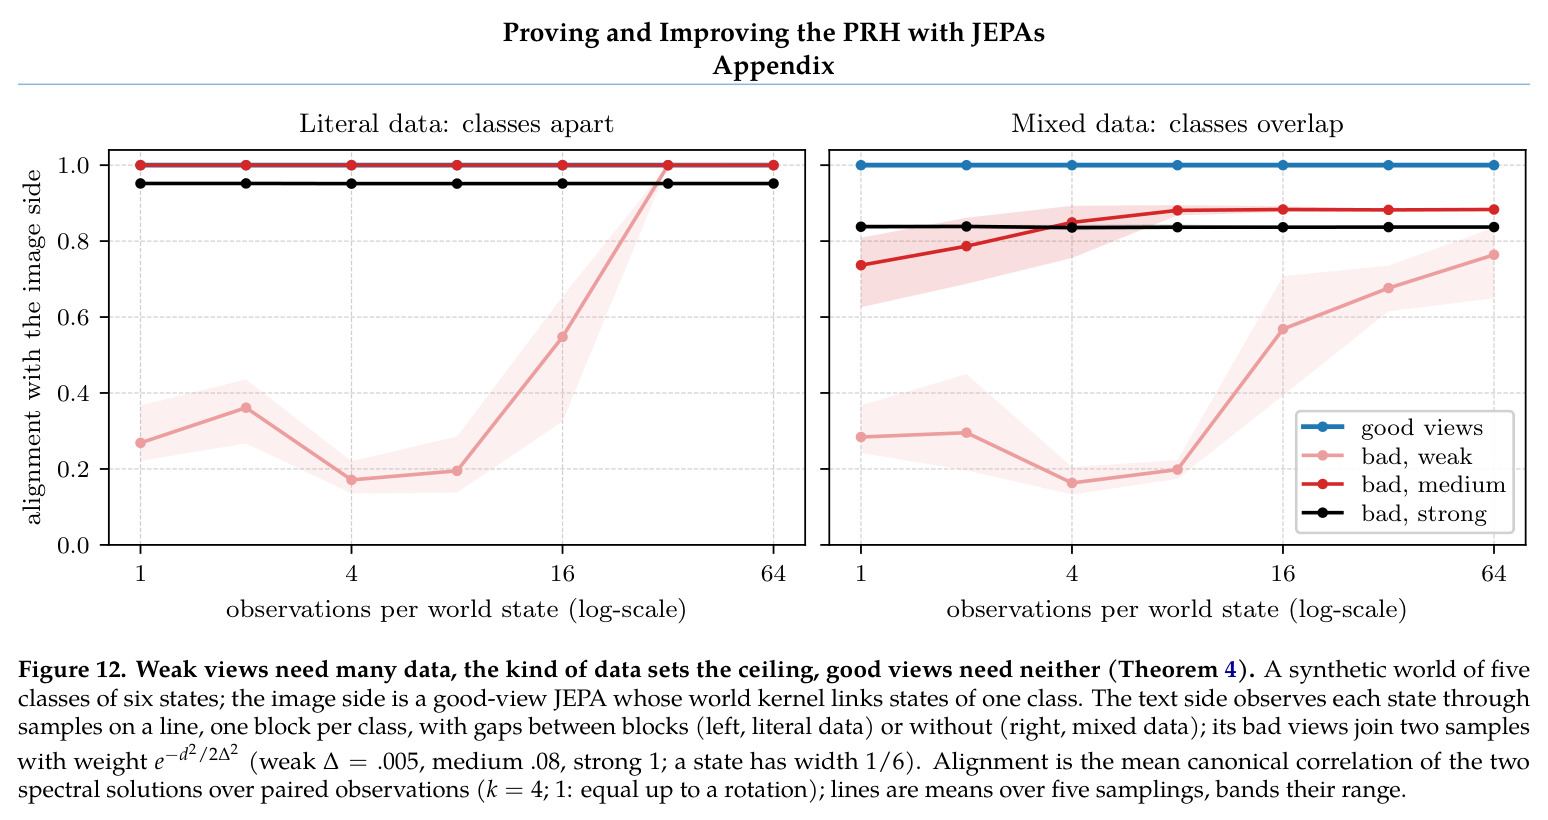
直觉上,白化二阶防坍缩的 JEPA 学到的不是泛泛的“增强不变性”,而是其正样本对在世界状态上画出的图的谱嵌入——这正是 Laplacian eigenmaps 的总体形式(Proposition 1:目标最小值 $2\sum_{i=1}^k(1-\mu_i)$,极小解恰为 $Q\Phi_\pi$)。如果两个模态渲染同一个世界,且正样本对连接同样的世界状态($\pi_1=\cdots=\pi_M=\pi$),那么它们的训练问题是同一个问题写在不同坐标系里,解自然相差一个旋转——这就是柏拉图表征定理(Theorem 1)。技术路线分四步:先在有限世界+单射渲染的理想化设定下证明共享正样本意味着相差一个旋转相等;再用 $K_{\pi_1}-K_{\pi_2}$ 的范数与谱隙 $\delta=\mu_k-\mu_{k+1}$ 给出正样本不一致时的错配上界(Theorem 2),并证明 k 对样本即可识别该旋转、而未配对数据的前两阶矩不行(Proposition 2);然后引入 nuisance 分析,量化 bad views 的对齐代价(Theorem 3),说明视角与数据共同决定世界 kernel(Theorem 4);最后把 next-token loss 改写成 JEPA 形式(Proposition 4)。实证部分用统一的 LeJEPA 配方,在 Flickr30k、MSR-VTT 与 Recap-DataComp 网页文本上系统对照三种正样本构造。
核心创新是“好视角让 PRH 成为定理”。关键观察是单射渲染只改变坐标:$\mathcal{L}_m(f)=\mathcal{L}_{\pi_m}(f\circ g_m)$,所以不同模态是否对齐完全取决于正样本分布 $\pi$ 是否相同。good views 的两个正样本是同一场景的独立观测,共享的只有场景本身,措辞、视角、光照等 nuisance 被独立采样,不会出现在任何一对的相关中,编码器花在 nuisance 上的维度为 0(场景解释比例 $\rho=1$);bad views 的两个正样本是同一观测的两个破坏,天然共享 nuisance(一条描述的用词、一张照片的视角),只要 nuisance 在某方向的相关 $\beta_1$ 大于状态第 k 方向的相关 $\alpha_k$,编码器必然把 $r$ 个维度花在 nuisance 上,与任何其他模态的最优旋转对齐误差至少 $2r$(Theorem 3)。由此,next-token prediction——正样本为文档内前缀与续写、防坍缩项为 $\log\sum_v e^{\langle h(c),w_v\rangle}$——被识别为 bad-view JEPA,其解只确定到 GL(k) 而非旋转,从机理上解释了语言模型对齐视觉为何只能靠规模。
方法步骤详情
第一步(形式化):设有限世界 $z\in Z$ 服从 $p(z)>0$,模态 $m$ 经单射渲染 $x=g_m(z,\nu)$ 观测($\nu$ 为与状态独立的 nuisance);JEPA 目标为 $\mathcal{L}_m(f)=\mathbb{E}_{(z,z')\sim\pi_m}\,\ell(f(g_m(z)),f(g_m(z')))+\Omega(f)$,其中 $\ell$ 与 $\Omega$ 都旋转不变。第二步(Theorem 1 + Proposition 1):当 $\pi_1=\cdots=\pi_M=\pi$ 且极小解唯一到旋转(白化二阶防坍缩加谱隙 $\mu_k>\mu_{k+1}$)时,$f_m^\star\circ g_m=Q_m h^\star$,任意两模态经单次旋转 $Q_mQ_{m'}^\top$ 相等。第三步(Theorem 2 + Proposition 2):正样本不同时,最优旋转后的均方根距离不超过 $2\sqrt{2}\min(\sqrt{k}\|K_{\pi_1}-K_{\pi_2}\|_2,\,\|K_{\pi_1}-K_{\pi_2}\|_F)/\delta$;该旋转可由 k 对样本经正交 Procrustes 唯一确定,而未配对数据的前两阶矩不行。第四步(Theorem 3/Prop. 3、Theorem 4):bad views 花在 nuisance 上的维度 r 由 $\beta_1>\alpha_k$ 刻画,对齐误差下界 $2r$;视角与数据共同决定世界 kernel,误差由 $\tau_1+\tau_2$ 控制。第五步(Prop. 4):把 next-token 损失拆成预测项 $-\langle h(c),w_y\rangle$ 与防坍缩项 $\log\sum_v e^{\langle h(c),w_v\rangle}$,其最优解只确定到 GL(k) 而非旋转。第六步(实验):统一 LeJEPA 配方(SIGReg $\lambda=0.02$、ViT-S/16 图像编码器、BERT-S/T/B/L 文本编码器 33M-335M、梯度裁剪),三种文本正样本(masked spans / 同图跨描述 caption views / next-token),从 Flickr30k 到 940M 网页图像文本,用 mutual 10-NN 与旋转后 R@1 评测。
技术新颖性
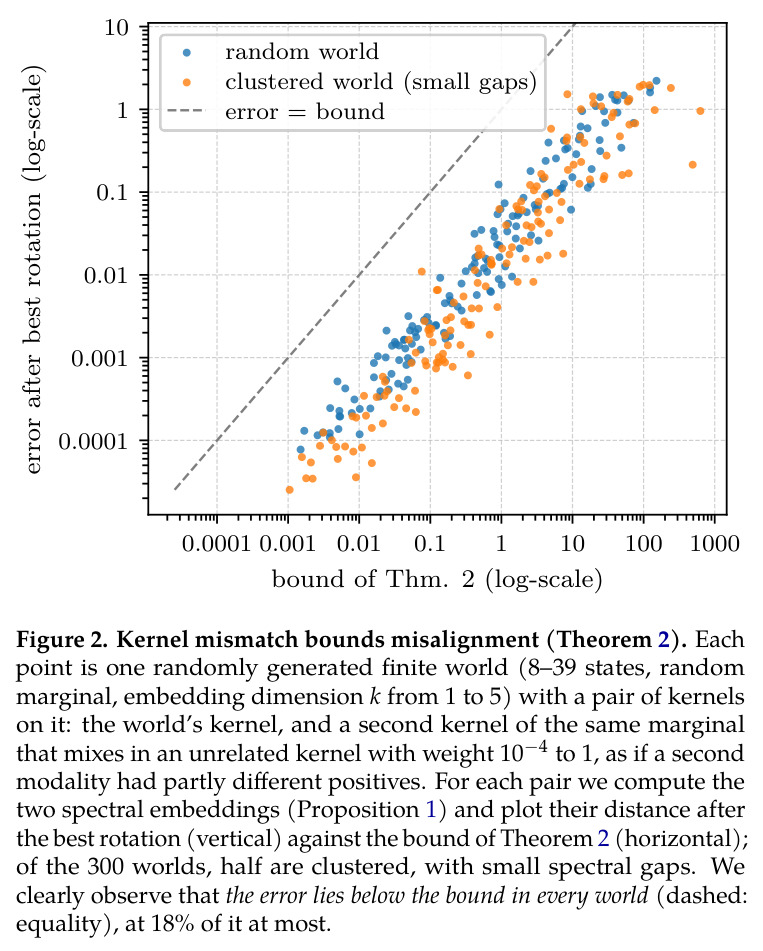
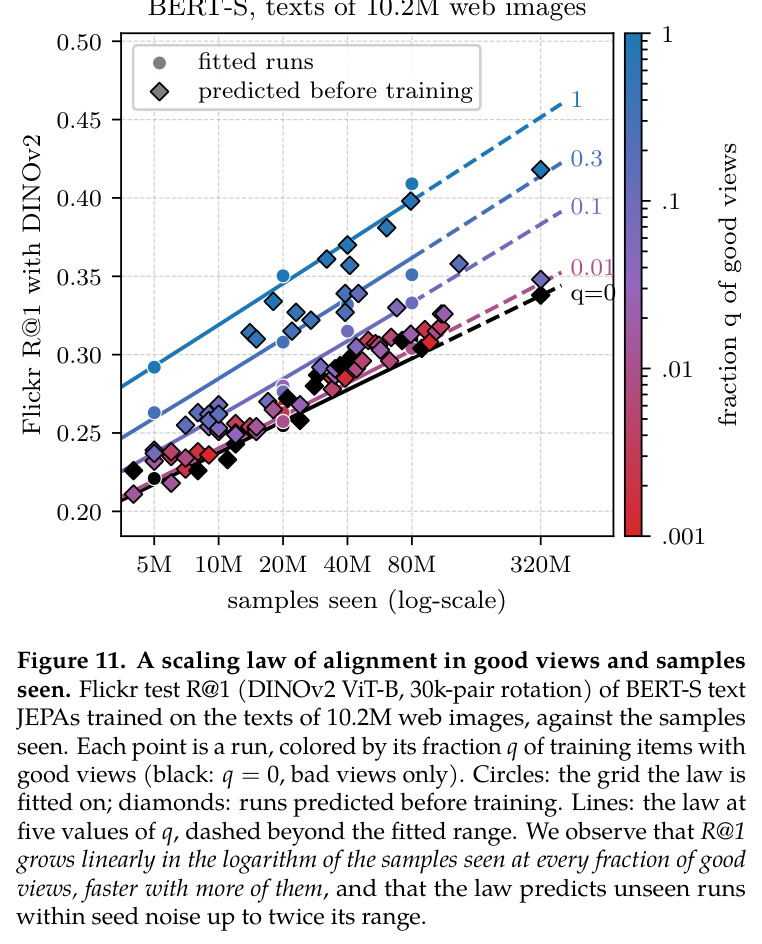
技术新颖性有五点。第一,首次为 PRH 给出充分条件定理,把“何时成立”化归为“正样本是否连接同样的世界状态”这一个可操作问题,且适用于任意数量、任意模态。第二,把 bad views 的失败机制定量化:Theorem 3 的场景解释比例 $\rho(f)=\mathrm{tr}\,C_f^{1/2}/k$ 与下界 $2k(1-\min_m\rho(f_m))$ 不仅在 300 个合成世界上验证(误差最多为界的 18%,图 2),还在真实编码器上直接测出(good .804 / bad .655 / next-token .608,k=32,表 6),界的排序与实测误差一致。第三,首次把 next-token prediction 形式化为 JEPA(Proposition 4),指出其防坍缩项即 softmax log-partition、最优解只确定到 GL(k) 而非旋转,把“LLM 靠规模对齐”从经验观察升级为机理。第四,拟合了对齐缩放律(式 7),能在训练前把新实验的 R@1 预测到与换随机种子同等的精度(RMSE .0093 对 .0096)。第五,应用层的“单旋转 captioner”只把一个正交映射拟合在图文对上,配合免配对几何对齐(Schnaus 协议),展示了理论的直接工程价值,并证明旋转比自由线性映射更可迁移。
实验结果
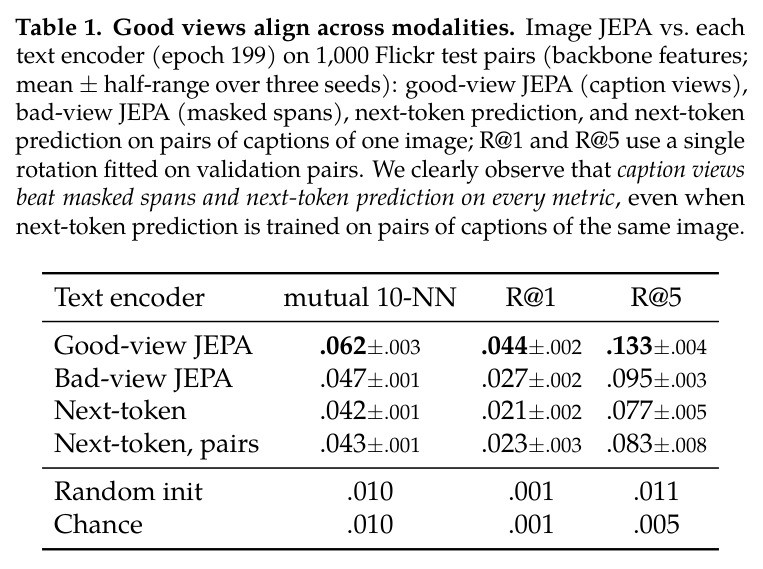
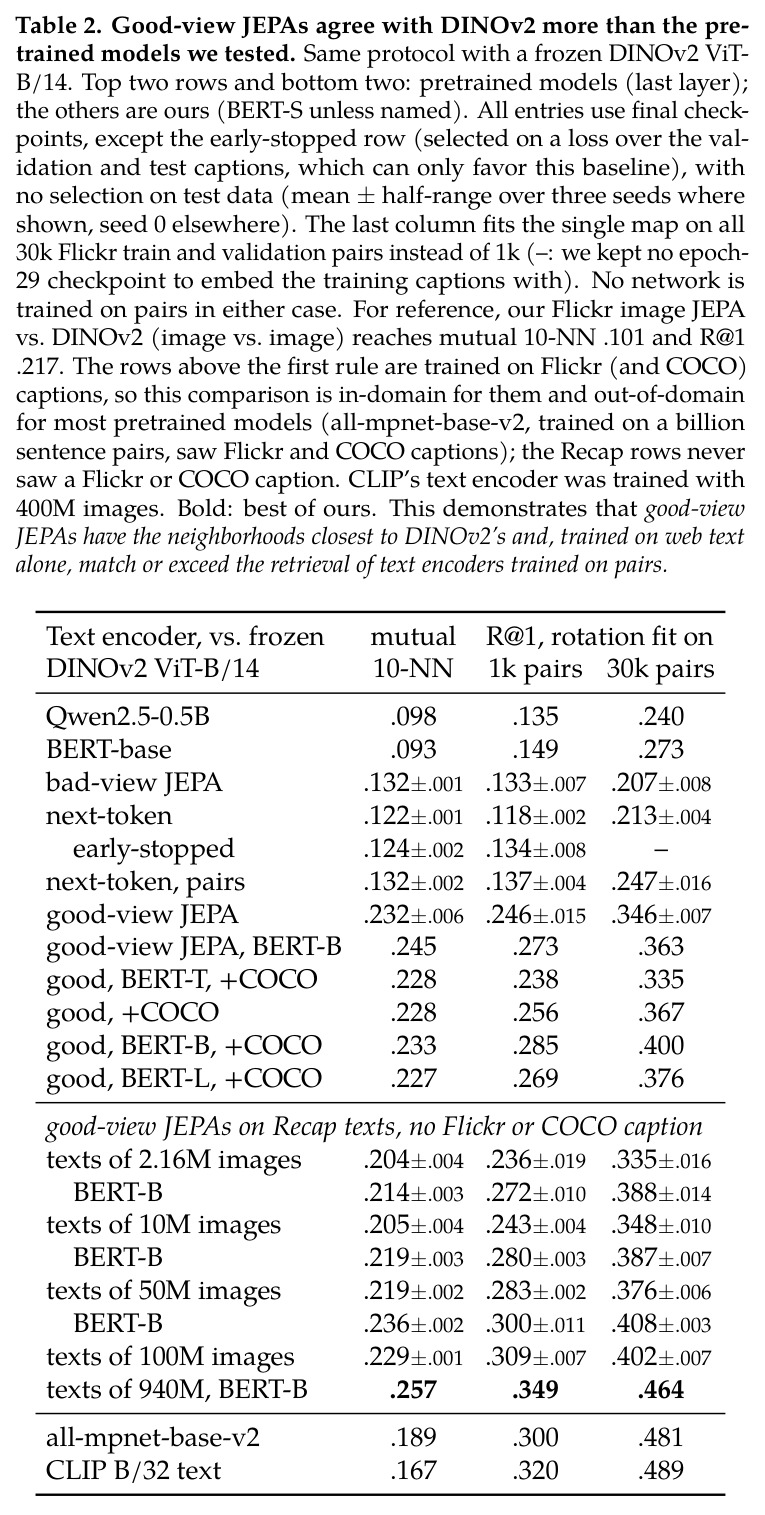
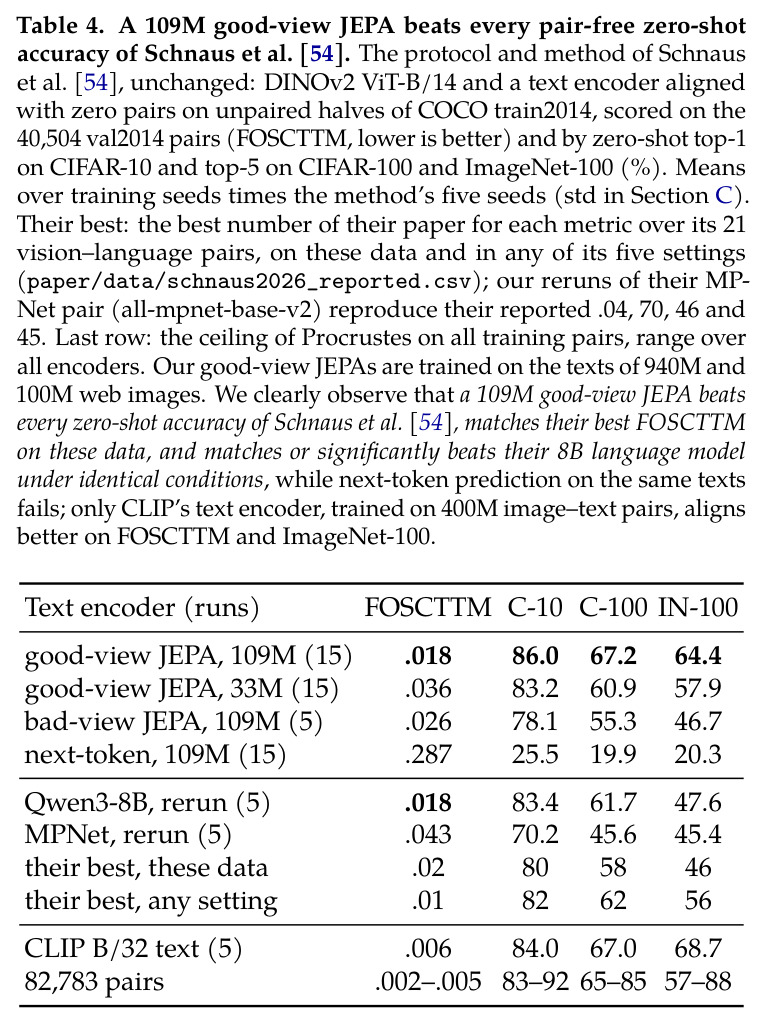
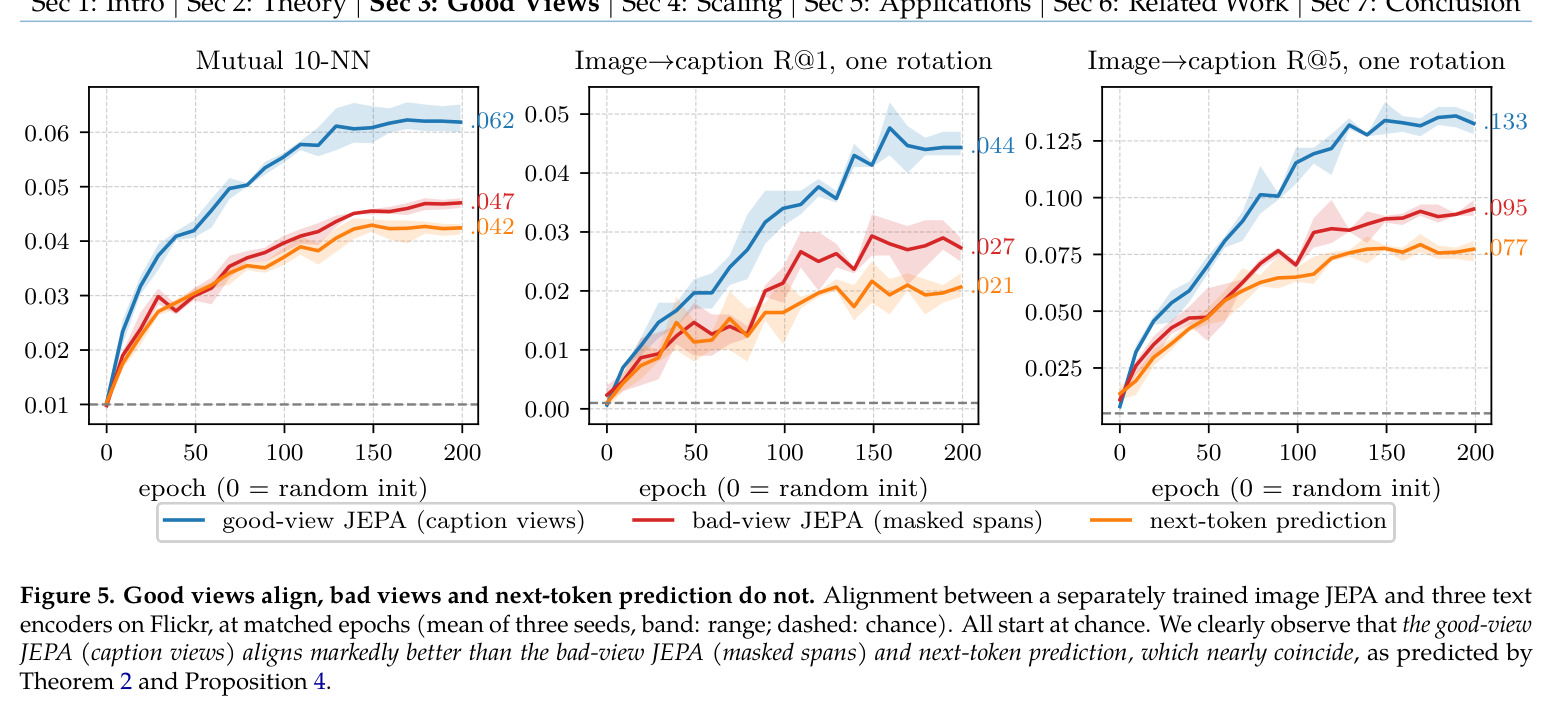
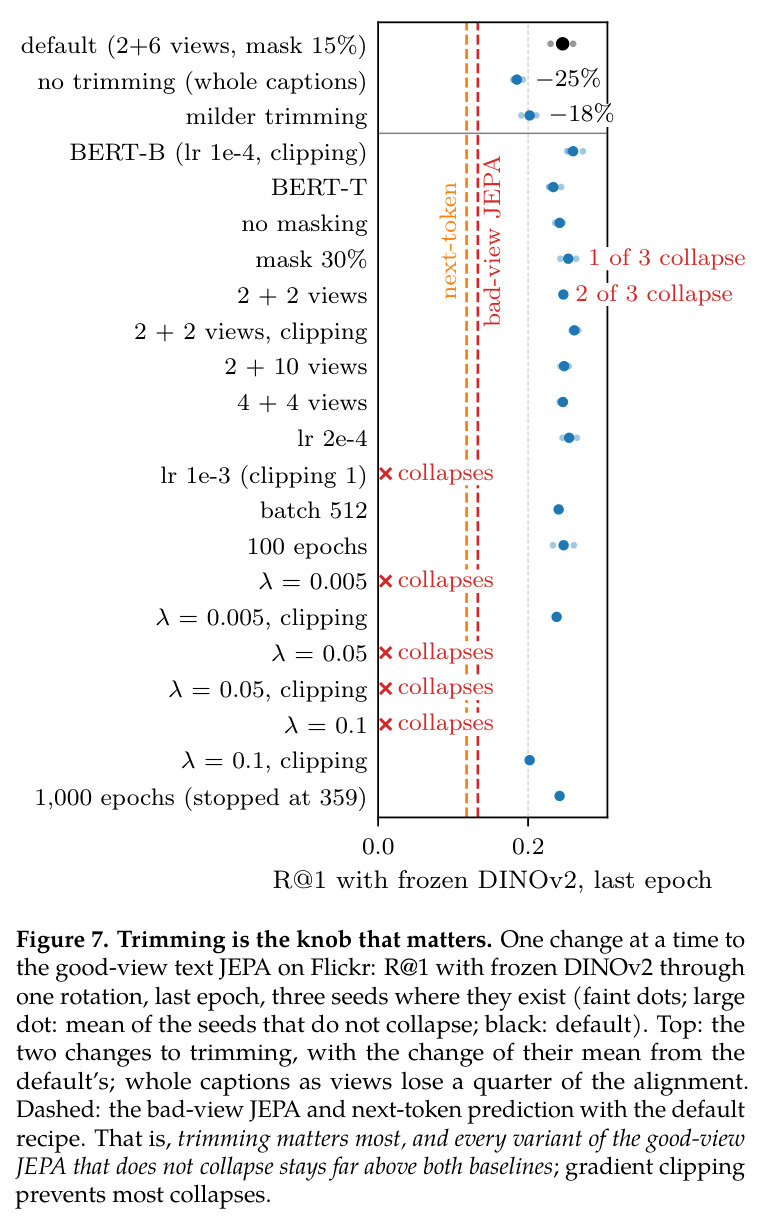
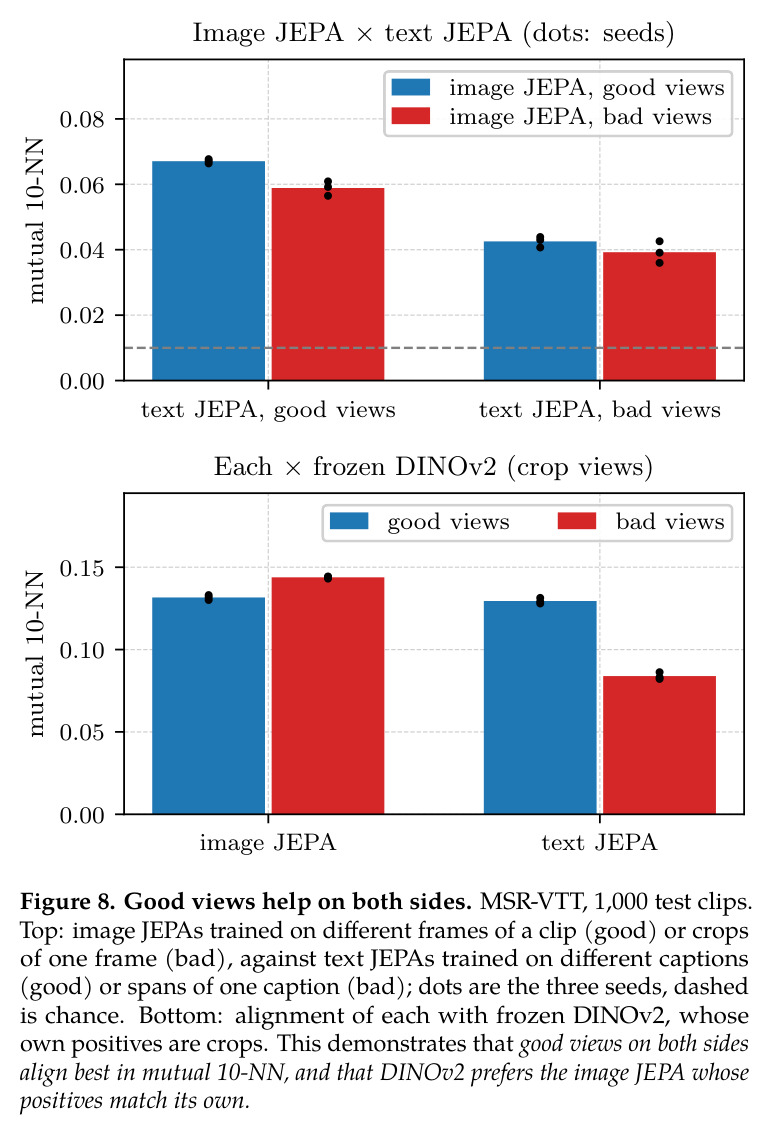
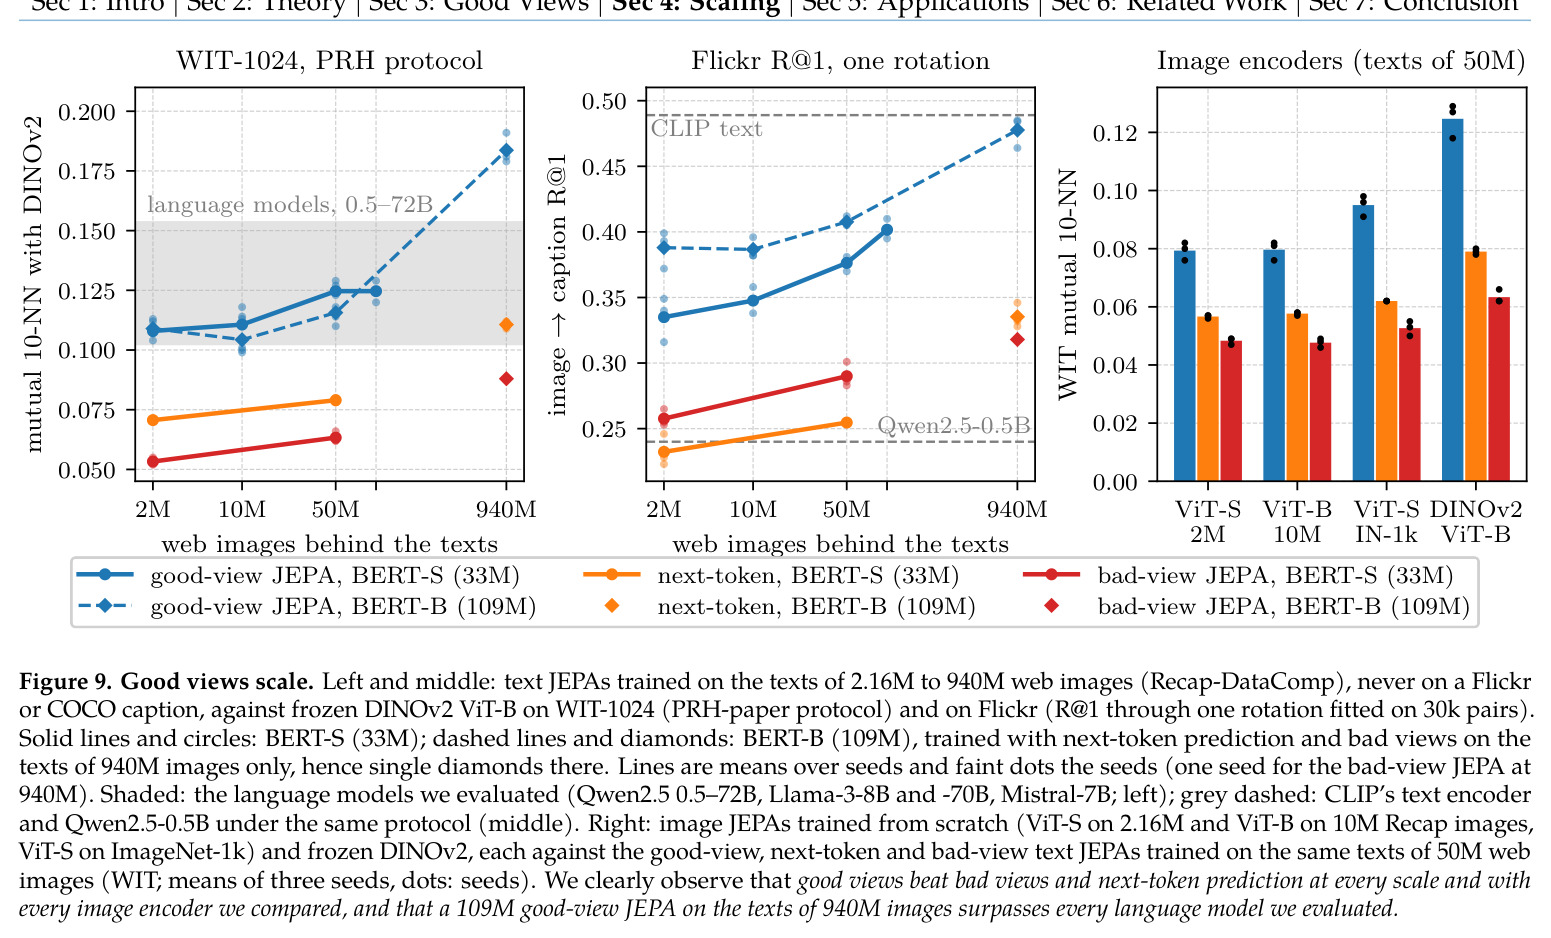
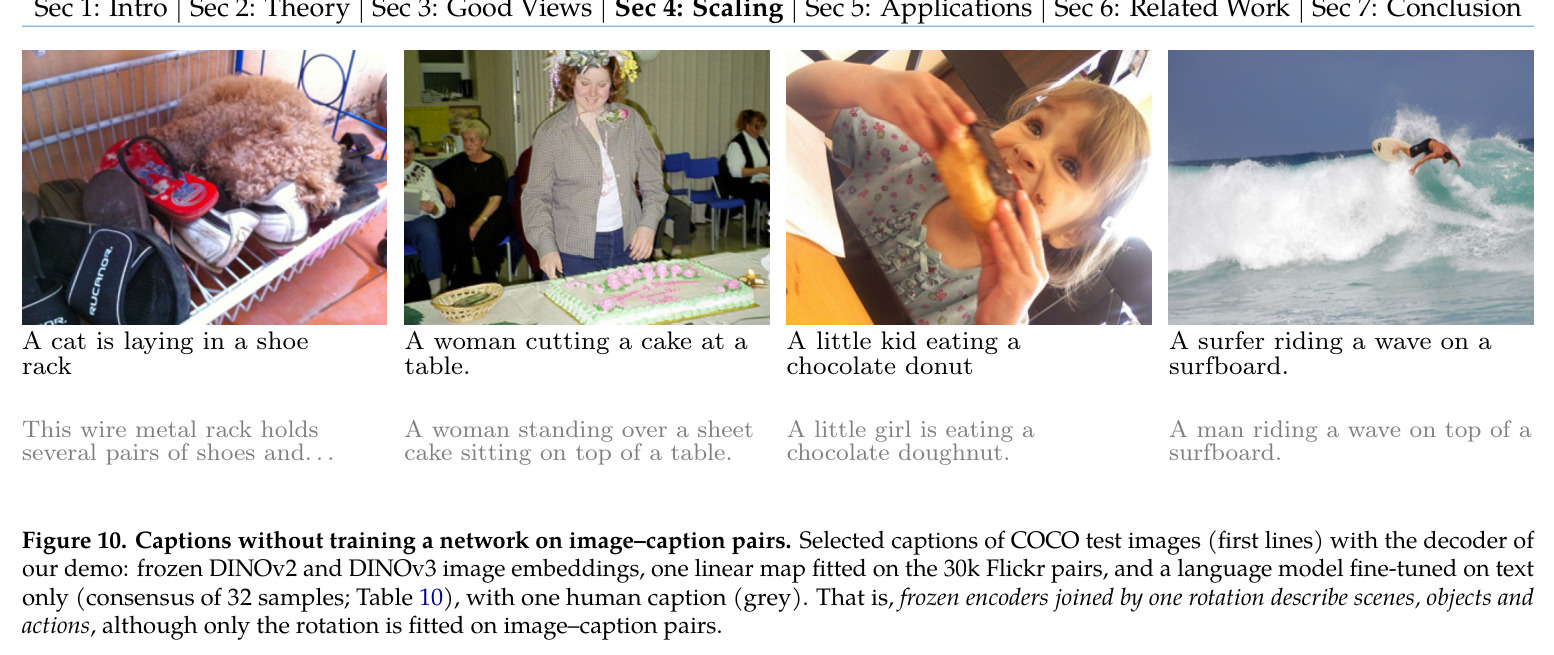
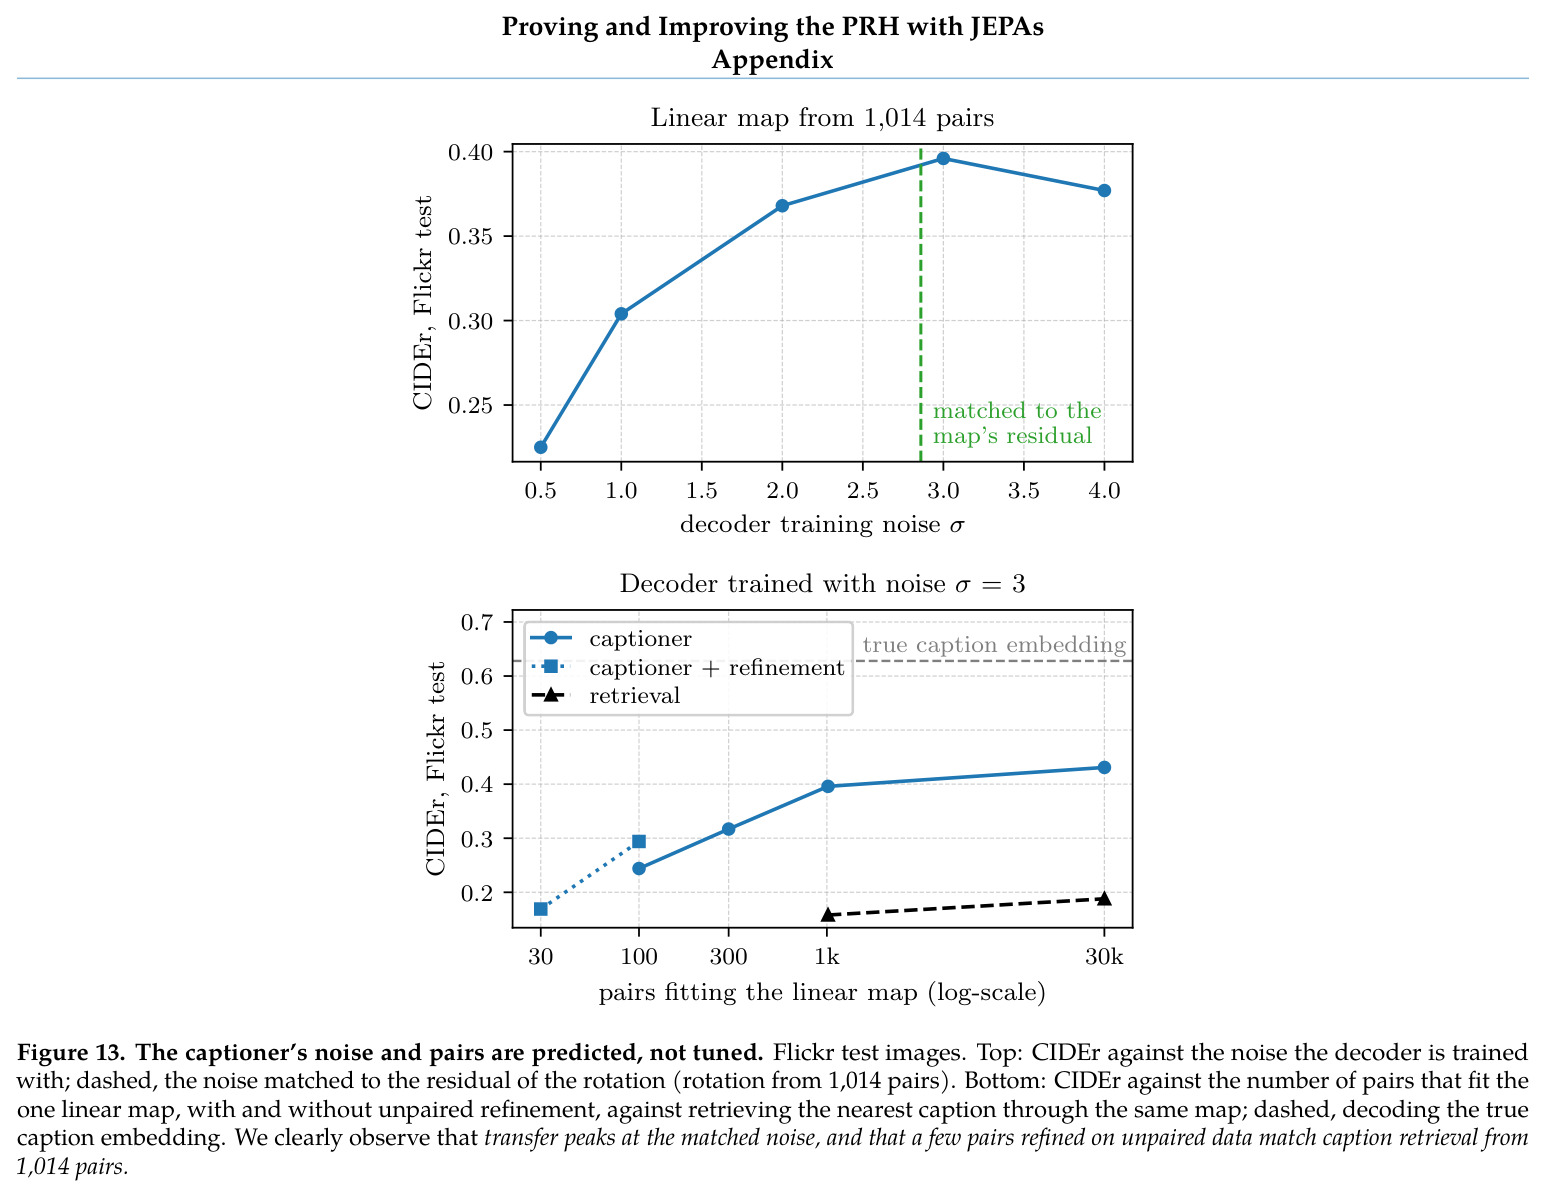
受控对照(表 1,Flickr 145k 条描述):数据、编码器、步数全同只改正样本时,good-view 文本 JEPA 的 mutual 10-NN .062±.003、旋转后 R@1 .044(chance 的 44 倍)、R@5 .133;bad-view .047/.027/.095;next-token .042/.021/.077,即便喂同一图像的两条描述也只有 .043/.023/.083——增益来自目标而非额外信息。理论量化(表 6):场景解释比例 $\rho$(k=32)依次为 .804/.655/.608,Theorem 3 下界 12.6/22.1/25.1 与实测误差 33.5/39.4/40.3 排序一致。消融(图 7):截断最关键(整句视图 .185 对默认 .246),其余超参影响 ≤.016,无梯度裁剪时 36 个 run 塌 3 个。视频(图 8,MSR-VTT):双侧 good .067 > 仅文本 .059 > 仅图像 .043 > 双侧 bad .039(chance .01);frozen DINOv2 更认同裁剪训练的图像 JEPA(.144 对 .132)。对预训练模型(表 2):good-view JEPA 与 DINOv2 的 10-NN .232,超 Qwen2.5-0.5B .098、CLIP 文本 .167、all-mpnet .189;940M 文本上的 BERT-B 达 .257。规模化(图 9/11、表 3):33M 编码器在 50M 网页图像文本上 WIT .125 追平 Qwen2.5-3B/-7B;109M 编码器读 116B token 后 WIT .184,超 Qwen2.5-72B .154(参数少 660 倍、token 少 100 多倍)与 CLIP 文本 .124,CLIP ViT-H 下 .230 对 .210,Flickr R@1 .478 对 .335;样本效率 42 倍:21.6M 样本 .109 ≈ next-token 900M 样本 .111。缩放律(式 7)预测 85 个新 run 的 RMSE .0093 ≈ 种子间 .0096;q=0 时图像量 0.41M→50.9M 对 WIT 无帮助(.054-.057),good views 从 .090 升到 .115。应用:单旋转 captioner 在 Flickr CIDEr .431(随机旋转 .043),最强组合 COCO .838,换任意线性映射掉到 .635;视频 MSR-VTT 零样本 .246 超 ZeroCap .058 与 MAGIC .074。免配对对齐(表 4):109M JEPA 在 Schnaus 协议上 FOSCTTM .018、CIFAR-10 86.0%、CIFAR-100 67.2%、IN-100 64.4%,超原基准全部报道值(≤82/62/56)与同条件 Qwen3-8B(83.4/61.7/47.6),接近用 400M 图文对训练的 CLIP 文本(84.0/67.0/68.7);同文本 next-token 半数 run 失败(FOSCTTM .287)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨模态对齐(WIT-1024,PRH 协议,对 DINOv2 ViT-B) | mutual 10-NN | .184(109M 文本 JEPA,940M 网页图像文本,116B tokens) | Qwen2.5-72B .154;Llama-3-70B .151;CLIP B/32 文本 .124 | 超最大语言模型 3.0 个点,参数少 660 倍、训练 token 少 100 多倍 |
| 同语料样本效率(文本 JEPA 对 next-token) | 达到 WIT mutual 10-NN ≈.11 所需训练样本数 | 21.6M 样本(good views,.109) | 900M 样本(next-token,.111) | 42 倍样本、14 倍文本 token、435 倍独立图像 |
| Flickr image→caption 检索(30k 对拟合旋转) | R@1 | .478(109M good-view JEPA,940M 图像文本) | 同文本同规模 next-token .335 | +14.3 个点,且未用任何跨模态损失 |
| 零样本图像描述(COCO Karpathy 5000 张) | CIDEr | .838(冻结 DINOv2 ViT-g + DINOv3 ViT-L、单旋转、文本预训练解码器、32 采样共识) | 随机旋转 .038;经同一旋转检索最近描述 .169;换任意线性映射 .652 | 除一个正交旋转外不训练任何图文网络;旋转的可迁移性远超自由线性映射 |
| 免配对零样本分类(Schnaus et al. 协议,COCO train2014 未配对两半拟合) | CIFAR-10 top-1 / CIFAR-100 top-5 / ImageNet-100 top-5 | 86.0% / 67.2% / 64.4%(109M good-view JEPA) | 原基准 21 对模型×5 设置最好 82% / 62% / 56%;Qwen3-8B 同条件重跑 83.4% / 61.7% / 47.6% | +4.0 / +5.2 / +8.4 个点(对已报道最好);+2.6 / +5.5 / +16.8 个点(对 Qwen3-8B) |
| 零样本视频描述(MSR-VTT 2990 片段) | CIDEr | .246(8 帧均值 + 用照片拟合的旋转,网络从未见过视频) | ZeroCap .058;MAGIC .074;DeCap .150-.186 | 1.3-4.2 倍,且不使用任何视频-文本对 |
局限与改进
作者承认的局限:所有定理都是有限世界、单射渲染、边缘分布匹配下的总体(population)陈述;真实模态有损——一条 caption 只能看到照片的一部分,这类偏离只通过 kernel 错配(Theorem 2)部分覆盖;“唯一到旋转”只对二阶防坍缩证明,未覆盖 LeJEPA SIGReg 的全分布约束;Theorem 2 只对谱解成立;且没有任何实验精确满足 Theorem 1 的假设(实验用 LeJEPA,图像侧正样本多为裁剪,即 bad views)。最重要的 caveat 是 good views 的来源:它们要求事先知道哪些文本描述同一场景(Flickr/COCO 依赖人工分组元数据);Recap-DataComp 每图三条文本中有两条由 LLaVA(视觉端为 CLIP ViT-L/14)生成,蒸馏了图文训练的信息——完全不用图像描述器时 WIT 只有 .060,而用重述达 .107,说明相当一部分对齐借助了“以文本形式间接见过的视觉”。我的补充观察:42 倍样本效率的对照是同一语料上的 next-token 基线,并非与真实 LLM 预训练配方(数据混合、课程学习)对比;缩放律只在单一配方(BERT-S、10.2M 图像)上拟合,外推到 320M 样本对 good views 已明显高估(.418 实测对 .455 预测);图像侧几乎全部依赖冻结的 DINOv2/DINOv3(其训练数据本身经过大规模人工策展),从零训练的 good-view 图像 JEPA 只在仅 7k 视频的 MSR-VTT 上短暂验证;对齐指标(10-NN、旋转后 R@1)度量几何相似而非下游推理能力。
独立分析的弱点
独立分析的弱点:(1)good views 依赖配对元数据——需要事先知道哪几条文本属于同一图像或视频帧,这在网页规模数据中并不天然存在;改进方向是训练场景聚类器、用跨模态检索构造伪 good views,或采集天然多观测数据(多机位、连拍、视频旁白)。(2)文本侧的“干净”程度存疑:Recap 重述携带 CLIP 蒸馏信息(.060 对 .107 的差距即为其贡献),跨模态对齐的“免训练”成色打折;改进方向是仅用纯文本模型生成改写并规模化验证(论文的 paraphrase 实验已达 .060,仍优于 bad views 的 .055,说明观点本身不依赖蒸馏)。(3)理论与实操有缝:唯一性只证到二阶防坍缩、谱解层面,而实验用 SIGReg;next-token 的 bad-view 归类是启发式(Proposition 3 严格来说不适用于其 GL(k) 解),只是被实验证实;改进方向是把唯一性推广到全分布约束、把 $\tau_m$ 界推广到非谱目标。(4)图像侧 good views 未规模化:MSR-VTT 仅 7k 片段,“good views 帮图像侧”的证据薄弱(作者也承认留给未来工作);改进方向是用大规模多视角或视频数据训练 good-view 图像 JEPA 再测对齐。(5)评测集中在几何对齐与零样本分类/检索,未检验下游世界建模能力(VQA、规划、机器人控制);理论声称适用于动作模态但没有任何实验;改进方向是在 embodied 基准上验证 platonic 表征的实用价值。
未来方向
作者明确提出:把 good views 推广到图像与文本之外——音频、视频、动作(理论对任意模态成立但实验只覆盖图文);规模化 good 图像视角(每场景需要多个观测,视频帧是最自然的来源);以及用刚发布的 DINOv3 等更强视觉编码器升级应用。基于其成果可延伸的方向:(1)用缩放律做对齐导向的数据规划——iso-alignment 线 $q\propto M^{-0.30}$ 说明训练步数只能次线性地替代 good views,数据混合应在好视角比例 $q$ 与独立场景数 $N$ 之间优化;(2)“免训练多模态拼接”工程化——一个旋转(甚至 Schnaus 的免配对几何对齐)即可把任意 good-view 文本编码器接到任意冻结视觉编码器上,可为现成 LLM 廉价加装视觉;(3)在机器人与动作模态上检验 Theorem 1,探索“同一任务的两个演示”作为正样本是否产生与世界模型对齐的表征;(4)理论延伸:覆盖带预测器(非恒等)的 JEPA、动作条件 JEPA、SIGReg 全分布约束下的唯一性,以及连续/无限世界的版本;(5)把场景解释比例 $\rho$ 发展成通用诊断指标,用于审计现有大规模模型表征的“柏拉图程度”,并与多语言模型内对齐理论(Doshi et al.)统一。
复现评估
复现条件总体友好。代码与在线 demo 随论文发布,附录多处点名 evaluate.py、tables.py、figures.py 等脚本,实验协议(数据划分、评测口径、种子数、统计检验)描述细致。数据全部公开:Flickr30k(Karpathy 划分)、MSR-VTT、Recap-DataComp、WIT-1024、COCO、CIFAR-10/100、ImageNet-100;文本侧可直接使用现成 Recap 重述,不必自己重跑 LLaVA。算力:小规模实验(145k 条 Flickr 描述、200 epochs、batch 256、BERT-S 33M + ViT-S)单卡即可;最大的 940M 图像文本 BERT-B 训练用 8-16 GPU、约 116B 文本 token,在中等实验室预算内;语言模型对照只需推理抽取嵌入(72B 模型需两张 GPU bfloat16)。风险点:训练稳定性对正则敏感——不加梯度裁剪时 36 个 run 中 3 个突然坍缩,SIGReg 权重需配合裁剪调整;随机种子方差不可忽略(单 run 种子间 RMSE .0096,免配对实验的 FOSCTTM 标准差达 ±.020);Recap 文本的生成依赖 LLaVA-LLaMA-3-8B 复现一致性。理论复现(附录 A 证明)需要谱图论与 Laplacian eigenmaps 背景,但全部主结果可通过运行其脚本验证。综合难度:中等——小规模验证一两天可完成,规模化复现约数周。
论文图表
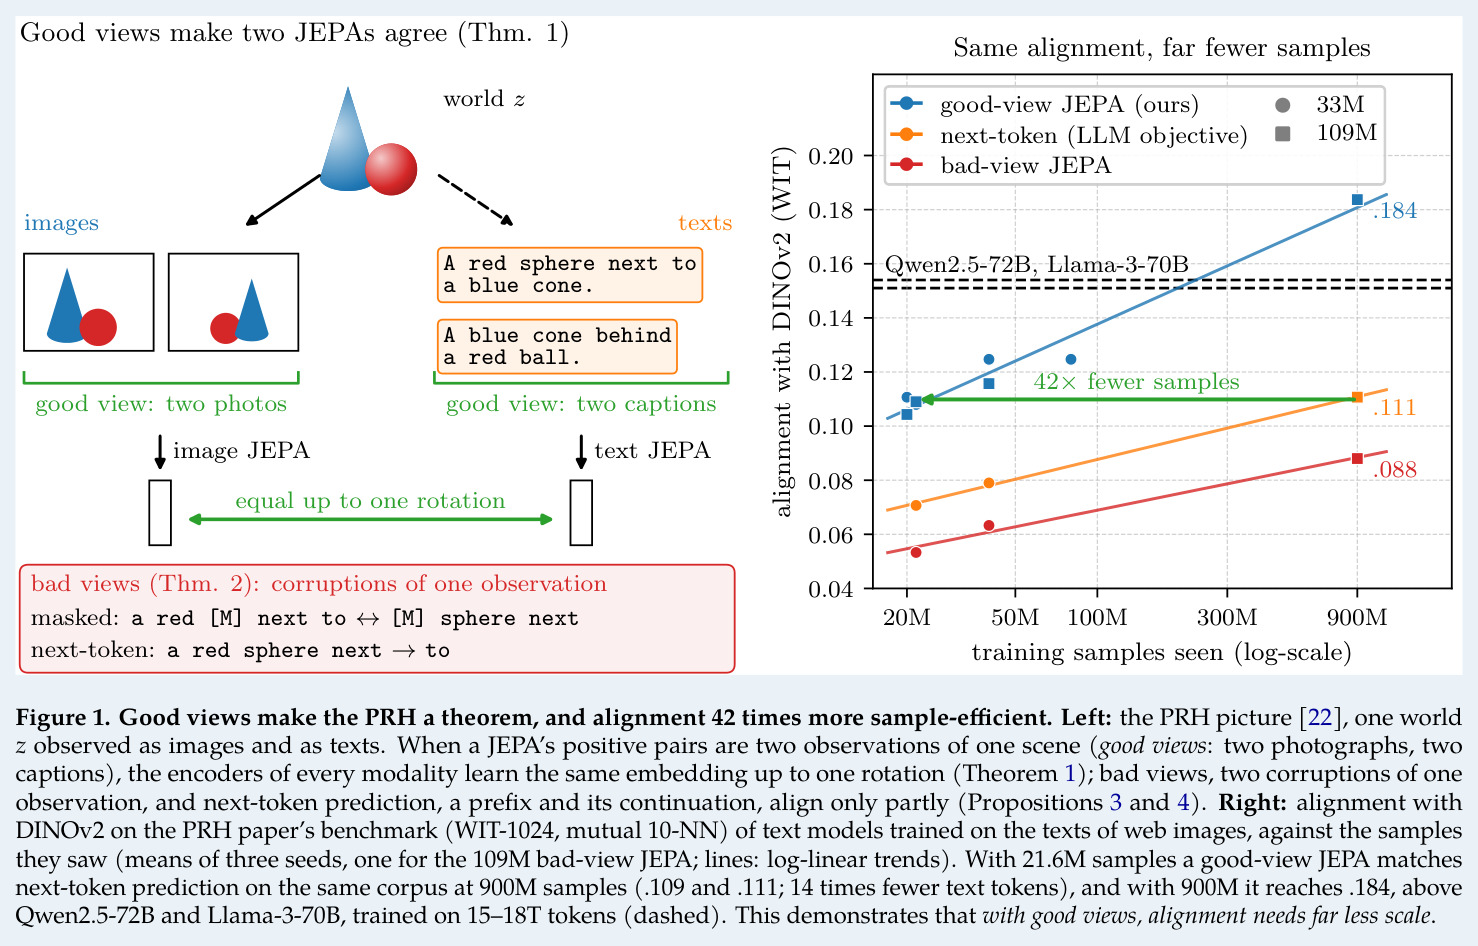
全文总览。左:PRH 示意——同一世界 z 被图像与文本观测;当 JEPA 的正样本是同一场景的两个观测(good views:两张照片、两条描述)时,各模态编码器学到相差一个旋转的同一嵌入(Theorem 1);bad views(同一观测的两个破坏)与 next-token(前缀与续写)只部分对齐(Propositions 3/4)。右:在 PRH 论文的 WIT-1024 基准(与 DINOv2 的 mutual 10-NN)上,文本模型对齐随训练样本数(log 轴)的变化:good-view JEPA 用 21.6M 样本即达 next-token 900M 样本的水平(.109 对 .111),900M 样本时达 .184,超过训练了 15-18T tokens 的 Qwen2.5-72B 与 Llama-3-70B(虚线)。
一图概括全文论点与最重要的 42 倍样本效率结论,是理解论文贡献的入口。