JEPA-Anything:跨异构世界的统一预测世界模型 JEPA-Anything: Learning Predictive Models across Different Worlds
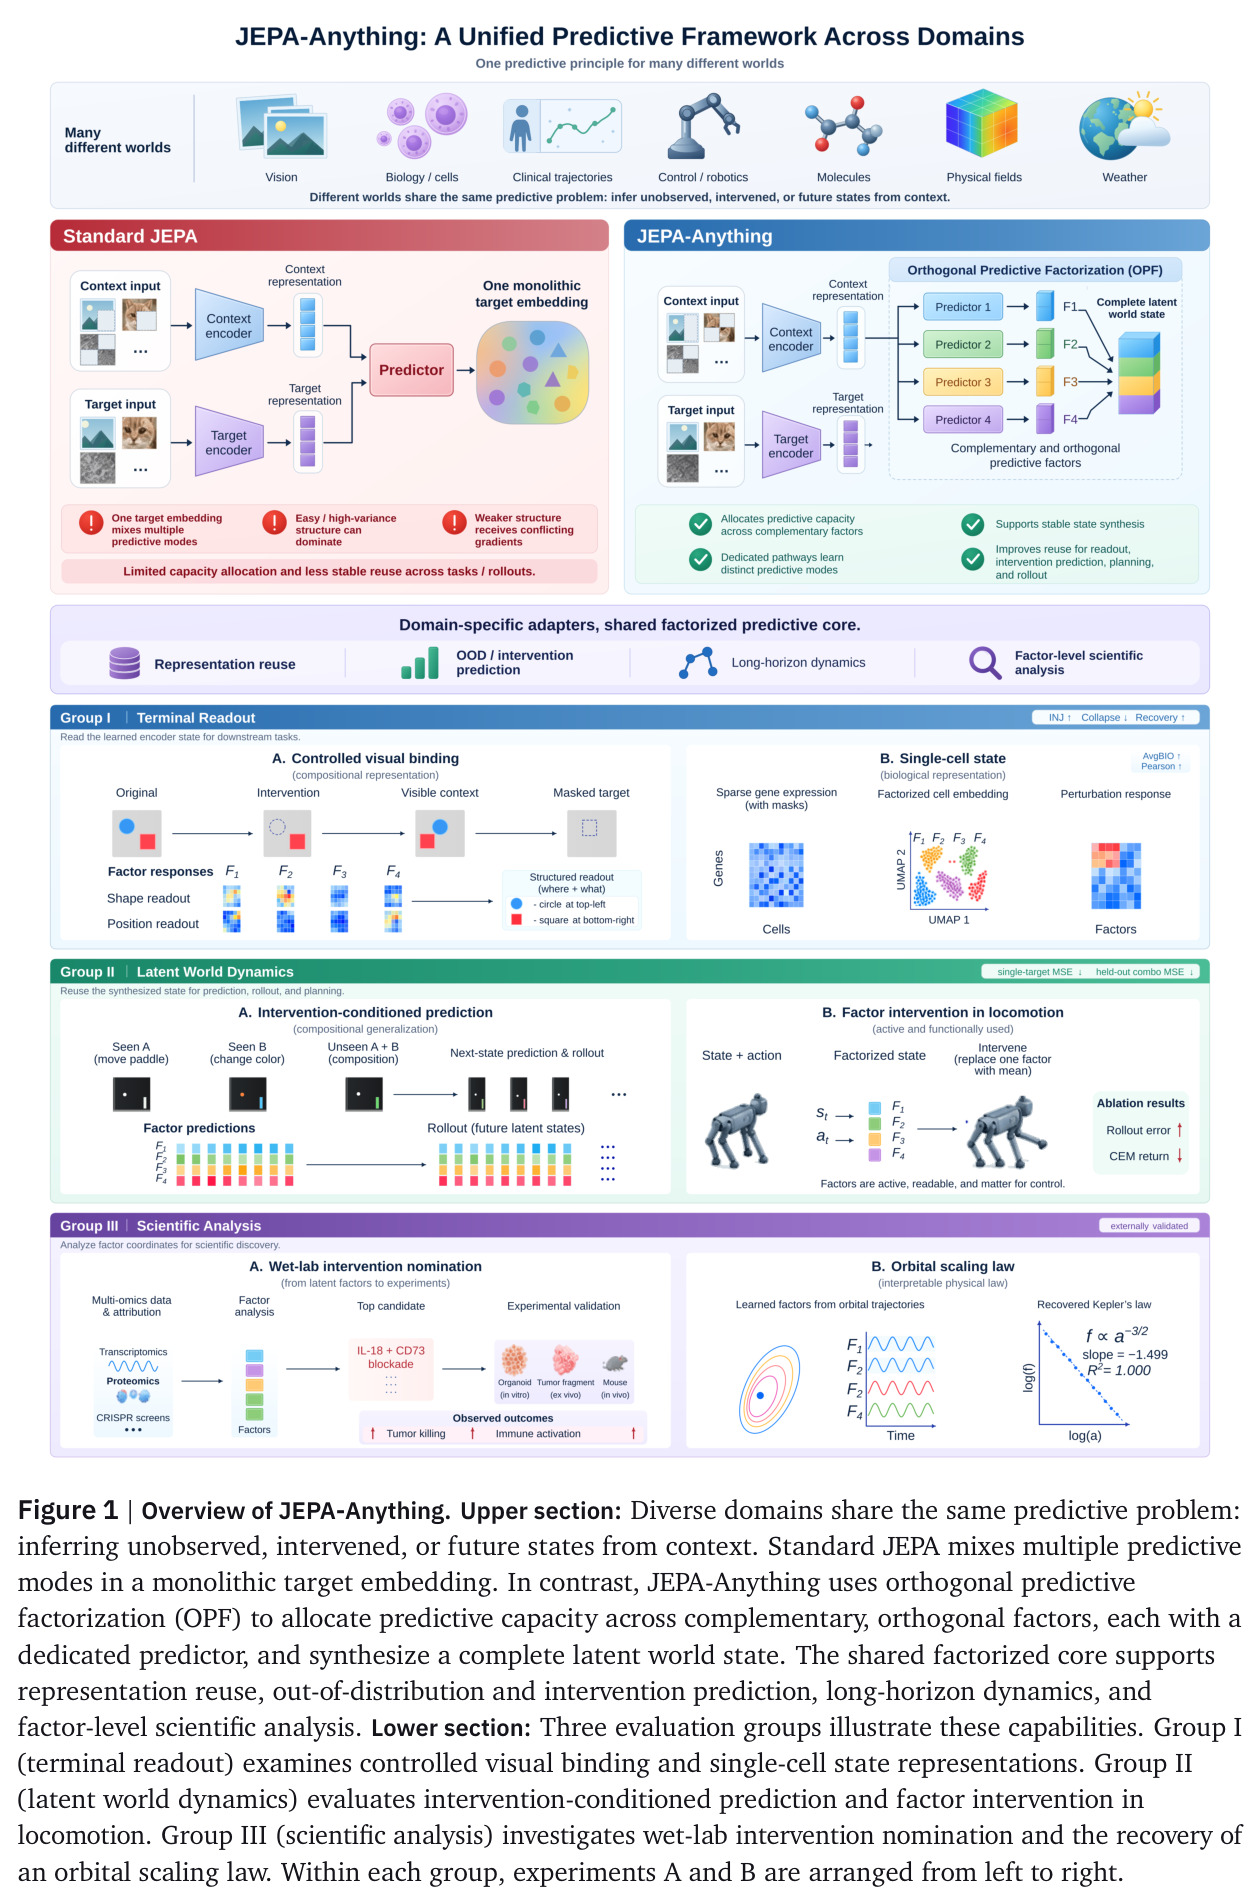
提出正交预测分解OPF,把JEPA单目标嵌入拆为互补正交因子,用一套核心横跨七个领域实现世界建模
前置知识
JEPA(联合嵌入预测架构)
Joint-Embedding Predictive Architecture,一种潜空间自监督学习范式:上下文编码器 $f_\theta$ 摘要可见部分,目标编码器 $f_{\bar\theta}$ 定义待预测状态,预测器在表示空间中从前者映射到后者,而不是在像素/原始空间做重建。潜空间预测让模型聚焦可预测的共享结构,避免重建任务把容量浪费在高方差但无用的局部纹理上。代表工作有 I-JEPA(图像掩码预测)与 V-JEPA(视频)。
本文是 JEPA 家族的通用化:理解'上下文→潜目标'这一基本接口,才能看懂 OPF 到底在改造什么——它不改变 JEPA 的接口,只改变目标嵌入被预测的方式。
EMA 目标编码器与停止梯度
目标编码器参数不接收梯度,而是按 $\bar\theta \leftarrow m\bar\theta + (1-m)\theta$ 指数滑动平均跟踪在线编码器,且对目标编码器输出施加 stop-gradient(记作 $\mathrm{sg}(z_t)$)。这防止了表征坍缩(所有输入映射到同一点),因为目标在缓慢移动、在线网络无法通过让两者同时塌缩来作弊。BYOL、I-JEPA 等均采用此机制。
OPF 分解的对象正是这个停止梯度后的 EMA 目标向量 $\tilde z_t$;论文中的因子活动正则 $\mathcal{L}_{\text{fac}}$ 与编码器方差正则 $\mathcal{L}_{\text{enc}}$ 是在 EMA 机制之外的第二道防坍缩保险。
正交投影、伪逆合成与条件数
若矩阵 $P$ 满足 $P^\top P = I$ 则为正交阵,保持向量范数与内积,条件数 $\kappa_2(P)=1$。给定分析算子 $P^\top$ 把目标切成 $K$ 个因子坐标,合成时用 Moore–Penrose 伪逆 $\hat z = (P^\top)^\dagger \hat u$ 还原完整状态;正交时伪逆退化为转置,重构精确且预测误差范数不变($\|\hat z - z\|_2 = \|e\|_2$)。病态(非正交)矩阵的最小奇异值趋零,微小预测误差会被放大。
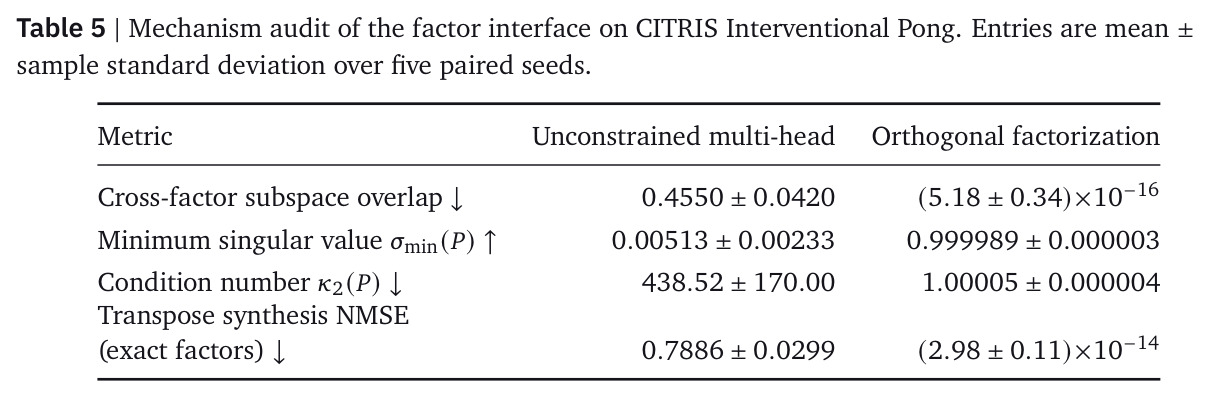
这是全文的数学核心:命题 1 与推论 1 证明 OPF 的合成稳定性,CITRIS 机制审计(Table 5)实测 $\kappa_2(P)$ 从无约束多头的 438.52 降到 1.00005,合成 NMSE 降到 $2.98\times10^{-14}$。
世界模型与潜空间 rollout
世界模型学习一个可被反复推进的潜状态:从上下文构造状态 $z_t$,经转移(可带动作 $\xi_t$ 或干预标签)预测 $z_{t+1}$,再解码、规划或自回归反馈。CEM(交叉熵方法)规划器在世界模型内部模拟大量候选动作序列、按估计回报选优并执行首个动作。误差会在多步 rollout 中复利放大,因此一步准确不等于长程稳定。
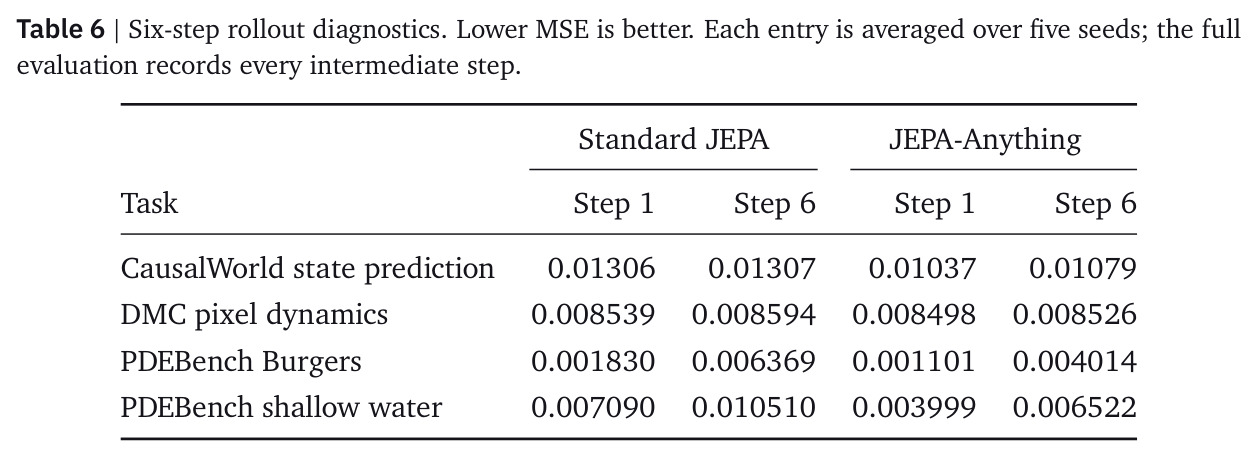
本文的'操作性世界模型模式'正是靠合成出的完整潜状态做自回归 rollout 与 CEM 规划;六步/50 步/100 步误差(Table 6-9)是检验世界模型质量的主指标。
干预预测与 OOD 泛化
干预指外部强制改变系统的某些状态因子(区别于智能体自主选择的动作),模型需根据'干预前观测+干预标签'预测结果状态。组合干预泛化指训练中见过各因子单独被干预,但推理时遇到从未同时出现的干预组合,考察模型是记住了完整干预模式还是学会了可重组的状态变化规则。OOD 泛化则指在未见初始条件/时间段上的预测能力。
CITRIS Interventional Pong 实验是 OPF 价值的最干净对照:单干预误差降 34.83%、未见组合降 12.90%,直接证明因子化预测核心支持可组合的干预响应。
研究动机
当前预测模型与世界模型高度领域专属:视觉用 I-JEPA/V-JEPA,单细胞用 Cell-JEPA,控制用 DreamerV3/TD-MPC2,各自定制结构。更关键的矛盾在于标准 JEPA 的目标表示方式:它用一个整体式目标嵌入和单一预测路径来表示被请求的世界状态。当局部掩码、全局结构、多实体、多尺度动态共享同一个目标向量时,容易预测或高方差的结构会主导优化,多个潜方向重复承担相似角色,而弱预测结构收到相互冲突的梯度——这本质上是一个预测容量分配问题。论文用七个领域的实测说明该矛盾的具体表现:受控 MuJoCo 视觉场景要求同时保留'变化发生在哪'与'发生了什么操作'两类信息;单细胞表达谱高维而极稀疏,逐基因重建会把容量浪费在技术 dropout 上(约 80 万肾脏细胞的预训练即受此困扰);纵向健康记录稀疏、不规则、只部分观测,一个未来患者状态要同时支撑 1,000 多种事件风险;而 PDE、气象与分子动力学则要求预测误差在 6 到 100 步自回归 rollout 中不发散。
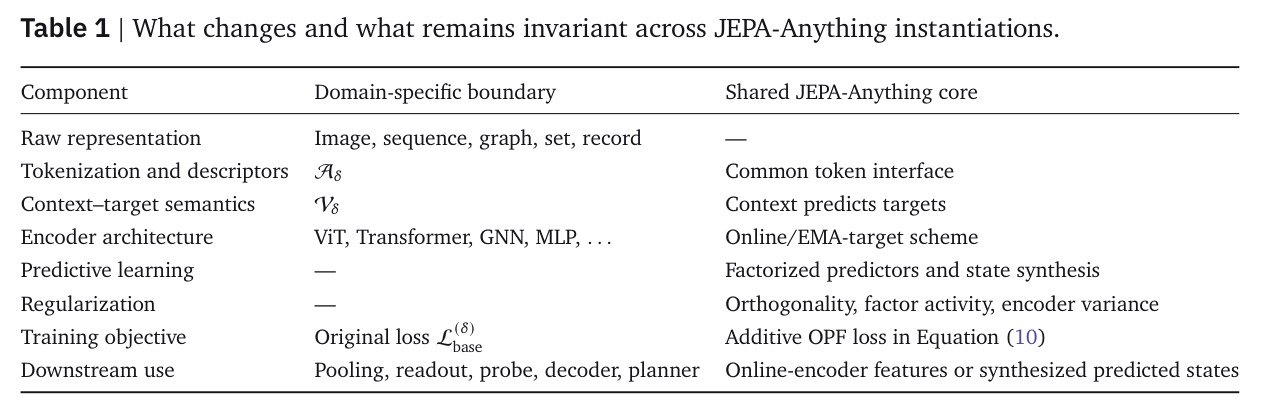
本文的目标是本文要回答一个统一性问题:一个共享的潜世界状态接口加一个领域无关的学习原则,能否支撑横跨截然不同系统的世界建模?具体目标是构建 JEPA-Anything 框架:领域适配器只负责定义观测几何(token 化、结构描述子、上下文–目标视图采样),而领域无关的正交预测分解(OPF)核心负责把潜目标分解为 $K$ 个互补正交分量,每个分量由专用预测器学习,并可经伪逆合成为完整潜状态。该状态必须同时服务三种用途:终端读出(视觉绑定、单细胞表征、疾病预测)、操作性动力学(干预条件预测、OOD 预测、长程 rollout、CEM 闭环规划)以及因子级科学分析(湿实验干预提名、物理标度律恢复)。评价标准是与'匹配的标准 JEPA'做严格对照——相同适配器、编码器、采样、优化预算与数据划分——并在 10 个动力学任务上全部取得一致改进。
与已有工作不同的是,切入角度的独特性在于'因子身份来自预测学习而非预设语义'。已有分解表征学习普遍假设因子有外在语义身份:β-VAE 假设独立生成变量、Slot Attention 假设实体对齐槽位、CITRIS 靠时序干预识别因果因子——这些都需要相应的归纳偏置或监督信号,且无监督语义解耦在仅凭观测时原则上不可识别。另一类冗余削减方法(Barlow Twins 的互相关匹配、VICReg 的方差-协方差正则)作用于单一嵌入的统计量,不产生显式的状态合成通道。OPF 则把块内/块间正交性与因子活动约束直接施加在学习到的预测目标子空间基 $P_k$ 上,不假设对象、因果或语义身份,同时经 Moore–Penrose 伪逆 $(P^\top)^\dagger$ 保留显式合成映射,把'冗余削减'与'完整潜世界状态'首次连成一条推理链,并用命题 1/推论 1 给出合成稳定性的形式化保证。
核心方法
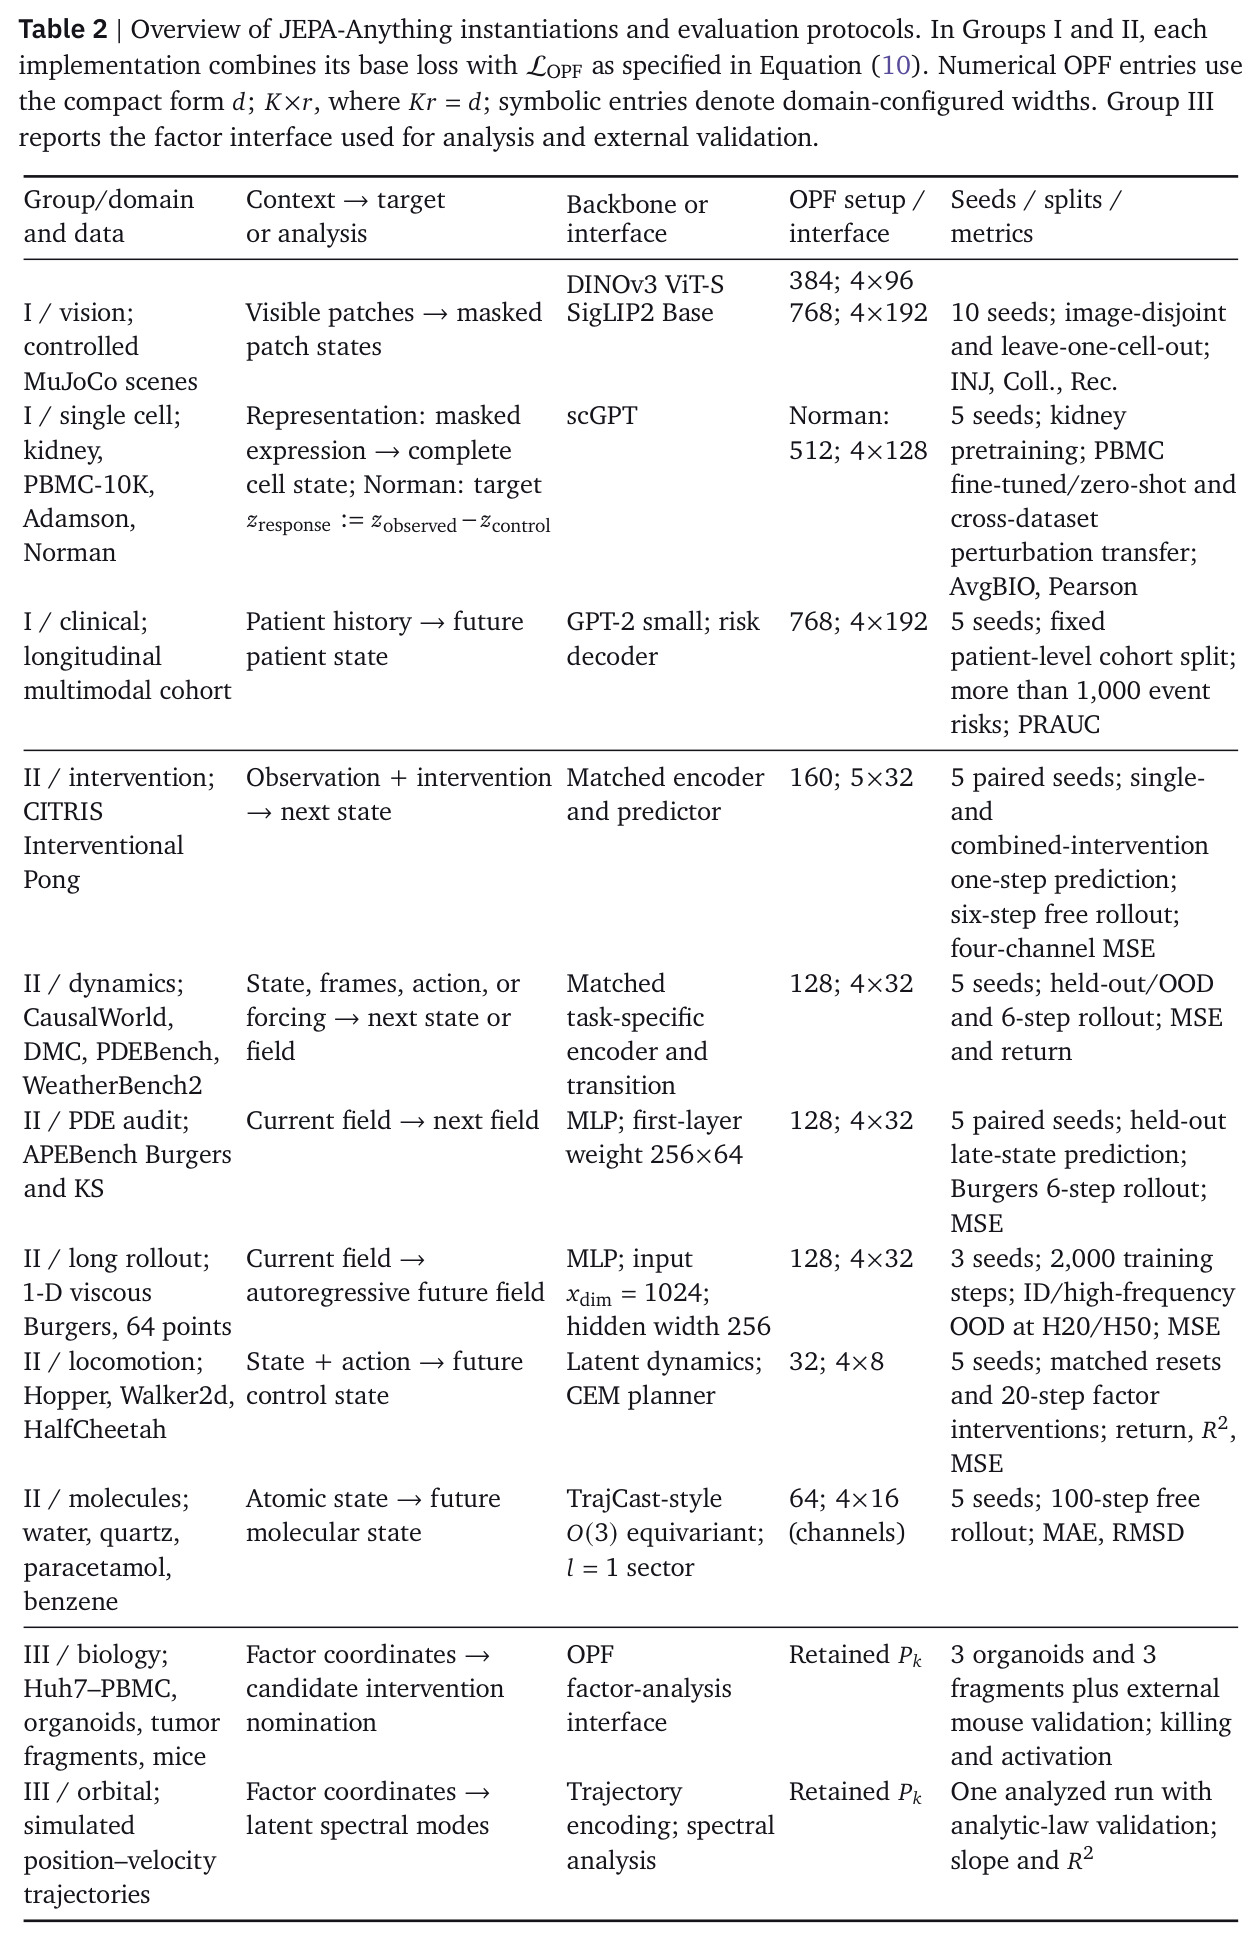
直觉:不同领域只是'上下文–目标'关系不同,而预测学习本身是同一件事,因此应当解耦'观测几何'与'预测容量分配'。技术路线上,任意领域观测 $x$ 先经领域适配器 $A_\delta$ 变成内容 token $H$ 与结构描述子 $S$(patch 坐标、时间戳、图位置等),视图采样器 $V_\delta$ 选出上下文索引 $C$ 与目标索引 $T$;在线编码器给出 $z_c = f_\theta(H_C, S_C)$,EMA 目标编码器给出潜目标 $z_t = f_{\bar\theta}(H,S)_t$。OPF 用 $K$ 个可学习投影 $P_k \in \mathbb{R}^{d\times r}$($Kr=d$)把停止梯度的目标分解为 $z_t^{(k)} = P_k^\top \mathrm{sg}(z_t)$,每个因子由专用预测器 $\hat z_t^{(k)} = q_k(z_c, s_t)$ 从共享上下文预测,拼接成 $\hat u_t$ 后用伪逆合成完整状态 $\hat z_t = (P^\top)^\dagger \hat u_t$。训练损失为领域基础损失加 OPF 项 $\mathcal{L}_{\text{OPF}} = \mathcal{L}_{\text{pred}} + \lambda_{\text{orth}}\mathcal{L}_{\text{orth}} + \lambda_{\text{fac}}\mathcal{L}_{\text{fac}} + \lambda_{\text{enc}}\mathcal{L}_{\text{enc}}$,各域按预测复杂度配置 $K\times r$(视觉 4×96、单细胞 4×128、分子 4×16、运动控制 4×8)。
核心创新是正交预测分解(OPF)及其几何保证。与标准 JEPA 的'单目标向量+单预测器'不同,OPF 把目标空间划分成 $K$ 个互不重叠的子空间,让易预测结构与弱结构各自获得专属容量和梯度通路,避免单头架构中的梯度冲突与方向冗余。命题 1 证明:当块内 $\|P_k^\top P_k - I_r\|_F$ 与块间 $\|P_i^\top P_j\|_F$ 罚项趋于零时,$P$ 为正交阵,因子空间构成正交直和,$\sum_k \|P_k^\top z\|_2^2 = \|z\|_2^2$ 信息无损且 $z = \sum_k P_k P_k^\top z$ 精确重构;推论 1 进一步证明此时 $\|\hat z - z\|_2 = \|e\|_2$、$\kappa_2(P)=1$,而无约束多头会出现重复方向导致 $P$ 秩亏或条件数任意大。CITRIS 机制审计实证了该理论:正交化使跨因子子空间重叠从 0.4550 降至 $5.18\times10^{-16}$,$\kappa_2(P)$ 从 438.52 降至 1.00005,合成 NMSE 从 0.7886 降至 $2.98\times10^{-14}$——正交性把多个预测输出变成完备、无重叠、数值稳定的统一世界状态接口。
方法步骤详情
训练循环六步,所有领域完全相同:(1) 适配器把原始观测 token 化并附描述子;(2) 视图采样器选出上下文与目标索引;(3) 在线编码器编码上下文,EMA 目标编码器(按 $\bar\theta \leftarrow m\bar\theta + (1-m)\theta$ 更新、不接收梯度)编码目标;(4) 各因子预测器 $q_k$ 从共享上下文与目标描述子预测对应因子;(5) 用基础损失加 OPF 损失更新在线编码器、投影与预测器——$\mathcal{L}_{\text{pred}}$ 直接回归因子目标,$\mathcal{L}_{\text{orth}}$ 约束块内近似标准正交与块间近似正交,$\mathcal{L}_{\text{fac}}$ 对投影目标坐标设经验标准差下限 $\gamma_{\text{fac}}$,$\mathcal{L}_{\text{enc}}$ 对在线上下文坐标设 $\gamma_{\text{enc}}$ 方差下限发送防坍缩梯度;(6) EMA 更新目标编码器。使用分三种模式:表征模式丢弃预测器、读在线编码器特征接任务读出头;操作性世界模型模式保留投影与预测器,用合成式得到下一潜状态供解码、CEM 规划或自回归 rollout;因子分析模式读 $u_k(x) = P_k^\top z_\delta(x)$ 做科学诊断。分子实例用 $P_k \otimes I_3$ 保持 $O(3)$ 等变性。
技术新颖性
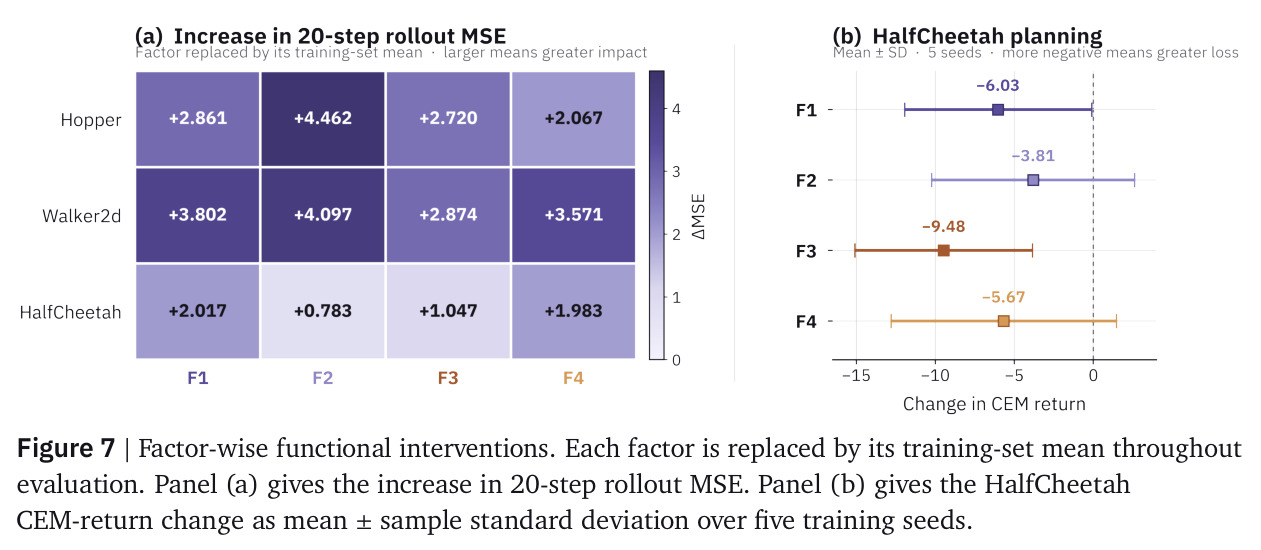
技术新颖性有五点:(1) 把 JEPA 的优化矛盾形式化为'共享接口不变、目标状态可分解'的容量分配问题,因子数与宽度按预测复杂度逐域配置(CITRIS 用 5×32,其余多为 4×r),接口层(式(1)之后)完全统一;(2) 正交性直接作用于学习到的预测目标子空间基,而非单嵌入统计量,与 Barlow Twins/VICReg 的冗余削减互补,并首次给出'稳定合成 vs 无约束头'的对比定理(推论 1);(3) 等变扩展:分子场景把通道投影作用于 $l=1$ 扇区的 64 通道乘性轴($d=64$, $K=4$, $r=16$),以 $P_k \otimes I_3$ 等价作用于三个分量,保持 $O(3)$ 等变性;(4) 可证伪的功能证据链:9 个预测任务路由统计显示平均 3.782 个有效因子、主因子占比仅 0.324(分布式活跃而非退化单头),运动控制中单因子 ridge 探针分别最可读出 Hopper 的足角($R^2=0.294$)、躯干高度(0.347)、躯干角度(0.424)、腿角(0.310),掩码任一因子都会增加 20 步 rollout MSE;(5) 因子坐标被用作科学接口,产出经湿实验验证的干预假设与开普勒标度律恢复。
实验结果
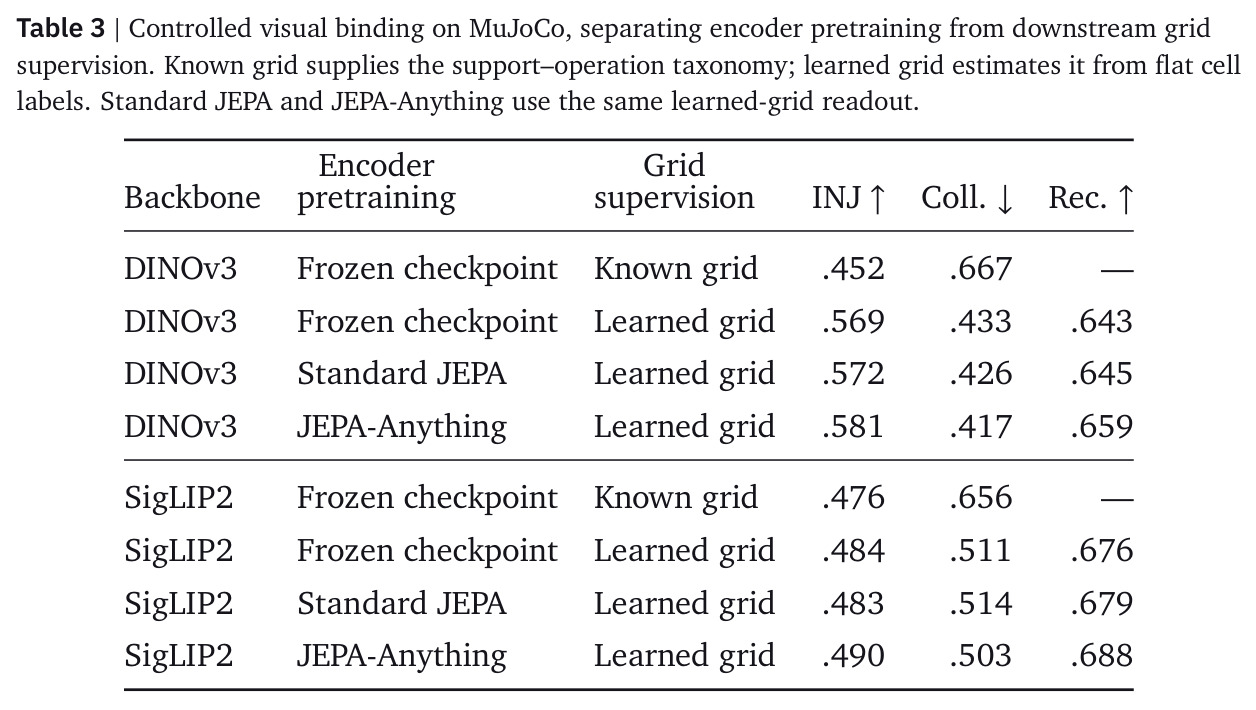
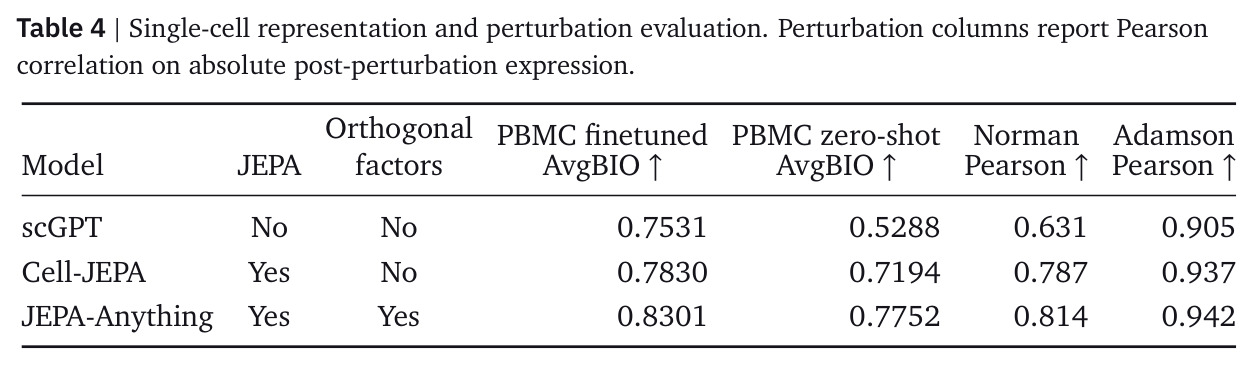
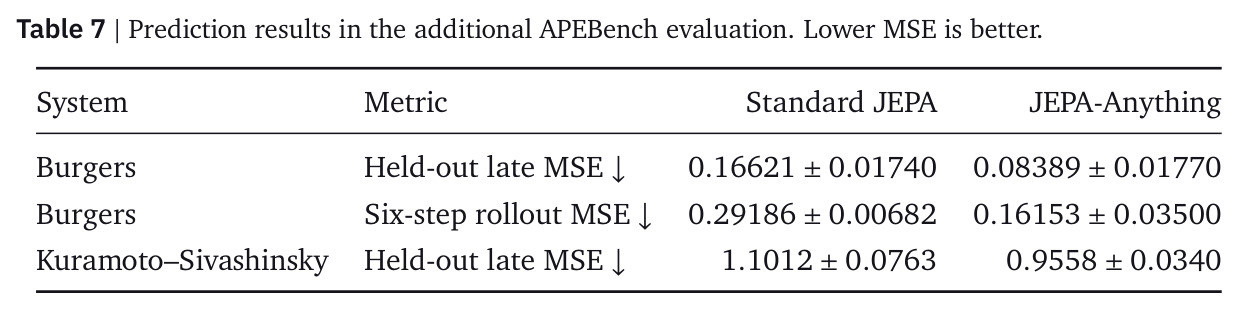
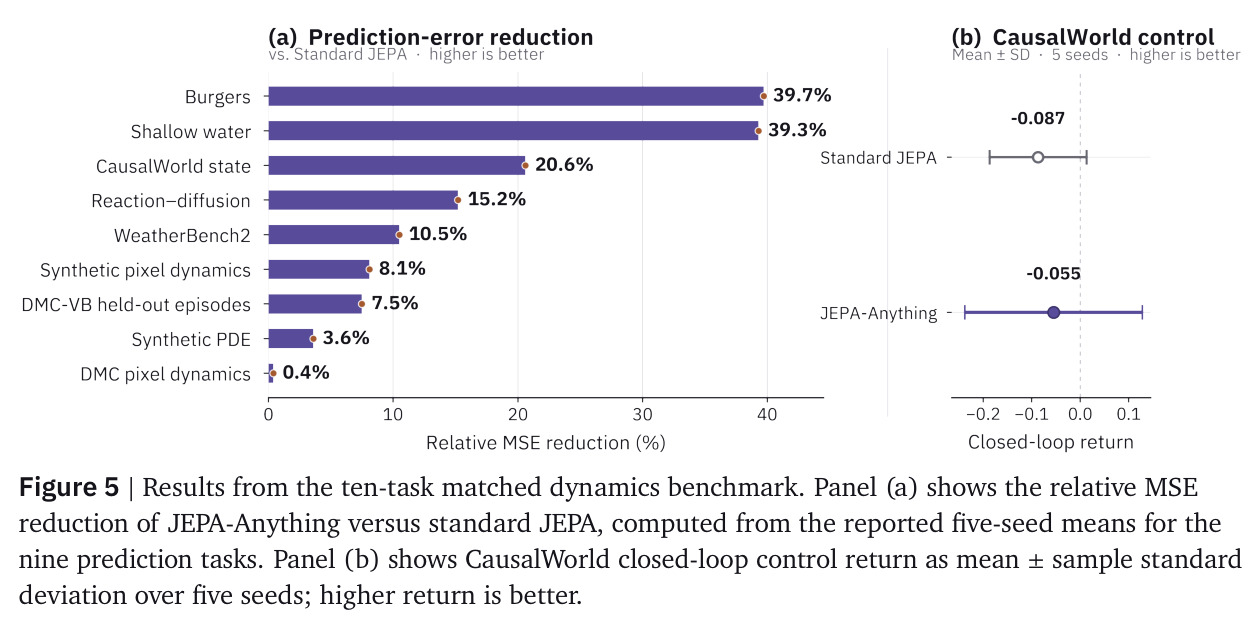
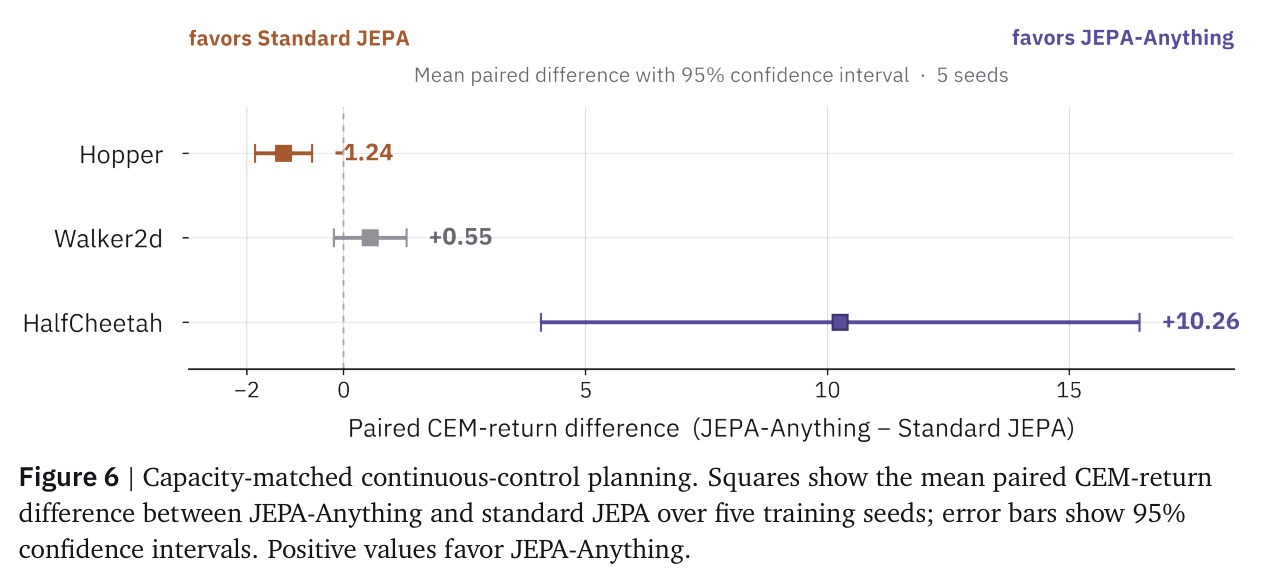
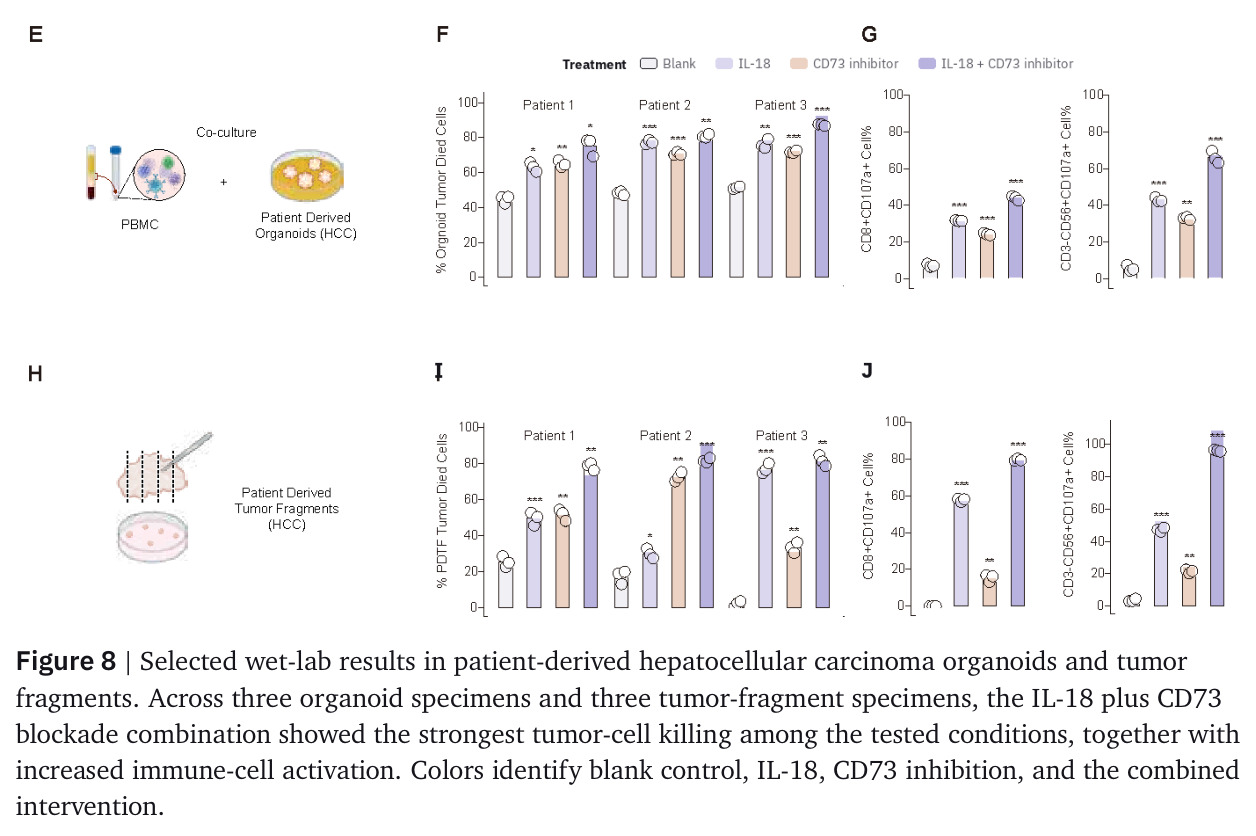
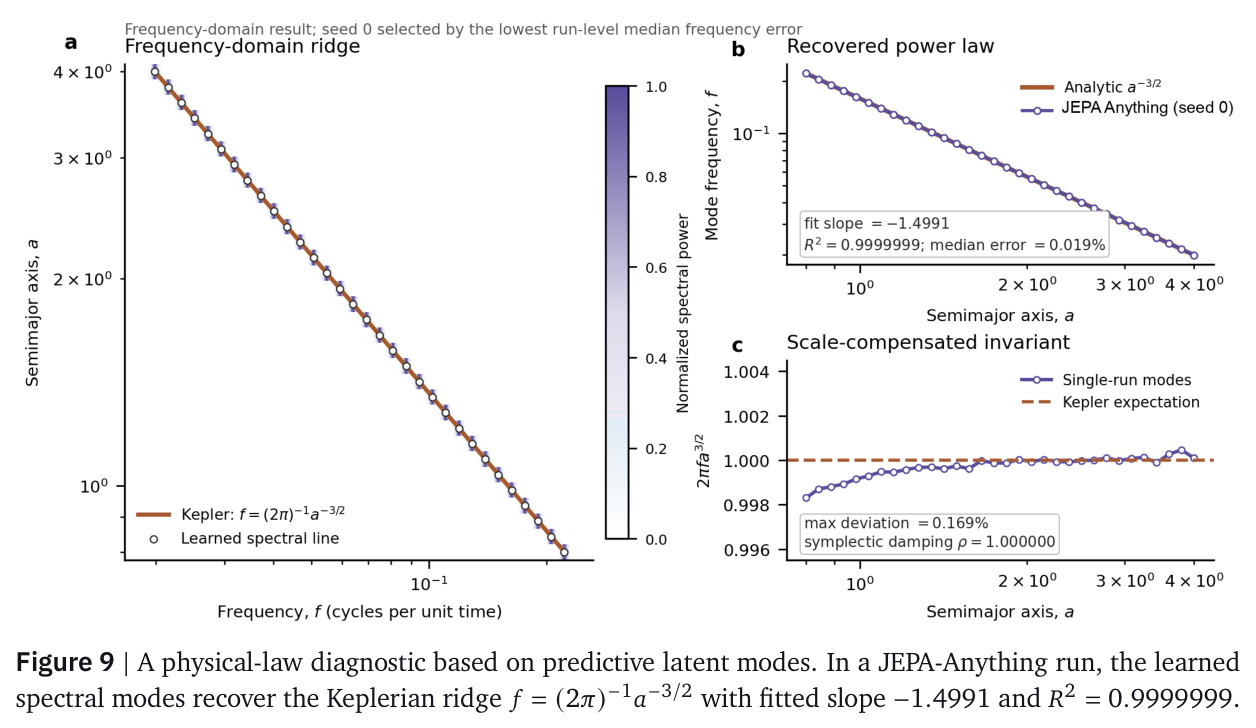
三组实验递进验证。Group I 终端读出:MuJoCo 视觉绑定上 DINOv3 的 INJ 从标准 JEPA 的 .572 升至 .581、坍缩率 .426→.417、网格恢复 .645→.659;SigLIP2 上 INJ .483→.490、Rec .679→.688。单细胞:PBMC-10K 聚类 AvgBIO 微调 .7830→.8301、零样本 .7194→.7752(scGPT 仅 .7531/.5288),Norman 扰动 Pearson .787→.814、Adamson .937→.942。临床预测在 1,000+ 事件上的平均 PRAUC 高于匹配 monolithic JEPA。Group II 动力学:CITRIS 单干预一步 MSE 0.009541→0.006218(−34.83%)、未见组合干预 −12.90%、六步 rollout −8.58%;10 任务匹配基准(CausalWorld/DMC/PDEBench/WeatherBench2)全部优于标准 JEPA,如浅水方程六步 0.010510→0.006522;APEBench Burgers 晚段 −49.5%、六步 −44.7%、KS −13.2%(每个 seed 均改善);50 步长程 ID 降 5.84%/3.15%、高频 OOD 降 5.01%/2.82%;分子四系统全部取得最低一步 MAE 与 100 步 RMSD(水 2.536→2.459 Å、对乙酰氨基酚 1.868→1.776 Å)。控制规划在 Walker2d 与 HalfCheetah 上 return 更高、Hopper 落后。Group III:OPF 提名的 IL-18+NT5E/CD73 阻断在 Huh7–PBMC 共培养、3 个类器官、3 个肿瘤切片与免疫健全小鼠中获最强肿瘤杀伤;轨道潜模式拟合开普勒标度斜率 −1.4991、$R^2=0.9999999$。
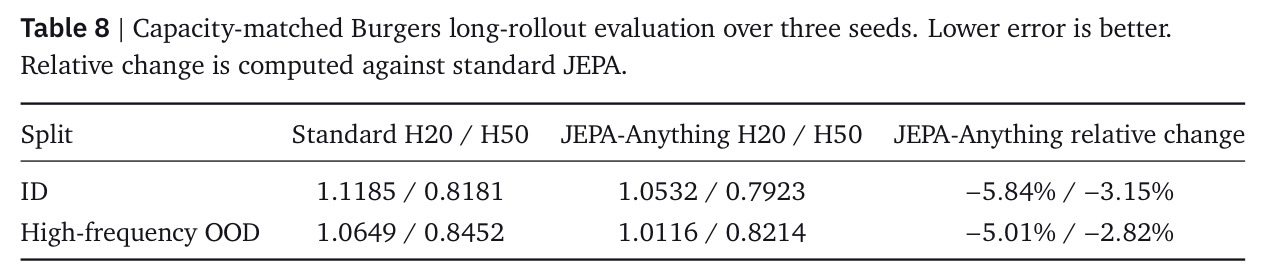
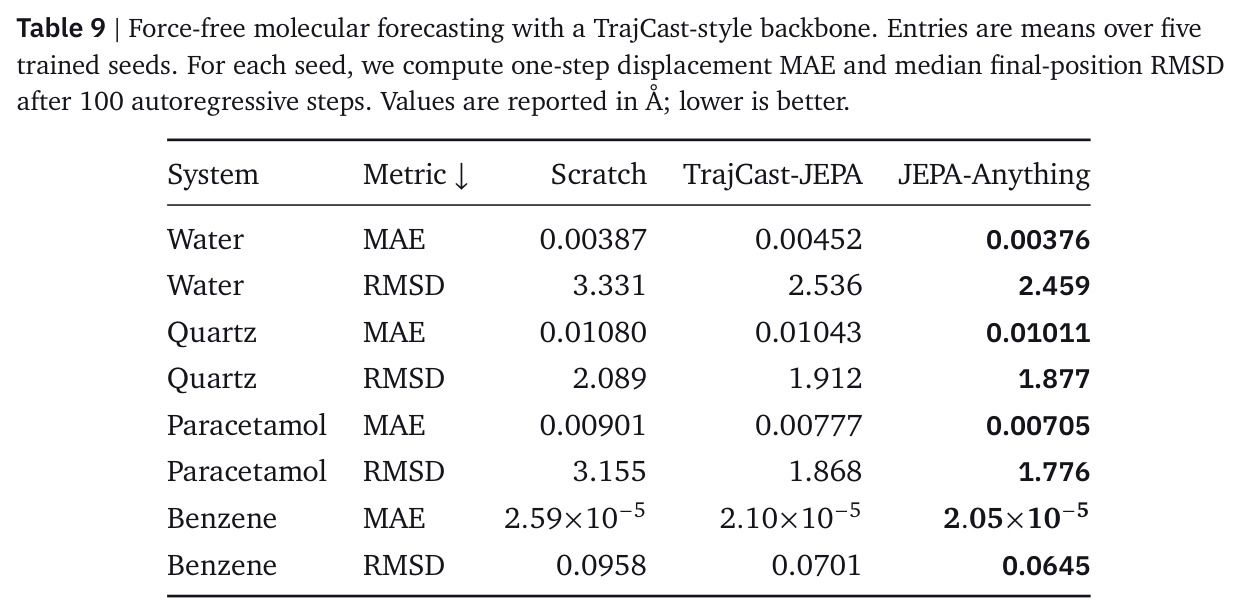
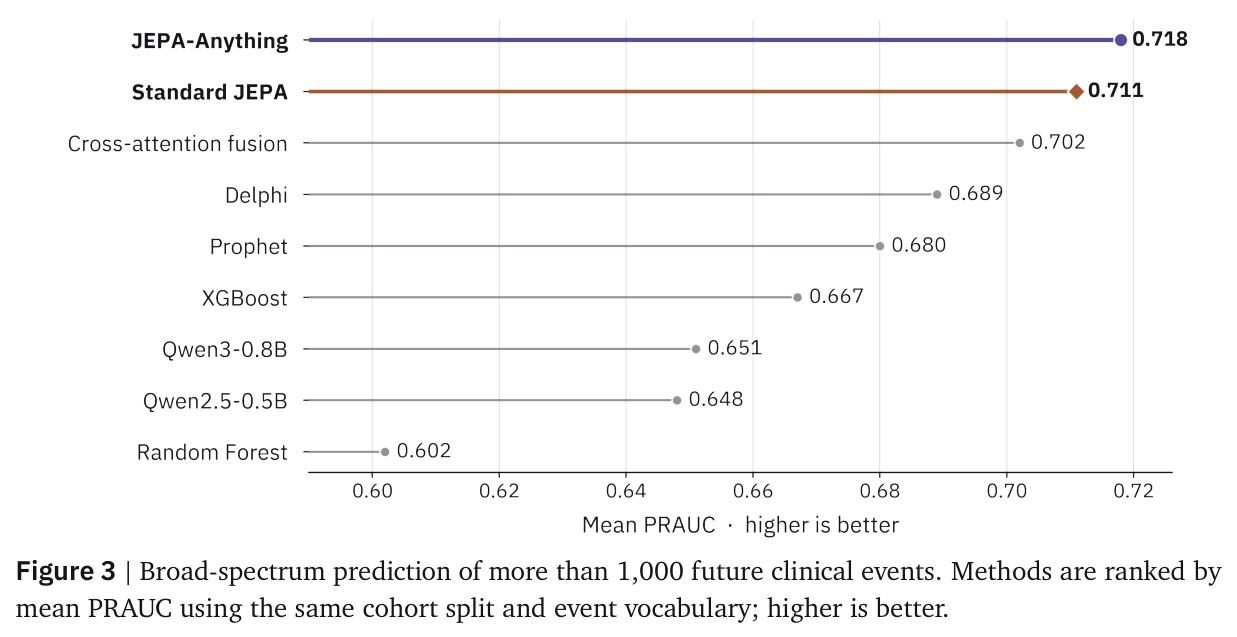
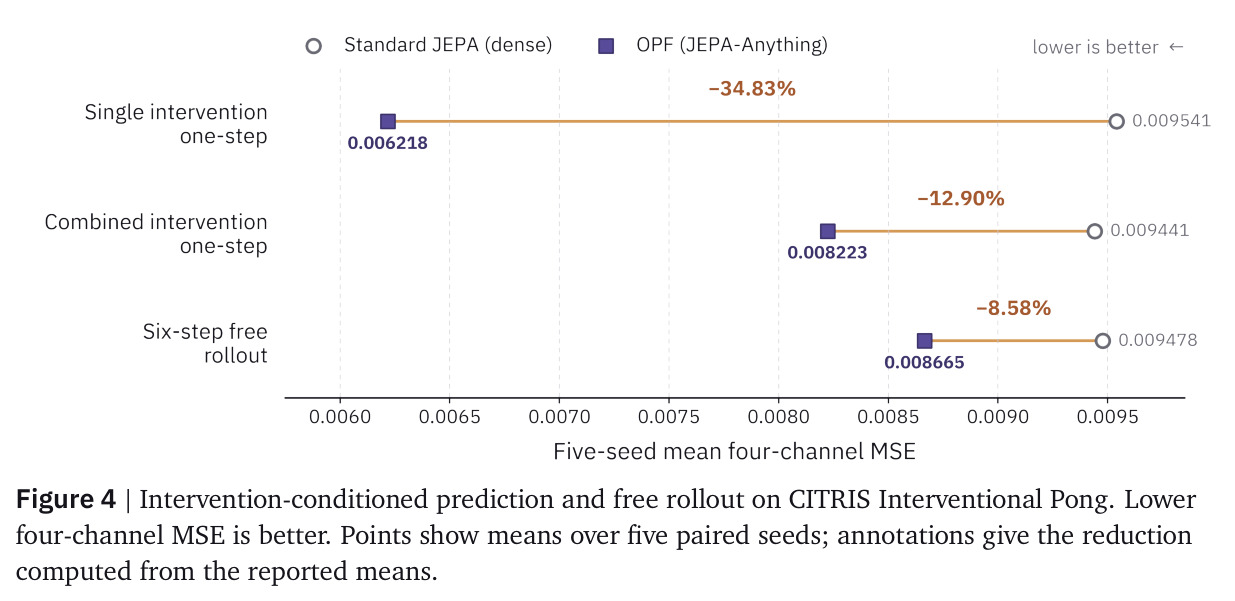
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| CITRIS Interventional Pong 单干预一步预测 | 四通道 MSE | 0.006218 | 标准 JEPA 0.009541 | 误差降低 34.83% |
| CITRIS 未见组合干预一步预测 | 四通道 MSE | 0.008223 | 标准 JEPA 0.009441 | 误差降低 12.90% |
| CITRIS 六步自由 rollout | 四通道 MSE | 0.008665 | 标准 JEPA 0.009478 | 误差降低 8.58% |
| 十任务匹配动力学基准(CausalWorld/DMC/PDEBench/WeatherBench2) | MSE(5 seeds) | 10/10 任务全部占优,如 PDEBench 浅水六步 0.006522 | 标准 JEPA 0.010510 | 全部任务 MSE 下降 |
| APEBench Burgers 晚段预测 | held-out late MSE | 0.08389 ± 0.01770 | 标准 JEPA 0.16621 ± 0.01740 | 降低约 49.5%,每个 seed 均改善 |
| 力场无关分子预测(水/石英/对乙酰氨基酚/苯) | 一步 MAE 与 100 步中位 RMSD | 四系统全部最低,如对乙酰氨基酚 RMSD 1.776 Å | TrajCast-JEPA 1.868 Å / 从零训练 3.155 Å | 四个系统一步与长程误差均为最优 |
| PBMC-10K 细胞类型聚类 | AvgBIO | 微调 0.8301 / 零样本 0.7752 | Cell-JEPA 0.7830/0.7194;scGPT 0.7531/0.5288 | 两个设定均为第一 |
| MuJoCo 受控视觉绑定(DINOv3,10 seeds) | INJ / Coll. / Rec. | .581 / .417 / .659 | 标准 JEPA .572 / .426 / .645 | INJ 与恢复率提升、坍缩率下降 |
局限与改进
作者明确承认的局限:连续控制结果环境依赖——Hopper 上标准 JEPA 的 CEM return 更高,因子分解不自动带来规划收益;因子读出的差异化运动偏好是'线性可访问'的,不等于预分配的一一对应语义标签;正交因子本身不建立因果机制;共享预测架构不保证跨域表征对齐;分布偏移下的不确定度校准以及'模型何时可靠到足以指导实验'尚未解决。我自己的观察:(1) 多处改进幅度偏小——DMC 像素动力学 MSE 仅从 0.008539 降到 0.008498,50 步 Burgers 增益收窄至 −3.15%/−2.82% 且随视界缩短;(2) Group III 的科学验证是单例:一个被提名的干预组合、一次轨道分析运行,缺乏多假设、多癌种、多系统的统计力;(3) 临床实验只与自家 monolithic JEPA 相对比较、未对标临床预测专用 SOTA,图 3 也未给出绝对 PRAUC 数值;(4) $K$、$r$、$\lambda$ 与 $\gamma$ 阈值需逐域调节(Table 2 显示每个域配置不同),削弱了'同一原则免定制'的叙事完整性;(5) 气象(WeatherBench2)未单独报告详细结果,仅并入 10 任务基准。
独立分析的弱点
(1) 增益不一致且部分微弱:Hopper 的配对 CEM return 为负、DMC 像素 MSE 仅降约 0.5%,说明目标低维或本就容易预测时正交分解收益有限;改进方向是基于因子活跃度自适应增删分支(自动选择 $K$),替代对 $\{1,2,4,8\}$ 的网格搜索。(2) 超参负担重:$\lambda_{\text{orth}}, \lambda_{\text{fac}}, \lambda_{\text{enc}}$ 与两个活动下限 $\gamma$ 需逐域调节,建议给出跨域默认值敏感性分析或梯度自动平衡。(3) 伪逆合成依赖软罚项:非严格正交时数值稳定性靠 $\lambda_{\text{orth}}$ 权衡,预测模型也可直接用 QR 重参数化 $P_{\text{raw}}=QR$ 硬保证正交(论文仅在受控几何分析中采用)。(4) 科学验证样本量单薄:一个干预提名、3 个类器官与 3 个肿瘤切片、一次轨道运行,需多假设、多癌种、多物理体系重复才能支撑'科学发现'主张。(5) 计算开销未报告:$K$ 个预测器加伪逆在百步 rollout 下的墙钟时间与显存成本没有与 $K=1$ 的对比。
未来方向
作者提出的方向:把 JEPA-Anything 作为 Discovery Foundation Models(DFM)的预测基底,接入 ScienceIDE 的可执行科学环境(运行分析、调用仿真、获取可验证反馈)与 ScienceBuddy 的交互式研究工作台(harness 进化与模型学习耦合),形成'世界模型提名候选干预→外部实验验证→按期望与观测的差距修正模型/变量/假设'的科学学习闭环;需突破的关键问题包括分布偏移下的不确定度校准、判断模型何时可靠到可以指导实验、以及新证据揭示缺失结构时如何修正预测因子。基于本文成果可延伸:把因子干预框架推广为主动因果发现——用因子级扰动在湿实验中系统探索干预空间并迭代更新世界模型;跨领域联合训练单一 OPF 核心检验因子可迁移性;与等变/几何自监督深度结合扩展到刚体、流体等更强对称性领域;在真实机器人上验证长程 rollout 稳定性增益能否转化为操作任务成功率。
复现评估
复现友好度较高。论文首页标注 Code: JEPA-Anything 与 Models: Jepa-Anything2026,承诺开源代码与模型;所有基准均为公开数据/环境(MuJoCo、PBMC-10K、Adamson、Norman、CITRIS、CausalWorld、DMC、PDEBench、WeatherBench2、APEBench、TrajCast 分子体系),并固定随机种子(动力学 {11,23,37,53,71}、控制 {42,123,456,789,2026})、匹配参数量(差异 <0.3%)与 FLOPs(<2%),五 seeds 报均值±标准差,对照设计干净。算力门槛分层:APEBench 的 MLP 仅训练 2,000 步、Burgers 长程协议 3 seeds,单卡即可;视觉绑定用冻结的 DINOv3 ViT-S/SigLIP2 Base 自训练,单卡可承受;单细胞需在约 80 万肾脏细胞上预训练 scGPT,需要中等规模 GPU。难点在 Group III:湿实验需要 Huh7–PBMC 共培养、患者来源类器官、肿瘤切片与免疫健全小鼠平台,纯计算实验室无法复现;轨道分析的模拟轨迹生成细节未完整公开。
论文图表
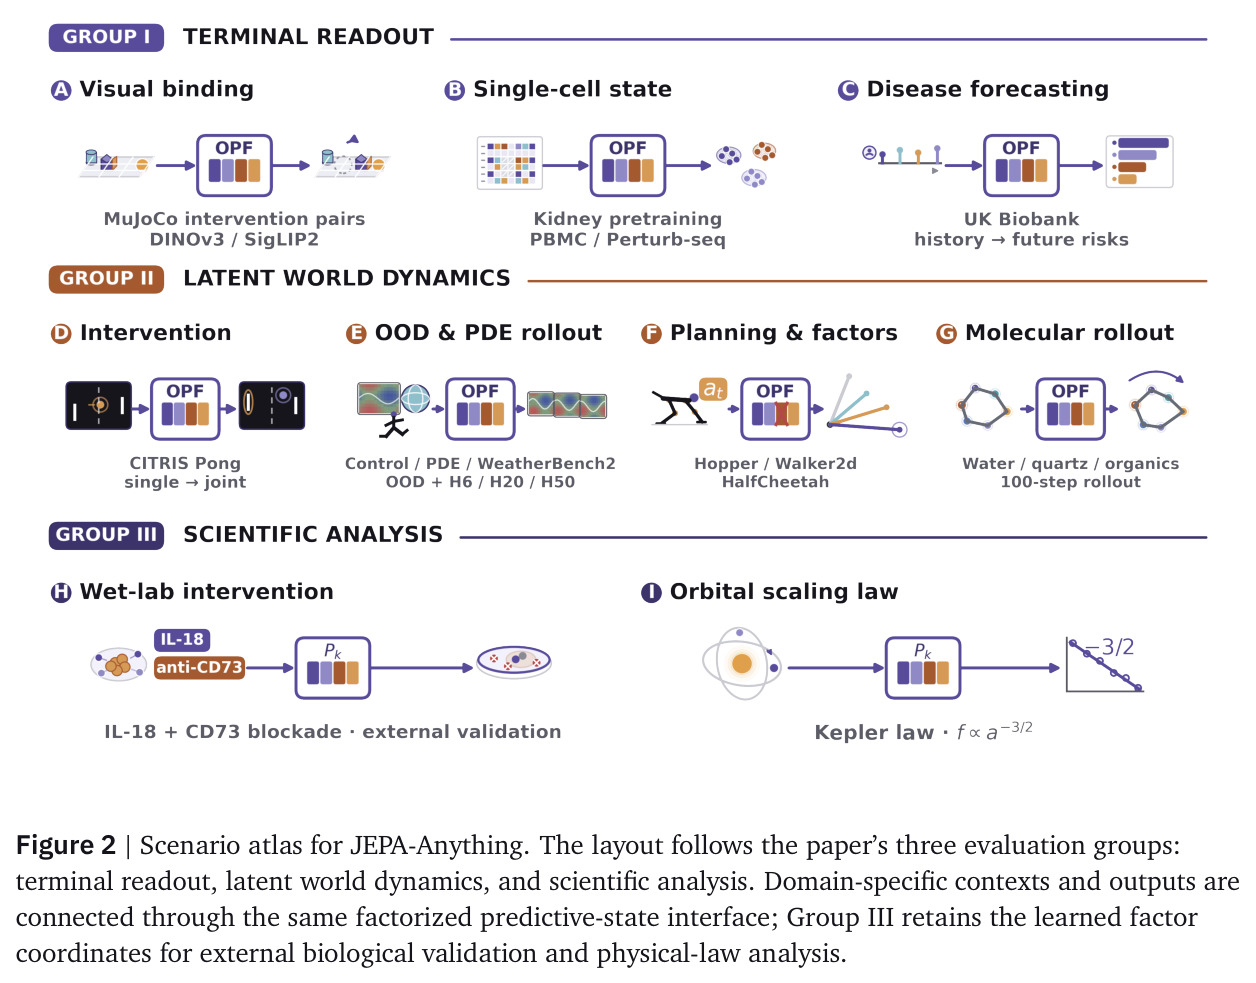
按论文三组评估(terminal readout、latent world dynamics、scientific analysis)排布的场景图谱:各领域的上下文与输出经由同一个因子化预测状态接口相连,Group III 保留学习到的因子坐标用于外部生物验证与物理定律分析。
帮助读者在进入实验细节前建立全局地图,理解七个领域如何共享同一接口以及各组实验验证的能力层次。