MemSteer:将用户历史转化为智能体记忆优化的监督信号 MemSteer: Turning User Histories into Supervision for Agent Memory Optimization
从无标注用户历史自动构建QA与证据监督,无需人工标注即可评估并迭代优化智能体记忆设计
前置知识
智能体外置记忆系统
智能体长期服务用户时,靠外置记忆系统存储并整理跨会话积累的对话、邮件、文档等历史记录;回答时先从记忆中检索相关内容,再拼装进上下文交给大模型作答。记忆设计通常分三层:存储(记录如何切分、组织成记忆单元并建索引)、检索(如何找到相关记录)、上下文构建(如何把检索结果组装给回答模型)。
本文全部目标就是自动优化这三层设计 $d=(s,r,c)$,实验中的失败诊断(storage/retrieval/answering 三类)也直接对应这三层,不懂这个框架就读不懂方法与实验。
合成QA与答案恢复一致性
缺少人工标注时,可让 LLM 从语料自动生成问题-答案对,再让一个只看问题与原始语料、不看标注的“盲”模型尝试作答;若其答案与参考答案一致,说明该 QA 在语料中确实可回答、可验证。这一 roundtrip 一致性过滤思想源自 Alberti et al. (2019) 合成阅读理解数据的工作。
MemSteer 的“盲答案恢复”验证是该思想的强化版(还要求引用覆盖每条证据记录),是整条监督流水线质量的关键闸门。
BM25与混合检索组件
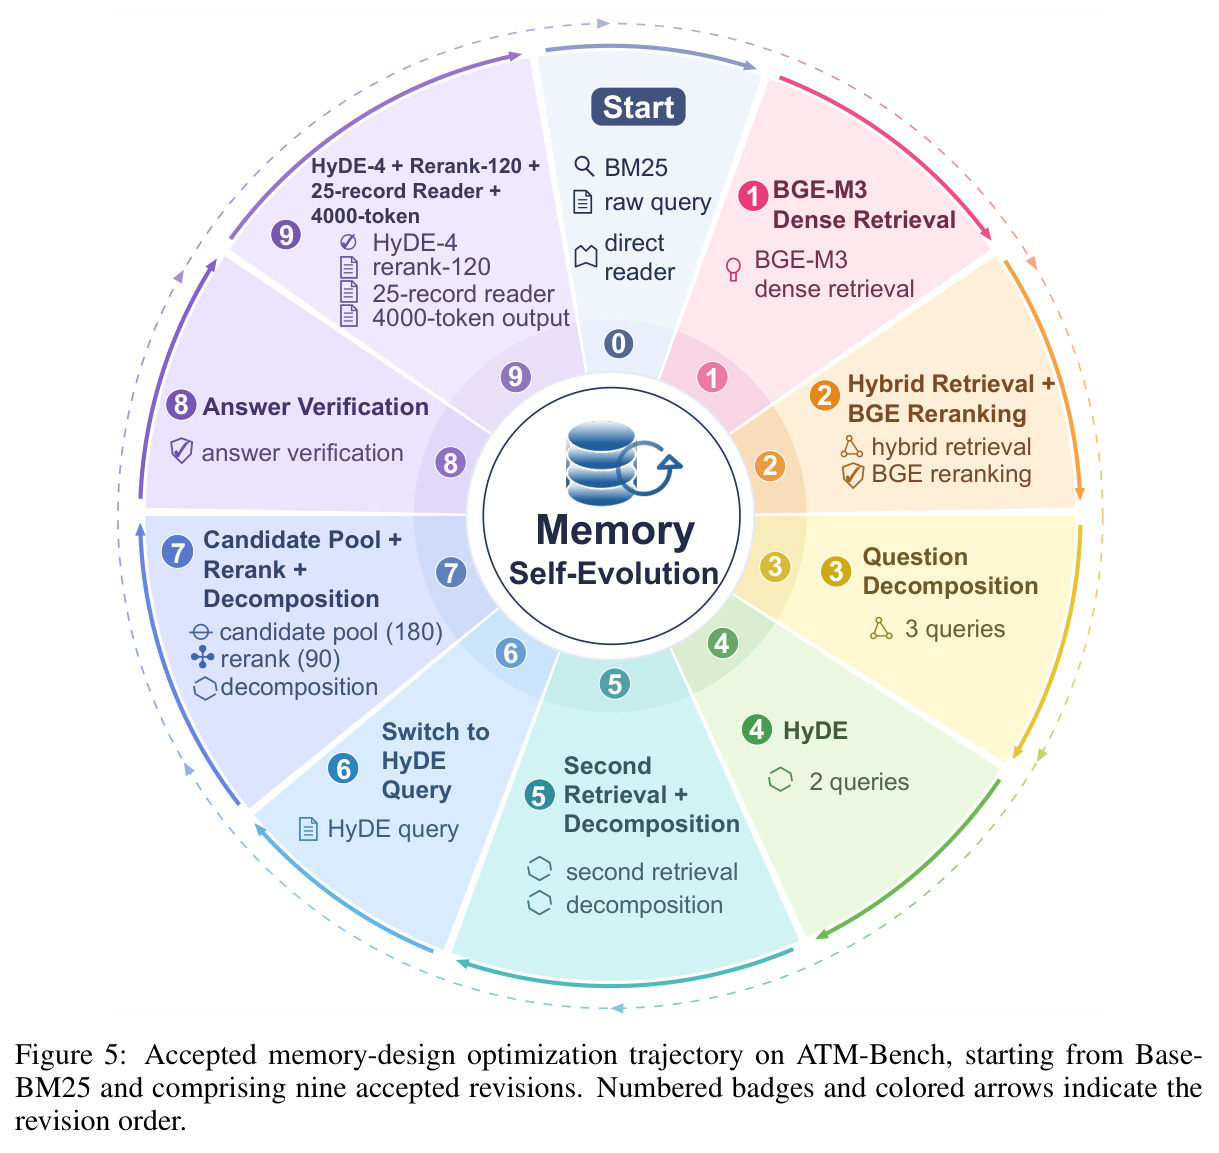
BM25 是基于词频与逆文档频率的稀疏检索算法,是本文所有优化的起点 Base-BM25。dense retrieval(如 BGE-M3 嵌入)做语义匹配;HyDE 让模型先生成假设答案再嵌入检索;rerank 用重排模型对候选精细排序;hybrid retrieval 融合多路检索结果。
Figure 5 的优化轨迹正是依次引入这些组件(BM25→dense→hybrid→rerank→问题分解→HyDE→答案验证),认识它们才能看懂优化出的最终设计长什么样。
LLM-as-a-judge开放式问答评分
对没有唯一标准答案的开放问题,用固定的大模型按协议判定预测是否正确。ATM-Bench 的 Question Score 综合三种计分:数值题精确匹配、列表题 Jaccard 部分得分、开放题由裁判打分。本文用 DeepSeek-V4-Flash 同时充当回答者、裁判与设计提议者。
论文所有主指标(QS、accuracy)都建立在这套协议上;且裁判与优化器共用同一模型这一点,也是评估结果可信度时需要注意的细节。
证据溯源与多跳问答
证据指支撑答案的源记录及具体片段(span)引用。多跳问题需要跨多条记录联合推理,ATM-Bench-Hard 是仅 31 题的困难多跳子集(Base-BM25 上 QS 仅 8.2)。用 gold evidence 直接作答的 Oracle 达 QS 71.8/46.2,说明检索与上下文组装仍有巨大提升空间。
证据标注是 MemSteer 区别于只生成 QA 的前作(MemBuilder、MemMA)的核心:有了记录级证据 ID,失败才能被机械地归因到存储/检索/回答具体环节。
研究动机
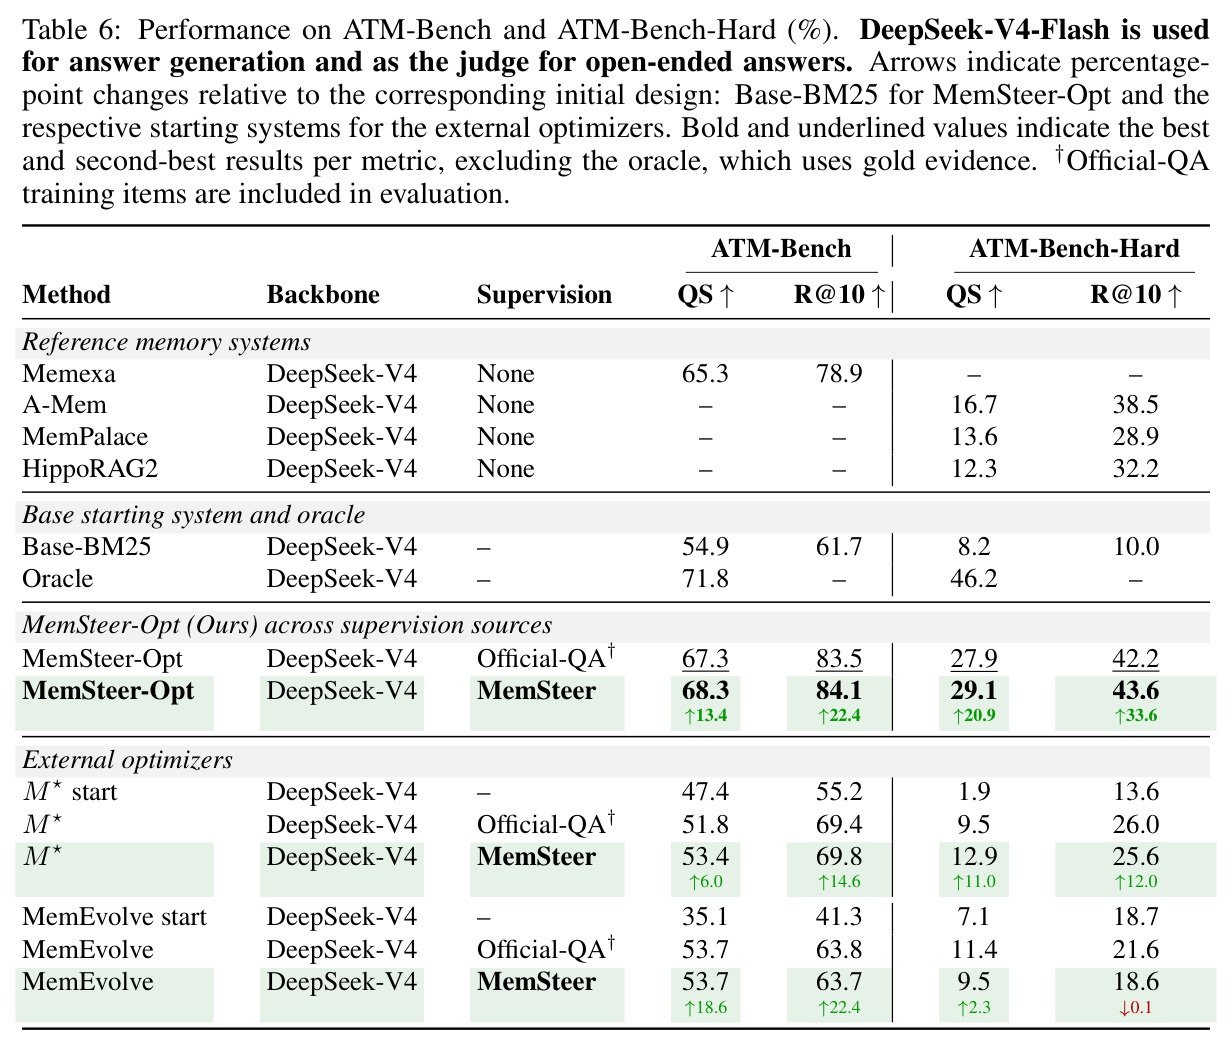
智能体记忆系统的设计——存储粒度、检索策略、答案上下文构建——决定用户历史能被利用到什么程度,而不同用户历史在内容、模态与组织方式上差异巨大,一个设计并不适合所有用户。近期工作 MemEvolve、ALMA、M$\star$ 通过下游任务反馈自动优化记忆设计,但它们依赖可执行任务天然产生的成功/失败信号;个人记忆场景中的邮件、照片、视频与日常对话并不携带这种信号,优化因此缺少反馈来源。人工标注 QA(问题+参考答案+支撑证据)可以提供信号(M$\star$ 即用官方 QA 引导优化),但为每个新用户标注成本高昂,无法随用户规模扩展。从基准看,LoCoMo、LongMemEval 等对话记忆基准已近饱和,而更有挑战的 ATM-Bench(约四年个人历史、11,034 条邮件/图像/视频记录)上,朴素的 BM25 检索直读系统在 1,013 题主集 Question Score 仅 54.9、31 题困难多跳集仅 8.2,证据召回 R@10 仅 61.7/10.0,与用 gold evidence 的 Oracle(71.8/46.2)差距巨大,说明现有记忆设计远未榨干用户历史的价值。
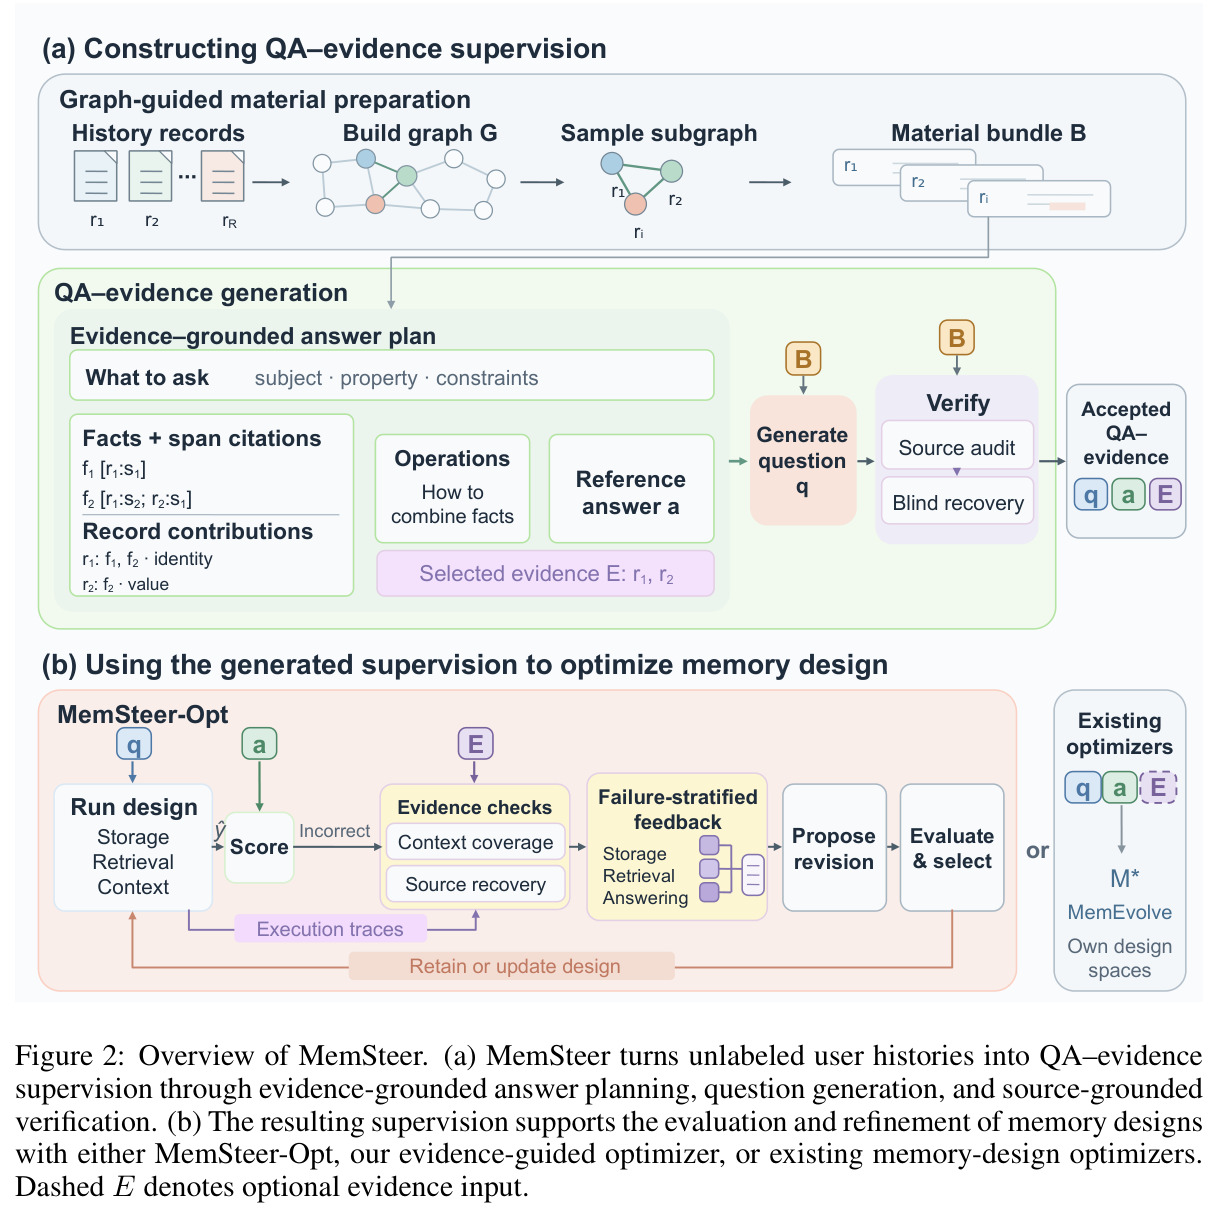
本文的目标是本文的目标是:给定无标注的用户历史 $H$,不依赖任何人工标注,自动构造 QA-证据监督 $D_H=\{(q_i, a_i, E_i)\}_{i=1}^N$,其中 $q_i$ 是关于历史的问题、$a_i$ 是参考答案、$E_i$ 是选中的源证据记录(附 span 级引用保证可溯源),再用这份监督去评估和迭代改进记忆系统设计 $d=(s,r,c)$(存储、检索、上下文构建),全程不更新任何模型参数。两类标注各司其职:参考答案提供候选设计优劣的评判标准(在验证集上算准确率 $A(d)$ 选设计),证据标注提供失败诊断的依据(判断错误出在存储、检索还是回答)。作者还要求这份监督是“通用燃料”:不仅能驱动自研的 MemSteer-Opt,也能插入 M$\star$、MemEvolve 等现有优化器各自的设计空间,并支持跨基准迁移和面向新用户的持续优化。
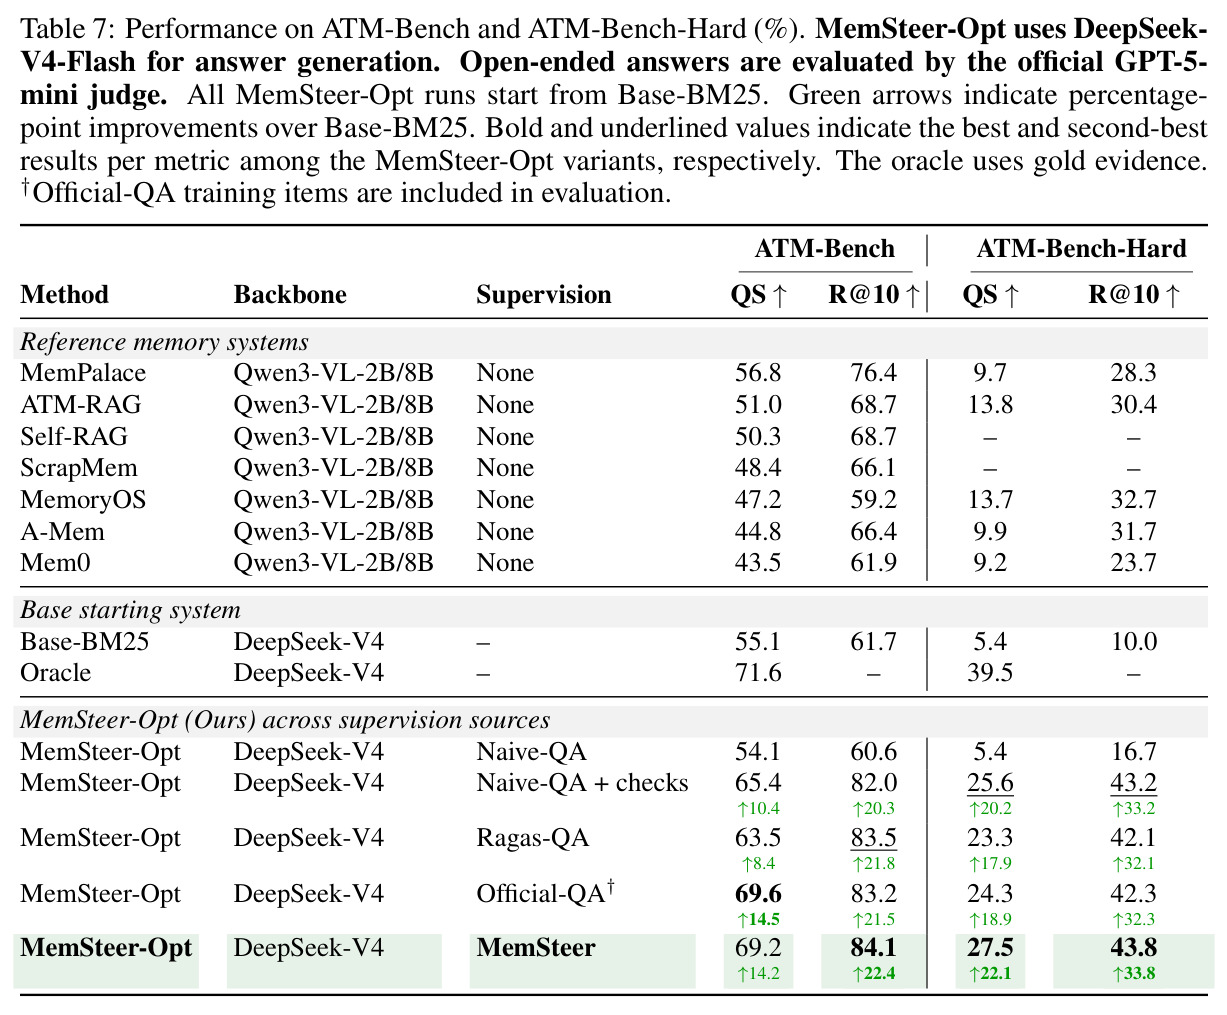
与已有工作不同的是,本文的独特切入在于“监督的构造与用法”。同为历史生成 QA:MemBuilder、CMI-Mem 把 QA 准确率当作 RL 奖励训练记忆构建模型,MemMA 用 QA 探针修复已存记忆——它们优化模型参数或记忆库本身;MemSteer 则让历史生成的 QA-证据充当“设计评审与诊断”的反馈,优化对象是记忆系统设计。与 RAG 合成基准工作(DataMorgana、Ragas)相比,MemSteer 不止生成题目,还强制先构建 evidence-grounded answer plan——显式规划哪些记录的哪些事实以何种操作联合支撑答案,再据此出题,并经程序化检查+语义审计+盲答案恢复三重验证;记录级证据使其能做阶段级失败归因,而 Ragas 类工具只产出测试题。与官方 QA 引导优化相比,MemSteer 的训练/验证题完全来自历史生成、与评测集严格分离,而 Official-QA 参照的训练题本身包含在评测集内;即便如此 MemSteer 仍略胜 Official-QA(ATM 主集 68.3 vs 67.3),这是“无标注历史足以替代人工标注”的最强证据。
核心方法
直觉上,MemSteer 是给无标注历史配一位“既能出题、又能标出答案对应原文出处”的自动阅卷老师:标准答案用于给候选记忆设计打分排名,证据出处用于在答错时定位是没存到、没检索到还是没答好。技术路线分两块。(a) 监督构造(§3.2):先把用户历史组织成源记录图 $G$(边来自共享会话、相邻文档节、显式引用、词法重叠),从种子路径扩展采样连通子图,打包成预算内的 material bundle $B$;LLM 规划器在 $B$ 上构建 evidence-grounded answer plan(问什么、支撑事实及 span 引用、各记录贡献、组合操作),先过程序化结构/溯源检查,再单独生成问题;随后源锚定验证:审查员做语义审计,盲读者只拿问题+答案类型+源记录作答并给引用,要求可答、类型规范化后精确匹配、引用覆盖全部证据。(b) 监督使用(§3.3):MemSteer-Opt 从 Base-BM25 出发迭代 20 轮,每轮对训练集失败做证据归因与分层采样,LLM 提议者据此修订 $(s,r,c)$,验证集准确率提升才接受;同一份监督也可直接供给 M$\star$、MemEvolve 在各自设计空间内优化。
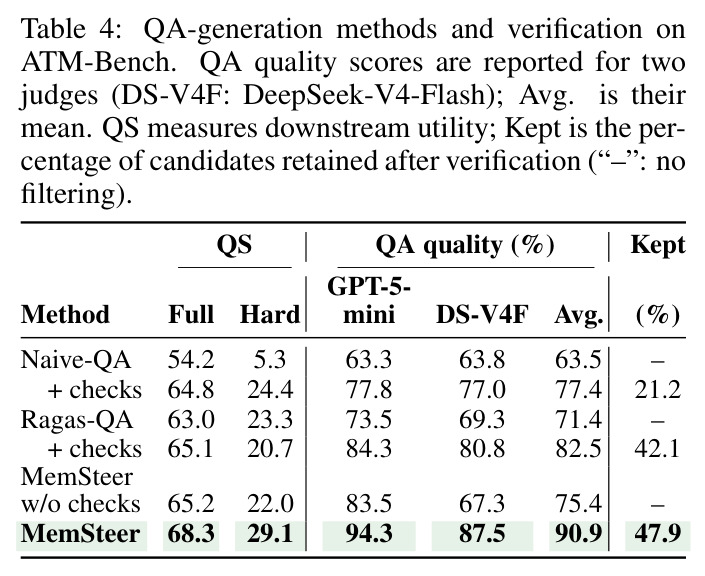
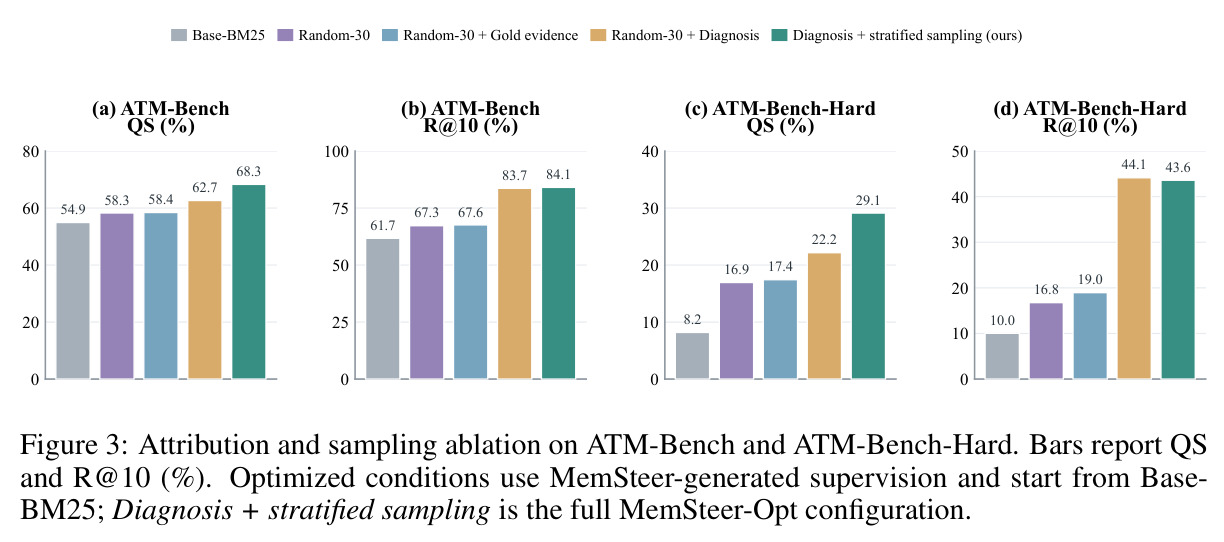
核心创新有两点。第一,evidence-grounded answer planning 前置于问题生成:先显式规划“哪些记录的哪些事实(带 span 引用)经何种操作联合支撑哪个答案”,再据此生成独立问题。Table 5 消融显示这是质量跃升的关键:一步直出质量仅 67.8%,同响应内先计划后出题 73.1%,两阶段达 85.9%。这与 Alberti et al. 的答案选择+roundtrip 过滤有本质区别——证据从生成的“附带产物”升级为“生成前提”。第二,source-grounded verification 三重闸门:程序化检查、语义审计(逐事实/逐记录的结构化判定)、盲答案恢复(类型规范化精确匹配+引用覆盖每条证据),把 QA 质量从 75.4% 提到 90.9%。正因为每条 QA 带有已验证的记录级证据,下游失败诊断才能机械化——检查证据是否进入最终上下文、缺失记录能否从记忆恢复——把模糊的“答错了”变成可操作的存储/检索/回答三类诊断;Figure 3 显示显式归因(QS 62.7)远比只给 gold evidence 不给归因(58.4)有效。
方法步骤详情
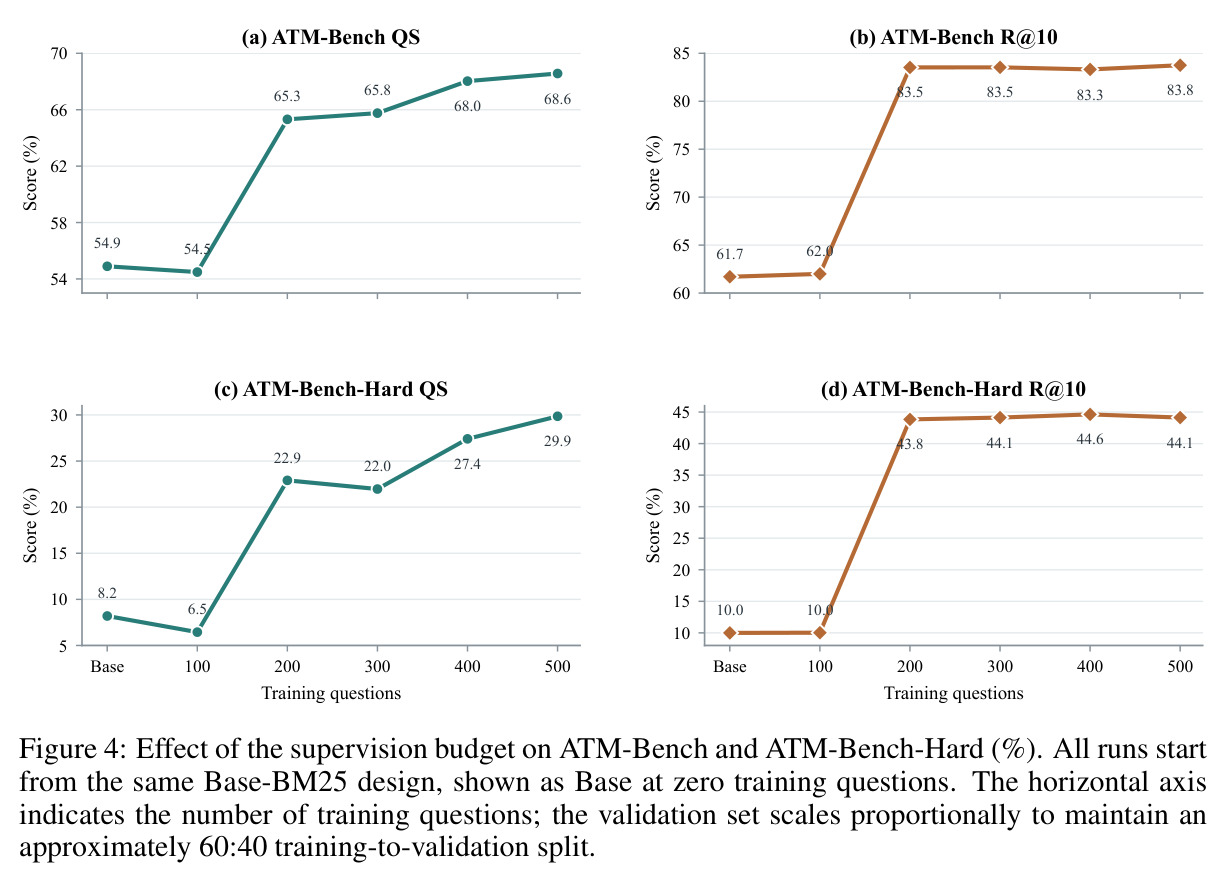
第 1 步·材料准备:历史记录建图 $G$,从种子路径扩展采样连通子图,输出预算内 material bundle $B$(含 span 引用)。第 2 步·答案规划:规划器读 $B$ 产出计划——问题主题、支撑事实如 $f_1[r_1{:}s_1]$、各记录贡献与组合操作;程序化检查结构一致性与溯源覆盖,不合格即拒。第 3 步·问题生成:基于通过检查的计划与 $B$ 生成 standalone 问题。第 4 步·验证:审查员输出结构化判定(逐事实源支持、问题-计划一致性);盲读者只拿问题+答案类型+源记录作答,须声明可答、类型规范化后一致、引用覆盖每条证据。第 5 步·划分训练/验证集(如 ATM 用 400+200,RHELM 788 题)。第 6 步·优化循环:构建记忆 $M_d=\mathrm{Stores}(H)$,检索组装上下文并作答;对训练集错误归因(证据全在上下文→answering;缺失且不可恢复→storage;缺失但可恢复→retrieval);按类别分层采样(每类≤10 例)交提议者产出修订 $d‘$;验证集上仅当 $A(d’)>A(d_t)$ 才替换;接受后重跑训练集刷新诊断。共 20 轮。
技术新颖性
新颖性有五层。(1) 定位:把“合成 QA”从训练信号(MemBuilder 的 RL 奖励)或记忆修复探针(MemMA)升级为设计级优化的监督源,且训练/验证题与评测集严格隔离——表中 † 标明 Official-QA 训练题包含在评测集内,MemSteer 则完全不碰评测题,对比更严格。(2) 机制:answer plan 使证据成为出题前提,两阶段解耦让程序化检查在出题前拦截坏计划(85.9% vs 直出 67.8%),代价是每题 105.1k tokens。(3) 验证:盲恢复不仅匹配答案还要求引用覆盖每条选中证据,把“可答性”与“证据链完整性”绑定(但不保证证据必要性)。(4) 反馈:失败归因完全机械可执行——证据 ID 已知,做上下文包含性与记忆可恢复性检查即可;分层采样(每类≤10 例)防止高频失败类型耗尽反馈预算。(5) 可移植:同一份监督插入 M$\star$(+6.0 QS,超 Official-QA 的 +4.4)与 MemEvolve(+18.6,持平)均有效,证明贡献在监督本身而非私有优化器。整体是把评测集合成技术移植到缺乏标注反馈的智能体记忆场景,并补齐证据归因这一关键环节。
实验结果
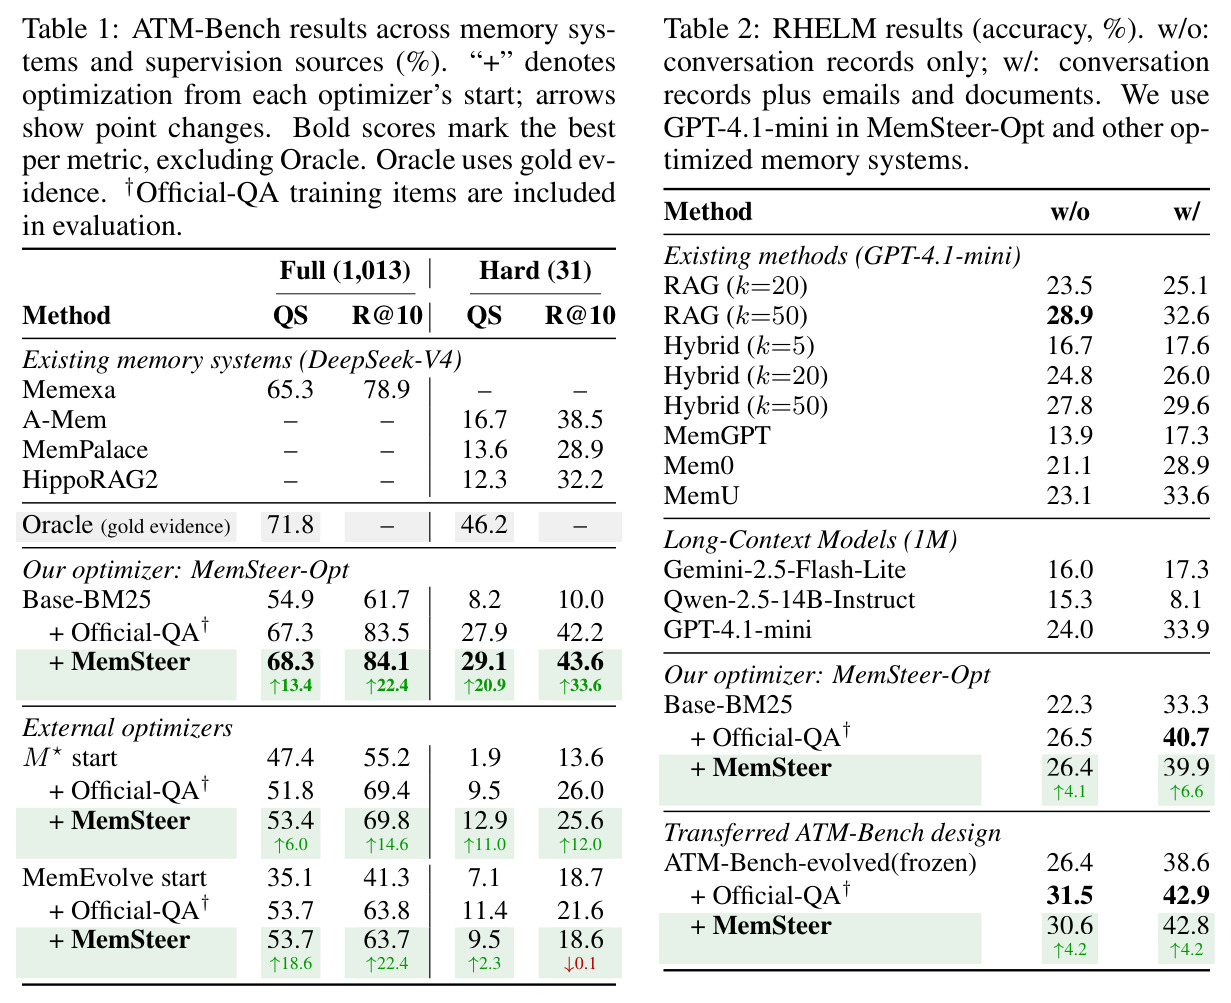
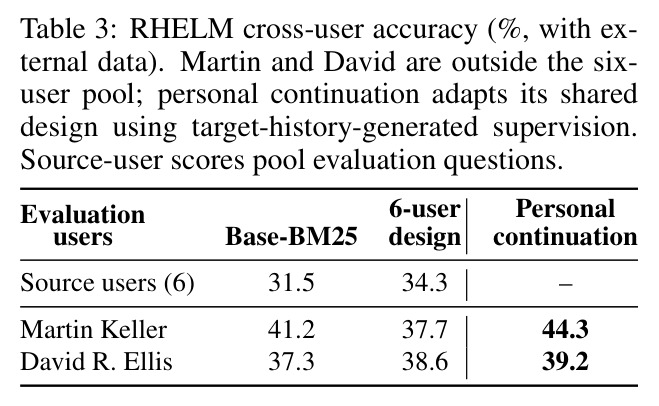
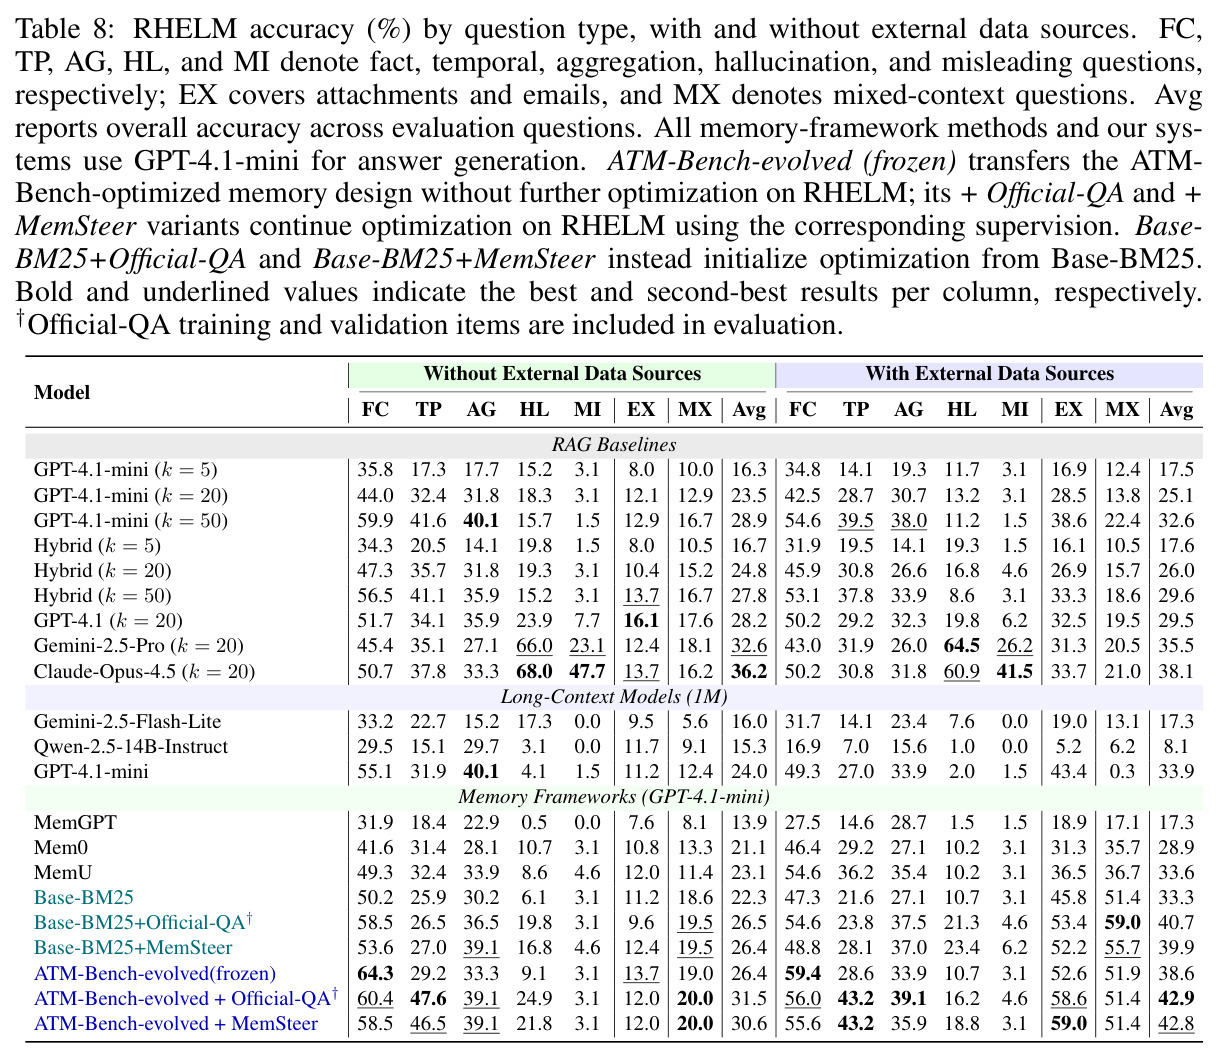
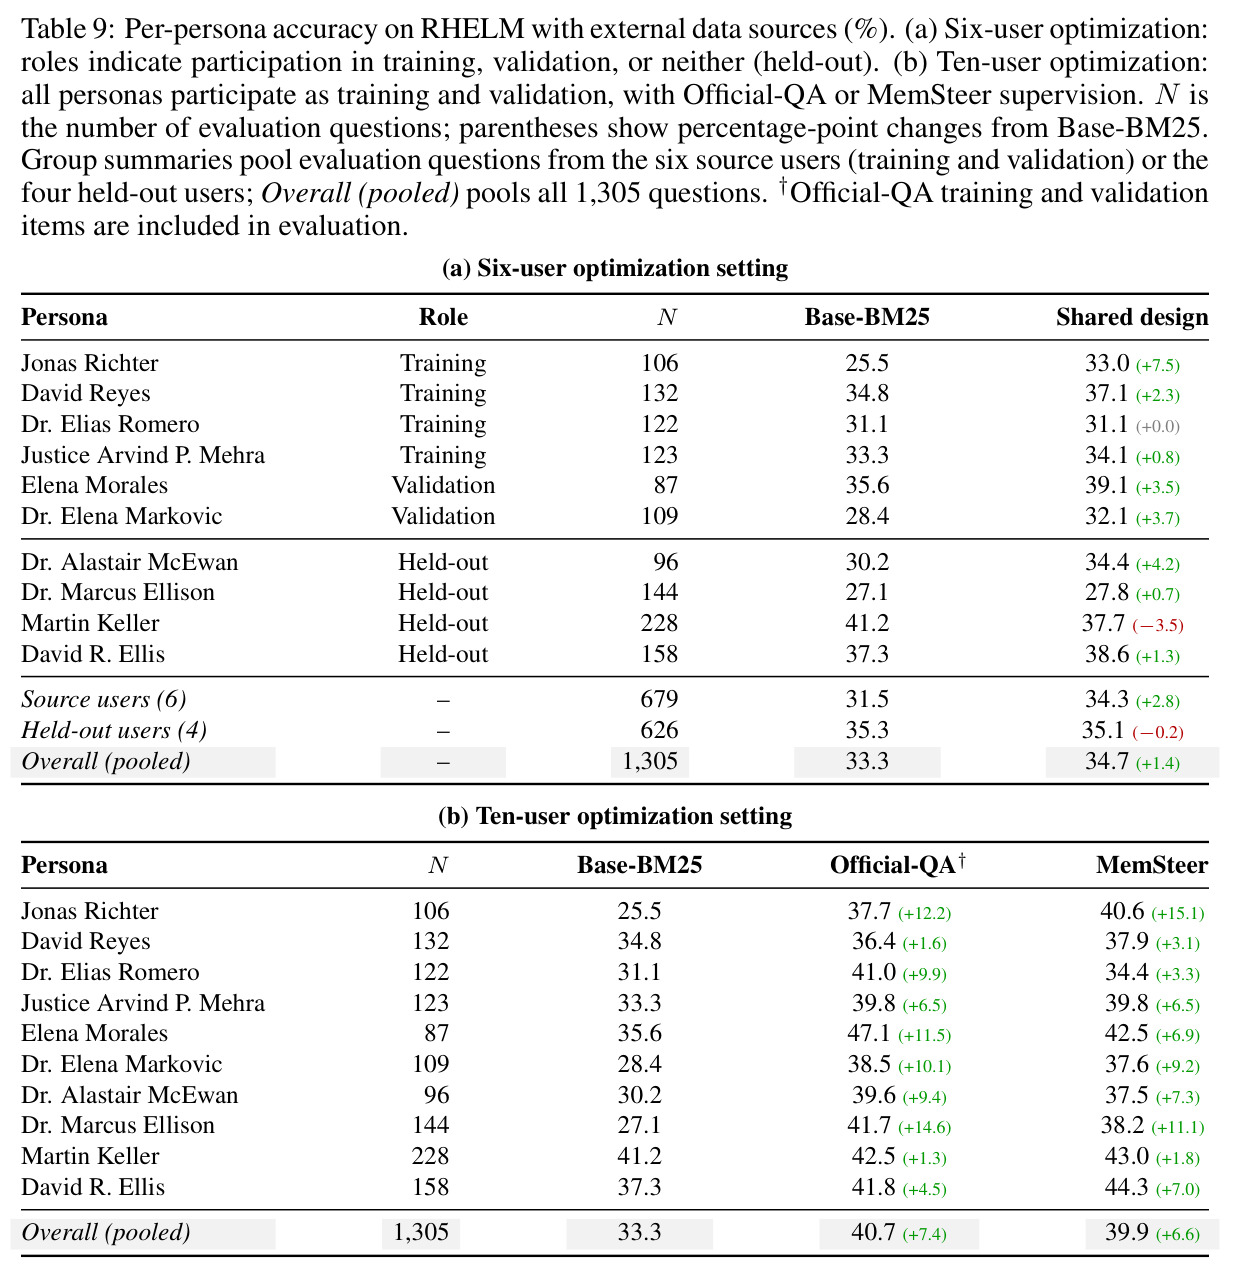
ATM-Bench:Base-BM25 QS 54.9、Hard 8.2;MemSteer 优化后 QS 68.3/R@10 84.1、Hard 29.1/43.6(+13.4/+22.4/+20.9/+33.6),略超 Official-QA(67.3/27.9)。RHELM:无外部数据 22.3→26.4,含外部 33.3→39.9,比 Official-QA 低 0.1/0.8。外部优化器:M$\star$ 47.4→53.4(+6.0,Official-QA 仅 +4.4);MemEvolve 35.1→53.7(持平),但 Hard 仅 +2.3、R@10 降 0.1。消融:验证将 QA 质量提到 90.9%、下游 QS 68.3(Ragas/Naive 加验证仅 82.5%/77.4%);Figure 3 反馈递进 58.3/58.4/62.7/68.3(随机→gold evidence→归因→分层采样)。迁移:ATM 设计迁移 RHELM +4.1/+5.3;共享设计对 held-out 用户无效,但 Martin Keller 用其历史的 421 条监督续优化 37.7→44.3。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ATM-Bench 主集(1,013 题)个人记忆 QA | Question Score (%) | 68.3 | Base-BM25 54.9;Official-QA 67.3;最强已有记忆系统 Memexa 65.3;Oracle 71.8 | +13.4(较 Official-QA 高约 1.1) |
| ATM-Bench-Hard(31 题多跳) | Question Score (%) | 29.1 | Base-BM25 8.2;Official-QA 27.9;Oracle 46.2 | +20.9 |
| ATM-Bench 证据检索 | R@10 (%) | 84.1 | Base-BM25 61.7;Official-QA 83.5 | +22.4 |
| RHELM(仅对话记录,无外部数据) | Accuracy (%) | 26.4 | Base-BM25 22.3;Official-QA 26.5;最强已列基线 RAG k=50 28.9 | +4.1(比 Official-QA 低 0.1) |
| RHELM(对话+邮件+文档) | Accuracy (%) | 39.9 | Base-BM25 33.3;Official-QA 40.7;所列最强 RAG/长上下文/记忆基线 33.9 | +6.6(超所列最强基线 6.0) |
| M$\star$ 优化器(ATM-Bench 主集) | Question Score (%) | 53.4(MemSteer 监督) | M$\star$ 起点 47.4;Official-QA 监督 51.8 | +6.0(Official-QA 仅 +4.4) |
| MemEvolve(ATM-Bench 主集) | Question Score (%) | 53.7(MemSteer 监督) | 起点 35.1;Official-QA 监督 53.7 | +18.6(与 Official-QA 持平,但 Hard 集弱于 Official-QA) |
| 跨用户个人续优化(Martin Keller,RHELM 含外部数据) | Accuracy (%) | 44.3 | 共享设计直接迁移 37.7;Base-BM25 41.2 | 较共享设计 +6.6 |
局限与改进
作者承认(Appendix C):监督全程由 LLM 生成与验证、无人工认证,规划、审计与盲恢复之间共享的错误或偏差可能一致地逃过三重验证;盲恢复只检查“答案可恢复+引用覆盖每条证据”,不保证证据必要性,可能混入冗余记录;问题分布跟随历史记录本身而非用户真实信息需求;设计空间受限且以检索为中心;评测仅两个基准且 RHELM 为合成 persona。我的观察:其一,同源评测风险——ATM 上回答者、裁判、设计提议者同为 DeepSeek-V4-Flash,模型系统性偏好可能同时影响监督验证与最终打分;其二,成本不小——两阶段规划约 105k tokens/题,优化需 20 轮、每轮在 600 题上重建记忆并全量评测;其三,外部优化器收益不均——MemEvolve 在 Hard 上用 MemSteer 反而不如 Official-QA(9.5 vs 11.4),提示监督与某些设计空间兼容性存疑;其四,跨用户共享设计迁移近乎失效(held-out 35.3→35.1,Martin 甚至 -3.5),有效路径是每个新用户重跑完整流水线,放大每用户成本。
独立分析的弱点
(1)验证链同源偏差:生成器、审计者、盲读者与裁判集中于少数大模型家族,若其对特定事实类型(时间推理、数值单位)有系统性误读,三重闸门可能同时放行坏标注。改进:跨模型家族交叉验证,小样本人工复核校准审计者。(2)证据必要性缺失:盲恢复只要求覆盖每条证据、不检查最小性,冗余证据会让检索归因误报“缺证据”。改进:逐条消融证据重跑盲读者,仍能答对则降级该记录。(3)问题分布偏移:生成的复合题可能远比用户真实提问更难更偏,优化方向或过拟合合成分布。改进:用任务画像或真实查询日志对题型重加权。(4)设计空间偏窄:Figure 5 轨迹几乎全是检索组件替换(BM25→dense→hybrid→rerank→HyDE→答案验证),记忆 schema 与存储组织演化不足;Base-BM25 起点偏弱也放大了提升幅度。改进:纳入 M$\star$ 式 schema/logic 演化算子。(5)成本高:每题 105k tokens 规划+20 轮×600 题评测,个人续优化意味着每个新用户重跑。改进:训练轻量质量估计器预筛高价值问题。(6)多模态语焉不详:ATM 含图像/视频,但视觉内容如何进入记录图与证据引用缺乏描述,复现存在不确定性。
未来方向
作者方向:缓解跨阶段共享偏差的多模型验证;扩展到真实异构用户历史;突破以检索为中心的受限设计空间。可延伸:(1)在线/流式持续优化——个人续优化已证明可行(Martin 37.7→44.3),可设计随新记录到来滚动生成监督、滚动修订的版本,让记忆设计终身进化;(2)监督价值预测——Table 4 显示 QA 质量分与下游 QS 强相关,可训练轻量估计器在海量候选题中筛选高价值子集,压缩 105k tokens/题的成本,呼应 Yue et al. (2022) 的问题价值估计;(3)多模态证据规划——把 span 引用扩展到帧级/区域级视觉证据,在 ATM 的图像/视频记录上做同样的设计与归因优化;(4)监督用于训练——将 QA-证据监督作为 RL 奖励训练记忆构建策略(与 MemBuilder 路线合流),或训练记忆质量评估器加速设计筛选;(5)隐私工程——伦理声明已指出跨记录组合可能泄露敏感信息,本地小模型执行规划/验证、差隐私过滤与用户知情同意是落地前提;(6)把“监督质量分”标准化为公开指标,与 DataMorgana/Ragas 社区的评测集合成交互验证闭环。
复现评估
复现评估:论文未提及开源代码仓库,作者只承诺方法与附录描述完整,管线需自行实现。数据可得性好:ATM-Bench(11,034 条记录)与 RHELM(10 persona、1,305 官方 QA)均公开;附录 A 评测人群交代很细——ATM 用 400 训练+200 固定验证生成题、RHELM 最终配置 788 生成题、Martin Keller 421 条(282/139)、David R. Ellis 337 条(223/114),答案归一化规则(文本/集合/数值单位/布尔)也有说明。算力:无训练、纯 API 调用,但 token 成本高——两阶段规划约 105k tokens/题(需数百题),优化 20 轮迭代、每轮重建记忆并在 600 题评测,涉及 DeepSeek-V4-Flash、GPT-4.1-mini、GPT-4.1、GPT-5-mini 多个角色。难度:中高。最大不确定性是 LLM 非确定性与供应商版本更新(作者自承输出会漂移),以及审计/盲恢复 prompt 未公开;建议以 Table 4 的质量消融为管线正确性中间校验点(质量应落在 77.4%–90.9% 区间),先复现主表趋势,绝对数值对齐较难。
论文图表
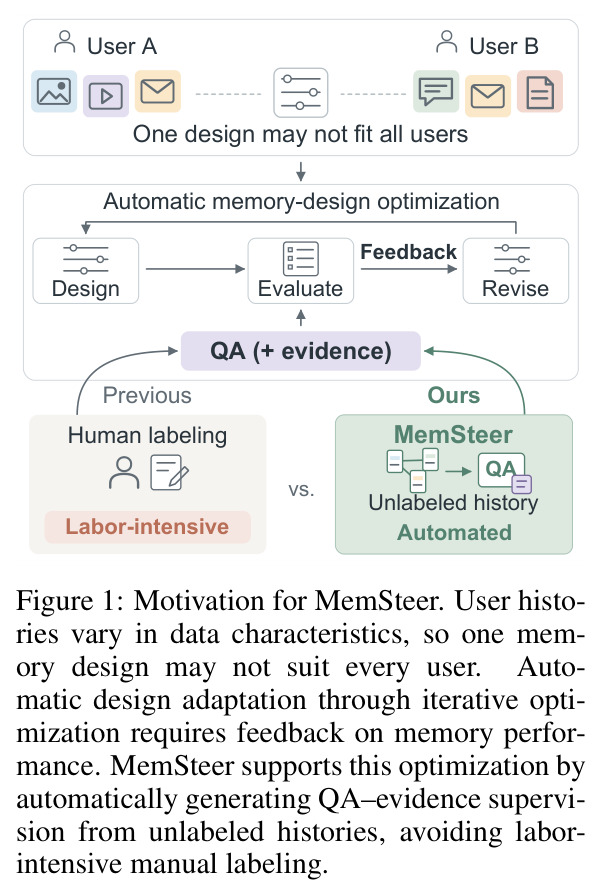
对比图:左侧展示 User A 与 User B 的历史各不相同,“一个设计不适合所有用户”;右侧对比两条路线——先前方法需要人工标注 QA(劳动密集),MemSteer 则从无标注历史自动生成 QA-证据监督,形成 设计→评估→修订 的自动优化闭环。
一图讲清论文的问题设定与核心主张:记忆设计需要按用户适配,适配需要反馈,MemSteer 用自动生成的监督替代人工标注来提供反馈。
ATM-Bench 主表:现有记忆系统参照(Memexa QS 65.3/R@10 78.9;Hard 上 A-Mem 16.7、MemPalace 13.6、HippoRAG2 12.3);Oracle 71.8/46.2;MemSteer-Opt 从 Base-BM25(54.9/61.7/8.2/10.0)用 Official-QA 优化到 67.3/83.5/27.9/42.2,用 MemSteer 到 68.3/84.1/29.1/43.6;外部优化器 M$\star$ 与 MemEvolve 用两种监督的提升对比。
核心主结果表:同时支撑三个主张——生成监督有效(+13.4 QS)、与人工标注相当甚至略优、且对第三方优化器(M$\star$ +6.0)同样有效;† 标注还揭示了 Official-QA 基线存在评测重叠。
三种生成流程的 QA 质量与成本对比(同一 600 任务、同一 DeepSeek-V4-Flash 生成器):Direct QA 质量 67.8%、64.0k tokens/题;Joint Plan–Q(同响应内先计划后出题)73.1%、68.2k;Two-stage Plan–Q(计划→程序化检查→独立出题)85.9%、105.1k。
隔离验证核心机制 answer planning 的价值:仅加计划(不拆阶段)提升 5.3 个点,程序化检查+两阶段解耦再提升 12.8 个点——直接支撑“先规划证据结构再出题”这一核心设计决策。