在何处学习与滚动多远:GUI 智能体的高效自适应训练 Where to Learn and How Far to Roll Out: Efficient Adaptive Training for GUI Agents
用动作分歧筛选训练状态并按任务进度自适应决定 rollout 范围,交互成本降 56-61%
前置知识
GRPO(组相对策略优化)
一种在线 RL 后训练算法:对同一输入采样一组(group)响应,用组内奖励的相对优势(减均值除标准差)作为基线来更新策略,免去训练独立价值网络。轨迹级 GRPO 即以整条任务轨迹的最终成败作为奖励信号,对轨迹上每个决策做策略梯度更新。
本文的全部对比基线就是轨迹级 GRPO(Vanilla GRPO),理解它的采样-组内归一化机制才能明白为什么任务级奖励粗粒度、为什么前缀重执行浪费算力。
On-policy rollout 与环境交互成本
策略更新必须由当前策略自己与环境交互产生的数据(on-policy rollout)支撑。GUI 环境里每一步都对应真实的界面操作与截图观测,交互步数直接决定训练墙钟时间,且环境状态恢复(重置或快照)也有额外开销。
论文优化的核心指标就是训练优化样本数与环境交互步数(rollout steps)两个成本,Method 里所有设计都围绕减少这两项开销。
动作分歧(Action Disagreement)与策略不确定性
在同一状态下对当前策略采 N 个响应,把响应按 GUI 动作等价规则聚类后统计每个动作的样本数 $n_j$,用 $\hat{D}(c_t)=1-\frac{\sum_j n_j(n_j-1)}{N(N-1)}$ 估计任意两个采样动作不同的概率。值越高说明策略在该决策上越犹豫。不同于 token 熵(逐词分布)或奖励方差(依赖结果分化),它直接作用于动作层面。
这是论文选 pivot 的核心信号,也是与 BPO、PivotRL 等前作的本质区别,读懂它才能理解 Stage I 的状态筛选逻辑。
容器检查点(CRIU/Podman 快照恢复)
CRIU 在操作系统层冻结并序列化进程完整状态(内存、文件描述符等),Podman 把检查点连同容器文件系统改动打包保存;恢复时在目标容器中还原运行现场,包括浏览器内存与 JavaScript 堆。一个快照可反复恢复成多个独立分支,无需重放前缀动作。
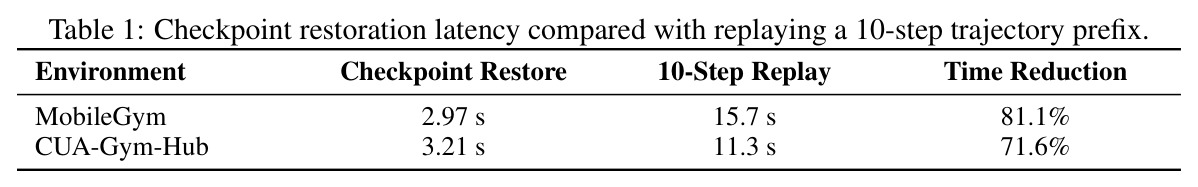
可复用中间检查点是整个框架的工程地基,Table 1 的 81.1%/71.6% 延迟节省和附录 A.1 的实现细节都依赖这套容器技术。
Avg@k 与 Pass@k 评估指标
对每个任务从任务根独立执行 k 次 rollout:Avg@4 是 4 次尝试成功率的平均值,衡量稳定求解能力;Pass@4 是至少成功一次的任务占比,衡量能力上限。论文在训练任务集(Train)与留出任务集(Held-Out)上分别报告,以区分记忆与泛化。
论文所有表格的数字都是 Avg@4/Pass@4 双指标加 Train/Held-Out 双切分,不熟悉这套记法就无法解读 Table 2 和 Table 3。
研究动机
现有 GUI 智能体训练普遍采用轨迹级 GRPO:从任务根开始 rollout 完整轨迹,用最终成败构造策略更新。这在 GUI 场景有两大低效:其一,任务级结果奖励只提供粗粒度监督,多步轨迹间的信用分配困难,无法指明哪些中间决策真正需要改进;其二,已掌握的前缀被反复重执行才能到达困难状态,浪费大量环境交互——GUI 每一步都是真实交互,Qwen-UI-Agent 等工作显示任务可超过百步,采样与信用分配成本随长度急剧上升。已有中间状态方法仍有缺口:弱策略难以自行到达有价值的下游状态;基于首 token 熵或局部奖励方差的筛选会漏掉"策略不确定但奖励尚未分化"的状态(例如 8 个采样动作各不相同但奖励全为 0 的状态);靠动作重放恢复 GUI 中间状态在异步加载、动画等动态界面下既昂贵又不可靠。
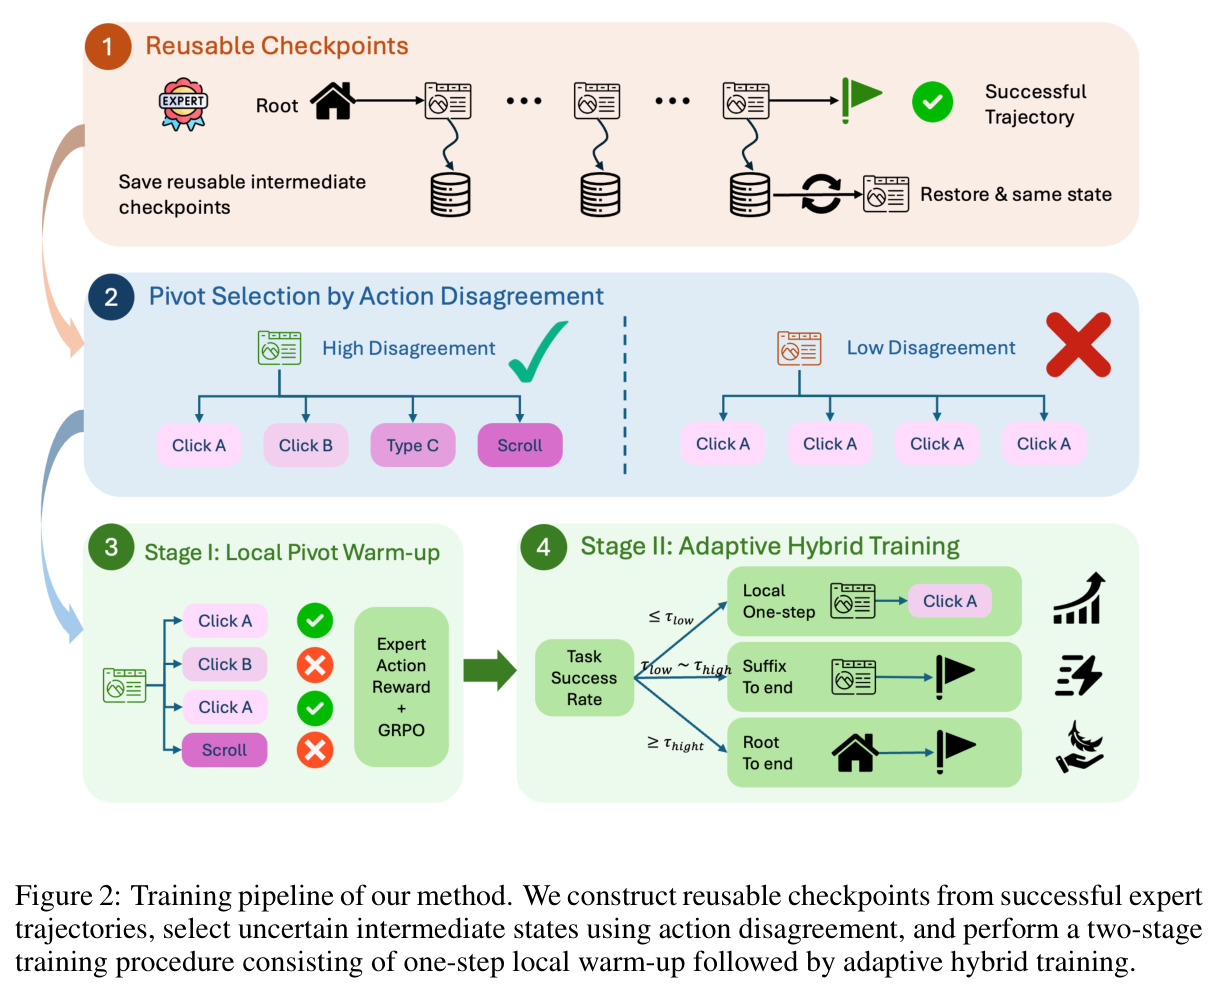
本文的目标是本文目标是构建同时回答"在何处学习(where to learn)"与"滚动多远(how far to roll out)"两个问题的统一训练框架,把有限 RL 预算精准投向仍有学习价值的中间决策,并随策略能力演化动态调整训练位置与 rollout 范围。具体路线:从验证成功的专家轨迹构造可复用中间检查点;用动作分歧指标选出策略最犹豫的 pivot 状态先做一步 RL 局部预热;再按根级成功率 $\hat{p}(x)$ 把任务路由到 Local、Suffix、Root 三档训练,Suffix 前沿随成功率提升单调前移。在 MobileGym 与 CUA-Gym-Hub 两个基准上的验证目标是:相对 Vanilla GRPO 减少 56–61% 环境交互的同时提升任务成功率与留出集泛化。
与已有工作不同的是,已有工作把两个决策割裂:PivotRL 用局部奖励方差选 pivot,BPO 选高熵决策并依赖沙箱快照,PivoARL/SRC 用自我反思或教师审查定位错误步并回退,Tree-GRPO 随机分支共享前缀——它们要么只决定"在哪些中间状态上训练",要么只决定"在哪里分支 rollout",且环境恢复依赖可重置环境或动作前缀重放(OSExpert 即靠重放,代价高且动态界面下易漂移)。本文的独特切入是把"训练位置"与"rollout 范围"作为两个联合自适应的旋钮:提出进度感知的 Local→Suffix→Root 单调晋升调度,使策略责任随能力同步扩张;提出直接作用于 GUI 动作空间的动作分歧信号,在奖励方差尚未出现时就能定位有价值状态;工程上用 Podman+CRIU 容器级快照解决 GUI 动态状态的可靠恢复。
核心方法
直觉上,RL 预算应花在策略“犹豫”的决策上,rollout 长度应随能力增长逐步放大。技术路线分三块协同:(1)可复用中间状态——沿成功专家轨迹保存检查点 $c_t=(x,h_t,o_t,e_t)$(任务、可见历史、观测、可恢复的环境引用),用 Podman+CRIU 在容器级捕获进程与浏览器内存,恢复 10 步前缀仅需 2.97 秒(MobileGym)/3.21 秒(CUA-Gym-Hub),比重放的 15.7/11.3 秒节省 81.1%/71.6%;(2)动作分歧选 pivot——每候选状态采 $N=8$ 个响应并按 GUI 动作等价规则聚类,计算 $\hat{D}(c_t)=1-\frac{\sum_j n_j(n_j-1)}{N(N-1)}$,保留 $\hat{D}>0.45$ 的状态作为 pivot;(3)两阶段训练——Stage I 在 pivot 上以专家下一动作为局部奖励做一步 RL 预热,Stage II 按根级成功率在 Local/Suffix/Root 三种模式间路由,并随成功率提升渐进扩张 rollout 范围直至全任务。
核心创新一:动作分歧作为 pivot 选择信号。与 BPO 的首 token 熵不同,它直接度量策略产出的 GUI 动作多样性;与 PivotRL 的奖励方差不同,它能在"8 个采样动作各不相同但奖励全为 0"时仍识别学习价值——此时组内无奖励方差、传统信号失效,但动作分歧已暴露策略犹豫,后续迭代中该状态可能产生混合结果而提供有效梯度。核心创新二:进度感知的混合训练路由。以 $\hat{p}(x)<\tau_{low}=0.25$、$\tau_{low}\le\hat{p}(x)\le\tau_{high}=0.75$、$\hat{p}(x)>\tau_{high}$ 三档把任务分到 Local/Suffix/Root:低成功率任务只做 pivot 一步更新;部分掌握的任务从最深 pivot 起做后缀 rollout,后缀成功率超过阈值后前沿前移一个 pivot;完全掌握的任务只留 2 次根级探针、仅在结果有分化时更新。两阶段互补:Stage I 修正局部犹豫决策,Stage II 把局部改进扩展为多步执行能力。
方法步骤详情
流程五步。(1)专家轨迹与检查点:Qwen3.8-Max/GPT6-Astra 分别在两环境执行任务,仅保留验证成功的轨迹,在动作间隙用 Podman+CRIU 保存容器快照,一个检查点可派生多个独立分支。(2)候选状态筛选:每检查点采 8 个响应,坐标类动作坐标差≤屏幕宽高 5% 视为等价、滑动按离散方向匹配、文本输入一律视为同类型,据此计算 $\hat{D}$ 并保留 $\hat{D}>0.45$ 的 pivot。(3)Stage I 局部预热:以专家下一动作构造二值局部奖励 $r_t^{(i)}=\mathbb{I}[\mathcal{M}(a_t^{(i)},a_t^E)]$ 做 GRPO 更新,取 Train Avg@4 最高检查点进入 Stage II。(4)初始路由:每任务 4 次根级 rollout 估 $\hat{p}(x)$ 定模式。(5)运行期调度:Local 用 8 样本一步 RL 并定期 4 次 root 重评;Suffix 用 8 次后缀 rollout、超阈值前沿前移一个 pivot;Root 仅 2 次探针,只在结果有分化时更新。
技术新颖性
新颖性有三层。信号层:动作分歧是首个直接作用于 GUI 动作空间的策略不确定性度量,把坐标容差、滑动方向、文本输入等 GUI 特有等价语义纳入聚类,比 token 熵更贴近"决策犹豫"本身,且不要求奖励方差先出现。结构层:首次把"选状态"与"定 rollout 范围"解耦为两个可独立调参又联合调度的机制,并引入单调前沿推进(Suffix 达标后前移、到 Root 后不再回退),使训练预算随能力增长自动从局部校正转向全局执行——Figure 5 显示 Root 占比从 31.96% 升至 82.29%(MobileGym)、从 53.78% 升至 86.97%(CUA-Gym-Hub)。系统层:Podman+CRIU 保留浏览器内存与 JS 堆等运行时状态,配合健康检查、截图与前后一致性测试验证恢复质量,比依赖沙箱快照(BPO)或动作重放(OSExpert)更适配动态 GUI;消融还表明 Stage I 预热让任务更早进入 Root 长程训练。
实验结果
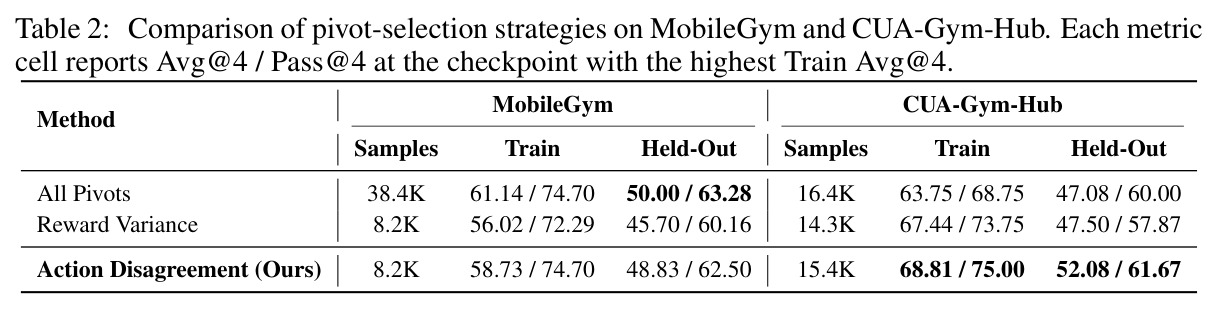
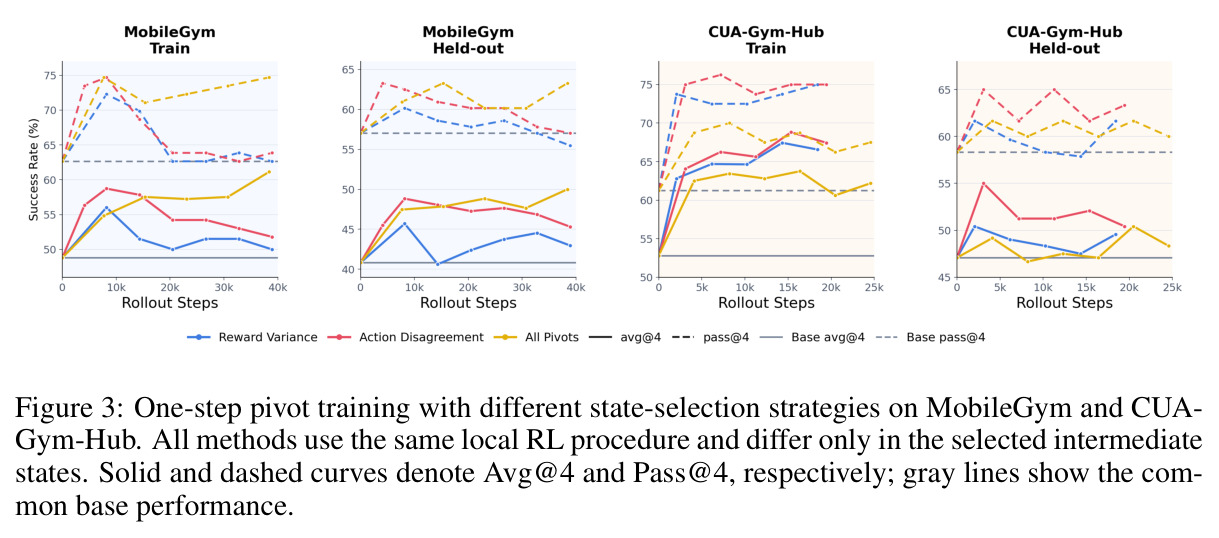
实验分三组,指标均为 Avg@4/Pass@4。(1)Pivot 消融(Table 2):一步 RL 设定下,MobileGym 上 Action Disagreement 用 8.2K 样本达 Train 58.73/74.70、Held-Out 48.83/62.50,以 All Pivots(38.4K 样本)21% 的预算逼近其 Held-Out 50.00,优于同预算 Reward Variance(45.70/60.16);CUA 上 15.4K 样本达 Held-Out 52.08/61.67,优于 Reward Variance 的 47.50/57.87。(2)训练效率(Figure 4):MobileGym 上 Base→Hybrid 用 17.9K 样本/25.0K 步达 Train Avg@4 58.43,Vanilla 需 43.3K/71.5K,省 58.6%/65.0%;CUA 上 9.0K/9.2K 对 33.3K/40.5K,Held-Out 55.83 对 45.83。(3)两阶段完整法(Table 3):Action→Hybrid 在 MobileGym 达 Train 63.86/79.52、Held-Out 50.20/67.97;CUA 达 70.00/77.50 与 57.92/66.67;比 Action→Vanilla 少 40.8% 样本与 50.2% 交互仍更优。对比 SFT:CUA 上 Train 同为 70.00,但 SFT Held-Out 仅 50.83,本文 57.92,泛化更强。
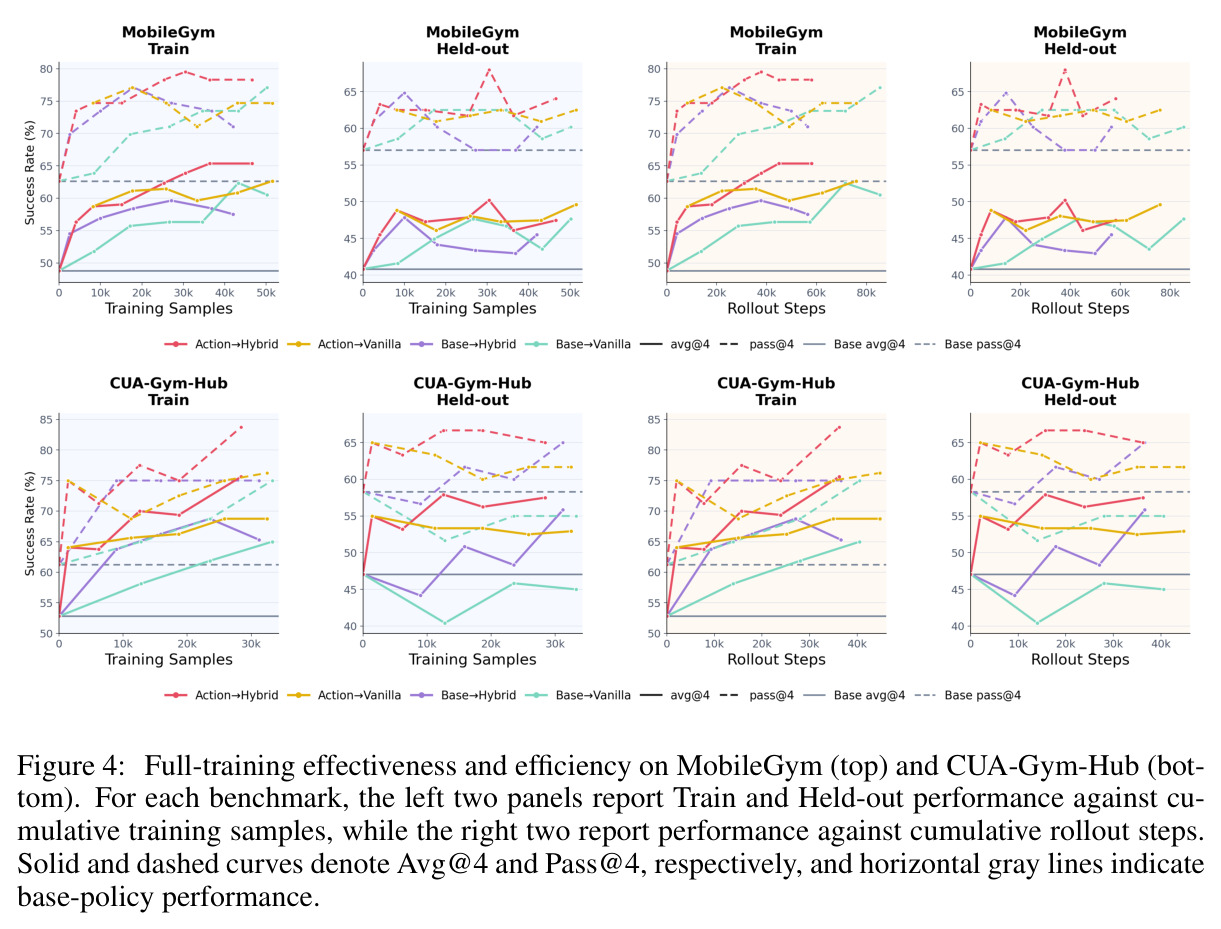
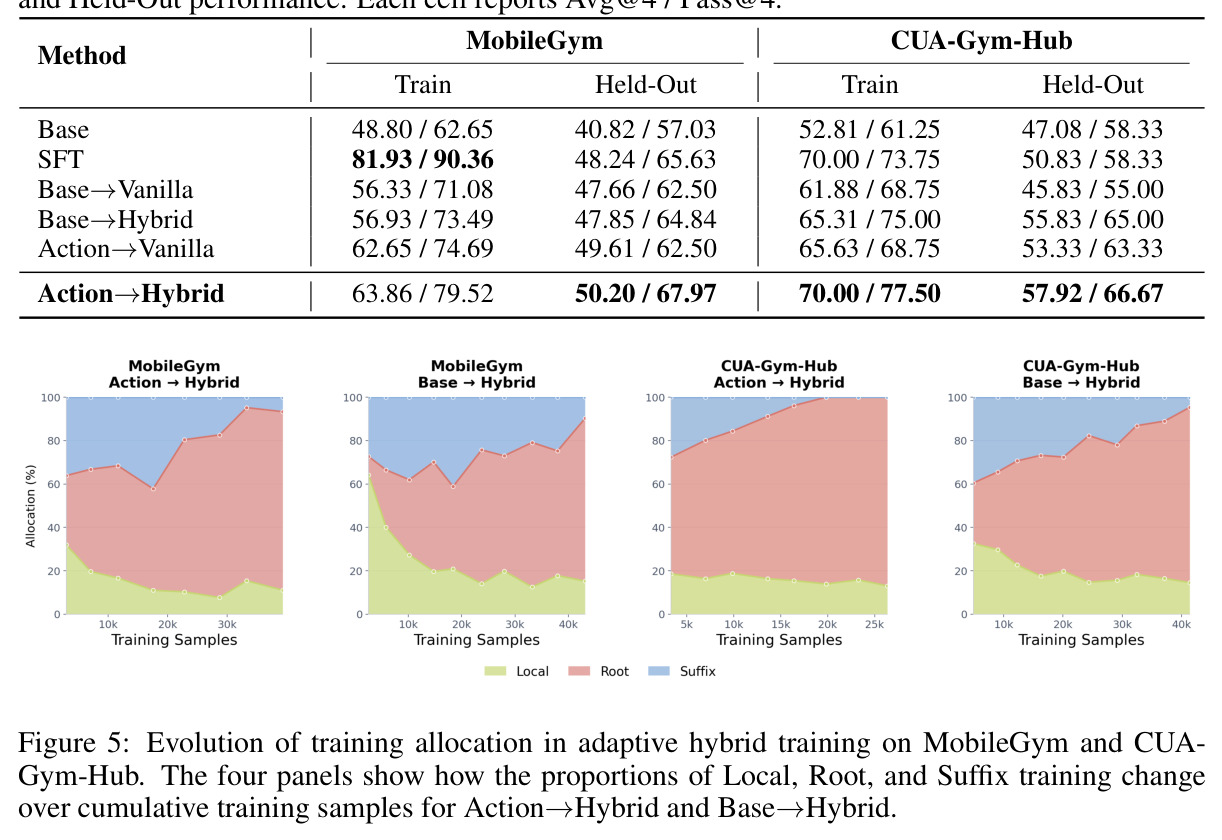
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MobileGym 完整训练(Held-Out 128 任务) | Avg@4 / Pass@4 | 50.20 / 67.97(Action→Hybrid) | Base 40.82 / 57.03;Base→Vanilla 47.66 / 62.50 | 较 Base +9.38 Avg@4,较 Vanilla +2.54 Avg@4,且样本省 40.8%、交互省 50.2% |
| CUA-Gym-Hub 完整训练(Held-Out 60 任务) | Avg@4 / Pass@4 | 57.92 / 66.67(Action→Hybrid) | SFT 50.83 / 58.33;Base→Vanilla 45.83 / 55.00 | 较 SFT +7.09 Avg@4、Pass@4 +8.34,较 Vanilla +12.09 Avg@4 |
| MobileGym 训练效率(达 Train Avg@4 58.43) | 训练样本 / 环境交互步 | 17.9K 样本 / 25.0K 步(Base→Hybrid) | 43.3K 样本 / 71.5K 步(Base→Vanilla) | 样本 −58.6%,交互 −65.0% |
| CUA-Gym-Hub 训练效率(达 Train Avg@4 63.75) | 训练样本 / 环境交互步 | 9.0K 样本 / 9.2K 步(Base→Hybrid) | 33.3K 样本 / 40.5K 步(Base→Vanilla) | 样本约 −73%,交互约 −77% |
| Pivot 选择消融(CUA-Gym-Hub 一步 RL,Held-Out) | Avg@4 / Pass@4 | 52.08 / 61.67(Action Disagreement,15.4K 样本) | Reward Variance 47.50 / 57.87(14.3K 样本);All Pivots 47.08 / 60.00(16.4K 样本) | Avg@4 +4.58(对 Reward Variance),样本还更少 |
| 检查点恢复 10 步前缀(MobileGym / CUA-Gym-Hub) | 恢复延迟 | 2.97 s / 3.21 s | 动作重放 15.7 s / 11.3 s | 时间减少 81.1% / 71.6% |
局限与改进
作者承认的局限:容器检查点恢复只通过健康检查、截图与前后一致性测试验证,“不构成完全状态等价的证明”,涉及异步事件或外部服务时不保证后续执行一致;恢复本身仍需约 3 秒且需环境特定适配。我观察到的局限:其一,主文 4.1 节写 $\tau_{suffix}=0.75$,附录 A.3 却写 $0.5$,关键超参自相矛盾,复现需自行消融;其二,MobileGym 上 All Pivots 最终 Held-Out Avg@4 50.00 略高于 Action Disagreement 的 48.83,效率换来约 1.2 点峰值损失;其三,仅测 Qwen3.5-4B 一个模型规模,结论向更大模型迁移未知;其四,$\tau_{low}/\tau_{high}/\tau_{dis}/\tau_{suffix}$ 均手工设定且无敏感性分析;其五,MobileGym 官方 256 任务中仅 83 个入训,Held-Out 仅 128/60 任务且每任务只评 4 次,统计功效有限;其六,任务晋升单调不回退,策略若在长程训练后退化,无法重新路由回 Local/Suffix 补课。
独立分析的弱点
独立分析五点弱点。其一,动作匹配把文本输入“无论内容一律视为同类型”,输入不同文本间的关键决策差异被抹平,动作分歧统计与局部奖励都受影响——可改用编辑距离或语义相似度做软匹配加权。其二,$\tau_{dis}=0.45$ 硬阈值把 6–2 分裂($\hat{D}=0.429$)滤除,可能丢掉真正双峰犹豫、即将分化出奖励方差的状态——可按任务难度自适应阈值,或把 $\hat{D}$ 作为连续采样权重而非二值门控。其三,pivot 池完全依赖专家成功轨迹,专家失败或不可执行的任务(MobileGym 256 任务中 45 个被验证淘汰)没有训练状态可用——可补充策略自生成轨迹中的成功中间状态构建混合 pivot 池。其四,Root 模式下探针全成功即不更新,缺少对已掌握任务的遗忘监测——可在探针中低频混入旧任务回放并跟踪成功率曲线。其五,局部奖励是“是否匹配专家动作”的二值指示 $\mathbb{I}[\mathcal{M}(\cdot,a_t^E)]$,无法奖励殊途同归的替代正确路径,也不提供部分正确度信号——可引入过程奖励模型或基于结果可达性的稠密奖励。
未来方向
作者层面的延伸:附录 A.1 已在完善环境特定检查点与验证协议(TCP 连接重置、前后一致性测试);框架天然适配更长轨迹场景,如 Qwen-UI-Agent 报告的跨移动/桌面/Web 超百步任务。基于成果可延伸的方向:(1)把动作分歧从离散 pivot 选择升级为连续课程权重,与 rollout 长度一起交由元控制器或 bandit 调度,免去 $\tau_{low}/\tau_{high}/\tau_{dis}/\tau_{suffix}$ 四个手工阈值;(2)Suffix 前沿推进改由组内优势方差等学习进度信号驱动,替代固定成功率阈值,动态加速或延缓晋升;(3)在策略自举轨迹上构造 pivot 池,摆脱对闭源专家(Qwen3.8-Max、GPT6-Astra)的依赖并覆盖专家失败任务;(4)引入过程奖励模型替代二值动作匹配,捕捉替代路径与部分正确性;(5)将容器检查点协议推广到 Web/桌面环境,并量化恢复不一致对训练稳定性的影响;(6)在更大规模模型(7B/30B 级)与更多环境中检验 56–61% 的交互节省是否保持。
复现评估
论文正文与附录均未给出开源代码链接,复现需自行实现。有利条件:MobileGym 与 CUA-Gym-Hub 均为公开基准;起点是 SFT 后的 Qwen3.5-4B,且 SFT 数据不含两个评测任务,无数据泄漏;超参披露完整:$N=8$、$\tau_{dis}=0.45$、$\tau_{low}=0.25$、$\tau_{high}=0.75$,附录还给出动作匹配容差(坐标差≤5% 屏幕宽高)与分歧分数对照表(Table 4)。风险点:$\tau_{suffix}$ 主文 0.75 与附录 0.5 矛盾,需自行消融;专家依赖 Qwen3.8-Max 与 GPT6-Astra 的 API 可得性;容器级 Podman+CRIU 检查点配置门槛高,需针对每个 GUI 环境做快照适配与健康检查。算力上 4B 模型加每状态 8 采样属单机多卡可承受范围,主要瓶颈是 GUI 环境交互吞吐而非 GPU。总体复现难度中偏高:算法清晰(Algorithm 1 给出完整伪代码),但容器快照与 GUI 环境工程栈搭建成本大,估计需数周投入。
论文图表
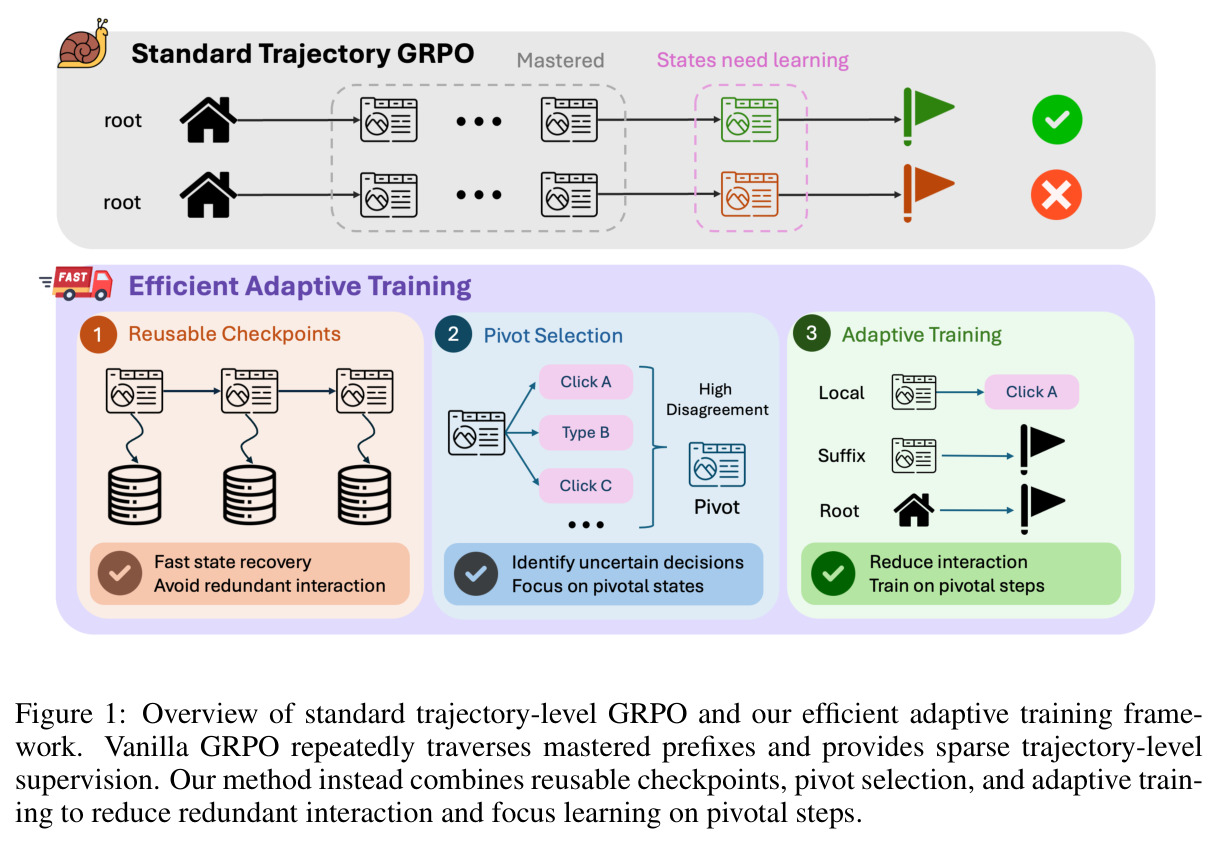
左右对比 Vanilla GRPO 与本文框架:前者反复从任务根遍历已掌握前缀、只提供稀疏的轨迹级监督;后者组合可复用检查点、pivot 选择与自适应训练,减少冗余交互并把学习聚焦到关键步骤。
一图看懂论文动机与整体框架,是理解"where to learn + how far to roll out"双问题的入口。
Base、SFT、Base→Vanilla、Base→Hybrid、Action→Vanilla、Action→Hybrid 六种配置的 Train/Held-Out Avg@4/Pass@4 汇总:Action→Hybrid 全面领先(MobileGym Held-Out 50.20/67.97,CUA 57.92/66.67),SFT 训练集高但泛化弱。
论文核心结果汇总表,所有主结论的数字出处。
列出 8、7–1、6–2、6–1–1、5–3、4–4 直到 1×8 等典型动作计数模式的分歧分数,说明 $\tau_{dis}=0.45$ 下 6–2(0.429)被滤除、6–1–1(0.464)与 5–3(0.536)被保留。
直观展示动作分歧阈值对实际采样分布的筛选行为,配合动作匹配规则理解 Stage I 的数据构成。