教师演化在线自蒸馏(TESD):让自教师随训练持续进化并按监督可靠性加权学生更新 On-Policy Self-Distillation with Teacher Evolution
让自教师边指导边进化、按指导可靠性加权学生损失,使 OPSD 持续提升
前置知识
RLVR(可验证奖励强化学习)
用规则而非奖励模型打分的 RL 后训练范式:数学对答案、代码跑测试。代表方法 GRPO 每题采样一组回答,以组内标准化 $A_i = (r_i - \text{mean})/\text{std}$ 免去 critic;缺点是把序列级奖励摊给所有 token,不分轻重。
TESD 的教师奖励设计与优势估计直接复用 GRPO 框架,全文对比的序列级基线也正是加强版 GRPO,不懂 GRPO 就看不懂教师优化的损失形式。
OPSD(在线自蒸馏)与自教师
不引入外部教师:让学生采样 rollout,把其中正确解答作为特权上下文喂回模型自身构成自教师 $\pi_\theta(\cdot \mid x, c)$,再沿学生 rollout 逐 token 最小化两者分布的散度(KL/JS)。监督是 token 级密集信号且保持 on-policy,对齐性好。
本文的全部问题诊断与方法改造都建立在 OPSD 之上,读懂其学生损失 $\mathcal{L}_S$ 的形式是理解 TESD 的前提。
特权上下文(privileged context)
学生看不到的额外信息,通常是该题的正确解答:教师输入 $(x, c)$,学生只有 $x$。SDPO 用学生自己采样出的成功 rollout 充当它,摆脱人工标注依赖;本文沿用,并让自教师再在 $(x, c)$ 下自己采样 rollout、接受环境检验。
特权上下文是自教师存在的根基,也是本文核心批评的对象——“教师只多一份线索、真实能力并未更强”,难以把它与多样 rollout 关联。
EMA 教师与蒸馏超参
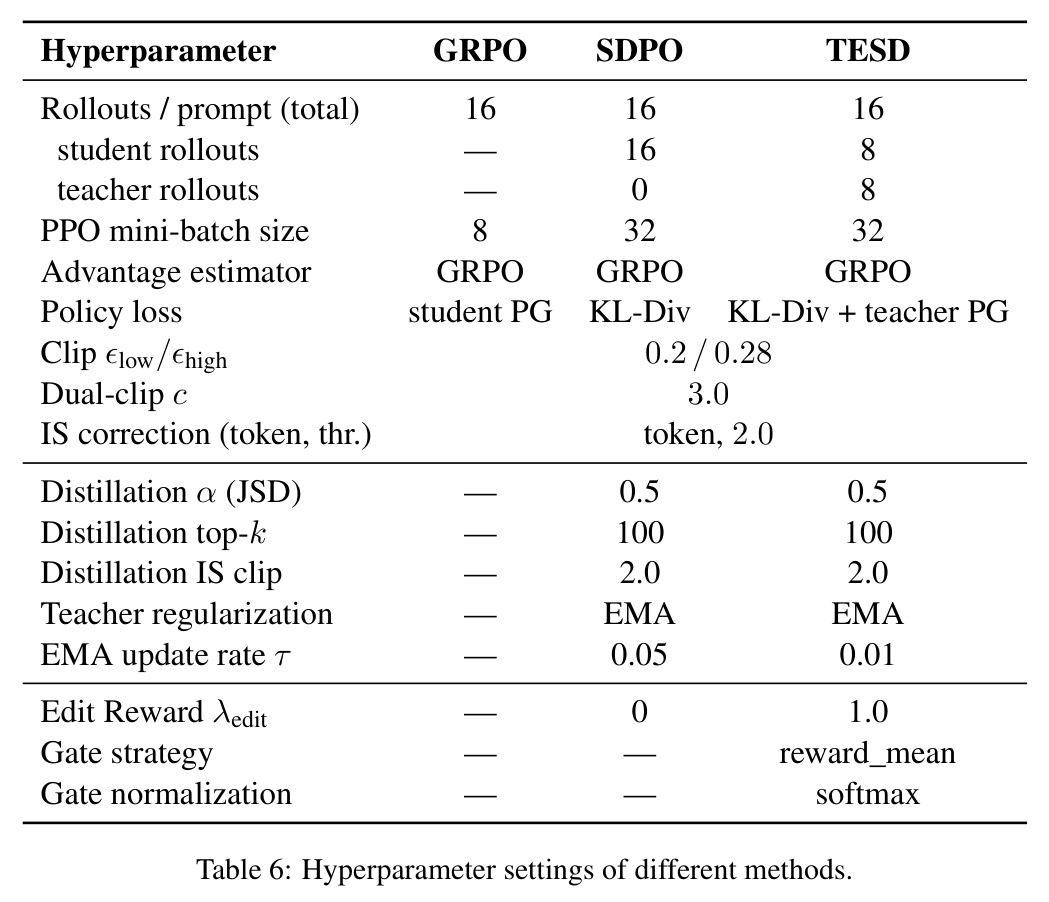
自教师不是独立副本,而是学生权重的指数滑动平均 $\theta_T \leftarrow \alpha\theta_T + (1-\alpha)\theta_S$;本文速率 0.01,SDPO 0.05。蒸馏用广义 JSD 在 top-100 logits 上近似,系数 0.5,重要性采样比裁剪 2.0。
EMA 的平滑特性被作者在局限性中点名为限制教师进化速度的关键约束,也是复现时最容易对不齐的工程细节。
编辑距离与 difflib.SequenceMatcher
文本相似度指标。将 rollout 与特权上下文小写分词为 $\tilde{y}, \tilde{c}$,算 $S_{edit} = 2M/(|\tilde{y}|+|\tilde{c}|)$,$M$ 为匹配块数;独立性奖励基于 $D_{edit} = 1 - S_{edit}$,鼓励教师生成不同于上下文的解答。
它是 TESD 独有的“上下文独立性”奖励的实现载体,直接针对论文在 Figure 2 中发现的“相似即自信”偏差。
研究动机
以 GRPO 为代表的 RLVR 把同一条序列级奖励平均摊给回答中每个 token,无法突出关键推理步骤,优化效率受限。OPSD 试图用密集监督解决这一问题:把学生的正确 rollout 作为特权上下文喂回模型自身构成“自教师”,沿学生 rollout 逐 token 对齐两者分布。但作者发现 OPSD 训练中性能提升不连续、早早停滞(Figure 1(c))。对 Qwen3-8B 在 SciKnowEval-Physics 上的诊断(Figure 2)揭示了根源:自教师对部分正确 rollout 只给出 0.0–0.5 的低置信度,却对大量错误 rollout 给出 0.5–0.8 的高置信度;且存在“相似即自信”偏差——高置信度 rollout 往往与特权上下文的编辑距离更小;更糟的是,以教师置信度与实际奖励的 Spearman 相关衡量的“教学能力”在训练中不升反降且剧烈波动。根源在于自教师只比学生多一份特权上下文、能力并未更强,难以把它与多样的学生 rollout 关联起来;而现有范式又强迫学生在所有样本上无差别跟随教师,错误指导被直接注入优化过程。
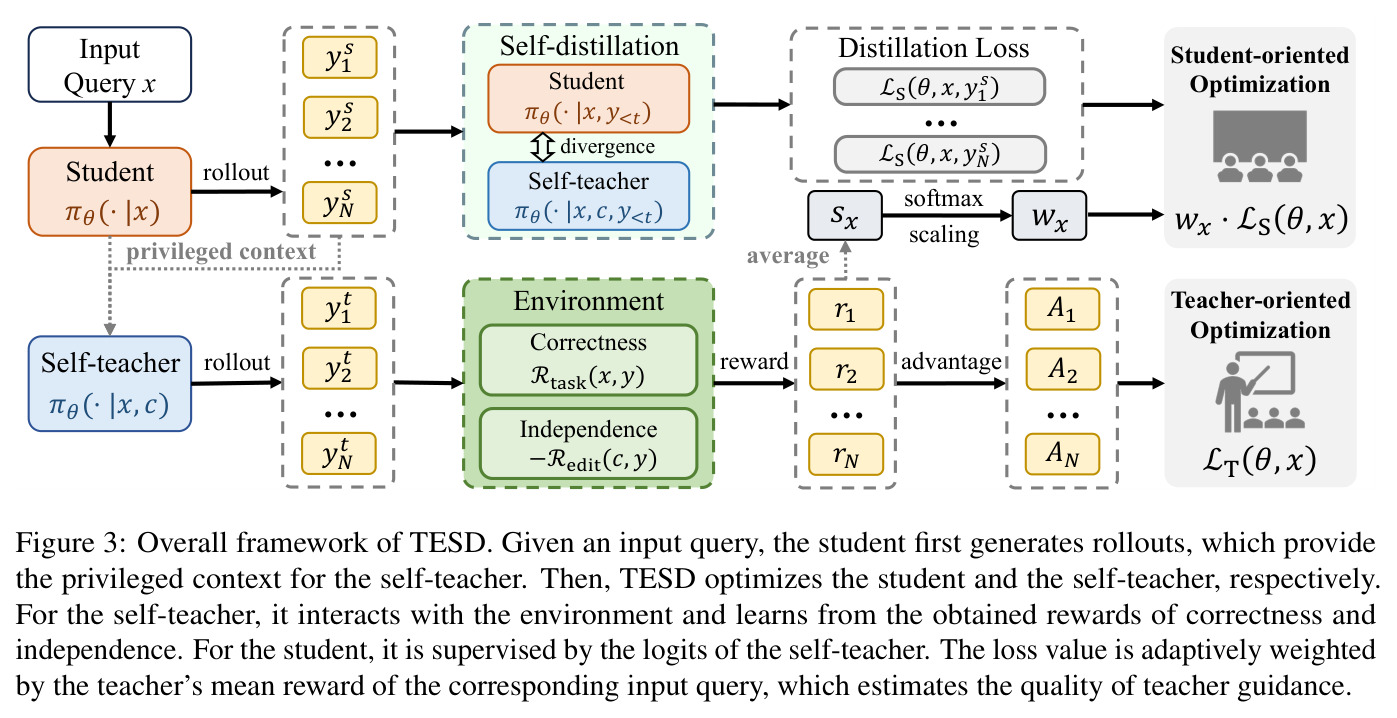
本文的目标是论文的目标是在不引入外部教师、不依赖人工标注标准答案的前提下,修复 OPSD 的监督质量瓶颈,使训练全程获得持续、稳定的性能提升。目标拆成两个互补部分:其一,让模型在“教师”角色上也被优化——允许自教师自己生成 rollout 并从环境获得可验证反馈,用这些奖励直接优化自教师,使其学会“给定特权上下文时给出正确且与学生 rollout 不同的解答”,扭转教学能力随训练下滑的趋势;其二,在“学生”角色上自适应减负——用教师 rollout 的平均奖励估计每个 query 上教师指导的可靠程度,据此对学生蒸馏损失逐样本加权,压制不可靠指导产生的梯度,避免训练早期弱教师误导学生。最终希望 TESD 在多个模型规模(Qwen3-1.7B/4B/8B、Olmo3-7B)和多种任务(科学问答、工具调用、代码生成)上同时超过代表性 token 级方法 SDPO 与序列级方法 GRPO。
与已有工作不同的是,已有工作几乎都从“特权上下文”一侧修 OPSD:Yu 等增加上下文数量、Pan 等用对比样本强化上下文,这类做法实际上把 OPSD 退化成 GRPO 的一个优势加权模块;Jin 等则用基于熵的路由更新策略。它们的共同点是只把模型当学生优化、只使用学生生成的 rollout。本文的独特切入是把模型的双重身份拆开同时优化:自教师不再是只会照抄上下文的“静态提示版学生”,而是自己采样 rollout、接受任务正确性加上下文独立性奖励、用 GRPO 式目标持续进化的学习者;同时教师奖励又被复用为学生损失的可靠性权重,一份信号喂饱两个角色。奖励中的“独立性”项(编辑距离)直接针对 Figure 2 发现的“相似即自信”偏差——已有方法从未显式惩罚教师抄近路。与 SDPO+GRPO 的朴素损失相加不同(Qwen3-8B 上 72.27%,反而低于纯 GRPO 的 74.94%),TESD 是按角色分工的原则性框架而非目标混合。
核心方法
直觉上,TESD 把“老师要持续进修”与“学生别盲信差老师”放进同一训练循环。学生损失 $\mathcal{L}_S$ 沿学生 rollout $y_s$ 逐 token 最小化学生与自教师分布的散度 $D$(JSD,stopgrad 固定教师侧 $\pi_\theta(\cdot \mid x, c, y_{s<t})$),自教师权重是学生的 EMA。TESD 增加教师损失 $\mathcal{L}_T$:自教师 $\pi_\theta(\cdot \mid x, c)$ 采样 $N$ 条 rollout,用奖励 $r_i = \mathcal{R}_{task} + \lambda_{edit}\mathcal{R}_{edit}$ 做 GRPO 式裁剪优化。总目标 $\mathcal{L}(\theta) = \frac{1}{|B|}\sum_{x \in B}[\mathcal{L}_S + \mathcal{L}_T]$,学生项逐 query 乘可靠性权重 $w_x$,两类优化共享同一套参数 $\theta$。
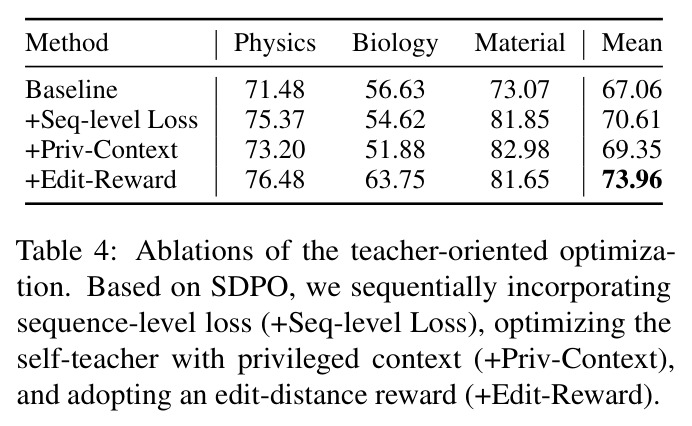
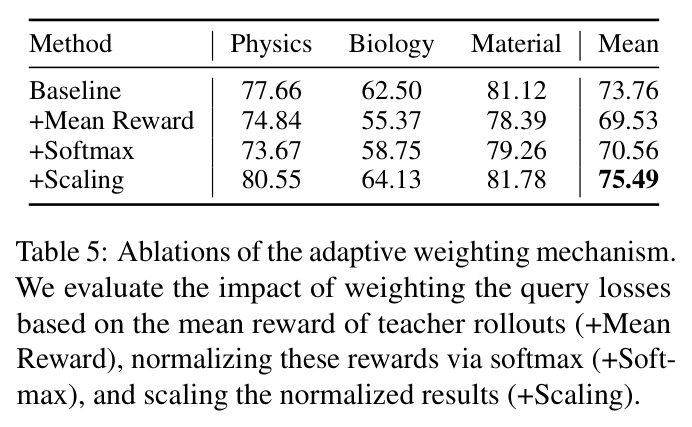
核心创新是教师奖励的双重复用与“上下文独立性”奖励设计。第一,同一个奖励 $r_i$ 既充当自教师的训练目标(推动教师进化),又通过均值 $s_x = \frac{1}{N}\sum_{i=1}^{N} r(x, c, y_{t_i})$ 变成学生损失的样本级权重(估计该 query 上教师指导的可靠度),一份环境信号同时改进两个角色。第二,奖励不止看答案对错:实验发现自教师有“相似即自信”偏差,只用正确性奖励会诱导教师直接照抄特权上下文(Table 4 中仅加特权上下文序列损失,性能从 70.61% 反降到 69.35%),加入独立性项后强迫教师学会在固定上下文条件下引导多样的 rollout,性能提升到 73.96%。第三,学生加权用按 batch size 缩放的 softmax 而非硬丢弃:$w_x = |B| \cdot \exp(s_x) / \sum_{x' \in B} \exp(s_{x'})$,既压制不可靠样本又保持损失总尺度——Table 5 显示去掉这一缩放设计会从 75.49% 掉到 70.56%。
方法步骤详情
输入为 batch 内 query $x$。第一步,学生采样 8 条 rollout,规则校验选成功者作特权上下文 $c$。第二步,自教师(学生 EMA,速率 0.01)在 $(x, c)$ 下再采样 8 条教师 rollout。第三步,计算奖励:$\mathcal{R}_{task} \in \{0,1\}$ 为规则正确性(选项/工具调用/沙箱测试);独立性项用 $S_{edit} = 2M/(|\tilde{y}|+|\tilde{c}|)$ 与 $D_{edit} = 1 - S_{edit}$,$\lambda_{edit}=1.0$。第四步,组内优势 $A_i = (r_i - \text{mean})/\text{std}$,以非对称裁剪(0.2/0.28、双裁剪 3.0)的 PPO 目标优化教师。第五步,$s_x$ 经 softmax($\tau=1.0$)归一并裁剪到 $[0.05, 5.0]$ 得 $w_x$。第六步,学生蒸馏损失乘 $w_x$ 与 $\mathcal{L}_T$ 相加联合更新,蒸馏 IS 比裁剪 2.0。第七步,EMA 更新自教师。
技术新颖性
技术新颖性体现在三点。其一,角色分化:现有 RLVR/OPSD 方法(GRPO、SDPO、SDFT、多 rollout 蒸馏)都把模型当单一学生,TESD 首次在同一套参数上显式区分教师/学生两种身份并各自设计目标——GRPO 式序列级信号专门喂教师,散度式 token 级信号专门喂学生;附录 A.3.2 强调这是“原则性框架而非朴素目标混合”,与把 OPSD 降级为 GRPO 加权模块的并发工作方向恰好相反(是“用 GRPO 赋能教师”而非“用 OPSD 加权 GRPO”)。其二,奖励语义创新:把“教师能否在固定上下文下引导多样 rollout”形式化为上下文独立性奖励,用编辑距离模拟学生 rollout 的多样性,这是对 Figure 2 实证偏差的直接回应,已有 OPSD 工作既没有教师能力的显式度量、更没有对教师的优化。其三,软加权机制:与硬丢弃不可靠样本(会导致训练不足)不同,softmax 加尺度保持的加权在压制噪声的同时不破坏损失量级。整体上 TESD 保持了 OPSD 的 on-policy 性质与短回答偏好,只增强了监督信号本身的质量。
实验结果
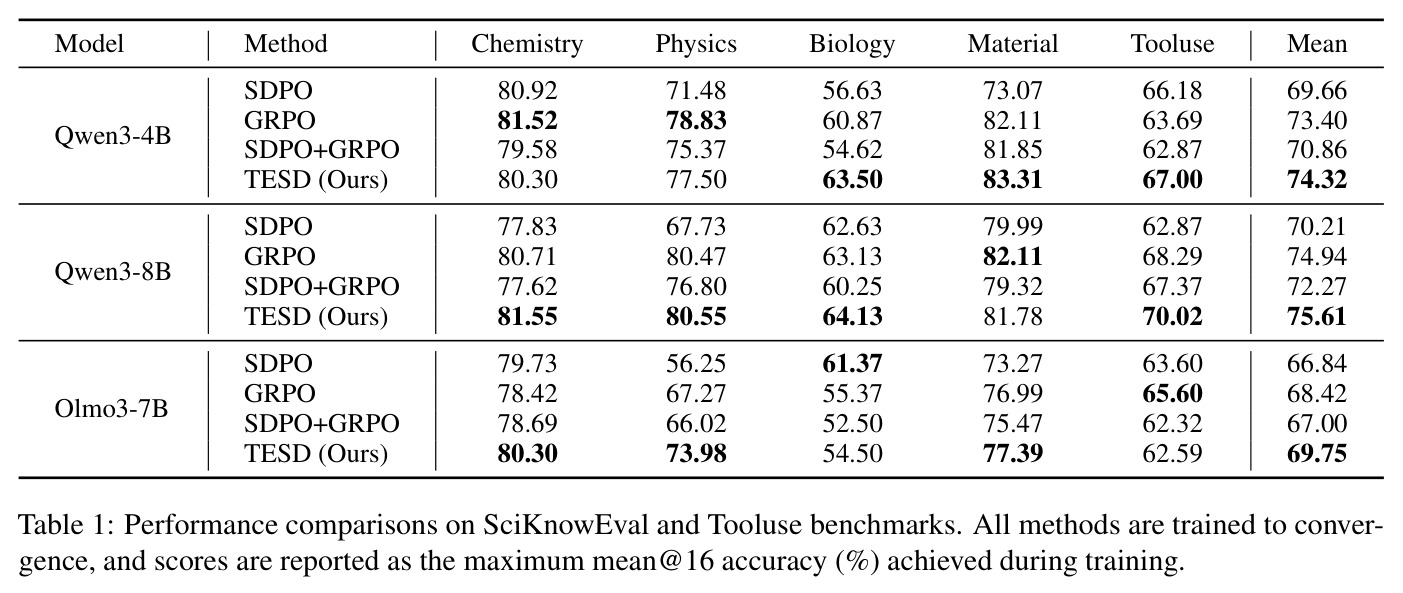
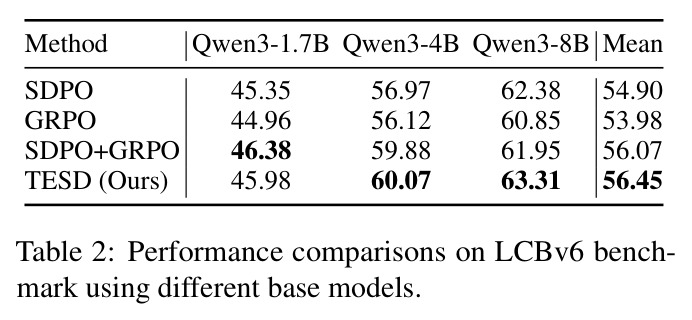
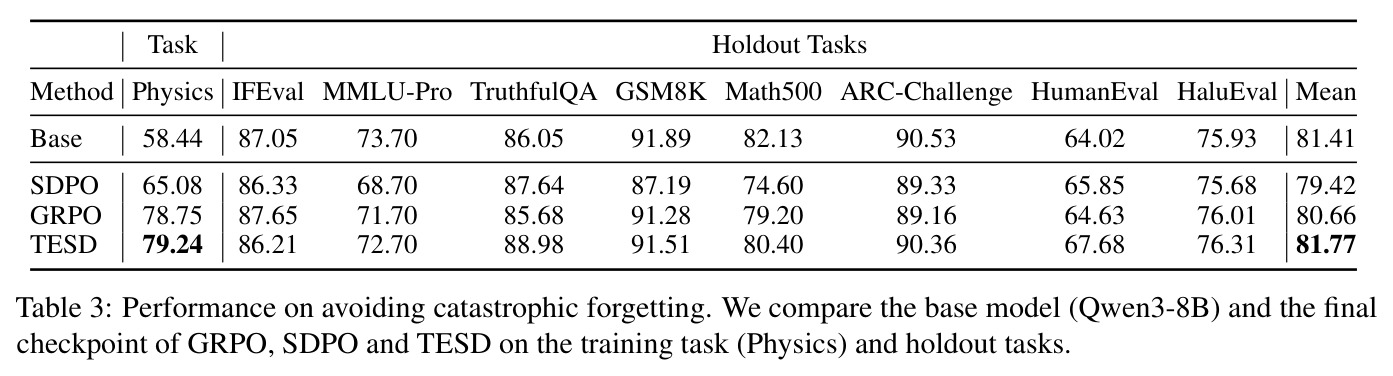
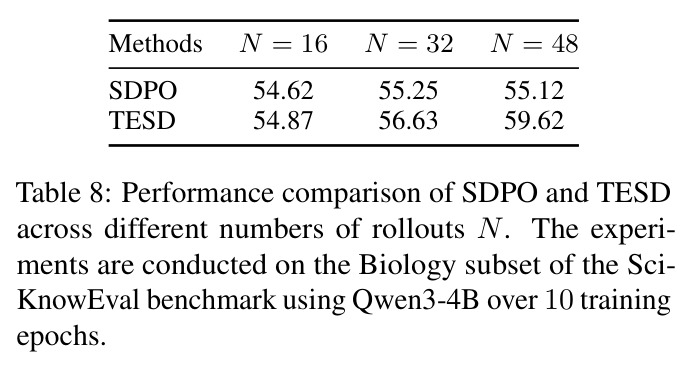
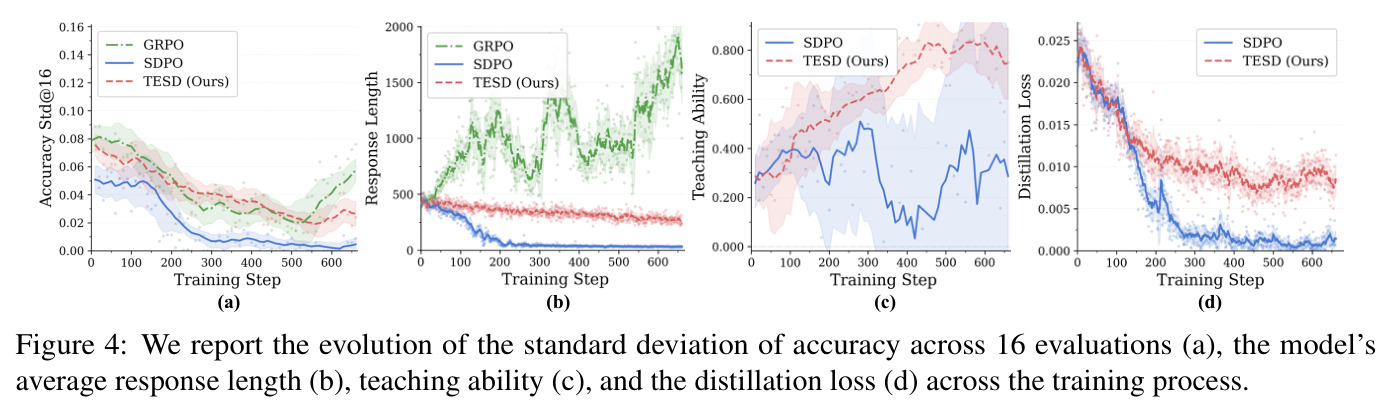
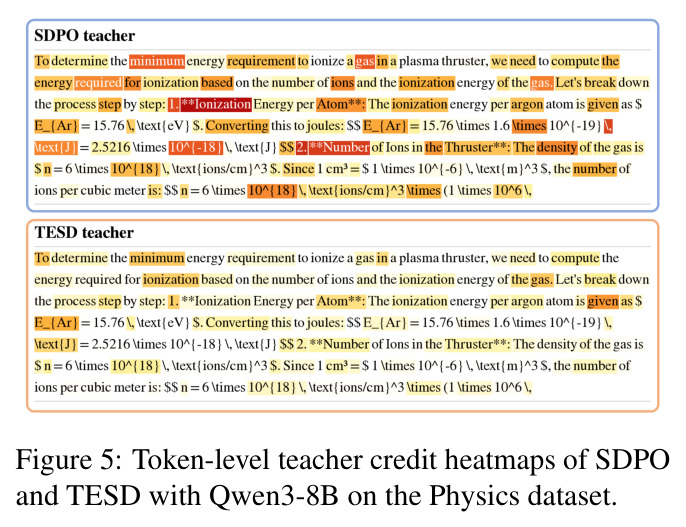
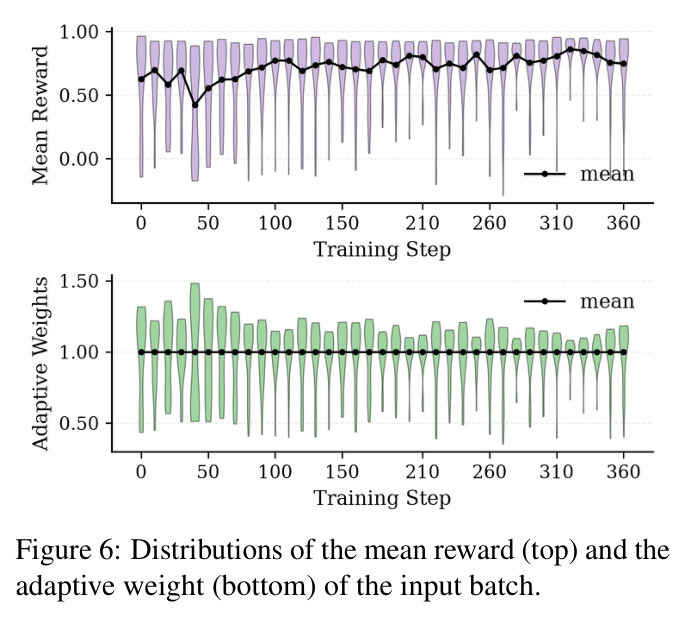
(1) 无富反馈(Table 1,mean@16):Qwen3-8B 上 TESD 75.61%,超 GRPO 74.94%、SDPO 70.21%;Olmo3-7B 69.75% 超 GRPO 68.42%。(2) 富反馈代码(Table 2,LCBv6):TESD 平均 56.45% 最高;Qwen3-1.7B 上 SDPO+GRPO 46.38% 反超 TESD 45.98%。(3) 遗忘(Table 3):Physics 训练后 TESD 79.24%(SDPO 65.08%),8 个 holdout 均值 81.77%。(4) 消融(Table 4/5):教师优化把基线 67.06% 推到 73.96%;自适应加权提到 75.49%,均值奖励直接加权掉到 69.53%。(5) rollout 扩展(Table 8):16→48 时 TESD 54.87%→59.62%,SDPO 停在 55%。(6) 分析(Figure 4–6):教学能力稳步上升、回答更短、不确定性更高;Figure 11 中 GRPO 长 5419 token,TESD 以 453 token 答对。
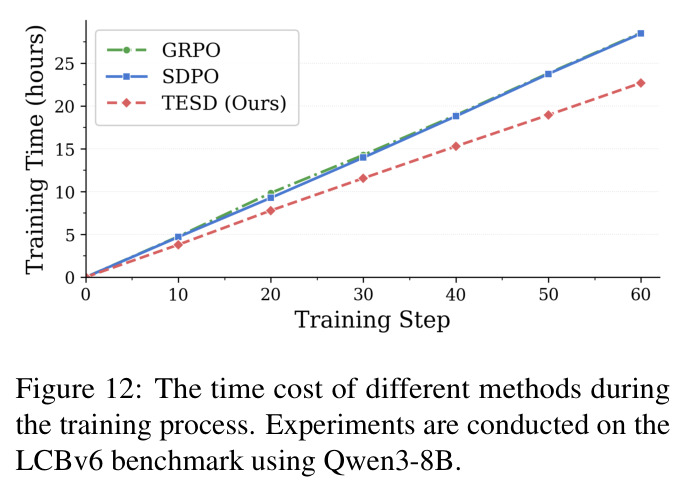
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SciKnowEval-L3 四子集 + ToolUse 平均(无富反馈,Qwen3-8B) | mean@16 峰值准确率 (%) | TESD 75.61 | SDPO 70.21 / GRPO 74.94 / SDPO+GRPO 72.27 | +5.40 vs SDPO,+0.67 vs GRPO |
| SciKnowEval-L3 四子集 + ToolUse 平均(无富反馈,Qwen3-4B) | mean@16 峰值准确率 (%) | TESD 74.32 | SDPO 69.66 / GRPO 73.40 / SDPO+GRPO 70.86 | +4.66 vs SDPO,+0.92 vs GRPO |
| SciKnowEval-L3 四子集 + ToolUse 平均(无富反馈,Olmo3-7B) | mean@16 峰值准确率 (%) | TESD 69.75 | SDPO 66.84 / GRPO 68.42 / SDPO+GRPO 67.00 | +2.91 vs SDPO,+1.33 vs GRPO |
| LiveCodeBench v6(富反馈代码,三模型平均) | mean@16 峰值准确率 (%) | TESD 56.45 | SDPO 54.90 / GRPO 53.98 / SDPO+GRPO 56.07 | +1.55 vs SDPO,+2.47 vs GRPO,+0.38 vs SDPO+GRPO |
| LCBv6(Qwen3-8B) | mean@16 峰值准确率 (%) | TESD 63.31 | SDPO 62.38 / GRPO 60.85 / SDPO+GRPO 61.95 | +0.93 vs最强基线 SDPO |
| 灾难性遗忘(Qwen3-8B 训练 Physics 后 8 个 holdout 任务) | 各任务指标平均 (%) | TESD 81.77 | Base 81.41 / SDPO 79.42 / GRPO 80.66 | 高于基线模型 +0.36,实现更优性能-遗忘权衡 |
局限与改进
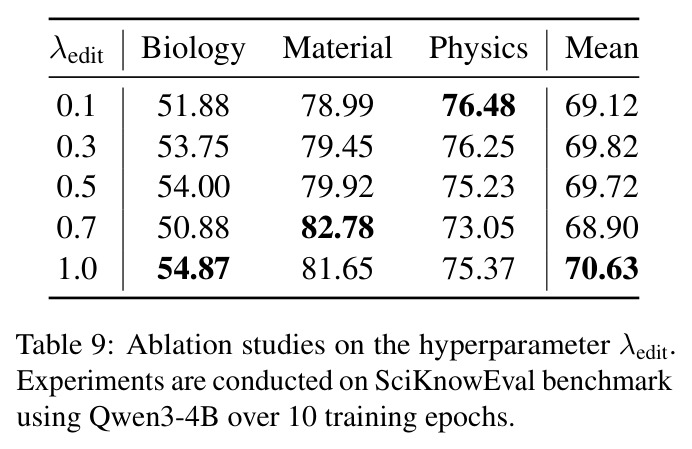
作者承认的局限有两点:一是引入了额外超参数(如 $\lambda_{edit}$,Table 9 显示 biology 最优 1.0、materials 最优 0.7,存在逐数据集调参成本);二是受 OPSD 范式的 EMA 教师更新机制约束,指数滑动平均天然平滑教师能力增长,限制教师进化速度。我自己的观察:第一,编辑距离是很表面的独立性代理——语义改写会被误罚、无关的字面替换被误奖,用语义相似度替代会更合理;第二,特权上下文仍依赖“学生能采样出正确 rollout”,当学生完全不会做时 TESD 无米下锅,这点与 SDPO 相同;第三,奖励依赖规则验证器,无法直接迁移到开放式生成任务;第四,8/8 的 rollout 固定分配并非自适应算力分配,弱模型上把一半算力给教师反而不如全给学生(Table 2 的 1.7B 结果暗示这一点);第五,训练集很小(如 Biology 仅 450 条训练样本),结果对随机性可能敏感;第六,权重裁剪区间 $[0.05, 5.0]$、EMA 速率 0.01 等关键超参的敏感性只在部分设置下验证。
独立分析的弱点
独立分析的弱点:其一,独立性奖励用字符级 SequenceMatcher 编辑距离,无法捕捉语义等价的改写——换一种措辞解同一题会被误判“太相似”而遭惩罚,改进方向是用句子嵌入相似度或轻量 NLI 模型做语义级独立性打分。其二,$\lambda_{edit}$ 的逐数据集最优值漂移(0.7–1.0),说明该权重与任务特性强耦合,可改为随训练进度或教师可靠度自动调节的自适应系数。其三,EMA 速率 0.01 使教师更新偏慢,Figure 6 显示训练早期自适应权重只有约 0.5,意味着初期大量算力浪费在低质量蒸馏上,可用双速率调度或对高奖励 rollout 做直接参数注入。其四,特权上下文只取一条成功 rollout,信息密度有限,与 Yu 等的多上下文方法正交,组合收益值得验证。其五,学生侧仅 8 条 rollout 的组内估计方差偏大,小模型(1.7B)上收益为负,可按模型能力动态分配 teacher/student 的 rollout 配比。其六,可靠性权重 $s_x$ 用教师奖励均值,与“学生能否学对”的目标存在错位,可引入学生侧学习信号(如加权后的梯度范数、学习进度)来校准。
未来方向
作者在结论与附录中提出的方向:研究 TESD 的优化几何;把方法推广到多模态推理;为教师奖励开发自适应的独立性项;深入研究教师更新与训练稳定性的内在机制;以及检验 TESD 是否呈现稀疏更新模式(延续作者在参数更新方向/稀疏调参方面的系列工作)。基于本文成果可自然延伸的方向:第一,把 TESD 与特权上下文增强方法(多上下文、对比样本)结合,两者从互补角度稳定 OPSD,论文自己也指出有集成潜力;第二,将独立性奖励升级为语义级并用模型判分,摆脱编辑距离的表面性;第三,动态分配 teacher/student 的 rollout 预算,形成“能力弱时多自练、能力强时多施教”的课程式策略;第四,推广到智能体长程任务与多轮工具使用,那里序列级奖励更稀疏、教师进化的收益理论上更大;第五,理论层面刻画教师-学生协同进化的收敛条件,解释独立性奖励为何能防止教师坍缩到“照抄上下文”的平凡解;第六,在开放式任务上用 LLM-as-judge 替代规则验证器,检验框架的泛化边界。
复现评估
复现友好:数据全开源(SciKnowEval、ToolAlpaca、LCBv6),训练集很小(Biology 450、Physics 720、Chemistry 1890、LCBv6 仅 131 条);模型为公开的 Qwen3-1.7B/4B/8B 与 Olmo3-7B-Instruct。算力适中:verl + FSDP,单节点 8×H20,batch 32 prompts/step,科学问答 30 epochs、ToolUse 15 epochs、LCBv6 40 steps。超参完整(Table 6):AdamW、常数学习率 10 步 warmup、1 PPO epoch、非对称裁剪 0.2/0.28、双裁剪 3.0、JSD top-100、蒸馏系数 0.5、IS 裁剪 2.0、EMA 0.01、$\lambda_{edit}=1.0$、权重裁剪 $[0.05,5.0]$;评测用 lm-evaluation-harness 报 mean@16。论文未明确承诺开源代码,可从 SDPO 官方实现与 verl 起步;有 verl 经验的团队约需一至两周即可复现主表。
论文图表
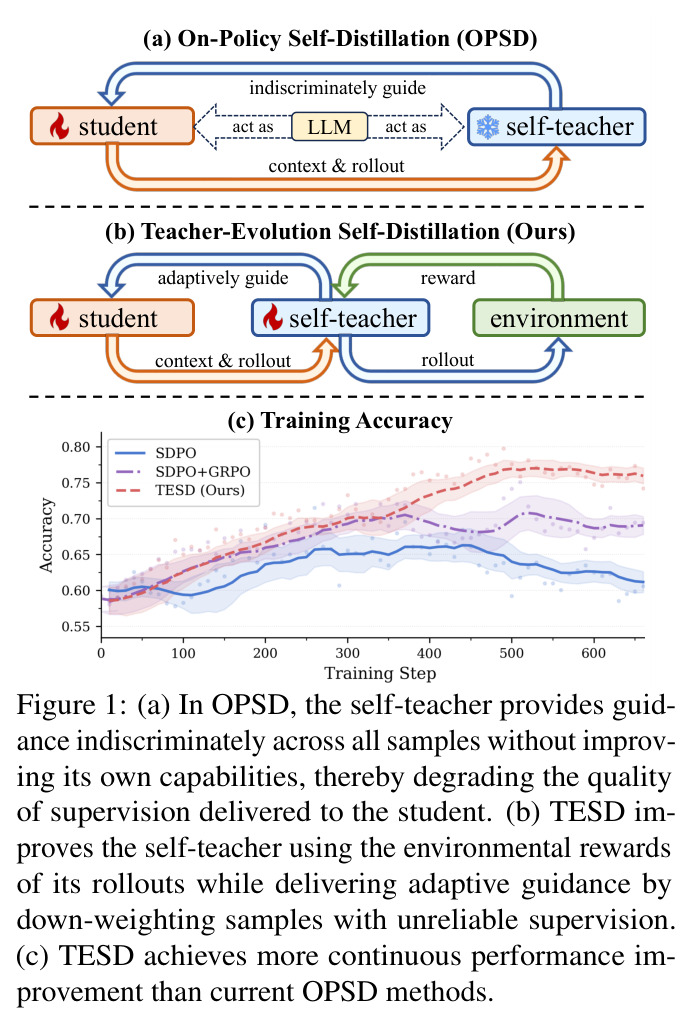
三联图:上半部分对比 OPSD 与 TESD 的框架示意——OPSD 中自教师仅凭特权上下文对所有学生 rollout 一视同仁地提供指导,自身能力不增长;TESD 中自教师自己生成 rollout、接受环境奖励,并按可靠性自适应指导学生。下半部分是训练精度曲线,显示现有 OPSD 方法提升不连续而 TESD 持续增长。
一图看懂论文的问题(OPSD 停滞)与解法定位(教师进化+自适应加权),是理解全文动机与框架的入口。
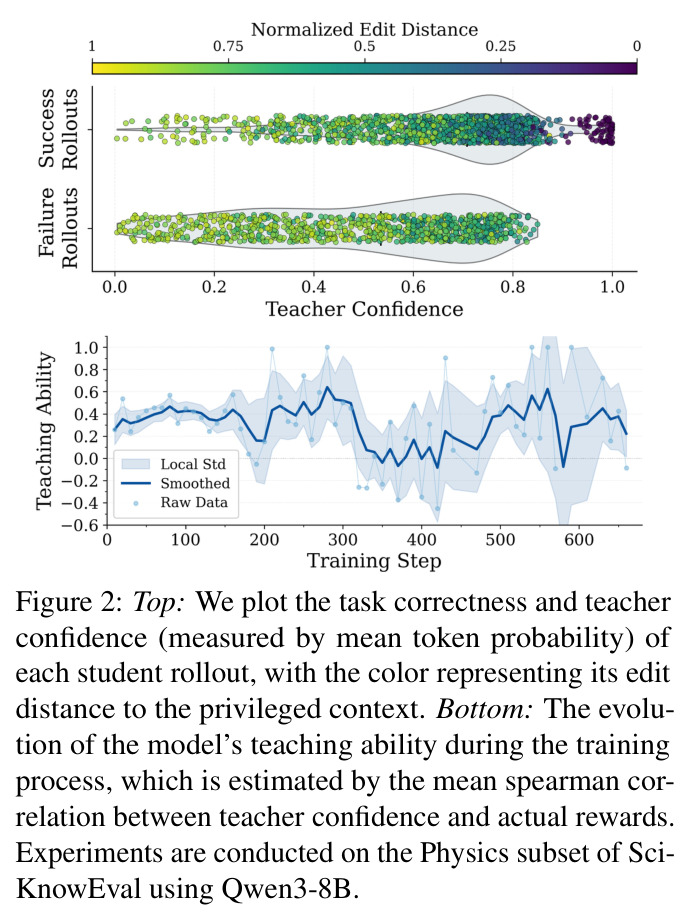
上图为 Qwen3-8B 在 SciKnowEval-Physics 上的散点图,显示自教师给部分正确 rollout 打 0.0–0.5 低置信度、却给大量错误 rollout 打 0.5–0.8 高置信度,且高置信度 rollout 的编辑距离普遍更小(相似即自信偏差);下图显示教学能力随训练不升反降且伴随剧烈波动。
这是全文的问题诊断证据:正是这两个实证发现催生了独立性奖励和教师导向优化两个核心设计,读懂它才能理解方法的必然性。