面向真实世界代码验证的规模化 Lean 定理证明系统 Scaling Lean Theorem Proving for Real-World Code Verification
免训练递归智能体近乎攻破现有定理证明基准,并自动生成更难的代码验证任务集AEGIS
前置知识
Lean 与内核检查证明(kernel-checked proof)
Lean 4 是交互式定理证明器兼编程语言,其内核独立重新检查每条证明,杜绝逻辑漏洞。一条证明被接受的标准是:目标陈述前缀冻结不可改动、文件编译无 sorry(未完成占位符)、所依赖公理的闭包落在允许清单内。满足这些条件后,证明的正确性只取决于陈述本身、允许的公理和 Lean 内核,任何人用相同工具链都能低成本复验。
本文所有结果都以内核检查的证明或反驳为准,agent 自己声称成功不算数;不理解这一验收标准就无法理解结果为何可信、系统如何防 reward hacking。
AENEAS 与 Rust→Lean 翻译
AENEAS 建在 CHARON 的 LLBC 中间表示之上,把安全 Rust 程序翻译成纯函数式的 Lean 模型:可能溢出、越界、除零的操作返回 $\mathrm{Result}\ \alpha$ 并用单子串接;每个 Rust 循环被函数化为返回 ControlFlow 的驱动函数加携带可变循环变量的元组;Box 包装在翻译中消失,递归 enum 变成 Lean 归纳类型;定点整数如 Std.U32 暴露数学投影 .val 并引入显式范围义务。
AEGIS 的全部验证任务都建在机械翻译出的 Lean 程序上,理解这一翻译才能明白任务为何难:实现级的定点算术、显式失败、生成循环和变异义务是数学竞赛基准没有的。
RLVR(可验证奖励的强化学习)
RLVR 指用可自动验证的结果(单元测试通过、形式化证明通过等)作为强化学习的奖励信号,替代昂贵的人工标注。单元测试只能提供有限正确性证据,还可能被 agent 钻测试框架的空子;而内核检查的形式化证明既验证便宜又不可被欺骗,是更干净的奖励来源。
论文强调 AEGIS 产出的每个任务都带内核检查的证明或反驳标签,可直接当作 RLVR 奖励,这是这套数据除了做基准之外的第二重价值。
递归智能体搜索与 MCTS 类比
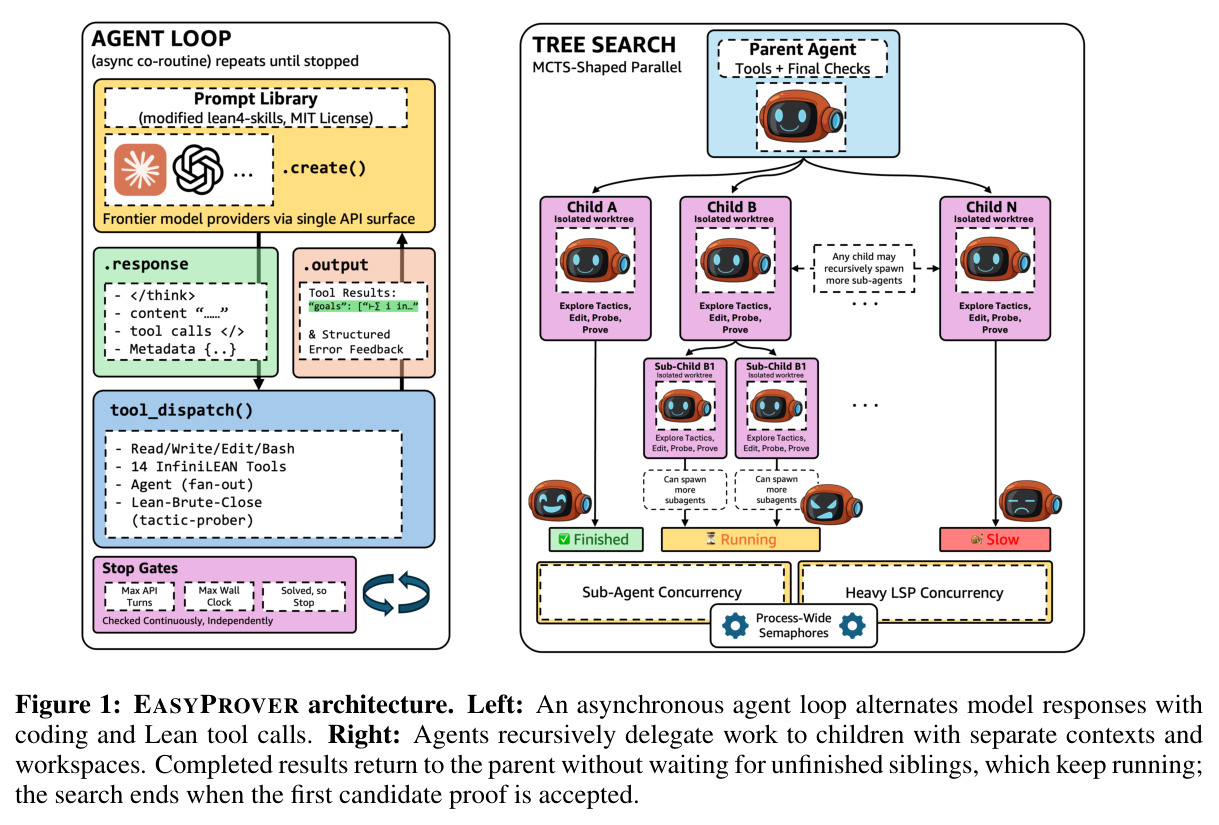
EASYPROVER 的搜索形似蒙特卡洛树搜索:父 agent 派生子 agent 去探索不同证明策略或推导辅助引理,每个子 agent 拿到全新上下文和项目私有副本,且同样拥有 Agent 工具故可继续递归委派。与 UCT 的本质区别在于分支选择由语言模型直接阅读子代理返回的完整证明、反例或部分发现来决定,不维护访问计数或 rollout 平均值估计。
这是方法章的核心机制:上下文隔离让搜索树的总探索量与任何单个 agent 需要携带的历史解耦,是系统能扩展到单题 300+ 子 agent 的关键。
差分测试(differential testing)
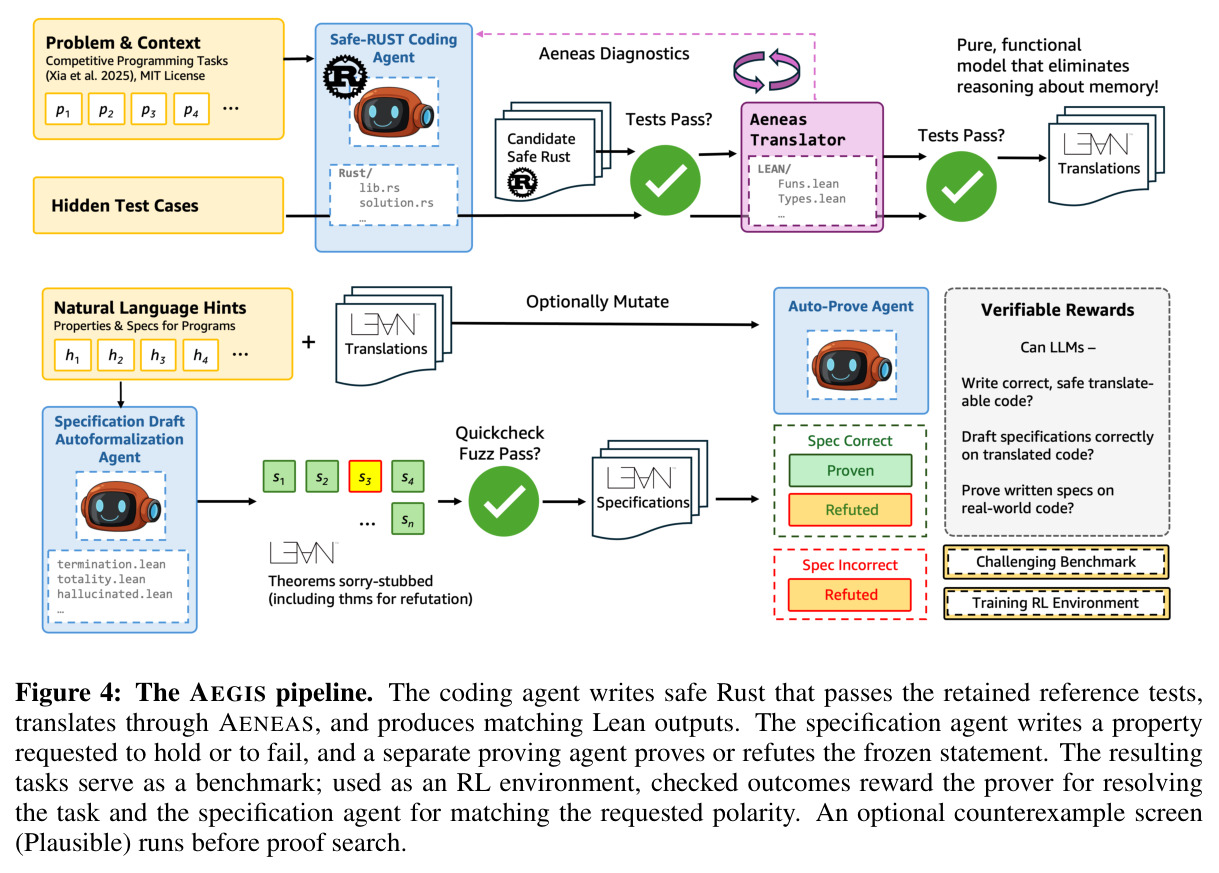
差分测试对同一组输入运行两个实现并逐项比较输出,以验证两者行为一致。AEGIS 中每个 Rust 实现先通过 cargo test 的全部参考用例,再经 CHARON 提取、AENEAS 翻译成可执行的 Lean 模型,最后让 Lean 在相同输入上求值并要求输出与 Rust 完全一致,全过才算验证通过的程序实例。
它为「翻译后的 Lean 程序确实等价于 Rust 源码」提供了经验证据,弥补了内核检查标签只保证陈述正确、不保证翻译正确这一空档。
研究动机
现有 LLM 加证明助手的系统进步神速,但评测基准濒临饱和:miniF2F 上已有系统报告 100%,PutnamBench 最好成绩达到 87.9% 甚至满分,继续用这些任务衡量新系统几乎没有区分度。另一头的真实代码验证基准又小又静态:VERINA 只有 189 题、CLEVER 161 题中 143 题可迁移、AlgoVeri 77 题、工业界 NTP4VC 600 题;编写每个验证任务需要同时精通编程、形式化规约和定理证明的专家,难以扩产,且静态任务集天然暴露于训练数据污染(n-gram 重叠审计、发布日期截断等缓解手段只能检测不能产出新任务)。此外,用单元测试给编码 agent 打分只能提供有限的正确性证据,还可能诱导 agent 钻测试框架的空子而非实现真实意图。结果就是:这个领域缺少既能挡住顶级证明系统、又能以算力自动化扩产、还能提供不可作弊标签的评测与训练环境。
本文的目标是论文目标有两个。其一是构建不微调、不训练任何策略或价值网络的证明系统 EASYPROVER,仅凭现成的 frontier 模型(Anthropic Fable-5)加上智能体框架工程,在形式数学基准(PutnamBench、IMO 2026、Putnam 2025)和代码验证基准(VERINA、CLEVER、AlgoVeri、NTP4VC)上以「内核检查的证明或反驳」为验收标准逼近或达到饱和,从而划定现有基准的能力上限。其二是构造 AEGIS:把竞赛编程题自动转化为针对真实实现——经 AENEAS 翻译的 Rust 程序——的 Lean 验证任务,机械化产出 2,045 个通过差分验证的 Rust–Lean 程序对和 11,533 条候选规格;用同一系统在分层抽样的 2,000 条陈述上测得 52.7% 的证明率,证明任务远未饱和。这些任务同时可用作评测其他证明器的基准和 RLVR 奖励。
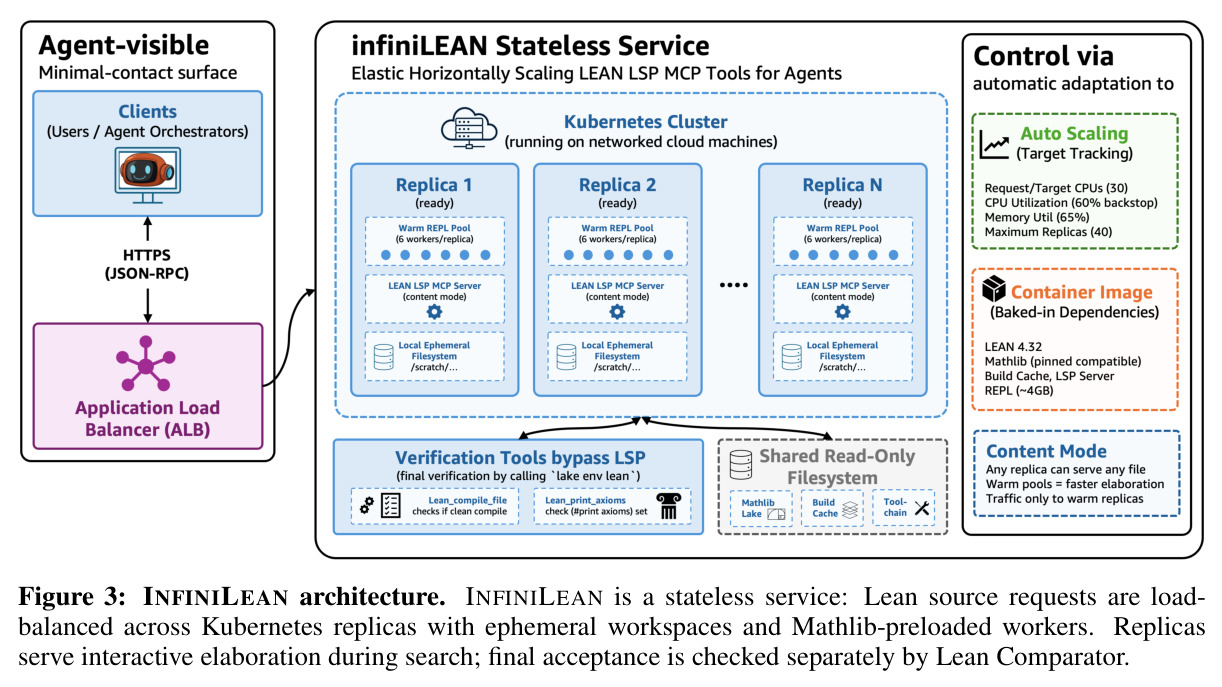
与已有工作不同的是,本文的独特切入点有三。第一,它不训练模型,把全部筹码押在智能体框架工程上:递归委派、上下文隔离、并行战术探测与无状态弹性 Lean 服务 INFINILEAN 的组合,让最难的一道证明动用了超过 300 个子 agent——这在一台机器上不可能完成,所以它把交互式 Lean 精化做成负载均衡的网络服务,突破了 LeanDojo 到 lean-lsp-mcp 等本地接口「一个证明器绑一台 Lean 服务器」的扩展瓶颈。第二,它同时攻击基准饱和与数据污染:AEGIS 的源题虽是公开 LeetCode 题,但翻译后的程序与规格是流水线新造的、历史上不存在,需要更多任务只需追加算力。第三,它把「证明或反驳」都算作解决:反驳提供的负标签是纯证明型或执行评分型自博弈循环产生不了的信号,且每个冻结陈述的标签任何人都能用内核复验,天然适配 RLVR。
核心方法
直觉上,这篇论文把证明搜索当成可用云工程无限扩展的并行计算问题:单个模型聪明但上下文有限,那就让许多模型副本组成一棵动态生长的搜索树,父 agent 只读子女的结论而不继承其失败历史。技术上 EASYPROVER 分三部分:一是异步智能体运行时,基于 ReAct 循环,工具经 MCP 暴露,涵盖沙箱 shell、Lean 证明状态与诊断检查、前提检索、并行战术探测和递归 Agent 工具;二是 INFINILEAN,无状态的 Lean 精化服务,客户端经 JSON-RPC 把源码发到 Kubernetes 副本池,任何就绪副本都能服务任何请求,预热 worker 上精化约 0.2 秒而导入 Mathlib 需数十秒,故复用 worker 摊薄成本;三是独立验收层 Lean Comparator,用共享只读工具链运行 lake env lean 与 #print axioms,只接受无 sorry 且公理闭包合规的证明。任务形式化为:给定环境 $\Gamma$ 与命题 $P$,目标是给出 $P$ 或 $\neg P$ 的内核检查证明,陈述前缀冻结,第一个被接受的候选结束搜索。
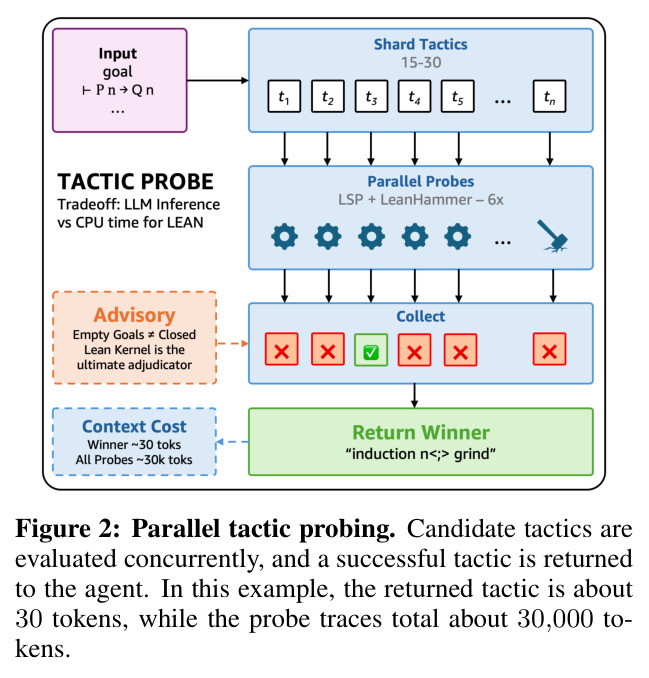
核心创新是把搜索树的扩展决策与状态评估全部交给语言模型,而把精化验证做成云上无状态服务,两者解耦后搜索宽度只受算力而非架构限制。与 Goedel-Prover-V2、DeepSeek-Prover-V2、Seed-Prover 等依赖专家迭代或强化学习训练的证明器相反,EASYPROVER 不做任何训练:搜索形似 MCTS,但父 agent 直接阅读子 agent 返回的完整证明、反例或部分发现来决定继续、修改或扩展哪条分支,不维护访问计数或 rollout 均值。上下文隔离是关键杠杆:子 agent 可能花几十次工具调用推导一个辅助引理,但只把引理交回父 agent,父 agent 无需导入背后的失败尝试与诊断,因此总探索量与任何单个 agent 携带的历史解耦。并行战术探测把「试一个战术」的上下文成本从约 30,000 token 的探针轨迹压缩到约 30 token 的成功战术。另一关键思想是用流程分离堵死作弊:规格由独立 agent 在证明者看到之前写好并冻结,验收独立于搜索复检,从机制上杜绝弱化定理、留 sorry、引入公理等 reward hacking。
方法步骤详情
流程分两条线。EASYPROVER 侧:输入是冻结陈述前缀的 Lean 文件(环境 $\Gamma$、命题 $P$);agent 在 ReAct 循环中读取证明状态,先用并行战术探测在当前目标上并发尝试多个候选战术,成功者连同诊断被返回而失败探针被丢弃;需要新引理或新策略时调用 Agent 工具递归委派,子 agent 获得全新上下文和项目私有副本;候选证明在锁保护下提升到解文件,由 Lean Comparator 复检(编译无 sorry、公理合规),失败则回滚,首个被接受的候选结束搜索;两个信号量把活跃子 agent 限为 64、并发昂贵 Lean 查询限为 16。AEGIS 侧:输入是 LeetCode 题目;编码 agent 写安全 Rust(单函数纯接口、一阶数据、整数有界),cargo test 过参考用例后经 CHARON 提取、AENEAS 翻译成可执行 Lean 模型,Lean 在相同输入上求值并与 Rust 差分比对,2,356 题中 2,045 题(86.8%)全过;规格 agent 拿到原题、完整 Lean 程序与若干已验证示例,写出带 sorry 的合法定理陈述及自然语言描述,含应成立(函数正确性、总体性、输出界、边界情况)与应失败(缺前提、差一错误)两类;去重滤掉平凡陈述后冻结;可选的 Plausible 测试先筛反例,之后由 EASYPROVER 尝试证明 $P$ 或 $\neg P$,通过验收即算解决。
技术新颖性
新颖性体现在四个层面。架构上,INFINILEAN 首次把交互式 Lean 精化做成无状态网络服务:从 LeanDojo 到 lean-lsp-mcp 的现有接口都让 Lean 与 agent 同机运行、以本地路径引用证明,把一个证明器绑死在一台服务器上;无状态化使负载均衡池中任意副本可服务任意请求,配合 Kubernetes 目标追踪自动扩缩,让单题动用 300+ 子 agent 成为可能。搜索上,它示范了「模型即搜索策略」:不训练价值网络,用 agent 间消息传递替代 MCTS 的统计估值,文中明确讨论了与 UCT 的对应与区别。数据上,AEGIS 的「翻译即任务」路线不同于人工编写的既有基准:义务来自定点算术(Std.U32 的数学投影 .val 与显式范围义务)、单子化的 Result 失败分支、函数化的循环与 index_mut 返回的反向重建函数,这些实现级义务是数学竞赛基准完全缺失的。标签上,证明与反驳双标签、陈述冻结加独立验收的设计,与 Leanstral 证不出就转证否定、DeepSeek-Prover 并行反驳过滤语句的做法相衔接,但把标签可信度统一收敛到内核复验。
实验结果
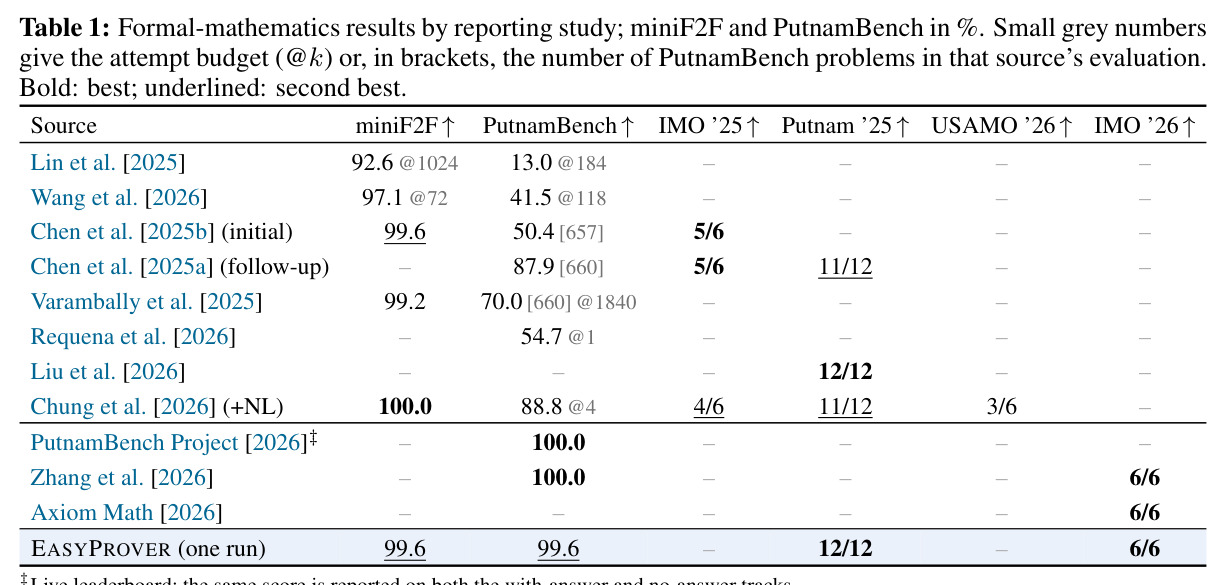
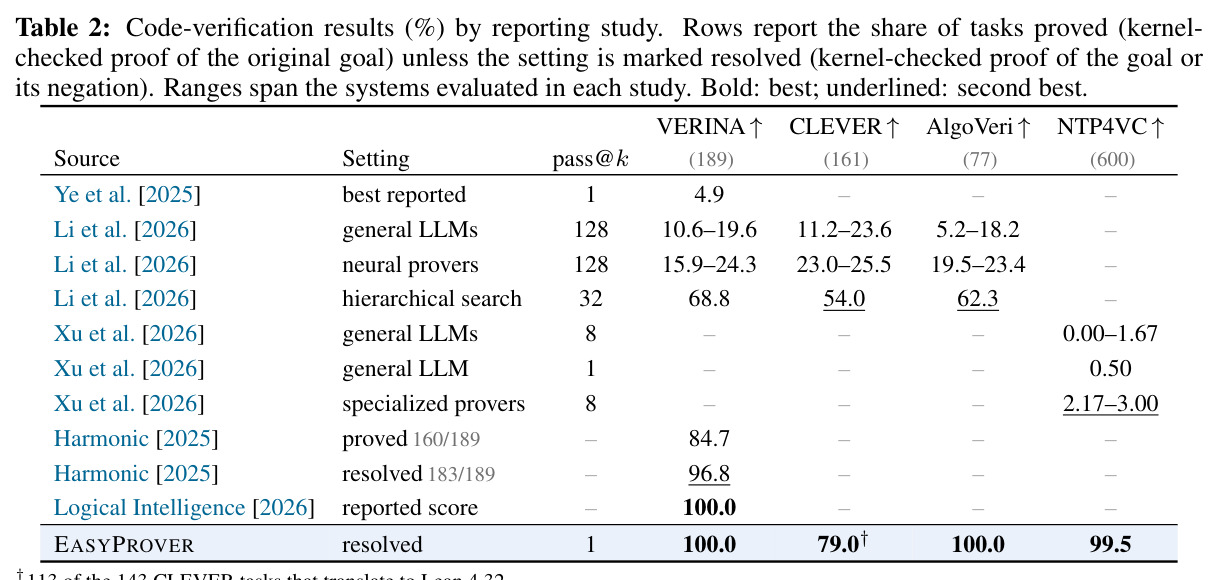
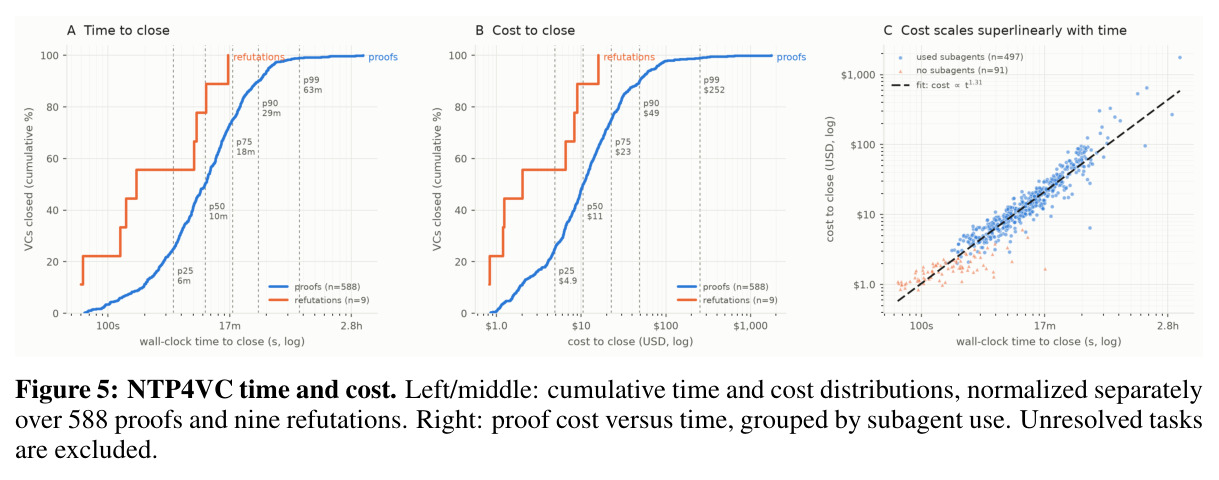
结果分三块。形式数学(表 1):单次运行 EASYPROVER 解出 672 题 PutnamBench 中的 669 题(99.6%),比最强已发表配置 Chung et al.(+NL,597/672)多 72 题;同时解出全部 6 道 IMO 2026 形式化和 12 道 Putnam 2025 题,miniF2F 得 99.6%,而模型未经任何微调、无策略或价值网络。代码验证(表 2):以「证明或反驳」口径解决全部 189 题 VERINA、全部 77 题 AlgoVeri、600 题工业 NTP4VC 中的 597 题(99.5%,588 证明加 9 反驳),远超专用证明器 2.17–3.00%@8 和 Harmonic 在 VERINA 的 resolved 96.8%;CLEVER 上解决可迁移到 Lean 4.32 的 113/143 题(79.0%)。图 5 显示 NTP4VC 按证明与反驳分别归一化的累计时间与成本分布,以及按子 agent 使用分组的成本散点。AEGIS:从 11,533 条候选规格分层抽样 2,000 条(覆盖 1,257 个翻译程序,剔除 Plausible 已筛出的),30 分钟/陈述预算内尝试 1,997 条,证明 1,054 条(52.7%),943 条未解决;证明率从边界情况类的 84.1% 到显式契约类的 31.0%,从 Easy 题的 66.7% 到 Hard 题的 37.6%——几乎攻破所有旧基准的同一个证明器在新任务上留下近半未解决,说明任务远未饱和。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PutnamBench(形式数学) | 解题率 | 669/672(99.6%,单次运行) | Chung et al. (+NL) 597/672(88.8%@4);Chen et al. 87.9% | 多解 72 题,绝对提升约 10.8 个百分点 |
| IMO 2026 形式化 | 解题数 | 6/6 | Chung et al. 4/6;Axiom Math 与 Zhang et al. 6/6 | 持平最强已发表系统 |
| Putnam 2025 | 解题数 | 12/12 | Chen et al. 与 Chung et al. 11/12 | 多解 1 题 |
| VERINA(代码验证) | 解决率(证明或反驳) | 189/189(100%) | Harmonic resolved 96.8%;层级搜索 68.8% pass@32 | 绝对提升 3.2 个百分点 |
| NTP4VC(工业验证条件) | 解决率 | 597/600(99.5%,588 证明+9 反驳) | 专用证明器 2.17–3.00%@8(Xu et al.) | 提升约 96 个百分点 |
| CLEVER | 解决率 | 113/143(79.0%,限可迁移到 Lean 4.32 的任务) | 层级搜索 54.0% pass@32(Li et al.) | 提升约 25 个百分点 |
| AlgoVeri | 解决率 | 77/77(100%) | 无已发表基线 | 首个报告结果 |
| AEGIS(本文新基准,2000 条分层样本) | 30 分钟预算内证明率 | 1,054/2,000(52.7%) | 新任务集无外部基线;内部跨度:边界情况类 84.1% 至显式契约类 31.0%,Easy 66.7% 至 Hard 37.6% | 不适用(任务远未饱和本身即是结论) |
局限与改进
作者承认的局限:miniF2F 是 99.6% 而非满分;CLEVER 有 30 题因无法翻译到 Lean 4.32 工具链被排除,覆盖率只有 79.0%;frontier 模型训练截止日期不公开,无法排除竞赛题污染训练数据——虽然这影响结果解读而不影响正确性(每个证明都经内核检查),且 AEGIS 的任务在本文之前不存在;作者未对 harness 各组件做消融,也未与「同一模型裸用 Lean 工具」对照,无法量化框架本身的贡献;AEGIS 用作 RLVR 环境、评测其他证明器、变异测试生成的任务均只提及未评测。我补充的观察:AEGIS 任务源限定 LeetCode、单函数一阶数据接口,排除了哈希表、闭包、嵌套引用、别名等特性,「真实世界」覆盖面仍限于算法题形态;差分验证只保证 Lean 模型与 Rust 在参考输入上一致,翻译的形式正确性仍依赖 AENEAS 的可信度;52.7% 证明率是单一系统的数字,缺少多系统横向对比确认任务难度排序的普适性。
独立分析的弱点
弱点一:无消融实验。作者以「每个配置都要全量跑基准」为由跳过消融,但读者无法知道 669/672 里递归委派、并行战术探测、INFINILEAN 各贡献多少;改进方向是在 AEGIS 分层子集上做组件消融——任务更难、区分度更高。弱点二:成本不透明。图 5 给了分布但正文未给总 API 花费、副本数与总算力,单题 300+ 子 agent、64 并发的搜索宽度对学界实验室可能不可负担;应公开预算-成功率帕累托曲线。弱点三:AEGIS 的规格质量依赖规格 agent。虽然极性错配会被结果检出(证明确认应成立的规格、反驳确认应失败的规格),但「应成立却永远证不出」的坏规格会与真正的难任务混在一起,抬高 943 条未解决中的噪声;应给规格加质量分层或多 agent 交叉验证后再冻结。弱点四:CLEVER 的 79% 短板被归因于工具链翻译,但未分析这 30 题失败在提取、翻译还是精化的哪一环,掩盖了 CHARON/AENEAS 管线的具体能力边界;应公开失败任务逐环节归因。
未来方向
作者明确提出的方向:用 AEGIS 评测其他证明器(如 Goedel-Code-Prover、Leanstral);把 AEGIS 用作 RLVR 环境——实现检查奖励编码 agent、内核检查结果奖励规格与证明 agent;多教师在线蒸馏;以及用变异测试从已验证程序生成貌似正确实则错误的变体以扩充负标签任务(文中已使用但未评测)。可延伸的方向:其一,把任务生成器接入 LeetCode 之外的源(真实开源 Rust 库、嵌入式 C 代码),检验实现级义务分布是否迁移,这才是「真实世界验证」的完全体;其二,在 AEGIS 上做专家迭代,把 EASYPROVER 成功与失败的搜索轨迹蒸馏回模型,测试框架收益与训练收益是否互补——毕竟本文刻意零训练,两者的乘积效应未知;其三,把 Plausible 反例筛选升级为自动构造反驳证明项,进一步压缩证明搜索预算;其四,INFINILEAN 的无状态精化服务本身就是可独立开源的通用基础设施,任何 LLM 证明 agent 都能受益,值得单独工程化。
复现评估
复现难度较高。论文未提及代码或数据开源;EASYPROVER 依赖 Anthropic Fable-5 这一闭源 frontier 模型,harness 的提示词、MCP 工具协议、候选提升锁语义只有架构级描述。AEGIS 管线的组件倒是全部公开:CHARON/AENEAS、Plausible、Lean Comparator 与 LeetCode 题目,理论上可重建,但需编码、规格、证明三套 agent 的提示工程和 2,356 次翻译尝试的算力。算力方面:单题最多 64 并发子 agent、16 并发 Lean 查询、总计超 300 个子 agent,外加 Kubernetes 自动扩缩的 Mathlib 预载副本池;AEGIS 抽样即需 2,000 条陈述各 30 分钟预算,没有云级预算难以复现完整结果。低成本验证路径:先用公开组件重建 50 题规模的 AEGIS 子集,再用任一开源 LLM 接本地 Lean 服务器复现简化版递归委派,在百条陈述上对比单 agent 与递归委派的证明率,即可检验本文最核心的主张。
论文图表