三思而后行:Metis-1.6 技术报告 Think Twice: The Metis-1.6 Technical Report
单人1.02T token训练的双遍循环MoE模型登上数据与算力帕累托前沿,并如实复盘全部训练失误
前置知识
混合专家模型 (Mixture-of-Experts, MoE)
MoE 把每层 FFN 换成多个并行“专家”网络,路由器为每个 token 选 top-k 个专家计算、其余跳过,从而总参数量大而每 token 计算量不变。本文用细粒度专家加 1 个常开共享专家,负载均衡靠无辅助损失的偏置更新加 router z-loss,专家在压缩潜空间中工作。
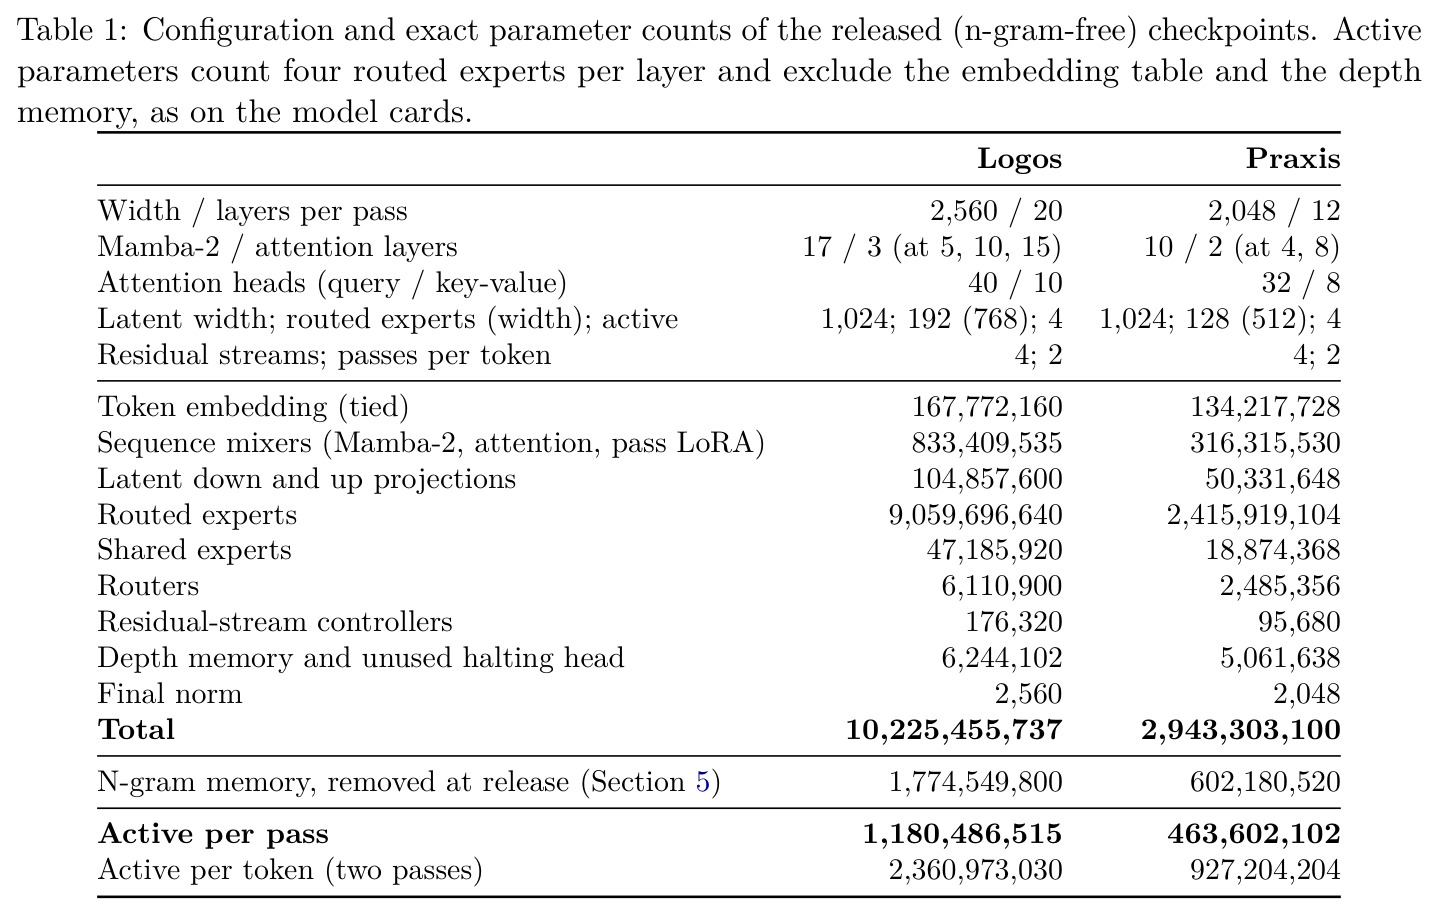
Metis-1.6 的每一层都以潜空间 MoE 收尾:Logos 存储 10.23B 参数但每 token 只激活 2.36B,“以 1/12 的数据打平大厂模型”的效率结论完全建立在这个机制上,不懂 MoE 就无法理解其参数账本。
Mamba-2 与混合序列混合器
Mamba-2 把选择性状态空间模型重写为结构化矩阵乘形式以利用矩阵硬件;它以线性复杂度处理序列、隐状态固定、天然携带位置信息,因此无需位置编码(NoPE)也没有逐 token 增长的 KV cache。混合架构(Jamba、Nemotron-H)在多数 SSM 层间插入少量注意力层保留检索能力。
Logos 的 20 层中有 17 层是 Mamba-2、只有 3 层保留 KV cache,这既是它长上下文显存便宜的原因,也是它 131K 上下文检索仍偏弱的结构根源;论文的长上下文短板分析依赖这一点。
循环/权重共享模型 (looped model)
自 Universal Transformer 以来的思路:让同一组网络块以共享权重反复执行,用“递归深度”替代堆叠参数。优点是参数省、可做自适应计算;难点是 label-shift 与残差缩放不稳定。本文最激进——把整个混合 trunk 对每个 token 完整跑两遍。
"one stack, two passes" 是本文的标题级设计(Think Twice),第 10 节的 10B-token 消融专门检验循环该怎么设计,其结论直接催生了下一代架构 MoRE。
GRPO 与组均值归一化优势
GRPO 对同一 prompt 采样一组回答(本文 16 个),用组内奖励均值 $\bar{r}$ 与标准差 $\sigma$ 把优势归一化为 $A_i=(r_i-\bar{r})/\sigma$,免去价值网络。其隐含假设是“中心化不改变奖励排序语义”,而本文第 7.2 节证明:通过率够高时长正确回答的优势会变号。
论文最重要的理论贡献——长度奖励在组均值归一化下的符号反转(Proposition 1)及其一行修复 $A_i\leftarrow\max(0,A_i)$——完全建立在这个机制上,是所有做 RLVR 的人都该知道的反直觉结论。
Muon/AdaMuon 优化器
Muon 对矩阵参数的动量更新做正交化(Newton–Schulz 迭代逼近),使更新在各奇异方向更均匀,配合 Nesterov 动量;AdaMuon/NorMuon 加入二阶矩归一化,Polar Express 给出更优正交化多项式。近年开源大模型训练常用它取代 AdamW 处理矩阵参数。
第 4.2 节的重大事故正是优化器错配:声明的 AdaMuon 从未被实例化,注意力参数因路由名不匹配而全程用 AdamW 训练;第 10 节还量化了修正后的 Muon 变体相对调优 AdamW 的收益($-0.18190$ nats),这是理解本文“错误复盘”主线的钥匙。
研究动机
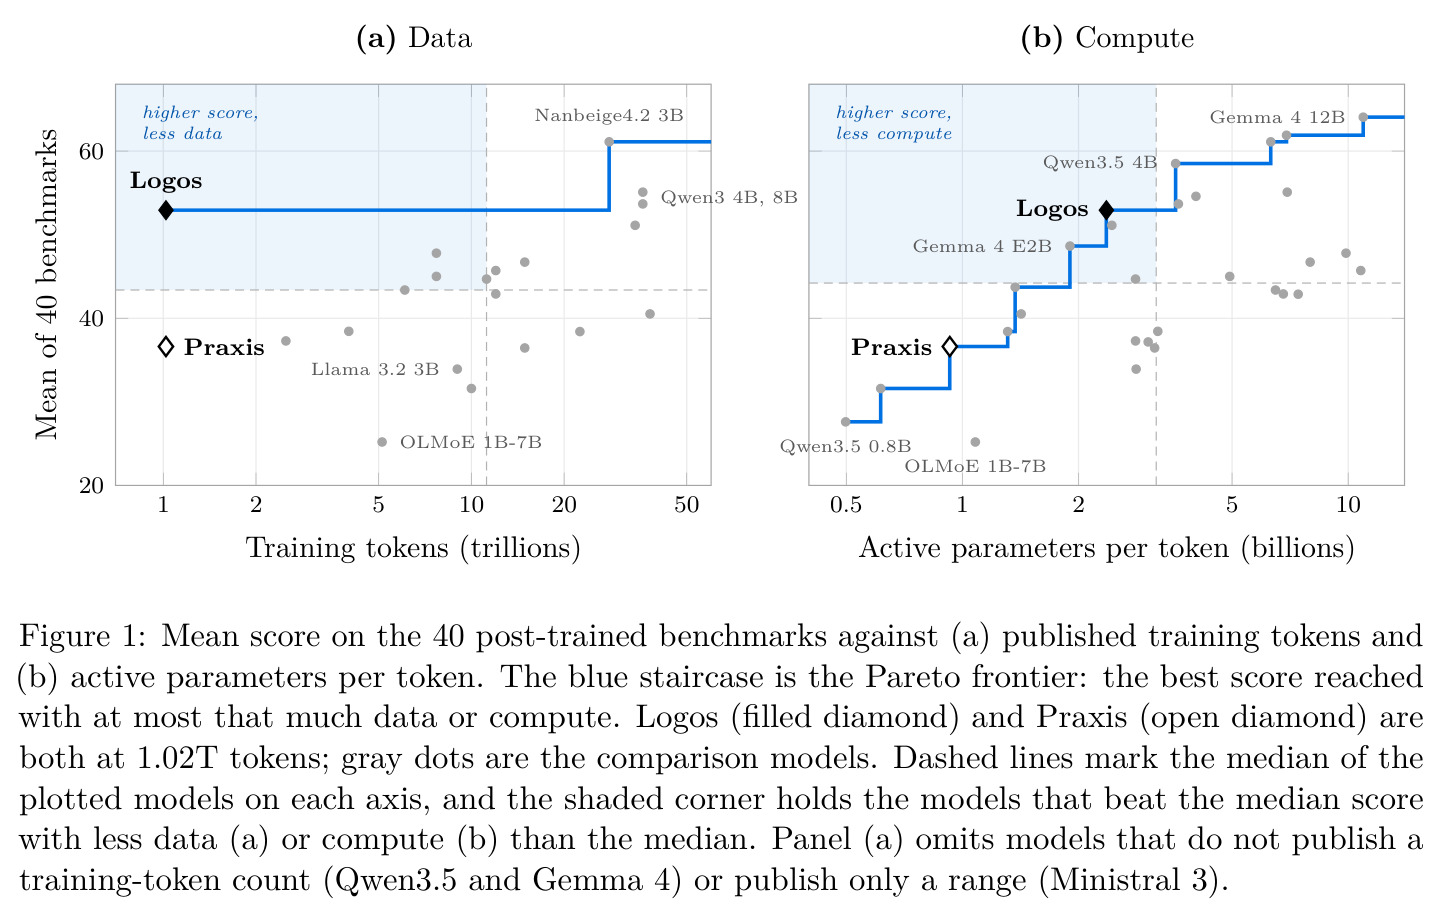
过去几年语言模型的能力进步基本是用规模买来的:模型不够强就把它做大,参数量像奖杯一样被公布,仿佛大小本身就是成就。但这笔账越来越付不起——在本报告的比较集中,所有 40 基准平均分超过 Logos 的开放模型里,披露训练数据量最低的也用了 28T token(Nanbeige4.2-3B 为 28T,Qwen3-4B 与 Qwen3-8B 各 36T),LFM2.5-8B-A1B 甚至用了 38T;中位数约为 12T。单人研究者根本无法负担这种预算,而更糟的是“安全选择”往往获胜:在 2023 年的配方上再加一万亿参数,而不是冒险换一个更好的配方。于是真正的问题变成:没有前沿预算的人,能否用更好的数据、训练算法与架构,以极低的成本(本文是 1.02T token)换回接近的能力,并在小规模上系统地验证这条路?
本文的目标是Metis-1.6 的目标从来不是挑战前沿模型,而是在小规模上检验 Metis 项目的核心赌注:更好的数据、更好的训练方法与新架构能买到参数买不到的能力,且成本只是零头。具体目标是:由一名研究者从零构建完整技术栈(数据采集与去污染、分词、训练内核、强化学习环境、评测 harness 全部自研,任何一环随时可换),训练两个模型——Praxis(2.94B 参数,每遍激活 0.46B)与 Logos(10.23B 参数,每遍激活 1.18B)——在总计 1.02T token(804.76B 预训练 + 18B 上下文扩展至 131,072 + 200B 监督微调)上,让模型从“能对话”(1.5)进化到“能真正使用”:解奥赛题、调用工具、遵循指令;同时公开 checkpoint 哈希谱系与全部基准数据,并诚实记录每一个错误,为 Metis-1.7 铺路。
与已有工作不同的是,本文的独特切入有三点。第一,架构上敢赌:不堆更多层,而是把同一个 Mamba-2+注意力混合栈对每个 token 完整跑两遍(“Think Twice”),配合 1,024 维潜空间 MoE 与 4 条残差流——这是大厂配方里看不到的组合。第二,方法论上把“失败”当作一等公民:常规发布报告只描述成功的配方,本报告用一半篇幅审计错误——静默错配整个预训练的优化器、被模型自己学会关闭的 1.77B 参数 n-gram 记忆、五个 SFT 失败模式、以及被证明并一行修复的长度奖励符号反转。第三,证明“单人可以靠快速迭代取胜”:想法出现的当天就试验,采用最新而非最安全的设计,冒大组织不敢冒的险,四代模型(1.3 的 201M 到 1.6 的 10.23B)每一代都做出前一代做不到的事。
核心方法
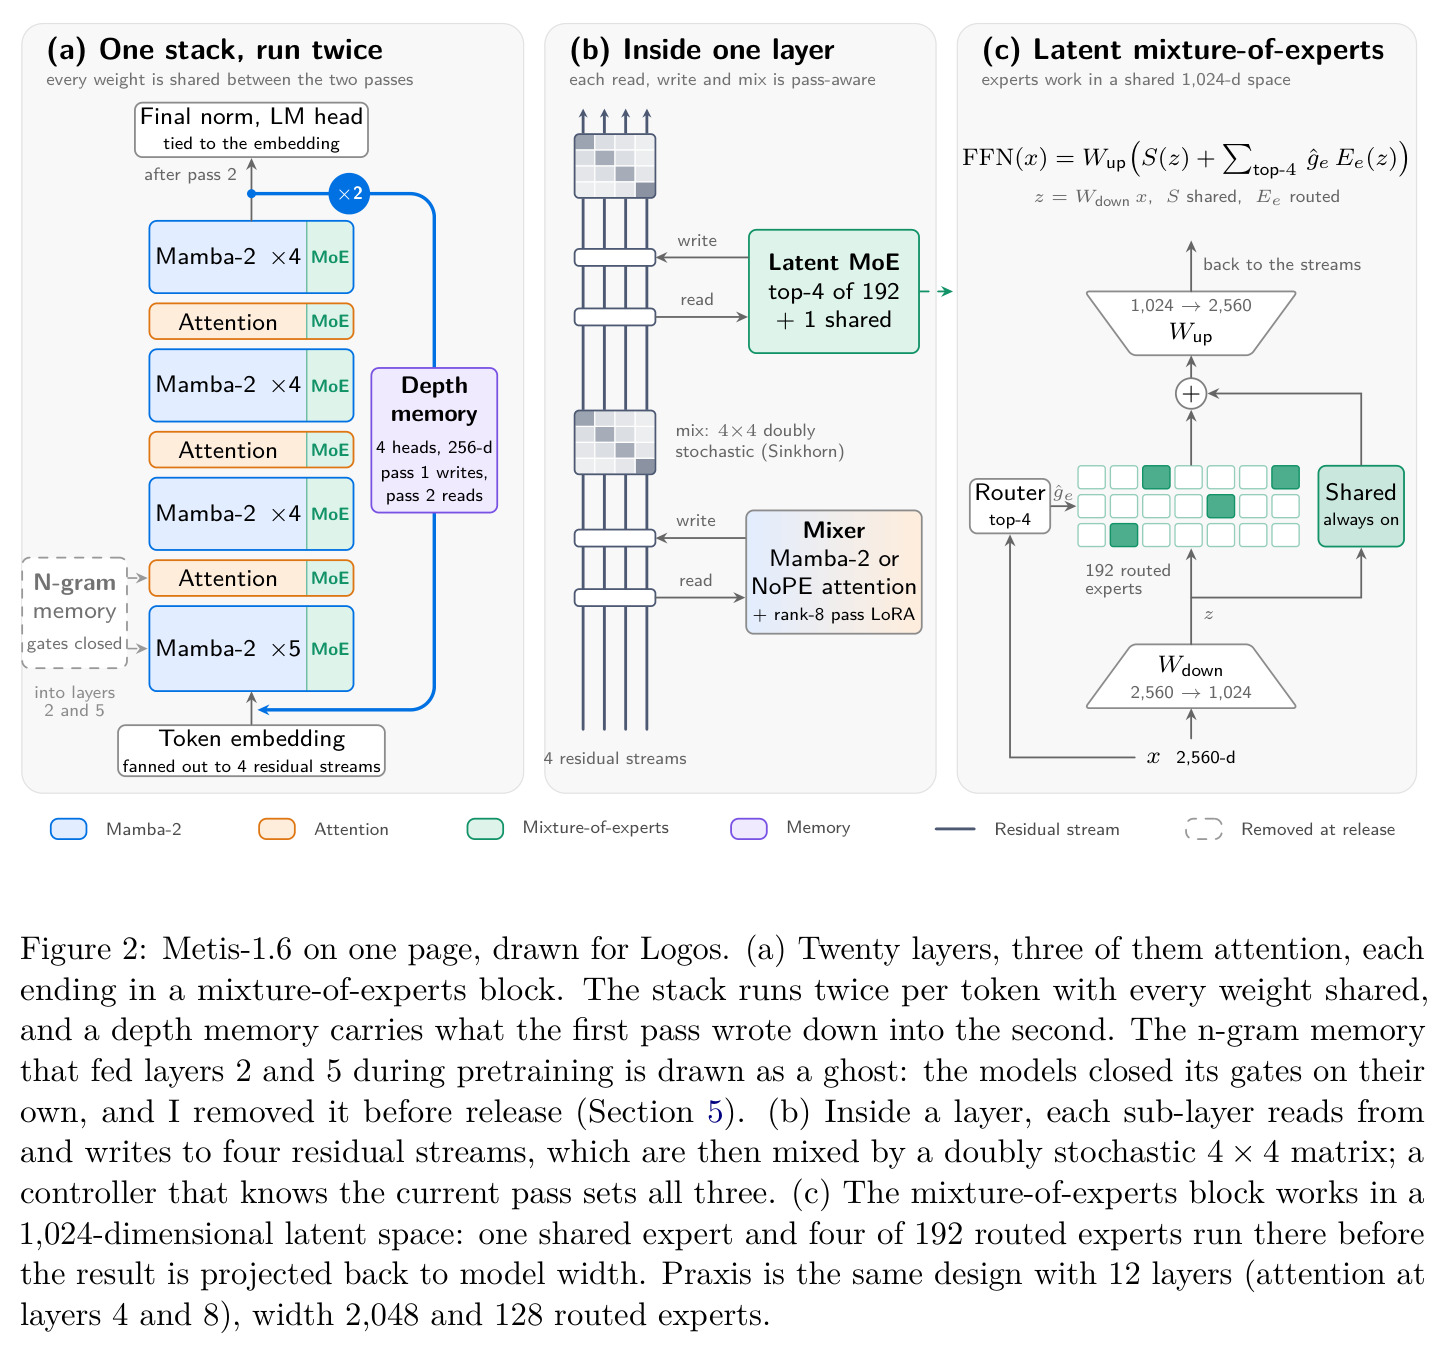
直觉上,模型对每个 token“看两次”:第一遍快速读上下文并写下笔记,第二遍带着笔记重新处理。技术上,Logos 由 20 层组成(宽 2,560),第 5、10、15 层是分组查询注意力(40 query 头/10 KV 头),其余 17 层是 Mamba-2(展开 2、状态 128、头维 64、宽 4 因果卷积);Praxis 是 12 层版本(宽 2,048,注意力在第 4、8 层)。每层末尾是潜空间 MoE:$z=W_{\text{down}}x$ 把表征压到 1,024 维,1 个常开共享 SwiGLU 专家加 top-4 路由专家(Logos 192 个宽 768,Praxis 128 个宽 512)在此计算后投影回模型宽度。整栈每 token 跑两遍,除注意力上的 rank-8 pass-LoRA 与 pass 嵌入外权重全共享;模型维护 4 条残差流,由感知 pass 的控制器读写,混合矩阵经 8 次 Sinkhorn–Knopp 迭代投影为双随机的 $4\times4$ 矩阵;一个 4 头、256 维、输出门初始化为 $-6$ 的跨 pass 深度记忆让第二遍读到第一遍的笔记。全程无位置编码(NoPE),KV cache 仅存在于 3/20 层,词表为 65,536 字节级 BPE。
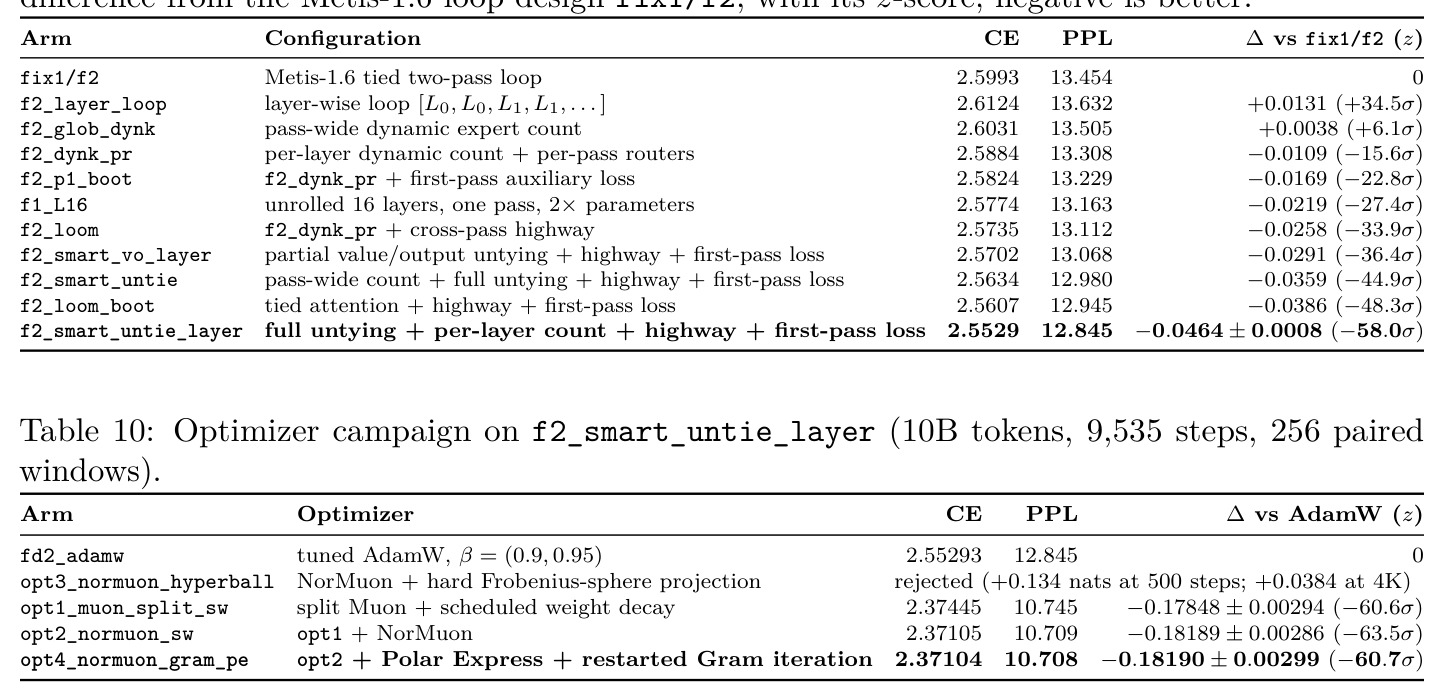
核心创新是 "one stack, two passes" 的两遍循环设计:与按 token 路由递归深度的既有工作不同,它把整个混合 trunk(序列混合器+MoE)对每个 token 完整执行固定两次,使每个 token 经历 40 个功能阶段(Logos)却只存储 20 层的参数。与简单堆叠的本质区别在于第二遍并非重复劳动:pass 嵌入让注意力经由 rank-8 低秩更新以不同方式行为,4 条残差流与跨 pass 深度记忆承载第一遍写下的中间结论。效率来自潜空间 MoE 与循环的结合——Logos 存储 10.23B 参数但每 token 只触碰 2.36B。第 10 节的受控消融进一步证明这个方向的天花板:把两遍权重完全解绑、加入逐层动态专家数、跨 pass 门控残差高速路与第一遍余弦衰减辅助损失后,循环模型的验证交叉熵达 2.5529(PPL 12.845),以 $-0.0464\pm0.0008$ nats 击败 Metis-1.6 循环(2.5993),并以 $-0.0245\pm0.0008$ 击败专家参数两倍的非循环 16 层模型(2.5774)——一个循环模型打赢两倍参数的非循环模型,正是 MoRE 架构的立足点。
方法步骤详情
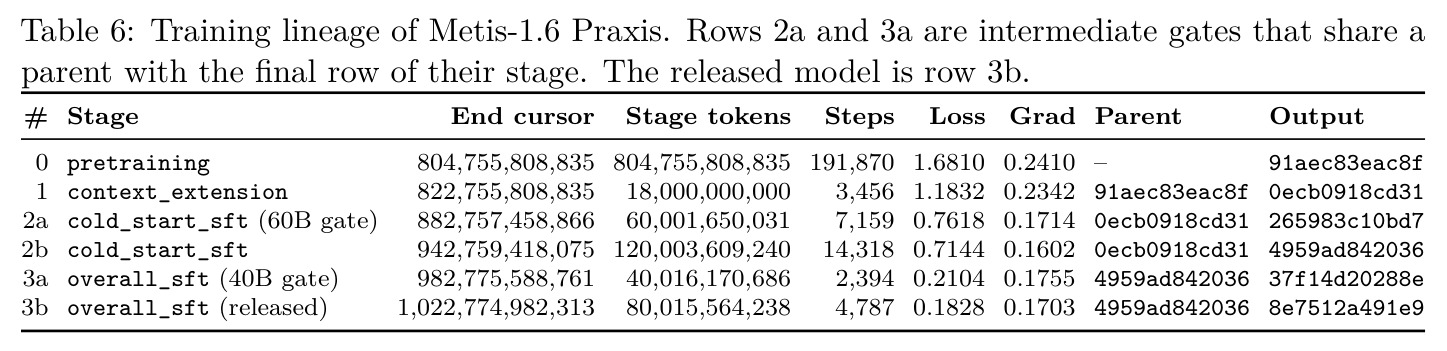
流水线分五步。第一步数据:密封数据集 metis-1.6-data-r2 共 806 个来源哈希分片、804,755,808,835 token,按三阶段课程服务——Phase A 68.9%(554.85B)广泛网络/书籍/科学/代码,Phase B 26.1%(209.67B)加权数学/科学/软件,Phase C 5.0%(40.24B)退火精选;每分片用 13-gram shingle 对评测基准去污染。第二步预训练:4,096-token 序列,Logos 219,280 步、Praxis 191,870 步(实际运行的优化器与配置不符,见 4.2 节)。第三步上下文扩展:18B token 长文档(打包至 163,840),Logos 1,968 步、Praxis 3,456 步,支持 131,072 上下文。第四步 SFT:response-only 交叉熵,metis-chat/v1 模板含 think/direct 双模式;cold-start 用 120.01B token 长推理链,overall 用 80.00B token 全域数据,两模型都发布在 Stage 2 末。第五步(仅 Logos)六阶段 RL 研究:GSPO 桥接 264 步、五个领域专家、on-policy 蒸馏——结论进报告但不进发布模型。最后以统一 harness 评测 40 个基准。
技术新颖性
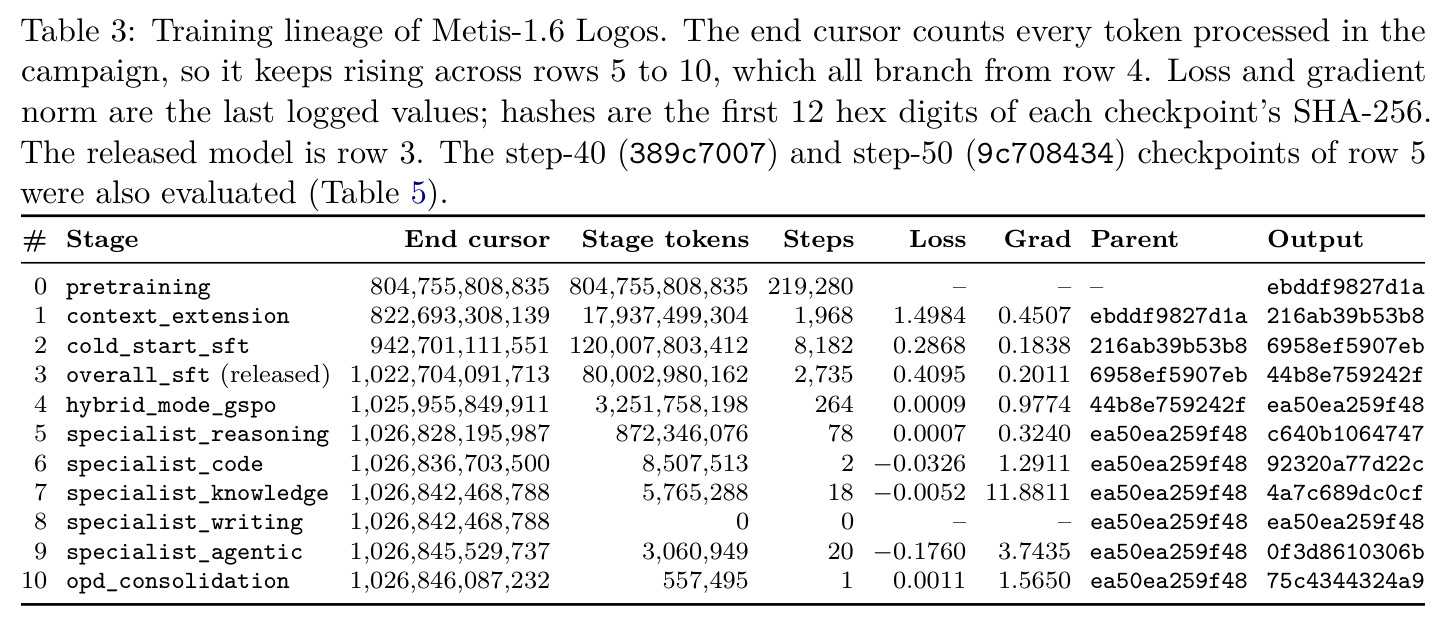
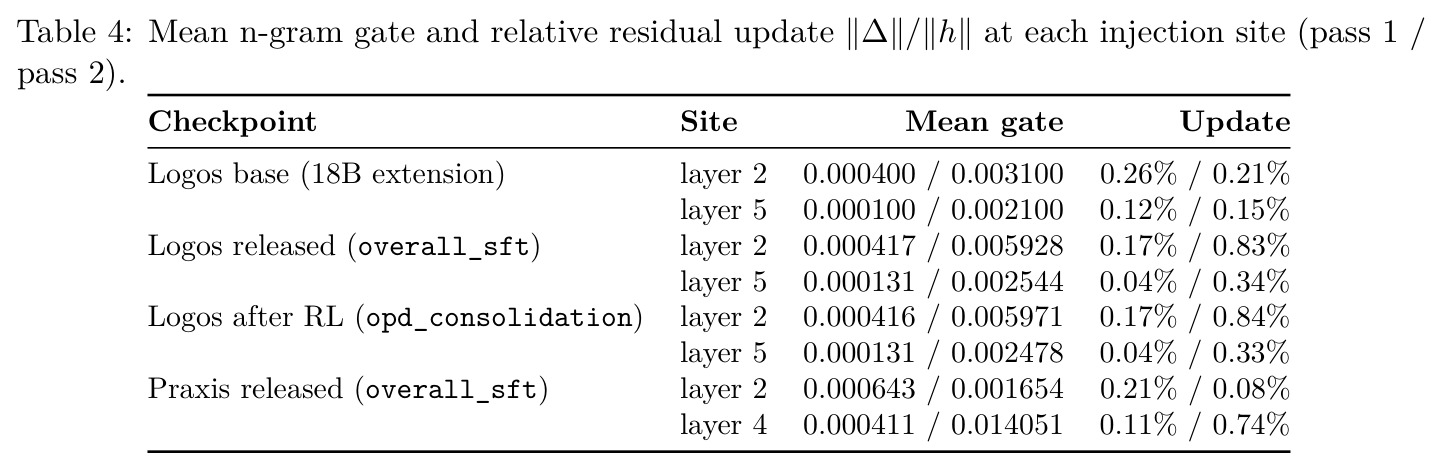
技术新颖性有四。(1) 架构组合:固定两遍循环+潜空间 MoE+pass 感知超连接是新的——既有工作或按 token 路由递归深度,或在循环迭代间加门控高速路,而“整栈跑两遍、权重共享、深度记忆传笔记、rank-8 LoRA 区分两遍”是本文特有设计,且 10B-token 消融给出了 11 个循环变体的量化排序(极差 0.0595 nats)。(2) 理论诊断:Proposition 1 证明组均值归一化下长度奖励符号反转的条件 $p>\frac{1-\lambda}{1-\lambda(1-q)}$(中位数分割、$\lambda=1/2$ 时即 $p>2/3$),与 Dr. GRPO/DAPO 的偏差分析同源但更具体,并给出一行修复 $A_i\leftarrow\max(0,A_i)$。(3) 负结果的证据强度:Engram 式 n-gram 记忆在两模型中都被学习关闭(门均值 0.0001–0.0031),删除 1.77B 参数表后 bits/byte 仅从 0.733898 变为 0.733894,并给出两个结构性解释。(4) 工程审计文化:全程记录 checkpoint SHA-256(Table 3/6)、从张量形状精确计数参数、用统一 harness 重跑所有比较模型。
实验结果
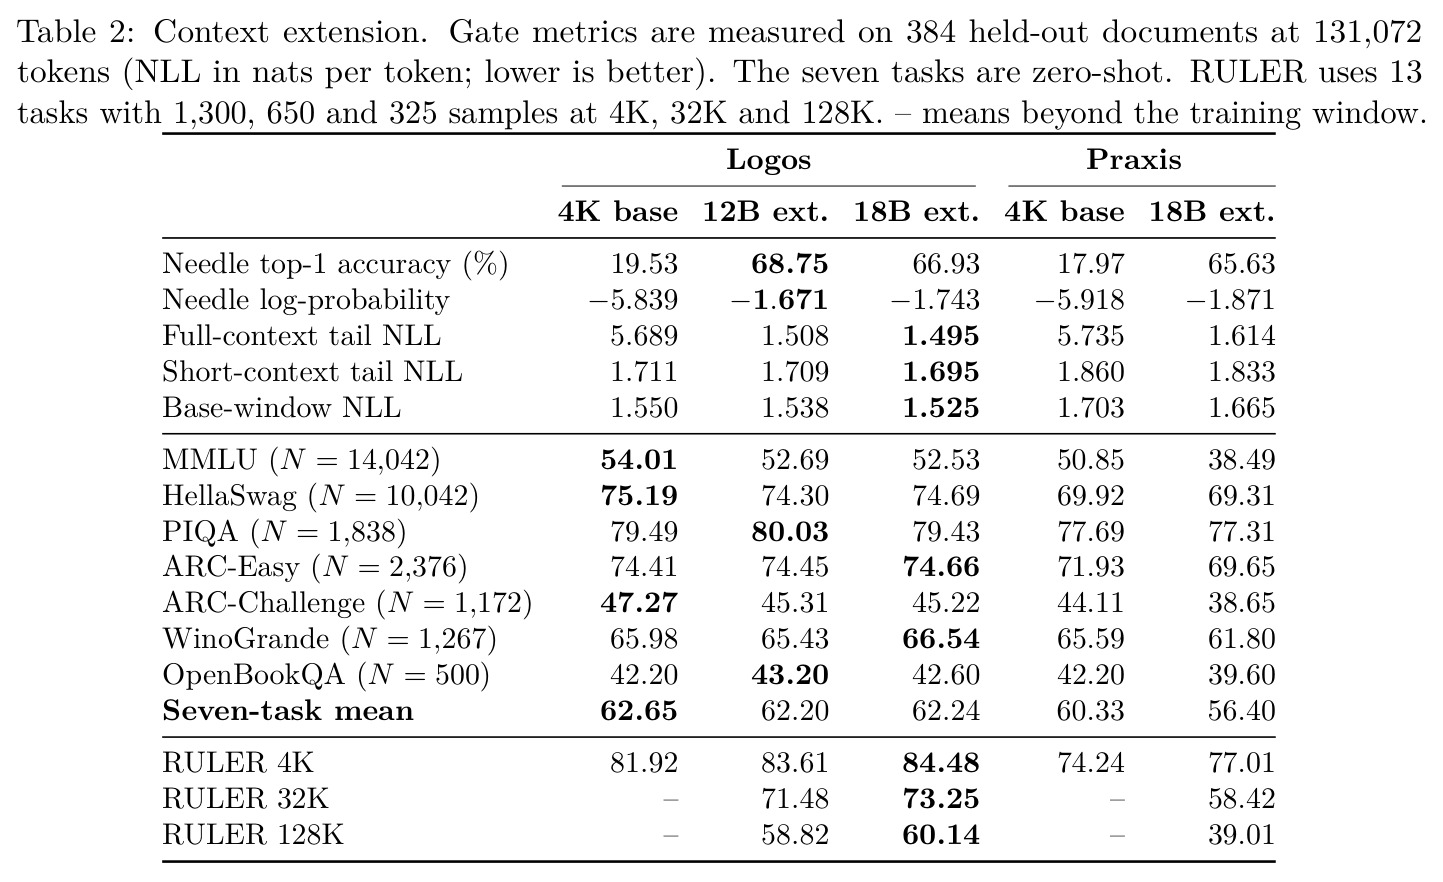
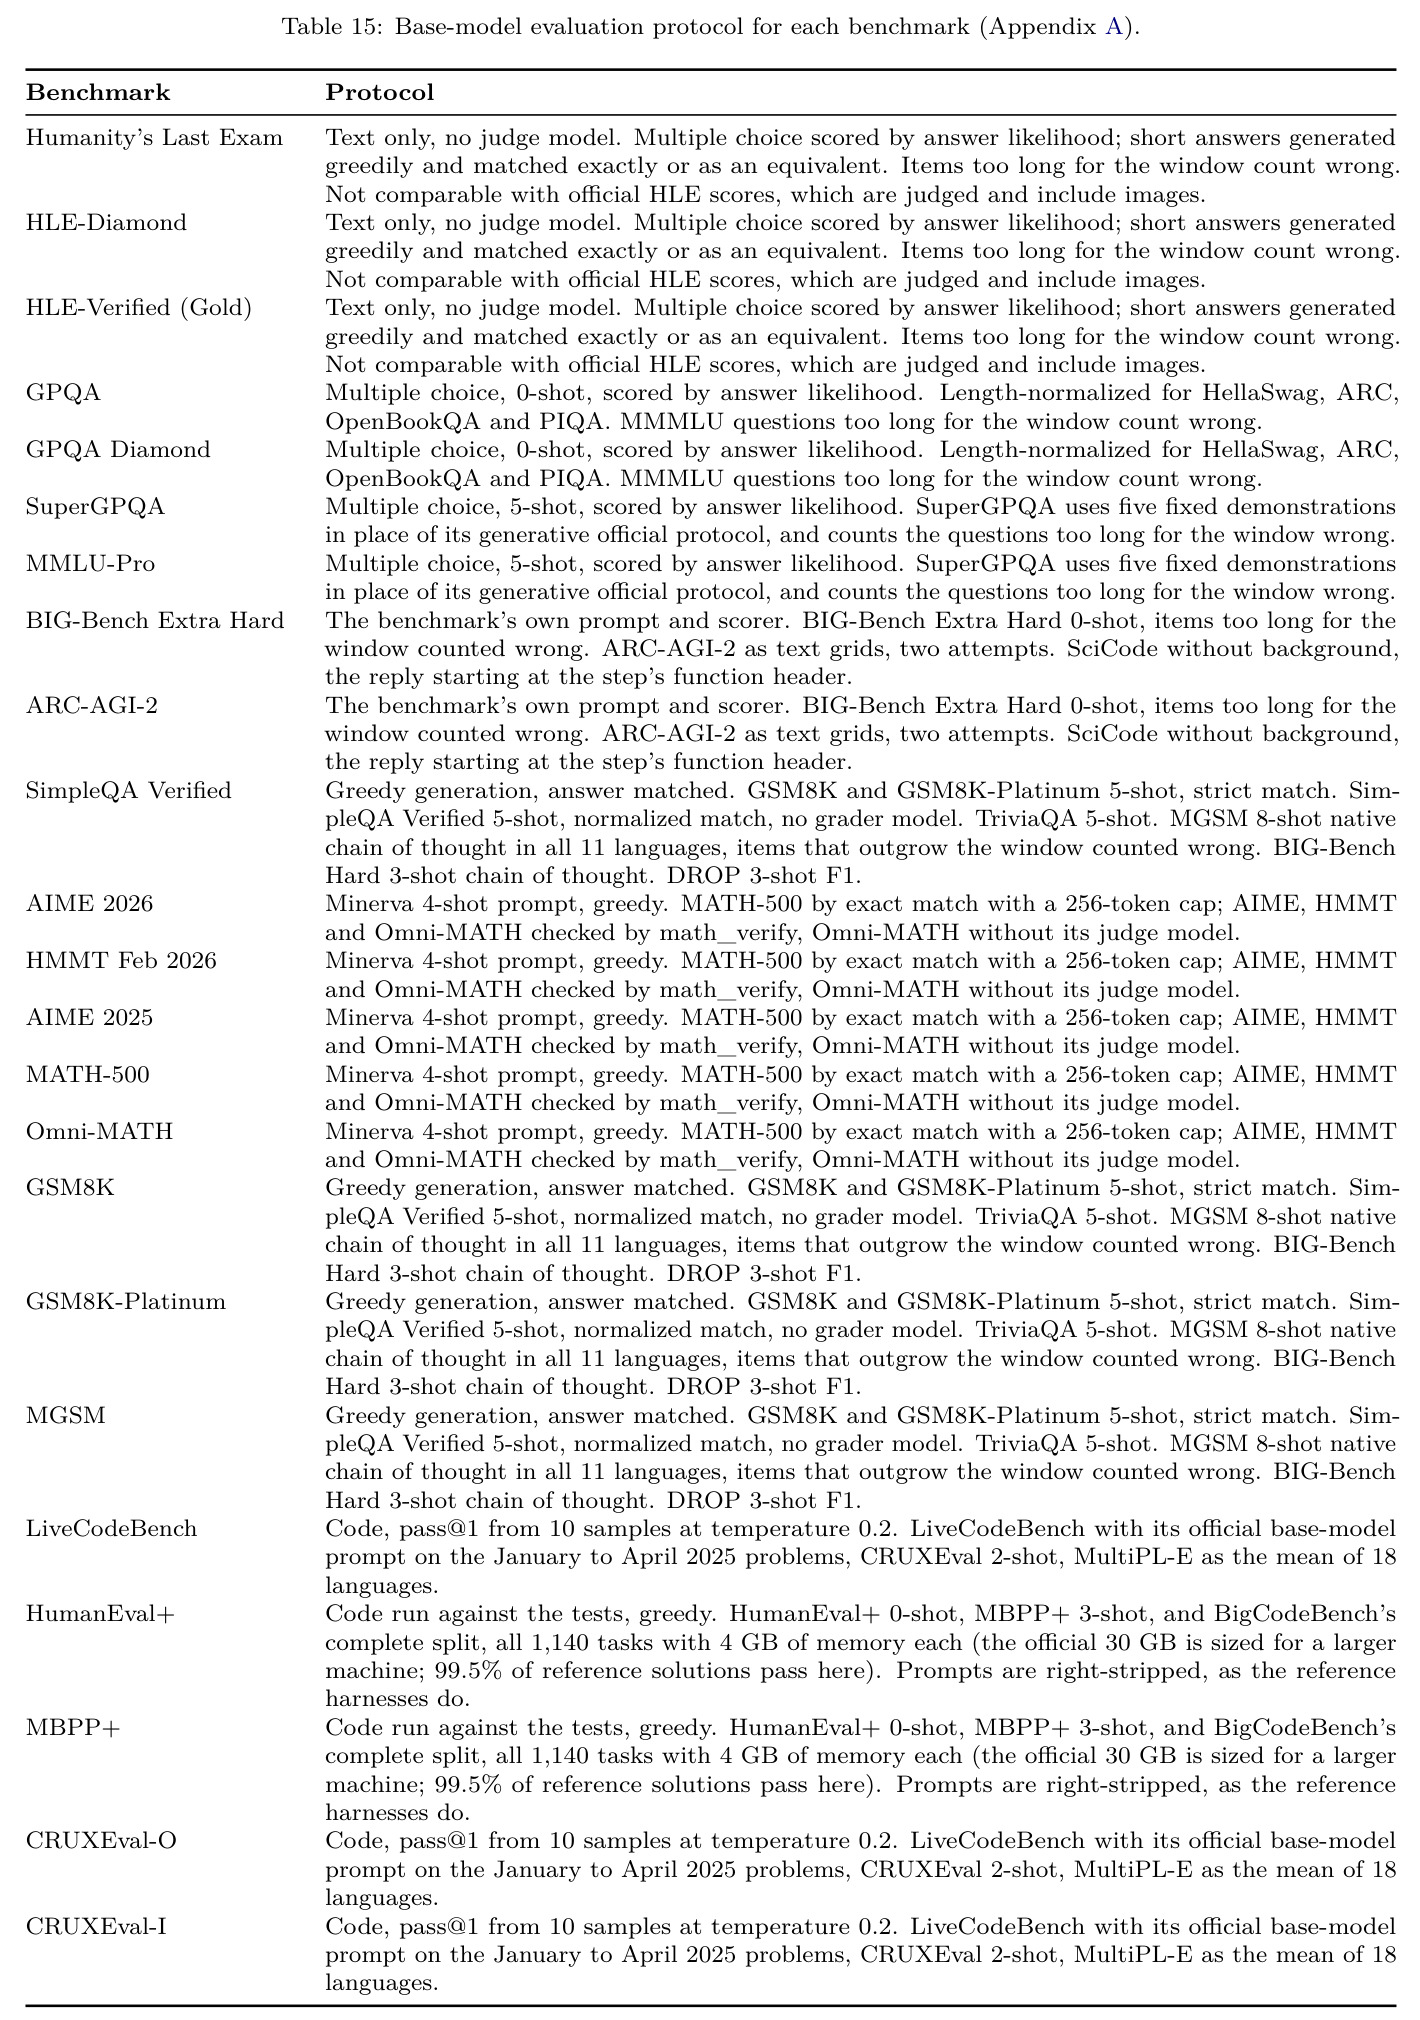
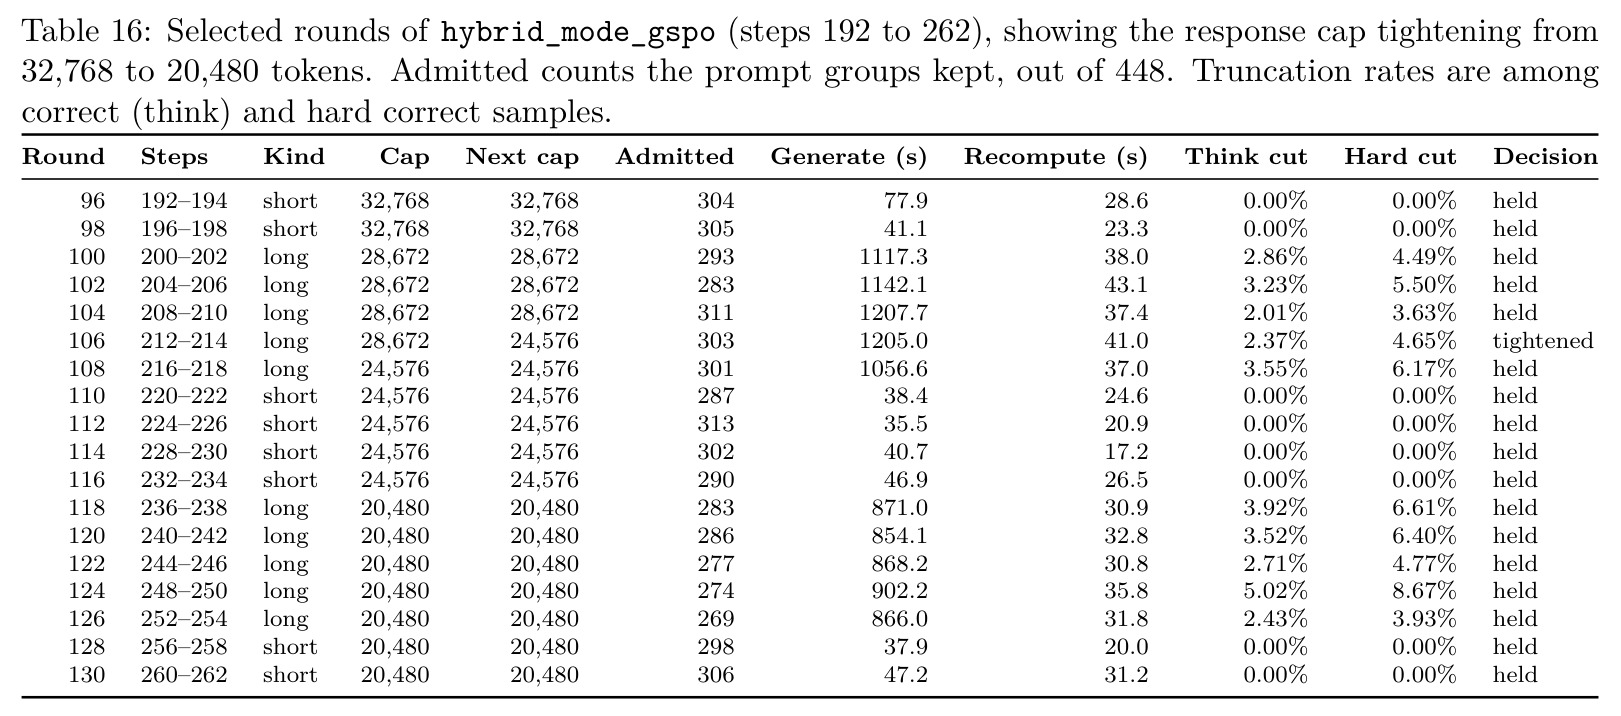
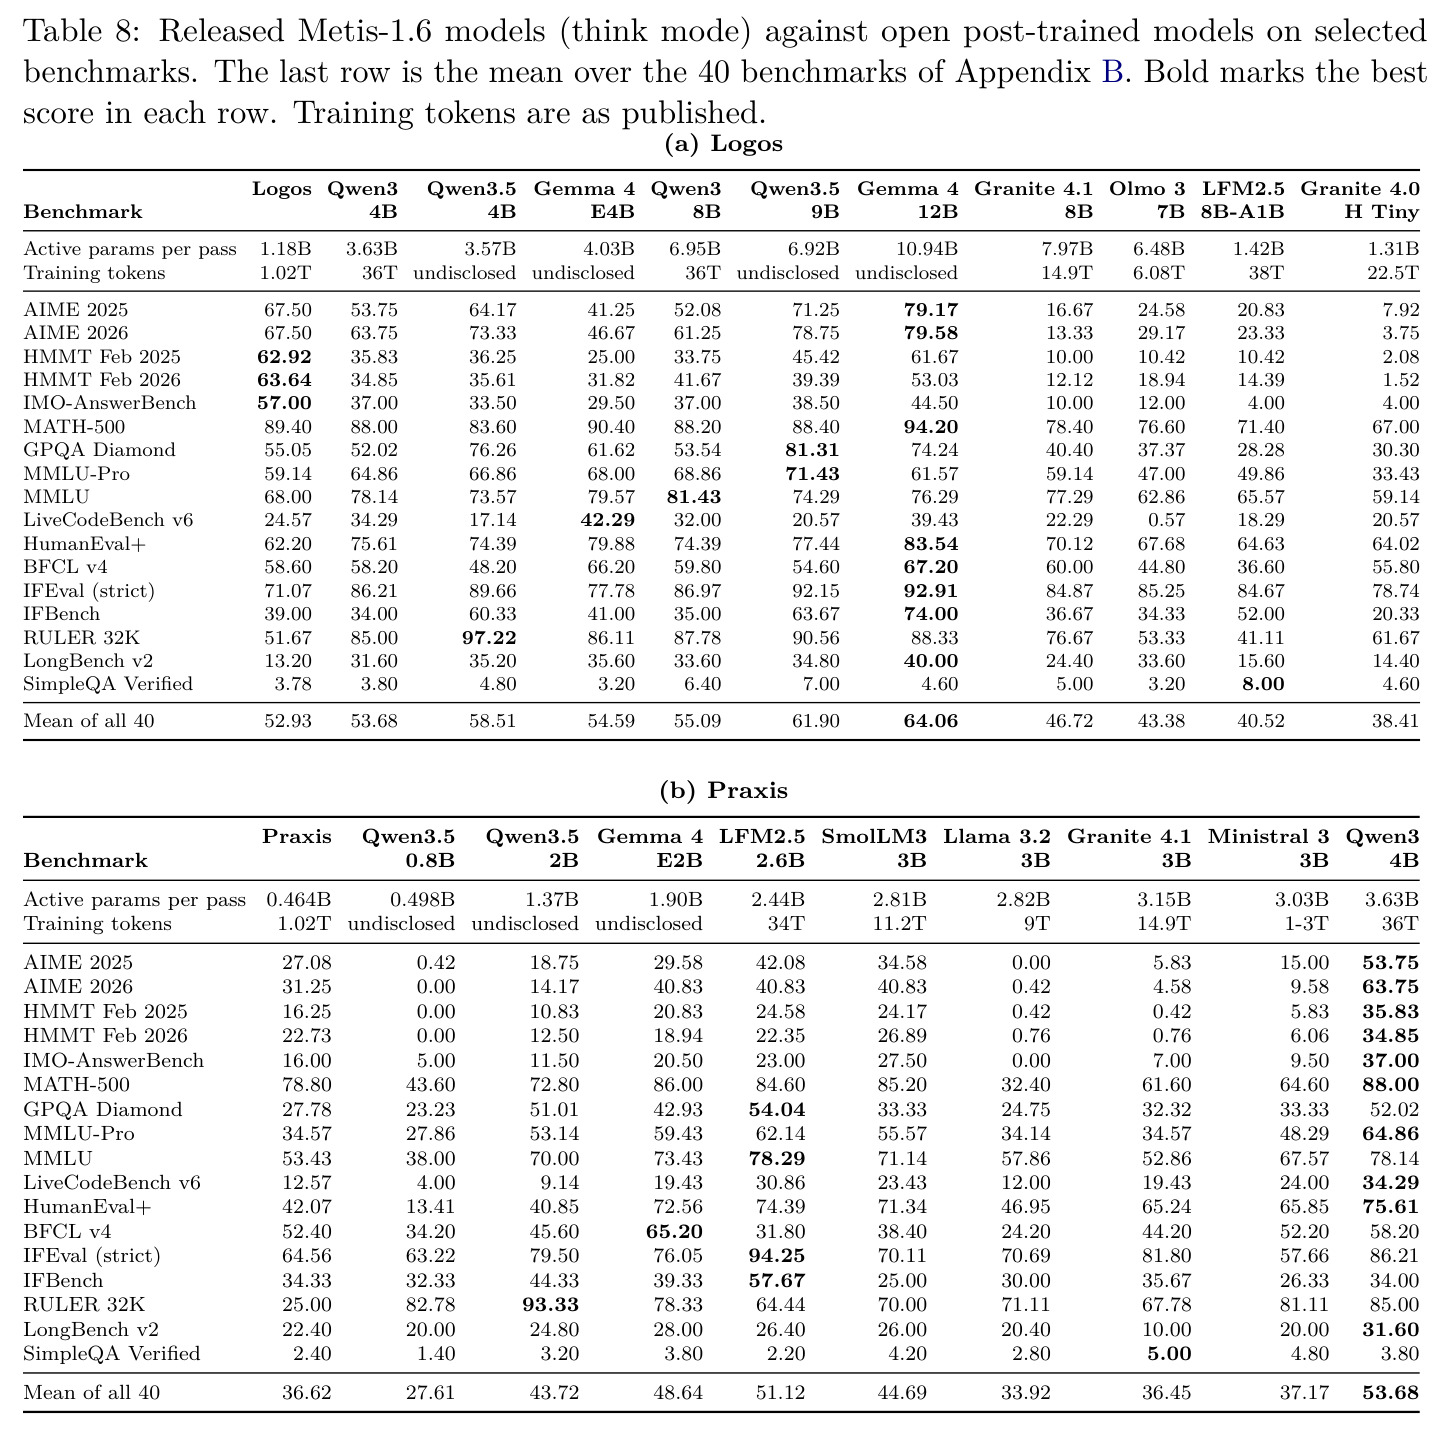
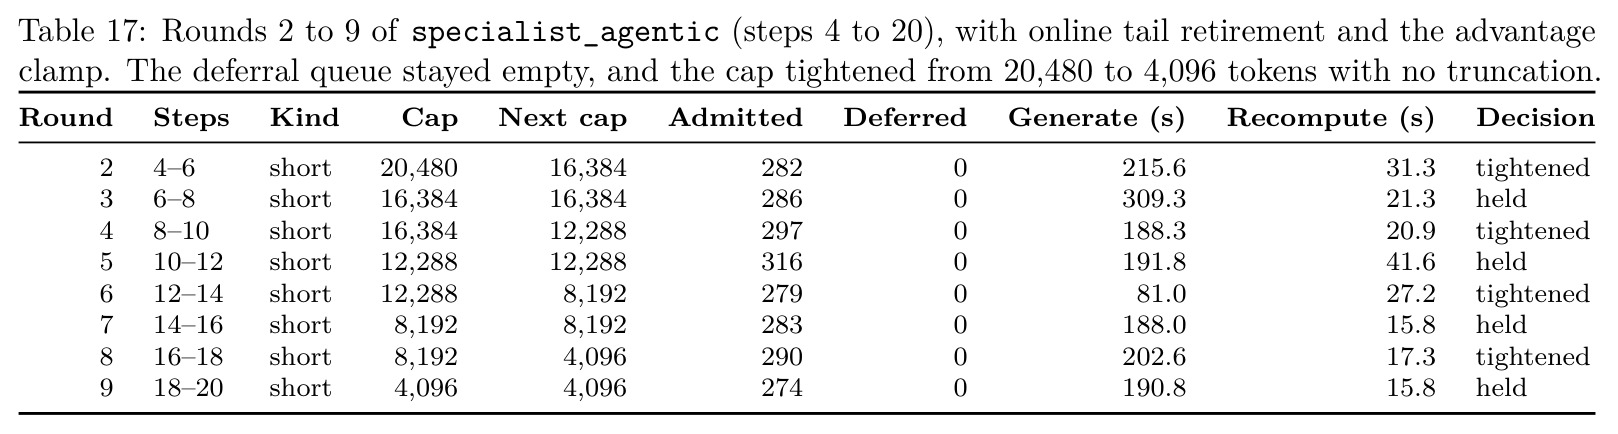
主结果:40 个 post-trained 基准上 Logos 平均 52.93,17 模型中第 7,落后 Qwen3-4B(53.68)0.75 分,被 Gemma 4 12B(64.06)等压过;但只用 1.02T token(比较集披露中位数 12T,超过它的模型至少 28T)、每 token 激活 2.36B 参数(超过它的模型为 3.57–10.94B),在数据与算力两轴都处于帕累托前沿。数学最强:11 基准平均 65.83,30 模型中第 2,仅落后 Gemma 4 12B 2.77 分;HMMT Feb 2025 62.92、HMMT Feb 2026 63.64、IMO-AnswerBench 57.00 均为集合最高。短板:代码工具 17/30(HumanEval+ 62.20 落后 13/15)、指令遵循 18/30(IFEval 71.07)、安全 19/30、长上下文 24/30(think 模式 RULER 从 4K 的 68.33 跌至 128K 的 34.17);Praxis 平均 36.62,18 中第 15。上下文扩展实验:131K 埋针检索 19.53%→68.75%,尾部 NLL 5.689→1.495,RULER 128K 达 60.14%。n-gram 记忆负结果:门均值仅 0.0001–0.0031,删除后损失变化小于 $10^{-3}$ nats。RL 实验:GSPO 第 198 步 IFEval +13.41 分但 AIME 60.00%→40.00%;推理专家第 40 步 GPQA Diamond +8.08 至 43.94%,第 78 步因符号反转(通过率超 2/3)回落至 34.34%。优化器消融:修正的 split-Muon+NorMuon 比调优 AdamW 好 $-0.18190\pm0.00299$ nats,即注意力全程误用 AdamW 的代价;循环消融中最优设计 2.5529 nats 击败两倍专家参数的非循环模型(2.5774)。
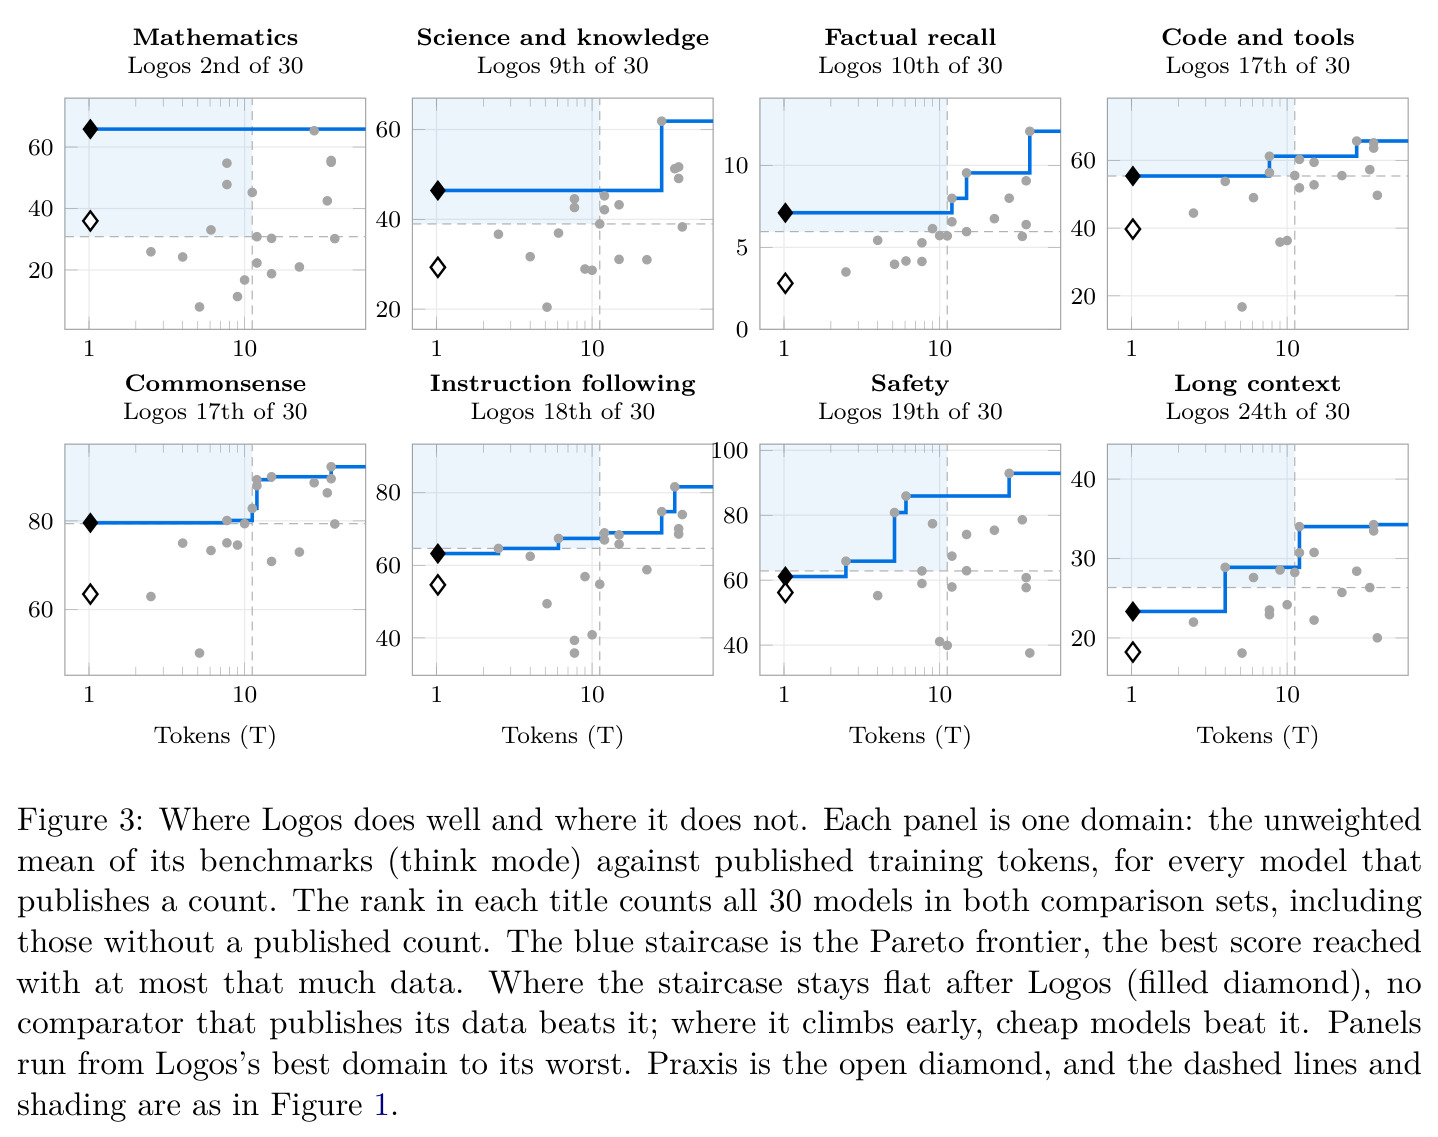
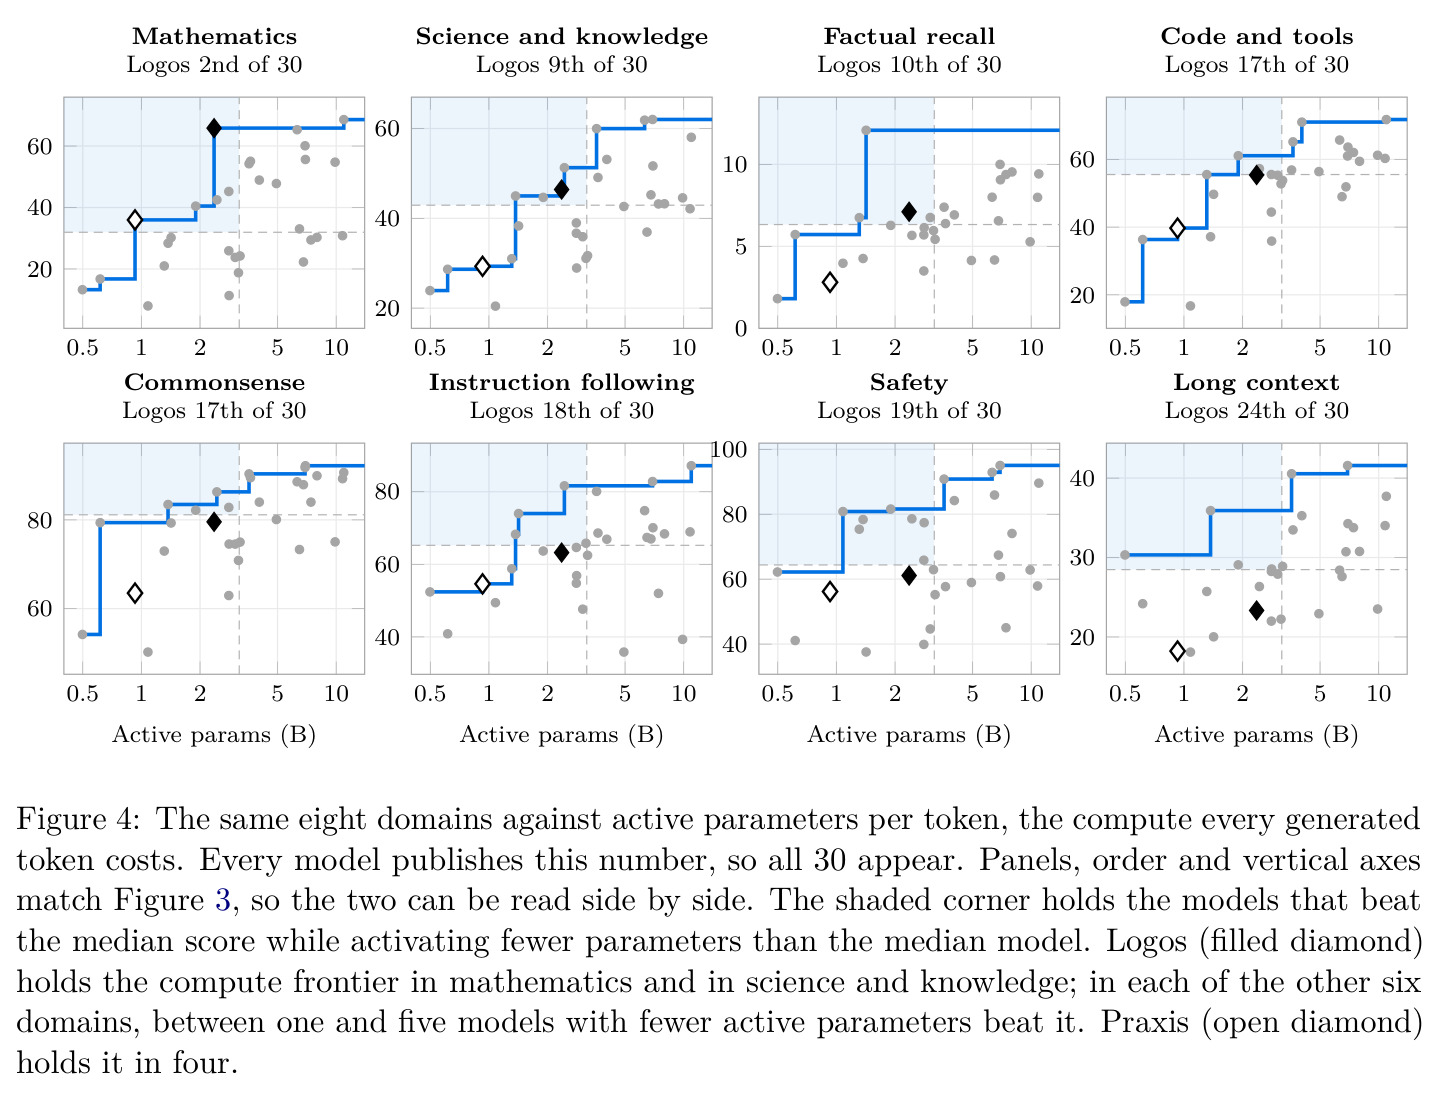
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 40 个 post-trained 基准平均(统一 harness) | 平均分 | 52.93(Logos) | Qwen3-4B 53.68;最优开放模型 Gemma 4 12B 64.06 | 落后 Qwen3-4B 仅 0.75 分,但训练 token 只有 1/35(1.02T vs 36T),每 token 激活参数只有 1/1.5–1/4.6,处于数据与算力双帕累托前沿 |
| 竞赛数学(11 个数学基准平均) | 平均分(30 模型排名) | 65.83,第 2 名 | Gemma 4 12B 68.60(第 1 名) | 落后 2.77 分;HMMT Feb 2025/2026 与 IMO-AnswerBench 为集合最高,无一个披露训练数据的比较模型超过它 |
| AIME 2025 | pass@1, avg@8 (%) | 67.50 | Qwen3-4B 53.75;Gemma 4 12B 79.17 | 集合第 3,超 Qwen3-4B 13.75 分 |
| HMMT February 2026 | pass@1, avg@8 (%) | 63.64 | Gemma 4 12B 53.03;Qwen3 8B 31.82 | 集合最高,超最强比较模型 10.61 分 |
| GPQA Diamond | pass@1 (%) | 55.05 | Qwen3-4B 52.02;Gemma 4 12B 81.31 | 集合第 5;首个在披露数据上超过它的模型用了 28T token |
| HumanEval+(代码,弱项) | pass@1 (%) | 62.20 | Gemma 4 12B 83.54 | 落后 13/15 比较者,代码域排名 17/30 |
| RULER 128K(长上下文,弱项) | 通过率 (%) | 60.14(direct 模式;think 模式 34.17) | 上下文扩展前远低于此;Qwen3.5 4B 在 32K 达 97.22 | 长上下文域排名 24/30,为最弱领域 |
| 10B-token 循环设计消融 | 验证交叉熵(nats,256 配对窗口) | 2.5529(f2_smart_untie_layer:完全解绑+逐层动态专家+高速路+第一遍辅助损失) | Metis-1.6 循环 2.5993;非循环 16 层、2 倍专家参数 2.5774 | 对 Metis-1.6 循环 $-0.0464\pm0.0008$;对两倍参数非循环模型 $-0.0245\pm0.0008$,均超 50σ |
| 10B-token 优化器消融 | 验证交叉熵(nats) | 2.37104(split Muon+NorMuon+Polar Express+调度权重衰减) | 调优 AdamW 2.55293 | $-0.18190\pm0.00299$,256/256 个评测窗口全胜 |
局限与改进
作者承认四点。(1) 去污染清单早于若干竞赛:AIME 2025/2026、HMMT 2025/2026、Brumo 2025、IMO-AnswerBench、Apex 2025 不在清单上,而 Logos 恰恰在这些基准上相对最强,存在训练-测试重叠风险。(2) 所有比较用自研 Lernex harness,比较模型在开发者推荐设置下可能更高。(3) 架构结论被优化器事故污染:注意力全程 AdamW、其余 plain Muon,无法分离架构贡献;10B 消融每臂只跑一次且用更小代理,标准误只反映评测噪声。(4) clamp 修复未在发现符号反转的推理专家上重跑。我的补充:基座非常弱(Logos base 44 基准平均 31.03,仅超 OLMoE 的 29.44;Praxis base 24.66 垫底),几乎全部能力来自 200B SFT 与课程加权,“更好配方”的归因还需基座层面对照;40 基准平均掩盖了“数学第 2、长上下文第 24”的巨大方差;RL 研究结论全部未进发布模型,有效性只有 8 套件 gate 的小规模证据。
独立分析的弱点
独立分析四条弱点。(1) 长上下文是结构性短板:think 模式 RULER 从 68.33(4K)跌至 34.17(128K)、LongBench v2 仅 13.20,每 token 只有 3/20 层注意力可能不足以支撑远距离检索——应提高注意力层比例、引入滑动窗口+局部注意力混合,并在退火阶段加入检索类长文档数据(上下文扩展仅占总预算不到 2%)。(2) 能力过度依赖后训练:基座几乎垫底而 post-trained 数学跃居第 2,说明 200B SFT 课程更像“教应试”而非改变表征,泛化存疑;应在预训练退火阶段注入推理数据并做基座-后训练配对消融。(3) 长度奖励与组归一化的交互是系统性陷阱:clamp $A_i\leftarrow\max(0,A_i)$ 是补丁,随通过率上升任何与长度耦合的奖励都会经组均值失真——更根本的解法是解耦正确性优势与长度整形(DAPO 式动态采样或按通过率分层归一化)。(4) 训练工程脆弱:一个名字匹配错误让注意力静默用错优化器 804.76B token 且损失曲线毫无异常;启动断言优化器组已被采纳,但权重范数漂移监测(当时 RMS 漂移 0.57–1.49 倍无人察觉)也应自动化。
未来方向
作者已规划的:Metis-1.7 采用 MoRE 架构——完全解绑两遍权重、逐层动态专家数+逐 pass 路由器、跨 pass 门控残差高速路、第一遍余弦衰减辅助损失(最优配置 f2_smart_untie_layer 达 2.5529 nats);优化器换成启动断言+分块正交化的 split-Muon+NorMuon($\beta_2=0.95$、$\epsilon=10^{-16}$、5 步 Polar Express+1 步重启 Gram 迭代、权重衰减随学习率调度 $\lambda_t=\lambda_0\eta_t/\eta_{max}$);n-gram 记忆扩到 50B 参数、三元格式(1.85 bit/值)存于加速器外并用量化感知直通估计训练;GSPO 桥接改为域平衡配方(30% 数学、20% 科学/STEM、15% 代码、15% 指令、10% 工具、10% 知识);SFT Stage 2 改用参考锚定采样目标(式 (3))混 10% 交叉熵;蒸馏钉住专家最佳 checkpoint 并跑 40–80 步全学习率。Metis-1.7 规模 12.48B 神经参数(每 pass 激活 0.794B、每 token 1.59B),外加 422M 视觉编码器与 204.8M 投机解码 drafter。可延伸方向:把 Proposition 1 推广到一般组归一化奖励整形并实证 clamp 的长期效应;让两遍循环在推理时可变(利用检查点中已有的 halting 头做自适应 pass 数);系统扫描 Mamba-2/注意力比例以修复长上下文短板。
复现评估
复现条件较好但并非开箱即用。开源情况:四个模型(Logos/Praxis 及其 -Base)在 HuggingFace Lernex 组织发布,仓库附带生成报告表格的基准数据、完整 checkpoint SHA-256 谱系(Table 3/6)与逐项精确参数表(Table 1);BF16 权重 Logos 20.80 GB、Praxis 6.16 GB,均已移除 n-gram 记忆。数据集为 sealed release(806 分片、SHA-256 65ef27f6...),是否公开下载未说明;训练、RL 与评测代码是否开源也未提及,这是复现的最大不确定性。算力:预训练在 AMD Instinct MI300A 上进行(1T token 的 10B 级 MoE 属社区可承担范围);RL 阶段用 224 个数据并行 rank、峰值保留显存 74.60 GiB、64 并发沙箱容器,个人复现门槛较高。综合评级:推理与评测容易(单卡即可跑这两个模型),端到端复现难(需重建数据管线、自研融合内核与统一 harness)。
论文图表