GEPA-Curator:面向自我改进智能体的精选学习 GEPA-Curator: Curated Learning for Self Improving Agents
给提示优化器外挂一个“数据策展人”:过滤噪声任务并检索历史成功轨迹,让智能体自我改进更可靠
前置知识
反思式提示优化(Reflective Prompt Optimization / GEPA)
一种不更新模型权重、只更新提示的优化范式:智能体在环境中执行任务产生轨迹(rollout),一个 Reflector 模型阅读失败轨迹与评估结果,总结教训并对系统提示提出文字版“变异”(mutation),在演化搜索中保留更好的提示版本。GEPA 是代表工作,它以轨迹级反思替代标量奖励,并用 held-out 验证集门控每次变异。
本文的 GEPA-Curator 就是搭建在 GEPA(以及对照 ACE、Meta-Harness)之上的外层框架,完全围绕这类优化器的信号流设计,不理解反思优化就无法理解“策展”在策什么。
LLM-as-a-Judge 与噪声学习信号
智能体任务的成功与否常由一个 LLM 评判器根据任务意图、动作历史和最终页面状态给出二值判断。评判本身有随机性:相似的终止状态可能时而判成功时而判失败(flaky),宽松的评判可能接受智能体“任务不可行”的借口,甚至任务描述本身有歧义或不可行,导致失败并非源于提示缺陷。
论文的核心论点正是这些非提示因素造成的失败会污染 Reflector 的归因,引发有害变异;动机实验专门构造了 Impossible 与 Flaky 任务组来验证这一危害。
智能体 Harness 与轨迹(rollout trajectory)
Harness 是包裹 LLM 的执行框架,负责把模型输出解析为工具调用、与外部环境(网页、API、文件系统)交互、并把观察结果回填给模型。一条轨迹记录了完整的推理、工具调用、环境反馈和最终评估结果,是反思优化的原始素材。
文中失败的原因除了提示,还可能出在 harness(如所需工具不可用)或环境(网页按钮失灵),Curator 需要阅读轨迹证据来区分这些来源,这正是它与纯数值型课程学习的区别。
课程学习与 minibatch 选择
课程学习研究训练数据的选取与排序如何影响优化效果,经典结论(如 LIMA)是少量高质量数据可能胜过大规模含噪数据。在本文语境下,它体现为每个优化步的 minibatch(本文固定 16 个任务)不该随机均匀采样,而应剔除当前无法提供有效学习信号的任务。
任务策展本质上是在线、智能体化的课程学习;论文还专门与只用二值成败计数的数值课程学习算法对比,证明语义级诊断的必要性。
Pareto 前沿候选选择
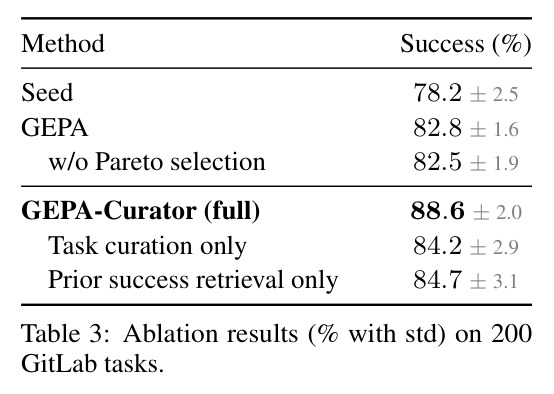
GEPA 原版在演化搜索中维护一个候选提示池,按各验证任务上的表现构成 Pareto 前沿,采样时优先从非支配的候选中选取,以保留多样性。本文改用简化版贪心变体:每个变异直接成为下一个检查点,只维护单一谱系,消融显示去掉 Pareto 选择影响不大(82.5% vs 82.8%)。
理解这一简化才能准确复现 GEPA-Curator 的实验设置,也便于分析方法中“去掉进化搜索多样性”这一潜在代价。
研究动机
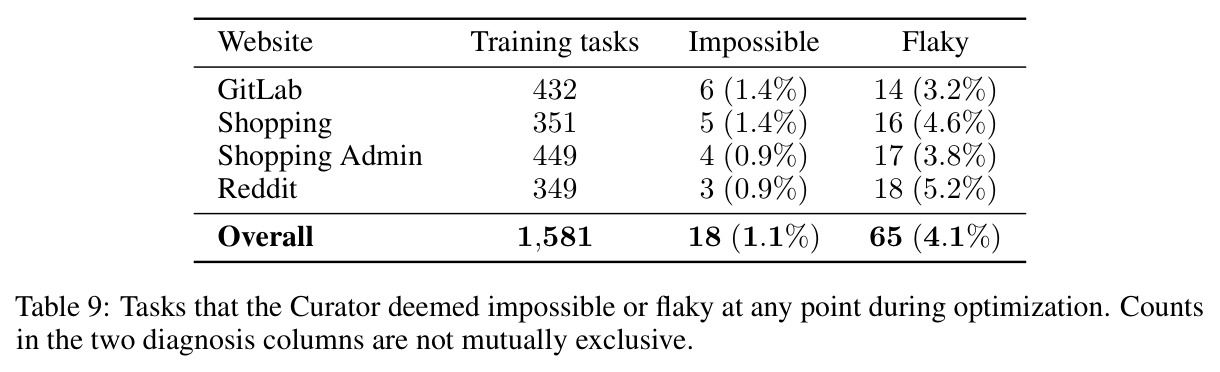
反思式提示优化器(如 GEPA)默认失败轨迹包含可泛化的学习信号,但智能体场景中失败的归因天然困难:执行由 harness 代理、环境是外部网站或 API、成功与否由 LLM-as-a-judge 判定。一次失败可能是提示缺陷,也可能是工具不可用、harness 限制、网页临时故障、任务描述歧义或评判器噪声。论文用购物例子说明:若失败源于 agent 漏选必填项,反思可修正提示;若失败只是购买按钮临时失灵,Reflector 却可能得出“应寻找替代购买途径”的过泛化结论,等按钮恢复后反而有害。作者用 GoBrowse(基于 WebArena 的 GitLab/Shopping/Shopping Admin/Reddit 四站点、共 2640 任务)的日志统计出问题的规模:Curator 在 1581 个训练任务中诊断出 75 个(4.7%)至少一次被判定为 impossible 或 flaky;在均匀采样下,一个 16 任务 minibatch 含至少一个此类任务的概率为 $1-(1-0.047)^{16}\approx 54\%$。附录 A.2 还给出一条完整的负迁移链:两个 Impossible 任务(全局搜索搜不到目标文件、层级列表无子组可展开)的失败使 Reflector 在第 7 次迭代加入“穷举探索”指令,导致原本 5 步即可完成的 WCAG 指南任务耗尽 30 步仍失败,而聚合 minibatch 分数从 8 升到 9,坏变异反而被门控接受。
本文的目标是本文的目标是让智能体能够可靠地从自身经验中自我改进:在不改动优化器本身的前提下,控制“哪些经验进入优化”。具体拆成两件事:其一,在每个优化步前由一个 Curator 智能体审查任务历史,构建一个大概率提供干净信号的 minibatch,跳过反复稳定成功(已掌握)、反复因提示外因素失败(环境/harness 不可行)、以及评估结果自相矛盾(flaky)的任务,且跳过是临时的——每个 epoch 重新考虑,因为已解决的任务可能因提示更新而回归, previously 太难的任务也可能随提示改进变得可解。其二,当 minibatch 中的任务失败时,为 Reflector 检索一条经交叉验证的可信历史成功轨迹作为对比参照,使其能做对比式归因而非凭空猜测修复方案。衡量标准是:在完全相同的种子提示、actor 模型、rollout 预算和评估协议下,held-out 测试成功率要一致超越 GEPA 与 ACE。
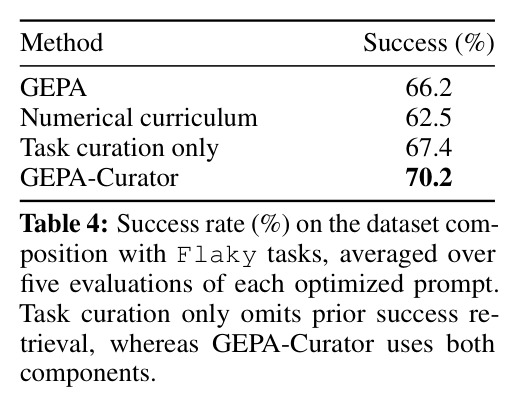
与已有工作不同的是,已有的防噪手段全是“事后门控”:用 held-out 验证集拒绝导致退化的变异(GEPA 还会在 minibatch 上复验)。论文指出这不够:门控依赖聚合分数,本身受执行与评估随机性污染,可能接受坏变异、拒绝好变异;且门控发生在变异生成之后,无法从根本上提升反思质量。本文的独特切入是把干预点前移到数据入口——“与其过滤变异,不如过滤喂给优化器的经验”。第二个独特性在于策展的方式:不同于 LIMA 式静态数据筛选或只依赖二值成败计数再减分除名的数值课程学习,Curator 是一个阅读完整轨迹与评估证据的 LLM 智能体,能区分“flaky(相似终态得到不一致评判)”“prompt-sensitive(提示变更前后行为有改善)”与“impossible(工具/UI 确实缺能力,需多次独立尝试佐证)”。论文用实验证明了这一区分不可省略:在含 21 个 Flaky 任务的数据集上,数值课程学习反而低于 GEPA(62.5% vs 66.2%),而任务策展达到 67.4%、完整方法 70.2%。
核心方法
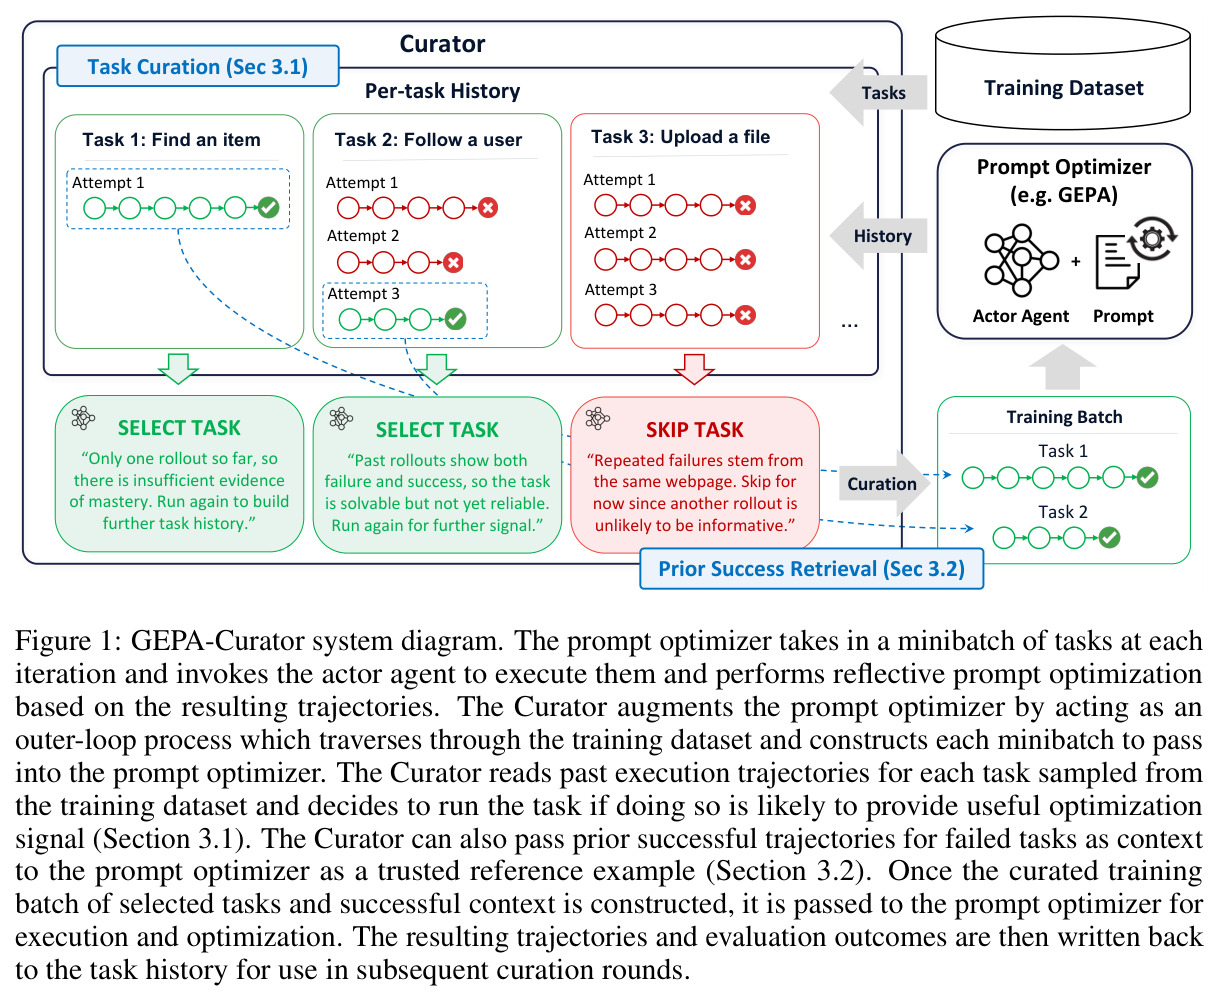
直觉上,反思优化的质量上限由学习信号的质量决定:喂给 Reflector 什么,决定了它能学到什么。GEPA-Curator 因此作为一个外层 harness 套在现成优化器(本文用简化贪心版 GEPA,即去掉 Pareto 候选选择的单谱系变体)之上,维护一份 per-task history:每个任务历次执行的轨迹、评估结果、以及先前的策展判断。每个优化步开始时,Curator 遍历训练集决定下一个 minibatch(任务策展,Section 3.1):优先探索不足的任务,有强证据时跳过噪声任务;对选中的任务,若历史中存在可信的成功轨迹,则挑出一条作为“锚点”(prior success retrieval,Section 3.2)与任务一起作为输入元数据传给优化器。优化器内部完全不变:actor 智能体(gpt-oss-120b)执行任务,Reflector 对比失败轨迹、评估结果和锚点成功轨迹生成提示变异,新轨迹与评估结果写回任务历史,每 16 次迭代在验证集评估一次,最终取验证最优提示做测试。工程上任务策展与成功检索合并在同一次 Curator LLM 调用中完成(输出 JSON:先 reason 后 decision,含 anchor 选择与佐证 ID),因此检索几乎零额外调用开销。
核心创新是把“哪些经验值得用来学习”本身变成一个智能体决策,而不是随机采样加事后门控。与 GEPA 的本质区别有两点。第一,数据入口:GEPA 均匀遍历任务集,Curator 主动跳过三类任务——已多次稳定干净成功的 mastered 任务、重复失败源于提示外因素的 impossible 任务(判据是工具 schema、轨迹诊断、评估证据的一致指向,单次“我做不了”的声称不算数)、相似行为得到不一致评判的 flaky 任务;并且跳过是临时的,每个 epoch 复审,因为提示更新可能让旧任务回归或难任务变可解。第二,反思输入:GEPA 的 Reflector 只看失败轨迹,Curator 额外提供一条经佐证的历史成功轨迹做对比学习——让 Reflector 看到“这个任务在旧提示下是怎样成功的”,从而把失败定位到具体差异,而非猜测。与数值课程学习的本质区别在于归因所用的信息:后者只用二值成败(失败计数 $s_t\leftarrow s_t+1$,成功则 $s_t\leftarrow\max(0,s_t-k)$,超阈值 $b$ 除名),无法区分 flaky 与 prompt-sensitive(两者都表现为时好时坏);Curator 读轨迹里的语义证据,这是 Table 4 中 62.5% 对 70.2% 差距的来源。
方法步骤详情
完整流程分五步。第一步(构建历史):优化开始时所有任务进 minibatch,actor(gpt-oss-120b,上下文上限 131072)执行后,轨迹、评估结果写入 per-task history。第二步(任务策展):每步 Curator 读取任务历史,按预置分类学判断——Mastered(跨多次独立 rollout 的稳定干净成功,一次成功不算)、Prompt-sensitive(变异前后评估对比显示提示可改善行为)、Operationally impossible(可用工具/UI 确实缺能力,需重复独立尝试一致指认同缺失能力)、No current optimization signal(同一失败模式跨多个相关变异持续存在)、Flaky(实质相似的行为与终态反复得到不一致结果且与提示变化无可信关联)、Evaluator-broken(标签错误或评估预期与用户请求矛盾的显式证据)、Infrastructure failure(超时、未重置导致的本地状态冲突等,不含提示信息)、Uncertain(宁跑勿跳,rollout 有信息价值);输出 run/skip 决定及引用具体历史证据的理由。第三步(成功检索,与第二步同一次调用):对将运行的任务,从带 ID 的历史“干净成功状态”中选一条锚点,要求其行为真正正确、代表可复现的成功模式,且至少另一条独立干净成功佐证;若无可信成功则输出 null 弃权,防止噪声正面样本误导。第四步(优化):精选 minibatch 与锚点作为元数据传入 GEPA,Reflector 基于失败轨迹+锚点做对比反思,生成并门控变异;每 16 迭代在验证集评估(τ-bench 因训练集小改为每 4 迭代),结束取验证最优。第五步(复审):被跳过的任务每 epoch 重新考虑;附录 Table 12 显示 impossible 任务的跳过连击从早期平均 5.50 个 epoch 增至后期 8.75,mastered 从 3.13 增至 5.81,flaky 保持在 1.33–5.00 以便尽快消歧。
技术新颖性
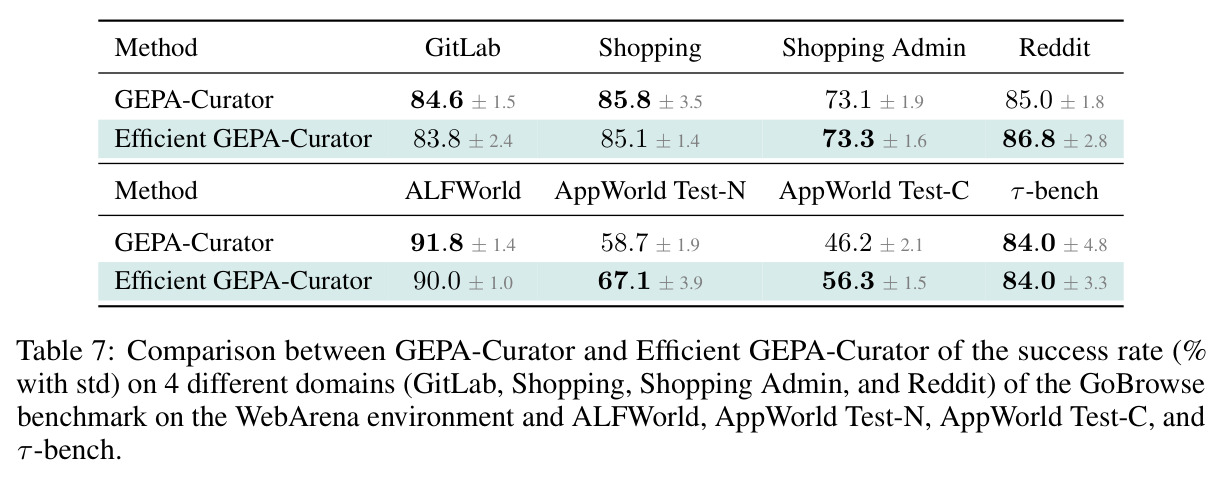
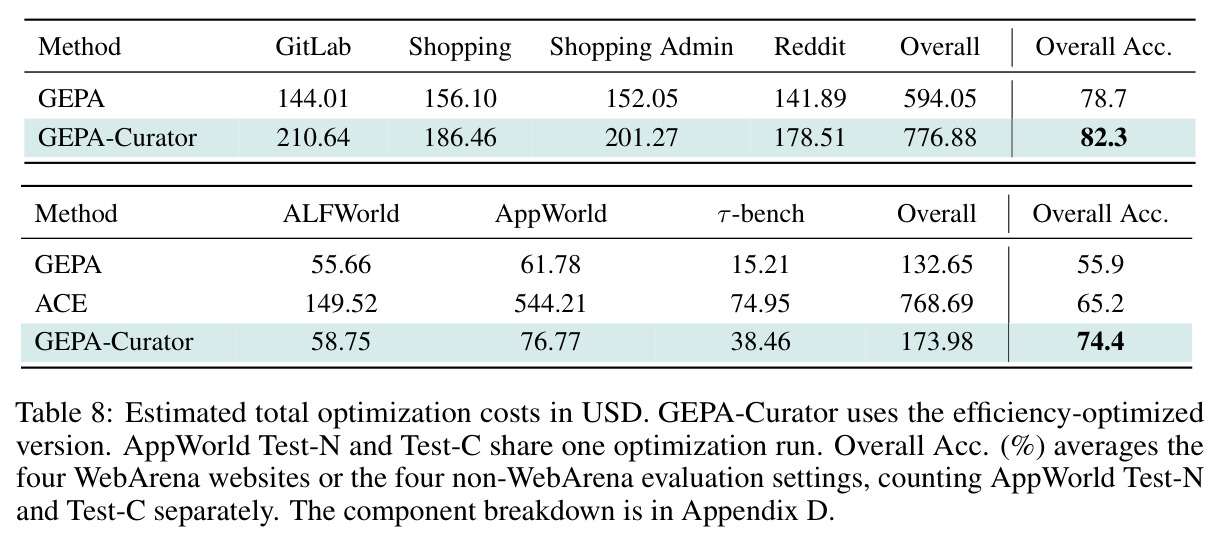
技术新颖性体现在四个层面。其一,问题层面:首次系统构造并实证了“噪声任务污染反思优化”的因果链(Figure 2 的受控混合实验与附录 A.2 的逐迭代负迁移追踪),把一个民间直觉变成可测量的现象。其二,机制层面:把 LIMA“少而精数据”的洞察从静态 SFT 迁移到在线提示优化的 minibatch 选择上,并用 LLM 智能体做语义级数据诊断——诊断结果可解释且有外部效度(66.7% 的 impossible 判定归因于 harness/环境限制,46.2% 的 flaky 判定归因于错误或欠规范的任务描述),这是任何二值统计方法做不到的。其三,架构层面:策展器与优化器通过元数据接口解耦,优化器零改动,因此可移植——论文把同一 Curator 思想嫁接到 Meta-Harness 的 harness 代码优化循环上(Meta-Harness-Curator),证明策展不只适用于提示,也适用于代码层面的自我改进。其四,工程层面:针对成本做了系统优化(跳过区间决策、紧凑历史摘要、保留单条完整成功轨迹),使高效变体以 1.31× GEPA 的成本换取精度提升,且比 ACE 便宜 4.42×,回应了“多一层智能体调用是否划算”的质疑。
实验结果
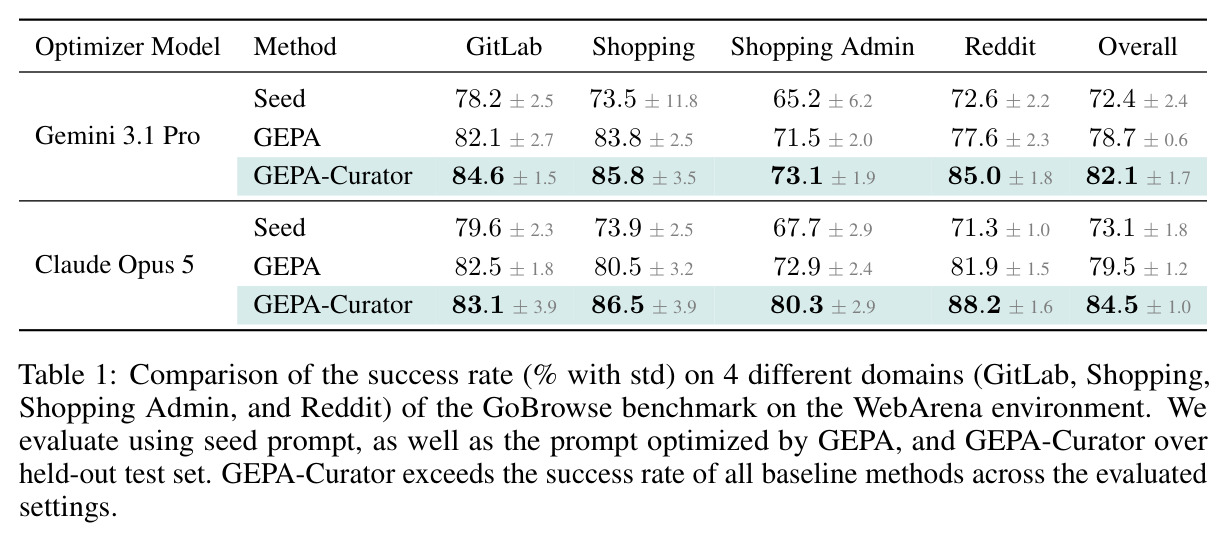
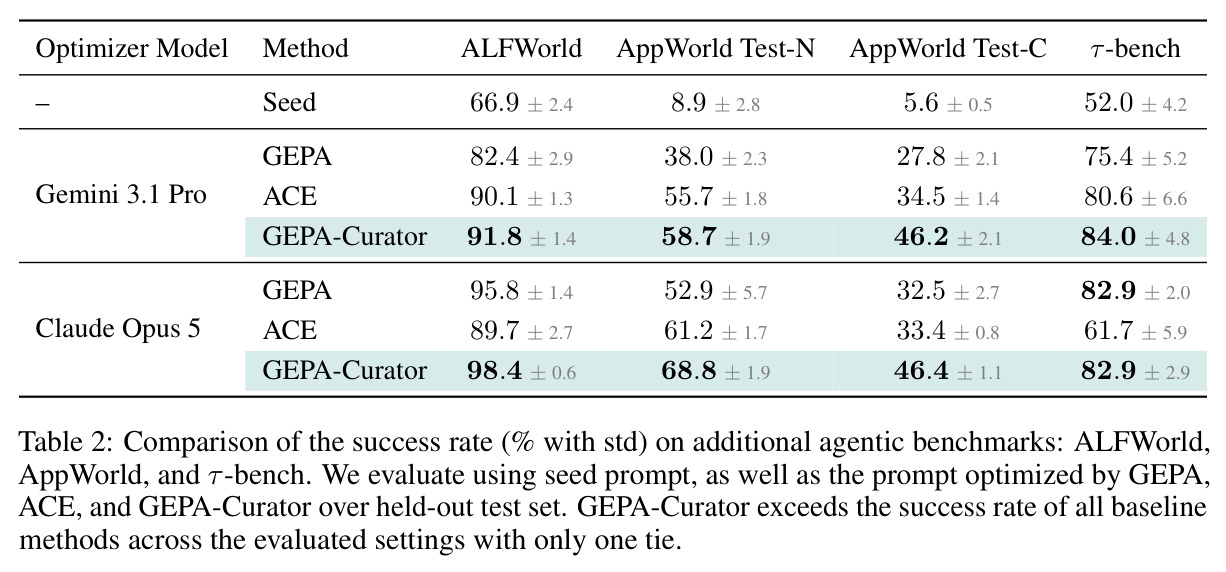
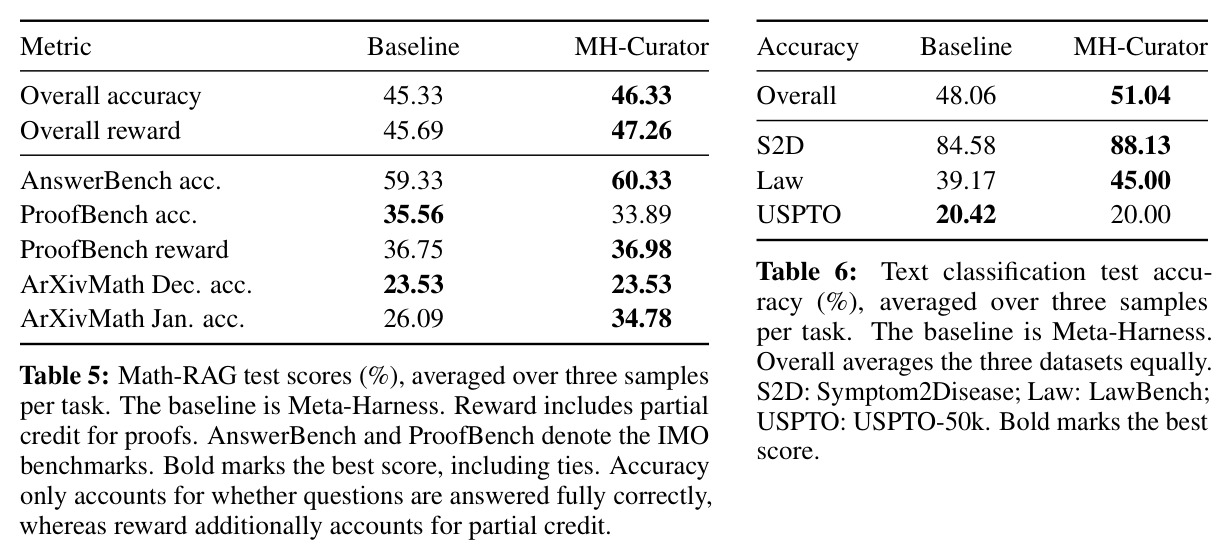
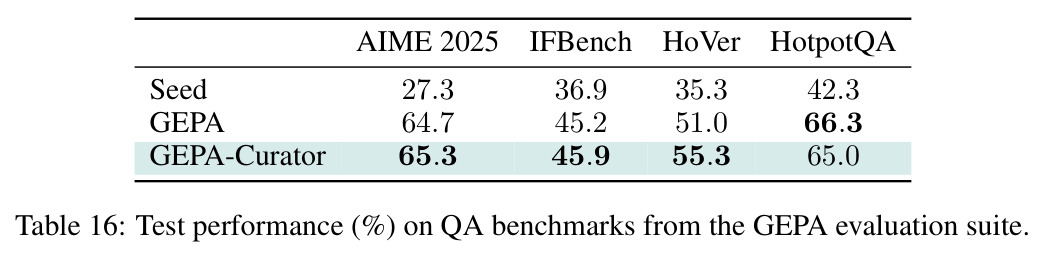
论文的证据链分五组。(1)WebArena/GoBrowse(Table 1,每站 5000 rollouts,5 次重复):Gemini 3.1 Pro 做优化器时,聚合成功率从 seed 72.4% 经 GEPA 78.7%(+6.3)到 Curator 82.1%(+9.7),四个网站全胜、单站增益 1.6–7.4%(Reddit 最大:77.6→85.0),聚合差 3.4%,相当于 1.54× GEPA 的优化增益;换 Claude Opus 5 后,73.1%→79.5%(+6.4)→84.5%(+11.4),聚合差 5.0%,1.78× GEPA 增益(Shopping Admin 72.9→80.3)。(2)ALFWorld/AppWorld/τ-bench(Table 2):Gemini 下 Curator 四个测试集全胜,平均比 GEPA +14.3%、比 ACE +5.0%(ALFWorld 91.8、AppWorld Test-N 58.7、Test-C 46.2、τ-bench 84.0);Opus 下 ALFWorld 98.4%(+2.6)、AppWorld Test-N 68.8%(+15.9)、Test-C 46.4%(+13.9)、τ-bench 82.9% 与 GEPA 持平,平均 +8.1%/+12.6%;摘要口径下相对 GEPA 最高 +20.7%、相对 ACE 最高 +21.2%(Opus τ-bench:82.9 对 ACE 的 61.7)。(3)消融(Table 3,GitLab 200 验证任务):完整方法 88.6% 对 GEPA 82.8%;仅任务策展 84.2%、仅成功检索 84.7%,单独有效、组合更强,证明两个机制互补。(4)诊断分析(Figure 3):1581 个训练任务中 75 个(4.7%)被诊断 impossible/flaky,其中 impossible 的 66.7% 源于 harness/环境限制,flaky 的 46.2% 源于错误/欠规范任务描述。(5)外推实验:Meta-Harness-Curator 在 Math-RAG 上把总准确率 45.33%→46.33%、奖励 45.69%→47.26%(ArXivMath Jan 26.09%→34.78%),文本分类总体 48.06%→51.04%(Law 39.17→45.00、S2D 84.58→88.13、USPTO 略降);高效变体(Table 7)性能不降反在 AppWorld Test-N/C 上升至 67.1/56.3;成本上(Table 8)WebArena 总花费 $776.88 对 GEPA 的 $594.05(1.31×)而精度 +3.6%,非 WebArena $173.98 对 ACE 的 $768.69(便宜 4.42×)而精度 +9.2%;QA 基准(Table 16)平均 57.9 对 GEPA 56.8,HoVer +4.3 但 HotpotQA −1.3,说明评估信号已经干净的 QA 任务上策展收益有限。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GoBrowse/WebArena 四站聚合(Gemini 3.1 Pro 优化器) | held-out 测试成功率 | 82.1 ± 1.7% | GEPA 78.7 ± 0.6%(seed 72.4%) | +3.4%(1.54× GEPA 优化增益,单站最高 +7.4%) |
| GoBrowse/WebArena 四站聚合(Claude Opus 5 优化器) | held-out 测试成功率 | 84.5 ± 1.0% | GEPA 79.5 ± 1.2%(seed 73.1%) | +5.0%(1.78× GEPA 优化增益) |
| ALFWorld(134 个 valid unseen 任务,Opus 5 优化器) | 成功率 | 98.4 ± 0.6% | GEPA 95.8 ± 1.4%;ACE 89.7 ± 2.7% | +2.6% vs GEPA |
| AppWorld Test-N(Opus 5 优化器) | Task Goal Completion | 68.8 ± 1.9% | GEPA 52.9 ± 5.7%;ACE 61.2 ± 1.7% | +15.9% vs GEPA |
| AppWorld Test-C(Opus 5 优化器) | Task Goal Completion | 46.4 ± 1.1% | GEPA 32.5 ± 2.7%;ACE 33.4 ± 0.8% | +13.9% vs GEPA |
| τ-bench retail 扁平化(Gemini 3.1 Pro 优化器) | 成功率 | 84.0 ± 4.8% | GEPA 75.4 ± 5.2%;ACE 80.6 ± 6.6% | +8.6% vs GEPA,+3.4% vs ACE |
| GitLab 消融(200 验证任务) | 成功率 | 88.6 ± 2.0%(完整方法) | GEPA 82.8 ± 1.6%;仅任务策展 84.2%;仅成功检索 84.7% | +5.8% vs GEPA,两组件组合最优 |
| 含 Flaky 任务的课程对比数据集(48 Easy/54 Optimizable/45 Impossible/21 Flaky) | 成功率(5 次评估平均) | 70.2%(GEPA-Curator) | GEPA 66.2%;数值课程学习 62.5%;仅任务策展 67.4% | +4.0% vs GEPA,+7.7% vs 数值课程 |
| Math-RAG(Meta-Harness 扩展) | 测试总准确率 / 奖励 | 46.33% / 47.26% | Meta-Harness 45.33% / 45.69% | +1.0 / +1.57 个百分点 |
| 在线文本分类(S2D/Law/USPTO) | 测试准确率(三数据集均权) | 51.04% | Meta-Harness 48.06% | +2.98 个百分点(Law +5.83,USPTO −0.42) |
局限与改进
作者承认的局限:其一,QA 类基准收益微弱——四个 GEPA 套件基准平均仅 +1.1%(57.9 对 56.8,1.05× 增益),HotpotQA 还下降 1.3%,作者归因于结构化 QA 的评估信号本就干净,说明方法价值集中在环境噪声大的智能体场景;其二,向 Meta-Harness 的扩展只是 modest 提升(Math-RAG acc +1.0,分类 +2.98,USPTO 反降 0.42),且该部分每个设置只跑一次优化、未报告方差;其三,τ-bench 上与 GEPA 打平(Opus 下同为 82.9)。我自己的观察:第一,Curator 依赖 Gemini 3.1 Pro/Opus 5 级别的优化器模型,其诊断可靠性未在弱模型上验证,成本敏感场景难以直接借用;第二,诊断本身会犯错——impossible 判定中 5.6% 属推测、5.6% 后来翻转,flaky 中 10.8% 推测、7.7% 翻转,跳过真实可解任务存在机会成本;第三,成功检索的实际介入率不高(失败反思中被配对锚点的比例稳定在约 50%,任务级“有意义决策”仅覆盖 554 个合格任务中的 11.6%),其贡献与“任务策展改善了历史质量”纠缠,难以单独归因;第四,贪心单谱系变体舍弃了 GEPA 的 Pareto 候选池,虽消融显示差异小,但可能损失面对局部最优的鲁棒性;第五,τ-bench 测试集仅 35 个任务、评估重复 5 次,置信区间较宽(±4.8);第六,评估依赖 LLM-as-a-judge,而 Curator 的 flaky 诊断与评判器噪声天然纠缠,缺少独立于评判器的金标准验证。
独立分析的弱点
弱点一:诊断能力与成本的耦合。任务策展和成功检索的有效性完全取决于 Curator 模型的归因能力,论文只用顶级模型(Gemini 3.1 Pro 高思考档、Opus 5 xhigh 推理)验证;若换成中档模型,speculative/reversed 诊断比例(合计约 11–18%)可能显著上升,甚至把可解任务永久误判为 impossible。改进方向:蒸馏一个专门的任务诊断小模型,或采用“规则预筛+LLM 复核”的分层架构,只把疑难任务交给大模型。弱点二:跳过决策的假阳性成本未被量化。论文展示了 skip 后复审机制,但没有报告“被跳过的任务后来其实可解”的比例与相应损失;改进方向是在跳过期间插入低成本的探针 rollout(如每 k 个 epoch 一次),或对 skip 决策引入置信度阈值。弱点三:成功检索的触发率低且证据链弱——早期阶段 75.5% 的失败反思因无历史成功而无锚点可用,任务级有意义决策仅 11.6%,同时消融中“仅成功检索”(84.7%)反而高于“仅任务策展”(84.2%),提示其价值可能更多来自为 Reflector 提供稳定的正面示例上下文,而非精细的锚点挑选;改进方向是支持跨任务检索相似任务的成功轨迹,以及多条锚点的自动对比。弱点四:贪心变体的搜索多样性损失未与完整 GEPA 的 Pareto 机制在噪声环境正面比较;改进方向是把策展作为 Pareto 候选池的前置过滤器,兼得两者。弱点五:负迁移的修复是被动的——66.7% 的 impossible 判定源于 harness/环境限制,但框架只能跳过而不能修复环境;改进方向是让 Curator 输出结构化的环境缺陷报告并自动提交 harness 补丁,与 Meta-Harness 的代码优化天然衔接。弱点六:所有结论建立在 gpt-oss-120b 这个相对便宜的 actor 上,论文自己也承认换更大的 actor 后成本比会变,方法在更强 actor(失败率更低、噪声结构不同)下是否仍有同等收益需要验证。
未来方向
作者提出或示范的方向:把策展思想推广到 harness 代码优化(Meta-Harness-Curator 已给出概念验证,但增益 modest,值得用更大的任务池与更长的搜索预算重试);发展更低成本的策展变体(跳过区间、紧凑历史已实现,可进一步压缩 Curator 上下文)。基于其成果可以自然延伸的方向:其一,把智能体化策展引入 RL 训练的数据筛选——反思优化中的噪声任务问题与 RL 中奖励噪声/不可验证奖励问题同构,Curator 可充当经验回放缓冲区的过滤器;其二,环境自修复闭环:既然多数 impossible 判定指向 harness/环境缺陷,可让优化循环自动定位并修复缺陷(如补全缺失工具),把“跳过”升级为“修复后重试”;其三,跨任务经验检索——当前锚点仅限同一任务的历史成功,可按任务语义相似度检索相关任务的成功模式,构建可积累的技能库(与 ACE 的 playbook 思路合流);其四,理论与度量:形式化刻画噪声任务比例 $\rho$ 与反思优化收敛的关系(Figure 2 已给出 $\rho=50\%$ 时的经验上界),并建立独立于 LLM judge 的信号质量度量;其五,在线部署场景的持续策展:生产环境中任务流天然含歧义与不可行请求,Curator 可同时充当请求可解性路由器;其六,缩小 Curator 规模的蒸馏研究,使策展对开源社区可行。
复现评估
复现条件总体友好但非开箱即用。代码基础全部开源:GEPA(gepa-ai/gepa,MIT)、ACE(ace-agent/ace,Apache-2.0)、Meta-Harness(stanford-iris-lab/meta-harness,MIT),基准亦全部开源(WebArena Apache-2.0、GoBrowse MIT、ALFWorld MIT、AppWorld Apache-2.0、τ-bench MIT),且论文附录 B 完整给出了 Curator 的任务策展与成功检索提示词、各基准种子提示和评判器提示,附录 F 逐项列出许可证,透明度高。需要自建的部分:GEPA-Curator 本身的 harness 代码与 per-task history 存储(论文未声明发布其实现)。算力方面:actor 用 gpt-oss-120b(Apache-2.0,可自托管,论文用 vLLM 在 8×H100-96GB、TP=1/DP=8 或 4×H200 上部署,温度 1.0,最大序列 131072);优化器需 Gemini 3.1 Pro 或 Claude Opus 5 的付费 API。数据量与预算:GoBrowse 每站 5000 rollouts(GitLab 720/Shopping 585/Shopping Admin 750/Reddit 585,3:1:1 划分)、ALFWorld 2000(测 134 unseen)、AppWorld 1500、τ-bench 800(48/32/35 划分);参考成本:单次 WebArena 优化约 $777–810、ALFWorld 约 $59、AppWorld 约 $77、τ-bench 约 $38(高效版,Gemini 计价)。复现难度评估:中等——主要障碍是 WebArena 自托管环境的搭建与维护(耗时且对网络敏感)和 API 费用,协议本身(5 次重复取均值、每 16 迭代验证、 minibatch 16)描述清晰,具备 Medium 级工程经验的团队约一到两周可复现主表。
论文图表
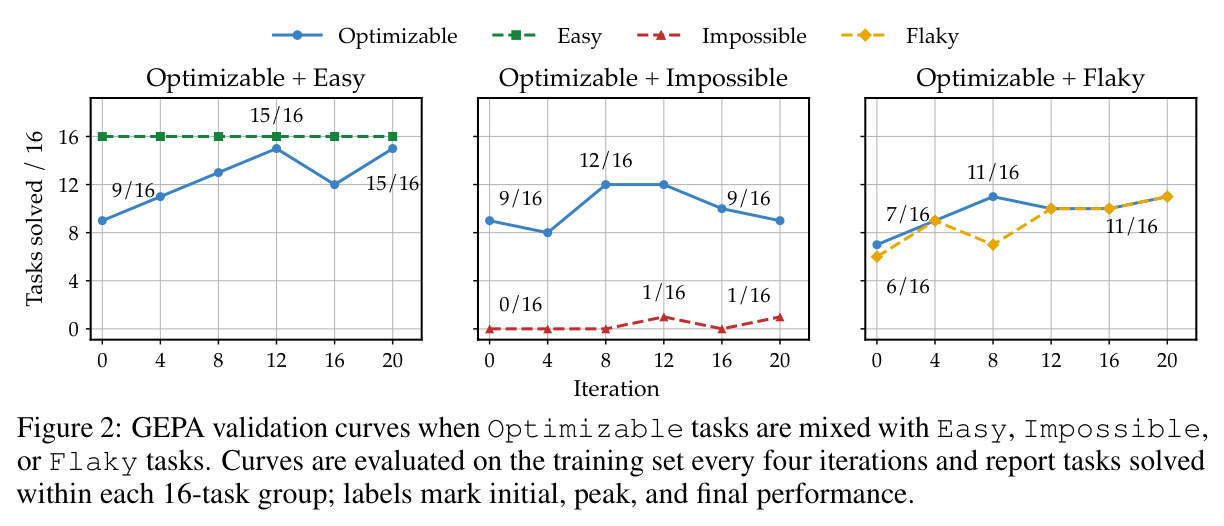
三张学习曲线对比:Optimizable 任务分别与 Easy、Impossible、Flaky 任务混合后跑 GEPA,每 4 迭代在训练集上评估 16 任务组的解题数。与 Easy 混合时接近满分(峰值 15/16);与 Impossible 或 Flaky 混合时峰值只有 12/16,且末期退化到 8/16、9/16、11/16 不等。
这是论文最核心的动机实验:用受控混合直接证明了噪声任务不只是“无信号”,而是主动污染提示、压低可解任务的学习上限,为整个策展框架提供了存在性证明。
三面板统计:(a) 全部 1581 个训练任务中 95.3% 判定良好、1.1%(18 个)impossible、3.6%(57 个)flaky;(b) impossible 的主因分解——66.7% 为 harness/环境限制、22.2% 为错误任务、5.6% 推测性诊断、5.6% 复查后翻转;(c) flaky 的主因分解——46.2% 错误/欠规范任务、29.2% harness/环境限制、10.8% 推测、7.7% 翻转、6.2% 可靠成功偶被误判。
它量化回答了“策展器到底在过滤什么”:被跳过的任务绝大多数确实有客观缺陷(环境或任务本身),而非模型能力问题,这是方法有效性和诊断可解释性的直接证据。