AREX-2:通过长程反思任务推进自改进智能体 AREX-2: Advancing Self-Improving Agents through Long-Horizon Reflective Tasks
在可验证域构造长程反思轨迹训练27B模型,实现测试时自我改进并跨域迁移
前置知识
测试时扩展
指不改变模型参数,通过在推理阶段投入更多计算(更多轮次、更长思考、更多工具调用)来提升解的质量。本文特指任务内的轮次扩展:对同一任务给的轮次预算越多,解的期望分数越高。与链式思考等单次扩展不同,它要求模型能把每轮反馈转化为有增益的修改,而不是简单重复。
作者把自改进直接定义为任务内的测试时扩展,整个形式化框架和评估协议(轮次预算、耗时预算)都建立在这个概念之上。
长程反思
作者提出的复合能力,包含两部分:反思指根据当前解和反馈产出比现有解更好的解;长程执行指让迭代过程在多轮内保持有效,即保留有用发现、从挫折中恢复。用公式分解为 $\bar{r} T^*$:反思决定单轮平均增益 $\bar{r}$,长程执行决定有效轮数 $T^*$,二者缺一不可。
这是论文的核心概念,也是训练数据的设计目标:全文讨论的就是如何造出让模型学到这两种能力的数据。
拒绝采样与自蒸馏
一类常见的智能体训练方法:让模型对任务生成多个解,用验证器筛出通过的,再用这些成功解微调模型自身,代表工作有 STaR、RFT、ReST 等。这类方法只向模型展示'正确解长什么样',中间的失败尝试、收到的反馈和后续修订全部被丢弃。
论文把这类一次性尝试式数据作为主要批判对象,其'丢弃过程'的缺陷正是本文'保留过程'这一数据构造思路的出发点。
可验证奖励与分级分数
可验证奖励指任务的解可以用程序化方式客观打分,例如隐藏测试通过率、留出集上的模型指标。分级分数是连续值而非二元通过/失败,比如通过测试的比例,或启发式解相对已知最优解的质量,这样每一轮小幅改进都能在分数上反映出来,信息量更大。
环境准入要求反馈无歧义且尽量分级,这决定了哪些域能够用来监督长程反思,是理解作者为什么选机器学习工程和算法编程两个域的关键。
操作性知识
指改进解所需的环境知识:仓库暴露哪些 API、数据加载器期望什么格式、问题约束允许哪些优化。这些知识不在任务陈述中给出,需要智能体通过读源码、查文献、跑小实验主动获取。本文将其部分固化为放进上下文的技能文档,分为通用技能和任务特定技能两类。
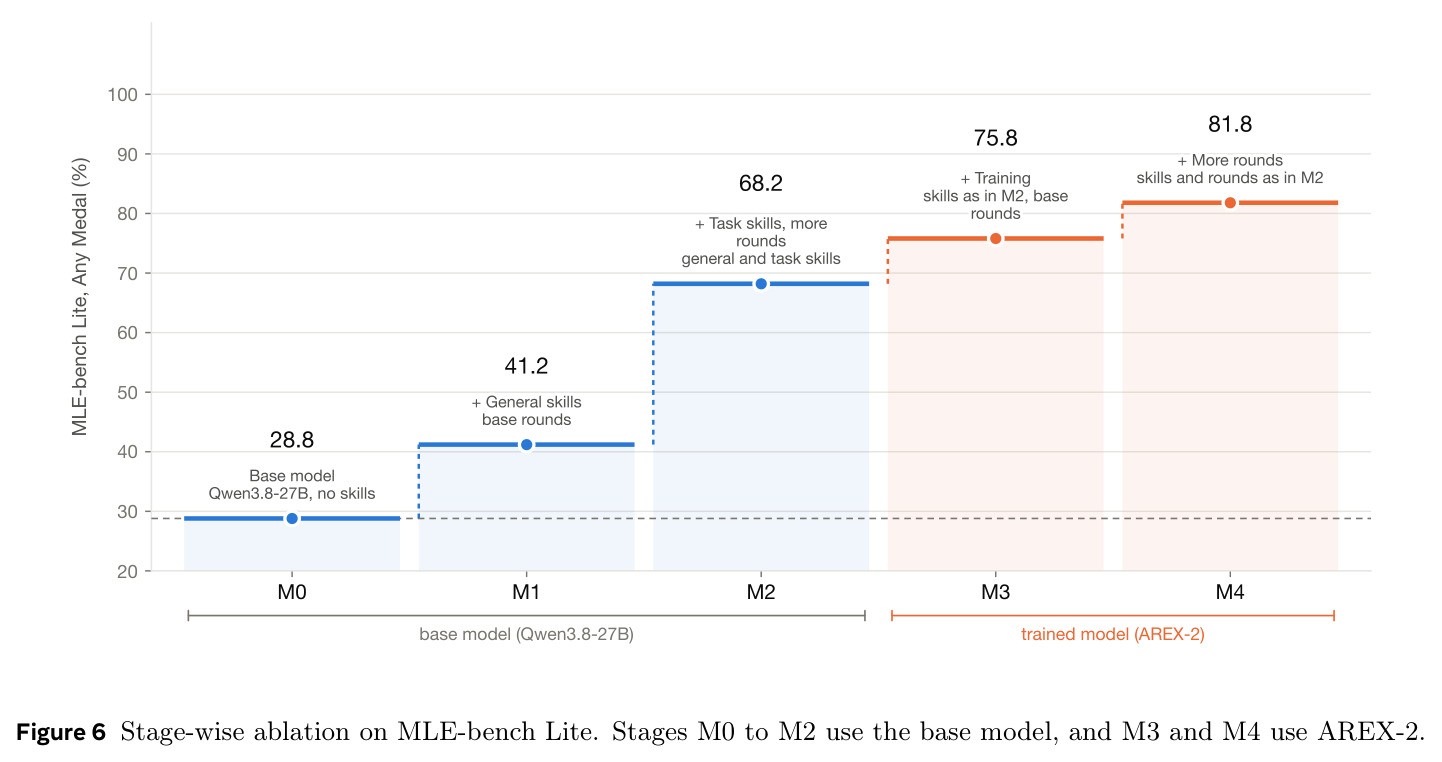
消融实验显示,仅通用技能加更多轮次就把基座模型从 28.8 分提到 68.2 分,这是理解本文收益来源和局限的关键概念。
MLE-bench Lite 与 Frontier-CS
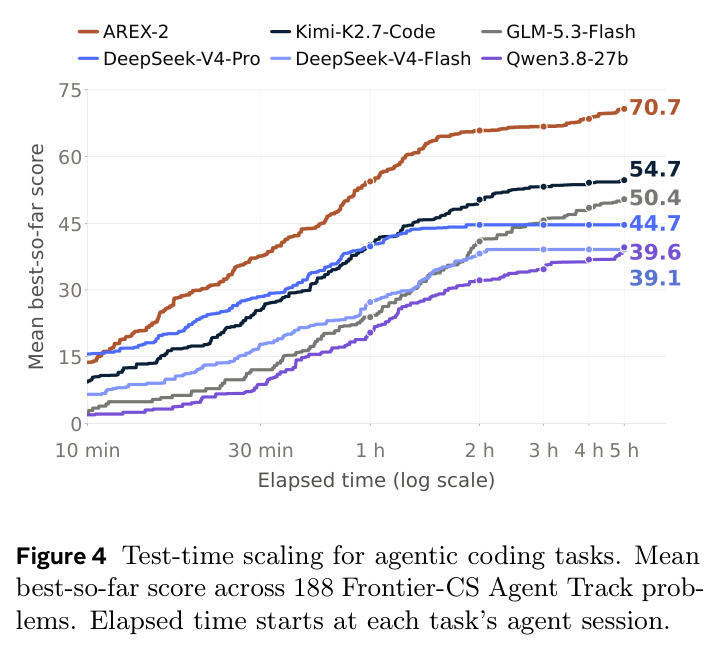
MLE-bench Lite 是机器学习工程基准,智能体需完成数据分析、实验、实现与模型评估的端到端流程,指标为 Any Medal(获得奖牌的竞赛比例,三种子均值),每题预算 12 小时;Frontier-CS 是算法编程基准,188 道开放题、分级计分,Agent Track 允许每题 5 小时内反复实现、测试与提交。
两者正是本文构造训练数据的两个来源域基准,也是验证'所学元技能是否有效'的第一组实验,核心成绩 81.8 和 70.7 都来自这里。
研究动机
当前智能体的训练数据几乎都是'一次尝试'式的:给定任务,模型产出一个解,验证器只判通过与否,被判定通过的解被保留用于训练,这与拒绝采样、STaR 等自蒸馏方法一脉相承。这种数据只展示'正确解长什么样',却从不展示'解是如何被改进的'——中间失败的尝试、收到的反馈、据此做出的修改全部被丢弃,而一次就通过的解恰恰最容易收集,所以漫长的改进过程最先丢失。与此同时,在绝大多数智能体系统里,'尝试—测量—修改'的循环其实由外部脚手架实现:harness 决定何时重试、保留什么,模型只负责单次产出,从未学会自我改进。作者指出,像智能体在同一个问题上连续工作数小时、不断测量与修订直到远超起点的轨迹,在现有训练数据中几乎不存在,必须专门构造。
本文的目标是本文想把改进循环'搬进模型内部':定义自改进为——对同一任务,给智能体更多轮次,它就能凭自己的判断把轮次转化为更好的解,即任务内的测试时扩展。作者将其分解为两个互补能力并形式化:设 $s_t$ 为 $t$ 轮后的历史最优分,$r_t = \mathbb{E}[s_t - s_{t-1}]$ 为第 $t$ 轮的期望增益,给定轮次预算 $T$,总提升为 $\mathbb{E}[s_T] - s_0 = \sum_{t=1}^{T} r_t$。若只有 $T^* \le T$ 轮的增益显著且这些轮的平均增益为 $\bar{r}$,则总提升约为 $\bar{r} T^*$:反思决定 $\bar{r}$(一轮有效修订值多少分),长程执行决定 $T^*$(多少轮之内保持有效),合称长程反思。目标是在两个便于监督的域学到这种能力,并验证它能迁移到训练域之外。
与已有工作不同的是,独特切入在于'域选择':与其在目标任务上直接造数据,不如选一个便于监督的域去学元技能。作者的核心假设是长程反思是域无关的元技能——判断解的缺陷、决定改什么、失败后继续,无论解是训练管线、程序还是研究报告,本质动作相同。若假设成立,训练域不必与目标域相似,而应按三个标准选择:反馈无歧义(验证分数或裁判判定直接显示修订是否有效)、有持续改进空间(从暴力程序到近似最优解、从基线到调优集成,长轨迹受奖励)、素材充足(GitHub 仓库与在线评测题库供应充分)。据此选择机器学习工程与算法编程两个域,再用跨域迁移实验检验假设,这与把训练直接对准目标基准的主流路线形成鲜明对比。
核心方法
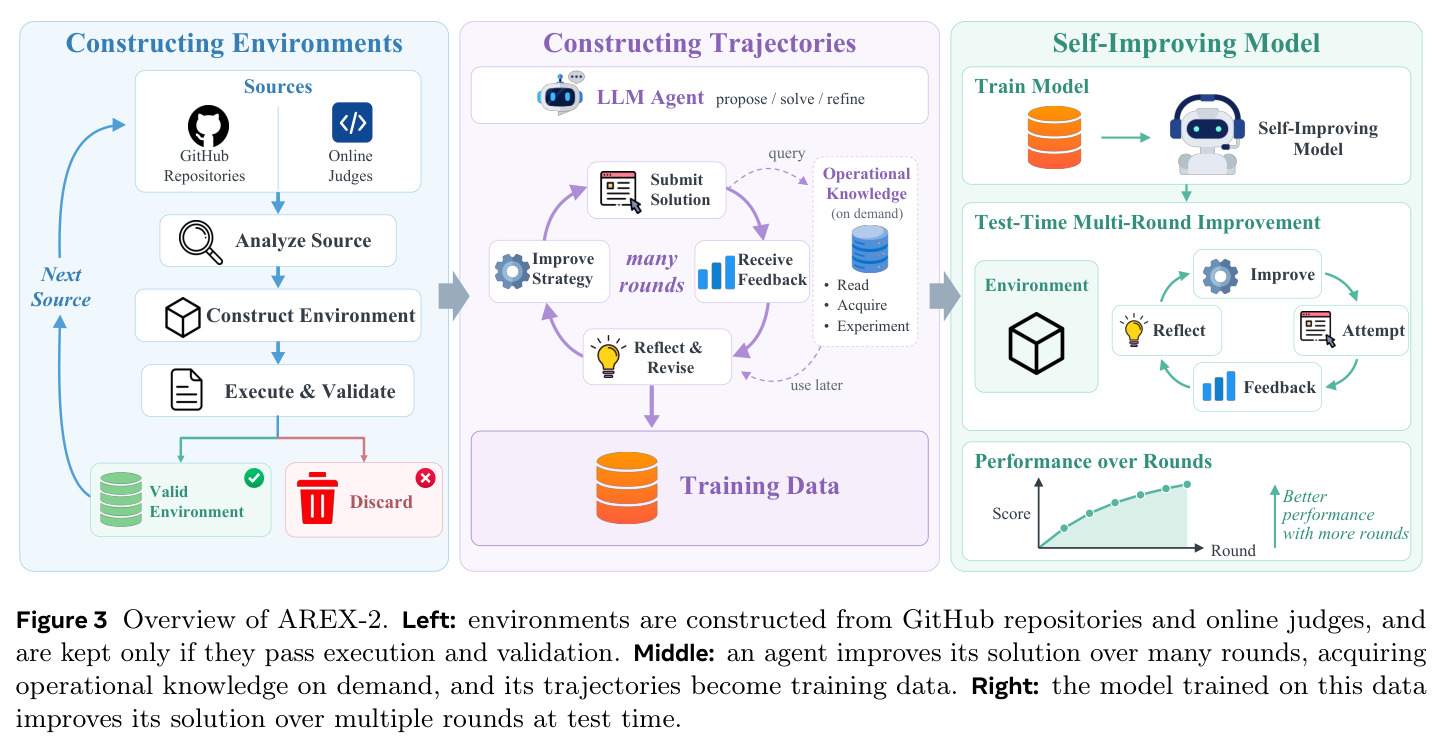
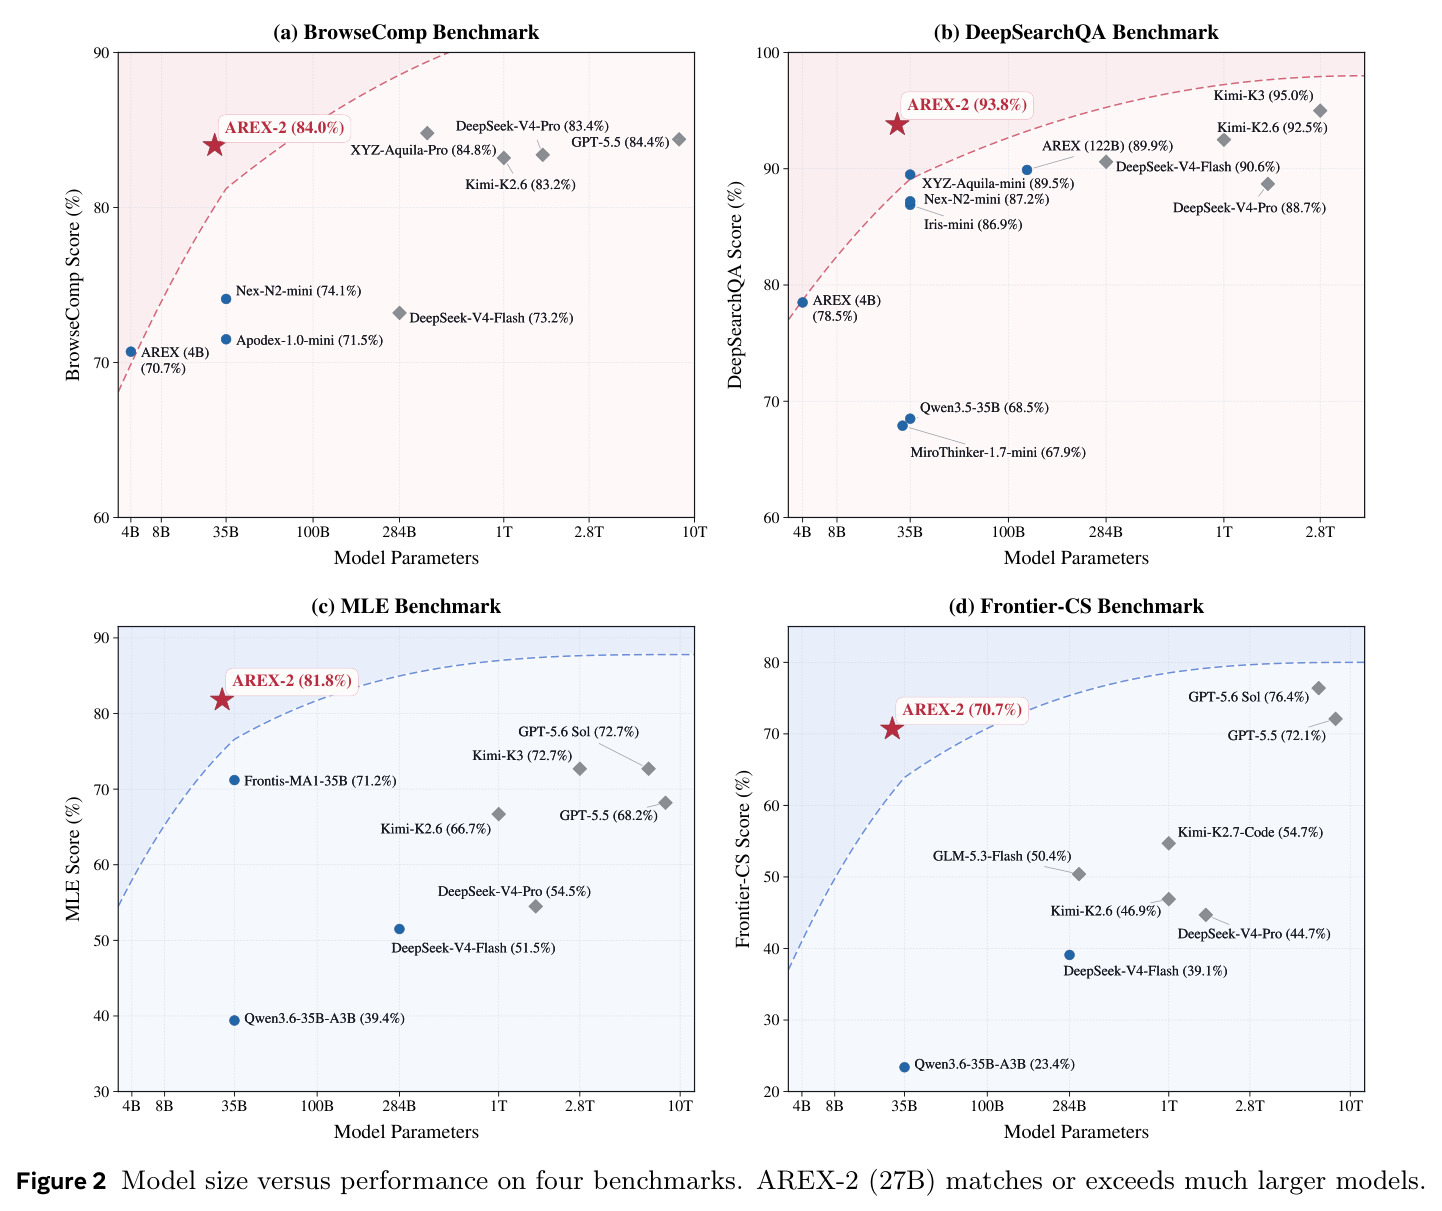
整体思路分三步:造环境、造轨迹、练模型。环境定义为 $e = (\sigma, S)$,$\sigma$ 是交给智能体的任务,$S$ 是把候选解映射为标量的打分函数(如验证集指标、隐藏测试通过率),并规定分数越高越好。第一步由教师模型把 GitHub 仓库与在线评测题转化为可执行环境;第二步让教师智能体在环境中工作几十轮(每题数小时、数百次工具调用),每轮提交解、看到分数与环境报告,再反思修订,同时按需获取操作性知识(读源码、查论文、跑小实验);第三步做轨迹级筛选——只要最终分数高且过程合规就整条保留,失败轮与回退都留在数据中。最后把这些轨迹与 AREX 配方的深度研究数据混合,对 Qwen3.8-27B 做模仿学习微调得到 AREX-2,在 MLE-bench Lite 取得 81.8、Frontier-CS 取得 70.7。
核心创新有三点。第一,把测试时收益公式 $\mathbb{E}[s_T] - s_0 \approx \bar{r} T^*$ 变成训练数据的设计依据:需要的数据不是最优解本身,而是'分数随轮次持续上升'的完整过程。第二,与拒绝采样只保留成功尝试相反,本文刻意保留失败轮、回退和被放弃的方案,但通过'轨迹级选择'保证整体质量——不要求单轮成功,只要求终分达标且过程合规(转写符合用户-助手-工具格式、每次工具调用有观察、以良构状态终止、未从留出分割重构答案或泄露凭据)。第三,损失设计:整条轨迹作为上下文,损失只施加在失败之后的诊断、修复、换策略、下一实验和提交更优解这些决策上。这样模型学到的是'如何从挫折中恢复并继续推进',而非只学一步到位。
方法步骤详情
步骤一,构造环境:对 GitHub 仓库,教师模型读代码找到所测指标,撰写任务描述、在智能体无法访问的留出分割上计算指标的打分脚本,以及装好仓库与数据的沙箱;对评测题,任务即题面,沙箱含编译器与样例,$S$ 为隐藏测试给出的分数,且尽量用分级分数(通过率、启发式解相对最优解的质量)而非二元判定。环境准入需双重执行验证:自带参考解(仓库模型或评测题的通过提交)能在 $S$ 下运行得分,且简单基线须显著低于参考解,否则丢弃。步骤二,构造轨迹:用三个条件诱导长程反思——轮次与时钟预算远大于单次尝试所需(数小时、数百次工具调用)并告知预算;提供操作性知识,包括从 ML 仓库预先整理的通用技能和针对任务检索(排除任务本身材料)的任务特定技能文档;每轮以提交结束并看到分数与报告,形成反馈闭环。步骤三,训练:按步分组(一个决策连同其后的动作),损失只加在推动解前进的决策上,无进展步骤(重复轮询、无新观察的调用、近重复轮次)、系统消息、环境报告和检索文档不计损失;新轨迹与 AREX 配方的深度研究数据混合,微调 Qwen3.8-27B。
技术新颖性
与已有工作的本质区别有四。其一,对 STaR、RFT、ReST 类自蒸馏(Zelikman et al. 2022;Gulcehre et al. 2023;Yuan et al. 2023),它们微调模型于自己的成功输出,只示范'终态',本文示范'过程',包括失败与恢复,填补了训练数据中长过程轨迹的空白。其二,逐步过滤会把失败尝试清除掉,模型遇挫便无从学习;本文的轨迹级选择保留这些内容,同时用终分与过程合规约束整体质量,是介于'全部保留'与'逐步过滤'之间的新数据筛选粒度。其三,技能文档作为环境的一部分提供给造数据的教师智能体,使它能产出值得模仿的轨迹;训练后的模型从轨迹中学会使用技能,技能成为可迁移的操作性知识载体。其四,域无关元技能假设通过'零新增深度研究数据仍全面超越 AREX 系列模型'得到交叉验证,方法论上把'在哪里训练'与'训练什么能力'解耦了。
实验结果
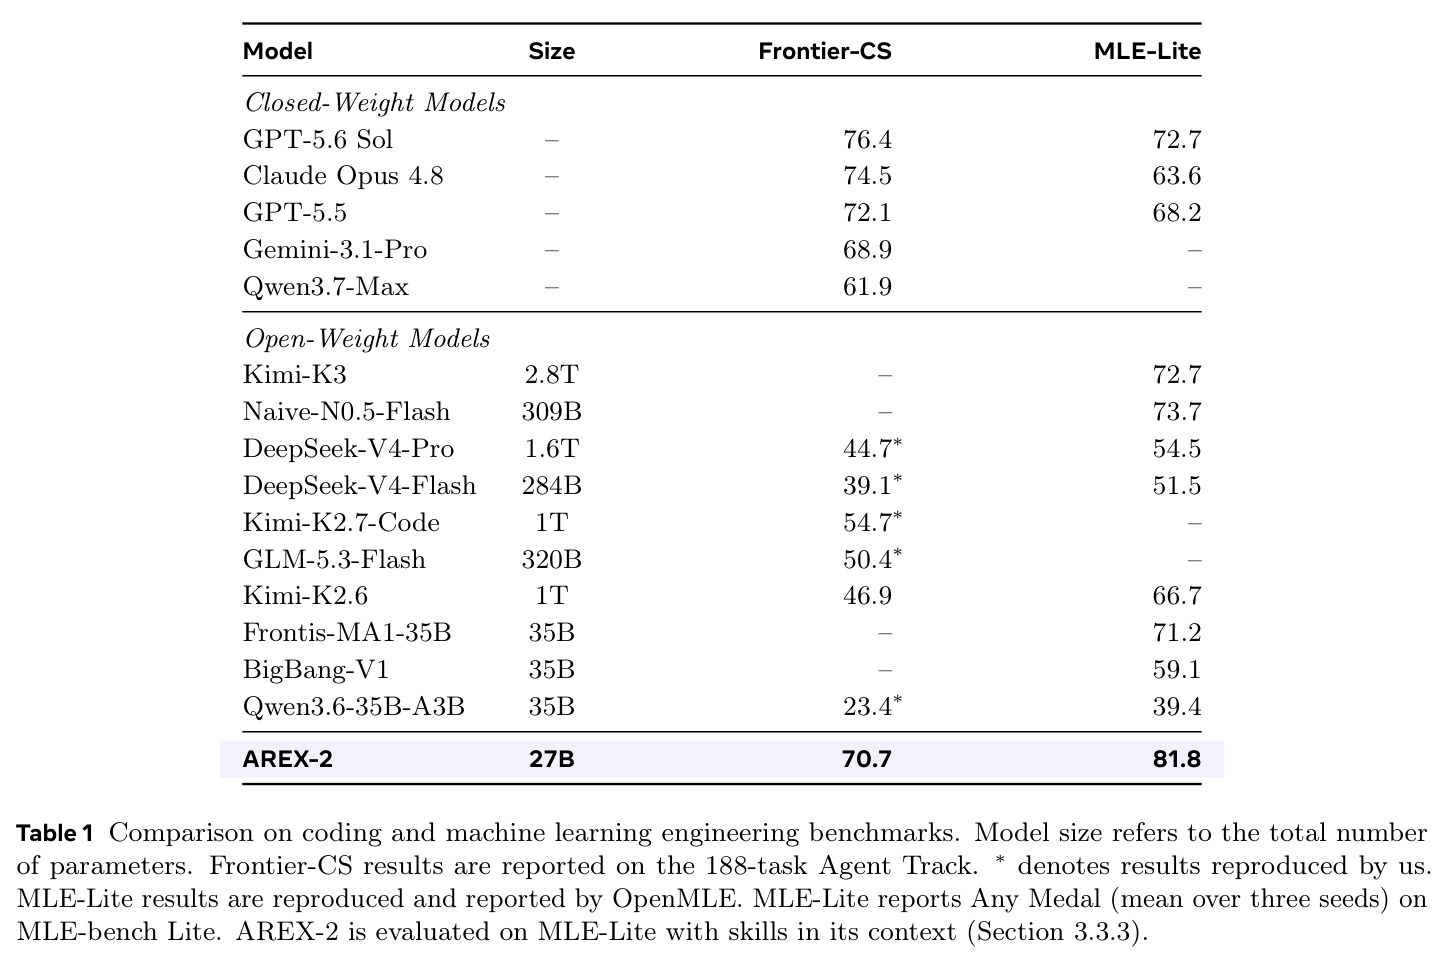
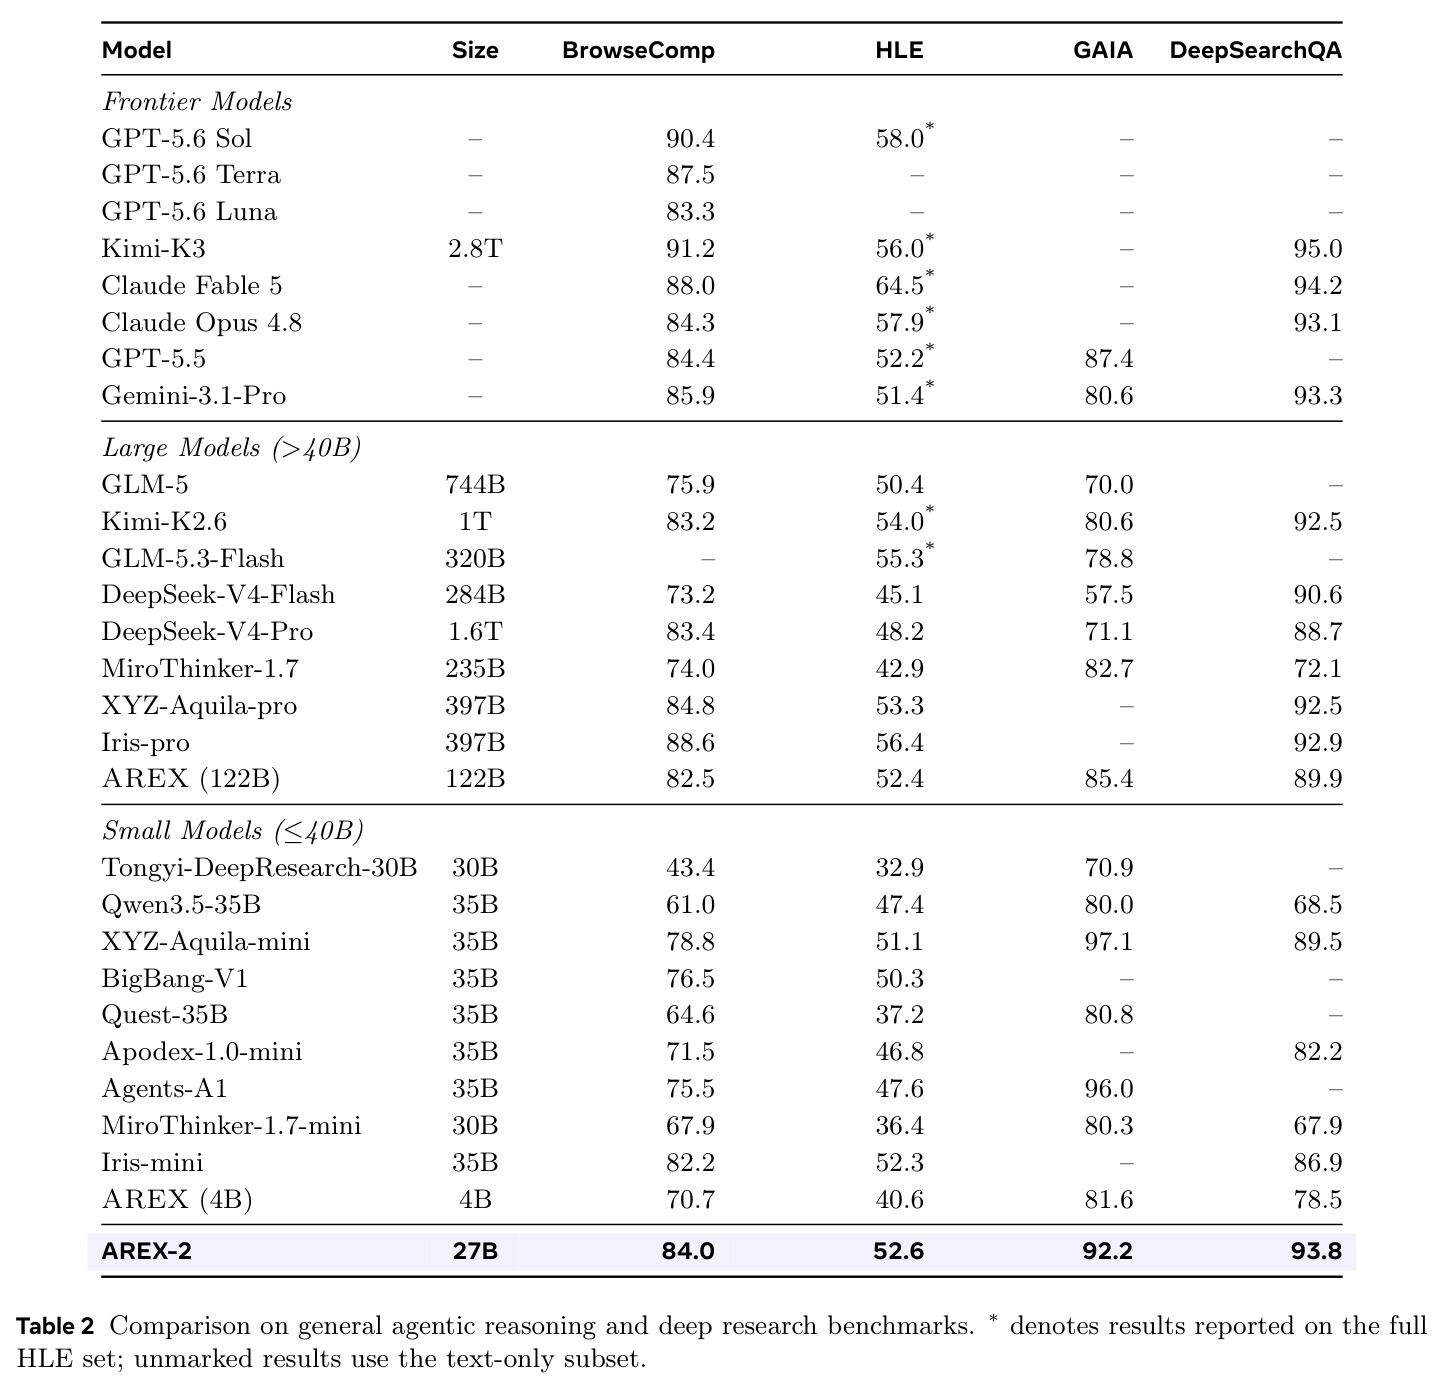
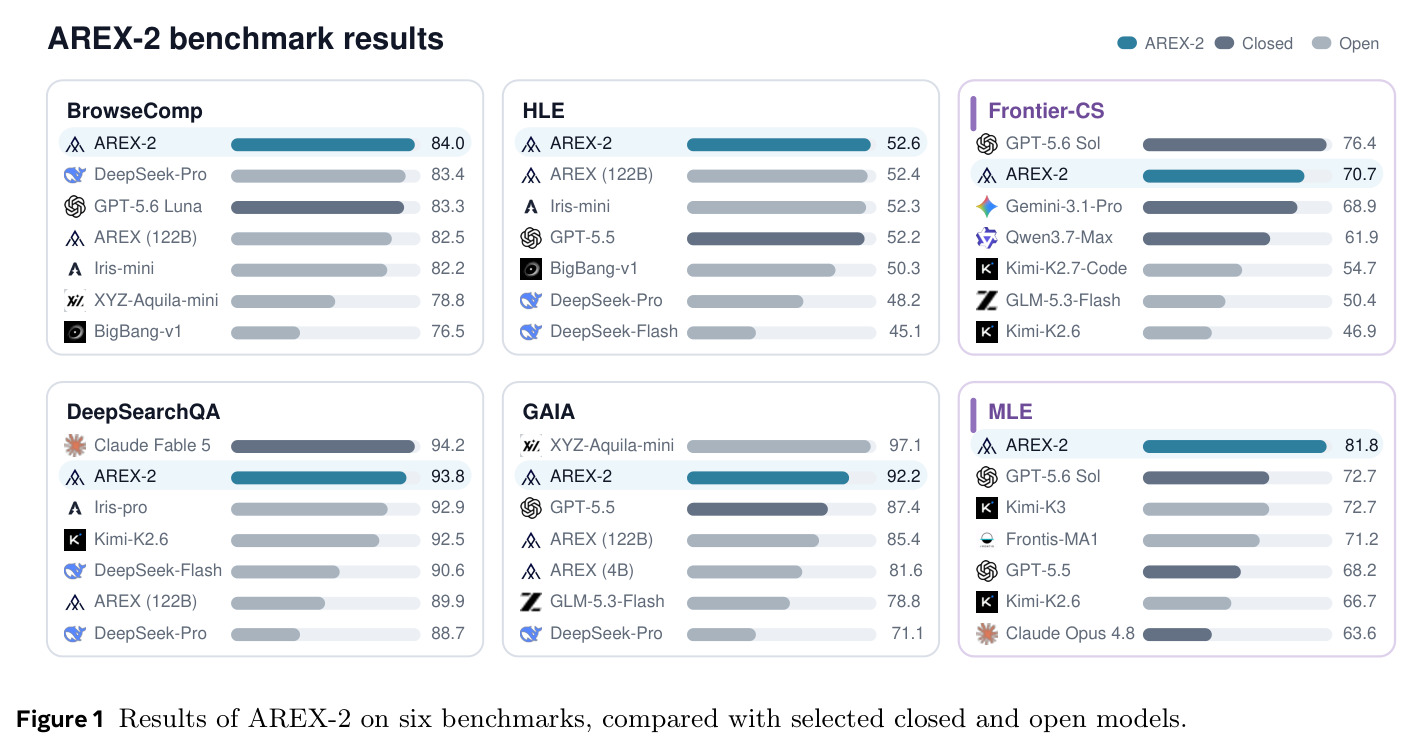
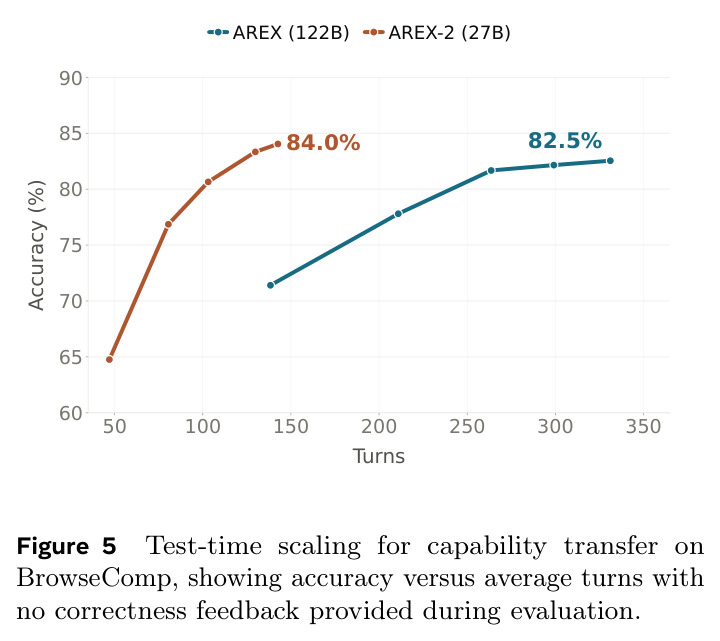
域内:MLE-bench Lite 81.8(Any Medal),超最强开源 8.1 分、最强闭源 GPT-5.6 Sol 9.1 分;Frontier-CS 70.7 为最强开源,超开源基线 16.0 分,距 GPT-5.6 Sol 仅 5.7 分。跨域迁移(零新增研究数据):BrowseComp 84.0、HLE 52.6、GAIA 92.2、DeepSearchQA 93.8,全超同配方训练的 AREX (4B)/(122B)(82.5/52.4/85.4/89.9),GAIA 升 6.8 分。测试时扩展:Frontier-CS 上 1 小时 54.4、2 小时 65.9、5 小时 70.7,最后一小时仍涨 2.2 分,而 DeepSeek-V4-Pro 2 小时后停在 44.7;BrowseComp 无反馈时准确率从 47 轮的 64.8 升至 143 轮的 84.0,每轮增益约为 AREX 的 3 倍。消融:基座 28.8 → 通用技能 41.2 → 加任务技能与轮次 68.2 → AREX-2 少轮次 75.8 → 多轮次 81.8,同条件训练净增 13.6 分。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 机器学习工程(MLE-bench Lite) | Any Medal(三种子均值) | 81.8 | 最强开源 Naive-N0.5-Flash 73.7;最强闭源 GPT-5.6 Sol 72.7 | +8.1(对最强开源)、+9.1(对最强闭源) |
| 算法编程(Frontier-CS Agent Track,188 题) | 5 小时预算平均分级得分 | 70.7 | 最强闭源 GPT-5.6 Sol 76.4;最强开源 Gemini-3.1-Pro 68.9 | 超最强开源 16.0 分,距最强闭源 5.7 分 |
| 深度研究(BrowseComp) | 准确率 | 84.0 | AREX (122B) 82.5;DeepSeek-Pro 83.4 | +1.5(对 AREX 122B),模型小到 1/4.5 |
| 通用推理(HLE,text-only) | 准确率 | 52.6 | AREX (122B) 52.4;Iris-mini 52.3 | +0.2(对 AREX 122B) |
| 工具增强推理(GAIA) | 准确率 | 92.2 | AREX (122B) 85.4;GPT-5.5 87.4 | +6.8(对 AREX 122B) |
| 信息检索与多步任务(DeepSearchQA) | F1 | 93.8 | Claude Fable 5 94.2;AREX (122B) 89.9 | +3.9(对 AREX 122B),落后最强闭源 0.4 |
局限与改进
作者承认与最强前沿模型仍有差距:BrowseComp 上 GPT-5.6 Sol 达 90.4、Kimi-K3 达 91.2,HLE 上 Claude Fable 5 达 64.5,AREX-2 的 84.0 与 52.6 尚有距离;域无关元技能假设也只在四个评测维度上得到验证。我自己的观察:其一,训练域依赖可验证、可分级打分的环境,构造每个环境都需要教师建模加双重执行验证,成本高,难以扩展到反馈嘈杂的领域(如开放式写作、真实用户交互);其二,评测时上下文要放技能文档,基座加技能与轮次就能到 68.2 分,说明相当一部分收益来自外部知识工程而非模型本身内化的能力;其三,评估预算极大——Frontier-CS 每题 5 小时、MLE-Lite 每题 12 小时,非编码基准内层最多 300 轮、总计 1500 轮,部署成本高;其四,纯模仿学习没有对 $\bar{r}$ 做显式优化,SFT 之后没有 RL 阶段,改进上界受限于教师智能体的水平。
独立分析的弱点
弱点一:对教师智能体和环境质量强依赖——环境决定数据上限,教师弱则轨迹弱,改进方向是用 RL 或多教师集成提升造轨质量,并对环境做自动质检与难度分层。弱点二:打分函数 $S$ 本身的偏差会被模仿放大,模型可能学会过拟合打分函数而非真正改进(例如钻留出分割的空子),建议对 $S$ 做鲁棒性审计,或用多个独立打分器交叉验证后再准入。弱点三:技能文档是预先/半自动准备的额外组件,基座模型没有技能时只有 28.8 分,系统对上下文工程敏感,改进方向是把技能获取本身训练成模型内能力,比如让模型自主生成、自评并维护技能库。弱点四:只验证了两个训练域向深度研究的迁移,域间差异更大时(具身控制、长程多轮对话)元技能假设未必成立,应补充负迁移检测与跨更多域的扩展实验。弱点五:$s_t$ 取历史最优且按终分筛选轨迹,模型可能学到保守提交、避免有风险的探索性尝试,可把探索收益显式建模进选择准则。弱点六:只在 27B 一个尺度上训练,元技能假设与模型规模的关系尚不清楚。
未来方向
作者明确提出三个方向:拓宽训练域(纳入更多可验证场景)、拉长轮次视野(继续提高有效 $T^*$)、闭合回路——让模型自己的轨迹成为下一代训练数据,形成自我改进飞轮。基于本文成果还可以延伸:其一,在 SFT 之上做 RL,以 $\bar{r} T^*$ 为目标显式奖励有效增益而非仅终分,直接优化轮次效率;其二,把技能生成全自动化并让模型自我维护技能库,消除对外部知识工程的依赖;其三,研究生成数据规模定律——轨迹数量、轮次预算、教师强度与下游增益之间的定量关系;其四,为弱反馈域寻找替代方案,如用过程奖励模型替代可执行打分器,把方法论推广到反馈嘈杂的真实任务;其五,向更小模型蒸馏长程反思能力,降低测试时扩展的推理成本,让 4B 级模型也具备数小时持续改进的行为。另外,把每轮增益 $r_t$ 作为细粒度监督信号(哪些行为模式对应高增益轮次)也值得研究。
复现评估
复现条件中等偏难。开源情况:论文给出主页 github.com/VectorSpaceLab/AREX-2,模型发布于 HuggingFace 的 BAAI/arex-2 集合,权重可下载用于推理复现,基准评测的 Agent Track 与 OpenMLE 协议都是公开的。但论文未披露的关键信息包括:最终用于训练的轨迹数量、生成轨迹消耗的总算力、教师模型的具体身份与环境构造管线的实现细节,因此完整复现数据管线需要大量工程投入。资源门槛方面:每条轨迹要求每题数小时、数百次工具调用的智能体运行;评估同样昂贵——Frontier-CS 每题 5 小时、MLE-Lite 每题 12 小时,普通实验室难以承受全量评估。比较可行的路径是:下载开源权重在单任务上复现推理行为,再以小规模自造轨迹(少量环境、短预算)验证'保留失败轮 + 轨迹级选择'这一方法论是否带来增益。基座 Qwen3.8-27B 的微调对算力充足的团队可行。
论文图表