PREEN:基于示例参照的智能手机编辑器预设色彩风格迁移 PREEN: Exemplar-Based Color Style Transfer with Smartphone Editor Presets
把参考图驱动的色彩风格迁移化为 29 维编辑器预设回归:教师反演监督,端侧 283 毫秒
前置知识
示例驱动的色彩风格迁移(PST)
给定一张内容图 $X$ 和一张用户喜欢的风格参考图 $Y$,把 $X$ 的色彩与色调改成接近 $Y$ 的观感,但保持内容与结构不变,也称照片级真实风格迁移。与纹理风格迁移不同,这里只改变图像的“颜色语言”,不改变物体形状与语义。
这是本文要解决的任务本身,所有方法设计、数据构造与评测指标都围绕“忠实参考又保真内容”这对内在张力展开。
可微分图像编辑器
把手机修图软件的滑杆操作(白平衡、对比度、饱和度、逐色相 HSL 等)写成一系列几乎处处可导的算子,按固定顺序作用于像素,记作 $E(X, P)$。因为可导,图像级损失和反演优化都能把梯度从输出图像传回参数向量。
论文的两个关键环节——伪预设反演(式 1)与 Phase 2 的图像级 CIELAB 损失——都依赖梯度穿过编辑器 $E$ 反传到 29 维参数上。
CIELAB 颜色空间与 $\Delta E^*_{ab}$
CIELAB 是感知上近似均匀的颜色空间:$L^*$ 表示亮度,$a^*$、$b^*$ 是红绿与黄蓝两个对立色通道。两种颜色的差异可用欧氏距离 $\Delta E^*_{ab}=\|\mathrm{LAB}_1-\mathrm{LAB}_2\|_2$ 度量,数值在 2–3 以内时人眼通常难以分辨。
Phase 2 的损失对 $a^*b^*$ 加权 5 倍、对 $L^*$ 加权 1 倍,评测也用 $\Delta E^*_{ab}$;理解这一空间才能明白为什么参数空间 MSE“感知不均匀”需要被图像级损失替换。
LoRA 低秩适配
冻结预训练权重 $W$,只训练低秩增量 $\Delta W = BA$,其中秩 $r \ll d$,可训参数量大幅下降;训练结束后可将增量合并回原权重,推理时零额外开销。本文在 CLIP 的全部注意力与 FFN 投影以及 MLP 头上挂 rank-16 LoRA。
Phase 2 靠 LoRA 做高效适配,训练后合并是端侧 INT8 模型实现 283 ms 单对延迟的前提;同时消融表明适配必须触及 CLIP 表征本身,只调 MLP 头只能恢复不到一半的色度收益。
3D/4D 查找表(LUT)风格化
LUT 是 RGB 立方体上的离散网格,把每个输入颜色映射为输出颜色,可高效实现全图统一调色;空间自适应变体(如 SA-LUT 的 4D LUT)按每像素上下文混合多个表,能做局部差异化调色,但输出是 $10^4$–$10^5$ 个数值的稠密网格,用户既读不懂也难以手动微调。
SA-LUT 既是本文的监督教师,又是主要对比基线和 PST50 基准的提出者;理解它“空间自适应但输出稠密、不可编辑”的属性是解读全部对比与消融结果的前提。
CLIP 视觉编码器
CLIP 是用数亿图文对做对比学习预训练的 ViT,其图像嵌入同时携带语义与外观信息。本文冻结 CLIP ViT-L/14,把内容图与参考图各编码为 768 维向量,与 123 维手工颜色统计拼接后送入回归 MLP;Phase 2 仅通过 LoRA 微调该编码器。
回归器的骨干就是 CLIP;表 4 的骨干消融显示它在色彩迁移任务上优于 DINOv3、SigLIP 2、InternViT 与无骨干基线,是理解架构选型与延迟构成的关键。
研究动机
主流学术方案(从神经风格迁移 AdaIN 到 SDEdit 及各类扩散编辑)无论质量如何,输出的都是一张不暴露任何编辑参数的光栅图;扩散类方法还有多秒级延迟和随机采样,既无法确定性复现,也不便二次编辑,与端侧、用户在环的消费级修图流水线格格不入。参数化路线中,Deep Preset 能从内容图-参考图对回归 69 个 Lightroom 开发控制项,但其监督“天然合成”——训练参考都是用采样的预设重新渲染的图,因此预设真值总存在;可这也把可学风格封闭在采样集合内,真实参考永远不会附带预设标注。另一边,带专家修图真值的 MIT-Adobe FiveK、PPR10K 数据集都属于自动增强设定,没有独立的风格参考;唯一同时具备参考条件与专家评级目标的 PST50 只有 50 对样本,仅够评测、根本不够训练。于是出现一个真空地带:想在真实参考上做可编辑的预设回归,却没有任何配对监督可用。
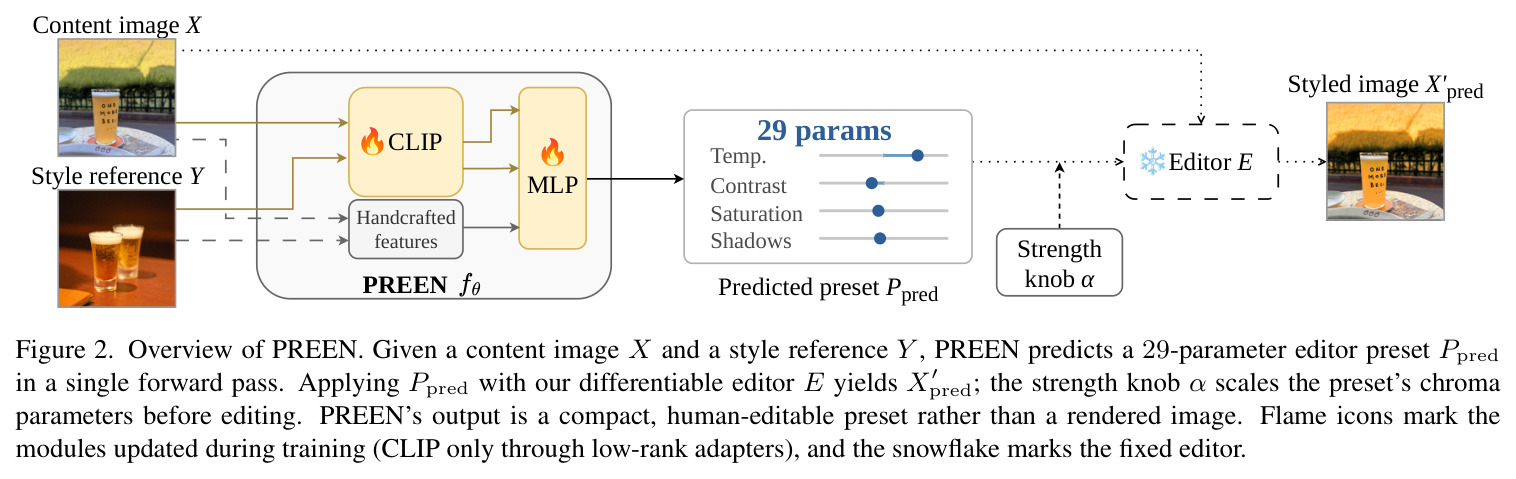
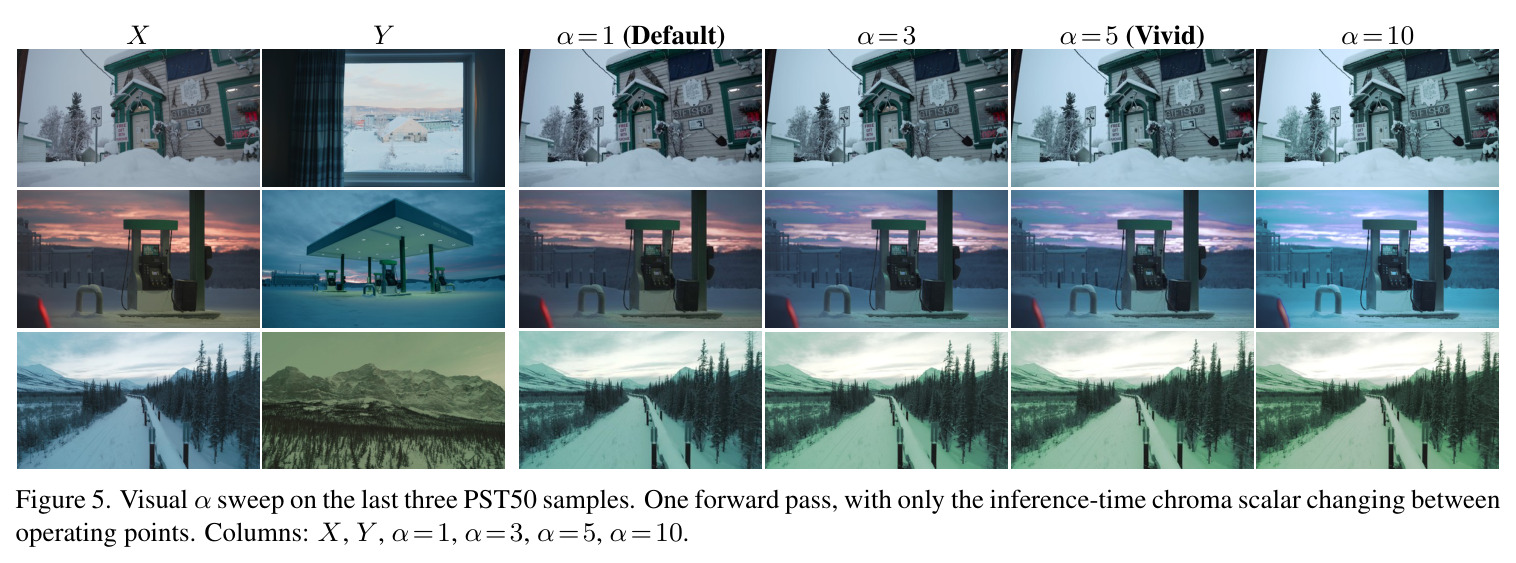
本文的目标是本文的具体目标是:给定内容图 $X$ 与风格参考 $Y$,用单次前向传播直接回归出 29 维智能手机编辑器预设 $P_{\text{pred}} \in [-1,1]^{29}$——即 8 个全局控制(色温、色调、亮度、曝光、对比度、高光、阴影、饱和度)加 7 个色相区(红橙黄绿青蓝品)各 3 个 HSL 通道——再由确定性编辑器 $E(X, P)$ 渲染出接近参考观感的结果。输出不是图而是一组“可解释、可存储、可二次编辑”的滑杆数值,推理时不含任何生成模型,端到端延迟压在亚秒级。作者还要一并解决两个工程问题:其一,在没有任何预设真值时用真实参考训练回归器;其二,在低维参数空间内提供一个无需重跑推理的强度旋钮,让用户在默认与浓郁之间连续切换且每个中间态都是合法预设。
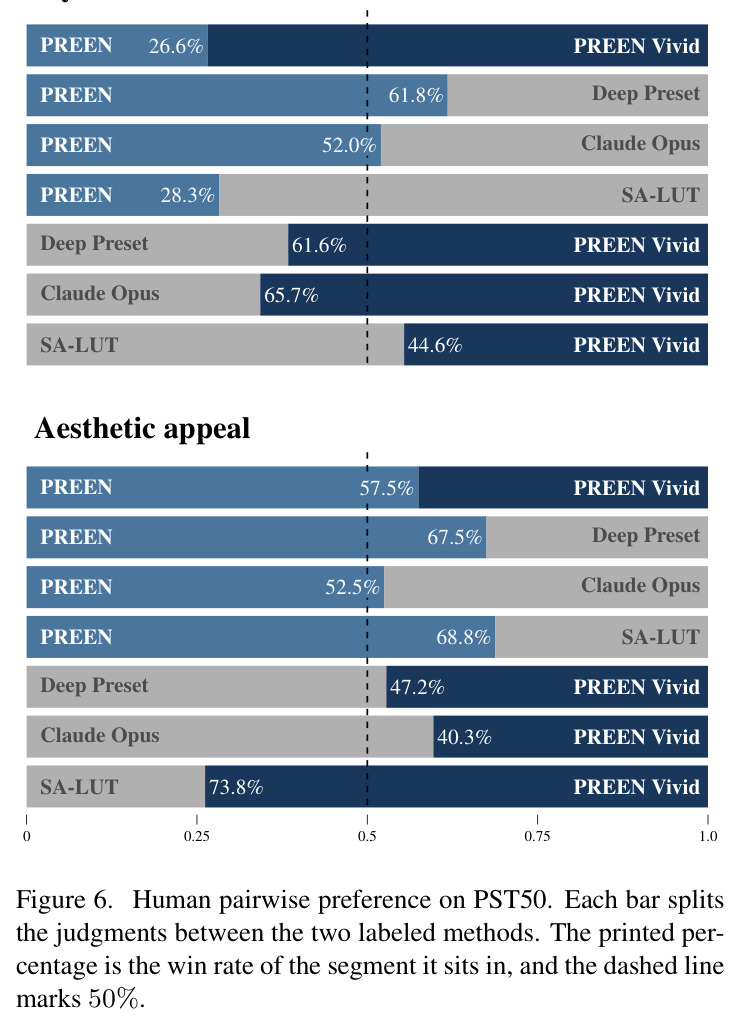
与已有工作不同的是,本文的独特切入是“教师反演”监督:既然真实参考没有预设真值,就用一个现成的风格迁移教师(SA-LUT)为任意 $(X, Y)$ 对生成伪目标 $\tilde{X}'$,再通过可微分编辑器把教师较丰富的编辑投影回 29 维参数子空间,得到伪预设 $\tilde{P}$ 充当监督信号。这使参考条件化的预设回归第一次摆脱采样预设监督,可学风格不再受限于某个采样集合。第二个独特视角是把低维子空间本身当作产品特性而非局限:压缩到 29 维后,色度切片可以用单个标量 $\alpha$ 在推理时连续缩放,得到一条从默认到浓郁的合法预设轨迹;作者还设计了两轴人因实验(风格匹配 vs 独立审美),揭示“像参考”与“作为照片好看”其实是两个不同目标,而 $\alpha$ 旋钮恰好横跨两者。
核心方法
直觉上,PREEN 把“生成一张风格化图片”换成“猜一组滑杆数值”:回归器 $f_\theta$ 读入内容图与参考图,一次前向输出 29 个编辑器参数 $P_{\text{pred}}$,由固定不变的确定性编辑器 $E$ 渲染成图,因此结果可复现、可存储、可继续编辑。技术路线是两阶段流水线。第一阶段解决监督来源:用 SA-LUT 教师对每对 $(X, Y)$ 生成伪目标 $\tilde{X}'$,按式 (1) 的梯度反演把教师编辑压进 29 维子空间得到伪预设 $\tilde{P}$,再在数十万 $(X, Y, \tilde{P})$ 三元组上预训练一个 CLIP 条件化的双残差 MLP 回归器(Huber 损失 + $\ell_2$ 预设正则)。第二阶段解决感知不均匀:参数空间损失对不同参数的可见度不一致——亮度滑杆动 $\pm 0.1$ 远比蓝色色相动 $\pm 0.1$ 显眼——于是冻结全部基座权重,只训练 rank-16 LoRA 适配器,在编辑器输出上施加图像级 CIELAB 重建损失,让模型容量集中到感知上最重要的色彩变化,同时保留 Phase 1 预训练带来的初始化优势。
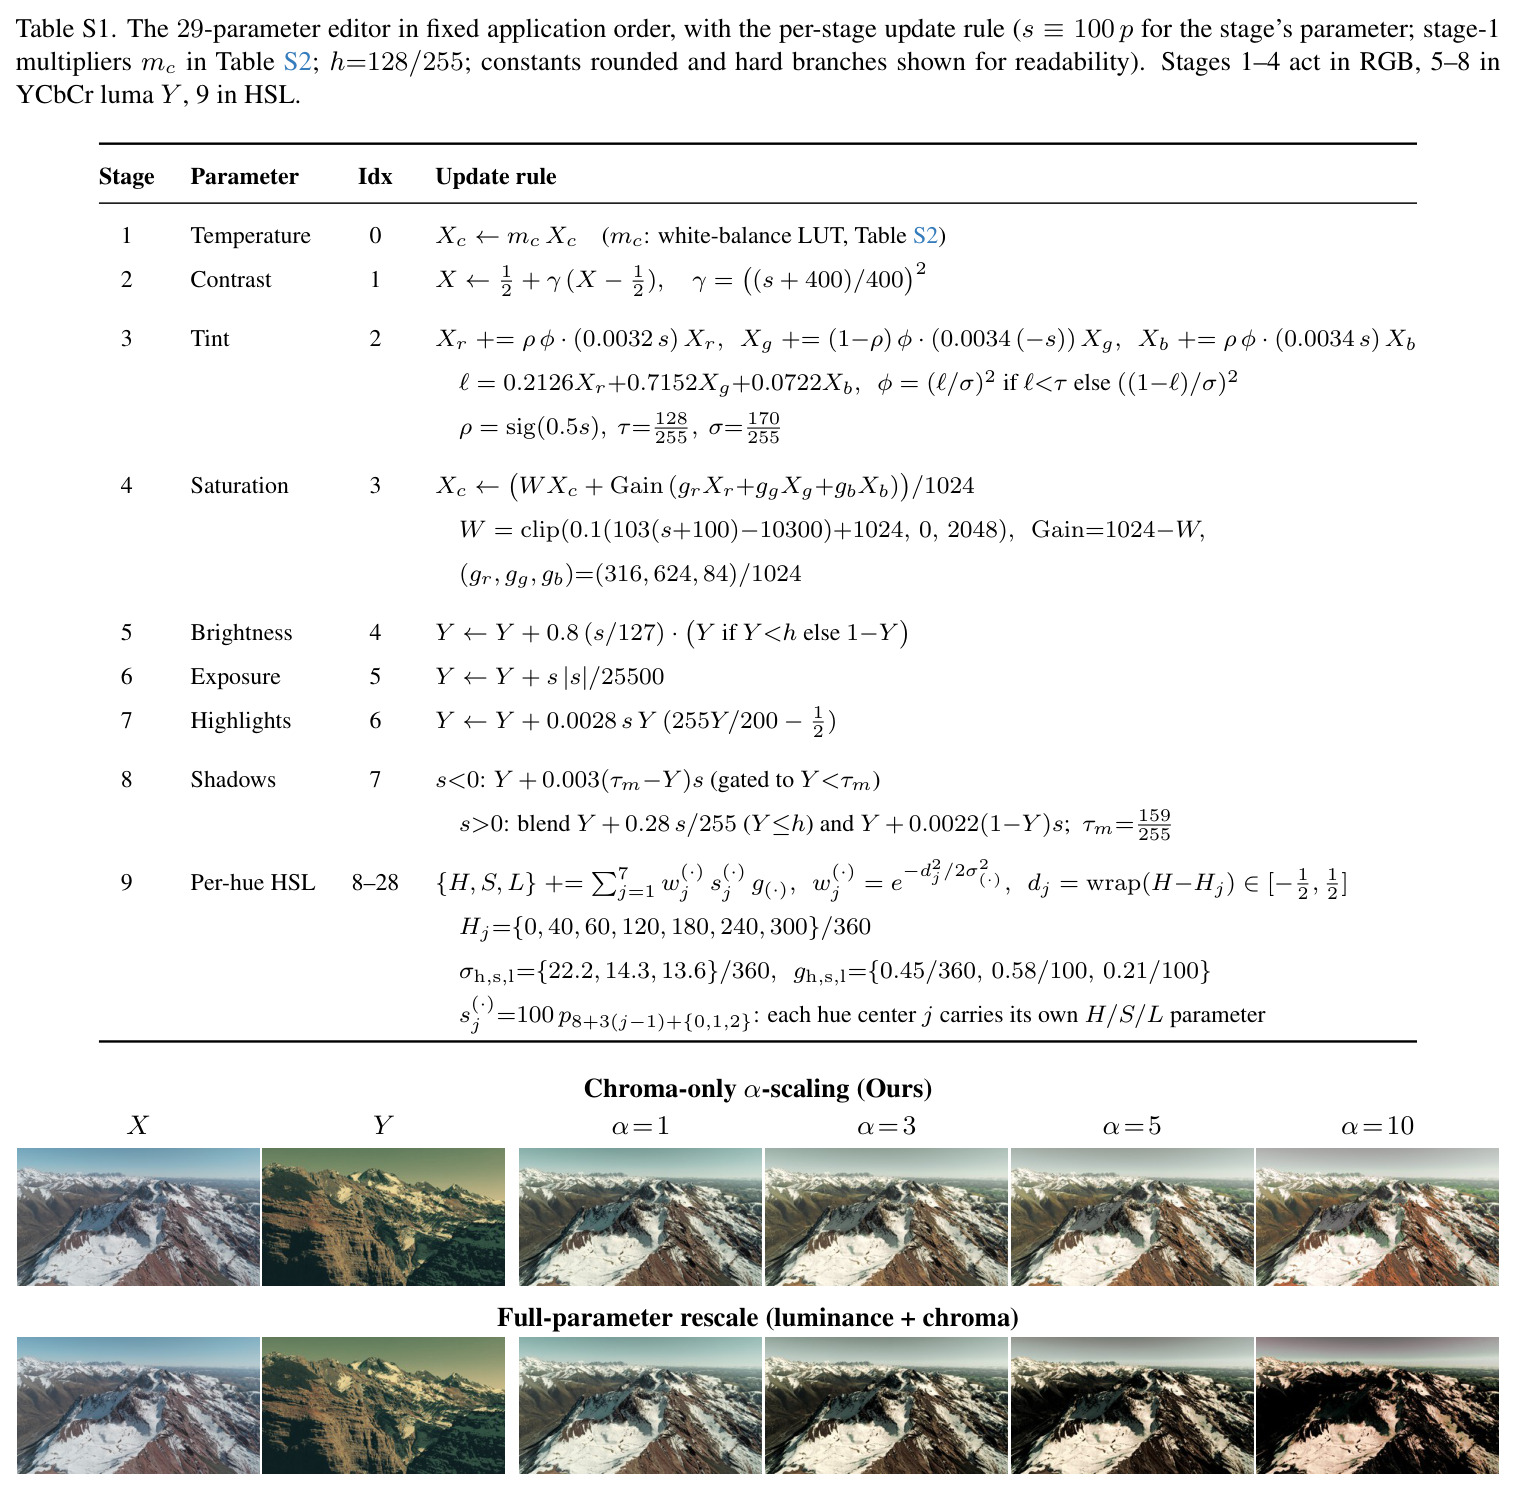
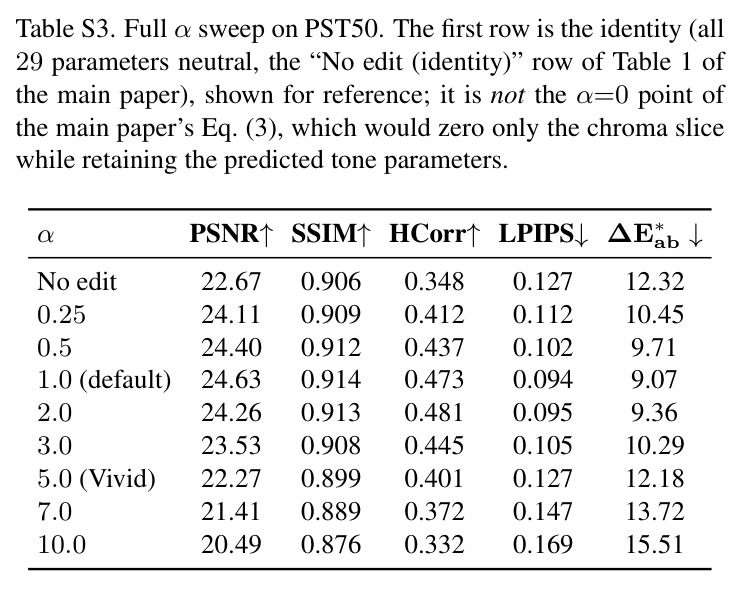
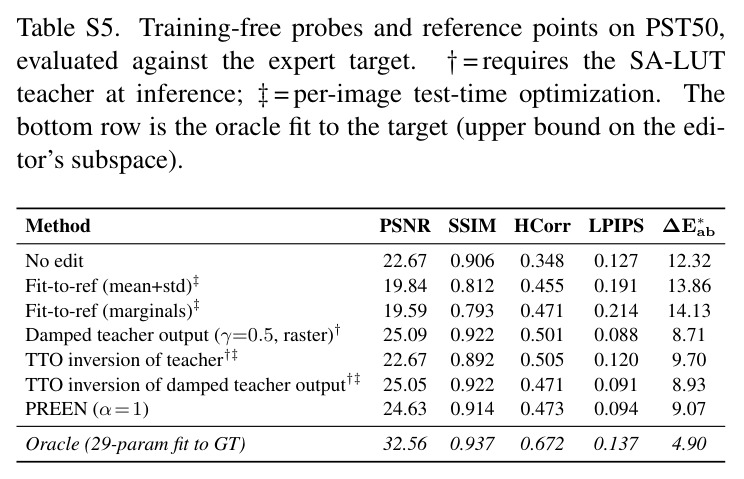
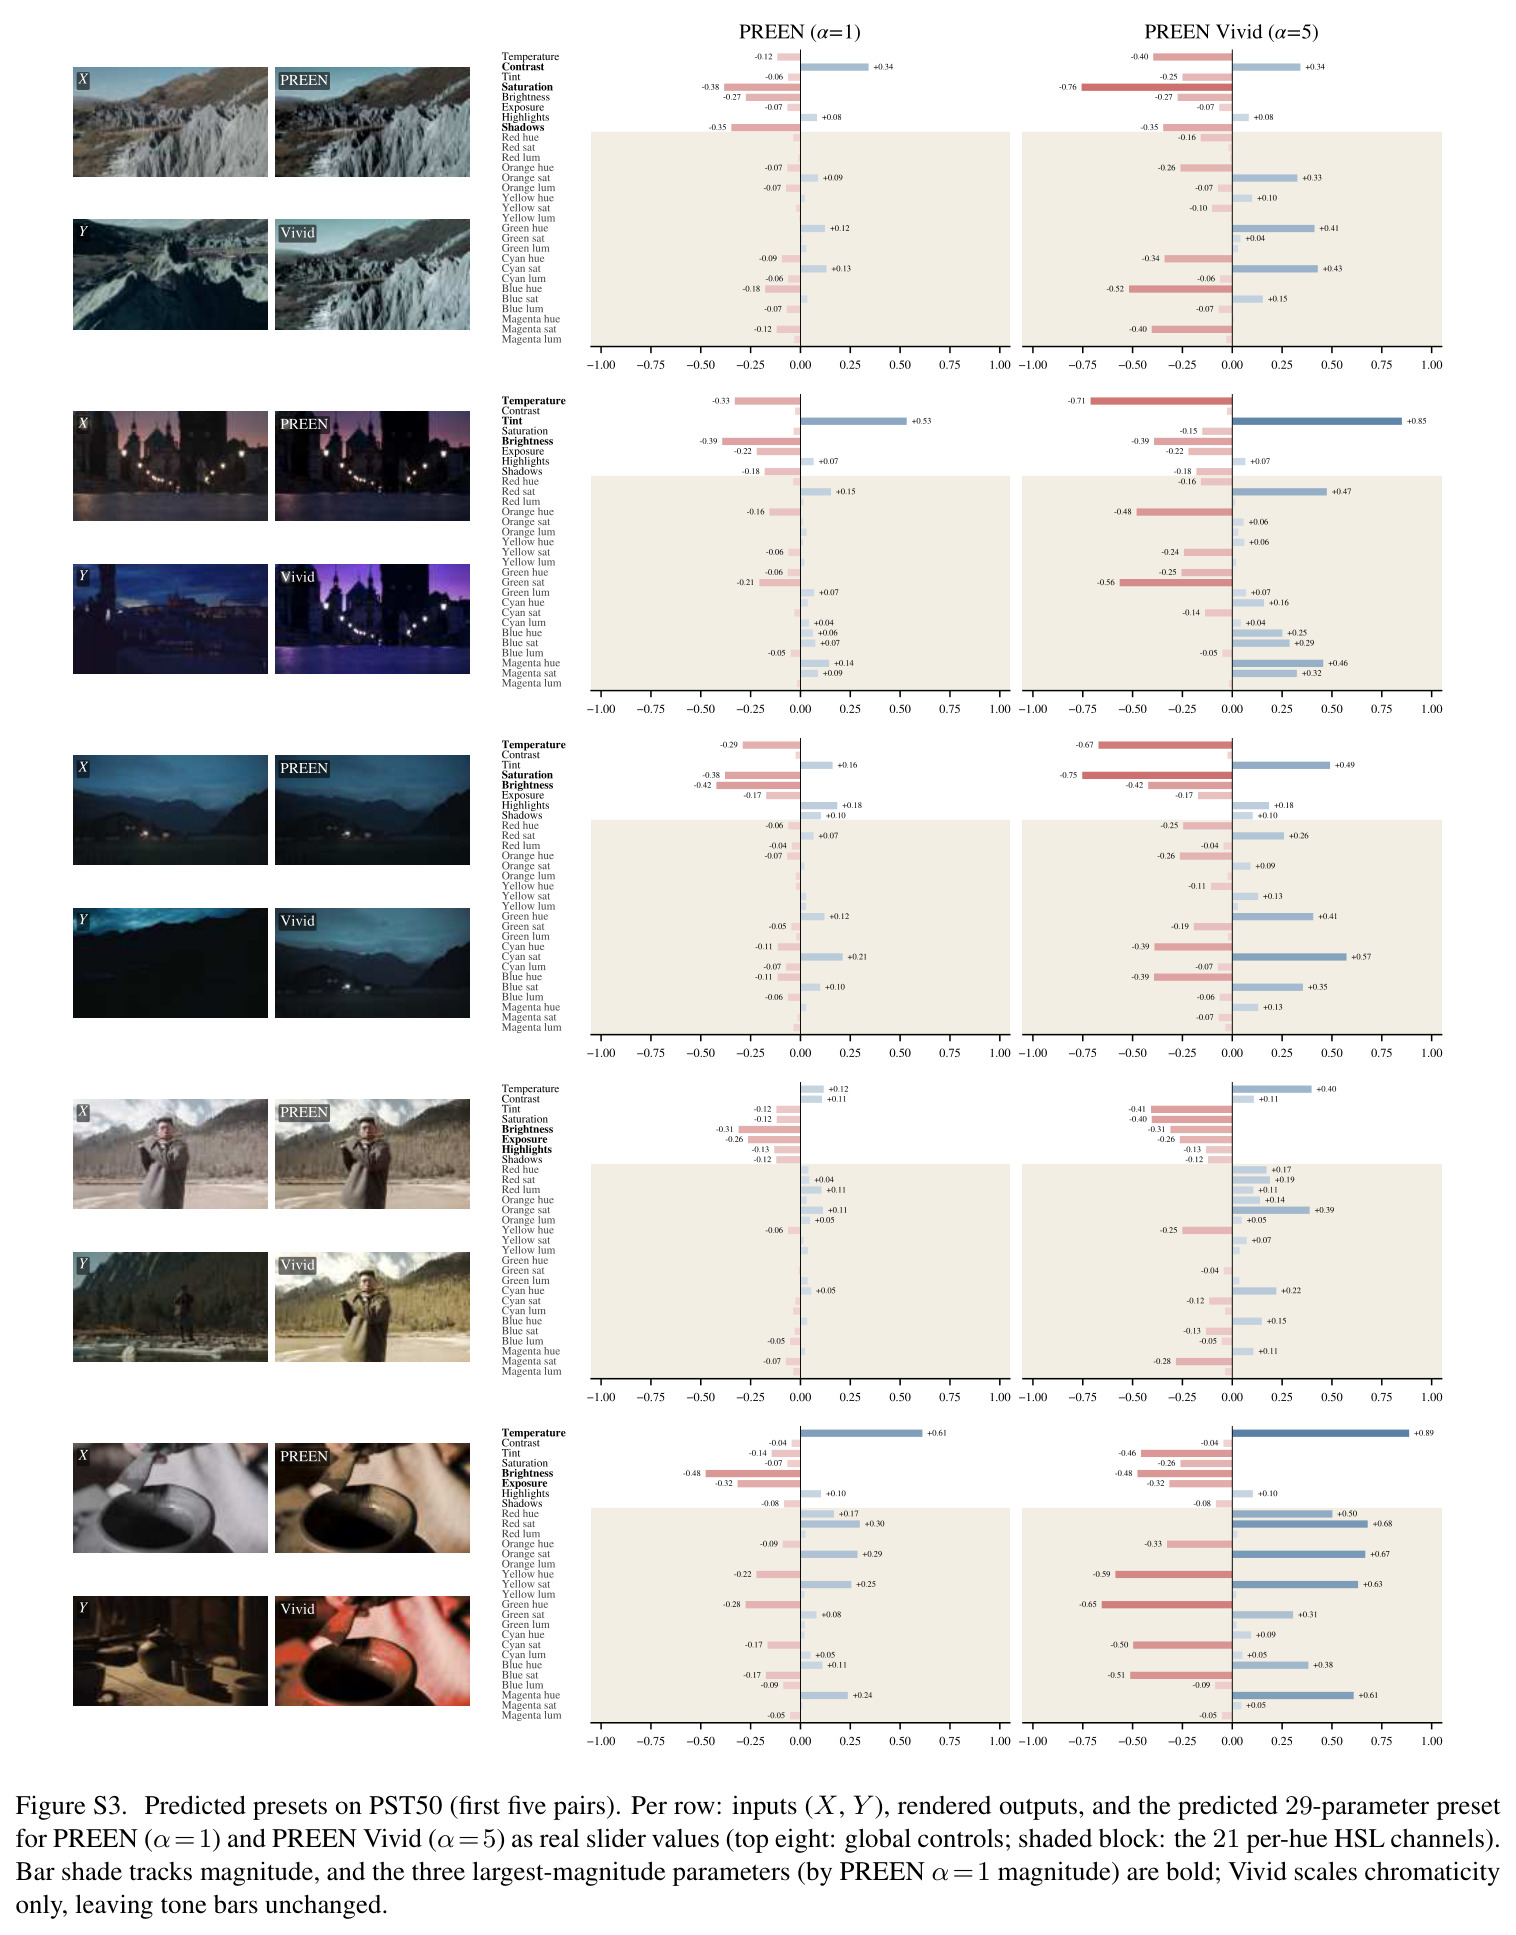
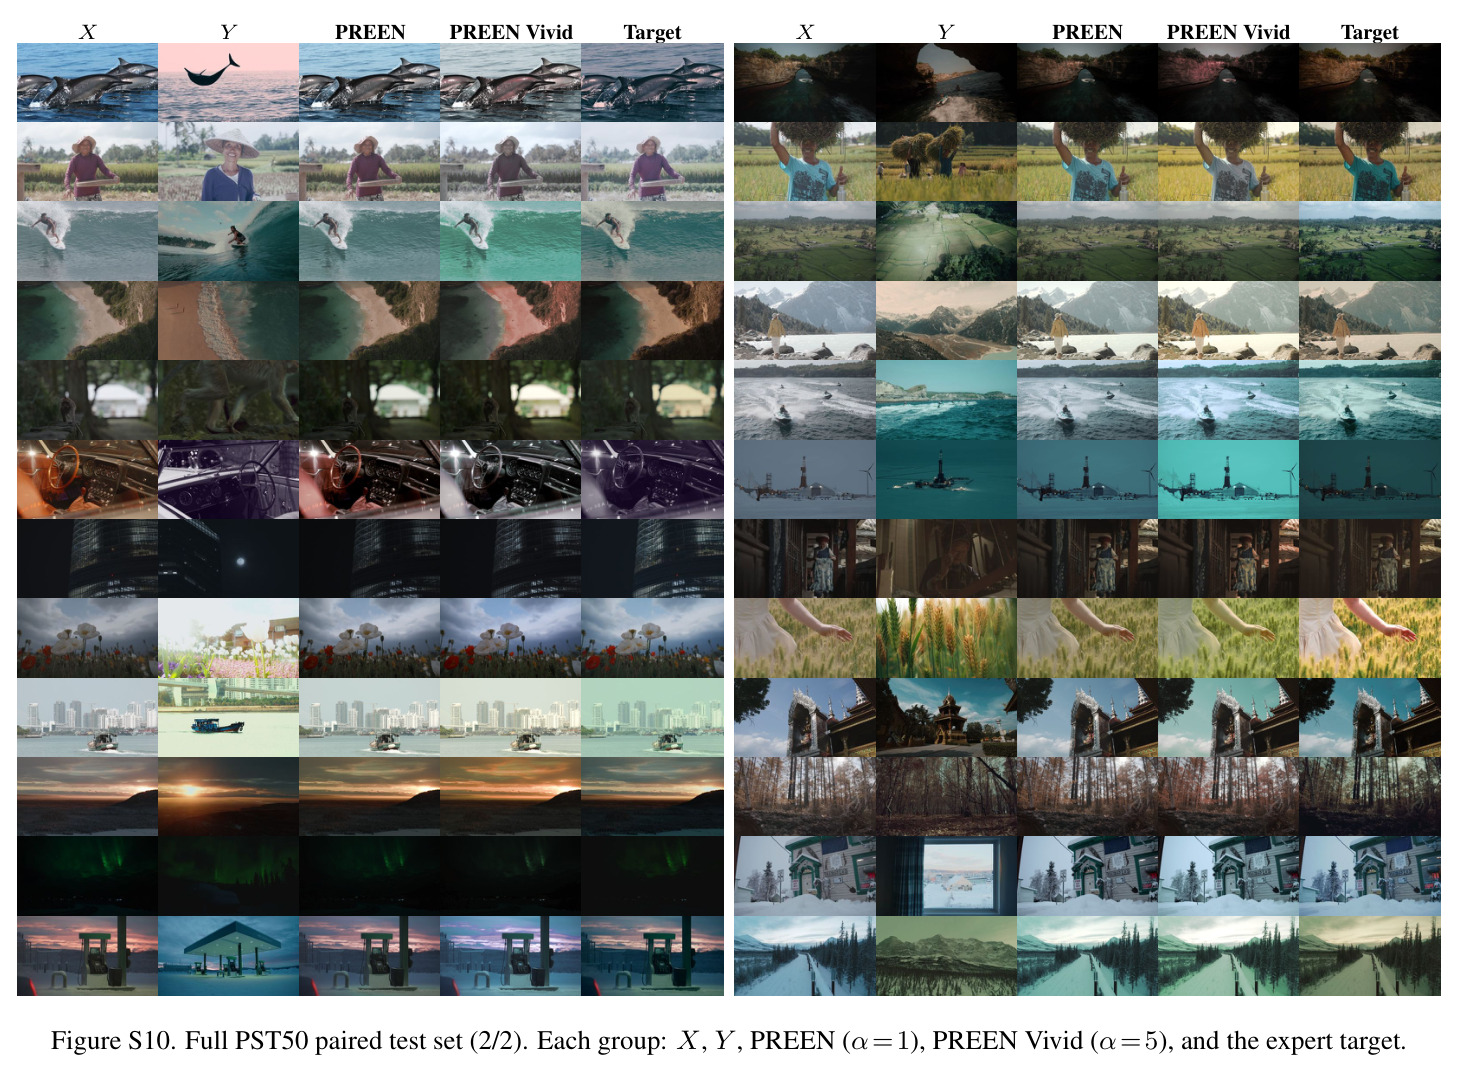
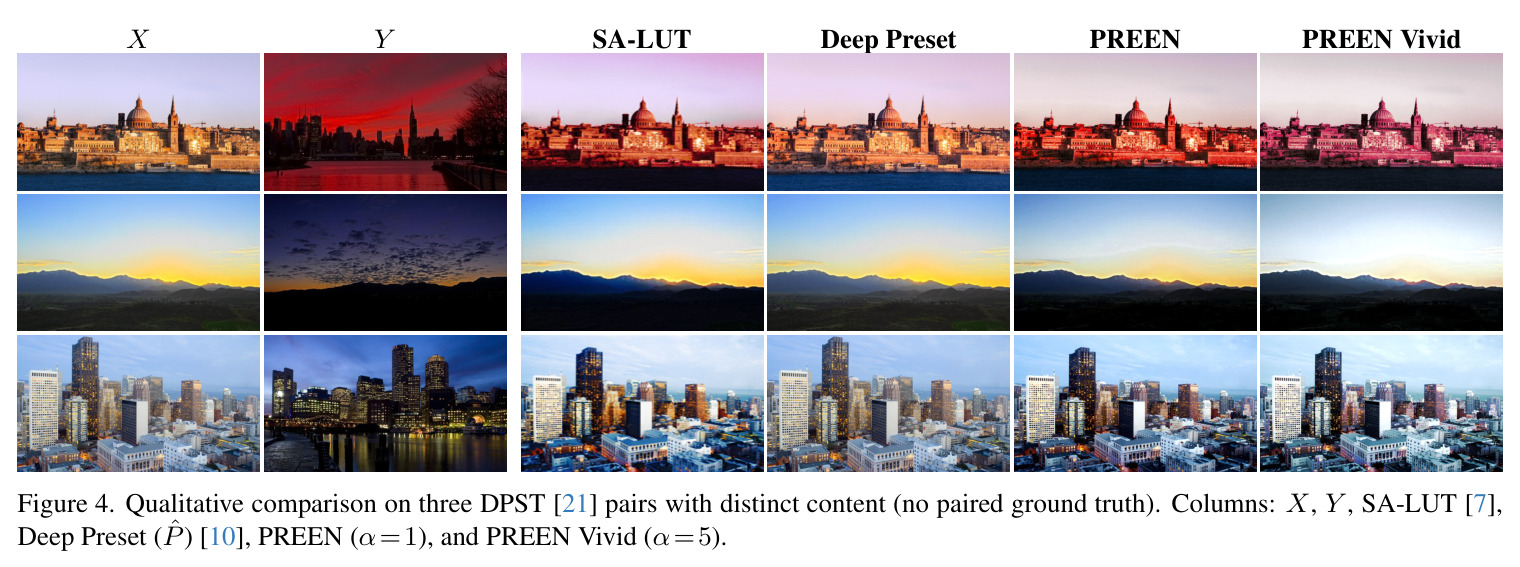
核心创新有二。其一是“教师输出反演成伪预设”:与 Deep Preset 依赖采样预设的合成监督本质不同,PREEN 对任意真实参考对求解 $\tilde{P}=\arg\min_{P}\mathcal{L}_{\text{rec}}(E(X,P),\tilde{X}')$($P\in[-1,1]^{29}$,$\lambda_{\text{lab}}=20$,AdamW 每对 1000 步),把“没有预设真值”转化为“将非参数教师投影进参数子空间”;投影几乎不损失保真度(SA-LUT 22.54 dB 投影后 22.67 dB),证明 29 维子空间并非表达瓶颈(oracle 32.56 dB)。其二是“色度-only 强度插值”:参数分为音调集 $\mathcal{I}_L$(12 个)与色度集 $\mathcal{I}_{ab}$(17 个),推理时仅对色度切片施加 $\hat{P}_i=\alpha P_i/(1+(\alpha-1)|P_i|)$——这恰是把 Softsign 头($P=z/(1+|z|)$)的预激活做 $z\mapsto\alpha z$ 后重新过 Softsign,故 $\alpha=1$ 精确还原原预测,任意 $\alpha$ 下输出恒保号、恒在 $[-1,1]$ 内且平滑饱和,每个中间态都是可存储、可再编辑的合法预设——这是光栅或 LUT 输出在原理上给不了的。只缩色度是刻意设计:连同亮度一起缩会共饱和全局色调、压碎阴影(图 S1)。
方法步骤详情
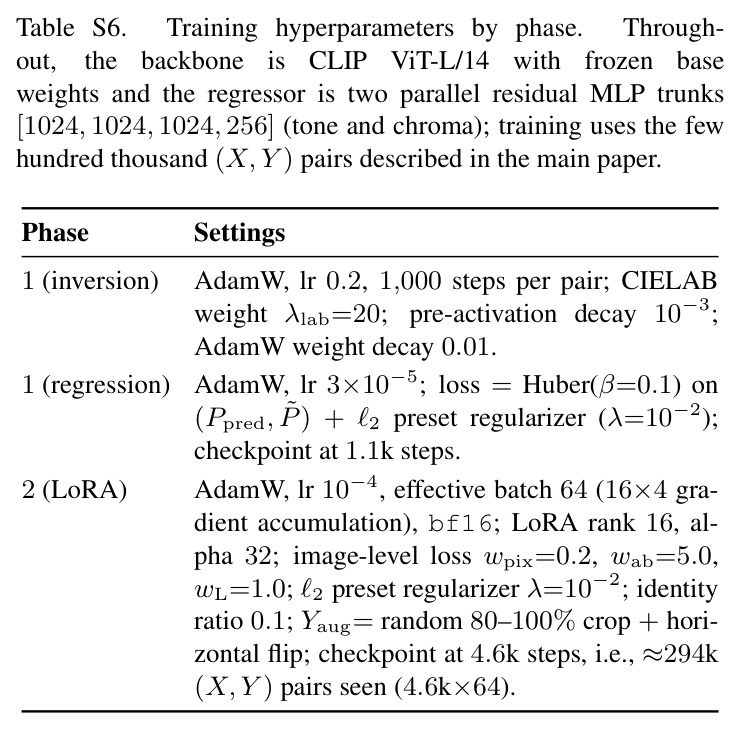
①数据构建:内容图取自 OpenImages,参考图取自 AVA 美学前 20%;用 CLIP ViT-L/14 嵌入,为每个 $X$ 配余弦相似度 top-10 的语义兼容参考,得数十万训练对,并以 0.1 比例混入恒等样本($Y=X$)防过度编辑。②教师标注与反演:发布版 SA-LUT 对增强后的 $(X,Y_{\text{aug}})$ 生成伪目标 $\tilde{X}'$,再按式 (1) 用 AdamW(lr 0.2、每对 1000 步、$\lambda_{\text{lab}}=20$)反演出伪预设 $\tilde{P}$。③Phase-1 回归:两图各过冻结 CLIP 得 768 维嵌入,拼接 123 维手工颜色统计,送入双残差 MLP 干 $[1024,1024,1024,256]$(音调干出 12 参数、色度干出 17 参数,Softsign 头保证 $[-1,1]$);以 Huber($\beta$=0.1)$+\ell_2$ 训练,lr $3\times10^{-5}$。④Phase-2 适配:CLIP 全部注意力/FFN 与 MLP 线性层加 rank-16 LoRA(训后合并、推理零开销);图像级损失 $\mathcal{L}_{\text{ph2}}=0.2\mathcal{L}_{\text{pix}}+5.0\mathcal{L}_{\text{ab}}+1.0\mathcal{L}_L+\lambda\|P\|_2^2$,$L^*$ 梯度只进音调干、$a^*b^*$ 只进色度干;lr $10^{-4}$、批 64、bf16、单张 L4,约 4.6k 步。⑤推理:单次前向输出 $P_{\text{pred}}$,可选按式 (3) 以 $\alpha$ 缩放色度后交编辑器渲染,默认 $\alpha=1$、Vivid $\alpha=5$。
技术新颖性
技术新颖性集中在三点。第一,监督范式:此前参考条件化预设回归只有“采样预设合成监督”一条路(Deep Preset),本文首次证明风格迁移教师的输出经可微分编辑器反演后可以替代预设真值,把可学风格从采样集合中解放出来;训练-free 探针显示投影仅让 SA-LUT 从 22.54 变 22.67 dB,佐证 29 维子空间不是瓶颈。第二,可控性原语:$\alpha$ 插值不是朴素线性外推,而是复用 Softsign 的重参数化,任何 $\alpha$ 下输出都是保号、保界的合法预设,中间态可存储、可继续编辑——这种“整条轨迹皆可用”的性质是光栅或 LUT 输出在原理上给不了的。第三,一组互相配合的训练细节:双干梯度路由(去掉损 0.38 dB PSNR 与 0.016 SSIM)、恒等样本防漂移(去掉后 SSIM 从 0.914 崩到 0.833)、CIELAB 损失中色度权重 5 倍于亮度以补偿参数空间损失的感知不均匀,这些设计共同把 29 维表示推到与维度大 1000 倍的 LUT 相当的水准。
实验结果
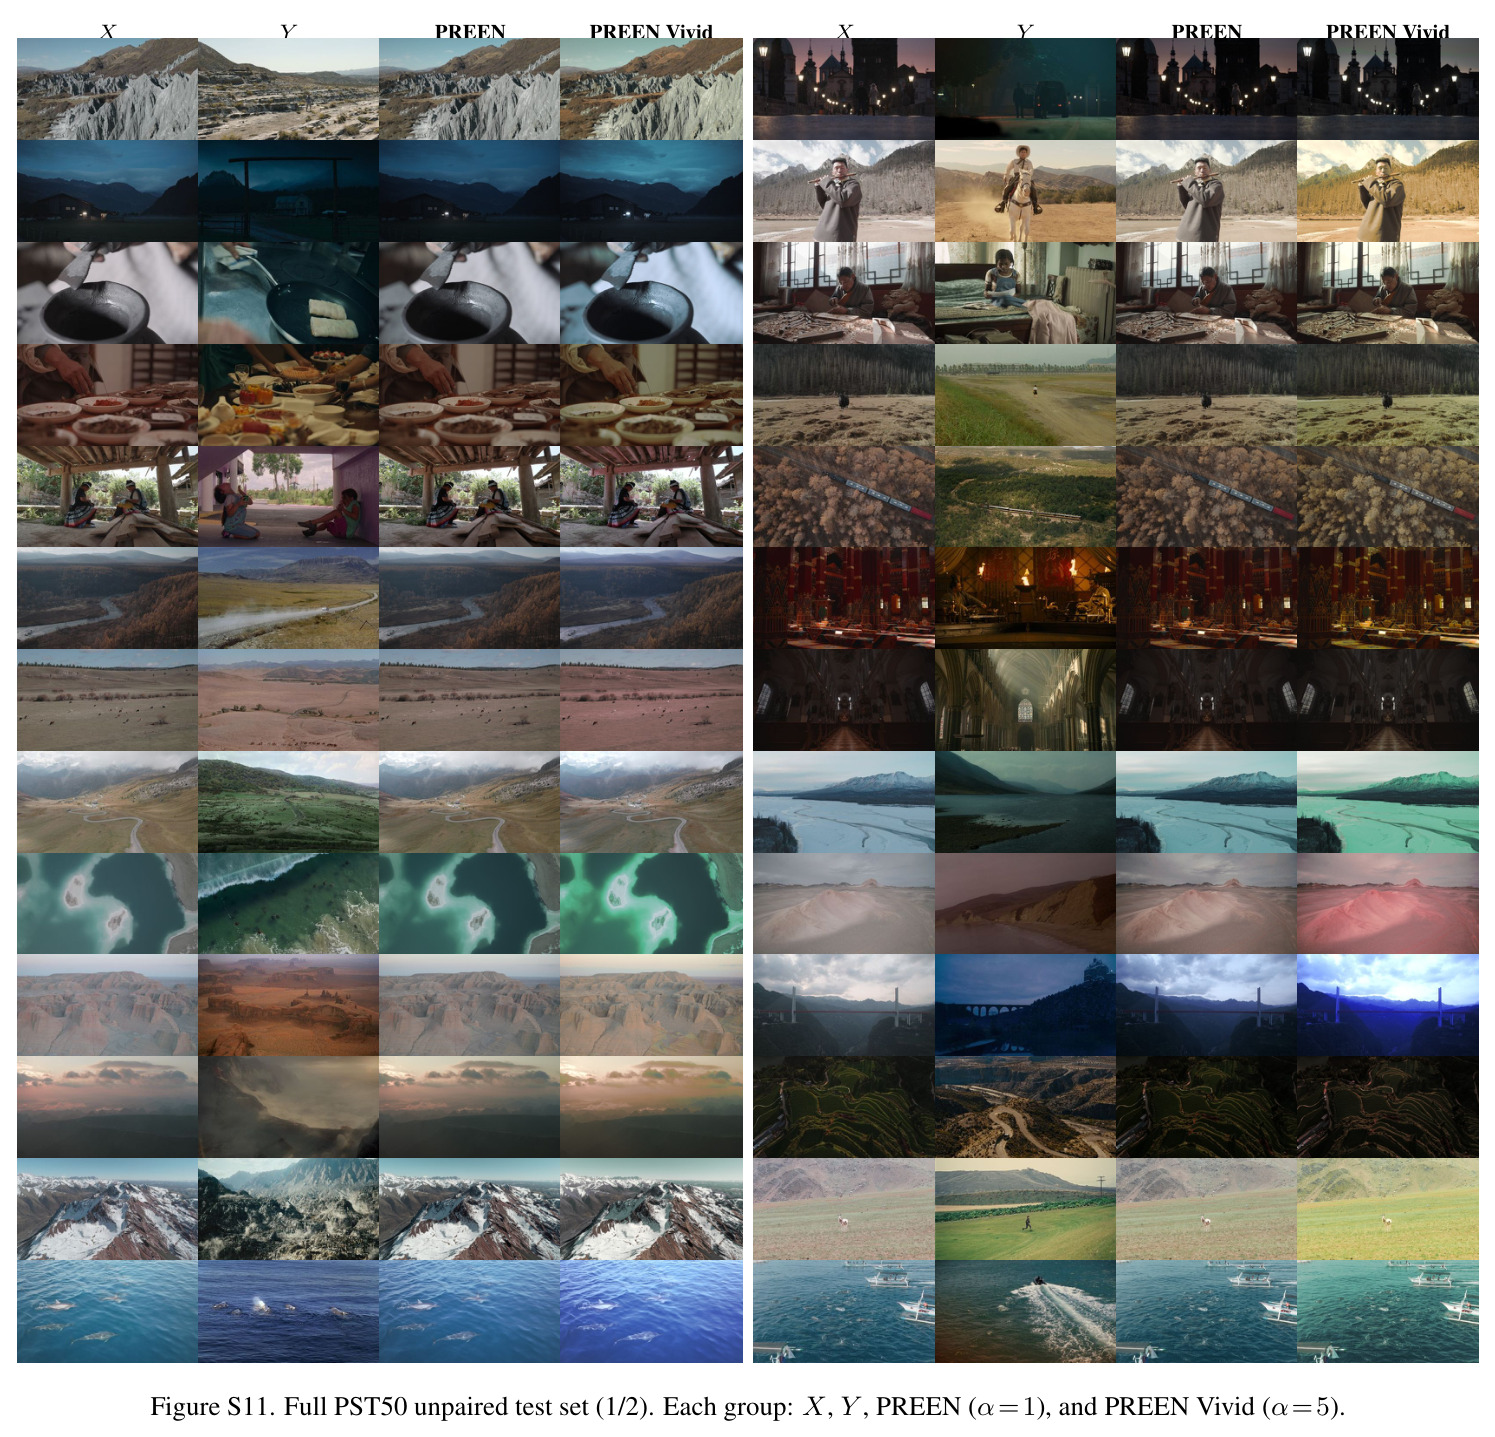
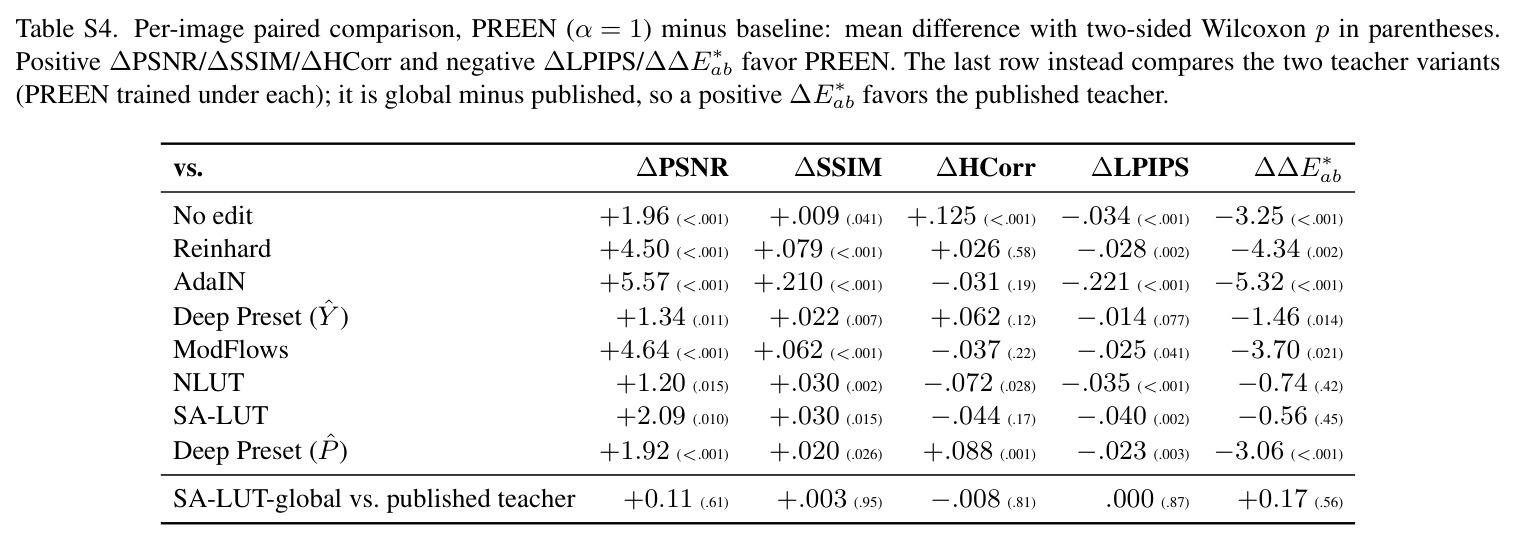
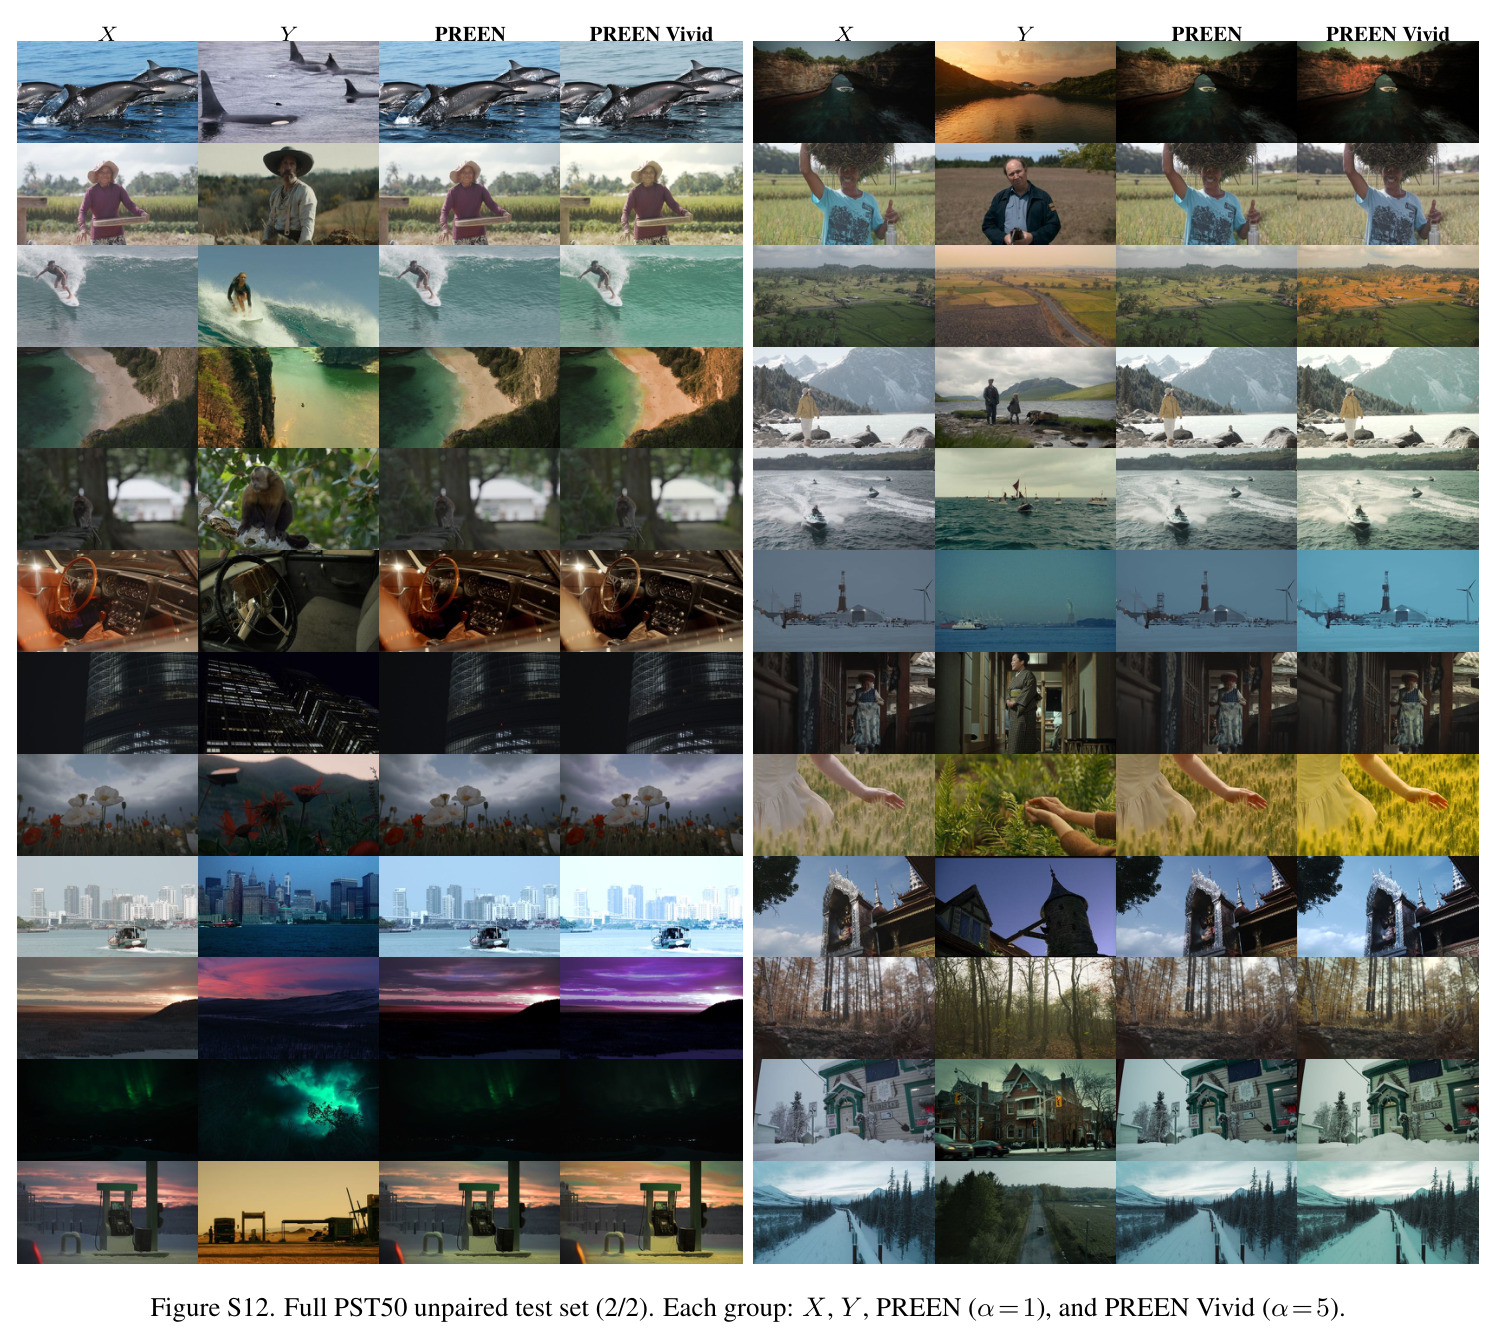
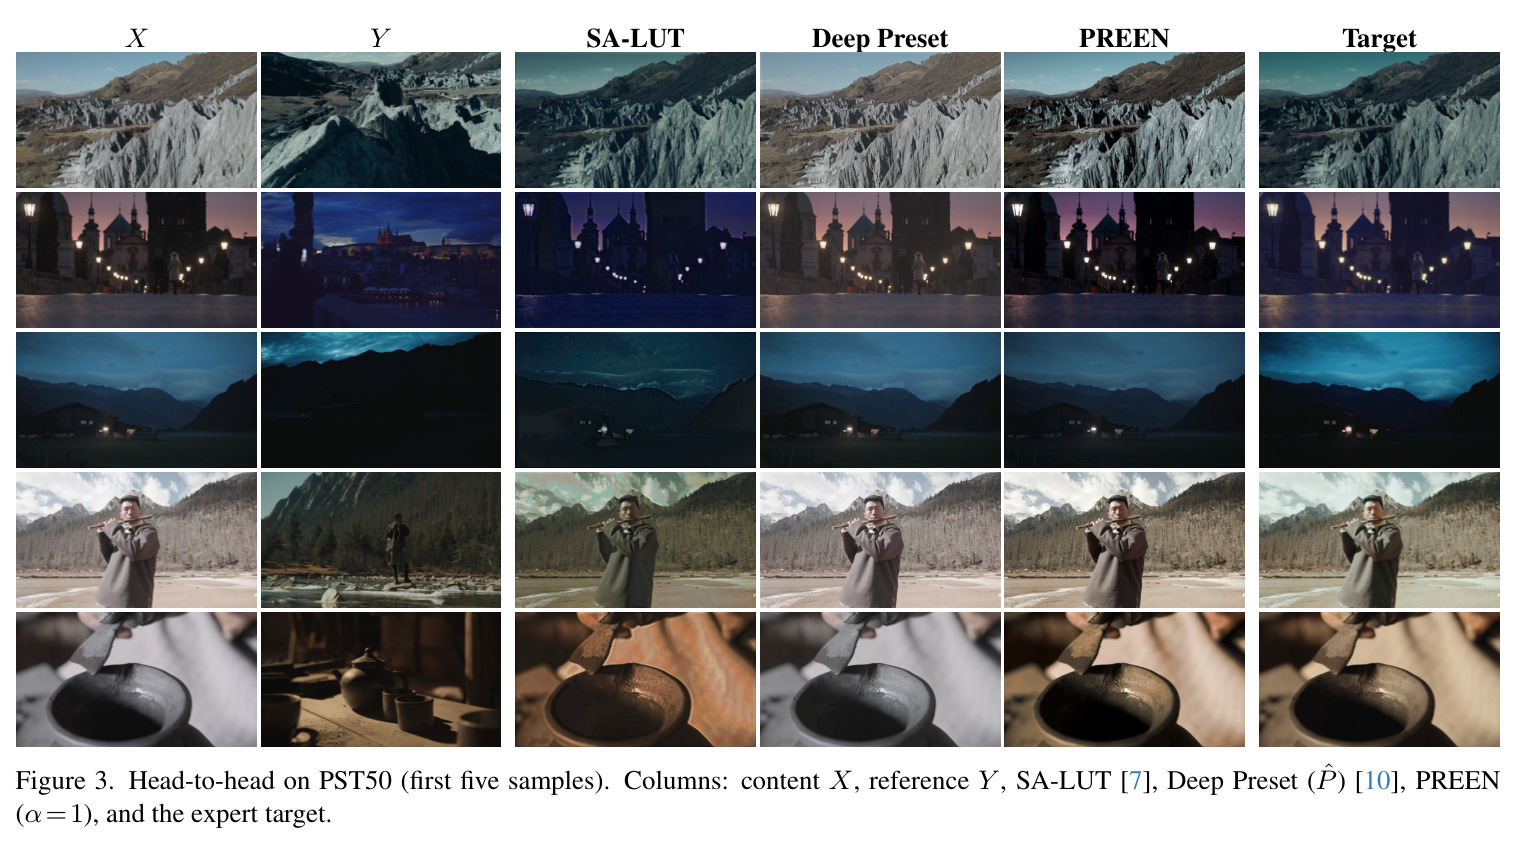
在 PST50(50 组三元组,256×256)上,PREEN 以 PSNR 24.63 dB、SSIM 0.914、LPIPS 0.094、$\Delta E^*_{ab}$ 9.07 领跑所有基线:比 Deep Preset 栅格输出高 1.34 dB、比次优 NLUT 高 1.20 dB、比不编辑高 1.96 dB;HCorr 从 0.348 升至 0.473,仍低于自由形态 LUT,但属预测 headroom 而非子空间限制(oracle 0.672),且 $\Delta E^*_{ab}$ 与 LUT 统计打平。消融(表 2):Phase 1 单独已达 23.60 dB,Phase 2 把 HCorr 从 0.383 拉到 0.473;单阶段全量微调仅 24.43 dB 且过早退化,说明 Phase 1 初始化不可省略。表 4–5 确认 CLIP 为最佳骨干、全局色调贡献最大单跳 +2.2 dB。对前沿模型(表 6):三个 VLM 直接预测参数仅 21.4–22.5 dB;Nano Banana Pro 生成像素 19.66 dB,保真差约 5 dB。端侧 INT8 后骁龙 8 Elite Gen 5 CPU 单对 283 ms,精度损失小于 0.3 dB。人因实验(图 6)揭示三方分裂:指标偏好默认档、风格匹配偏好 Vivid(对默认赢 73.4%)、独立审美回到默认(Vivid 仅 43.3%),两种模式均优于教师全强度输出(68.8%/73.8%)。
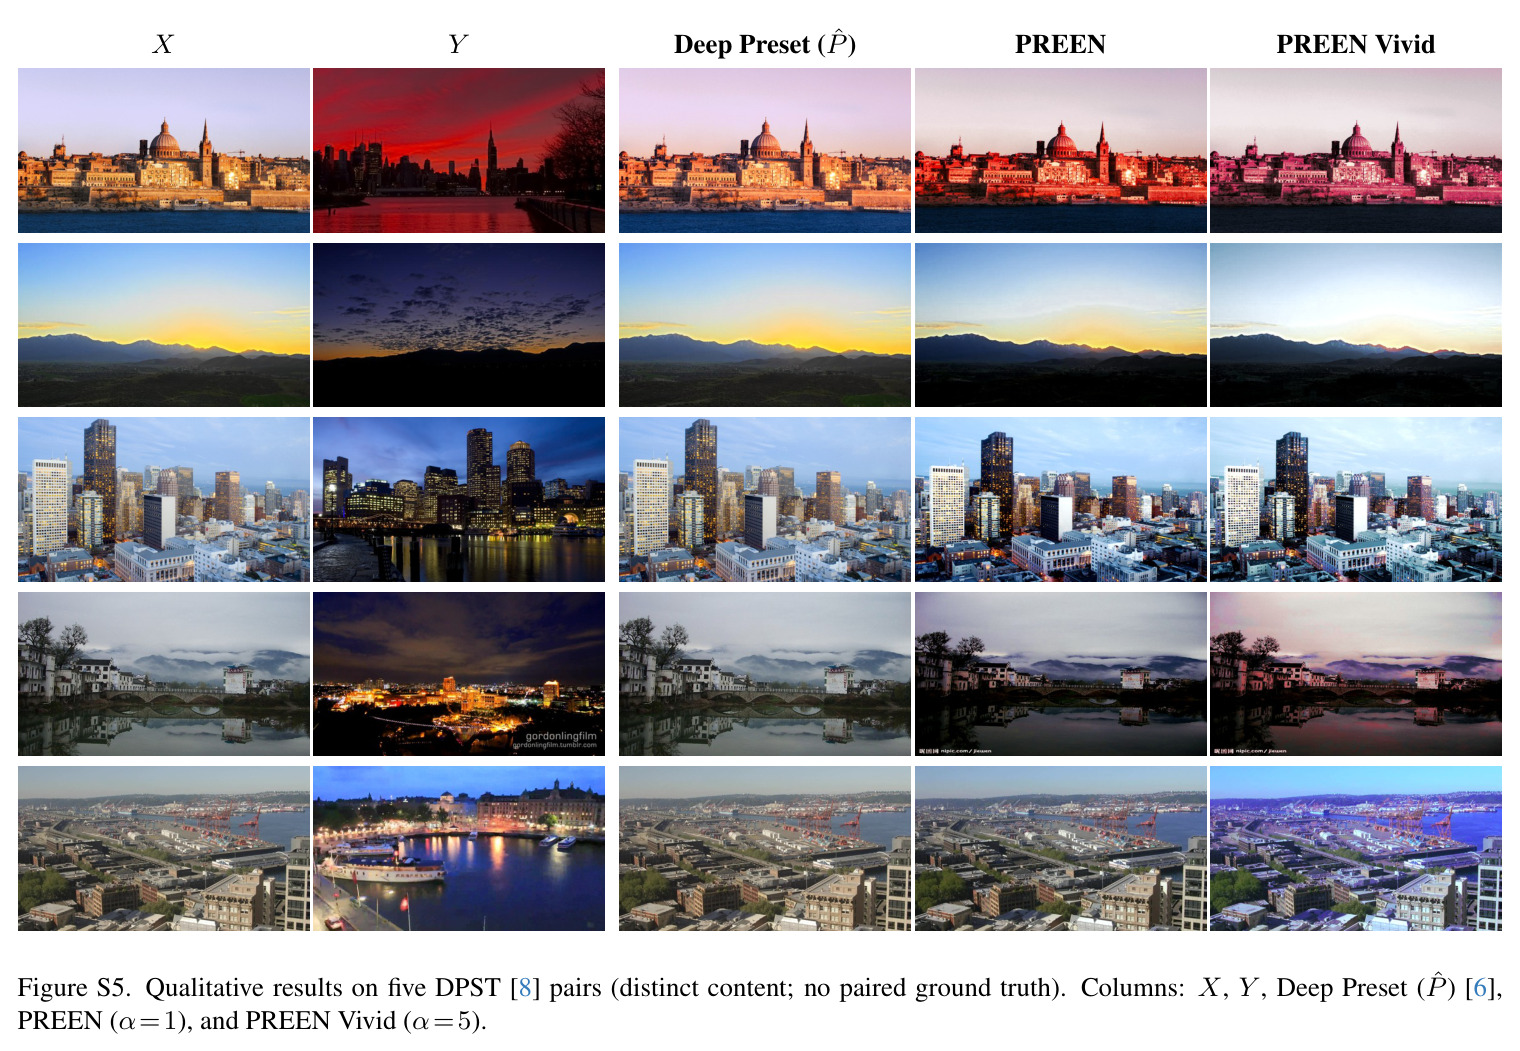
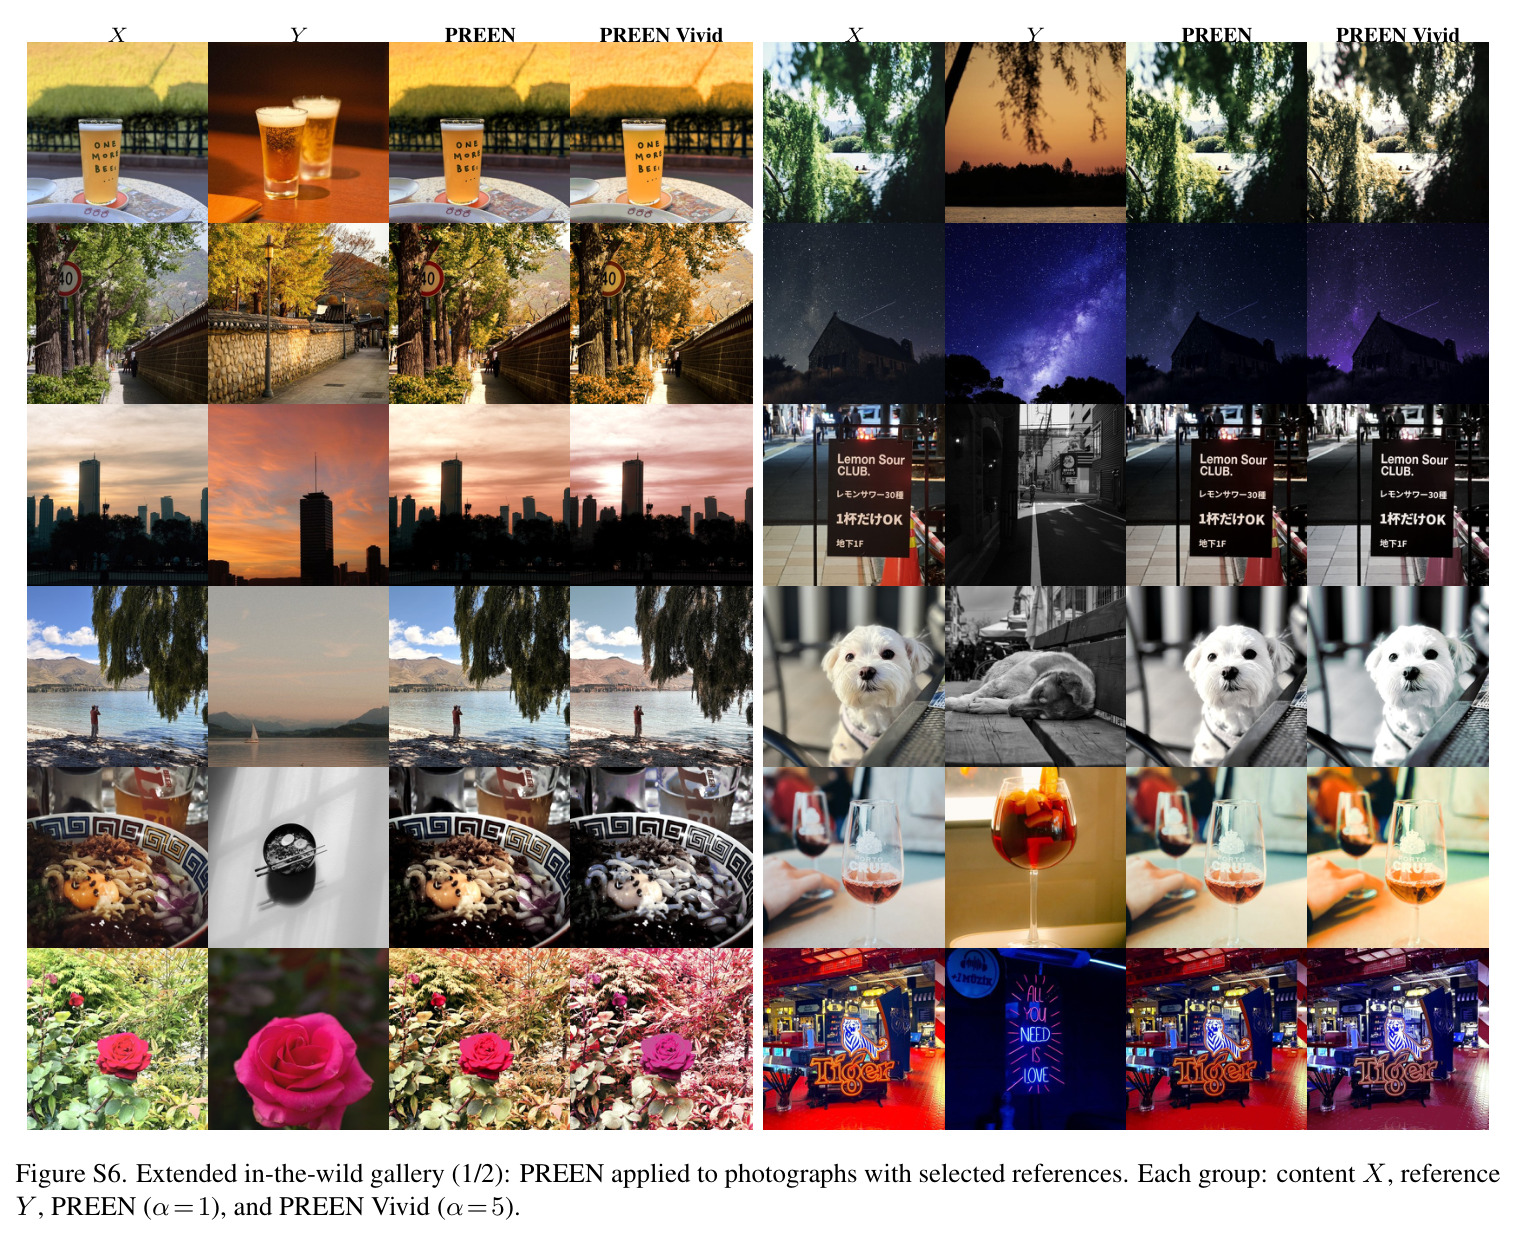
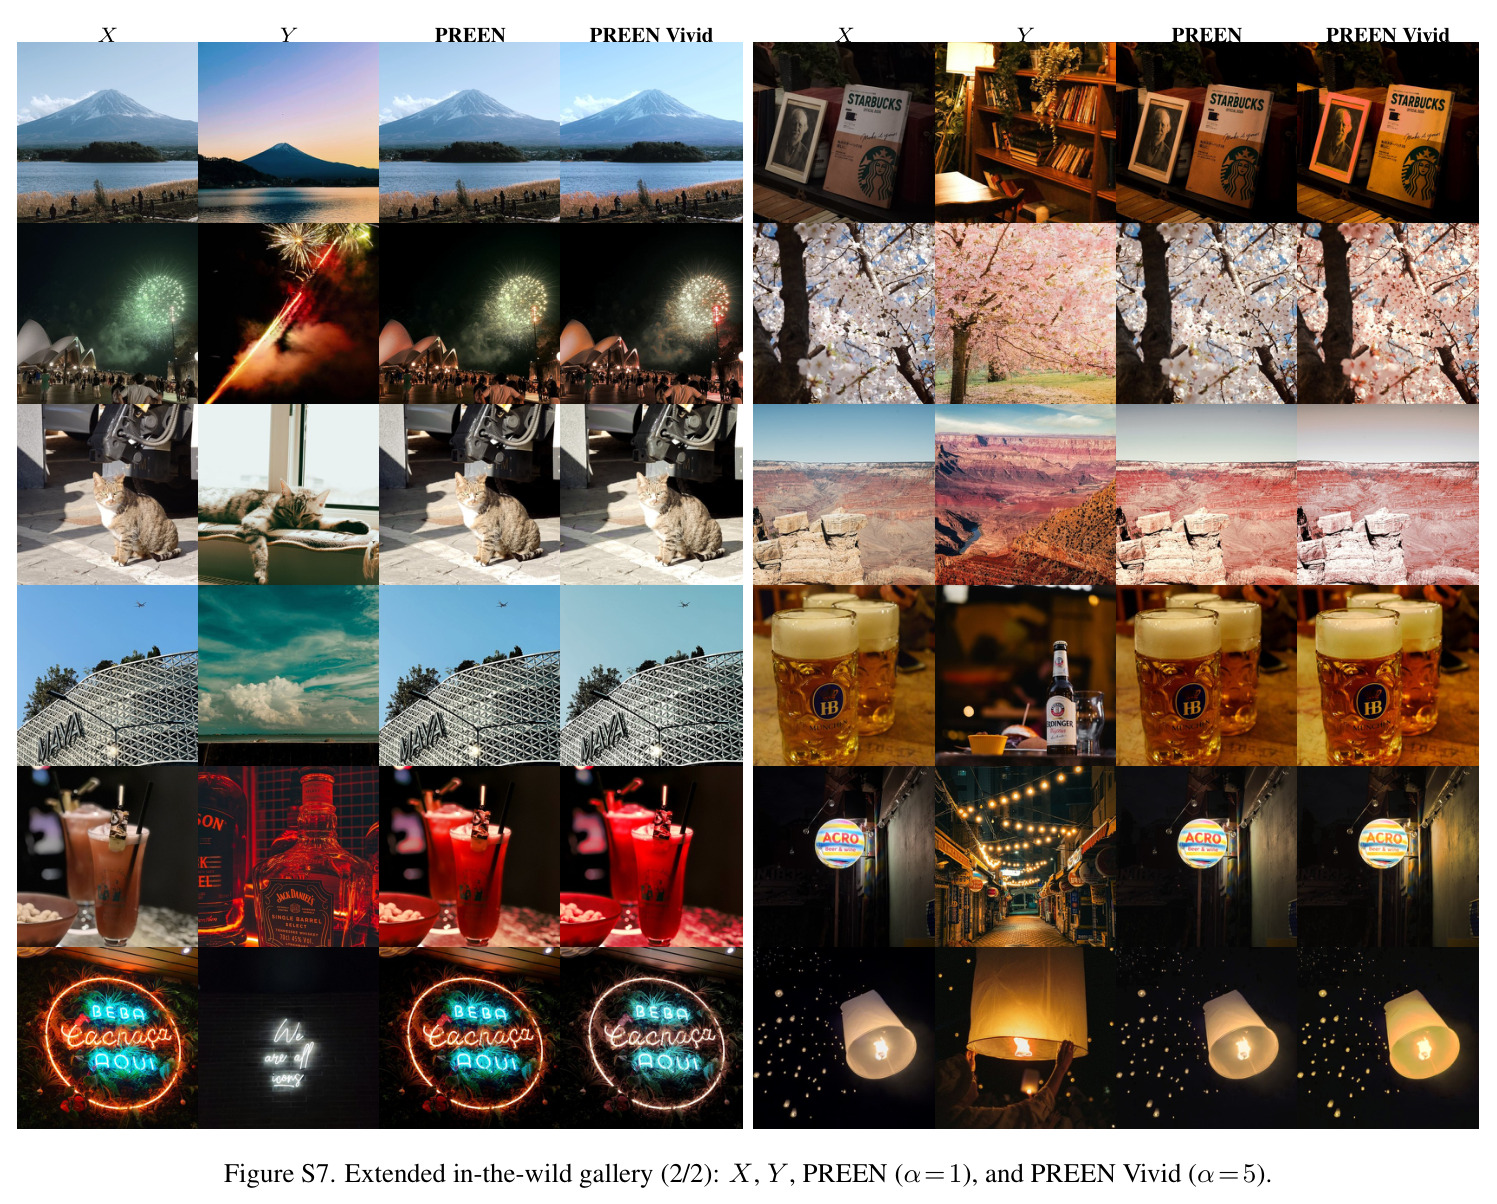
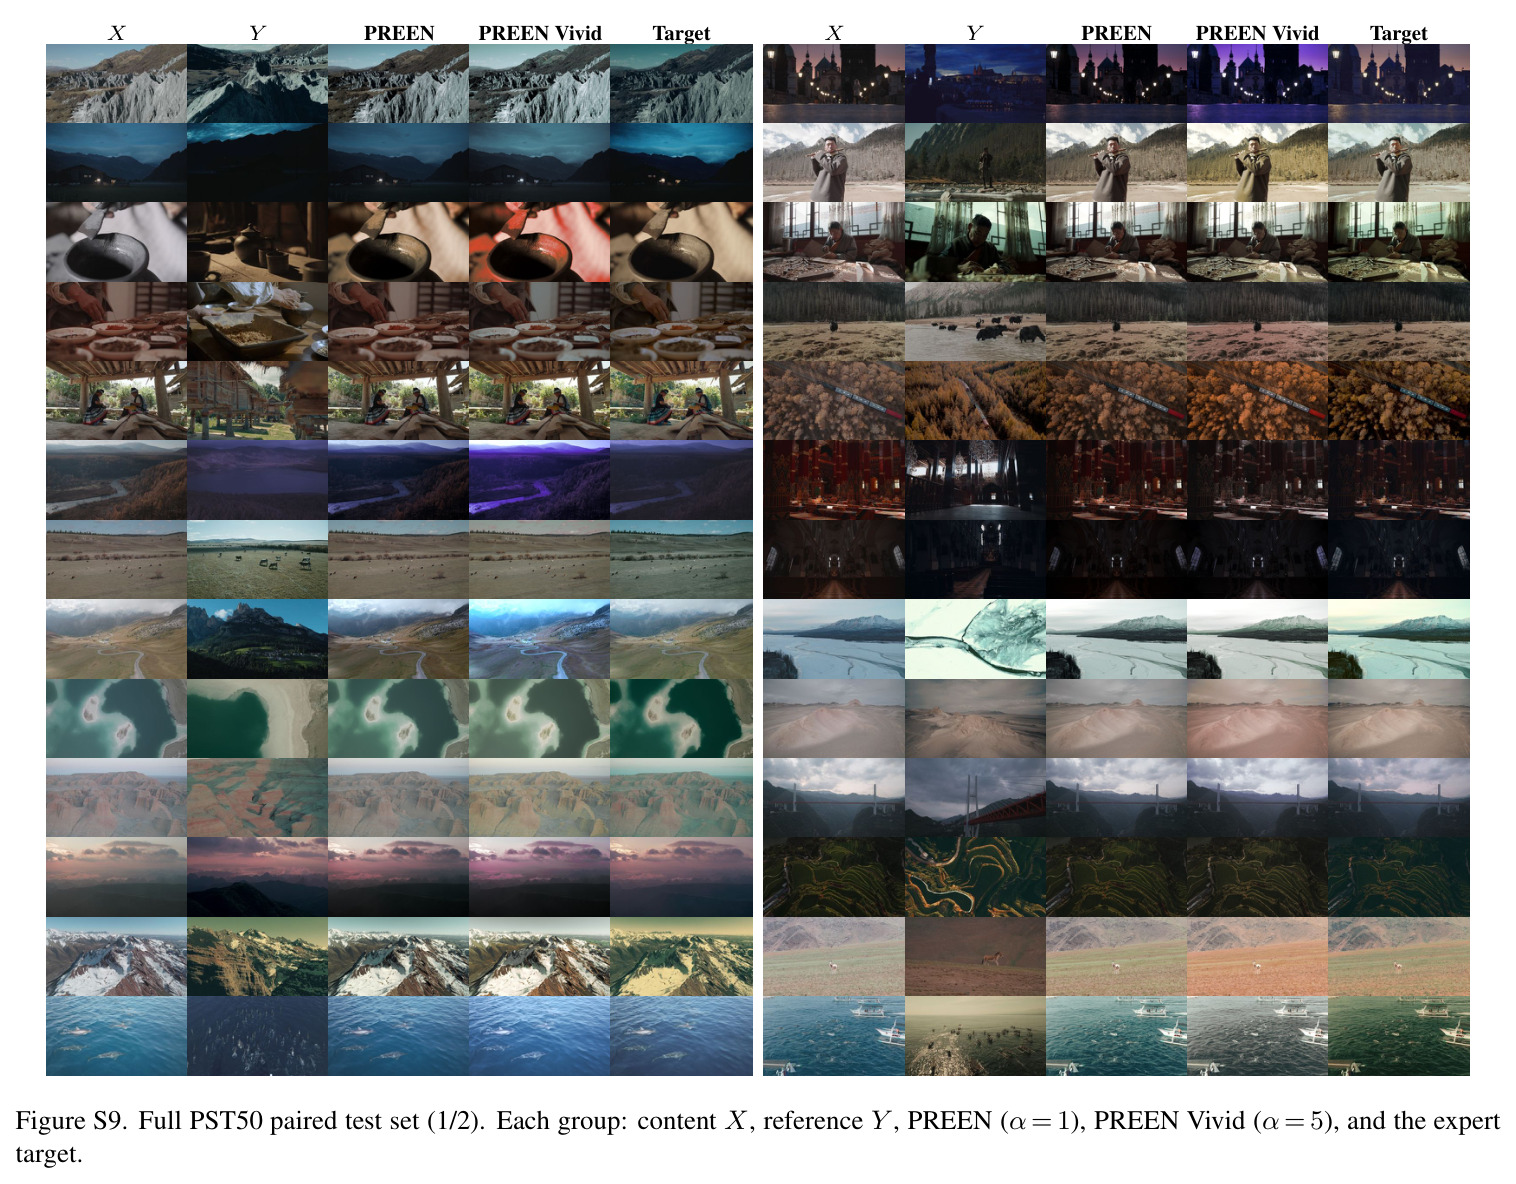
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PST50 风格迁移像素保真 | PSNR (dB) | 24.63 | Deep Preset ($\hat{Y}$) 23.29;NLUT 23.43;不编辑 22.67 | +1.34 dB(对最强栅格基线),+1.96 dB(对不编辑) |
| PST50 结构保真 | SSIM | 0.914 | Deep Preset ($\hat{P}$) 0.895;不编辑 0.906 | +0.019 / +0.008 |
| PST50 感知质量 | LPIPS(越低越好) | 0.094 | Deep Preset ($\hat{Y}$) 0.107;SA-LUT 0.133 | -0.013 / -0.039 |
| PST50 颜色直方图相似度 | HCorr | 0.473 | NLUT 0.545;SA-LUT 0.516;不编辑 0.348 | 较无编辑 +0.125;落后空间自适应 LUT 0.043–0.072(oracle 0.672,属预测 headroom) |
| PST50 平均色差 | $\Delta E^*_{ab}$(越低越好) | 9.07 | SA-LUT 9.63;NLUT 9.81 | -0.56 / -0.74(逐图检验 $p \ge .42$,统计打平) |
| Preset 输出紧凑性 | 参数维度 | $\mathbb{R}^{29}$ | SA-LUT $\mathbb{R}^{3\times2\times17^3}$($10^4$–$10^5$ 个数值) | 约 1000× 压缩且可解释、可二次编辑 |
| VLM 直接预测预设 | PSNR (dB) | 24.63 | Claude Opus 4.8 22.49;Qwen3-VL 235B 21.87;Gemini 3.1 Pro 21.40 | +2.1 至 +3.2 dB(guided 提示下) |
| 生成式像素编辑 | PSNR (dB) | 24.63 | Nano Banana Pro 19.66 | +4.97 dB,SSIM +0.169,LPIPS 减半以上 |
| 端侧推理延迟(CPU-only) | 单对时延 (ms) | 283(INT8,骁龙 8 Elite Gen 5) | 测试时反演约 60000 ms/张(需教师 + 每图 1000 步优化) | 约 200× 加速且推理时无需教师 |
局限与改进
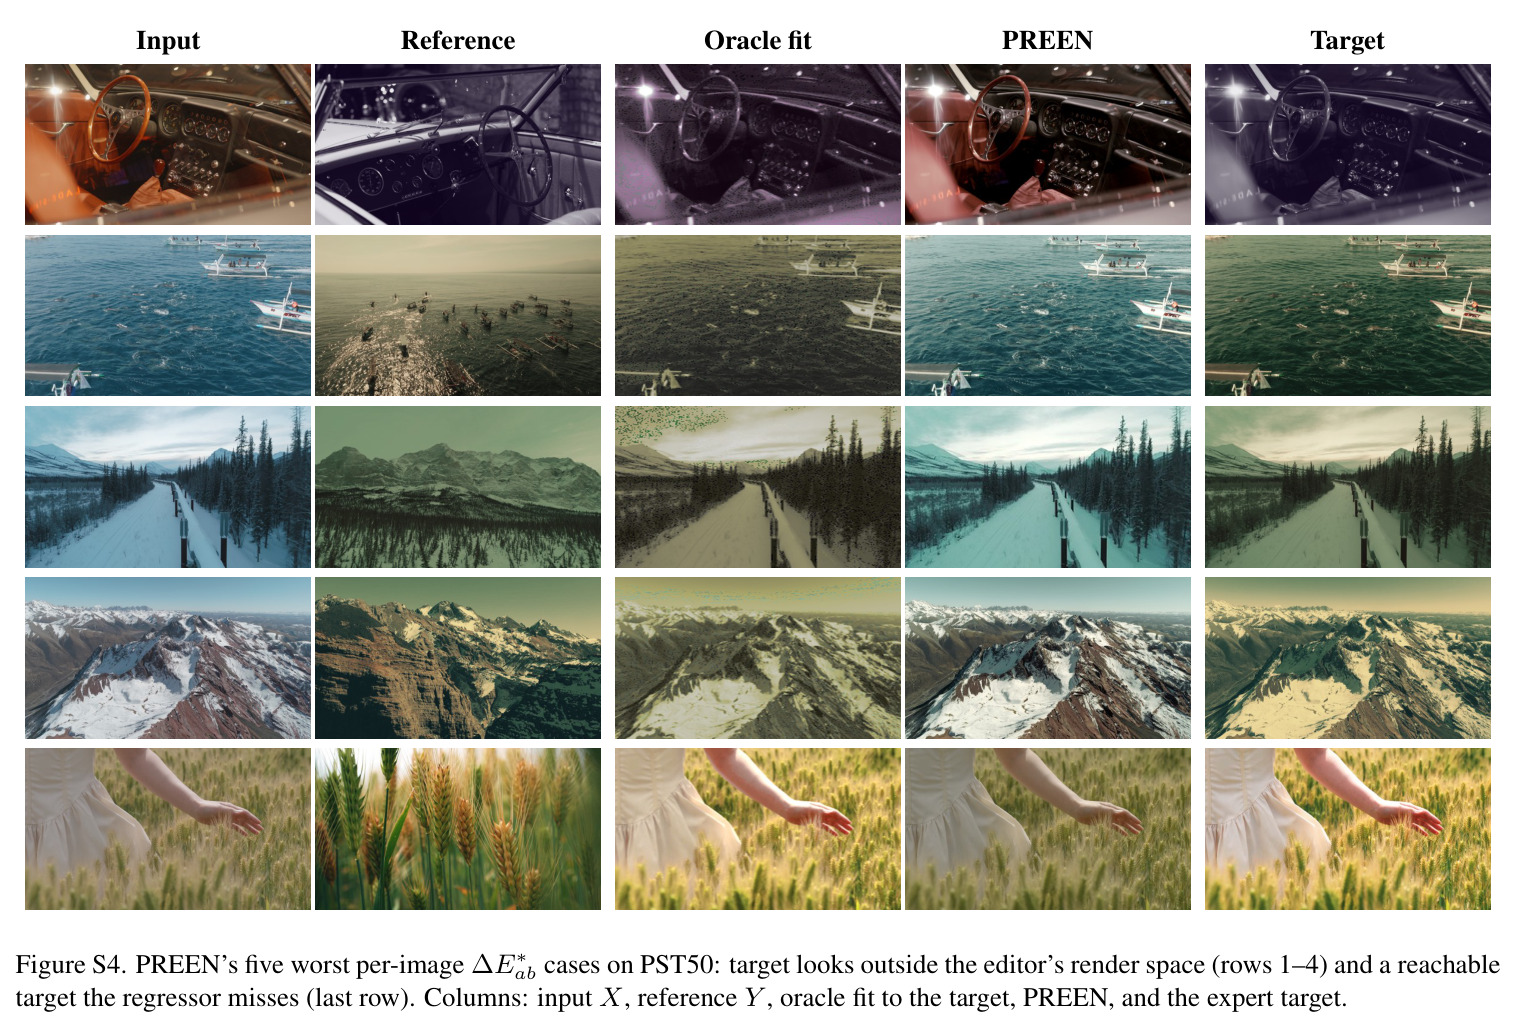
作者坦承两点。其一,PST50 的专家目标本身克制保守,PREEN 的高保真分数反映的是目标保守而非模型表达力更强——教师的完整编辑其实“过头”,PREEN 靠恒等采样与 $\ell_2$ 正则把它压回(预测预设范数仅为教师投影的约 1/4;把教师阻尼到 $\gamma=0.5$ 反而能在五个指标中的四个上超过 PREEN)。其二,编辑器空间决定能力上限:整色调单色、整体换色板这类“重映射颜色”的风格,以及颗粒、暗角、局部加深等局部效果都在 29 维全局预设之外——失败样本上连逐图 oracle 都不行(oracle $\Delta E^*_{ab}$ 8.7–11.0 对全基准中位数 4.1),PREEN 五个最大逐图误差中四个属于这类编辑器受限情形。我的补充观察:HCorr 与 LUT 的差距是真实的预测 headroom(oracle 32.56 dB 对 24.63 dB);评测只在 256×256 进行,高分辨率表现未验证;训练对依赖 CLIP 相似度配对,隐含“参考语义兼容”假设,未测试语义无关参考;用户研究仅 150 名评分者、Fleiss'$\kappa$ 0.15–0.34 属轻微到中等一致;PST50 仅 50 图,PSNR 的 95% CI 宽达 [23.28, 25.92]。
独立分析的弱点
第一,全局预设无法表达空间变化的编辑:SA-LUT 能对天空与主体分别调色,PREEN 只能一套参数全图生效,这是 HCorr 落后 0.04–0.07 的结构性原因;改进方向是按语义掩码预测多套参数做软混合。第二,教师依赖:训练必须先跑 SA-LUT 生成伪标签,教师风格先验会传导给学生(尽管学生更保守——$\|P\|$ 仅为教师投影的 0.24 倍,但教师风格覆盖面仍是能力上限);可考虑多教师集成或从更强的扩散教师蒸馏。第三,$\alpha$ 只是作用于 17 个色度参数的单标量:音调强度无法调节,也不能单独增强某个色相;可为音调集或每色相组提供独立旋钮。第四,CLIP 骨干占 304M/315M 参数、是 283 ms 延迟的大头;换 MobileCLIP/FastViT 级编码器有望压到百毫秒内。第五,评测统计功效有限:PST50 仅 50 图、$\Delta E^*_{ab}$ 对 LUT 的领先不显著,应在更大规模人工评级集上复核并补充分辨率实验。第六,VLM 基线只查询一次且非确定,可用多次采样加自一致性夯实该对比结论。
未来方向
作者明确提出的方向:用更轻的编码器(MobileCLIP、FastViT)缩小 CLIP 主导的延迟占比;缩小与 oracle 的差距——oracle 32.56 dB/HCorr 0.672 对 PREEN 24.63 dB/0.473,这约 8 dB 是仅凭 $(X,Y)$ 观测的预测误差,值得研究更强的跨图配对推理结构。基于本文成果可延伸:其一,把 $\alpha$ 推广为参数组级或用户自定义的连续轨迹,甚至用自然语言控制“再暖一点但别更饱和”这类解耦指令;其二,扩展编辑器算子集,纳入局部滤镜、颗粒、暗角并保持可微,让 split-tone 类风格进入子空间——oracle 在这些样本上同样失败,说明必须先扩空间再谈回归;其三,测试语义无关参考、加入配对难度递进课程;其四,利用预设的符号化输出做“回归 + 库内预设检索”两级方案,进一步压低延迟并保证输出永远是产品支持的合法预设;其五,把人因实验揭示的三方分歧转化为在线学习信号,让默认 $\alpha$ 随用户群体自适应;其六,迁移到视频调色,在帧间一致性约束下回归时序平滑的预设序列。
复现评估
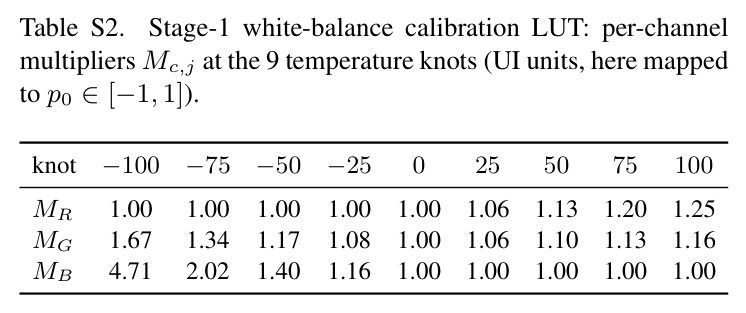
复现条件中等偏友好。数据全部公开:内容图 OpenImages、参考图 AVA(美学分前 20%)、评测集 PST50 随 SA-LUT 论文发布,作者声明 PST50 未进入训练并用 DCT 感知哈希核验无重复;教师直接用 SA-LUT 发布版,无需改动。超参完整:表 S6 给出两阶段全部学习率、LoRA rank 16/alpha 32、损失权重 (0.2, 5.0, 1.0)、恒等比例 0.1 与检查点步数;表 S1 完整公开 29 参数编辑器逐级更新公式(含白平衡校准 LUT);图 S8 给出 VLM 基线完整提示词。算力门槛低:Phase 2 只需单张 NVIDIA L4、bf16、批 64;最贵环节是 Phase 1 反演——每对 1000 步 AdamW,几十万对的反演预算是复现的主要成本。主要工作量在于按表 S1 自行实现与消费级编辑器对齐的可微编辑器管线,以及复刻 Lightroom 15.2.1 中的 Deep Preset ($\hat{P}$) 基线渲染;论文未提及官方代码开源,端侧 TFLite INT8 数字(283 ms)需要骁龙 8 Elite Gen 5 真机验证。总体难度:硕士水平工程团队约数周可复现核心结果。
论文图表
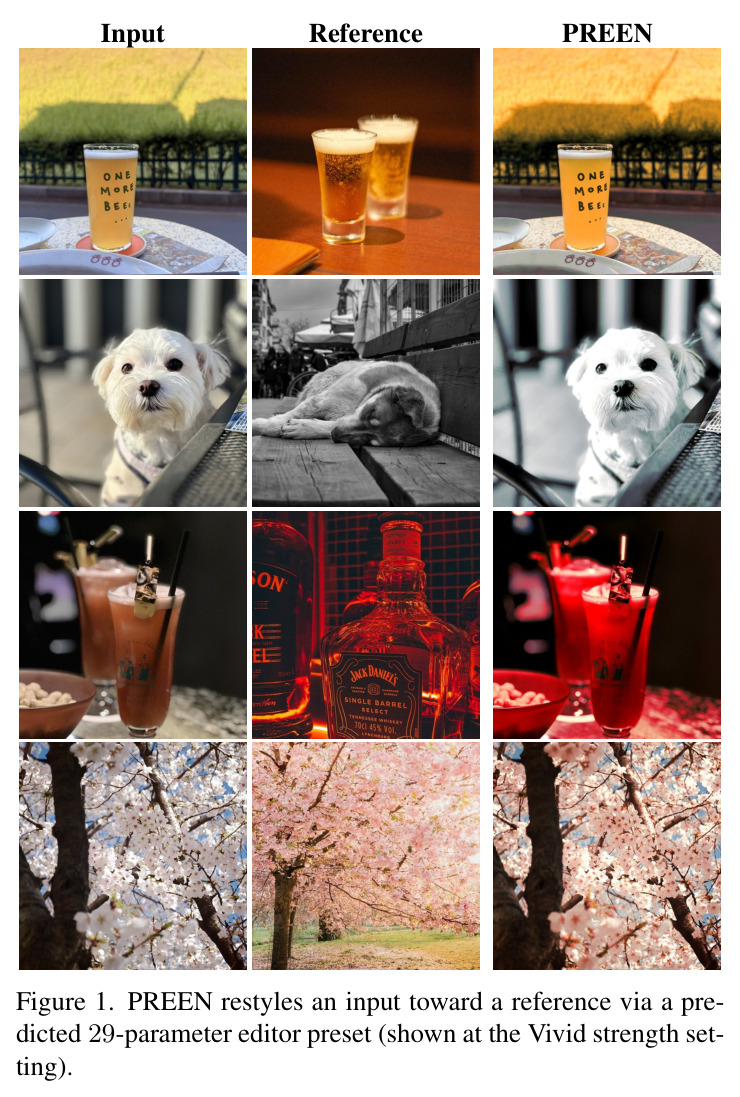
并排展示内容图 $X$、风格参考 $Y$ 与 PREEN 在 Vivid 强度设定下的输出,直观呈现“把一张照片的色彩语言改成参考照片的样子”这一任务,并注明结果由 29 参数预设驱动。
一图定义任务与最终产品形态:读者第一眼就能理解输入输出是什么、预设驱动的风格化长什么样。
五个最大误差样本的诊断:前四行是编辑器无法渲染的目标风格(split-tone 近单色、整体换色板),连 oracle 拟合都失败(oracle $\Delta E^*_{ab}$ 8.7–11.0 对基准中位数 4.1);最后一行是可达目标但回归器没抓住(oracle 4.6 vs PREEN 22.2)。
精确划分失败来源:区分“编辑器空间限制”与“预测误差”两类失败,直接指明改进方向的分界线。
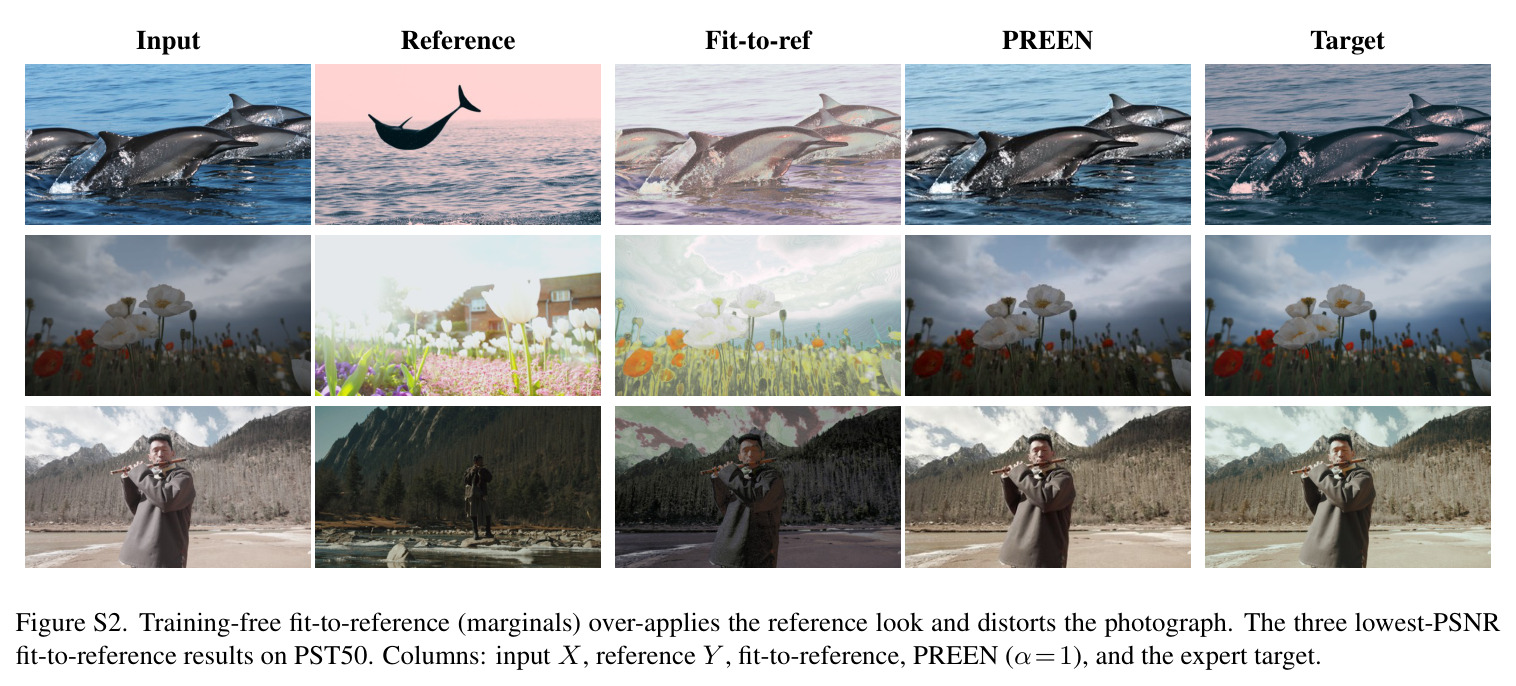
展示“直接把参考图颜色统计套到内容图”这一朴素方案在三个最低 PSNR 样本上的失败:参考是另一场景,其原始统计并非编辑目标,过度套用会扭曲照片;同样本上 PREEN 的克制编辑紧贴专家目标。
说明为什么需要学习式校准而非统计搬运:为 HCorr 必须与保真指标联合阅读提供直观论据。