NLD-Uni:跨范式在线蒸馏与弹性自精化的统一扩散大语言模型 Nemotron-Labs-Diffusion-Uni: Elastic Self-Refining Unified Diffusion LLM with Cross-Paradigm On-Policy Distillation
以跨范式在线蒸馏与渐进自精化扩散,让统一扩散LLM同时看懂并生成图像,达到SOTA
前置知识
掩码扩散语言模型(MDM / DLLM)
离散扩散语言模型把文本或图像表示为离散 token,训练时随机把部分 token 替换为掩码符 $[m]$,模型用双向注意力学习在给定上下文下恢复被掩码内容;推理时从全掩码序列出发多步逐步揭示,同一步可并行生成多个 token,因此比自回归解码更快。其核心局限是二值状态:每个 token 要么干净要么掩码,揭示后就永久固定。
NLD-Uni 的底座就是 MDM,读懂它对“一步跳变”局限的分析是理解自精化扩散的起点。
块级半自回归扩散(SBD)
将序列划分为若干块,块与块之间按自回归方式因果依赖(当前块只能看到之前的干净块),块内部用扩散过程并行生成,训练目标是给定之前干净块和当前块的部分掩码版本时预测干净块。当块大小为 1 时 SBD 严格退化为标准自回归模型,因此同一模型可在 AR 视图与扩散视图之间自由切换。
NLD-Uni 用 SBD 统一文本与图像建模,块大小可变是实现跨范式蒸馏和弹性架构的关键机制。
在线策略蒸馏(On-Policy Distillation, OPD)
一种知识蒸馏方式:教师模型在学生自己生成的序列上提供逐步监督信号(对齐学生的分布),而不是像离线蒸馏那样只在教师自己的输出上做监督。由于监督落在学生真实会到达的分布上,学生学到的是“在我会走到的地方该怎么走”,收敛更快、更不容易偏离自身生成分布。
本文把 OPD 从同范式扩展到跨范式(AR 教师、连续流教师 → 扩散学生),是全文两大创新之一。
向量量化(VQ)与码本几何
图像 patch 经 VQ 编码器映射为码本中的离散 code,每个 code 对应嵌入空间中的一个向量,语义相近的 token 在该空间中距离较近,形成可利用的几何结构。NLD-Uni 使用约 131k 个 VQ code 表示图像 token,输出图像完全以 VQ code 序列表示,再经 VQ 解码器还原。
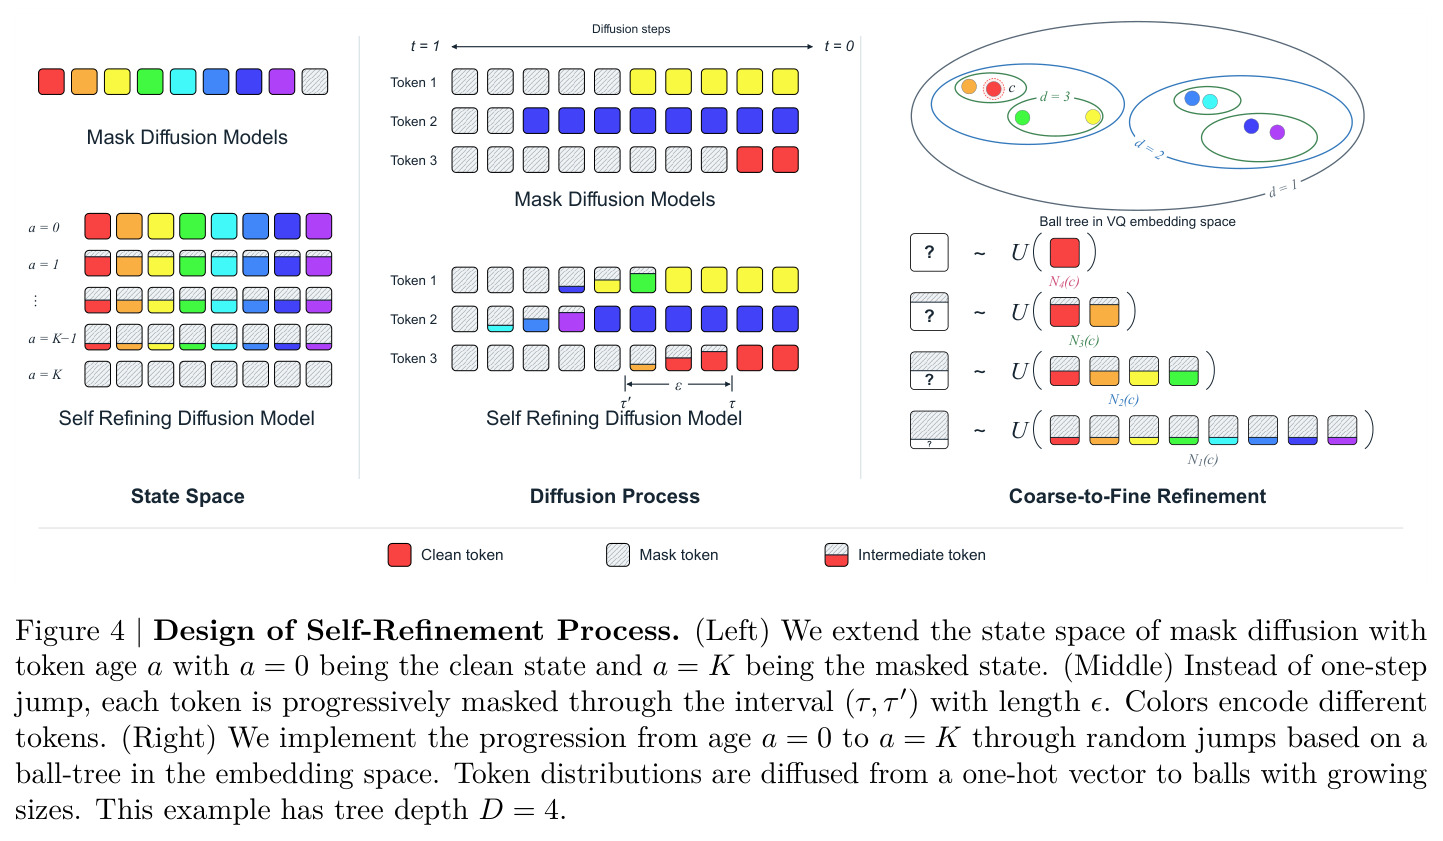
自精化扩散正是利用码本几何构造球树,把一步掩码拆解为从语义近邻到远邻的多级噪声状态。
球树(Ball Tree)
一种高维最近邻搜索常用的树结构:每个节点代表嵌入空间中的一个超球,父节点半径大于子节点,根节点覆盖整个码本,叶子节点只含单个 token。深度为 D 的平衡二叉球树可用一维数组表示,查询任意 token 在各层级的邻域集合非常高效。
论文用它定义“按 token 年龄递增的腐蚀分布”:131k 码本算成对距离矩阵需 32GB 显存,球树只需 524KB。
研究动机
统一多模态大模型目前有三条路线。AR 统一路线(如 Emu3、Janus-Pro)把文本和图像都当离散 token 自回归生成;AR+Diffusion 混合路线(如 BAGEL)文本自回归、图像用连续流模型,需要小心平衡两个相互冲突的训练目标。第三条 unified DLLM 路线(MMaDA、LaViDa-O、LLaDA2-Uni)用单一的掩码扩散目标统一建模所有模态,目标简洁且可并行解码,但实际性能差距明显:LLaDA2-Uni 在 11 项理解基准上平均仅 61.2 分,GUI 接地基准 ScreenSpot-Pro 几乎不可用(仅 0.4 分),MathVista 推理只有 67.2;同时掩码扩散在图像生成时每个 token 从掩码态一步跳到确定态后就不再改变,而同一张图的 token 高度相关、却被当作条件独立采样,导致视觉保真度不足——在人类偏好指标 HPSv3 上,离散扩散模型普遍低于 FLUX.1-dev、Qwen-Image 等连续扩散模型(如 NLD-Image 仅 9.61)。
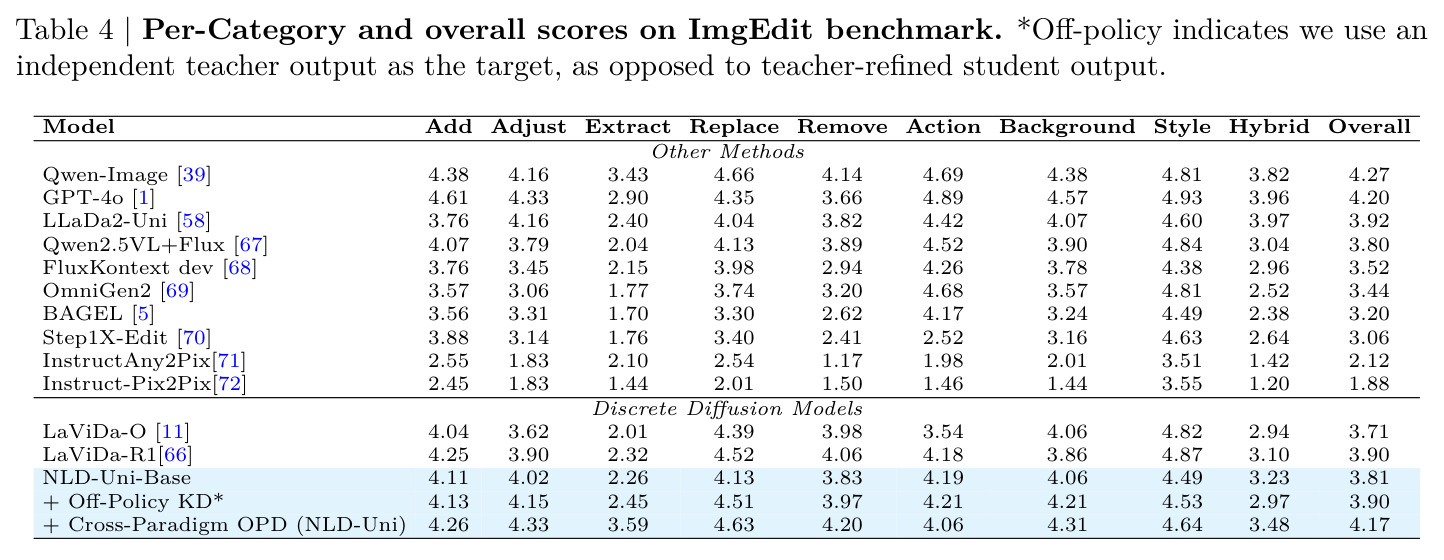
本文的目标是本文要把 unified DLLM 的能力拉到接近乃至追平领域专家模型,同时保留单一训练目标和并行解码的范式优势。可量化的目标包括:图像理解 11 基准平均分超过自回归专才模型 Qwen3-VL-8B(最终 78.3 对 78.1);多模态推理 MathVista 达 77.0;文生图 GenEval 达 0.89,并在 HPSv3 上超过 FLUX.1-dev(10.88)与 Qwen-Image(10.91);图像编辑 ImgEdit 总分 4.17,仅次于 GPT-4o(4.20)与其教师 Qwen-Image(4.27);同时相对 LLaDA2-Uni 与 BAGEL 获得约 1.4×–3.1× 的推理加速。
与已有工作不同的是,作者抓住了两个被忽视的点。其一,在线策略蒸馏已在 AR VLM(提升理解)和连续流模型(提升生成)上分别被验证有效,但没人能把它用到掩码扩散模型上——因为不存在强 MDM 教师,而 AR 教师和流教师与扩散学生的范式根本不同,无法直接提供分布级监督。本文提出跨范式 OPD 系统性解决教师范式不匹配问题。其二,MDM 缺乏迭代精修能力的根源被归于二值状态空间;此前的补救(LaViDa-O 的置信度调度、NLD-Image 的事后 token 编辑)都是推理时启发式补丁,对置信阈值敏感且存在训练-推理不一致。本文改为从训练过程本身入手扩展状态空间,让渐进精修成为扩散过程的内生属性,训练与推理天然一致。
核心方法
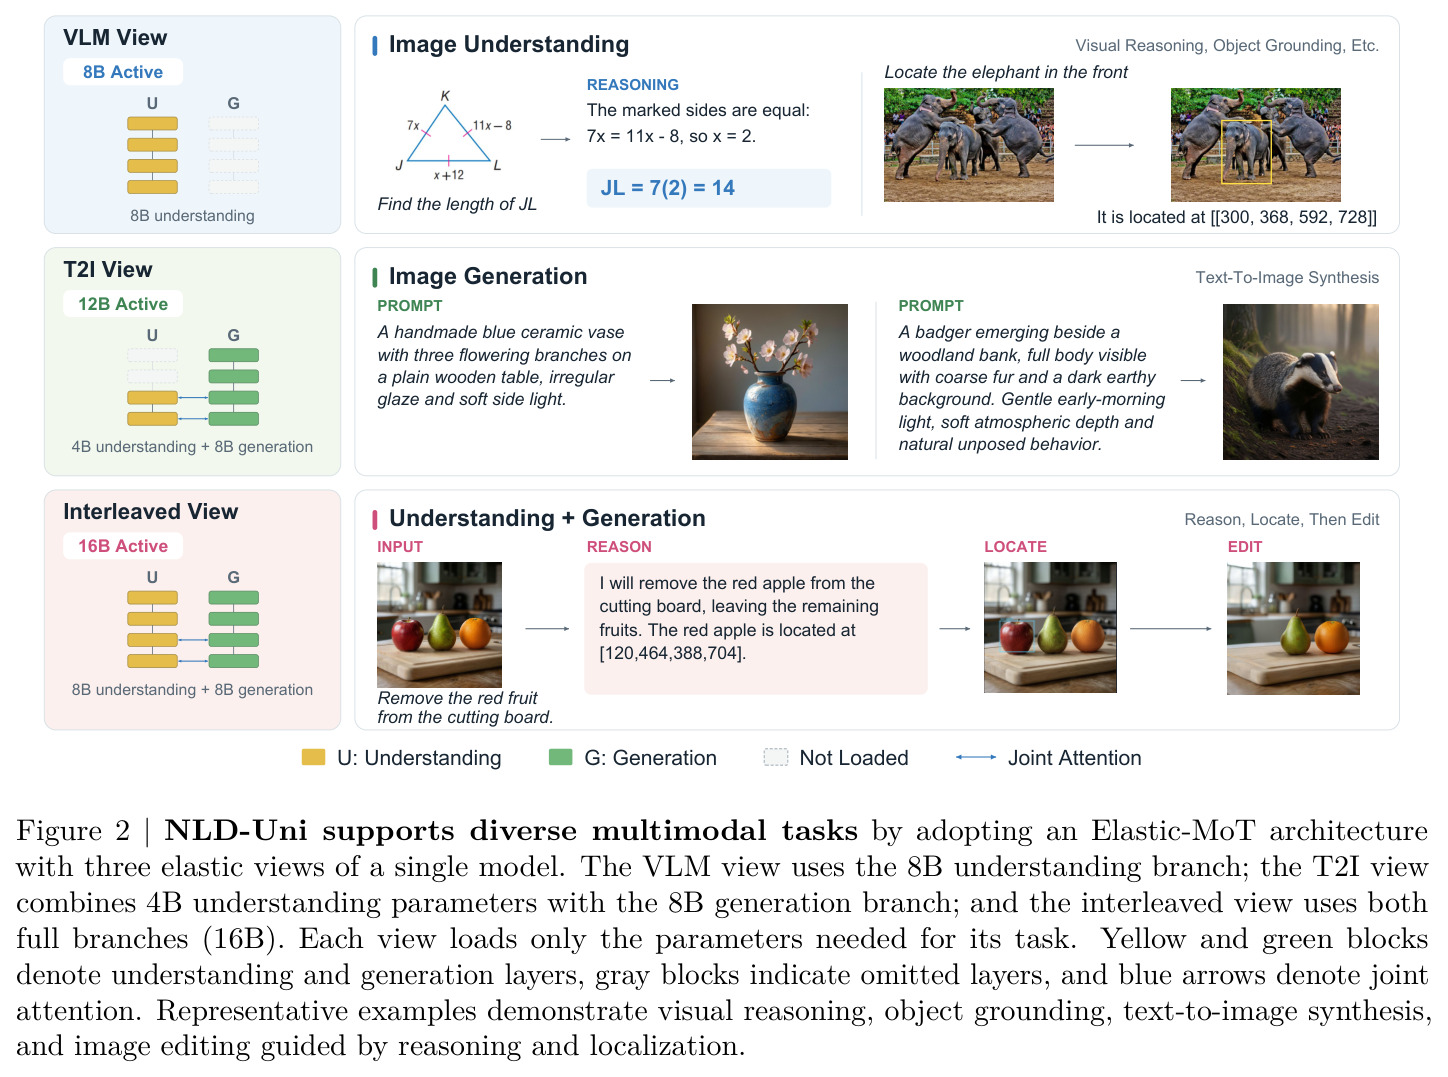
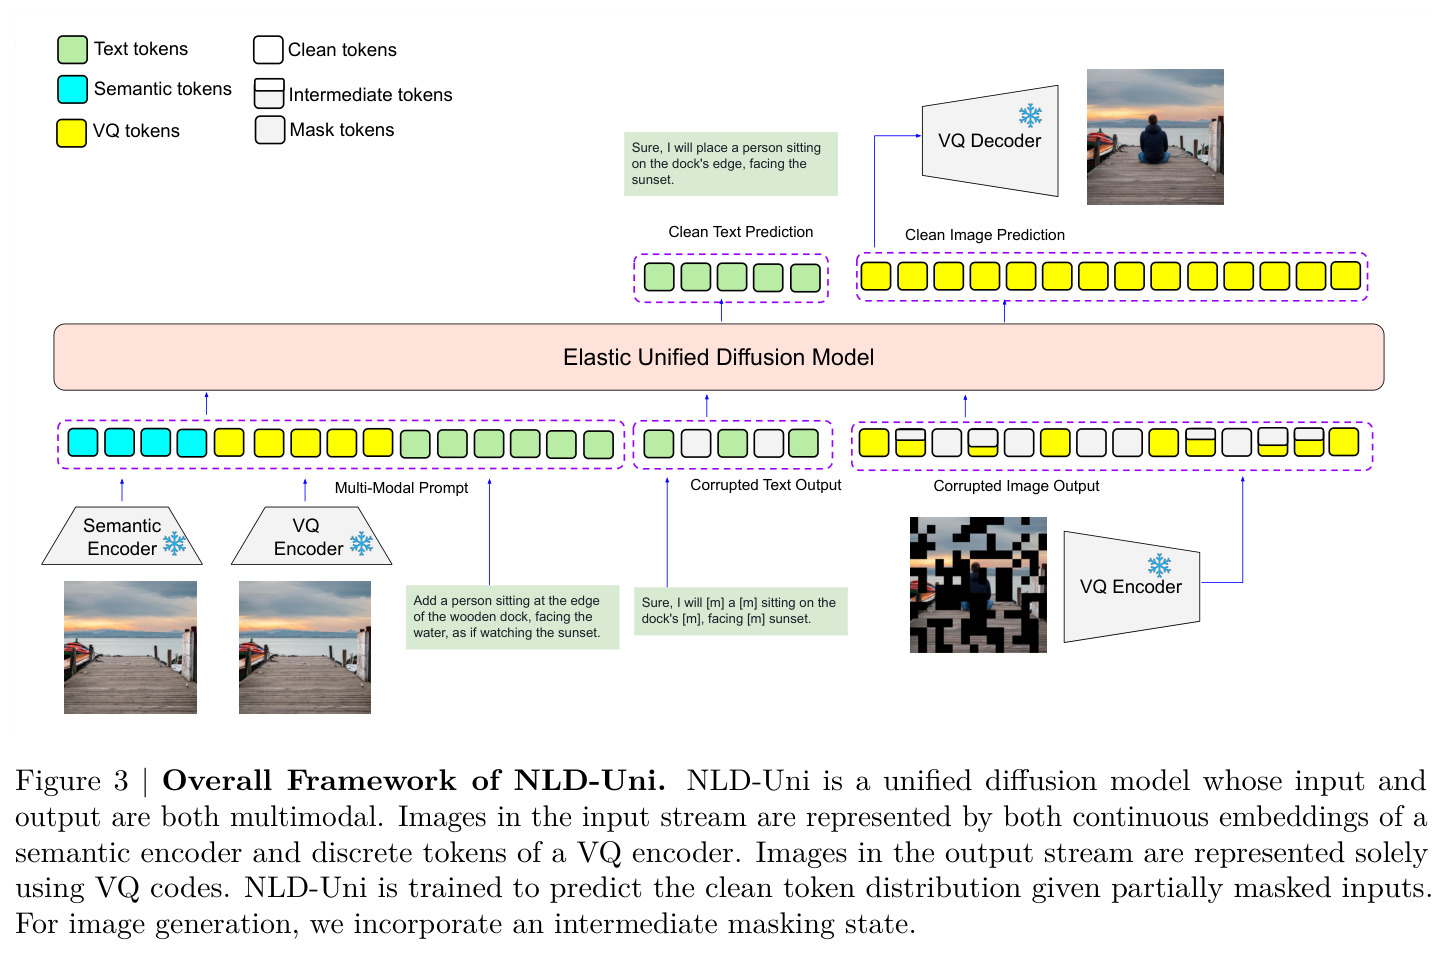
直觉上,NLD-Uni 的训练像培养一个学徒:(1) 不直接抄老师的答案,而是在自己写答案的过程中请老师逐步指点——这是跨范式在线蒸馏;(2) 不要求一次写对,而是学会把粗糙草稿一步步精修成成品——这是渐进自精化扩散。技术路线上,模型采用双塔弹性混合 Transformer(Elastic MoT):理解塔与生成塔各 8B,均初始化自 NLD 扩散语言模型的副本,通过 joint attention 交互;图像输入同时经语义编码器(连续嵌入)与 VQ 编码器(离散 code)双路表示,输出图像只用 VQ code。训练分三阶段:先做图文对齐与生成基础,再引入指令跟随、编辑、接地与交错生成,最后做统一跨范式 OPD,全程 64 张 H100 训练 26 天,其中 OPD 阶段 5 天。状态空间从 $\mathcal{V} \cup \{[m]\}$ 扩展为 $\mathcal{V} \times \mathcal{A}$,token 以年龄 $a \in \{0,1,\dots,K\}$ 渐进腐蚀而非一步跳到掩码态。
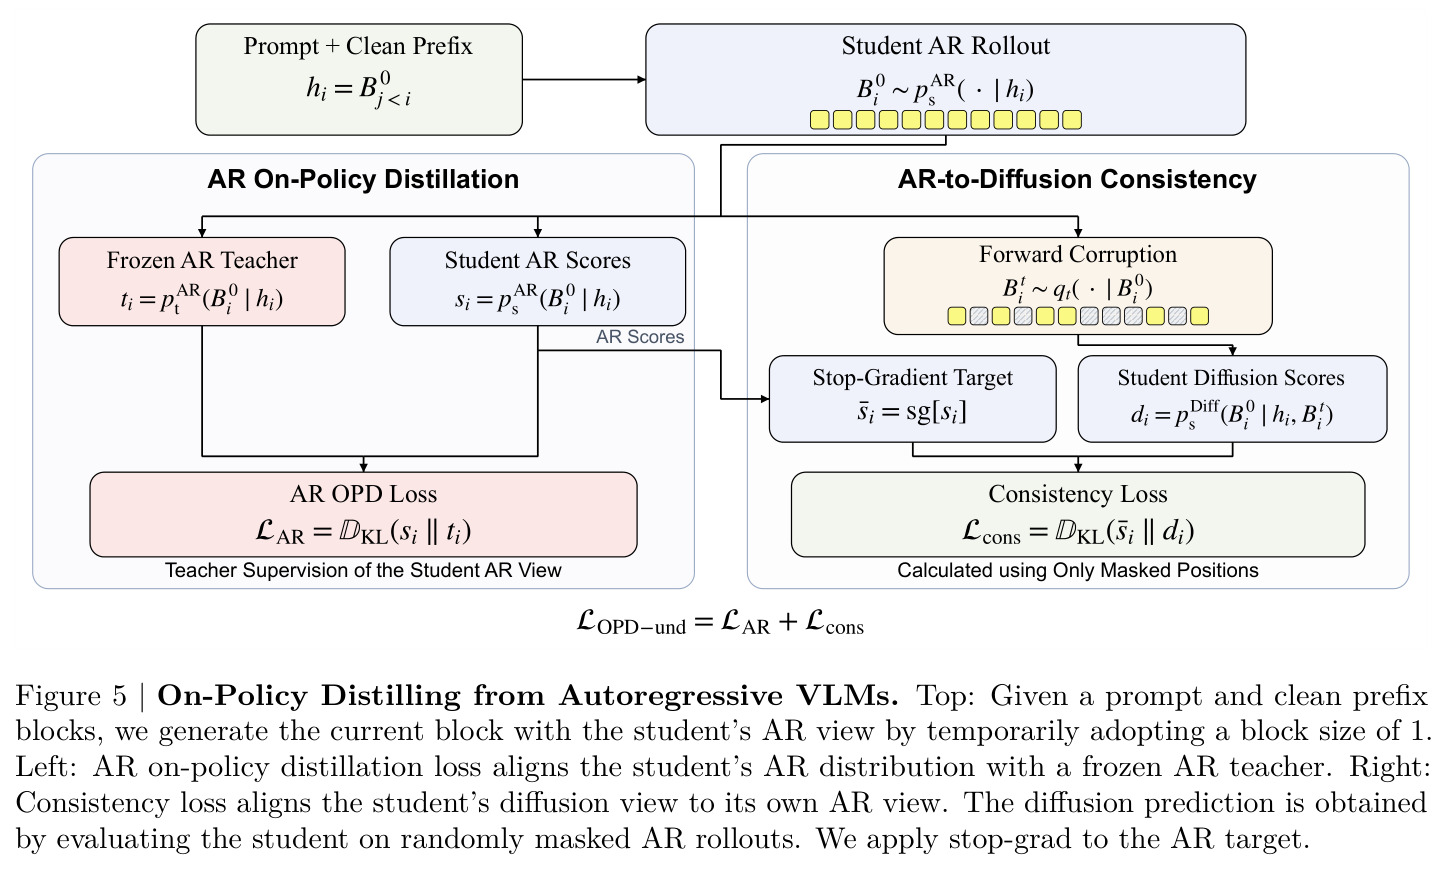
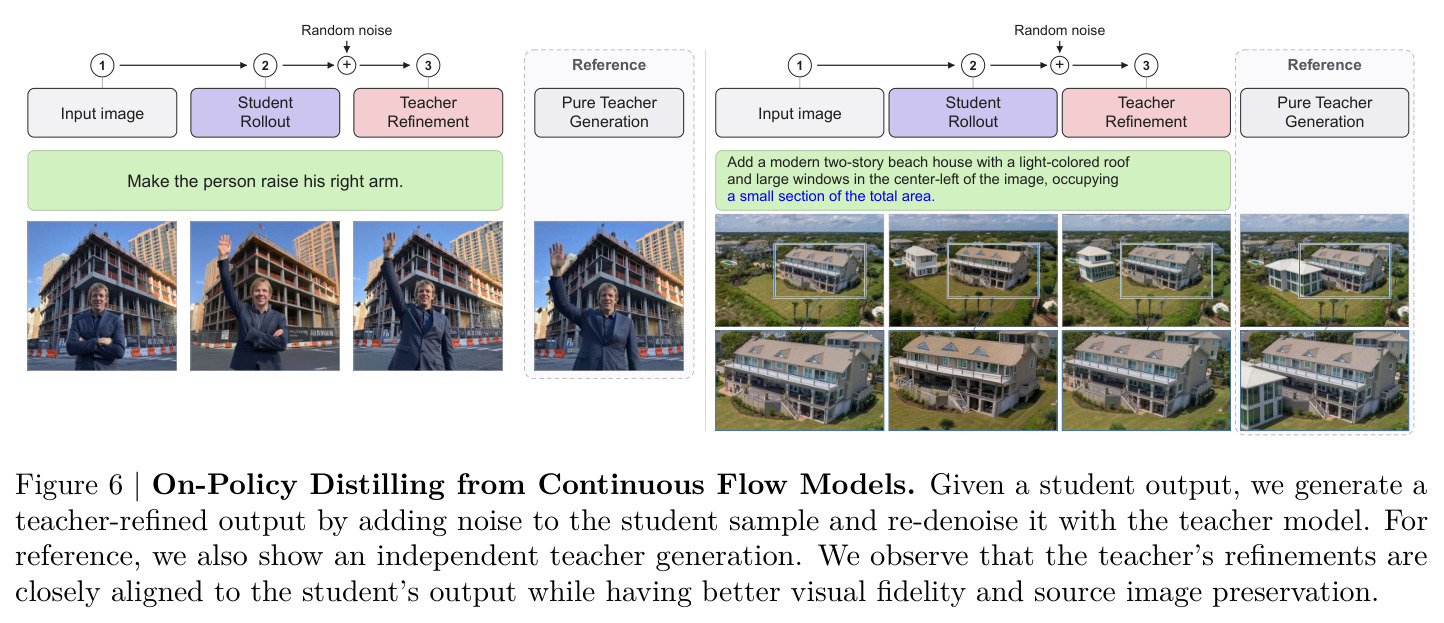
两大核心创新。第一是跨范式 OPD 的“传递性”设计。直接把 AR 教师的 token 分布拷贝给学生的扩散视图(OPD-LM 做法)会产生病态监督:例如学生已答出“Jason visited San Francisco”,教师对“New”的高置信度会引导扩散视图在“[m] Francisco”处生成“New Francisco”这类病句。本文改为让学生以块大小 1 的 AR 视图在自己 rollout 上对齐 AR 教师分布,再用带 stop-gradient 的一致性损失让扩散视图对齐学生自己的 AR 视图:$\mathcal{L}_{\text{OPD-und}} = D_{\mathrm{KL}}(p^{s}_{\mathrm{AR}} \| p^{t}_{\mathrm{AR}}) + D_{\mathrm{KL}}(p^{s}_{\mathrm{AR}} \| p^{s}_{\mathrm{Diff}})$。生成侧则发明“教师精修学生输出”:把学生采样图在 Qwen-Image 的 VAE 潜空间加噪后重降噪,得到语义对齐但保真度更高的训练目标。第二是自精化扩散:状态空间扩为 token×年龄 $a \in \{0,\dots,K\}$,按 VQ 码本上的球树让 token 逐步腐蚀到越来越远的随机 token,把一步掩码拆成 $K$ 步由近到远的过渡;推理时 token 在 $[\tau_i, \tau_i']$ 内逐级精修,实现训练与推理一致的迭代自我纠错。
方法步骤详情
完整流程分五步。第一步,架构初始化:理解塔与生成塔各为一份 NLD 扩散 LM 副本,图像按分辨率决定块大小,经语义编码器与 VQ 编码器双路编码。第二步,阶段一训练:用大规模文本-图像对做基础对齐与生成能力训练,优化 SBD 损失 $\mathcal{L}_{\mathrm{SBD}} = \mathbb{E}[-\log p(B^{0}_{i} \mid B^{0}_{j<i}, B^{t}_{i})]$。第三步,阶段二训练:加入指令跟随、图像编辑、目标接地和交错生成数据。第四步,阶段三跨范式 OPD:理解任务以 Nemotron-3 Nano Omni 为 AR 教师,学生以块大小 1 生成 rollout,施加 AR OPD 损失与一致性损失;图像编辑以 Qwen-Image 为教师,对学生 rollout 在教师 VAE 潜空间加噪再重降噪得到 teacher-refined 目标并做 SFT;同时混入 T2I SFT 批次防止遗忘(T2I 基模型已强于候选教师,不设 OPD)。第五步,推理:文本块间序贯、块内并行扩散;每 token 预采样跳跃区间 $\tau_i \sim U([0, 1-\epsilon])$、$\tau_i' = \tau_i + \epsilon$,图像 token 在 $[\tau_i', 1]$ 保持掩码、在 $[\tau_i, \tau_i']$ 逐级精修、在 $[0, \tau_i]$ 冻结;理解任务用置信度采样器,评测统一 64 扩散步。
技术新颖性
与 OPD-LM 的区别:OPD-LM 是同一模型的 AR→Diffusion 转换,师生初始分布差距为零;本文蒸馏更大更强的异构教师(AR VLM、连续流模型),初始分布差距可观,因此必须设计传递性目标避免病态监督。与 MDM-prime 的区别:后者把 token 拆成子 token 实现部分掩码,但只在 32×32 低分辨率图像上验证、无法扩展到 131k 码本的本文场景;本文利用码本几何实现粗到细的掩码/解掩码,无需学习显式子 token 表示。与 LaViDa-O 置信度调度、NLD-Image token 编辑的区别:那些是推理时启发式修正,本文的渐进腐蚀内生于训练目标,训练推理一致。实现上,18 层二叉球树仅用 524KB 显存替代需要 32GB 的成对距离矩阵,是让该方法在 131k 码本上工程可行的关键。
实验结果
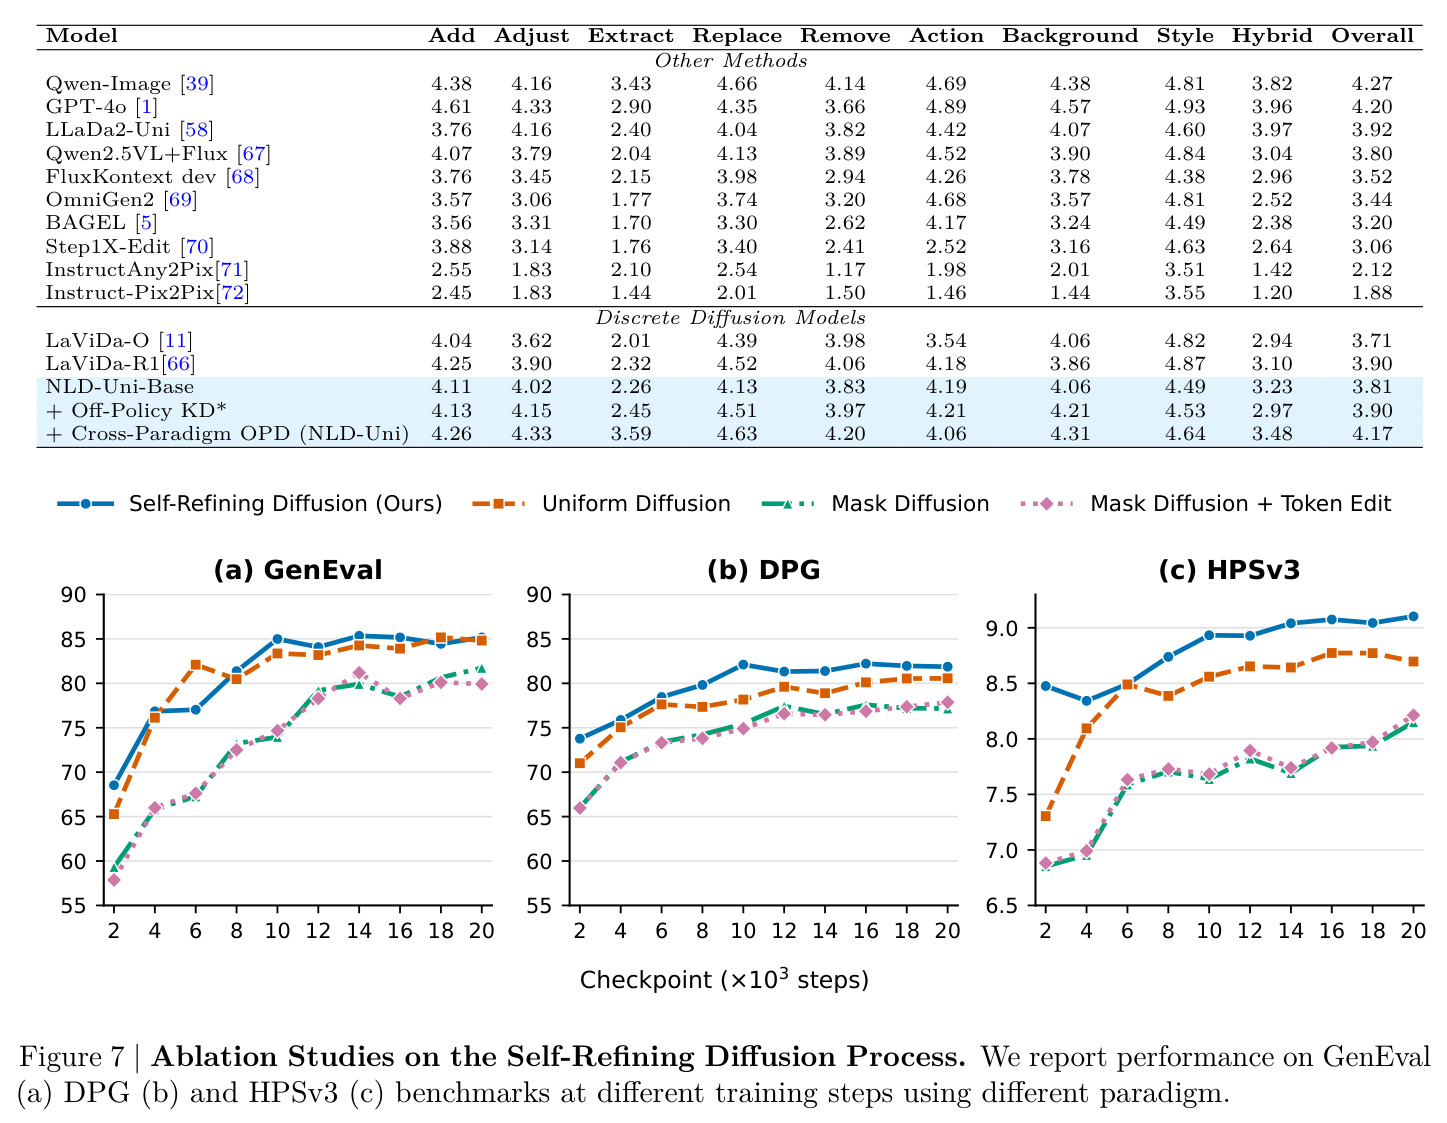
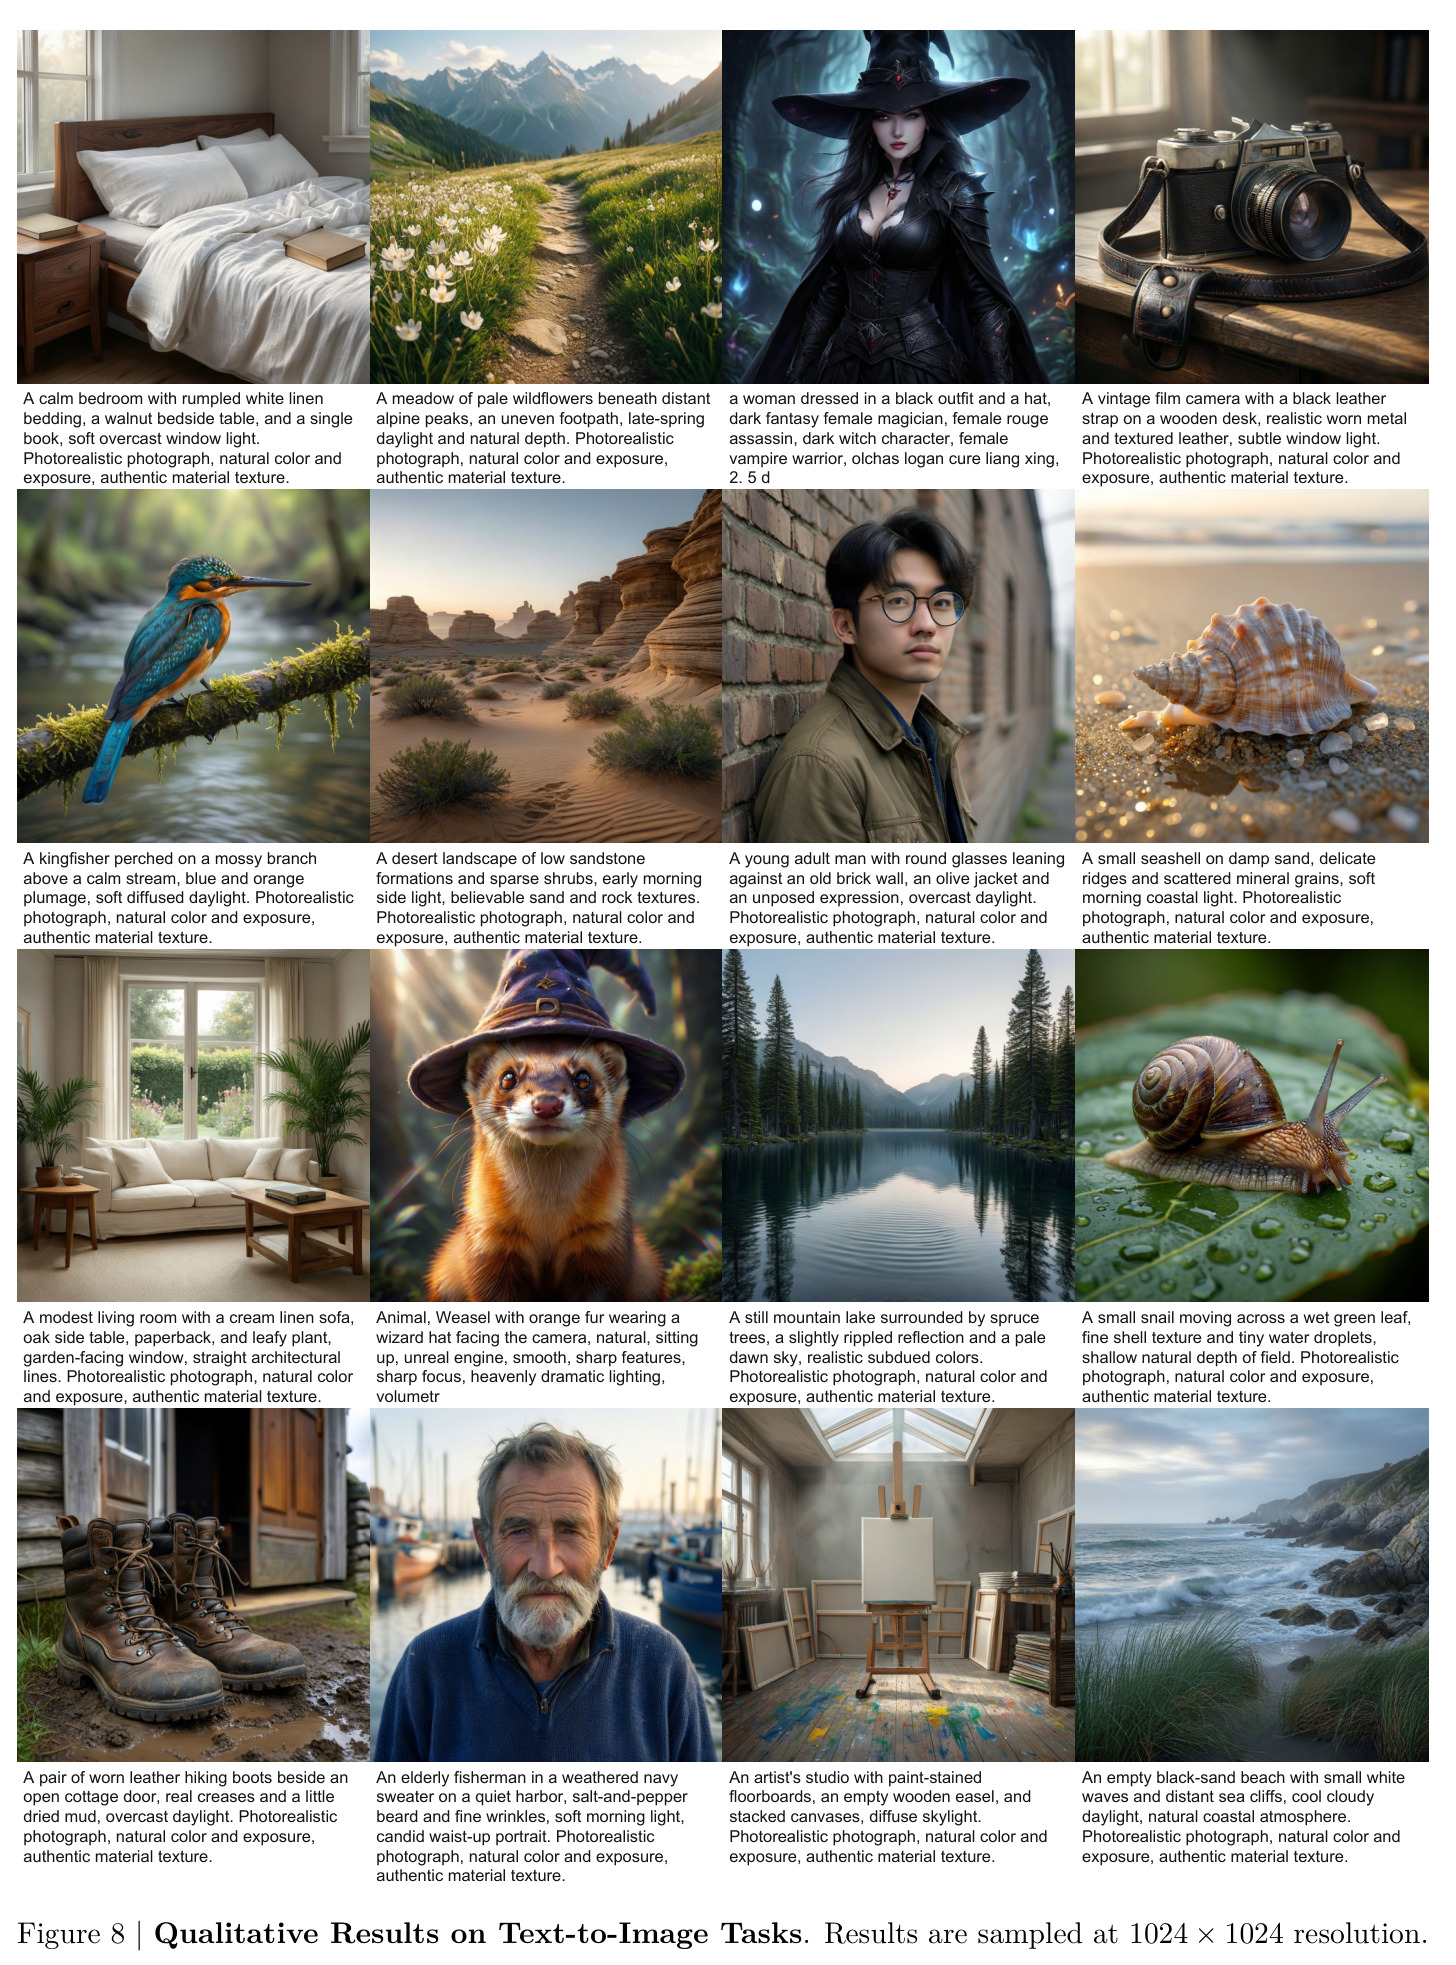
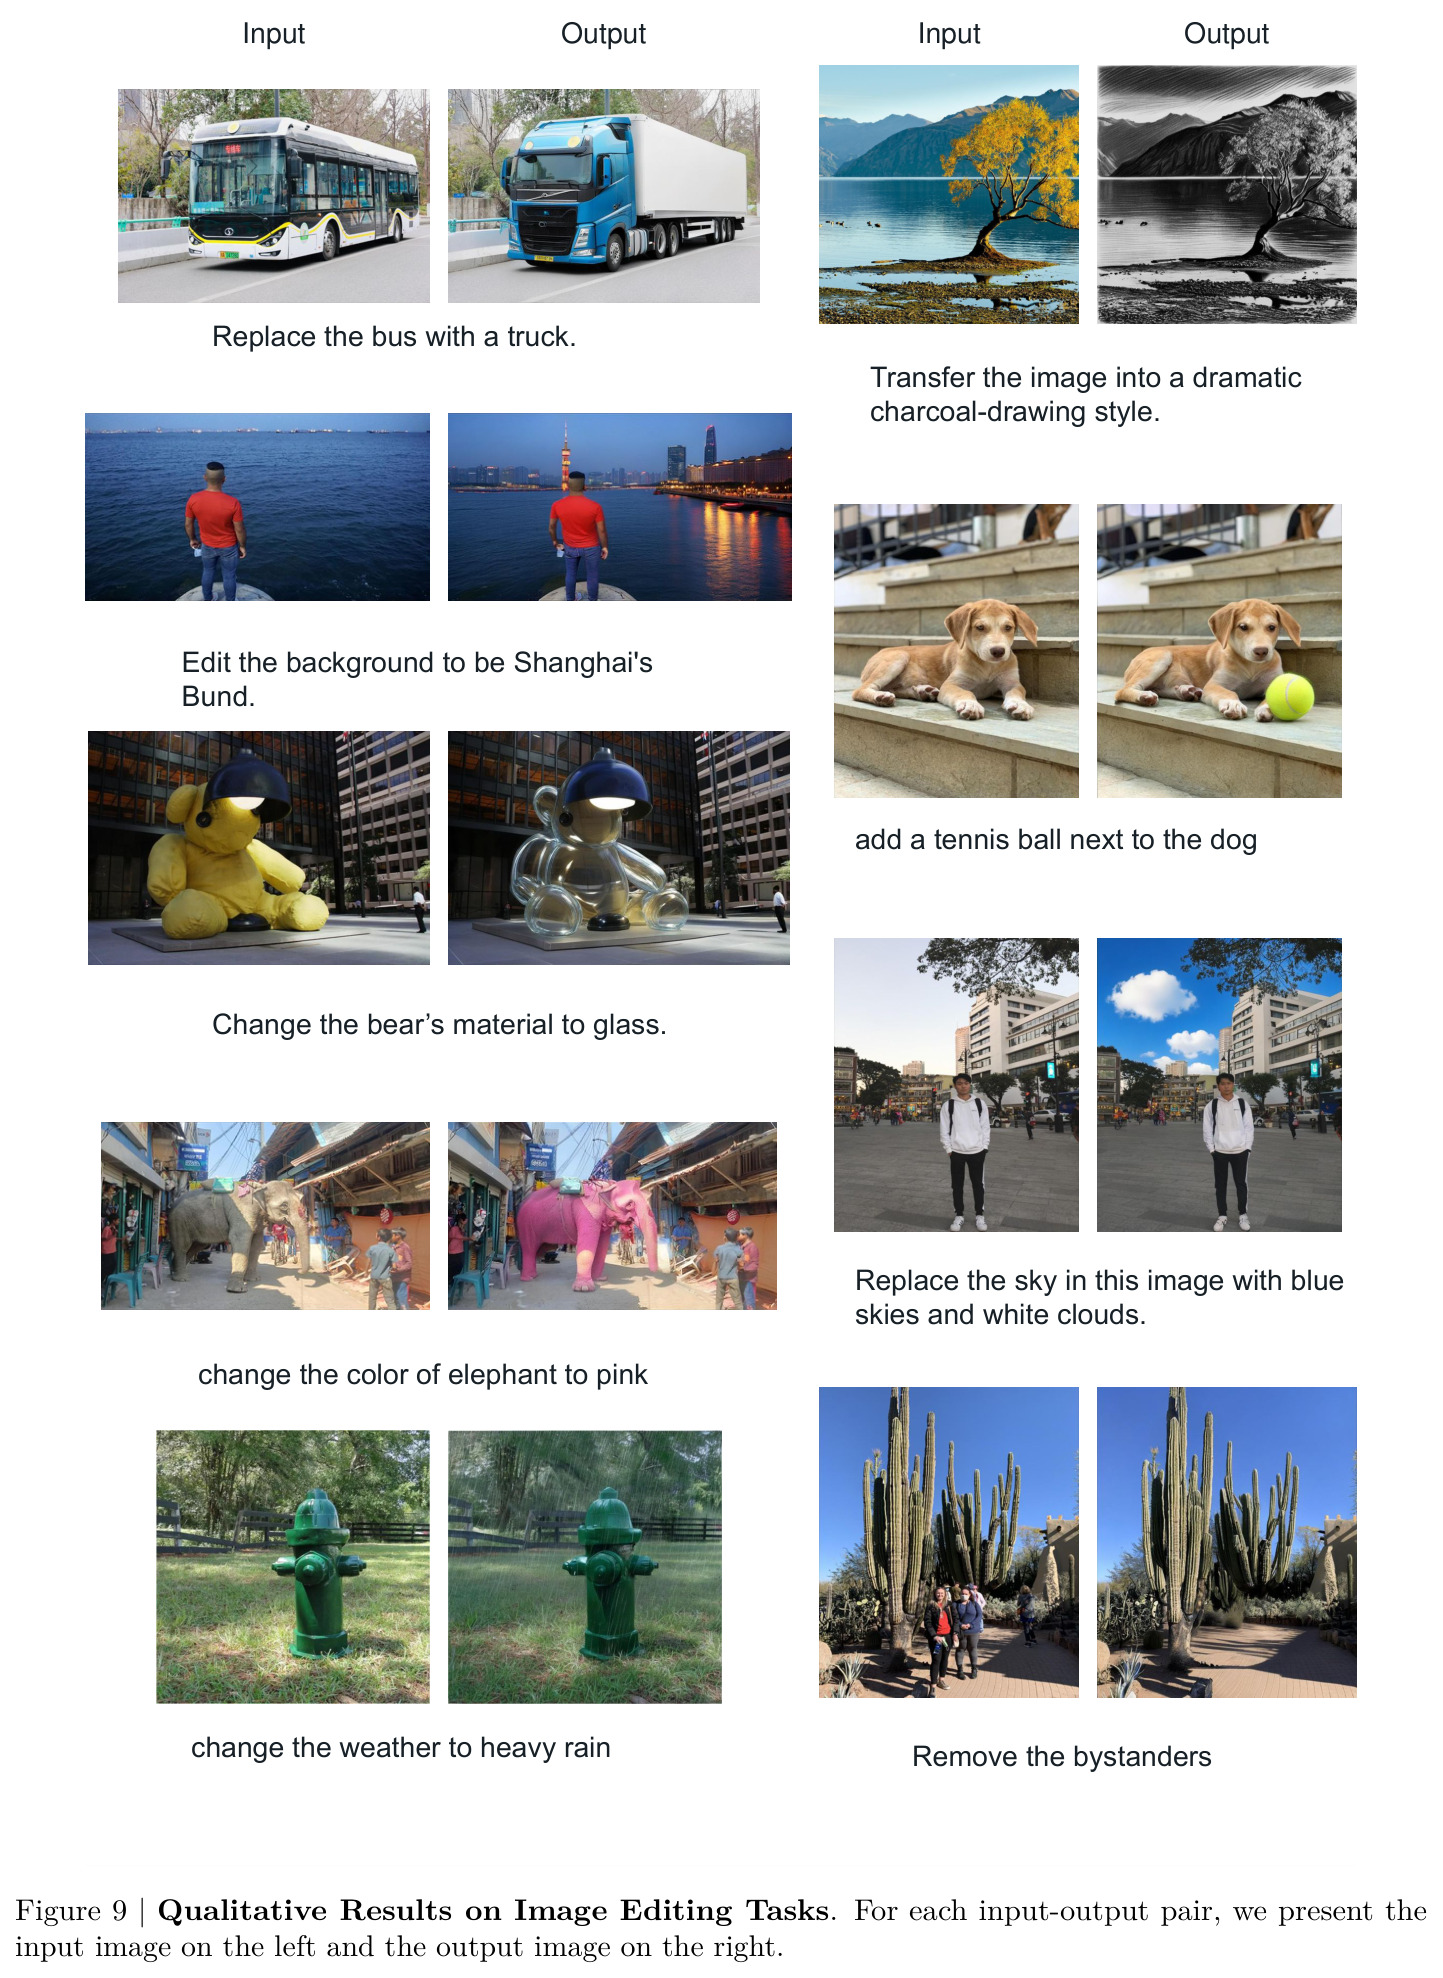
图像理解(Table 1):NLD-Uni 在 11 项基准(含 MMMU、ChartQA、RefCOCO、ScreenSpot-Pro)平均 78.3,比扩散 SOTA LLaDA2-Uni(61.2)高 17.1 分,略超 AR 教师级模型 Qwen3-VL-8B(78.1);ScreenSpot-Pro 从 0.4 升到 49.2(+48.8),RefCOCO 94.1、MMMU 60.7。多模态推理(Table 2):MathVista 71.5→77.0,We-Math 59.8→74.9(+15.1),Geometry3k 54.4→67.9;而朴素 OPD(直接拷贝教师分数)使 MathVista 暴跌至 47.7,反向证明一致性损失必不可少。文生图(Table 3):GenEval 0.89(仅 12B 激活参数,LLaDa-2-Uni 需 16B+6B 混合架构才达 0.89),DPG 86.6,HPSv3 达 11.12,超过 FLUX.1-dev(10.88)与 20B 的 Qwen-Image(10.91),首次让离散扩散模型在人类偏好指标上反超连续扩散模型。图像编辑(Table 4):ImgEdit 4.17,比 Base(3.81)高 0.36,比 Off-Policy KD(3.90)高 0.27,仅低于 Qwen-Image(4.27)与 GPT-4o(4.20),Extract 类从 2.26 跃升至 3.59。消融(Figure 7)显示自精化扩散在 64 步采样、20k 步训练全程优于 uniform/mask/mask+token-edit,HPSv3 提升最显著,收益主要在视觉保真度。
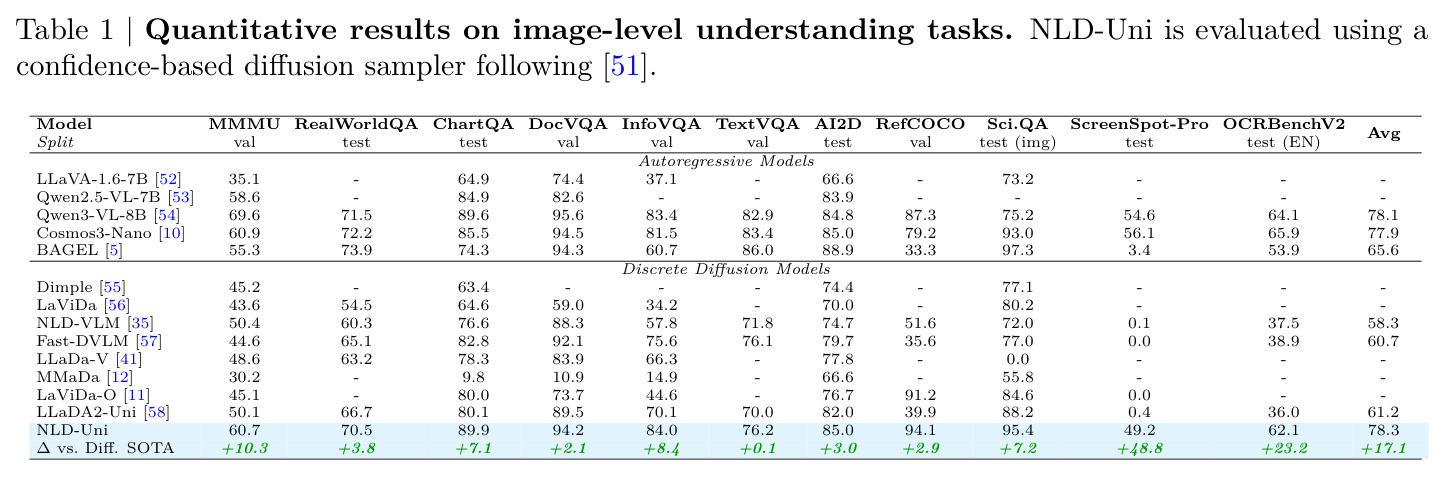
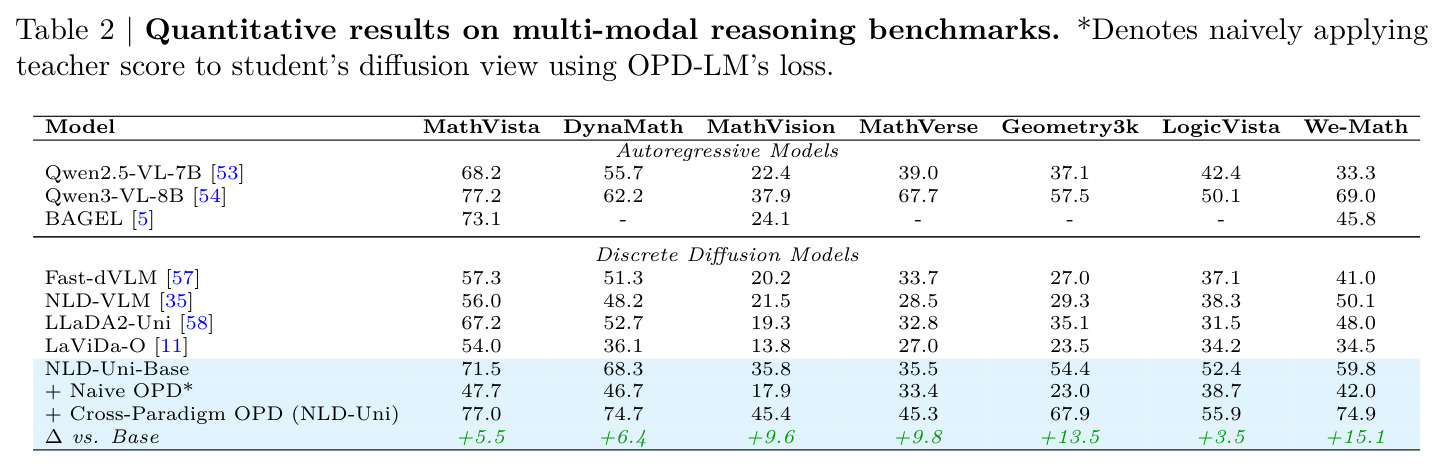
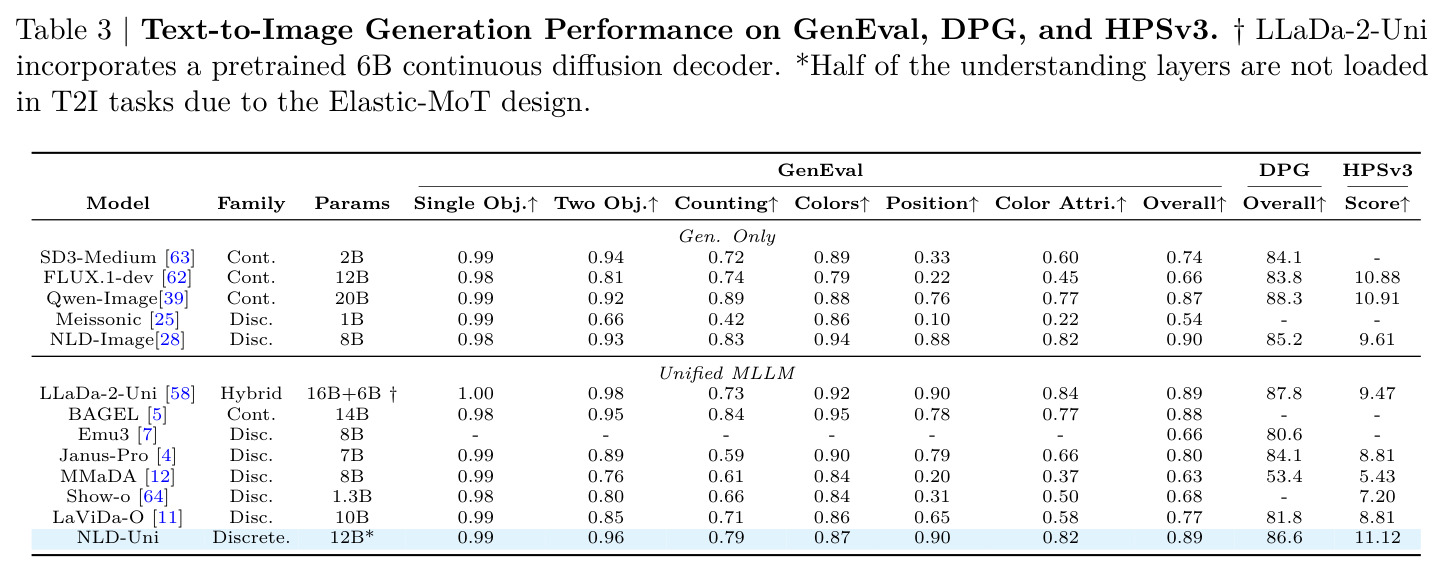
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 图像理解(11 基准平均) | Average Acc | 78.3 | LLaDA2-Uni 61.2;Qwen3-VL-8B 78.1 | +17.1 vs 扩散 SOTA,并略超最强 AR 基线 |
| GUI 接地 ScreenSpot-Pro | Acc | 49.2 | LLaDA2-Uni 0.4 | +48.8,从几乎不可用到可用 |
| 多模态推理 MathVista | Acc | 77.0 | NLD-Uni-Base 71.5;Qwen3-VL-8B 77.2 | +5.5,追平 AR 教师级模型 |
| 多模态推理 We-Math | Acc | 74.9 | NLD-Uni-Base 59.8 | +15.1,OPD 增益最大的推理基准 |
| 文生图 GenEval | Overall | 0.89 | LLaDa-2-Uni 0.89(16B+6B);LaViDa-O 0.77 | 以 12B 激活参数持平混合架构,超 LaViDa-O +0.12 |
| 文生图 HPSv3 | Score | 11.12 | Qwen-Image 10.91;FLUX.1-dev 10.88 | +0.21/+0.24,离散扩散首次反超连续扩散 |
| 图像编辑 ImgEdit | Overall | 4.17 | NLD-Uni-Base 3.81;Qwen-Image 4.27 | +0.36,距教师仅 0.10;OPD 比离线 KD 高 0.27 |
局限与改进
作者承认两点:模型还可通过更好的数据配比与架构优化继续提升(贡献列表末尾明确说明);且理解任务的多数增益“主要归因于扩大训练数据”而非方法本身,跨范式 OPD 与自精化的净贡献主要体现在推理与生成指标上。我的观察:其一,自精化机制只在图像 VQ token 上演示,文本 token 是否受益、中间态在文本上是否有意义未验证;其二,生成侧 OPD 本质是 teacher-refined SFT,依赖教师 VAE 潜空间质量与加噪率超参(附录 C 研究了噪声率),并不是严格的分布匹配蒸馏;其三,ScreenSpot-Pro 49.2 虽大幅超越扩散同类,但仍低于 Cosmos3-Nano(56.1)与 Qwen3-VL-8B(54.6);其四,Elastic-MoT 的三档视图(4B/8B/16B)参数切分是固定的,并非任意粒度的弹性推理。
独立分析的弱点
第一,一致性损失以学生自己的 AR 视图为目标,若 AR 视图早期偏弱,扩散视图会被拉向错误的自身分布,存在自我强化偏差的风险;改进方向是引入教师参与的一致性目标,或按训练进度做课程式权重调度。第二,球树腐蚀假设 VQ 嵌入空间的欧氏距离近似语义距离,但码本几何未必语义连贯,中间态可能对应无意义的“半噪声”token,反而干扰学习;改进方向是改用残差量化(RQ-VAE)等自带粗到细层次的码本,使中间态天然有意义。第三,生成侧因流模型在连续潜空间无法做 KL 匹配,只能用 SFT 式精修,这可能限制学生超越教师精修能力的上限;改进方向是结合分布匹配蒸馏,或对学生 rollout 与教师精修目标做隐式分布对齐。第四,训练成本极高(64×H100×26 天,OPD 阶段 5 天),中小团队无法复现完整流程;改进方向是研究仅在最后阶段做 LoRA 式 OPD、或用小批次高重放的廉价蒸馏方案。第五,三档弹性视图固定切分,实际部署中任务参数需求是连续谱;可与逐层早退、token 剪枝结合做更细粒度控制。
未来方向
作者明确提出模型可通过更好的数据配比与架构优化继续提升。在此基础上可以延伸:把跨范式 OPD 用于纯文本扩散 LM,用强 AR 文本教师对齐学生 rollout,检验传递性目标在纯文本场景的效果;把自精化的中间态思想推广到文本生成,让中间态对应语义近邻词,实现文本的迭代纠错式解码;将 Elastic-MoT 与 token 剪枝、提前退出结合,实现任意推理预算的弹性控制;把 OPD 与在线 RL(如 GRPO)结合,用教师精修质量作为奖励信号做进一步对齐;以及把该框架扩展到视频等更长序列,检验球树腐蚀在大码本、长序列下的可扩展性与采样步数-质量的权衡。
复现评估
论文声明 Model and Code are publicly available,权重与代码开源是复现的最大利好。但三阶段完整训练需 64 张 H100 跑 26 天(约 1600 H100·天),其中 OPD 阶段 5 天,学术界从零复现训练不现实;正文未列全数据配比细节(在附录 B),语义编码器与 VQ 码本的具体来源、ball-tree 构建脚本是否随代码发布需要在仓库中确认。评估侧门槛低得多:所有基准(GenEval、DPG、HPSv3、ImgEdit、MathVista、ScreenSpot-Pro 等)公开可用,推理用 64 步扩散采样,12B 激活参数在单张高端卡上可跑。对工程团队的务实建议:直接下载权重做微调、或把它蒸馏到更小的学生模型是可行路径;从零复现三阶段训练则不建议尝试。
论文图表
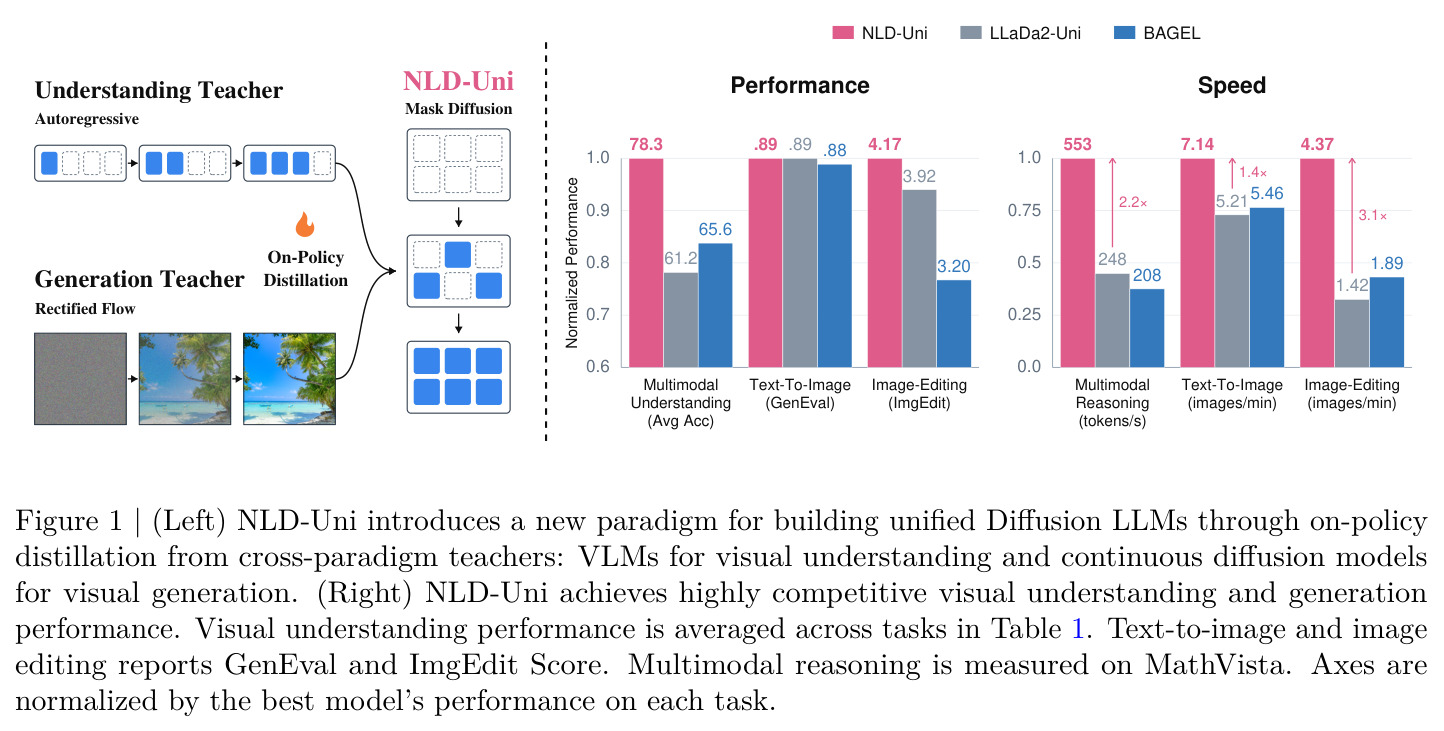
左图展示新范式:从 AR VLM 教师蒸馏视觉理解、从连续扩散教师蒸馏视觉生成到统一 DLLM;右图用归一化轴对比 NLD-Uni、LLaDA2-Uni、BAGEL 在多模态理解(平均准确率 78.3)、文生图(GenEval 0.89)、图像编辑(ImgEdit 4.17)与推理速度上的表现。
一张图讲清论文的问题定位(DLLM 落后于专才模型)和最终成绩单与速度优势,是判断论文价值的入口。