LociArt:自由风格局部视频风格化的统一范式 LociArt: A Unified Paradigm for Free-Style Local Video Stylization
以极坐标风格掩码统一「改哪里」与「什么风格」,单区域单风格训练即可零样本组合多区域多风格
前置知识
生成精炼网络(GRN)与二值潜码
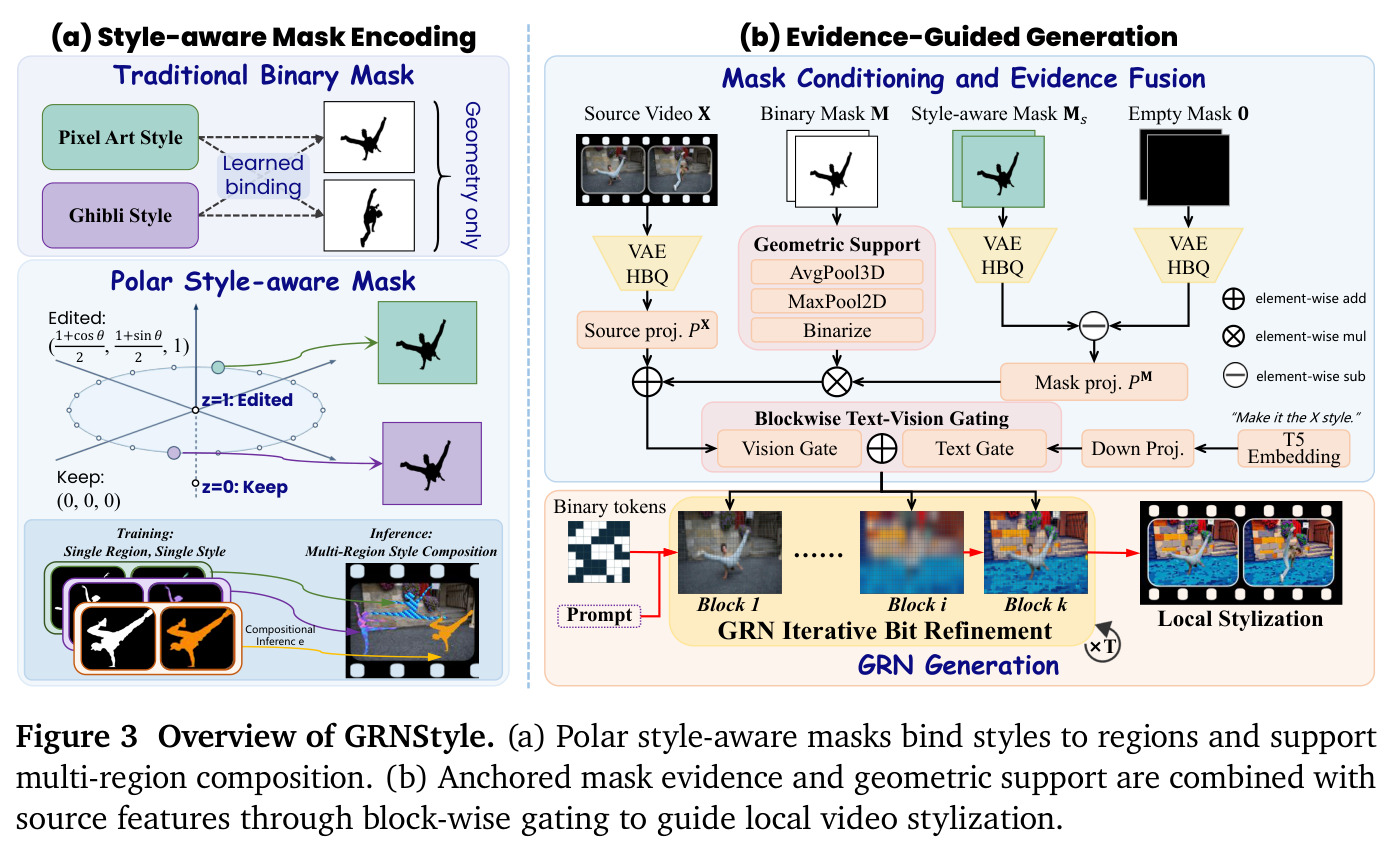
GRN 是一种非扩散的视频生成范式:视频先经编码器 $E$ 与二值量化器 $Q$ 压缩为 $L$ 个位置、每位置 $D$ 比特的二值码 $B_X = Q(E(X)) \in \{0,1\}^{L\times D}$,随后模型从随机或部分随机的二值状态出发,通过并行迭代精炼逐步把比特翻转成目标视频的码,最后解码回视频。GRNEdit 进一步把源视频码作为「证据」输入网络,指示哪些比特保留、哪些改变,从而实现源引导的视频编辑,风格码也采用等范数形式以避免人为排序。
GRNStyle 直接构建在 GRN/GRNEdit 之上,理解二值比特精炼与源证据保留机制,是读懂其「证据引导生成」设计与全文比特交叉熵损失的前提。
极坐标等范数风格编码
把每个风格类别映射到单位圆上固定角度 $\theta_s$ 的方向向量 $\boldsymbol{a}_s=(\cos\theta_s,\sin\theta_s)$,满足 $\|\boldsymbol{a}_s\|_2=1$。风格之间靠方向区分而非数值大小,因此风格码之间不存在人为的标量排序;论文使用固定 100 槽圆形码本,相邻方向最小距离为 $2\sin(\pi/100)\approx 0.063$,而所有风格码到空条件的距离至少 $\sqrt{7}-2\sqrt{2}\approx 2.04$。
这是核心创新「极坐标风格感知掩码」的数学基础,也是推理时零样本叠加多区域多风格、以及新风格无回放扩展实验能够成立的关键。
掩码条件化的表征-几何权衡
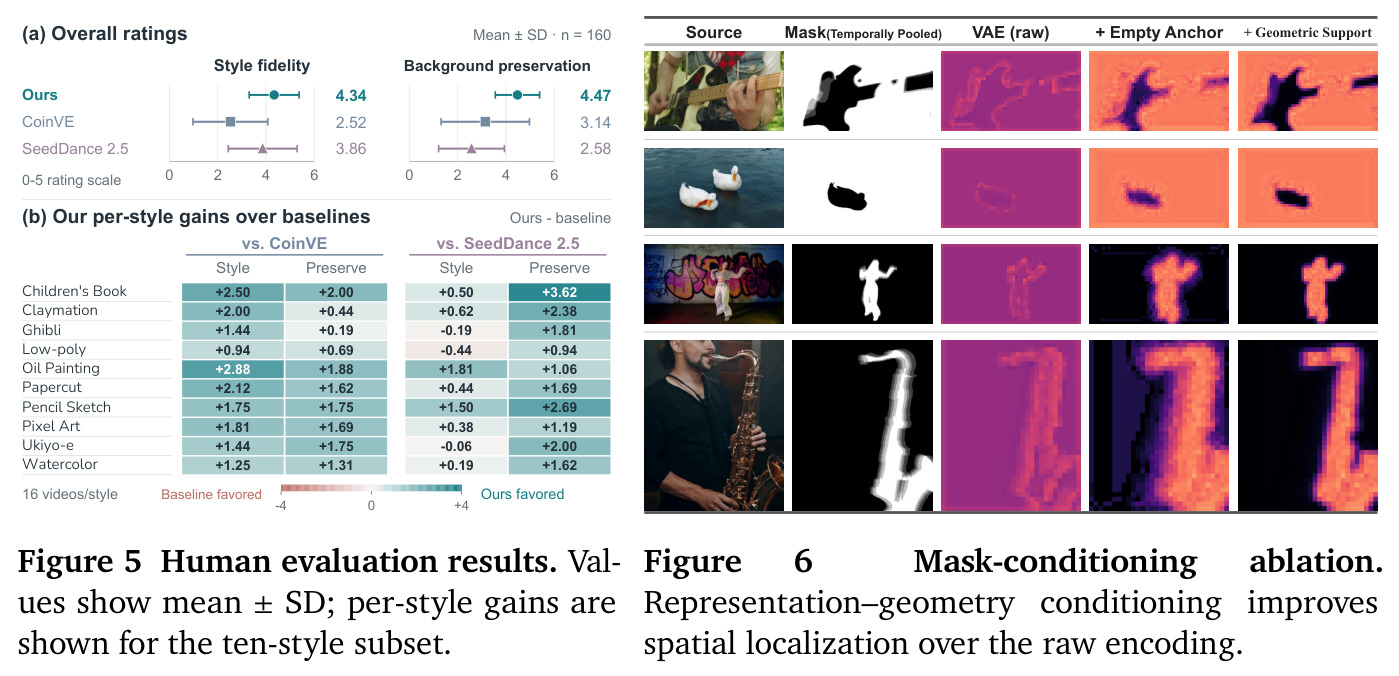
视频生成模型在 VAE 潜空间上工作:掩码若经 VAE 编码可获得与时序特征对齐的语义上下文,但压缩会模糊几何边界;若直接对原始二值掩码池化重采样则保留空间结构却缺少时序语境。本文用两条互补通路兼得二者:空掩码锚定 $\Delta Z_M=\Phi(M^s)-\Phi(0)$ 提供表征证据,几何支撑 $\Omega(M)=\mathbb{1}[\mathrm{MaxPool}(\mathrm{AvgPool}(M))\ge 0.5]$ 提供定位。
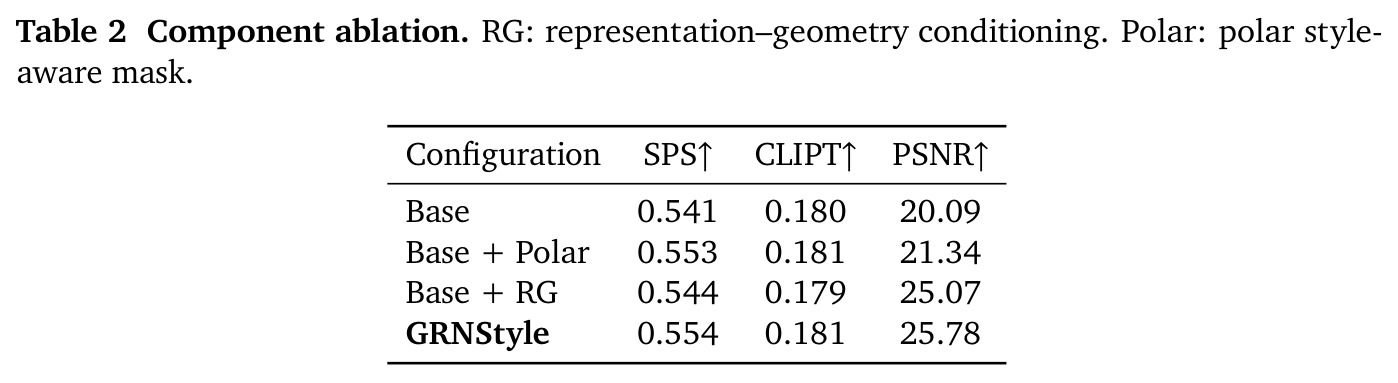
论文的「表征-几何条件化(RG)」正是围绕这一权衡设计,是理解消融实验中 RG 使 PSNR 从 20.09 提升到 25.07 dB 的关键。
CSD 与风格原型相似度(SPS)
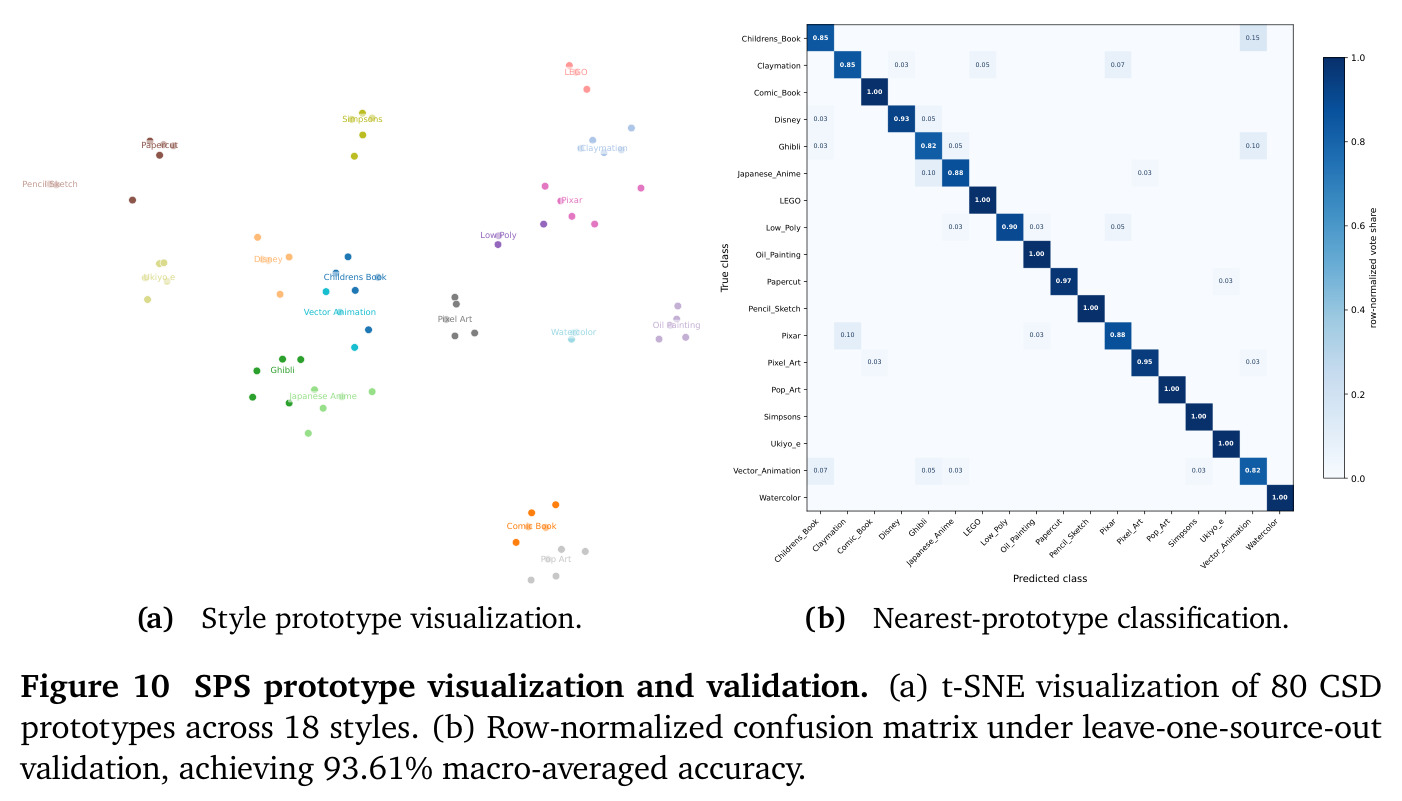
对比风格描述子(CSD)是专为度量图像风格设计的特征空间。SPS 先对通过质量门的风格化视频逐帧提取 768 维 CSD 描述子,按风格做 k-means(候选簇数 $k\in\{3,5\}$,按轮廓系数自动选择)得到 18 类风格共 80 个原型;评分时取编辑区域描述子与所属风格原型集的最大余弦相似度,再按帧、按视频两级平均。留一源验证的 18 类分类精度达 93.61%。
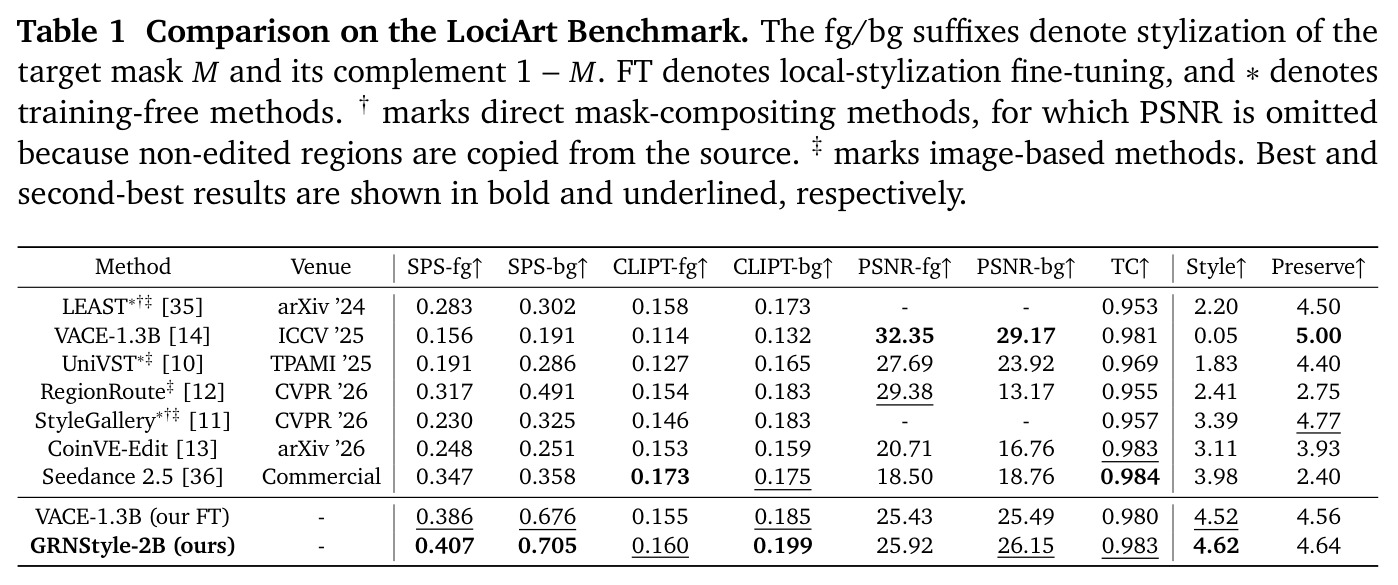
SPS 是 LociArt Benchmark 的核心指标,主实验表(Table 1)的 SPS-fg/SPS-bg 两列直接衡量「区域风格保真度」,看懂主结果必须理解它的构造方式。
视频对象移除与 alpha matting 合成
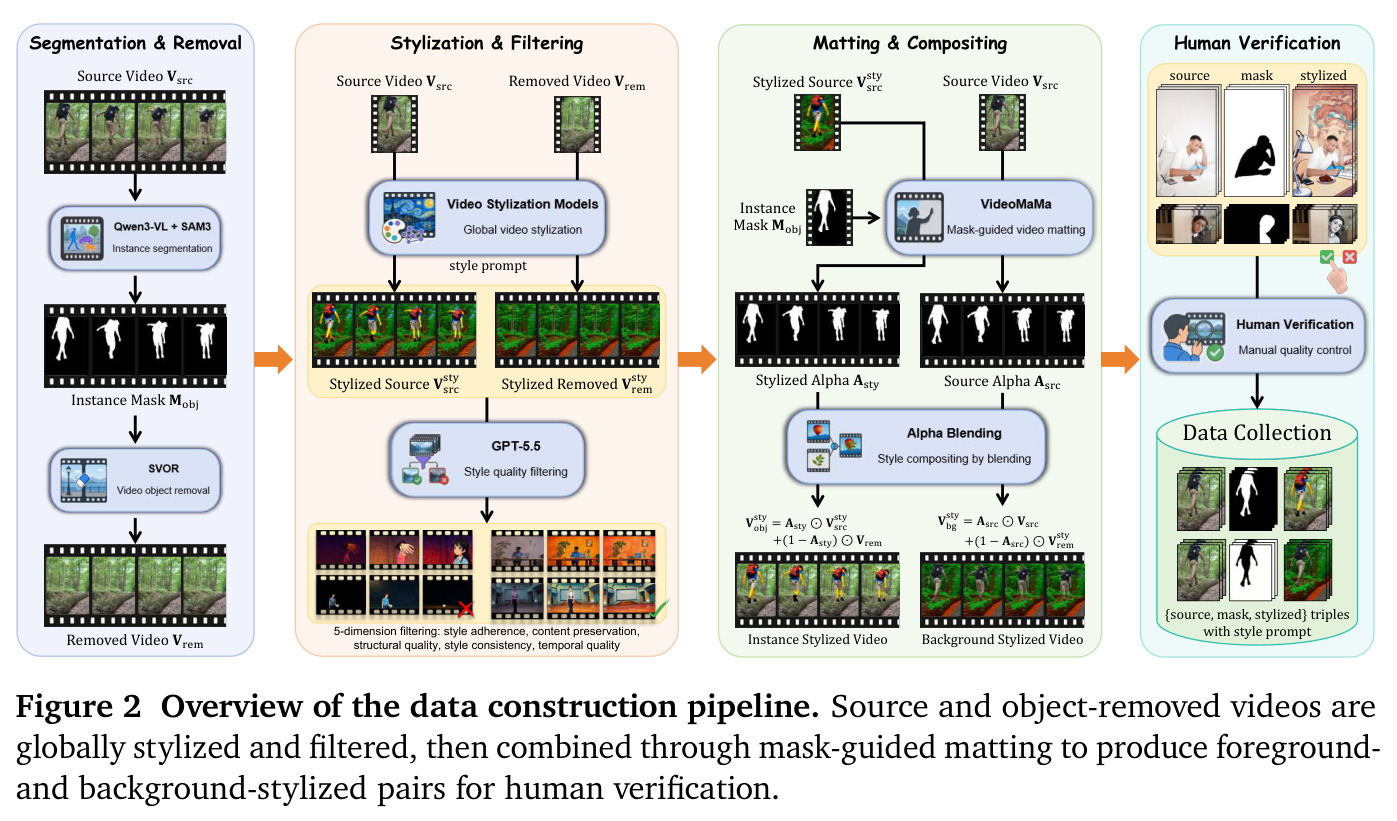
视频对象移除(如 SVOR)把选中物体从视频中抹掉并补全背景,得到无遮挡的「干净底版」;alpha matting(如 VideoMaMa)为前景估计逐像素软透明度 $A\in[0,1]$,能贴着真实轮廓混合。合成公式 $V^{sty}_{fg}=A^{sty}\odot V^{sty}_{src}+(1-A^{sty})\odot V^{rem}$ 用风格化前景与干净背景按各自轮廓软混合,避免鬼影和轮廓裁剪。
这是 LociArt-100K 数据构建的核心技术,解释了训练对如何同时监督「编辑区域风格化」与「非目标保留」这两件看似矛盾的事。
研究动机
现有视频风格化方法大多做全片全局变换:要么按文本提示把整个场景统一转成某种画风,要么以参考图驱动整体外观迁移。但实际艺术创作常需要局部控制——让运动中的主体变成铅笔素描而背景不动、把环境重画成水彩而主体保留、甚至同一镜头内不同物体呈现不同风格(论文 Figure 1 展示了前景、背景、全局、多掩码单风格、前+后景组合、双主体双风格共六种情形)。把视频分割掩码当空间先验只解决了「改哪里」,但二值掩码本身不携带「改成什么风格」的信息,风格只能由独立文本提供,模型必须自己学会把外观与区域对齐。可靠局部控制还要求在运动中保持区域边界:VAE 编码掩码虽能与视频特征对齐但压缩会模糊几何,直接重采样保留空间结构却缺时序语境,这是个两难。此外监督与评估都有缺口:全局风格化配对数据无法直接监督「局部编辑+周围保留」,指令式视频编辑数据集覆盖面广但不针对风格化;而全局相似度和视频平均分会掩盖「区域风格弱、目标外误改、瞬时闪烁」等局部失败。
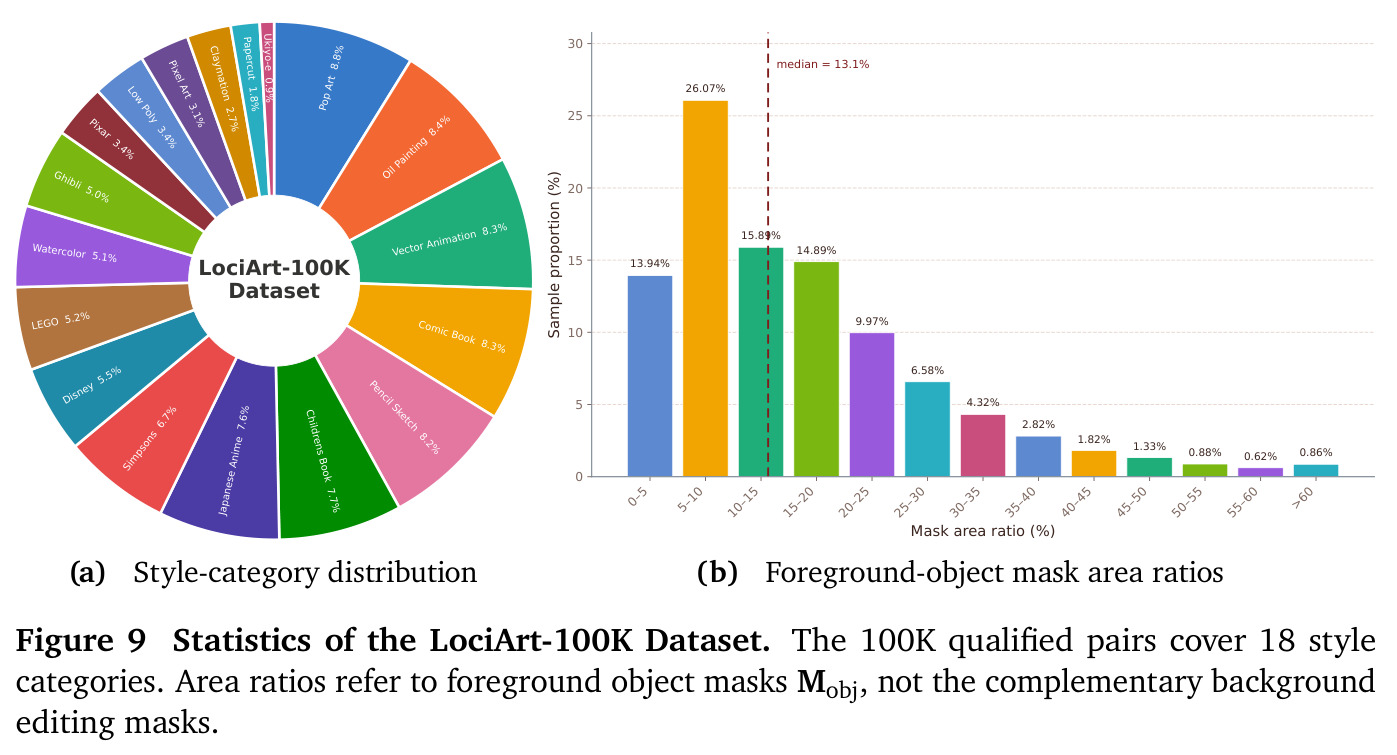
本文的目标是本文要建立「自由风格局部视频风格化」的统一范式:给定源视频、编辑掩码和风格指令,模型只把掩码指定区域变换成指定风格,同时严格保留非目标内容并在时间轴上保持一致;且不依赖组合式训练对,就能在推理时零样本地把多个区域组合成相同或不同风格。论文交付三个可量化组件:其一是自动化数据流水线构建的 LociArt-100K(100K 对、18 类风格,含源视频-掩码-指令-局部风格化目标四元组);其二是 GRNStyle 模型(GRN-2B 骨干 + 极坐标风格感知掩码 + 表征-几何条件化);其三是 LociArt Benchmark(80 源视频、84 个对象-掩码单元、前/后景双协议共 168 个案例)以及以 SPS 为核心、辅以保留度与时序一致性的区域感知评估体系。
与已有工作不同的是,已有局部编辑工作各缺一角:UniVST 等免训练方法靠掩码传播加 AdaIN/注意力操纵,无成对监督且边界控制粗糙;VACE、VideoPainter 等掩码条件模型能统一视频条件,却把掩码当纯几何通道,风格仍靠文本间接绑定;RegionRoute、StyleGallery 等图像方法有区域控制但难以保证时序一致。本文抓住两个被忽视的点:其一,「风格-区域绑定」应当在视频编码之前就显式写进输入表示,而不是让网络从分离的掩码与文本中隐式学交互——附录 B.3 证明任何加性读出 $f(m,s)=f_M(m)+f_S(s)$ 的最小平方误差 $\beta(1-\beta)(1-\|\boldsymbol{\mu}\|^2)$ 严格为正,而极坐标编码的线性读出误差恰为零;其二,训练与评估都应区域感知,用全局分评估局部编辑会系统性高估。数据侧的「全局风格化+对象移除+matting+合成」分解,则提供了免人工成对采集的可扩展路径。
核心方法
直觉上,GRNStyle 像一位按图施工的画师:你在视频上圈出区域(掩码),并在圈内直接「涂」上风格编号(极坐标方向),模型据此只改圈内内容、圈外逐帧保持原样。技术路线分四块:(1) 输入表示——把三通道 VAE 掩码输入改造成极坐标风格感知掩码 $\mathcal{M}^s(q)=\mathcal{M}(q)\left[\frac{1+a_{s,1}}{2},\frac{1+a_{s,2}}{2},1\right]$,前两通道存风格方向、第三通道保留二值占据;(2) 条件化——冻结映射 $\Phi=\phi\circ Q\circ E$ 同时编码源视频与掩码,掩码证据用空掩码锚定 $\Delta Z_M=\Phi(M^s)-\Phi(0)$ 保证「无编辑=零证据」,几何支撑 $\Omega(M)$ 由平均池化加最大池化加阈值化得到,负责在潜网格上定位;(3) 注入——源投影与掩码证据相加得 $U=P_X(Z_X)+\Omega(M)\odot P_M(\Delta Z_M)$,经视觉加文本的通道门控后以残差注入第 1/13/25 个 DiT 块,条件分支仅新增 8.50M 参数(约 0.43%);(4) 生成——GRN 式并行比特迭代精炼,全视频逐比特交叉熵同时监督风格化与保留。
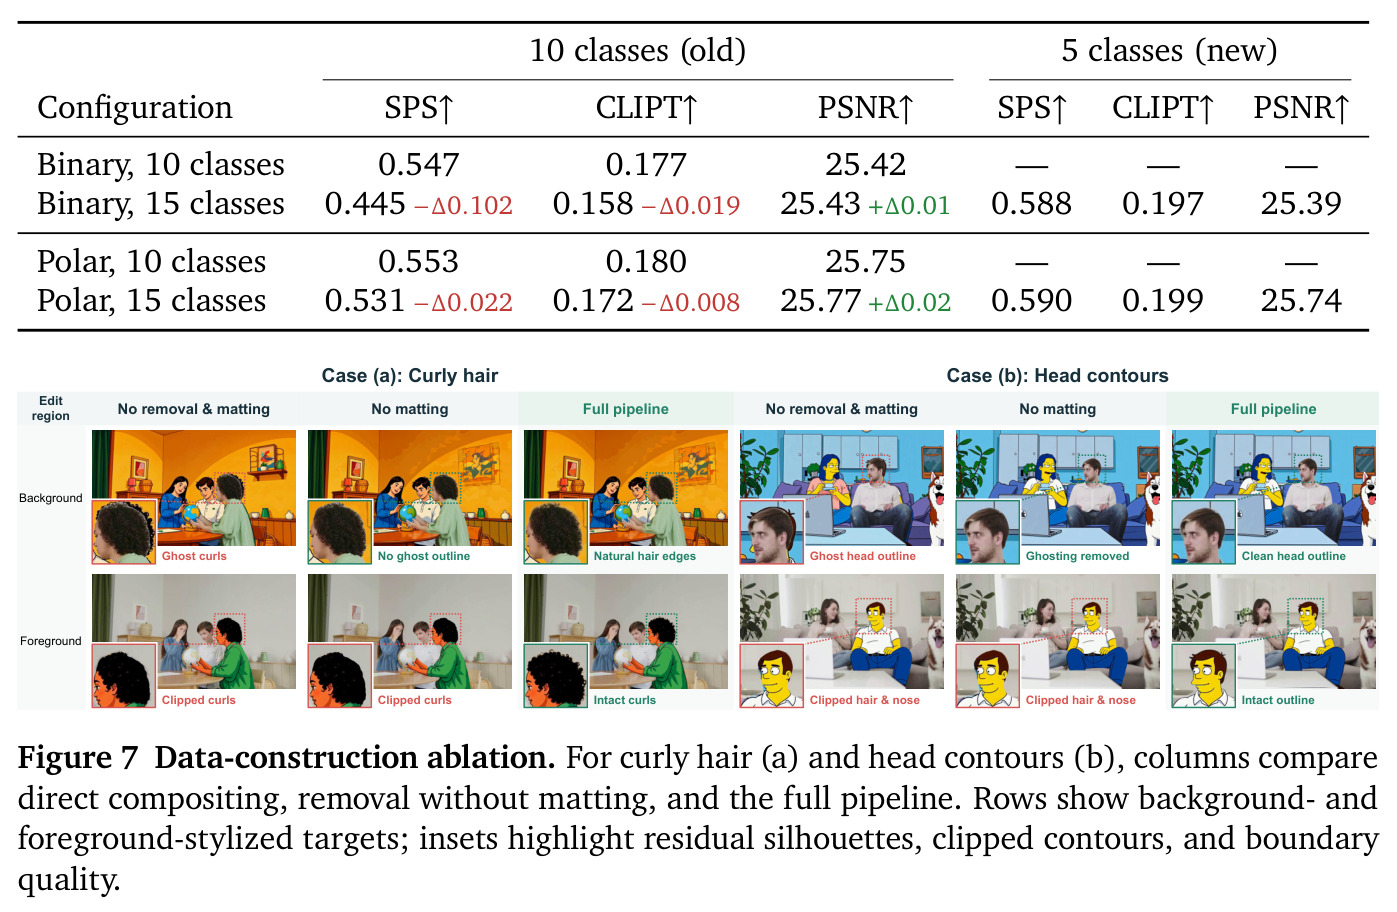
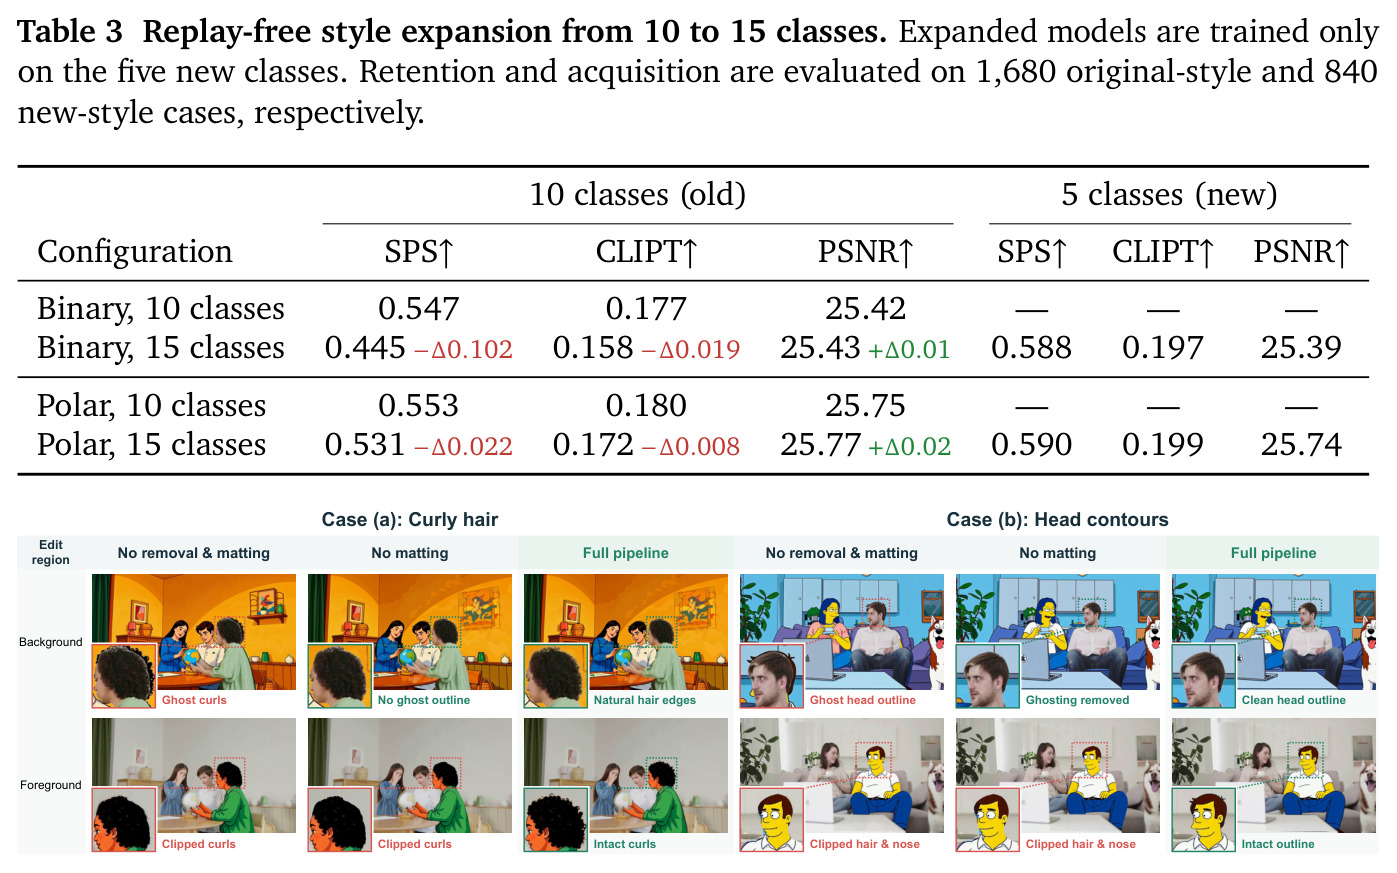
核心创新是「极坐标风格感知掩码」:风格身份不再由分离的文本条件隐式指定,而是在视频编码之前就以等范数方向的形式写进掩码像素本身。由于 $\|\boldsymbol{a}_s\|_2=1$,各风格仅靠方向区分,避免了把风格排成一条假想数轴;第三通道保留二值占据,使「编辑/保留」判别线索与风格类别无关,并让所有风格码远离空掩码条件($\sqrt{7}-2\sqrt{2}\approx 2.04$,而球面编码只有 $\sqrt{3}-1\approx 0.73$)。这带来两个本质区别:其一,线性读出 $R(\mathcal{M}^s(q))=\mathcal{M}(q)\boldsymbol{a}_s$ 精确恢复区域-风格交互,训练只见过单区域-单风格,推理时按 $\mathcal{M}^s_{multi}(q)=\sum_r \mathcal{M}^s_r(q)$ 直接叠加即可零样本组合多区域多风格,全程单条精炼轨迹、不加通道不加 token;其二,显式风格身份让新增风格只需学一个新方向,无回放把 10 类扩到 15 类时旧类 SPS 仅降 0.022,而二值掩码方案降 0.102。这与把掩码当纯几何通道的 VACE 类模型形成鲜明对比。
方法步骤详情
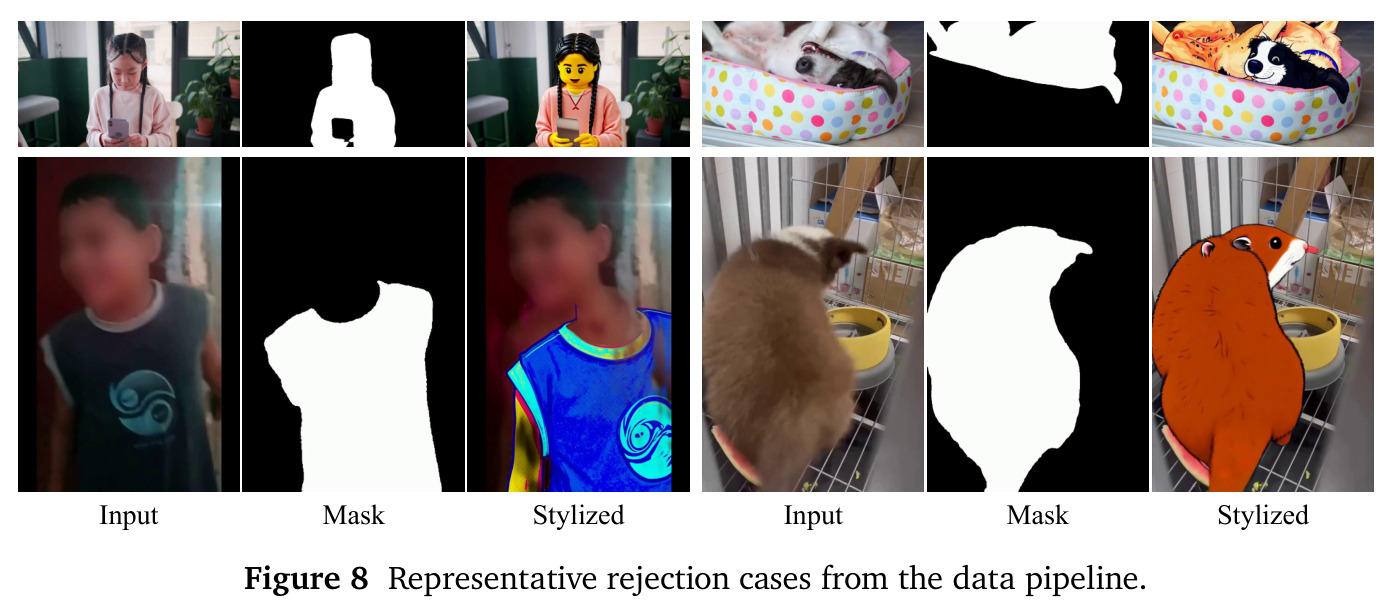
第一步,数据构建(Figure 2):Qwen3-VL-32B 从 SA-V 与 Ditto-1M 源视频中识别显著物体,SAM3 生成时序跟踪掩码(要求超 40% 帧非空、单帧面积不超过 85%),SVOR 移除物体得到干净背景 $V^{rem}$;Ditto 与内部微调的 VACE 分别对源视频和去物视频做全局风格化 $V^{sty}_{src}=G(V^{src},p)$、$V^{sty}_{rem}=G(V^{rem},p)$;GPT-5.5 在 81 帧中采 5 帧,按五维 1-5 分级联双门过滤(风格 4/内容 4/结构 3/一致性 4/时序 4),通过率 52.4%;VideoMaMa 对源与风格化视频分别估计 alpha $A^{src},A^{sty}$,按 $V^{sty}_{fg}=A^{sty}\odot V^{sty}_{src}+(1-A^{sty})\odot V^{rem}$ 及对称公式合成前景/背景两类目标,人工复核通过率 65%,最终得 100K 对、18 风格、81 帧 720p。第二步,训练:从预训练 GRNEdit 初始化,全量微调 2B 骨干与条件分支(冻结视频分词器与 T5),61 帧 20fps 片段、50% 概率把风格文本替换为通用「跟随掩码」指令,10 epochs、8 卡 H200、峰值学习率 $4\times10^{-5}$、BF16。第三步,推理:随机目标比特在同样条件下迭代精炼并解码;多区域时按 $\mathcal{M}^s_{multi}(q)=\sum_r \mathcal{M}^s_r(q)$ 直接叠加极坐标编码并用 $\Omega(M_{union})$ 定位证据,单条轨迹完成组合生成。
技术新颖性
与现有技术的具体区别:(1) 相比 AdaIN/注意力操纵类免训练方法(UniVST、Xia et al.),本文有成对监督,且风格-区域在输入层显式绑定而非事后操纵特征;(2) 相比 VACE/VideoPainter 把掩码当几何条件通道,本文掩码同时携带风格身份(极坐标通道)与几何支撑(MaxPool/AvgPool 二值通路),并用空掩码锚定保证无编辑时零响应;(3) 相比区域注意力学习类方法需要在注意力结构上动手,本文只改 VAE 输入的三个通道语义,不增加通道或条件 token,条件分支仅 8.50M 参数;(4) 相比扩散模型逐步去噪,GRN 二值比特并行精炼天然支持源证据保留,全视频比特交叉熵把风格化与保留统一进一个目标;(5) 附录 B.3 给出可证明的表示优势——任何加性读出存在下界为正的交互误差,而极坐标场编码后线性读出误差为零,这在新风格无回放扩展实验(旧类 SPS 降 0.022 对二值的 0.102)中得到实证支撑。
实验结果
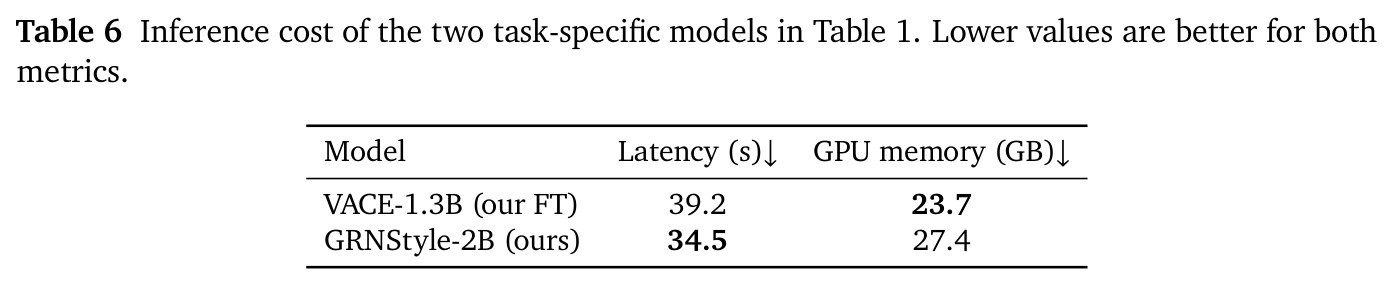
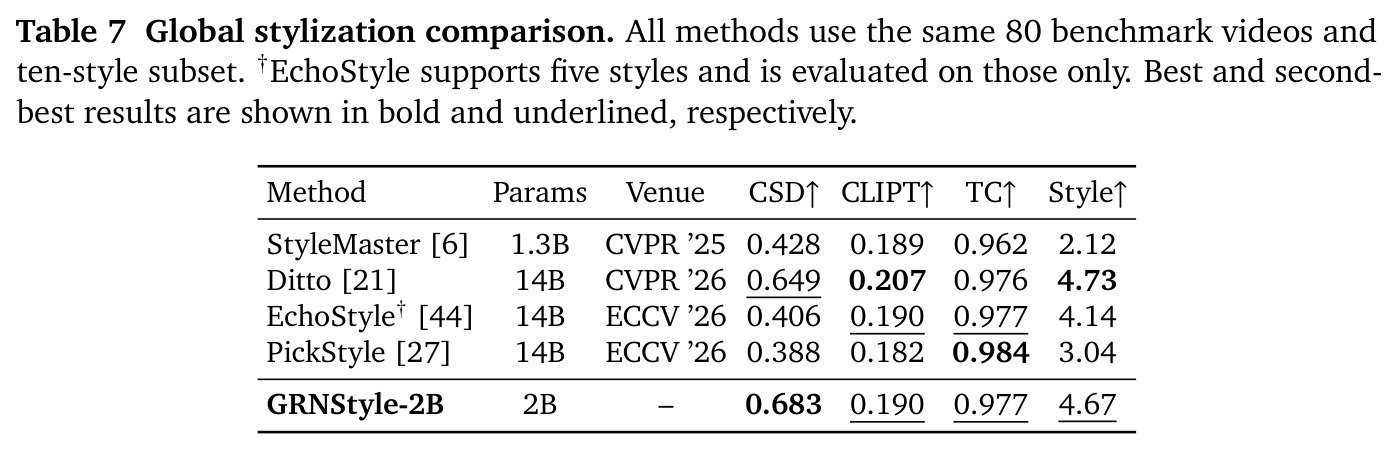
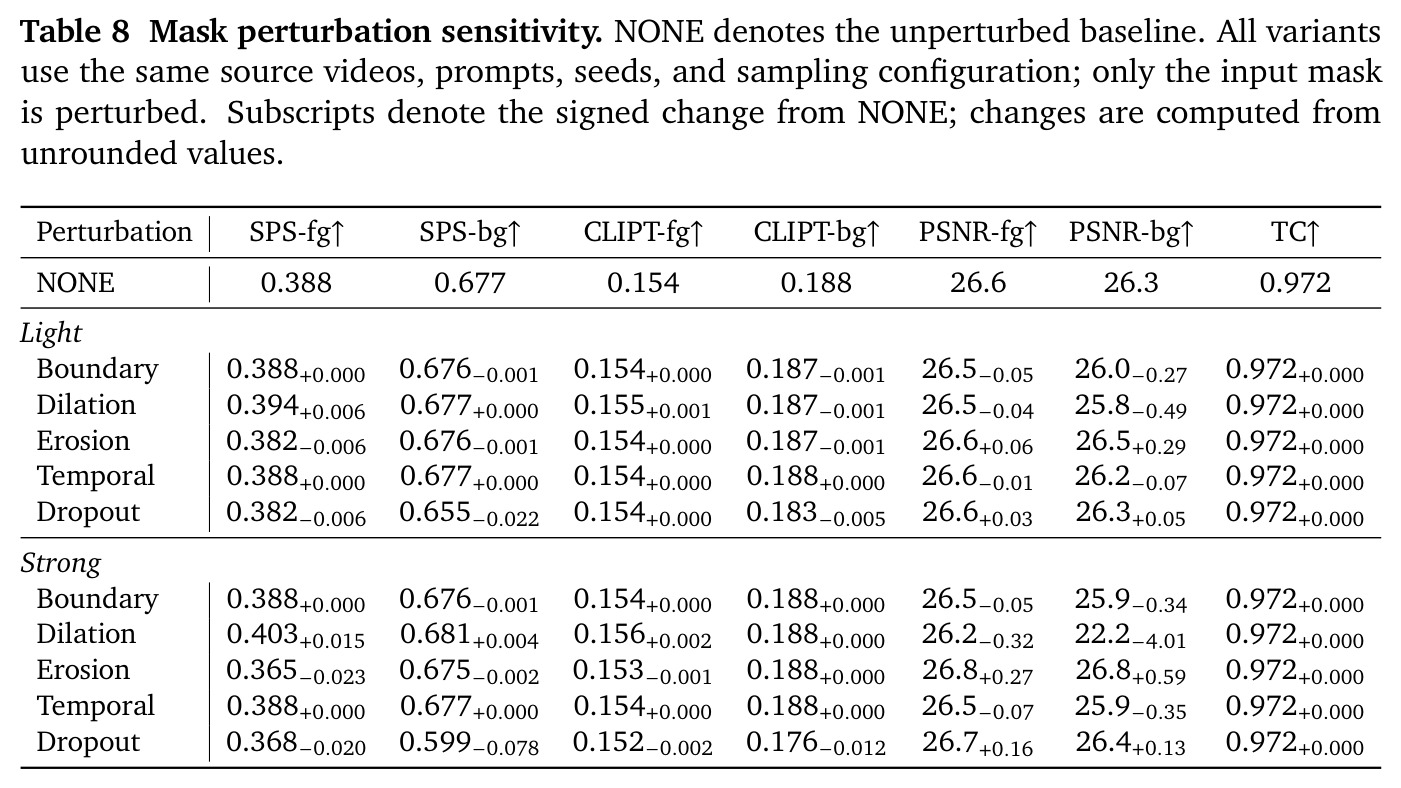
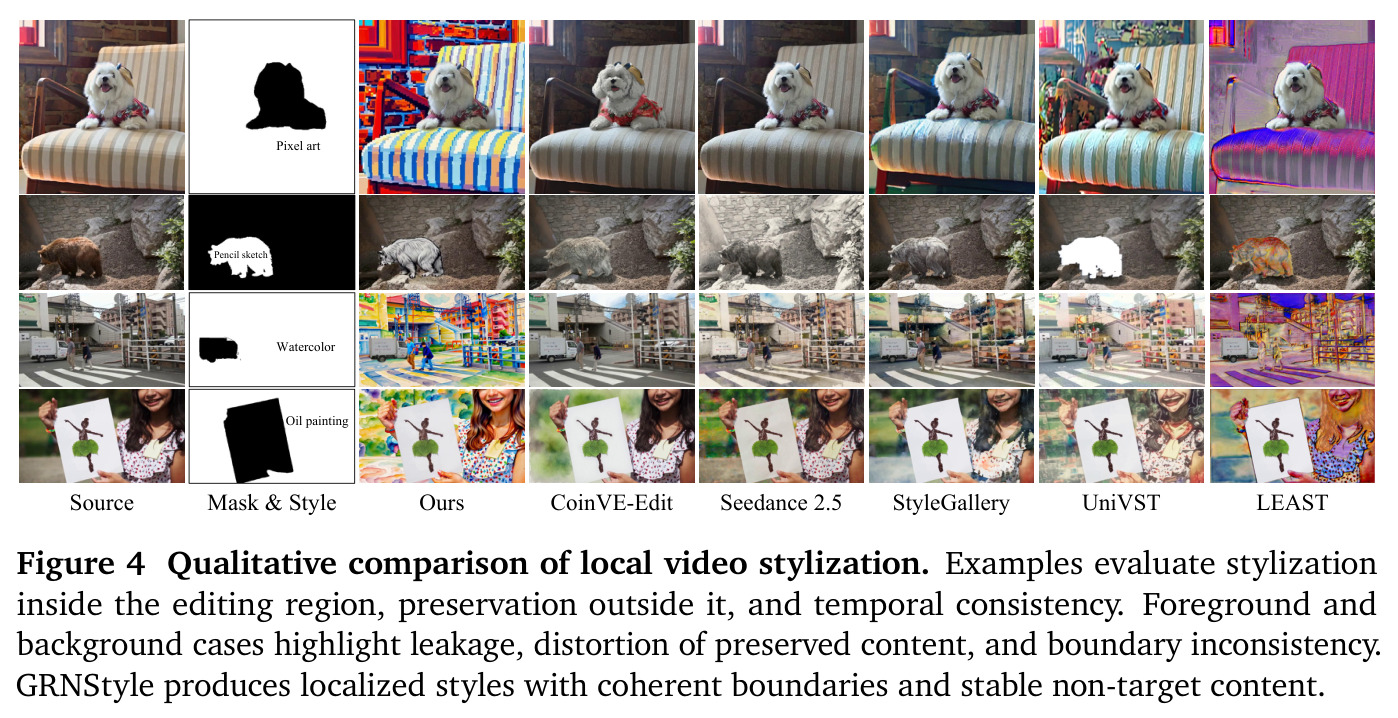
主实验(Table 1,168 案例):GRNStyle-2B 取得最佳 SPS-fg 0.407 与 SPS-bg 0.705(次优为 RegionRoute 的 0.317/0.491,未微调 VACE-1.3B 仅 0.156/0.191),最佳 CLIPT-fg 0.160 与 CLIPT-bg 0.199,背景 PSNR 26.15 dB 次优、TC 0.983 接近最优,VLM 分数 Style 4.62 最高且 Preserve 4.64 同为最高,说明风格化提升不以牺牲保留为代价;同数据微调的 VACE-1.3B(0.386/0.676)仍全面落后,证明收益来自条件化设计而非单纯任务数据(原版 VACE 的高 PSNR 32.35 来自几乎不做风格化,不构成更好的权衡)。用户研究(20 人×160 案例):GRNStyle 风格保真 4.34、背景保留 4.47 均最高,对比 CoinVE-Edit 的 2.52/3.14 与 Seedance 2.5 的 3.86/2.58,对 CoinVE 十风格两项全胜,对 Seedance 保留十项全胜、风格保真 7/10 胜。消融(Table 2):RG 把 PSNR 从 20.09 提到 25.07 dB 而 SPS 几乎不变,叠加 Polar 后 SPS 0.541→0.554、PSNR 25.78 dB,二者正交互补。无回放扩展(Table 3):10→15 类时极坐标旧类 SPS 仅降 0.022,二值方案降 0.102,新类得分两者持平略优。全局风格化(Table 7):全一掩码免重训下 CSD 0.683 超过 14B 的 Ditto(0.649)。效率(Table 6):34.5s/27.4GB,比微调 VACE-1.3B 快 12%。鲁棒性(Table 8):轻度掩码扰动各指标变化不超过 0.006/0.49dB。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 局部视频风格化(前景) | SPS-fg | 0.407 | Seedance 2.5: 0.347 | +0.060 |
| 局部视频风格化(背景) | SPS-bg | 0.705 | VACE-1.3B(our FT): 0.676;RegionRoute: 0.491 | +0.029 / +0.214 |
| 区域-风格文本对齐 | CLIPT-fg / CLIPT-bg | 0.160 / 0.199 | Seedance 2.5: 0.173 / 0.175 | fg 略低,bg +0.024 |
| 非目标内容保留 | PSNR-bg (dB) | 26.15 | VACE-1.3B(our FT): 25.49 | +0.66 dB |
| 时序一致性 | TC | 0.983 | Seedance 2.5: 0.984 | 基本持平(-0.001) |
| VLM 感知评估 | Style / Preserve(0-5) | 4.62 / 4.64 | Seedance 2.5: 3.98 / 2.40 | +0.64 / +2.24 |
| 用户研究(风格保真) | 0-5 主观评分 | 4.34 | Seedance 2.5: 3.86;CoinVE-Edit: 2.52 | +0.48 / +1.82 |
| 无回放风格扩展 10→15 类 | 旧类 SPS 保持 | -0.022(0.553→0.531) | 二值掩码: -0.102(0.547→0.445) | 遗忘减少约 4.6 倍 |
| 全局风格化(全一掩码免重训) | CSD | 0.683(2B) | Ditto 14B: 0.649 | +0.034,约 1/7 参数量反超 |
| 推理效率 | 时延 (s) / 显存 (GB) | 34.5 / 27.4 | VACE-1.3B(our FT): 39.2 / 23.7 | 时延 -12%,显存 +15.6% |
局限与改进
作者承认三点:快速运动物体(尤其运动边界附近)的时序一致性会退化,可能出现局部闪烁或边界不一致;数据流水线依赖的对象移除模型可能把物体投影一并抹掉,导致部分训练目标缺少本应存在的阴影,模型会学出「擦阴影」的倾向;评估体系缺少边界贴合度指标,且不同风格会有意扩张或收缩物体轮廓,统一边界真值难以定义。我的补充观察:SPS/CLIPT 的区域定位依赖 VideoMaMa 对输出视频的 alpha 估计,评估本身存在循环性——模型边界出错时指标定位也跟着错;SPS 原型库全部来自同一数据流水线的全局风格化输出,对该流水线的系统性偏差有偏好;训练与评测都限定在 18 个离散风格类别,自由文本描述的新风格能否泛化未经验证;SPS-bg 0.705 与 SPS-fg 0.407 的巨大差距说明前景区域风格保真仍远未解决(前景面积小、轮廓运动更剧烈);此外数据过滤与评估分别依赖 GPT-5.5 与 Gemini 3.6 Flash 等闭源模型,第三方复现与长期可比性受限。
独立分析的弱点
弱点一:极坐标码本是固定的 100 槽类别码,风格表达粒度受限——用户想要「七分 Ghibli 加三分水彩」或训练集外风格时无法表达;改进方向是扩展为连续风格流形,或与参考图风格注入(IP-Adapter/AdaIN 类)结合。弱点二:训练分布是单区域-单风格的合成对,多区域组合纯属外推,论文只有定性展示而未提供多区域案例的定量基准;当两个风格方向在 100 槽圆上相邻($2\sin(\pi/100)\approx 0.063$)时存在混淆风险,应建立方向距离与组合错误率的量化关系。弱点三:合成数据的边界来自 matting 模型的软 alpha,对风格化后轮廓大变甚至拓扑改变的对象(如像素化的细枝末节)监督可能失真,可引入多候选轮廓或形状先验。弱点四:阴影缺失是系统性伪影来源,应做阴影感知移除或显式阴影通道监督。弱点五:GRN 二值量化有信息损失,34.5 秒的时延对交互式编辑偏慢,可蒸馏到更小骨干或减少精炼步数。弱点六:评估对闭源 VLM 与 alpha 定位的双重依赖会放大方差,建议开源带区域级人工标注的评测子集。
未来方向
作者明确提出的:运动感知条件化与边界跟踪,改善快速运动下的区域对齐与时序稳定;阴影感知的数据构建与显式阴影保留监督;风格感知的边界评估指标,区分有意的形状变形与掩码泄漏。基于其成果可延伸的:把固定类别码本升级为文本-方向联合嵌入以支持开放词表风格;构建多区域组合的系统性定量基准(区域数、风格方向间距与错误率的关系);与个性化参考图风格迁移结合,让用户上传一张风格图即获得新的极坐标方向;在 GRN 比特精炼中引入光流对齐的比特传播先验以减少运动边界闪烁;探索流式/近实时推理路径(引言提到 SAM3 流式分割,若配少量精炼步可做交互预览);将该数据流水线范式推广到其他局部属性编辑任务如材质、光照、天气与季节变换。
复现评估
复现难度中高。论文未提及开源代码或模型权重,项目页(https://higherhu.github.io/lociart/)目前是展示页;数据构建依赖多个第三方模型:Qwen3-VL-32B、SAM3、SVOR、Ditto(14B,CC BY-NC-SA)、内部微调的 VACE(未公开)、GPT-5.5 过滤、VideoMaMa(CC BY-NC)以及评估用的 Gemini 3.6 Flash,多数可获取但组合成本高,且许可限制非商业使用。训练需 8×NVIDIA H200、BF16、10 epochs、100K 对,算力门槛不低;GRN/GRNEdit 预训练权重是否可得直接影响起点。相对而言,评测协议复现容易:benchmark 仅 168 案例,SPS 可用公开 CSD 权重加 k-means 重建(93.61% 留一源验证精度提供参照),附录 C 给出了 PSNR/TC/CLIPT 的完整定义和 VLM 评审的完整 prompt,附录 D 给出全部训练超参与证据注入位置(第 1/13/25 块)。总体判断:评估侧可复现性好,模型与数据侧需要大量算力和多个外部模型许可,建议关注项目页后续是否放出 checkpoint 与数据。
论文图表
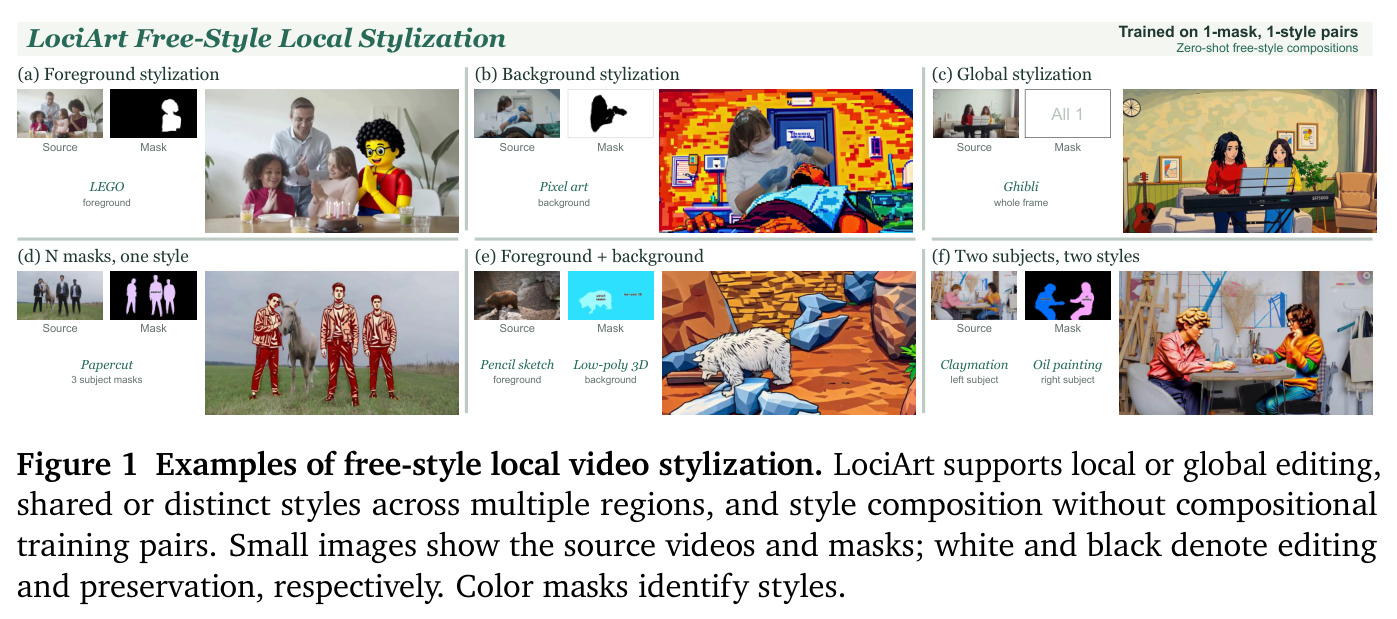
六个案例展示任务全貌:(a) 前景风格化(乐高)、(b) 背景风格化(像素画)、(c) 全局风格化(吉卜力)、(d) 多掩码单风格(纸艺)、(e) 前景+背景组合(铅笔素描+低多边形)、(f) 双主体双风格(黏土+油画)。小图为源视频与掩码,白=编辑、黑=保留,彩色掩码标识风格。
一图定义「自由风格局部视频风格化」任务的完整输入输出空间,包括训练时从未见过的多区域多风格组合,是理解论文目标与零样本组合能力的起点。