SO-101 Bench:低成本机械臂的语言条件空间操作基准 SO-101 Bench: Accessible Spatial Manipulation
SO-101数字孪生仿真基准:纯仿真训练系统真机排名零违约,LLM智能体83.2%登顶
前置知识
VLA(视觉-语言-动作模型)
将摄像头图像、机器人本体状态和自然语言指令直接映射为机械臂动作序列的端到端神经网络,通常由视觉语言骨干网络加动作解码头构成,先在海量机器人数据上预训练,再在目标任务示教数据上微调。典型代表如 π0.5、GR00T N1.7、Galaxea 0.5、MolmoAct2。
本文排行榜的主体就是九个 VLA/世界-动作模型,它们在相同 36 小时算力预算下微调后同台比较,理解 VLA 是看懂实验设计与排行榜的前提。
数字孪生与 Sim2Real
数字孪生指在物理仿真器(本文用 Isaac Lab,物理 240 Hz、策略 30 Hz)中用真实房间的扫描结果和逐一调校过的物体资产精确复刻真实硬件环境;Sim2Real 关注仿真中训练的策略或得出的结论能否迁移到真实机器人上,核心问题是仿真结论(尤其是策略排名)在真机上是否成立。
本文的全部主张建立在一个前提上:孪生体中的策略排名能完整迁移到 $120 的真实 SO-101 上,这是理解论文价值的钥匙。
Spearman ρ 与 MMRV
Spearman ρ 是秩相关系数,衡量两个排名的单调一致性,取值 1 表示排序完全相同;MMRV(Mean Maximum Rank Violation,平均最大排名违约)由 SIMPLER 提出,度量排名被违反的平均最大幅度,取 0 表示没有任何一对策略在两个域中排序颠倒。两者共同量化「仿真排名是否等于真机排名」。
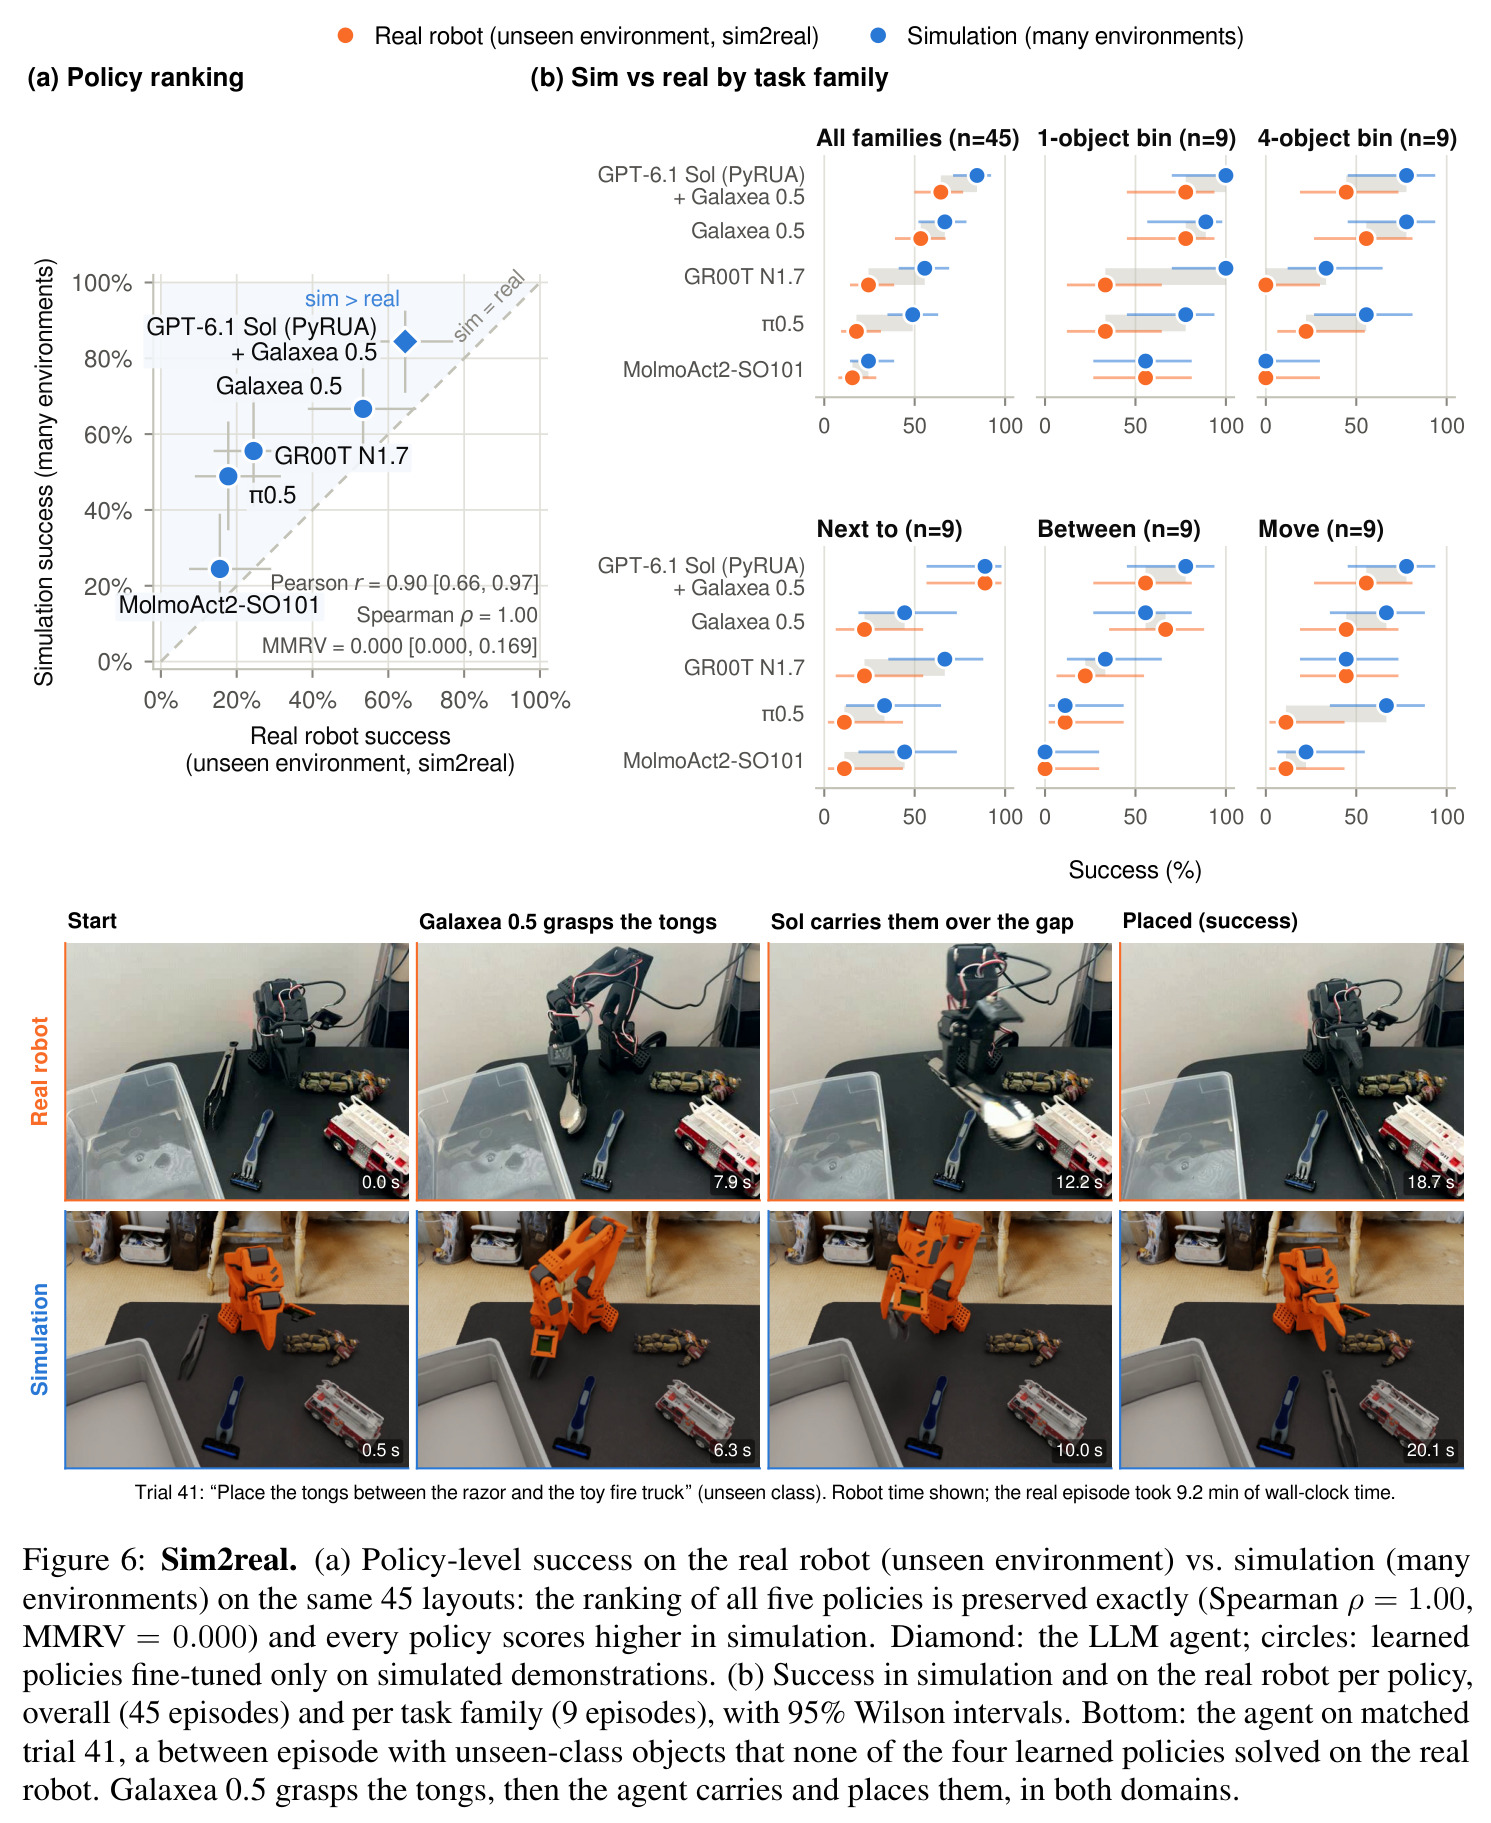
本文 sim2real 结论的关键指标是 Spearman $\rho = 1.00$、MMRV $= 0.000$(95% CI $[0.000, 0.169]$),不懂这两个指标就无法判断这条证据的强度与局限。
Code-as-Policy 与智能体 harness
harness 指连接大语言模型与机器人的脚手架。「直接工具调用」让 LLM 通过工具直接输出末端执行器运动命令;code-as-policy(本文用 PyRUA-Lean)让 LLM 编写 Python 代码,内部调用开放词汇分割(SAM3)、3D 定位与逆运动学来规划机械臂动作;「+Galaxea 交接」再进一步把抓取这一步交给微调好的 VLA 策略执行,LLM 负责定位、规划和放置。
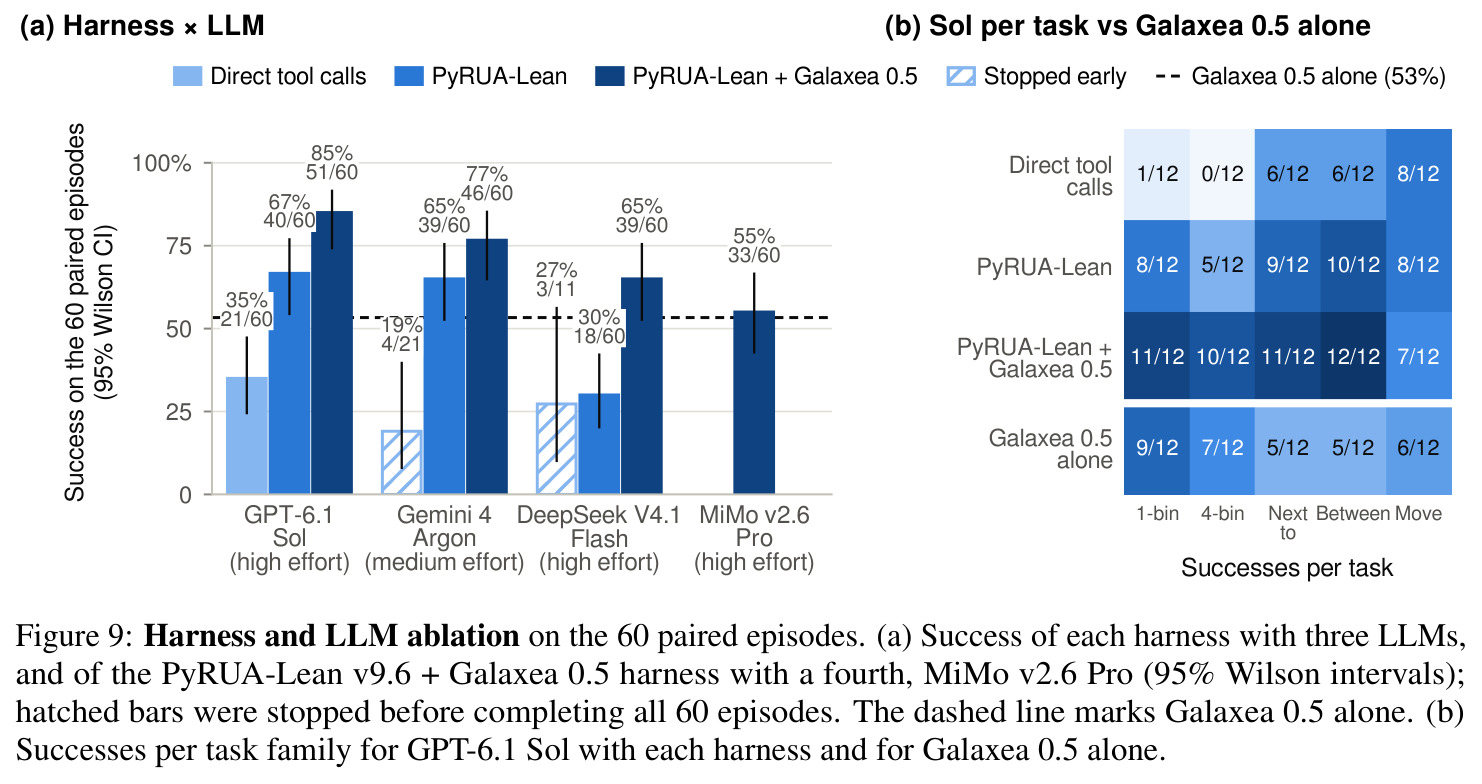
第七节消融显示同一模型换 harness 成功率从 35% 升到 85%,harness 的影响超过换更强的语言模型,这是本文最有实践价值的发现。
WAM(世界-动作模型)
在动作之外还联合建模未来观测的模型:InternW0-Δ、FLUX 3 Action 同时建模视频与动作,ImageWAM 用图像编辑骨干,LaWAM 预测 DINOv3 潜状态。通过显式预测「世界会变成什么样」来隐式学习动力学,理论上更有利于需要空间推理的任务。
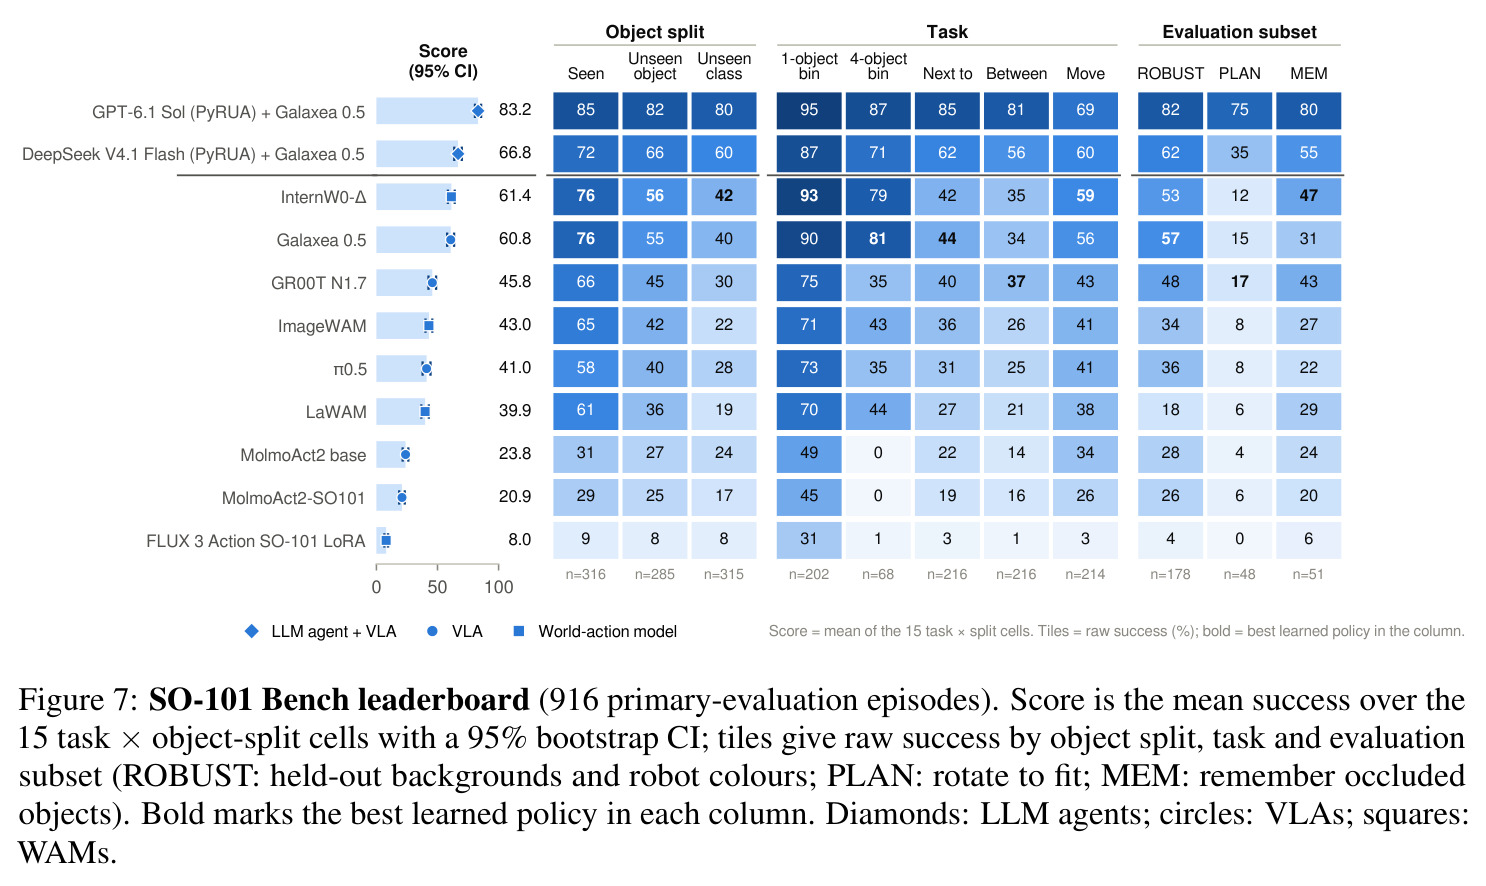
排行榜上 InternW0-Δ(61.4)恰好是最佳学习策略且拥有原生记忆(MEM 子集最强 47%),理解 VLA 与 WAM 的区别有助于解读这个格局。
SO-101 与 LeRobot
SO-101 是开源 3D 打印六串行总线舵机机械臂,从动臂零件成本约 $120–150,约为 ALOHA 单臂($4,900)的四十分之一;HuggingFace LeRobot 库支持其从遥操作到部署的全流程。据作者 2026 年 10 月统计,LeRobot 标签数据集中 57%(976 个中的 559 个)声明为 SO-100/101 机型,SmolVLA 用 481 个社区数据集预训练。
SO-101 是本文的硬件载体,「低成本臂已成为机器人学习的入口」正是全部研究动机的出发点。
研究动机
低成本机械臂已成为机器人学习最主流的入口:SO-101 从动臂约 $120–150,仅为 ALOHA 单臂 $4,900 的四十分之一,HuggingFace Hub 上 57% 的 LeRobot 数据集(976 个中 559 个)来自 SO-100/101。但评测严重滞后:截至本文发表,没有任何已发布策略能在陌生环境和陌生物体上开箱即用地完成空间约束的语言条件任务;2026 年出现的四个 SO-101 基准全部只在物理硬件上运行,每个条件通常只负担得起几十次 rollout,且结果高度依赖具体装配——伺服偏移因臂而异、某机械臂农场相机错位、物体在评测中被磨损。仿真一侧同样不理想:LIBERO 已被刷爆,一个 0.54M 参数的策略达到 95.1%,三次忠实协议的 VLA 评估平均分只差 1.36 点,指令条件化很大程度上只是从记忆任务中选择;已知唯一的仿真 SO-101 任务集只有八个无语言抓放任务。社区因此既无法可靠比较方法强弱,也不知道仿真结论能否信到真机。
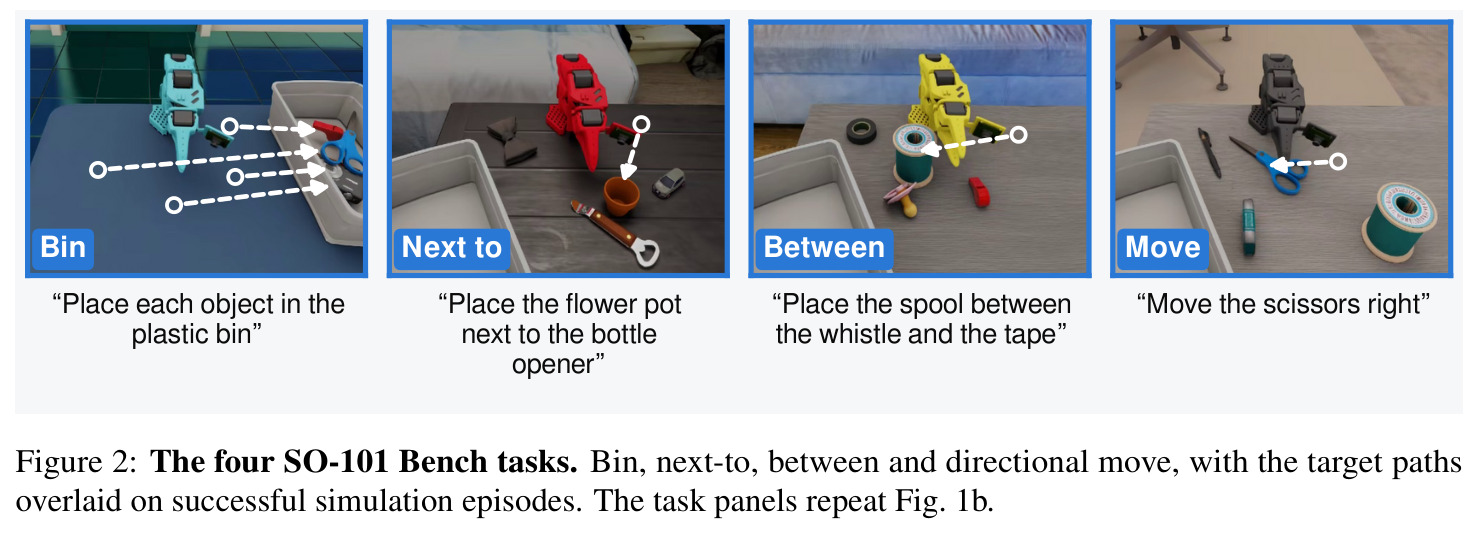
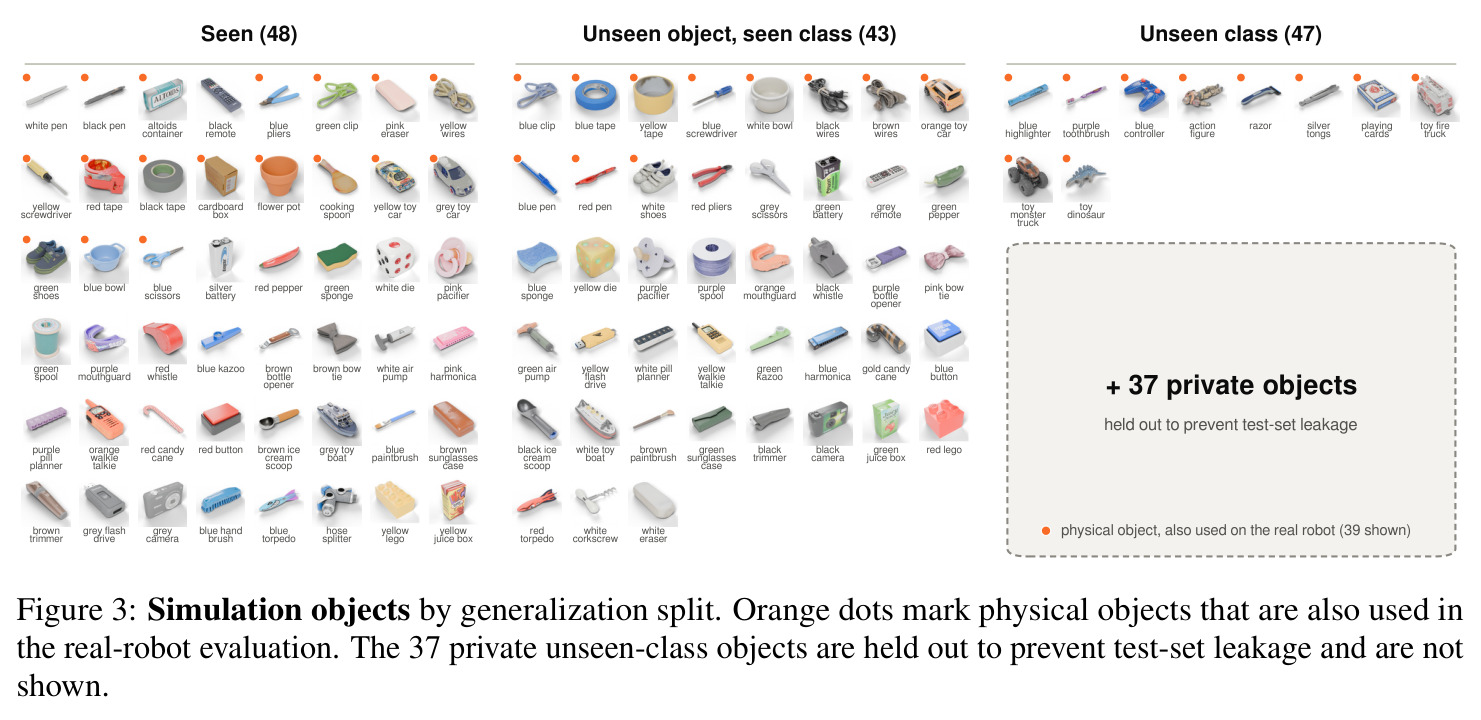
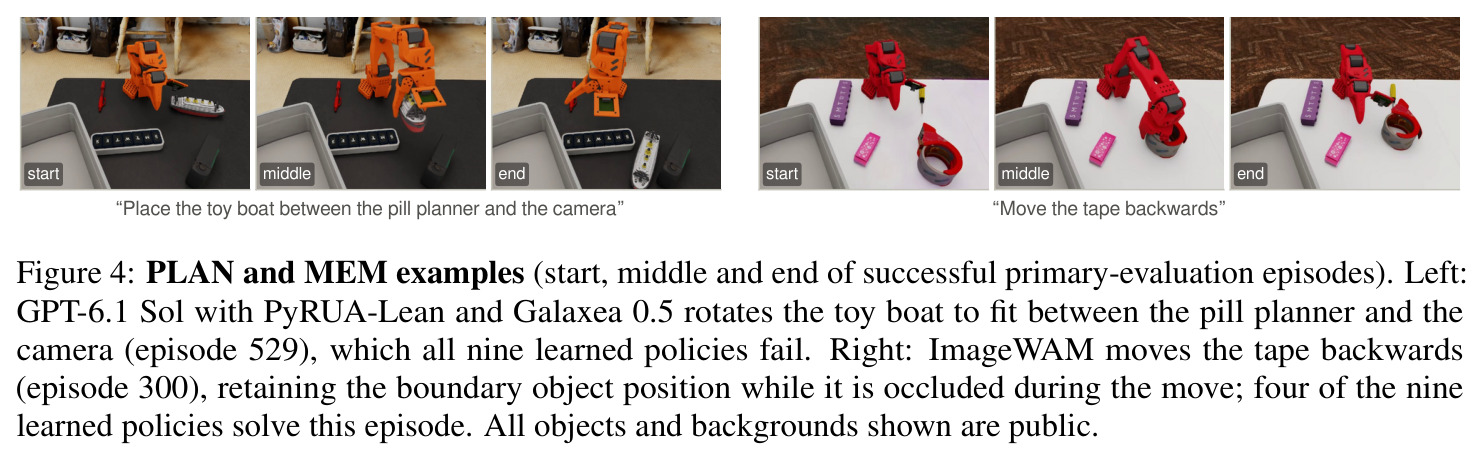
本文的目标是作者要构建一个「排名可迁移」的仿真基准:在 Isaac Lab 中为真实 SO-101 环境建立数字孪生,提供四个语言条件空间任务、按五个任务族计分(1 物体装筐、4 物体装筐、放到参照物旁边、放到两参照物之间、沿指定方向推动到边界),138 个家庭物品按 seen(48)/unseen-instance(43)/unseen-class(47,其中 37 个私有防泄漏)分割,共 916 个经可行性检查的评测集,外加 ROBUST(held-out 外观)、PLAN(旋转适配狭小空间)、MEM(记忆被遮挡物体)三个能力子集;所有学习策略都在同一份 3,629 集仿真遥操作数据、相同 36 小时 × 4×A100 算力预算下微调。在此之上回答三个递进的问题:孪生体是否复现真机的难度结构与失败模式?纯仿真训练的同一份权重上真机后排名是否保持?九个 VLA/WAM 与 LLM 智能体在同一协议下差距多大、瓶颈在哪?
与已有工作不同的是,已有 real2sim 研究(SIMPLER、SimFoundry 等)证明过对齐良好的仿真器可以排出真机名次,但存在三个空白。其一,这些验证大多是单向的——把真实数据训练的策略放进孪生体,而如今策略越来越多只用仿真数据训练,需要证明「同一份纯仿真权重在真机上排名不变」:本文用五个从未见过本设置真实数据的系统(四 VLA + 一个 LLM 智能体)在 45 个匹配布局上完成了这一验证。其二,以往智能体评测各自采用发表时的协议,harness 与语言模型的贡献混在一起无法分离;本文用 60 个预注册配对集分别消融两者,发现 harness(35%→85%)的影响远超模型本身。其三,此前不存在针对 SO-101、带 held-out 物体分割、且仿真排名经真机验证的语言条件基准;「放到两物之间」和「旋转物体适配」这类闭环空间技能也几乎没有基准测试过。这三个空白共同定义了本文的独特切入角度。
核心方法
直觉上,作者想回答:在便宜仿真里比出的名次,搬到约 $120 的真实机械臂上还算不算数。技术路线分四层。第一层,资产与孪生:用 3D AI Studio 的 image-to-3D 制作 138 个物体,约 60 个物理物体由实物照片重建并逐一调校仿真外观与物理属性;Isaac Lab 中物理 240 Hz、策略 30 Hz,头顶与腕部双相机各 640×480,22 个背景(4 个 held-out)与 10 种机器人颜色,真实臂关节标定对齐仿真运动学使权重互通。第二层,任务与评分:四任务五任务族,全部从仿真器状态自动判分——next-to 要求目标轮廓落在参照物 2 英寸内,between 要求参考点距两参照点连线 1.75 英寸内,成功须连续保持 5 秒,30 秒超时(4 物体装筐 75 秒)。第三层,统一协议:所有学习策略在同一份 3,629 集仿真数据、相同 36h×4×A100 预算下微调,用 39 集 held-out 验证集选 checkpoint。第四层,验证与对比:916 集主评估报 15 格平均分与 bootstrap 95% CI,45 布局 sim2real 对照,60 配对集的 harness 与模型消融。
核心创新是把「排名可迁移性」当作基准的一等设计目标,而非事后的附加验证。具体体现在三点。第一,泛化分割设计:seen/unseen-instance/unseen-class 三分割把「换实例」与「换类别」两种迁移分开度量,并把 37 个 unseen-class 物体私有化以防止测试集泄漏,直接回应 LIBERO 被「用任务 ID 嵌入替换指令仍接近最优」这类探针攻破的教训。第二,防止聚合分数掩盖真相:每个格子报原始成功率加 bootstrap 置信区间,checkpoint 在独立验证集上选,所有策略同数据同算力,杜绝训练量不公平导致的虚假排名。第三,把 LLM 智能体与学习策略放进同一组 916 集、并在真机上也运行智能体(45 集中 64% 对 Galaxea 0.5 的 53%),再拆开 harness 与语言模型两个变量,证明「LLM 写代码 + 把抓取交给 VLA」的组合优势主要来自 harness 的选择而非模型本身。这与以往各跑各协议、只在单一维度比较的智能体评测在方法论上本质不同。
方法步骤详情
构建流程分六步。第一步,物体资产:138 个物体经 image-to-3D 管线生成,约 60 个物理物体从照片重建并对照实物调校(附录 E),全部为刚体且经遥操作验证可被抓取,保证失败归因于策略而非硬件。第二步,孪生体:Isaac Lab 按房间扫描重建场景,物理 240 Hz、策略 30 Hz,观测为双相机(640×480)加关节位置;22 个背景中 18 个用于训练。第三步,任务与判分:bin/next-to/between/move 从仿真状态自动评分,如目标轮廓距参照物 ≤2 英寸、between 参考点距连线 ≤1.75 英寸且比参照物彼此更近、move 须沿直线路径推进至边界 2 英寸内或前进至少 2 英寸,非目标物体移动超 1 英寸即失败,成功须持续 5 秒。第四步,数据:so101_bench_sim 含 3,629 集遥操作演示(18.5 小时 @30fps,仅 seen 物体:1,892 bin、1,150 next-to/between、587 move),另发布约 4,400 集真机数据 so101_bench_real。第五步,微调:九个学习策略统一 36h×4×A100-80GB 预算,按各作者推荐配方(FLUX 3 Action 用 LoRA),39 集验证集选 checkpoint。第六步,评估:916 集主评估报 15 格平均分与 bootstrap CI;sim2real 用 40 个持有的物理物体在 45 个匹配布局上验证;消融用 60 个预注册配对集(30 易 + 30 难,含 11 个 PLAN 集)。
技术新颖性
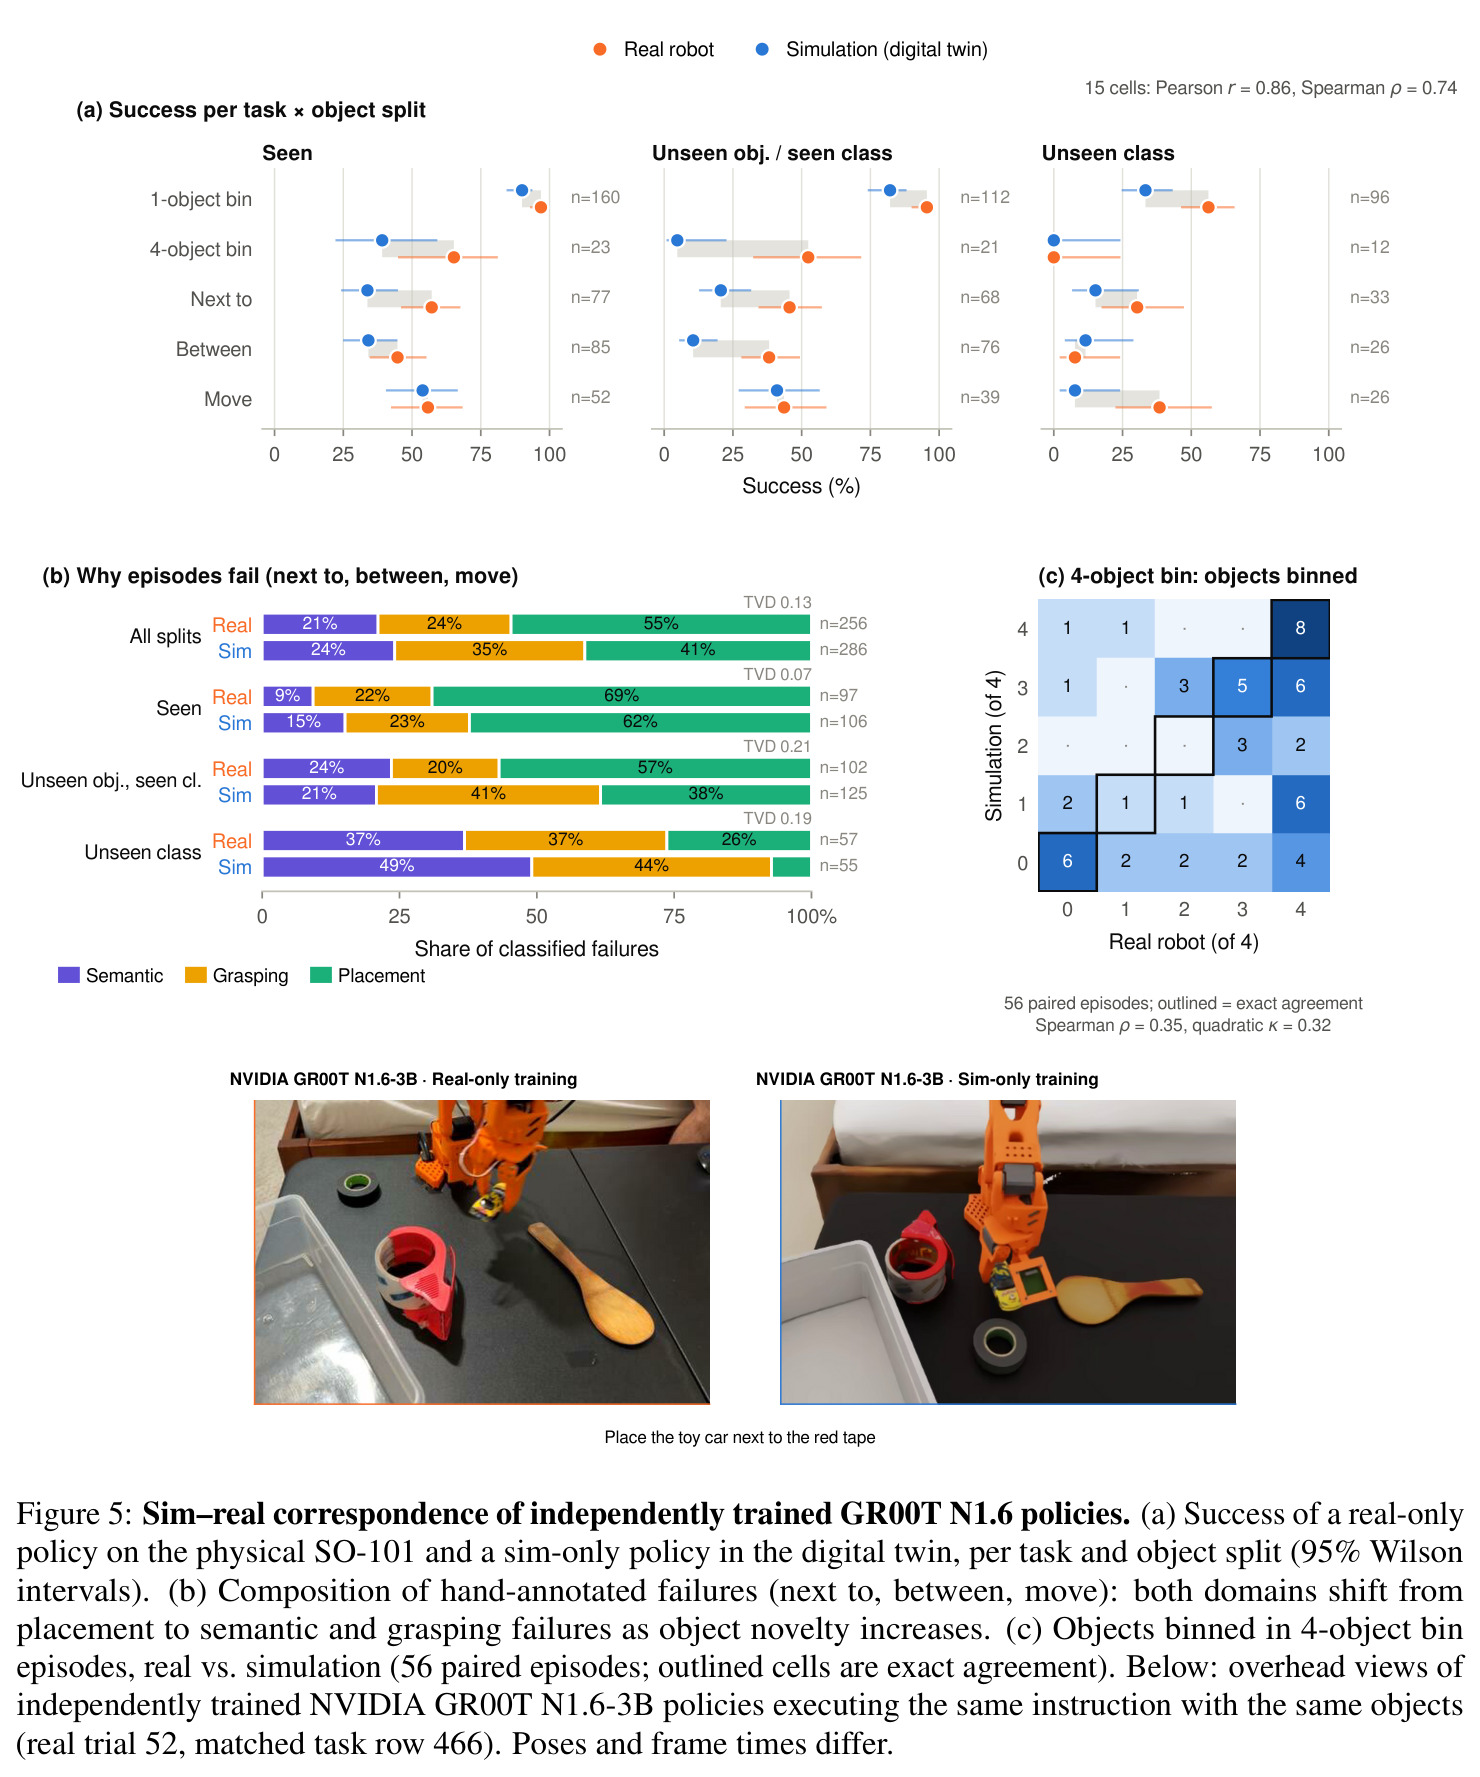
新颖性体现在四点。其一,首个语言条件、带实例/类别级 held-out 分割、且仿真排名经真机验证的 SO-101 基准——此前仿真侧只有八个无语言任务,真机侧四个基准全依赖物理 rollout。其二,sim2real 验证方向翻转:SIMPLER 等把真实数据训练的策略放进孪生体,且在三仿真器、五策略、1,115 次 rollout 研究中排名一致性较弱;本文证明纯仿真训练的权重直接上真机时五系统排名完全保持(Spearman $\rho = 1.00$、MMRV $= 0.000$、Pearson $r = 0.90$),并有独立的条件级(real-only vs sim-only GR00T N1.6,$r = 0.86$)与失败模式级(TVD 0.13)对应证据。其三,评测设计吸收近年审计教训:37 个私有测试物体防泄漏、同数据同算力、独立验证集选 checkpoint、bootstrap CI,并引入 PLAN(最佳学习策略仅 17%)与 MEM 这类闭环空间能力测试。其四,把 LLM 智能体纳入统一排行榜并在真机复验(64% vs 53%),再用配对消融分离 harness 与模型贡献,识别出「code-as-policy + VLA 交接」这一当前最强范式(83.2%)。
实验结果
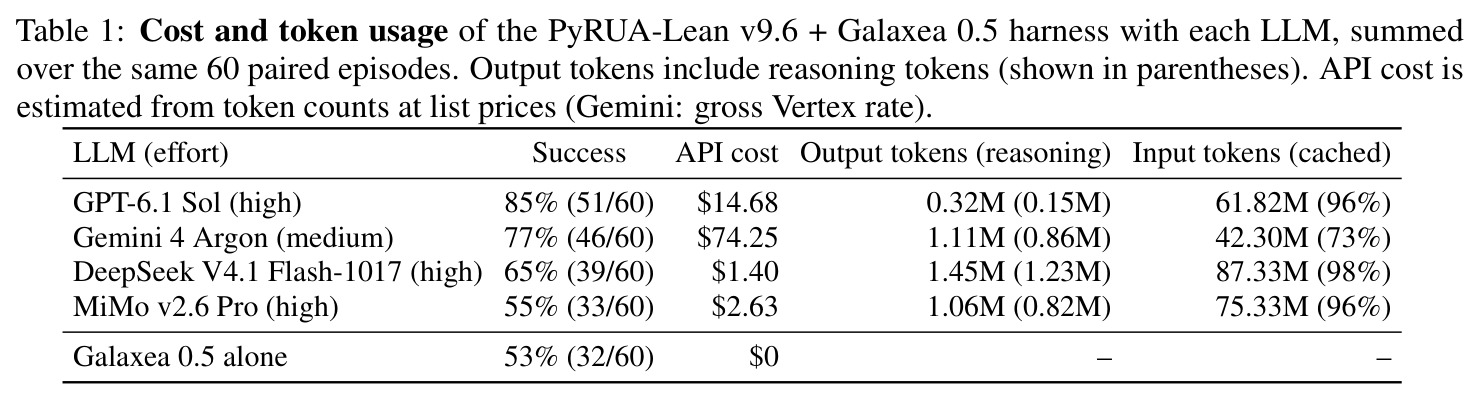
结果分四组。第一组,孪生体复现难度结构:real-only GR00T N1.6 真机 61%(552/906)、sim-only 孪生体 45%(409/906),差 -15.8pp,但 15 个条件 Pearson $r = 0.86$、Spearman $\rho = 0.74$,失败构成同步从 placement(seen 物体 69%/62%)转向 semantic+grasping(unseen-class 74%/93%,总体 TVD 0.13)。第二组,sim2real:五个纯仿真训练系统排名完全一致——Sol+Galaxea 84%/64%、Galaxea 67%/53%、GR00T N1.7 56%/24%、π0.5 49%/18%、MolmoAct2-SO101 24%/16%(仿真/真机),$\rho = 1.00$、MMRV $= 0.000$、$r = 0.90$,但仿真高估每家 9–31pp(67 次不一致中 57 次为仿真成功真机失败)。第三组,916 集排行榜:Sol+Galaxea 83.2、DeepSeek 66.8、InternW0-Δ 61.4、Galaxea 60.8、GR00T N1.7 45.8、ImageWAM 43.0、π0.5 41.0、LaWAM 39.9、MolmoAct2 23.8/20.9、FLUX 3 Action 8.0;学习策略抓熟悉物体已基本解决(单物体装筐 90–93%),瓶颈在空间任务(next-to/between 仅 34–44%)与 unseen-class(最强者掉 30–43 点),PLAN 全军覆没(≤17%,智能体 75%)。第四组,消融:同一 Sol 换 harness 从直接调用 35%(21/60)→ PyRUA-Lean 67%(40/60)→ +Galaxea 交接 85%(51/60),对照 Galaxea 单独 53%;固定 harness 换模型得 Sol 85%、Argon 77%、DeepSeek 65%、MiMo 55%,成本 $14.68/$74.25/$1.40/$2.63。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SO-101 Bench 主评估(916 集,15 个任务族×分割格子) | 格子平均成功率(95% bootstrap CI,格内重采样) | GPT-6.1 Sol (PyRUA) + Galaxea 0.5:83.2(CI [80.7, 85.7]) | 最佳学习策略 InternW0-Δ 61.4(CI [58.5, 64.1])、Galaxea 0.5 60.8;DeepSeek V4.1 Flash 智能体 66.8 | 相对最佳学习策略 +21.8 个百分点,且在 PLAN/MEM 子集和 unseen-class 分割上优势最大 |
| Sim2Real 排名迁移(45 个匹配布局,5 个纯仿真训练系统) | Spearman ρ / MMRV / Pearson r | ρ = 1.00、MMRV = 0.000(95% CI [0.000, 0.169])、Pearson r = 0.90 [0.66, 0.97],真机上智能体 64% vs Galaxea 0.5 53% | SIMPLER 在三仿真器、五策略、1,115 次真实 rollout 的研究中与真机排名仅弱一致 | 排名零违约,首次在纯仿真训练权重(含 LLM 智能体)上完成同权重双向验证 |
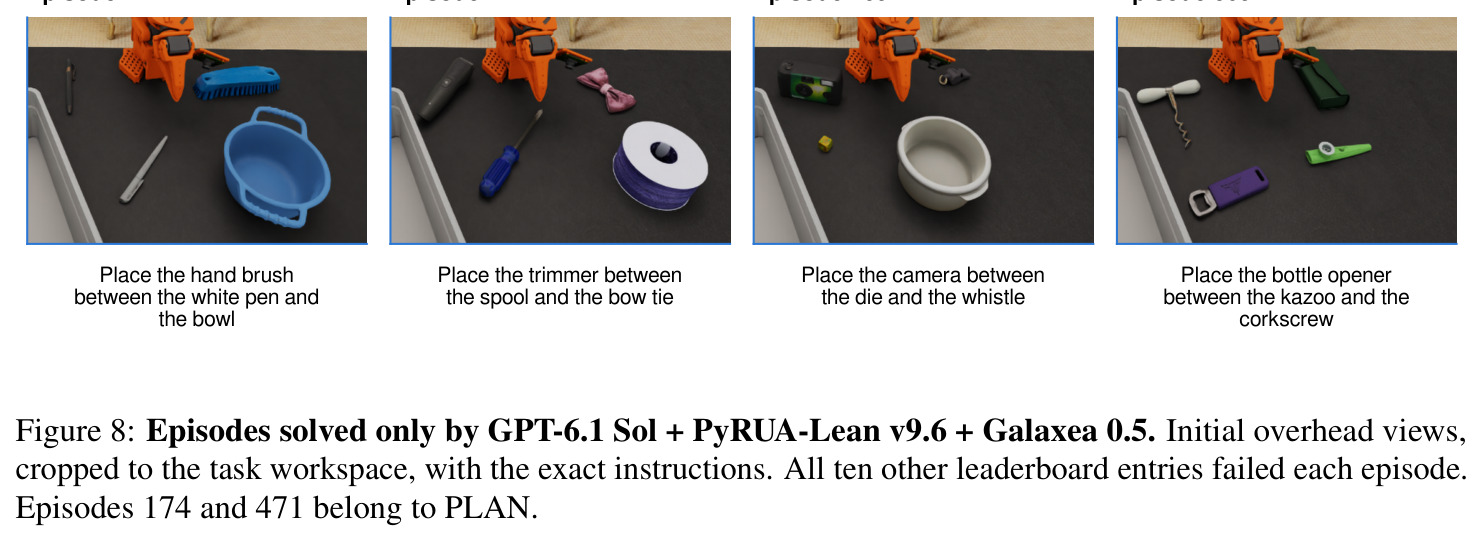
| PLAN 旋转适配子集(48 集) | 成功率 | GPT-6.1 Sol + PyRUA-Lean + Galaxea 0.5:75%(真机亦解出含 PLAN 的智能体独有集) | 最佳学习策略 GR00T N1.7 仅 17%,其余学习策略 0–15% | +58 个百分点,暴露端到端策略在抓取后重定向规划上的系统性缺失 |
| Harness 消融(60 个预注册配对集,固定 GPT-6.1 Sol) | 成功率(95% Wilson 区间) | PyRUA-Lean + Galaxea 0.5 交接:85%(51/60),API 成本 $14.68 | 直接工具调用 35%(21/60);PyRUA-Lean 67%(40/60);Galaxea 0.5 单独 53%(32/60) | 交接相对直接调用 +50 个百分点,且比纯代码方案更省($18.44 → $14.68) |
| LLM 模型消融(固定 PyRUA-Lean + Galaxea 0.5,60 配对集) | 成功率 / API 成本 / 输出 token | GPT-6.1 Sol:85%(51/60),$14.68,0.32M 输出 token | Gemini 4 Argon 77%($74.25,1.11M)、DeepSeek V4.1 Flash 65%($1.40,1.45M)、MiMo v2.6 Pro 55%($2.63) | 能力最强且成本约为 Argon 的 1/5、token 最少;DeepSeek 以约 1/10 价格提供 65% |
局限与改进
作者坦承:sim2real 只有 5 个策略、45 个布局、单一真实环境,MMRV 的 95% CI $[0.000, 0.169]$ 较宽,只能作「排名正确」的证据而非精确校准;仿真高估所有策略 9–31pp,绝对成功率只能当上界读;固定 36 小时预算使部分模型欠训练——各策略样本量相差 30 倍,MolmoAct2 只完成 0.5–0.6 epoch 且损失仍在陡降,FLUX 3 Action 仅 0.2 epoch,低分不代表能力上限;智能体时间限制只计控制时间(仿真暂停、真机悬停等模型计算),掩盖实时成本——真机 rollout 中位墙钟 197 秒对 Galaxea 0.5 的 38 秒。我补充几点:bin 任务高估部分归因于真实塑料筐远比仿真轻、易被撞动(GR00T N1.7 装筐 9/9 vs 3/9),属物理保真问题;多个大物体被缩放到 0.7–0.9 倍,改变了任务几何;评分阈值(2 英寸、1.75 英寸)较宽松,未测更精细的放置公差;基准只覆盖刚体与单臂,可变形物体、双臂与动态干扰缺位。
独立分析的弱点
独立分析有四个值得注意的弱点。第一,仿真物理保真不均匀:bin 任务真机失败主要由真实塑料筐太轻被机械臂碰动造成,且大物体被缩放 0.7–0.9 倍,意味着对质量敏感或涉及大物体的任务,孪生体虽保住排名但水平差达 20–30pp;改进方向是对关键道具做质量/摩擦/质心的系统辨识,而非逐物体手工调参。第二,智能体评测的「暂停仿真」设定对部署有误导:模型计算时真机完全静止,中位墙钟 197 秒对 38 秒,任何动态元素(人、传送带、其他机器人)进入场景即失效;应引入实时预算或可中断动作接口,报告墙钟约束下的成绩。第三,固定 36h 预算对数据吞吐量大的策略不公平——样本量差 30 倍使 FLUX 3 Action 的 8.0 分更像 LoRA 配方欠训练而非模型能力上限;改进方向是报告多条预算点的等算力曲线,或按 epoch 数而非墙钟对齐。第四,37 个私有 unseen-class 物体使社区无法本地复现完整 unseen-class 成绩,防泄漏与可复现性存在张力;可采取定期轮换私有集、提供官方盲测提交服务、或发布同类替代物体作开发集来平衡。
未来方向
作者明确提出的方向:把孪生体扩展到可变形物体与双臂操作;为智能体加入实时约束(不再暂停仿真/真机);利用孪生体的排名作为先验来设计更便宜的真机评测(用少量真机 rollout 精化仿真结论);以及像 ASPIRE、RoboRSI 那样在孪生体中反复 rollout 以精炼控制程序、积累经过验证的可复用技能,同时保持 held-out 评测集不变。基于本文成果还可延伸:其一,harness 消融(35%→67%→85%)暗示 harness 本身可被自动搜索甚至让 LLM 合成,未来可做「harness 基因组」系统研究;其二,PLAN 上 75% 对 ≤17% 的鸿沟说明结构化规划是端到端 VLA 的最大短板,可尝试把智能体的代码规划蒸馏回端到端模型,或给 VLA 加显式位姿推理模块;其三,「数字孪生 + 排名迁移」的方法论可复制到其他低成本臂与仿真器,形成排名可迁移性认证的标准流程;其四,unseen-class 上最强学习策略掉 30–43 点,指向物体级开放词汇泛化,值得引入更大规模生成式资产做课程式训练。
复现评估
复现条件总体友好。数据方面,作者发布了 so101_bench_sim(3,629 集仿真遥操作,18.5 小时,含 WM 变体)与 so101_bench_real(约 4,400 集真机数据,约 20 小时、约 35 个物体),网站、GitHub 与 Hugging Face 均公开;唯一不可见的是 37 个私有 unseen-class 物体(防泄漏),本地无法复现完整官方 unseen-class 成绩。算力方面,复现单个学习策略需 36h×4×A100-80GB,跑满九个策略约 1,300+ A100 小时,是论文级复现的主要门槛;作为基准使用者只需提交策略跑 916 集仿真评测,门槛低得多。智能体侧按 Table 1 每 60 集 API 花费 $1.40–74.25,可负担。真机部分需要一台 SO-101(零件约 $120–150)、约 40 个对应实体物体和固定光照房间,流程较繁琐:布局需按仿真投影复现,225 个真机集间相机漂移 ≤2.6px、亮度变化 ≤7%。仿真复现依赖 Isaac Lab 与 3D AI Studio 资产管线,附录 C/E/F 提供各策略配方、物体重建管线与背景细节。总体评级:基准使用低-中等难度,完整排行榜复现较难,真机 sim2real 验证最难。
论文图表
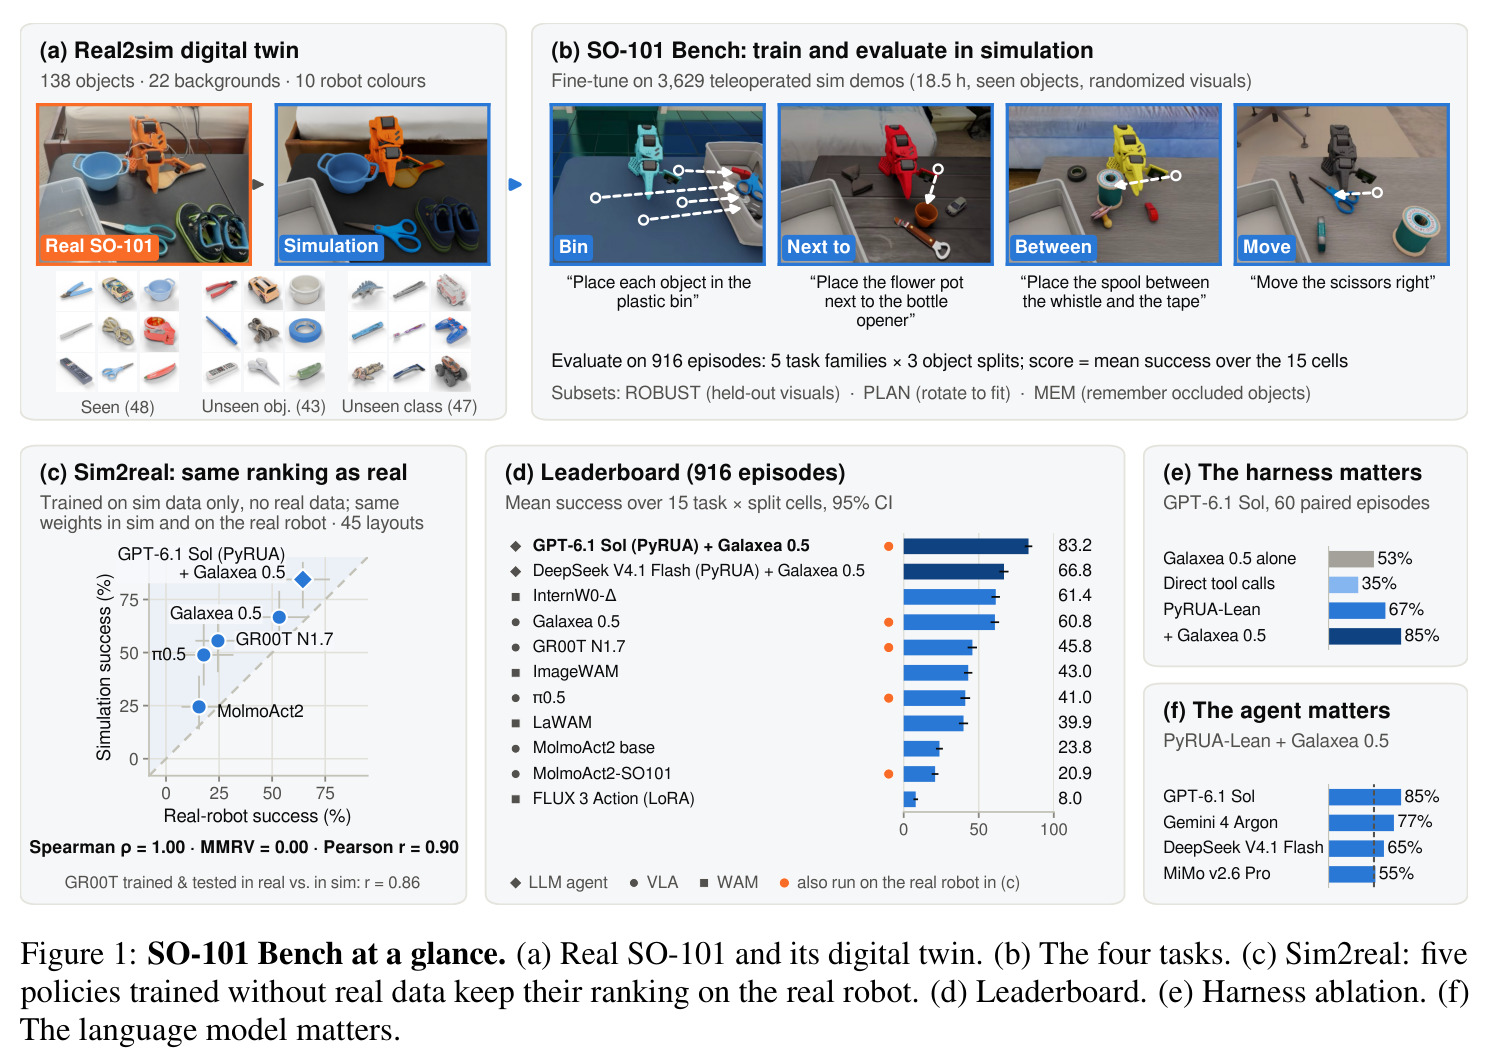
六联概览图:(a) 真实 SO-101 与其 Isaac Lab 数字孪生;(b) 四个任务(装筐/旁边/中间/移动)与训练-评测流程,138 物体×22 背景×10 机器人颜色,916 个评测集按 5 任务族×3 物体分割计分;(c) sim2real 散点:五系统仿真-真机成功率,Spearman ρ=1.00、MMRV=0.00、Pearson r=0.90;(d) 排行榜,GPT-6.1 Sol+Galaxea 0.5 以 83.2 居首;(e) harness 消融:直接调用 35%、PyRUA-Lean 67%、+Galaxea 85%;(f) 模型消融:Sol 85%、Argon 77%、DeepSeek 65%、MiMo 55%。
一张图浓缩了论文全部核心贡献:基准构成、sim2real 关键证据、排行榜与两组消融结论,是快速把握全文逻辑的入口。