HandsOn:面向可泛化灵巧操作的大规模仿真基准 HandsOn: A Large-Scale Simulation Benchmark for Generalizable Dexterous Manipulation
66个仿真灵巧任务配1.8万条人类演示,最佳多任务策略仅29.1%成功率
前置知识
VLA(视觉-语言-动作模型)
把摄像头图像与自然语言指令映射为机器人动作的大规模预训练模型,通常继承视觉语言模型主干,再接动作解码头(扩散头或自回归 token 头),在互联网级图文与机器人遥操作轨迹上联合训练,具备一定语言理解和零样本泛化能力。本文评测 π0.5、DM0.5、LingBot-VLA、HY-Embodied、Spatial Forcing 五个 VLA。
Core-50 榜单一半方法是 VLA,理解“看图+听指令→出动作”的机制,才能读懂论文中语言条件化探针、指令是否被真正读取等关键分析。
WAM(世界-动作模型)
在动作预测之外显式建模未来观测(未来帧或潜状态)的模型,相当于给策略一个对动作后果的内部预期,通常以较大 action chunk(本文中 16 步/查询)执行。本文评测 OpenWAM、FastWAM、Motus 三个 WAM,它们包揽 Core-50 前两名。
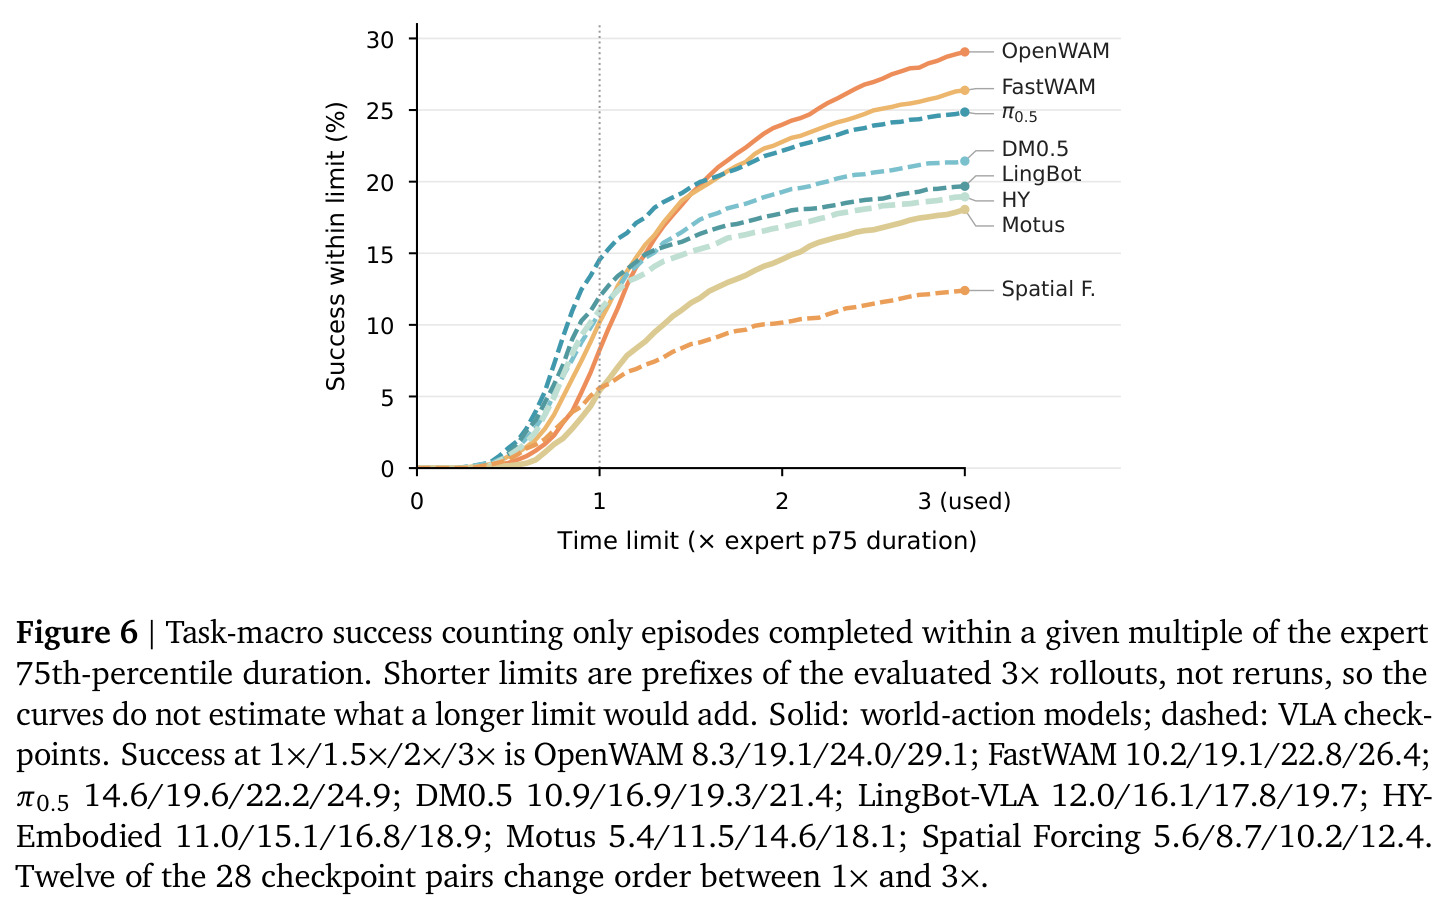
OpenWAM 以 29.1% 夺冠,且论文发现“WAM 完成得晚但完成得多”(完成中位时长 1.13–1.27 倍专家 P75),这是理解结论的关键现象。
Diffusion Policy(扩散策略)
用扩散模型表示动作分布的模仿学习方法:从高斯噪声出发逐步去噪,生成一段动作块(action chunk),天然适合表达多模态动作分布。本文把它作为单任务参照基线,为每个 Core-50 任务单独训练一个 3 万更新的模型,平均成功率仅 9.7%。
它是“不做多任务共享、不做预训练”的对照点,用于判断多任务 checkpoint 的优势来自数据共享还是预训练与模型规模。
遥操作演示与行为克隆
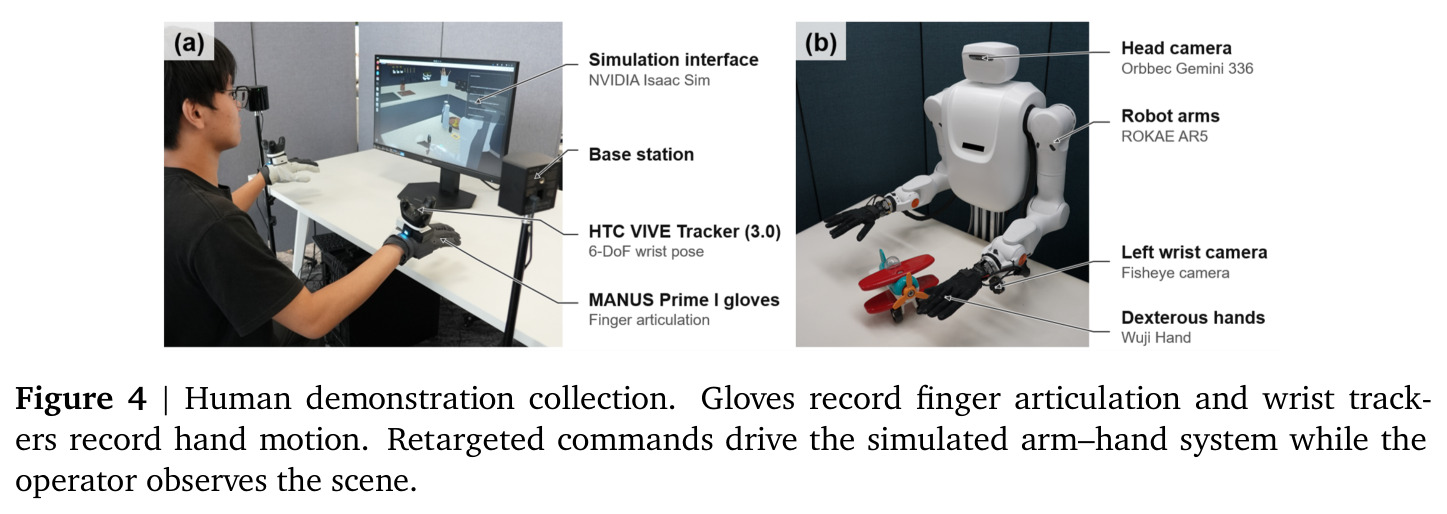
行为克隆把策略学习当作监督学习,直接拟合演示中的“观测→动作”映射。HandsOn 的演示由 MANUS Prime I 手套捕捉 21 个手部关键点、腕部 HTC VIVE 追踪器捕捉手腕位姿,经运动学与 Wuji 重定向转换为 ROKAE 机械臂和 Wuji Hand 每手 20 关节的指令,在 Isaac Sim 中以 30 Hz 记录。
论文的 1.8 万条、56 小时演示正是这样采集的,数据质量保障流程(三角色分离审核、≥98% 一致率门槛)是其可信度的核心卖点。
任务宏平均与有序进度
宏平均指对每个任务的成功率先取平均再汇总,不按回合数加权,防止简单任务主导总分。有序进度定义为 $P_e = L_e / K_i$,其中 $L_e$ 是回合 $e$ 中最长完成的有序阶段前缀长度,$K_i$ 是任务总阶段数,用来给未完成的回合记部分分。
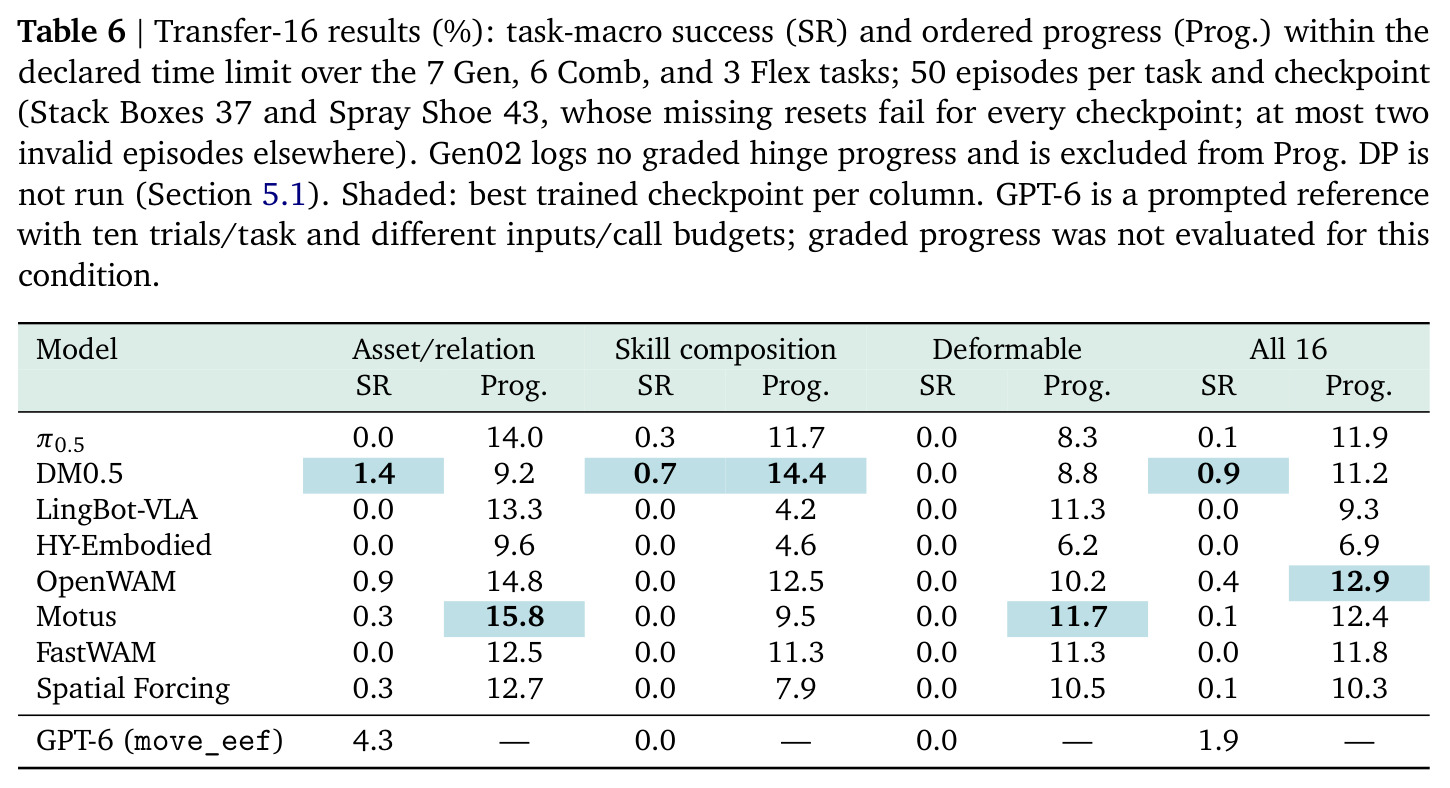
Transfer-16 上所有训练模型成功率几乎为零,宏成功率失去区分度,论文改用有序进度给 checkpoint 排名,这是读懂泛化实验的钥匙。
Sim-to-real 与仿真平台对应
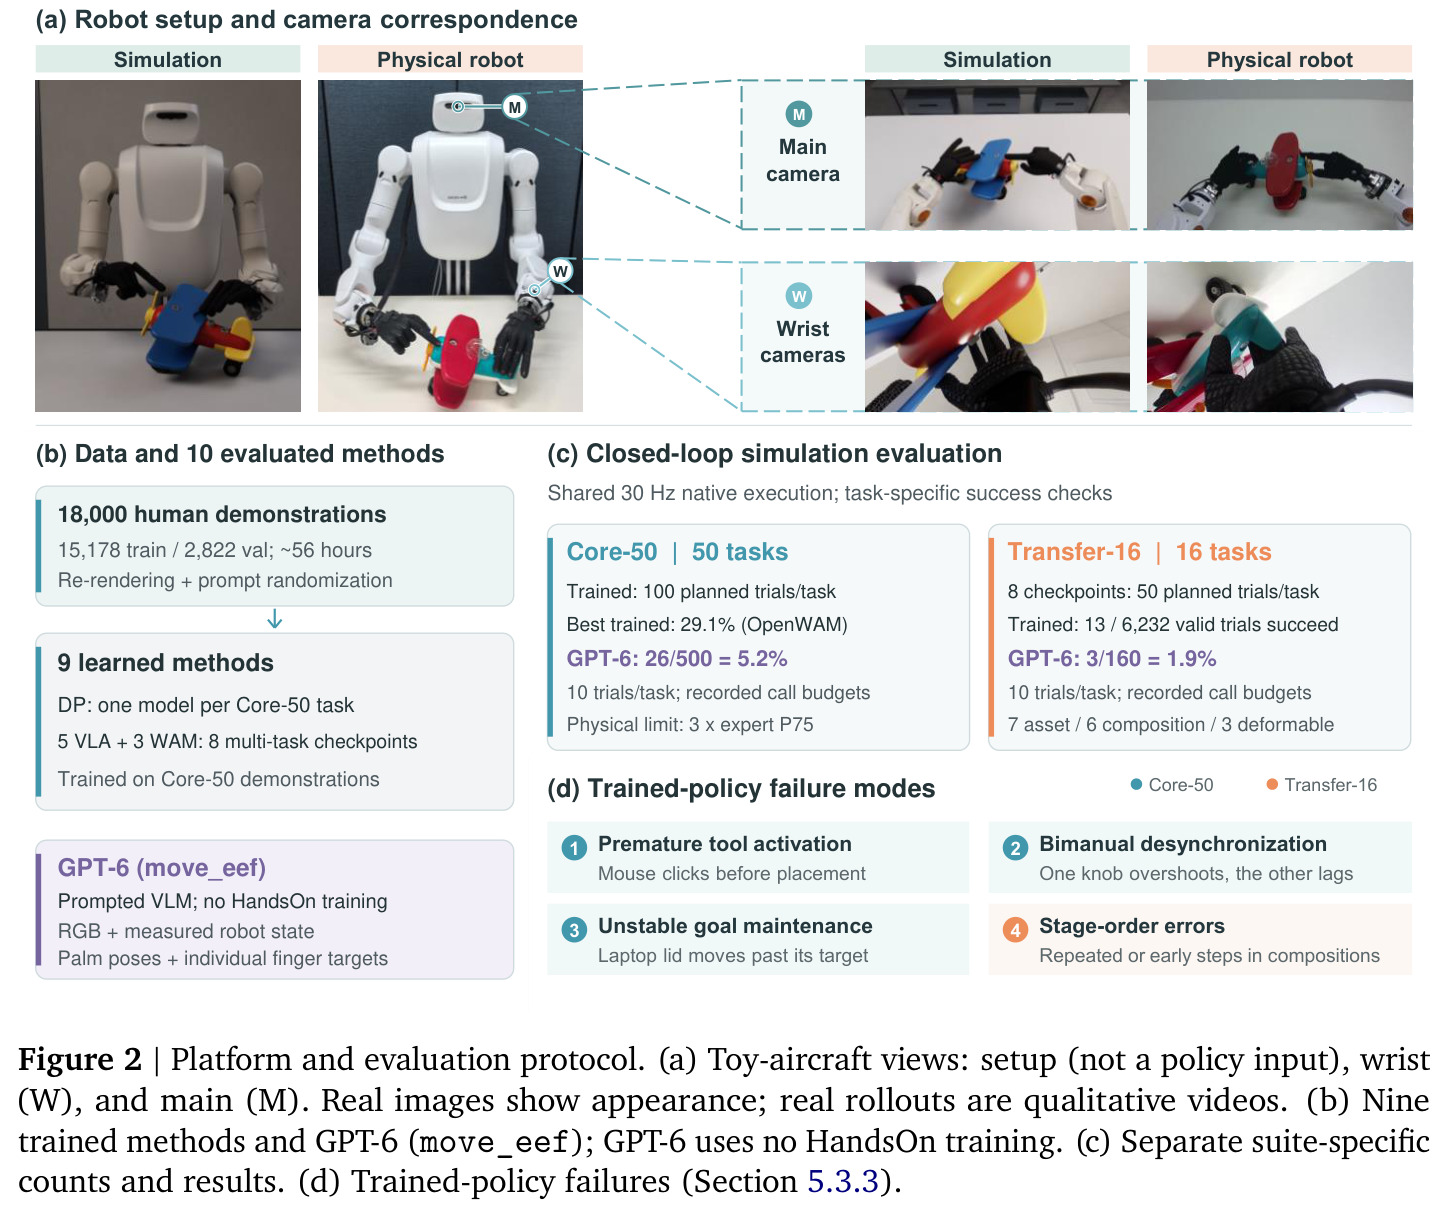
在仿真中训练策略再迁移到真实机器人执行,需要仿真与真实系统在运动学、资产尺度、相机、状态/动作坐标系与时间轴上一一对应。HandsOn 的仿真本体严格跟随物理平台(ROKAE AR5-08 七自由度臂、5 kg 负载、683 mm 臂展,第一代 Wuji Hand 每手 20 个主动关节),并给出对应性记录。
论文展示的是定性真机 rollout 而非真机成功率,理解其“仿真先行、真机定性佐证”的定位,才能正确评估结论的适用范围。
研究动机
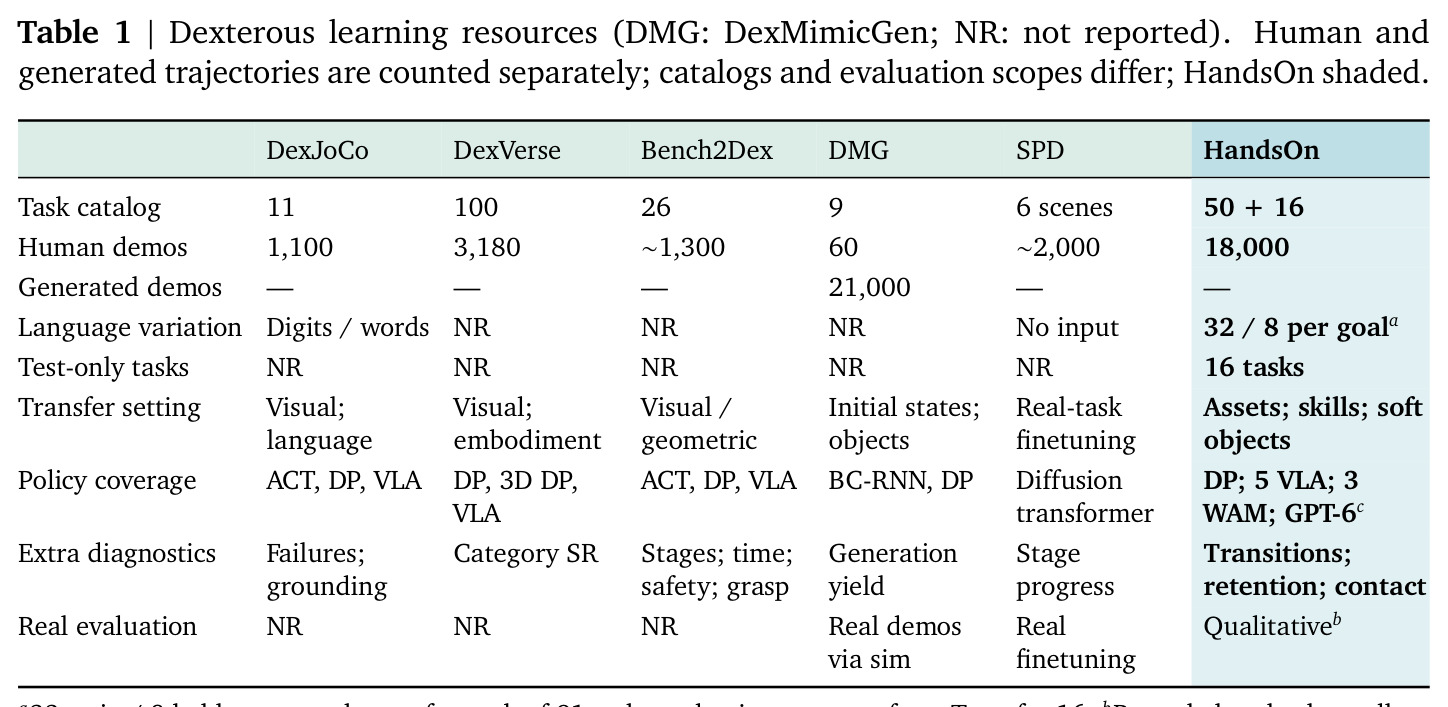
灵巧操作的本质是控制“接触如何随操作过程变化”:移动鼠标不能提前触发点击,同时设置两个旋钮时两个旋钮必须同时保持在目标位置,放置杯盖时松手瞬间必须保持对齐。现有灵巧操作基准(DexJoCo、DexVerse、Bench2Dex、LabDex)虽然扩展了任务与本体覆盖,但人类演示规模很小——DexMimicGen 只有 60 条人类种子轨迹(靠自动生成扩展到 2.1 万条),Bench2Dex 约 1300 条,DexJoCo 1100 条——而且它们的任务几乎从不包含专门留作评估、不提供训练演示的 held-out 任务,因此无法区分“学过任务的执行能力”与“对未见任务的泛化能力”。此外,这些基准大多只报告聚合成功率,无法定位策略究竟在哪一步失败:是抓取时误触了功能、双手节奏失调,还是到手后保持不住目标状态。
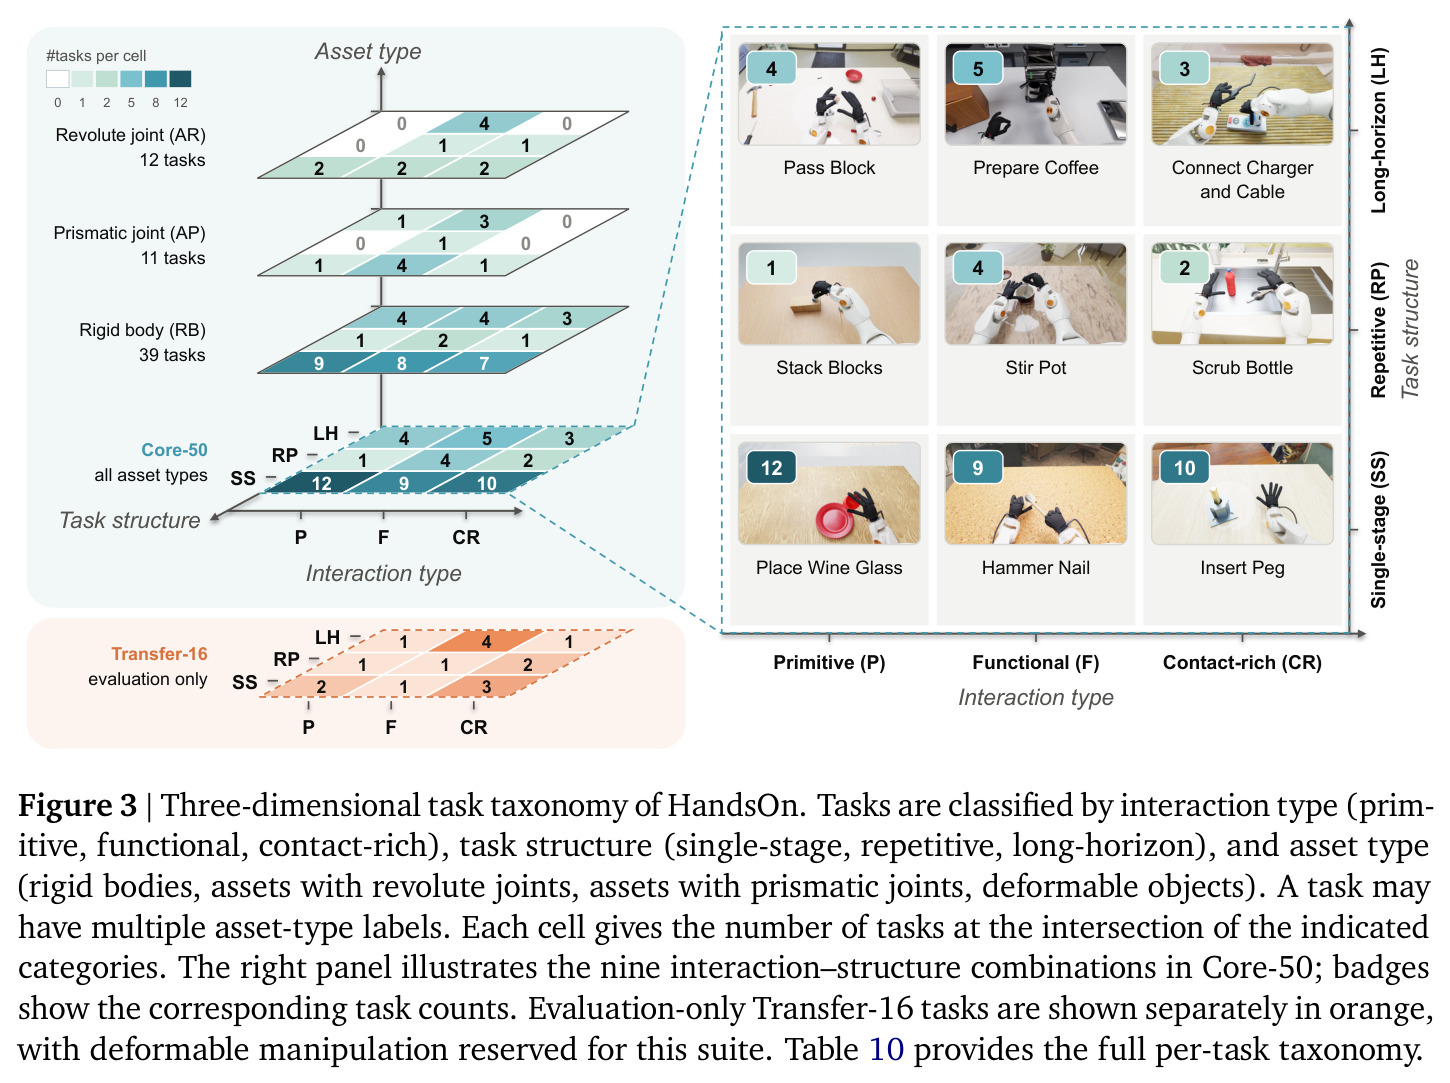
本文的目标是本文要构建一个可组合的跨本体灵巧操作仿真平台与基准:支持 5 种机械臂、6 种灵巧手、约 200 个刚性/铰接/可变形资产;提供 18,000 条精选人类演示(约 56 小时交互、三路同步相机视角),规模是代表性灵巧基准的 5.7–16.4 倍;设计两个互补套件——Core-50(50 个带演示的任务,支持演示学习与全新 rollout 评估)和 Transfer-16(16 个只评泛化的任务,涵盖新资产关系、技能组合和 3 个无可变形演示的可变形任务);配套原生阶段检查器、按专家 P75 时长冻结的时间预算、细粒度诊断指标和严格的统计报告规范;并系统评测扩散策略、5 个 VLA、3 个 WAM 以及无微调的 GPT-6 提示控制器,共 10 种方法。
与已有工作不同的是,本文的独特切入有四点。其一,演示规模与质量并重:1.8 万条演示全部在评测所用仿真器(Isaac Sim 5.1)内采集,状态/动作监督精确,且经过“操作员采集—独立评审—第三方仲裁”三角色分离的审核流程。其二,重渲染管线在回放已录交互的同时随机化外观与语言(每条任务-目标 32 条训练改述+8 条保留改述),扩大观测覆盖而不改变标签,弥补了“采集固定了一组外观”的缺陷。其三,训练套件与泛化套件严格分离,16 个评测专属任务直接量化资产迁移、技能组合与可变形操作三类零样本泛化。其四,诊断导向的评估哲学:不只问成功与否,还用有序进度、三处手部转换定位、语言交换探针、协变量调整的技能组回归等手段回答“策略在哪里、为什么失败”,并把无微调的 GPT-6(move_eef 接口)以 660 次试验纳入对照,披露其接口与调用预算。
核心方法
直觉是:要测量“可泛化的灵巧操作”,必须同时拥有大量高质量演示和一个防作弊的评估体系。平台因此分为两半。采集侧在 NVIDIA Isaac Sim 5.1 中进行:MANUS Prime I 手套记录手指关节,腕部 HTC VIVE 追踪器记录手部位姿,帧配准与时间对齐后,腕部运动和以掌心为中心的 21 关键点手部表示被转换为指令——手臂分支经运动学求解产生可行的末端目标,Wuji 重定向把手部关键点映射为第一代 Wuji Hand 每手 20 个关节目标;仿真以 30 Hz 同步记录观测、实测状态、指令动作、语言与来源元数据。重渲染侧则在回放录制交互时随机化外观(4 种桌面材质、3 种背景、3 种天花板,以及纹理尺度/朝向、粗糙度/色调、光照方向/强度/色温)与语言指令,交互本身与标签保持不变。评估侧采用固定原生执行协议:每个动作恰好推进 1/30 s,任务专用成功谓词逐步判定,时间预算冻结为 3 倍专家 P75 时长。
核心创新有三。第一,任务-资产层与硬件解耦:任务定义、资产、成功谓词与演示集独立于具体硬件,代码支持换装 KUKA/UR/ABB/FANUC 机械臂、两代 Wuji Hand 与 Sharpa Hand,以及 PhysX/Newton 两种物理后端,测的是“操作能力”而非某套硬件。第二,训练与泛化严格分账:Core-50 提供每任务 46–463 条训练轨迹(中位 268),Transfer-16 的 16 个任务(7 个资产/关系泛化 EVAL-Gen、6 个技能组合 EVAL-Comb、3 个可变形 EVAL-Flex)不提供任何目标任务演示。第三,把专家表现量化为时限与诊断:Core-50 任务 $i$ 的预算取演示帧长升序的非插值分位数 $q_i$(第 75 百分位),时限 $H_i = 3q_i/30$ 秒,最大动作数 $B_i$ 为其 30 倍取整;诊断上区分“抓取工具”与“驱动工具”、requested 数值设定与任意执行器运动、铰接行程与单纯接触,并定义有序进度 $P_e = L_e / K_i$。
方法步骤详情
第一步,任务设计与可行性验证:任务卡固定目标、标准初末态、独立于程序成功标志的完成证据(物体位姿/关节状态/图像)、允许与禁止动作、时限及版本哈希;新任务先由至少 20 名操作员试采并全人工评审,标签与客观证据一致率至少 98% 才入库,采集期约 20% 分层盲审、5–10% 复审。第二步,演示采集:至少 10 名操作员、1050+ 场次,手套与腕部追踪器数据经运动学求解和 Wuji 重定向输出臂末端目标与每手 20 个关节指令,30 Hz 记录,产出 18,000 条精选轨迹(15,178 训练/2,822 验证),按任务组 500/300/100 配额,中位轨迹 262 步。第三步,重渲染与语言随机化:32 采样/像素捕获,外观按轨迹采样一次并在回放中固定,相机 ±2 mm/±0.3° 扰动;语言库 91 条活跃条目、每条 32 训练+8 保留改述,训练混合 20% 规范句+80% 改述。第四步,闭环评测:动作按 30 Hz 原生执行、每步检查成功/任务失败/超时,时限 $H_i = 3q_i/30$ 秒($q_i$ 为专家帧长 75 分位),Transfer-16 的 13 个非柔性任务用原子任务时长代理,柔性任务显式 240/180/180 s。第五步,统计报告:Wilson 区间、任务+回合双单元 bootstrap、成对任务重采样与逐任务信噪比。
技术新颖性
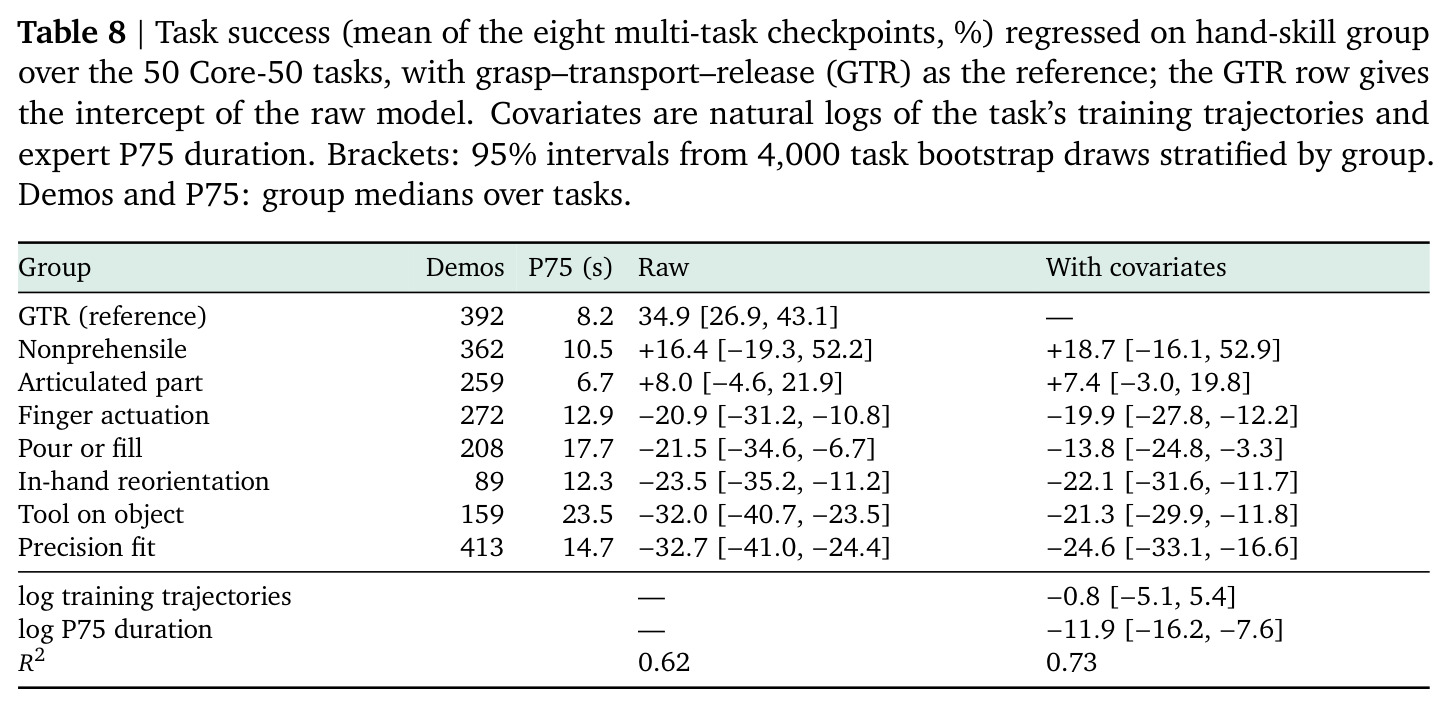
与 DexMimicGen 靠自动轨迹生成放大 60 条人类种子不同,HandsOn 坚持人工精选加上三角色分离审核的数据质量路线;与既有基准把全部任务都开放训练不同,其 evaluation-only 套件直接量化三类零样本泛化,且用有序进度在成功率失效时仍能区分模型。诊断学的系统化是最大新颖点:把聚合成功率分解为阶段转换事件、目标保持诊断(是否“曾到达且最终仍在”)、语言交换探针(离线比较换名指令下 1 秒后掌心端点位移)、以及以对数演示数和对数专家时长为协变量的技能组回归($R^2$ 从 0.62 升至 0.73),证明工具/精配/手内/手指组的 20–25 分差距不是数据量或时长造成的。GPT-6 实验也属首次在此类目录上系统披露 VLM 提示控制器的观测接口、move_eef 函数签名(绝对掌位姿+每手 20 个独立手指关节目标)、调用预算与 660 次试验结果,为“VLM 作为高层规划器”的研究提供了可比较的基准条件。
实验结果
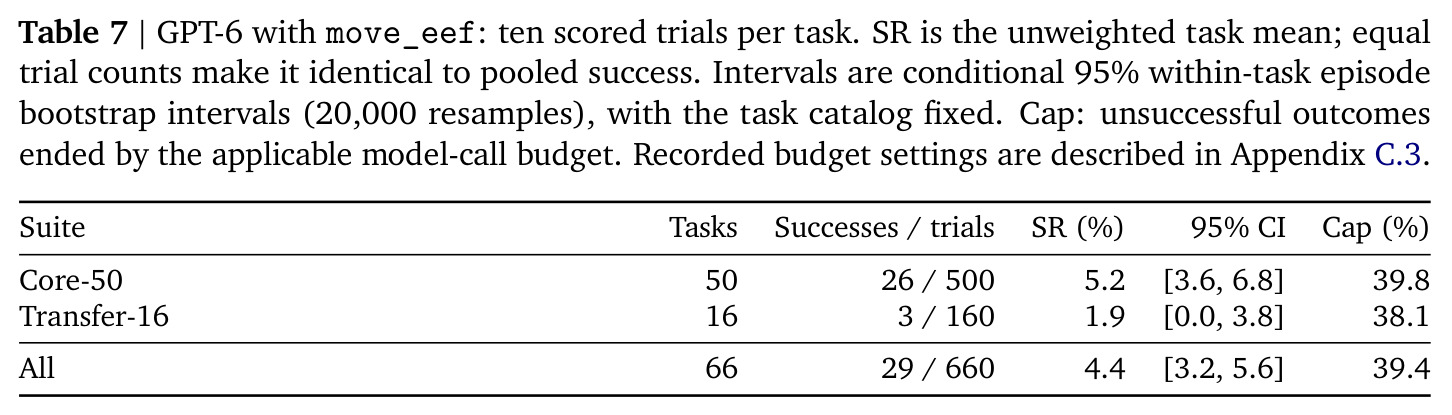
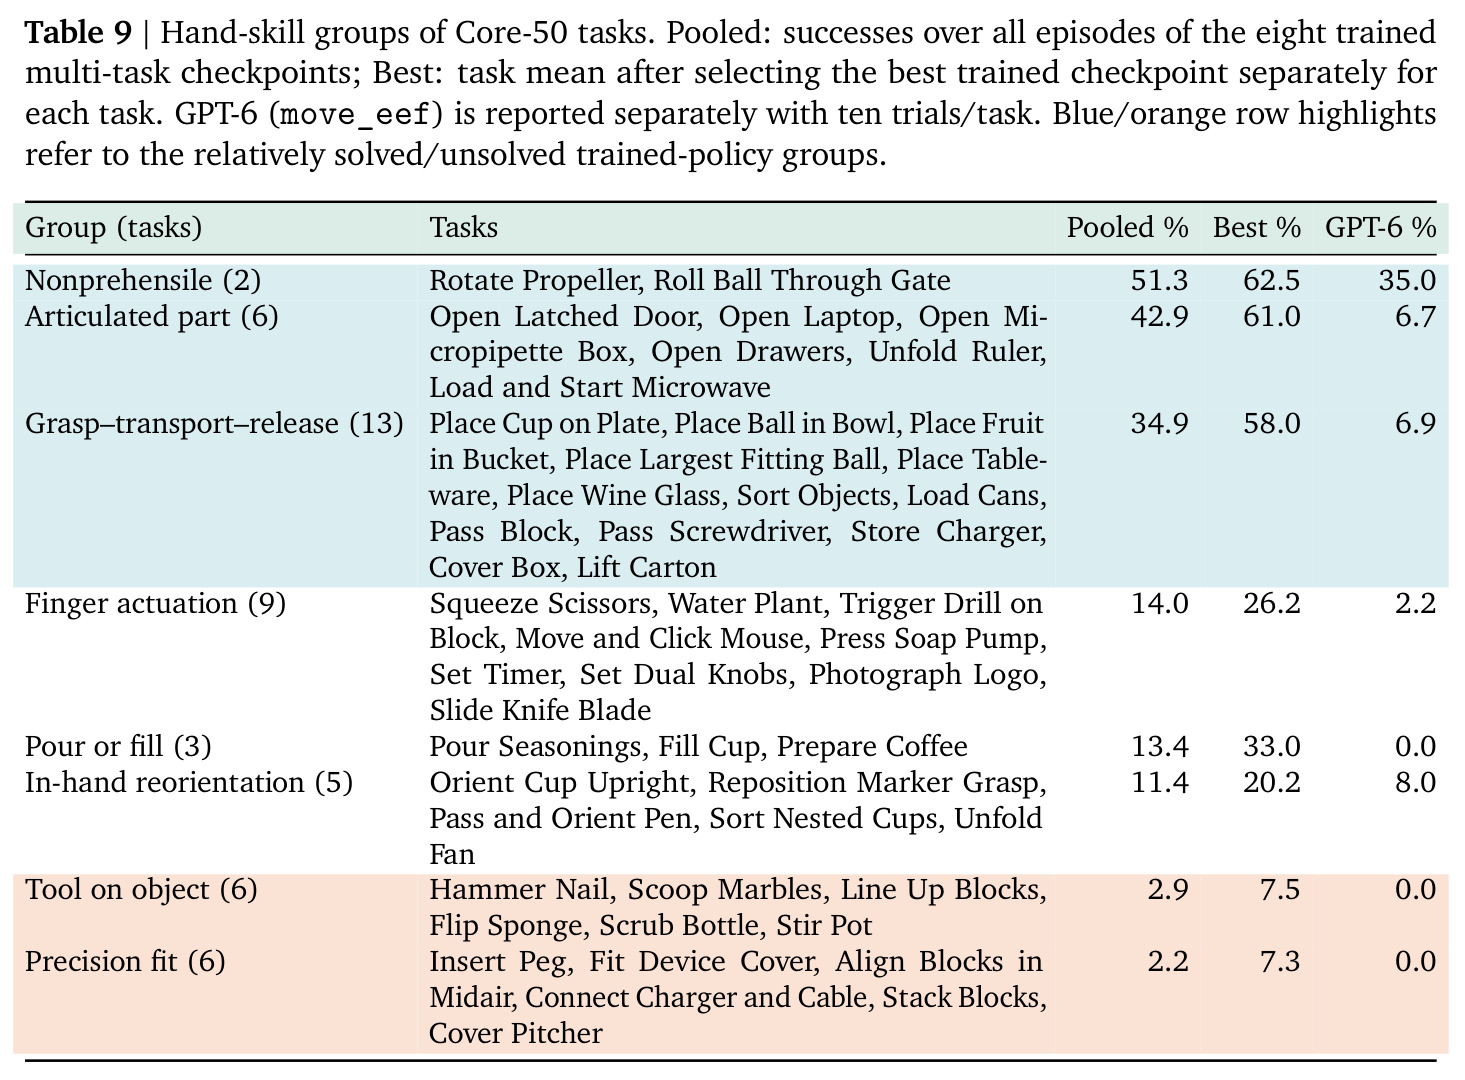
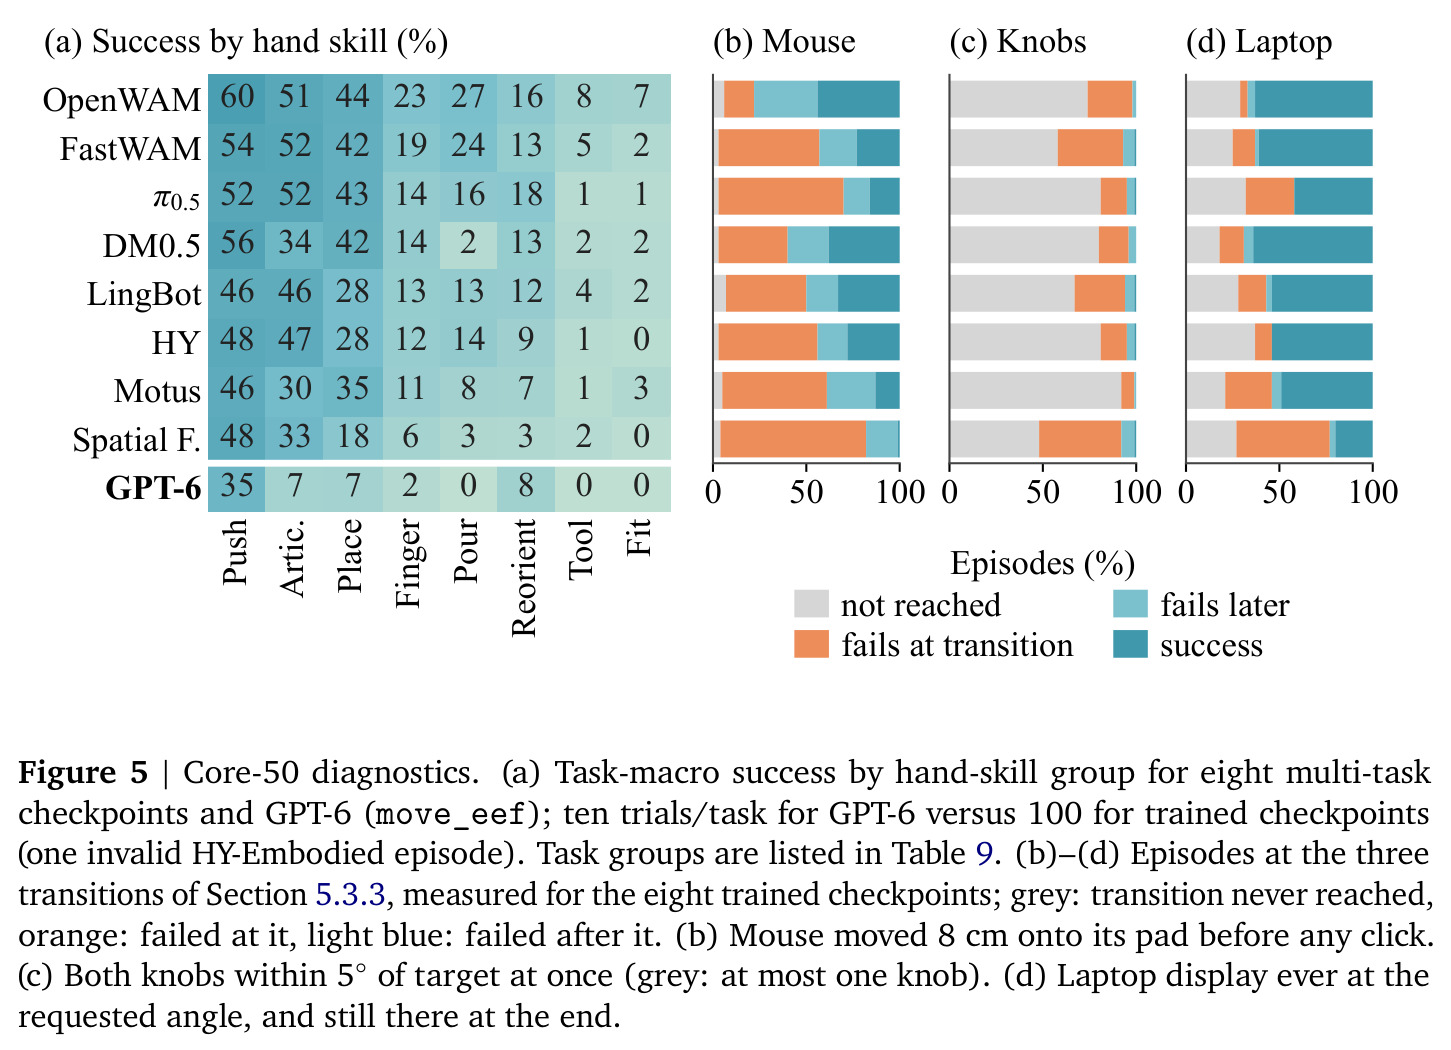
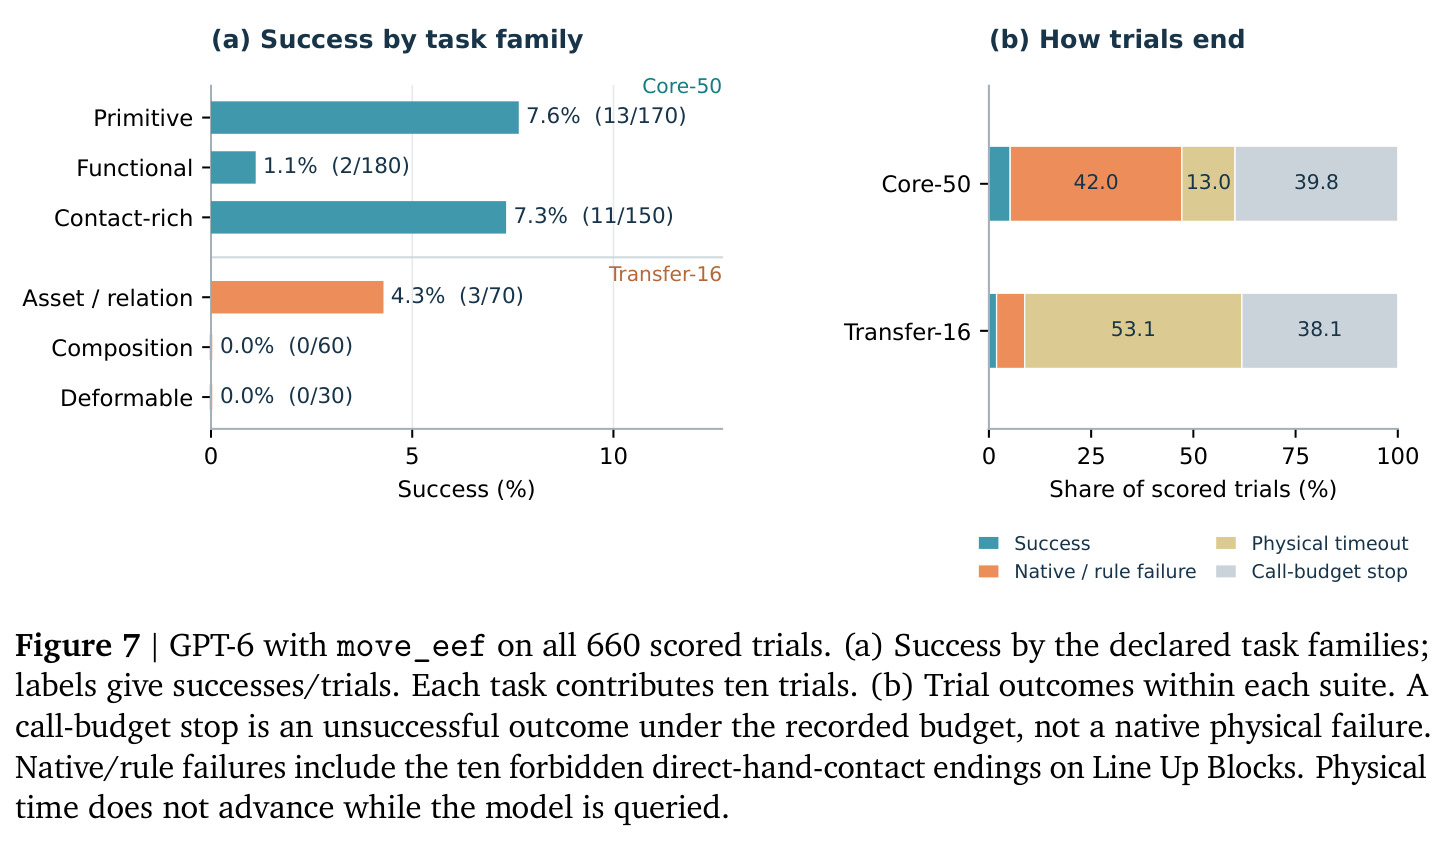
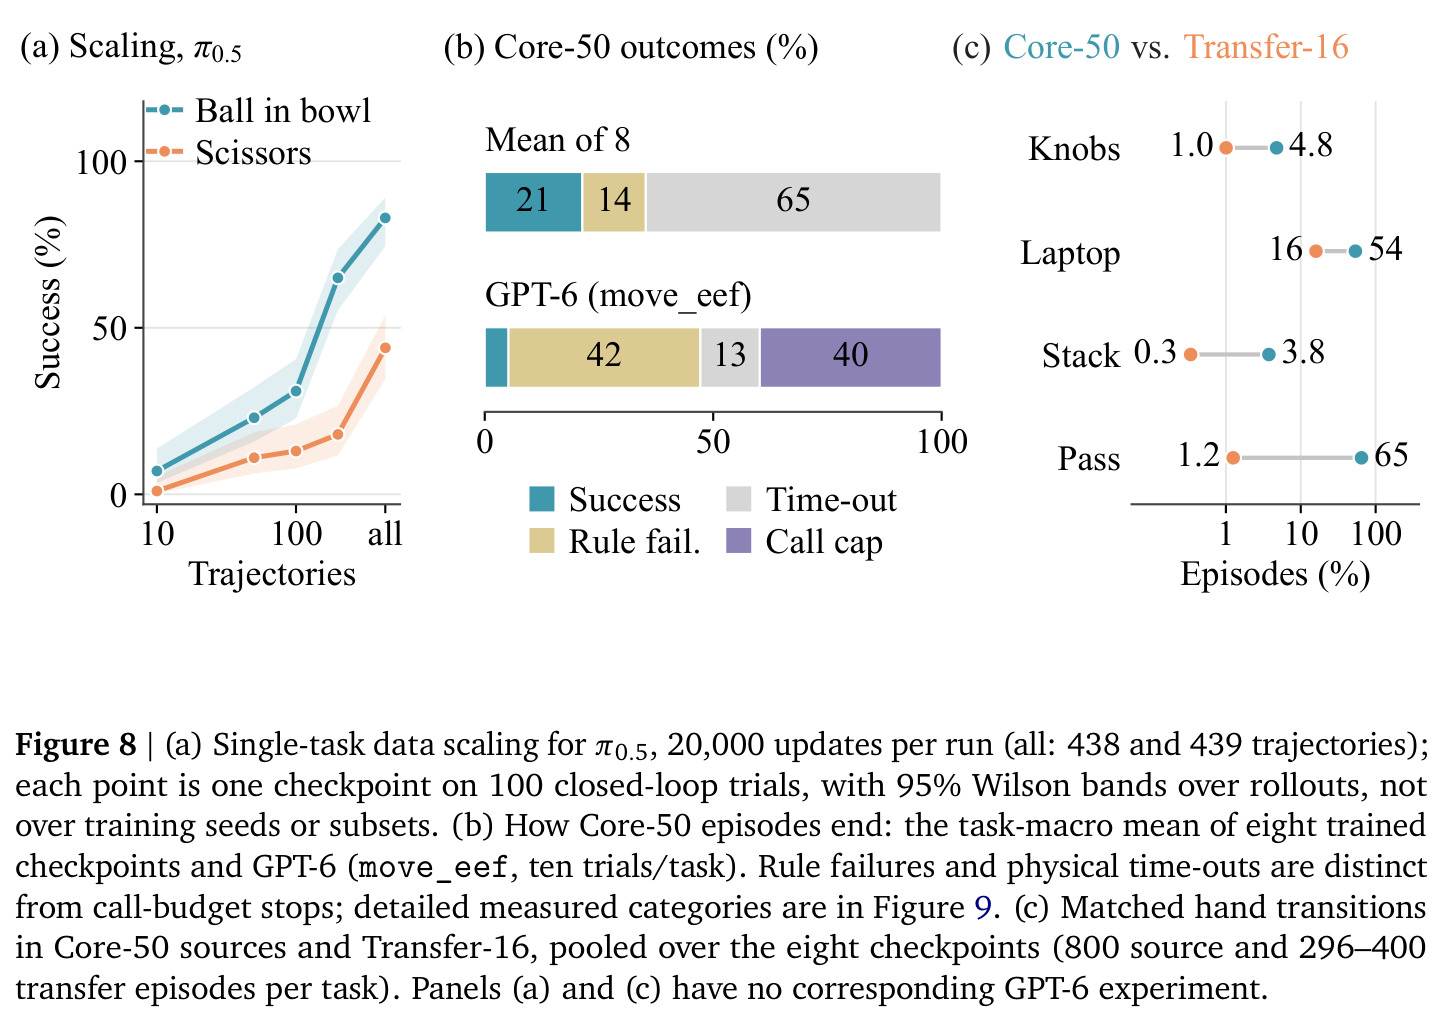
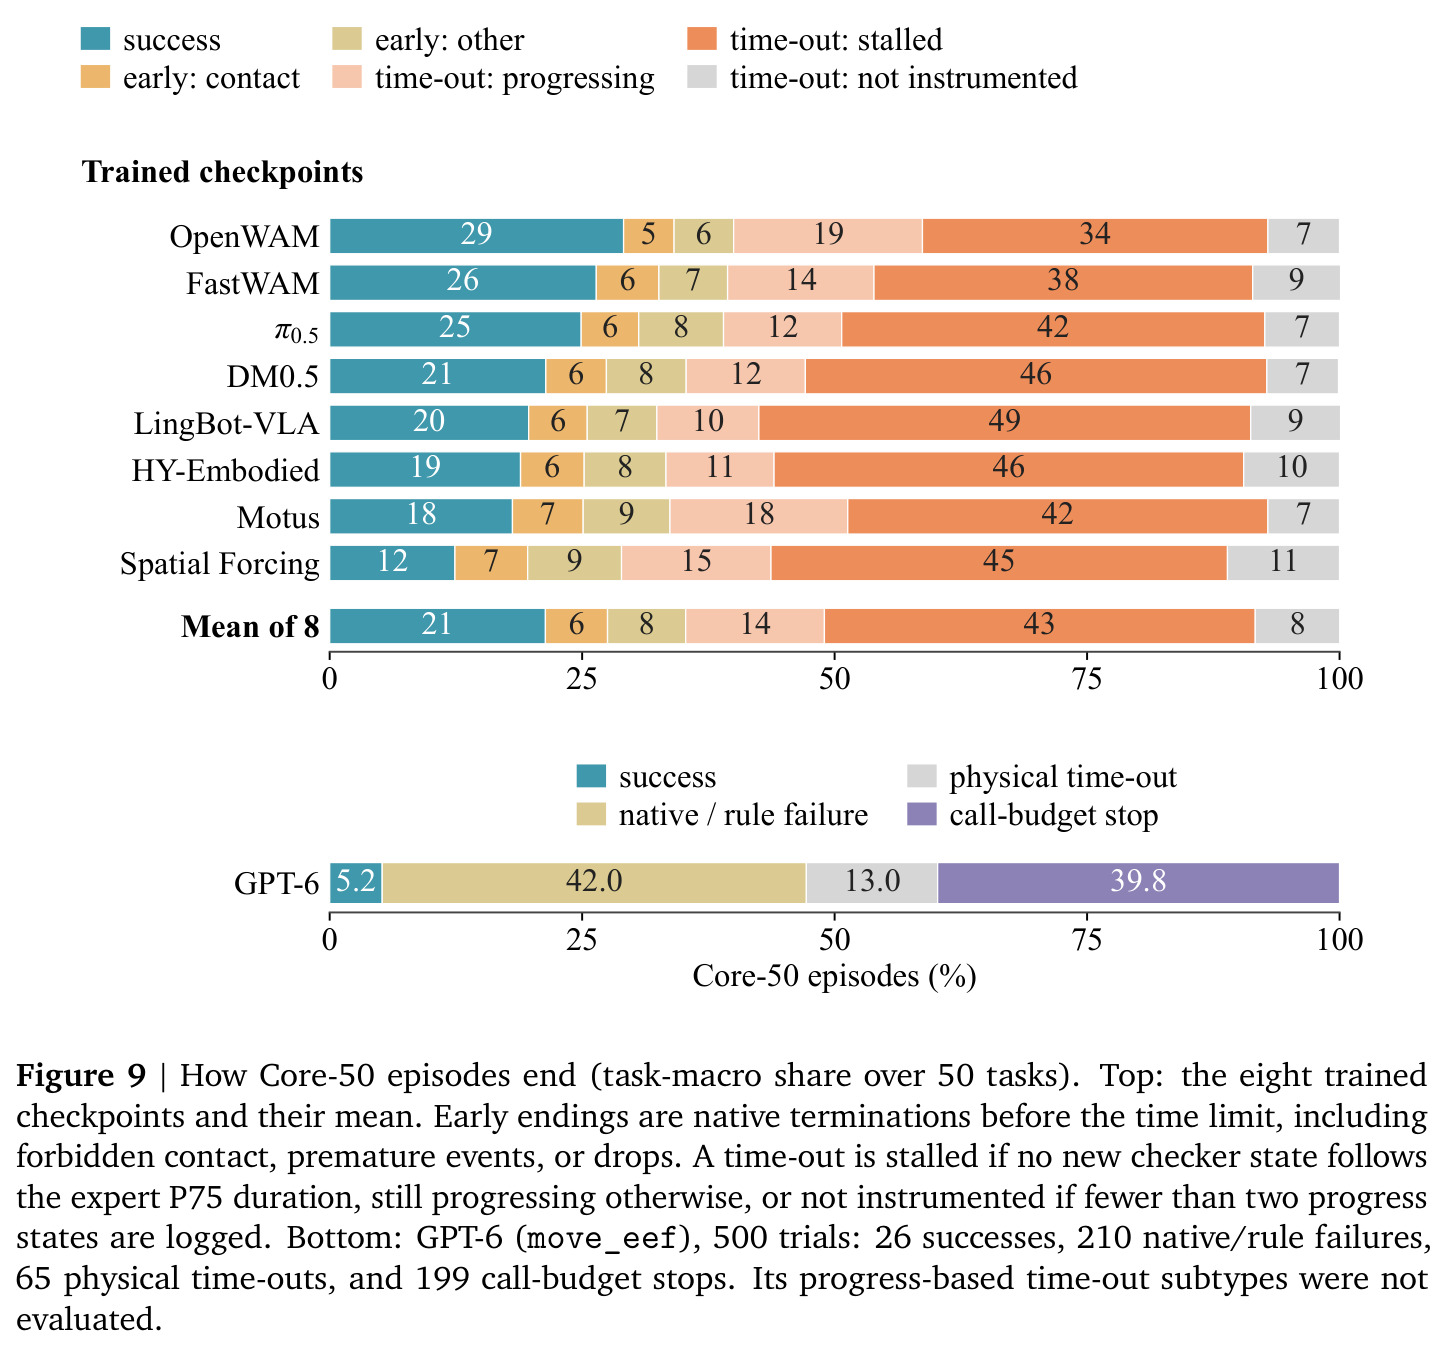
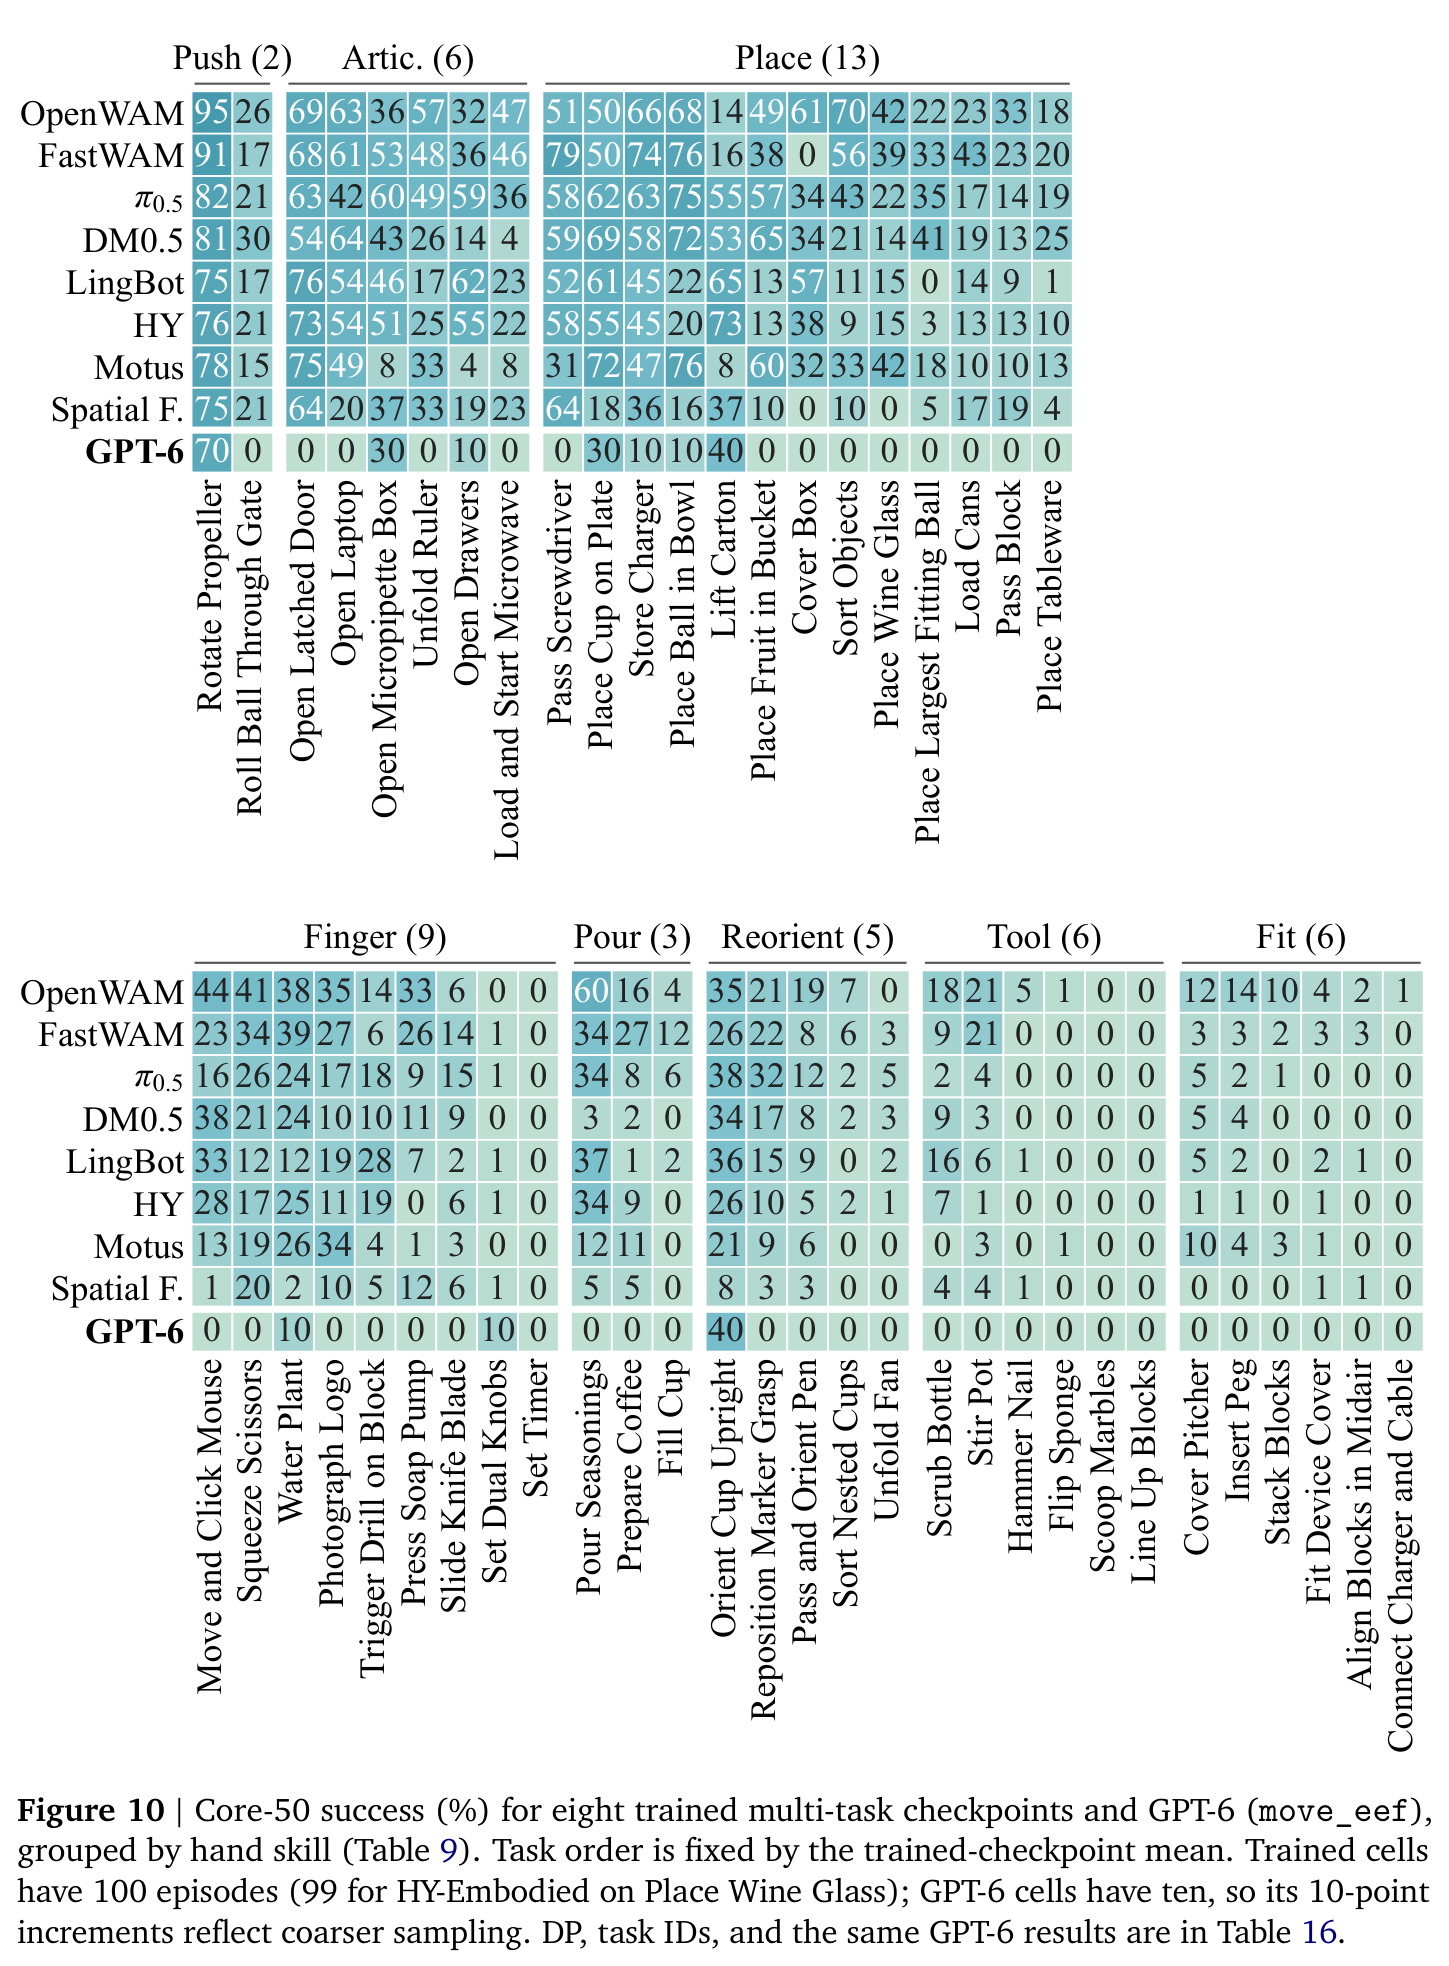
Core-50(每任务 100 回合)上 OpenWAM 以 29.1% 居首(区间 22.8–36.0),FastWAM 26.4%、π0.5 24.9%、DM0.5 21.4%、LingBot-VLA 19.7%、HY-Embodied 18.9%、Motus 18.1%、Spatial Forcing 12.4%,逐任务选优 35.4%,单任务 DP 仅 9.7%。技能分解:推动 51%、关节 43%、抓-运-放 35% 可解,手指驱动 14%、倾倒 13%、手内重定向 11%、持械 2.9%(137/4800)、精配 2.2%(107/4800);控制演示数与专家时长后四个困难组仍低 20–25 分($R^2$=0.73),成功率与演示数 Spearman ρ 仅 0.27。时限敏感性:WAM 完成中位 1.13–1.27×p75 对 VLA 的 0.88–0.99,只计 1× 时 π0.5 以 14.6% 反超,28 对模型 12 对换序。语言探针:HY/LingBot 换对象名端点仅移 7.3/8.5 cm(≈采样噪声 8.8/8.1),换名后 57%/71% 仍奔原目标。扩展实验:π0.5 在 Ball in Bowl 从 10 条轨迹的 7% 到 438 条的 83%,Scissors 1%→44%。Transfer-16 训练模型近乎全灭(合计 13/6232),有序进度 OpenWAM 12.9% 最高,可变形任务全未解。GPT-6 无微调 660 试验 29 成(4.4%;Core-50 5.2%、Transfer-16 1.9%),成功仅集中 12/66 任务,39.4% 试验死于调用预算。失败定位:平均 21.4% 成功、64.8% 超时(65–83% 停滞);三处转换——鼠标任务 443/800 因过早点击终局(OpenWAM 16 次 vs Spatial Forcing 78 次)、双旋钮同时达标仅 38/800(成功 5)、笔记本 Spatial Forcing 73 次到达但只 23 次保持(148/154 因过开中位 31.5° 失守);Pass Block 未接管时 175/179 在给手松开后中位 0.30 s 掉落。组合任务叠加第四种失败:步骤重复/提前启动(399 回合中 311 次水果入桶前按快门)。
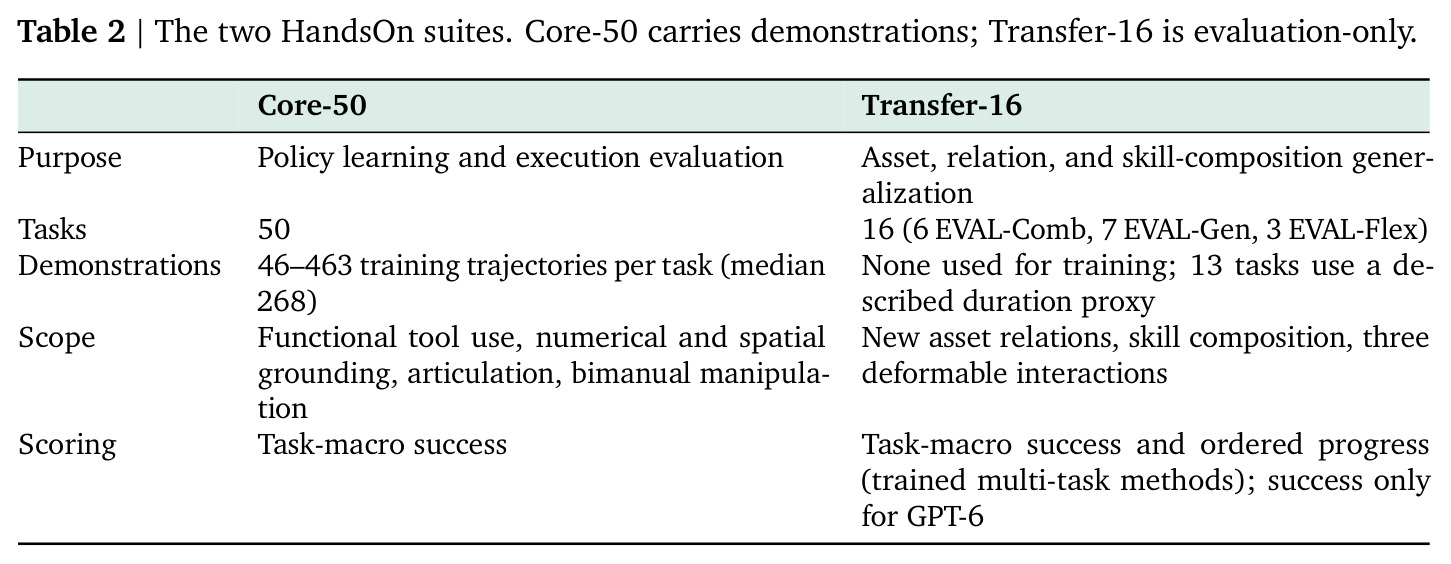
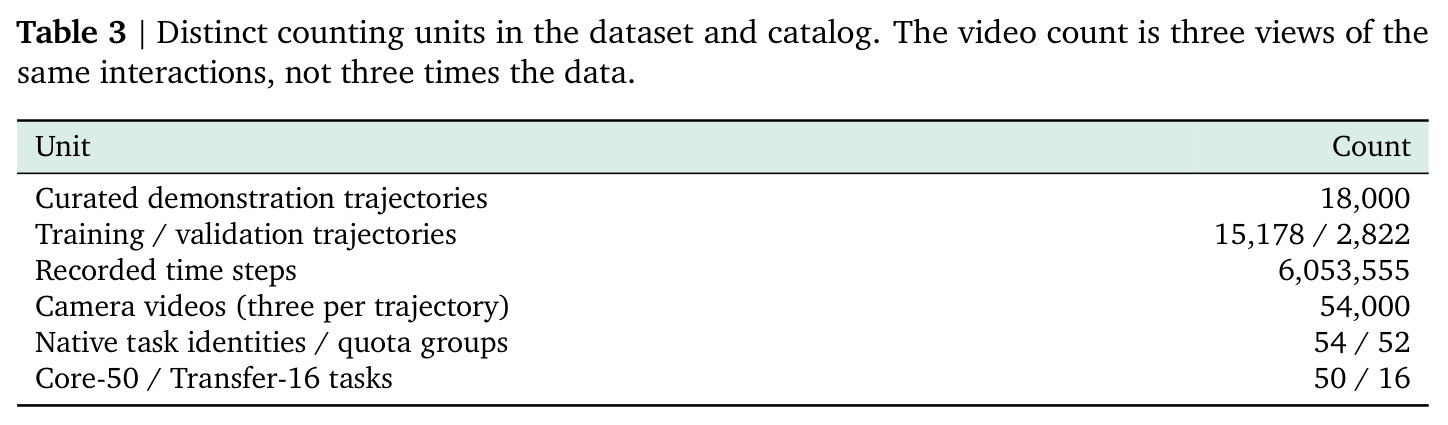
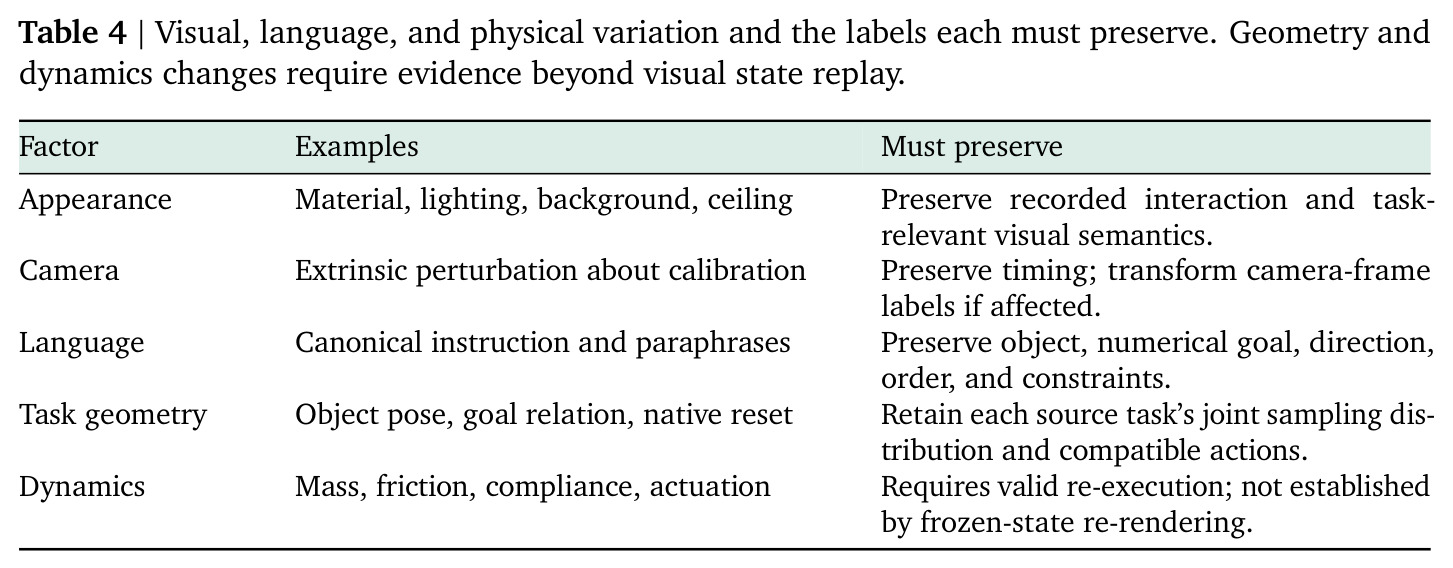
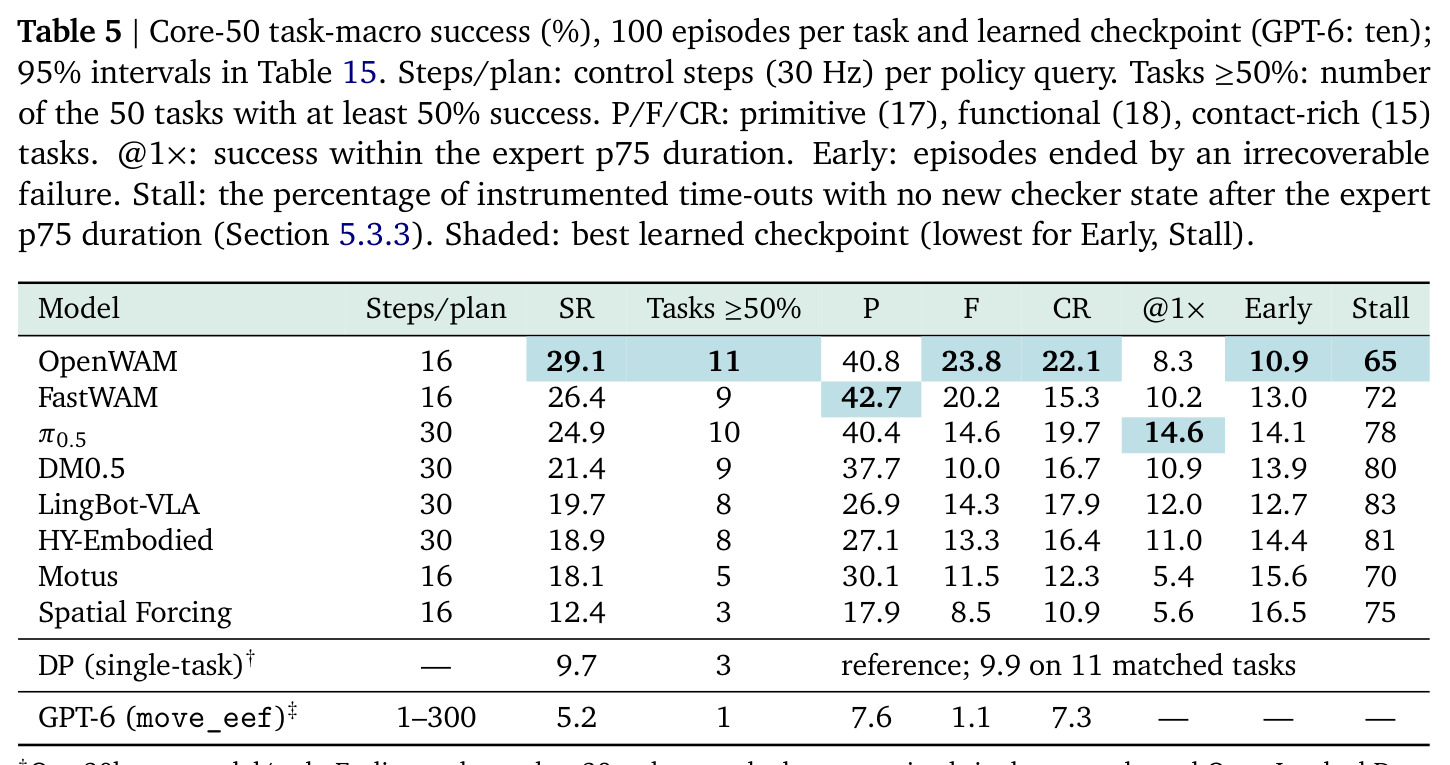
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Core-50 多任务灵巧操作(50 任务) | 任务宏平均成功率(每任务 100 回合) | OpenWAM 29.1%(最佳训练多任务;逐任务选优 35.4%) | 单任务 Diffusion Policy 9.7%;GPT-6 (move_eef) 5.2% | 最佳多任务约为 DP 的 3 倍、GPT-6 的 5.6 倍 |
| Transfer-16 零样本泛化(16 任务) | 任务宏成功率 / 有序进度 | 成功率最高 0.9%(OpenWAM 资产迁移族);有序进度最高 12.9%(OpenWAM) | 其余 checkpoint 进度 6.9–12.4%,成功率 0.0–0.4% | 有序进度 +0.5 至 +6.0 分;三个可变形任务全部未解 |
| Transfer-16(GPT-6 无微调提示控制) | 成功率(每任务 10 次试验,共 160) | 1.9%(3/160);资产迁移族 4.3%,组合与可变形 0.0% | 训练 checkpoint 合计约 0.2%(13/6232) | GPT-6 在资产迁移族略占优,但不具备可变形与组合能力 |
| Core-50(GPT-6 无微调提示控制) | 成功率(每任务 10 次试验,共 500) | 5.2%(26/500,95% CI [3.6, 6.8]) | 最弱训练 checkpoint(Spatial Forcing)12.4% | 低于全部八个学习式 checkpoint,但成功分布显示任务级规划潜力 |
局限与改进
作者承认:真机部分仅定性 rollout 视频、无物理成功率,附录 B.5 的成对真机协议尚未执行;所有报告实验只用一个配置(ROKAE AR5-08 臂+一代 Wuji Hand+PhysX),跨本体可移植性未经实测;GPT-6 每任务仅 10 次试验且受 API 成本与调用预算约束,39.4% 试验死于预算而非物理失败,无法区分规划不足与接口太薄;Transfer-16 的 13 个任务时长是代理而非实测 P75;技能组划分是分析透镜而非任务内在属性。我的补充观察:其一,演示全部来自仿真遥操作,操作员技能分布与真实部署用户可能不同,策略继承的“专家风格”未必匹配场景;其二,重渲染只覆盖静态外观域,Table 4 明确几何与动力学变化需重新执行验证,时变噪声与动力学随机化未建立;其三,成败完全由原生检查器判定,动作自然度、能耗、安全不计分,可能鼓励“能过检查器即可”的怪异策略;其四,GPT-6 与训练策略在观测接口、步数与调用预算上均不同构,横向比较只能定性解读;其五,训练侧为单种子(扩展实验明确只有一个训练种子),曲线未覆盖训练方差。
独立分析的弱点
第一,无触觉反馈是结构性盲区:腕部相机装在手上,抓握一旦形成被控区域就被遮挡——按钮按下瞬间被手指盖住、剪刀远侧把手接触丢失、手把目标推过头时目标恰被手挡住,论文报告的失败恰好都在视觉盲区。改进:仿真与实体手布置一致的 taxel 触觉阵列,先验证而非假设接触模型。第二,GPT-6 harness 过薄:只有 move_eef 一个函数,模型须同时推断物体几何与接触、输出最多 40 个手指关节目标并从被拒动作中恢复,没有抓取基元、避障规划、位姿估计与触觉,踪迹中充满反复的运动学拒绝。改进:层次化 harness——VLM 只做子目标规划,下层用反馈驱动技能库,并做匹配 harness 消融以分离规划与接口贡献。第三,泛化近乎全军覆没:Transfer-16 上八个 checkpoint 合计仅 13/6232 回合成功,新物体把失败前移到抓取阶段(Pass Glue Stick 左手 400 回合只拿起 5 次),说明多任务模仿没学到可组合的表示。改进:物体中心表示、显式步骤完成信号、技能库+组合泛化目标。第四,评估成本高:每 checkpoint 每任务 100 回合×50 任务,GPT-6 依赖付费 API;可用论文自证的 12/24 任务子集(复现 96%/100% 排序)做低成本初筛。第五,单配置实验与跨本体声明不匹配,应至少完整实例化第二组臂/手/物理后端。
未来方向
作者提出四个方向:其一,触觉感知——在仿真与实体手放置相同 taxel、验证接触模型、设计仍可视觉解出的任务,使视觉与触觉策略在同一谓词上可比;其二,量化真机评估——按附录 B.5 协议做成对仿真/真实实例、可执行谓词、固定试验数与失败模式报告,并在显式数据预算下比较仿真+真实与纯真实训练;其三,长时程家庭与生产任务——数十步操作、物体需寻找、以吞吐与返工计分,需要允许恢复的阶段模型(而非严格有序前缀)与报告进度/干预次数的评估;其四,跨 harness 评测 VLM——固定模型比 harness、共享 harness 比模型,控制任务/重置/物理时间与查询预算,测量成功、子目标完成、恢复与推理成本。基于本文成果还可延伸:把三处转换(接触建立、双手同步、目标保持)做成显式监督或奖励塑形信号(接触角色标签、双手依赖图、进度跟踪头);利用重渲染+语言库做指令接地预训练,直接针对 HY/LingBot“不读指令”的缺陷;把有序进度 $P_e$ 用作离线 RL 的优势估计信号;在 Transfer-16 上系统研究免演示技能组合(LLM 规划+低层技能库),这正是 GPT-6 实验暗示但未证实的机会。
复现评估
复现条件总体良好:代码开源(github.com/TsinghuaC3I/HandsOn),18,000 条演示随基准发布,并携带轨迹/会话级训练-验证划分与归一化来源台账;任务卡、检查器版本哈希、冻结时长预算表、语言库(91 条活跃条目、2912 训练+728 保留改述)与计数口径说明(54,000 路视频=18,000 交互×3 视角)一应俱全;检查器变更需复现、影响分析、双人评审、回归测试与重新试采,协议文档化程度在同类工作中罕见。难点在算力与费用:训练八个多任务 checkpoint(π0.5 12 万更新、DM0.5 8.6 万、OpenWAM 7 万、Motus/FastWAM 10 万、Spatial Forcing 9 万、HY-Embodied 12.5 万、LingBot-VLA 15.1 万更新)加上 50 个每任务 3 万更新的 DP 模型需要可观 GPU 资源;闭环评估每 checkpoint 每任务 100 回合,GPT-6 评测 660 次 gpt-6-astra API 调用费用不低;仿真基于 Isaac Sim 5.1,需 GPU 工作站。若只复现分析(语言探针、失败统计、回归),只需已发布数据与 checkpoint 的推理算力,门槛显著更低。
论文图表
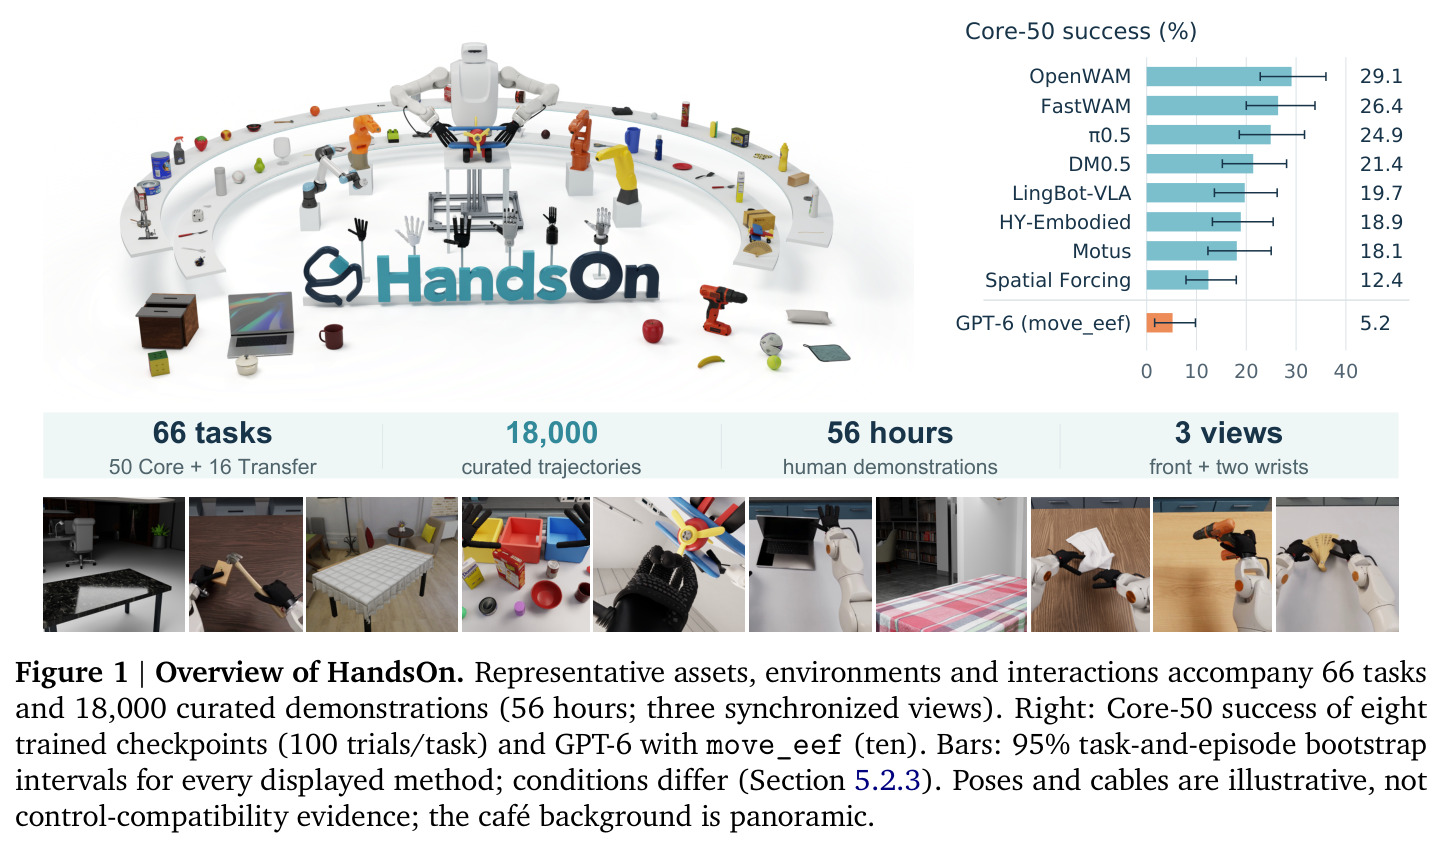
总览图:左侧展示代表性资产、环境与交互,标注 66 个任务(50 Core + 16 Transfer)、18,000 条精选轨迹(56 小时)、3 路同步视角;右侧柱状图给出八个训练 checkpoint 的 Core-50 成功率(OpenWAM 29.1% 至 Spatial Forcing 12.4%)以及 GPT-6 (move_eef) 的 5.2%,均带 95% 任务+回合 bootstrap 区间。
一张图浓缩了基准的规模声明与主榜结果,是快速把握论文贡献与“最佳多任务策略仅约三成成功率”这一核心结论的入口。