Skill∞:智能体技能优化的递归自我改进 Skill^{infty}: Recursive Self-Improvement for Agent Skill Optimization
把技能优化流程本身写成技能,让优化器在双循环中既优化任务技能也优化自己。
前置知识
递归自我改进(Recursive Self-Improvement, RSI)
指系统不仅改进自己在任务上的表现,还改进“产生这些改进的流程”本身,每次改进又能加速下一次改进。思想可追溯到 Good 1966 年的智能爆炸假说与 Schmidhuber 2003 年的哥德尔机:一个程序在能证明改写有益时改写自己的代码。STOP 等近期工作让语言模型脚手架改写自己的代码或提示,是这一愿景的初步实现,但作者指出模型本身未被改变,尚非完全的 RSI。
本文的核心主张正是“技能优化流程本身可被编码为技能,从而被同一流程优化”,读懂 RSI 才能理解两层循环为何能互相加强、以及它与哥德尔机、STOP 等前人的联系与区别。
Agent Skills / SKILL.md 技能包
Anthropic 提出的开放规范(Claude Code、Codex CLI、OpenCode 共用):一个技能是一个目录,以 SKILL.md 为核心,front matter 声明 name 与 description,正文是指令,还可捆绑脚本、参考文件等资源。智能体按渐进披露(progressive disclosure)方式加载:先只看到名称与描述,判断有用才加载完整指令并打开资源,因此技能可以打包可执行流程而不只是文字建议。
Skill∞ 的元技能就是一个标准技能包;论文的几乎所有机制——自改进能改什么、部署时如何生效、成本如何摊销——都建立在“技能即可移植目录”这一格式之上。
原生技能发现(native skill discovery)
智能体框架内置的技能加载机制:技能安装在 harness 的标准位置,智能体最初只看到每个技能的名称与描述,自行决定是否加载完整指令与资源。没有 prompt 注入、也没有任何指令要求加载。因为激活与否取决于 description,所以描述文本也在优化范围内。
论文坚持两层技能(任务技能与元技能)都通过原生发现加载、与部署条件一致,这保证了优化期测得的增益无需任何注入就能在部署时兑现,也是理解其实验设定与“harness 无关”主张的关键。
元技能与技能优化任务
元技能(meta-skill)是描述“如何优化技能”的技能包。技能优化任务 $q=(s_0^q, \mathcal{T}_q, B_q)$ 要求元智能体在预算 $B_q$ 内把种子任务技能 $s_0^q$ 在任务集上优化得更好,其奖励是优化前后的得分差(增益)$g(m,q)$;元技能的元得分 $S(m;Q)$ 就是在一组此类任务上的平均增益。
这是论文的形式化骨架:外层循环用平均增益客观评估候选元技能,内层循环执行具体优化,看懂这两个定义才能理解自改进如何被打分、如何防止自吹自擂。
执行轨迹诊断与独立评审
诊断指元智能体阅读父技能的执行轨迹(任务智能体的动作、工具结果、验证器输出),把失败归因到具体环节;独立评审指一个上下文完全隔离的评审者,仅依据父/候选技能包、提案与支持证据判定接受或拒绝,会拒绝无实质修改、从未被激活、或照原样无法使用的候选,对元技能候选还核查其核心职责(包括评审本身)未被破坏。
这两道机制是 Skill∞ 防止“把噪声当进步”和防止收益来自奖励篡改的关键,也是自改进案例中“更严格证据标准”的落点。
研究动机
技能正成为语言智能体沉淀可复用程序性知识的通用格式,SkillOpt、CoEvoSkills、SkillEvolver 等方法已能从执行反馈中优化技能,但它们共享一个设计选择:优化器遵循一条人工设计的流程。SkillEvolver 把优化流程写成固定元技能,用它驱动独立智能体审计候选技能;MetaSkill-Evolve 更进一步,让每个搜索分支携带一个配置五智能体流水线的元技能并自我精炼,但流水线的角色与接线仍然固定,且每个元技能都与它共同进化的那个任务技能绑定——为一个任务学到的“怎么优化”无法迁移到下一个任务。此外一些方法在偏离部署的设定下优化:把技能注入 prompt 或指示智能体加载,从不检验智能体是否会自发加载技能。作者据此指出:只改进技能而不改进自身流程的优化器终将停滞,流程中的短板(例如“只看候选是否提到了修复,而不验证修复是否真的生效”)会被固定流水线永远保留。
本文的目标是本文的目标是把技能优化改造成递归自我改进(RSI):让一个元智能体遵循元技能去优化任务技能,同时用完全相同的流程去优化元技能本身。具体拆成三个可验证的子目标:(1) 优化由智能体主导——诊断执行轨迹、提出候选、请求独立评审、分配搜索预算这些步骤都定义在元技能里,因而可被自改进改写;(2) 元技能与任务技能解耦——先在一组跨领域的技能优化任务上把种子元技能 $m_0$ 精炼成 $m^\star$,再用同一个 $m^\star$ 去优化各领域的任务技能,把自改进成本摊销到后续所有优化中;(3) 两层技能都通过原生技能发现加载、与部署一致,增益不需要注入就能兑现。最终检验标准是在 SkillsBench 的 83 个智能体任务上超过人工精选技能,在 KernelBench 的 GPU 核优化上超过 SkillEvolver。
与已有工作不同的是,独特切入角度是把“优化器的流程”本身物化为一个标准技能包,使递归自我改进变得直接、可解释、与 harness 无关。与 STOP(脚手架改写自己的代码但模型不变)、哥德尔机(要求证明每次改写有益)不同,Skill∞ 改写的是一份可移植的 SKILL.md 指令与脚本;与 MetaSkill-Evolve 固定五智能体流水线不同,这里没有任何硬编码步骤——Algorithm 1 的六步写在元技能里,自改进可以改写包括评审与父节点选择在内的任何环节,让流程突破人类设计者的先见。同时它提出“搜索即推理”:不是按分数驱动的启发式,而是让元智能体结合档案中的诊断与评审来解释每个候选为何有效。最后,因为部署时技能靠名称加描述被原生发现,description 也进入优化范围——这是注入式方法普遍忽略的环节。
核心方法
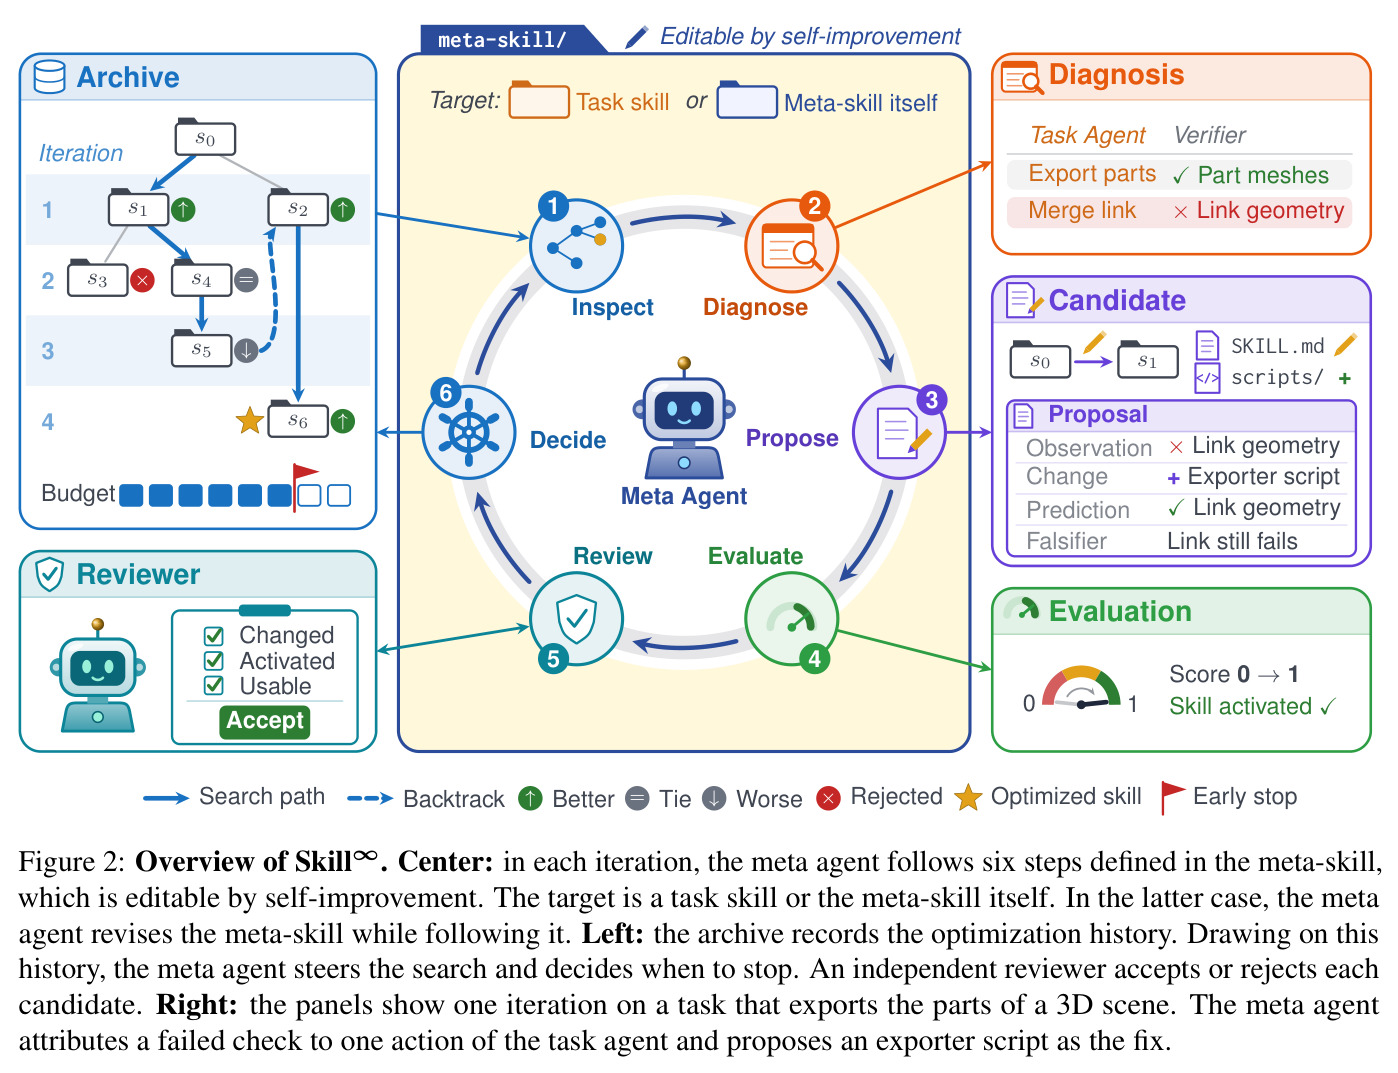
直觉上,既然技能是“可移植的流程”,那么“优化技能的流程”也可以是一个技能;让同一个智能体先遵循它去优化任务技能,再让它把这份流程当作优化对象,就构成两个在元技能处相遇、互相喂养的循环(题名中的 ∞ 形,见 Figure 1)。技术路线上论文先形式化:任务 $\tau$ 由指令、环境、验证器组成,技能 $s$ 在任务集 $T$ 上的得分是每任务 $n$ 次试验奖励的宏平均 $S(s; T) = \frac{1}{|T|}\sum_{\tau\in T}\frac{1}{n}\sum_{j=1}^{n} r_j(s,\tau)$;技能优化任务 $q=(s_0^q, \mathcal{T}_q, B_q)$ 的奖励是增益 $g(m,q)=S(s^\star_q(m);\mathcal{T}_q)-S(s_0^q;\mathcal{T}_q)$,元技能的元得分 $S(m;Q)$ 是在 $Q$ 上增益的均值。内层循环由元智能体执行 Algorithm 1 优化一个任务技能;外层循环用同一算法在 $Q$ 上优化元技能,每个候选元技能的得分就是它指导的内层优化带来的平均增益。精炼后的 $m^\star$ 与任务技能解耦,随后被复用于各领域的任务技能;两层技能都装在 harness 的标准技能位置,经原生技能发现加载。
核心创新有三点。第一,递归自应用:元技能既是元智能体遵循的流程,又是该流程的优化目标——智能体“在遵循它的同时修订它”,修订后的元技能再由它在技能优化任务上指导的优化结果来评判,使改进自我强化。第二,搜索即推理:每轮创建多少候选、选哪个父节点、何时停止、平局候选如何取舍,都交给元智能体的推理而非人工启发式——分数只说明候选是否变好而不说明为什么,元智能体要结合档案里的诊断与评审来解释,例如保留一个分数持平但在目标失败上取得进展的候选,或回溯到更早的技能。第三,用独立评审加原生发现保证测得的增益“部署即得”:评审者上下文隔离,只看父/候选包、提案与证据,拒绝无实质修改、从未激活或不可用的候选;两层技能都不注入 prompt,激活取决于 description,因此 description 也在优化范围内。与已有方法的本质区别是:MetaSkill-Evolve 等虽进化元技能,但流水线角色与接线固定且元技能与单个任务技能绑定;Skill∞ 的流程完全可改写且跨任务复用。
方法步骤详情
Algorithm 1 的输入是目标技能 $s_0$(任务技能或元技能本身)、元技能 $m$、任务集与预算 $B$,每次迭代六步:(1) 为元智能体安装 $m$(若目标是元技能则安装其候选版本);(2) 用 archive.py 检查档案中的优化历史、父节点、剩余预算;(3) 用 evoctl rollout 请求父技能的 rollout 并做诊断——阅读任务智能体的轨迹与验证器输出,把失败归因到具体动作;(4) 在剩余预算内创建 $1\le k\le\min(2,b)$ 个候选,每个是父技能目录的完整副本并附 proposal.json,内含观察、修改、预期效果与可证伪结果(例如“链接 OBJ 的 Chamfer 距离仍 $\ge 0.0002$ 则本提案失败”),创建即扣预算(含未评估草稿);(5) 用 evoctl evaluate 平行评估候选并写入档案,再把每个候选交给一个上下文全新、不继承元智能体思路的评审者,评审者可拒绝或要求修正后复审,元技能候选还须核查核心职责未被破坏;(6) 权衡验证分数、评审、历史与剩余预算,选择下一个父节点或提前停止,允许回溯。自改进阶段内层预算为每个技能优化任务 2 个候选,元技能候选至多 4 个;精炼后的元技能再逐个优化任务技能。附录 C 的案例展示了完整链路:Three.js 导出任务的种子技能测试全挂,诊断发现单个 mesh 通过而合并 link 文件因组归属与世界坐标变换失败(Chamfer 距离 103.0 对阈值 0.0002),元智能体于是新增导出脚本、把所有权与世界矩阵规则写进 SKILL.md、改写 description,优化后技能 5/5 全过。
技术新颖性
技术新颖性体现在四层。其一,把元级优化“去程序化”:前人把优化器写成程序(STOP、Hyperagents、Darwin Gödel machine)或训练一个编排策略(R2 Flow),Skill∞ 把它写成技能,使流程与任务技能同构、可被同一机制编辑、可随标准规范跨 harness 移植。其二,“搜索即推理”取代分数驱动启发式:进化算法按适应度机械保留个体,这里由元智能体基于诊断证据决定保留平局候选或回溯,搜索变成“对每个目标技能失败模式的推理”,不同目标技能获得不同的预算分配节奏。其三,解耦与摊销:元技能先在跨领域任务集 $Q$ 上精炼(元得分天然偏好跨领域都有效的修改),再复用于之后的全部任务技能——自改进花费约 11 次任务技能优化的 token,摊到 83 个技能上每个仅增加不到 15% 的开销。其四,部署一致性:以往方法注入技能导致“优化设定不等于部署设定”,本文两层都用原生发现,连 description 都处在选择压力之下。自改进还表现出行为级变化:精炼后的元技能对平局候选的选择率从种子的 83% 降到 54%,说明被改写的不只是指令文字,而是元智能体的实际决策行为。
实验结果
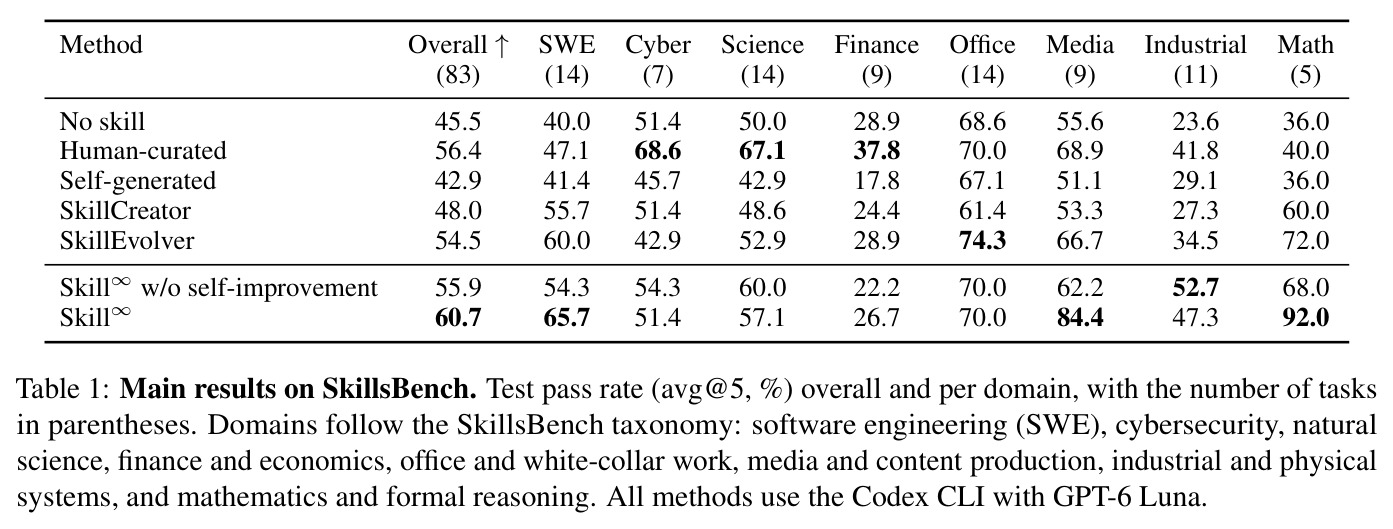
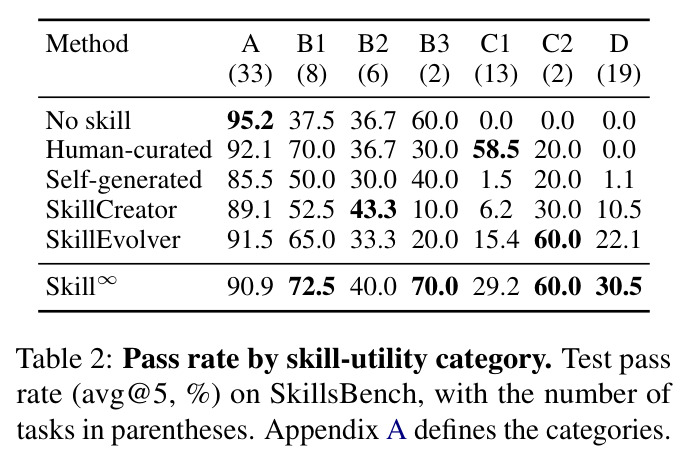
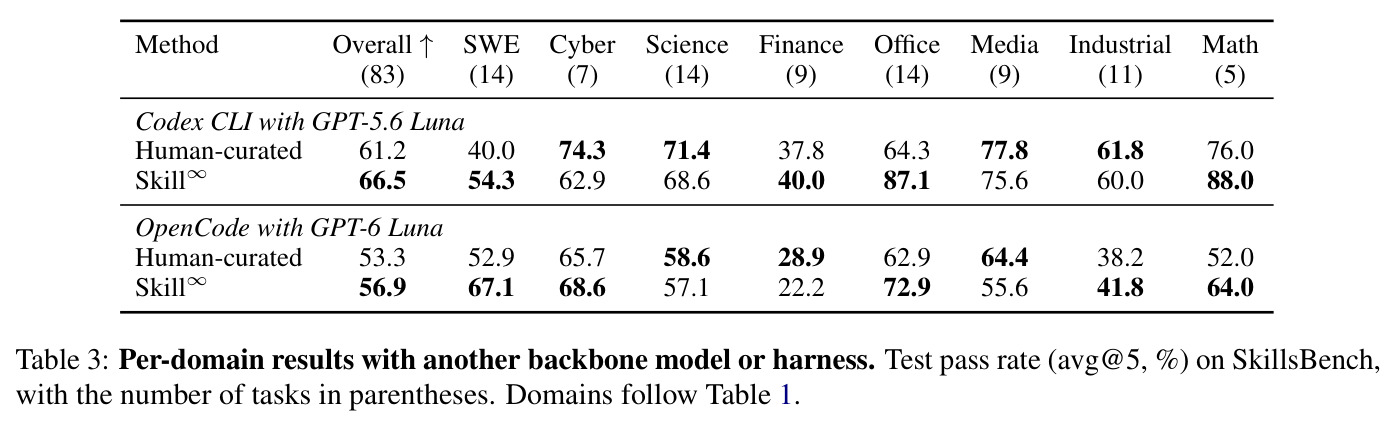
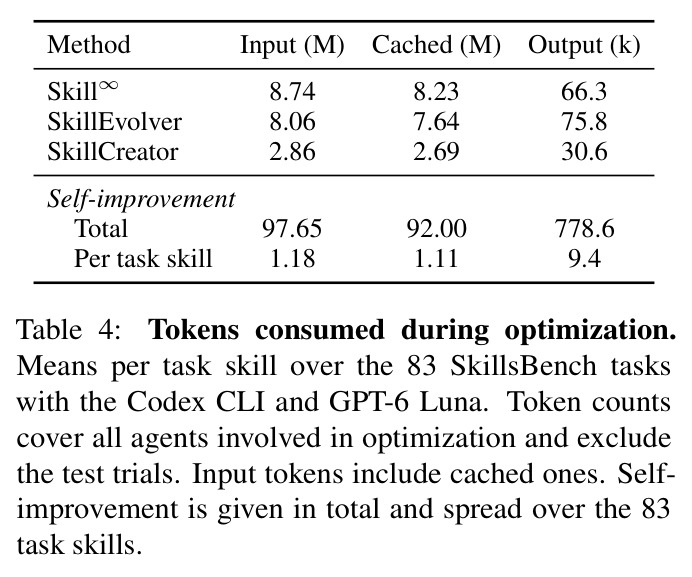
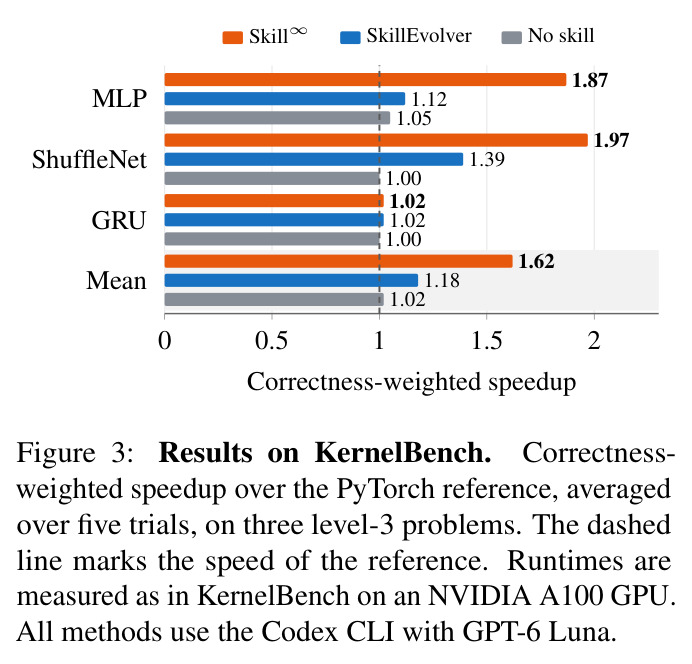
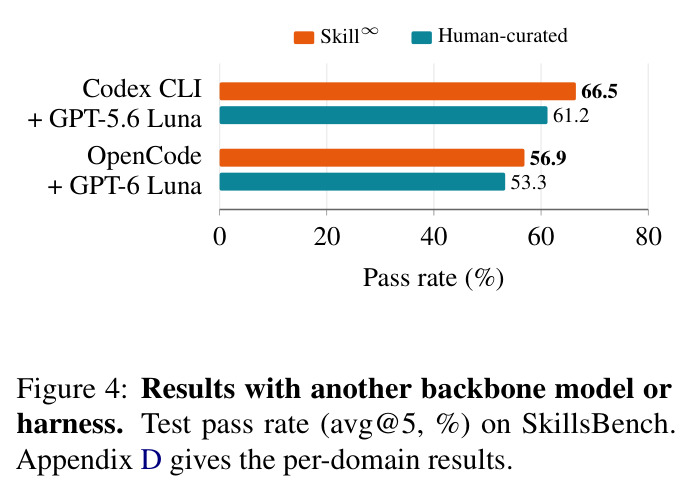
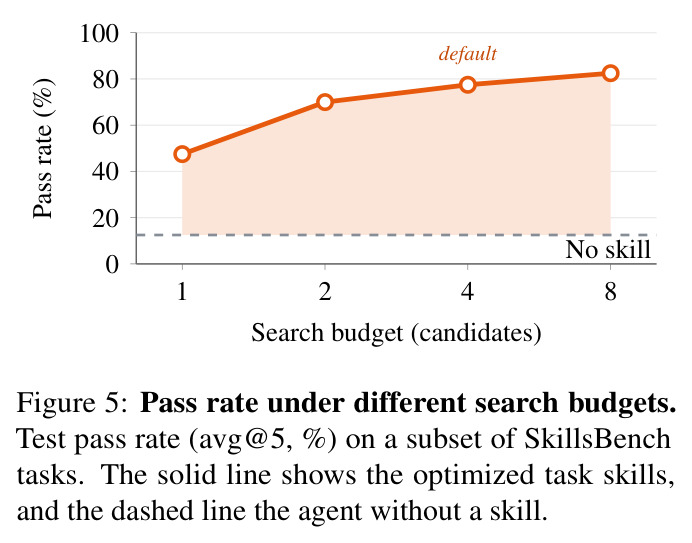
主实验在 SkillsBench 的 83 个任务(8 个领域)与 KernelBench 的 3 个 level-3 问题上进行,统一使用 Codex CLI 加 GPT-6 Luna(高推理档位),Harbor 执行试验,指标为 avg@5 通过率与正确性加权加速比,结果为 5 次独立运行的平均,每个任务技能搜索预算 4 个候选。SkillsBench 总通过率:Skill∞ 60.7% > 人工精选 56.4% > Skill∞ 去自改进 55.9% > SkillEvolver 54.5% > SkillCreator 48.0% > 无技能 45.5% > 自生成 42.9%。分域看,Skill∞ 在软件工程 65.7、媒体 84.4、数学 92.0 领先(人工精选分别为 47.1、68.9、40.0);消融显示自改进对数学 +24.0、媒体 +22.2、软件工程 +11.4 个百分点,作者归因于自改进把“更严格的证据标准”写入元技能——只有候选 rollout 显示对目标失败有实际进展才确认修复,而非仅仅提到修复。KernelBench 上正确性加权加速:Skill∞ 均值 1.62,对 SkillEvolver 1.18 与无技能 1.02;其中 MLP 1.87 对 1.12、ShuffleNet 1.97 对 1.39(GRU 上两者都接近 1.0,基本无提升),相对无技能的增益约为 SkillEvolver 的近 4 倍。换主干模型或 harness 仍领先:Codex CLI + GPT-5.6 Luna 下 66.5% 对人工精选 61.2%,OpenCode + GPT-6 Luna 下 56.9% 对 53.3%。按技能效用分类(Table 2),在“无技能与人工精选都解不了”的 D 类 19 个任务上达 30.5%(SkillEvolver 22.1%),在仅人工精选可解的 C1 类上达 29.2%(15.4%)。预算消融(Figure 5):候选数从 1 翻倍到 8,通过率从 47.5% 升至 82.5%(无技能 12.5%)。成本(Table 4):每个任务技能优化约 8.74M 输入/66.3k 输出 token(SkillEvolver 8.06M/75.8k),自改进总计 97.65M 输入 token,约等于 11 次任务技能优化,摊到 83 个技能上每个增加不到 15%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SkillsBench 83 任务总体 | pass rate (avg@5, %) | 60.7 | 人工精选技能 56.4;SkillEvolver 54.5;无技能 45.5 | 较人工精选 +4.3 个百分点,较 SkillEvolver +6.2 个百分点 |
| SkillsBench 数学域(5 任务) | pass rate (avg@5, %) | 92.0 | Skill∞ 去自改进 68.0;人工精选 40.0 | 自改进贡献 +24.0 个百分点 |
| SkillsBench 媒体域(9 任务) | pass rate (avg@5, %) | 84.4 | 去自改进 62.2;人工精选 68.9 | 自改进贡献 +22.2 个百分点 |
| KernelBench 3 个 level-3 问题(MLP/ShuffleNet/GRU) | correctness-weighted speedup | 1.62(均值) | SkillEvolver 1.18;无技能 1.02 | 相对无技能的增益约为 SkillEvolver 的近 4 倍 |
| KernelBench ShuffleNet | correctness-weighted speedup | 1.97 | SkillEvolver 1.39;无技能 1.00 | +0.58 |
| SkillsBench D 类:无技能与人工精选均无法解决(19 任务) | pass rate (avg@5, %) | 30.5 | SkillEvolver 22.1;人工精选 0.0 | +8.4 个百分点 |
| 换主干模型(Codex CLI + GPT-5.6 Luna) | pass rate (avg@5, %) | 66.5 | 人工精选 61.2 | +5.3 个百分点 |
| 换 harness(OpenCode + GPT-6 Luna) | pass rate (avg@5, %) | 56.9 | 人工精选 53.3 | +3.6 个百分点 |
局限与改进
作者承认三点局限:(1) 主干模型保持固定,因此增益受技能包表达力的上界约束——技能只能教模型更好地使用既有能力,不能改变模型本身;(2) 两层优化都依赖自动验证器计算奖励(元得分由任务奖励算出),所以只适用于奖励能被可靠计算的领域;(3) 智能体主导的优化用灵活性换取强制性——没有任何工具强制元智能体遵循元技能,遵循度取决于主干模型对长指令的服从,只能靠元技能本身与独立评审兜底。我自己的观察:第一,分域并非全面占优——网络安全 51.4 与无技能持平、远低于人工精选 68.6,金融 26.7 低于人工精选 37.8 甚至低于无技能 28.9,且自改进在工业域反而把 52.7 拉低到 47.3、科学域从 60.0 降到 57.1、网络域从 54.3 降到 51.4,说明跨领域平均化的元技能并非处处有益;第二,多个分域样本极小(数学仅 5 个任务、C2 类仅 2 个任务),论文只报告 5 次运行的平均而未给方差或显著性检验,60.7% 对 56.4% 的差距稳健性存疑;第三,技能优化任务与测试任务同源(都来自 SkillEvolver 数据集),尽管内层用验证得分评估,仍存在对任务分布过拟合的隐患;第四,“得分超出自改进触及范围、收益不可能来自奖励篡改”的论证依赖工作区只读与评审隔离的工程保证,论文未给出形式化证明。
独立分析的弱点
弱点一:流程遵从无强制。元智能体“遵循”元技能只是软约束,长指令下模型可能跳步(例如不检查平局候选的 rollout 就直接选择),评审本身也是模型、同样可能失职。改进方向:把关键步骤改为代码强制钩子(如选父前必须提交带证据的 rollout 检查记录才能写 decision.json),或用受限动作接口让流程不可绕过。弱点二:域间回归风险。工业 52.7→47.3、科学 60.0→57.1、网络 54.3→51.4,说明在 $Q$ 上取平均的元得分可能牺牲单域表现。改进方向:按域加权元得分、引入回归惩罚项,或维护按域特化的元技能池并在任务级路由。弱点三:依赖可自动验证的标量奖励,写作、咨询等开放域无法直接套用;可延伸到成对偏好判断、LLM 评委或人类抽检构成的学习型奖励。弱点四:成本与可复现性绑定闭源旗舰模型(GPT-6 Luna),自改进一次需 97.65M 输入 token,且模型版本升级可能导致元技能行为漂移,缺乏跨版本的稳健性评估。弱点五:安全机制单薄——优化出的技能捆绑可执行脚本且会被智能体自发激活,论文仅在伦理声明中建议部署前人工审查,缺少运行时沙箱、权限声明或激活审批的机制化方案。
未来方向
作者的展望是“这一视角邀请更多关于会改进‘改进方式本身’的智能体的工作”。基于成果可延伸的方向:(1) 打破技能包表达力上界——让自改进同时触及模型微调与工具创建,形成技能→流程→模型的三层递归;(2) 不可验证域的元评分——用成对偏好、LLM 评委或在线人类反馈替代标量验证器,并研究其被操纵的风险;(3) 元技能的持续学习与版本管理——跨项目积累“优化经验库”,研究元技能随任务分布漂移的更新与回滚策略;(4) 理论刻画——为这种无证明要求的递归自改进分析收敛性或单调改进条件,回应哥德尔机式的“可证明改进”理想;(5) 安全与治理——为自动激活且带工具权限的技能研究能力边界声明、审批门与事后审计机制;(6) 规模规律——在数百个领域上检验解耦式元技能是否继续泛化,刻画预算 $B$、域数 $|Q|$ 与收益的 scaling law(论文只展示了 1→8 候选的单调上涨,Figure 5)。此外,精炼后元技能把平局候选选择率从 83% 降到 54% 的发现值得单独研究:元级搜索的探索-利用权衡是否可以被自改进自动校准。
复现评估
开源情况较好:论文承诺代码发布于 github.com/taowangcheng/Skill-Infinity;评测任务来自 SkillEvolver 随文发布的数据集(MIT 许可),KernelBench 公开(MIT),试验执行用开源的 Harbor 框架;种子元技能(SKILL.md 加 3 个参考文件加 archive.py 脚本)与种子任务技能模板在附录 F/G 中逐字给出,Workspace 结构、evoctl 接口、评审政策均有完整文档,流程信息相当充分。主要障碍:(1) 主实验依赖 GPT-6 Luna 与 GPT-5.6 Luna 两个闭源 API 模型,若无法获取则只能验证方法趋势而无法复现具体数字;(2) 成本不低——每个任务技能优化约 8.7M 输入 token,83 个技能再乘 5 次独立运行,加上自改进的 97.65M token,一次完整复现粗估需要数亿 token 量级的 API 费用;KernelBench 计时需要 NVIDIA A100 GPU;(3) 结果为 5 次运行平均且未报告方差,复现者需自行多次运行做显著性检验。综合评估:对有 API 预算的团队,复现主表可行,工作量集中在工程拼接(Codex CLI/OpenCode + Harbor + evoctl 工具链);复现预算消融与跨 harness 实验难度类似,总体属于中等偏上难度。
论文图表
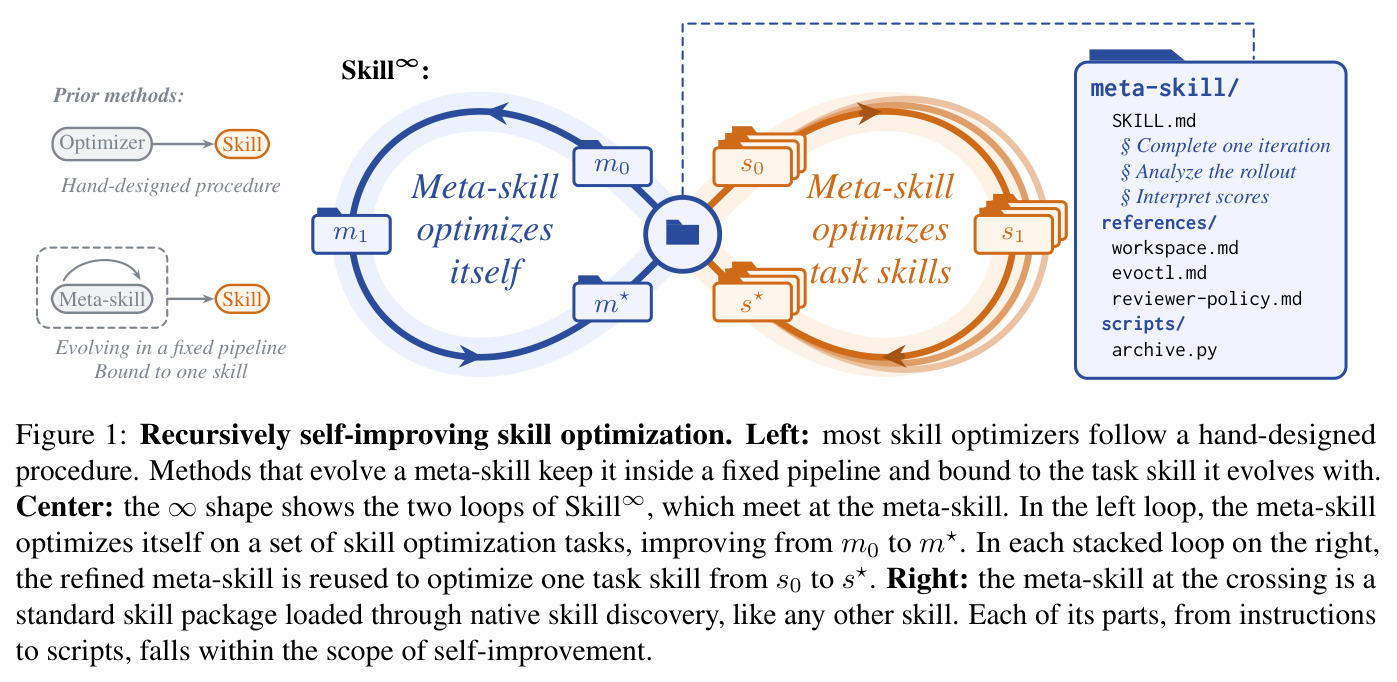
左侧:以往技能优化器遵循人工设计的流程,进化元技能的方法把它困在固定流水线中并与它所进化的单个任务技能绑定。中间:∞ 形表示 Skill∞ 的两个循环在元技能处相遇——左环中元技能在一组技能优化任务上自我优化,从 $m_0$ 提升到 $m^\star$;右侧每个堆叠环中,精炼后的元技能把一个任务技能从 $s_0$ 优化到 $s^\star$。右侧面板:位于交点的元技能本身就是一个通过原生技能发现加载的标准技能包,从指令到 references 与 scripts 的每个部分都在自改进范围内。
一图讲清论文的核心概念“两个互相喂养的循环”以及元技能的双重身份(既是流程又是优化目标),是理解题名中 ∞ 与全文动机的钥匙。