GraphSkillEvo:图结构智能体技能的进化优化 GraphSkillEvo: Evolutionary Optimization of Graph-Structured Agent Skills
把智能体技能表示为图结构,用变异与交叉进化算子优化,平均超越SkillOpt 1.3~4个百分点
前置知识
LLM Agent 与 Harness(执行框架)
LLM 智能体是由大语言模型驱动、能多轮调用工具并与环境交互来完成任务的系统。Harness 指包裹 LLM 的执行框架(如 Codex CLI),负责管理工作区、文件读写、沙箱与工具调用协议。同一个 LLM 配不同 harness,行为和成绩可以差别很大。
本文明确把智能体拆成「LLM + harness」两部分并保持二者冻结,只优化技能工件;实验还分别在无 harness 和 Codex harness 两种设置下做对比,不理解 harness 概念就无法理解实验设计。
Agent Skill(技能:可复用的提示级工件)
技能是附加在智能体提示中的可复用自然语言文档,编码某类任务的工作流程、领域知识、操作规则和输出约束(类似 Claude 的 Agent Skills)。它的核心价值是跨模型可移植:模型更新换代时,任务经验可以保留在新模型上,不必重新积累。
整篇论文的对象就是「技能」:如何表示技能(非结构化文本 vs 图结构)、如何自动优化技能。技能的定义和跨模型可移植性是理解其动机(RQ3 迁移实验)的前提。
技能优化与轨迹反思(Skill Optimization)
类比深度学习训练:把任务数据分成 $\mathcal{D}_{train}$、$\mathcal{D}_{val}$、$\mathcal{D}_{test}$,让智能体携带当前技能在训练集上执行,收集执行轨迹 $\tau_{x,s}$ 与得分 $r_{x,s}$,用 LLM 分析失败轨迹生成技能补丁,再在验证集上把关(validation gating),改进被接受否则回退,循环迭代。
基线 SkillOpt 和本文的变异算子都建立在轨迹反思之上;本文的 $J_{\mathcal{D}}(s)=\frac{1}{|\mathcal{D}|}\sum_{x\in\mathcal{D}} r_{x,s}$ 优化目标、验证集选择机制全部沿用了这套深度学习式的流程。
进化计算(种群、变异、交叉、选择)
进化计算(EC)是一类受生物进化启发的随机搜索方法:维护一个候选解种群,通过变异(对单个解做局部修改)、交叉(交换两个解的组成部分)生成新解,再按适应度做选择保留优秀个体,重复多代以探索远超单链贪心搜索的解空间。
GraphSkillEvo 本质是把技能当成进化个体:种群 $N=4$、进化 $T=5$ 代、四个算子轮转、按排名采样父代并做截断选择,读懂算法必须熟悉这些 EC 基本组件。
有向图与工作流路径
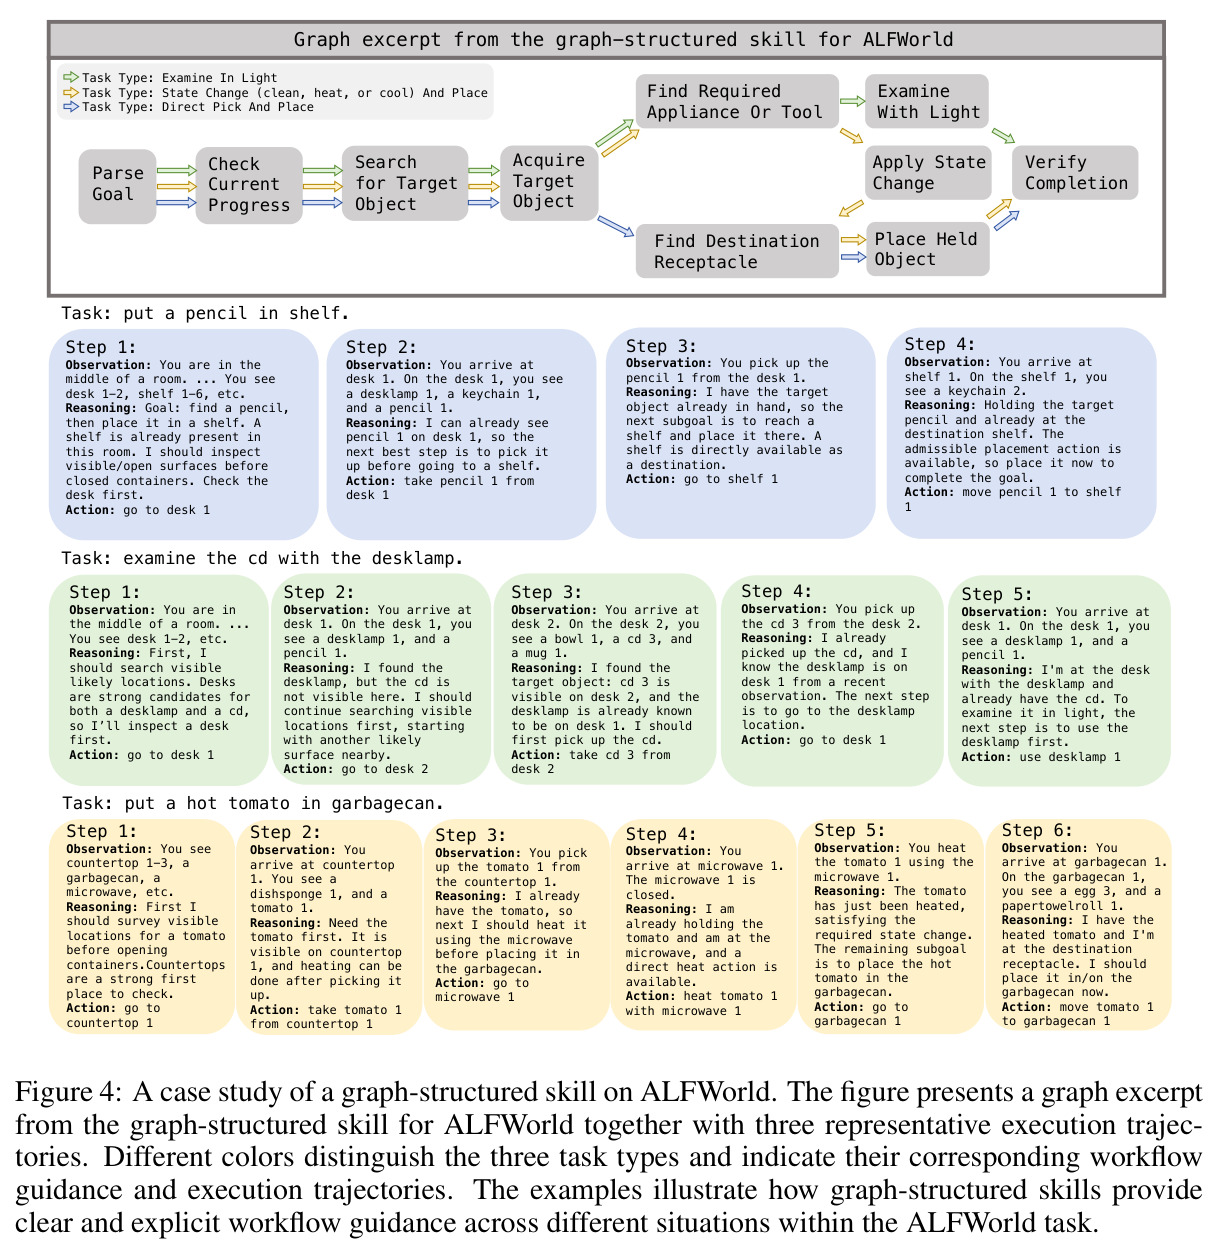
有向图 $g_s=(V_s,E_s)$ 由节点集和有向边集组成。本文用节点表示可复用的执行步骤,用「适用条件 + 有序节点序列」定义多条工作流路径,路径中相邻节点构成有向边;不同工作流可以共享节点、在不同条件下走出不同执行路径。
图结构技能是本文的核心表示:$s=\langle h_s, g_s\rangle$。变异/交叉算子作用的正是节点与工作流路径,结构校验器检查的也是图的一致性(引用的节点必须已定义、每个节点至少被一条工作流使用)。
Welch's t 检验与显著性
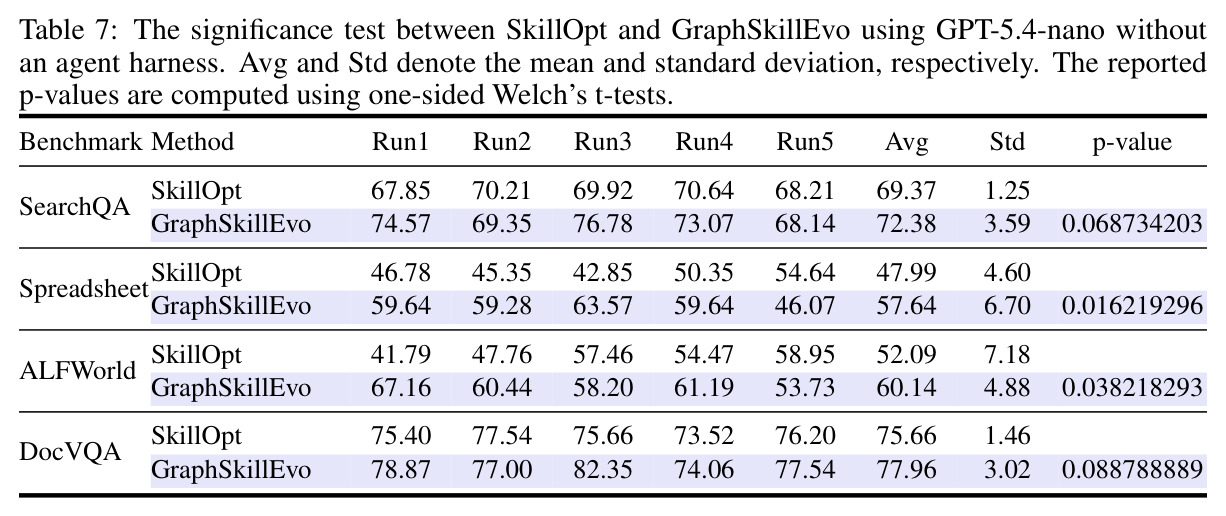
Welch's t 检验是对方差不假设相等的两组均值差异检验方法。本文用单侧 Welch's t 检验,基于 5 次独立优化运行的成绩判断 GraphSkillEvo 是否显著优于 SkillOpt,p 值小于 0.05 视为显著。
附录 C.1 的显著性检验直接关系结论可信度:程序性基准(Spreadsheet p=0.016、ALFWorld p=0.038)显著,而 QA 类基准 p 值在 0.05~0.10 之间只是边缘显著,这是理解论文证据强弱的关键。
研究动机
LLM 智能体越来越多地依赖「技能」这类提示级自然语言工件来获得任务特定的流程性指导,而技能优化(如 EvoSkill、Trace2Skill、SkillX、SkillOpt)通过执行轨迹的迭代反思来打磨技能。但现有方法把技能表示为非结构化自然语言文本,带来两个具体问题。其一,技能执行困难:优化出的技能往往是冗长的清单或要点列表,只提供粗粒度的工作流指引,智能体难以判断当前阶段哪条指引相关、下一步该做什么;这对能力较弱的模型(如 GPT-5.4-nano)尤其致命——面对过长指令时更容易迷失,例如在无技能时 GPT-5.4-nano 五个基准平均只有 39.04%,远低于 GPT-5.4 的 60.49%。其二,技能优化困难:缺乏显式结构导致搜索空间巨大且高度冗余,同一个工作流可以写成无数种不同的文本形式,优化器被迫探索大量不对应任何实质流程变化的表示变体。以代表性方法 SkillOpt 为例,它在 SpreadsheetBench 上(GPT-5.4-nano、无 harness)只能把成绩从 35.12% 推到 50.11%,且纯 LLM 自反思的串行打补丁方式在优化曲线上很早就收敛,无法继续提升。
本文的目标是本文的目标是重新设计技能的表示形式,使得(1)执行层面:工作流级指引显式化,智能体在每个执行阶段都能明确定位到相关指令和下一步动作,对小模型尤其友好;(2)优化层面:通过显式组织执行步骤及其依赖关系来压缩表示冗余,得到一个更紧凑、结构化的搜索空间,让自动化优化更有效。在此表示之上,构建一个基于种群的进化优化框架 GraphSkillEvo,用结构感知的变异和交叉算子对图结构技能进行搜索,目标是在覆盖事实问答、表格操作、视觉文档理解、数学推理和具身交互的五个基准、两个 LLM(GPT-5.4 与 GPT-5.4-nano)、两种 harness(无 harness 与 Codex)共 14 个设置上,一致超越最强的技能优化基线 SkillOpt,同时降低优化阶段的 token 消耗。
与已有工作不同的是,本文的独特切入有两点。第一,表示层面:作者注意到技能与流程图在提供分步流程指导上的天然相似性,首次把「单个技能本身」表示为图结构自然语言工件——节点是自包含的执行步骤(含指令、规则、约束),边通过多条带适用条件的工作流路径定义,不同工作流共享节点。这不同于此前所有把技能当纯文本优化流的工作。第二,相关工作虽有「图 + 技能」的组合,但用途完全不同:Graph-of-Skills、SkillDAG、GraSP、HiSkill 等是用图来组织「技能库」以辅助检索与组合(图存在于技能之间),而本文的图存在于「技能内部」,并专门为它设计了结构感知的变异/交叉算子,把进化计算引入技能优化——用种群并行探索 + 跨个体重组,替代 SkillOpt 式的单技能串行自反思,从根本上拓宽了对技能空间的探索广度。
核心方法
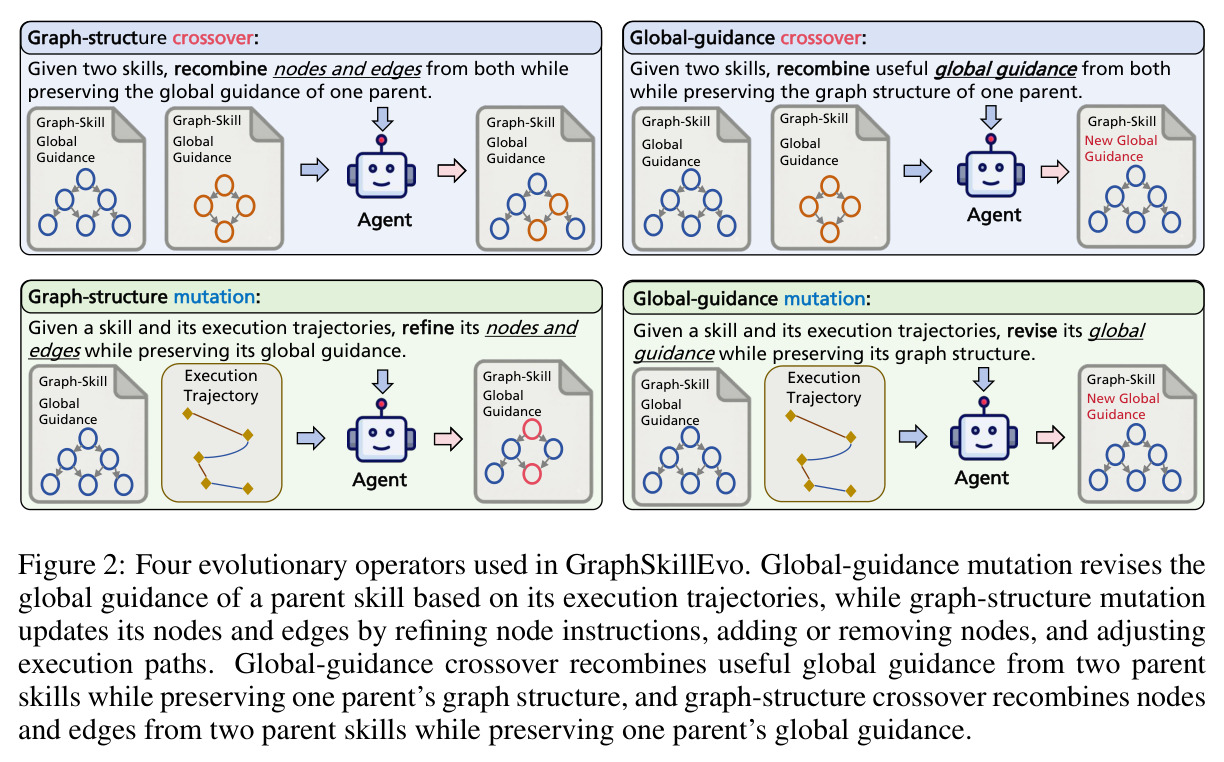
直觉上,一份好技能应该像流程图:既有全局须知,又有分步骤的操作说明,还能根据任务条件走不同分支。技术上,作者把技能形式化为 $s=\langle h_s, g_s\rangle$:全局指引 $h_s$ 收纳任务描述、通用原则和共享模板;有向图 $g_s=(V_s, E_s)$ 中,节点集 $V_s=\{v_1,\dots,v_{n_s}\}$ 的每个节点是一个可复用的执行步骤(如解析目标、检索证据、执行操作、验证答案),自带该步骤所需的指令、规则与约束;边集则通过 $M$ 个工作流 $\{(c_m, p_m)\}$ 指定,其中 $c_m$ 是适用条件,$p_m$ 是有序节点序列(执行路径),相邻节点即定义有向边,不同工作流可共享节点。优化框架 GraphSkillEvo 是标准的种群进化循环:初始化 $N=4$ 个图结构技能(1 个初始技能 + 3 个由 LLM 多样性生成);每代从 $\mathcal{D}_{train}$ 采样 $B=15$ 个实例,让每个技能执行并保留至多 $K=5$ 条失败轨迹作为反思信息;通过四个进化算子(全局指引变异、图结构变异、全局指引交叉、图结构交叉)轮转生成 $N$ 个新技能,每个新技能经脚本化结构校验器验证图合法性(不合格则丢弃重生成);所有新技能在完整验证集 $\mathcal{D}_{val}$ 上评估适应度后做截断选择,保留新旧候选中 top-$N$;重复 $T=5$ 代,返回最终种群中适应度最高的技能。
核心创新是与 SkillOpt 等已有方法的两个本质区别。区别一在表示:非结构化技能文档变成「全局指引 + 节点 + 多工作流路径」的图结构工件,带来三个性质——低冗余(多条工作流共享的指令只需在一个复用节点里写一次,而不是在文档各处重复)、显式工作流指引(每条工作流给出有序步骤序列,智能体能精确知道当前处于哪一步、该应用哪个节点的指引)、以及更紧凑的搜索空间(优化器直接在显式的步骤与依赖上搜索,而不是在不同文本表述之间绕圈)。区别二在搜索:SkillOpt 是单技能、纯 LLM 自反思的串行补丁循环,而 GraphSkillEvo 维护多个候选技能组成的种群,变异算子基于各自失败轨迹做局部修订,交叉算子把不同搜索轨迹上发现的互补有效组件(节点、边、工作流或全局指引)重组到一起。消融实验定量支撑了这套设计:去掉图结构平均分从 71.52 掉到 64.08(-7.44),去掉变异掉到 54.50(-17.02,降幅最大),去掉交叉掉到 66.59(-4.93)——结构、变异、交叉三者缺一不可。
方法步骤详情
完整流程分四步。Step 0(种群初始化):从初始技能 $s_1$ 出发,用初始化提示让 LLM 再生成 $N-1$ 个多样化图结构技能组成 $P^{(1)}$,每个个体都要通过结构校验器(校验工作流引用的节点都已在 $V_s$ 中定义、每个声明的节点至少出现在一条工作流中),然后在完整 $\mathcal{D}_{val}$ 上评估得到适应度 $J_{\mathcal{D}_{val}}(s)$。Step 1(训练集执行):第 $t$ 代从 $\mathcal{D}_{train}$ 采样一批 $B=15$ 个实例,每个技能 $s_i^{(t)}$ 挂到智能体上执行得到轨迹集 $\mathcal{T}_i^{(t)}=\{\tau_{x,s_i^{(t)}}\}$,并保留至多 $K=5$ 条得分 $r_{x,s}=0$ 的失败轨迹作为反思信息 $\mathcal{F}_i^{(t)}$。Step 2(新技能生成):先按轮转调度从四个算子中选一个;再按 $p\propto 1/(r+N)$($r$ 为适应度排名)采样父代——变异选一个父代、交叉选两个;最后由生成智能体 $A_{gen}$ 执行算子:全局指引变异只根据失败轨迹修改 Global Guidance 部分;图结构变异只修改节点与工作流(细化节点指令、增删节点、调整路径),保留全局指引;全局指引交叉融合两个父代的全局指引并保留其一图结构;图结构交叉重组两个父代的节点和边并保留其一全局指引。生成结果若未通过结构校验则丢弃重生成。Step 3(种群选择):$N$ 个新技能与当前种群共 $2N$ 个候选全部在完整 $\mathcal{D}_{val}$ 上评估,取适应度最高的 $N$ 个组成 $P^{(t+1)}$。重复 $T=5$ 代后返回最优个体。任务层面:SpreadsheetBench 无 harness 时允许最多 30 轮代码迭代,Codex harness 下单轮生成;ALFWorld 每回合限 50 步交互。
技术新颖性
技术新颖性体现在三个层面。表示层面:此前技能优化方法(SkillOpt、EvoSkill、Trace2Skill、SkillX 等)一律把技能当无约束自然语言,本文首个把单个技能内部结构显式建模为「全局指引 + 复用节点 + 多条件工作流路径」的图;与 Graph-of-Skills、SkillDAG、GraSP、HiSkill 这些用图组织技能库做检索/编排的工作也不同——那些图跨越技能之间,本文的图在技能内部且服务于优化而非检索。算子层面:四个算子按「全局指引 vs 图结构 × 变异 vs 交叉」正交分解,每个算子都保持另一半不变(如全局指引变异冻结图结构、图结构交叉冻结全局指引),这种解耦让 LLM 每次只需专注修改技能的一个维度,同时由外部校验器以硬约束保证图 schema 一致性(节点名精确匹配、无悬挂引用、路径可执行),弥补了 LLM 生成结构化内容容易出错的问题。搜索层面:把进化计算引入技能优化,交叉对应「组合不同搜索轨迹各自发现的有效组件」,这在机制上是单链自反思做不到的;消融显示即使保留种群和变异、只去掉交叉(等价于多条并行 SkillOpt),也会损失 4.93 分,说明收益确实来自跨个体信息交换而非仅仅多种子并行。此外整体 token 效率更优:总消耗比 SkillOpt 低约 24%(GPT-5.4:61.94M vs 81.08M)和 27%(nano:75.94M vs 103.54M)。
实验结果
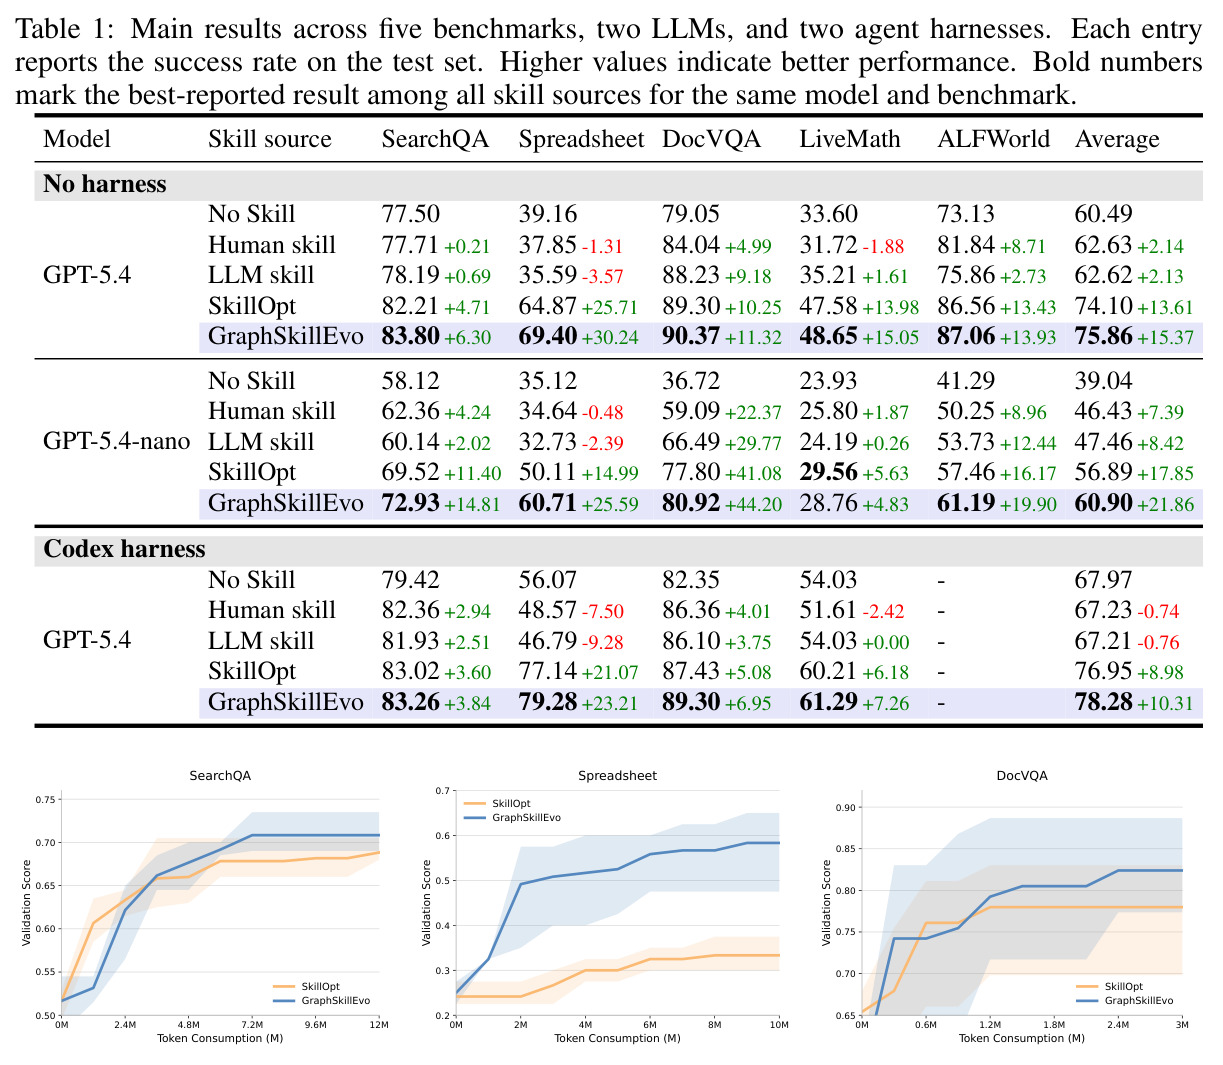
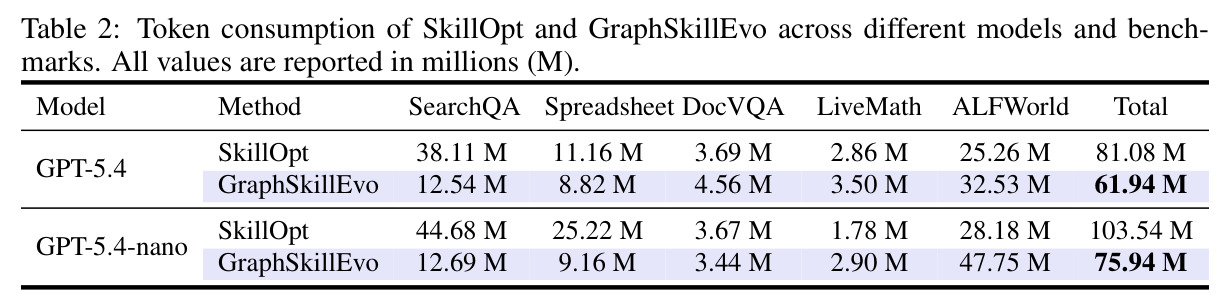
主实验(Table 1)覆盖 5 基准 × 2 LLM × 2 harness 共 14 个设置(ALFWorld 不支持 Codex harness 故留空),GraphSkillEvo 在 13 个设置中取得最佳,所有结果为 3 次独立优化运行的平均。以无技能基线计:GPT-5.4 无 harness 平均从 60.49 提升到 75.86(+15.37),GPT-5.4-nano 无 harness 从 39.04 提到 60.90(+21.86),GPT-5.4 Codex harness 从 67.97 提到 78.28(+10.31)。以最强基线 SkillOpt 计:三个设置分别净赚 +1.76、+4.01、+1.33 个百分点。两个关键规律:一是小模型受益更大(nano 上 +4.01 vs 大模型 +1.76),印证了显式工作流指引对弱模型的帮助;二是程序性任务提升最猛——SpreadsheetBench 上超过 SkillOpt 10.60 分(nano:60.71 vs 50.11)、ALFWorld 上超 3.73 分(61.19 vs 57.46),唯一例外是 LiveMath + nano(28.76 vs 29.56,落后 0.80)。优化曲线(Figure 3)显示 SkillOpt 早期即收敛,而 GraphSkillEvo 随 token 投入持续爬升到更高的验证分。Token 消耗(Table 2):SkillOpt 总耗是本文的 1.31 倍(GPT-5.4,81.08M vs 61.94M)和 1.36 倍(nano,103.54M vs 75.94M),但分基准看并不均匀——ALFWorld 上本文反而更耗(nano:47.75M vs 28.18M)。RQ1 执行消融(Table 3):把优化出的图技能拆掉工作流组织、只留全局指引和节点指令,五个基准全线下跌(-4.52 / -2.50 / -4.19 / -1.35 / -0.75),证明显式工作流本身贡献了真实的执行收益。RQ2 消融(Table 4,nano,三基准平均 71.52):去图结构 64.08(-7.44)、去变异 54.50(-17.02,最大降幅)、去交叉 66.59(-4.93)。RQ3 迁移(Table 5):用 nano 优化的技能部署到 GPT-5.4,三个基准全部超过无技能基线;SpreadsheetBench 上迁移版 GraphSkillEvo 技能达 71.78,不仅高于其直接优化版(69.40),更把迁移的 SkillOpt 技能(53.21)甩开 18.57 分。显著性检验(Table 7,5 次运行,单侧 Welch's t):Spreadsheet(p=0.016)和 ALFWorld(p=0.038)显著优于 SkillOpt,SearchQA(p=0.069)和 DocVQA(p=0.089)处于 0.05~0.10 的边缘区间。
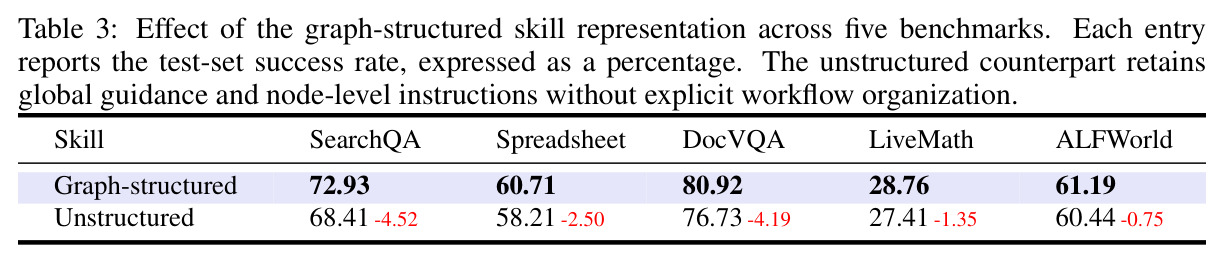
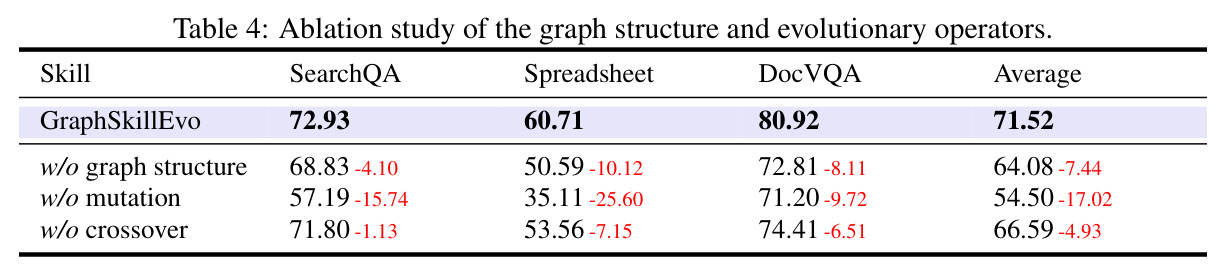
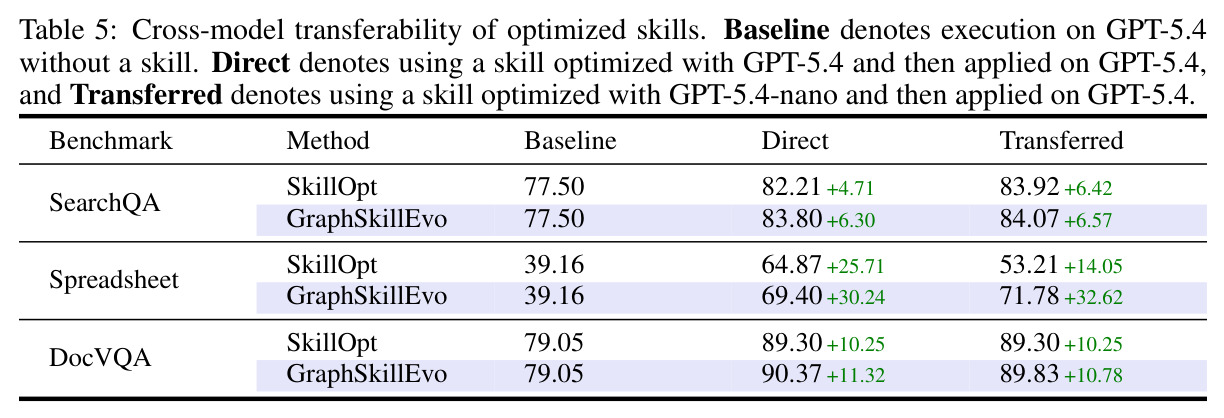
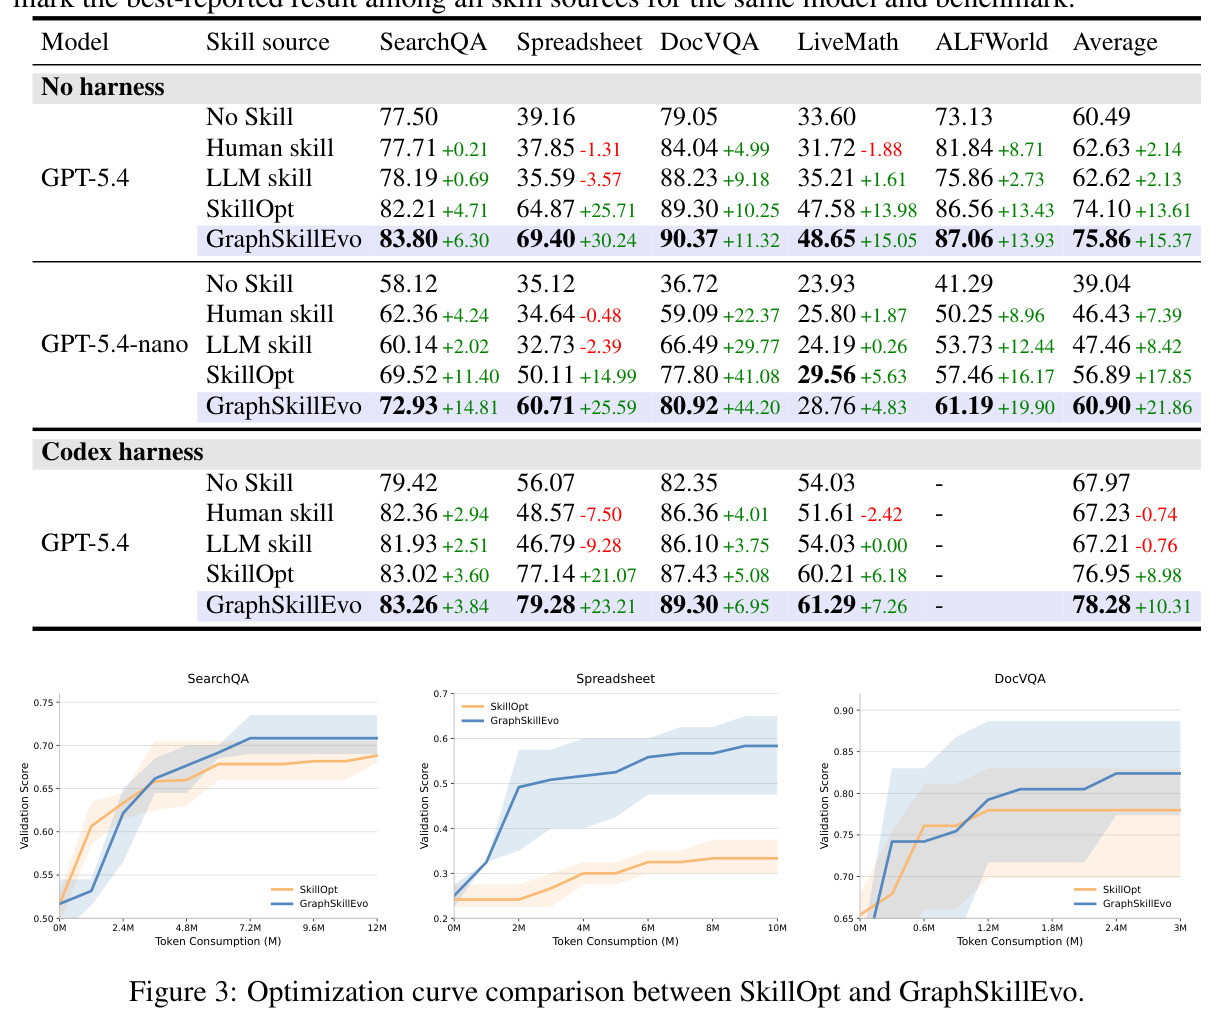
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SpreadsheetBench(GPT-5.4-nano,无 harness) | 测试集成功率 (%) | 60.71 | SkillOpt 50.11 | +10.60 |
| SpreadsheetBench(GPT-5.4,无 harness) | 测试集成功率 (%) | 69.40 | SkillOpt 64.87 | +4.53 |
| SpreadsheetBench(GPT-5.4,Codex harness) | 测试集成功率 (%) | 79.28 | SkillOpt 77.14 | +2.14 |
| ALFWorld(GPT-5.4-nano,无 harness) | 50 步内通过率 (%) | 61.19 | SkillOpt 57.46 | +3.73 |
| SearchQA(GPT-5.4-nano,无 harness) | 精确匹配准确率 (%) | 72.93 | SkillOpt 69.52 | +3.41 |
| DocVQA(GPT-5.4-nano,无 harness) | 精确匹配准确率 (%) | 80.92 | SkillOpt 77.80 | +3.12 |
| LiveMath(GPT-5.4-nano,无 harness) | 选择题准确率 (%) | 28.76 | SkillOpt 29.56 | -0.80(唯一落后项) |
| 五基准平均(GPT-5.4-nano,无 harness) | 平均成功率 (%) | 60.90 | SkillOpt 56.89 | +4.01 |
| 五基准平均(GPT-5.4,无 harness) | 平均成功率 (%) | 75.86 | SkillOpt 74.10 | +1.76 |
| 四基准平均(GPT-5.4,Codex harness) | 平均成功率 (%) | 78.28 | SkillOpt 76.95 | +1.33 |
| 优化 token 总消耗(GPT-5.4-nano,五基准) | token 数(M) | 75.94 | SkillOpt 103.54 | 节省 26.7%(1.36 倍效率) |
局限与改进
作者承认的局限:其一,LiveMath + GPT-5.4-nano 是唯一落后的设置(28.76 vs 29.56),说明数学多选推理这类非程序性任务未必受益于工作流式指引;其二,QA 类基准的显著性只在 0.05~0.10 区间(SearchQA p=0.069、DocVQA p=0.089),优势并不稳固;其三,Codex 标准 adapter 不支持持久环境交互,导致 ALFWorld 无法在 Codex harness 下评测,实验矩阵出现缺口。我自己的观察还有几点:进化预算极小(种群 $N=4$、仅 $T=5$ 代),既可能低估了 EC 的潜力,也没验证方法在更大规模下是否仍然有效;适应度完全依赖小验证集(18~200 条)上的全量评估,top-$N$ 截断选择容易选中在小验证集上运气好的技能,存在过拟合验证集的风险,且适应度没有复杂度惩罚,节点和工作流数量在长期进化中可能膨胀;四个算子用固定 round-robin 调度,而消融表明变异远比交叉重要,均匀轮转明显不是最优的资源分配;优化基线只对比了 SkillOpt 一家,未涉及 EvoSkill、Trace2Skill、SkillX 等同类方法;跨模型迁移只在 GPT 家族内部单向测试(nano→GPT-5.4);效率收益不均匀,ALFWorld 上优化 token 反而比 SkillOpt 多 71%(nano:47.75M vs 28.18M);此外新技能由 LLM 以 JSON 输出完整图文档,校验失败需重新生成,既带来额外成本也引入不确定性。
独立分析的弱点
独立分析的弱点及改进方向。第一,小验证集上的适应度噪声:$\mathcal{D}_{val}$ 仅 18 条(LiveMath)到 200 条(SearchQA),成功率估计的方差很大,而种群选择恰恰按这个噪声信号做 top-$N$ 截断,容易把「运气好」的技能选进下一代;改进方向是引入 bootstrap 置信区间、多折交叉验证式评估,或使用噪声感知选择(如对边界技能二次复评)。第二,缺少图复杂度控制:变异可自由增删节点和工作流,适应度又不惩罚规模,进化后期可能出现节点膨胀、技能变长,反而加重小模型的指令负担,与初衷相悖;改进方向是在适应度中加入最小描述长度(MDL)式的复杂度正则,或设置节点数预算。第三,固定 round-robin 算子调度:消融已显示变异贡献(-17.02)远大于交叉(-4.93),但四个算子仍被等概率轮转,浪费了生成预算;改进方向是用多臂老虎机(如 UCB)根据历史收益自适应分配算子。第四,任务内单技能、任务间孤立:每个任务从头进化一个图技能,不同任务的相似节点(如「验证答案」「解析目标」)无法复用;改进方向是维护跨任务的节点池,允许交叉从任务外引入组件。第五,反思信号只取 $r=0$ 的完全失败轨迹:SpreadsheetBench 这类部分得分任务中「错了一半」的轨迹信息被浪费;改进方向是利用部分得分做细粒度步骤归因,把反思定位到具体节点。第六,进化随机性下的稳定性:Table 7 显示单次运行间标准差可达 3~7 分,实际部署需要多次运行取优,进一步推高成本;改进方向是更稳定的变异提议机制或早停策略。
未来方向
作者在结论中提出三个方向:与参数化优化方法结合(例如把图技能的软提示版本与权重微调联合训练);扩展到更丰富的图组合机制(如层次图、带条件分支与循环的控制流原语);开发跨领域图结构技能的合并方法。基于本文成果还可以自然延伸:用自适应算子选择和更大种群/代数检验方法的规模效应;为适应度加入复杂度正则研究「性能-技能长度」的帕累托前沿;把迁移实验扩展到异构模型族(如 Qwen、DeepSeek、Gemini)并研究哪些图组件迁移性好、哪些过拟合于源模型;将技能库中的子图检索与本文的技能内图结构结合,实现「检索一个子图注入当前技能」的持续学习闭环;利用工作流的天然可解释性做执行审计与失败定位(每个失败都能归因到具体节点或边);以及把 crossover 思想移植到多智能体系统,让不同智能体各自进化的技能通过结构化重组共享知识。
复现评估
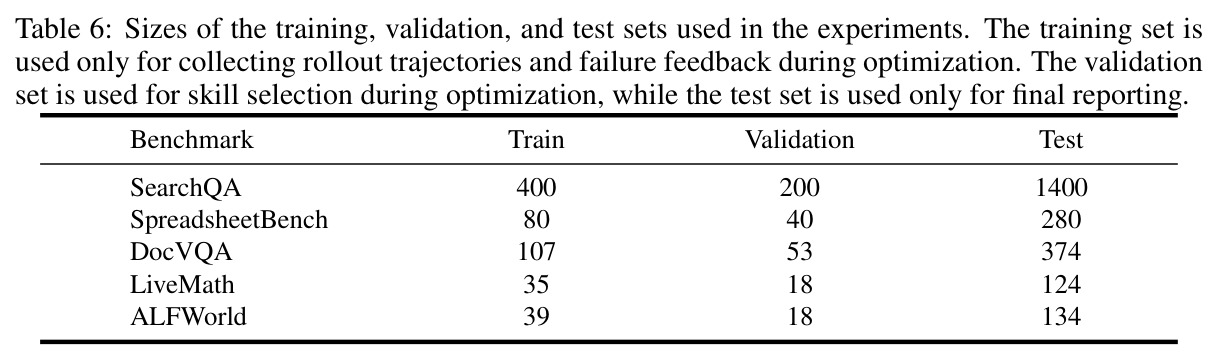
复现条件总体较好。代码已开源(https://github.com/ruisun7/GraphSkillEvo);五个基准全部公开可得(SearchQA、SpreadsheetBench CC-BY-SA-4.0、DocVQA Apache-2.0、LiveMathematicianBench、ALFWorld MIT),数据划分用固定 seed=42 的确定性过程且与所有基线完全一致,附录 Table 6 给出每个集合的大小(如 SearchQA 400/200/1400,SpreadsheetBench 80/40/280);附录 B.4 提供完整算法伪代码,E.1~E.2 给出四个进化算子和初始化的完整 prompt,E.3~E.4 附带优化后的图技能示例与非结构化对照版本,基线 SkillOpt 本身也是 MIT 协议开源(microsoft/SkillOpt)且附录 D.1 列出了其全部超参。算力方面没有训练需求,瓶颈是 API 成本:需要 GPT-5.4 与 GPT-5.4-nano(medium reasoning effort)的访问权限,单次完整优化按基准消耗约 3M~48M token,两个模型五个基准合计约 62M~104M token,正式结论基于 3 次重复、显著性实验 5 次重复,估计需要数百美元量级的 API 预算;Codex harness 实验还需 Codex SDK,ALFWorld 实验需搭建文本交互环境。难度中等:算法本身不复杂,但管线依赖 LLM 输出合规 JSON 图文档外加结构校验器,工程调试量不小,且进化随机性意味着要复现具体数字需要同样的重复次数。
论文图表
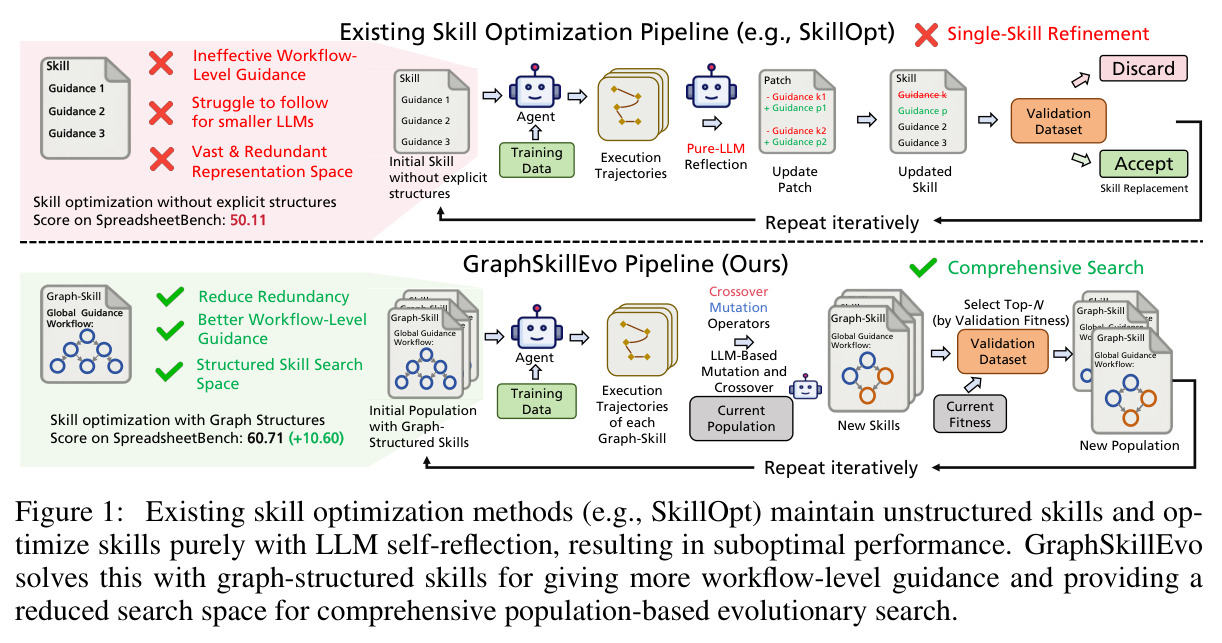
上下对照的总览图。上半部分是现有方法(SkillOpt)的流水线:非结构化技能在训练数据上执行产生轨迹,纯 LLM 反思生成补丁、验证后整块替换,技能缺乏工作流级指引、搜索空间巨大且冗余,在 SpreadsheetBench 上只达到 50.11 分。下半部分是 GraphSkillEvo 流水线:技能以「全局指引 + 节点 + 工作流」的图结构存在,种群中每个技能经变异/交叉生成新技能、验证集选优组成新一代,压缩了搜索空间并实现全面搜索,在 SpreadsheetBench 上达到 60.71 分(+10.60)。
这是全文的路线图:一图讲清两类方法的本质差异(非结构化单技能自反思 vs 图结构种群进化)和核心卖点(+10.60 分),读懂它就抓住了论文的问题设定与解决方案骨架。
列出所有资源的获取链接与许可证:SearchQA(未注明)、SpreadsheetBench(CC-BY-SA-4.0)、DocVQA(Apache-2.0)、LiveMathematicianBench(未注明)、ALFWorld(MIT)、基线 SkillOpt(MIT,github.com/microsoft/SkillOpt)。
对复现者而言这是资源清单:确认了所有数据与基线均可公开获取及各自的使用许可限制,是评估论文可复现性与合规性的直接依据。