iPrefBench:面向个性化移动使用代理的用户中心基准 iPrefBench: A User-Centric Benchmark for Personalized Mobile Use Agents
首个区分「可推断」与「仅能询问」信息的移动代理个性化基准,暴露执行强、个性化弱的巨大差距
前置知识
计算机使用代理(Computer-Use Agent, CUA)
通过截图观察屏幕、以点击/输入/滑动等原子操作驱动真实或模拟 GUI 界面来完成数字任务的大模型代理。它通常以「截图 + 操作历史」为输入,循环执行「观察→推理→动作」,直到调用停止动作或耗尽步数预算。Apple、Anthropic 等公司的手机/桌面助手都是这一形态。
本文的评测对象就是移动端 CUA,理解其「视觉观察 + 原子操作」的执行范式,才能明白为什么个性化决策(订哪家餐厅、几点、几个人)会散落在多步 GUI 操作中难以做好。
任务欠指定(Underspecified Task)
指用户指令没有给出完成任务所需的全部参数,如「订我常去的那家餐厅,明天」省略了餐厅、时间、人数。代理必须从两个渠道补全:从用户历史活动中推断(infer),或直接向用户提问(ask)。补全方式错误会导致行动偏离用户真实意图。
iPrefBench 的全部 130 个任务都是欠指定任务,且每个缺失信息都被标注为「可推断」或「仅能询问」,这是整篇论文评测设计的基石。
信息来源标注(Resolution Source)
论文对每个缺失细节 $u$ 强制标注唯一来源:$u \in U^{\text{infer}}_t$ 表示其目标值可从活动历史 $H$ 中的主导模式或明确事实恢复;$u \in U^{\text{ask}}_t$ 表示历史中不存在该信息(如当前场合的细节),只能问用户。二者互斥且人工校验。
这是本文区别于以往个性化/交互基准的核心:只有知道每个信息「应该从哪来」,才能评判代理是该推断还是该问,进而计算提问的精确率与召回率。
LLM 评审与 Rubric 评估(LLM-as-Judge)
为每个任务编写任务专属评分细则(rubric),把动作完成类标准(如「是否创建了预订」)和个性化类标准(如「餐厅是否订对」)分开,由 LLM 依据执行轨迹(截图、动作、最终回答)、用户画像和隐藏上下文逐条判 pass/fail。本文用 Claude Sonnet 5 当裁判,并与人工标注对照校验。
整个基准的得分(成功率、动作完成率、个性化分)都产自这套流程,理解它才能判断 95.7% 的人工一致率($\kappa=0.89$)意味着结果有多可信。
交互精确率与召回率(Interaction Recall & Precision)
受 Grice 合作原则启发:先用 LLM 把代理的 ask_user 消息分解为请求多重集 $Q_t$,再语义匹配到仅能询问的需求集合 $U^{\text{ask}}_t$,得到已引出的不同需求集合 $E_t$。召回率 $\text{Recall}=\sum_t|E_t|/\sum_t|U^{\text{ask}}_t|$ 衡量该问的问全了没;精确率 $\text{Precision}=\sum_t|E_t|/\sum_t|Q_t|$ 惩罚问可推断信息、无关信息和重复提问。
这两项指标是论文「知道何时该问」命题的量化载体,没有它们就只能数提问次数,无法区分「该问的没问」和「不该问的乱问」。
研究动机
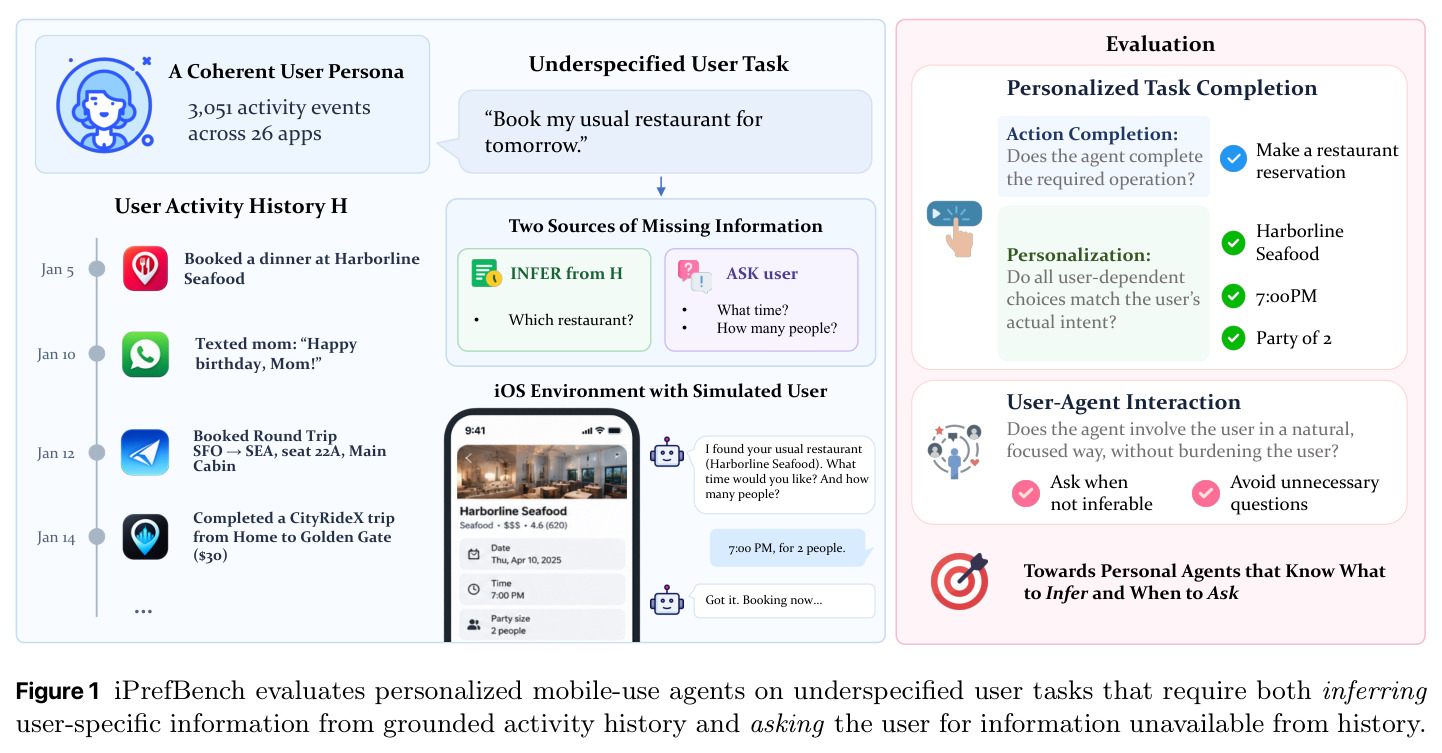
现实中的用户请求几乎总是欠指定的:用户会说「订我常去的那家餐厅,明天」,而不是「在 Harborline Seafood 订明天 7:30 PM、两人桌」。要正确服务这样的请求,代理必须从用户历史中推断一部分缺失信息(常去的餐厅),同时就另一部分历史无法回答的信息(今晚几点、几个人)主动询问用户。但现有评测完全没覆盖这一点:典型 CUA 基准(如 AndroidWorld、iOSWorld 系列)把每条指令写得面面俱到,且代理对用户一无所知,无可推断也无需提问;个性化基准(如 PreferenceBench 类工作)提供用户历史却没有可以询问的对象;交互式澄清基准(Ask-before-Plan、AppWorld-UL 等)有模拟用户却没有任何用户历史,所有缺失信息都得靠问;VitaBench 2.0、KnowU-Bench 虽然历史和模拟用户都有,却不区分每个缺失细节应该推断还是询问,因此无法衡量代理「是否只在必要时提问」。结果是,社区只知道代理会执行任务,完全不知道它们会不会为「这一个用户」把任务做对。
本文的目标是本文的目标是构建一个可执行、可复现的基准,精确度量个性化移动代理的两项核心能力:一是「推断」——从用户的真实活动历史中恢复缺失偏好并正确落地到 GUI 操作;二是「询问」——识别哪些信息只能来自用户本人,在恰当的时机以恰当的粒度提问,既不默默瞎猜,也不用连环追问轰炸用户。为此,作者在 iOSWorld 的可执行 iOS 模拟器上构建了围绕单一连贯人格「Jordan Avery」的环境:26 个互相联通的 mock 应用、3,051 条历史活动事件、130 个欠指定任务,每个缺失细节都被标注唯一来源(可推断/仅能询问),并配套三类扰动任务检验历史偏好失效时的行为。
与已有工作不同的是,本文的独特切入是「来源可控」(provenance control):作者不是简单地同时提供历史和模拟用户,而是在任务构造时就强制规定每个缺失信息的唯一解析来源——可推断信息必须在历史中有主导模式或明确事实支撑,仅能询问信息必须无法从历史恢复、且目标值刻意与 App 预填默认值不同以防蒙对。基于这一标注,评估被拆成四个正交维度:动作完成(操作是否执行)、个性化(用户相关决策是否对)、提问召回率(该问的问全没)和提问精确率(问的是否都是必要的)。这使 iPrefBench 成为第一个能回答「代理知道该推断什么、何时该问吗」的基准,而不只是又一个任务成功率排行榜。
核心方法
iPrefBench 的技术路线是「环境 + 任务 + 模拟用户 + 评分」四层叠加。环境层:在 iOSWorld 的可执行 iOS 模拟器中植入 26 个数据互联的 mock 应用(订餐、航班、网约车、消息、健身等),种子数据围绕人格 Jordan Avery 展开共 3,051 条活动事件,串成按时间排列的活动历史 $H$,作为代理唯一先验上下文。任务层:130 个欠指定任务,平均含 2.09 条动作完成标准和 2.87 条个性化标准(可推断 1.98 条、仅能询问 0.89 条),58.5% 的任务至少含一个仅能询问需求,26.9% 需跨应用迁移偏好,另含 11/10/13 个指令/偏好/环境扰动任务。交互层:在标准 GUI 动作空间上扩展 ask_user 动作,由基于 13 维结构化用户画像 $P$ 与任务专属隐藏上下文驱动的 LLM 扮演用户,被约束「只答所问、不主动补充」。评估层:LLM 裁判按任务专属 rubric 输出动作完成分、按来源拆分的个性化分,以及交互召回率与精确率。
核心创新是把「缺失信息该从哪来」变成受控变量。以往基准要么只有历史(只能考推断),要么只有模拟用户(只能考提问),iPrefBench 通过对每个 $u \in U_t$ 强制标注互斥来源 $U^{\text{infer}}_t$ 或 $U^{\text{ask}}_t$,让「该推断还是该问」本身成为被测能力。在此基础上,交互评估借鉴 Grice 会话准则「信息量恰如其分」:先把 ask_user 消息经 LLM 分解为请求多重集 $Q_t$(一条消息里的多个独立请求分别计数,重复请求也计为多次出现),再语义匹配到仅能询问需求,得 $E_t = \{u \in U^{\text{ask}}_t \mid \exists q \in Q_t, \phi_t(q)=u\}$,于是 $\text{Recall}=\sum_t|E_t|/\sum_t|U^{\text{ask}}_t|$,$\text{Precision}=\sum_t|E_t|/\sum_t|Q_t|$。这组指标同时惩罚「闷头瞎猜」(召回低)和「事事都问」(精确低),是以往只看任务成功率或提问数量的工作做不到的。
方法步骤详情
整个基准经三阶段流水线构建并双重人工把关。第一步,代码代理携带任务撰写技能,输入应用源码、活动历史 $H$、画像 $P$ 和 iOSWorld 原始全指定任务,生成候选个性化任务及其 rubric 草稿,并为每个缺失细节标注来源与目标值。第二步,人类任务专家逐条审核修订:可推断细节必须有历史中的主导模式或明确事实支撑,证据薄弱时直接修改种子数据使偏好清晰;仅能询问细节必须确保历史不可恢复,且目标值尽量偏离 App 预填默认值,使「沉默接受默认值」或蒙猜难以侥幸得分;此轮同时去重并扩广度,覆盖尽可能多的偏好与应用。第三步,资深验证专家在模拟器里实跑每个任务,确认环境可行性和 rubric 正确性并修正残留问题——即每个任务都经过两轮人工审校。评测时,每个 episode 在新种子的模拟器上运行,代理获得完整历史 $H$(另有单独实验改变暴露量)、观察截图、以点击/输入/滑动/ask_user/stop 等动作执行,上限 50 步;结束后 LLM 裁判依据轨迹、$P$、隐藏上下文和 rubric 逐条打分,全部标准通过才算任务成功。
技术新颖性
与最接近的工作相比,新颖性体现在三处。其一,对 iOSWorld:原环境虽种入连贯人格,但既不把历史暴露给代理、也不支持用户交互,本文补上了历史 $H$、画像 $P$ 和 ask_user 动作三件套,把它改造成个性化测试床。其二,对 VitaBench 2.0 / KnowU-Bench 这类「历史+模拟用户」基准:它们不区分缺失细节的来源,因此无法判断代理问的问题是否必要;本文的来源标注使交互效率(精确率)首次可测。其三,对 Ask-before-Plan / AppWorld-UL 这类交互基准:它们没有用户历史,无法考「能推断就别问」。此外,三类扰动设计(指令扰动:明说这次要商务舱而历史一贯省钱;偏好扰动:近三个月全选靠走道而长期模式是靠窗;环境扰动:常去餐厅关门)把「历史何时会骗你」也纳入考核,这在同类基准中前所未有。质量保障上,96.6% 的模拟用户回答忠于画像、LLM 裁判与人工标注在 rubric 条目上一致率 95.7%($\kappa=0.89$),为新颖设计提供了可信度背书。
实验结果
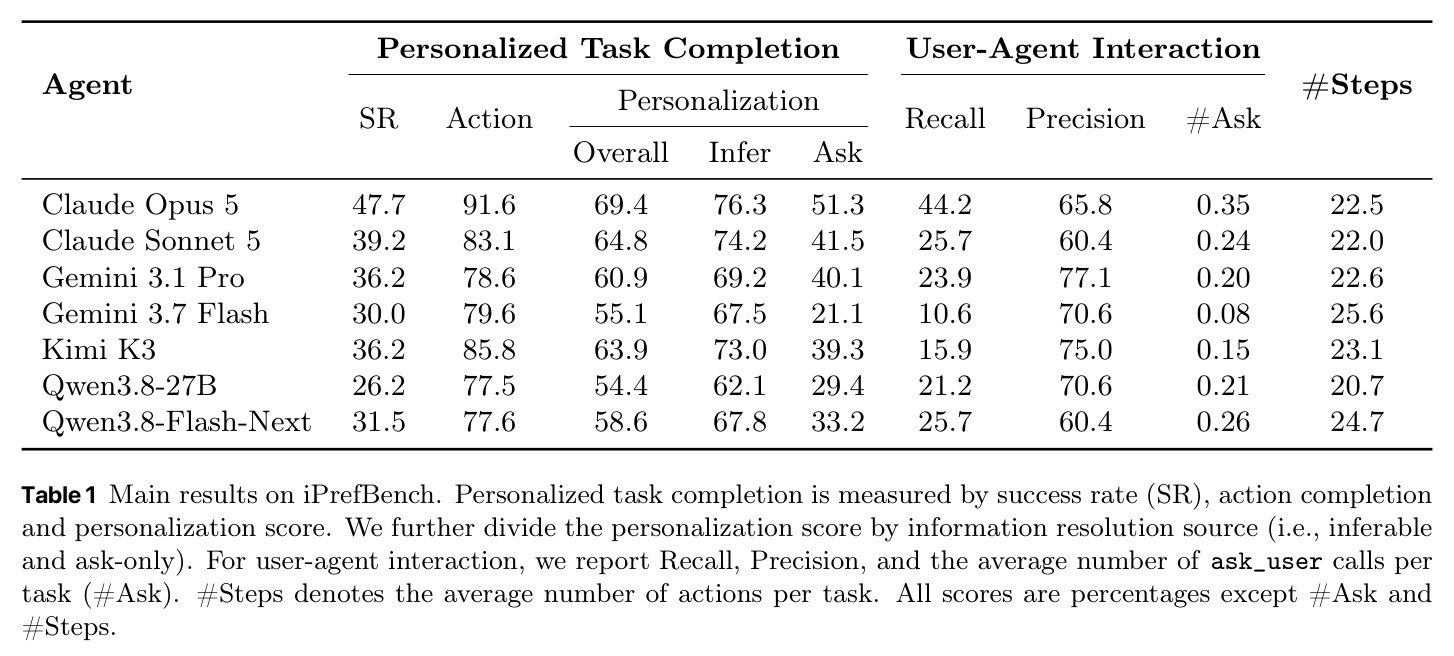
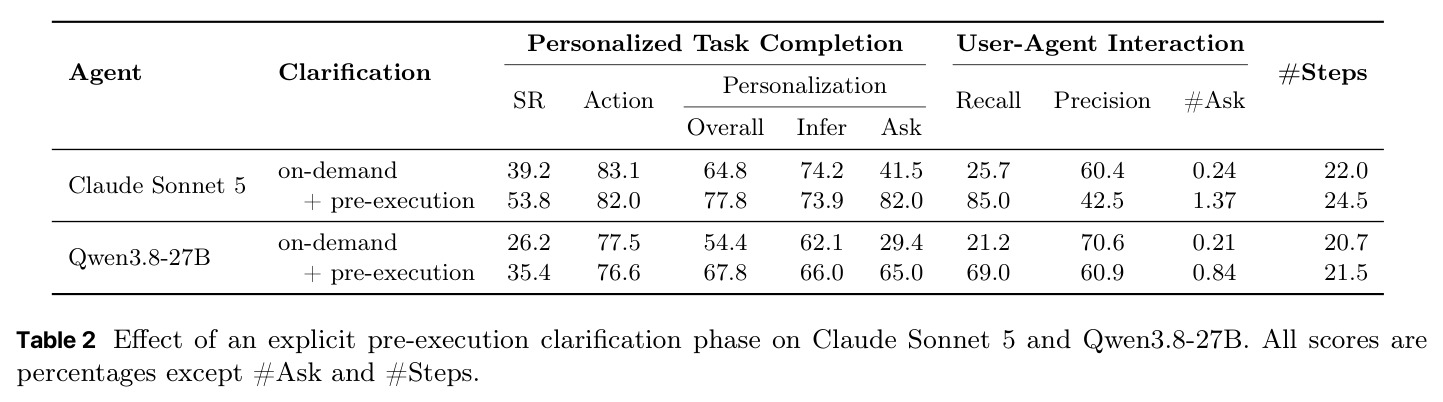
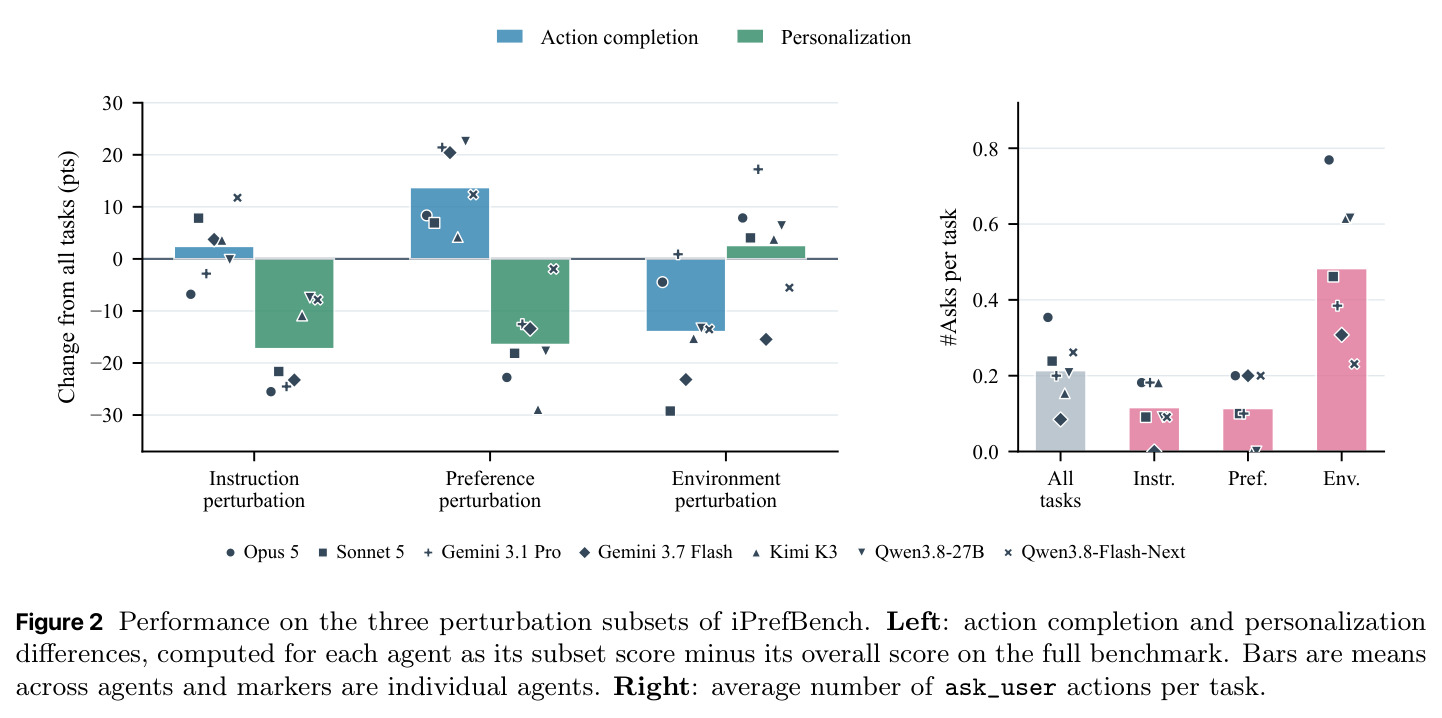
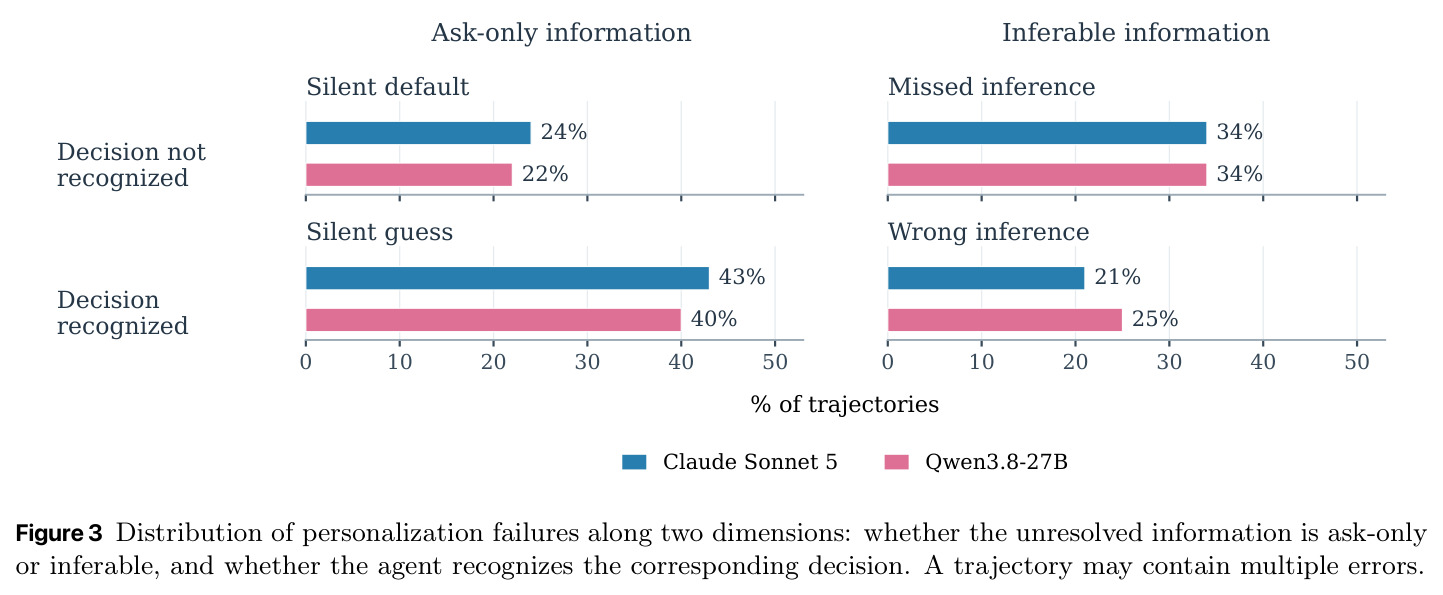
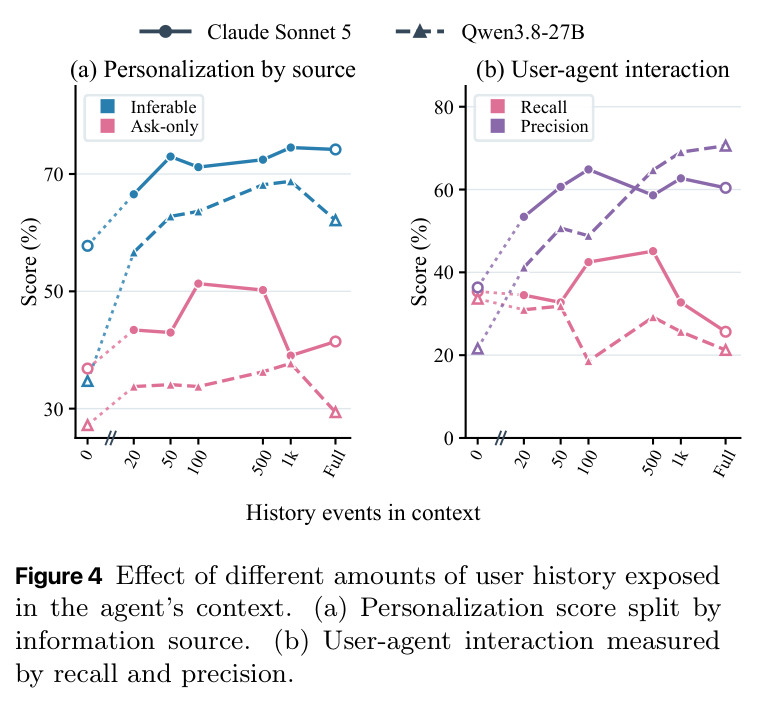
七个前沿代理在同一 harness 下评测,结论一致:执行强、个性化弱。最强的 Claude Opus 5 动作完成分高达 91.6%,但个性化分仅 69.4%(可推断 76.3%、仅能询问 51.3%),全标准通过的任务成功率只有 47.7%;其余代理成功率 26.2%–39.2%。仅能询问信息全线比可推断信息差,最大差距 46 分(Gemini 3.7 Flash:67.5% vs 21.1%)。交互层面暴露根因:任务平均含 0.89 个仅能询问需求,但代理每任务只发 0.08–0.35 次 ask_user,召回率最高仅 44.3%,而已发提问中又有 22.9%–39.6% 不必要(精确率 60.4%–77.1%)。扰动分析显示指令/偏好扰动使个性化分低于均值,环境扰动却让提问增至 2.3 倍且所有代理的 ask-only 个性化分上升——代理对显式环境障碍敏感,对需自行察觉的不确定性迟钝。消融实验:给 Sonnet 5 加执行前强制澄清阶段,成功率 39.2%→53.8%、召回 25.7%→85.0%,但精确率 60.4%→42.5%、#Ask 0.24→1.37,只是用过度提问换覆盖。历史暴露实验:Qwen3.8-27B 的可推断分从 35% 升到 top-50 事件的 63% 后饱和,仅能询问几乎不动,且召回反而从 33.6% 降到 21.2%。错误分析显示 ask-only 上「沉默瞎猜」占 43%/40%、「沉默默认」占 24%/22%;可推断上「漏推断」占 34%/34%、「推错」占 21%/25%(Sonnet 5 / Qwen3.8-27B)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 个性化移动任务(130 个欠指定任务全量) | 任务成功率 SR(所有 rubric 标准全过) | Claude Opus 5 最高 47.7% | 其余 6 个前沿代理 26.2%–39.2%,最低 Qwen3.8-27B 26.2% | 最佳代理也仅有约一半任务能完全正确,暴露 91.6% 动作完成与 47.7% 成功率之间的个性化鸿沟 |
| 仅能询问信息个性化 | 个性化分(ask-only 子项,%) | Claude Opus 5 51.3% | Gemini 3.7 Flash 仅 21.1%,全模型显著低于各自可推断子项(差距最大 46 分) | 证明「知道何时该问」是当前代理的最大短板 |
| 用户-代理交互 | Recall / Precision(%) | 最佳召回 44.3%(Opus 5),精确率区间 60.4%–77.1% | 每任务 ask_user 仅 0.08–0.35 次,远低于平均 0.89 个仅能询问需求 | 首次量化「问得太少且问得不准」的双重失败模式 |
| 执行前显式澄清阶段(Sonnet 5 消融) | SR / Recall / Precision(%) | SR 39.2→53.8,Recall 25.7→85.0 | 按需提问的原始设置 | 任务成功提升 14.6 个百分点,但精确率 60.4→42.5,付出过度提问代价 |
局限与改进
作者承认的局限:显式澄清提示只能提升提问数量与召回,无法提升精确率,说明「判断何时该问」尚无现成解法;专门的 GUI 代理因上下文容量不足或频繁产生非法动作而无法纳入有效对比。我自己观察到的局限:其一,整个基准围绕单一虚构人格 Jordan Avery 构建,偏好多样性受限于设计者的想象力,跨人格、跨文化的泛化性未知;其二,130 个任务规模偏小,且仅能询问需求平均每任务仅 0.89 个,召回/精确率的方差可能很大;其三,用户模拟器和裁判都用 Claude Sonnet 5,与被评的 Sonnet 5 同源,可能存在自偏;其四,请求分解与语义匹配 $\phi_t(q)$ 依赖 LLM,尽管人工一致率 93.9%–95.2%,边界案例仍可能被误判;其五,50 步预算和「只答所问」的模拟用户约束都是人为设定,真实用户会主动补充信息,实际人机协作可能比评测显示的更宽容。
独立分析的弱点
第一,单人格设计是最明显的软肋:所有 3,051 条历史事件、13 维画像都服务于 Jordan Avery 一人,代理可能学到的是「这个人的偏好」而非「推断偏好」的通用策略;改进方向是构造多人格(不同职业、消费水平、作息)并检验得分的相关性。第二,仅能询问信息的目标值刻意偏离 App 默认值,这只防了「接受默认」这一种偷懒,防不住基于常识分布的高概率猜测(如订餐时间猜晚上 7 点);可引入对抗性目标值分布或报告「猜测基线」上界。第三,交互指标把重复提问计为精确率惩罚项,但真实场景中适当确认关键操作(如付款金额)是好行为,指标无法区分「冗余重复」与「合理确认」;建议为确认类请求单设豁免通道。第四,评测只测了通用前沿模型在同一 harness 下的零样本表现,没有尝试微调或在提示中加入不确定性估计策略来专门优化「何时问」决策,基准与解法之间还缺一座桥。第五,历史检索实验用的 text-embedding-3-small 是很弱的检索器,top-50 之外的相关事件可能被漏掉,「完整历史无额外增益」的结论可能低估了更强检索/记忆架构的价值。
未来方向
作者明确希望 iPrefBench 成为构建「知道该推断什么、何时该问」的代理的试验田,可延伸方向包括:训练时的澄清策略优化——把召回/精确率的加权调和分(类似 F 值)作为奖励信号做 RL,让代理学会在信息熵高的决策点上提问;不确定性感知执行——在行动前对每个用户相关参数估计置信度,低于阈值才触发 ask_user,从机制上解决「沉默瞎猜」占 40%+ 的失败模式;偏好漂移建模——偏好扰动任务只占 10 个,可扩展为系统性研究如何从时间加权历史中识别 evolving preference;多轮长期记忆——研究跨 session 的画像更新与遗忘机制;跨平台泛化——把来源标注方法论移植到桌面、网页和语音助手场景;以及人因研究——用真实用户替代 LLM 模拟器,验证 Grice 式提问度量与人类满意度的相关性。
复现评估
复现难度中等偏上。环境基础 iOSWorld 是开源的可执行 iOS 模拟器框架,26 个 mock 应用随环境分发,种子数据、3,051 条活动历史、130 个任务、rubric 和画像 $P$ 论文声明构成完整基准(论文落款 Apple,正式开源情况需关注作者发布)。复现需要:macOS 上的 iOS 模拟器运行环境、被评代理的 API 额度(7 个前沿模型)、用于模拟用户与裁判的 Claude Sonnet 5 API(每任务约 20–26 步轨迹 + 逐条 rubric 评审,130 个任务的评测成本不低)、历史检索实验还需 text-embedding-3-small。质量复现的更大障碍是人工环节:任务经两轮专家审校、错误分析靠人工标注失败轨迹、裁判验证需 100 条轨迹的人工标注——若从零自建类似基准,人力成本远高于算力成本。好的一面是所有评测代码路径(模拟器种子、动作空间、ask_user、LLM 裁判提示)在附录 B/C/E/F 中有系统描述,工程上按图索骥可行。
论文图表