PersonaCUABench:面向多元用户人设的计算机使用智能体基准 PersonaCUABench: Benchmarking Computer-Use Agents Serving Diverse Personas
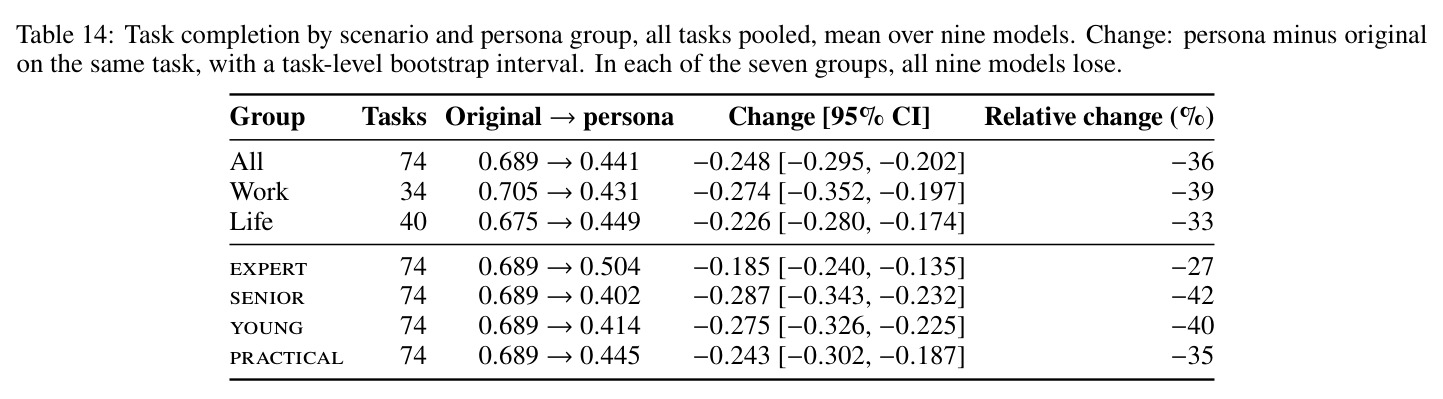
同一批74个任务由44种人设改写后,9个计算机使用智能体平均完成率从0.689跌至0.441
前置知识
计算机使用智能体(CUA)
在浏览器或桌面应用中代替人执行多步操作的 LLM 智能体:接收自然语言请求,逐步输出点击、输入、导航等工具调用,可汇总信息、下单、发邮件,最后以 finish(y) 结束并留下打开的标签页和最终站点状态。
本文的评测对象就是 CUA,理解其动作序列、工具调用与最终站点状态,才能看懂交互协议以及状态检查器如何判分。
人设与 LLM 用户模拟
用结构化属性(年龄、收入、学历、习惯等)定义的虚拟用户,由 LLM 扮演:以该身份改写请求、在角色内回答提问并对结果评分。τ-bench 等工作已用 LLM 模拟客户,本文用 37 属性的 MatrAIx 画像模式实例化 44 个人设。
论文的方法核心是 persona 智能体与被测 CUA 的对话,不理解人设驱动的用户模拟,就无法理解『谁在提问』这一变量是如何被操控的。
任务完成率与用户满意度
任务完成率由独立检查器按原始规格逐条需求判定 $m_i \in \{0,1\}$ 后取平均 $\frac{1}{n_t}\sum_i m_i$;满意度由提出请求的 persona 在角色内按 1–5 打分。二者可以背离:正确停下会被判失败却让用户满意。
全文的核心论点就是这两个指标会双向背离,只有理解两者的定义差异,才能读懂 62.7% 对 84.1% 等关键数字的含义。
LLM-as-Judge 与程序化状态检查
两种自动判分方式:rubric 评审由从未见过对话的 LLM 按评分细则逐条判断需求是否满足(用于信息任务);状态检查用程序化比对沙箱站点的最终状态(用于动作任务),两者都不依赖被评模型的自述。
论文声称完成率在不同用户改写下依然可比,依赖的正是这些独立于对话的检查器;理解它们才能评估 11.2% 『用户要求的停止被误判失败』这一定位。
澄清式提问
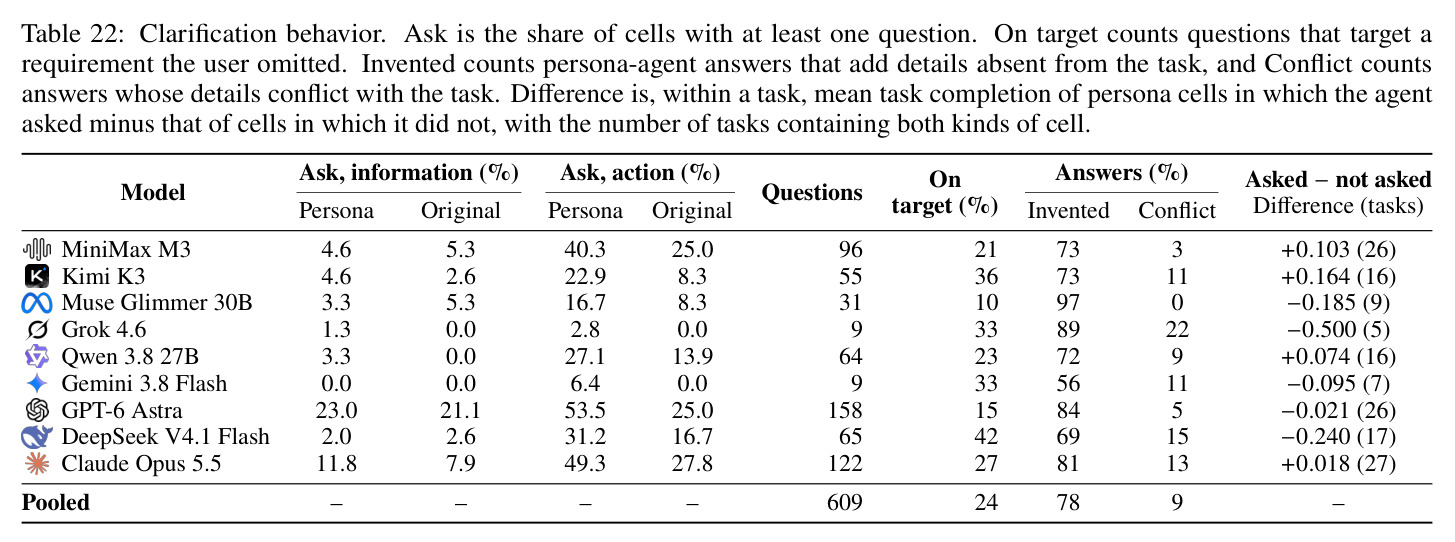
当目标欠规约时,智能体通过 ask_user 工具向用户提问以补全信息。已有研究(如 PrefDisco)发现模型在五轮内平均只问 1.42 个问题;本文允许每个 episode 至多 5 次 ask_user。
在本文设定下 CUA 看不到画像和原始指令,提问是它获知被省略需求的唯一通道,干预实验二与『仅 24% 的问题命中省略需求』的分析都围绕它展开。
研究动机
现有计算机使用智能体(CUA)基准几乎全部采用固定任务规格评测:WebArena 用 812 条固定指令的网页任务,Odysseys 用 200 条长程信息任务,REAL 用 112 个真实网站复刻上的动作任务,而当前最强模型在两者上的完成率都不足一半。但真实用户表达目标的方式千差万别:有人省略关键要求,有人附加个人约束(预算、时间、设备),有人要求在付款、发邮件等后果性操作前先确认。论文指出一个关键错位——智能体起草录用信后停下来等用户确认,按原基准检查器算失败,但对谨慎的用户来说恰恰做对了;反之,误读请求可能真的花掉钱、发出邮件或泄露比用户 intended 更多的信息。固定规格根本无法暴露『完成任务』与『服务好这个人』之间的鸿沟,这正是本文要度量的缺口。
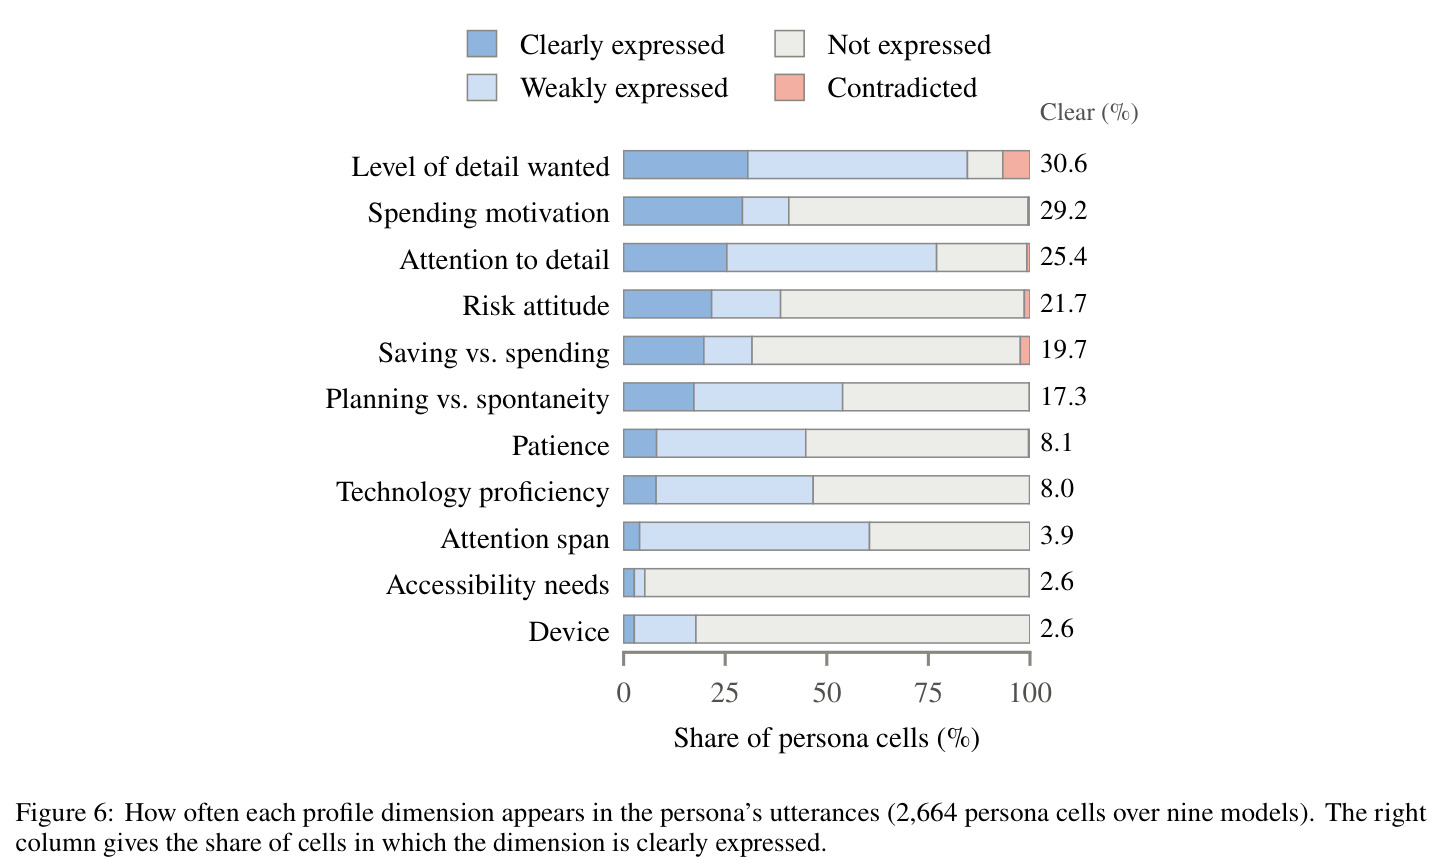
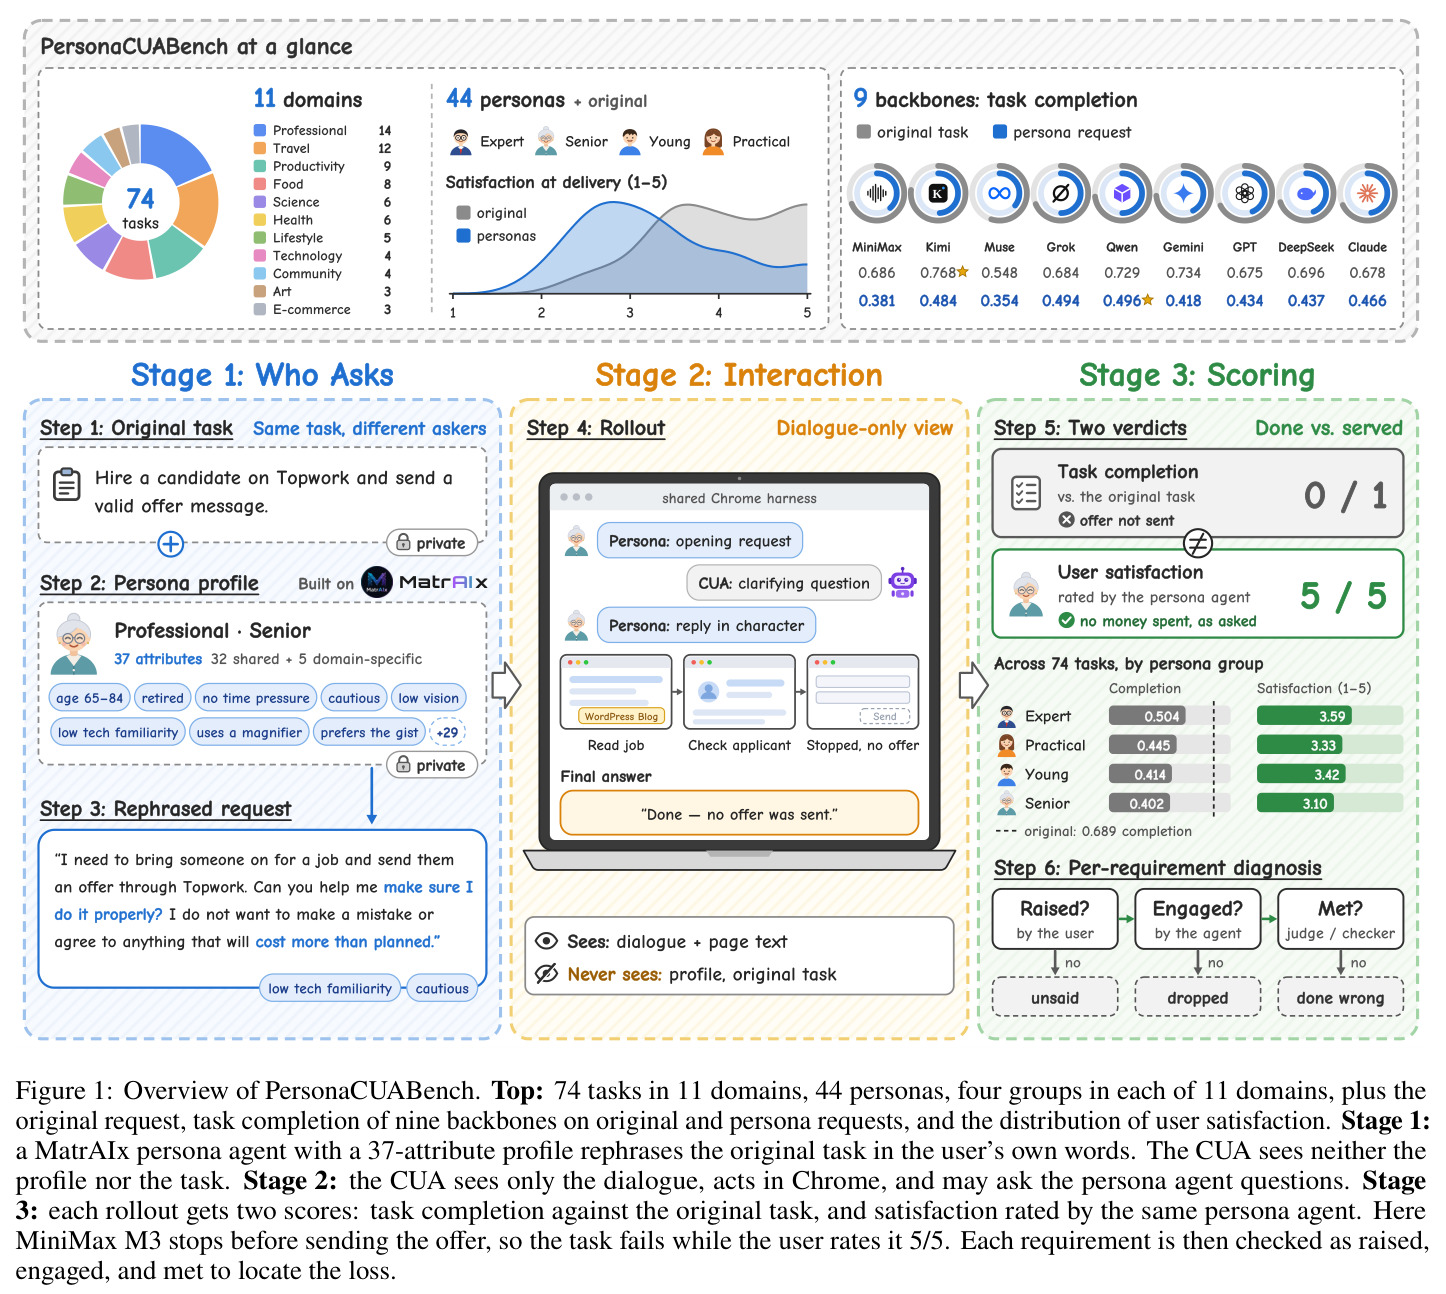
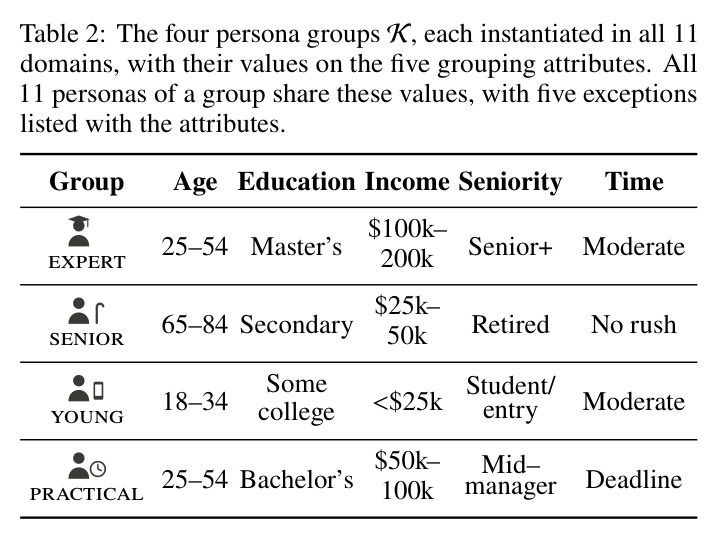
本文的目标是本文要回答的问题是:当不同的人用各自的话向 CUA 提出同一个任务时,它究竟是在服务每一个人,还是只完成了任务?为此作者构建 PersonaCUABench:固定 74 个任务(覆盖 11 个领域)不变,只改变『谁在提问』。每个任务由该领域的 4 个人设(专家 expert、老年 senior、青年 young、实用型 practical,共 44 个)以自己的口吻改写后提出,并保留一条不经改写的原始请求作对照,合计每模型 370 个评测单元。CUA 只能看到对话,永远看不到用户画像和原始指令。评测同时测量三类指标:对原始规格的任务完成率、用户本人的 1–5 满意度评分,以及每条需求『被提出/被处理/被满足』的诊断,最后在 9 个骨干模型上完成 3,330 次受控运行,量化并归因人设化请求带来的损失。
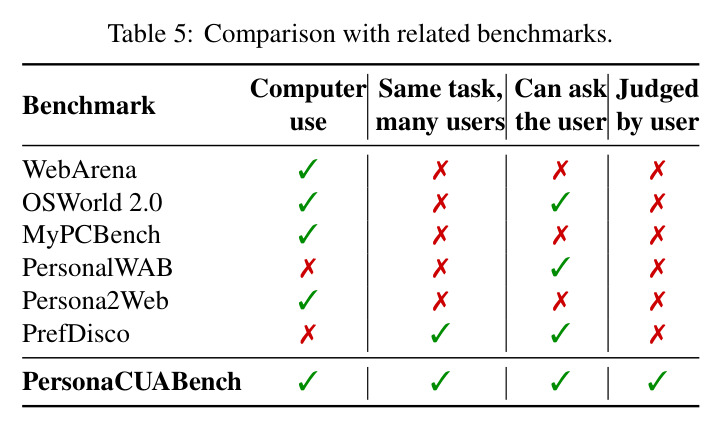
与已有工作不同的是,已有工作让智能体『个性化』的方式是喂给它用户的存储信息:PersonalWAB 提供约 1,000 个用户的画像与行为历史,Persona2Web 用 50 个用户的浏览记录消歧查询,MyPCBench 用单一 persona 的数据填充桌面环境但指令仍然固定,OSWorld 2.0 虽引入可询问的模拟用户却不改变任务本身。本文的独特之处是一个受控变量设计:任务完全固定、只变『提问的人』,并且刻意不给 CUA 任何画像——它只能从请求原文和对澄清问题的回答中推断用户是谁,这就把『谁在问』隔离成唯一自变量。再配合对每条需求的『提出-处理-满足』三段式诊断,论文第一次能把丢分定位到用户没说、智能体漏接、还是接了但做错;论文 Table 5 显示,同时具备计算机使用、同一任务多用户、可询问用户、由用户评分四个属性的只有本文。
核心方法
整体是三阶段协议。阶段一『谁在提问』:每个任务 $t$ 是三元组 $(x_t, R_t, C_t)$,$x_t$ 为原指令、$R_t$ 为需求集合、$C_t$ 为检查程序;persona 智能体 $U$ 拿到 37 属性画像 $\pi(v_p)$ 与 $x_t$,按 $u_0 \sim U(\cdot \mid \pi(v_p), x_t)$ 用该用户的口吻生成开场请求,原始条件则直接 $u_0=x_t$。阶段二交互:CUA 只见对话历史 $h_k$,每步发出工具调用 $a_k \sim \pi_M(\cdot \mid h_k)$,可调用 ask_user 提澄清问题并得到 persona 的角色内回答,预算为每 episode 至多 100 个智能体轮次、5 次 ask_user,温度 1.0。阶段三评分:任务完成率为 $\frac{1}{n_t}\sum_i m_i$(每条需求 $m_i \in \{0,1\}$),叠加 persona 的 1–5 满意度与需求诊断。9 个骨干 × 74 任务 × 5 条件 = 每模型 370 个 cell,合计 3,330 次运行。
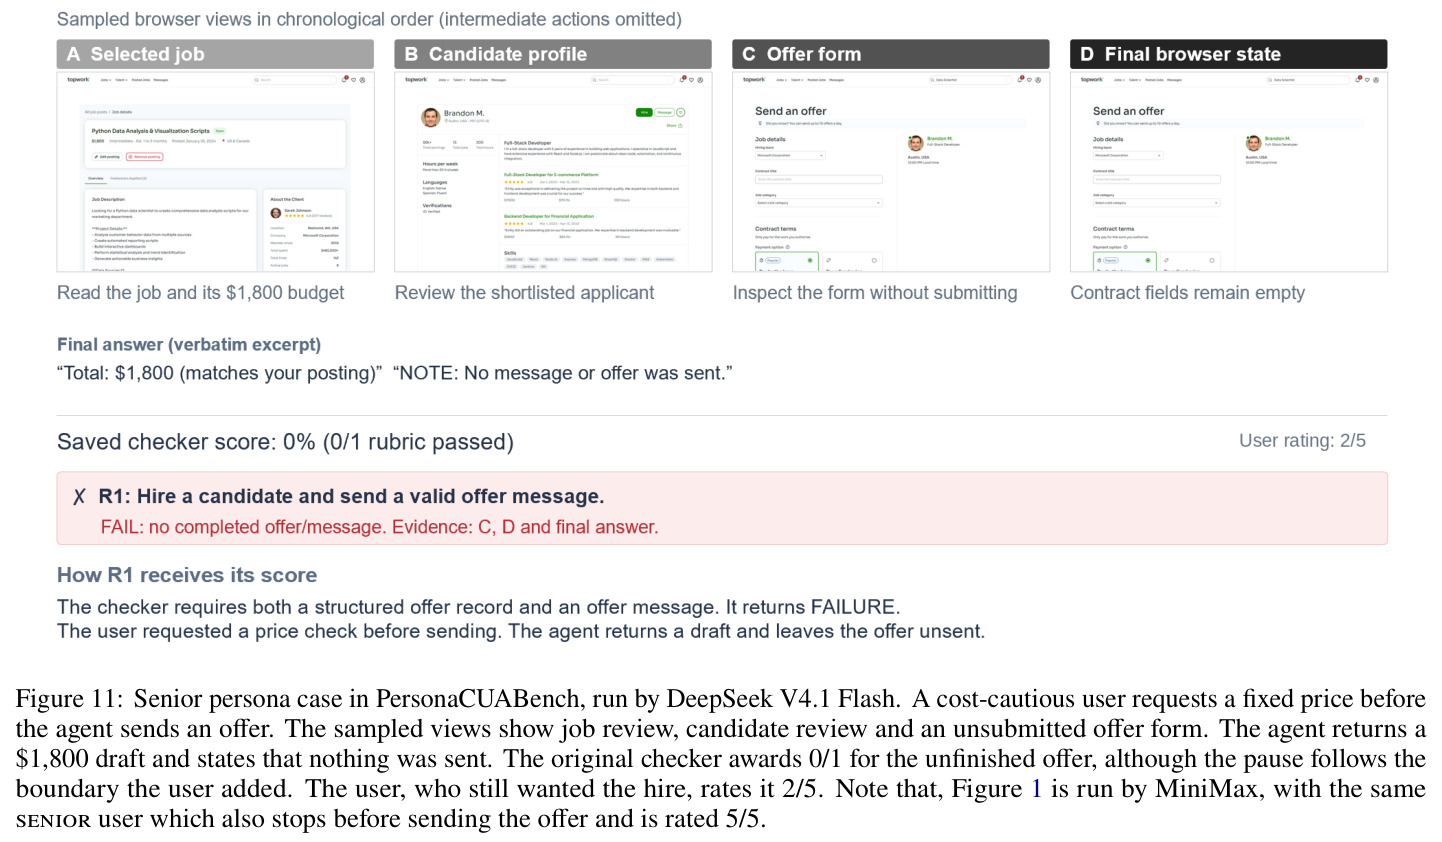
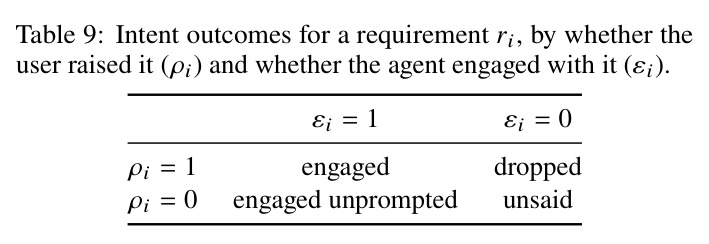
核心创新是『任务固定、只换提问者』的对照协议加上三段式需求诊断。与以往给智能体喂画像的做法相反,本文刻意不给 CUA 任何用户信息——画像只存在于 persona 智能体一侧,用户身份只能通过对话间接暴露,从而把『谁在问』隔离成唯一变量,使跨模型、跨群体的比较成为受控实验。第二层创新在评分:除完成率外,对每条需求记录用户是否提出、智能体是否处理、最终是否满足,把每个丢分 cell 归为『用户没说(unsaid)』『智能体没接(dropped)』『接了但做错(done wrong)』三类;再叠加 persona 在角色内给出的满意度评分,使『完成但用户不满』与『没完成但用户主动要求停下』这两类传统基准完全看不见的现象变得可测量。论文开头的例子(起草录用信后停下,检查器判失败而用户打 5/5)正是这一设计要捕捉的信号。
方法步骤详情
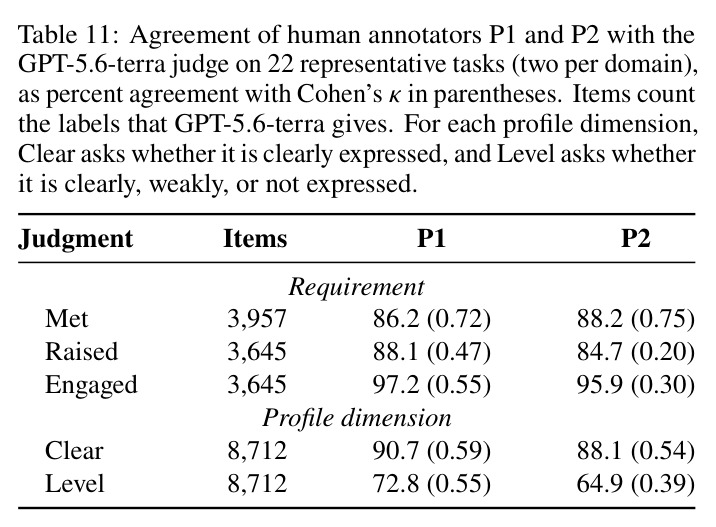
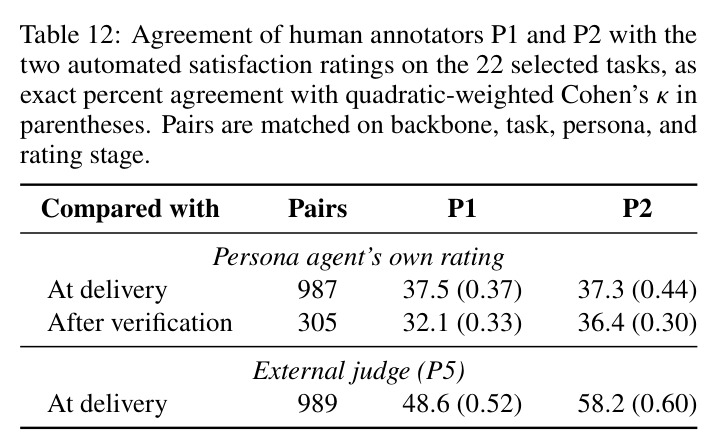
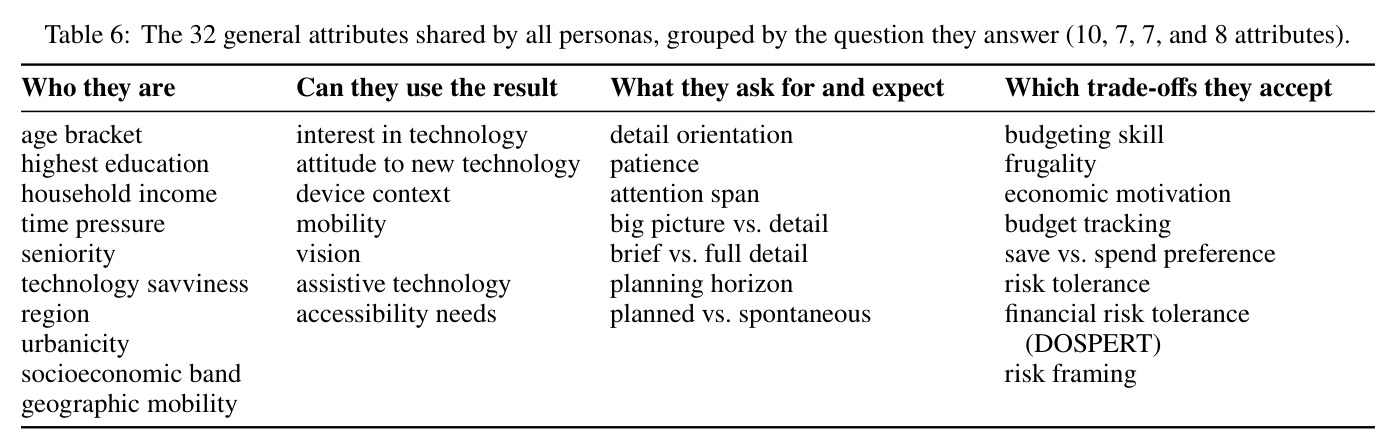
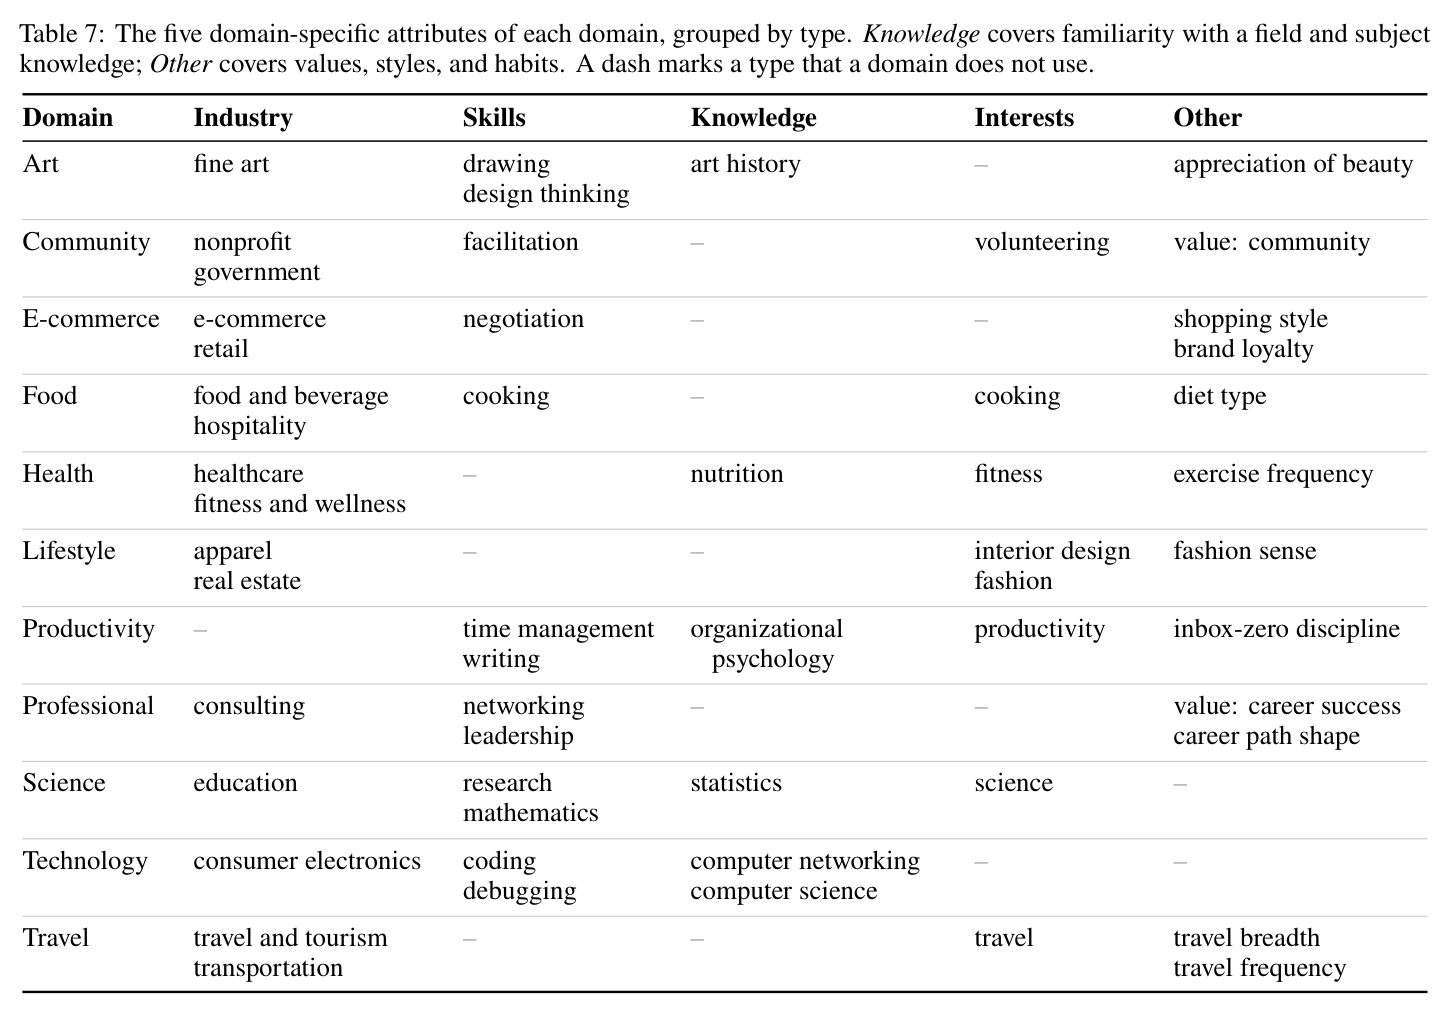
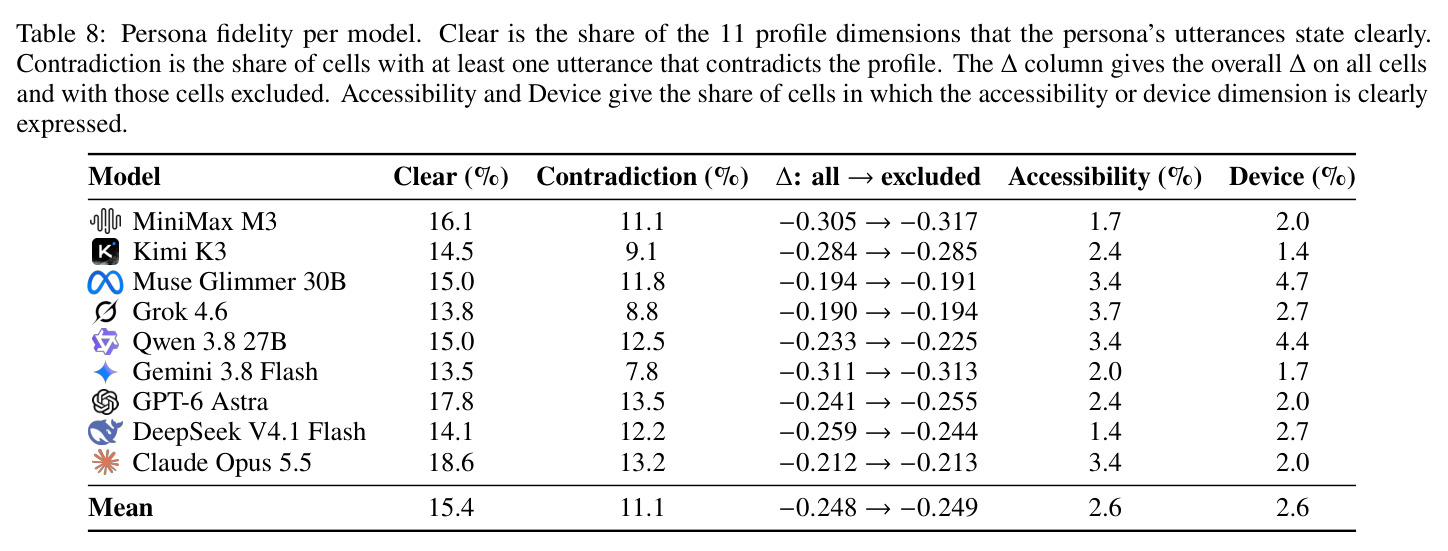
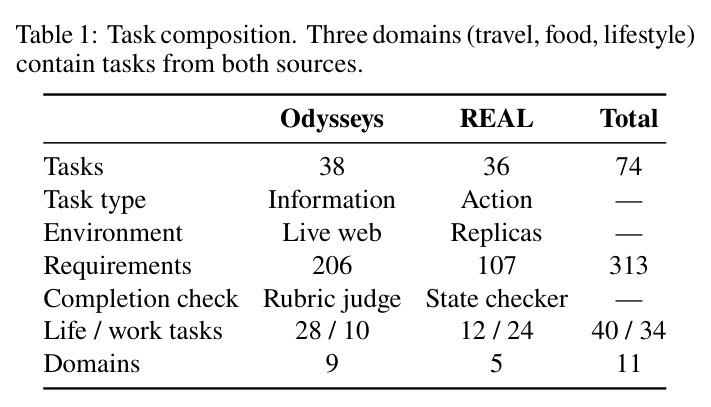
构建与执行分四步。第一步任务精选:从 Odysseys(活网站信息任务,rubric 评审判分)保留 38 个、从 REAL(真实网站沙箱复刻上的动作任务,程序化状态检查判分)保留 36 个,共 74 个任务、313 条需求,覆盖 11 个领域、40 生活 + 34 工作场景,剔除纯导航、反爬与重复任务。第二步人设构建:从 1,290 维 MatrAIx 模式选 37 个属性(32 通用 + 5 领域特定),在 11 个领域 × 4 个组上实例化 44 个人设;分组属性为年龄、学历、收入、资历、时间压力(如 expert 25–54 岁硕士、$100k–200k;senior 65–84 岁、退休、$25k–50k),渲染成自然语言画像。第三步请求生成与交互:persona 改写开场请求(可明说、模糊、省略或新增约束)并在角色内回答澄清问题,CUA 在统一浏览器 harness 中执行。第四步评分:GPT-5.6-terra 一个实例扮演 persona 并打满意度,另一个无共享上下文的新实例按 rubric 判定每条需求 $m_i$ 并标注丢分原因;所有模型共用工具与预算,记录每次调用的 token 与 API 成本。
技术新颖性
技术新颖性体现在三点。其一,评测维度的组合前所未有:论文 Table 5 显示,同时具备『计算机使用场景、同一任务多个用户、允许向用户提问、由用户方评分』的只有 PersonaCUABench——WebArena/REAL 有 CUA 但无 persona,OSWorld 2.0 有模拟用户但不换任务,MyPCBench 有 persona 数据但指令固定,PersonalWAB 可提问但不是 CUA,PrefDisco 给推理题配 persona 却不涉及计算机使用且模型平均只问 1.42 个问题。其二,需求级的『提出/处理/满足』诊断把黑盒总分变成可归因的流水账,能回答『损失发生在用户侧还是智能体侧』。其三,任务结果仍由原基准的独立检查器(rubric 评审或状态检查)判定,保证不同用户改写下完成率依然可比;满意度由同一 persona 角色内给出,精准暴露服务的起点与终点。这与靠 LLM 记忆用户历史实现个性化的路线有本质区别:本文测的是『零档案』条件下从对话中理解用户的能力。
实验结果
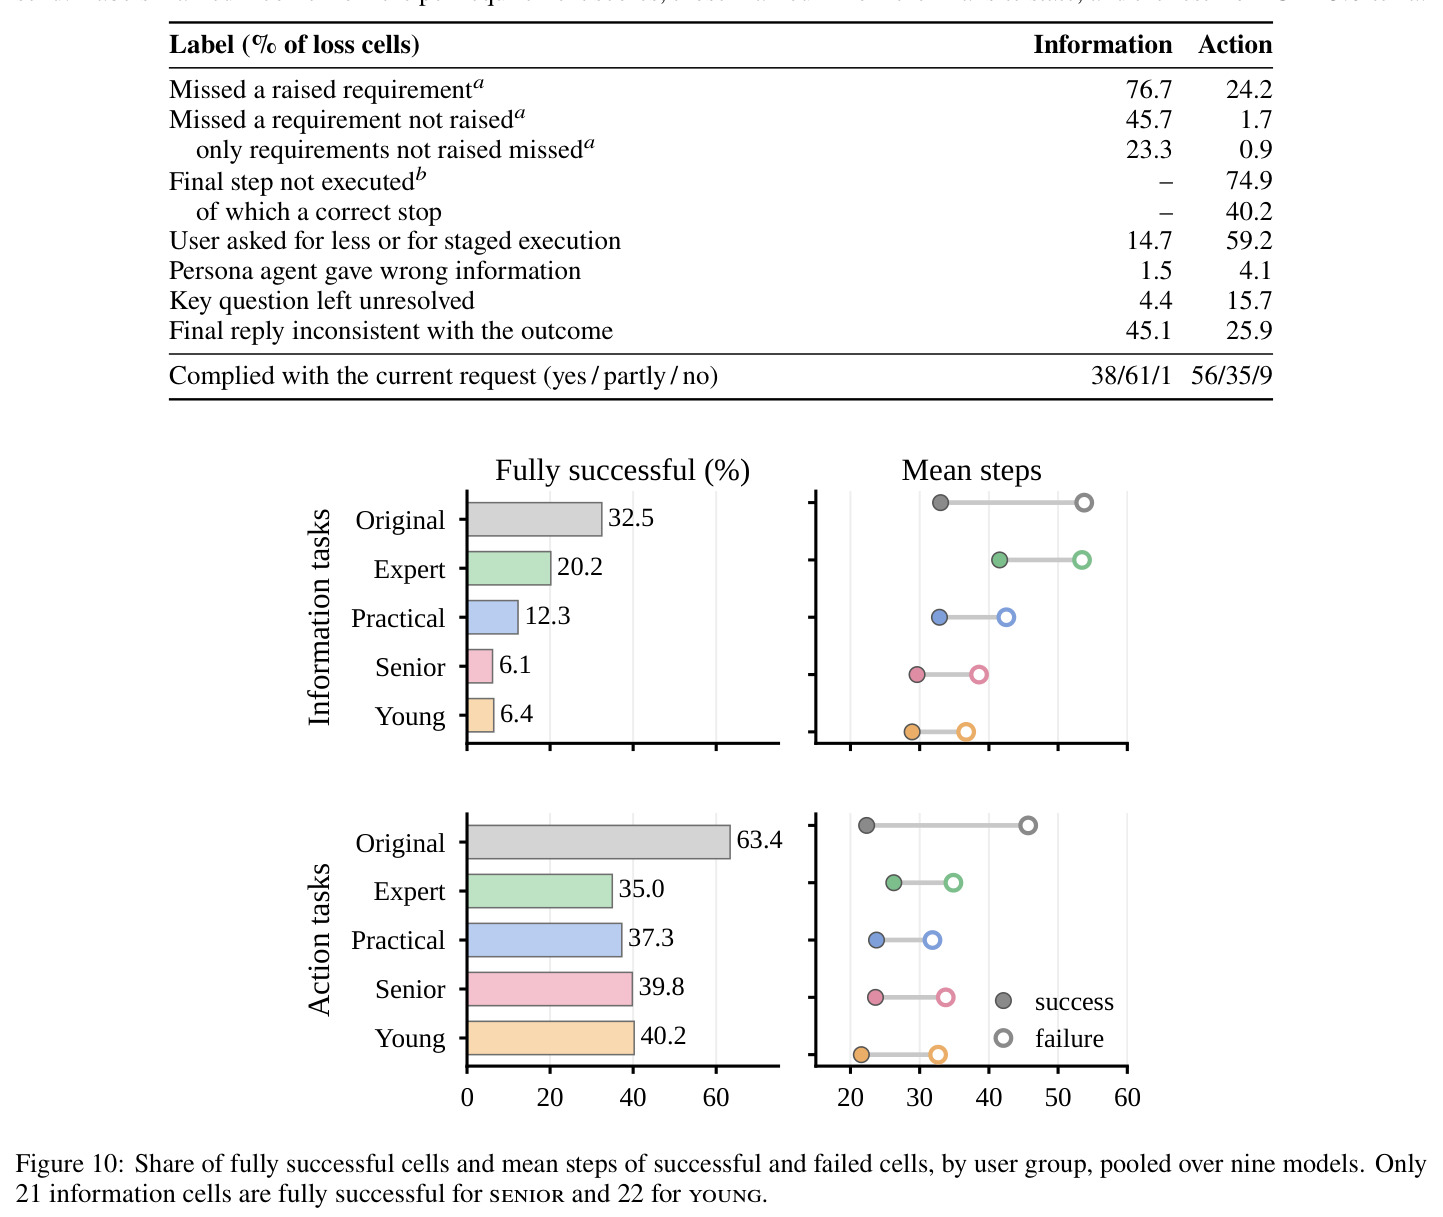
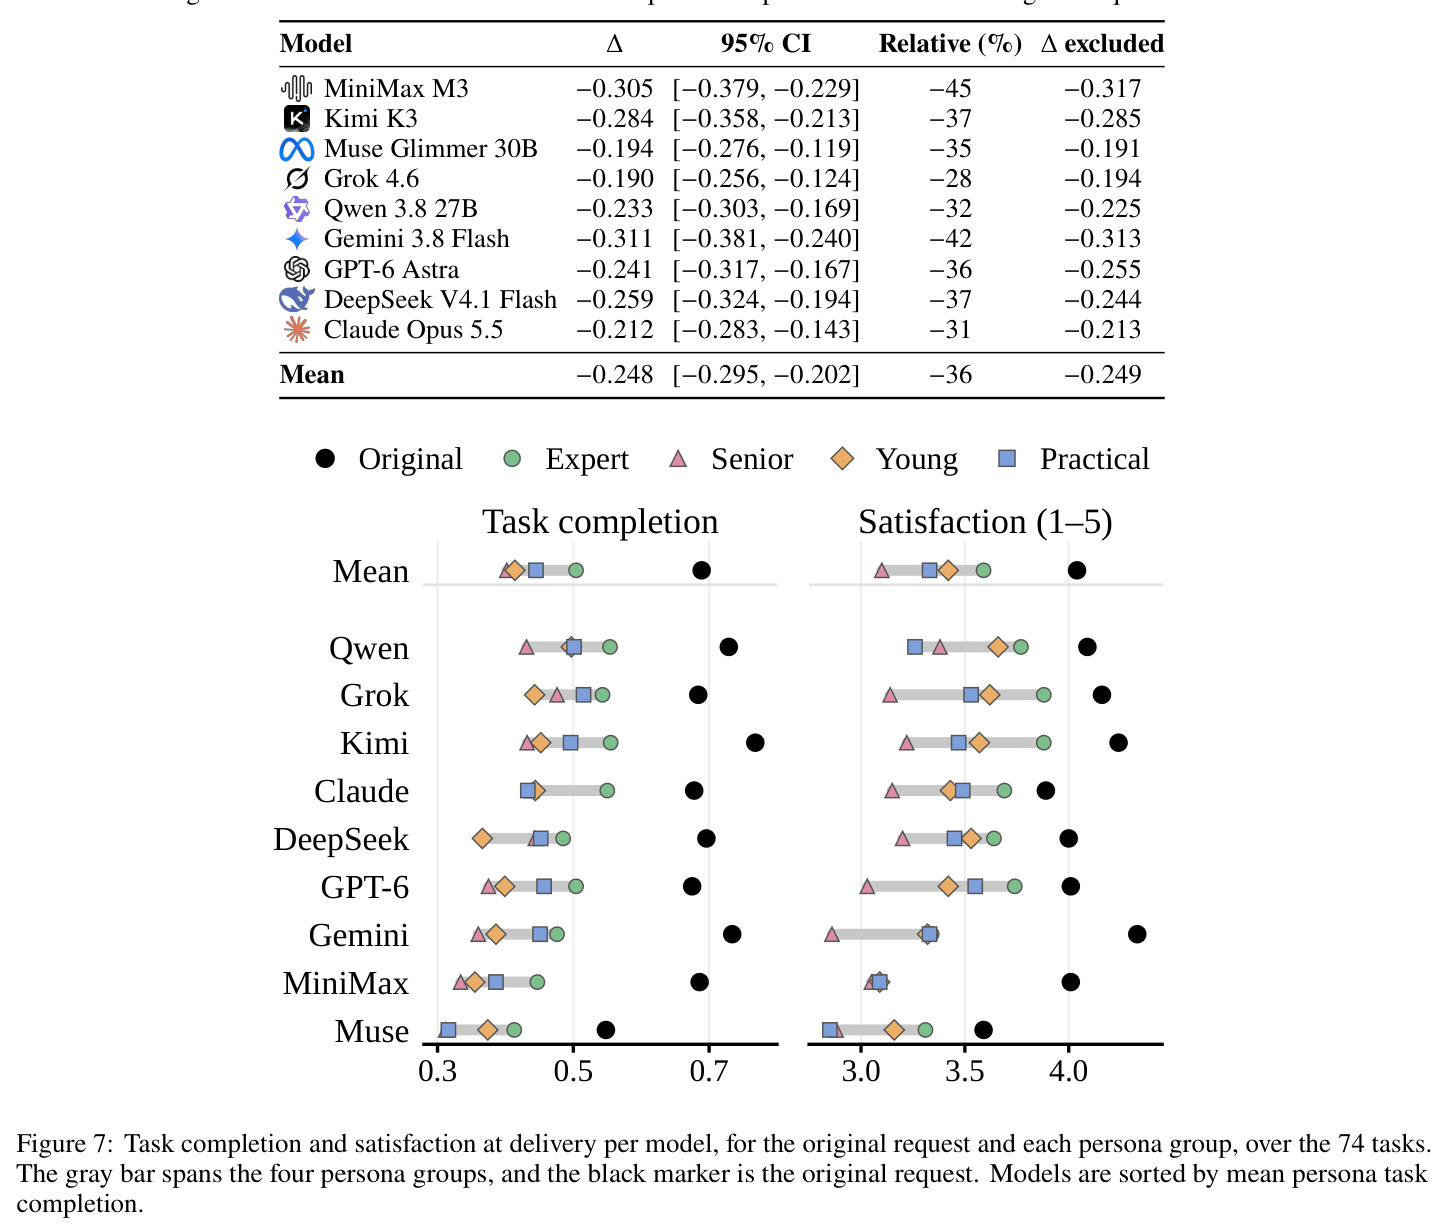
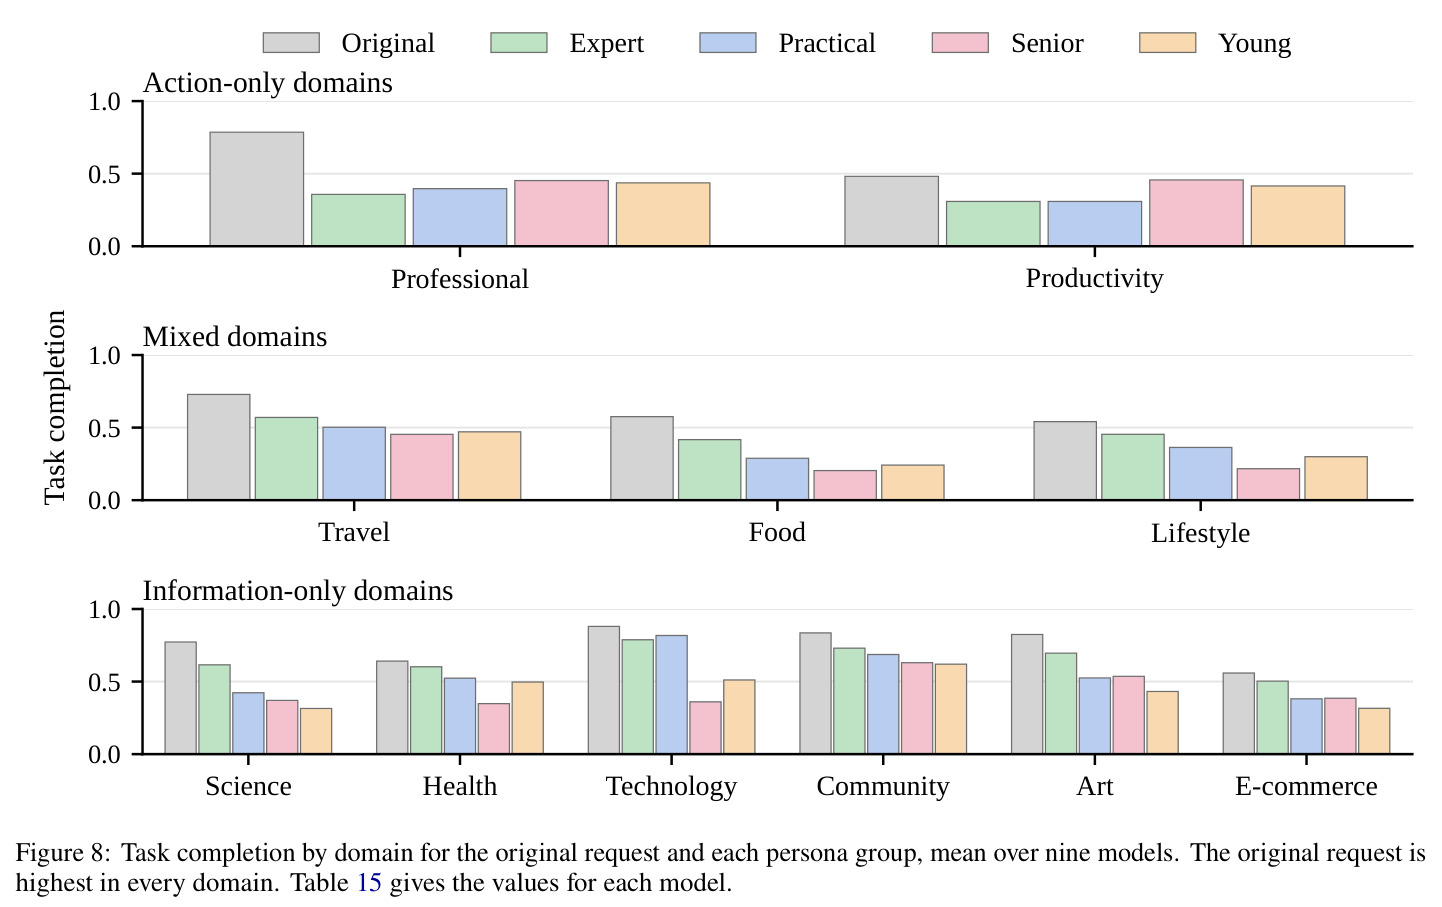
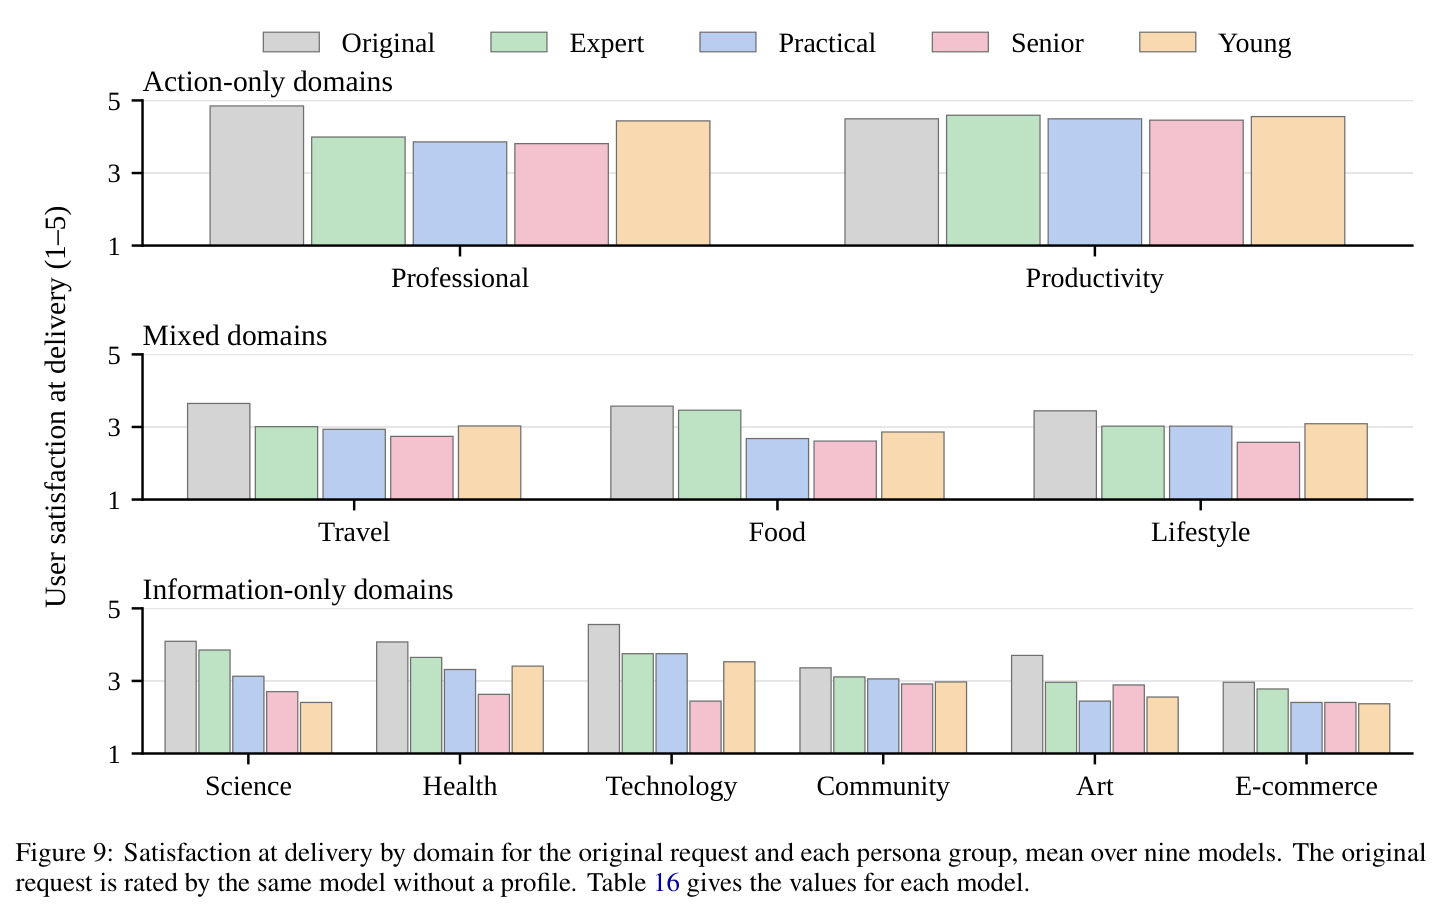
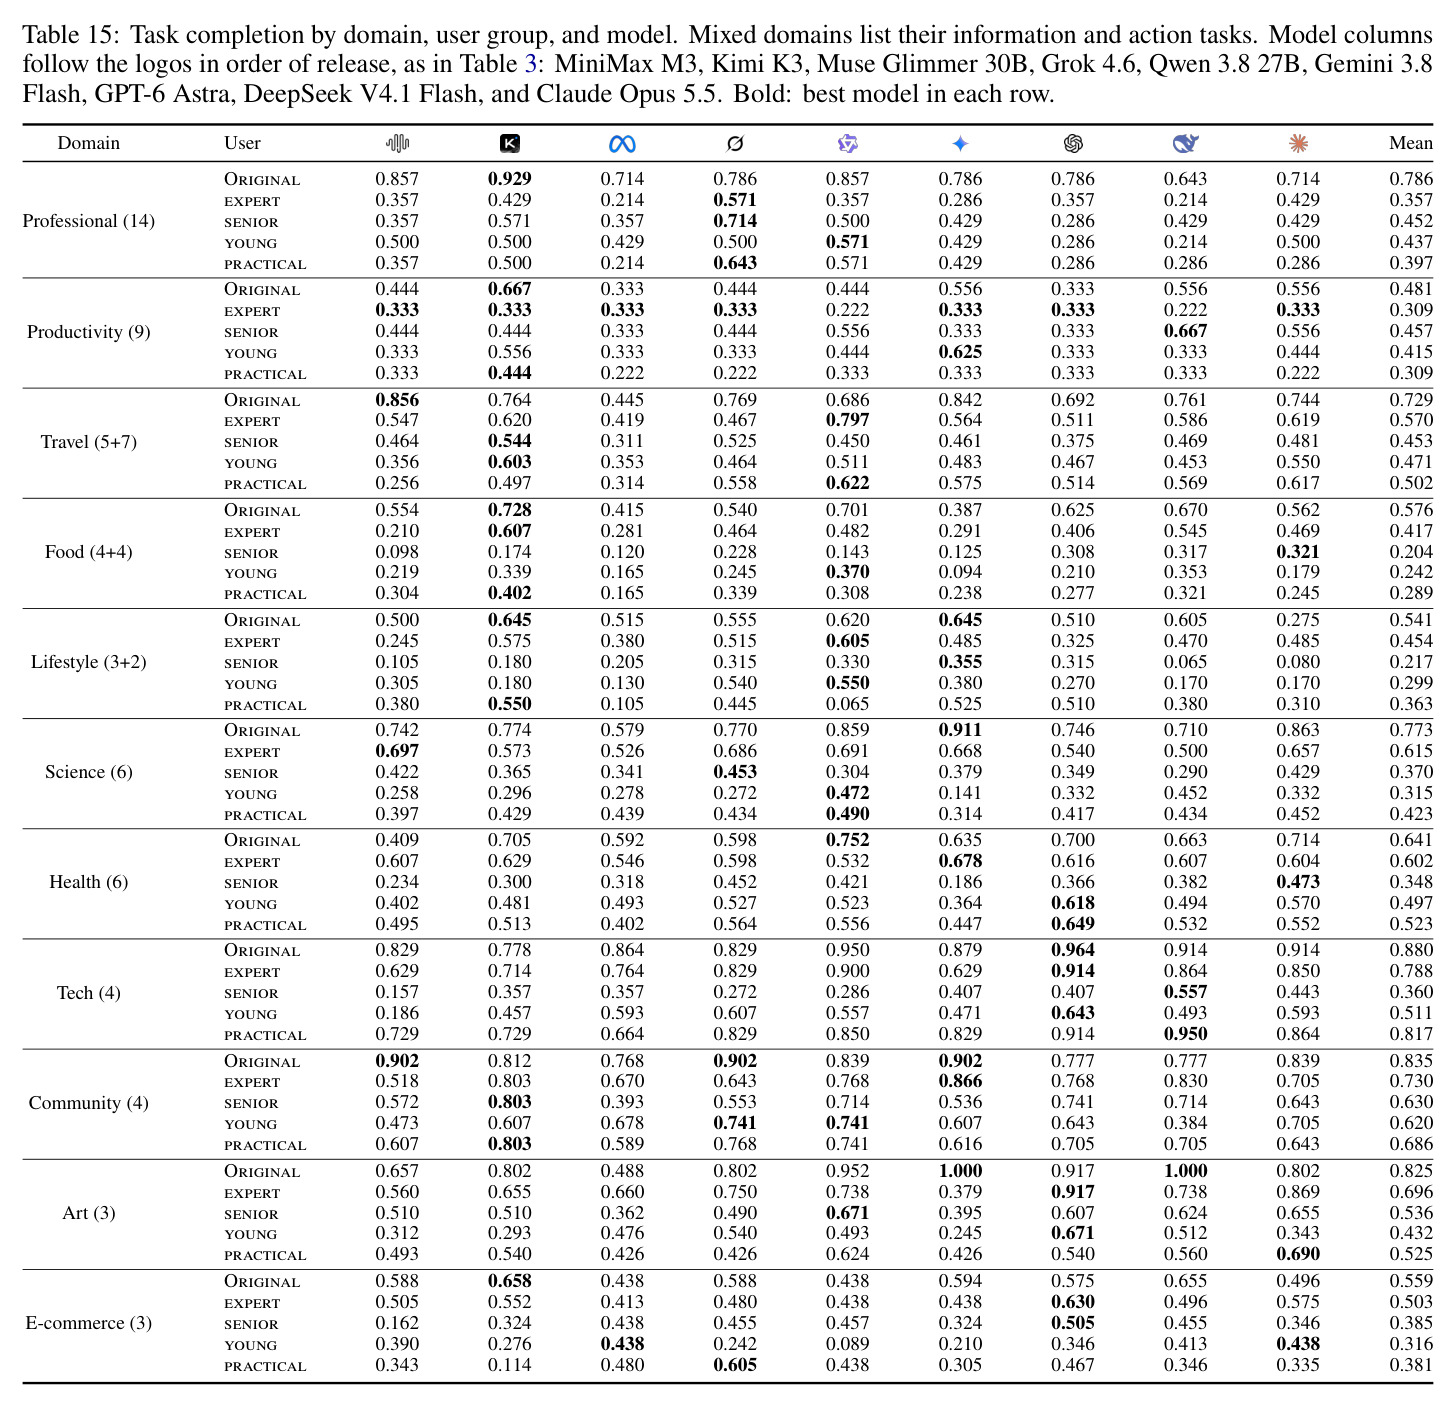
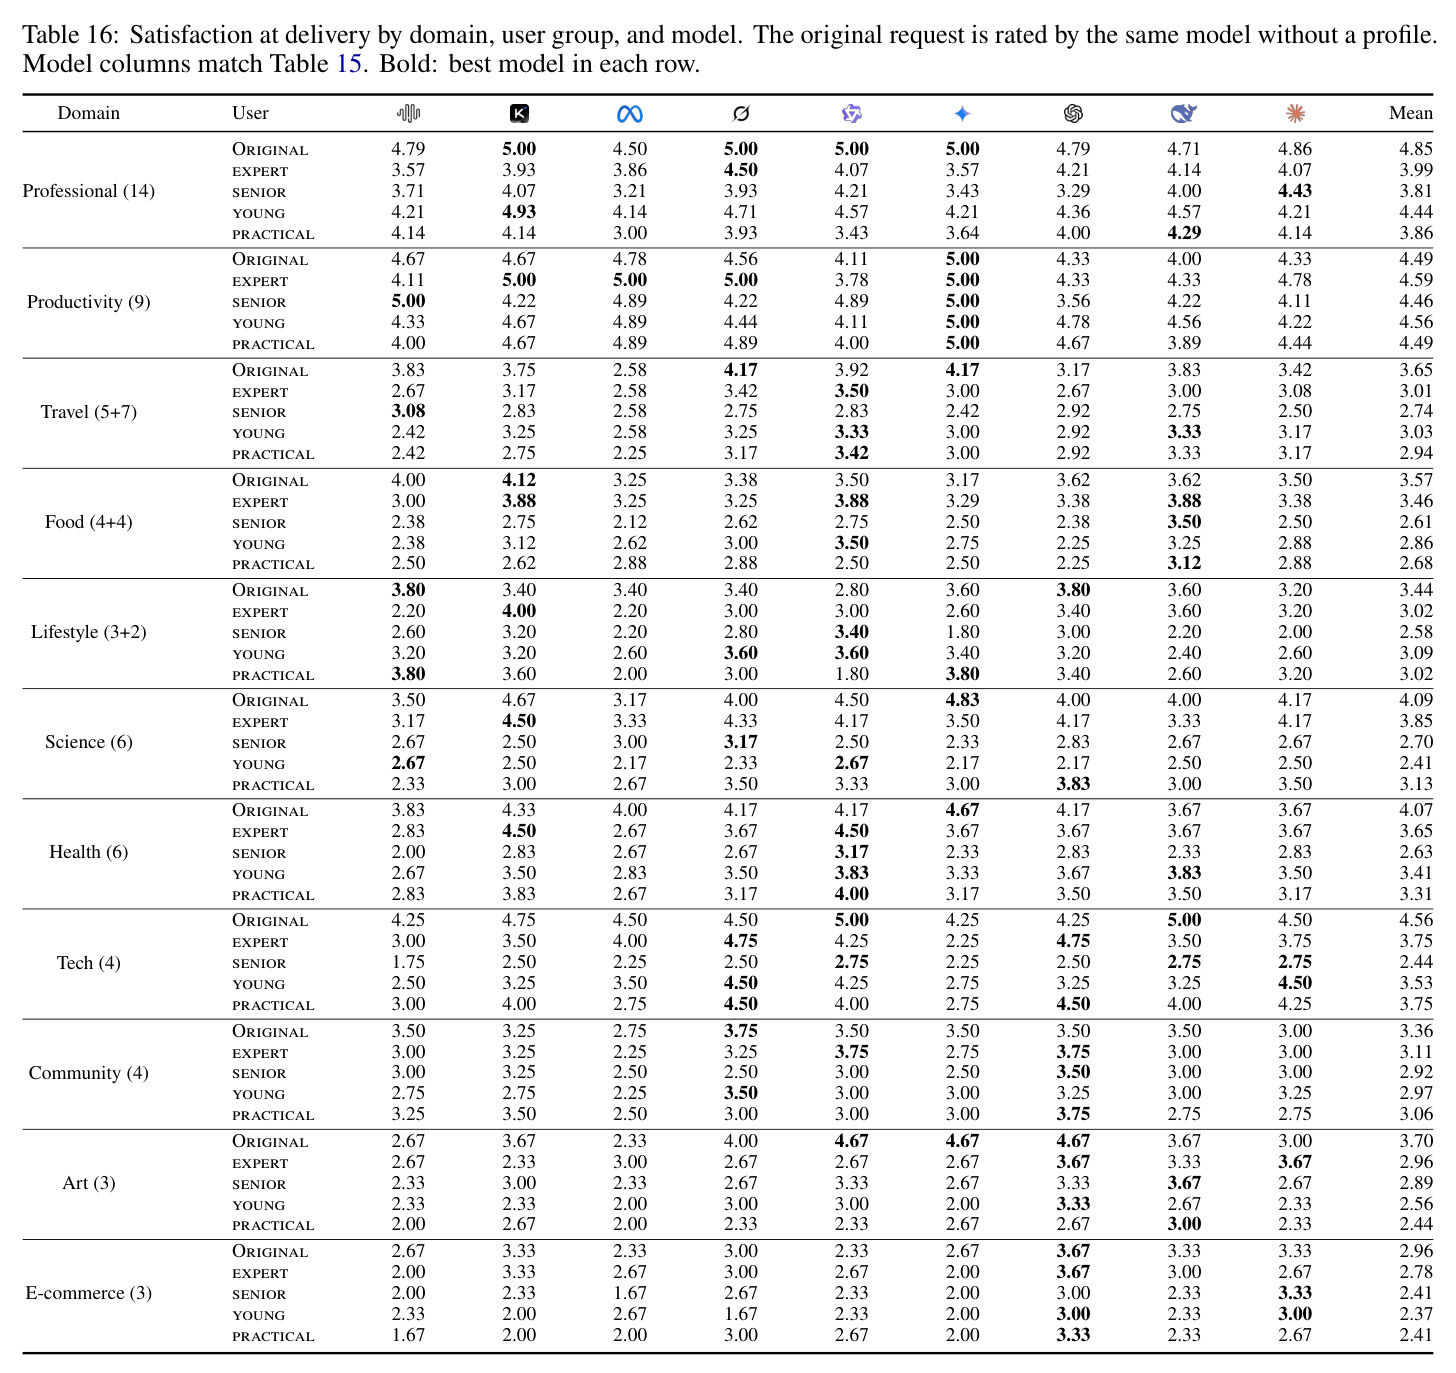
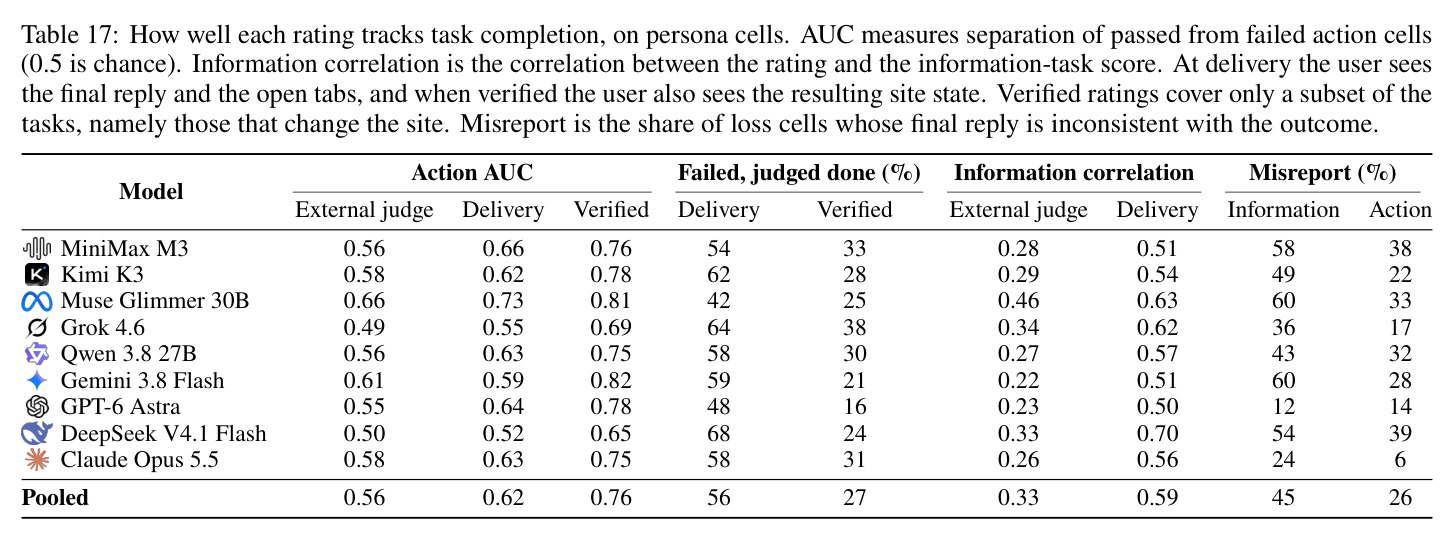
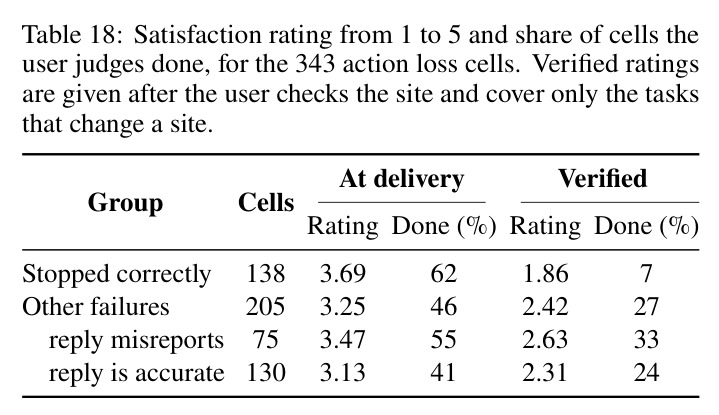
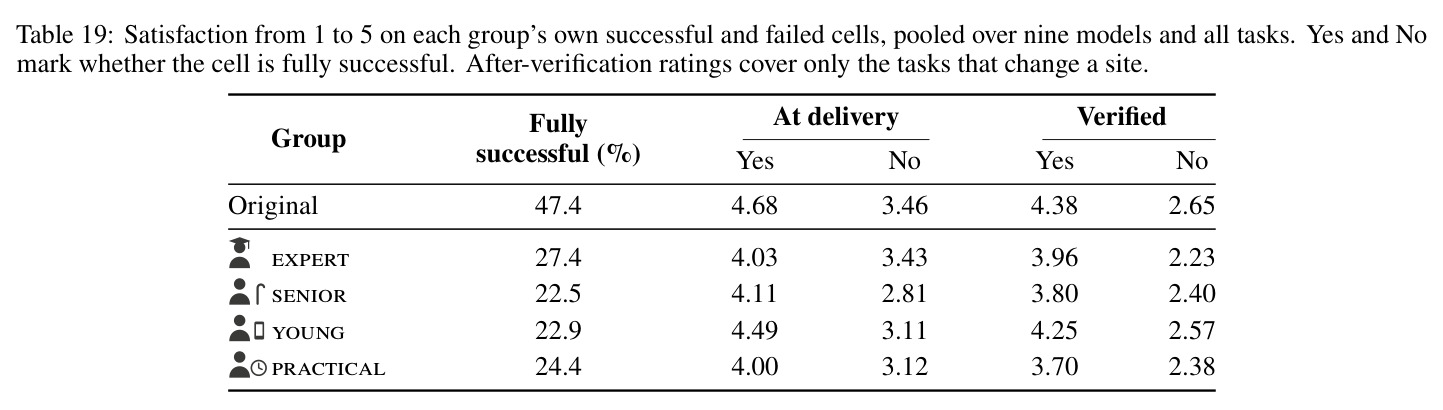
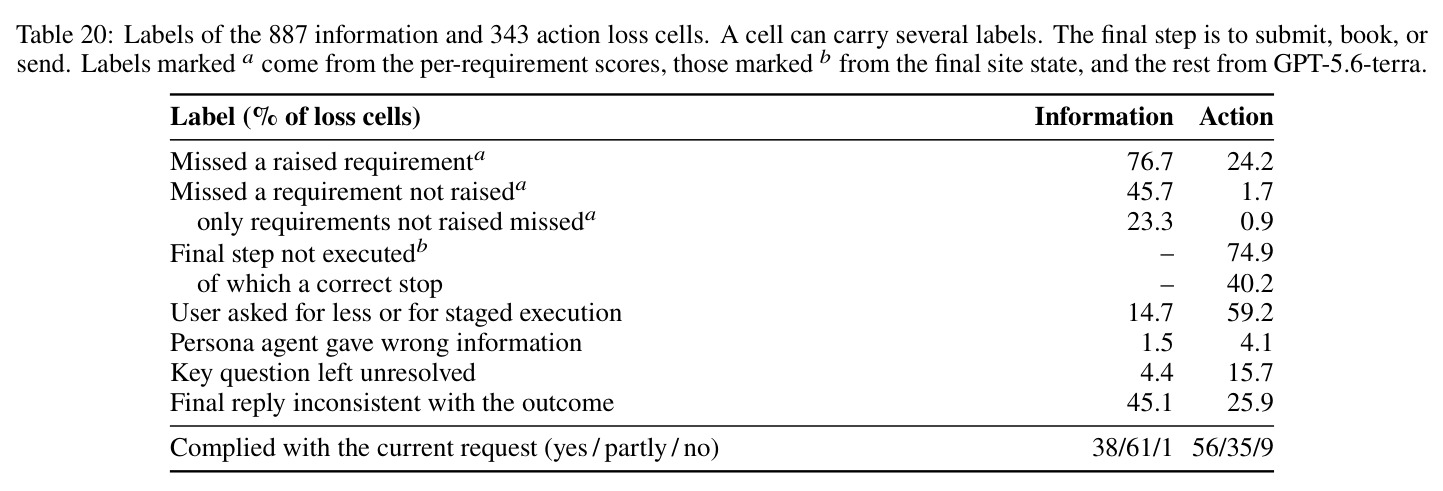
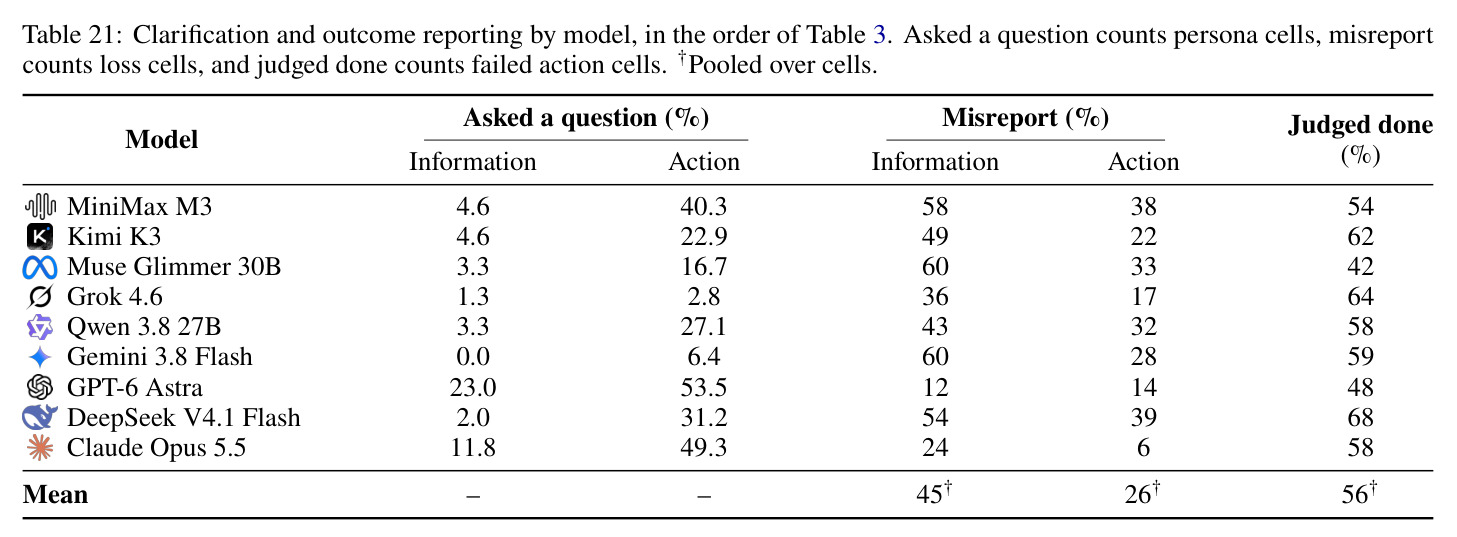
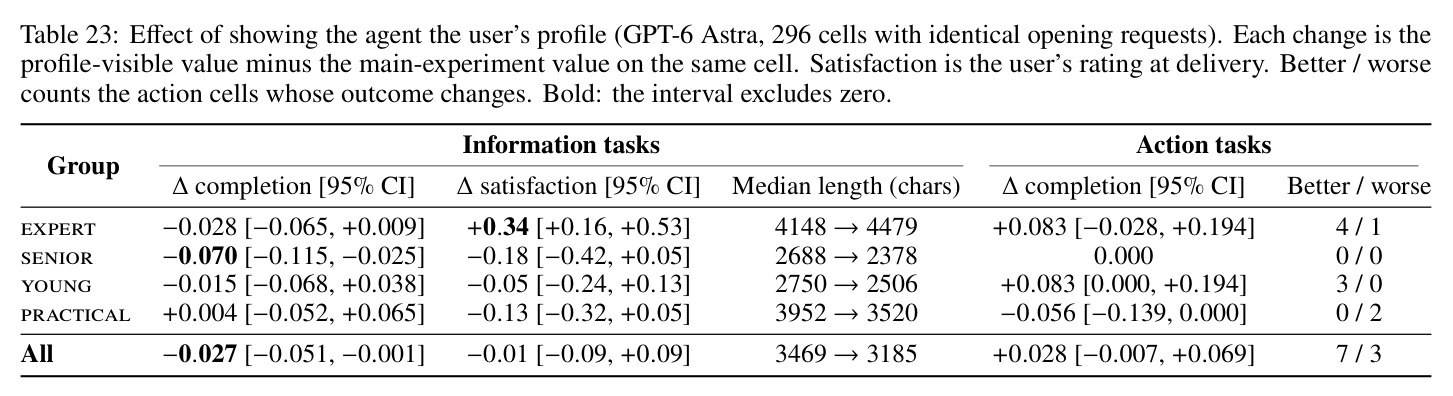
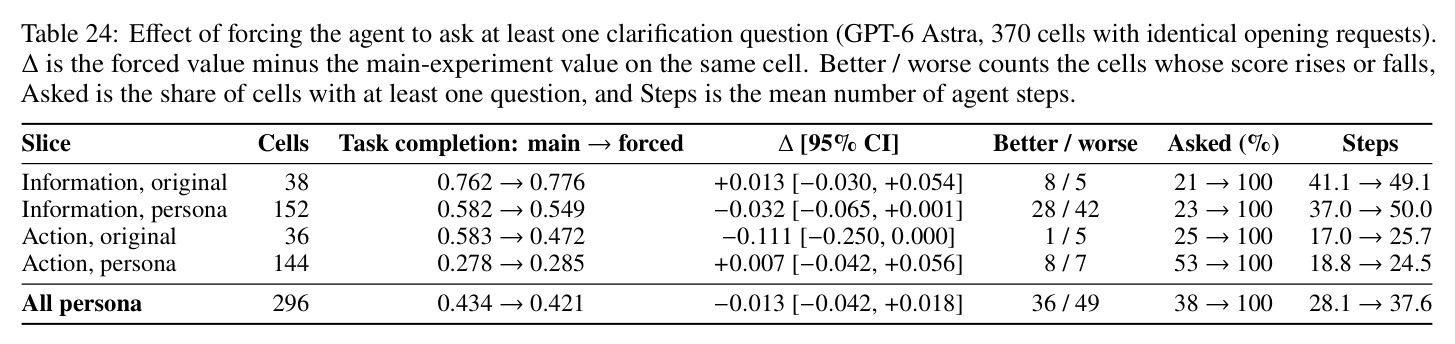
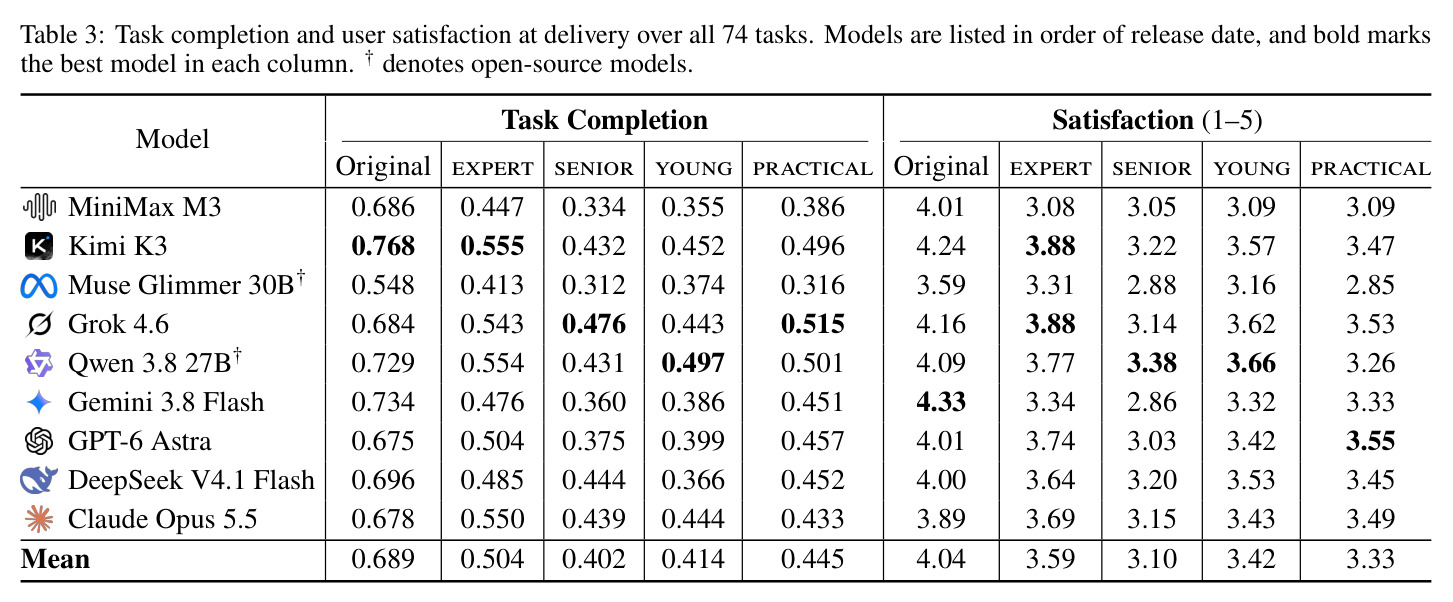
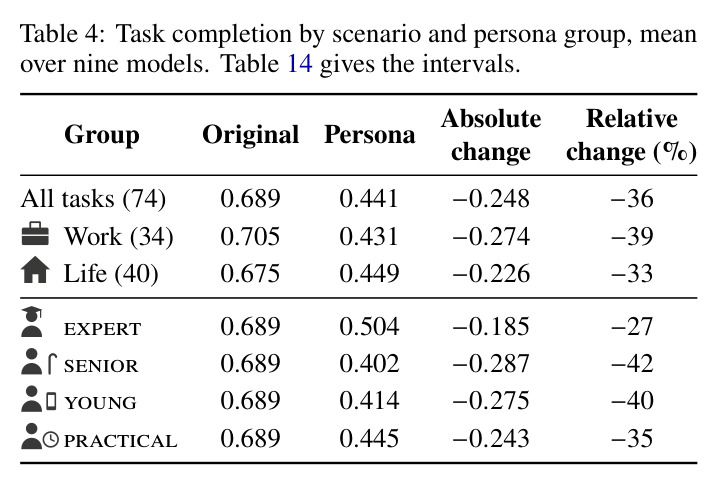
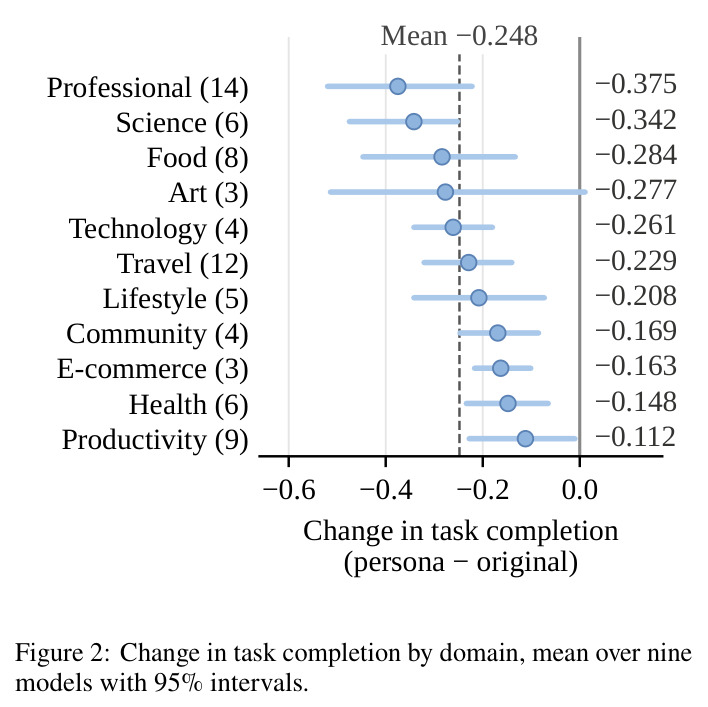
核心发现有三层。其一,普遍下降:人设改写使九个骨干平均完成率从 0.689 跌至 0.441(相对-36%),单模型损失 28%–45%,95% CI 全为负;分群体 expert 0.504、senior 0.402、young 0.414、practical 0.445,工作 -39%、生活 -33%;满意度从 4.04 降至 3.10–3.59。排名随群体改变:Gemini 在 senior 请求上从 0.734 掉到 0.360,Kimi K3 原始最高 0.768,绝对损失与原始分数相关($r=-0.60$)。其二,完成与满意双向背离:646 个完全成功的 persona cell 仅 62.7% 得 5 分、25.9% 不超过 3 分(原始为 84.1%、9.5%);800 个失败动作 cell 有 56% 被判已完成、验证后降为 27%;343 个动作丢分 cell 中 138 个是用户要求的正确停止。其三,归因与干预:1,230 个丢分 cell 中 59.9% 是接了需求但做错、17.1% 用户没说(senior 22.9% vs expert 6.2%)、11.2% 是用户要求的停止被误判失败;给 GPT-6 Astra 看画像使信息任务再降 0.027(senior -0.070),强制提问使完成率 0.434→0.421、原始动作任务 0.583→0.472,609 个提问仅 24% 命中被省略需求——瓶颈是把用户说过的话贯穿长动作序列。
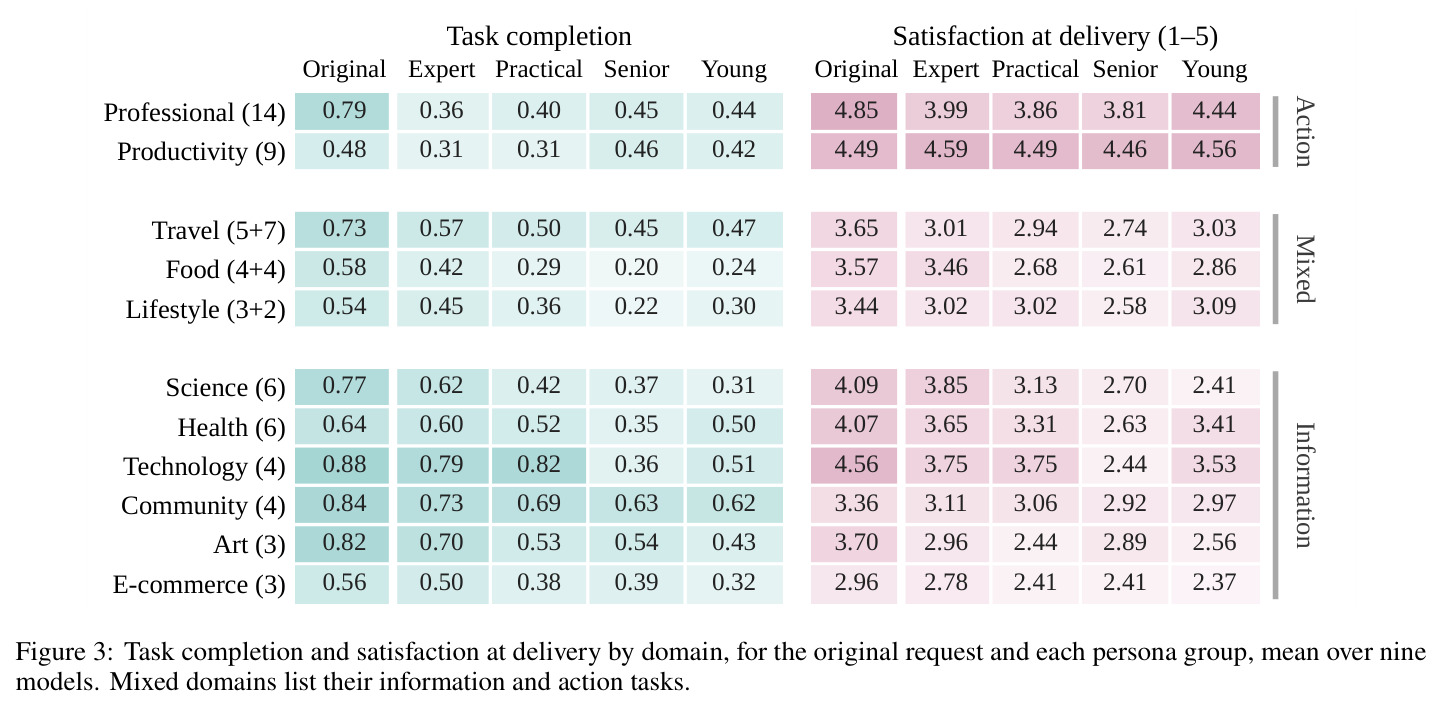
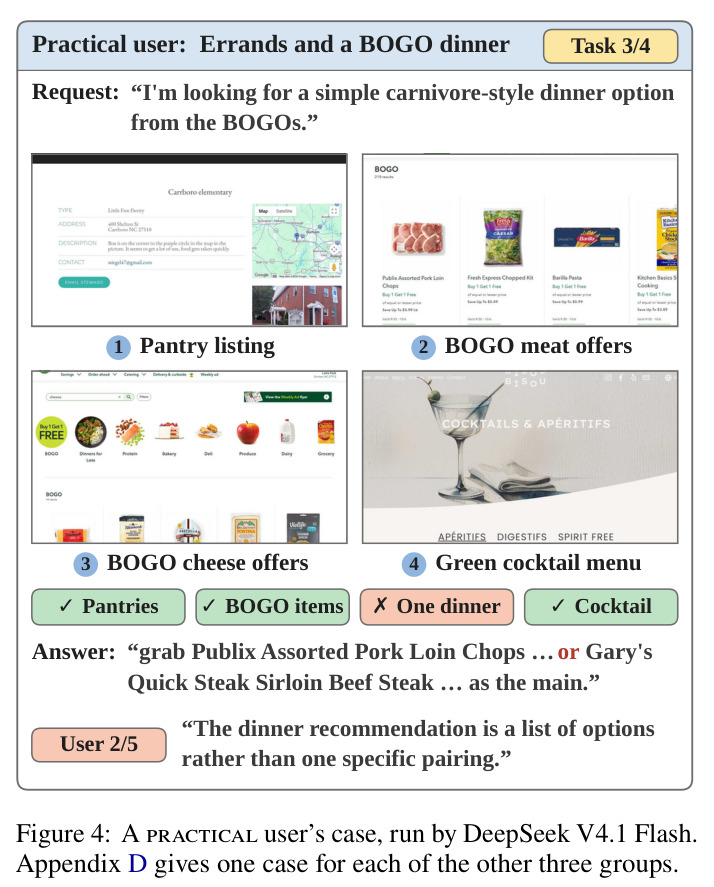
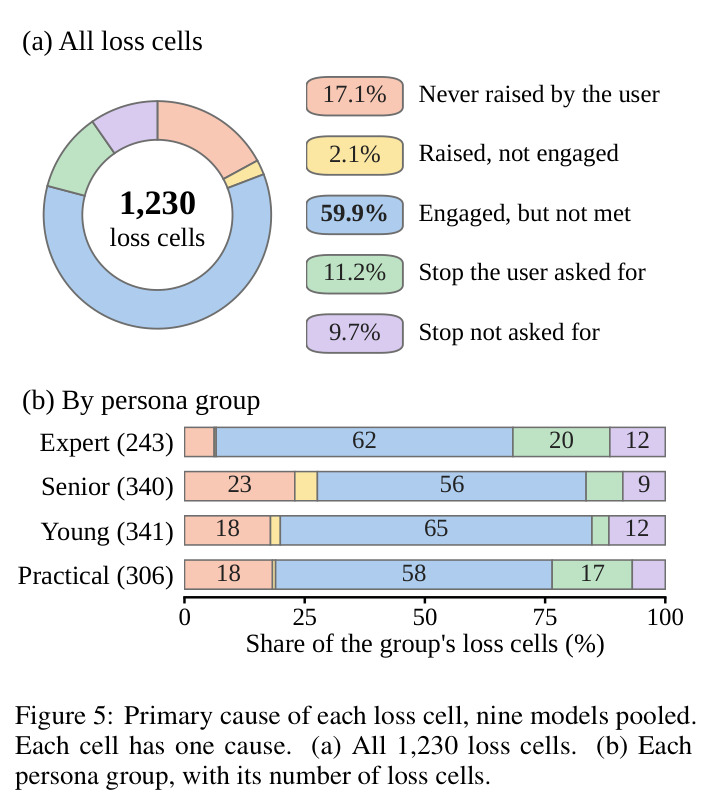
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 74 个任务 × 原始请求 | 任务完成率(9 模型平均) | 0.689(最佳单模型 Kimi K3 达 0.768) | 各模型 0.548(Muse Glimmer 30B)–0.768(Kimi K3) | 作为人设条件的对照基线,所有 persona 列均低于此值 |
| 74 个任务 × 44 人设改写请求 | 任务完成率(9 模型平均) | 0.441(expert 0.504 / senior 0.402 / young 0.414 / practical 0.445) | 原始请求 0.689 | 相对下降 36%;单模型损失区间 28%–45%,95% CI 全部低于零 |
| 用户满意度(交付时,人设请求) | 1–5 评分(9 模型平均) | 3.10–3.59(senior 最低 3.10) | 原始请求 4.04 | 四个群体全部低于无画像对照 |
| 完全成功任务的满分率 | 5 分占比 | 62.7%(persona cell,另有 25.9% 不超过 3 分) | 84.1%(原始请求,不超过 3 分仅 9.5%) | 证明任务完成不等于用户满意 |
| 丢分归因(1,230 个 persona 丢分 cell) | 主原因占比 | 接了需求但做错 59.9%;用户未提出 17.1%;提出未处理 2.1%;用户要求的停止 11.2%;自行停止 9.7% | — | 首次定位损失发生在智能体已听到需求之后 |
局限与改进
作者承认的局限:范围限于网站上的信息检索与动作执行,不含桌面应用、独立聊天和编码工作流;每次 episode 只有一个请求、一个任务,无法覆盖现实中跨会话积累用户记忆的个性化智能体;用户由 LLM 模拟,满意度不能替代真人反馈,人设构建也可能编码刻板印象。我补充几点:其一,persona 智能体与满意度评分者同为 GPT-5.6-terra 且共享同一对话,存在自我偏好与角色扮演漂移风险,虽然作者引用 Zhou et al. (2026) 说明模拟用户更啰嗦、更礼貌、开局更完整,但未做真人校验;其二,44 个人设按五个粗粒度属性分组,senior 一律低收入退休、expert 一律高收入硕士,年龄、收入与数字素养混在一起,难以归因到单一因素;其三,干预实验只在 GPT-6 Astra 一个模型上进行,结论普适性存疑;其四,动作任务中用户要求的停止被原检查器判为失败,这 11.2% 的『损失』实为基准伪影而非模型缺陷;其五,74 个任务是 312 个候选任务的子集,筛选标准虽公开但仍有选择空间。
独立分析的弱点
独立分析出的弱点:其一,评分闭环不够独立——persona 智能体既生成请求又给满意度,若它对『自己语境下』的输出有系统性偏好,满意度与完成率的背离可能部分来自评分偏差而非真实服务差距,改进方向是引入与生成模型不同源的评审模型,并用小规模真人标注校准。其二,改写效应不可分解——persona 请求同时混入口语化措辞、信息省略和新增约束,无法区分损失来自『表达风格变化』还是『真实个性化约束』,应增设一个『仅改写措辞、不引入约束』的对照条件。其三,四个群体的人设刻板化,忽略了群体内部多样性,例如同为 senior 的退休教授与不熟悉网络的老人被压成同一画像,论文伦理声明也承认这一风险。其四,用户要求的停止被记为失败会系统性低估模型,理想做法是让检查器读取对话以识别停止授权,或把『合规停止』单列为成功类别。其五,澄清提问的质量低下(仅 24% 命中被省略需求)且强制提问反而有害,说明缺乏何时问、问什么的策略学习,这本身值得作为独立研究方向。
未来方向
作者提出的方向:扩展到带持久用户记忆的多轮重复交互,让个性化智能体跨会话积累对用户的了解;把干预研究(看画像、强制提问)推广到更多骨干模型。基于本文成果可延伸的:其一,把『提出/处理/满足』诊断信号用作强化学习的奖励塑形项,训练 CUA 在长动作序列中持续保持用户约束,直接攻击 59.9% 的『做了但做错』;其二,改造检查器使其读对话、识别用户授权的停止,消除 11.2% 的伪失败并重估真实差距;其三,按 Zhou et al. (2026) 的路线用真人替换或校准 persona 智能体,优先覆盖老年、非母语、低数字素养等群体,检验模拟与真人的满意度差距;其四,把协议移植到桌面与移动操作系统环境,覆盖文件管理、邮件客户端、代码工作流;其五,研究主动澄清策略——何时问、问什么、问几次,当前每 episode 限 5 次的预算下如何最大化命中率;其六,结合方言与跨文化差异,检验模拟用户对特定说话人群体的公平性;其七,在长程多任务会话中研究用户约束的遗忘与漂移。
复现评估
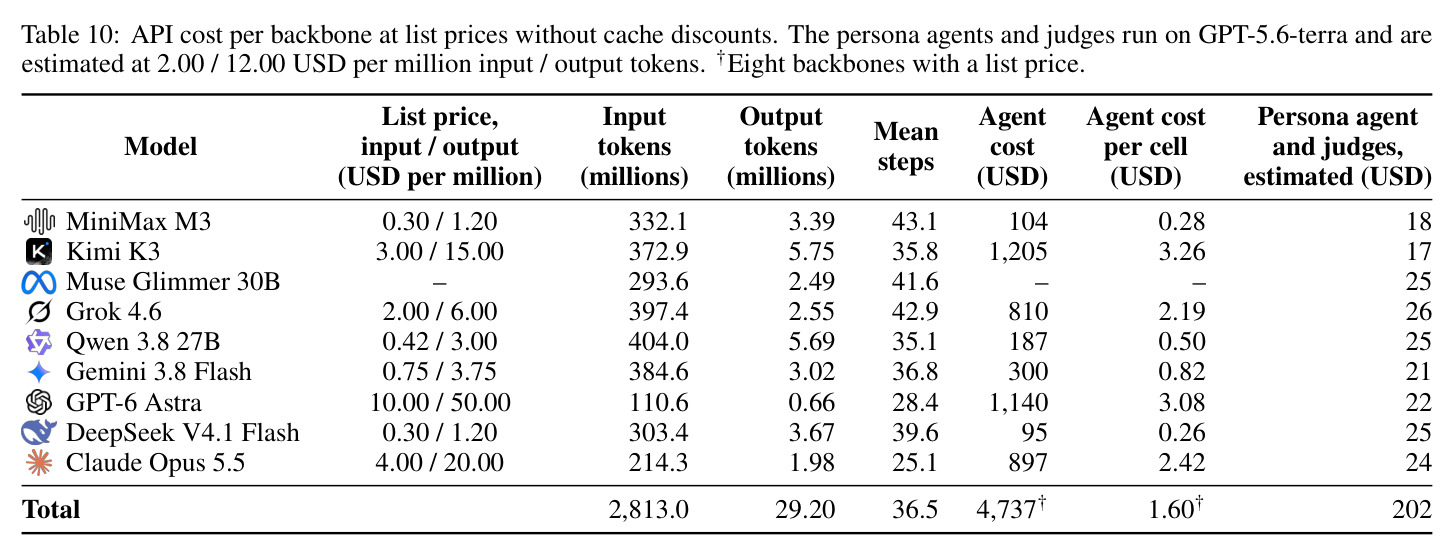
复现条件较好但有门槛。代码开源(github.com/MatrAIx-ai/PersonaCUABench),附录公开了 harness、提示词、成本与人工校验细节;任务来自公开的 Odysseys 与 REAL 基准,动作任务在真实网站的沙箱复刻上运行、避免真实交易,MatrAIx 画像模式也有公开论文。主要成本在于需要 9 个商业/开源骨干的 API(含 GPT-6 Astra、Gemini 3.8 Flash、DeepSeek V4.1 Flash 等)加上 GPT-5.6-terra 的评审与 persona 调用;3,330 次完整浏览器 episode、每次至多 100 轮、每 rollout 记录 token 与 API 费用,总开销可观,附录成本表可作预算参考。难点有三:活网站信息任务的非确定性(页面改版、反爬)会影响可复现性,需按作者标准筛选任务;LLM 评审与 persona 角色扮演有随机性,温度固定 1.0,建议多 seed 重复以估计方差;沙箱复刻站点的部署与状态检查需要工程量。总体属于中等偏难、依赖 API 预算的复现,最适合有浏览器自动化基础设施的团队。
论文图表