SearchHorizonBench:面向 AI 智能体搜索价值的基准 SearchHorizonBench: A Benchmark for Search Value in AI Agents
以成对延续和重复执行量化“再搜一次值不值”,并连接预测质量与决策效用
前置知识
Brier 分数
Brier 分数衡量概率预测与二值结果的均方误差:$\text{Brier} = \frac{1}{n}\sum_i (q_i - y_i)^2$,其中 $q_i$ 是预测成功概率、$y_i \in \{0,1\}$ 是实际结果,数值越低预测越准。它是本文评测“预测某动作下是否答对”的主要指标,也是把误差分解成难度层与增益层这一核心技术的载体。
论文三大评测目标(动作成功率、增益、决策效用)都以 Brier 类平方损失为基础,所有关键数字(如 Brier 从 0.2145 降到 0.1797)都是 Brier 分数。
预期搜索增益 $\Delta(x)$
在同一公开历史 $x$ 下,设直接作答(THINK)与先检索再作答(SEARCH)的真实成功率为 $p_T(x)=E[Y_T|x]$、$p_S(x)=E[Y_S|x]$,则增益 $\Delta(x)=p_S(x)-p_T(x)$ 表示“再搜一次”带来的期望成功率提升。它不同于题目难度(由水平 $\ell=(p_T+p_S)/2$ 刻画),才是搜索决策真正需要估计的量。
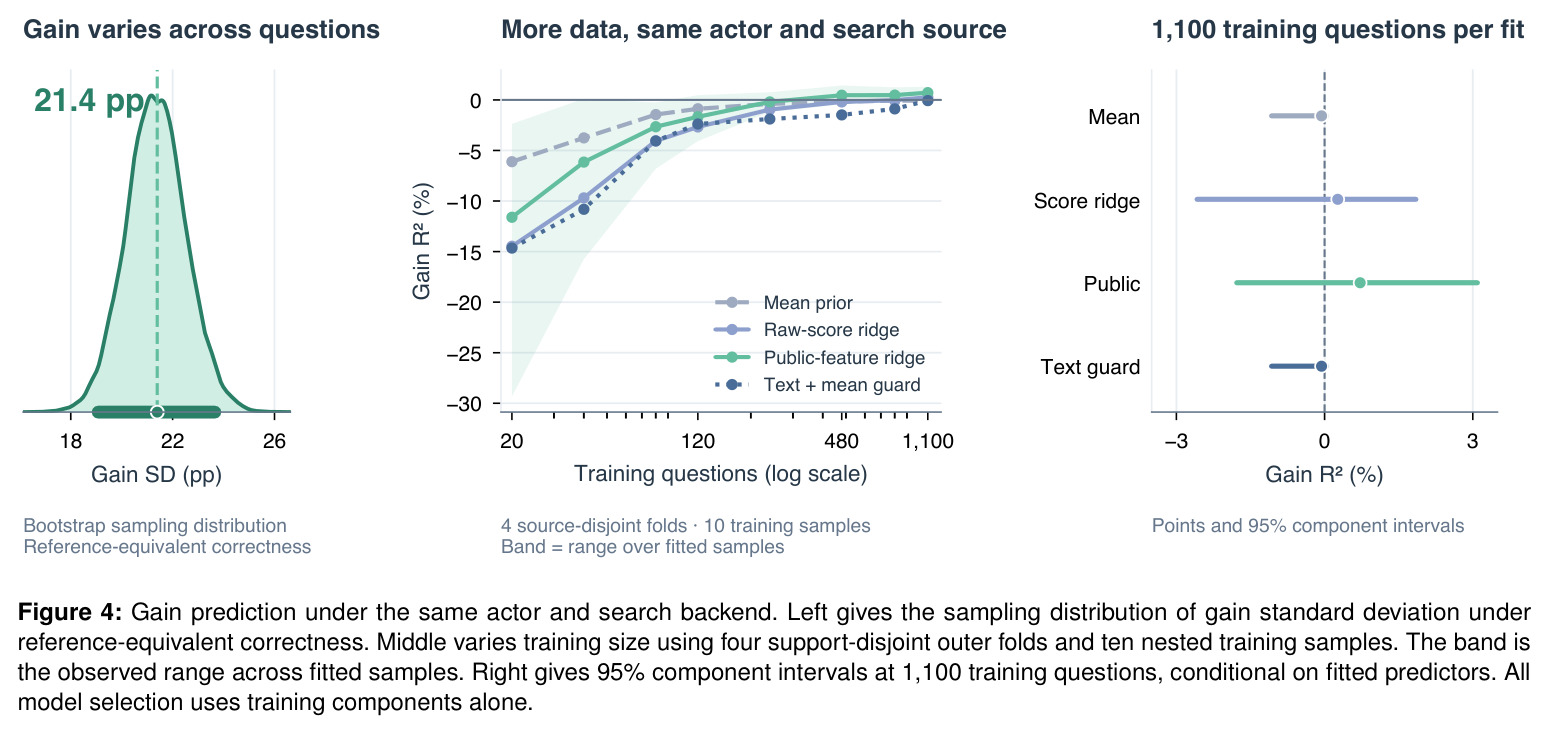
整篇论文的核心就是把 $\Delta(x)$ 从生成噪声中干净地估计出来,并评估预测它的能力;增益标准差 21.4 个百分点、$R^2$ 不足 2% 等结论都围绕它。
成对反事实延续
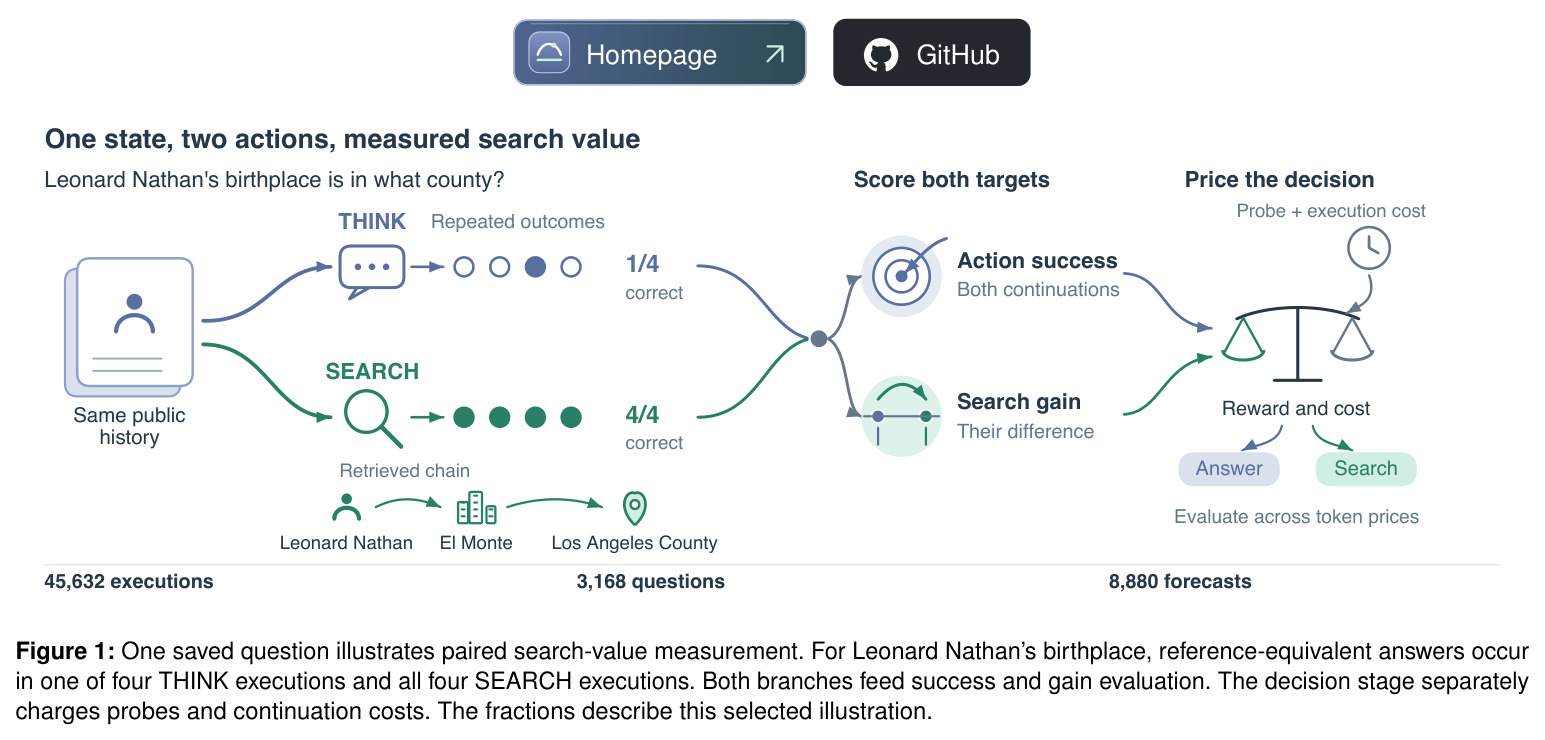
在合法动作边界保存检查点后,从完全相同的公开历史出发分别真实执行 THINK 与 SEARCH 两条延续,使两条分支共享同一份已缓存检索证据。这样能做反事实比较:同一条题、同一个状态,唯一差异是“搜还是不搜”,从而把搜索的贡献与历史本身蕴含的难度分离开。
这是该基准区别于普通 QA 评测的根本设计,所有增益测量与决策效用评估都建立在这种成对结构上。
重复执行与 U-统计量
LLM 生成有随机性,单次执行测得的增益混有噪声。本文每条分支独立重复 4 次,用 U-统计量 $\hat{\theta}_x$(基于独立结果对的乘积项,如 $\sum_{i\neq j} Y_{S_i}Y_{S_j}/(m_S(m_S-1))$)无偏估计 $E[\Delta(x)^2]$;配对比较两个预测器时共享的结果方差 $V_x$ 精确抵消,从而把期望增益误差与生成噪声分开。
不理解这种噪声修正机制,就无法读懂“增益标准差 21.4 个百分点”与“已测估计器解释不足 2% 方差”这两个核心结论的含义。
Brier 三项分解
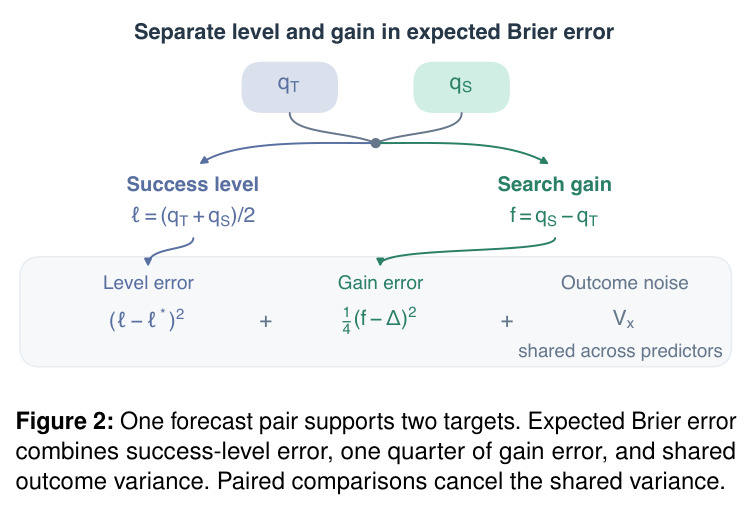
论文证明平均二值 Brier 误差可精确分解为 $E[\text{Brier}|x] = (\ell - \ell^*)^2 + \frac{1}{4}(f-\Delta)^2 + V_x$,其中 $\ell=(q_T+q_S)/2$ 是成功水平、$f=q_S-q_T$ 是预测增益、$V_x$ 是固定延续的二值结果方差。两个预测器做配对差分时 $V_x$ 相消,改进可完全归因到水平信息与四分之一增益信息。
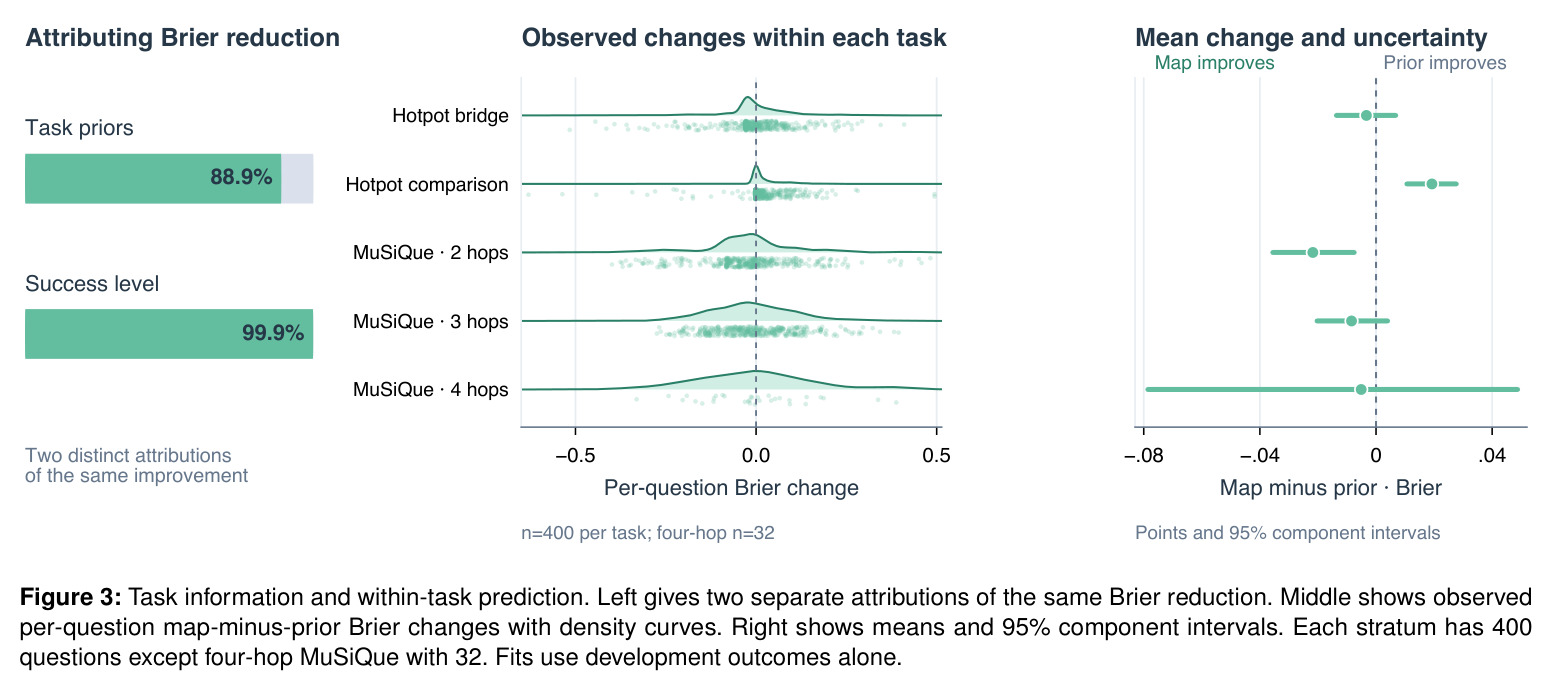
论文据此得出“校准改进的 99.9% 来自成功水平、增益项仅贡献 −0.000037”这一关键归因结论。
决策效用与 token 定价
路由效用定义为 $U = Y - \lambda T/1000$,$T$ 是 actor 与预测的总 token 数,$\lambda$ 为每千 token 价格(评测 $\{0, 0.001, 0.005, 0.01, 0.02\}$,焦点价 0.005)。换算规则 $\lambda = c/v$:每百万 token 成本除以每多答对一题的价值,如 1 美元/百万 token、0.2 美元/题时 $\lambda=0.005$。
决策效用把预测质量落到“省钱还是提分”的实际权衡上;2.49 个百分点机会、两探针一致性 −1.25 分等结论都依赖该定价框架。
研究动机
网络搜索智能体在实践中大量迭代改写查询,每多一次搜索既可能补上缺失的实体或关系,也消耗真金白银。论文用 Test-400 量化了这个两难:允许搜索使参考等价答案成功率从 69.38% 升到 73.56%(约 +4.2 个百分点),但平均 actor token 从 1,069 暴涨到 6,829,约 6.4 倍。现有评测只度量“最终答对没答对”,即题目难度,回答不了“对这条题再搜一次值不值”。Self-RAG、FLARE、DRAGIN、Adaptive-RAG 等自适应检索方法靠置信度、熵等启发式触发检索,Stop-RAG、HALT、TASR、Agentic Abstention 研究停止时机,SearchJev 给合法搜索决策打分,但都缺少对“未来动作价值”的前瞻性测量;而单次执行的评测会把搜索的真实增益与 LLM 生成噪声混在一起,测出的边际价值本身不可信。
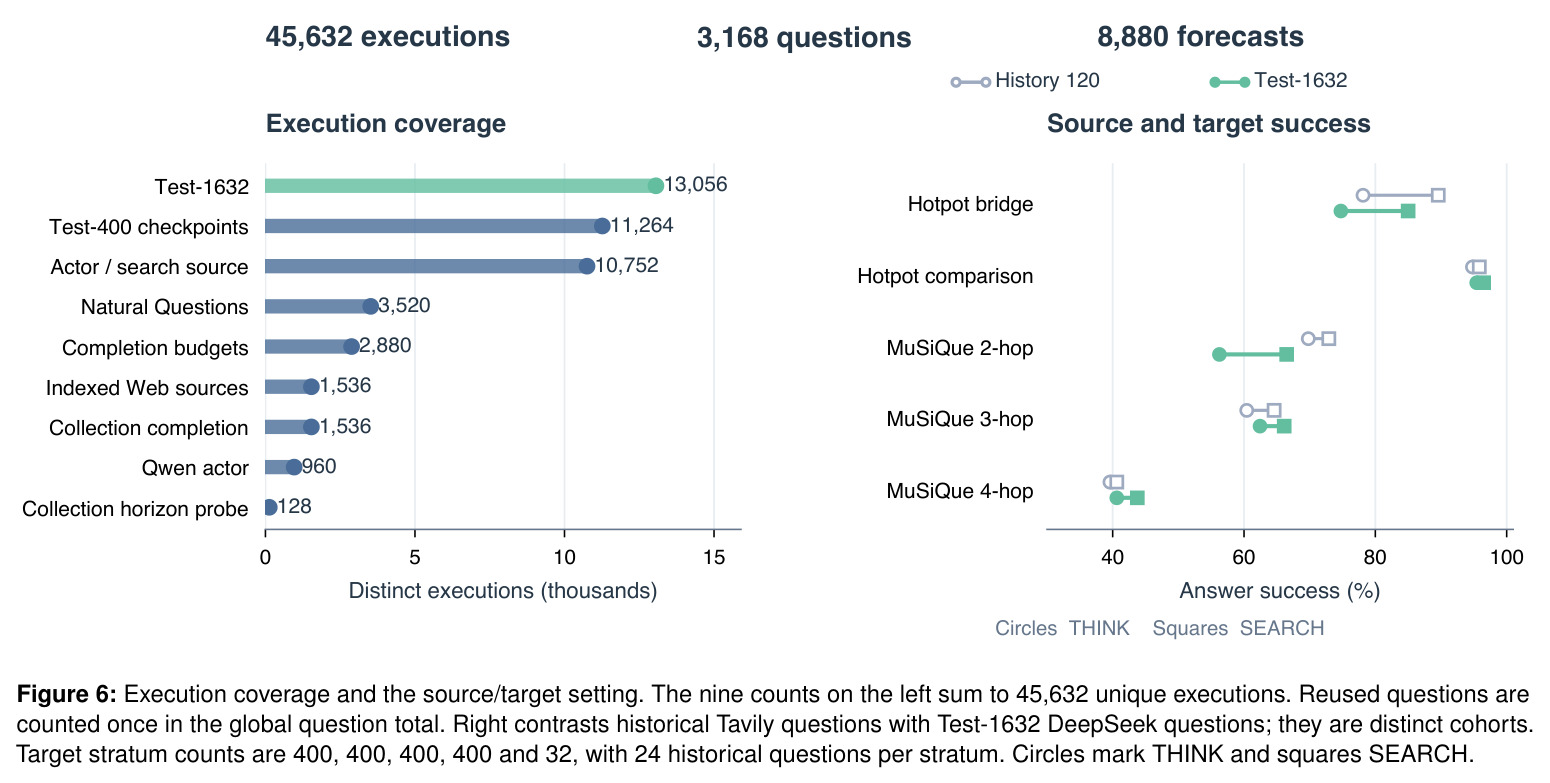
本文的目标是本文要构建一个专门学习和评测“搜索价值”的基准。它把搜索价值定义为同一公开历史下“继续搜索”与“直接作答”两条延续的期望奖励差 $\Delta(x) = p_S(x) - p_T(x)$;通过成对延续与每分支 4 次重复执行,把期望搜索增益与生成噪声分开;把预测质量(Brier 误差、增益 $R^2$)与决策效用(所选动作奖励减去获取信息的代价)直接连接起来;并配套可复用的历史、冻结的数据划分、强历史基线与打分工具,让价值感知搜索智能体的研究有共同基础。资源最终包含 45,632 次执行、3,168 道题、8,880 条预测,覆盖多个 actor、检索后端、预算与奖励形式。
与已有工作不同的是,独特切入角度有三点。第一,原生成对执行:每个保存的状态都同时支持 THINK 与 SEARCH 两条真实延续,反事实比较不是事后模拟,且用精确查询与检索参数缓存响应,保证重复执行共享同一份证据。第二,用重复结果修正生成噪声:借助处理效应估计中的 U-统计量无偏估计 $E[\Delta(x)^2]$,配对比较精确抵消共享方差 $V_x$,这是以往单次执行评测做不到的。第三,把“决策所需信息”做成可独立操控的因子:2×2 因子实验分别变化查询特定的增益信息与代价信息,把两种信息的价值分开定价;同时要求任何决策信号先偿付自身探针成本(如两探针一致性的 2,210 token),把信息获取成本纳入评价本身。
核心方法
直觉上,判断“再搜一次值不值”最干净的办法,是同一条题在完全相同的状态下把“搜”与“不搜”都真实跑一遍再比较。技术上,状态 $x$ 是完整公开交互历史,检查点是合法动作边界上的保存状态;在每个检查点,主 actor(deepseek-flash,开启推理、8,192 token 补全预算、最多三次额外搜索)可执行 THINK(用现有证据作答)或 SEARCH(先检索再作答),两条分支从同一历史出发,缓存机制让重复执行共享相同证据。预测器接收公开历史、actor 身份、工具与延续指令,在见结果前输出成功概率 $q_T$、$q_S$。围绕它们定义三层测量:动作成功预测(各延续下是否答对)、增益预测($q_S - q_T$ 的误差)、决策效用(奖励减去信息获取代价)。数据涵盖 Test-400(120 开发 + 400 测试)、Test-1632(1,632 道经参考支持筛选的测试题)、组件研究(Flash/Pro × STOP/DeepSeek/Serper,10,752 次执行)、ClueWeb22 与 FineWeb 索引源、DeepSearchQA 集合补全及 Qwen3-4B 跨族控制,合计 45,632 次执行。
核心创新是把一次预测拆成两个可分别评测的目标,并精确分解其误差。对答案正确性 $Y_a \in \{0,1\}$,预测目标为 $p_a(x)=E[Y_a|x]$ 与增益 $\Delta(x)=p_S(x)-p_T(x)$。关键定理是 Brier 分解:$E[\text{Brier}|x] = (\ell-\ell^*)^2 + \frac{1}{4}(f-\Delta)^2 + V_x$,其中 $\ell=(q_T+q_S)/2$ 是成功水平、$f=q_S-q_T$ 是预测增益、$V_x$ 是共享结果方差;两个预测器配对差分时 $V_x$ 精确抵消,Brier 改进可完全归因到水平信息与四分之一增益信息。与已有方法的本质区别:Self-RAG/FLARE 等只在运行时用启发式决定是否检索,缺少对齐的执行数据;本基准用 U-统计量(条件期望为 $\Delta(x)^2$)构造无偏增益风险 $\hat{L}_x(f) = f_x^2 - 2f_x(\bar{Y}_S - \bar{Y}_T) + \hat{\theta}_x$,再以 $R^2_\Delta = 1 - \hat{L}/\hat{V}_\Delta$ 衡量解释增益方差的能力。
方法步骤详情
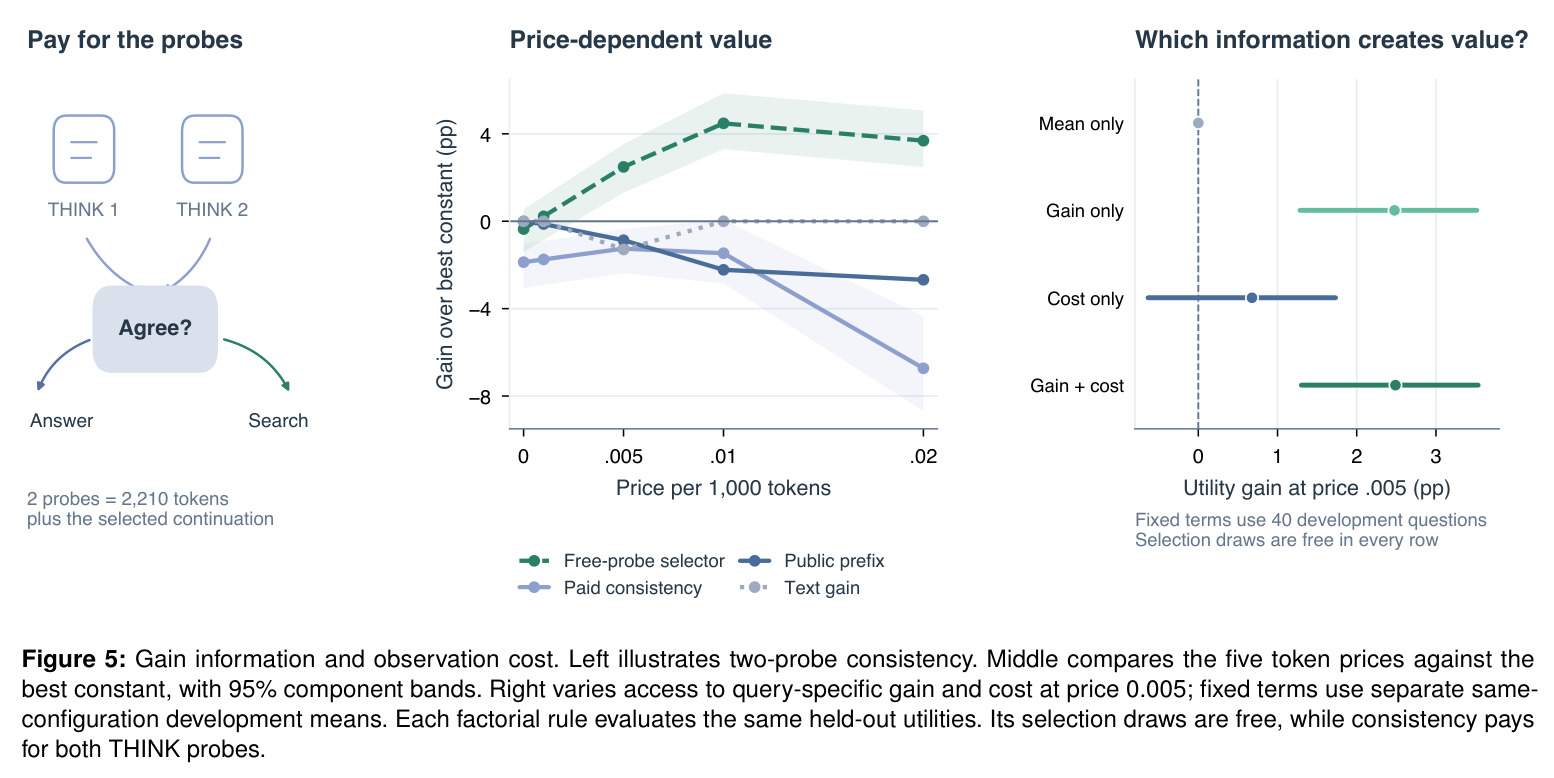
流程六步。第一步,题目筛选:8,000 个候选经 Flash 盲解与双评审支持性审查后 2,325 题获支持,四跳仅 32 题全部入选,构成 Test-1632 五个等权任务层。第二步,保存检查点:初始状态及第一、二次搜索后的状态,缓存精确查询与检索响应。第三步,执行与评分:每分支独立重复 4 次,主配置为 Flash + DeepSeek 搜索 + 8,192 token + 最多 3 次搜索;正确性按冻结参考答案的参考等价规则打分,无效输出计零分。第四步,预测:输出 $(q_T, q_S)$,格式损坏取 (0.5, 0.5)。第五步,校准:在 120 道开发题上拟合仿射修正 $\hat{e}_p(x)=\text{clip}_{[0,1]}\{b+z(q(x))B\}$,岭惩罚由开发折选择,测试期冻结;另设历史均值、任务先验、公共前缀岭等控制。第六步,评估:U-统计量算增益风险与 $R^2_\Delta$;效用 $U=Y-\lambda T/1000$ 在五个价格下评测;因子实验交叉增益与代价信息;两探针一致性在两个 THINK 答案一致时选 THINK,并支付 2,210 token。
技术新颖性
技术新颖性体现在四点。其一,测量对象创新:不测“答案对不对”而测“动作的边际价值”,把 $\Delta(x)$ 确立为独立的基准目标——数据显示其标准差高达 21.4 个百分点,而已测历史估计器只能解释不足 2% 的方差,证明这是真实且未解决的学习问题。其二,统计工具创新:把处理效应估计的 U-统计量与配对差分引入智能体评测,精确抵消 $V_x$,把增益误差从生成噪声中分离,式(5)对固定预测是无偏的。其三,归因方法创新:同一 Brier 改进可做两种独立归因(任务先验解释 88.9%、成功水平解释 99.9%),配合分层证据(如 MuSiQue 2 跳上映射 0.2239 对先验 0.2457)区分题目级规律与题内预测信息。其四,评价哲学创新:信号必须自付获取成本——两探针一致性节省 3,451 token 但探针花费 2,210、成功率损失 1.87 点,净效用为负;“把信息获取计入评价”的设计在检索决策基准中是新的。
实验结果
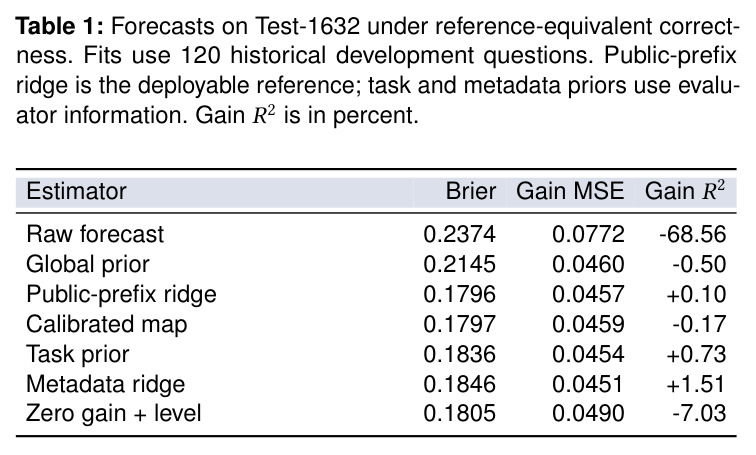
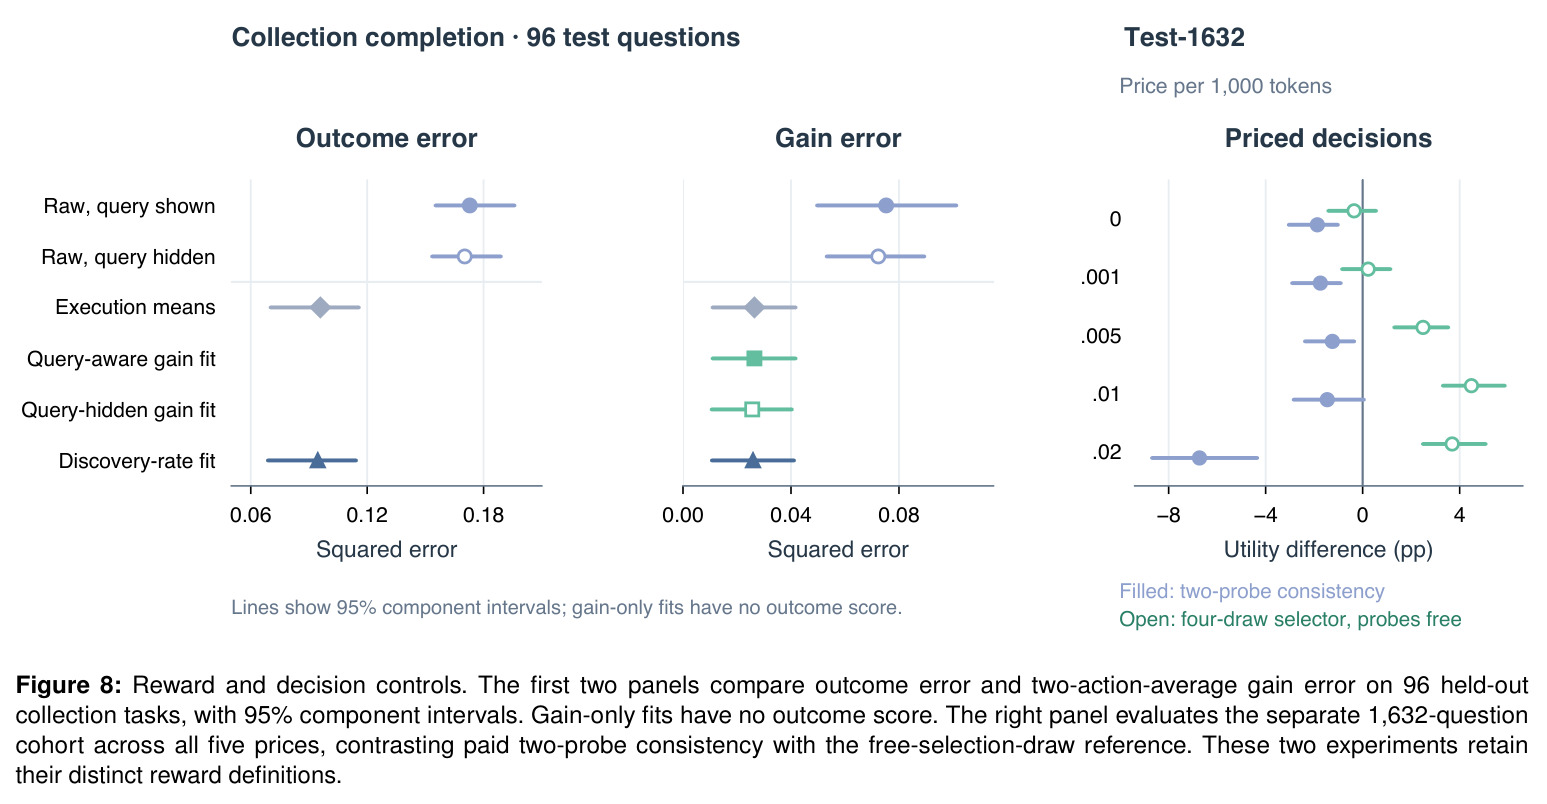
(1)校准捕获任务结构:Test-1632 上冻结映射把 Brier 从全局均值 0.2145 降到 0.1797,改进 16.2%,任务层均值 0.1836 解释该改进的 88.9%;公共前缀岭 0.1796;精确分解显示成功水平误差占总改进的 99.9%,增益项仅 −0.000037。(2)增益变化大但难预测:增益标准差 21.4 个百分点;历史映射增益 $R^2$ 仅 −0.17%,公共前缀岭 +0.10%,均不足 2%。(3)更多数据学不会:同配置曲线(20–1,100 题)上公共特征岭从 −1.67% 升到 +0.72%,文本守卫模型退回均值。(4)效用主要来自增益信息:$\lambda=0.005$ 时免费选择观测相对最优常量 +2.49 分;只加增益信息 +2.48,只加代价信息 +0.68。两探针一致性一致率 65.0%,净省 1,241 token 但成功率损失 1.87 点。跨设置:索引源 Brier 0.1417/0.1498 对历史均值 0.1982/0.1981;搜索上限 3→6 使 8k 预算长度失败 +2.5 点、16k 可消除;集合补全三次搜索对一次的 F1 差 −0.0386。审计:812 条答案双面板一致率 95.4%、$\kappa=0.918$。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Test-1632 成功校准(五任务层等权) | Brier 分数 | 校准映射 0.1797(公共前缀岭 0.1796) | 全局先验 0.2145(原始预测 0.2374) | 相对全局先验降低 16.2%,配对区间 [−0.0530, −0.0169] |
| Test-1632 增益预测 | 增益 $R^2$(生成噪声修正) | 公共前缀岭 +0.10%,历史映射 −0.17% | 全局先验 −0.50% | 所有已测估计器解释不足 2% 方差,接近无技能 |
| 增益变化量刻画(Test-1632) | 增益标准差 | 21.4 个百分点(方差 0.05675,均值 0.0490) | — | 确立了困难的问题特定预测目标(区间 [0.0364, 0.0560]) |
| 同配置学习曲线(20→1,100 训练题) | 增益 $R^2$ | 公共特征岭 1,100 题时 +0.72% | 120 题时 −1.67%;常量增益参考 | +2.39 个百分点但仍在零附近,区间 [−1.78, 3.09]% |
| 决策效用(λ=0.005,免费选择观测) | 相对最优常量动作的效用点数 | 增益+代价信息 +2.49 分 | 最优常量动作(0 分) | 其中增益信息 +2.48、代价信息仅 +0.68 |
| 两探针一致性路由(λ=0.005) | 效用点数(含探针成本) | −1.25 分 [−2.38, −0.35] | 总是 SEARCH | 净省 1,241 token 但成功率损失 1.87 点,信号未覆盖自身成本 |
| 索引检索源(ClueWeb22 / FineWeb) | Brier 分数 | 0.1417 / 0.1498 | 历史均值 0.1982 / 0.1981 | 仿射 Brier 差 −0.0565 [−0.0872, −0.0271] / −0.0483 [−0.0703, −0.0274] |
| MuSiQue 2 跳题内预测 | Brier 分数 | 校准映射 0.2239 | 任务层均值 0.2457 | −0.0218(区间 [−0.0356, −0.0075]),题内信息仅在部分层有效 |
局限与改进
作者承认的局限:已测历史估计器对增益方差的解释力不足 2%,同配置学习曲线在 20–1,100 题上增益技能始终贴近常量参考,说明现有特征与模型族无法预测题级增益;两探针一致性等部署规则需偿付探针成本(2,210 token),在 $\lambda=0.005$ 下效用为负(−1.25 分);独立审计两个面板使用同一评审模型族,一致率只反映族内稳定性;后续检查点人口取决于能否到达该状态,重复题比较保留该依赖;四跳层仅 32 题,等权分析只能给点估计。我的补充观察:答案评分依赖固定 Flash 语义评审,参考等价、词形包含与精确匹配三种目标会给出符号相反的结论(−0.0173 对 +0.0113),说明结论对评分规则敏感;主结果全部建立在 deepseek-flash 生成的历史上,Pro 与 Qwen 只是条件迁移控制,对其他 actor 的普适性未知;token 定价集合(0–0.02)是人为选择,不同定价可能改变效用排序;任务类型局限于多跳 QA 加一个集合补全任务,未覆盖长程研究等场景;参考答案静态,无法处理时效性问题;Qwen 扩展仅 120 条预测,统计功效有限。
独立分析的弱点
独立分析的弱点:第一,增益预测几乎无技能($R^2 < 2\%$),意味着“何时该搜”这一核心问题在基准上尚无可用解法——基准成功暴露了问题却未提供高于弱基线的方法,改进方向是引入检索日志、实体覆盖度、问题—证据图结构等更强特征,或直接训练专用价值头而非线性岭回归。第二,16.2% 的 Brier 改进中 88.9% 来自任务层先验,本质上来自“知道这是几跳题”,题内信息贡献很小,可部署信号的信息上限可能很低。第三,两探针一致性亏损(−1.25 分)表明自一致性信号性价比为负,改进方向是共享前缀的批量采样(一次请求采多答)或用 logits 熵等廉价信号替代完整生成探针。第四,搜索上限从 3 提到 6 反而使长度失败增加 2.5 点,暴露 actor 在预算内分配能力的缺陷,可做预算感知的查询规划或证据提前压缩。第五,U-统计量要求每分支至少 4 次执行,采集昂贵(反向 Flash 同 actor 历史耗 1,590,189 token、组合式 4,712,303 token),论文已给出三对组合估计(式 7–9,2,560 个结果 vs 单对 1,024 个),可进一步研究更少执行数下的无偏性与成本—精度前沿。
未来方向
作者提出的方向:以学习曲线为共同尺度参考,评测更丰富的决策信号(更强的文本头、微调预测器);把信号获取成本纳入部署评价(政策评分器同时计预测与延续 token);扩展到更多奖励形式(集合 F1、索引源、跨模型族已内置)。基于成果可延伸的方向:用 45,632 次执行训练端到端价值模型或强化学习策略(类似 Search-R1 但以 $\Delta(x)$ 为奖励信号);研究跨 actor/后端的增益迁移与组合估计的成本—精度权衡;把增益 × 代价的因子实验推广到其他工具调用决策(代码执行、数据库查询、API 调用);动态定价下路由策略的理论分析(作者已给出 $\lambda = c/v$ 的换算与零价 oracle 上界 $H = (E|\Delta| - |E\Delta|)/2$,Test-1632 的代入区间为 [0, 0.0823]);以及用可验证奖励或更细评分准则替换参考等价评审,检验增益结论对评分目标的稳健性。
复现评估
复现评估:论文提供 Homepage 与 GitHub 链接,附录 A 说明完整发布公共预测记录(历史、actor 身份、动作定义)、评估记录(参考答案、观测奖励、支持组、资源计量)、完整预测矩阵、逐案判定、全部定价设置与机器可读清单,打分器与图表源码可复现所有报告对比。算力方面主体依赖 DeepSeek API(deepseek-flash 与 deepseek-v4-pro),Qwen3-4B 用本地 llama.cpp(Q4_K_M,固定 revision 与版本号)即可完成跨族控制;采集成本有明确账目:反向 Flash 同 actor 历史采集 1,590,189 token、组合式 4,712,303 token,另需 128/256 个缓存检索包及 Tavily、Serper、ClueWeb22 分片 0–3、FineWeb 7 分片等检索基础设施。总体难度中等:用发布数据训练预测器并提交打分较容易(划分冻结、基线齐全、开发折与惩罚网格都写明);从零重建执行库则需要 API 预算与工程量。注意 DeepSeek 请求不设 temperature/seed,采样行为按 2026-10-25 服务商文档记录,精确逐 token 复现受服务端行为影响。
论文图表
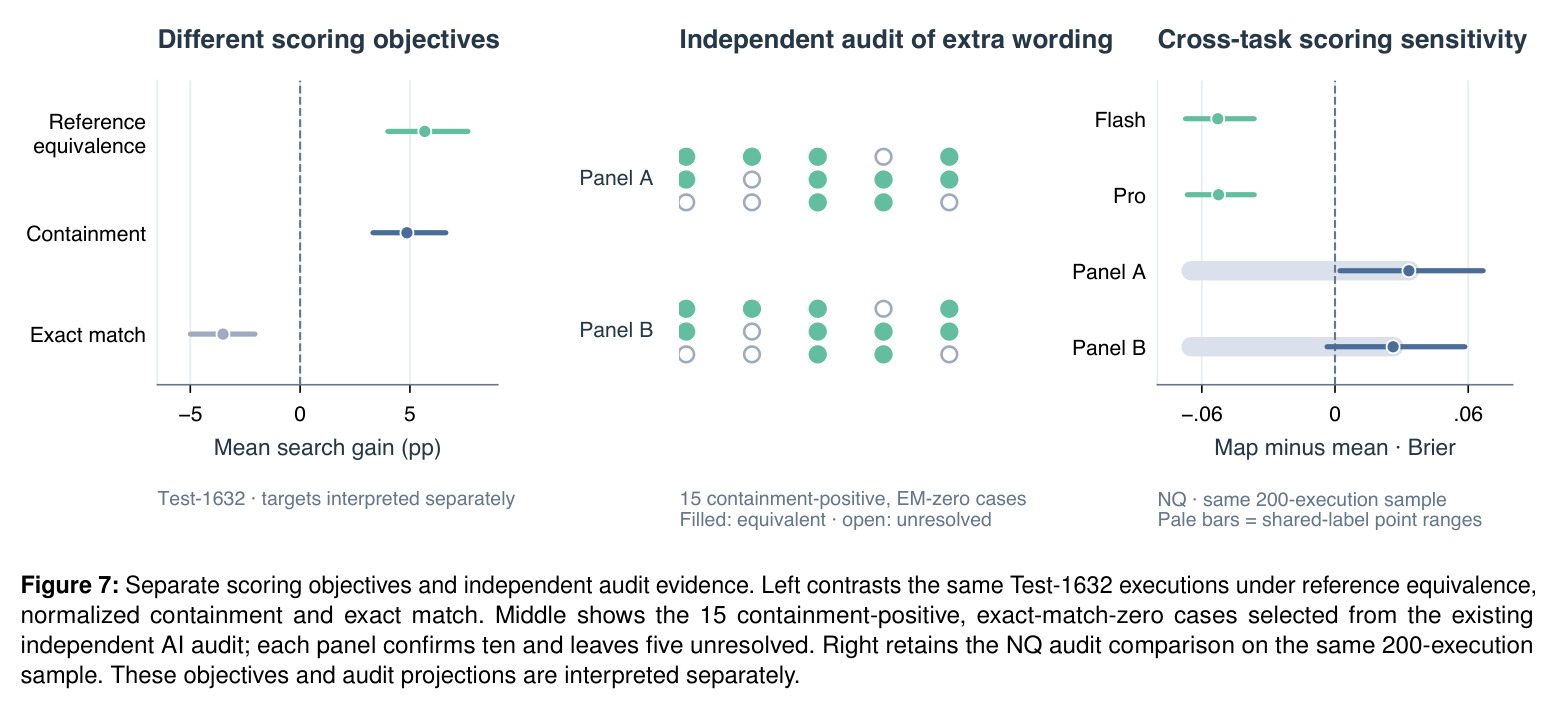
左图在参考等价、规范化包含、精确匹配三种评分目标下对比同一批 Test-1632 执行(参考等价下 actor 匹配的映射减均值增益对比为 −0.0173,精确匹配下为 +0.0113);中图为独立 AI 面板对 15 个包含为正、精确匹配为零案例的审查(每面板确认 10 个、5 个未决;两个面板评审 812 条答案的总体一致率 95.4%、$\kappa=0.918$);右图保留 NQ 在同一 200 执行样本上的审计对比。
说明评分目标的选择会改变增益结论的符号,独立审计支撑了语义评分的可信度,是评估结果稳健性的关键证据。