InteractiveWorld:面向交互式多模态助手的可验证以人为中心环境 InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants
首个可验证的人机闭环交互环境与基准:最强MLLM助手通过率仅41.7%,感知、记忆与通信是主要瓶颈
前置知识
MLLM(多模态大语言模型)
以大型语言模型为核心、能同时处理文本与图像输入的模型,如本文评测的 Claude Fable 5.1、GPT-5.6 Sol、Gemini 3.1 Pro 等 12 个前沿模型。它们把视觉 token 与语言 token 统一编码,可以对第一人称图像序列进行描述、问答、规划与对话。
本文的被评对象正是 MLLM:被测模型扮演助手,读取第一人称视频帧与对话历史并输出自然语言指导。理解 MLLM 的图像输入方式与轮次输出协议,是读懂整套评测设置的前提。
第一人称视角(Egocentric View)
摄像头戴在人头上、以佩戴者自我为中心的视角,画面随头部转动、身体移动和手部动作不断变化。Ego4D、EPIC-KITCHENS 等大规模数据集奠定了这一感知范式,穿戴设备上的 AI 助手正是以此方式看到用户所见。
InteractiveWorld 中助手没有自己的身体,只能通过人类头部相机观察世界,视野随人类动作实时改变,这是它与机器人中心仿真器(AI 直接输出机器人动作)的根本差异。
闭环 vs 开环评测
开环评测中模型对固定数据(如预录视频)一次性作答,输出不影响后续输入;闭环评测中模型输出会改变环境状态,环境再生成新观察反馈给模型,形成观察—决策—执行—反馈循环,考验持续跟踪、异常检测与动态重规划能力。
论文核心论点是现有基准几乎全为开环、测不出真实助手的闭环适应能力;InteractiveBench 的价值正在于闭环。理解二者区别才能读懂五大发现,尤其是长任务上性能骤降的现象。
SMPL+H 参数化人体模型
统计学习的参数化人体网格模型:输入形状系数与姿态参数(21 个身体关节加每只手 15 个关节的轴角向量 $q\in\mathbb{R}^{156}$),经前向运动学与线性混合蒙皮生成带手部的全身网格,相机可挂在头部得到第一人称视角。
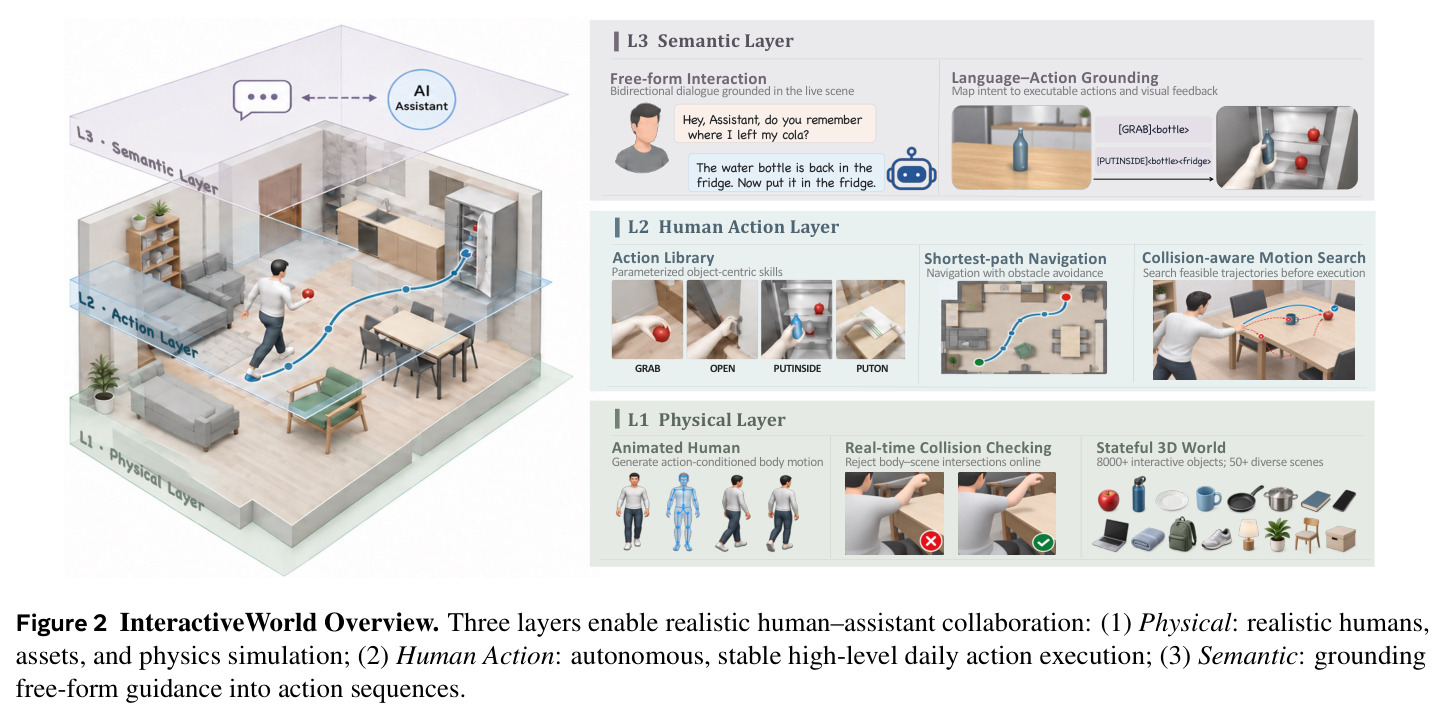
InteractiveWorld 用固定形状($\beta=0$)的 SMPL+H 男性模型充当人类,头部挂相机作为第一人称眼睛;运动学驱动保证动作确定、可复现、不会摔倒,这是整个平台可验证性的物理基础。
A* 寻路算法
在栅格地图上按 $f(n)=g(n)+h(n)$(已走代价加启发式估计)搜索最低代价路径的经典图搜索算法。本文在 0.10 m 栅格上做八连通 A*,代价函数额外加入净空惩罚项,引导路径远离障碍、避开窄道卡死。
人类 agent 收到 [Walk]<目标> 后的自主导航就由这套 A* 实现,是 Human Action Layer 保证无碰撞、可复现移动的关键组件,理解它才能明白人类执行为何可信。
基于状态的可验证奖励
不靠 LLM 裁判或答案匹配,而是直接查询模拟器中物体的真实物理关系来判定任务成败:支持 ON、INSIDE、HELD、OPEN、CLOSED、CUT、COOKED、UNMOVED 等 14 种谓词,只有全部核心状态满足才算成功,且开场已满足的谓词被基线排除,助手宣告完成也无法凭空制造成功。
这是 InteractiveBench 被称为可验证的原因,也是作者未来用它做强化学习训练的基础;读懂 Pass/MCR 与 C1–C9 能力评测点的计算方式,必须先理解这套状态校验机制。
研究动机
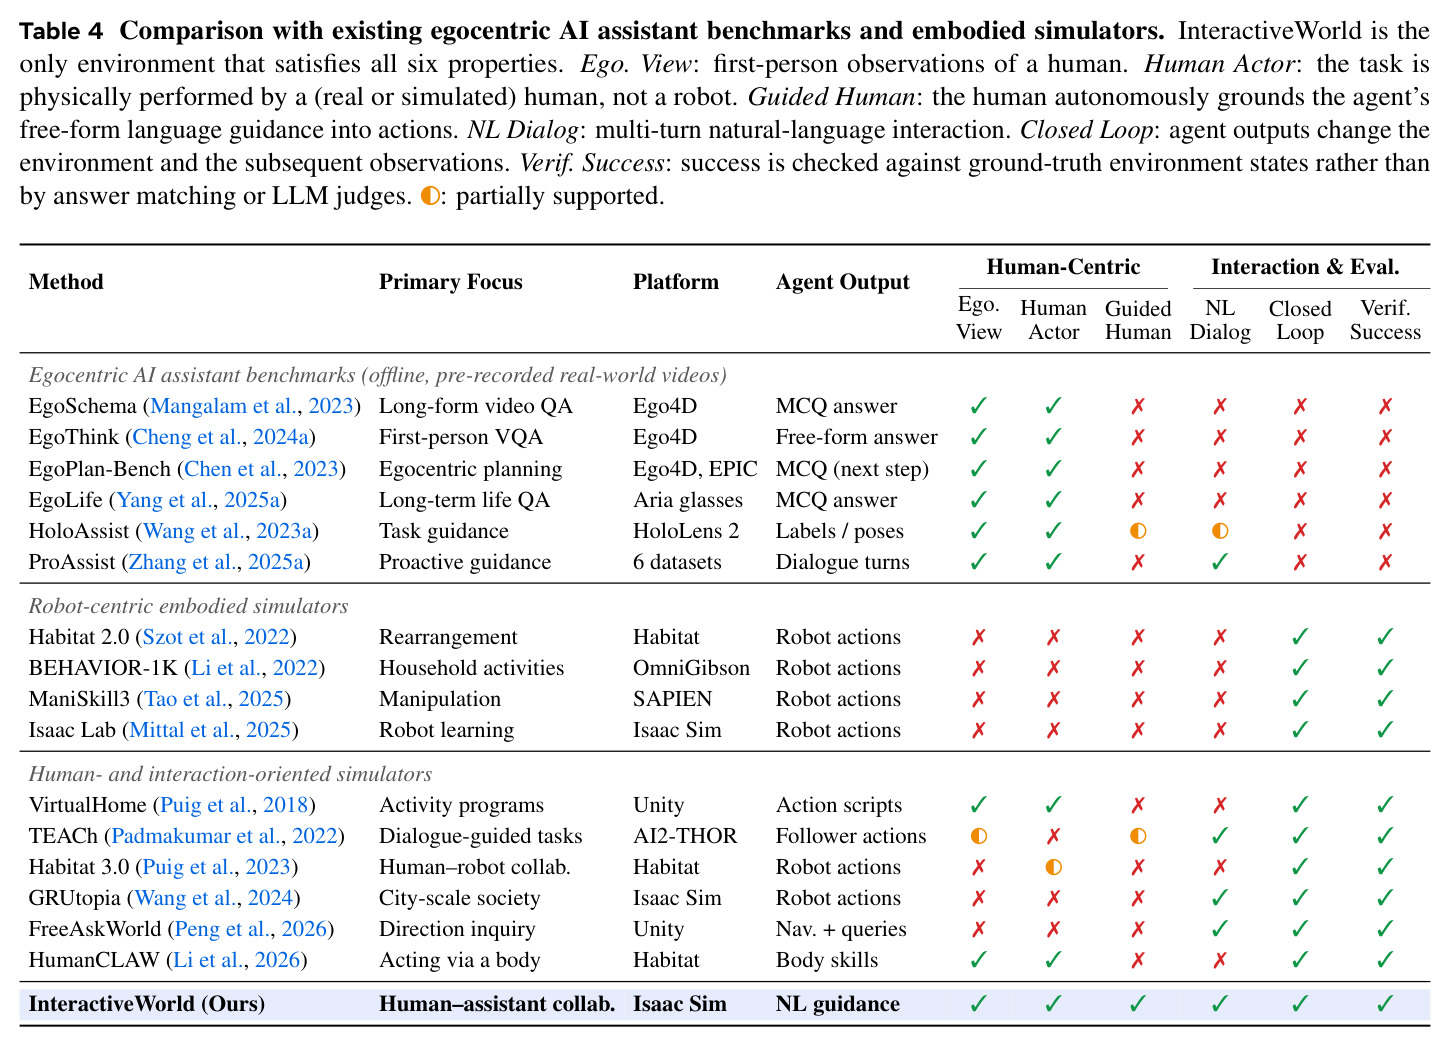
要让戴在头上的 AI 助手真正帮上忙,必须先能衡量它是否真的帮到人,而这恰恰缺位。真实用户实验昂贵且难以扩展、难以复现,少量参与者的研究(如 Verghese et al., 2025)已经证明离线指标与在线表现并不一致。现有基准几乎全是静态开环的:EgoSchema、HourVideo 测长视频问答,EgoThink/VidEgoThink 测第一人称推理,EgoPlan-Bench 测下一步规划,HoloAssist、ProAssist 测任务指导——无论模型说什么,预录视频都不会改变,因此无法考察闭环适应(自己的指导改变了场景后如何持续调整)与多技能组合(跟踪物体状态、记住事件、清晰表达的联合运用)。另一侧,机器人中心仿真器(Habitat 2.0、BEHAVIOR-1K、ManiSkill3、Isaac Lab)里被评模型直接输出机器人动作,人要么缺席要么只是布景;TEACh、CVDN 等对话任务中模型只当被指导者。于是那个关键问题始终没有答案:今天的 MLLM 到底能不能在物理世界中帮助人类?
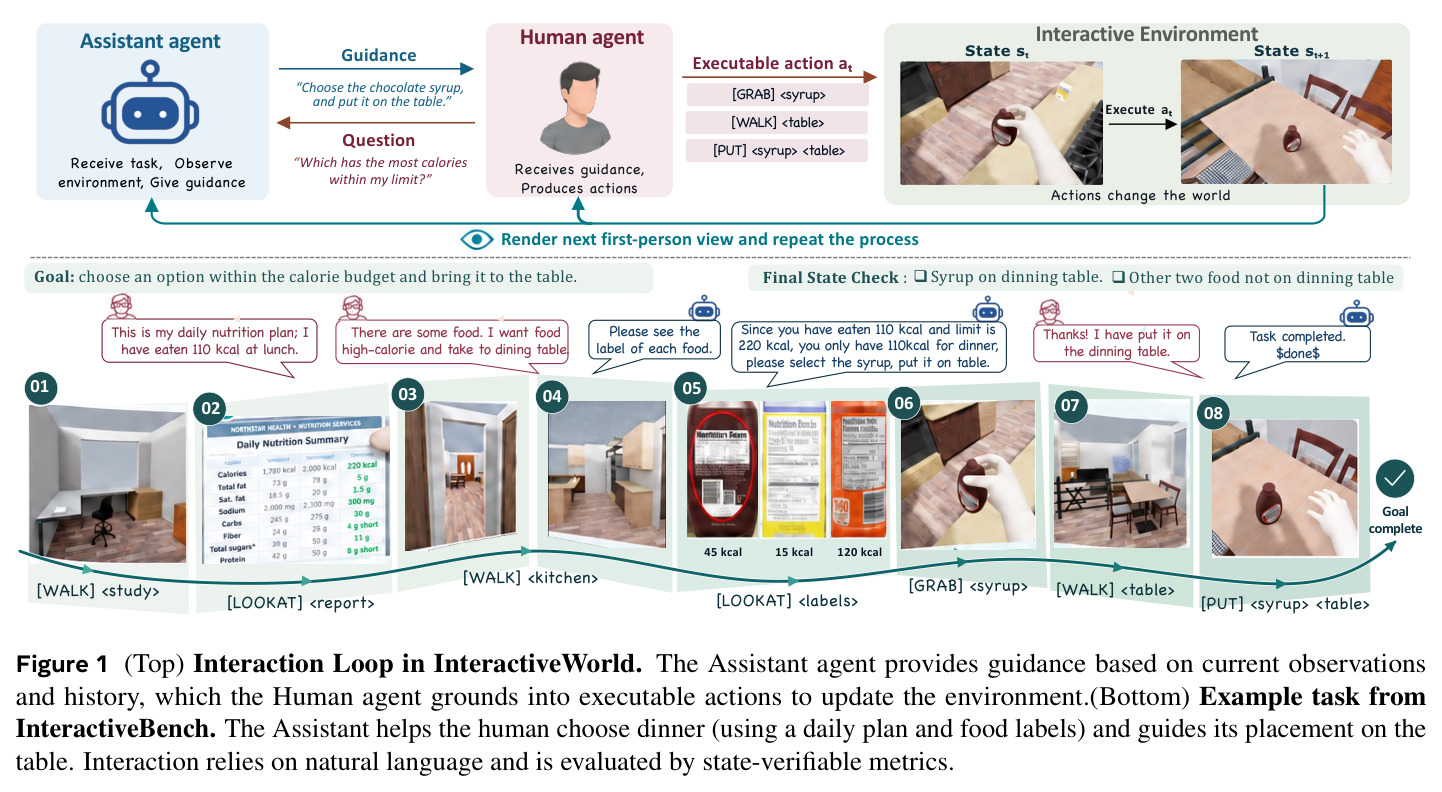
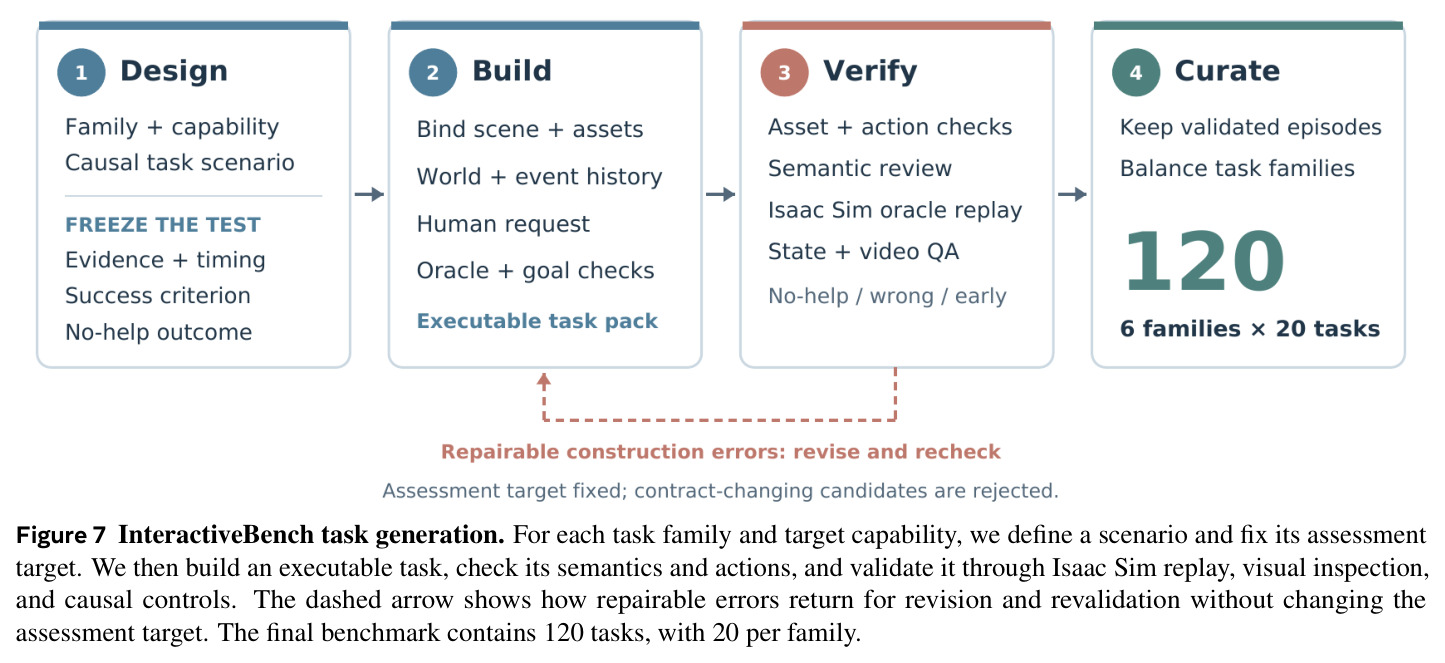
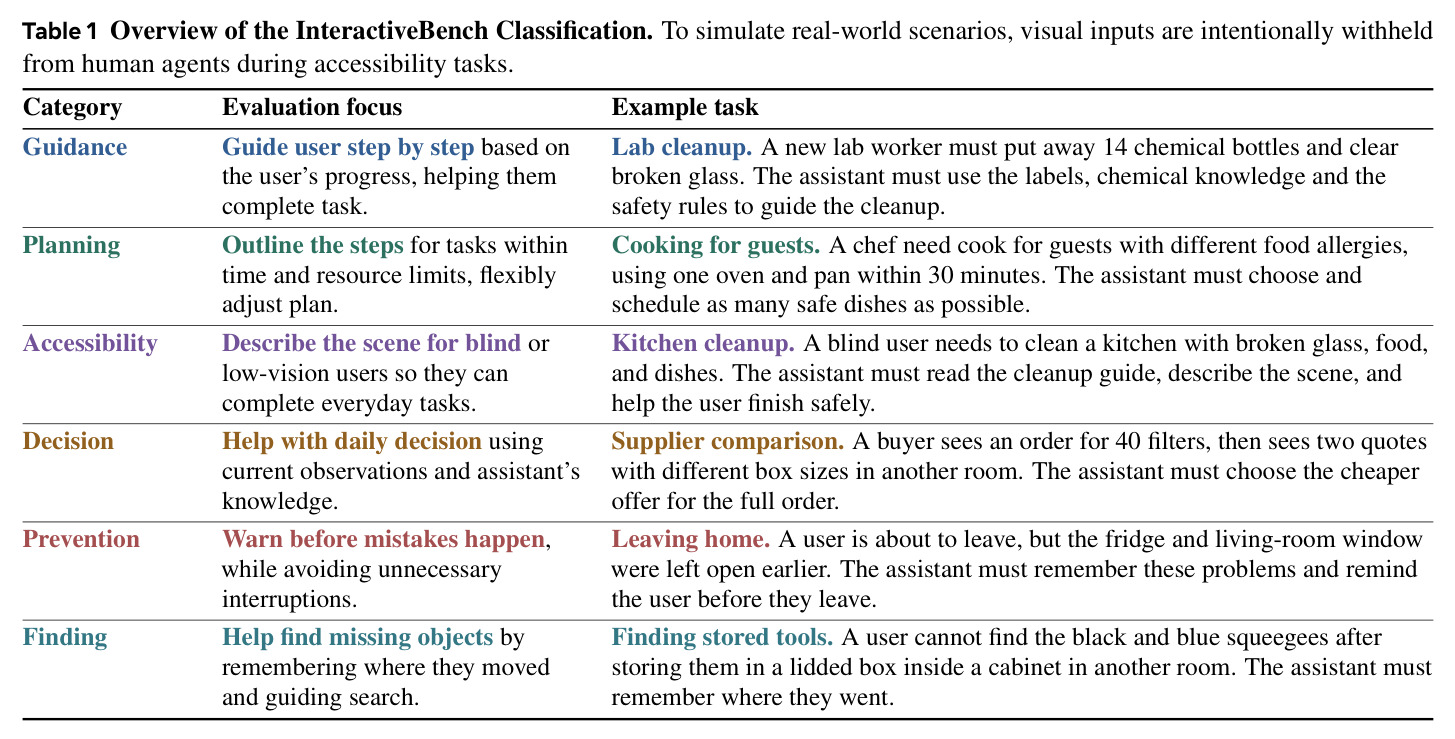
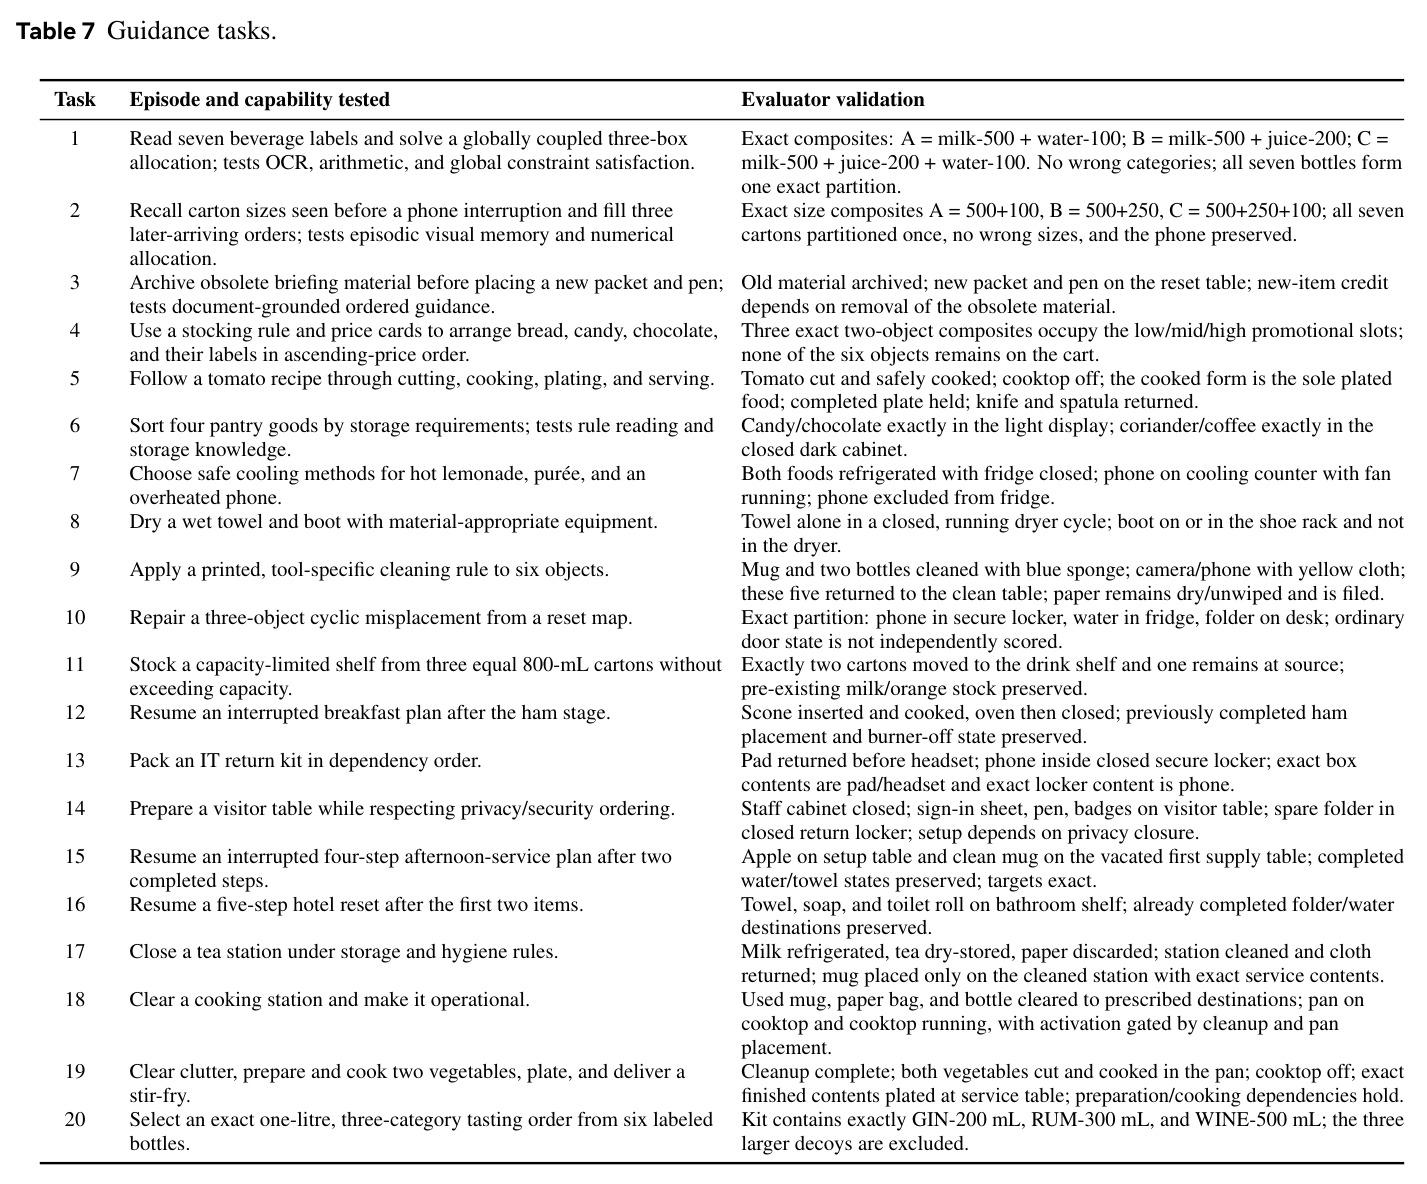
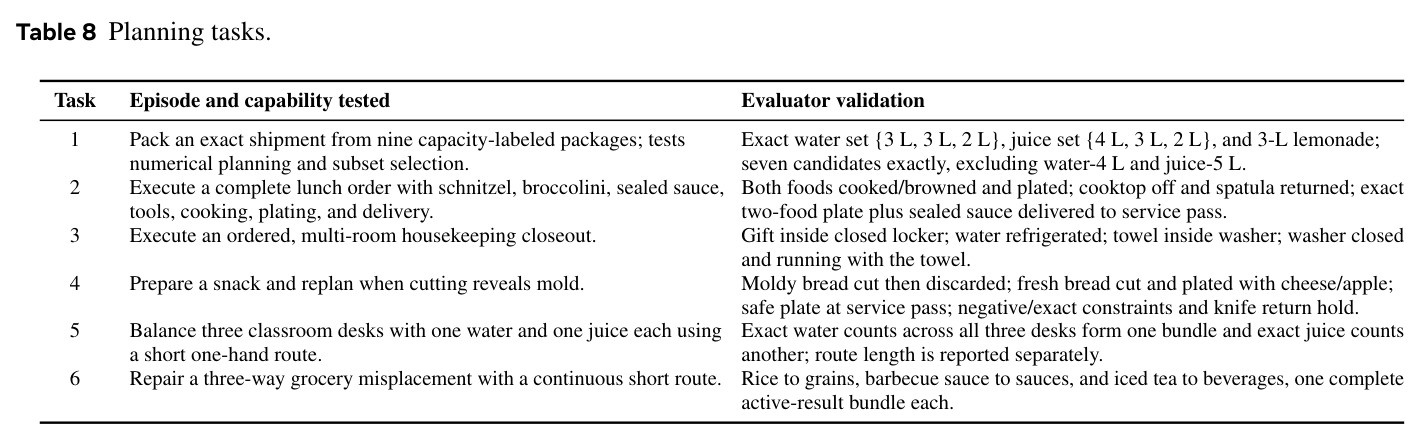
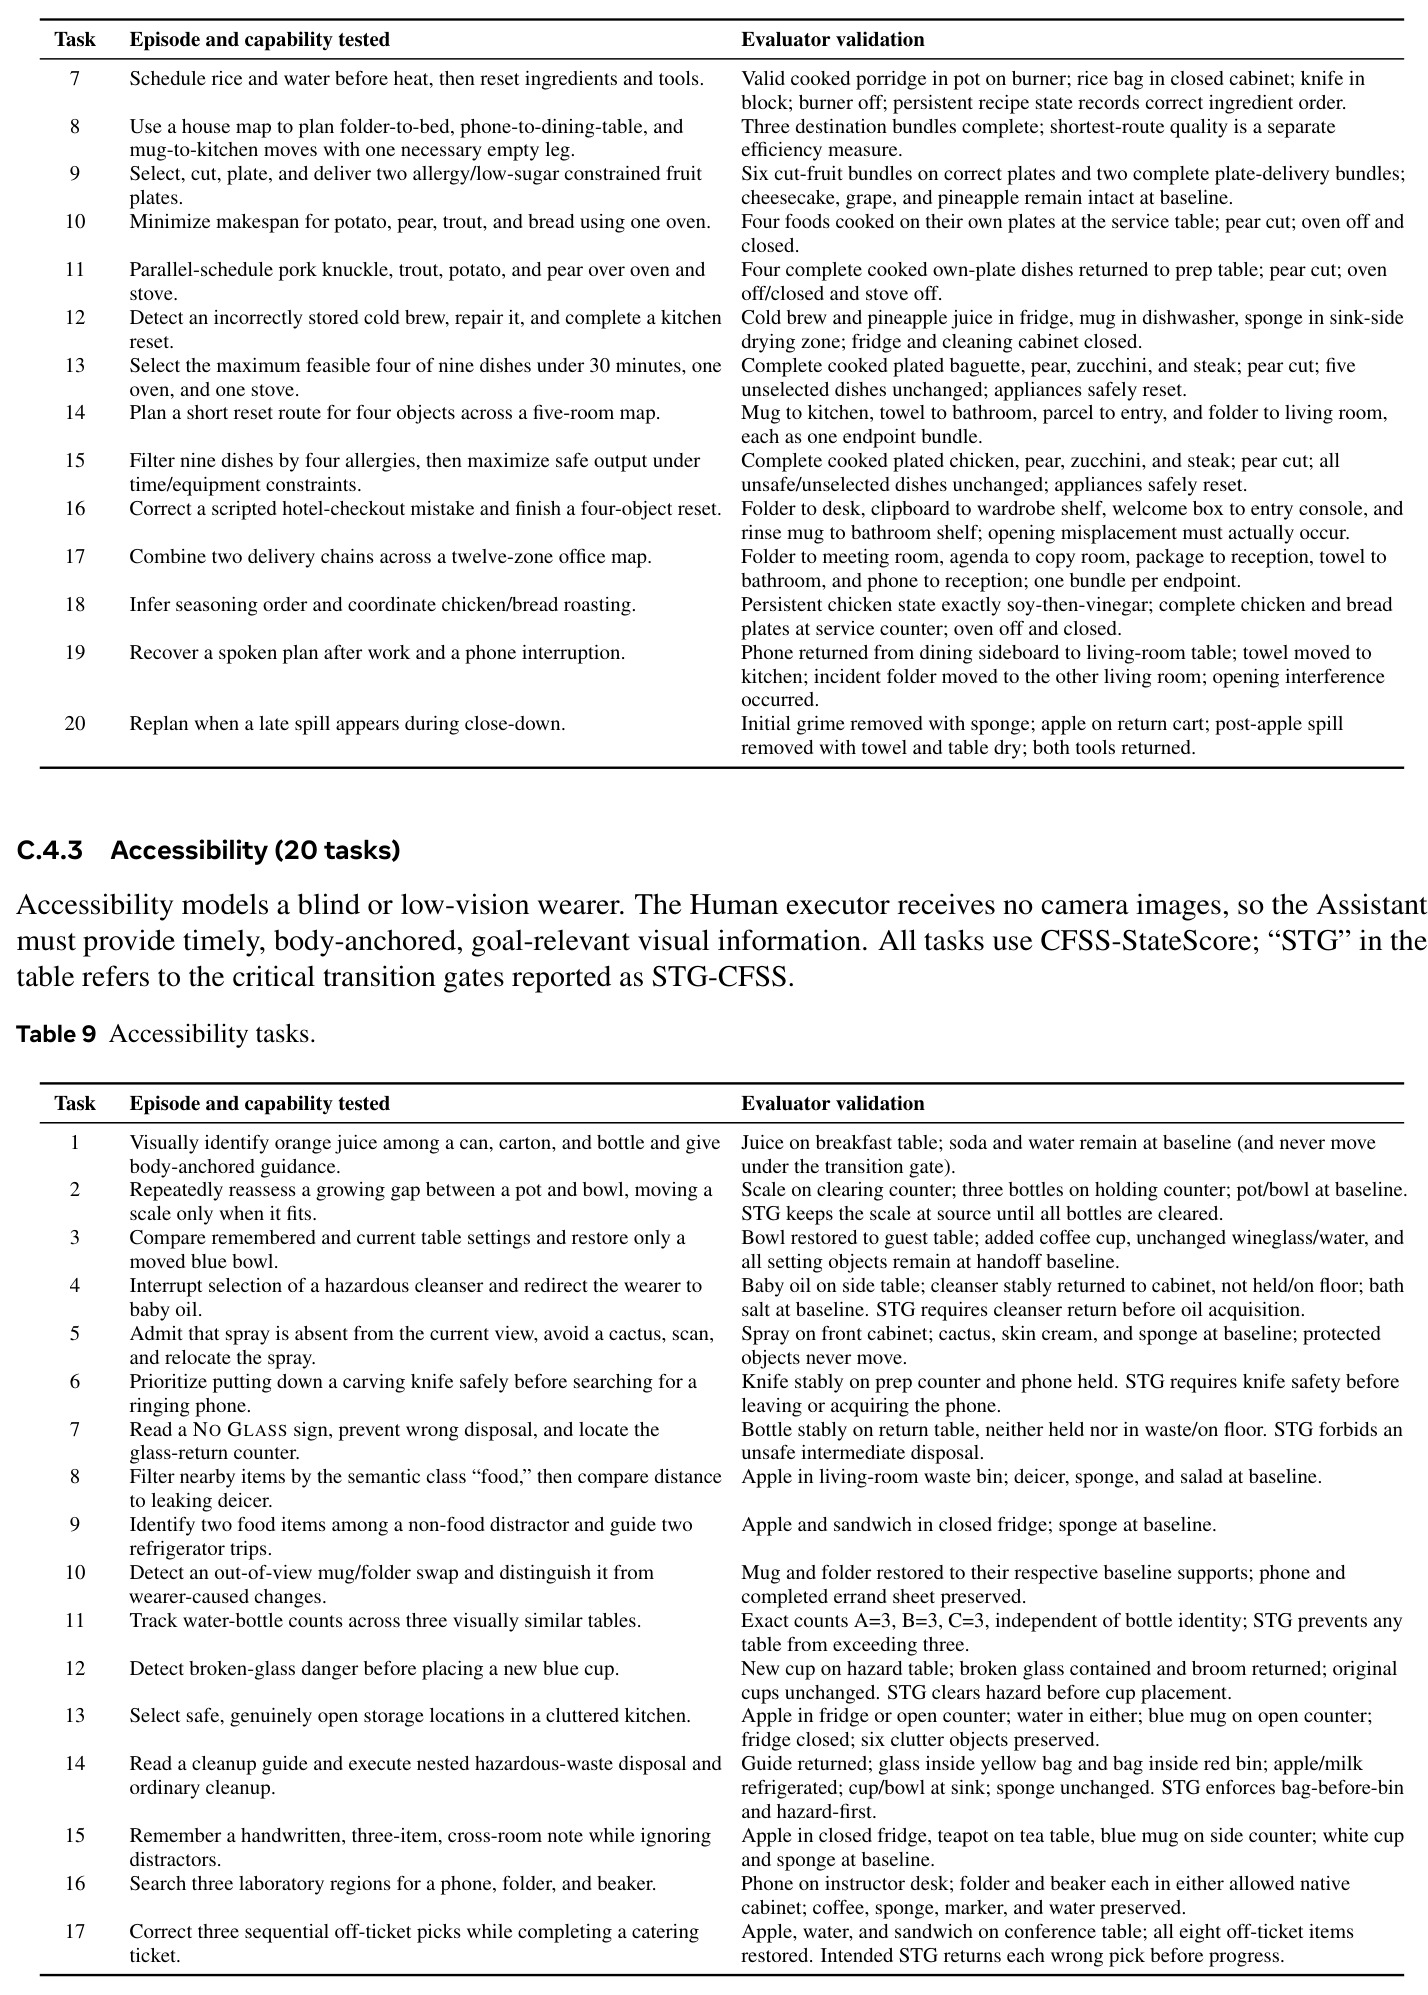
本文的目标是本文要为自我中心 AI 助手建立首个可验证的闭环评测体系,目标有三层。第一,构建 InteractiveWorld:建立在 NVIDIA Isaac Sim 上、以人为中心的交互环境,从 BEHAVIOR-1K 导入 8000+ 可交互物体与 50+ 场景,让助手通过自然语言指导一个能自主观察场景、理解指令、独立行动的人类 agent,复现助手说、人类做、环境变、再观察的真实协作。第二,构建 InteractiveBench:首个动态闭环基准,120 个经人工审查的多轮任务,按 Guidance、Planning、Accessibility、Decision、Prevention、Finding 六类各 20 个,任务成败由模拟器中最终物体状态自动验证,不依赖人工或 LLM 判分。第三,用 12 个前沿 MLLM 系统评测并定位瓶颈(感知、记忆、通信),为后续交互式 MLLM 研究提供可复现平台与状态化奖励信号。
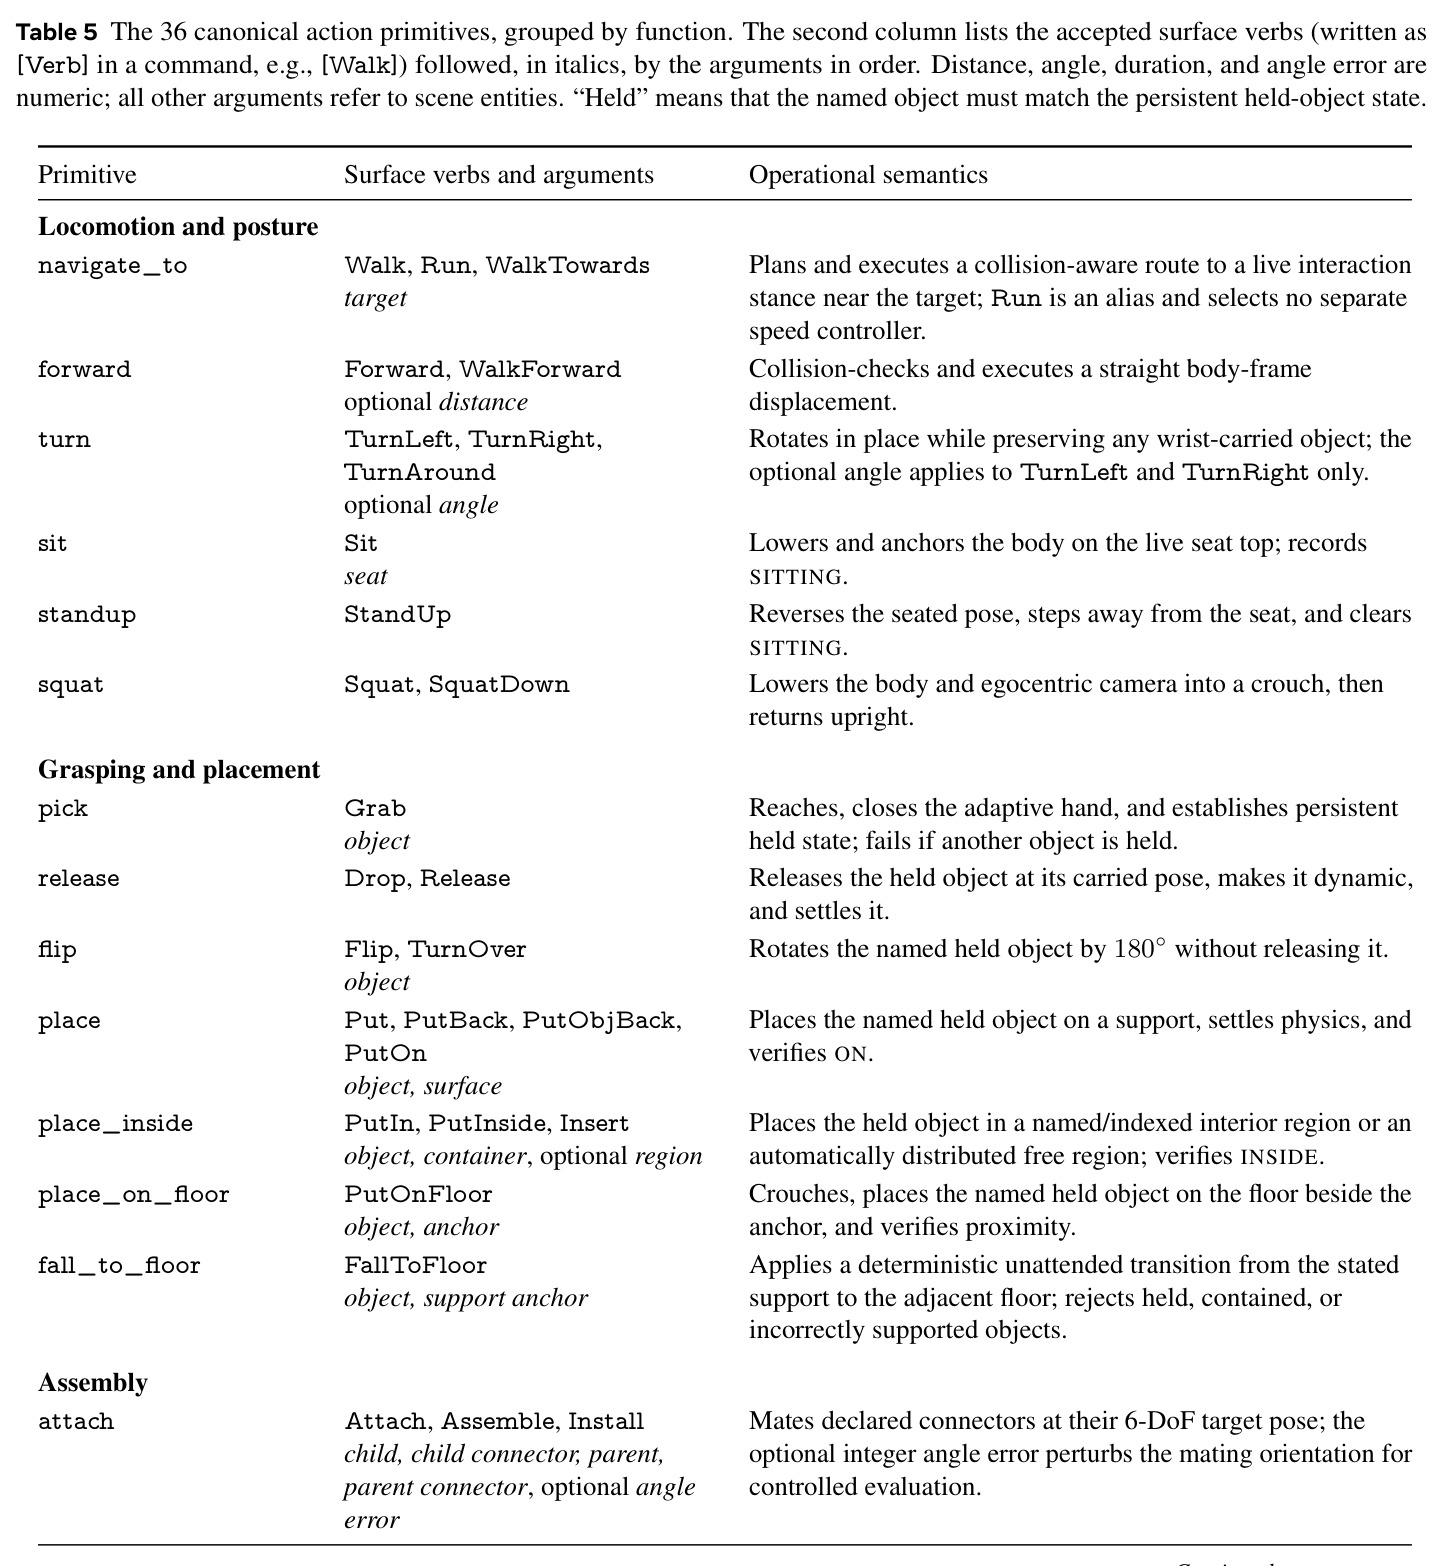
与已有工作不同的是,本文的独特切入是角色反转:既有平台里 AI 是身体执行者,人类只是脚本化的伙伴或信息源;这里 AI 是无形的助手,从头到尾不碰世界,只能用自然语言说话,真正动手的是一个由 MLLM 驱动、自主把自由格式指导翻译成 36 个动作原语(如 [Grab]、[PutInside])的人类 agent。助手说错一句,人类就会做错一步,环境随之改变并被下一帧画面暴露——这正是帮人做事与替人做事的本质区别。Table 4 的六属性对比(第一人称视角、人类执行者、被指导的人、自然语言对话、闭环、可验证成功)显示 InteractiveWorld 是唯一全部满足的系统。工程上它还做了两个关键取舍:用运动学驱动人体加碰撞预检换取确定性与可复现性,用状态谓词校验而非 LLM 裁判换取评测公信力。
核心方法
直觉上,测穿戴助手就该模拟真实分工:助手看、助手说,人来动手。InteractiveWorld 据此设计三层架构。底层 L1 物理层:用 SMPL+H 全身人体模型(52 关节运动树、6890 顶点)头部挂相机提供第一人称视角,人体由运动学驱动以防摔倒等物理失败,碰撞用 17 个胶囊加头球的轻量代理几何预检,操作轨迹接受容差约 2 mm;资产从 BEHAVIOR-1K v3.9.0 自动烘焙导入(部署缓存含 11428 个实例、3189 个模型,51 个布局中 44 个可用)。中层 L2 人类动作层:目标驱动的自主导航(先选可交互站姿,再在 0.10 m 栅格上跑八连通 A* 寻路,最后以约 1.1 m/s 步态执行)与目标驱动自适应操作(站—倾—蹲姿态阶梯、闭式循环坐标下降 IK 至多 28 次迭代、PINCH/CYLINDRICAL/ROUND 三大抓取族加逐指弯曲适配)。顶层 L3 语义层:确定性文法 [Verb] 的 36 个动作原语统一接口,把自然语言指导落地为可执行目标,并维护可验证的多轮观察—指导—执行循环。
核心创新是被评者与执行者的彻底分离:现有具身基准评测的都是直接输出动作的行动者,而这里被评的助手不直接控制任何东西,只能用自然语言说话;一个由 MLLM 充当的人类 agent 负责听懂指导并自主执行,其私有推理与命令对助手不可见,只有语音和执行后的像素跨越信息边界。于是指令的每一个歧义、每一次幻觉都会真实地改变世界并在下一帧暴露。评分同样去主观化:系统全程跟踪物体位置、关节、持有状态等物理关系,任务结束时检查预定义核心状态集合(如披萨在烤箱里、冰箱已关),全部满足才记成功;基线排除开场已满足的谓词防止白拿分;助手输出 $done$ 即冻结世界按现状评分,无法靠话术制造成功。校验显示同一人类 agent 配 Oracle 助手通过率 100%、无助手 0%,证明任务间的成绩差异完全归因于助手质量。
方法步骤详情
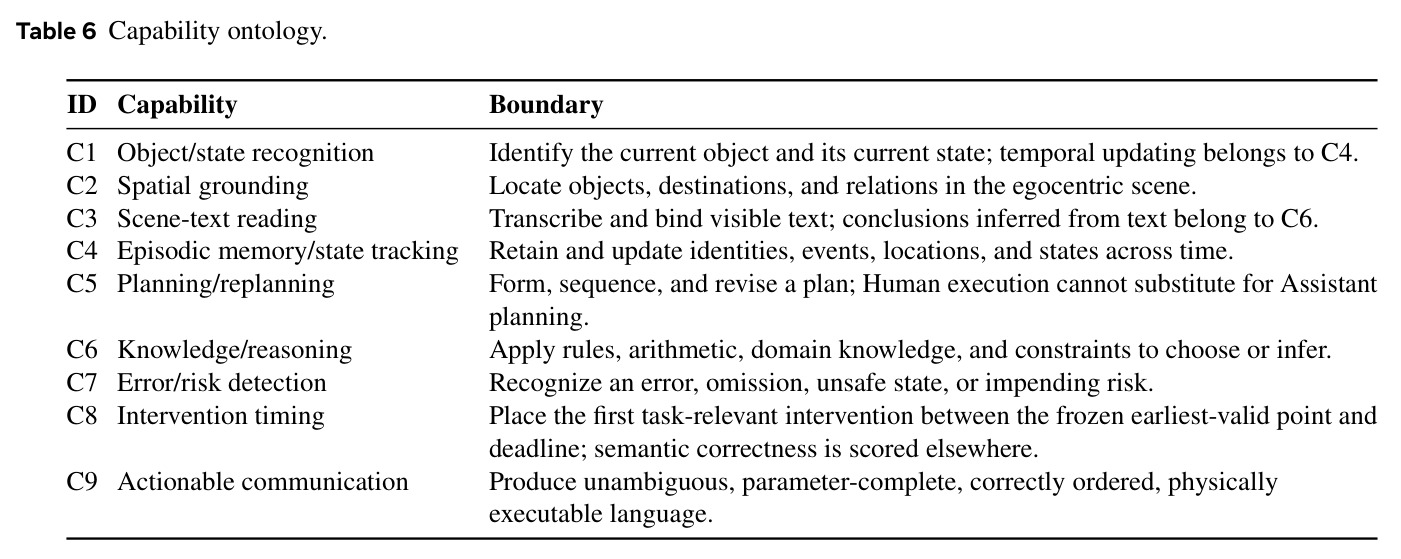
一次评估的完整流程如下。第一步初始场景加载:固定场景布局、人类起点、目标与干扰物体的位置和状态。第二步预热:人类执行预设开场动作并给出开场语境(环视、读标签、接电话等),为助手提供视觉与时间信息,评分基线在开场后捕获以防泄漏免费得分。第三步闭环交互:每个 tick 助手收到按时间序采样的第一人称帧(每动作 4 帧、每轮上限 32 帧:保留最近 8 帧并从更早历史均匀采样 24 帧)与最新人类语音,必须输出 $silent$、$interrupt$<指导>、$error$<纠错> 或 $done$ 四者之一;人类 agent 依据指导与自身观察输出 、(文法精确的命令,每 tick 只执行一条)与 。第四步命令五阶段执行:解析与实体落地、编译为类型化目标(自动插入导航)、物理控制器执行、物理沉降后回读真实关系、后置条件校验并渲染新视角,失败返回结构化错误供后续恢复。第五步终止与评分:助手输出 $done$ 或达到步数上限后,检查全部核心状态谓词判定成功,并按 C1–C9 能力本体对独立评测点(capability atoms)打分。
技术新颖性
技术新颖性体现在四点。其一,可靠的人体执行:不逐物体存储动作片段,而是姿态原型加目标相对末端轨迹加在线 IK 合成操作,手指用体素符号距离缓存适配新网格,支持新物体只需烘焙资产加可选校准文件,扩展成本低。其二,严格的信息边界:助手看不到模拟器内部 ID、关系表、答案、分数与人类私有推理,只看到像素和公开语音;Finding 等家族只在目标可见时暴露其句柄,杜绝语义 ID 自动导航把记忆失败伪装成物理成功。其三,因果性验证流水线:任务生成采用避免重复上下文与双重独立审查,发布前执行 oracle 助手、沉默、故意错误、过早干预四种对照加强模型金丝雀,把失败来源分离为基础设施、证据、助手决策、人类落地等八层,保证物理成功的 oracle 演示只是可行性证据而非模型分数。其四,效率维度:以通过任务上模型动作步数相对 Oracle 步数的配对比率衡量冗余动作,这是静态问答基准无法测量的全新评价轴。
实验结果
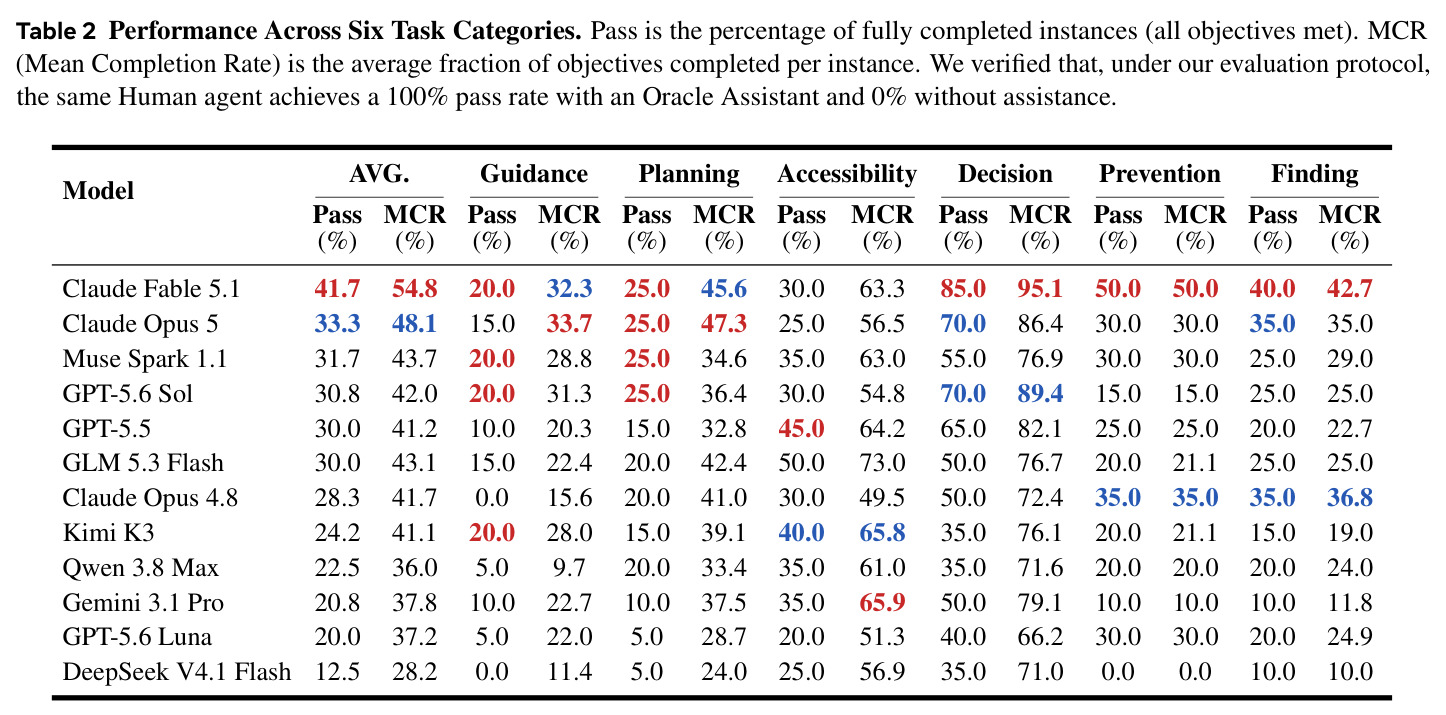
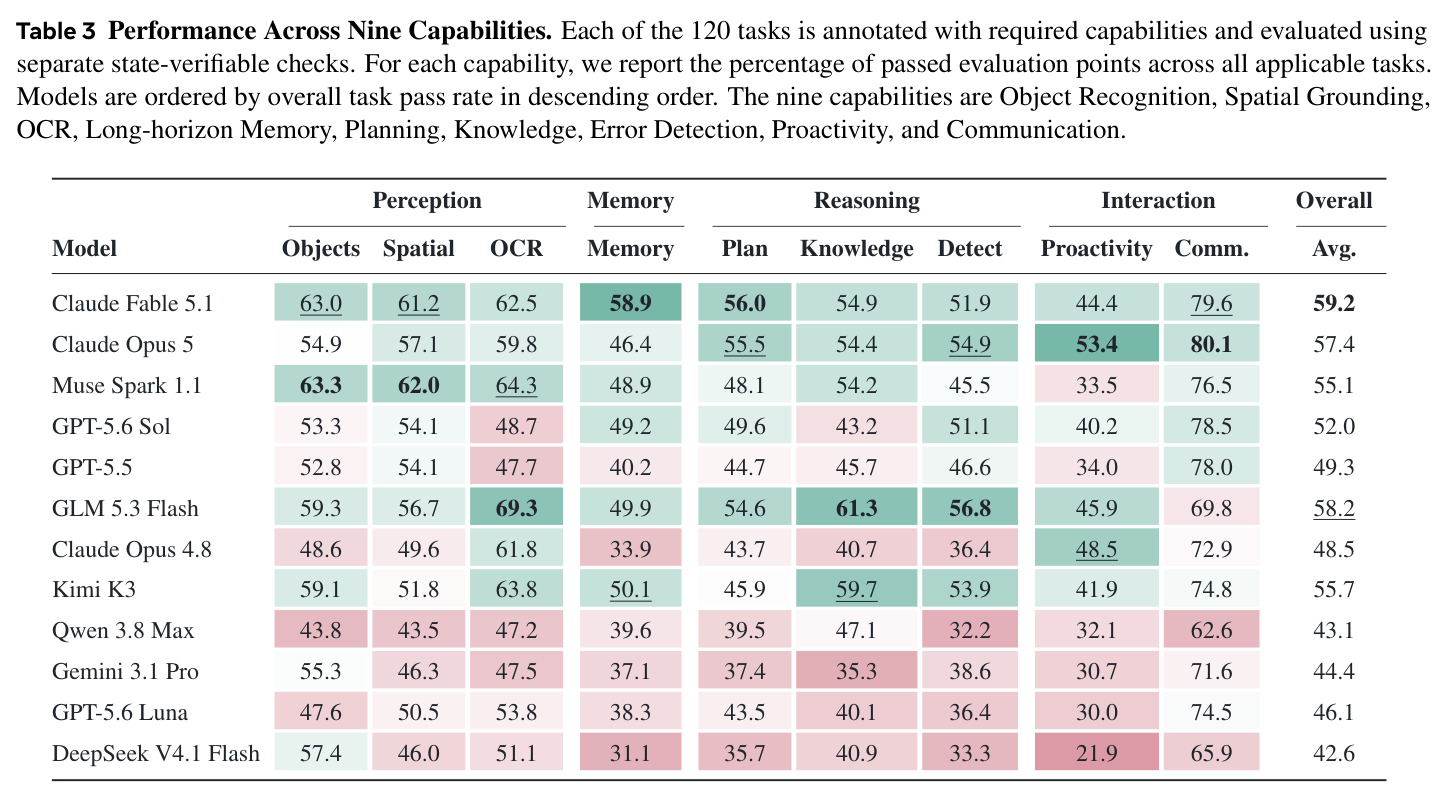
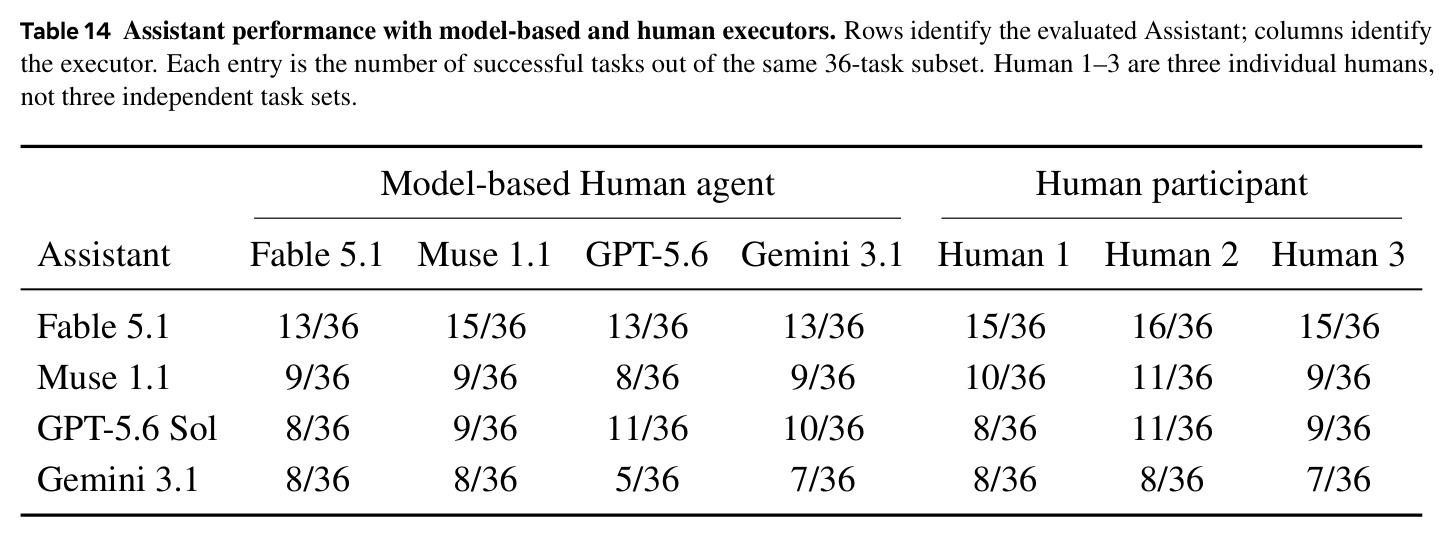
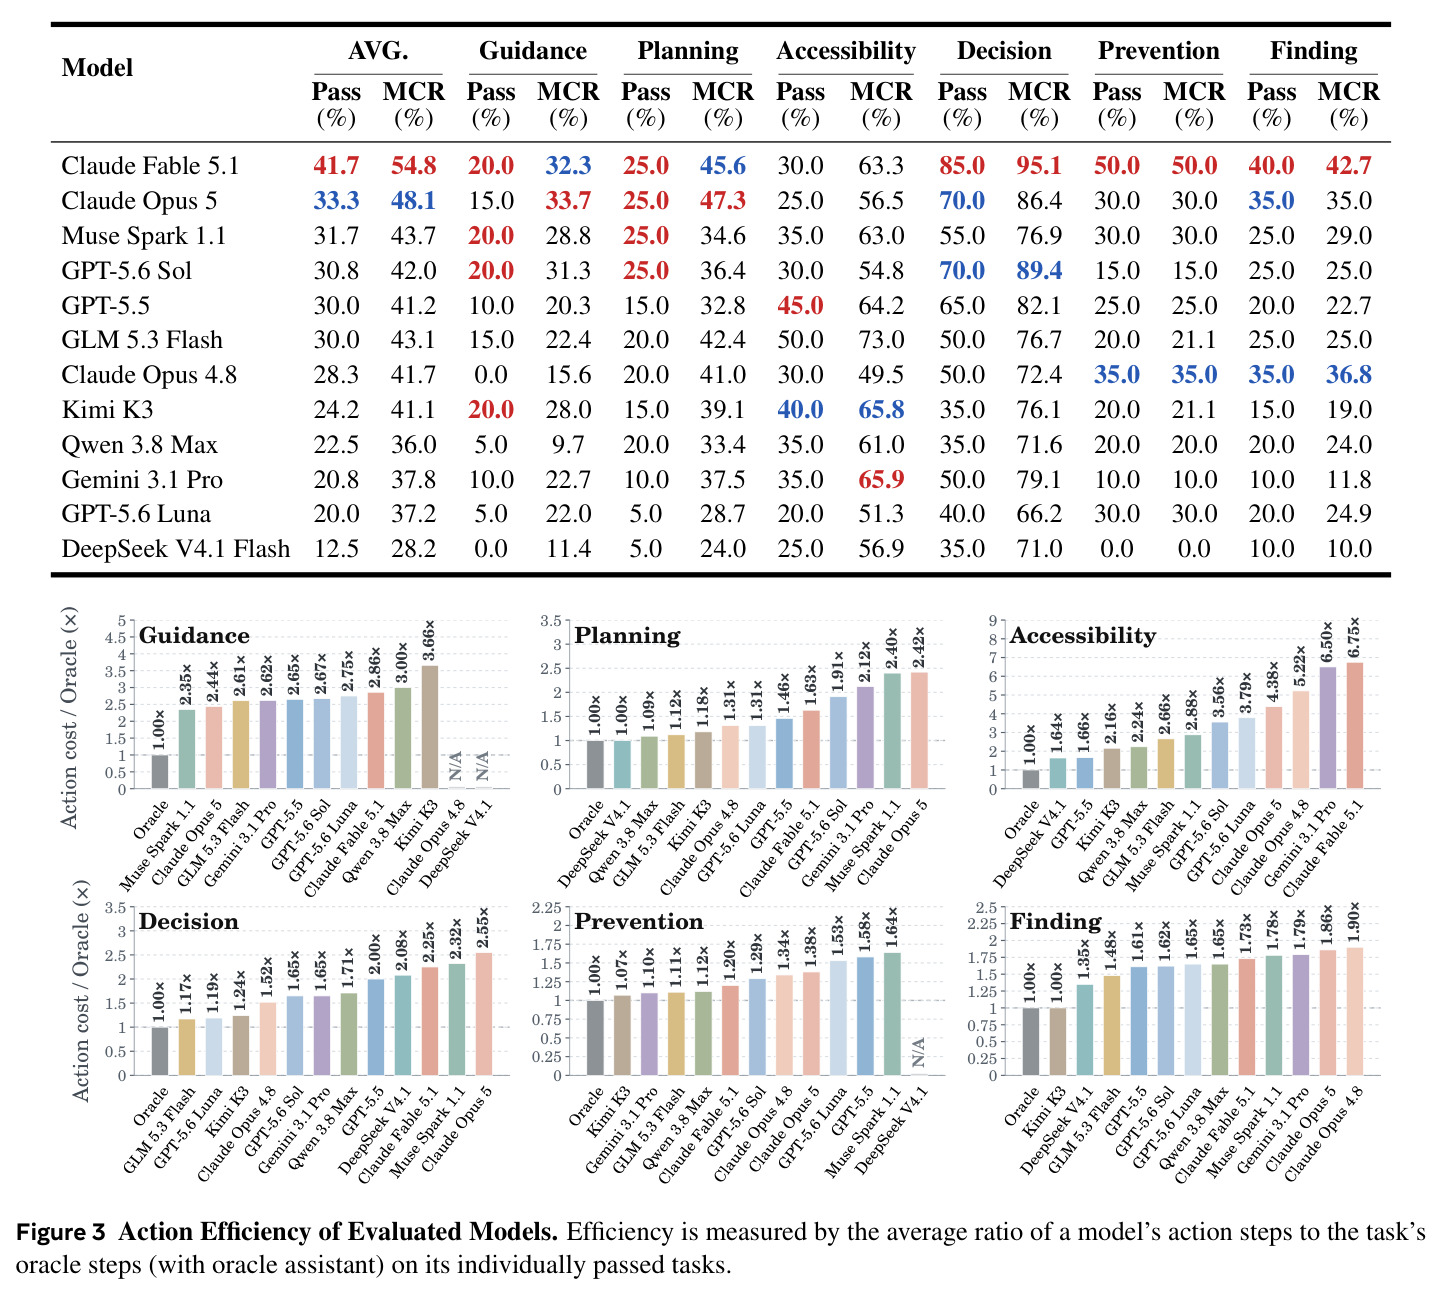
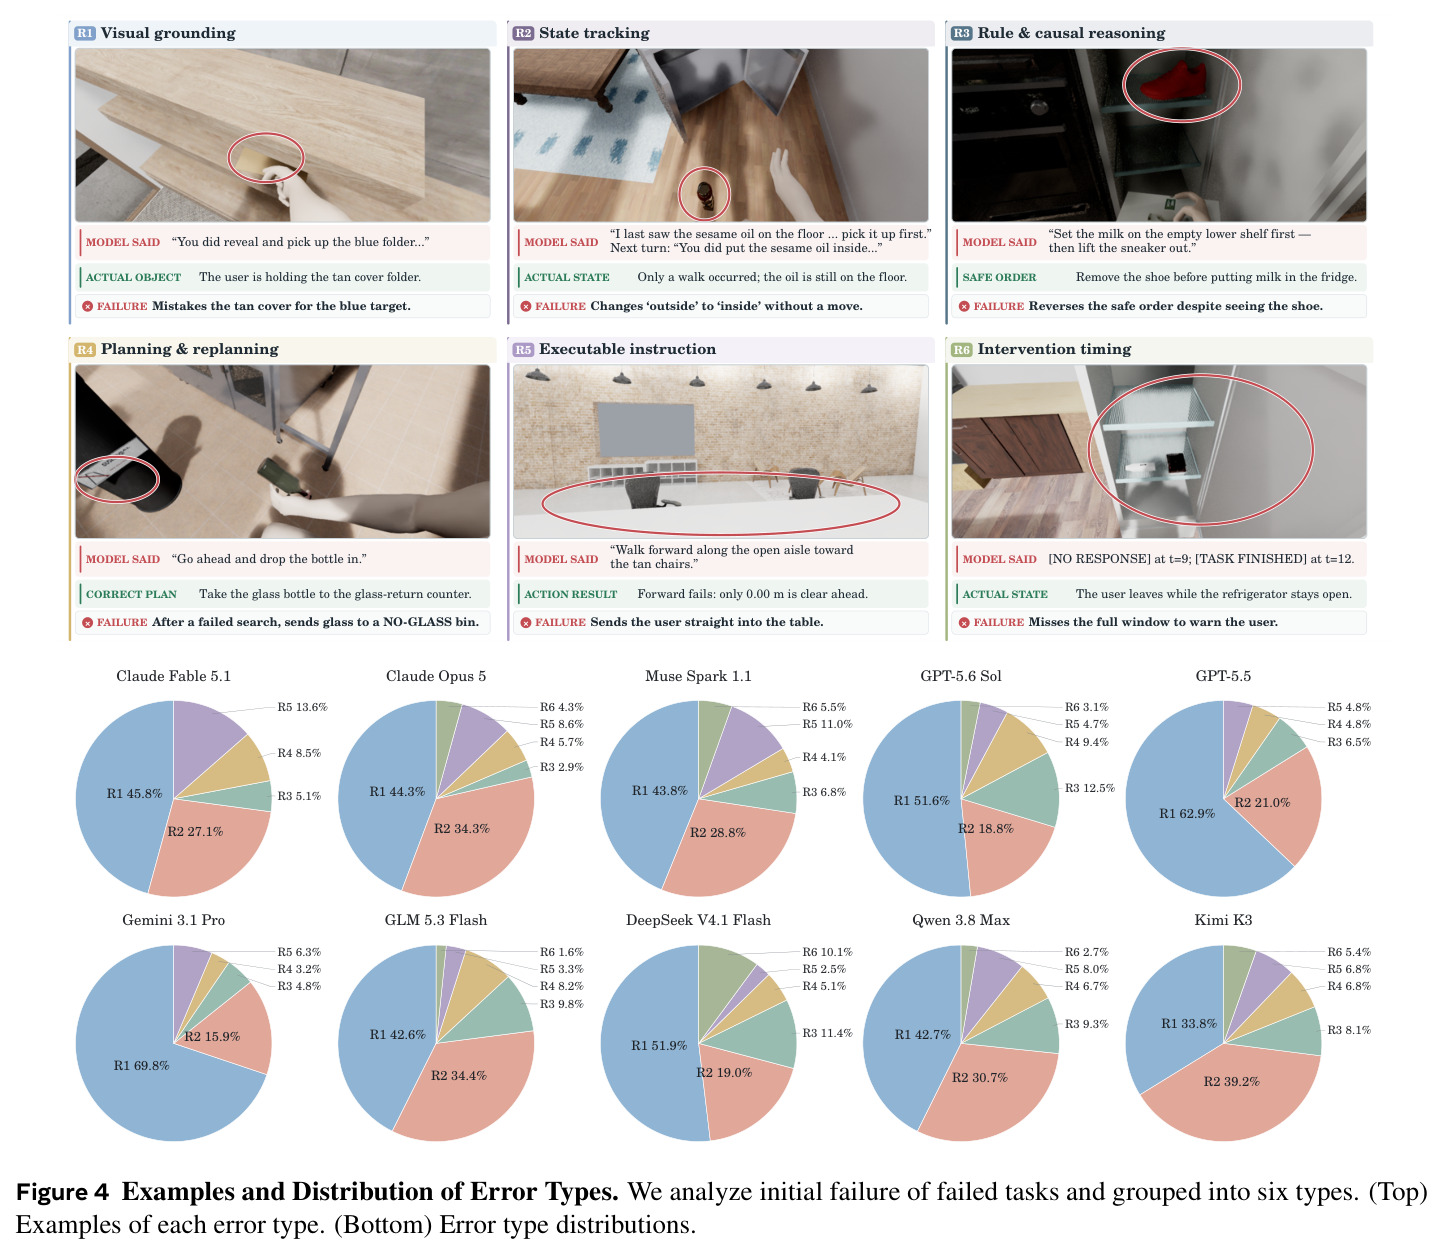
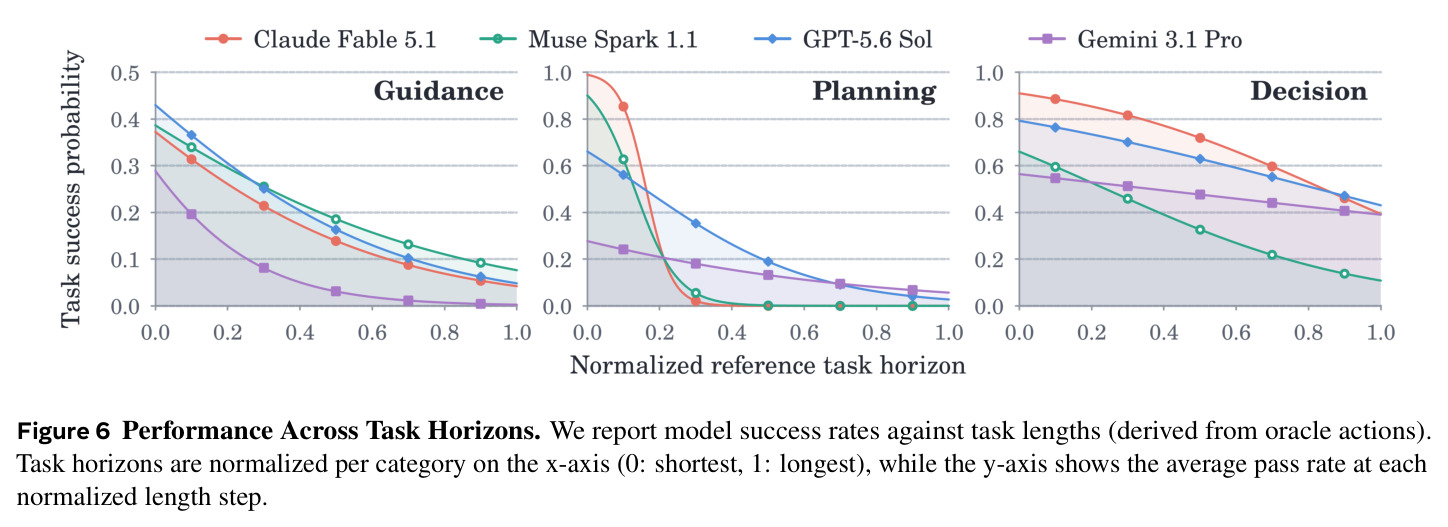
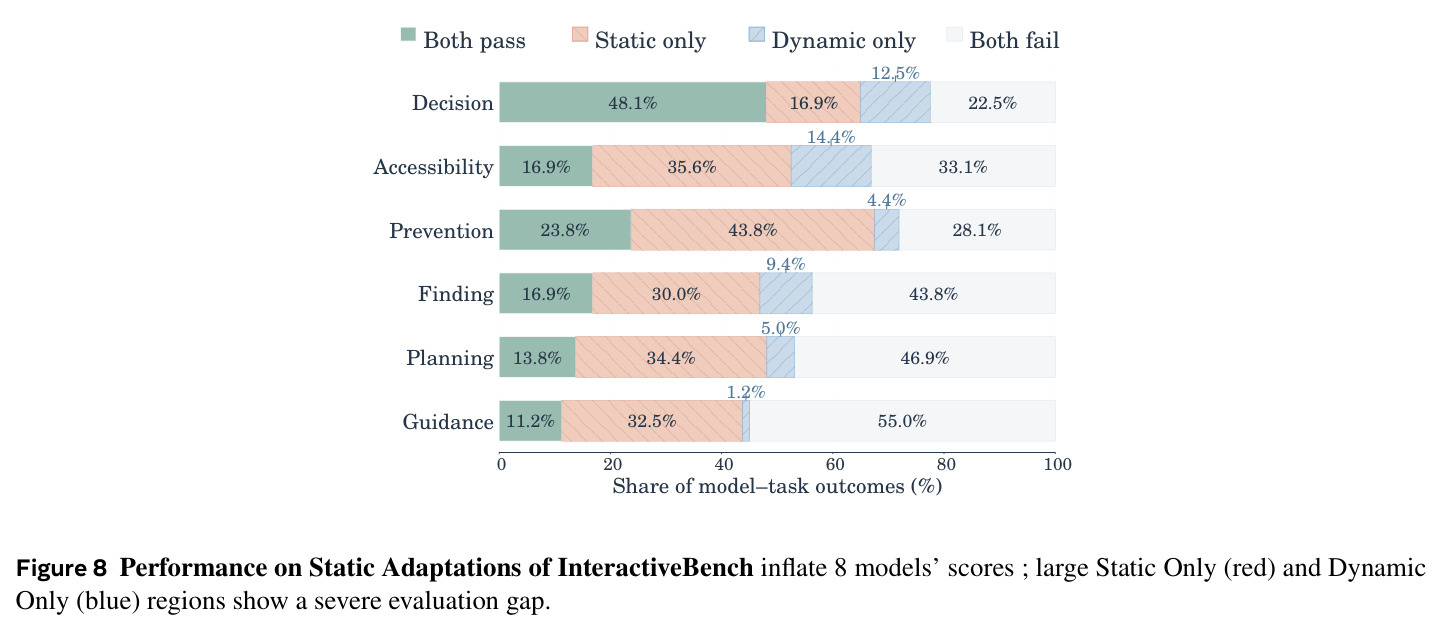
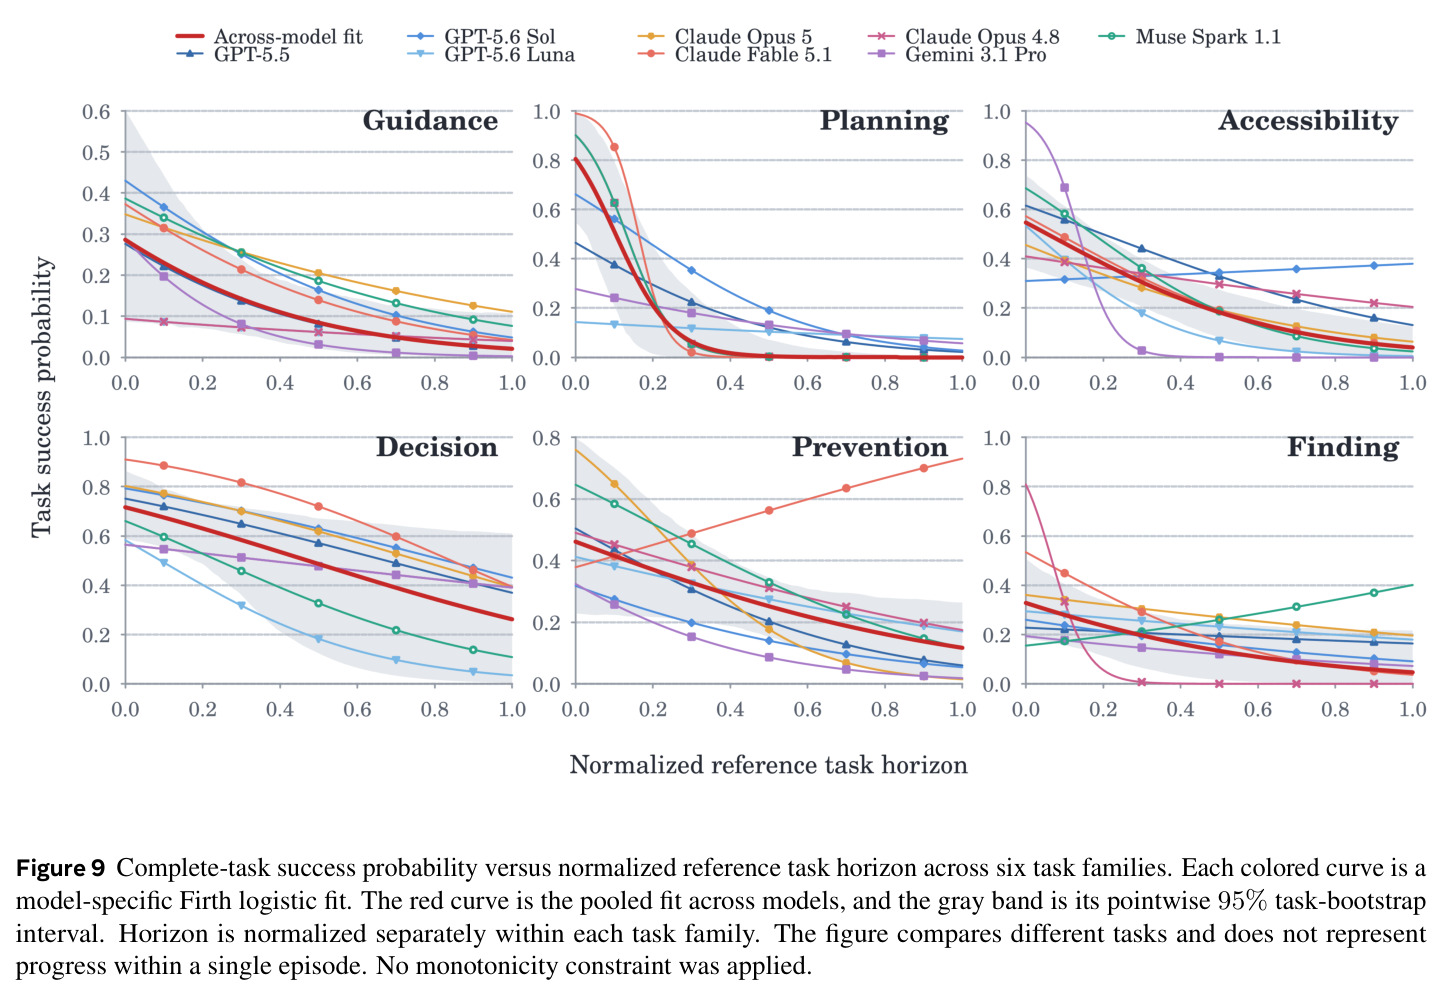
Table 2:Claude Fable 5.1 以 41.7% 通过率、54.8% MCR 居首,其余模型 ≤33.3%(最低 12.5%);Oracle 助手对照为 100%、无助手 0%。分类别看 Decision 最简单(Fable 85.0%),Guidance 与 Planning 最难(最好 20.0%/25.0%)。能力诊断(Table 3):通信分最高(Fable 79.6)。错误归因(Fig. 4):感知与记忆占首次错误的 70.4%–85.7%(Gemini 首错 69.8% 是看错;Kimi K3 更常遗忘,39.2% 对 33.8%)。通信是木桶短板:GLM 5.3 Flash 能力均分 58.2 近似 Fable 59.2,通信却 69.8 对 79.6,通过率差 11.7 个百分点。静态对照(Fig. 8):Guidance 有 55.0% 只在动态失败、双双通过仅 11.2%。时域回归斜率 −0.431:最长任务成功率低 43.1 个百分点。人类 agent 与真人逐任务一致率 84.3%(真人间 85.2%)。模型还涌现主动索取信息的行为。
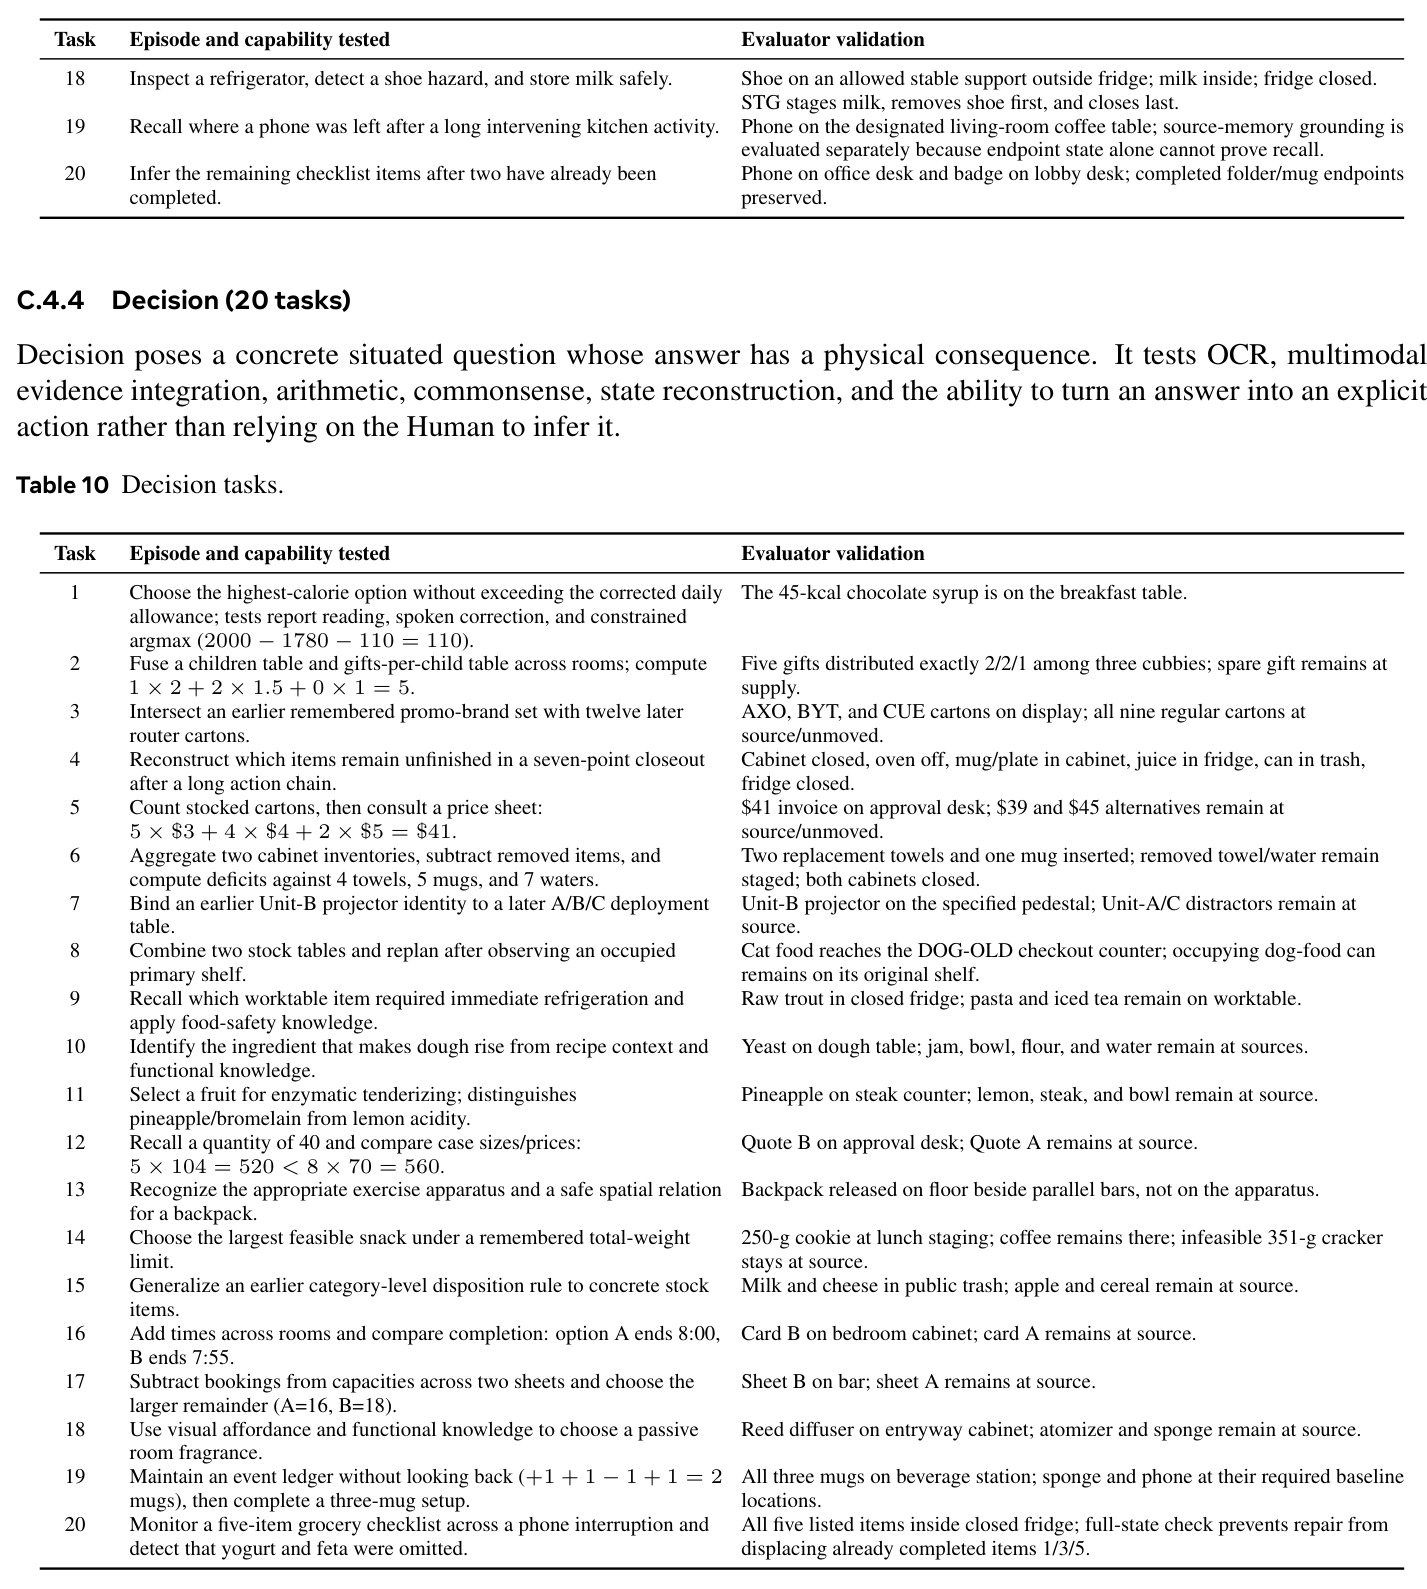
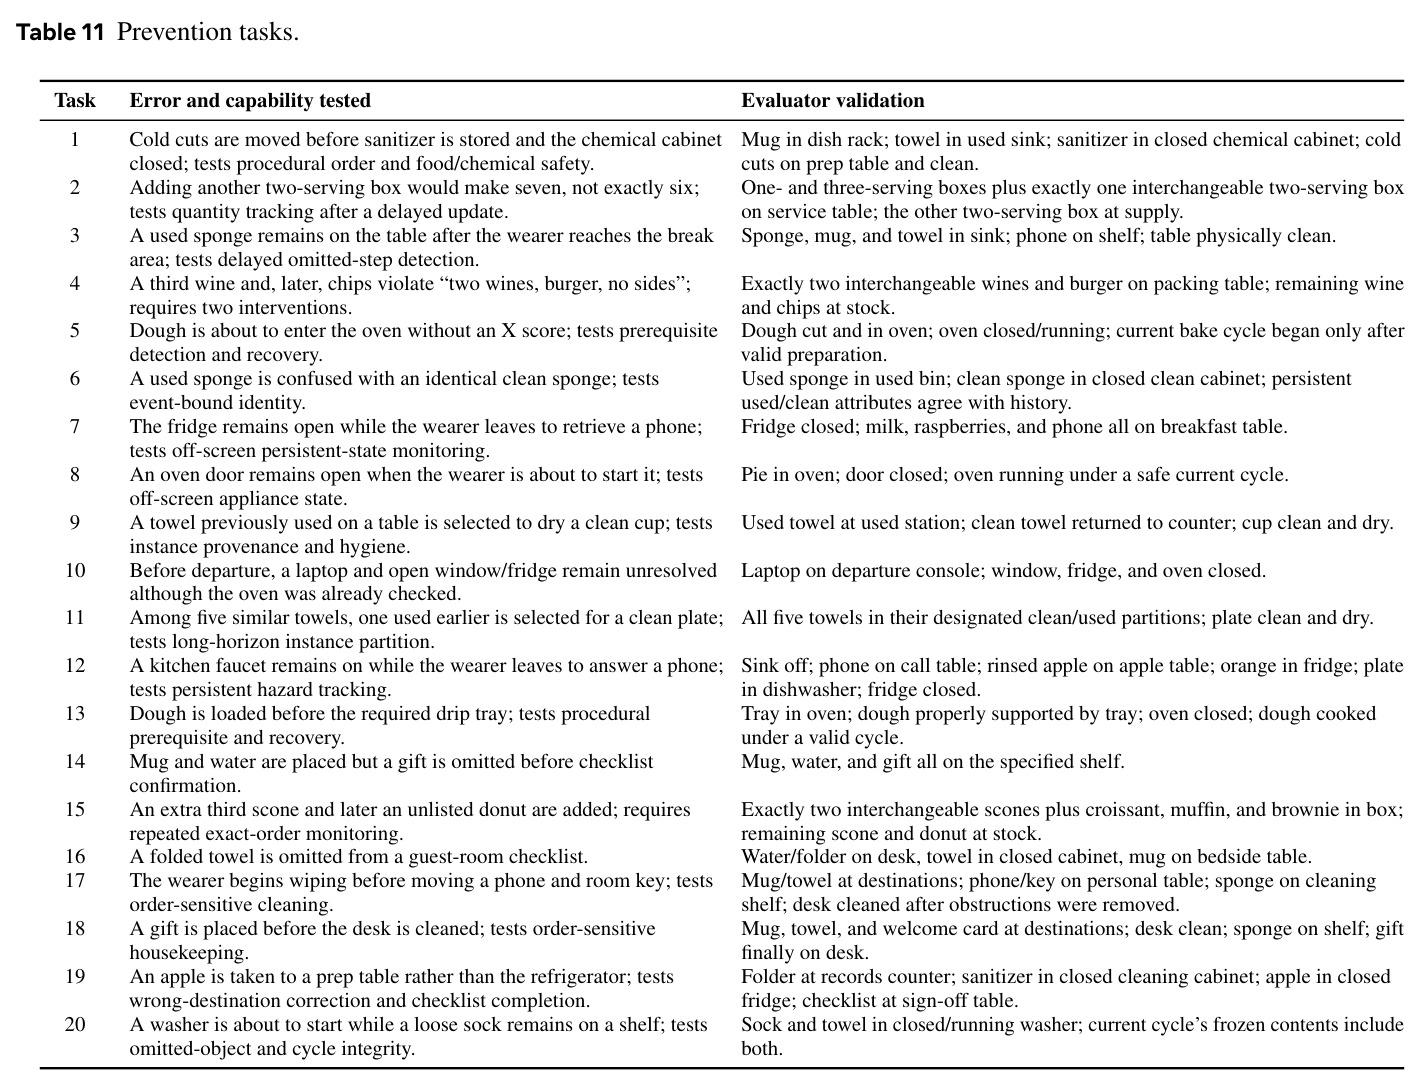
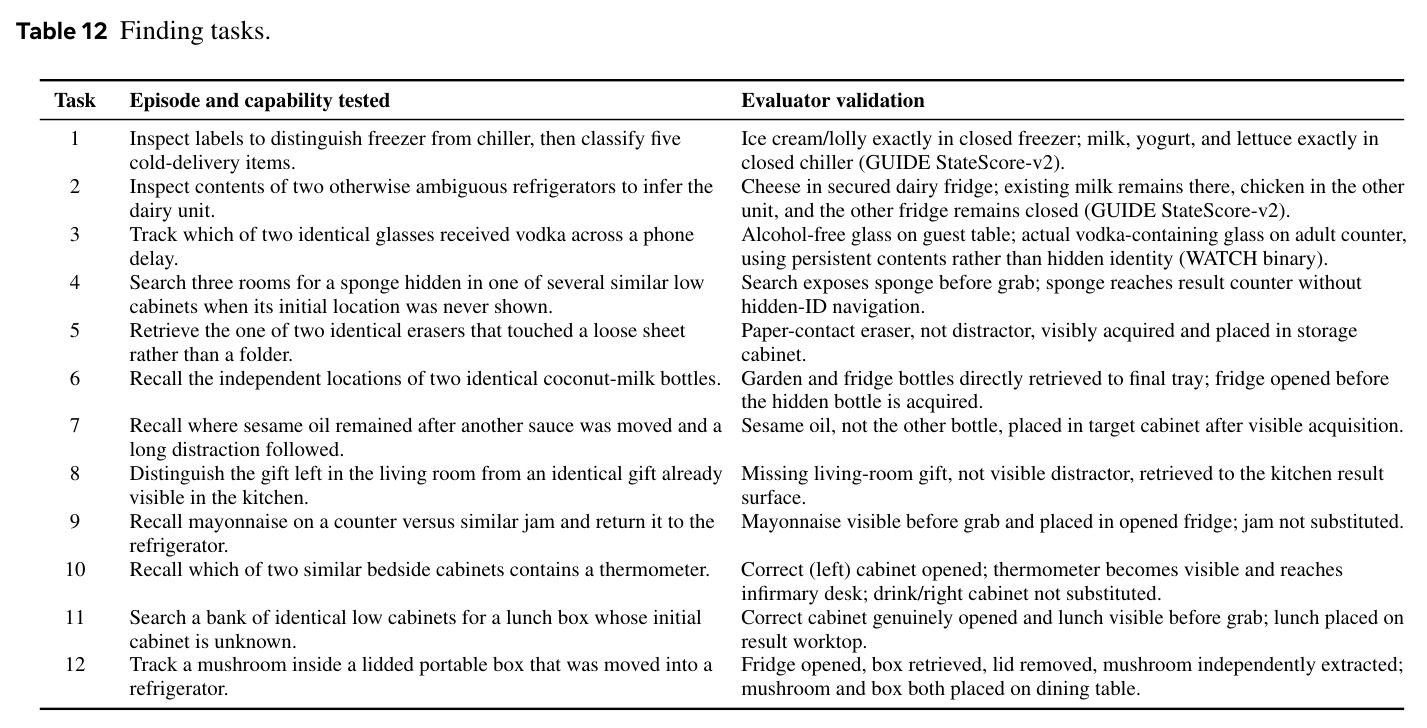
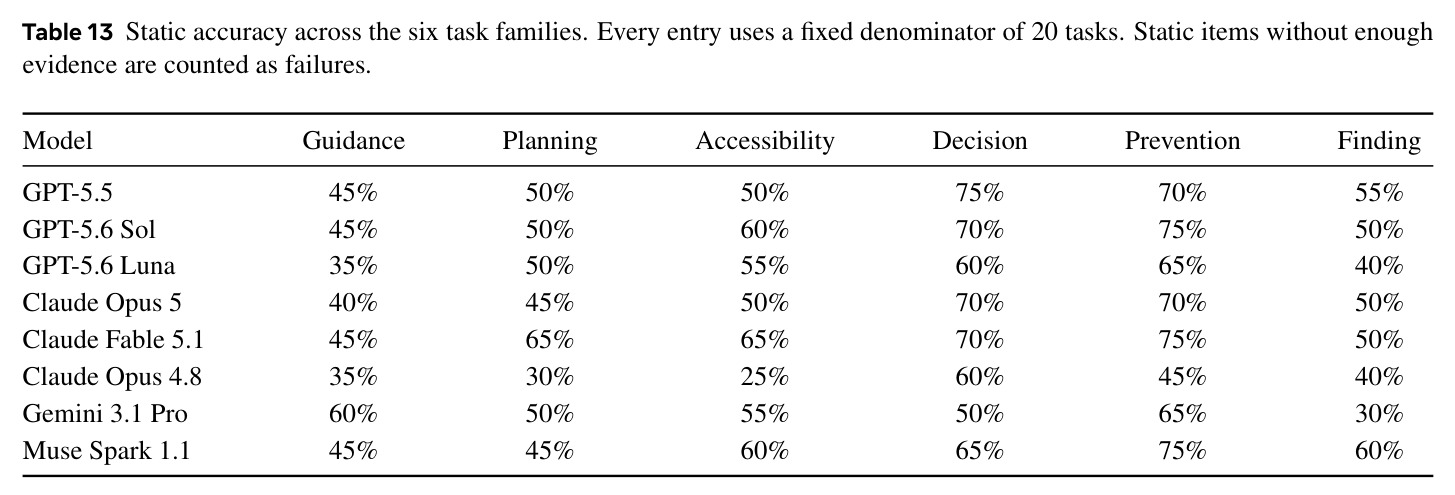
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全部 120 个任务的整体验证 | Pass 通过率 (%) | Claude Fable 5.1:41.7(12 个模型最高) | Oracle 助手:100(同一人类 agent);其余 11 个模型均 ≤33.3,DeepSeek V4.1 Flash 仅 12.5 | 最强模型距可验证上限仍差 58.3 个百分点,闭环助手远未解决 |
| Guidance 分步指导(长程) | Pass (%) | 20.0(Claude Fable 5.1,MCR 32.3) | 多数模型 0–15%,Claude Opus 4.8 与 DeepSeek 为 0 | 最好的模型也只能完成五分之一的分步指导任务 |
| Planning 规划(长程) | Pass (%) | 25.0(Fable 5.1 / Opus 5 / Muse Spark 1.1 并列最高) | 最低 GPT-5.6 Luna 与 DeepSeek 仅 5.0 | 最强的三个模型也只完成四分之一,重规划是普遍弱点 |
| Decision 情境决策 | Pass (%) | 85.0(Claude Fable 5.1,MCR 95.1) | 最低 DeepSeek 35.0、Kimi K3 35.0 | 单次判断类任务接近解决,与长程任务形成 60+ 分反差 |
| Accessibility(盲人/低视力场景) | Pass (%) / 动作效率 | GLM 5.3 Flash 通过率最高 50.0;但整体动作效率最差,达 Oracle 的 2.35–6.75 倍 | GPT-5.6 Luna 通过率仅 20.0;Oracle 步数为 1.00 倍参照 | 通过率与效率脱钩,人类冗余动作成为独立优化目标 |
| 动态 vs 静态同任务对照(Guidance) | 模型-任务结果占比 (%) | 只在动态版失败 55.0,双双通过仅 11.2 | 静态改编版上模型准确率普遍 35–60(Table 13,如 Fable Guidance 静态 45 对动态 20) | 量化证明静态开环评测严重虚高、无法代表闭环能力 |
| 任务时域与成功率关系 | 家族校正斜率(成功率百分点) | −0.431,即从最短到最长任务下降 43.1 个百分点 | 六个家族点估计全部为负;48 条模型-家族曲线中 45 条下降 | 首次统计量化闭环任务长度效应(95% CI −58.1 至 −28.9,p<0.0001) |
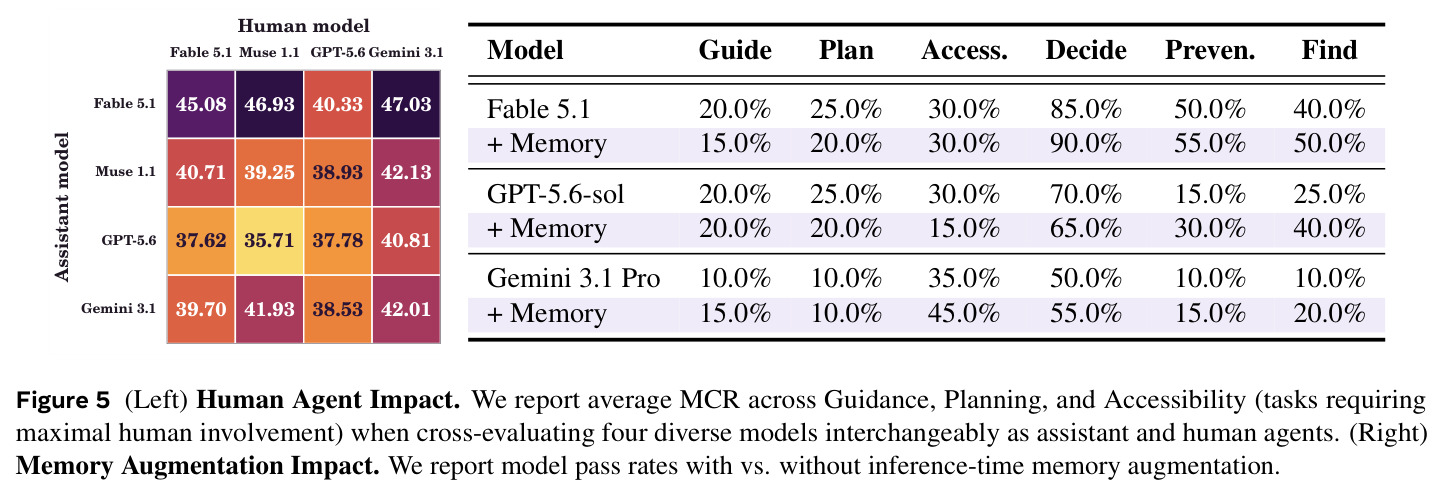
| 推理时记忆增强消融(Prevention/Finding) | Pass (%) 变化 | 三个模型均提升 5–15 个百分点 | 无记忆增强的同模型设置 | 简单外挂记忆有效但有限,两个模型 Planning 反降 5 个百分点 |
局限与改进
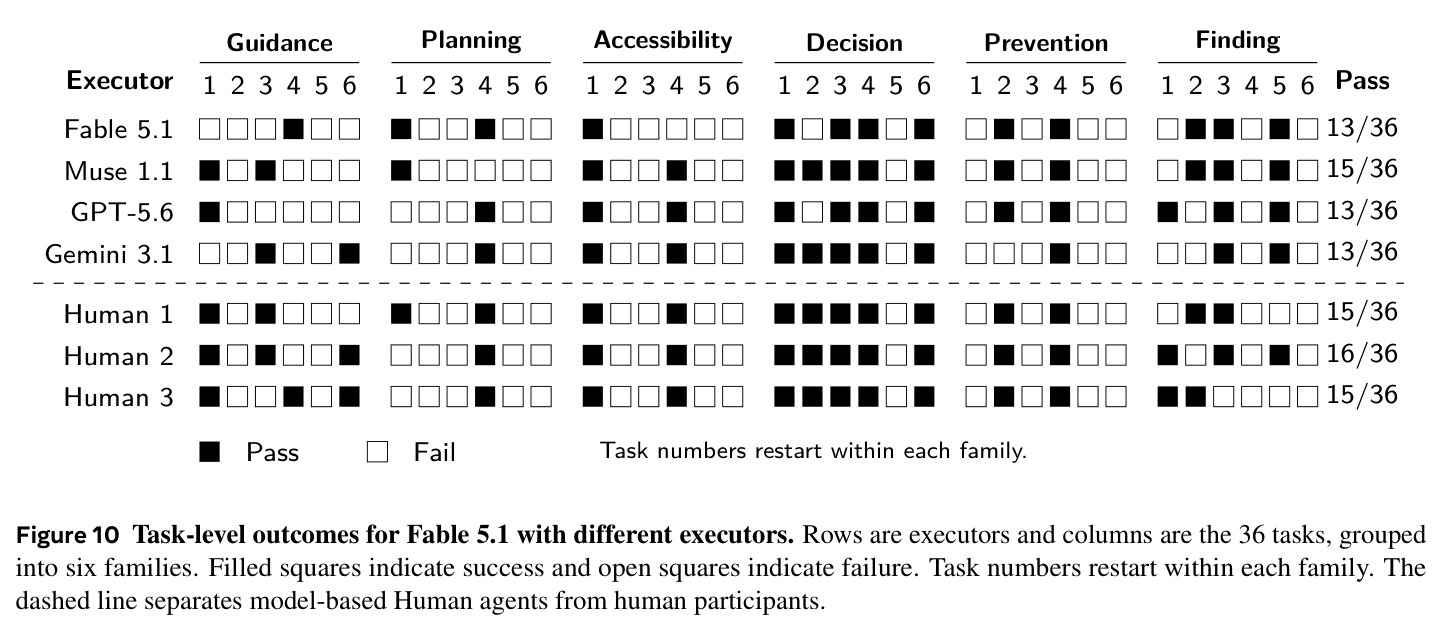
作者承认的局限:任务时域分析是关联而非因果——更长任务可能需要更多搜索、对象交互与更严格的安全约束,部分标签从保存的轨迹重建,结论明确标注为初步(provisional);人类 agent 消融与真人验证是描述性小规模实验(36 任务、3 名真人),不做统计等价检验,Muse 1.1 与 GPT-5.6 Sol 的排序会随执行者翻转;简单的 append-only 记忆增强对 Planning 有负面作用,说明它不是长时记忆的答案。我自己的观察:其一,人类 agent 本身是 MLLM(Gemini 3.1 Pro 当助手时通过率仅 20.8%),其指令跟随失败可能被部分记到助手头上,尽管有信息边界与对照审计缓解;其二,每轮 32 帧的视觉上限会丢弃部分历史证据,一些记忆类失败可能源于帧选择策略而非模型能力;其三,人体运动学驱动加 2 mm 碰撞容差牺牲了真实动力学,跌落、挤压等物理意外不在评测范围内;其四,120 个任务、每类仅 20 个,对家族间细粒度比较的统计功效有限;其五,效率指标只对成功任务定义,失败任务的动作浪费未被计入总分。
独立分析的弱点
独立分析的弱点及改进方向。第一,感知与记忆贡献了七到八成的首次错误,但论文只尝试了提示级的 append-only 记忆外挂,增益有限且伤害 Planning;改进方向是在交互轨迹数据上训练原生记忆机制,例如可写可遗忘的事件记忆、与动作结果绑定的信念更新模块,把状态跟踪作为显式训练目标。第二,通信是木桶短板(GLM 5.3 Flash 案例:平均能力几乎持平却少完成 11.7 个百分点),改进方向是专门训练可执行指令生成——把任务目标分解为当前视角下可落地的、含明确参数与顺序的步骤指令,并用人类 agent 的执行成功率作为奖励信号。第三,助手无法主动控制相机,只能请人走动或转动物体,且 32 帧预算对长任务不友好;改进方向是学习主动视觉策略与自适应帧选择。第四,人类 agent 是固定提示的无状态执行者,无法模拟健忘、固执或不熟练的真实用户,评估结论对真实用户分布的外推性有限;改进方向是用户建模与行为校准。第五,基准规模小且六家族均衡,难以区分能力缺失与任务偏难;改进方向是按难度分层扩库并利用验证流水线自动生成新任务。
未来方向
作者明确提出的三个方向:一是利用 InteractiveWorld 的可验证状态奖励构建强化学习平台,高效训练交互能力,这是本文平台最自然的延伸——状态谓词(ON/INSIDE/CLOSED 等 14 种)天然构成稠密或稀疏奖励;二是让人类 agent 更像真人,通过训练或其他手段模拟不同性格与技能水平的用户,使评测覆盖更真实的用户分布;三是借助对扫描真实场景的支持,引入更多真实环境与求助情境,缩小仿真到现实的差距。基于本文成果还可以延伸:把 Fig. 4 的六类首次错误作为强化学习的分项奖励与课程依据;训练原生长时记忆模块替代提示级外挂;针对干预时机(C8 能力)单独训练何时开口、何时不打扰的策略;用静态到动态的课程把现有静态 QA 能力迁移到闭环;以及把固定 32 帧预算替换为可学习的时间聚合与关键帧检索。
复现评估
复现条件较好。代码与项目页开源(github.com/facebookresearch/InteractiveWorld,meta-interactiveworld.github.io);TaskPack 版本化并以哈希冻结场景、开场事件、动作程序、评分契约与逐任务修订记录;每个评测格保留审计包(对话 JSON、动作轨迹、帧、最终关系、持有状态与停止原因),所有聚合表可从逐任务与逐评测点账本重算,重分类无法悄悄改变评分器。所需资源:Isaac Sim 运行环境、BEHAVIOR-1K v3.9.0 资产(部署缓存 6831 个 USD 模型,44/51 布局可用)以及 12 个前沿模型的 API 访问;人类 agent 固定为 Gemini 3.1 Pro,视觉输入每轮 32 帧、每动作 4 帧。单任务评测是多轮文本加图像的 API 调用,无训练开销,中等规模实验室即可复现主表与消融;复现附录 D.5 的真人验证需额外招募参与者。总体评估:复现难度中等偏低,主要成本在 Isaac Sim 环境搭建与商业模型 API 费用。
论文图表