RoboJev:面向机器人操作成功检测的开源视觉语言裁判 RoboJev: An Open Vision-Language Judge for Robot Success Detection
开源27B视觉语言裁判,单次前向判定机器人操作成败并输出校准概率
前置知识
LoRA(低秩适配)
一种参数高效微调方法:冻结预训练权重,只在权重矩阵旁注入一对低秩矩阵 $A\in\mathbb{R}^{d\times r}, B\in\mathbb{R}^{r\times k}$(秩 $r\ll\min(d,k)$),训练时只更新 $BA$ 的增量。本文用 rank-32 的 LoRA 作用于语言模型分量(alpha 64、dropout 0.05),产生约 2.33 亿可训练参数,视觉编码器完全冻结。
RoboJev 的全部领域适配都发生在这个小适配器里,理解 LoRA 才能明白为什么训练只要 7 张 H100 跑 5.5 小时,以及为什么存在 adapter 缩放这一校准自由度。
KL 散度与 KL 正则化
$D_{\mathrm{KL}}(q\Vert p)=\sum_y q(y)\log\frac{q(y)}{p(y)}$ 度量两个分布的差异。本文把未适配模型 $q_0$ 对适配模型 $q_\theta$ 的 KL 散度加进损失,作为锚定项,防止微调把模型拉离基座行为太远——即权重空间之外的一种"权重插值"式正则。
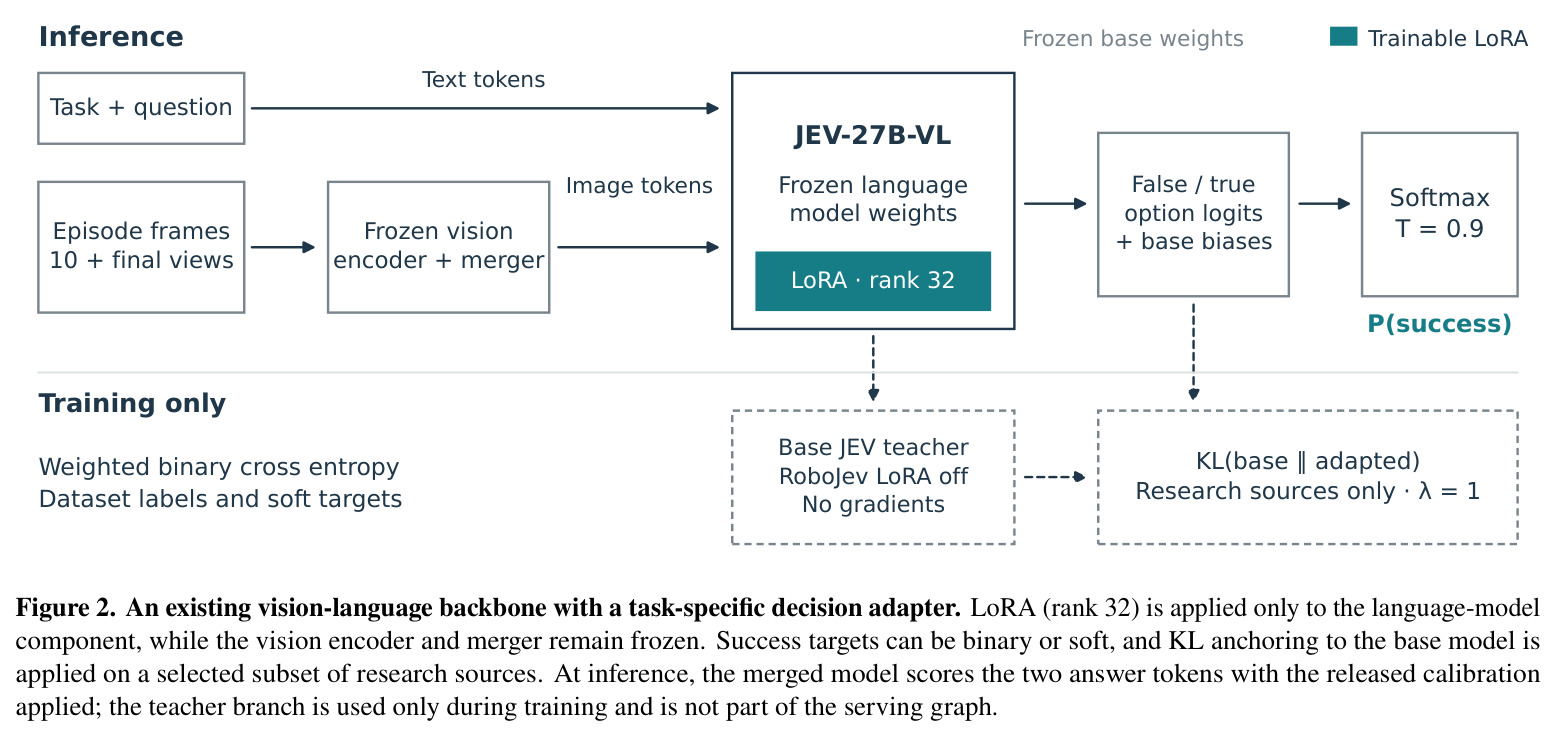
源条件 KL 锚定($\lambda=1$,仅研究数据源)是本文保护未见域迁移的关键设计,消融显示没有它未见域 AUROC 会从 0.890 掉到 0.847。
AUROC 与平衡准确率
AUROC 是 ROC 曲线下面积,衡量模型对正负样本的排序能力,对阈值不敏感;平衡准确率是灵敏度(成功率召回)与特异度(失败率召回)的均值,适合类别不平衡的成败数据。本文二值判定统一用 0.5 阈值。
论文三大评测(SO-101、未见域、社区)交替报告这两个指标,且用逐 episode 配对 bootstrap 计算置信区间,是读懂所有结果表的前提。
温度缩放与期望校准误差(ECE)
温度缩放对 logits 除以温度 $T$ 后再做 softmax:$p_i=\mathrm{softmax}(z_i/T)$,$T$ 在验证集上最小化负对数似然选出,是最简单的后验校准方法。ECE 把预测概率分成若干 bin,比较每 bin 平均预测概率与实际成功率,10 bins 时记作 ECE$_{10}$。
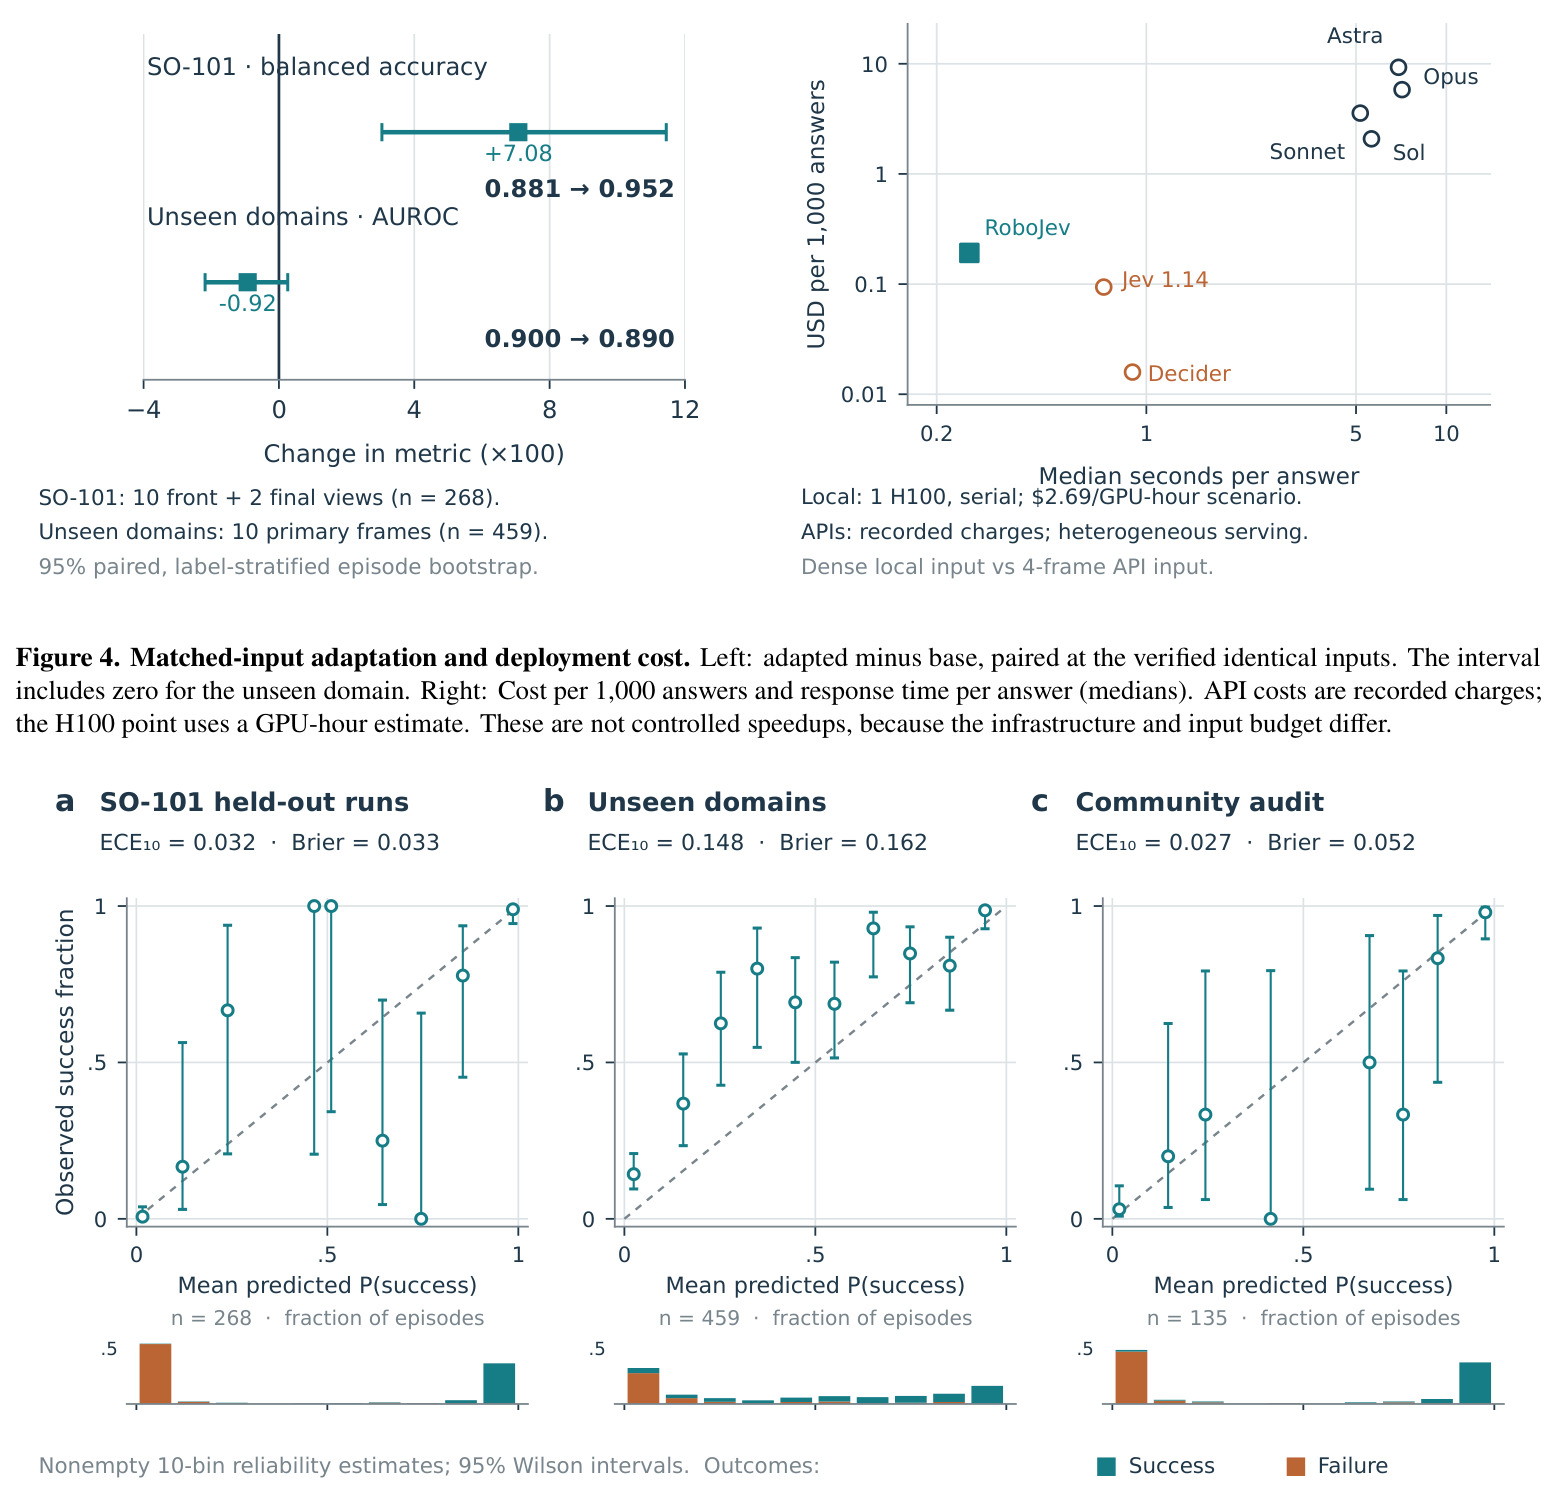
RoboJev 的卖点之一是校准概率输出,而论文最重要的发现之一正是校准不跨域迁移(ECE 从 SO-101 的 0.032 恶化到未见域的 0.148),不懂 ECE 就读不懂 Figure 5。
两 token 读出(logit 读出)
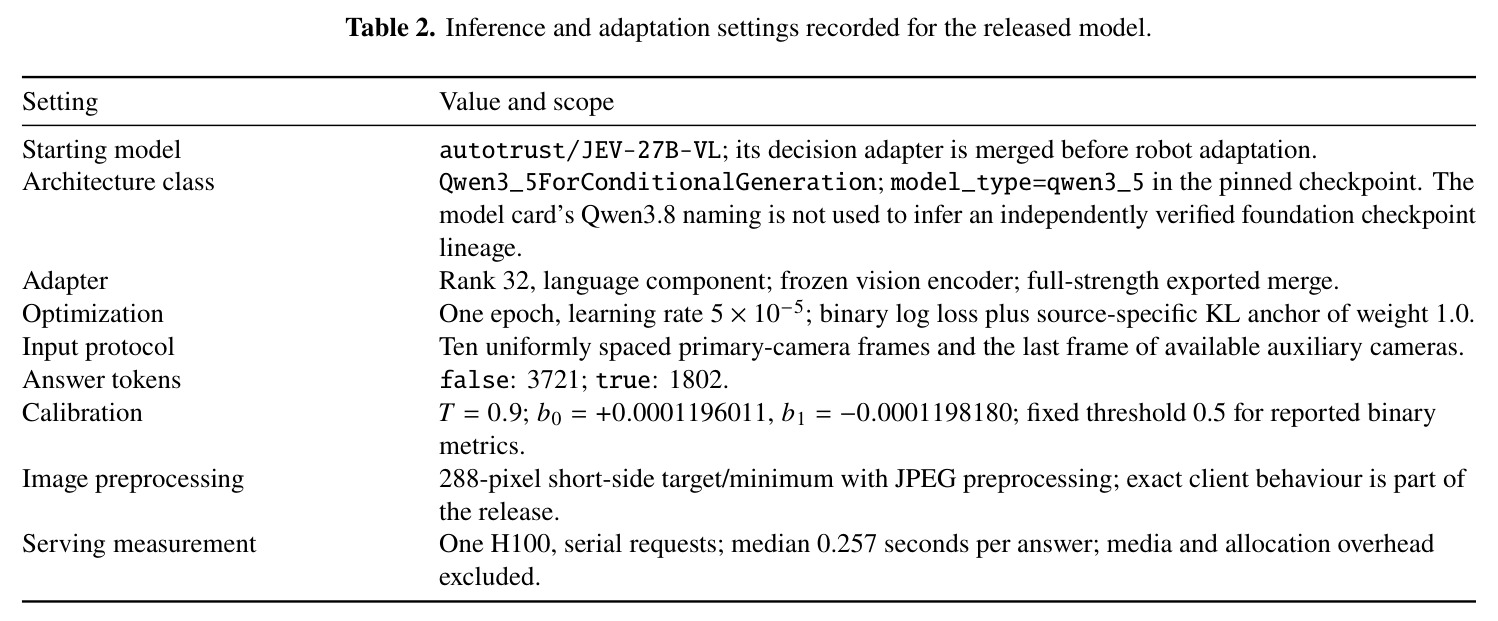
不做自由文本生成,而是让模型在 prompt 指定的答案位置只对 "false"(token 3721)与 "true"(token 1802)两个 token 产生 logits $z_0,z_1$,对其做带偏置 $b_c$ 和温度 $T$ 的 softmax 得到成功概率。等价于把整个 VLM 用作一个二分类头。
这是 RoboJev 与生成式奖励模型的本质区别:单次前向、确定性输出、无解析开销,也是 0.257 秒/条低成本推理的基础。
视觉语言模型(VLM)
接收图像与文本混合输入的 Transformer 模型,通常由视觉编码器(输出 patch/帧级 embedding)、模态合并器(merger)和语言模型主干组成。本文底座 JEV-27B-VL 支持 10+ 帧视频序列输入,架构类为 Qwen3_5ForConditionalGeneration。
论文对视觉编码器与 merger 冻结、只调语言模型的选择,以及帧数协议(dense-v1 十帧 vs clip-v1 四帧)对性能的影响,都需要 VLM 的基本结构知识来理解。
研究动机
机器人操作任务"最终是否成功"的标签通常只有人能判断:AutoEval、RoboArena 这类真实世界评估流程要靠人工逐条观看回放再打分,而 Open X-Embodiment、DROID 等大规模数据集里大量 episode 根本没有机器可读的成败标注。轨迹长度、平滑度、数据来源这类低层启发式无法回答"物体是否真的插进了孔里"。已有奖励模型路线输出的是连续分数而非二元结论:RoboCLIP 从文本指令或视频演示生成轨迹级奖励,Video-Language Critic 用对比损失和时序排序损失训练可迁移奖励,RoboReward 与 Robometer(RBM-1M)关注通用奖励与进度建模;SuccessVQA 虽把成败当作视觉问答,但未发布可直接部署的检测器。对需要复盘失败案例、构建学习型终止奖励或批量评测策略仓库的团队来说,缺少一个便宜、可本地部署、可复现的 episode 级成功判定工具。
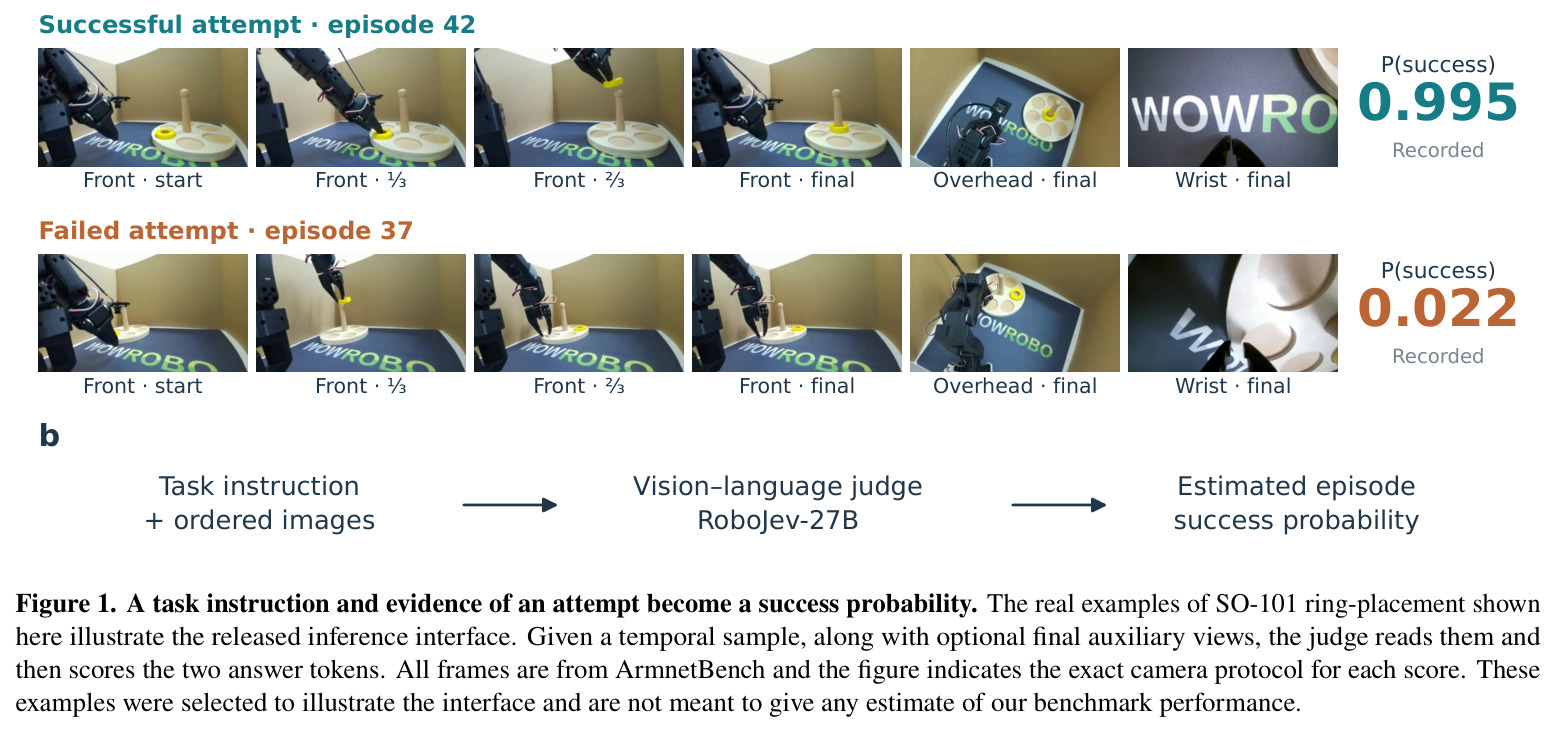
本文的目标是构建一个开源权重的任务条件化 episode 裁判 RoboJev-27B:输入任务指令、主摄像头均匀采样的 10 帧、以及每个辅助摄像头(俯视、腕部等)的最后一帧,单次前向传播输出校准的成功概率。明确目标包括:(1) 在与训练数据同分布的 SO-101 held-out 数据上取得 95% 以上的平衡准确率;(2) 在未见过的实验室/机器人域上保持可用的排序能力(AUROC 约 0.89),即使这可能略低于未微调的基座模型;(3) 推理成本控制在每千次约 0.19 美元(单张 H100、中位延迟 0.257 秒),比 API 前沿模型便宜一个量级以上;(4) 连同训练配方、校准文件与全部逐 episode 预测记录公开,让已发表的所有指标都能被第三方在 CPU 上重算。
与已有工作不同的是,本文的独特之处在于把"专业化与迁移的权衡"本身作为受控研究对象,而不是宣称微调全面胜出。作者把 RoboJev 和基座 JEV-27B-VL 放在完全相同的输入上(相同图像哈希 + 相同任务文本,覆盖 727 条 SO-101 与未见域 episode)做配对比较,用数据回答"微调到底买来了什么、又损失了什么"。方法层面不生成自然语言解释,只对 false/true 两个答案 token 的 logits 做温度校准的 softmax 读出,把 VLM 当作标准二分类器,输出接口与 API 决策模型完全对齐;并引入仅作用于研究数据源的源条件 KL 锚定来保护域外排序能力。评测上发布 20,628 条逐 episode 预测、29 个模型/协议条目的完整 artifact,支持逐条审计,并诚实标注训练教师与 API 基线重合等循环性风险,这种透明度在机器人评测文献中很少见。
核心方法
直觉上,判断“机器人有没有完成任务”主要靠视觉证据,现代开源 VLM 的视觉-语言对齐能力已经足够,缺的只是一个固定、可校准的输出接口和领域适配。技术路线:以开源 JEV-27B-VL 为底座,先合并其自带的 decision adapter,再冻结视觉编码器与 merger,只在语言模型上插入 rank-32 LoRA(alpha 64、dropout 0.05,约 2.33 亿可训练参数)。训练数据为 52,598 条真实 episode(策略失败、人类演示、仿真交互的混合,来自 RBM-1M、ArmnetBench、教师标注社区数据、ViFailback、DROID),增广后每轮 102,172 个样本。损失是源平衡加权的二元交叉熵,加上仅对研究源生效的 KL 锚定项($\lambda=1$)。推理时在答案位置读取 false/true 两 token 的 logits,经 $T=0.9$ 温度缩放与微小偏置后 softmax 得到 P(success),单次前向完成,H100 上中位延迟 0.257 秒。
核心是三个设计。(1) 两 token 校准读出:不生成解释文本,直接取答案位置的 $z_0,z_1$,按 $p_\theta(y{=}1\mid u,V)=\exp((z_1+b_1)/T)/\sum_{c\in\{0,1\}}\exp((z_c+b_c)/T)$ 归一化,token ID(false=3721、true=1802)、偏置与 $T=0.9$ 固化在 decision.json。(2) 源条件 KL 锚定:损失 $\mathcal{L}_i=w_i\,\mathrm{CE}(y_i,q_\theta(x_i))+\lambda\,a(x_i)\,D_{\mathrm{KL}}(q_0\Vert q_\theta)$,指示函数 $a(x_i)$ 只对 RBM 系研究源置 1,社区与 ArmnetBench 数据自由拟合;消融显示锚定把未见域 AUROC 从 0.847 拉回 0.890,是保护迁移的关键。(3) 样本加权:合成负例固定 $w_i=0.5$,原始样本按来源做逆频率类别平衡并截断到 [0.25, 4],防止单一来源主导。三点把 VLM 改造成接口稳定、成本可控、可审计的 episode 级二分类器。
方法步骤详情
第一步,数据准备:汇总 RBM-1M 处理集 28,170、ArmnetBench 1,388、教师标注社区 10,216、社区演示 3,718、ViFailback 4,962、DROID 成功转换 4,144,共 52,598 条 fit 记录;社区标签要求 GPT-6 Astra 与 Sol 在四帧上高置信一致(≥0.9 或 ≤0.1),多教师概率取均值只留两端样本,剔除验证样本与 106 个 owner 后剩 10,216 条。第二步,增广:截断正例与指令错配作启发式负例,加 JPEG 重压缩与颜色扰动,60% 概率走 10 帧协议,共 102,172 个样本。第三步,训练:AdamW、学习率 5e-5、5% warmup 加余弦衰减、梯度裁剪 1.0、全局 batch 14、单 epoch,7 张 H100 约 5.5 小时。第四步,校准:在四个验证源上搜索 adapter 缩放 {0, 0.25, 0.5, 0.75, 1}(约束各源不落后基座 0.005 AUROC,取 1),温度网格 0.25–5.20 最小化验证 NLL 得 $T=0.9$。第五步,推理:主摄 10 帧 + 辅助末帧(dense-v1),288 像素短边 JPEG 预处理,单次前向读出两 token 概率。
技术新颖性
新颖性不在新架构(作者明确声明只是组合现成组件),而在评估方法学与工程诚实度。(1) 首次把“微调裁判在匹配输入下是否仍优于其基座”做成受控实验:相同图像哈希与任务文本下,SO-101 平衡准确率 +7.08 个百分点(95% CI [3.04, 11.45]),未见域 AUROC 差 $-0.0092$(CI 含零),给出“适配带来同域收益但不产生可迁移改进”的直接证据,对微调 VLM 做奖励模型的路线是有价值的负结果。(2) 源条件 KL 锚定区别于全局正则化:允许社区数据自由拟合同域分布、同时用研究数据锚住基座行为,消融证明其独立贡献约 4.3 个 AUROC 点。(3) 发布逐 episode 预测 artifact(20,628 条、29 个条目),全部 118 个已发表数字可用 CPU 脚本重算到给定精度,可审计性罕见。(4) 把 20 多个决策类 API 与开源模型纳入同一协议面板横评,并如实声明与 API 基线的输入帧数不对等。
实验结果
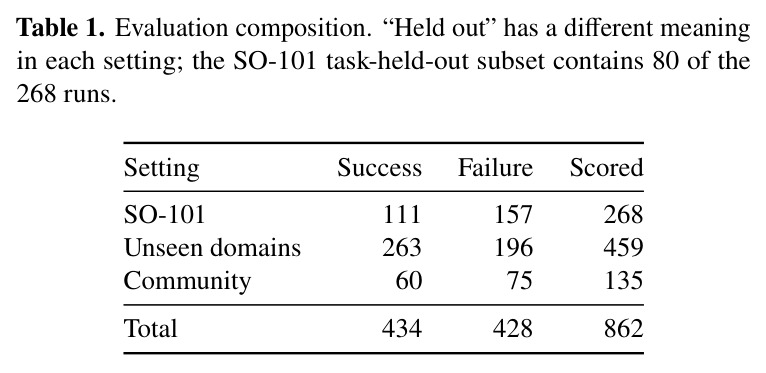
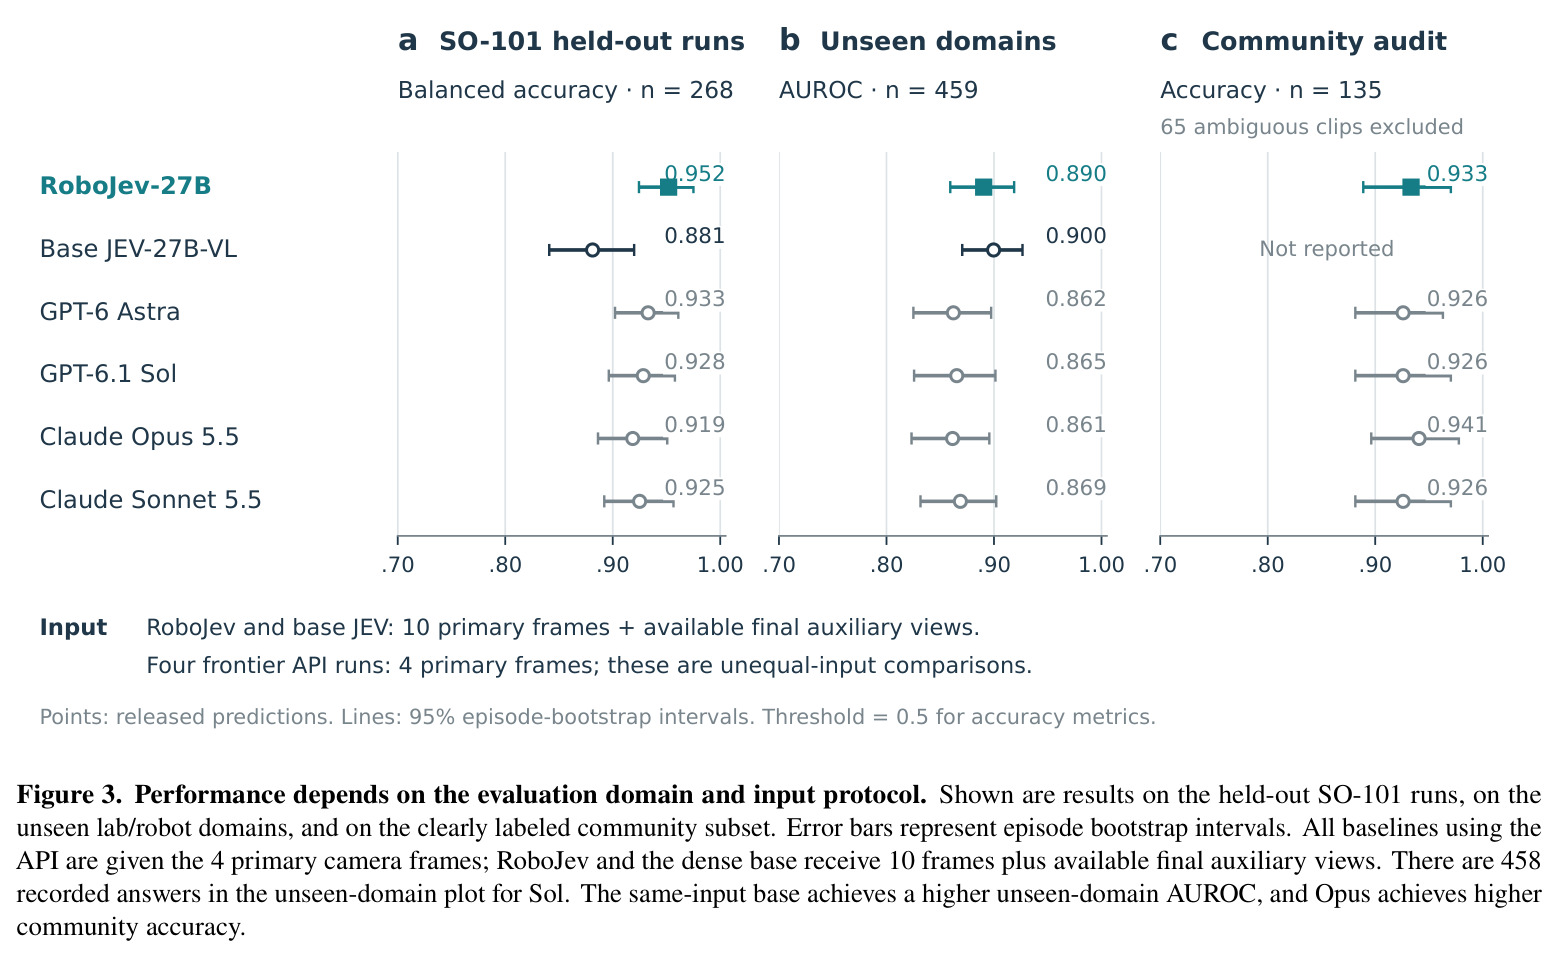
(1) 同域判别:268 条 SO-101 held-out 上 RoboJev 平衡准确率 95.2%、AUROC 0.993、ECE 0.032;同输入基座 JEV-27B-VL 为 88.1%/0.979,配对差 +7.08pp(CI [3.04, 11.45])显著。(2) 迁移失败:459 条 RBM-1M OOD 上 RoboJev 78.2%/0.890,基座同输入 79.4%/0.900,AUROC 差 $-0.0092$(CI 含零);对 4 帧 Astra 的非受控比较高 0.0282。(3) 任务级 held-out:80 条 held-out 任务上 RoboJev 92.5%(AUROC 0.986)胜基座 91.3%,但 4 帧 Astra/Sol 达 96.3%。(4) 社区视频:135 条明确标注上 RoboJev 93.3%(126/135,AUROC 0.984),Opus 5.5 最高 94.1%,65 条模糊视频保留不计分。(5) 消融:KL 锚定使未见域 AUROC 0.890 vs 无锚定 0.847;只用末帧降至 0.776,时间上下文关键。(6) 校准与成本:ECE 从 0.032(SO-101)恶化到 0.148(未见域);H100 中位 0.257 秒/条、约 $0.192/千次,比 API 模型便宜 5–50 倍。
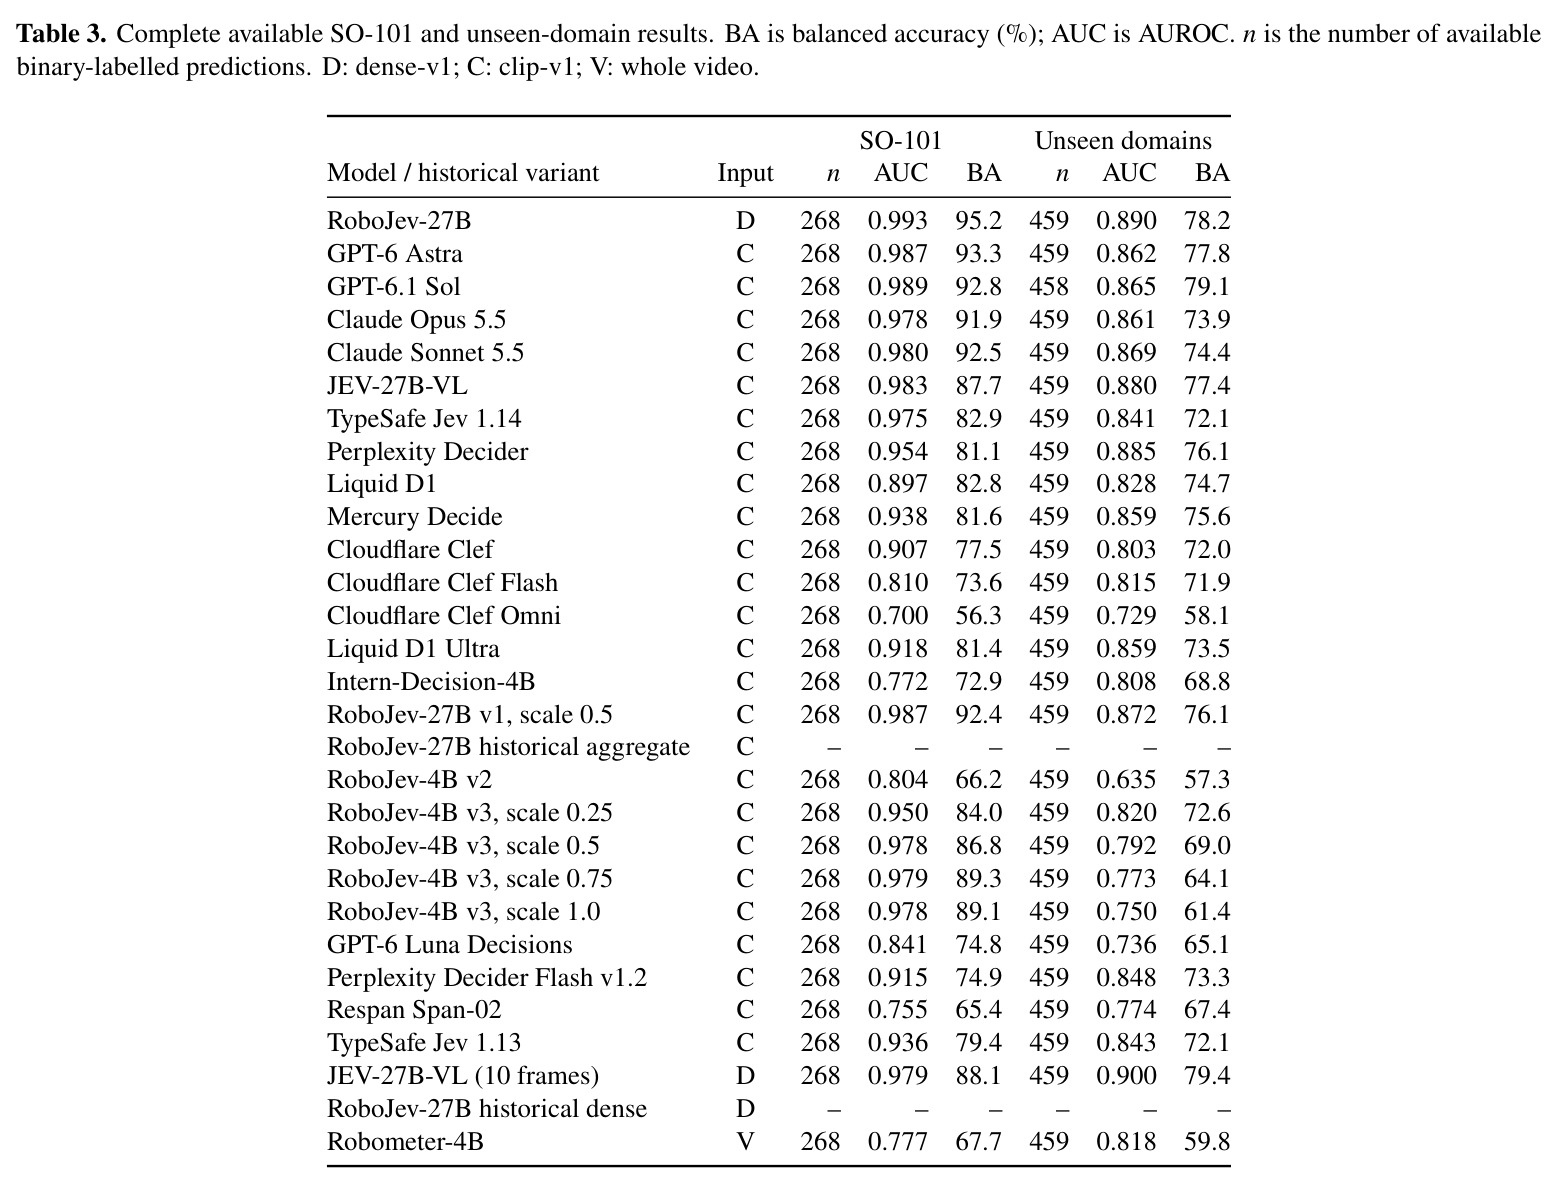
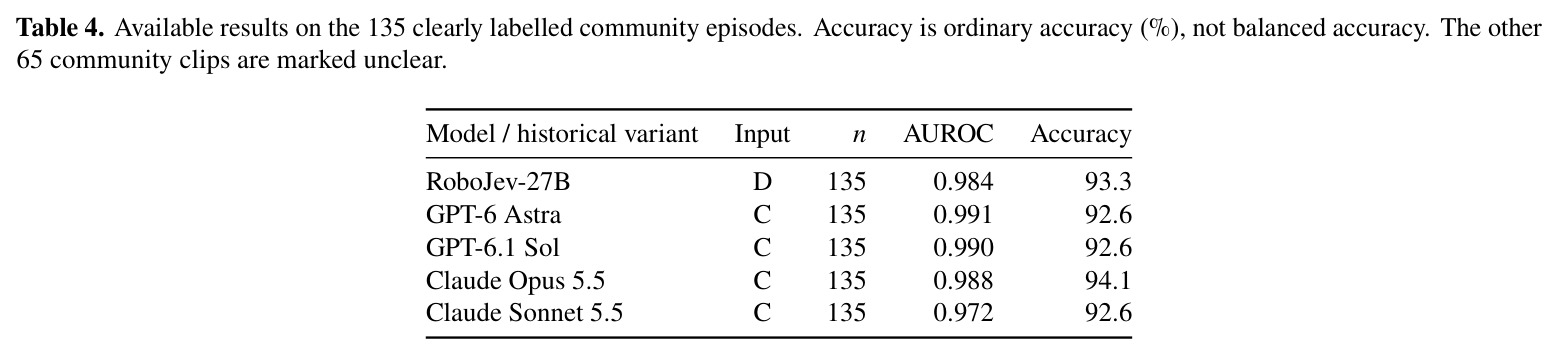
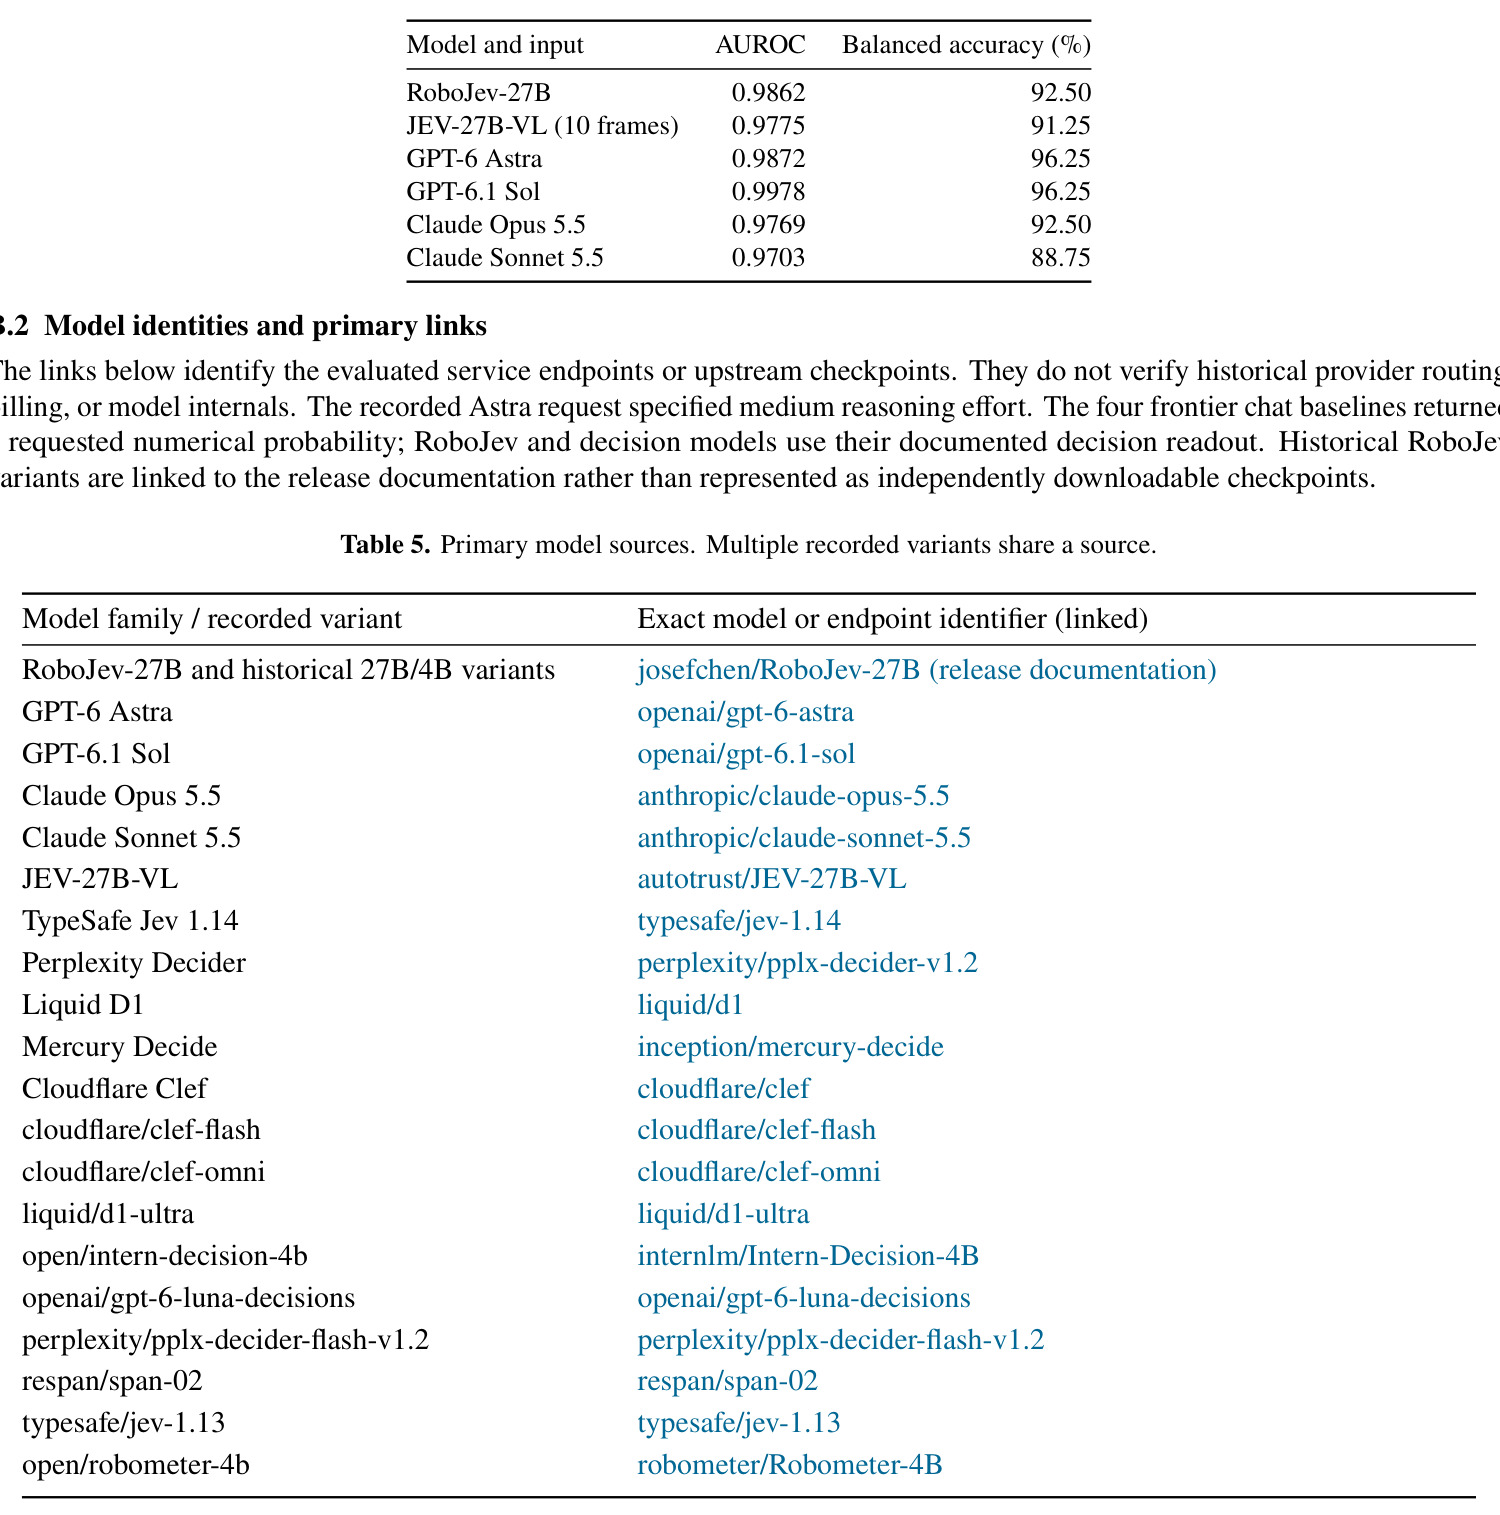
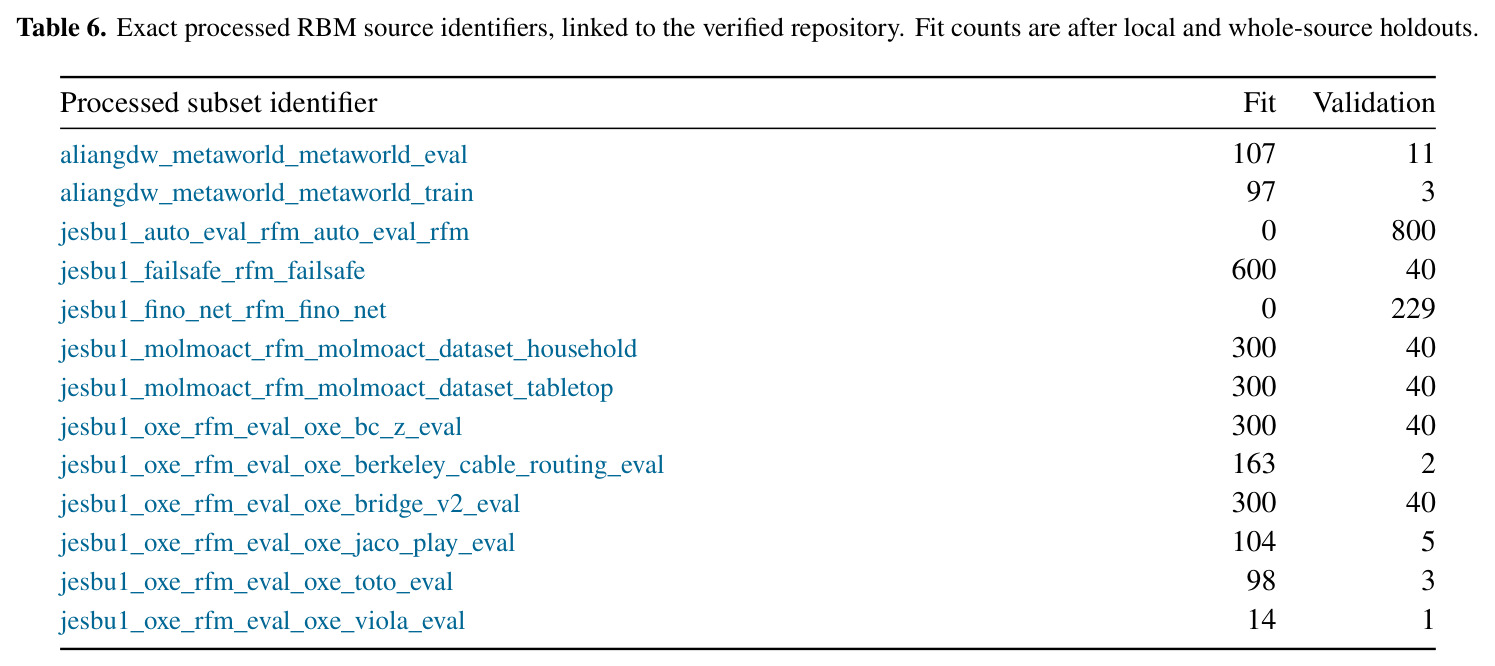
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SO-101 held-out 成功判定(268 条) | 平衡准确率 | 95.2% | 基座 JEV-27B-VL(同 10 帧输入)88.1% | +7.08pp(95% CI [3.04, 11.45],显著) |
| SO-101 held-out 成功判定 | AUROC | 0.993 | GPT-6 Astra(4 帧输入)0.987 | +0.006(输入不对等的非受控比较) |
| 未见实验室/机器人域(459 条 RBM-1M OOD) | AUROC | 0.890 | 基座 JEV-27B-VL(同输入)0.900 | -0.010(CI 含零,无迁移收益) |
| 未见域(消融) | AUROC | 0.890 | 无 KL 锚定变体 DB 0.847 | +0.043(锚定的独立贡献) |
| 社区明确标注视频(135 条) | 准确率 | 93.3%(AUROC 0.984) | Claude Opus 5.5(4 帧)94.1% | -0.8pp(差异在噪声范围内) |
| 部署成本 | 每 1000 次判定成本 / 中位延迟 | 约 $0.19 / 0.257 秒(1×H100) | API 决策模型约 $1–10 / 0.2–10 秒 | 成本降低约 5–50 倍 |
局限与改进
作者承认的:可观测性限制(腕部相机看不到目标、视频过早结束、稀疏采样会错过接触、溅洒、恢复等瞬时事件);社区训练标签由 GPT-6 系教师生成,一致性过滤无法消除教师间的相关错误;社区测试标签仅 1 名人工标注者,无标注者间一致性估计;无法保证与基础模型预训练数据无重叠;已发布测试集在建模过程中被检视过,不是完全一次性盲测;仅覆盖 8 个测试域,对实际部署的代表性有限;验证集上校准的温度不代表新域校准(未见域 ECE 0.148 即为实证);未测试指令改写敏感性(VLM 奖励模型的已知弱点);每个模型只跑单种子未做平均。我的补充:(1) 与 API 基线输入不对等(10+2 帧 vs 4 帧),头条数字可能被误读为同等条件胜出;(2) 训练教师(Astra/Sol/Opus)与 API 基线面板重合,社区标注存在循环性风险;(3) 社区 loader 报告的 11,415 条与最终 11,387 个 key 之间 28 条差异原因未查明;(4) 数据 harvest 未固定到仓库历史版本,字节级不可重建;(5) 二元输出丢弃过程信息,不能直接用于奖励塑形或进度监控。
独立分析的弱点
(1) 迁移失败只是被诚实记录而非解决:adapter 缩放只在 {0, 0.25, 0.5, 0.75, 1} 里按社区验证选了 1。改进方向:按机器人族路由的多 adapter、域平衡采样、或把锚定强度 $\lambda$ 从二值指示改成按源自适应的连续调度。(2) 校准跨域崩坏(ECE 0.032→0.148)且系统性低估成功概率:可引入新域上少量标注的局部重校准,或用 conformal prediction 给出带覆盖保证的预测集。(3) 与 API 的比较输入不对等:应补一组给 API 模型喂 10+2 帧、或给 RoboJev 只喂 4 帧的 matched-budget 实验,分离“模型能力”与“输入预算”。(4) 教师标签循环性:训练教师(Astra/Sol/Opus)与 API 基线面板重合,社区标注可能偏向自家教师;改进是引入与基线面板无关的人工或跨厂商标注,并做多人标注、报告一致性系数。(5) 未测指令改写鲁棒性,而已有基准证明 VLM 奖励模型对措辞脆弱。(6) 单人作者加模型辅助写作,验证依赖脚本重算而非独立端到端复现。
未来方向
作者提出的:(1) 在匹配输入的更受控设置下与前沿模型重新比较;(2) 纳入更多人工标注的域;(3) 探索把 RoboJev 作为学习型终止奖励训练下游策略——已实现 LeRobot 插件(计算 episode 奖励 + 阈值化 processor)与 grader,但未测对策略学习的实际影响;在线闭环使用还需研究控制器对奖励错误的利用与过早终止问题。基于成果可延伸的方向:(1) 用已测得的约 4.9 GPU-小时成本把 68,555 条 episode、7,641 个公开数据集、501.17 小时的目录全量重评,建立公开的"数据集质量审计"排行榜;(2) 在同一底座上加进度回归头或逐帧打分头,统一成功判定与过程奖励,服务策略学习场景;(3) 指令改写鲁棒性基准(沿 ROBORMBENCH 方向);(4) 把 KL 锚定推广为按域自适应的 $\lambda$ 调度并研究其与权重插值的组合效应;(5) 用裁判对海量无标签 episode 做主动学习式筛选,让失败案例反哺策略训练(failure-driven data curation)。
复现评估
开源程度很高:Apache-2.0 权重(pinned commit e089a9b6,bf16 约 55GB,面向 80GB GPU)、推理代码、校准文件(token ID false=3721 / true=1802,$T=0.9$,偏置约 $\pm1.2\times10^{-4}$)、LeRobot 插件与 grader、20,628 条逐 episode 预测数据集、纯 CPU 的指标重算脚本(118 个已发表数字全部复现到给定精度)。附录 C 给出 41 个 RBM 源 key 的精确标识符与 fit/validation 计数。算力:训练 7×H100 约 5.5 小时(约 38.5 GPU-小时),单卡 H100 即可推理。缺口:数据 harvest 未固定到历史仓库版本,无法字节级重建全部训练输入;社区训练源列表未完全公开且部分源已不可访问;若干 RBM 源无明确 license;API 基线是历史调用记录,无法精确复现。总体:复现推理与指标=容易;复现训练=中等;复现 API 对比=不可能逐字节。这种连 28 条差异都如实标注“原因未确定”的披露水平属同类最佳实践。
论文图表
三个域的 10-bin 可靠性图:ECE$_{10}$ 分别为 0.032(SO-101)、0.148(未见域)、0.027(社区),Brier 分数 0.033/0.162/0.052,竖线为 95% Wilson 区间,直方图按成败分离。未见域面板清楚显示模型经常把成功 bin 的概率压低,即系统性低估成功概率。
校准不跨域迁移的直接可视化证据,支撑"部署到新域前应做局部标注校准"的实践建议。