RoboJudge:面向具身视频生成的多模态大模型裁判 RoboJudge: Multimodal Language Models as Judges for Embodied Video Generation
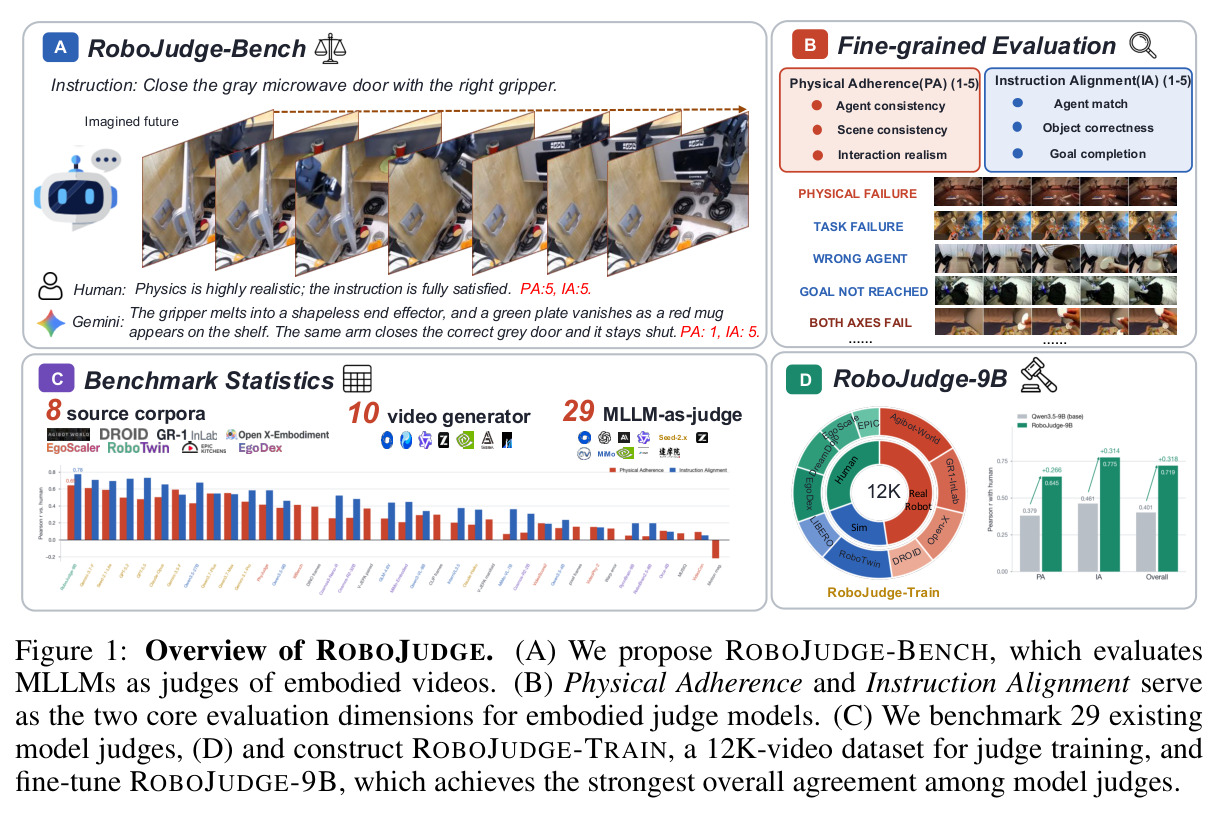
构建具身视频裁判基准并训练9B裁判模型,与人类评分相关性达0.719居首
前置知识
MLLM-as-a-Judge(多模态大模型裁判)
用 GPT、Gemini、Qwen-VL 等多模态大模型代替人类,对生成内容(图像、视频)按给定评分标准打分或排序的做法。裁判输入视频帧与评分标准,输出分数和评分理由,其可靠性用与人类评分的一致性(如相关系数、精确匹配率)来衡量。
本文研究的正是这类裁判在具身视频上是否可靠,并据此训练出更可靠的专用裁判 RoboJudge-9B。
具身世界模型(Embodied World Model)
以视频生成模型为基础、能预测机器人执行动作或任务指令后物理世界如何演变的模型。它为规划与策略学习提供“想象”的未来轨迹(rollout),因此 rollout 必须物理有效且与指令一致,否则下游规划会被误导。
论文动机所在:裁判评估的对象正是这些 rollout 的物理有效性(PA)与指令一致性(IA)。
SFT 与 GRPO
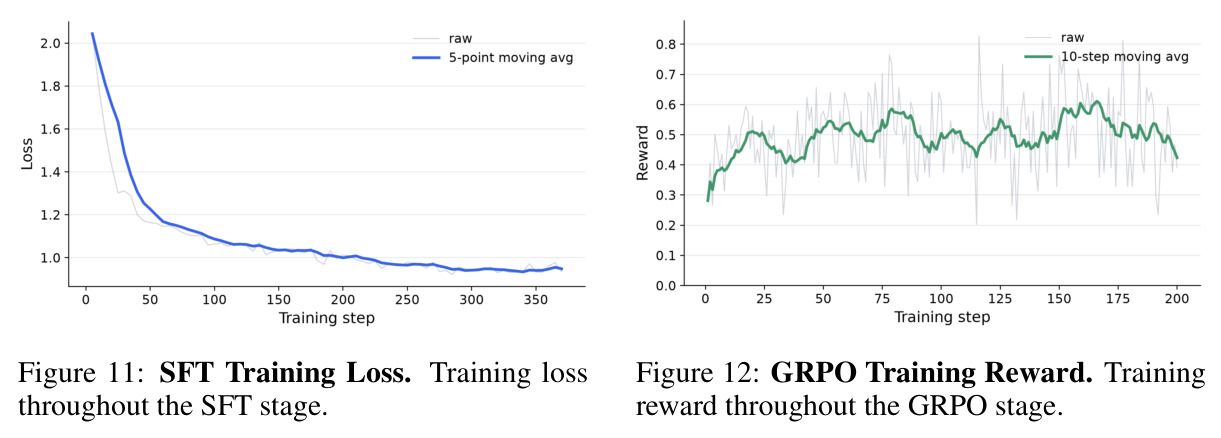
SFT(监督微调)用标注好的输入-输出对全参数训练模型;GRPO(组相对策略优化)是强化学习算法,对同一 prompt 采样一组回答,用组内相对优势更新策略,无需独立价值网络。本文 GRPO 的奖励在预测分数与人类分数精确相等时取 1,否则取 0。
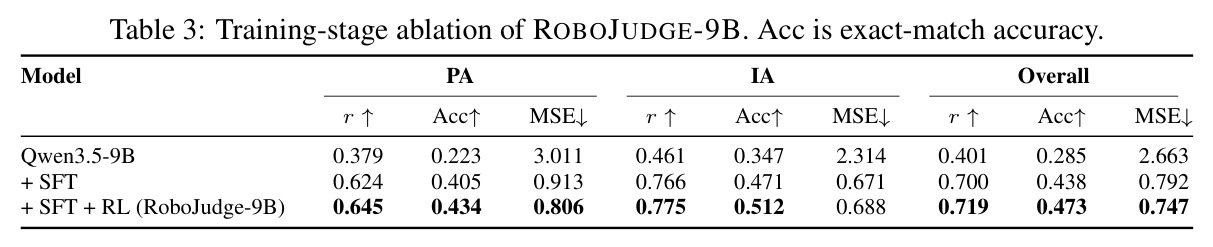
RoboJudge-9B 就是 Qwen3.5-9B 先 SFT 后 GRPO 训出来的,两阶段分别把总体相关性从 0.401 提到 0.700 再提到 0.719。
一致性指标:Pearson r / 精确匹配 / MSE
Pearson 相关系数 $r$ 度量模型分数与人类分数的线性相关,对整体打分尺度的系统性偏移不敏感;精确匹配 Acc 要求预测分数与人类分数完全相等;MSE 则对系统性评分偏移敏感。三者互补,构成完整的裁判评测协议。
论文主表与所有结论都用这三个指标表述,如 RoboJudge-9B 总体 $r=0.719$、Acc 0.473、MSE 0.747。
首帧条件视频生成(I2V)
给定初始帧图像和文本指令,视频生成模型从该帧出发外推后续画面。本文数据流水线即从真实操作片段提取首帧-指令对,交给 Veo 3.1 Lite、Wan、CogVideo 等 14 个生成器生成“想象的未来”视频。
评测样本全部由这条流水线产生;理解首帧条件才能看懂 IA 评分中“第一帧是初始场景”的设定与数据构建步骤。
研究动机
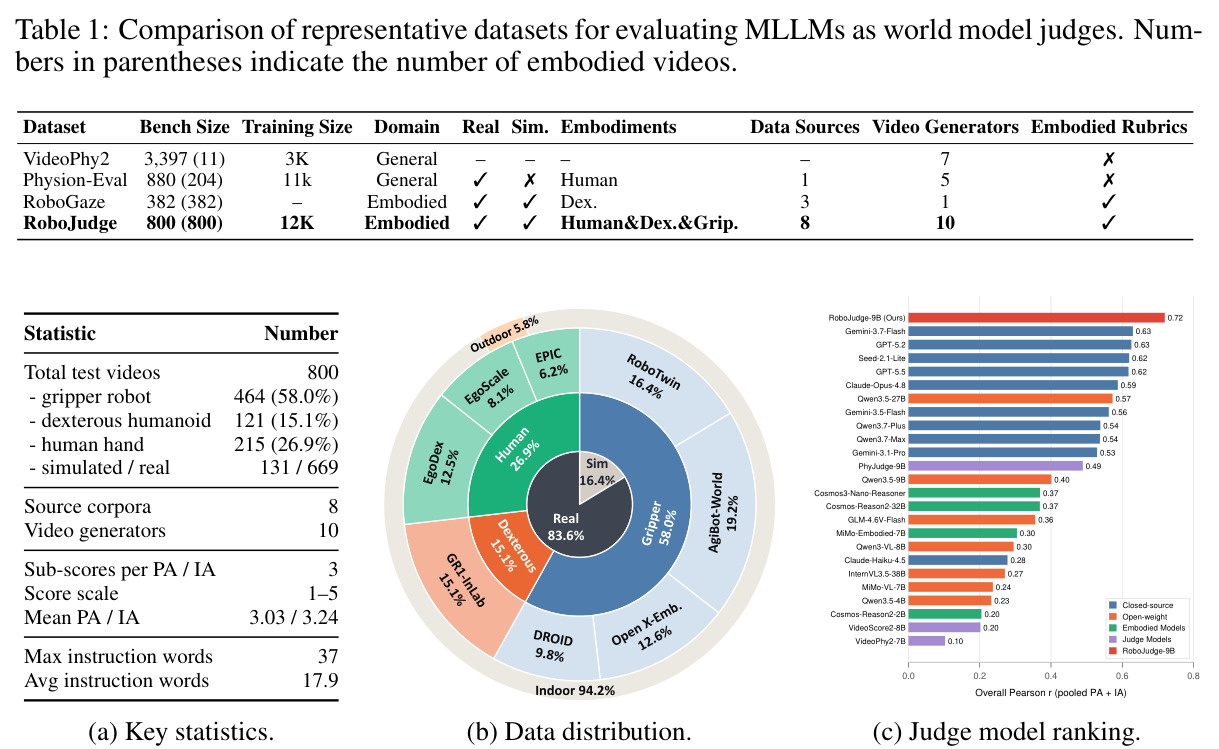
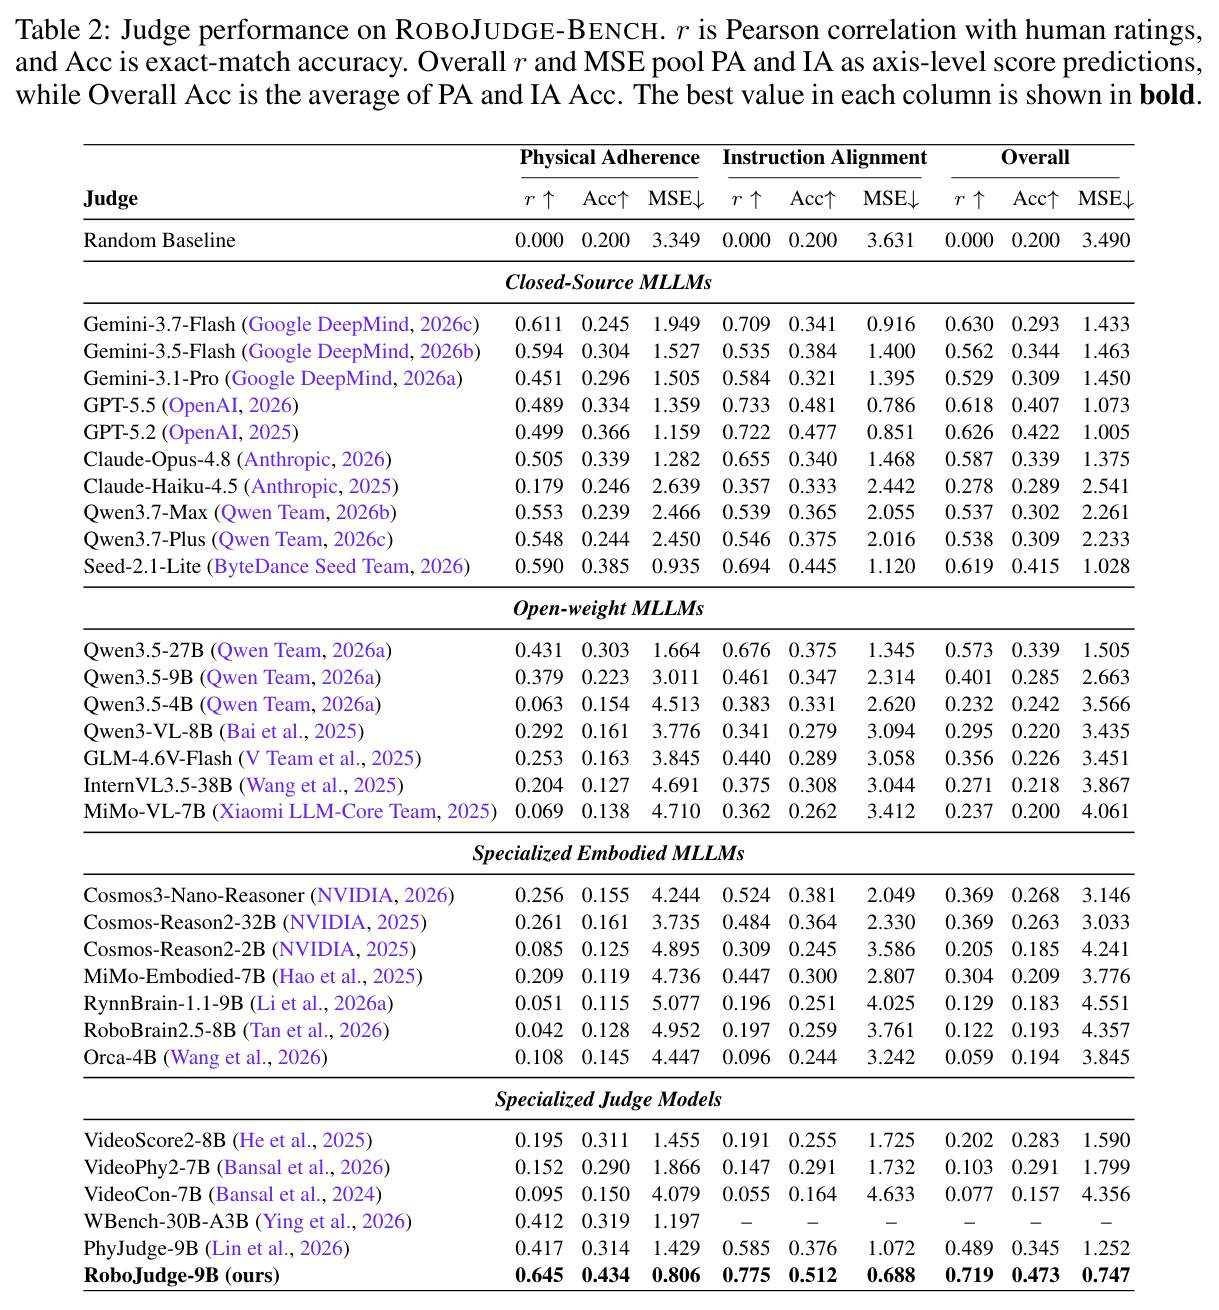
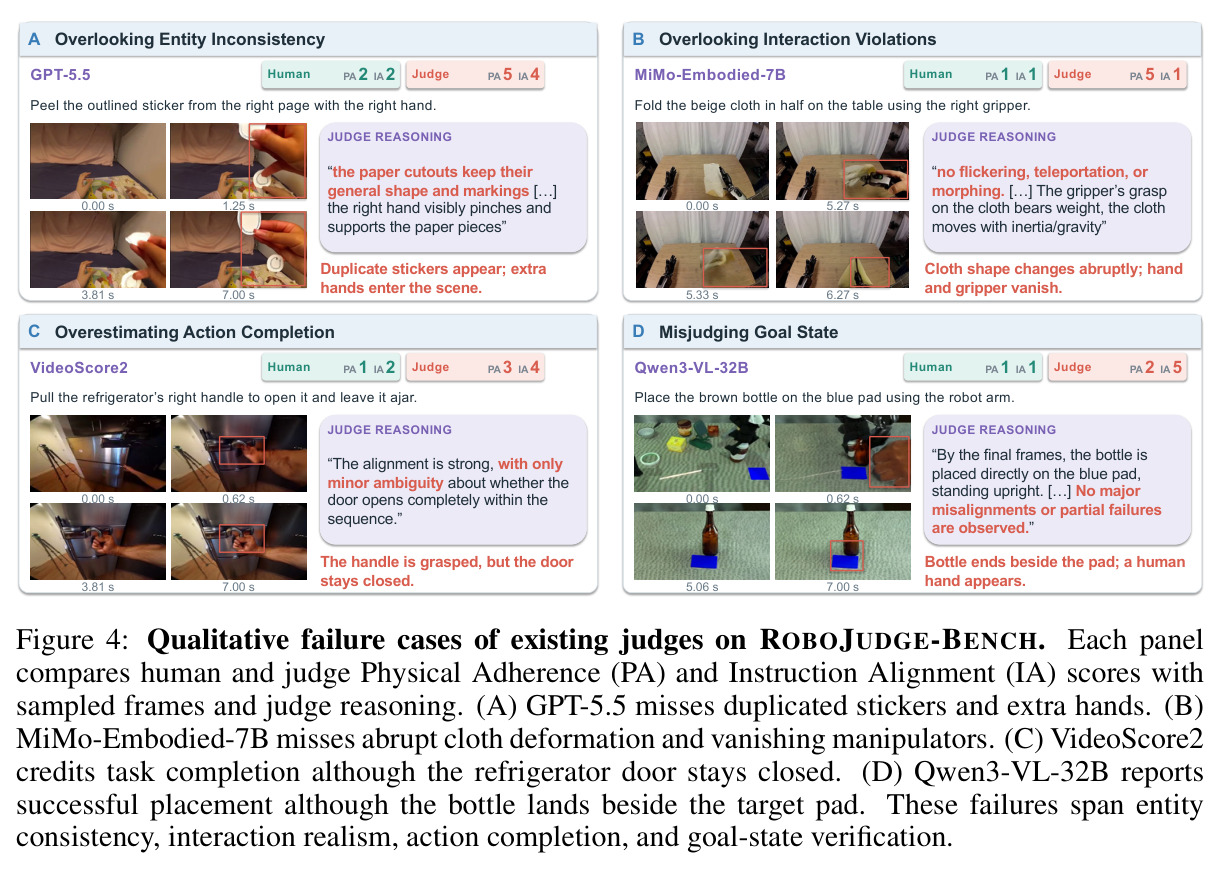
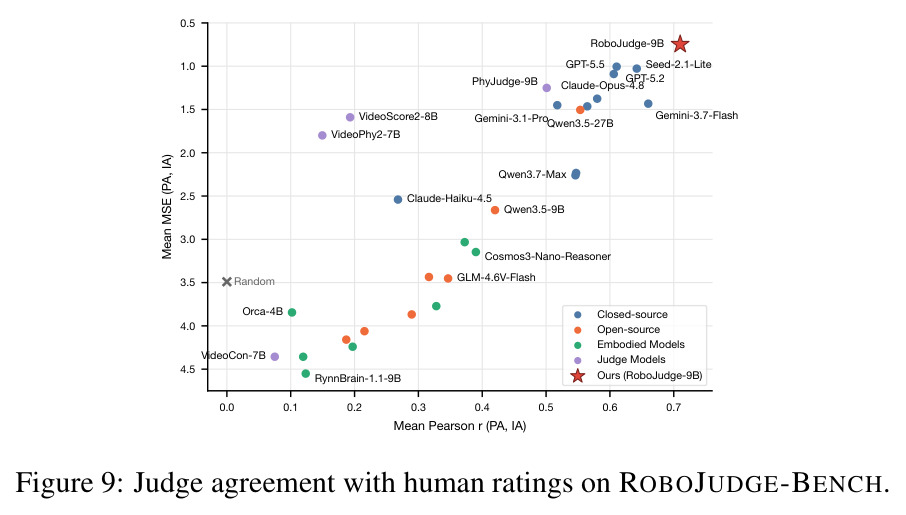
视频生成模型正被寄望于成为具身世界模型,为机器人规划提供“想象”的未来轨迹,这要求 rollout 不仅视觉逼真,还必须物理有效且忠于任务指令,但现有评估手段无法同时覆盖这两点。像素、感知和表征级指标(PSNR/SSIM、FVD、CLIP/DINO/V-JEPA 相似度)只能度量与参考轨迹的相似性,而开放任务执行使参考式比较本质上不可靠,更无法区分“物理崩坏”与“任务失败”。通用 MLLM 缺乏具身校准:本文评测中最好的闭源模型 GPT-5.5 在物理 adherence(PA)上与人类评分的相关系数仅 $r=0.49$。专用视频裁判(VideoPhy2、VideoScore2 等)面向通用域质量或物理常识,迁移到具身场景后 PA 最多 $r=0.42$、IA 最多 0.59。具身专用 MLLM 更差:RoboBrain2.5-8B、RynnBrain-1.1-9B 在 PA 上接近随机($r\leq 0.07$)。失败分析显示,现有裁判会漏掉重复出现的贴纸和凭空多出的手、忽略布料瞬变与手部消失,甚至把冰箱门没打开、瓶子落在垫子旁边判为任务成功。
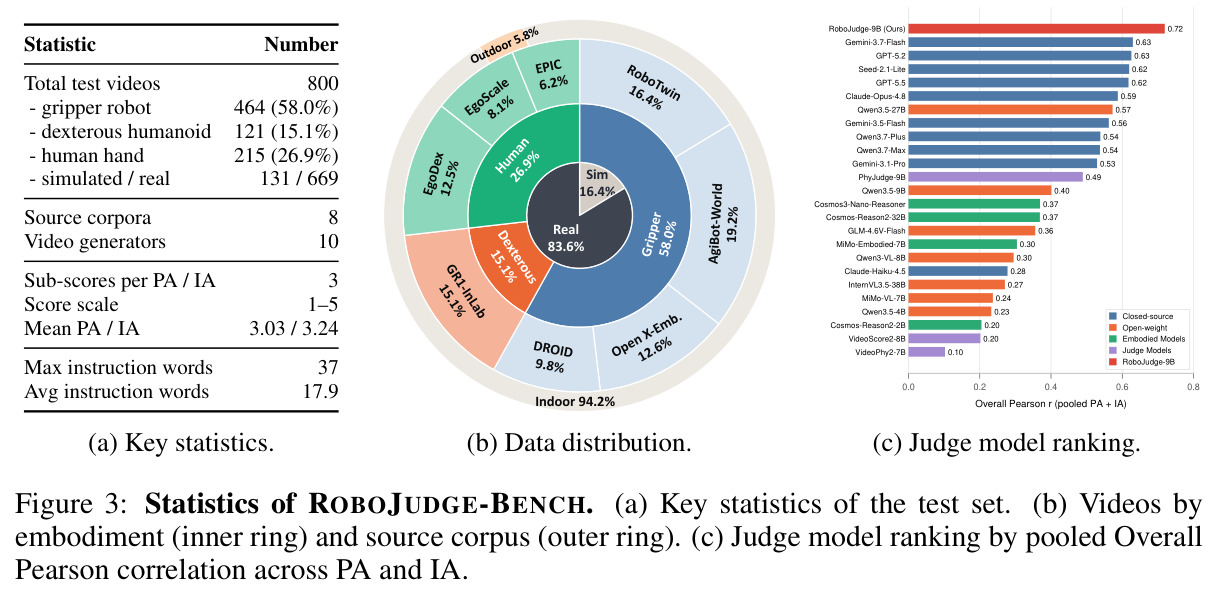
本文的目标是本文要回答的问题不是“哪个视频生成器更强”,而是“我们用来评视频生成器的裁判到底可不可靠”。具体目标分三层。第一,构建 RoboJudge-Bench:800 条带指令的生成视频,来自 8 个具身源语料库、由 10 个视频生成模型生成,覆盖机器人夹爪、灵巧手、人手三类执行器与真实/仿真两种环境,每条视频由人工按 1-5 分标注物理 adherence(PA)与指令对齐(IA)两个维度并附评分依据,采用标注员四轮校准、交叉复核加专家仲裁的质量控制。第二,系统测量 29 个模型裁判与 8 个非 MLLM 指标和人类评分的一致性,定位失败模式。第三,构建 12K 视频、25K 人工核验分数的 RoboJudge-Train 训练集,微调出 9B 专用裁判 RoboJudge-9B,在基准上取得最高一致性(总体 $r=0.719$),在 VideoPhy2、Physion-Eval 等外部基准验证泛化,最后作为下游评测器给 17 个视频生成模型按 PA/IA 双轴排名。
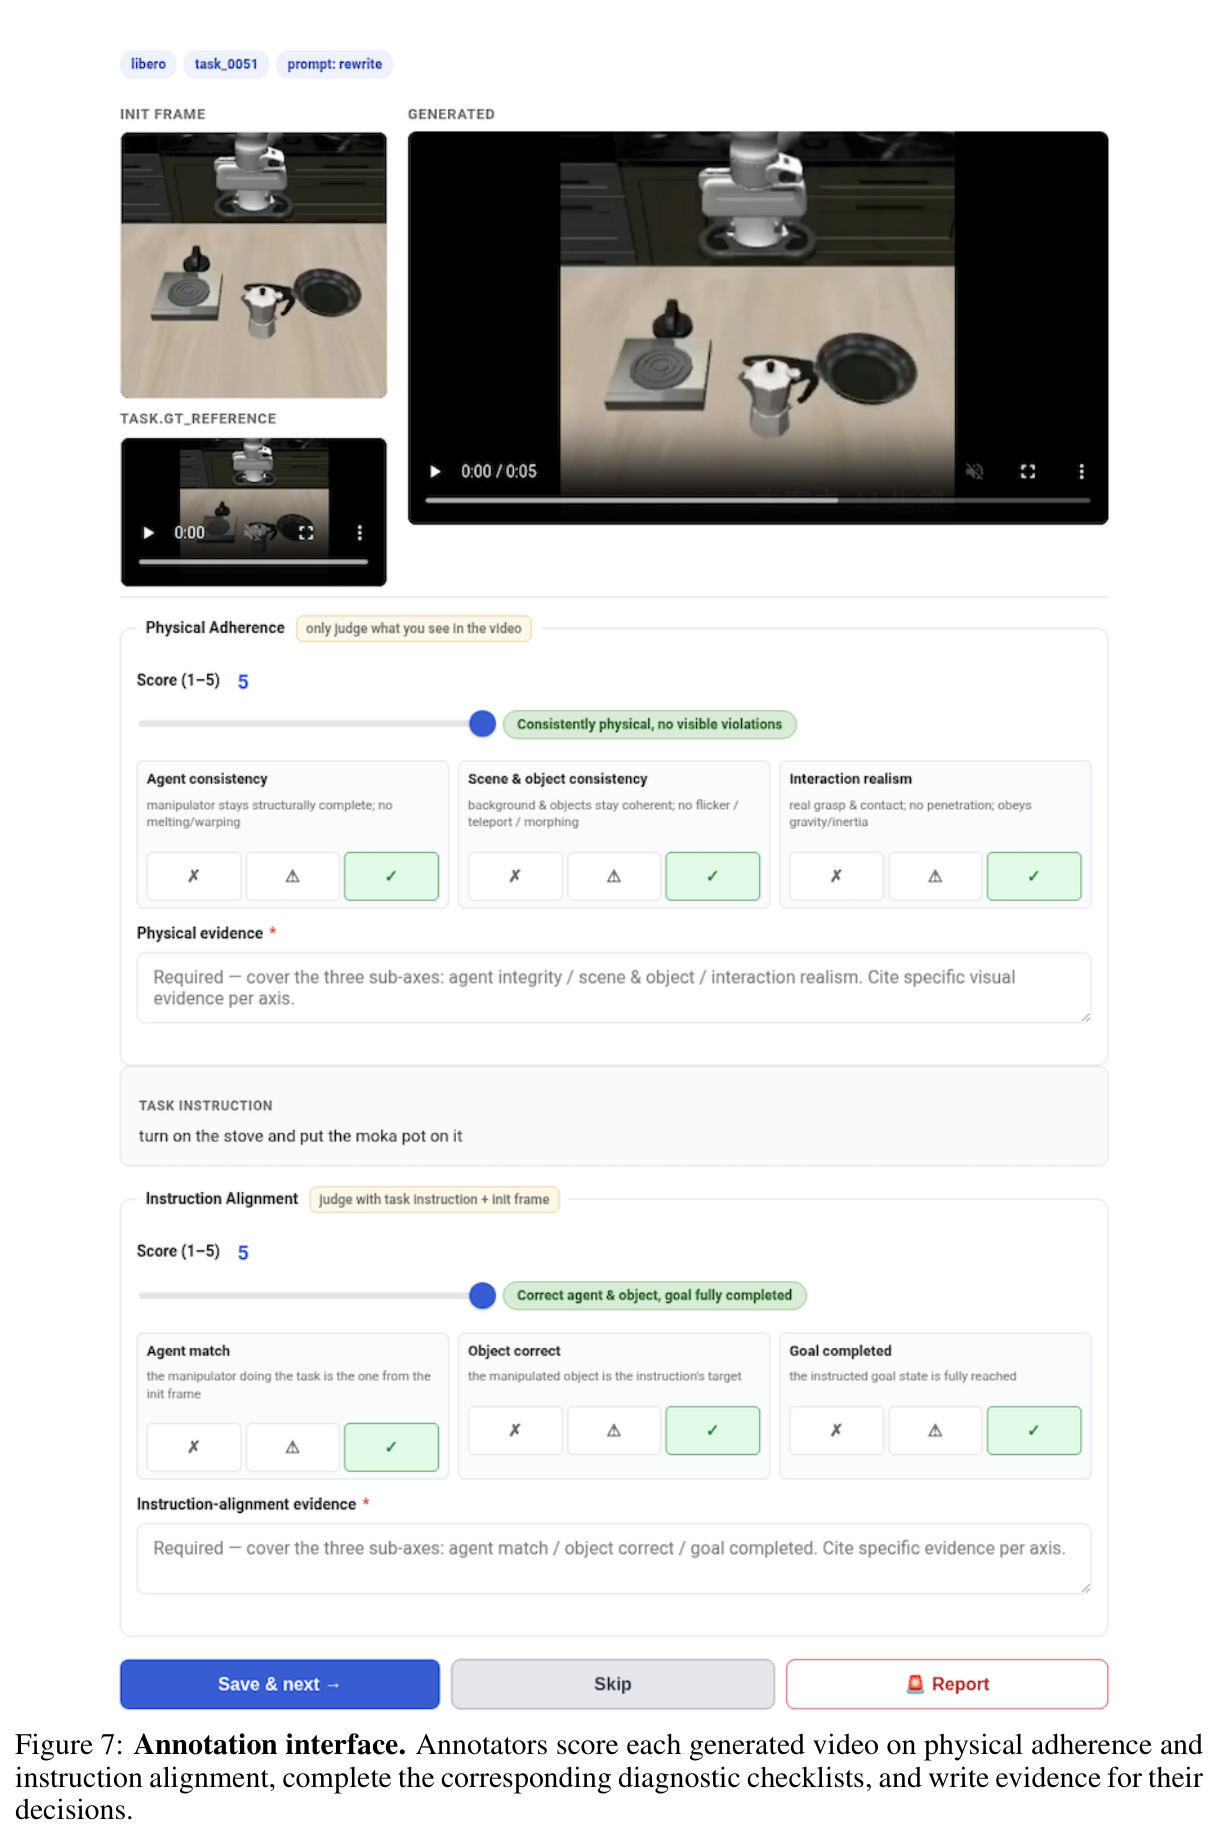
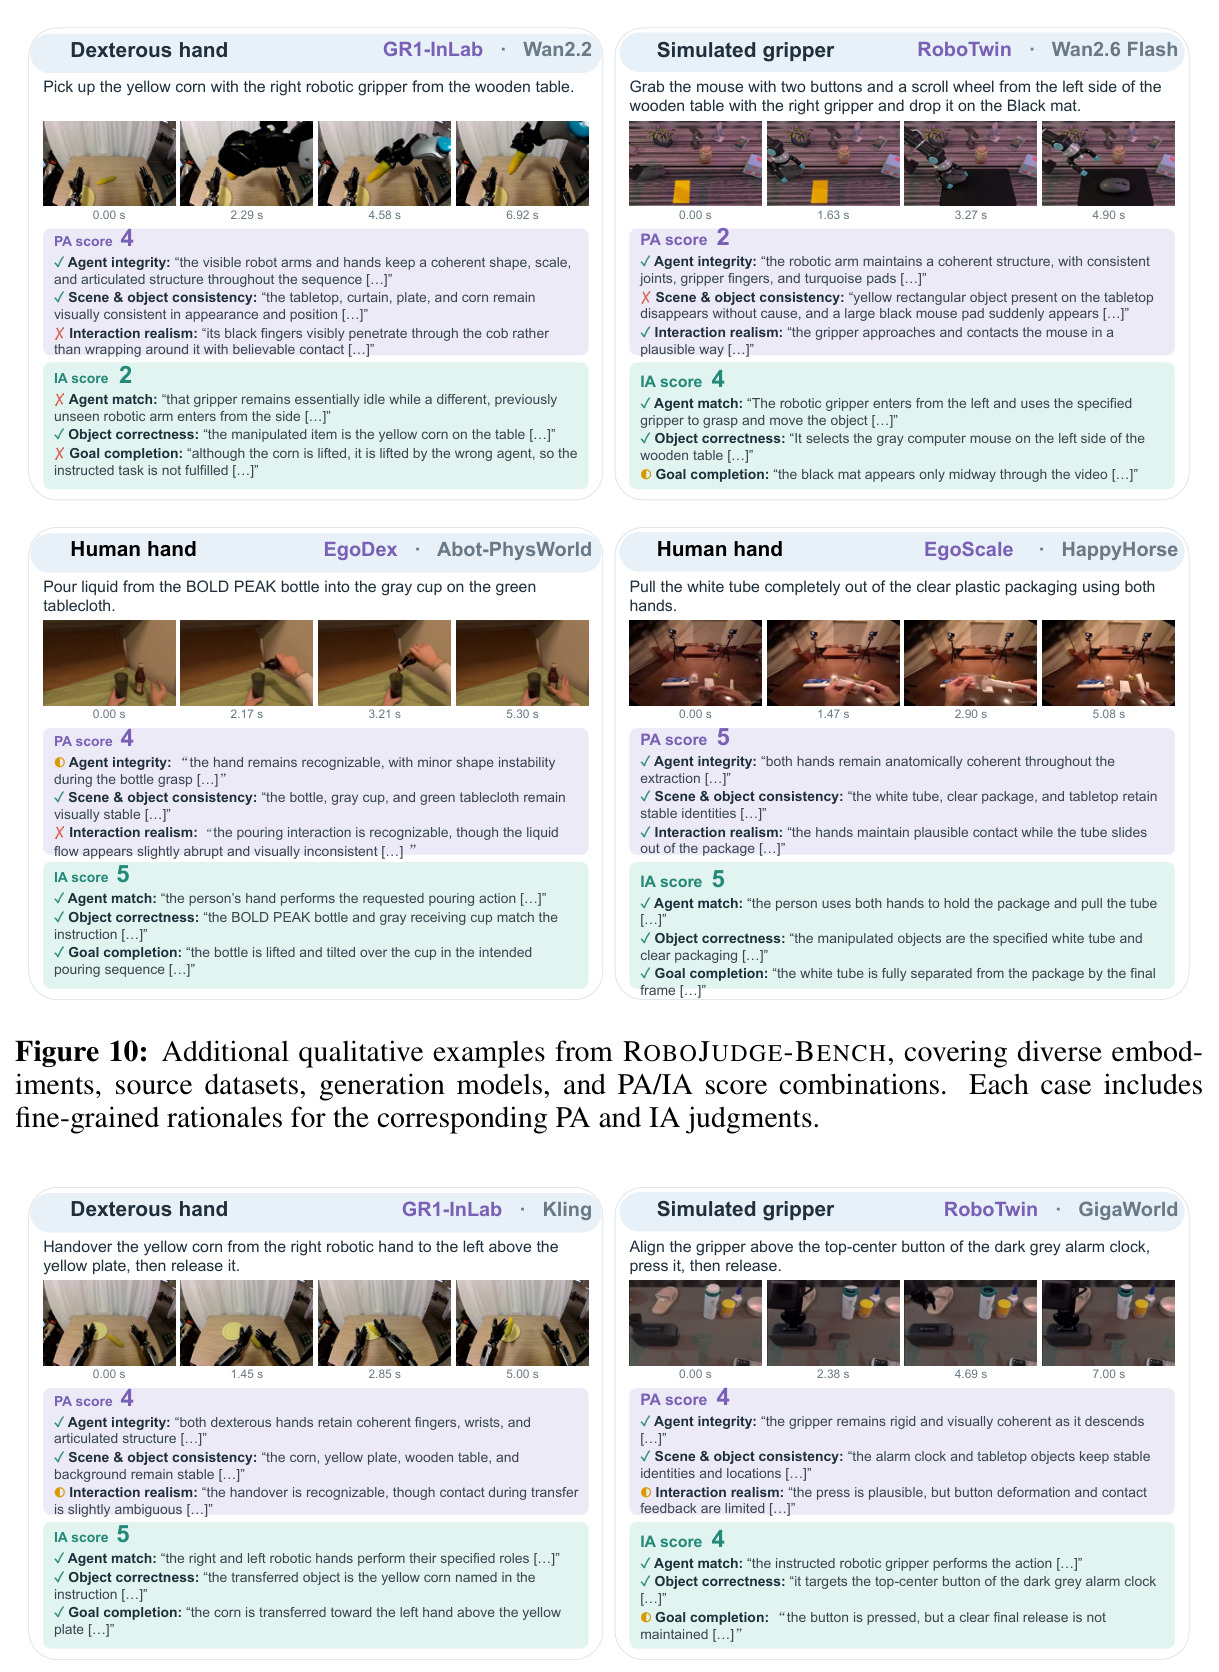
与已有工作不同的是,独特切入角度有三点。其一,评测对象倒转:现有具身世界模型基准(WorldArena、EWMBench 等)评测生成器本身,本文评测“裁判的可靠性”——裁判可信是一切下游排名的前提,这一视角此前缺乏系统研究。其二,双轴解耦的评分体系:把物理合理性(PA)定义为与指令无关、只看视频本身是否遵守物理(执行错动作但物理正常仍可拿满分),把指令对齐(IA)定义为条件于指令和首帧的任务执行质量,两轴各拆三个细粒度评分项(PA:agent 完整性/场景一致性/交互真实性;IA:agent 匹配/对象正确性/目标达成),并用真实案例证明两者会背离——如一段视频 PA=4 但 IA=2(物理正常却没把物品装进袋子)。其三,规模化的人机协同监督:三个闭源 MLLM 预标取平均、人工修正、再由 GPT-5.5 按人类核验分数改写结构化推理链,以较低成本获得 24,702 条轴级训练样本;训练时用 GRPO 直接优化“分数精确匹配”这一评测指标本身,而非泛化的偏好奖励。
核心方法
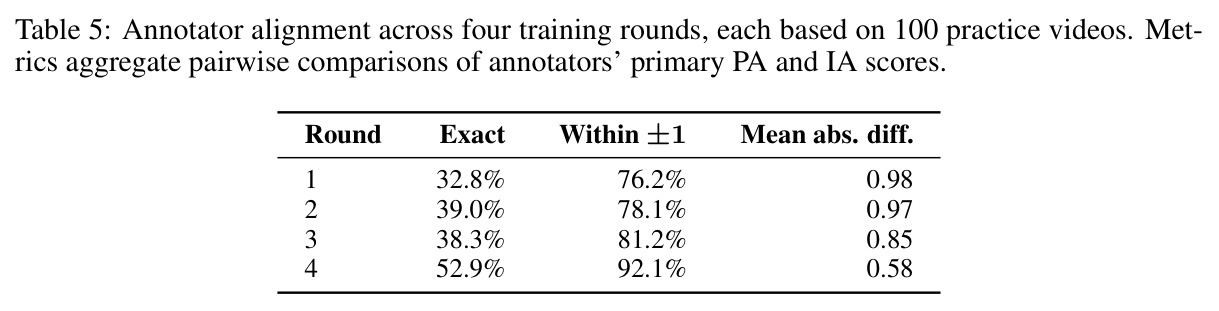
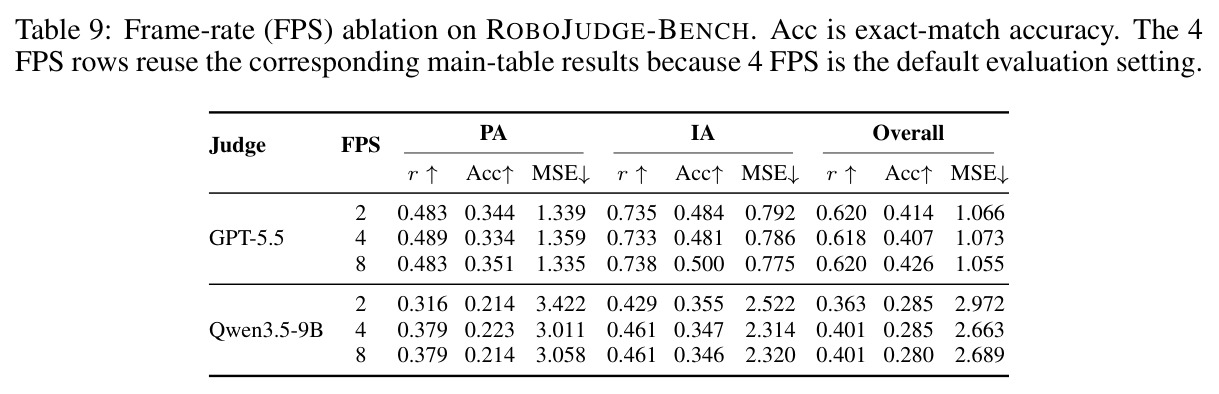
直觉上,这件事像培养一位懂机器人操作的质检员:给他看一段 AI 生成的操作视频和任务指令,他要在两套评分表上打分——物理上哪里穿帮(夹爪融化、物体凭空出现、接触穿透),任务上哪里没做到(抓错物体、目标状态未达成)。技术路线分三步。第一步数据构建:从 8 个源语料库抽取操作片段,提取首帧-指令对,GPT-5.5 起草精炼指令并由人工对照首帧校验,再用 5 个改写模板加 5 个前缀模板构造 10 种 prompt 变体,喂给 14 个生成器得到数据池(测试集取其中 10 个的 800 条)。第二步标注:20 名研究生标注员经 4 轮校准(精确一致率 32.8%→52.9%),测试集由一人标注、一人交叉复核、专家仲裁定稿,训练集采用模型预标加人工修正流水线。第三步训练:从 Qwen3.5-9B 出发,先全参数 SFT 一个 epoch(batch 64,学习率 $1\times10^{-5}$,约 2 小时),再用 GRPO 训练 200 步(学习率 $1\times10^{-6}$),全程仅需 4 张 NVIDIA H20。
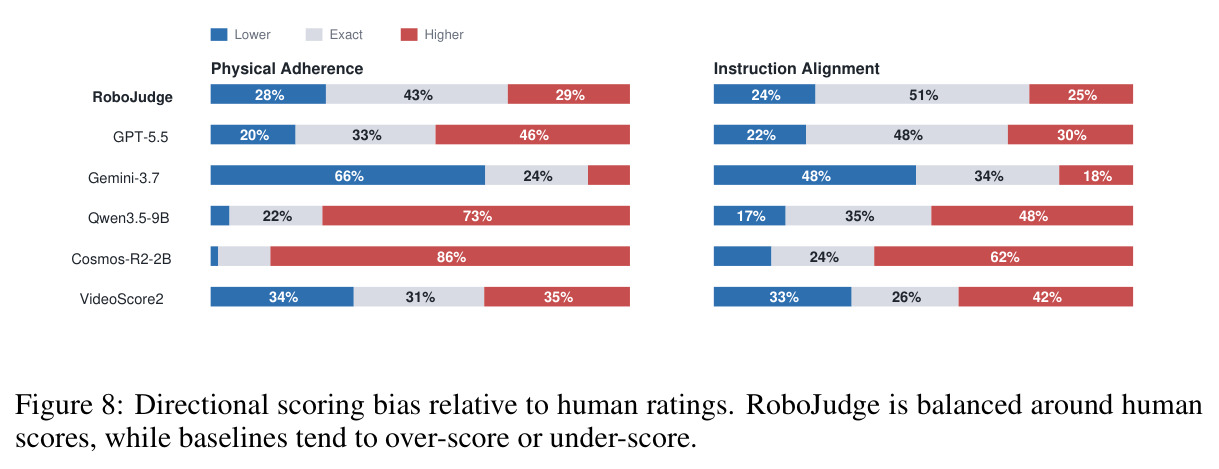
核心创新有三点。其一,研究问题的重定义:不给生成模型再添一个排行榜,而是先问“裁判与人类的一致性有多少”,并给出可复现的测量协议——统一 4 FPS、最多 32 帧的输入采样和统一 JSON 输出 prompt,让打分差异只反映裁判行为而非提示词差异。其二,PA/IA 双轴评分体系与证据链标注:PA 与指令解耦,IA 按“谁在做、对什么做、做到什么程度”的验证顺序展开;标注不只给分,还必须写证据笔记,例如“夹爪与包装接触处轻微穿透”,使监督信号带有人类可核查的推理依据。其三,训练目标与评测指标严格对齐:GRPO 的奖励 $R_{\text{acc}}$ 定义为预测分数与人类分数精确相等时取 1、否则取 0(公式 1),直接优化精确匹配准确率而非代理目标;同时训练显著纠正了方向性打分偏置——基座 Qwen3.5-9B 在 PA 上高估 73.3% 的样本,Gemini-3.7-Flash 低估 65.5%,而 RoboJudge-9B 在 PA 上高估/低估分别为 29.1%/27.5%,接近平衡,这也是其 MSE 大幅领先的原因。
方法步骤详情
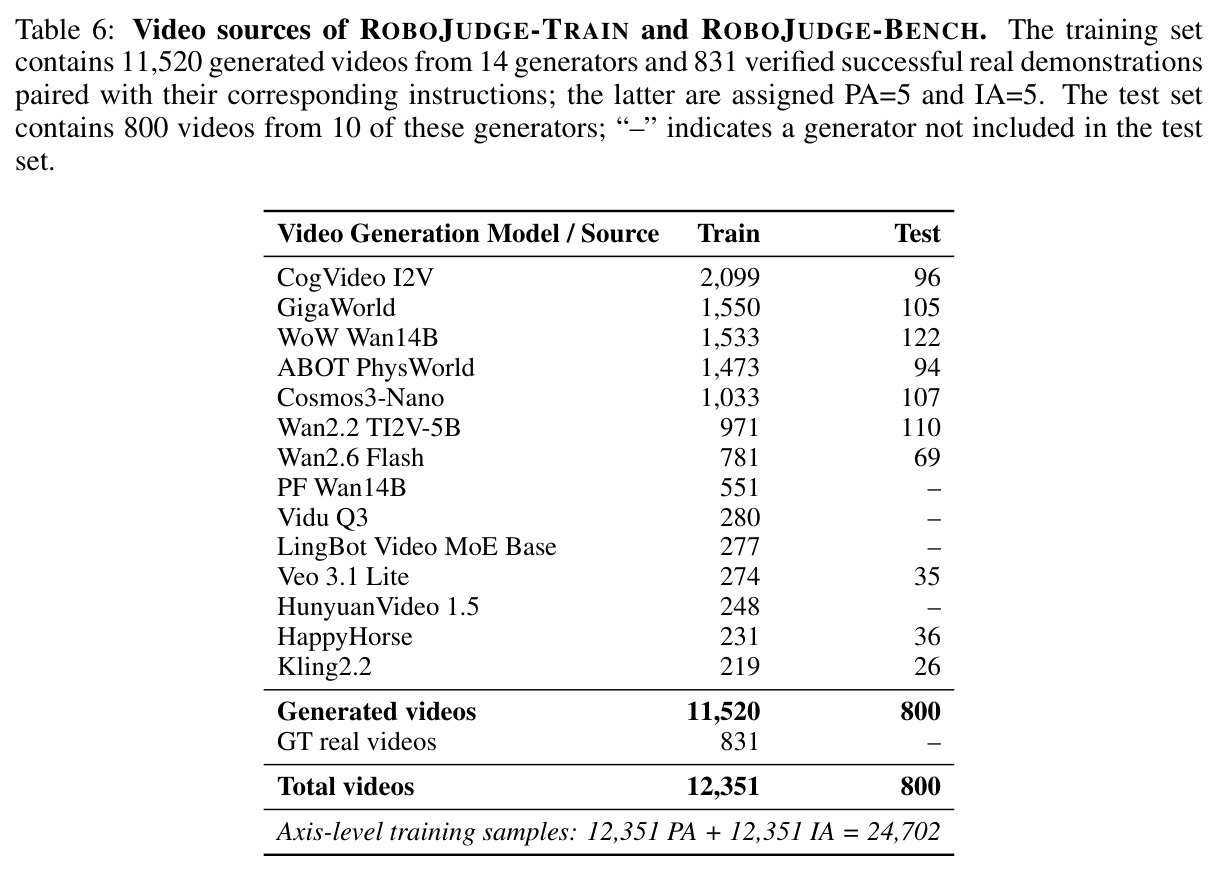
完整流程如下。(1)源片段采集:从 AgiBot-World、DROID、EgoDex、EPIC-KITCHENS 等七个真实语料库加仿真库 RoboTwin 抽取片段,输出首帧与指令。(2)指令精化:GPT-5.5 起草精炼指令,人工校验修正。(3)prompt 工程:5 个改写模板(叙事式、任务分解式、祈使式等,上限 100 词)加 5 个固定前缀模板,每个片段得 10 种 prompt 变体。(4)视频生成:14 个生成器构建数据池——训练集 11,520 条生成视频加 831 条人工核验的真实成功演示(记 PA=5、IA=5),合计 12,351 条;测试集 800 条来自其中 10 个生成器,源片段与训练集不相交以防泄漏。(5)标注:测试集一人标注加交叉复核加专家仲裁;训练集由三个闭源 MLLM 预标取平均、人工修订并写证据笔记、GPT-5.5 按核验分数改写推理链,共得 24,702 条轴级样本。(6)SFT:Qwen3.5-9B 全参数微调 1 epoch。(7)GRPO:以公式 (1) 的精确匹配奖励训练 200 步。评测统一输入 4 FPS、最多 32 帧采样。
技术新颖性
与最接近的工作对比(原文 Table 1):VideoPhy2 有 3,397 条评测数据但只有 11 条具身视频且无具身评分标准;Physion-Eval 880 条中仅 204 条具身、只覆盖人手、单一真实源;RoboGaze 382 条全具身但只有 3 个源、1 个生成器、无训练集。RoboJudge-Bench 是第一个同时满足 800 条全具身、8 个源、10 个生成器、三类执行器(夹爪/灵巧手/人手)、真实加仿真、带 PA/IA 双轴 rubric 与评分证据的裁判评测基准,并且配套 12K 视频的训练集——此前该领域只有基准没有训练集。技术层面,用 GRPO 优化离散 1-5 分的精确匹配奖励是把可验证奖励(RLVR)思想移植到评分任务上的新用法;“三模型预标+人工修正+按核验分数重写推理链”的标注流水线为大规模评分类监督提供了可复用的降本方案。消融证明两条腿缺一不可:仅 SFT 总体 $r=0.700$,加 RL 后达 0.719。
实验结果
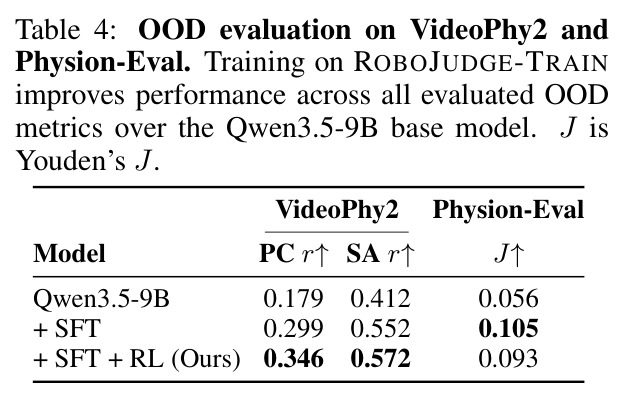
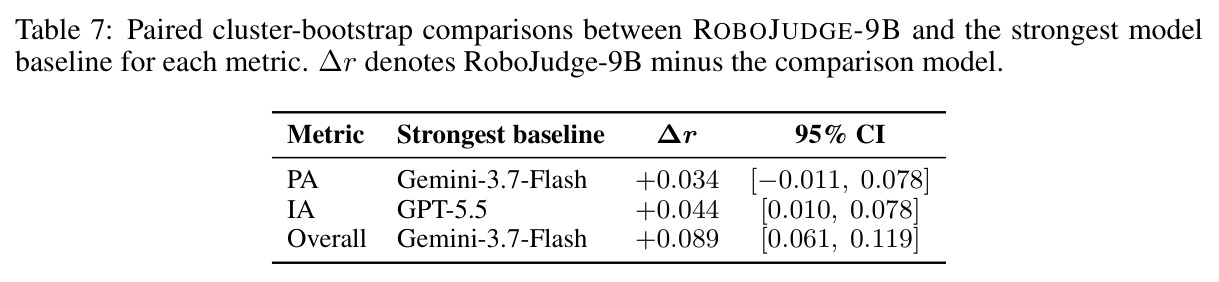
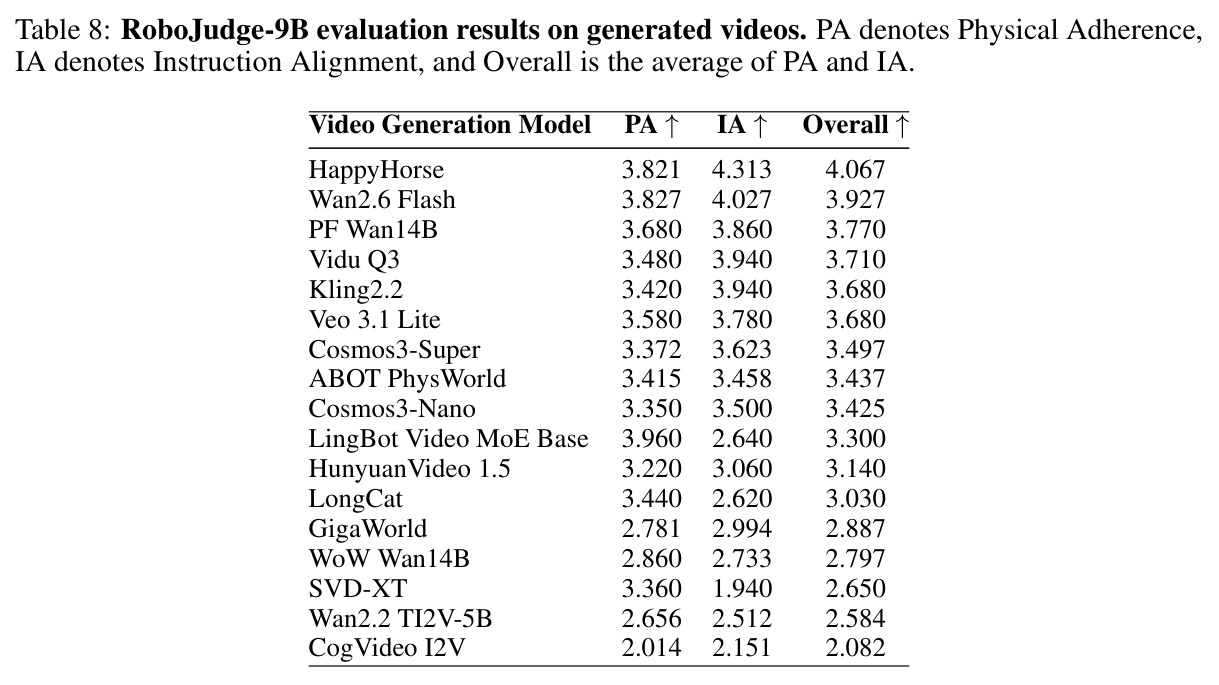
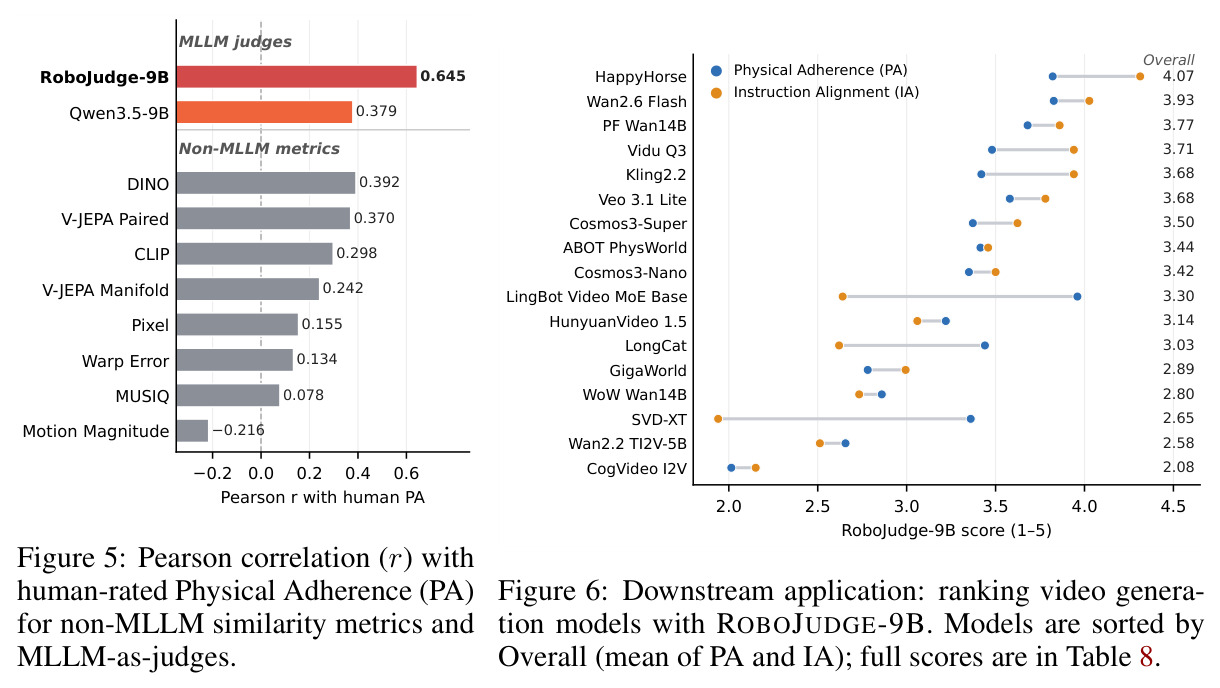
主实验(Table 2):RoboJudge-9B 总体 $r=0.719$ 全列第一;PA $r=0.645$、IA $r=0.775$。对比最强闭源基线 Gemini-3.7-Flash(0.630),bootstrap 显示 +0.089(CI [0.061, 0.119])显著;IA 超最佳 GPT-5.5(0.775 对 0.733);PA 上 0.645 对 0.611(CI 跨零)。裁判最佳 IA 0.733 远高于最佳 PA 0.611;具身专用 MLLM 的 PA 不超过 0.261;专用裁判中 PhyJudge 最佳(0.489);非 MLLM 指标最高仅 DINO 0.392。消融:SFT 把基座 Qwen3.5-9B 总体 r 从 0.401 拉到 0.700,RL 再到 0.719。泛化:VideoPhy2 上 PC 0.179→0.346、SA 0.412→0.572,Physion-Eval J 0.056→0.105。排行榜:HappyHorse 4.067 居首;LingBot PA 3.96 但 IA 仅 2.64,证明物理好不等于任务好。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 具身视频裁判·总体一致性 | Pearson r(PA+IA 合并) | 0.719(RoboJudge-9B) | 0.630(Gemini-3.7-Flash,最强闭源基线) | +0.089(95% CI [0.061,0.119],统计显著) |
| 物理 adherence(PA) | Pearson r | 0.645 | 0.611(Gemini-3.7-Flash) | +0.034(CI [-0.011,0.078],不显著) |
| 指令对齐(IA) | Pearson r | 0.775 | 0.733(GPT-5.5) | +0.042(bootstrap +0.044,CI [0.010,0.078]) |
| 同模型训练消融 | Pearson r(总体) | 0.719(SFT+RL) | 0.401(Qwen3.5-9B 基座);0.700(仅 SFT) | 较基座 +0.318,较纯 SFT +0.019 |
| OOD:VideoPhy2 | PC r / SA r | 0.346 / 0.572(SFT+RL) | 0.179 / 0.412(基座) | +0.167 / +0.160 |
| OOD:Physion-Eval | Youden's J | 0.105(SFT) | 0.056(基座) | +0.049 |
| 生成器排行榜(下游应用) | RoboJudge 总体分(1-5) | 17 个生成器完成排名,HappyHorse 4.067 最高 | CogVideo I2V 2.082 最低 | PA/IA 分离揭示 LingBot PA 3.96 对 IA 仅 2.64 的劈叉现象 |
局限与改进
作者承认的局限:PA 上对 Gemini-3.7-Flash 的 +0.034 提升,其 95% CI [-0.011, 0.078] 跨零,即在最难的物理维度上优势并不显著;Physion-Eval 上 SFT+RL(J=0.093)反而低于纯 SFT(0.105),提示 RL 阶段可能轻微过拟合本基准的评分风格;整体精确匹配 Acc 只有 0.473,1-5 离散打分的绝对命中率仍有限。我的补充观察:其一,测试集仅 800 条、室内场景占 94.2%、以桌面操作为主,对户外、导航、大位移场景的外推性存疑;其二,训练与测试共享 10 个生成器、同一标注员群体和同一 rubric,虽然源片段不重叠,但生成器风格泄漏难以排除,RoboJudge 的高分可能部分来自对基准分布的自洽适配;其三,4 FPS、最多 32 帧的均匀采样可能漏掉短暂而关键的物理事件(如瞬间穿透);其四,推理链由 GPT-5.5 单一模型改写,可能携带该模型的风格与偏见;其五,下游排行榜仅用 50 条 prompt 且未报告置信区间,相邻名次的差异未必稳定。
独立分析的弱点
独立分析的弱点与改进方向。(1)物理细粒度仍是瓶颈(PA $r=0.645$ 明显低于 IA 的 0.775):接触穿透、力反馈、柔体形变等信号在 RGB 帧中非常微弱。改进方向:给裁判增加轨迹、深度、物体掩码等输入,或调用关键点追踪/光流做工具增强,甚至用物理仿真器对可疑片段做反演校验。(2)精确匹配奖励过于稀疏:差 1 分与差 4 分都得零奖励,浪费 RL 信号。改进方向:改用距离衰减奖励 $R = 1 - |\hat{s} - s|/4$,或在轴内构造成对偏好样本做 DPO 式训练。(3)自评闭环风险:同一批标注员、同一 rubric、共享 10 个生成器风格,可能让裁判过拟合本基准分布。改进方向:引入跨实验室 held-out 标注、对抗性物理样本,并纳入带仿真器真值(接触力、物体位姿)的数据做客观校准。(4)排行榜仅 50 条 prompt 且无置信区间,相邻名次差异不可靠。(5)1-5 分粒度较粗,Acc 0.473 说明多数评分不精确命中,可考虑更细的评分尺度。
未来方向
作者提出的方向:把 RoboJudge-9B 用作在线物理 rollout 评估器,在具身规划中做 Best-of-N 选择——生成 N 条候选轨迹视频、由裁判挑最可信的一条执行;以及支持 agentic 具身视频生成中的质量控制。基于本文成果可自然延伸:(1)把裁判反过来当 reward model 训练视频生成器,用 PA/IA 分数做可验证奖励,形成“生成-评判”共进化闭环;(2)利用标注中已存在的六项 0-2 分 checklist 子项做过程监督或维度级 RL,让模型先定位具体是哪一项失败再给分,有望突破 PA 的 0.645 瓶颈;(3)扩展 embodiment 与场景:双臂协作、导航、户外(目前室内占 94.2%)以及接触丰富的柔体操作;(4)与世界模型策略学习结合,用裁判过滤 rollout 数据后再训练策略,量化数据质量提升对下游任务成功率的影响;(5)测试时自适应帧采样,对快速接触事件动态加密采样帧,替代固定 4 FPS;(6)探索裁判对长时程、多阶段任务(子目标链)的时序归因能力。
复现评估
开源与复现情况:论文给出项目页(spherelab.ai/RoboJudge),附录完整公开了评测 prompt(附录 B,含 PA/IA 的系统与用户提示词全文)、五个专用裁判的原生接口映射(附录 B.2)、14 个生成器的 prompt 工程模板(附录 D)、训练超参数与算力细节(附录 G:4 张 NVIDIA H20,SFT 1 epoch 约 2 小时,GRPO 200 步约 12 小时;SFT 学习率 $1\times10^{-5}$、全局 batch 64;GRPO 学习率 $1\times10^{-6}$、每更新 512 个 completion)。训练本身的复现门槛很低,单节点多卡即可完成。难点全在数据侧:800 条测试集需要 20 名研究生标注员经 4 轮校准后做交叉复核加专家仲裁;12,351 条训练视频需调用 14 个生成器(含 Veo 3.1 Lite、Kling2.2 等商用闭源 API)生成并人工核验;评测 29 个基线还需多家闭源 API。若基准与训练数据按承诺开源,复现 RoboJudge-9B 训练属中等难度;从零重建整套基准则属高难度。
论文图表
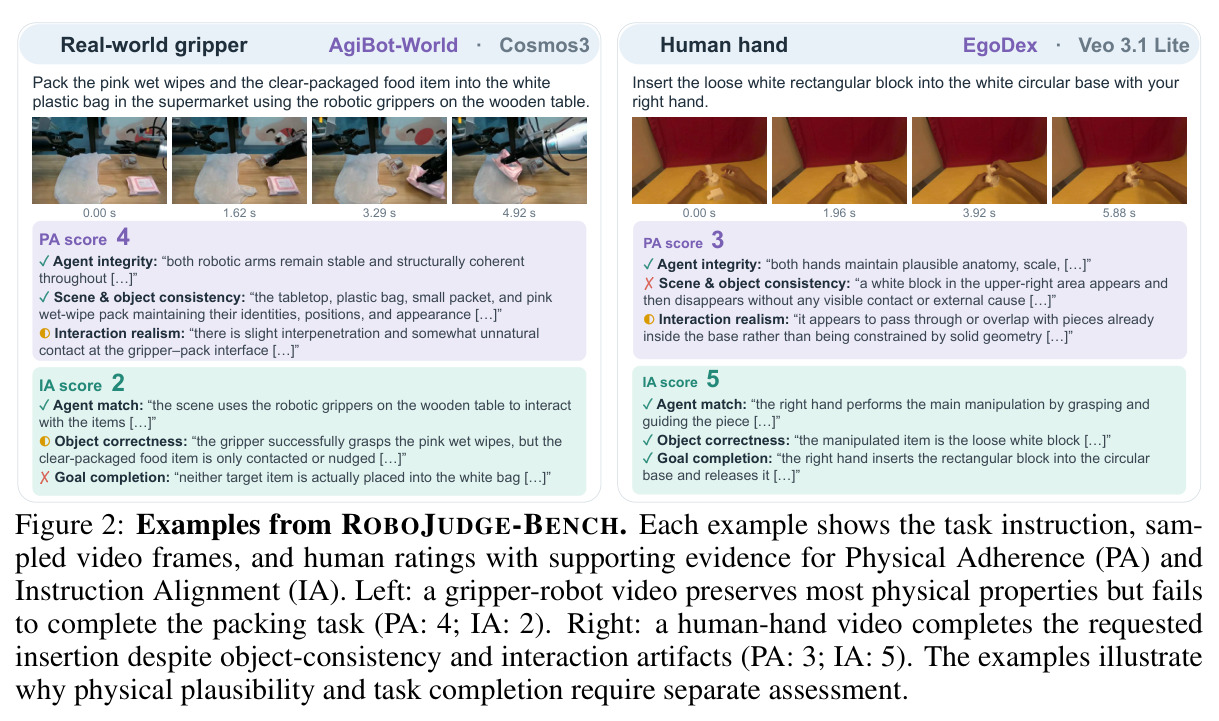
两个标注实例:左侧夹爪视频(AgiBot-World·Cosmos3)物理保持良好但没把物品装进袋子(PA 4、IA 2);右侧人手视频(EgoDex·Veo 3.1 Lite)完成插块任务但物体一致性有瑕疵(PA 3、IA 5)。每例附首帧、采样帧与逐项评分依据,如“夹爪与包装接触处轻微穿透”“白块无故出现又消失”。
直观展示 PA 与 IA 为何必须分开评、六个评分项如何落地成文字证据,是理解评分体系的关键图。
非 MLLM 指标与 MLLM 裁判在人类 PA 评分上相关系数的条形对比:RoboJudge-9B 0.645 最高;非 MLLM 指标中 DINO 0.392、V-JEPA Paired 0.370、CLIP 0.298、V-JEPA Manifold 0.242、Pixel 0.155、Warp Error 0.134、MUSIQ 0.078。
证明传统视觉质量/表征相似度指标不足以度量物理合理性,凸显 MLLM 裁判路线的必要性。
GRPO 阶段 200 步的奖励曲线,精确匹配奖励随训练上升,表明 RL 有效提升分数命中率。
展示 RL 阶段的优化过程,佐证 SFT+RL 消融中 RL 带来的增益。