Mycelium:跨来源、类型学与粒度的幻觉检测元研究 Mycelium: A Meta-Study of Hallucination Detection Across Provenance, Typology, and Granularities
幻觉检测分数是检测器与基准的联合属性:本文提出三轴分析框架与 Span Coverage F1
前置知识
幻觉(Hallucination)与忠实性/事实性之分
LLM 生成流畅但无证据支持、与来源矛盾或与既有事实不符的内容即为幻觉。本文区分两类:忠实性(faithfulness)指输出是否被给定上下文 $C(x)$ 或检索材料 $R(x)$ 支持;事实性(factuality)指输出是否与带时间戳的世界知识 $W_t$ 一致。内容可能事实正确但不被上下文支持,也可能上下文支持却与世界知识矛盾,二者是不同的失败。
全文的核心操作对象就是幻觉,而不同基准对'什么算幻觉'的操作化定义不同,正是论文'分数不可比'论证的起点。
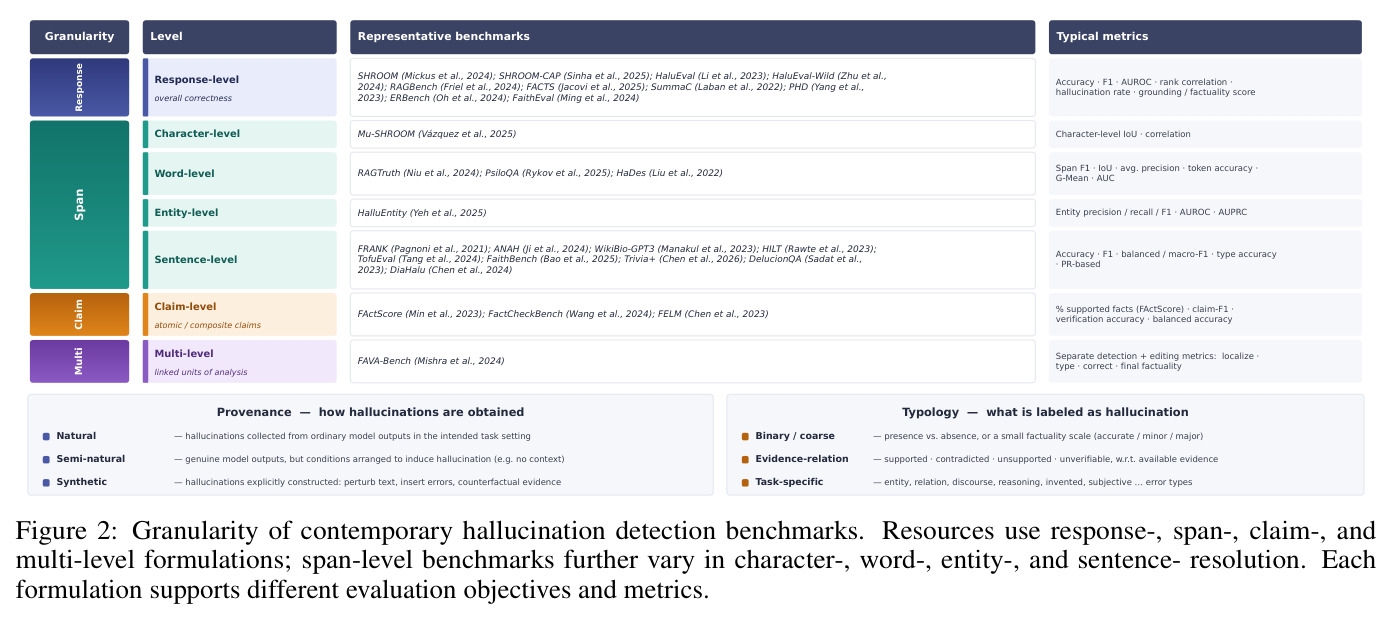
粒度(Granularity)与 span 级定位
指幻觉被标注、预测和评估的单元:response 级(整条回答一个判定)、span 级(字符/词元/实体/句子级区间)、claim 级(原子化可验证命题)、multi 级(检测+定位+类型+纠正联动)。span 级要求模型标出文本中的具体错误区间,如回答中错误的 "599 dollars",并用区间重叠类指标打分。
Span Coverage F1 这一度量创新完全建立在 span 级标注的'边界非唯一'问题之上;不懂粒度差异就无法理解为什么同一分数在不同基准下含义迥异。
黑盒 vs 白盒检测器
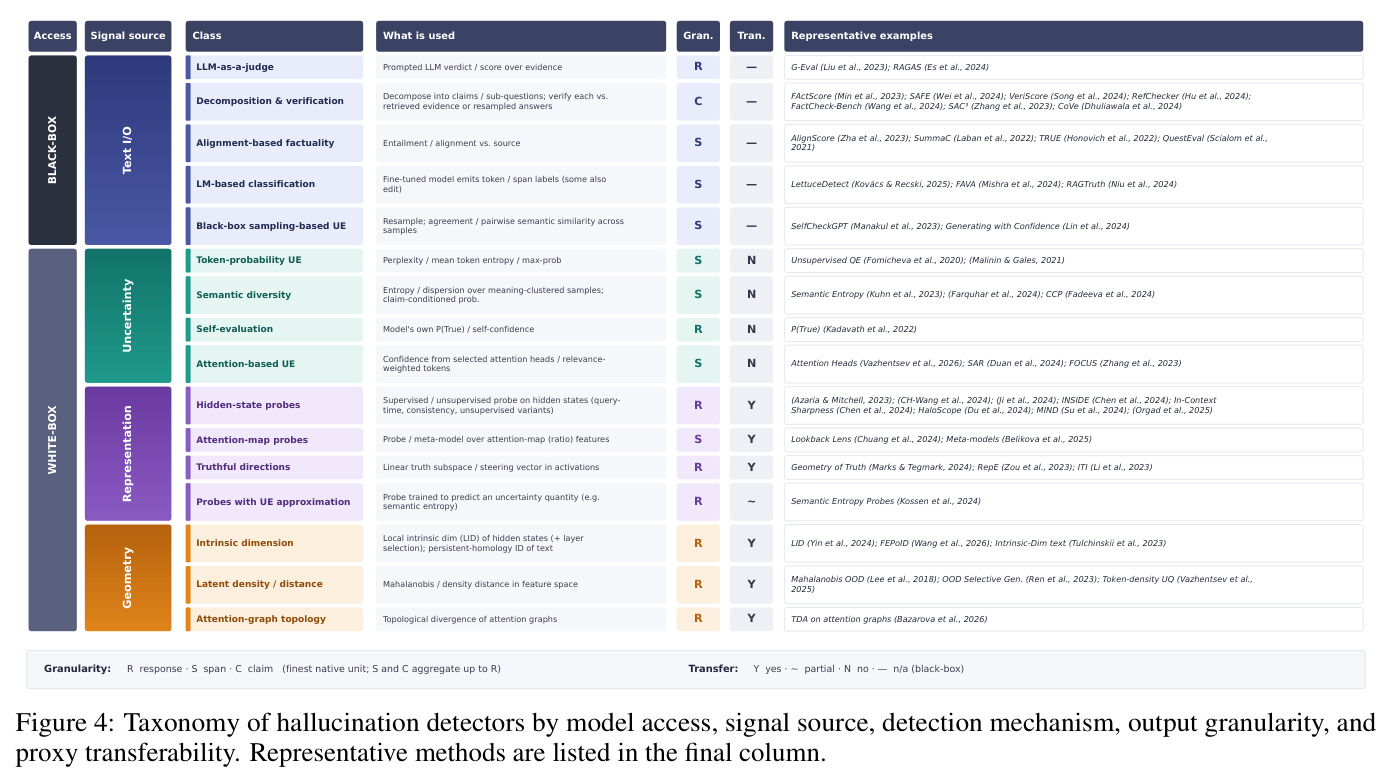
黑盒方法只用文本输入输出:LLM 裁判(G-Eval、RAGAS)、分解-验证流水线(FActScore、CoVe)、对齐模型(AlignScore)、采样一致性(SelfCheckGPT)。白盒方法用生成器内部信号:token 概率、语义熵、隐状态探针、注意力模式、激活空间几何。白盒信号更强但绑定具体模型;用开放权重 inspector 模型可代理但改变了信号本身。
论文用访问假设、信号源、输出粒度、代理可迁移性四维组织检测器清单(Figure 4),这是把检测器与基准条件对接的桥梁。
重叠型评测指标(精确匹配 / F1 / IoU)
评估两个 span 集合匹配程度的度量:exact span F1 只奖励逐字一致的边界;character F1/IoU 把区间折叠成字符掩码,按交集与并集(或参考长度)的比例计算,对边界内外偏差对称惩罚。OCR 领域的 DetEval 与 CLEval 还显式处理一对多(拆分)与多对一(合并)对应,本文将其适配为一维区间版本。
论文实证部分系统比较六种度量在标注边界变异下的行为差异,是提出 Span Coverage F1 并论证'度量回答不同评估问题'的实验基础。
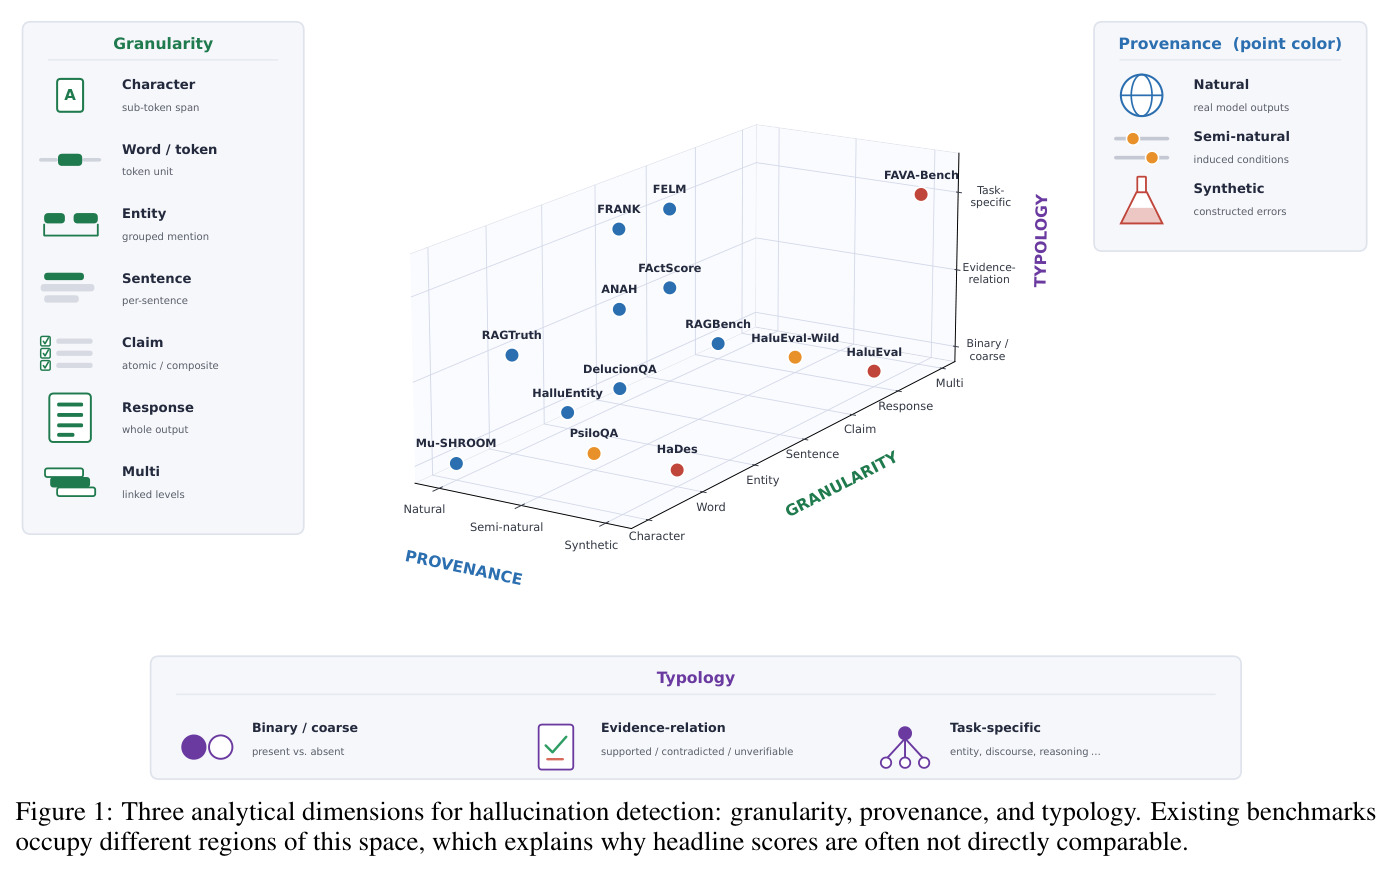
数据来源(Provenance):自然 / 半自然 / 合成
描述幻觉如何进入基准:自然数据在真实任务设定下采集模型输出再标注(RAGTruth、SHROOM);半自然保留真实输出但刻意安排诱发条件(PsiloQA 扣掉回答所需上下文、HaluEval-Wild 挑选易失败的真实查询);合成数据直接构造错误(HADES 扰动文本、FAVA-Bench 注入错误、FaithEval 构造反事实上下文)。
来源决定基准的错误分布与检测器可获得的信号,直接决定一个基准上的成绩能否说明部署场景下的表现,是三轴框架之一。
研究动机
被冠以"幻觉检测"之名的方法,实际上在解决差异巨大的预测问题。claim 级评估器(如 FActScore、VeriScore)的得分取决于回答如何被分解为可验证命题、各命题判定如何聚合;span 级检测器(如在 RAGTruth、PsiloQA 上评估的 LettuceDetect 等)的得分取决于标注边界与重叠度量;response 级 judge(如在 HaluEval、SHROOM 上评估的 LLM 裁判)的得分取决于聚合与判定协议。三者即使都报告"幻觉检测 F1",headline 分数也不可直接比较。问题的现实后果很具体:在检索增强生成(RAG)中,幻觉表现为回答不忠于检索到的上下文;在 agent 与多智能体系统中,一个不忠实的中间输出会被下游工具调用、写入记忆、被其他 agent 复用,使局部错误传播为系统级失败。基准构造决定了错误分布、标签所暴露的区分维度以及检测器可获得的信号——自然、半自然、合成数据给出的是不同的预测任务,二元与类型化标注暴露的失败模式也不同。这些选择并非偶然:它们操作化了"什么算幻觉",也就决定了检测器被评估去识别什么。
本文的目标是本文的目标是把幻觉检测重新表述为一个"基准条件化的测量问题",并给出可操作的共同语言。具体包括四件事:其一,建立统一的形式化框架,把基准表示为 $B=(D, p, g, L, \lambda, \mu)$(实例分布、来源、粒度、标签空间、标注规则、评估度量),把检测器分数写成 $S(d; B) = \mathbb{E}_{(x,y,E,\ell)\sim D_{B}}\, \mu_{B}(\hat{\ell}, \ell)$,其中 $\hat{\ell} = \Pi_{B\leftarrow d}\, d(x, y, E)$,明确分数刻画的是"检测器-基准对"而非检测器本身;其二,沿 provenance(幻觉如何产生:自然/半自然/合成)、typology(标签代表什么区分:二元/证据关系/任务特定)、granularity(标注、预测与评估的单元:response/span/claim/multi)三个轴系统盘点现有基准的构造、标注协议、证据制度与指标;其三,把检测器按访问假设、信号源、输出粒度、代理可迁移性组织成方法级清单;其四,聚焦 span 级评估中标注边界变异这一具体测量问题,实证其对六种常用度量的影响,并提出 Span Coverage F1 作为补充度量。最终目的是澄清检测器分数究竟测量了什么、跨基准比较为何危险,并推动对跨基准条件泛化的显式评估。
与已有工作不同的是,已有工作的切入角度与此不同:Ji et al. (2023) 与 Huang et al. (2025) 等综述按幻觉的原因、类型、检测、评估与缓解给出宽泛分类法;Qi et al. (2024) 等评估中心研究按粒度、设计与评估标准组织现有评估器——这些工作都以"方法"为中心。本文的独特视角是以"检测基准"为中心:把基准当作测量仪器来研究,追问基准如何操作化幻觉、其构造选择如何决定检测器被评估去识别什么。技术上的独特之处在于用单一公式(Eq. 1)把三个分析轴精确映射到测量的不同组件:granularity 决定目标表示 $g_B$ 并可能改变对齐算子 $\Pi_{B\leftarrow d}$ 与度量 $\mu_B$;provenance 决定实例分布 $D_B$;typology 决定标签空间 $L_B$ 与标注规则 $\lambda_B$。这使"分数不可比"从模糊直觉变成可归因的机制。另一个独特条件是数据:Mu-SHROOM 共享任务保留了同一输出的多份标注者 span 集,使"标注边界非唯一"从假设变为可观测现象——作者据此在 6,280 个非空且不相同的标注对中识别出 1,403 对(22.3%)为边界嵌套情形,为度量设计提供了实证锚点。
核心方法
直觉上,幻觉检测分数像测量仪的读数:读数离不开仪器,分数也离不开基准。作者先把基准形式化为 $B=(D, p, g, L, \lambda, \mu)$,把"检测器 $d$ 在基准 $B$ 下的分数"写成 $S(d; B) = \mathbb{E}_{(x,y,E,\ell)\sim D_B}\, \mu_B(\hat{\ell}, \ell)$,其中 $\hat{\ell} = \Pi_{B\leftarrow d}\, d(x, y, E)$。$\Pi_{B\leftarrow d}$ 是把检测器原生输出对齐到基准所需表示的全部操作:阈值化、span 投影、claim 分解、聚合等。因此 $S$ 刻画的是检测器-基准对的联合性质,只有当目标语义、粒度、标签空间、对齐程序、度量与实例分布都足够兼容时,跨基准分数才可比。在此基础上论文做三件事:第一,按 granularity 盘点 response/span/claim/multi 四类基准及其典型指标(Figure 2),span 内部还分 character/word/entity/sentence 四档分辨率;第二,按 provenance 与 typology 分析基准构造如何塑造错误分布与标签语义;第三,把检测器按 access(黑盒/白盒)、信号源、输出粒度、代理可迁移性组织成清单(Figure 4)。在 span 级评估上,论文比较六种度量的评估语义并提出新的 Span Coverage F1。整体技术路线是分析性的:形式化 + 系统盘点 + 一个度量的实证研究,而非提出新检测模型。
核心创新有两点。第一是把"分数不可比"系统地归因:同一个检测器换一个基准可能得到不同分数,原因可能是实例不同(provenance 改变 $D_B$)、目标不同(granularity 改变 $g_B$ 与对齐 $\Pi_{B\leftarrow d}$)、或表示与度量不同(typology 改变 $L_B$、$\lambda_B$ 与 $\mu_B$)——这些是性质不同的变异源,框架让人能把它们分开谈论。第二是 Span Coverage F1,一个为"包含"语义设计的实例级定位度量:预测覆盖 $P_{\text{cov}} = |\{p \in P : \exists g \in G,\ p \subseteq g\}| / |P|$,参考覆盖 $R_{\text{cov}} = |\{g \in G : \exists p \in P,\ p \subseteq g\}| / |G|$,取二者调和平均。它是方向性的:更窄的预测若完整落入某个参考 span 内算定位成功,越出参考区域的预测不算。这与既有度量本质不同——exact span F1 要求边界逐字一致;character F1/IoU 把 span 折叠成字符掩码、按共享文本量对内外偏差对称惩罚;DetEval-1D/CLEval-1D 处理拆分合并但不表达包含关系。其动机直接来自观测:Mu-SHROOM 中 22.3% 的标注对边界嵌套,说明标注往往给出"可容许区域"而非唯一最小边界,此时检测器指出更具体的子短语不应被惩罚。
方法步骤详情
方法按六步展开。第一步,划定范围并形式化:幻觉被视为"被评估配置"(输入 $x$、输出 $y$、证据 $E$、评估单元)的属性而非模型内在属性;证据可为给定上下文 $C(x)$、检索材料 $R(x)$ 或带时间戳的世界知识 $W_t$,命题相对证据可为 supported/contradicted/undetermined。第二步,粒度盘点:划分 response/span/claim/multi 四档并列出代表性基准与指标;用 Figure 3 的例子说明同一预测 "599 dollars" 在 character IoU 下得 0.27、token/span F1 得 0.67、entity F1 与 sentence F1 得 1.00。第三步,度量研究:比较 exact span F1、character F1、character IoU,以及把二维文本区域度量 DetEval、CLEval 适配到一维区间的 DetEval-1D/CLEval-1D——区间 $[s,e]$ 长度 $\ell([s,e])=e-s+1$,交 $I_{ij}=|g_i\cap p_j|$,$\sigma_{ij}=I_{ij}/|g_i|$,$\tau_{ij}=I_{ij}/|p_j|$;DetEval-1D 一对一匹配要求参考覆盖 $\ge 80\%$ 且预测覆盖 $\ge 40\%$,拆分/合并各记 0.8 分;CLEval-1D 把参考 span 每个字符视为伪中心、沿用 0.3 精度阈值,重复匹配扣减信用。第四步,定义 Span Coverage F1(Eq. 3-4)。第五步,Mu-SHROOM 实证:英文测试集 154 例、1,665 个标注者级 span 集,采用留一标注者(LOO)协议——held-out 标注者的 span 集作为预测,其余标注者按 majority(窄共识)或 union(宽包络)构造参考;另设 BoundaryNested(n=376)、OverlapPartial、1-Char(平均仅保留 3.1% 参考字符)三个诊断子集。第六步,provenance/typology 分析、检测器清单(Figure 4)及监督与校准讨论。
技术新颖性
技术新颖性体现在三个层面。度量层面:Span Coverage F1 是为"非唯一边界下包含关系"语义设计的度量,它有三个少见的性质组合——方向性(只奖励向内细化、不奖励越界)、实例级保持(保留"每个标注区域是否被定位"的信息,而字符掩码度量会抹平实例结构)、对内收边界细化不变。这与从 OCR/场景文本检测领域借来的 DetEval-1D、CLEval-1D 形成互补:后两者处理拆分与合并,但都不表达"预测是参考的子集"这一关系;把二维度量的阈值语义(0.8/0.4/0.3)严格适配到一维区间本身也是干净的技术工作。视角层面:把 benchmark 当作测量仪器、用 Eq. 1 把三轴映射到测量的不同组件,是对"评测不应只看排行榜"这一普遍呼声的具体化——此前综述只是并列列举基准与指标,没有给出"分数为何不可比"的机制性解释。证据层面:利用 Mu-SHROOM 多标注者设计把边界非唯一性量化(6,280 对中 22.3% 嵌套;LOO 下多数度量的分数随参考从 majority 换成 union 大幅波动),使度量选择从哲学讨论变成有数据的工程决策。检测器清单层面:新增"代理可迁移性"维度,指出用另一个开放权重 inspector 模型代替生成器内部信号会改变检测所依据的信息,应显式报告而非视为与直接访问生成器等价。
实验结果
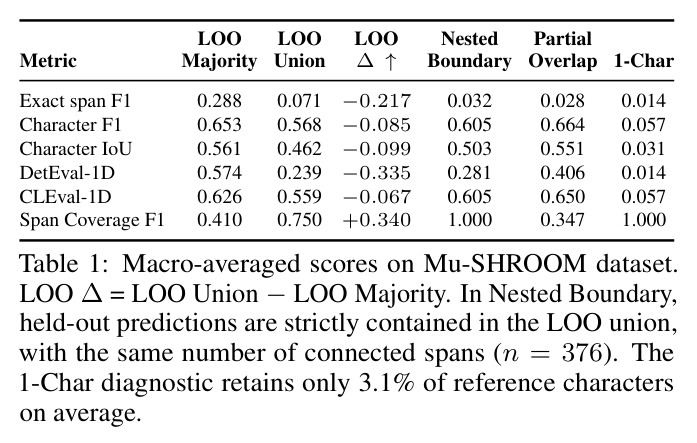
核心实证是六种度量在 Mu-SHROOM 英文集(154 例、1,665 个标注者 span 集)留一标注者协议下的表现(Table 1)。宏平均:当参考从窄的 majority 换成宽的 union 时,Span Coverage F1 从 0.410 升到 0.750($\Delta$+0.340),因为它对"包含在更宽参考内"的预测给满分;而 exact span F1 反向暴跌(0.288→0.071,$\Delta$−0.217),因为宽参考几乎不保持逐字边界;DetEval-1D 也大跌(0.574→0.239,$\Delta$−0.335);character F1(0.653→0.568)、character IoU(0.561→0.462)、CLEval-1D(0.626→0.559)变化温和。微观聚合方向一致:SC F1 0.369→0.713、DetEval-1D 0.534→0.198、character IoU 0.455 vs 0.461 几乎不动。关系特异分析:在 376 个边界嵌套例上 SC F1 按构造得 1.000,而 DetEval-1D 仅 0.281、CLEval-1D 与 character F1 为 0.605、character IoU 0.503、exact span F1 0.032;部分重叠时 SC F1 降至 0.347、不重叠为 0——证明其高分反映包含本身而非普遍宽容。压力测试暴露代价:每个参考 span 内只预测 1 个字符(平均仅覆盖参考字符的 3.1%)时 SC F1 仍为 1.000,而 character IoU 只有 0.031,故必须与重叠敏感度量并用。定性结论:各度量回答不同的评估问题,并非从严格到宽松的单一刻度;同一预测在不同标注分辨率下得分可在 0.27–1.00 之间(Figure 3);合成基准上的性能未必迁移到自然失败分布。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Span 定位评估对标注边界变异的敏感性(LOO,majority→union 参考,宏平均) | Span Coverage F1 | 0.410 → 0.750(Δ+0.340),微观聚合 0.369 → 0.713 | Exact span F1:0.288 → 0.071(Δ−0.217);DetEval-1D:0.574 → 0.239(Δ−0.335) | 方向相反:SC F1 随参考变宽而上升,精确匹配与拆分合并度量大幅下降,暴露度量语义差异 |
| 边界嵌套子集(BoundaryNested,n=376,held-out 预测严格包含于 LOO union 且连通分量数相同) | 宏平均分数 | Span Coverage F1 = 1.000(按构造满分,体现包含不变性) | DetEval-1D 0.281;CLEval-1D / character F1 0.605;character IoU 0.503;exact span F1 0.032 | 同一批案例上各度量得分从 0.032 到 1.000,相差超 30 倍,证明度量为不同评估问题 |
| 1-Char 退化压力测试(每参考 span 内仅预测 1 字符,平均覆盖参考字符 3.1%) | Span Coverage F1 vs Character IoU | Span Coverage F1 = 1.000(暴露包含度量的盲区) | Character IoU = 0.031;character F1 = 0.057 | 证明 SC F1 必须与重叠敏感度量互补报告,单独使用会被退化策略刷满 |
| 部分重叠诊断子集(OverlapPartial) | Span Coverage F1 | 0.347(不重叠时为 0) | Character F1 0.664;character IoU 0.551;CLEval-1D 0.650 | SC F1 高分专属于包含关系而非一般空间宽容,验证其度量的方向性 |
局限与改进
作者明确承认的局限:Span Coverage F1 的包含语义完全忽略参考 span 被恢复的比例——1-Char 测试显示一个退化策略(每参考 span 撒一个字符,平均覆盖 3.1%)即可得满分 1.000,因此它只能作为与 character F1/IoU 并用的补充度量,单独报告会误导;三轴之间的跨分类体系对应是多对多的,类别含义依赖任务、证据制度与标注规则,不能机械映射;论文本身是分析性工作,不提供新检测器,也不给出统一的跨基准排行榜。我的补充观察:第一,实证基础相当小——仅 Mu-SHROOM 英文测试集 154 例、单一任务形态(上下文验证型 QA),结论对 RAGTruth、FAVA-Bench 等其他 span 级基准是否成立未验证,LOO 协议还隐含标注者可交换假设;第二,框架是定性的,论文没有量化"基准条件"对检测器排名的实际影响(例如同一批检测器跨多个基准的秩相关或迁移矩阵),可归因不等于已归因;第三,检测器清单(Figure 4)是文献盘点而非统一协议下的实测对比,四个维度的标注(如代理可迁移性 Y/~/N)带有作者主观判断;第四,范围限定在文本、声明式内容,多模态、非英语、agent/记忆场景中的幻觉仅被提及而未分析。
独立分析的弱点
独立分析三个弱点。其一,Span Coverage F1 可被退化策略刷满:"每参考 span 内预测一个字符"即得 1.000,若有人只报告该指标会严重高估定位质量。改进方向:给包含关系加最小长度或覆盖率约束(如要求预测 $p$ 覆盖参考 $g$ 的至少 $\alpha$ 比例),或设计对内收细化给部分而非满分的平滑版本,并把 SC F1 与 character IoU 的二维剖面作为标准报告格式。其二,实证外部效度有限:结论来自 154 例、单一基准与任务形态,且 LOO 的 majority/union 是参考边界的两种人造极端,真实"可容许区域"的分布并未被建模。改进方向:在 RAGTruth、PsiloQA 等带多标注或有歧义边界的语料上重复实验;把标注建模为分布而非单点,发展概率化 gold 与相应的期望度量。其三,框架缺少量化工具:三轴分类是定性的,无法回答"这两个基准有多相似""某检测器的分数能迁移多远"。改进方向:在 $(D, p, g, L, \lambda, \mu)$ 六元组上定义基准相似度核,再跑受控网格实验——同一批检测器跨多基准——验证各轴与性能差距的经验相关,把框架从描述工具升级为预测工具。
未来方向
作者提出的方向:评测应超越"在单一基准上刷更高分",转向对检测器鲁棒性的受控评估——跨数据构造方式、错误类型、标注单元与度量语义四个维度系统变化条件,观察性能如何衰减;评测协议应显式声明哪些标注变异被定义为不变量、哪些构成检测器错误,Span Coverage F1 的 1-Char 失败正好示范了"没有单一度量能覆盖定位质量的所有方面"。基于其成果可自然延伸的方向:其一,把 $(D, p, g, L, \lambda, \mu)$ 六元组做成基准元数据标准,要求排行榜随分报告,并据此自动检测不可比的比较;其二,做跨基准迁移矩阵实验,量化 provenance/typology/granularity 各轴对可迁移性的边际贡献;其三,把 claim 分解显式建模为可学习的对齐算子 $\Pi_{B\leftarrow d}$,分离抽取质量与验证质量;其四,训练多粒度统一检测器(span/claim/response 共享表征),利用迁移的不对称性(细粒度可聚合到粗、粗粒度无法细化);其五,扩展到 agent 记忆系统与多智能体传播链中的幻觉检测(作者引用 HaluMem 一线工作),那里被评估的单元是消息与轨迹而非句子;其六,为度量语义建立标准化诊断套件(nested/partial/1-char 已是雏形),用于系统性地"评测评测"。
复现评估
复现条件非常友好。代码与全部材料已在 GitHub 公开(github.com/lmeribal/mycelium);实证数据 Mu-SHROOM 英文测试集本身公开,其 154 例、1,665 个标注者级 span 集是共享任务自带的多标注设计。算力需求近乎为零:全部度量计算(exact span F1、character F1/IoU、DetEval-1D、CLEval-1D、Span Coverage F1)是对区间/字符掩码的确定性 CPU 运算,不涉及任何模型训练或推理。论文对度量细节给出足够复现的规格:DetEval-1D 的一对一匹配阈值为参考覆盖 ≥80%、预测覆盖 ≥40%,拆分/合并各记 0.8;CLEval-1D 沿用 0.3 精度阈值并按字符数计信用扣减;LOO 协议的 majority/union 参考构造、BoundaryNested(n=376)、OverlapPartial、1-Char(平均保留 3.1% 参考字符)子集都有明确定义。主要不确定性在于:三轴分类和检测器四维标注含人为判断,不同人执行会略有出入;若在自有数据上重复 LOO 实验需要多位标注者。综合评估:跑通原文数字的复现难度低(预计半天内可完成),把框架应用到新基准属于中等难度的分析性工作。
论文图表
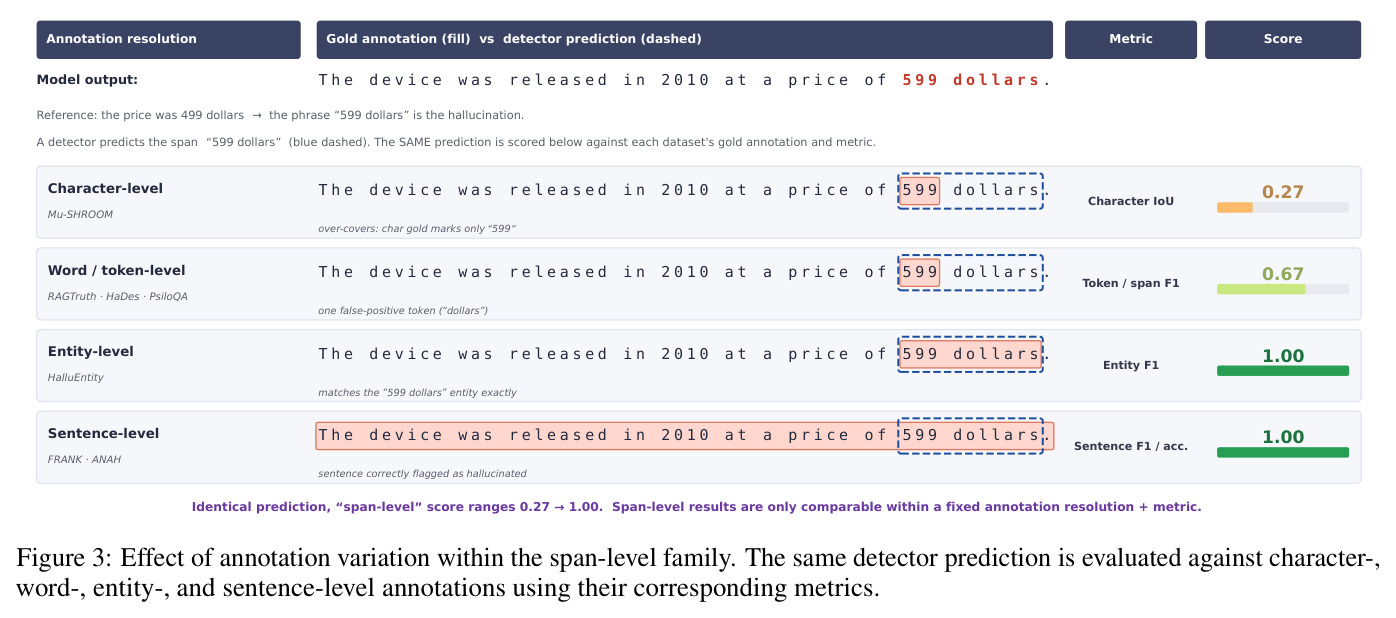
用同一个例子做受控对比:模型输出"The device was released in 2010 at a price of 599 dollars",参考标注 599 dollars 为幻觉,检测器恰好预测同一短语;该预测在 Mu-SHROOM 的 character IoU 下得 0.27、RAGTruth/HaDes/PsiloQA 的 token/span F1 下得 0.67、HalluEntity 的 entity F1 与 FRANK/ANAH 的 sentence F1 下均得 1.00。
全文最有说服力的动机图:完全相同的预测,仅因标注分辨率与度量不同,得分从 0.27 摆到 1.00,直观证明了"span 级结果只在固定分辨率+度量内可比"的核心主张。