ENOKI:基于文本锚定开放信息抽取的高效多层级幻觉检测 Enoki: Efficient Multi-Level Hallucination Detection
用文本锚定的事实三元组统一声明级验证与跨度级定位,三档抽取后端兼顾精度与效率。
前置知识
幻觉检测(Hallucination Detection)
大模型生成的文本可能流畅但缺乏证据支持或与事实相悖,即幻觉。检测系统将模型回答与参考证据(如 RAG 中检索到的文档)对比,判断哪些内容不受支持,输出真实性标签、错误跨度定位或结构化验证结论。评测粒度从粗到细包括:回答级、句子级、声明级、跨度级与实体级。
本文的全部目标就是构建更高效、更细粒度的幻觉检测器,理解幻觉的不同粒度定义是读懂其动机与三组实验(实体级/跨度级/句子级)的前提。
开放信息抽取(Open Information Extraction, OpenIE)
从句子中抽取模式自由的关系三元组 $(subject, predicate, object)$,不依赖预定义本体或关系词表。经典系统(Stanford OpenIE、ClausIE、MinIE)基于句法/依存模式,神经方法(OpenIE6 的迭代网格标注 IGL)用序列标注,新方法(CycleOIE)用 LLM 提示生成式抽取。
ENOKI 把多粒度幻觉检测形式化为「文本锚定的 OpenIE」,三元组是其统一声明级验证与跨度定位的共享中间表示,不理解 OpenIE 就无法理解方法本体。
自然语言推理(NLI)
判断前提与假设的语义关系,三分类:蕴含、中立、矛盾。现代 NLI 模型(如本文用的 ModernBERT-large-nli,约 395M 参数)输出三个标签的概率分布,可作为轻量事实核查器:把待验事实当作假设、把参考证据当作前提,单次前向即可打分。
ENOKI 的验证阶段就是 NLI 式打分:幻觉概率定义为矛盾与中立概率之和,阈值 0.5;长上下文通过分块、块间单句重叠、跨块取最大蕴含分来处理。
声明级 vs 跨度级检测
声明级方法(FActScore、SAFE、RefChecker 等)遵循「分解—验证」范式:把回答切成原子事实单元逐一验证,可解释但单元不与原文字符对齐;跨度级方法(lettucedetect、haldetect 等)直接在原文字符上标注不支持片段,便于检查编辑,但不暴露被检验的事实结构。
两类方法互补却割裂,正是 ENOKI 要弥合的空档;理解二者差异才能领会「用同一中间表示同时输出两种粒度」这一核心贡献的分量。
匈牙利匹配与集合预测损失
集合预测(如目标检测中的 DETR)不假设预测与真值按位置一一对应,而是计算预测-真值两两代价矩阵 $C_{ij}$,用匈牙利算法求最优二分匹配 $\sigma^\star = \arg\min_\sigma \sum_i C_{i,\sigma(i)}$,只在匹配对上计算损失,从而对预测排列保持不变。
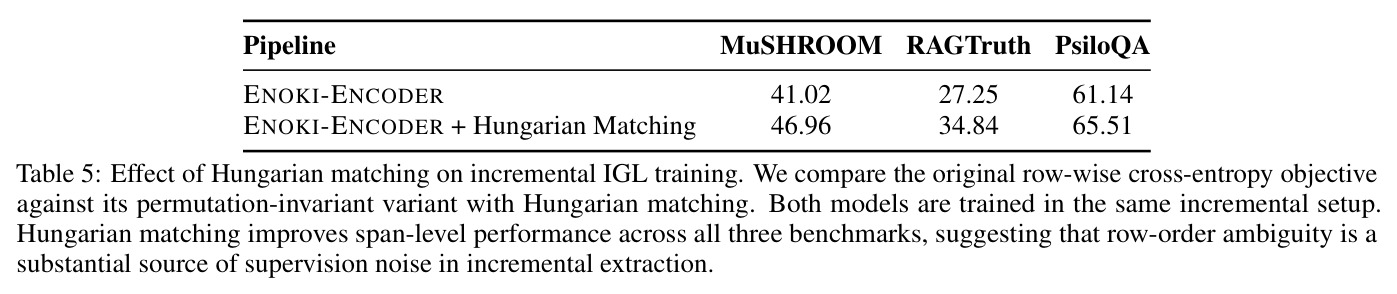
ENOKI-ENCODER 用它替换 OpenIE6 IGL 的行序交叉熵,解决增量抽取中多个仅精细度不同的金标行序不稳定问题,是其训练层的关键创新,消融显示能显著提升 span F1。
Span Coverage F1
论文采用的跨度级评测指标:预测跨度被任一金标跨度完全包含($g_s \le p_s$ 且 $p_e \le g_e$)计为精确率命中;金标跨度包含至少一个预测跨度计为召回率命中;$F_1 = 2PR/(P+R)$,跨样本微平均聚合。相比要求边界完全一致的精确匹配,它奖励比标注更细粒度的预测。
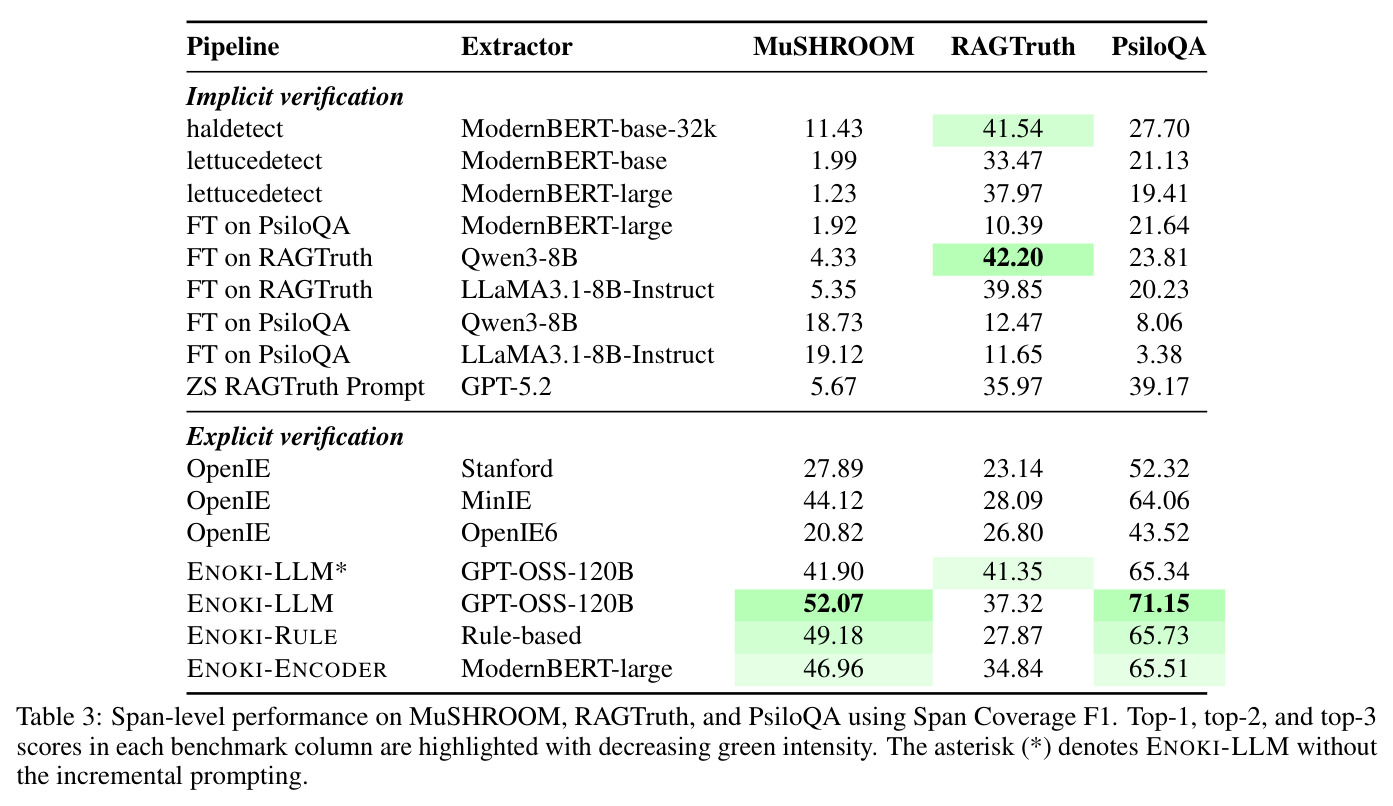
论文所有跨度级实验(MuSHROOM、RAGTruth、PsiloQA)均用此指标,且附录用两个例子论证了边界敏感指标在幻觉标注噪声下的误导性,不理解定义就无法正确解读 Table 3。
研究动机
部署在知识密集与高风险场景(检索增强问答、医疗、法律)的大模型经常生成流畅但无证据支持的陈述,用户需要的不仅是二元的真实性分数,而是「哪段文字错了、对应什么事实」的可操作反馈。现有检测器却只工作在单一层级:声明级方法(FActScore、SAFE、VeriScore、RefChecker 等)把回答分解为事实单元逐一验证,可解释性强,但可靠性完全依赖分解质量——遗漏论元、修饰语或时间条件会让验证器评估的对象偏离原答案,且抽取的声明不与原文字符对齐;跨度级方法(lettucedetect、haldetect 等)在 RAGTruth、Mu-SHROOM、PsiloQA 等基准上直接标注不支持的文本片段,便于检查与编辑,却不暴露被检验的事实结构。要同时获得两种视图,通行做法是「分解→验证→声明到跨度对齐」三段式管线:需要多次分解与验证调用,成本高昂,且误差会在三个阶段之间传播,可解释的验证单元与被定位的错误跨度之间始终存在鸿沟。
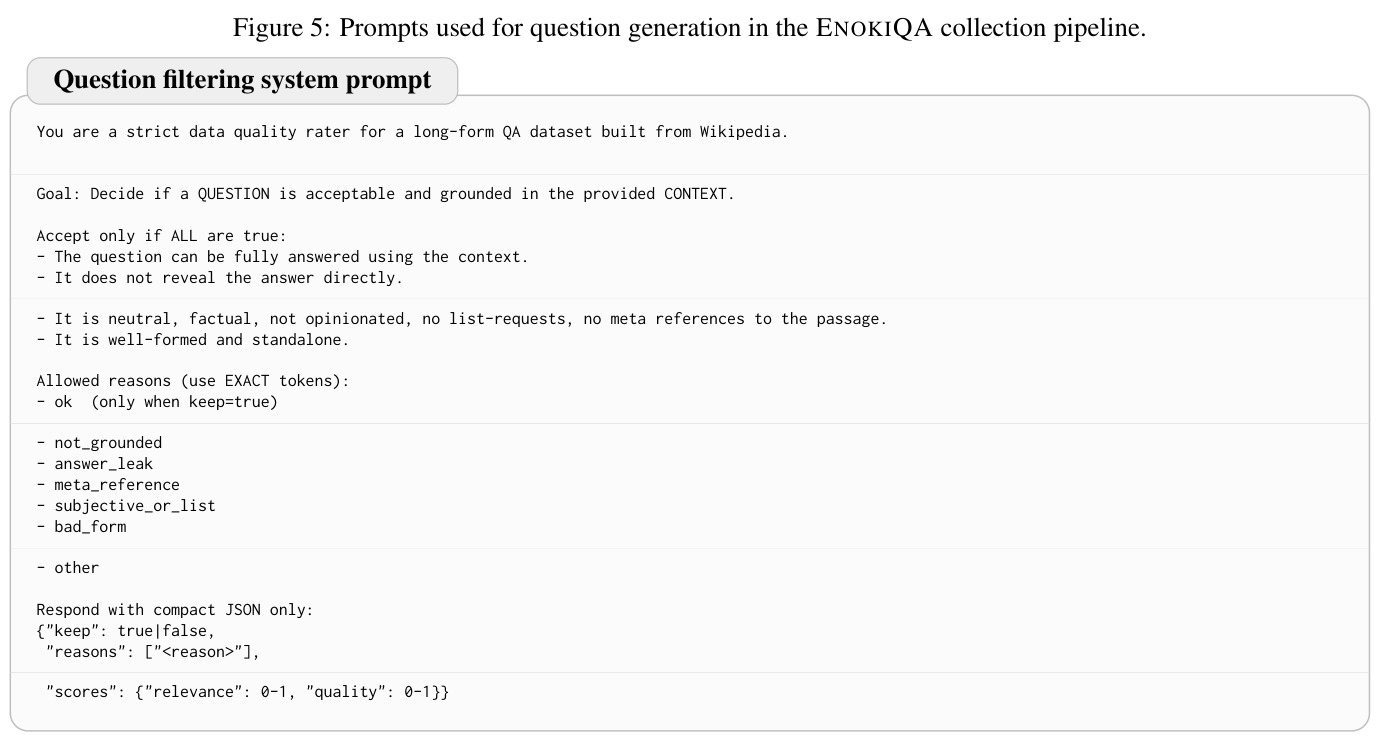
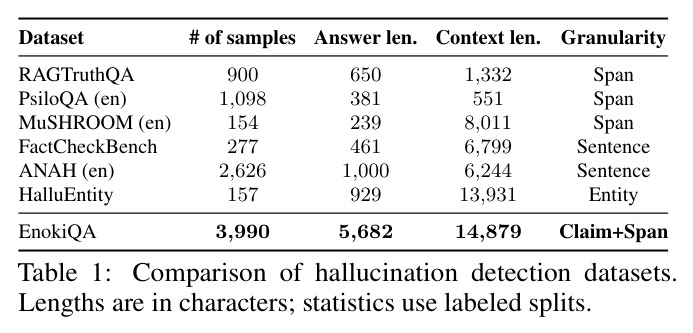
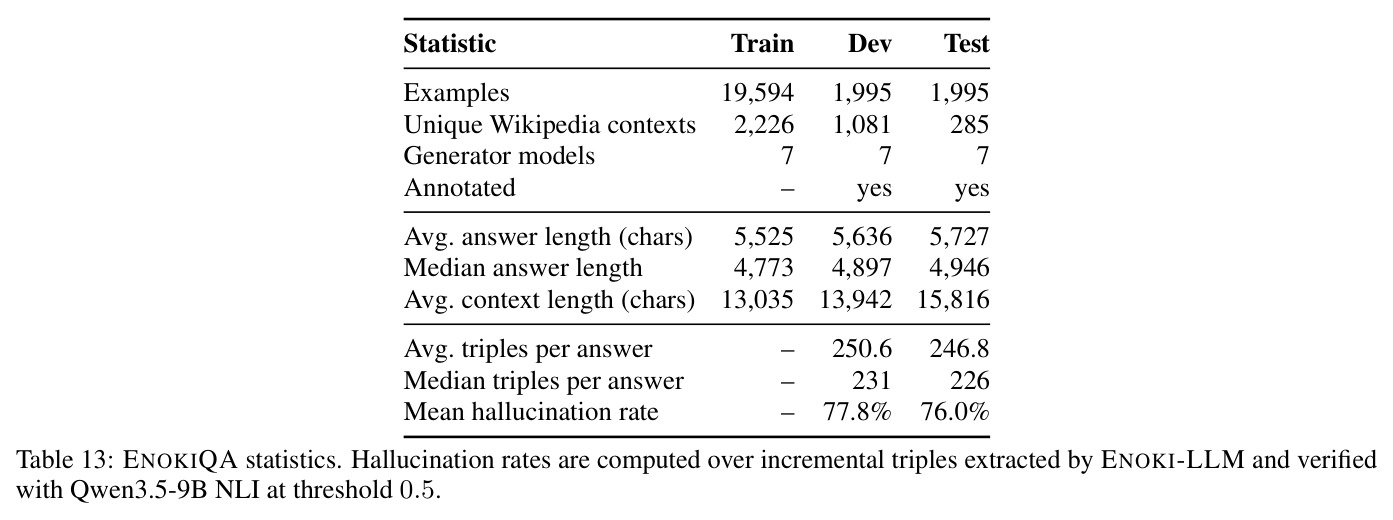
本文的目标是本文的具体目标是构建一个统一的多层级幻觉检测框架:用同一种中间表示同时支持声明级验证与跨度级定位,从而免去单独的声明-跨度对齐模块及其误差传播。具体拆解为三点:其一,抽取的事实必须保持与答案原文锚定,未通过验证的事实能直接投影回答案中的精确字符片段;其二,提供 LLM 抽取(最高分解质量)、编码器抽取(可训练、低成本)与规则抽取(确定性、免训练)三种后端,通过统一接口在精度与推理成本之间灵活权衡,让规则/编码器变体以低约两个数量级的延迟保留大部分收益;其三,发布 ENOKIQA 数据集——带对齐的声明级验证与跨度级标注、多段落答案与全文证据上下文的双粒度资源,弥补现有基准要么只有跨度标注、要么只有句子级标签、且上下文普遍偏短的缺口。
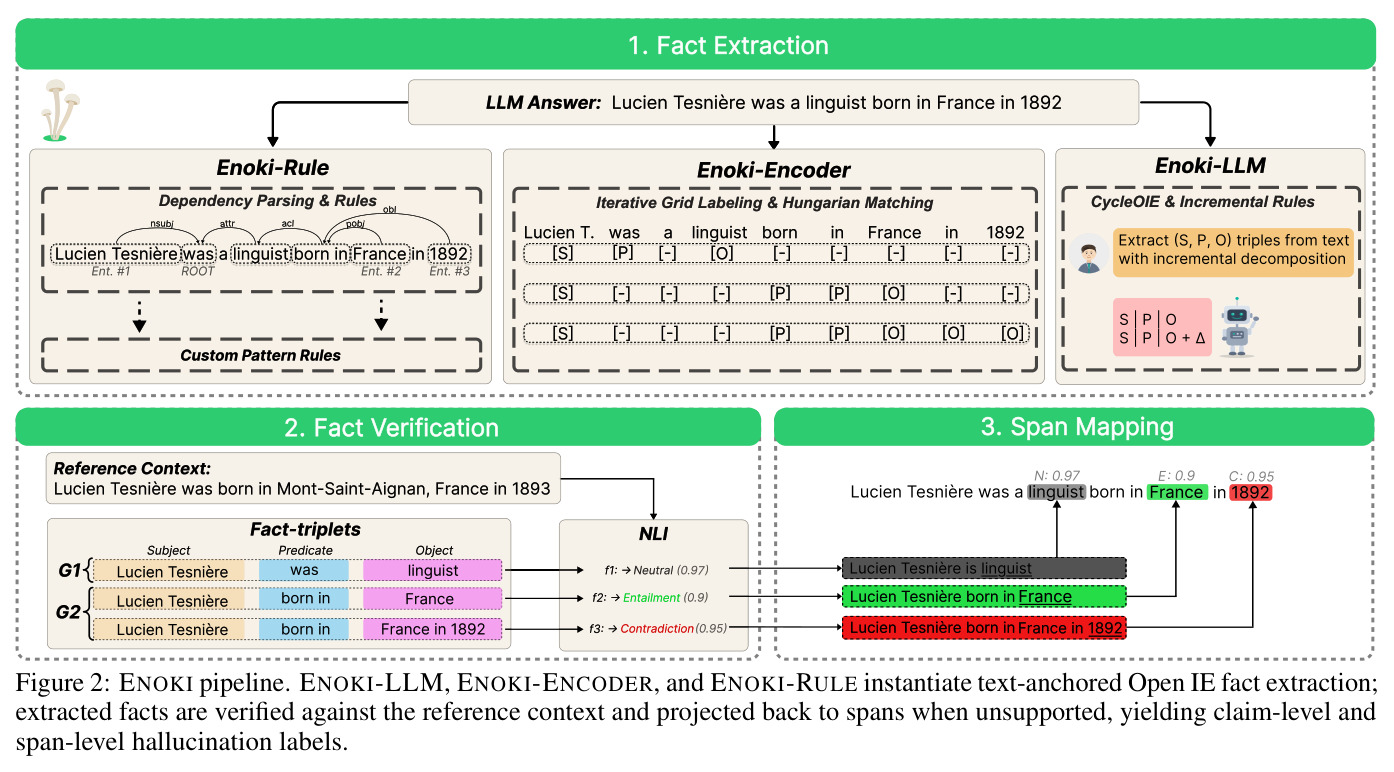
与已有工作不同的是,本文的独特切入是把多粒度幻觉检测重新形式化为「文本锚定的开放信息抽取」。与一般 OpenIE 不同,ENOKI 允许谓词为验证目的做规范化,但强制幻觉相关论元保持与答案 span 对齐,因此同一个三元组既能送入 NLI 验证器得到声明级标签,又能在验证失败时把对象论元的新增增量直接映射为幻觉跨度,无需事后对齐。第二个独特设计是增量式事实构造:相关事实被组织成一系列自包含的细化步骤(如「Enoki|is|mushroom」→「Enoki|cultivated in|China」→「…northern China」),每步只新增少量信息,验证器可以区分「被支持的粗粒度事实」与「不被支持的新增修饰」,把错误精确定位到新引入的 delta 片段——这正是引言中 Tesnière 例子里「被支持的出生年份得以保留、错误的出生地被定位」的机制化。「抽取即锚定、验证即定位」的视角是先前分解-验证管线与端到端跨度检测器都不具备的。
核心方法
ENOKI 是一个两阶段管线:事实抽取 + 事实验证,最后把不支持的事实投影回原文。直觉上,它把每句回答拆成一束「谁—做了什么—对象」的小事实,逐条与证据对质,对不上号的事实再回头指出答案中具体哪几个词出了问题。技术路线:(1)用 spaCy 分句,逐句抽取 OpenIE 风格三元组 $(subject, predicate, object)$;(2)把三元组转成文本假设,用 NLI 式验证器对照参考证据打分,幻觉概率取矛盾与中立概率之和,阈值 0.5;(3)验证失败时输出对象论元的增量 delta 作为幻觉跨度。参考上下文常超过模型输入上限,故将证据分块(块间单句重叠),每个事实与所有分块比对、取跨块最大蕴含分,兼顾长上下文与最相关证据匹配。抽取后端三选一:ENOKI-LLM(GPT-OSS-120B)、ENOKI-RULE(35 条依存规则)、ENOKI-ENCODER(ModernBERT-large 上的 IGL 架构);验证器默认 ModernBERT-large-nli(约 395M 参数)。
核心创新是「文本锚定 + 增量事实构造」的共享表示。与 FActScore/RefChecker 等分解-验证管线的本质区别:ENOKI 抽出的三元组不是自由浮动的命题,其幻觉相关论元始终绑定答案中的字符跨度,声明级标签与跨度级定位从同一中间表示自然导出,省去独立的 claim-to-span 对齐步骤,也避免了三段式管线的误差传播。与 lettucedetect 等端到端跨度检测器的本质区别:每个被定位的错误都保留显式关系结构(哪个主语、哪个谓词、哪个论元不被支持),可解释、可编辑。增量构造进一步细化归因逻辑:同一命题以从窄到宽的多个自包含版本出现,例如「Enoki | cultivated in | China」判为蕴含而「Enoki | cultivated in | northern China」判为不支持,验证时只有新增的 delta(northern)被判为幻觉,被支持的部分得以保留。一句话概括:一般 OpenIE 追求还原语义,ENOKI 追求「语义还原不破坏字符锚定」,这一个约束同时解锁了两种检测粒度。
方法步骤详情
流程:(1)分句——spaCy 切分回答,逐句独立抽取。(2)事实抽取,三选一后端。ENOKI-LLM 用 CycleOIE 提示追加三条增量分解指引(论元跨度渐进扩展或拆分、复合论元可拆、修饰增广须自包含),由 GPT-OSS-120B 执行;ENOKI-RULE 在 spaCy 依存树上应用 35 条自包含模式规则,每条只输出锚定文本的主谓宾头词,跨度塑造阶段确定性生成 span;规则库由「代理生成候选 + 固定接受门控」两阶段协议开发,接受分 $S = F_1 + 0.25 \cdot \mathrm{cov}$,第一阶段在 OpenIE6+LSOIE 的 5,063 句黄金子集上从零收敛到 16 条($S=0.7233$),第二阶段在 ENOKIQA 开发集 5.8 万句上补齐增量扩展与复合谓词,收敛到 35 条;ENOKI-ENCODER 复用 OpenIE6 的迭代网格标注(IGL)架构,编码器换 ModernBERT-large,在 ENOKIQA 开发集 5,474 句、36,865 个增量三元组上训练,深度 14、学习率 $2\times10^{-5}$、批大小 32,用置换不变的匈牙利匹配损失替换行序交叉熵。(3)事实验证——三元组转文本假设,NLI 验证器对上下文分块逐一打分、取最大值。(4)投影输出——未通过验证的事实把对象论元增量标为幻觉 span,三元组验证标签同时作为声明级输出;ENOKIQA 标注即用该管线(GPT-OSS-120B 抽取 + Qwen3.5-9B 验证)自动生成。
技术新颖性
新颖性有三。其一,表示层:以「文本锚定」约束重新定义 OpenIE 在验证场景的角色——谓词可规范化、幻觉相关论元必须锚定原文,一个约束同时解锁声明级与跨度级输出,是对「分解-验证-对齐」范式的结构性简化而非组件改良。其二,训练目标:增量抽取使同一句子产生多个仅精细度不同的金标行,原行序目标 $\mathcal{L}_{\mathrm{row}} = \frac{1}{D}\sum_{d=1}^{D}\mathrm{CE}(\hat{y}_d, y_d)$ 会惩罚行序正确但位置不同的预测;ENOKI 借鉴 DETR 集合预测思想,计算两两代价 $C_{ij} = \mathrm{CE}(\hat{y}_i, y_j)$,求 $\sigma^\star = \arg\min_\sigma \sum_i C_{i,\sigma(i)}$,只在匹配对上计损失;消融显示该改动把 MuSHROOM span F1 从 41.02 提到 46.96、RAGTruth 从 27.25 到 34.84、PsiloQA 从 61.14 到 65.51。其三,工程方法:规则库采用协议化代理开发——LLM 代理只提候选规则,接受与否由固定验证协议(双种子复验、精确率下限 $\Delta P \ge -0.0075$)把关,把代理随机性限制在候选生成环节,保证可复现。
实验结果
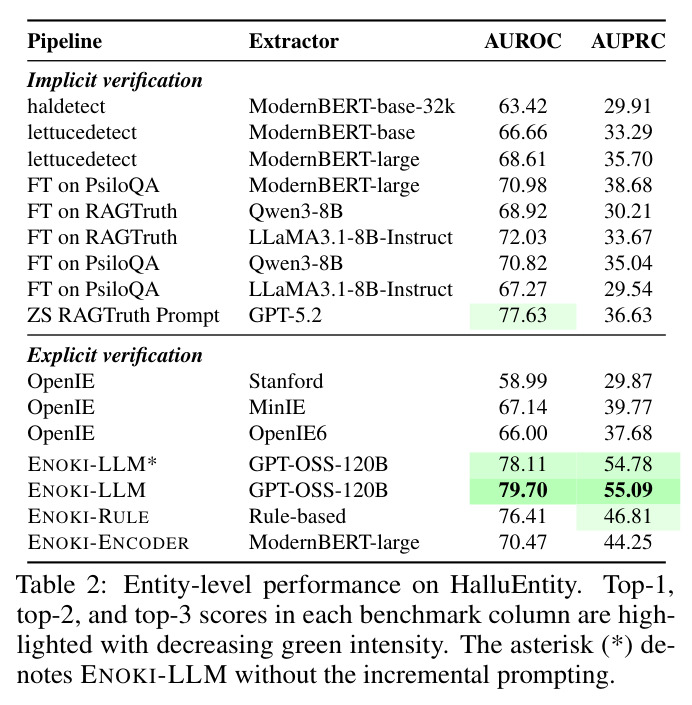
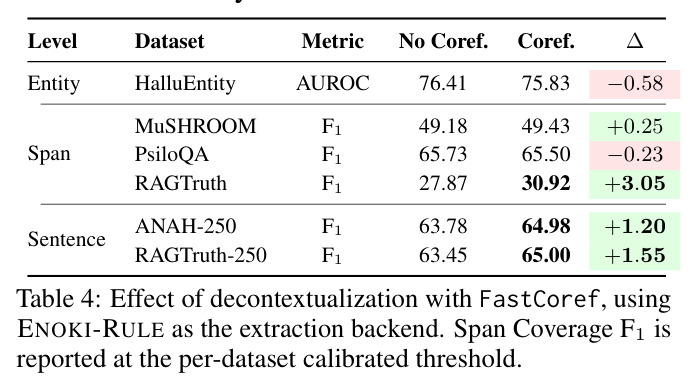
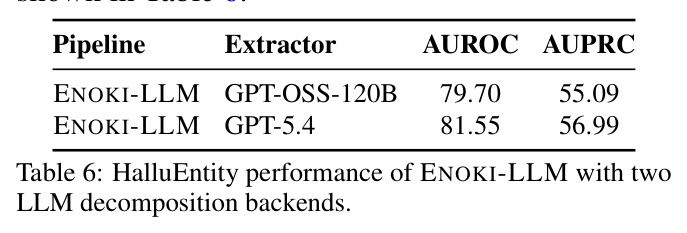
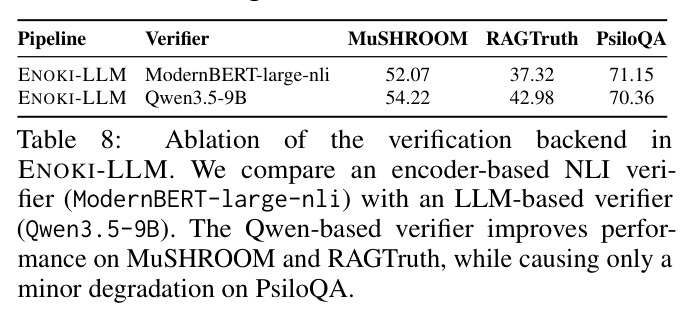
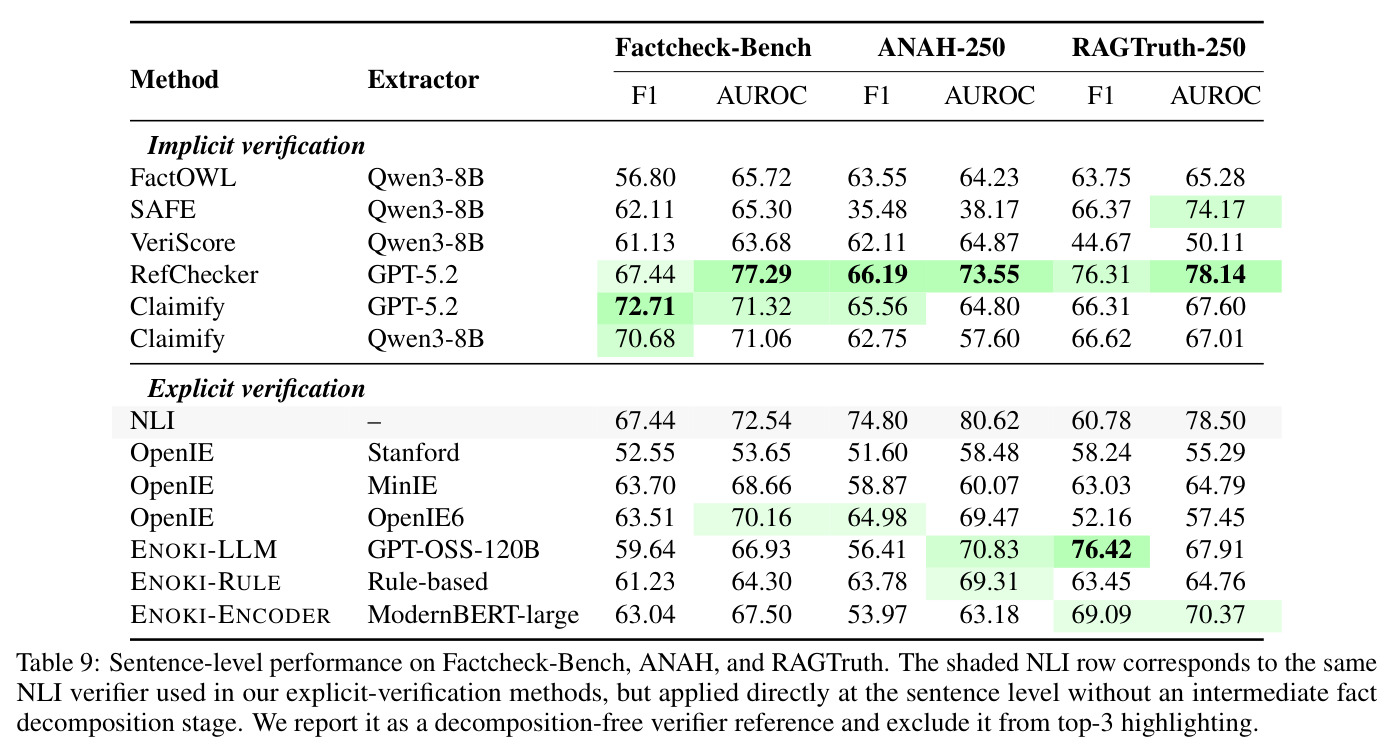
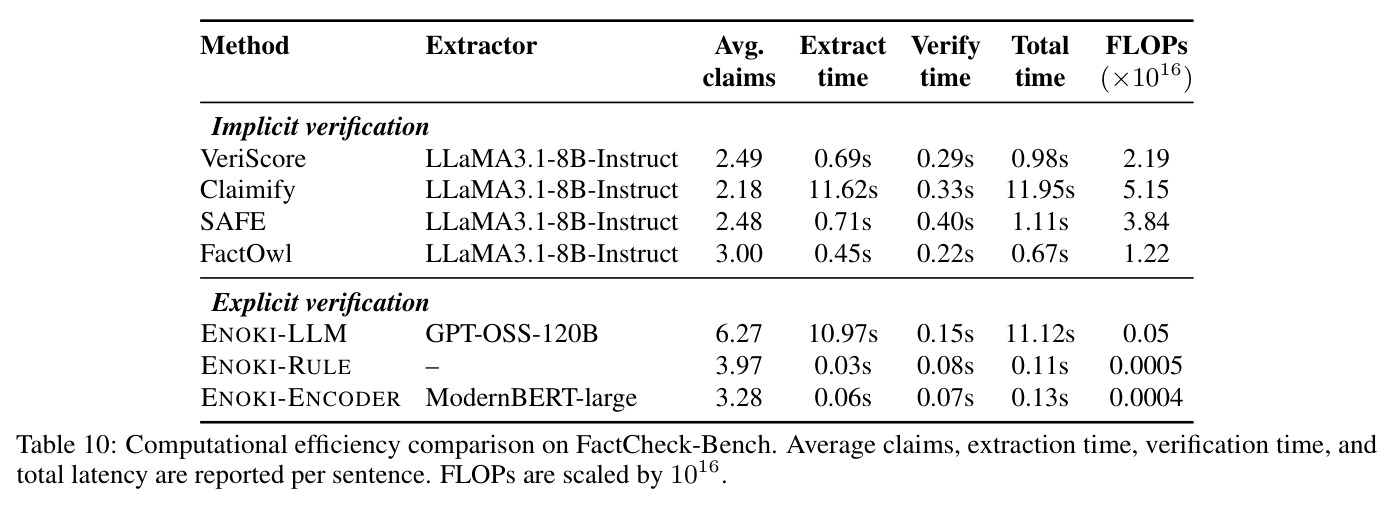
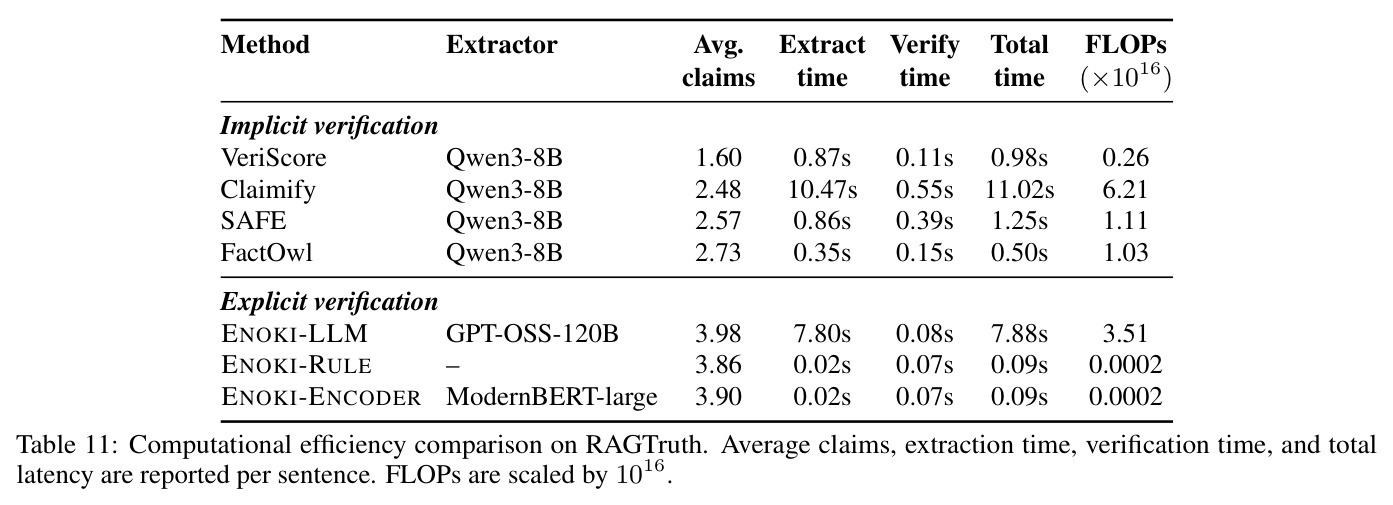
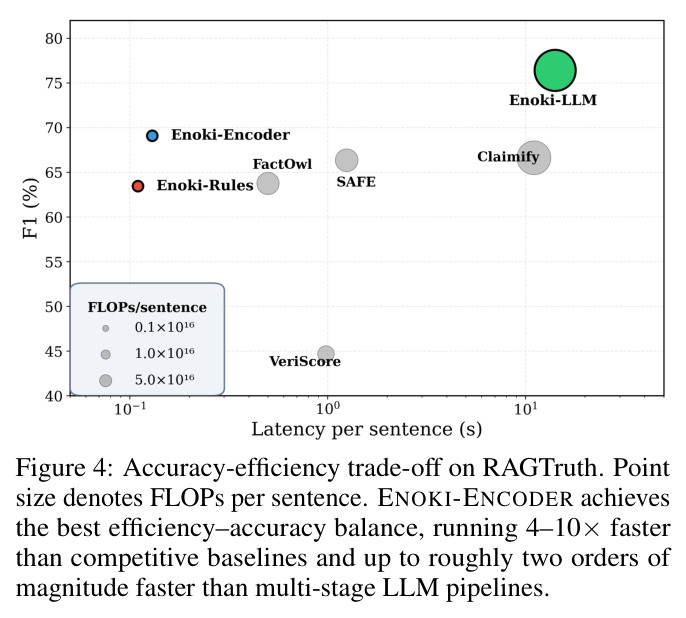
实体级(Table 2):HalluEntity 上 ENOKI-LLM 达 79.70 AUROC / 55.09 AUPRC 最佳,非增量变体 78.11/54.78 紧随;最强先前检测器被大幅超越(零样本 GPT-5.2 为 77.63/36.63,MinIE 为 67.14/39.77),论文报告相对最强先前检测器 AUPRC +15.3;规则版 76.41/46.81、编码器版 70.47/44.25 也优于所有标准 OpenIE 基线。跨度级(Table 3):MuSHROOM 上 ENOKI-LLM 得 52.07 Span Coverage F1(最佳先前基线 MinIE 44.12,lettucedetect-large 仅 1.23),PsiloQA 上 71.15(MinIE 64.06);RAGTruth 上 37.32 落后于域内微调的 Qwen3-8B(42.20),但 ENOKI-ENCODER 以 34.84 接近 RAGTruth 微调的 lettucedetect(37.97),尽管它只在 ENOKIQA 上训练。句子级(Table 9):结果分化,ENOKI-LLM 在 RAGTruth-250 以 76.42 F1 领先(超 Claimify Qwen3-8B +9.8),但在 FactCheck-Bench(59.64)与 ANAH-250(56.41)落后于 Claimify GPT-5.2(72.71)与无分解 NLI 基线(ANAH 74.80),说明粗粒度二分类下分解未必划算。效率(Figure 4、Table 10/11):ENOKI-ENCODER 每句 0.13 秒达 69.1 F1,比竞争基线快 4–10 倍、比多阶段 LLM 管线快约两个数量级(Claimify 11.95 秒/句、$5.15\times10^{16}$ FLOPs,对比其 $0.0004\times10^{16}$)。消融:换 Qwen3.5-9B 验证器使 MuSHROOM 52.07→54.22、RAGTruth 37.32→42.98;抽取器换成 GPT-5.4 仅 +1.85 AUROC;FastCoref 去上下文化在 RAGTruth +3.05、ANAH +1.20,但 HalluEntity −0.58、PsiloQA −0.23,故仅作可选项。数据质量:ENOKIQA 双标注者 Cohen κ=0.580,自动管线对人工裁定标签句子级 F1=0.867、跨度级 F1=0.569。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 实体级幻觉检测(HalluEntity) | AUROC / AUPRC | ENOKI-LLM 79.70 / 55.09 | 最强先前检测器(零样本 GPT-5.2:77.63 / 36.63;最佳 OpenIE 基线 MinIE:67.14 / 39.77) | 论文报告相对最强先前检测器 AUPRC +15.3;相对零样本 GPT-5.2 AUPRC +18.5 |
| 跨度级定位(MuSHROOM,英文) | Span Coverage F1 | ENOKI-LLM 52.07 | 最佳先前基线 MinIE 44.12;隐式检测器 lettucedetect-large 仅 1.23 | +8.0(论文摘要口径,相对最强先前检测器) |
| 跨度级定位(PsiloQA,英文) | Span Coverage F1 | ENOKI-LLM 71.15 | 最佳先前基线 MinIE 64.06;零样本 GPT-5.2 为 39.17 | +7.09 |
| 句子级事实性分类(RAGTruth-250) | F1 | ENOKI-LLM 76.42 | Claimify(Qwen3-8B)66.62;Claimify(GPT-5.2)66.31 | +9.8(延迟与 Claimify 相当) |
| 推理效率(RAGTruth,每句) | 时延 / FLOPs | ENOKI-ENCODER 0.13 秒、69.1 F1(FLOPs 约 0.0002–0.0004 ×10^16) | 多阶段 LLM 管线 Claimify 11.02–11.95 秒/句(FLOPs 5.15–6.21 ×10^16) | 比竞争基线快 4–10 倍,比多阶段 LLM 管线快约两个数量级 |
局限与改进
作者承认四点局限。其一,依赖事实抽取:验证只在被抽取的事实上进行,若抽取器遗漏命题、合并事实或产生过粗论元跨度,验证器无法恢复缺失结构——同一表示既是可解释性的来源也是召回率的上限。其二,增量投影不完美:当同一事实多个部分同时不被支持、或错误以非局部方式交互时,把不支持性归到单一 delta 会产生比人类最小标注更粗的跨度。其三,句子级处理范围:逐句抽取使跨句共指、省略与篇章级归属只被 FastCoref 部分覆盖,且其收益因数据集而异(RAGTruth +3.05 但 PsiloQA −0.23),未默认开启。其四,验证器敏感性:最终决策依赖验证器的校准与鲁棒性,脆弱的验证器会让良构事实也失败。我的补充观察:ENOKIQA 标注由 ENOKI-LLM 加 Qwen 验证自动产生,而 ENOKI-ENCODER 又在该数据上训练,存在自蒸馏偏差循环;跨度级人工一致性仅 F1=0.569,标注噪声不可忽略;数据集幻觉率高达 76–78%,分布偏斜可能使固定阈值 0.5 在真实低幻觉率场景失准;MuSHROOM 无训练集只能对所有方法用默认阈值,跨方法公平性存疑。
独立分析的弱点
独立分析的弱点与改进方向:第一,抽取是单点故障——ENOKI-LLM 在 FactCheck-Bench 平均每句仅抽 6.27 个事实,漏抽即漏检,可做多抽取器集成或对低覆盖句子触发 LLM 兜底。第二,对象级投影的表达上限:论文自己的 RAGTruth 示例中错误是主语替换(摘要写成「Waze is the leading cause…」,原文主语是 ambush attacks),而 delta 机制主要面向对象论元,主语或谓词级错误可能定位不精,应把增量投影扩展到 subject/predicate。第三,分块最大值聚合可能产生巧合蕴含——某块局部支持而全文矛盾,可引入跨块证据聚合或对 max 分数做校准。第四,句子级任务上无分解 NLI 基线(ANAH 74.80)强于多数显式管线,说明分解在粗粒度任务是纯开销,可训练轻量路由器按需启用分解。第五,固定阈值 0.5 用于所有显式方法,而各基准幻觉率从约 20% 到 78% 不等,逐数据集校准或 conformal 预测会更稳健。第六,ENOKI-ENCODER 学到的是「ENOKI-LLM + Qwen 管线」的行为近似而非人工金标,可用小规模人工修正集做蒸馏纠偏。
未来方向
作者提出的方向:更强的篇章感知抽取以处理共指、省略与跨句归属(当前去上下文化收益不一致,说明需要原生的跨句增量组而非事后代词替换);把 ENOKIQA 用作训练资源推动更好的跨度检测器。基于本文成果可延伸:其一,多语言扩展——MuSHROOM 本身是多语言共享任务,文本锚定 OpenIE 原则上语言无关,可检验规则库与增量提示的跨语言迁移;其二,验证器蒸馏——Table 8 显示 Qwen3.5-9B 验证器带来明确增益(RAGTruth 37.32→42.98),可把 LLM 验证信号蒸馏进小型 NLI 模型以保持低成本;其三,增量组内联合判定,对同组多个 delta 的非局部错误交互建模,替代逐 delta 独立归因;其四,把结构化事实输出接入检测-编辑闭环(Mishra et al. 2024),实现「定位即修复建议」;其五,与检索式验证(SAFE 的搜索-验证)结合,覆盖需要外部知识的无证据场景;其六,利用 ENOKIQA 的 19,594 条无标注样本做半监督训练。
复现评估
复现条件良好。代码在 GitHub(s-nlp/Enoki),ENOKIQA 在 HuggingFace(s-nlp/EnokiQA)。组件均公开:ENOKI-LLM 用开源权重的 GPT-OSS-120B(换 GPT-5.4 仅提升 1.85 AUROC,不强依赖闭源模型),验证器 ModernBERT-large-nli 约 395M 参数可直接下载;ENOKI-RULE 只需 spaCy、零训练、每句约 0.02–0.03 秒;ENOKI-ENCODER 基于 ModernBERT-large(约 400M),在 1,995 个样本(5,474 句、36,865 三元组)上训练,学习率 $2\times10^{-5}$、批大小 32、深度 14,单卡可完成。主要开销在 ENOKI-LLM 抽取(每句 7.8–11 秒),但规则/编码器变体提供免 LLM 路径。附录详尽:完整提示词(I–K)、规则库与代理协议(H)、超参(C)、指标定义(E)、效率测算(G)。注意 ENOKIQA 标注由自动管线生成(人工核验仅 100 例,κ=0.580),训练时应容忍约 0.57 的跨度级标注质量上限。总体复现难度:中低。
论文图表
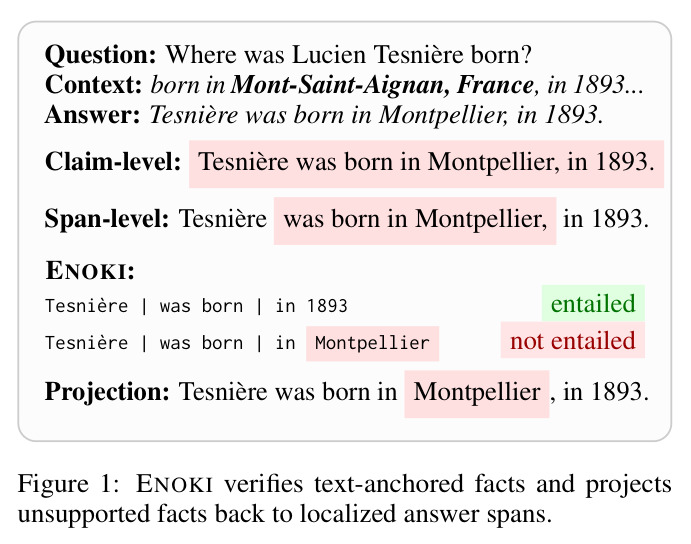
以「Tesnière 出生于哪里」为例对比三种输出:声明级检测把整句「Tesnière was born in Montpellier, in 1893」视为单个不支持单元;跨度级检测只圈出错误片段但不暴露被检验的事实结构;ENOKI 则抽出「Tesnière | was born | in 1893」(蕴含)与「Tesnière | was born | in Montpellier」(不支持)两个锚定事实,把不被支持的 Montpellier 投影回答案中的精确跨度,同时保留被支持的年份。
用最小例子说明论文的核心主张:声明级验证与跨度级定位是互补视图,而文本锚定的事实三元组可以统一二者,是理解全文动机的入口。