AdaPRA:面向数据科学智能体的自适应评分表过程奖励监督 AdaPRA: Process Reward Agents with Adaptive Rubrics for Data Science
过程奖励智能体借助持久工作区与自适应rubric监督,大幅提升数据科学Agent的Kaggle百分位
前置知识
过程奖励模型(PRM)与过程奖励智能体(PRA)
PRM对推理或行动的中间步骤打分,而不是只看最终结果,源自数学证明验证的 step-by-step 监督思想。过程奖励智能体(PRA)更进一步:评判者本身是个智能体,会主动执行代码、检索文件、探索工作区来取证,然后再给步骤或轨迹打分,而不是凭一段文字盲判。
AdaPRA 的核心组件就是一个 PRA。只有理解它和结果奖励模型(只看最终分数)的区别,才能明白为什么它能抓住轨迹上不留痕迹的静默错误。
Kaggle 排行榜百分位与奖牌阈值
百分位表示提交成绩在全部参赛队中的相对位置(0-100,越高越好)。论文用四个任务级比率做指标:Pct.(私有排行榜百分位,无私有则用公开)、Valid(提交被 Kaggle 接受并计分的任务占比)、>Median(分数超过排行榜中位数的任务占比)、Medal(达到奖牌阈值的任务占比),且分母固定为全部任务数,无效提交计零分。
论文所有主表(Table 1/2)和消融都用这四个指标报告,不理解其定义就无法正确解读 +24.5、90.7% 这些数字。
交叉验证、OOF 预测与数据泄露
k 折交叉验证(CV)把训练数据分成 k 份轮换充当验证集;out-of-fold(OOF)预测指每条样本在其未参与训练的那一折上得到的预测,是估算泛化性能的基石。常见的过程错误是泄露:用全量数据做拟合预处理、用最终模型在自己训练数据上的预测冒充 OOF、随机 k 折用于时间序列等,都会让本地 CV 虚高而排行榜暴跌。
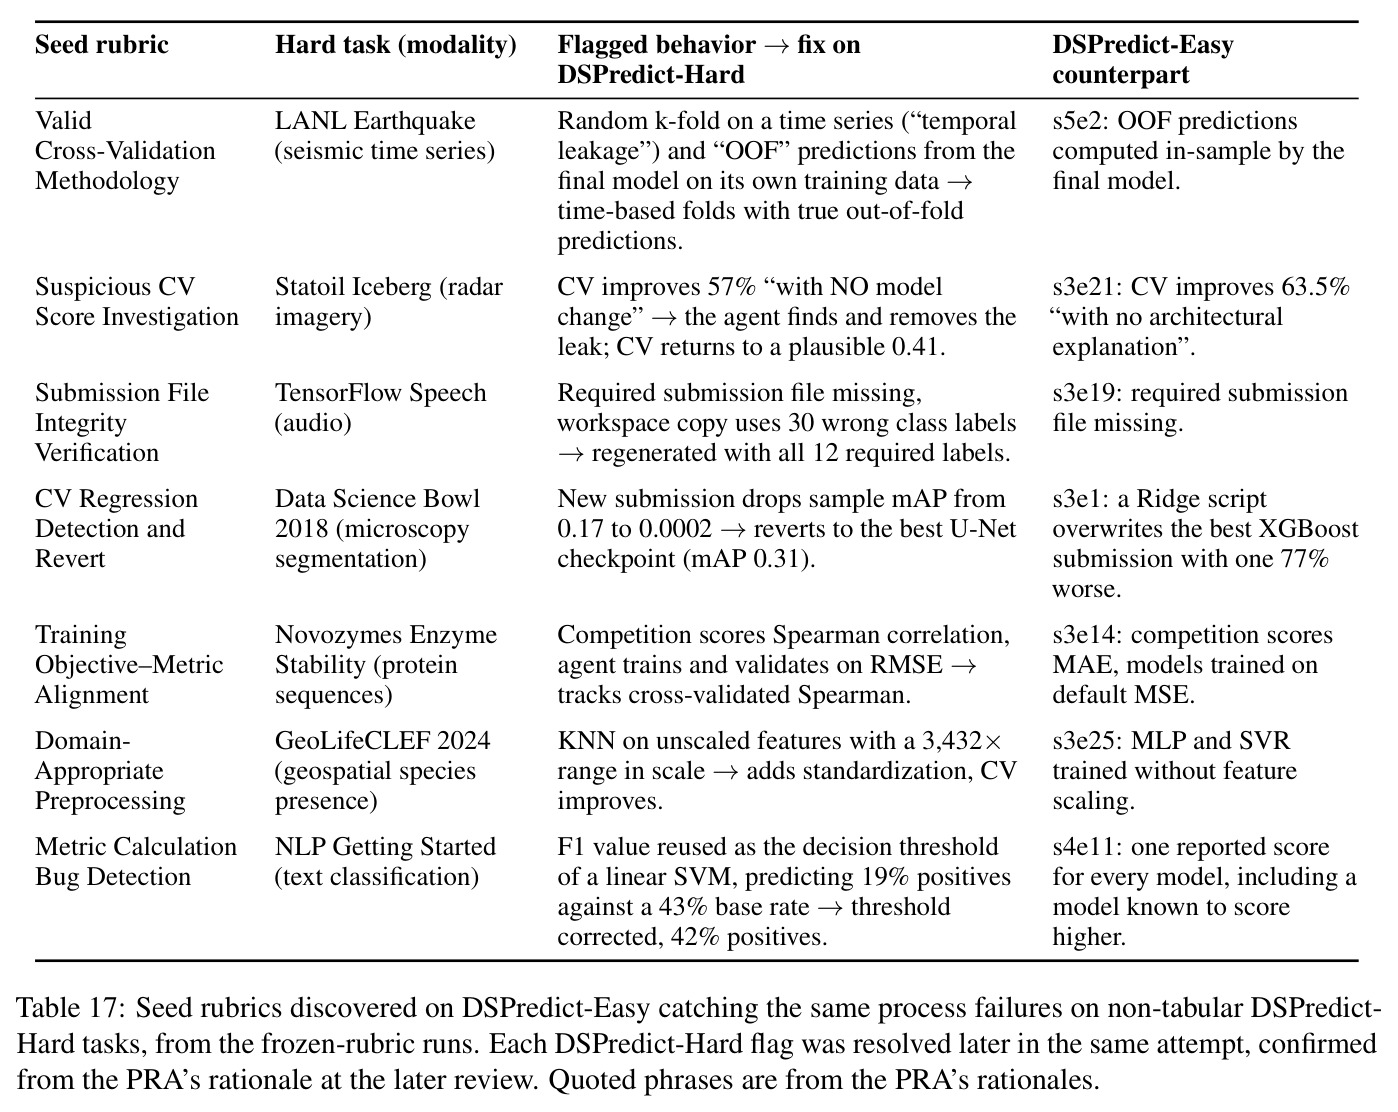
19 条种子 rubric 里最重要的就是验证类(Valid CV、CV Score Registry、Suspicious CV);Table 17 的易到难迁移案例大半是泄露类错误。
简单性偏差(simplicity bias)
指 agent 一旦找到第一条能跑通的流水线就停下来提交,不再探索更强的模型族、预处理方案或特征工程。这是数据科学 agent 与人类选手差距的最大来源之一,也是一种静默错误——提交合法、轨迹无异常,但分数平庸。
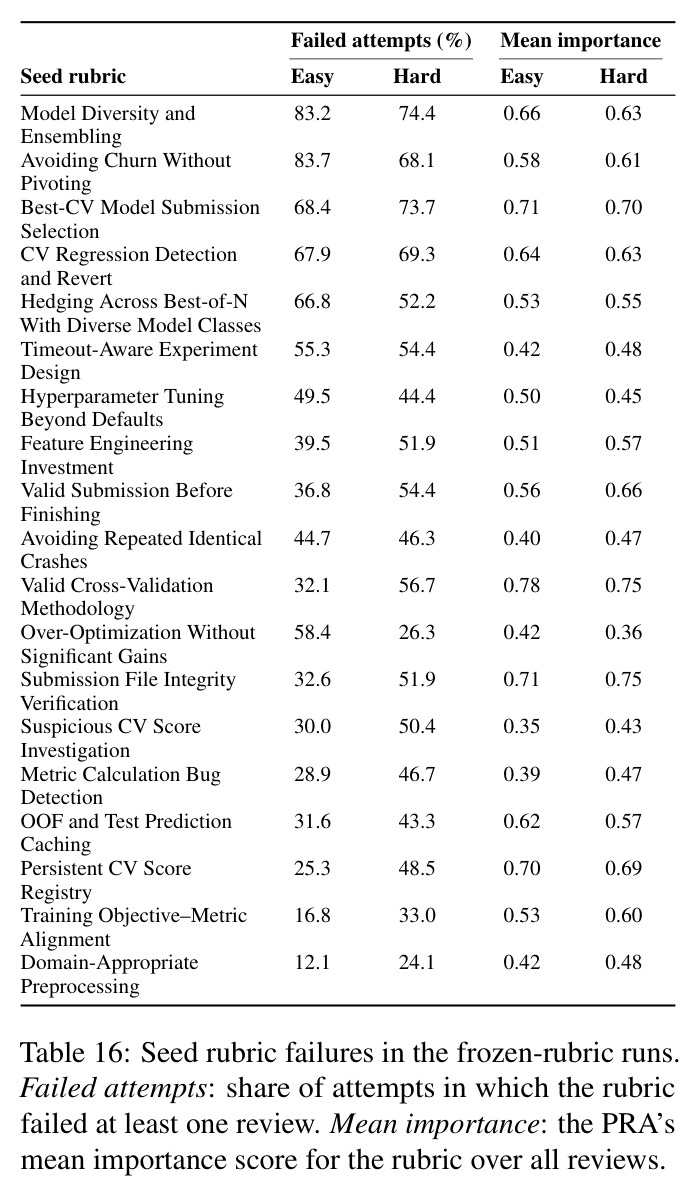
论文显示两条反简单性 rubric(模型多样性不足、重复相似实验不转向)在两个基准上都有 68-84% 的尝试失败,是支撑 rubric 可迁移性论点的关键证据。
智能体 harness、轨迹与工作区
harness 是驱动 LLM agent 的执行框架(终端、文件编辑器、上下文压缩、预算控制)。轨迹 $\tau=(a_1,o_1,\dots,a_T,o_T)$ 是动作-观察序列,记录 agent 说过什么、跑过什么命令;工作区 $W$ 是文件系统上的代码、模型、数据、中间预测与提交文件。有些错误只在轨迹可见(反复重试失败命令),有些只在工作区可见(引用不存在的文件路径)。
证据来源的二分法是全文方法设计的根基:AdaPRA 对每条 rubric 标注 artifact-grounded 或 trajectory-grounded,并据此决定如何取证。
Rubric(评分表)作为奖励规范
用自然语言判据(如"至少与一个更强模型族的基线比较")代替标量偏好标签作为奖励或监督规范。每条 rubric 可输出满足概率 $p_j$、重要性 $i_j$、理由 $e_j$ 与建议动作 $\hat{a}_j$,比单一分数更可解释、更可执行。
AdaPRA 的全部监督都以 rubric 为载体:种子 rubric 如何离线挖掘、运行时如何用代码检查、如何按任务增删,是理解本文的主线。
研究动机
数据科学 agent 已能端到端跑通机器学习工作流,但在 DSGym 这样的 Kaggle 竞赛基准上与人类排行榜差距仍然很大,差距主要来自过程错误(process errors)。第一类是简单性偏差:agent 停在第一条有效流水线上,不去探索更强的模型族、预处理和特征。第二类是验证不健全与目标错配:例如对时间序列用随机 k 折造成泄露、本地 CV 虚高、训练目标与比赛指标不一致。第三类最棘手——静默错误:流水线照常产出合法提交、轨迹上看不到任何异常,但结果全错。论文开篇的例子中,一个错误的文件路径让 158,538 条测试语音全部读成静音音频,所有预测都被判为 unknown 命令,而轨迹却显示一切正常。此外,agent 不会利用重复尝试:DSGym 这类 harness 在每次尝试之间重置工作区,导致每次都重复做 EDA、重建基线、重蹈已失败的策略,浪费固定预算。只读轨迹的 LLM 评审抓不住静默错误,而轨迹动辄数百回合、工作区里有代码、模型和数据,把所有证据塞进上下文窗口也不可行。
本文的目标是本文的目标是构建一个能在固定预算内持续监督长时程数据科学 agent 的系统 AdaPRA:让每次尝试都把预算花在新实验上,而不是重复之前的劳动;在尝试进行中(而非结束后)发现并纠正过程错误,包括轨迹上不留痕迹的静默错误。目标分解为四个子任务:其一,harness 跨尝试保留工作区,让 EDA 笔记、特征、训练好的模型、验证结果和提交都能被下一次尝试复用;其二,监督者(PRA)以固定节奏审计轨迹与工作区,并用代码执行来取证;其三,评分表 rubric 不靠专家手写——跨大量任务维护手写 rubric 不可行——而是从过往 agent 运行中自动挖掘;其四,rubric 能按任务自适应,覆盖通用规则无法预见的领域陷阱。全程的硬约束是:agent 与 PRA 永远看不到 Kaggle 分数、测试标签等任何外部反馈,分数只在评测时使用,因此不能靠结果奖励来监督。
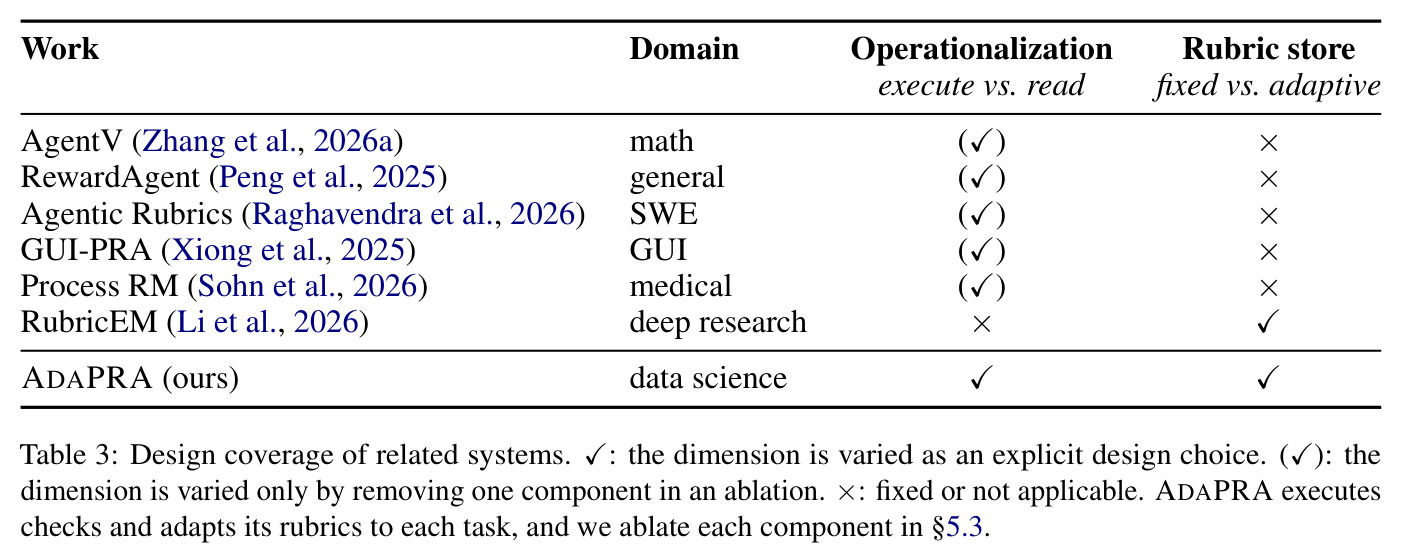
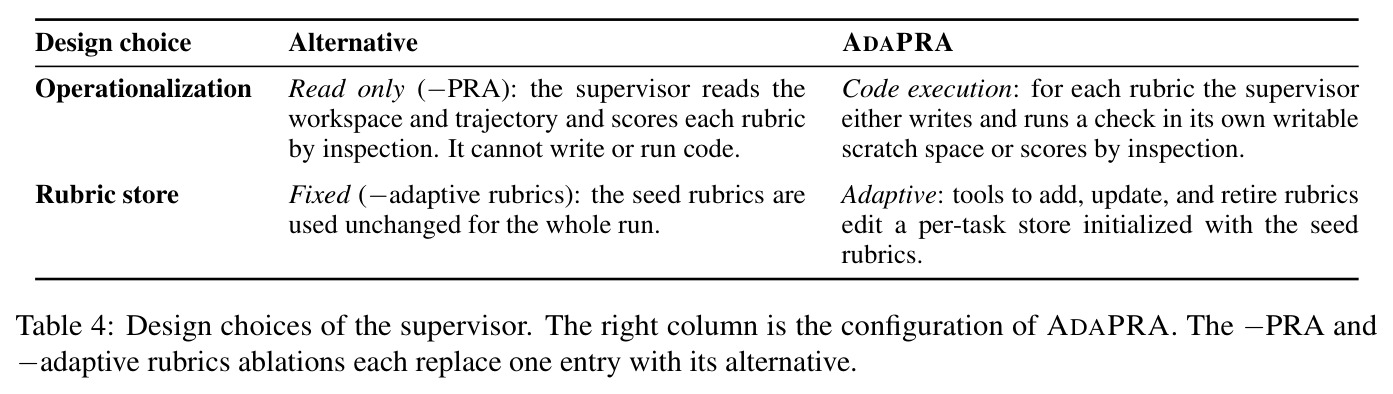
与已有工作不同的是,已有工作各有缺口,AdaPRA 的切入角度是把四个此前从未组合的维度拼在一起。工程化 scaffold(AIDE、ML-Master)用树搜索挑候选解、每步给精挑的短上下文,但搜索由 scaffold 主导、工作区不跨尝试保留;DSGym 的 REPL 式 harness 每次尝试都重置。过程奖励智能体方面,数学(AgentV-RL)、软件工程(Agentic Rubrics)、GUI(GUI-PRA)、医疗(Process RM)、通用奖励(RewardAgent)都会执行代码验证,但全部依赖静态 rubric 集;RubricEM 与 Zhang et al. 的对比式 rubric 挖掘只从回复或轨迹总结经验,不挖掘工作区产物,且 RubricEM 服务于 meta-RL 训练循环而非测试时监督。DataPRM 这类生成式 PRM 逐步打三元分(1/0.5/0),无法覆盖"停在第一条有效流水线"这类横跨多步的策略性错误。Table 3 的系统对照清晰显示:此前没有工作同时具备"执行检查"与"自适应 rubric 库"两个维度,而这正是 AdaPRA 独特的位置。
核心方法
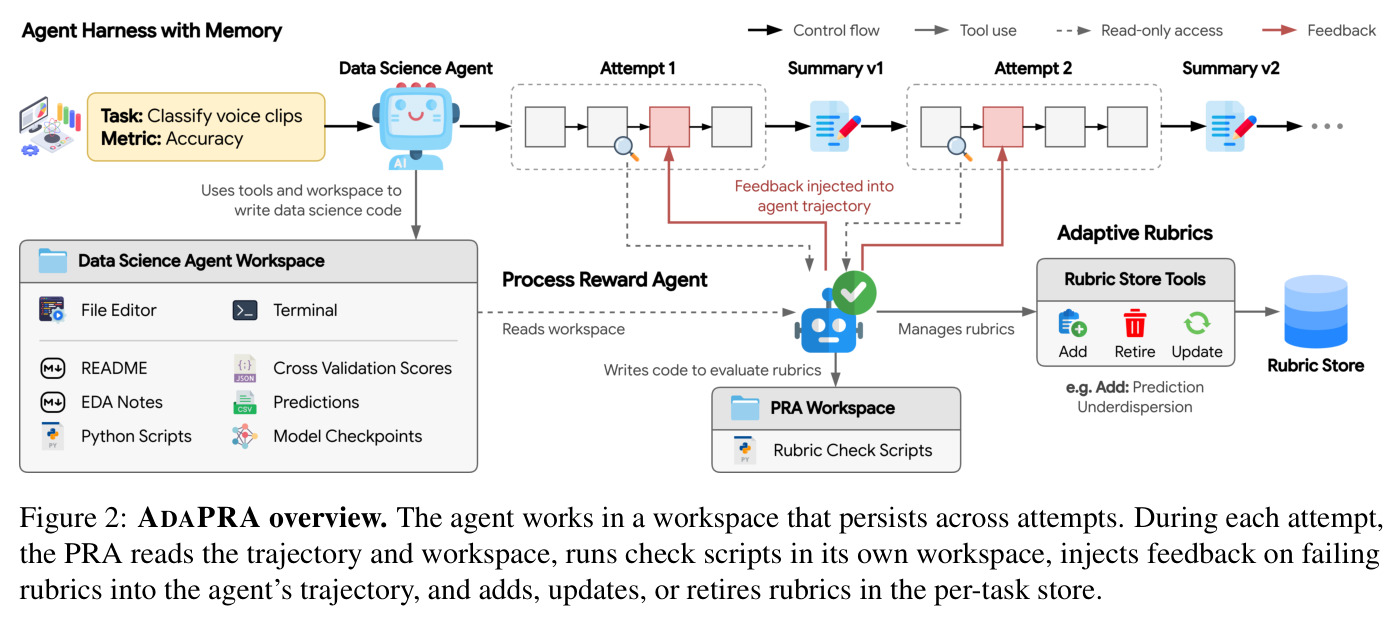
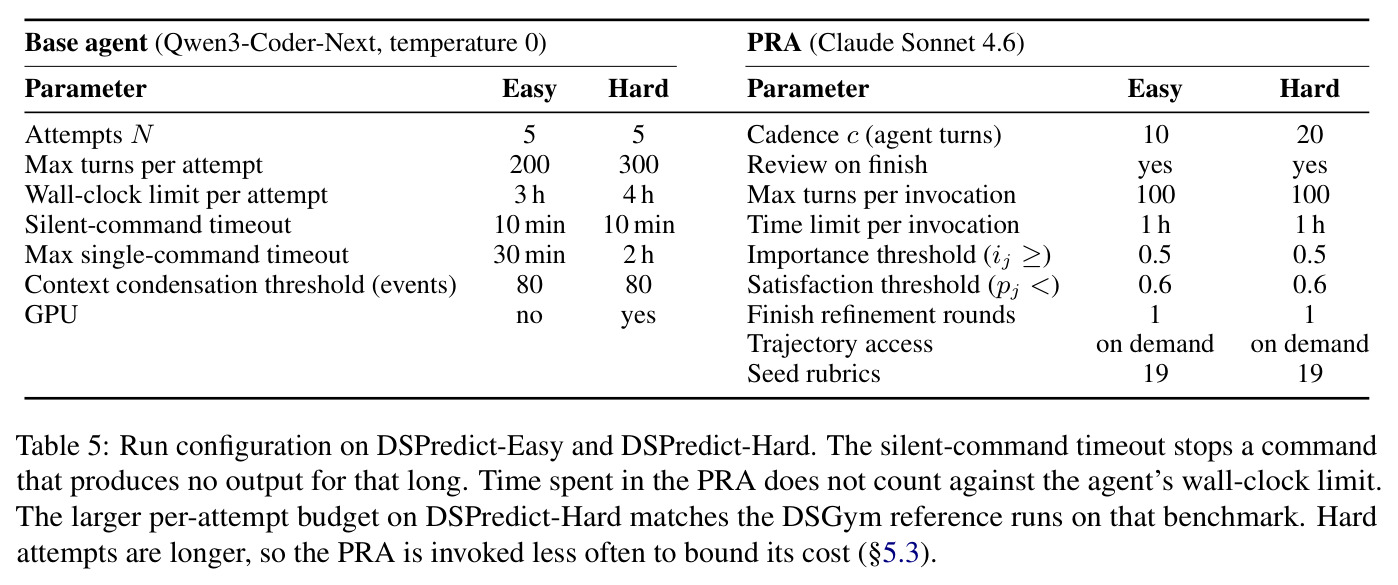
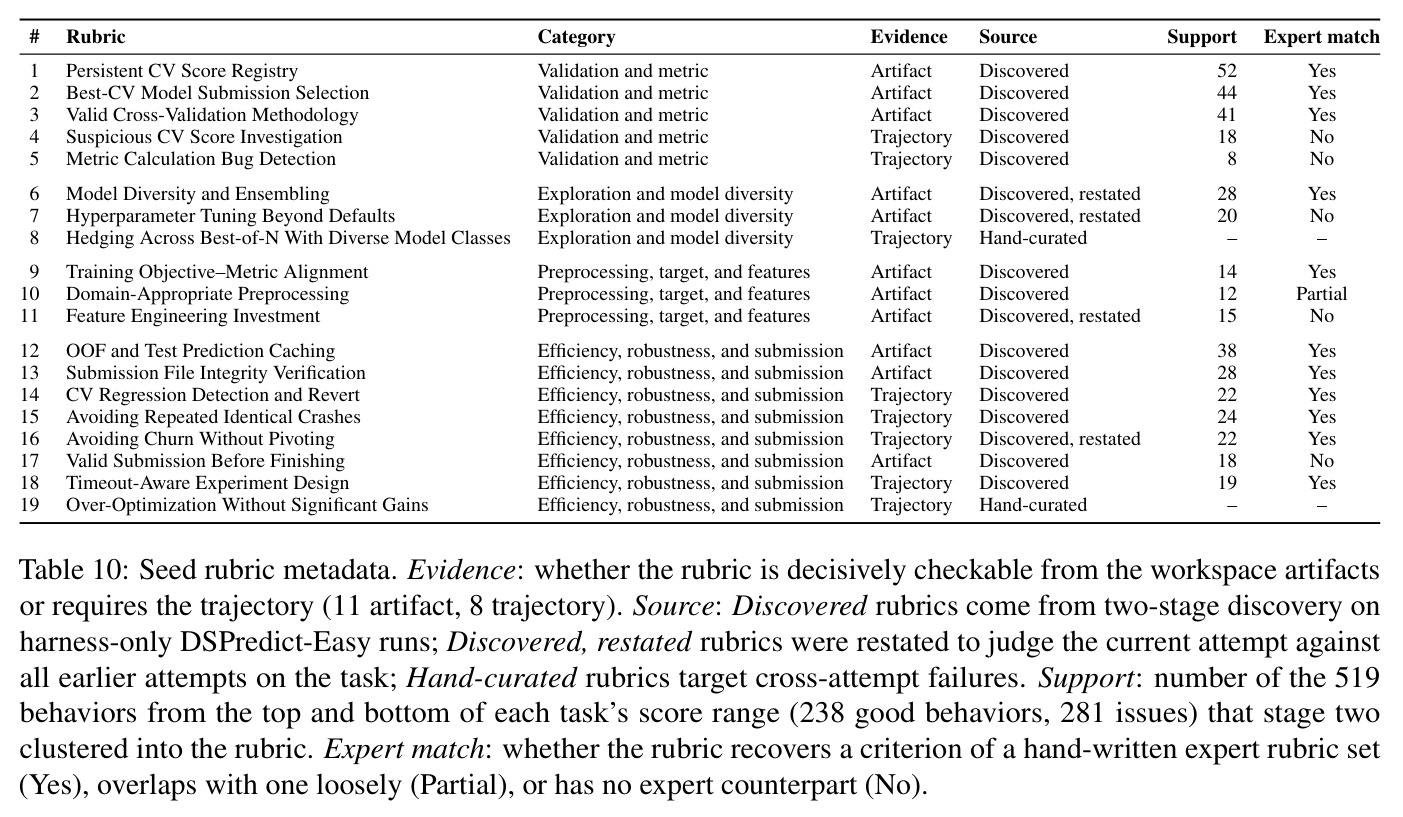
直觉上,AdaPRA 像一位带着终端权限的资深同事坐在 agent 旁边:不只读工作日志(轨迹),还亲自检查它留下的文件——代码、OOF 预测、提交文件——按清单逐项核对;问题在尝试进行中就被指出,而非结束后复盘;它还把前几次尝试踩过的坑记成新的检查项。技术路线由四个组件构成:其一,持久 harness——基于 OpenHands,每任务一个工作区跨全部 $N=5$ 次尝试保留,仅模型上下文重置,后一次尝试还会读到前几次的总结;其二,PRA——由 Claude Sonnet 4.6 驱动,每 $c$ 个回合(Easy 取 10、Hard 取 20)及尝试结束时各评审一次,对每条 rubric $\rho_j$ 输出 $S(x,W,\tau_{:t},\rho_j)=(p_j,i_j,e_j,\hat{a}_j)$:满足概率、重要性、理由与建议动作;其三,离线 rubric 挖掘——从过往运行对比强弱尝试,自动提炼 19 条种子 rubric;其四,按任务自适应——PRA 在每任务独立的 rubric 库中增改删条目。
核心创新有三点相互咬合的设计。第一,证据源分工:过程错误分两类——"反复重试同一条失败命令"只在轨迹可见,"引用不存在的文件路径使所有测试样本读成静音"只在工作区可见;因此每条 rubric 被标注证据来源(工件型/轨迹型),PRA 在自己的可写沙箱里写脚本验证 agent 的只读工作区(如从保存的 OOF 预测重算 CV 分数),使满足概率 $p_j$ 有执行结果背书而非文本推断。第二,反馈经济性:早期版本报告所有 rubric 结果,几乎全是通过的正反馈,淹没了失败建议,agent 行为不变;改为只注入 $i_j\ge0.5$ 且 $p_j<0.6$ 的失败项、按重要性排序并附建议动作后才有效。第三,rubric 的可迁移性假设:过程错误是 agent 的属性而非领域的属性——简单性偏差在表格、语音、地震时序、分子任务上都以 68-84% 的比例出现,因此在易任务上挖出的种子 rubric 能直接迁移到难任务,再由按任务自适应补上领域特定的坑(如 House Prices 上新增的"预测离散度被压向均值"rubric)。
方法步骤详情
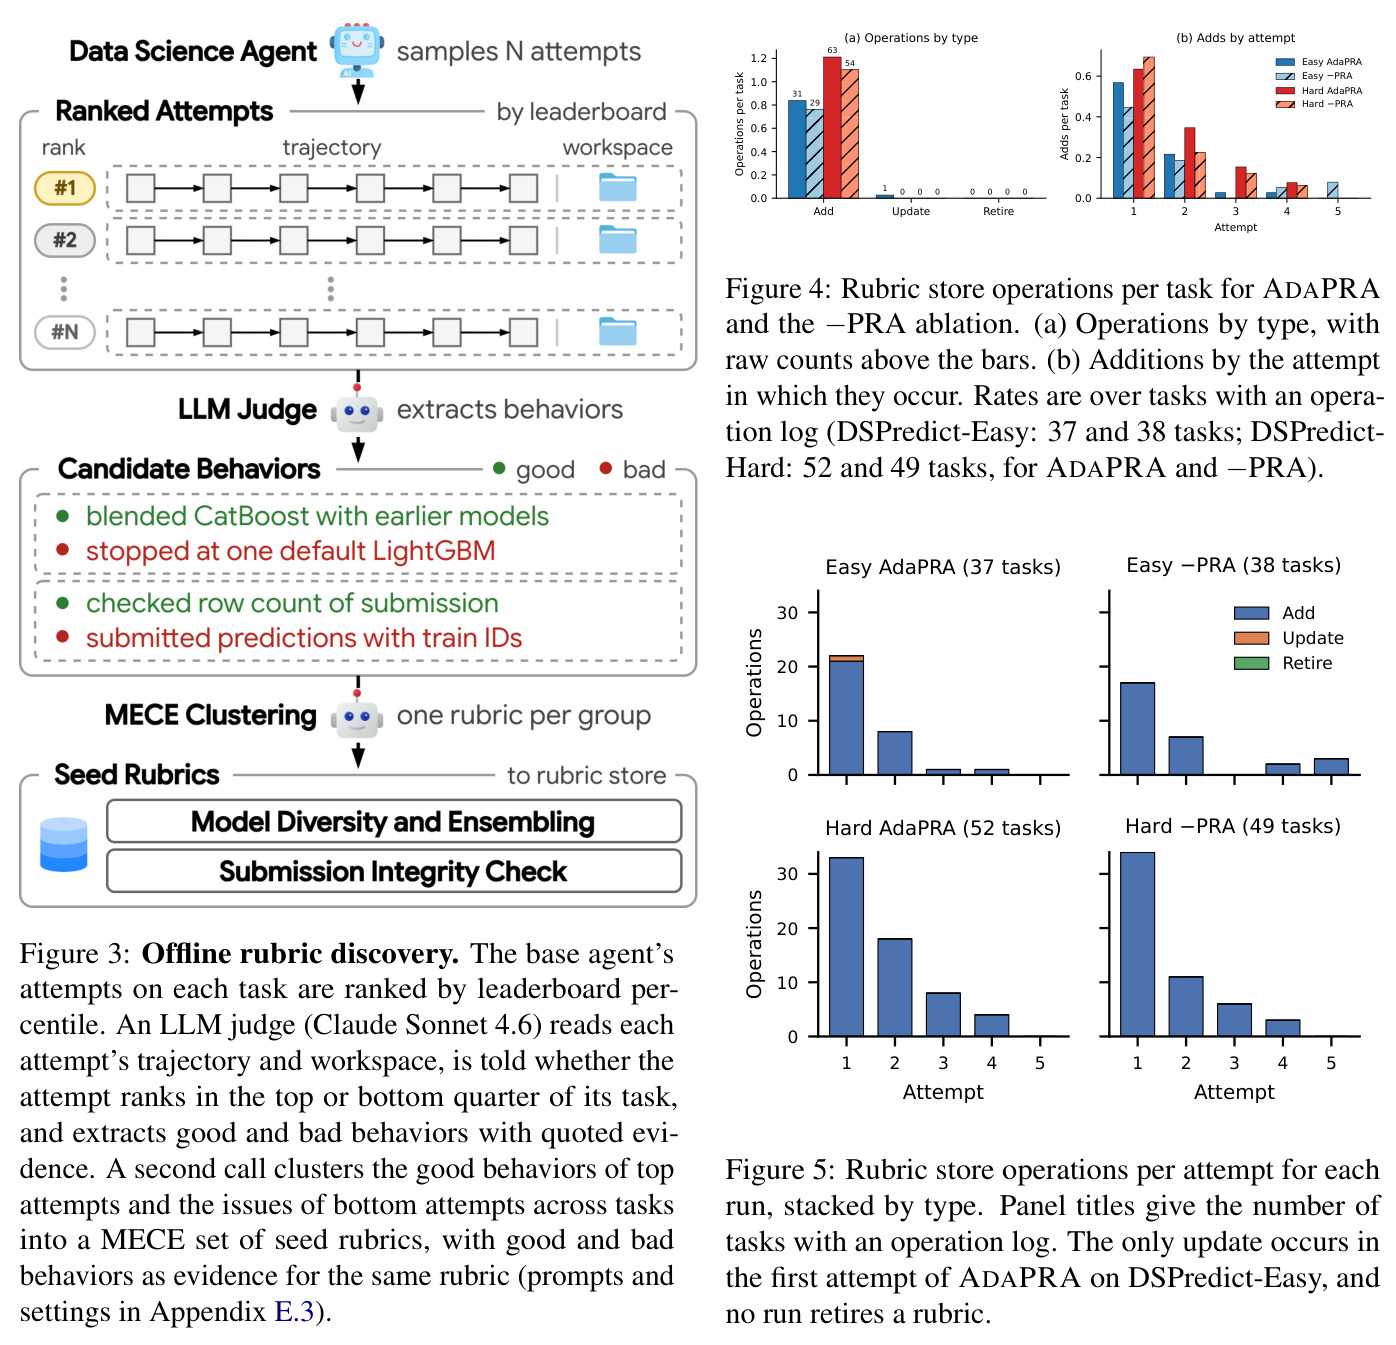
流程分五步。(1) 问题设定:任务 $x$ 为文件加 prompt,agent 每次尝试产生轨迹并在工作区中工作,共 $N=5$ 次尝试。(2) 离线挖掘:在 DSPredict-Easy 的 38 个任务上跑 harness-only 运行;阶段一让 LLM 评审读每次尝试的轨迹与工作区(按前/后四分之一分组),提取带引用的行为共 906 条(564 问题/342 好行为);阶段二把 519 条行为聚成 MECE 集,加 2 条手工 rubric 共 19 条种子(11 工件型、8 轨迹型)。(3) 运行时监督:PRA 每隔 $c$ 回合及尝试结束时被调用,轨迹写成文件按需检索;打分后只把 $i_j\ge0.5$、$p_j<0.6$ 的失败项编译成报告注入 agent 消息流;需计算的 rubric 由 PRA 在沙箱写代码执行取证;结束评审不过再给一轮修正。(4) 自适应:PRA 用 add/update/retire 编辑每任务独立的 rubric 库,新 rubric 通常附检查脚本。(5) 评测:报告排行榜百分位与 Valid、>Median、Medal,用配对置换检验。
技术新颖性
与最近邻工作的本质区别可从 Table 3 的二维设计空间看清:监督者是否执行代码、rubric 库是否自适应。AgentV-RL、RewardAgent、Agentic Rubrics、GUI-PRA、Process RM 只做执行检查且 rubric 固定;RubricEM 只做自适应(服务于 meta-RL)不执行;AdaPRA 是唯一两者兼具并对每个组件独立消融的系统。与 DataPRM 的对比刻意保持 supervisor 之外一切一致,干净隔离"逐步打分的通用 PRM"与"跨步 rubric 审计":DataPRM 每次调用中位 126 秒验证约 10 步、43% 调用返回 FAIL,但逐步打分无法惩罚"整体策略过于保守"这类横跨数十步的行为。新颖性还体现在挖掘源扩展:此前 rubric 发现只用回复或轨迹,本文证明工作区工件不可或缺——342 条好行为中 235 条是工件型,只看轨迹会系统性漏掉好行为。"只报失败项"的设计也不是先验假设,而是从早期版本消融实证得出。
实验结果
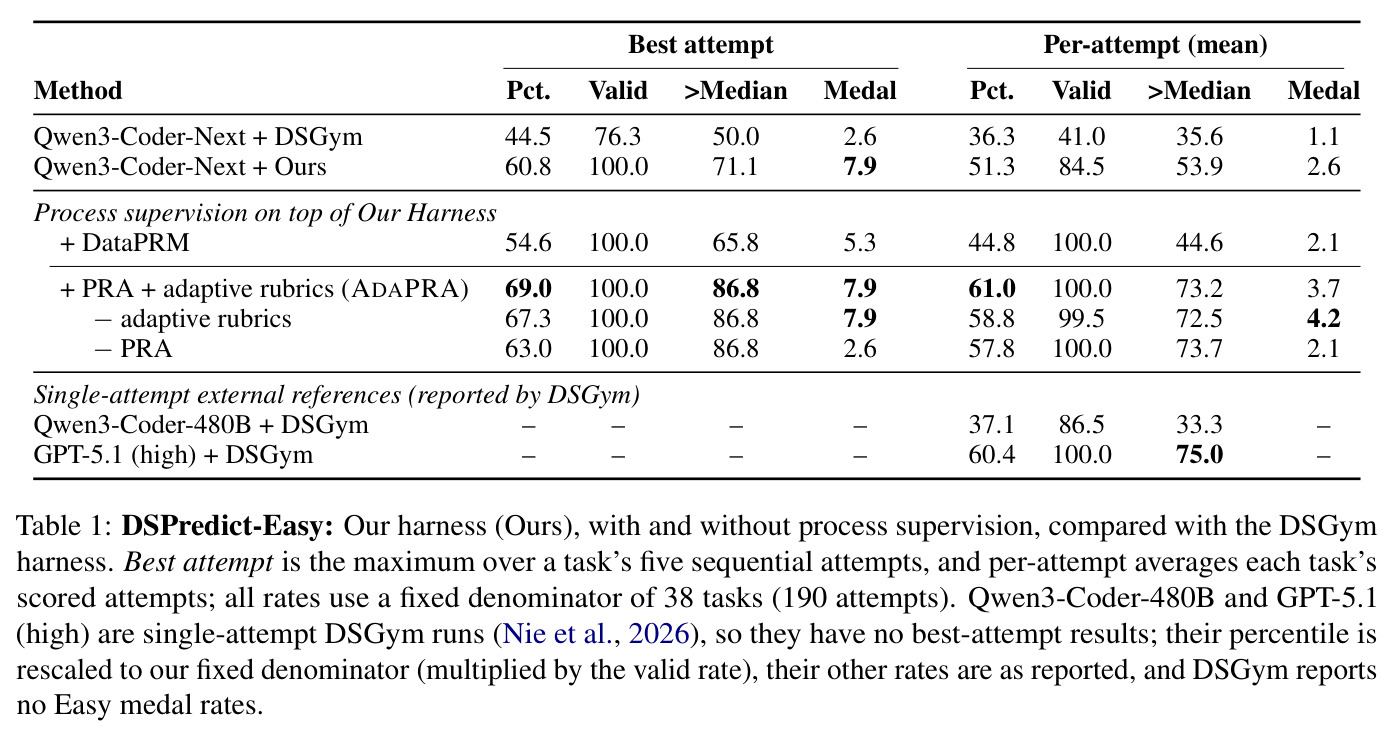
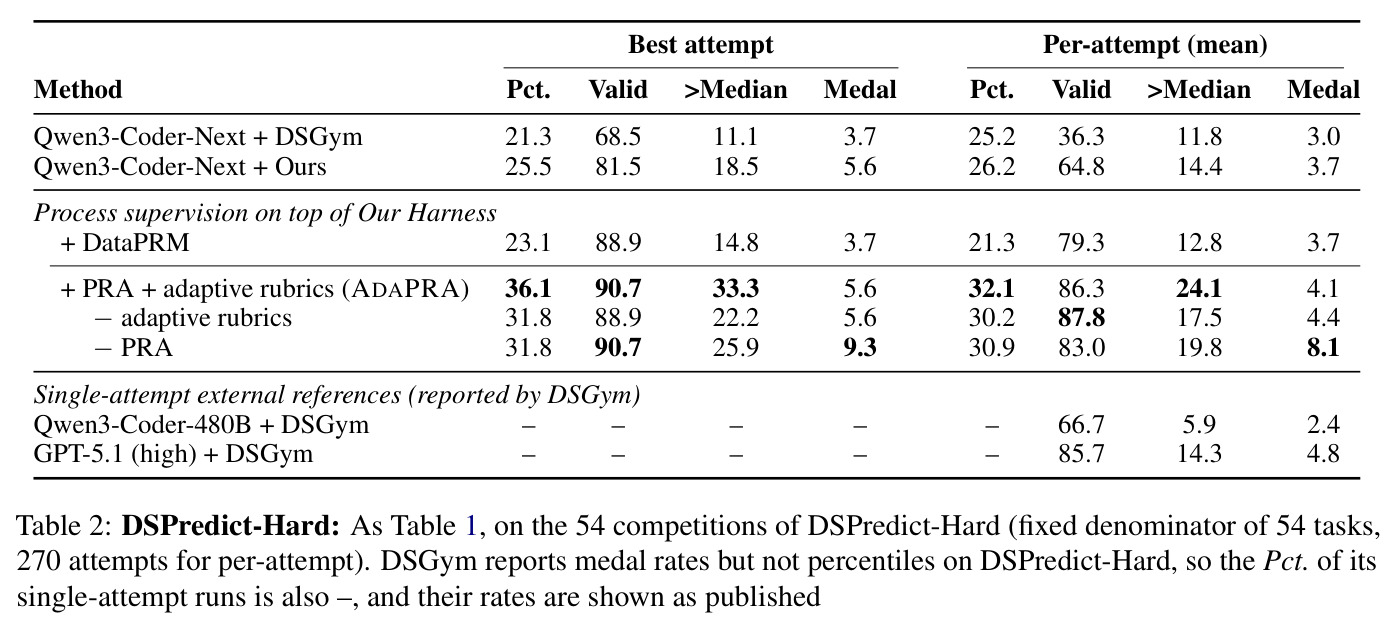
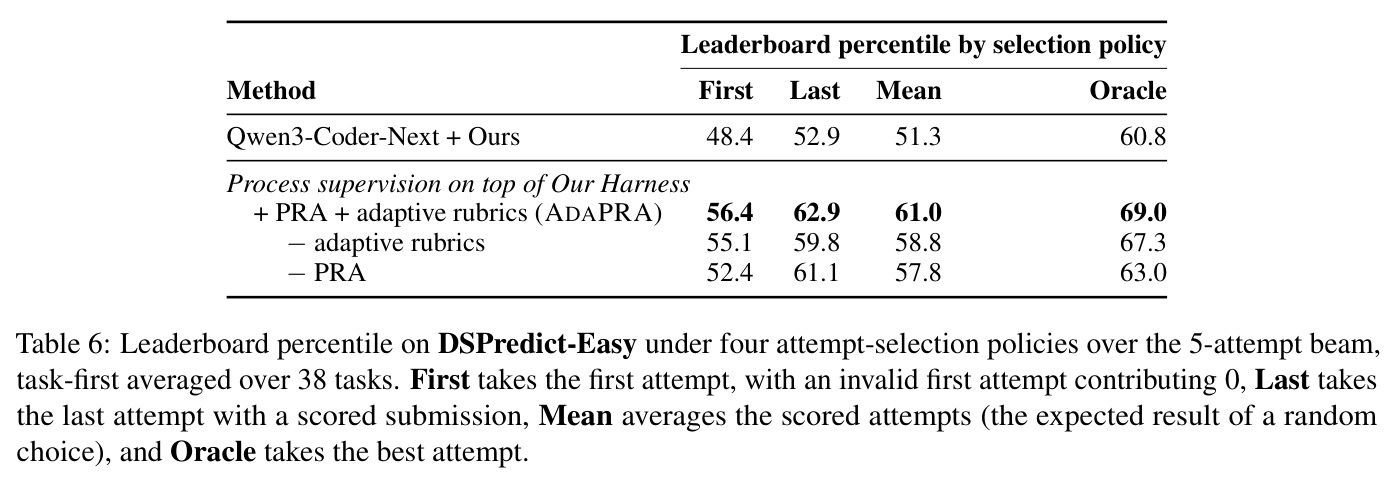
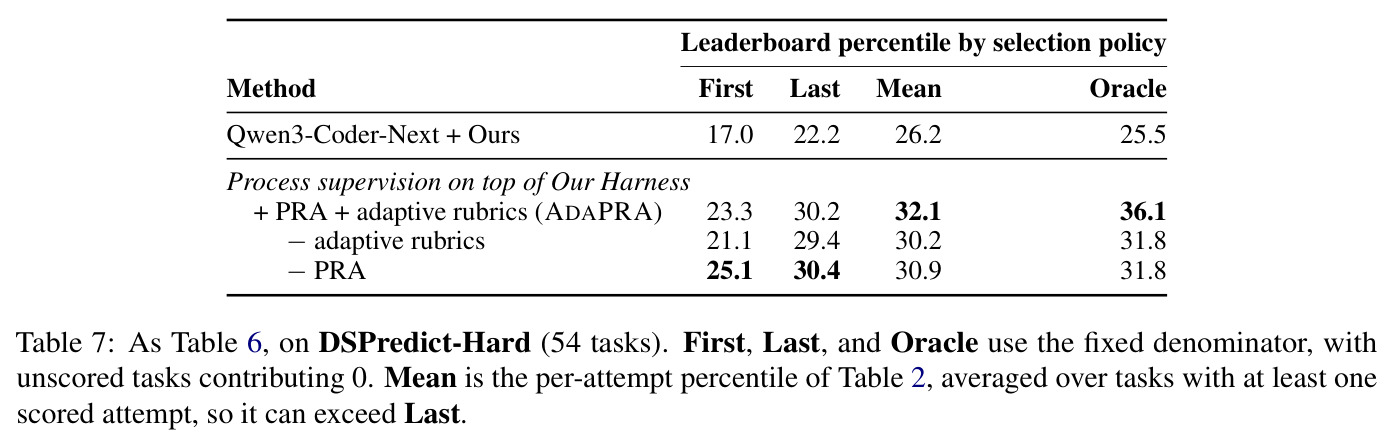
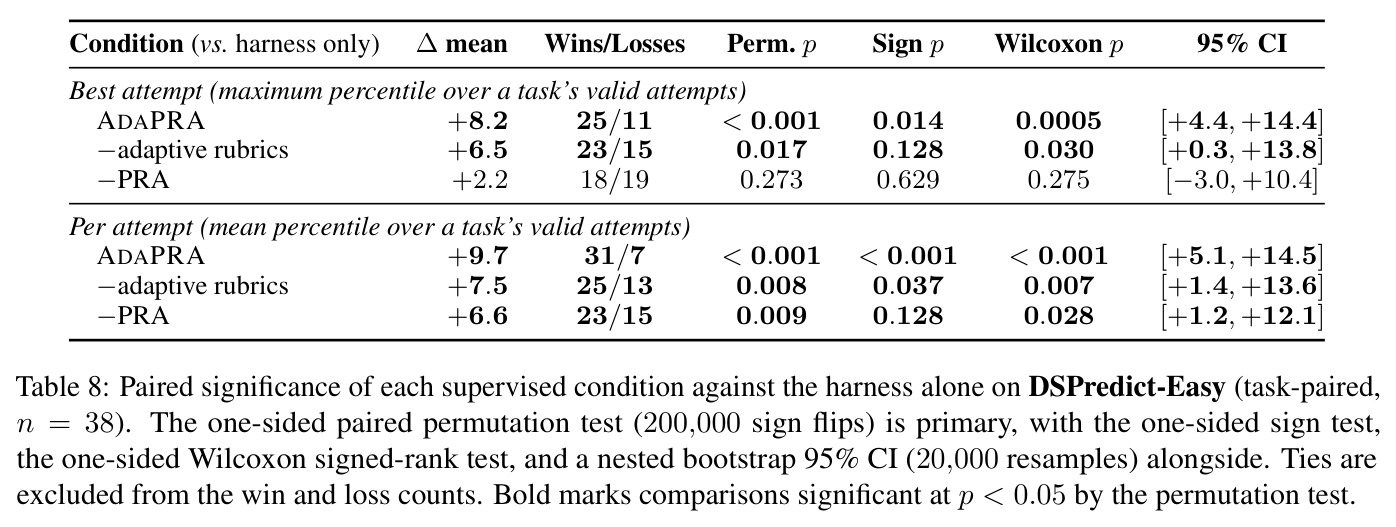
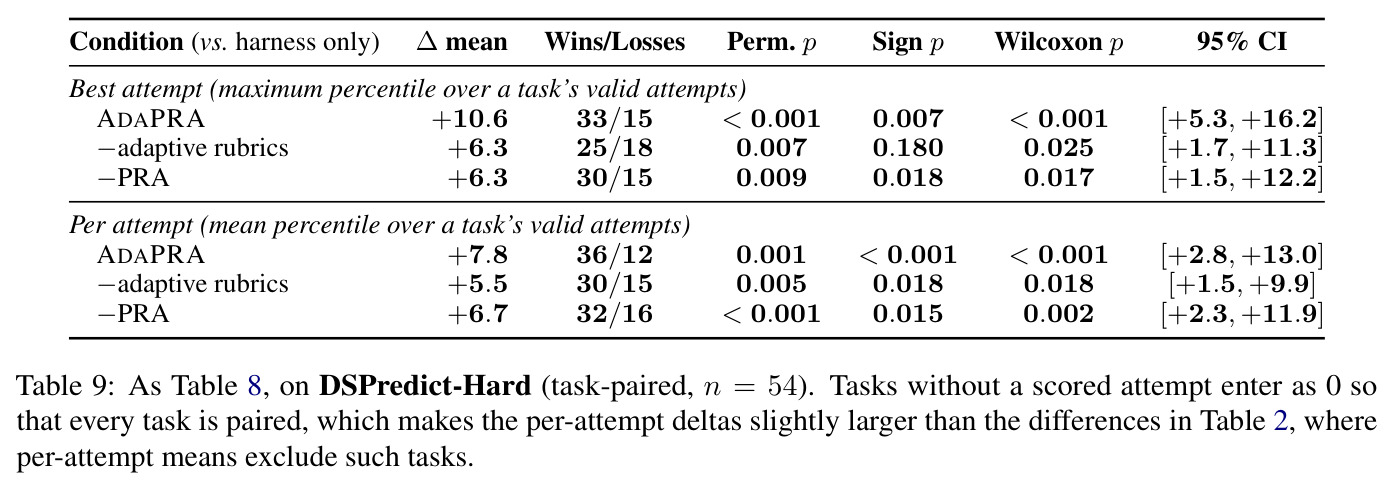
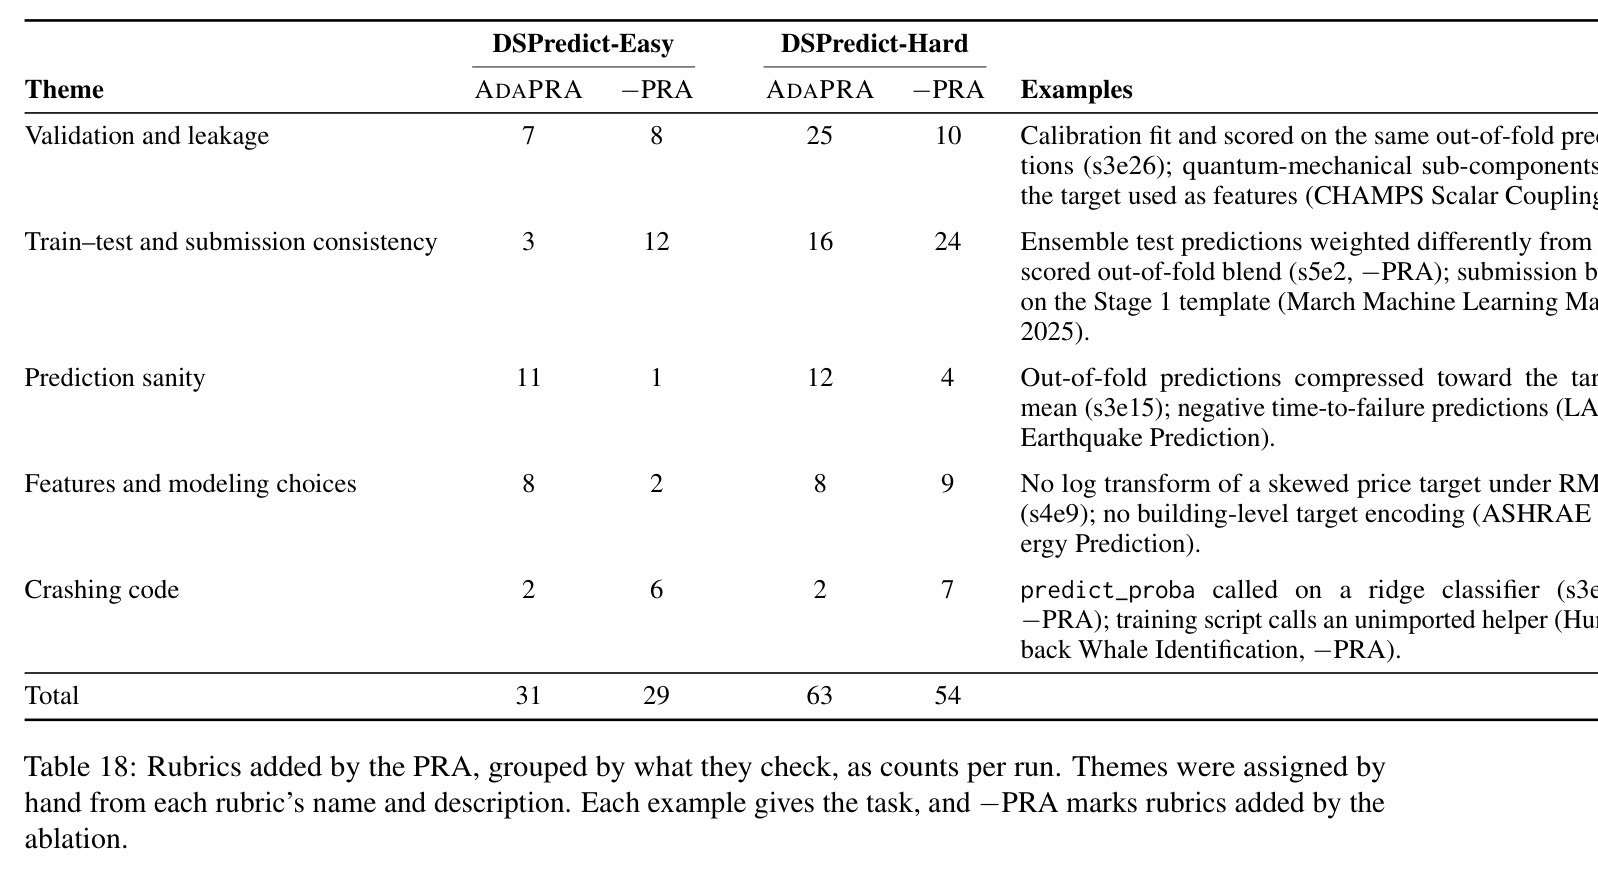
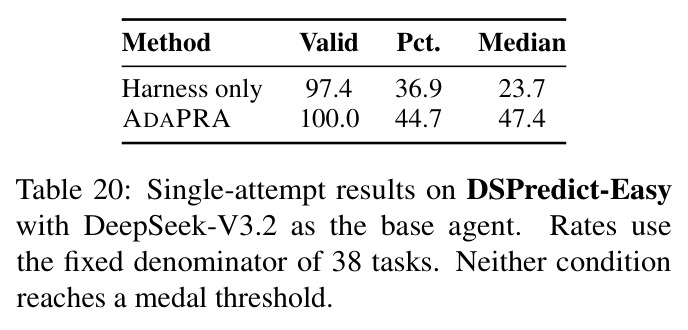
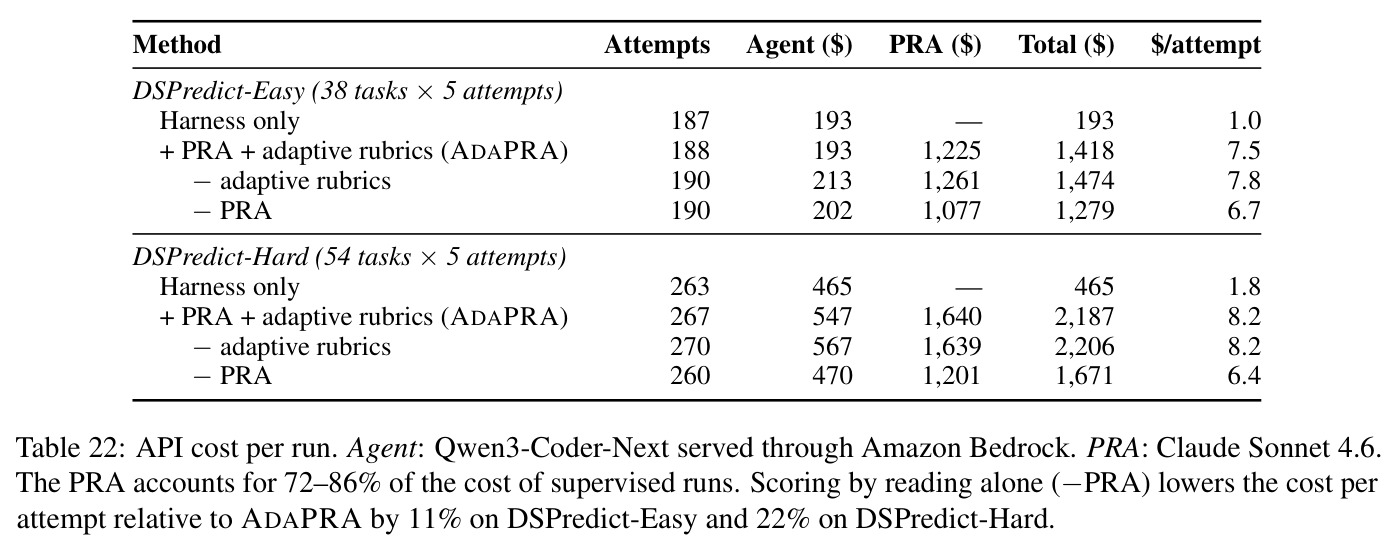
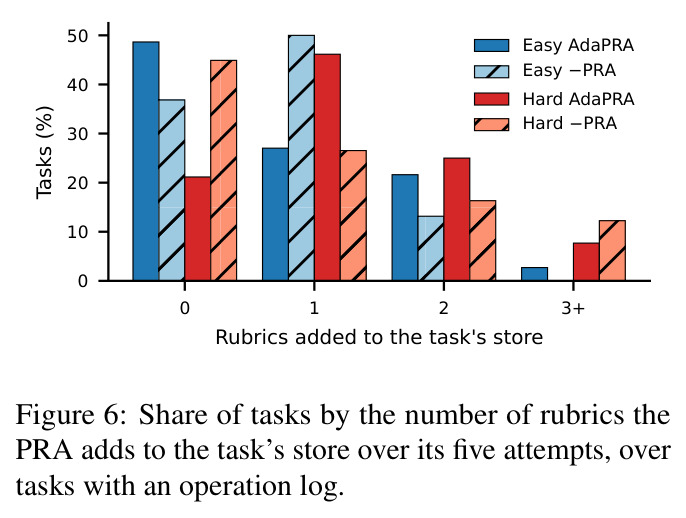
实验在 DSGym 两个基准(Easy/Hard)上进行,基座 80B 的 Qwen3-Coder-Next,每条件 5 次尝试。Easy 平均百分位从 44.5 升至 69.0(+24.5,p<0.001),>Median 50.0%→86.8%;Hard 从 21.3 到 36.1(+14.8);每尝试均值 61.0 超 GPT-5.1 (high) 的 60.4,DataPRM 仅 54.6/23.1。消融:harness/监督分别贡献 Easy +16.3/+8.2、Hard +4.2/+10.6,难任务更要监督;冻结 rubric 掉 1.7/4.3 点,去掉代码执行降至 63.0/31.8。种子 rubric 冻结用于 Hard 仍 +6.3(p=0.007),失败率排序跨基准一致($\rho$=0.91)。自适应共 177 增/1 改/0 删;"预测合理性"类新增占 35%/19%,无执行仅 3%/7%。换 DeepSeek-V3.2 基座百分位 36.9→44.7,rubric 跨模型有效。成本每尝试约 7.5/8.2 美元,PRA 占 72-86%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DSPredict-Easy(38 个 Kaggle 竞赛)排行榜百分位(最佳尝试) | Leaderboard Pct. | 69.0 | 44.5(Qwen3-Coder-Next + DSGym harness) | +24.5(p<0.001) |
| DSPredict-Hard(54 个跨模态竞赛)排行榜百分位(最佳尝试) | Leaderboard Pct. | 36.1 | 21.3(Qwen3-Coder-Next + DSGym harness) | +14.8(p<0.001) |
| DSPredict-Easy 超过排行榜中位数的任务占比 | >Median | 86.8% | 50.0%(DSGym harness) | +36.8 个百分点 |
| DSPredict-Hard 超过排行榜中位数的任务占比 | >Median | 33.3% | 11.1%(DSGym harness) | +22.2 个百分点 |
| DSPredict-Easy 对比过程奖励模型(同 harness 同预算) | Leaderboard Pct.(最佳尝试) | 69.0(AdaPRA) | 54.6(DataPRM,4B 生成式 PRM) | +14.4 |
| DSPredict-Easy 单尝试、更换基座为 DeepSeek-V3.2 | Leaderboard Pct. / >Median | 44.7 / 47.4%(AdaPRA) | 36.9 / 23.7%(harness only) | +7.8 / +23.7 个百分点(25 胜 11 负,p=0.005) |
| DSPredict-Easy 单次尝试均值(外部参照) | Leaderboard Pct. | 61.0(每尝试均值) | 60.4(GPT-5.1 high + DSGym,单尝试) | 持平略超 |
局限与改进
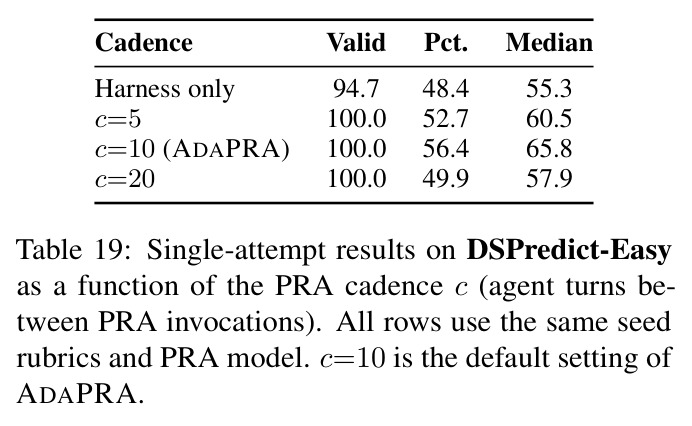
作者承认的限制:Hard 上为控成本用 c=20 而非最优 c=10,可能低估收益;只在 DSGym 两个 Kaggle 型基准评测,未验证开放式分析任务;多尝试固定 N=5,未研究尝试数增多时收益变化;自适应几乎只增不删(177/1/0),无逐条功劳分配;主结果只用一个基座与一个闭源 PRA,DeepSeek-V3.2 仅在 Easy 单尝试验证。我的补充:其一,奖牌率在稠密排行榜上对微小分差极敏感,-PRA 在 Hard 上奖牌率反而最高(9.3% vs 5.6%)可能只是噪声;其二,无测试分数时如何选最佳提交仍未解决,Hard 上 last(30.2)与 oracle(36.1)差距明显;其三,$i_j\ge0.5$、$p_j<0.6$、$c$ 等阈值均为手工设定,敏感性只测了 3 个取值;其四,PRA 运行时暂停 agent 且不占其墙钟预算,真实部署会转嫁为用户等待时间。
独立分析的弱点
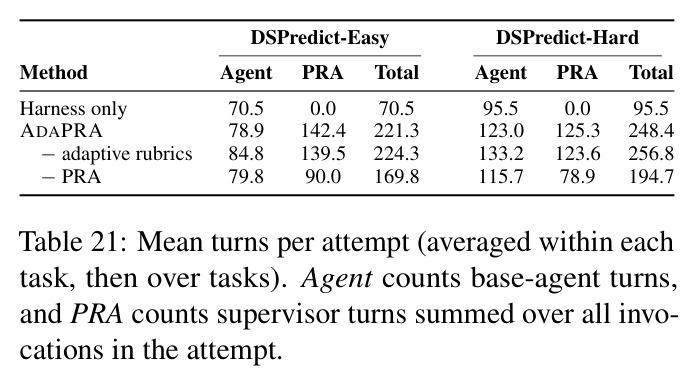
其一,监督成本与延迟高:PRA 用 Claude Sonnet 4.6、63,999 thinking budget、单次调用上限 1 小时,占监督运行成本 72-86%,Hard 尝试回合数膨胀 1.6 倍(123.0 vs 95.5);改进方向是蒸馏小型开源评论模型,或只在提交、全量重训练等高风险动作前后触发评审。其二,自适应缺信用分配:rubric 库只增不减,冲突或过时条目可能长期吸收回合(论文举了 Titanic 上多样性 rubric 被字面遵守却缺验证的例子);可为每条新增 rubric 记录其后局部 CV 变化,做 A/B 式留存或自动退役。其三,种子挖掘依赖昂贵的离线运行:需 38 任务 × 5 尝试的 harness-only 轨迹,换新领域要重跑;可少量任务冷启动、在线增量挖掘。其四,评测域窄:Kaggle 竞赛有唯一排行榜指标,对无标准答案的分析型任务适用性未知。其五,反馈只有失败项与建议动作、缺结构化计划修订,方向性策略错误修复率明显低(模型多样性 16%、hedging 22%、不转向 28%,对比流水线类 55-83%)。
未来方向
作者提出四个方向:其一,用 PRA 的稠密反馈训练基座 agent,把过程判据内化进权重,降低测试时对监督的依赖;其二,为单条 rubric 做功劳分配,让增改删更有依据(当前从不退役);其三,训练开源小模型替代闭源 PRA,把 Gandhi et al. 的非 agentic 评论模型扩展为 agentic PRA;其四,借鉴 Meta-Harness 对 harness 本身做进化优化。基于论文成果还可延伸:跨域迁移研究——验证"过程错误属于 agent 而非领域"这一核心假设在 SWE、深度研究等域是否同样成立,若成立可建立跨域共享的 rubric 库;自适应节奏——按轨迹的风险信号动态调整评审频率 $c$,替代固定的 10/20 回合;无测试分数下的最佳提交选择策略(当前 last attempt 与 oracle 仍有约 6 分差距);把 rubric 反馈作为 RL 奖励训练基座模型,与 RubricEM 的 meta-RL 闭环对接;以及作者点名的组合方向——在持久工作区之上运行 AIDE/ML-Master 式的候选解树搜索,两条互补路线合流。
复现评估
作者声明公开代码。数据上,两个基准由 DSGym 定义(Kaggle Playground 系列及经典竞赛),公开可得。算力上:Slurm 集群、AMD EPYC 7763 CPU,Hard 另配 NVIDIA A100 80GB;每次运行 12 核/100GB 内存,Hard 2 张 A100;DataPRM 用 vLLM 0.12.0 单卡 A100 服务。软件栈:OpenHands SDK、LiteLLM、Apptainer 容器,每任务独立、一次并行 4 个。模型上:基座 Qwen3-Coder-Next(80B 开源权重)与 PRA Claude Sonnet 4.6 均经 Amazon Bedrock API 访问——PRA 闭源是主要风险,作者承认复现依赖该模型持续可用且行为不变。成本参考:Easy 全量运行 API 费约 1,418 美元、Hard 约 2,187 美元,挖种子 rubric 还需一轮 harness-only 预运行。总体复现难度中等偏高:方法不复杂,但工程链路长(容器、调度、双 agent 编排、评测管线),API 成本与闭源依赖需提前预算。
论文图表
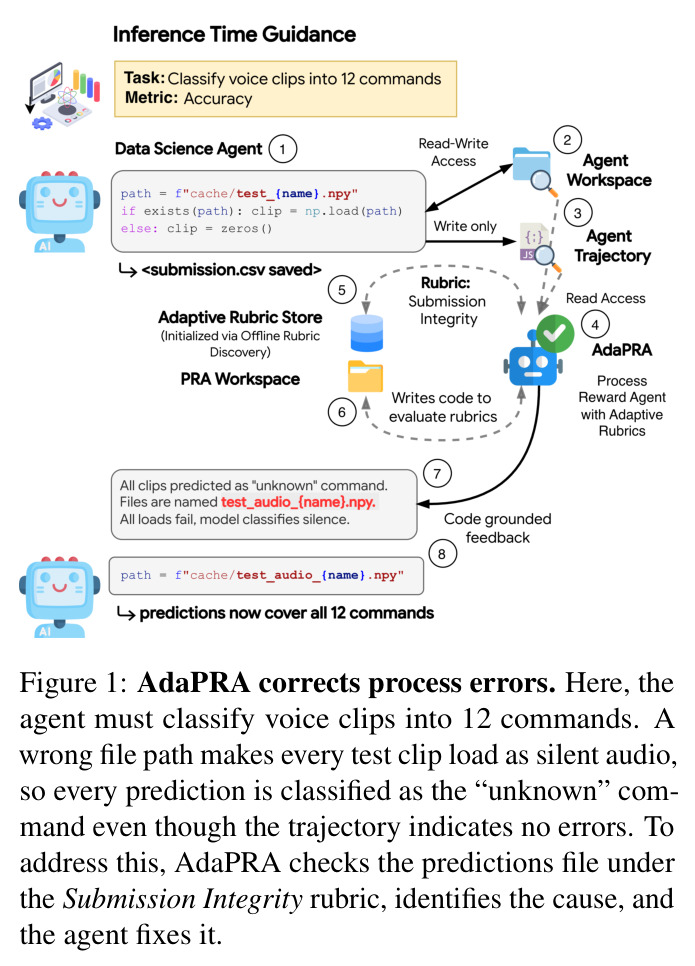
一个静默错误的完整案例:语音命令分类任务中,错误文件路径让 158,538 条测试音频全部读成静音,所有预测被判为 unknown,而轨迹上没有任何报错;AdaPRA 在 Submission Integrity rubric 下检查预测文件、发现所有预测完全相同并确认代码引用了不存在的路径,指出原因后 agent 修复了它。
一图说清全文动机:为什么只读轨迹的 LLM 评审抓不住关键错误、为什么 PRA 必须直接检查工作区工件。
两阶段离线挖掘流程:先把同任务各尝试按排行榜百分位排序,LLM 评审读每次尝试的轨迹与工作区、被告知其处于前/后四分之一,提取带引用的好行为与问题(共 906 条);第二次调用把强弱尝试的行为跨任务聚成 MECE 的种子 rubric 集,正反证据对应同一 rubric。
种子 rubric 的来源与"任务内相对比较"设计是可迁移性结论的基础,此图是复现挖掘流程的蓝图。
按任务统计 rubric 库操作:四个运行合计 177 次新增、1 次更新、0 次退役;新增集中在第 1-2 次尝试(81-94%),说明后期尝试面对的是一个已趋稳定的 rubric 库。
直观展示自适应的实际形态——几乎只有增加,支撑"缺信用分配、从不退役"这一局限性讨论。
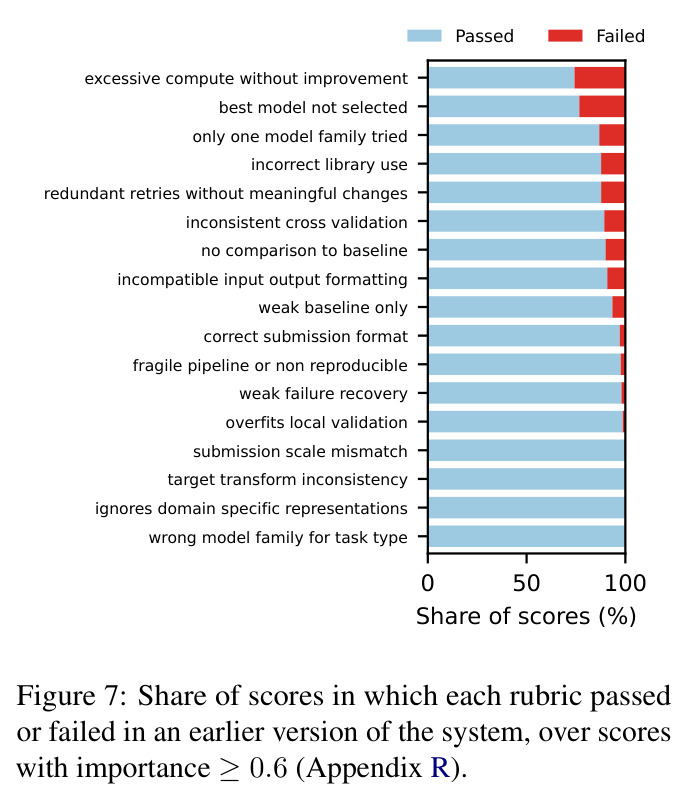
早期版本(把所有 rubric 结果都报告给 agent)中每条 rubric 的通过/失败占比:绝大多数 rubric 在几乎每次评审中都通过,报告充斥正反馈,agent 的下一个动作有无失败建议几乎一样。
"只报失败项"这一关键设计决策的实证来源,体现作者从失败版本中迭代出反馈经济性原则的过程。