演化以匹配能力:通过技能适配改进 Harness 自我进化 Evolving to Match Capabilities: Improving Harness Self-Evolution via Skill Adaptation
同一技能让强模型涨31.1分、最弱模型跌8.8分,元技能改写让弱模型从失败证据中稳定自进化
前置知识
Harness(智能体执行框架)
LLM 智能体 = 模型 + harness。harness 是包裹模型的外部执行框架,包括工具调用、提示组织、上下文管理、技能加载、记忆等组件,让模型能实际操作文件、代码与环境。harness 自我进化指用执行轨迹和反馈自动构建并精炼这些组件,而模型参数全程冻结。这是一条与微调权重正交的能力改进路线。
本文的研究对象就是 harness 中最核心的组件之一——技能文本,全部实验都围绕「harness 收益如何随执行者能力变化」这一问题域展开,必须先理解 harness 与模型参数之间的边界。
Agent Skill / SKILL.md
技能是可组合的指令、代码与资源包,按需加载,能在不改变模型参数的情况下扩展模型能力,已成为与工具、记忆并列的 harness 标准层。典型形态是 SKILL.md 文件:由人类专家编写或从强模型轨迹蒸馏,经公共注册表分发,惯例是「一次写成、跨模型原样发布」,公共注册表上已有数以万计的技能。
论文的改写对象就是 SKILL.md。理解技能「一次写成、全模型通用」的分发惯例,才能理解「强到弱技能失配」为何是一个普遍而未被检查的问题。
能力分层与技能敏感对
把模型按无技能时的任务得分分为 frontier / moderate / weak 三层;对每个任务–技能对计算层增益 $\Delta_G$(层内模型从无技能到有技能的平均分差)。若 $\Delta_G \ge \tau$ 且比弱层高出至少 $\tau$(论文取 $\tau=0.10$),或 frontier 已饱和(无技能均分 ≥0.95)而 moderate 受益,则该对为技能敏感对。
这是论文筛选 103 个测试任务、组织所有实验对比的基本单位,不掌握这套定义就读不懂主结果图和表格中分数的含义。
执行轨迹与验证器
轨迹是智能体一次任务执行的完整记录(工具调用、中间输出、最终交付物);验证器是给任务打分的程序或 LLM 判分器。失败归因依靠「轨迹 + 验证器输出」取证;自进化循环中第 $t$ 轮改写的输入正是第 $t-1$ 轮的轨迹与验证器反馈,这是「有证据改写」与「无证据改写」的分界线。
四类失败模式的标注、元技能的改写规则、自进化循环的信息来源全部建立在这两个概念上;论文的关键结论(验证类失败必须依赖执行证据)直接取决于改写器能看到什么。
研究动机
Harness 自我进化让智能体不更新参数、仅凭执行轨迹和反馈改进外部框架,主流做法是从轨迹蒸馏可复用技能。但作者在三个独立构建的基准(SkillsBench 87 题、DocOps 186 题、Tessl 334 题,共 607 个可靠执行任务)× 7 个模型上系统评测发现:技能收益并不同质。按无技能表现把模型分为 frontier(GPT-5.6-luna、Claude-Opus-5)、moderate(GPT-5.4-mini、Claude-Sonnet-4.6)、weak(Qwen3.6-flash、Qwen3.5-9B、Gemma-4-E4B)三层,用 $\tau=0.10$ 的层增益判据筛出 103 个技能敏感任务–技能对:在这些对上 GPT-5.6-luna 提升 31.1 分、Opus-5 提升 27.3 分,而 Qwen3.5-9B 仅 +2.0 分,最弱的 Gemma-4-E4B 反而从 0.117 跌到 0.029(−8.8 分)。更关键的诊断是:这不是信息缺失——86% 的弱模型带技能仍然失败的运行,违反的要求早已写在技能文本里。技能「写得对」不等于弱模型「用得动」,这正是「提取经验→忠实转译」范式漏掉的一环。
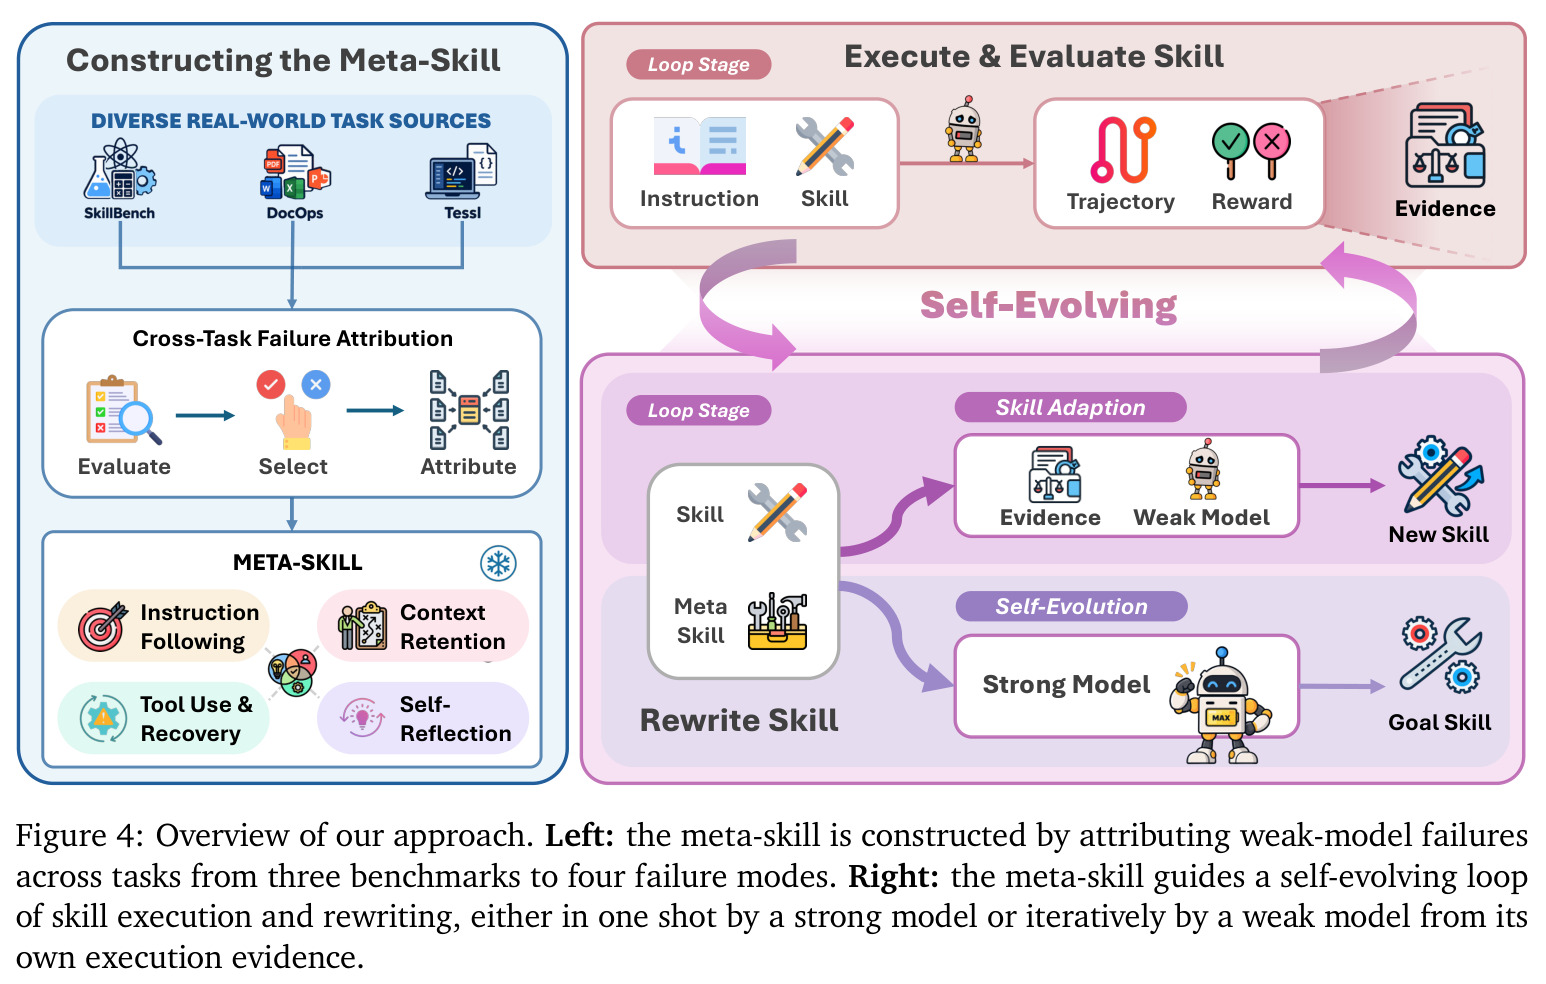
本文的目标是本文的目标是让 harness 自我进化不仅捕获有用经验,还把经验的形式适配到执行者的能力上,即技能适配:在不改模型参数、不训练的前提下,把已有技能改写成弱执行者能够可靠执行的版本。具体分三步:第一,在 103 个技能敏感对上归因弱模型失败,归纳出工具执行、上下文管理、指令遵循、验证四类可复现的失败模式(共 131 个标签);第二,把这些诊断固化为一个固定的、与任务无关的元技能——一份把每类失败模式翻译成具体改写规则的协议;第三,验证元技能在两种现实场景中都有效:无执行证据时由强模型(Kimi-K3 等)一次性改写,以及嵌入五轮自我进化循环,让 7 个执行者(从 Gemma-4-E4B 到 Kimi-K2.5)依据自己的轨迹与验证器反馈改写自己的技能,并沉淀出可操作的设计指南。
与已有工作不同的是,已有技能工程研究的关注点是「如何高效提取经验、忠实转译成程序化指导」,隐含假设是技能一次写成、跨模型通用;早期证据提示这很脆弱,但固定技能的收益如何随模型能力变化此前未被系统检查。本文的独特切入有三:一是问题刻画新,首次用 3 基准 × 7 模型 × 103 对的量化证据揭示强到弱的技能失配现象;二是方法形态新,不学习一个改写器,而是把失败诊断压缩成固定的元技能协议,使改写在完全没有执行证据时也能生效,且与技能检索、压缩、安全等方向正交;三是设定覆盖新,同一协议同时检验「强改写弱」(对应 Meta-Harness 式外部强优化器)与「弱改自己」(对应 Self-Harness 式自查轨迹有界编辑)两类 harness 演化设计,并证明失败证据是弱 rewriter 能用元技能而不漂移的前提。
核心方法
直觉上,弱模型拿不到技能收益,大多不是技能缺信息,而是信息的组织方式超出了它的执行能力:调用工具列表里不存在的函数、把技能附带的参考文件当成任务本身、要求只完成一半、结果错了没人复核。因此与其训练模型,不如改写技能文本。技术路线分三步。第一步,测试床构建:607 题上每模型跑 w/o 与 w/ skill 两条件并归一到 [0,1],技能增益定义为 $\Delta_m(T_i)=s_m(T_i,S_i)-s_m(T_i,\emptyset)$,按 $\Delta_G \ge \tau$ 且 $\Delta_G-\Delta_W \ge \tau$($\tau=0.10$)选出 103 个技能敏感对。第二步,失败归因:逐条阅读弱模型带技能失败的轨迹,标注「首次可观察失败」,得到工具执行(51)、指令遵循(35)、上下文管理(28)、验证(17)共 131 个标签。第三步,元技能蒸馏:与 Claude-Opus-5 协作,把四类模式编译成改写协议——工具区分与环境检查、任务范围与交付路径先行、每条要求带动作+对象+完成条件、结尾强制独立校验循环;该协议既支持无证据的一次性改写,也支持有轨迹证据的五轮自进化。
核心洞见:harness 的收益不是 harness 自身的属性,而是 harness 与执行者能力的匹配属性——同一份 SKILL.md 对 Opus-5 是 +27.3 分的助力,对 Gemma-4-E4B 却是 −8.8 分的毒药。与已有方法的本质区别在于:既往技能进化把「捕获有用经验」当终点,本文论证必须再加一道「形式适配」工序;承载这道工序的元技能,本质是把「86% 失败违反已写明要求」这一诊断翻译成可执行的改写规则:针对工具执行,技能必须区分可调用工具与文档、内置环境检查与错误恢复路径;针对上下文管理,开头必须声明任务、允许的修改范围与交付路径,把示例与当前任务显式分离;针对指令遵循,每条要求必须含动作、对象与完成条件;针对验证,结尾必须有「重读结果→换方法重算→对照显式阈值→循环直到通过」的独立校验。相比 Meta-Harness 的外部强优化器与 Self-Harness 的自查编辑,元技能是固定的、任务无关的协议,一份协议同时服务两种设定,无需训练即可移植。
方法步骤详情
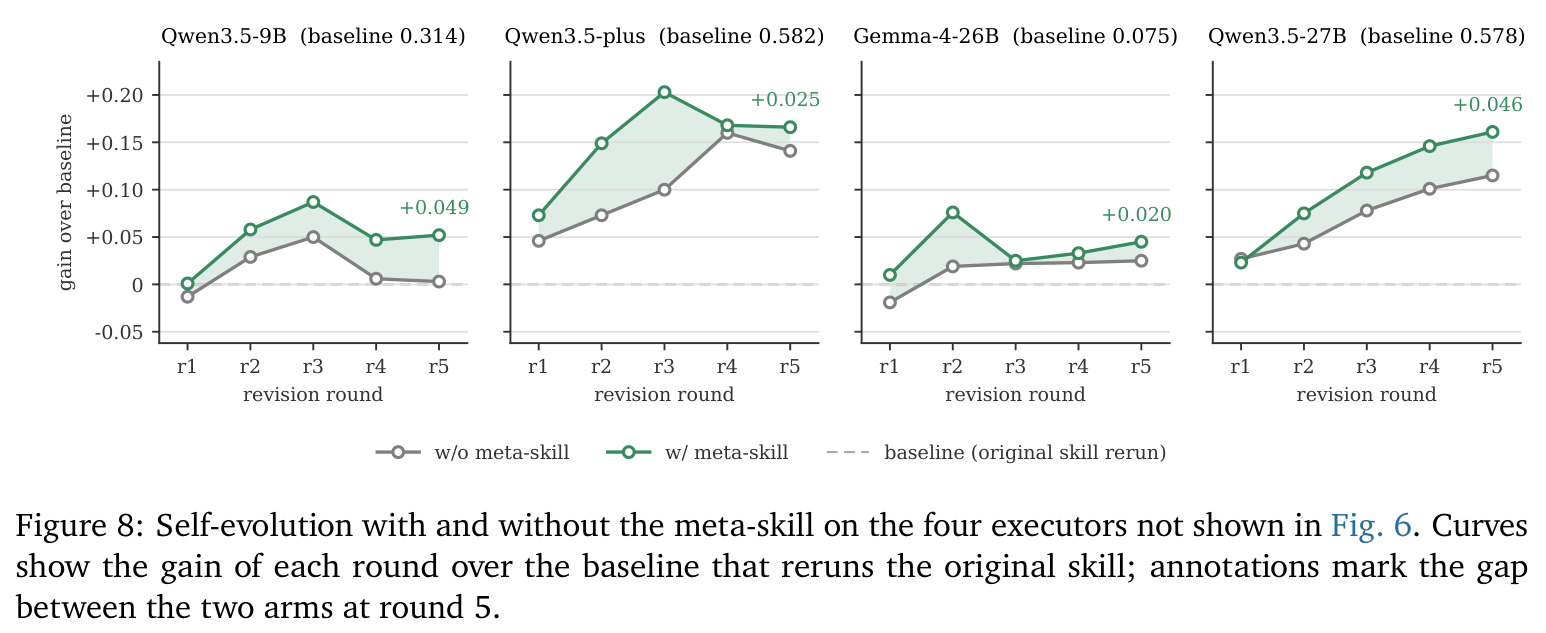
第一步(测试床):在 SkillsBench、DocOps、Tessl 共 607 个可靠执行的任务上,7 个模型分别以 w/o skill 与 w/ skill 两条件各跑一次,用各基准原生 judge 判分并归一到 [0,1];按层增益规则选出 103 个技能敏感对,弃掉弱层带技能已 ≥0.80 的对。第二步(失败标注):对每对的三个弱模型轨迹标注首次可观察失败,仅凭轨迹与验证器输出取证,共得 131 个标签。第三步(元技能):作者与 Claude-Opus-5 协作撰写,把四类失败模式转成改写规则,并规定有轨迹时先修复首次失败再处理后续步骤。第四步(一次性适配):GPT-5.6-sol、GPT-5.6-luna、GLM-5.3、Kimi-K3 四个 rewriter 各改一遍 103 个技能,输入只有任务、原技能与执行者工具列表;泄漏答案或加载失败的改写被丢弃并回退原技能;三个弱执行者各运行每份改写一次。第五步(自进化循环):rewriter=executor,第 $t$ 轮输入任务、第 $t-1$ 轮技能、工具列表以及第 $t-1$ 轮轨迹与验证器输出,产出修订技能后再执行,重复 5 轮,与同窗口「原技能重跑」基线对比;除 3 个弱执行者外还扩展到 Qwen3.5-27B、Gemma-4-26B、Qwen3.5-plus、Kimi-K2.5 共 7 个执行者。
技术新颖性
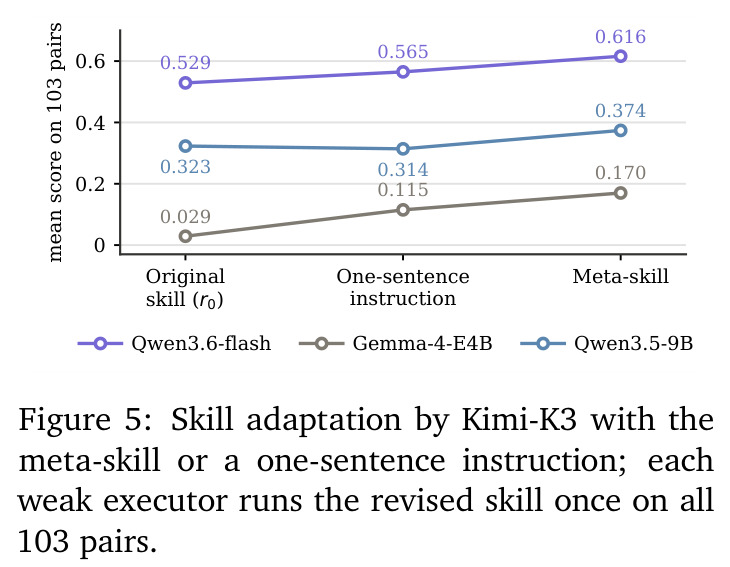
新颖性有三层。问题层:首次量化「技能收益随基础能力分层而系统性变化」,103 对上 frontier 平均 +27 分、weak 仅 +1.2 分、最弱者 −8.8 分,把「强到弱技能失配」从轶事变成可测现象。方法层:元技能是一种「诊断→改写规则」的固定编译层,把一次性的失败分析成果复用为与任务无关的协议——不同于学习式改写器或搜索式 harness 进化,它不训练、不检索、即插即用,且同一协议同时覆盖无证据(外部强模型改写)与有证据(弱模型自我改写)两种信息条件,统一了 Meta-Harness 与 Self-Harness 两条线。实证层:作者用一句话通用指令做对照,分离出「rewriter 本身强」与「知道该改什么」两种效应——仅一句话指令时 Kimi-K3 只提升 2/3 执行者(Qwen3.5-9B 得 0.314 反而略低于原技能 0.323),元技能在相同 rewriter 上再加 +5.1~6.0 分,证明增益主要来自失败模式知识而非 rewriter 的通用能力;同时发现失败证据是弱自我改写不漂移的前提(无证据时平均 0.271 < 原技能 0.294)。
实验结果
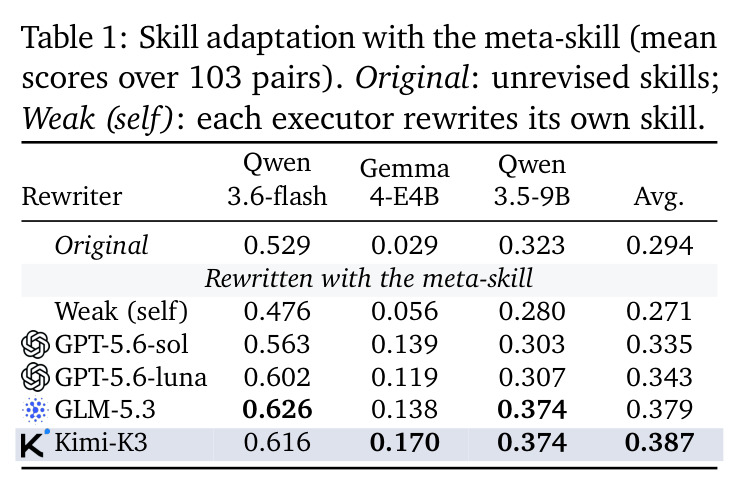
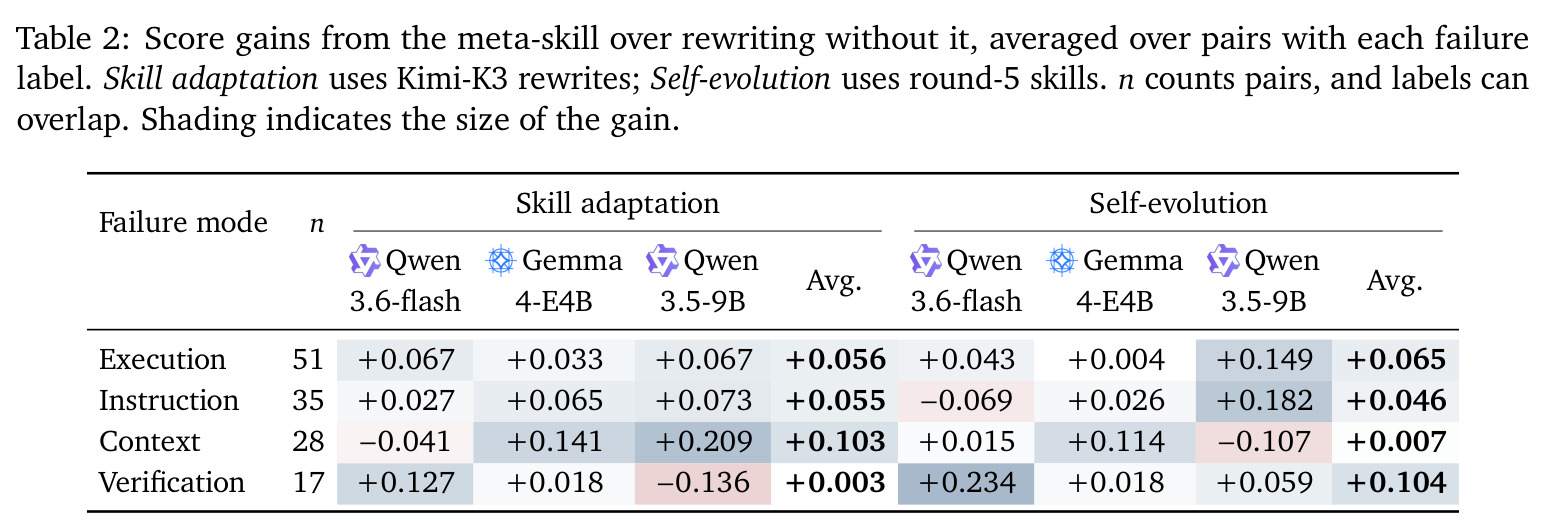
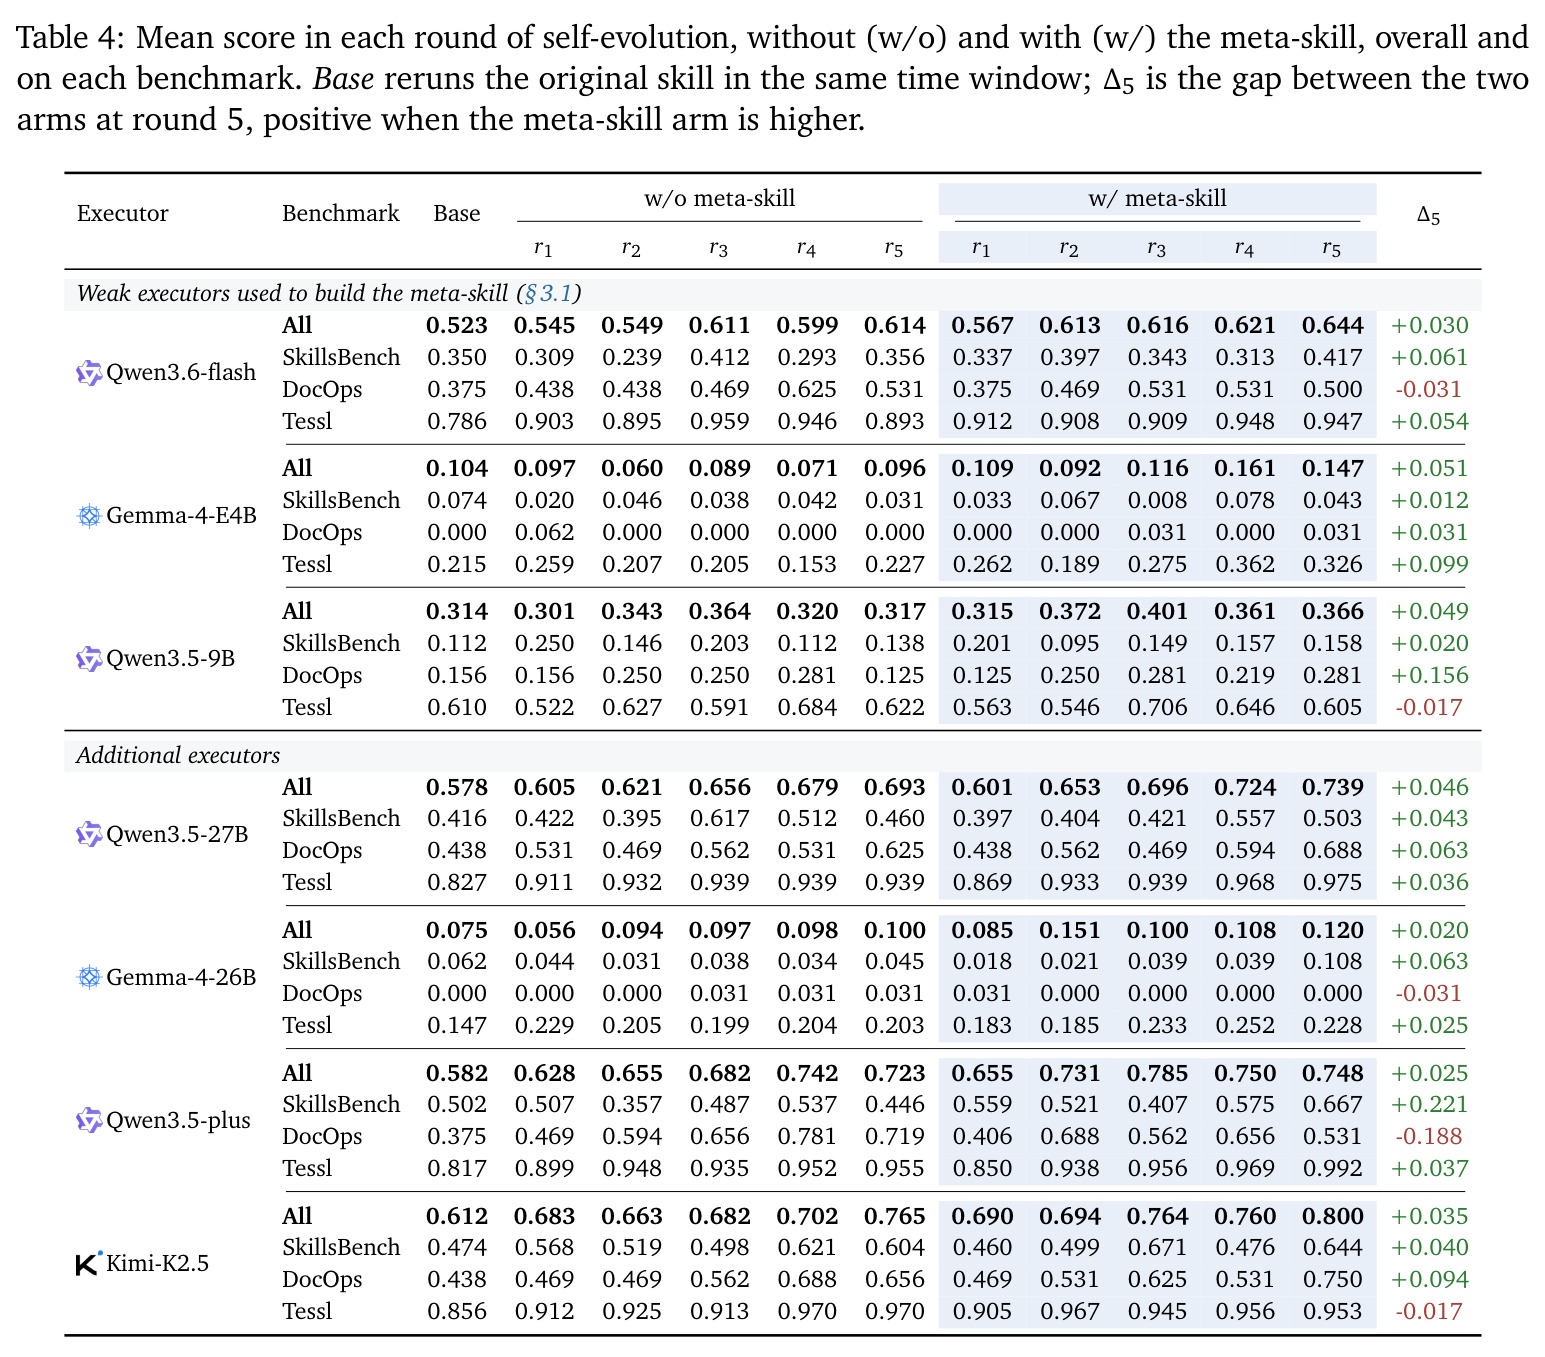
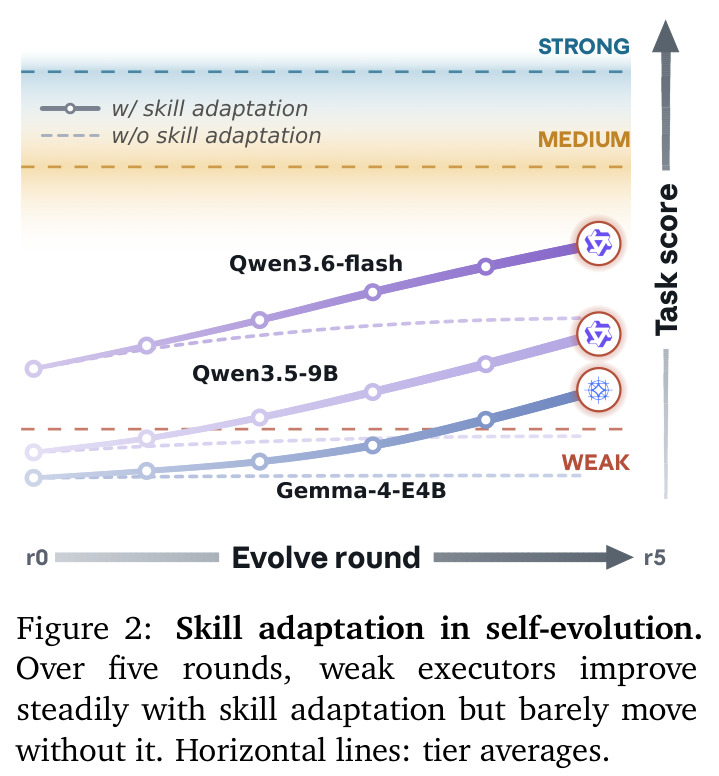
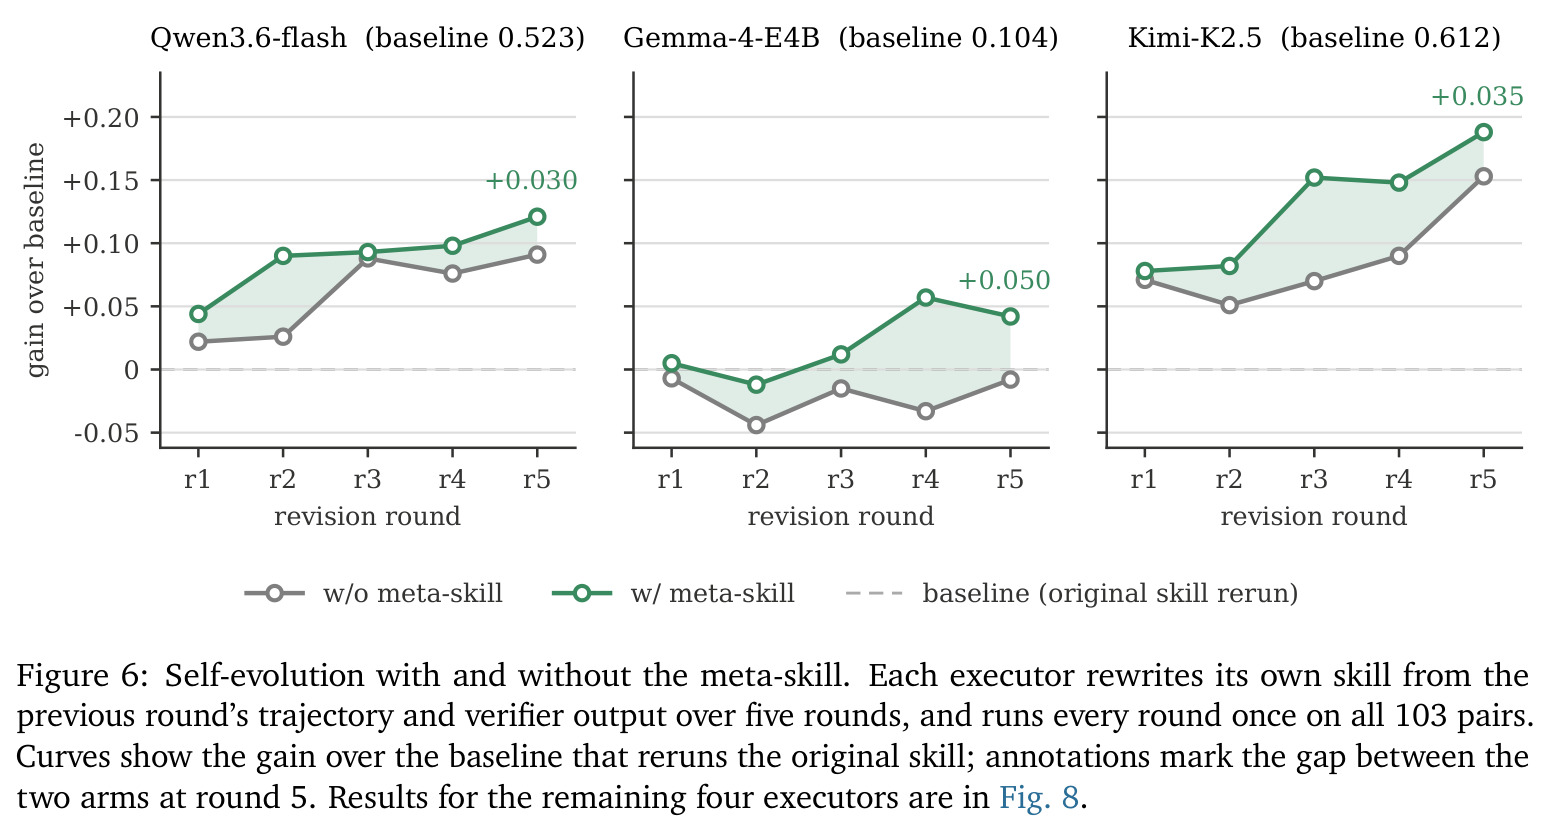
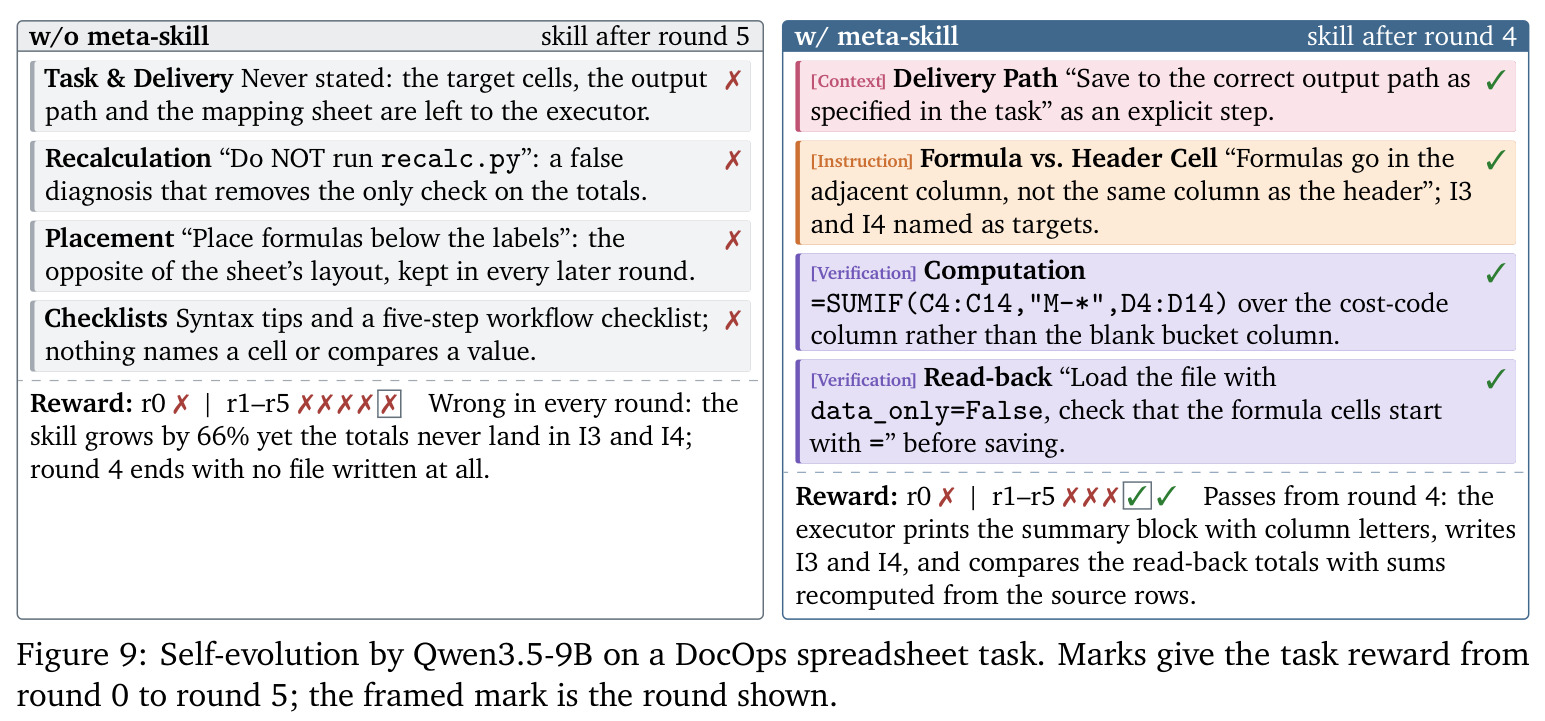
诊断实验(Fig 3b):103 个技能敏感对上,GPT-5.6-luna 0.578→0.889(+31.1)、Opus-5 +27.3、Sonnet-4.6 +24.3、GPT-5.4-mini +23.8,而 Qwen3.6-flash 仅 +10.5、Qwen3.5-9B +2.0、Gemma-4-E4B −8.8;131 个标签中工具执行最多、验证最少,86% 失败违反已写明要求。一次性适配(Table 1):Kimi-K3 + 元技能把三弱执行者平均从 0.294 提到 0.387:Gemma-4-E4B 0.029→0.170(+14.1)、Qwen3.6-flash 0.529→0.616、Qwen3.5-9B 0.323→0.374(+5.1);GLM-5.3 平均 0.379;弱模型自我改写反而降到 0.271。消融(Fig 5):一句话指令下 Kimi-K3 得 0.565/0.115/0.314,元技能再加 +5.1~6.0 分,占平均收益一半以上。自进化(Fig 6/8):5 轮后 7 个执行者全部高于无元技能臂,第 5 轮差距为 Gemma-4-E4B +5.0、Qwen3.5-27B +4.6、Kimi-K2.5 +3.5、Qwen3.6-flash +3.0、Qwen3.5-plus +2.5、Gemma-4-26B +2.0 分;无元技能时 Gemma 每轮低于基线、Qwen3.5-9B 第 3 轮见顶回落。按失败模式(Table 2):一次性适配在 Execution/Instruction/Context 平均 +0.056/+0.055/+0.103,Verification 仅 +0.003;自进化把 Verification 提到 +0.104(高出 0.101),说明验证类失败必须依赖执行证据。案例(Fig 7):Qwen3.6-flash 无元技能时五轮全错,有元技能时 4/5 轮通过,唯一失败是改了脚本却没重跑——技能文本管不住执行者本身。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 一次性技能适配:Kimi-K3 用元技能改写后,3 个弱执行者在 103 对上的平均得分 | 平均得分([0,1]) | 0.387(Gemma-4-E4B 0.170) | 0.294(原技能,Gemma-4-E4B 0.029) | +9.3 分;单执行者最高 +14.1 分(Gemma) |
| 消融:Kimi-K3 改写,元技能 vs 一句话通用指令(103 对) | 3 个弱执行者得分 | 0.616 / 0.170 / 0.374(平均 0.387) | 0.565 / 0.115 / 0.314(平均约 0.331) | 每执行者 +5.1~6.0 分 |
| 五轮自我进化:7 个执行者(Gemma-4-E4B 到 Kimi-K2.5) | 第 5 轮相对无元技能臂的增益 | 全部为正:+2.0 ~ +5.0 分 | 同一循环去掉元技能(Gemma 每轮低于基线) | 符号在全部 7 个执行者上一致 |
| Verification 标签任务(n=17)的元技能增益 | 平均分差 | +0.104(自进化,round-5 技能) | +0.003(一次性适配,Kimi-K3 改写) | 执行证据带来 +0.101 额外增益 |
局限与改进
作者承认的局限:只评估已注入上下文的技能,检索与渐进披露不在范围内;多技能按捆绑评估,无法归因单个技能的贡献;自进化固定 5 轮且不更新参数;每对每轮只跑一次,作者自己也声明 0.02–0.05 的自进化差距只能看符号不能读大小;部分失败源于执行者自身(编辑脚本后不重跑、多约束下只保留技能强调的那条),技能文本无法修复。我的补充观察:其一,元技能由 Claude-Opus-5 协助撰写且内容固定,规则集覆盖面依赖人工归纳的四类失败模式,遇到新失败类型没有自适应能力;其二,131 个标签采用「首个可观察失败」的单标签策略,会低估复合失败,也未报告标注一致性检验;其三,$\tau=0.10$ 与弱层 <0.80 才保留的硬阈值缺乏敏感性分析;其四,协议并非处处安全——一次性适配中 Context 在 Qwen3.6-flash 上 −0.041、Verification 在 Qwen3.5-9B 上 −0.136;其五,模型池全部是特定版本的闭源/开源模型,结论对更弱或更新的模型外推性待验证。
独立分析的弱点
第一,元技能是静态的、人工诊断起源的:四类失败模式来自 103 对的一次性标注,规则集不会随新失败类型更新。改进方向:让元技能本身参与进化(元-元技能),或在更多基准上增量扩充失败模式库并做版本管理。第二,评测噪声:单次运行、无置信区间,自进化 2 分量级的增益难以统计确认。改进:每对重复 3–5 次或用 bootstrap 置信区间报告,重点报告符号一致性而非点估计。第三,技能文本只能修「说得清」的失败:验证类失败在无证据的一次性适配中平均仅 +0.003,且 Qwen3.5-9B 上 −0.136。改进:把适配对象从 SKILL.md 扩展到工具接口、上下文管理与外部校验器,多组件联合适配。第四,捆绑技能无法归因:多技能任务按整体评估,改写可能顾此失彼。改进:设计可分离单个技能贡献的消融式注入协议。第五,弱模型无证据时改写会漂移(0.271 < 0.294),甚至一次性适配中弱模型自我改写在两个执行者上低于原技能。改进:强制弱 rewriter 先积累至少一轮失败证据再放开改写,或限制其可修改的技能区域(如只允许改验证段)。
未来方向
作者提出的方向:追踪每次技能修订是否解决了触发它的那个失败(而非只看总分变化),把后续更新导向持续性难题,并保留跨尝试仍然有用的修订;把类似的失败分析指导推广到工具接口与 agent 工作流的适配。基于本文成果可延伸的研究:把技能适配与检索/渐进披露结合,形成「先检索后适配」的完整管线;验证器与技能协同进化,让校验阈值随执行者能力动态调整;跨任务迁移失败画像——同一执行者在不同任务上的失败模式统计可作为先验注入改写;把「harness 收益 = 经验质量 × 形式匹配度」形式化并给出可优化的代理指标;在真实生产 harness(CI、数据管线)而非学术基准上验证 2–5 分量级增益的工程价值;探索弱模型群体进化,例如多个弱执行者共享改写经验与失败证据,弥补单模型证据不足的问题。
复现评估
复现条件较好。作者承诺评审结束后开源评估、技能适配与自进化代码,以及任务列表与实验配置;元技能全文、改写协议、有效性检查与基线 prompt 在附录 B/C,七个执行者的逐轮绝对分数在附录 D Table 4;三个基准(SkillsBench、DocOps、Tessl)均为公开基准,判分使用各自原生 judge,无需自建评测器。算力方面完全不涉及训练,全部是推理调用:初始评测约 607×7×2≈8500 次任务运行,一次性适配约 4 个 rewriter × 103 个技能加 3 个执行者 × 103 对 × 4 个改写版本,自进化约 7×103×5≈3600 次加同窗口基线重跑,总计数万次 agent 调用,API 成本估计数千美元量级,无需 GPU 集群。难点有三:闭源模型版本漂移(GPT-5.6、Kimi-K3 等迭代后行为可能变化)、失败标注的主观性(131 个标签需重新人工核对)、单次运行噪声。综合评估:中等难度,协议清晰可复刻,数字可能有小幅偏差但结论方向稳健。
论文图表
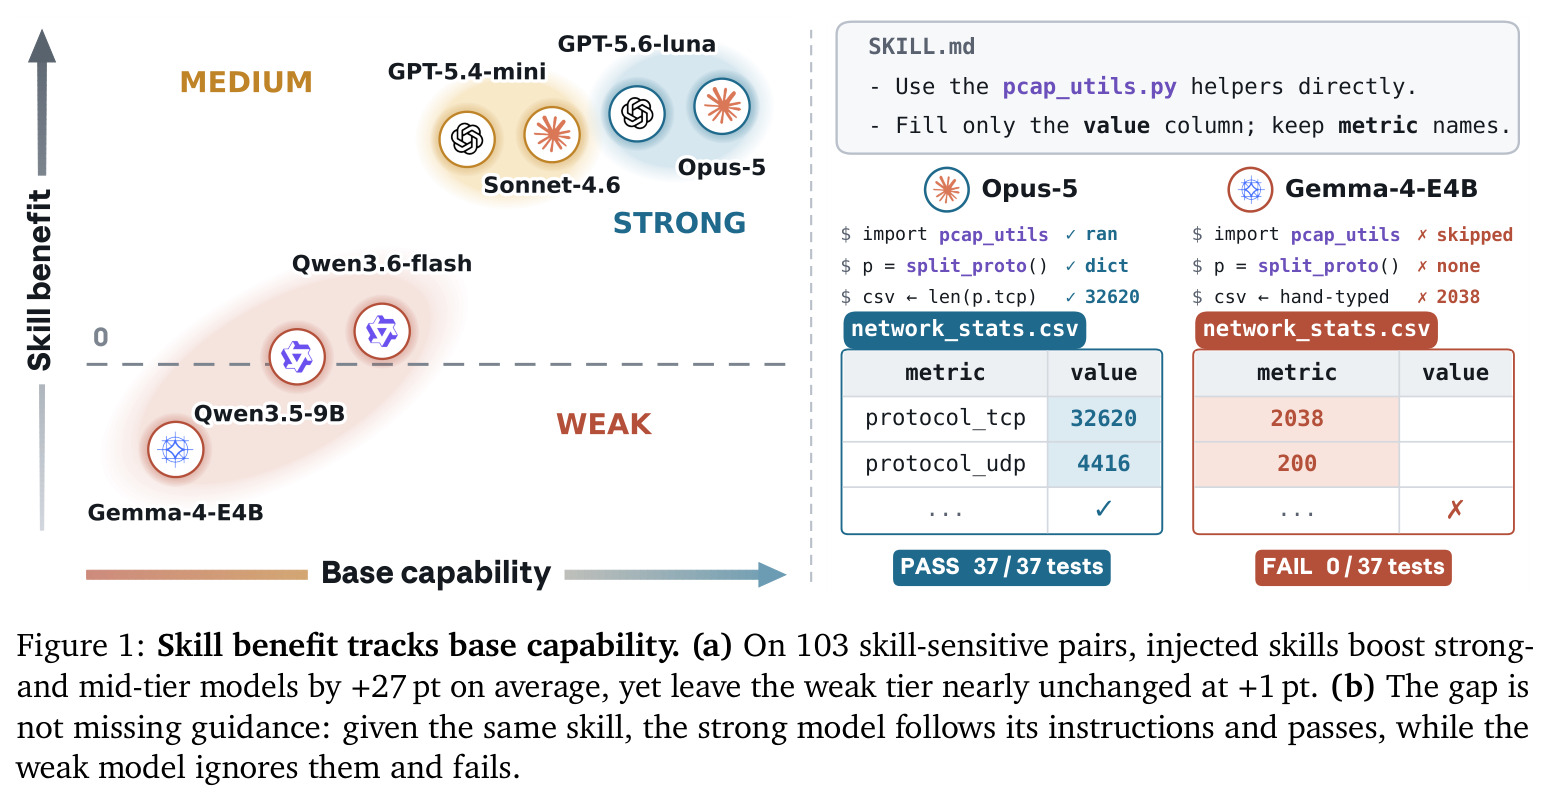
图 (a) 展示 103 个技能敏感对上按能力分层的平均增益:强层与中层平均 +27 分,弱层几乎不动(+1 分)。图 (b) 是 pcap 网络分析任务的对照案例:同一份 SKILL.md(要求直接用 pcap_utils.py 的 helper、只填 value 列),Opus-5 照做并跑通 37/37 测试,而 Gemma-4-E4B 跳过 import、手打数值 2038(正确值 32620),0/37 失败。说明弱模型缺的不是信息而是执行力。
这是全文的核心现象与核心证据:一图同时给出「技能收益随能力分层」的量化结论(+27 vs +1)和「不是缺指导而是不执行」的定性证明,是整篇论文问题陈述的基石。
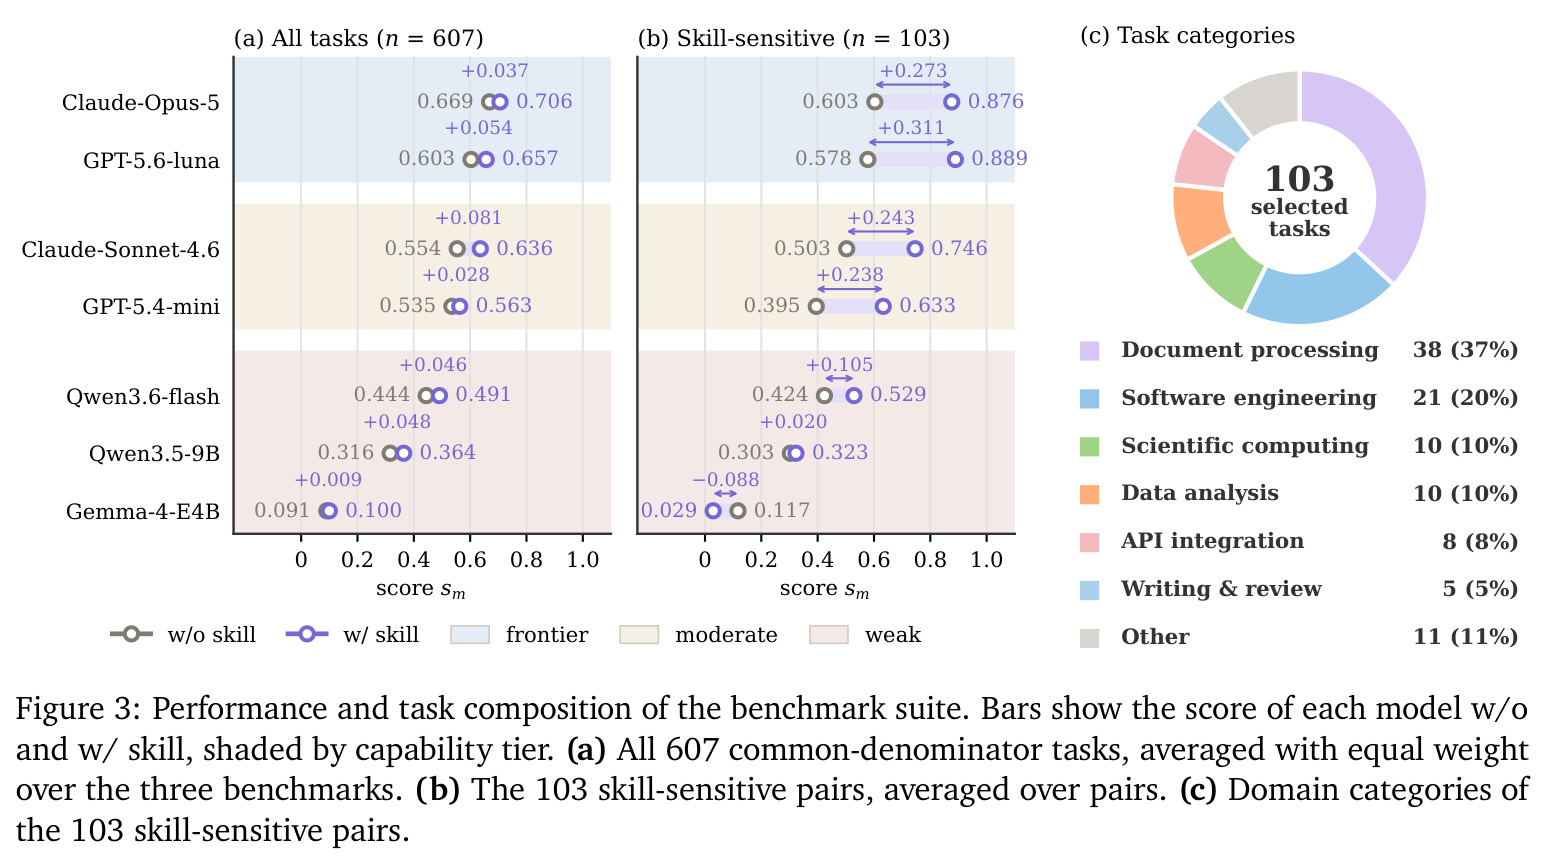
图 (a):607 题全集上技能对所有 7 个模型的收益都很小且无层次规律(Gemma-4-E4B 仅 +0.009)。图 (b):103 个技能敏感对上分层剧烈分化——GPT-5.6-luna +0.311、Opus-5 +0.273、Sonnet-4.6 +0.243、GPT-5.4-mini +0.238,Qwen3.6-flash +0.105、Qwen3.5-9B +0.020、Gemma-4-E4B −0.088。图 (c):103 对的任务构成——文档处理 38(37%)、软件工程 21(20%)、科学计算与数据分析各 10(10%)、API 集成 8(8%)、写作与评审 5(5%)、其他 11(11%)。
解释了为什么必须先做「技能敏感对」筛选:全集上看不到差异,筛选后失配现象才显形;同时给出测试床的任务分布,方便判断结论的领域覆盖面。