RynnUnify:迈向统一具身大脑 RynnUnify: Towards Unified Embodied Brain
16B 统一具身模型,以交错视频-语言推理打通理解、预测与机器人控制。
前置知识
统一多模态模型(UMM)
指在单一模型内同时具备视觉-语言理解(输入图像/视频、输出文本)与视觉生成(输出图像/视频)能力的多模态大模型,典型代表有 BAGEL、RxBrain、Cosmos 3。它们通常包含一个理解分支和一个生成分支,通过共享或联合的注意力机制交换信息,目标是像人类一样既能“看懂”也能“想象”。
本文的出发点就是现有 UMM 在具身任务上理解偏弱、长时程生成不一致,RynnUnify 本身就是一个 UMM,全文的架构、训练与评测都围绕如何让 UMM 服务具身智能展开。
Mixture-of-Transformers(MoT)
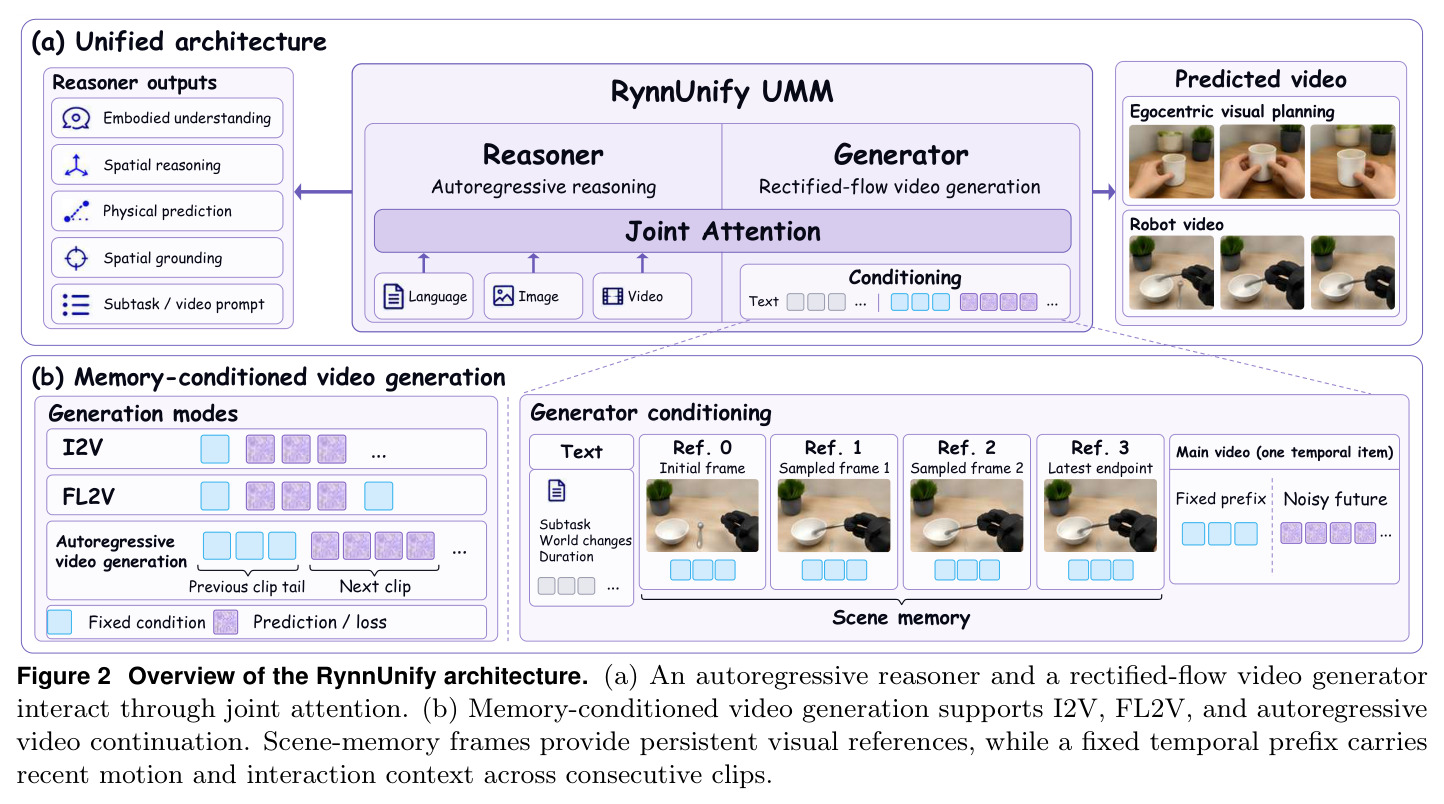
一种多模态架构设计:不同模态(文本、图像、视频)各用一套独立的 Transformer 参数(独立权重分支),但在注意力层面通过 joint attention 相互可见——例如生成器分支可以读取推理器分支产生的文本表征。本文的 RynnUnify 继承 Cosmos3 的 MoT 结构:8B 自回归推理器 + 8B 扩散生成器,共 16B 参数。
理解 RynnUnify 的所有训练流程(先训 reasoner 再冻结训 generator)、信息流动方式(结构化提示如何进入生成器)以及 WAM 的动作头设计,都需要先理解这种双分支但深度耦合的架构。
整流流与流匹配(Rectified Flow / Flow Matching)
一类生成建模方法:学习一个速度场 $v_\theta$,把噪声分布沿近似直线的概率流“搬运”到数据分布。训练目标是回归目标速度 $\mathcal{L}=\mathbb{E}\|v_\theta(z_t,t)-v^\star_t\|^2$,推理时从噪声出发做若干欧拉积分步即可采样。相比扩散模型路径更直、步数更少。
RynnUnify 的视频生成器和 WAM 的动作头都用流匹配训练:生成器用公式 (3) 的加权流匹配损失,动作头用公式 (11) 学习 48×12 动作块的速度场,推理时 16 步欧拉积分产出动作。
因果视频 VAE 与视觉 token 化
把原始视频压缩为低维 latent 的编解码器,“因果”指编码每一帧时只能看到当前及之前的帧,适合流式/自回归生成。本文的 VAE 空间压缩 16 倍、时间压缩 4 倍,latent 再按空间 patch 化成 token 序列,生成器在这些 token 上做去噪。
论文中 4n+1 帧的长度约束、前缀长度 k∈{2,4,8} 对应 5/13/29 帧、主视频最多 241 帧等细节都由 VAE 的 4 倍时间压缩决定,不理解 VAE 就无法理解跨 chunk 记忆与续写的具体机制。
Self-forcing(自强迫训练)
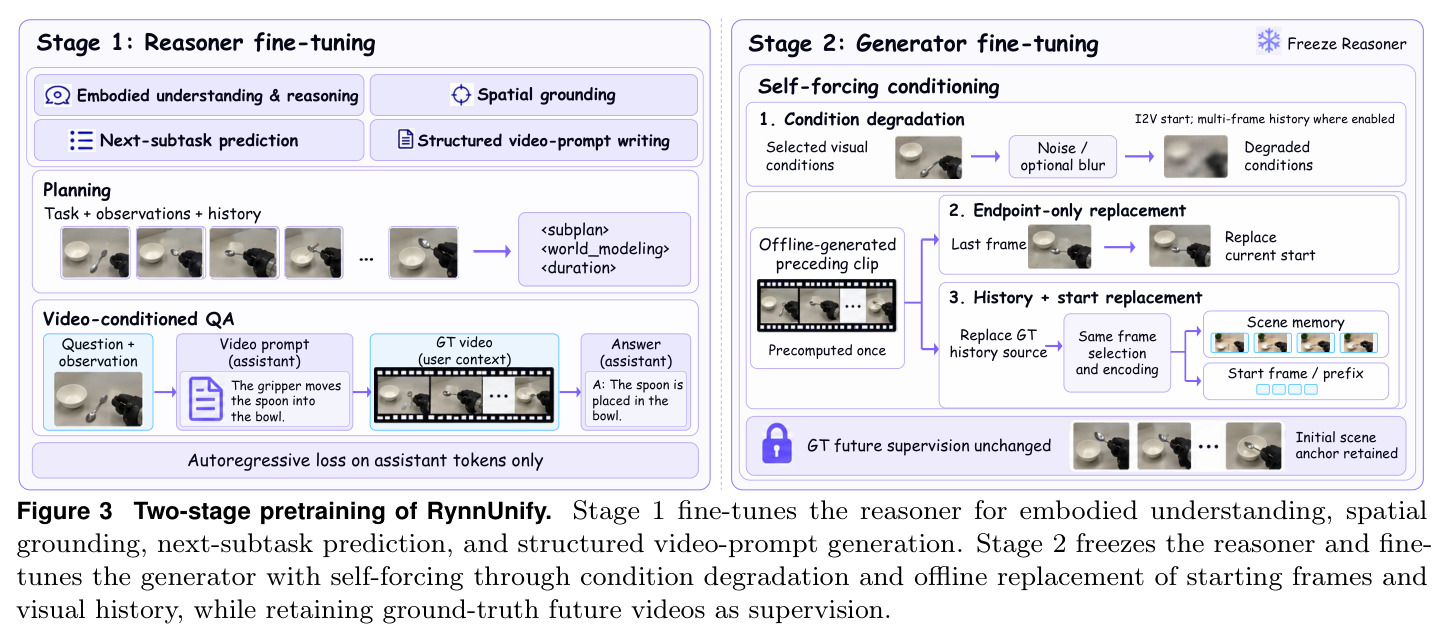
针对自回归视频生成“训练时见真值、推理时见自身不完美预测”的暴露偏差问题:训练时故意把条件输入替换或扰动为模型自己生成的低质量内容,同时保留真值作为预测目标。本文用了三种策略:像素级条件退化(加噪 σ~U(0,0.15)、下采样模糊)、离线端点替换(用缓存的历史生成帧替换真值起始帧)、联合历史替换(整段历史都换成缓存生成内容)。
这是 RynnUnify 长时程视觉规划取得 PI +15.16 提升的关键训练技术之一,理解它才能明白为什么模型能在连续 15 步 rollout 中保持场景一致。
GSPO(序列级策略优化)
一种面向 LLM/多模态模型的强化学习算法:与 PPO 在 token 级计算重要性比不同,GSPO 在整条序列级别计算重要性比率(当前与 rollout 策略的平均 token 对数概率差的指数),并用序列级裁剪控制更新幅度,适合以最终答案质量为奖励的长序列优化。
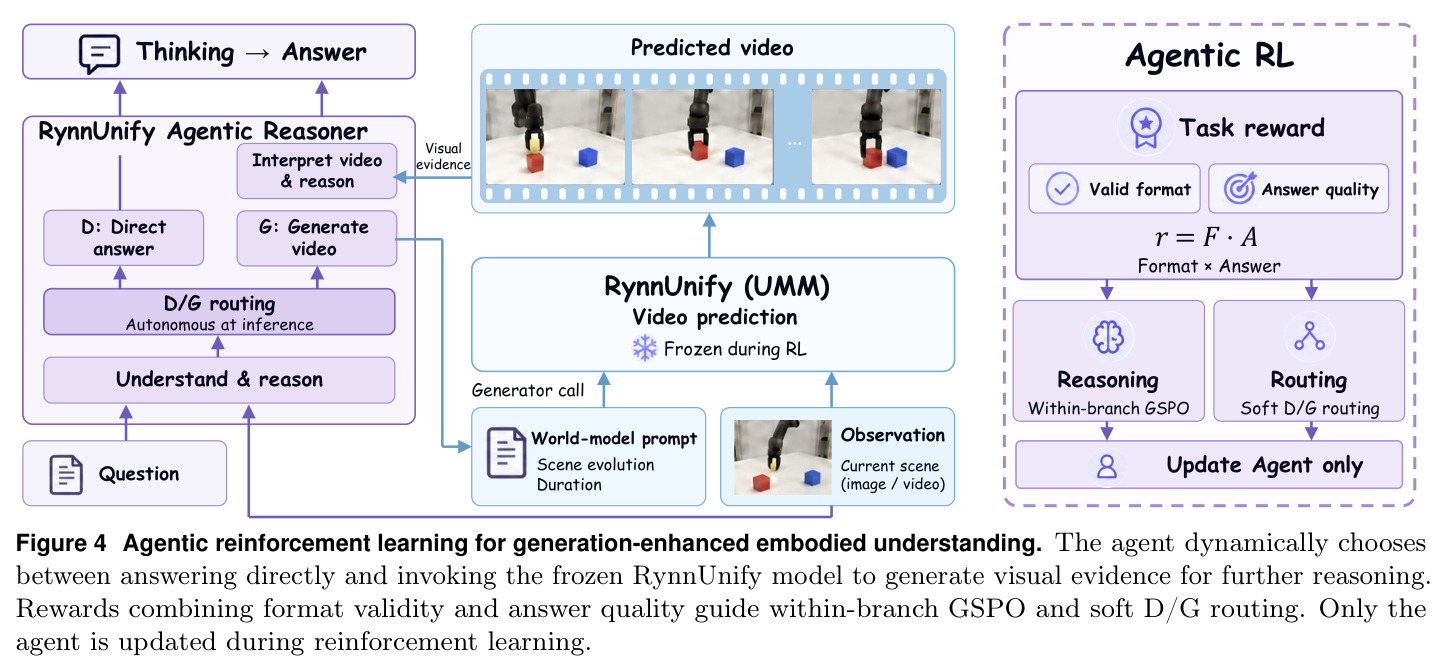
本文提出的 BCPO 框架在分支内使用 GSPO 优化“直接回答”和“生成辅助回答”两类轨迹,是理解 Stage 3 Agentic RL 损失函数(公式 4、5)的基础。
世界-动作模型(WAM)与 VLA
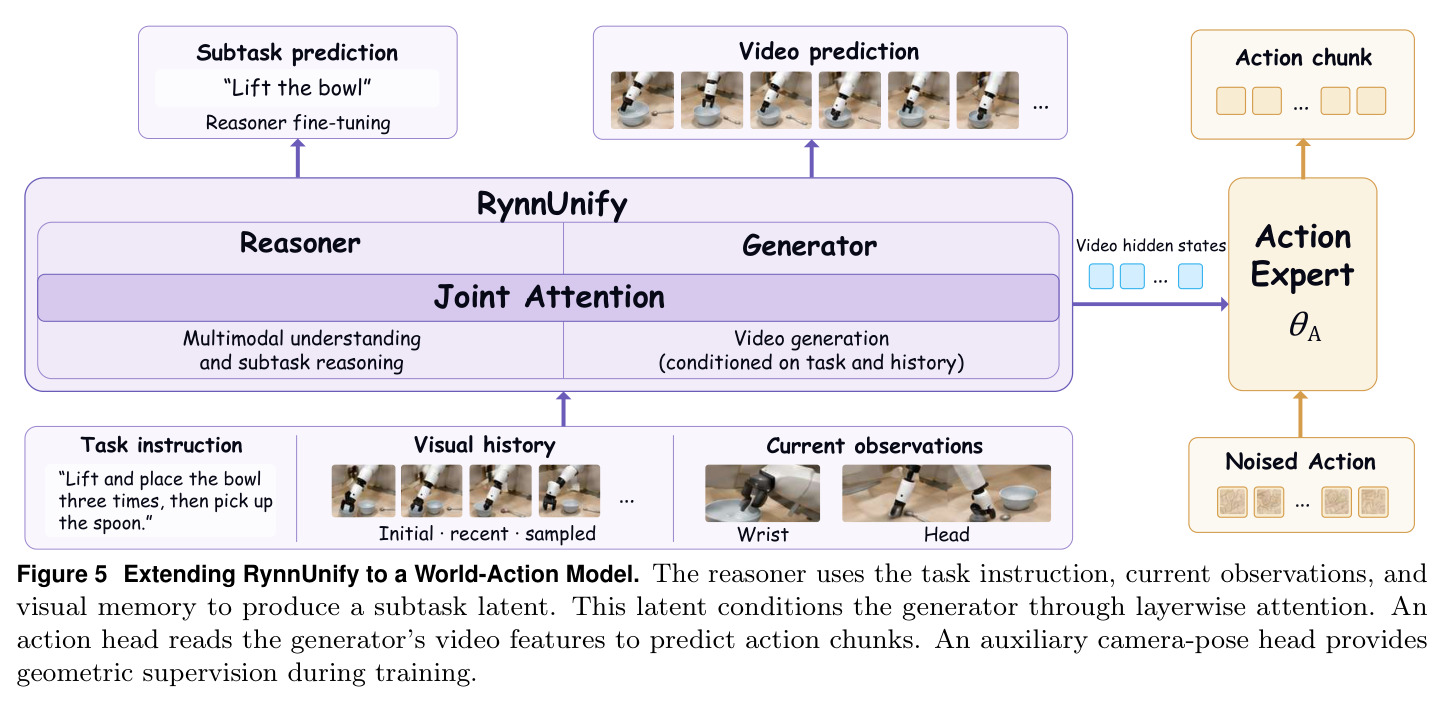
视觉-语言-动作(VLA)模型直接把观测和指令映射为机器人动作;世界-动作模型(WAM)则更进一步,让模型先隐式预测“世界会如何演变”(未来视频),再从该预测的表征中读出动作。本文 WAM 中推理器输出子任务 latent 条件化生成器,动作头从生成器 36 层视频隐状态交叉注意力读取特征来预测动作块。
WAM 是本文三大贡献之一,其设计哲学——动作应建立在“对世界演化的预测”之上——是全文“理解、预测、控制统一”主题的落点,也是与 π0、GR00T 等基线本质不同的地方。
研究动机
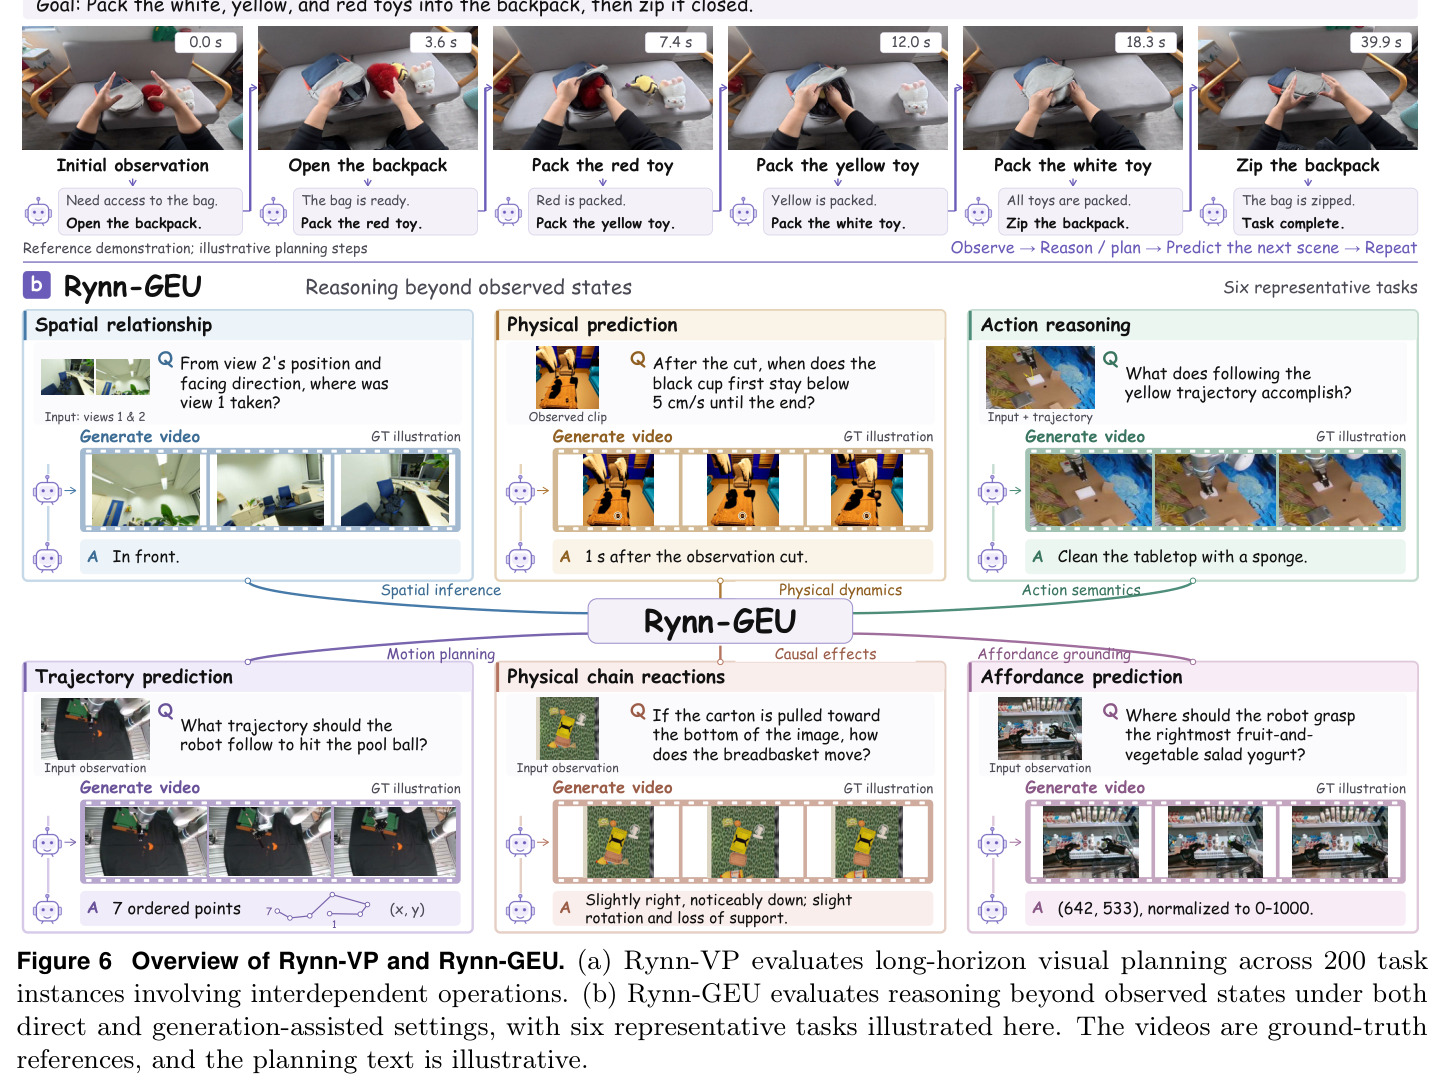
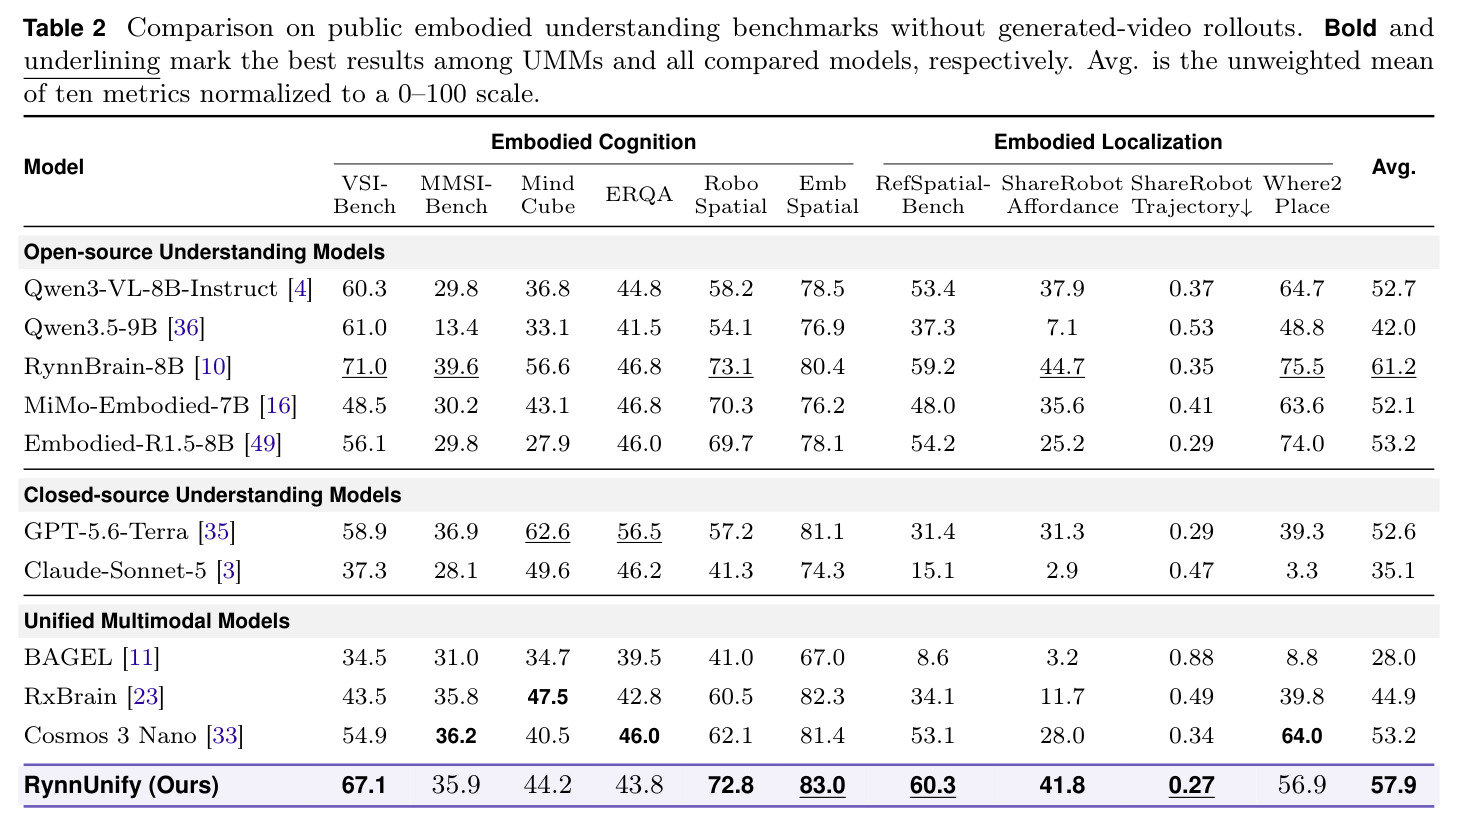
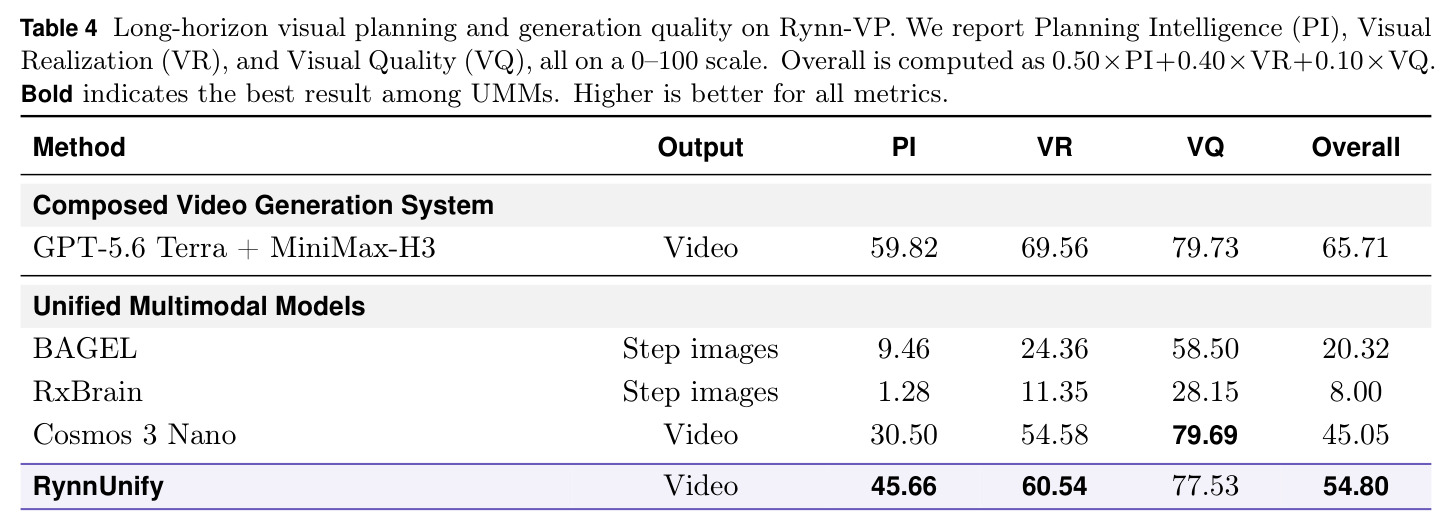
通用机器人大脑要求模型能理解物理世界、预期交互结果并把任务意图转化为行动:机器人在多步骤相互依赖的操作中必须识别子目标、预测场景如何变化、并判断这些变化如何影响后续决策。现有统一多模态模型(UMM)虽然已能联合建模理解与生成,但在具身场景存在三类具体问题。其一,具身理解能力明显弱于专用模型:论文在十项公开基准(VSI-Bench、MMSI-Bench、MindCube、ERQA、RoboSpatial、EmbSpatial、RefSpatial-Bench、ShareRobot 两项、Where2Place)上的汇总显示,UMM 阵营中 BAGEL 平均仅 28.0、RxBrain 44.9,最强的 Cosmos 3 Nano 也只有 53.2,落后于专用具身理解模型 RynnBrain-8B 的 61.2,例如 BAGEL 在 ShareRobot-Affordance 上只有 8.6 分。其二,长时程规划中误差持续累积:场景随子任务推进不断变化,单次静态视频预测无法覆盖中间动力学,连续生成时物体凭空出现/消失、尺度突变、背景漂移等问题会破坏任务一致性。其三,评测缺位:此前没有专门衡量“视觉规划能否在长时程中与任务和先前操作保持一致”的基准,也没有数据能回答“显式生成视频究竟是否、以及在什么条件下能提升对未观测未来状态的推理”。
本文的目标是论文要构建一个“统一具身大脑”:用单个 16B 模型同时支撑三类能力——(1)强具身理解,包括空间推理(视角、几何关系)、物理预测(运动与交互结果)和空间定位(可供性点、放置区域、轨迹);(2)长时程视觉规划,通过交错的视频-语言推理把子任务决策与视觉预测串联起来,让每一步预测的末帧成为下一步推理的观测;(3)机器人控制,把理解与预测能力迁移到真实与仿真操作。围绕这一目标,论文还要补齐两块评测空白:建立 Rynn-VP(200 个自我中心任务场景,评估长时程视觉规划的任务进展、依赖满足与视觉一致性)和 Rynn-GEU(十个子集,评估动作后果、物理变化与视角变化后的空间关系等前瞻性推理,支持直接回答与生成辅助两种设定);并验证两个延伸命题——通过强化学习训练一个 8B agent 学会“何时值得生成视频再作答”,以及通过 WAM 后训练让统一模型直接输出机器人动作。
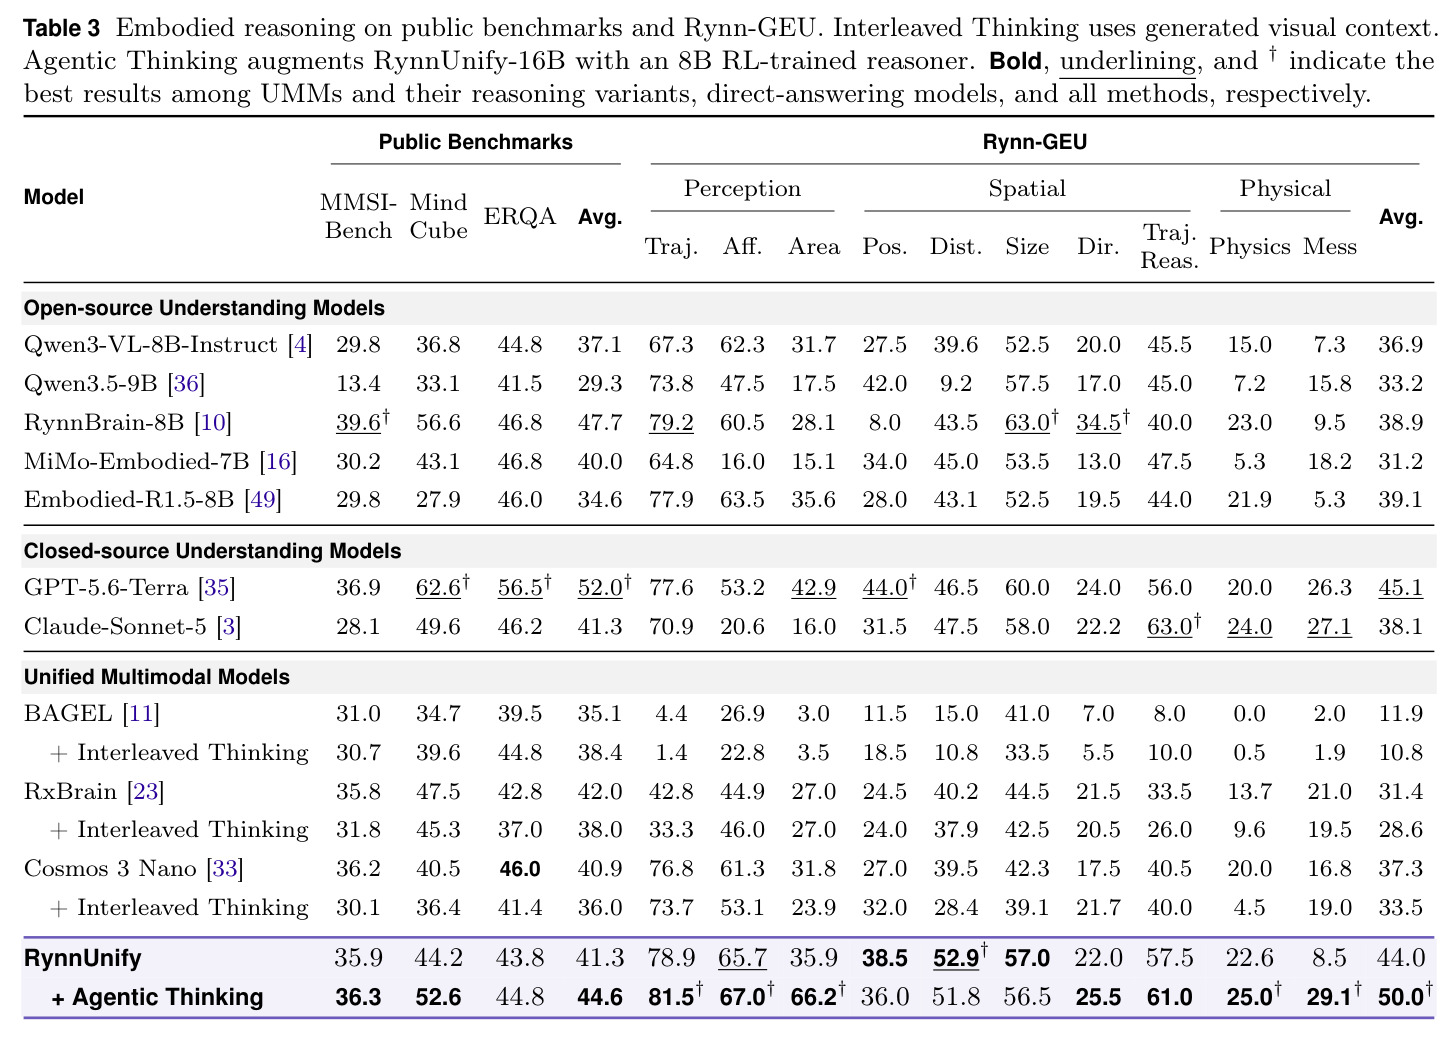
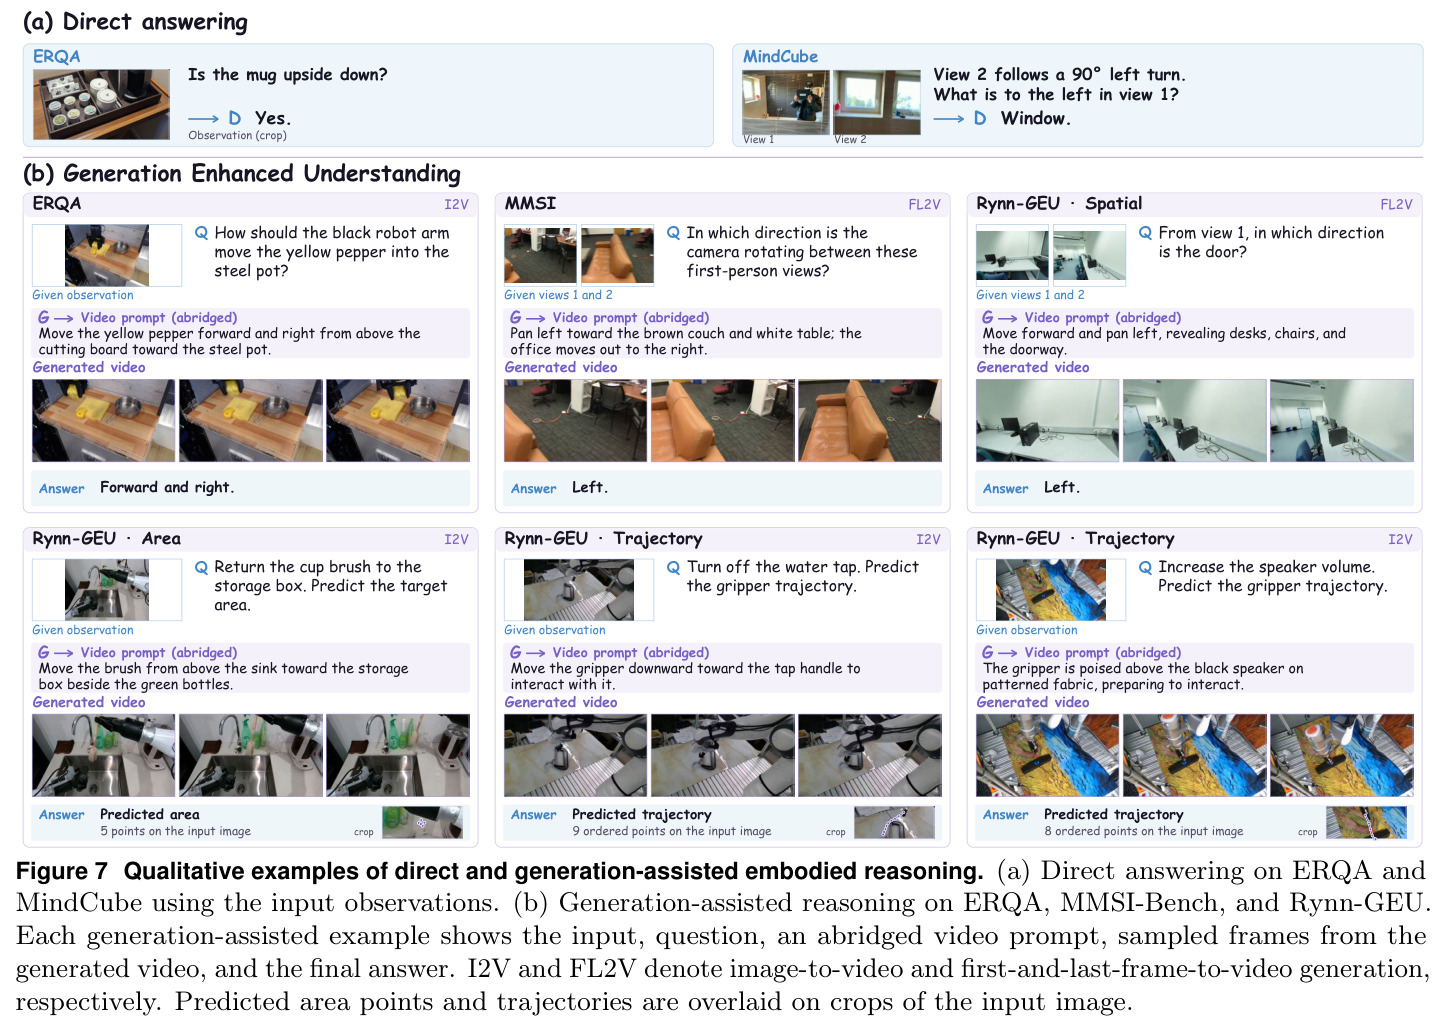
与已有工作不同的是,本文的独特切入角度有三点。第一,用“交错视频-语言推理”作为统一范式:推理器与生成器通过 joint attention 深度耦合,推理器不仅输出子任务文本,还输出结构化的世界建模提示(场景配置、预期视觉演化、时长),生成器据此预测视频、其末帧又回喂推理器形成“观测→推理→预测→再观测”的闭环,而不是理解和生成两个输出头各自为政。第二,把视频生成当作可选择性调用的“推理工具”:此前其他 UMM 对所有问题无差别地做 interleaved rollout,结果在 Rynn-GEU 上平均反而下降(BAGEL 11.9→10.8、RxBrain 31.4→28.6、Cosmos 3 Nano 37.3→33.5);本文提出 BCPO 强化学习框架,用两个分支的奖励差显式学习“何时生成”,保留直接回答路径。第三,从同一个预训练 UMM 出发做 WAM 三阶段后训练(子任务 latent 规划 + 视频-动作联合训练),而非从头训练独立的 VLA,使世界知识直接服务于控制。
核心方法
直觉上,RynnUnify 想让一个模型同时会“看懂场景、想象接下来会发生什么、并据此行动”。技术路线基于 Cosmos3 的 Mixture-of-Transformers 架构:8B 自回归推理器负责多模态理解与语言生成,8B 扩散生成器通过整流流预测连续视觉 latent,两分支参数独立、经 joint attention 交互,生成器可读取推理器的文本表征。视觉输入经因果 VAE(空间 16 倍、时间 4 倍压缩)patch 化为 token。生成器支持三种模式:I2V(图生视频)、FL2V(首末帧条件生成)与跨 chunk 续写;跨 chunk 场景记忆由 4 个独立编码的参考帧(固定初始观测 + 2 个历史关键帧 + 最近参考)加一段来自前一 clip 尾部的连续前缀(推理时取最后 13 帧,主视频最多 241 帧)组成,记号即 $S_t=[S^{AR};Z_{mem};z_t]$。训练分两阶段:Stage 1 微调推理器(具身理解、空间定位、下一子任务预测、结构化视频提示写作、视频条件问答);Stage 2 冻结推理器,用流匹配损失加 self-forcing 微调生成器。在此之上还有两个扩展:从微调后的 8B 推理器出发,用 BCPO 强化学习后训练一个会“按需调用生成”的 agent;把整个 16B 模型经三阶段后训练成 WAM,推理器产出子任务 latent 条件化生成器,18-block 动作头从生成器 36 层视频特征预测 $A_t\in\mathbb{R}^{48\times 12}$ 的动作块。
核心创新是“理解引导生成、生成反哺理解”的双向闭环及其配套的记忆与鲁棒性机制,这与已有方法的本质区别在于信息流的组织方式。推理器的输出不是简单文本,而是三段结构化标记: 指定下一可执行子任务、 详细描述场景配置与预期视觉演化(但不泄露结果,把“怎么收场”留给生成器预测)、 指定操作时长,从而同时约束生成内容与时间跨度;生成视频的末帧成为下一步观测,使规划建立在自身预测之上。针对长时程一致性,跨 chunk 场景记忆把 4 个参考帧独立编码为 token 组、置于主视频 token 之前(不占用主视频时间轴),与前缀共享的边界帧只算一次,无需额外记忆编码器或交叉注意力模块。针对暴露偏差,self-forcing 三策略让生成器在训练时就面对自身的不完美条件。而 Agentic RL 的本质区别在于“选择性”:BCPO 不是无差别生成,而是用分支间平均奖励差构造软路由目标 $q_G(x)=\mathrm{sg}[\sigma((\mu_G-\mu_D)/T_{route})]$,从输入源头预测生成是否值得,这直接解释了为何其他 UMM 的 rollout 普遍掉分而 RynnUnify 反而提升 6.0 分。
方法步骤详情
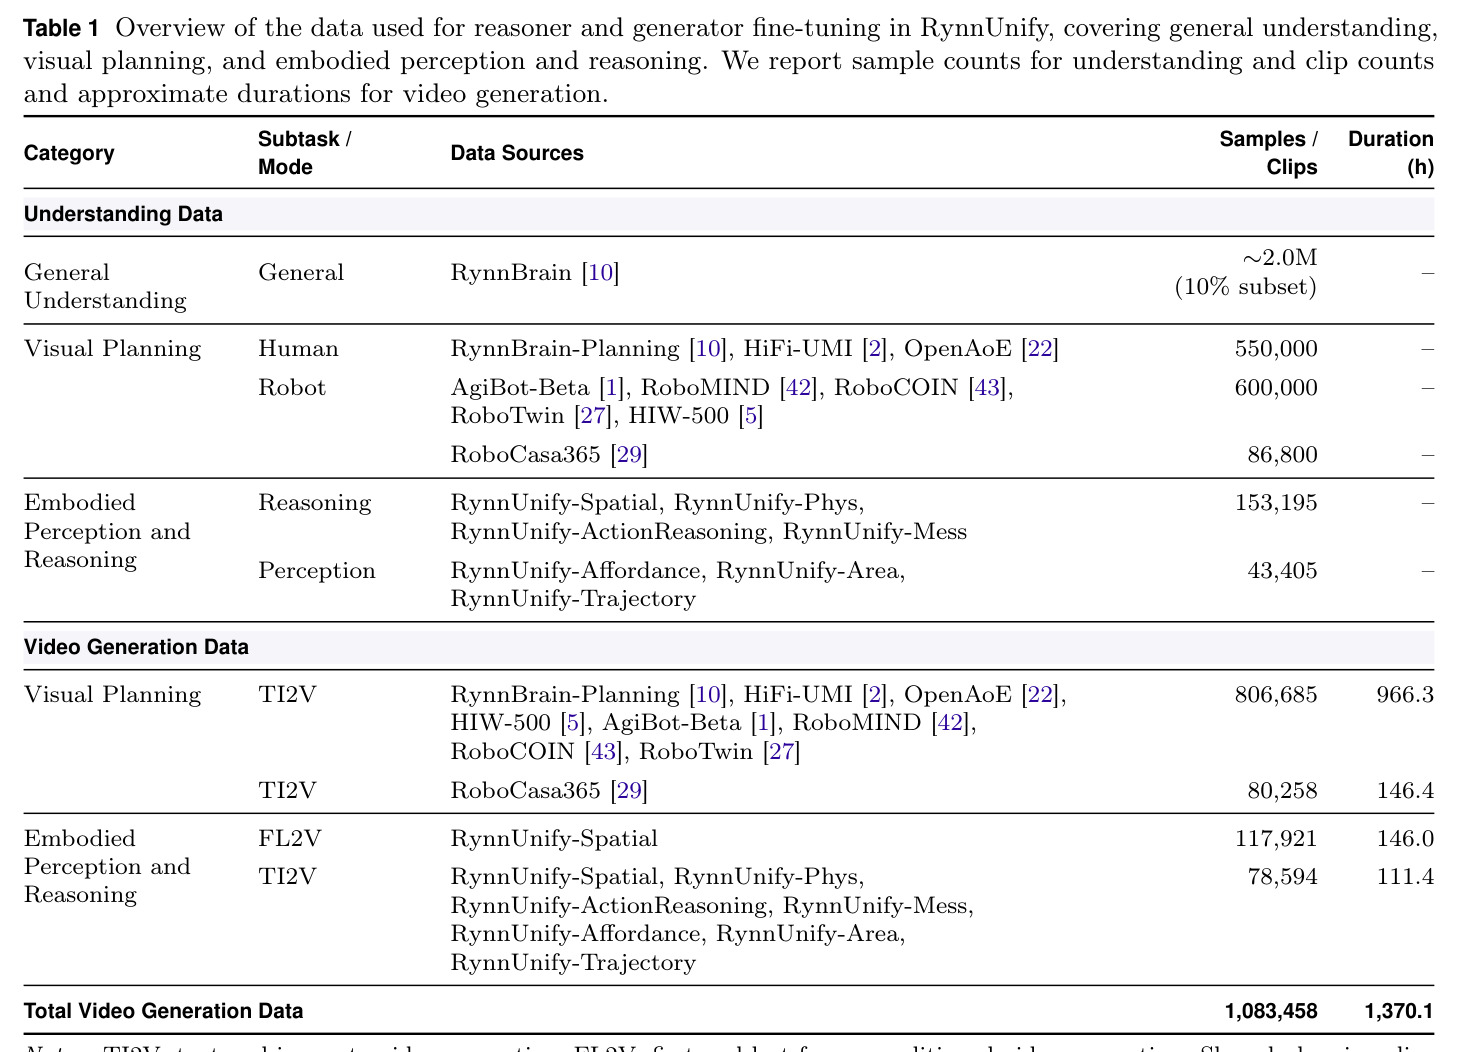
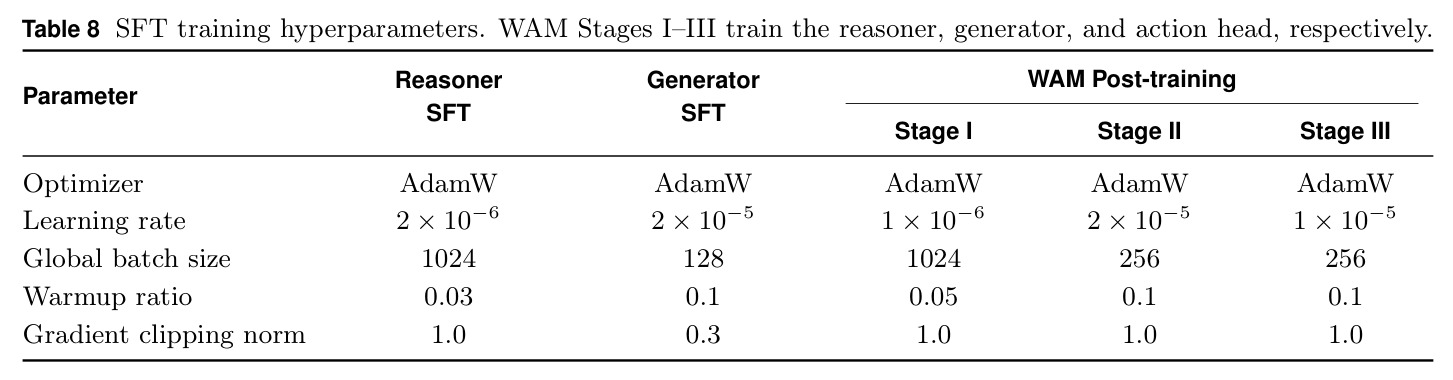
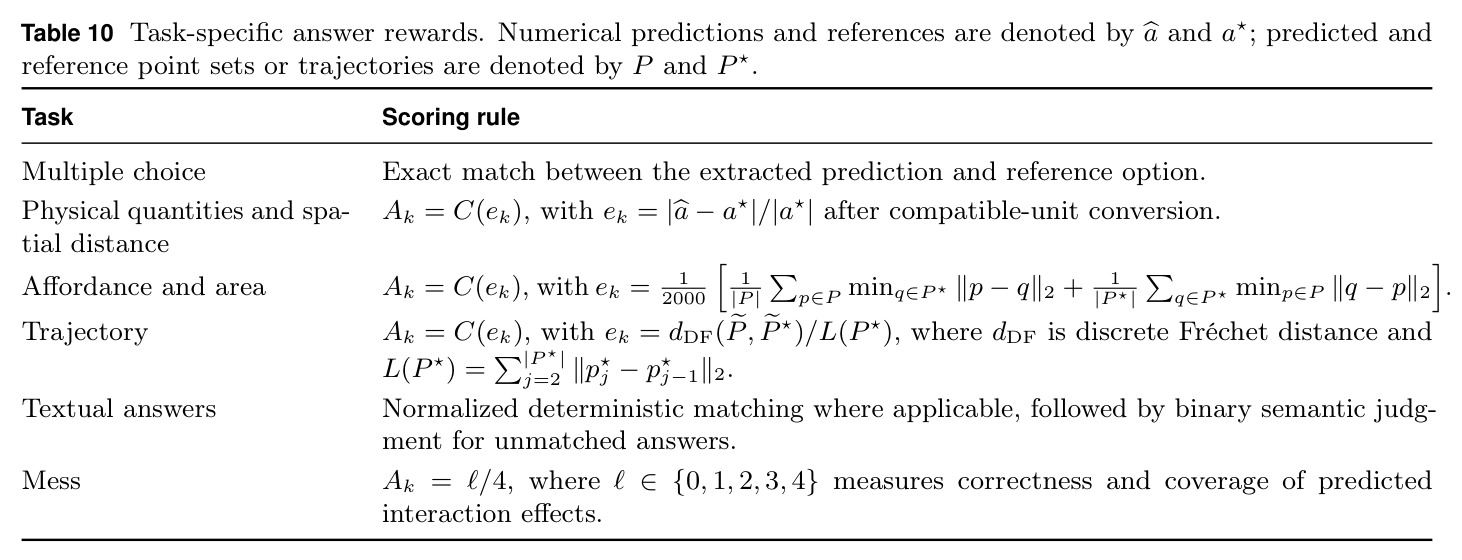
方法全流程分五步。第一步,数据构建:约 200 万通用理解样本(RynnBrain 语料 10% 子集);规划数据 123.7 万条(人类/UMI 演示 55 万、机器人演示 60 万、RoboCasa365 8.68 万),感知与推理数据 19.66 万条;生成数据共 1,083,458 个 clip、约 1,370.1 小时。用 Qwen3.6-27B 对无子任务标注的长演示做时序切分与重标注(clip 尽量 2-10 秒),GPT-5.6-Terra 把子任务指令重写为基于 clip 的结构化视觉提示;GEU 数据(Phys 10,028 条 SFT + 1,553 条 RL 题、Spatial 10 万条、ActionReasoning 1.4 万条、Affordance+Area 3.38 万条、Trajectory 9,892 条)统一组织为“观测+问题→世界建模指令→视频→推理答案”的交错对话。第二步,Stage 1 推理器 SFT:以自回归损失 $\mathcal{L}_R=-\sum_{i\in\mathcal{I}_R}\log p_{\theta_R}(s_i\mid s_{<i})$ 只监督 assistant 响应 token,同时习得理解、定位、子任务规划与提示写作四种能力。第三步,Stage 2 生成器 SFT:冻结推理器,以流匹配损失 $\mathcal{L}_G$(仅在需预测的主视频位置上归一化)训练 8,000 步,AdamW 峰值学习率 2×10⁻⁵、前 800 步线性 warmup 后余弦衰减、梯度范数裁剪 0.3;self-forcing 中条件退化以概率 0.3 施加(高斯噪声 σ~U(0,0.15),另有概率 0.5 施加下采样-上采样模糊),端点与历史替换使用一次性预生成的离线缓存。第四步,Stage 3 BCPO:在 22,007 道题上训练,每个可路由问题采样 4 条直接 + 4 条生成辅助轨迹(每批 64 题×8 rollouts=512 条),分支内用 GSPO 优势 $\hat{A}_{z,i}=(r_{z,i}-\mu_z)/(\sigma_z+\epsilon)$,分支间拟合软路由目标,总目标 $\mathcal{L}_{RL}=\mathcal{L}_{GSPO}+\lambda_{route}\mathcal{L}_{route}+\beta\mathcal{L}_{KL}-\eta H$;奖励 $r(\tau)=F(\tau)\cdot A_k$,连续塑形 $C(e)=\max(0,1-e/\delta)^3$(δ=0.30),agent 以恒定学习率 10⁻⁶ 训练 1 个 epoch,生成器全程冻结。第五步,WAM 三阶段:Stage I 用子任务/技能标注只训推理器语言层;Stage II 冻结推理器、以等权的视频+动作流匹配损失训生成器;Stage III 联合训练生成器与 18-block 动作头,损失 $\mathcal{L}_{III}=\mathcal{L}_{act}+0.01\,\mathcal{L}_{pose}+0.005\,\mathcal{L}_{rel}$(辅助相机位姿头提供几何监督);机器人适配使用约 1,600 小时原子任务 + 177 小时复合任务的 RoboCasa365 轨迹,推理时 16 步欧拉积分产出 48 步动作块、执行前 16 步。
技术新颖性
技术新颖性可从四处评估。第一,视觉条件组织方式:把场景记忆实现为“独立编码的 token 组 + 连续时间前缀”的双通道设计(公式 1),参考帧作为场景外观与布局的视觉锚点、前缀保留近期运动与交互上下文,二者共用生成器既有注意力层而无需新模块,是对 Cosmos3 条件机制的最小侵入式扩展。第二,self-forcing 的工程化改造:离线缓存只生成一次、训练全程不刷新,在“暴露于自身误差”与“算力开销”之间取得实用平衡;联合历史替换保证最近历史与起始观测来自同一次预测,消除了混合真值/生成历史时的分布割裂。第三,BCPO 是针对“分支条件路由”的具身 RL 框架:分支内 GSPO 学“沿每条路径怎么答”,分支间软目标学“要不要调用生成”,且生成器在 RL 中完全冻结、只更新 8B agent,把工具使用的决策成本与工具本身的训练解耦——据论文所述这是首个系统检验“生成是否、何时提升具身推理”的训练框架。第四,WAM 的动作表征:动作 token 作为 query 对相邻两层生成器视频特征做交叉注意力,把动作锚定在“预测中的世界”的层级化表征上,并辅以跨相机相对位姿一致性损失 $\mathcal{L}_{rel}$ 提供几何约束,这类“动作头读取世界模型隐状态”的设计在统一具身模型中尚属少见。
实验结果
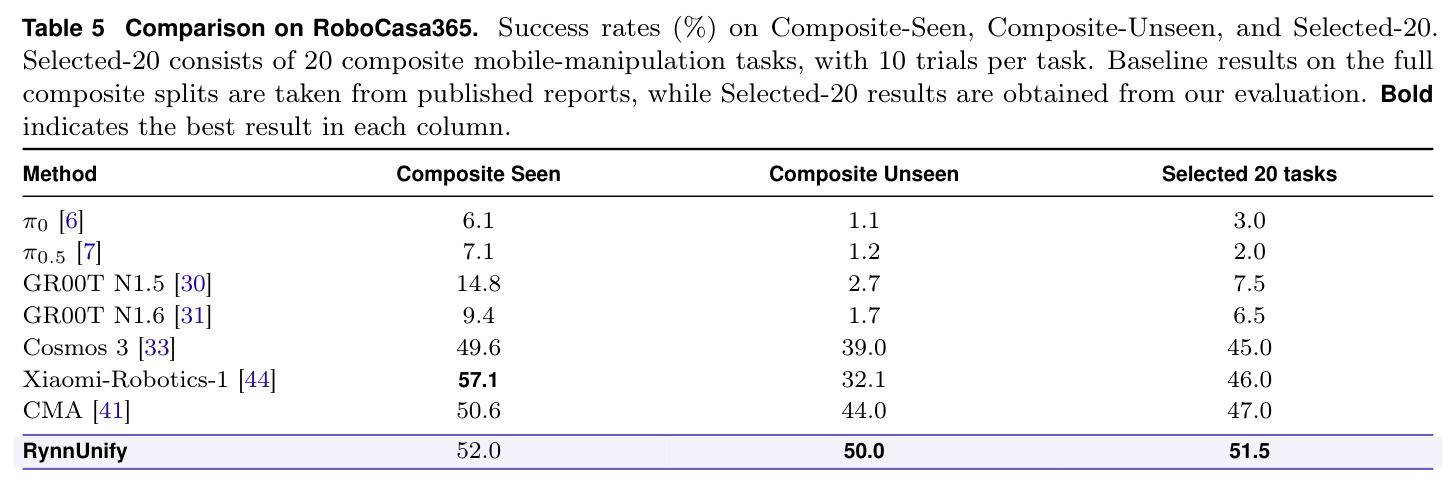
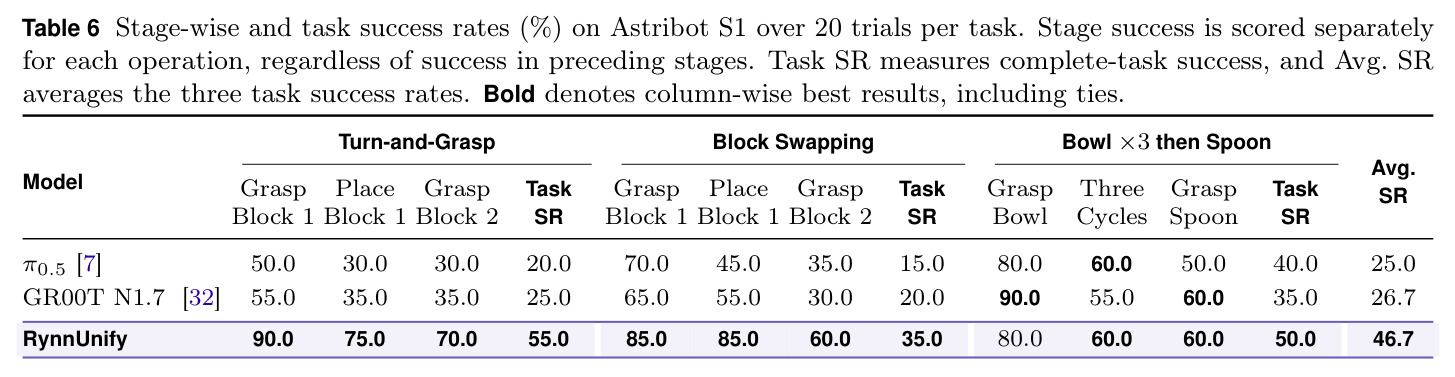
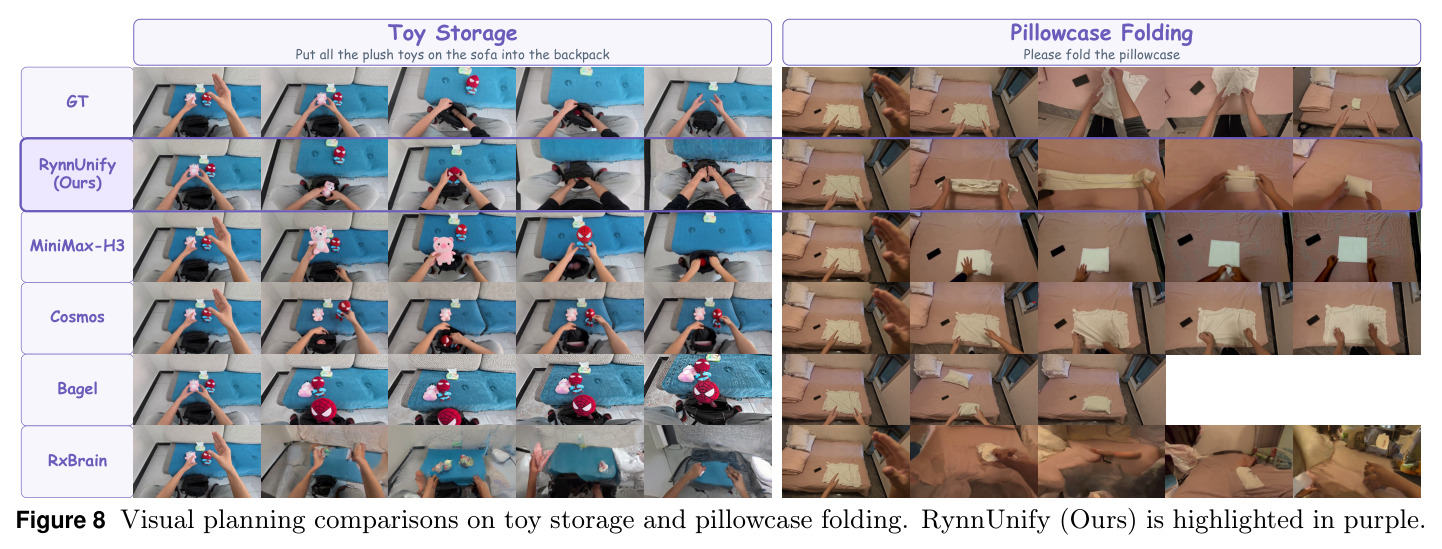
论文的实验覆盖五组。(1)公开具身理解(Table 2):RynnUnify 以 57.9 的归一化平均分成为所有被评 UMM 中最高,超过 Cosmos 3 Nano 的 53.2,十项指标中六项领先;与 Cosmos 3 Nano 相比,VSI-Bench 67.1(+12.2)、RoboSpatial 72.8(+10.7);ShareRobot-Affordance 从 28.0 提升到 41.8;并在 EmbSpatial(83.0)、RefSpatial-Bench(60.3)、ShareRobot-Trajectory(0.27,越低越好)上取得所有对比模型(含 GPT-5.6-Terra、Claude-Sonnet-5)的最佳成绩。(2)前瞻性推理与 Agentic 生成(Table 3):Rynn-GEU 直接回答平均 44.0,为 UMM 最高;经 BCPO 训练的 agentic 版本升至 50.0,全场最高、超 GPT-5.6-Terra 4.9 分;十个子任务中七个较直接回答提升,其中 Area 从 35.9 升至 66.2、Mess 从 8.5 升至 29.1;公共推理基准平均从 41.3 升至 44.6(MindCube +8.4 至 52.6)。对照组证据鲜明:BAGEL、RxBrain、Cosmos 3 Nano 做无差别 interleaved rollout 后 Rynn-GEU 平均反而从 11.9/31.4/37.3 降至 10.8/28.6/33.5;但 RynnUnify 的 Position/Distance/Size 三项也微降(38.5→36.0、52.9→51.8、57.0→56.5),暴露几何保真问题。(3)长时程视觉规划(Table 4):Rynn-VP 总分 54.80,比 Cosmos 3 Nano 的 45.05 高 9.75,其中规划智能 PI 30.50→45.66(+15.16)、视觉实现 VR 54.58→60.54(+5.96)、视觉质量 VQ 77.53 略低于 79.69,说明提升来自规划与一致性而非画质;BAGEL(步图输出)仅 20.32、RxBrain 8.00,而 GPT-5.6 Terra + MiniMax-H3 组合系统仍以 65.71 领先。(4)仿真操作(Table 5):RoboCasa365 上 Composite-Seen 52.0%(第二,低于 Xiaomi-Robotics-1 的 57.1%)、Composite-Unseen 50.0%(第一,超 CMA 6.0、超 Cosmos3 11.0 个百分点)、Selected-20 移动操作任务 51.5%(第一,超 CMA 4.5 个百分点;π0 仅 3.0%、π0.5 2.0%、GR00T N1.5 7.5%)。(5)真机操作(Table 6,Astribot S1 每任务 20 次试验):三任务平均完整成功率 46.7%,远超 GR00T N1.7 的 26.7% 与 π0.5 的 25.0%;Turn-and-Grasp 55.0%、Block Swapping 35.0%、Bowl×3 then Spoon 50.0%(超最强基线 10 个百分点),阶段成功率如 Grasp Block1 达 90.0%,验证了身体重定向、小物体精确操作与依赖交互历史的重复循环执行能力。
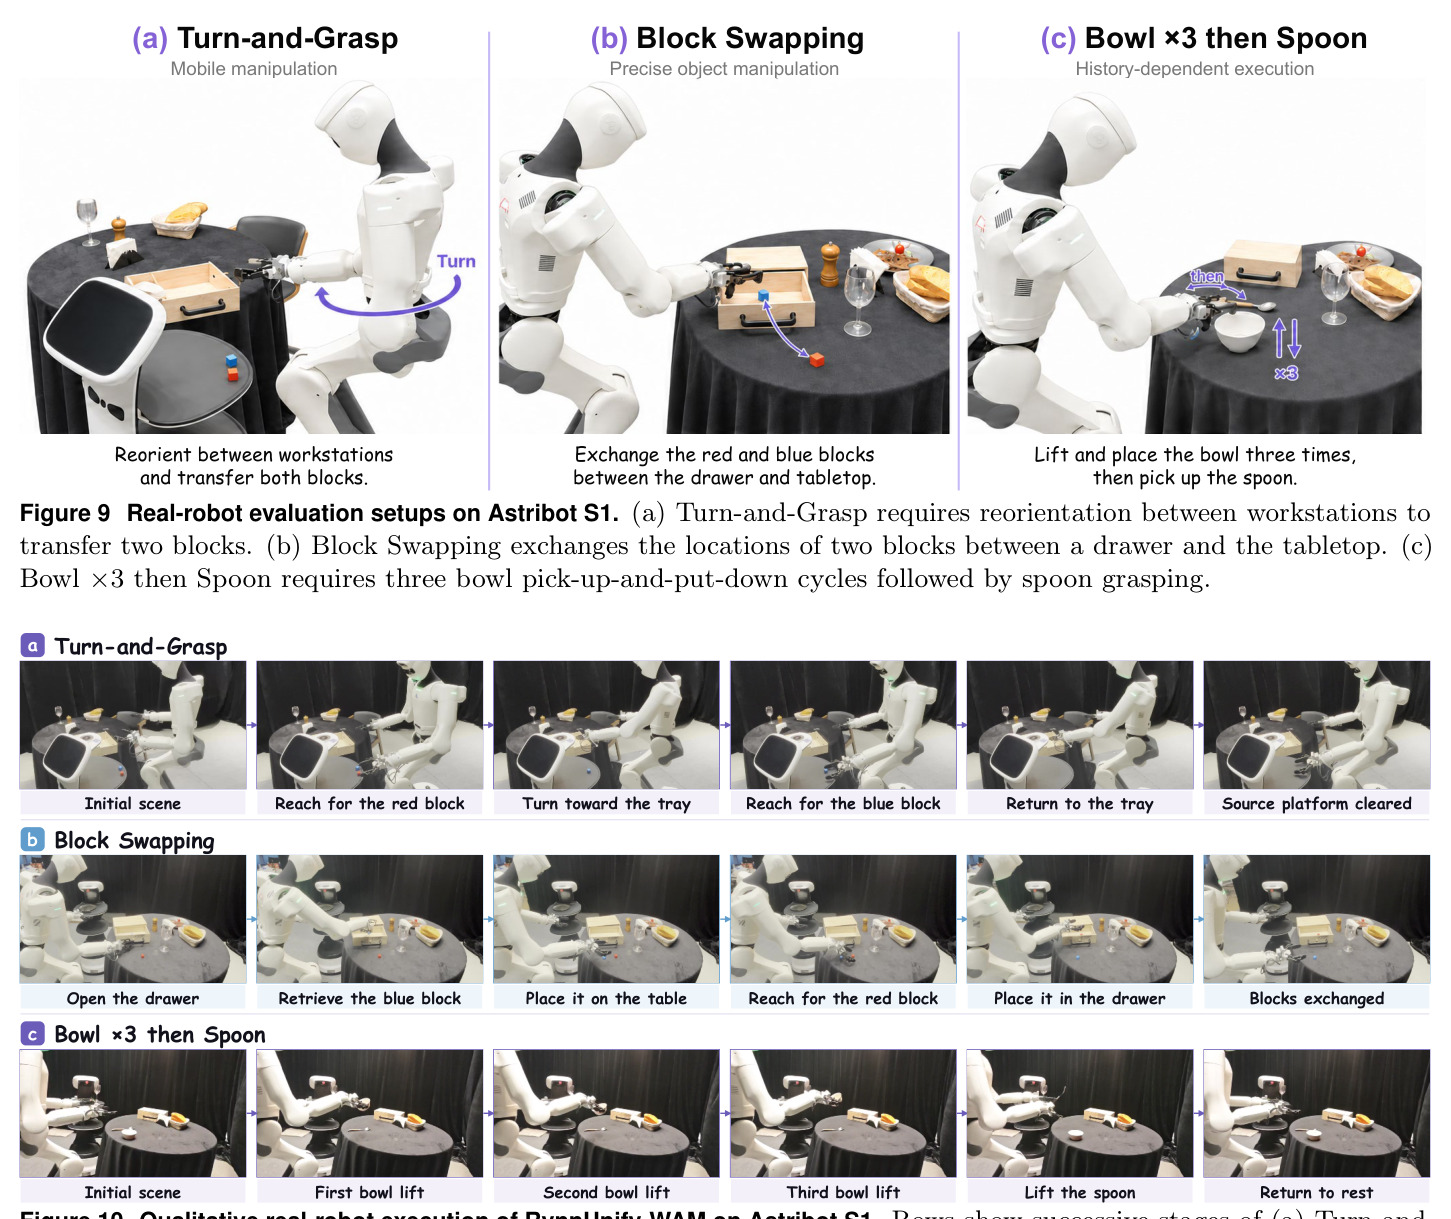
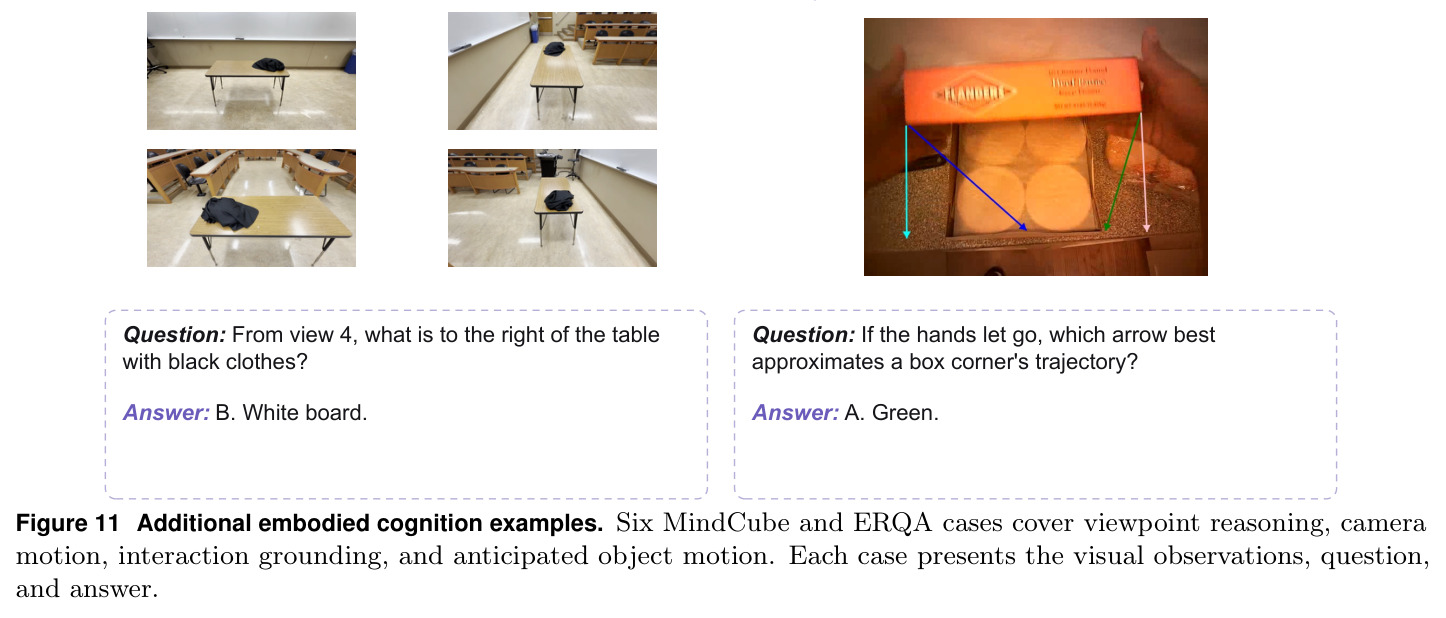
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 公开具身理解(VSI-Bench、RoboSpatial、EmbSpatial 等 10 项) | 0-100 归一化平均分 | 57.9(十项中六项第一,EmbSpatial 83.0 为全场最佳) | Cosmos 3 Nano 53.2;RxBrain 44.9;BAGEL 28.0 | +4.7 分(vs 最强 UMM 基线 Cosmos 3 Nano) |
| Rynn-GEU 前瞻性具身推理(10 个子集) | 各子集 0-100 平均分 | 50.0(Agentic Thinking);直接回答 44.0 | GPT-5.6-Terra 45.1;Cosmos 3 Nano 37.3;其他 UMM 加 rollout 后均下降 | +6.0 分(vs 自身直接回答);+4.9 分(vs GPT-5.6-Terra) |
| Rynn-VP 长时程视觉规划(200 个任务场景) | Overall = 0.5×PI + 0.4×VR + 0.1×VQ | 54.80(PI 45.66 / VR 60.54 / VQ 77.53) | Cosmos 3 Nano 45.05;BAGEL 20.32;RxBrain 8.00;GPT-5.6 Terra + MiniMax-H3 组合 65.71 | +9.75 分(vs Cosmos 3 Nano) |
| RoboCasa365 Composite-Unseen(仿真复合任务) | 任务成功率 (%) | 50.0 | CMA 44.0;Cosmos 3 39.0;GR00T N1.5 2.7 | +6.0 个百分点(vs CMA,排名第一) |
| RoboCasa365 Selected-20(20 个复合移动操作任务) | 任务成功率 (%),每任务 10 次试验 | 51.5 | CMA 47.0;Xiaomi-Robotics-1 46.0;Cosmos 3 45.0 | +4.5 个百分点(vs CMA,排名第一) |
| Astribot S1 真机三任务(转向抓取/积木交换/三次放碗后取勺) | 完整任务成功率 (%),每任务 20 次试验 | 46.7(55.0 / 35.0 / 50.0) | GR00T N1.7 26.7;π0.5 25.0 | +20.0 个百分点(vs GR00T N1.7) |
局限与改进
作者明确承认的局限有三:其一,生成视频会扭曲细粒度几何——agentic rollout 后 Rynn-GEU 的 Position、Distance、Size 三项得分下降(38.5→36.0、52.9→51.8、57.0→56.5),说明扩散预测的空间保真度尚不足以支撑精确的几何判断,生成的“证据”在某些任务上反而引入误导;其二,免模拟器的视觉规划评估(Rynn-VP)尚未与广泛的物理执行验证对接,规划得分高不代表真机执行好;其三,交错生成的计算成本对闭环控制而言仍然过高。基于我自己的阅读,还有几点值得注意:Rynn-VP 上 GPT-5.6 Terra + MiniMax-H3 的组合系统(65.71)仍显著领先 RynnUnify 的 54.80,说明开源 16B 统一模型与专有前沿模型组合尚有约 11 分差距;RoboCasa365 Composite-Seen 上输给 Xiaomi-Robotics-1(52.0% vs 57.1%),在领域内专用方法面前优势并不全面;真机评估仅三个任务、每任务 20 次试验且均为室内桌面场景,统计功效与泛化性有限;BCPO 只在 22,007 题上训练 1 个 epoch,路由策略的泛化边界与失败模式未充分分析;Rynn-VP 评测依赖 GPT-6-sol 的 LLM 判分,自动评判的主观性与稳定性是潜在风险。
独立分析的弱点
独立分析出以下弱点。第一,几何保真不足:Position/Distance/Size 在生成辅助后下降,改进方向是在生成训练中加入几何一致性监督(深度、位姿或光流约束),或让 agent 生成后调用确定性几何工具对预测进行校验再作答。第二,视觉质量反噬:Rynn-VP 的 VQ(77.53)低于 Cosmos 3 Nano(79.69),说明具身微调部分牺牲了画质,可引入感知质量正则项或冻结一部分生成器参数的低秩适配来缓解。第三,场景记忆是手工规则:固定 4 帧(初始 + 2 关键帧 + 最近)与启发式选帧没有学习能力,面对需要回溯远处状态的任务可能检索失败,方向是可学习的、任务驱动的记忆检索与压缩。第四,控制频率受限:动作块 48 步只执行前 16 步即重新推理(约 0.8 秒@20Hz),每次重规划都伴随视频生成开销,长任务闭环延迟大,可探索异步世界模型预测与动作执行并行、或自适应动作块长度。第五,路由决策过于二元:BCPO 只在“直接回答/调用生成”之间选择,未考虑部分生成、多次迭代生成或与其他工具(深度估计、分割)组合的复合策略。第六,Sim2Real 与失败恢复未讨论:真机适配从仿真原子任务模型初始化、只在少量真机演示上训生成器与动作头,域差与执行失败后的恢复策略没有系统评估。
未来方向
作者提出的研究方向包括:提高生成视频的几何保真度并研究如何选择可靠的生成证据;研究 Rynn-VP 视觉规划分数与机器人真实执行结果之间的相关性,使规划评测成为控制能力的代理指标;以及降低交错生成在闭环控制中的计算成本。基于本文成果还可自然延伸:其一,把 Rynn-VP 风格的规划质量评估作为 WAM 训练的中间奖励信号,打通“规划→执行”的信用分配,实现规划与控制的联合强化学习;其二,主动感知——让 agent 生成“假设视角”的视频来决定下一步把身体或相机移到哪里,把视觉规划从被动预测升级为主动探索;其三,把 BCPO 的二分支路由扩展为多工具多分支(生成、几何工具调用、向人类询问),并研究工具组合策略;其四,记忆机制的可学习化:用检索或压缩模型替代固定 4 帧规则,支持跨房间、跨日期的长时程任务;其五,WAM 目前只取单步去噪的视频特征供动作头使用,可探索多步 rollout 的想象-执行交替训练,让动作决策建立在多步未来预测之上;其六,把 GEU 范式推广到更多“答案在输入中不可见”的任务类型(如可变形物体、流体、多物体因果链)。
复现评估
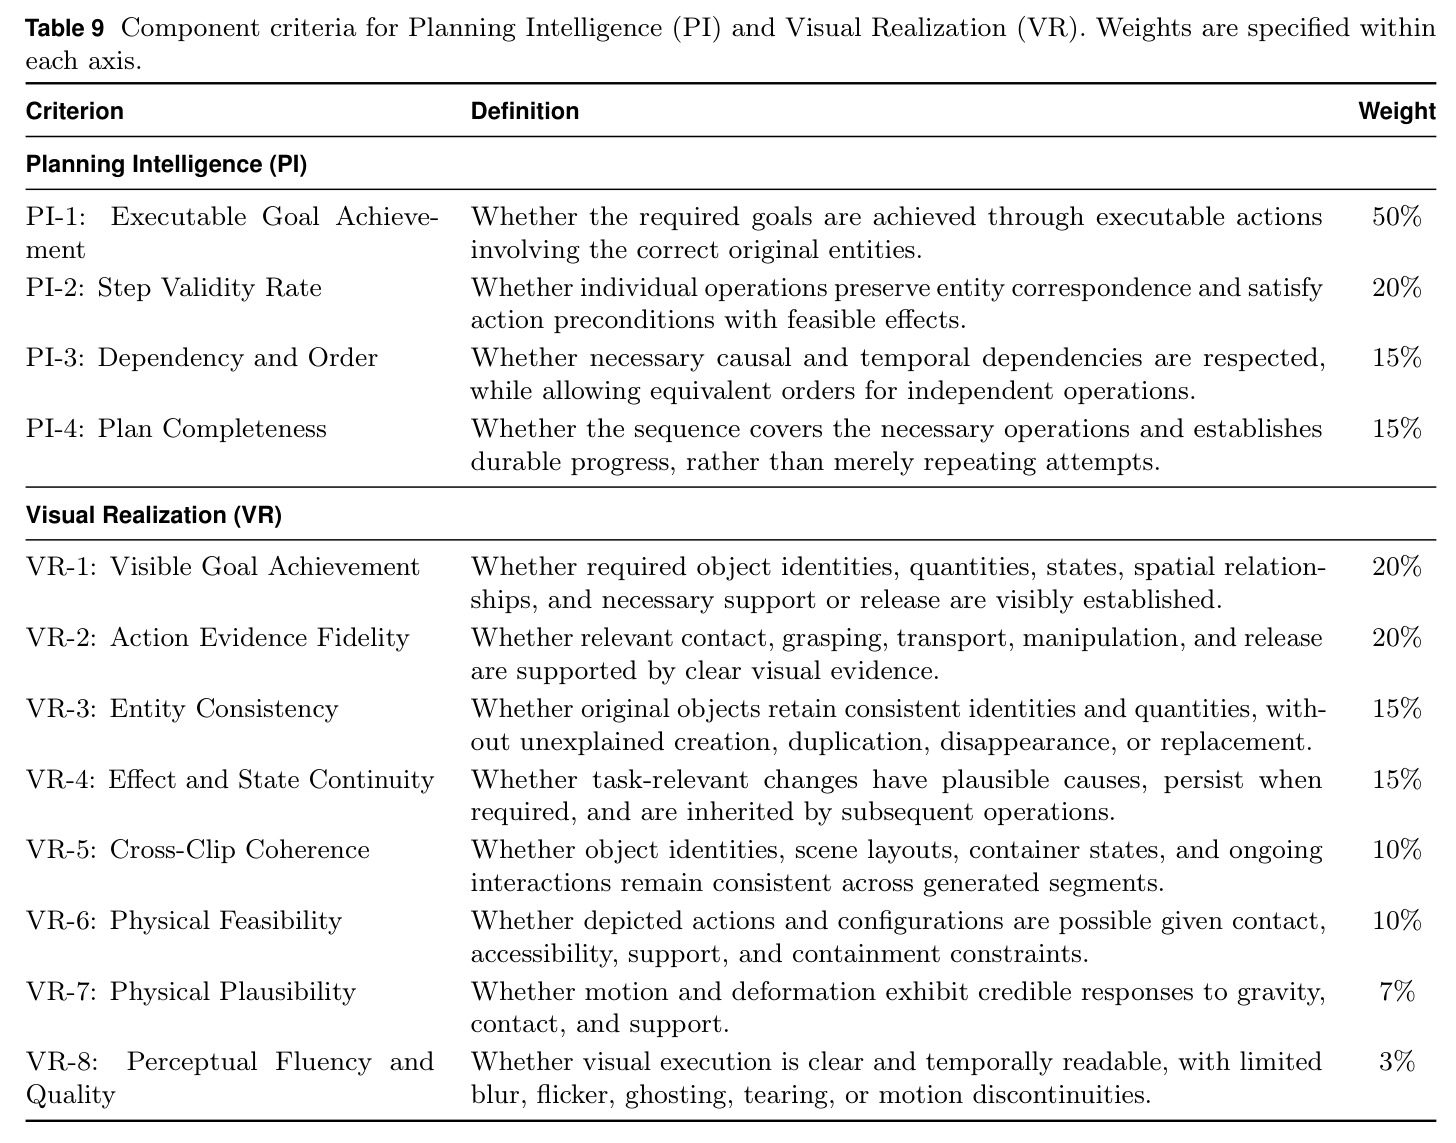
开源情况良好:代码在 GitHub(alibaba-damo-academy/RynnUnify)、模型权重在 HuggingFace(Alibaba-DAMO-Academy/RynnUnify 集合)公开,并有项目主页;附录提供了较完整的复现细节——Table 8 给出推理器/生成器/WAM 三阶段的 SFT 超参数,Table 9 给出 Rynn-VP 的 PI/VR 评分标准与子项权重,Table 10 给出各任务奖励的精确定义,附录 D 还描述了 Rynn-VP 的人工校验流程。数据方面,训练语料大部分来自公开数据集(RynnBrain、HiFi-UMI、OpenAoE、AgiBot-Beta、RoboMIND、RoboCOIN、RoboTwin、RoboCasa365、ScanNet++、PhysInOne、RH20T 等),但构建管线重度依赖 Qwen3.6-27B 时序切分、GPT-5.6-Terra 提示重写、GPT-5.6-Luna 审计与链路标注、MiniMax-H3 生成 FL2V 训练视频、GPT-6-sol 执行 Rynn-VP 评判、Qwen3.8-27B-FP8 做 RL 语义判分——这些专有或前沿模型是完整复现数据与评测管线的最大障碍。算力方面论文未披露 GPU 规模,但 16B MoT 预训练、生成器 8,000 步微调、RL 阶段 22,007 题每题 8 条轨迹(512 条/批)、WAM 使用约 1,777 小时机器人数据,推测需要多节点高端 GPU 集群,从零复现门槛很高;相对务实的路径是使用开源权重,仅复现 BCPO(生成器冻结、只训 8B agent)或 WAM 后训练。
论文图表
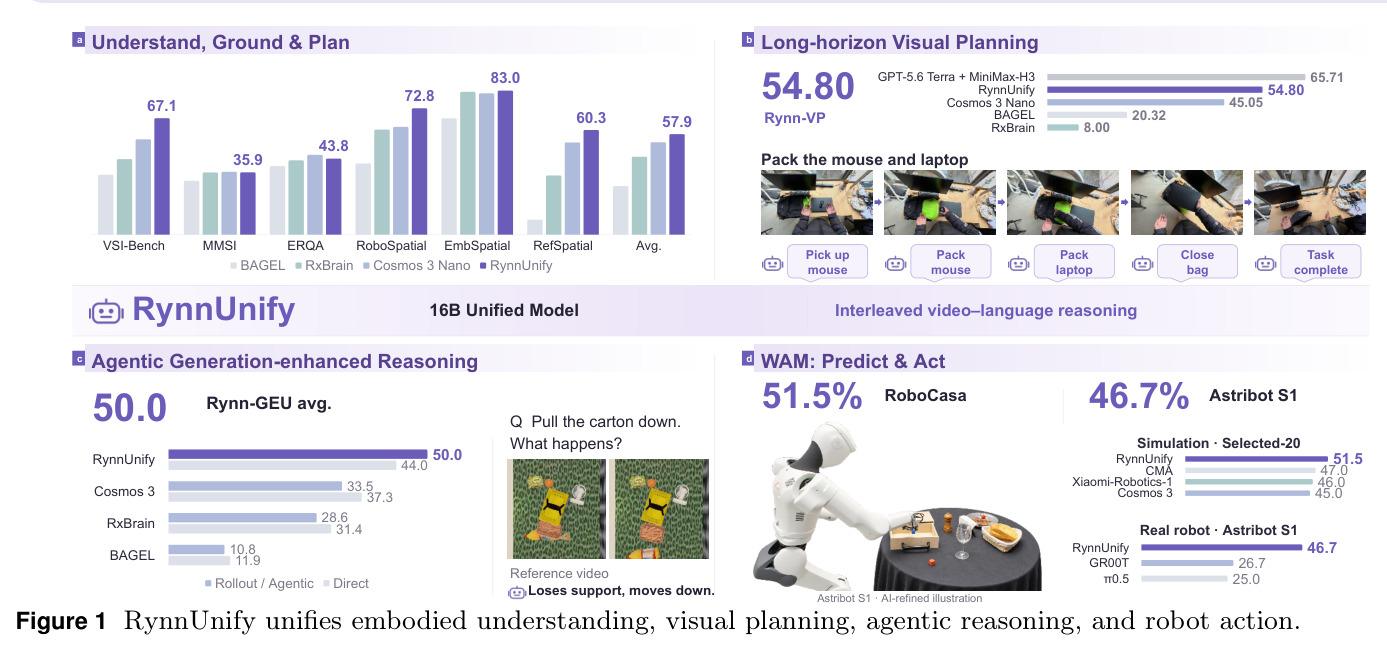
四联总览图:(a) 理解-定位-规划能力上 RynnUnify 平均 57.9 对比 BAGEL/RxBrain/Cosmos 3 Nano;(b) 长时程视觉规划示例“把鼠标和笔记本装包”,对比 Rynn-VP 总分 54.80 vs Cosmos 3 Nano 45.05、GPT-5.6 Terra+MiniMax-H3 65.71;(c) Agentic 生成增强推理,Rynn-GEU 平均 50.0 对比直接回答与各基线;(d) WAM 在 RoboCasa365 Selected-20 达 51.5%、真机 Astribot S1 达 46.7%。
一图概括全文四大能力与核心数字,是快速把握论文贡献版图和各基线相对位置的入口,适合作为导读。