HoloBoxing:单GPU仅7分钟训练的人形机器人拳击简易配方 HoloBoxing: A Simple Recipe for Humanoid Boxing with 7 Minutes of Single-GPU Training
复用预训练全身控制器,单GPU训练约7分钟即可学会人形机器人拳击
前置知识
全身运动控制器
接收高层目标(如未来身体点位姿)与机器人当前状态、输出底层关节命令的预训练网络。本文使用的HoloMotion v2通过运动模仿从参考轨迹学得行走、出拳等通用全身技能,以纯反馈方式执行,训练后全程保持冻结。它决定机器人“能不能做”,而不决定“什么时候做”。
整篇论文的前提:拳击任务学习被严格限制在该控制器之上,理解其冻结复用是理解7分钟账目与成本边界的关键。
潜在动作空间与目标解码器
先用自编码器在参考目标窗口上学习压缩表示:编码器把225维目标窗口压成32维潜在向量,解码器 $D_\phi$ 再将其还原为结构合法的目标坐标(恢复物理统计量、把朝向投影为合法旋转)。部署时只保留解码器,任务策略输出32维潜在动作经解码器变成控制器请求,从而缩小强化学习的探索空间。
解码器是本文动作接口的核心,也是消融实验(直接预测225维目标导致Elo跌至1428)所验证的关键组件。
PPO(近端策略优化)
主流策略梯度强化学习算法:策略网络与环境交互收集rollout,用裁剪代理目标 $\min(r_t A_t,\ \mathrm{clip}(r_t,1\pm\epsilon)A_t)$ 限制每次更新幅度,并配合价值估计器计算优势函数,兼顾样本效率与训练稳定性。本文用128个并行环境、24步rollout,共32次站立热身更新加128次交互更新。
第三阶段任务学习的优化器,理解其更新预算才能读懂84.9秒/275.3秒的时间构成与消融实验的匹配预算设计。
实测状态模仿学习
行为克隆的一种变体:不从参考轨迹的理想状态取标签,而是在冻结控制器实际追踪参考动作时,记录真实机器人观测 $o$ 与对应未来目标 $x$,用损失 $\mathcal{L}_{IL}$ 经冻结解码器监督规划器。这样初始策略见到的输入分布与之后强化学习交互时的分布一致,避免“参考态—实测态”偏移。
这是配方中提供初始行为的关键步骤(20轮仅6.7秒),去掉它后Elo从1541跌到1362、50场对局0次有效接触。
对抗动作先验(风格判别器)
AMP类方法:训练一个判别器区分策略生成的运动与真实参考运动,把判别信号折算成风格奖励加入强化学习,使学到的动作保持自然的人类运动风格。本文奖励为0.8的任务塑形(接近、面向、接触、平衡)加0.2的风格奖励,判别器对比仿真动作与参考样本。
决定拳击动作看起来“像不像真人格斗”,是奖励构成的重要一项,理解奖励设计才能分析行为质量的来源。
Elo等级分
源自国际象棋的对局评分体系:每场对局后按预期胜率与实际结果更新分数,$\mathrm{Elo}'=\mathrm{Elo}+K(S-S_{exp})$,双方分差越大、爆冷得分越多。本文联赛Elo从1500起步、$K=16$,六个策略两两各打10场共150场,用最终Elo排序竞技能力。
论文所有竞技结论(1541分排名第二、消融变体掉分)都建立在该评分上,不了解K值与场次就难以评估结论的可信度。
研究动机
现有人形机器人运动研究通常把动作执行与任务决策耦合在一起学习。若从关节命令层面端到端训练拳击这类对抗任务,策略必须同时掌握全身平衡、肢体协调、接近对手与出拳时机,动作空间动辄数百维(如直接预测225个未来身体点位坐标),训练动辄数小时:同类系统SLMP报告两智能体格斗策略约需8小时训练(服务器配双RTX 4090),RoboStriker与GGSD则分别只给出未报告墙钟时间、70,000次更新等模糊信息,成本无法对齐比较。此外,从随机策略出发的强化学习在稀疏的击打奖励下难以起步,早期几乎全部跌倒,探索效率极低。作者追问的核心问题是:当通用全身运动控制器已经可用时,拳击任务真正需要新学的东西还有多少、额外训练时间最低能压到多少?
本文的目标是本文目标是给出一个可复用的“简单配方”:在已发布的HoloMotion v2全身控制器之上,用单张RTX 4090、以分钟级时间让Unitree G1人形机器人学会交互式拳击。具体拆为三点:其一,把可复用的运动能力与任务决策严格解耦,控制器全程冻结,任务学习只针对一个紧凑的上层反馈规划器;其二,用学到的目标解码器把规划器动作从225维未来坐标压缩为32维潜在动作,缩小探索空间并保证目标结构合法;其三,先在实测机器人状态上做模仿学习为PPO提供初始行为,再经站立热身与固定站立对手的交互训练打磨对抗策略。量化目标是把全部新增训练(含复用的表征拟合与初始化)压进约7.0分钟(422.2秒),并在固定六策略联赛中用Elo、胜负与接触数客观度量所得行为。
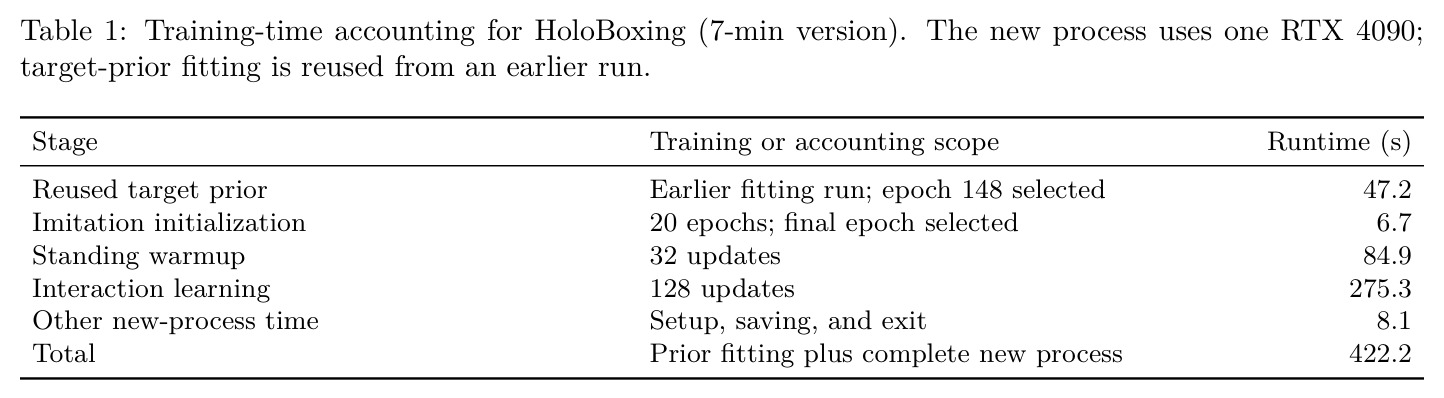
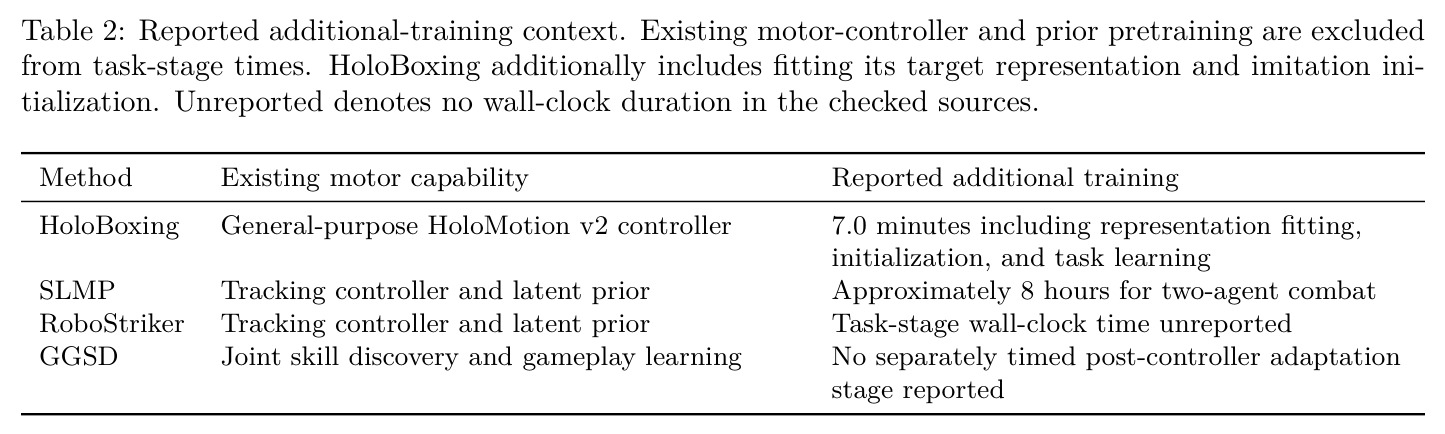
与已有工作不同的是,独特之处在于对“训练成本边界”的严格审计:作者只统计已有通用控制器之上的新增任务训练,明确排除控制器预训练、数据下载、重定向、观测采集、评估与超参搜索,并用Table 1逐项列出422.2秒的构成,再以同一口径归类SLMP(约8小时)、RoboStriker(未报告)、GGSD(70,000次更新),使“7分钟”可核对、可比较。方法层面,与SLMP、RoboStriker等“跟踪控制器+潜在先验”组合不同,HoloBoxing让任务策略只经由32维潜在动作与冻结解码器这个唯一接口请求未来身体点目标;同时模仿监督标签在实测(而非参考)机器人状态上采集,弥合了参考轨迹与物理执行之间的偏差;消融实验(去模仿、去解码器)进一步逐一验证每个组件的必要性,而非只展示最终结果。
核心方法
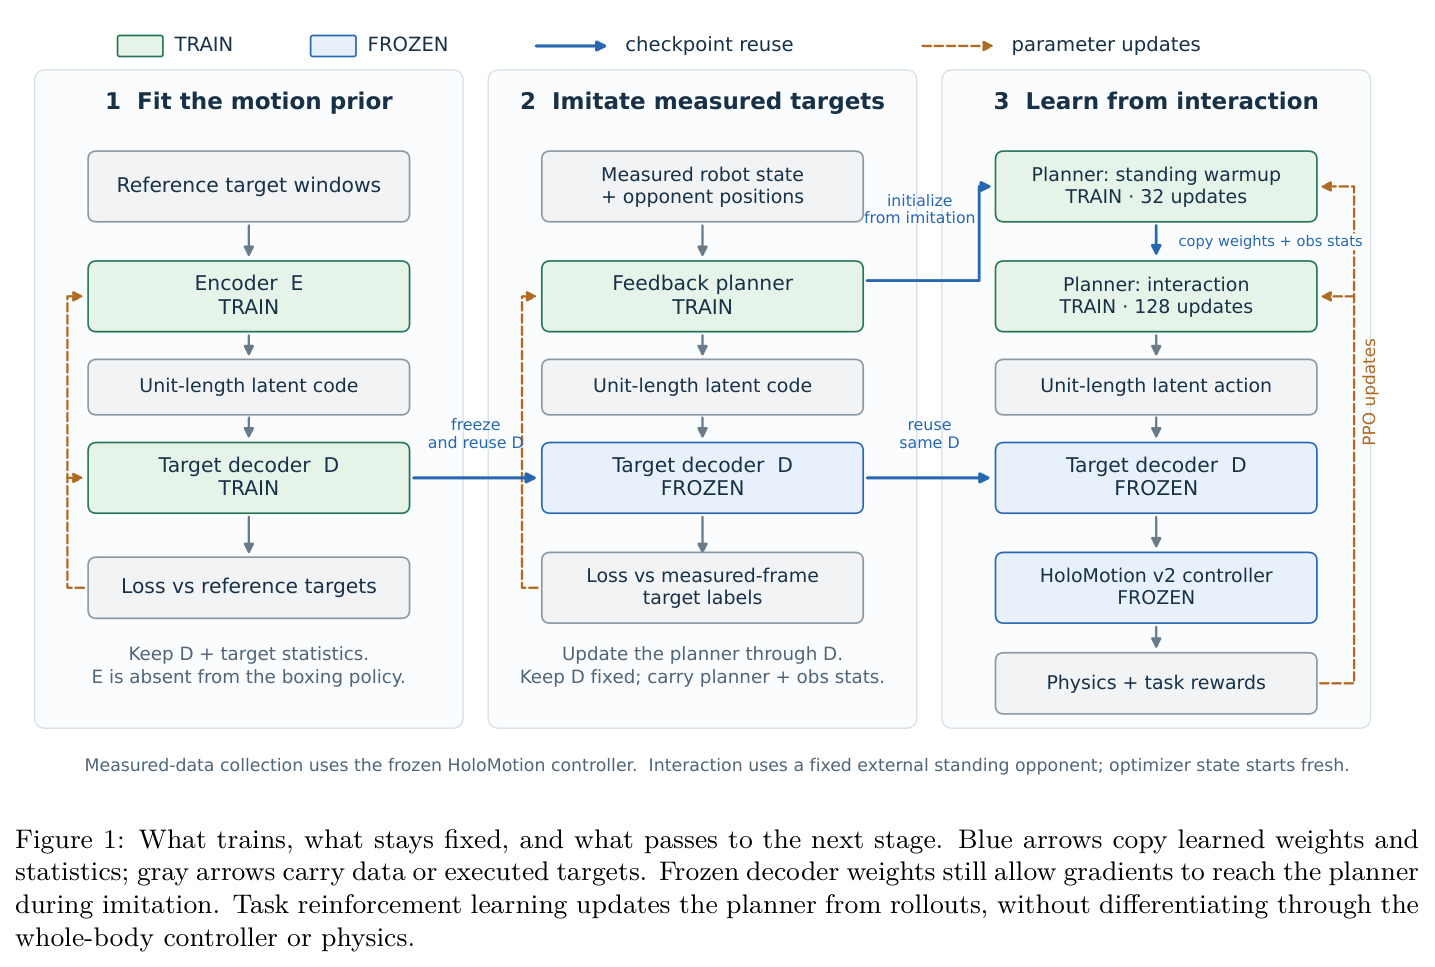
HoloBoxing的整体思路是“三层分工、逐级复用”。底层为冻结的HoloMotion v2全身控制器 $\pi_{HM}$,把目标请求与机器人反馈 $c_t$ 转成关节命令;中层为从参考动作学出的目标解码器 $D_\phi$,把32维单位长度潜在动作映射为225个未来身体点位姿坐标(骨盆、双腕、双踝共5个点、5个未来时刻,跨度20–100毫秒);顶层为紧凑反馈规划器 $f_\theta$(隐层宽256和128的MLP),从1095维归一化观测中读取63个自身特征与15个对手位置特征(其余掩码置零),执行链为 $z_t=N(f_\theta(M(o_t)))$、$g_t=D_\phi(z_t)$、$a_t=\pi_{HM}(c_t,g_t)$。训练分三阶段:先以自编码器拟合目标先验(47.2秒);再用实测观测—目标标签做模仿初始化(20轮仅6.7秒);最后用PPO做32次站立热身更新(84.9秒)与128次交互更新(275.3秒),奖励为0.8任务塑形加0.2对抗动作风格。全程使用Unitree G1、128并行环境与24步rollout。
核心创新是“接口复用”:任务学习不重新学任何运动能力,只在两个冻结接口之上训练一个仅做决策的小网络。与SLMP、RoboStriker、GGSD等格斗系统的本质区别有三。第一,动作表示:用学到的解码器把规划器动作压缩为32维单位球面上的潜在向量 $z_t=u/\|u\|$,解码器负责恢复物理统计 $(\mu_x,\sigma_x)$ 并把朝向投影为合法旋转,任务策略从不直接触碰225维坐标。第二,初始化方式:模仿标签不是取自参考轨迹状态,而是在冻结控制器追踪参考动作时采集的实测状态(标签统一表达在当前骨盆坐标系并做共享水平对齐),使初始策略的输入分布与交互时真实反馈一致,PPO得以从合理行为出发做局部细化而非盲目探索。第三,成本核算:把复用的先验拟合47.2秒也计入总账422.2秒,首次给出“分钟级任务适应”的可审计证据。
方法步骤详情
第一步“拟合运动先验”:对归一化目标窗口 $\tilde{x}=(x-\mu_x)\oslash\sigma_x$ 训练编码器 $E_\psi$ 与解码器 $D_\phi$,最小化 $\mathcal{L}_{prior}=\mathbb{E}_x[\frac{1}{225}\|\hat{x}-x\|_2^2]$;数据含21148个训练、11074个验证、3246个测试窗口,选定第148个epoch(47.2秒),此后解码器与统计量冻结。第二步“实测状态模仿初始化”:冻结控制器追踪参考动作,采集实测观测与未来目标标签,规划器经冻结解码器学习 $\mathcal{L}_{IL}(\theta)=\mathbb{E}_{(o,x)}[\ell_{target}(D_\phi(N(f_\theta(M(o)))),x)]$,误差归一化等权,20轮仅6.7秒,保留权重与观测统计。第三步“PPO任务强化学习”:先32次站立热身更新(84.9秒),再128次交互更新(275.3秒,优化器重置),对手为自身热身检查点的冻结副本且不刷新;奖励=0.8任务塑形+0.2风格判别器,裁判独立判定胜负。
技术新颖性
技术新颖性体现在四点。其一,目标窗口潜在化:5个身体点×5个未来时刻(20–100毫秒)的225维目标被压成32维潜在动作,PPO的探索几何大幅简化,同时解码器结构保证输出目标可被控制器执行。其二,实测帧监督:模仿标签统一表达在实测机器人当前骨盆坐标系(共享水平对齐),作者还证明实测帧标签比成对参考帧标签更难重建,这解释了为何必须专门在实测状态上初始化。其三,表征质量验收标准:不只看重建误差,还要求物理可执行——所选表征与未压缩目标同样完成80/81个预定义验证窗口(且失败于同一窗口),而一个重建损失更低的后选表征因引入额外追踪失败、丢失帧覆盖被否决。其四,分钟级成本边界:Table 2首次把SLMP(约8小时)、RoboStriker(未报告)、GGSD(70,000次更新)置于统一“控制器之上新增训练”口径下,支撑了分钟级拳击适应的论断。
实验结果
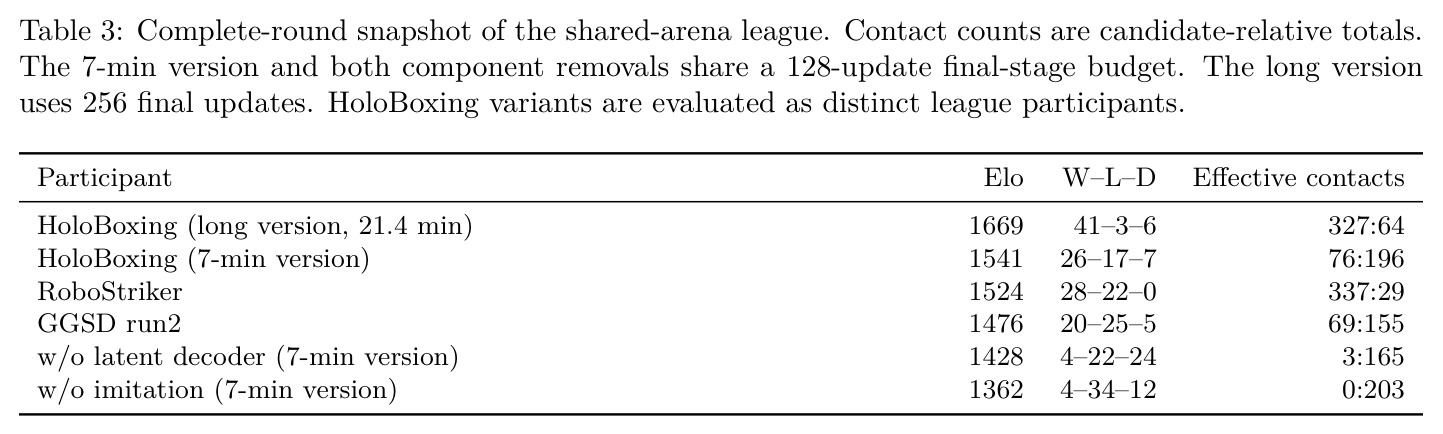
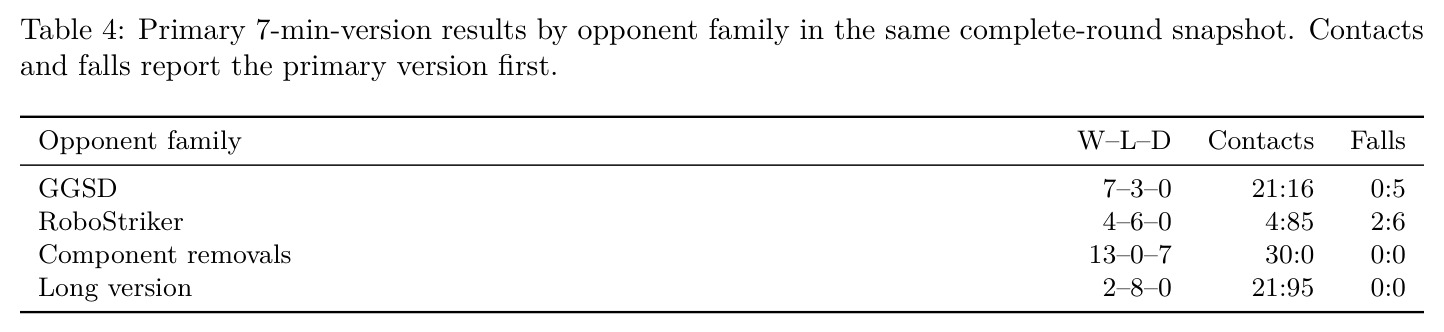
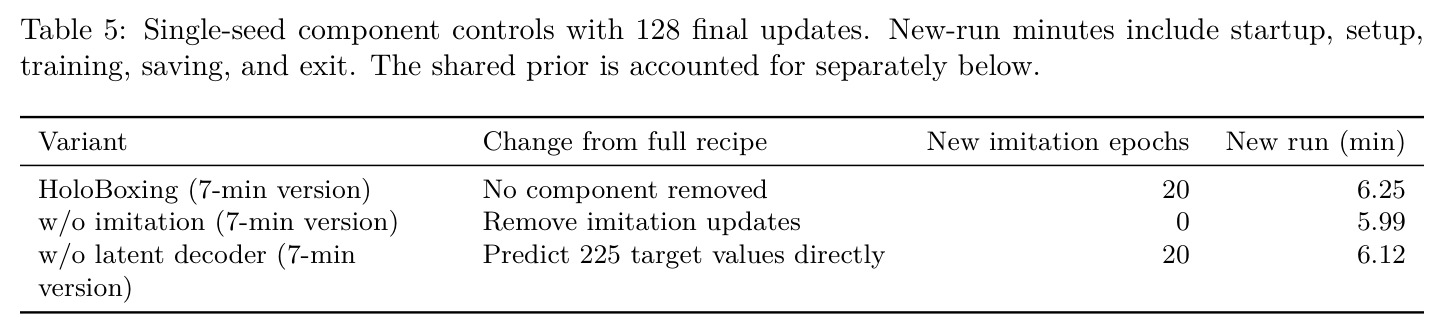
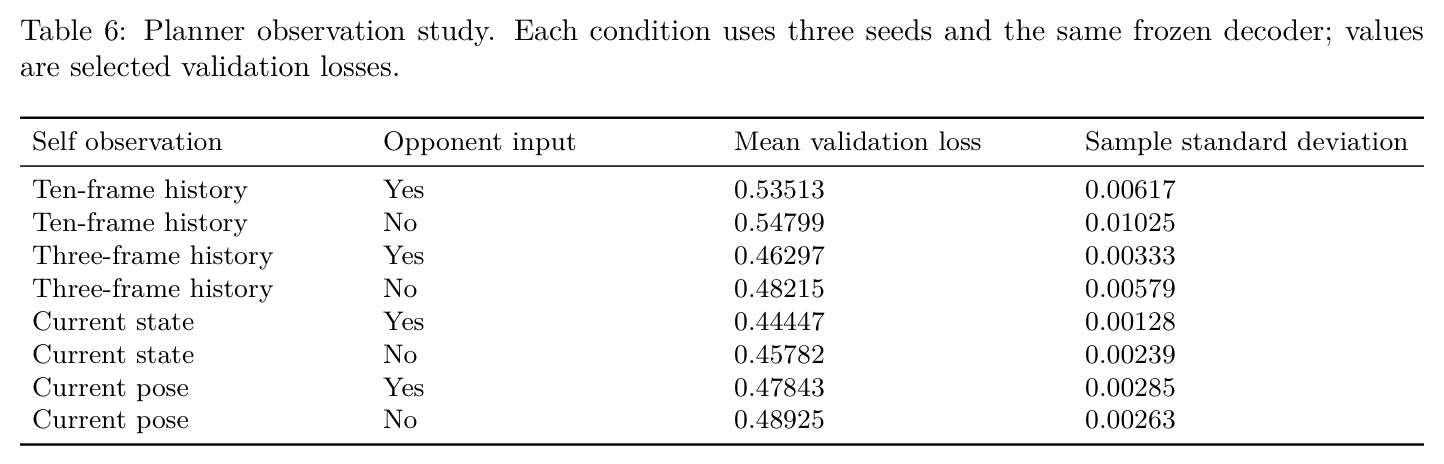
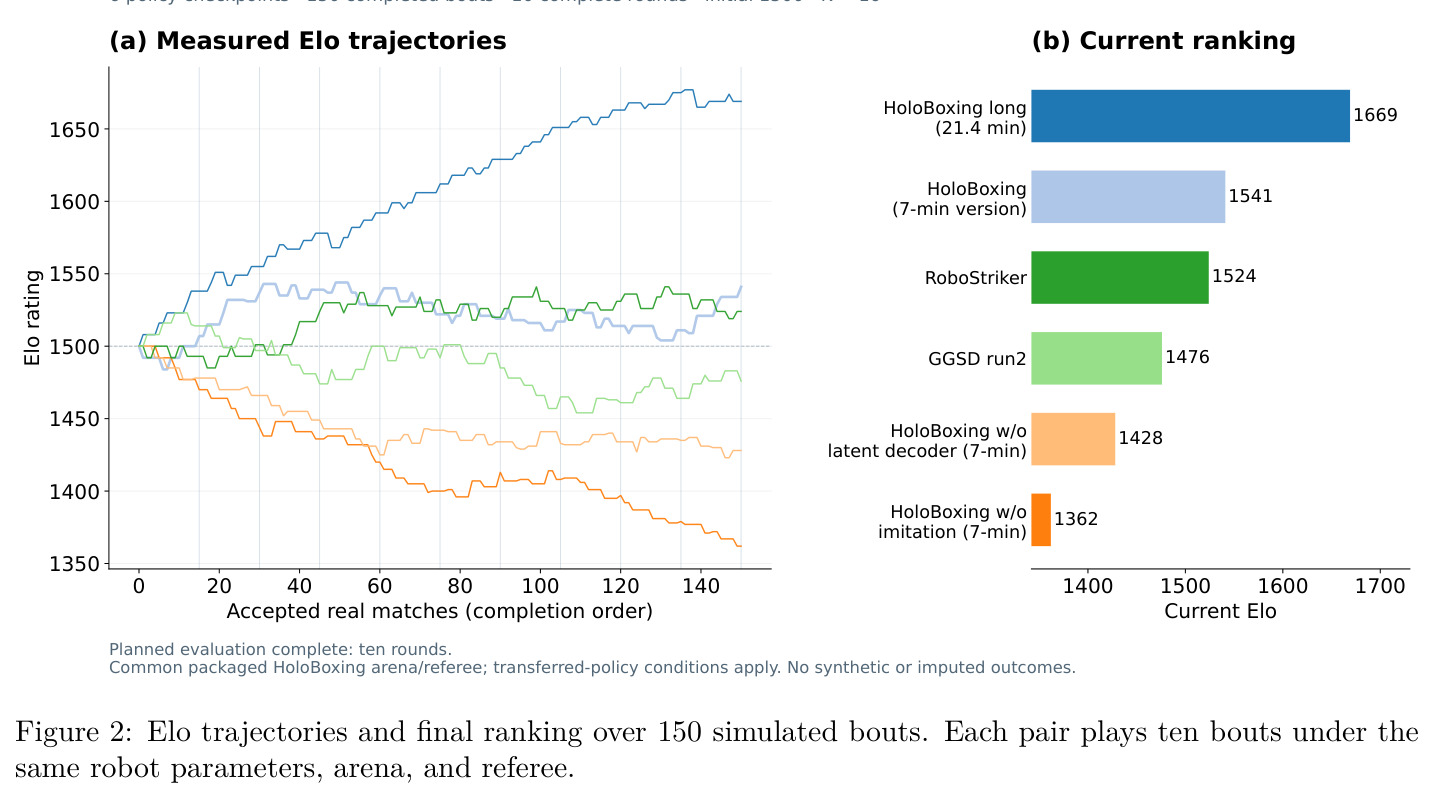
实验给出三组关键数字。其一,训练成本:7分钟版本总账422.2秒(单张RTX 4090),构成是复用先验47.2秒、模仿初始化6.7秒(20轮)、站立热身84.9秒(32次更新)、交互学习275.3秒(128次更新)、其他8.1秒;长版本(256次更新)为21.4分钟。其二,六策略联赛(10轮×15对,150场对局,Elo初始1500、K=16):长版本1669分居首,7分钟版本1541分第二,胜过RoboStriker(1524)与GGSD run2(1476);去掉潜在解码器Elo降至1428,去掉模仿初始化降至1362,后者50场0次有效接触。分对手看,7分钟版对GGSD 7胜3负0平(跌倒0:5占优),对RoboStriker 4胜6负(接触4:85落后),对两个消融变体13胜0平7负且接触30:0,对长版本2胜8负。其三,观测与表征:当前状态+对手输入的验证损失0.44447最低,比十帧历史+对手(0.53513)低16.9%;所选表征与未压缩目标同样完成80/81个验证窗口。注意7分钟版有4场胜利不含任何得分击打,纯靠对手跌倒获胜。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六策略拳击联赛(150场对局) | Elo(初始1500,K=16) | 7分钟版本1541分(第二);21.4分钟长版本1669分(第一) | RoboStriker 1524、GGSD run2 1476、去解码器1428、去模仿1362 | 较最强外部对手RoboStriker高17分,较GGSD高65分 |
| 组件消融(128次最终更新,匹配预算491520个learner transitions) | Elo与有效接触数 | 完整配方1541分、76次接触 | 去解码器1428分(3次接触);去模仿1362分(0次接触) | 高于两个消融变体113与179 Elo分,验证模仿初始化与结构化动作接口均必要 |
| 任务适应训练时间 | 墙钟时间(单张RTX 4090) | 422.2秒(7.0分钟,含复用先验47.2秒);长版本21.4分钟 | SLMP约8小时(双RTX 4090服务器);RoboStriker与GGSD未报告墙钟时间 | 比SLMP低约两个数量级 |
| 规划器观测选择(8种条件×3种子) | 验证损失 | 当前状态+对手输入 0.44447(±0.00128) | 十帧历史+对手输入 0.53513(±0.00617) | 低16.9% |
局限与改进
作者承认的局限:运动语料很小(重定向后仅14条原始动作、共212.88秒),任务训练只有单一随机种子,组件消融(每组491520个learner transitions)未经多种子独立验证;报告时间排除控制器预训练、数据准备、评估与搜索,跨方法比较受不同硬件、观测接口与继承运动能力干扰;全部实验在仿真中完成,真机拳击与迁移未测试。我的补充观察:其一,交互训练对手是自身热身检查点的冻结副本且不刷新,更像固定陪练而非真自博弈,策略对多样化对手的适应能力未被检验;其二,联赛每策略仅50场对局,K=16时Elo方差不小,1541对1524这类差距的统计显著性存疑;其三,4场胜利无得分击打、纯靠对手跌倒,说明评分与行为质量之间存在缝隙;其四,7分钟账目中47.2秒先验拟合来自“此前一次运行”,严格成立依赖先验可复用的前提;其五,解码器只覆盖骨盆、腕、踝5个点,躯干与头部姿态细节缺失,可能限制近身缠斗行为的表达。
独立分析的弱点
弱点一:对手过于静态。交互阶段对手固定为自身热身检查点的冻结副本、无对手刷新,策略可能过拟合单一风格;对RoboStriker 4胜6负、接触数4:85的劣势或与此有关。改进方向:引入对手池或基于种群的自博弈,周期性刷新对手快照。弱点二:样本量小、单种子。每策略联赛仅50场,K=16下1541对1524的差距置信区间很可能重叠;消融只有单种子。改进:用3–5个种子重复训练与评估,报告Elo标准差或改用贝叶斯技能评级。弱点三:评分与行为质量错位。4场胜利无得分击打,说明0.8任务塑形对“有效进攻”引导不足,可能诱导“等对手自己摔倒”的保守策略。改进:加入进攻主动性、连续命中、组合拳等密集塑形项,或在裁判评分中区分KO与判负。弱点四:语料仅212.88秒、14条动作,动作多样性受限;解码器仅5个身体点,缺少躯干细节。改进:扩充动作库并增加上身点位,引入步法专项数据。弱点五:纯仿真结论,执行器建模与真机差距未知,需要sim-to-real验证。
未来方向
作者提出的方向:扩大运动与重置覆盖、测试其他底层控制器、真机部署与迁移验证、以及独立种子加匹配时长的对照研究以分离各组件对学习速度的贡献。基于本文成果还可延伸:第一,把“新增训练成本账目”方法推广为任务适应成本的标准化度量,为不同任务与控制器建立公开基准;第二,在线对手刷新或自博弈,让128次交互更新面对演化对手,有望把名次从第二推向第一;第三,把目标解码器扩展为覆盖步法、格挡、组合拳的多模态技能先验,并结合视觉感知(对手姿态估计)做真机闭环,替代目前的真值对手位置输入;第四,研究训练预算的scaling规律——从128到256次更新Elo提高约128分(1541→1669),继续加倍是否仍有收益值得系统实验;第五,与高层战术规划(如LLM)结合,把规则与指令翻译为潜在动作序列,检验接口的可组合性;第六,扩展到击剑、摔跤等其他对抗任务,验证配方的通用性。
复现评估
复现条件较好。代码已开源(GitHub HorizonRobotics/HoloMotion仓库的holoboxing子目录),所依赖的HoloMotion v2控制器为已发布版本,外部对手RoboStriker与GGSD run2均使用公开权重且不做目标域微调;数据来源明确,为InterHuman配对数据加RoboStriker公开轨迹,重定向后212.88秒。算力门槛极低:主实验只需单张RTX 4090,新流程375秒、先验拟合47.2秒,即使完全重跑也在10分钟内完成,消融每组491520个learner transitions同样轻量。评估协议完全确定:打包的机器人、执行器、竞技场与裁判,固定十轮联赛、随机化站位加记录的初始状态种子、150场对局可离线回放无需重跑仿真,Elo初始1500、K=16,附录A–D给出维度、网络宽度、优化设置、评分阈值与评级公式。风险点:论文未披露具体随机种子数值,单种子结果可能有波动;仿真器与打包环境版本需从仓库确认;真机部分不存在,无需额外硬件。
论文图表