基于逐层误差模型搜索推进 SVD 大模型压缩 Advancing SVD-based LLM Compression via Layer-Wise Error Model Search
LEMS 误差模型驱动 ILP 秩分配,KFAC-SVD 修复 Fisher 秩坍缩
前置知识
SVD 低秩压缩
把权重矩阵 $W$ 分解为 $U\Sigma V^\top$,只保留前 $r$ 个最大奇异值得到近似 $\hat W_r$,再用两个连续小矩阵 $B, C$ 替代原矩阵($y=C(Bx)$),从而减少参数与计算量。对 Frobenius 重构误差 $\|W-W_r\|_F$ 而言截断 SVD 是最优解,但权重误差小不等于模型性能损失小——这才是本文要解决的核心矛盾。
全文围绕两个 SVD 压缩核心问题展开:每层的秩 $r$ 怎么选(LEMS)、截断本身怎么更准(KFAC-SVD)。
激活感知与白化目标
激活感知方法不再最小化权重误差,而是最小化层输出误差 $\|WX-W_rX\|_F$。SVD-LLM 用输入激活协方差 $A$ 的因子对 $W$ 白化,在白化坐标下截断即得该目标的最优秩-$r$ 解。Fisher 加权进一步引入输出端因子 $G$,目标变为 $\|G^{1/2}(W-\hat W)A^{1/2}\|_F$,最优解为 $W_c=G^{-1/2}U_r\Sigma_rV_r^\top A^{-1/2}$。
LEMS 的形状项和 KFAC-SVD 的加权截断都定义在这个白化目标上,不懂它就看不懂论文的公式 (3)-(5)。
Fisher 信息与 K-FAC 近似
Fisher 矩阵 $F$ 近似压缩引起的损失曲率,二阶泰勒展开后压缩目标为 $\min \Delta\theta^\top F\Delta\theta$。由于 $F$ 尺寸达 $(d_{out}d_{in})\times(d_{out}d_{in})$ 无法存储,K-FAC 用 Kronecker 积 $F\approx A\otimes G$ 近似。GFWSVD 用 $k$ 条序列梯度拟合该积,其秩不超过样本数 $k$。
本文 KFAC-SVD 改进的正是 Fisher 因子的估计方式,理解秩瓶颈 $\mathrm{rank}(\hat F)\le k$ 才能明白其动机。
谱坍缩(秩瓶颈)
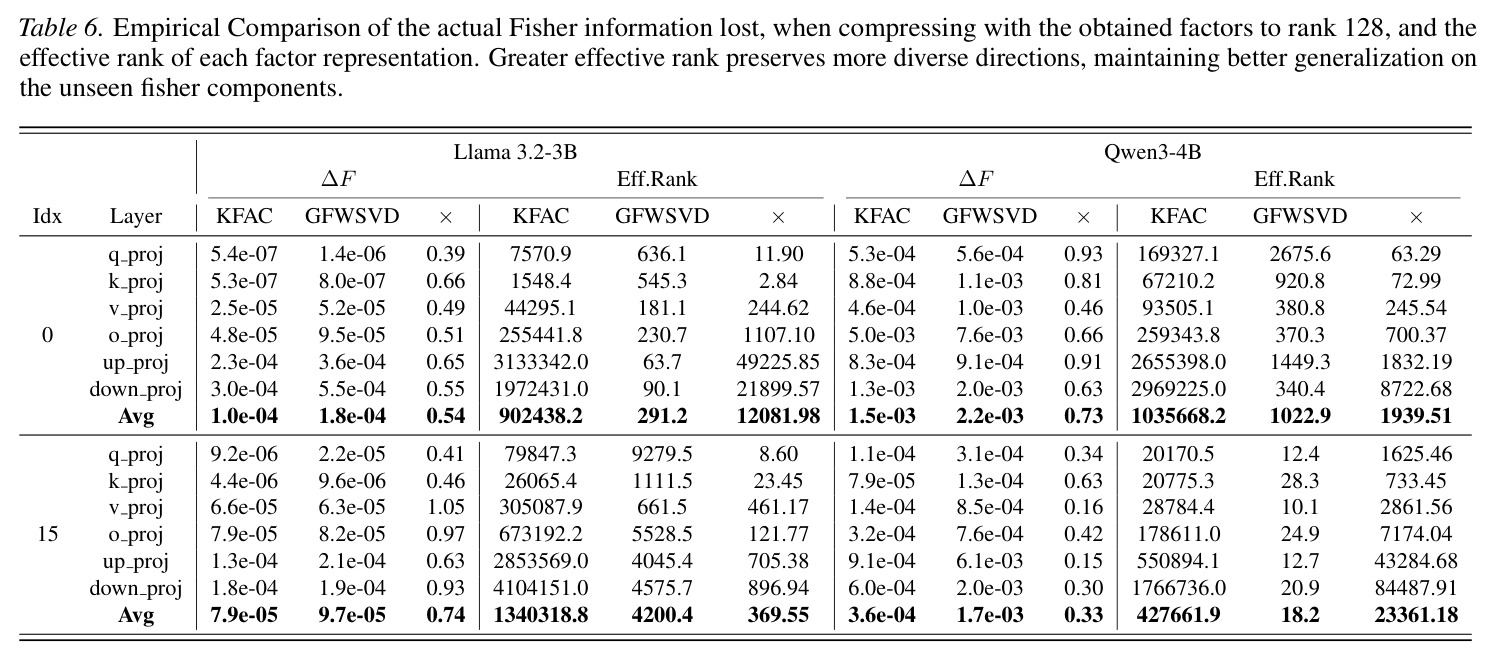
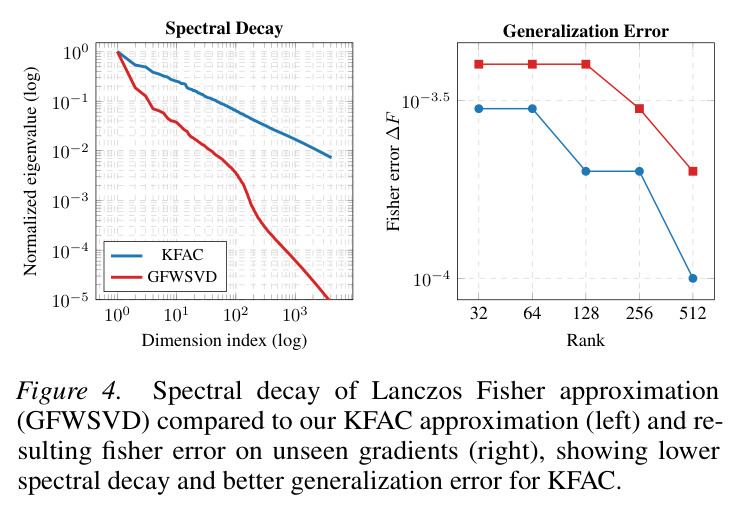
当 Fisher 从有限样本(如 $k\le 256$ 条序列梯度)拟合时,$\hat F$ 是 $k$ 个外积之和,秩被硬性限制在 $k$,而层参数维度 $d_{out}d_{in}$ 远大于 $k$。结果是特征谱快速衰减、条件数恶化,截断时丢失大量曲率方向,压缩后性能急剧退化,即所谓 spectral collapse。
谱坍缩是旧 Fisher-SVD 失败的根源,也是 Figure 4 用来说明 KFAC-SVD 有效的关键证据。
整数线性规划(ILP)
组合优化问题:在整数变量与线性约束下最小化线性目标。本文为每个线性层设 0-1 变量 $x_{ij}$ 表示是否选择秩配置 $j$,约束每层恰选一个、总保留参数不超过预算 $P_{target}$,目标是最小化估计的总退化,用 Gurobi 求解器可在秒级得到该代理目标下的全局最优分配。
LEMS 把秩分配从贪心/启发式升级为一次性全局优化,ILP 是这一步的数学载体。
研究动机
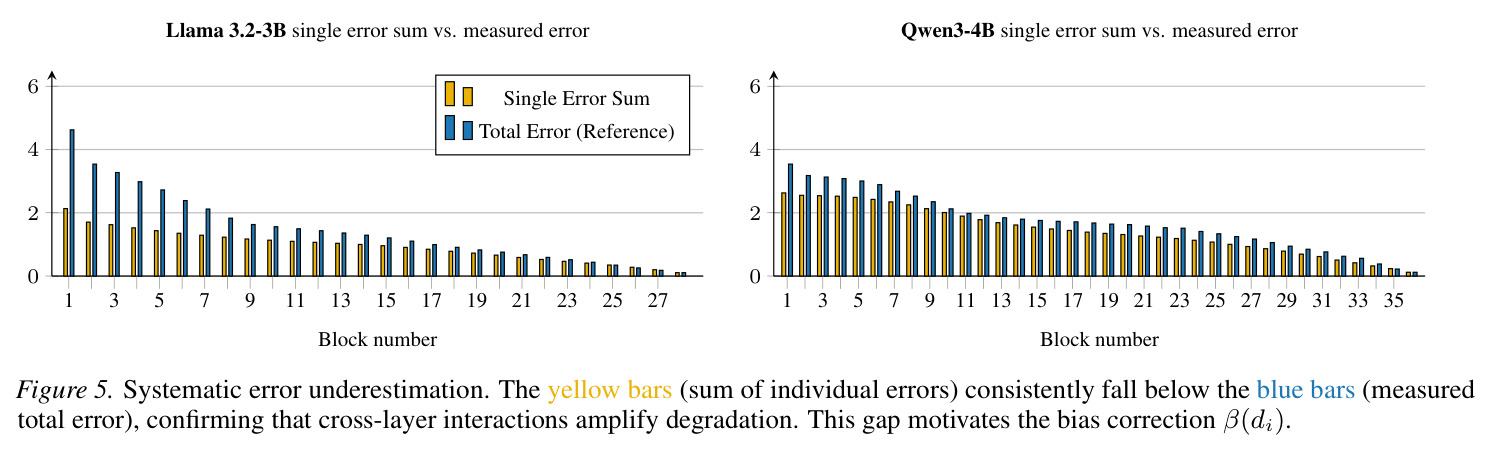
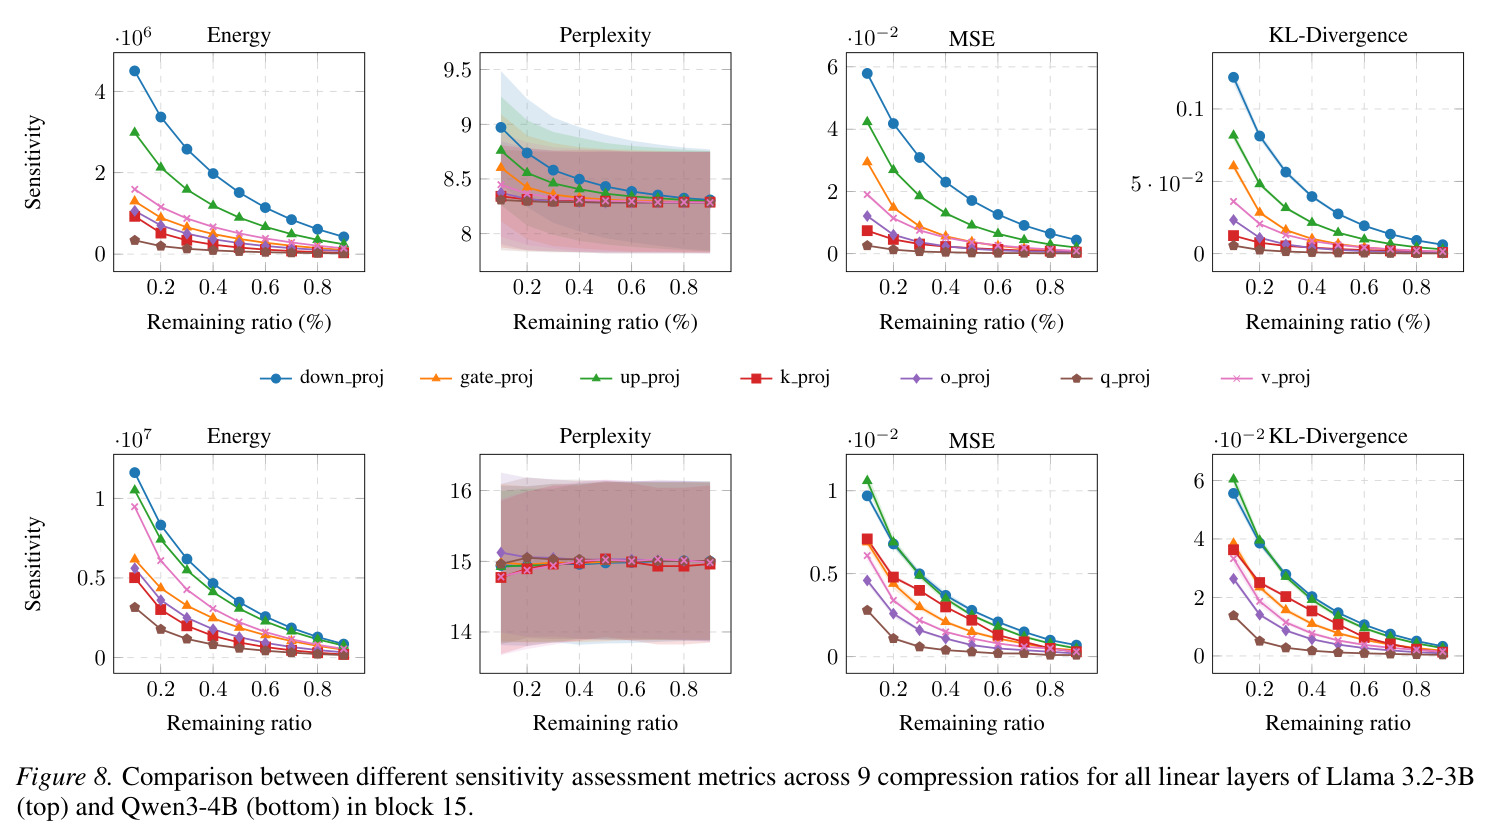
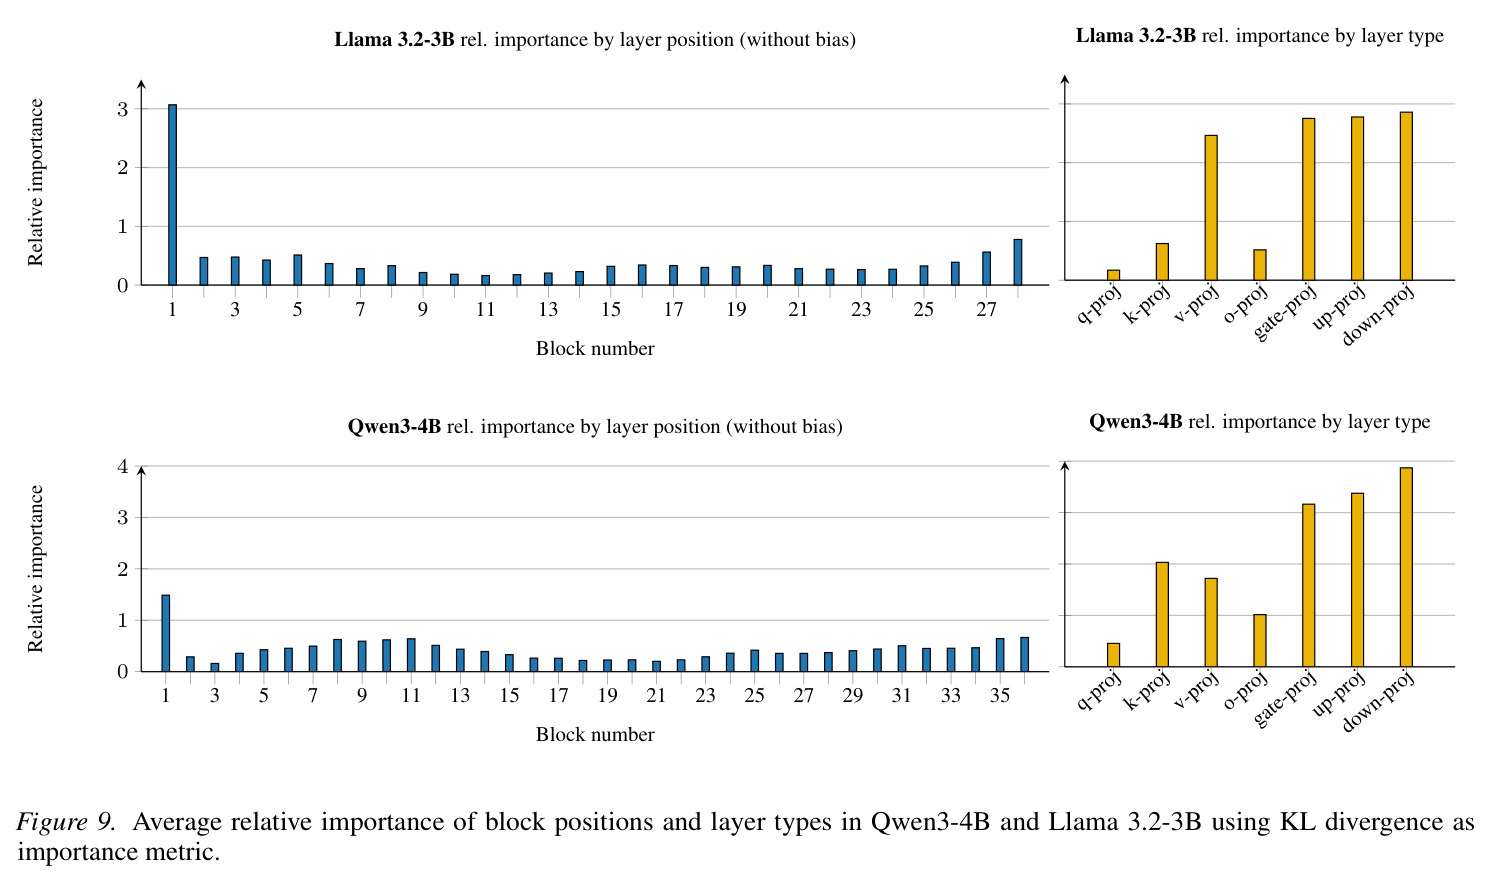
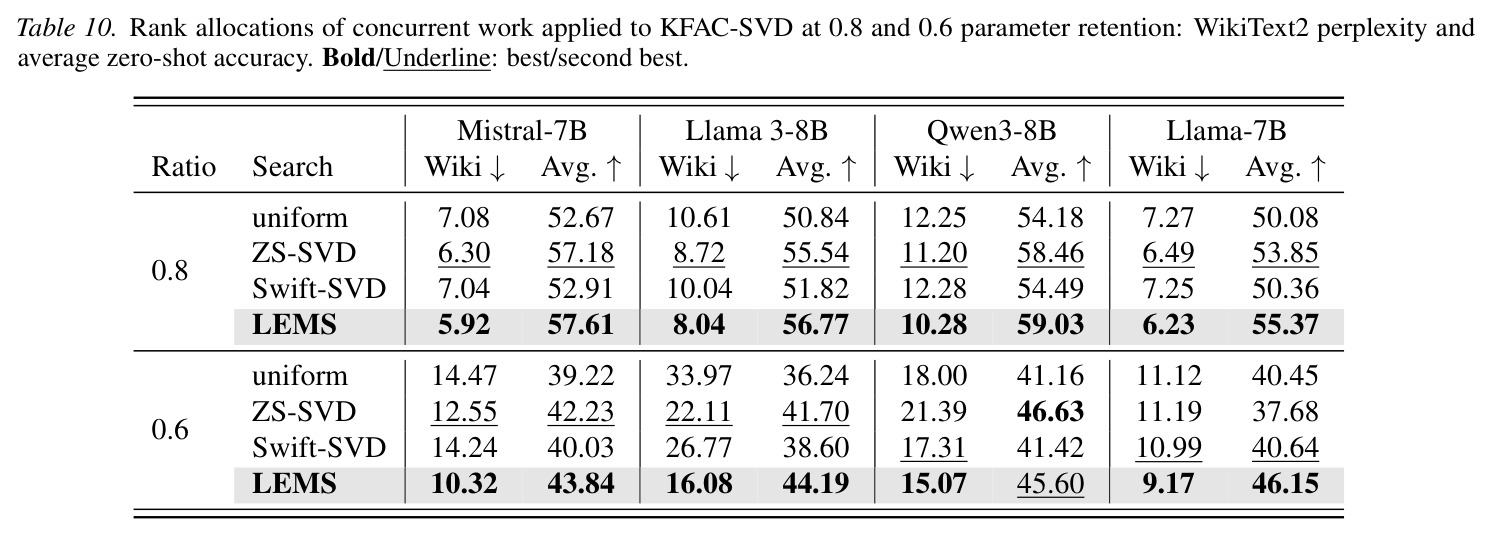
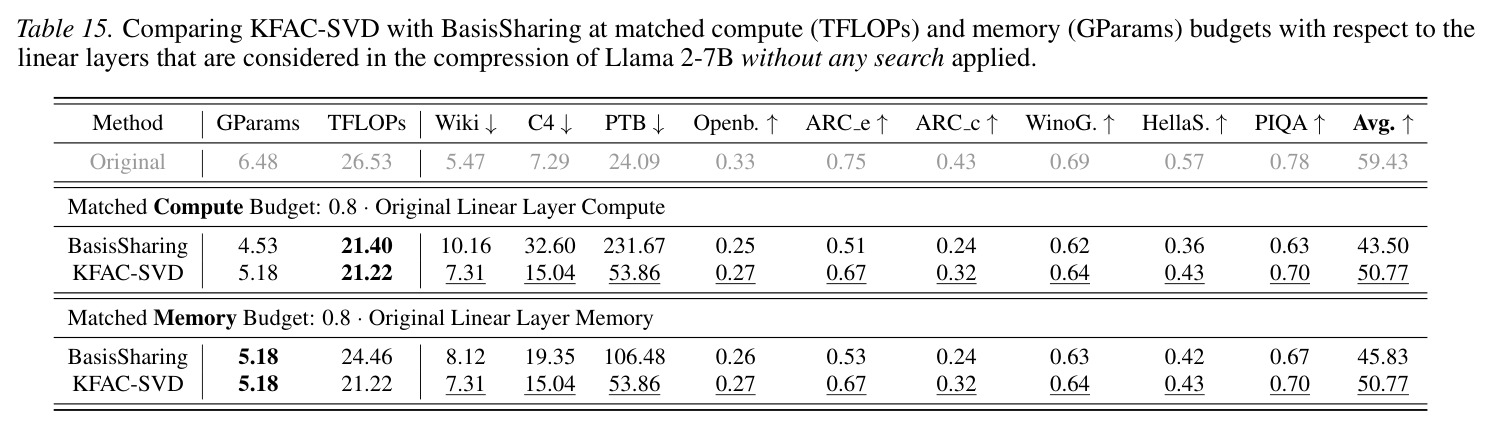
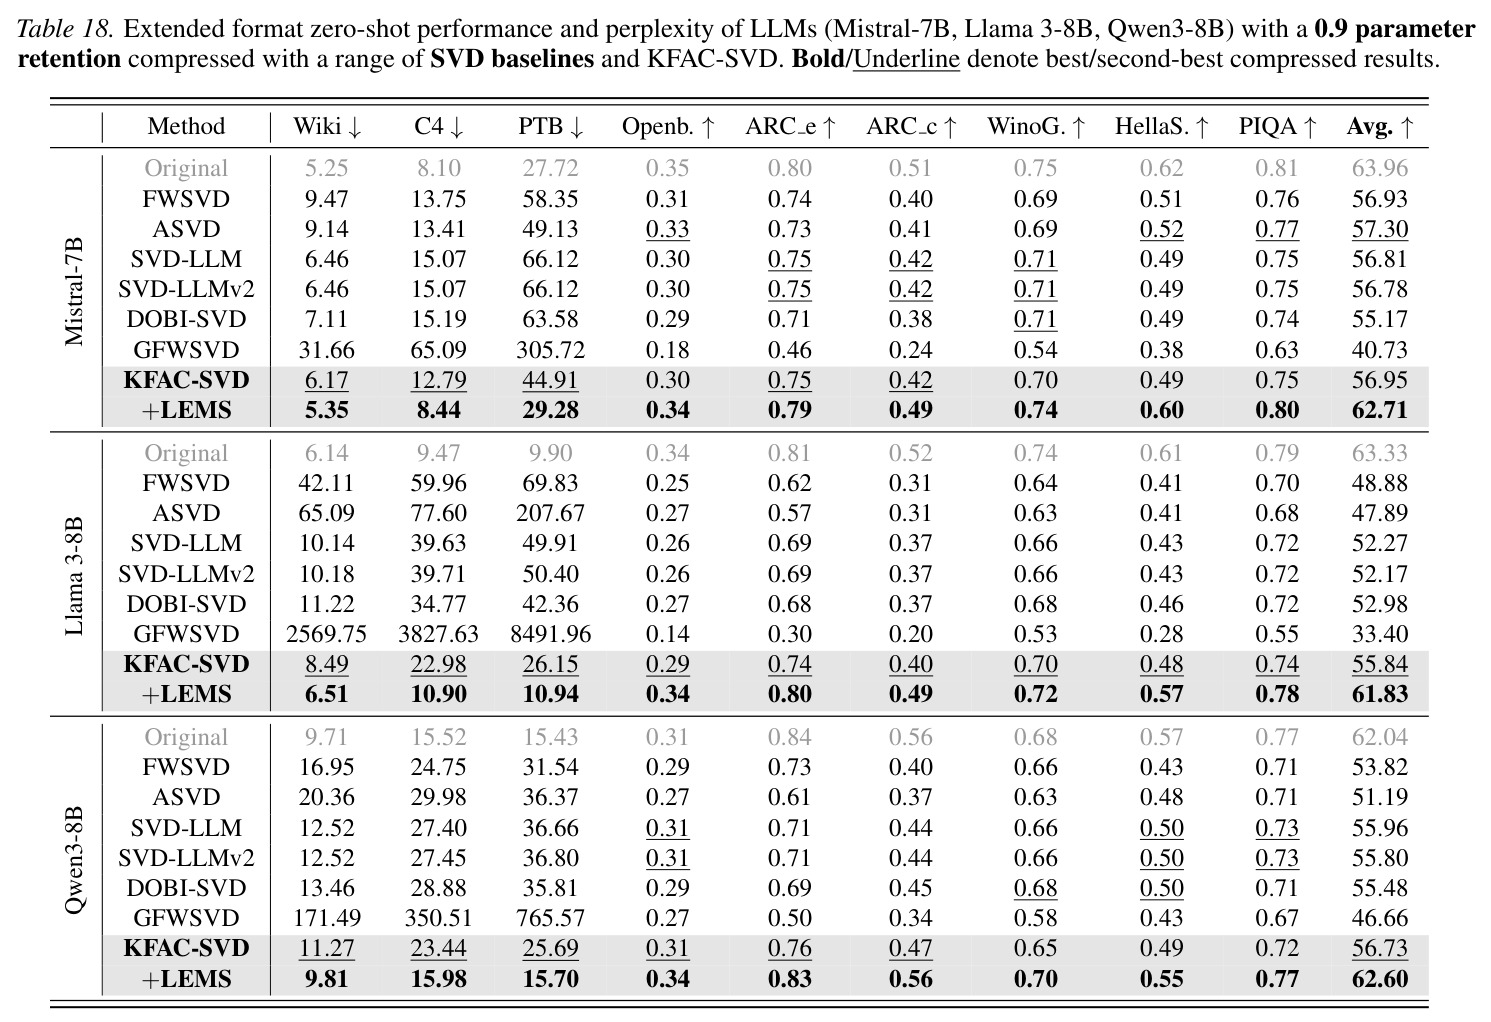
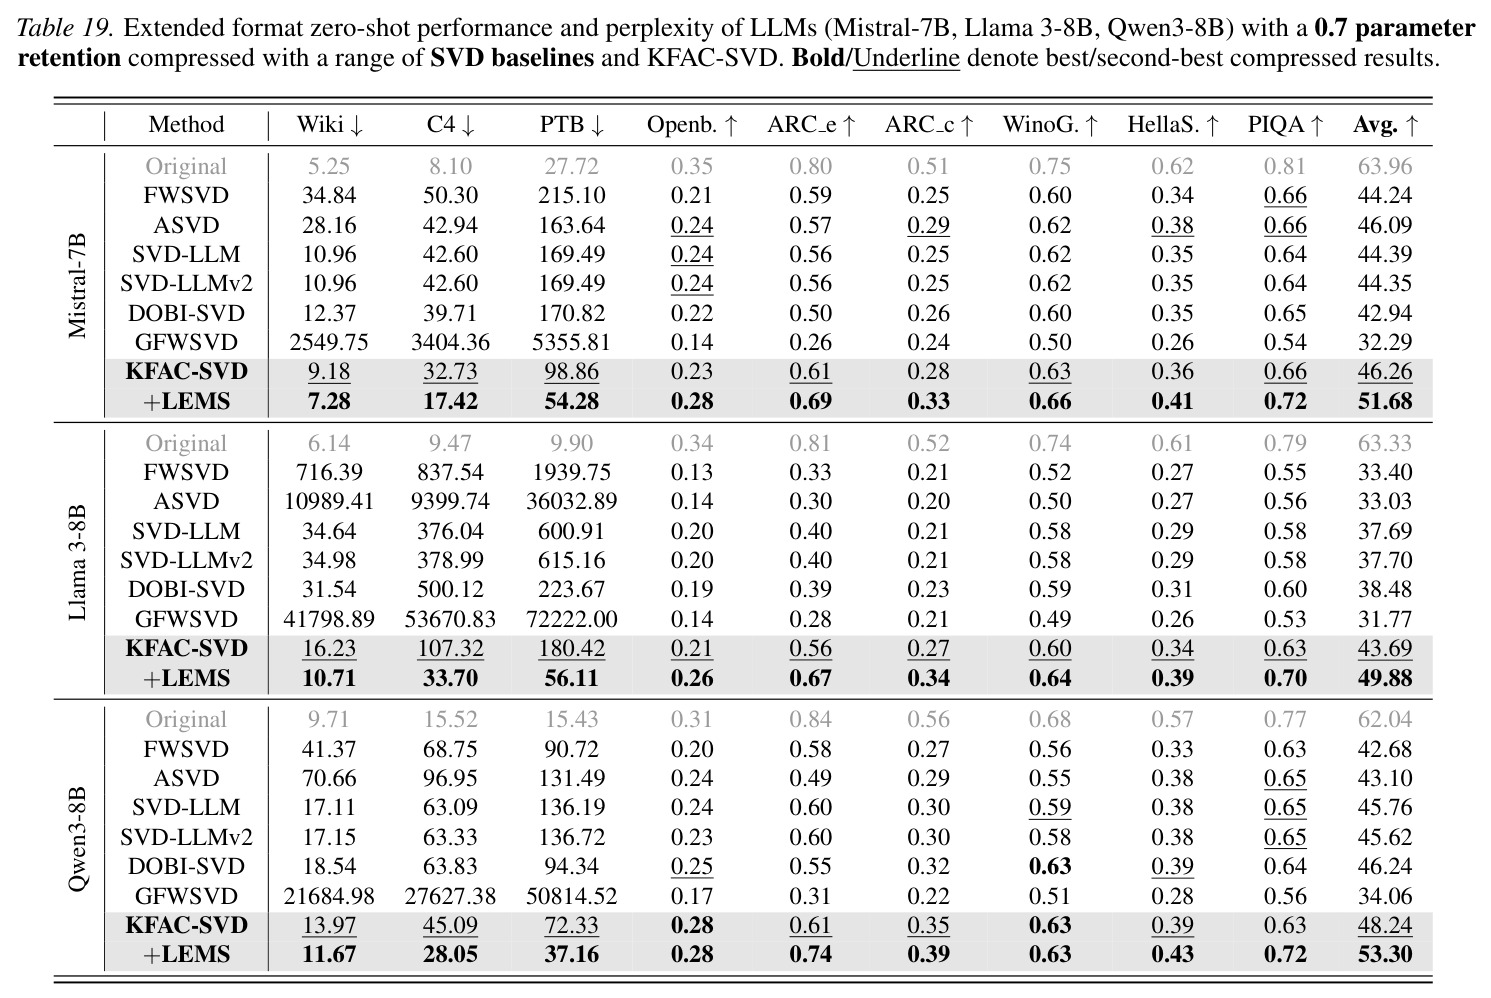
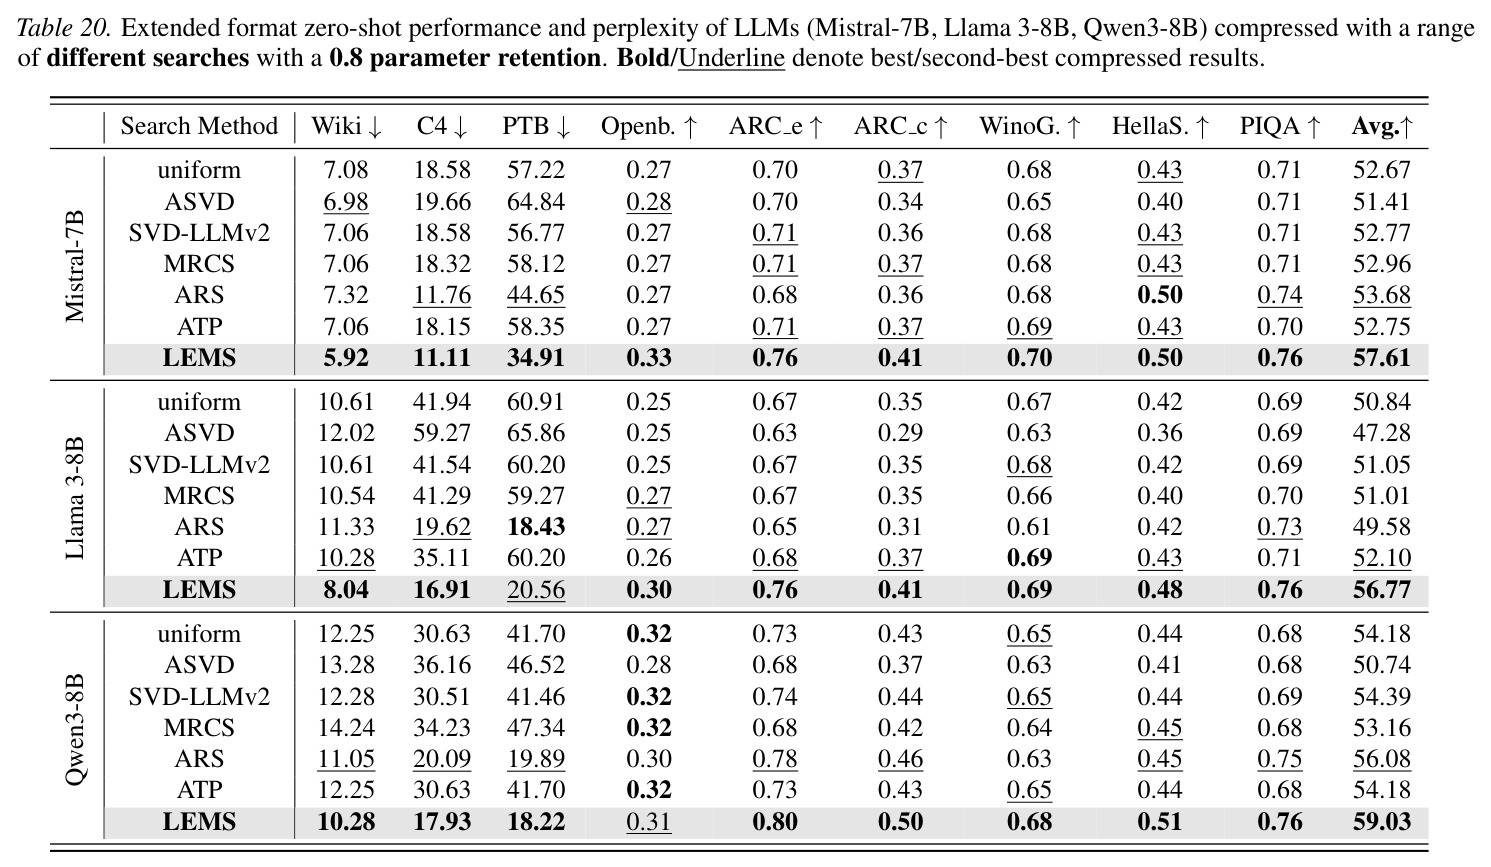
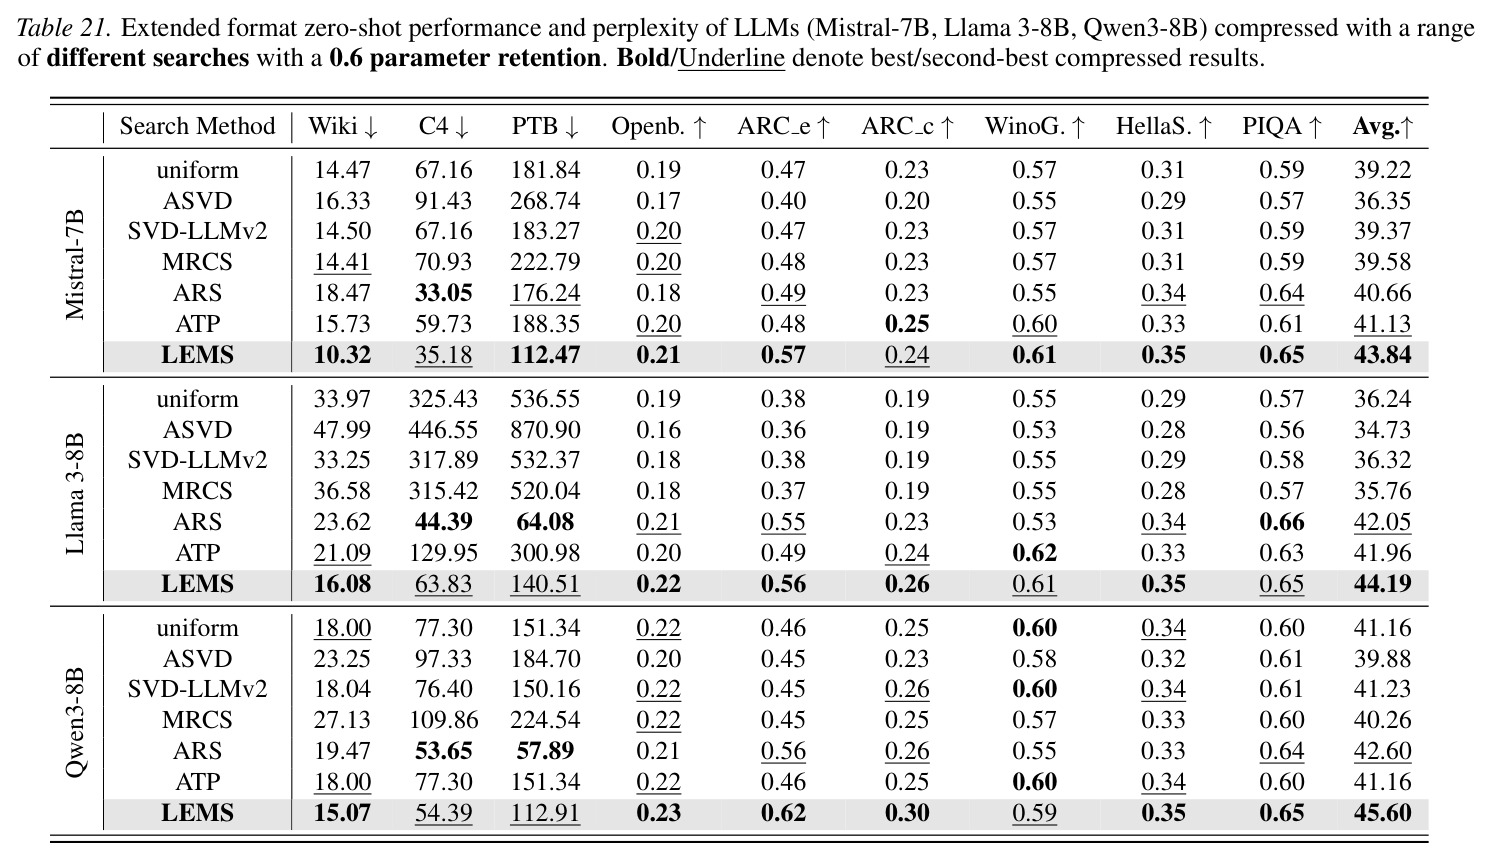
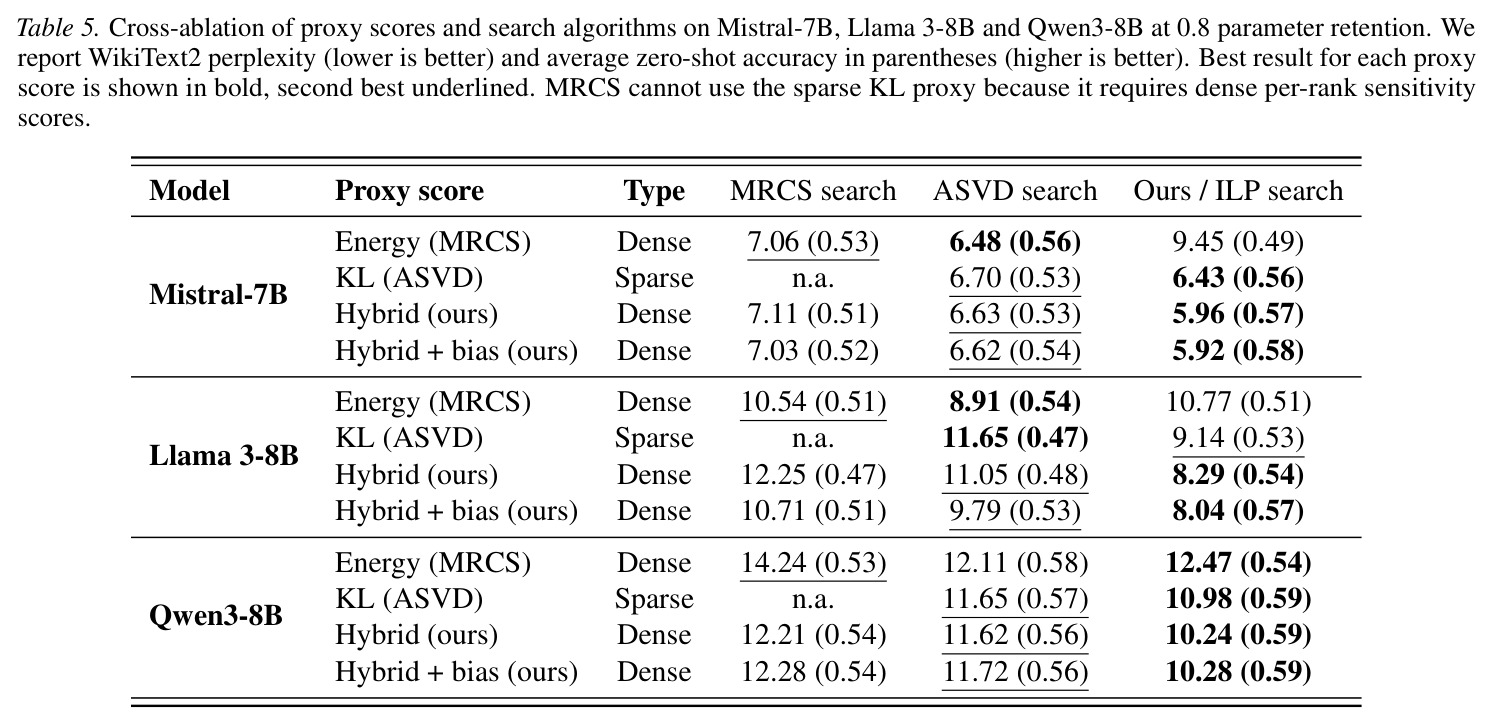
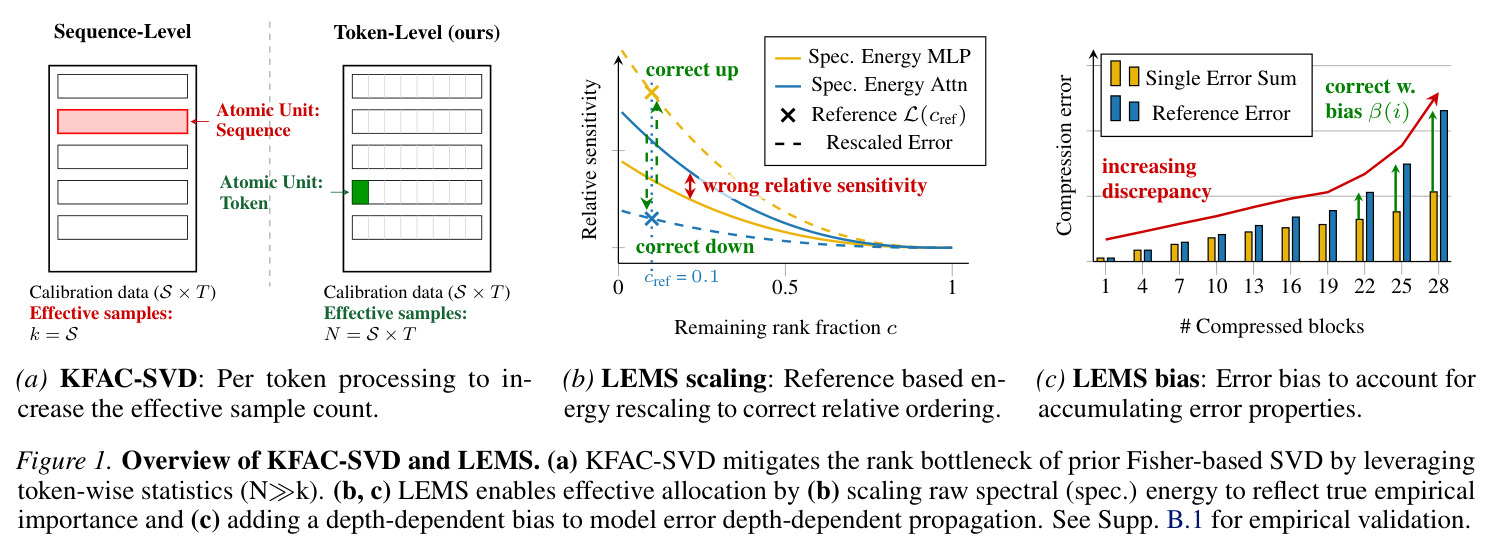
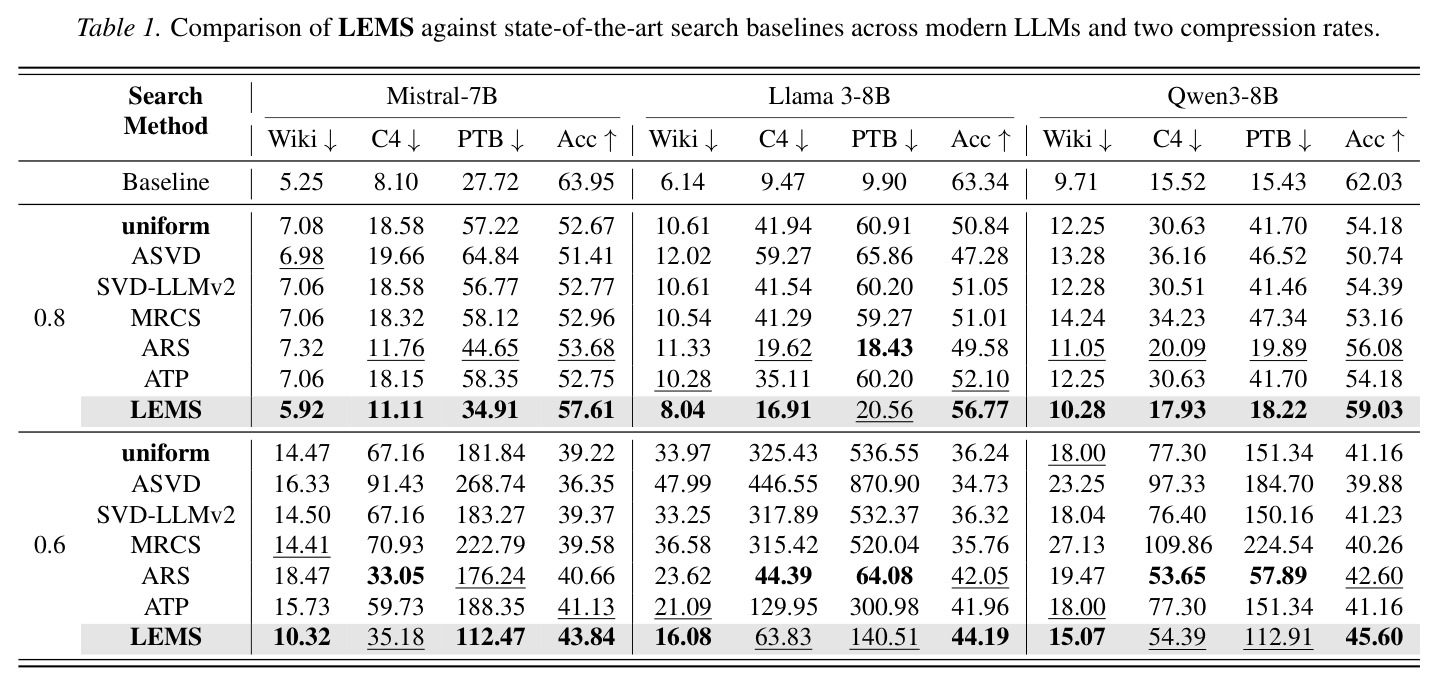
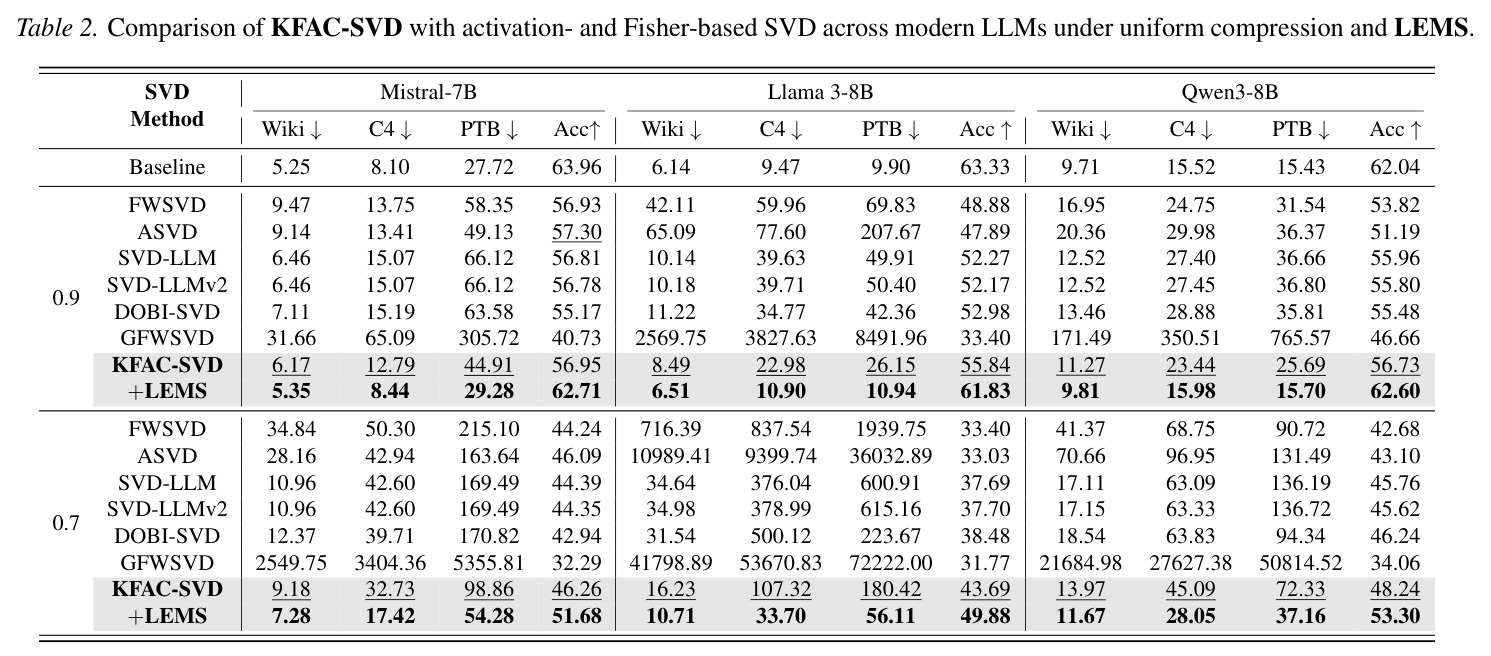
SVD 低秩压缩要把 LLM 每个线性层的权重 $W$ 换成秩为 $r$ 的近似,核心难题是在固定参数预算下为每层选秩。现有做法有两大痛点。其一,全局秩分配依赖未校准的误差代理:ASVD、SVD-LLMv2 等用奇异谱能量或均匀重构误差做代理,但一个 MLP 投影损失 10% 谱能量与一个 attention 投影损失 10% 对最终输出的影响完全不同;且深层网络中早期误差会传播放大,简单逐层求和会系统性低估全局退化。论文实测显示这种代理确实会误导搜索:0.6 保留率下 Mistral-7B 用 ASVD 搜索得到 WikiText2 困惑度 16.33,反而比均匀分配的 14.47 更差。其二,分解质量受限:理论上更优的 Fisher 加权 SVD(GFWSVD)用不超过 256 条序列梯度拟合 Kronecker 因子,秩被样本数硬性限制导致谱坍缩,Llama 3-8B 在 0.9 保留率下困惑度高达 2569.75,几乎不可用。两个问题叠加,使 SVD 压缩在高压缩率下的实用性大打折扣。
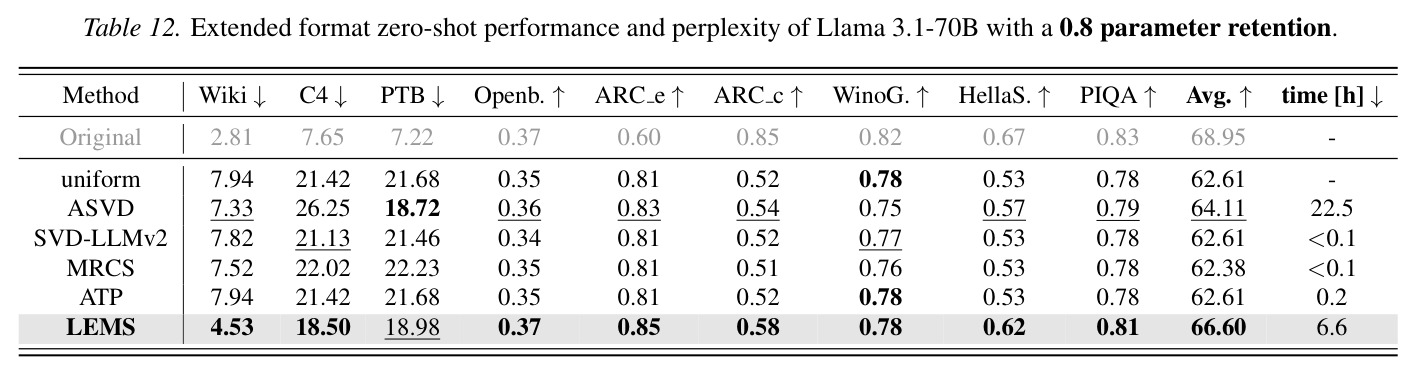
本文的目标是本文要同时解决「秩给哪层」和「秩怎么截」两个问题,并给出可量化的目标。分配端:构造一个层级误差代理模型,把局部敏感性、经验校准和误差传播统一成可加成本,再用整数线性规划在预算约束下求全局最优秩组合,目标是跨 Mistral、Llama 3、Qwen3 三个家族一致超越现有搜索策略,零样本准确率提升 2.1-4.7 个百分点,并能扩展到 70B 规模(Llama 3.1-70B 上 WikiText2 困惑度从 7.9 降到 4.5、准确率从 62.6 升到 66.6)。分解端:设计 KFAC-SVD,把 Fisher 的 Kronecker 因子估计从序列级梯度改为 token 级二阶矩,消除秩瓶颈,目标是相对基线平均改善 WikiText2 困惑度约 19%。作者还强调 LEMS 应与具体分解目标解耦,对激活感知的 SVD-LLM 同样有效,且全程只需单张 H200。
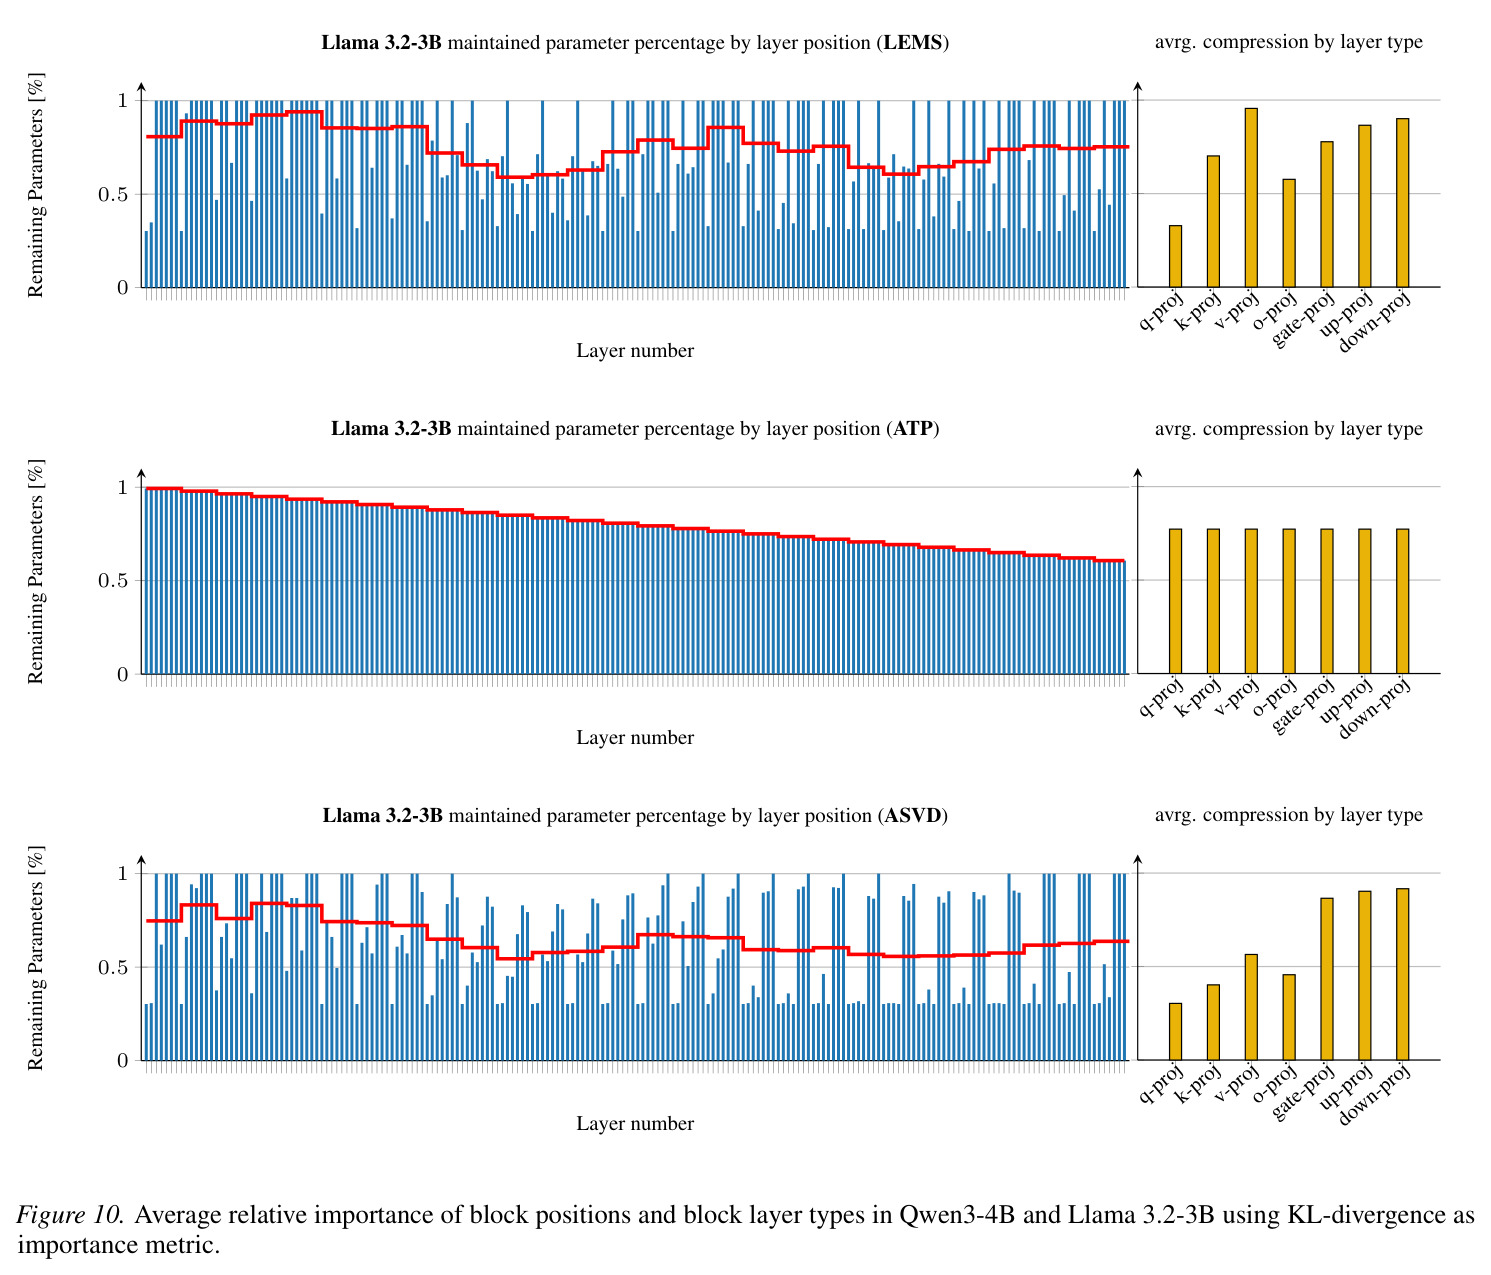
与已有工作不同的是,本文的独特切入是「把误差代理拆成三个正交因子分别修好,再交给全局优化器」。已有方法各修一角:谱能量法(SVD-LLMv2、MRCS)只有形状没有尺度,层间量纲不可比;均匀误差阈值(ASVD 的二分搜索、Flar-SVD)强行让各层误差相似,等价于假设层重要性均匀;ATP 虽建模传播但用刚性线性深度先验并强制块级均匀压缩率,牺牲了层敏感性;测量型方法(逐配置前向)准确但不可扩展。LEMS 用乘法结构 $L_i(c)=S_i(c)\cdot\alpha_i\cdot(1+\beta(d_i))$ 把形状(免费的解析谱)、尺度(只测一个参考点的一次性校准)、偏差(TPE 标定的软深度先验)解耦,使 ILP 能秒级求解。分解端,作者敏锐指出 GFWSVD 失败的根源不是 Fisher 目标本身,而是序列级梯度的样本量限制——换成 token 级矩估计,有效样本量从 $k=S$ 提升到 $N=S\times T$(约 $5.2\times10^5$),谱坍缩自动消失。
核心方法
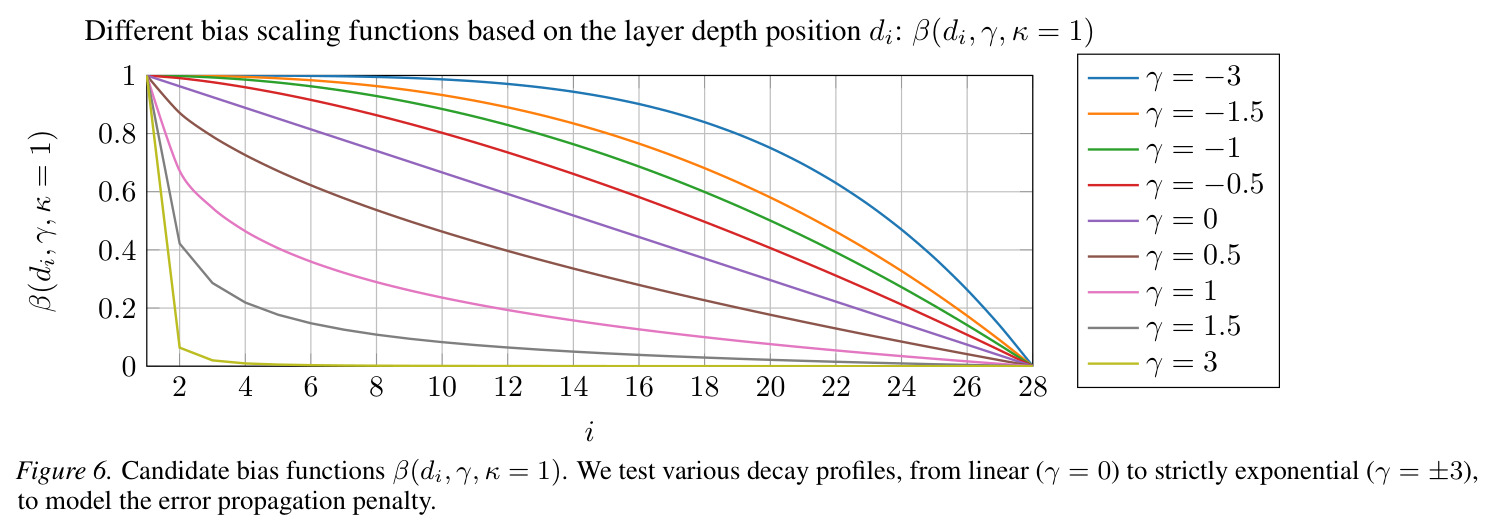
把压缩预算想象成一笔固定的钱,问题变成「把秩投资到哪些层最划算」。LEMS 给每个线性层一个校准过的价格标签 $L_i(c)=S_i(c)\cdot\alpha_i\cdot(1+\beta(d_i))$:$S_i(c)$ 是白化权重奇异谱的归一化尾部能量,刻画同层内秩越低代价增长多快(形状);$\alpha_i$ 用该层单独压到参考压缩率 $c_{ref}$ 时实测的 KL 散度校准量纲,让 attention 与 MLP 层的成本可比(尺度);$\beta(d_i)$ 是随深度谐波衰减的惩罚,模拟浅层误差沿深度累积放大(偏差)。随后为每层设 0-1 变量选候选秩($c_i\in[0.3,1.0]$),用 Gurobi 解 ILP:最小化总成本,约束每层恰选一个配置且总参数不超预算,秒级得到全局最优。KFAC-SVD 在分解端发力:Fisher 的 Kronecker 因子改用 token 级二阶矩估计 $\hat A=\frac{1}{N}\sum x_ix_i^\top$、$\hat G=\frac{1}{N}\sum\delta_i\delta_i^\top$,秩上界从序列数 $k$ 升到 $\min(d,N)$,再做白化截断 $W_c=G^{-1/2}U_r\Sigma_rV_r^\top A^{-1/2}$ 部署。
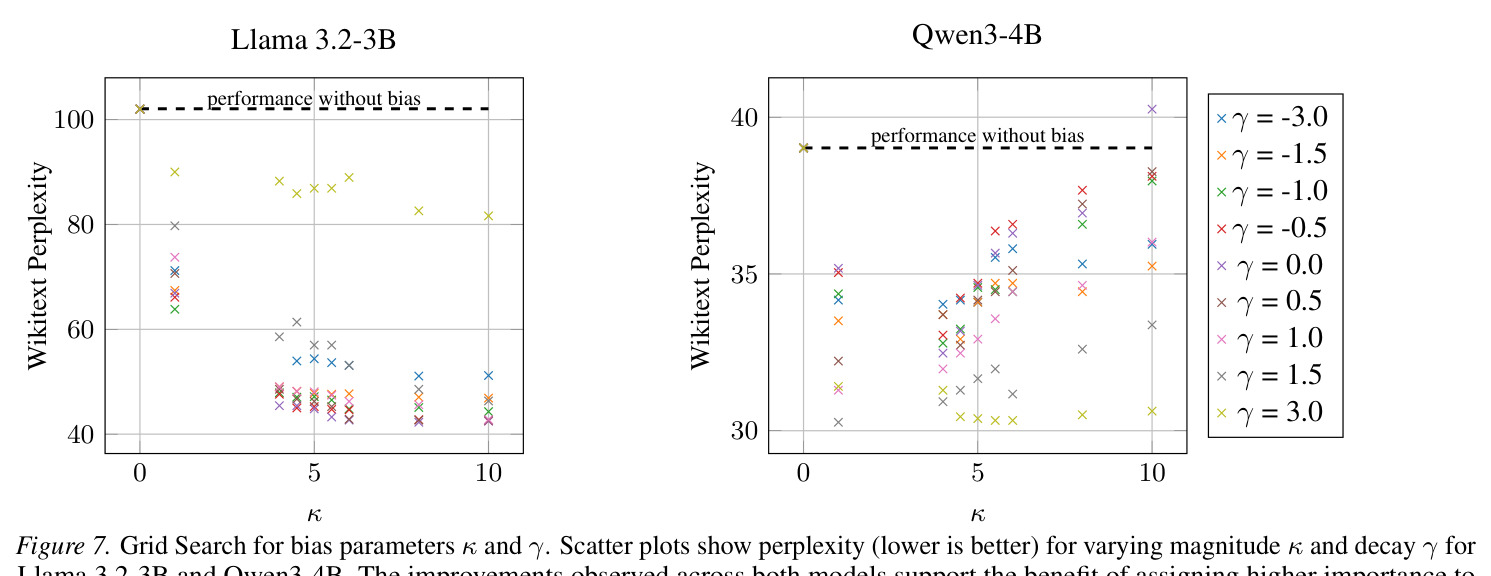
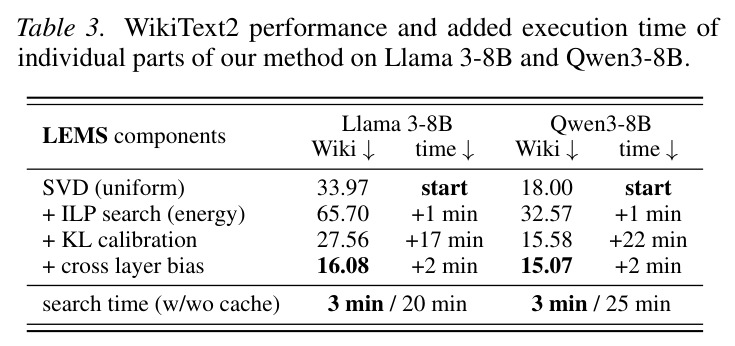
核心创新两条。第一,LEMS 首次把「代理必须校准」与「误差会传播」同时纳入秩分配,并用乘法结构解耦:$S_i(c)$ 提供免测量、高分辨率的相对代价曲线,解决候选秩粒度问题;$\alpha_i$ 用单点实测 KL 把谱形状映射到真实损失,解决 attention/MLP 不可比问题;$\beta(d_i)=\kappa\cdot\frac{B+1-d_i}{\sum_{k=1}^{B}k^{-\gamma}}$ 用软调制而非刚性约束建模传播,避免拉格朗日松弛与 ILP 离散罚项的冲突。Table 3 证明三者缺一不可:纯谱能量的 ILP 在 Llama 3-8B 上比均匀分配差 93%(33.97→65.70),加校准降 19% 到 27.56,加偏差再降 42% 到 16.08。第二,KFAC-SVD 指出旧 Fisher-SVD 的失败源于统计粒度而非理论缺陷:把 K-FAC 期望近似 $E[xx^\top]\otimes E[\delta\delta^\top]$ 从 $k$ 个序列梯度换成 $N=S\times T$ 个 token 矩估计,不增加额外前向反向成本(数据本来就逐 token),秩瓶颈自动消失;Figure 4 显示其 held-out Fisher 误差在所有截断秩上低于 GFWSVD。
方法步骤详情
流程七步。第一步,数据准备:256 条 WikiText2 序列(长度 2048)做协方差与梯度统计,另取 32 条做搜索校准。第二步,统计估计:用输入 $x$ 与输出梯度 $\delta=\partial\mathcal{L}/\partial y$ 计算 token 级矩 $\hat A=\frac{1}{N}\sum x_ix_i^\top$、$\hat G=\frac{1}{N}\sum\delta_i\delta_i^\top$($N=S\times T\approx5.2\times10^5$),得白化权重 $\hat W=G^{1/2}WA^{1/2}$ 及奇异谱。第三步,形状项:对候选压缩率 $c_i\in[0.3,1.0]$ 计算归一化尾部能量 $S_i(c)=\sum_{k>r_i}\sigma_{i,k}^2/\sum_k\sigma_{i,k}^2$,纯解析、可全缓存。第四步,尺度项:每层孤立压到 $c_{ref}=0.1$,测与原模型输出的 KL 散度,$\alpha_i=L_{KL,i}(c_{ref})/(S_i(c_{ref})+\epsilon)$,耗时 17-22 分钟但跨压缩率复用。第五步,偏差项:TPE 标定 $\kappa,\gamma$,算 $\beta(d_i)=\kappa\cdot\frac{B+1-d_i}{Z}$($Z=\sum_{k=1}^{B}k^{-\gamma}$),约 2 分钟。第六步,ILP:0-1 变量 $x_{ij}$ 选秩,Gurobi 秒级求全局最优。第七步,部署:$W_c=G^{-1/2}U_r\Sigma_rV_r^\top A^{-1/2}$ 对称拆成两个连续线性层。8B 模型首跑 20-25 分钟,缓存后重搜仅 3 分钟。
技术新颖性
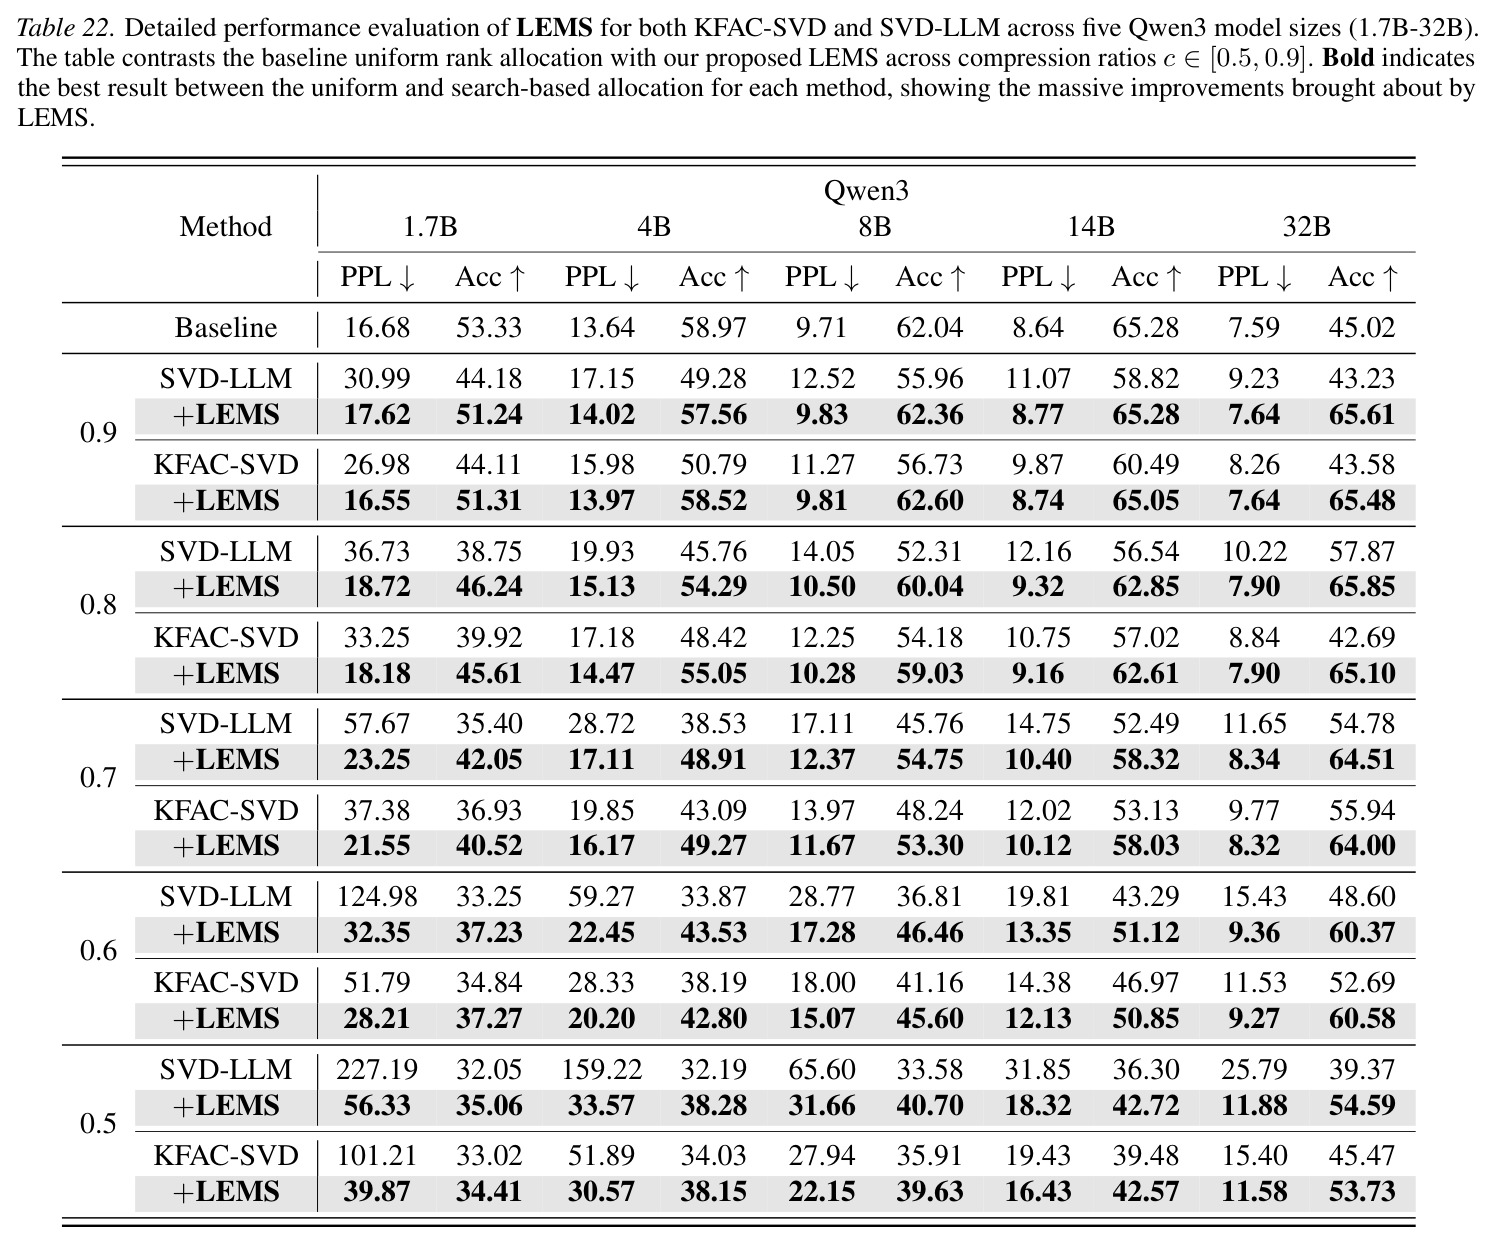
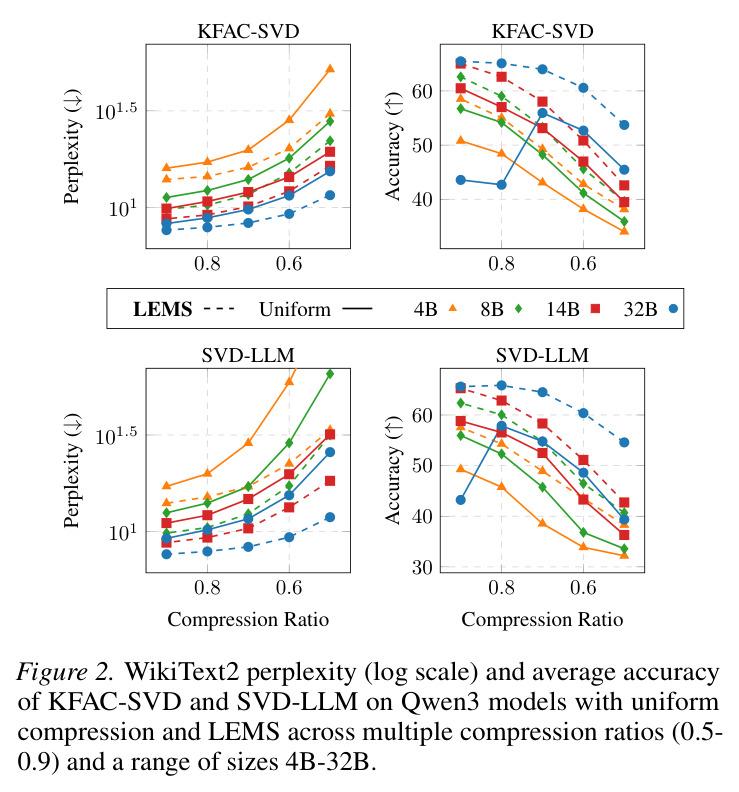
与已有工作的本质区别有三。搜索范式上:greedy(MRCS、FastLRD)与均匀误差阈值(ASVD、SVD-LLMv2)不提供全局最优性保证,梯度掩码法(ARS、ComCat)需要调参和稳定调度;LEMS 借鉴结构化剪枝 MDP 的 ILP 思路,但误差模型不是单一代理而是「形状×尺度×偏差」三因子,且偏差采用软调制形式,避免了刚性单调约束对离散优化的干扰。传播建模上:ATP 是唯一显式建模误差累积的基线,但假设线性深度函数并强制块级均匀压缩率;LEMS 的谐波偏差只调制成本,允许任意非单调的逐层分配。分解端:GFWSVD 用 Lanczos 对 $k$ 个序列梯度拟合 Kronecker 积,秩 $\le k$,谱坍缩不可避免;KFAC-SVD 的矩估计虽舍弃跨 token 二阶矩(如权重共享引发的耦合),却换来 $\mathrm{rank}(\hat A)\le\min(d_{in},N)$ 的保证,实践证明这笔交换非常划算。另外 LEMS 与分解目标解耦,对 KFAC-SVD 和 SVD-LLM 两种分解都带来一致增益(Figure 2),这种正交性验证在搜索方法论文中少见。
实验结果
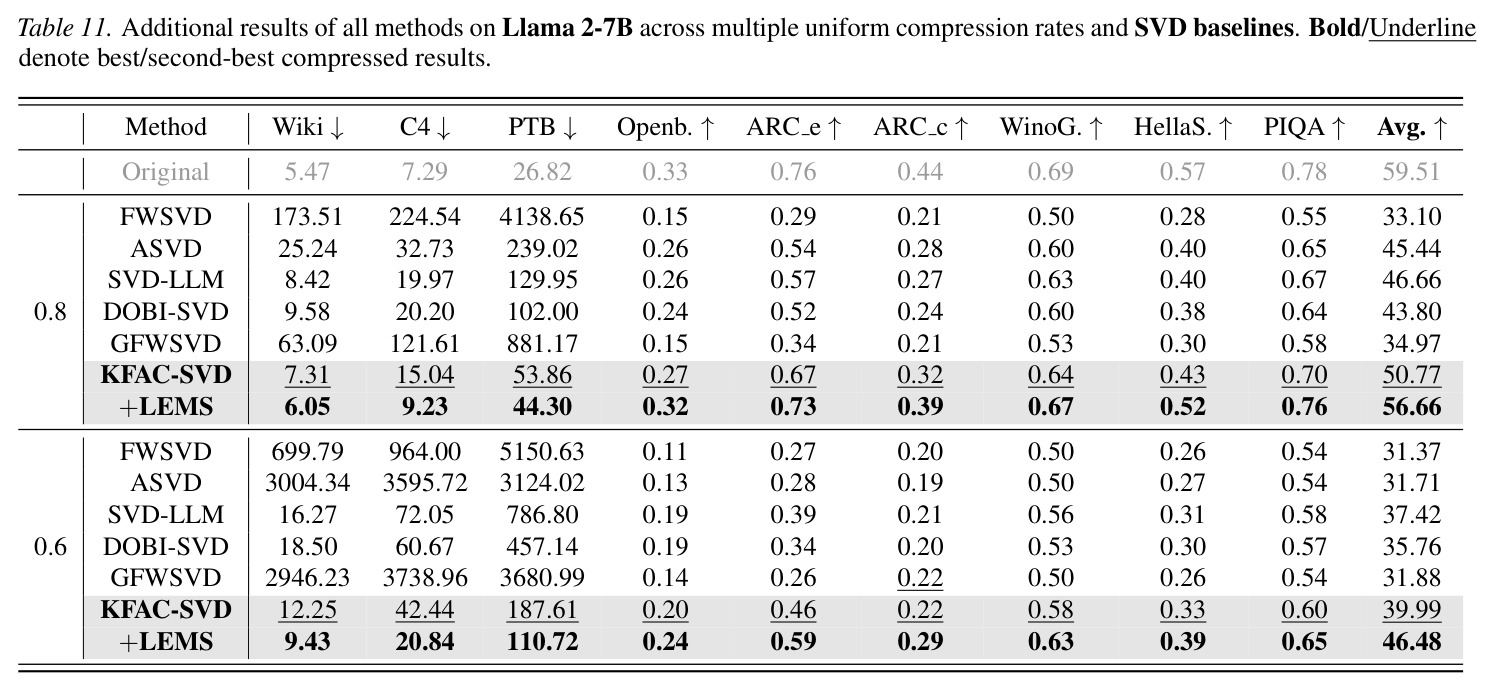
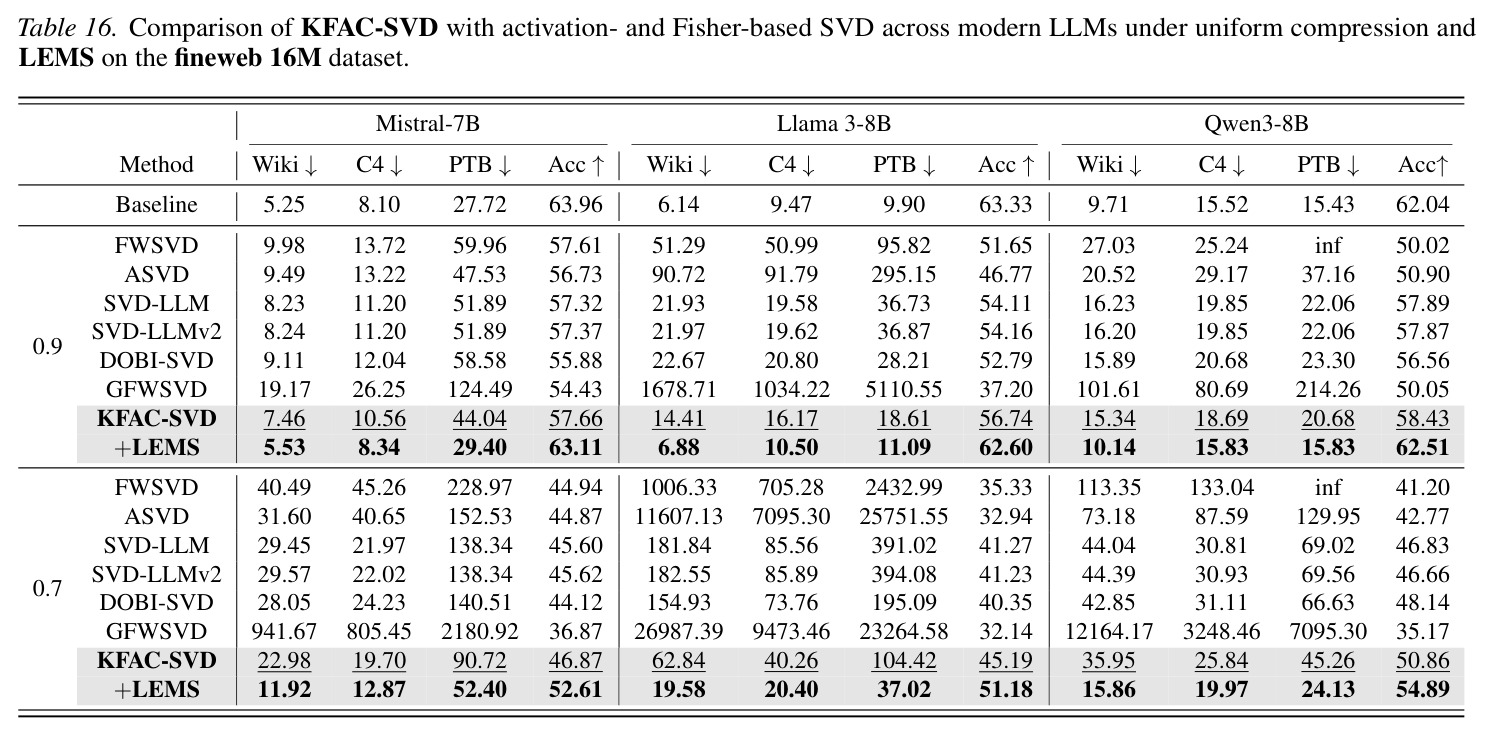
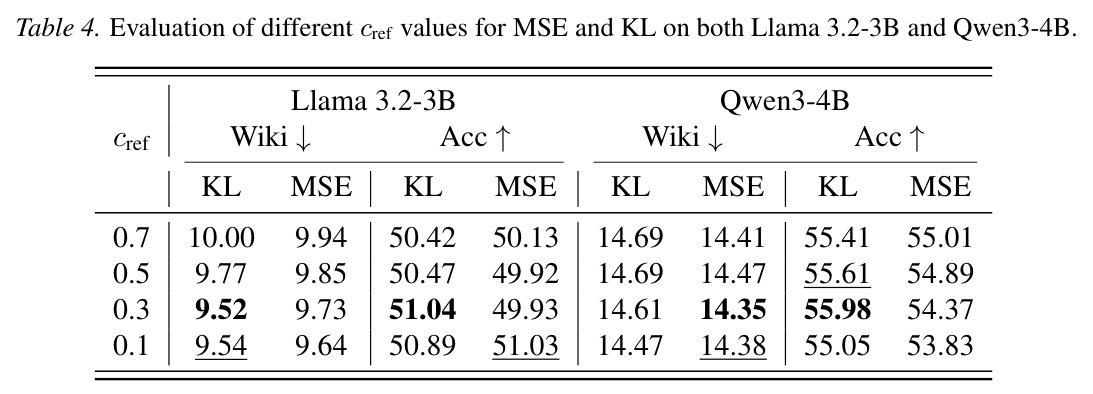
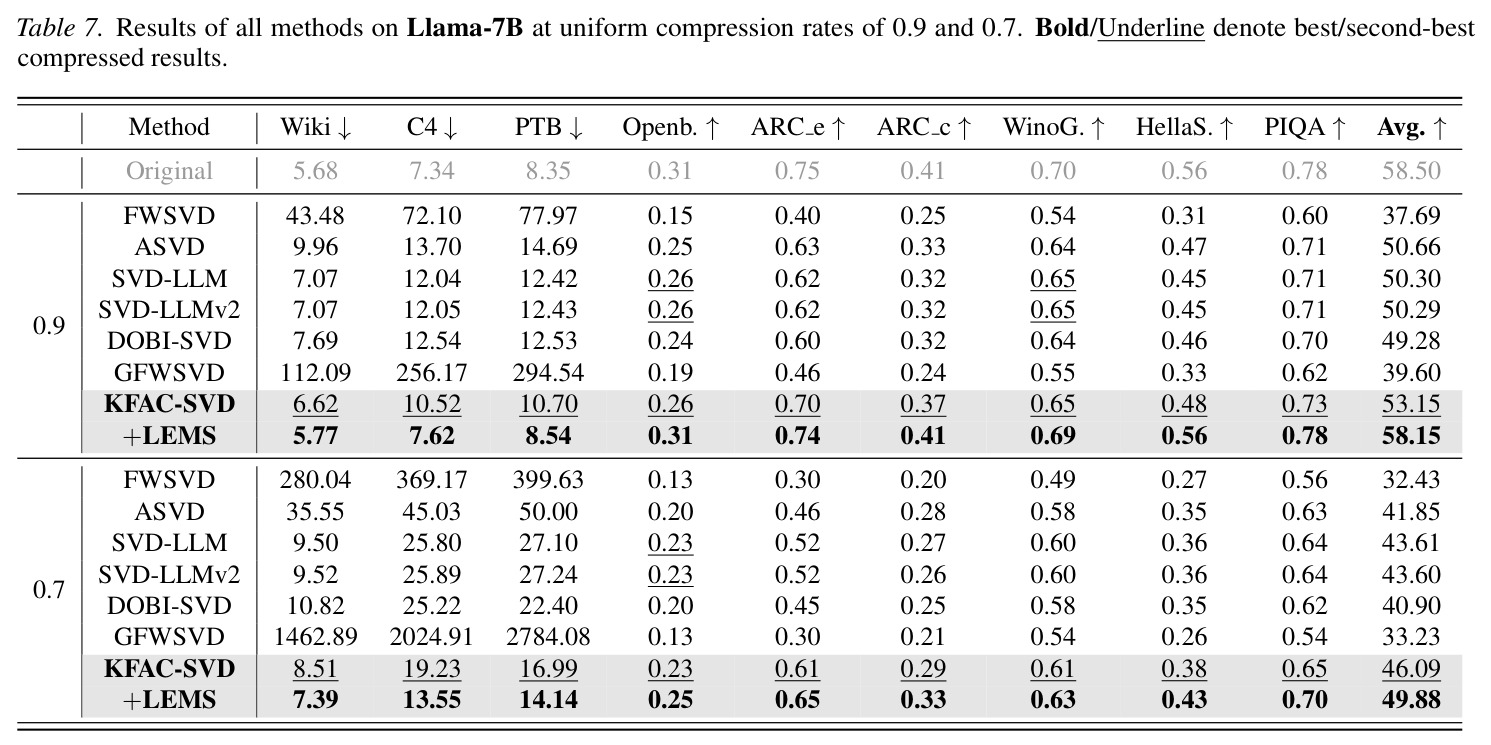
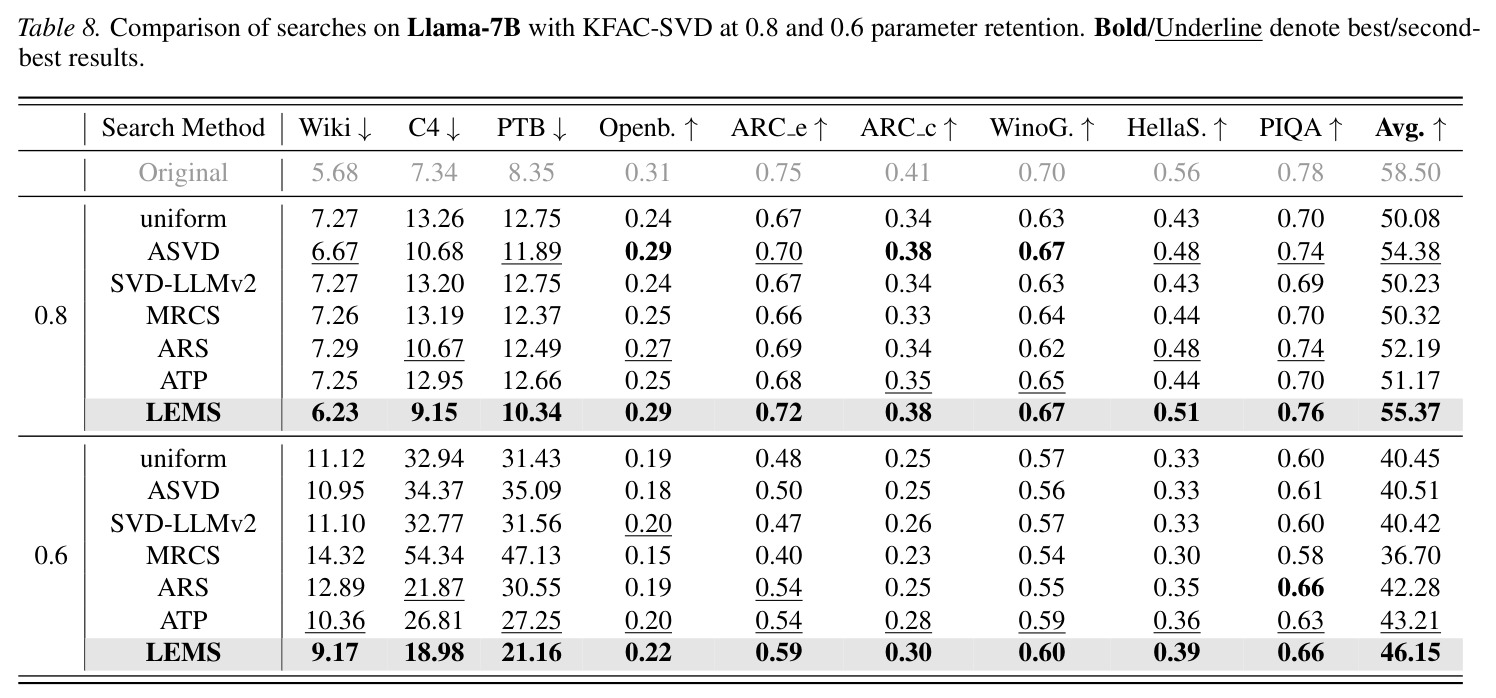
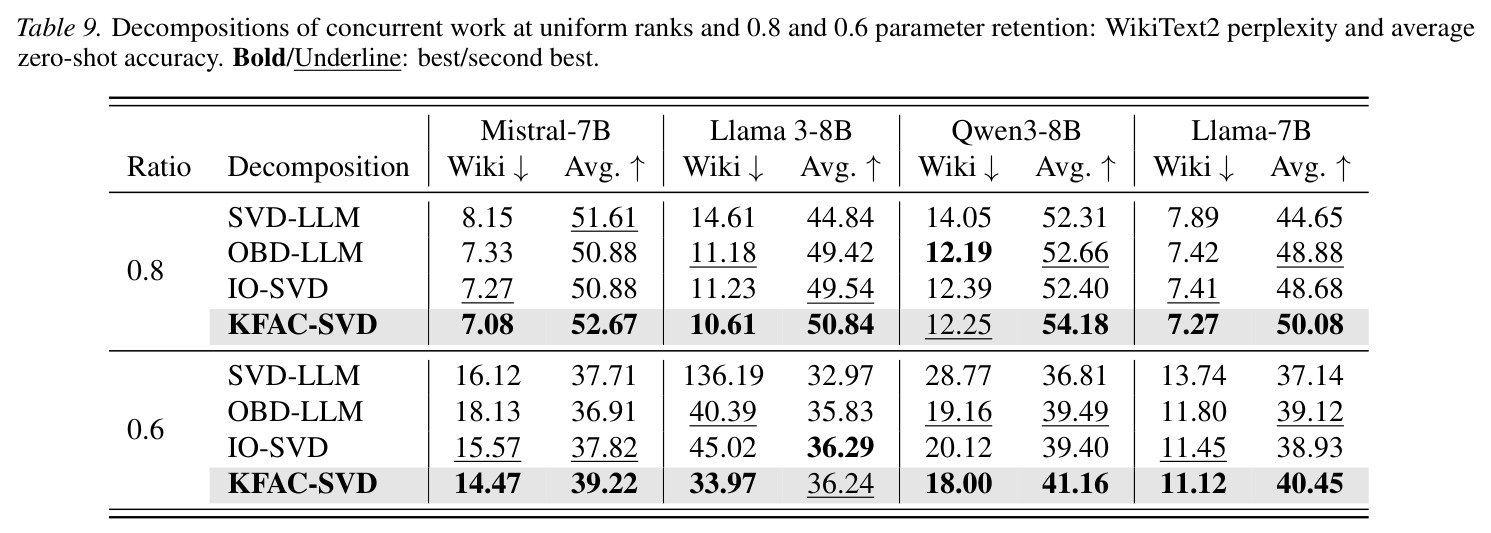
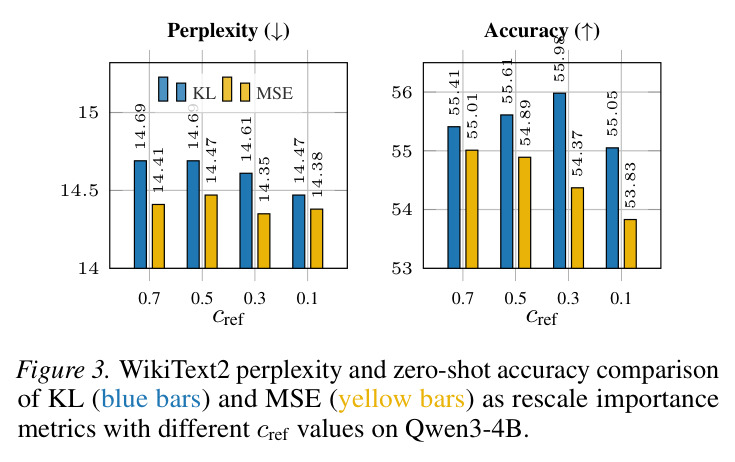
实验覆盖 Mistral-7B、Llama 3-8B、Qwen3-8B 及 Qwen3 4B-32B、Llama 3.1-70B,指标为 WikiText2/C4/PTB 困惑度与六个零样本基准(PIQA、OpenBookQA、HellaSwag、ARC-E/C、Winogrande)平均准确率。(1) 秩分配(Table 1,0.8/0.6 保留率):LEMS 六个设置准确率全部第一,比第二名高 2.14-4.67 p.p.,困惑度相对均匀降 26.06-75.40%;最亮眼是 Llama 3-8B @0.6:Wiki 16.08 vs 均匀 33.97,准确率 44.19% vs 36.24%。最强基线 ARS(四设置第二)的 Wiki 困惑度在 4/6 设置仍不如均匀,ASVD、SVD-LLMv2 经常输给均匀。(2) 分解(Table 2,0.9/0.7):KFAC-SVD 几乎全面最低,@0.7 比最佳基线 DOBI-SVD 改善 49%,叠加 LEMS 达 66%(Llama 3:31.54→16.23→10.71);GFWSVD 因谱坍缩灾难性失败(Llama 3 @0.7 达 41798.89);唯一例外是 Mistral @0.9 时 ASVD 准确率高 0.35 p.p.。(3) 扩展性(Figure 2):Qwen3 4B-32B 与 Llama 3.1-70B 上,LEMS 平均降困惑度 17%(KFAC-SVD)/34%(SVD-LLM)、升准确率 +7.2/+9.1 p.p.,0.5 极限压缩降 26%/57%;70B 上 Wiki 7.9→4.5、准确率 62.6→66.6。(4) 消融(Table 3):Llama 3-8B 从 uniform 33.97 → 纯能量 ILP 反升 65.70 → +KL 校准 27.56 → +深度偏差 16.08。(5) 校准(Figure 3):KL 优于 MSE 最多 1.6 p.p.,$c_{ref}=0.1$ 困惑度最好(14.5 vs 14.7)。(6) 估计质量(Figure 4):KFAC 的 held-out $\Delta F$ 在 32-512 所有截断秩上低于 GFWSVD。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全局秩分配搜索(3 模型 × 0.8/0.6 保留率,共 6 设置) | 平均零样本准确率 / 三语料困惑度 | LEMS 六个设置全部第一,准确率比第二名高 2.14-4.67 p.p.(如 Llama 3-8B @0.6 达 44.19%,Wiki 16.08) | 最强基线 ARS(四设置第二);uniform、ASVD、SVD-LLMv2、MRCS、ATP | 相对均匀分配困惑度降 26.06-75.40%,准确率最高提升约 8 p.p. |
| SVD 分解质量(0.7 保留率,Llama 3-8B) | WikiText2 困惑度(越低越好) | KFAC-SVD 16.23;KFAC-SVD+LEMS 10.71 | 最佳基线 DOBI-SVD 31.54;GFWSVD 41798.89(谱坍缩失效) | 比 DOBI-SVD 改善 49%,叠加 LEMS 达 66% |
| 70B 规模扩展(Llama 3.1-70B) | WikiText2 困惑度 / 平均零样本准确率 | 7.9 → 4.5 / 62.6 → 66.6 | 均匀秩分配(相同分解管线) | 困惑度降约 43%,准确率 +4.0 p.p. |
| 多尺寸扩展(Qwen3 4B/8B/14B/32B,压缩率 0.5-0.9) | 平均困惑度 / 平均零样本准确率 | LEMS 平均降困惑度 17%(KFAC-SVD)/34%(SVD-LLM),升准确率 +7.2/+9.1 p.p. | 均匀秩分配 | 0.5 极限压缩时困惑度降 26%/57%,准确率升 +4.8/+8.7 p.p. |
| Fisher 估计泛化能力(held-out 梯度) | Fisher 退化 $\Delta F$ / 特征谱衰减 | KFAC 估计在 32-512 所有截断秩上 $\Delta F$ 更低,谱衰减平缓无坍缩 | GFWSVD(Lanczos 序列级拟合,秩 ≤ 256) | 消除谱坍缩导致的截断后曲率信息丢失 |
局限与改进
作者承认两点:KFAC-SVD 仍需反向传播计算输出梯度 $\delta$,限制了计算效率;LEMS 的逐层校准随模型深度线性增长。我的补充观察:其一,尺度项 $\alpha_i$ 只在单一参考点 $c_{ref}=0.1$ 校准,隐含假设层间重要性比例在整个压缩区间恒定,而 Figure 3 显示 $c_{ref}$ 从 0.3 换到 0.1 准确率差 0.9 p.p.,说明该比例确实随压缩深度漂移;其二,谐波偏差 $\beta(d_i)$ 是人为设定的函数形式,$\kappa,\gamma$ 由 TPE 在具体架构上标定,跨架构泛化依赖经验而非理论保证,作者也把「形式化传播解析界」列为未来工作;其三,成本模型仍是加性代理,作者自述「损失并非严格可加」,偏差项只是近似修正;其四,KL 校准要求每个候选层单独前向,层数多时开销大(8B 上 17-22 分钟,70B 会按深度继续增长);其五,实验只覆盖稠密 Transformer 的线性层,未涉及 MoE、VLM、embedding 与 lm_head(作者列为未来方向)。
独立分析的弱点
独立分析四点弱点。第一,单点校准的线性外推假设脆弱:$\alpha_i$ 假设谱形状与实测 KL 的比例在 $c\in[0.3,1]$ 全程不变,但不同层的谱衰减曲率差异很大(Figure 1b 正是为了说明层类型不可比),在极端压缩区间该比例可能失真。改进方向:用两个参考点(如 0.1 与 0.5)拟合局部斜率,成本仅翻倍且结果可缓存复用。第二,偏差先验的架构特异性:$\kappa,\gamma$ 靠 TPE 在每个架构上重新标定,换新模型需重跑校准,且固定谐波形式无法表达「某几层特别敏感」的非单调结构。改进:用逐块插入式压缩的实测端到端 KL 回归偏差曲线,替代解析形式。第三,KFAC-SVD 忽略跨 token 二阶矩,对 attention 这类权重复用严重的模块理论上欠精确,虽然实践上消除谱坍缩的收益远大于此损失。改进:对序列内梯度做平均后补充一个低秩序列级项。第四,KL 校准依赖校准数据分布:32 条 WikiText2 文本可能让秩分配偏向语言域,代码或多语场景下 $\alpha_i$ 排序可能漂移,论文未报告跨域鲁棒性。改进:混合域校准集并按目标域加权 KL。
未来方向
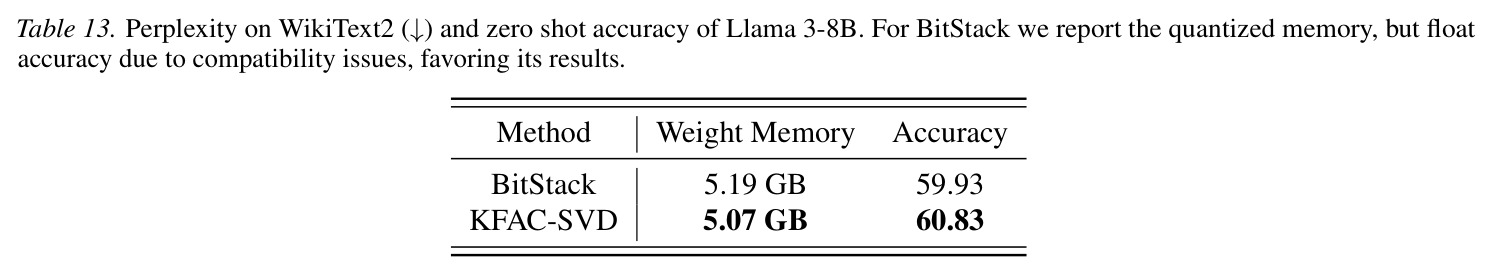
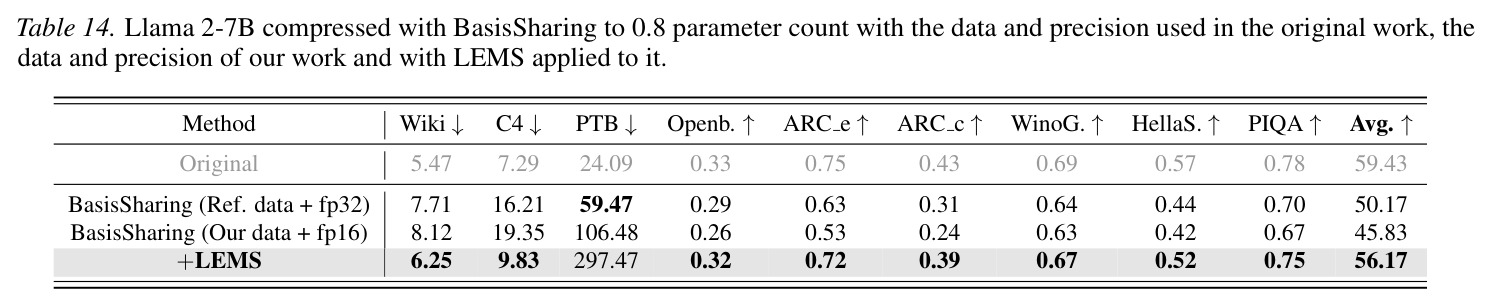
作者提出的方向:形式化误差传播的解析上界,替代目前的谐波偏差经验先验,进一步提升建模精度;把方法扩展到视觉-语言模型(VLM)与混合专家(MoE)架构——MoE 的路由稀疏性会让「每层独立成本」假设失效,需要新的条件成本模型。基于成果可延伸的方向:其一,token 级 K-FAC 思想可迁移到量化,论文强调低秩与量化正交、可叠加,满秩曲率估计也可能改进 GPTQ 类二阶量化方法;其二,LEMS 的成本曲线天然支持动态推理——按输入难度在线选择不同秩组合,实现「难样本多花算力」;其三,校准降本:目前逐层测 KL 需要对每层做孤立压缩前向,可用影响函数或跨层共享测量减少次数;其四,把 ILP 分配器做成「即插即用」组件,论文 Supplement 已验证与 BasisSharing、BitStack 等非标准 SVD 兼容,可形成分解器无关的分配生态。
复现评估
复现条件较为友好。代码与项目页:https://lems-svd.github.io(论文声明 Project Page & Code 公开)。数据全部公开:校准用 WikiText2 的 256 条序列(长度 2048)加 32 条搜索样本,评测用 LM-Eval 库的六个零样本基准和 WikiText2/C4/PTB。算力:所有主实验单张 NVIDIA H200 完成,8B 模型上 LEMS 首跑 20-25 分钟、缓存后续搜索仅 3 分钟,ILP 秒级求解;复现 8B 实验约需单张 80GB 级 GPU(H100/A100),70B 需多卡。注意方法需要反向传播取输出梯度,不是纯推理压缩。工程难点主要在三处:token 级矩的高效累积、逐层 KL 校准流程、ILP 建模——Gurobi 是商业求解器(有学术免费许可),从秒级求解规模看也可换 HiGHS 等开源方案。Supplement 提供完整算法(Section C)、逐任务准确率表和与非标准 SVD(BasisSharing、BitStack)的对比,消融数据齐全,整体复现难度中等。
论文图表