面向神经网络压缩的可学习函数子空间 Learning Functional Subspaces for Neural Network Compression
把每层要删除的子空间参数化为可学习正交投影,端到端对齐网络输出,高压缩率下大幅超越现有低秩压缩方法
前置知识
低秩分解与截断SVD
把权重矩阵 $W\in\mathbb{R}^{d_{out}\times d_{in}}$ 近似为两个瘦矩阵之积 $W\approx BA$,其中 $B\in\mathbb{R}^{d_{out}\times r}$、$A\in\mathbb{R}^{r\times d_{in}}$,参数量从 $d_{out}d_{in}$ 降到 $(d_{out}+d_{in})r$。对 $W$ 直接做截断SVD是最朴素的做法,但预训练Transformer权重的奇异值衰减很慢,截断会严重破坏模型。真正可行的是利用层间激活本身集中在低维子空间这一经验事实来选择保留哪些方向。
本文的全部工作发生在低秩分解这一框架内:LSP最终也输出两个瘦因子,区别只在'删哪个子空间'是怎么决定的。不懂低秩分解的参数账,就无法理解压缩率、绑定组节省和推理加速从何而来。
正交投影子
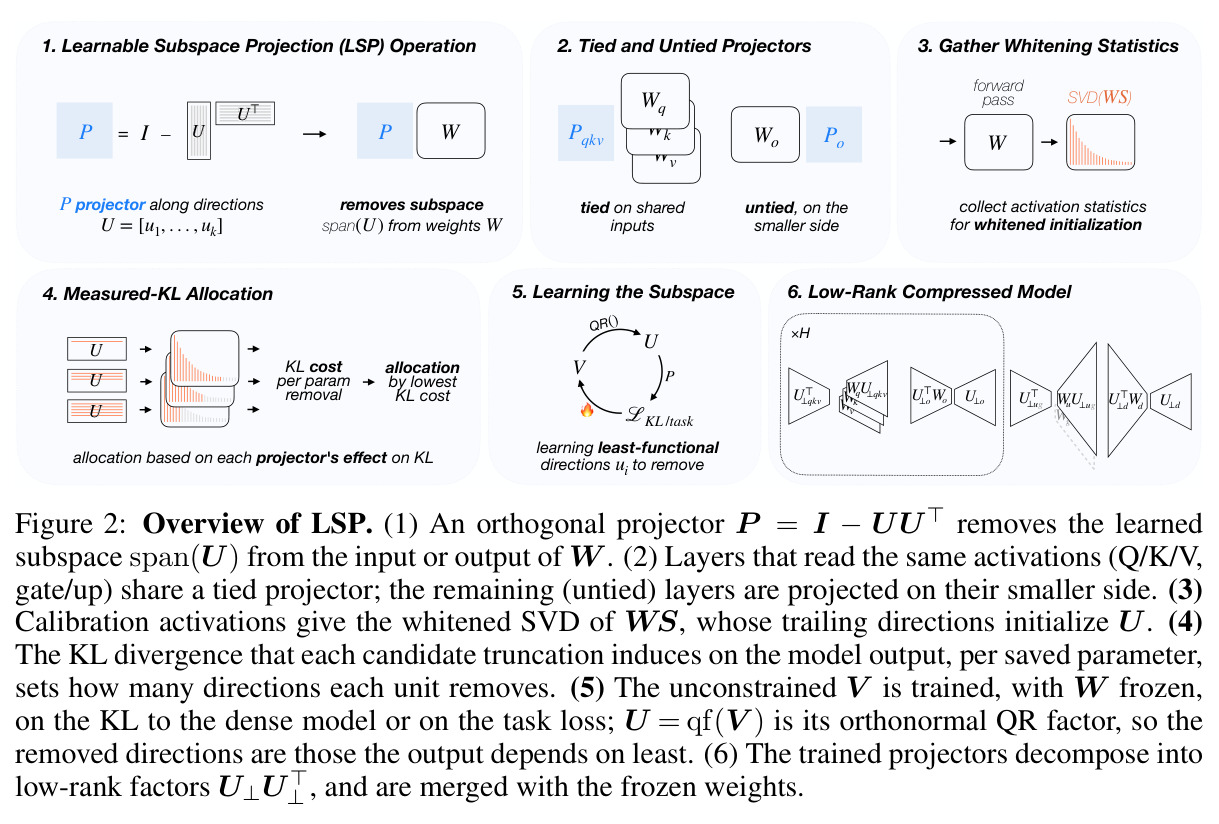
$P=I-UU^\top$,其中 $U\in\mathbb{R}^{d\times k}$ 列正交。$P$ 满足 $P^2=P$、$P^\top=P$,作用是把任意向量沿 $\mathrm{span}(U)$ 的分量清零、同时完全不改动其正交补空间。给权重乘上 $P$ 后秩最多降 $k$,因此自然分解为低秩因子。论文命题A.1证明:在所有把 $\mathrm{span}(U)$ 置零的算子中,$P$ 是Frobenius范数意义下唯一离恒等映射最近的(最优值 $\sqrt{k}$),即'删除某子空间时扰动最小的手术方式'。
把'选一个要删除的子空间'等价转化为'学一个正交投影子'是本文的核心公式化。$P$ 的正交性保证了删除的连续性和可逆合并,理解 $P$ 才能看懂参数化 $U=\mathrm{qf}(V)$ 和训练技巧。
白化截断(Whitened Truncation)
SVD-LLM提出的层内最优截断:收集 $n$ 条校准输入 $X$,其Gram矩阵 $G=\frac{1}{n}X^\top X=SS^\top$($S$ 为Cholesky因子),对 $WS$ 做SVD并保留前 $r$ 个奇异方向。这等价于最小化白化后的层输出重构误差 $E(Z)=\|(W-Z)S\|_F^2$,即按'方向对层输出的实际影响'而非原始奇异值排序。本文把它重铸成正交投影子并扩展到绑定组,作为训练的初始化。
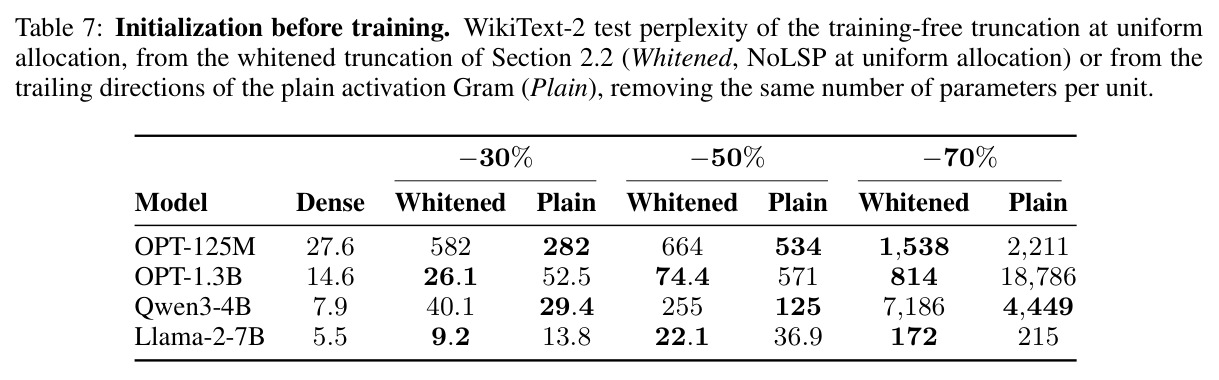
白化截断是LSP的初始化方案(NoLSP对照),也是最重要的免训练基线。论文用实验证明:即便这个层内最优的起点,删错方向仍会导致困惑度222.8,必须靠端到端学习纠正。
KL散度输出蒸馏
令压缩模型 $p_{compressed}$ 在同一输入上模仿稠密模型的完整输出分布 $p_{dense}$,损失为 $\mathcal{L}_{KL}=\mathbb{E}_{x\sim\mathcal{D}_{cal}}\mathrm{KL}\big(p_{dense}(\cdot|x)\,\|\,p_{compressed}(\cdot|x)\big)$。相比只在单一gold token上算交叉熵,KL目标保留了教师的完整'软'分布信息,且不需要任何标注数据——任何无标签文本池都能当校准集。本文蒸馏的teacher是同一网络关闭投影($\alpha=0$)的形态,无需额外存储一份权重。
KL蒸馏是LSP的默认训练目标(LSP变体),也是秩分配阶段度量'删掉某方向伤害多大'的尺子。ViT实验进一步用它支撑一个重要结论:无标签蒸馏让压缩对校准分布偏移最稳健。
KV缓存与潜在缓存
自回归解码时每步都要缓存所有历史token的Key和Value以做注意力,显存随上下文线性膨胀,小batch解码因此是访存瓶颈。潜在缓存(如DeepSeek的MLA、Palu)把K/V压到低维:缓存潜在向量 $z=Ax$,注意力时再重建 $K=B_kz$、$V=B_vz$。本文的独特之处是Q/K/V共享同一个输入因子 $A$(绑定组),因此只需存一个潜在 $z$ 就能同时重建K和V,而未绑定的分解要存两个。
潜在缓存是LSP把精度优势转化为实际部署红利(13.5×显存节省、322k超长上下文)的关键机制,也是绑定组设计存在的第二个理由,理解它才能读懂3.3节效率实验。
研究动机
现代Transformer能力强大但内存与算力开销巨大,低秩权重分解是少数能同时降两者、且保持矩阵稠密(对标准硬件友好)的压缩路线。问题在于'删掉哪个子空间':现有方法都用局部闭式准则决定——按层输入激活能量(ASVD、SliceGPT、MoDeGPT)、按层输出重构误差(SVD-LLM、Swift-SVD)、或按损失的二阶曲率近似(LLM-Surgeon、FW-SVD)。这些准则只看见单个层,完全不知道误差如何随深度传播累积:一个低能量方向会被删掉,哪怕网络输出强烈依赖它。后果在高压缩率下极为惨烈:直接截断SVD本就因权重奇异值衰减慢而失效,而Llama-2-7B在-70%压缩时,ASVD的WikiText-2困惑度爆到超过$10^4$,即使用层内最优的白化截断(未训练的NoLSP)也有222.8,而稠密模型仅5.5。损失感知方法引入了网络信息,但只通过局部代理——Fisher加权重构或二次曲率模型——这类近似仅在稠密权重的小邻域内成立,激进压缩早已远离该邻域;Dobi-SVD虽然直接优化损失,却只学习每个矩阵的截断秩,不学习方向本身。
本文的目标是本文要让网络的全局目标本身来决定删除哪些方向。具体目标分三层:其一,为每个目标线性层(或共享同一输入激活的绑定层组)配置一个可学习的正交投影子,以全局目标——默认为对稠密模型输出分布的KL散度,替代方案为原始训练损失——端到端联合优化所有投影子,同时冻结全部预训练权重,保证模型不偏离原始能力;其二,训练结束后投影子必须能无损合并为标准低秩因子,使部署模型不含任何LSP专用算子,且每个绑定组共享一个输入因子;其三,利用Q/K/V输入绑定的结构,在注意力中以一个窄潜在向量替代完整的K和V缓存,从而在精度提升之外额外兑现解码加速与KV显存节省。作者希望在OPT-125M/1.3B、Qwen3-4B、Llama-2-7B和ViT-B/16上验证:学习删除的子空间在压缩率越高时优势越大,且对校准数据分布偏移最稳健。
与已有工作不同的是,本文的独特切入是一个简单但没人做过的等价转化:选择一个保留的子空间,等价于选择一个正交投影子——对权重施加秩为 $r$ 的投影子后秩至多为 $r$,自然分解为两个瘦矩阵,于是'寻找功能子空间'可以被干净地写成'在投影子空间上做端到端优化'。已有工作的差别在于信息来源:免训练方法从激活统计读出子空间,损失只用来做局部近似、定秩或截断后修复权重,从未直接选择被删除的方向;可学习'删什么'的思想虽已出现在结构化剪枝中(MaskLLM等可学习掩码),但那里删除集是离散坐标集合,需要Gumbel或直通估计等离散松弛技巧,而LSP的删除集是连续子空间,天然可微、无需任何松弛,节省还直接实现为稠密低秩因子。与最近的Dobi-SVD对比最能凸显定位:Dobi在闭式基内只学秩,LSP连基(方向)一起学。
核心方法
直觉先行:论文标题里的'函数子空间'对应Figure 1的核心观察——谱能量不等于功能。层输入空间中每个方向有两个属性:携带的谱能量(箭头长度)和网络输出对它的依赖程度(箭头朝向),激活式方法保留前者,而真正该保留的是后者。技术路线分四步:第一步,给每个线性层或绑定组配一个正交投影子 $P=I-UU^\top$,作用于权重得 $WP=W-(WU)U^\top$,秩至多降 $k$;为了可微,优化无约束变量 $V\in\mathbb{R}^{d_{in}\times k}$,每次前向用QR分解的正交因子 $U=\mathrm{qf}(V)$,正交性由构造保证。第二步,用白化截断给每个单元一个有序初始基,并按'实测KL'分配各单元删多少方向。第三步,冻结全部预训练权重,联合优化所有 $V$,目标是对稠密模型输出的KL蒸馏(LSP)或原始任务损失(LSP$^T$),配以warm-up、方向dropout和正交惩罚三项稳定化技巧。第四步,把训练好的投影子经thin SVD合并为低秩因子 $WP=BA$,绑定组共享因子 $A$,部署时不含任何特殊算子。
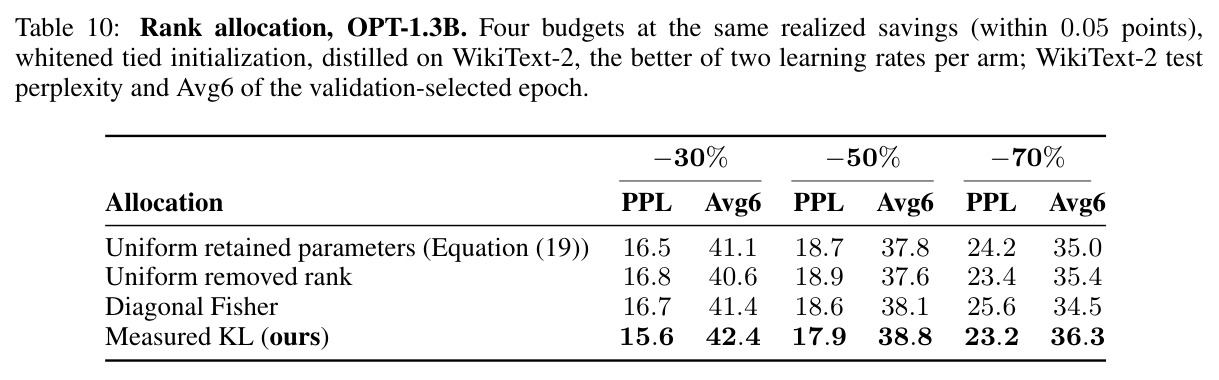
核心创新是'删除哪个子空间'首次由网络输出端到端决定。与已有方法的本质区别有四点。第一,全局目标选择方向:所有投影子跨网络联合训练,而ASVD/SliceGPT/SVD-LLM等闭式准则只见单层,层内最优不等于网络最优。第二,实测KL秩分配:对每个单元单独施加有限截断、直接量测它引起的输出KL变化 $\Delta_u(k)$,再按每节省一个参数的KL代价贪心分配预算——不同于LLM-Surgeon的二阶曲率估计只在稠密权重邻域有效,实测KL度量的是穿过整个网络的有限截断的真实影响。第三,绑定组共享投影:Q/K/V读同一归一化激活,gate/up亦然,它们共享一个投影子,同预算下省出的 $(|G|-1)d_{in}r$ 个参数可换取更高秩,且K/V输入绑定时注意力可缓存单个潜在 $z=Ax$。第四,正交投影的最优性:命题A.1证明固定删除子空间后 $P=I-UU^\top$ 是唯一扰动最小的 annihilator,训练因此只搜子空间、不搜算子形式,搜索空间干净。
方法步骤详情
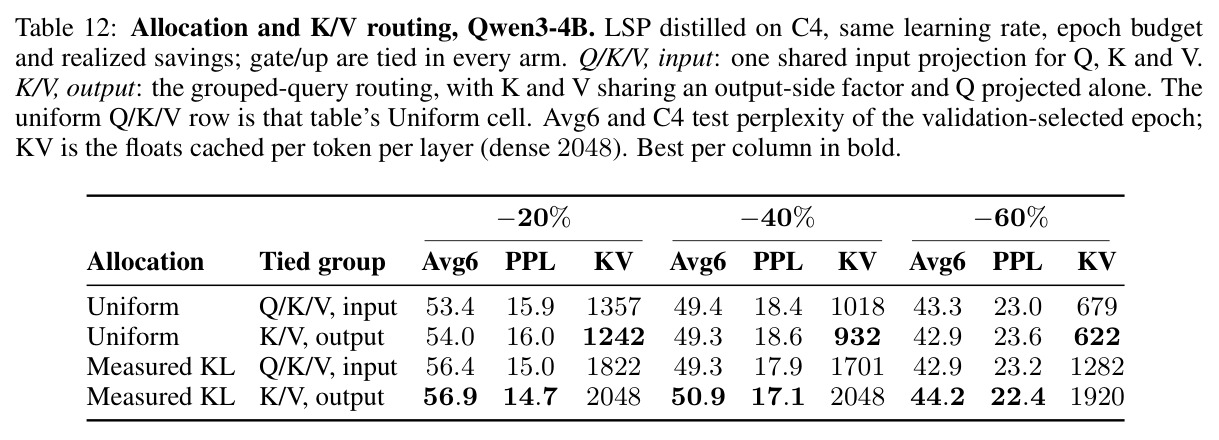
完整流水线(Algorithm 1)五步。①分组替换与统计:除嵌入、LM head外的线性层换成LSP形式,Q/K/V与gate/up按输入绑定(Qwen3-4B因GQA改为K/V输出绑定);在1024条2048 token校准序列上无梯度累积各单元输入Gram矩阵 $G=\frac{1}{n}X^\top X=SS^\top$。②建基:绑定组对行堆叠白化权重 $\bar{W}S$ 做SVD(Eckart–Young定理保证最优共享子空间),输入侧按命题1重铸为正交投影,得到按重要性排序的基。③实测与分配:缓存一次稠密输出,逐单元在删除网格($i/8$ 或 $i/16$)上截断并记录KL增量 $\Delta_u(k)$,取滑动最大保证单调;从稠密出发每步选边际代价 $(\tilde{\Delta}_u(k')-\tilde{\Delta}_u(k))/(s_u(k')-s_u(k))$ 最小的移动直到预算用尽,此时的模型即NoLSP对照。④训练:Adam加线性预热余弦调度,调制 $P_{\alpha,m}=I-\alpha U\,\mathrm{diag}(m)\,U^\top$ 的 $\alpha$ 首个epoch从0升到1避免输出突变,$m$ 以 $p=0.05$ 做方向dropout,总损失 $\mathcal{L}=\mathcal{L}_{obj}+0.05\,\mathcal{L}_{ort}$(后者惩罚 $V$ 列间相关以稳定QR梯度),验证集早停。⑤合并:对行堆叠投影权重做thin SVD得 $W_mP=B_mA$,$A=U_\perp^{\top}$ 为绑定组共享,丢弃容差0.05以下的奇异值,导出不含任何LSP算子的纯低秩模型。
技术新颖性
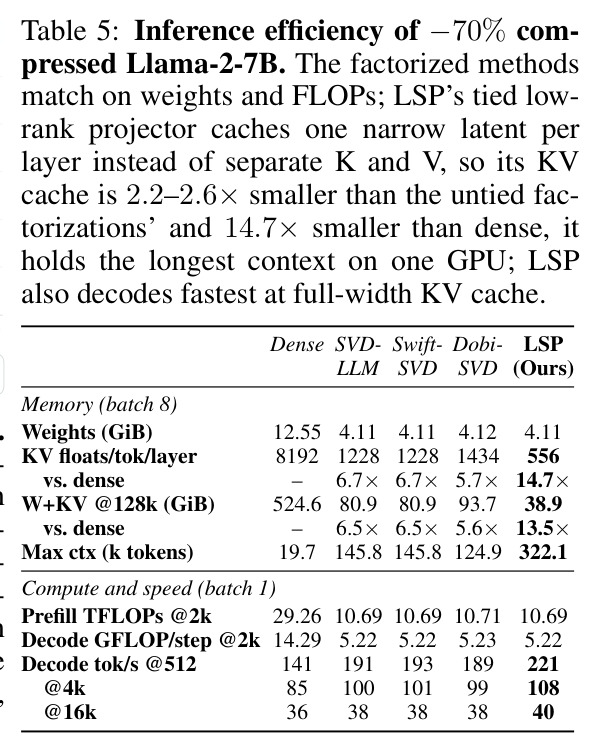
技术新颖性可从四个维度评估。概念层面:首次把低秩压缩中被删除的子空间本身作为端到端可学习变量——此前'学习删什么'只存在于剪枝的可学习掩码(离散、需松弛)和Dobi-SVD的秩学习(闭式基内),连续子空间+冻结权重的组合是新的。理论层面:命题1把白化截断重铸为正交投影并扩展到绑定组,明确刻画了输入侧斜投影的过剩误差 $\|\Sigma_r^w C_r^+C_{>r}\|_F^2$ 及其消失条件,让初始化有了严格保证;命题A.1则从所有annihilator中锁定正交投影。工程层面:三项设计使十亿参数规模可训——激活空间形式 $W(x-U(U^\top x))$ 避免物化稠密的 $WP$ 及其梯度;fused QR反向只需 $O(d_\ell k_\ell+k_\ell^2)$ 状态(显式Gram–Schmidt为 $O(d_\ell k_\ell^2)$);teacher复用同网络关投影的前向,不存第二份权重。系统层面:绑定组共享因子不只是省参数——它让同一压缩率下发出的矩阵乘更少、更大(Q/K/V共享一个输入因子而非三个),这是LSP成为唯一在-30%时仍快于稠密模型的因子化方法的根源,也直接换来单潜在KV缓存。
实验结果
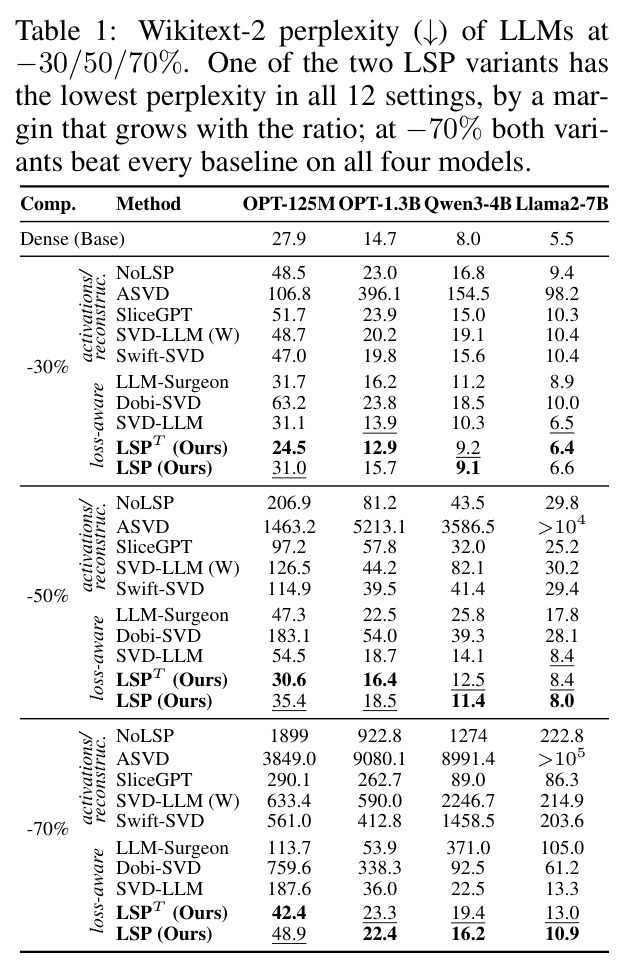
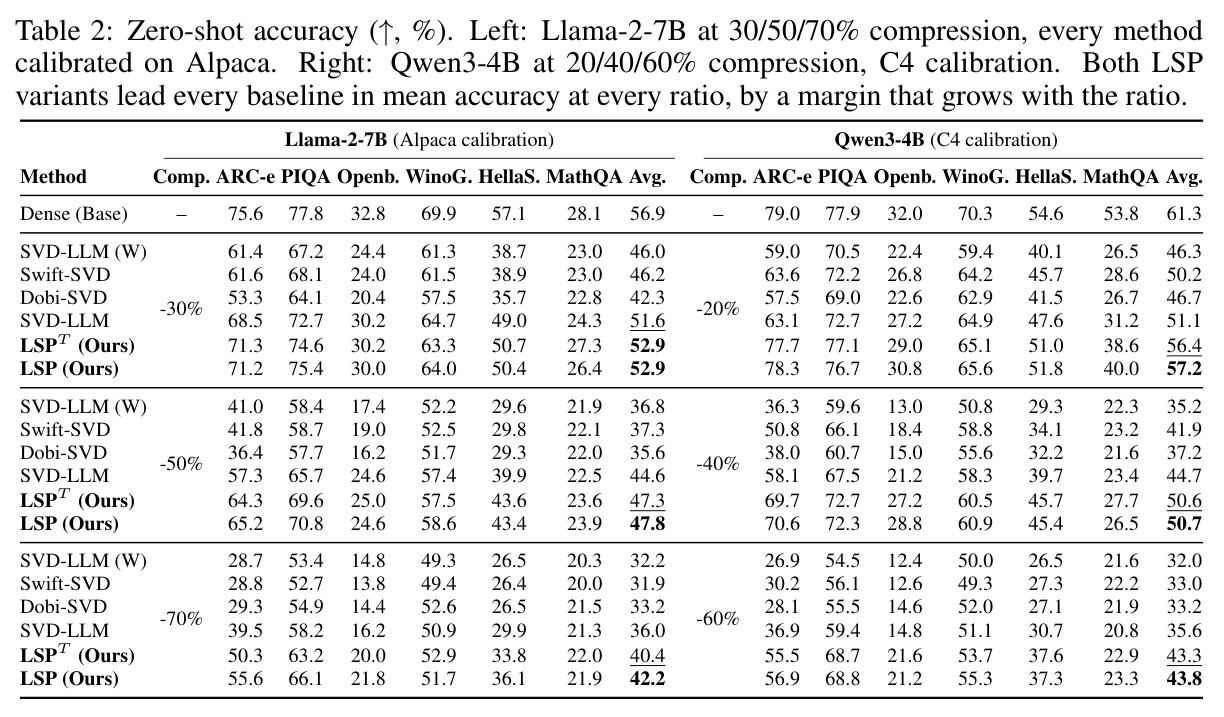
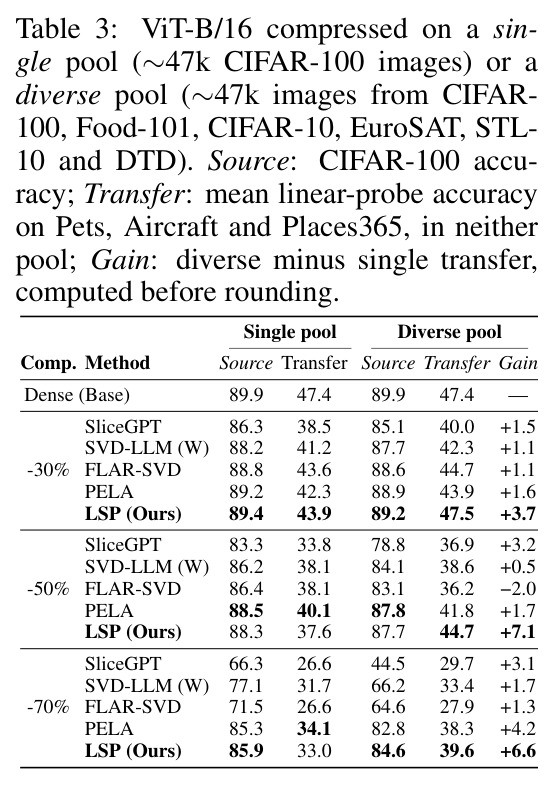
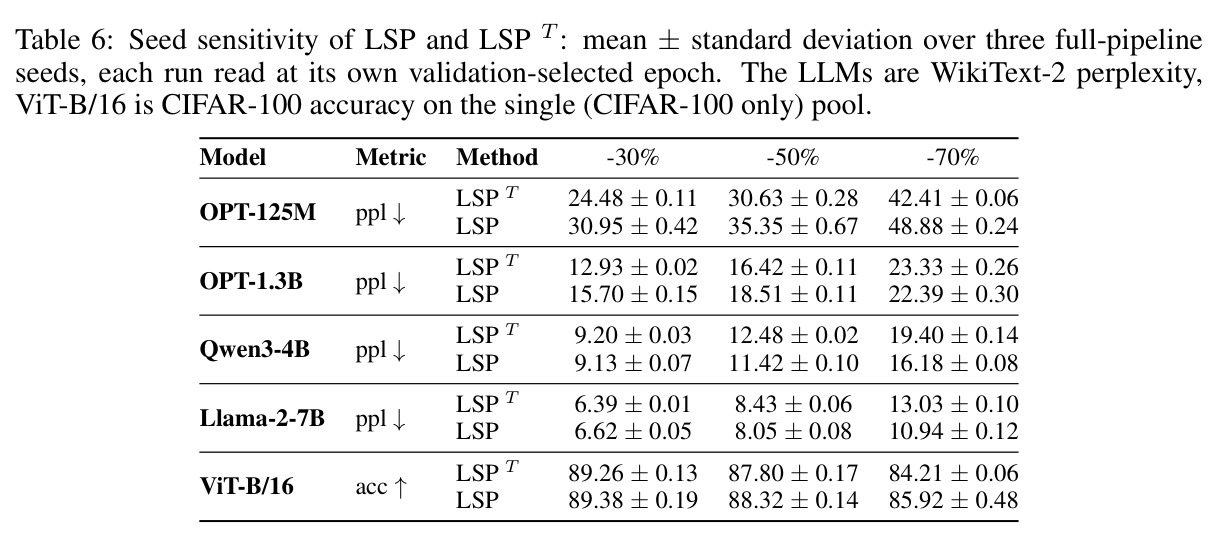
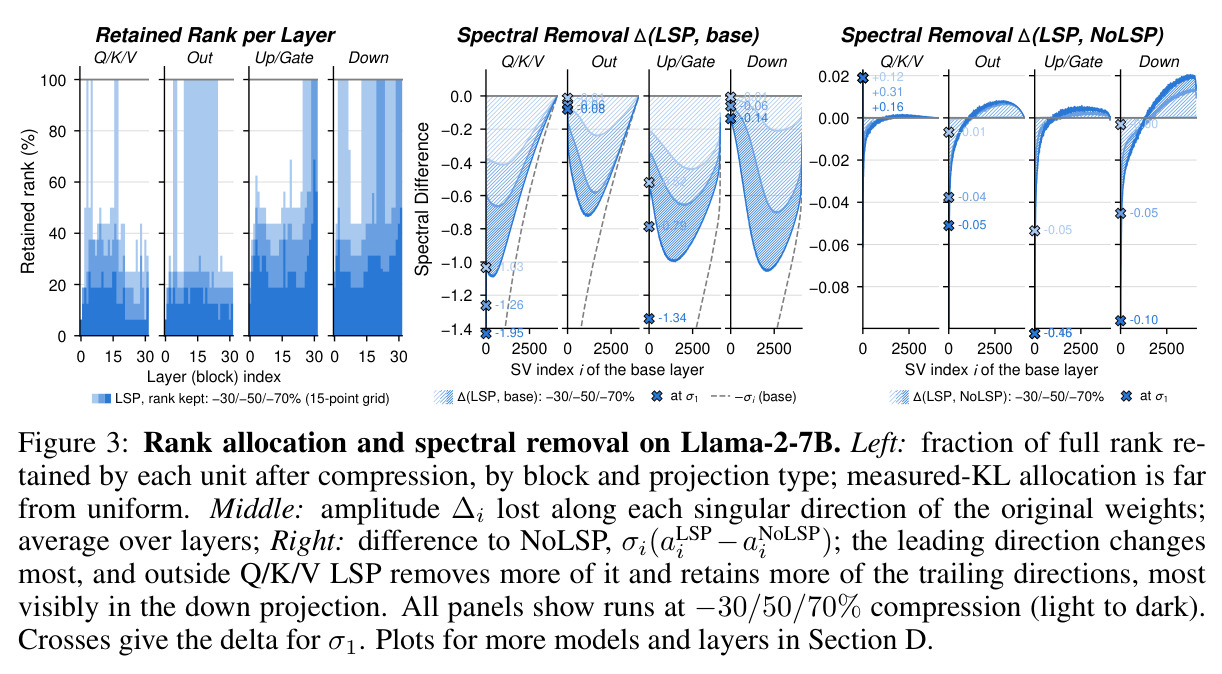
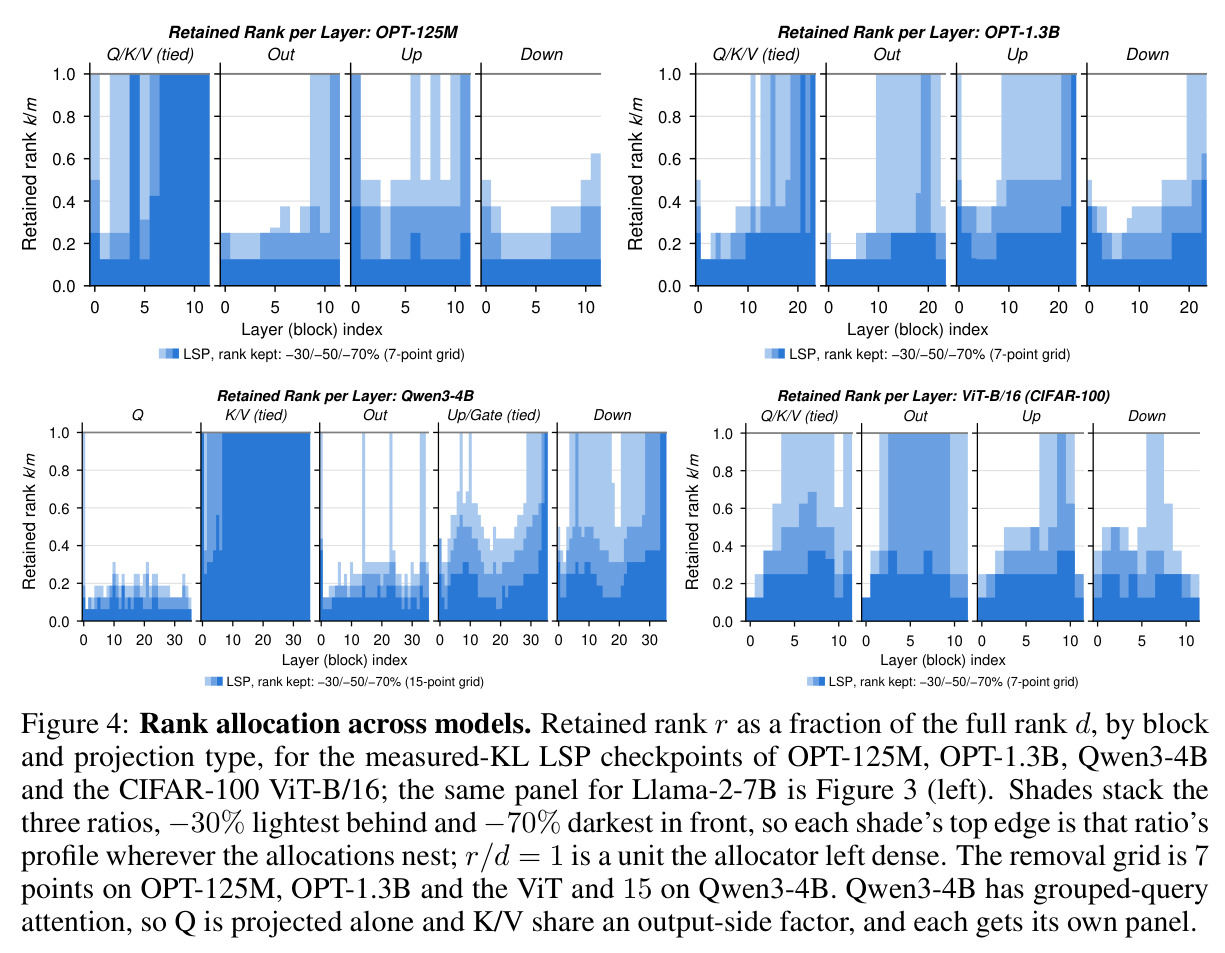
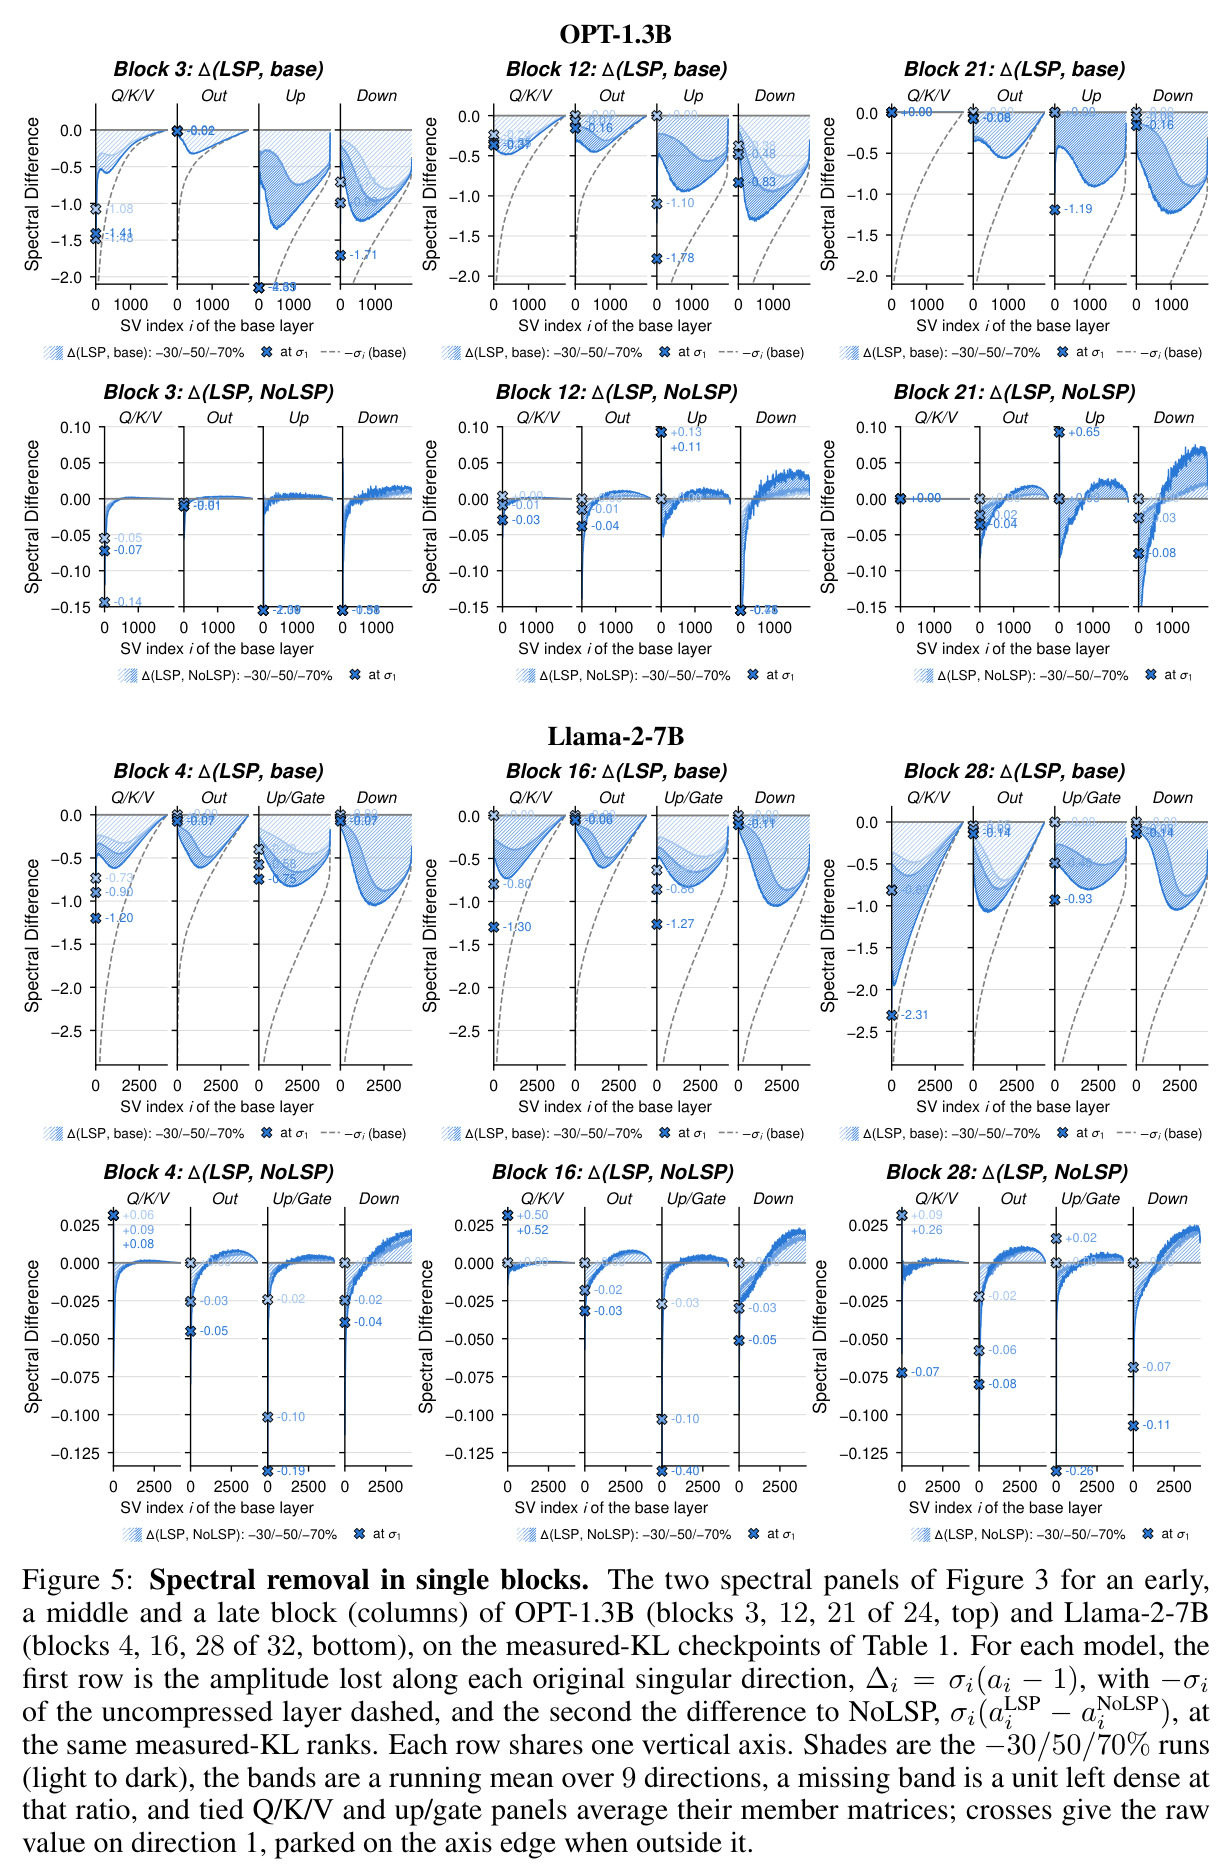
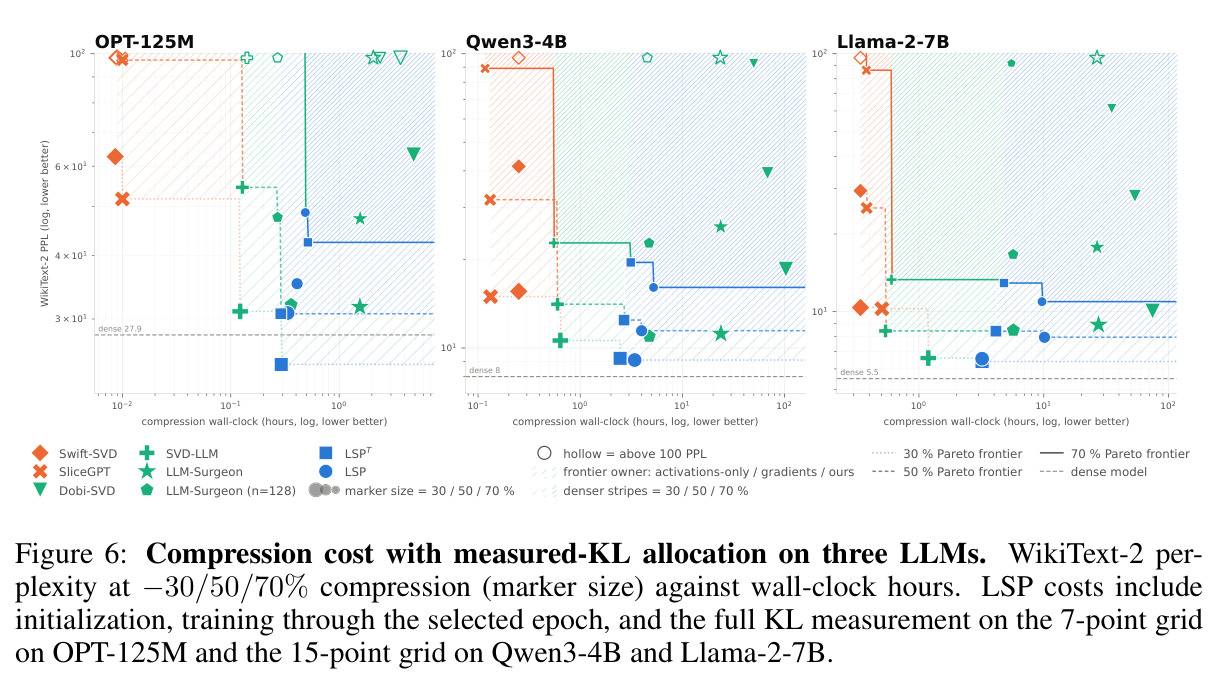
困惑度(Table 1):4个LLM×3个压缩率共12个设置中,LSP两变体之一全部最低,优势随压缩率扩大。-70%时Llama-2-7B:LSP 10.9,最强基线(带LoRA恢复的SVD-LLM)13.3,未学习的NoLSP 222.8,稠密5.5;Qwen3-4B -70%为16.2对22.5。-30%时LSP$^T$在两个OPT上(24.5对稠密27.9;12.9对14.7)甚至低于稠密,反映任务损失向校准域特化;蒸馏型LSP则在更大模型与更高压缩率上领先。零样本(Table 2):六基准平均,LSP领先最强免训练基线6.7–10.5点(Llama-2-7B,Alpaca校准)与6.2–10.8点(Qwen3-4B,C4校准),-70% Llama-2-7B为42.2%对36.0%(稠密56.9%);两目标相差不到2点,说明保留的是通用能力而非过拟合校准目标。视觉(Table 3):ViT-B/16在-70%单一池校准下源精度85.9(稠密89.9,最强免训练基线77.1);换成同规模多样池后LSP全部三个比率迁移最高(47.5/44.7/39.6),多样性增益+3.7/+7.1/+6.6也大于重训全部权重的PELA(+1.6/+1.7/+4.2)。推理效率(Table 4/5):解码比稠密快1.21×/1.36×/1.56×(-30/50/70%,batch 1),未绑定分解在-30%时均慢于稠密;潜在缓存每token每层556浮点,为稠密8192的1/14.7;128k上下文batch 8下权重+KV共38.9 GiB,较稠密524.6 GiB省13.5×(未绑定最多6.5×),95.5 GiB单卡可容322.1k token。可压缩性分析(3.4节):Q/K/V被压远多于MLP——尽管gate/up每方向省26,112参数、Q/K/V只省16,384,按每参数KL代价注意力输入仍便宜得多;-30%时128个单元中53个保持稠密;学习使删除深入头部奇异方向,第1方向相对NoLSP变化最大,正是学习把-70%困惑度从222.8降到10.9。压缩成本(Figure 6):每模型×比率0.5–10小时(KL测量占0.17/1.74/1.11小时),而Dobi-SVD花2–103小时在Llama-2-7B -70%仍只有61.2。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语言建模:Llama-2-7B,WikiText-2,-70%压缩 | 测试困惑度(越低越好) | LSP 10.9(LSP^T 13.0) | SVD-LLM+LoRA恢复 13.3;NoLSP 222.8;稠密 5.5 | 较最强基线降低18.0%;较未学习初始化降低95.1% |
| 语言建模:Qwen3-4B,WikiText-2,-70%压缩 | 测试困惑度(越低越好) | LSP 16.2 | SVD-LLM(W) 22.5;Dobi-SVD 92.5;稠密 8.0 | 较最强基线降低28.0% |
| 零样本推理:Llama-2-7B,-70%,6基准平均(Alpaca校准) | 平均准确率(越高越好) | LSP 42.2% | SVD-LLM 36.0%;Swift-SVD 31.9%;稠密 56.9% | 较最强免训练基线+6.2点 |
| 零样本推理:Qwen3-4B,-60%,6基准平均(C4校准) | 平均准确率(越高越好) | LSP 43.8% | Swift-SVD 33.0%;SVD-LLM 35.6%;稠密 61.3% | 较最强免训练基线+8.2点(各比率领先6.2–10.8点) |
| 视觉源任务:ViT-B/16 CIFAR-100,-70%,单一校准池 | Top-1准确率(越高越好) | LSP 85.9% | SVD-LLM(W) 77.1%;PELA 85.3%;稠密 89.9% | 较最强免训练基线+8.8点;与重训全部权重的PELA相当或更优 |
| 视觉迁移:Pets/Aircraft/Places365线性探针,-70%,多样校准池 | 平均线性探针准确率(越高越好) | LSP 39.6%(多样性增益+6.6) | PELA 38.3%(+4.2);SVD-LLM(W) 33.4%(+1.7) | 全部三个比率迁移最高,且从校准多样性获益最大 |
| 解码吞吐:Llama-2-7B,-70%,batch 1,512上下文 | tokens/s(越高越好) | LSP 221 tok/s | Swift-SVD 193;Dobi-SVD 189;稠密 141 | 比稠密快1.56×;全部模型×比率设置中最快的因子化模型 |
| 显存容量:Llama-2-7B,-70%,128k上下文,batch 8 | 权重+KV缓存总显存(越低越好) | 38.9 GiB(较稠密13.5×节省) | 未绑定分解 80.9 GiB(6.5×);稠密 524.6 GiB | 节省幅度约为未绑定分解的2倍;单卡可容322.1k token(稠密19.7k) |
局限与改进
作者明确承认的局限(A.7节)有三:其一,实测KL分配是加性局部代理——每个单元的代价在其余单元稠密时孤立测量,忽略交互作用,实测中压缩模型联合KL超过孤立代价之和2.1–4.3×(Llama-2-7B)、1.7–3.3×(Qwen3-4B)、最高达14×(ViT),分配没有全局最优性保证,个别设置(如Qwen3-4B的零样本,均匀分配在部分基准占优)均匀秩反而更好。其二,压缩并非免费:需要KL测量加投影训练,虽然测量可跨压缩率与目标复用,且Figure 6论证这是一次性成本。其三,绑定组只有在K/V输入绑定时才能兑现潜在缓存节省,而Qwen3-4B精度最佳的配置是K/V输出绑定,享受不到该红利,存在精度-效率权衡。我自己的补充观察:潜在缓存需要专用的注意力实现(类似MLA/Palu),每步要从潜在量重建K并施加旋转位置编码,代价随上下文长度线性增长,因此潜在缓存服务的是容量而非速度;蒸馏目标以稠密模型为天花板,压缩模型不可能超越教师;压缩率只统计线性层,嵌入与LM head不在其列;实验止步于7B模型,未验证更大规模或MoE;方法与量化正交但论文未做联合集成。
独立分析的弱点
独立分析的主要弱点及改进方向:第一,孤立测量的分配策略——联合KL可达孤立和的数倍,说明单元间交互不可忽略;改进方向是在贪心分配后加入若干轮联合重分配(按当前压缩模型的梯度敏感性迭代更新秩),或为交互项建立一阶修正。第二,绑定分组是人工固定的(Q/K/V、gate/up按输入,Qwen按输出);改进方向是让分组本身可学习,例如按激活统计的子空间重叠度自动聚类哪些层该共享投影。第三,两个目标各有软肋:KL蒸馏以稠密模型为天花板,任务损失则可能过拟合校准域(OPT上低于稠密困惑度即是信号);可探索两目标的混合或在蒸馏目标上加域正则。第四,潜在缓存的工程代价:需要定制注意力内核,K重建成本随上下文线性增长;改进方向是设计分块潜在缓存、把RoPE吸收进因子,或与KV量化结合进一步压窄潜在宽度。第五,低秩分解的prefill FLOPs并不下降,加速只体现在访存受限的小batch解码场景;对吞吐敏感的服务应与剪枝、量化组成混合压缩栈。第六,校准分布偏移仍伤害所有方法——LSP最稳健但在-50/-70%单池迁移上仍落后于PELA;值得研究无数据(data-free)或自监督的校准方式。第七,分配网格与测量需要额外前向(约0.17–1.74小时),小模型上占比可观,可探索用少量单元的测量外推其余。
未来方向
作者在文中提出的延伸点较少(结论偏总结),以下结合成果可自然延伸:一是把实测KL分配升级为联合可微分配,消除加性代理的次优性,并给出分配质量的理论保证;二是与量化(Dobi-SVD已含量化组件)、非结构化剪枝组成统一压缩框架,冲击-80%以上压缩率;三是把输入绑定+单潜在缓存的思路推广到原生潜在缓存的架构(如MLA类模型),或反向用LSP改造标准MHA模型获得MLA式部署;四是扩展到MoE专家、多模态编码器与嵌入层(当前明确排除在外),检验'函数子空间'假设的普适性;五是压缩与继续训练的统一——训练后的低秩因子 $(B,A)$ 本身就是天然的参数高效微调载体,可在压缩后继续适配下游任务;六是按作者伦理声明的提醒,系统评估压缩损失在子群体、域与罕见事件上的不均匀分布,建立压缩模型的公平性协议;七是把ViT实验揭示的'多样无标签校准池提升零样本迁移'发展成一条独立的压缩数据配方研究线(论文Table 16已有规模对照,可进一步扩大池规模与多样性)。
复现评估
复现评估:论文未提及发布官方代码仓库(正文与致谢中均无链接,仅说明所有基线用其官方代码运行),需要自行实现。有利条件是实现细节异常完整:Algorithm 1给出端到端伪代码,关键超参数全部明示——$\lambda_{ort}=0.05$、方向dropout $p=0.05$(Llama上0.1)、合并容差0.05、分配子集128K token、删除网格 $i/8$ 或 $i/16$、线性预热余弦调度与验证早停;校准数据全部公开(WikiText-2训练集、Alpaca、C4、CIFAR-100等);种子鲁棒性好(Table 6显示三个完整流水线种子的标准差多在±0.5以内,如Llama-2-7B -70% LSP为10.94±0.12)。算力门槛:OPT-125M与ViT-B/16单卡即可复现(压缩算术fp64);7B模型全局batch 8(4路数据并行×微批1),压缩总成本每模型×比率0.5–10墙钟小时(含KL测量1.11小时),需A100/H100级多卡,推理验证在GH200(95.5 GiB)。主要门槛有二:白化重铸与命题1的数学细节需要仔细推导验证(作者自述AI辅助证明并经两人逐步核查);高效实现(fused QR反向、激活空间投影、潜在缓存注意力内核)有相当工程量。综合评级:中等偏上难度,无代码情况下完整复现全部主表需数周投入,但复现核心思想(如OPT-125M)一周内可行。
论文图表
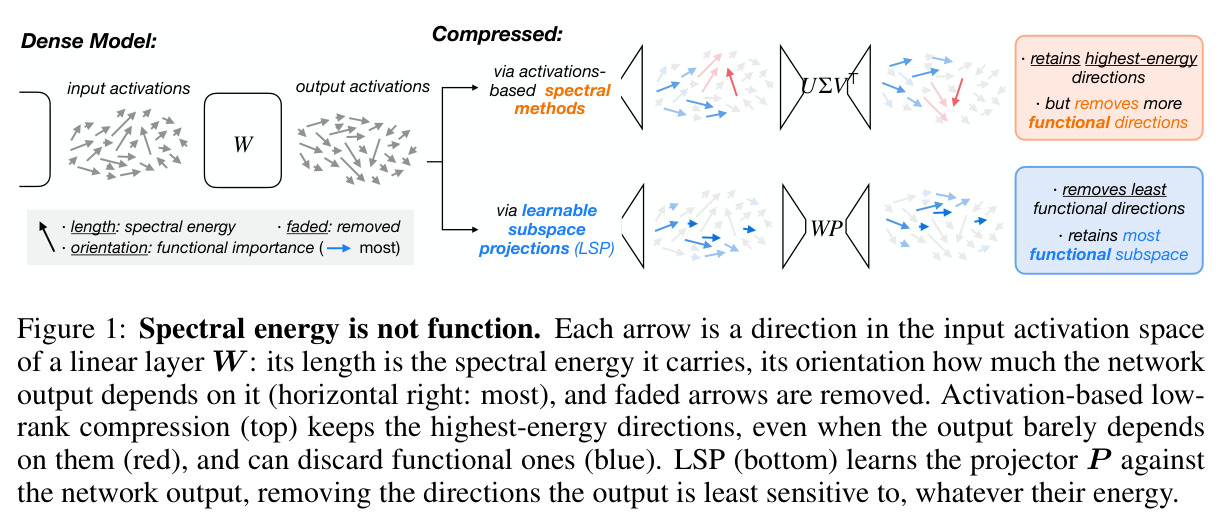
把线性层 $W$ 输入激活空间中的每个方向画成箭头:长度为它携带的谱能量,朝向为网络输出对它的依赖程度(向右最强),虚化箭头表示被删除的方向。激活式低秩压缩(上半)保留最高能量方向,即使输出几乎不依赖它们(红色),同时可能丢掉功能方向(蓝色);LSP(下半)对着网络输出学习投影 $P$,删除输出最不敏感的方向,无论其能量高低。
一图点明全文的核心动机——谱能量不等于功能重要性。理解了这张图,就理解了为什么层内闭式准则(激活能量、重构误差)在高压缩率下必然失效,以及为什么需要端到端学习子空间。