在线策略自训练:大语言模型的无数据自我改进 On-Policy Self-Training: Data-Free Self-Improvement in Large Language Models
仅凭主题词让模型自编题目自造答案,经自蒸馏循环实现零数据自我提升
前置知识
在线策略蒸馏(On-Policy Distillation, OPD)
知识蒸馏的在线版本:学生模型自己采样推理轨迹,教师在学生实际访问的每个状态上提供稠密的下一 token 目标分布,学生逐 token 对齐教师。与之相对,SFT 在教师强制的轨迹上做 token 级模仿,存在 exposure bias 且会侵蚀已有能力;RLVR/GRPO 则把整条轨迹的信号压缩成一个标量奖励。OPD 兼得自采样轨迹与稠密监督,训练信号效率高。
本文的训练目标正是在 OPD 框架上构造教师与数据,理解 OPD 才能看懂 Eq. 3 的逐 token 散度损失。
在线策略自蒸馏(OPSD)与特权信息
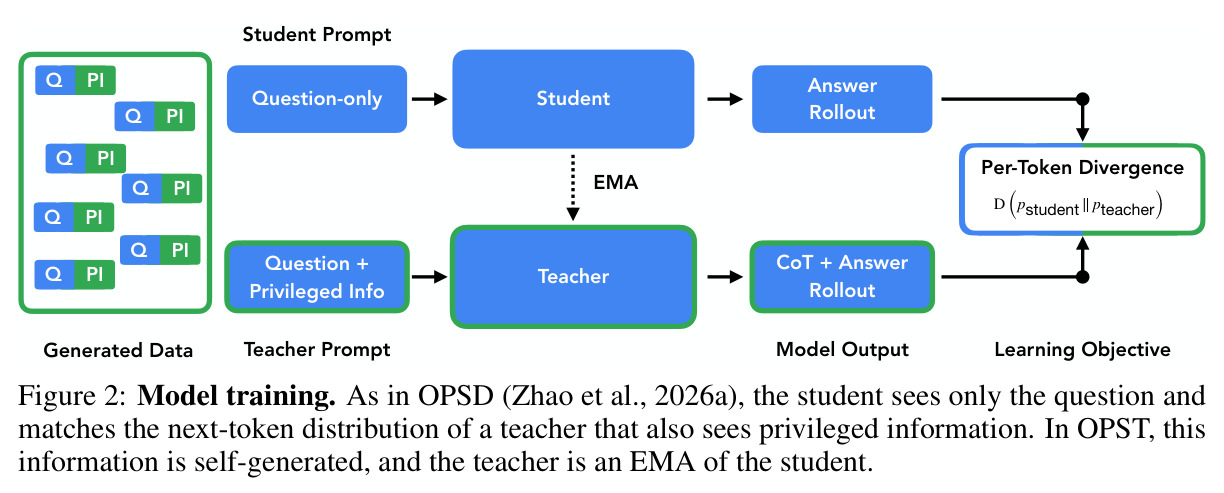
OPSD 把 OPD 中的『更强外部教师』也去掉:教师与学生从同一组参数出发,唯一差别是教师额外看到特权信息 $z$——学生看不到的附加上下文(通常是标准答案或专家示范),用『信息差』替代『能力差』来产生监督信号。本文中 $z$ 是模型自己生成的理由与候选答案,而非外部提供的参考解。
OPST 是 OPSD 的数据自由版,核心公式与训练流程完全沿用 OPSD,只是把特权信息的来源从外部改为自产。
RLVR 与 GRPO
可验证奖励强化学习(RLVR)用规则化的正确性检验(如答案匹配)给模型 rollout 打分,GRPO 是其代表算法:对同一问题采样一组 rollout,按组内相对优势计算策略梯度更新。其监督密度为每条轨迹一个标量,且需要标准答案来判定对错,奖励稀疏但外部依赖少。
GRPO 是本文的主基线之一(表 1、表 2),『稠密上下文监督 vs 稀疏标量奖励』的对比正是论文的中心论点。
EMA(指数滑动平均)教师
教师参数取学生历史权重的指数滑动平均:每次梯度更新后按 $\phi \leftarrow (1-\beta)\phi + \beta\theta$ 缓慢跟随学生,$\beta$ 越小教师越平滑。权重平均能滤掉单批梯度噪声,且平均后的模型往往比当前学生更准,思想上类似视觉自监督中的动量编码器(如 DINO)。
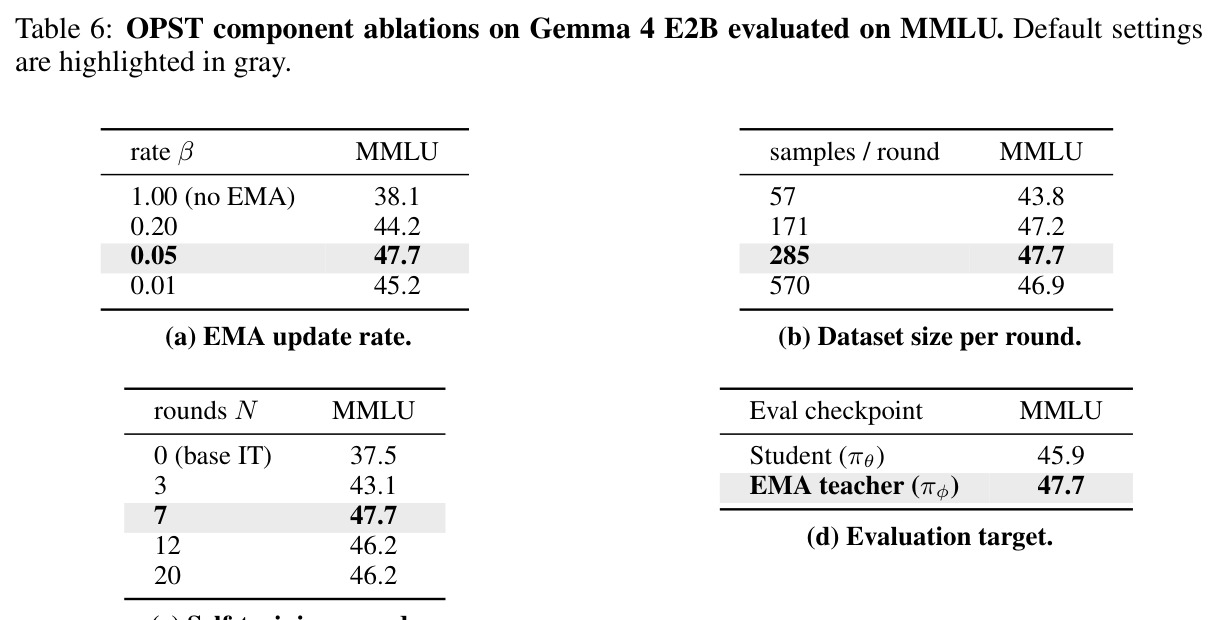
OPST 的教师、数据生成器、验证器与最终部署模型都是这个 EMA,$\beta$ 的取值直接决定自训练循环是否稳定(表 6a 显示 $\beta=1$ 时几乎无增益)。
偏斜 Jensen–Shannon 散度
一种有界的概率散度:用插值混合分布 $\bar{q}=(1-\alpha)q+\alpha p$ 把前向 KL 与反向 KL 凸组合,$D_\alpha=\alpha D_{KL}(q\|\bar{q})+(1-\alpha)D_{KL}(p\|\bar{q})$,上界为二元熵 $H(\alpha)$。$\alpha\to 0$ 趋向模式覆盖的前向 KL,$\alpha\to 1$ 趋向模式寻求的反向 KL,本文取 $\alpha=0.8$ 偏向模式寻求。
这是训练损失的核心(Eq. 5),有界性保证合成数据引入的局部异常 token 不会以近乎无穷的 KL 主导梯度更新。
自一致性(Self-Consistency)
对同一问题采样多条推理路径,抽取各自答案并统计一致率,以多数票作为最终答案。直觉是正确的推理路径更容易殊途同归;常用于思维链推理的答案聚合,也被用于无参考答案时构造伪标签,是当前无监督 RL(如多数投票奖励)的常见构件。
本文的共识门与伪验证都源自自一致性思想,但用法相反:不是选多数答案,而是丢弃学生已能稳定答对的题。
研究动机
后训练是大模型能力增长的主要驱动力,但沿『训练轨迹来源』与『学习信号密度』两个维度演进时,每一种范式都只是把外部监督换个位置保留下来:SFT 需要人工整理的参考解(对一个数学语料做过程级标注需要约 800,000 条人工步骤标签),RLVR/GRPO 需要标准答案作奖励,OPD 需要一个更强的教师模型,OPSD 虽去掉了外部教师,但仍需要特权上下文——通常就是标准答案。即便把答案换成模型自产的(STaR、R-Zero、Absolute Zero 等),这些方法依然在人类策划的题集上训练,出题权仍在人类手里;OpenAssistant 这类开放指令数据依赖超过 13,000 名志愿者的众包。换句话说,监督从『答案』转向『题目』后始终没有被真正移除,每换一个任务都要重新收集一批题集,这限制了自我改进的规模化。
本文的目标是本文把监督压到极限:不提供任何人工题目、答案或参考解,只给一组粗粒度的主题描述符 $T=\{\tau_1,\ldots,\tau_K\}$(如『抽象代数』『常识因果推理』),让模型围绕主题自行合成训练问题 $x$ 与特权信息 $z$(推理理由 $r$ 加候选答案 $a$),再通过在线策略自蒸馏在纯自产数据上训练。具体目标有二:其一,模型在所播种的领域内推理能力要显著提升,并在同等监督水平下超越 SFT、GRPO、u-OPSD、R-Zero 等替代方案;其二,训练信号完全无人工把关,模型必须在不自训的域上保持原有能力,才能支撑多轮迭代不崩坏;此外框架要能推广到多模态,仅凭无标注图像自我改进视觉问答。
与已有工作不同的是,被忽视的切入点在于:模型出题时并不只产生一个题目,还顺带产生了作答理由与候选答案,而此前的 self-play 工作(Absolute Zero、R-Zero 等)把这部分信息压缩成一个标量奖励。作者观察到,把这些自产内容改用作自蒸馏教师的前提上下文,可以从模型参数化知识中引出稠密的逐 token 监督,信息量远超标量奖励。另外,已有 OPSD 变体(特权示范、特权观测、多数投票答案的 u-OPSD)全部运行在给定题集上,最接近的 π-Play 虽不需外部数据但题目构建锚定在外部语料检索上;OPST 则完全凭参数化知识出题,首次研究了『模型能否从自己出的题中以稠密 token 级监督获益』这一通用推理设定,填补了 self-play(标量奖励)与 OPSD(给定题集)之间的空白。
核心方法
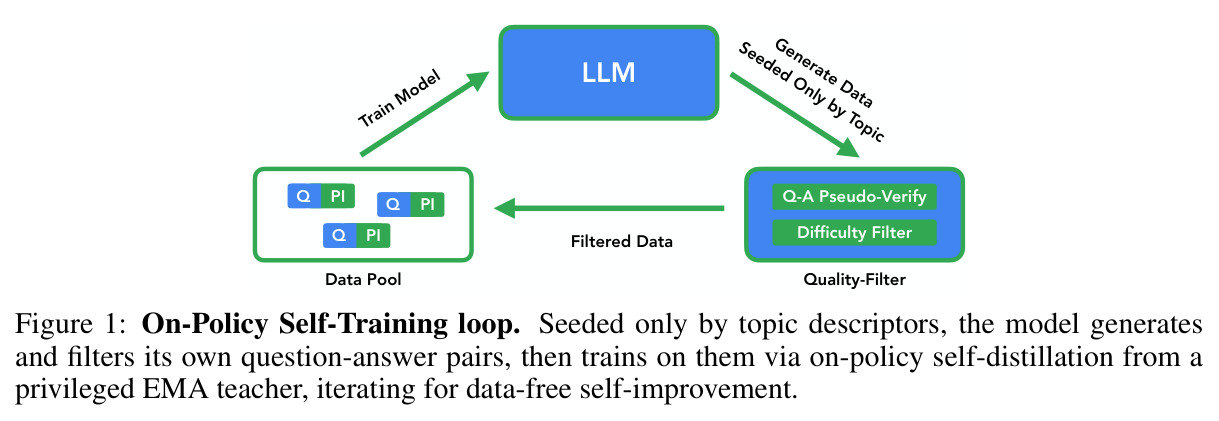
直觉上像让学生自己编考试题并附上答案,再用『看过答案的自己』当老师辅导『没看答案的自己』。技术路线是一个闭环:给定主题描述符 $\tau$,生成器产出(问题 $x$、理由 $r$、候选答案 $a$)三元组;经伪验证与共识门两级过滤后,保留恰好落在学生能力边界上的样本;训练时学生只看问题,在自己的采样轨迹上逐 token 对齐教师分布,而教师是学生的指数滑动平均(EMA)且额外看到 $(x,z)$。形式化地,学生在状态 $y_{<t}$ 的分布为 $p_t=\pi_\theta(\cdot|x,y_{<t})$,教师为 $q_t=\pi_\phi(\cdot|x,z,y_{<t})$,最小化 $\mathcal{L}_{OPST}=\frac{1}{B}\sum_i \frac{1}{\sum_t M_{i,t}}\sum_t D_\alpha(p_{i,t}\|q_{i,t})$。默认超参为 $\alpha=0.8$、$\beta=0.05$、每轮约 285 个样本、迭代 7 轮,最终评估并部署 EMA 教师。整个循环无需任何人工题目或答案,只有主题词是外部输入。
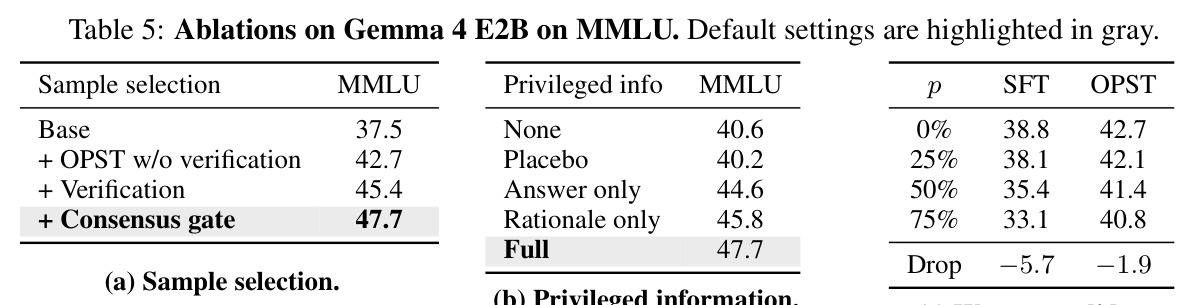
核心创新是把自产答案当作教师的上下文而非优化目标,这一区别在纯合成数据设定下至关重要。SFT 直接最大化 $\log\pi_\theta(z|x)$,把生成答案的每个 token 当作正确目标,错误与遗漏被照单全收;GRPO 用它与 rollout 的一致性作标量奖励,同样以生成质量为上限。OPST 中教师拿到候选答案 $a$ 与理由 $r$ 后,从自身参数化知识重新推导一份完整 rollout 作为监督:其一,理由里没写出的步骤教师能自行补全,向着 $a$ 推进的 token 被上调权重;其二,目标表达在模型自身的分布而非 $z$ 的表面措辞上,学生不会模仿生成文本的格式;其三,模型先验限制了错误 $z$ 的影响——错误只在模型觉得可信的范围内移动目标,不可信处教师保留原判断。附录 A.1 将此总结为『学生学到的是模型在提示 $z$ 下能推断出什么,而非 $z$ 本身』,表 5c 显示 75% 答案被换成错误答案时 OPST 仅掉 1.9 点而 SFT 崩掉 5.7 点,直接验证了这一机制。
方法步骤详情
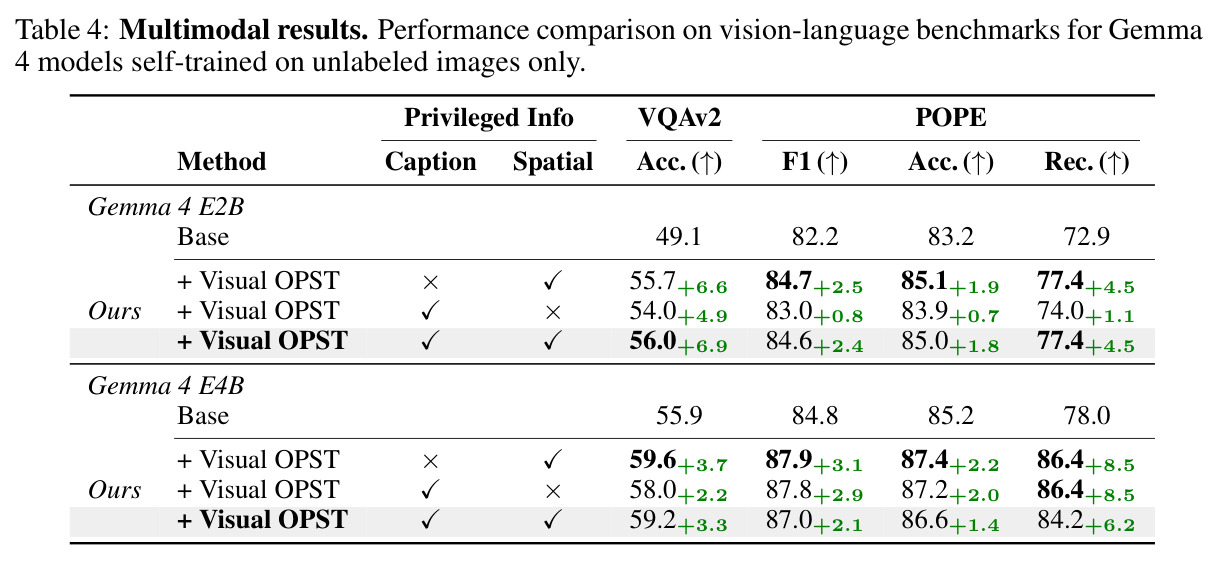
完整流程分五步。第一步主题播种出题:生成器 $\pi_{gen}$(取 EMA 教师或冻结初始副本)对每个 $\tau$ 采样 $(x,z)$,$z=(r,a)$ 含理由与候选答案。第二步伪验证:在全新上下文低温重解要求 $\hat{a}(x)=a$,改写为 $x'$ 后重解要求 $\hat{a}(x')=a$,剔除病态题与措辞依赖题。第三步共识门:学生采 $G$ 条推理路径,与候选答案全对(一致率 $c=1$)则丢弃,留下的题恰在学生能力边界上,课程难度随学生进步自动演化。第四步训练:最小化偏斜 JSD $D_\alpha=\alpha D_{KL}(q\|\bar{q})+(1-\alpha)D_{KL}(p\|\bar{q})$,$\alpha=0.8$ 偏向模式寻求;每次更新后教师按 $\phi_k=(1-\beta)\phi_{k-1}+\beta\theta_k$、$\beta=0.05$ 跟随。第五步迭代:共 $N=7$ 轮并跨轮去重,最终返回 EMA 教师。Visual OPST 引入无标注图像与场景描述或检测框空间关系作特权信息,用增强视图一致性验证。
技术新颖性
技术新颖性体现在四处:一是设定本身,首次在无检索、无外部语料锚定的通用推理场景中验证『自出题加稠密自蒸馏』可行,此前 self-play 把自产题目信息压缩为标量奖励、OPSD 系列又依赖给定题集,OPST 同时移除了两者;二是两级过滤器方向相反的设计——伪验证保证样本稳定到可当特权信息,共识门则主动丢弃学生已会解的样本,二者夹逼出『稳定且有信息量』的训练带;三是课程难度因共识门依赖当前学生而隐式自演化,无需人工调度课程;四是损失设计,偏斜 JSD 以二元熵 $H(\alpha)$ 为上界,防止合成提示引入的局部伪影 token 以巨大 KL 主导梯度。此外 EMA 教师同时充当生成器、验证器与最终部署模型,三个角色随训练共同进化,形成自我强化的循环。
实验结果
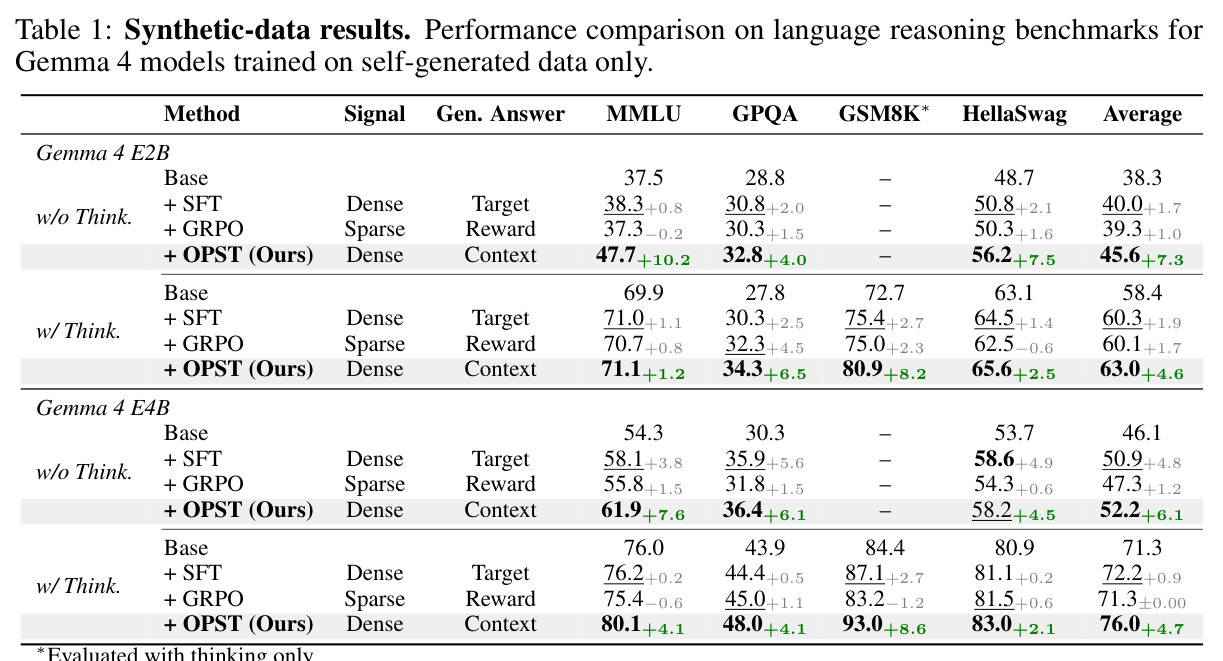
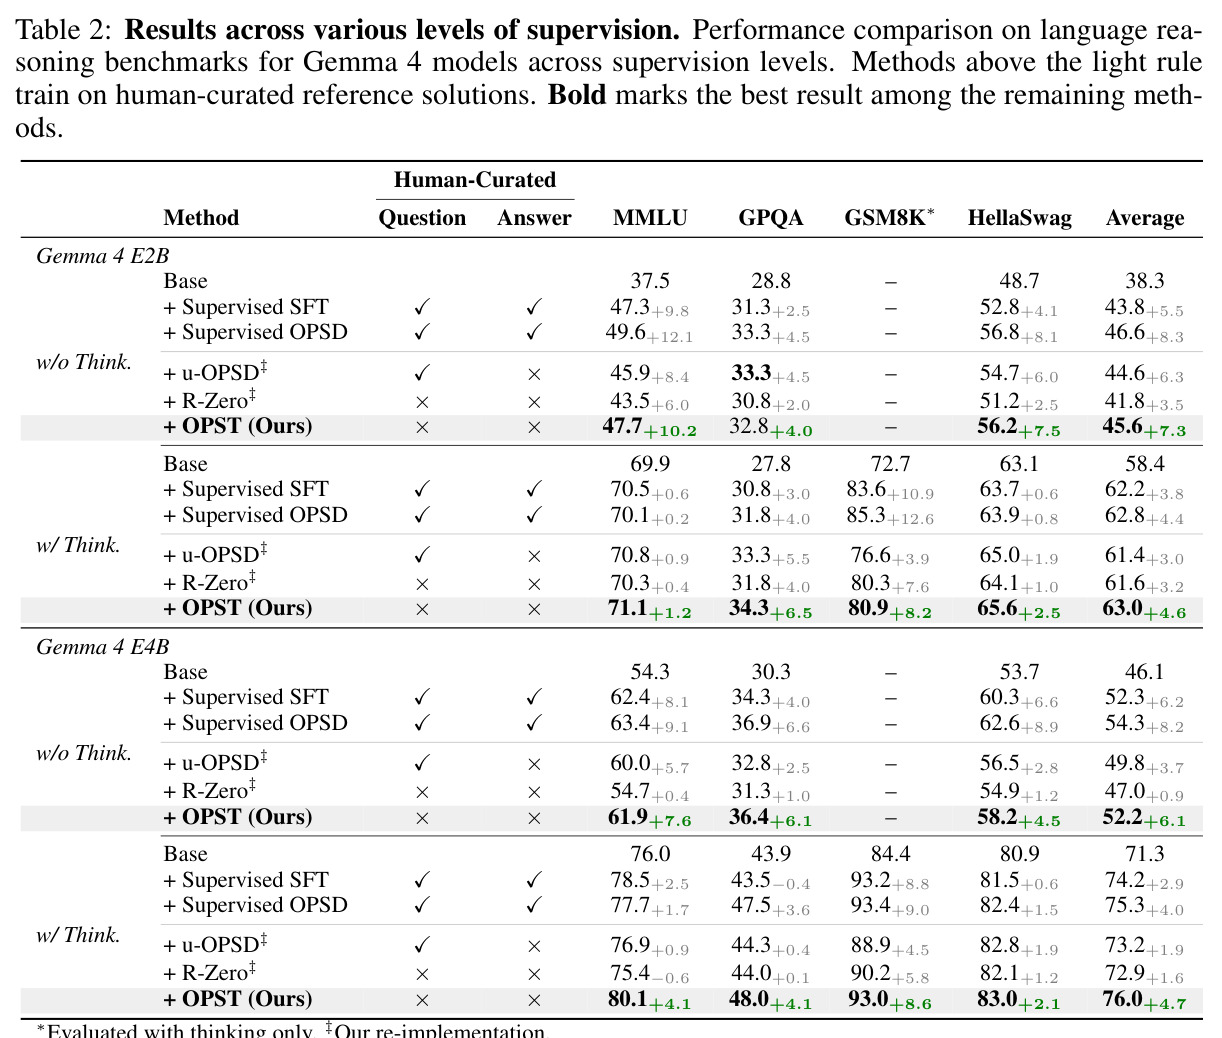
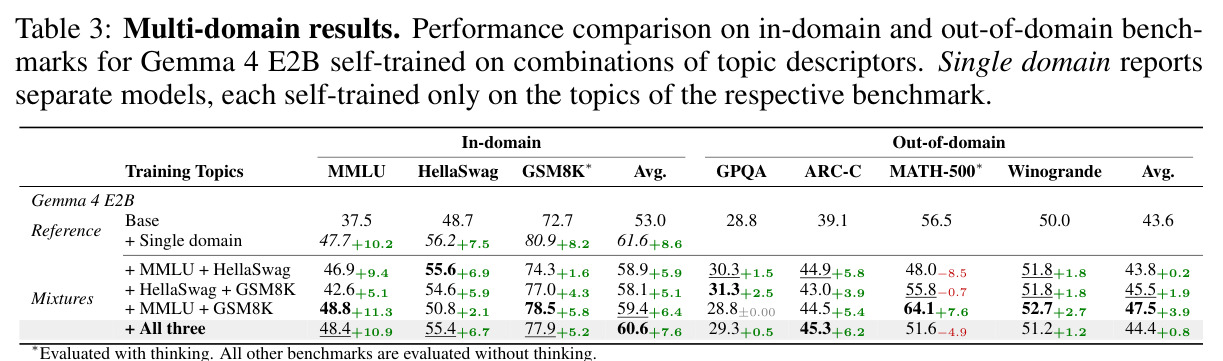
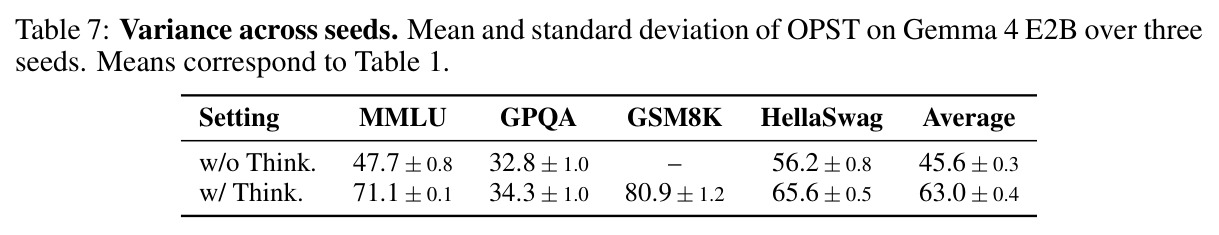
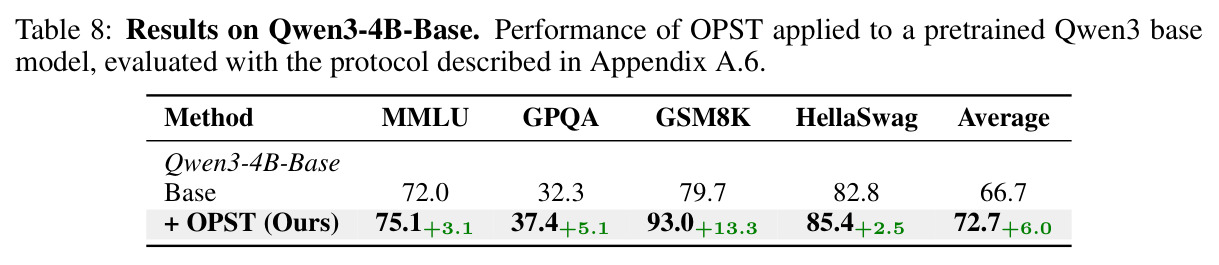
三大发现。其一,纯自产数据即可显著提升:Gemma 4 E2B 无思考模式下 MMLU 37.5→47.7(+10.2)、GPQA +4.0、HellaSwag +7.5,平均 +7.3,远超同一份自产数据上的 SFT(+1.7)与 GRPO(+1.0);带思考模式下 GSM8K 72.7→80.9(+8.2)、GPQA +6.5。E4B 无思考平均 +6.1,带思考 MMLU 76.0→80.1、GSM8K 84.4→93.0(+8.6)。其二,与监督水平阶梯对比:OPST 在四种设置下均为无参考解方法最佳,超 u-OPSD 1.0–2.8 点、超 R-Zero 1.4–5.2 点,2B 无思考恢复有监督 OPSD 增益的 88%(+7.3/+8.3),带思考时追平有监督 OPSD;多域混合训练域内平均 +7.6 且与单域最佳仅差 1.0 点,MMLU+GSM8K 混合让 MMLU 涨 11.3 点、域外平均 +3.9 最佳,即便不含任何 MMLU 主题 MMLU 也涨 5.1 点。其三,Visual OPST 仅用无标注图像使 2B 的 VQAv2 49.1→56.0(+6.9)、POPE 召回 +4.5;Qwen3-4B-Base 上平均 +6.0、GSM8K +13.3,且选择题按选项对数似然打分,证明方法跨模型族、跨预训练/指令微调模型均可迁移。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MMLU(Gemma 4 E2B,无思考) | 准确率 | 47.7 | Base 37.5;同数据 SFT 38.3、GRPO 37.3 | +10.2(超 SFT +9.4、超 GRPO +10.4) |
| GPQA Diamond(E2B,无思考) | 准确率 | 32.8 | Base 28.8 | +4.0 |
| HellaSwag(E2B,无思考) | 准确率 | 56.2 | Base 48.7 | +7.5 |
| GSM8K(E2B,带思考) | 准确率 | 80.9 | Base 72.7 | +8.2 |
| GSM8K(E4B,带思考) | 准确率 | 93.0 | Base 84.4 | +8.6 |
| MMLU(E2B,无思考,监督水平对比) | 准确率 | 47.7 | u-OPSD 45.9、R-Zero 43.5、有监督 OPSD 49.6 | 超 u-OPSD +1.8、超 R-Zero +4.2,恢复有监督增益的 88% |
| VQAv2(Gemma 4 E2B) | 准确率 | 56.0 | Base 49.1 | +6.9 |
| Qwen3-4B-Base 四基准平均 | 平均准确率 | 72.7 | Base 66.7 | +6.0(其中 GSM8K +13.3) |
局限与改进
作者承认的局限:OPST 只能放大模型已有知识,无法注入真正的新知识;伪验证度量的是自洽性而非正确性,模型一致犯的错会进入训练;主题描述符靠人工挑选;实验仅限 E2B/E4B 与 Qwen3-4B 等小模型。我补充观察:表 3 显示域外保持并不完全稳健,三域混合训练使 MATH-500 回退 4.9 点(56.5→51.6),MMLU+HellaSwag 混合更暴跌 8.5 点至 48.0,说明数学类能力的遗忘风险仍在,需靠混合 GSM8K 主题缓解;表 6c 显示 7 轮后增益封顶(12/20 轮回落到 46.2 左右),但文中没有给出无标签的停止准则;表 5c 的鲁棒性测试是在关闭两级过滤的前提下进行的,实际管线中过滤器与训练相互耦合,错误答案的真实影响可能被低估;另外共识门依赖低温重解与多次 rollout,每个样本的生成与验证开销数倍于训练本身,成本-收益曲线未报告。
独立分析的弱点
独立分析三个弱点。其一,能力天花板与错误回灌:数据由同一模型生成并验证,验证器自身会错,学生与教师共享的系统性错误(如共同的错误概念)无法被共识门发现,且会被逐轮强化;改进方向是引入工具执行器或检索证据做外部锚定校验,只对无法工具化验证的样本保留伪验证。其二,课程耗尽问题:共识门丢弃学生全对的题,随着学生逼近主题上限,可训练样本迅速枯竭,表 6b 显示每轮 285 样本即饱和、570 反而降到 46.9;改进方向是按信息量加权采样,或让生成器显式瞄准学生的错误模式做主动出题。其三,计算不对称与任务适配:每个样本需要生成、改写重解、G 条学生 rollout 加教师 rollout,再训练一个含 EMA 的模型,端到端 token 开销数倍于 SFT;在 E4B 无思考的 HellaSwag 上 SFT 反而略胜 0.4 点,说明模型较大或任务较简单时性价比存疑;改进方向是级联验证(先用低开销启发式筛掉大多数样本,仅对高不确定性样本跑完整流程)。
未来方向
作者提出的方向:设计无标签的停止准则,判断自我改进何时饱和以免错误随轮次累积;以工具执行或检索为锚的验证机制,弥补自洽性验证无法发现一致错误的问题。基于成果可延伸的方向:把 OPST 放到更大模型与更长迭代链条上,检验增益是否随规模持续;将主题描述符本身也交给模型自举——自动发现能力盲区并定向出题,形成完全无人工的元课程;结合过程奖励模型对教师 rollout 做逐 token 加权,进一步压制合成噪声;把 Visual OPST 的特权信息从检测框空间关系扩展到深度图、物体属性表等结构化先验;以及在多智能体设定下让提议者与求解者分别训练,探索自博弈与自蒸馏混合的规模化路径。
复现评估
复现条件较好但无官方代码。论文为 Google 预印本,未提及开源仓库或数据发布;不过所有关键超参数披露完整:偏斜 JSD 的 α=0.8、EMA 速率 β=0.05、每轮约 285 个样本、共 7 轮、共识门用 G 条学生 rollout、视觉验证用 K 个增强视图(排除水平翻转),附录 A.7/A.8 给出全部出题、学生、教师及视觉验证的 prompt 模板原文,附录 A.6 说明评测基于 EleutherAI lm-evaluation-harness 适配 Gemma 4 聊天模板,选择题按选项对数似然打分。基模型 Gemma 4 E2B/E4B 与 Qwen3-4B-Base 均为开放权重,E2B 级别的训练用少量 GPU 即可尝试,三种子方差不超过 1.2 点说明稳定性好。主要风险:Gemma 4 具体权重的可得性、生成数据的过滤通过率与吞吐等工程细节未报告,且部分引用文献为 2026 年预印本,复现难度中等偏高。
论文图表