RSIHub:面向智能体进化方法的可组合框架 RSIHub: A Composable Framework for Agent-Evolution Methods
把四类智能体进化方法拆成可组合算子,统一执行、评测与溯源,实现公平对比与可信实验。
前置知识
智能体进化(Agent Evolution)
指利用任务执行的反馈信号(成功/失败轨迹、报错、评分)自动迭代改进 LLM 智能体的闭环方法,改进对象可以是提示词、可复用技能、工具或编排结构。典型代表包括 GEPA(轨迹反思+Pareto 选择优化提示词)、AHE(基于执行证据修订 harness 文件)、A-Evolve(面向持久系统状态的目标导向部署期适应)与 Hyperagents(任务智能体与可自修改的元智能体共存于同一可编辑程序)。每次迭代都要选父代、跑任务、收集证据、生成并评估新候选。
RSIHub 就是为这类方法提供共享基础设施,理解这四种方法各自进化什么,才能看懂框架抽象出的算子接口为什么这样切分。
配方与算子
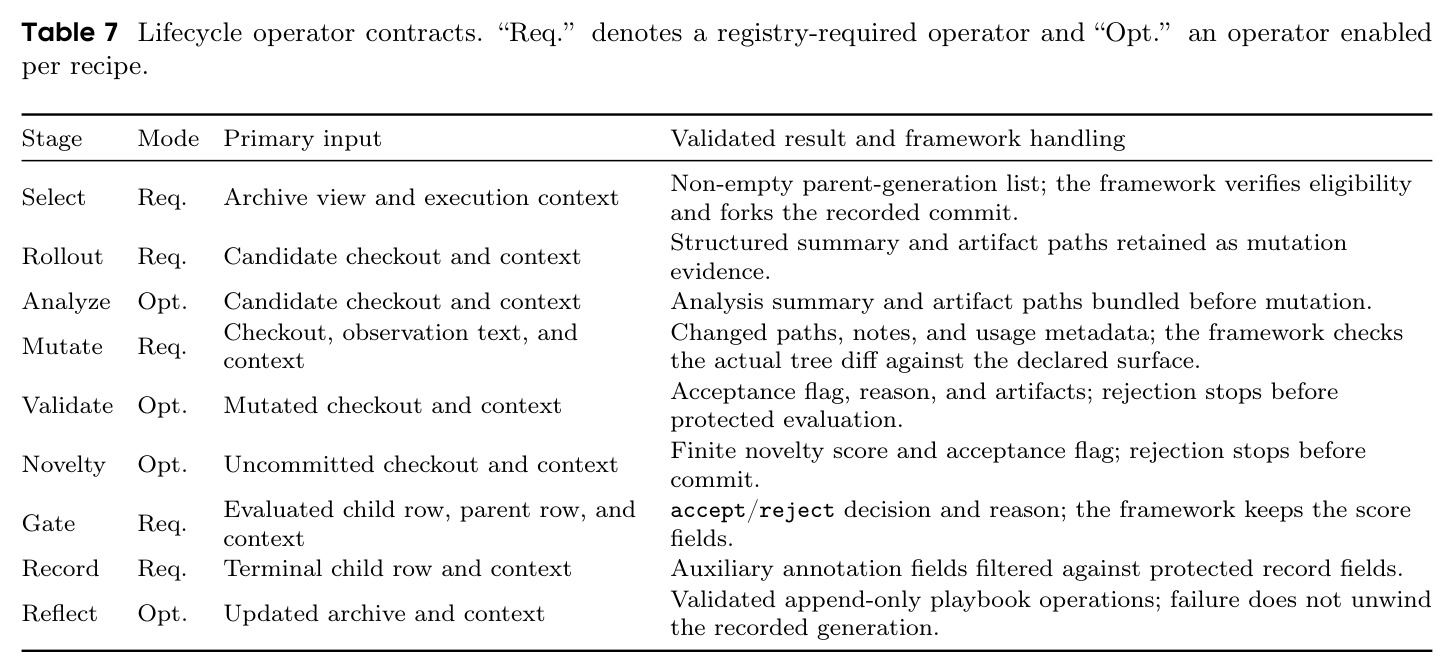
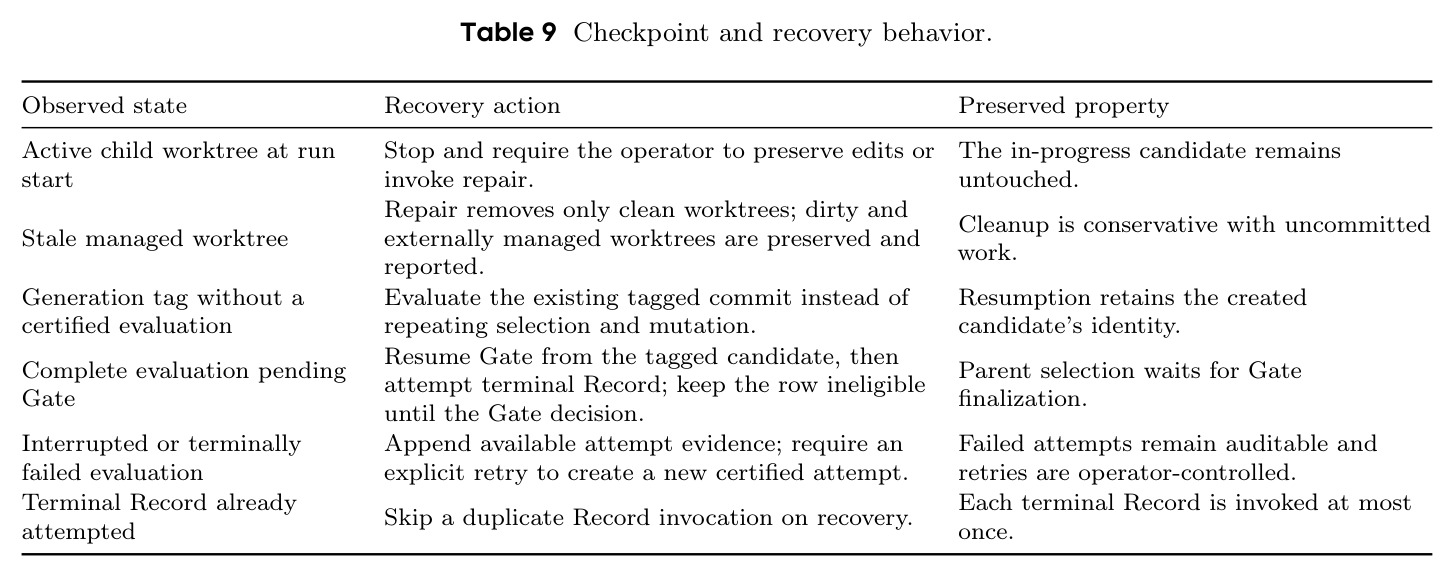
RSIHub 把进化生命周期固定为七个阶段(Select、Rollout、Analyze、Mutate、Guardrail、Evaluate、Absorb),每个阶段是一个插槽,算子是插槽的一种具体实现。配方是一份声明式配置:为五个必需算子接口(Select、Rollout、Mutate、Gate、Record)与四个可选接口(Analyze、Validate、Novelty、Reflect)各绑定一个实现并设参数,同时声明可变表面与运行配置。换掉某个算子实现即换一种方法策略。
这是全文的核心抽象,'方法即配置'的思想以及四个方法能在零框架改动下实例化,全部建立在它之上。
可变表面
配方中 surface 块显式声明的、候选程序允许修改的资源集合,例如仅提示词、技能文件,或整个 harness。每次变异后框架用 Guardrail 检查实际目录树 diff 是否越出该表面,越界编辑被排除出候选。与配置变异代理行为的 mutate 块一起,它把'方法可以改什么、能看到什么'从隐含的代码逻辑变成显式的实验变量。
表面约束是'评测在方法够不着的地方'这一安全设计的对照面,不理解它就无法理解归因保证从何而来。
Train/Gate/Sealed 三分数据划分
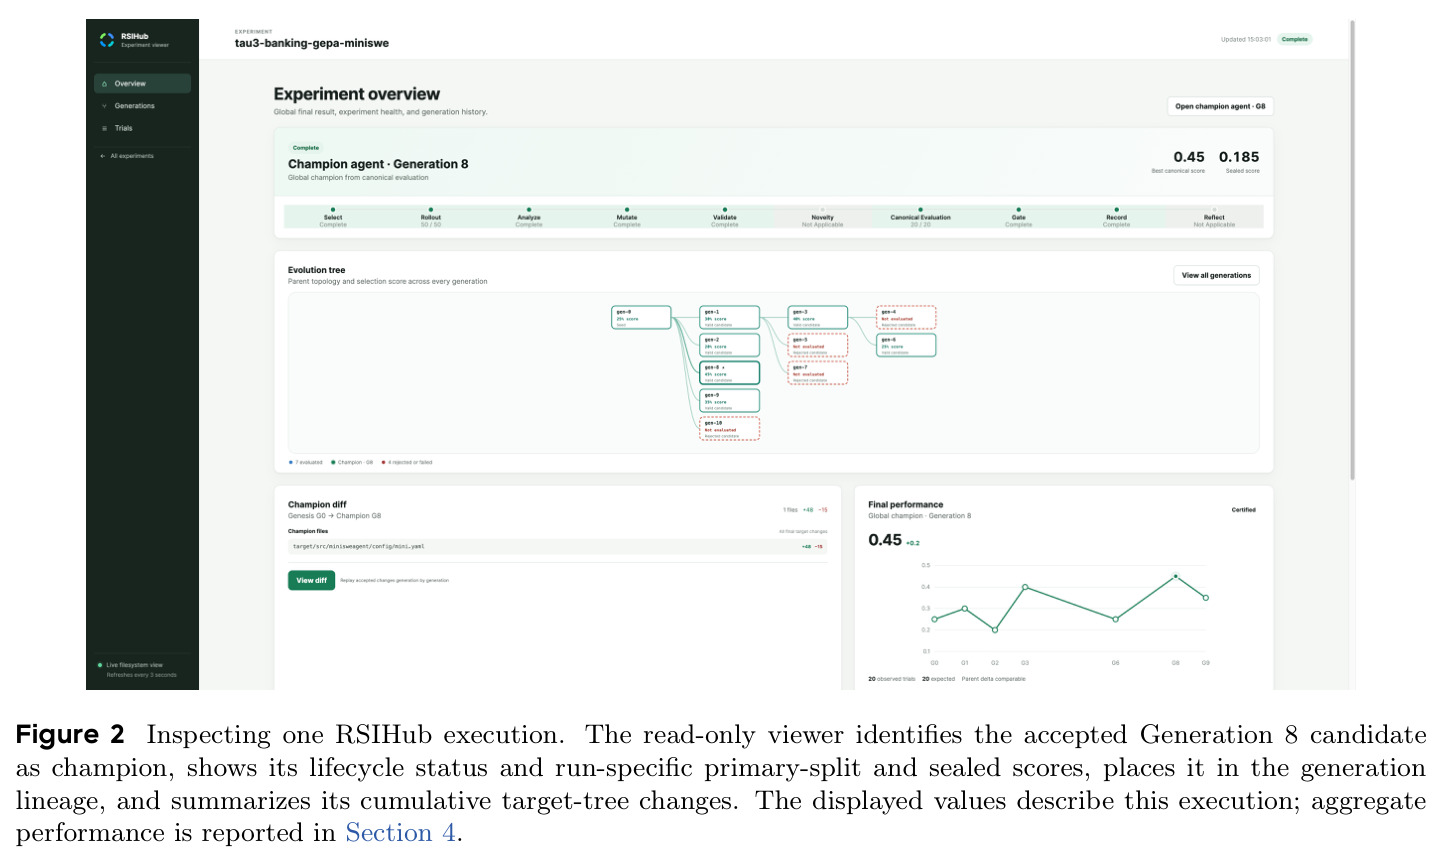
每个基准任务被划分为训练集(为进化提供反馈轨迹)、门控集(评估候选并决定其能否被准入为父代)与封存集(对变异反馈完全不可见,仅用于留出报告)。论文按任务贡献计分,每个划分列的贡献为 $N_{pass,s}/N_{all}$,三列之和等于整体 pass@1。Terminal Bench 2 的 89 个任务按 50/19/20 划分,τ³ Banking 的 97 个任务按 50/20/27 划分。
论文的核心实证结论'增益不保证迁移到留出任务'完全依赖这套划分语义,看不懂划分就看不懂 Table 1。
认证评估记录与溯源
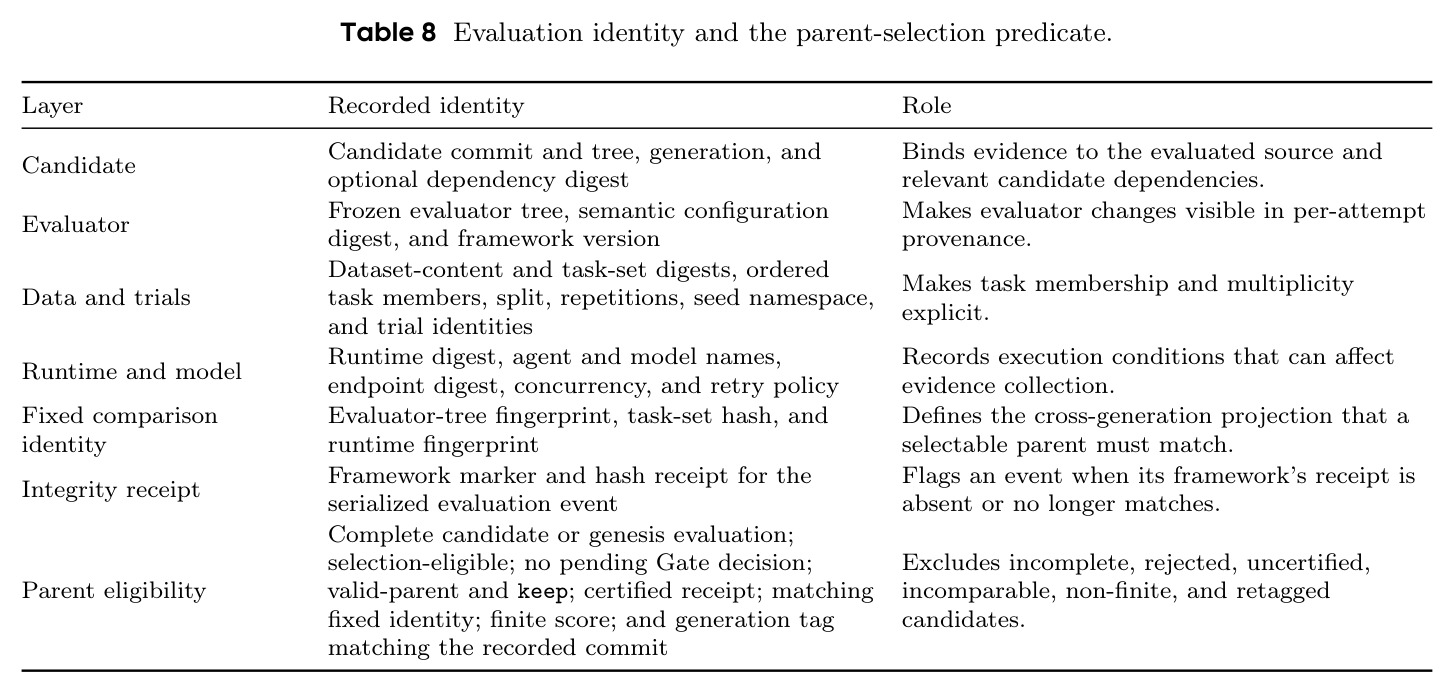
框架管理的评估事件把已提交候选、父代、配方快照与评测器指纹、任务集指纹、试验结果、得分、成本、工件引用和谱系绑定在一起;哈希引用的契约还可记录评估器配置摘要、数据内容摘要、划分与重复设置、模型身份、重试策略和框架版本。算子只能提议方法注解,经框架过滤后写入,任何算子都无法修改认证评估字段。
论文 RQ3 的完整性主张(防伪造档案、防篡改评测、中断后可归因恢复)全部由这套机制兑现。
研究动机
智能体进化方法(GEPA、AHE、A-Evolve、Hyperagents,以及 Promptbreeder、ACE、STOP、ADAS、DGM、AlphaEvolve 等)都用'执行反馈→修订候选→再评估'的循环改进智能体,但每篇工作的实现都把方法策略和大量重复的基础设施捆绑在一起:隔离开的候选工作区、任务执行与评测、工件留存、中断恢复、谱系记录。后果有两个:一是实现一个新方法等于再造一个端到端系统,工程成本高到劝退;二是比较两个方法必须先调和各自的 runner、配置格式和评测器接口,结论常常不可比。更隐蔽的问题是归因风险:在广泛可变的进化系统里,如果方法侧能改动评测逻辑或记录写入,表观提升就可能来自'改了尺子'或'改了账本'而非真实能力提高——文献中已有奖励篡改、代理奖励过优化和在可博弈环境中出现奖励篡改行为的警示案例。这些问题使该领域进展快但证据质量参差。
本文的目标是本文要做开源、可组合的框架 RSIHub(Apache-2.0,Simple Agent Lab 发布),把方法策略与执行、评测、恢复、溯源等通用机制分离,让研究者只写进化策略。目标可量化:其一,用统一配方抽象在不改框架核心源码的前提下表达 AHE、Hyperagents、A-Evolve、GEPA 四种方法,每个方法只需几十行配方加方法专属算子代码;其二,提供共享候选生命周期,覆盖候选执行、恢复、工件、认证评估记录与谱系;其三,在共同基准上公平对比——用 MiniSWE 与 Codex 两个种子智能体、Terminal Bench 2 与 τ³ Banking 两个基准、固定的 GPT-5.4 目标模型与冻结评测器跑全部配方;其四,自检框架本身:是否改变未进化智能体的能力(保真度)、能否从中断中恢复并守住边界(完整性)、运行时与代码开销多大。
与已有工作不同的是,已有工作几乎都把精力花在进化策略本身,基础设施被当作每篇论文的一次性脚手架;RSIHub 反过来把基础设施做成研究对象和贡献主体。具体有三处被忽视的设计:一是把'方法能改什么、能看到什么'变成配方的显式声明(surface 块与 mutate 块),使提示词级与整体 harness 级研究共用同一套算子接口;二是把评测和档案放在可变表面之外、框架控制之下,并把'选父代'(Select)与'评估后是否准入为父代'(Gate)拆成两个独立决策,直接针对归因风险;三是借鉴相邻领域研究框架'稳定接口+共享运行时'的组织方式,容器执行委托给 Harbor,自己只补版本化进化生命周期、配方级方法组合与跨方法公共溯源。此外它预留了 agent-driven 模式:外层智能体可在迭代间修订配方,但评测器与封存集始终受保护。
核心方法
直觉上,RSIHub 像一座自动化实验室:研究者只设计实验方案(配方),种子的培育、测量仪器的校准、实验记录本的登记都由场馆固定流程完成,任何人不得动仪器和账本。技术上,一份配方为五个必需算子接口绑定实现并配置参数,声明可变表面和运行配置(目标、评测器、运行时、数据划分),另配一个最简 hill_climb 基线配方。框架管理的进化循环按七阶段调用算子:Select 选父代、Rollout 在训练任务上收集执行证据、Analyze 蒸馏证据、Mutate 编辑候选、Guardrail 校验 diff 未越表面、Evaluate 在门控任务上打分并认证、Absorb 由 Gate 决定准入并由 Record 写注解。容器执行、轨迹捕获与逐任务校验委托给 Harbor。每次迭代前框架校验并快照配方,算子在独立进程中运行且输出经结构化校验;认证评估事件再与候选、父代、配方快照、评测器/任务集指纹、得分、成本与谱系绑定,写成可核查的档案。
核心创新是'方法即配置 + 评测在方法够不着的地方'这一对分离。与 GEPA、AHE 等原实现把策略和工程捆绑不同,RSIHub 把生命周期固定为稳定插槽,方法退化为一份几十行的配方加少量方法专属算子,四个方法实例化时零框架源码改动。更关键的是受保护运行时:评测与档案位于配方声明的可变表面之外,由框架服务独占写入,Gate、Record、Reflect 只能追加策略输出而不能改认证字段;Guardrail 用目录树 diff 硬性拦截越界编辑;Novelty 可在消耗评测预算前丢弃近重复候选。这直接回应宽口径可变系统的归因风险——方法既改不了尺子(评测)也改不了账本(记录),任何表观提升都能绑定到确切的候选提交与评估条件上。配套的 train/gate/sealed 划分与以认证记录为检查点的恢复机制,让留出迁移可审计、中断可归因恢复。
方法步骤详情
一次候选事务即算法 1 的 EvolveOne(R, H),输入为校验过的配方快照 R 与档案历史 H,输出更新后的 H。流程:Select 依搜索策略(如 pareto)选合格父代,框架校验身份并 fork 其确切提交;Rollout 让父代在训练划分上运行,返回证据摘要与工件引用(或用 replay 模式复用已记录评估);可选的 Analyze 把 rollout 案例蒸馏成有界变异证据;Mutate 通常是一个多轮智能体,在表面内提出编辑,可在训练任务上小规模试跑;Guardrail 中框架核对真实目录树 diff 是否越出表面,可选的 Validate 做评测前检查、Novelty 丢弃近重复 diff;Evaluate 提交审查过的树、在干净检出上跑门控任务并认证结果,封存任务绝不参与;Absorb 由 Gate 依认证分决定是否成为父代、Record 提议方法注解、可选的 Reflect 把经验写入独立 playbook。任何拒绝、失败、畸形输出或超时(Stops)都走 CloseAndRecord,作为带类型的已归档尝试关闭,不污染档案。
技术新颖性
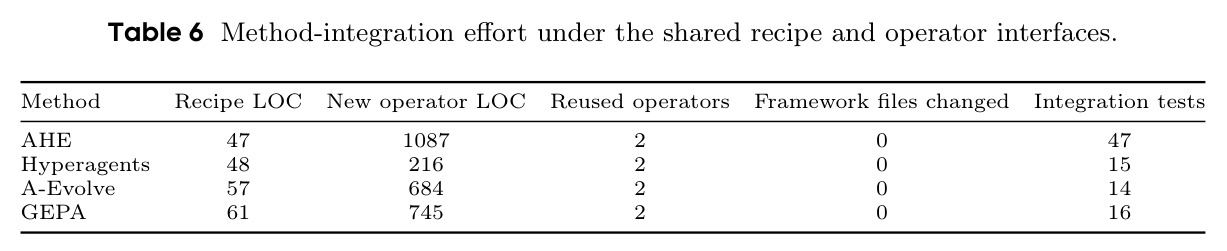
与相邻系统的边界划得很清楚:相对 Harbor 与 OpenHands SDK,RSIHub 把容器执行、轨迹捕获、逐任务校验外包给 Harbor,自己新增版本化进化生命周期、配方级方法组合与跨方法公共溯源,做的是'进化层'而非'执行层';相对 DSPy/TextGrad 这类程序优化器,它不提供优化算法,而是提供让任何优化策略可比、可核查的底盘;相对软件溯源与可复现性系统,它把血缘绑定到候选提交、配方快照与评估条件指纹上,并过滤算子私自写入的注解;相对 AI4AI 综述指出的'测量增益/保持/留出迁移'混淆,它用划分语义把三者显式分开。工程上的新颖性证据是:四个方法适配各用 47–61 行配方、216–1,087 行方法专属算子代码,每个复用两个算子绑定、零框架改动。把方法实现压缩到'配置+插件'量级是本文最实在的贡献。
实验结果
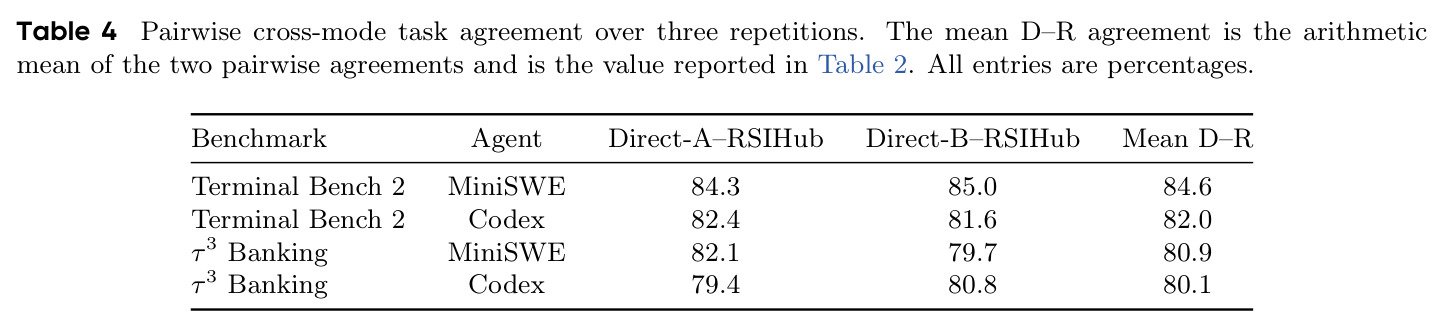
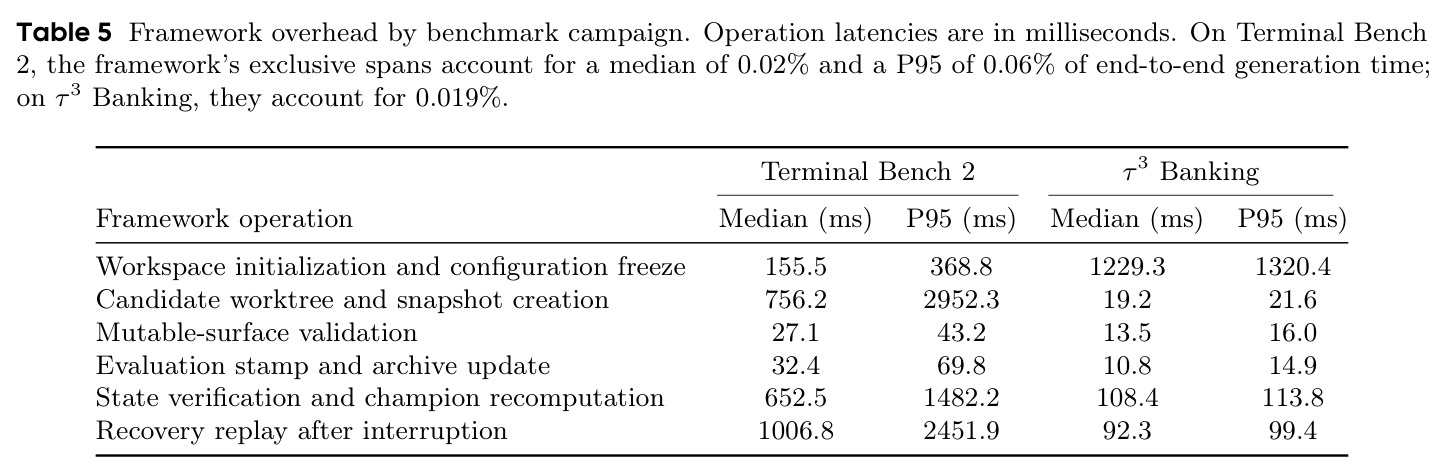
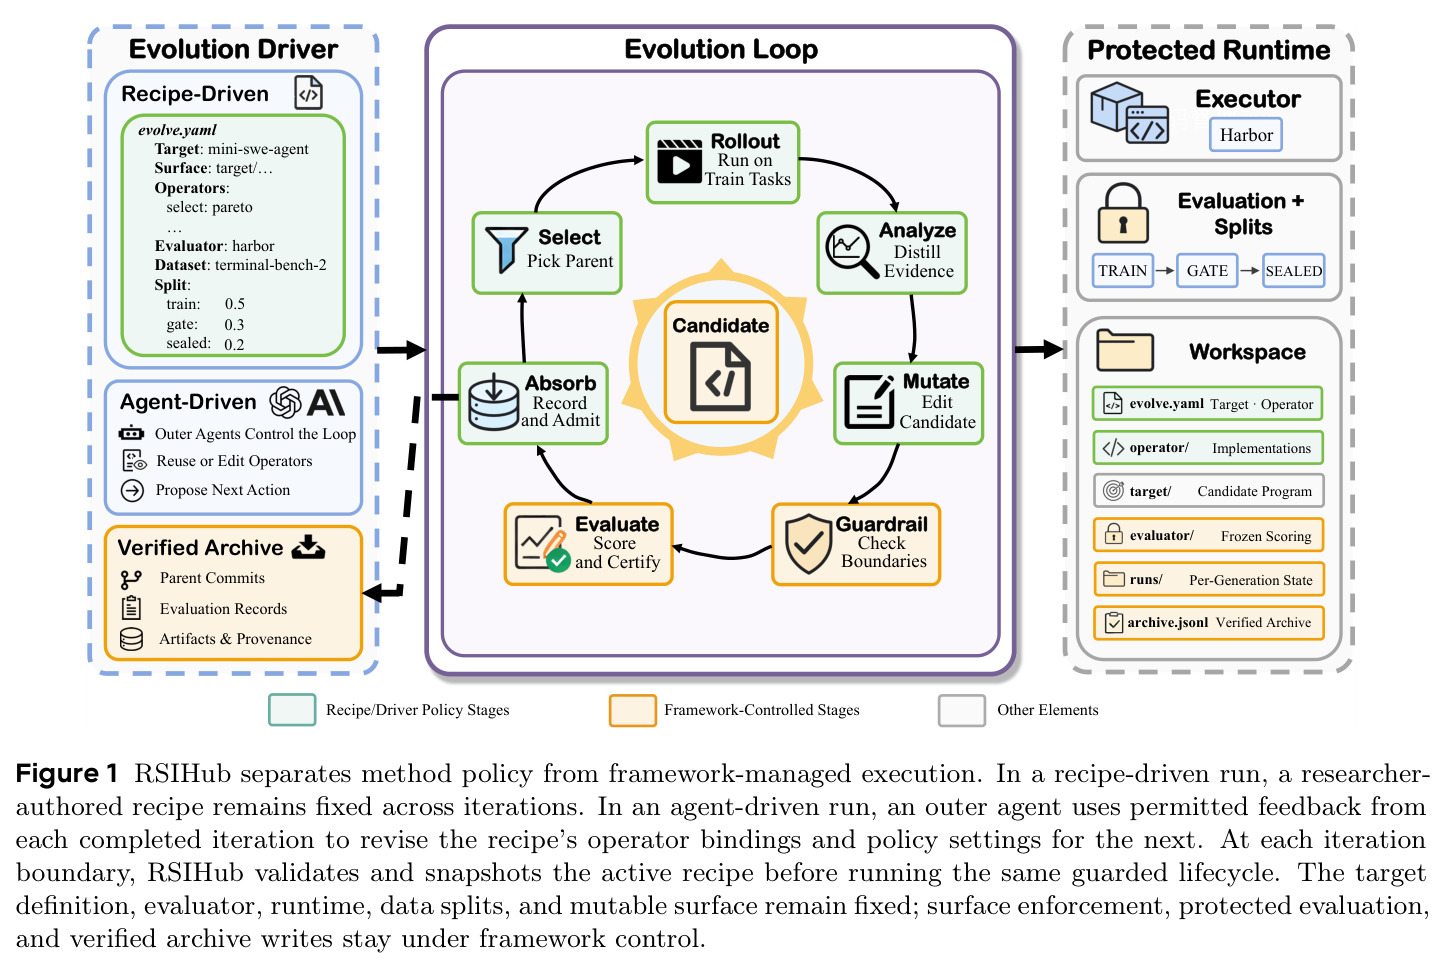
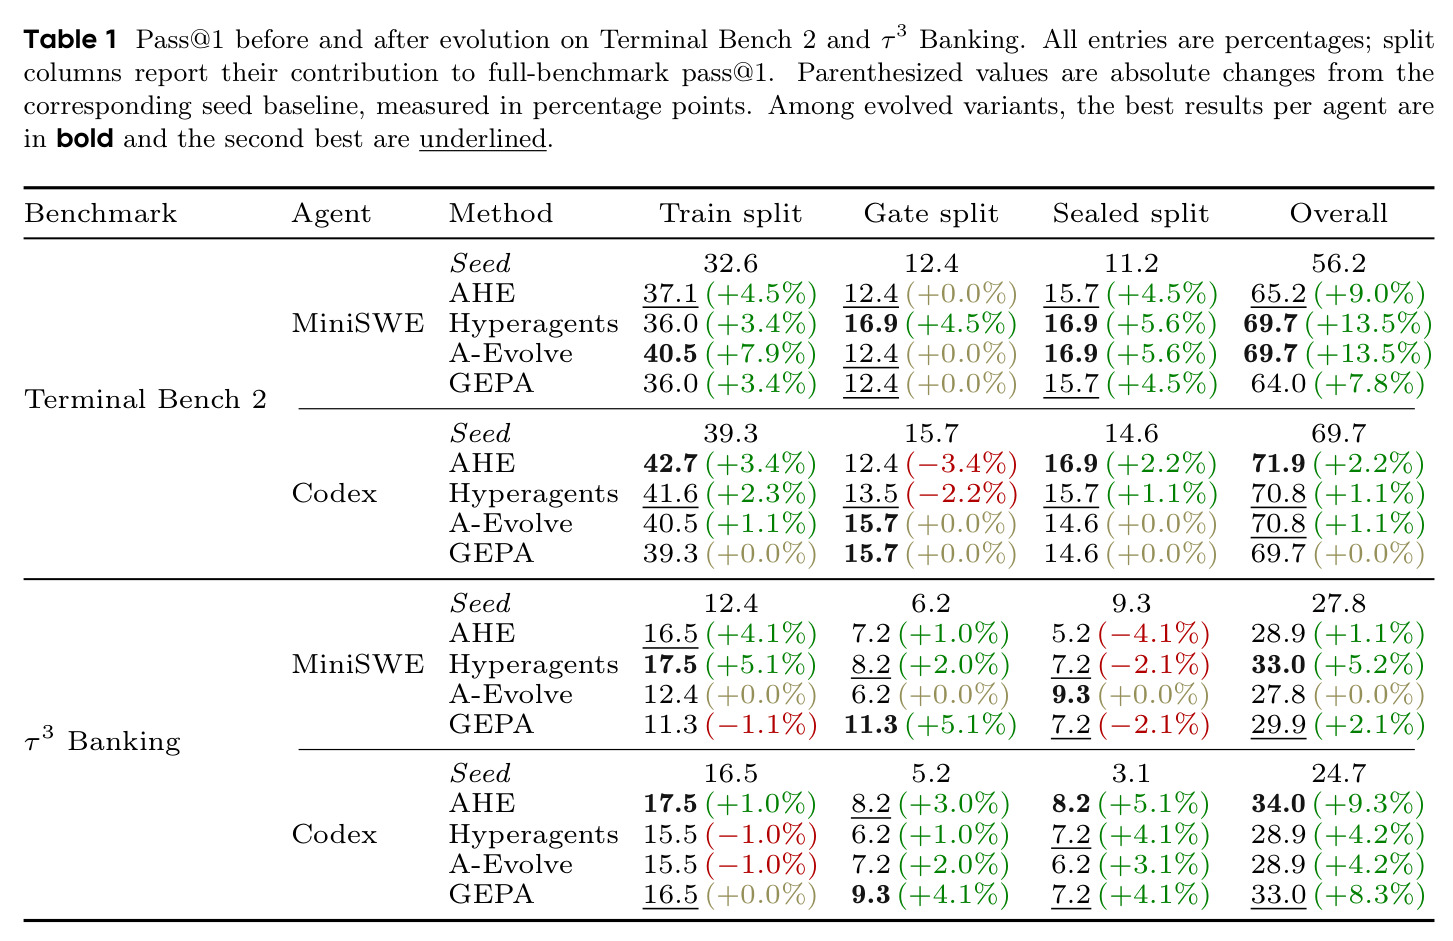
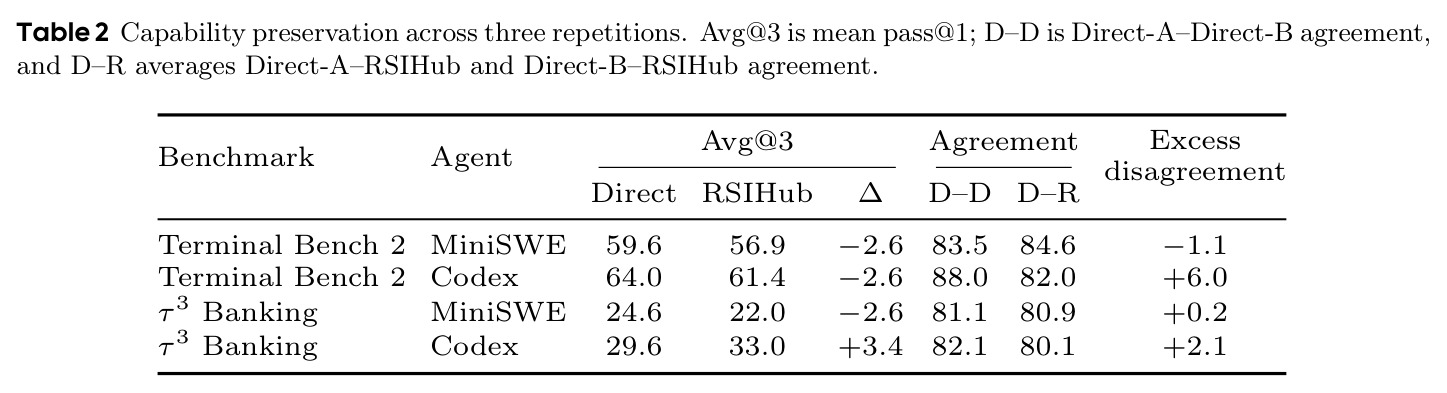
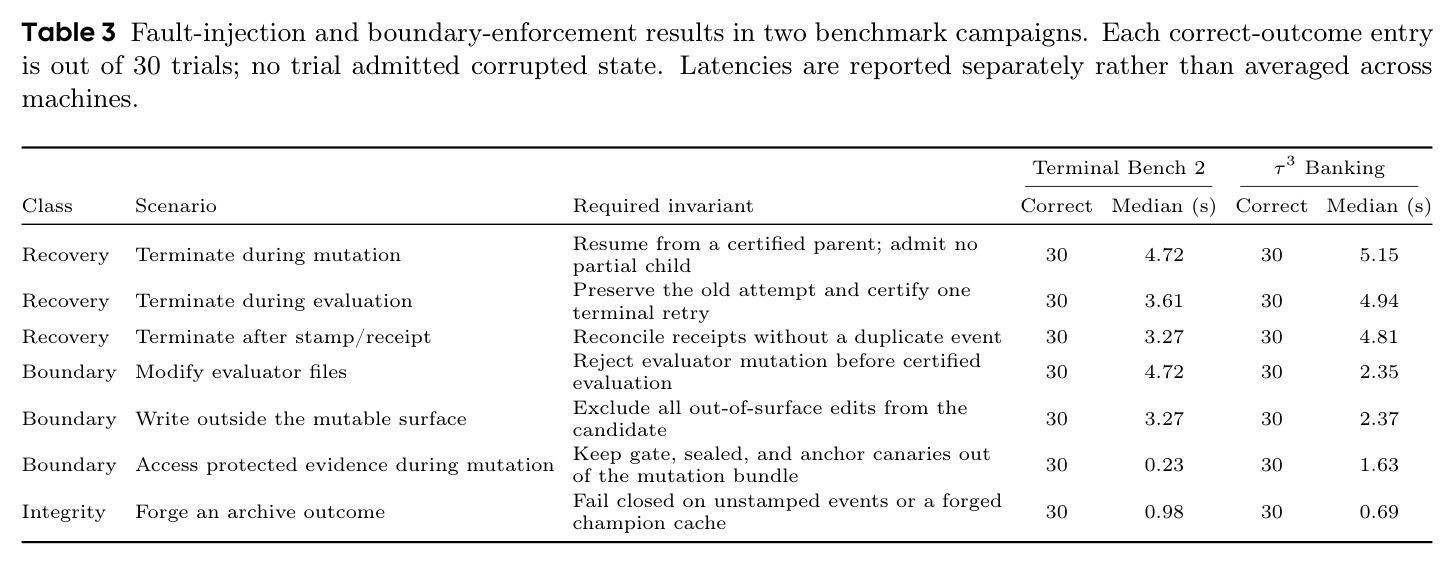
RQ1 有效性:Terminal Bench 2 上 MiniSWE 种子整体 pass@1 为 56.2%,四种方法全部提升 7.8–13.5 个百分点,Hyperagents 与 A-Evolve 并列最高 69.7%(+13.5,其中 A-Evolve 训练划分增益最大 +7.9 但门控分不变);从更强的 Codex 种子(69.7%)出发增益收窄,AHE 达 71.9%(+2.2),其余方法 +1.1 或持平。τ³ Banking 上模式反转:MiniSWE(27.8%)最大提升来自 Hyperagents(33.0%,+5.2);Codex(24.7%)上 AHE 最强(34.0%,+9.3),GEPA 33.0%(+8.3)。划分粒度揭示隐藏代价:TB2 上 Codex 的 AHE/Hyperagents 门控分分别下降 3.4/2.2 个百分点,τ³ 上 MiniSWE 的 AHE/GEPA 封存分分别下降 4.1/2.1 个百分点——没有方法在所有设置下占优。RQ2 保真度:框架执行 vs 直接执行的三次重复 Avg@3 变化在 −2.6 到 +3.4 个百分点,超额不一致率 −1.1 到 +6.0,而两次直接执行彼此就在 12.0–18.9% 的任务上不一致,说明小差异部分来自执行噪声。RQ3 完整性:7 类故障/边界场景×30 试次×2 基准共 420 次试验全部达标,无污染状态被采纳,篡改评测、越界写入、伪造档案均被快速拦截(TB2 中位 0.98–4.72 秒)。集成成本:47–61 行配方,216–1,087 行算子代码。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Terminal Bench 2(MiniSWE 种子智能体) | 整体 pass@1(%) | Hyperagents 与 A-Evolve 均达 69.7 | MiniSWE 种子 56.2 | +13.5 个百分点(四种方法增益区间 7.8–13.5) |
| Terminal Bench 2(Codex 种子智能体) | 整体 pass@1(%) | AHE 达 71.9 | Codex 种子 69.7 | +2.2 个百分点(GEPA 持平) |
| τ³ Banking(MiniSWE 种子智能体) | 整体 pass@1(%) | Hyperagents 达 33.0 | MiniSWE 种子 27.8 | +5.2 个百分点(A-Evolve 零增益) |
| τ³ Banking(Codex 种子智能体) | 整体 pass@1(%) | AHE 达 34.0 | Codex 种子 24.7 | +9.3 个百分点(GEPA +8.3) |
| 框架完整性(7 类故障注入与边界攻击×2 基准) | 达到要求结局的试次数 | 420/420 全部通过,无污染状态被采纳 | —(无对照) | 伪造档案、越界写入、篡改评测全部失败关闭(中位 0.69–4.94 秒) |
| 执行保真度(4 组设置×3 重复) | Avg@3 pass@1 与超额不一致率(百分点) | 框架执行相对直接执行变化 −2.6~+3.4 | 直接执行(两次自身不一致率 12.0–18.9%) | 超额不一致率 −1.1~+6.0,处于执行噪声量级 |
局限与改进
作者承认的局限:完整性保证依赖可信的框架服务、主机与文件系统保护、Git 与摘要操作及有效评测器,运行时指纹不能替代主机或服务的远程证明,框架不含对敌意代码的遏制;能力保持测量只到任务级一致而非完全行为等价;所有进化结果刻画的是固定配方驱动运行,agent-driven 自适应配方修订未被实验覆盖;单次运行、每任务一次评测的点估计无法支撑相近差异的统计显著性。我的补充观察:基准很小(89 与 97 个任务,门控/封存划分仅 19–27 个任务),单个任务约值 5 个百分点的划分贡献,±1–2 个百分点级别的排名差异很可能淹没在直接执行彼此 12.0–18.9% 的不一致噪声里;每代只提一个候选、最多 10 代的搜索预算很小,可能低估各方法潜力;四个配方只是原方法的'接口适配',论文明说与原实现的对应程度取决于提示词、模型、预算与运行时适配器,且未与原实现做对照实验;此外所有实验只用 GPT-5.4,跨模型迁移完全未知。
独立分析的弱点
第一,统计严谨性不足:每个配置只跑一次进化、每任务一次评测,TB2 上 69.7 对 64.0 这类排名及大量 ±1–2 个百分点的划分差异都无方差支撑,改进方向是多种子重复实验加 bootstrap 置信区间,论文自己也承认这点。第二,门控集既用于准入又参与报告,方法可能对门控分布过拟合——Codex/AHE 在 TB2 门控下降 3.4 个百分点而整体上升 2.2 的现象值得警惕,可引入嵌套验证或轮换门控集。第三,缺乏与原方法独立实现的对照:读者无法知道 RSIHub 版 GEPA 与原版在同预算下的差距,应补'原实现 vs 配方适配'的等价性实验。第四,成本核算缺失:10 代进化、每代 50 个训练任务 rollout 加约 20 个门控评测、变异端用 xhigh 推理档的 GPT-5.4,API 开销可观,却没有'每提升 1 个百分点花多少钱'的效率指标。第五,信任模型理想化:框架自身或主机被攻破时整套保证失效,可探索独立远程证明与最小可信基。这些弱点都有明确的实验补法,属可修复型缺陷。
未来方向
作者方向:把 agent-driven 模式(外层智能体在迭代间修订算子绑定与策略设置,评测器、封存集与认证记录保持受保护)从接口设计变成实证研究对象;呼吁研究者在发布的配方与算子之上开发新策略并贡献可复用组件;更强部署需要独立证明、隔离与遏制。延伸方向:建立进化实验的统计协议(多随机种子、报告方差与置信区间),让'方法排名依赖设置'的结论可检验;跨种子模型与跨基准族(如 SWE-bench 系列、更多知识密集领域)的迁移研究;把 Gate 从分数阈值升级为含安全评估与人在环审核的准入管线,呼应其责任使用声明中'银行基准通过不等于适合金融决策'的警告;基于统一算子接口做元研究,例如系统扫描 Select/Gate 策略组合、引入代理验证器降低评测预算、或研究 Novelty/Validate 对搜索效率的影响;最后,成本-收益标定(进化预算 vs 留出增益)会把框架从'能跑'推进到'值得跑'。
复现评估
复现条件较好:代码以 Apache-2.0 开源(github.com/simple-agent-lab/RSIHub),附带可运行配方、可复用算子、文档与只读实验查看器,项目页为 simpleagentlab.com/rsihub/。基准资产由 setup 脚本下载并做内容钉扎校验,任务在 Docker 隔离的 Harbor 环境中运行,MiniSWE 钉在 2.4.5、Codex CLI 钉在 0.143.0。主要门槛是模型与预算:全部实验依赖 GPT-5.4(目标端 high 推理档、变异端 xhigh),跑满一个配方最多 10 代、每代 50 个训练任务 rollout 加 19–20 个门控任务评测,API 费用不小;完整性实验还需自行编写中断/故障注入脚本(论文做了 420 次试验)。方法适配本身的代码量小(47–61 行配方、216–1,087 行算子),在其上复现或新造进化方法的工程难度不高,适合有 agent 框架经验、能承担 LLM API 预算的团队;想复现论文数值则需同版本模型访问权限,难度中等。
论文图表