DraMaze:具备前瞻记忆的多智能体微短剧剧本生成流水线 DraMaze: A Multi-Agent Pipeline with Future-Aware Memory for Diverse Microdrama Script Generation
用母题引导的进化树搜索与面向未来的叙事记忆,生成多样且连贯的微短剧剧本。
前置知识
密集检索(Dense RAG)
把文本嵌入向量空间,按余弦相似度取回语义最近的记忆片段,是长文本生成中最常用的历史信息管理手段。本文将其作为基线,并用实验证明它会加剧情节套路的复用。
理解论文动机需要先知道 Dense RAG 的工作方式,才能明白为什么「语义相似」的检索会重新引入旧解决方案、漏掉真正有用的伏笔。
叙事母题(Trope)
情节推进背后抽象的因果套路。论文将其形式化为 Cause–Method–Outcome–Response(C–M–O–R)四元组,抽取时删除角色名、地点、道具等表面元素,使「用现金贿赂守卫」和「用珠宝贿赂守卫」被识别为同一机制。
母题记忆库、进化搜索的新颖性打分以及全部重复率/熵指标都建立在这个抽象单元之上。
进化树搜索与变异算子
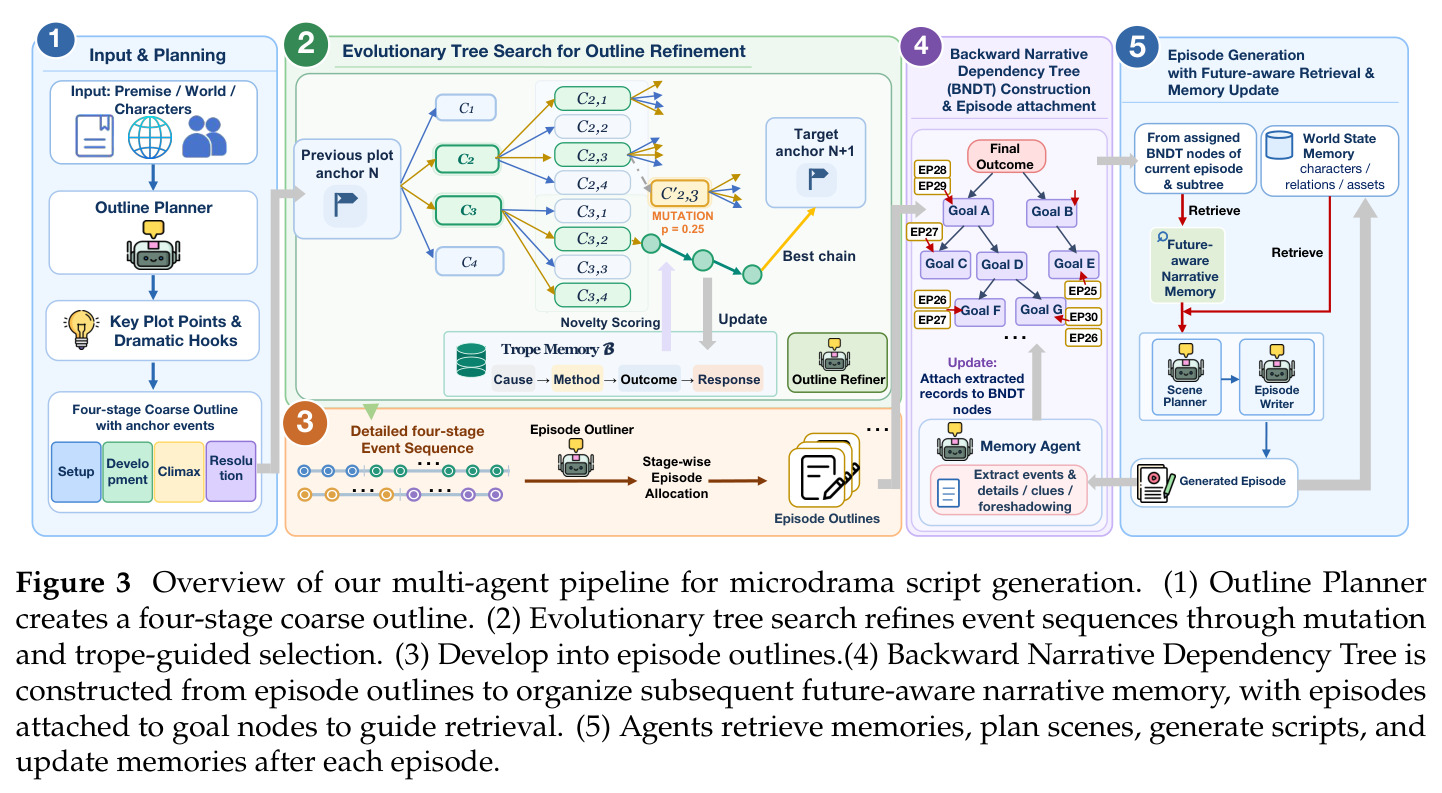
借鉴进化算法的搜索框架:从当前情节长出局部搜索树,每个节点扩展多个候选续写,按适应度(一致性、新颖性、可行性加权)保留最优分支继续生长;变异算子以概率(本文 $p_{mut}=0.25$)扰动最高分候选的因果链接,生成额外分支以跳出局部最优。
这是 DraMaze 在规划阶段保证情节多样性的核心机制,不懂得树搜索就无法理解候选因果路径如何被探索和筛选。
条件熵
衡量已知前一环节取值时下一环节取值的不确定性。论文用支持度加权归一化条件熵 $\bar{H}$,取 $\hat{H}(M|C)$、$\hat{H}(O|M)$、$\hat{H}(R|O)$ 三项平均。值越高说明因果链各环节组合越多样,越低说明剧情走向可预测。
它是论文量化叙事多样性的三个因果模式指标之一,读实验表格必须知道其方向性(越高越好)。
LLM-as-a-Judge 多智能体评估
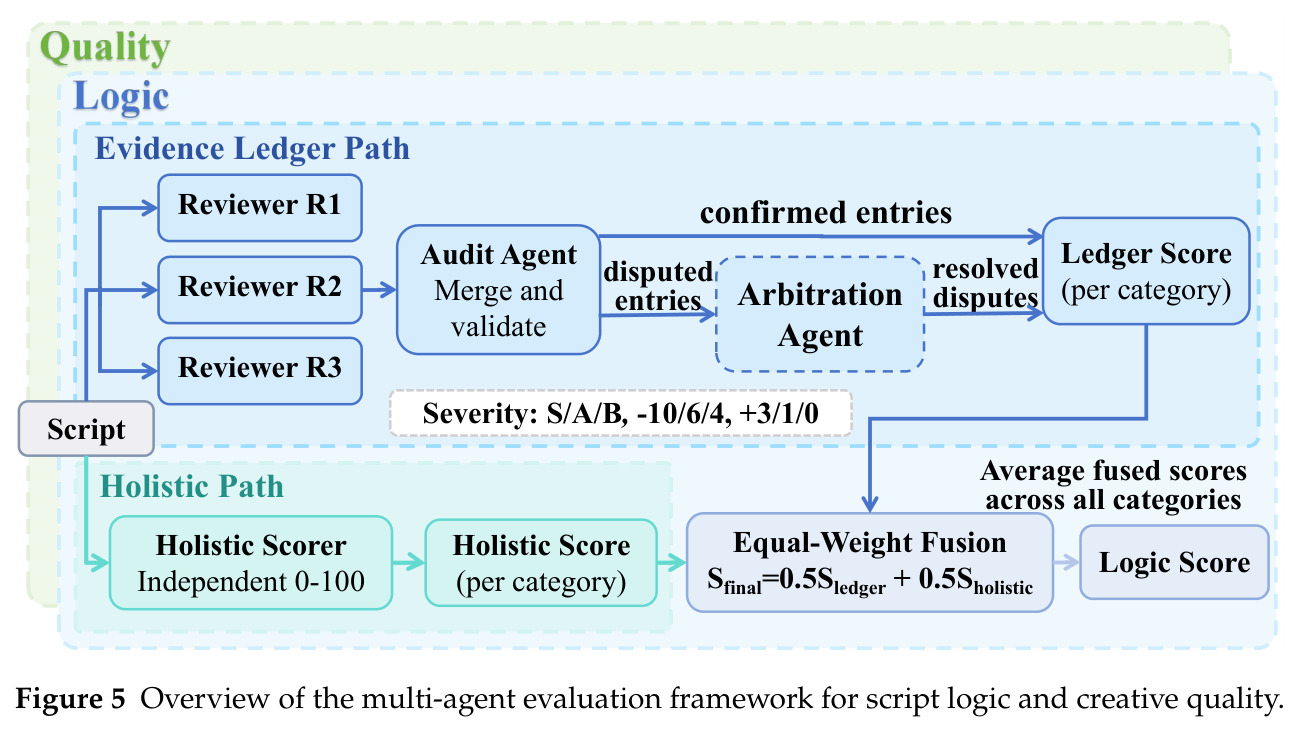
用 LLM 充当评审的自动化评估范式。本文让 3 个独立评审按细粒度标准把问题与亮点连同证据写入台账,审计 Agent 去重并校准严重级(S/A/B 级分别扣 10/6/4 分),仲裁 Agent 解决争议,再与独立整体打分融合:$S_{final}=0.5S_{ledger}+0.5S_{holistic}$。
论文的 Logic/Quality 分数完全由该框架产生,不先理解它就无法正确解读实验数字的含义与可信度。
PG-19 数据集
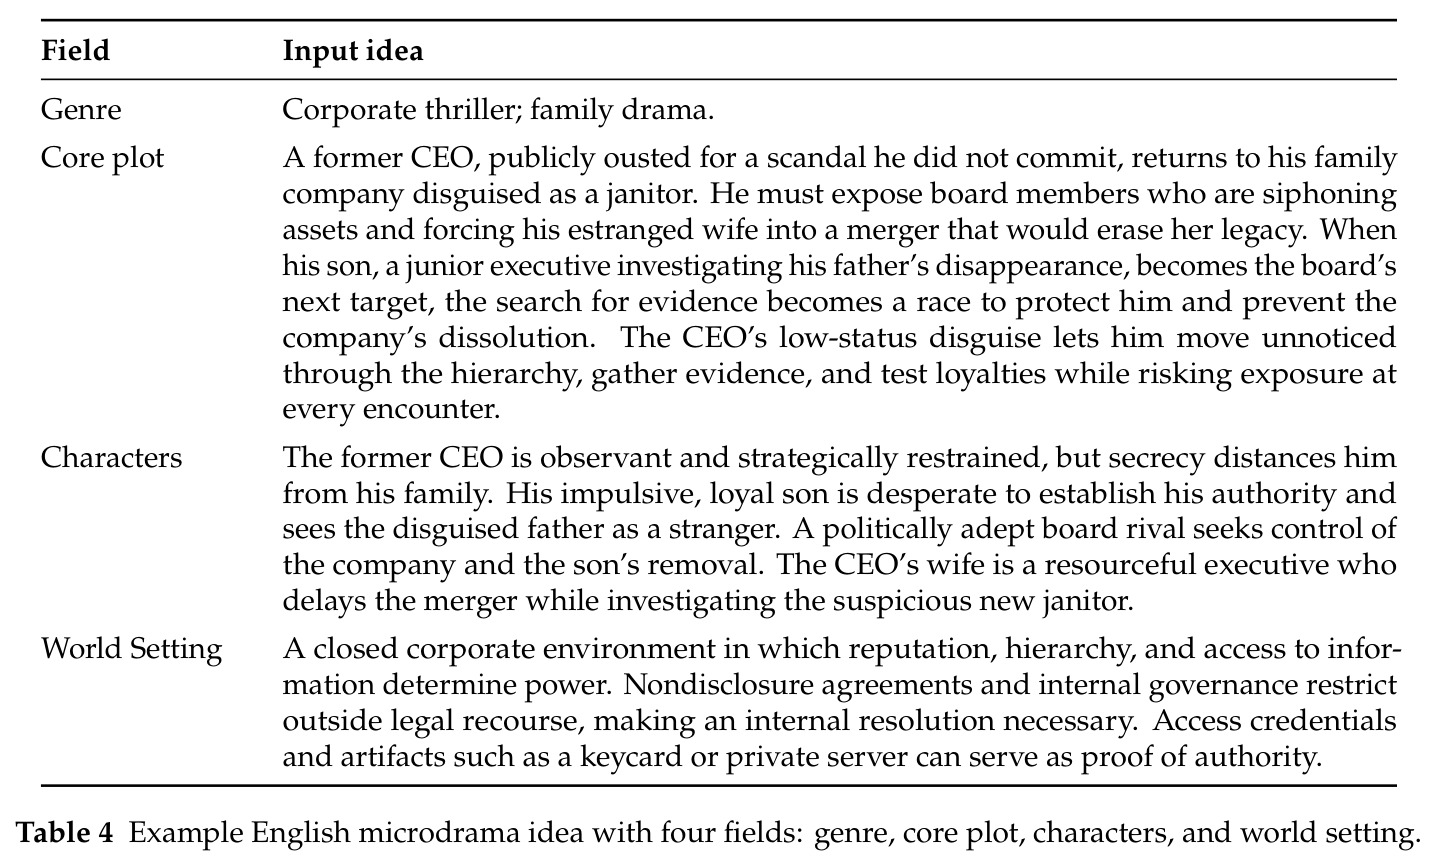
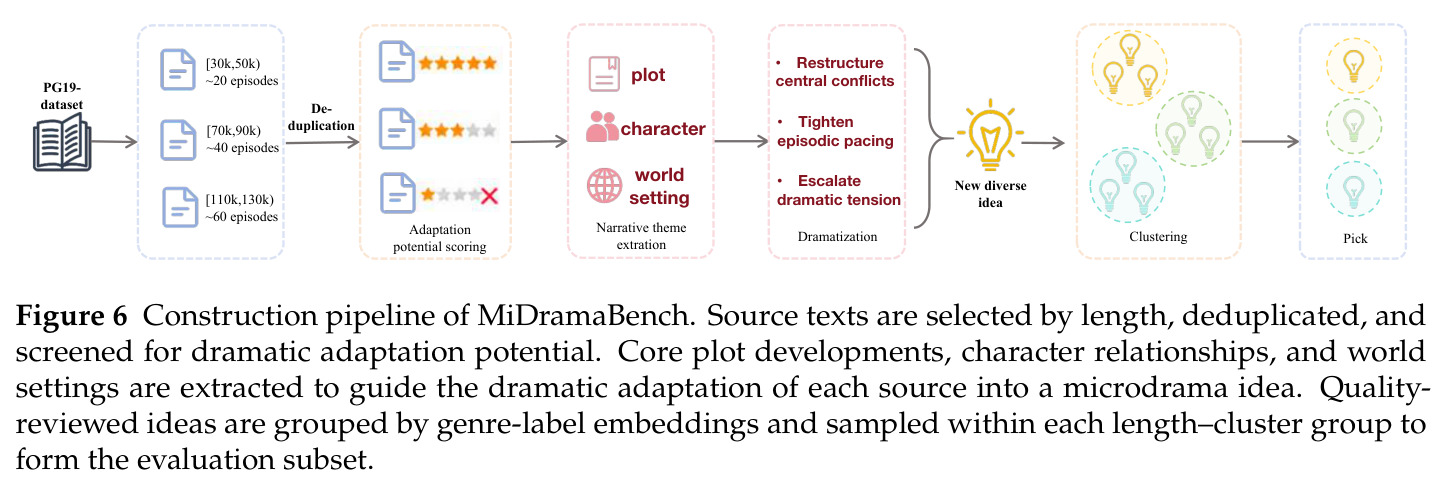
DeepMind 发布的公开数据集,收录 Project Gutenberg 1919 年前的书籍全文,常用于长文本语言建模研究。本文从其中按词数分桶筛选源文本,经改编潜力打分后转写为微短剧创意,构建 MiDramaBench 基准。
基准的数据来源与构建流程决定评测集的分布和规模,也直接影响复现难度与结果的可比性。
研究动机
微短剧爆发式增长带来高质量剧本的产能缺口,LLM 逐集生成长剧本(20–60 集)面临两大顽疾。其一是叙事同质化:随着生成推进,候选续写越来越集中于少数叙事机制。作者用 Qwen3.6-27B 从同一前提生成 40 集剧本,在检查点固定上下文并采样 32 个候选下一事件,经 LLM 两两判定机制相似后做完整链接聚类,计算机制熵 $H=-\sum_{k}p_k\log_2 p_k$,发现第 20 集之后熵持续下降且结尾附近最明显;Dense RAG 在后半程始终低于无检索基线,DOME 在多数后期检查点同样更低——常规检索不仅不能阻止、反而加剧机制集中。其二是语义检索与叙事价值的错位:用一部人工微短剧的第 1–20 集作历史、第 21–30 集梗概作未来目标,Dense RAG 与 DOME 式图检索各取前 30 条记忆,对续写真正关键的 27 个历史子事件只召回 7 个(25.93%);用这些记忆续写后因果母题重复率高达 23.30%(Dense RAG)与 16.67%(DOME),远差于人工挑选记忆的 7.14% 和原剧本的 5.56%。
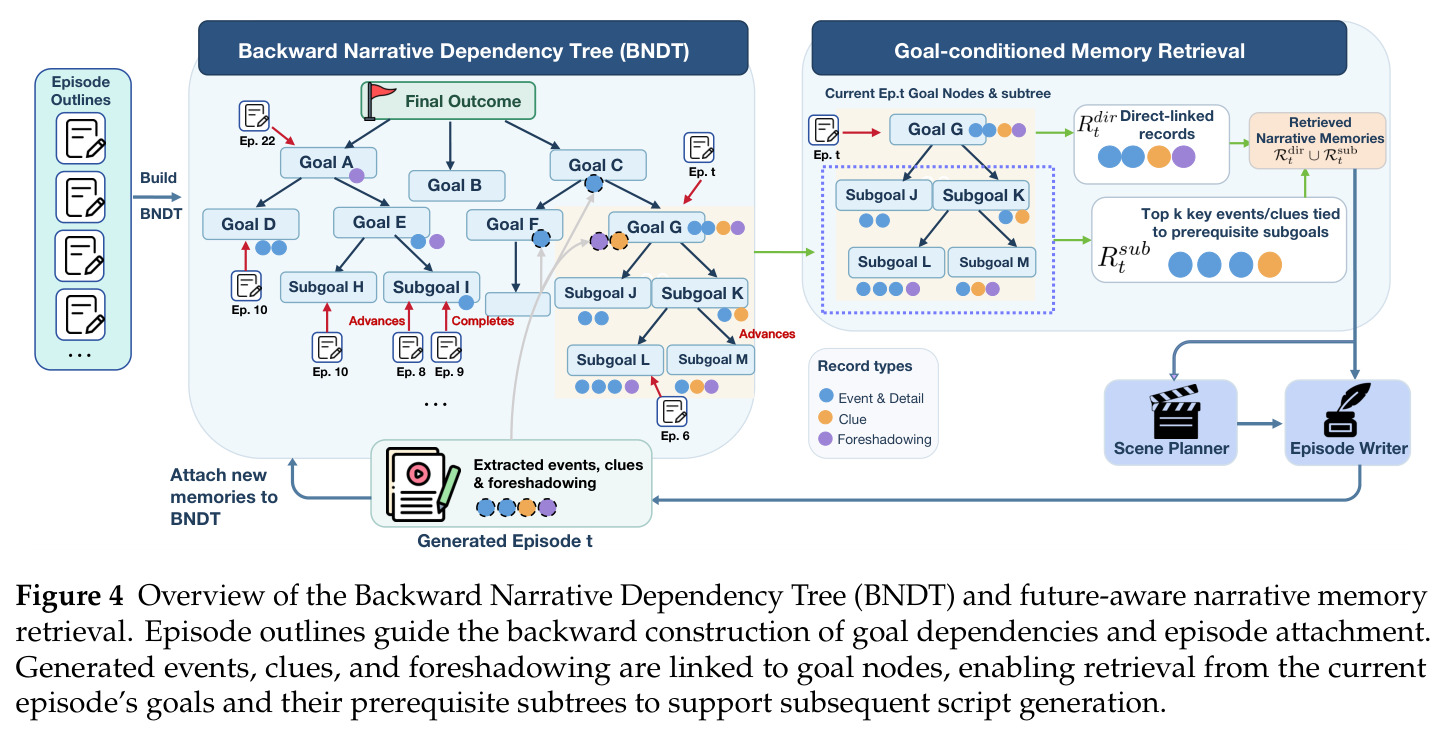
本文的目标是本文的目标是让 LLM 在 20/40/60 集的微短剧生成中同时做到「探索多样情节路径」与「保持长程因果连贯」。核心洞察是:历史信息的价值取决于它对未来情节发展的贡献,因此应该用未来叙事目标来指导记忆的保留与检索。具体拆成三个可操作的子目标:(1) 规划阶段用母题记忆引导的进化树搜索探索多样因果路径,显式给候选续写的机制新颖性打分,并以变异算子拓宽搜索空间,避免跨冲突复用同一套解决方案;(2) 写作之前从计划的结局反向构建 Backward Narrative Dependency Tree(BNDT),把关键事件、线索、伏笔按其支撑的未来目标组织成索引;(3) 逐集写作时按当前集的目标节点及其前置子树做目标条件化检索,并配合持续更新的世界状态记忆维护角色、关系与资产的一致性。最终在自建的 MiDramaBench 上用 Logic、Quality 分数与因果模式重复率/熵指标全面超越 DOME 与 StoryWriter 两类基线。
与已有工作不同的是,已有的长文本生成框架(DOME 的时序知识图、StoryWriter 的多智能体规划加动态历史压缩、SCORE 的层级摘要、STORYTELLER 的实体知识图等)都在解决「如何把相关历史塞进上下文」,但记忆的组织与检索单位始终是语义相似度、实体或时间邻近。本文的独特切入点是论证并利用「语义相关 ≠ 叙事价值」这一鸿沟:与当前情境或角色语义相似的历史事件可能只是重提旧解决方案,反而鼓励母题复用;而对后续情节必不可少的因果前置事件(如某条伏笔的埋设)却可能因表面语义差异被漏掉。作者用 25.93% 的关键信息召回率与 23.30% 的母题重复率把这一鸿沟量化,进而提出把记忆的组织原则从「匹配当前状态」翻转为「锚定未来目标」——以因果依赖为索引,即当前集要推进哪些目标、这些目标依赖哪些前置事件与伏笔。此外,作者把「同质化」从主观感受操作化为可计算的 C–M–O–R 因果模式指标,使这一问题首次可以在基准上被系统评测。
核心方法
直觉上,长剧本生成有两类失败:反复用相同因果套路推进情节,以及伏笔丢失导致长程断裂。DraMaze 用「规划—写作—记忆更新」五阶段多智能体流水线同时应对:(1) Outline Planner 生成四阶段粗纲(Setup/Development/Climax/Resolution),含锚点事件与戏剧钩子;(2) 对每个锚点做进化树搜索精化——每个展开节点生成 4 个候选下一事件,与母题记忆库 $\mathcal{B}$ 比较局部因果母题得新颖分,保留 top-2 继续,以 $p_{mut}=0.25$ 概率对最高分候选变异以跳出既有模式,终止链按 $S(c)=0.4C(c)+0.3N(c)+0.3F(c)$ 选最优并回写 $\mathcal{B}$;(3) 最优事件序列分配到各集并展开成集级大纲;(4) 记忆规划 Agent 从结局反向构建 BNDT;(5) 逐集生成:按当前集目标做未来感知检索,Scene Planner 与 Episode Writer 生成剧本,再从成稿提取事件、线索、伏笔挂回 BNDT 并更新世界状态记忆。粗纲决定去向,搜索决定路径,BNDT 决定记住什么。
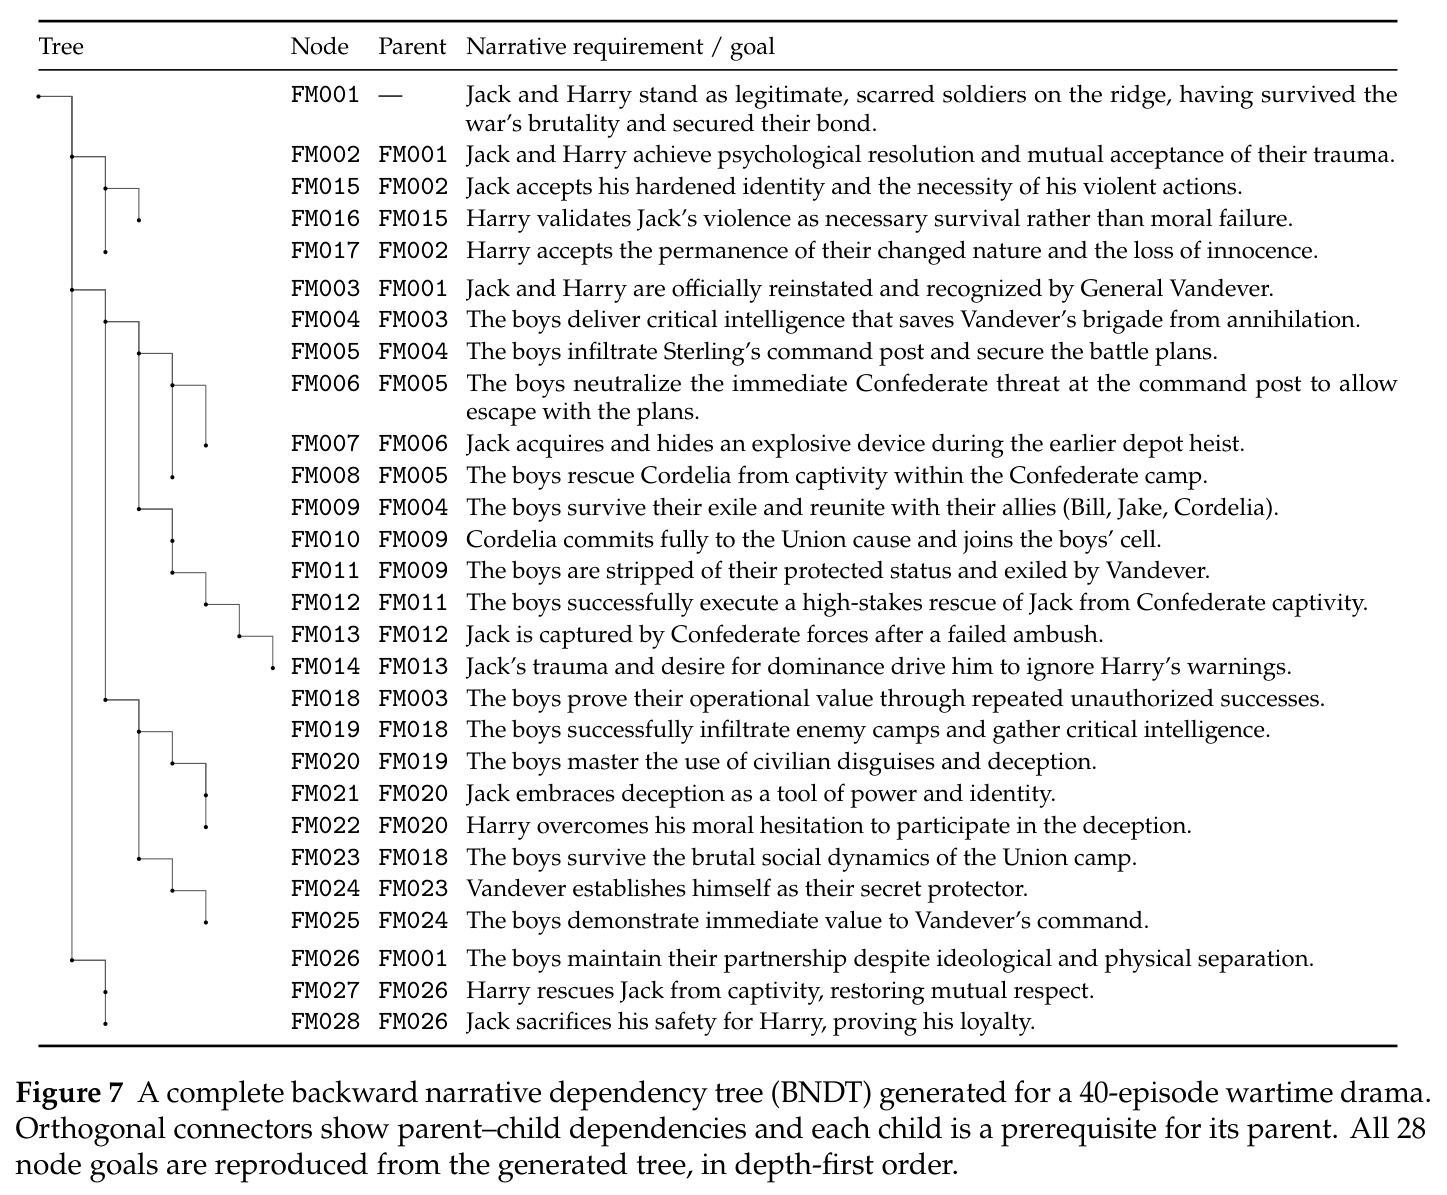
核心创新是把记忆系统从「向后看」改成「向前看」。已有方法(DOME 时序知识图、StoryWriter 动态历史压缩)记录「已发生什么」,检索匹配当前情境;DraMaze 的 BNDT 从最终结局反向递归分解:根是 Final Outcome,子节点是父目标的因果前置,每集映射到它铺垫/推进/完成的目标集 $Q_t\subseteq V$。写作后只保留对未来目标有叙事价值的记忆,挂到目标节点并记录长期叙事重要性分;写作前检索直接命中 $\mathcal{R}^{dir}_t=\{m:\Lambda(m)\cap Q_t\neq\emptyset\}$,再下钻子树按重要性补至多 10 条,伏笔只走直接链接。第二个创新是母题记忆引导的进化树搜索:把已定稿事件的因果模式抽成去表面化(删角色名/地点/道具)的 cause–method–outcome–response 四元组存入 $\mathcal{B}$,候选续写按与库相似度评新颖分参与选择,变异算子显式重排最高分候选的因果链接。两者使「反同质化」与「保连贯」同时成为搜索与检索的显式目标,而非副产物。
方法步骤详情
第一步,粗纲规划:输入前提、世界与角色,Outline Planner 输出含锚点与戏剧钩子的四阶段粗纲。第二步,进化树搜索:每个展开节点生成 4 个候选下一事件,抽取其局部因果母题并与 $\mathcal{B}$ 比较得新颖分 $N$,结合一致性 $C$ 选 top-2 扩展;每节点以 $p_{mut}=0.25$ 概率变异——保持锚点不变、重排最高分候选的因果链接生成额外分支;到达锚点或上限后按 $S(c)=0.4C(c)+0.3N(c)+0.3F(c)$ 选出最优链 $c^*$,其模式并入 $\mathcal{B}$。第三步,事件序列按集分配并细化为集级大纲。第四步,抽取 Final Outcome 为根,反向分解出中间目标与基础铺垫构成 BNDT,每集映射到目标集 $Q_t$。第五步,逐集写作:按 $Q_t$ 检索直接链接记忆,再从子树按重要性取至多 10 条补全,伏笔只走直接链接;世界状态记忆按文本相关加实体匹配取回;Scene Planner 与 Episode Writer 生成剧本;Memory Agent 从成稿提取事件、线索、伏笔挂到 BNDT 并更新世界状态。
技术新颖性
新颖性在四个层面。(1) 问题层:首次把「机制熵下降」量化为可测指标——对固定上下文采样 32 个候选续写、LLM 判定两两机制相似后做完整链接聚类,用 $H=-\sum_{k}p_k\log_2 p_k$ 度量集中度,并证明 Dense RAG 与 DOME 的熵反而低于无检索基线,是对「检索必然有益」假设的反例。(2) 记忆层:BNDT 把记忆组织单位从「事件/实体/时间」换成「未来目标及其因果前置」,检索由目标条件化驱动,直接针对 25.93% 召回率暴露的语义—叙事错位。(3) 搜索层:把进化算法的变异算子与 LLM 抽取的抽象母题结合,用 $S(c)=0.4C+0.3N+0.3F$ 加权把新颖性作为一等公民写进选择准则,区别于只优化连贯性的规划方法。(4) 评估层:MiDramaBench 与 C–M–O–R 因果模式指标(4-gram/3-gram 重复率加归一化条件熵 $\bar{H}$)把同质化变成可复现的量化评测,评估融合证据台账与整体分 $S_{final}=0.5S_{ledger}+0.5S_{holistic}$。
实验结果
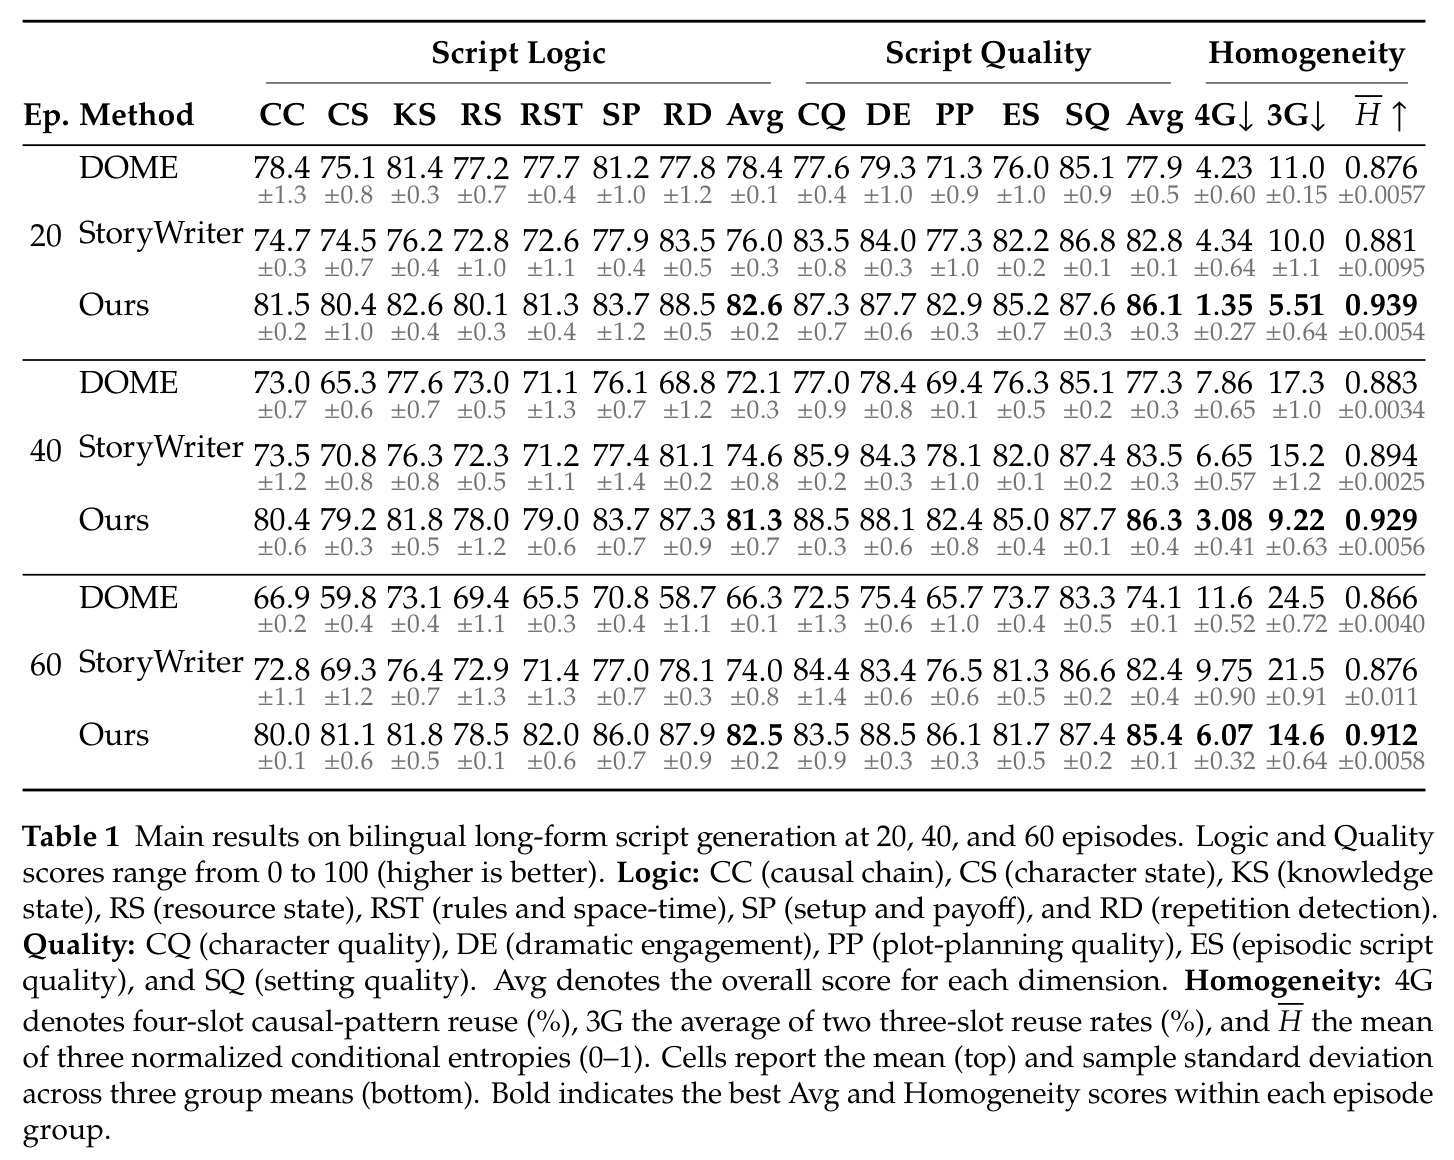
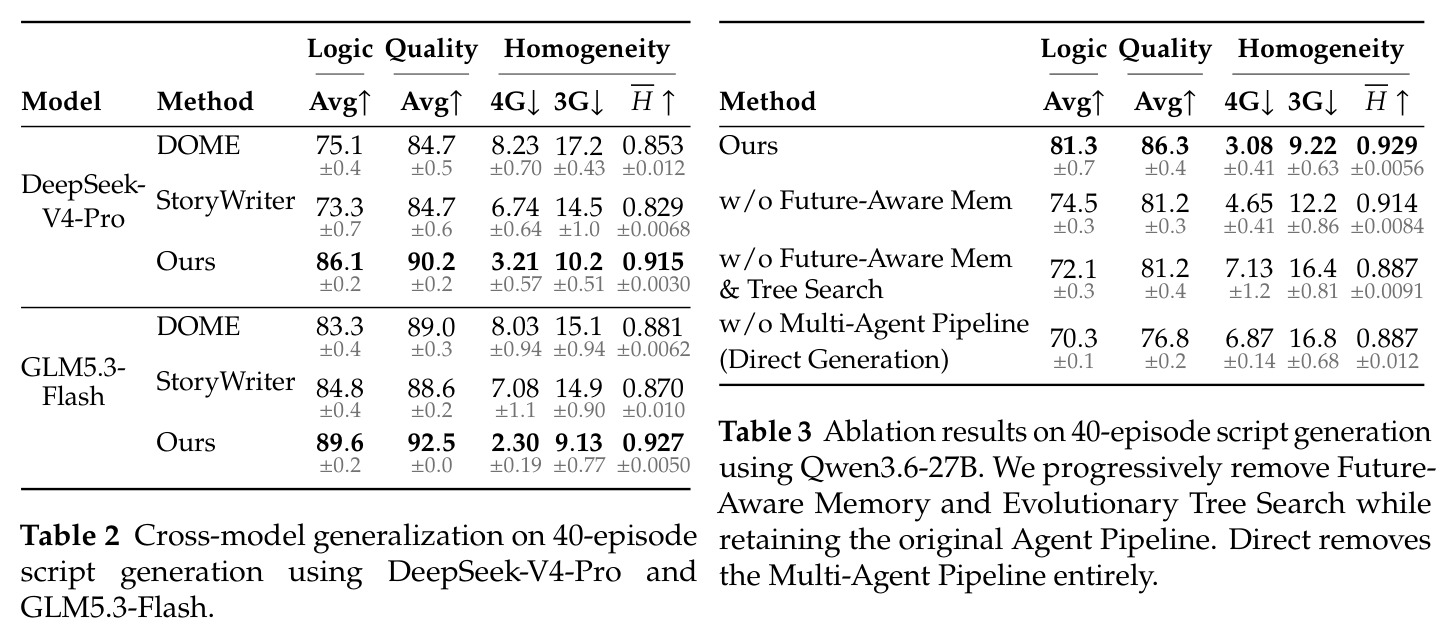
结果分三块。(1) 主实验(Qwen3.6-27B,重复 3 次):20 集时 Logic 82.6 / Quality 86.1 / 4G 1.35% / 3G 5.51% / 熵 0.939,全面最优;40 集 81.3 / 86.3 / 3.08% / 9.22% / 0.929;60 集 82.5 / 85.4 / 6.07% / 14.6% / 0.912。优势随长度扩大:Logic 领先从 4.2 分(20 集)增至 8.5 分(60 集,基线最高仅 74.0);60 集 3G 重复 14.6% 对基线 21.5%,相对降 32.1%。(2) 跨模型(40 集):DeepSeek-V4-Pro 上 86.1/90.2,GLM5.3-Flash 上 89.6/92.5,提升 Logic 4.8–11.0 分、Quality 3.5–5.5 分。(3) 消融:去未来感知记忆跌至 74.5/81.2,3G 升至 12.2%;再去树搜索,4G 升至 7.13%、熵降至 0.887;直接生成仅 70.3/76.8。重复检测子项提升最明显(20 集 88.5 对 DOME 77.8)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 60 集微短剧剧本生成(Qwen3.6-27B) | Logic Score(0–100) | 82.5 | StoryWriter 74.0 / DOME 66.3 | +8.5 分(对最强基线) |
| 60 集微短剧剧本生成(Qwen3.6-27B) | 3-gram 因果模式重复率(%,越低越好) | 14.6% | StoryWriter 21.5% | 相对降低 32.1% |
| 40 集微短剧剧本生成(Qwen3.6-27B) | Logic / Quality / 条件熵 | 81.3 / 86.3 / 0.929 | StoryWriter 74.6 / 83.5 / 0.894;DOME 72.1 / 77.3 / 0.883 | Logic +6.7 分,4G 重复 3.08% 对 StoryWriter 6.65% |
| 40 集微短剧剧本生成(DeepSeek-V4-Pro) | Logic / Quality | 86.1 / 90.2 | DOME 75.1 / 84.7;StoryWriter 73.3 / 84.7 | Logic +11.0 分 |
| 40 集微短剧剧本生成(GLM5.3-Flash) | Logic / Quality | 89.6 / 92.5 | StoryWriter 84.8 / 88.6;DOME 83.3 / 89.0 | Logic +4.8 分,4G 重复 2.30% 对 7.08% |
| 消融:去除未来感知记忆(40 集,Qwen3.6-27B) | Logic / Quality / 3-gram 重复率 | 完整版 81.3 / 86.3 / 9.22% | 去记忆后 74.5 / 81.2 / 12.2%;再去树搜索 72.1 / 81.2 / 16.4% | 记忆模块贡献 Logic +6.8 分;树搜索再贡献 4G 7.13%→4.65% |
局限与改进
作者承认的局限:结构性重复仍随长度增长——4-gram 重复率从 20 集 1.35% 升到 60 集 6.07%,3-gram 从 5.51% 升到 14.6%,条件熵从 0.939 降到 0.912,说明方法只是缓解而非消除同质化;多智能体流水线(树搜索每节点 4 候选加变异加判分、逐集多 Agent)的计算成本显著高于直接生成。我自己的观察:(1) 评估完全依赖 LLM 评审(Qwen3.8-27B,温度 0.1),虽然融合了证据台账与整体分,但无法排除评估器对结构化流水线输出系统性偏好的可能;(2) 动机部分的实证(熵下降曲线基于 5 个脚本、25.93% 召回基于单一案例的 27 个子事件)样本量小,且机制判定依赖单一 LLM,泛化性存疑;(3) 母题抽象依赖「删除角色名/地点/道具」的去表面化规则,抽象粒度是隐含超参,过粗漏掉真实重复、过细误杀合理复用;(4) BNDT 在写作前一次性构建,若生成过程偏离原大纲,缺乏动态修复机制的讨论;(5) MiDramaBench 由 PG-19 小说改编而来,与真实微短剧(竖屏节奏、强钩子、付费卡点)的分布仍有差距。
独立分析的弱点
弱点一:成本不透明。树搜索阶段每个锚点节点要生成 4 个候选、每个候选都需抽取母题并与记忆库比对、还要以 0.25 概率变异,60 集多锚点的 LLM 调用量可能比直接生成高一个数量级,论文未报告 token 或时间开销。改进方向:用小模型做候选生成与母题抽取,只在最终链选择时用大模型。弱点二:评估闭环风险。评审模型 Qwen3.8-27B 与生成骨干 Qwen3.6-27B 同源,可能共享偏好。改进:引入人工标注子集校准,或用多家族评审模型交叉验证。弱点三:重要性分数无监督。长期叙事重要性由记忆 Agent 打出,而子树检索恰好按分数取 top-10,错误打分会被放大。改进:成稿后按「该记录是否被后续集实际使用」回溯校准分数。弱点四:C–M–O–R 四元组表达力有限,无法刻画节奏、情绪曲线、镜头语言等重复维度。改进:扩展风格/节奏槽位。弱点五:核心实证样本小(5 个脚本、单一案例),结论强度受限,应在多模型多题材上复验熵下降现象。
未来方向
作者方向:结论强调多样化情节探索与未来目标引导检索结合的价值,可直接延伸的方向包括——把 BNDT 推广到多线叙事与群像剧(多结局树而非单根);让 BNDT 在生成过程中动态重构,而非写作前一次性固化;把母题记忆做成跨剧本可复用的行业级「套路库」,作为低成本的反同质化插件。基于成果可延伸:(1) 强化学习化——把 $S(c)=0.4C+0.3N+0.3F$ 的启发式加权换成可学习打分器,用观众完播率、留存等真实反馈做奖励;(2) 交互式生成——把用户反馈作为新的目标节点插入 BNDT,支持人在回路的方向调整;(3) 多模态扩展——将因果模式指标迁移到分镜与视频生成中的镜头重复检测;(4) 检索理论化——「目标条件化检索」可形式化为因果图上的可达性检索,与因果发现、反事实推理结合;(5) 评估工具化——把证据台账+审计+仲裁的多智能体评估框架抽象为通用长文本评估开源工具,并在人工标注上系统校准 LLM 评审的偏差。
复现评估
代码已开源(https://github.com/rimory6/DraMaze.git)。数据方面 MiDramaBench 基于 PG-19 公开数据集,流程完整可循:按词数分桶 [30k,50k)、[70k,90k)、[110k,130k) 对应 20/40/60 集,Qwen3.8-27B 打改编潜力分筛选,BGE-large-en-v1.5 嵌入加 k-means 聚成 10 个题材组,共 899 个候选,分层评测集每长度 30 条。构建依赖特定模型版本,复刻需对齐 Qwen3.8-27B 与该 embedding 模型。算力方面:骨干为 27B 级模型(主实验 Qwen3.6-27B,跨模型 GLM5.3-Flash、DeepSeek-V4-Pro,评估 Qwen3.8-27B),流水线免训练,单卡 A100/H100 或量化推理即可,门槛在 API 调用成本。难点在评估的多智能体 prompt 与扣分细则(S/A/B 级 -10/6/4、亮点 +3/1/0、起始 90 分)需对齐附录 D;母题抽取判定有随机性,论文报 3 次重复的均值与标准差可对照。总体复现难度:中等。
论文图表
在使用 Qwen3.6-27B 的 40 集生成实验中,对比三种策略(无检索 BASE、Dense RAG、DOME 式图检索)在各生成检查点(约第 4 至 39 集)上候选续写的叙事机制熵曲线。熵在第 20 集后总体下降、结尾附近最明显,Dense RAG 在后半程始终低于 BASE,DOME 在多数后期检查点也低于 BASE。
这是支撑全文动机的核心实证图:它首次量化了「长文本生成中叙事机制熵持续下降」的现象,并证明常规检索无法阻止甚至加剧机制集中,直接引出 DraMaze 的设计必要性。
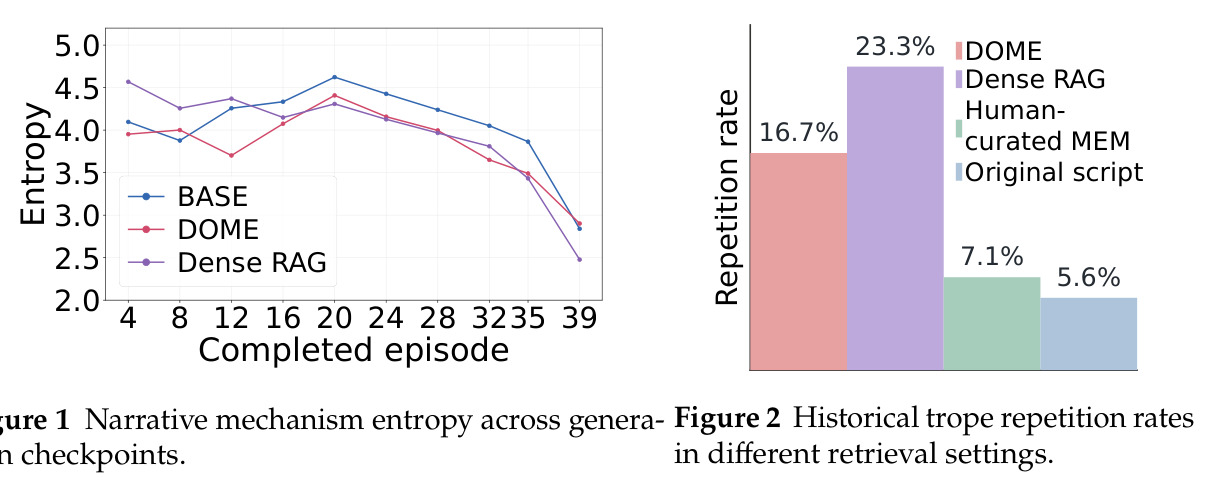
在同一续写设置(第 1–20 集为历史、第 21–30 集梗概为目标)下对比不同记忆来源的母题重复率:Dense RAG 23.30%、DOME 16.67%、人工挑选记忆 7.14%、原剧本本身 5.56%。
该图量化了「语义—叙事鸿沟」的另一半证据:自动检索不仅漏掉关键历史信息,还会鼓励复用已有的冲突解决策略与因果机制,是 BNDT 目标条件化检索设计的直接依据。