DramaChain Bench:面向短剧生成的端到端评测基准 DramaChain Bench: An End-to-End Benchmark for Short-Drama Generation
首个评测短剧生产链全部六个阶段的基准,自动裁判与人类一致性 PLCC 达 0.918
前置知识
短剧生产流水线
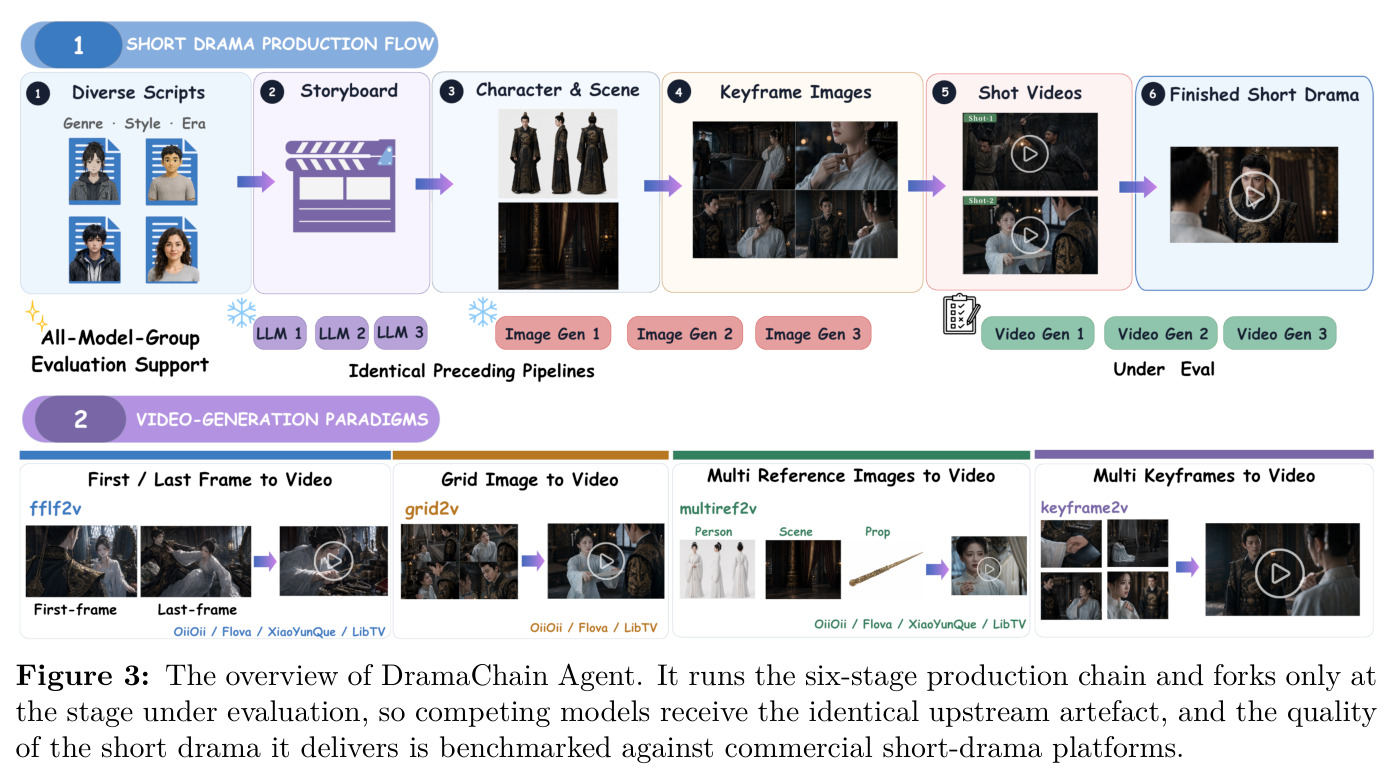
商业短剧平台(OiiOii、Flova、小云雀、LibTV 等)普遍采用的多阶段生产链:从用户的故事前提出发,先写剧本(script),再拆解成分镜脚本(storyboard),然后渲染关键帧图像(keyframe),再动画化为单镜头视频(shot video),最后组装成完整短剧(short drama)。每一阶段的产出是下一阶段的输入,上游交付物的质量决定了下游所有阶段的能力上限。学术界的多智能体框架(MAViS、ViMax 等)也收敛到了同一范式。
本文的核心论点是评测必须沿这条链逐阶段进行。理解流水线结构,才能理解为什么设置六个评测粒度、为什么缺陷会级联放大、以及分叉评测(fork)的设计动机。
PLCC 与 SRCC
PLCC(Pearson 线性相关系数)衡量两组分数的线性相关程度,SRCC(Spearman 秩相关系数)只衡量排名的一致性,取值都在 $[-1,1]$。评测基准论文用它们验证自动评分器与人类评分是否一致:模型级相关回答「排行榜排名对不对」,条目级相关回答「每个具体分数准不准」。两者常被一起报告,因为排名对不等于分数准。
论文的核心验证结论「自动裁判平均 PLCC 0.918」以及全部一致性分析(Table 3、8、9)都建立在这两个指标上,不懂它们就无法理解自动评测是否可信。
留一法人类基线(hb)
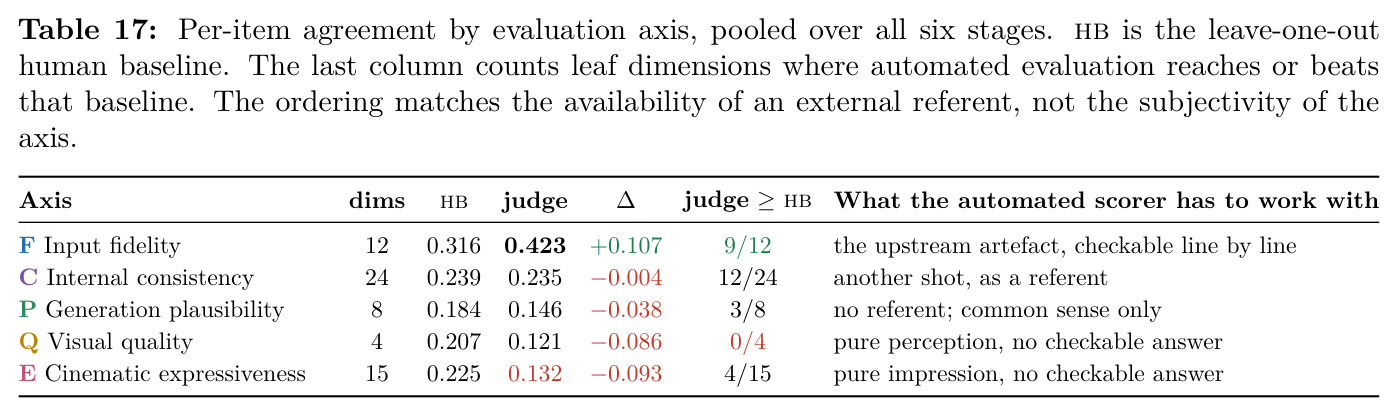
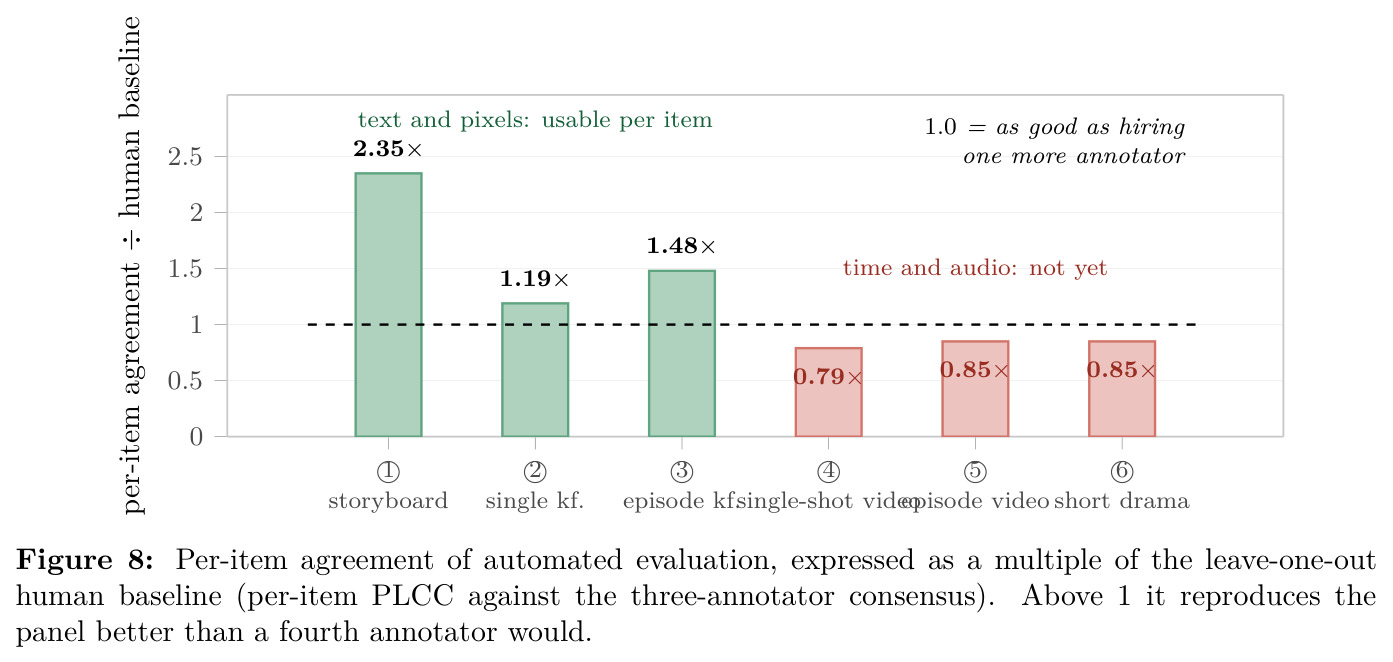
leave-one-out 基线:让一名标注员去预测另外两名标注员的平均分,轮转 pooling 后得到「第四个独立人类标注员」所能达到的条目级一致性水平。自动评分器与该基线的比值(如 $2.35\times$)直接回答:机器评测顶不顶得上多雇一个人类标注员。比值大于 1 才说明自动化真正超越了人力。
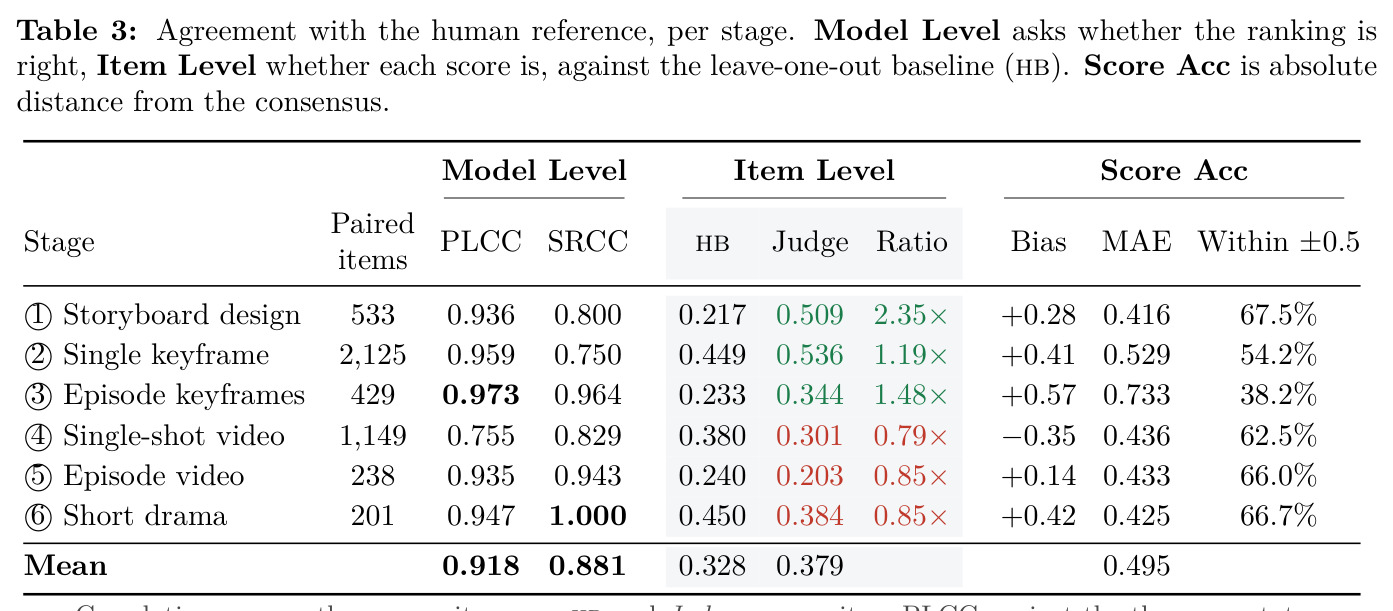
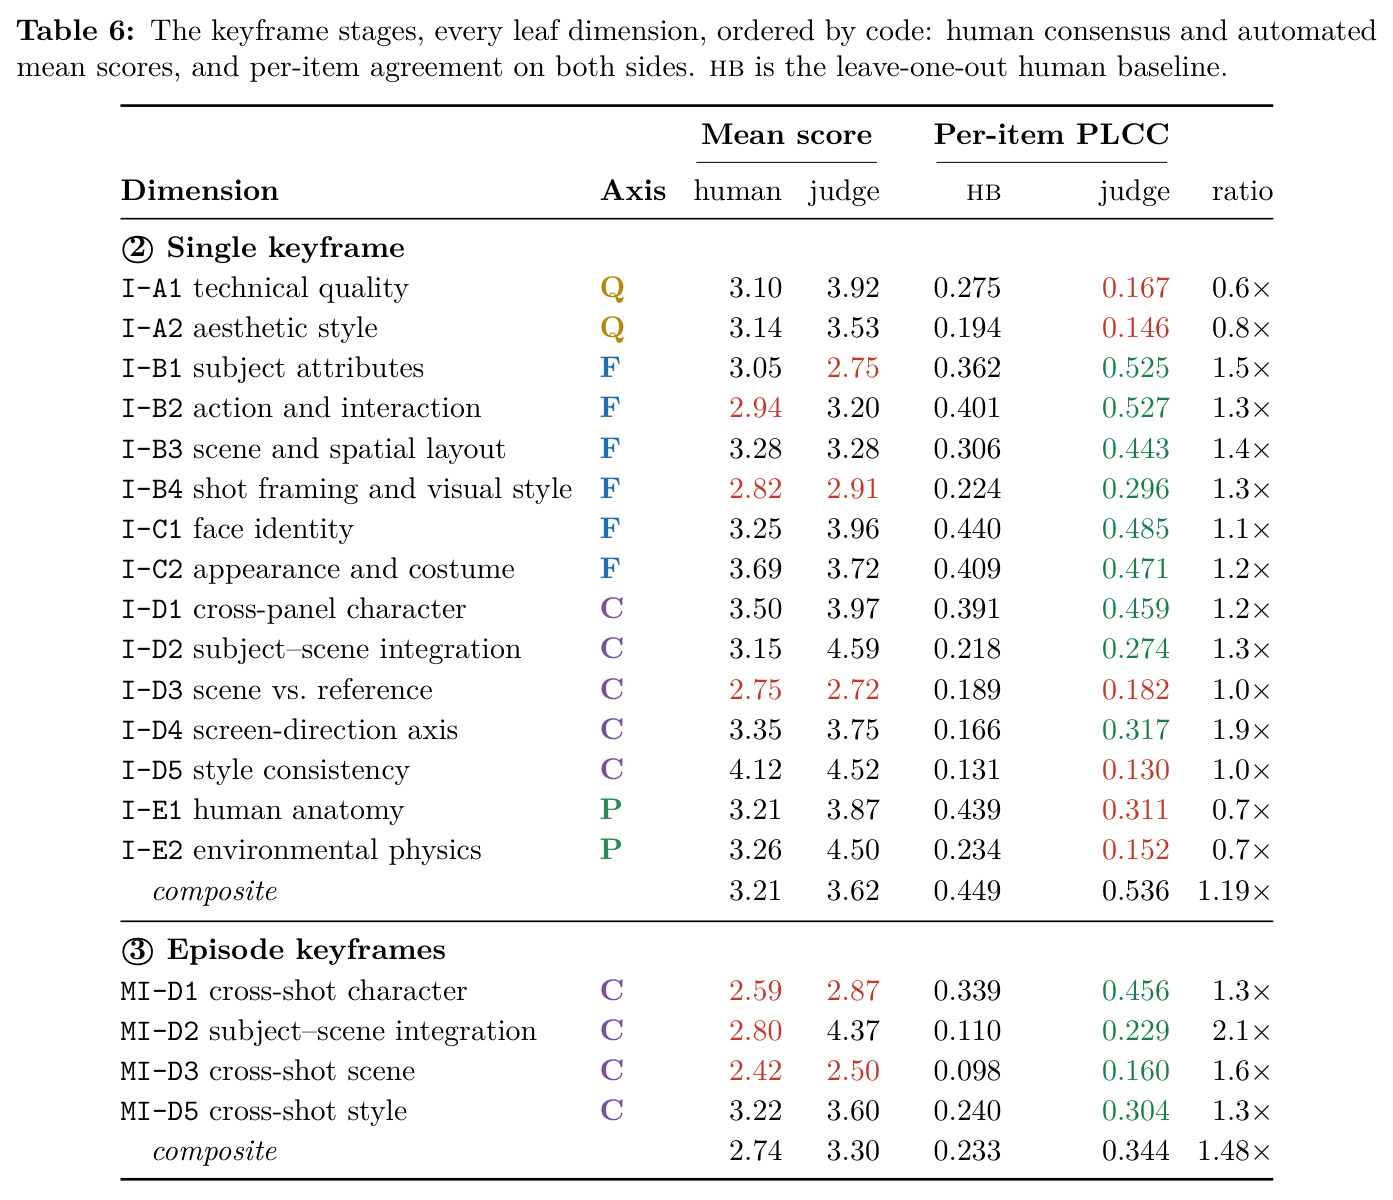
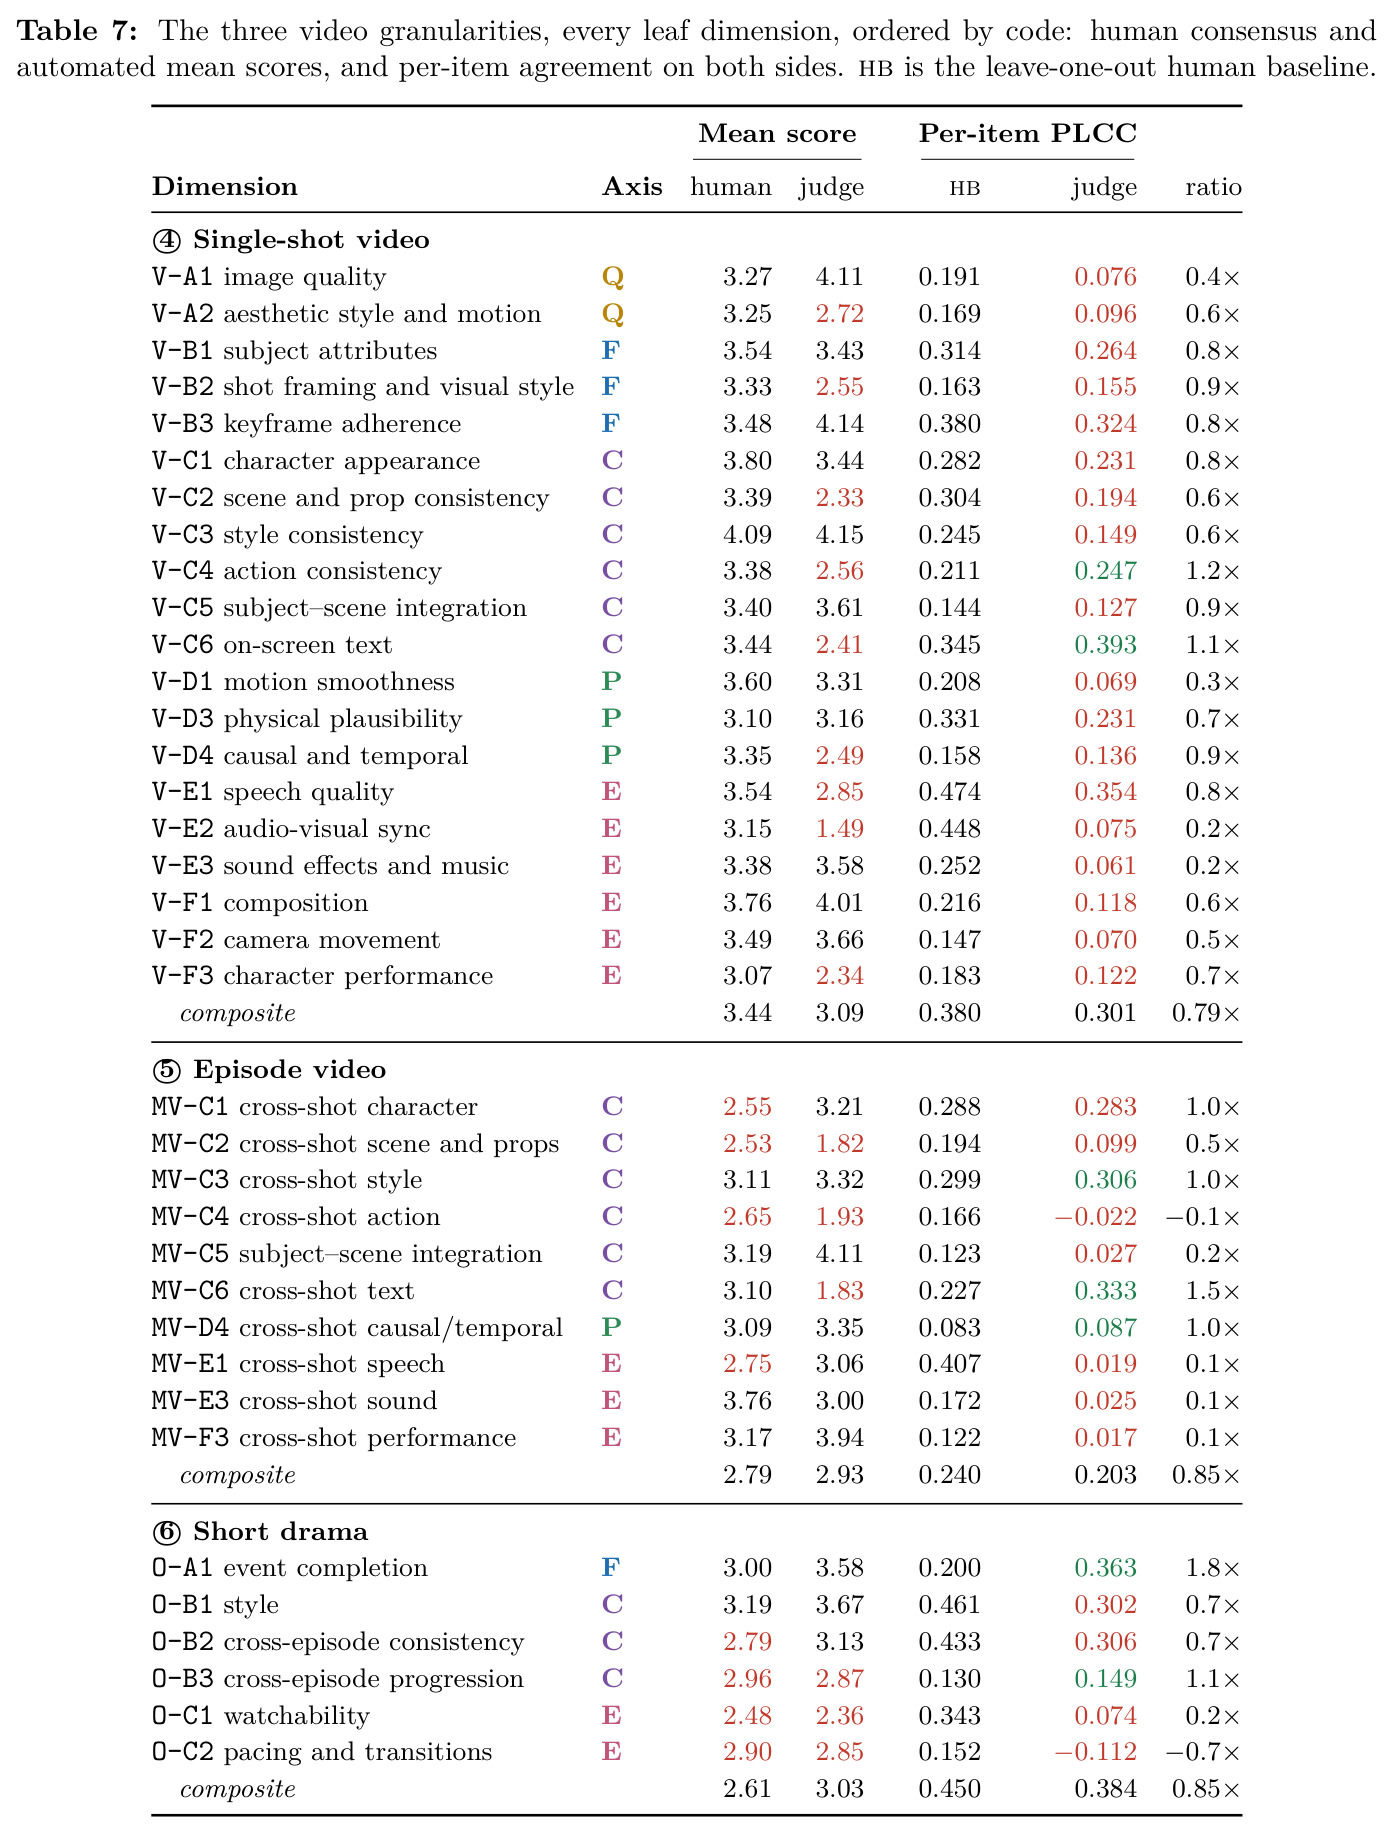
论文反复用 judge/hb 比值来判断某个阶段能否零成本全自动评测:分镜设计 $2.35\times$ 通过,而单镜头视频只有 $0.79\times$ 不通过,这是全文可自动化性结论的度量衡。
VLM 裁判与 Agentic 评估
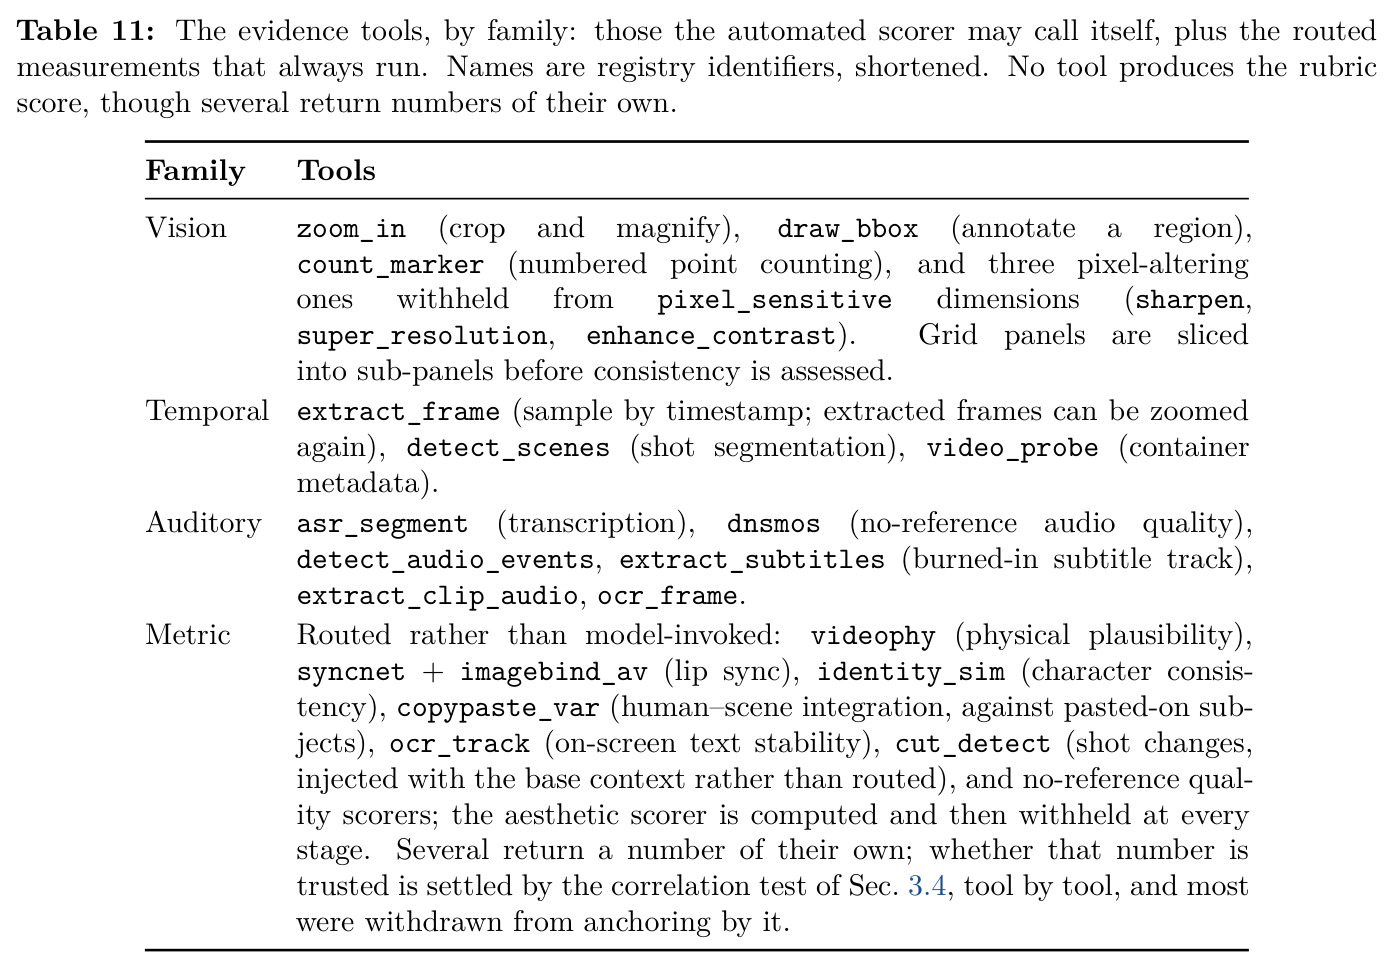
用视觉语言模型(VLM)代替人类给生成内容打分。单次直接打分容易漏掉局部帧区域或段间不连续处的缺陷;Agentic 方式则让模型在多轮交互中调用工具(区域放大、按时间戳抽帧、专用检测器)主动收集证据,最后对照逐条 checklist 作出裁决,并输出缺陷标签与时空定位。近期研究表明这类裁判在语义对齐上强、在需要时间分辨率的维度上弱。
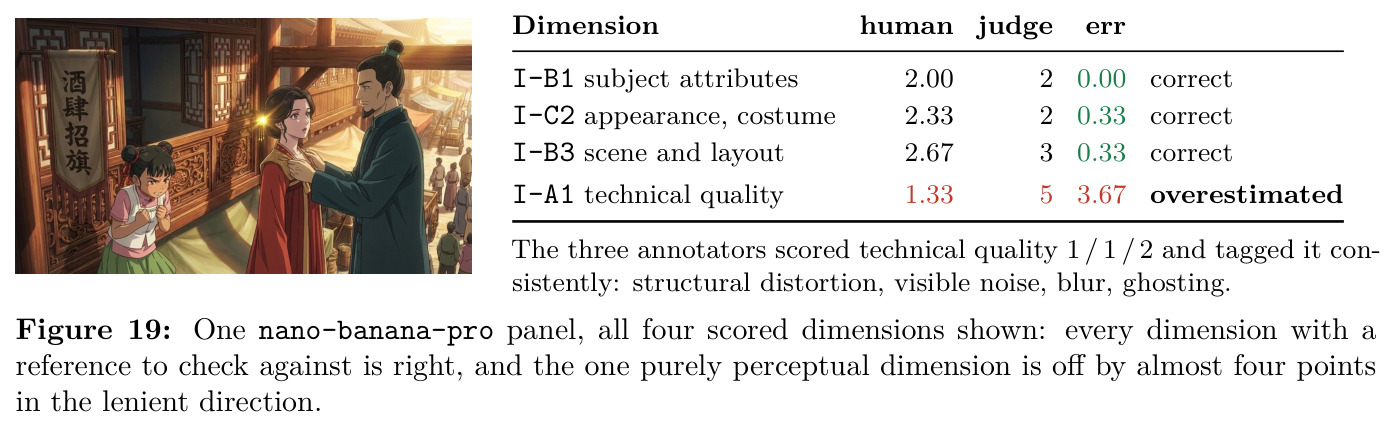
DramaChain Agentic Judge 正是这套范式的工程化:先审计专用指标与人类的相关性、淘汰失效指标,再用多轮代理式评分复现人类参照标准,达成 0.918 的平均一致性。
时空定位归因标注
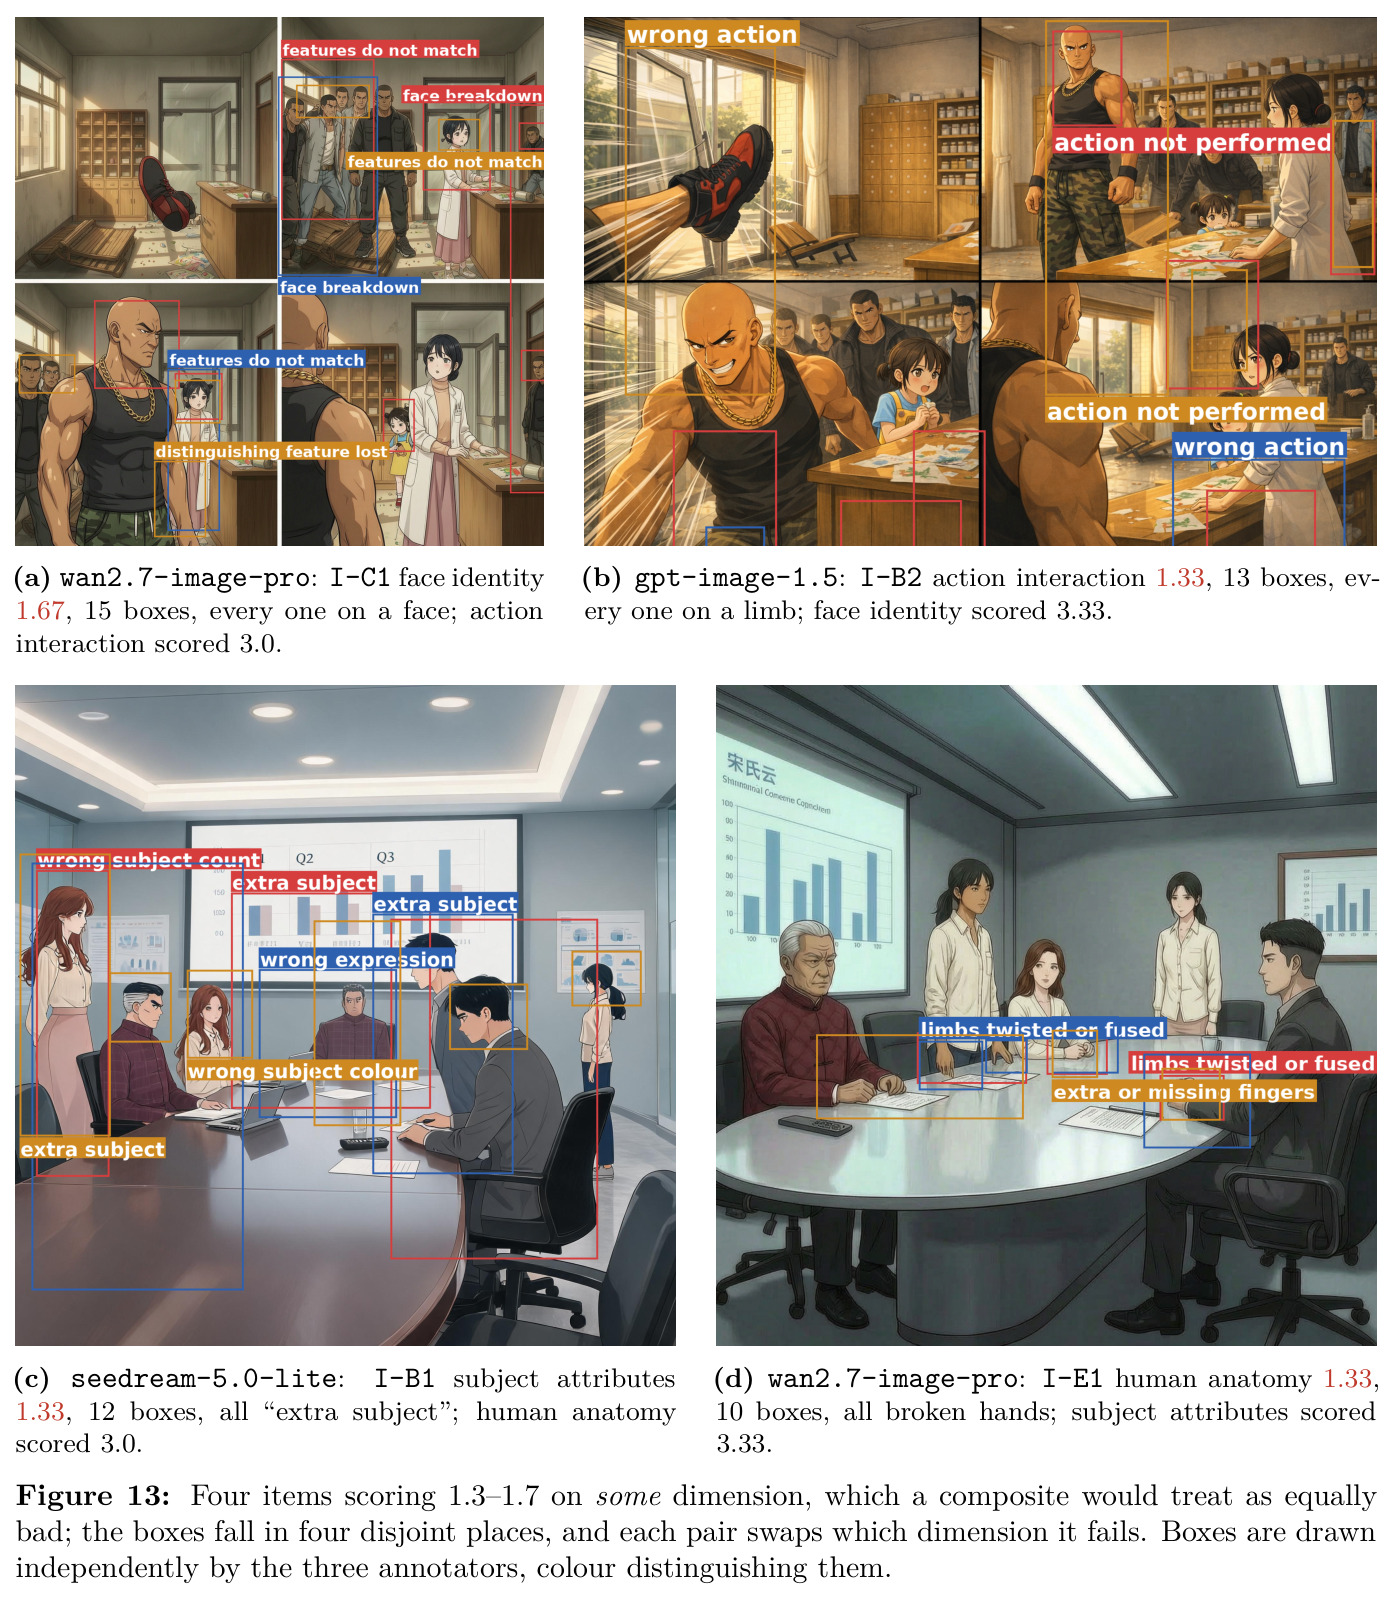
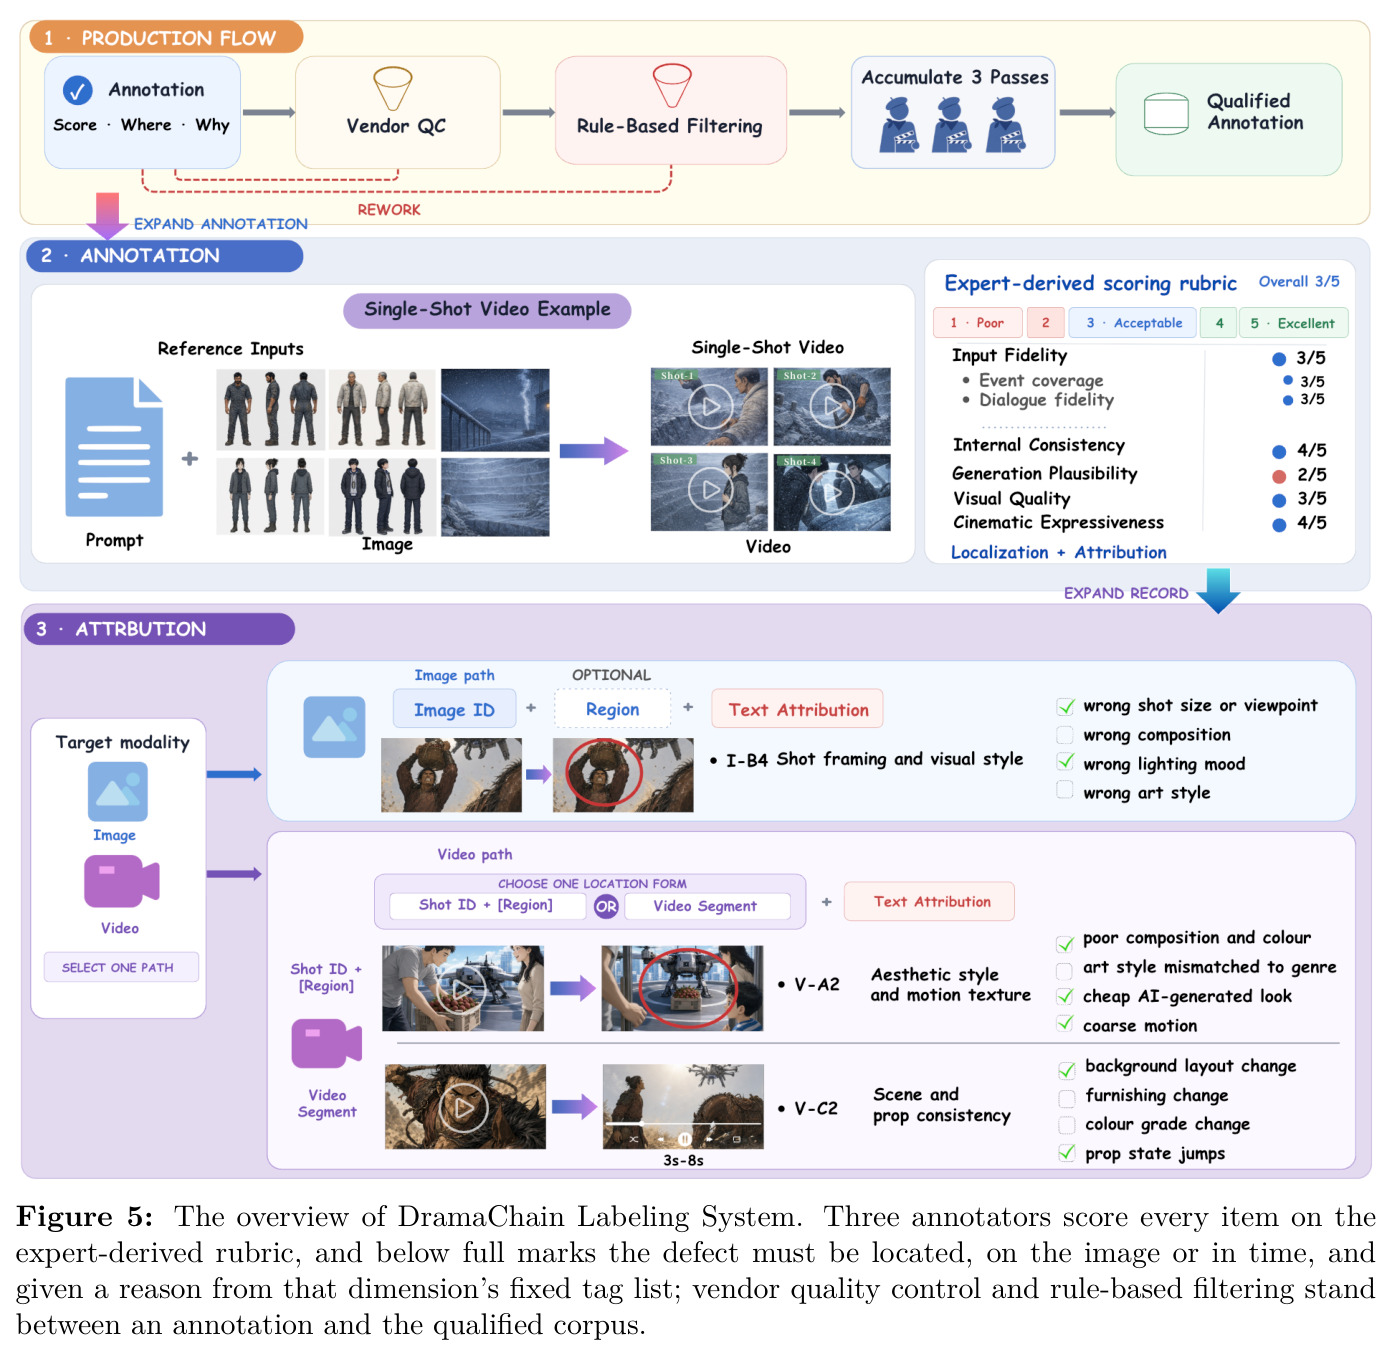
一种强约束的标注协议:任何未得满分的维度,标注员必须指出缺陷在画面中的区域(边界框选帧)、时间区间、镜头序号或范围,并从该维度预定义的封闭标签集中选择原因。这使每一条扣分都可核查,能区分「三个标注员都不喜欢这个输出」与「三个标注员锁定了同一个缺陷」这两种本质不同的情形。
这是论文能验证自动评分「找没找到真缺陷」而不只是「分数接不接近」的基础,也是 255,925 条可追溯归因记录的来源;没有它,链级缺陷归因分析无从谈起。
视频阶段输入范式
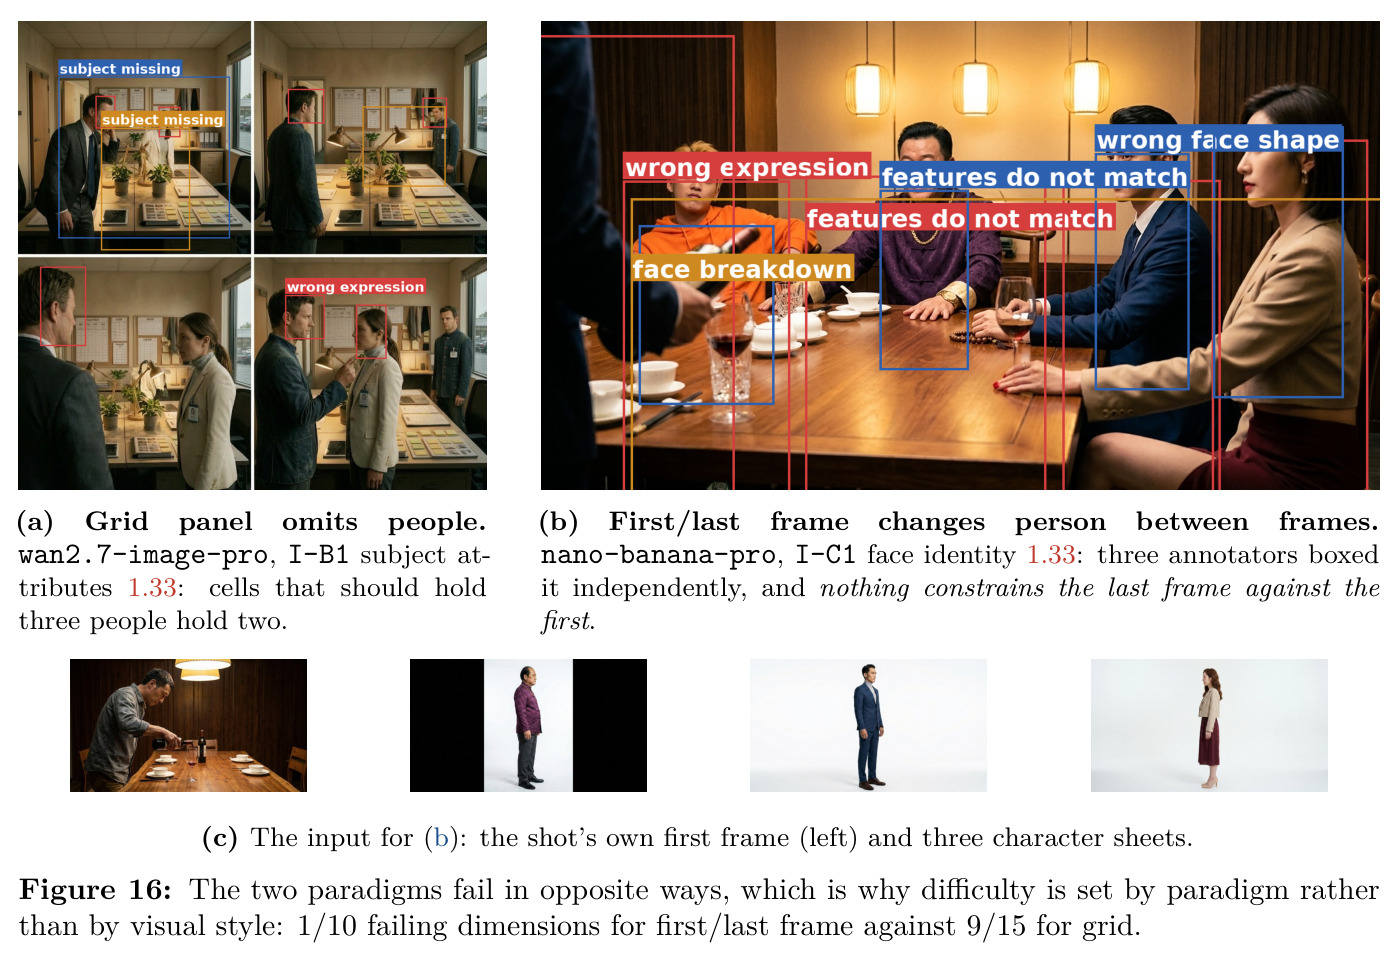
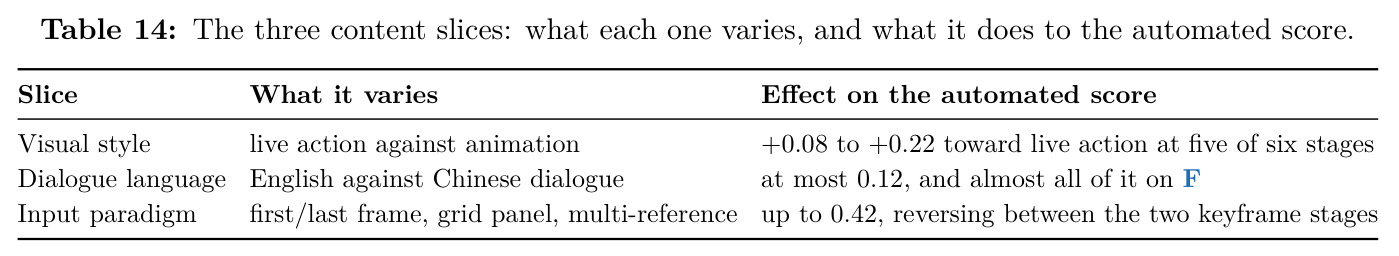
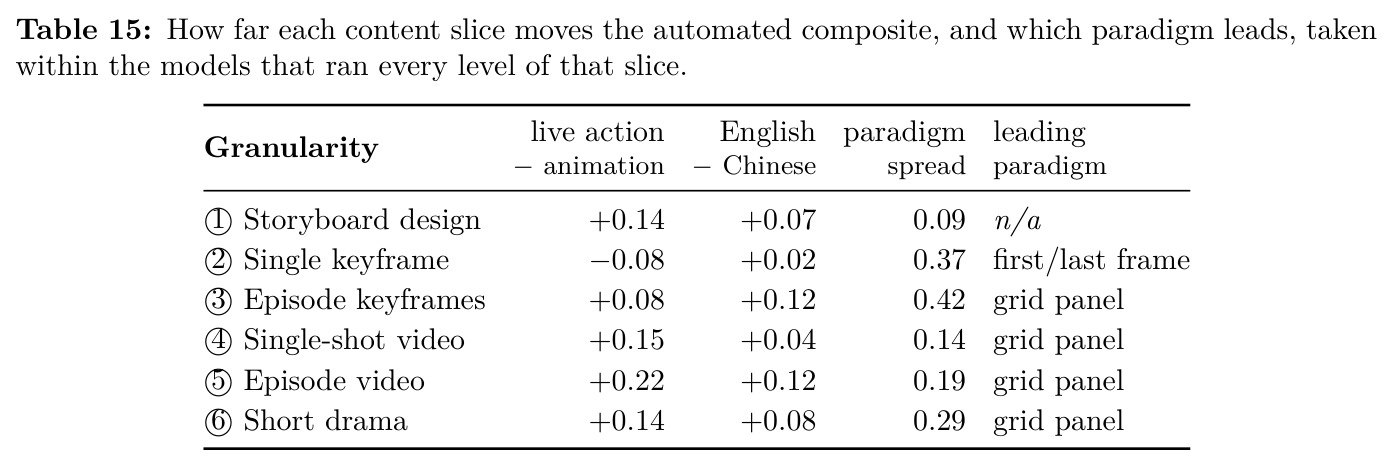
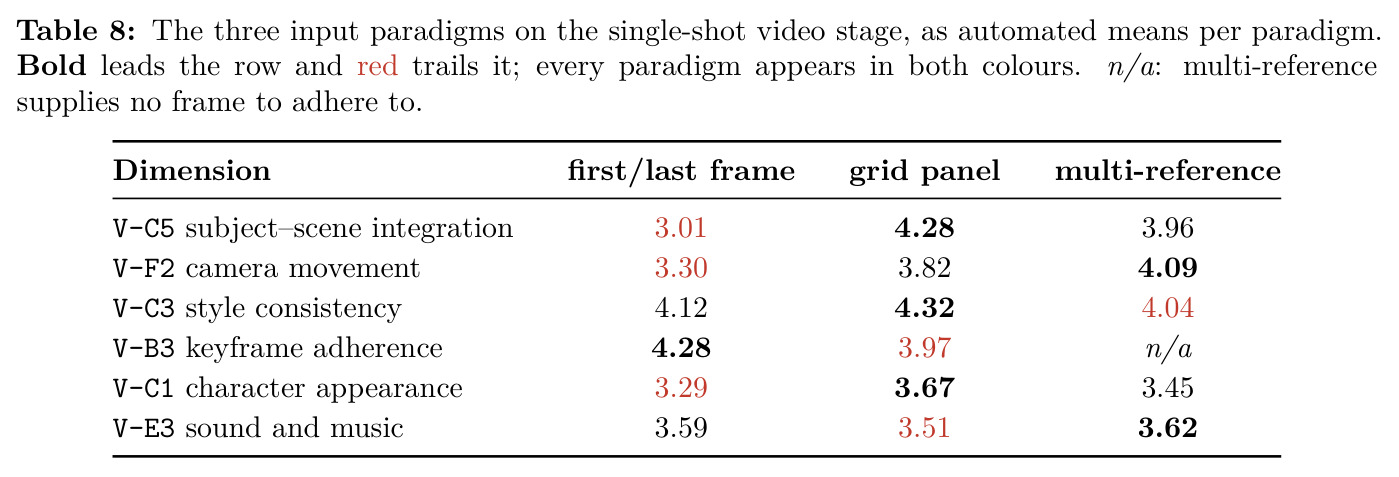
商业平台驱动视频生成模型的方式各不相同:fflf2v 提供首尾帧对(first/last frame),grid2v 提供切片网格图(多镜头拼进一张图,每个镜头对应图中一个局部格子),multiref2v 只提供角色/元素/场景参考图而不给任何帧,keyframe2v 给独立绘制的逐镜头关键帧。不同范式约束的内容不同,模型的能力表现也随之系统性地不同。
论文 Table 8 显示每种范式恰好在他所约束的维度上占优(如首尾帧范式关键帧遵循度最高 $4.28$),证明输入格式是影响落地质量的部署决策,而非实现细节。
研究动机
短剧已是生成式视频最重要的落地场景之一:2025 年全球微短剧收入达 110 亿美元,预计 2026 年达 140 亿美元,其中中国贡献约 83%,Omdia 预测 2026 年非中国市场收入 30 亿美元;2025 年国内上线约 33,000 部短剧、观众近 7 亿。商业平台与学术 agent 框架都收敛到同一条多阶段流水线:剧本→分镜→关键帧→单镜头视频→成片。但评测没有跟上这条链的形态:第一代基准(VBench)只评单个视频片段,第二代(FilmBench 等)扩展到电影语言与多镜头设置,第三代开始沿生产流程组织指标,但没有任何工作对一条流水线内部各阶段实际交付的中间产物打分。这留下三大问题:其一,各阶段被孤立测试,无法回答交付缺陷由哪个阶段造成、又传播了多远;其二,评测输入是为测试而人工编造的(反向工程的提示词、从现有素材剪出的镜头),干净且自洽,与生产中阶段实际接收的机器生成上游产物不同;其三,人类监督不做缺陷定位——标注只是模型级相关性验证、偏好或整体评分,不记录哪个维度失败、在哪里失败、为什么失败,因此自动评分器只在排名上被验证过,从未被验证是否真的找到了缺陷。
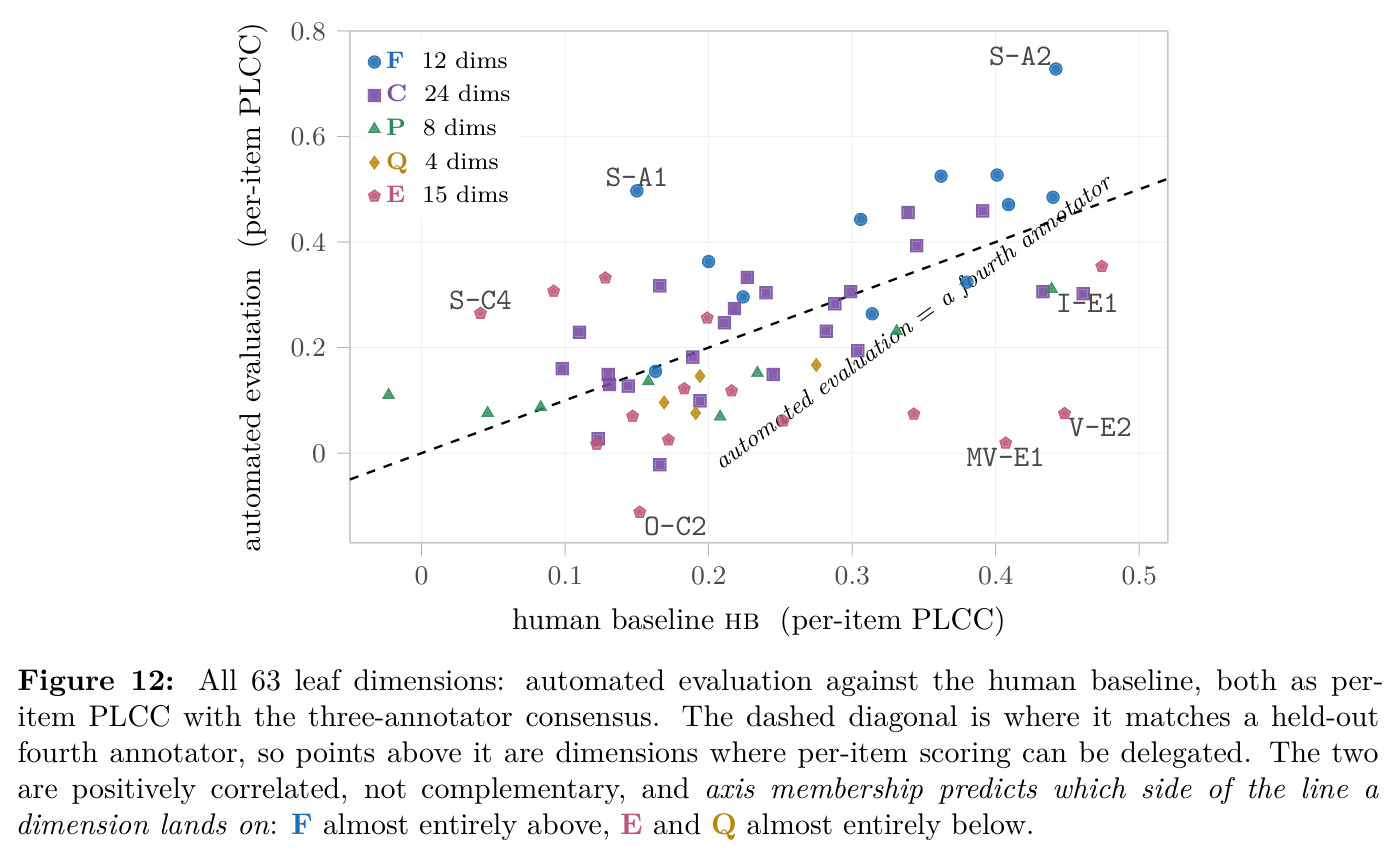
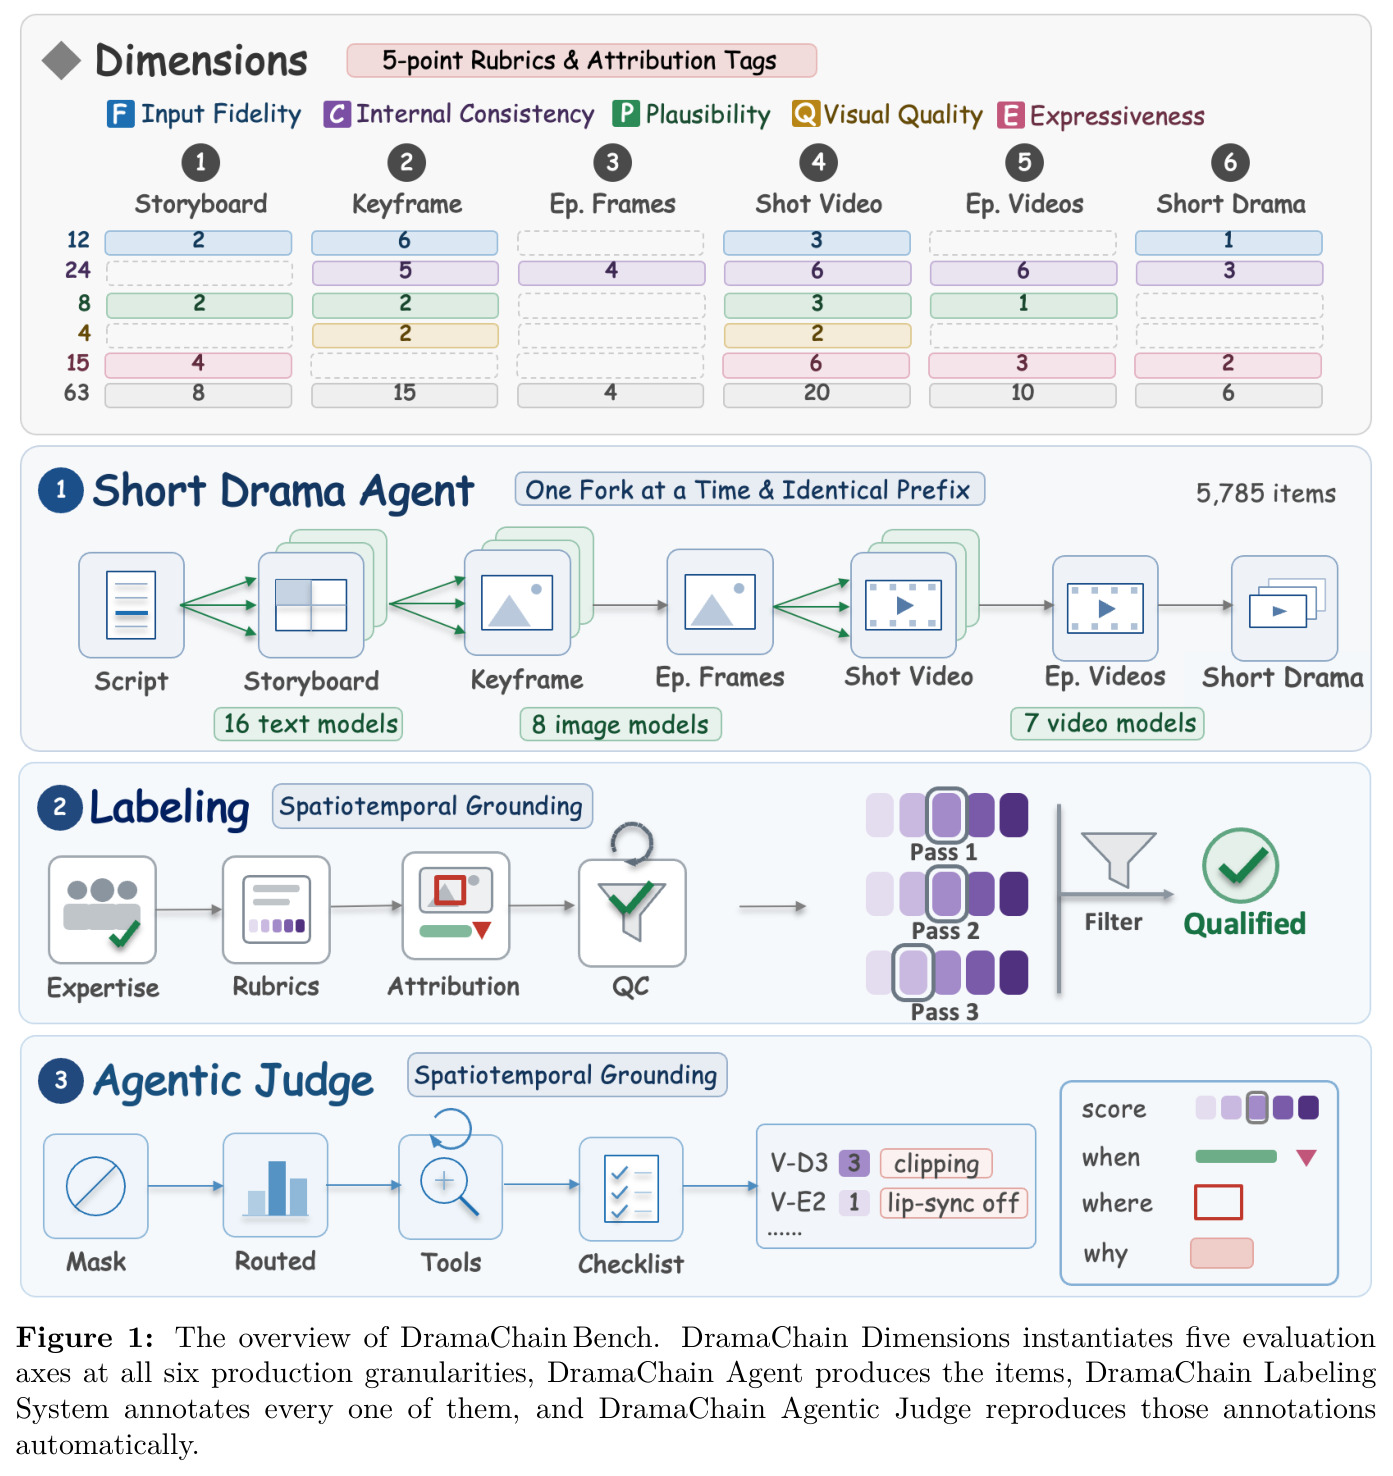
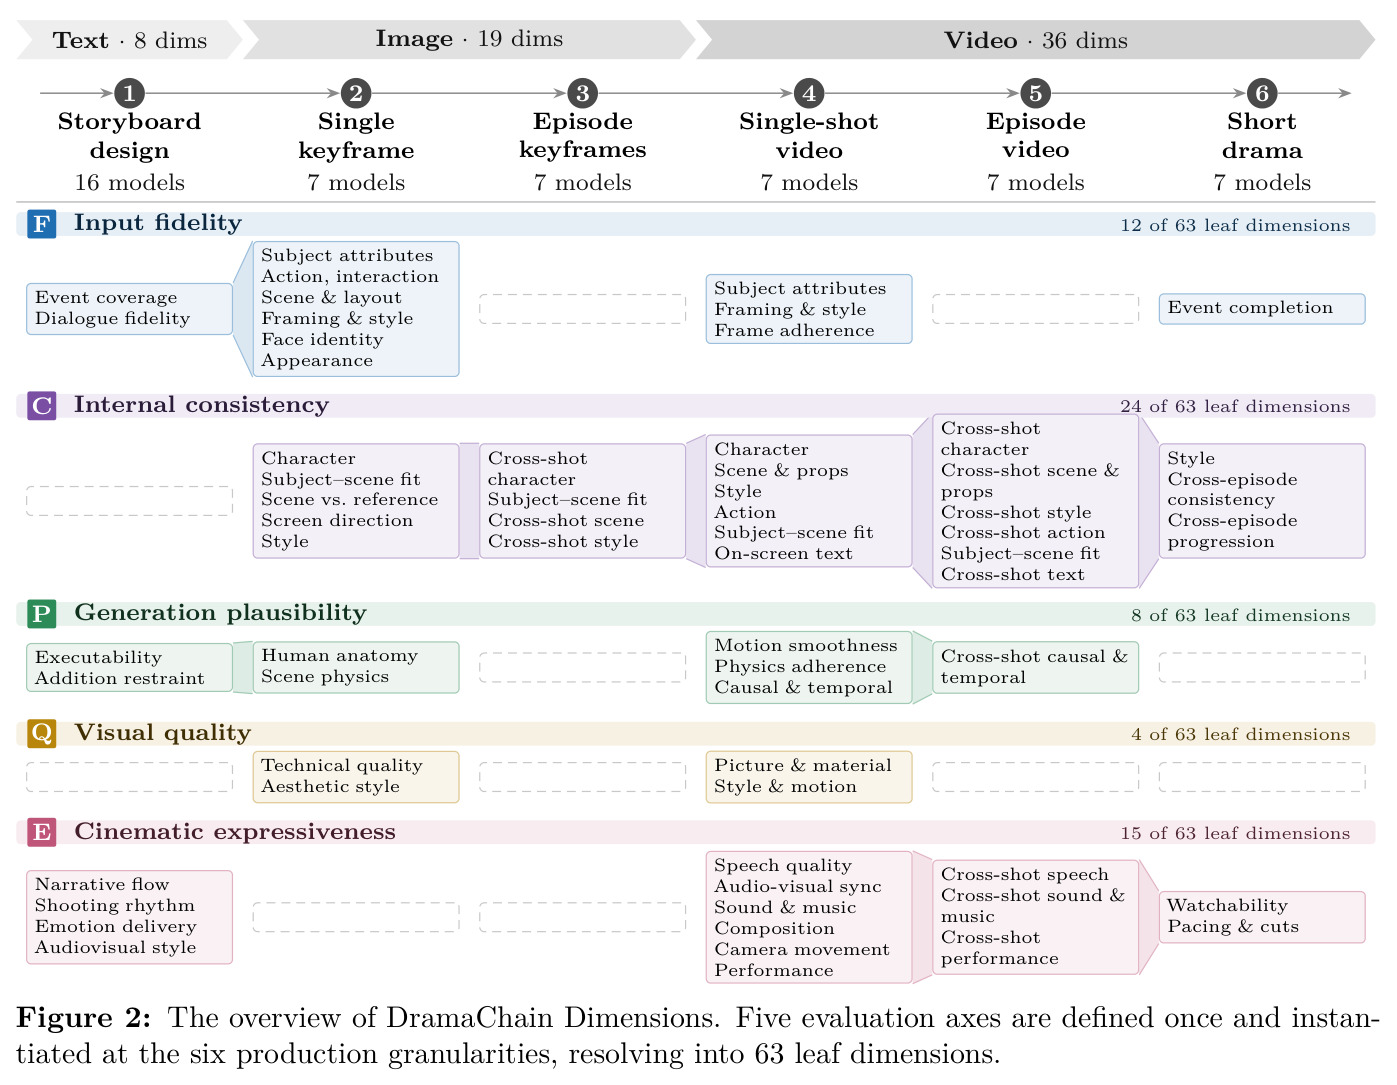
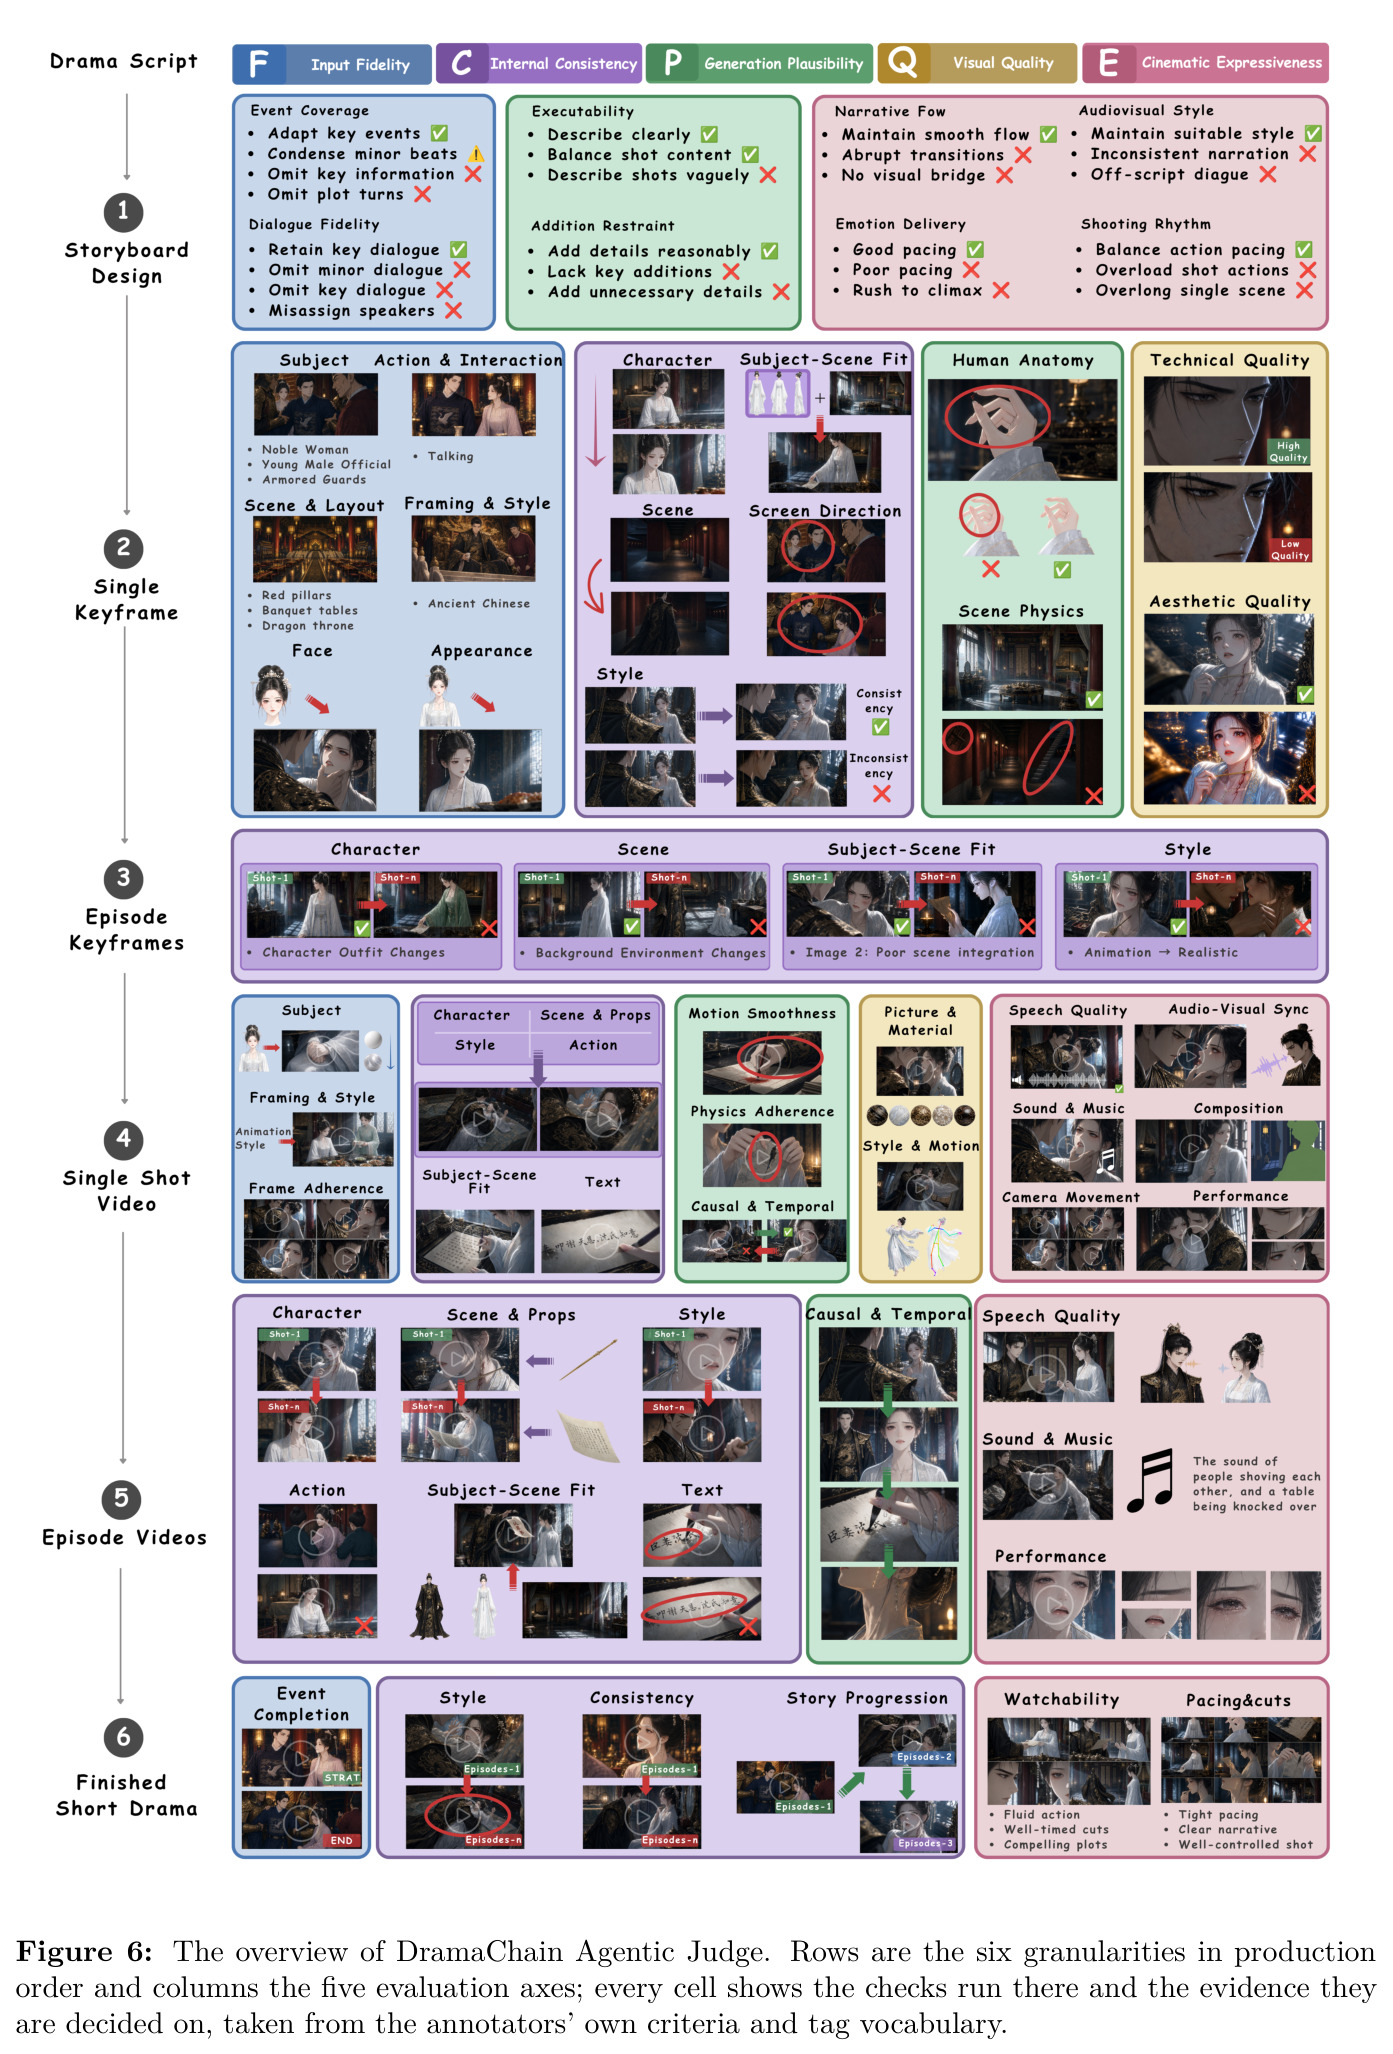
本文的目标是本文要构建第一个对完整生产链每个阶段都打分的短剧评测基准,并让「新模型接入评测」变成零人工标注成本的操作。具体拆成四个子目标:第一,定义统一维度语言——五条评测轴(输入保真 F、内部一致性 C、生成合理性 P、视觉质量 Q、电影表现力 E)在六个生产粒度(分镜设计、单关键帧、剧集关键帧、单镜头视频、剧集视频、成片短剧)上一次性定义、逐级实例化,解析为 63 个叶维度,使同一标准可沿链追踪;第二,所有评测条目由一条与商业平台工作流和成片质量都对齐的自建自动化流水线产出,且只在被测阶段分叉,保证模型间分数差异可归因于模型本身;第三,人类标注侧由三名专业标注员对每一条目独立打分,全部扣分强制时空定位并归因到封闭标签表,最终产出 17,488 个有效分数和 255,925 条可追溯归因记录;第四,构建一个经人类参照校准的多轮 agentic 自动裁判,使模型级平均 PLCC 达到 0.918,从而新模型可以零标注成本进入榜单。
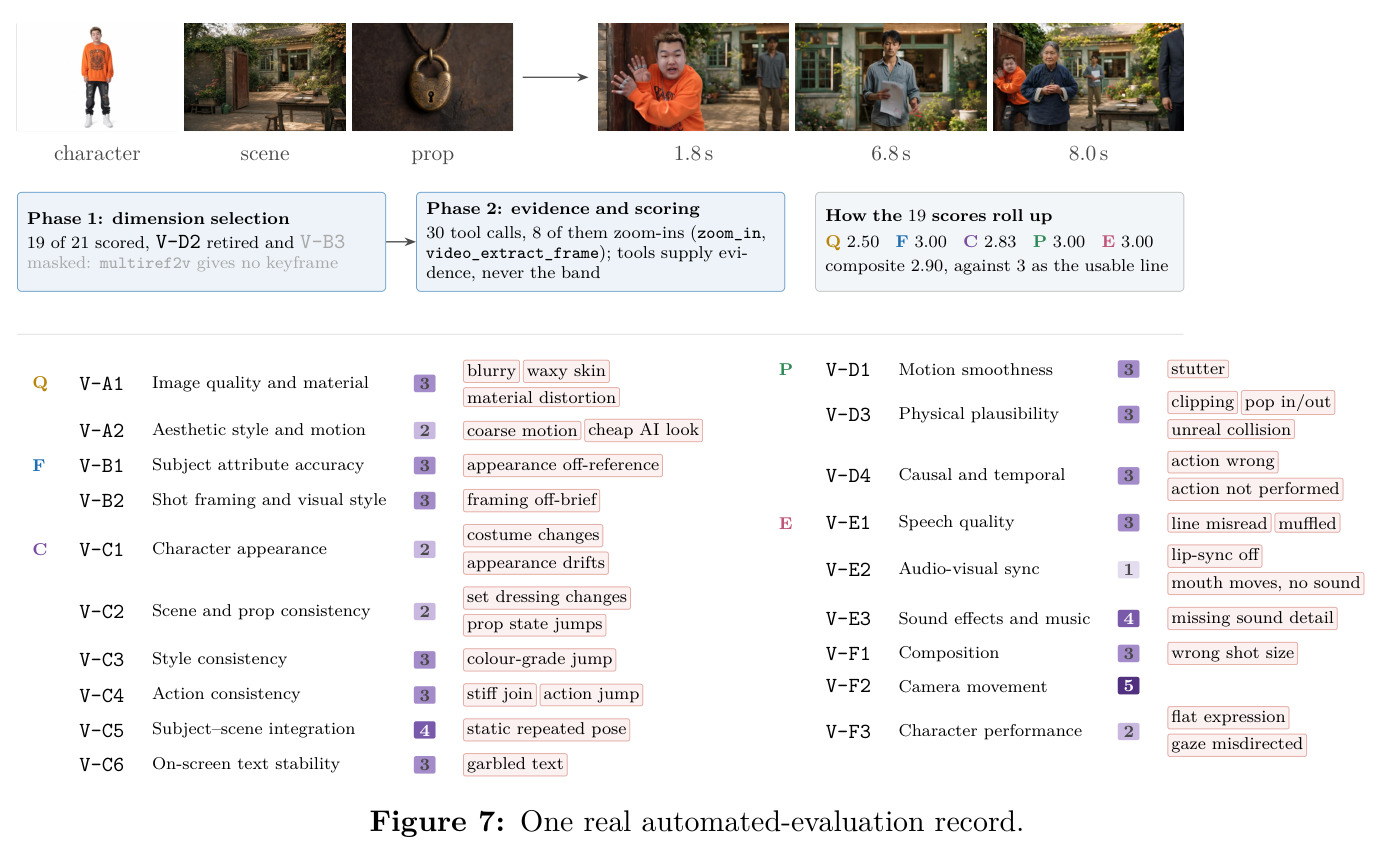
与已有工作不同的是,本文的独特切入角度是把「参照答案本身当作工程产物」,并让评测对象变成链上交接物。与以往把评测对象定为最终成片、把输入当作给定条件不同,这里每个阶段的评测条目都由被测流水线自己生产:每个镜头槽位由每个参赛模型恰好生成一次,其余阶段完全固定,参赛模型收到的是真实的上游机器产物和完全相同的提示串。另一个独特之处是拒绝「小模型测量喂给大模型裁决」的惯用混合管线:作者先对全套专用指标做人类对齐审计,发现大多数指标 $|SRCC| \leq 0.2$、十四个摄影导向的美学/画质指标甚至与人类负相关,据此淘汰失效指标,只保留有相关性的低层感知信号作辅助线索,再让 agent 在多轮中调用区域放大、按时间戳抽帧等工具收集证据,用与标注员完全相同的 rubric 文本和缺陷词表逐项裁决。这使自动评分的输出格式(缺陷标签加时空定位)可以直接与人类标注互查,而不是只对最终分数负责。
核心方法
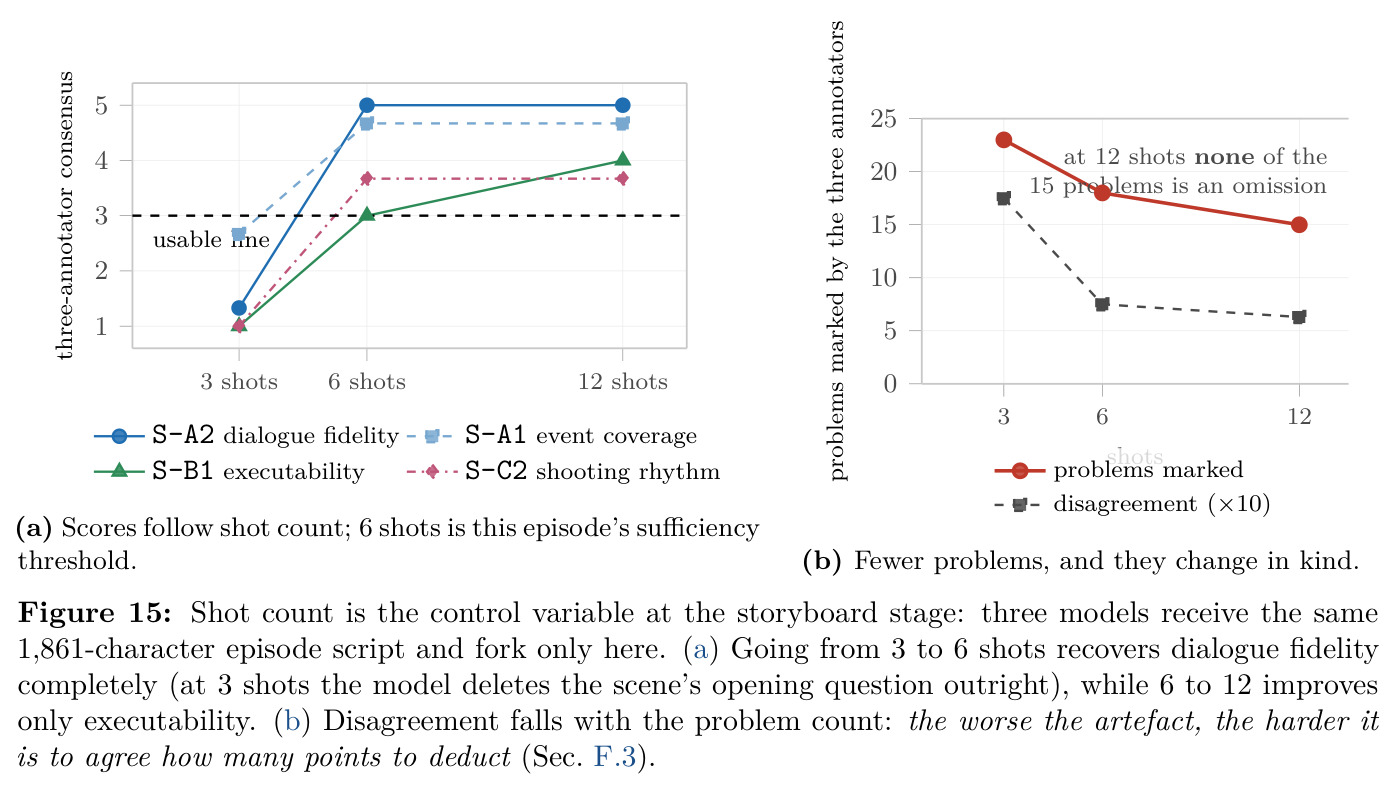
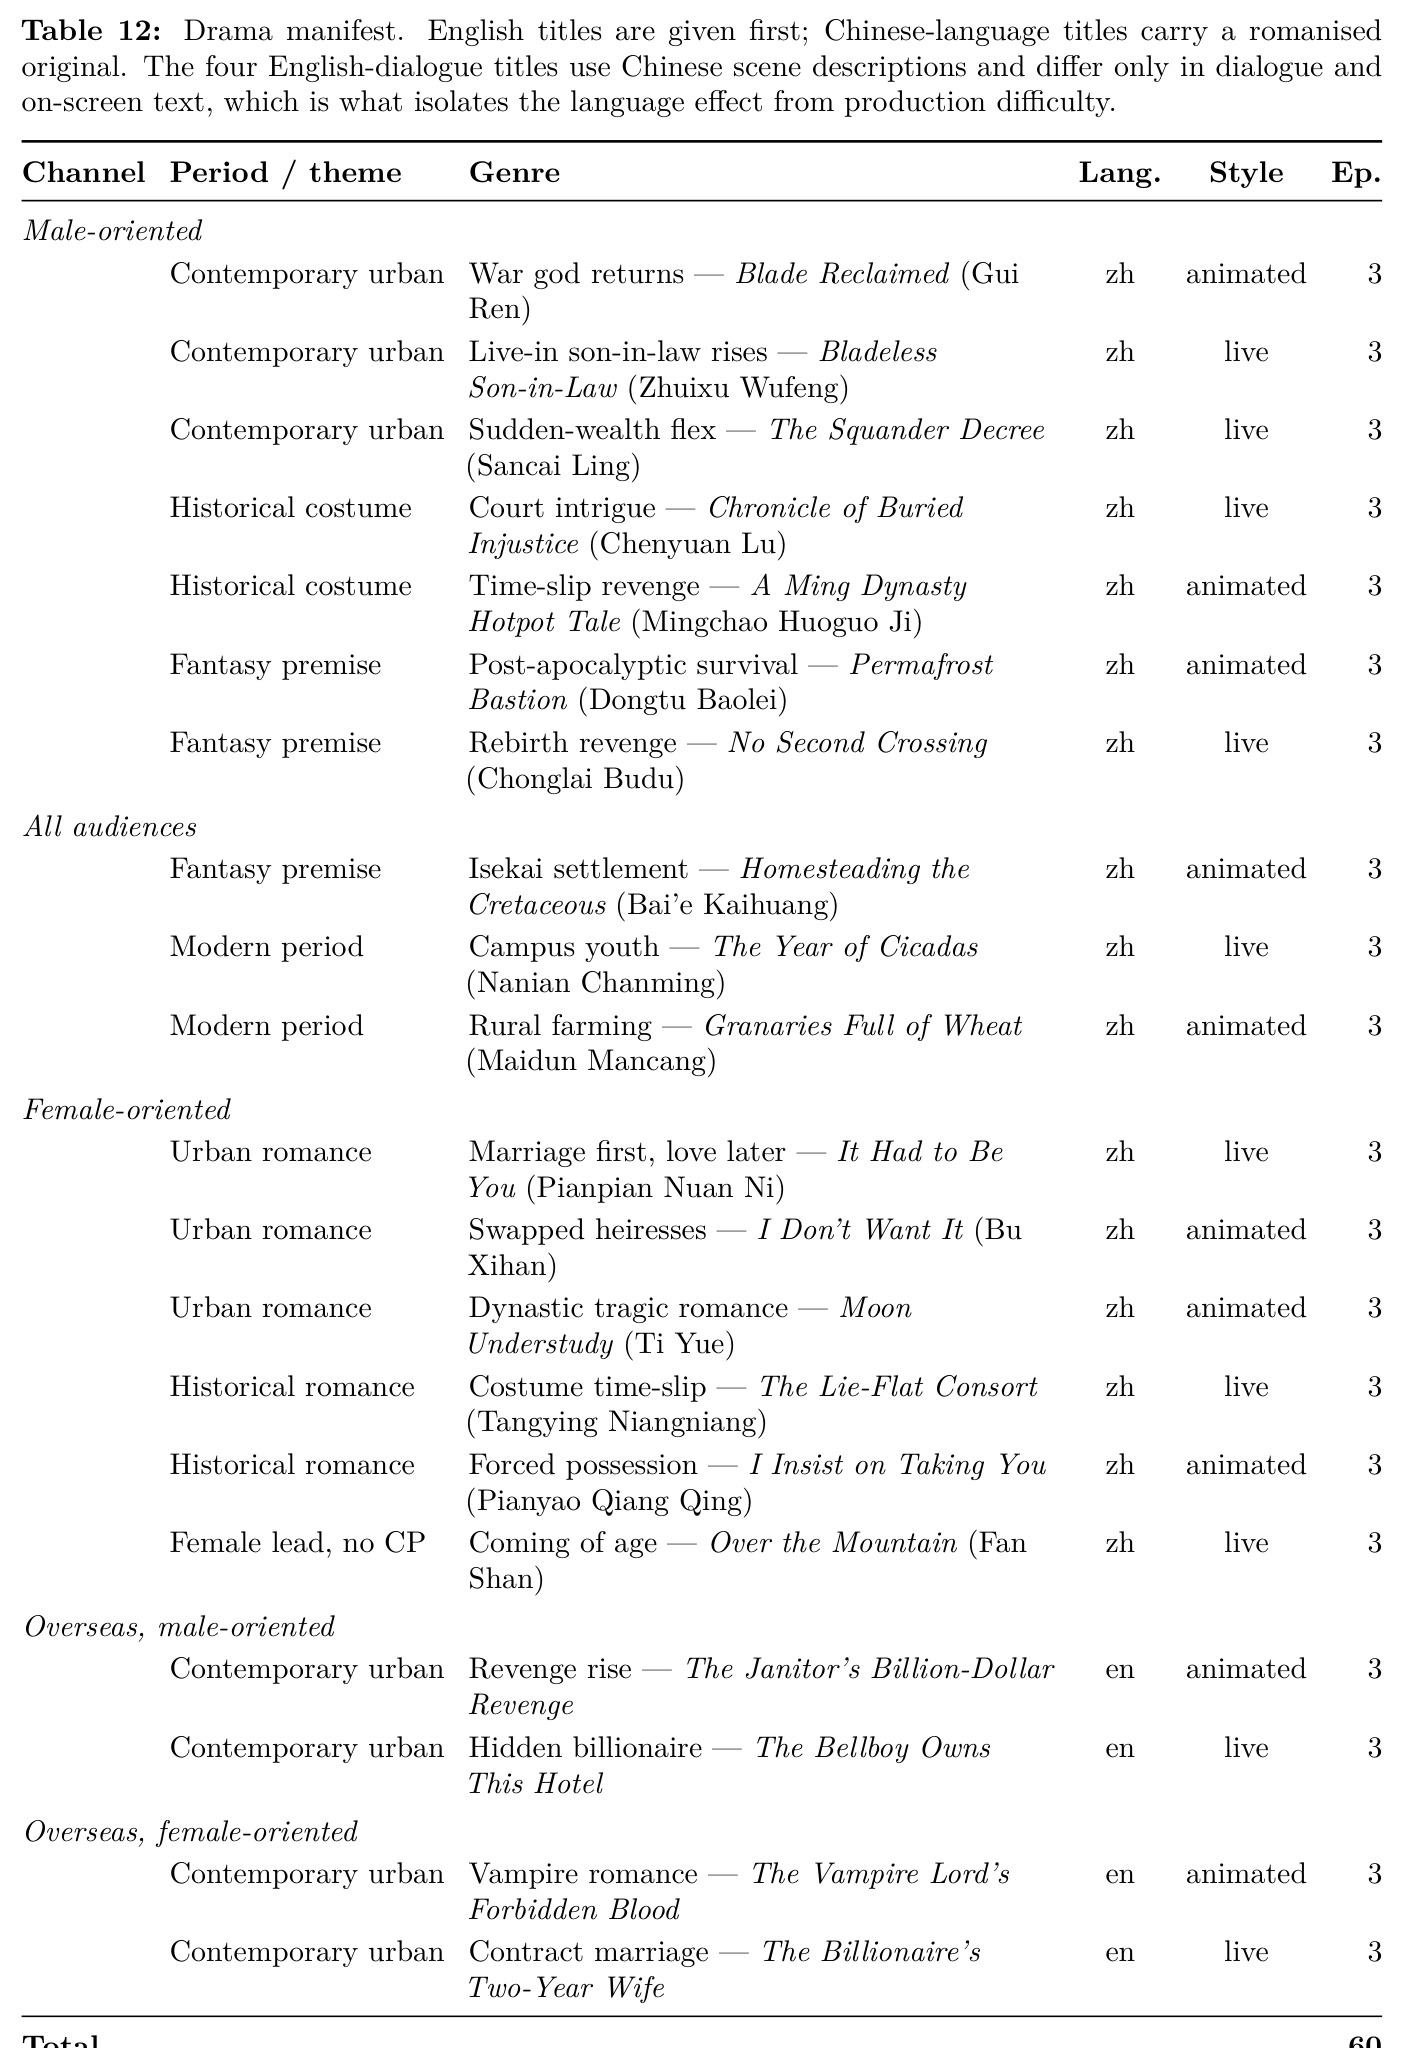
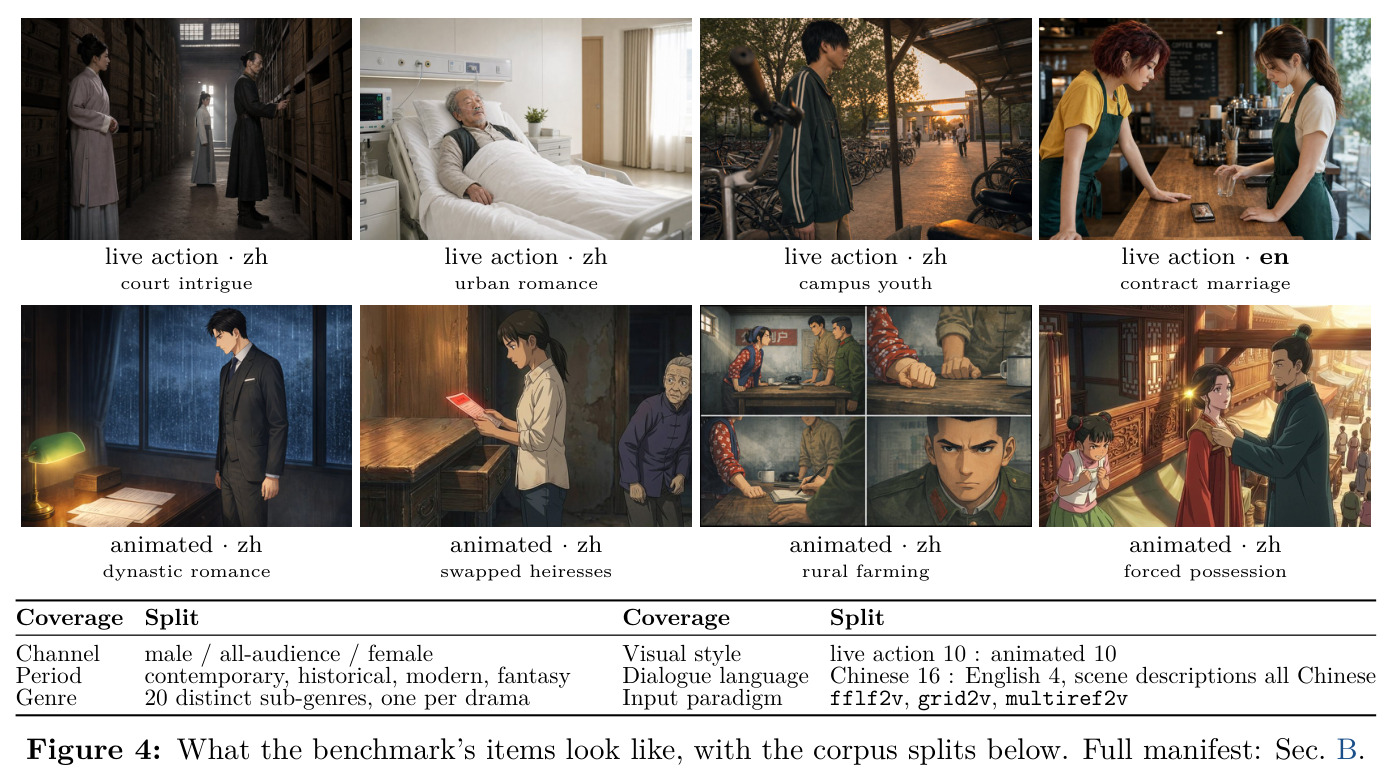
整体直觉是:要回答「成片缺陷是谁的锅」,必须同时具备三样东西——一条可信的生产链(否则测的是管线不是模型)、一套跨阶段可比的维度语言(否则缺陷无法沿链追踪)、一份逐条定位的参照答案(否则自动评分只对排名负责)。技术路线上,DramaChain Bench 等于三套自建系统加一个维度体系。DramaChain Dimensions 把五轴在六个粒度实例化为 63 个叶维度(F 轴 12 个、C 轴 24 个、P 轴 8 个、Q 轴 4 个、E 轴 15 个;文本阶段 8 维、图像 19 维、视频 36 维)。DramaChain Agent 基于 ViMax 框架、按逆向自商业平台的流程搭建,全自动生成 20 部短剧乘 3 连续集共 60 集的语料(真人 10 部对动画 10 部、中文 16 部对英文 4 部、20 个子题材各一部),实现 fflf2v/grid2v/multiref2v 三种视频输入范式,并与三个商业平台端到端对比、经专家评审确认输出处于同一水平带。DramaChain Labeling System 组织 543 名按阶段技能筛选的标注员,三人对每条目独立评分、中位耗时 23 分钟。DramaChain Agentic Judge 按阶段配置裁判模型:分镜用 gpt-5.6-sol-xhigh 与 claude-fable-5 变体的平均以消除模型族偏差,关键帧用 doubao-seed-2.1-pro,镜头视频用 gemini-3.1-pro。
核心创新有三层,且层层咬合。第一层是「只在被测阶段分叉」的 fork 设计:上游所有阶段只生成一次,参赛模型在被测阶段接收完全相同的上游产物与提示串,因此评测一个新模型只需跑一个阶段而非重建整个语料,同时保证分数差异来自模型本身而非输入差异——这解决了以往基准「输入为测试而造」的根本缺陷。第二层是把人类参照当工程产物:五分制可判定 rubric、每个维度固定的归因标签集、任何扣分强制时空定位,三人对每条目独立打分,产出 255,925 条可核查的归因记录;这使自动裁判被迫输出同构的证据(标签加定位),人与机器的结果可以直接逐条对账。第三层是指标审计驱动的 agentic 评分:与其默认专用指标可信,不如先测量它们与人类标注的相关性——结果大多数 $|SRCC| \leq 0.2$、十四个摄影美学指标负相关、三个叶维度(含人类基线近乎随机的 V-D2)被判无效——然后只保留有相关性的指标作辅助线索,由 agent 多轮调用工具、对照逐项 checklist 打分。与 VideoWeaver 只检查流程是否走完、DirectorBench 只在单元之间定位瓶颈不同,本文对每个中间产物的每个维度按 rubric 实打分并归因。
方法步骤详情
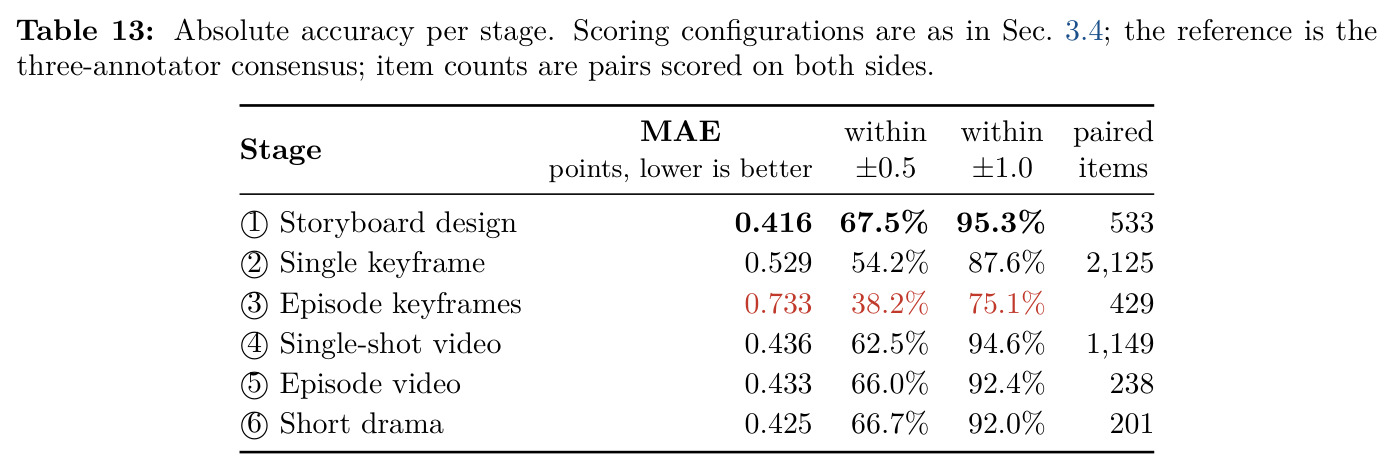
第一步,维度体系设计:五轴定义一次、六个生产粒度逐一实例化,每个叶维度配有五档可判定的文字描述和一组固定归因标签,人类与机器读同一份 rubric 文本、从同一词表取标签。第二步,流水线生产条目:剧本由流水线按商业 App 的题材库自动撰写、经自动检查加专家编剧把关后才入集;每个镜头槽位由每个参赛模型恰好生成一次,仅在被测阶段分叉。最终规模:分镜 533 项、单关键帧 2,125 项、剧集关键帧 429 项、单镜头视频 2,186 项、剧集视频 306 项、成片 206 项,合计 5,785 项。第三步,人工标注:按阶段技能筛选标注员(分镜标注员须有导演或编剧背景),三人对每条目的每个适用维度独立打五分制分数;任何扣分必须用界面支持的方式(边界框选帧、时间区间、单镜头或镜头范围、自由文本)定位并从该维度标签表选因;供应商按默认五分之一比例抽检,质检面板用九条启发式规则(如标注速度远低于粒度匹配中位数、扣分无归因、与留一共识近零相关)打回重标。第四步,指标审计与自动评分:先测全部候选指标与人类的相关性并淘汰失效者;每个叶维度独立并发地多轮评分,系统自动路由相关测量,agent 按需调用区域放大、按时间戳抽帧等感知工具,最终对照逐项 checklist 输出分数、缺陷标签和时空定位。第五步,双级验证:模型级对照三人共识排名,条目级对照留一法人类基线 hb。
技术新颖性
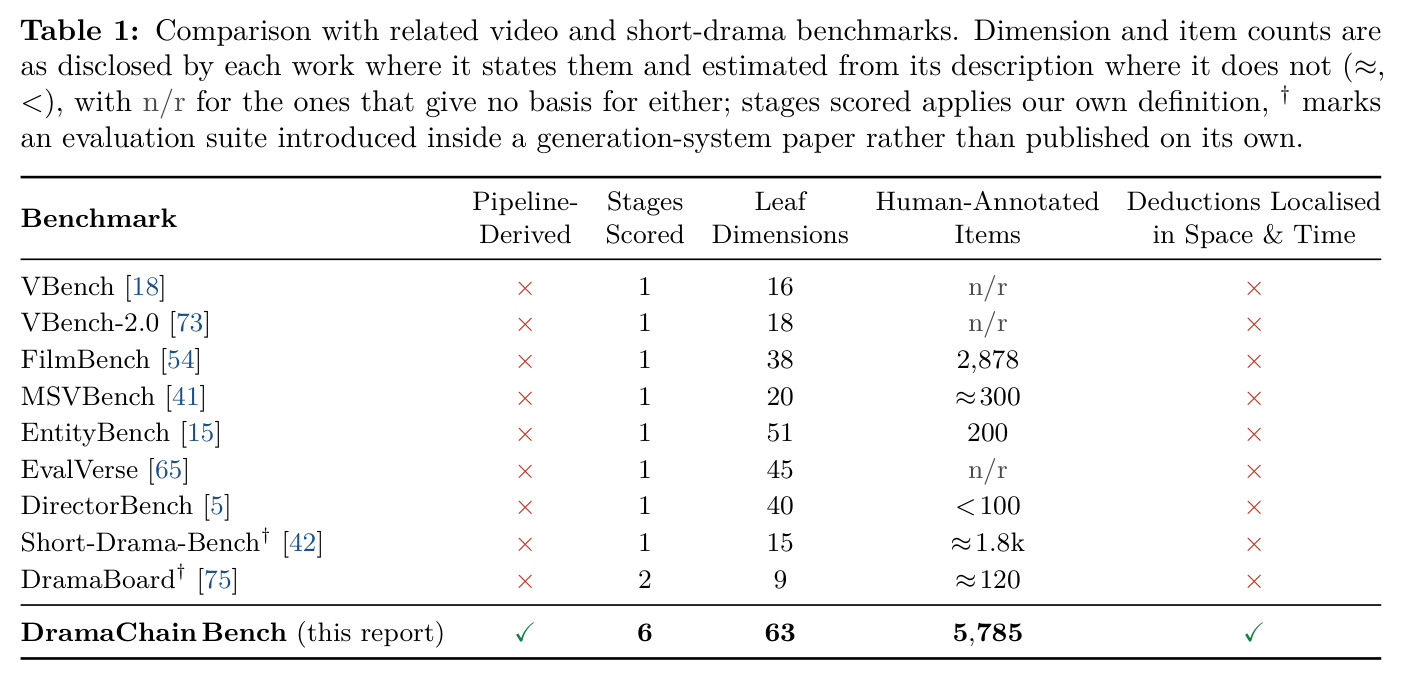
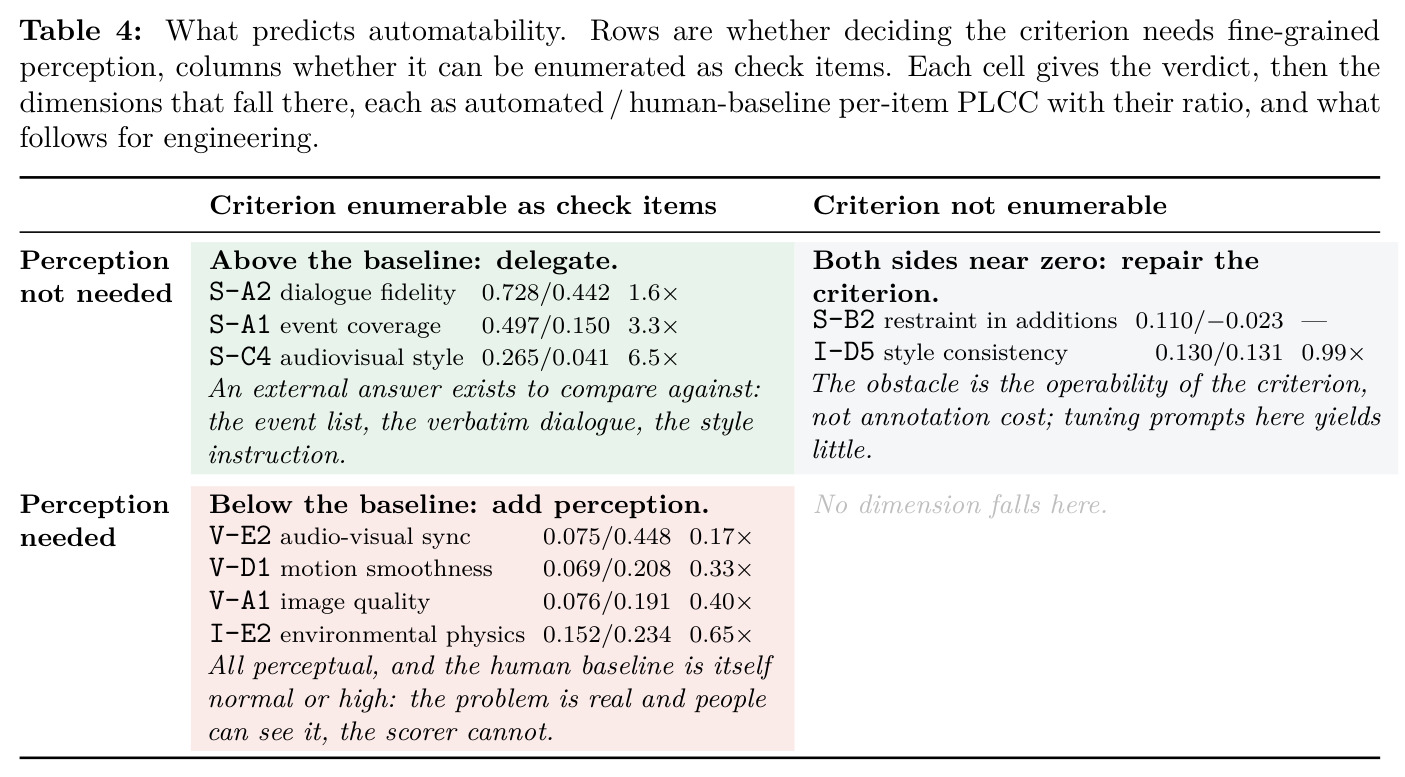
相对 VBench 一系「对成片按能力维度打分」的模板,本文把评测单元从最终产物改为链上交接物,并让这些交接物由被测管线自己生产——Table 1 显示此前没有任何基准同时具备「流水线衍生条目、评六个阶段、条目级人工标注、扣分时空定位」四个性质。相对 EvalVerse(只对齐评测标准而条目仍按成片评)与 DirectorBench(以检查点粒度诊断、只在单元之间定位瓶颈),本文真正给每个中间产物逐维度打分,因此能把「分镜把三个说话者压进一个镜头」这类缺陷记到分镜阶段而非默认扣在视频模型头上。相对 DramaDirector、One Sentence One Drama 等自带评测套件的生成系统论文,本文评测体系独立于被测系统且与商业平台做了对齐。方法论层面,「先审计指标、再淘汰、然后多轮 agent 工具链加逐项 checklist」的裁判构建流程,以及用「是否可枚举为检查项乘是否需要细粒度感知」的 2×2 矩阵预测可自动化性、并推翻「主观性决定可自动化性」直觉的分析框架,都是可迁移到其他生成评测领域的通用贡献。
实验结果
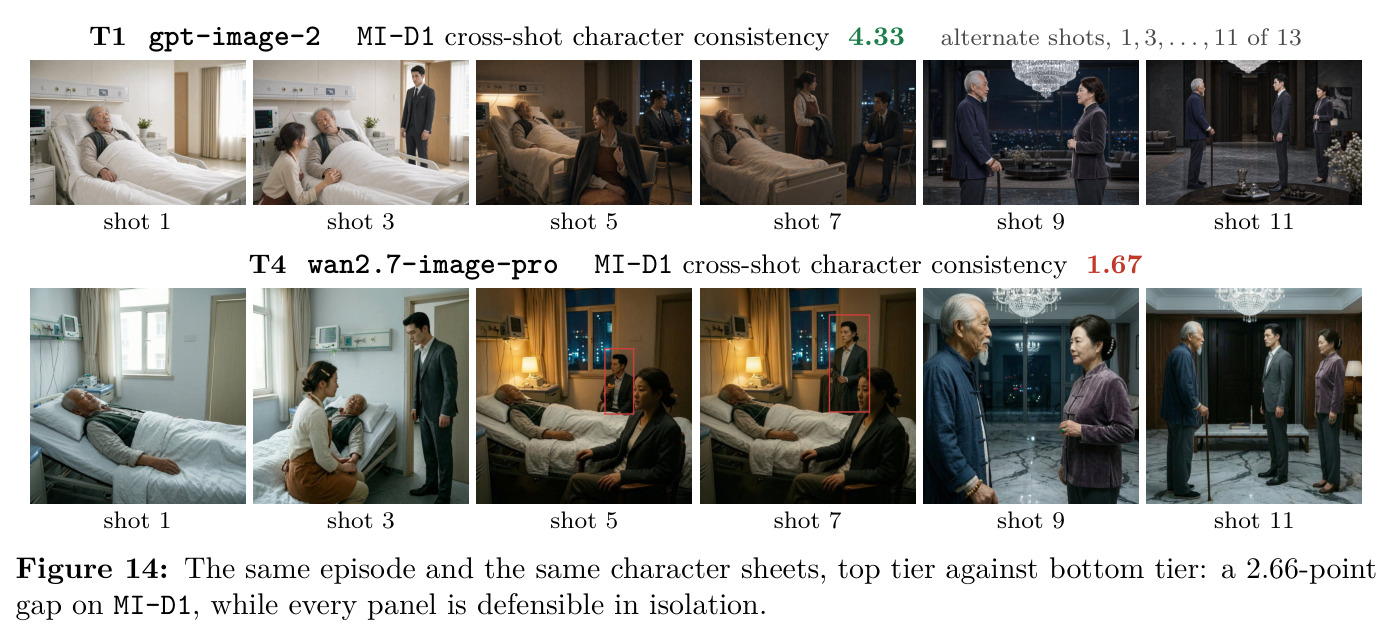
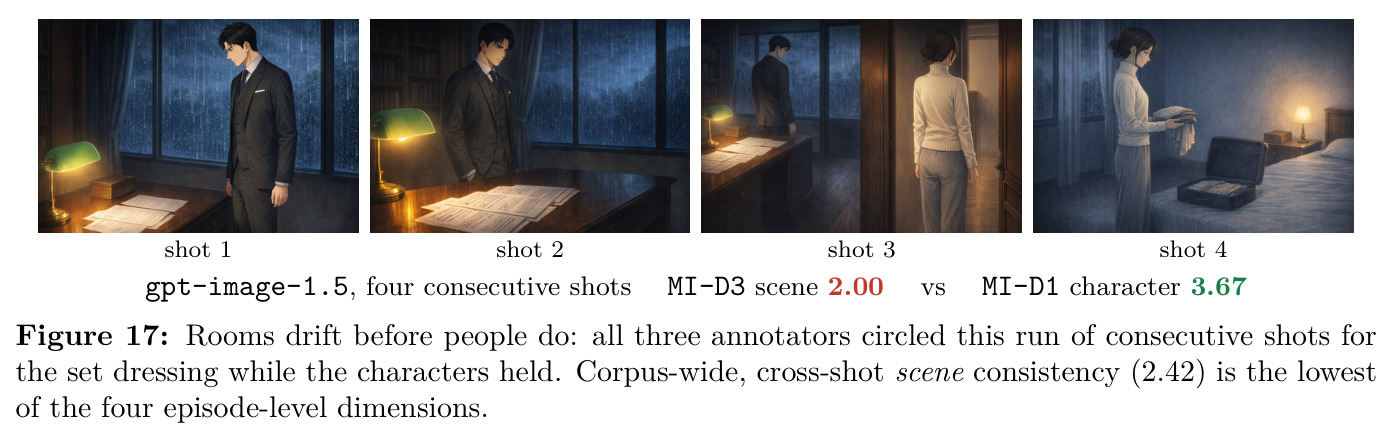
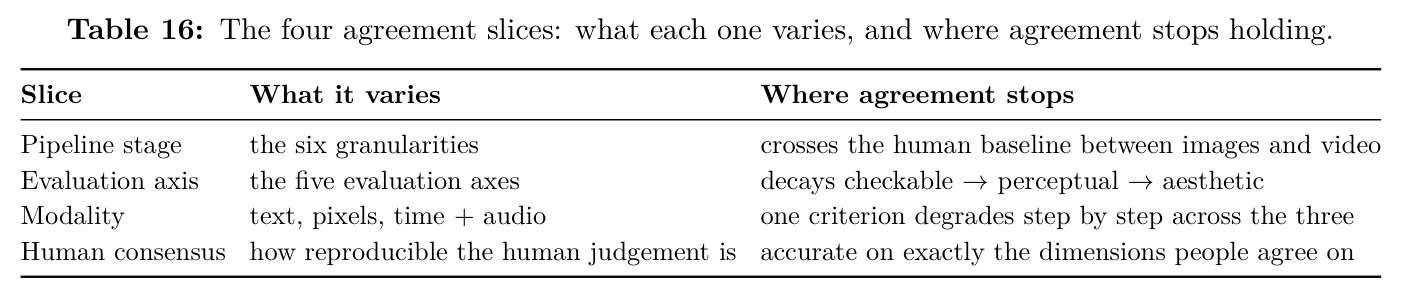
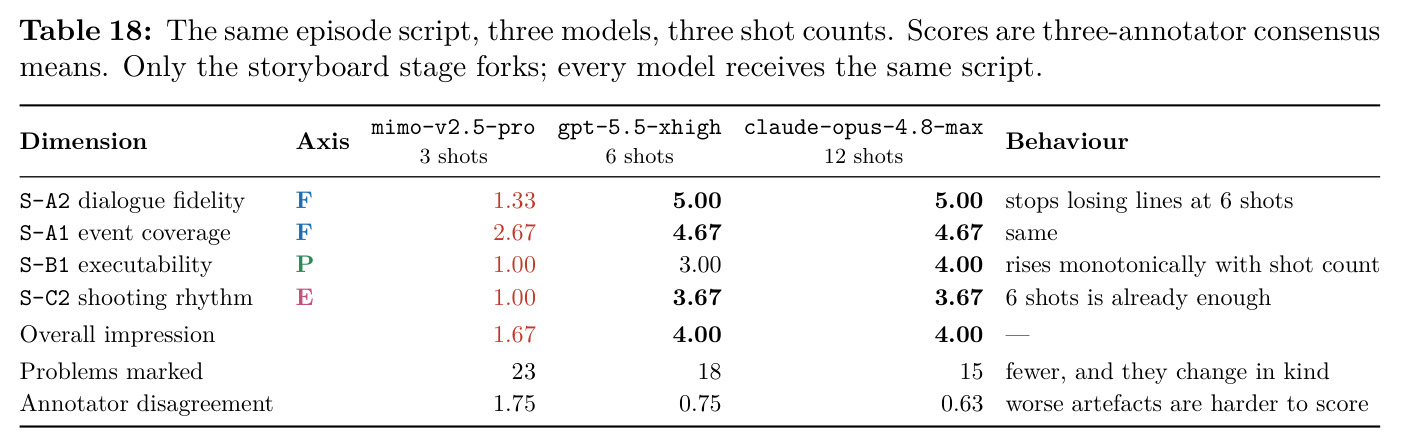
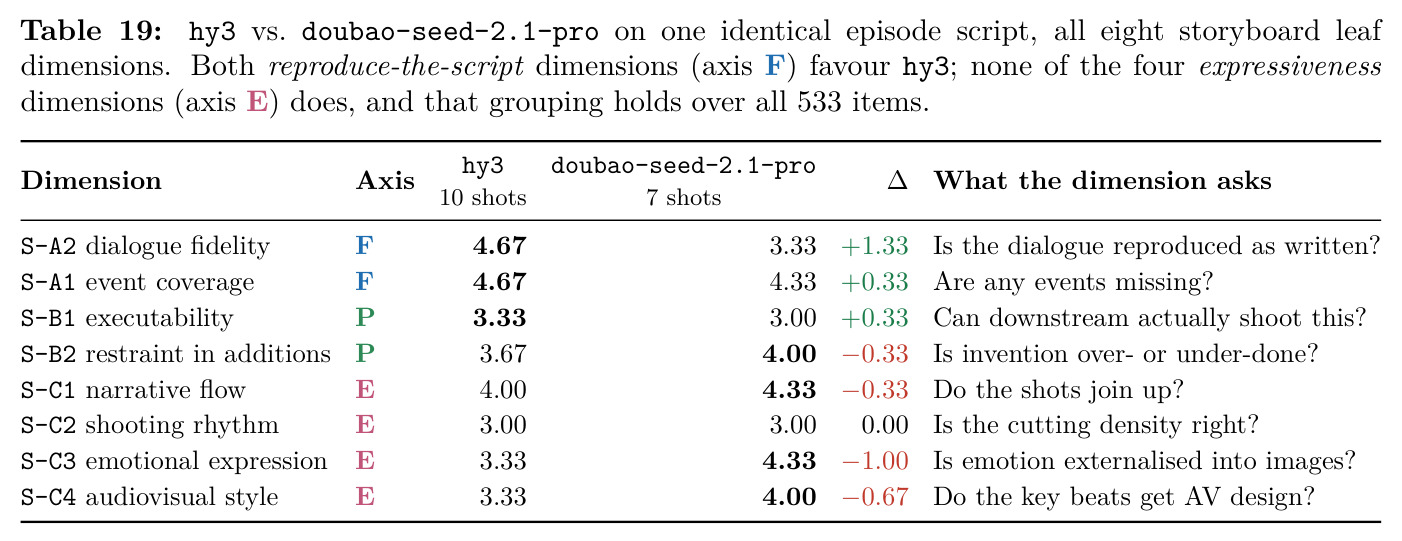
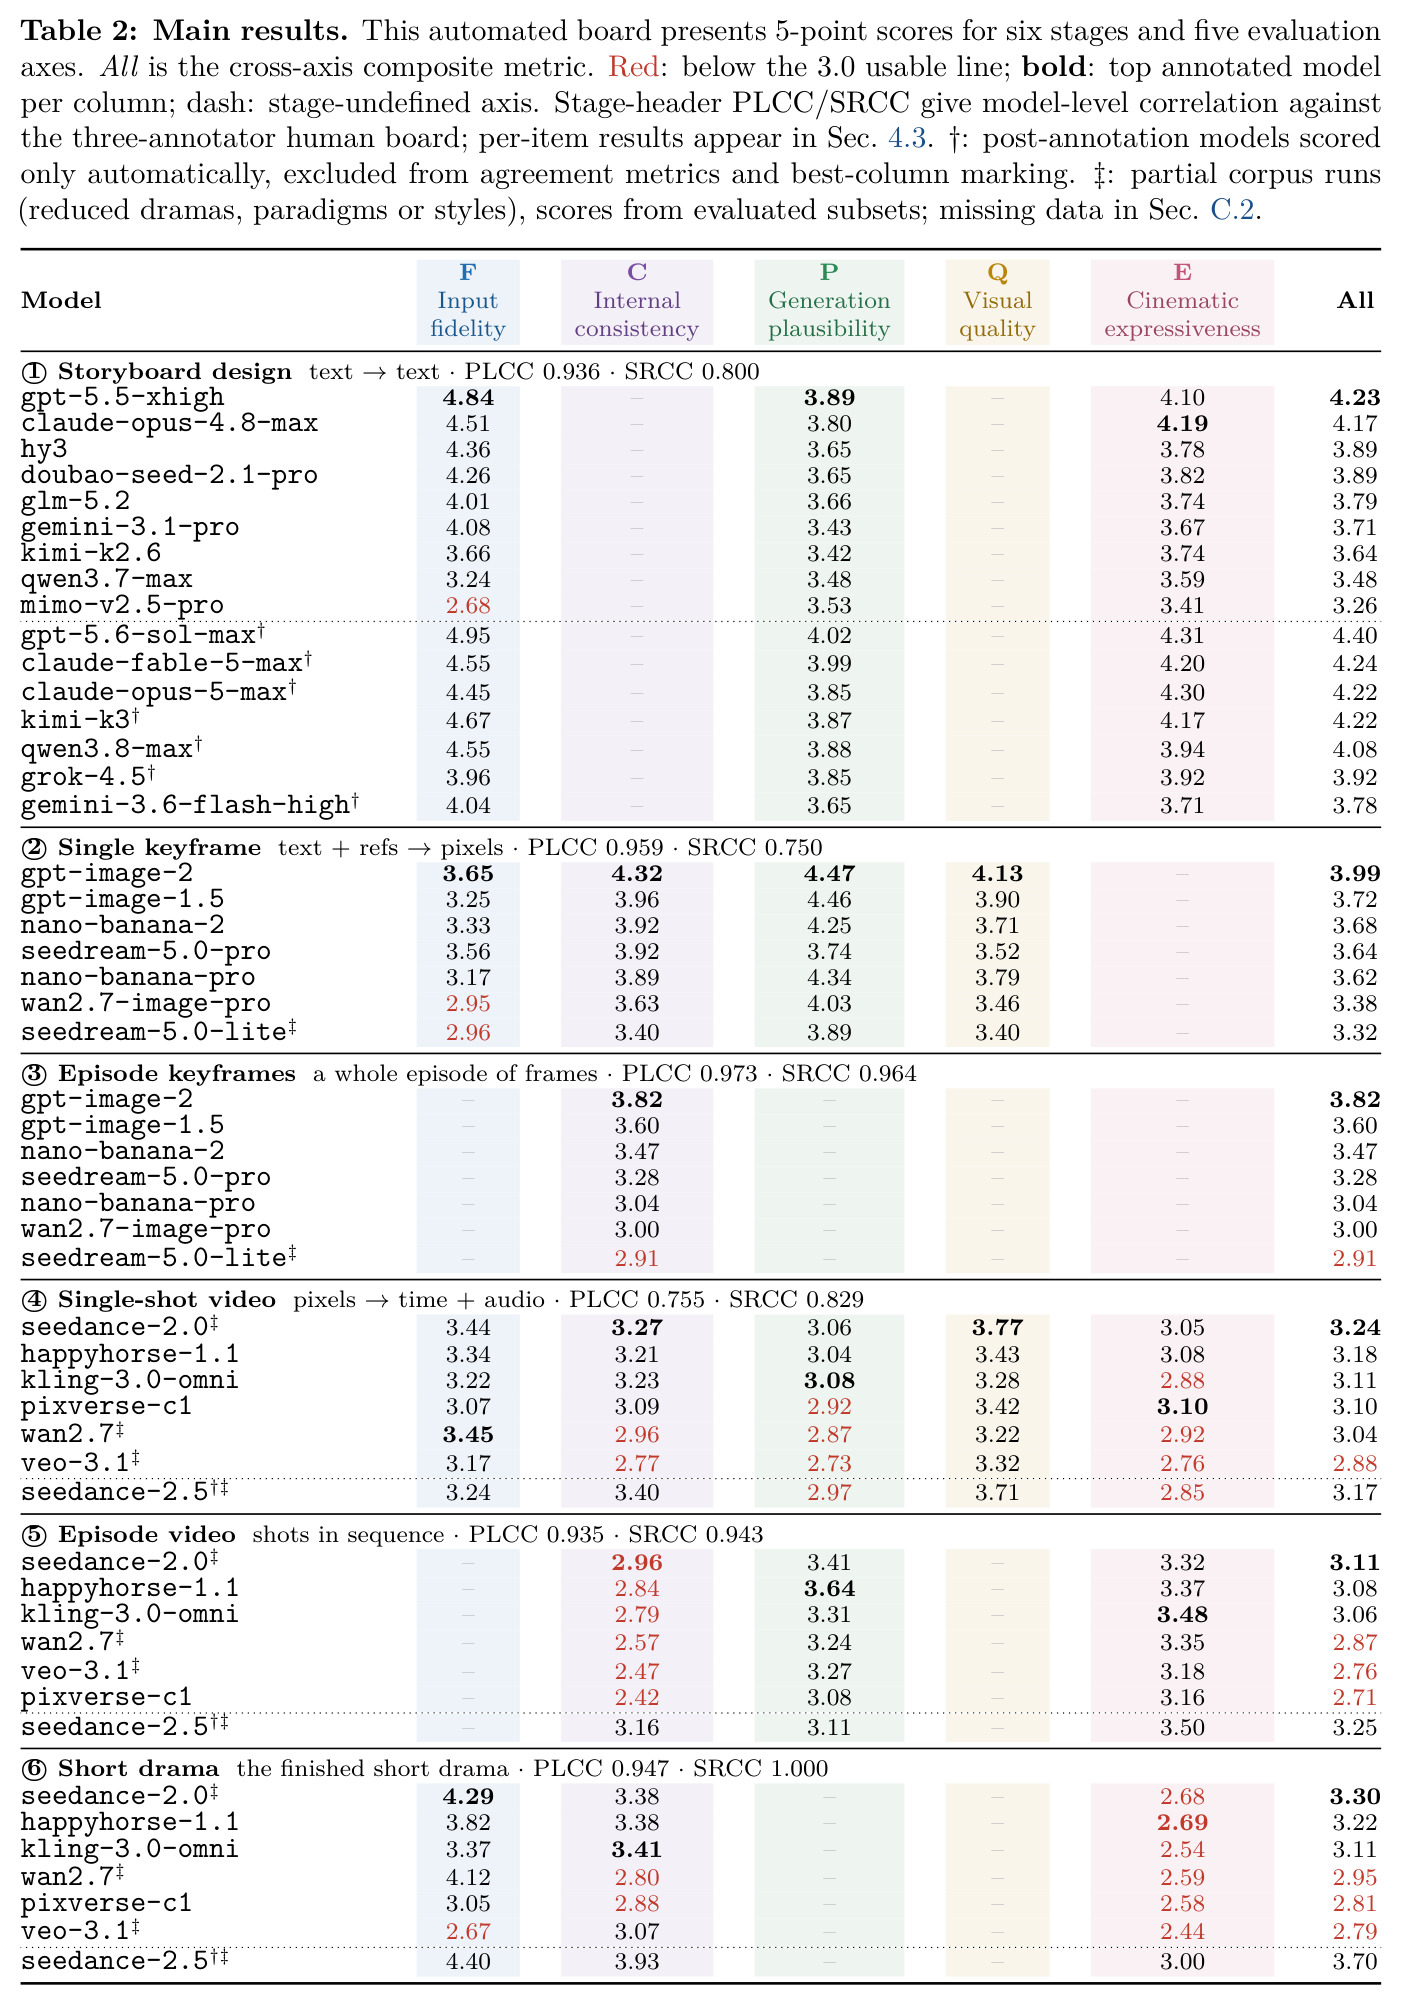
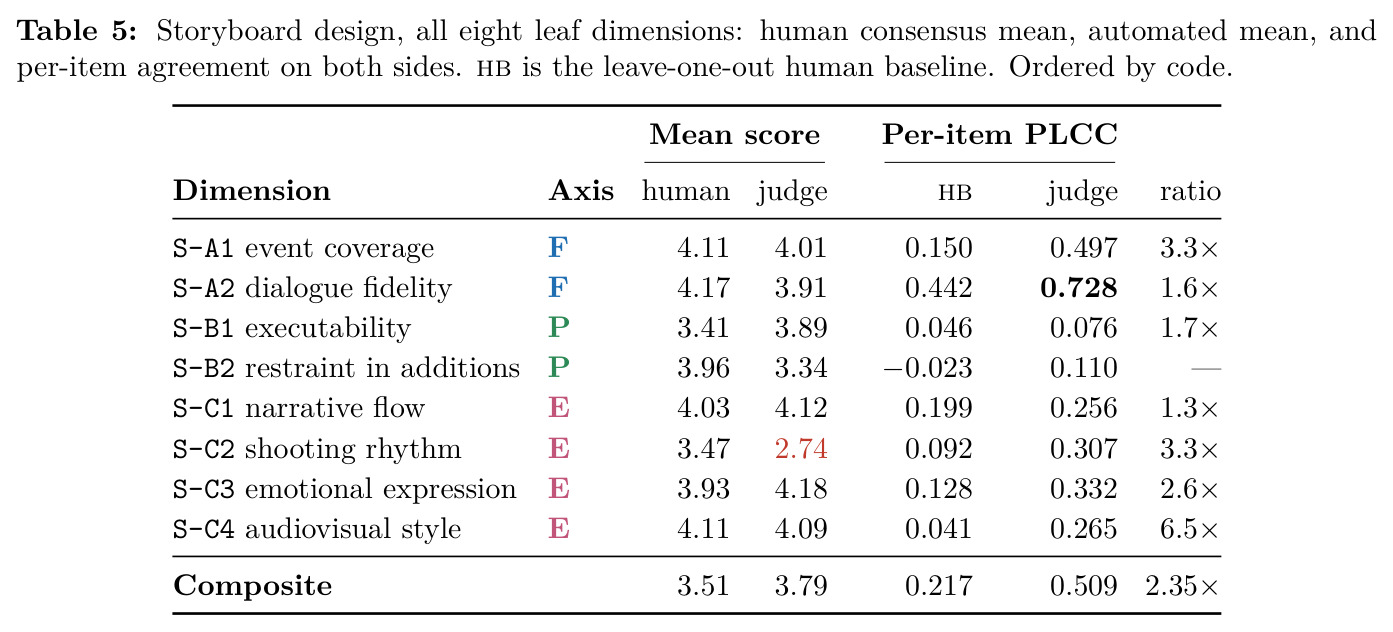
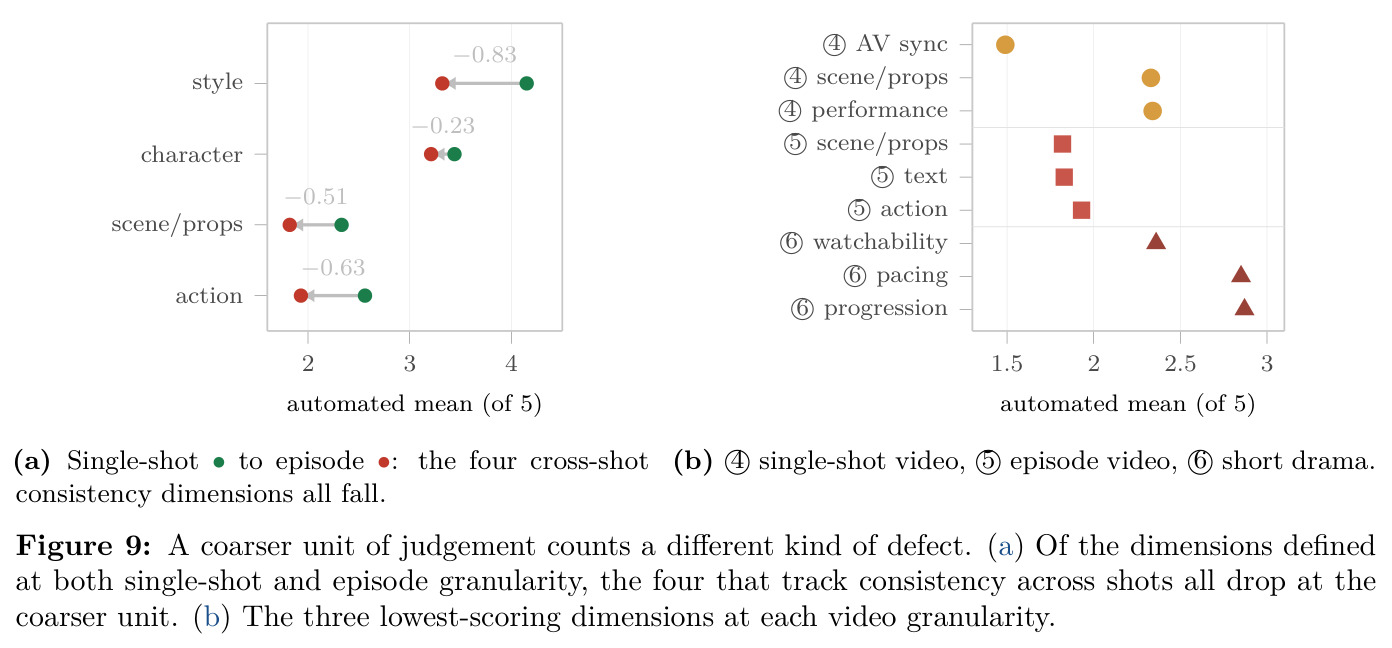
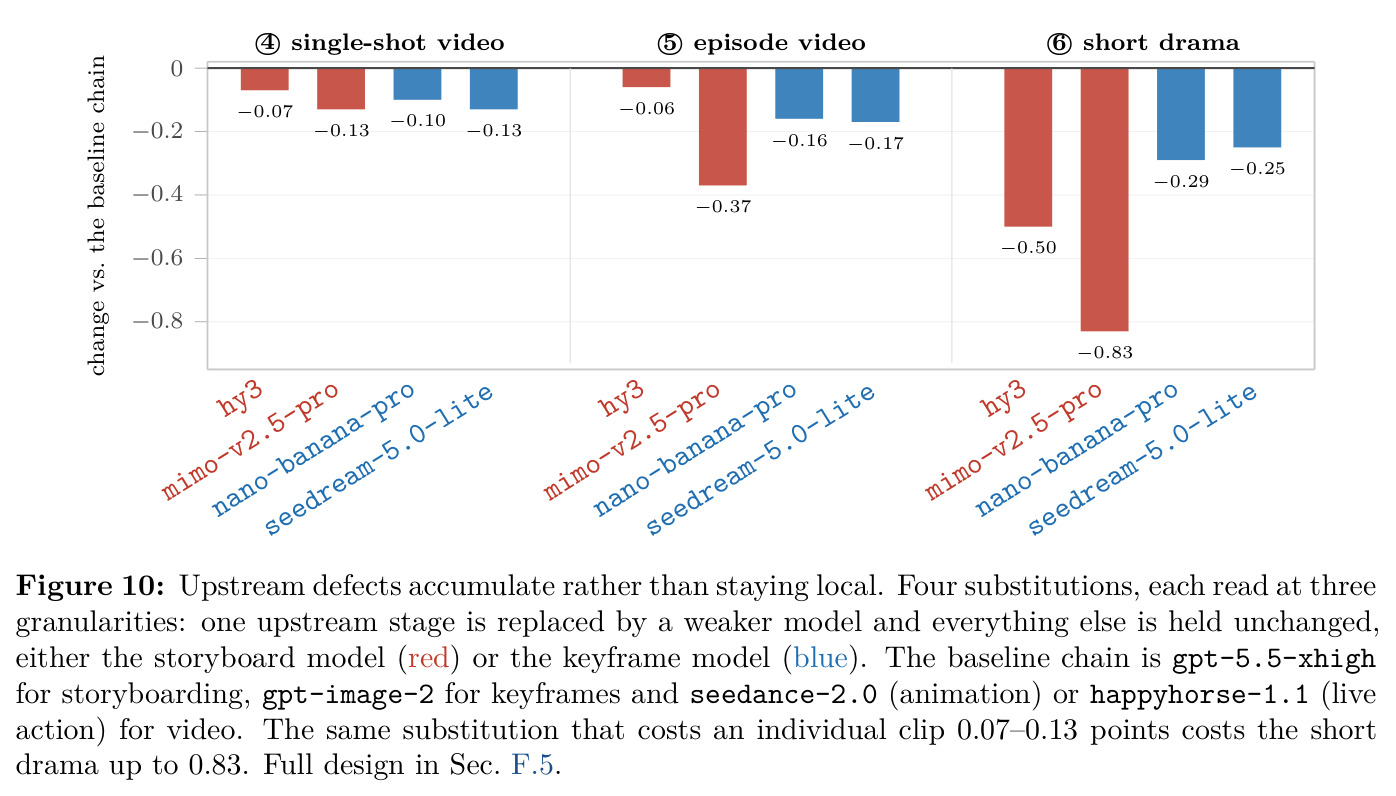
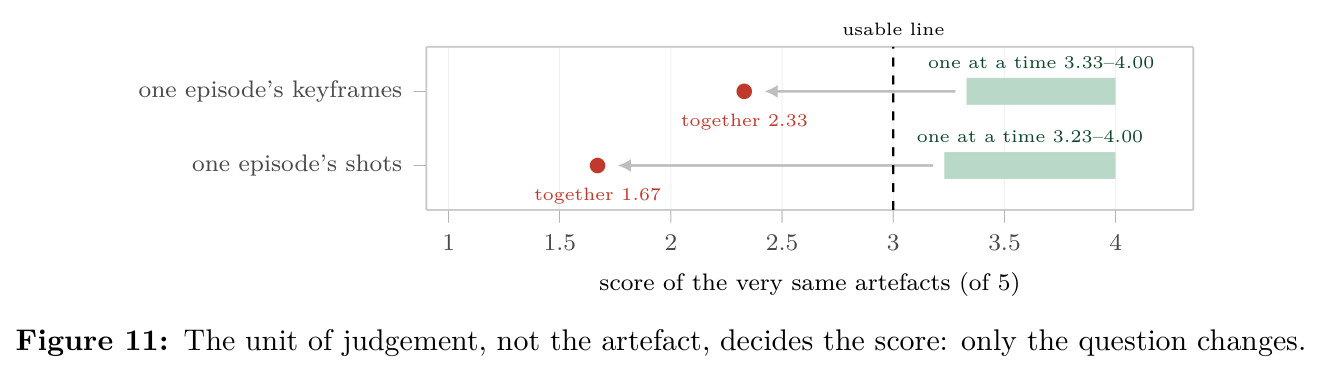
全文有六大发现。第一,存在一条全阶段领先的模型链:gpt-5.5-xhigh(分镜综合 4.23)加 gpt-image-2(单关键帧 3.99、剧集关键帧 3.82)加 seedance-2.0(视频三阶段 3.24、3.11、3.30),其成片 3.30 分仅高出 3.0 可用线 0.3 分——今天最强的链也只是在及格线上挣扎。第二,质量沿链递减:五轴均值从分镜 3.78 依次降到单关键帧 3.62、剧集关键帧 3.30、单镜头 3.09、剧集视频 2.93,成片小幅回升至 3.03;三个视频粒度全部落在可用线 0.1 以内、剧集视频在线下。第三,判别力跟随参照锚点的显式程度:首尾模型差距 F 轴 1.22、C 轴 0.70、Q 轴 0.64、P 轴 0.53、E 轴 0.42,弱锚定轴上的小差距反映的是基准局限而非模型相当。第四,综合分掩盖维度权衡:seedream-5.0-pro 与 nano-banana-pro 综合分只差 0.02,但 F 轴差 0.39、P 轴反向差 0.60;kling-3.0-omni 与 pixverse-c1 综合差 0.01,P 与 E 上却有 0.16 与 0.22 的反向差距。第五,一致性验证:六阶段模型级平均 PLCC 0.918、成片阶段 SRCC 1.000;条目级上分镜达人类基线的 $2.35\times$、剧集关键帧 $1.48\times$、单关键帧 $1.19\times$ 达标,三个视频阶段仅 $0.79$ 至 $0.85\times$ 未达标;可自动化性由「可枚举检查项乘是否需细粒度感知」预测而非主观性——最主观的视听风格维度反而达 $6.5\times$ 基线,客观的音画同步却只有 $0.17\times$。第六,上游缺陷级联放大:把单阶段换成弱模型只损失单镜头 $0.07$ 至 $0.13$ 分,但成片损失 $0.25$ 至 $0.83$ 分;同一集关键帧单张评 $3.33$ 至 $4.00$、合并评 $2.33$,镜头单评 $3.23$ 至 $4.00$、合并评 $1.67$。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 自动裁判与人类面板的模型级排名一致性(六阶段平均) | PLCC | 0.918 | 各阶段 PLCC 区间 0.755–0.973;成片阶段 SRCC 1.000(与人类排名完全一致) | 使 8 个新模型零人工标注成本进入榜单 |
| 分镜设计·条目级一致性 | per-item PLCC(自动裁判 vs 留一人类基线 hb) | 0.509 | 0.217 | 2.35×,优于再雇一名独立标注员 |
| 单关键帧·条目级一致性 | per-item PLCC(judge vs hb) | 0.536 | 0.449 | 1.19×,达到人类基线 |
| 剧集关键帧·条目级一致性 | per-item PLCC(judge vs hb) | 0.344 | 0.233 | 1.48×,超过人类基线 |
| 单镜头视频·条目级一致性 | per-item PLCC(judge vs hb) | 0.301 | 0.380 | 0.79×,未达基线,仍需人工 |
| 剧集视频·条目级一致性 | per-item PLCC(judge vs hb) | 0.203 | 0.240 | 0.85×,未达基线 |
| 成片短剧·条目级一致性(模型级 SRCC 达 1.000) | per-item PLCC(judge vs hb) | 0.384 | 0.450 | 0.85×,排名全对但单项分数仍逊于人类 |
| 最强全链成片质量(gpt-5.5-xhigh + gpt-image-2 + seedance-2.0) | 5 分制综合分(3.0 为可用线) | 3.30 | 3.0 可用线 | +0.30,安全边际极小;剧集视频阶段 2.93 在线下 |
| 上游单阶段替换的缺陷传播(分镜换 hy3/mimo-v2.5-pro、图像换 nano-banana-pro/seedream-5.0-lite) | 成片得分下降幅度 | −0.25 至 −0.83 | 同一替换在单镜头级仅 −0.07 至 −0.13 | 缺陷沿链放大 3–6 倍,证明成片质量不由视频生成单独决定 |
| 同一剧集产物按不同粒度评分 | 5 分制 | 关键帧合并评 2.33、镜头合并评 1.67 | 关键帧单张评 3.33–4.00、镜头单评 3.23–4.00 | 粒度差 1–2 分,单资产基准系统性高估交付质量 |
局限与改进
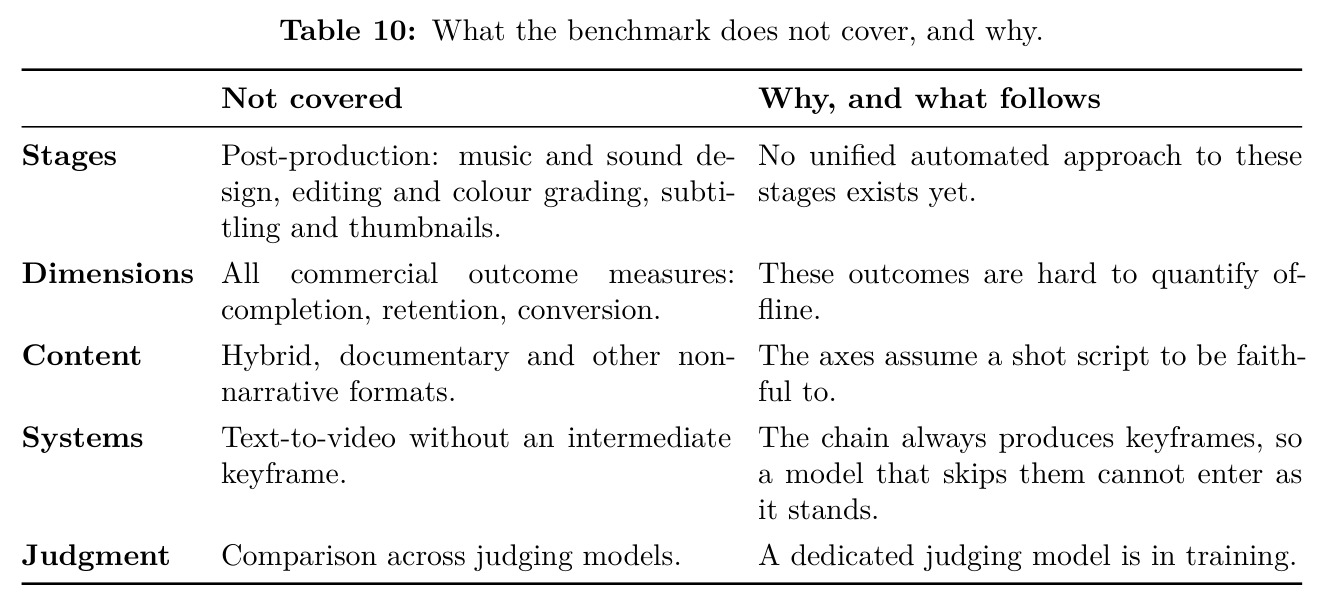
作者明确承认的局限(Table 10):不覆盖后期阶段(配乐与音效设计、剪辑、调色、字幕、封面);不覆盖商业结果指标(完播率、留存、转化),这些离线难以量化;不含混合、纪录片等非叙事格式;链条强制经过关键帧,跳过关键帧的端到端文生视频模型无法按现状进入;未做裁判模型之间的对比(专用裁判模型在训)。我自己的观察补充五点:其一,平台对齐验证只跑了「一个相同剧本、三个商业平台、专家定性评审」,没有量化指标,对齐主张带主观成分;其二,三个视频阶段的条目级一致性低于人类基线(0.79–0.85 倍),音画同步维度自动评分仅 0.075 对基线 0.448、接近失效,但榜单仍给出自动分数,读者可能误读这些数字的可靠性;其三,单镜头视频阶段的模型级 PLCC 只有 0.755,是链条上模型排名最不可靠的一环;其四,语料仅 20 部剧 60 集、中文比英文为 16 比 4,语言与文化语境覆盖有限;其五,Q 视觉质量与部分 P 轴维度自动评分普遍不过基线,意味着「哪个模型画质更好」这类问题目前仍必须依赖人工。
独立分析的弱点
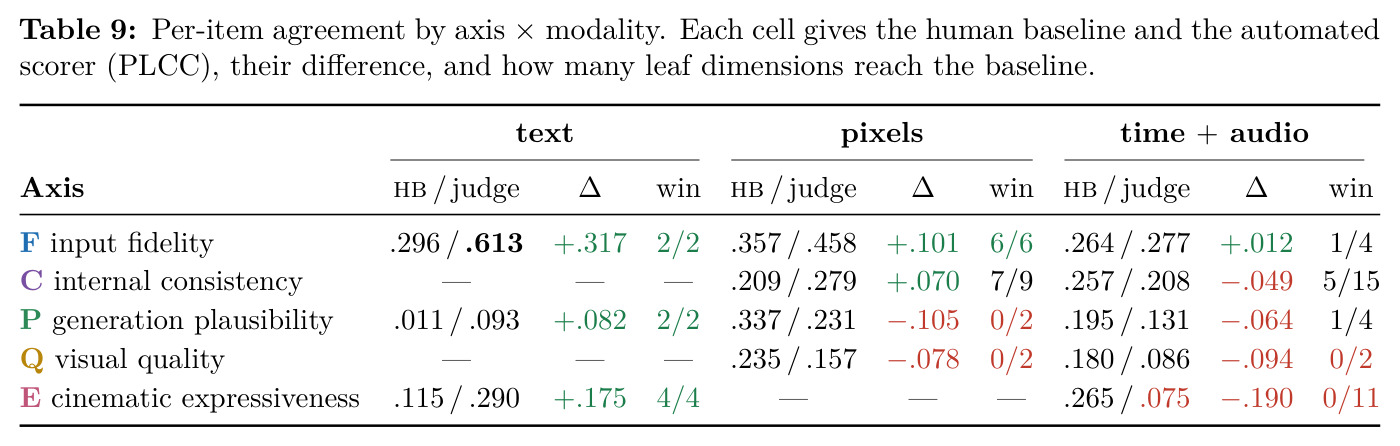
弱点一,覆盖面断裂:无后期与商业化指标,而短剧实际交付高度依赖剪辑节奏与投流素材。改进方向是把剪辑、字幕、封面纳入链条评测,并引入代理商业指标(如小规模 A/B 完播测试)。弱点二,裁判的视频盲区:time+audio 模态下 E 轴 11 个维度中 0 个超过人类基线,音画同步既是全场最低分维度(1.49)又是机器几乎测不出的维度(0.075 对基线 0.448)。改进方向是接入专门的音画对齐感知模块(如唇形-音素对齐检测器、跨镜头声源连续性检测),而非指望通用 VLM。弱点三,评分单位敏感:同一产物按镜头评与按集评相差 1 到 2 分,任何单资产基准都会系统性高估交付质量。改进方向是把成片级评分作为一等公民报告,并强制同时给出粒度敏感性分析。弱点四,语料规模与语言偏斜:20 部剧、英文仅 4 部,题材与语言的外推力有限,应扩充多语言版本并报告子集置信区间。弱点五,平台 parity 验证缺量化:可增加专家盲评一致率或评级分布统计检验。弱点六,模型板是静态快照:虽有零标注接入机制,但维度体系与 rubric 随模型能力演化的更新机制没有说明,长期可能过时。
未来方向
作者提出的方向:把评测放到短剧生产真实的失败点上——阶段交界处与集内镜头之间,而不是孤立片段;流水线、维度体系与评分配置可直接复用,新模型单阶段接入零标注;正在训练专用裁判模型以解决视频维度一致性不足。基于成果可延伸的方向:其一,把「指标审计加多轮 agentic 裁决」范式迁移到长视频、电影预告片、广告片等其他多阶段生成场景;其二,用 255,925 条定位归因记录训练缺陷检测与定位模型,反向给生成管线提供可执行的修订回路——论文已证明链上没有任何模块能修复继承缺陷,这是最自然的闭环;其三,研究分叉评测的统计功效:多少剧集与镜头数才能显著区分两个相近模型;其四,探索链上条件优化:给定下游失败证据,自动重写分镜或关键帧指令再局部重生成;其五,校准 3.0 可用线与真实完播率、留存的相关性,让质量分数接上商业语义;其六,扩展到交互式叙事、游戏化短剧等非固定剧本形态,弥补非叙事格式的空白。
复现评估
开放情况:论文承诺发布 DramaChain Dimensions(63 个叶维度的完整定义与 rubric 在附录 A)、DramaChain Agentic Judge 框架,以及一个精选子集的基准数据——注意完整 5,785 项乘三人标注不会全部放出,DramaChain Agent 流水线代码与全部 255,925 条归因记录的开放程度未明确承诺。复现难点有三:其一,人类标注面板的规模惊人——543 名专业标注员、条目中位耗时 23 分钟、17,488 个有效分数,普通实验室在成本上无法复制同等人类参照;其二,自动裁判依赖特定商用模型(gpt-5.6-sol-xhigh、claude-fable-5、doubao-seed-2.1-pro、gemini-3.1-pro),模型更迭会直接改变一致性表现,跨时期结果不可比;其三,22 个加 8 个被测模型中多个是内部或商用系统(hy3、happyhorse-1.1、pixverse-c1 等),第三方无法完整复跑整张榜单。可行的复现路径:用官方放出的裁判框架和子集数据,在自己的目标模型上做单阶段诊断;按附录 A 的维度定义与评分 prompt 自建小规模人工面板做局部验证。综合评估:框架与维度体系可复用性高,人类参照不可复制,整体复现难度中高。
论文图表