FLORA:用于规模化机器人数据引擎的开源模型套件 FLORA: An Open Model Suite for Scaling Robotics Data Engines
开源三模型数据引擎,低成本量产机器人视频的时间戳标注与奖励标签
前置知识
结果奖励与过程奖励
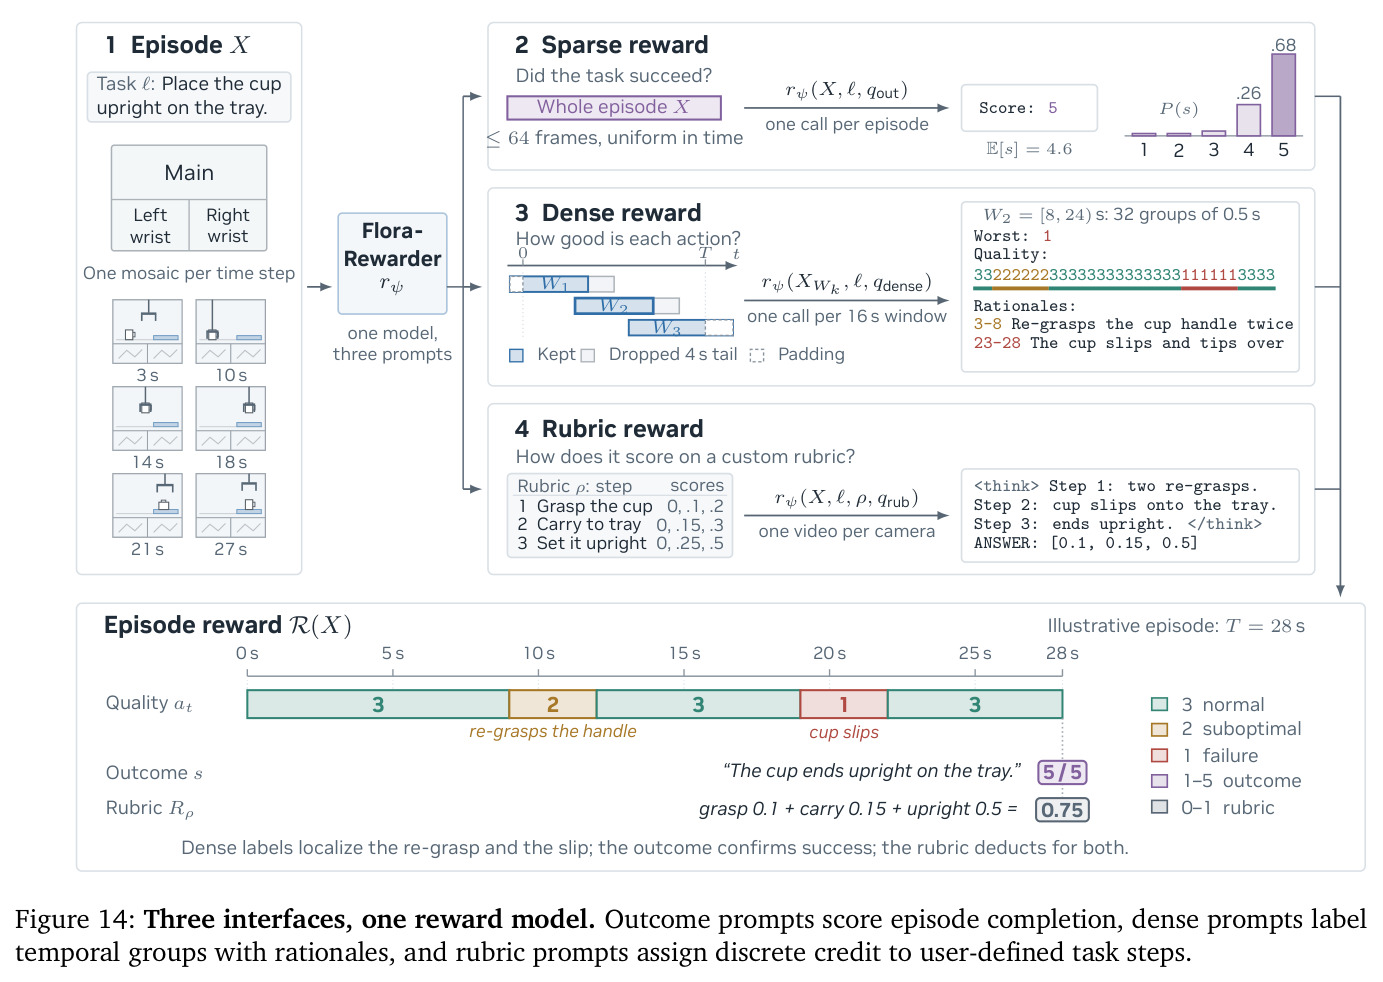
结果奖励(outcome reward)对整段轨迹打一个总分,判断任务是否完成(本文用 1–5 分),用于部署监控、数据筛选与策略评估;过程奖励(process/dense reward)对轨迹内每个 0.5 秒步打分(失败/次优/正常),用于 RL 后训练中的逐步 credit assignment。这对应语言模型中 outcome-based 与 process-based supervision 的经典区分。
FLORA 的三大能力正是时间戳字幕、过程奖励与结果奖励,分清两者的用途差异才能理解论文的标注体系设计与各奖励基准分别在测什么。
GRPO(组相对策略优化)
DeepSeekMath 提出的强化学习算法:对每个输入采样一组 rollout,用组内平均结果作 baseline 计算相对优势,免去价值网络,通常配合对固定参考策略的 KL 正则。本文用它配合可验证奖励(时间 F1、点质量分数)继续优化 SFT 后的分割器与字幕器。
分割器与字幕器的最终性能都来自 SFT 之后的 GRPO 阶段,理解组内优势与 KL 正则才能读懂 4.3 节与附录 F 的训练配方。
时序 IoU(tIoU)与 F1
时序动作定位的标准指标:预测区间与参考区间的交集时长除以并集时长,超过阈值(0.5 或 0.75)才算命中;再做一对一是最大基数匹配后计算 F1 = 2TP/(|预测|+|参考|)。分割质量、联合标注质量都以此为基础。
WGO-Bench 与 DenseCaptionBench 的所有分割分和 joint 分都建立在 tIoU 匹配上,不懂 tIoU 就无法解读主结果表中的数字含义。
LoRA 低秩适配
冻结预训练权重,只为每层训练低秩分解矩阵的增量更新(本文分割器用 rank-32、缩放 α=64),大幅节省显存与算力。RL 阶段也只更新 LoRA 参数,并用 KL 正则约束到固定的 SFT 策略,训练代价低、不易遗忘。
FLORA 三个模型的 SFT/RL 配置细节(哪些模块冻结、哪些走 LoRA)直接决定复现方式,也是成本估算 $0.72/小时的部署基础。
Rubric 奖励(评分细则奖励)
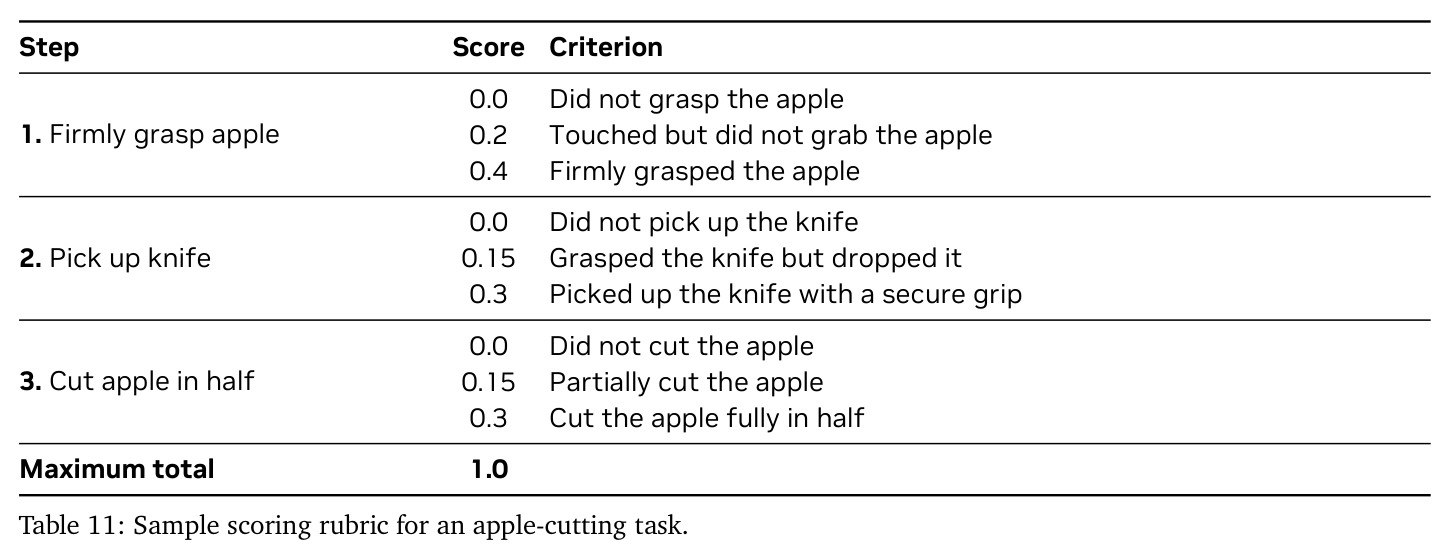
用户在测试时自定义的评分规则:把任务拆成若干步骤,每步给定允许的分数档(如 0/0.2/0.4),各步满分之和为 1,模型逐步给分后求和得到总奖励 $R_\rho(X)=\sum_j \hat{y}_j$。它让奖励模型无需重新训练就能适配新任务的评价标准。
RubricBench 与公式 (3) 展示了 FLORA 的第四种能力,是与只输出固定分数的传统奖励模型的本质差异之一。
研究动机
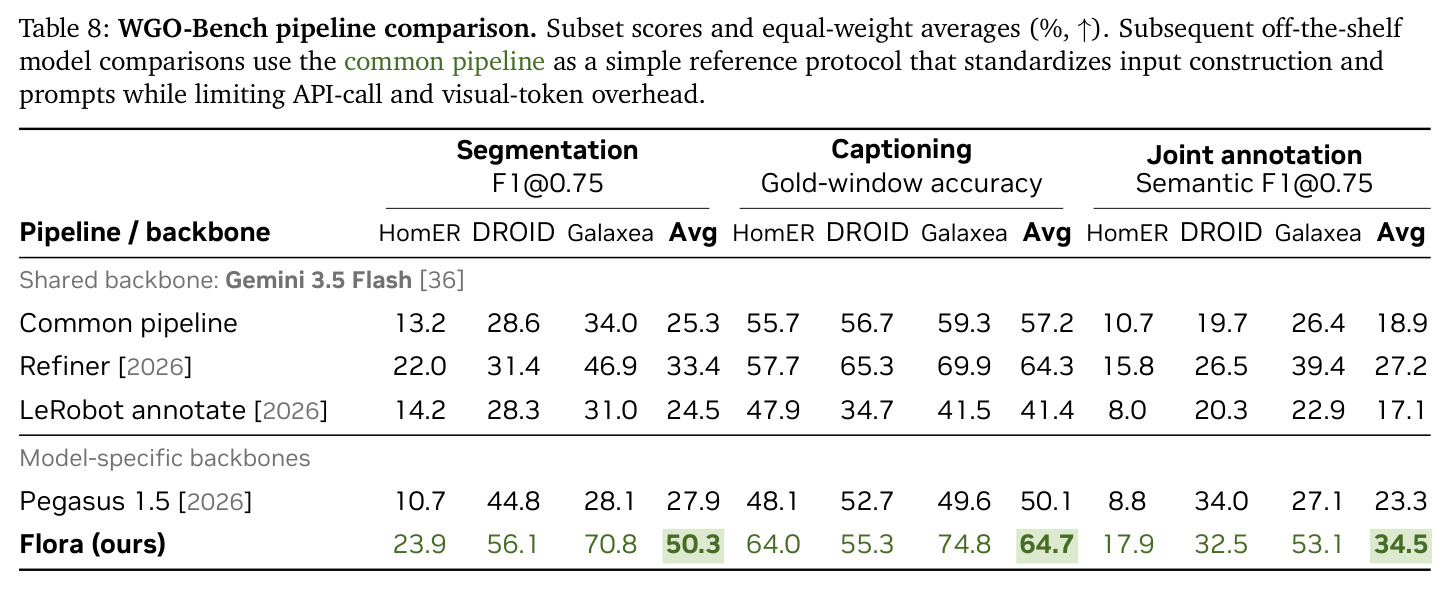
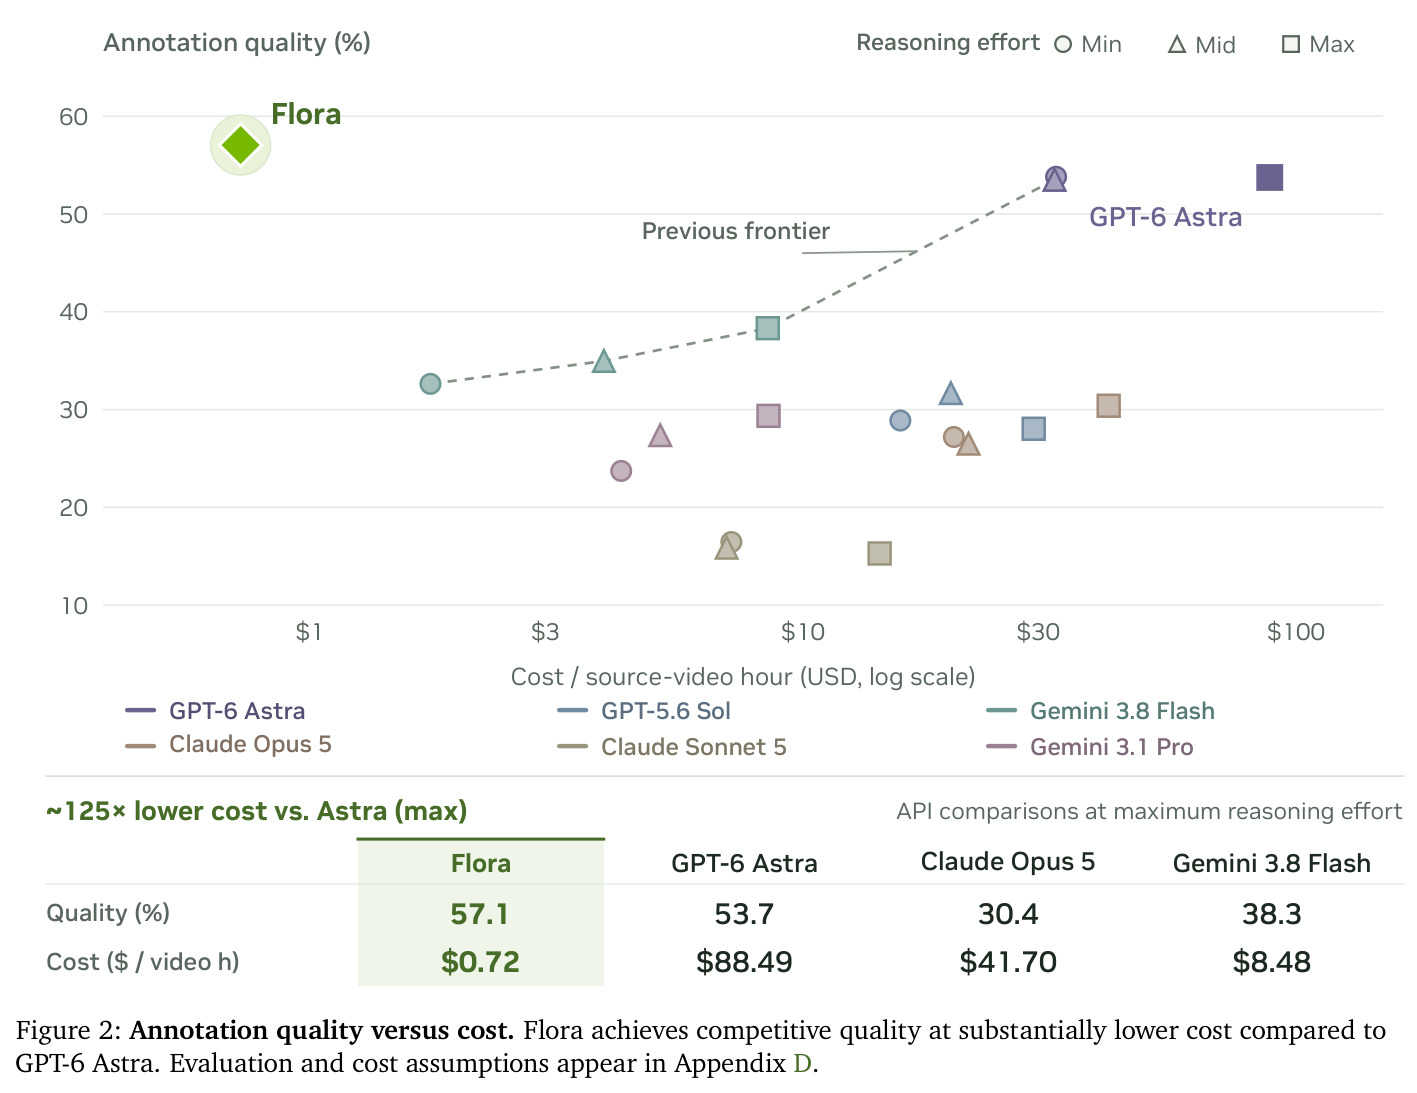
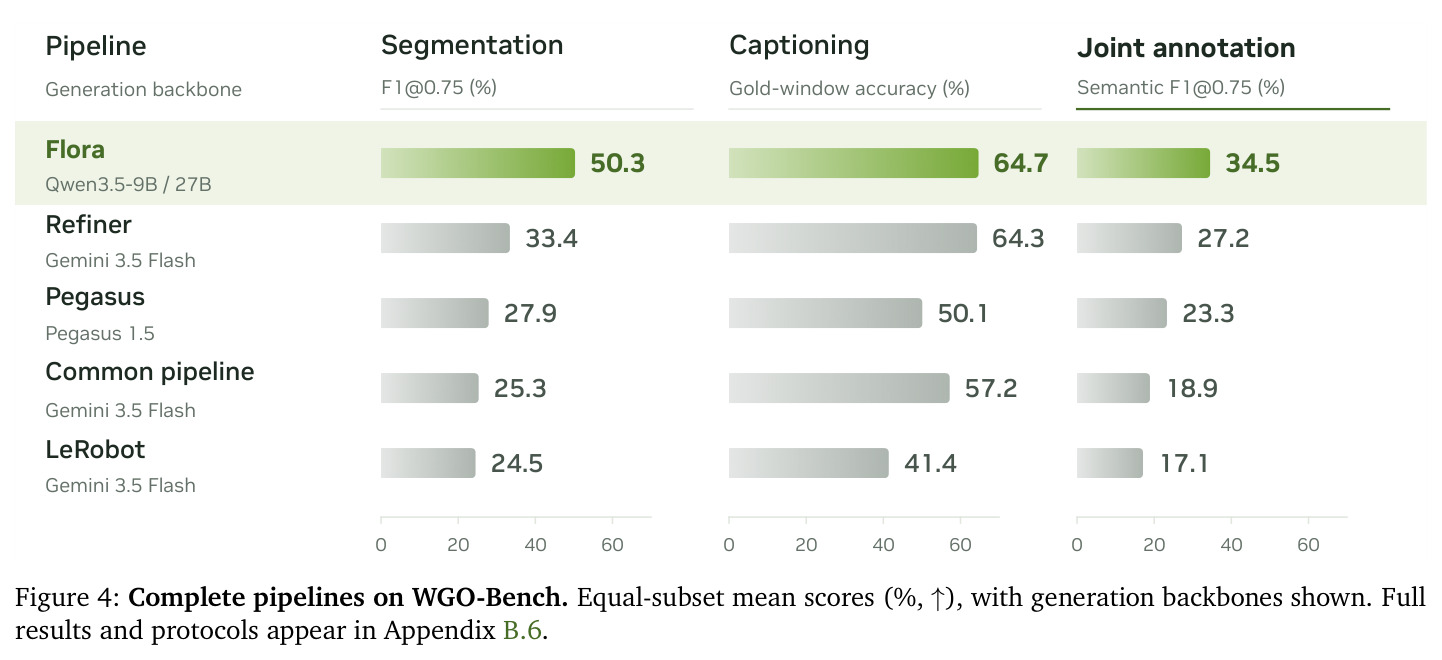
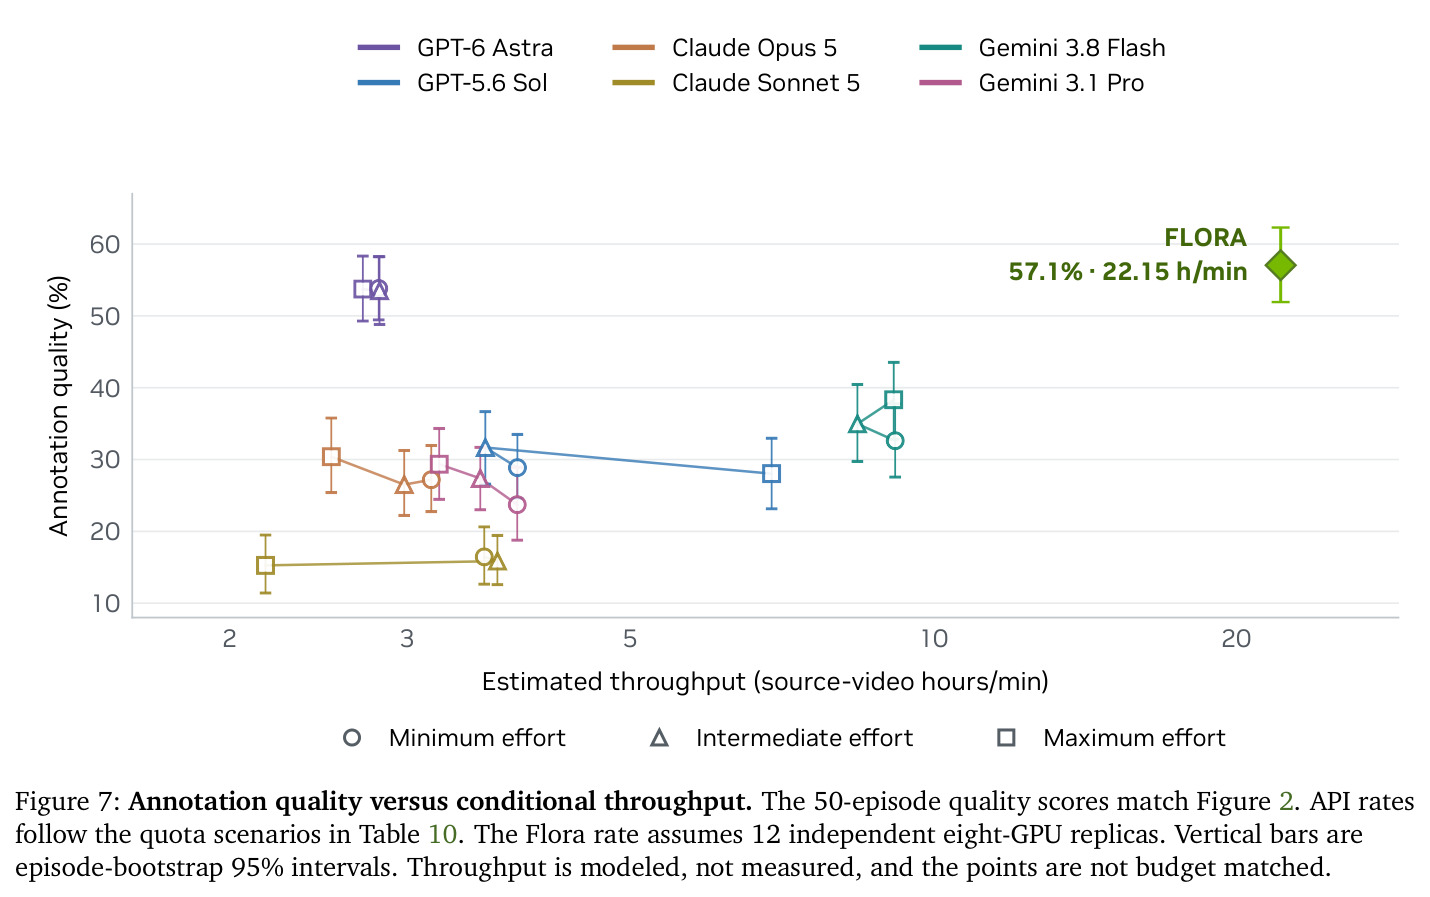
机器人基础模型的生命周期严重依赖数据标签,但三类标签目前由互不覆盖的系统分别提供:预训练需要带时间戳的动作字幕来做语言条件化和数据配比再平衡;RL 后训练需要过程奖励做逐步 credit assignment;部署需要结果奖励监控机群、检测失败并大规模评估策略。现有开源流水线大多只覆盖一种标注类型,且靠现成 VLM 加提示词拼装:在 WGO-Bench 上,用 Gemini 3.5 Flash 的 common pipeline 分割 F1@0.75 只有 25.3%、联合 F1 仅 18.9%,LeRobot 更低(24.5%/17.1%)。通用前沿模型(GPT-6 Astra 等)虽能提供多种标注,但成本无法承受:Astra 在最大推理档下标注一小时源视频要 $88.49,而现代机器人数据集动辄数万小时,用 API 全量标注在经济上不可行。
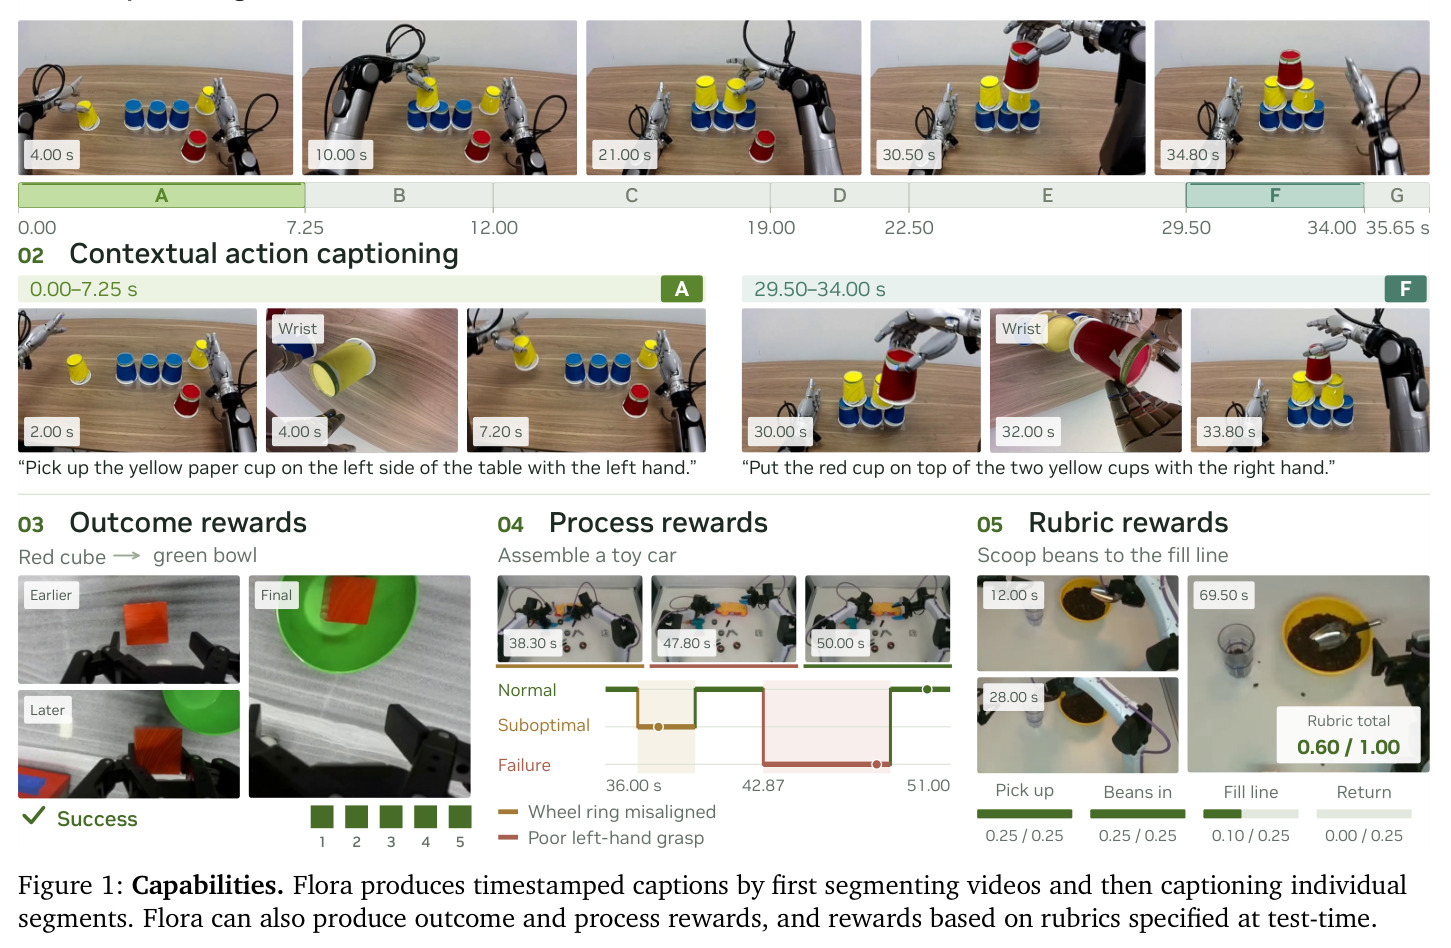
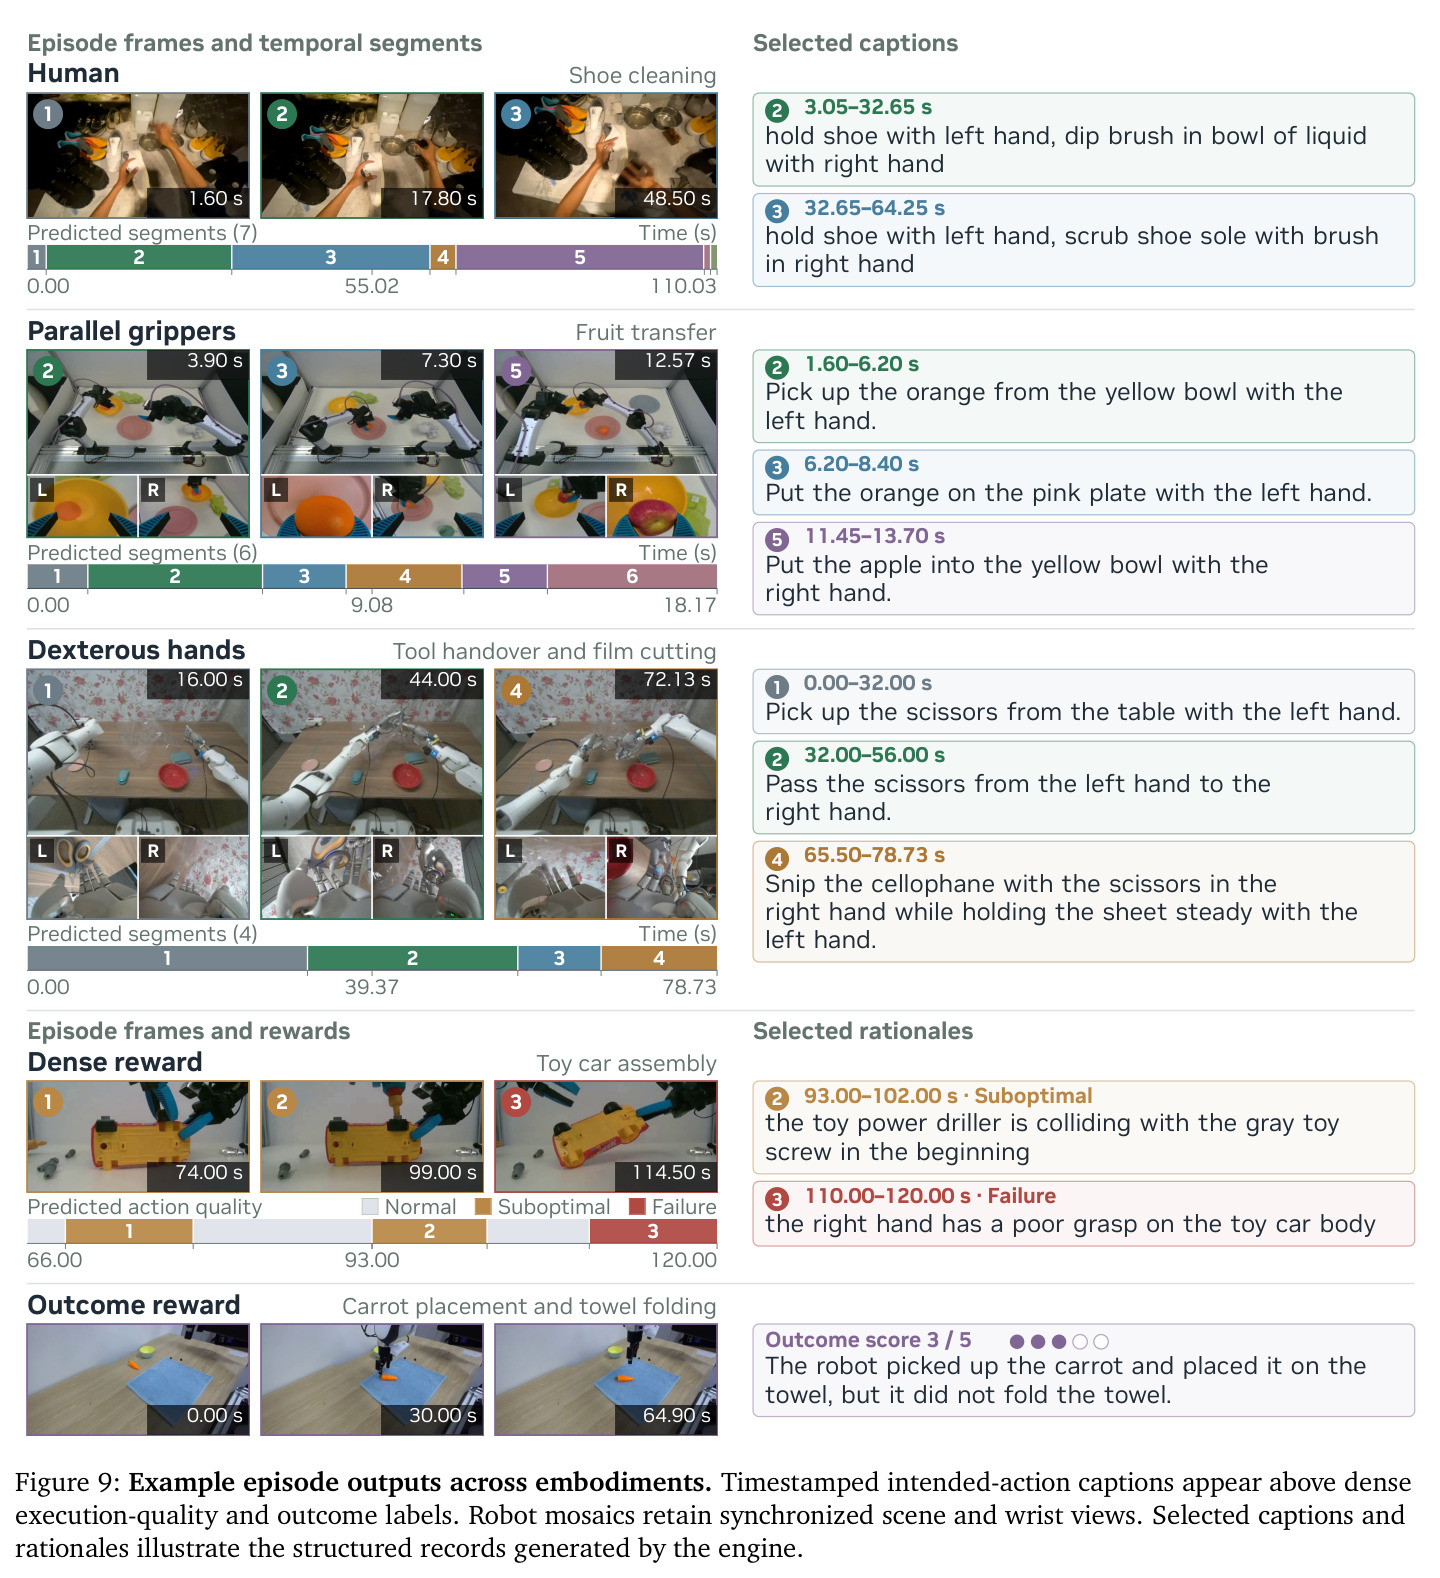
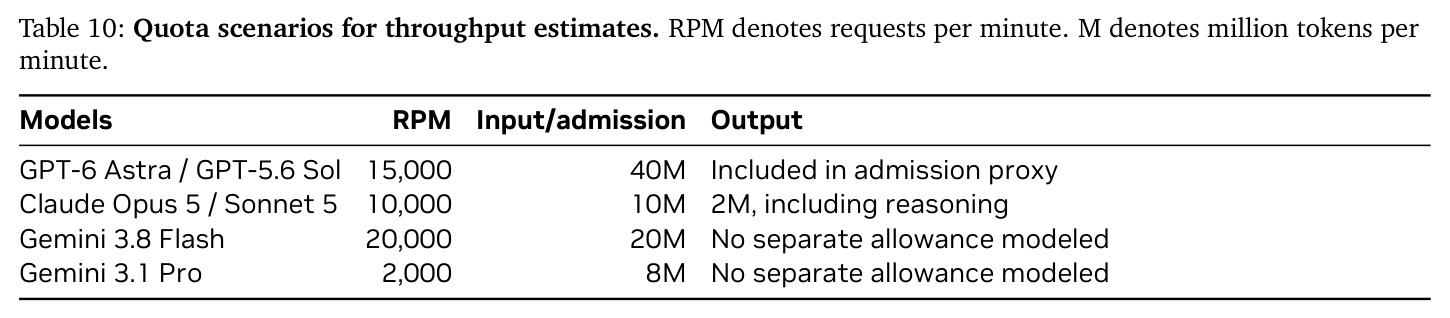
本文的目标是本文要构建一个工业级的开源机器人数据引擎 FLORA(曾用于训练 GR00T 模型),用一套模型同时覆盖四类标注能力:(1)时间戳动作字幕——先分割再逐段描述意图动作;(2)结果奖励——1–5 分的任务完成度评分;(3)密集过程奖励——每 0.5 秒一步的 failure/suboptimal/normal 标签加理由;(4)测试时可自定义的 rubric 奖励。质量目标是:在字幕基准 WGO-Bench 与自建 DenseCaptionBench 上达到或逼近 GPT-6 Astra,在 RoboReward/Robometer 奖励基准上超过已发表的专用奖励模型;成本目标是把标注单价压到约 $1/视频小时以内,并能在 512 块 GB300 上实现每天 20 万小时标注的吞吐,让社区可以自己放大机器人数据集。
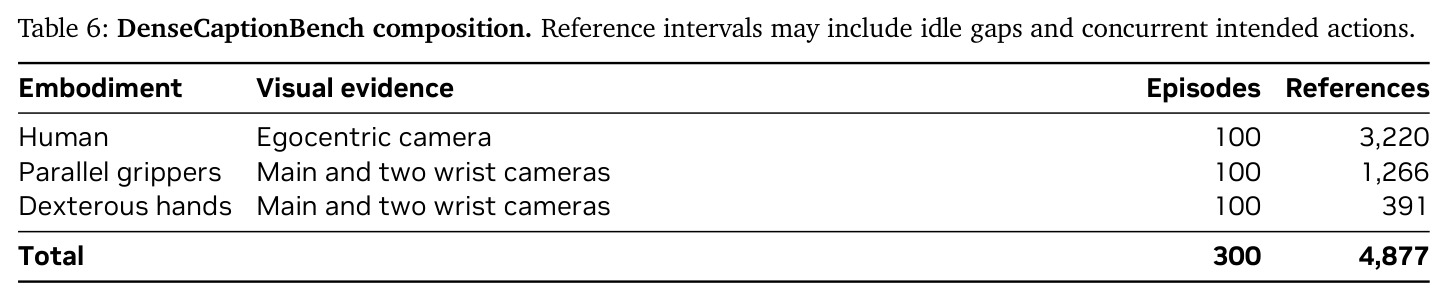
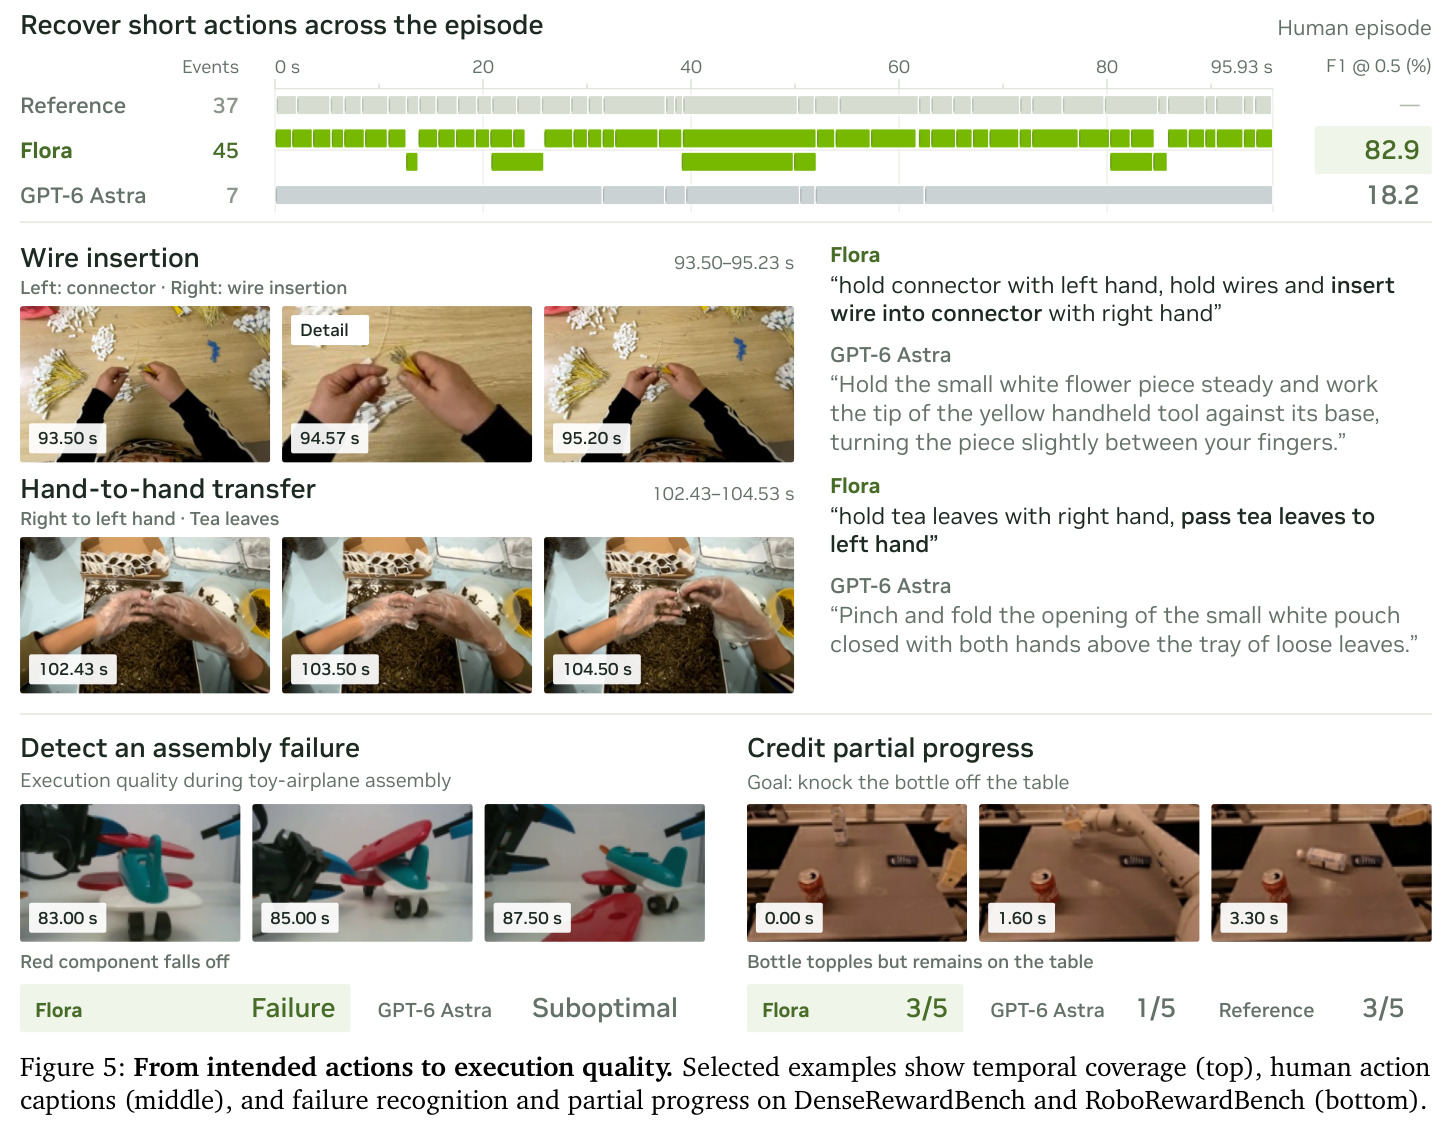
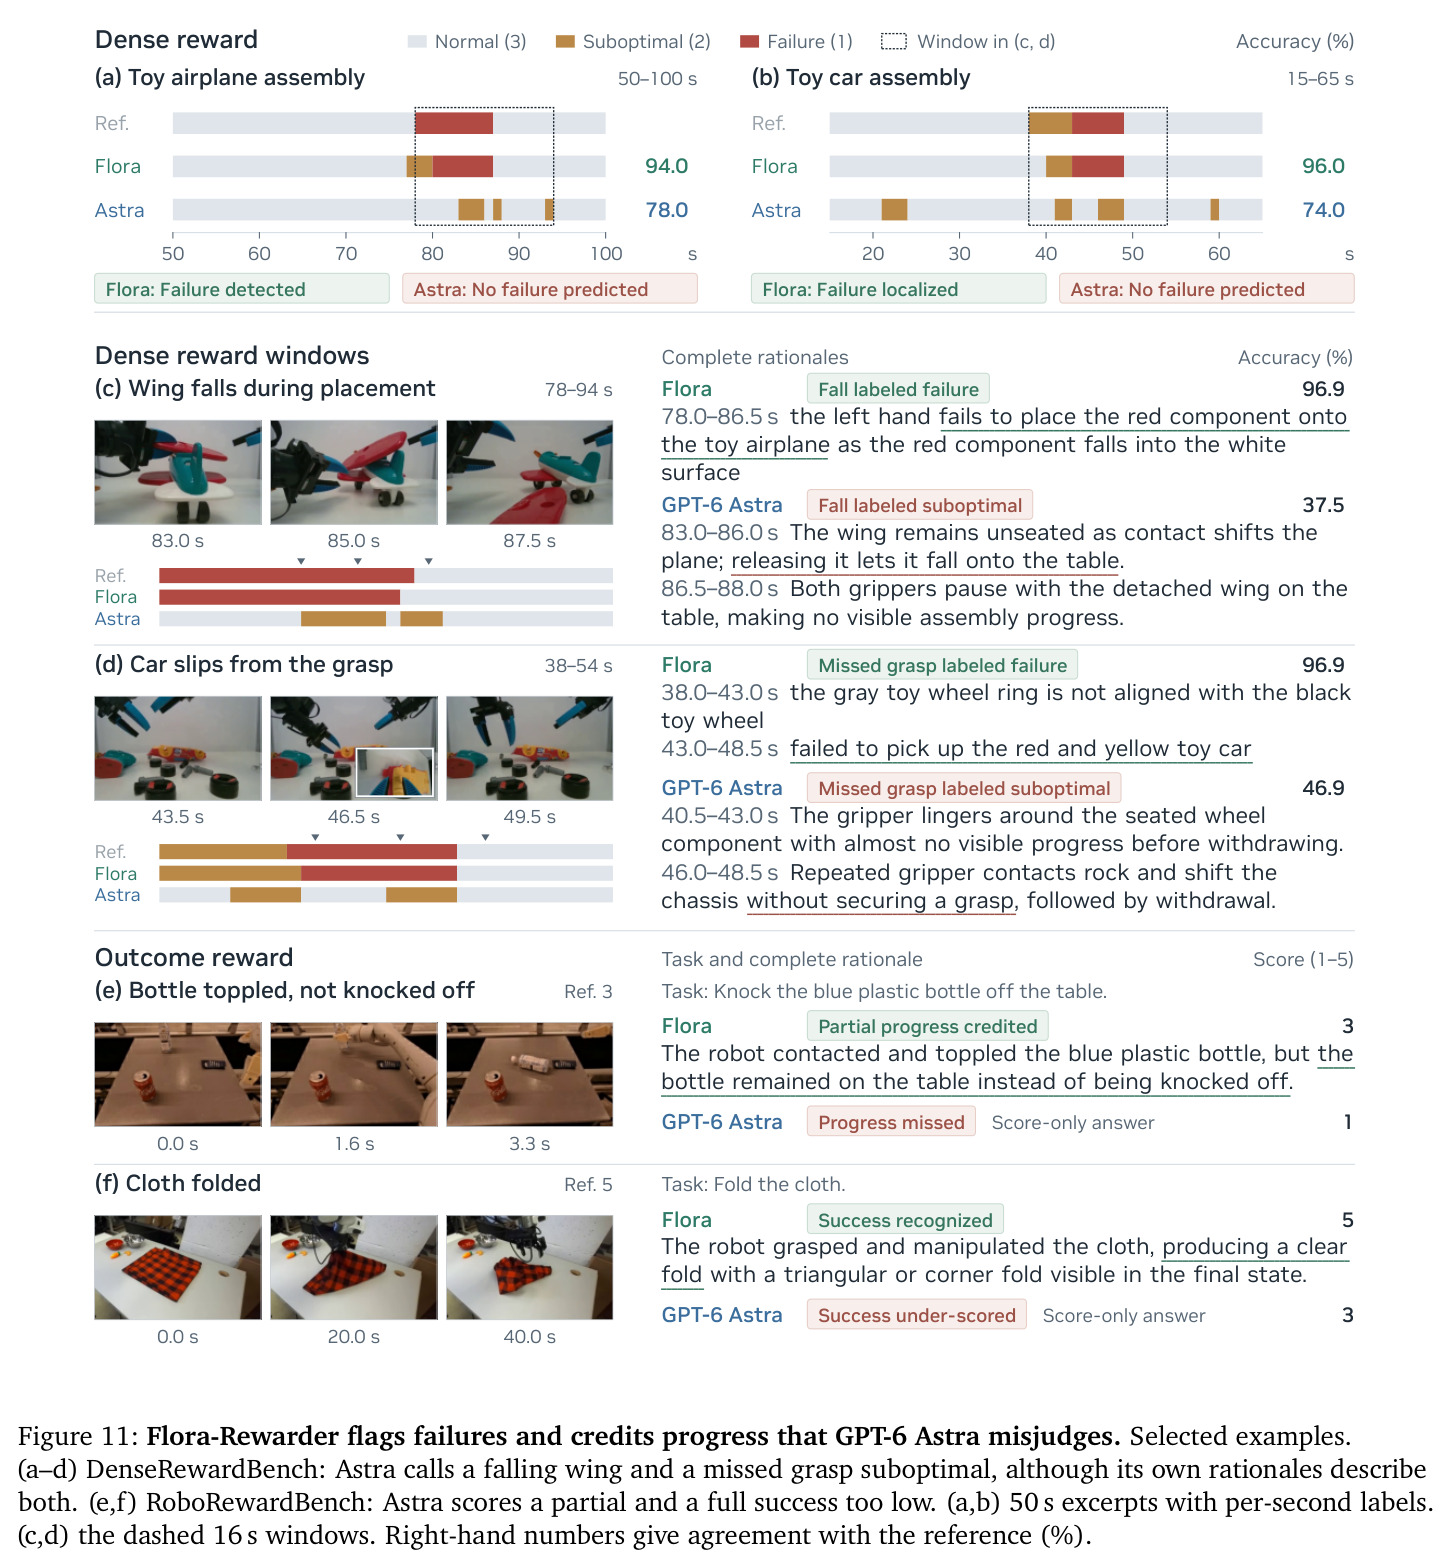
与已有工作不同的是,本文的独特切入角度有四点。其一,不做单一任务的专用模型,而是把『数据引擎』当作产品:三个小模型(9B 分割器 + 27B 字幕器 + 27B 奖励器)组成流水线覆盖全生命周期标签,这不同于 Refiner/LeRobot 只做字幕、RoboReward/Robometer 只做奖励的碎片化格局。其二,以往奖励模型只输出整段分数或进度值,FLORA-Rewarder 把『意图动作描述』与『执行质量』对齐,既能定位失败瞬间,又能给部分完成记分(如推倒瓶子但没推下桌记 3/5,而 Astra 给 1/5)。其三,方法上不满足于提示词工程,而是对每个组件做领域 SFT 加可验证奖励的 GRPO,并引入窗口延续标志、前/目标/后上下文块、多相机马赛克等工程化设计。其四,提出 DenseCaptionBench(300 集、含灵巧手与多视角),补足 WGO-Bench 只有 100 个单视角片段、不测部分覆盖的缺陷。
核心方法
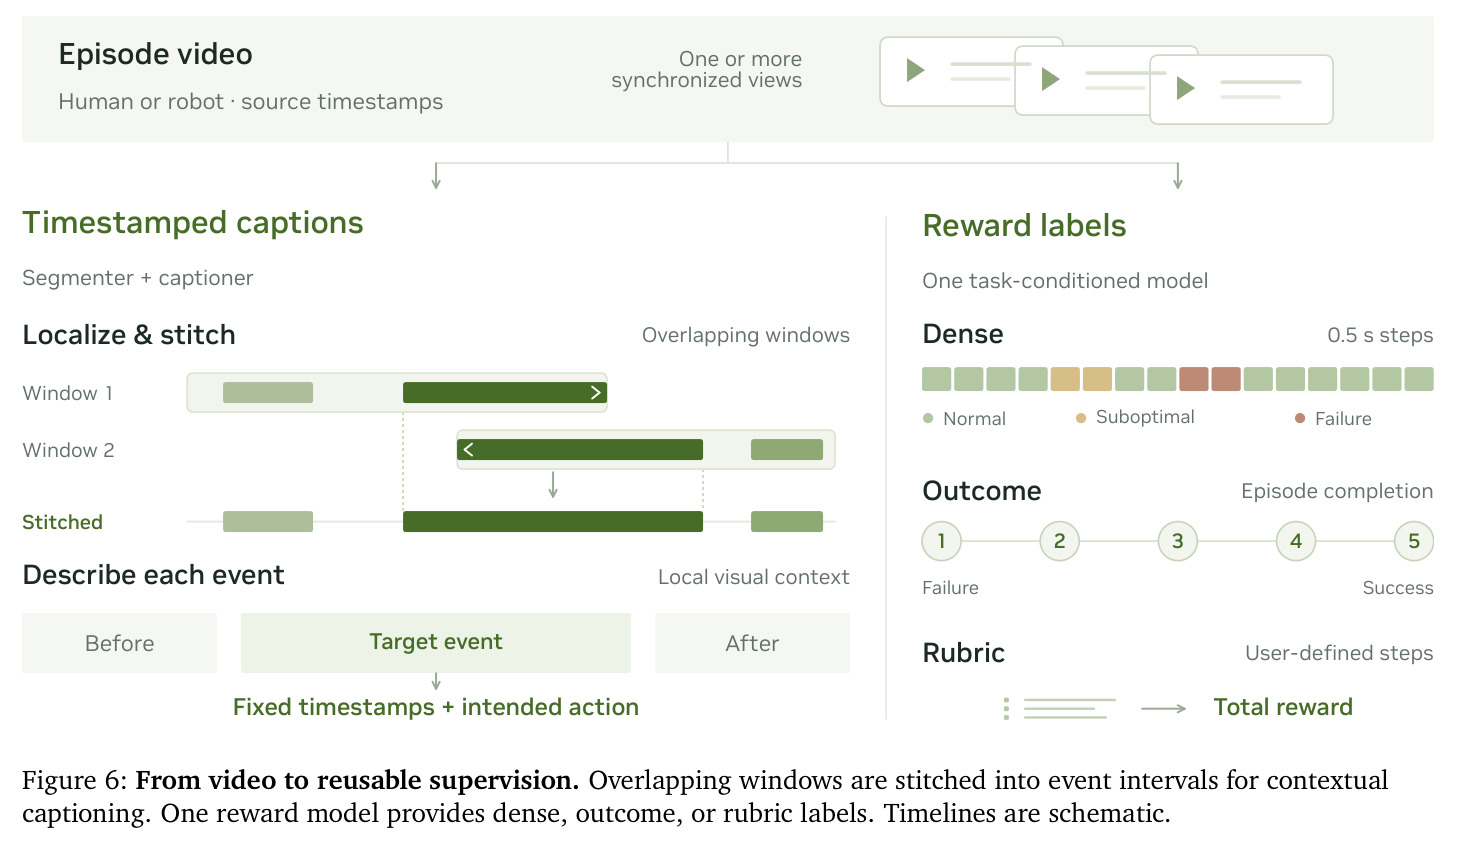
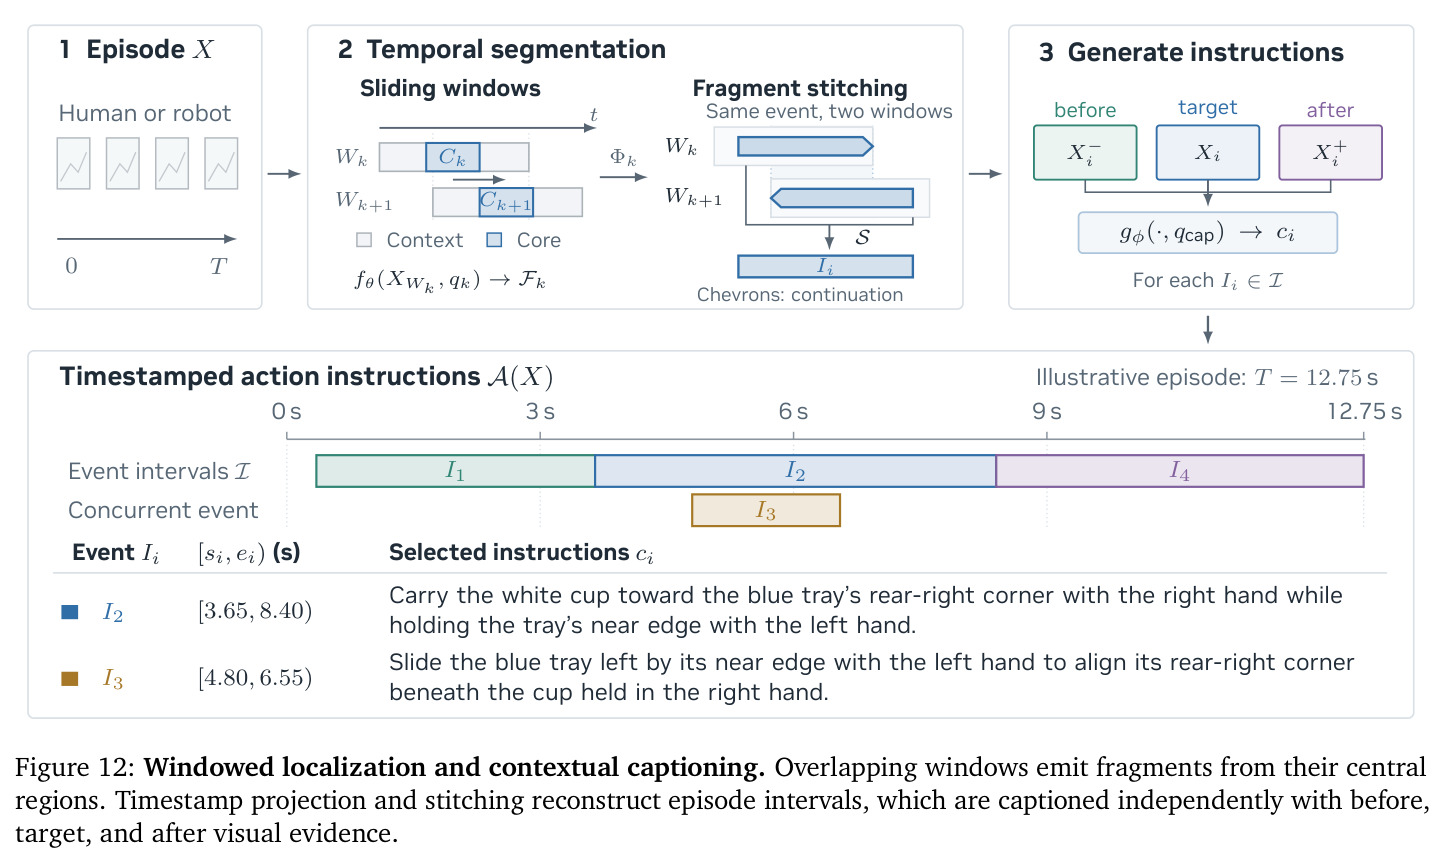
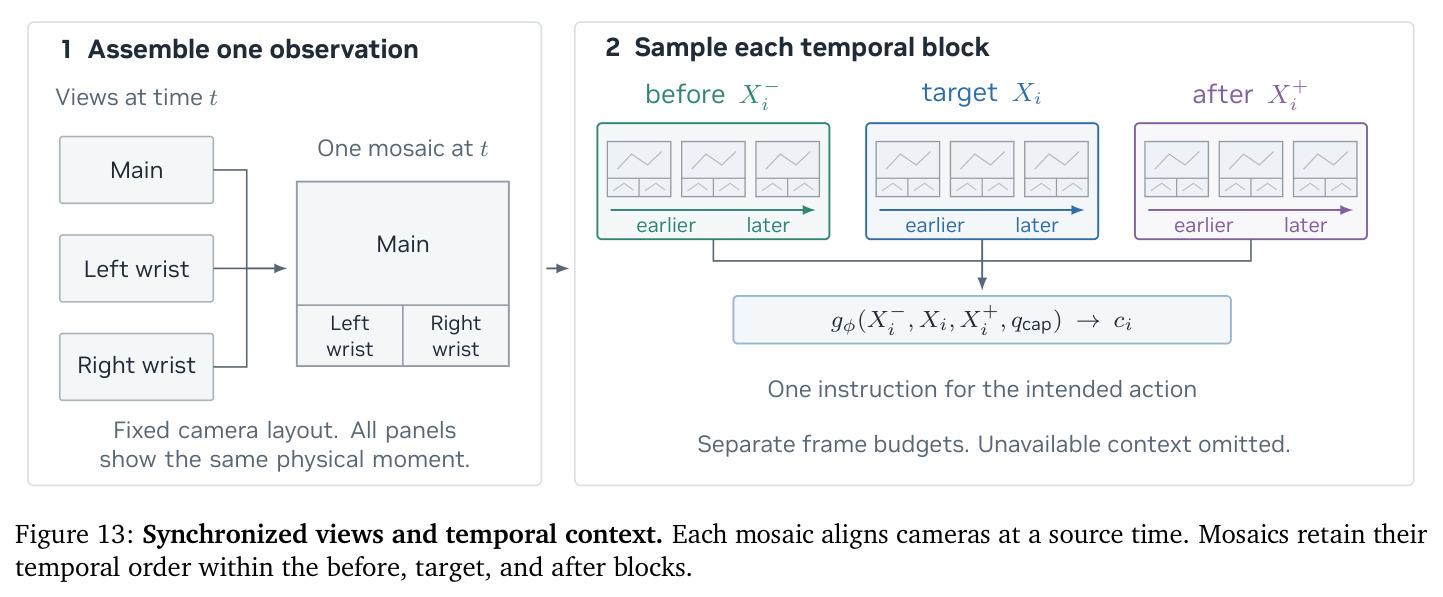
直觉上,机器人视频标注要回答两件事:什么时候发生了什么、做得好不好。FLORA 拆成两个互补模型族。字幕流水线(4.1 节):对时长 $T$ 的视频 $X$ 输出 $\mathcal{A}(X)=\{(s_i,e_i,c_i)\}$——分割模型 $f_\theta$ 在重叠窗口内预测局部区间加左右延续标志,确定性拼接器把局部时间戳投影回整集时钟、按重叠与延续标志缝合碎片(保留并发动作)并精修边界;字幕模型 $g_\phi$ 对每个区间用前/目标/后三个视觉块生成 $c_i=g_\phi(X_{-i},X_i,X_{+i},q_{cap})$,多相机在每个采样时刻平铺成一张马赛克。奖励模型 $r_\psi$(4.2 节)是单个 27B 模型、靠提示词切换三种接口:结果奖励读 1–5 分 score token 分布并线性映射到 $[0,1]$ 连续奖励;密集奖励对 16 秒窗口内 32 个 0.5 秒组输出三档质量标签与理由;rubric 模式在 thinking 模式下对用户定义步骤按允许档位打分求和。
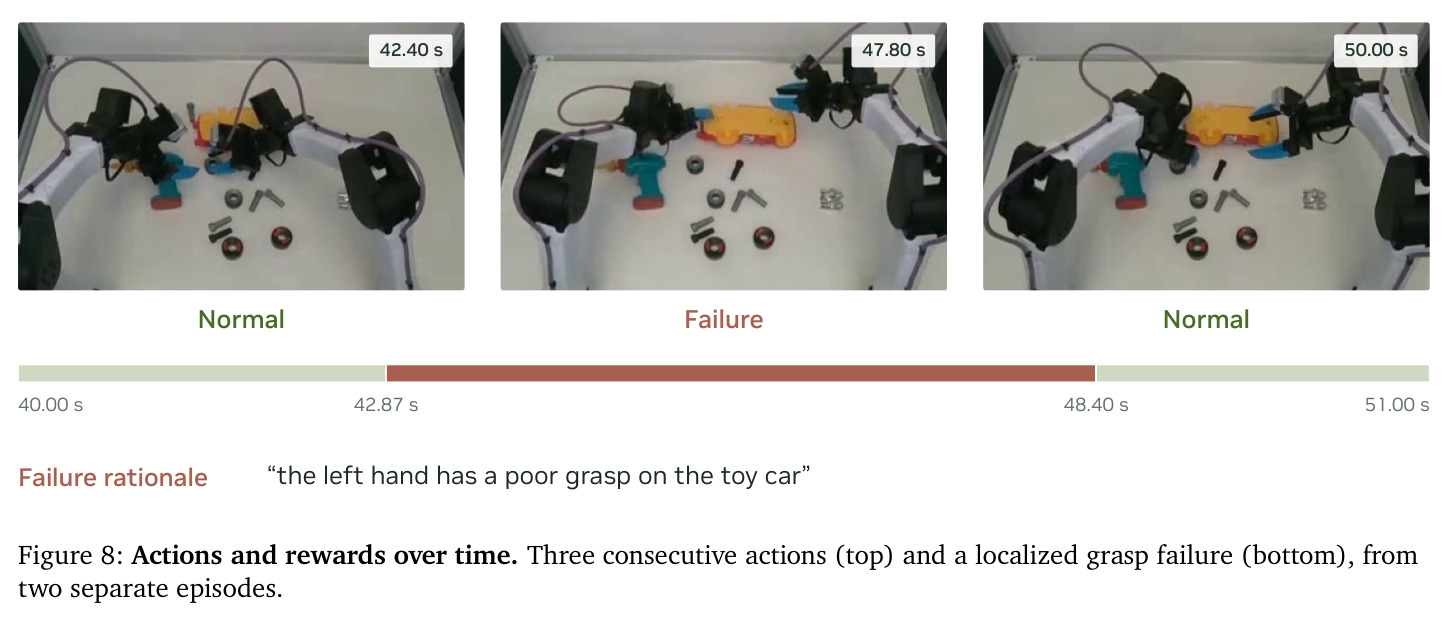
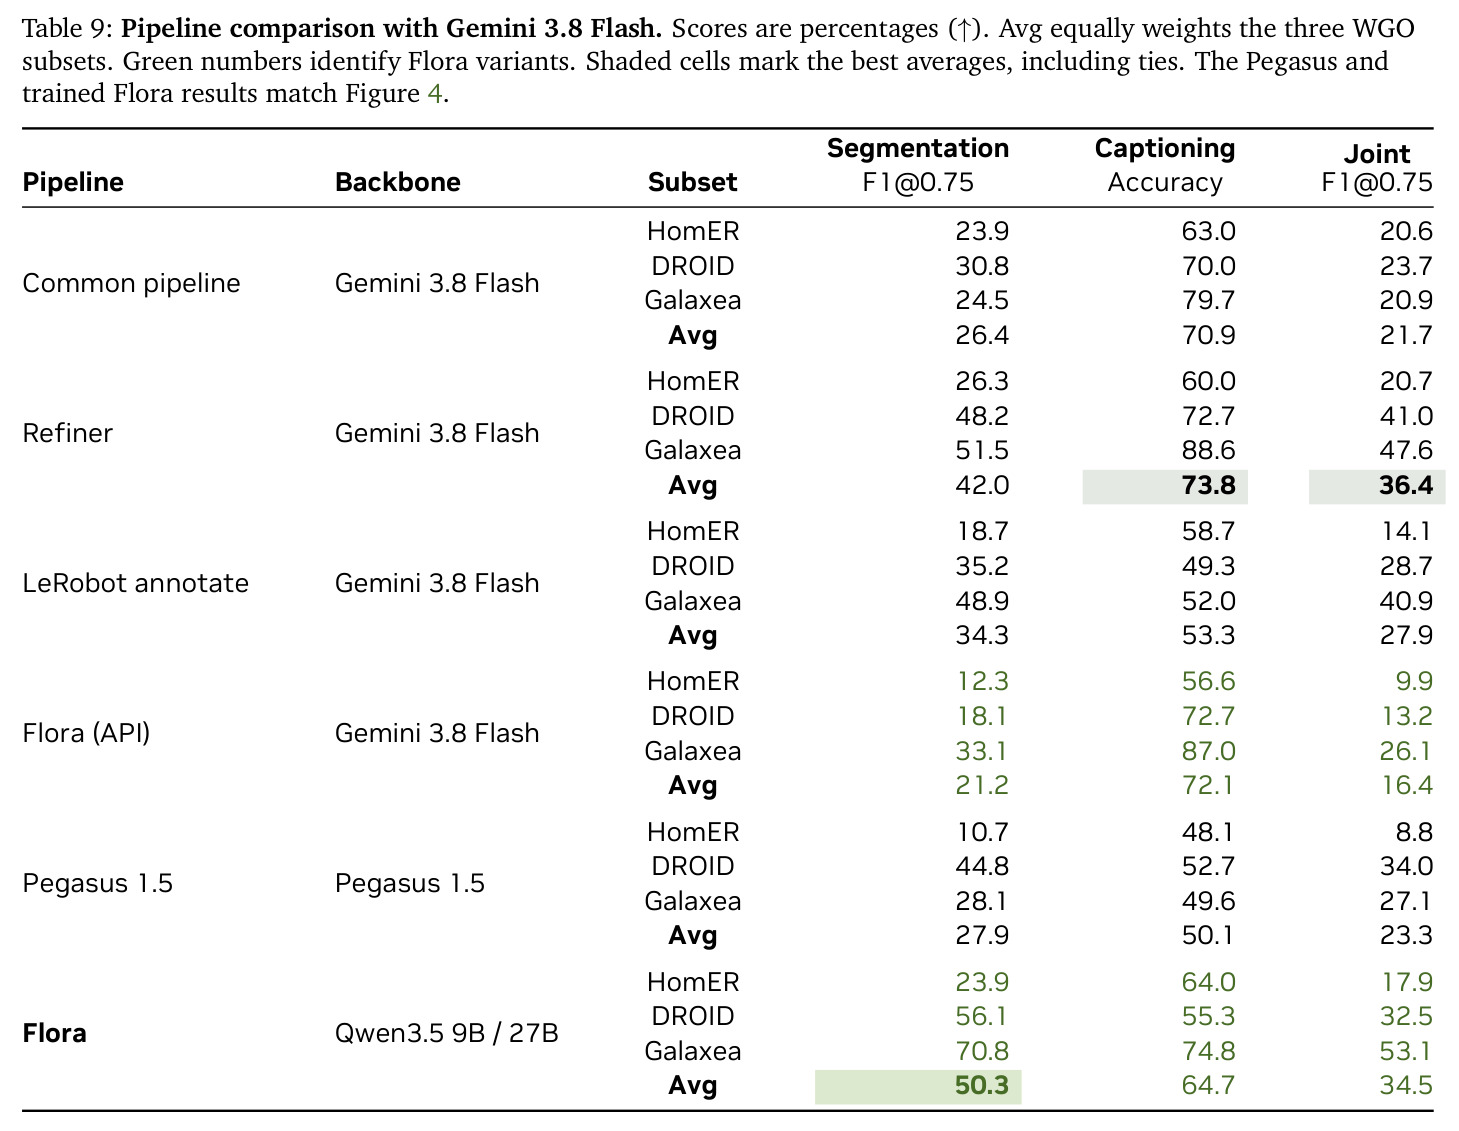
核心创新在于:与『现成 VLM + 提示词』的开源流水线或单一专用奖励模型不同,FLORA 是第一个针对机器人标注做端到端领域训练(SFT + 可验证奖励 RL)的多功能开源模型套件。本质区别有三。第一,分割目标不是直接回归全局时间,而是窗口局部坐标加延续标志:每个窗口只在中央发射区输出、用左右标志声明越界延续,任意长视频因此可分解为固定窗口内的受限解码问题,再用确定性规则无缝缝合——API 替换诊断证明这套训练过的系统无法用提示词复刻(换 Gemini 3.8 Flash 仅得 21.2%/16.4%,远低于训练版的 50.3%/34.5%)。第二,密集奖励是『回溯式』设计:窗口几何故意让每个保留的 0.5 秒组后面还有至少 4 秒后续画面作证据(窗口步进 10 秒、丢弃最后 4 秒),保证标签以可见后果为依据而非猜测。第三,字幕器 RL 用基于参考要求的点质量奖励 $r_{cap}=2M/(R+M+F)$,对被支持的内容给部分得分、对事实性错误罚款,比二值匹配更能塑造细节覆盖与协调动作描述。
方法步骤详情
分三步。① SFT:分割器从 Qwen3.5-9B 初始化(LoRA rank-32、$\alpha=64$,冻结视觉编码器),目标是序列化的窗口局部区间与延续标志;字幕器与奖励器从 Qwen3.5-27B 初始化,字幕器更新语言模型与视觉 merger,奖励器另更新视觉编码器(更低学习率),最小化输出交叉熵;奖励三族数据混洗共训一个 epoch,rubric 用 thinking 作答。② RL(GRPO):分割器用 $r_{seg}=0.45F_{0.5}+0.15F_{0.75}+0.25P_{0.5}+0.15B$($B$ 衡量端点与延续标志正确性);字幕器用 $r_{cap}=2M/(R+M+F)$;都用组均值优势、KL 正则、只更新 LoRA,验证集独立选点。③ 推理:16 秒窗口(12 秒核心+2 秒保护带)4Hz 采 64 帧,按重叠+延续标志拼接并精修边界;字幕上下文限 2 秒/侧;密集奖励步进 10 秒、丢尾 4 秒后缝合;结果奖励采样 $\min(64,\max(2,\lfloor 10T\rfloor))$ 帧,取 top-20 分数 token 归一化求期望。
技术新颖性
技术新颖性体现在四个层面。其一,延续标志式窗口分割把开放时长视频的时序定位变成固定窗口内带结构化输出的受限解码问题,配合确定性缝合与移位窗口边界精修,是一个可训练、可验证、可扩展到任意长视频的格式设计。其二,回溯式密集奖励的窗口几何(步进 10 秒、丢尾 4 秒)与输出格式(Worst 值 + 32 位质量串 + 非正常区间的证据理由,由正则约束解码)是标注可靠性与可解析性的联合设计,文献中的奖励模型通常只输出帧级分数而无证据链。其三,单模型多接口奖励:结果/密集/rubric 三族数据无重加权共训于同一 27B,使一个模型在 RoboReward MAE 40.0、DenseRewardBench macro F1 46.2、RubricBench L1 6.5 上同时具备竞争力,而 GPT-6 Astra 在失败召回上为 0.0,说明通用大模型并不天然擅长失败检测。其四,评测协议上提出点质量联合标注(joint F1 要求时间与语义同时匹配、给部分覆盖记分),并以覆盖度贪心选择构建 300 集 DenseCaptionBench,弥补公开基准只测单视角二值匹配的不足。
实验结果
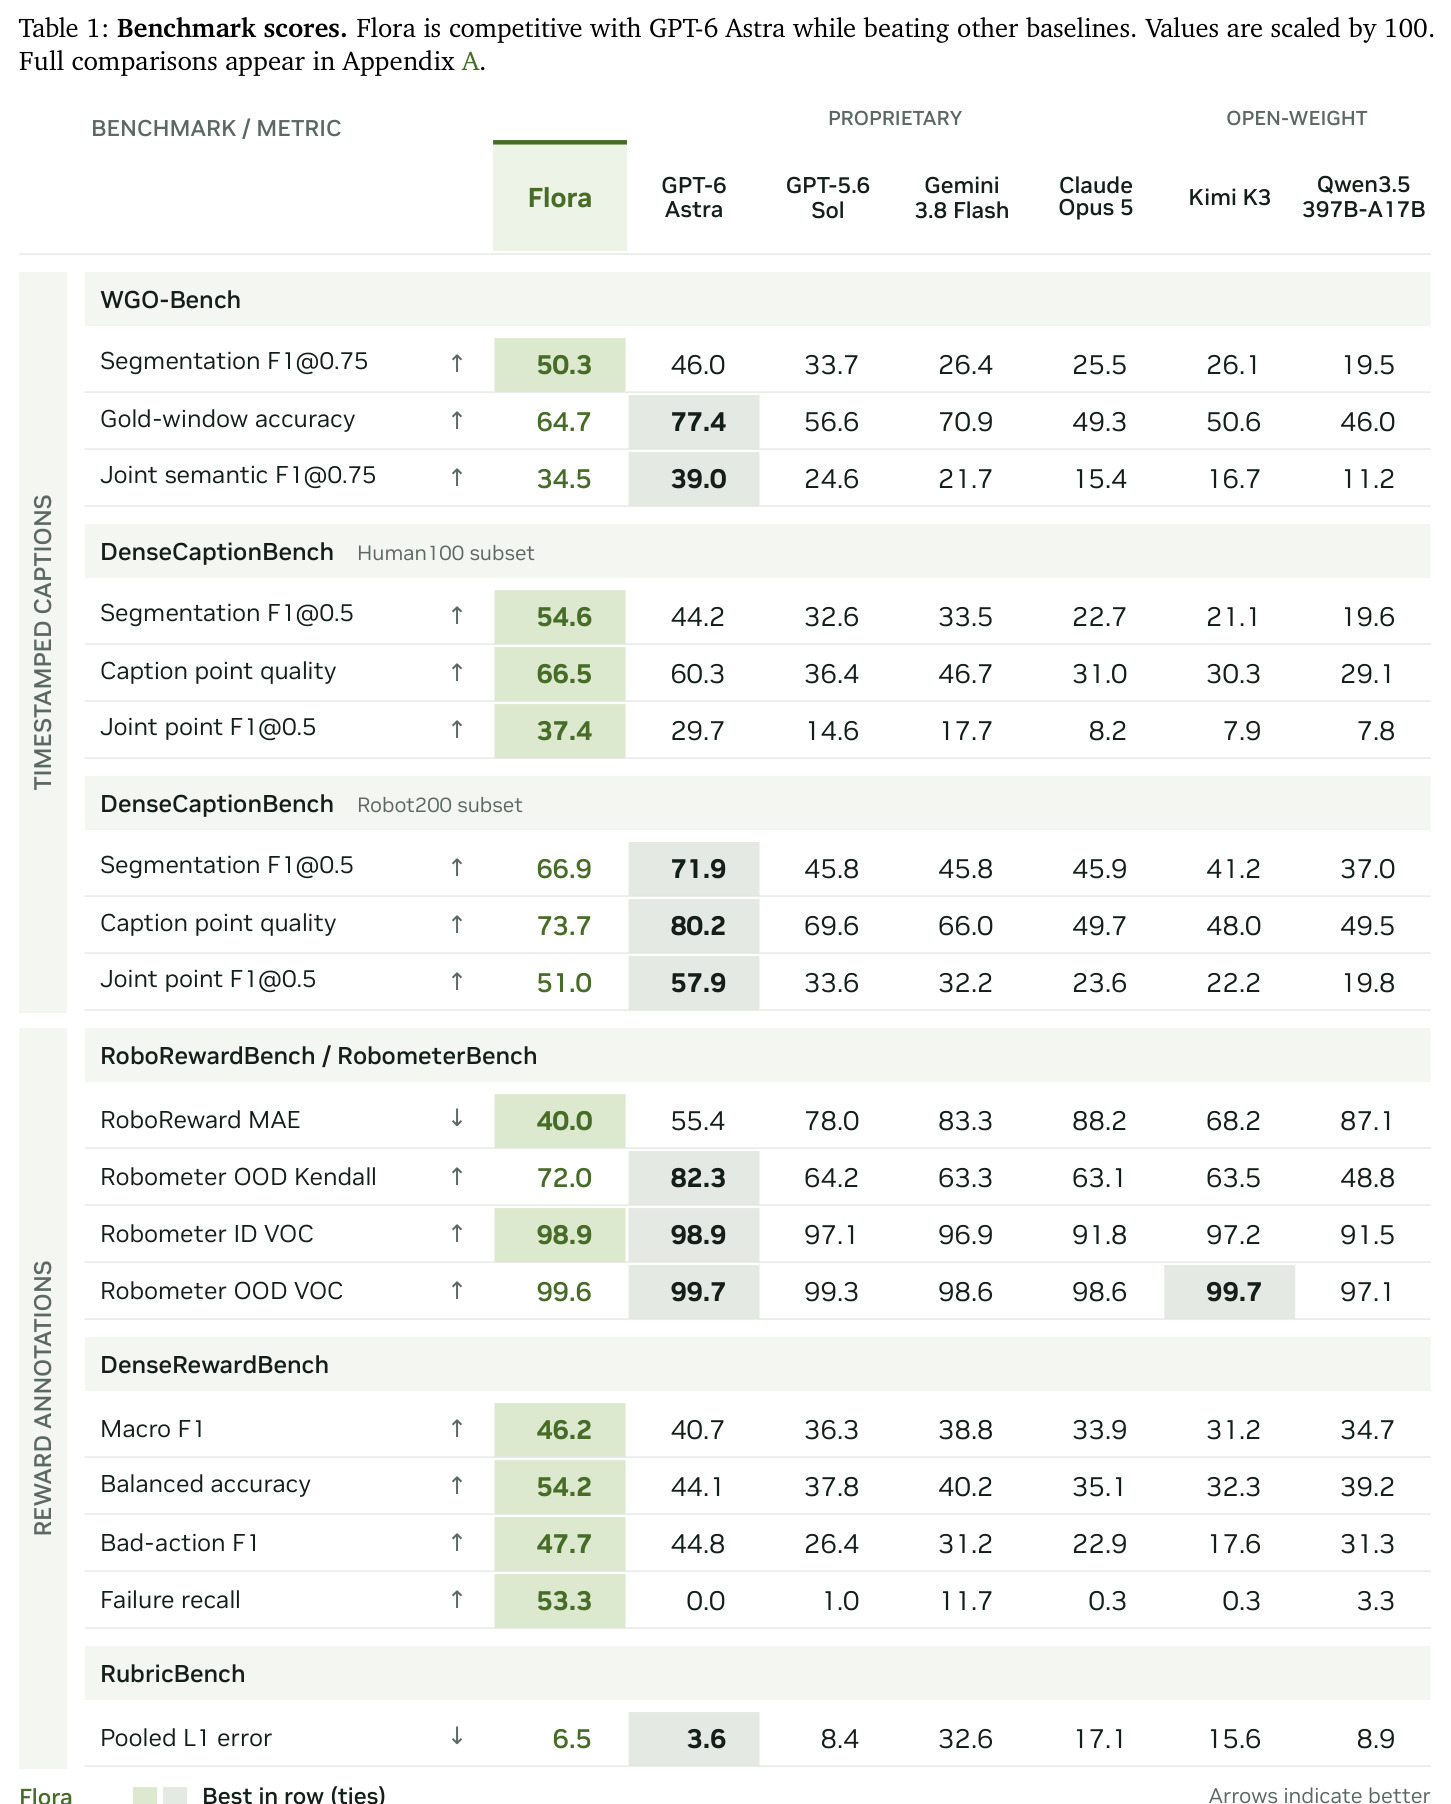
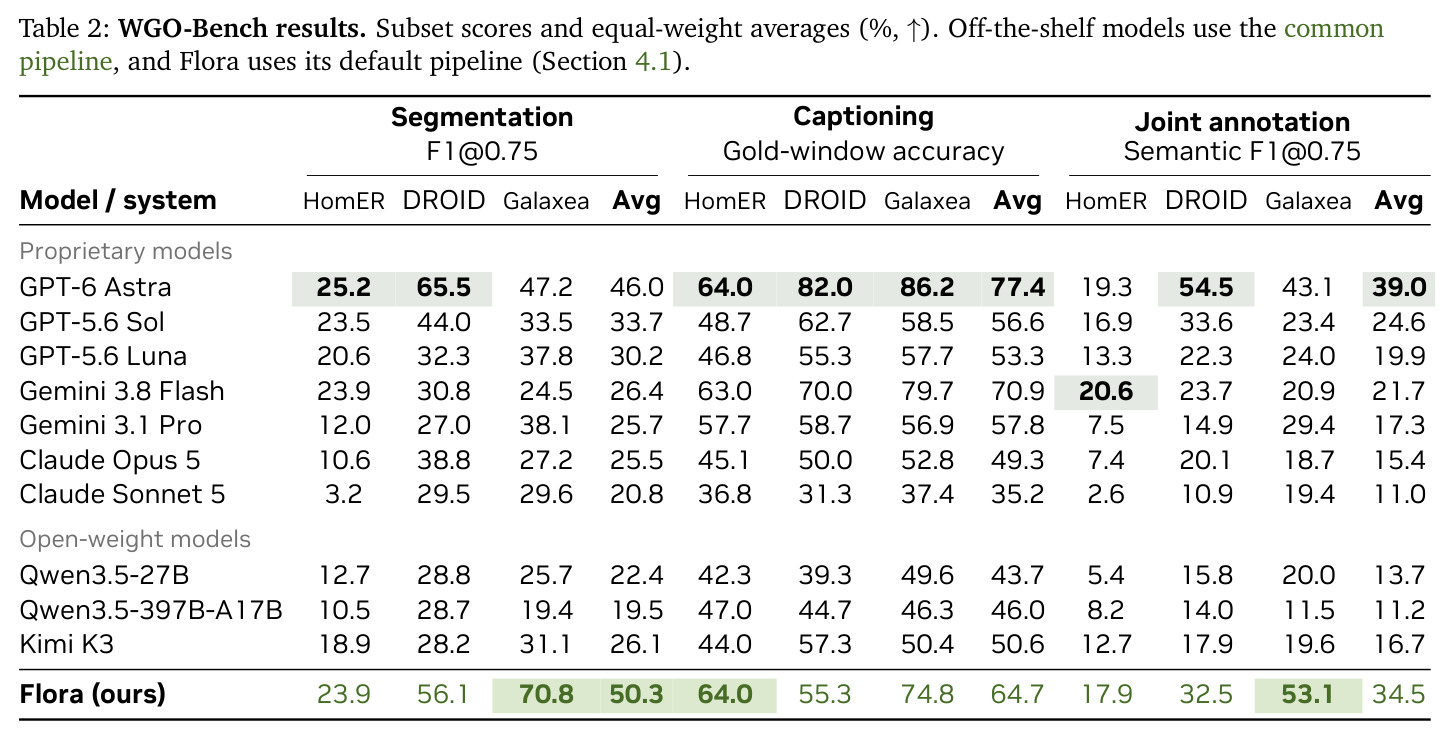
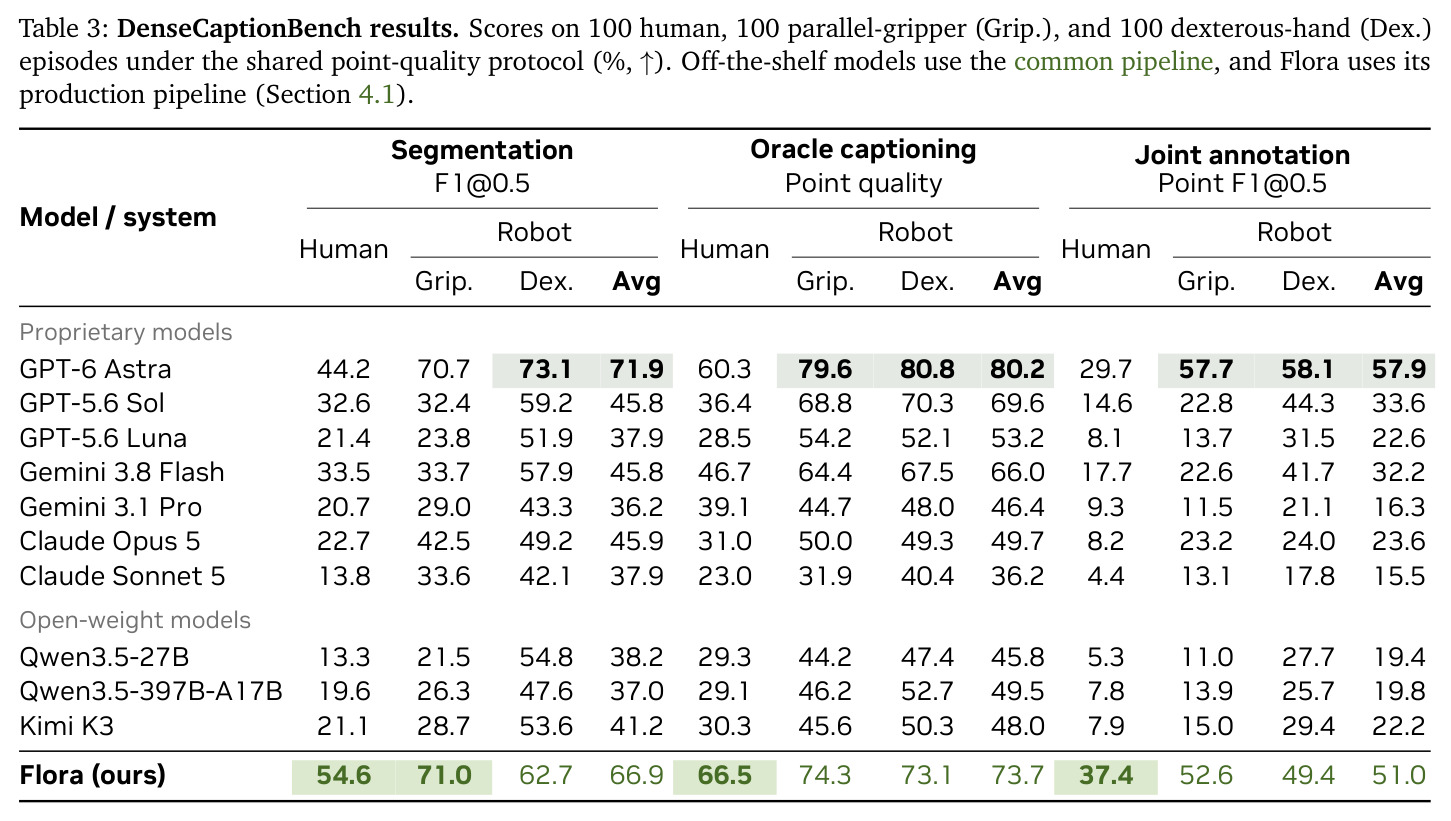
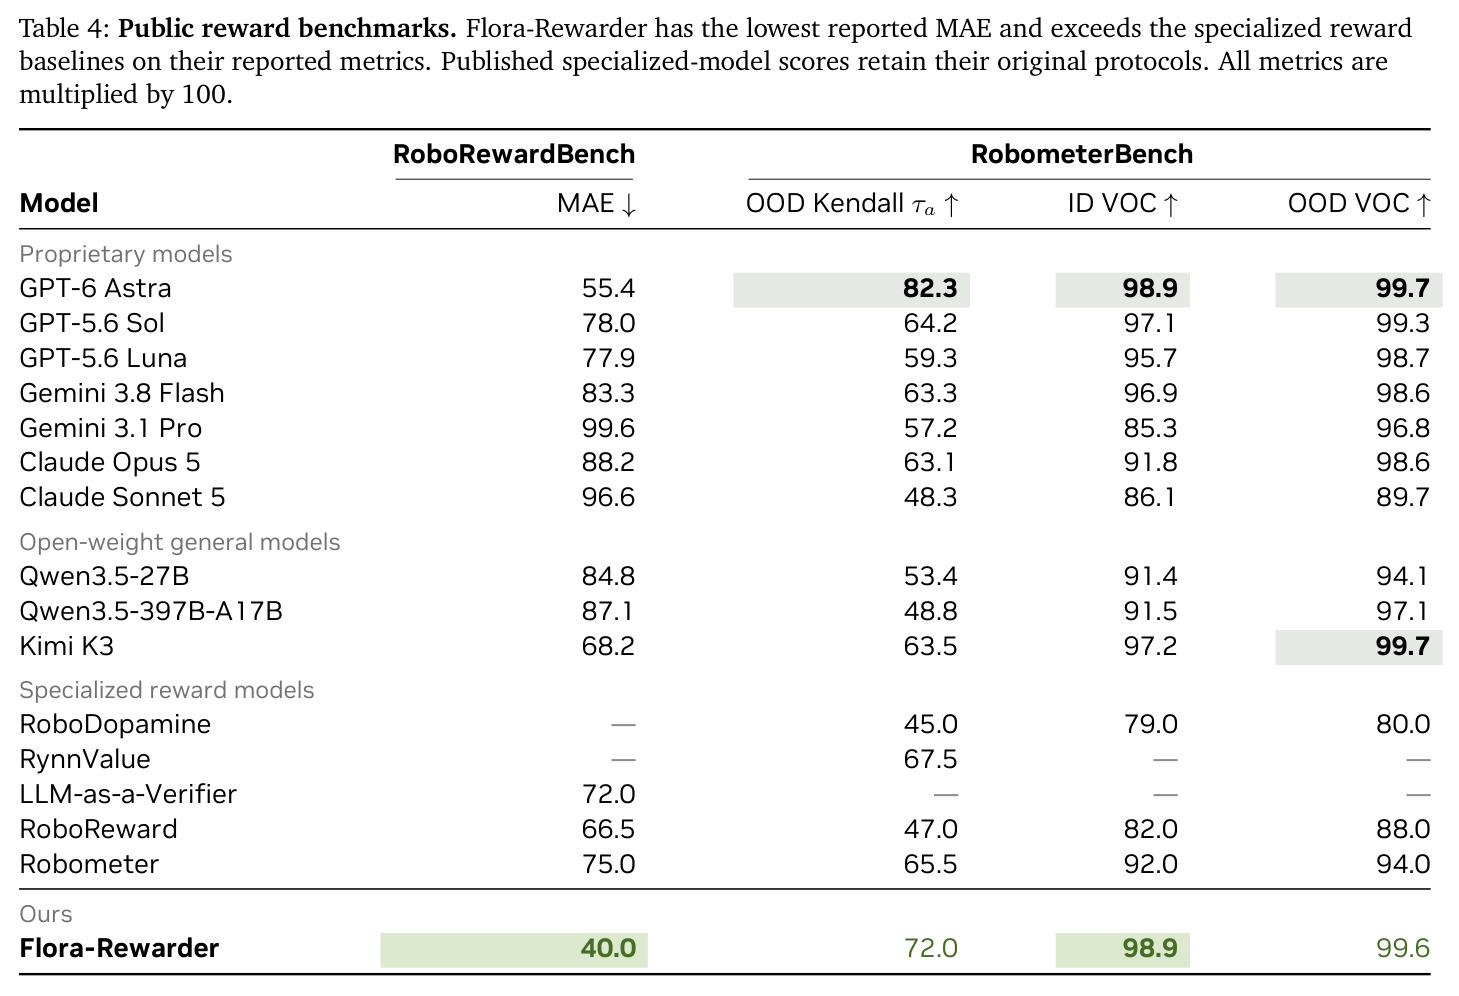
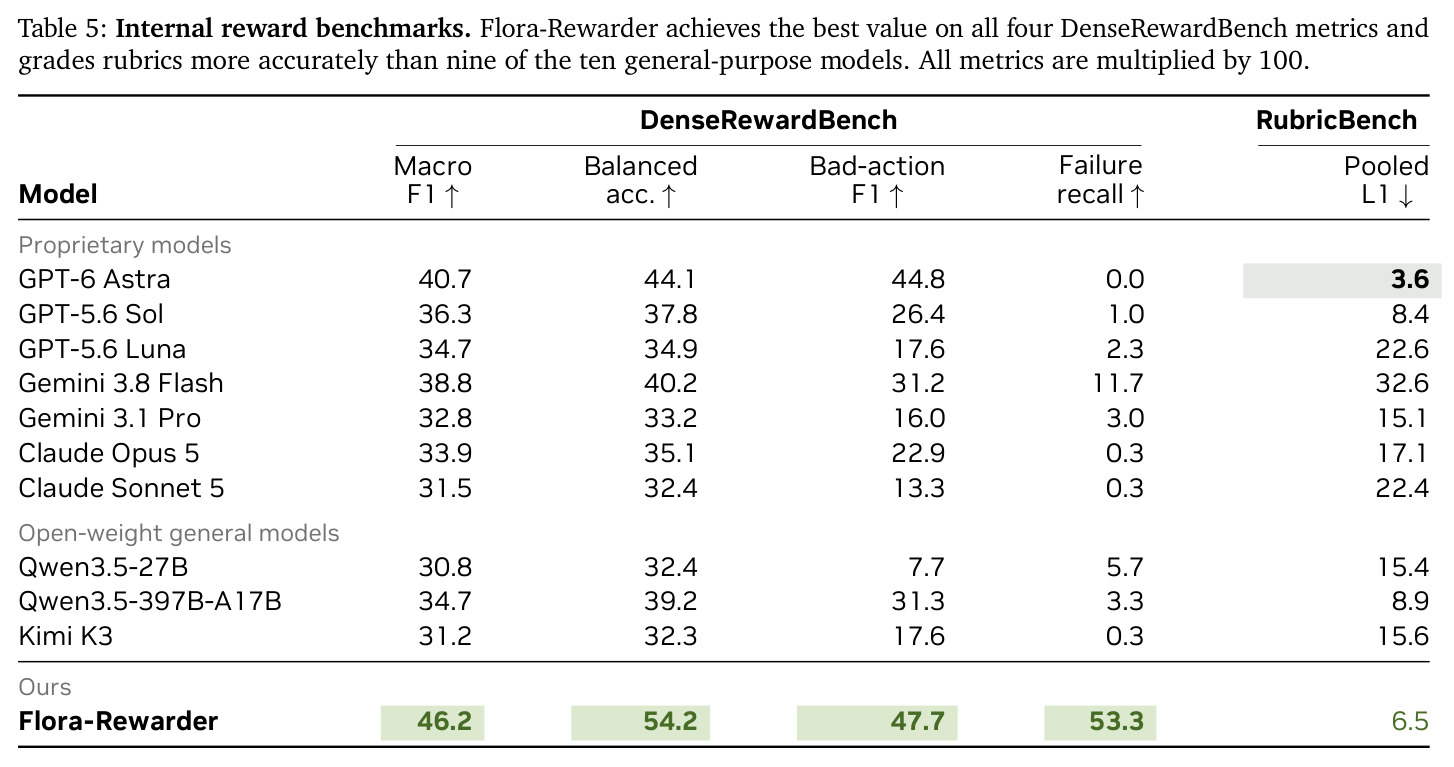
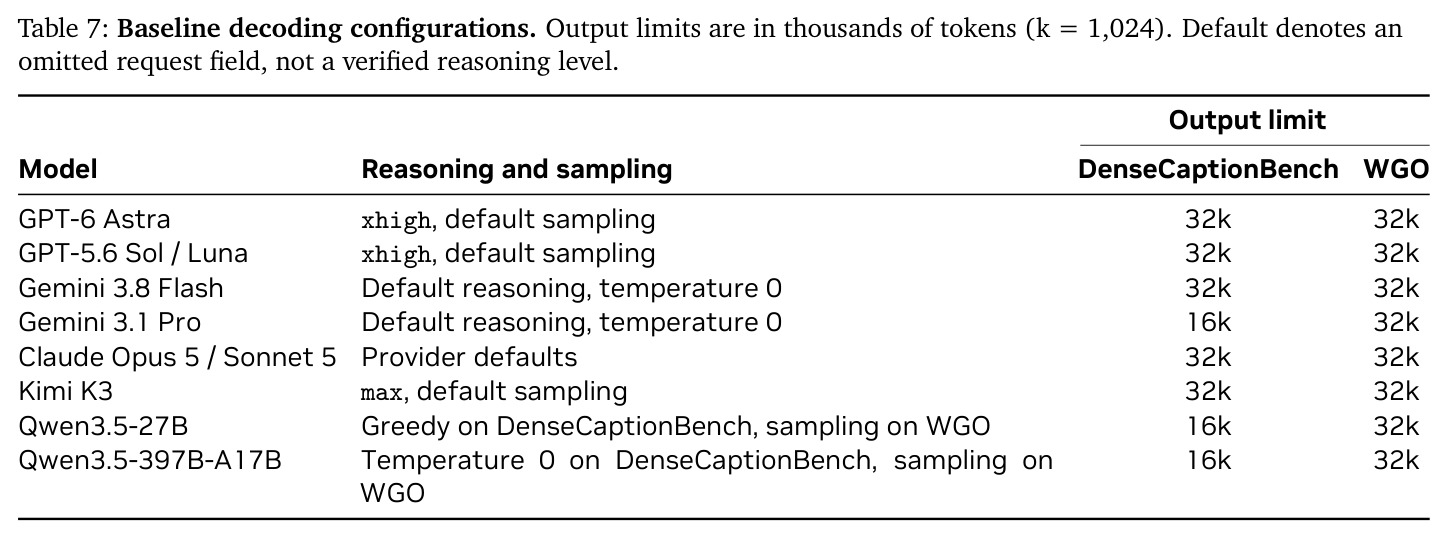
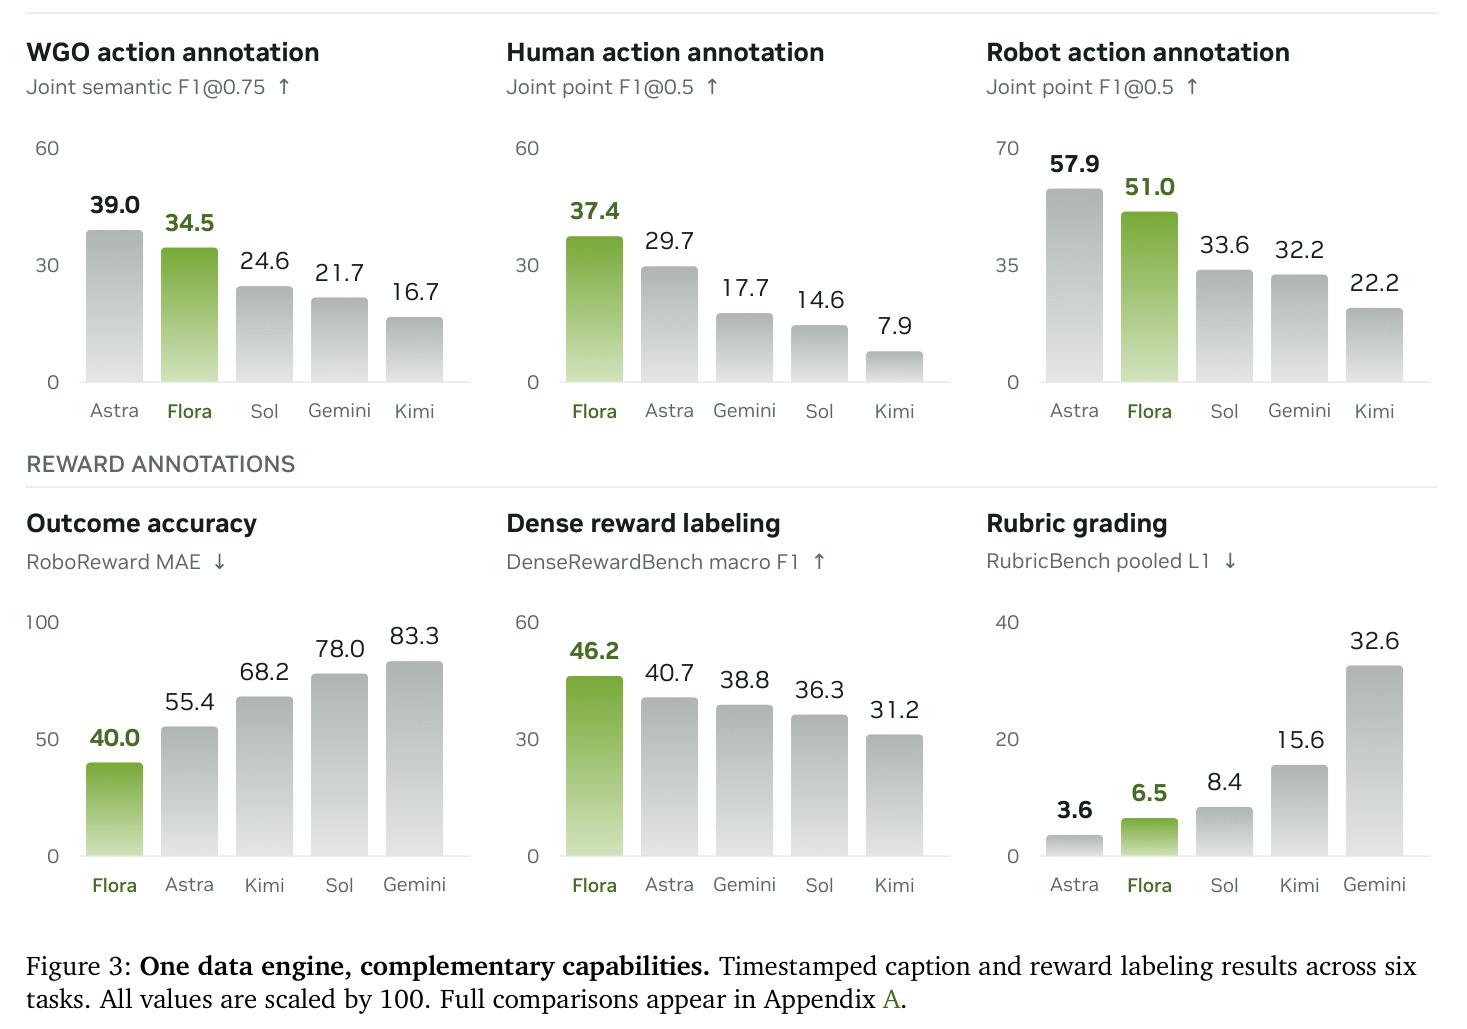
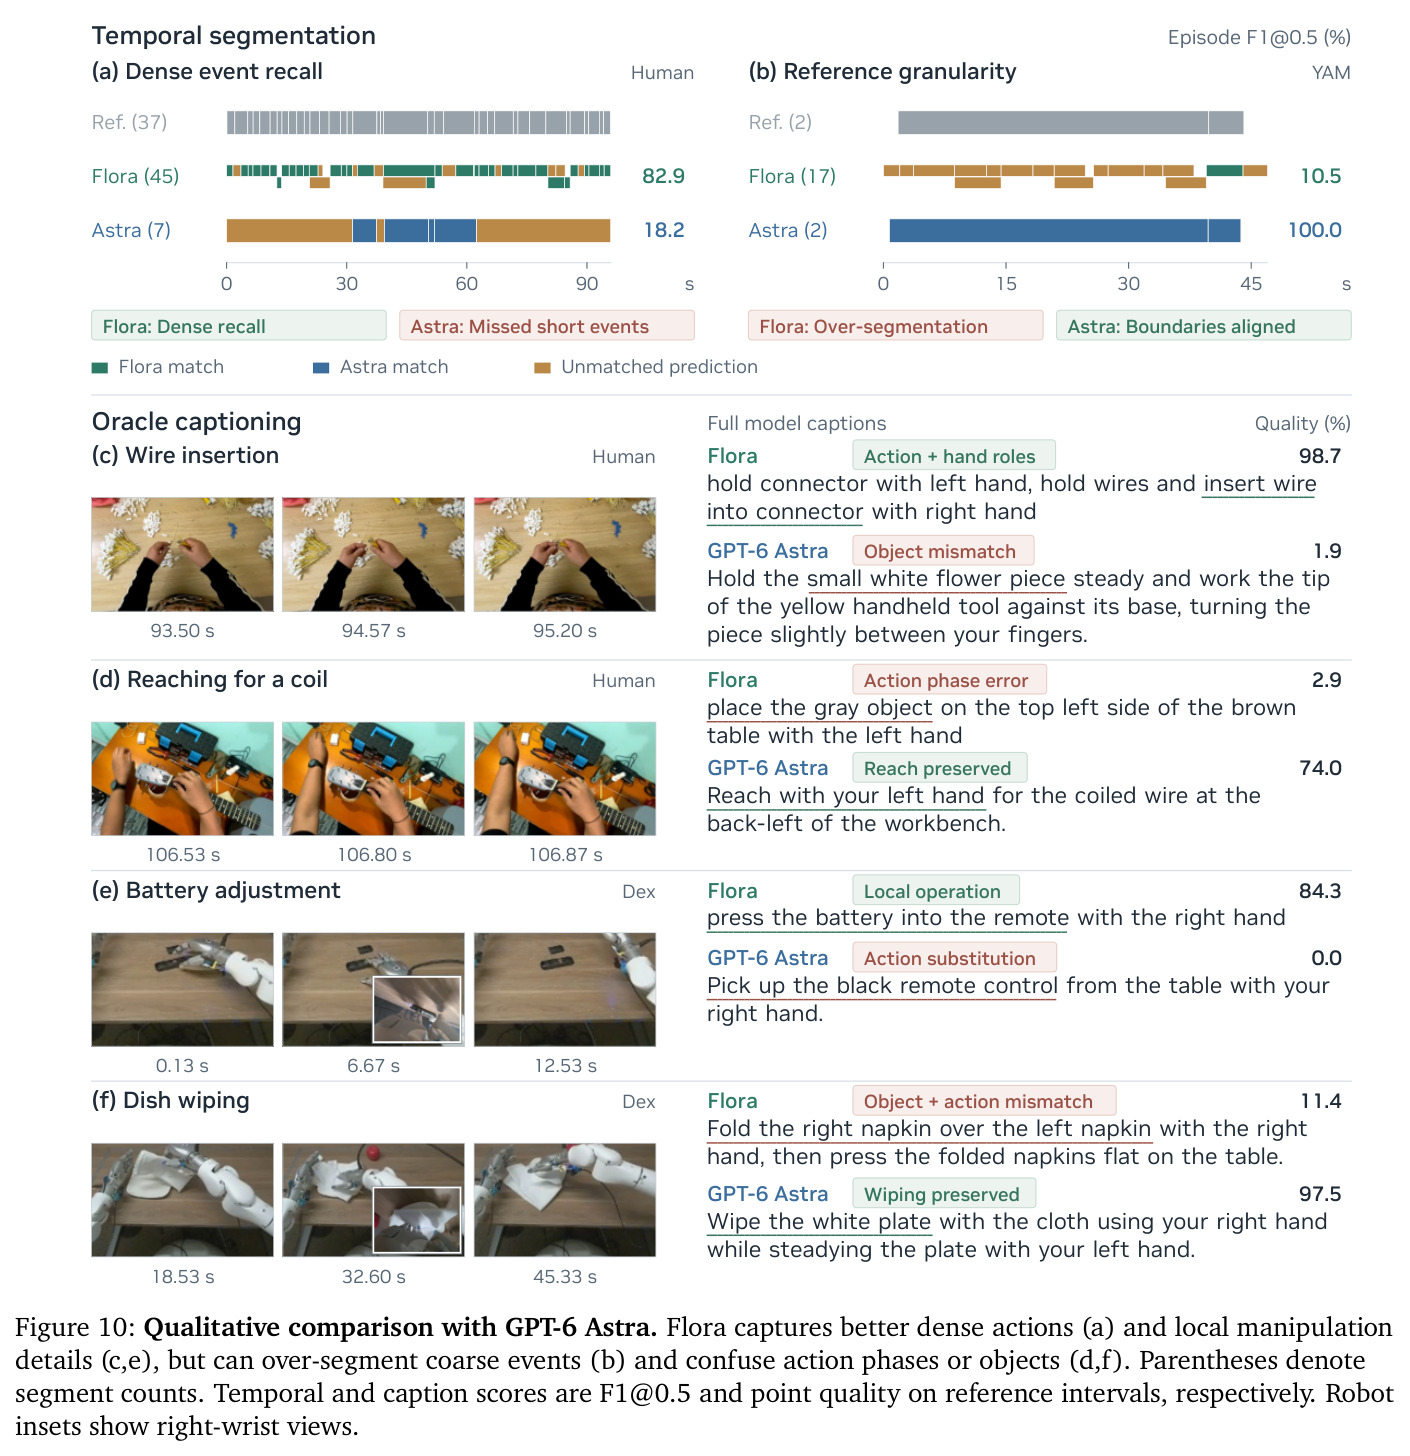
字幕:WGO-Bench 分割 F1@0.75 平均 50.3%,超 GPT-6 Astra 的 46.0%(Galaxea 子集 70.8%);gold-window 64.7% 低于 Astra 77.4%,联合 F1 34.5% 次于 Astra 39.0%,增益主要来自时间定位。自建 DenseCaptionBench(300 集):Human100 三项全第一(54.6/66.5/37.4,联合超 Astra 7.7 分),Robot200 第二(66.9/73.7/51.0,落后 Astra)。流水线对比比 Refiner 分割高 16.9、联合高 7.3 分。奖励:RoboRewardBench MAE 40.0,比 Astra 55.4 低 27.8%,远低于专用 RoboReward 66.5;Robometer OOD Kendall 72.0(Astra 82.3)、OOD VOC 99.6 超专用基线;DenseRewardBench 四项全优(macro F1 46.2),失败召回 53.3% 对基线 ≤11.7%(Astra 为 0),代价是约 11% 正常步误标失败;RubricBench L1 6.5 优于十个通用模型中的九个(Astra 3.6)。成本:57.1% 质量下 $0.72/视频小时,Astra 53.7% 需 $88.49,约 125× 便宜且高 3.3 分。512 GB300 日标 20 万小时;定性上 37 个参考区间命中 34 个(Astra 仅 4 个)。整体来看,Flora 的优势集中在『找得准』(时间定位与失败检测)与『标得起』(成本与吞吐)两件事上,而『说得细』(字幕语义质量)与机器人端的联合标注仍逊于 Astra;其在部分完成轨迹上的评分能力是结果奖励优势的关键来源,失败召回的大幅领先则直接来自密集标签的回溯式设计与领域训练。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| WGO-Bench 时序分割(人/机器人视频子任务定位) | 分割 F1@0.75(%,越高越好) | 50.3 | GPT-6 Astra 46.0;Refiner+Gemini3.5 33.4 | 较最强基线 +4.3,较开源流水线 Refiner +16.9 |
| WGO-Bench 联合标注(时间+语义同时匹配) | 联合语义 F1@0.75(%) | 34.5 | GPT-6 Astra 39.0 | 第二名,落后 4.5 分;但大幅领先其余模型(Sol 24.6) |
| DenseCaptionBench Human100(自我中心人体视频) | 联合点质量 F1@0.5(%) | 37.4 | GPT-6 Astra 29.7 | +7.7 分,三项指标全部第一 |
| DenseCaptionBench Robot200(平行夹爪+灵巧手) | 联合点质量 F1@0.5(%) | 51.0 | GPT-6 Astra 57.9;第三名 Sol 33.6 | 落后 Astra 6.9 分,但领先其余基线 17.4 分以上 |
| RoboRewardBench 结果奖励(2,831 集,1–5 分人工标注) | MAE(×100,越低越好) | 40.0 | GPT-6 Astra 55.4;专用模型 RoboReward 66.5 | 较 Astra 降低 27.8%,较专用模型降低 39.8% |
| RobometerBench OOD 轨迹排序(567 条) | Kendall τa(×100) | 72.0 | GPT-6 Astra 82.3;专用 Robometer 65.5 | 第二名,超过专用基线 6.5 分 |
| DenseRewardBench 密集质量标注(40 集、4,861 步) | 失败步召回率(%) | 53.3 | 所有基线 ≤11.7(Gemini 3.8 Flash);GPT-6 Astra 0.0 | 超过最强基线 41.6 分,是四项指标中优势最大的 |
| DenseRewardBench 密集质量标注 | Macro F1(%) | 46.2 | GPT-6 Astra 40.7 | +5.5 分,四项指标全部第一 |
| RubricBench 自定义评分细则(内部 40 集 10 任务) | Pooled L1 误差(×100,越低越好) | 6.5 | GPT-6 Astra 3.6;十个通用模型中其余 ≥8.4 | 优于 10 个通用模型中的 9 个,仅逊于 Astra |
| 标注成本效率(DenseCaptionBench 50 集子集) | 每源视频小时成本(美元)@ 质量 | $0.72 @ 57.1% | GPT-6 Astra(最大推理档)$88.49 @ 53.7% | 约 125× 便宜且质量高 3.3 个百分点 |
局限与改进
作者承认:WGO gold-window 准确率 64.7% 低于 Astra 77.4% 与 Gemini 3.8 Flash 70.9%,增益主要来自时间定位而非描述质量;Robot200 三项均输给 Astra;更高失败召回的代价是约 11% 正常步被误判为失败;DenseCaptionBench 用 Astra 当裁判存在 generator–judge 自偏好;DenseRewardBench/RubricBench 为内部基准;成本估算基于假定 $10/GPU-h,$0.51–$1.26 是工程情景而非置信区间,吞吐为建模非实测。我补充:密集奖励是回溯式设计,只能离线标注,无法服务实时控制或在线 RL;论文只评标注质量,缺下游策略训练收益实验,数据引擎的价值闭环缺一环;Refiner 换 Gemini 3.8 Flash 后联合 F1 36.4% 反超 Flora 34.5%,基座进步可能侵蚀自训优势;机器人参考含 293 条观察操作代理、98 个裁判任务不可用;Fig.10(b) 显示对粗粒度事件过分割(2 条参考切成 17 段仅中 1 条)。
独立分析的弱点
①字幕语义不足:gold-window 64.7% 落后 Astra 12.7 分,附录 E 显示会把『伸手拿线圈』说成『放置物体』、『擦盘』说成『叠餐巾』,27B 字幕器对操作相位与物体身份的判别弱于前沿模型,改进方向是扩大字幕器规模、增强视觉编码器或加长上下文。②过分割倾向:把 2 条粗参考切成 17 段仅匹配 1 条(YAM 子集 F1@0.5 仅 10.5%,Astra 反而 100%),可在拼接后加粒度对齐/事件合并后处理,或在 RL 奖励中加入碎片惩罚。③约 11% 正常步被误标失败:接入 RL 后训练会污染 credit assignment,可输出置信度并做代价敏感校准,或在消费端用保守阈值。④关键评测资产不开放:DenseRewardBench、RubricBench、DenseCaptionBench 均未确认公开,第三方难以独立核实优势,应发布基准与裁判协议。⑤缺下游闭环验证:没有实验证明 Flora 标签训练的策略优于人工标签或其他自动标签,应做消融式 VLA 训练对比实验。
未来方向
作者提出的方向:开放 FLORA 后,社区可探索『物理自动研究』(physical auto-research,让机器人系统自动完成收集—标注—训练的闭环科学发现)和『人到机器人迁移』(human-to-robot transfer,用低廉的人体示范视频直接生成机器人训练数据);时间戳字幕可继续用于预训练数据过滤与配比平衡,rubric 奖励支撑测试时灵活定义评价标准。基于本文成果可延伸:(1)把密集过程奖励接入 VLA 的 RL 后训练,量化逐步 credit assignment 对真实机器人成功率的增益,这是论文明示但未实验的部分;(2)把分割、字幕、奖励三个模型蒸馏或统一进单个 VLM,减少流水线调用成本;(3)用 rubric 接口构建在线人类偏好收集回路,做 test-time 奖励迭代;(4)针对 11% 失败误报与过分割问题,研究标注噪声鲁棒的 RL 聚合方法;(5)主动学习式标注,只对不确定片段调用人工复核以进一步降本;(6)扩展到导航、移动操作等非桌面操作场景。
复现评估
模型套件已在 HuggingFace 开源(nvidia/FLORA collection:9B 分割器、27B 字幕器与奖励器)。评测资产:WGO-Bench、RoboRewardBench、RobometerBench 公开可获取;DenseCaptionBench 发布情况不明(附录 B 有完整构建协议),DenseRewardBench 与 RubricBench 为内部基准未公开,这两块优势无法独立复现。算力:训练基于 Qwen3.5-9B/27B 的 LoRA SFT + GRPO,用 NeMo AutoModel 与自研 PyTorch RL 栈,中等集群可承受;标注部署最低 8×GB300,估算 $0.72/小时。难点:SFT 数据含大量授权与内部人工标注(时间戳字幕、双臂动作质量标签、rubric 评分),外部难以获得同等规模数据;密集奖励的正则约束解码与缝合规则(Eq.22)已详述但实现工作量不小;API 基线依赖 2026 年 10 月版本与价格。总体:推理/标注复现中等偏易,训练复现较难(卡在数据),完整评测复现中等。
论文图表