WeVisOne-VL:从物体到像素的统一视觉感知模型 WeVisOne-VL: Unified Visual Perception from Objects to Pixels
腾讯开源统一感知 VLM,一个模型打通检测、指代、计数、OCR、分割与抠图
前置知识
结构化下一词元预测与坐标 Token 化
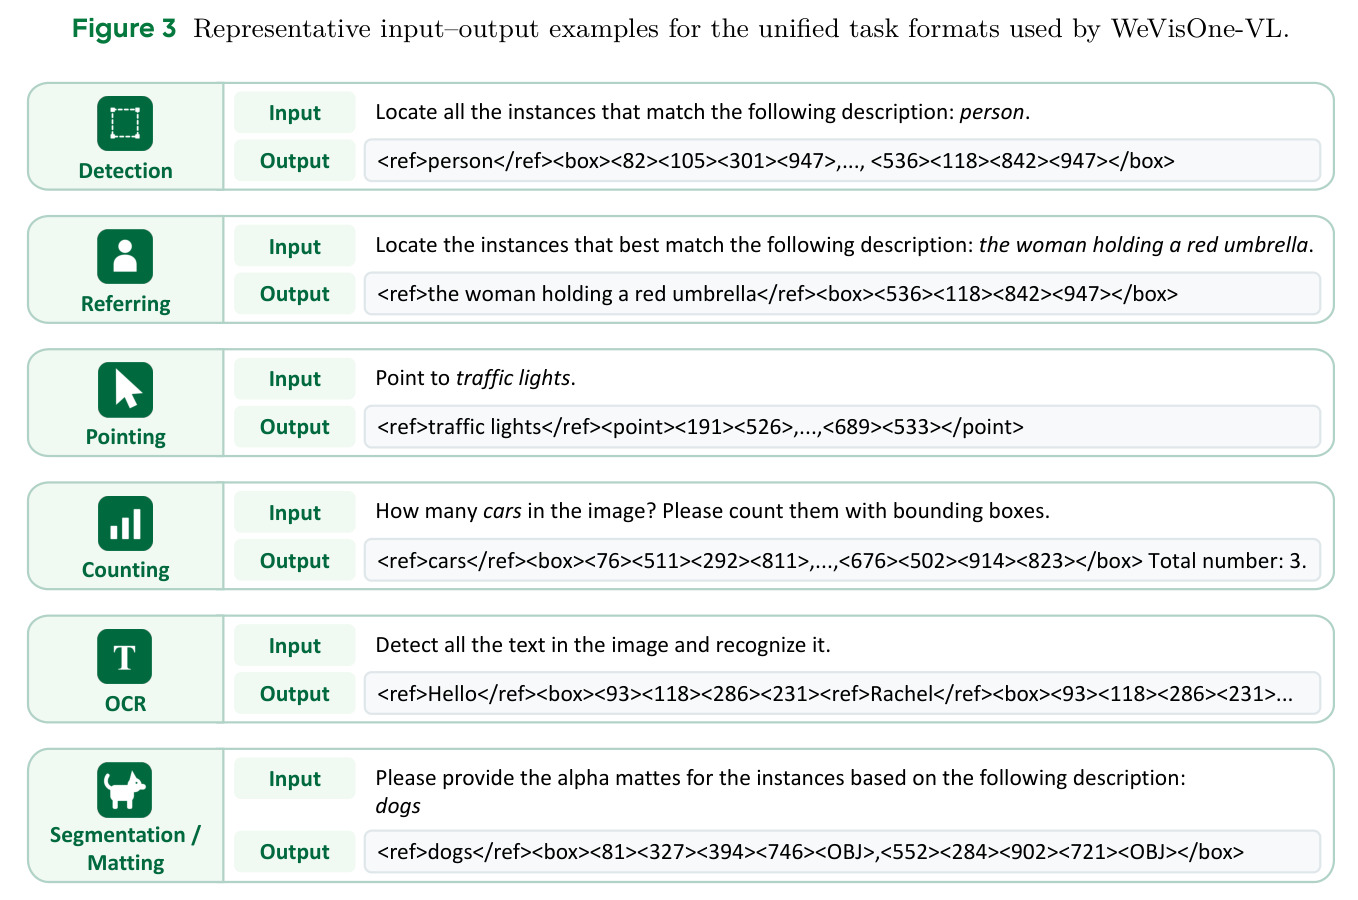
视觉语言模型(VLM)把所有输出当作文本序列逐 token 自回归生成。本文延续 Rex-Omni 的做法,引入从 <0> 到 <1000> 的 1001 个专用坐标 token,把归一化到 0–1000 的坐标离散编码:一个检测框就是 [x0, y0, x1, y1] 四个 token,点则是两个 token,目标缺失时坐标字段填 None。相比让模型输出普通数字字符串,这种方案序列更紧凑、解析更可靠,也让强化学习的奖励计算变得简单确定。
全文的任务格式、评测解析和 RL 奖励都建立在坐标 token 这套约定上,看不懂它就看不懂输入输出示例和奖励公式。
Deformable DETR 与可变形注意力
Deformable DETR 是稀疏注意力的目标检测范式:维护一组 instance query,先通过自注意力让实例之间互相通信,再用多尺度可变形交叉注意力只采样参考点附近少量位置的特征,从而以极低的计算代价融合多层级的视觉特征,最终由每个 query 解码出一个框或掩码。
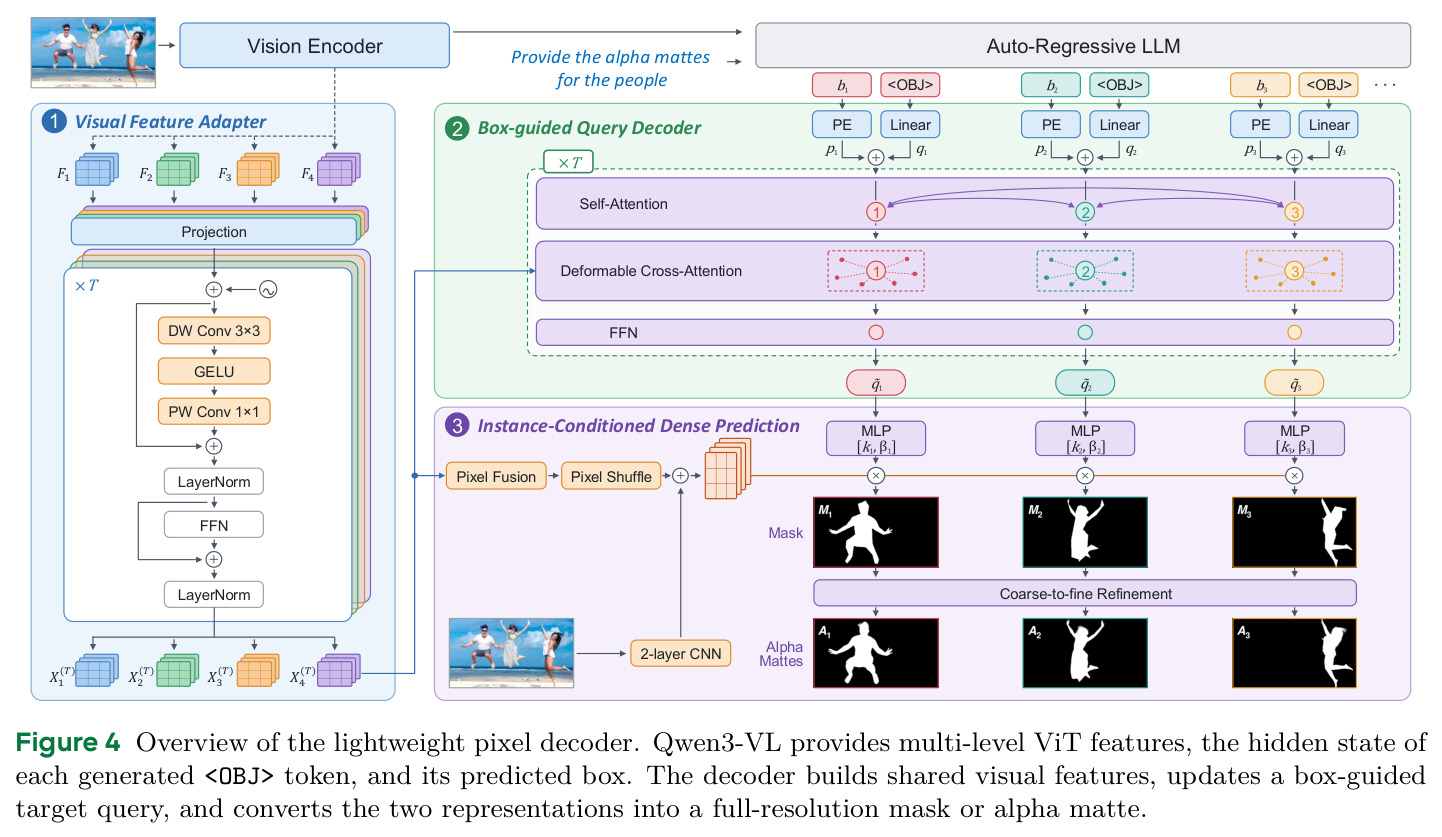
本文像素解码器的中段核心模块直接沿用该设计,但做了一个关键改动——查询不再静态学习,而是从 VLM 输出动态实例化。
GRPO(组相对策略优化)
Group Relative Policy Optimization 是面向大模型的在线强化学习算法:对同一个提示采样一组 G 个完整回答,计算每个回答的任务奖励,用组内均值作基线、方差作归一化得到相对优势信号来更新策略,不需要额外训练价值网络。它天然适合奖励可以显式计算的任务(如定位 IoU)。
SFT 之后的混合任务 RL 就是用 GRPO 做的,模型的定位精度提升和「目标不存在就拒绝」的行为都靠它的奖励函数塑造。
Alpha Matting(图像抠图)
分割输出的是 0/1 二值掩码,而抠图为每个像素估计连续的前景不透明度 $\alpha \in [0,1]$,能保留发丝、毛发、半透明边界等细节。训练常用 L1、梯度、Laplacian 损失的组合,评测指标包括 MAD、MSE、Grad、Conn、SAD(数值越低越好)。高质量 alpha 标注非常昂贵,是限制该领域规模化的核心瓶颈。
抠图是本文像素级任务的压轴能力,也是它与 SAM 系列分割模型拉开差距、以及数据引擎工程价值体现最充分的地方。
F1 与 cIoU 评测协议
生成式 VLM 不输出校准的置信度分数,传统检测的 AP 指标不适用,因此社区改用 F1:预测框与未匹配真值框的同类别 IoU 超过阈值记为命中,按类别平均精确率和召回率后取调和平均,通常在 IoU=0.5、0.95 及 0.5–0.95 平均(Mean)三档报告;分割任务则用 cIoU(全数据集累计交并比)或 gIoU。数值越高越好。
论文 30 多个基准几乎全部用 F1/cIoU 报告,理解这套协议才能正确解读所有结果表格。
研究动机
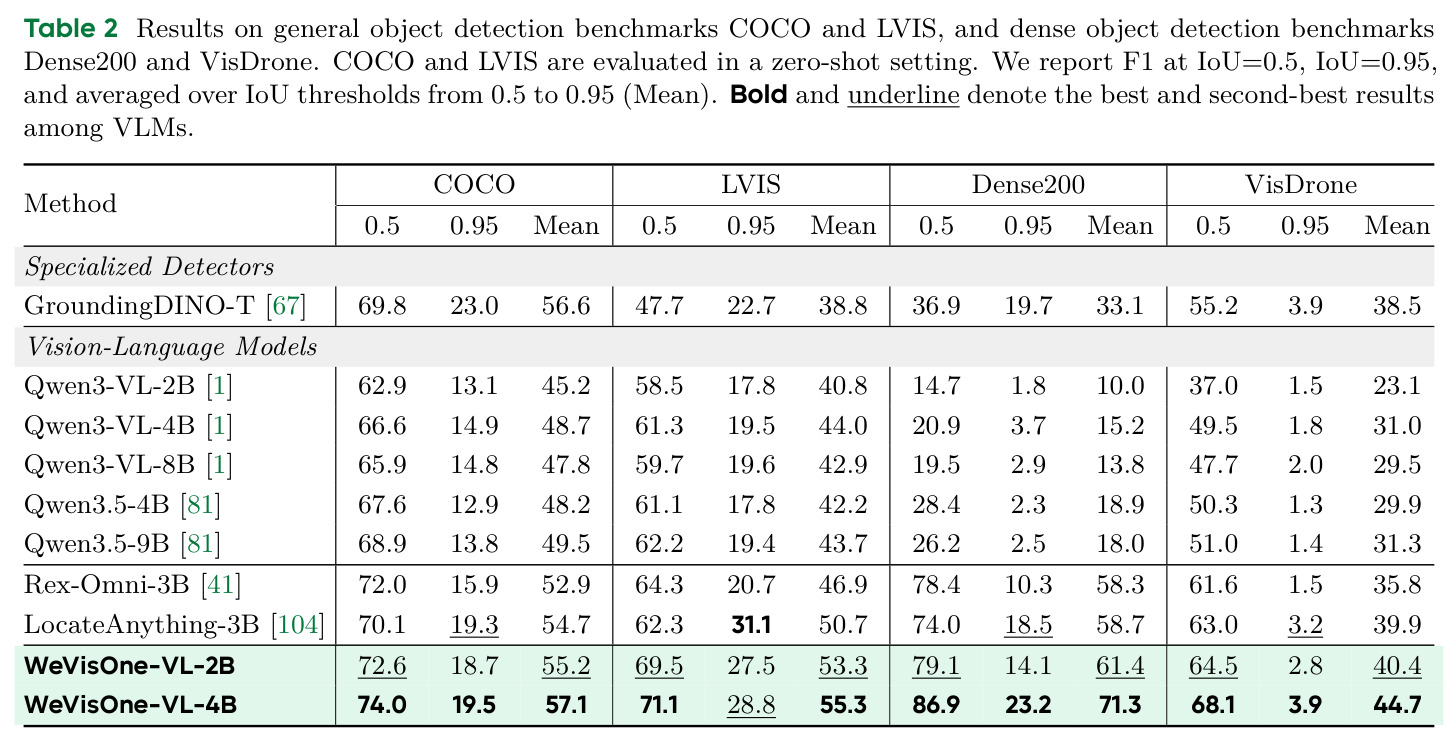
现有 VLM 在细粒度视觉感知上不可靠,具体表现为三类失败:幻觉出不存在的物体、误解用户的指代表达、漏检不显著的实例导致召回不全。论文用数据把问题钉死:通用能力最强的 Qwen3-VL-8B 在密集检测基准 Dense200 上 F1@0.5 只有 19.5、Mean 只有 13.8,VisDrone 上 Mean 也仅 29.5,在无人机航拍这类小目标密集场景基本不可用;即使最新的 Qwen3.5-9B 在 Dense200 上也只有 26.2。另一个被普遍忽视的失败模式是「不会拒绝」:在修改后目标并不存在的 RefCOCOg-Rej 上,Qwen3-VL-8B 的拒绝率只有 22.5%,指代分割模型更糟——GSVA-7B 只有 41.9%,UniPixel-7B 低至 0.3%,即图里没有目标时模型照样硬输出一个 mask。另一侧,传统检测与分割系统各有短板:GroundingDINO-T 在 Dense200 上 Mean 仅 33.1,长尾类别识别差;像素级任务通常要外挂 SAM 或 Matting Anything 等独立大模型,两套系统两套部署;高质量 alpha 标注昂贵,合成换背景又有光照与边界不自然的问题,语言条件(category/referring prompt)的抠图在现有工作里几乎是空白。
本文的目标是本文目标是构建一个统一的视觉感知 VLM:以 Qwen3-VL 为底座,做 2B 和 4B 两个规模,通过单一自然语言接口、结构化下一词元预测同时支持七个任务——目标检测、指代定位、计数、目标指向(pointing)、OCR、指代分割和图像抠图,覆盖从点、框到掩码再到 alpha matte 的任意用户指定粒度。可衡量的目标包括:在 30 多个基准上,object-level 与 pixel-level 任务都要达到或超过同规模通用 VLM 和专用视觉系统(如 Dense200 上大幅超越 Rex-Omni/LocateAnything,抠图 MAD 显著低于 SAM2-Matting);在目标缺失查询上保持高拒绝率(RefCOCOg-Rej、Ref-ZOM);为支撑训练,配套构建 WeVisOne-VL 数据引擎(WDE),产出约 1 亿图像、36 亿框的实例对齐监督,使同一实例在 box、mask、alpha 三个层级共享同一语言 query。
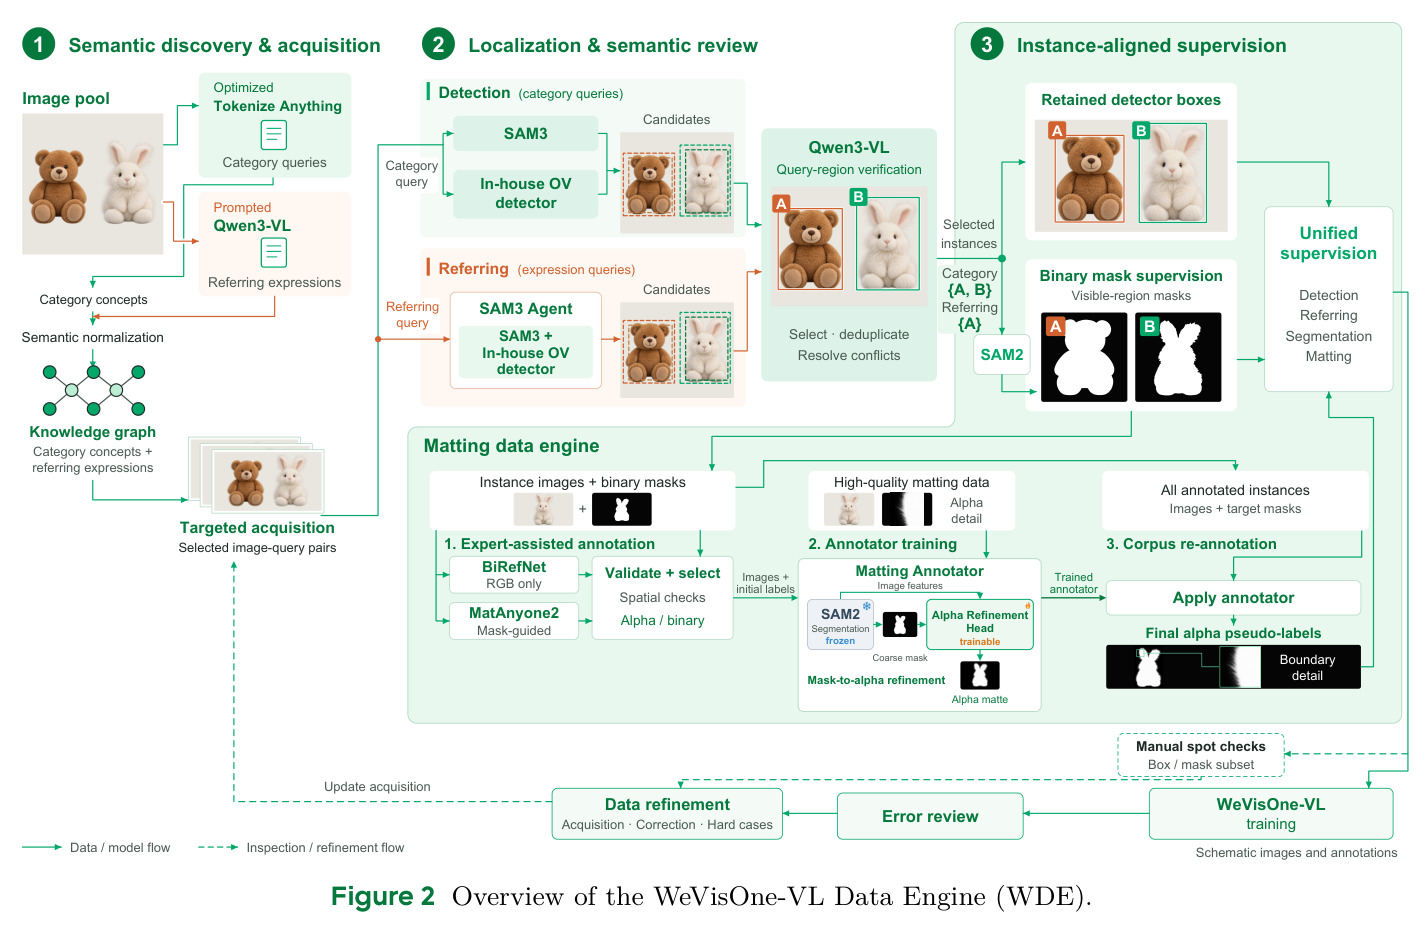
与已有工作不同的是,本文抓住了几个被现有工作忽视的点。第一,离散与连续输出的桥梁问题:此前路线要么把 mask 序列化成文本(Text4Seg)、要么外挂 SAM2 等大分割模型(Sa2VA)、要么训练 7B 以上模型配大解码器(LISA/GSVA/UniPixel),本文则用一个特殊 token 的隐藏状态即时实例化一个仅 9.6M 参数的轻量像素解码器查询,无需任何独立分割模型。第二,语义组织问题:以往自动标注流水线把类别和指代词当扁平查询,本文把两者组织进共享知识图谱,用来指导定向采集、歧义消解和难例构造。第三,把「拒绝能力」当作一等公民:构造目标集为空的 hard negative,显式教模型「什么都不输出」。第四,数据-模型闭环:每轮训练后审查模型错误,反哺采集、标注修正与难例采样,让数据随模型一起迭代。
核心方法
直觉上,可以把这个系统想象成一个「会画图的速记员」:它先用文字写出看到的每个实例——指代词或类别名加一串坐标 token 组成的框——写到每个框后面时再盖一个 印章,这个印章的隐藏状态就像该实例的身份证;一旁的轻量像素解码器拿着身份证,去共享的视觉记忆(Qwen3-VL ViT 的多层特征)里提取对应区域的证据,最后在全图画布上画出该实例的掩码或 alpha matte。技术路线分三层。任务格式层:所有任务统一为 ...[]... 的结构化序列,点任务用 标签,计数附总数,OCR 把识别文本当类别标签,目标缺失填 None。架构层:Qwen3-VL 负责感知与生成,新增像素解码器含三个组件——视觉特征适配器把 L 层 pre-merging ViT 特征整理成多级共享记忆 $M \in \mathbb{R}^{LH_pW_p \times d}$;box-guided query decoder 用 6 个 deformable block 更新由 隐藏状态 $h_i$ 和框 $b_i$ 初始化的实例查询 $q_i = W_h h_i$、$p_i = \mathrm{MLP}(\phi(b_i))$($\phi$ 为 Fourier 编码);instance-conditioned dense prediction 先多级像素融合并与 1024×1024 输入图的浅层 CNN 特征相加得到 $P$,再用动态核 $[k_i, \beta_i] = \mathrm{MLP}(\tilde{e}_q^i)$、$M_i = k_i^\top P + \beta_i$ 出初始 mask,最后经三阶段 coarse-to-fine 细化输出。整个解码器含细化模块约 9.6M 参数。训练层:三阶段课程 SFT 加混合任务 RL。
全文最核心的创意是「查询即输出」:像素解码器的 instance query 不再是 DETR 里静态学习的嵌入,也不是从图像里检索出来的,而是直接从模型自己刚生成的 token 隐藏状态 $h_i$ 与预测框实例化而来。这带来三个本质变化。其一,语言理解、离散定位与连续像素预测在同一个自回归流里天然对齐——指代理解错了框就会错,错了像素也会错,误差可以端到端传播,不存在外挂系统之间的接口损耗;其二,模型完全复用共享 ViT 特征,不需要 SAM 这样的独立大分割模型,9.6M 参数的解码器就完成分割与抠图,抠图只额外增加一个轻量细化头;其三, 是任务无关的通用接口,这使「任意语言条件下的像素级输出」(包括category 和 referring prompt 的抠图)成为可能。数据侧的本质创新是「实例对齐监督」:WDE 保证同一语言 query 下同时产出 box、binary mask、alpha matte 三种监督且目标身份一致,检测和分割学到的永远是同一个目标,杜绝了跨任务监督错位;而 hard negative 用空目标集显式训练拒绝行为,是「目标不存在」这一语义第一次被系统性地写进训练数据。
方法步骤详情
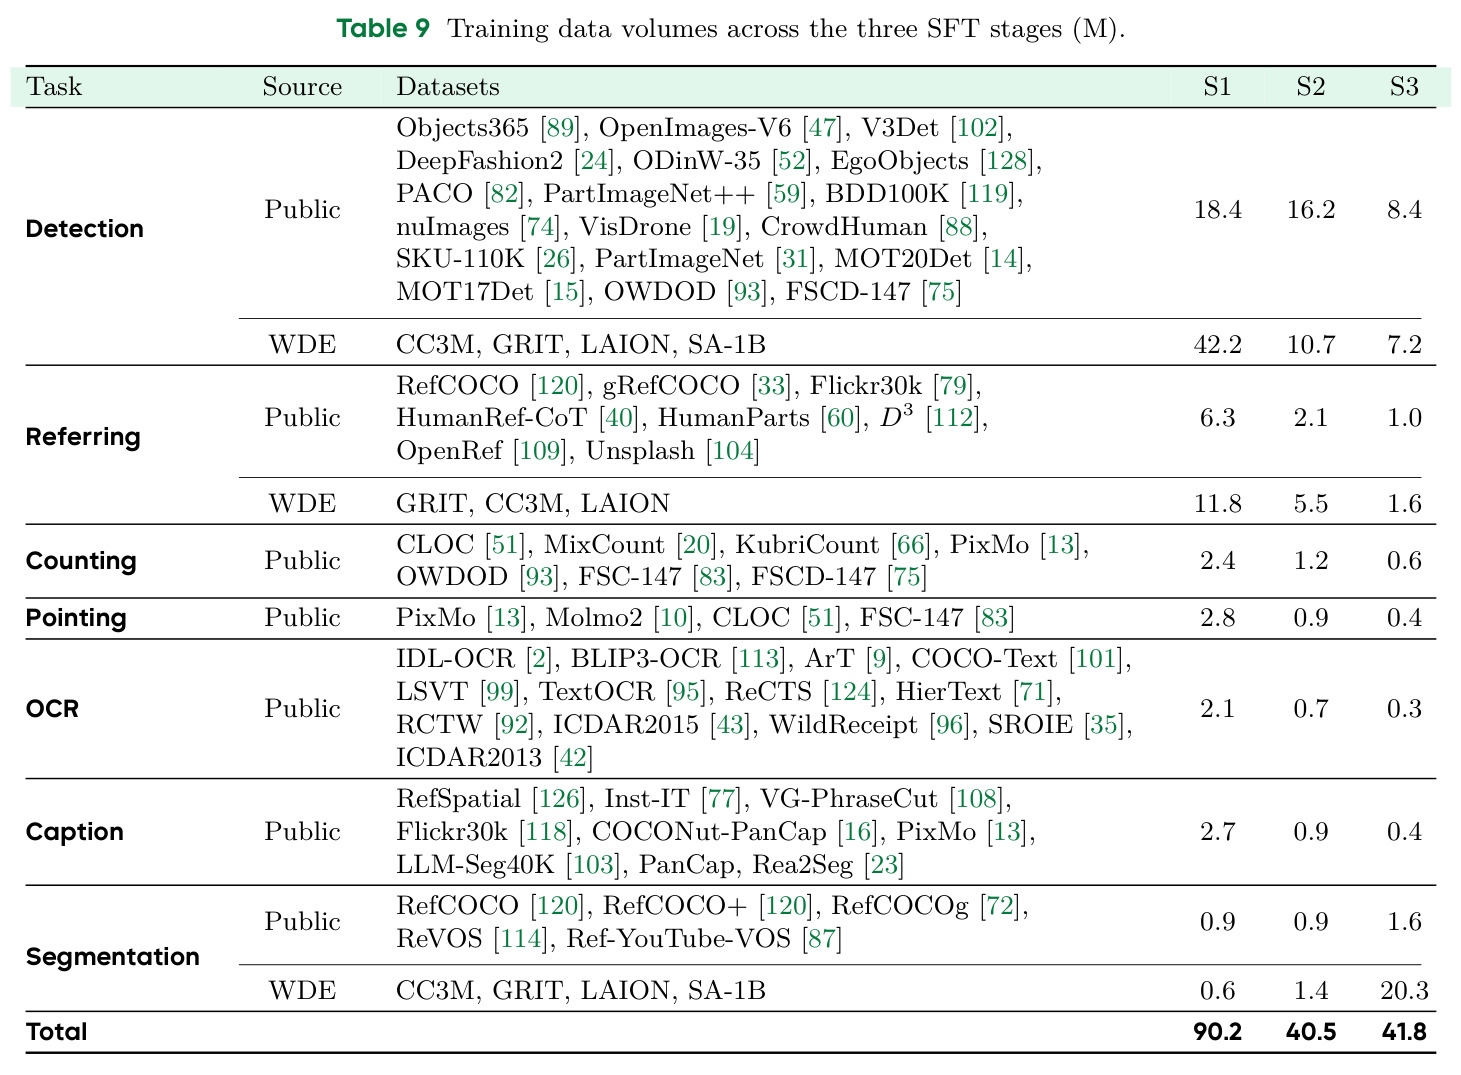
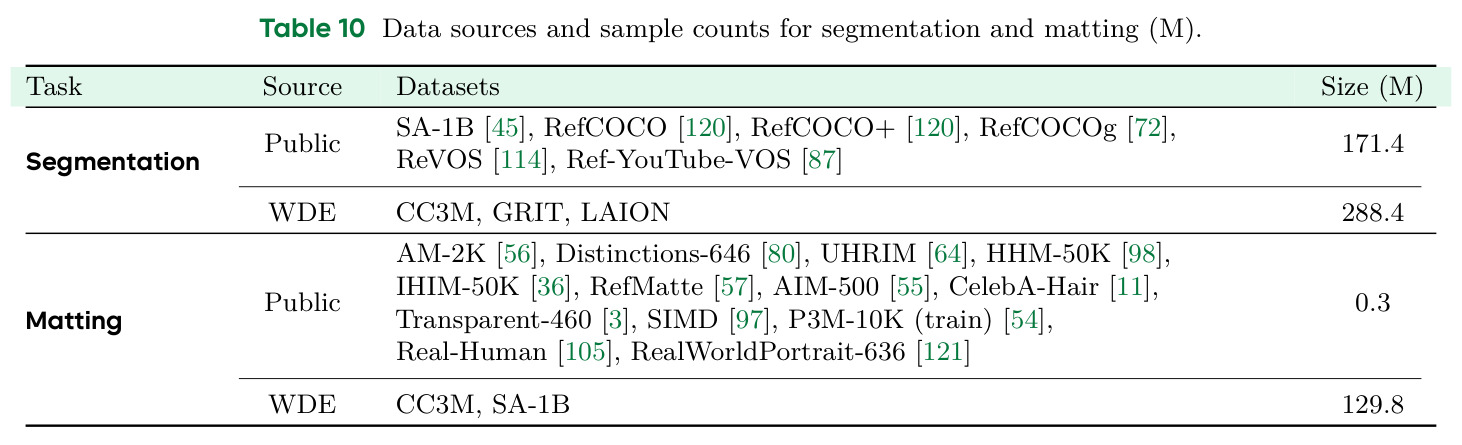
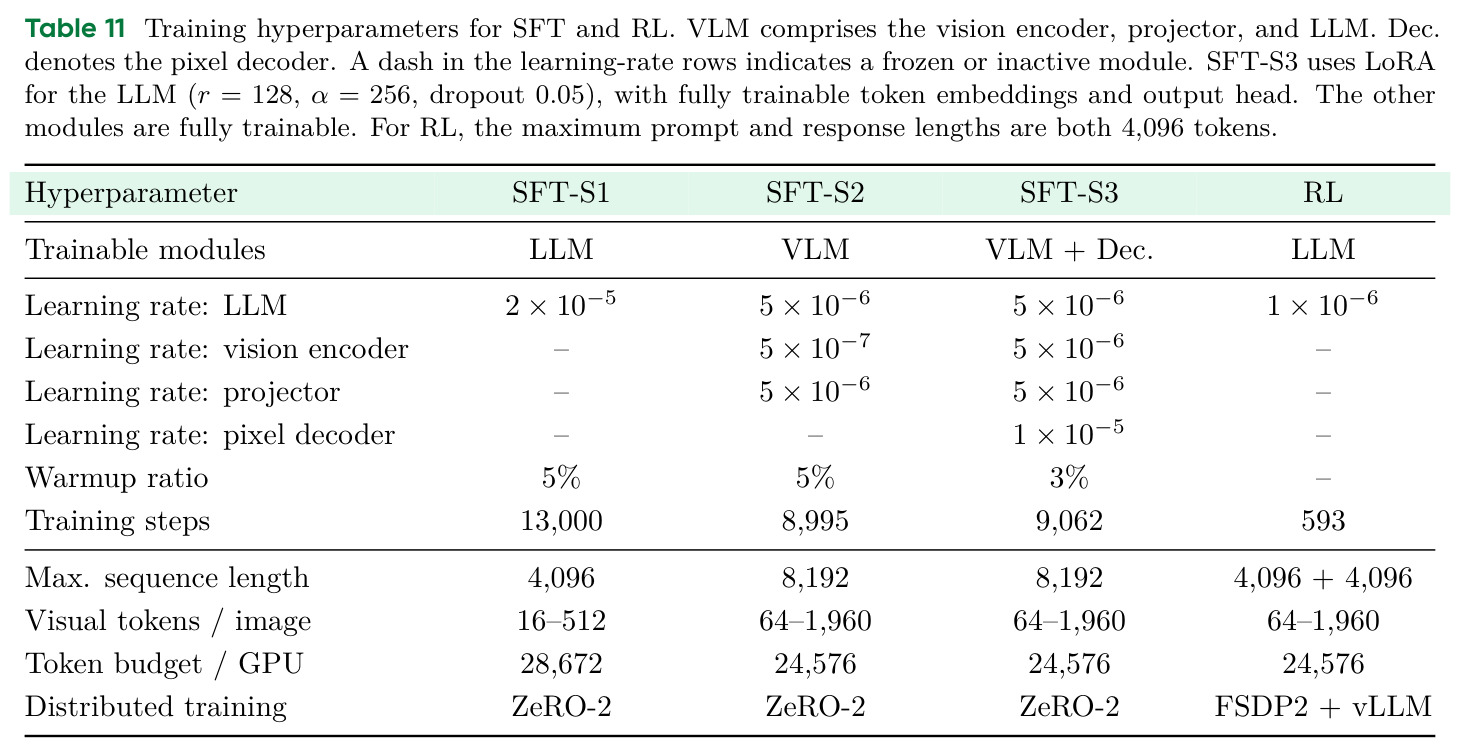
第一步,数据引擎 WDE(Section 2)。知识图谱以 Wikipedia/WordNet 初始化,组织类别概念与 referring 表达并做规范化;据此定向采集图像-query 对。检测标注:SAM3 与自研 DINO 式开放词汇检测器并行出候选,合并成共享候选池,再用 Qwen3-VL 逐候选做 query-区域语义复核、去重并解决冲突。Referring 标注:在 SAM3 Agent 框架上加入自研检测器作为第二定位专家,Qwen3-VL 检查表达中的属性、状态、动作、关系约束并区分目标与上下文物体。随后 SAM2 为每个实例生成可见区域 binary mask,mask 继承所属 query。难例构造:从混淆概念、视觉相似类别、受控改写(如把「红车」改成「蓝车」必须全图复核确认图中确无蓝车才能成为负例)与模型失败四种来源构造;hard negative 的目标集为空,教模型拒绝。Matting 流水线:对每个带 mask 的实例取 BiRefNet 的 $\alpha_B$ 与 MatAnyone2 的 $\alpha_M$ 两个候选,BiRefNet 候选须通过八项空间一致性检查($|B| \ge 8$、IoU$\ge 0.5$、覆盖率$\ge 0.5$、前景精度$\ge 0.8$、面积比$\in[0.5,2]$、框 IoU$\ge 0.7$、质心偏移$\le 0.15$ 倍对角线等),否则在 IoU$\ge 0.9$ 时回退 MatAnyone2,再不行保留原 mask;然后用冻结的 SAM2.1-Base+ 加可训练 matting head(多尺度 L1 与 Laplacian 损失训练)训练专用标注器,对全部实例重标注生成最终 alpha 伪标签。每轮训练后组织错误审查,区分模型错误与标注错误,分别走采样加权或退回修正。最终产出 1 亿图像、约 36 亿框。第二步,三阶段课程 SFT(Table 1、11)。S1 任务对齐:冻结 ViT 与 projector,只训 LLM,90.2M 样本、13K 步,每图 16–512 visual token,上下文 4096,单类响应限 50 框以内以防极稠密样本引发的重复输出坍塌,像素任务此时只做下一词元预测监督。S2 分辨率与密度扩展:解冻全部模块,visual token 上限提到 1960、单响应最多 500 框、上下文 8192,40.5M 样本 9K 步。S3 token–pixel 交替:先用 250M 分割样本对随机初始化的解码器 warm-up 100K 步($\mathcal{L}_{seg} = 20\mathcal{L}_{focal} + \mathcal{L}_{dice}$,512×512 输出),只保留解码器权重与学到的 嵌入挂回 S2 checkpoint;再以 1:1 比例交替 NTP 与分割任务联合训练 9K 步($\mathcal{L}_{joint} = \mathcal{L}_{NTP} + 10\mathcal{L}_{seg}$,LLM 用 LoRA r=128);最后冻结 VLM,用 130M matting 样本以 1024×1024 分辨率微调解码器 100K 步($\mathcal{L}_{mat} = 200\mathcal{L}_{l1} + 5\mathcal{L}_{grad} + 50\mathcal{L}_{lap} + \mathcal{L}_{hard}$)。第三步,混合任务 RL:用 SFT 模型对候选 prompt 采样一组回答计算奖励,以不确定性分数 $U(x) = 4\mu_x(1-\mu_x)\sigma_x$ 挑出「有时成功有时失败」的中等难度样本约 140K,补齐框监督与 pointing 数据共 178K;用 GRPO(每组 G=8)优化完整结构化响应的 grounding reward:$r_i = 2\sum_{(\hat{b},b^*) \in \mathcal{M}_i} \mathrm{IoU}(\hat{b},b^*)^3 \big/ (N_{gt} + N_{pred})$,其中 $\mathcal{M}_i$ 是按语义类别做的匈牙利一对一匹配,IoU 取三次方以放大高 IoU 区间的精度差异,同时惩罚漏检与重复;负样本只有不输出任何目标才得奖励 1;分割任务要求框后必须跟 。SFT 用 128 卡、RL 用 160 卡。
技术新颖性
与最近的 VLM 定位模型相比:Rex-Omni 同样用量化坐标 token 和几何感知 RL,但输出止步于框/点/OCR 文本,本文在其上加 →像素输出的桥梁,并系统性训练拒绝能力;LocateAnything 走并行解码路线追求速度,本文坚持自回归但补齐像素与拒绝。与指代分割模型相比:LISA 把 [SEG] 类 token 映射到 mask 解码器,但查询与本文的「 隐藏状态 + 框先验 Fourier 编码」实例化方式不同,且均无 alpha 连续输出,Ref-ZOM 拒绝率(GSVA 41.9%、UniPixel 0.3%)远低于本文 86.0%;Text4Seg 把 mask 序列化为文本,token 开销大且边界精度受限。与 MLLM+SAM 组合(Sa2VA、SAM2-Matting、Matte Anything)相比:省去独立大分割模型,语言条件抠图开箱即用,WeRefMat 上 referring prompt 的 MAD 9.8 对 Qwen3.5-9B+SAM2-Matting 的 22.4。数据侧与 GRIT 等自动标注工作的区别在于:共享知识图谱驱动的语义发现、跨任务实例对齐、alpha 监督扩展和错误反馈闭环是系统工程层面的创新,而非单一标注技巧。训练侧的不确定性感知样本选择 $U(x)=4\mu(1-\mu)\sigma$ 也是对 GRPO 数据效率的针对性改进。
实验结果
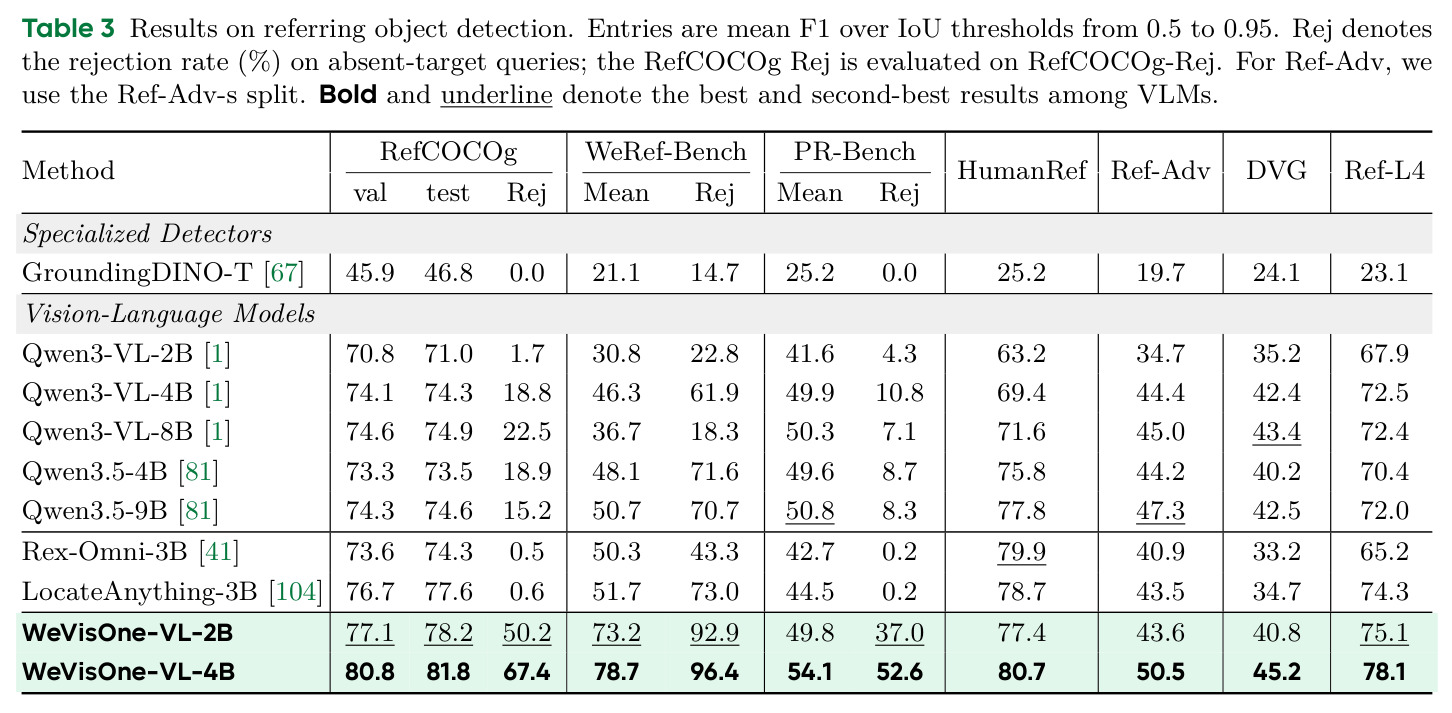
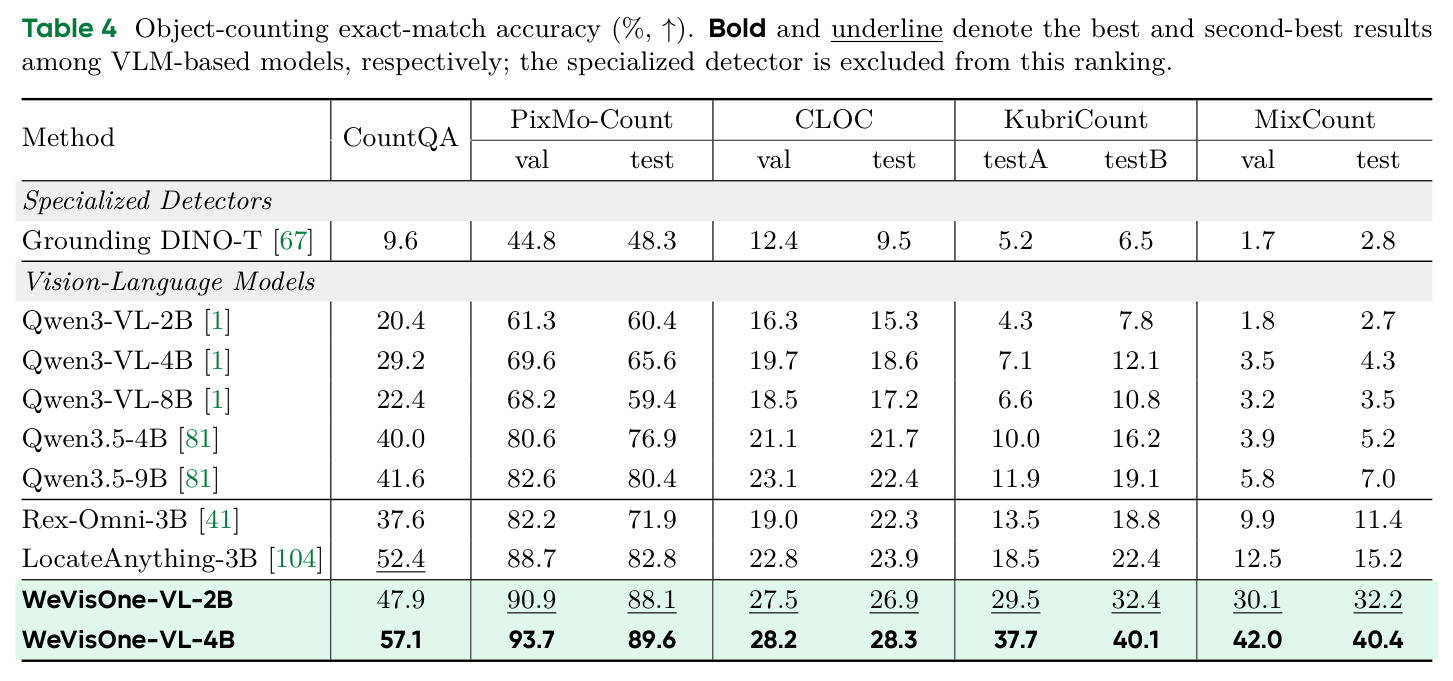
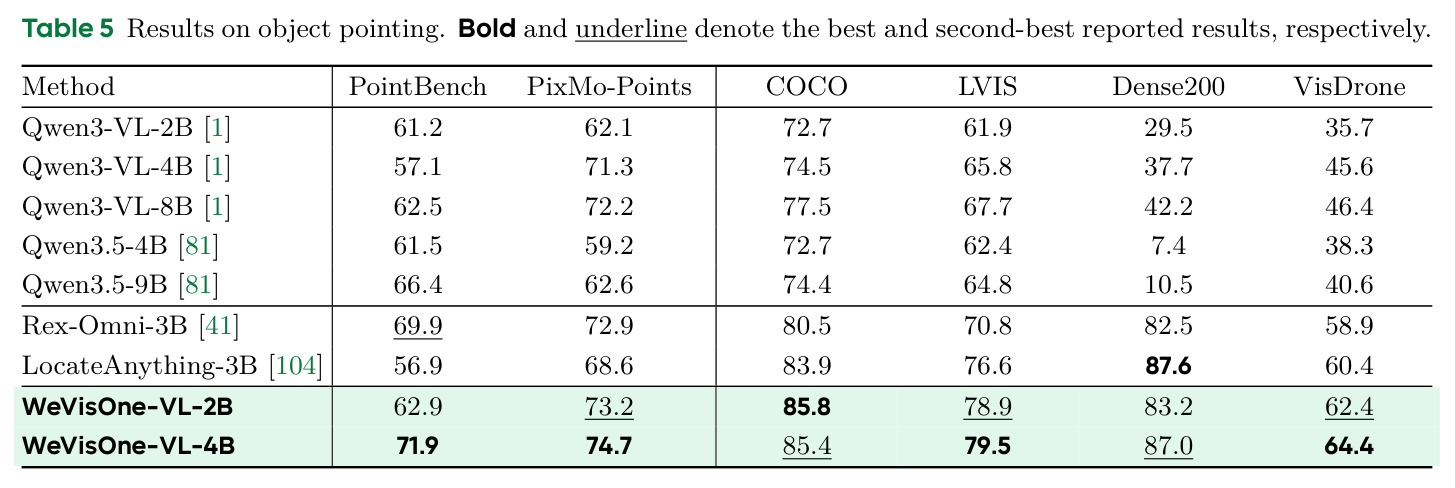
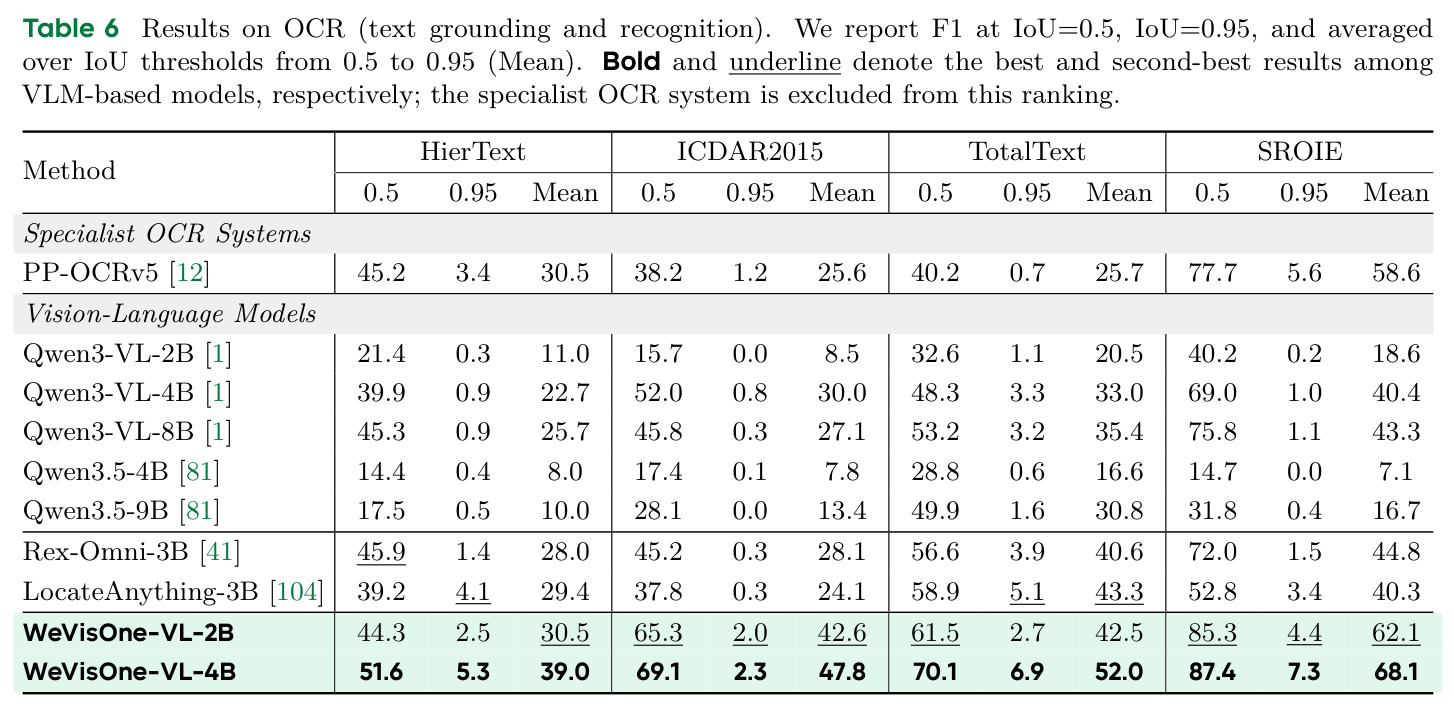
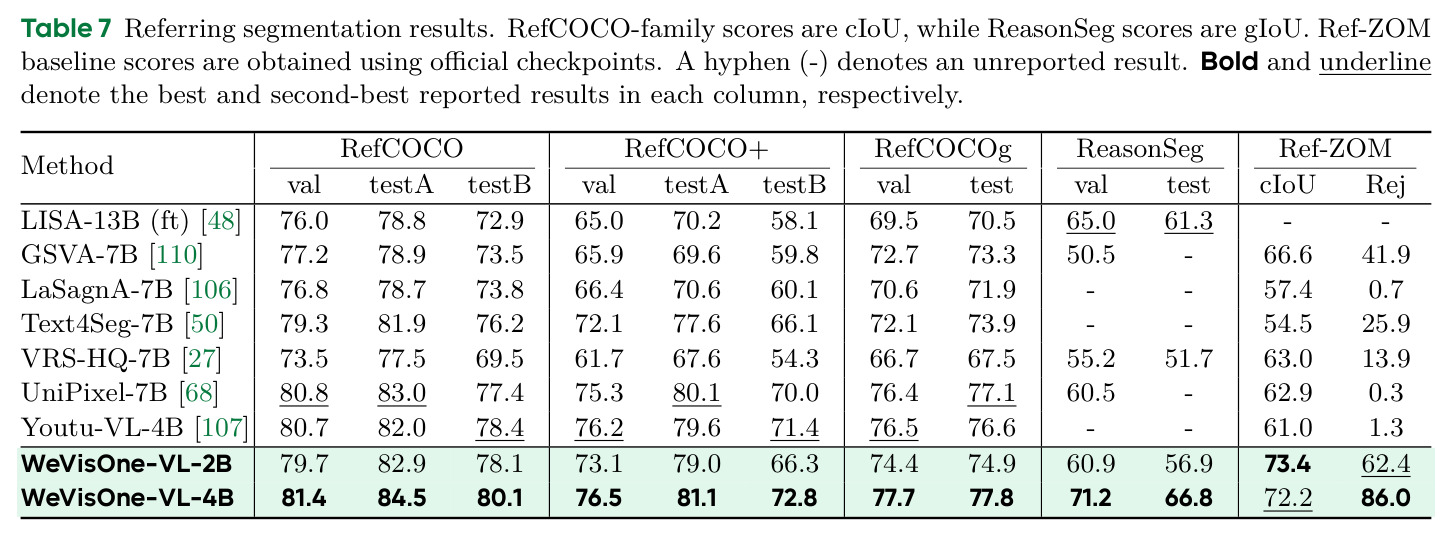
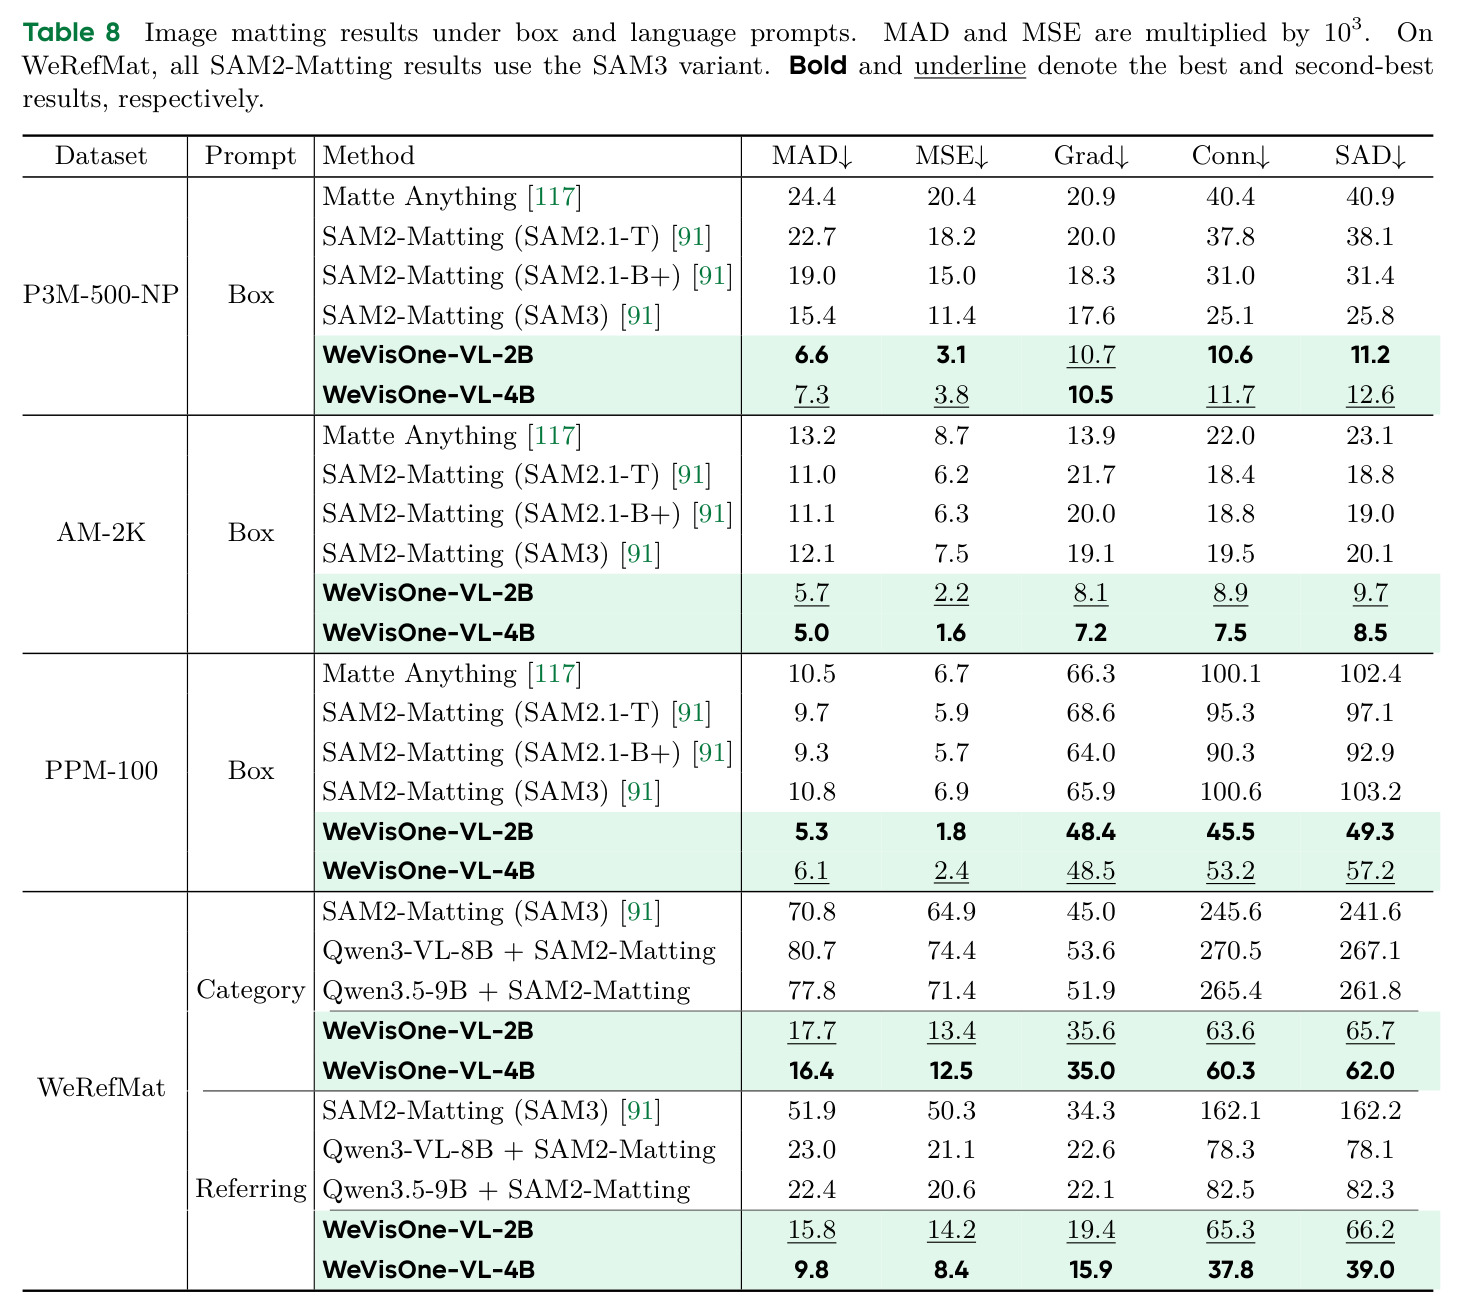
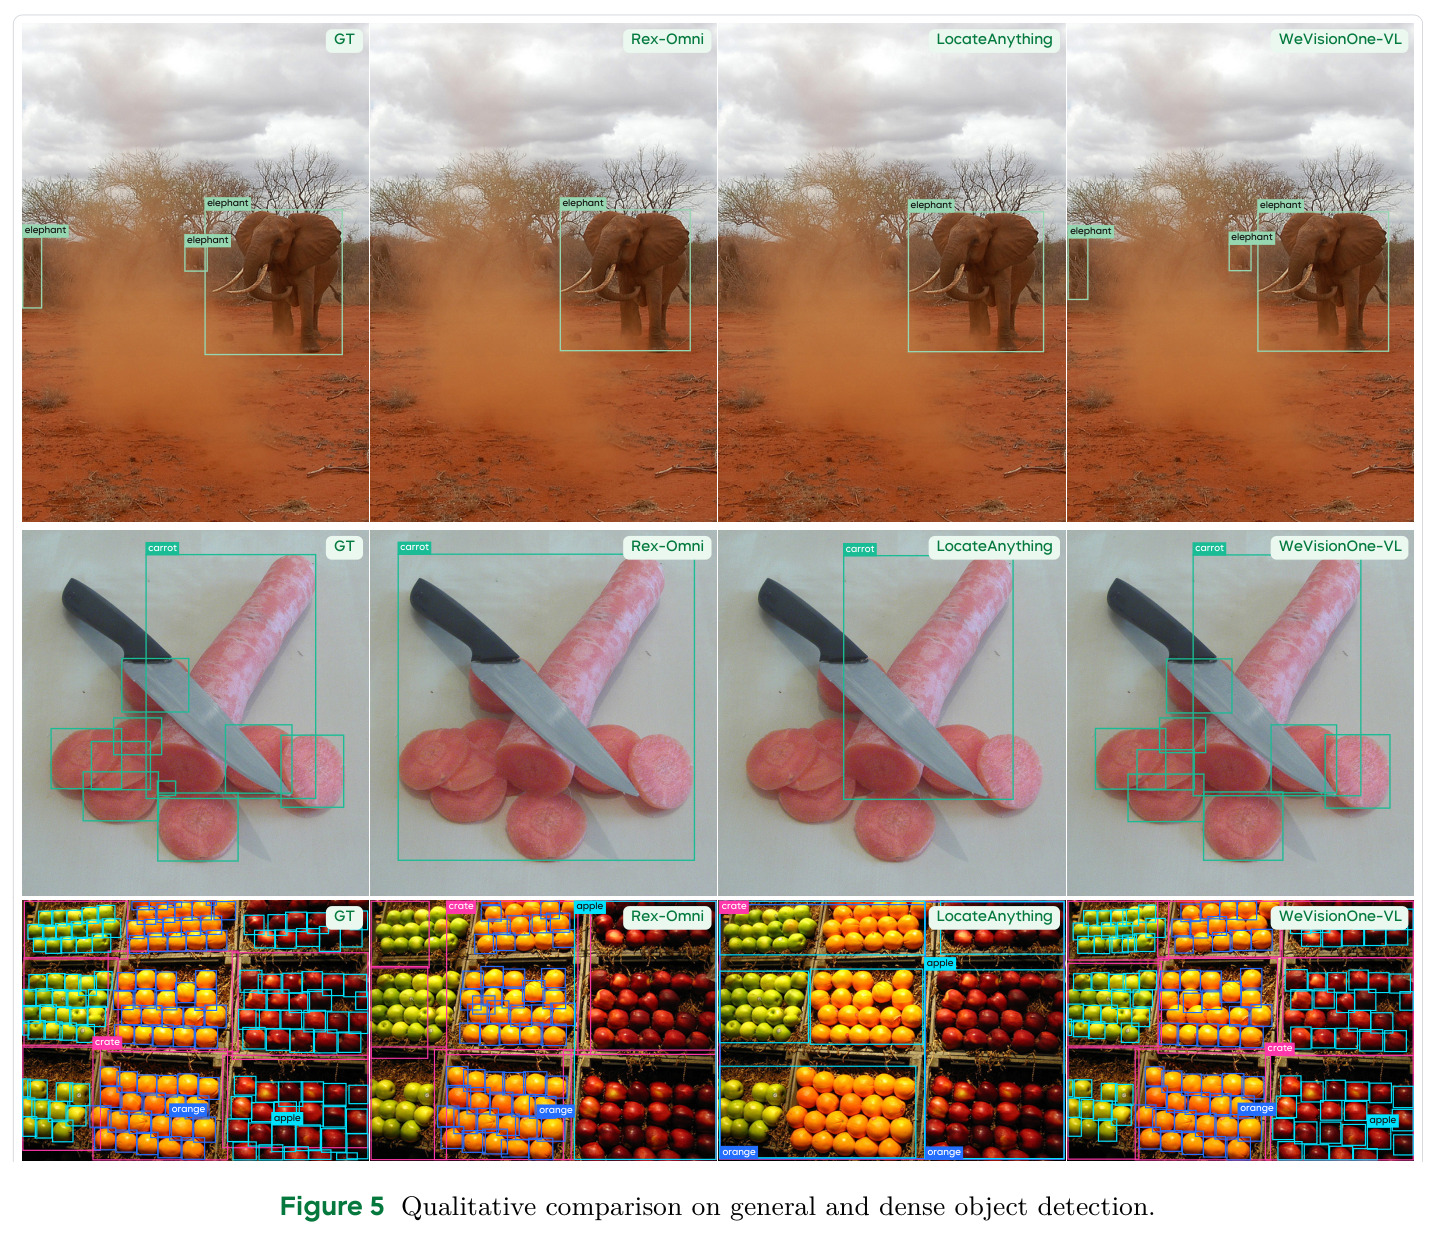
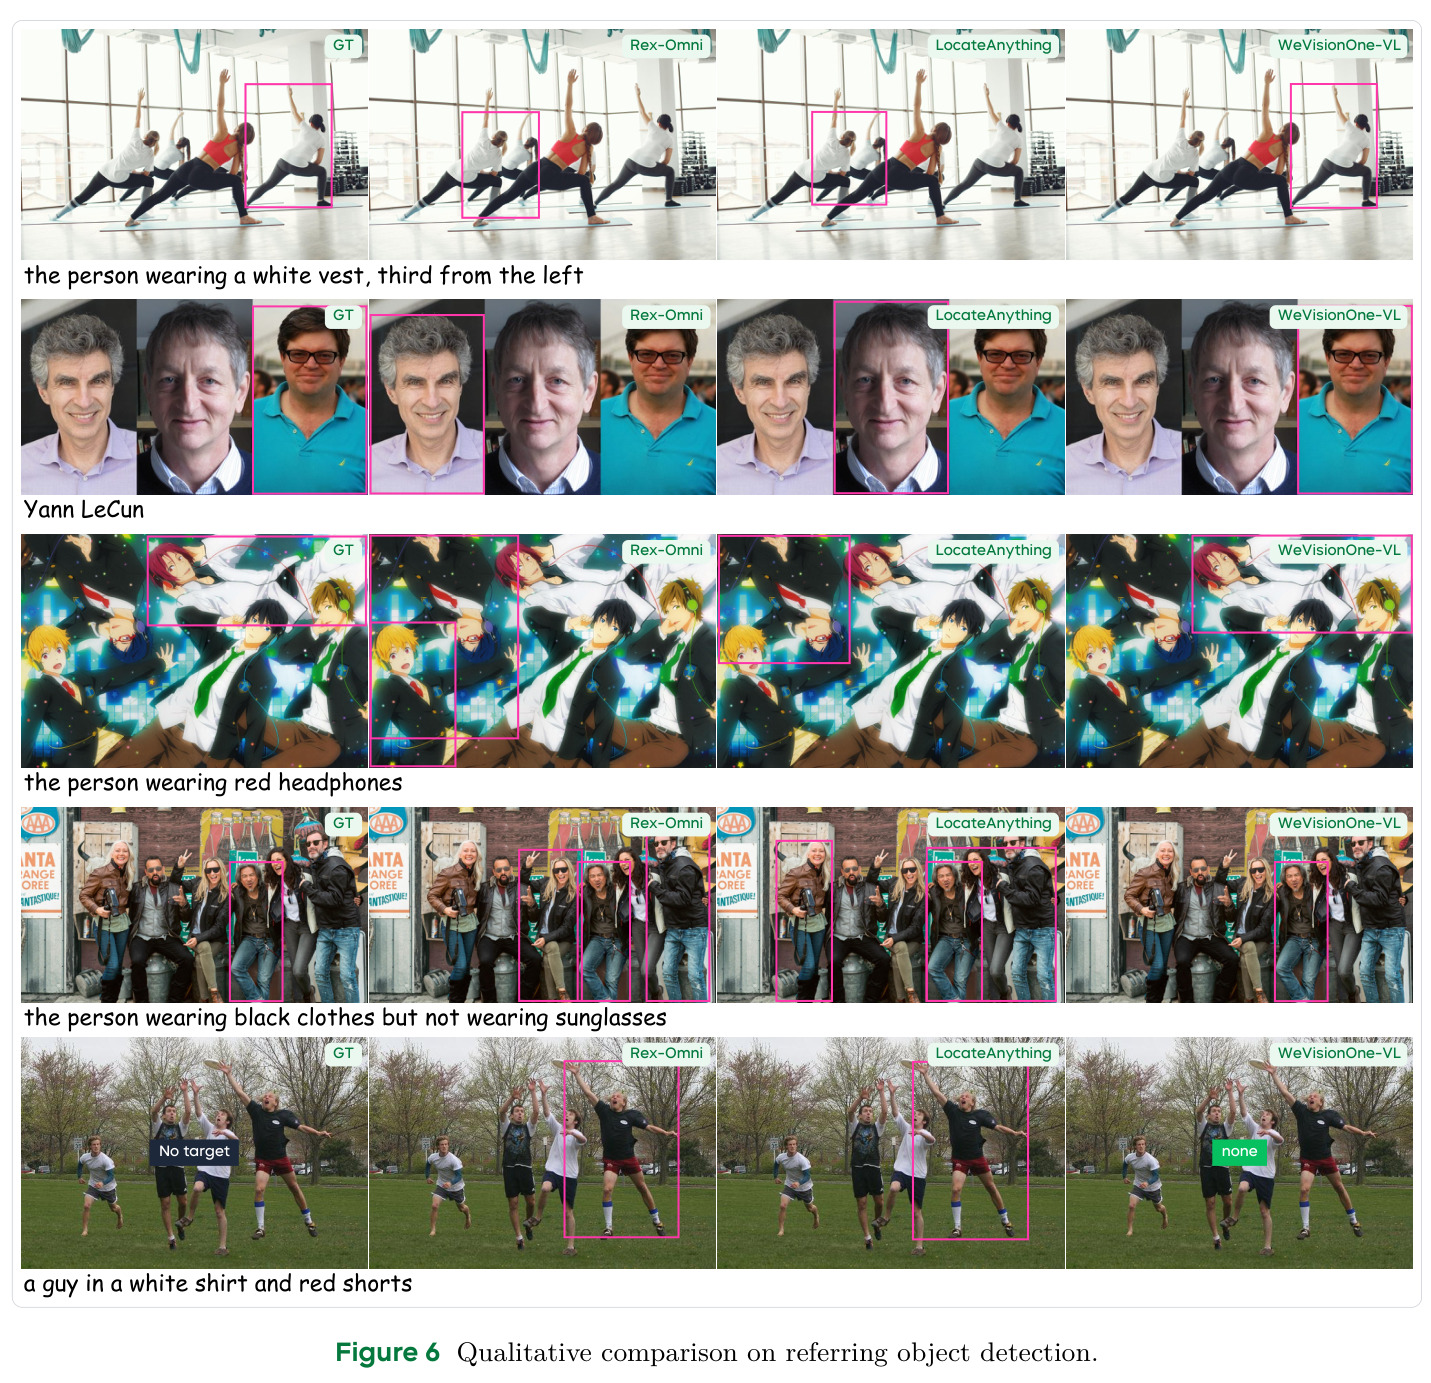
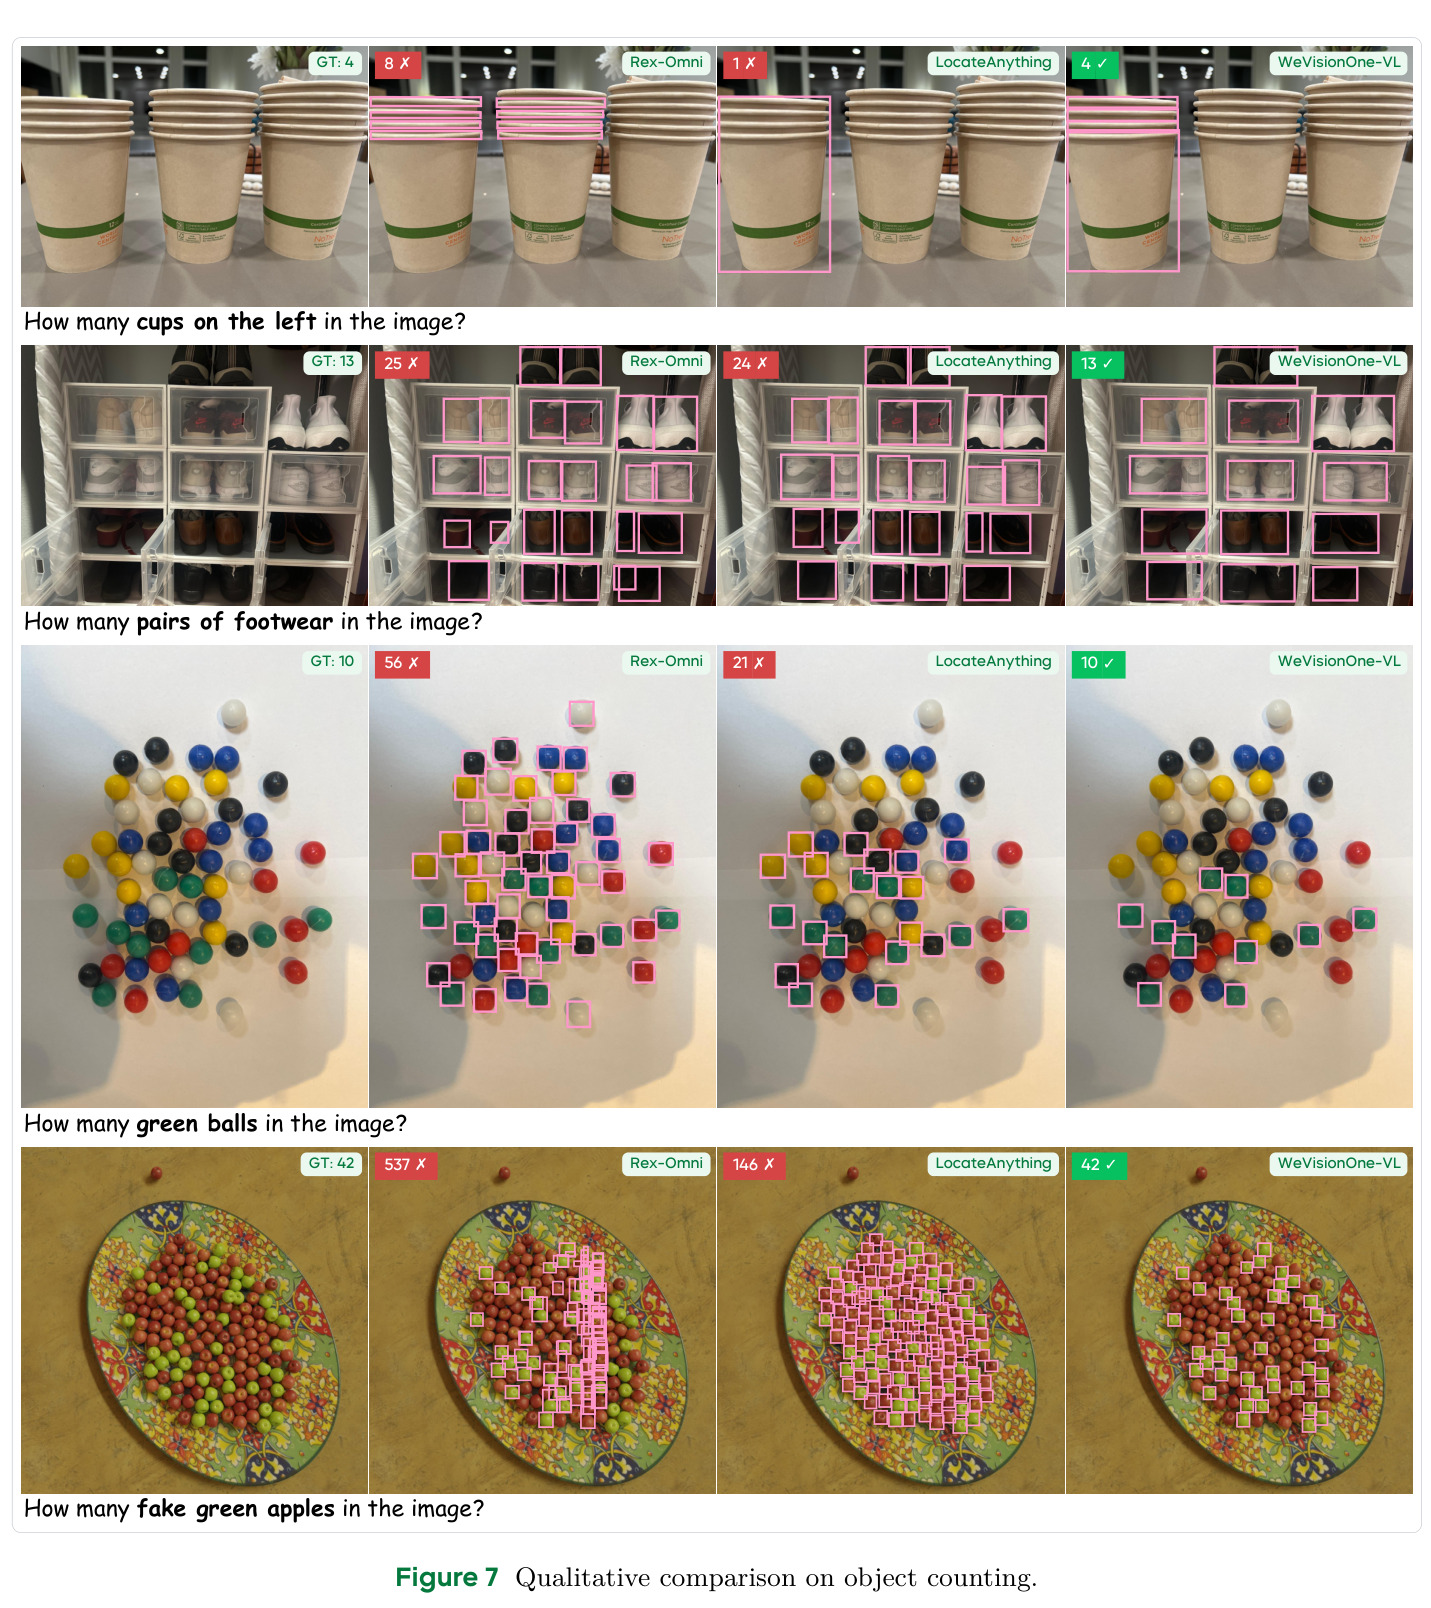
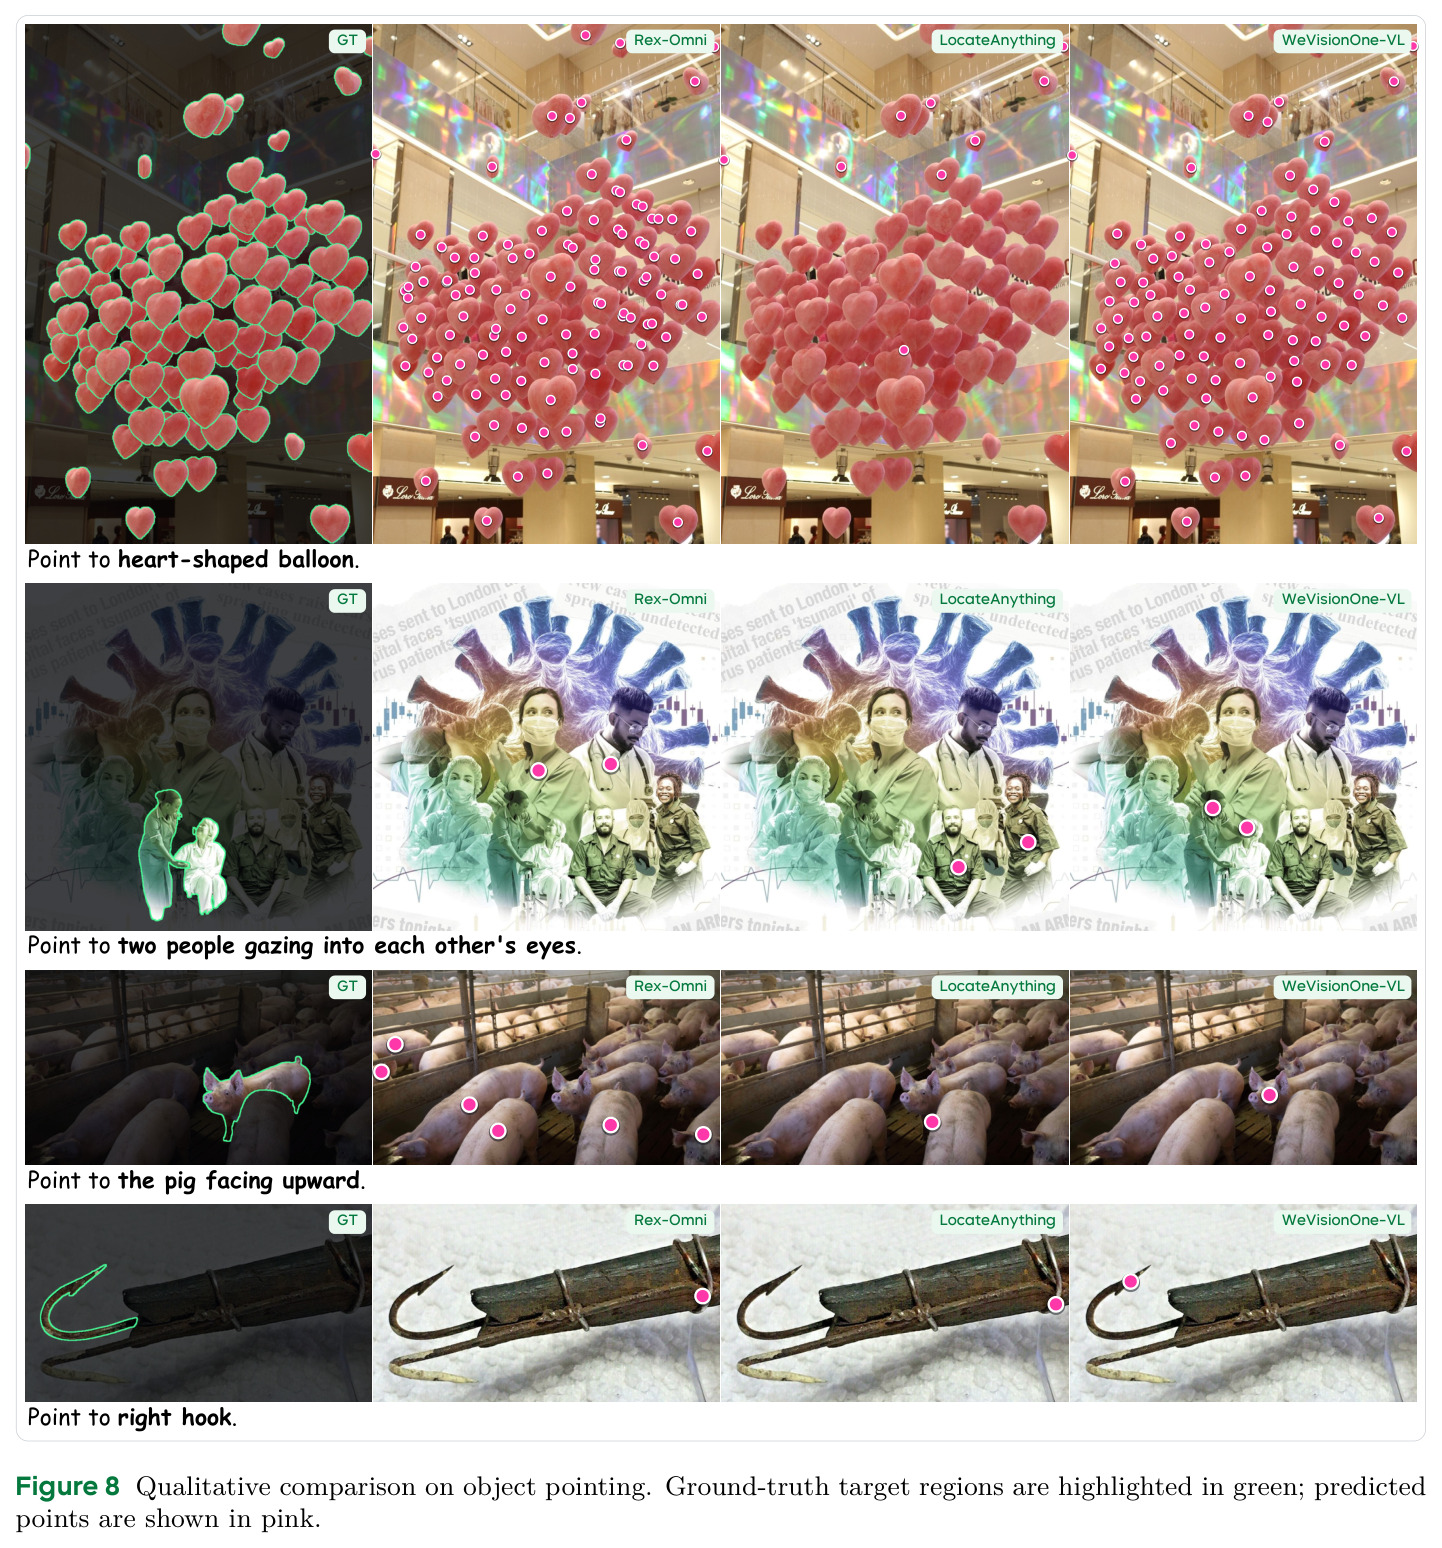
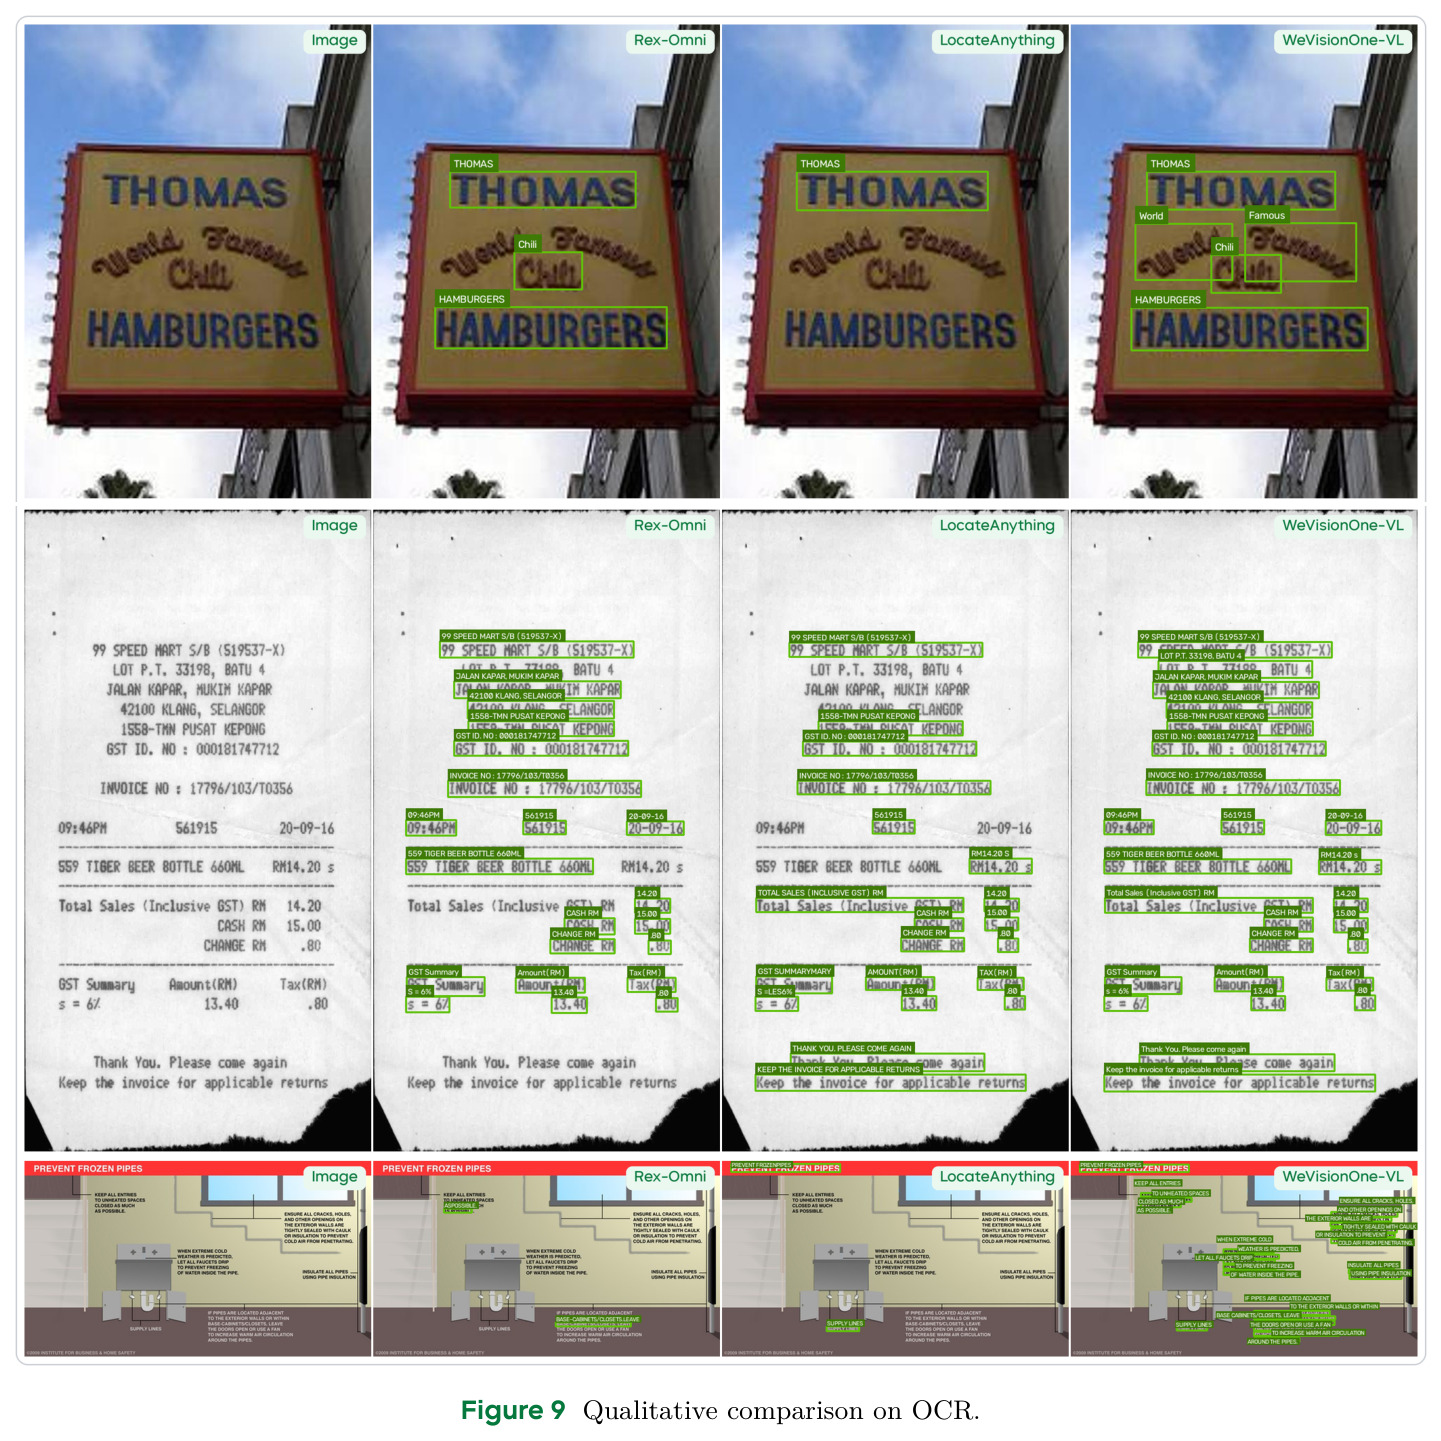
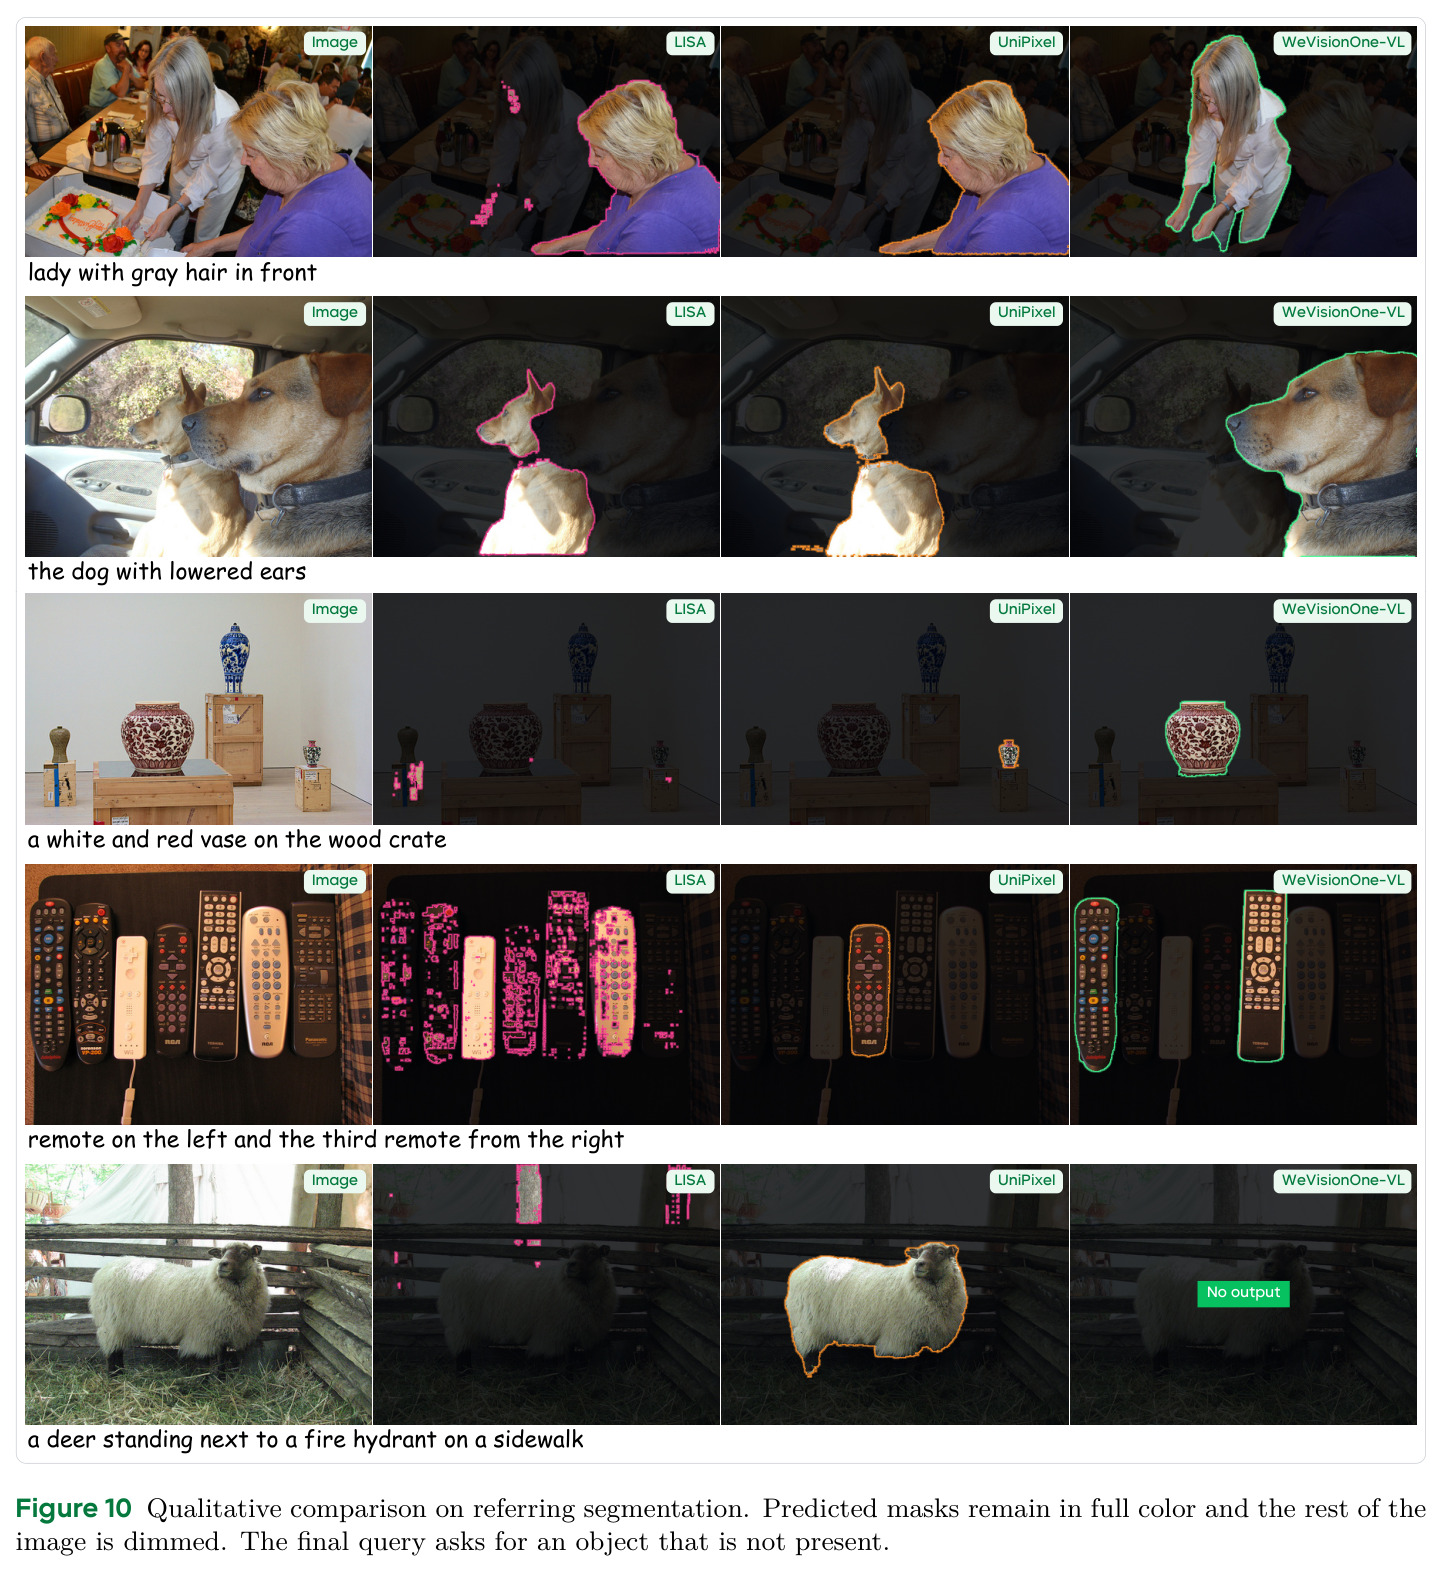
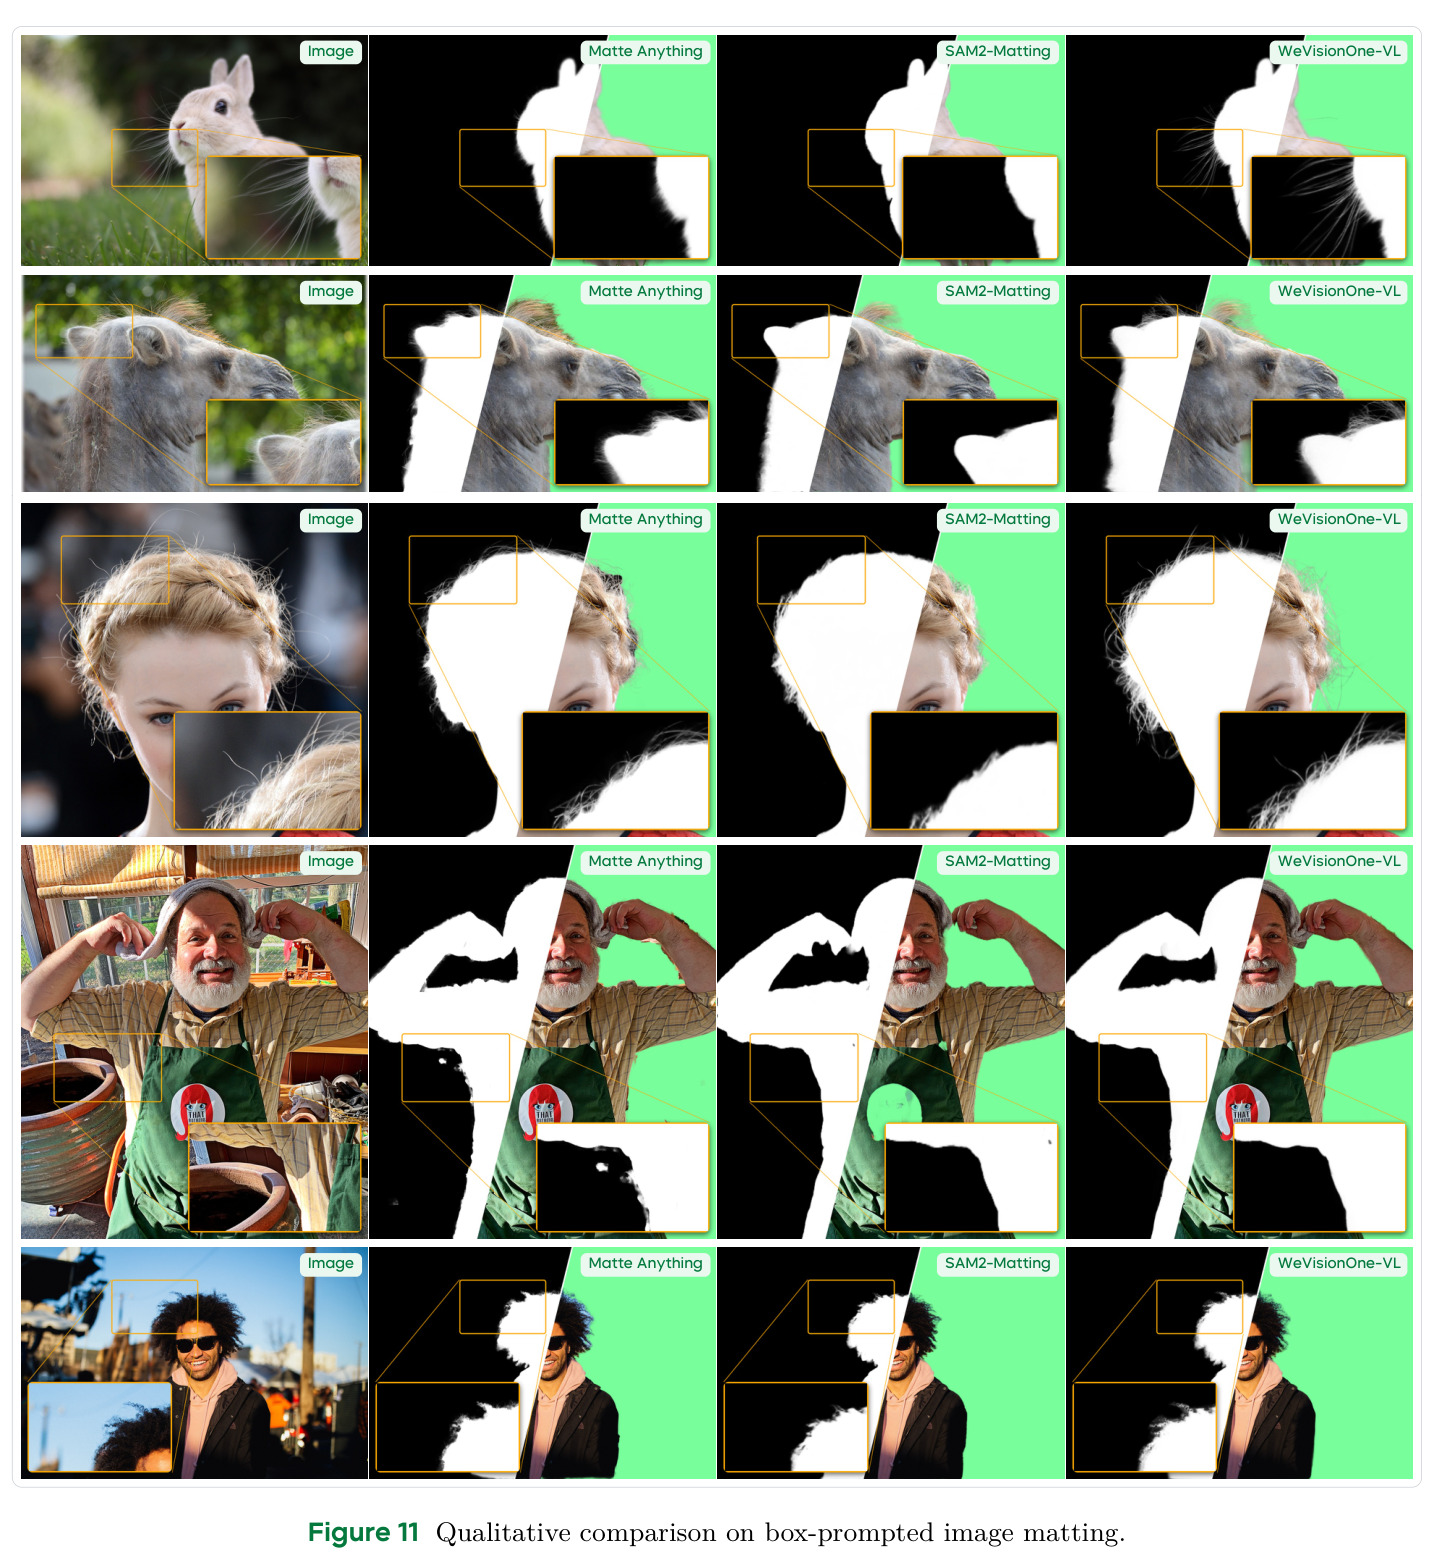
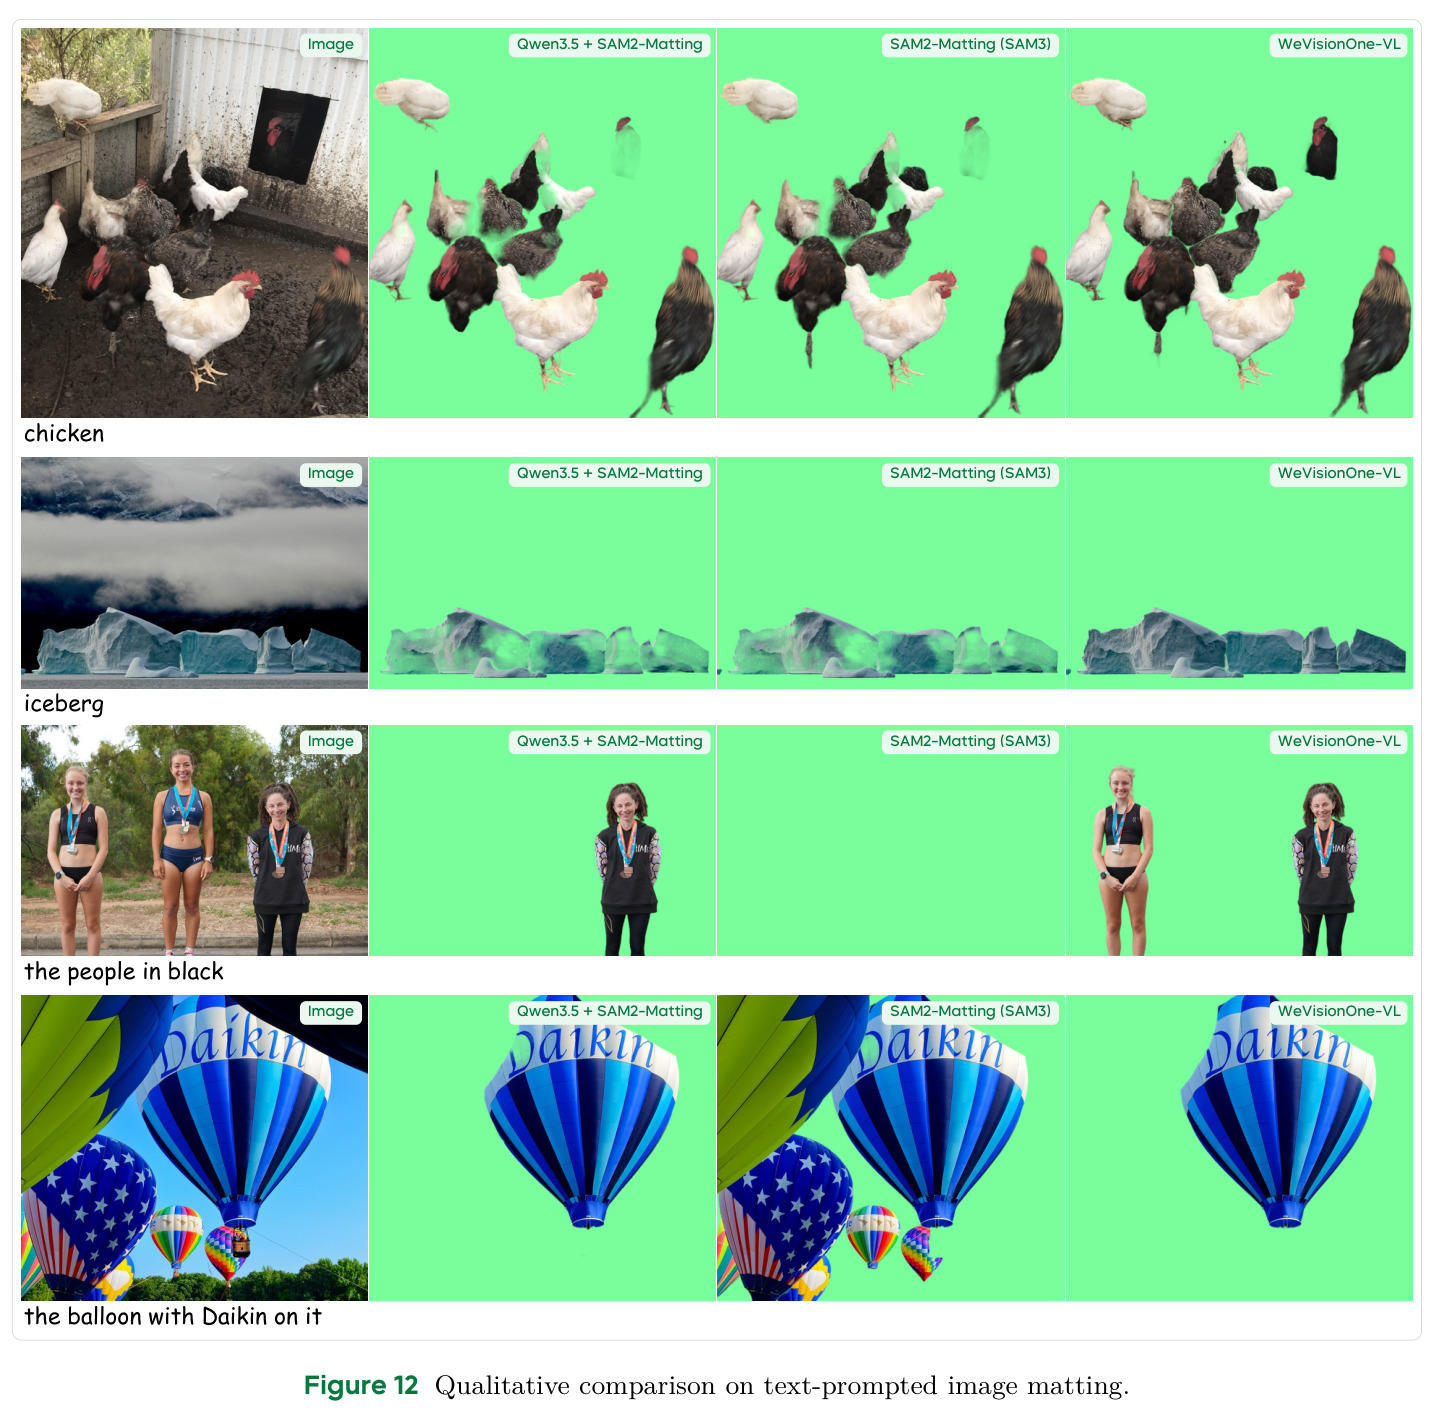
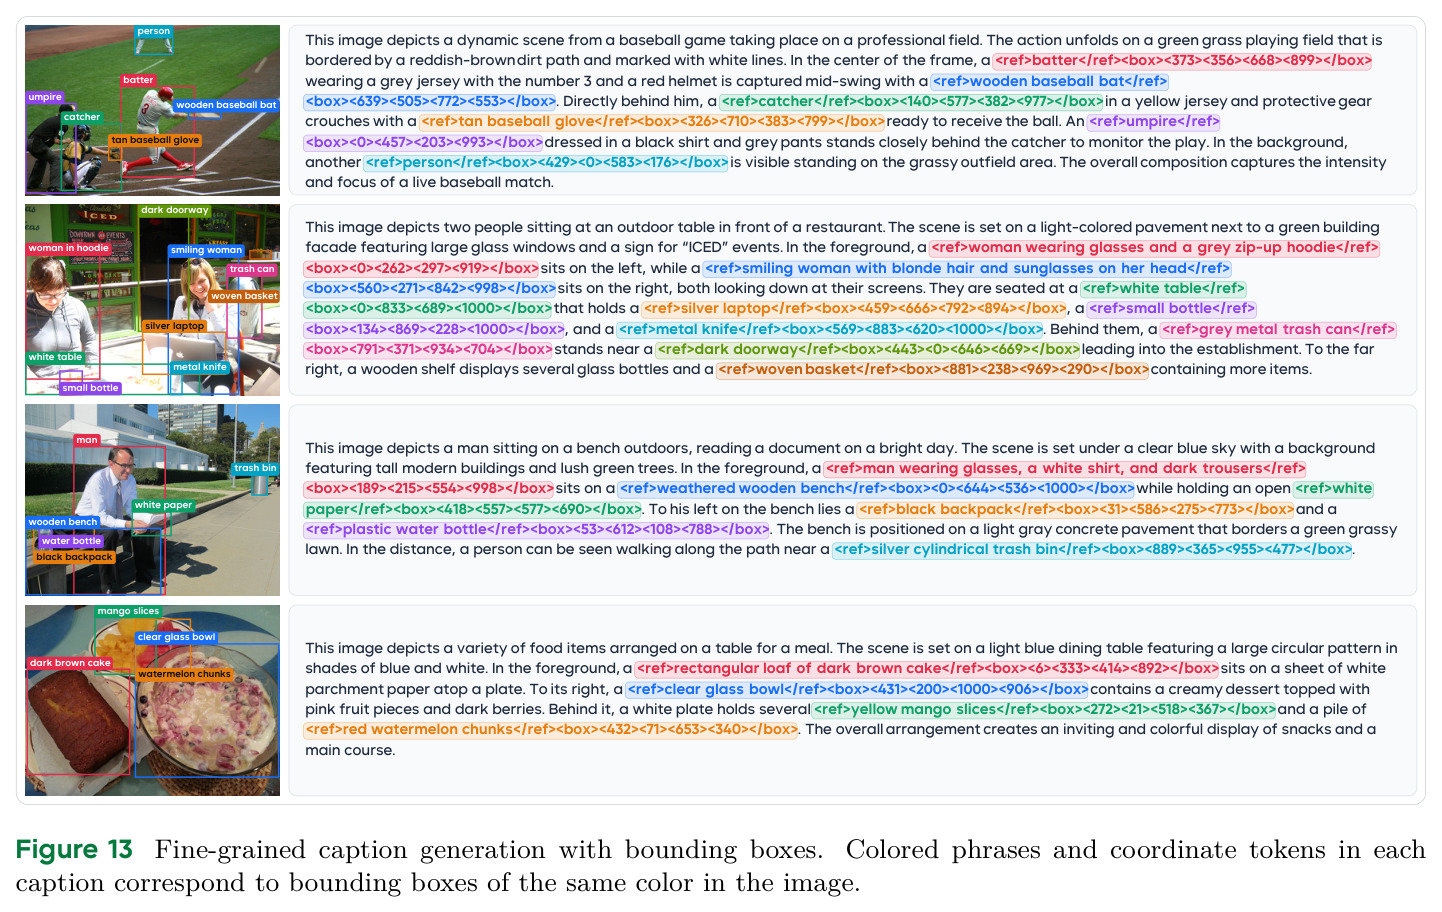
检测(Table 2):WeVisOne-VL-4B 在 COCO 上 F1@0.5/0.95/Mean 为 74.0/19.5/57.1,超过 LocateAnything-3B(54.7)与 Rex-Omni-3B(52.9);长尾的 LVIS Mean 55.3;优势最大的是密集场景——Dense200 Mean 71.3(LocateAnything 58.7,+12.6),F1@0.5 高达 86.9,VisDrone Mean 44.7 对 39.9;作为参照,Qwen3-VL-8B 在 Dense200 上只有 13.8,说明密集小目标感知是通用 VLM 的系统性短板,而本文靠高分辨率数据(S2 的 1960 token)和密集检测 RL 补齐。指代定位(Table 3):RefCOCOg val/test 80.8/81.8,HumanRef 80.7、Ref-Adv 50.5、DVGBench 45.2、Ref-L4 78.1 全面第一;最亮眼的是拒绝能力——RefCOCOg-Rej 拒绝率 67.4%(Qwen3-VL-8B 22.5%、Rex-Omni 0.5%),自建的 WeRef-Bench(2880 条中英文查询)上 F1 Mean 78.7、缺席拒绝率 96.4%。计数(Table 4):所有基准所有 split 全部第一,PixMo-Count 93.7/89.6(val/test),MixCount 42.0/40.4 是最强基线 LocateAnything(15.2)的近 3 倍,CountQA 57.1,KubriCount testA/B 37.7/40.1。指向(Table 5):PointBench 71.9、PixMo-Points 74.7,检测派生基准上 Dense200 87.0、VisDrone 64.4 亦领先。OCR(Table 6):SROIE Mean 68.1 超过专用系统 PP-OCRv5 的 58.6,ICDAR2015 47.8、TotalText 52.0、HierText 39.0,覆盖密集文档、场景文字、弯曲文本和票据。指代分割(Table 7):RefCOCO family 全线第一(RefCOCO val/testA/testB 81.4/84.5/80.1,RefCOCO+ 76.5/81.1/72.8),ReasonSeg gIoU test 66.8 超 UniPixel-7B 的 60.5 且无需显式 CoT;Ref-ZOM 上 cIoU 73.4(2B)/72.2(4B)之外,拒绝率 86.0% 对 GSVA 41.9%、UniPixel 0.3%,直接证明负例训练有效。抠图(Table 8):box prompt 下 P3M-500-NP 的 MAD 低至 6.6(2B,SAM2-Matting SAM3 为 15.4),AM-2K MAD 5.0、PPM-100 MAD 5.3;语言 prompt 的自建 WeRefMat 上,category prompt MAD 16.4 对 SAM3 原生文本定位的 70.8,referring prompt MAD 9.8 对 Qwen3.5-9B+SAM2-Matting 的 22.4,说明语言条件目标选择与边界敏感的透明度估计确实能在统一模型内兼得。定性结果(Figures 5–12)补充展示了遮挡远处大象的召回、按序数/世界知识/否定属性选人、按「双」计数鞋类、目标缺失时不输出、发丝级抠图边界等能力,Figure 13 还展示了带框的细粒度 caption 生成。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 通用目标检测 COCO | F1 Mean (IoU 0.5:0.95) | 57.1 (4B) | LocateAnything-3B 54.7 / Rex-Omni-3B 52.9 | +2.4 |
| 密集小目标检测 Dense200 | F1 Mean | 71.3 (4B) | LocateAnything-3B 58.7 / Qwen3-VL-8B 13.8 | +12.6 |
| 航拍密集检测 VisDrone | F1 Mean | 44.7 (4B) | LocateAnything-3B 39.9 | +4.8 |
| 长尾检测 LVIS | F1 Mean | 55.3 (4B) | LocateAnything-3B 50.7 / Qwen3.5-9B 43.7 | +4.6 |
| 指代定位 RefCOCOg val | F1 Mean | 80.8 (4B) | LocateAnything-3B 76.7 / Qwen3-VL-8B 74.6 | +4.1 |
| 缺席目标拒绝 RefCOCOg-Rej | 拒绝率 % | 67.4 (4B) | Qwen3-VL-8B 22.5 / Rex-Omni-3B 0.5 | +44.9 |
| 开放词汇计数 MixCount val | 精确匹配准确率 % | 42.0 (4B) | LocateAnything-3B 12.5 | +29.5 |
| 目标指向 PointBench | F1@Point | 71.9 (4B) | Rex-Omni-3B 69.9 / Qwen3.5-9B 66.4 | +2.0 |
| OCR 票据识别 SROIE | F1 Mean | 68.1 (4B) | PP-OCRv5 58.6 / Rex-Omni-3B 44.8 | +9.5 |
| 推理分割 ReasonSeg test | gIoU | 66.8 (4B) | UniPixel-7B 60.5 / LISA-13B 61.3 | +5.5 |
| 含负例指代分割 Ref-ZOM | 拒绝率 % | 86.0 (4B) | GSVA-7B 41.9 / UniPixel-7B 0.3 | +44.1 |
| box 提示抠图 P3M-500-NP | MAD (×10³) ↓ | 6.6 (2B) | SAM2-Matting (SAM3) 15.4 | -8.8 |
| 语言条件抠图 WeRefMat (referring) | MAD (×10³) ↓ | 9.8 (4B) | Qwen3.5-9B + SAM2-Matting 22.4 | -12.6 |
局限与改进
作者在 Section 8 承认四点:通用训练数据比例有限,相对基座可能损害通用能力;为推理效率直接输出结构化结果、不做思维链(CoT),限制复杂推理任务表现;当前只支持单轮预测,多轮工具交互的 agent 化留待未来;基准里的 prompt 清晰规整,而真实用户指令往往模糊犹豫,需要更强的意图推理。我的独立观察还有几点:第一,RL 奖励只评 box 不评 mask/alpha(论文明确说分割和抠图 RL 只用 box-based reward),像素输出质量完全由 SFT 阶段决定,强化学习无法继续改进边界精度,这与「抠图是核心能力」的定位不完全匹配;第二,三个关键评测(WeRef-Bench、WeRefMat 以及 Dense200 之外的密集基准用法)中前两个是自建,WeRefMat 上基线 MAD 高达 70.8 可能有域差异成分,横向可比性需谨慎;第三,2B 在 P3M-500-NP(MAD 6.6 vs 4B 的 7.3)和 PPM-100 上反超 4B,说明模型规模与像素任务的关系不单调,选型时不能默认越大越好;第四,F1 协议虽然对无置信度的生成模型公平,但解析与匹配实现细节会影响跨论文可比性;第五,自研开放词汇检测器是数据引擎的关键组件但未公开,第三方难以完整复刻 WDE。
独立分析的弱点
第一,级联误差没有修复机制: 的掩码完全依赖先验框,框错了 mask 必错,而 RL 又不提供像素反馈。改进方向是把 cIoU/MAD 纳入 GRPO 奖励做全链路优化,或对 表示施加与像素特征的对比学习约束,让隐藏状态携带更充分的实例证据。第二,自监督数据闭环有自我强化风险:WDE 用 SAM3+Qwen3-VL 标注再回头训练同源模型,系统性偏差可能被逐轮放大,人工抽检比例论文未披露。改进方向是对高争议样本提高人工复核覆盖率,并引入异构模型交叉验证降低同源偏差。第三,通用能力退化未被量化:报告没有给出 MMMU 或通用 VQA 的前后对比,无法评估「感知专用化」的代价,这对想拿它当通用助手的用户是盲区。改进方向是混入通用多模态指令数据,或以 LoRA 适配器形式发布感知能力便于叠加。第四,无 CoT 的推理上限:Ref-Adv 对抗指代只有 50.5,否定加多约束的组合表达仍易错,Figure 6 的成功案例都是单约束场景。改进方向是提供可选的 thinking 模式,或测试时自验证循环(生成候选→自查语义约束→修正)。第五,解码器画布固定(分割 512、抠图 1024):对 4K 输入的发丝、远处细小文字可能欠采样,WeRefMat 上 referring MAD 9.8 距离 box prompt 的精度仍有差距也部分源于此。改进方向是分块推理或多分辨率 refinement 级联。
未来方向
作者明确提出的方向:集成 agent 框架,通过多轮工具交互渐进细化视觉理解;加强意图推理以应对真实世界中模糊、犹豫的用户指令;持续向可部署的可靠感知系统演进。基于论文成果可以自然延伸的方向包括:(1)把 grounding reward 从 box 层面扩展到 mask/alpha 层面,让 RL 直接优化边界质量,补齐「RL 不碰像素」的短板;(2)沿着 SAM3 的概念提示思路把统一感知扩展到视频——跟踪、视频指代分割与视频抠图,WDE 的实例对齐监督范式可以直接迁移到时序;(3)Figure 13 展示的 grounded caption 能力有数据价值,可批量产出「短语-区域」对齐语料反哺 VLM 预训练,形成数据飞轮;(4)把 WDE 本身开源为通用自动标注基础设施,其知识图谱驱动的定向采集对其他感知模型同样适用;(5)坐标 token 接口向 3D 定位、深度与时序坐标扩展,探索具身场景下的统一感知输出空间。
复现评估
开源情况良好:代码在 GitHub(Tencent/WeVisOne-VL)、权重在 HuggingFace(collections/tencent/wevisone-vl)、项目页齐全,提供 2B/4B 两个规模。推理非常友好:模型小、贪心解码、无 CoT, 解码器仅 9.6M 参数,单卡消费级 GPU 即可部署,工程集成成本低。但完整复现训练门槛很高:WDE 语料(1 亿图像、36 亿框)与关键组件自研开放词汇检测器均未开源,公共数据(SA-1B、CC3M、GRIT、LAION 等)可以拼凑但规模打折;训练需要 128 GPU(SFT)+ 160 GPU(RL),BF16 精度、ZeRO-2/FSDP2 分布式,附录 Table 11 给出了完整超参(含 LoRA r=128、α=256、各阶段学习率 2e-5/5e-6/1e-6 等),细节披露充分。合理路径是:下载权重做推理与下游微调(容易);按论文数据配方复刻一个小规模 WDE 并在开源数据上重训(中等偏难);完整预训练(不建议,性价比低)。总体判断:用起来容易,从头复现难,难点在数据而非算法。
论文图表
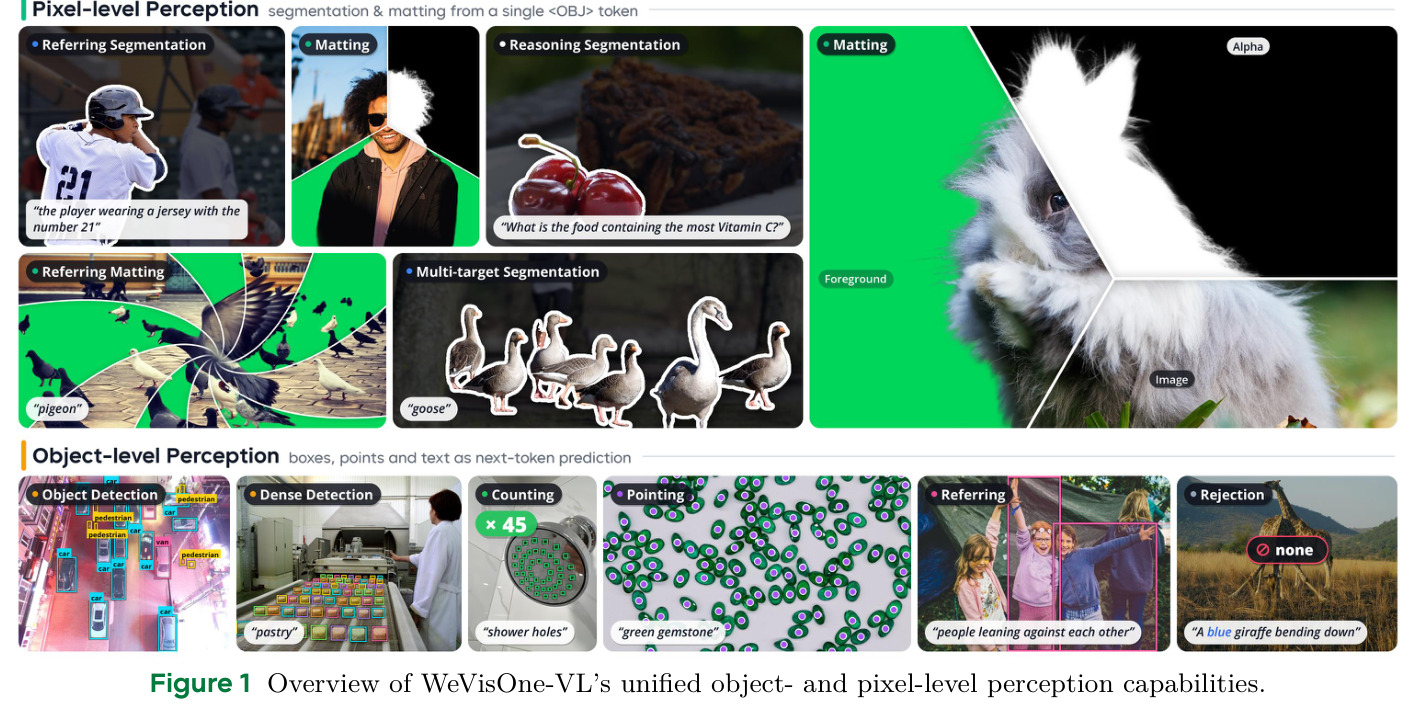
模型能力总览图:同一个模型通过自然语言接口同时支持目标检测、指代定位、计数、OCR、指代分割与抠图,输出粒度从点、框延伸到掩码和 alpha matte。
一图看懂论文要统一的任务范围与输出粒度,是理解「object-level 到 pixel-level」这一主线的入口。
训练各阶段的数据构成:SFT-S1 90.2M、S2 40.5M、S3 41.8M 样本及任务占比(S1 检测 67.2%/指代 20.1%,S3 分割占 52.4%),分割 warm-up 250M、matting 微调 130M、RL 178K 的来源比例;WDE 在后期阶段占比迅速升高。
三阶段课程的设计意图(先对齐、再高分辨率密集、最后像素级)完全体现在数据配比上,是理解训练策略的关键。